Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
論文読み会 / Deep Multi-Modal Sets
Search
chck
June 29, 2020
Research
45
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
論文読み会 / Deep Multi-Modal Sets
社内論文読み会、PaperFridayでの発表資料です
chck
June 29, 2020
More Decks by chck
See All by chck
Research Engineerという仕事 / Research Engineering: Bridging Research and Business
chck
1
370
CyberAgent AI Lab研修 / Social Implementation Anti-Patterns in AI Lab
chck
7
5.1k
CyberAgent AI Lab研修 / Container for Research
chck
1
2.4k
CyberAgent AI Lab研修 / Code Review in a Team
chck
3
2.6k
論文読み会 / Socio-Technical Anti-Patterns in Building ML-Enabled Software: Insights from Leaders on the Forefront
chck
0
170
CyberAgent AI事業本部MLOps研修Container編 / Container for MLOps
chck
3
6.3k
論文読み会 / GLAZE: Protecting Artists from Style Mimicry by Text-to-Image Models
chck
0
120
論文読み会 / On the Factory Floor: ML Engineering for Industrial-Scale Ads Recommendation Models
chck
0
96
論文読み会 / GUIGAN: Learning to Generate GUI Designs Using Generative Adversarial Networks
chck
0
84
Other Decks in Research
See All in Research
Model Predictive Control for Uncertain Systems: Robust & Data-Driven Designs
kohlerjohannes
0
150
2026年 オープンキャンパス 研究室紹介
junkurihara
0
240
MIRU2026 チュートリアル講演2:三次元データ処理の動向
nnchiba
8
5.3k
[WebDB2026]セレンディピティ指向推薦システム再考 ―セレンディピティの原義・類型・発生過程に基づく設計指針―
recsyslab
PRO
0
200
2025年度秋葉原ウォーカブルプロジェクト調査報告 「アキバらしいウォーカブル」とは何か
izumiyama_lab
1
250
ふとした出会いで生まれたSkillが、 社内利用1位になるまで
mikimhk
22
25k
論文紹介: Understanding Epistemic Language with a Language-augmented Bayesian Theory of Mind
hisaokatsumi
0
190
OWASP AISVS - C7
shiell
2
830
Evaluation génomique des femelles laitières croisées : comprendre la méthode pour accompagner les éleveurs à son utilisation
institutdelelevage
PRO
0
170
Byzantine Eventual Consistency for Reliable Local-First Software
ept
0
190
Language and AI
ayaniwa
0
320
JICA QUEST 共創×革新プログラム Impact Report(海ノ向こうコーヒー)
ontheslope
0
810
Featured
See All Featured
How To Stay Up To Date on Web Technology
chriscoyier
790
250k
ピンチをチャンスに:未来をつくるプロダクトロードマップ #pmconf2020
aki_iinuma
128
56k
The SEO identity crisis: Don't let AI make you average
varn
0
580
Organizational Design Perspectives: An Ontology of Organizational Design Elements
kimpetersen
PRO
1
840
How to Build an AI Search Optimization Roadmap - Criteria and Steps to Take #SEOIRL
aleyda
1
2.2k
Amusing Abliteration
ianozsvald
1
340
A Soul's Torment
seathinner
8
3.7k
Designing Dashboards & Data Visualisations in Web Apps
destraynor
232
55k
My Coaching Mixtape
mlcsv
0
350
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
590
What Being in a Rock Band Can Teach Us About Real World SEO
427marketing
0
1.1k
Google's AI Overviews - The New Search
badams
0
1.6k
Transcript
Deep Multi-Modal Sets 20/06/29 PaperFriday, Yuki Iwazaki@AI Lab
2 Point: 特徴のDown SamplingやScalabilityを考慮した Multi-Modal Encoderを提案 Authors: Austin Reiter, Menglin
Jia, Pu Yang, Ser-Nam Lim - Facebook AI Research, Cornell University 選定理由: - Creative Researchのslackでちょっと話題に出た - 俺より強いマルチモーダル表現に会いに行く
The Multi-Modal Problem 3
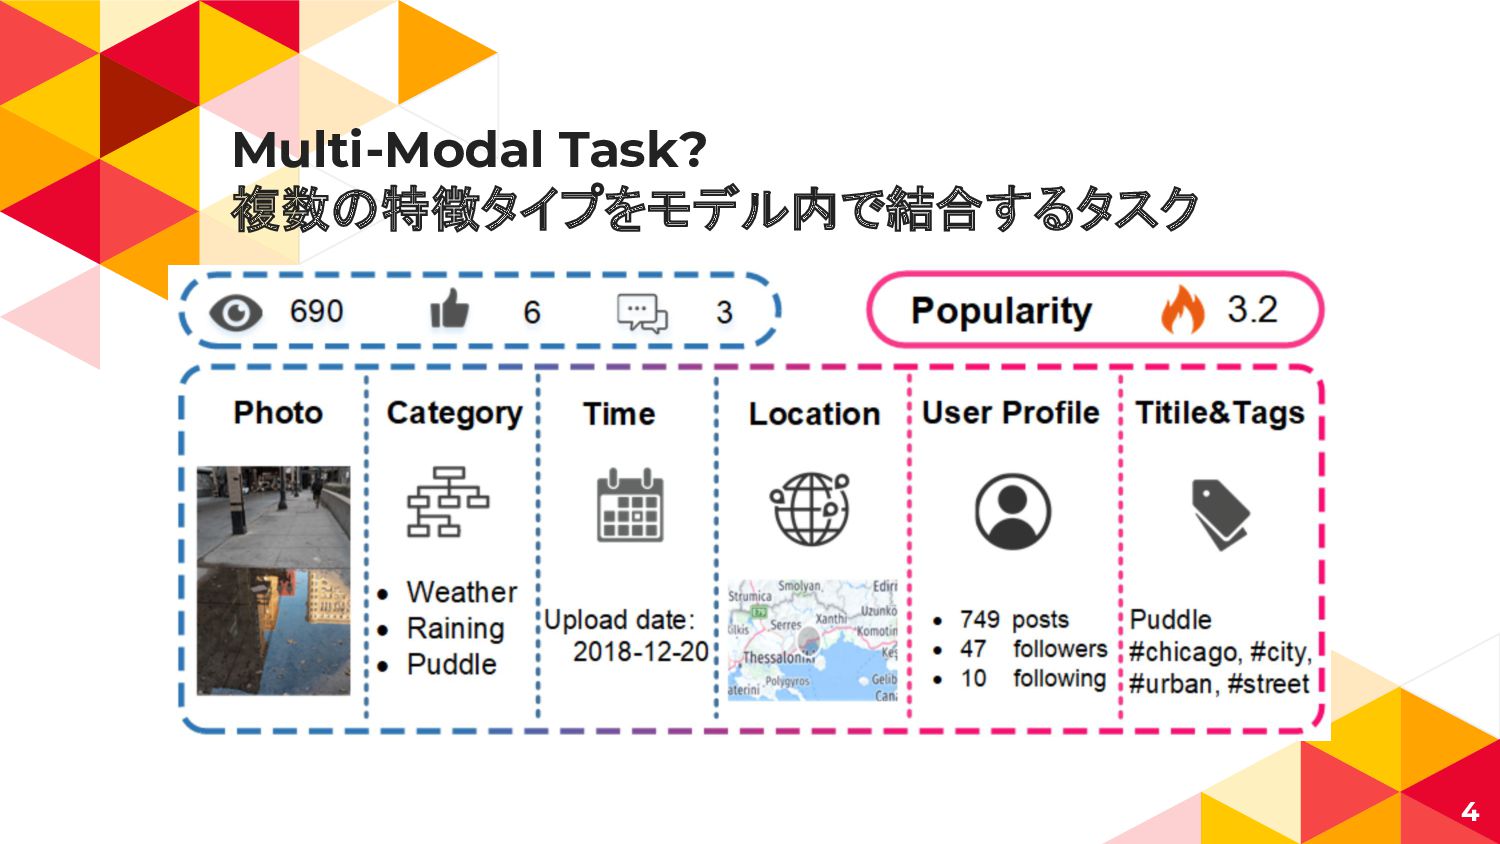
Multi-Modal Task? 複数の特徴タイプをモデル内で結合するタスク 4
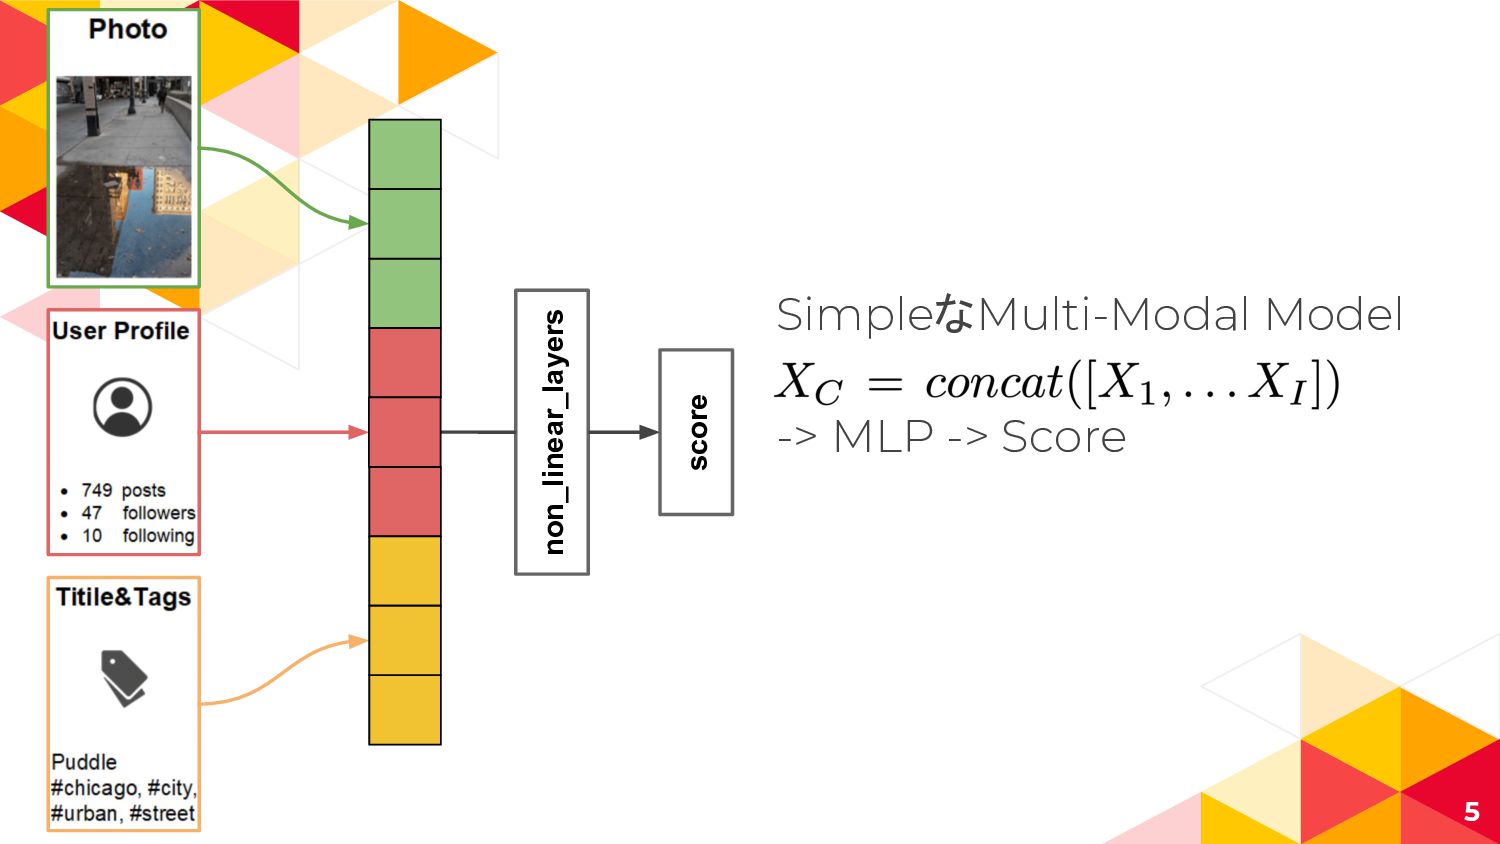
non_linear_layers score 5 SimpleなMulti-Modal Model XC = concat([X1, . .
. XI ]) -> MLP -> Score
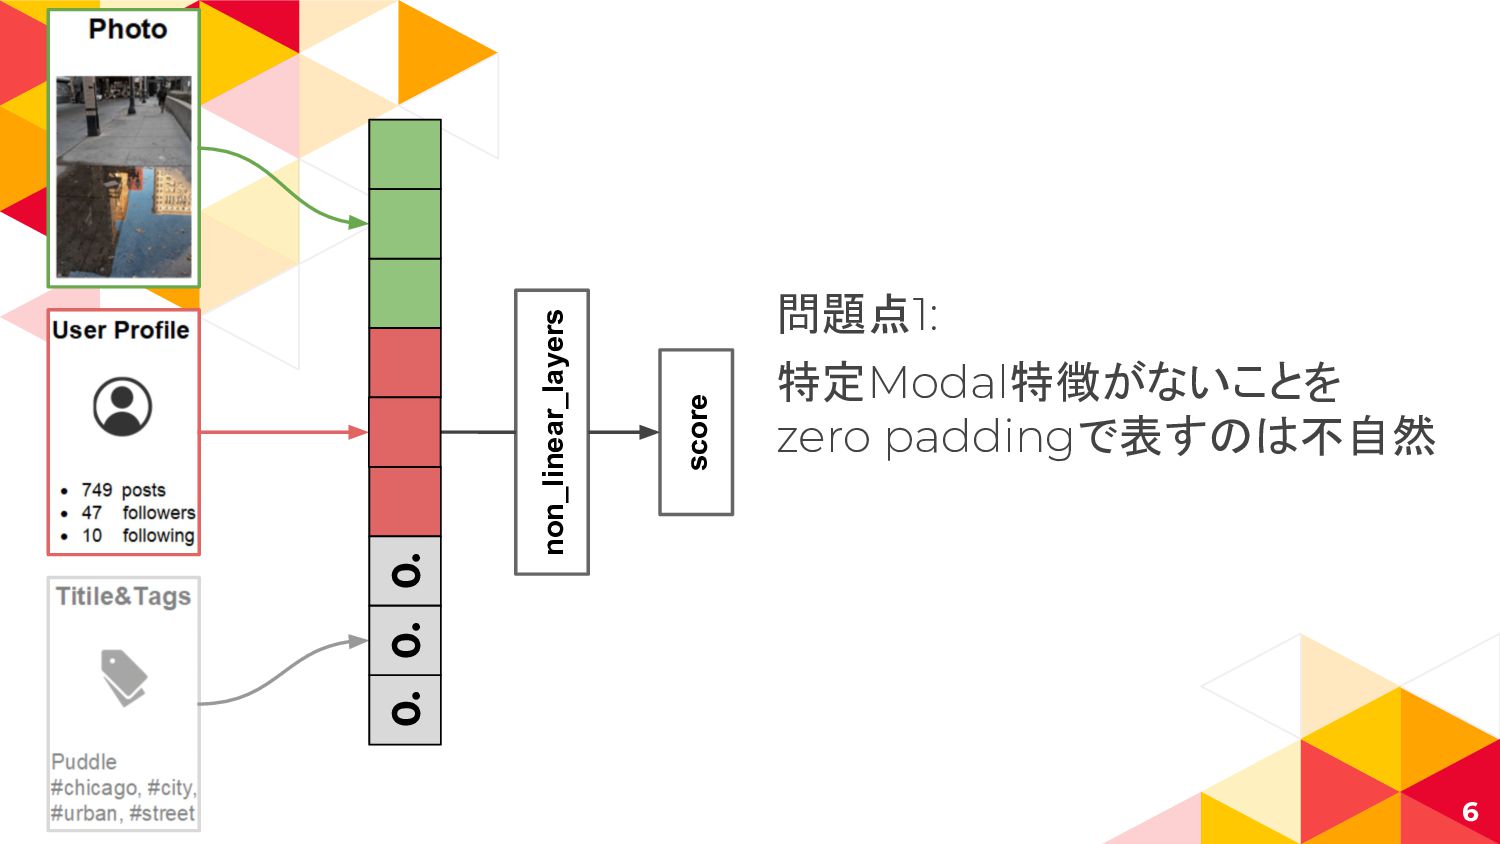
non_linear_layers score 6 問題点1: 特定Modal特徴がないことを zero paddingで表すのは不自然 0. 0. 0.
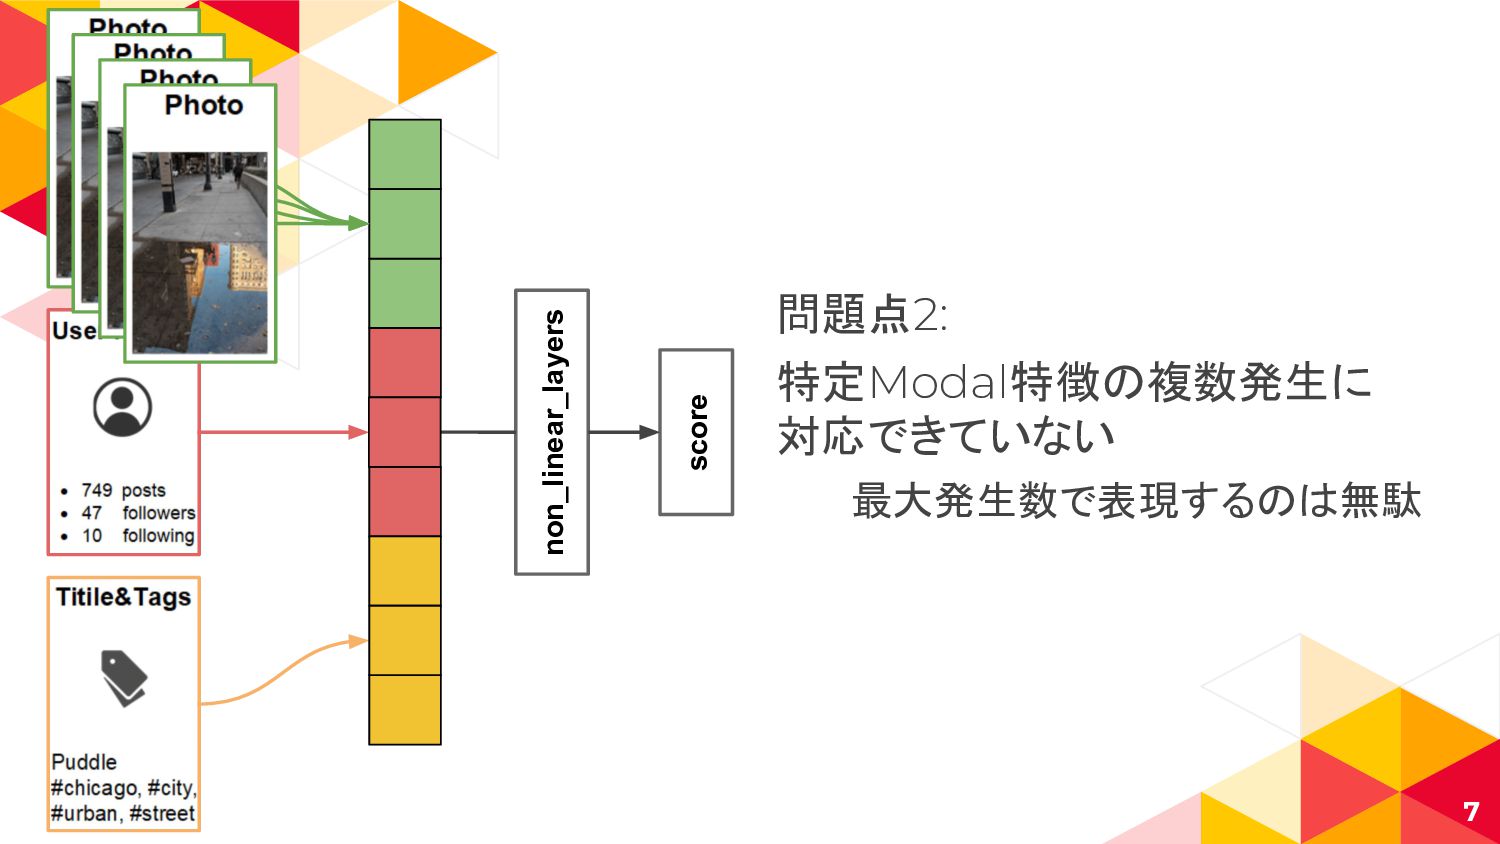
non_linear_layers score 7 問題点2: 特定Modal特徴の複数発生に 対応できていない 最大発生数で表現するのは無駄
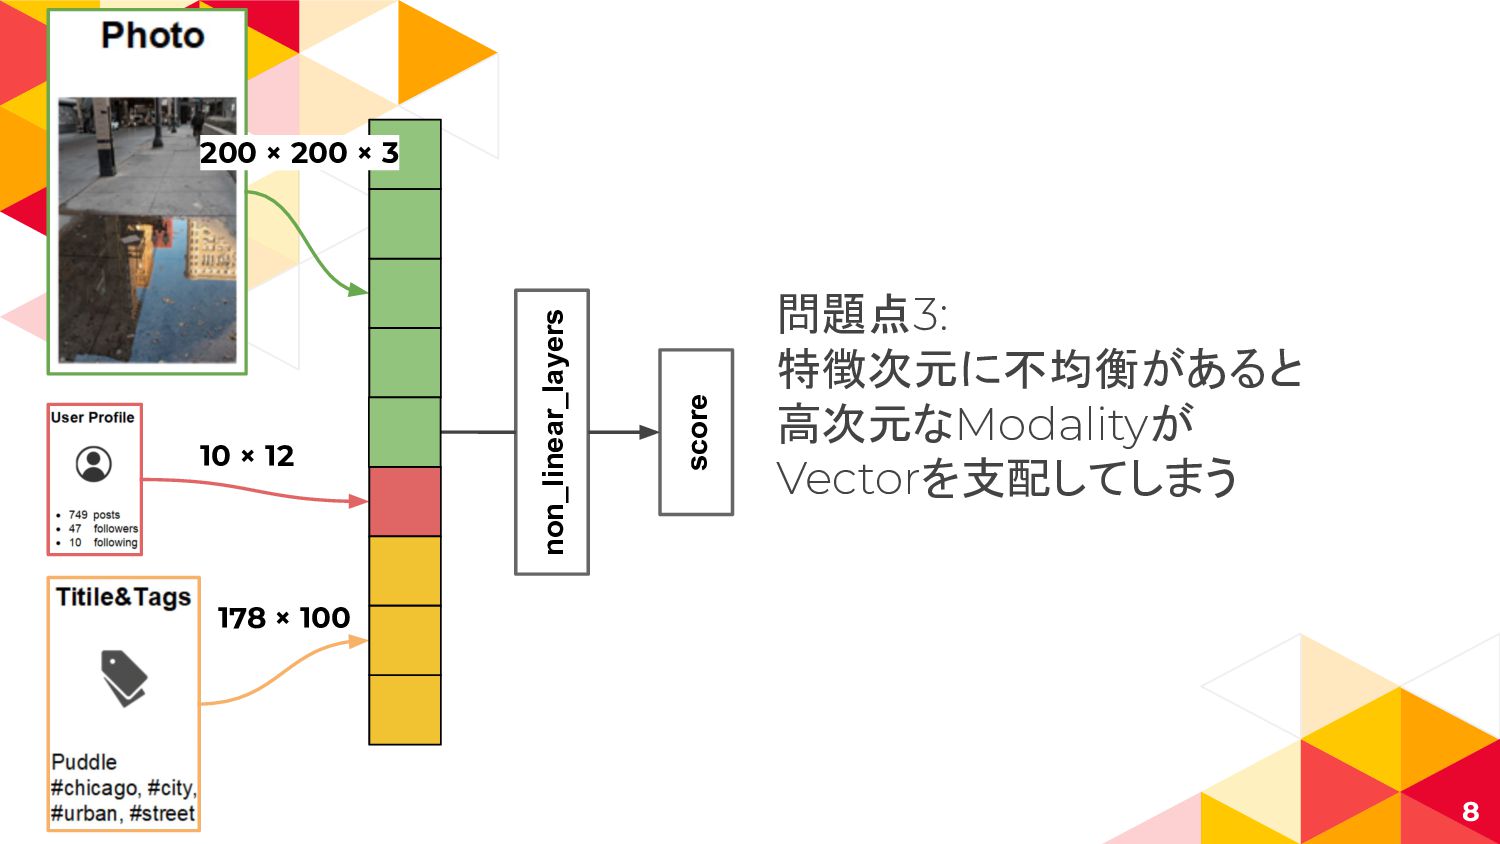
non_linear_layers score 8 問題点3: 特徴次元に不均衡があると 高次元なModalityが Vectorを支配してしまう 10 × 12
178 × 100 200 × 200 × 3
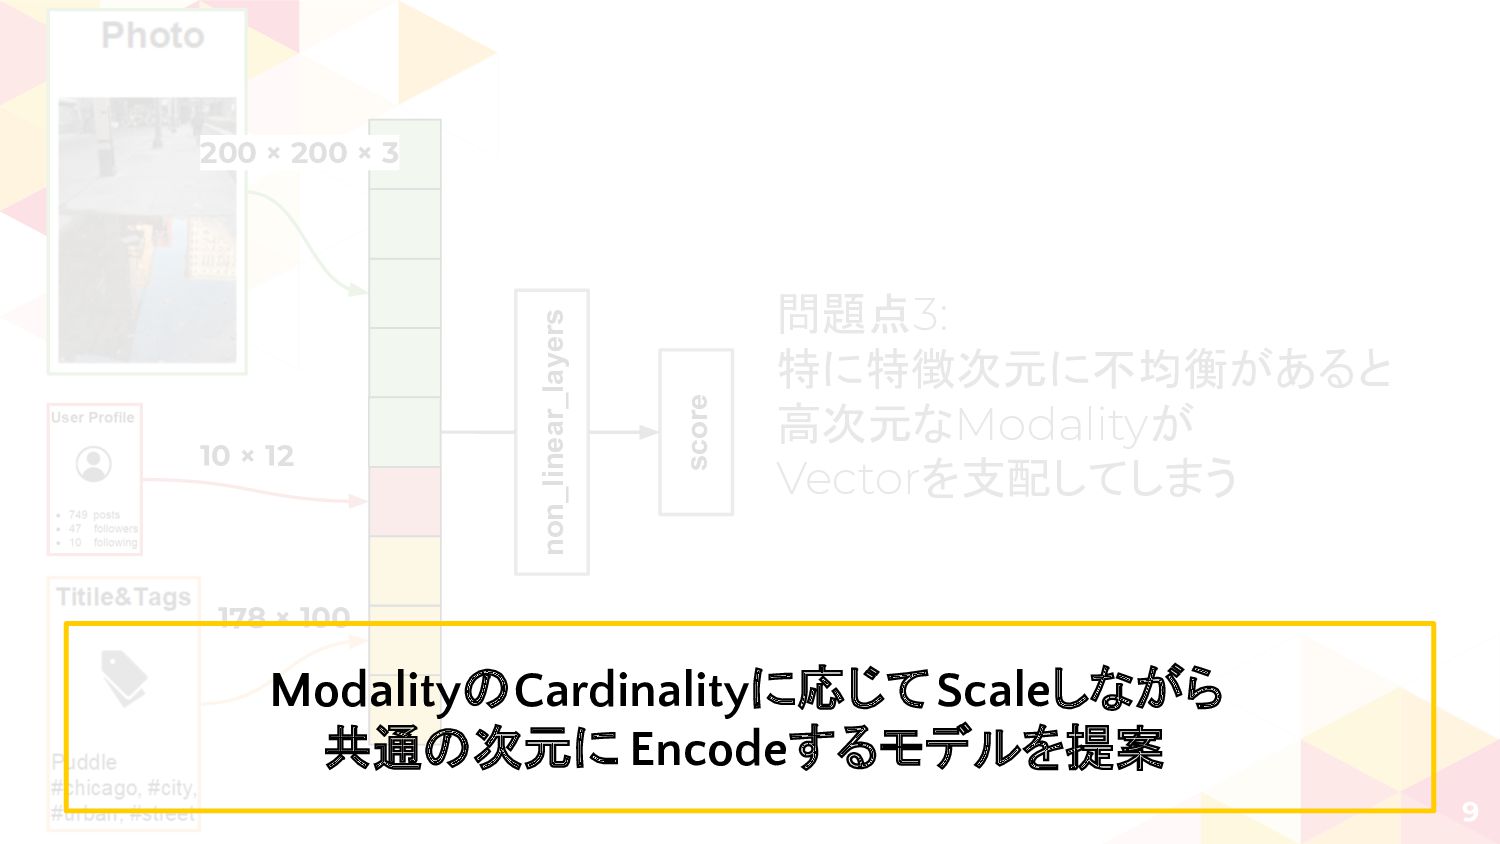
non_linear_layers score 9 問題点3: 特に特徴次元に不均衡があると 高次元なModalityが Vectorを支配してしまう 10 × 12
178 × 100 200 × 200 × 3 ModalityのCardinalityに応じてScaleしながら 共通の次元に Encodeするモデルを提案
Pooling Layer 10
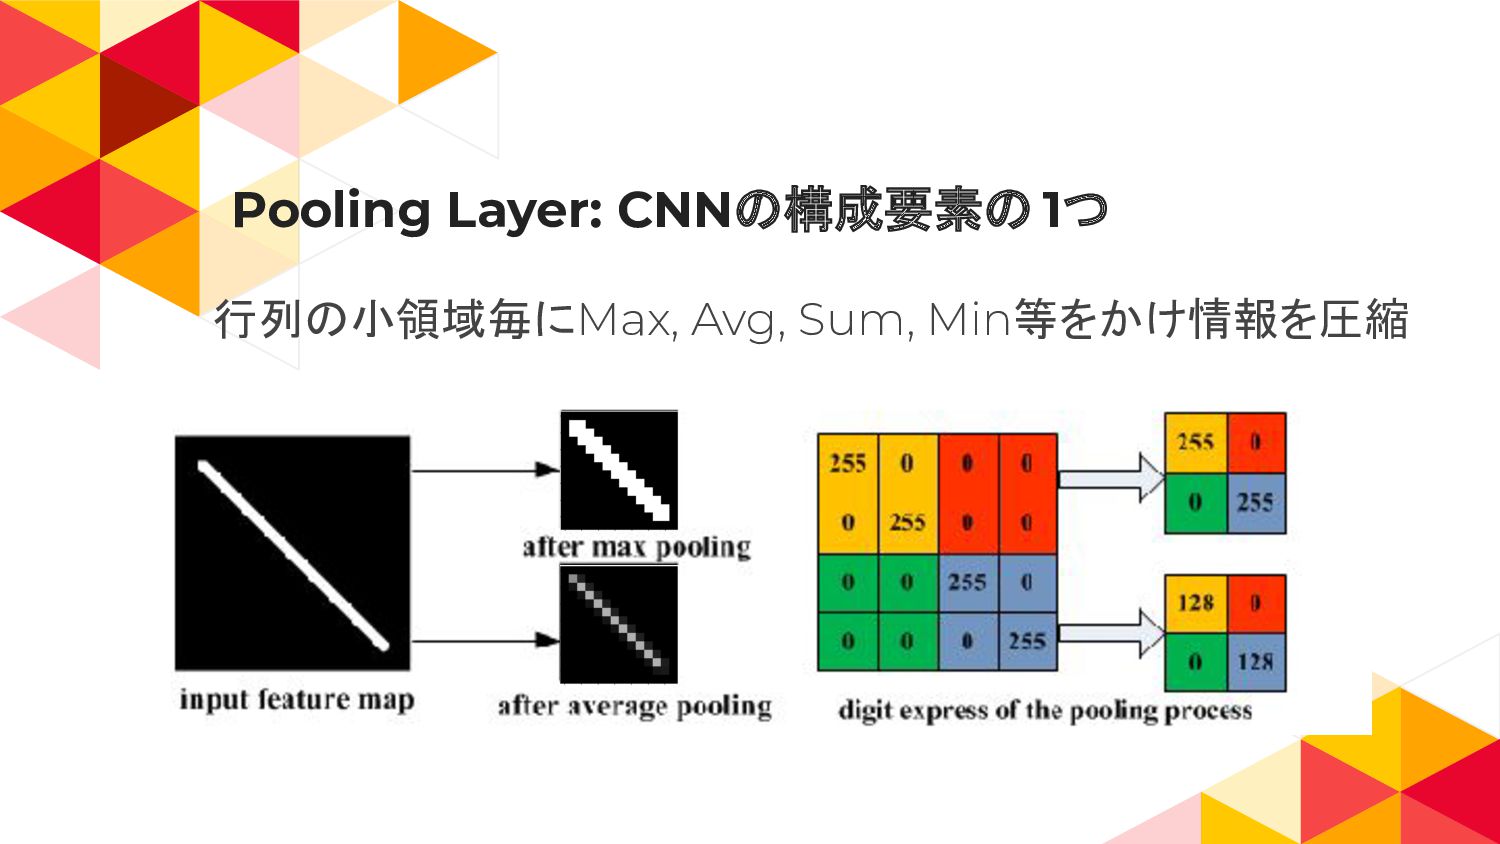
Pooling Layer: CNNの構成要素の 1つ 行列の小領域毎にMax, Avg, Sum, Min等をかけ情報を圧縮
Deep Sets 12
Deep Sets [Zaheer, 17] CNN(Pooling)の位置不変性を利用して Scalableな埋め込み表現を学習するモデル CNNでいう画像サイズが変わろうが、GCNでいうユー ザに対するアイテムの順番が変わろうが、 各要素、特徴自体の位置はPoolingのおかげで 大きく変わらない
15 Graph Convolutional Network
Proposed Method 16
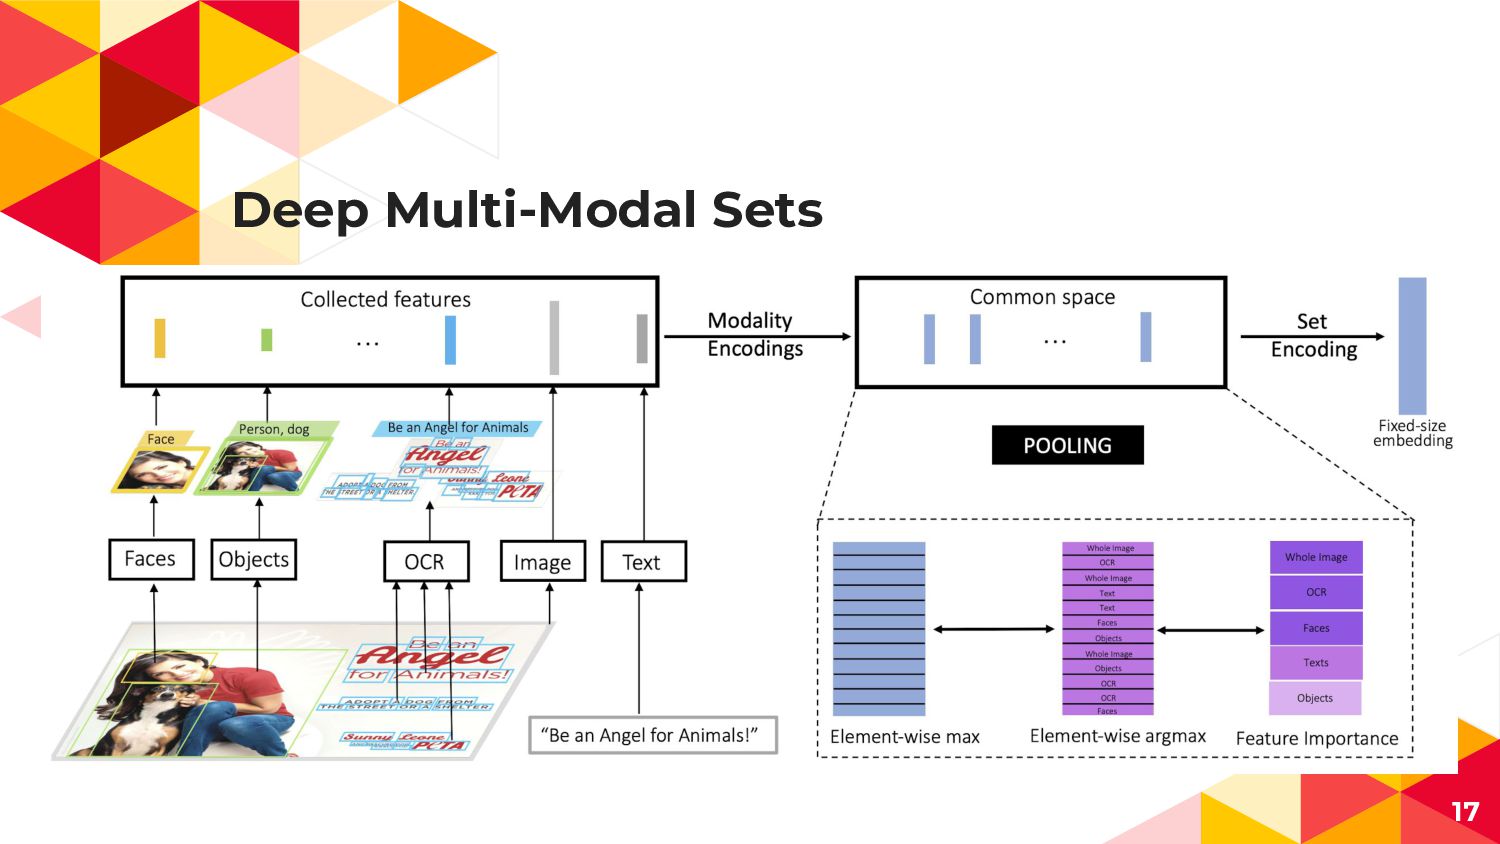
Deep Multi-Modal Sets 17
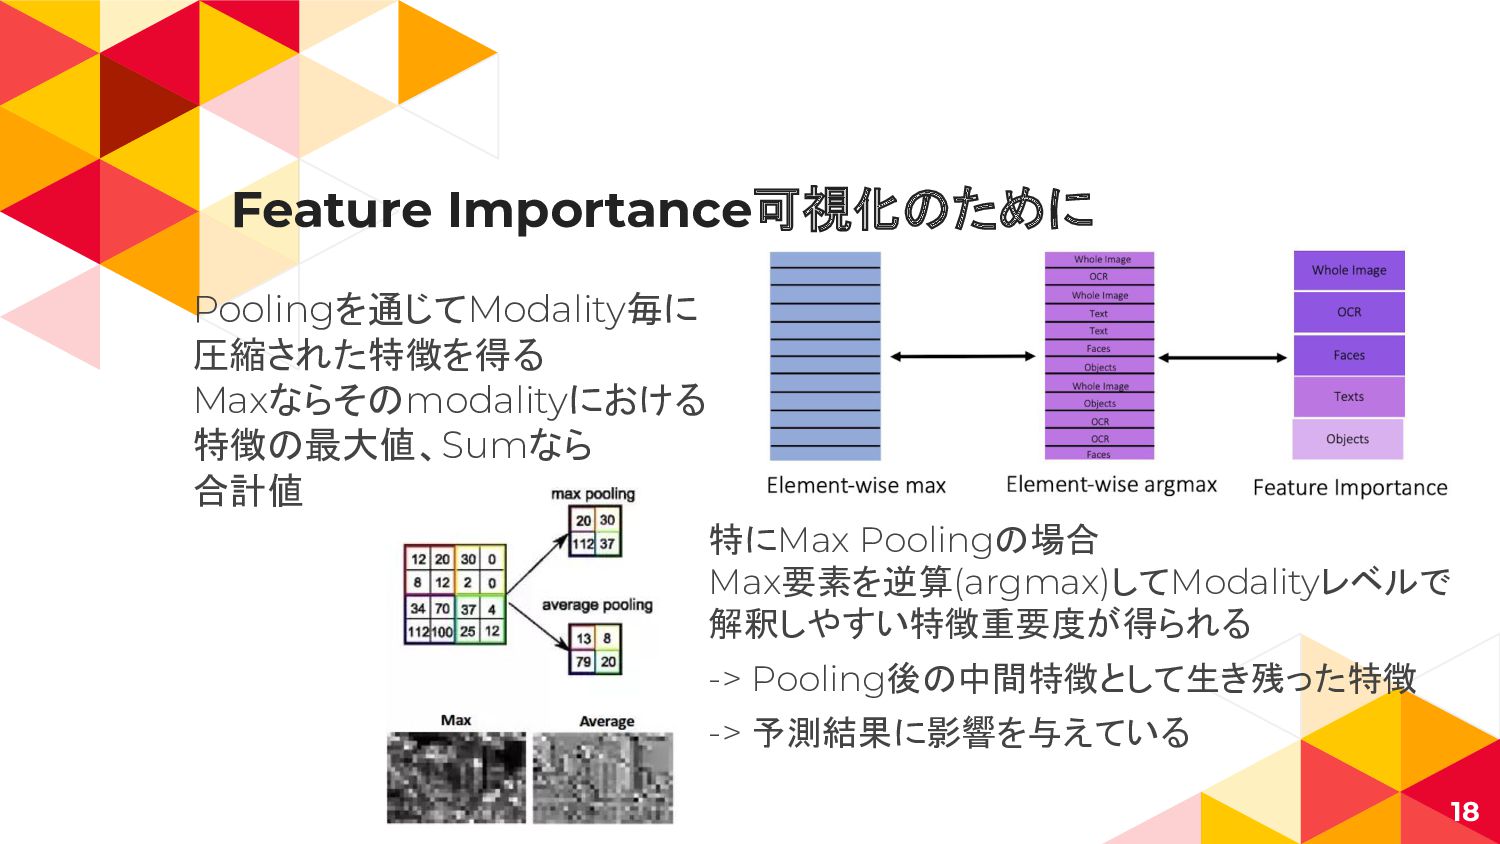
Feature Importance可視化のために Poolingを通じてModality毎に 圧縮された特徴を得る Maxならそのmodalityにおける 特徴の最大値、Sumなら 合計値 18 特にMax Poolingの場合
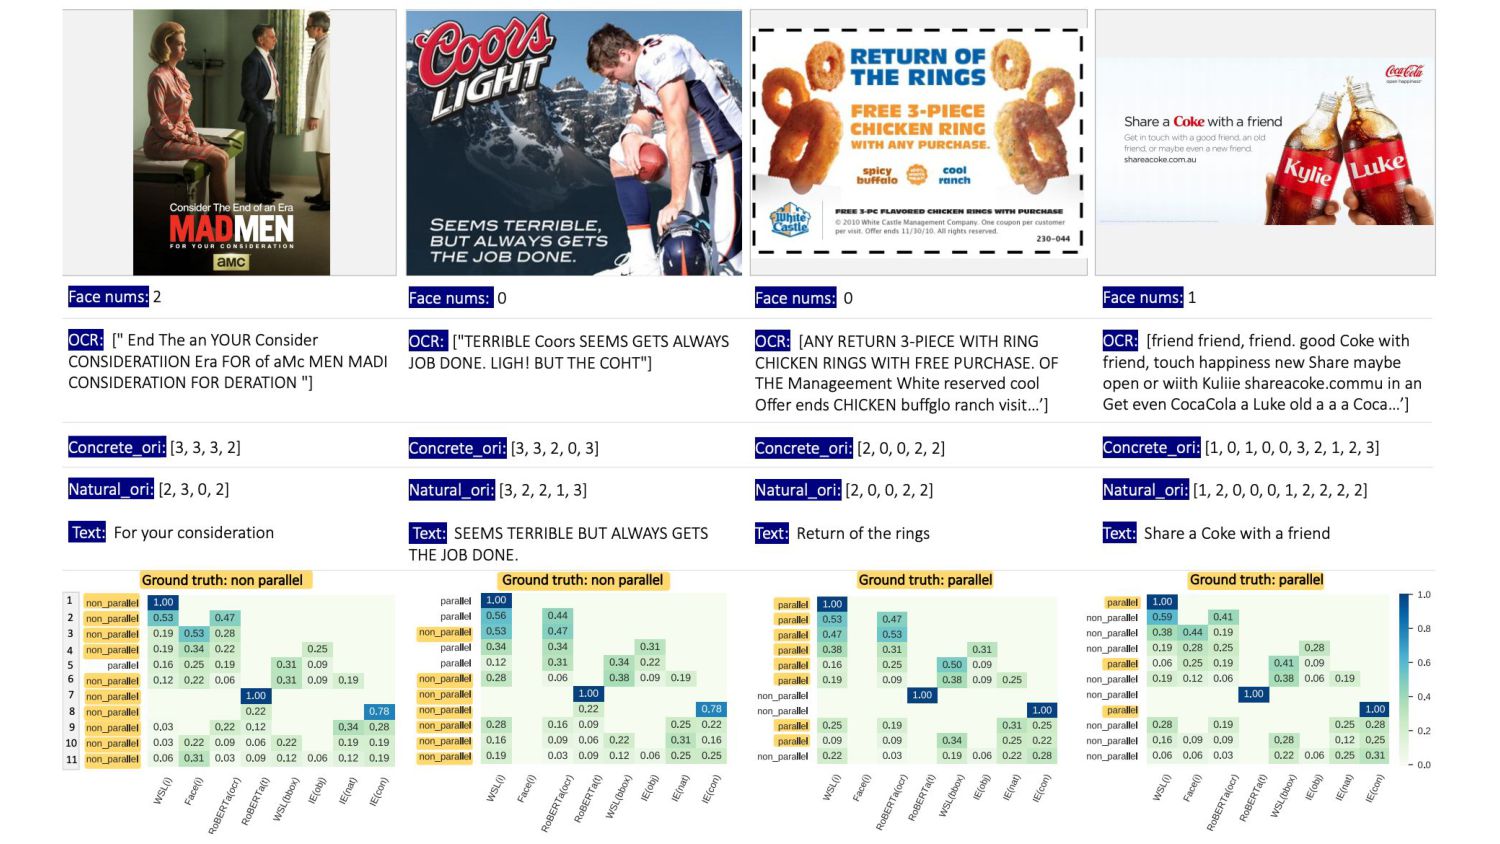
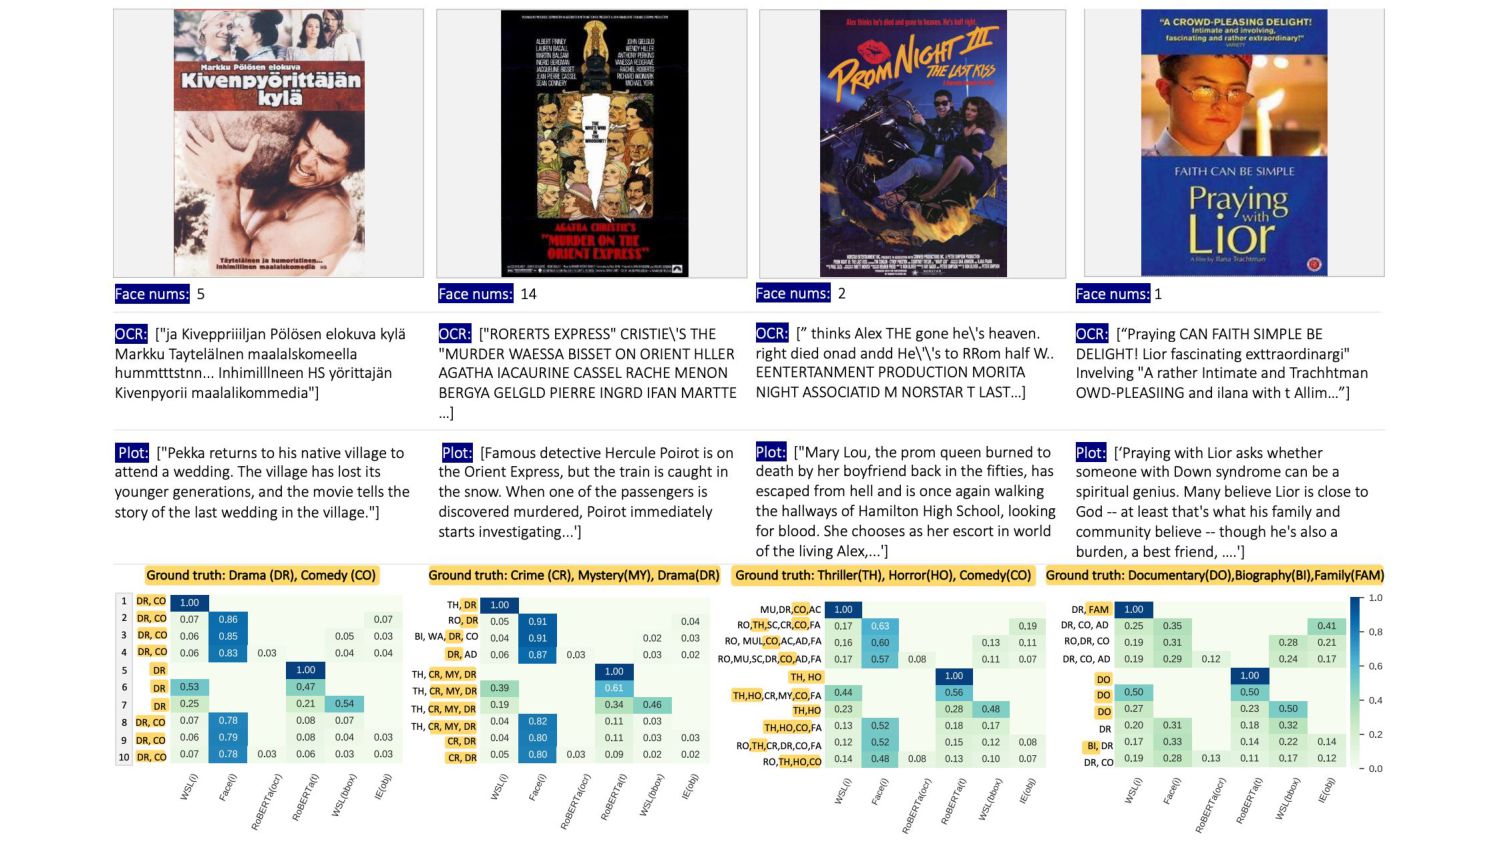
Max要素を逆算(argmax)してModalityレベルで 解釈しやすい特徴重要度が得られる -> Pooling後の中間特徴として生き残った特徴 -> 予測結果に影響を与えている
Experiments 19
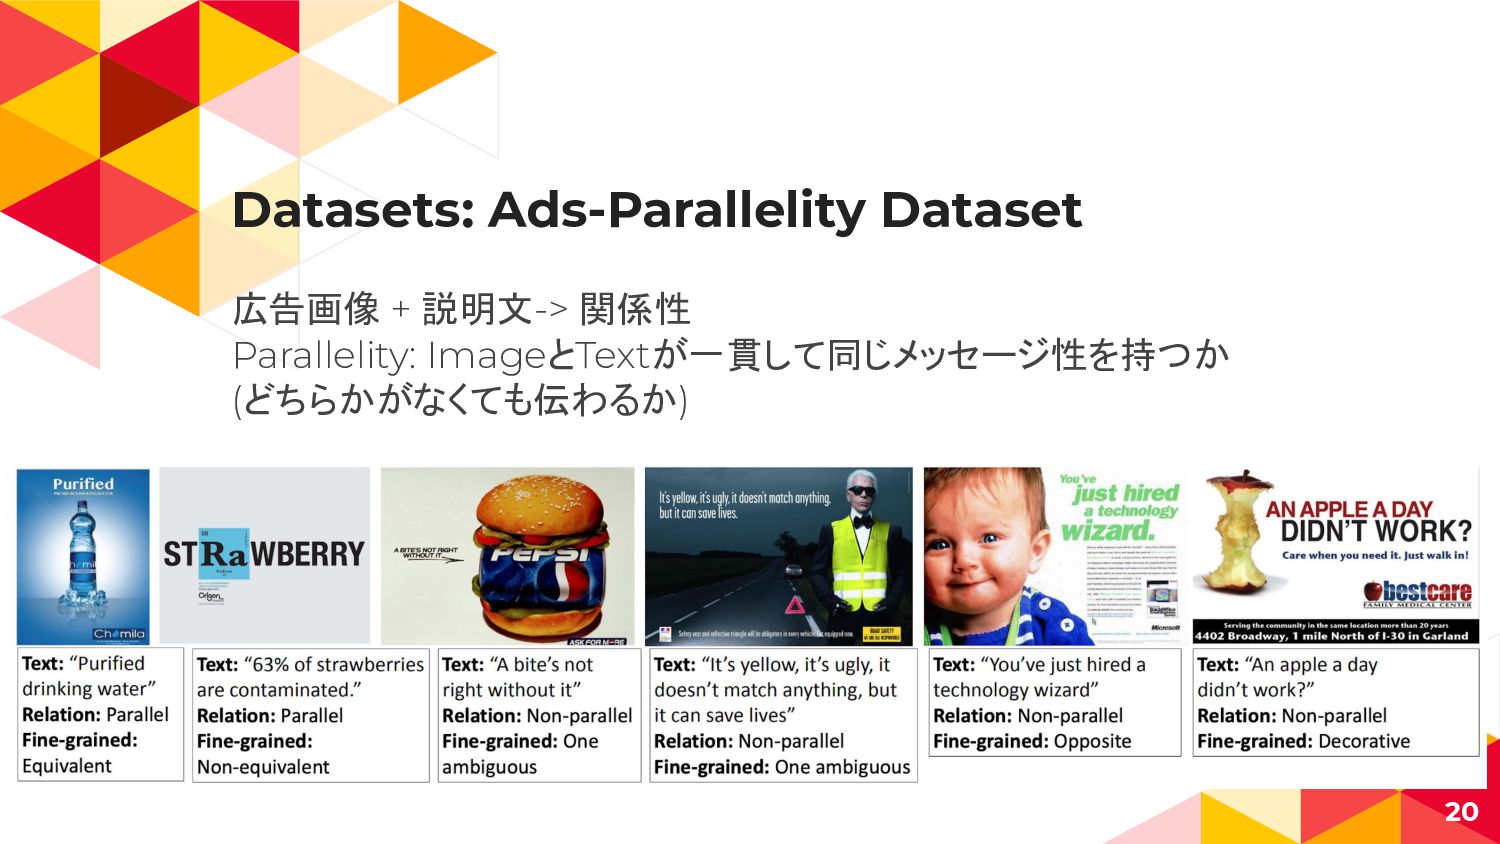
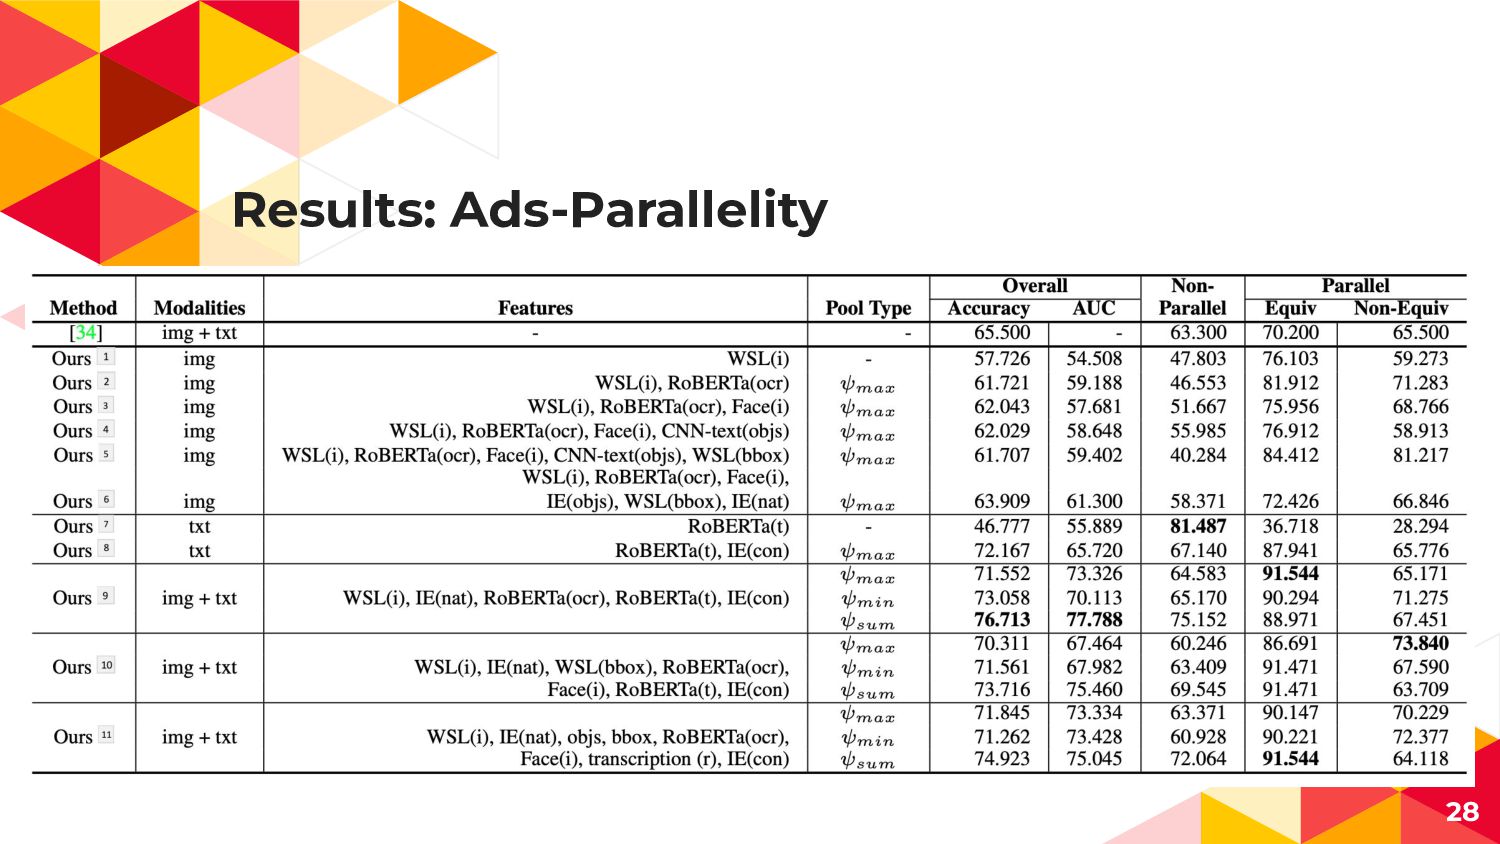
Datasets: Ads-Parallelity Dataset 広告画像 + 説明文-> 関係性 Parallelity: ImageとTextが一貫して同じメッセージ性を持つか (どちらかがなくても伝わるか)
20
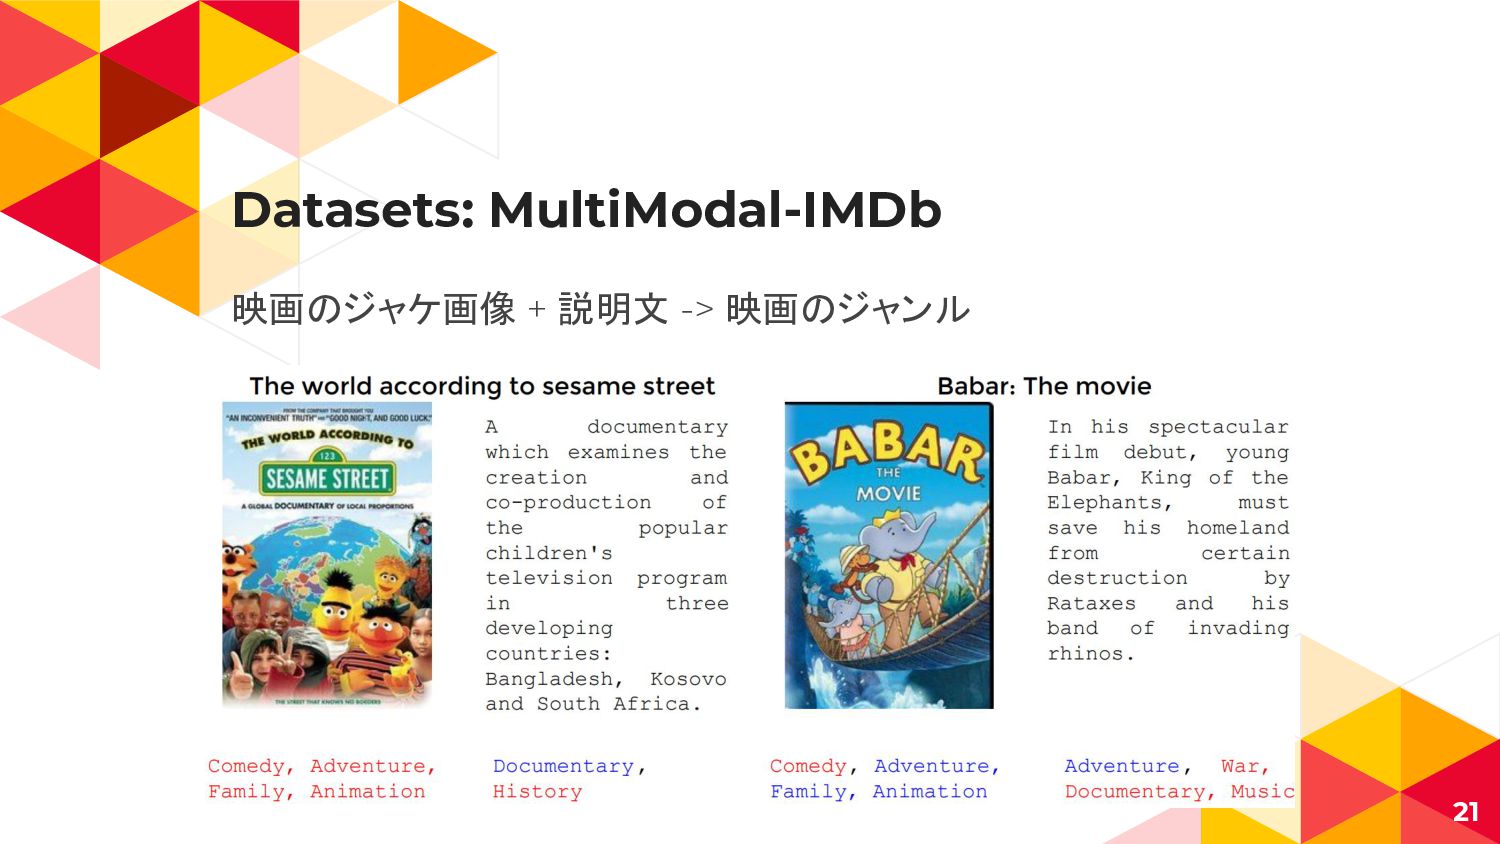
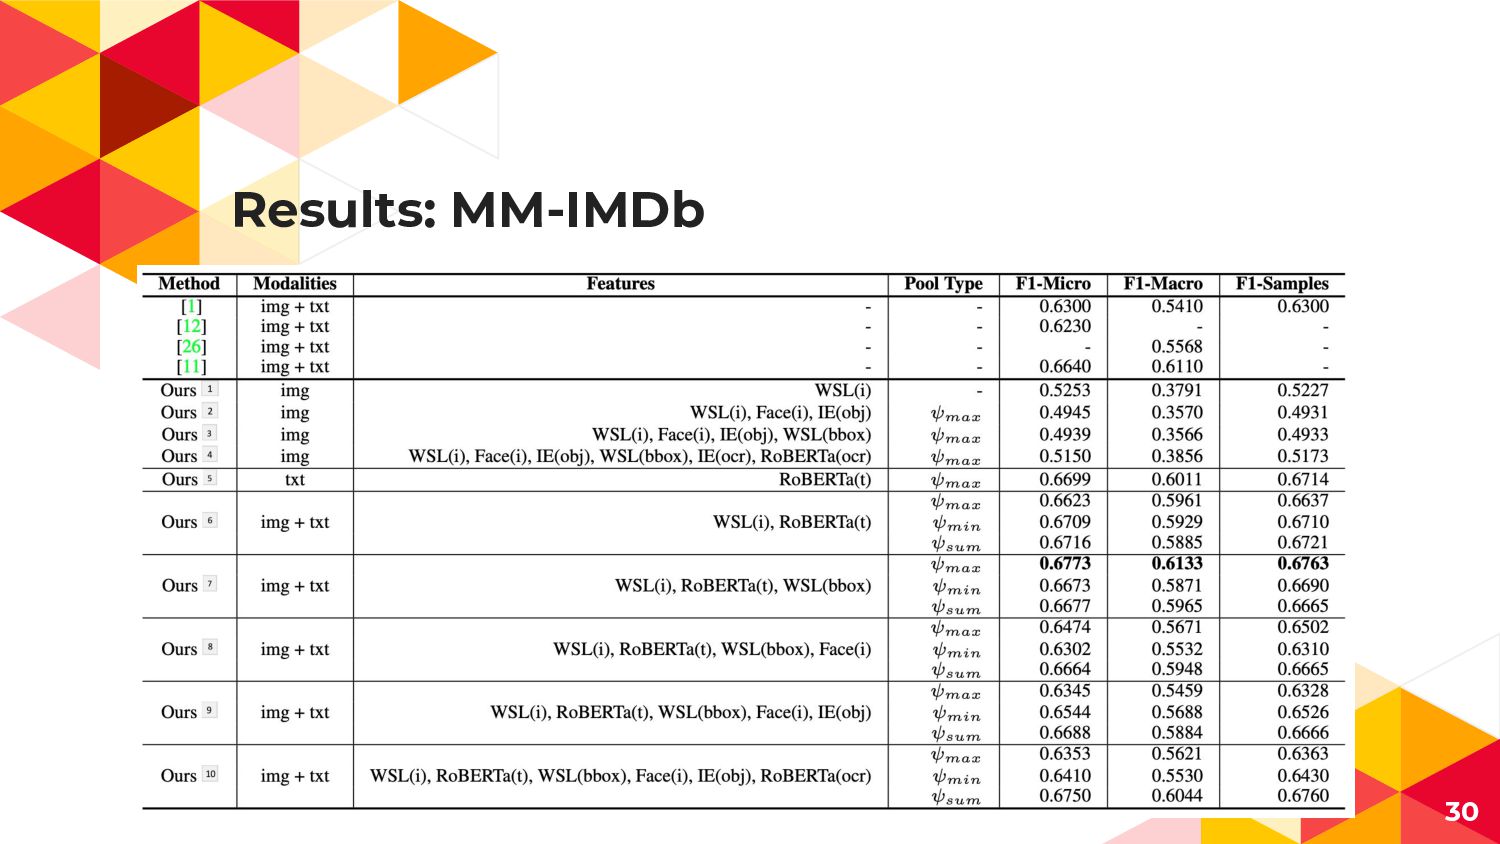
Datasets: MultiModal-IMDb 映画のジャケ画像 + 説明文 -> 映画のジャンル 21
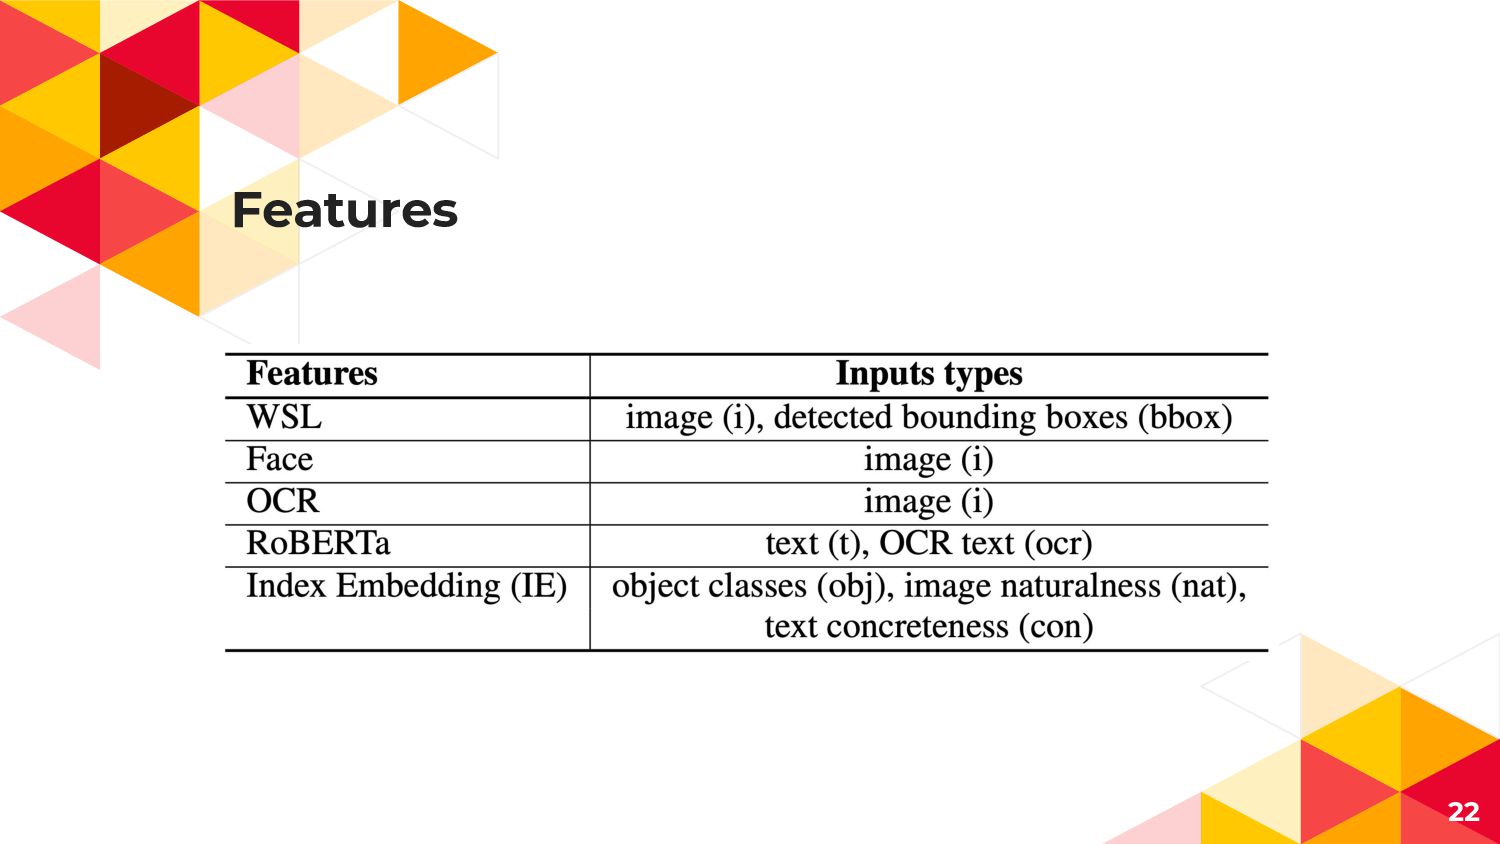
Features 22
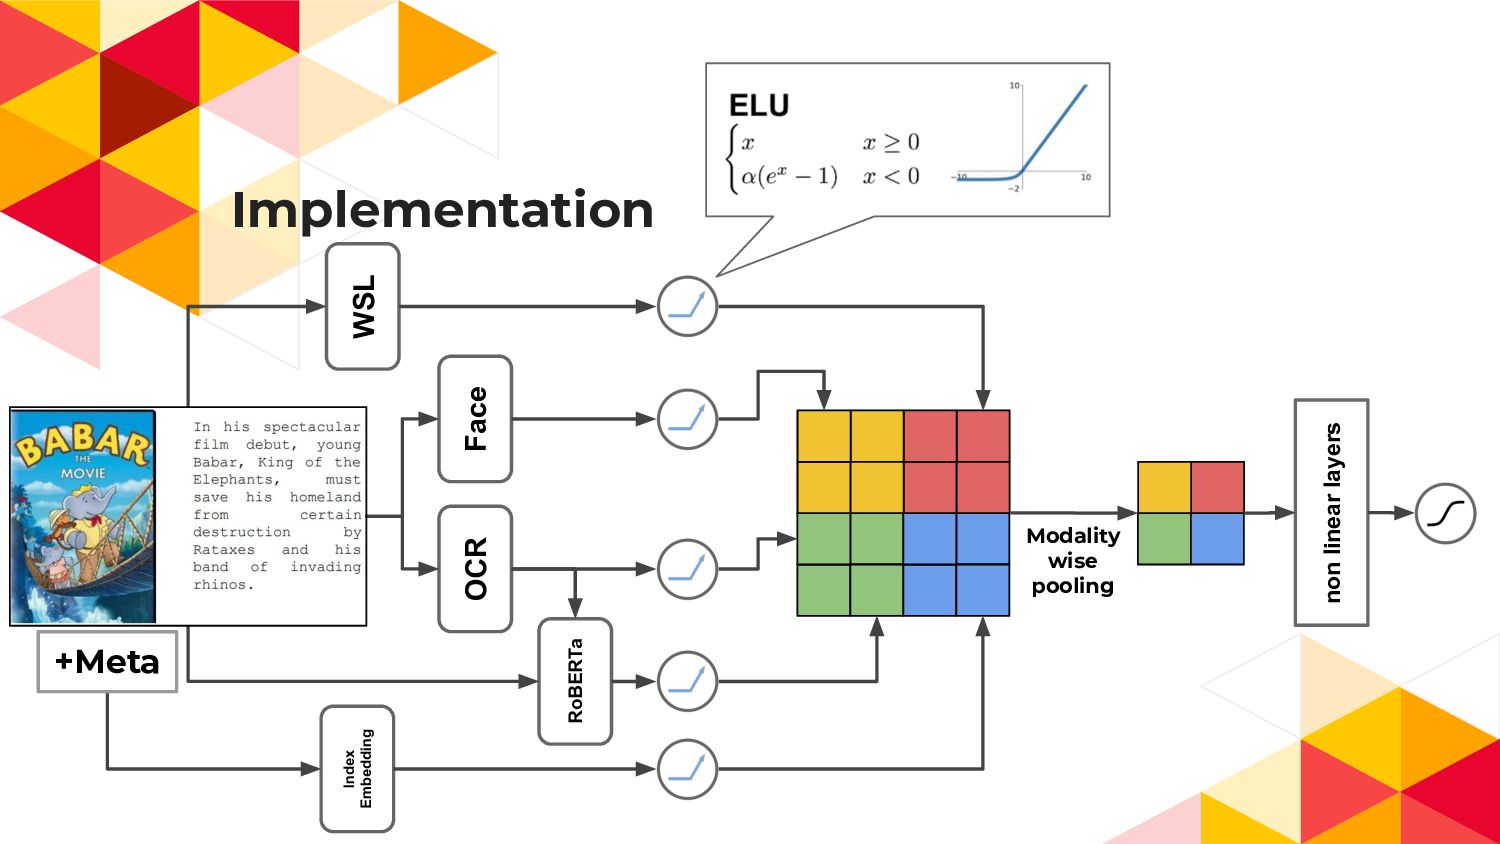
Implementation non linear layers Modality wise pooling WSL Face OCR
RoBERTa Index Embedding +Meta
Results: Ads-Parallelity 28
None
Results: MM-IMDb 30
None
Conclusion 37
Conclusion and Future Work ◂ DynamicなModalityをうまくモデリングできる Multi-Modal Architectureを提案 ◂ PoolingがDown
Samplingのように働く ◂ Max-Poolingを用いた重要度の可視化 ◂ エラー分析が容易に ◂ Videoへの拡張が今後の課題 38
Comment - Pooling自体はシンプルで直感的なので実装しやすい - 特徴抽出器まではfreezeなので計算コストも低そう - Pooling Encoderの出力次元Dがハイパラで肝 - Adsは32次元,
MM-IMDbは1024次元らしい - 説明文(RoBERTa)だけでそこそこ精度が出ている気がする - タスクによるが説明文があればOCRテキストはそこまで要らない? - OCR自体の検出性能が絡んでいそう 39
References - Permutation-equivariant neural networks applied to dynamics prediction -
Graph Neural Networks and Permutation invariance - Connections between Neural Networks and Pure Mathematics - Deep Sets 40
41 Thanks! Any questions? You can find me at ◂
@chck ◂ #times_chck ◂
[email protected]
Feedback - 特徴抽出器もコミコミのe2e? - GPUも1枚なのでおそらく抽出後が入力 - それはそれで実装が重いですね - pooling type結局どれがいいのか
- 精度大差ないのでFeature Importanceとの兼ね合いで Maxでいいのでは


 chck
 kohlerjohannes
 junkurihara
 nnchiba
 recsyslab
 izumiyama_lab
 mikimhk
 hisaokatsumi
 shiell
 institutdelelevage
 ept
 ayaniwa
 ontheslope
 chriscoyier
 aki_iinuma
 varn
 kimpetersen
 aleyda
 ianozsvald
 seathinner
 destraynor
 mlcsv
 reverentgeek
 427marketing
 badams