Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
オンラインの技術カンファレンスを安定稼働させるための取り組み / SRE activity f...
Search
Kohei Ota
November 09, 2021
Technology
1.4k
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
オンラインの技術カンファレンスを安定稼働させるための取り組み / SRE activity for online conference platform
Kohei Ota
November 09, 2021
Transcript
22 slides
オンラインの技術カンファレンスを 安定稼働させるための取り組み Presented by @inductor
自己紹介 Kohei Ota (@inductor) •アーキテクト@HPE •CNCF Ambassador •Google Developer Expert
(GCP) •CloudNative Days Tokyo 運営 •Container Runtime Meetup 運営 •Kubernetes SIG-Docs Japanese owner •Docker Meetup Tokyo 運営
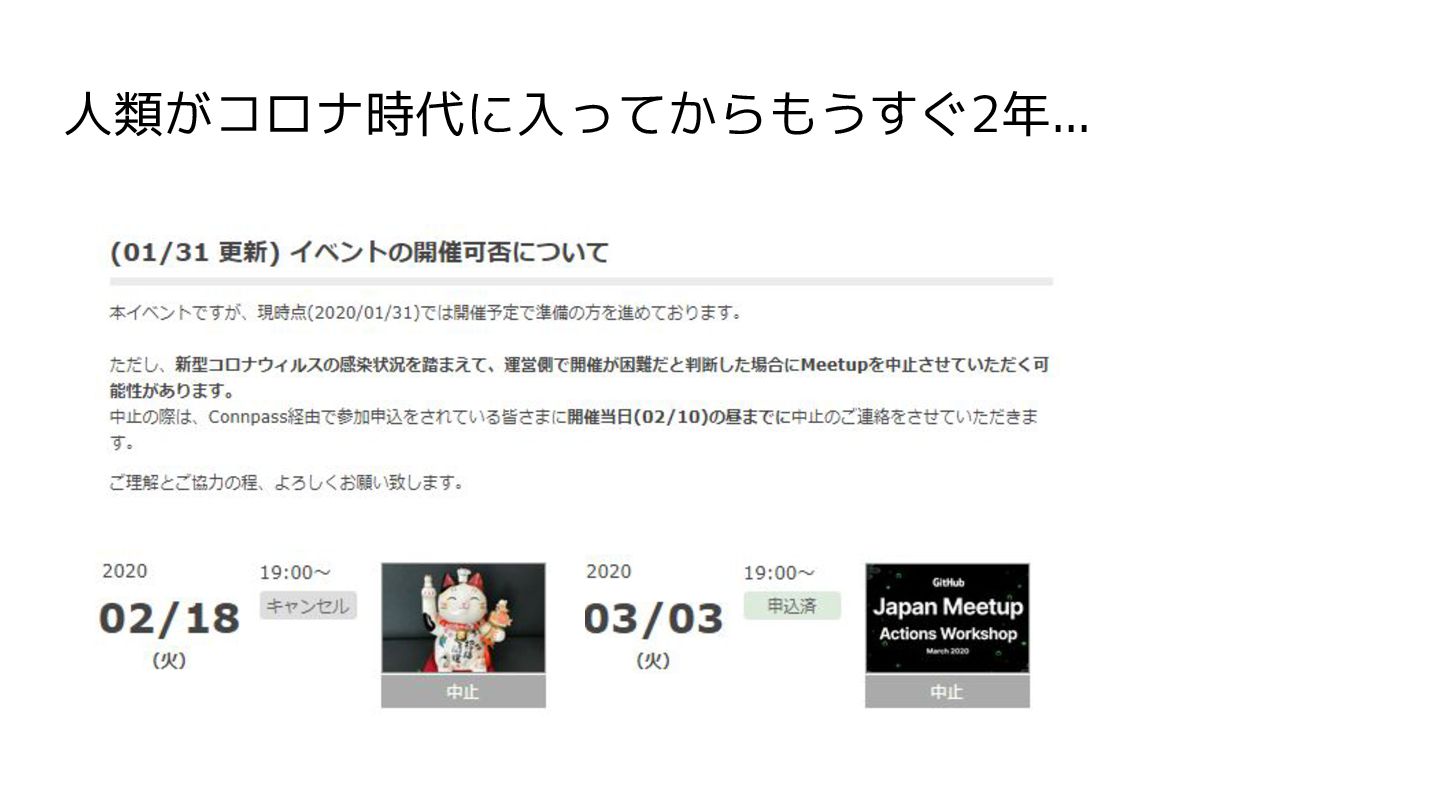
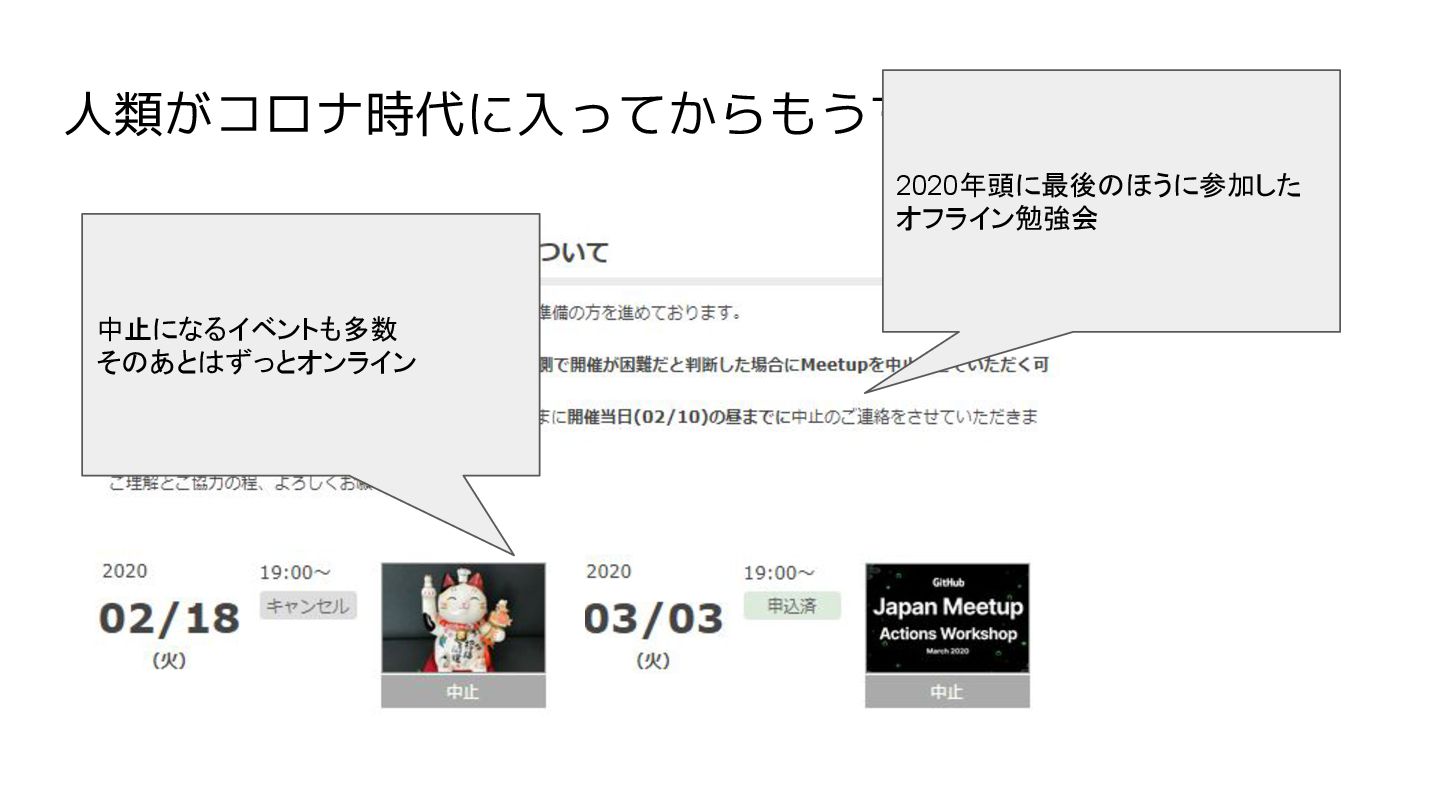
人類がコロナ時代に入ってからもうすぐ2年...
人類がコロナ時代に入ってからもうすぐ2年... 2020年頭に最後のほうに参加した オフライン勉強会 中止になるイベントも多数 そのあとはずっとオンライン
ミートアップでの取り組み • ZOOMの配信機能がかなり便利だった ◦ ほぼゼロコンフィグでYouTube Liveとの連携が終わる ◦ ただし細かいことはいじれないのでレールに乗っかるしかない • 配信機材調達や環境の準備が面倒
◦ 家で配信することになるので人によって音質・画質・回線品質がまちまち • 懇親会や質問による人間のやりとりがやりづらい ◦ Sli.doやTwitterなどのみでは質問内容や回答できる範囲に限界が・・・ → 大変になった部分もあったけど、やればやれないことはないレベル
カンファレンスとミートアップの違い • 単にconnpassを用意して配信環境を用意するでもいいけど・・・ ◦ カンファレンスたるもの、提供できる形をもっと練るべき ◦ 月1とかじゃなくて年に数回のお祭りの体験が損なわれるのはコミュニティとしても損失 • 既存のプラットフォームを検討するも ◦
やりたい形に沿わないプラットフォームのSaaS ◦ 高い利用料 ◦ そもそも品質に疑問があることも → スポンサーやバックの企業ともつながりのあるカンファレンスでは そう簡単にはいかなかった...
カンファレンスとミートアップの違い • 単にconnpassを用意して配信環境を用意するでもいいけど・・・ ◦ カンファレンスたるもの、提供できる形をもっと練るべき ◦ 月1とかじゃなくて年に数回のお祭りの体験が損なわれるのはコミュニティとしても損失 • 既存のプラットフォームを検討するも ◦
やりたい形に沿わないプラットフォームのSaaS ◦ 高い利用料 ◦ そもそも品質に疑問があることも → スポンサーやバックの企業ともつながりのあるカンファレンスでは そう簡単にはいかなかった... 自分たちでプラットフォームを作ってこそ エンジニアじゃないか! →つくった
None
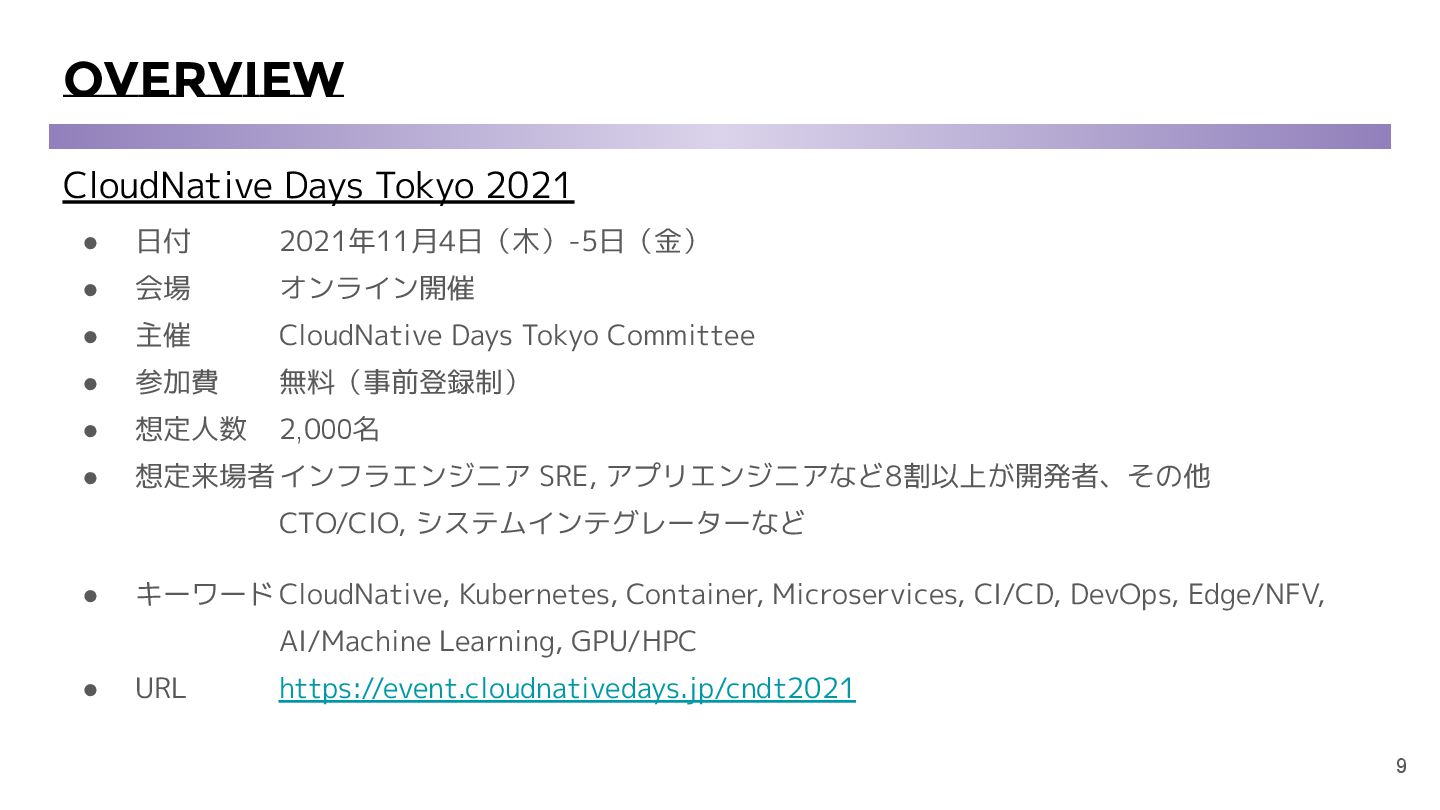
CloudNative Days Tokyo 2021 • 日付 2021年11月4日(木)-5日(金) • 会場 オンライン開催
• 主催 CloudNative Days Tokyo Committee • 参加費 無料(事前登録制) • 想定人数 2,000名〜3,000名 • 想定来場者インフラエンジニア SRE, アプリエンジニアなど8割以上が開発者、その他 CTO/CIO, システムインテグレーターなど • キーワードCloudNative, Kubernetes, Container, Microservices, CI/CD, DevOps, Edge/NFV, AI/Machine Learning, GPU/HPC • URL https://event.cloudnativedays.jp/cndt2021 Overview 9
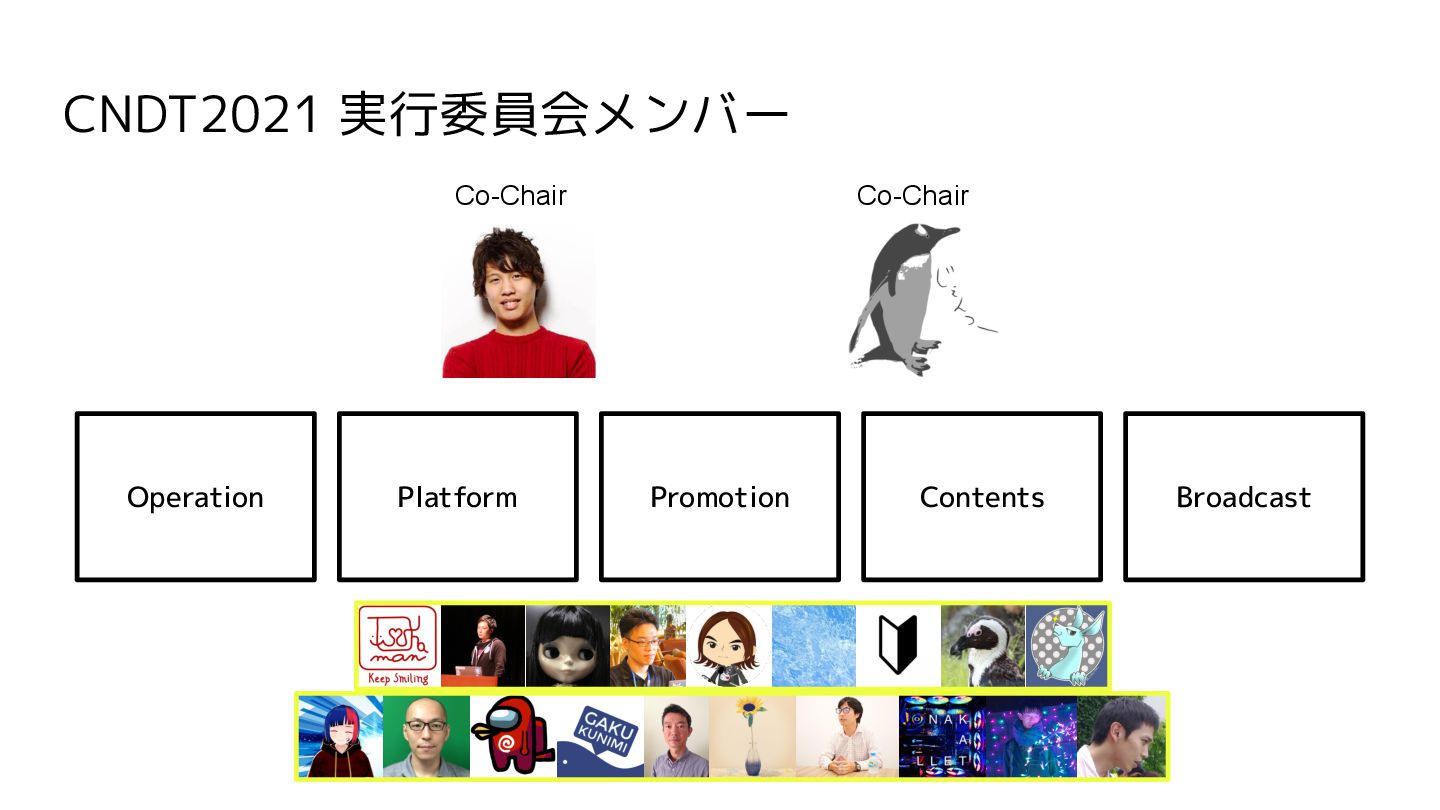
CNDT2021 実行委員会メンバー Co-Chair Operation Platform Promotion Contents Broadcast Co-Chair
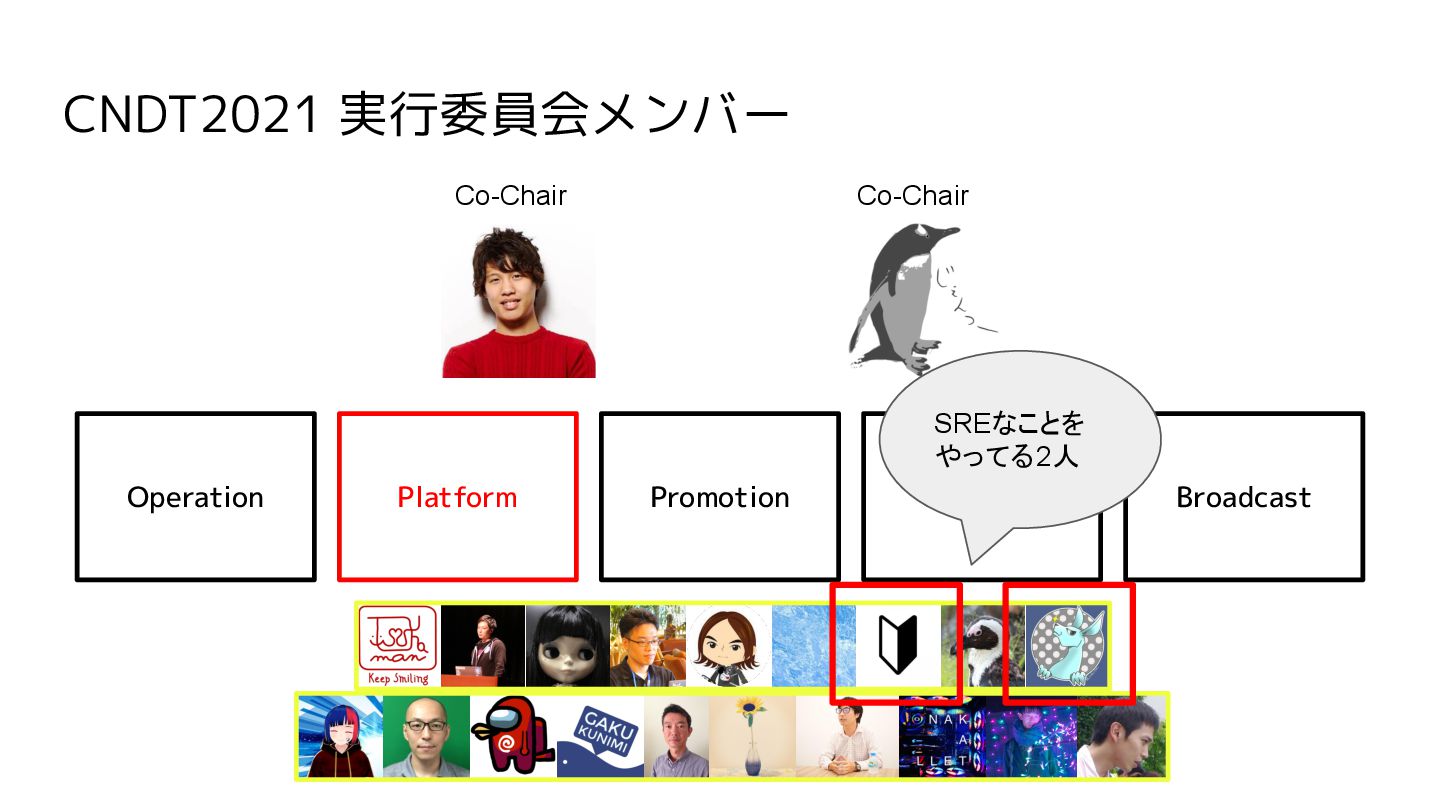
CNDT2021 実行委員会メンバー Co-Chair Operation Platform Promotion Contents Broadcast Co-Chair SREなことを
やってる2人
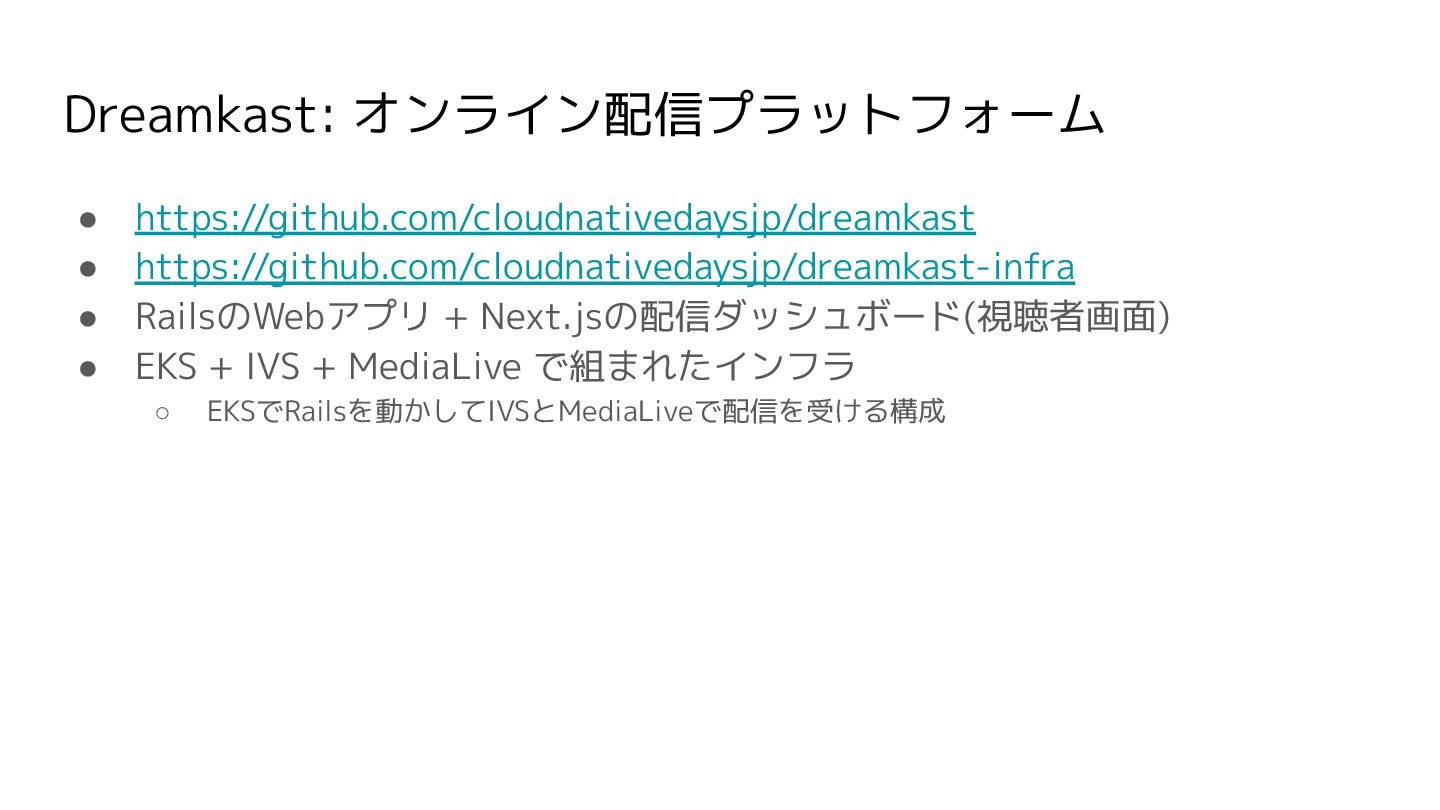
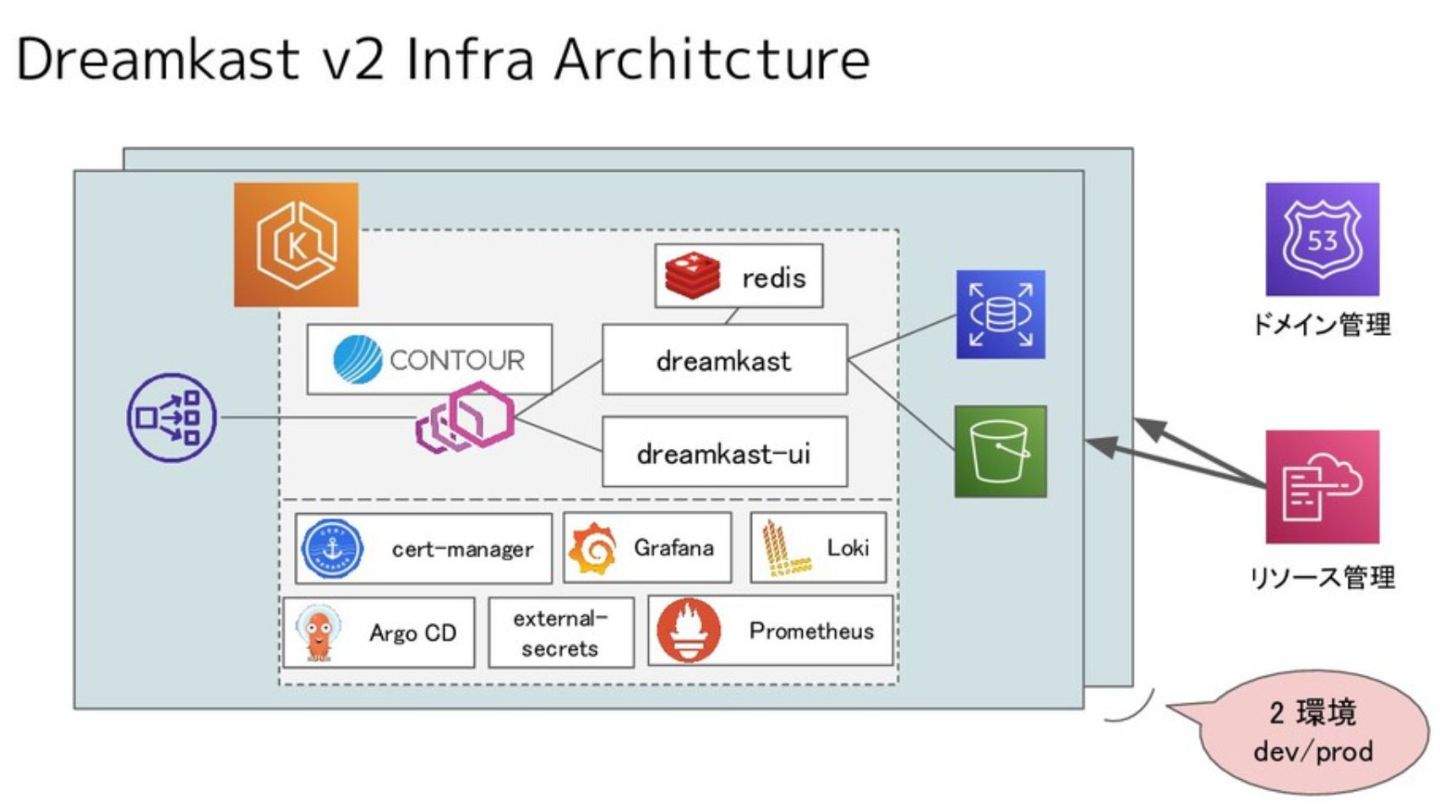
Dreamkast: オンライン配信プラットフォーム • https://github.com/cloudnativedaysjp/dreamkast • https://github.com/cloudnativedaysjp/dreamkast-infra • RailsのWebアプリ + Next.jsの配信ダッシュボード(視聴者画面)
• EKS + IVS + MediaLive で組まれたインフラ ◦ EKSでRailsを動かしてIVSとMediaLiveで配信を受ける構成
CNDT2021 実行委員会メンバー Co-Chair Operation Platform Promotion Contents Broadcast Co-Chair SREなことを
やってる2人 プラットフォームとしての改善の話はこの スライドを見てください
None
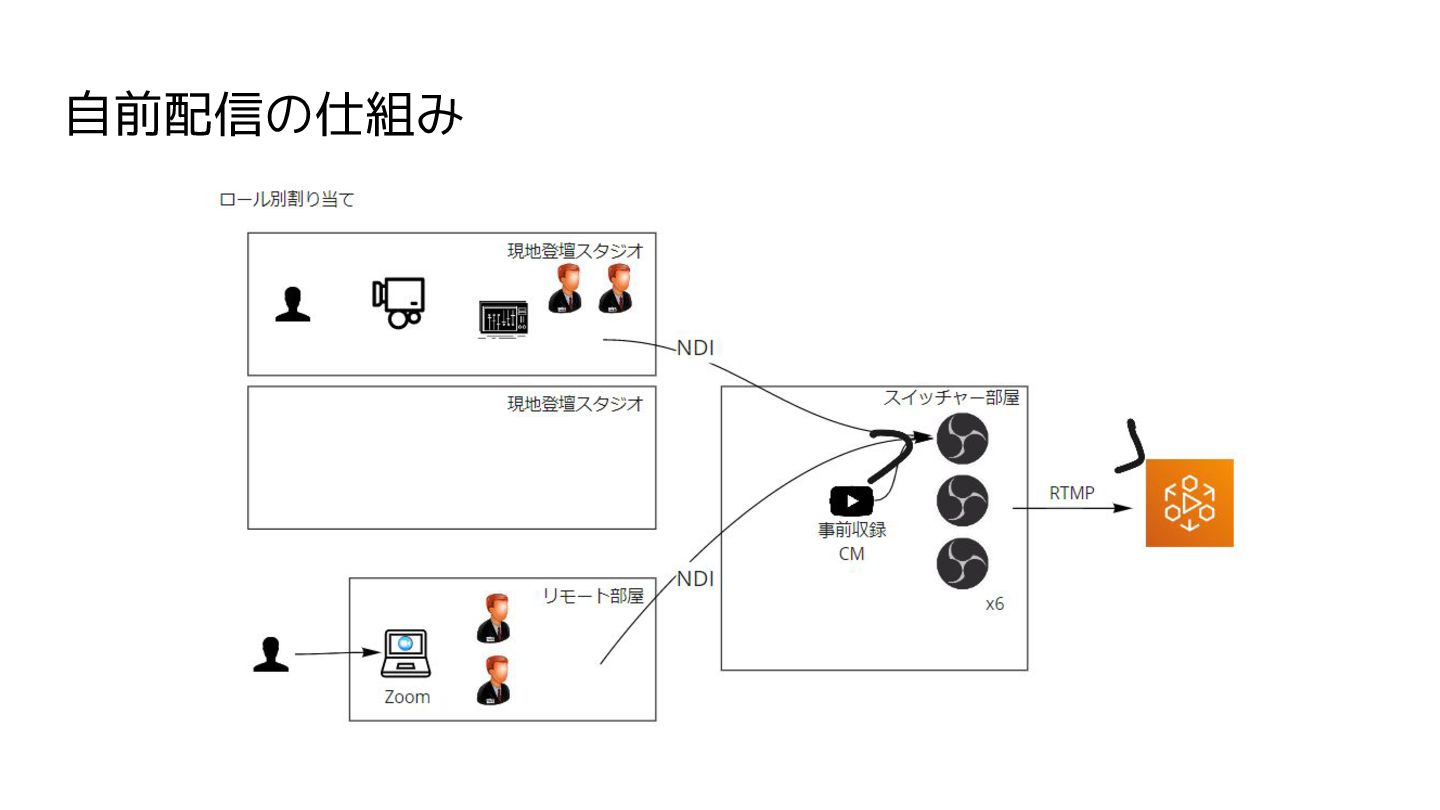
自前配信の仕組み
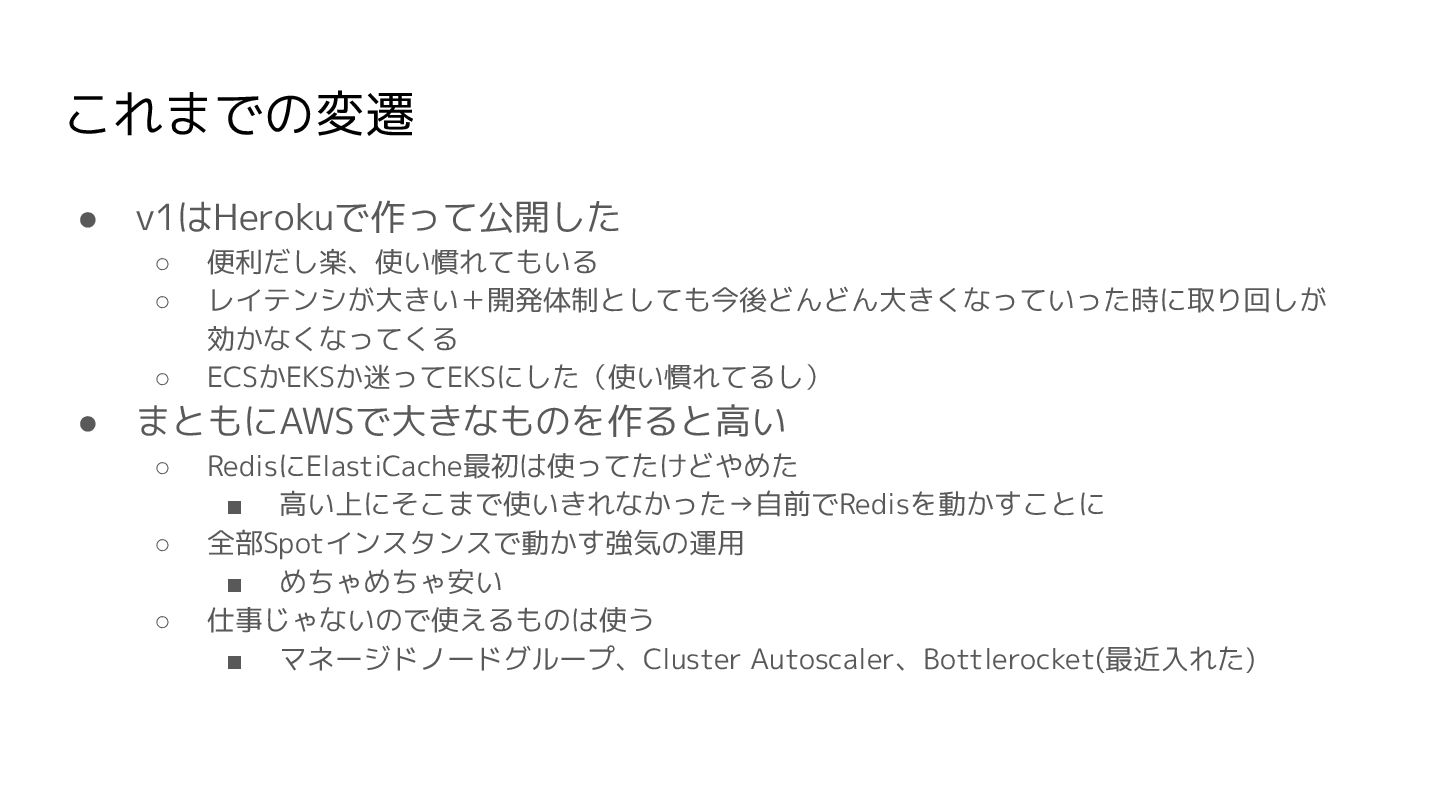
これまでの変遷 • v1はHerokuで作って公開した ◦ 便利だし楽、使い慣れてもいる ◦ レイテンシが大きい+開発体制としても今後どんどん大きくなっていった時に取り回しが 効かなくなってくる ◦ ECSかEKSか迷ってEKSにした(使い慣れてるし)
• まともにAWSで大きなものを作ると高い ◦ RedisにElastiCache最初は使ってたけどやめた ▪ 高い上にそこまで使いきれなかった→自前でRedisを動かすことに ◦ 全部Spotインスタンスで動かす強気の運用 ▪ めちゃめちゃ安い ◦ 仕事じゃないので使えるものは使う ▪ マネージドノードグループ、Cluster Autoscaler、Bottlerocket(最近入れた)
改善してきたこと • 運用のために使っているKubernetesマニフェストとCloudFormationの YAMLファイルはかなり成長してきた ◦ それなりの規模で動かしても大丈夫なくらいにはまともなコードになりつつあると思う • 相方のSREがPull requestベースでステージング上に検証用のPodが立ち上 がってLBに登録されるみたいなやつをオペレーター実装してくれた
• AWS自体で取り組まれている改善は極力リアルタイムに入れている ◦ 運用周りのオペレーターとか、新機能の追加検証とか、好きに実験してる ◦ さっきのページの「仕事じゃないので使えるものは使う」に同じ ◦ Fargateは最初入れたけどスケールが遅いのでやめた
今まで起こったプラットフォーム周りのあれこれ • イベント開始直後に500エラーが頻発(EKSにしてから最初のイベント) ◦ アクセス過多でスケールが間に合わなくて捌ききれなかった ◦ 手動でスケールしてどうにかしたけど次からはちゃんと負荷試験かけるようにした ◦ 本番ではなくプレイベントでよかった・・・(これ以外にもプレイベントでは本番で困らない ようにたくさんのことを実験しています)
• ArgoCDが重くて動かなくなった ◦ リポジトリ登録数が増えて負荷が高くなった ◦ デフォルトで設定されていたCPU Limitsを引き上げて解決 • 激アツ!Redis再起動 ◦ ログインセッションがブチッと切れる→こまる ◦ 実はまだ改善しないといけないポイント
今後直したい課題 • アプリケーションログの整理と集約、整備 ◦ Loki入れてるには入れてるけど活用できてない & CloudWatchのContainer Insightsはずっ と動かしてるとカネがかかる •
Railsアプリの分散トレーシング ◦ Jaeger検証中だけどRuby(Rails) + Open Telemetryもうちょっと枯れてほしい ◦ X-rayは検証した限り使い物にならなくてやめた • 運用ドキュメントもうちょっと整備したい • 入れたHelmとかオペレーターのメンテナンスどうするか ◦ バージョンアップ手動おじさんの限界
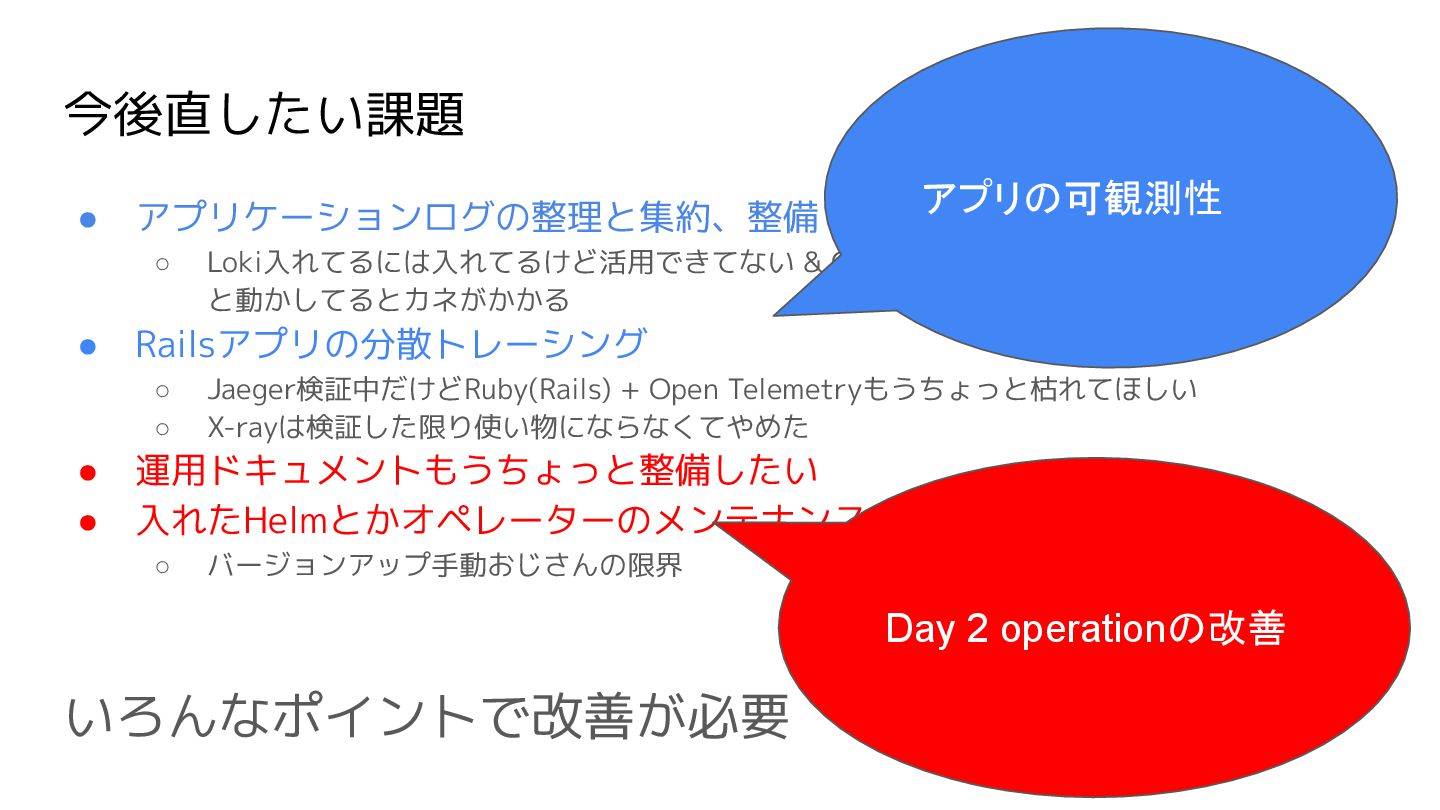
今後直したい課題 • アプリケーションログの整理と集約、整備 ◦ Loki入れてるには入れてるけど活用できてない & CloudWatchのContainer Insightsはずっ と動かしてるとカネがかかる •
Railsアプリの分散トレーシング ◦ Jaeger検証中だけどRuby(Rails) + Open Telemetryもうちょっと枯れてほしい ◦ X-rayは検証した限り使い物にならなくてやめた • 運用ドキュメントもうちょっと整備したい • 入れたHelmとかオペレーターのメンテナンスどうするか ◦ バージョンアップ手動おじさんの限界 いろんなポイントで改善が必要 アプリの可観測性 Day 2 operationの改善
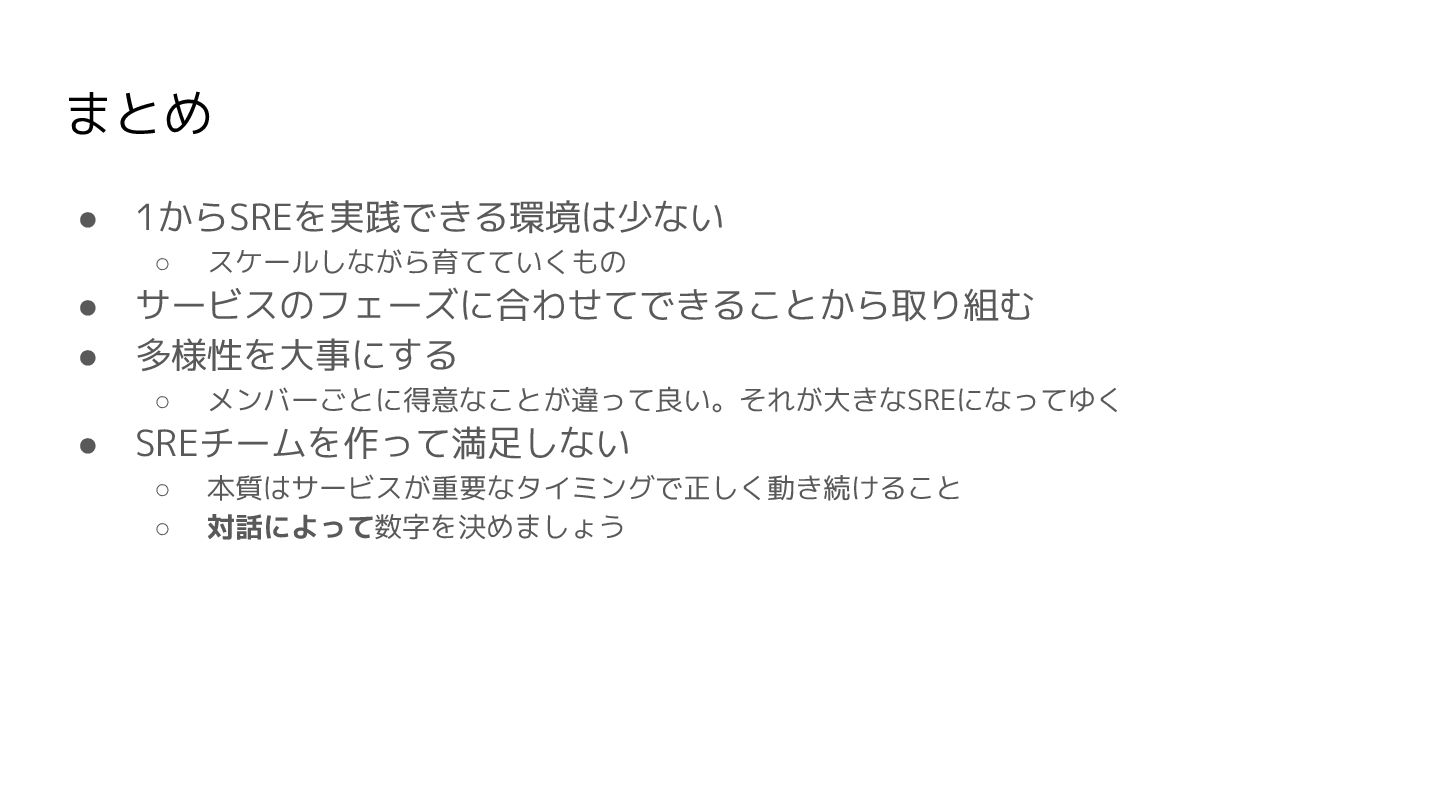
まとめ • 1からSREを実践できる環境は少ない ◦ スケールしながら育てていくもの • サービスのフェーズに合わせてできることから取り組む • 多様性を大事にする ◦
メンバーごとに得意なことが違って良い。それが大きなSREになってゆく • SREチームを作って満足しない ◦ 本質はサービスが重要なタイミングで正しく動き続けること ◦ 対話によって数字を決めましょう
We are hiring!! (運営メンバー)
More Decks by Kohei Ota
See All by Kohei Ota
CloudNative Meets WebAssembly: Exploring Wasm's Potential to Replace Containers
inductor
4
3.7k
The Cloud Native Chronicles: 10 Years of Community Growth Inside and Outside Japan
inductor
0
220
Cracking the KubeCon CfP
inductor
2
960
KubeCon Recap -Platform migration at Scale-
inductor
1
1.1k
コンテナビルド最新事情 2022年度版 / Container Build 2022
inductor
3
620
データベースとストレージのレプリケーション入門 / Intro-of-database-and-storage-replication
inductor
28
6.7k
KubeConのケーススタディから振り返る、Platform for Platforms のあり方と その実践 / Lessons from KubeCon case studies: Platform for Platforms and its practice
inductor
3
1.1k
Kubernetesネットワーキング初級者脱出ガイド / Kubernetes networking beginner's guide
inductor
23
8.1k
コンテナネイティブロードバランシングの話 / A story about container native load balancing
inductor
2
2.5k
Other Decks in Technology
See All in Technology
パスワードのない鍵で、 データを手元に置く
ginjihayashi
0
310
AI対話型分析を作成し、リリースするまでの話 / The Road to Release: Buiding AI Conversational Analytics
yappli_developers
0
170
[関西Kaggler会 20261113] 続・コミュニティコンペのススメ
nejumi
0
140
E2E Test というハーネス — AI時代の自動テスト民主化
daishukojima
10
5.6k
2026-11-16 JAWS-UG コンテナ支部 #31 ゆるLT大会 ECR のライフサイクルポリシーを いい感じに設定したい / ECR Lifecycle policy
masasuzu
2
500
_マネジメントする人される人ナイト_2026__良いチームを作っていきたい_お気持ち_.pdf
xkxaxkx
0
780
人の努力に頼らないセキュリティをエンジニアリングする在り方 / An approach to engineering security that does not rely on human effort
carta_engineering
0
220
マネージャーをエスパーにしない マネジメントされる側から始める、働きやすい現場づくり
comi190327
1
760
「任されビリティ」で引き受けて「よしなりてぃ」に頼らず任せる / Accept tasks with "makasarebility" and hand them over without relying on "yoshinarily"
pauli
1
780
AIで実装が加速したのに、 なぜ私は仕事の大半で人と話し続けていたのか?
say_no_w
0
190
20261113_JAWS_Osaka
takuyay0ne
1
580
思考過程から秘密が漏れる:Amazon Bedrock上のKimi K3を5つの方法で攻めたら、25回中22回漏洩した話
yama3133
1
170
Featured
See All Featured
Money Talks: Using Revenue to Get Sh*t Done
nikkihalliwell
0
560
Self-Hosted WebAssembly Runtime for Runtime-Neutral Checkpoint/Restore in Edge–Cloud Continuum
chikuwait
0
950
Designing Dashboards & Data Visualisations in Web Apps
destraynor
232
55k
We Have a Design System, Now What?
morganepeng
55
8.4k
[RailsConf 2023 Opening Keynote] The Magic of Rails
eileencodes
31
10k
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2.1k
Into the Great Unknown - MozCon
thekraken
41
2.8k
The Art of Programming - Codeland 2020
erikaheidi
57
15k
Building Better People: How to give real-time feedback that sticks.
wjessup
371
20k
Jamie Indigo - Trashchat’s Guide to Black Boxes: Technical SEO Tactics for LLMs
techseoconnect
PRO
0
750
Between Models and Reality
mayunak
4
590
DevOps and Value Stream Thinking: Enabling flow, efficiency and business value
helenjbeal
2
450


 inductor
 ginjihayashi
 yappli_developers
 nejumi
 daishukojima
 masasuzu
 xkxaxkx
 carta_engineering
 comi190327
 pauli
 say_no_w
 takuyay0ne
 yama3133
 nikkihalliwell
 chikuwait
 destraynor
 morganepeng
 eileencodes
 joshbly
 thekraken
 erikaheidi
 wjessup
 techseoconnect
 mayunak
 helenjbeal