Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
統計的機械翻訳は意訳しにくいのか?
Search
自然言語処理研究室
March 31, 2009
Research
120
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
統計的機械翻訳は意訳しにくいのか?
竹元 勇太, 山本 和英. 統計的機械翻訳は意訳しにくいのか?. 言語処理学会第15回年次大会, pp.228-231 (2009.3)
自然言語処理研究室
March 31, 2009
More Decks by 自然言語処理研究室
See All by 自然言語処理研究室
データサイエンス14_システム.pdf
jnlp
0
430
データサイエンス13_解析.pdf
jnlp
0
550
データサイエンス12_分類.pdf
jnlp
0
380
データサイエンス11_前処理.pdf
jnlp
0
510
Recurrent neural network based language model
jnlp
0
190
自然言語処理研究室 研究概要(2012年)
jnlp
0
170
自然言語処理研究室 研究概要(2013年)
jnlp
0
130
自然言語処理研究室 研究概要(2014年)
jnlp
0
160
自然言語処理研究室 研究概要(2015年)
jnlp
0
240
Other Decks in Research
See All in Research
Être éleveur dans un monde en transition : Comprendre les changements pour mieux les accompagner
institutdelelevage
PRO
0
140
CDCL を用いた MILP の厳密解法
imai448
0
300
CVPR2026論文紹介_VLMにとって良いvision encoderとは何か?Rethinking Model Selection in VLM Through the Lens of Gromov-Wasserstein Distance
kobayashi31
1
270
Volatilité des marchés et sécheresse historique, l’élevage bovin viande sous contraintes en 2026
institutdelelevage
PRO
0
130
Local Development Companies Network - National Conference 2026
ldcn
0
110
湯村研究室の紹介2026 / yumulab2026
yumulab
0
140
The Conductor Pattern -Multi-Granularity Feedback for Creative Agents-
shibuiwilliam
2
110
Cross-Media Human-Information Interaction
signer
PRO
0
280
SLAMはどこまで解決されたのか?
tomonom
0
1.5k
[IEICE-Soceity-Conf2026] セマンティック通信を見据えたマルチスケールセンシングと 学習の融合によるデジタルツイン基盤 / Digital Twin Infrastructure via the Fusion of Multi-Scale Sensing and Learning toward Semantic Communications
pman0214
0
110
Bilan travail en élevage : première restitution des enquêtes 2025-2026
institutdelelevage
PRO
0
230
Vector Map as Language: Toward Unified Remote Sensing Vector Mapping
satai
3
320
Featured
See All Featured
技術選定の審美眼(2025年版) / Understanding the Spiral of Technologies 2025 edition
twada
PRO
120
120k
YesSQL, Process and Tooling at Scale
rocio
174
15k
Connecting the Dots Between Site Speed, User Experience & Your Business [WebExpo 2025]
tammyeverts
11
1.1k
State of Search Keynote: SEO is Dead Long Live SEO
ryanjones
0
320
So, you think you're a good person
axbom
PRO
2
2.2k
The SEO Collaboration Effect
kristinabergwall1
1
590
Designing for Timeless Needs
cassininazir
1
530
AI: The stuff that nobody shows you
jnunemaker
PRO
10
1.2k
Technical Leadership for Architectural Decision Making
baasie
3
600
Game over? The fight for quality and originality in the time of robots
wayneb77
1
310
Utilizing Notion as your number one productivity tool
mfonobong
4
620
Side Projects
sachag
456
43k
Transcript
統計的機械翻訳 は意訳しにくい 長岡技術科学大学 山本研究室 竹元勇太 山本和英
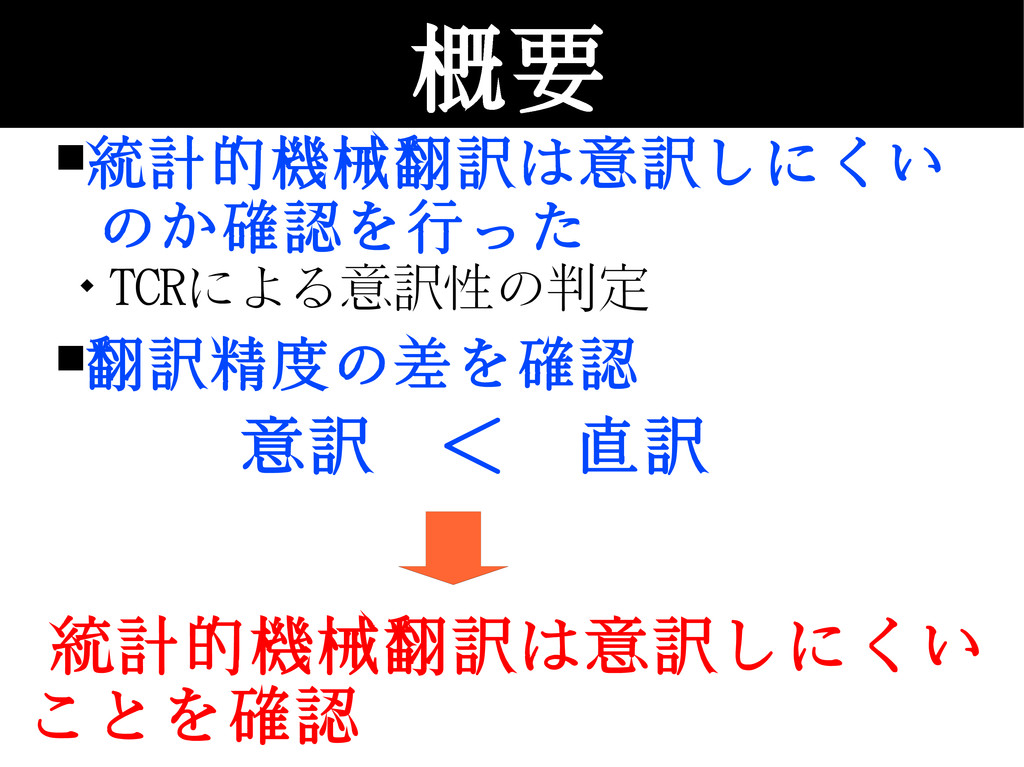
概要 ▪統計的機械翻訳は意訳しにくい のか確認を行った TCRによる意訳性の判定 ▪翻訳精度の差を確認 意訳 < 直訳 統計的機械翻訳は意訳しにくい ことを確認
関連研究 ▪直訳性を利用した機械翻訳知識の自 動構築[今村 04] 日英対訳コーパス TCR 英語 日本語 1.00 --a--
--A-- 0.96 --b-- --B-- 0.85 --c-- --C-- 0.82 --d-- --D-- . . 0.65 --g-- --G-- 0.43 --g-- --G-- 0.10 --h-- --H-- 直訳的対訳文を用いた 翻訳モデル 意訳的対訳文を用いた 翻訳モデル
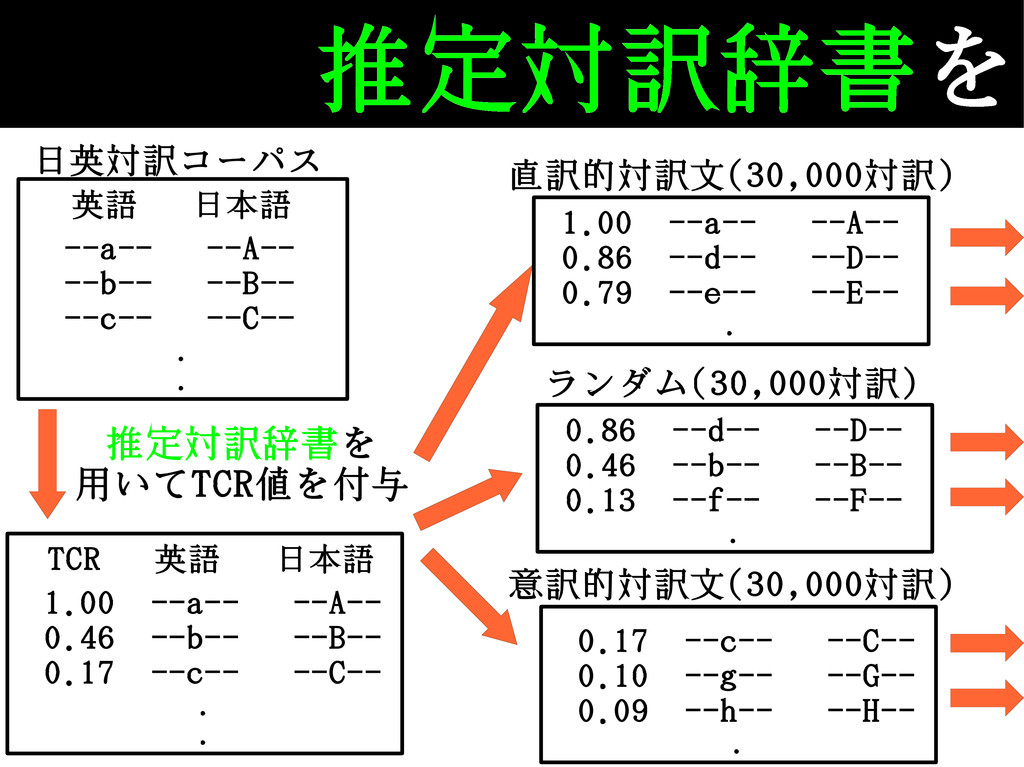
推定対訳辞書を TCR 英語 日本語 1.00 --a-- --A-- 0.46 --b-- --B--
0.17 --c-- --C-- . . 英語 日本語 --a-- --A-- --b-- --B-- --c-- --C-- . . 日英対訳コーパス 推定対訳辞書を 用いてTCR値を付与 1.00 --a-- --A-- 0.86 --d-- --D-- 0.79 --e-- --E-- . 0.86 --d-- --D-- 0.46 --b-- --B-- 0.13 --f-- --F-- . 0.17 --c-- --C-- 0.10 --g-- --G-- 0.09 --h-- --H-- . 直訳的対訳文(30,000対訳) ランダム(30,000対訳) 意訳的対訳文(30,000対訳)
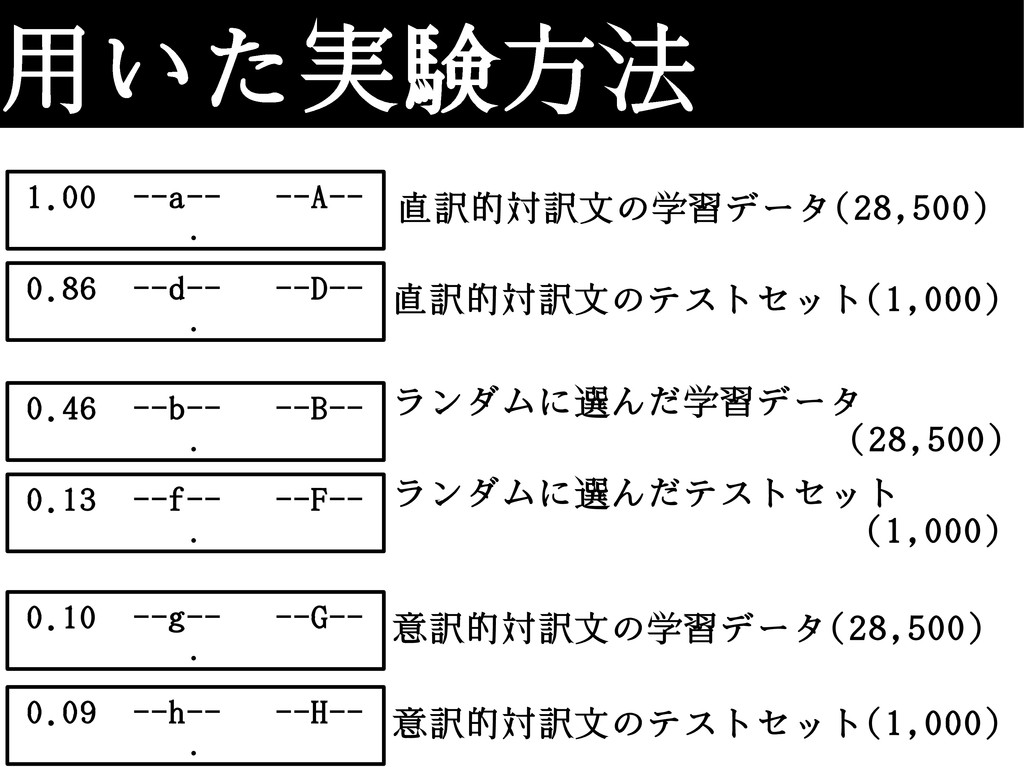
用いた実験方法 1.00 --a-- --A-- . 0.86 --d-- --D-- . 0.46
--b-- --B-- . 0.13 --f-- --F-- . 0.10 --g-- --G-- . 0.09 --h-- --H-- . 直訳的対訳文の学習データ(28,500) 直訳的対訳文のテストセット(1,000) ランダムに選んだ学習データ (28,500) ランダムに選んだテストセット (1,000) 意訳的対訳文の学習データ(28,500) 意訳的対訳文のテストセット(1,000)
推定対訳辞書を用いた実験結果 ▪意訳のテストセットは直訳やランダムの テストセットに比べて翻訳精度が1/2程度 ➔ 意訳しにくいということを表している 翻訳 モデル テストセット 直訳 意訳
ランダム 直訳 0.297 0.087 0.257 意訳 0.201 0.125 0.226 ランダム 0.270 0.099 0.229 平均 0.256 0.104 0.237 Table1 翻訳モデルの違いによる各テストセットの評価結果(BLEU)
英辞郎対訳辞書を ▪推定対訳辞書を用いた実験結果は GIZA++の特徴が表れていた? 英辞郎対訳辞書を用いて再実験 ▪評価用データの作成 26,095対訳をテストセットに使用 TCR値でソートし、2,610対訳ごとに分割
各2,610対訳からテストセット1,000対訳 を抽出
▪翻訳モデルの構築 テストセットを除いた359,431対訳を使用 して翻訳モデルを構築 ▪言語モデルの構築 対訳コーパスの目的言語を使用 テストセットは除いている
5-gramまで 用いた実験方法
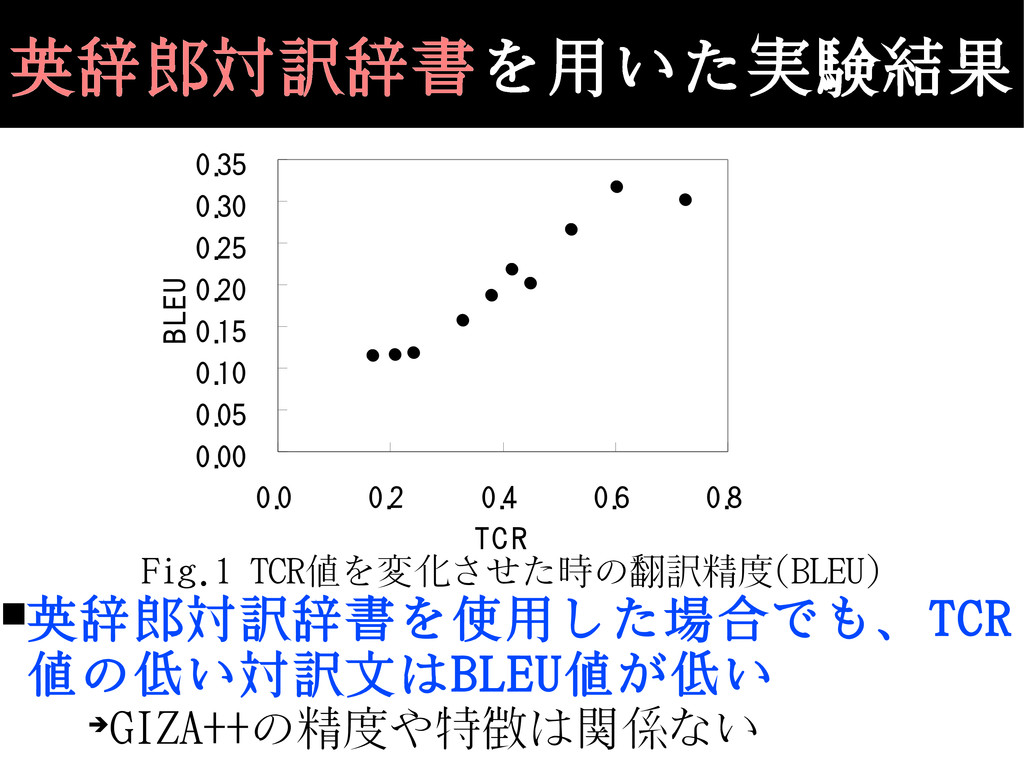
0. 00 0. 05 0. 10 0. 15 0. 20
0. 25 0. 30 0. 35 0. 0 0. 2 0. 4 0. 6 0. 8 TC R BLEU ▪英辞郎対訳辞書を使用した場合でも、TCR 値の低い対訳文はBLEU値が低い ➔ GIZA++の精度や特徴は関係ない Fig.1 TCR値を変化させた時の翻訳精度(BLEU) 英辞郎対訳辞書を用いた実験結果
コーパスサイズを変化させて実験 ▪翻訳モデル構築方法の違いによる影響 を3種類の翻訳モデルによって確認 全体モデル ➔ 全対訳文(360,000対訳)から構築 直訳モデル ➔
TCR値の高い方から30,000対訳ずつ増やして 構築(11個のモデルを構築) 意訳モデル ➔ TCR値の低い方から30,000対訳ずつ増やして 構築(11個のモデルを構築)
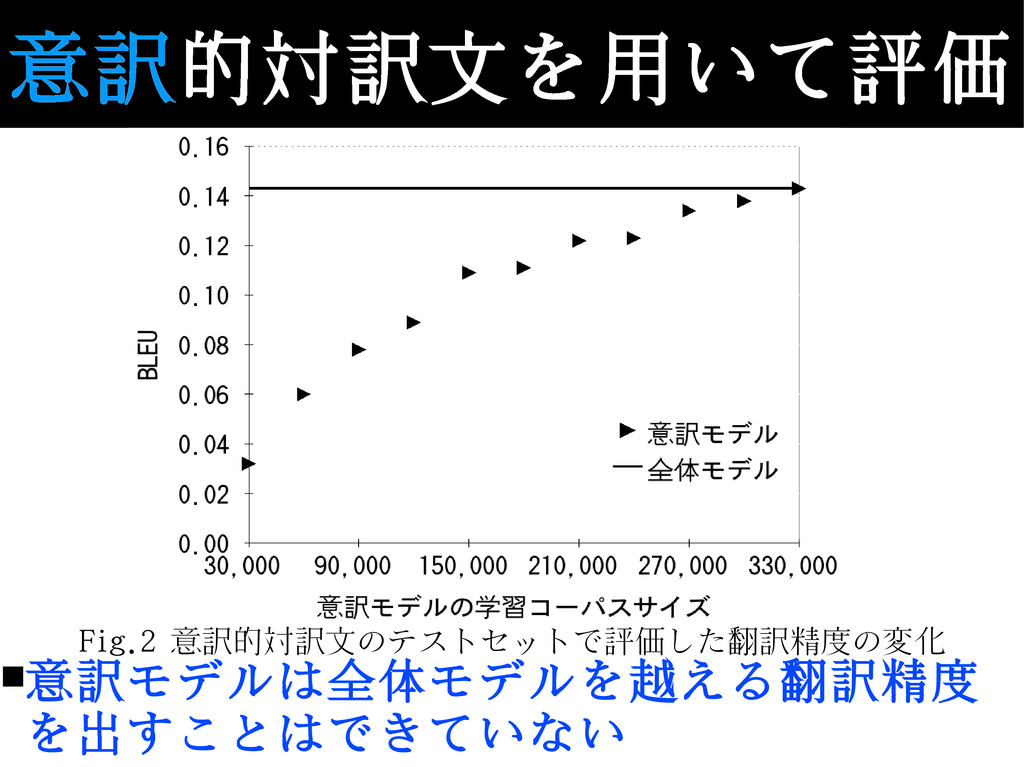
意訳的対訳文を用いて評価 Fig.2 意訳的対訳文のテストセットで評価した翻訳精度の変化 ▪意訳モデルは全体モデルを越える翻訳精度 を出すことはできていない
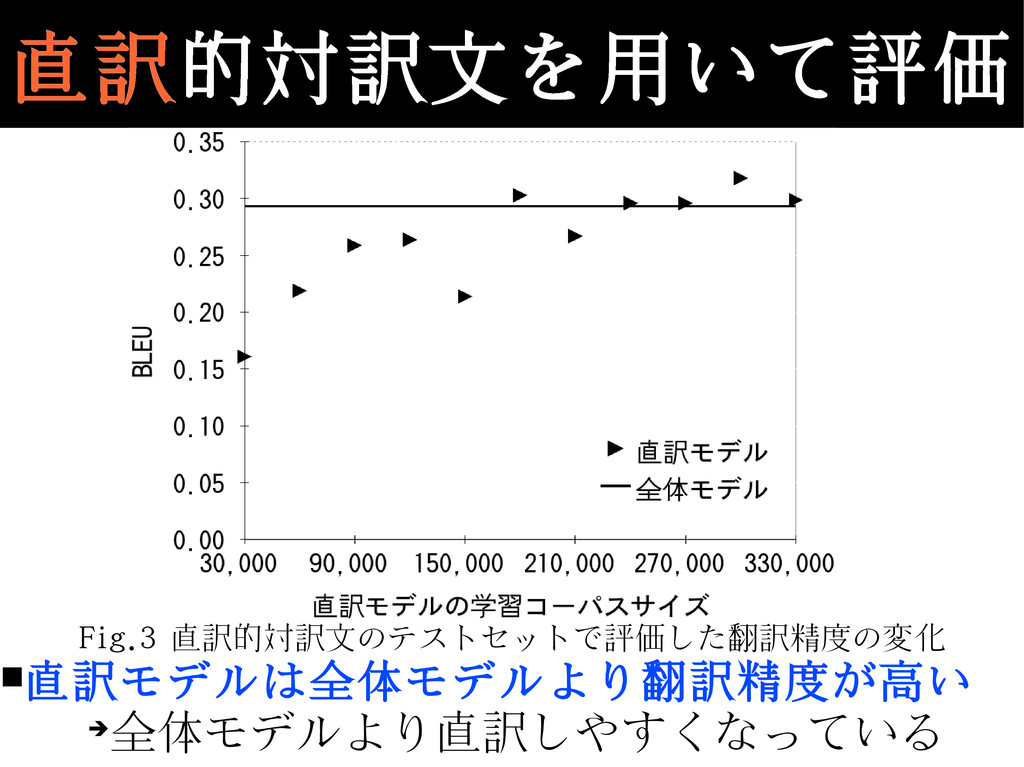
Fig.3 直訳的対訳文のテストセットで評価した翻訳精度の変化 ▪直訳モデルは全体モデルより翻訳精度が高い ➔ 全体モデルより直訳しやすくなっている 直訳的対訳文を用いて評価
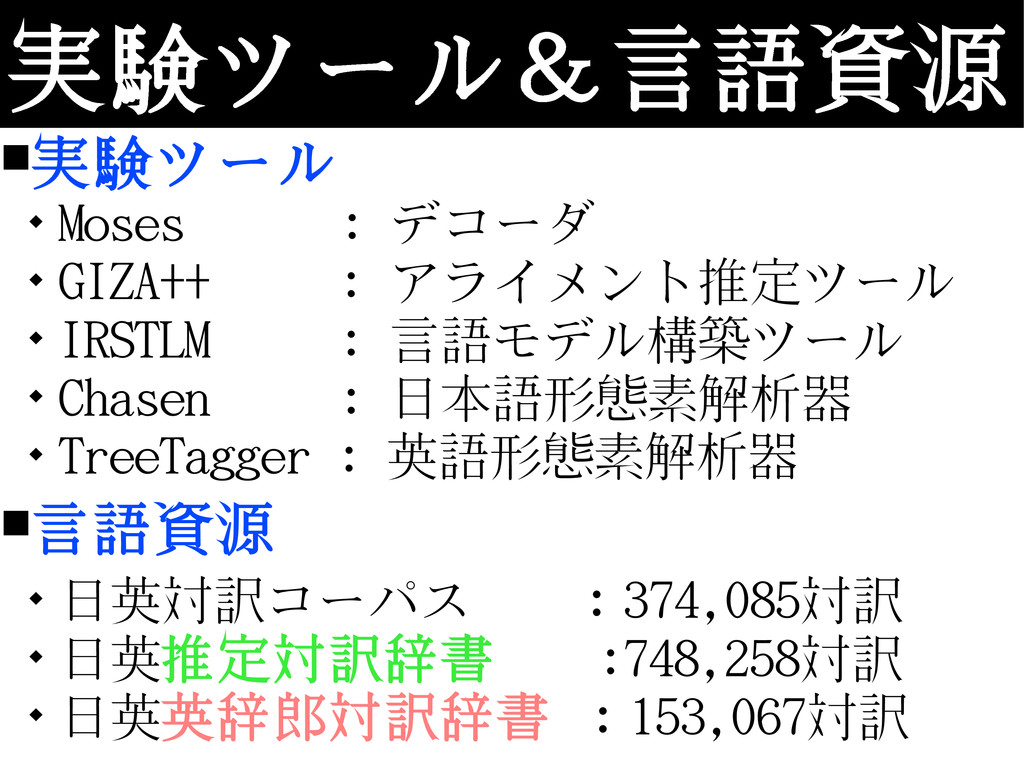
実験ツール&言語資源 ▪実験ツール Moses : デコーダ GIZA++ : アライメント推定ツール
IRSTLM : 言語モデル構築ツール Chasen : 日本語形態素解析器 TreeTagger : 英語形態素解析器 ▪言語資源 日英対訳コーパス :374,085対訳 日英推定対訳辞書 :748,258対訳 日英英辞郎対訳辞書 :153,067対訳
TCRの計算方法 TCR = 2 ×対訳辞書中に対訳としてある数 [L ] 対訳辞書中にある原文の単語数 [Ts ]+
対訳辞書中にある翻訳結果の単語数 [Tt ] 丸囲み単語の個数がTs及びTt、直線の数がLに値する
英辞郎対訳辞書を用いた実験 ▪評価用データの作成方法 辞書Bは辞書Aに比べ対訳数が1/5と少ない TCR値の信頼度を上げるために、以下の式 を満たす対訳文だけをテストセットとする 対訳辞書中にある原文の単語数 [Ts ]+
対訳辞書中にある翻訳結果の単語数 [Tt ] 原言語の単語数 [Ws ]+目的言語の単語数 [Wt ] ≥0.9


 jnlp
 institutdelelevage
 imai448
 kobayashi31
 ldcn
 yumulab
 shibuiwilliam
 signer
 tomonom
 pman0214
 satai
 twada
 rocio
 tammyeverts
 ryanjones
 axbom
 kristinabergwall1
 cassininazir
 jnunemaker
 baasie
 wayneb77
 mfonobong
 sachag