Share
Embed
[IT] Perché l'encoding é importante
Ticino XP - Bedano (CH), February 11, 2016 - F. Sblendorio, M. Piccinetti
Jobrapido
March 11, 2016
Transcript
25 slides
-
Perché l'encoding è importante? 2015 Francesco Sblendorio 11 marzo 2016
Iniziativa “TicinoXP” Bedano (CH) -
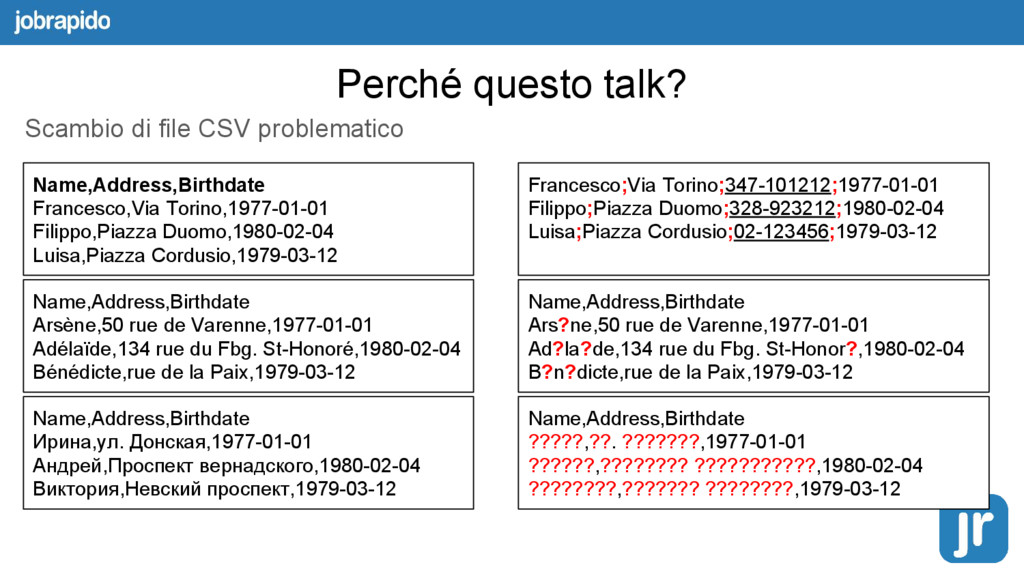
Perché questo talk? Scambio di file CSV problematico Francesco;Via Torino;347-101212;1977-01-01
Filippo;Piazza Duomo;328-923212;1980-02-04 Luisa;Piazza Cordusio;02-123456;1979-03-12 Name,Address,Birthdate Francesco,Via Torino,1977-01-01 Filippo,Piazza Duomo,1980-02-04 Luisa,Piazza Cordusio,1979-03-12 Name,Address,Birthdate Arsène,50 rue de Varenne,1977-01-01 Adélaïde,134 rue du Fbg. St-Honoré,1980-02-04 Bénédicte,rue de la Paix,1979-03-12 Name,Address,Birthdate Ars?ne,50 rue de Varenne,1977-01-01 Ad?la?de,134 rue du Fbg. St-Honor?,1980-02-04 B?n?dicte,rue de la Paix,1979-03-12 Name,Address,Birthdate Ирина,ул. Донская,1977-01-01 Андрей,Проспект вернадского,1980-02-04 Виктория,Невский проспект,1979-03-12 Name,Address,Birthdate ?????,??. ???????,1977-01-01 ??????,???????? ???????????,1980-02-04 ????????,??????? ????????,1979-03-12 -
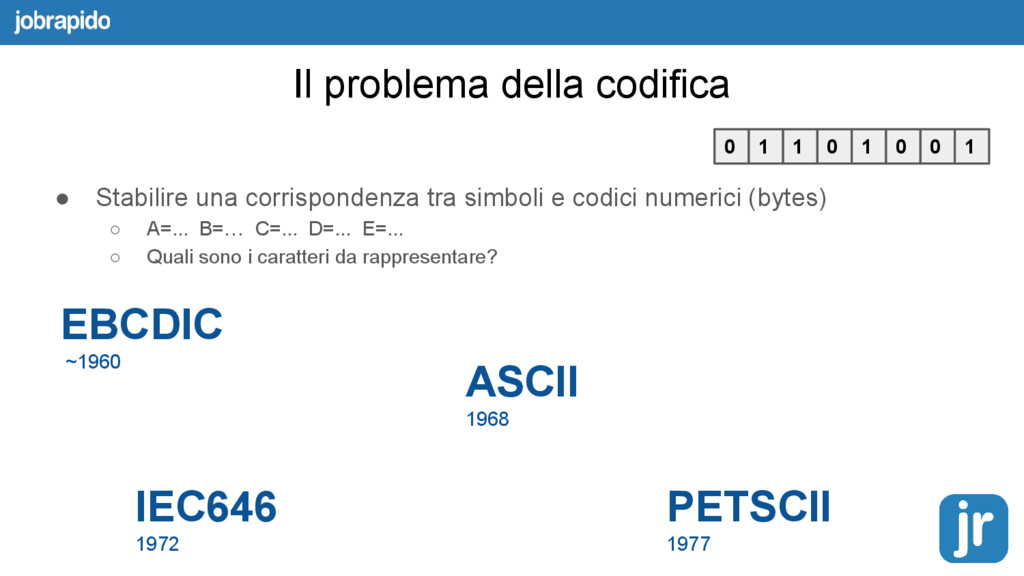
Il problema della codifica • Stabilire una corrispondenza tra simboli
e codici numerici (bytes) ◦ A=... B=… C=... D=... E=... ◦ Quali sono i caratteri da rappresentare? IEC646 1972 ASCII 1968 PETSCII 1977 EBCDIC ~1960 0 1 1 0 1 0 0 1 -
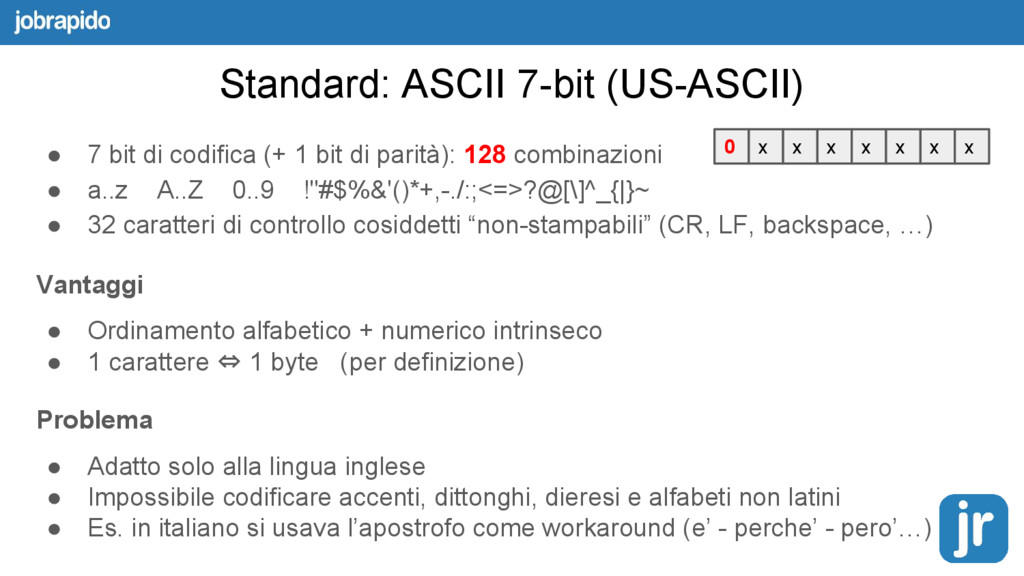
Standard: ASCII 7-bit (US-ASCII) • 7 bit di codifica (+
1 bit di parità): 128 combinazioni • a..z A..Z 0..9 !"#$%&'()*+,-./:;<=>?@[\]^_{|}~ • 32 caratteri di controllo cosiddetti “non-stampabili” (CR, LF, backspace, …) Vantaggi • Ordinamento alfabetico + numerico intrinseco • 1 carattere ⇔ 1 byte (per definizione) 0 x x x x x x x Problema • Adatto solo alla lingua inglese • Impossibile codificare accenti, dittonghi, dieresi e alfabeti non latini • Es. in italiano si usava l’apostrofo come workaround (e’ - perche’ - pero’…) -
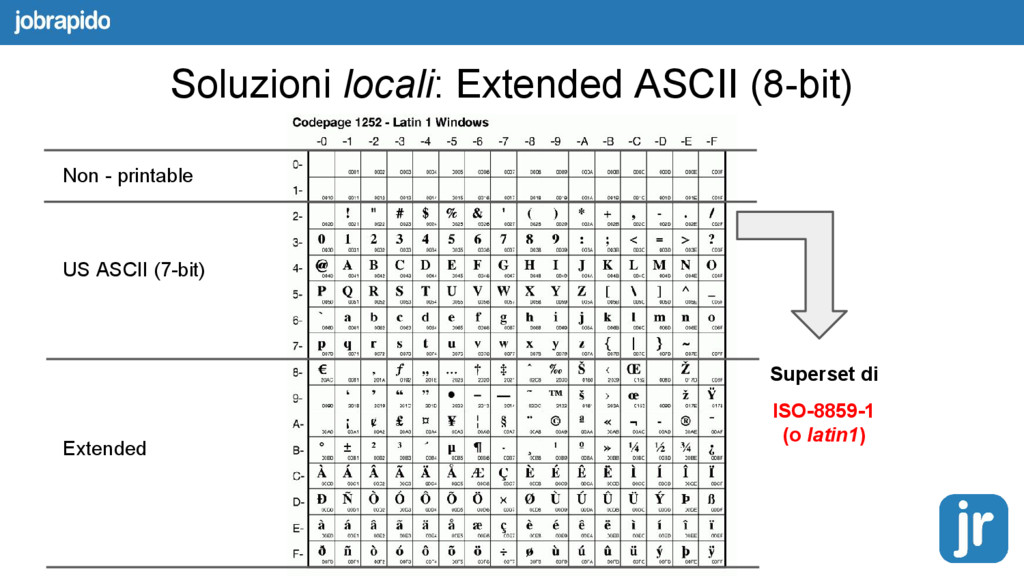
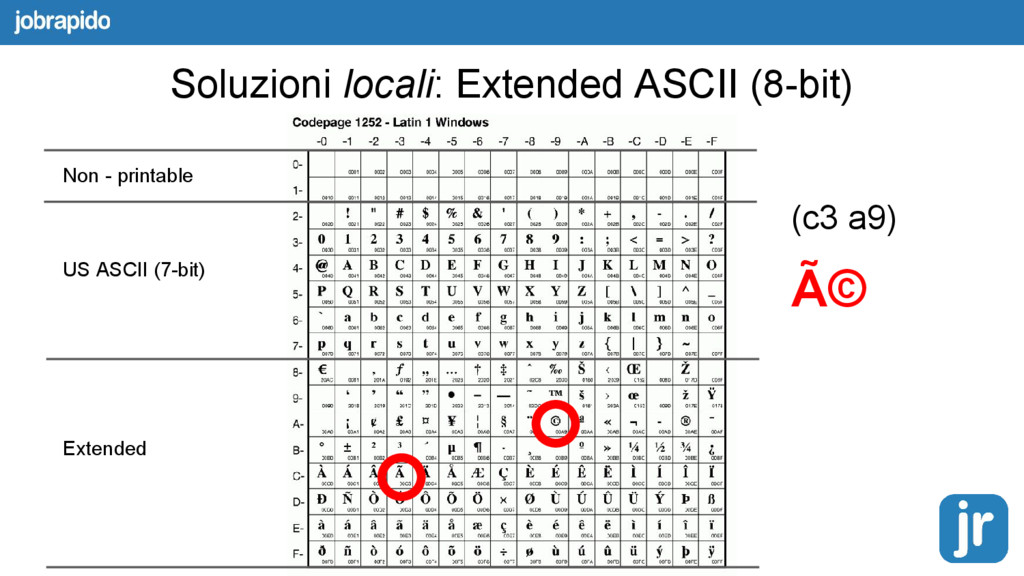
Soluzioni locali: Extended ASCII (8-bit) • Usare il vecchio bit
di parità per raddoppiare le combinazioni (che diventano 256) • Per diverse famiglie linguistiche esistono diverse varianti di “Extended ASCII” • Le prime 127 combinazioni sono le stesse di US-ASCII, le altre dipendono da quale variante di “Extended ASCII” viene utilizzata • Esempi: CODEPAGEs in MS-DOS x x x x x x x x -
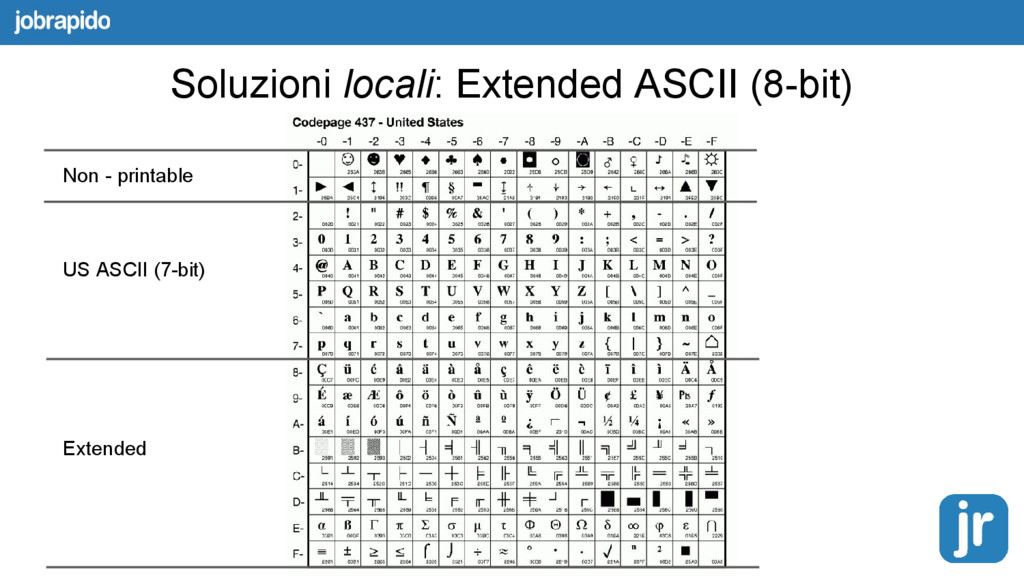
Soluzioni locali: Extended ASCII (8-bit) Non - printable US ASCII
(7-bit) Extended -
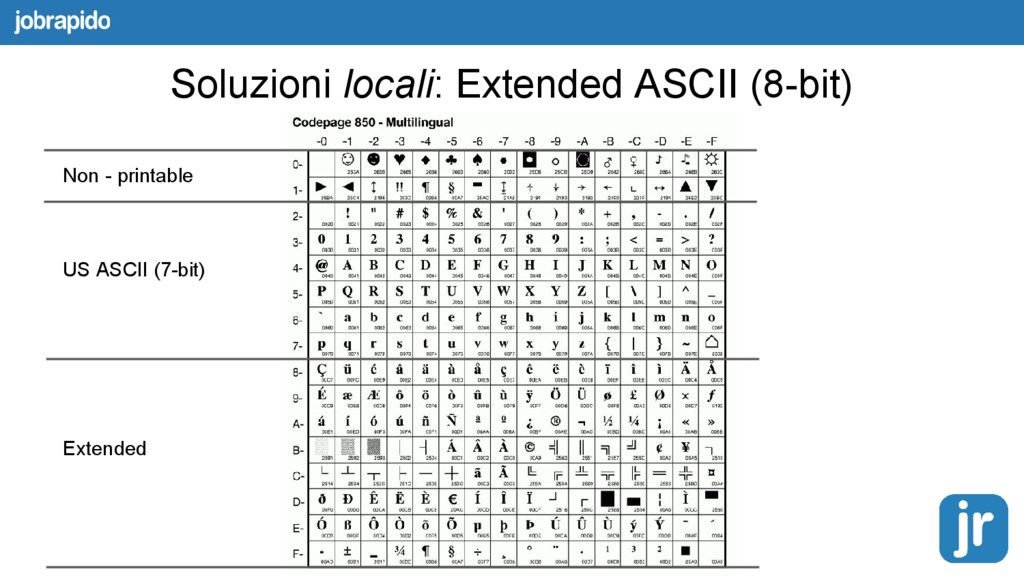
Soluzioni locali: Extended ASCII (8-bit) Non - printable US ASCII
(7-bit) Extended -
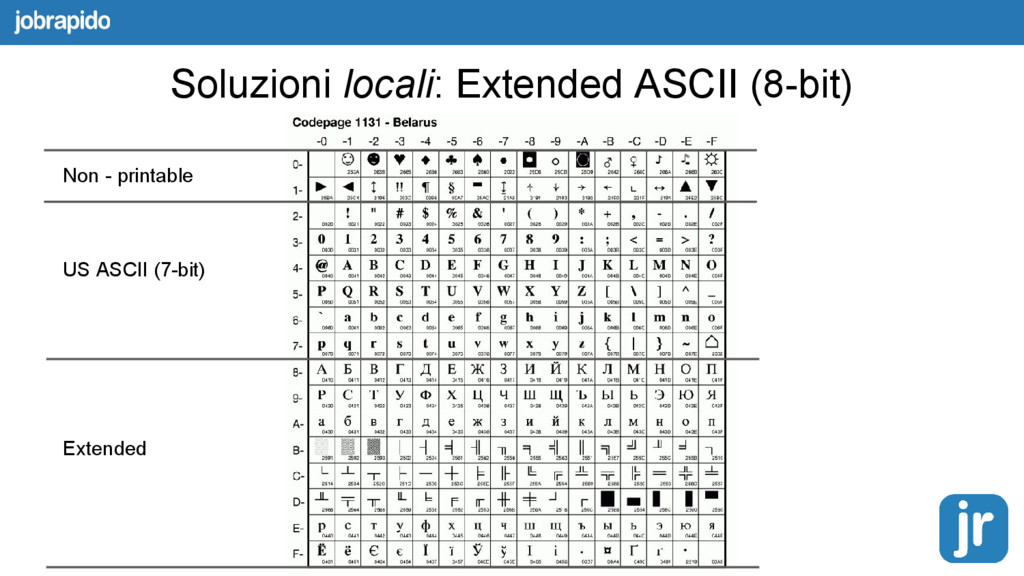
Soluzioni locali: Extended ASCII (8-bit) Non - printable US ASCII
(7-bit) Extended -
Soluzioni locali: Extended ASCII (8-bit) Superset di ISO-8859-1 (o latin1)
Non - printable US ASCII (7-bit) Extended -
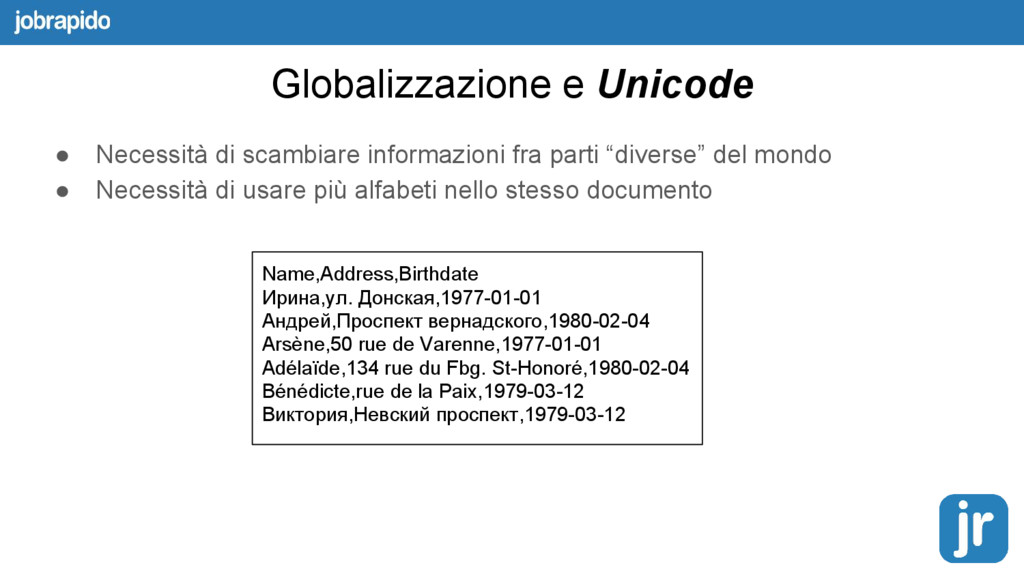
Globalizzazione e Unicode • Necessità di scambiare informazioni fra parti
“diverse” del mondo • Necessità di usare più alfabeti nello stesso documento Name,Address,Birthdate Ирина,ул. Донская,1977-01-01 Андрей,Проспект вернадского,1980-02-04 Arsène,50 rue de Varenne,1977-01-01 Adélaïde,134 rue du Fbg. St-Honoré,1980-02-04 Bénédicte,rue de la Paix,1979-03-12 Виктория,Невский проспект,1979-03-12 -
Globalizzazione e Unicode • Idea iniziale: usare 2 byte per
carattere = 65536 combinazioni possibili • 5 anni dopo la versione 1.0 si giungono ad assegnare 178500 combinazioni • La versione 8.0 (2015) assegna 260319 combinazioni • 2 byte non sono più sufficienti: Unicode è una specifica da codificare a sua volta • Curiosità: sono assegnati anche simboli di alfabeti appartenenti a lingue artificiali, come i Tengwar della lingua elfica creata da J.R.R Tolkien e “parlata” in Lord of Rings. Qualcuno ha proposto di inserire l’alfabeto Klingon ma la proposta è stata rifiutata perché con l’alfabeto latino si riesce benissimo a scrivere in Klingon. -
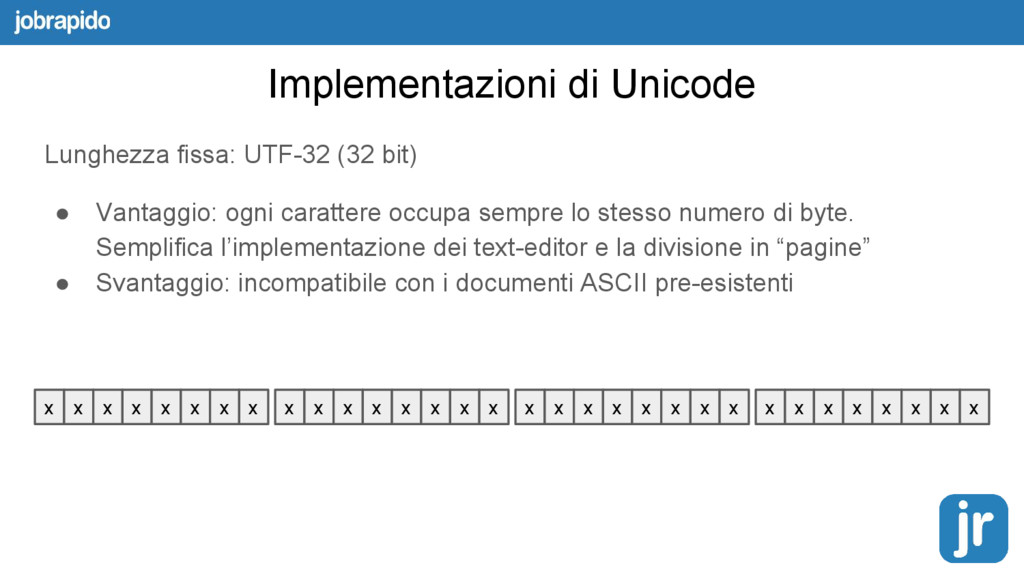
Implementazioni di Unicode Lunghezza fissa: UTF-32 (32 bit) • Vantaggio:
ogni carattere occupa sempre lo stesso numero di byte. Semplifica l’implementazione dei text-editor e la divisione in “pagine” • Svantaggio: incompatibile con i documenti ASCII pre-esistenti x x x x x x x x x x x x x x x x x x x x x x x x x x x x x x x x -
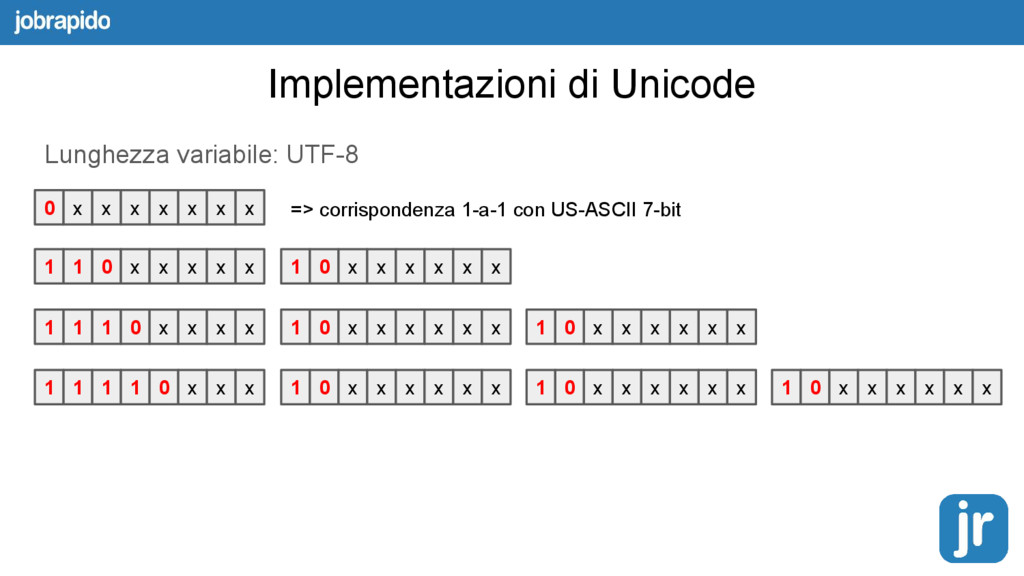
Implementazioni di Unicode Lunghezza variabile: UTF-8 1 1 0 x
x x x x 1 1 1 0 x x x x 1 1 1 1 0 x x x 0 x x x x x x x => corrispondenza 1-a-1 con US-ASCII 7-bit 1 0 x x x x x x 1 0 x x x x x x 1 0 x x x x x x 1 0 x x x x x x 1 0 x x x x x x 1 0 x x x x x x -
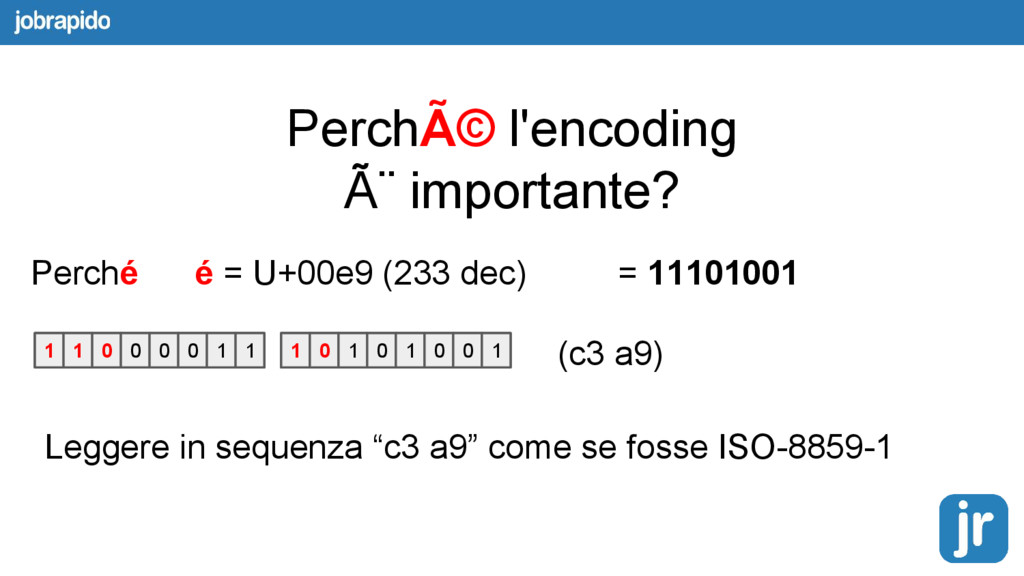
Perché l'encoding è importante? Perché é = U+00e9 (233 dec)
= 11101001 (c3 a9) Leggere in sequenza “c3 a9” come se fosse ISO-8859-1 1 1 0 1 0 1 1 0 1 1 1 0 1 0 1 0 0 1 1 1 0 0 0 0 1 1 1 0 1 0 1 0 0 1 -
Soluzioni locali: Extended ASCII (8-bit) Non - printable US ASCII
(7-bit) Extended (c3 a9) é -
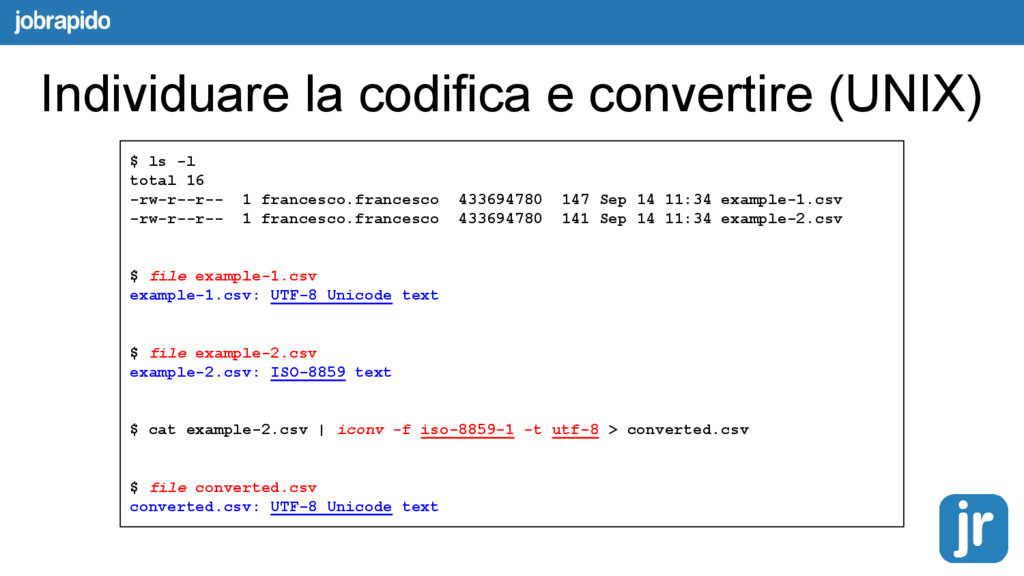
$ ls -l total 16 -rw-r--r-- 1 francesco.francesco 433694780 147
Sep 14 11:34 example-1.csv -rw-r--r-- 1 francesco.francesco 433694780 141 Sep 14 11:34 example-2.csv $ file example-1.csv example-1.csv: UTF-8 Unicode text $ file example-2.csv example-2.csv: ISO-8859 text $ cat example-2.csv | iconv -f iso-8859-1 -t utf-8 > converted.csv $ file converted.csv converted.csv: UTF-8 Unicode text Individuare la codifica e convertire (UNIX) -
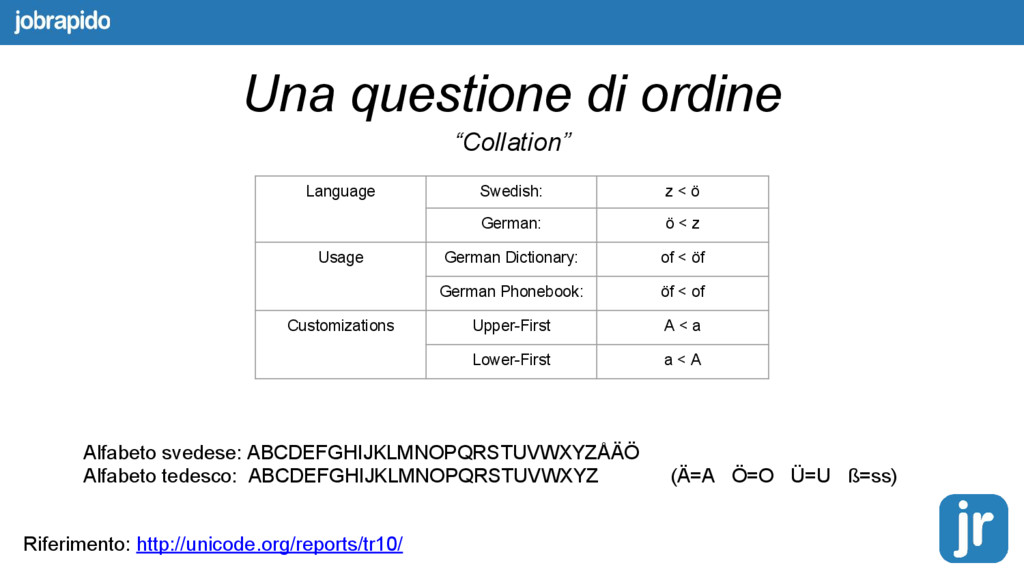
Una questione di ordine “Collation” Language Swedish: z < ö
German: ö < z Usage German Dictionary: of < öf German Phonebook: öf < of Customizations Upper-First A < a Lower-First a < A Riferimento: http://unicode.org/reports/tr10/ Alfabeto svedese: ABCDEFGHIJKLMNOPQRSTUVWXYZÅÄÖ Alfabeto tedesco: ABCDEFGHIJKLMNOPQRSTUVWXYZ (Ä=A Ö=O Ü=U ß=ss) -
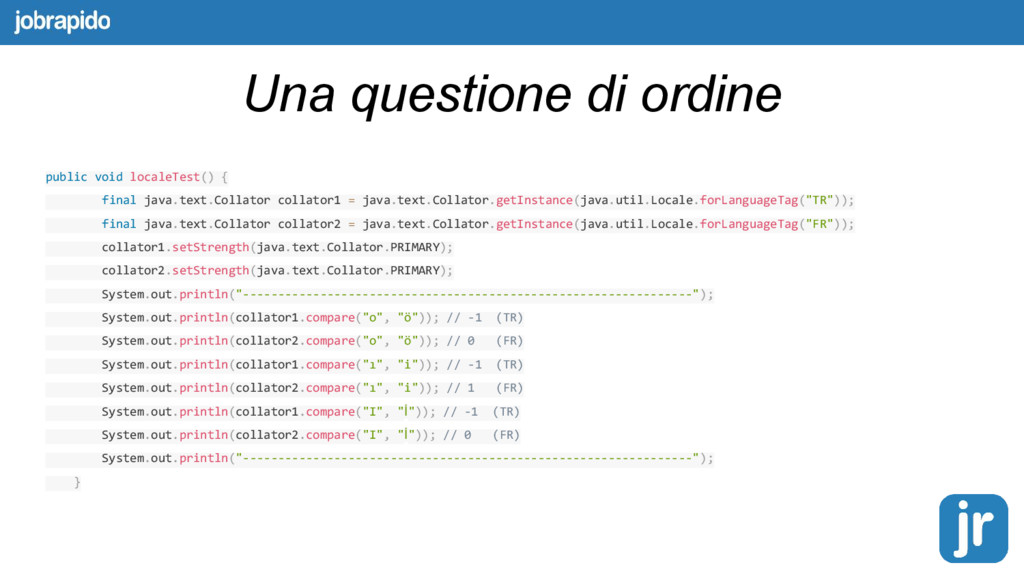
Una questione di ordine public void localeTest() { final java.text.Collator
collator1 = java.text.Collator.getInstance(java.util.Locale.forLanguageTag("TR")); final java.text.Collator collator2 = java.text.Collator.getInstance(java.util.Locale.forLanguageTag("FR")); collator1.setStrength(java.text.Collator.PRIMARY); collator2.setStrength(java.text.Collator.PRIMARY); System.out.println("----------------------------------------------------------------"); System.out.println(collator1.compare("o", "ö")); // -1 (TR) System.out.println(collator2.compare("o", "ö")); // 0 (FR) System.out.println(collator1.compare("ı", "i")); // -1 (TR) System.out.println(collator2.compare("ı", "i")); // 1 (FR) System.out.println(collator1.compare("I", "İ")); // -1 (TR) System.out.println(collator2.compare("I", "İ")); // 0 (FR) System.out.println("----------------------------------------------------------------"); }