Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
AI駆動開発で行ったテスト手法
Search
kagu3
November 13, 2026
Technology
6
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
AI駆動開発で行ったテスト手法
kagu3
November 13, 2026
Transcript
21 slides
QA AI駆動開発で行ったテスト手法 〜 カバレッジ × ミューテーションテスト × 関数型アーキテクチャ 〜 かぐ(kagu3)
ABOUT ME 自己紹介 かぐ(kagu3) プロダクト開発エンジニア VRChatでITエンジニア向けキャリア相談会を主催 TODAY AI駆動開発の現場で、AIが書いたコードとテストの品質をどう担保したか ※ 今回は、PjM
兼 アーキテクト 兼 AI駆動開発推進担当をした時の話です AI駆動開発で行ったテスト手法 2 / 21
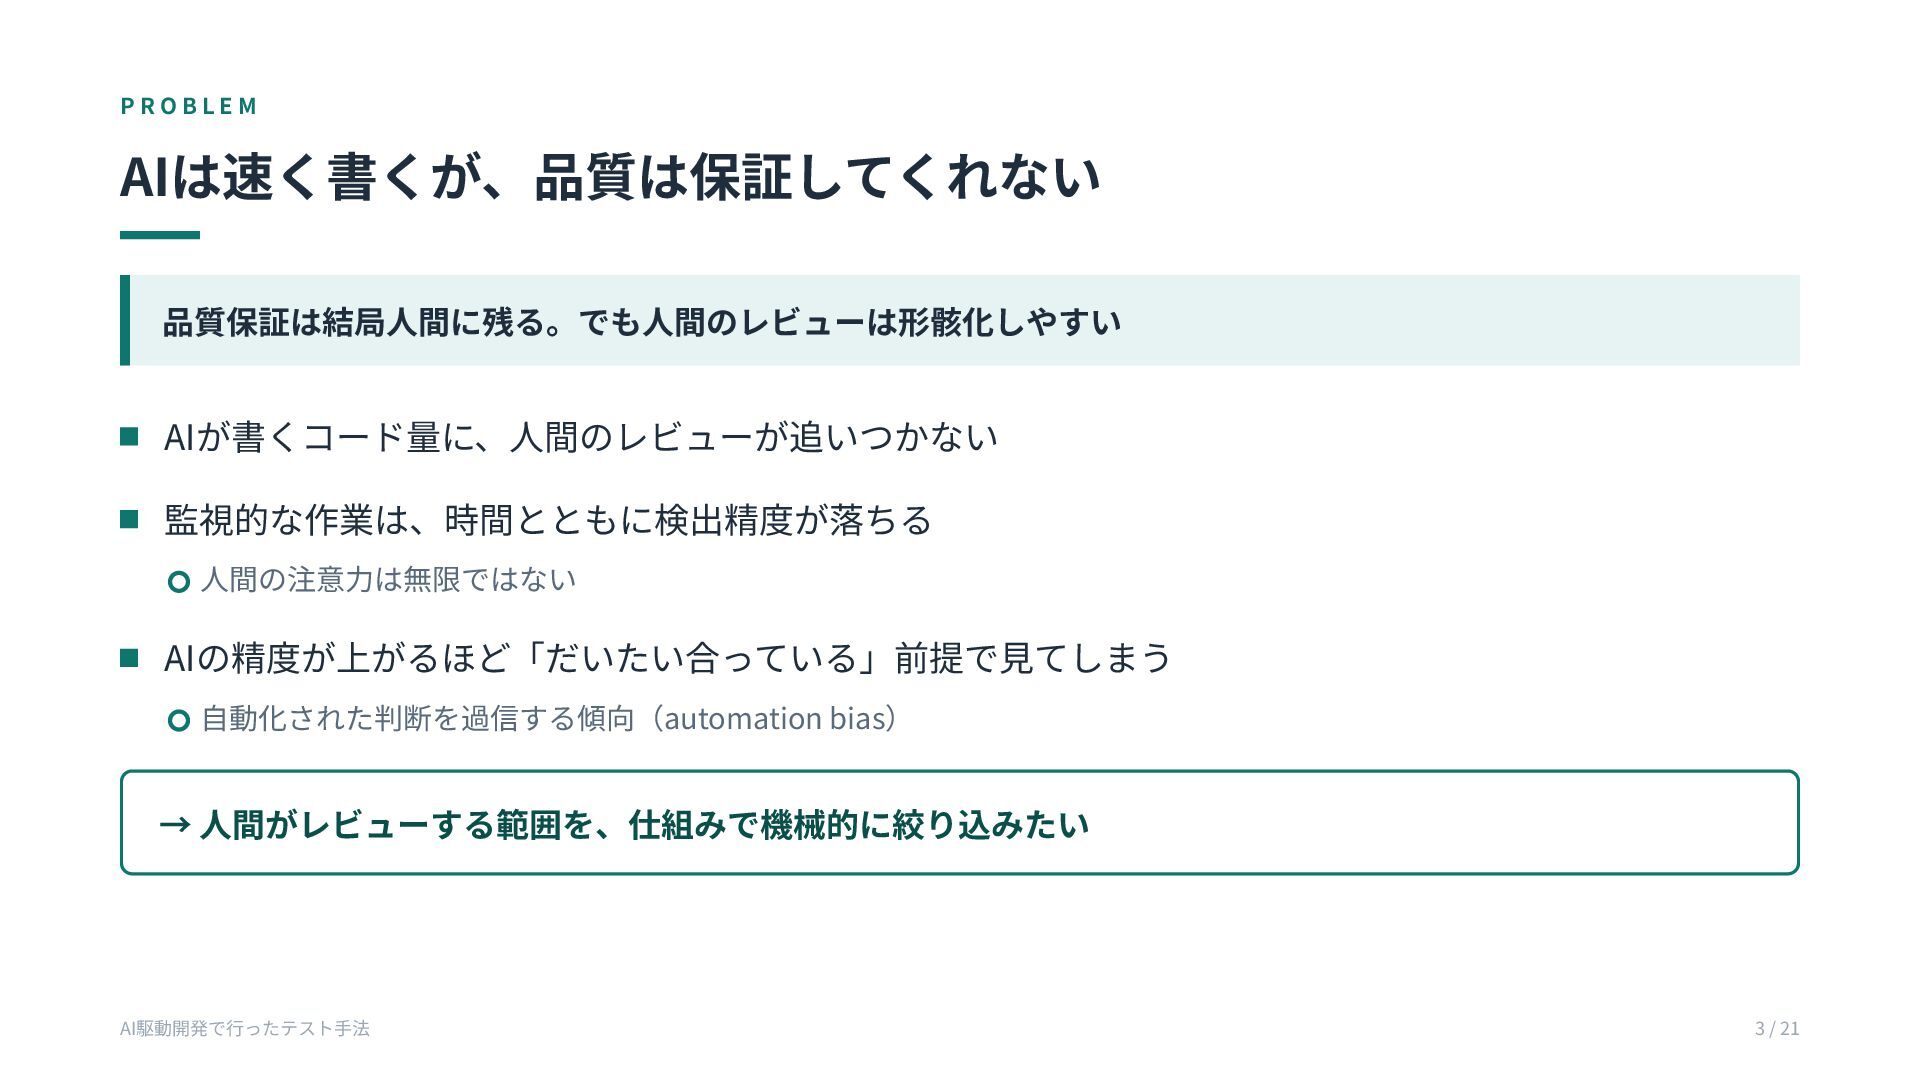
PROBLEM AIは速く書くが、品質は保証してくれない 品質保証は結局人間に残る。でも人間のレビューは形骸化しやすい AIが書くコード量に、人間のレビューが追いつかない 監視的な作業は、時間とともに検出精度が落ちる 人間の注意力は無限ではない AIの精度が上がるほど「だいたい合っている」前提で見てしまう 自動化された判断を過信する傾向(automation bias) →
人間がレビューする範囲を、仕組みで機械的に絞り込みたい AI駆動開発で行ったテスト手法 3 / 21
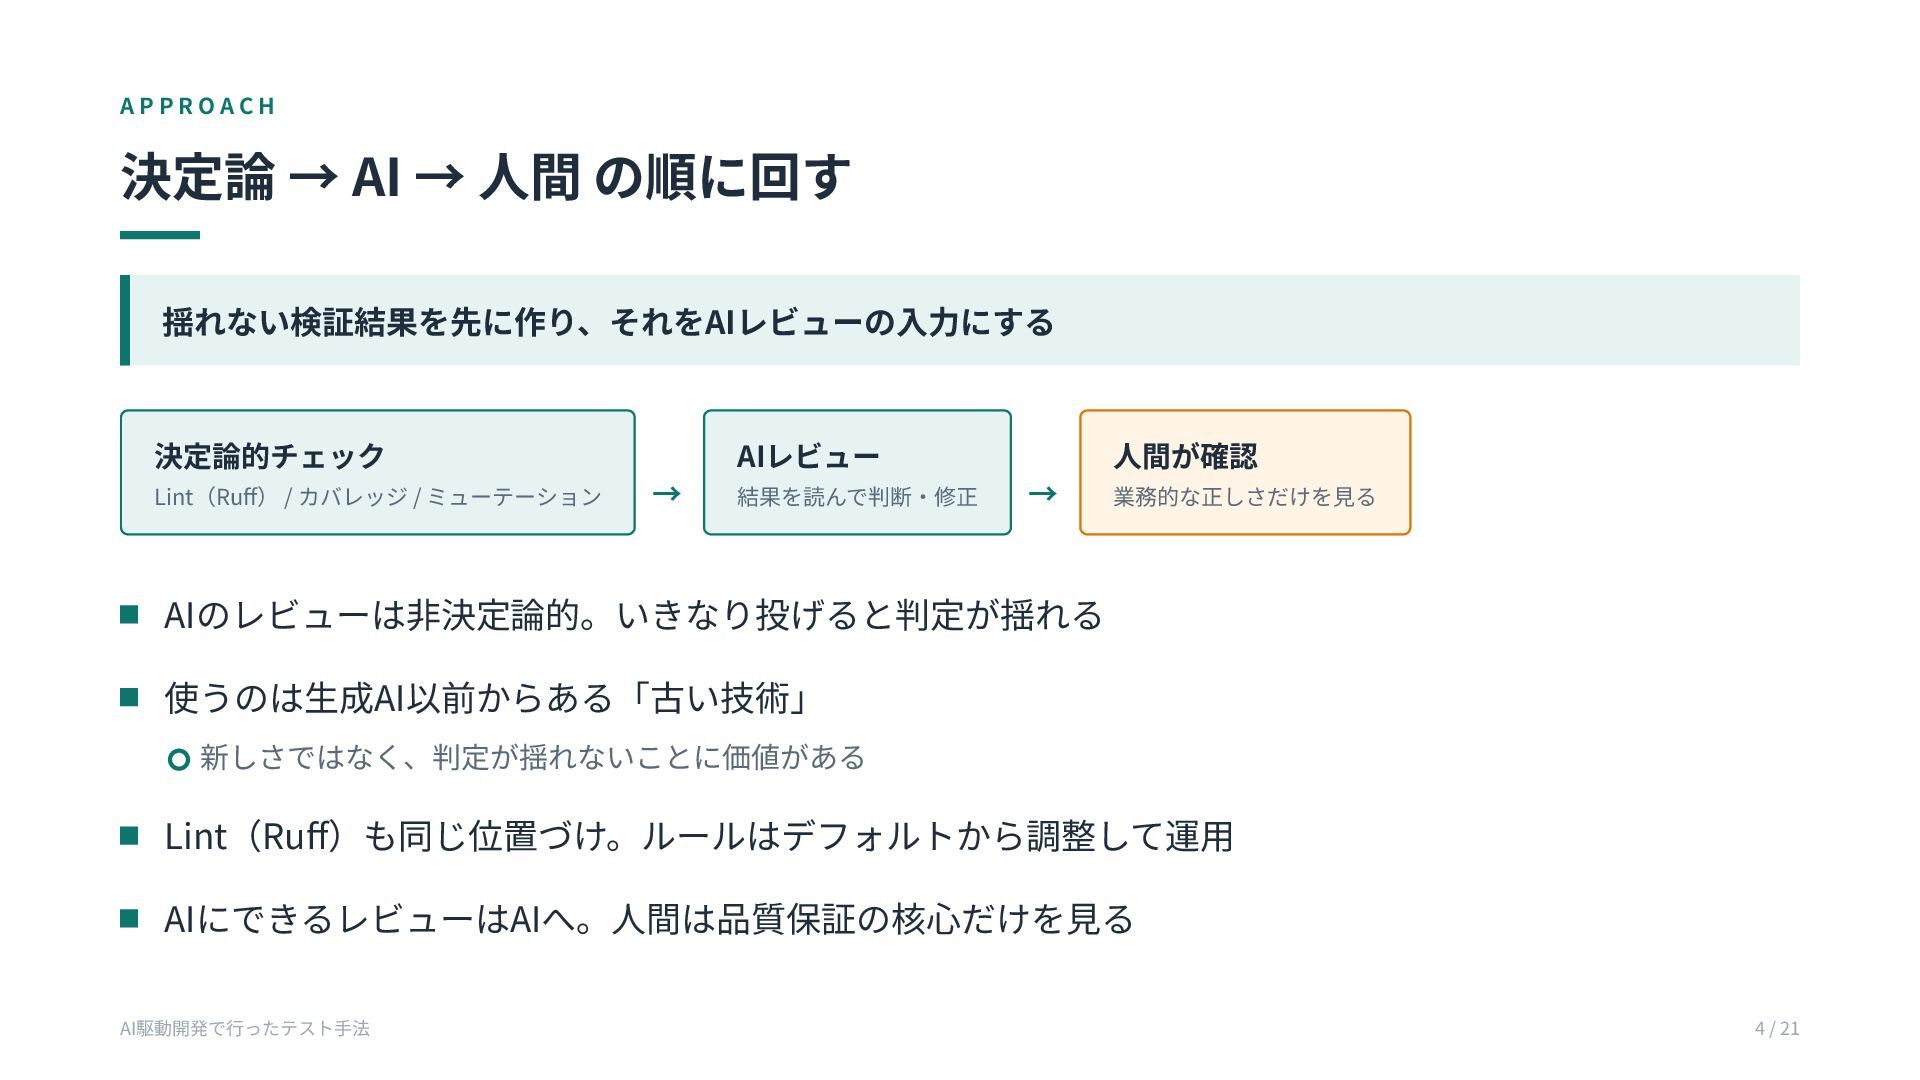
APPROACH 決定論 → AI → 人間 の順に回す 揺れない検証結果を先に作り、それをAIレビューの入力にする 決定論的チェック Lint(Ruff)
/ カバレッジ / ミューテーション → AIレビュー 結果を読んで判断・修正 → 人間が確認 業務的な正しさだけを見る AIのレビューは非決定論的。いきなり投げると判定が揺れる 使うのは生成AI以前からある「古い技術」 新しさではなく、判定が揺れないことに価値がある Lint(Ruff)も同じ位置づけ。ルールはデフォルトから調整して運用 AIにできるレビューはAIへ。人間は品質保証の核心だけを見る AI駆動開発で行ったテスト手法 4 / 21
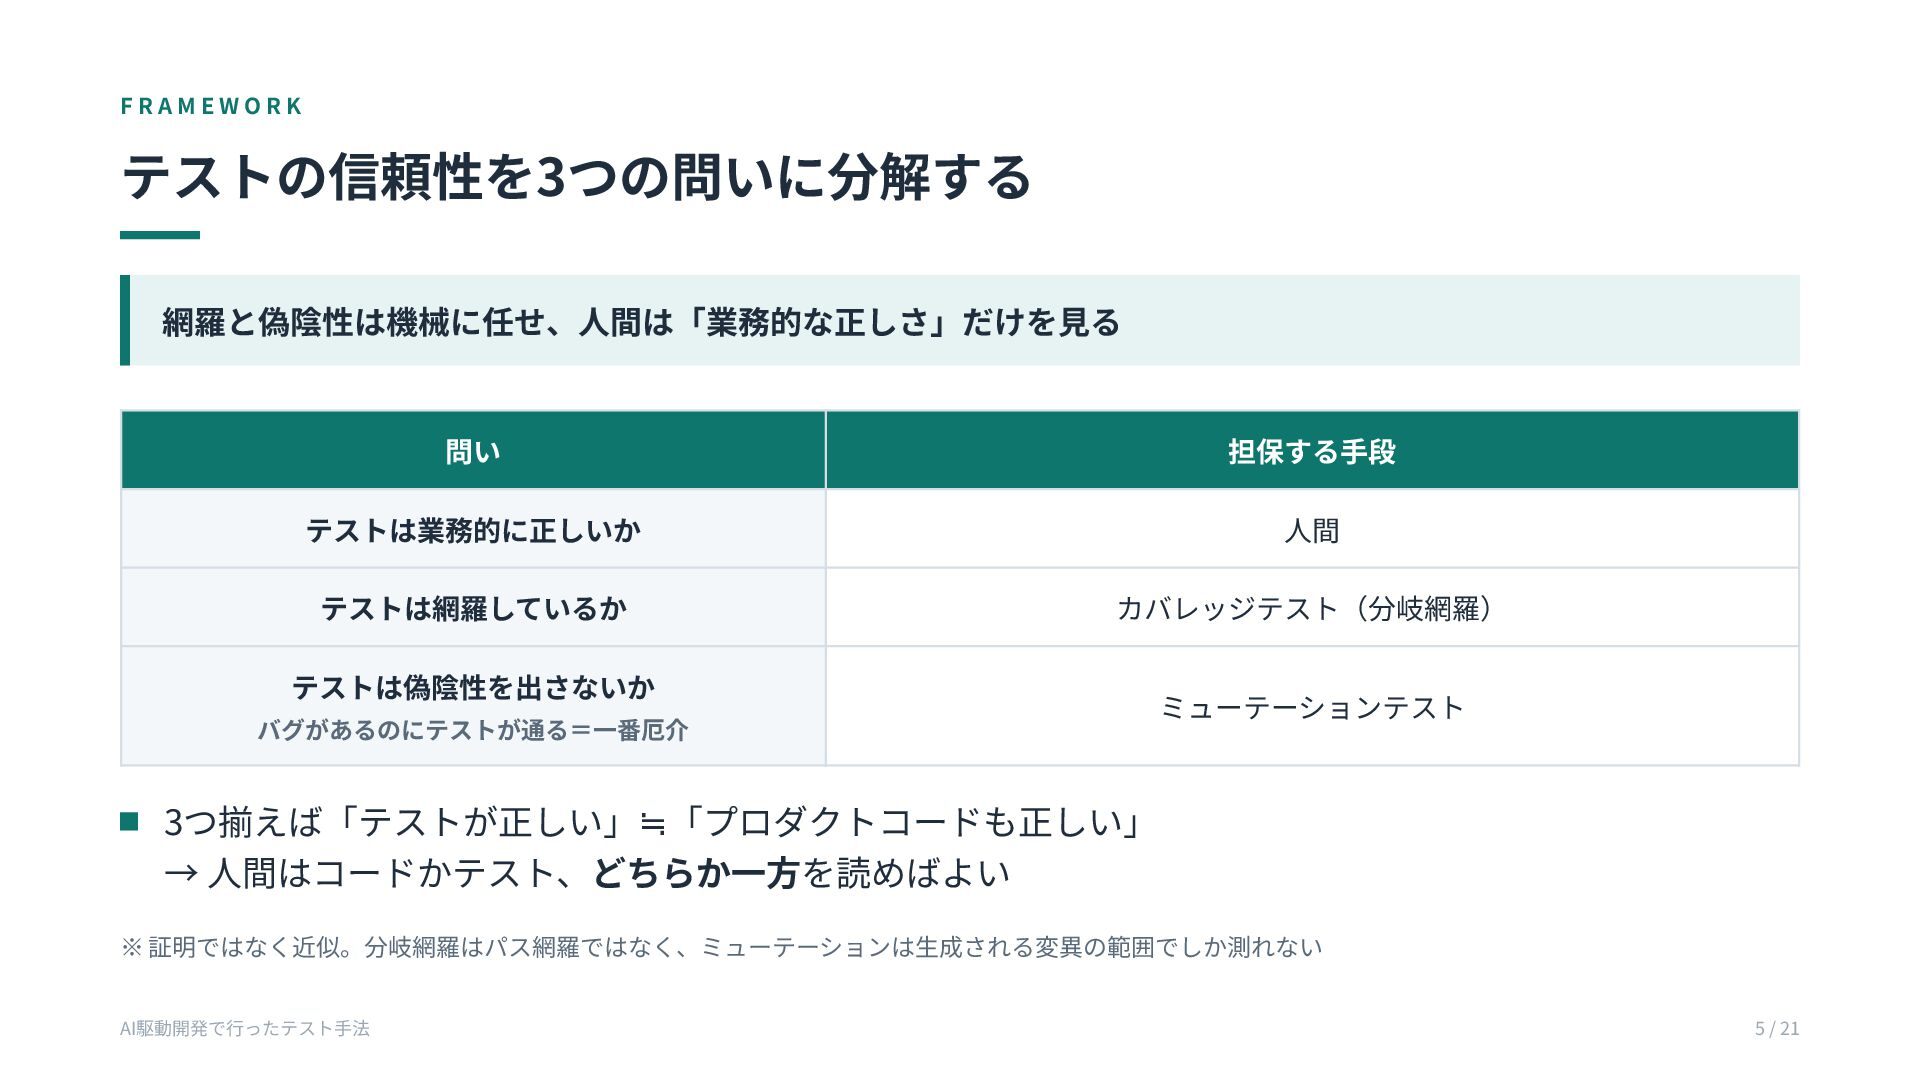
FRAMEWORK テストの信頼性を3つの問いに分解する 網羅と偽陰性は機械に任せ、人間は「業務的な正しさ」だけを見る 問い 担保する手段 テストは業務的に正しいか 人間 テストは網羅しているか カバレッジテスト(分岐網羅) テストは偽陰性を出さないか
バグがあるのにテストが通る=一番厄介 ミューテーションテスト 3つ揃えば「テストが正しい」≒「プロダクトコードも正しい」 → 人間はコードかテスト、どちらか一方を読めばよい ※ 証明ではなく近似。分岐網羅はパス網羅ではなく、ミューテーションは生成される変異の範囲でしか測れない AI駆動開発で行ったテスト手法 5 / 21
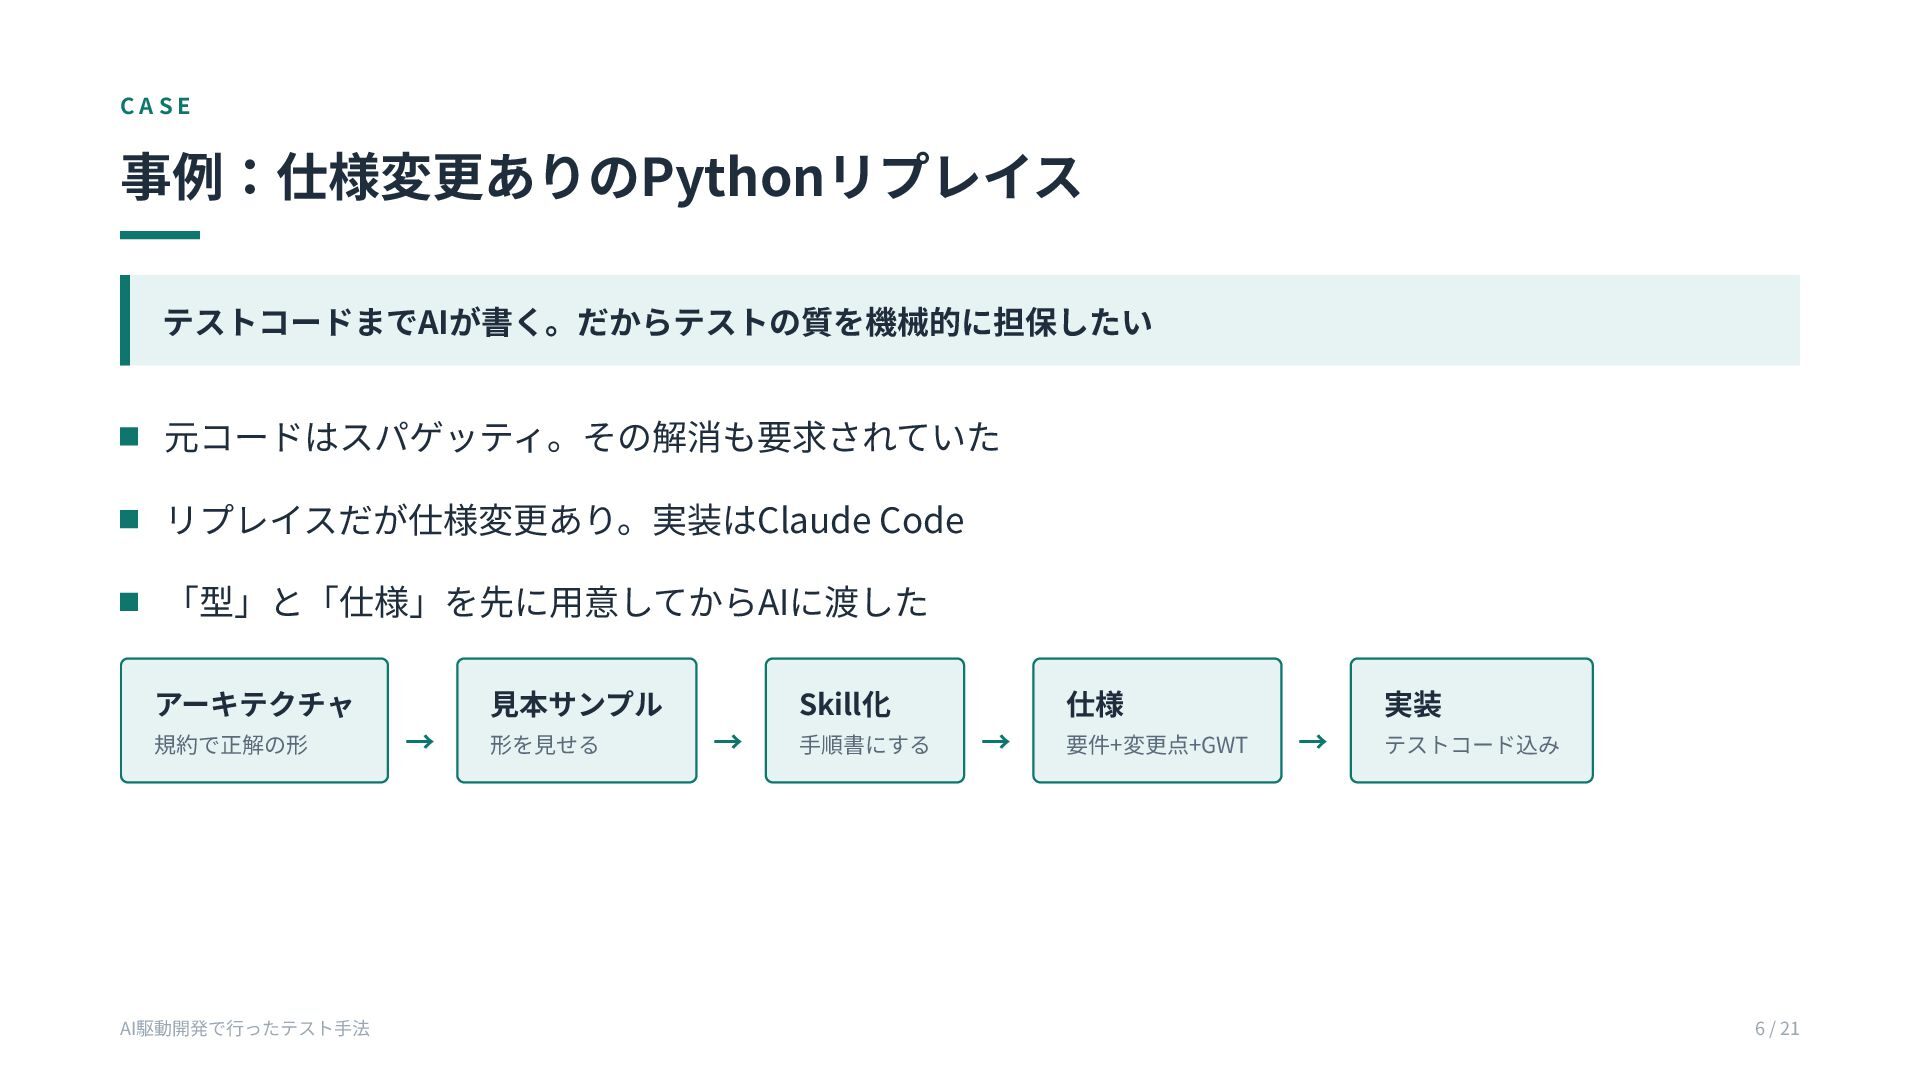
CASE 事例:仕様変更ありのPythonリプレイス テストコードまでAIが書く。だからテストの質を機械的に担保したい 元コードはスパゲッティ。その解消も要求されていた リプレイスだが仕様変更あり。実装はClaude Code 「型」と「仕様」を先に用意してからAIに渡した アーキテクチャ 規約で正解の形 AI駆動開発で行ったテスト手法
→ 見本サンプル 形を見せる → Skill化 手順書にする → 仕様 要件+変更点+GWT → 実装 テストコード込み 6 / 21
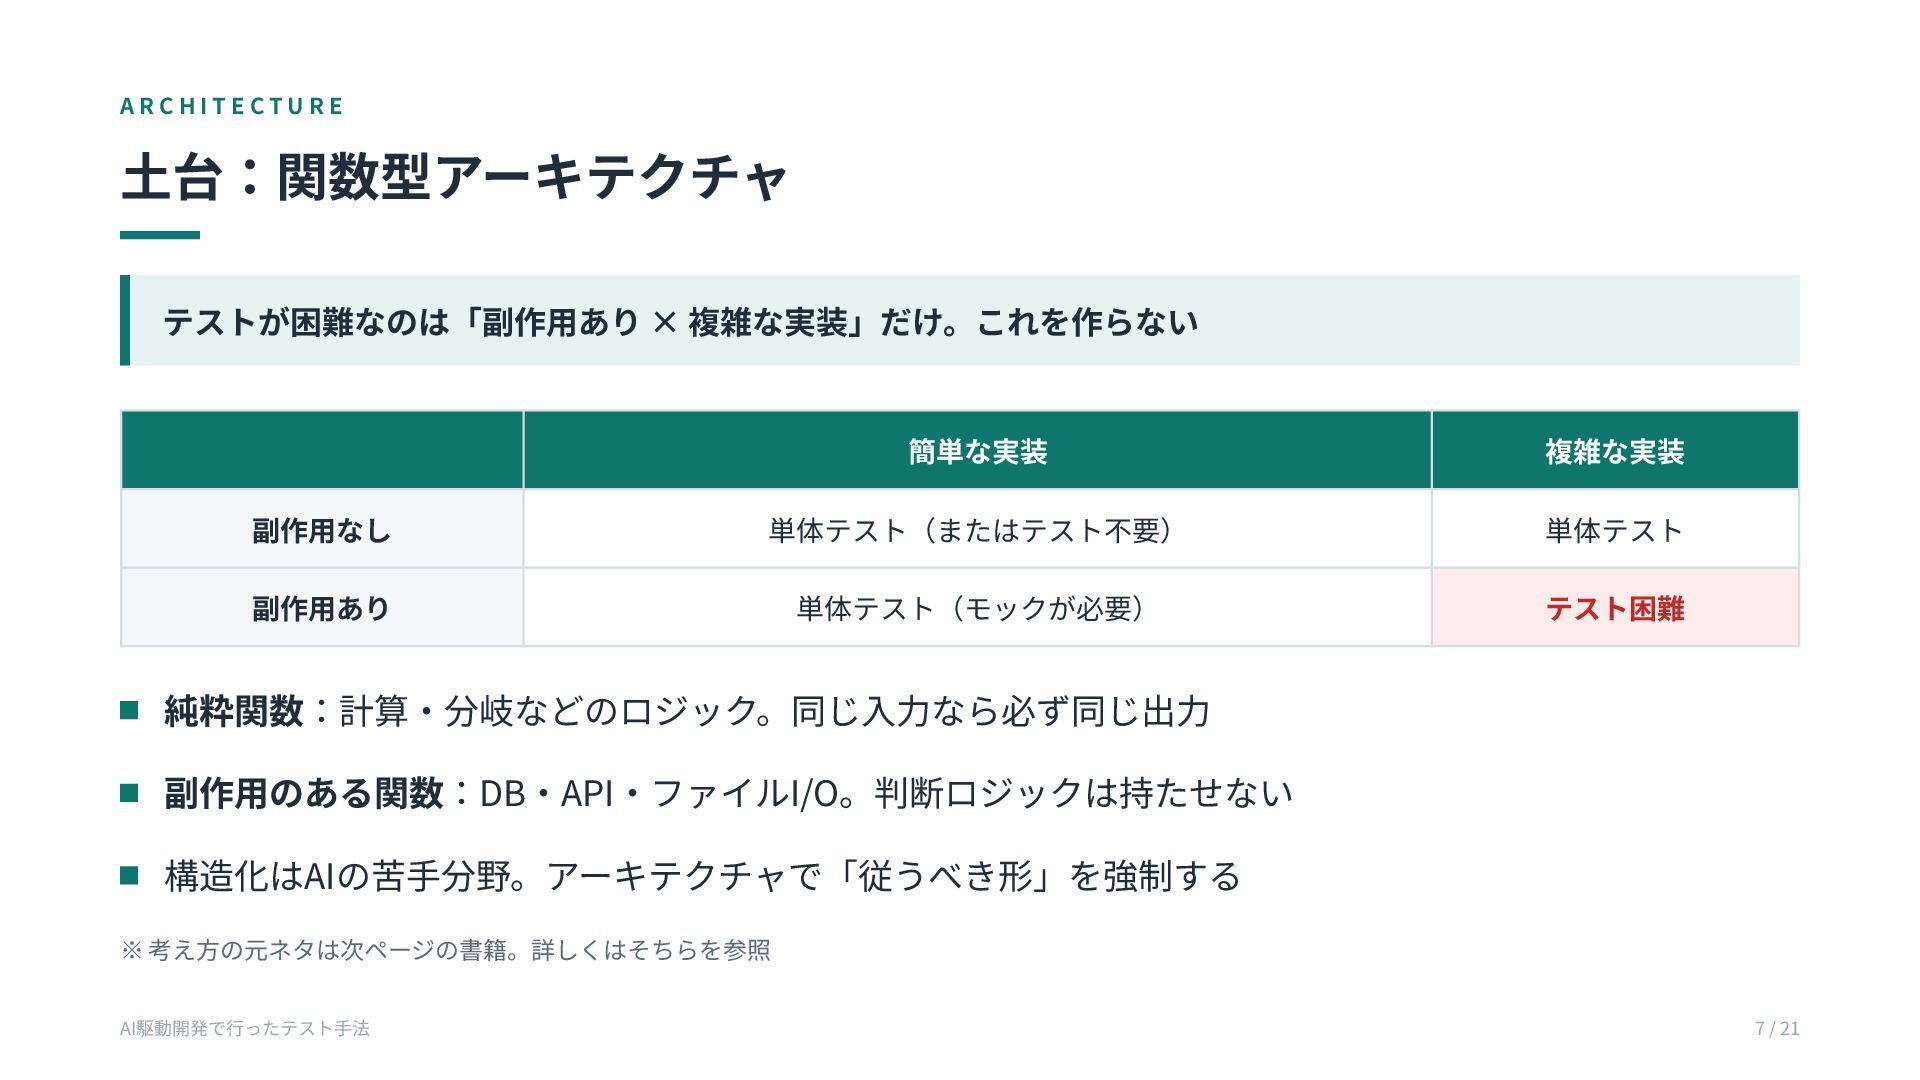
ARCHITECTURE 土台:関数型アーキテクチャ テストが困難なのは「副作用あり × 複雑な実装」だけ。これを作らない 簡単な実装 複雑な実装 副作用なし 単体テスト(またはテスト不要) 単体テスト
副作用あり 単体テスト(モックが必要) テスト困難 純粋関数:計算・分岐などのロジック。同じ入力なら必ず同じ出力 副作用のある関数:DB・API・ファイルI/O。判断ロジックは持たせない 構造化はAIの苦手分野。アーキテクチャで「従うべき形」を強制する ※ 考え方の元ネタは次ページの書籍。詳しくはそちらを参照 AI駆動開発で行ったテスト手法 7 / 21
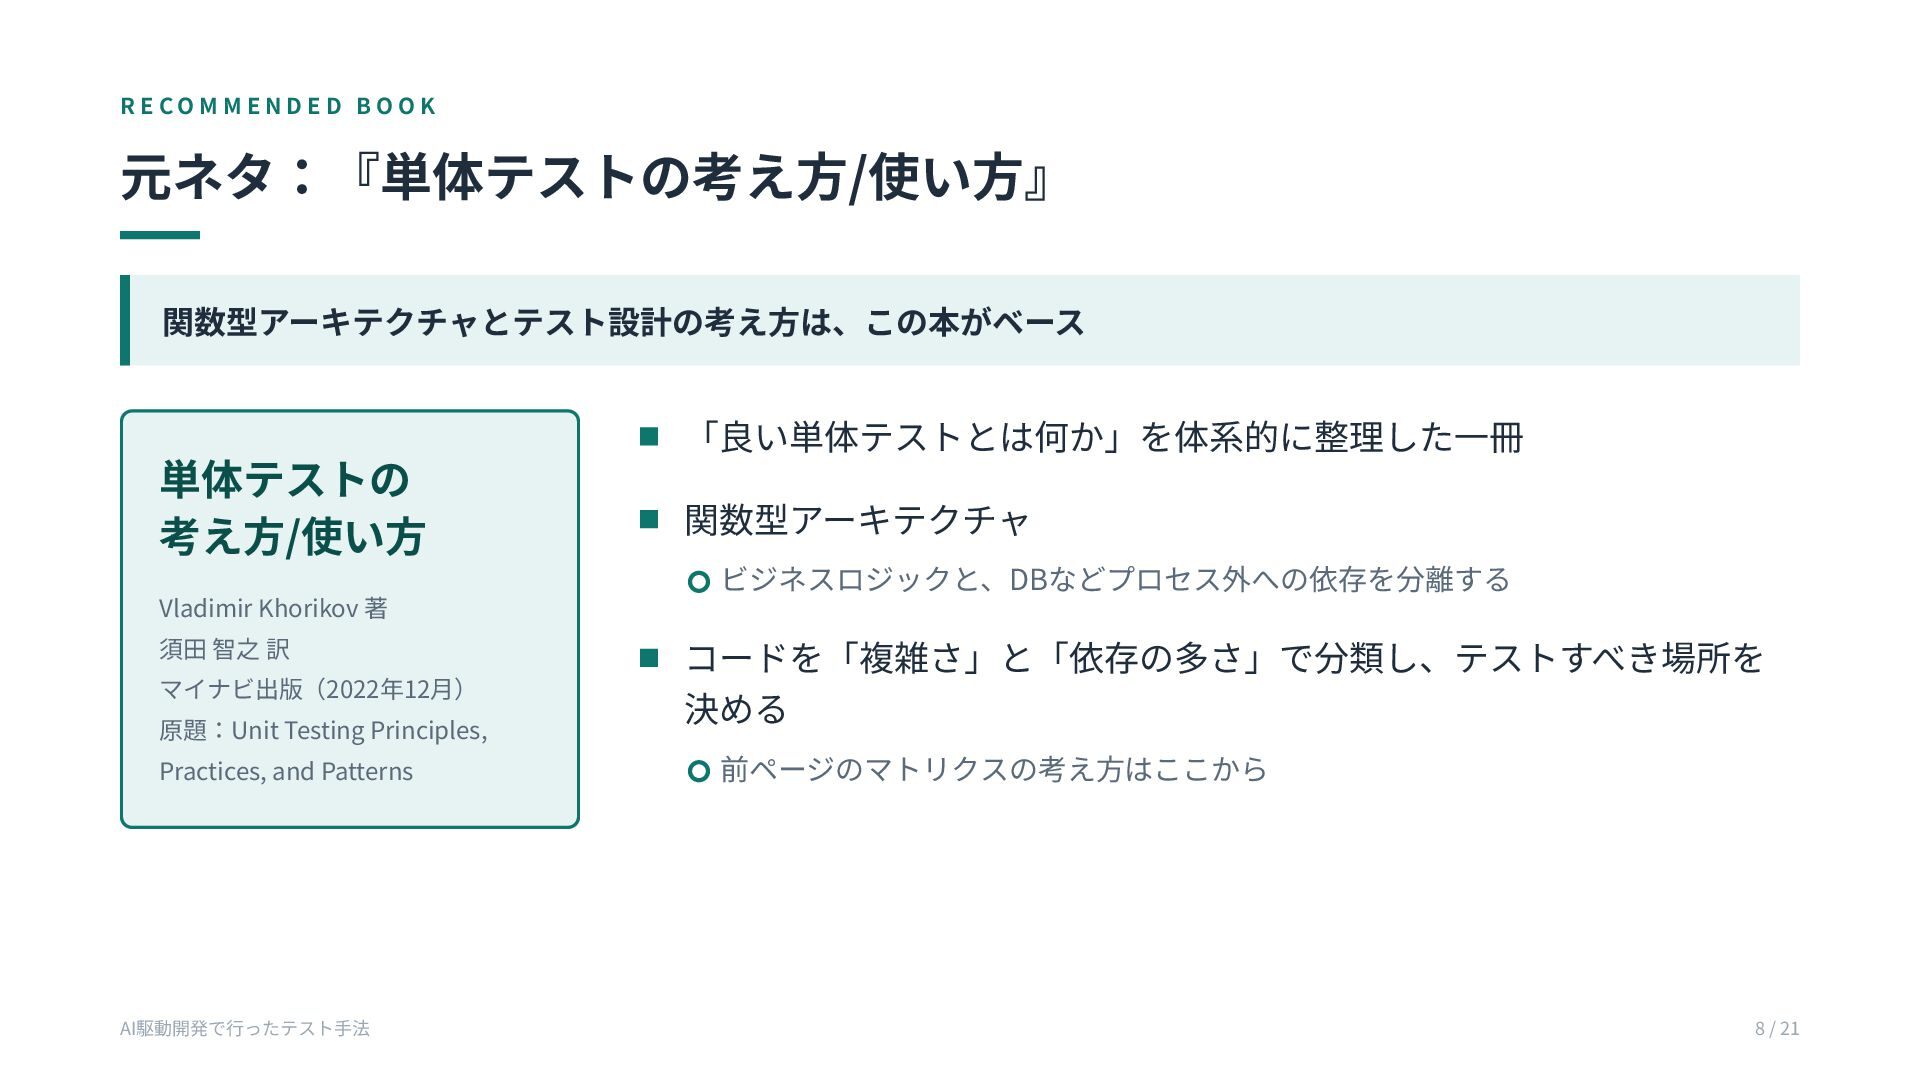
RECOMMENDED BOOK 元ネタ:『単体テストの考え方/使い方』 関数型アーキテクチャとテスト設計の考え方は、この本がベース 単体テストの 考え方/使い方 Vladimir Khorikov 著 須田
智之 訳 マイナビ出版(2022年12月) 原題:Unit Testing Principles, Practices, and Patterns AI駆動開発で行ったテスト手法 「良い単体テストとは何か」を体系的に整理した一冊 関数型アーキテクチャ ビジネスロジックと、DBなどプロセス外への依存を分離する コードを「複雑さ」と「依存の多さ」で分類し、テストすべき場所を 決める 前ページのマトリクスの考え方はここから 8 / 21
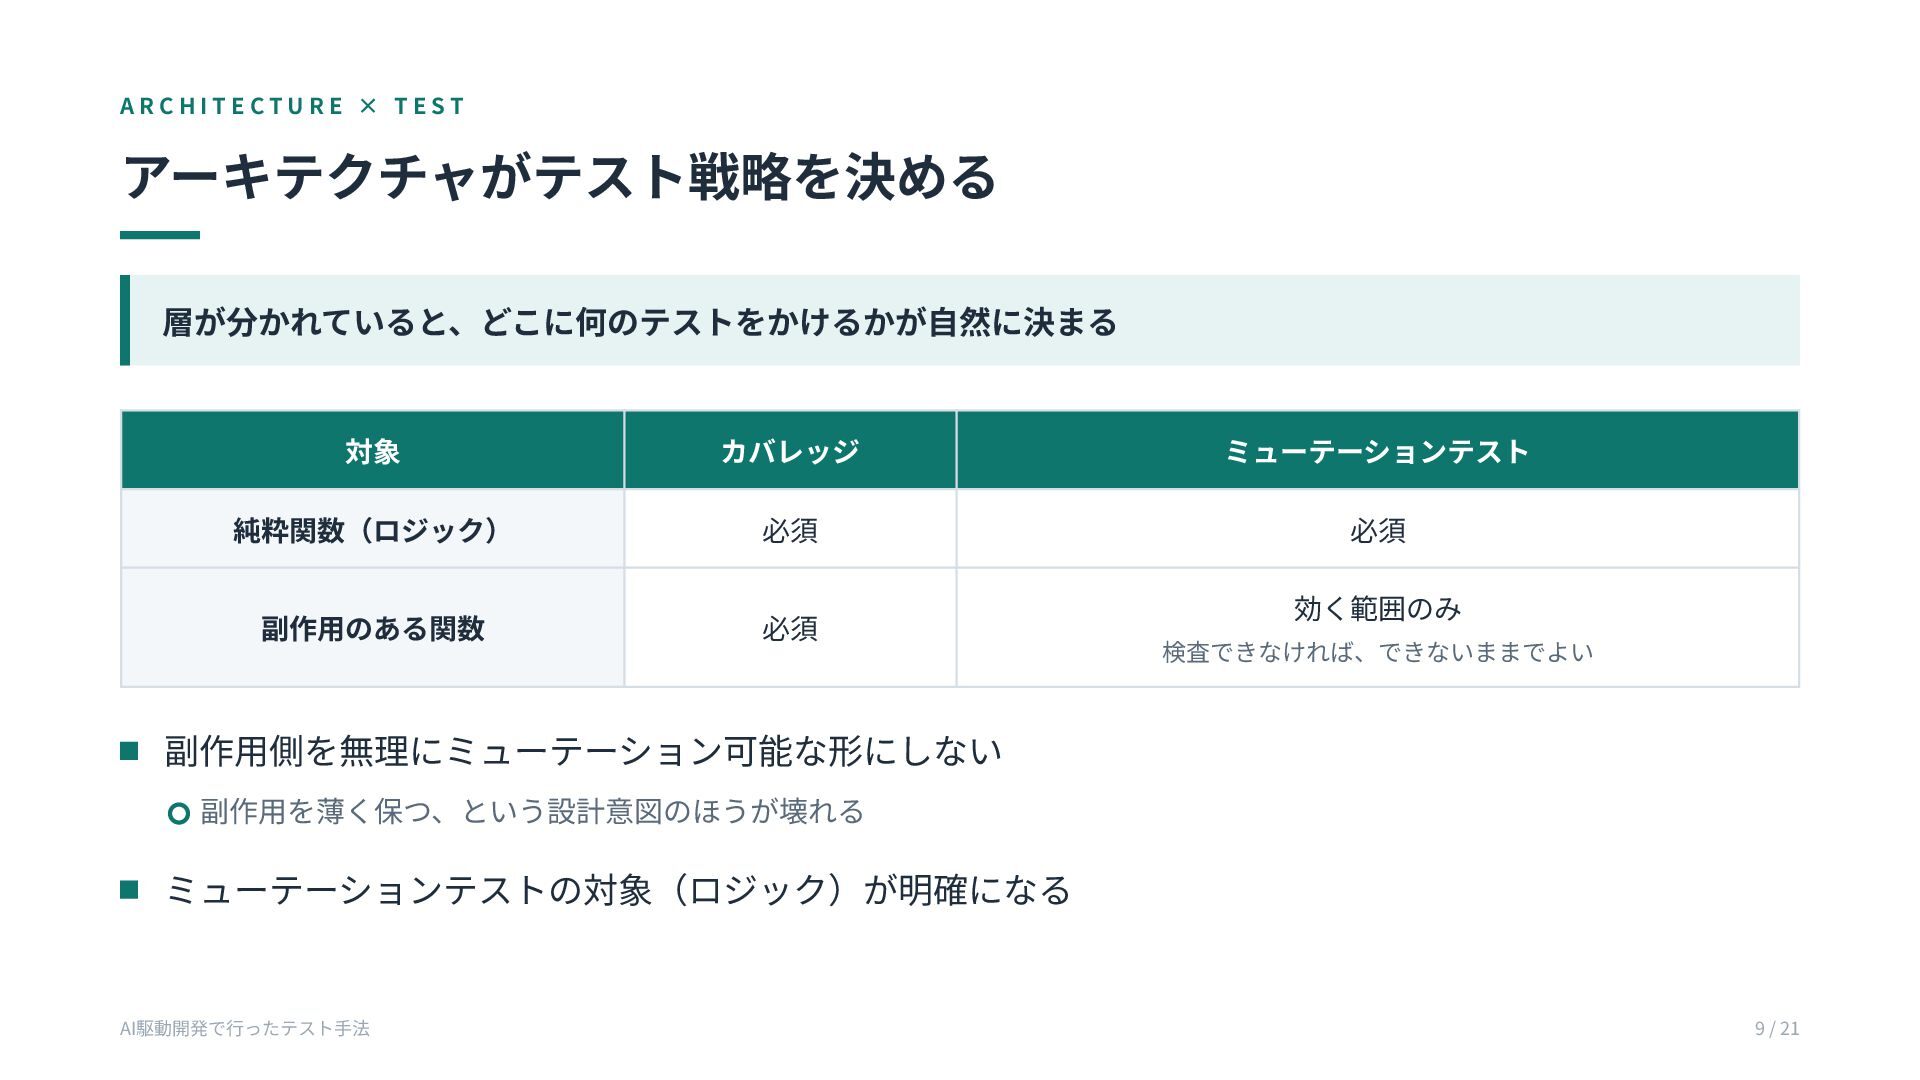
ARCHITECTURE × TEST アーキテクチャがテスト戦略を決める 層が分かれていると、どこに何のテストをかけるかが自然に決まる 対象 カバレッジ ミューテーションテスト 純粋関数(ロジック) 必須
必須 副作用のある関数 必須 効く範囲のみ 検査できなければ、できないままでよい 副作用側を無理にミューテーション可能な形にしない 副作用を薄く保つ、という設計意図のほうが壊れる ミューテーションテストの対象(ロジック)が明確になる AI駆動開発で行ったテスト手法 9 / 21
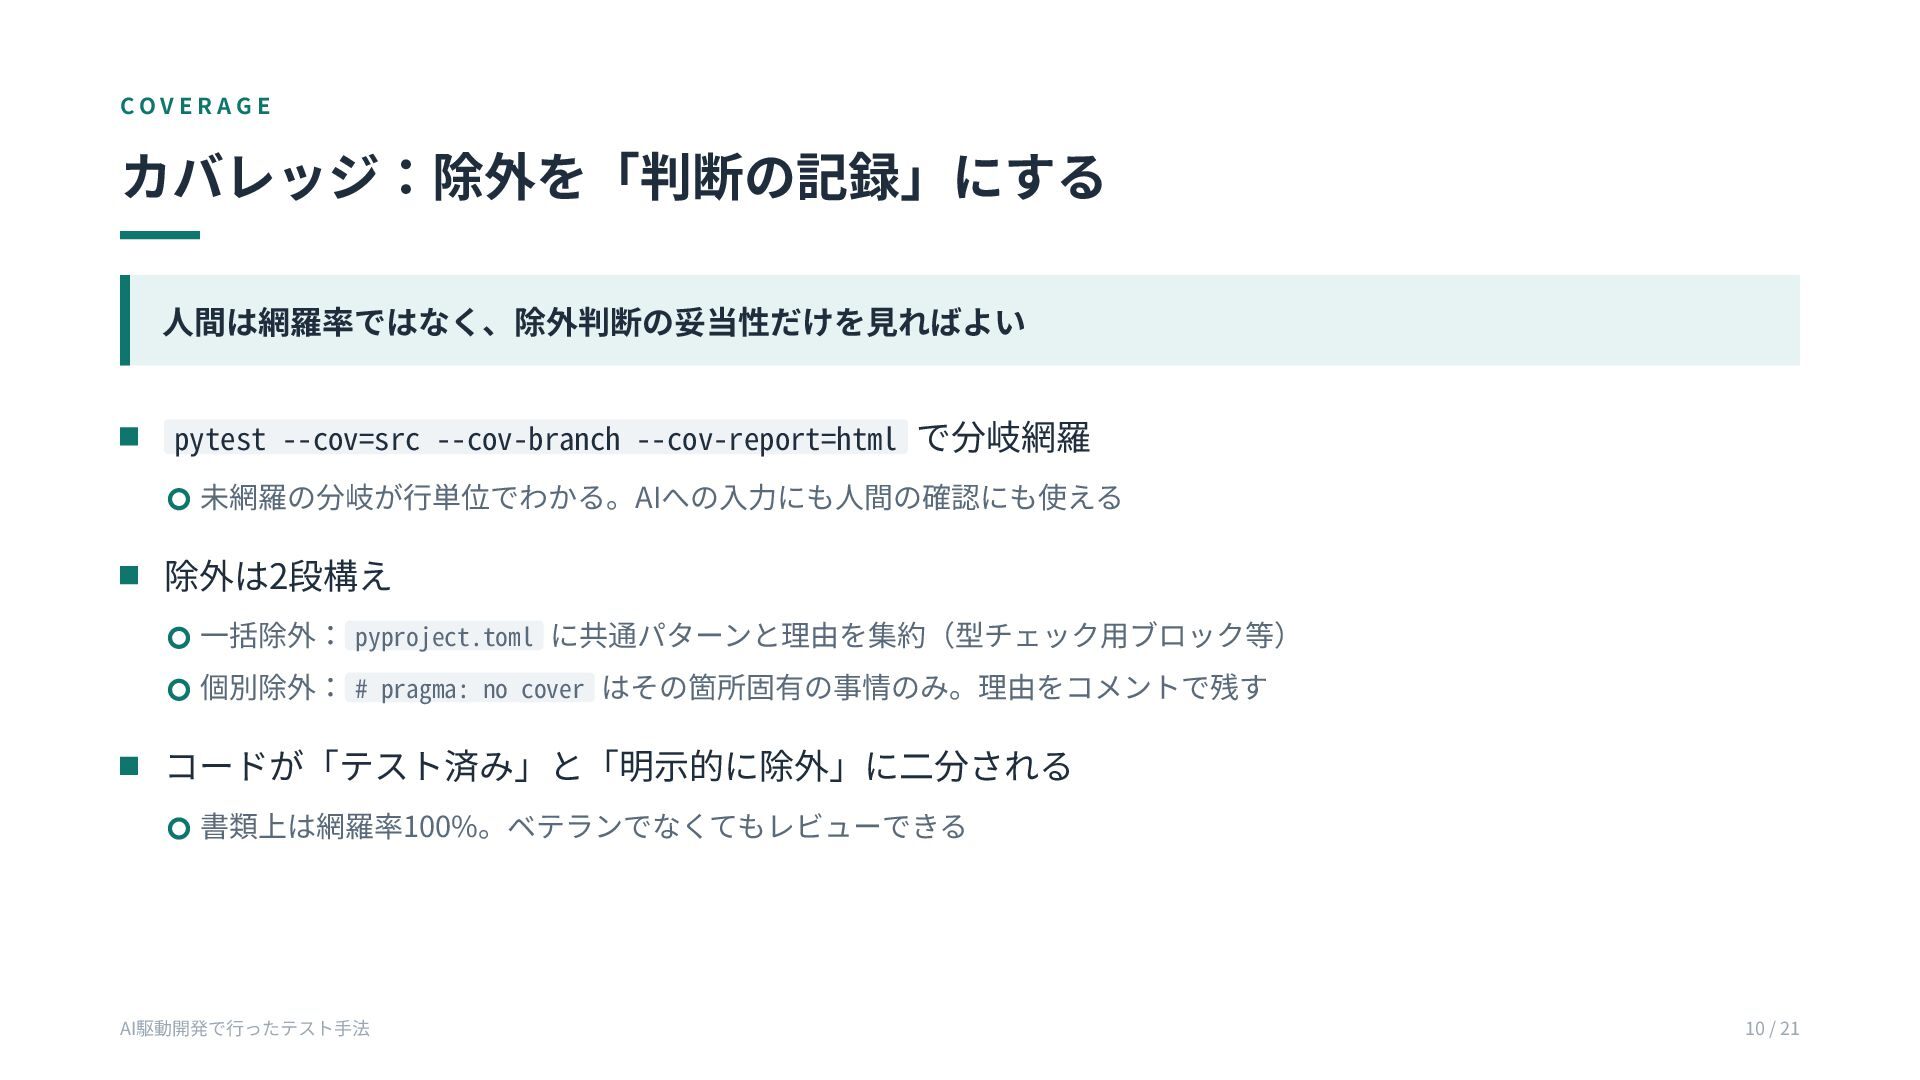
COVERAGE カバレッジ:除外を「判断の記録」にする 人間は網羅率ではなく、除外判断の妥当性だけを見ればよい pytest --cov=src --cov-branch --cov-report=html で分岐網羅 未網羅の分岐が行単位でわかる。AIへの入力にも人間の確認にも使える 除外は2段構え
一括除外: pyproject.toml に共通パターンと理由を集約(型チェック用ブロック等) 個別除外: # pragma: no cover はその箇所固有の事情のみ。理由をコメントで残す コードが「テスト済み」と「明示的に除外」に二分される 書類上は網羅率100%。ベテランでなくてもレビューできる AI駆動開発で行ったテスト手法 10 / 21
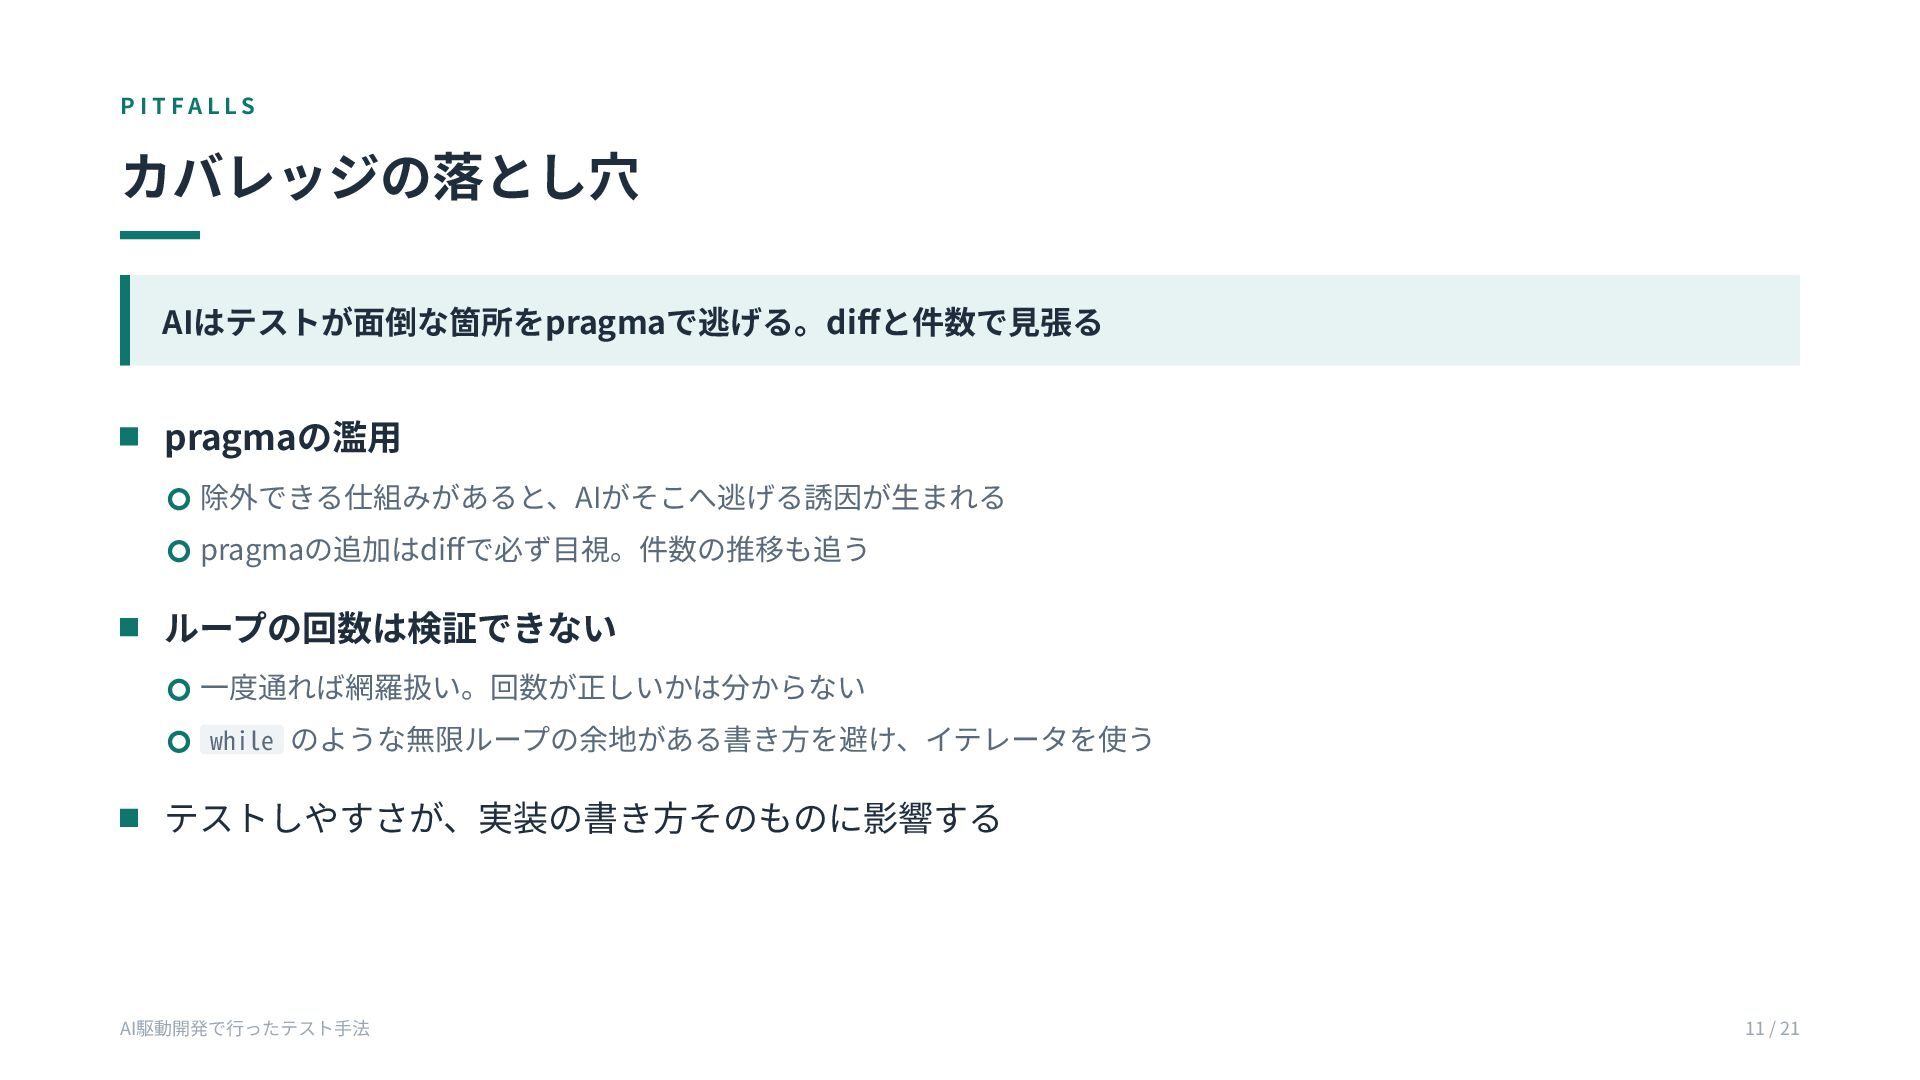
PITFALLS カバレッジの落とし穴 AIはテストが面倒な箇所をpragmaで逃げる。diffと件数で見張る pragmaの濫用 除外できる仕組みがあると、AIがそこへ逃げる誘因が生まれる pragmaの追加はdiffで必ず目視。件数の推移も追う ループの回数は検証できない 一度通れば網羅扱い。回数が正しいかは分からない while のような無限ループの余地がある書き方を避け、イテレータを使う
テストしやすさが、実装の書き方そのものに影響する AI駆動開発で行ったテスト手法 11 / 21
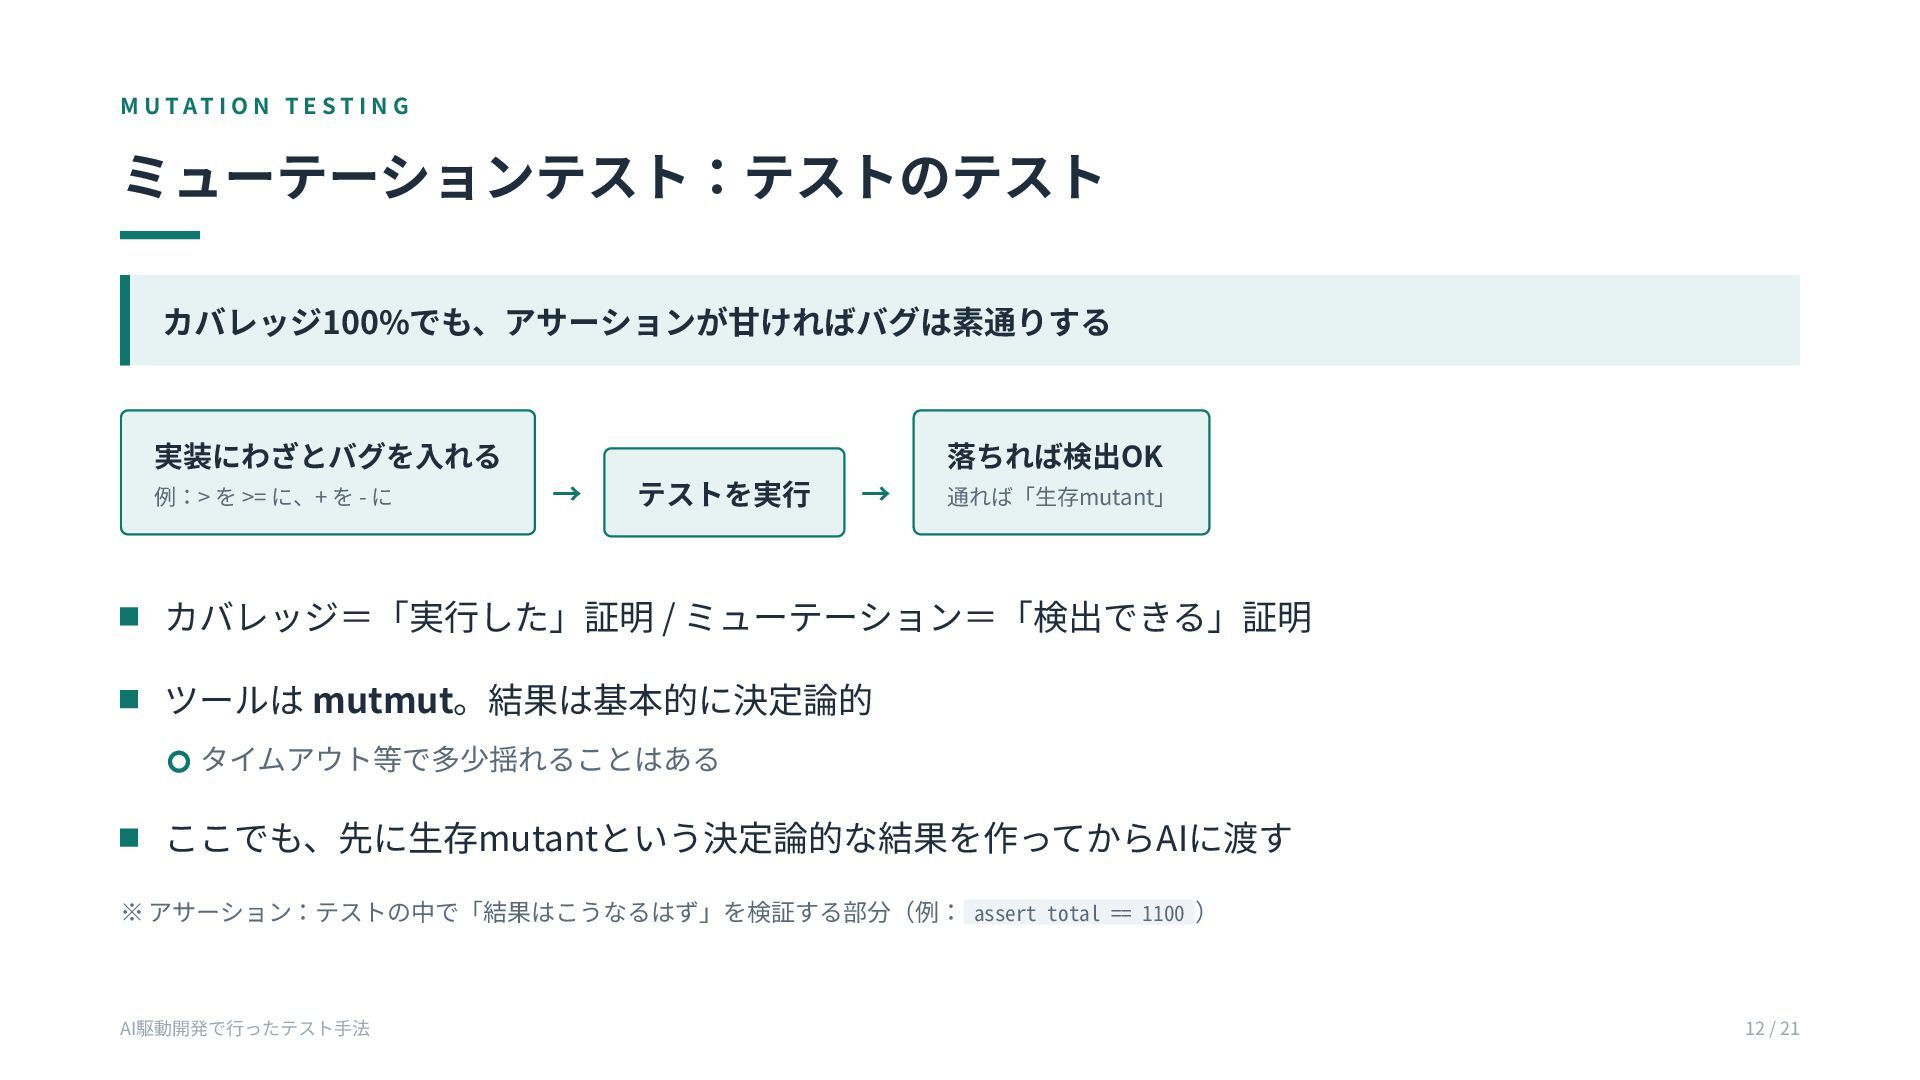
M U TAT I O N T E S T
I N G ミューテーションテスト:テストのテスト カバレッジ100%でも、アサーションが甘ければバグは素通りする 実装にわざとバグを入れる 例:> を >= に、+ を - に → テストを実行 → 落ちれば検出OK 通れば「生存mutant」 カバレッジ=「実行した」証明 / ミューテーション=「検出できる」証明 ツールは mutmut。結果は基本的に決定論的 タイムアウト等で多少揺れることはある ここでも、先に生存mutantという決定論的な結果を作ってからAIに渡す ※ アサーション:テストの中で「結果はこうなるはず」を検証する部分(例: assert total == 1100 ) AI駆動開発で行ったテスト手法 12 / 21
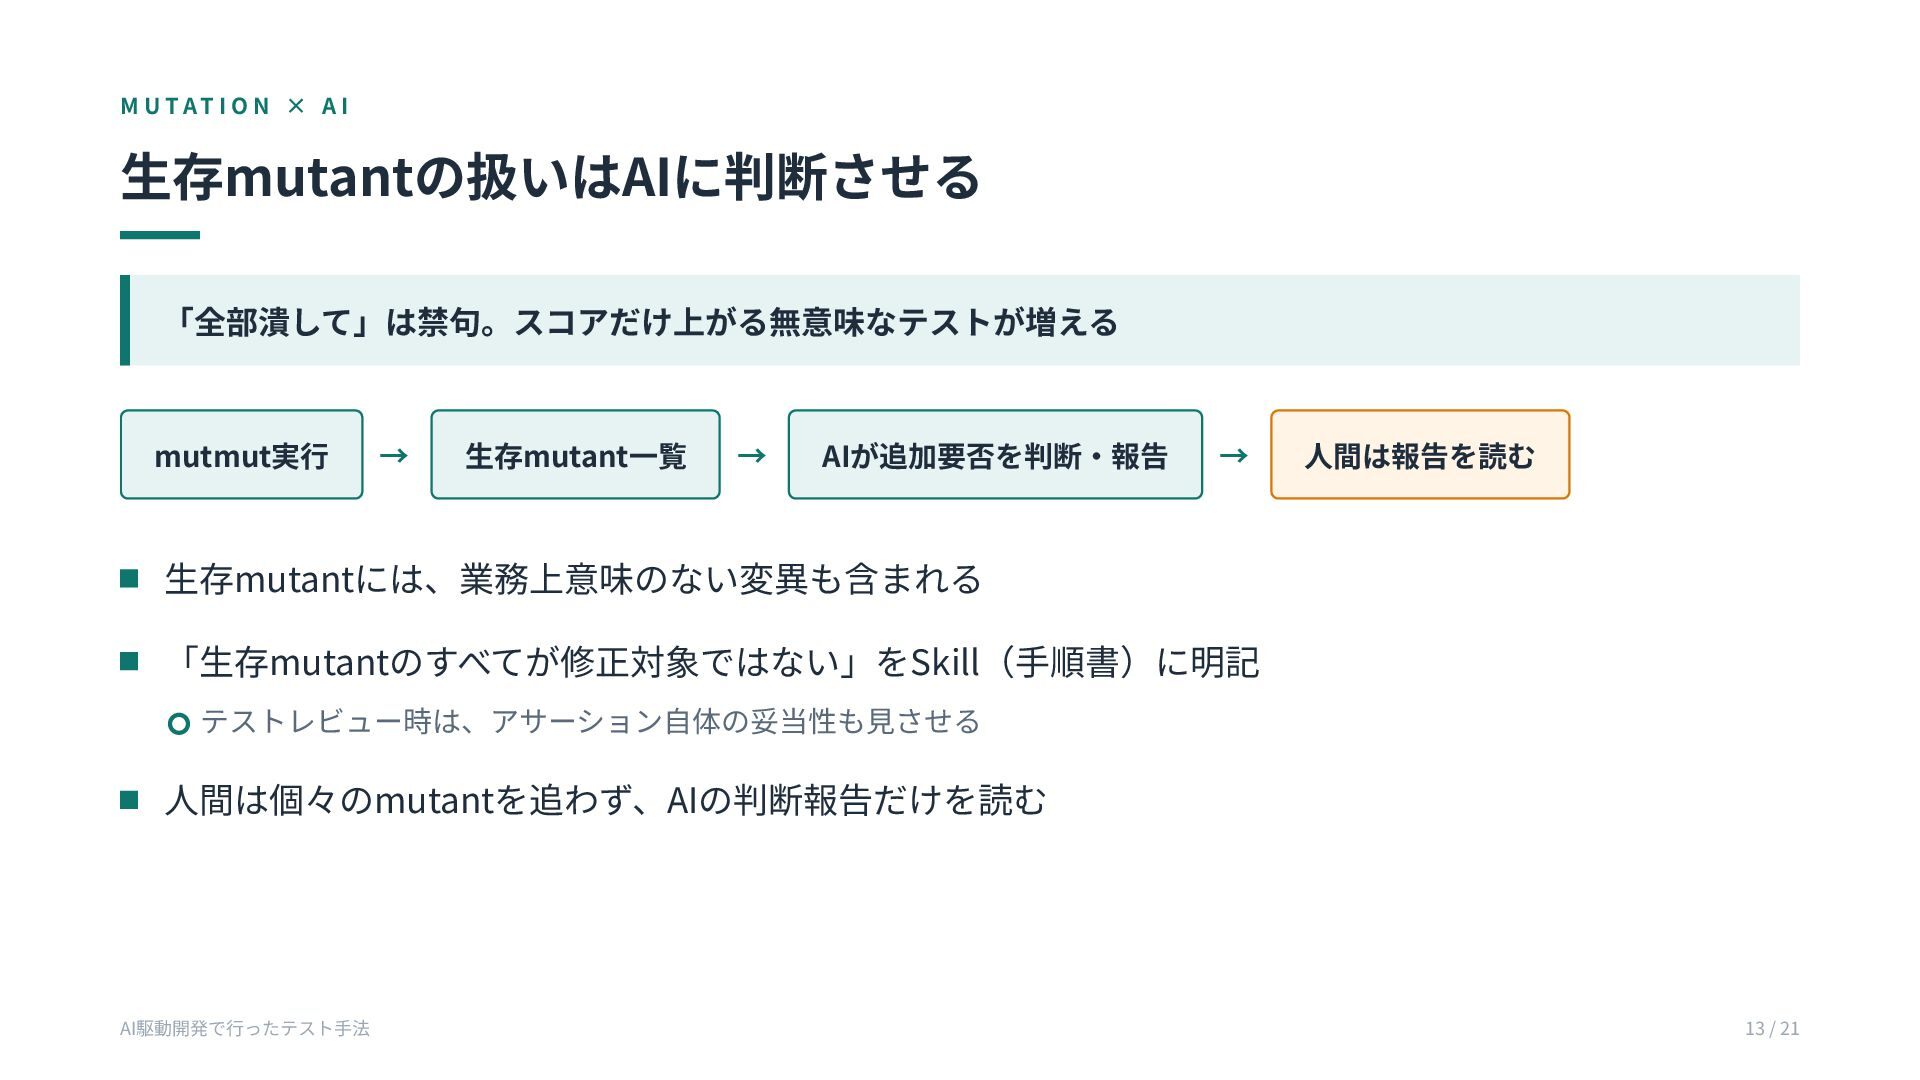
M U TAT I O N × A I 生存mutantの扱いはAIに判断させる
「全部潰して」は禁句。スコアだけ上がる無意味なテストが増える mutmut実行 → 生存mutant一覧 → AIが追加要否を判断・報告 → 人間は報告を読む 生存mutantには、業務上意味のない変異も含まれる 「生存mutantのすべてが修正対象ではない」をSkill(手順書)に明記 テストレビュー時は、アサーション自体の妥当性も見させる 人間は個々のmutantを追わず、AIの判断報告だけを読む AI駆動開発で行ったテスト手法 13 / 21
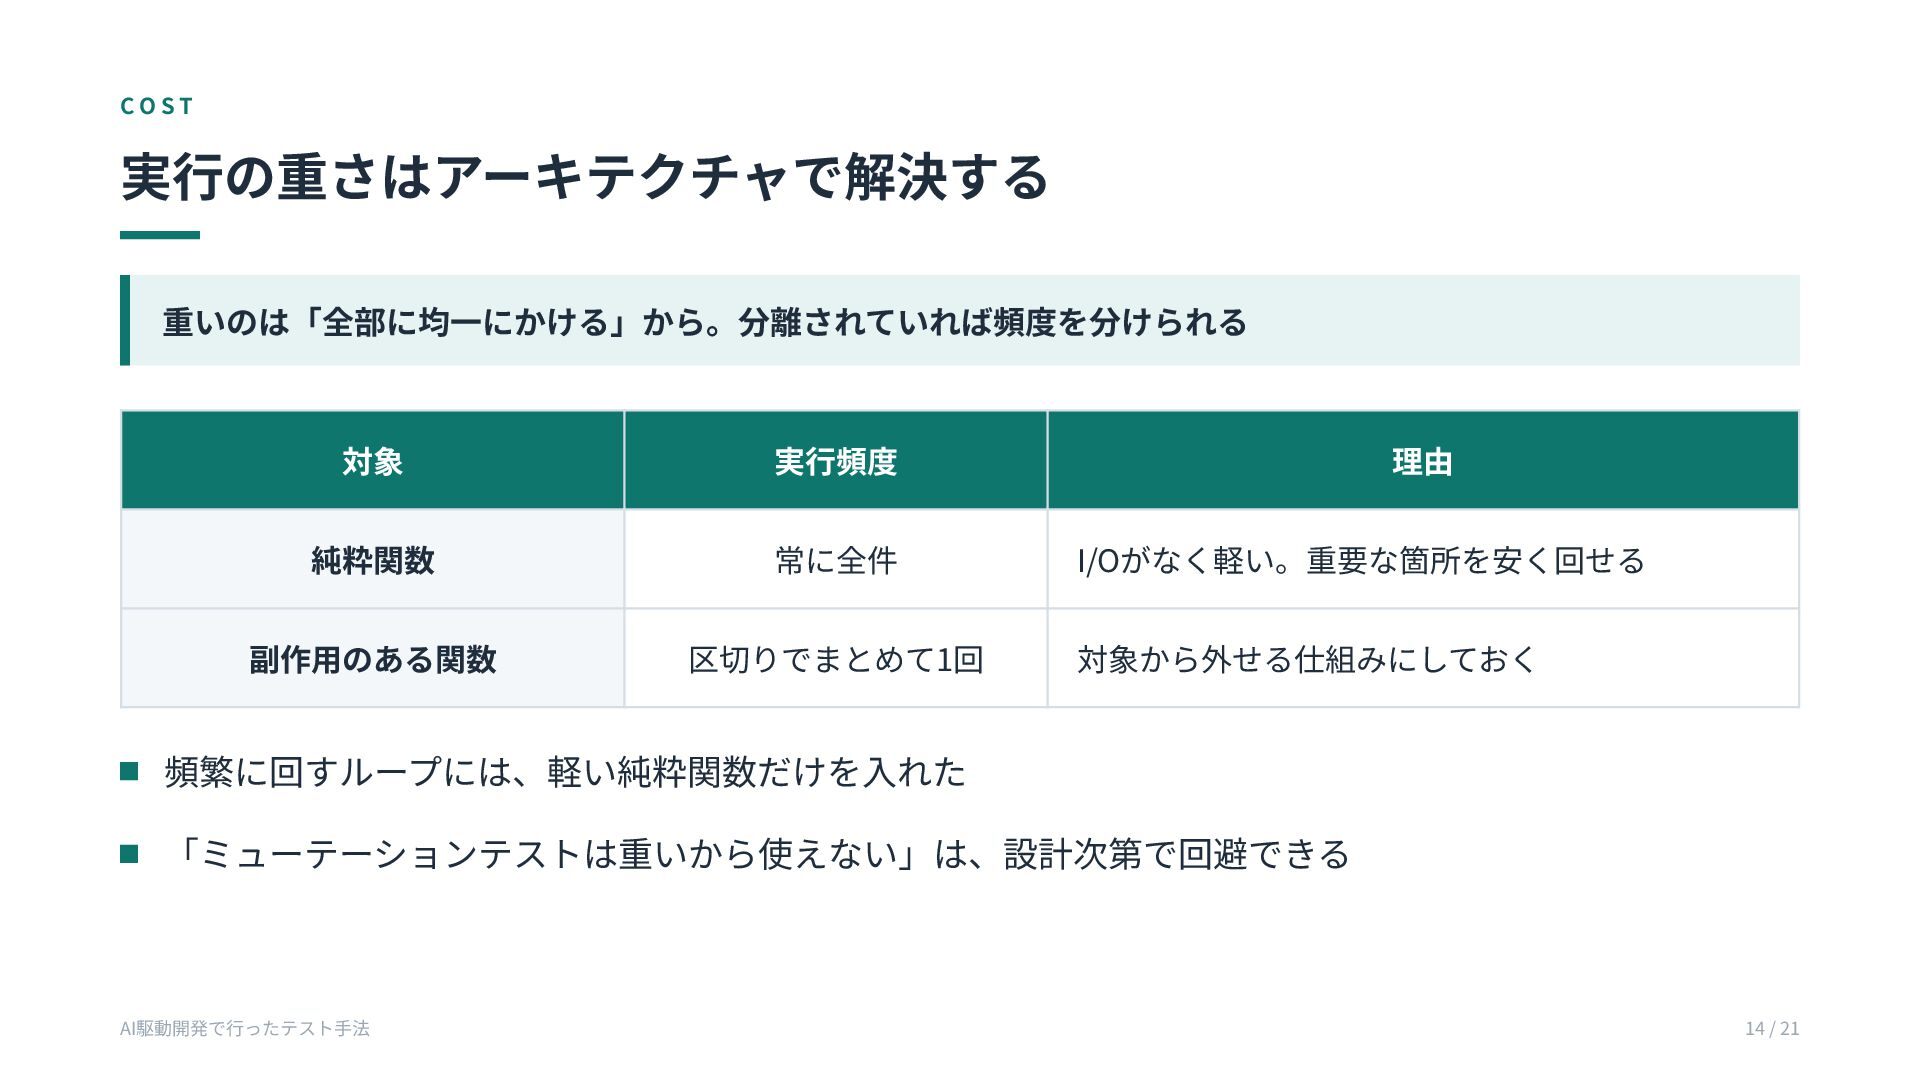
COST 実行の重さはアーキテクチャで解決する 重いのは「全部に均一にかける」から。分離されていれば頻度を分けられる 対象 実行頻度 純粋関数 常に全件 副作用のある関数 区切りでまとめて1回 理由
I/Oがなく軽い。重要な箇所を安く回せる 対象から外せる仕組みにしておく 頻繁に回すループには、軽い純粋関数だけを入れた 「ミューテーションテストは重いから使えない」は、設計次第で回避できる AI駆動開発で行ったテスト手法 14 / 21
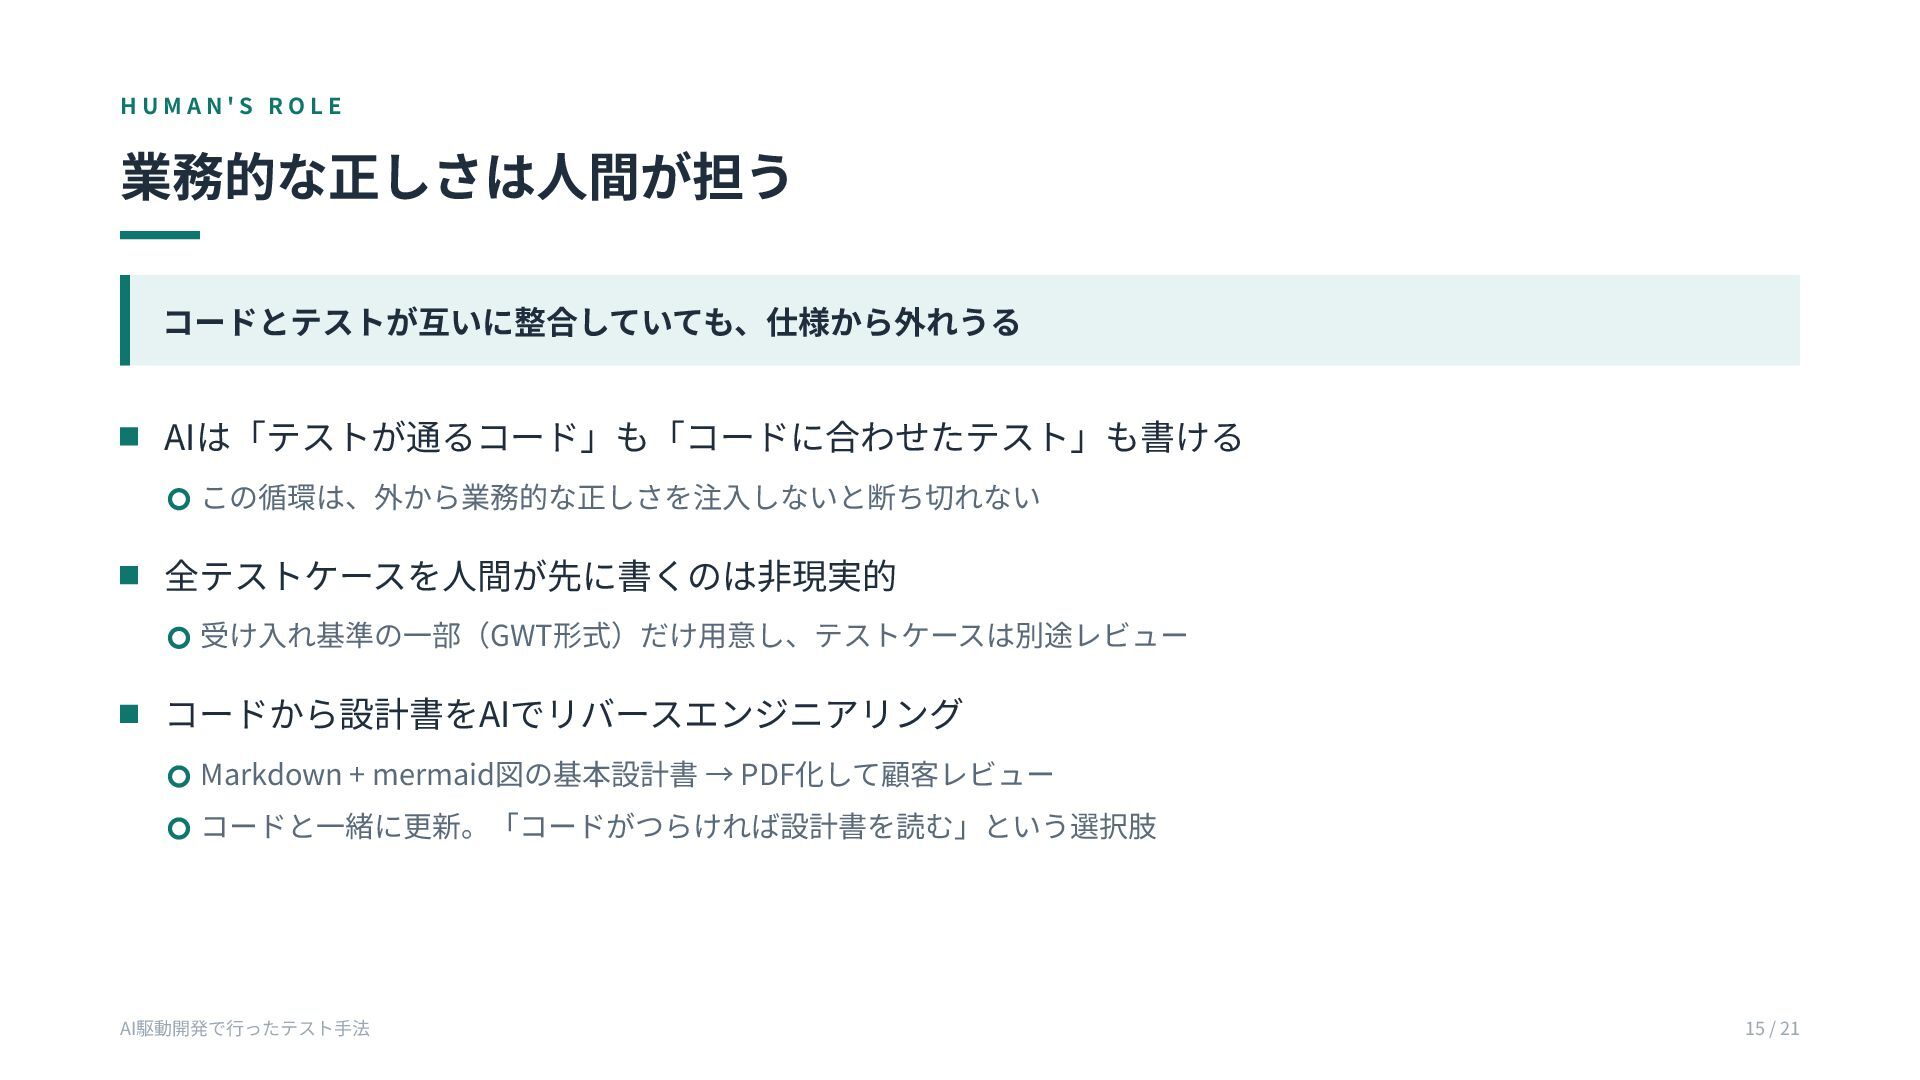
HUMAN'S ROLE 業務的な正しさは人間が担う コードとテストが互いに整合していても、仕様から外れうる AIは「テストが通るコード」も「コードに合わせたテスト」も書ける この循環は、外から業務的な正しさを注入しないと断ち切れない 全テストケースを人間が先に書くのは非現実的 受け入れ基準の一部(GWT形式)だけ用意し、テストケースは別途レビュー コードから設計書をAIでリバースエンジニアリング Markdown
+ mermaid図の基本設計書 → PDF化して顧客レビュー コードと一緒に更新。「コードがつらければ設計書を読む」という選択肢 AI駆動開発で行ったテスト手法 15 / 21
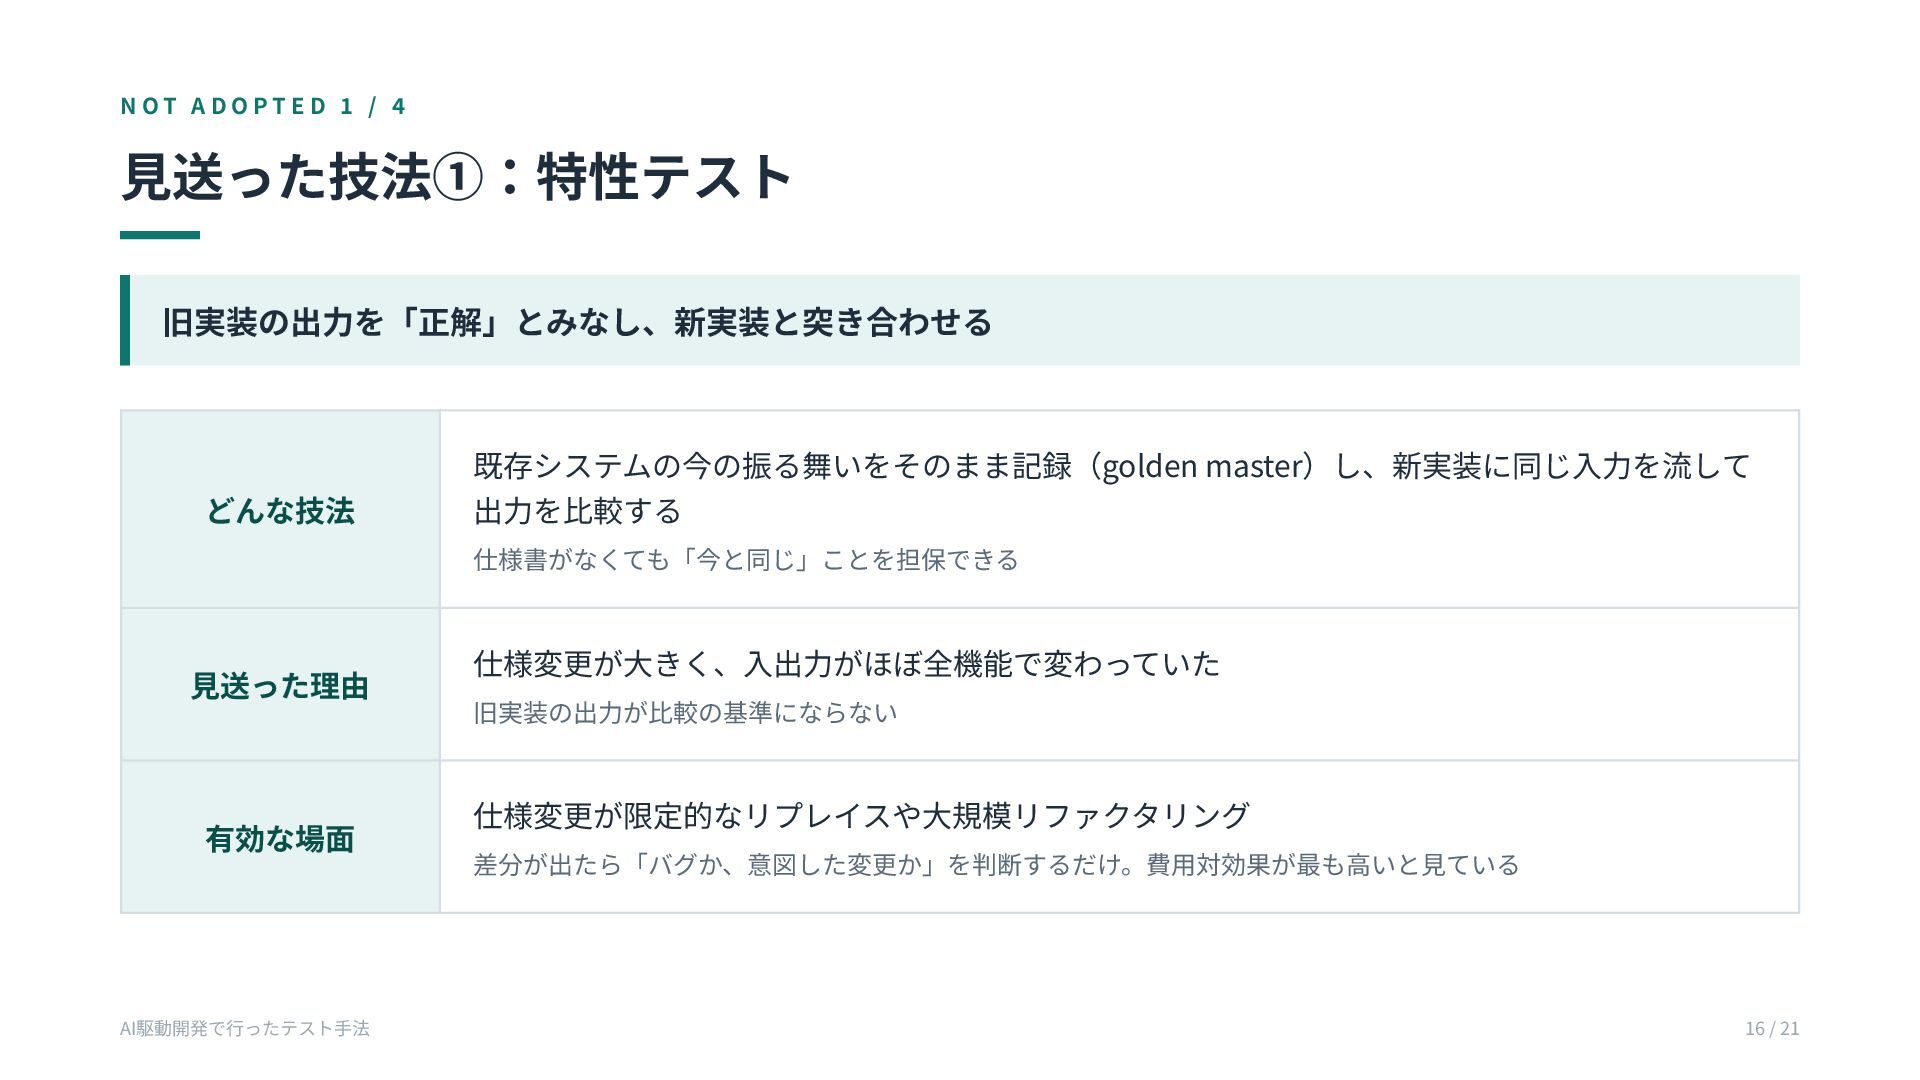
NOT ADOPTED 1 / 4 見送った技法①:特性テスト 旧実装の出力を「正解」とみなし、新実装と突き合わせる どんな技法 既存システムの今の振る舞いをそのまま記録(golden master)し、新実装に同じ入力を流して
出力を比較する 仕様書がなくても「今と同じ」ことを担保できる 見送った理由 有効な場面 AI駆動開発で行ったテスト手法 仕様変更が大きく、入出力がほぼ全機能で変わっていた 旧実装の出力が比較の基準にならない 仕様変更が限定的なリプレイスや大規模リファクタリング 差分が出たら「バグか、意図した変更か」を判断するだけ。費用対効果が最も高いと見ている 16 / 21
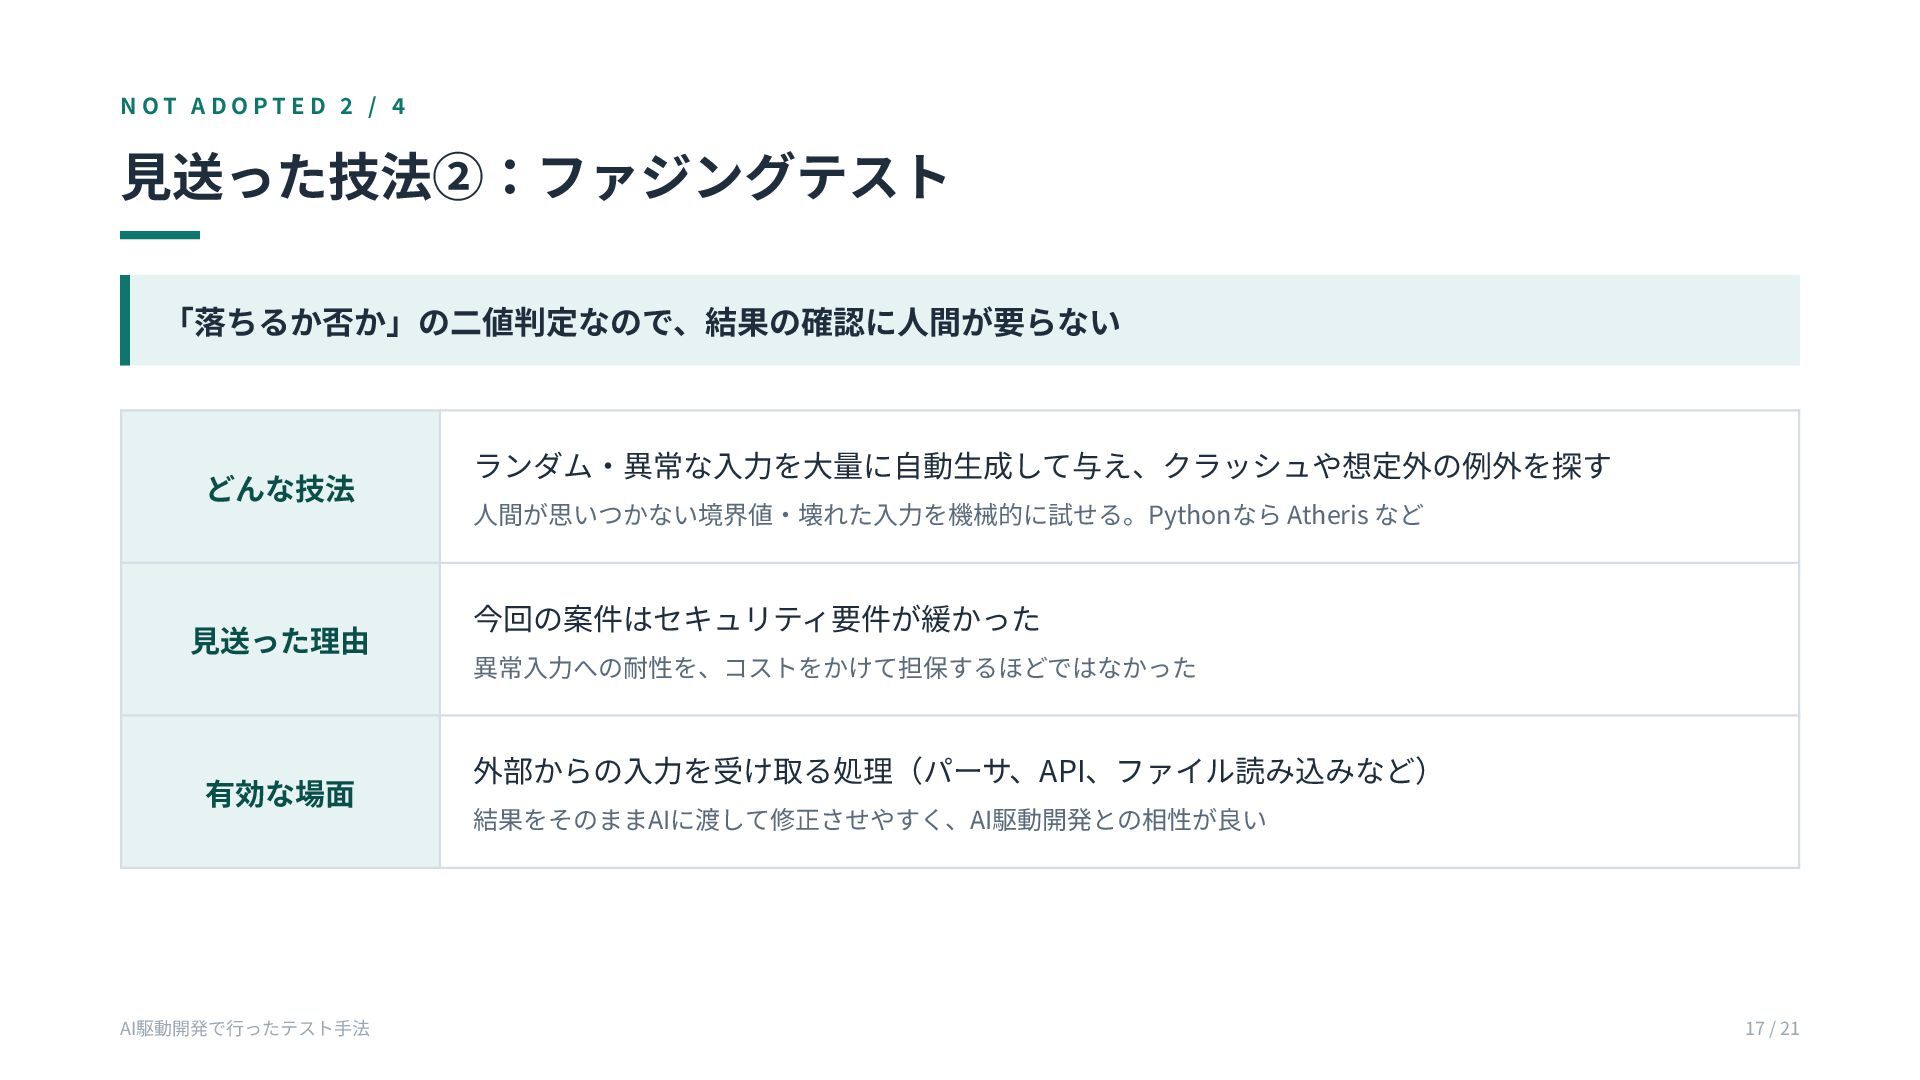
NOT ADOPTED 2 / 4 見送った技法②:ファジングテスト 「落ちるか否か」の二値判定なので、結果の確認に人間が要らない どんな技法 見送った理由 有効な場面
AI駆動開発で行ったテスト手法 ランダム・異常な入力を大量に自動生成して与え、クラッシュや想定外の例外を探す 人間が思いつかない境界値・壊れた入力を機械的に試せる。Pythonなら Atheris など 今回の案件はセキュリティ要件が緩かった 異常入力への耐性を、コストをかけて担保するほどではなかった 外部からの入力を受け取る処理(パーサ、API、ファイル読み込みなど) 結果をそのままAIに渡して修正させやすく、AI駆動開発との相性が良い 17 / 21
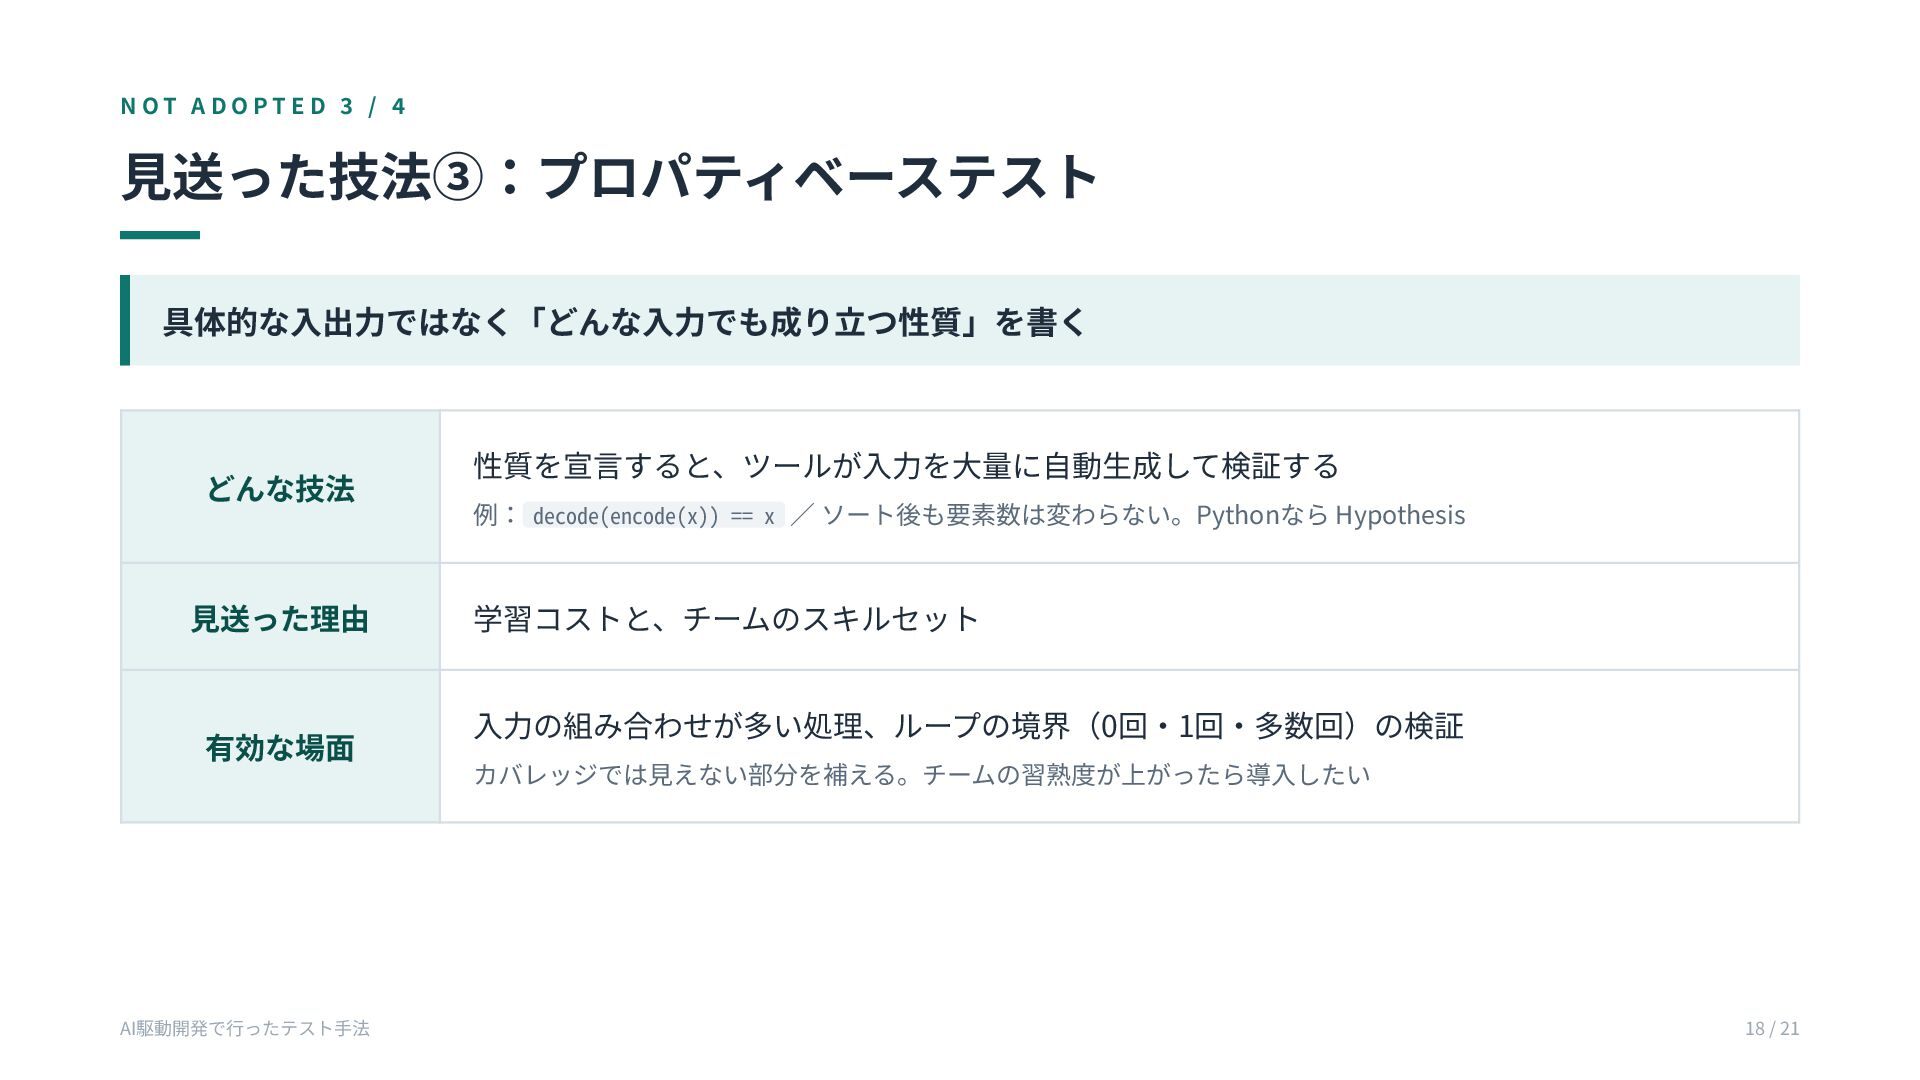
NOT ADOPTED 3 / 4 見送った技法③:プロパティベーステスト 具体的な入出力ではなく「どんな入力でも成り立つ性質」を書く どんな技法 見送った理由 有効な場面
AI駆動開発で行ったテスト手法 性質を宣言すると、ツールが入力を大量に自動生成して検証する 例: decode(encode(x)) == x / ソート後も要素数は変わらない。Pythonなら Hypothesis 学習コストと、チームのスキルセット 入力の組み合わせが多い処理、ループの境界(0回・1回・多数回)の検証 カバレッジでは見えない部分を補える。チームの習熟度が上がったら導入したい 18 / 21
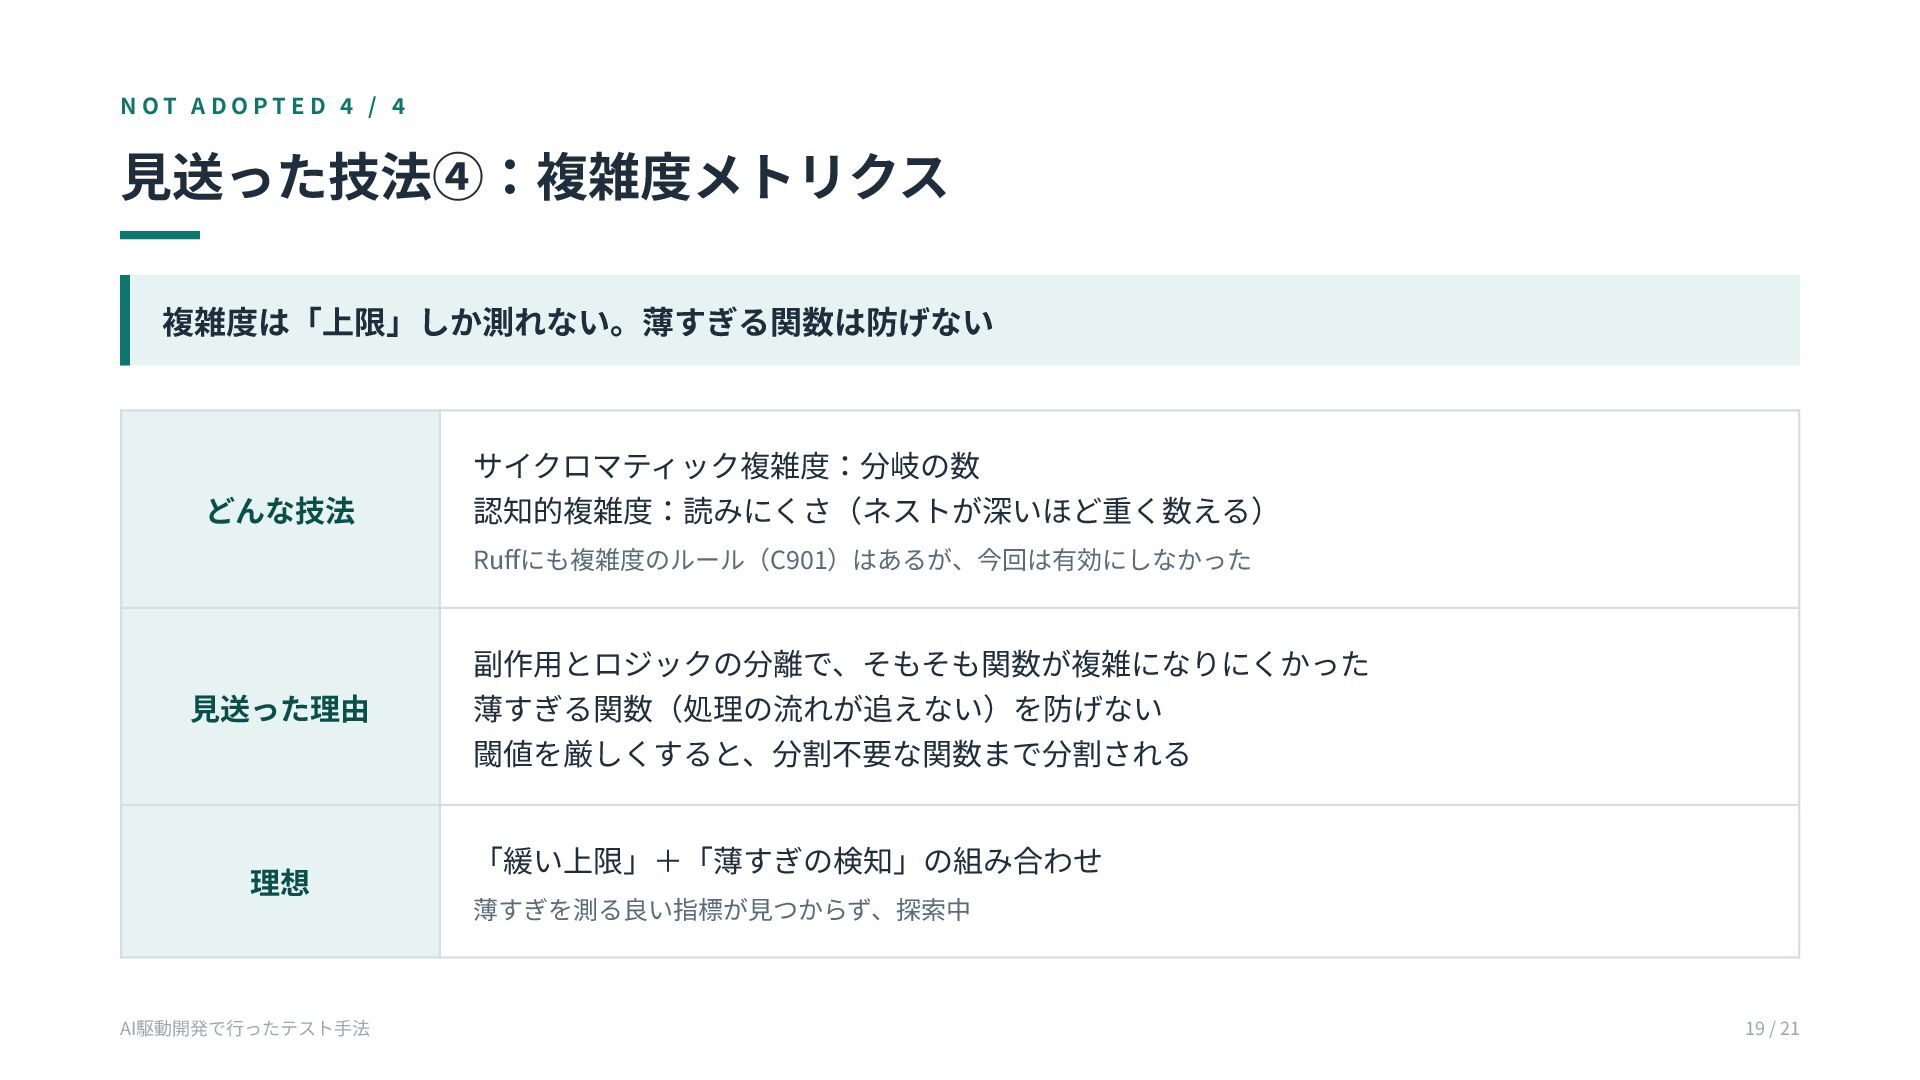
NOT ADOPTED 4 / 4 見送った技法④:複雑度メトリクス 複雑度は「上限」しか測れない。薄すぎる関数は防げない どんな技法 サイクロマティック複雑度:分岐の数 認知的複雑度:読みにくさ(ネストが深いほど重く数える)
Ruffにも複雑度のルール(C901)はあるが、今回は有効にしなかった 見送った理由 理想 AI駆動開発で行ったテスト手法 副作用とロジックの分離で、そもそも関数が複雑になりにくかった 薄すぎる関数(処理の流れが追えない)を防げない 閾値を厳しくすると、分割不要な関数まで分割される 「緩い上限」+「薄すぎの検知」の組み合わせ 薄すぎを測る良い指標が見つからず、探索中 19 / 21
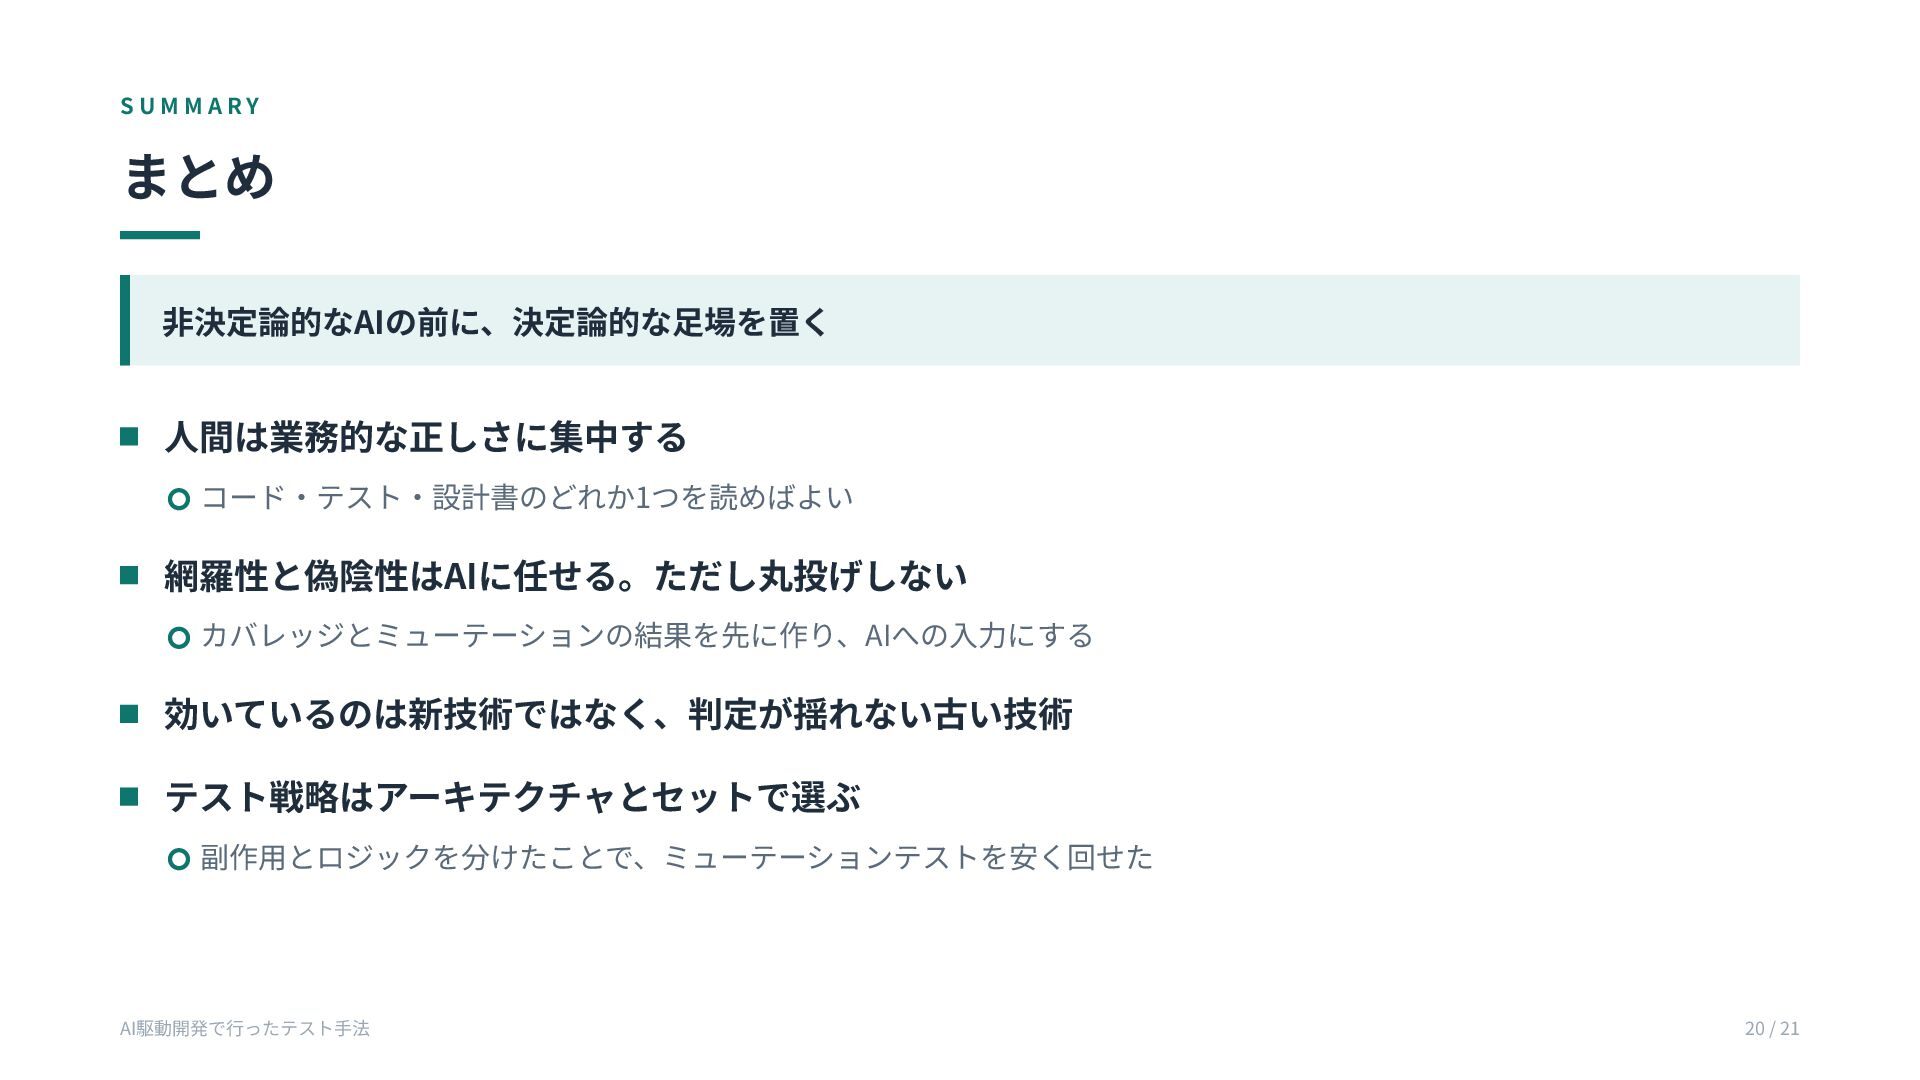
SUMMARY まとめ 非決定論的なAIの前に、決定論的な足場を置く 人間は業務的な正しさに集中する コード・テスト・設計書のどれか1つを読めばよい 網羅性と偽陰性はAIに任せる。ただし丸投げしない カバレッジとミューテーションの結果を先に作り、AIへの入力にする 効いているのは新技術ではなく、判定が揺れない古い技術 テスト戦略はアーキテクチャとセットで選ぶ 副作用とロジックを分けたことで、ミューテーションテストを安く回せた
AI駆動開発で行ったテスト手法 20 / 21
QA CLOSING 網羅と偽陰性は、揺れないテスト結果を入力にAIへ 人間は、業務的な正しさだけを見る ご清聴ありがとうございました
More Decks by kagu3
See All by kagu3
AI駆動開発で実践してきたこと
kagu3
0
14
仕様(spec)駆動開発、仕様はどう書く?
kagu3
0
38
PDFでドキュメントをレビュー -コメント記入マニュアル
kagu3
0
13
AIはどこまでタスクを自動化できるのか
kagu3
0
13
ハーネスは育てるもの
kagu3
1
21
なぜAI駆動開発でExcelは嫌われるのか
kagu3
0
22
はじめてのClaude Code
kagu3
0
19
Vivliostyle -MarkdownをPDFドキュメントに-
kagu3
0
10
Other Decks in Technology
See All in Technology
Kiro CLI 入門 (ターミナルと CI で使う) | 目指せ Kiro マスター 03
inariku
PRO
2
150
MCPでネットワーク障害調査を自動化する前に直すべき3つのこと
yama3133
0
360
Intro to Kiro (One agent, every surface) | Kiro: Zero to Hero 01
inariku
PRO
2
140
長い仕事を任せる (Workflows、クラウドセッション、Kiro Web) | 目指せ Kiro マスター 10
inariku
PRO
3
200
Kansai WordPress Meetup@大阪『ブロックテーマを作る上で知っておくべきこと
torounit
0
110
[NW-JAWS DAY]「うちのAWS、インターネット出られないんで」― AWS外の自社サービスをPrivateLinkでシュッと公開する方法
ykimi
2
560
Sonnetだけで業務はまわる?
kintotechdev
1
130
Agent Harnessはどう作る?事例から学ぶAI Agentの設計思想
sergicalsix
0
320
2026-11-11 Tamachi.sre#7 PaCにインフラリソースの命を救われました。 / PaC saves the infra resource life
masasuzu
1
180
「AIチャットからもできないの?」と言われたら ~業務アプリをMCP対応するときの認証・認可の勘所
oidfj
0
340
AI時代における医療情報システムのセキュリティ / Security of Healthcare IT Systems in the AI Era
henryofficial
0
170
狙われているAPIの脆弱性!今こそ手をつけるべき根本的な対策とは?
nagix
0
130
Featured
See All Featured
Designing Experiences People Love
moore
143
24k
A Tale of Four Properties
chriscoyier
163
24k
[RailsConf 2023] Rails as a piece of cake
palkan
59
7.1k
Claude Code どこまでも/ Claude Code Everywhere
nwiizo
68
60k
The Language of Interfaces
destraynor
162
27k
Fantastic passwords and where to find them - at NoRuKo
philnash
53
4k
Designing Powerful Visuals for Engaging Learning
tmiket
1
650
Visualizing Your Data: Incorporating Mongo into Loggly Infrastructure
mongodb
50
10k
Between Models and Reality
mayunak
4
580
Marketing to machines
jonoalderson
1
6k
Producing Creativity
orderedlist
PRO
348
41k
The B2B funnel & how to create a winning content strategy
katarinadahlin
PRO
1
610


 kagu3
 inariku
 yama3133
 torounit
 ykimi
 kintotechdev
 sergicalsix
 masasuzu
 oidfj
 henryofficial
 nagix
 moore
 chriscoyier
 palkan
 nwiizo
 destraynor
 philnash
 tmiket
 mongodb
 mayunak
 jonoalderson
 orderedlist
 katarinadahlin