Share
Embed
短距離古典分子動力学法のSIMD化及びC++コンパイラへの要望について / About FCC
メニーコア時代のアプリ性能検討WGにおける報告資料。以下も参照
http://www.ssken.gr.jp/MAINSITE/download/wg_report/mcap/index.html

Transcript
33 slides
-
ISSP, Univ. of Tokyo 1/33 短距離古典分子動力学法のSIMD化 及び C++コンパイラへの要望について 渡辺宙志 東京大学物性研究所
2017年7月25日「メニーコア時代のアプリ性能検討WG第3回会合」@九州大学伊都キャンパス ※ メニーコア時代のアプリ性能検討WG 成果報告書を参照 http://www.ssken.gr.jp/MAINSITE/download/wg_report/mcap/index.html -
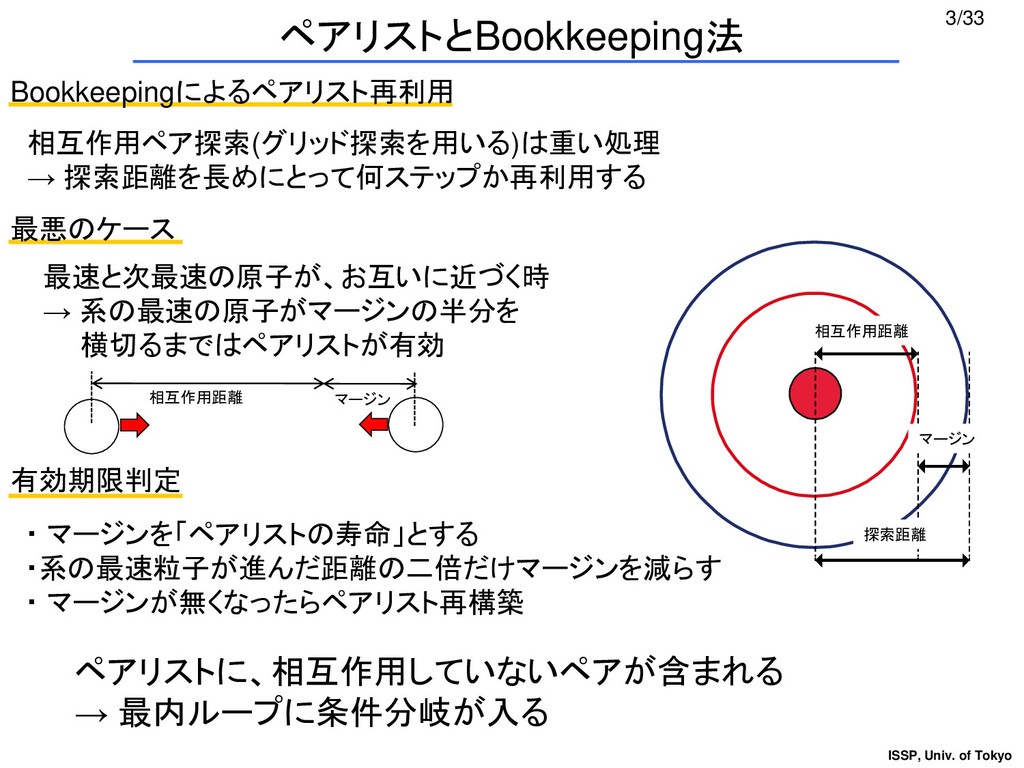
ISSP, Univ. of Tokyo 3/33 ペアリストとBookkeeping法 Bookkeepingによるペアリスト再利用 相互作用ペア探索(グリッド探索を用いる)は重い処理 → 探索距離を長めにとって何ステップか再利用する
相互作用距離 探索距離 マージン ・ マージンを「ペアリストの寿命」とする ・系の最速粒子が進んだ距離の二倍だけマージンを減らす ・ マージンが無くなったらペアリスト再構築 相互作用距離 マージン 最悪のケース 最速と次最速の原子が、お互いに近づく時 → 系の最速の原子がマージンの半分を 横切るまではペアリストが有効 有効期限判定 ペアリストに、相互作用していないペアが含まれる → 最内ループに条件分岐が入る -
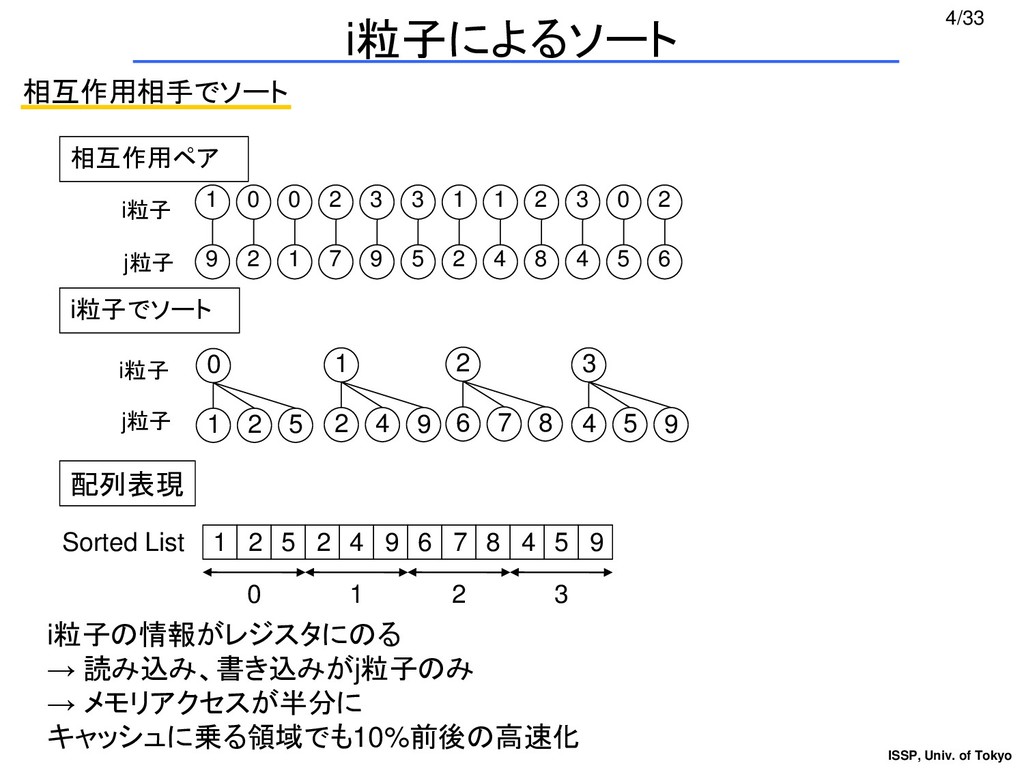
ISSP, Univ. of Tokyo 4/33 i粒子によるソート 相互作用相手でソート 相互作用ペア 1 9
0 2 0 1 2 7 3 9 3 5 1 2 1 4 2 8 3 4 0 5 2 6 i粒子でソート 1 2 5 2 4 9 6 7 8 4 5 9 Sorted List 0 1 2 5 1 2 4 9 2 6 7 8 3 4 5 9 配列表現 0 1 2 3 i粒子の情報がレジスタにのる → 読み込み、書き込みがj粒子のみ → メモリアクセスが半分に キャッシュに乗る領域でも10%前後の高速化 i粒子 j粒子 i粒子 j粒子 -
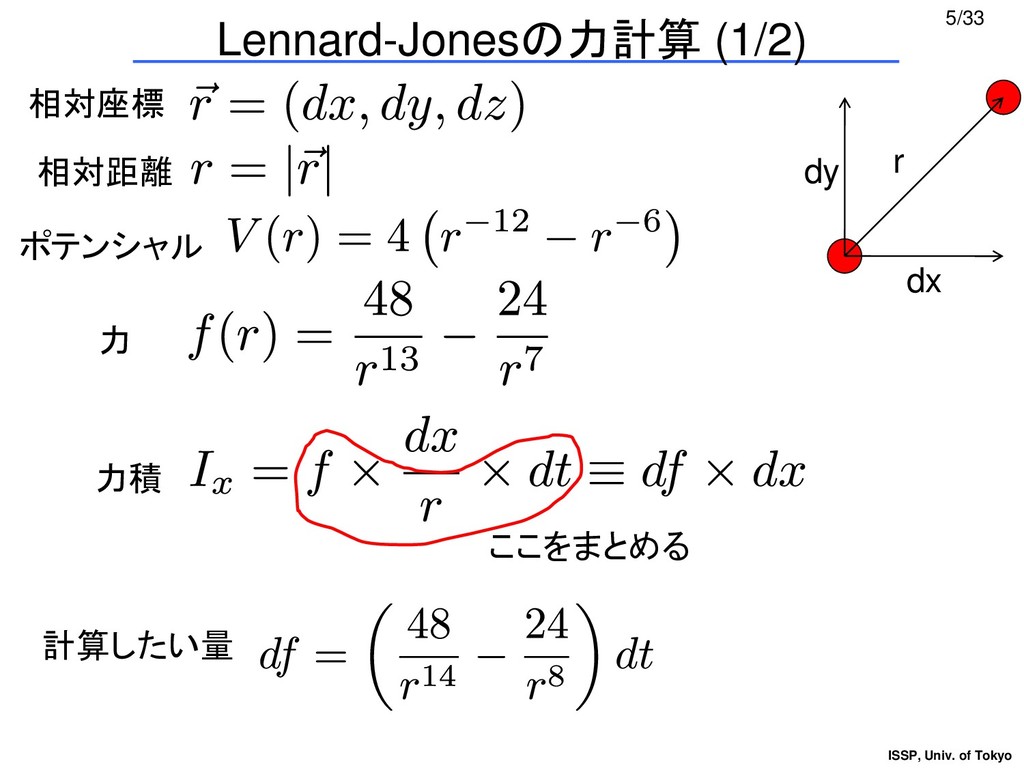
ISSP, Univ. of Tokyo 5/33 Lennard-Jonesの力計算 (1/2) r dx dy
ポテンシャル 力 力積 ここをまとめる 計算したい量 相対座標 相対距離 -
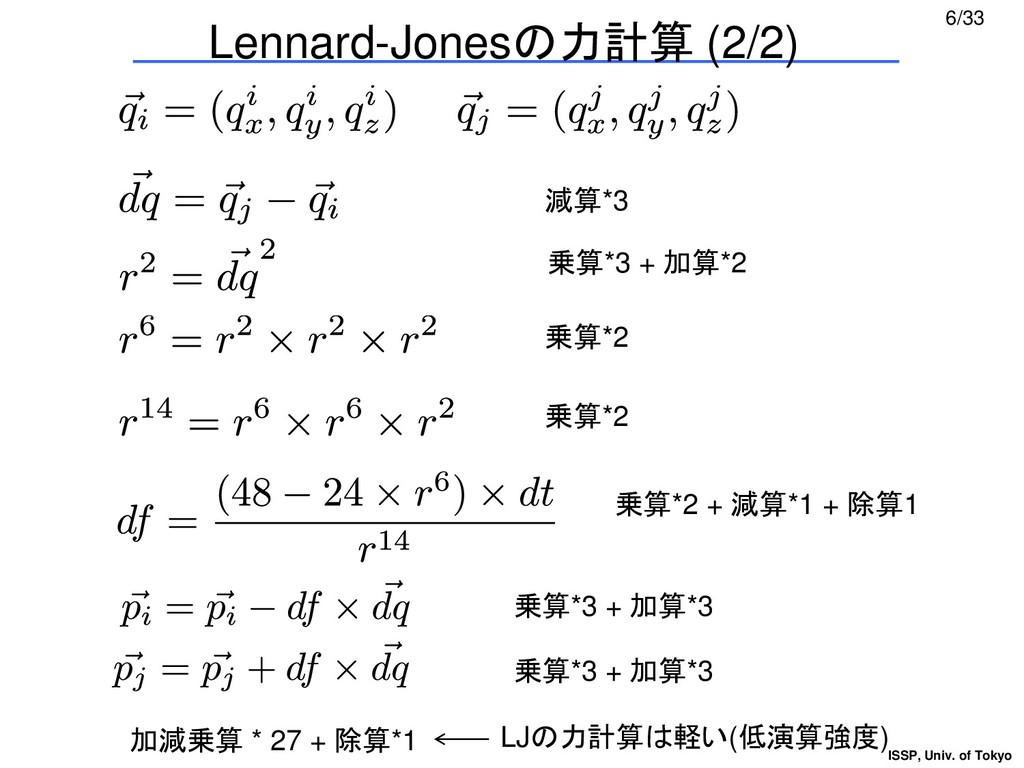
ISSP, Univ. of Tokyo 6/33 Lennard-Jonesの力計算 (2/2) 減算*3 乗算*3 +
加算*2 乗算*2 乗算*2 乗算*2 + 減算*1 + 除算1 乗算*3 + 加算*3 乗算*3 + 加算*3 加減乗算 * 27 + 除算*1 LJの力計算は軽い(低演算強度) -
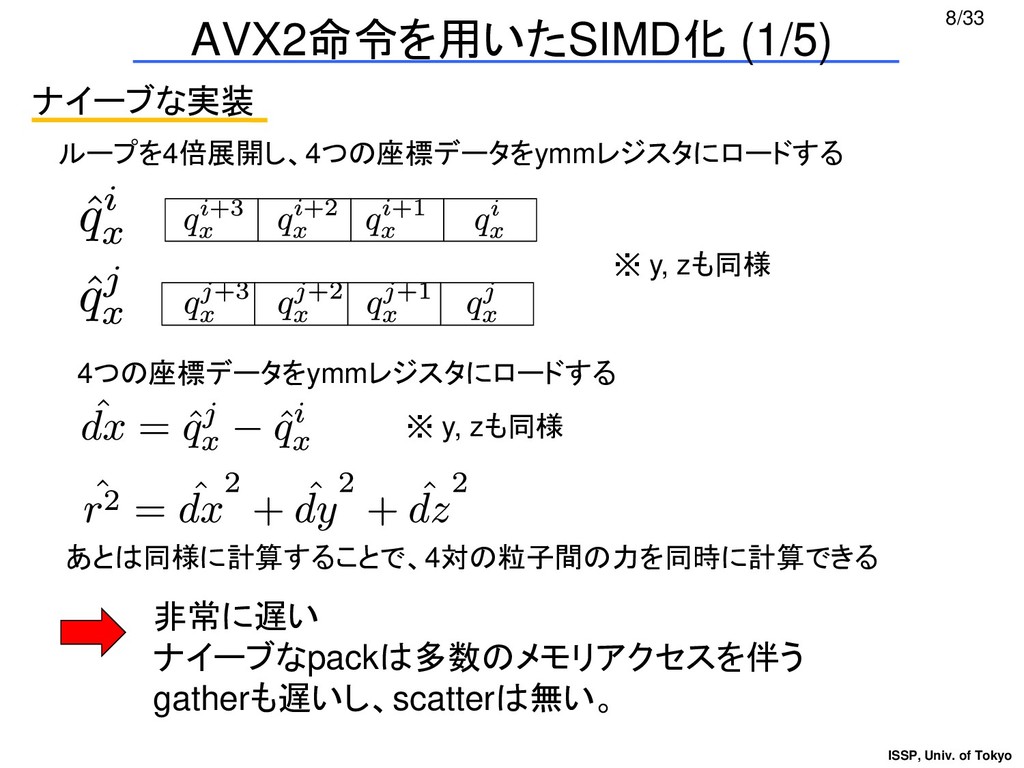
ISSP, Univ. of Tokyo 8/33 AVX2命令を用いたSIMD化 (1/5) ナイーブな実装 ループを4倍展開し、4つの座標データをymmレジスタにロードする 4つの座標データをymmレジスタにロードする
※ y, zも同様 ※ y, zも同様 あとは同様に計算することで、4対の粒子間の力を同時に計算できる 非常に遅い ナイーブなpackは多数のメモリアクセスを伴う gatherも遅いし、scatterは無い。 -
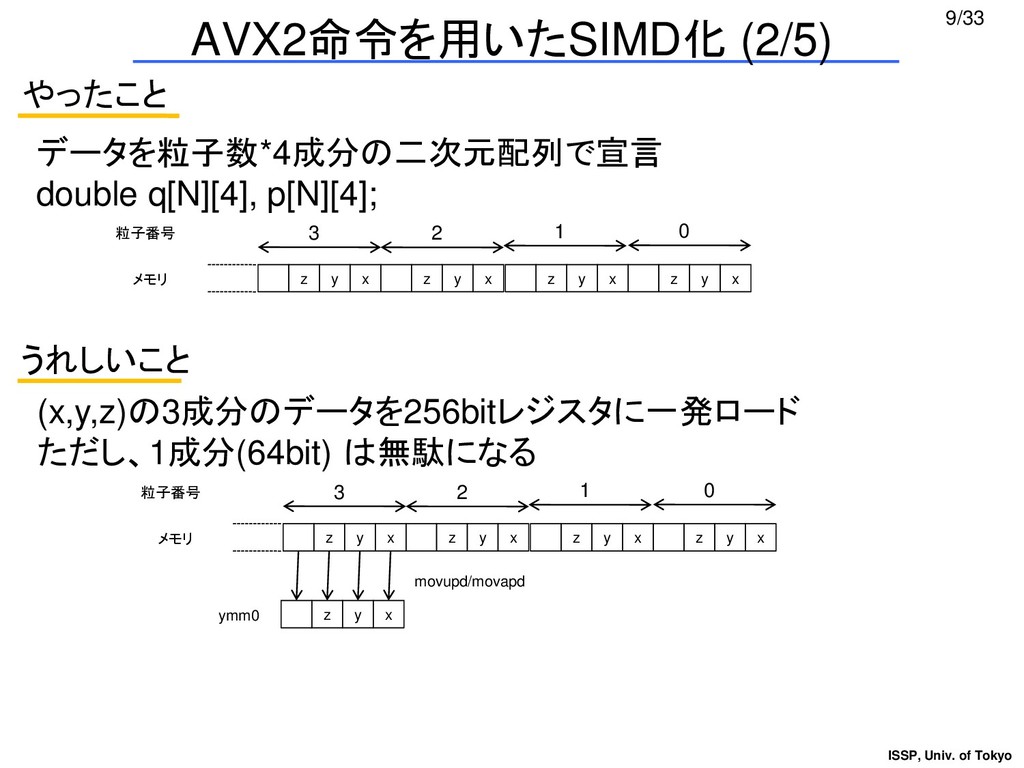
ISSP, Univ. of Tokyo 9/33 AVX2命令を用いたSIMD化 (2/5) やったこと データを粒子数*4成分の二次元配列で宣言 double
q[N][4], p[N][4]; z y x z y x メモリ z y x 0 1 2 z y x 3 粒子番号 うれしいこと (x,y,z)の3成分のデータを256bitレジスタに一発ロード ただし、1成分(64bit) は無駄になる z y x z y x メモリ z y x 0 1 2 z y x 3 粒子番号 z y x movupd/movapd ymm0 -
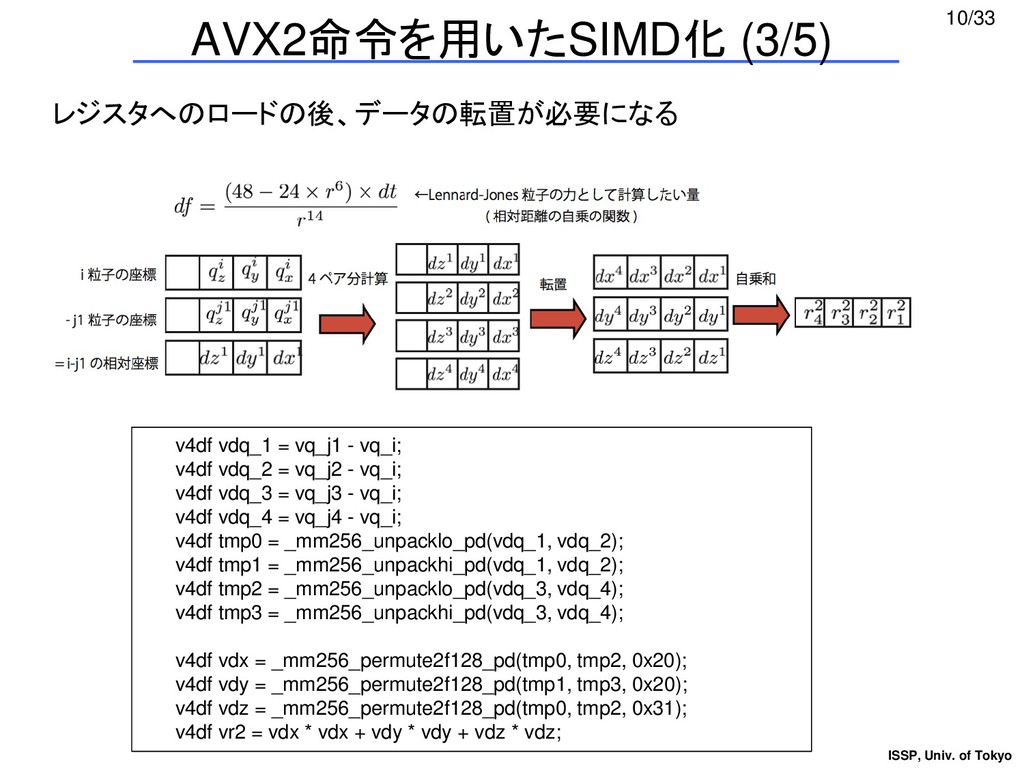
ISSP, Univ. of Tokyo 10/33 AVX2命令を用いたSIMD化 (3/5) v4df vdq_1 =
vq_j1 - vq_i; v4df vdq_2 = vq_j2 - vq_i; v4df vdq_3 = vq_j3 - vq_i; v4df vdq_4 = vq_j4 - vq_i; v4df tmp0 = _mm256_unpacklo_pd(vdq_1, vdq_2); v4df tmp1 = _mm256_unpackhi_pd(vdq_1, vdq_2); v4df tmp2 = _mm256_unpacklo_pd(vdq_3, vdq_4); v4df tmp3 = _mm256_unpackhi_pd(vdq_3, vdq_4); v4df vdx = _mm256_permute2f128_pd(tmp0, tmp2, 0x20); v4df vdy = _mm256_permute2f128_pd(tmp1, tmp3, 0x20); v4df vdz = _mm256_permute2f128_pd(tmp0, tmp2, 0x31); v4df vr2 = vdx * vdx + vdy * vdy + vdz * vdz; レジスタへのロードの後、データの転置が必要になる -
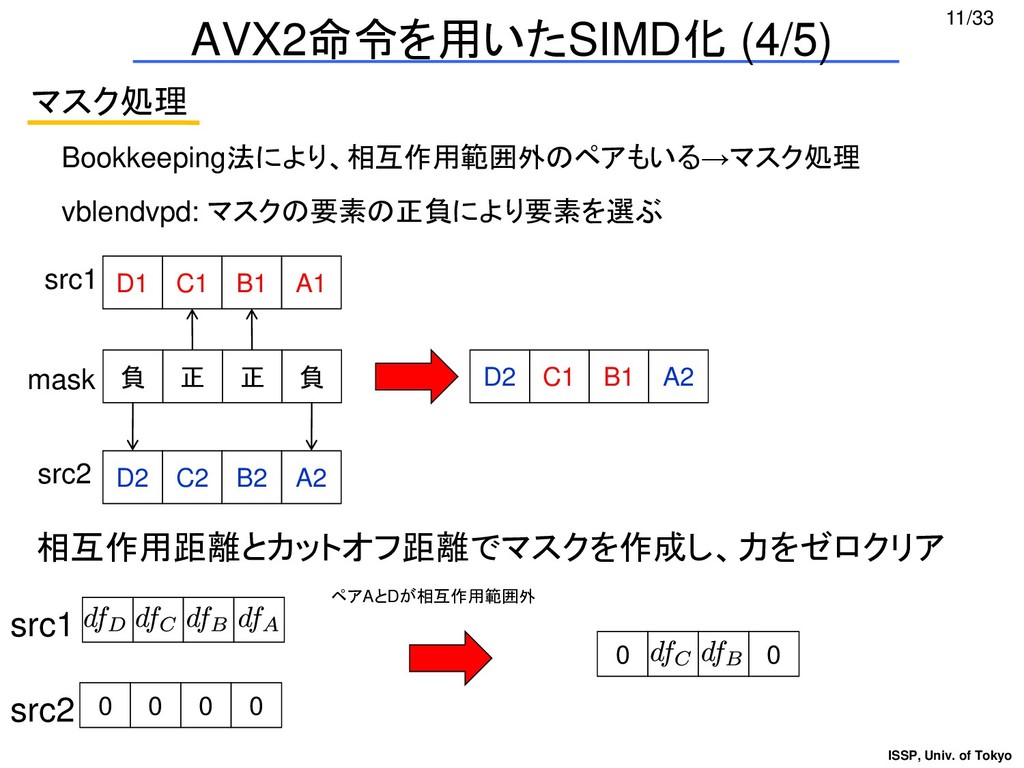
ISSP, Univ. of Tokyo 11/33 AVX2命令を用いたSIMD化 (4/5) マスク処理 Bookkeeping法により、相互作用範囲外のペアもいる→マスク処理 D2
C2 B2 A2 D1 C1 B1 A1 負 正 正 負 src1 src2 mask D2 C1 B1 A2 vblendvpd: マスクの要素の正負により要素を選ぶ 相互作用距離とカットオフ距離でマスクを作成し、力をゼロクリア 0 0 0 0 src1 src2 0 0 ペアAとDが相互作用範囲外 -
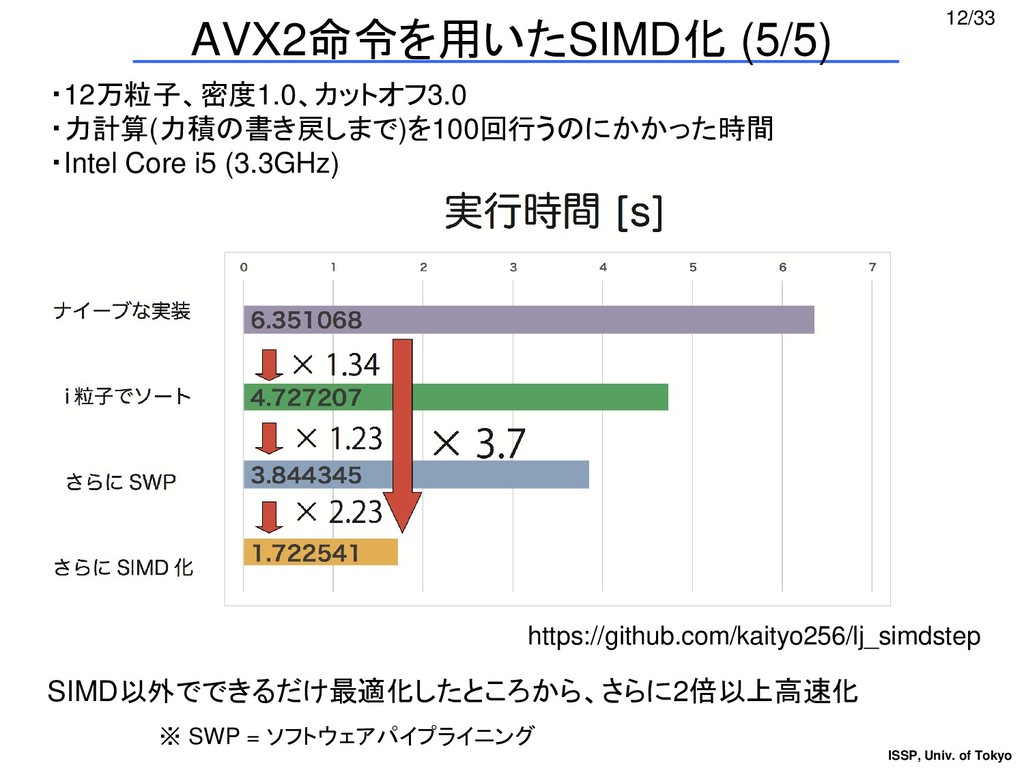
ISSP, Univ. of Tokyo 12/33 AVX2命令を用いたSIMD化 (5/5) ・12万粒子、密度1.0、カットオフ3.0 ・力計算(力積の書き戻しまで)を100回行うのにかかった時間 ・Intel
Core i5 (3.3GHz) SIMD以外でできるだけ最適化したところから、さらに2倍以上高速化 ※ SWP = ソフトウェアパイプライニング https://github.com/kaityo256/lj_simdstep -
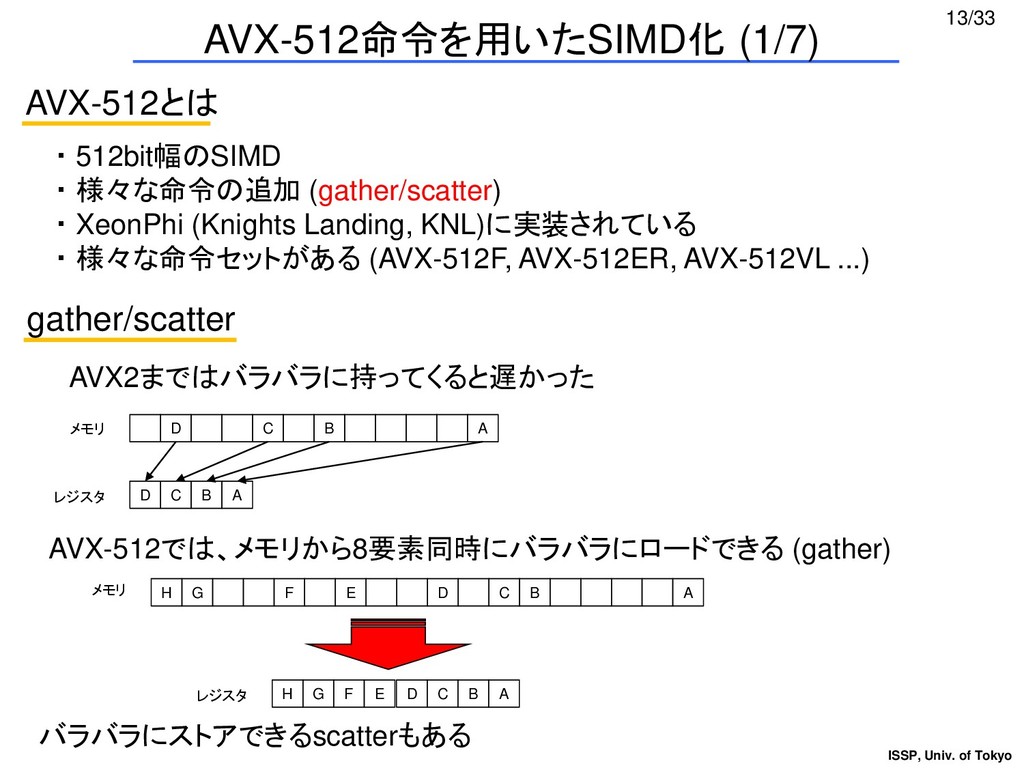
ISSP, Univ. of Tokyo 13/33 AVX-512命令を用いたSIMD化 (1/7) AVX-512とは ・ 512bit幅のSIMD
・ 様々な命令の追加 (gather/scatter) ・ XeonPhi (Knights Landing, KNL)に実装されている ・ 様々な命令セットがある (AVX-512F, AVX-512ER, AVX-512VL ...) gather/scatter D C B A メモリ レジスタ D C B A AVX2まではバラバラに持ってくると遅かった H G F E D C メモリ レジスタ H G F E AVX-512では、メモリから8要素同時にバラバラにロードできる (gather) D C B A B A バラバラにストアできるscatterもある -
ISSP, Univ. of Tokyo 14/33 SIMD化前 実行時間 [s] ナイーブな実装 i粒子でソート
さらにSWP ・ KNLのシングルコアの実行速度はCore i5 (Skylake)の6〜7倍遅い AVX-512命令を用いたSIMD化 (2/7) https://github.com/kohnakagawa/lj_knl KNL向け実装は物性研の中川さんのコードを参考にしました -
ISSP, Univ. of Tokyo 15/33 データ構造の変更 double q[N][4], p[N][4]; double
q[3][N], p[3][N]; ひっくり返す Array of Structure (AoS) Structure of Array (SoA) データ構造の変更により 3倍高速化 AVX-512命令を用いたSIMD化 (3/7) -
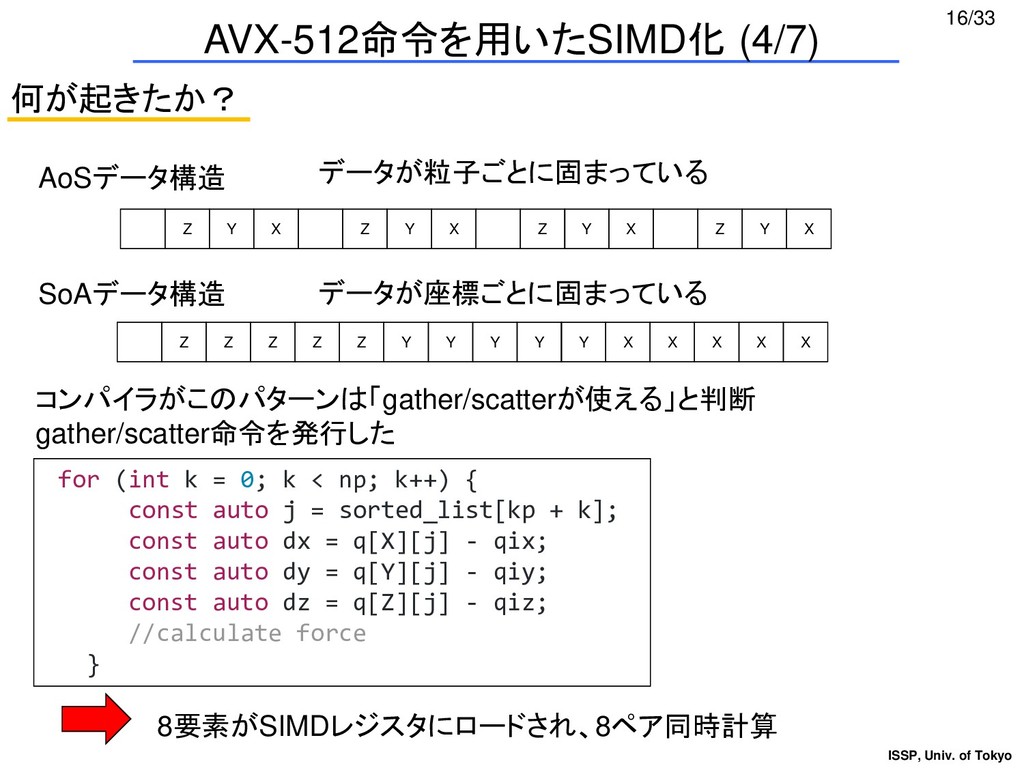
ISSP, Univ. of Tokyo 16/33 何が起きたか? AoSデータ構造 Z Y X
Z Y X Z Y X Z Y X SoAデータ構造 Z Z Z Z Z Y Y Y Y Y X X X X X データが粒子ごとに固まっている データが座標ごとに固まっている for (int k = 0; k < np; k++) { const auto j = sorted_list[kp + k]; const auto dx = q[X][j] - qix; const auto dy = q[Y][j] - qiy; const auto dz = q[Z][j] - qiz; //calculate force } コンパイラがこのパターンは「gather/scatterが使える」と判断 gather/scatter命令を発行した 8要素がSIMDレジスタにロードされ、8ペア同時計算 AVX-512命令を用いたSIMD化 (4/7) -
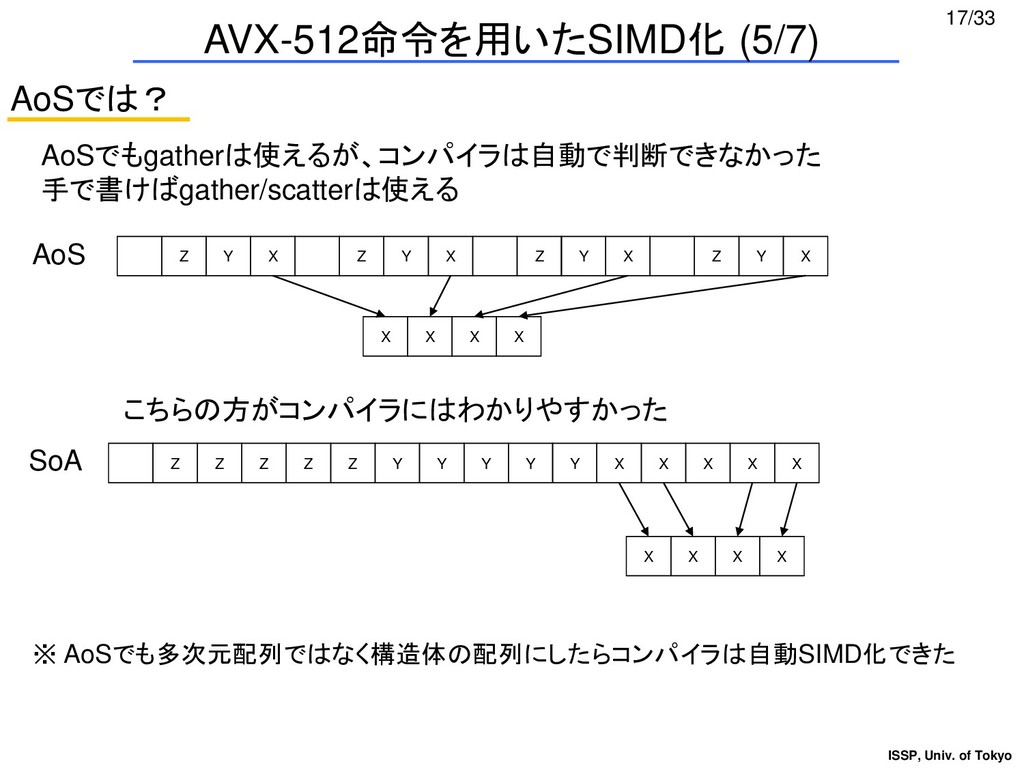
ISSP, Univ. of Tokyo 17/33 AoSでは? Z Y X Z
Y X Z Y X Z Y X Z Z Z Z Z Y Y Y Y Y X X X X X AoSでもgatherは使えるが、コンパイラは自動で判断できなかった 手で書けばgather/scatterは使える X X X X X X X X AoS SoA こちらの方がコンパイラにはわかりやすかった AVX-512命令を用いたSIMD化 (5/7) ※ AoSでも多次元配列ではなく構造体の配列にしたらコンパイラは自動SIMD化できた -
ISSP, Univ. of Tokyo 18/33 SoAとAoS gather/scatterを手で書けば、SoAとAoSの速度はどちらも大差ないが ここでもう少しデータ構造を工夫してみる double q[N][4],
p[N][4]; Array of Structure (AoS) double z[N][8]; 運動量と座標をまとめてしまう 8要素パック+手動gather/scatterにより 35%高速化 AVX-512命令を用いたSIMD化 (6/7) -
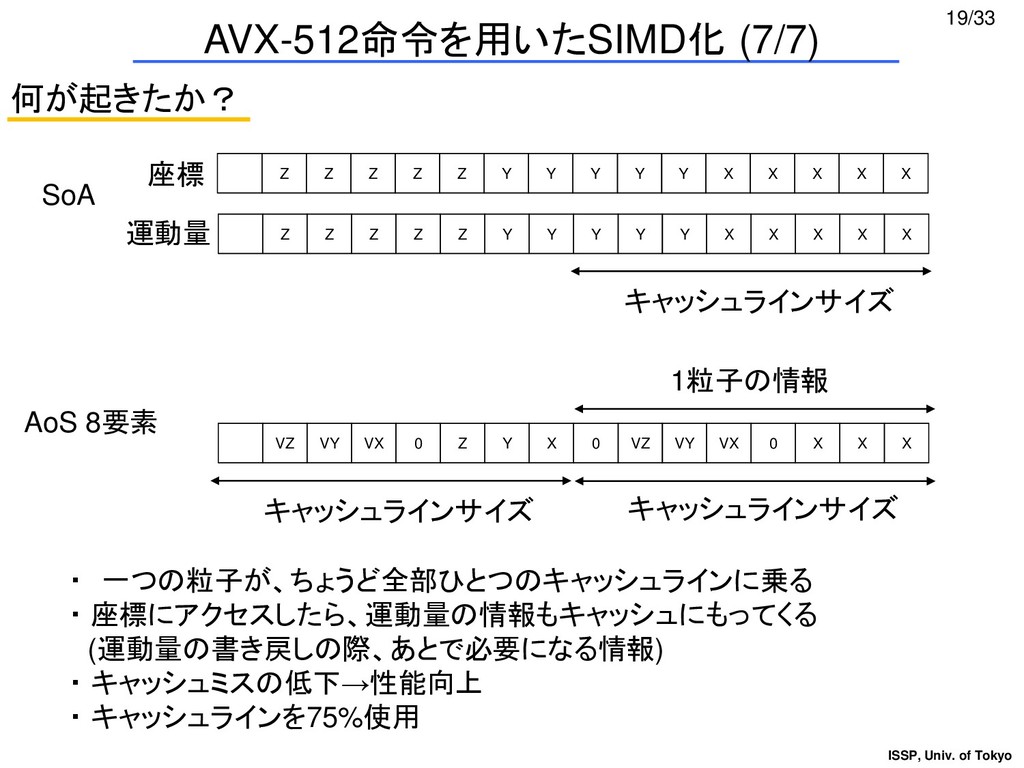
ISSP, Univ. of Tokyo 19/33 何が起きたか? Z Z Z Z
Z Y Y Y Y Y X X X X X SoA Z Z Z Z Z Y Y Y Y Y X X X X X 座標 運動量 キャッシュラインサイズ AoS 8要素 VZ VY VX 0 Z Y X 0 VZ VY VX 0 X X X キャッシュラインサイズ キャッシュラインサイズ 1粒子の情報 ・ 一つの粒子が、ちょうど全部ひとつのキャッシュラインに乗る ・ 座標にアクセスしたら、運動量の情報もキャッシュにもってくる (運動量の書き戻しの際、あとで必要になる情報) ・ キャッシュミスの低下→性能向上 ・ キャッシュラインを75%使用 AVX-512命令を用いたSIMD化 (7/7) -
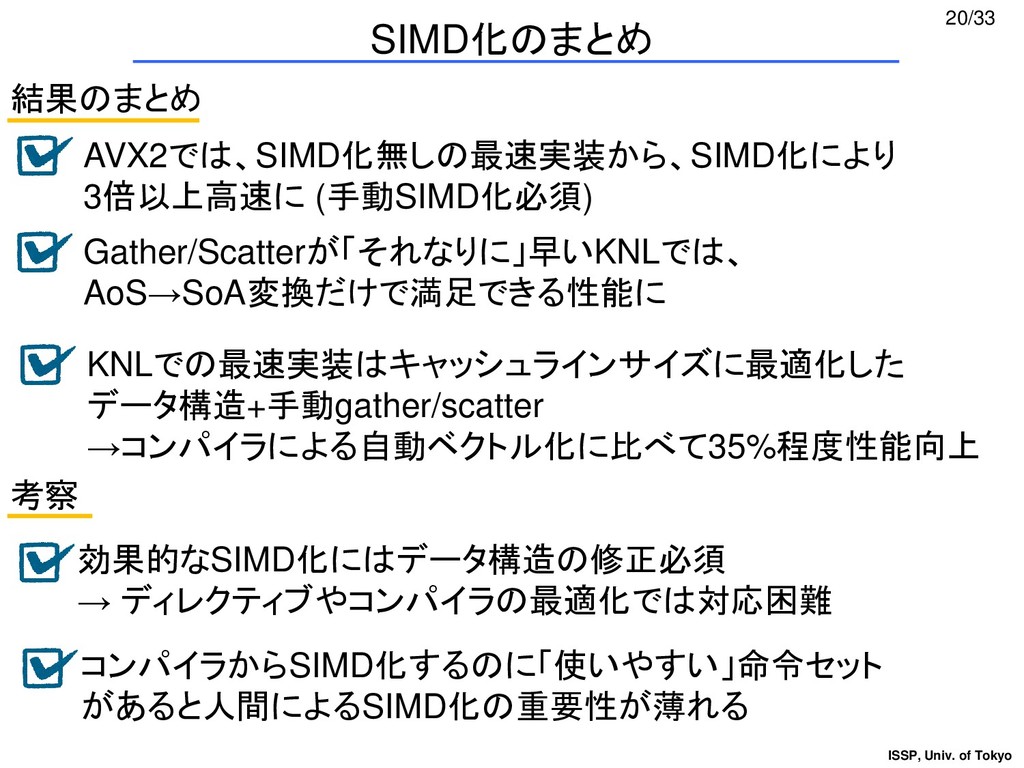
ISSP, Univ. of Tokyo 20/33 SIMD化のまとめ Gather/Scatterが「それなりに」早いKNLでは、 AoS→SoA変換だけで満足できる性能に AVX2では、SIMD化無しの最速実装から、SIMD化により 3倍以上高速に
(手動SIMD化必須) KNLでの最速実装はキャッシュラインサイズに最適化した データ構造+手動gather/scatter →コンパイラによる自動ベクトル化に比べて35%程度性能向上 コンパイラからSIMD化するのに「使いやすい」命令セット があると人間によるSIMD化の重要性が薄れる 効果的なSIMD化にはデータ構造の修正必須 → ディレクティブやコンパイラの最適化では対応困難 結果のまとめ 考察 -
ISSP, Univ. of Tokyo 21/33 C++コンパイラあれこれ 計算環境:京(Env_base: K-1.2.0-22) FCCpx: Fujitsu
C/C++ Compiler Driver Version 1.2.0 P-id: L30000-14 (Nov 30 2016 16:23:07) K-1.2.0-22 -
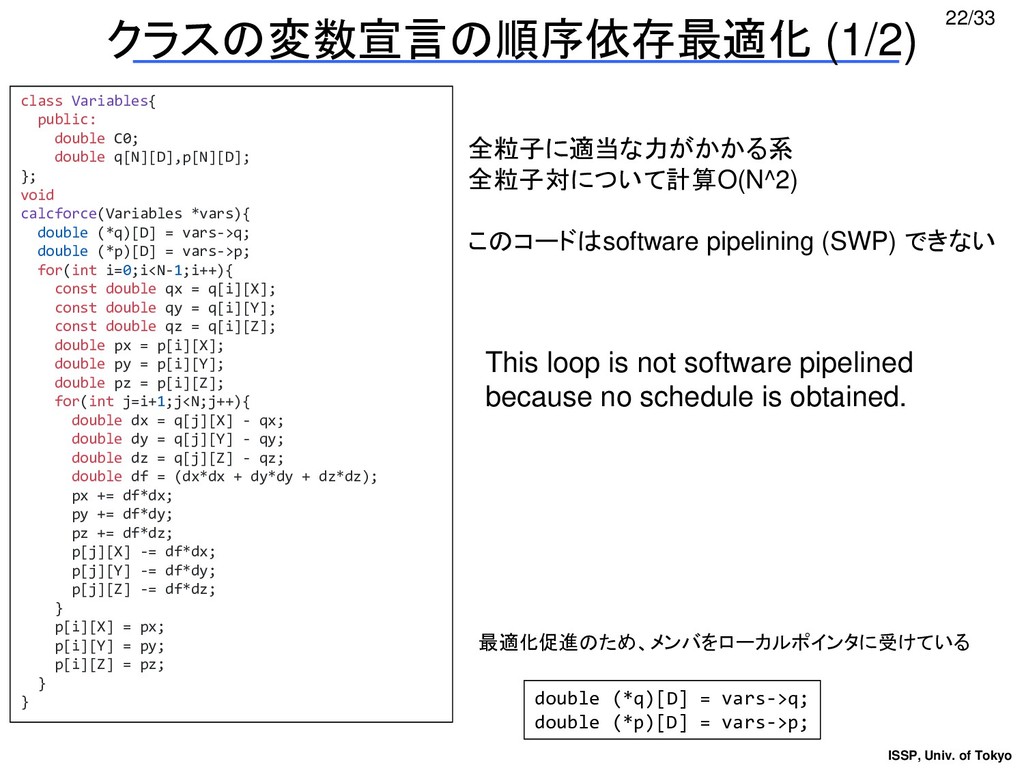
ISSP, Univ. of Tokyo 22/33 クラスの変数宣言の順序依存最適化 (1/2) class Variables{ public:
double C0; double q[N][D],p[N][D]; }; void calcforce(Variables *vars){ double (*q)[D] = vars->q; double (*p)[D] = vars->p; for(int i=0;i<N-1;i++){ const double qx = q[i][X]; const double qy = q[i][Y]; const double qz = q[i][Z]; double px = p[i][X]; double py = p[i][Y]; double pz = p[i][Z]; for(int j=i+1;j<N;j++){ double dx = q[j][X] - qx; double dy = q[j][Y] - qy; double dz = q[j][Z] - qz; double df = (dx*dx + dy*dy + dz*dz); px += df*dx; py += df*dy; pz += df*dz; p[j][X] -= df*dx; p[j][Y] -= df*dy; p[j][Z] -= df*dz; } p[i][X] = px; p[i][Y] = py; p[i][Z] = pz; } } 全粒子に適当な力がかかる系 全粒子対について計算O(N^2) このコードはsoftware pipelining (SWP) できない This loop is not software pipelined because no schedule is obtained. double (*q)[D] = vars->q; double (*p)[D] = vars->p; 最適化促進のため、メンバをローカルポインタに受けている -
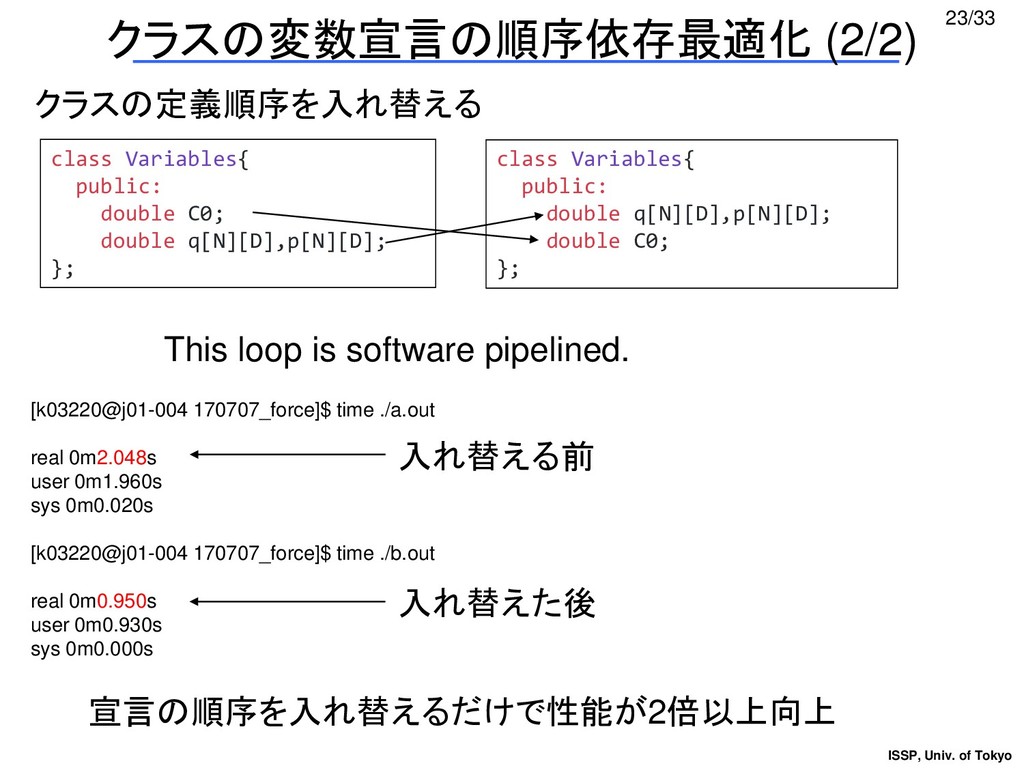
ISSP, Univ. of Tokyo 23/33 クラスの変数宣言の順序依存最適化 (2/2) class Variables{ public:
double C0; double q[N][D],p[N][D]; }; class Variables{ public: double q[N][D],p[N][D]; double C0; }; クラスの定義順序を入れ替える This loop is software pipelined. [k03220@j01-004 170707_force]$ time ./a.out real 0m2.048s user 0m1.960s sys 0m0.020s [k03220@j01-004 170707_force]$ time ./b.out real 0m0.950s user 0m0.930s sys 0m0.000s 宣言の順序を入れ替えるだけで性能が2倍以上向上 入れ替える前 入れ替えた後 -
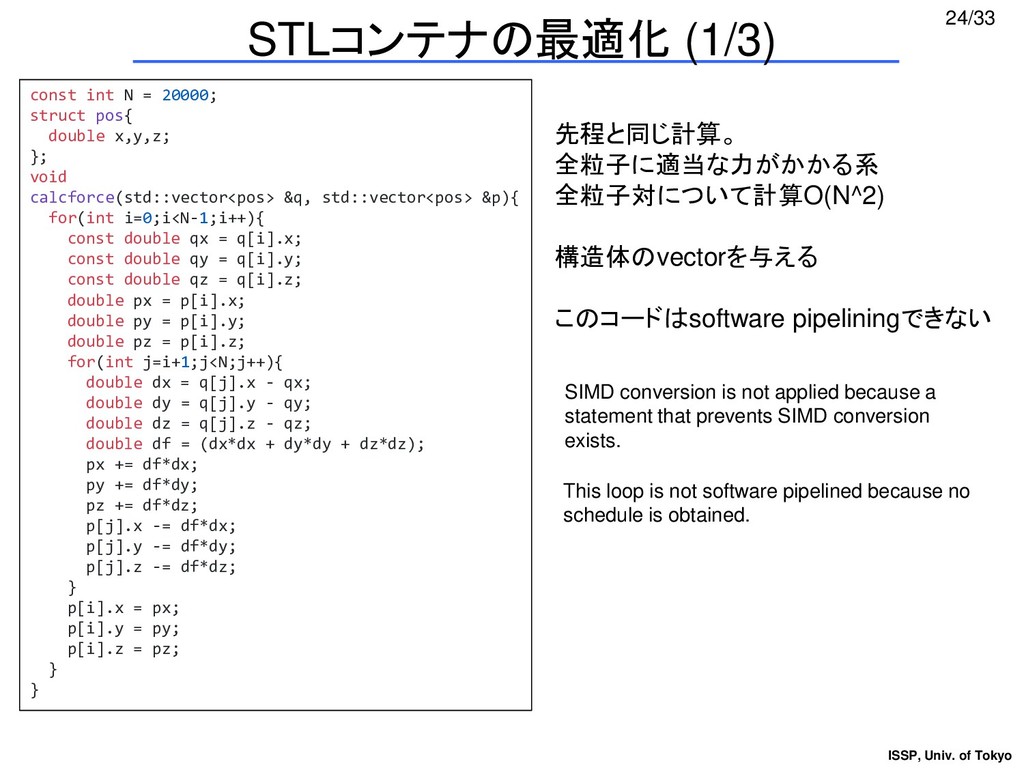
ISSP, Univ. of Tokyo 24/33 STLコンテナの最適化 (1/3) const int N
= 20000; struct pos{ double x,y,z; }; void calcforce(std::vector<pos> &q, std::vector<pos> &p){ for(int i=0;i<N-1;i++){ const double qx = q[i].x; const double qy = q[i].y; const double qz = q[i].z; double px = p[i].x; double py = p[i].y; double pz = p[i].z; for(int j=i+1;j<N;j++){ double dx = q[j].x - qx; double dy = q[j].y - qy; double dz = q[j].z - qz; double df = (dx*dx + dy*dy + dz*dz); px += df*dx; py += df*dy; pz += df*dz; p[j].x -= df*dx; p[j].y -= df*dy; p[j].z -= df*dz; } p[i].x = px; p[i].y = py; p[i].z = pz; } } 先程と同じ計算。 全粒子に適当な力がかかる系 全粒子対について計算O(N^2) 構造体のvectorを与える このコードはsoftware pipeliningできない SIMD conversion is not applied because a statement that prevents SIMD conversion exists. This loop is not software pipelined because no schedule is obtained. -
ISSP, Univ. of Tokyo 25/33 STLコンテナの最適化 (2/3) void calcforce(pos q[N],
pos p[N]){ ... } void calcforce(std::vector<pos> &q, std::vector<pos> &p){ ... } 固定長配列std::arrayもSWPできない void calcforce(std::array<pos, N> &q, std::array<pos, N> &p){ ... } 可変長配列std::vectorはSWPできない This loop is not software pipelined because the loop contains an instruction not covered by software pipelining, such as function call. 普通の配列を渡すとSWPできる This loop is software pipelined. -
ISSP, Univ. of Tokyo 26/33 STLコンテナの最適化 (3/3) void calcforce(pos q[N],
pos p[N]){ ... } void calcforce(std::vector<pos> &q, std::vector<pos> &p){ ... } void calcforce(std::array<pos, N> &q, std::array<pos, N> &p){ ... } それぞれの実行時間@京 2.950s 1.930s 1.020s std::vector std::array 生配列 STLコンテナは使ってはいけない ちなみにインテルコンパイラは上記コードを全て ベクトル化し、実行時間に速度差はほとんどない ただし、なぜかstd::arrayだけ若干遅い -
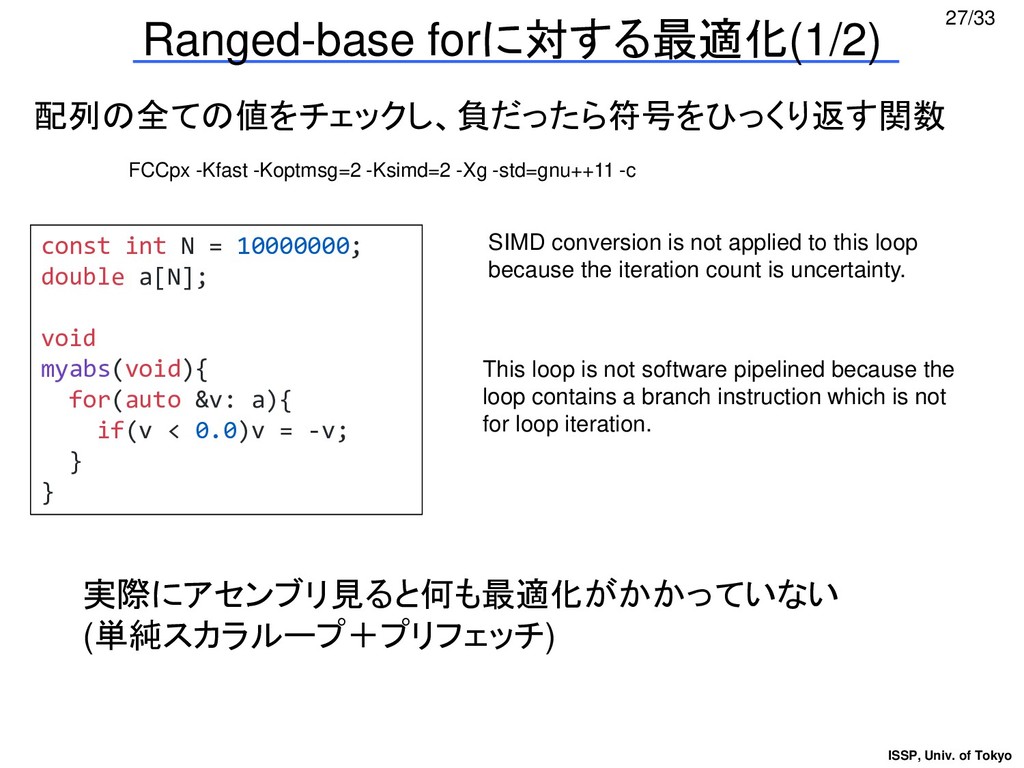
ISSP, Univ. of Tokyo 27/33 Ranged-base forに対する最適化(1/2) const int N
= 10000000; double a[N]; void myabs(void){ for(auto &v: a){ if(v < 0.0)v = -v; } } 配列の全ての値をチェックし、負だったら符号をひっくり返す関数 FCCpx -Kfast -Koptmsg=2 -Ksimd=2 -Xg -std=gnu++11 -c SIMD conversion is not applied to this loop because the iteration count is uncertainty. This loop is not software pipelined because the loop contains a branch instruction which is not for loop iteration. 実際にアセンブリ見ると何も最適化がかかっていない (単純スカラループ+プリフェッチ) -
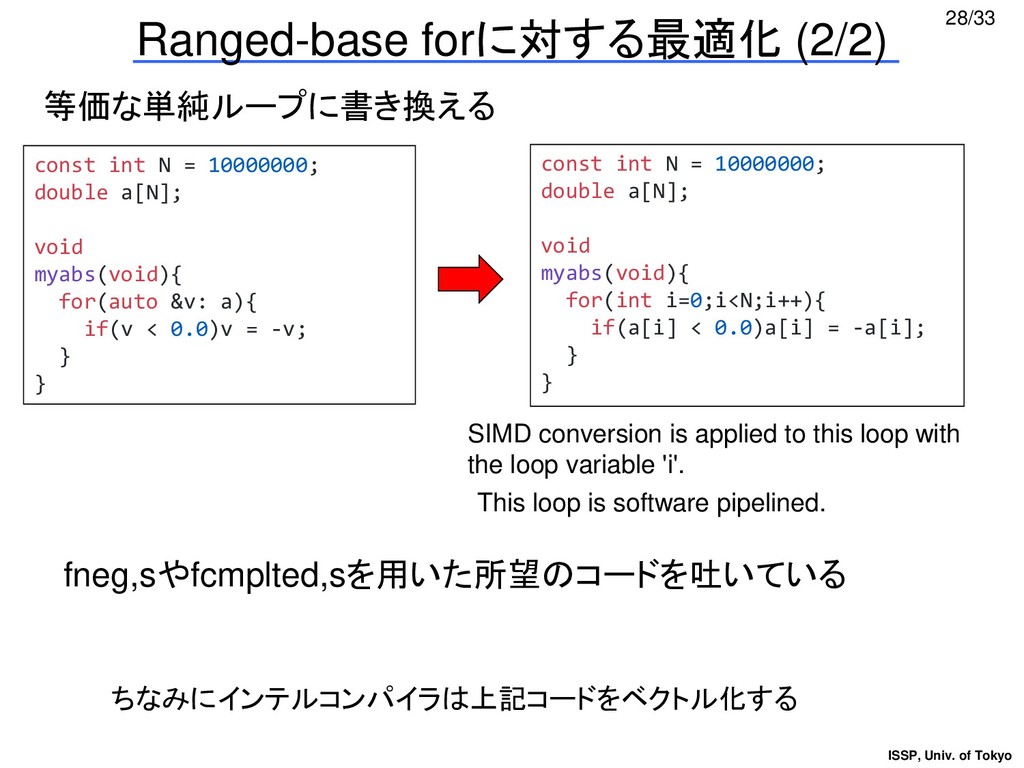
ISSP, Univ. of Tokyo 28/33 Ranged-base forに対する最適化 (2/2) const int
N = 10000000; double a[N]; void myabs(void){ for(int i=0;i<N;i++){ if(a[i] < 0.0)a[i] = -a[i]; } } const int N = 10000000; double a[N]; void myabs(void){ for(auto &v: a){ if(v < 0.0)v = -v; } } 等価な単純ループに書き換える SIMD conversion is applied to this loop with the loop variable 'i'. This loop is software pipelined. fneg,sやfcmplted,sを用いた所望のコードを吐いている ちなみにインテルコンパイラは上記コードをベクトル化する -
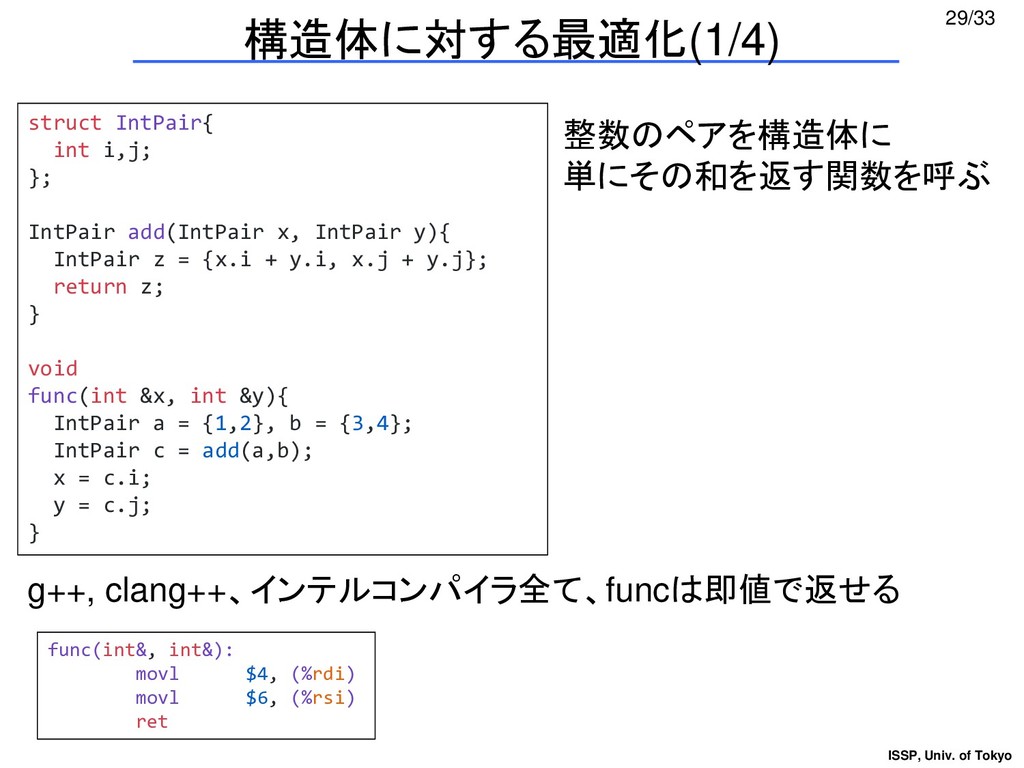
ISSP, Univ. of Tokyo 29/33 構造体に対する最適化(1/4) struct IntPair{ int i,j;
}; IntPair add(IntPair x, IntPair y){ IntPair z = {x.i + y.i, x.j + y.j}; return z; } void func(int &x, int &y){ IntPair a = {1,2}, b = {3,4}; IntPair c = add(a,b); x = c.i; y = c.j; } 整数のペアを構造体に 単にその和を返す関数を呼ぶ g++, clang++、インテルコンパイラ全て、funcは即値で返せる func(int&, int&): movl $4, (%rdi) movl $6, (%rsi) ret -
ISSP, Univ. of Tokyo 30/33 構造体に対する最適化 (3/4) func(int&, int&): add
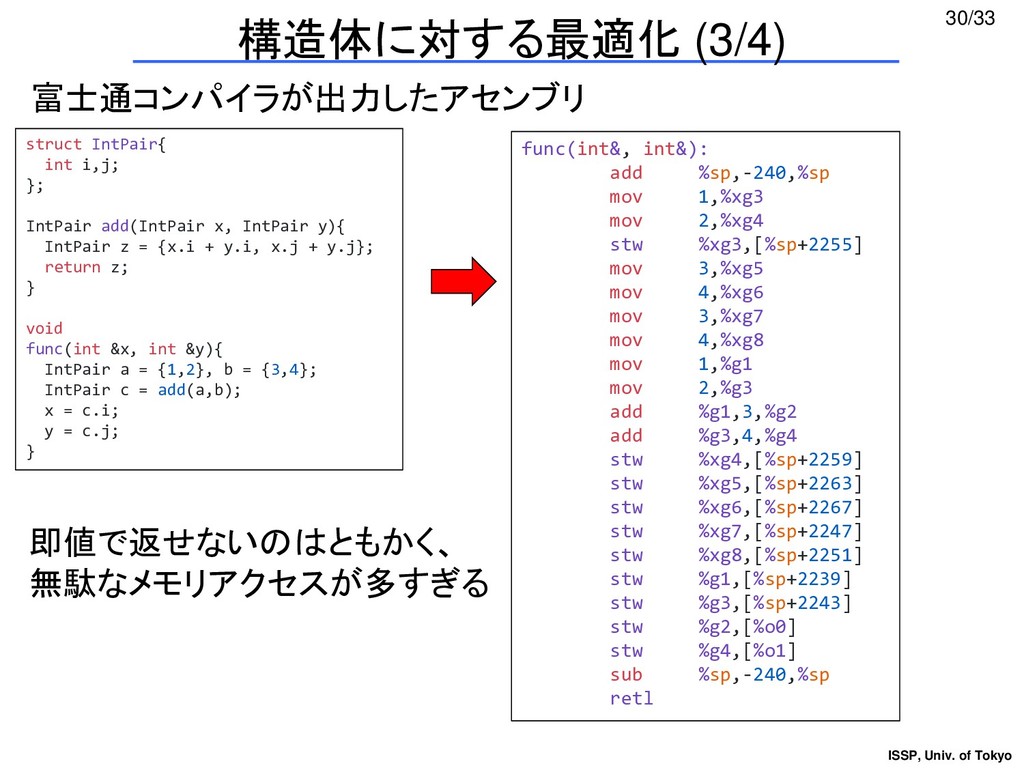
%sp,-240,%sp mov 1,%xg3 mov 2,%xg4 stw %xg3,[%sp+2255] mov 3,%xg5 mov 4,%xg6 mov 3,%xg7 mov 4,%xg8 mov 1,%g1 mov 2,%g3 add %g1,3,%g2 add %g3,4,%g4 stw %xg4,[%sp+2259] stw %xg5,[%sp+2263] stw %xg6,[%sp+2267] stw %xg7,[%sp+2247] stw %xg8,[%sp+2251] stw %g1,[%sp+2239] stw %g3,[%sp+2243] stw %g2,[%o0] stw %g4,[%o1] sub %sp,-240,%sp retl struct IntPair{ int i,j; }; IntPair add(IntPair x, IntPair y){ IntPair z = {x.i + y.i, x.j + y.j}; return z; } void func(int &x, int &y){ IntPair a = {1,2}, b = {3,4}; IntPair c = add(a,b); x = c.i; y = c.j; } 富士通コンパイラが出力したアセンブリ 即値で返せないのはともかく、 無駄なメモリアクセスが多すぎる -
ISSP, Univ. of Tokyo 31/33 構造体に対する最適化(3/4) こういうことが起きたらしい void func(int &x,
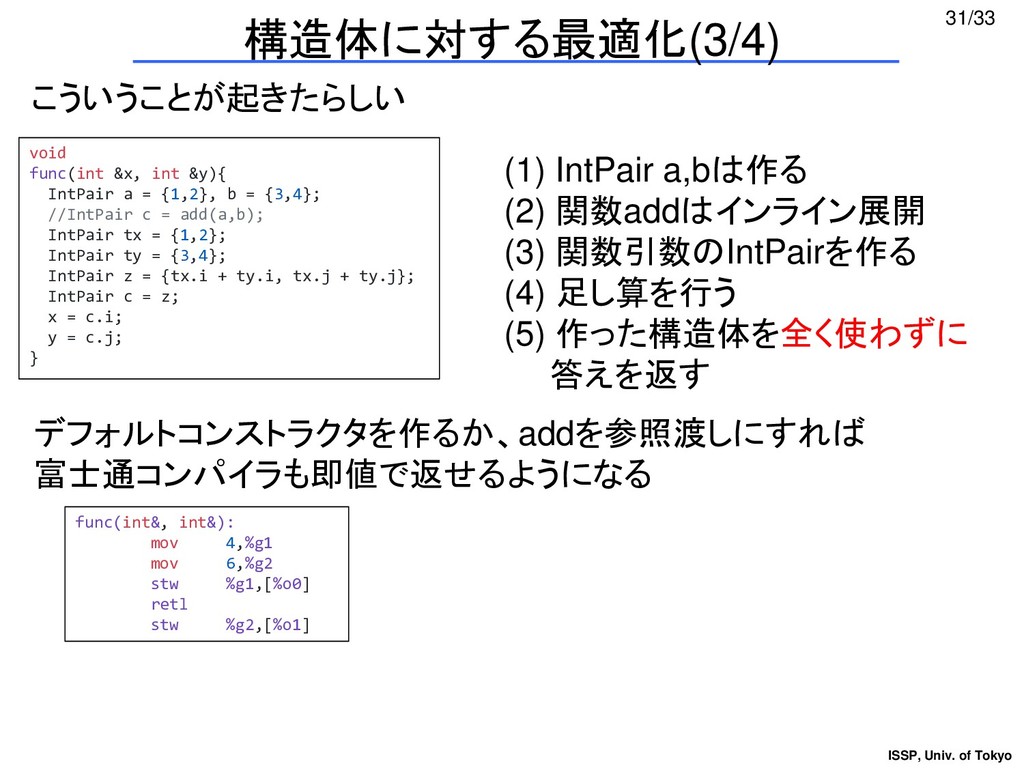
int &y){ IntPair a = {1,2}, b = {3,4}; //IntPair c = add(a,b); IntPair tx = {1,2}; IntPair ty = {3,4}; IntPair z = {tx.i + ty.i, tx.j + ty.j}; IntPair c = z; x = c.i; y = c.j; } (1) IntPair a,bは作る (2) 関数addはインライン展開 (3) 関数引数のIntPairを作る (4) 足し算を行う (5) 作った構造体を全く使わずに 答えを返す デフォルトコンストラクタを作るか、addを参照渡しにすれば 富士通コンパイラも即値で返せるようになる func(int&, int&): mov 4,%g1 mov 6,%g2 stw %g1,[%o0] retl stw %g2,[%o1] -
ISSP, Univ. of Tokyo 32/33 構造体に対する最適化(4/4) func(int&, int&): add %sp,-240,%sp
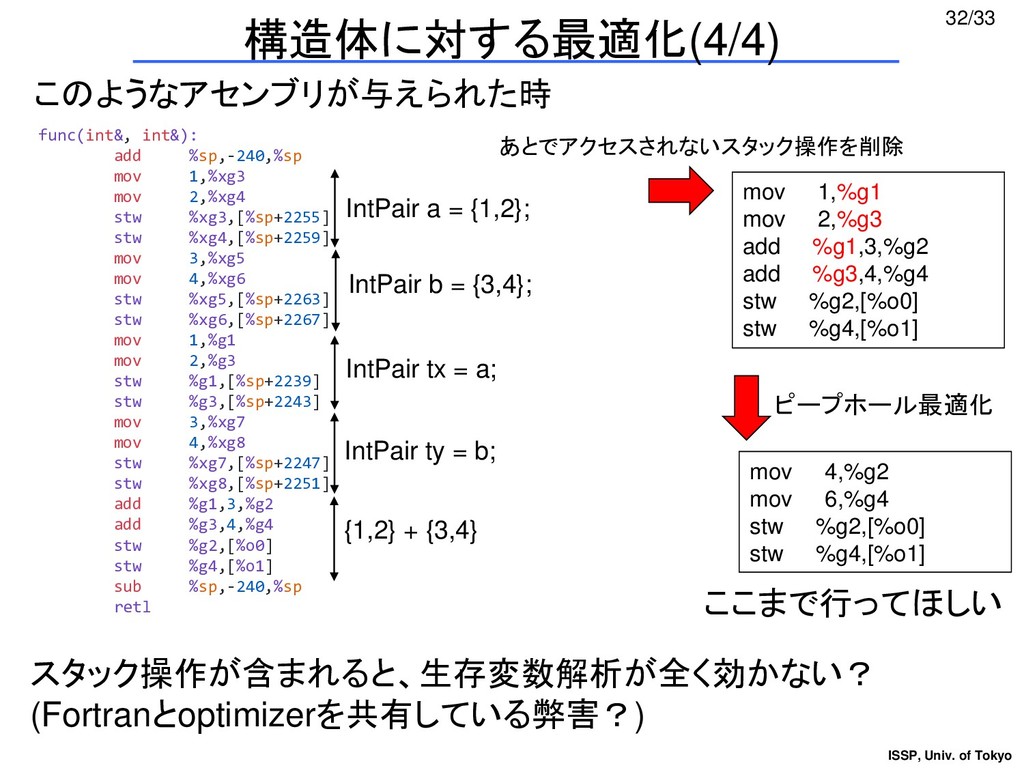
mov 1,%xg3 mov 2,%xg4 stw %xg3,[%sp+2255] stw %xg4,[%sp+2259] mov 3,%xg5 mov 4,%xg6 stw %xg5,[%sp+2263] stw %xg6,[%sp+2267] mov 1,%g1 mov 2,%g3 stw %g1,[%sp+2239] stw %g3,[%sp+2243] mov 3,%xg7 mov 4,%xg8 stw %xg7,[%sp+2247] stw %xg8,[%sp+2251] add %g1,3,%g2 add %g3,4,%g4 stw %g2,[%o0] stw %g4,[%o1] sub %sp,-240,%sp retl IntPair a = {1,2}; IntPair b = {3,4}; IntPair tx = a; IntPair ty = b; {1,2} + {3,4} このようなアセンブリが与えられた時 スタック操作が含まれると、生存変数解析が全く効かない? (Fortranとoptimizerを共有している弊害?) mov 1,%g1 mov 2,%g3 add %g1,3,%g2 add %g3,4,%g4 stw %g2,[%o0] stw %g4,[%o1] mov 4,%g2 mov 6,%g4 stw %g2,[%o0] stw %g4,[%o1] あとでアクセスされないスタック操作を削除 ピープホール最適化 ここまで行ってほしい -
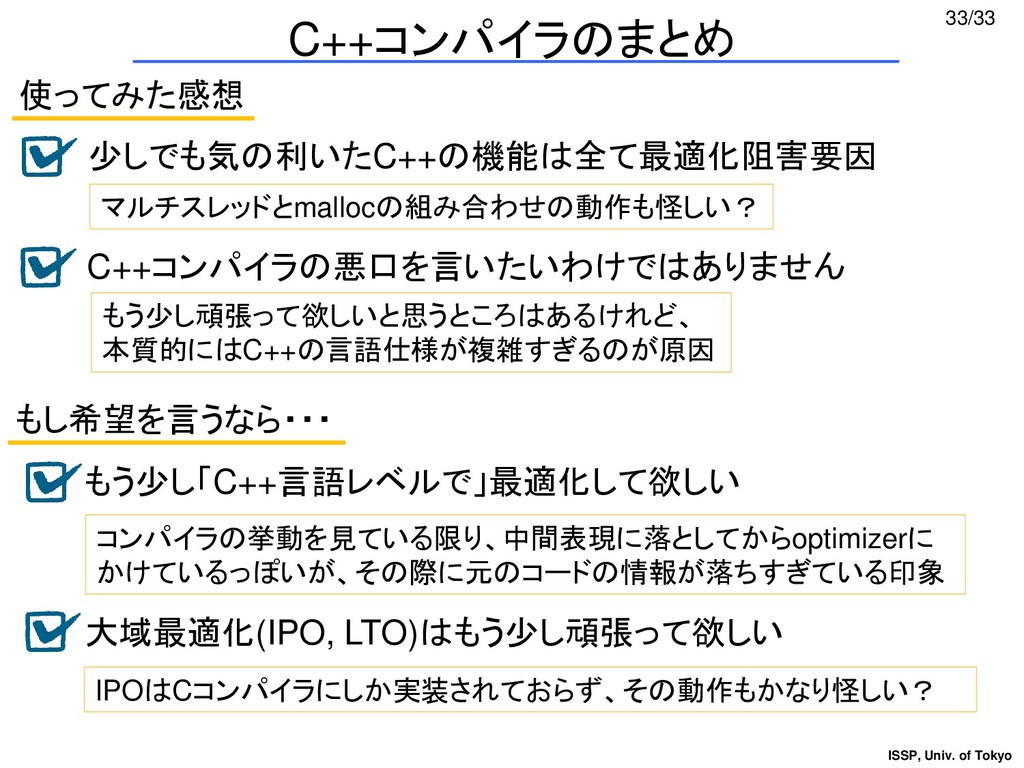
ISSP, Univ. of Tokyo 33/33 C++コンパイラのまとめ C++コンパイラの悪口を言いたいわけではありません もう少し頑張って欲しいと思うところはあるけれど、 本質的にはC++の言語仕様が複雑すぎるのが原因 もう少し「C++言語レベルで」最適化して欲しい
使ってみた感想 少しでも気の利いたC++の機能は全て最適化阻害要因 もし希望を言うなら・・・ コンパイラの挙動を見ている限り、中間表現に落としてからoptimizerに かけているっぽいが、その際に元のコードの情報が落ちすぎている印象 大域最適化(IPO, LTO)はもう少し頑張って欲しい IPOはCコンパイラにしか実装されておらず、その動作もかなり怪しい? マルチスレッドとmallocの組み合わせの動作も怪しい?
 kaityo256
 chigichan24
 ochtum
 kmkim
 dalinaum
 yahir0
 fornewid
 kinakomoti321
 quramy
 ryunakayama
 minodriven
 hasutosasaki
 hal_spidernight
 panda_program
 lindahogenes
 reverentgeek
 charlesmeaden
 helenjbeal
 garrettdimon
 michielstock
 paigeccino
 axbom
 akademiya2063
 katarinadahlin
 akashhashmi