Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ハイパースレッディングの 並列化効率への影響 / Hyperthreading and Par...
Search
kaityo256
PRO
May 23, 2013
Programming
73
5
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ハイパースレッディングの 並列化効率への影響 / Hyperthreading and Parallel Efficiency
ハイパースレッディングの有無が実アプリ(分子動力学法)に与えるの影響を1024ノード規模で調べた結果。
測定日は2011年6月と古いので注意。
kaityo256
PRO
May 23, 2013
More Decks by kaityo256
See All by kaityo256
生成AIとの付き合い方/ How to work with AI
kaityo256
PRO
3
890
パズルゲームの作り方 / how to make puzzle games
kaityo256
PRO
2
290
What is XAI?
kaityo256
PRO
0
210
勾配ブースティングと決定木の話 / gradient boosting and decision trees
kaityo256
PRO
7
1.9k
GNU Makeの使い方 / How to use GNU Make
kaityo256
PRO
16
6.1k
この講義について / 00-setup
kaityo256
PRO
2
550
GitHubによるWebアプリケーションのデプロイ / 07-github-deploy
kaityo256
PRO
2
490
演習:Gitの基本操作 / 04-git-basic
kaityo256
PRO
1
740
演習:Gitの応用操作 / 05-git-advanced
kaityo256
PRO
1
440
Other Decks in Programming
See All in Programming
作って学ぶSpring BootのAuto Configuration / JJUG Night Seminar 2026-10-19
rshindo
0
150
Simple Storage Service(S3) is not simple
iwatsukayura
0
290
RAG の “R” を Swift で覗いてみる 〜「意味から探す」検索の仕組み〜
nao_randd
0
160
Railsのためのパスキー実践入門 〜マルチテナントSaaSでの意思決定〜
utakaha
2
600
Web Framework Benchmark Battle 2026, Any%
a_matsuda
2
2.2k
設計次第でAIコードの読む量は減らせる / designing-for-code-reading
minodriven
35
17k
カツオ、ご期待ください
suneo3476
0
190
ActionController meets Protocol Buffers
sorah
0
530
Herb in Rails 8.2: Your ERB views, now HTML-aware @ Kaigi on Rails 2026, Tokyo, Japan
marcoroth
2
230
[2026-09-26]空論ジェネリックプロセス~テスト資産とAIで紡ぐ、再現可能なパフォーマンスチューニングの話~
tosite
0
270
外から家のPCの電源入れたい!をPHPで解決する
kawashimo0
1
130
ジョジョの世界をXRで再現する
mofurune
0
170
Featured
See All Featured
AI Search: Where Are We & What Can We Do About It?
aleyda
0
8.1k
The Director’s Chair: Orchestrating AI for Truly Effective Learning
tmiket
1
330
Navigating the Design Leadership Dip - Product Design Week Design Leaders+ Conference 2024
apolaine
2
480
Building a Scalable Design System with Sketch
lauravandoore
464
34k
HTML-Aware ERB: The Path to Reactive Rendering @ RubyCon 2026, Rimini, Italy
marcoroth
5
820
VelocityConf: Rendering Performance Case Studies
addyosmani
331
25k
How Fast Is Fast Enough? [PerfNow 2025]
tammyeverts
3
940
The State of eCommerce SEO: How to Win in Today's Products SERPs - #SEOweek
aleyda
2
12k
Fantastic passwords and where to find them - at NoRuKo
philnash
53
4k
Stop Working from a Prison Cell
hatefulcrawdad
274
21k
Music & Morning Musume
bryan
48
7.4k
Writing Fast Ruby
sferik
630
63k
Transcript
1/13 ハイパースレッディングの 並列化効率への影響 東京大学物性研究所 渡辺宙志 2013年5月23日
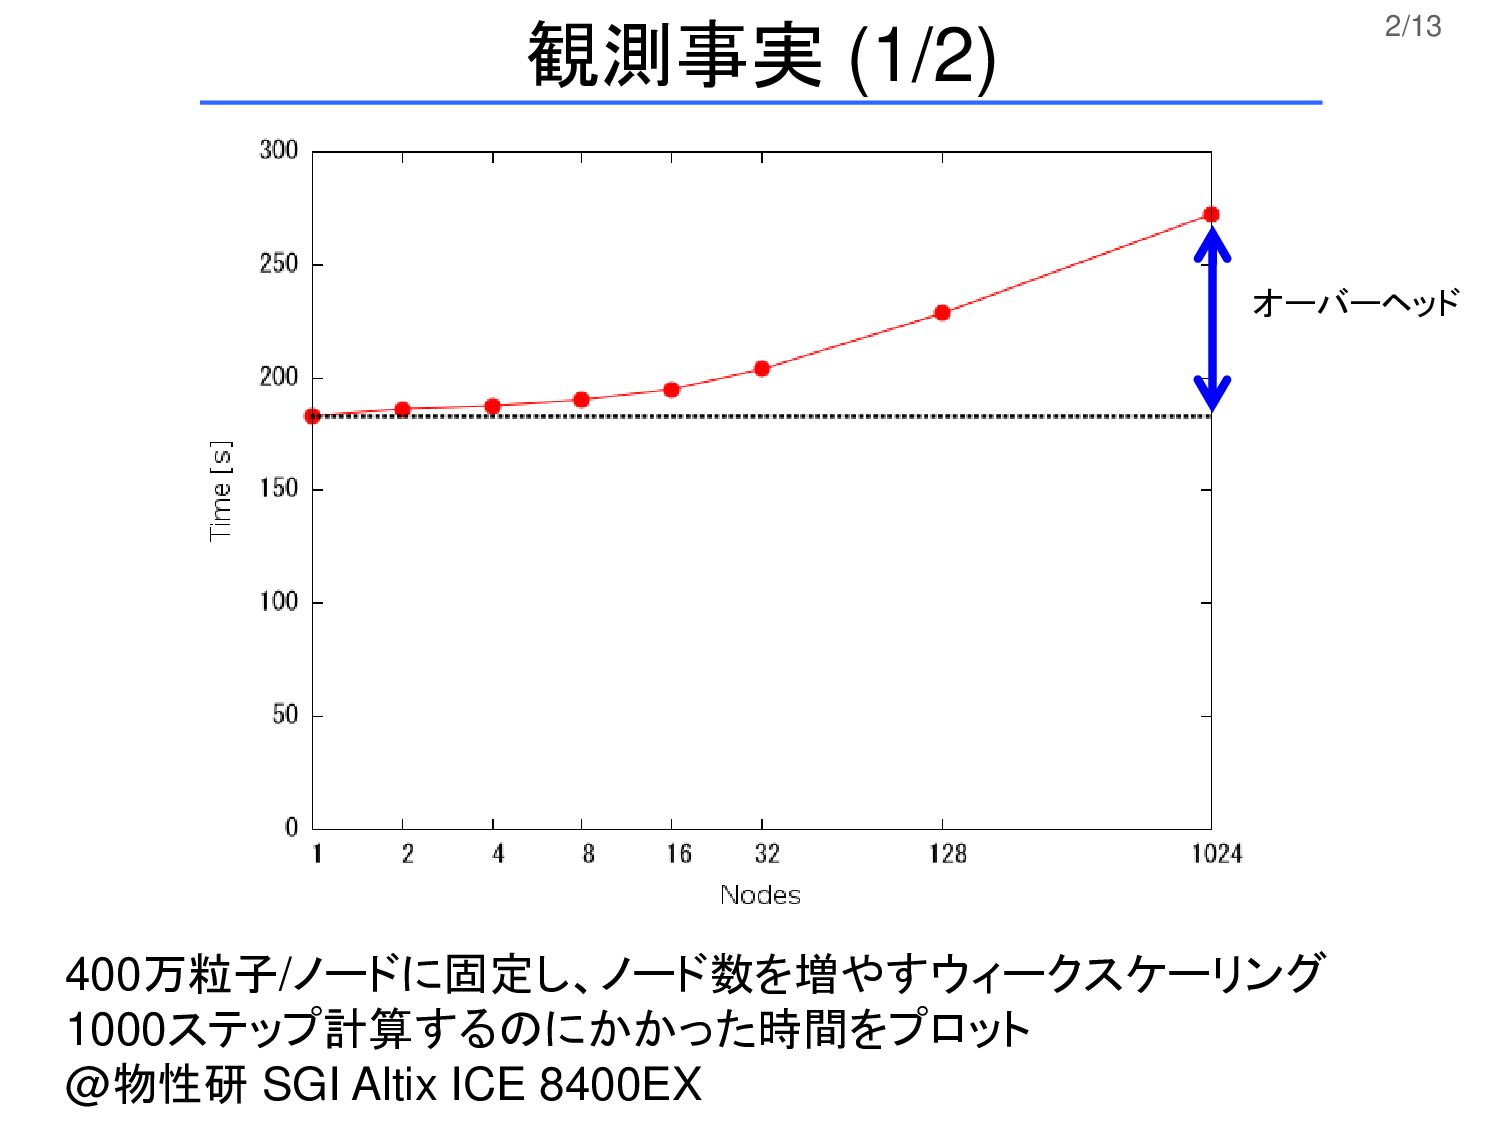
2/13 400万粒子/ノードに固定し、ノード数を増やすウィークスケーリング 1000ステップ計算するのにかかった時間をプロット @物性研 SGI Altix ICE 8400EX 観測事実 (1/2)
オーバーヘッド
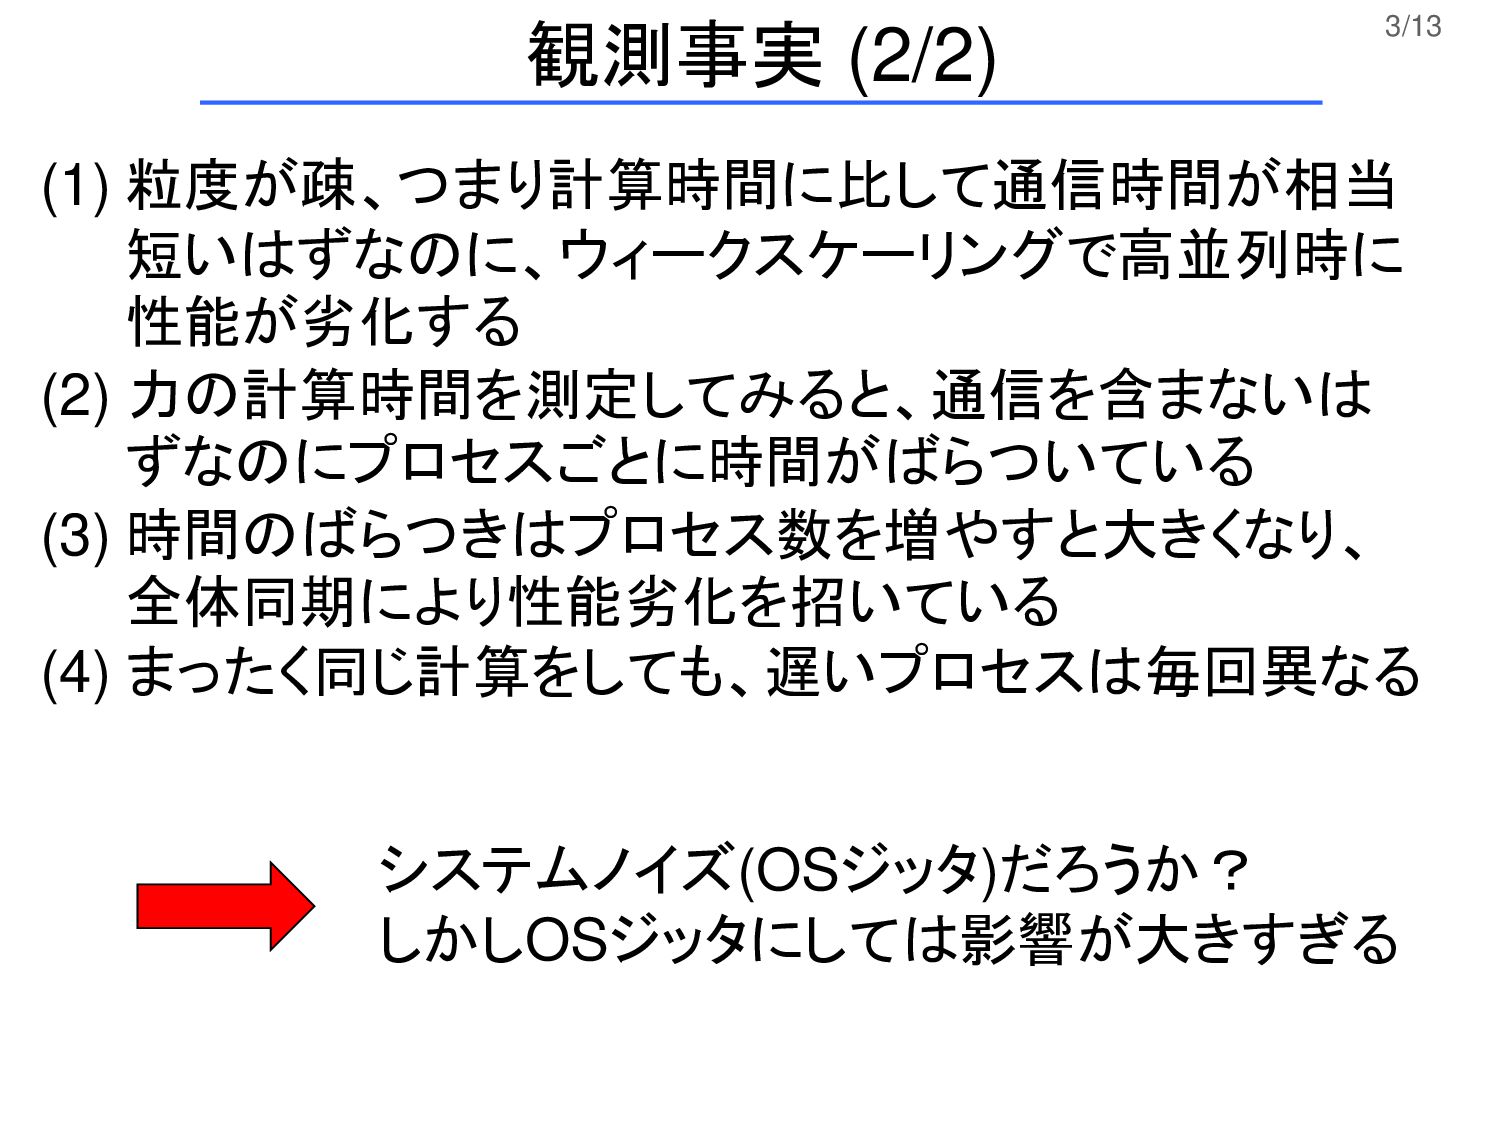
3/13 観測事実 (2/2) (1) 粒度が疎、つまり計算時間に比して通信時間が相当 短いはずなのに、ウィークスケーリングで高並列時に 性能が劣化する (2) 力の計算時間を測定してみると、通信を含まないは ずなのにプロセスごとに時間がばらついている
(3) 時間のばらつきはプロセス数を増やすと大きくなり、 全体同期により性能劣化を招いている (4) まったく同じ計算をしても、遅いプロセスは毎回異なる システムノイズ(OSジッタ)だろうか? しかしOSジッタにしては影響が大きすぎる
4/13 調べたいこと (1) プロセスの実行時間の揺らぎを精密に調べる (2) ハイパースレッディング(HT) の並列性能への影響を 調べる
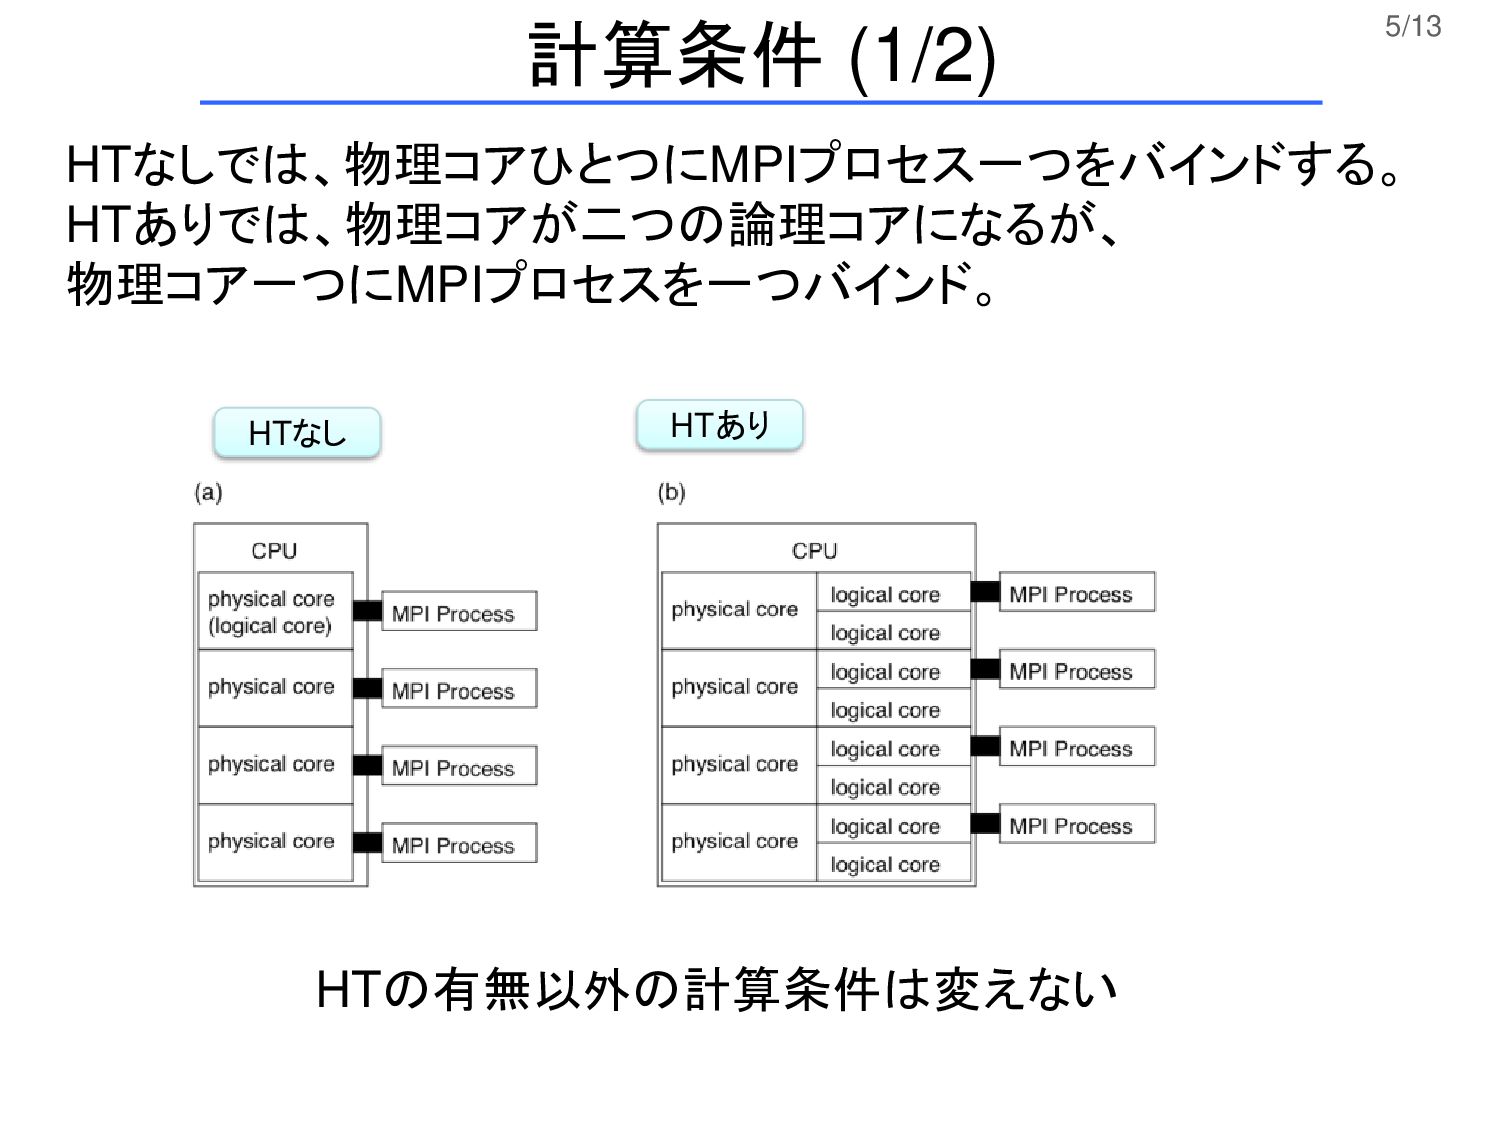
5/13 HTなし HTあり HTなしでは、物理コアひとつにMPIプロセス一つをバインドする。 HTありでは、物理コアが二つの論理コアになるが、 物理コア一つにMPIプロセスを一つバインド。 計算条件 (1/2) HTの有無以外の計算条件は変えない
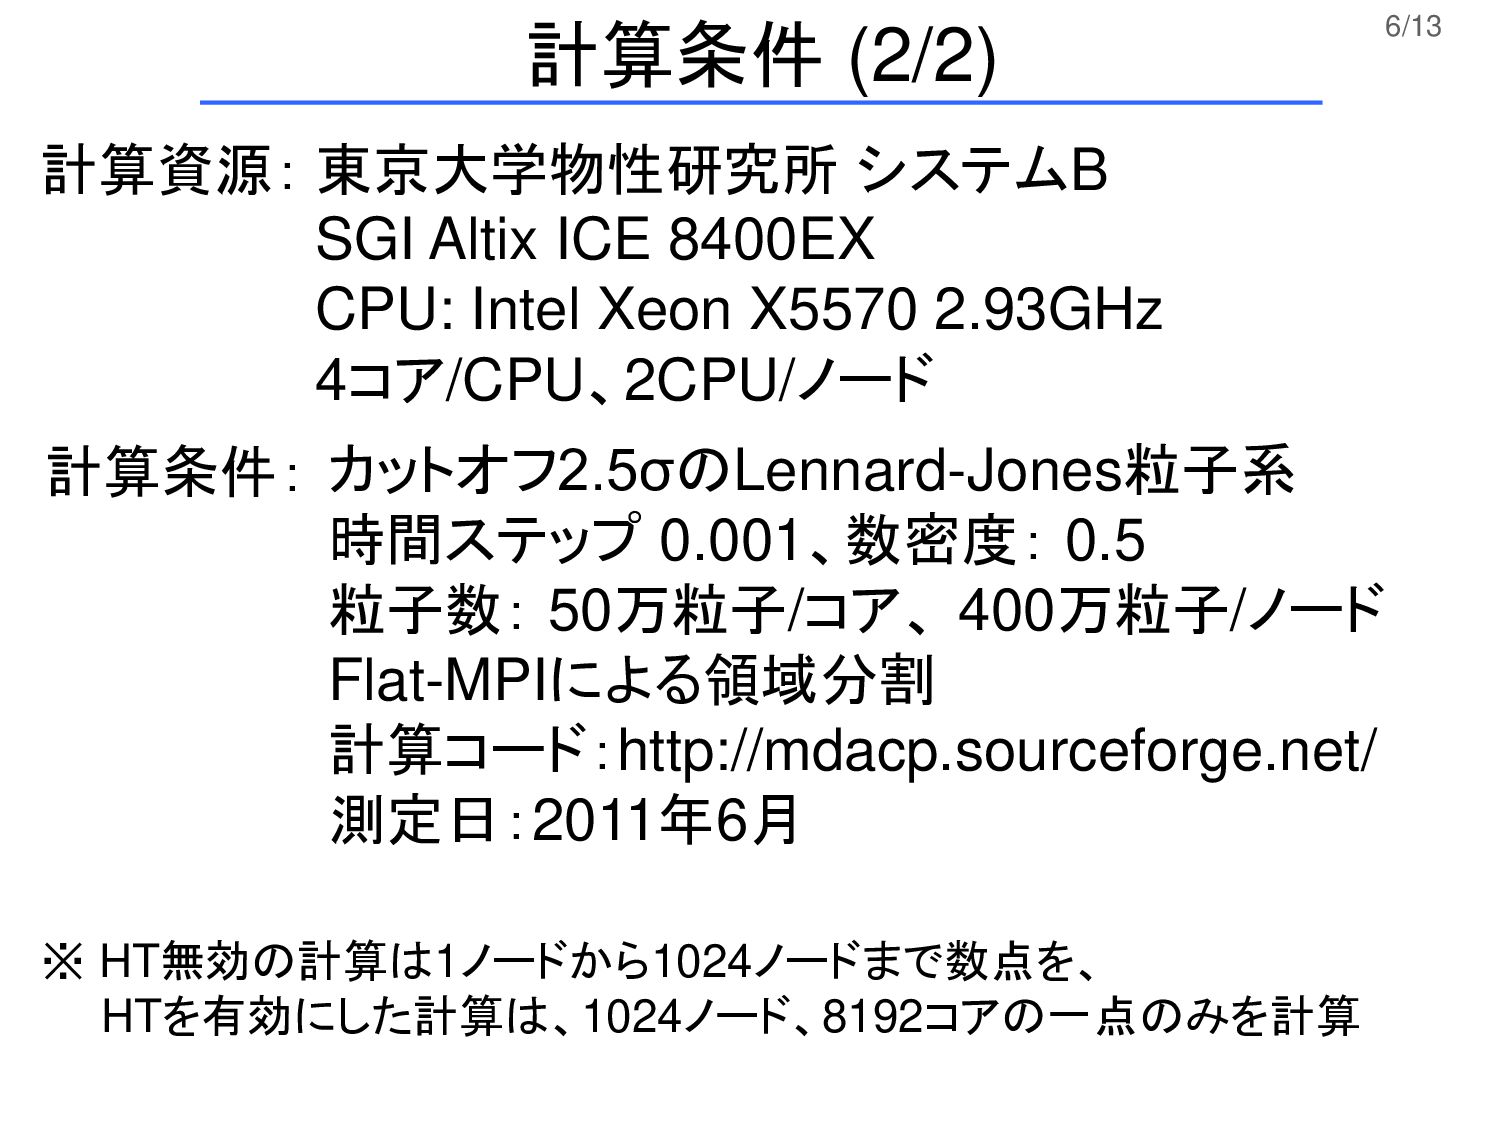
6/13 計算条件 (2/2) 東京大学物性研究所 システムB SGI Altix ICE 8400EX CPU:
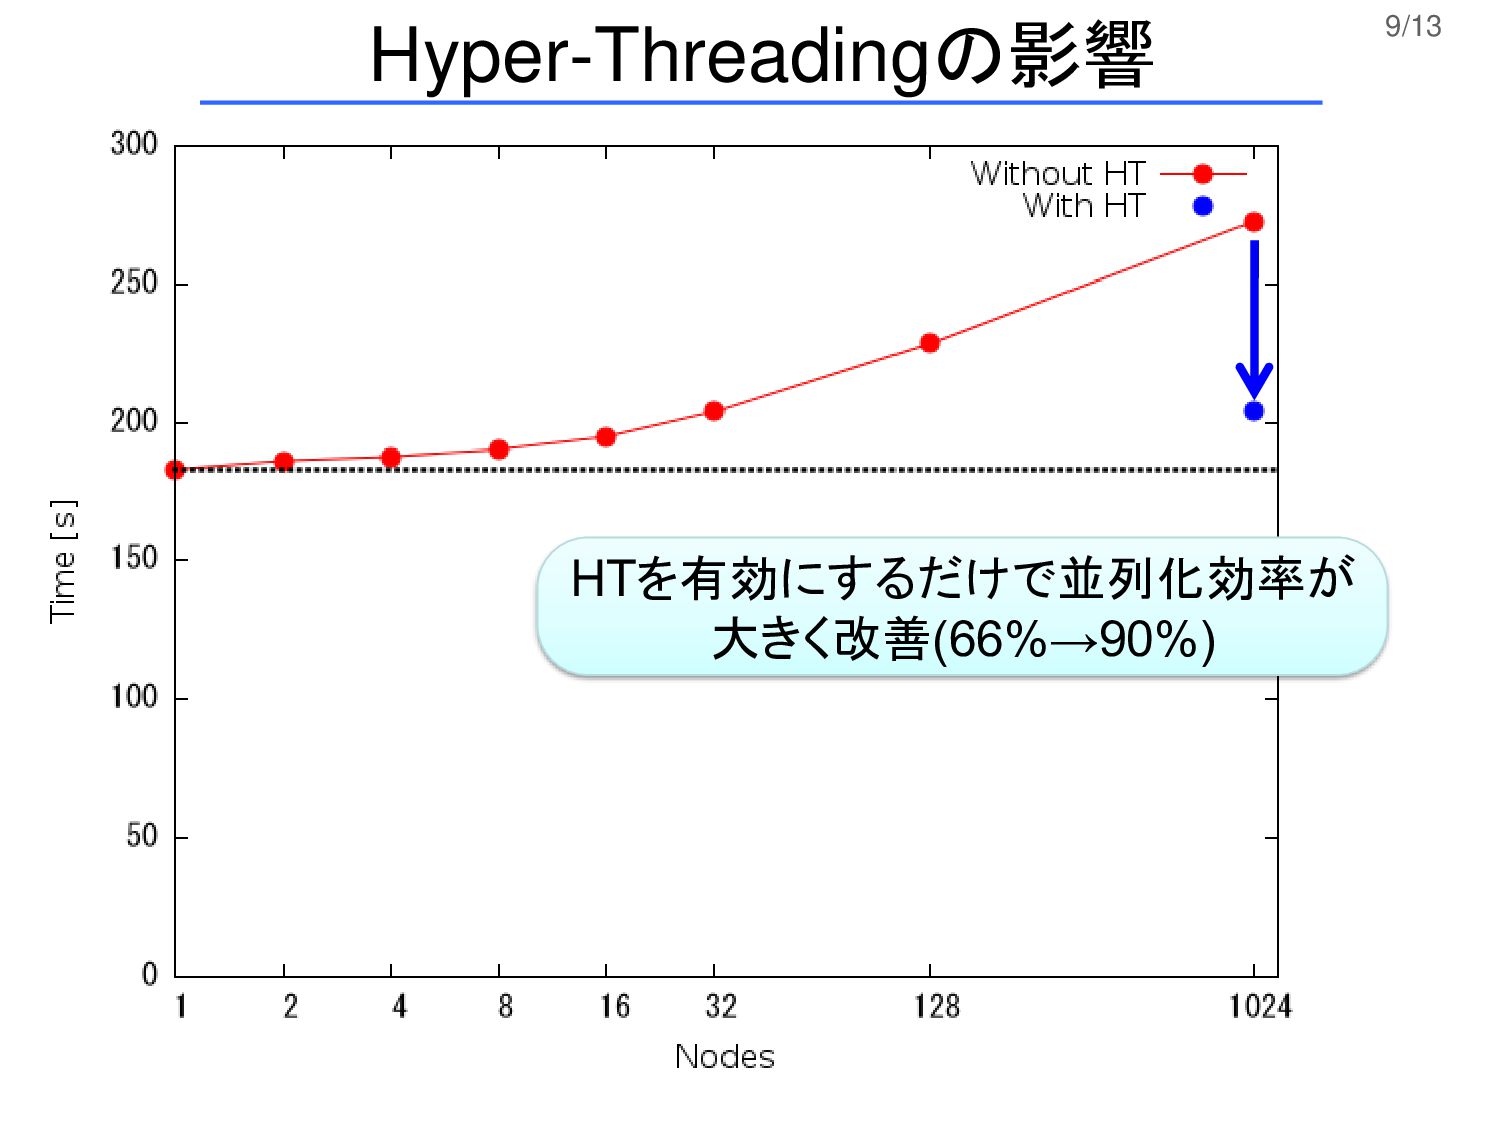
Intel Xeon X5570 2.93GHz 4コア/CPU、2CPU/ノード 計算資源: 計算条件: カットオフ2.5σのLennard-Jones粒子系 時間ステップ 0.001、数密度: 0.5 粒子数: 50万粒子/コア、 400万粒子/ノード Flat-MPIによる領域分割 計算コード:http://mdacp.sourceforge.net/ 測定日:2011年6月 ※ HT無効の計算は1ノードから1024ノードまで数点を、 HTを有効にした計算は、1024ノード、8192コアの一点のみを計算
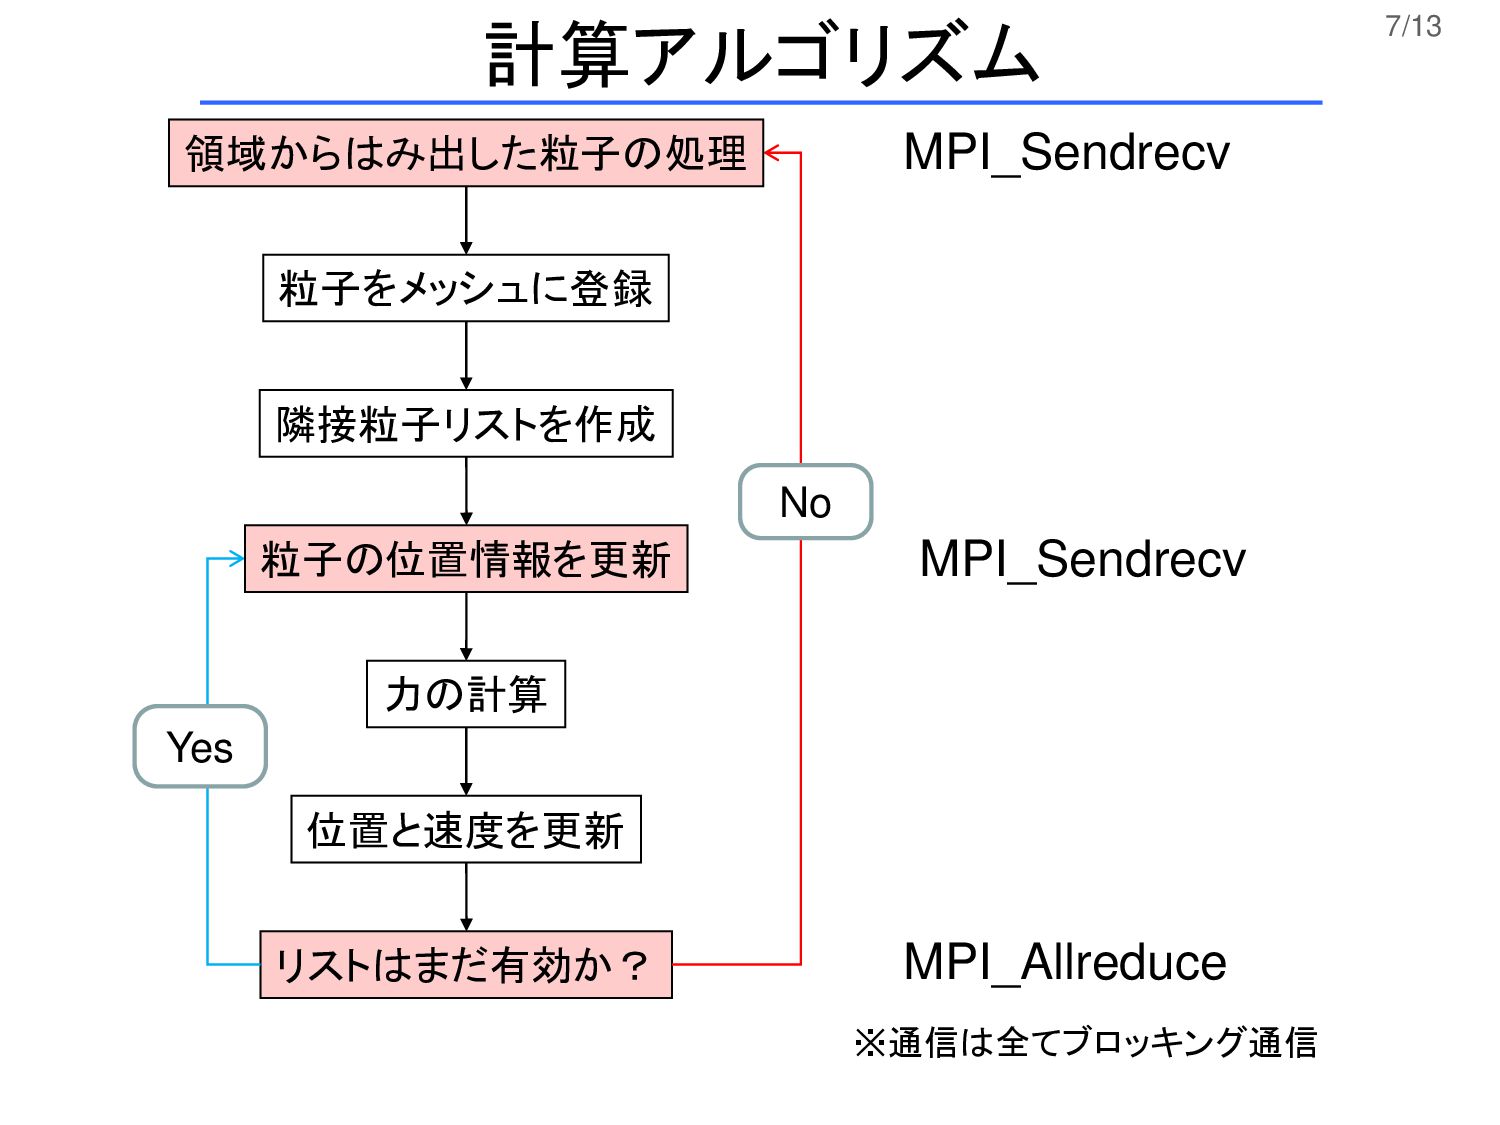
7/13 粒子をメッシュに登録 隣接粒子リストを作成 力の計算 位置と速度を更新 リストはまだ有効か? No Yes 領域からはみ出した粒子の処理 粒子の位置情報を更新
MPI_Sendrecv MPI_Sendrecv MPI_Allreduce 計算アルゴリズム ※通信は全てブロッキング通信
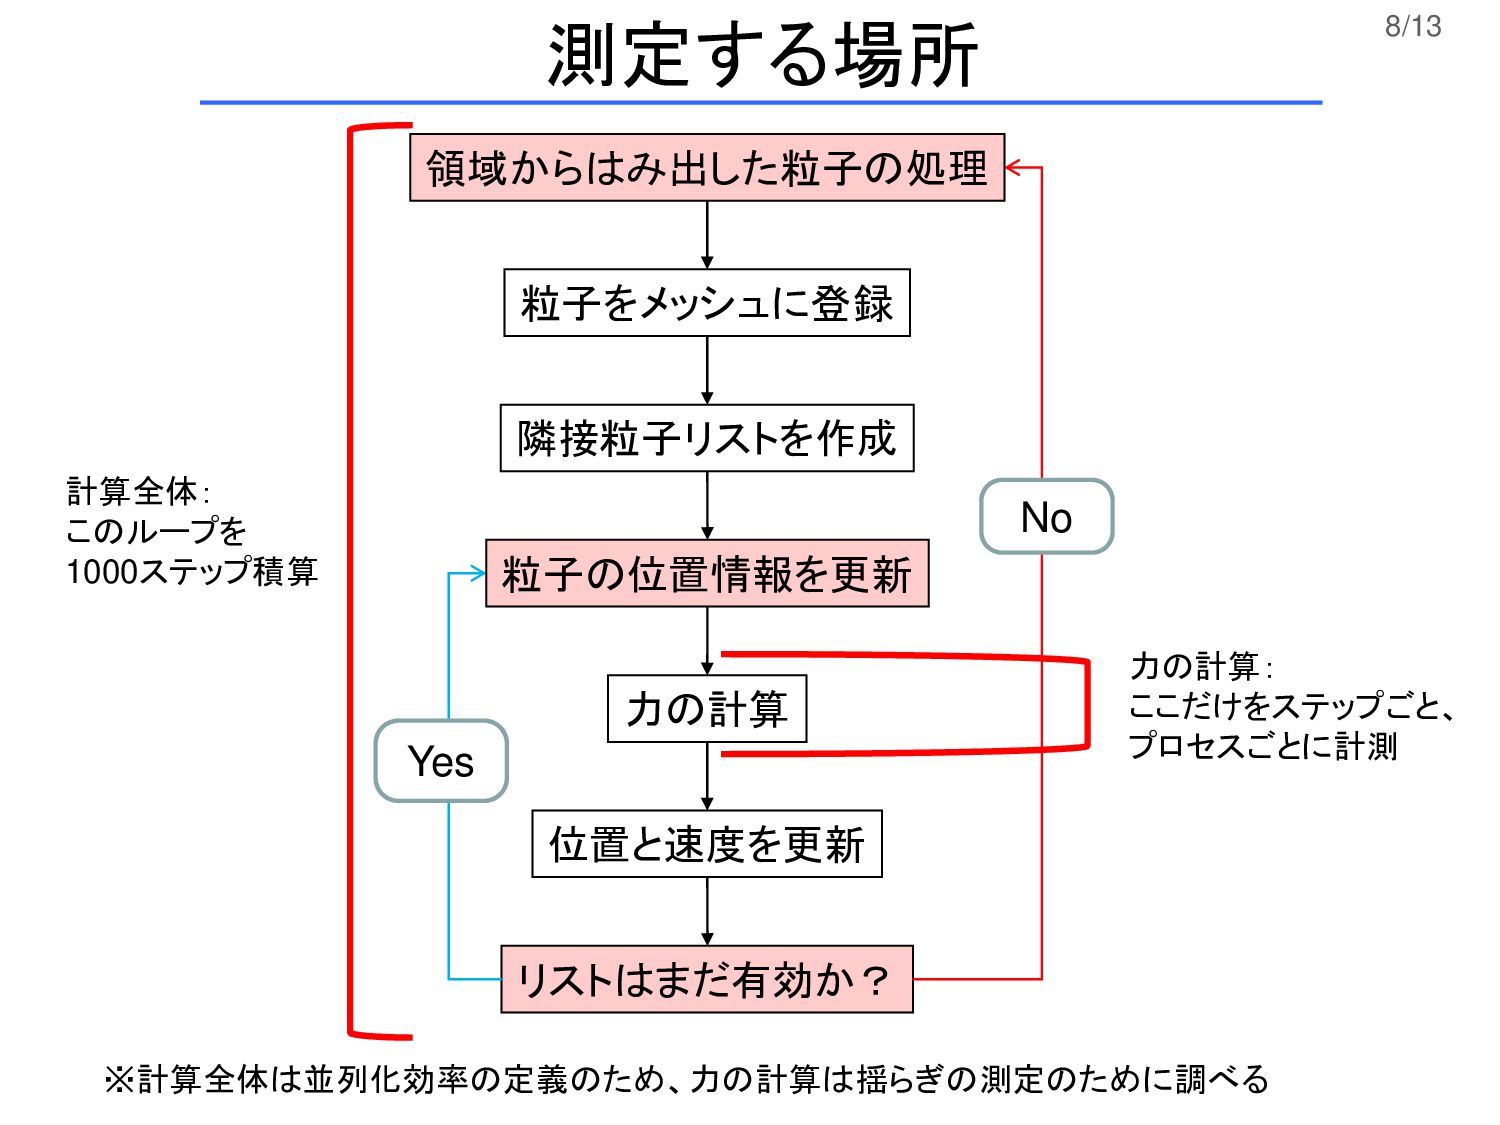
8/13 粒子をメッシュに登録 隣接粒子リストを作成 力の計算 位置と速度を更新 リストはまだ有効か? No Yes 領域からはみ出した粒子の処理 粒子の位置情報を更新
測定する場所 計算全体: このループを 1000ステップ積算 力の計算: ここだけをステップごと、 プロセスごとに計測 ※計算全体は並列化効率の定義のため、力の計算は揺らぎの測定のために調べる
9/13 Hyper-Threadingの影響 HTを有効にするだけで並列化効率が 大きく改善(66%→90%)
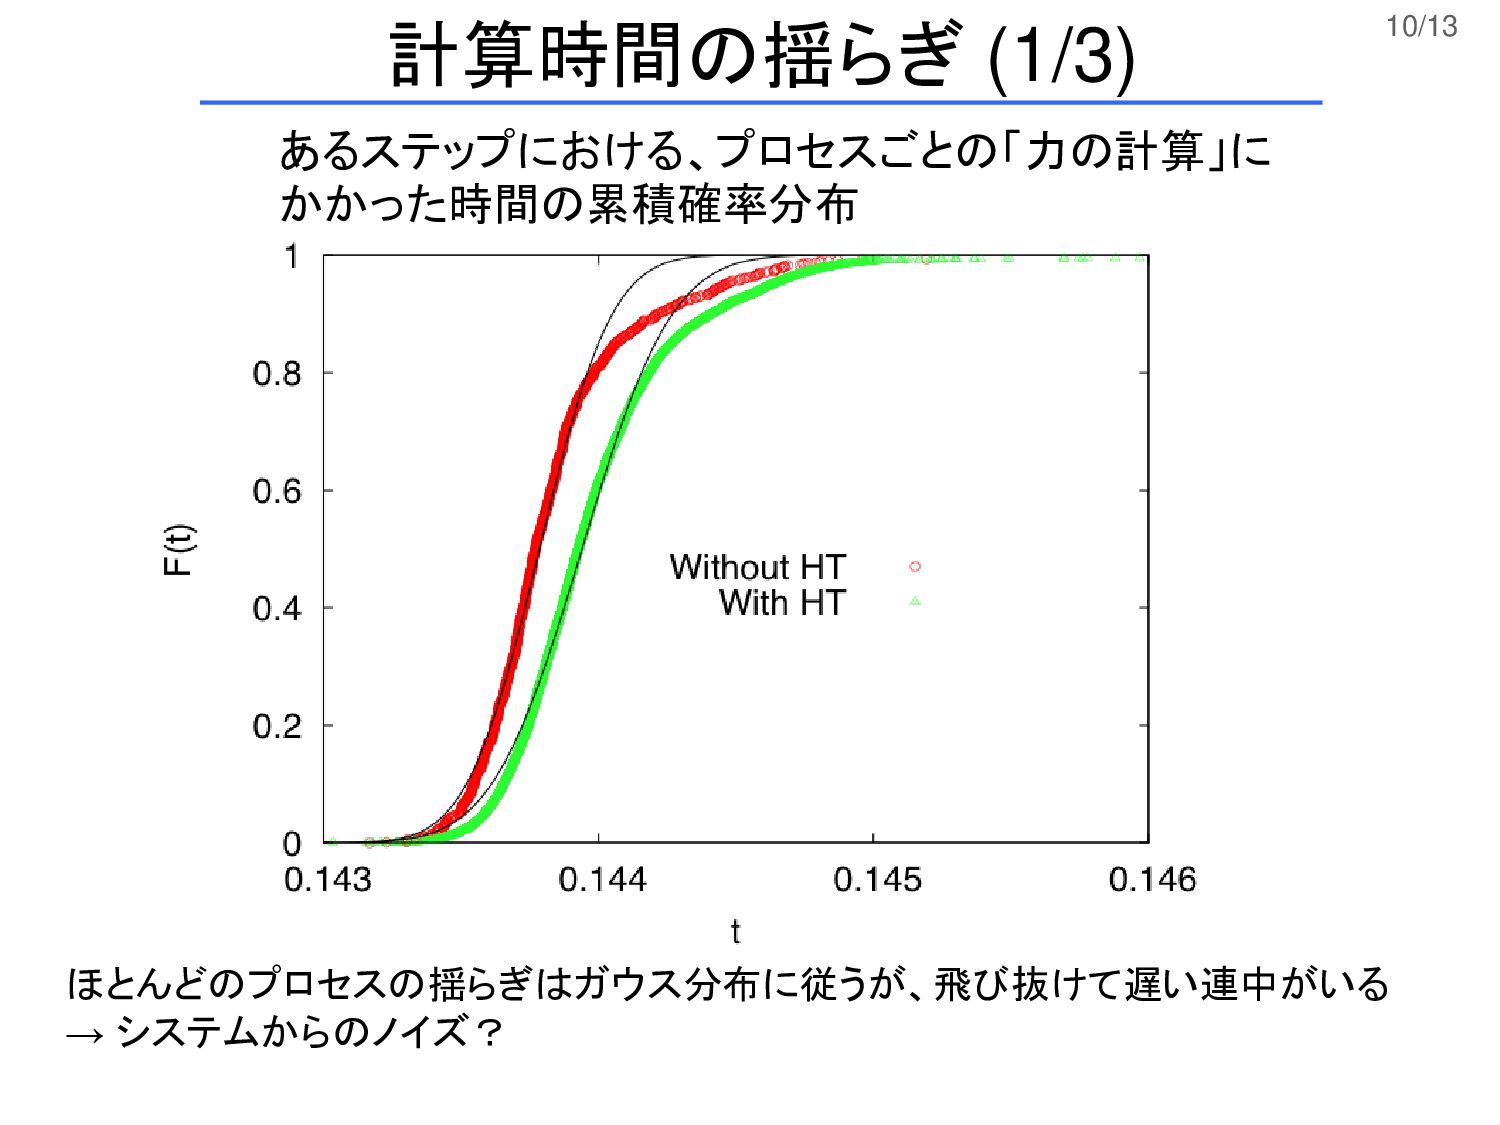
10/13 あるステップにおける、プロセスごとの「力の計算」に かかった時間の累積確率分布 ほとんどのプロセスの揺らぎはガウス分布に従うが、飛び抜けて遅い連中がいる → システムからのノイズ? 計算時間の揺らぎ (1/3)
11/13 誤差関数でフィットしてみる 特徴的な時間「τ」 ガウス分布の標準偏差に相当 HTなし:平均時間 143.785 [ms] 標準偏差 0.29 [ms]
HTあり:平均時間 143.940 [ms] 標準偏差 0.36 [ms] 一番遅かったプロセス: HTなし: 221.543 [ms] HTあり: 164.009 [ms] 平均からのずれが256σ 統計情報からはHTなしの方が優れている(平均も揺らぎも小さい)が・・・ 一番遅いプロセスの実行時間がHTにより大きく改善された 計算時間の揺らぎ (2/3)
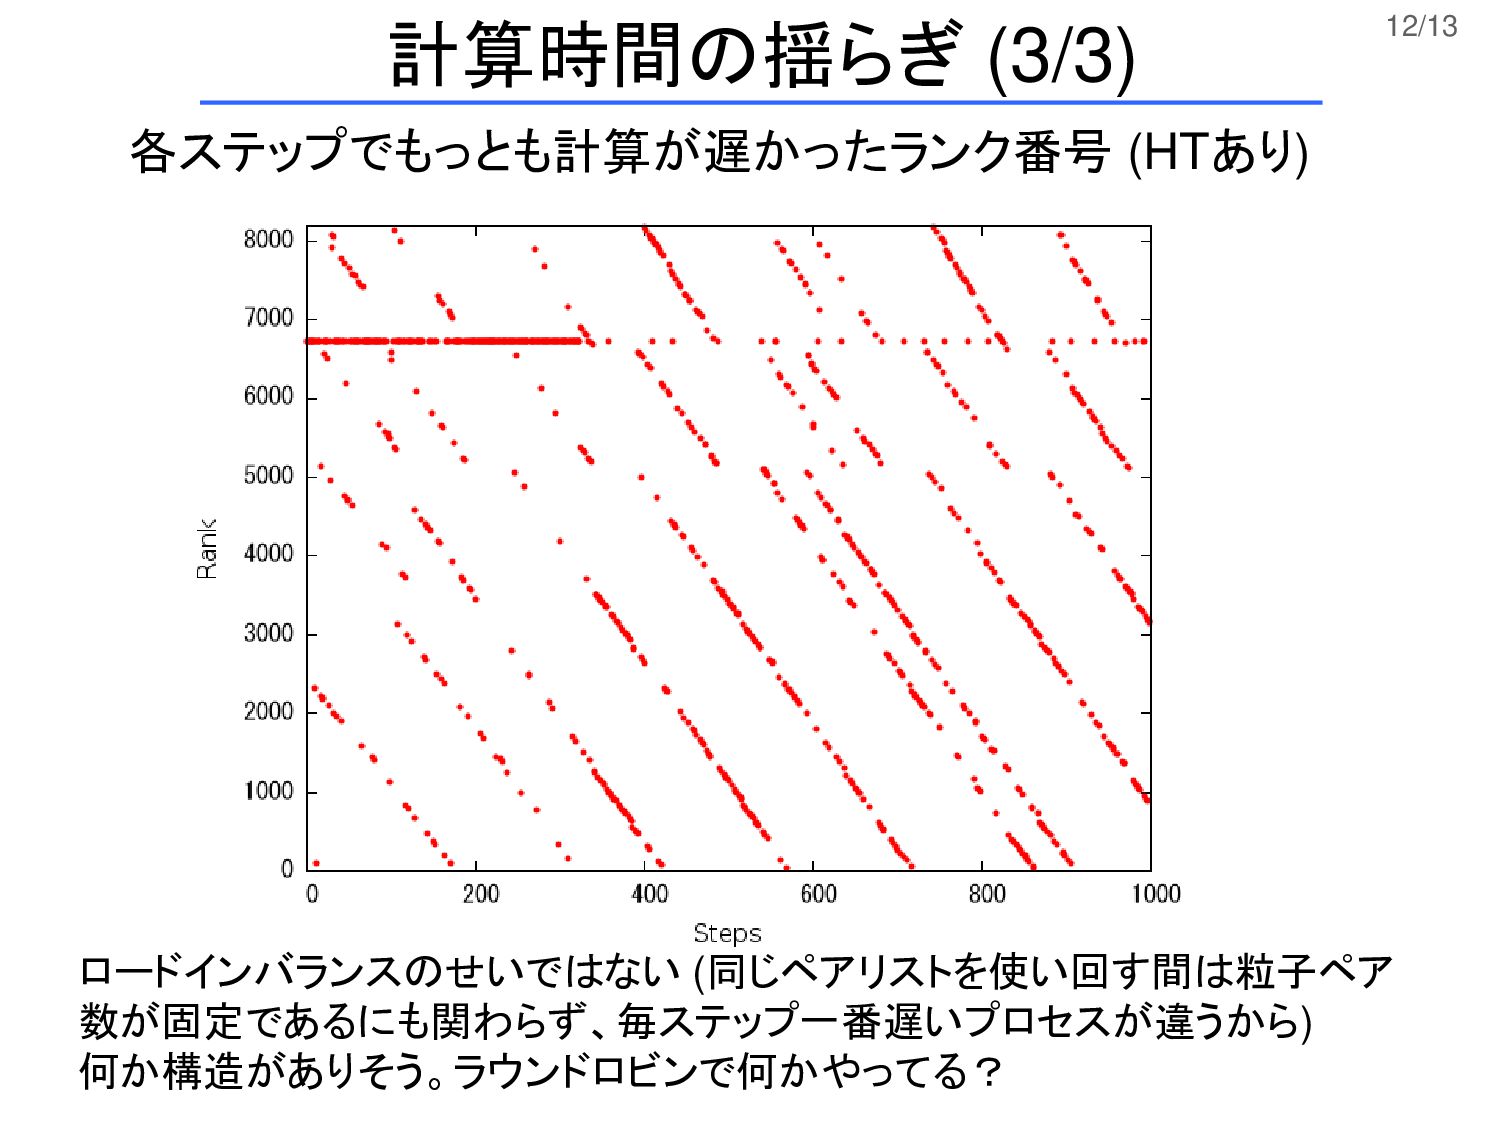
12/13 計算時間の揺らぎ (3/3) 各ステップでもっとも計算が遅かったランク番号 (HTあり) ロードインバランスのせいではない (同じペアリストを使い回す間は粒子ペア 数が固定であるにも関わらず、毎ステップ一番遅いプロセスが違うから) 何か構造がありそう。ラウンドロビンで何かやってる?
13/13 まとめのようなもの (1) Hyper-Threading Technologyを有効にすることで 並列化効率が大きく向上→HTによるスムーズなス レッドの切り替えが要因? (2) 揺らぐ時間は80ミリ秒といったオーダー →
OSジッタとしては大きすぎる (3) 通信を含まないはずの領域を測定しているのに、計 算時間が大きく揺らぐ →通信の後処理が割り込んでいる?


 kaityo256
 rshindo
 iwatsukayura
 nao_randd
 utakaha
 a_matsuda
 minodriven
 suneo3476
 sorah
 marcoroth
 tosite
 kawashimo0
 mofurune
 aleyda
 tmiket
 apolaine
 lauravandoore
 addyosmani
 tammyeverts
 philnash
 hatefulcrawdad
 bryan
 sferik