Share
Embed
[Journal club] Energy-Based Learning for Scene Graph Generation
Semantic Machine Intelligence Lab., Keio Univ. PRO
September 16, 2022
Transcript
30 slides
-
Energy-Based Learning for Scene Graph Generation Mohammed Suhail1,2, Abhay Mittal4,
Behjat Siddiquie4, Chris Broaddus4, Jayan Eledath4, Gerard Medioni4, Leonid Sigal1,2,3 (1University of British Columbia, 2Vector Institute for AI , 3Canada CIFAR AI Chair, 4Amazon) 慶應義塾⼤学 杉浦孔明研究室 B4 和⽥唯我 Mohammed Suhail et al., “Energy-based learning for scene graph generation”, in CVPR(2021) CVPR 2021 -
概要 2 ü 背景 • Scene Graph⽣成において, Cross Entropyには精度・多様性の問題がある ü
提案⼿法 • Energy Based Modelに基づいたEBM-lossを提案 ü 結果 • Cross EntropyによるScene Graph学習を上回る定量・定性的結果を記録 -
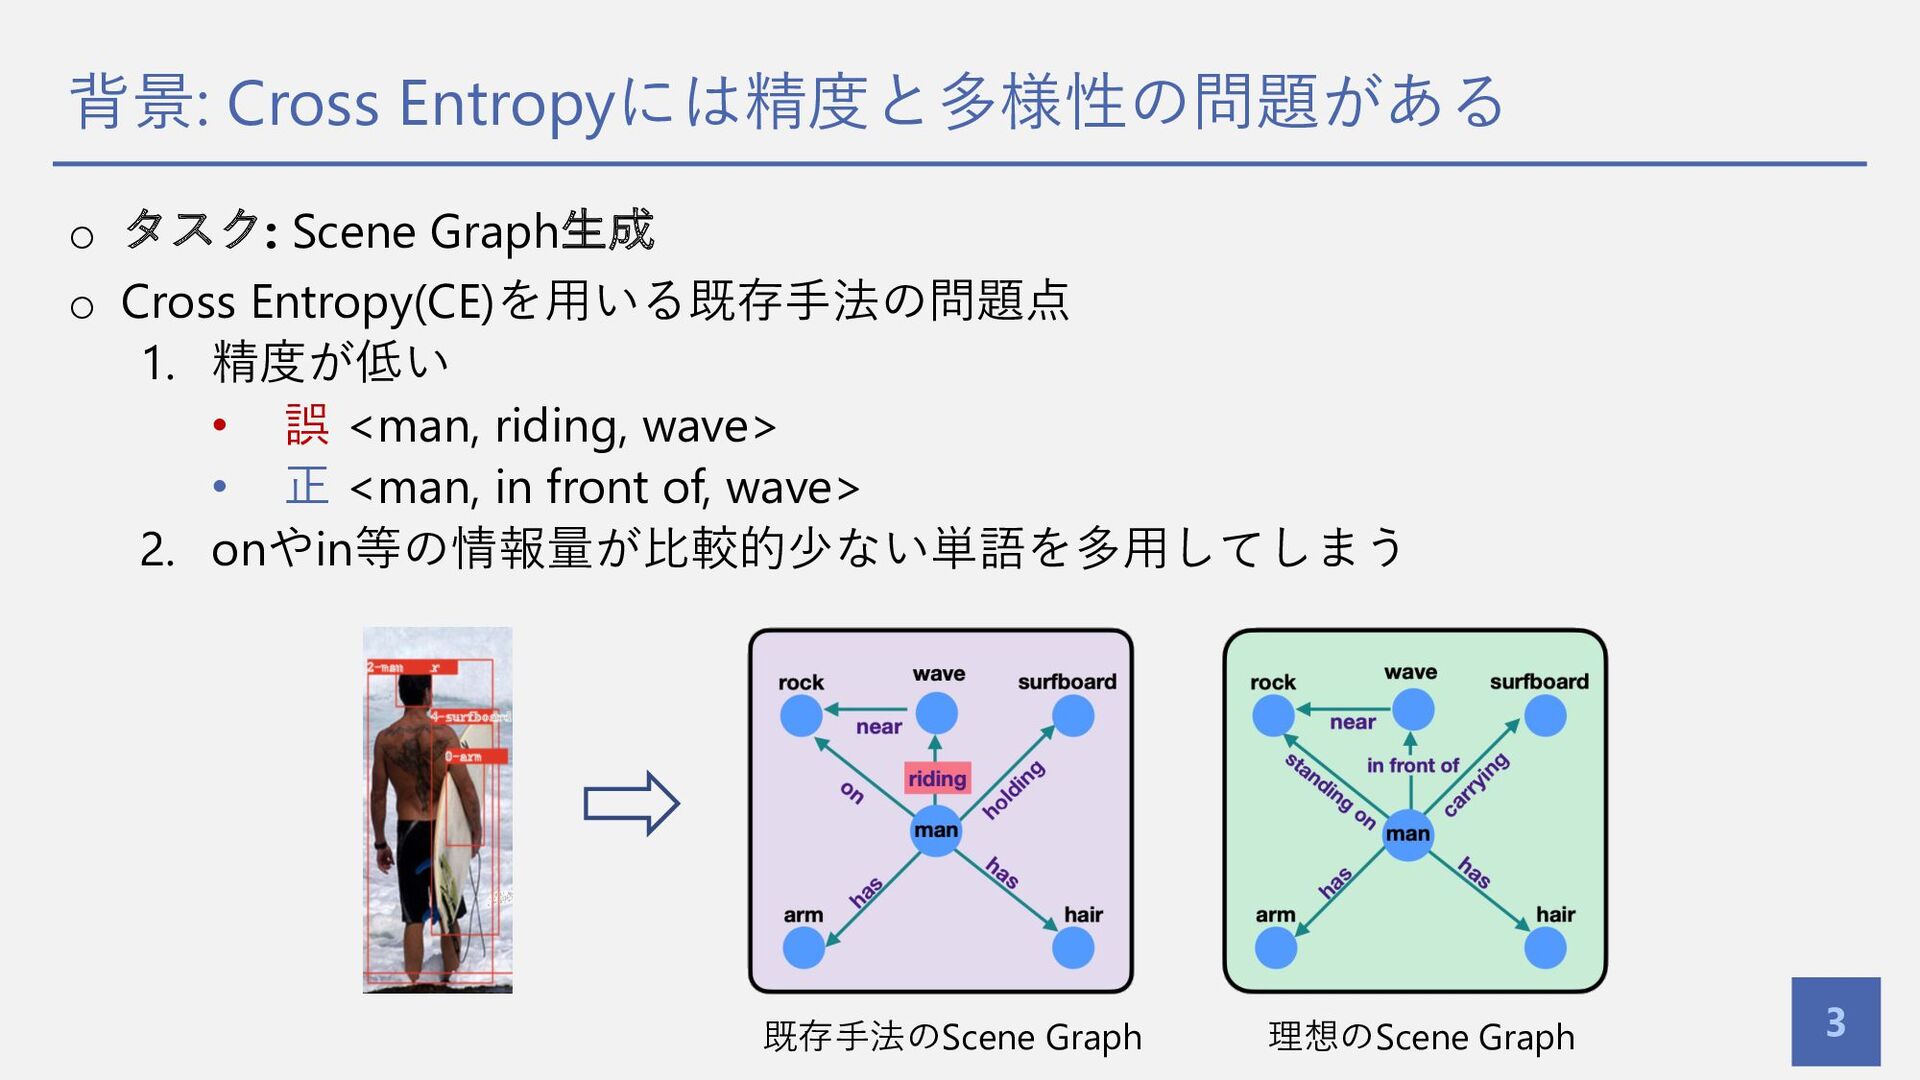
背景: Cross Entropyには精度と多様性の問題がある 3 o タスク: Scene Graph⽣成 o Cross
Entropy(CE)を⽤いる既存⼿法の問題点 1. 精度が低い • 誤 <man, riding, wave> • 正 <man, in front of, wave> 2. onやin等の情報量が⽐較的少ない単語を多⽤してしまう 既存⼿法のScene Graph 理想のScene Graph -
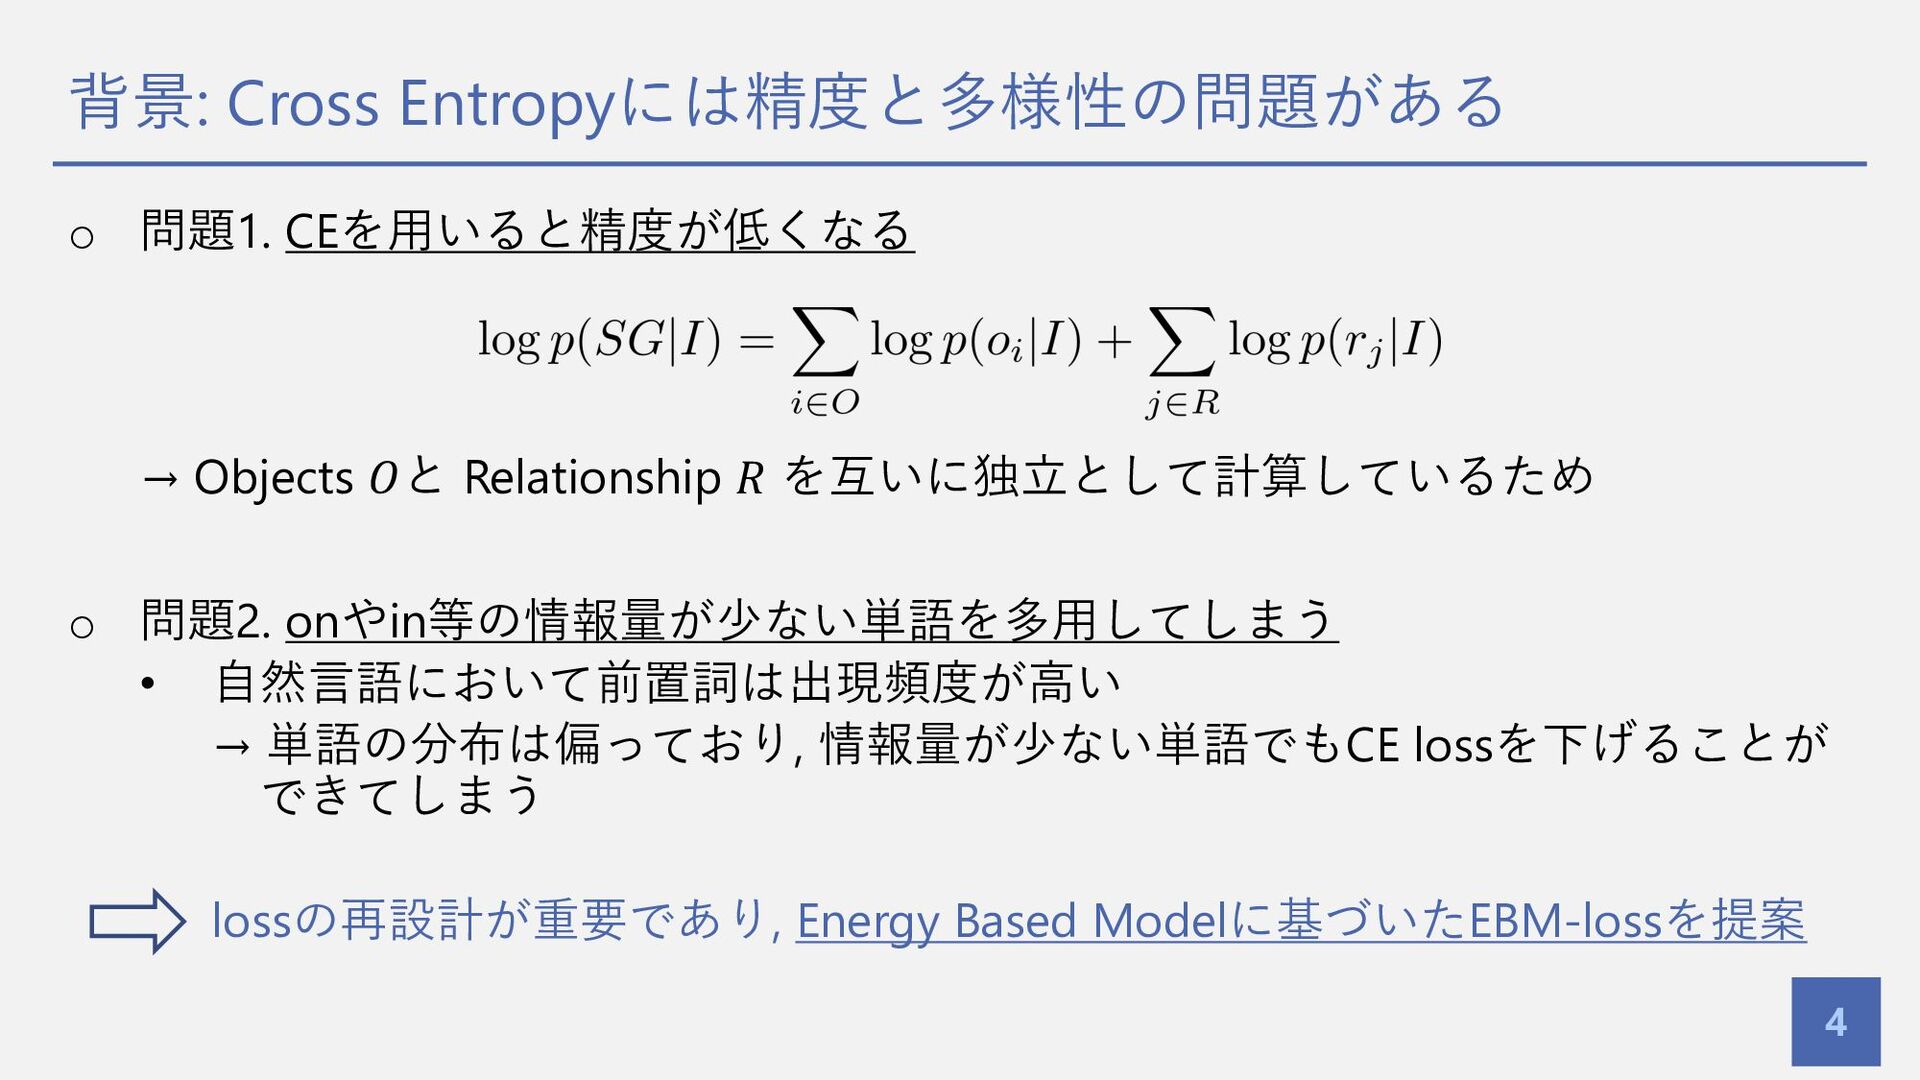
背景: Cross Entropyには精度と多様性の問題がある 4 o 問題1. CEを⽤いると精度が低くなる → Objects 𝑂と
Relationship 𝑅 を互いに独⽴として計算しているため o 問題2. onやin等の情報量が少ない単語を多⽤してしまう • ⾃然⾔語において前置詞は出現頻度が⾼い → 単語の分布は偏っており, 情報量が少ない単語でもCE lossを下げることが できてしまう lossの再設計が重要であり, Energy Based Modelに基づいたEBM-lossを提案 -
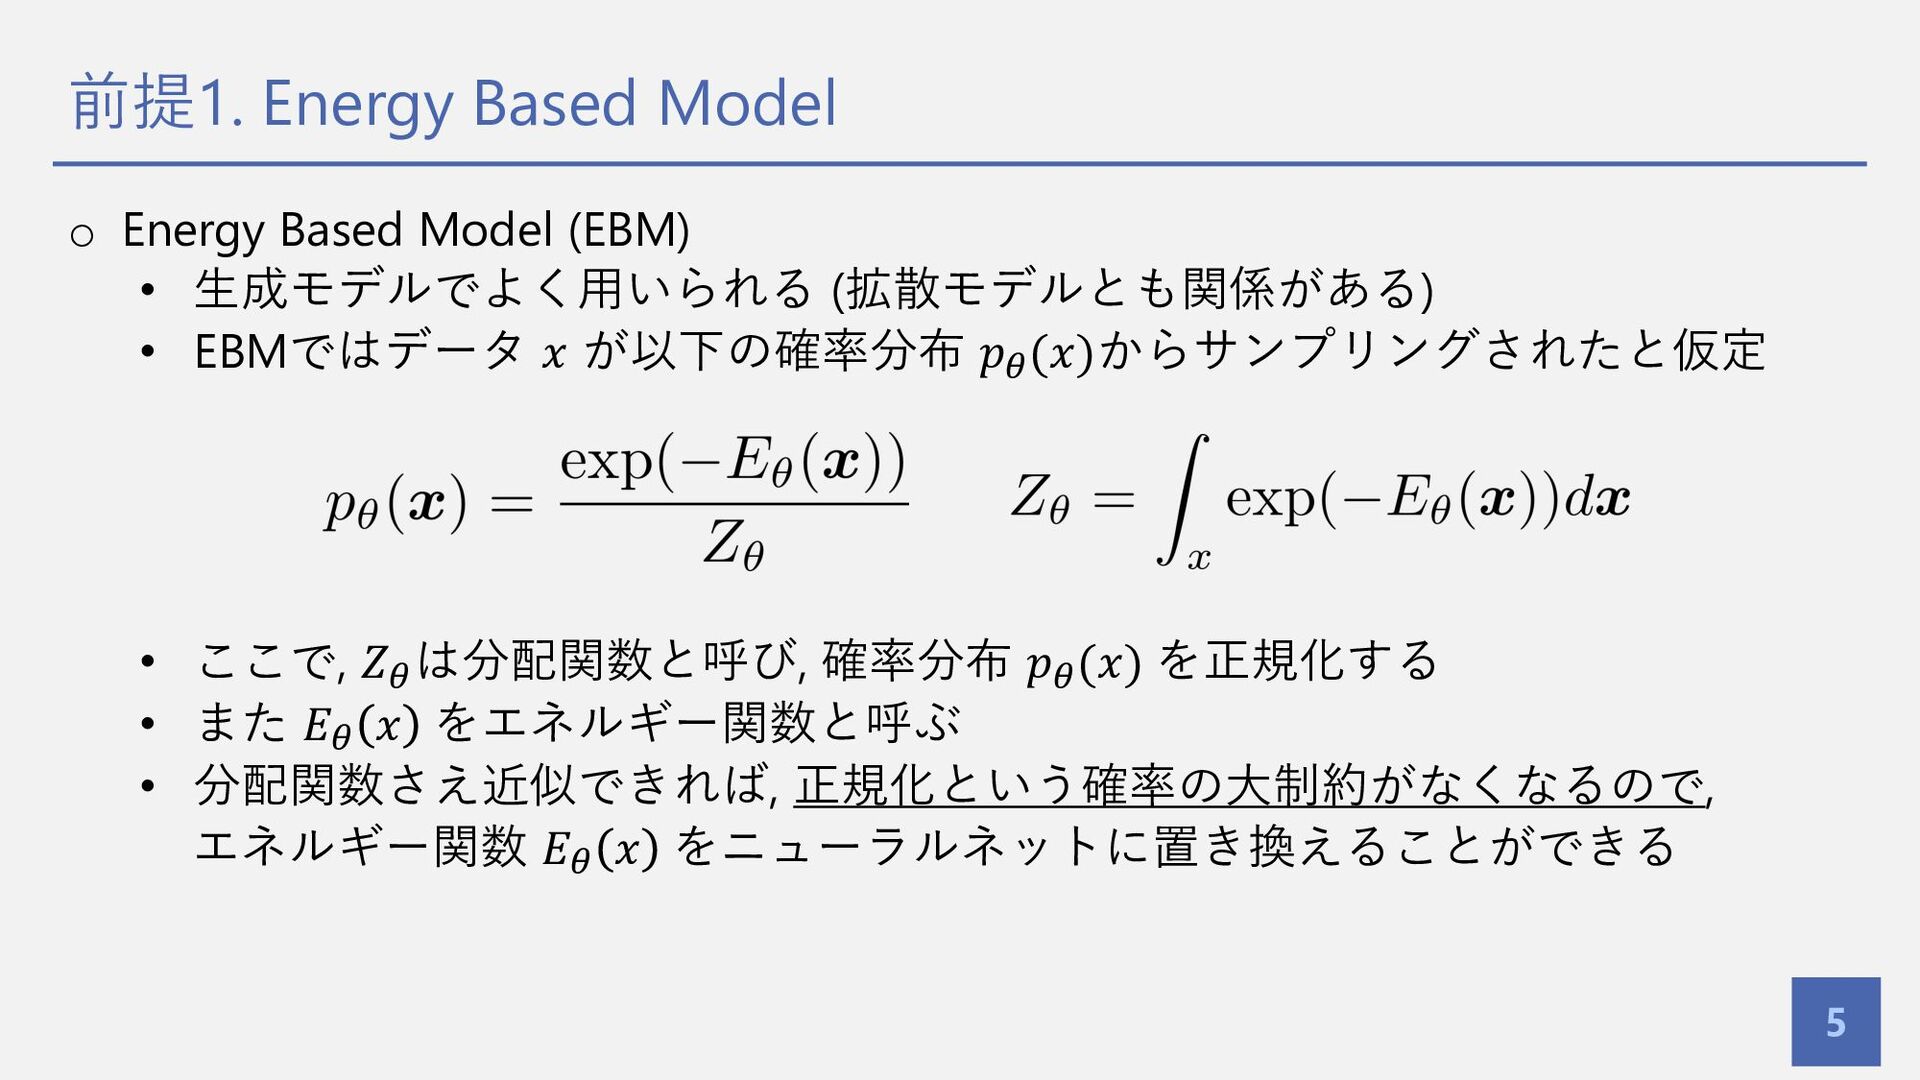
前提1. Energy Based Model 5 o Energy Based Model (EBM)
• ⽣成モデルでよく⽤いられる (拡散モデルとも関係がある) • EBMではデータ 𝑥 が以下の確率分布 𝑝! (𝑥)からサンプリングされたと仮定 • ここで, 𝑍! は分配関数と呼び, 確率分布 𝑝! (𝑥) を正規化する • また 𝐸! 𝑥 をエネルギー関数と呼ぶ • 分配関数さえ近似できれば, 正規化という確率の⼤制約がなくなるので, エネルギー関数 𝐸! 𝑥 をニューラルネットに置き換えることができる -
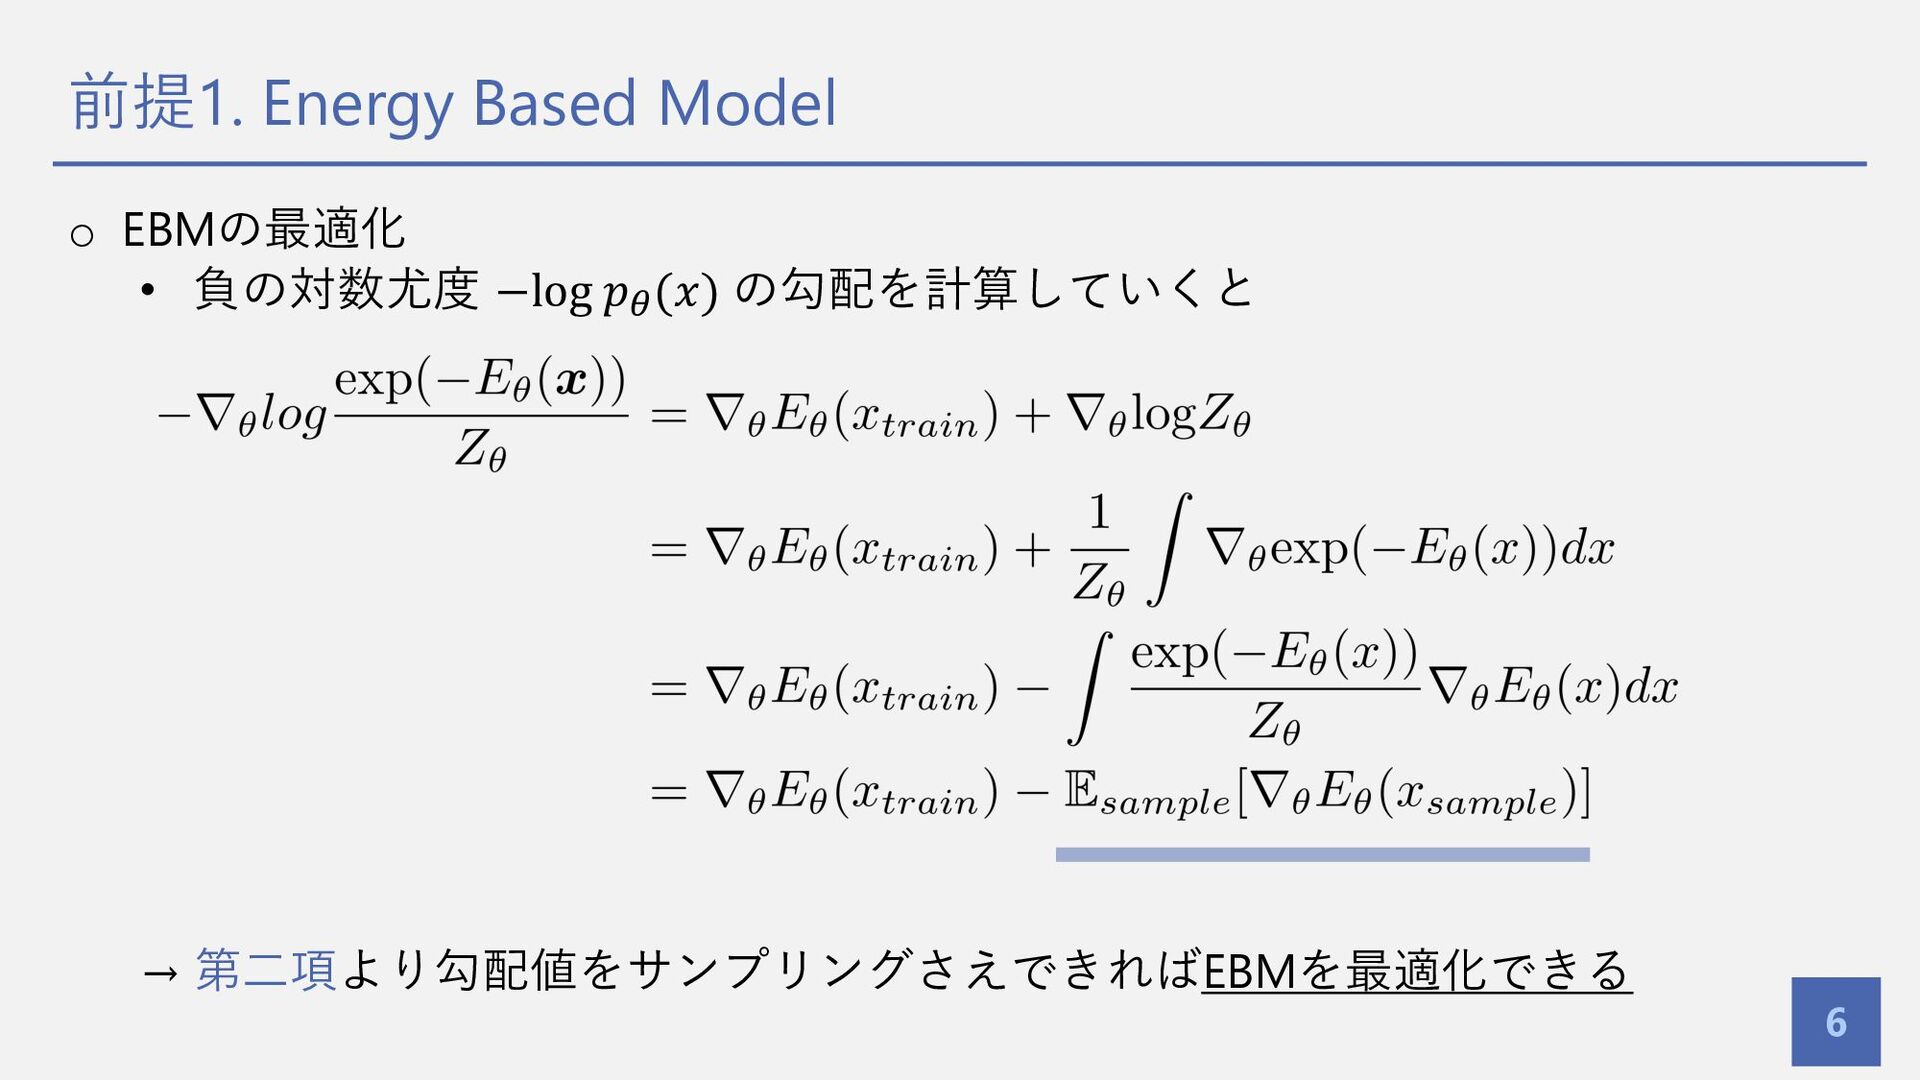
前提1. Energy Based Model 6 o EBMの最適化 • 負の対数尤度 −log
𝑝! (𝑥) の勾配を計算していくと → 第⼆項より勾配値をサンプリングさえできればEBMを最適化できる -
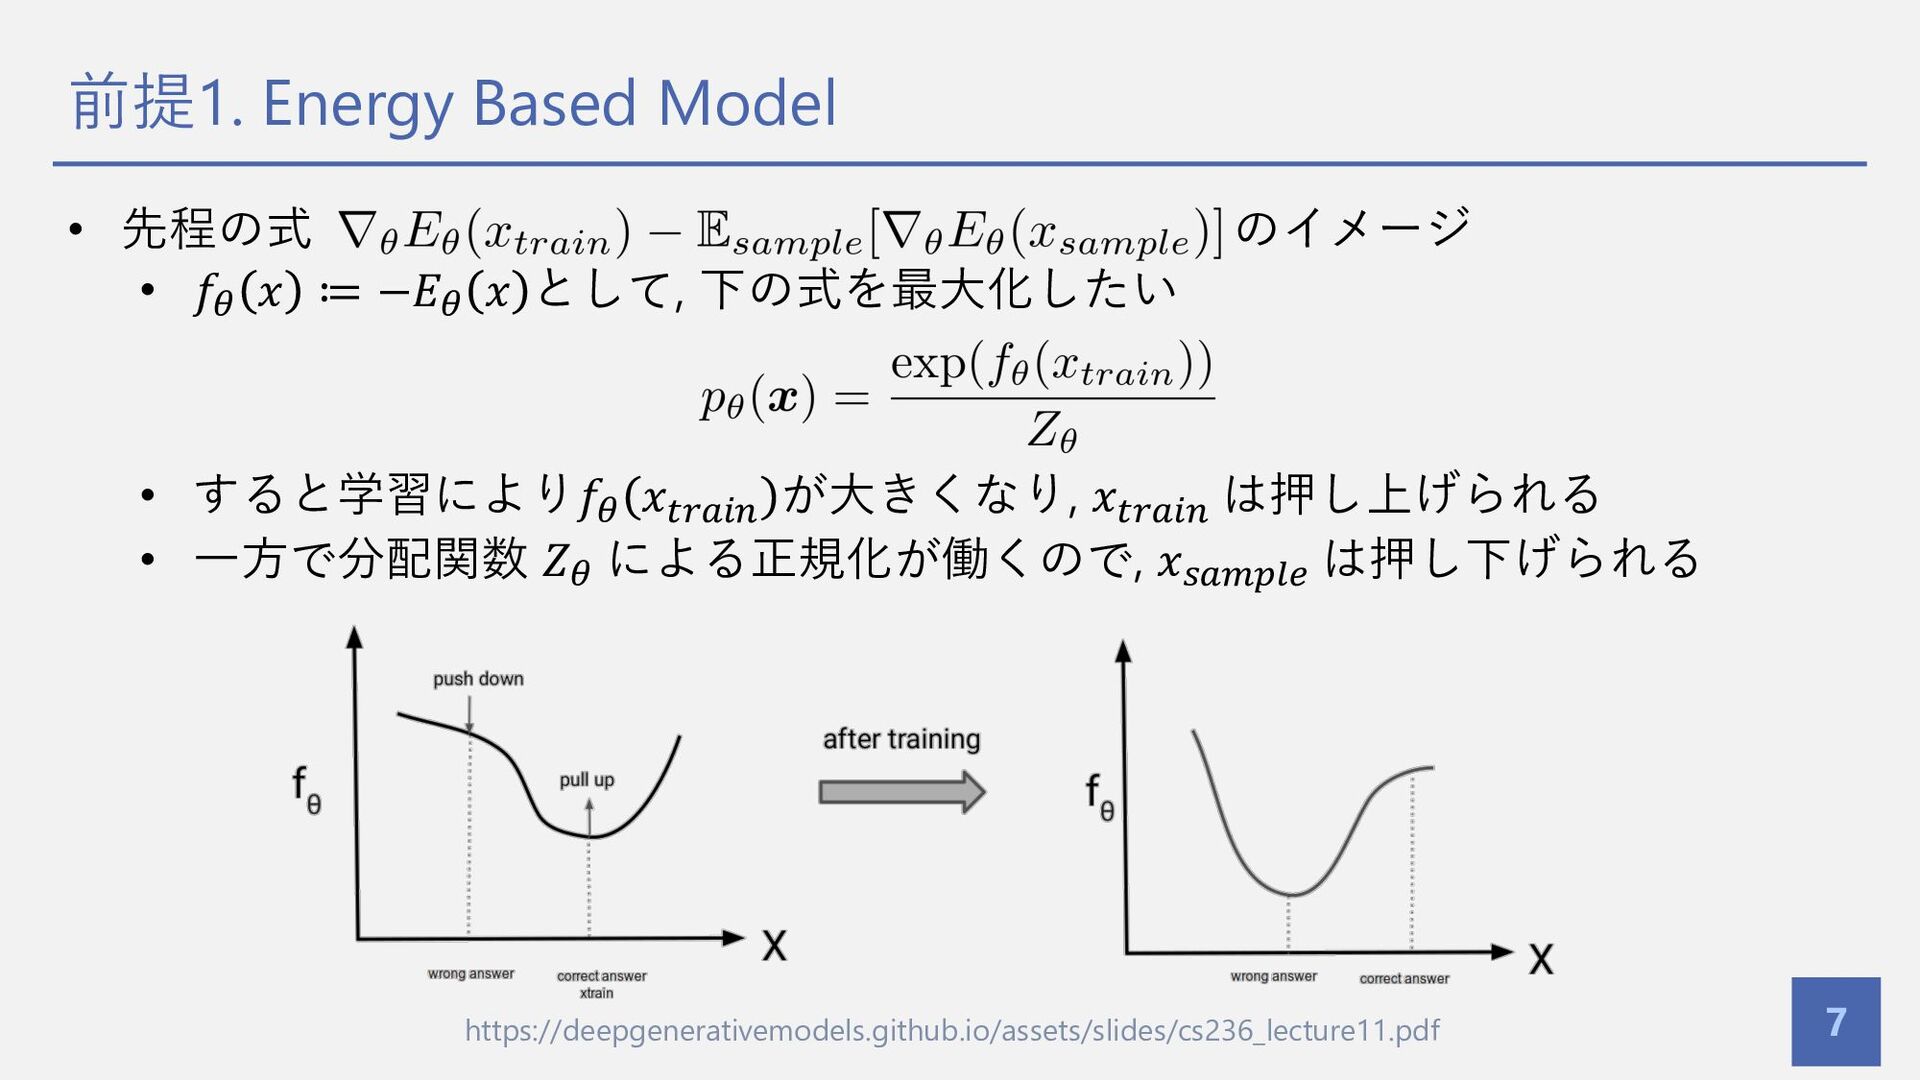
前提1. Energy Based Model 7 • 先程の式 のイメージ • 𝑓!
𝑥 ≔ −𝐸! 𝑥 として, 下の式を最⼤化したい • すると学習により𝑓! 𝑥"#$%& が⼤きくなり, 𝑥"#$%& は押し上げられる • ⼀⽅で分配関数 𝑍! による正規化が働くので, 𝑥'$()*+ は押し下げられる https://deepgenerativemodels.github.io/assets/slides/cs236_lecture11.pdf -
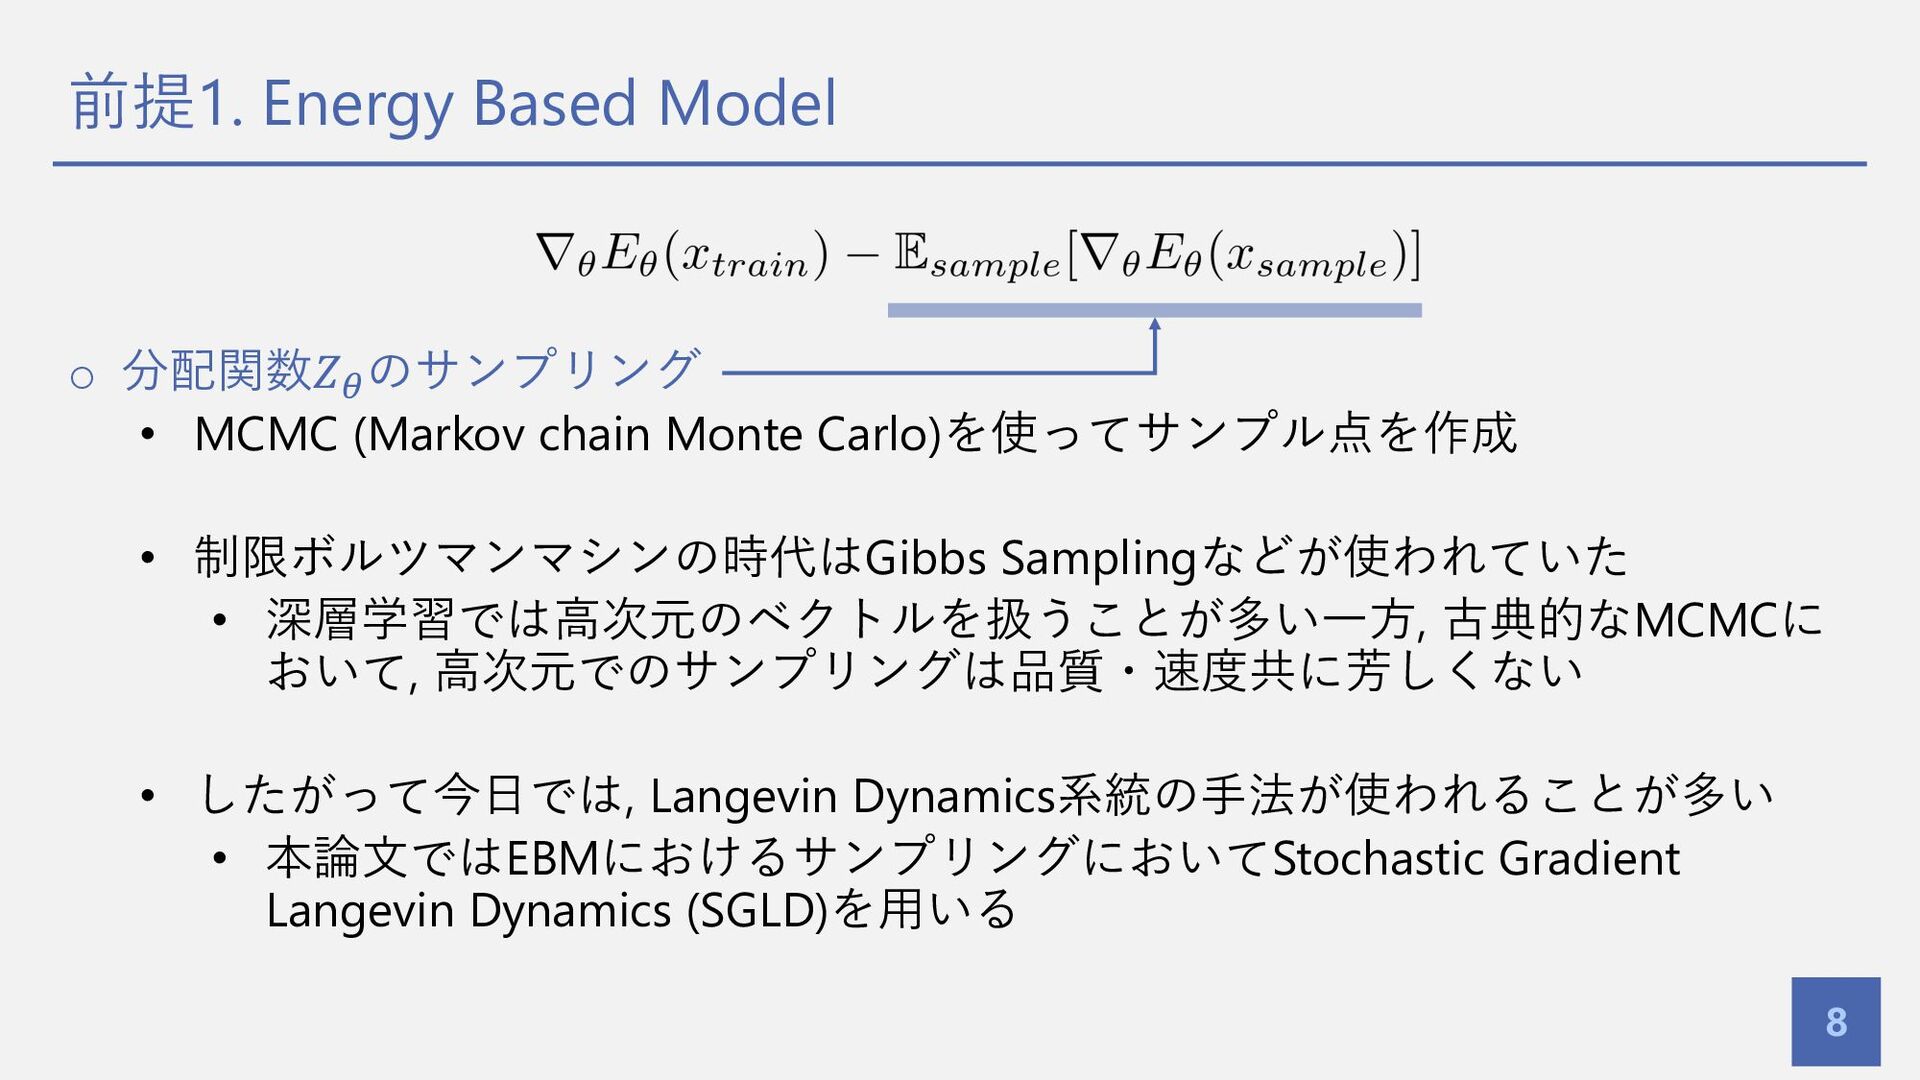
前提1. Energy Based Model 8 o 分配関数𝑍! のサンプリング • MCMC
(Markov chain Monte Carlo)を使ってサンプル点を作成 • 制限ボルツマンマシンの時代はGibbs Samplingなどが使われていた • 深層学習では⾼次元のベクトルを扱うことが多い⼀⽅, 古典的なMCMCに おいて, ⾼次元でのサンプリングは品質・速度共に芳しくない • したがって今⽇では, Langevin Dynamics系統の⼿法が使われることが多い • 本論⽂ではEBMにおけるサンプリングにおいてStochastic Gradient Langevin Dynamics (SGLD)を⽤いる -
前提2. MCMC (Markov chain Monte Carlo) 9 • MCMCについて以下の流れでSGLDまで説明する 1.
Metropolis-Hastings (MH) 2. Hamiltonian Monte Carlo (HMC) 3. Langevine Dynamics (LD) 4. Stochastic Gradient Langevine Dynamics (SGLD) • ただし Metropolis-Hastingsについては既知とする. • (B4は必ず知ってるはず) -
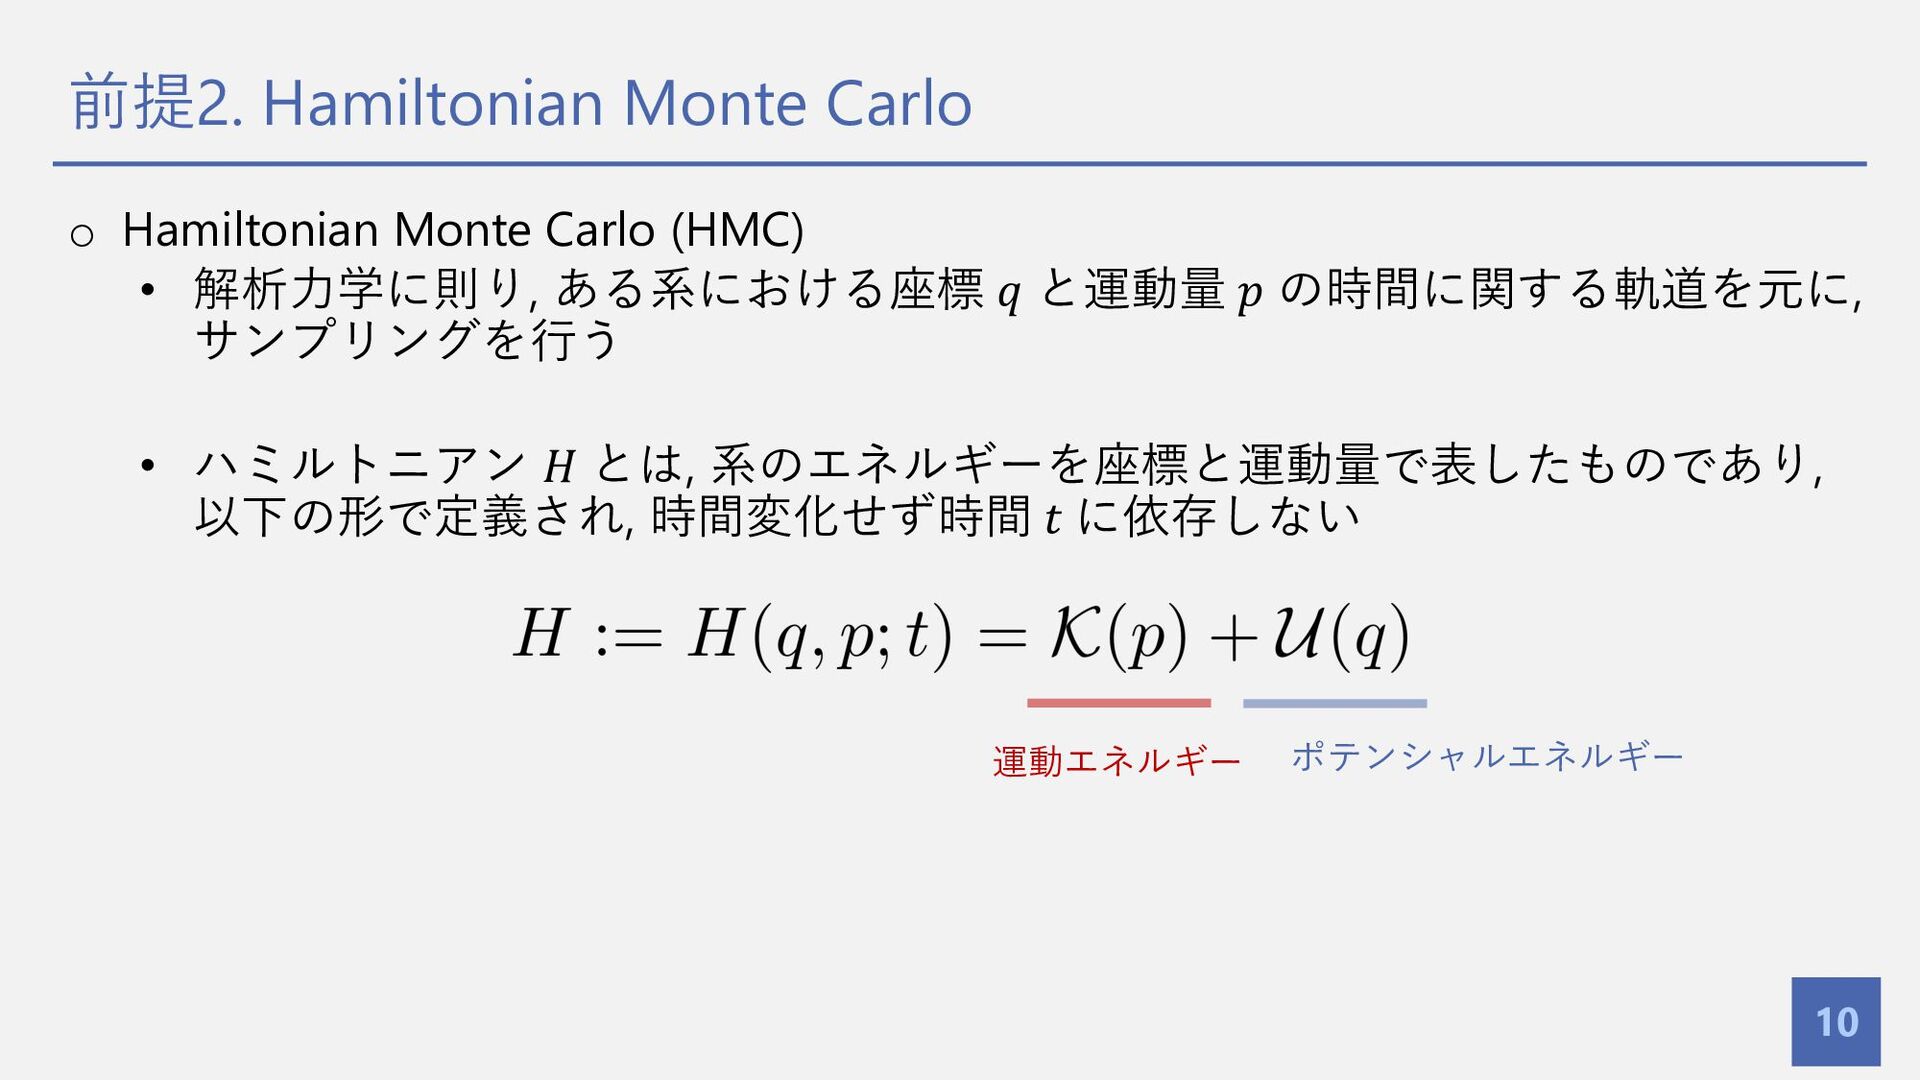
前提2. Hamiltonian Monte Carlo 10 o Hamiltonian Monte Carlo (HMC)
• 解析⼒学に則り, ある系における座標 𝑞 と運動量 𝑝 の時間に関する軌道を元に, サンプリングを⾏う • ハミルトニアン 𝐻 とは, 系のエネルギーを座標と運動量で表したものであり, 以下の形で定義され, 時間変化せず時間 𝑡 に依存しない 運動エネルギー ポテンシャルエネルギー -
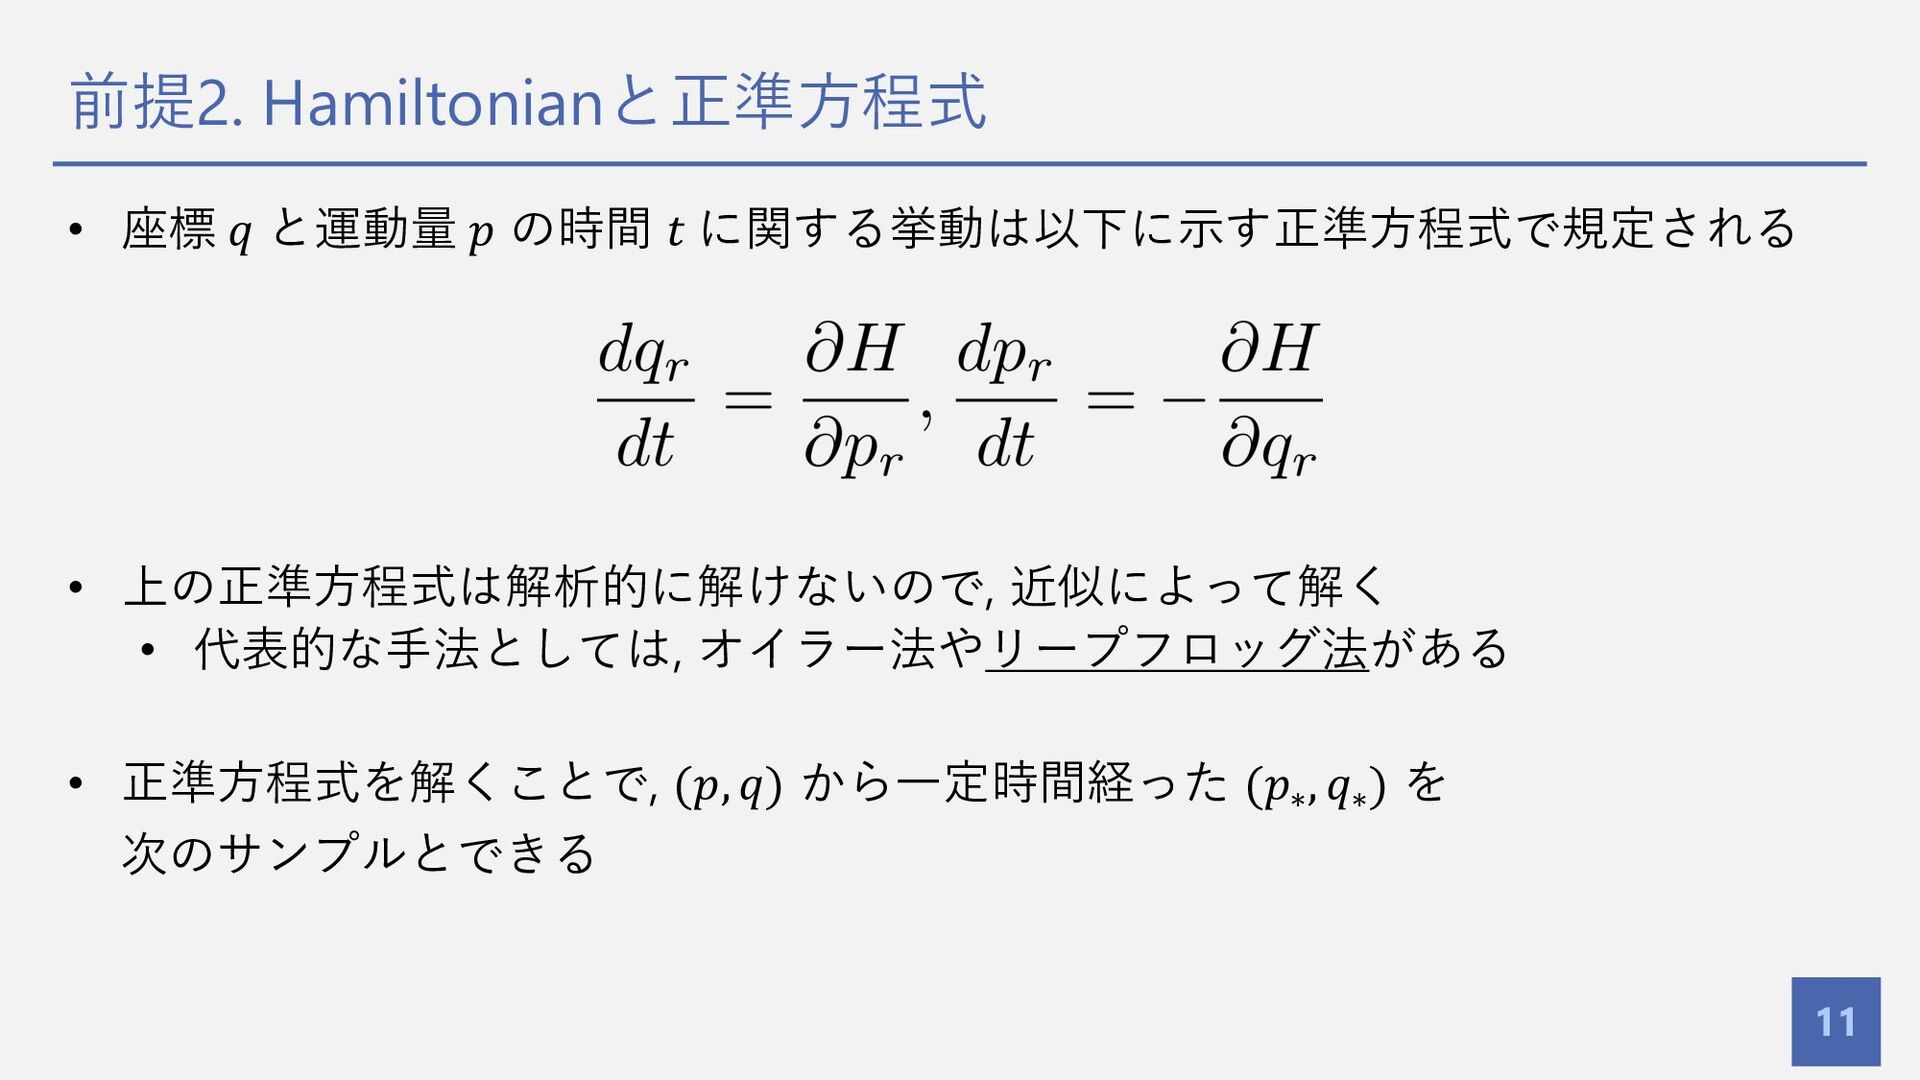
前提2. Hamiltonianと正準⽅程式 11 • 座標 𝑞 と運動量 𝑝 の時間 𝑡
に関する挙動は以下に⽰す正準⽅程式で規定される • 上の正準⽅程式は解析的に解けないので, 近似によって解く • 代表的な⼿法としては, オイラー法やリープフロッグ法がある • 正準⽅程式を解くことで, (𝑝, 𝑞) から⼀定時間経った (𝑝∗ , 𝑞∗ ) を 次のサンプルとできる -
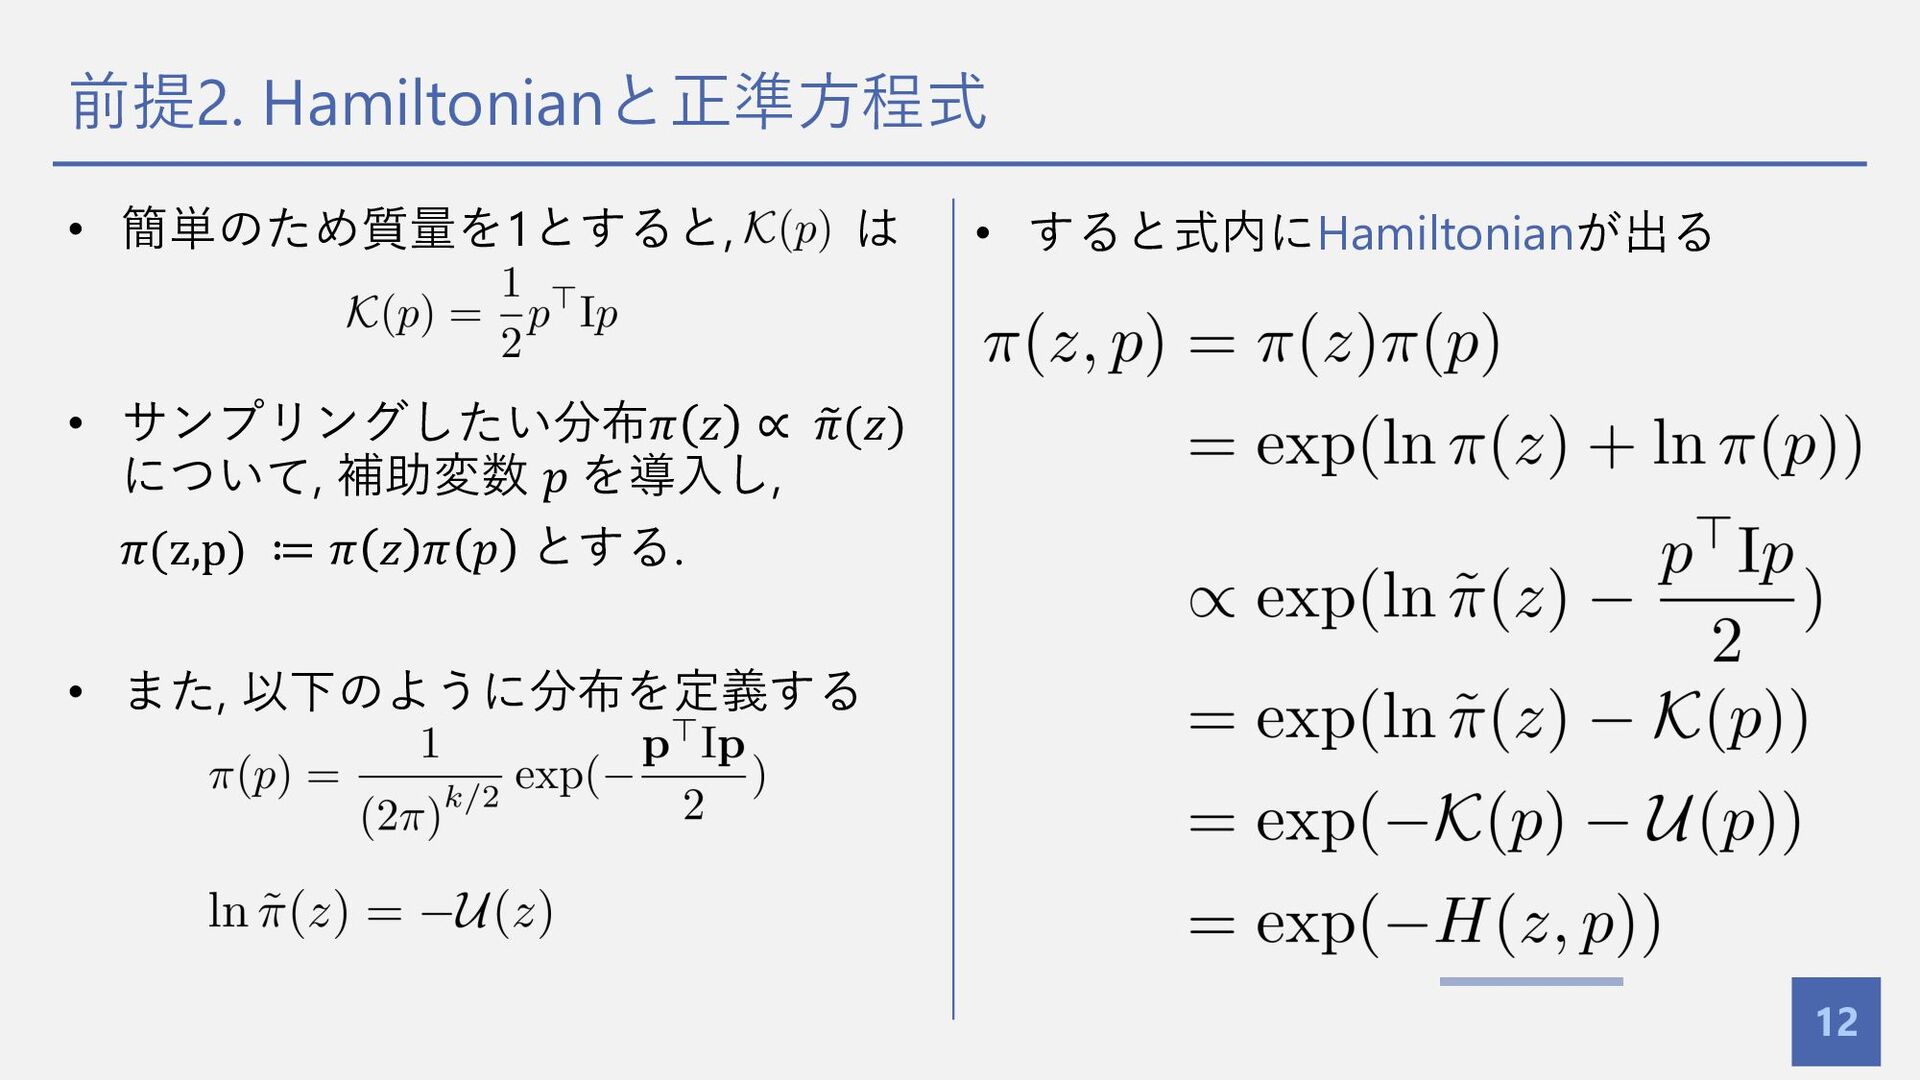
前提2. Hamiltonianと正準⽅程式 12 • 簡単のため質量を1とすると, は • サンプリングしたい分布𝜋 𝑧 ∝
6 𝜋(𝑧) について, 補助変数 𝑝 を導⼊し, 𝜋(z,p) ≔ 𝜋 𝑧 𝜋 𝑝 とする. • また, 以下のように分布を定義する • すると式内にHamiltonianが出る -
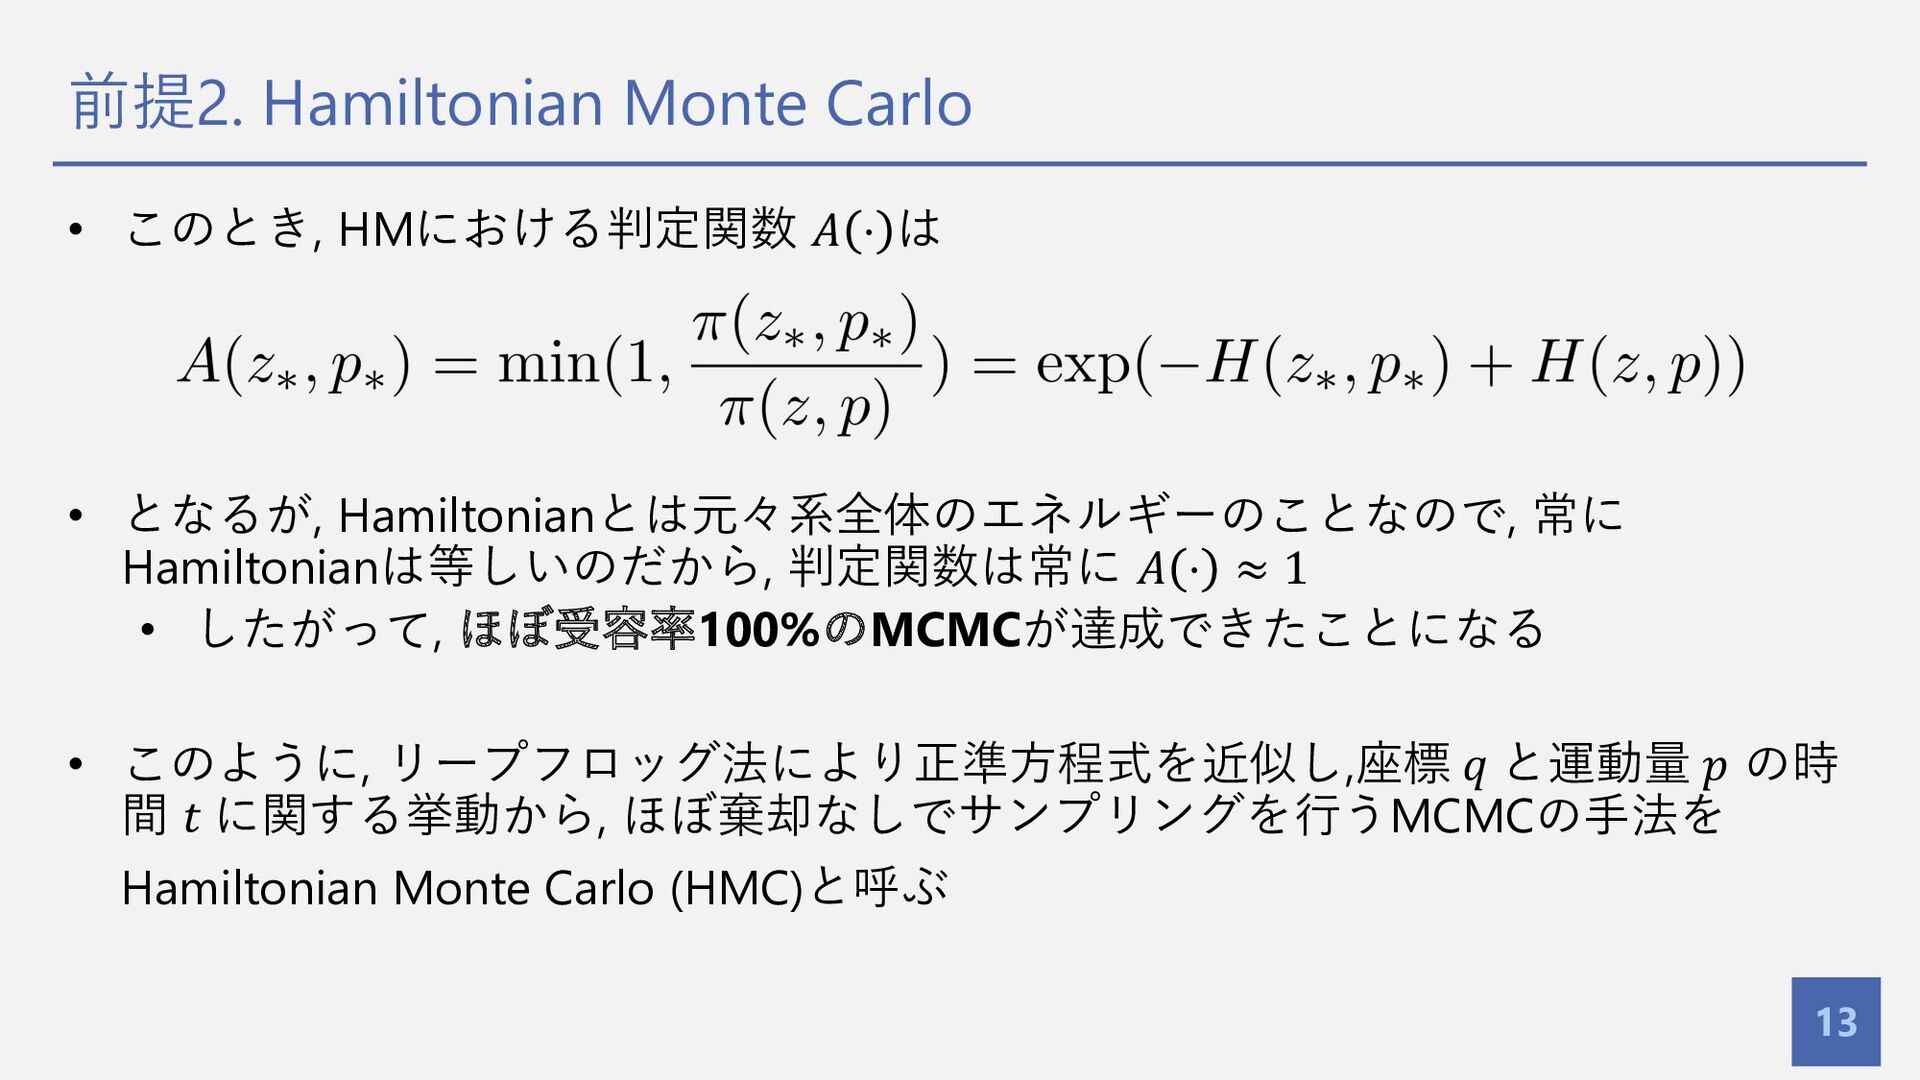
前提2. Hamiltonian Monte Carlo 13 • このとき, HMにおける判定関数 𝐴 ⋅
は • となるが, Hamiltonianとは元々系全体のエネルギーのことなので, 常に Hamiltonianは等しいのだから, 判定関数は常に 𝐴 ⋅ ≈ 1 • したがって, ほぼ受容率100%のMCMCが達成できたことになる • このように, リープフロッグ法により正準⽅程式を近似し,座標 𝑞 と運動量 𝑝 の時 間 𝑡 に関する挙動から, ほぼ棄却なしでサンプリングを⾏うMCMCの⼿法を Hamiltonian Monte Carlo (HMC)と呼ぶ -
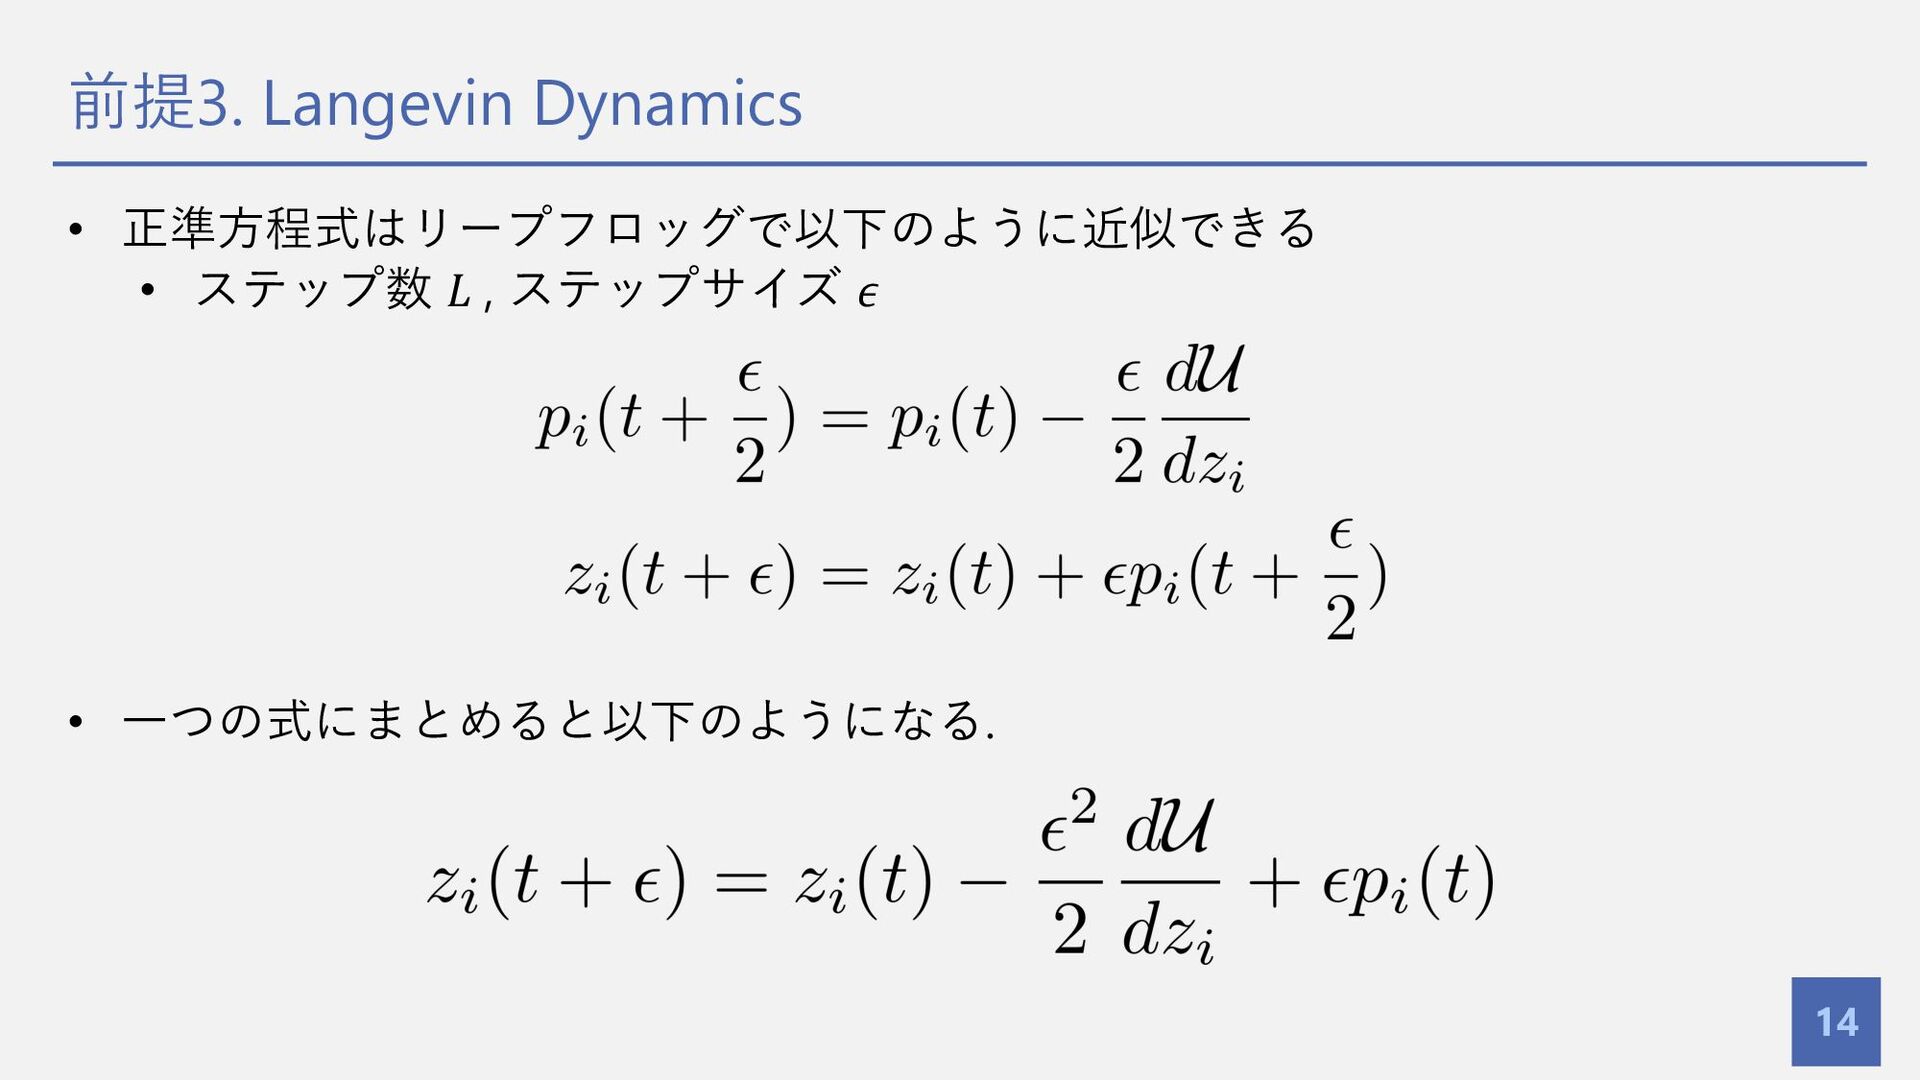
前提3. Langevin Dynamics 14 • 正準⽅程式はリープフロッグで以下のように近似できる • ステップ数 𝐿 ,
ステップサイズ 𝜖 • ⼀つの式にまとめると以下のようになる. -
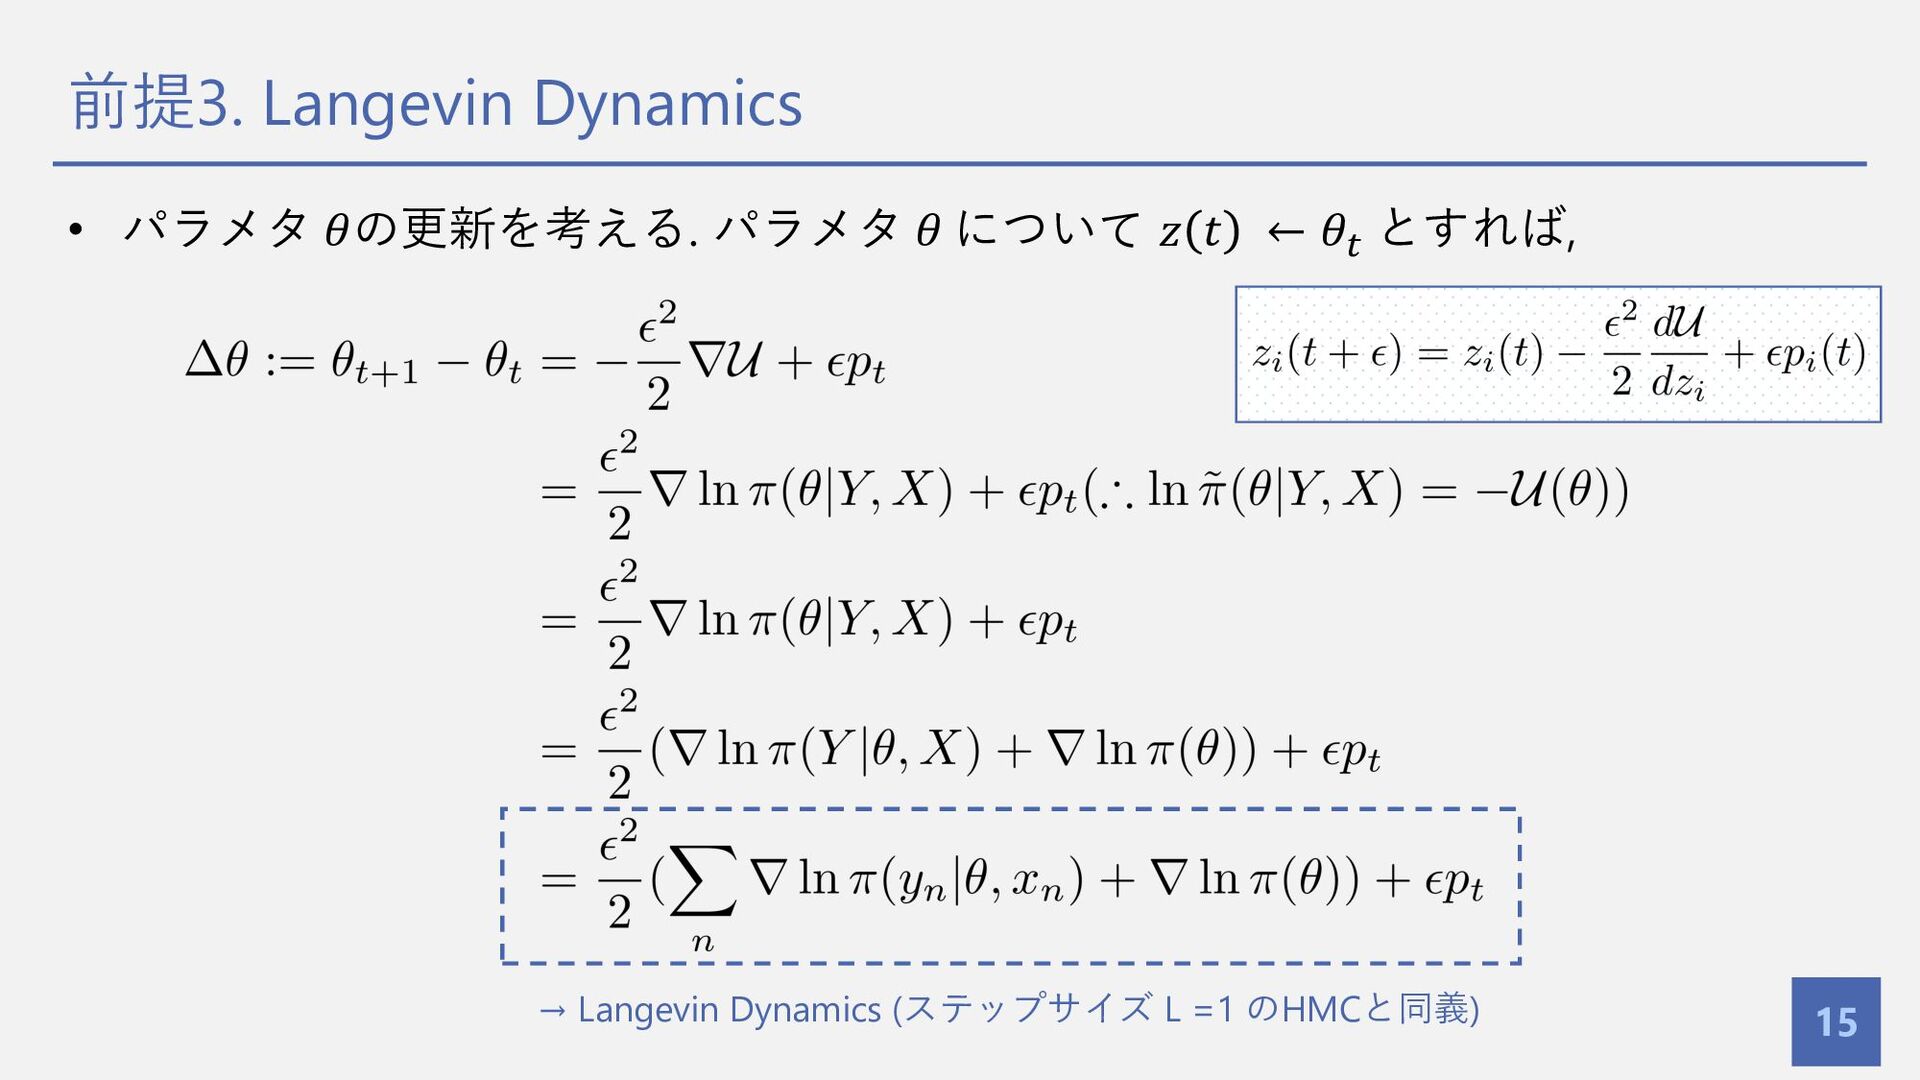
前提3. Langevin Dynamics 15 • パラメタ 𝜃の更新を考える. パラメタ 𝜃 について
𝑧 𝑡 ← 𝜃" とすれば, → Langevin Dynamics (ステップサイズ L =1 のHMCと同義) -
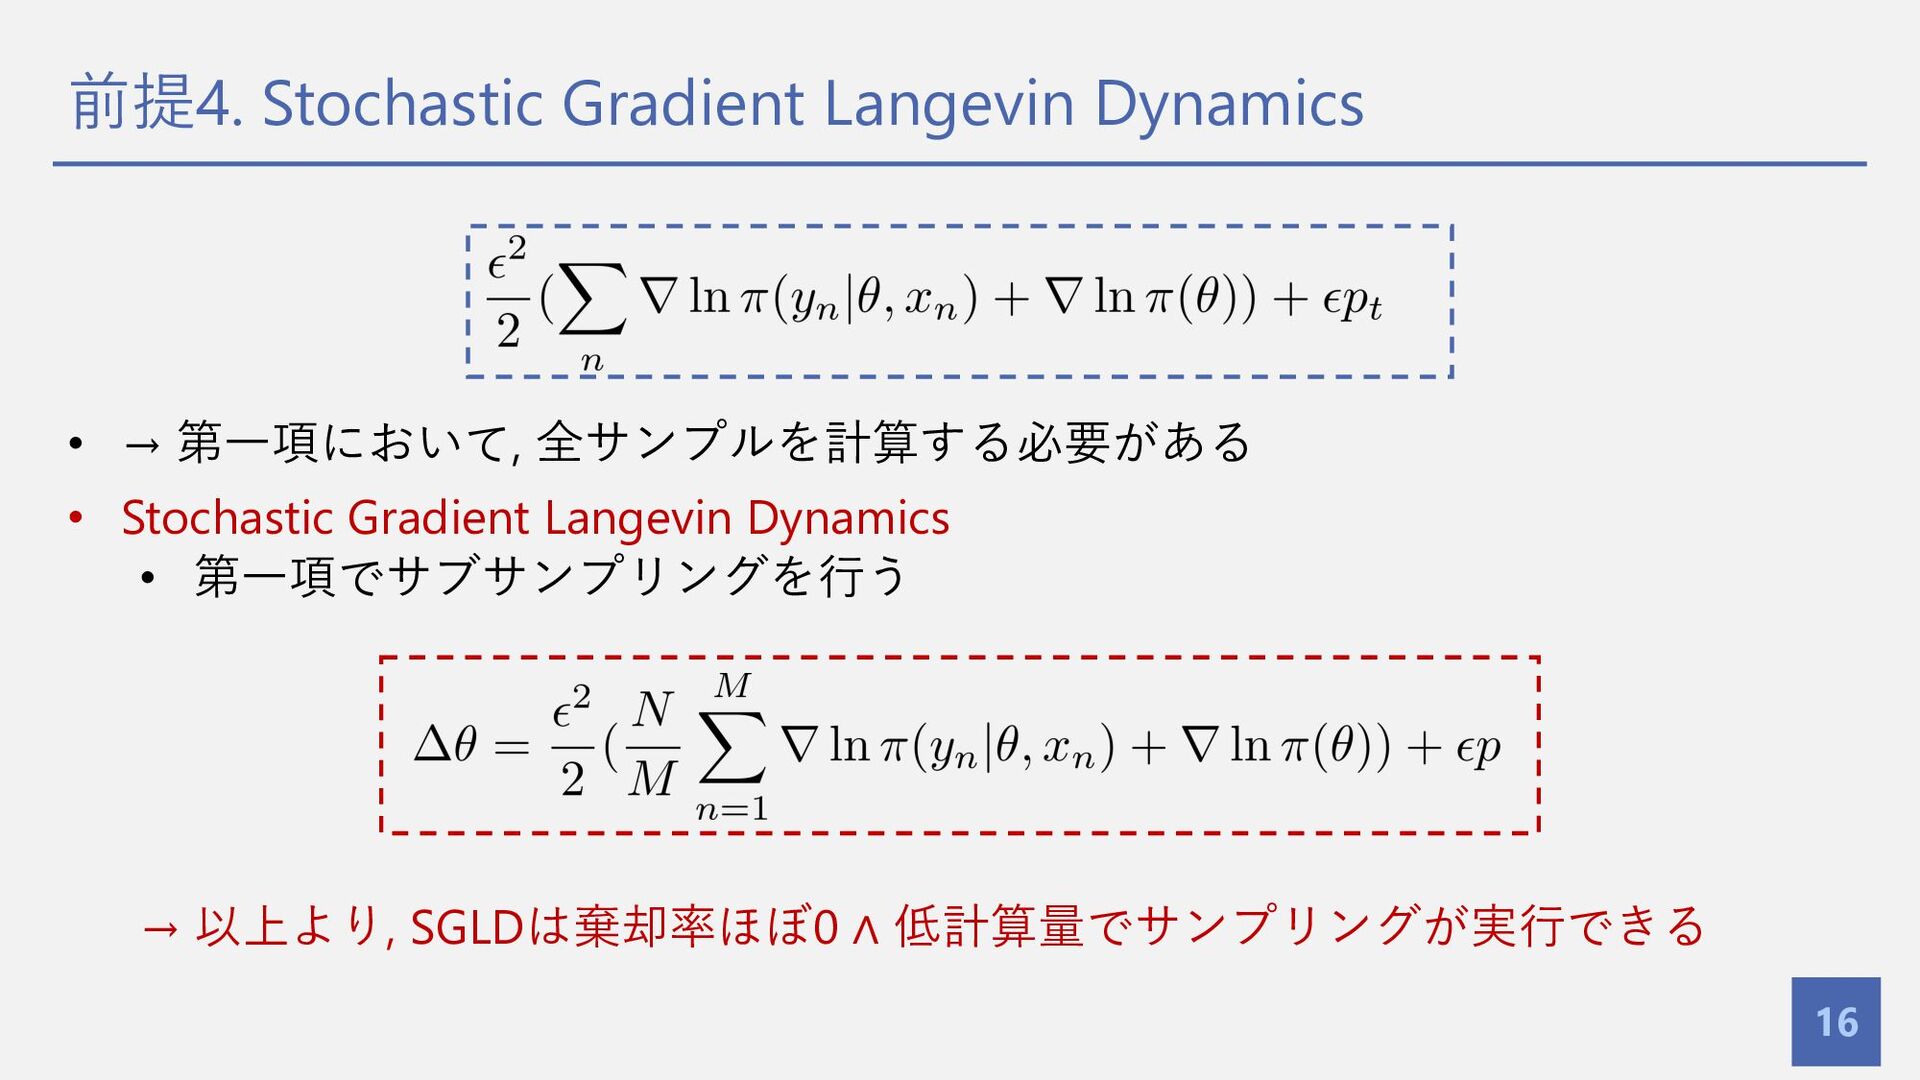
前提4. Stochastic Gradient Langevin Dynamics 16 • → 第⼀項において, 全サンプルを計算する必要がある
• Stochastic Gradient Langevin Dynamics • 第⼀項でサブサンプリングを⾏う → 以上より, SGLDは棄却率ほぼ0 ∧ 低計算量でサンプリングが実⾏できる -
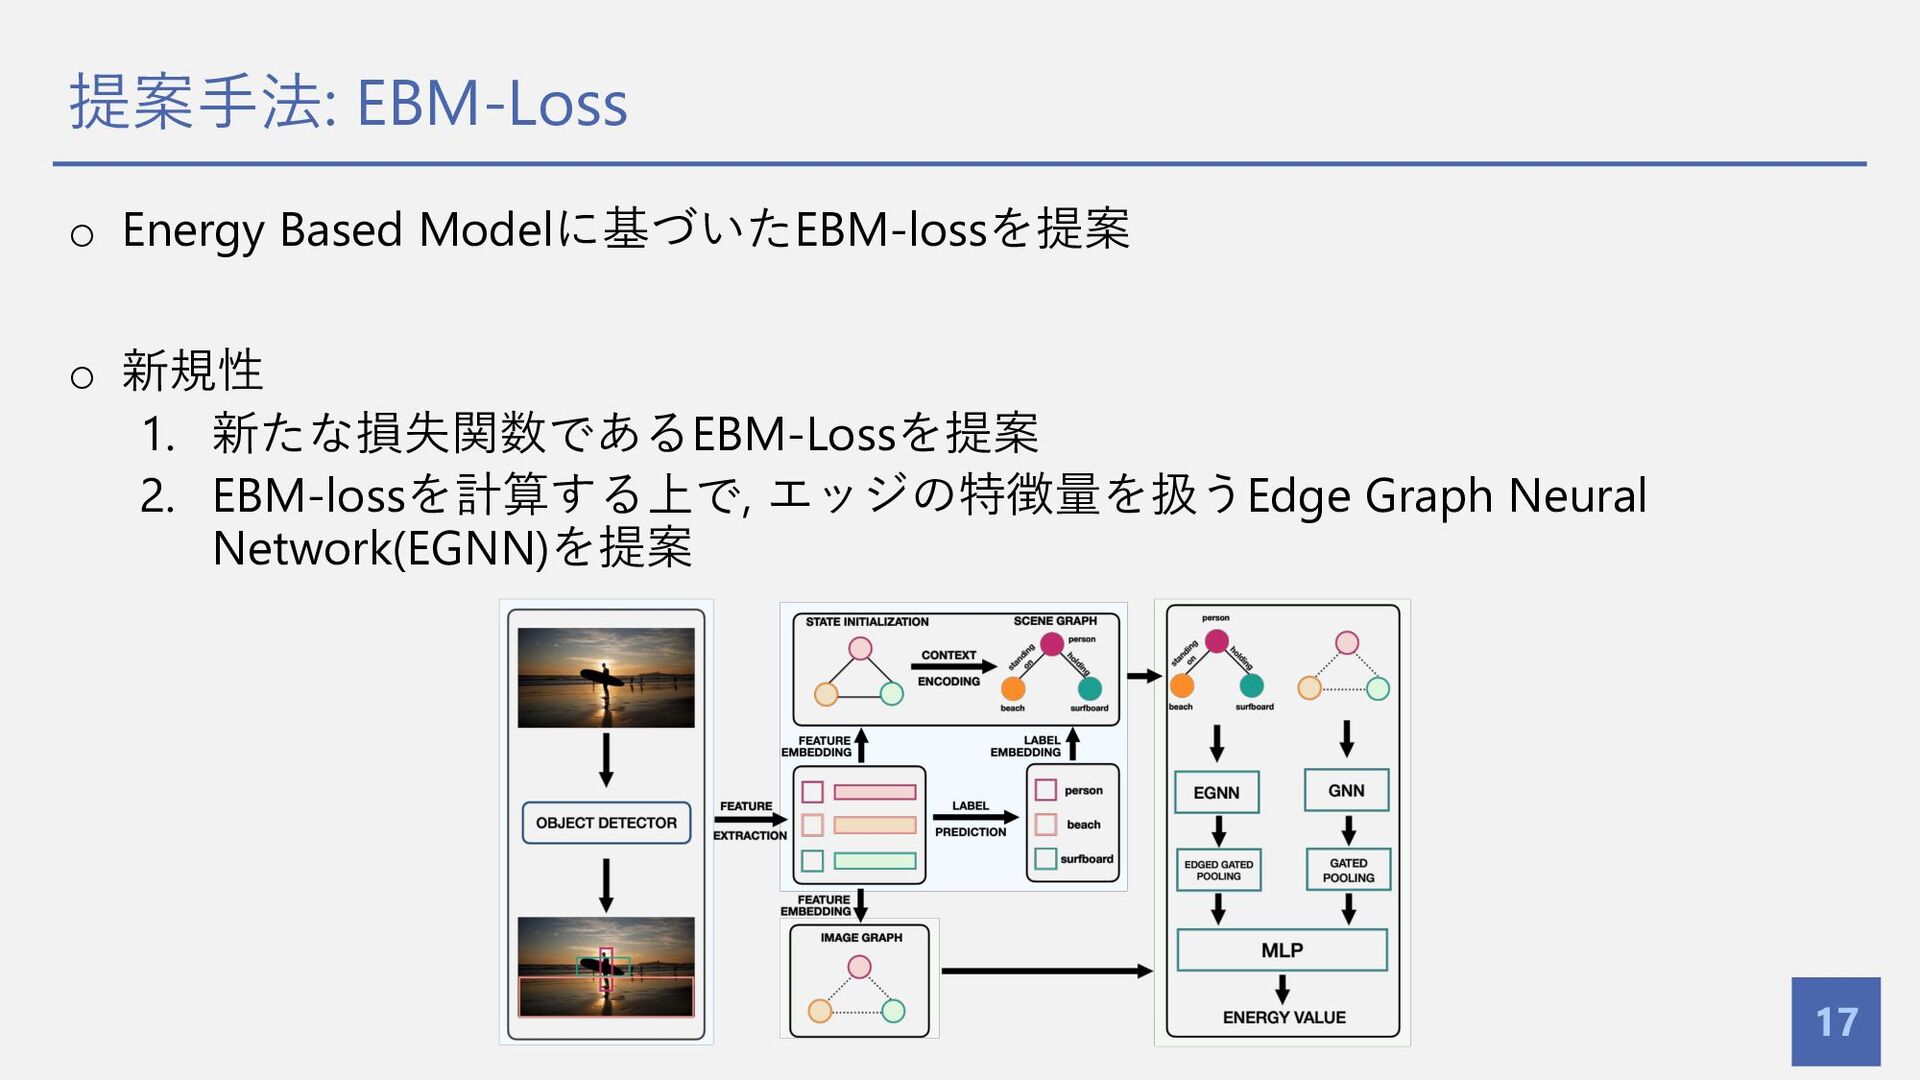
提案⼿法: EBM-Loss 17 o Energy Based Modelに基づいたEBM-lossを提案 o 新規性 1.
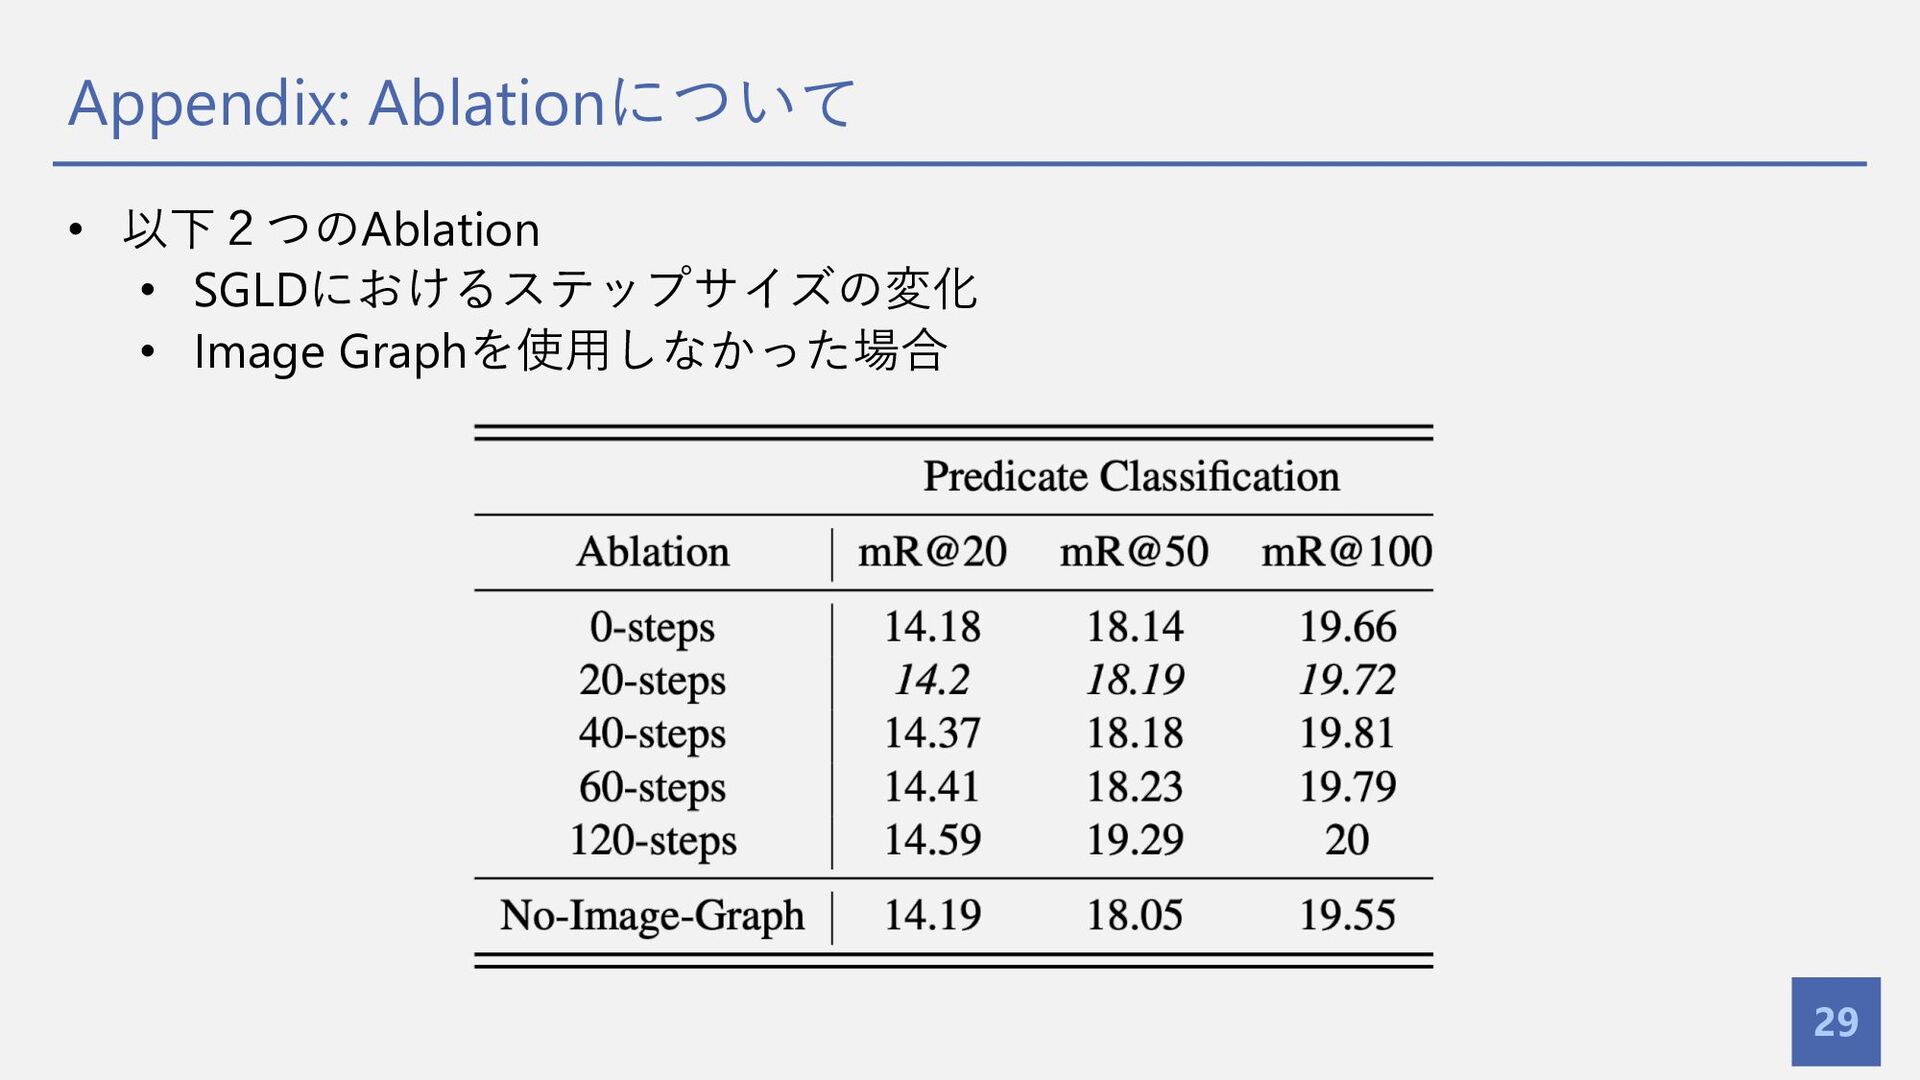
新たな損失関数であるEBM-Lossを提案 2. EBM-lossを計算する上で, エッジの特徴量を扱うEdge Graph Neural Network(EGNN)を提案 -
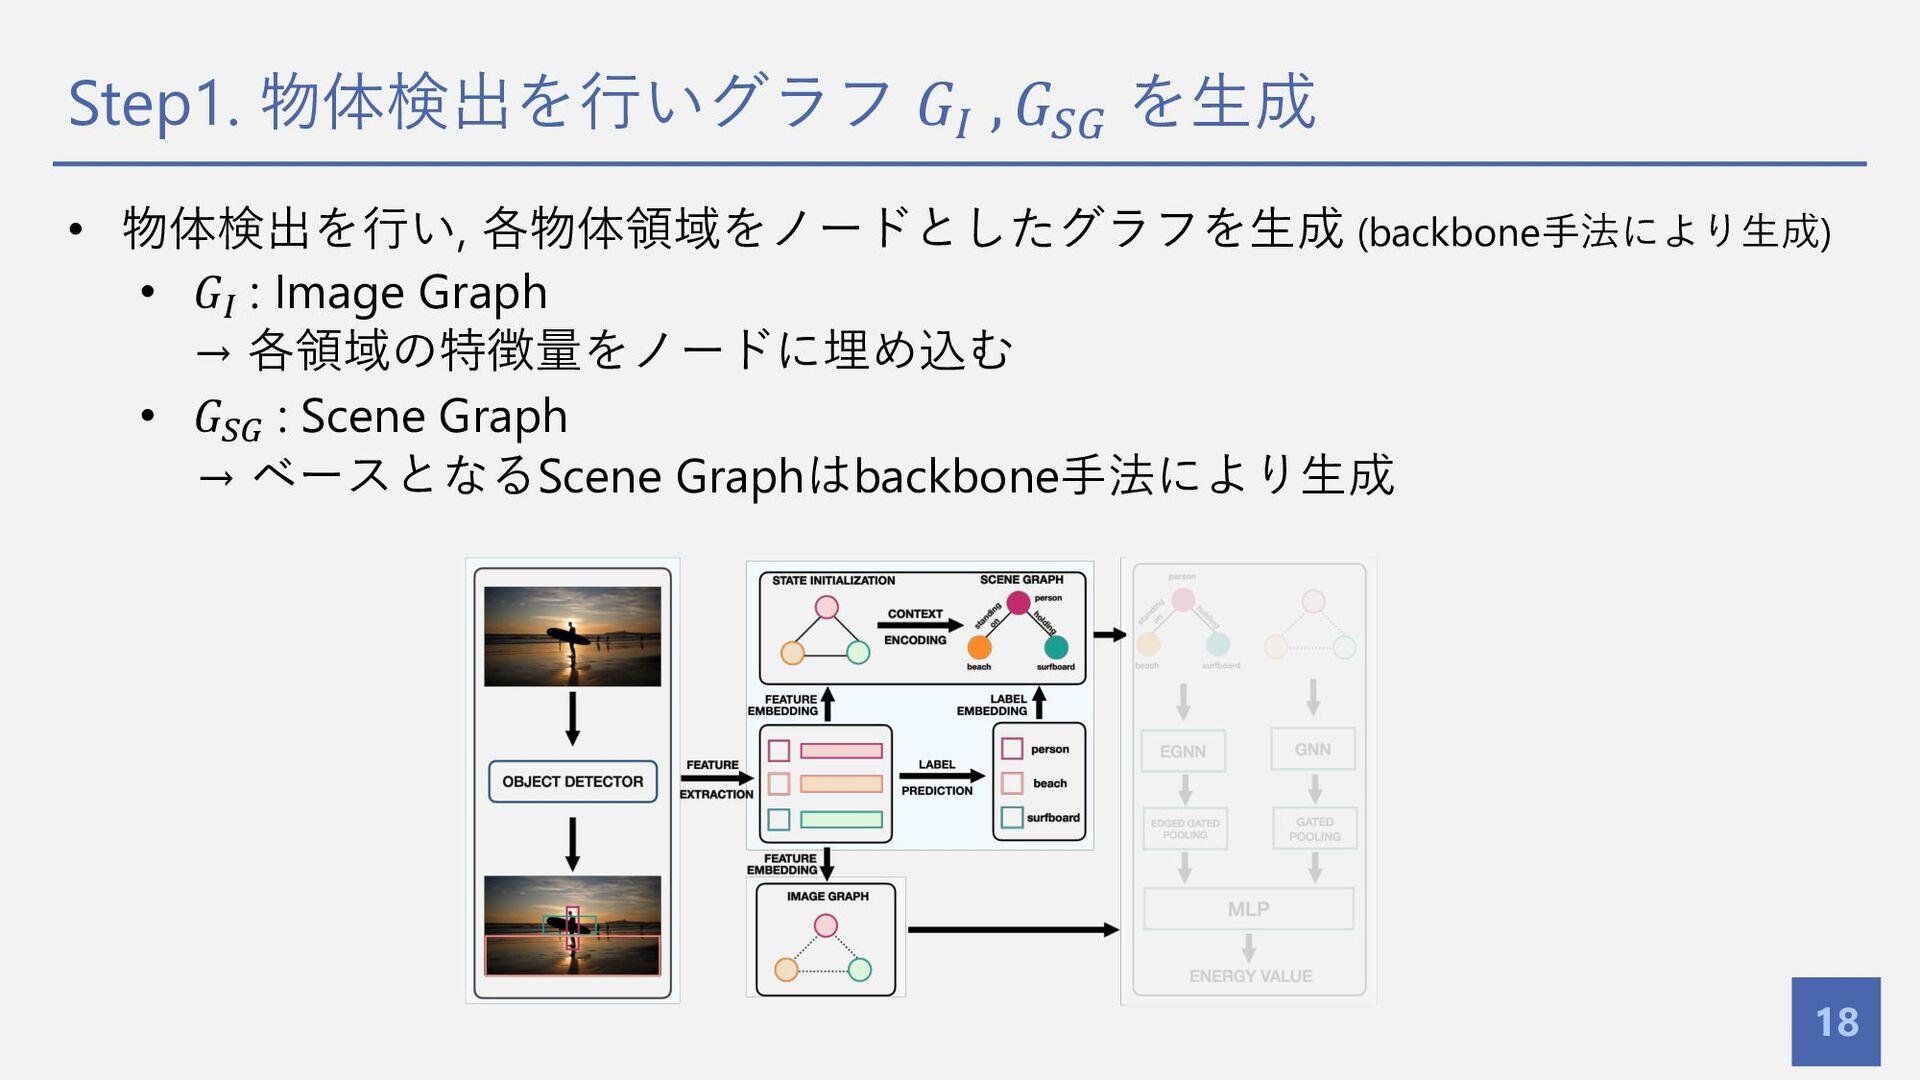
Step1. 物体検出を⾏いグラフ 𝐺! , 𝐺"# を⽣成 18 • 物体検出を⾏い, 各物体領域をノードとしたグラフを⽣成
(backbone⼿法により⽣成) • 𝐺- : Image Graph → 各領域の特徴量をノードに埋め込む • 𝐺./ : Scene Graph → ベースとなるScene Graphはbackbone⼿法により⽣成 -
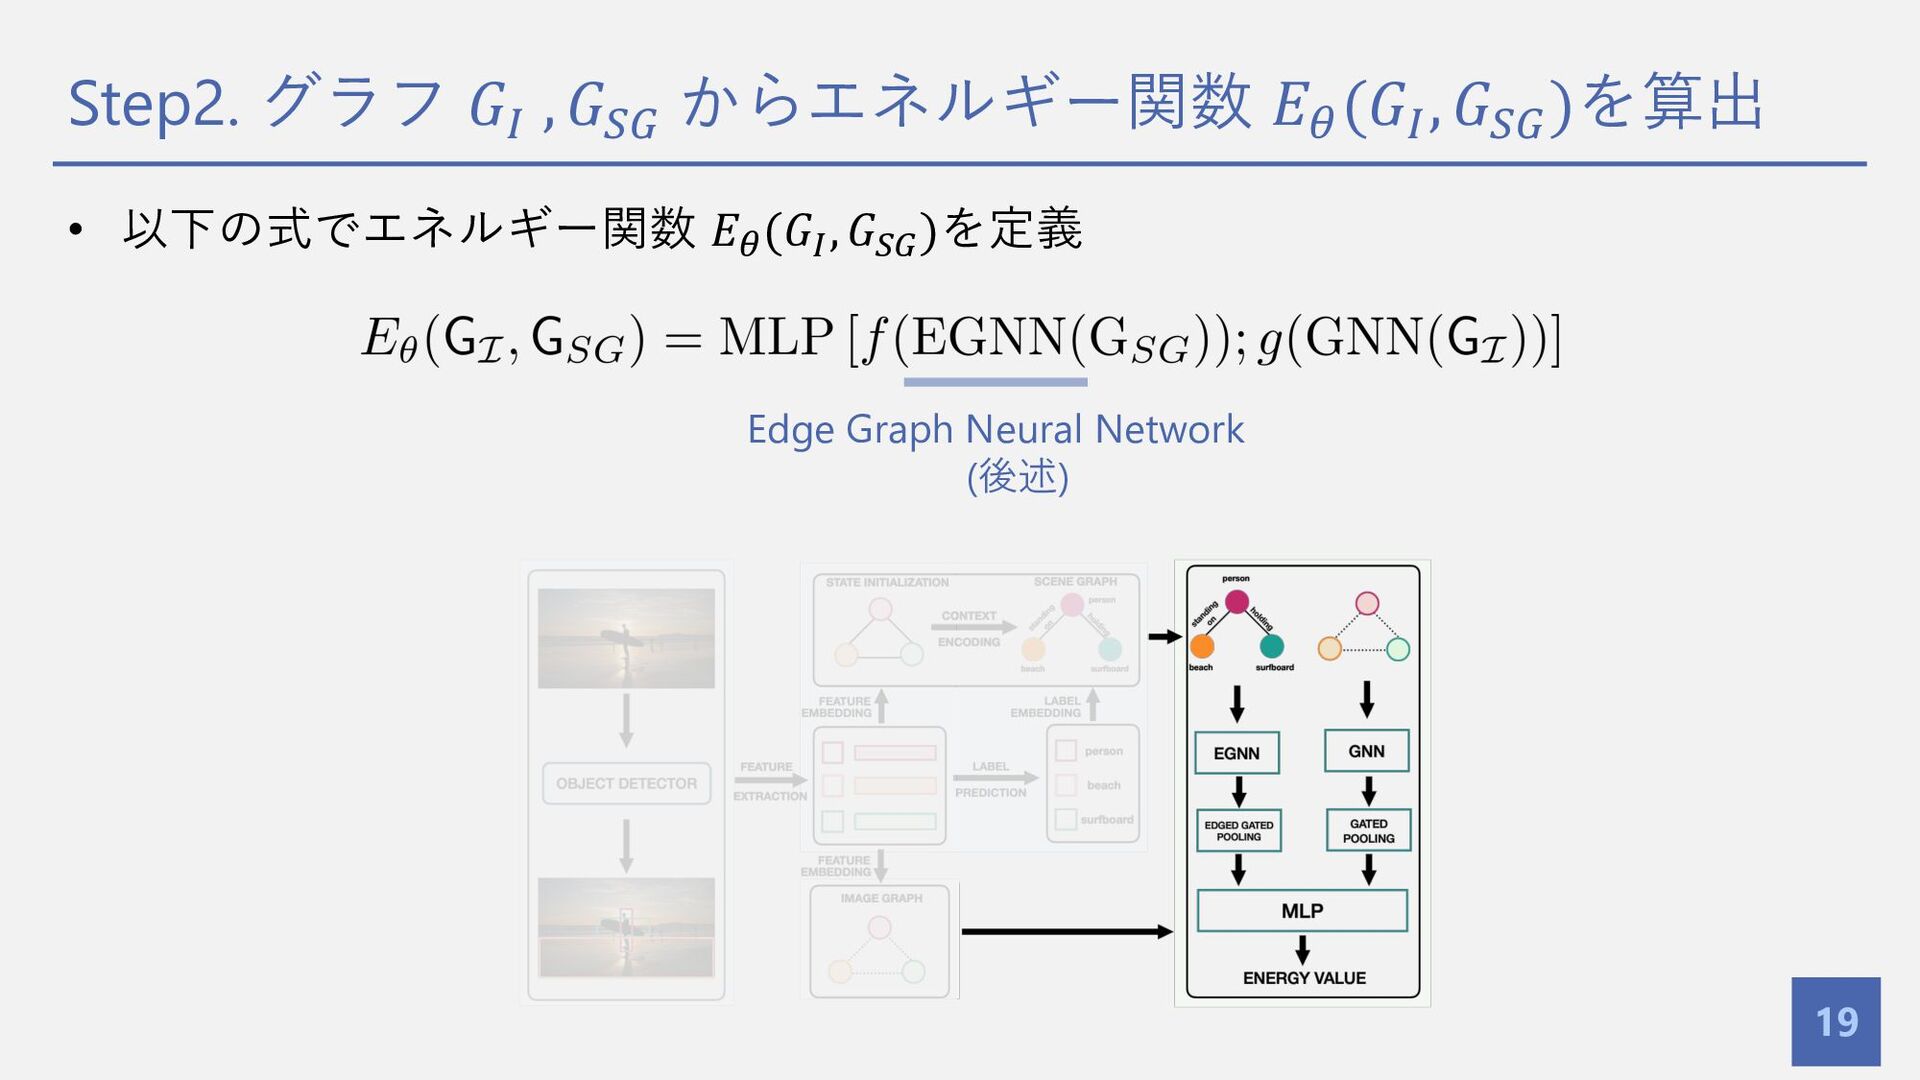
Step2. グラフ 𝐺! , 𝐺"# からエネルギー関数 𝐸$ (𝐺! , 𝐺"#
)を算出 19 • 以下の式でエネルギー関数 𝐸! (𝐺- , 𝐺./ )を定義 Edge Graph Neural Network (後述) -
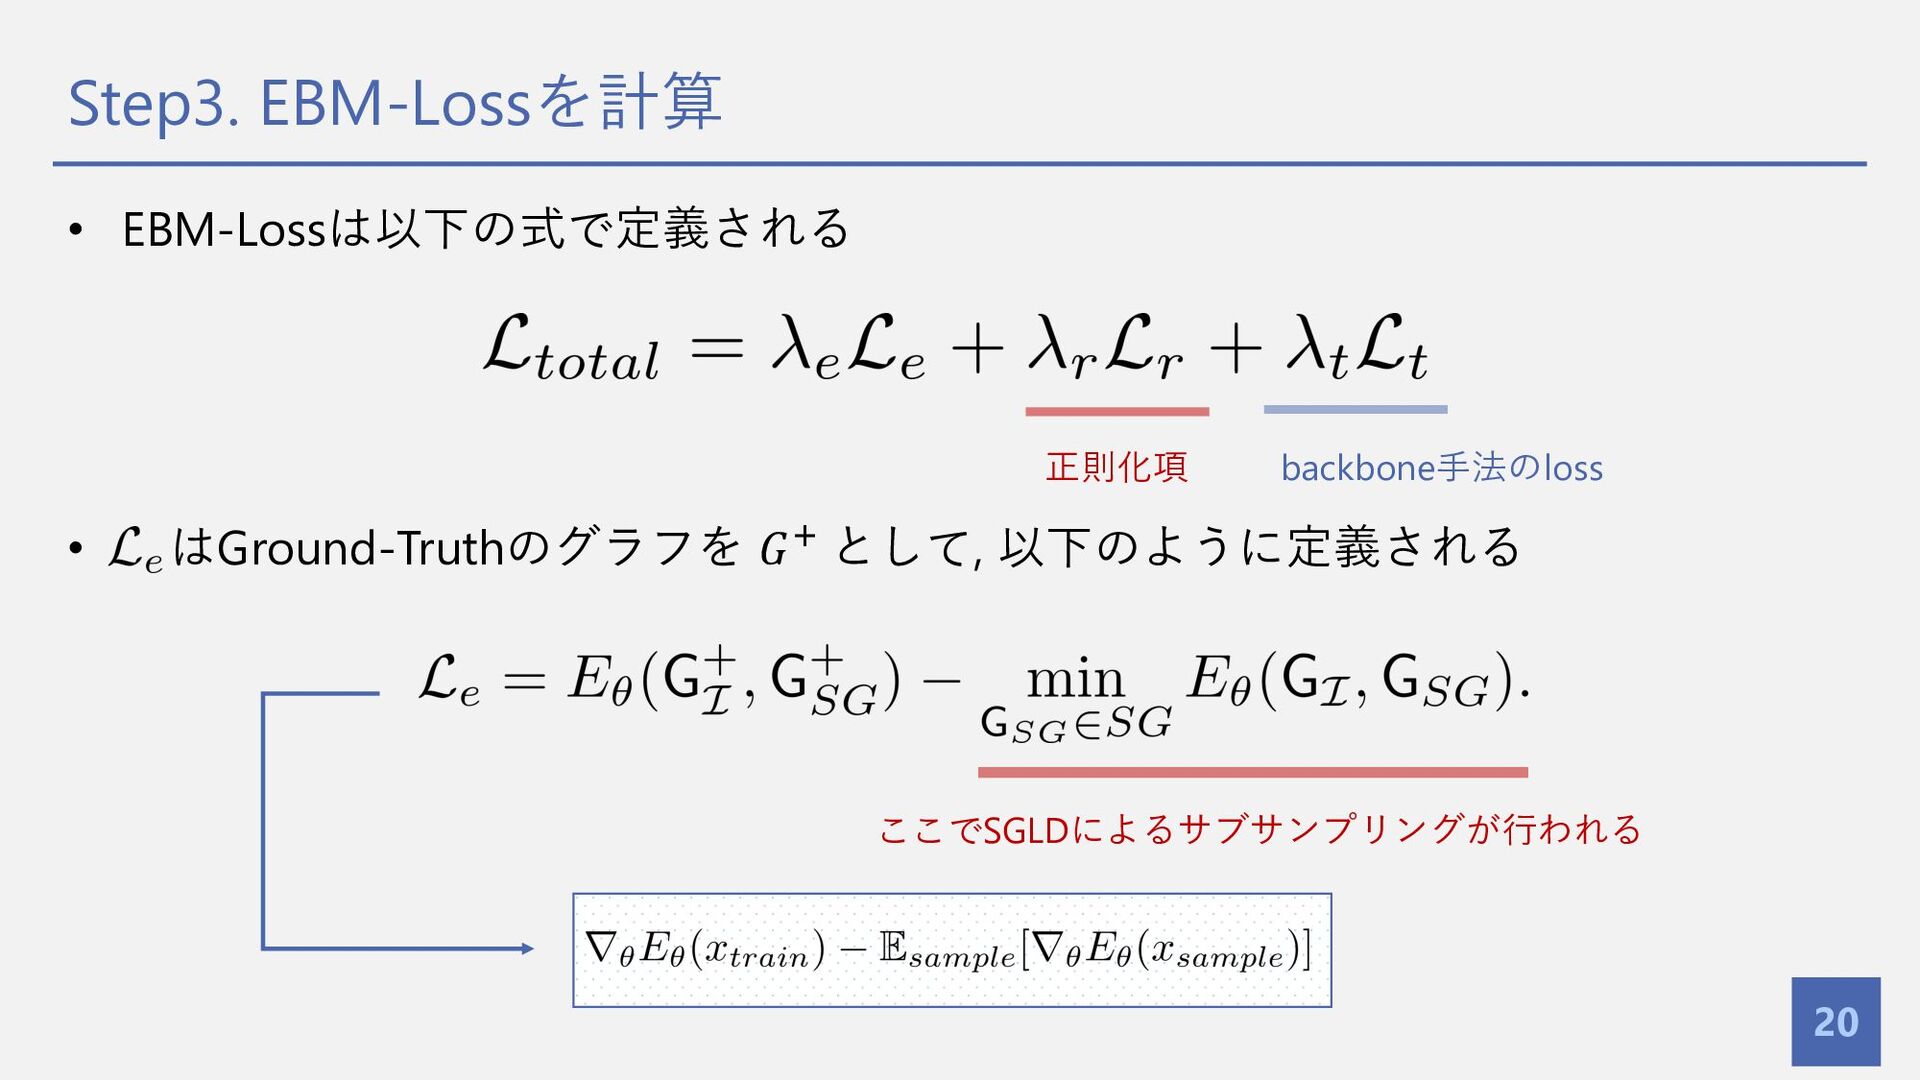
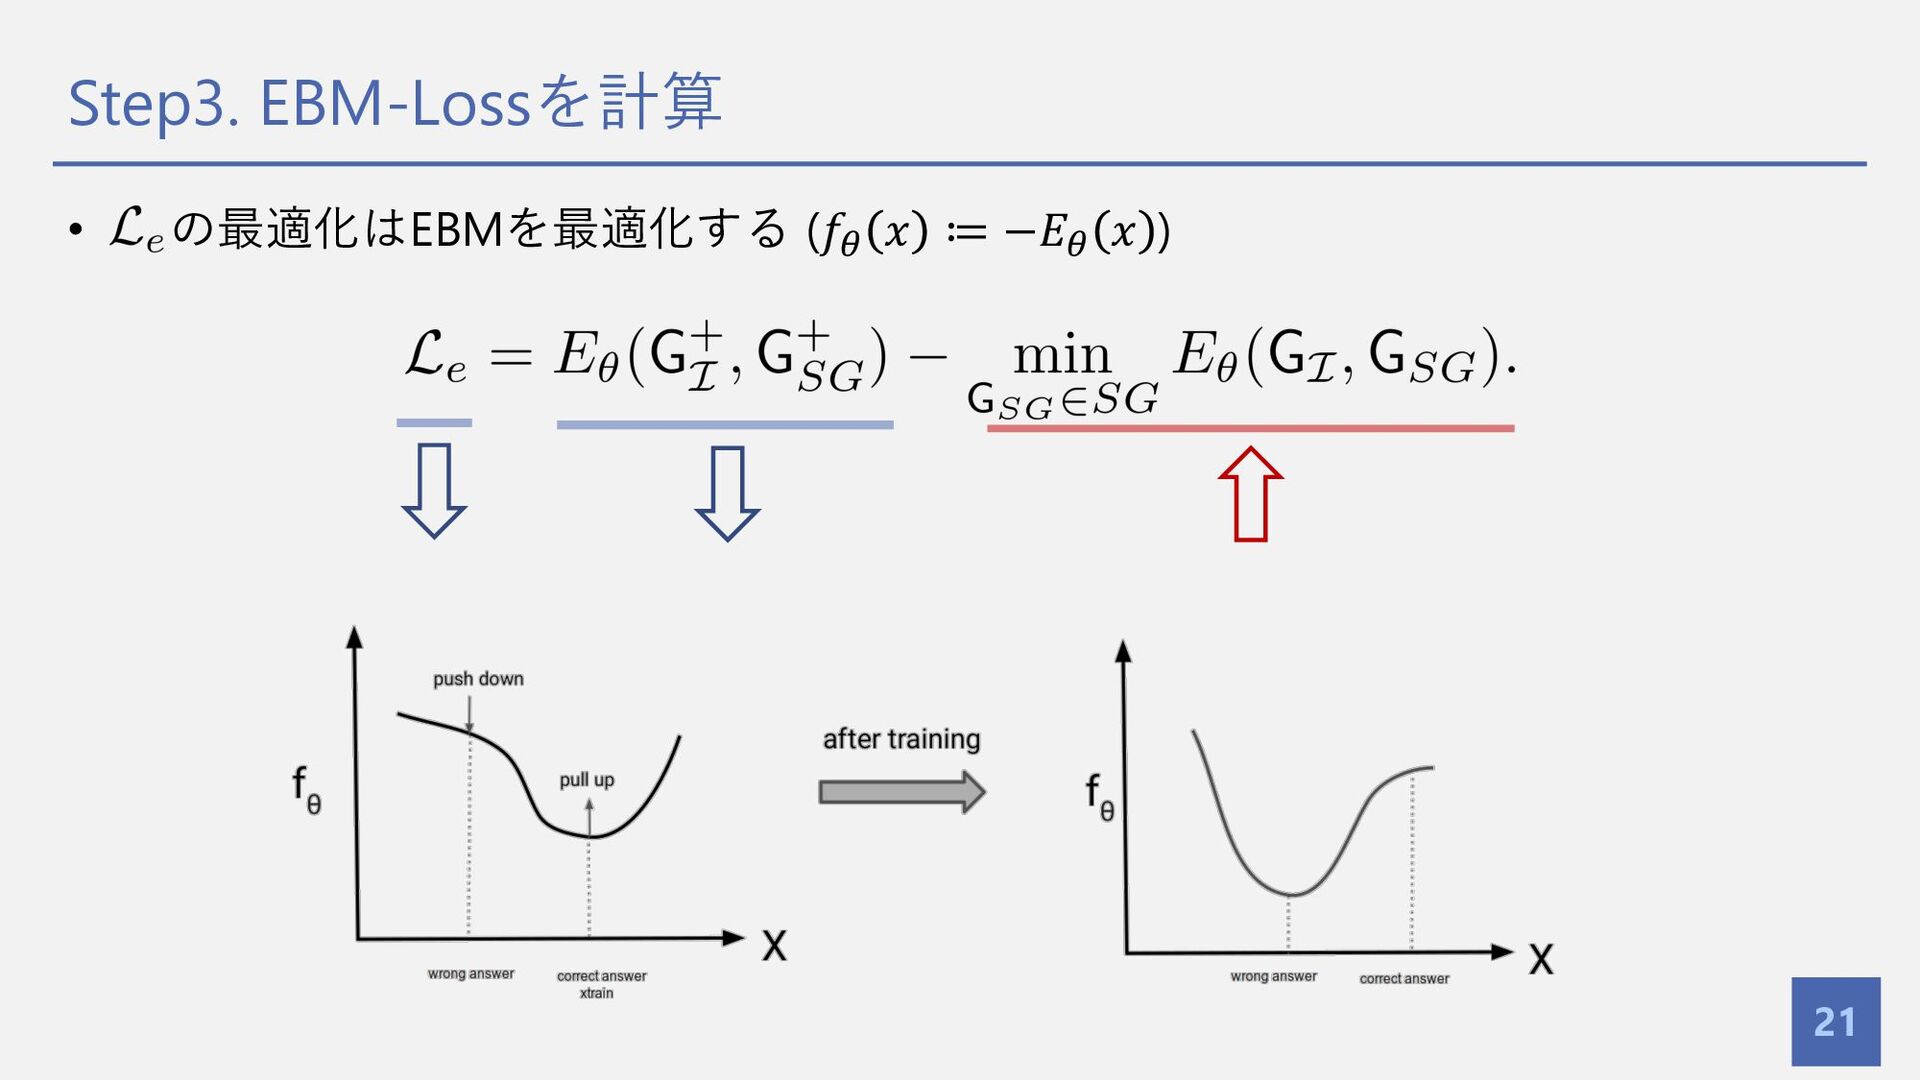
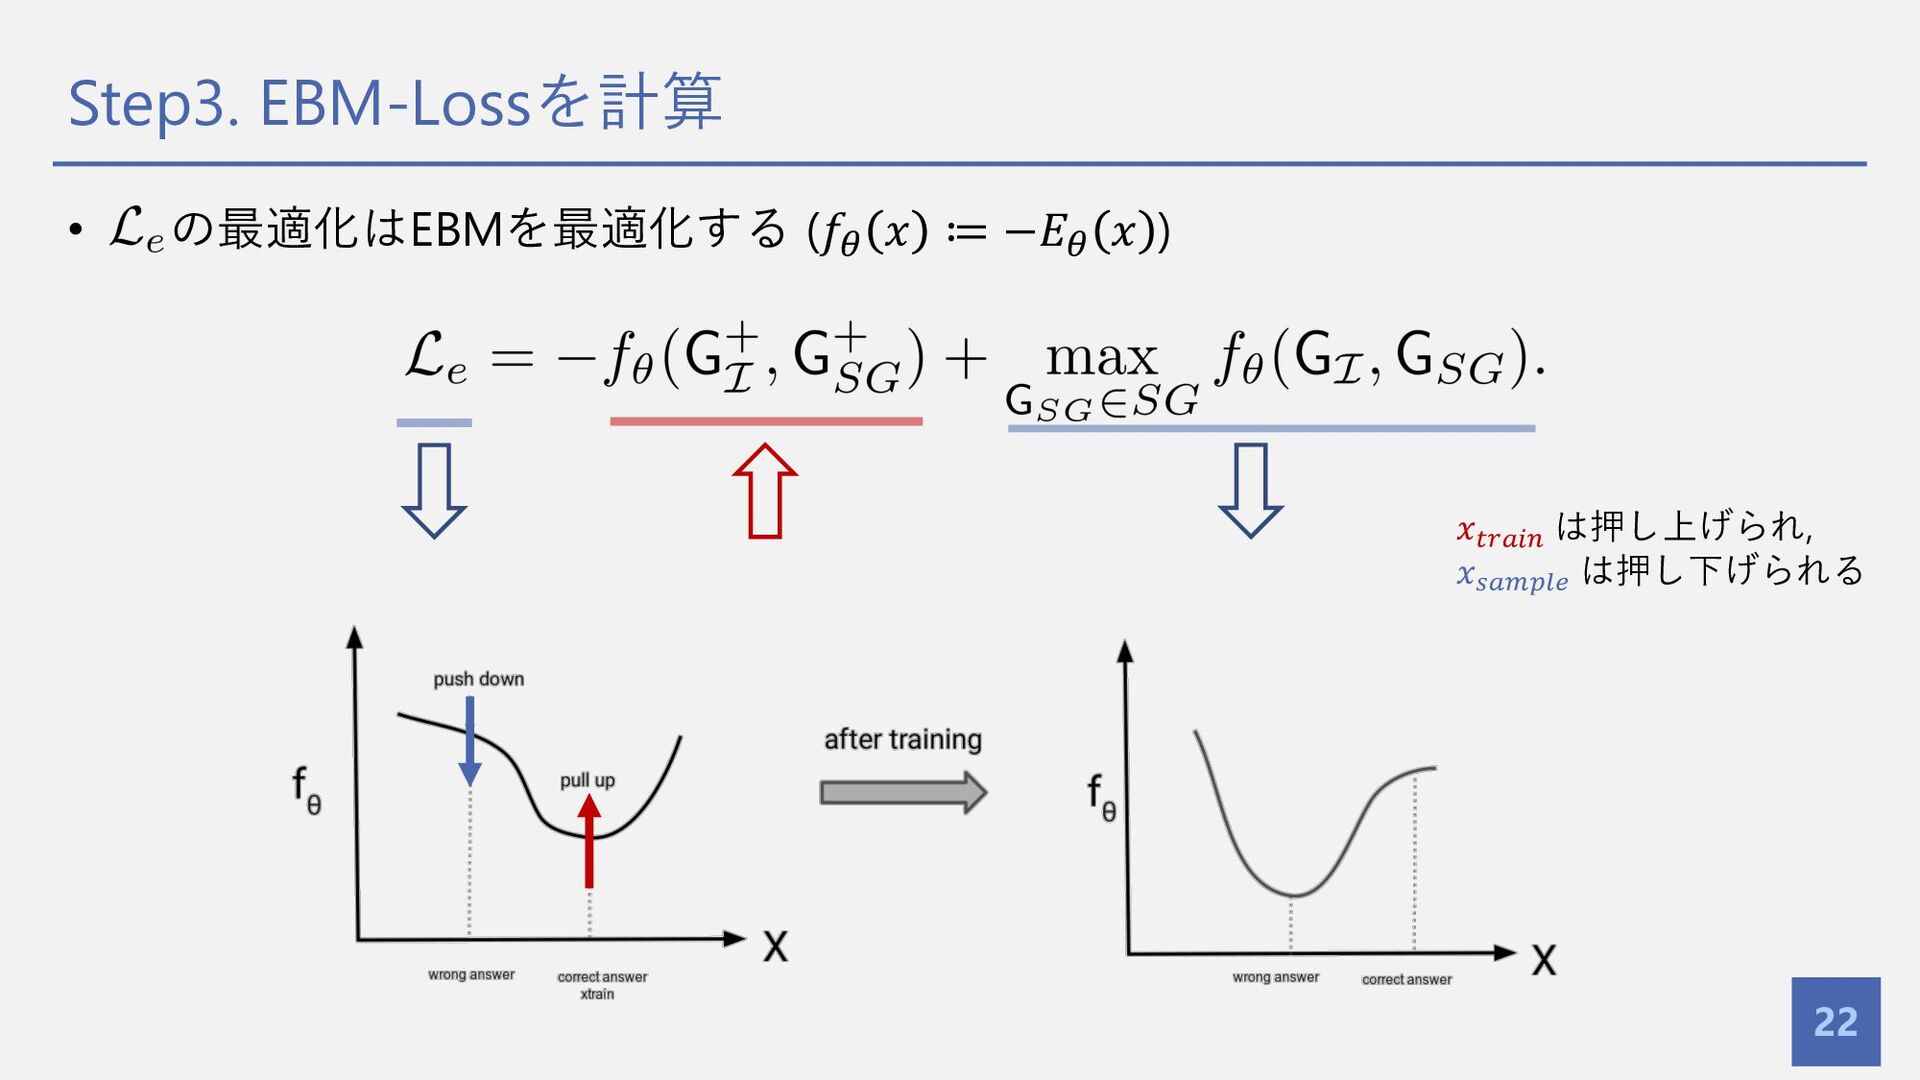
Step3. EBM-Lossを計算 20 • EBM-Lossは以下の式で定義される • はGround-Truthのグラフを 𝐺0 として, 以下のように定義される
正則化項 backbone⼿法のloss ここでSGLDによるサブサンプリングが⾏われる -
Step3. EBM-Lossを計算 22 • の最適化はEBMを最適化する (𝑓! 𝑥 ≔ −𝐸! 𝑥
) 𝑥!"#$% は押し上げられ, 𝑥&#'()* は押し下げられる -
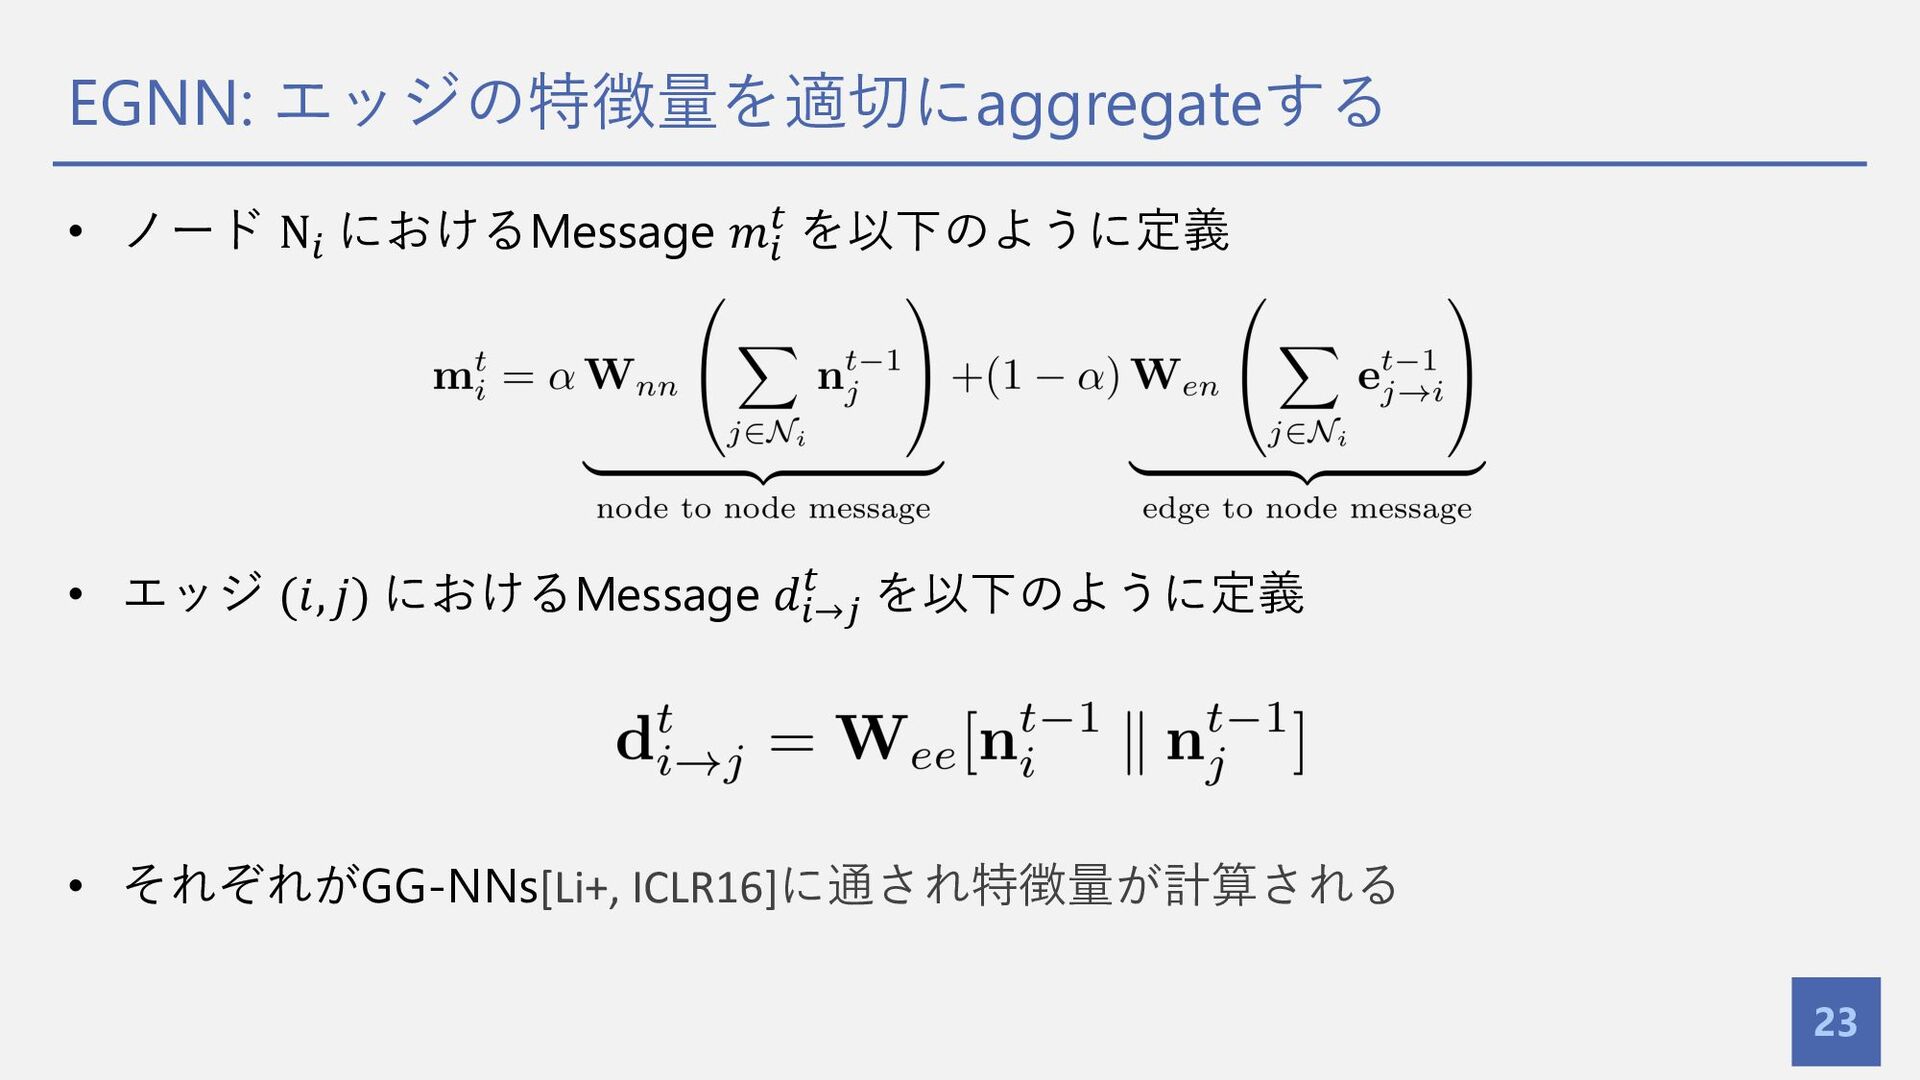
EGNN: エッジの特徴量を適切にaggregateする 23 • ノード N% におけるMessage 𝑚% " を以下のように定義
• エッジ (𝑖, 𝑗) におけるMessage 𝑑%→3 " を以下のように定義 • それぞれがGG-NNs[Li+, ICLR16]に通され特徴量が計算される -
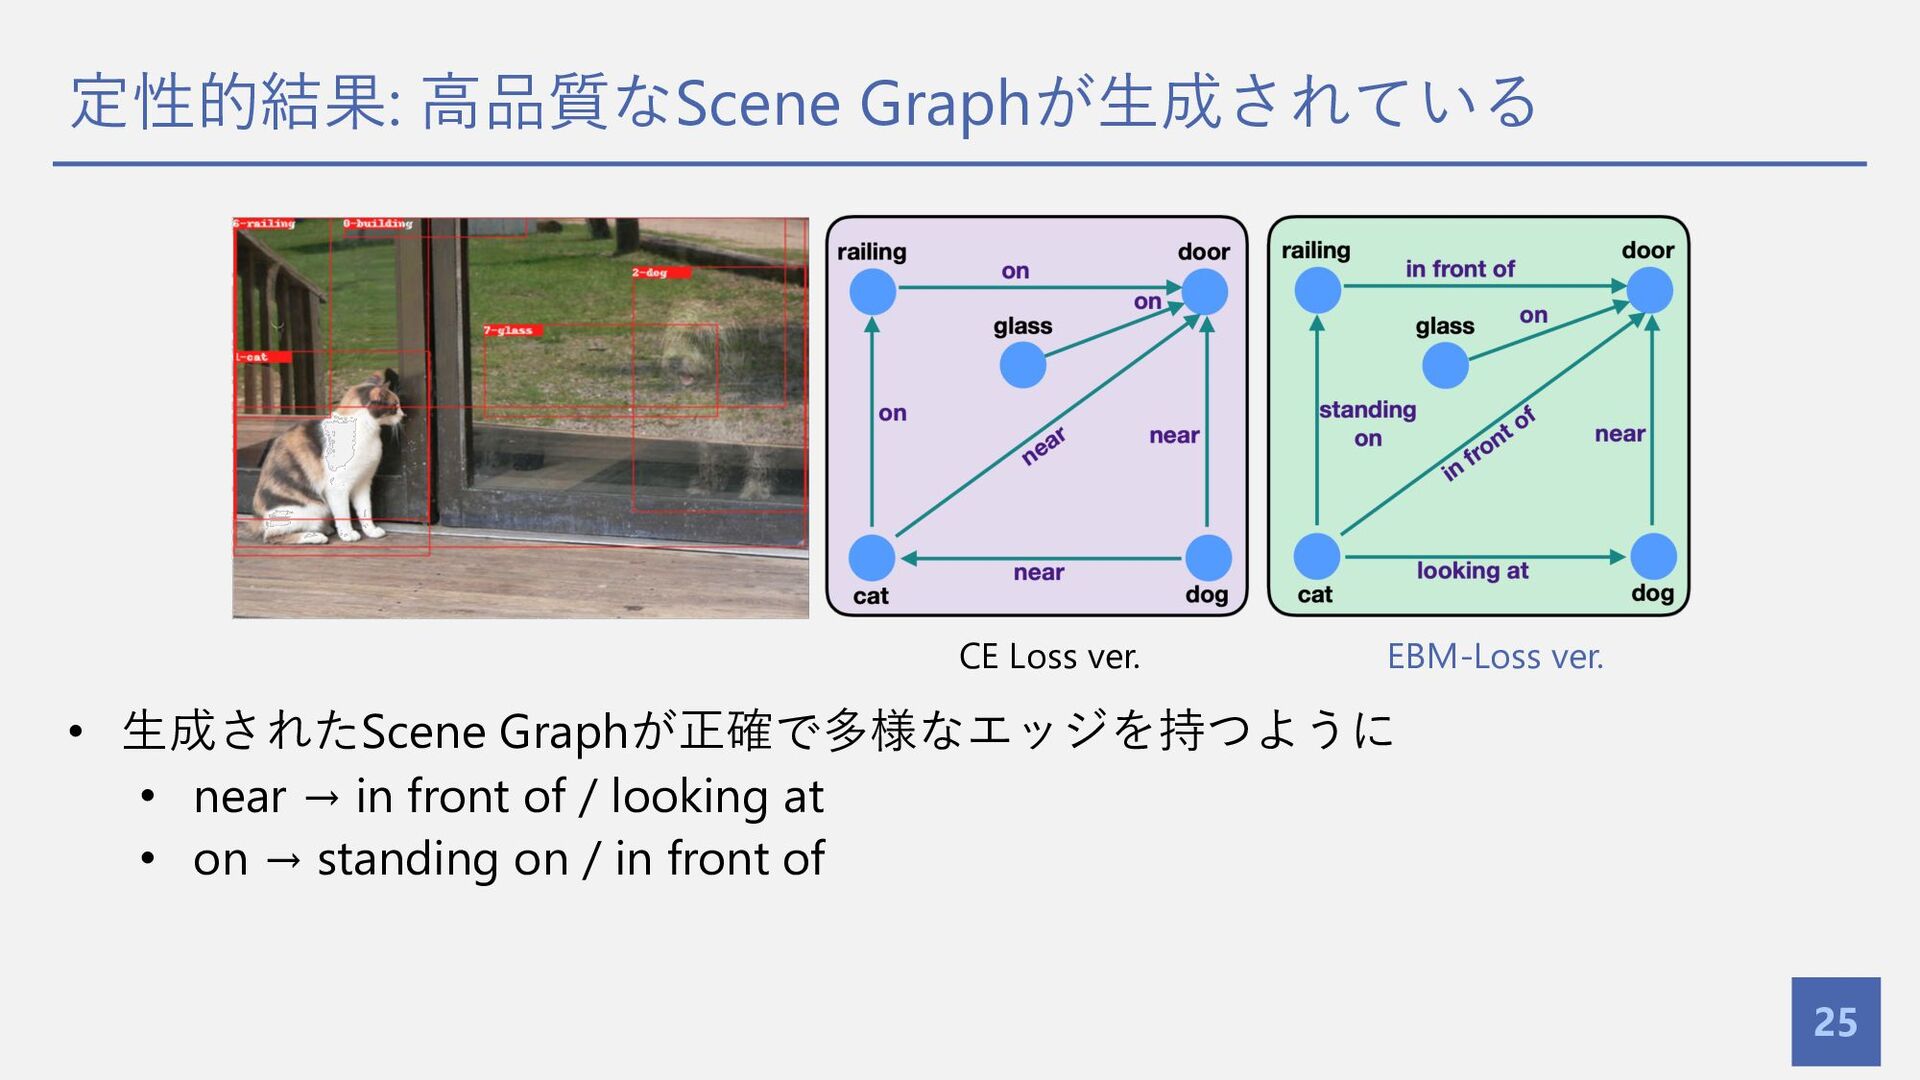
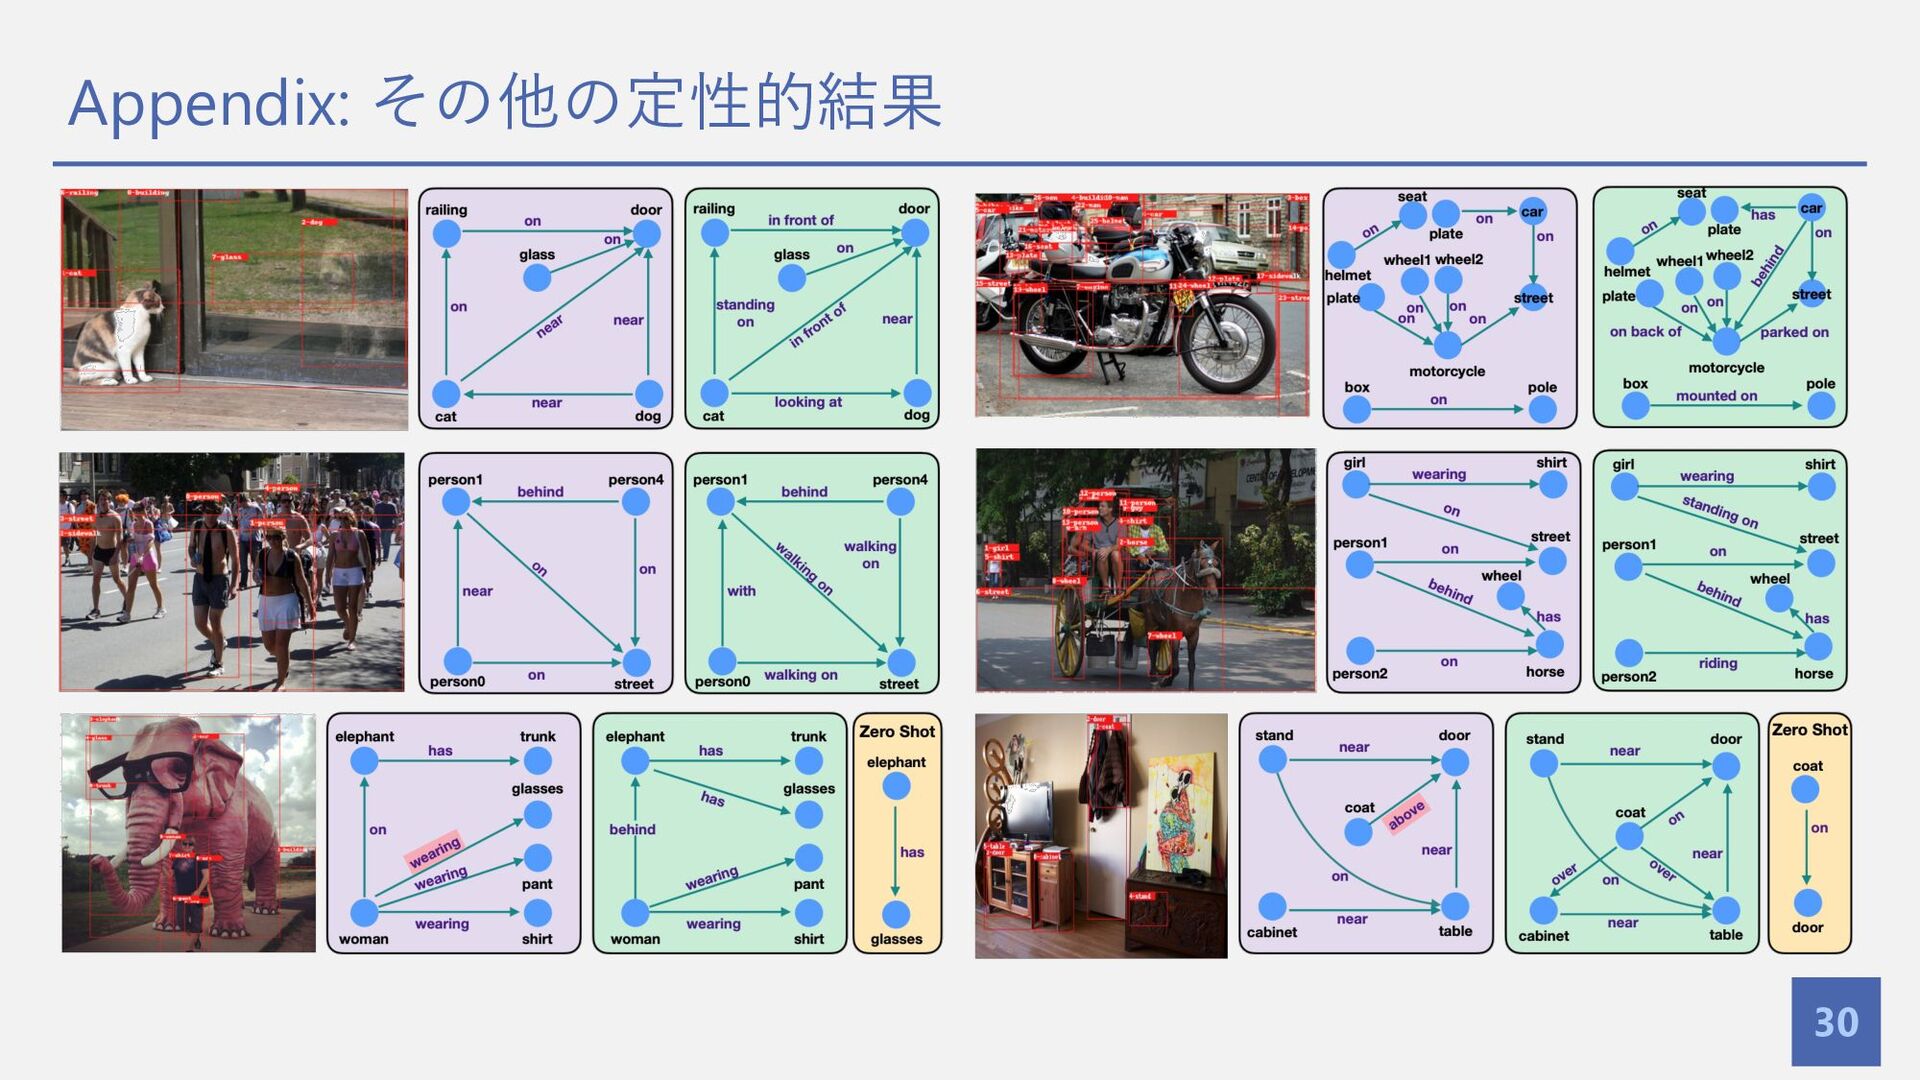
定性的結果: ⾼品質なScene Graphが⽣成されている 25 • ⽣成されたScene Graphが正確で多様なエッジを持つように • near →
in front of / looking at • on → standing on / in front of CE Loss ver. EBM-Loss ver. -
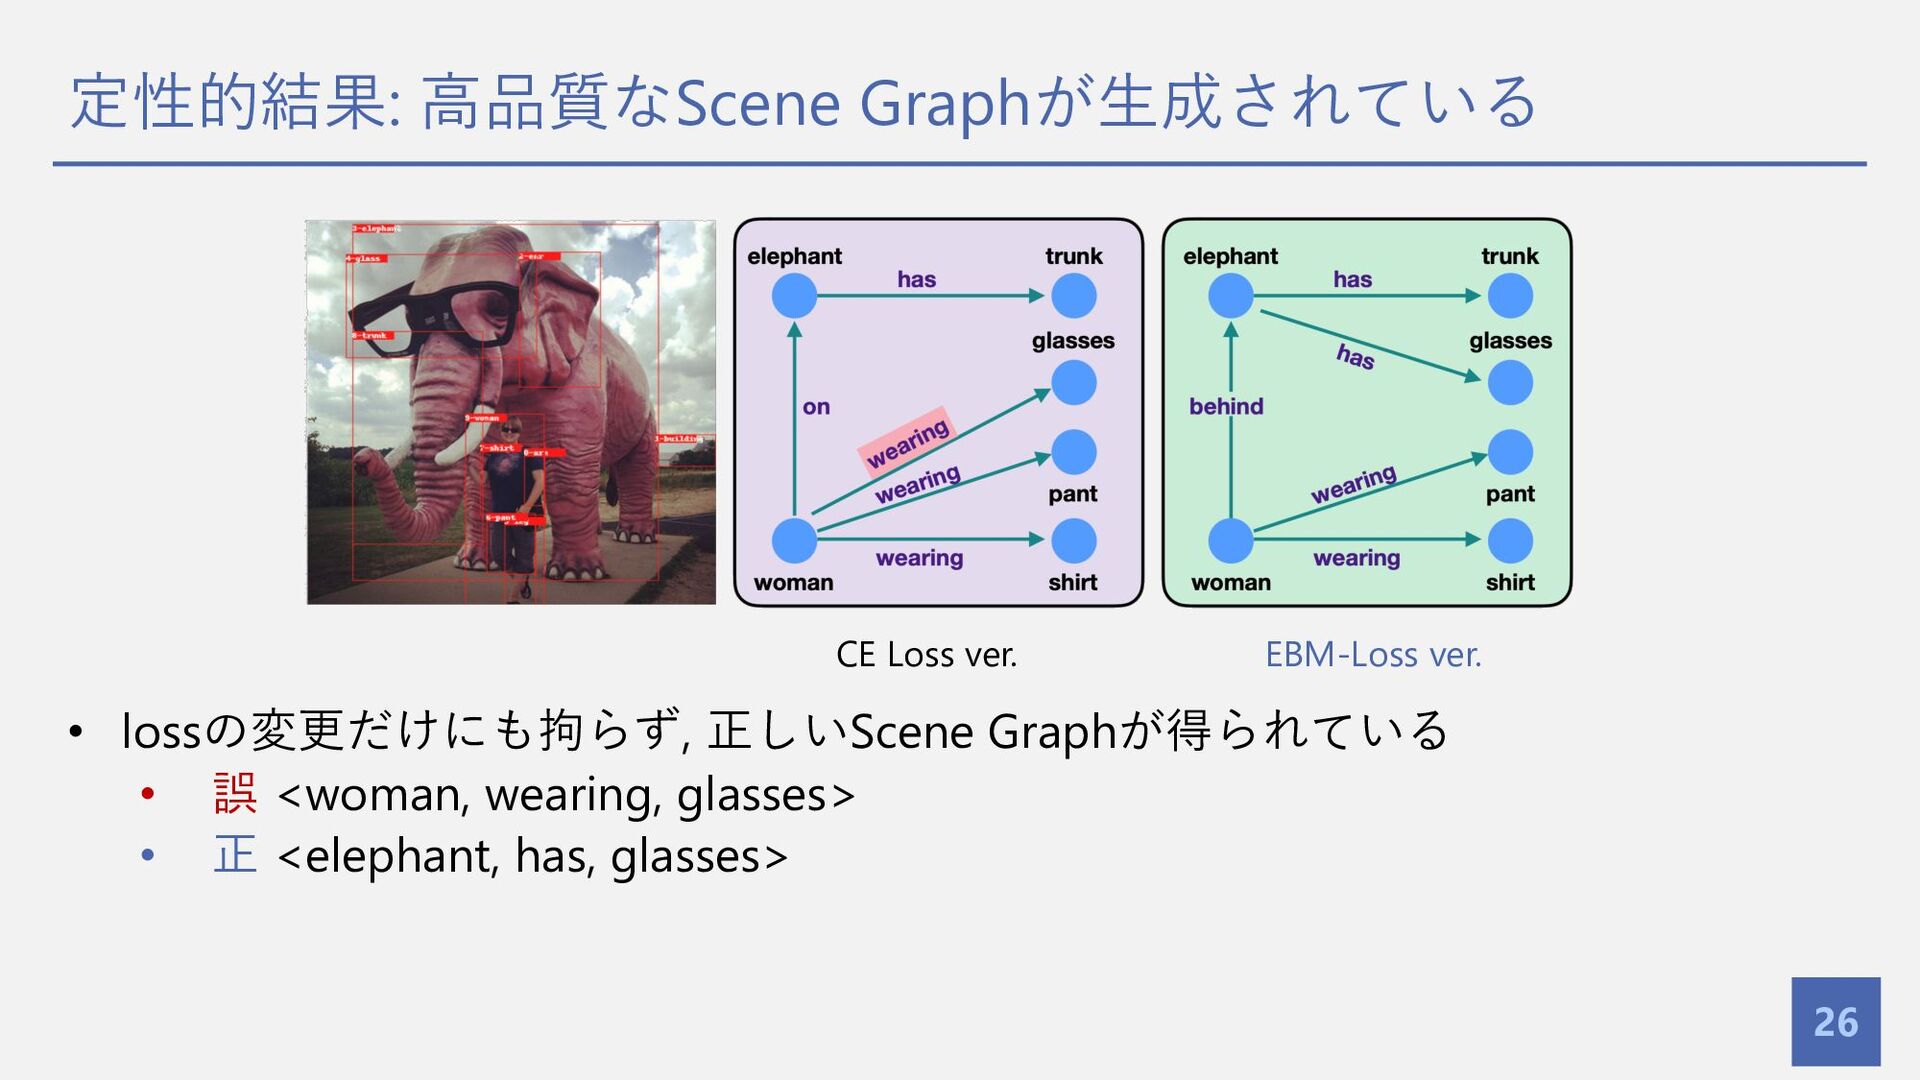
定性的結果: ⾼品質なScene Graphが⽣成されている 26 • lossの変更だけにも拘らず, 正しいScene Graphが得られている • 誤
<woman, wearing, glasses> • 正 <elephant, has, glasses> CE Loss ver. EBM-Loss ver. -
まとめ 27 ü 背景 • Scene Graph⽣成において, Cross Entropyには精度・多様性の問題がある ü
提案⼿法 • Energy Based Modelに基づいたEBM-lossを提案 ü 結果 • Cross EntropyによるScene Graph学習を上回る定量・定性的結果を記録 -
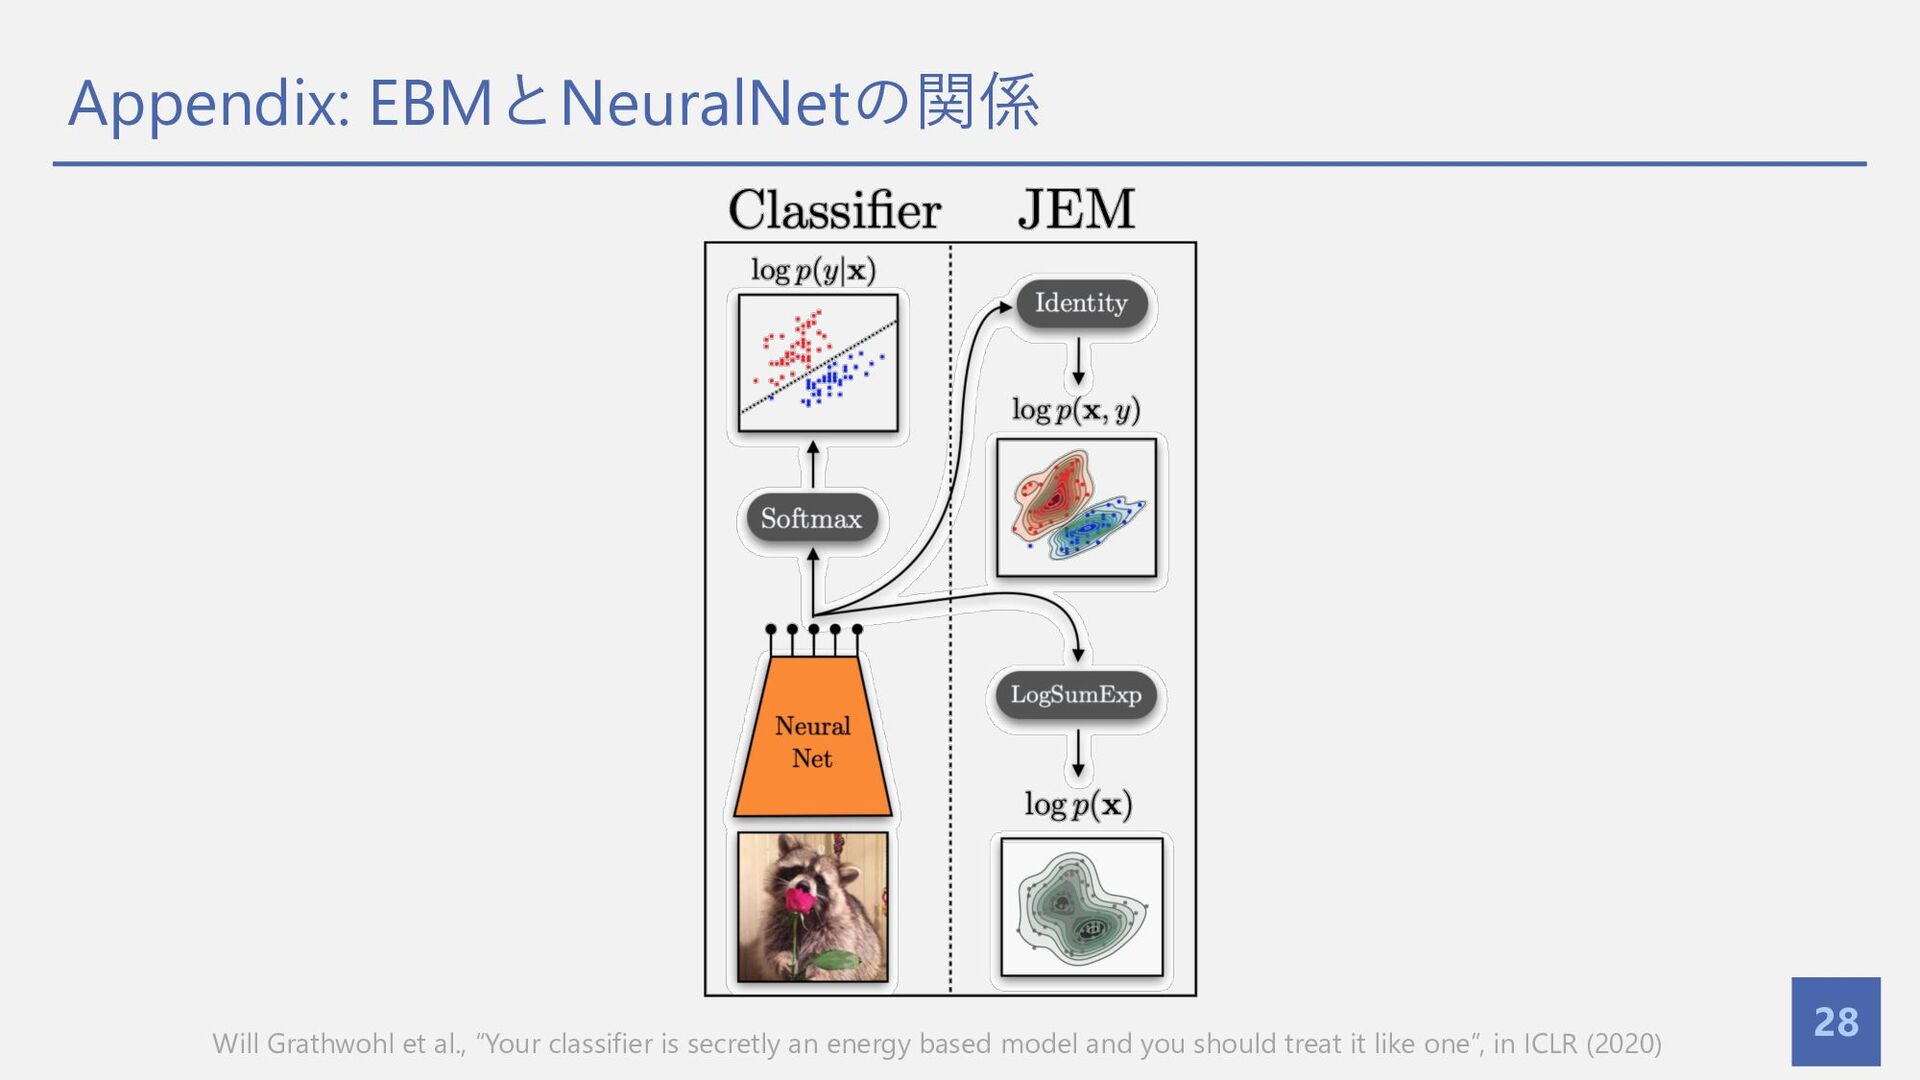
Appendix: EBMとNeuralNetの関係 28 Will Grathwohl et al., “Your classifier is
secretly an energy based model and you should treat it like one”, in ICLR (2020)