Upgrade to Pro — share decks privately, control downloads, hide ads and more …

[Journal club] Steering Your Generalists: Impro...

[Journal club] Steering Your Generalists: Improving Robotic Foundation Models via Value Guidance

Transcript

18 slides
  1. Mitsuhiko Nakamoto1 Oier Mees1 Aviral Kumar2 Sergey Levine1 1UC Berkeley

    2Carnegie Mellon University Steering Your Generalists: Improving Robotic Foundation Models via Value Guidance 杉浦孔明研究室 妹尾 幸樹 CoRL24 Nakamoto, M., Mees, O., Kumar, A., & Levine, S. “Steering Your Generalists: Improving Robotic Foundation Models via Value Guidance”. In 8th Annual Conference on Robot Learning, 2024.
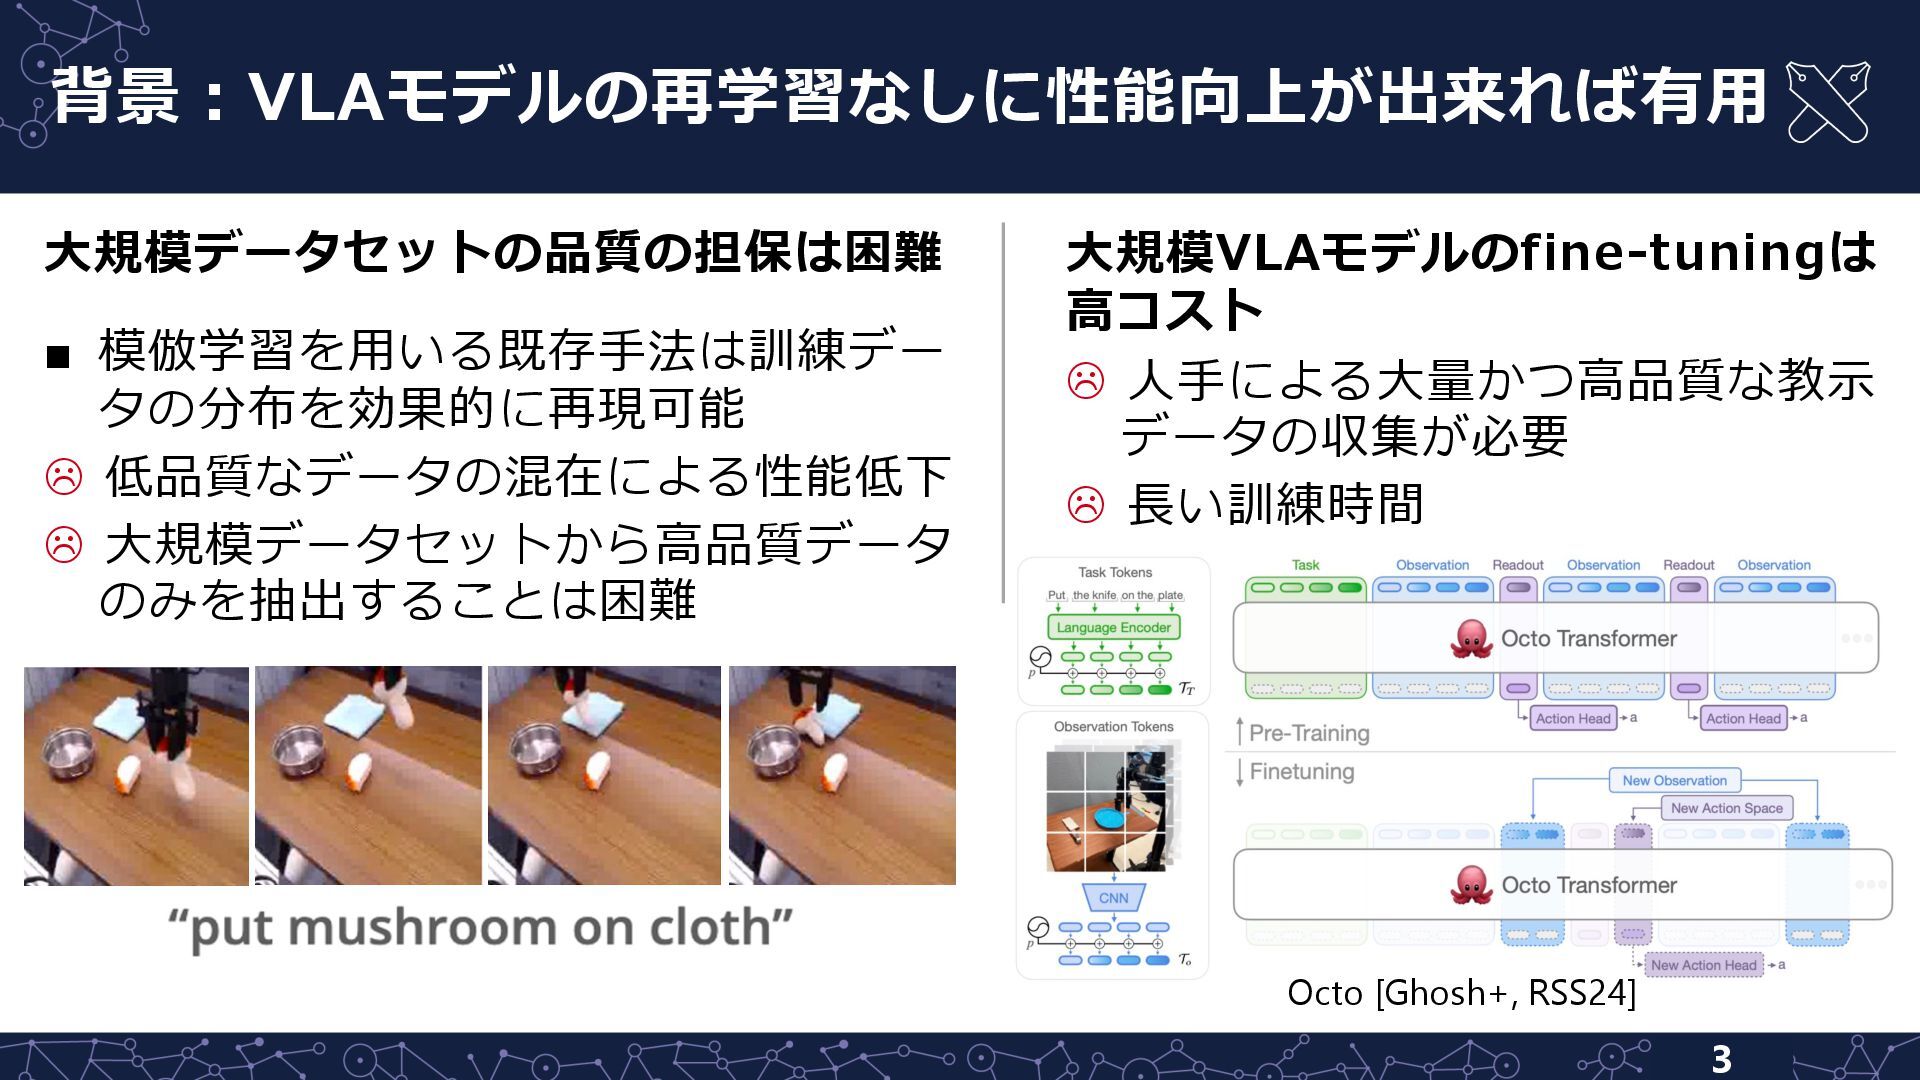
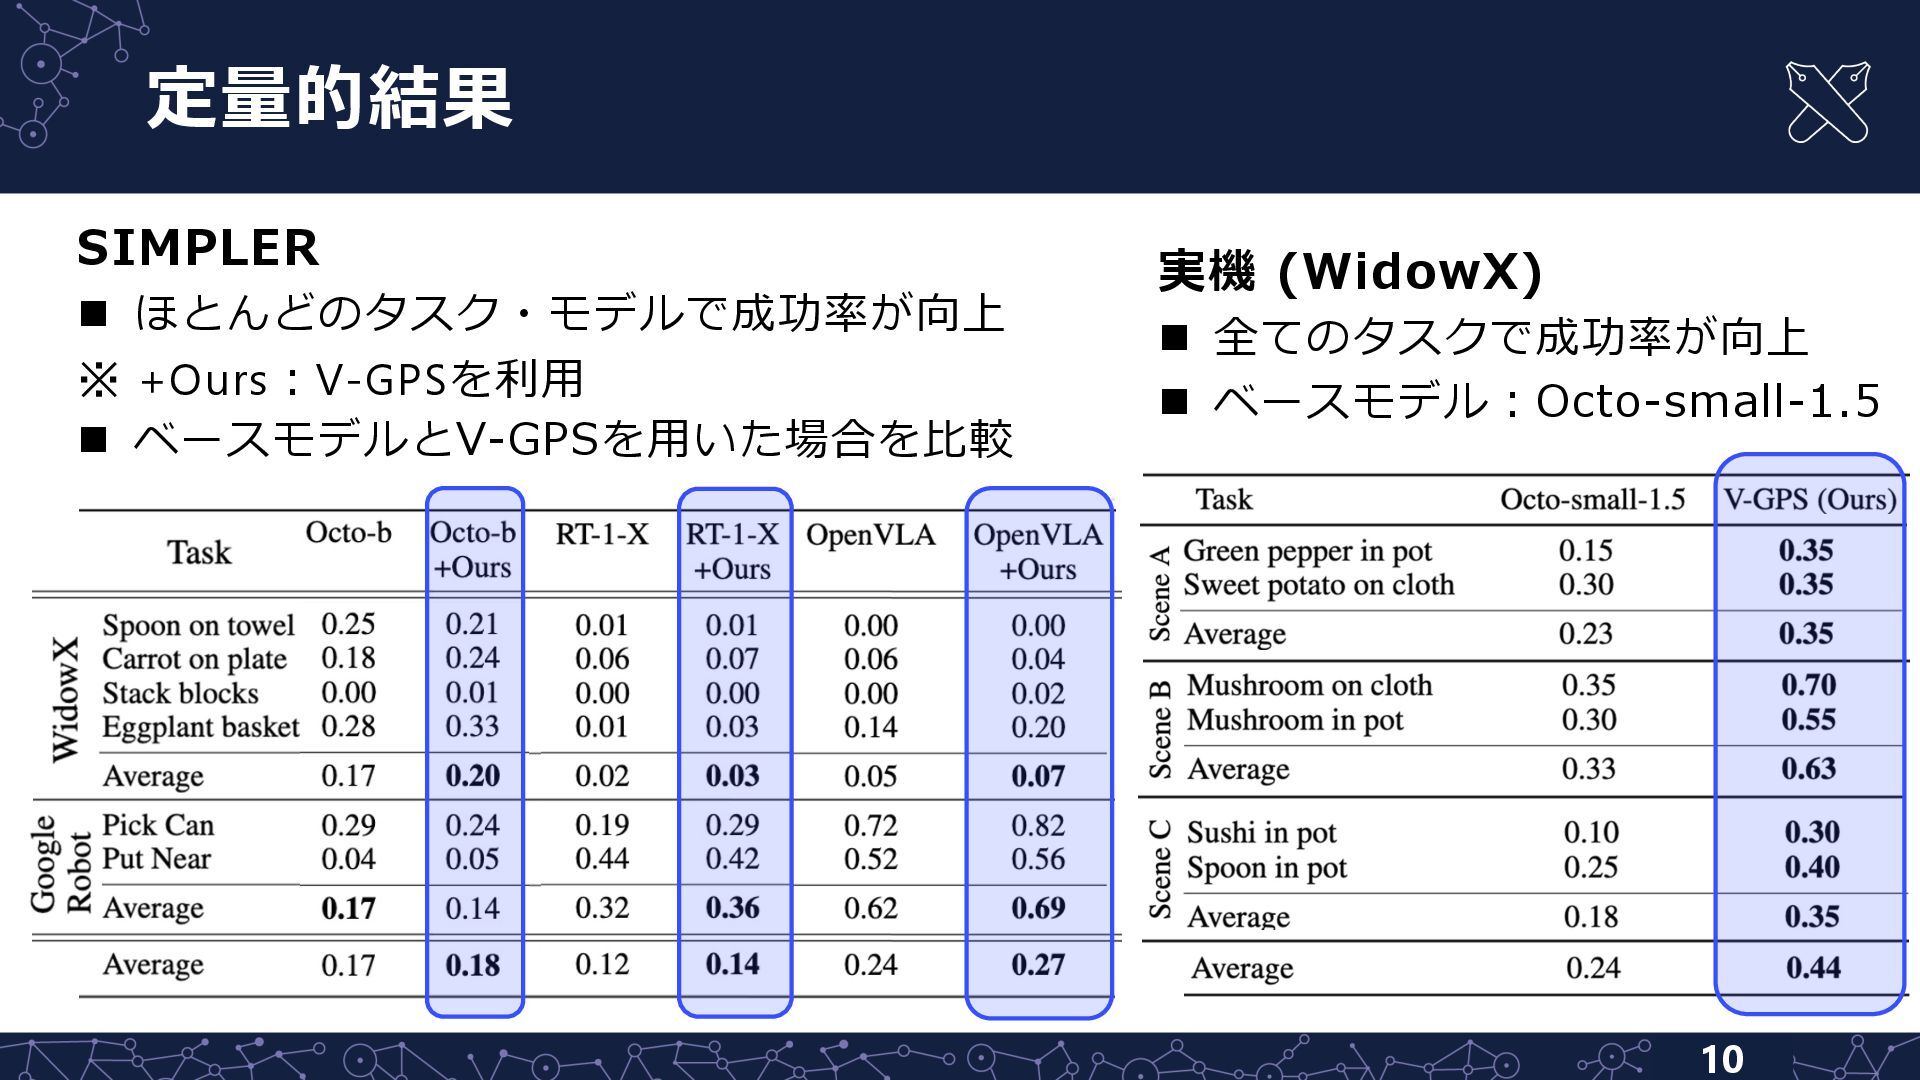
  2. 概要 2 n 背景 n ⼤規模データセットから⾼品質なデータのみを抽出することは困難 n ⼤規模VLAのfine-tuningは⾼コスト n 提案⼿法︓V-GPS

    n 多様な教⽰データを⽤いて価値関数を学習 n 事前学習済みVLAモデルの出⼒をRe-Rankingすることで性能を向上 n 結果 n 計12タスク,複数のVLAモデルを⽤いて評価 n ほとんどのタスクでベースモデルの成功率が向上
  3. 関連研究︓価値関数に基づく⾏動選択はVLAモデルで未活⽤ 4 ⼿法 特徴 Cobbe et al. [Cobbe+, 21] 数学の問題に対してVerifierモデルを学習し、LLMからの複数の出⼒

    のうち正答の確率が最も⾼い解答を選択 V-STaR [Hosseini+, CoLM24] GeneratorモデルとVerifierモデルを同時に学習し,複数の解答候補 の中から最も正しいものを選択 VAS [Han+, 24] LLMの重みを変更せずに、価値関数を⽤いて出⼒分布をトークンご とに補正することで、報酬最適化を⾏う Q-Probe [Li+, ICML24] LLMの出⼒に対して軽量な線形関数で再重み付け Q-Probe [Li+, ICML24] V-STaR [Hosseini+, CoLM24]
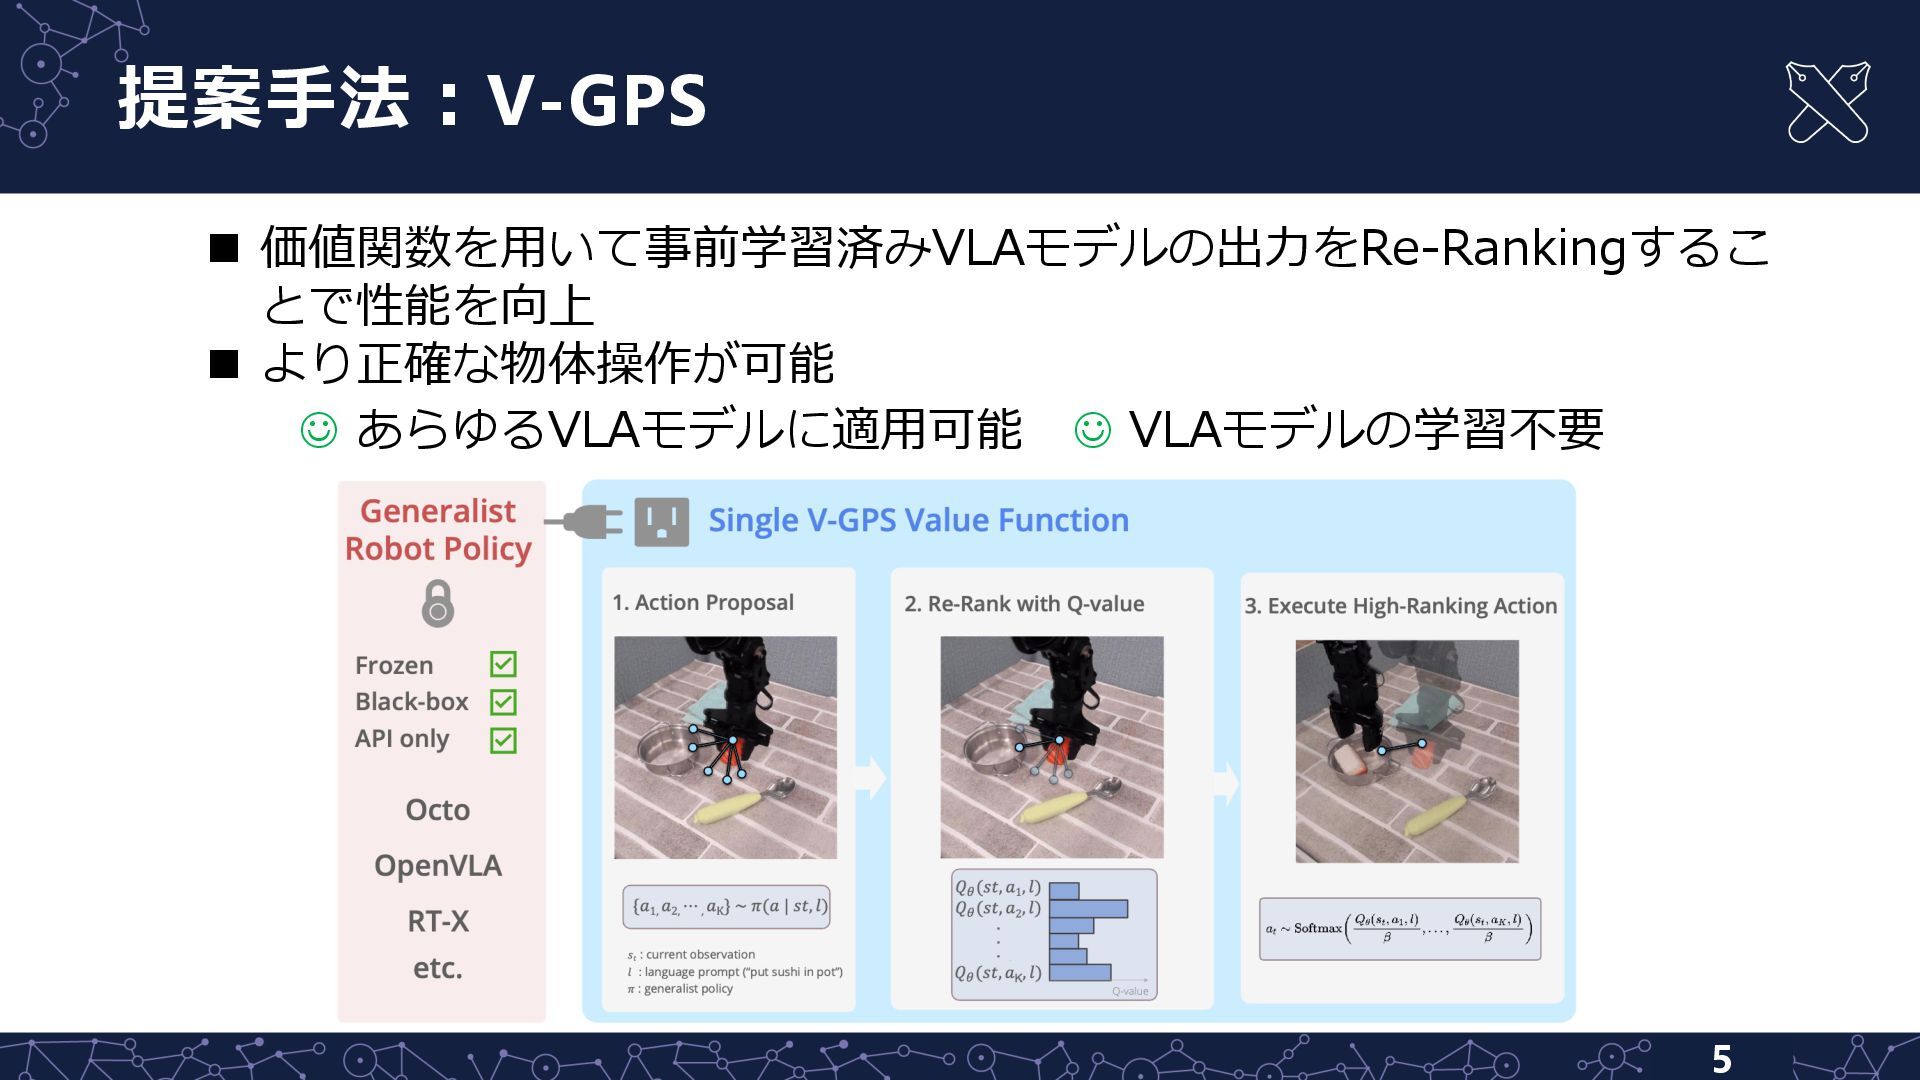
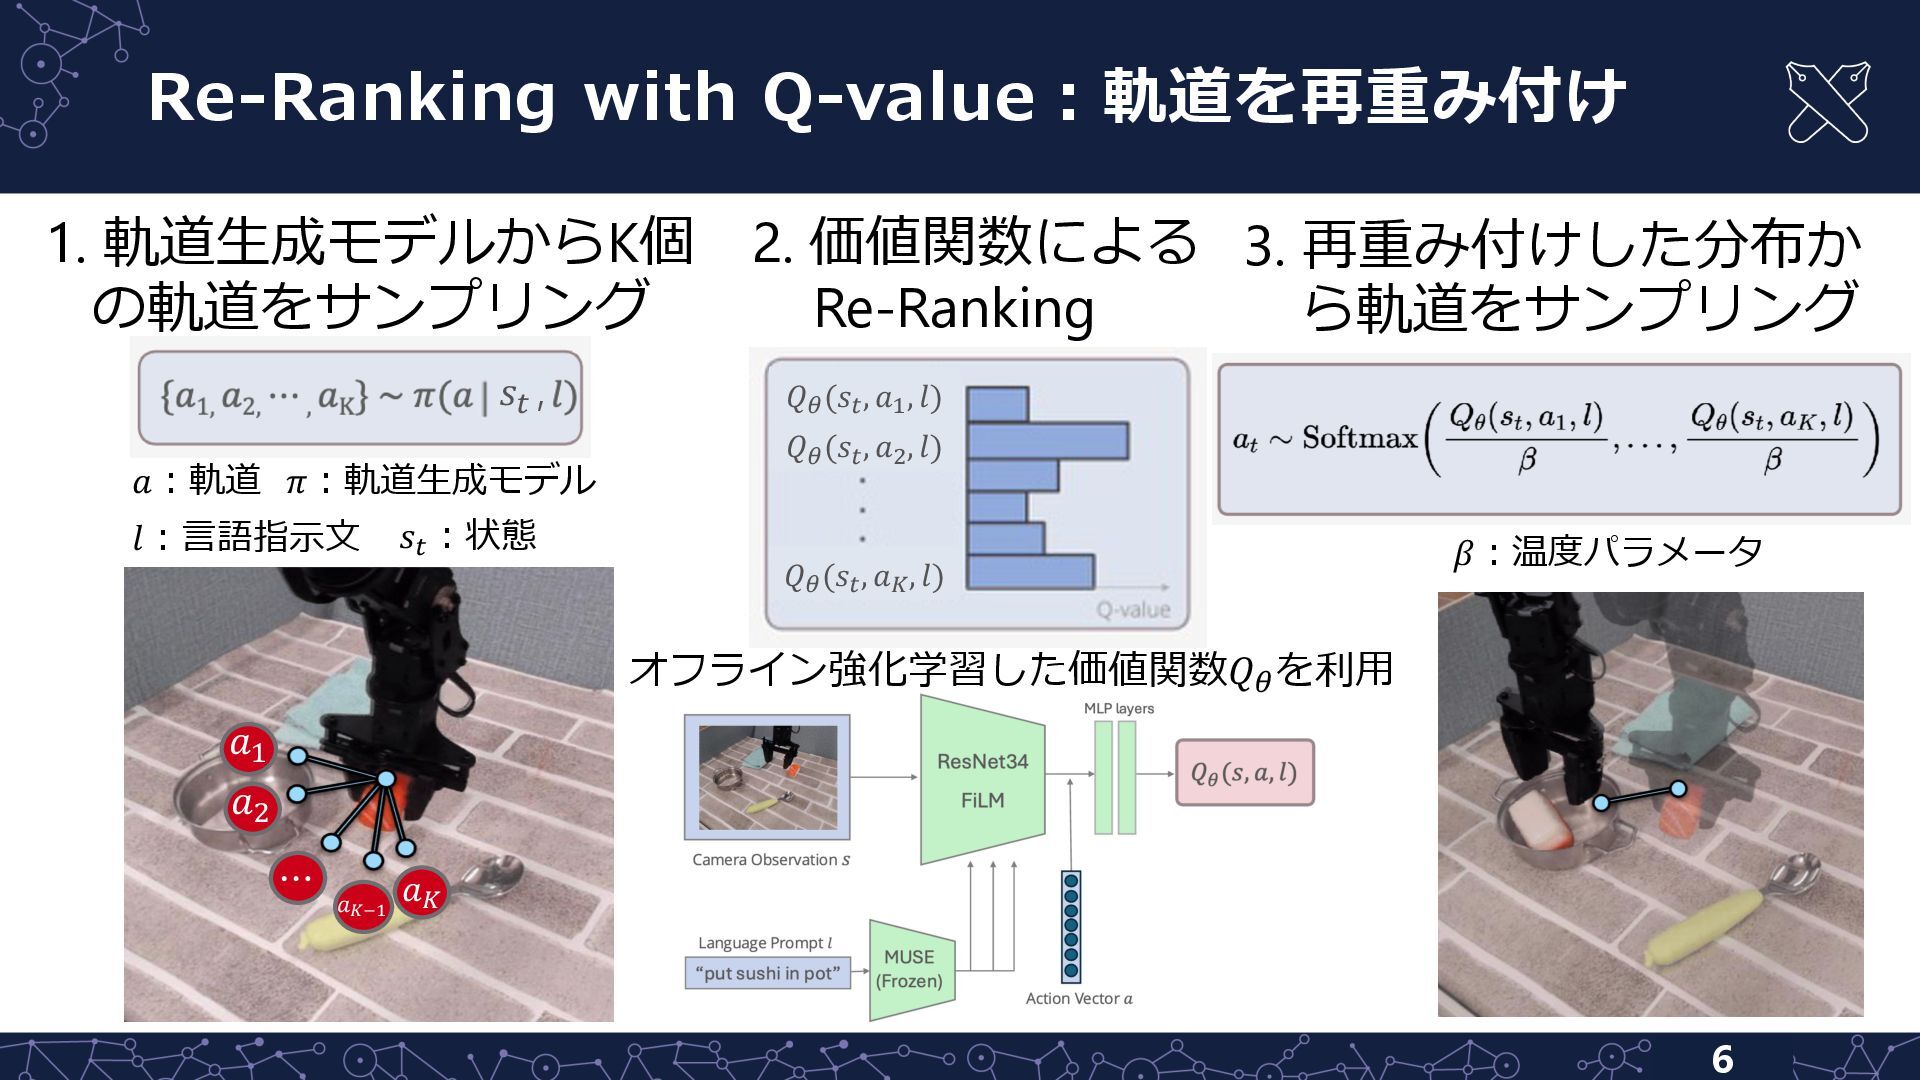
  4. Re-Ranking with Q-value︓軌道を再重み付け 6 1. 軌道⽣成モデルからK個 の軌道をサンプリング 3. 再重み付けした分布か ら軌道をサンプリング

    𝑎︓軌道 𝜋︓軌道⽣成モデル 𝑠! ︓状態 𝑙︓⾔語指⽰⽂ 𝑠! , 𝑎" 𝑎# ⋯ 𝑎!"# 𝑎" 𝑄"(𝑠#, 𝑎$, 𝑙) 𝑄" (𝑠# , 𝑎% , 𝑙) 𝑄"(𝑠#, 𝑎&, 𝑙) オフライン強化学習した価値関数𝑄$ を利⽤ 𝛽︓温度パラメータ 2. 価値関数による Re-Ranking
  5. 損失関数 7 ▪ 強化学習⼿法としてCal-QL [Nakamoto+, NeurIPS23]を採⽤ ▪ 第1項(Calibrated conservative regularizer︓保守的正則化項)

    ▪ OOD(Out-of-Distribution︓訓練データに含まれない) 出⼒に対して過⼤なQ値を出⼒しないように制約を付与 ▪ 第2項(Temporal Difference loss︓TD誤差項) ▪ Q関数の⼀貫性を保つ,Bellman誤差 ▪ 遅延項による学習の安定化 𝑄#︓参照⽅策 𝜇 によるQ関数 𝑠︓状態 𝛼︓保守項の重み 𝒟︓データセット ℬ%𝑄 𝑠, 𝑎, 𝑙 = 𝔼&'~% 𝑟 + 𝛾𝑄 𝑠(, 𝑎(, 𝑙 𝑄$ % ︓遅延したQ関数 𝑠&︓次ステップの状態 𝑟︓報酬 𝛾︓割引率
  6. 実験設定 (1/2)︓訓練データセット 8 Fractal [Brohan, RSS23] n Google Robot n

    130Kエピソード Bridge V2 [Walke+, CoRL23] n WidowX Robot Arm n 24環境で収集した45Kエピソード “put the carrot on the plate” “pick apple from white bowl”
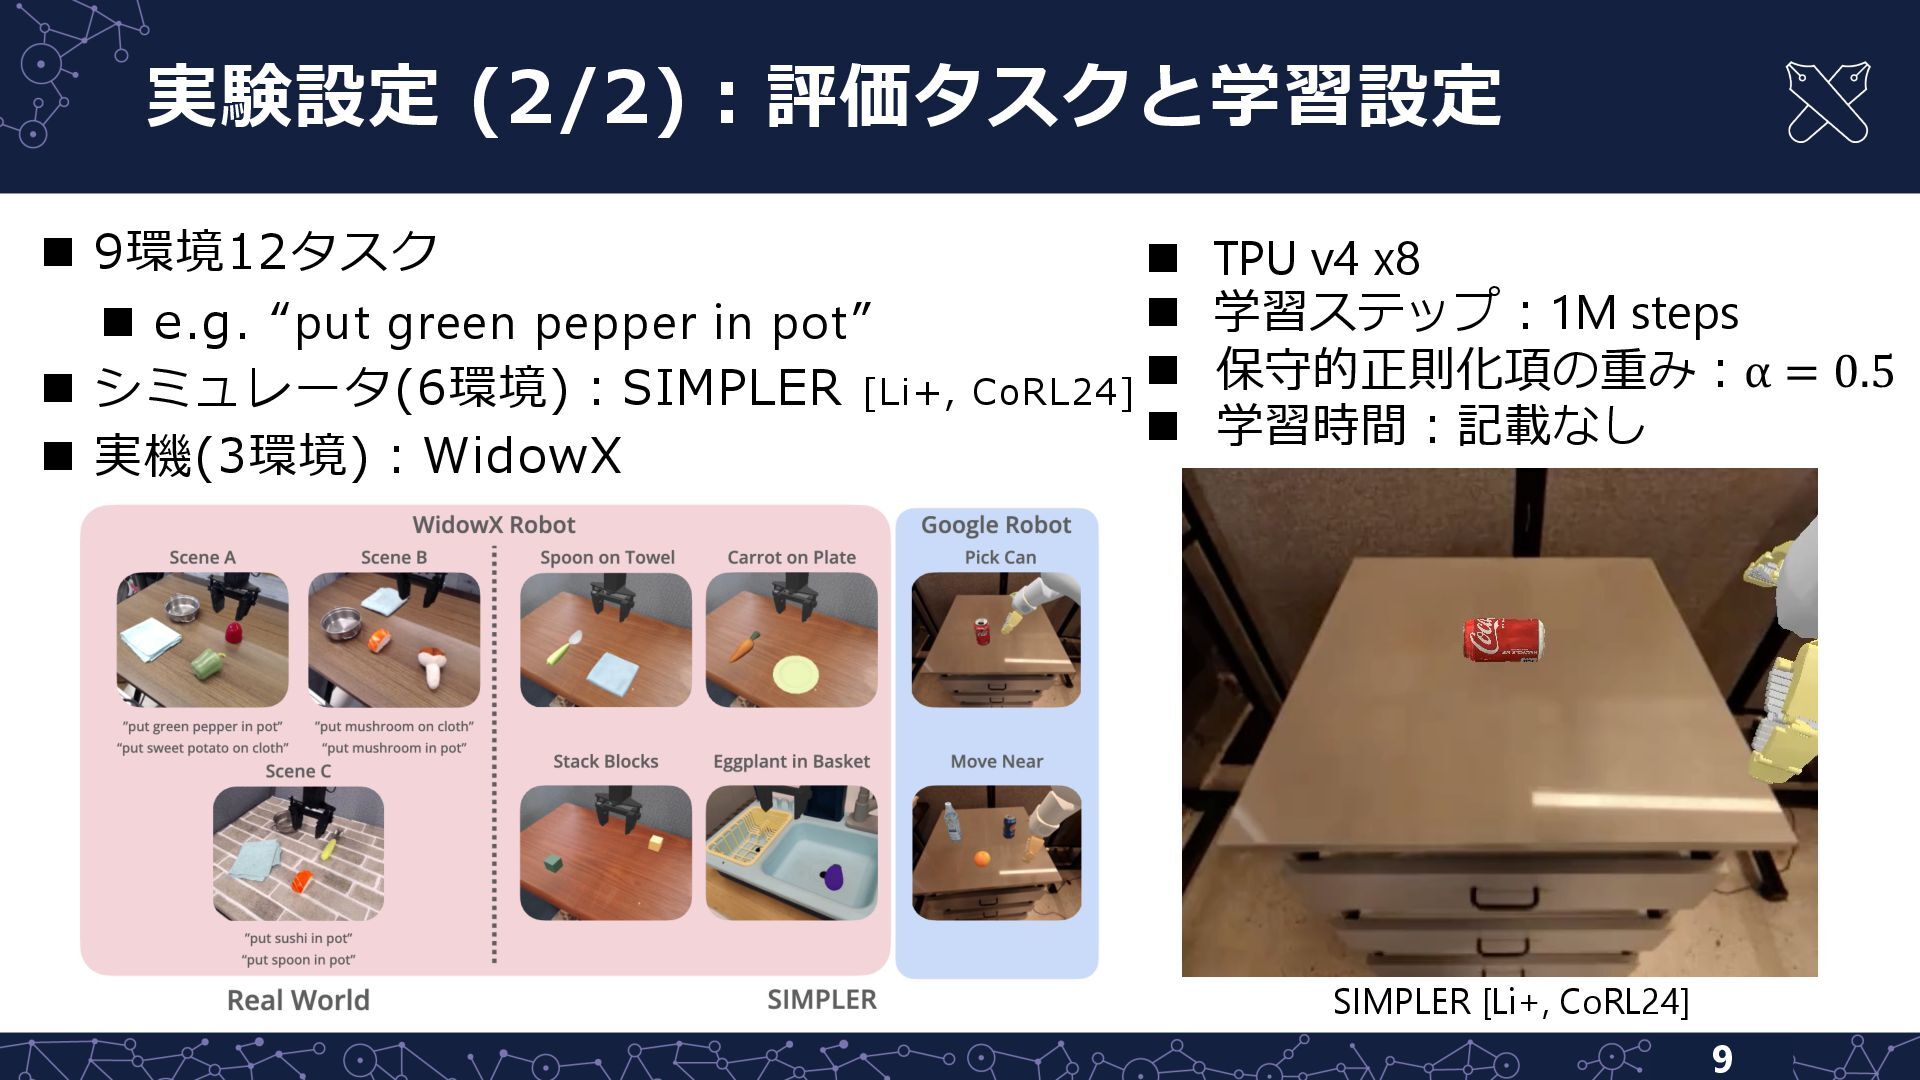
  7. 実験設定 (2/2)︓評価タスクと学習設定 9 n 9環境12タスク n e.g. “put green pepper

    in pot” n シミュレータ(6環境)︓SIMPLER [Li+, CoRL24] n 実機(3環境)︓WidowX n TPU v4 x8 n 学習ステップ︓1M steps n 保守的正則化項の重み︓α = 0.5 n 学習時間︓記載なし SIMPLER [Li+, CoRL24]
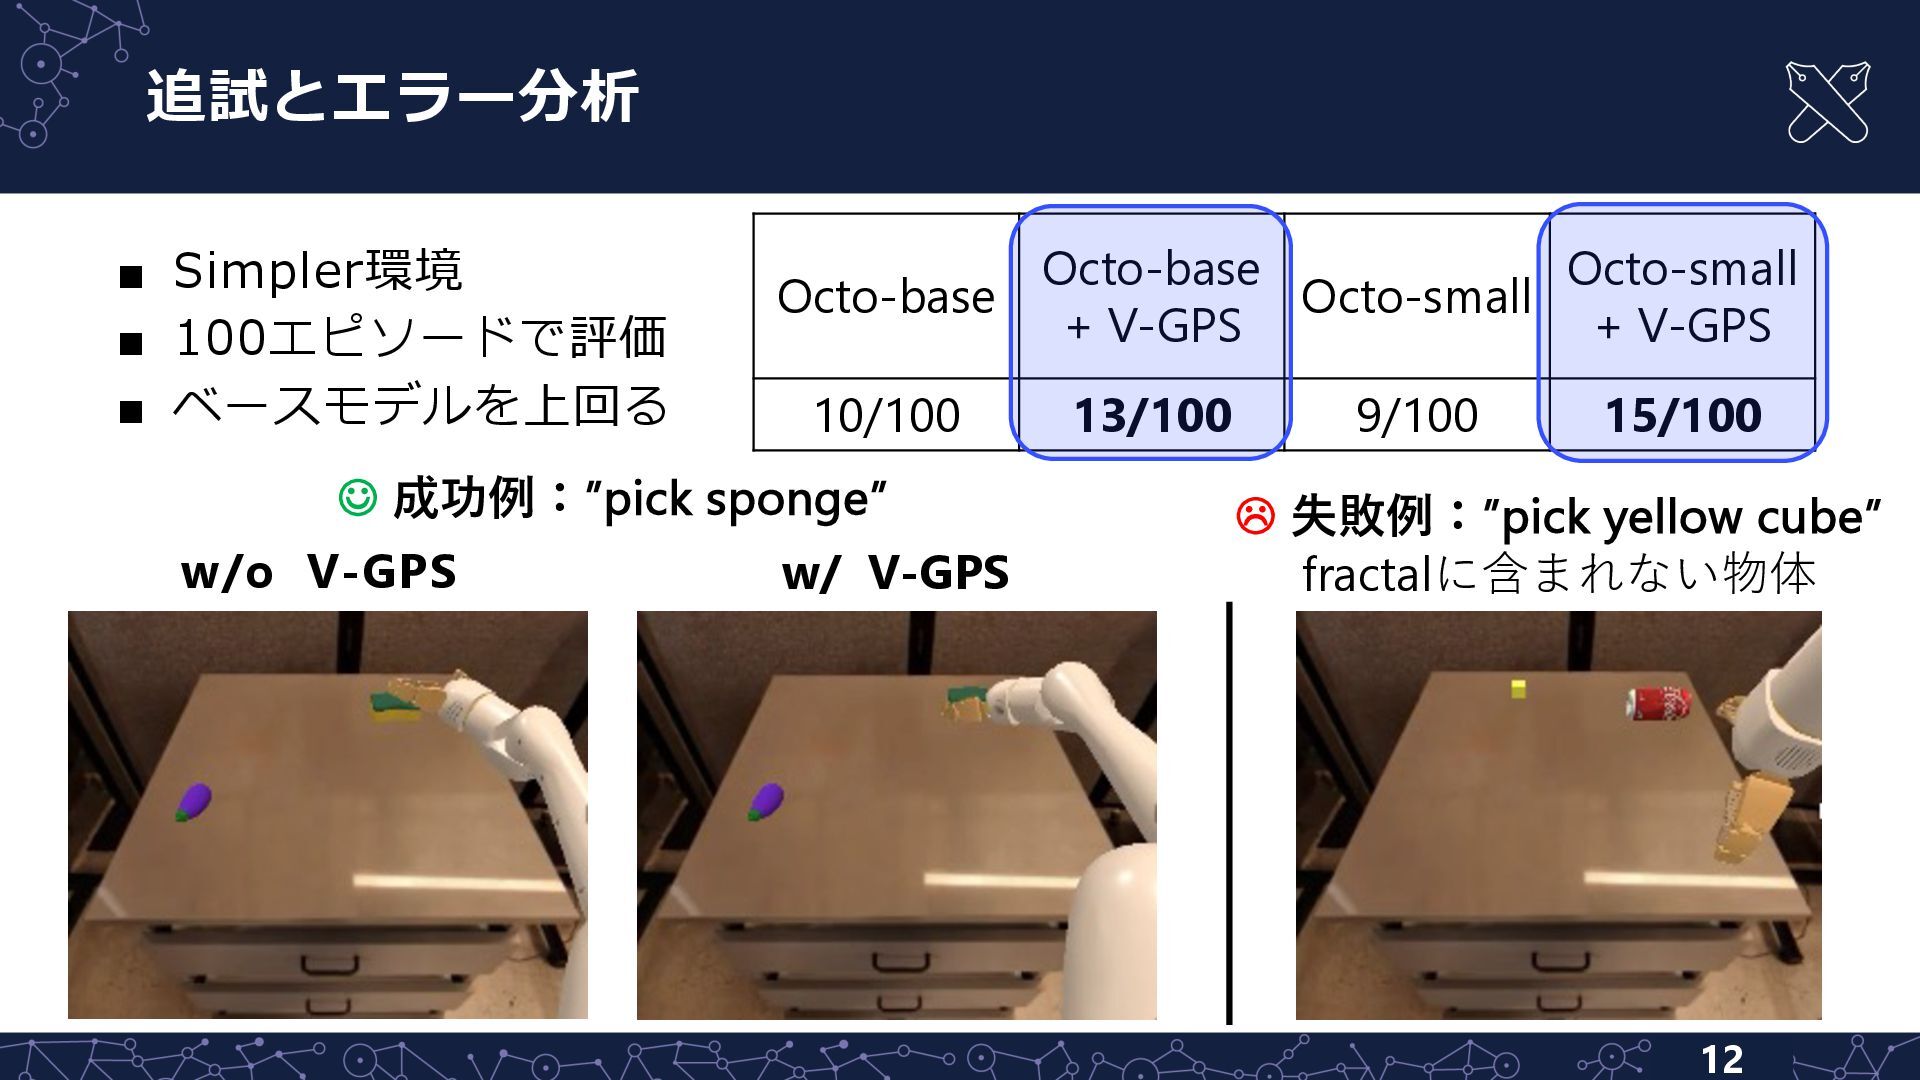
  8. 追試とエラー分析 12 ▪ Simpler環境 ▪ 100エピソードで評価 ▪ ベースモデルを上回る Octo-base Octo-base

    + V-GPS Octo-small Octo-small + V-GPS 10/100 13/100 9/100 15/100 w/o V-GPS w/ V-GPS J 成功例:”pick sponge” L 失敗例:”pick yellow cube” fractalに含まれない物体
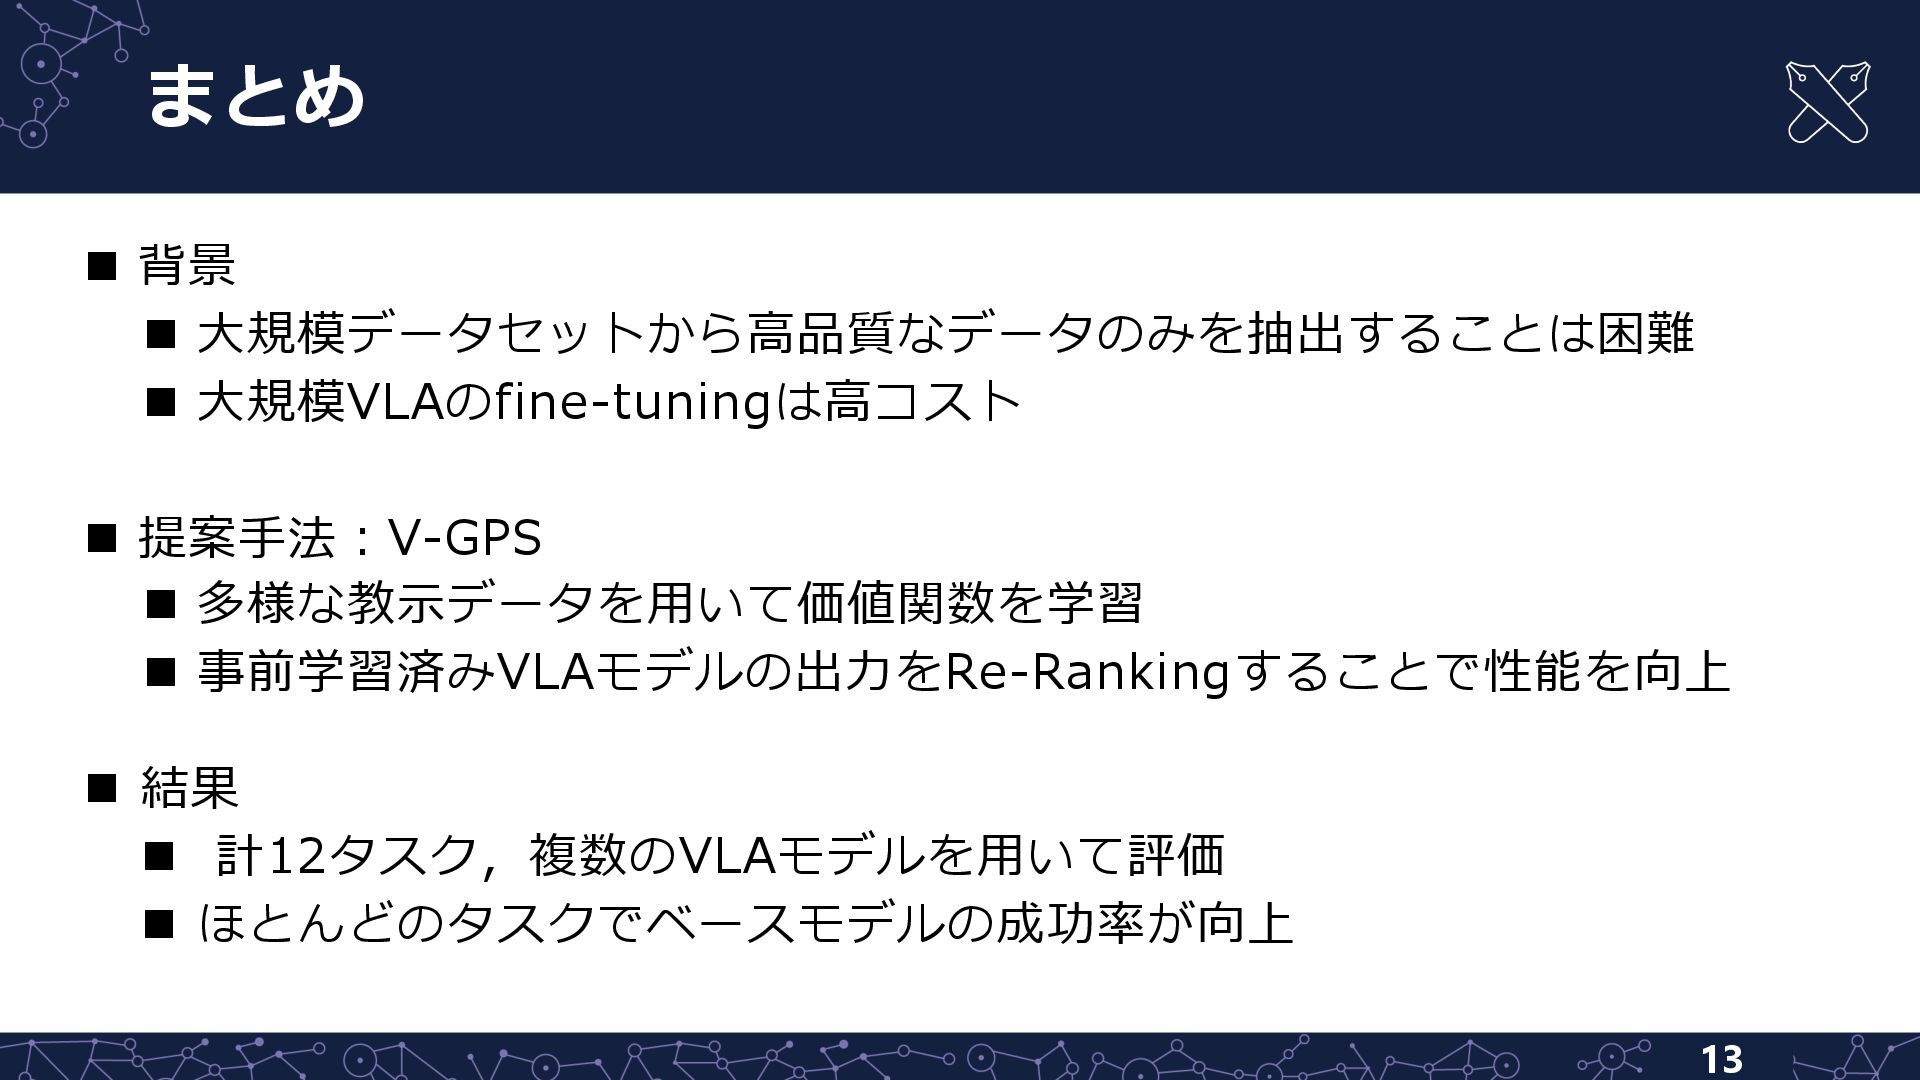
  9. まとめ 13 n 背景 n ⼤規模データセットから⾼品質なデータのみを抽出することは困難 n ⼤規模VLAのfine-tuningは⾼コスト n 提案⼿法︓V-GPS

    n 多様な教⽰データを⽤いて価値関数を学習 n 事前学習済みVLAモデルの出⼒をRe-Rankingすることで性能を向上 n 結果 n 計12タスク,複数のVLAモデルを⽤いて評価 n ほとんどのタスクでベースモデルの成功率が向上
  10. Appendix︓あらゆるオフライン強化学習⼿法を使⽤可能 14 IQL [Kostrikov, NeurIPS21]を使⽤した場合もベースモデルの成功率が向上 𝑠︓状態 𝒟︓データセット 𝑄$ % ︓遅延したQ関数

    𝑠&︓次ステップの状態 𝑟︓報酬 𝛾︓割引率 𝑎︓軌道 𝜏︓ハイパーパラメータ 𝑙︓⾔語指⽰⽂ 𝑉' ︓価値関数 𝑄︓学習対象のQ関数
  11. Appendix︓fine-tuningよりも効果的 15 ▪ ⼤規模VLAモデルのfine-tuningは困難 L closed-source (e.g. RT-1 [Brohan, RSS23]は⼀部のみ公開)

    L API-only (e.g. RT-2-X [OʼNeill+, ICRA23]) L ⾼い訓練コスト (e.g. OpenVLA [Kim+,CoRL24]はA100 x8,5-15h) ▪ fine-tuningを含む既存⼿法を上回る ※ Octo-finetuned︓OXE [OʼNeill+, ICRA23]で事前訓練,Bridge V2でfine-tuning ※ Octo-scratch︓Bridge V2で訓練 ※ Resnet-DP︓Diffusion Policy [Chi+, RSS23] w/ Resnet34エンコーダ

More Decks by Semantic Machine Intelligence Lab., Keio Univ.

Other Decks in Technology