Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
強化学習
Search
Kazuhisa Fujita
November 05, 2026
Education
1
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
強化学習
Kazuhisa Fujita
November 05, 2026
More Decks by Kazuhisa Fujita
See All by Kazuhisa Fujita
教師あり学習と教師なし学習
kfujita
0
6
人工知能時代の到来/IntroAI01
kfujita
0
50
人工知能とは/IntroAI02
kfujita
0
120
人工知能ゼミ03 /aizemi03
kfujita
3
250
情報処理工学問題集 /infoeng_practices
kfujita
2
920
人工知能ゼミ1-ガイダンス- /aizemi01
kfujita
2
200
人工知能ゼミ02 /aizemi02
kfujita
0
220
大学生活はスマホ・パソコンとともに! 安全な使い方とAIのチカラ /DigitalLiteracy
kfujita
0
170
情報処理工学14資料 /infoeng14
kfujita
0
810
Other Decks in Education
See All in Education
CLASSIFICATION OF CRUDE DRUGS
pawan_pharm
0
270
Introduction to M&A
bvr7352
0
260
AIができることを人はなぜ学ぶのか ― 専門性を育て、AIと学び続ける大学へ
gmoriki
0
180
【ainiチャット操作ガイド】
ainischool
0
200
Tema 1. El relieve de España: Formación y características
juanmartin2026
0
39k
1014
cbtlibrary
0
230
2026年度秋学期 統計学 第5回 分布をまとめるー記述統計量(平均・分散など) (2026. 10. 27)
akiraasano
PRO
0
160
Merger Process
bvr7352
0
180
新型コロナ禍をともに「楽しみながら開いていこう!」 :中門 吉松 会員(2720 Japan O.K.ロータリーEクラブ)卓話 : 2026.10.19.例会・卓話
2720japanoke
0
710
CSS3 and Responsive Web Design - Lecture 5 - Web Technologies (1019888BNR)
signer
PRO
1
3.5k
Database Handling in Python: SQLite3, MySQL and CRUD Operations
madhuri28
0
150
Sekolah Sabat - Triwulan 4 2026 - Pelajaran 3
hiola
0
7.2k
Featured
See All Featured
Neural Spatial Audio Processing for Sound Field Analysis and Control
skoyamalab
0
600
sira's awesome portfolio website redesign presentation
elsirapls
0
480
A better future with KSS
kneath
240
18k
It's Worth the Effort
3n
188
29k
Stewardship and Sustainability of Urban and Community Forests
pwiseman
0
580
StorybookのUI Testing Handbookを読んだ
zakiyama
31
7k
[RailsConf 2023] Rails as a piece of cake
palkan
59
7.1k
The #1 spot is gone: here's how to win anyway
tamaranovitovic
4
1.2k
The Myth of the Modular Monolith - Day 2 Keynote - Rails World 2024
eileencodes
28
3.7k
Accessibility Awareness
sabderemane
1
280
Into the Great Unknown - MozCon
thekraken
41
2.8k
How to train your dragon (web standard)
notwaldorf
96
6.9k
Transcript
人工知能5 強化学習 藤田 一寿 Ver.20260430
強化学習
強化学習とは • 数値化された報酬信号を最大にするために,何をすべきか(どのようにして状 況に基づく動作選択を行うか)を学習する.(Sutton and Barto (三上,皆川 訳) 強化学習) •
答えは与えられていない. • 報酬という手掛かりはある. • 試行錯誤で良い行動(それを生み出す方策)を探す. • 環境に働きかけることで情報を得る.
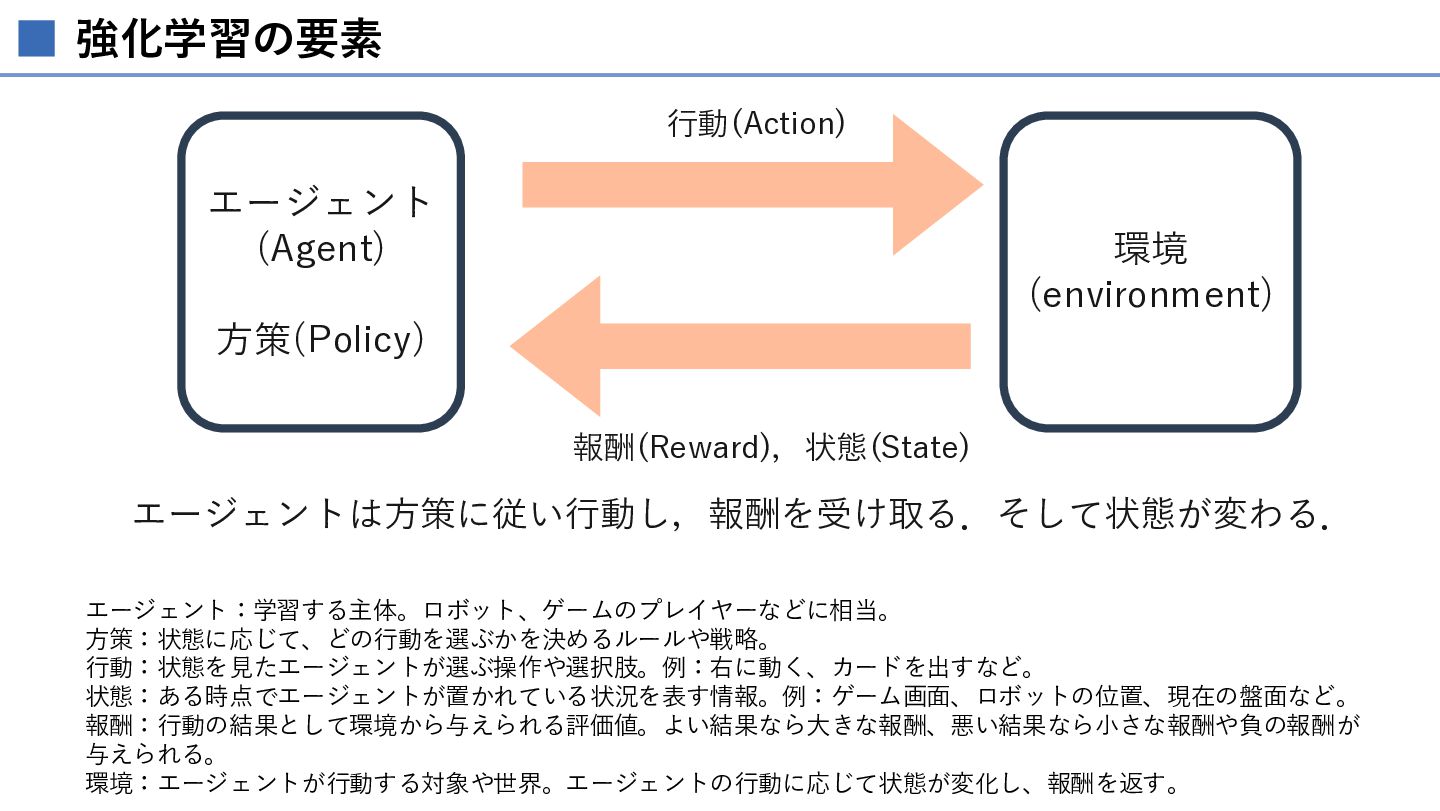
強化学習の要素 行動(Action) エージェント (Agent) 環境 (environment) 方策(Policy) 報酬(Reward),状態(State) エージェントは方策に従い行動し,報酬を受け取る.そして状態が変わる. エージェント:学習する主体。ロボット、ゲームのプレイヤーなどに相当。
方策:状態に応じて、どの行動を選ぶかを決めるルールや戦略。 行動:状態を見たエージェントが選ぶ操作や選択肢。例:右に動く、カードを出すなど。 状態:ある時点でエージェントが置かれている状況を表す情報。例:ゲーム画面、ロボットの位置、現在の盤面など。 報酬:行動の結果として環境から与えられる評価値。よい結果なら大きな報酬、悪い結果なら小さな報酬や負の報酬が 与えられる。 環境:エージェントが行動する対象や世界。エージェントの行動に応じて状態が変化し、報酬を返す。
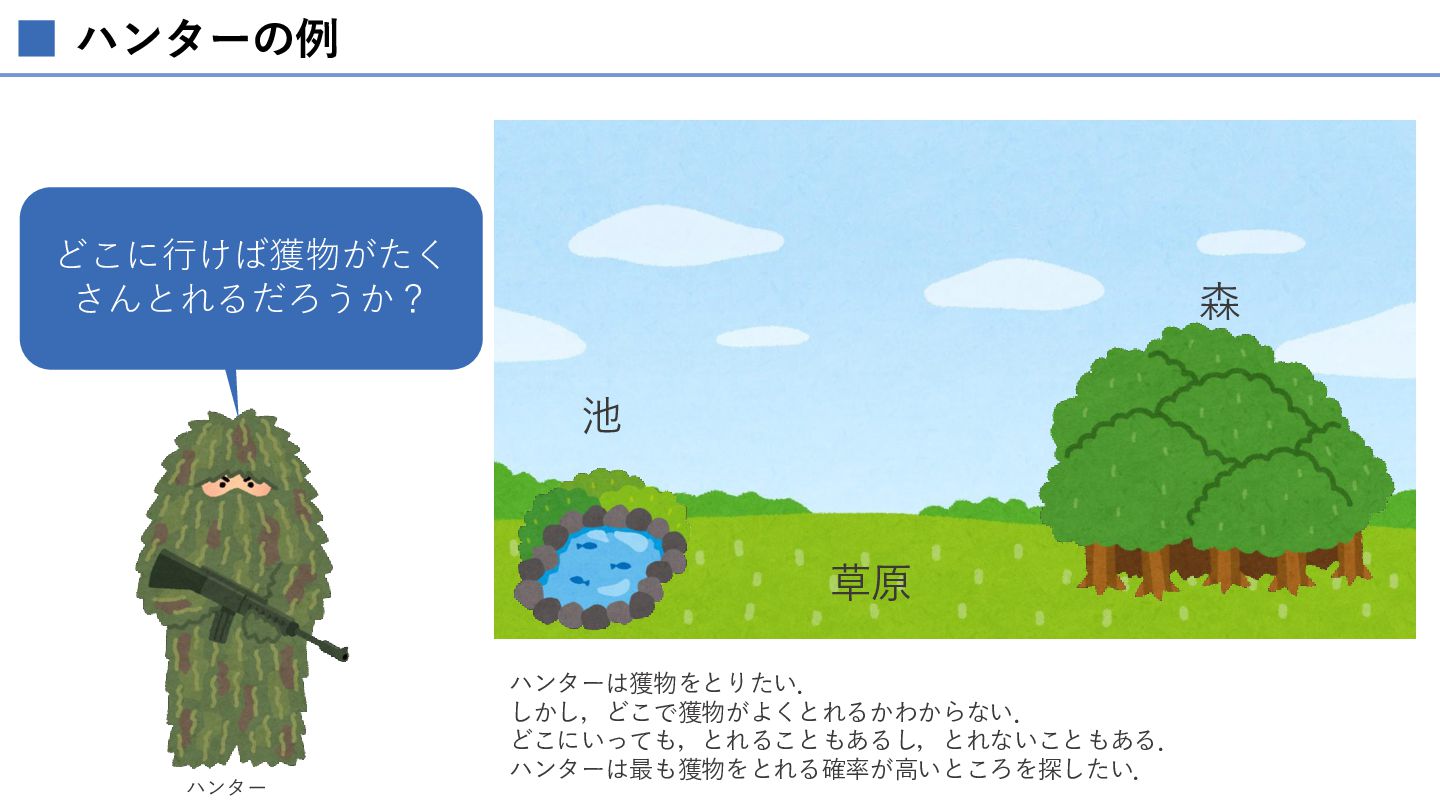
ハンターの例 どこに行けば獲物がたく さんとれるだろうか? 森 池 草原 ハンター ハンターは獲物をとりたい. しかし,どこで獲物がよくとれるかわからない. どこにいっても,とれることもあるし,とれないこともある.
ハンターは最も獲物をとれる確率が高いところを探したい.
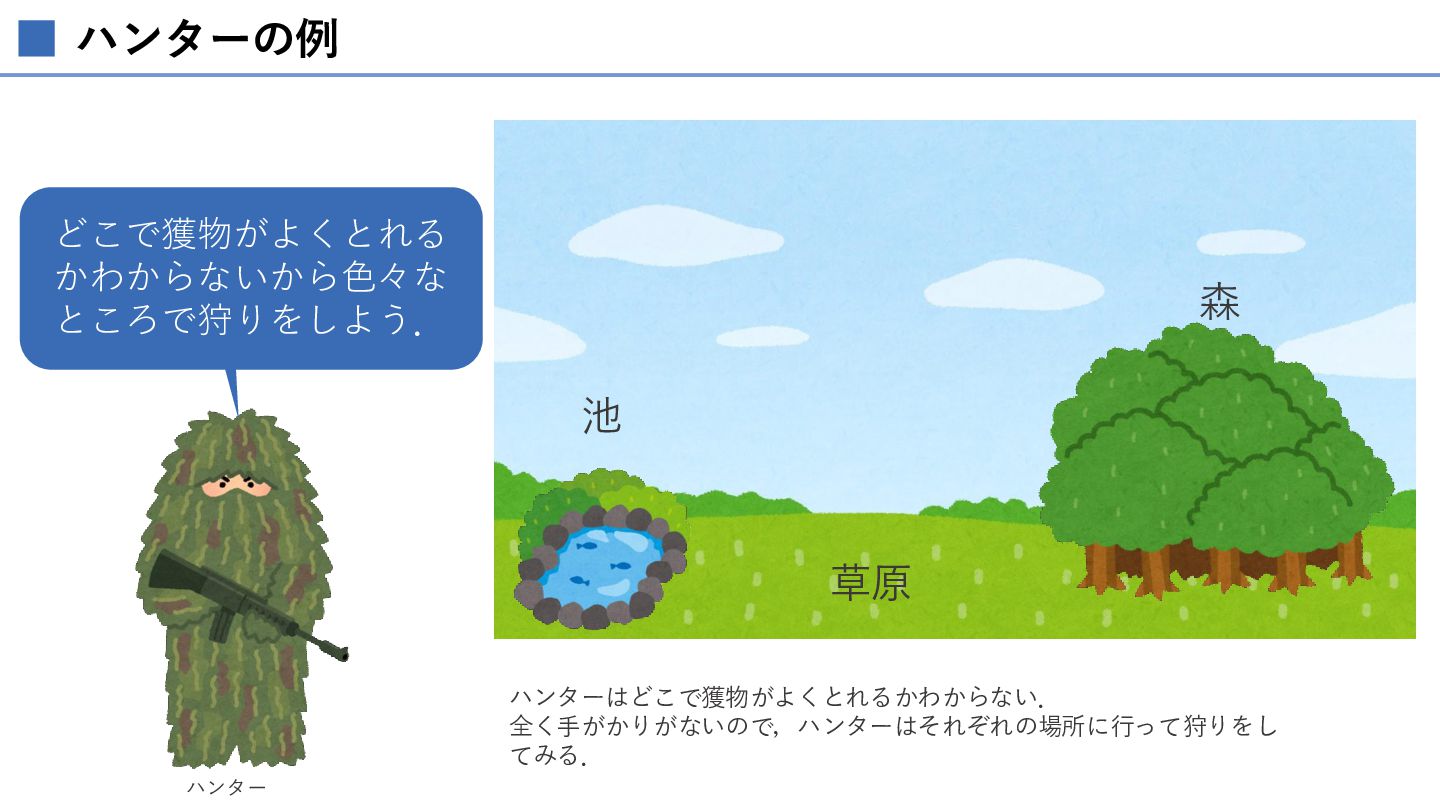
ハンターの例 どこで獲物がよくとれる かわからないから色々な ところで狩りをしよう. 森 池 草原 ハンターはどこで獲物がよくとれるかわからない. 全く手がかりがないので,ハンターはそれぞれの場所に行って狩りをし てみる.
ハンター
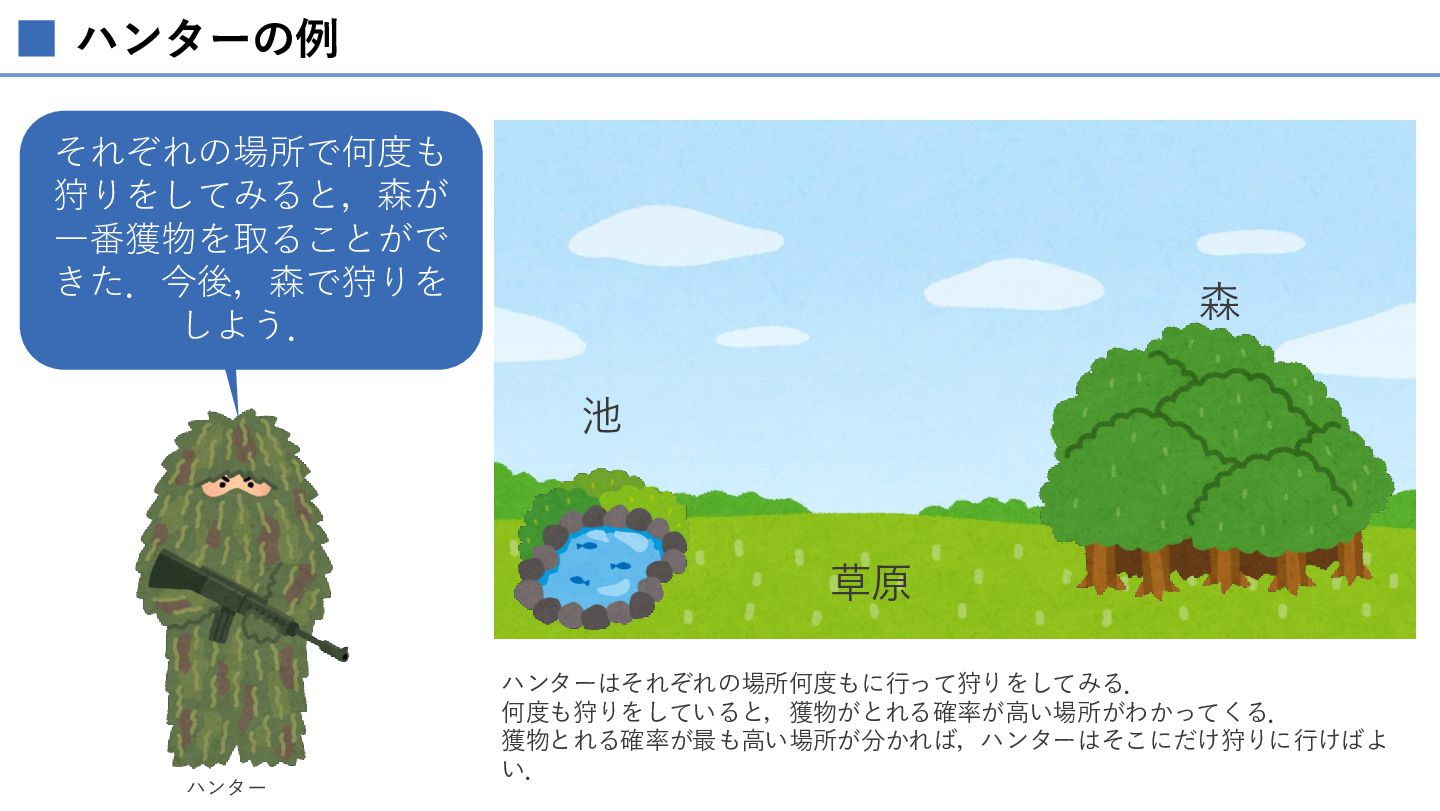
ハンターの例 それぞれの場所で何度も 狩りをしてみると,森が 一番獲物を取ることがで きた.今後,森で狩りを しよう. 森 池 草原 ハンター
ハンターはそれぞれの場所何度もに行って狩りをしてみる. 何度も狩りをしていると,獲物がとれる確率が高い場所がわかってくる. 獲物とれる確率が最も高い場所が分かれば,ハンターはそこにだけ狩りに行けばよ い.
ハンターの例のまとめ • 初めは,ハンターは,どこで獲物がよくとれるか分からない. • ハンターは手がかりを得るために,それぞれの場所で狩りをする. • それぞれの場所で何度か狩りをして手がかりとなる情報を得た後,よく獲物が とれる場所を決める.
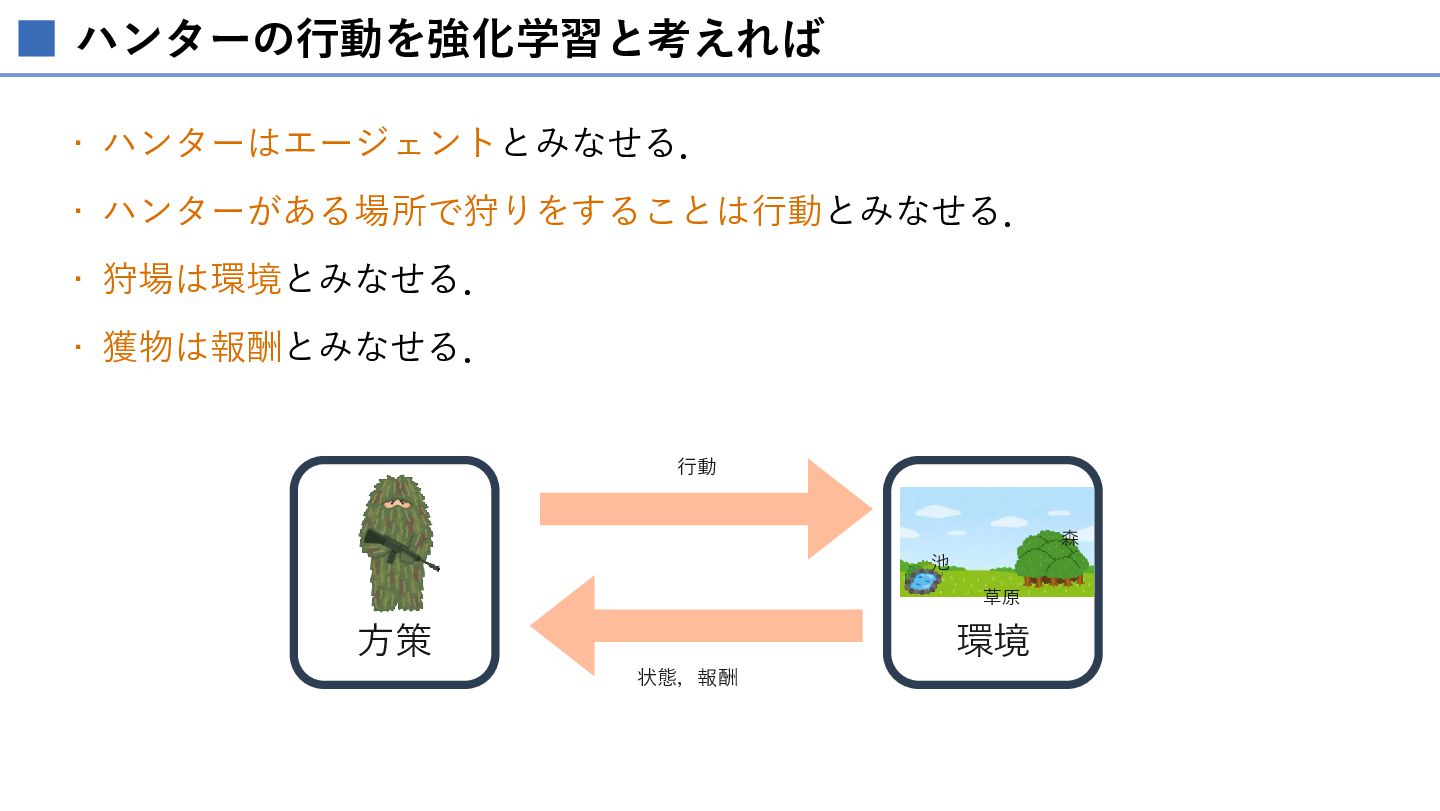
ハンターの行動を強化学習と考えれば • ハンターはエージェントとみなせる. • ハンターがある場所で狩りをすることは行動とみなせる. • 狩場は環境とみなせる. • 獲物は報酬とみなせる. 行動
森 池 草原 方策 環境 状態,報酬
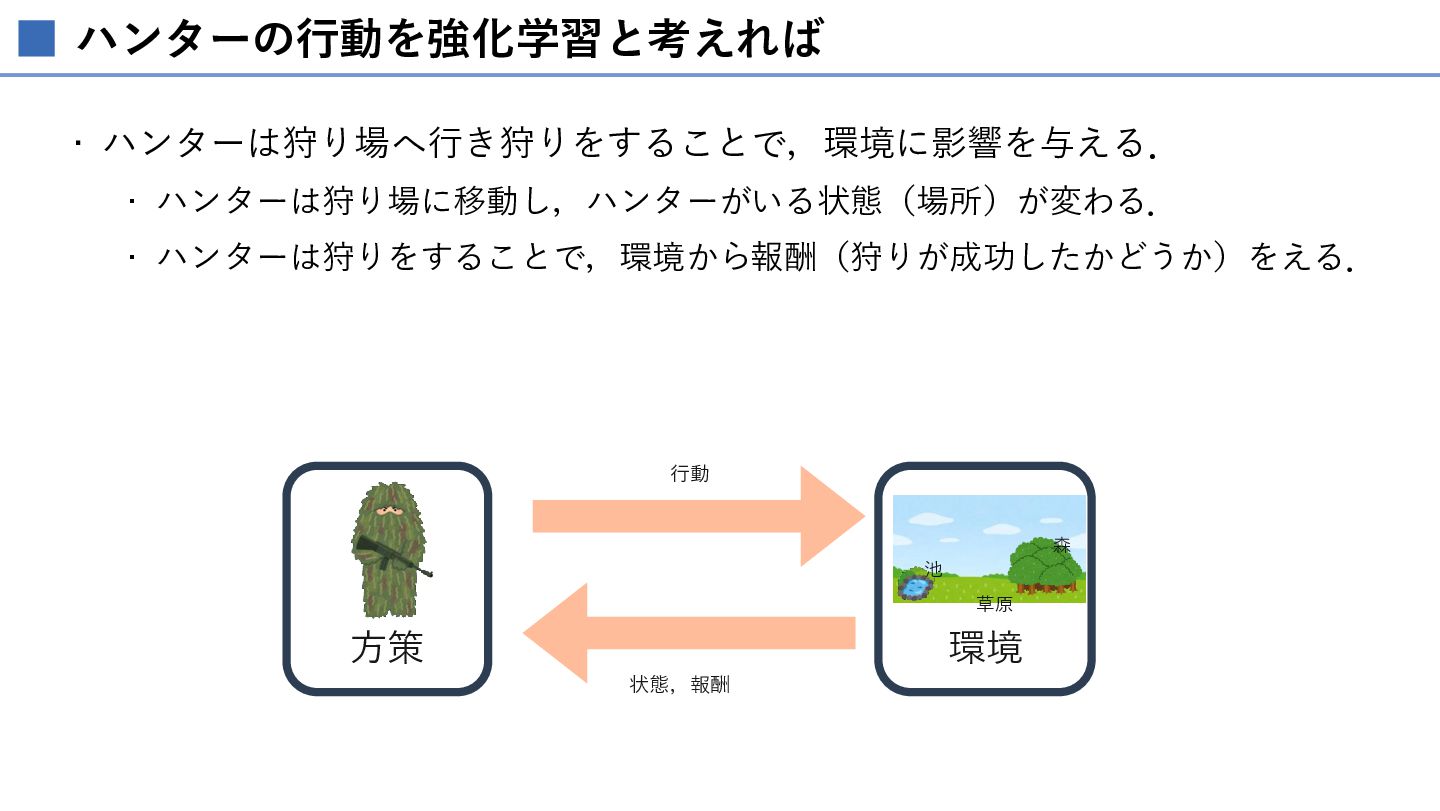
ハンターの行動を強化学習と考えれば • ハンターは狩り場へ行き狩りをすることで,環境に影響を与える. • ハンターは狩り場に移動し,ハンターがいる状態(場所)が変わる. • ハンターは狩りをすることで,環境から報酬(狩りが成功したかどうか)をえる. 行動 森 池
草原 方策 環境 状態,報酬
強化学習の目的は何か(ハンターの例から) • ハンターの目的は,よく獲物がとれる場所を知ること. • 最も報酬を得られる方策(行動)を知りたい. • 欲を言えば,よく獲物がとれる場所をなるべく早く探したい. • 最も報酬を得られる方策をなるべく早く探す. •
もしくは,なるべく損をせずに,よく獲物がとれる場所を探したい. • 行動を通して得られる報酬の総和を最大化する.
探索と知識利用のトレードオ フ
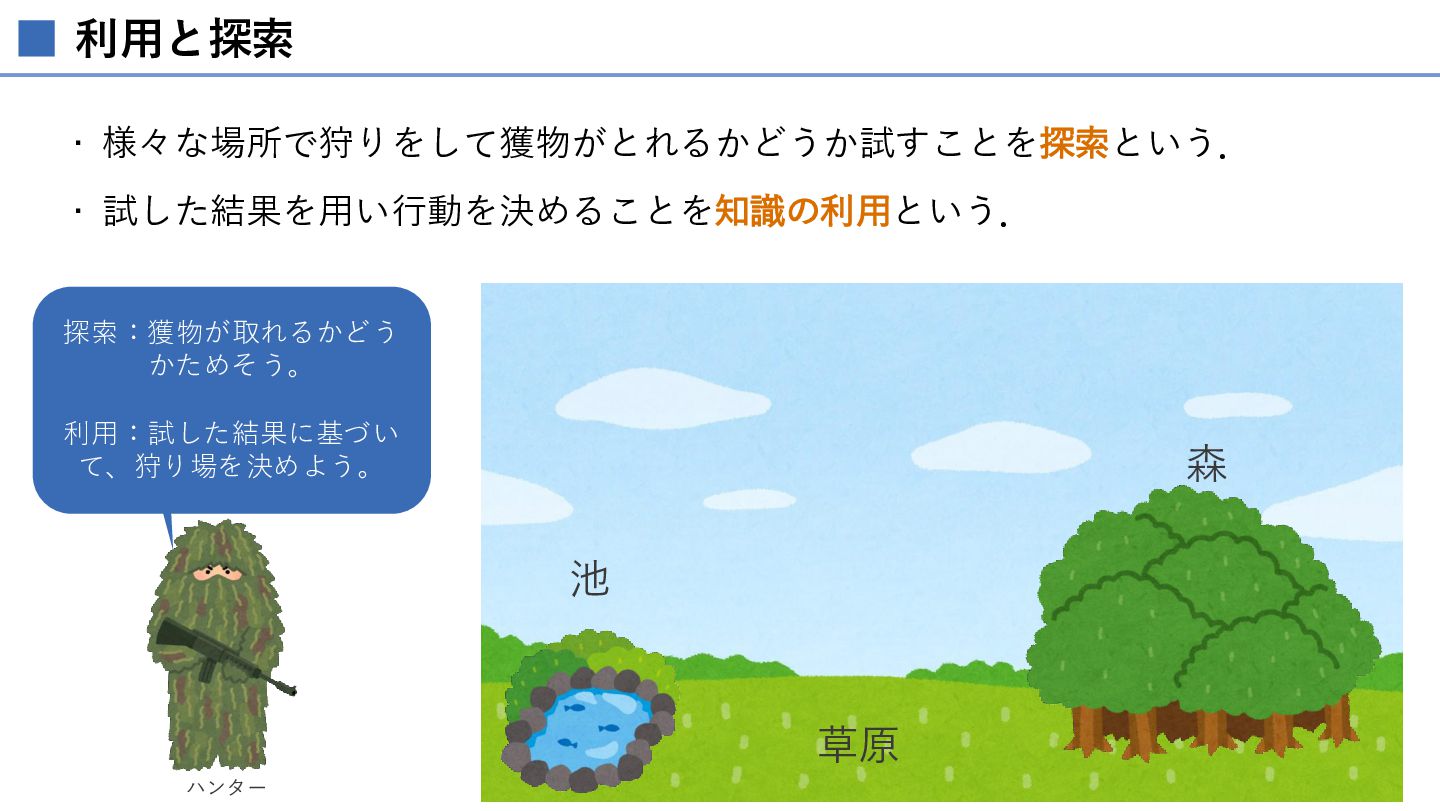
利用と探索 • 様々な場所で狩りをして獲物がとれるかどうか試すことを探索という. • 試した結果を用い行動を決めることを知識の利用という. 探索:獲物が取れるかどう かためそう。 利用:試した結果に基づい て、狩り場を決めよう。 森
池 草原 ハンター
利用と探索 • エージェントは,できるだけ大きな報酬を得られる行動を選びたい. • これまでの経験に基づいて,現時点で最も良いと考えられる行動を取ることを知識 の利用という. • しかし,それだけでは,他により良い行動があるかどうかわからない. • そこで,より良い行動を見つけるために,様々な行動を試すことを探索という.
利用と探索 • ハンターは獲物がよくとれる狩場を探したいので,いろいろな場所で何度も狩 りを行いたい. • ハンターは獲物がよくとれる場所で早く狩りをしたい. • 探索する回数が少なければ少ないほどハンターは嬉しい. • しかし、少ない探索回数から得た知識から良い狩場を見つけたとしても,その狩
場より良い狩場があるかもしれない問題がある. • ハンターは,良い場所を探さがしたい気持ちと早く良い場所で狩りをしたい気 持ちの板挟みになっている.
探索と知識利用のトレードオフ • 探索ばかりでは,いつまでたっても良い選択肢を選べないが,利用ばかりでは 最も良い行動を見逃しているかも知れない. • これを,探索と知識利用のトレードオフという.
不確かなときは楽観的に • 探索しなければ正確に報酬を得られる確率を獲得できないが,正確に知るため には何回も探索しなければならない.(探索と知識利用のトレードオフ) • 「不確かなときは楽観的に」という考え方で探索と利用のトレードオフを回避 する. • 「不確かなときは楽観的に」とは •
エージェントが見積もっている報酬が得られる期待(報酬の期待値)が真の期待 値より低いと探索されることが少なく修正されにくい. • 見積もりが真の期待値より高いと探索され,修正されることで見積もりが真の期 待値に近づく.
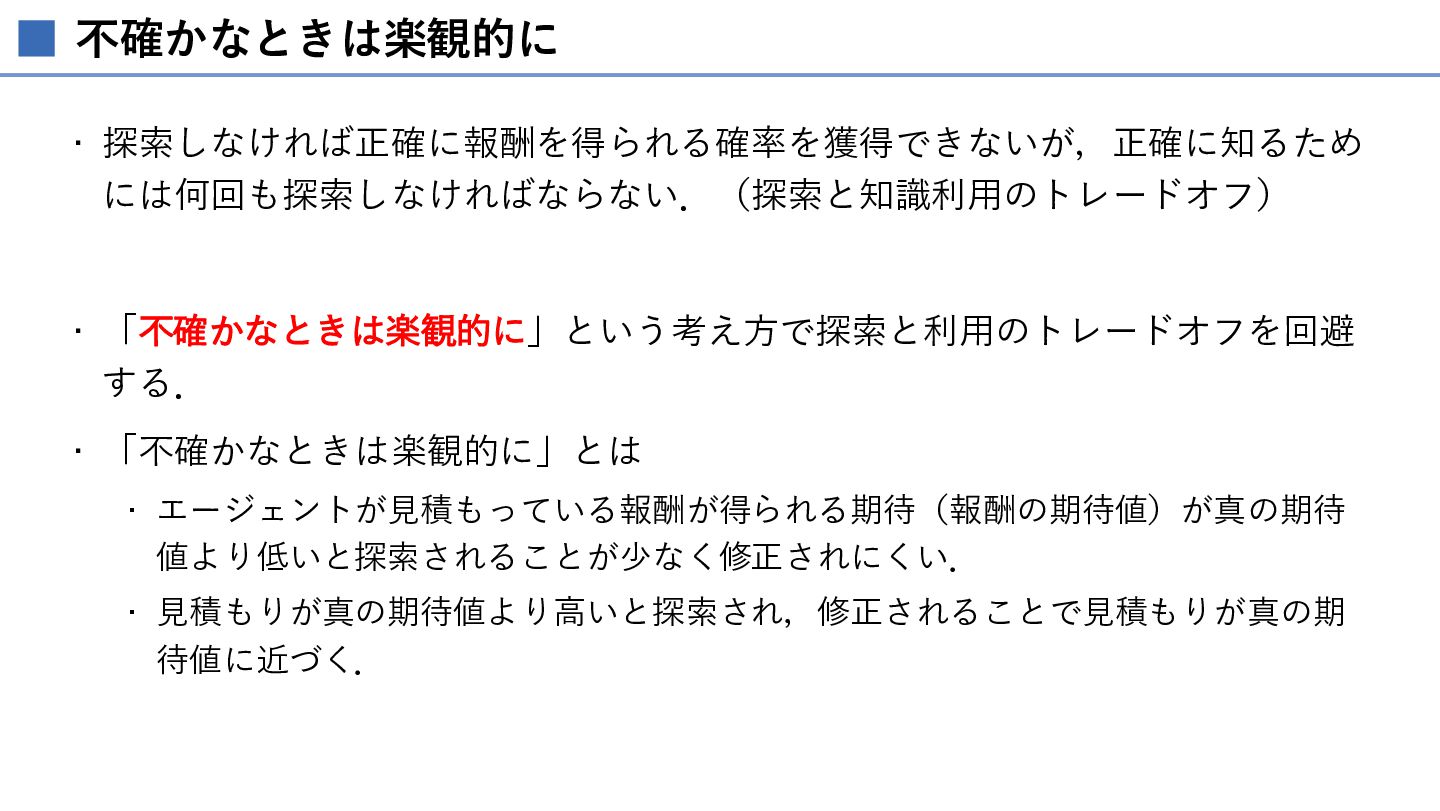
不確かなときは楽観的に:悲観ハンターの場合1 森 期待値0 何処に行っても獲物は取 れないだろう. 池 期待値0 草原 期待値0 ハンターはどの狩場でも獲物は取れないと悲観的に思っている.
ハンター
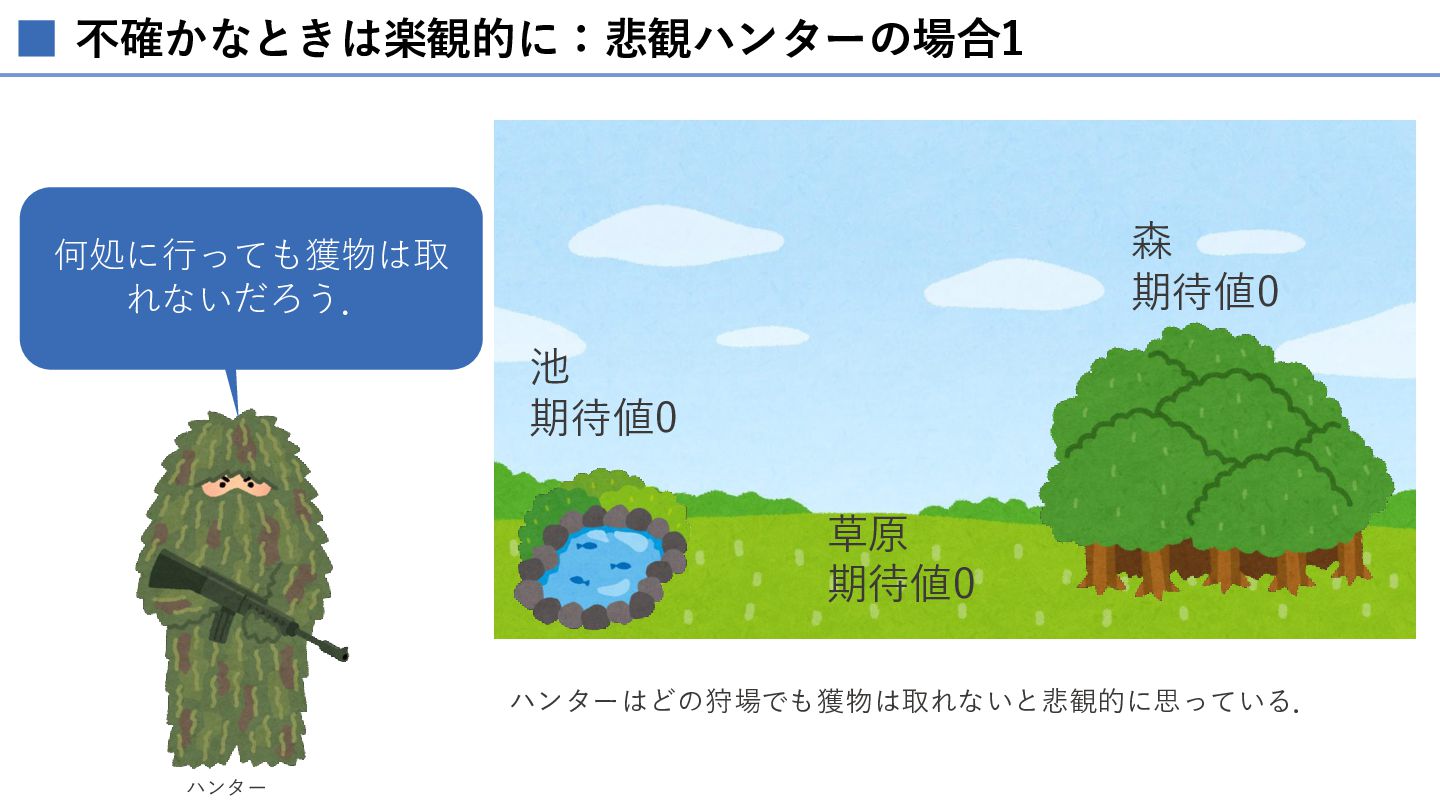
不確かなときは楽観的に: 悲観ハンターの場合2 たまたま池で獲物が取れた 森 期待値0 池に行ったら獲物が取れ た.池は良い狩場だ. 池 期待値1 草原
期待値0 ハンター たまたま池で獲物が取れる、池の期待値が上がり、ハンターは池が良 い狩場だと思う。悲観的なので,他の狩場には期待はしておらず試さ ないため,他の場所の期待値が修正されない.
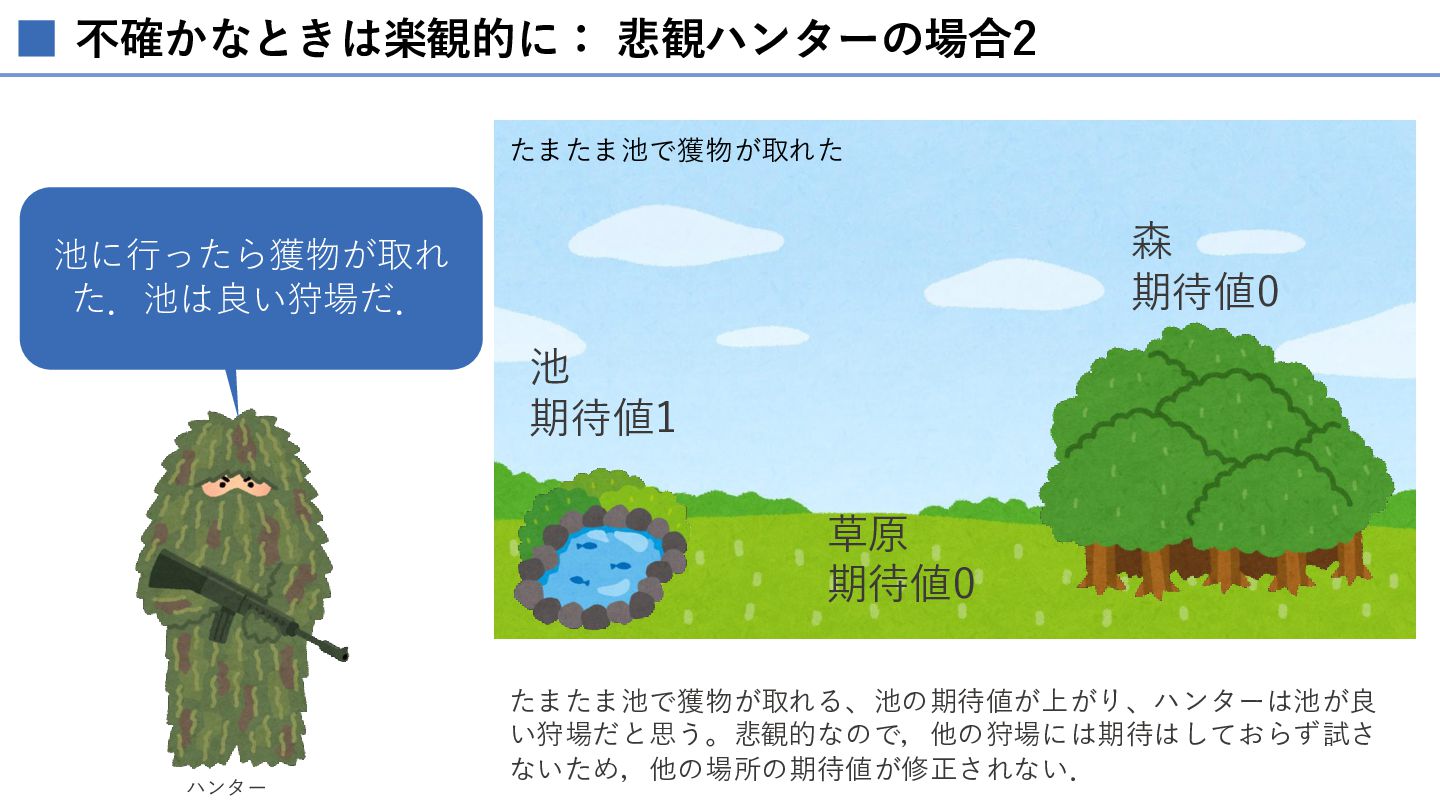
不確かなときは楽観的に: 悲観ハンターの場合2 池で獲物が取れず、期待値が下がった 池に行ったら獲物が取れ なかったが,以前は取れ たから良い狩場だ. 森 期待値0 池 期待値0.5
草原 期待値0 池で獲物が取れる無かったとしても、依然として他の期待値は低いた め,他の狩場を試さない. ハンター
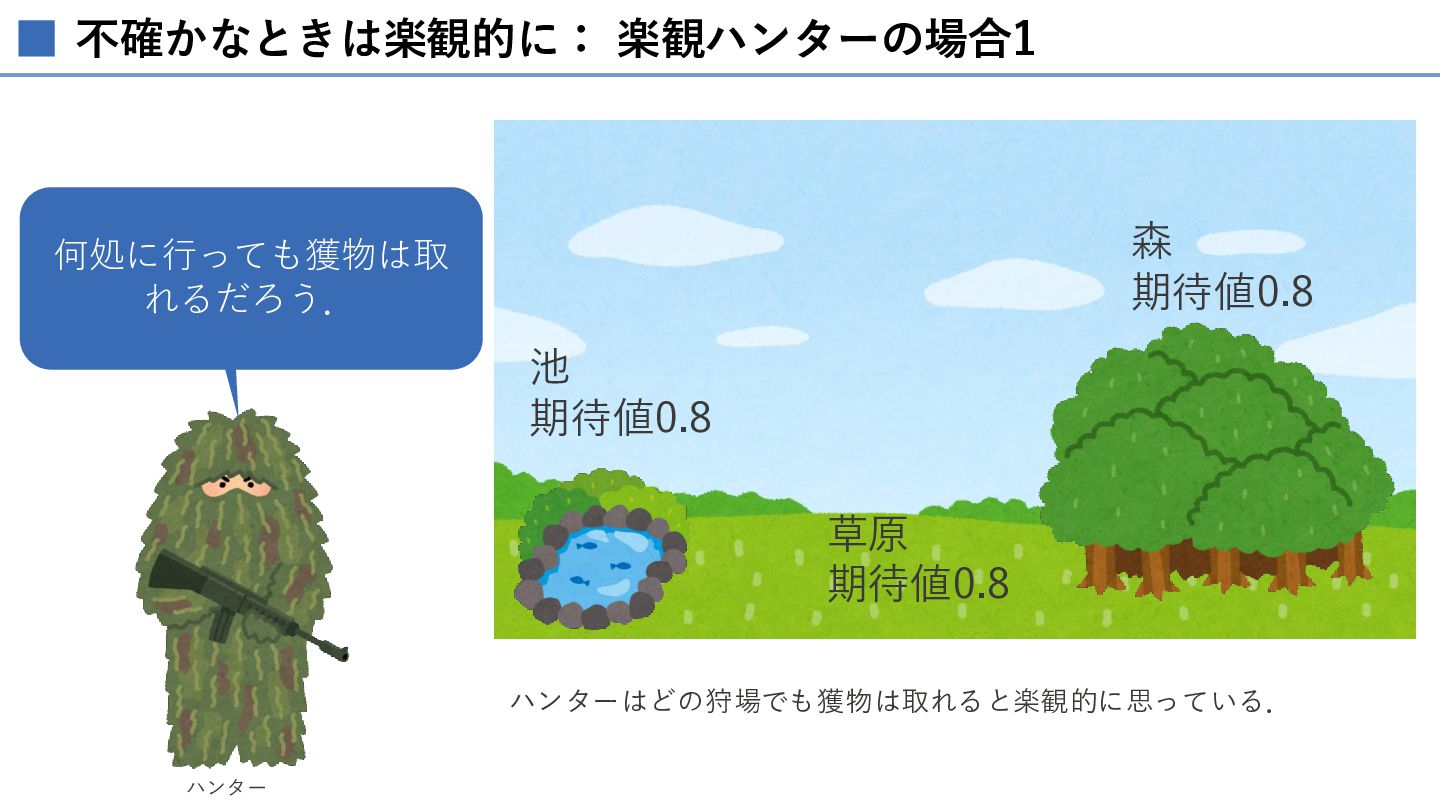
不確かなときは楽観的に: 楽観ハンターの場合1 森 期待値0.8 何処に行っても獲物は取 れるだろう. 池 期待値0.8 草原 期待値0.8
ハンターはどの狩場でも獲物は取れると楽観的に思っている. ハンター
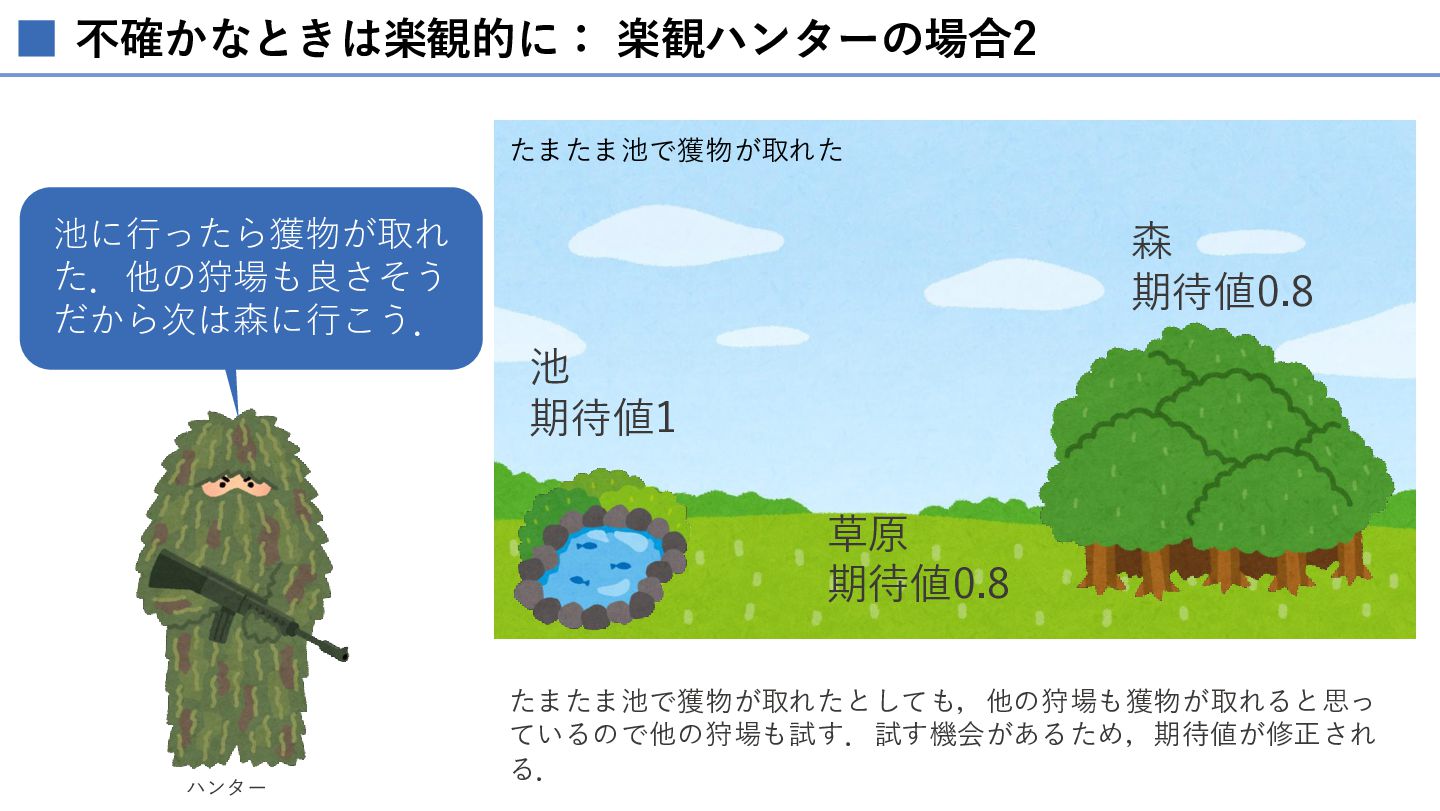
不確かなときは楽観的に: 楽観ハンターの場合2 たまたま池で獲物が取れた 池に行ったら獲物が取れ た.他の狩場も良さそう だから次は森に行こう. 森 期待値0.8 池 期待値1
草原 期待値0.8 ハンター たまたま池で獲物が取れたとしても,他の狩場も獲物が取れると思っ ているので他の狩場も試す.試す機会があるため,期待値が修正され る.
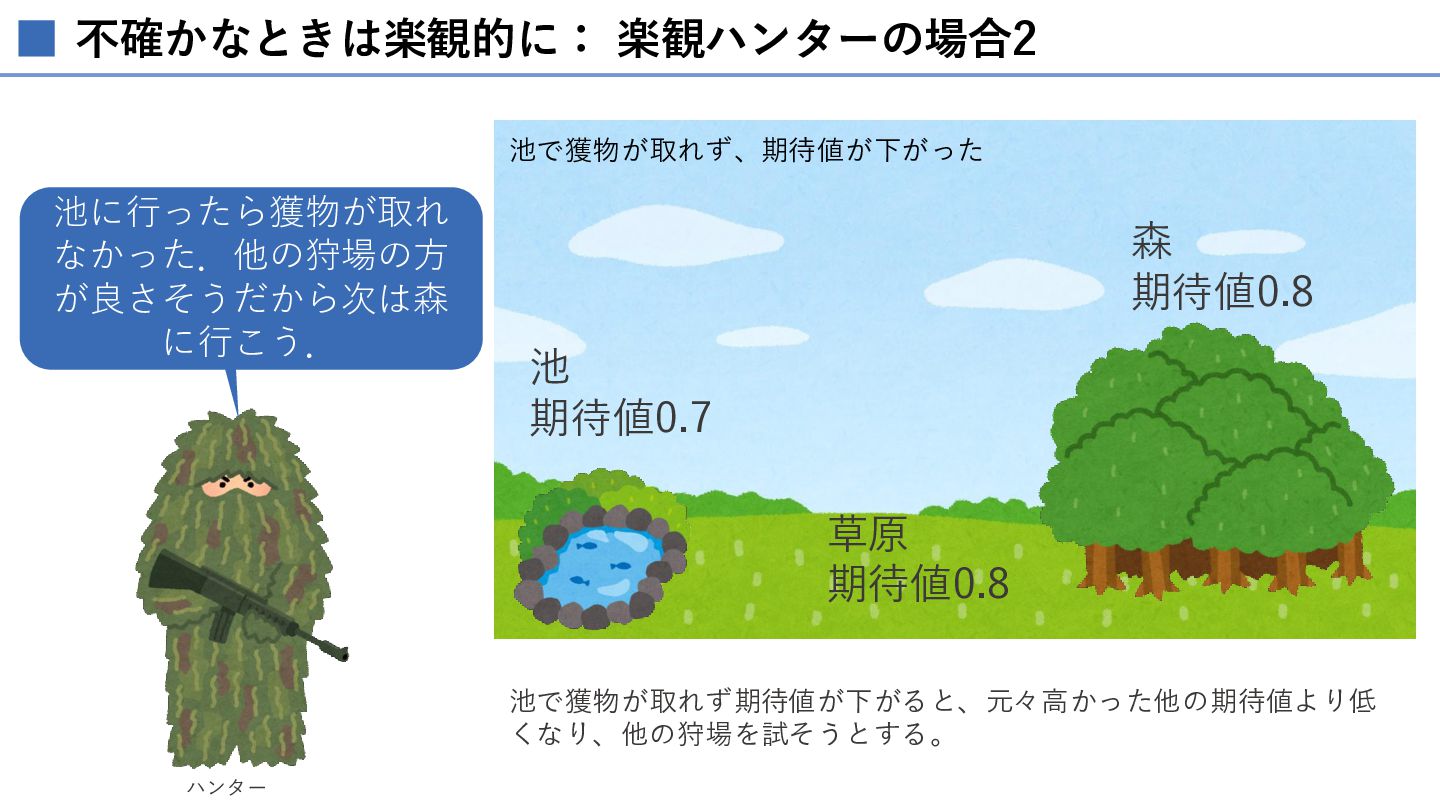
不確かなときは楽観的に: 楽観ハンターの場合2 池で獲物が取れず、期待値が下がった 池に行ったら獲物が取れ なかった.他の狩場の方 が良さそうだから次は森 に行こう. 森 期待値0.8 池
期待値0.7 草原 期待値0.8 池で獲物が取れず期待値が下がると、元々高かった他の期待値より低 くなり、他の狩場を試そうとする。 ハンター
多腕バンディット問題
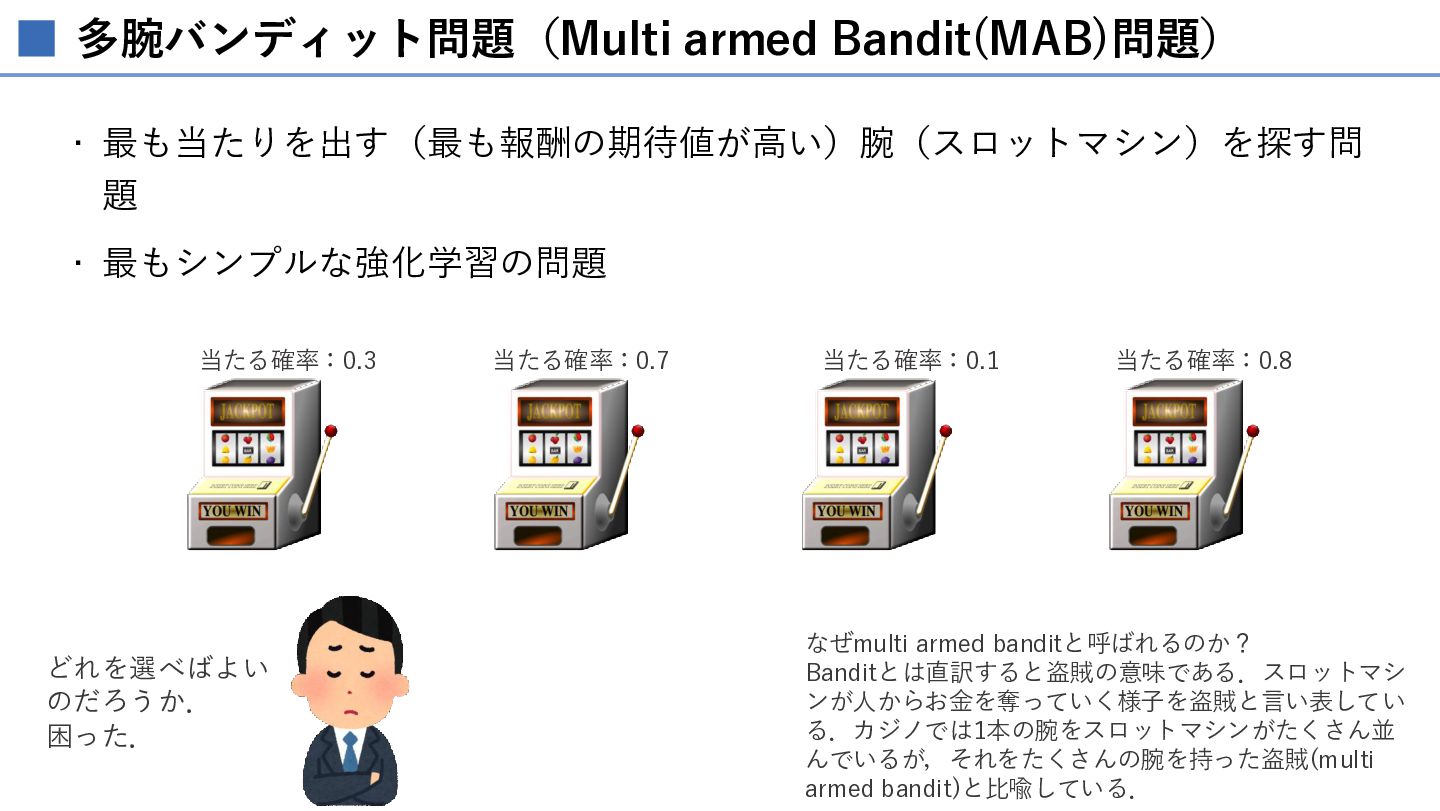
多腕バンディット問題(Multi armed Bandit(MAB)問題) • 最も当たりを出す(最も報酬の期待値が高い)腕(スロットマシン)を探す問 題 • 最もシンプルな強化学習の問題 当たる確率:0.3 どれを選べばよい
のだろうか. 困った. 当たる確率:0.7 当たる確率:0.1 当たる確率:0.8 なぜmulti armed banditと呼ばれるのか? Banditとは直訳すると盗賊の意味である.スロットマシ ンが人からお金を奪っていく様子を盗賊と言い表してい る.カジノでは1本の腕をスロットマシンがたくさん並 んでいるが,それをたくさんの腕を持った盗賊(multi armed bandit)と比喩している.
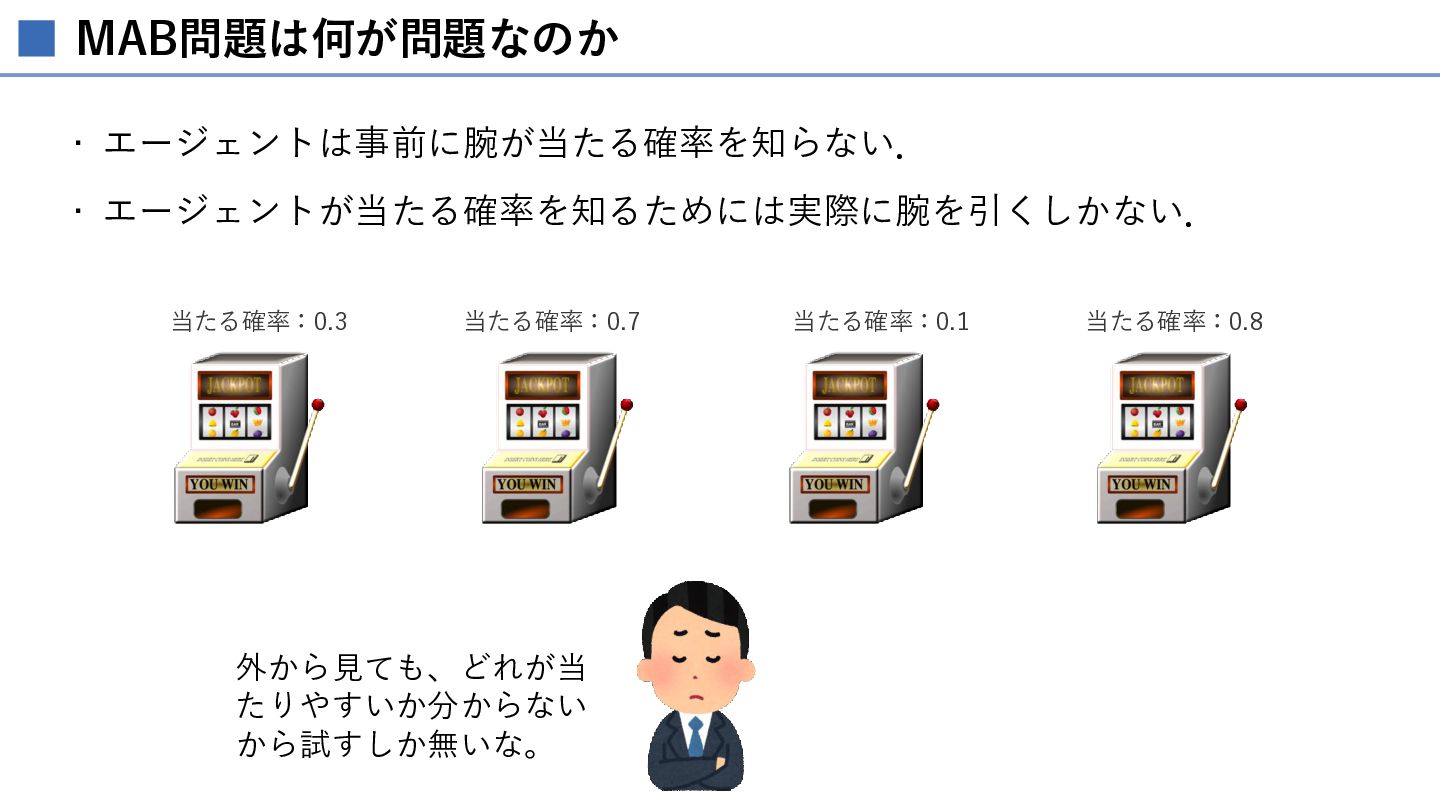
MAB問題は何が問題なのか • エージェントは事前に腕が当たる確率を知らない. • エージェントが当たる確率を知るためには実際に腕を引くしかない. 当たる確率:0.3 当たる確率:0.7 外から見ても、どれが当 たりやすいか分からない から試すしか無いな。
当たる確率:0.1 当たる確率:0.8
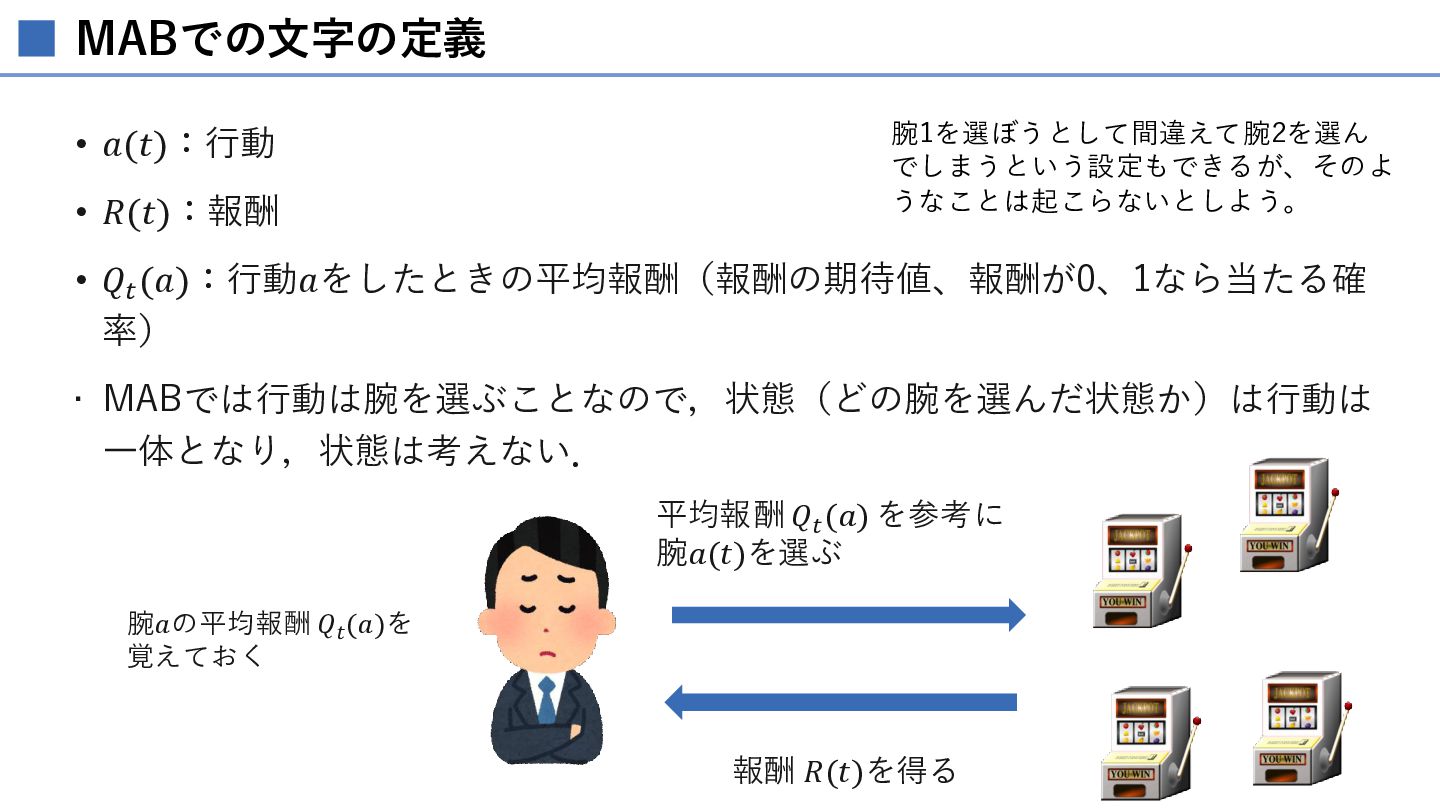
MABでの文字の定義 • 𝑎(𝑡):行動 • 𝑅(𝑡):報酬 腕1を選ぼうとして間違えて腕2を選ん でしまうという設定もできるが、そのよ うなことは起こらないとしよう。 • 𝑄𝑡
(𝑎):行動𝑎をしたときの平均報酬(報酬の期待値、報酬が0、1なら当たる確 率) • MABでは行動は腕を選ぶことなので,状態(どの腕を選んだ状態か)は行動は 一体となり,状態は考えない. 平均報酬 𝑄𝑡 (𝑎) を参考に 腕𝑎(𝑡)を選ぶ 腕𝑎の平均報酬 𝑄𝑡 (𝑎)を 覚えておく 報酬 𝑅(𝑡)を得る
MAB問題を解く代表的なアルゴリズム • greedyアルゴリズム • greedy(貪欲)に腕を選ぶ. • これまでの経験から最も報酬を得られる可能性が高い行動をする. • ε-greedyアルゴリズム •
これまでの経験から最も報酬を得られる可能性が高い行動をするが,たまに違う 腕を選ぶ. • UCB1アルゴリズム • これまでの経験から最も報酬を得られる可能性が高い行動をするが,あまり選ん でいない腕も優先して選ぶ.
Greedyアルゴリズム
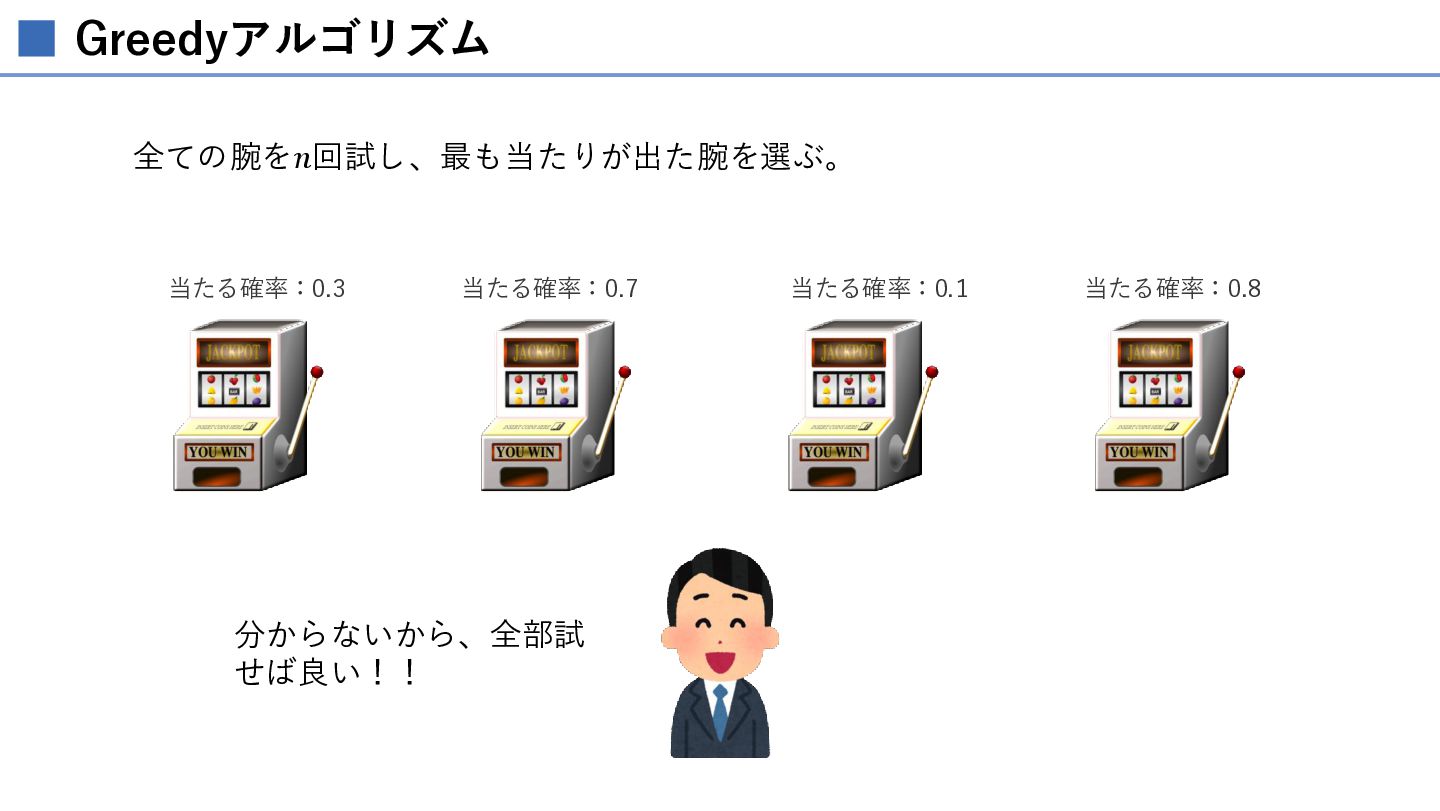
Greedyアルゴリズム 全ての腕を𝑛回試し、最も当たりが出た腕を選ぶ。 当たる確率:0.3 当たる確率:0.7 分からないから、全部試 せば良い!! 当たる確率:0.1 当たる確率:0.8
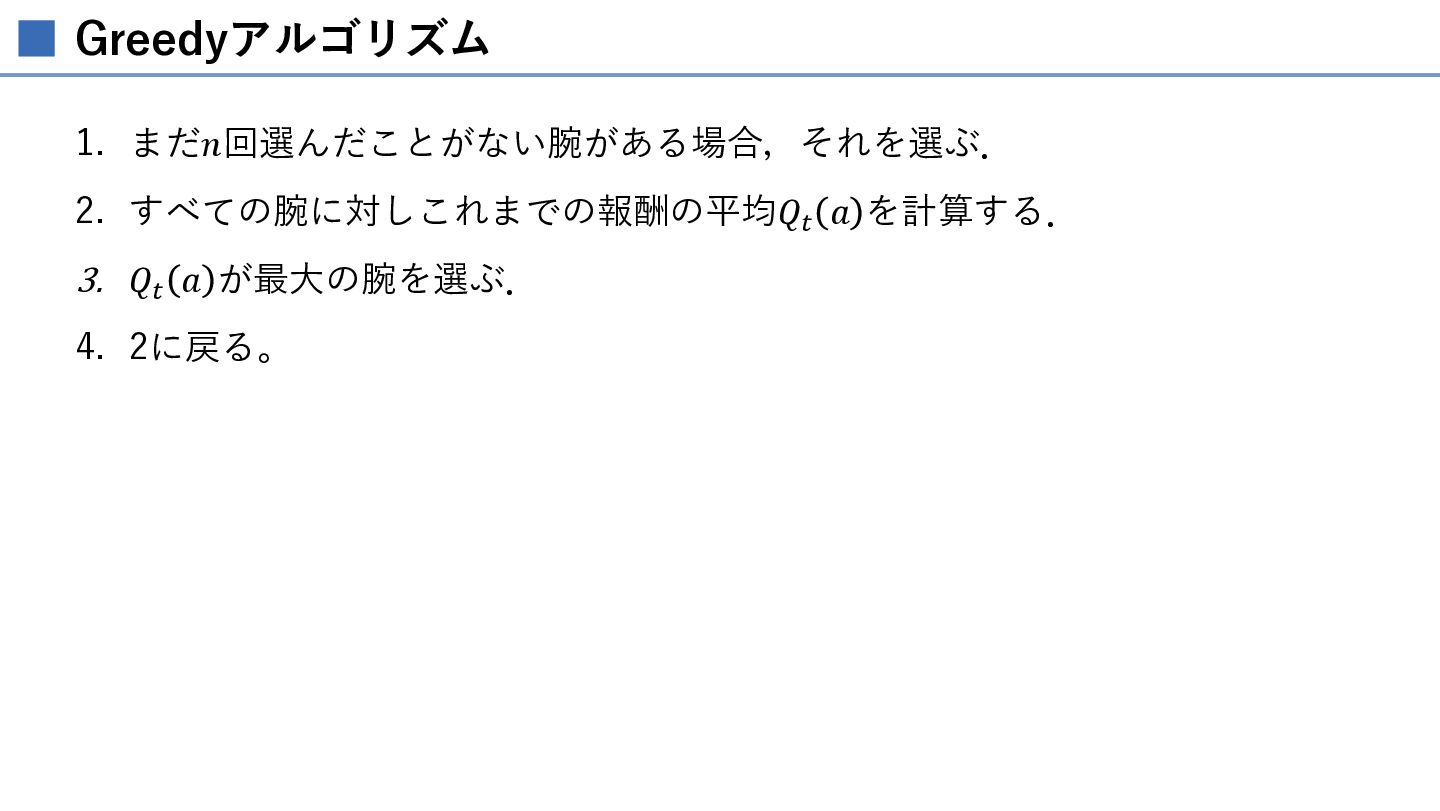
Greedyアルゴリズム 1. まだ𝑛回選んだことがない腕がある場合,それを選ぶ. 2. すべての腕に対しこれまでの報酬の平均𝑄𝑡 𝑎 を計算する. 3. 𝑄𝑡 𝑎
が最大の腕を選ぶ. 4. 2に戻る。
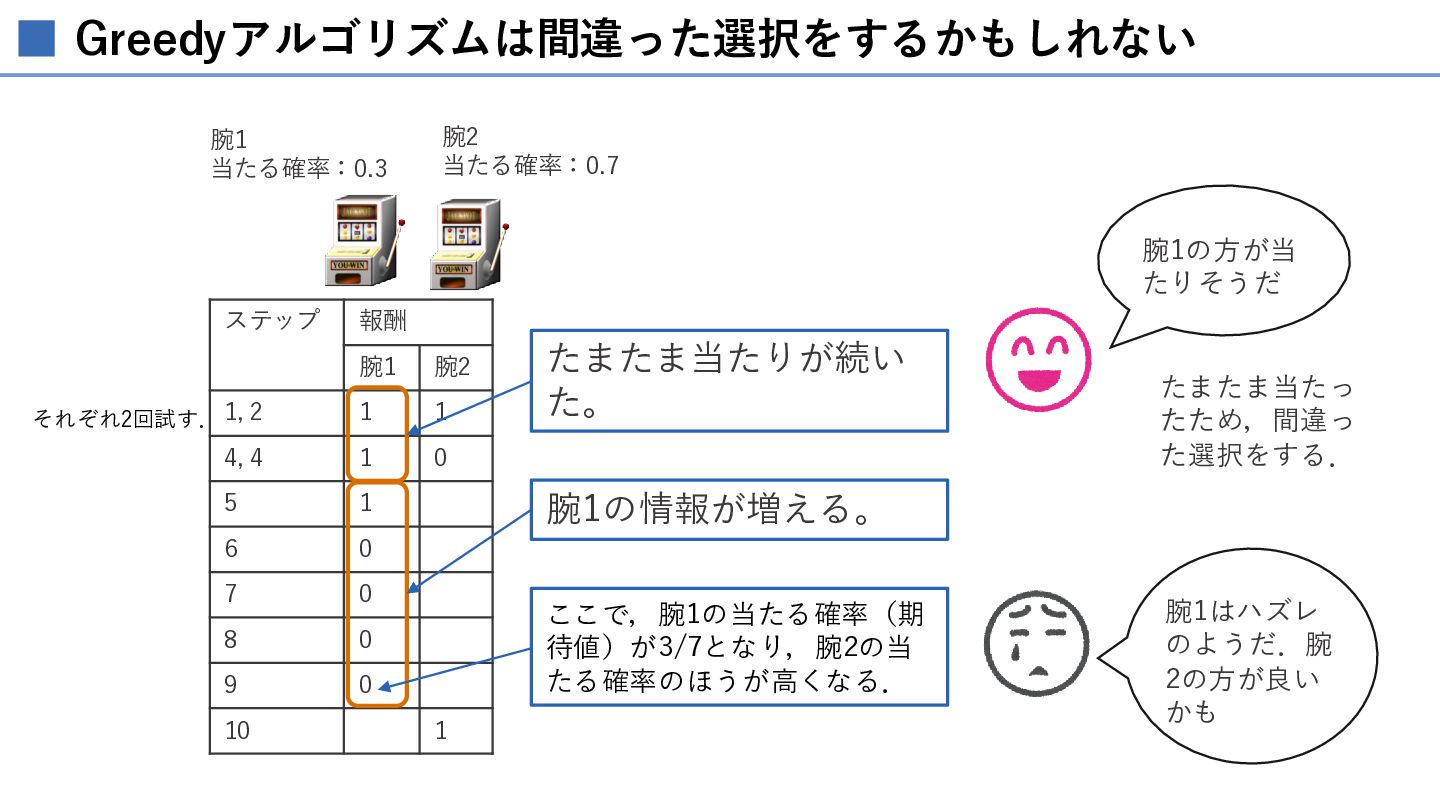
Greedyアルゴリズムは間違った選択をするかもしれない 腕1 当たる確率:0.3 腕2 当たる確率:0.7 腕1の方が当 たりそうだ ステップ 報酬 腕1
腕2 それぞれ2回試す. 1, 2 1 1 4, 4 1 0 5 1 6 0 7 0 8 0 9 0 10 たまたま当たりが続い た。 たまたま当たっ たため,間違っ た選択をする. 腕1の情報が増える。 ここで,腕1の当たる確率(期 待値)が3/7となり,腕2の当 たる確率のほうが高くなる. 1 腕1はハズレ のようだ.腕 2の方が良い かも
Greedyアルゴリズムの欠点 • 本当はあまり当たらない腕だがたまたま当たりが多く出た場合(もしくは最も 当たる腕にも関わらず、たまたまハズレばかりだった場合),あまり当たらな いハズレの腕ばかり選んでしまう可能性がある. • つまり、greedyアルゴリズムでは最も当たる腕を探せる保証はない。
ε-greedyアルゴリズム
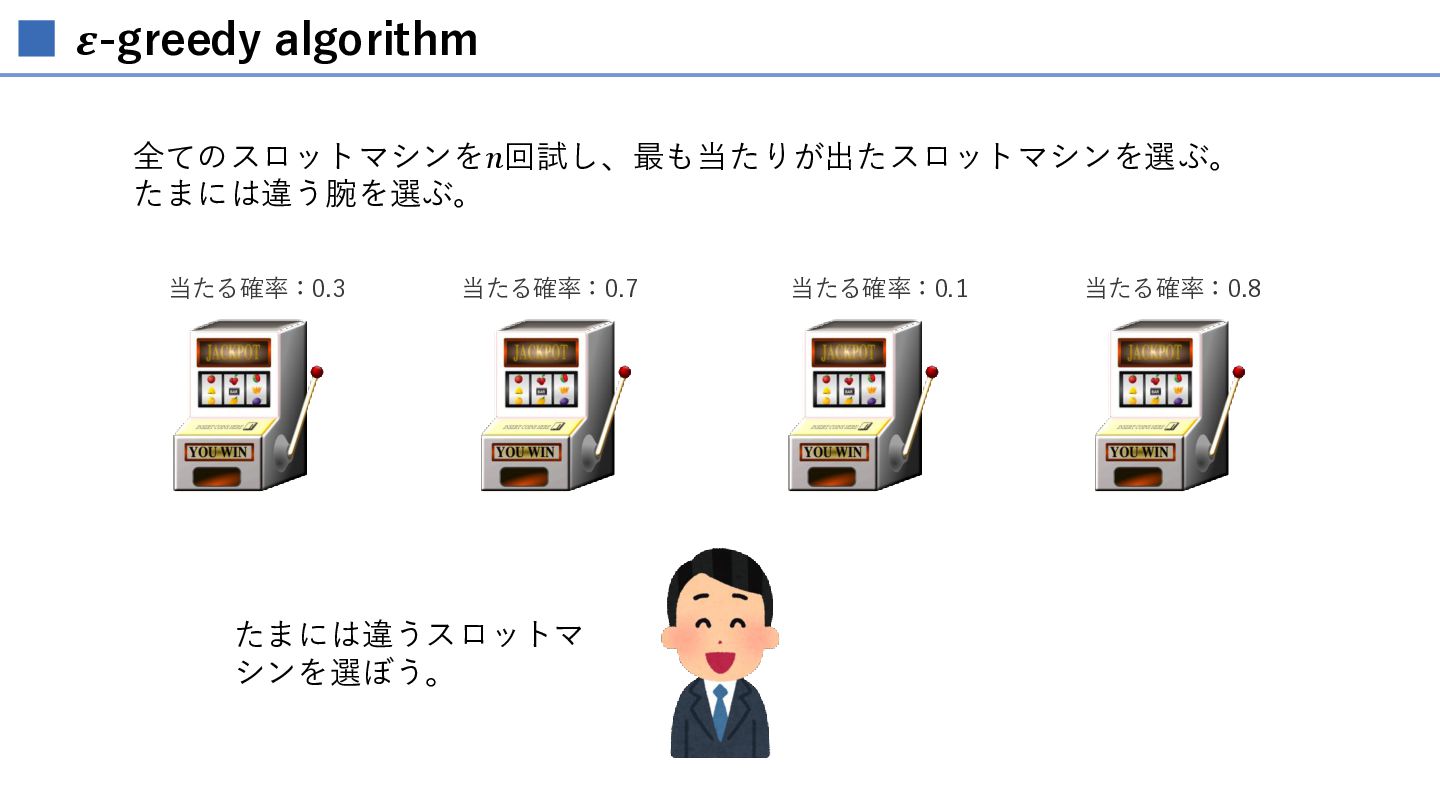
𝜺-greedy algorithm 全てのスロットマシンを𝑛回試し、最も当たりが出たスロットマシンを選ぶ。 たまには違う腕を選ぶ。 当たる確率:0.3 当たる確率:0.7 たまには違うスロットマ シンを選ぼう。 当たる確率:0.1 当たる確率:0.8
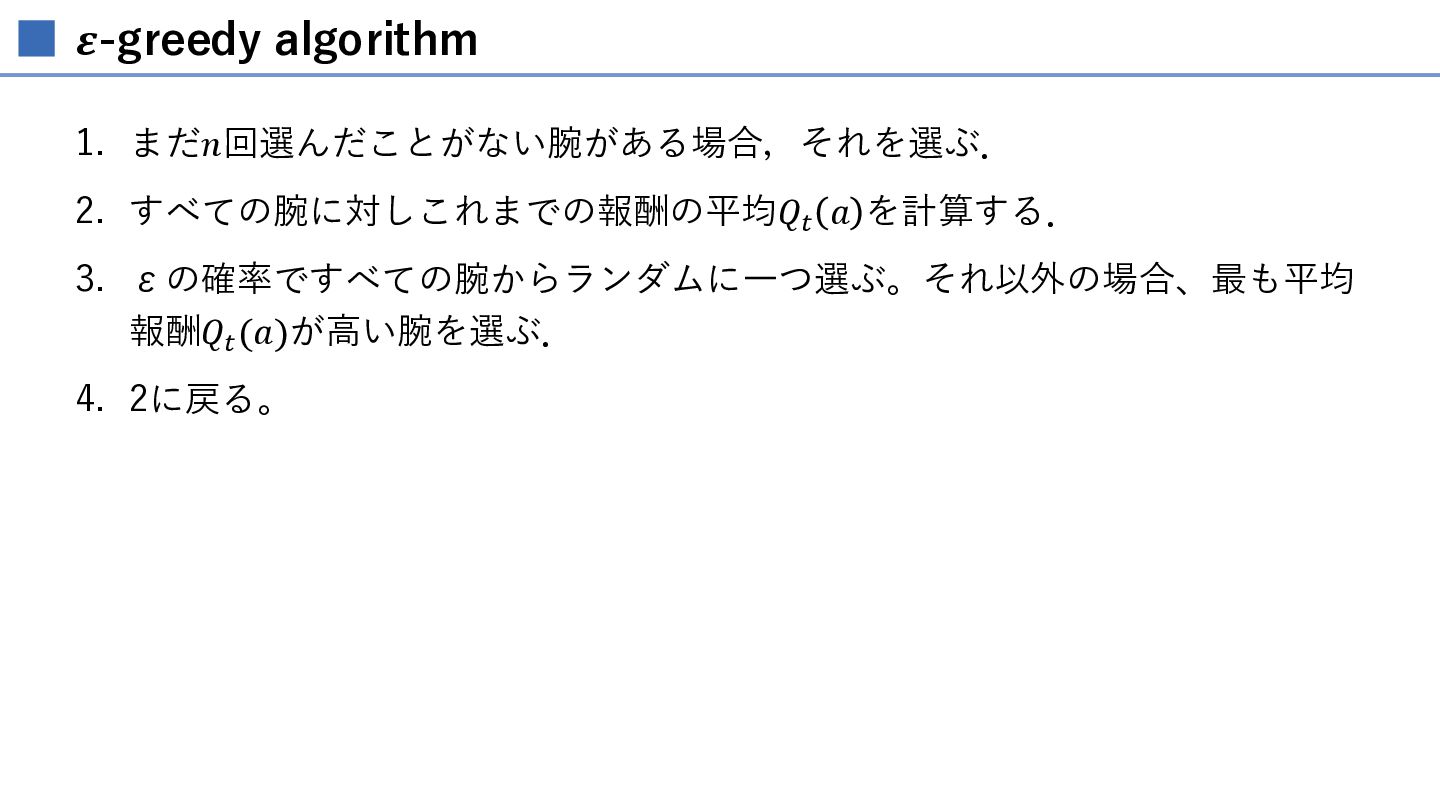
𝜺-greedy algorithm 1. まだ𝑛回選んだことがない腕がある場合,それを選ぶ. 2. すべての腕に対しこれまでの報酬の平均𝑄𝑡 𝑎 を計算する. 3. εの確率ですべての腕からランダムに一つ選ぶ。それ以外の場合、最も平均
報酬𝑄𝑡 (𝑎)が高い腕を選ぶ. 4. 2に戻る。
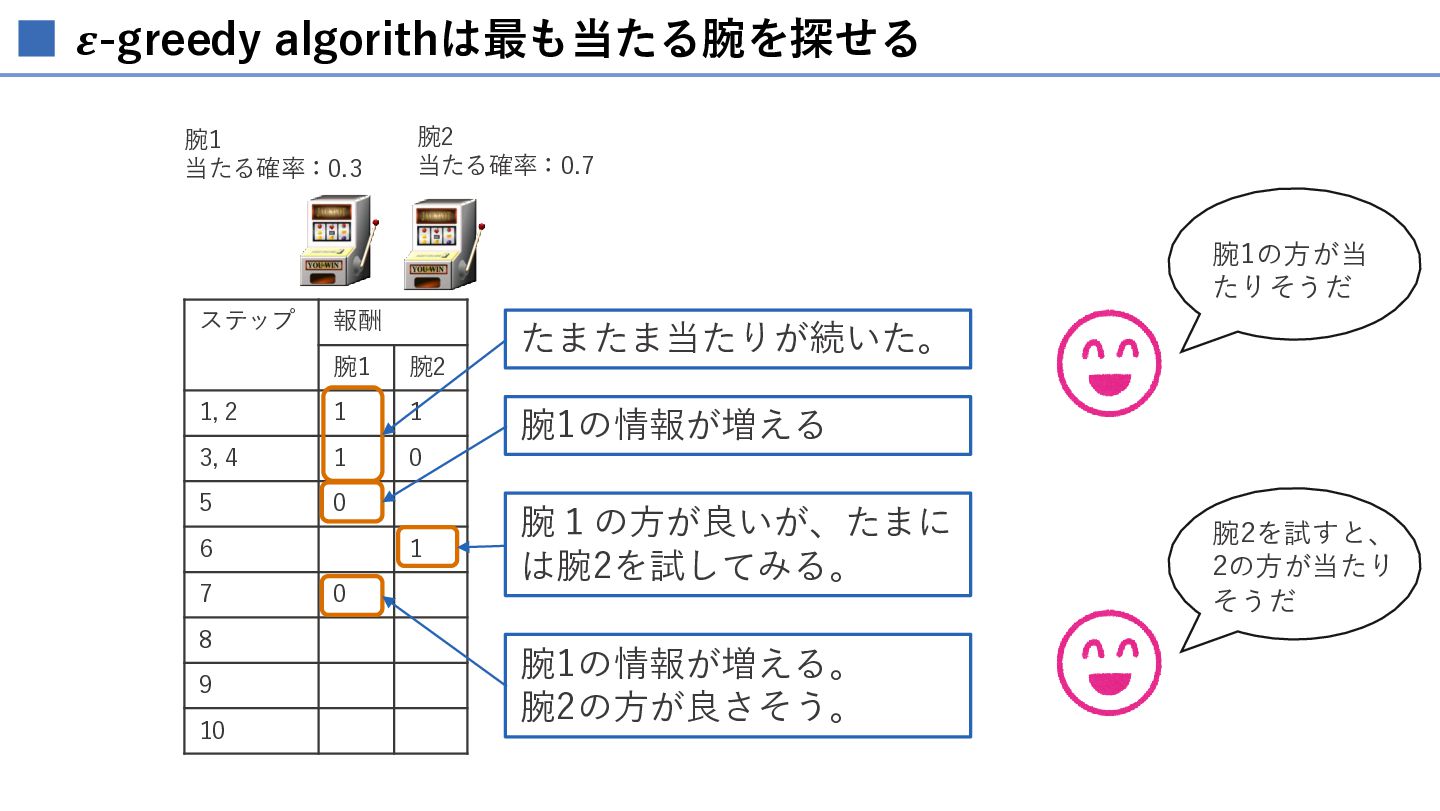
𝜺-greedy algorithは最も当たる腕を探せる 腕1 当たる確率:0.3 腕2 当たる確率:0.7 腕1の方が当 たりそうだ ステップ 報酬
腕1 腕2 1, 2 1 1 3, 4 1 0 5 0 6 7 8 9 10 1 0 たまたま当たりが続いた。 腕1の情報が増える 腕1の方が良いが、たまに は腕2を試してみる。 腕1の情報が増える。 腕2の方が良さそう。 腕2を試すと、 2の方が当たり そうだ
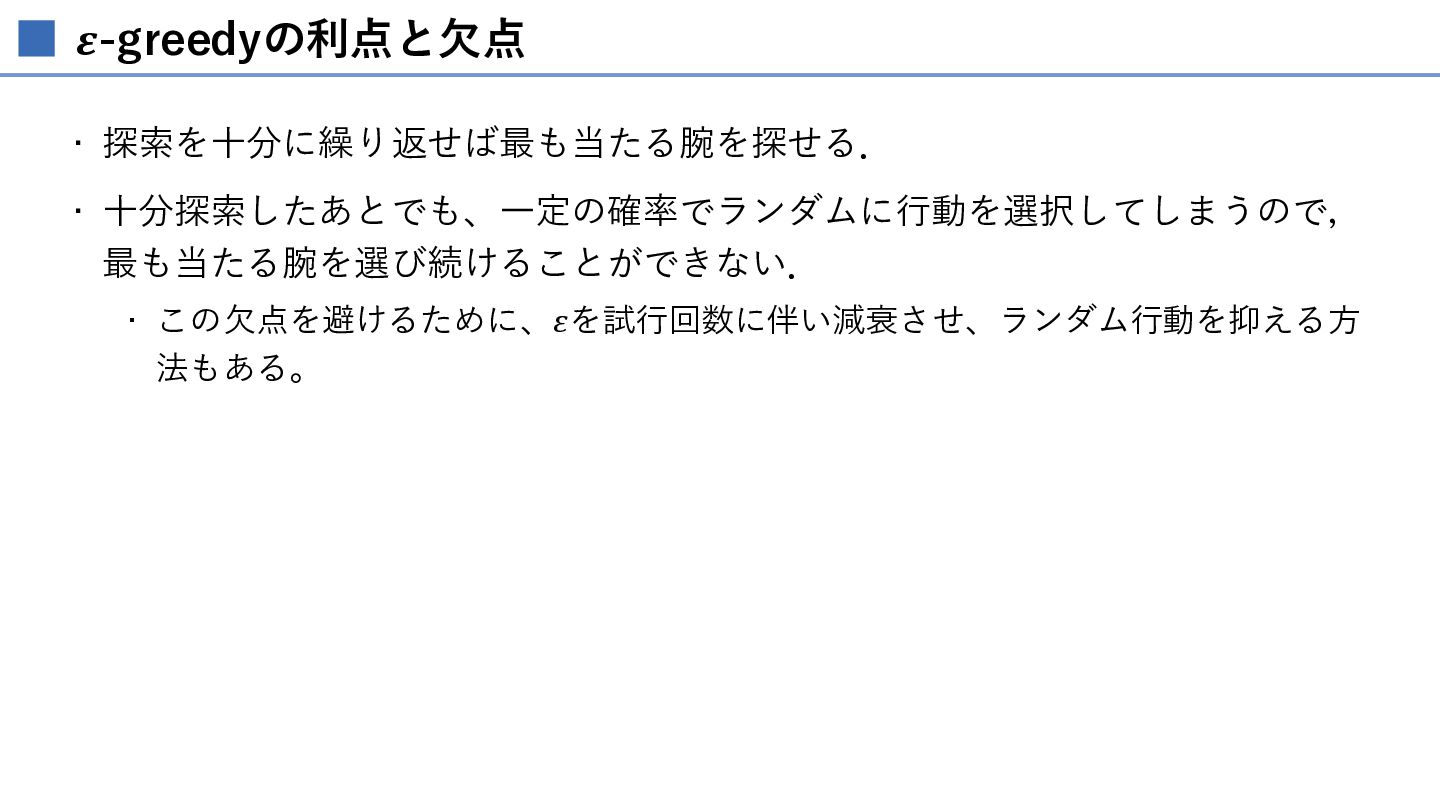
𝜺-greedyの利点と欠点 • 探索を十分に繰り返せば最も当たる腕を探せる. • 十分探索したあとでも、一定の確率でランダムに行動を選択してしまうので, 最も当たる腕を選び続けることができない. • この欠点を避けるために、𝜀を試行回数に伴い減衰させ、ランダム行動を抑える方 法もある。
UCB1
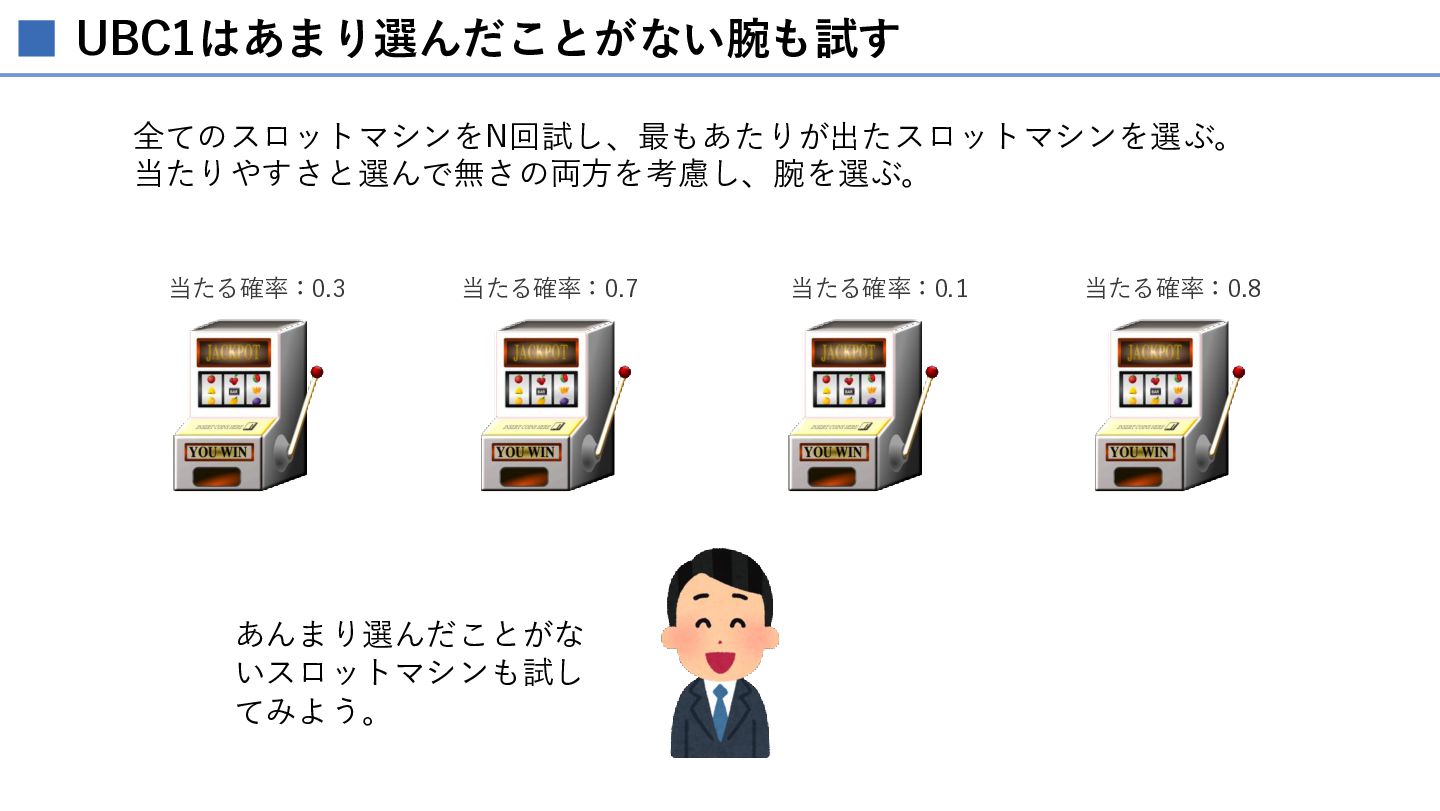
UBC1はあまり選んだことがない腕も試す 全てのスロットマシンをN回試し、最もあたりが出たスロットマシンを選ぶ。 当たりやすさと選んで無さの両方を考慮し、腕を選ぶ。 当たる確率:0.3 当たる確率:0.7 あんまり選んだことがな いスロットマシンも試し てみよう。 当たる確率:0.1 当たる確率:0.8
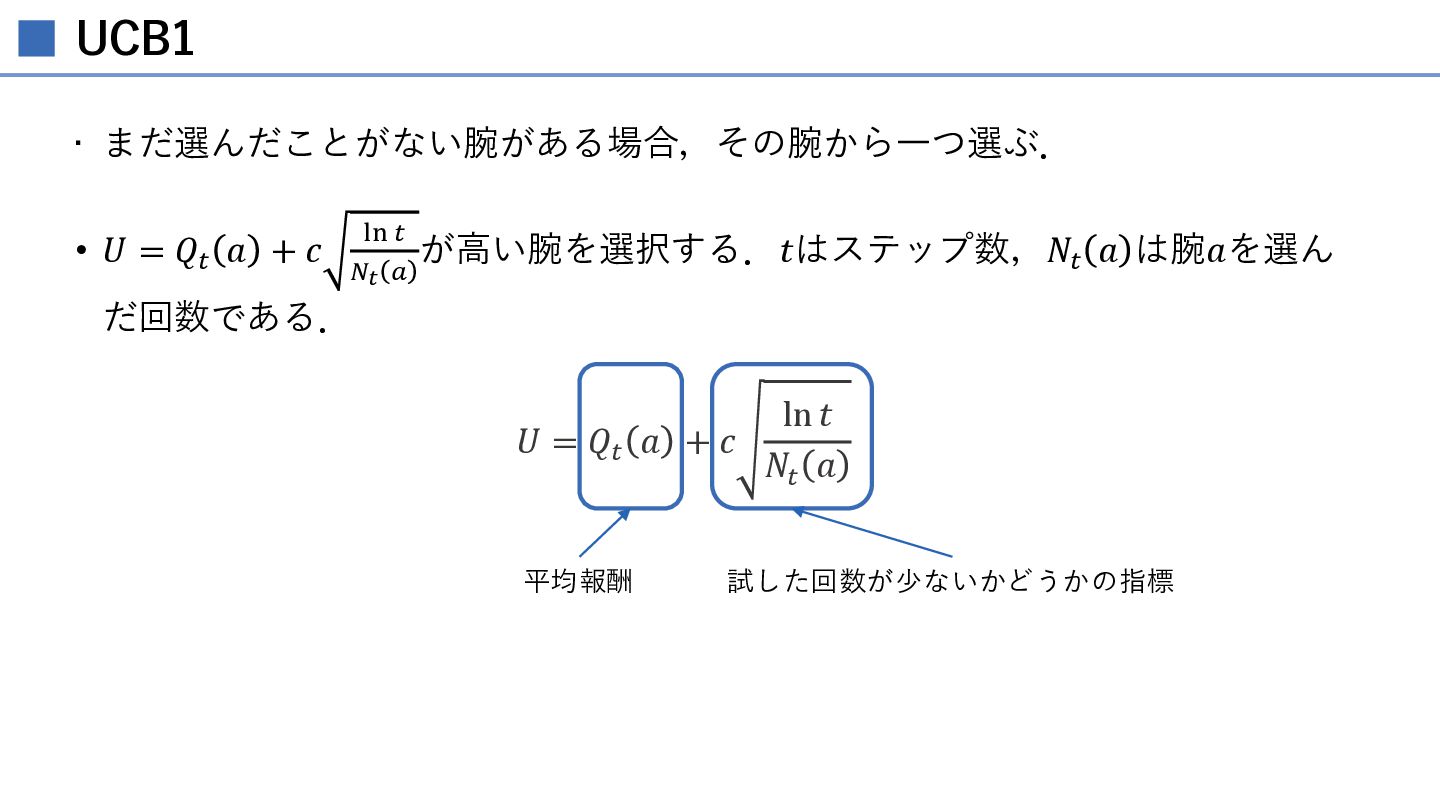
UCB1 • まだ選んだことがない腕がある場合,その腕から一つ選ぶ. • 𝑈 = 𝑄𝑡 𝑎 + 𝑐
ln 𝑡 𝑁𝑡 𝑎 が高い腕を選択する.𝑡はステップ数,𝑁𝑡 𝑎 は腕𝑎を選ん だ回数である. 𝑈 = 𝑄𝑡 𝑎 + 𝑐 平均報酬 ln 𝑡 𝑁𝑡 𝑎 試した回数が少ないかどうかの指標
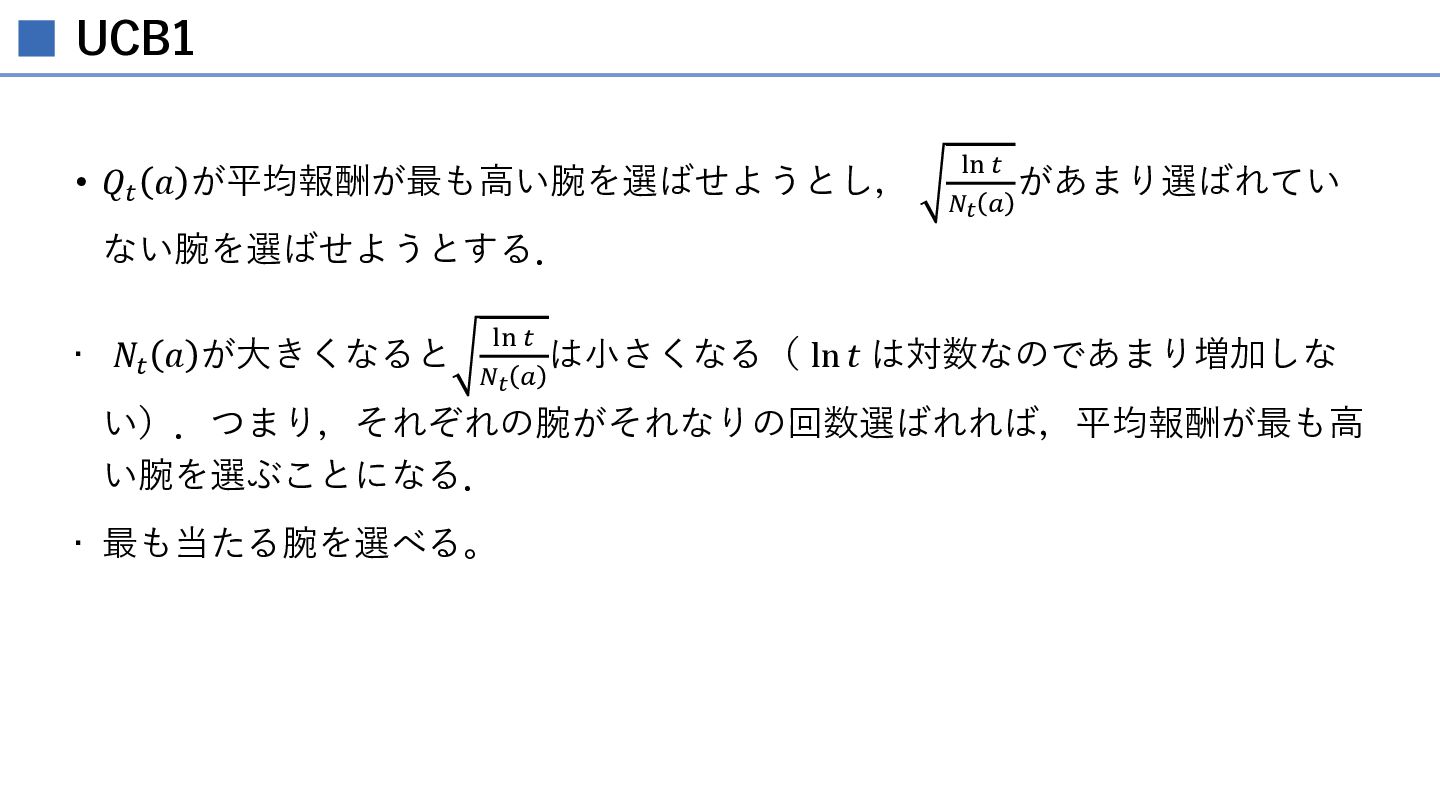
UCB1 • 𝑄𝑡 𝑎 が平均報酬が最も高い腕を選ばせようとし, ln 𝑡 𝑁𝑡 𝑎 があまり選ばれてい
ない腕を選ばせようとする. • 𝑁𝑡 𝑎 が大きくなると ln 𝑡 𝑁𝑡 𝑎 は小さくなる( ln 𝑡 は対数なのであまり増加しな い).つまり,それぞれの腕がそれなりの回数選ばれれば,平均報酬が最も高 い腕を選ぶことになる. • 最も当たる腕を選べる。
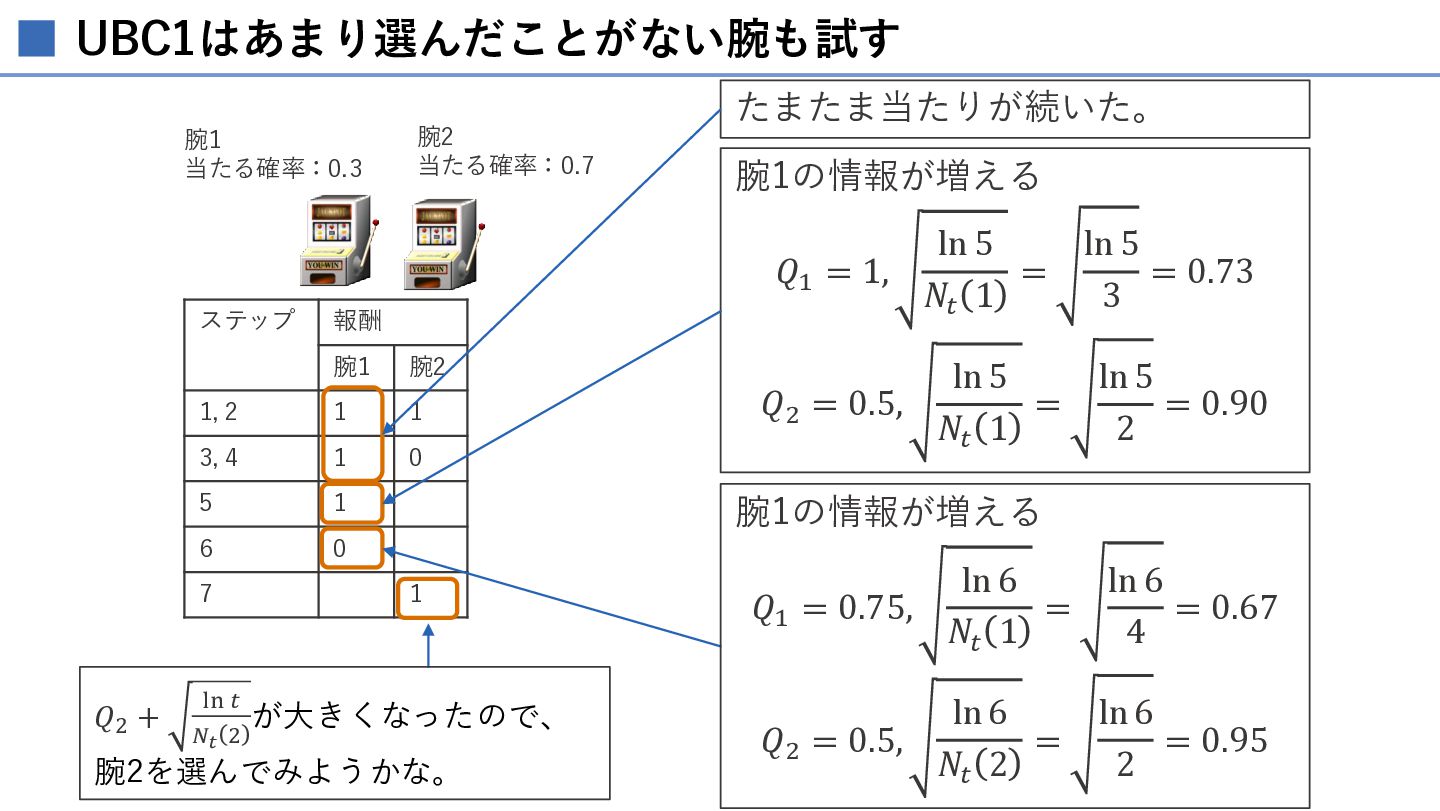
UBC1はあまり選んだことがない腕も試す 腕1 当たる確率:0.3 ステップ 報酬 腕1 𝑄2 + 腕2 当たる確率:0.7
腕1の情報が増える ln 5 𝑄1 = 1, = 𝑁𝑡 1 ln 5 = 0.73 3 ln 5 = 𝑁𝑡 1 ln 5 = 0.90 2 腕2 1, 2 1 1 3, 4 1 0 5 1 6 0 𝑄2 = 0.5, 腕1の情報が増える 7 1 ln 𝑡 が大きくなったので、 𝑁𝑡 2 たまたま当たりが続いた。 腕2を選んでみようかな。 ln 6 𝑄1 = 0.75, = 𝑁𝑡 1 ln 6 = 0.67 4 ln 6 = 𝑁𝑡 2 ln 6 = 0.95 2 𝑄2 = 0.5,
UBC1 の利点と欠点 • 探索を十分繰り返せば最も当たる腕を探せる. • 選んでいないことを高評価してしてしまい、無駄な探索をする可能性がある。 • 1度も試していないと0割りが起こり、無限大に発散する。 • 0割りに対する手当が必要となる。
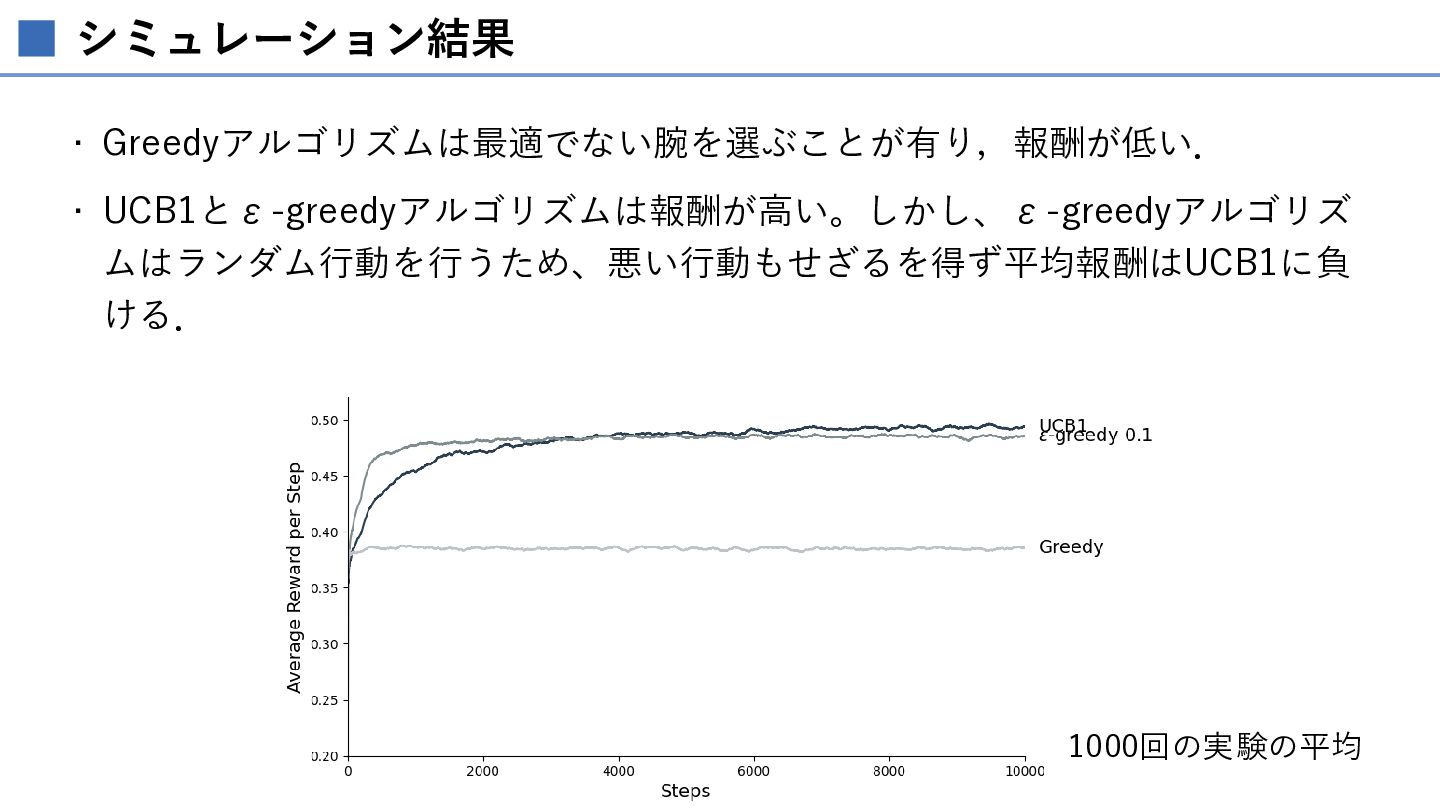
シミュレーション結果 • Greedyアルゴリズムは最適でない腕を選ぶことが有り,報酬が低い. • UCB1とε-greedyアルゴリズムは報酬が高い。しかし、ε-greedyアルゴリズ ムはランダム行動を行うため、悪い行動もせざるを得ず平均報酬はUCB1に負 ける. 1000回の実験の平均
MAB問題の応用事例
MAB問題の応用 • 配置問題 • モンテカルロ木探索 • 深層強化学習 • AlphaZero
配置問題
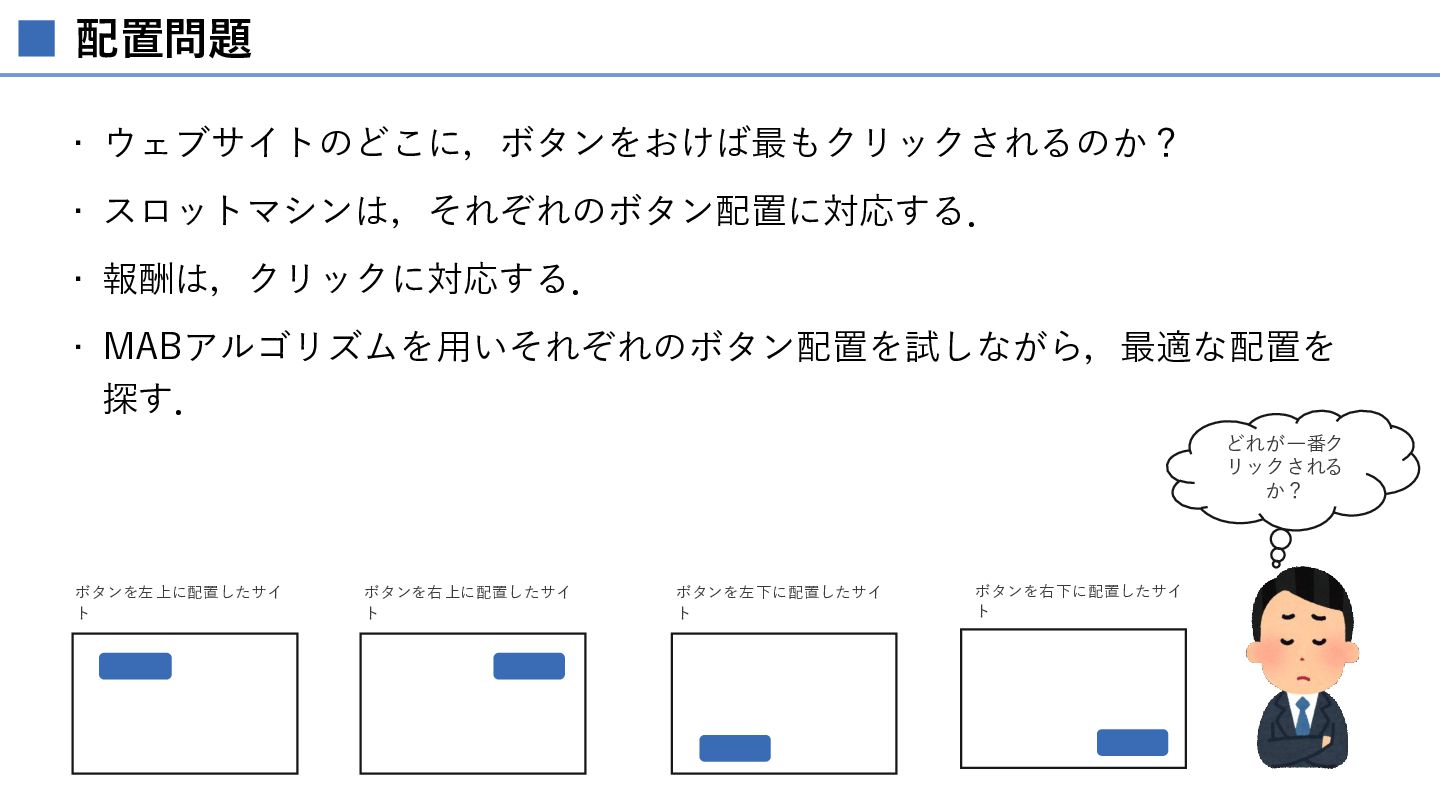
配置問題 • ウェブサイトのどこに,ボタンをおけば最もクリックされるのか? • スロットマシンは,それぞれのボタン配置に対応する. • 報酬は,クリックに対応する. • MABアルゴリズムを用いそれぞれのボタン配置を試しながら,最適な配置を 探す.
どれが一番ク リックされる か? ボタンを左上に配置したサイ ト ボタンを右上に配置したサイ ト ボタンを左下に配置したサイ ト ボタンを右下に配置したサイ ト
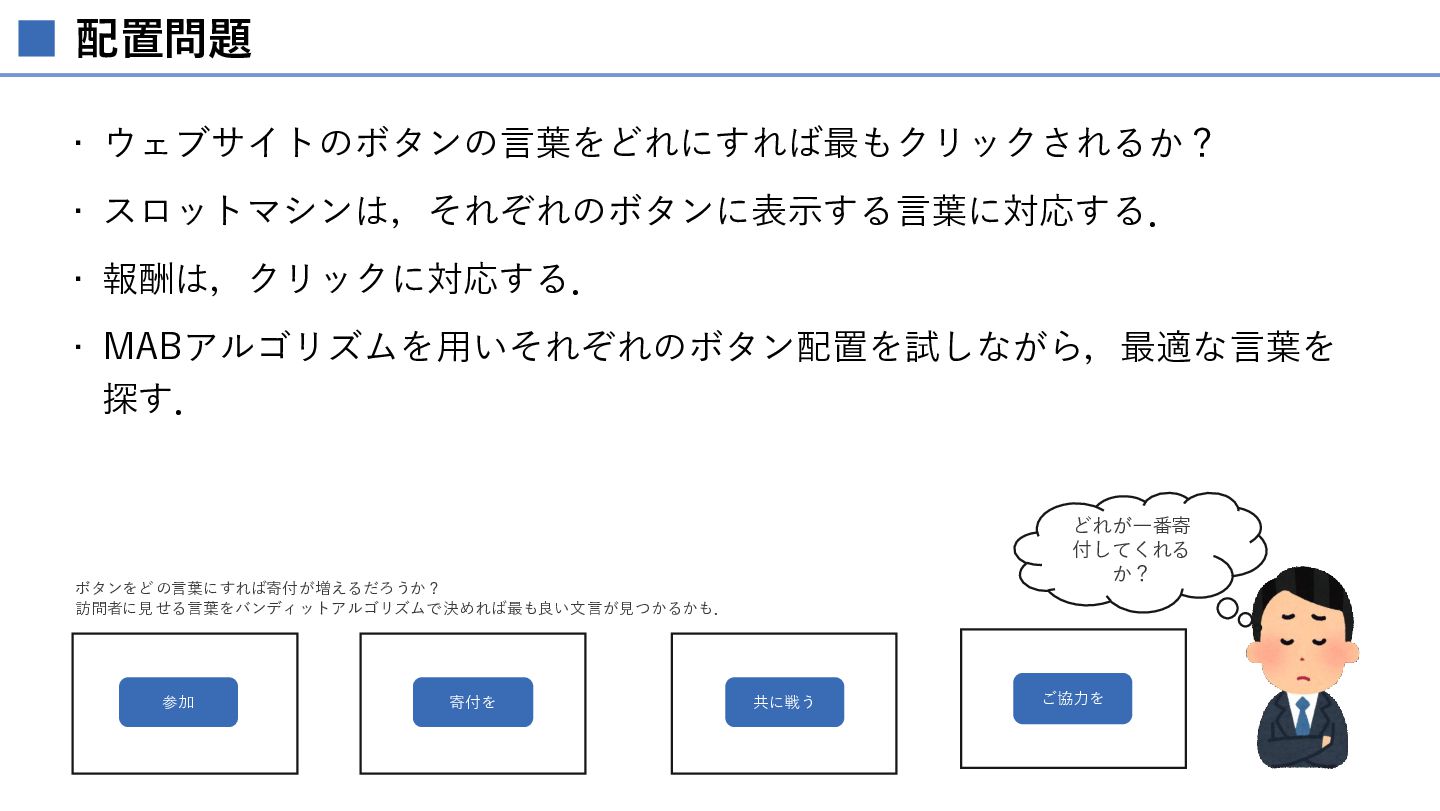
配置問題 • ウェブサイトのボタンの言葉をどれにすれば最もクリックされるか? • スロットマシンは,それぞれのボタンに表示する言葉に対応する. • 報酬は,クリックに対応する. • MABアルゴリズムを用いそれぞれのボタン配置を試しながら,最適な言葉を 探す.
どれが一番寄 付してくれる か? ボタンをどの言葉にすれば寄付が増えるだろうか? 訪問者に見せる言葉をバンディットアルゴリズムで決めれば最も良い文言が見つかるかも. 参加 寄付を 共に戦う ご協力を
モンテカルロ木探索
モンテカルロ木探索とは • ゲーム木を探索するためアルゴリズム. • 囲碁AIのアルゴリズムとして有名. • 多腕バンディットが活用されている. • モンテカルロ木探索(Monte Carlo
Tree Search: MCTS)
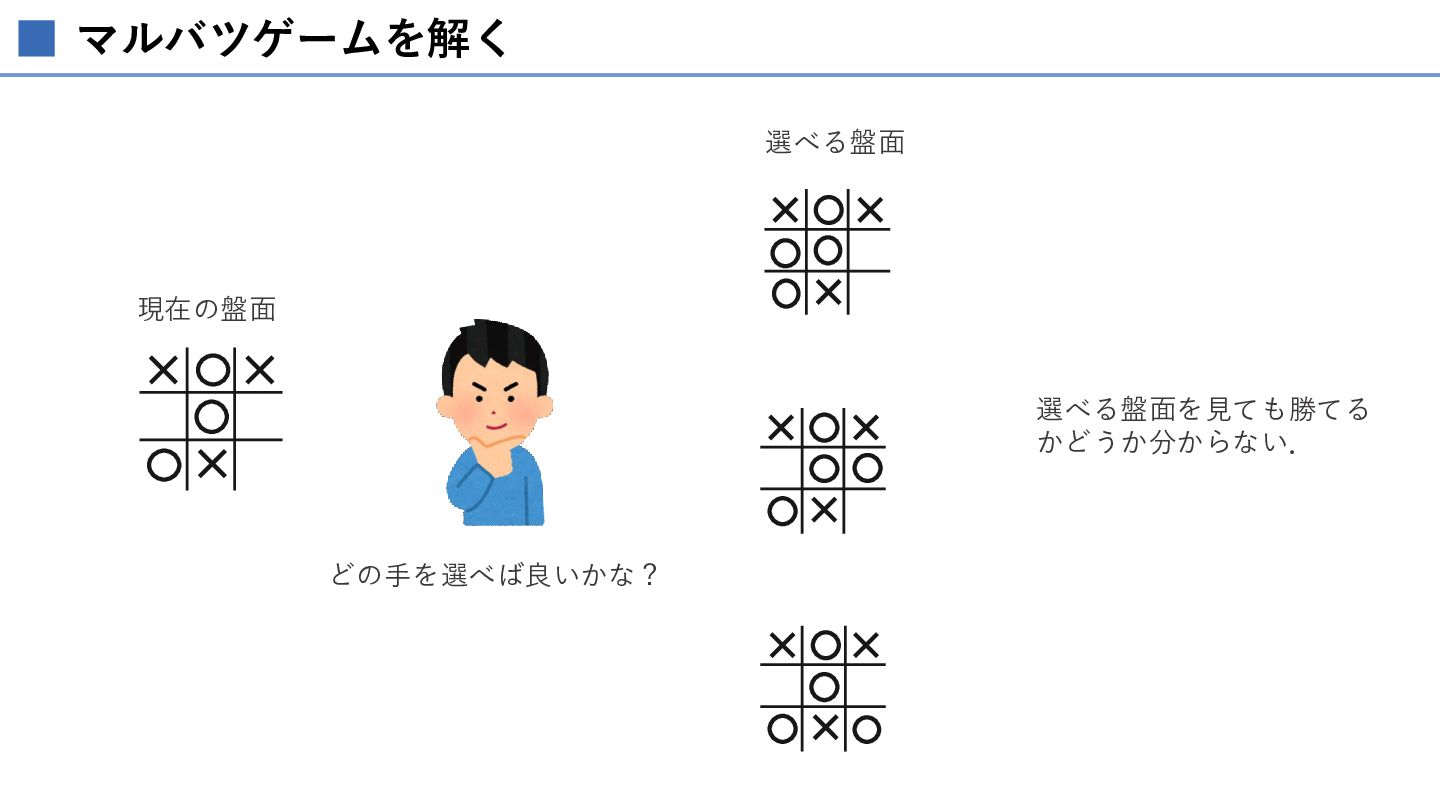
マルバツゲームを解く 選べる盤面 現在の盤面 選べる盤面を見ても勝てる かどうか分からない. どの手を選べば良いかな?
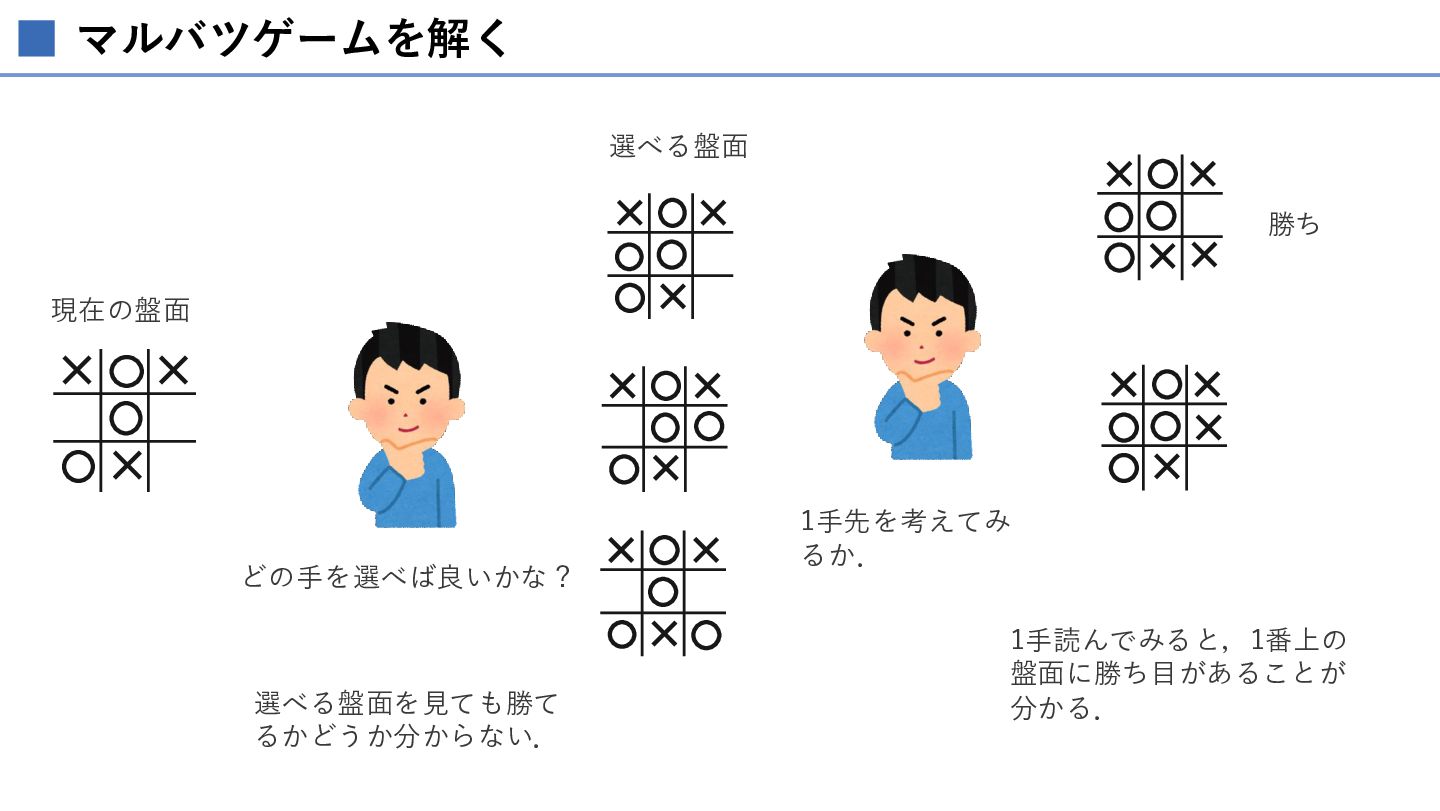
マルバツゲームを解く 選べる盤面 勝ち 現在の盤面 どの手を選べば良いかな? 選べる盤面を見ても勝て るかどうか分からない. 1手先を考えてみ るか. 1手読んでみると,1番上の
盤面に勝ち目があることが 分かる.
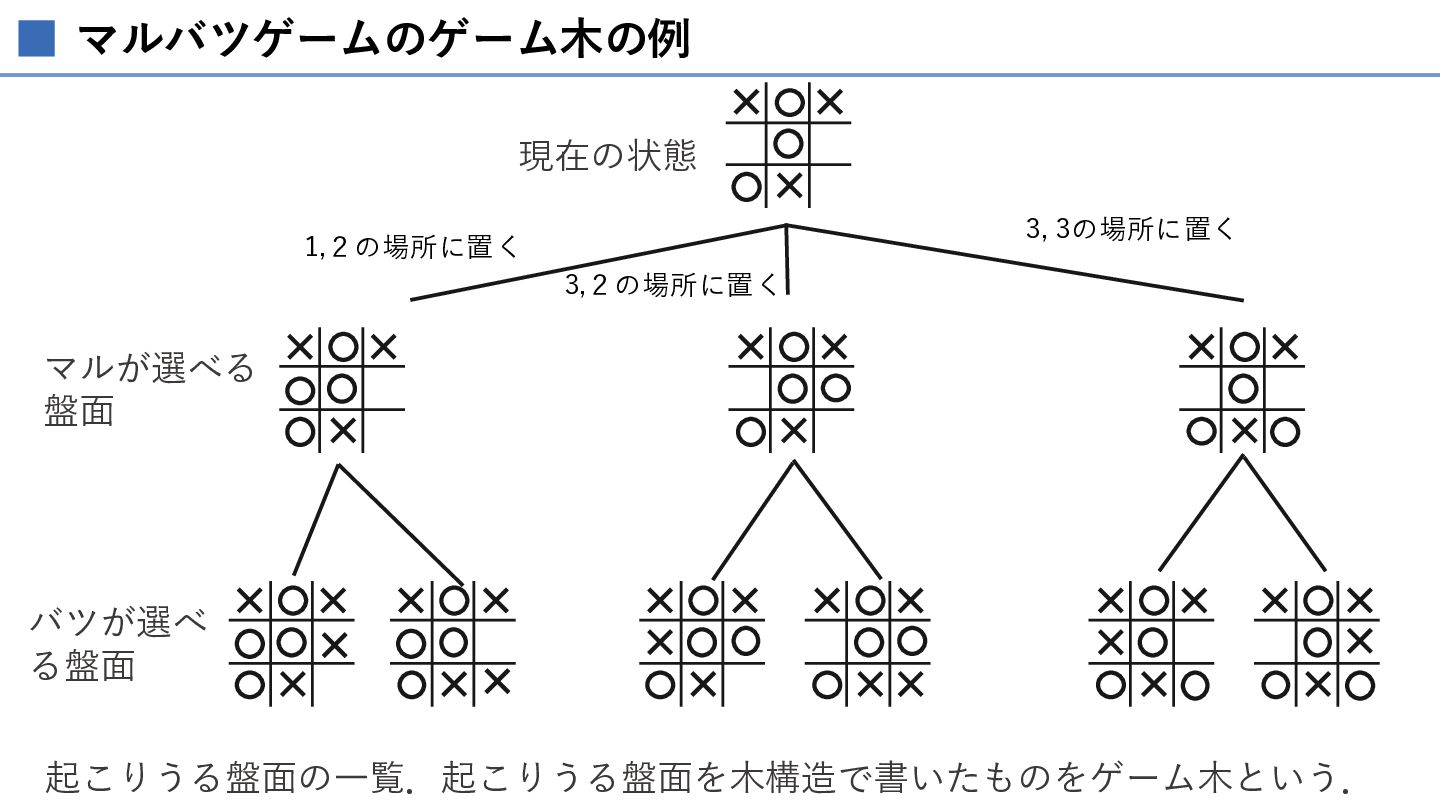
マルバツゲームのゲーム木の例 現在の状態 3, 3の場所に置く 1,2の場所に置く 3,2の場所に置く マルが選べる 盤面 バツが選べ る盤面
起こりうる盤面の一覧.起こりうる盤面を木構造で書いたものをゲーム木という.
木探索でゲームは解けるが… • ゲームで起こりうる全ての盤面を網羅したゲーム木を作れば、必勝(もしくは 負けない)手を探すことが出来る。 • オセロ、将棋、囲碁などより複雑なゲームだと、全ての盤面を網羅することが 計算量的に不可能である。 • そうやってゲーム木の探索をすればよいか? •
全ての盤面を網羅しない。 • 不可能だから。 • 木探索をランダムに行う。 • 盤面を網羅しないとしても、探索しなければならないので、ランダムに探索してみる。 • バンディット問題を応用する。 • 完全にランダムだと効率が悪いだろうから、バンディット問題の適用をしてみる。
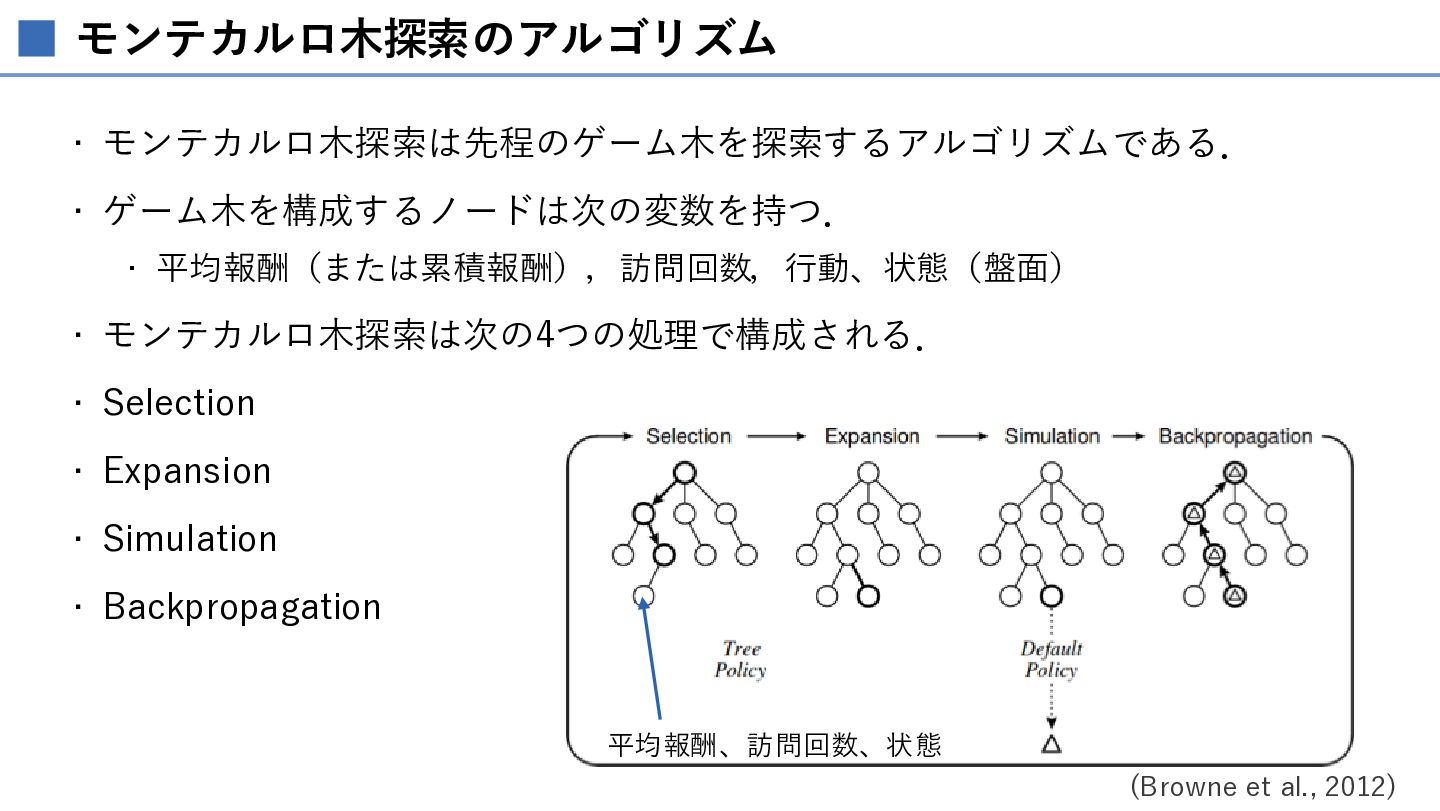
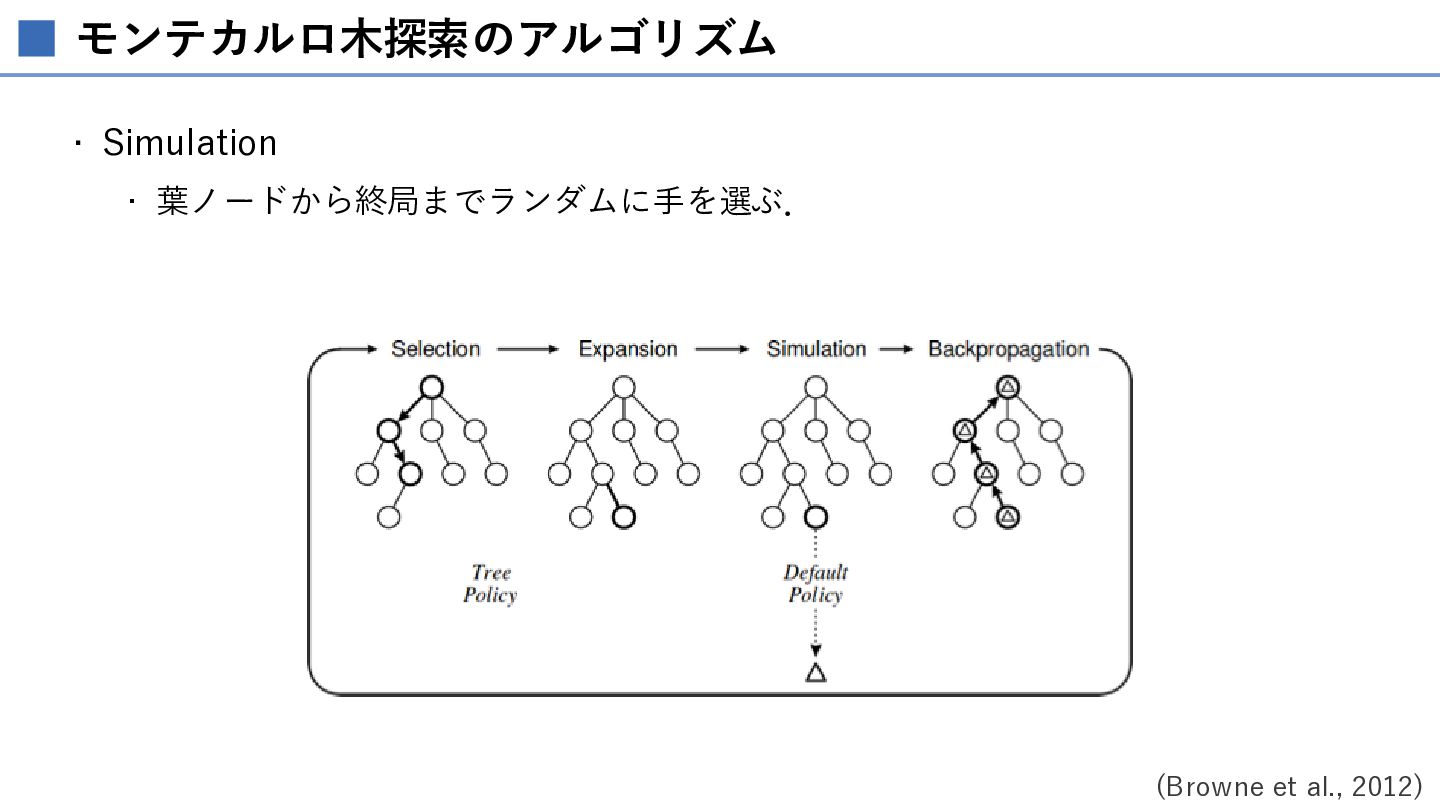
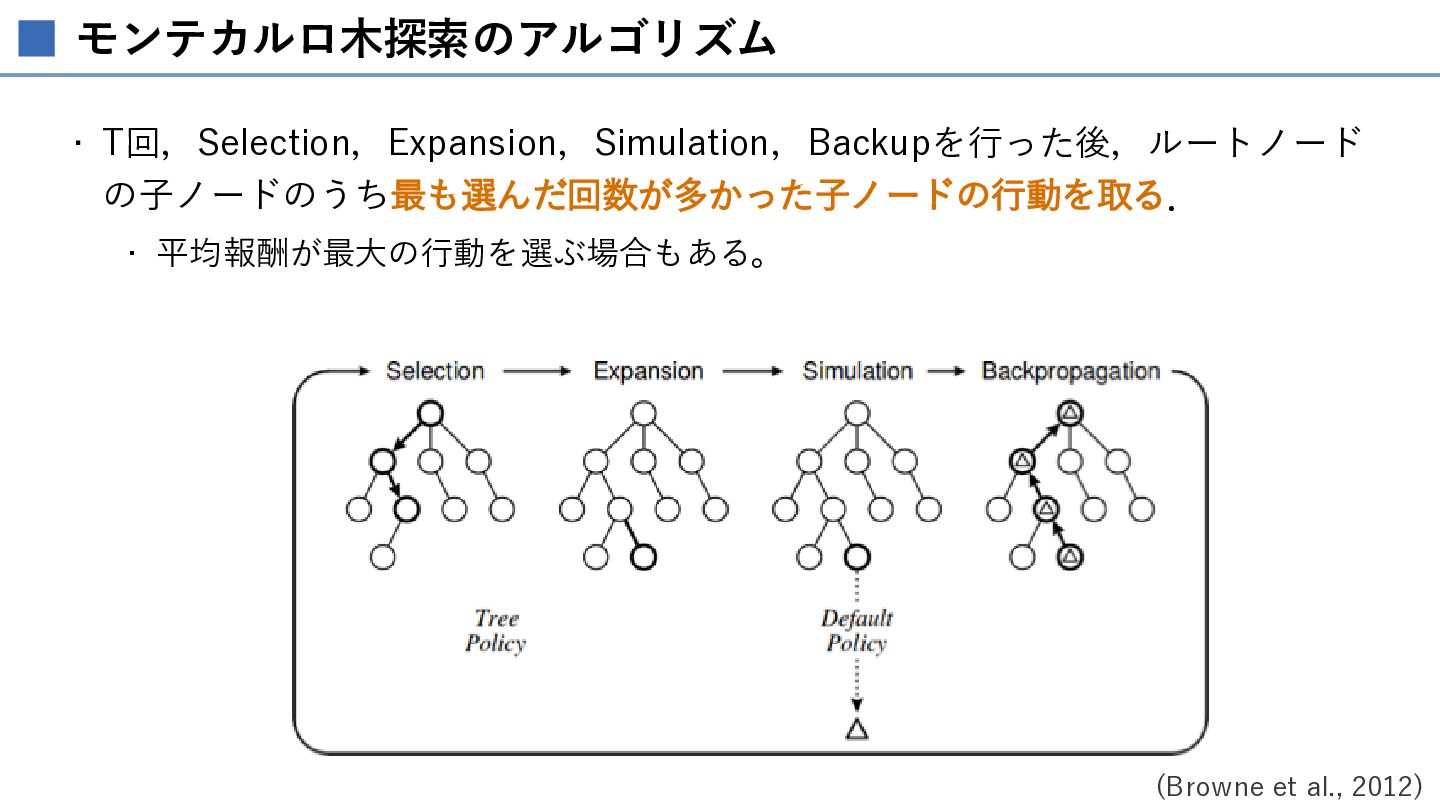
モンテカルロ木探索のアルゴリズム • モンテカルロ木探索は先程のゲーム木を探索するアルゴリズムである. • ゲーム木を構成するノードは次の変数を持つ. • 平均報酬(または累積報酬),訪問回数,行動、状態(盤面) • モンテカルロ木探索は次の4つの処理で構成される. •
Selection • Expansion • Simulation • Backpropagation 平均報酬、訪問回数、状態 (Browne et al., 2012)
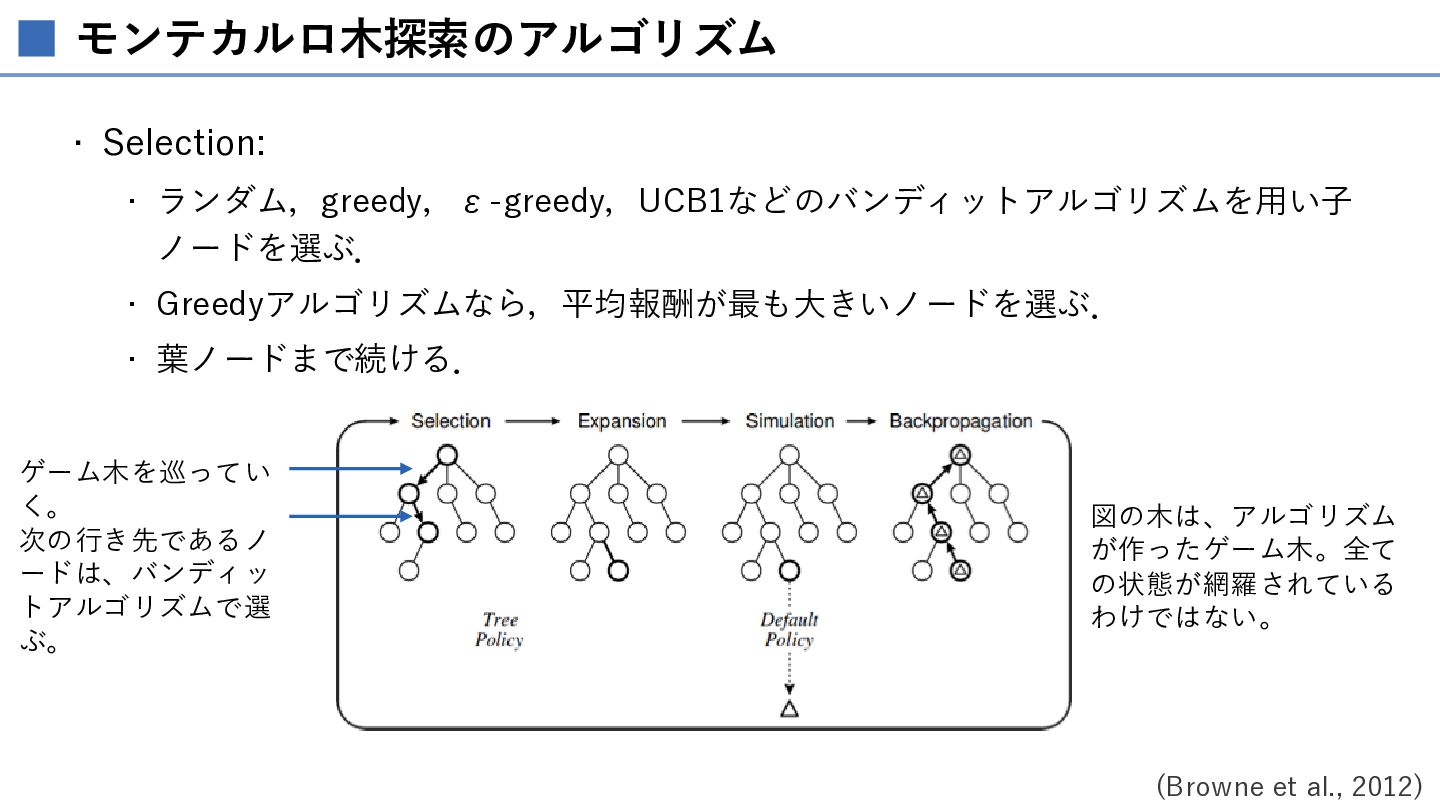
モンテカルロ木探索のアルゴリズム • Selection: • ランダム,greedy,ε-greedy,UCB1などのバンディットアルゴリズムを用い子 ノードを選ぶ. • Greedyアルゴリズムなら,平均報酬が最も大きいノードを選ぶ. • 葉ノードまで続ける.
ゲーム木を巡ってい く。 次の行き先であるノ ードは、バンディッ トアルゴリズムで選 ぶ。 図の木は、アルゴリズム が作ったゲーム木。全て の状態が網羅されている わけではない。 (Browne et al., 2012)
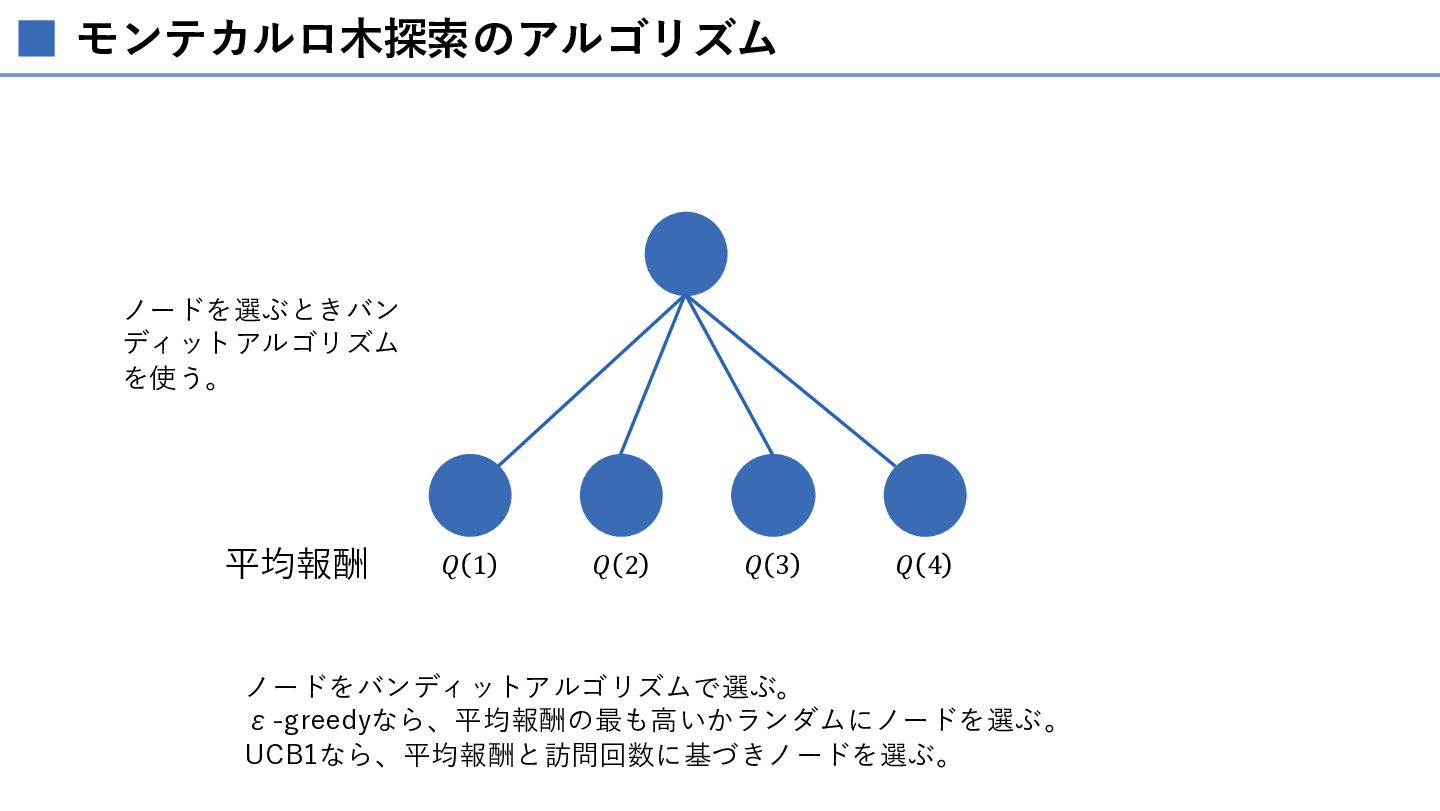
モンテカルロ木探索のアルゴリズム ノードを選ぶときバン ディットアルゴリズム を使う。 平均報酬 𝑄 1 𝑄 2 𝑄
3 𝑄 4 ノードをバンディットアルゴリズムで選ぶ。 ε-greedyなら、平均報酬の最も高いかランダムにノードを選ぶ。 UCB1なら、平均報酬と訪問回数に基づきノードを選ぶ。
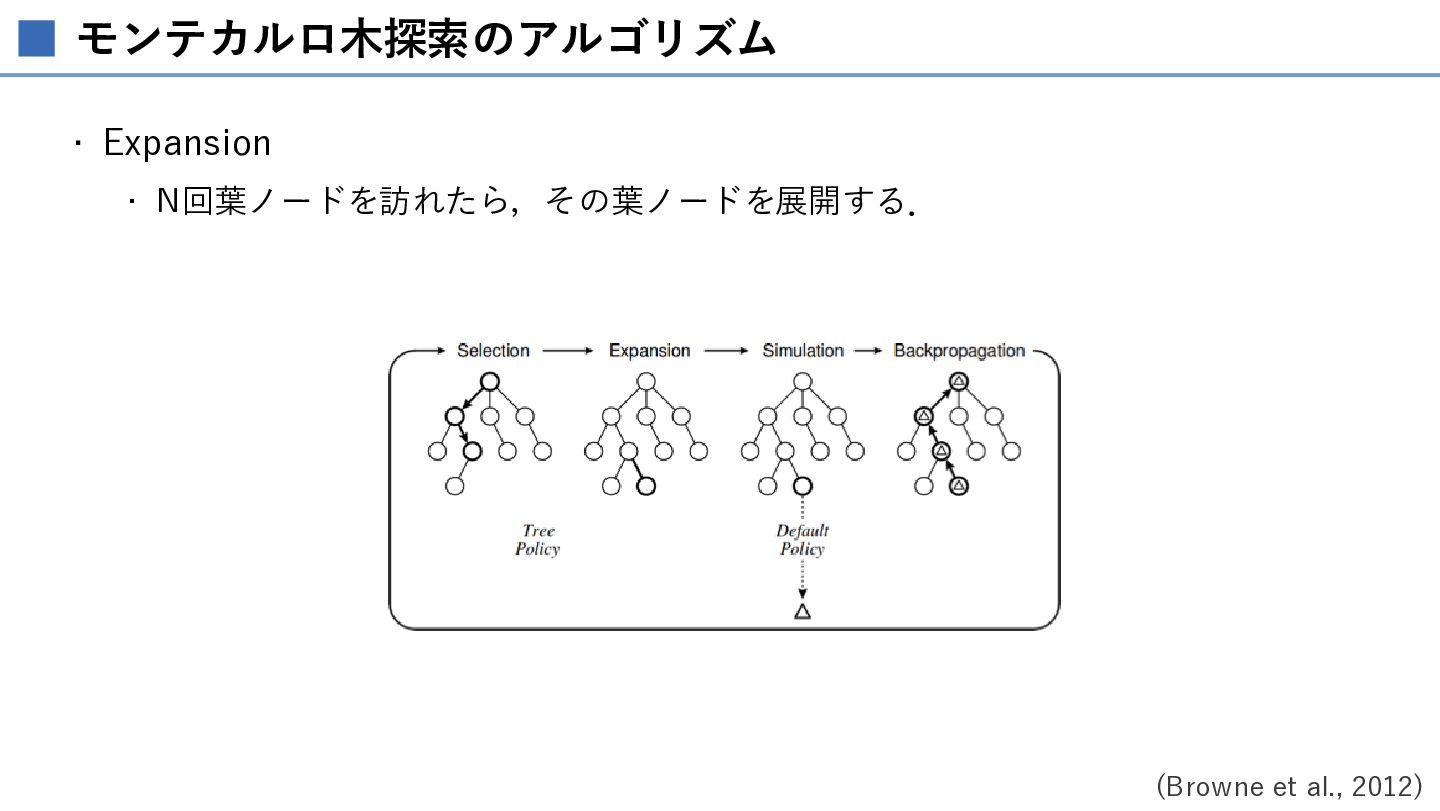
モンテカルロ木探索のアルゴリズム • Expansion • N回葉ノードを訪れたら,その葉ノードを展開する. (Browne et al., 2012)
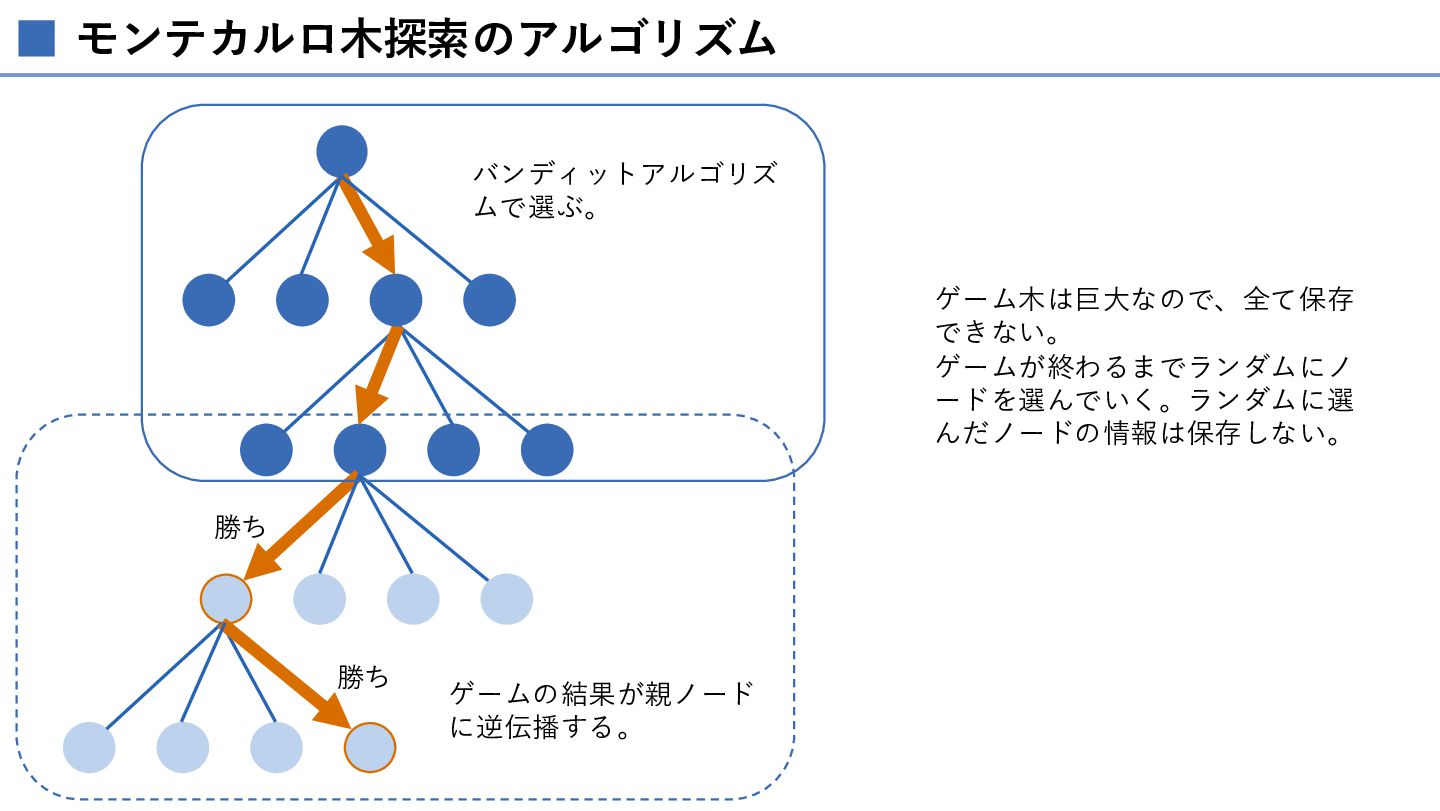
モンテカルロ木探索のアルゴリズム • Simulation • 葉ノードから終局までランダムに手を選ぶ. (Browne et al., 2012)
モンテカルロ木探索のアルゴリズム バンディットアルゴリズ ムで選ぶ。 ゲーム木は巨大なので、全て保存 できない。 ゲームが終わるまでランダムにノ ードを選んでいく。ランダムに選 んだノードの情報は保存しない。 勝ち 勝ち
ゲームの結果が親ノード に逆伝播する。
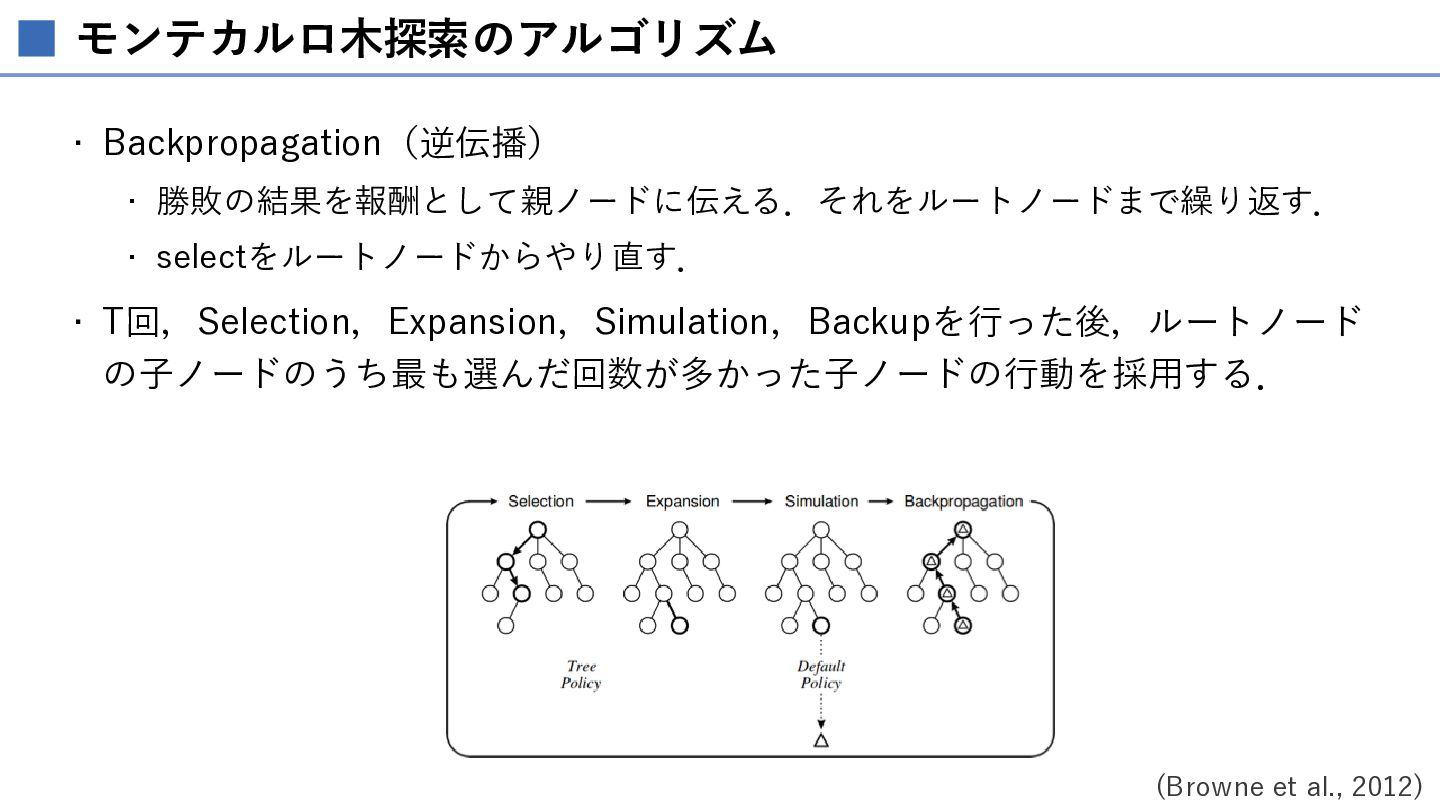
モンテカルロ木探索のアルゴリズム • Backpropagation(逆伝播) • 勝敗の結果を報酬として親ノードに伝える.それをルートノードまで繰り返す. • selectをルートノードからやり直す. • T回,Selection,Expansion,Simulation,Backupを行った後,ルートノード の子ノードのうち最も選んだ回数が多かった子ノードの行動を採用する.
(Browne et al., 2012)
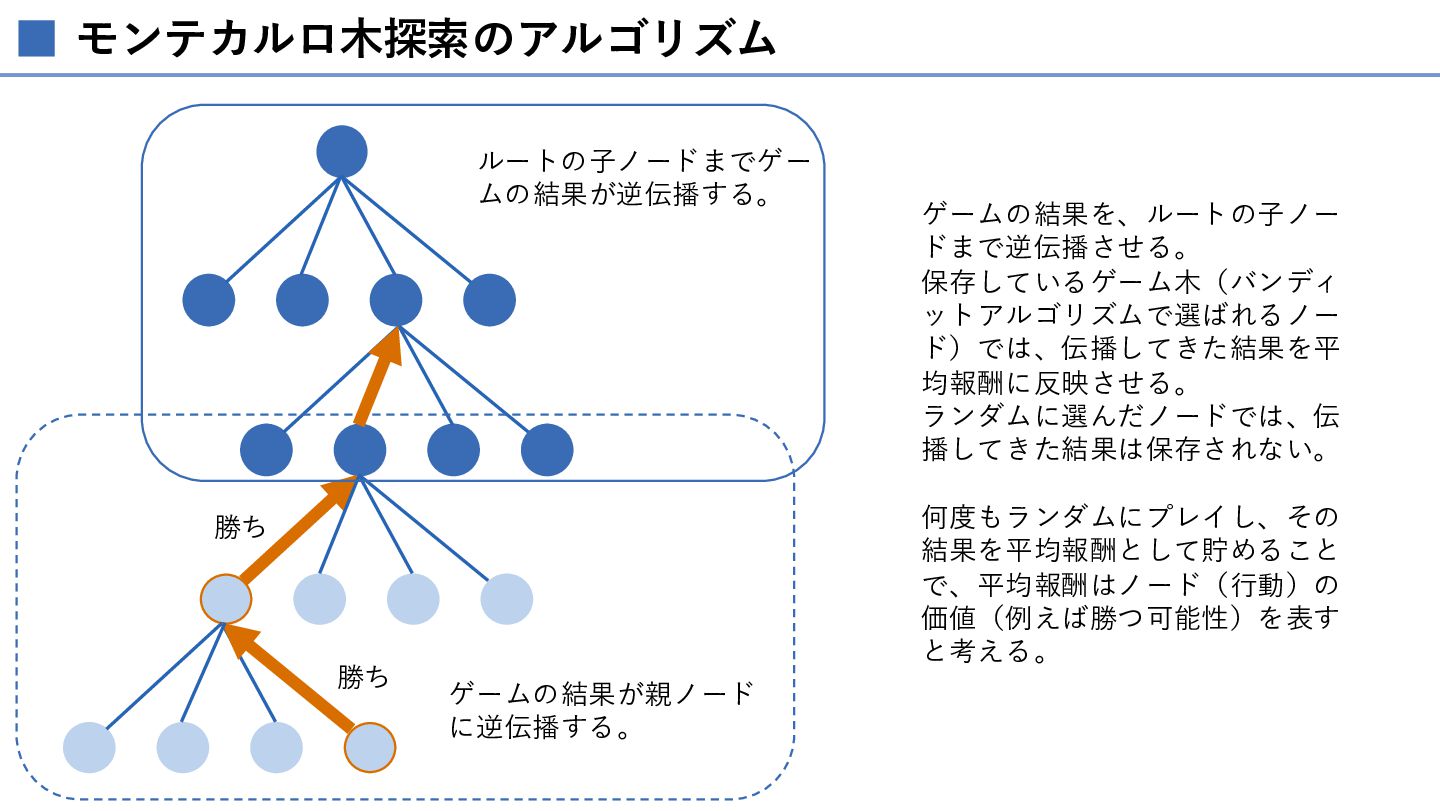
モンテカルロ木探索のアルゴリズム ルートの子ノードまでゲー ムの結果が逆伝播する。 何度もランダムにプレイし、その 結果を平均報酬として貯めること で、平均報酬はノード(行動)の 価値(例えば勝つ可能性)を表す と考える。 勝ち 勝ち
ゲームの結果を、ルートの子ノー ドまで逆伝播させる。 保存しているゲーム木(バンディ ットアルゴリズムで選ばれるノー ド)では、伝播してきた結果を平 均報酬に反映させる。 ランダムに選んだノードでは、伝 播してきた結果は保存されない。 ゲームの結果が親ノード に逆伝播する。
モンテカルロ木探索のアルゴリズム • T回,Selection,Expansion,Simulation,Backupを行った後,ルートノード の子ノードのうち最も選んだ回数が多かった子ノードの行動を取る. • 平均報酬が最大の行動を選ぶ場合もある。 (Browne et al., 2012)
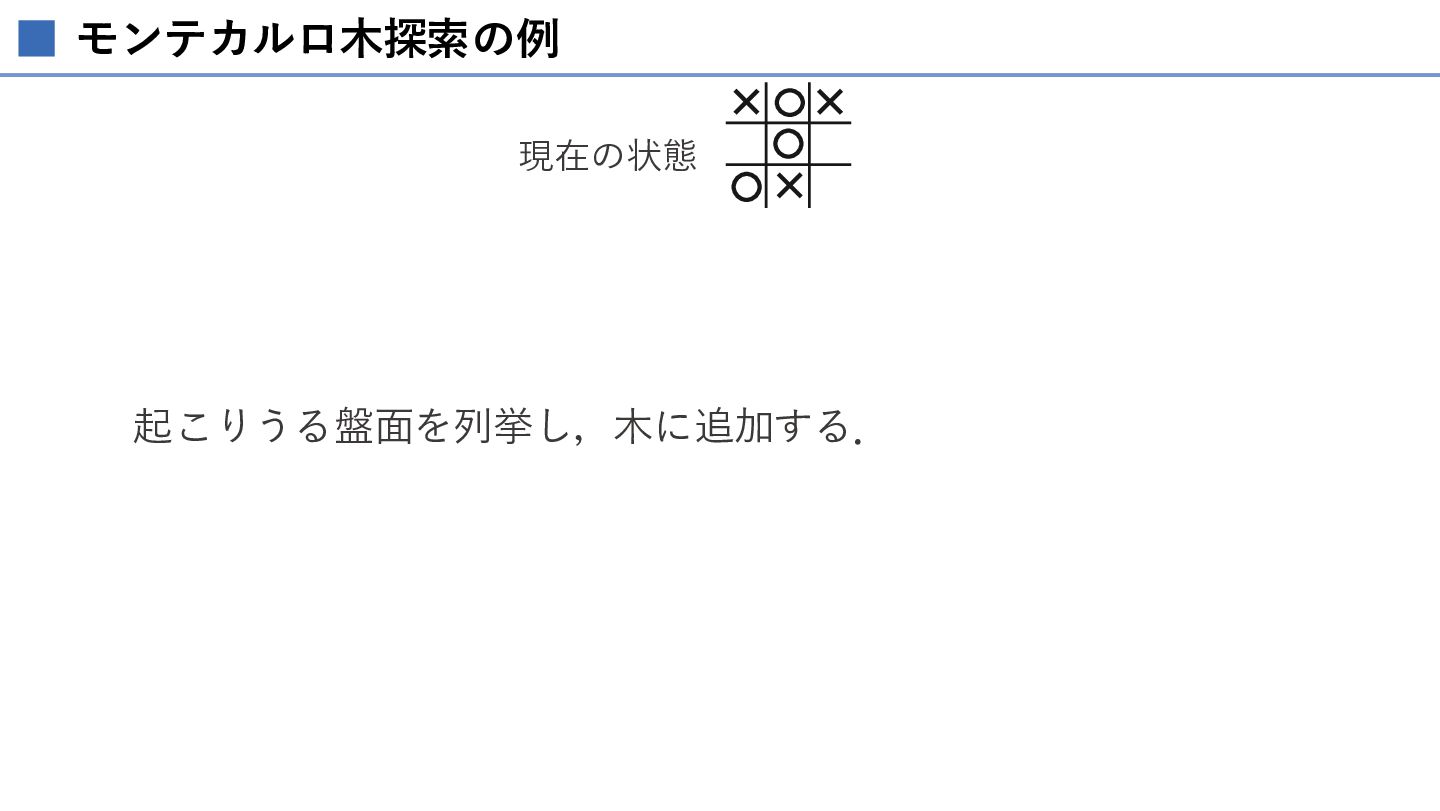
モンテカルロ木探索の例 現在の状態 起こりうる盤面を列挙し,木に追加する.
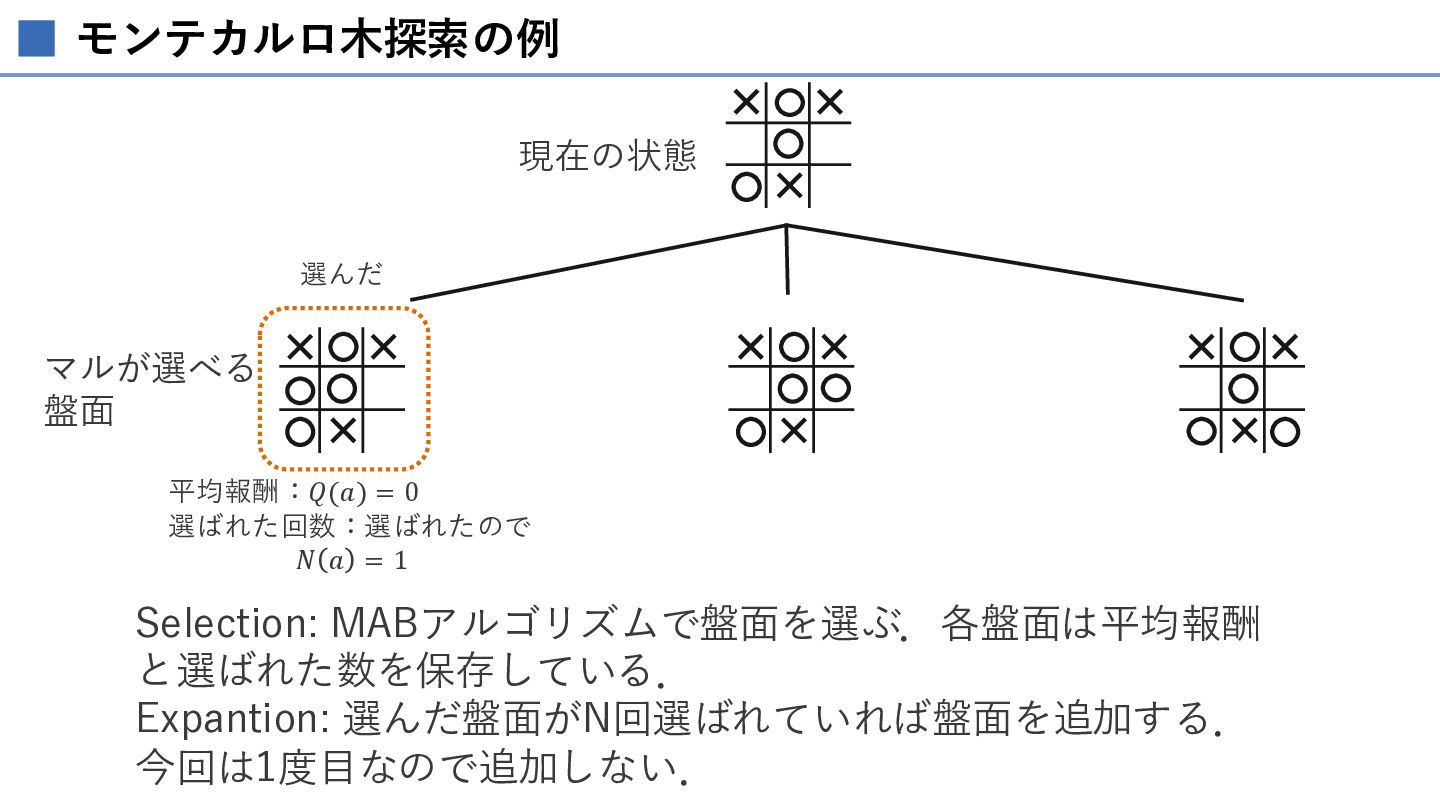
モンテカルロ木探索の例 現在の状態 選んだ マルが選べる 盤面 平均報酬:𝑄(𝑎) = 0 選ばれた回数:選ばれたので 𝑁
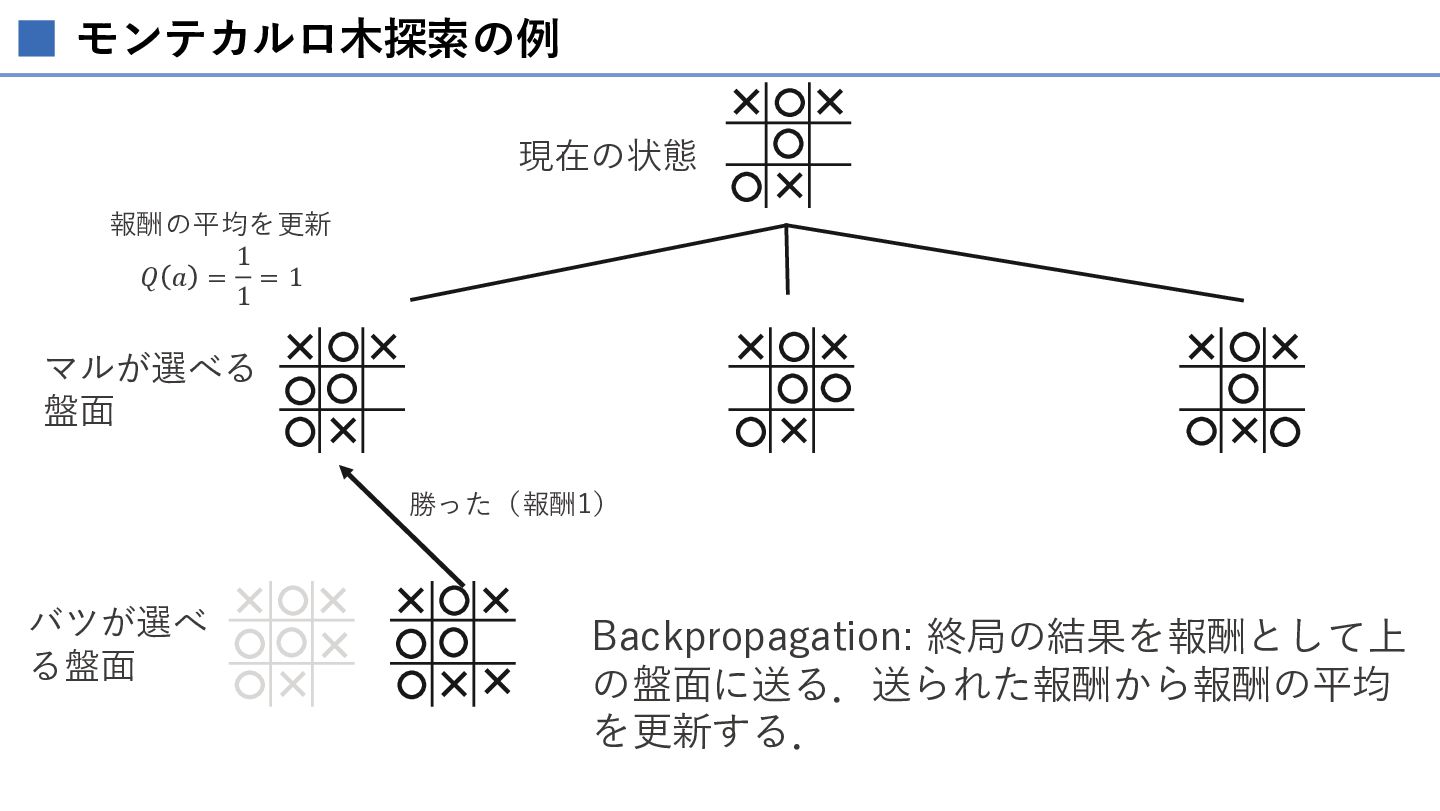
𝑎 =1 Selection: MABアルゴリズムで盤面を選ぶ.各盤面は平均報酬 と選ばれた数を保存している. Expantion: 選んだ盤面がN回選ばれていれば盤面を追加する. 今回は1度目なので追加しない.
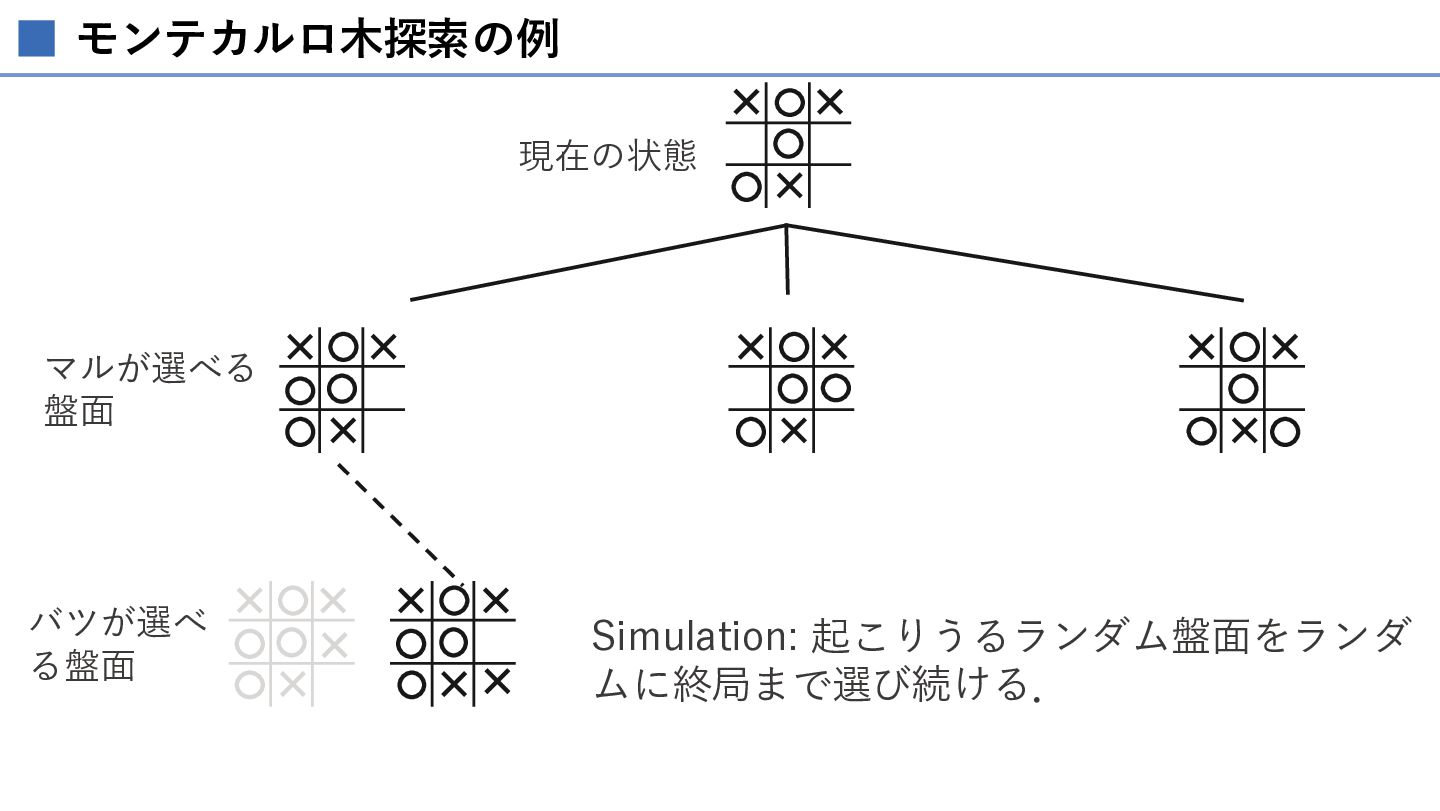
モンテカルロ木探索の例 現在の状態 マルが選べる 盤面 バツが選べ る盤面 Simulation: 起こりうるランダム盤面をランダ ムに終局まで選び続ける.
モンテカルロ木探索の例 現在の状態 報酬の平均を更新 1 𝑄 𝑎 = =1 1 マルが選べる
盤面 勝った(報酬1) バツが選べ る盤面 Backpropagation: 終局の結果を報酬として上 の盤面に送る.送られた報酬から報酬の平均 を更新する.
AlphaZero
モンテカルロ木探索の欠点 • モンテカルロ木探索は探索回数が多ければ多いほど正確な結果を導ける. • しかし,手数が多いゲームでは,計算時間の制限から探索しきれないため正確 な結果を出せないかもしれない. • ゲーム木が幅広く深い場合は,探索空間が広く探索回数を増やさないと良い行動 を導けない. •
計算時間が制限されているため探索回数は限られている.その条件下でより正 確な結果を導く必要がある. • この問題を深層ニューラルネットワーク(DNN)で解決したのがAlphaZeroで ある.
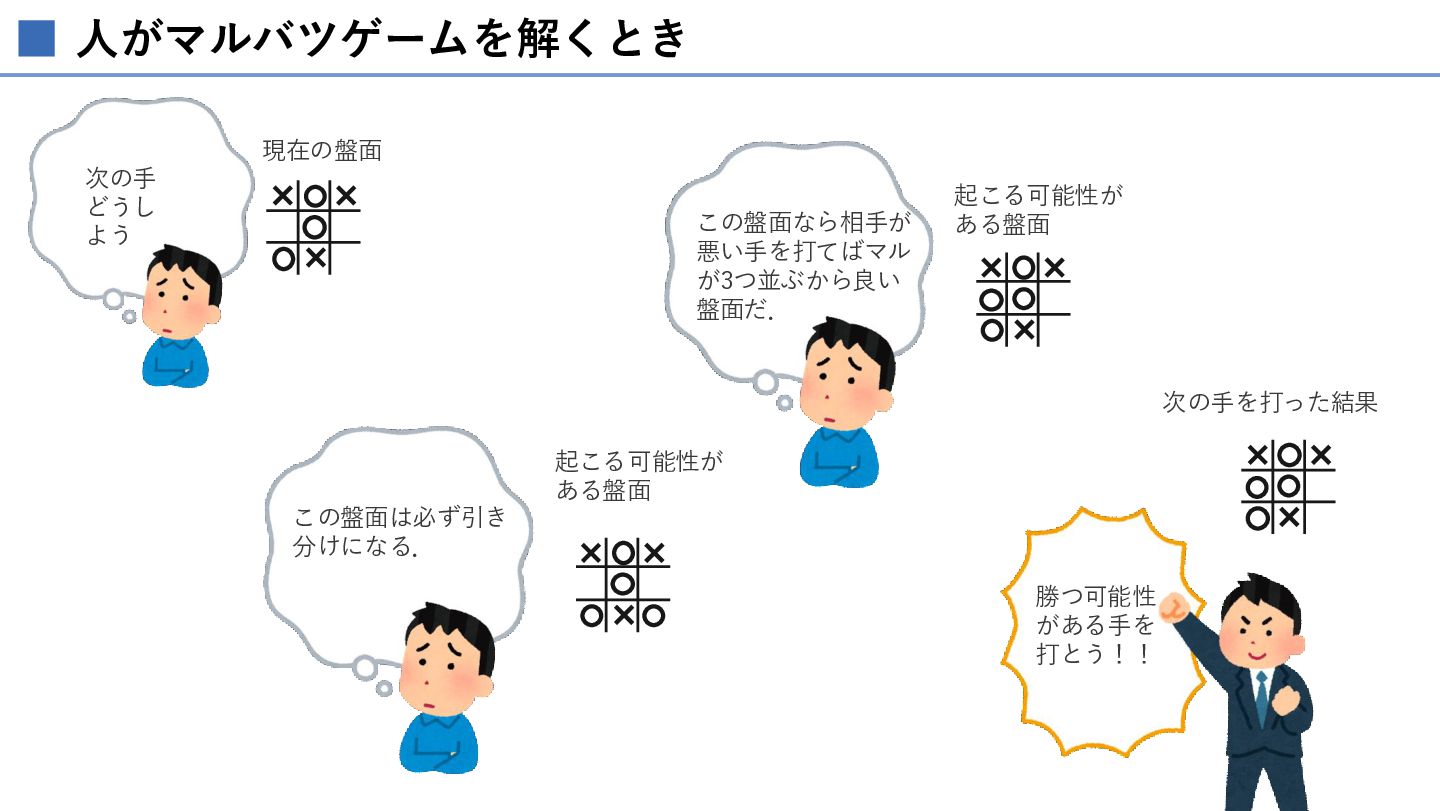
人がマルバツゲームを解くとき 現在の盤面 次の手 どうし よう この盤面なら相手が 悪い手を打てばマル が3つ並ぶから良い 盤面だ. 起こる可能性が
ある盤面 次の手を打った結果 起こる可能性が ある盤面 この盤面は必ず引き 分けになる. 勝つ可能性 がある手を 打とう!!
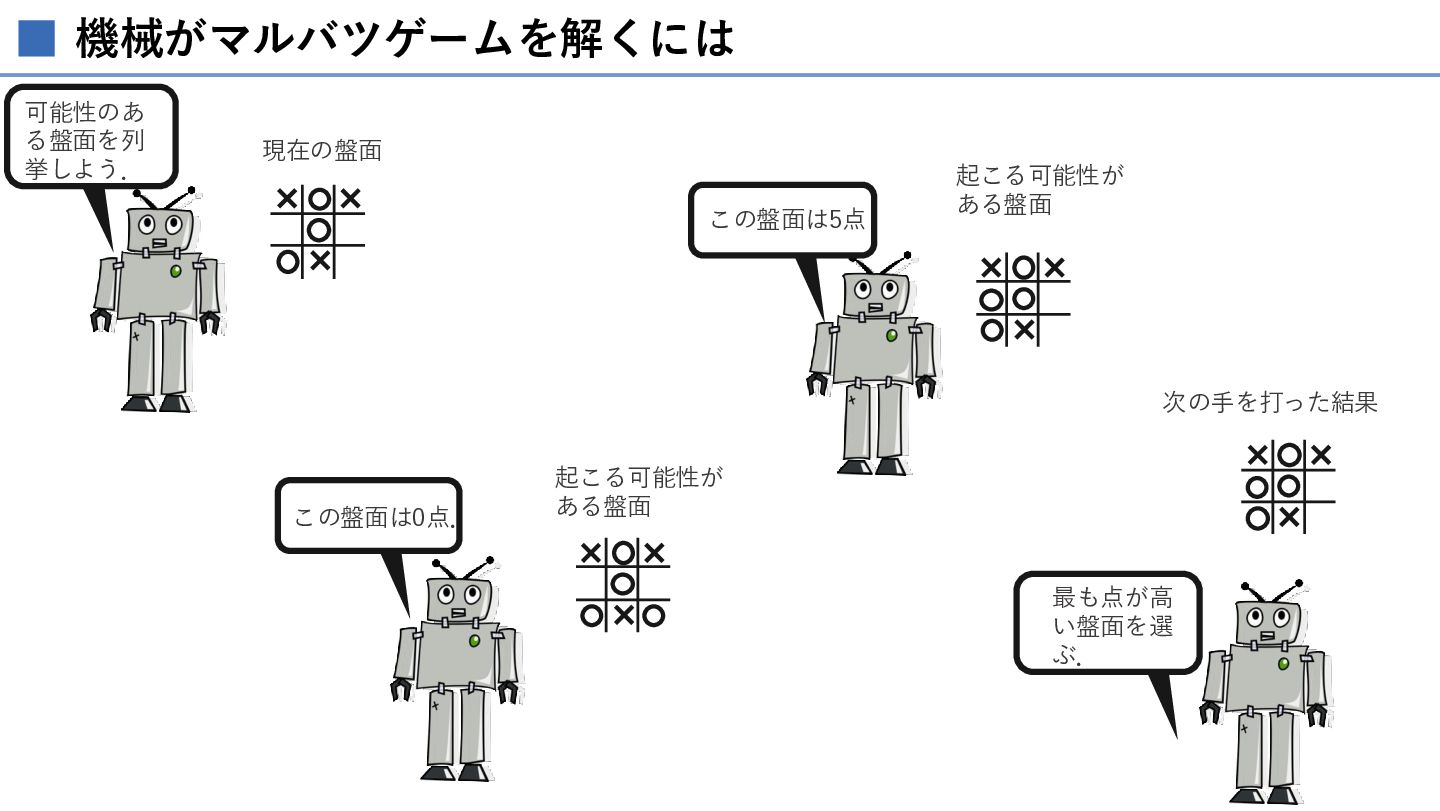
機械がマルバツゲームを解くには 可能性のあ る盤面を列 挙しよう. 現在の盤面 この盤面は5点 起こる可能性が ある盤面 次の手を打った結果 この盤面は0点.
起こる可能性が ある盤面 最も点が高 い盤面を選 ぶ.
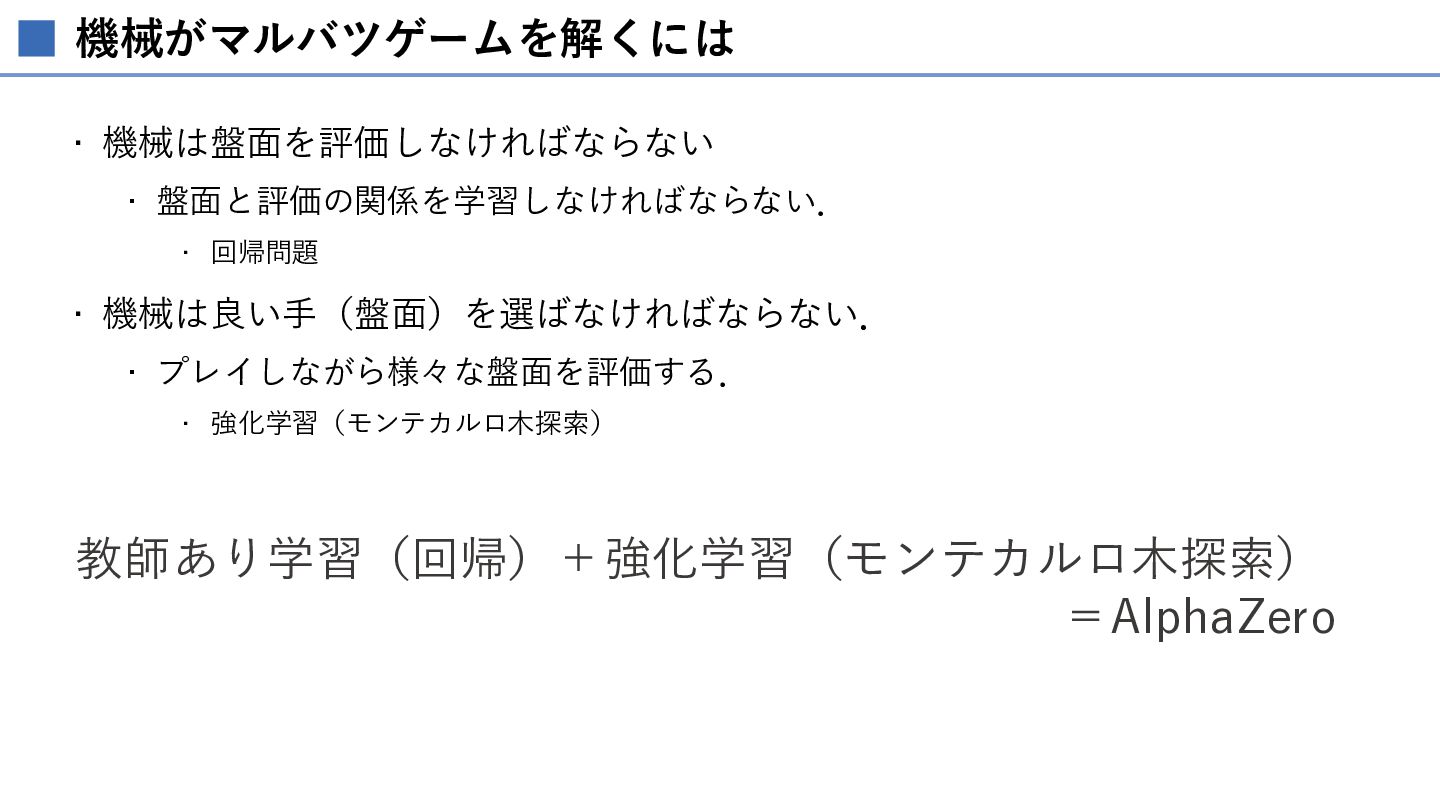
機械がマルバツゲームを解くには • 機械は盤面を評価しなければならない • 盤面と評価の関係を学習しなければならない. • 回帰問題 • 機械は良い手(盤面)を選ばなければならない. •
プレイしながら様々な盤面を評価する. • 強化学習(モンテカルロ木探索) 教師あり学習(回帰)+強化学習(モンテカルロ木探索) =AlphaZero
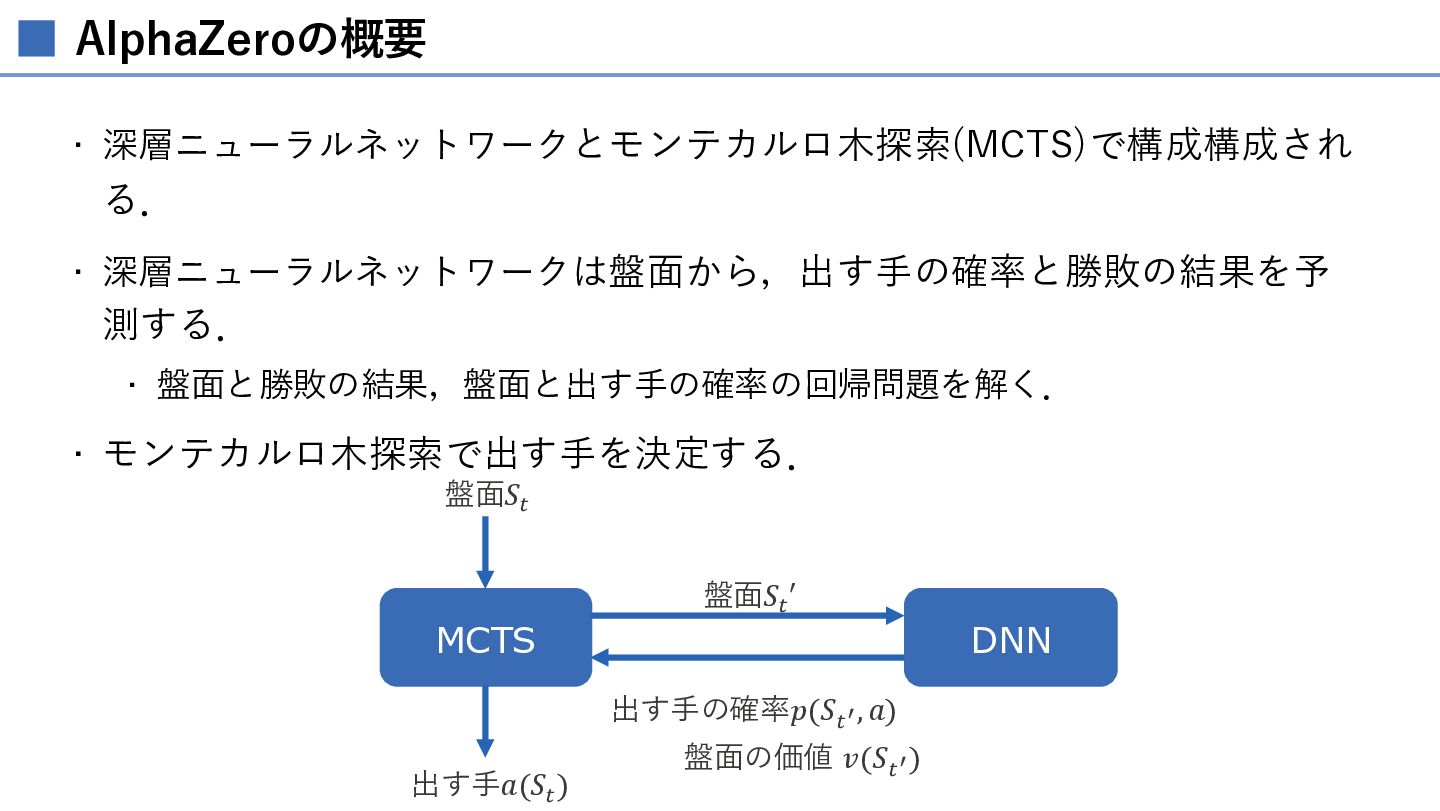
AlphaZeroの概要 • 深層ニューラルネットワークとモンテカルロ木探索(MCTS)で構成構成され る. • 深層ニューラルネットワークは盤面から,出す手の確率と勝敗の結果を予 測する. • 盤面と勝敗の結果,盤面と出す手の確率の回帰問題を解く. •
モンテカルロ木探索で出す手を決定する. 盤面𝑆𝑡 MCTS 盤面𝑆𝑡 ′ 出す手の確率𝑝(𝑆𝑡 ′ , 𝑎) 出す手𝑎(𝑆𝑡 ) 盤面の価値 𝑣(𝑆𝑡 ′ ) DNN
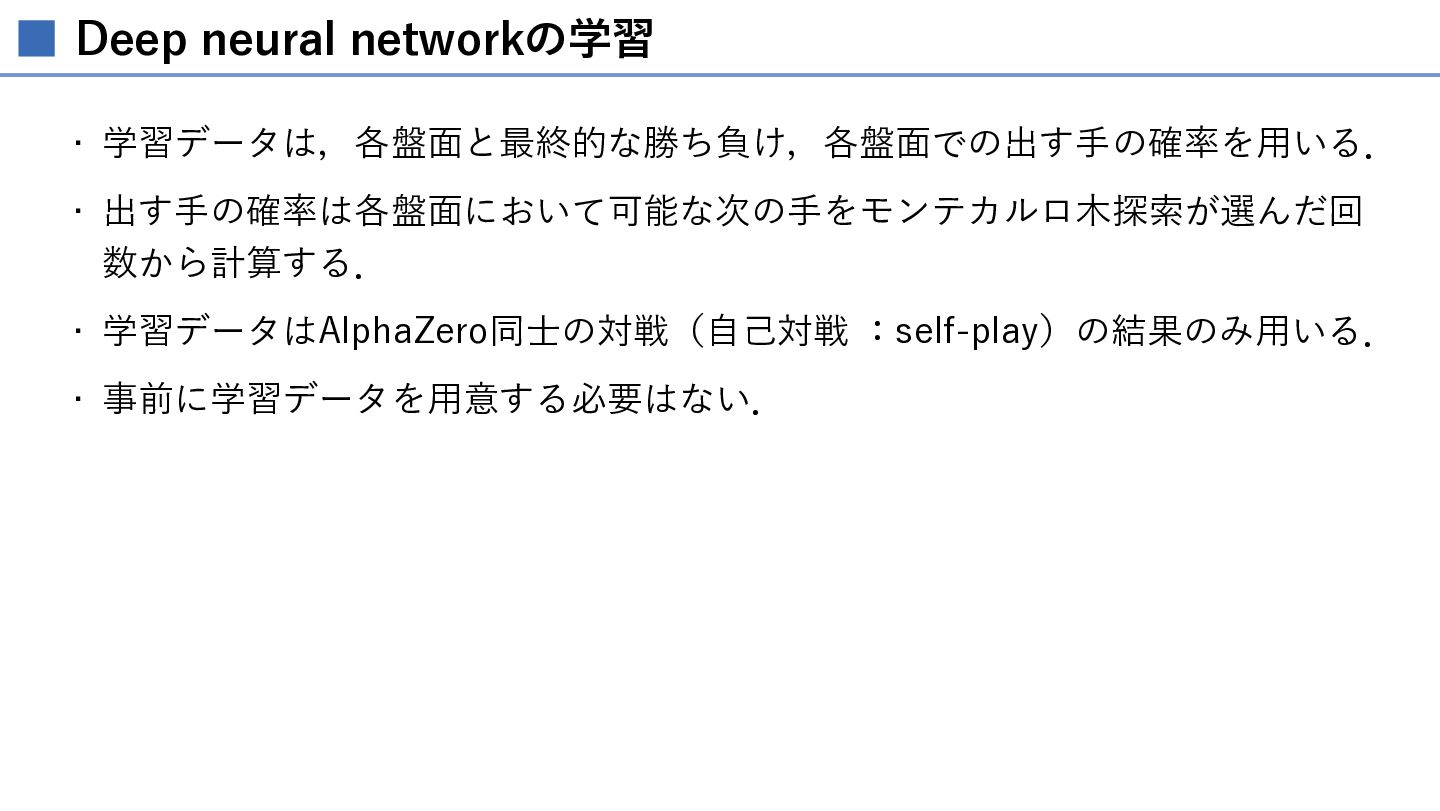
Deep neural networkの学習 • 学習データは,各盤面と最終的な勝ち負け,各盤面での出す手の確率を用いる. • 出す手の確率は各盤面において可能な次の手をモンテカルロ木探索が選んだ回 数から計算する. • 学習データはAlphaZero同士の対戦(自己対戦
:self-play)の結果のみ用いる. • 事前に学習データを用意する必要はない.
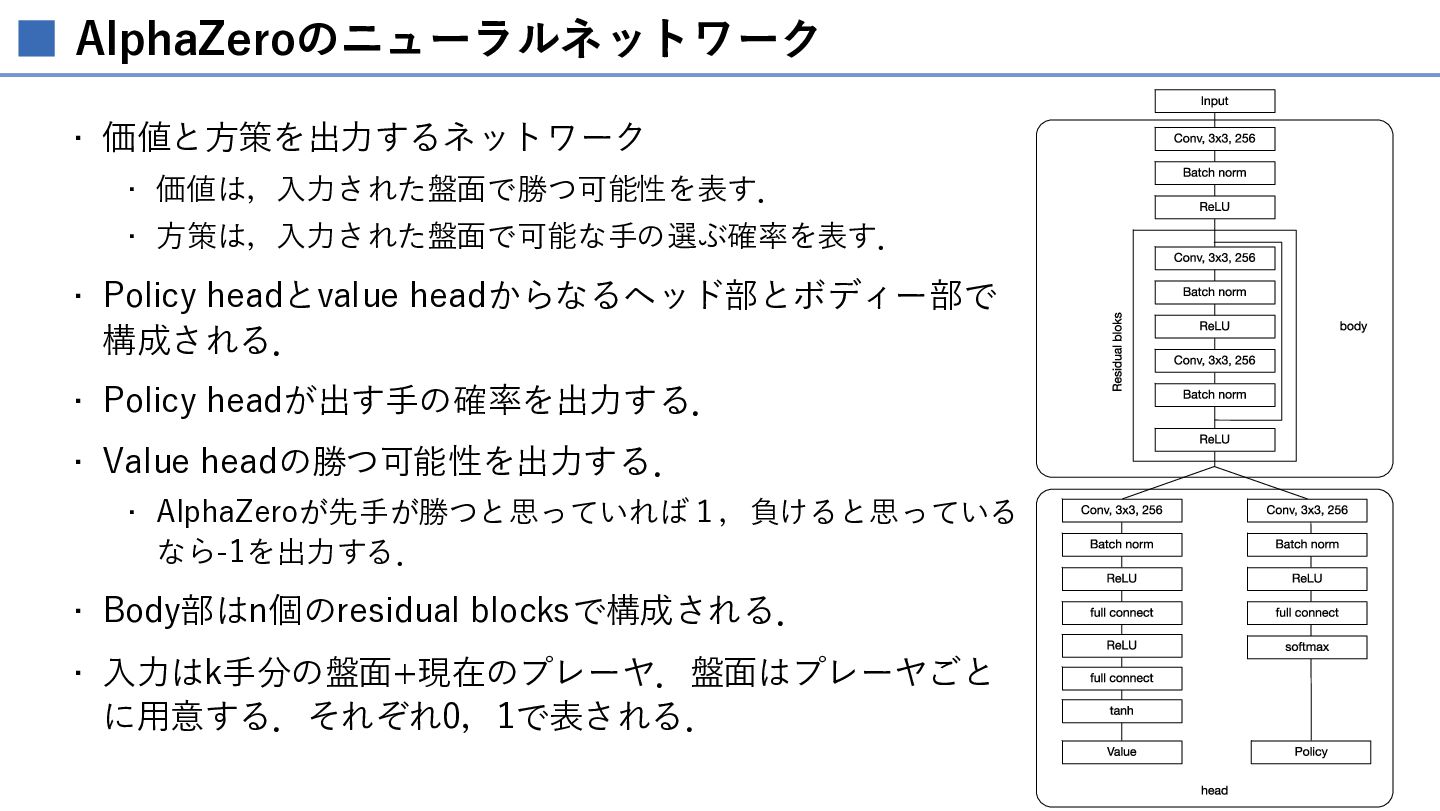
AlphaZeroのニューラルネットワーク • 価値と方策を出力するネットワーク • 価値は,入力された盤面で勝つ可能性を表す. • 方策は,入力された盤面で可能な手の選ぶ確率を表す. • Policy headとvalue
headからなるヘッド部とボディー部で 構成される. • Policy headが出す手の確率を出力する. • Value headの勝つ可能性を出力する. • AlphaZeroが先手が勝つと思っていれば1,負けると思っている なら-1を出力する. • Body部はn個のresidual blocksで構成される. • 入力はk手分の盤面+現在のプレーヤ.盤面はプレーヤごと に用意する.それぞれ0,1で表される.
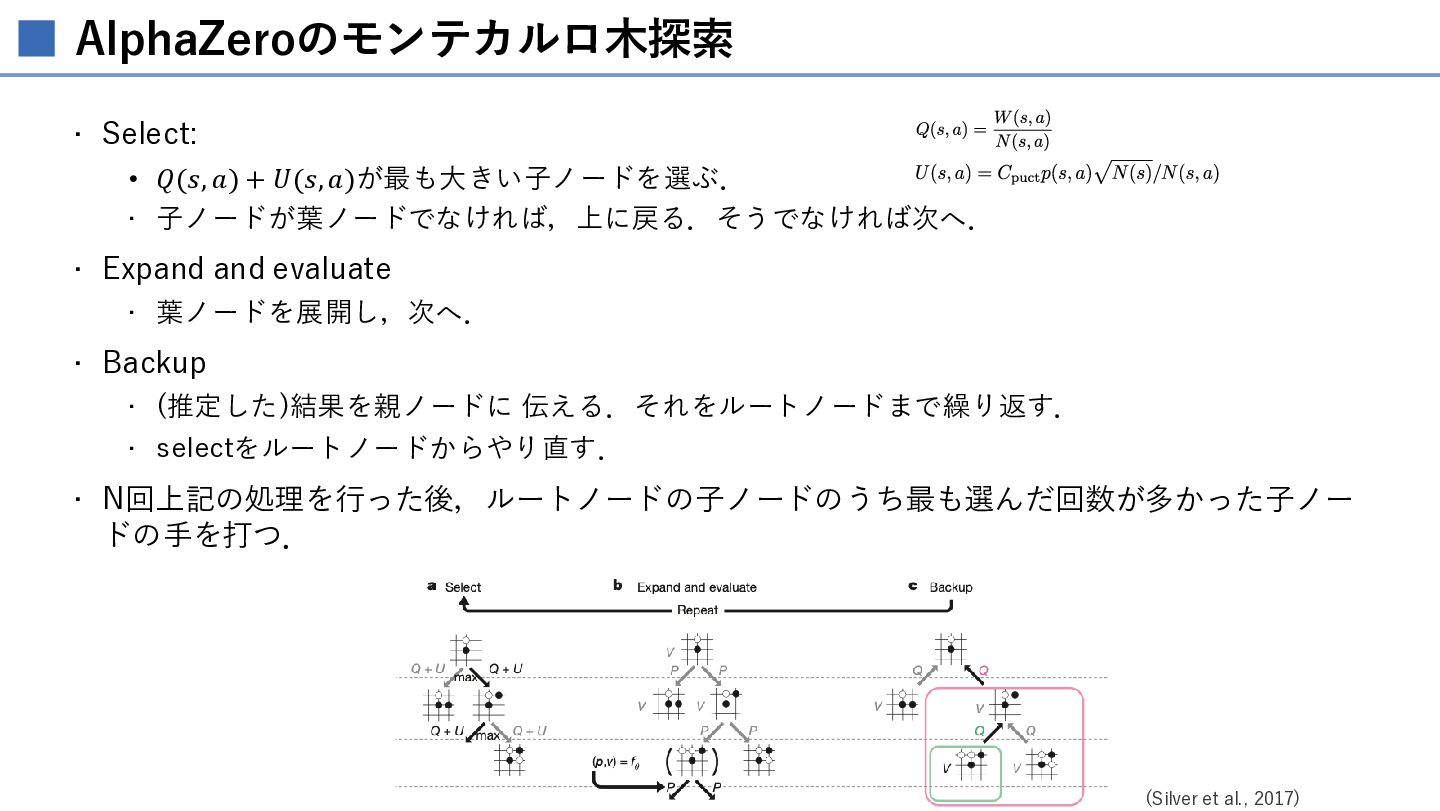
AlphaZeroのモンテカルロ木探索 • Select: • 𝑄(𝑠, 𝑎) + 𝑈(𝑠, 𝑎)が最も大きい子ノードを選ぶ. •
子ノードが葉ノードでなければ,上に戻る.そうでなければ次へ. • Expand and evaluate • 葉ノードを展開し,次へ. • Backup • (推定した)結果を親ノードに 伝える.それをルートノードまで繰り返す. • selectをルートノードからやり直す. • N回上記の処理を行った後,ルートノードの子ノードのうち最も選んだ回数が多かった子ノー ドの手を打つ. (Silver et al., 2017)
モンテカルロ木探索との違い • AlphaZeroはモンテカルロ木探索の一種である. • モンテカルロ木探索との違いは,Simulationにおいて終局までゲーム木を探索 しない点である. • AlphaZeroは終局までゲーム木を探索しない代わりに,報酬を深層ニューラル ネットワークで計算する. •
モンテカルロ木探索の場合,盤面から得られる報酬は終局での勝ち負けで算出 したが,AlphaZeroではvalue headの出力を報酬とする.
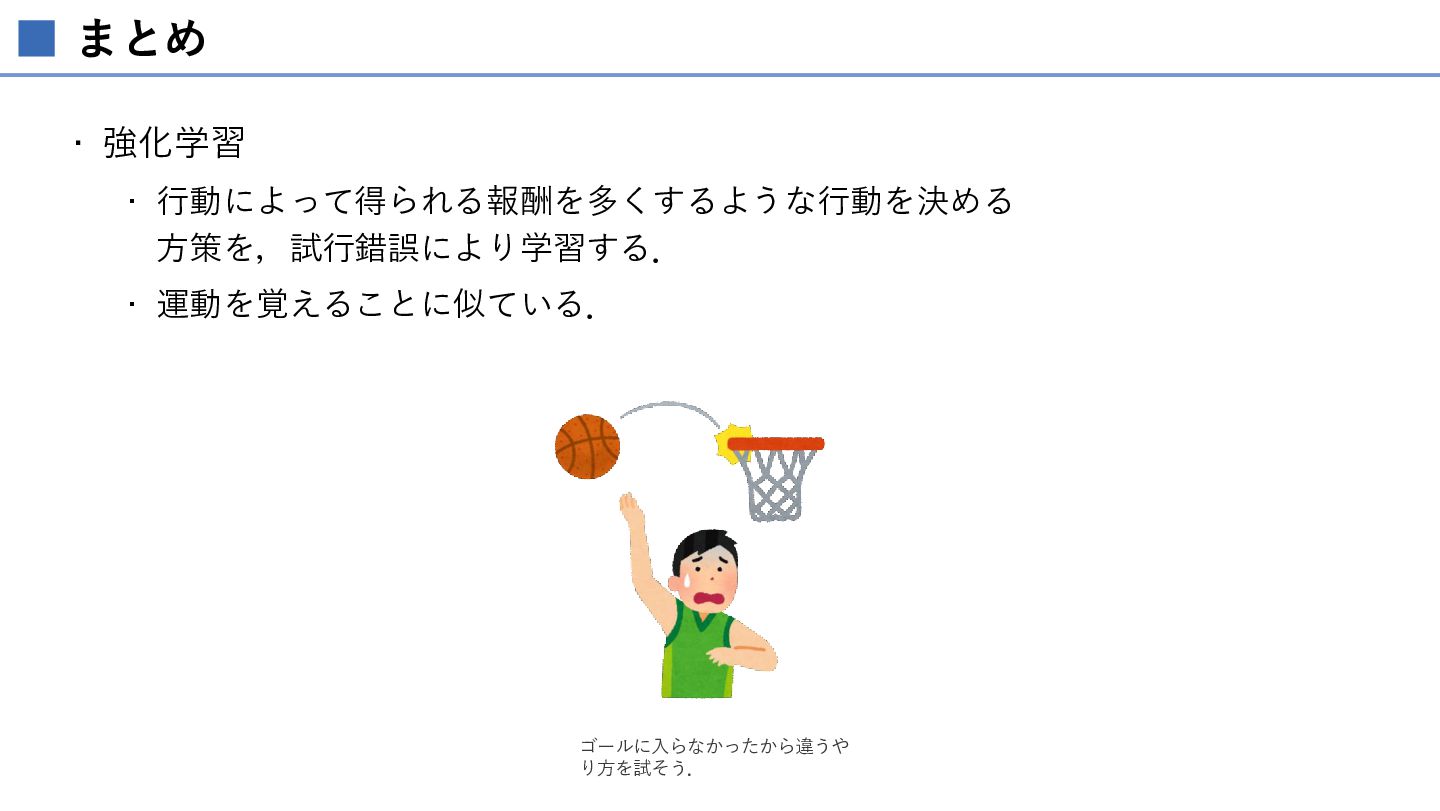
まとめ • 強化学習 • 行動によって得られる報酬を多くするような行動を決める 方策を,試行錯誤により学習する. • 運動を覚えることに似ている. ゴールに入らなかったから違うや り方を試そう.
出席確認レポート • 強化学習では、なぜ現在最も良いと思われる行動だけを選び続けてはいけない のでしょうか。簡単に説明してください。


 kfujita
 pawan_pharm
 bvr7352
 gmoriki
 ainischool
 juanmartin2026
 cbtlibrary
 akiraasano
 2720japanoke
 signer
 madhuri28
 hiola
 skoyamalab
 elsirapls
 kneath
 3n
 pwiseman
 zakiyama
 palkan
 tamaranovitovic
 eileencodes
 sabderemane
 thekraken
 notwaldorf