Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
教師あり学習と教師なし学習
Search
Kazuhisa Fujita
November 03, 2026
Education
19
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
教師あり学習と教師なし学習
Kazuhisa Fujita
November 03, 2026
More Decks by Kazuhisa Fujita
See All by Kazuhisa Fujita
強化学習
kfujita
0
40
人工知能時代の到来/IntroAI01
kfujita
0
55
人工知能とは/IntroAI02
kfujita
0
120
人工知能ゼミ03 /aizemi03
kfujita
3
250
情報処理工学問題集 /infoeng_practices
kfujita
2
920
人工知能ゼミ1-ガイダンス- /aizemi01
kfujita
2
200
人工知能ゼミ02 /aizemi02
kfujita
0
220
大学生活はスマホ・パソコンとともに! 安全な使い方とAIのチカラ /DigitalLiteracy
kfujita
0
180
情報処理工学14資料 /infoeng14
kfujita
0
820
Other Decks in Education
See All in Education
Session 4 - Teknik Lobby dan Negosiasi
adeputra13
0
700
Sekolah Sabat - Triwulan 4 2026 - Pelajaran 1
hiola
0
13k
CSS3 and Responsive Web Design - Lecture 5 - Web Technologies (1019888BNR)
signer
PRO
1
3.5k
General Introduction, Composition, Chemistry & Chemical Classes, Biosources, Therapeutic uses and Commercial Application of Secondary Metabolites.
drpoonamkc
0
220
[2026後期火5] 論理学(京都大学文学部 後期 第3回)「∀ の規則と固有変数条件」
yatabe
0
150
2026年度秋学期 統計学 第5回 分布をまとめるー記述統計量(平均・分散など) (2026. 10. 27)
akiraasano
PRO
0
200
Railsチュートリアル × 反転学習の事例紹介
yasslab
PRO
3
190k
響け!ユーフォニアムと考える「決め方」/Thinking About Decision-Making with Sound! Euphonium
3l4l5
1
230
【ainiチャット操作ガイド】
ainischool
0
210
DRUGS ACTING ON THE PERIPHERAL NERVOUS SYSTEM
pawan_pharm
0
230
Concours Photo - UGE - 2026
echaille
0
160
Invest Early, Build Together
rashwhitman
0
990
Featured
See All Featured
Mind Mapping
helmedeiros
1
430
No one is an island. Learnings from fostering a developers community.
thoeni
21
3.9k
Agile that works and the tools we love
rasmusluckow
331
22k
Music & Morning Musume
bryan
48
7.5k
Lightning Talk: Beautiful Slides for Beginners
inesmontani
PRO
2
770
How People are Using Generative and Agentic AI to Supercharge Their Products, Projects, Services and Value Streams Today
helenjbeal
2
390
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
77k
The Cost Of JavaScript in 2023
addyosmani
56
10k
Bash Introduction
62gerente
615
220k
Marketing Yourself as an Engineer | Alaka | Gurzu
gurzu
0
370
Product Roadmaps are Hard
iamctodd
55
13k
Fight the Zombie Pattern Library - RWD Summit 2016
marcelosomers
234
18k
Transcript
人工知能5 教師あり学習と教師なし学習 藤田 一寿 Ver.20261105
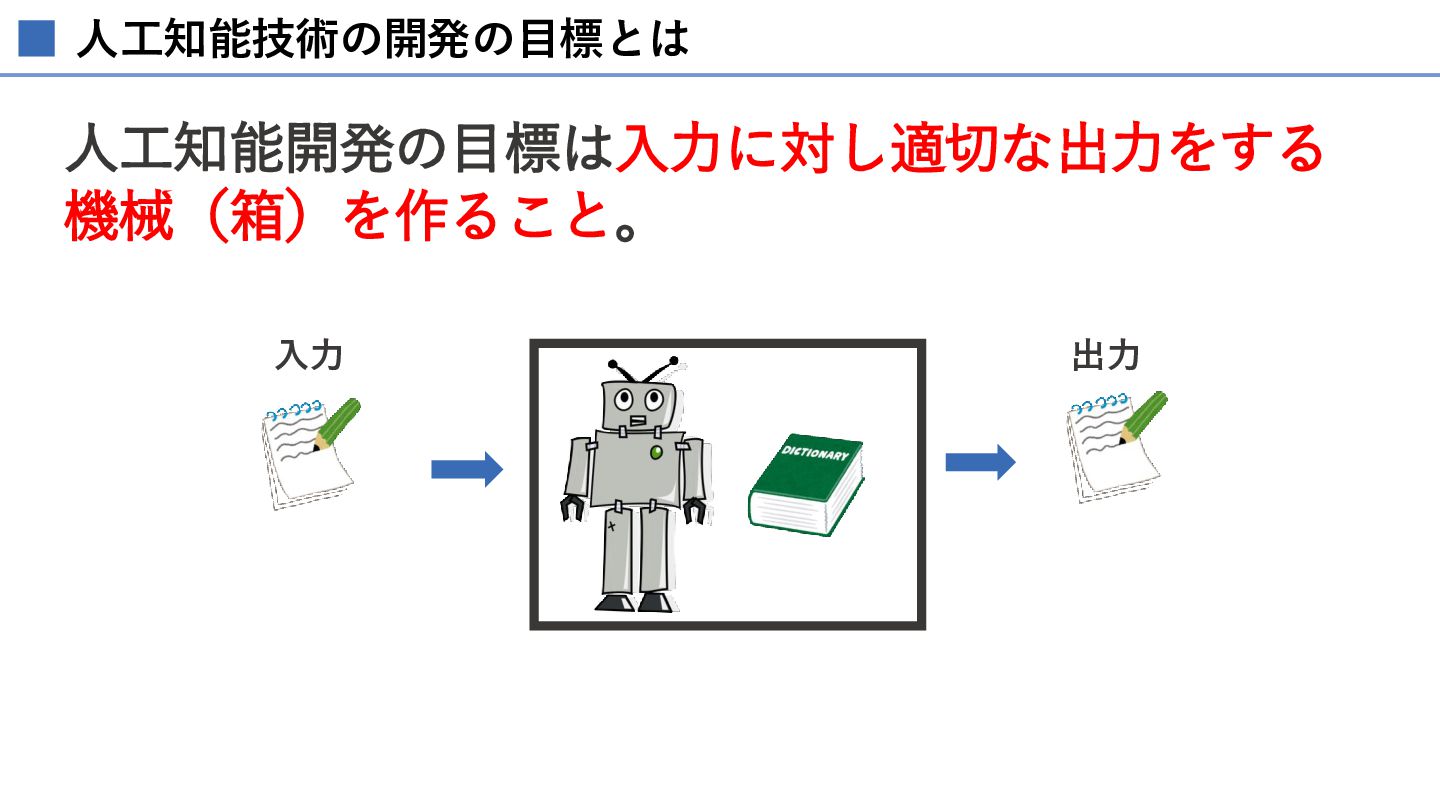
人工知能技術の開発の目標とは 人工知能開発の目標は入力に対し適切な出力をする 機械(箱)を作ること。 入力 出力
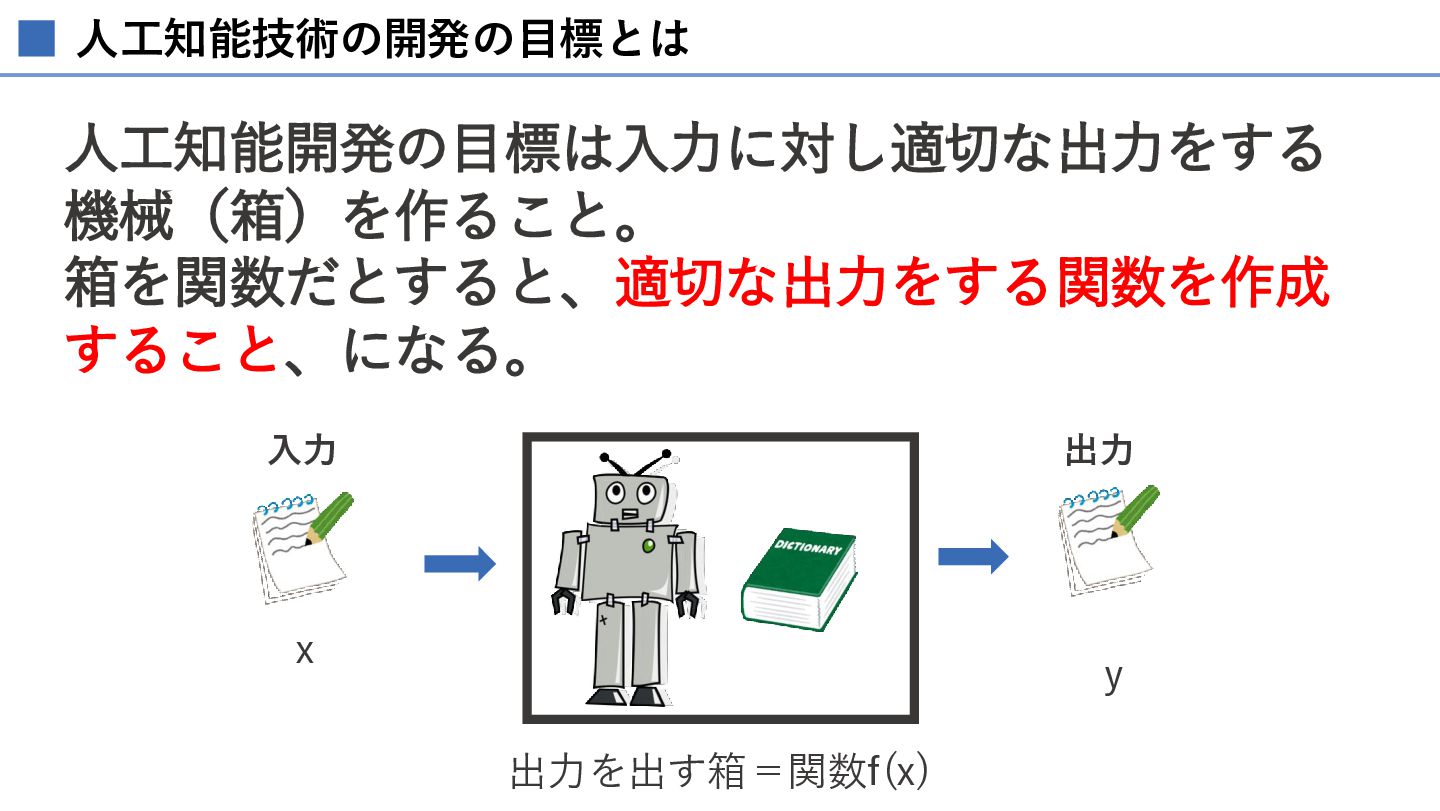
人工知能技術の開発の目標とは 人工知能開発の目標は入力に対し適切な出力をする 機械(箱)を作ること。 箱を関数だとすると、適切な出力をする関数を作成 すること、になる。 入力 出力 x y 出力を出す箱=関数f(x)
学習の手法
教師あり学習
教師あり学習 • 人工知能が、入力と答え(お手本)の組み合わせからなるデータ( 訓練データ、学習データ)を用い学習し、入力と答えの関係を学ぶ ことを教師あり学習という。 • 答えを用い人工知能の出力を修正するため、答えを教師と捉えることがで きる。 • 答えのことを教師信号とも言う。
教師あり学習=答え付きデータを用いた学習
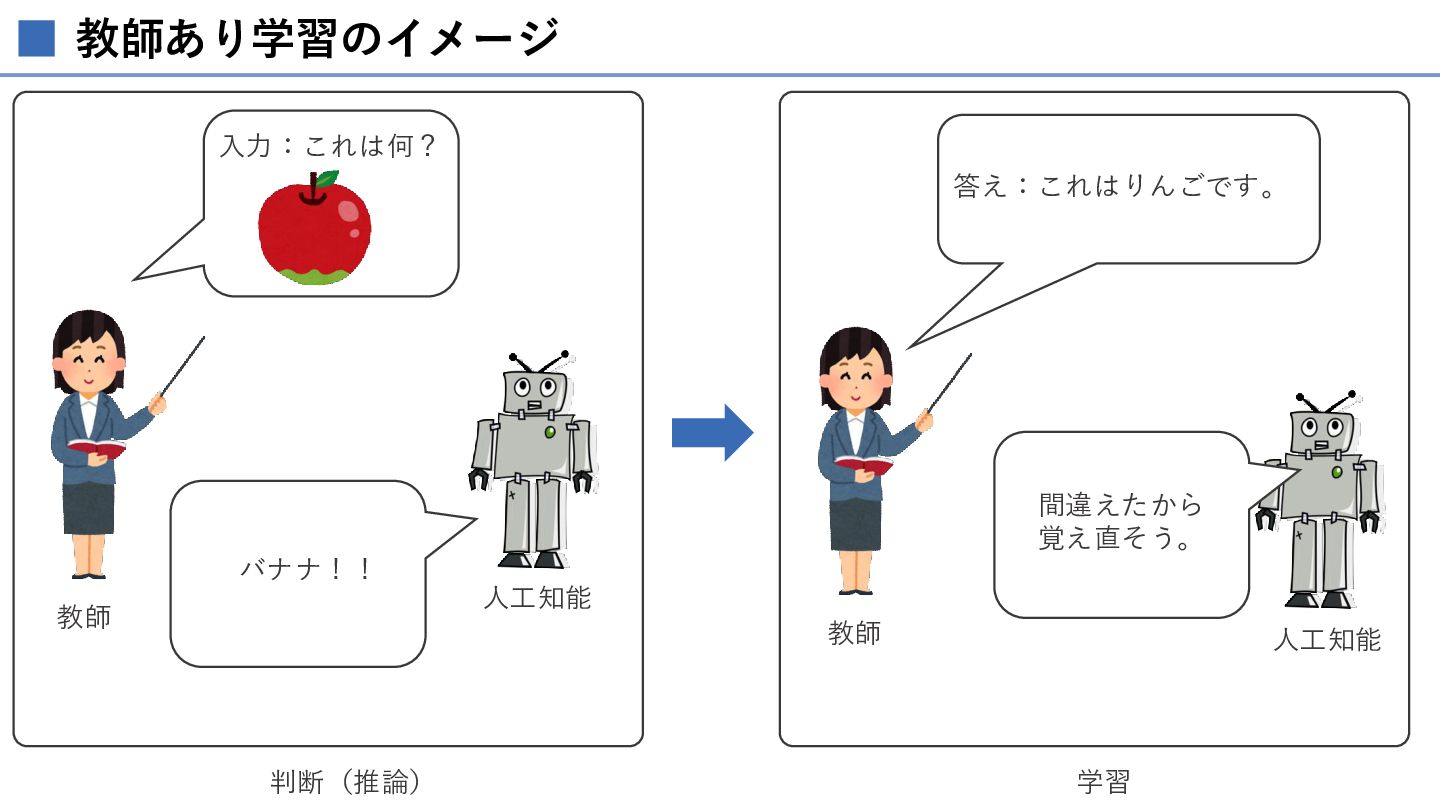
教師あり学習のイメージ 入力:これは何? 答え:これはりんごです。 間違えたから 覚え直そう。 バナナ!! 人工知能 教師 教師 判断(推論)
人工知能 学習
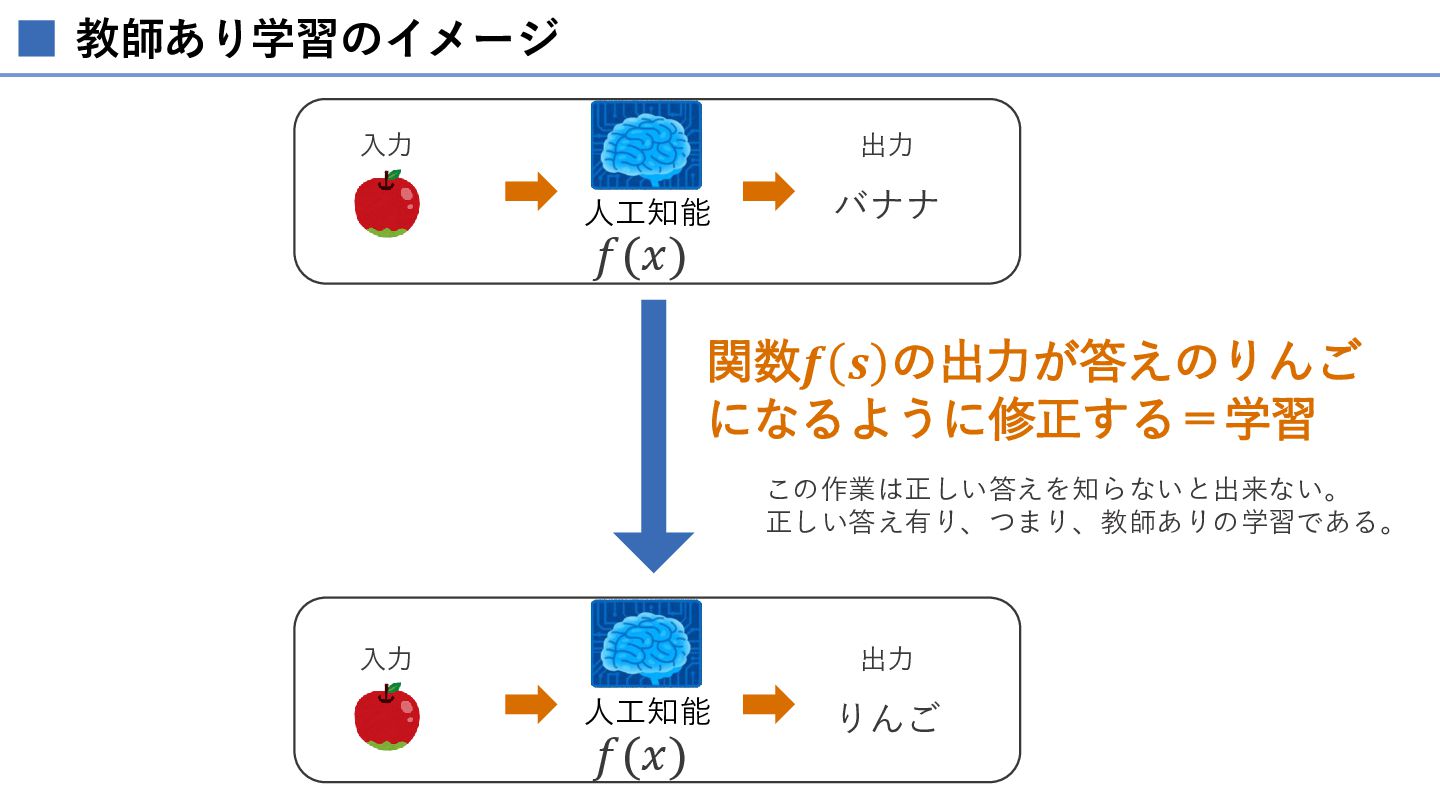
教師あり学習のイメージ 入力 出力 人工知能 バナナ 𝑓(𝑥) 関数𝒇 𝒔 の出力が答えのりんご になるように修正する=学習
この作業は正しい答えを知らないと出来ない。 正しい答え有り、つまり、教師ありの学習である。 入力 出力 人工知能 𝑓(𝑥) りんご
学習とは • 学習とは、人工知能の中の関数を変える(修正する)こと • 対話型人工知能と会話しているときは、人工知能の関数は変わらないので 人工知能は学習していない。
回帰問題を例により具体的に 考える
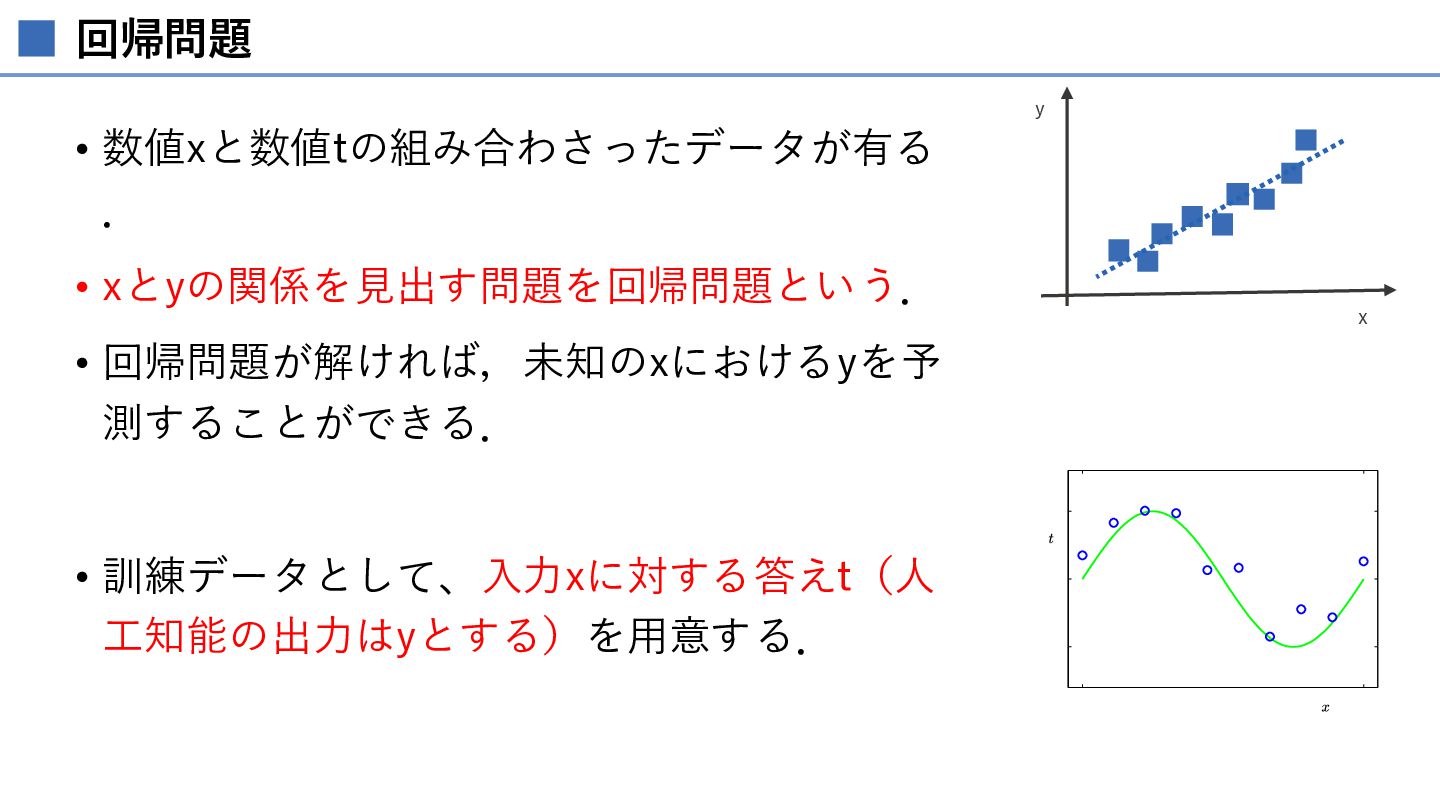
回帰問題 t, y • 数値xと数値tの組み合わさったデータが有る . • xとtの関係を見出す問題を回帰問題という. • 回帰問題が解ければ,未知のxにおけるtを予
測することができる.人工知能の出力はyとす る。 • 訓練データとして、入力xに対する答えtを用 意する. x
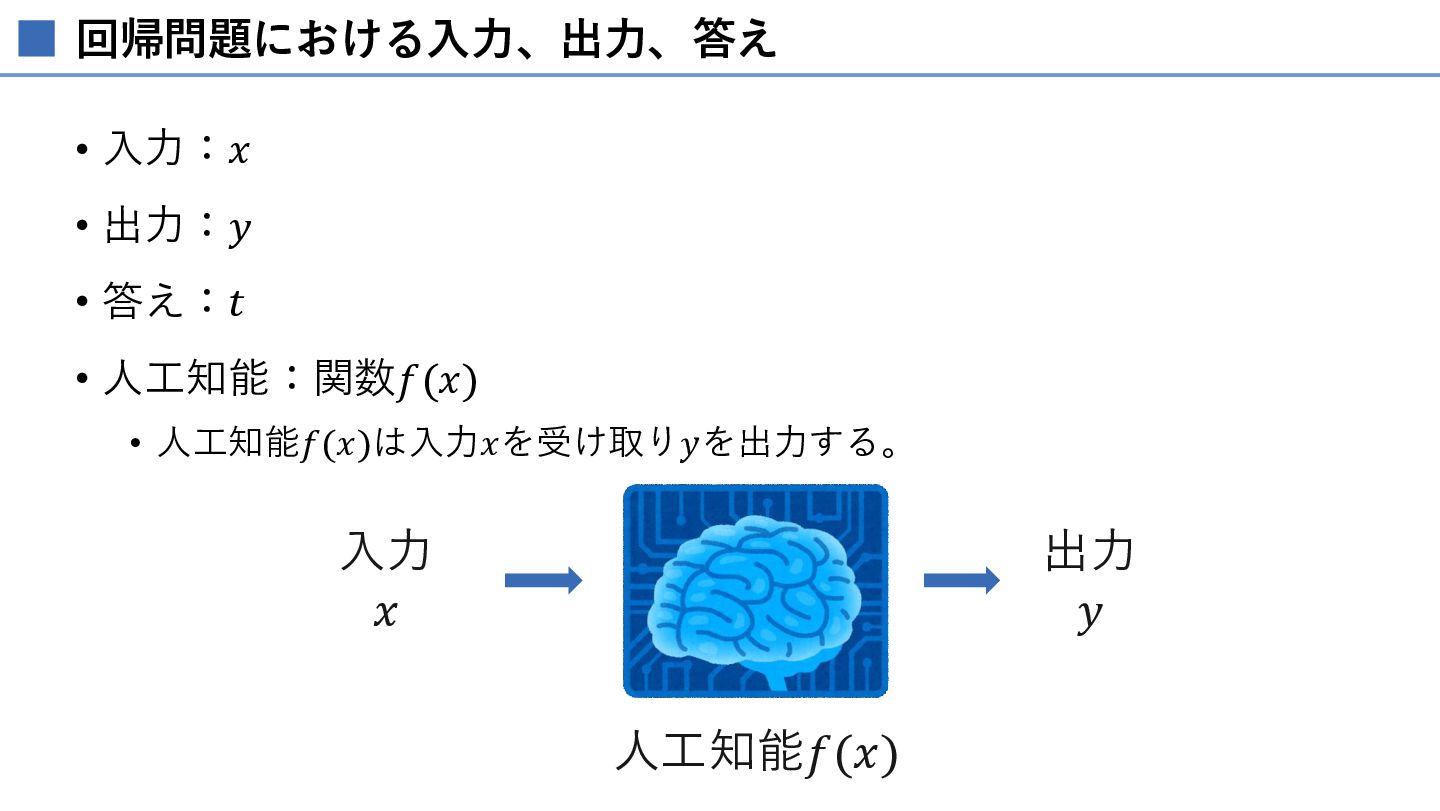
回帰問題における入力、出力、答え • 入力:𝑥 • 出力:𝑦 • 答え:𝑡 • 人工知能:関数𝑓(𝑥) •
人工知能𝑓(𝑥)は入力𝑥を受け取り𝑦を出力する。 入力 𝑥 出力 𝑦 人工知能𝑓(𝑥)
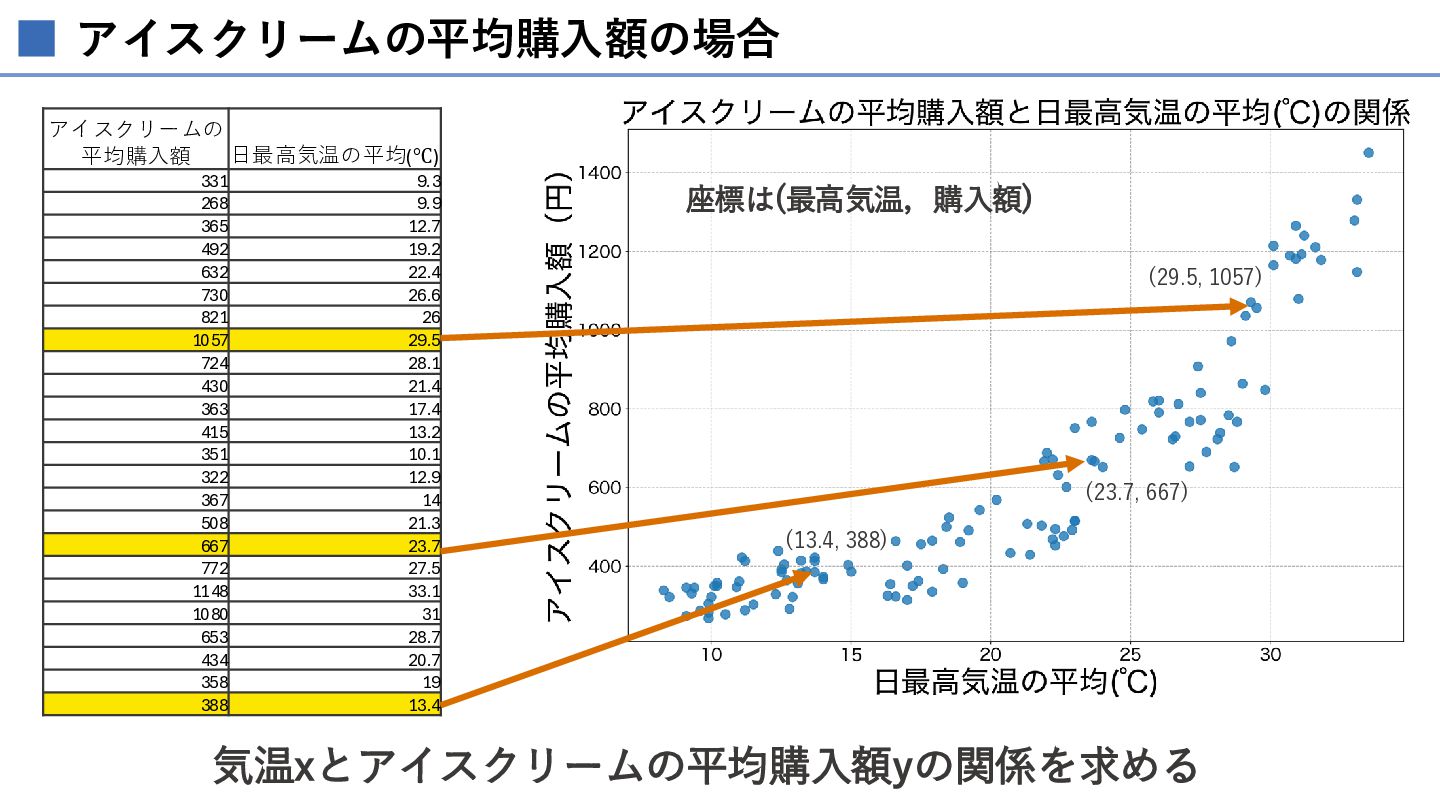
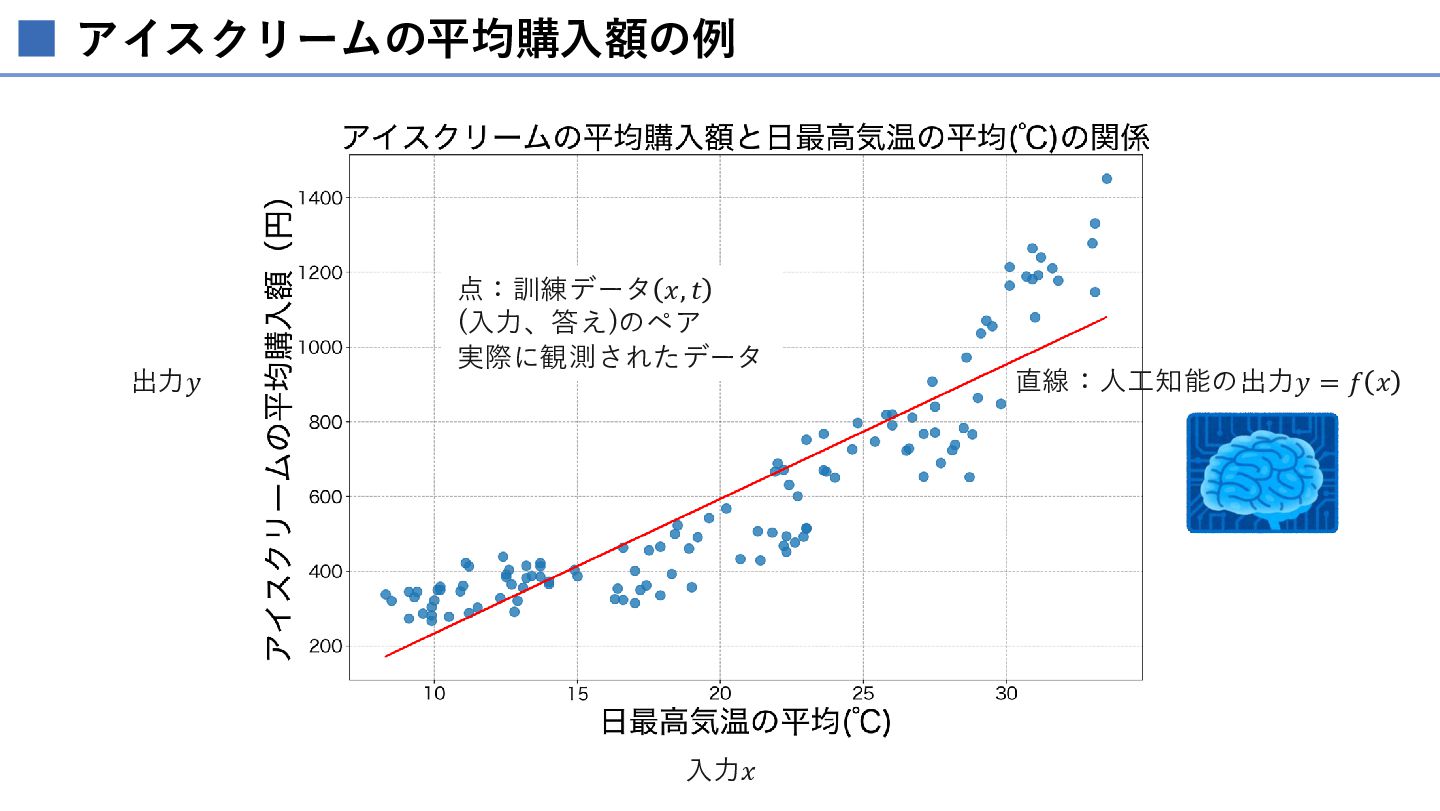
アイスクリームの平均購入額の場合 アイスクリームの 日最高気温の平均(℃) 平均購入額 331 268 365 492 632 730
821 1057 724 430 363 415 351 322 367 508 667 772 1148 1080 653 434 358 388 9.3 9.9 12.7 19.2 22.4 26.6 26 29.5 28.1 21.4 17.4 13.2 10.1 12.9 14 21.3 23.7 27.5 33.1 31 28.7 20.7 19 13.4 座標は(最高気温,購入額) (29.5, 1057) (23.7, 667) (13.4, 388) 気温xとアイスクリームの平均購入額yの関係を求める
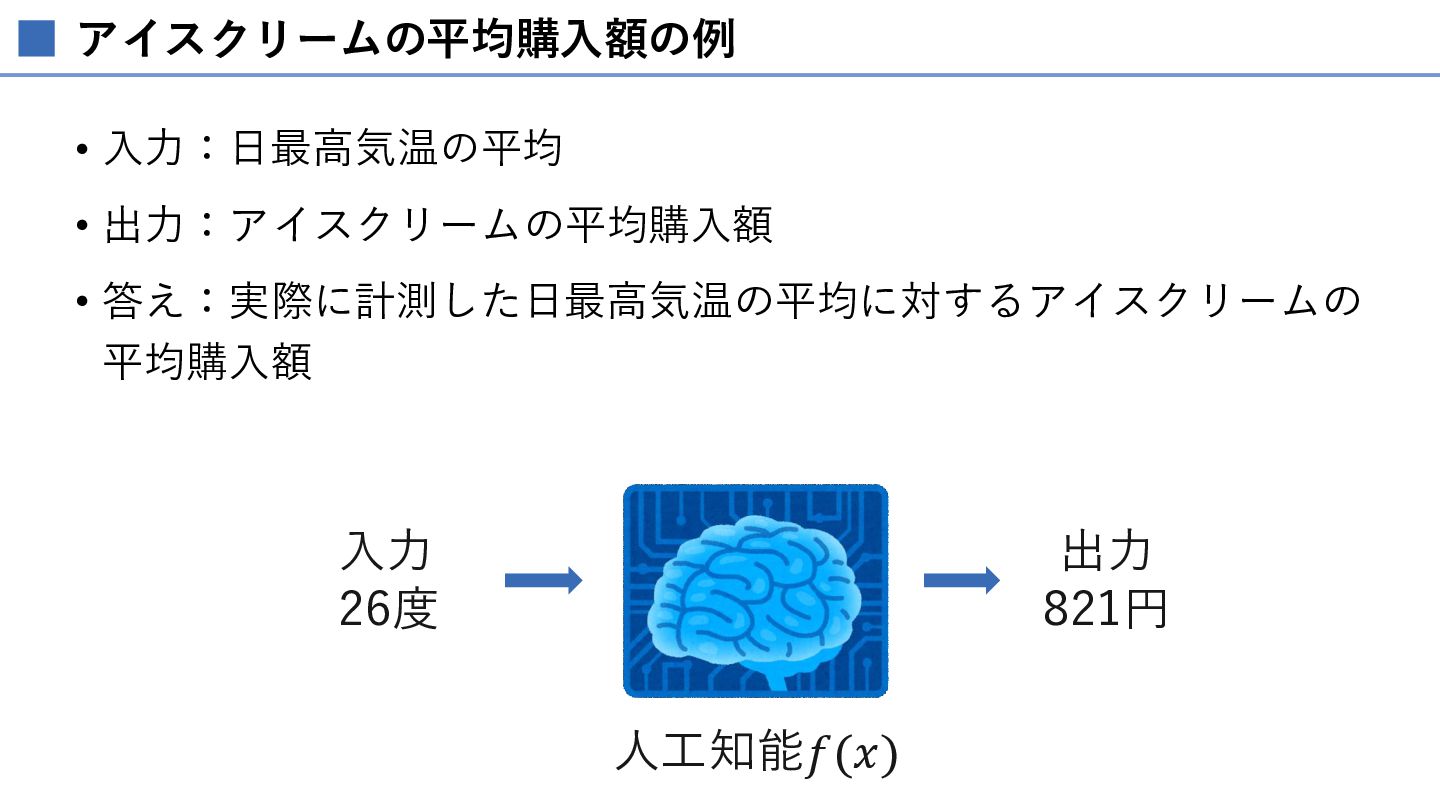
アイスクリームの平均購入額の例 • 入力:日最高気温の平均𝑥 • 出力:アイスクリームの平均購入額の予測𝑦 • 答え:実際に計測した日最高気温の平均に対するアイスクリームの 平均購入額𝑡 入力 x=26度
答え t=821円 出力 y=820円 人工知能𝑓(𝑥)
アイスクリームの平均購入額の例 出力𝑦 点:訓練データ 𝑥, 𝑡 (入力、答え)のペア 実際に観測されたデータ 入力𝑥 赤い直線:人工知能の 関数(脳)
𝑦=𝑓 𝑥
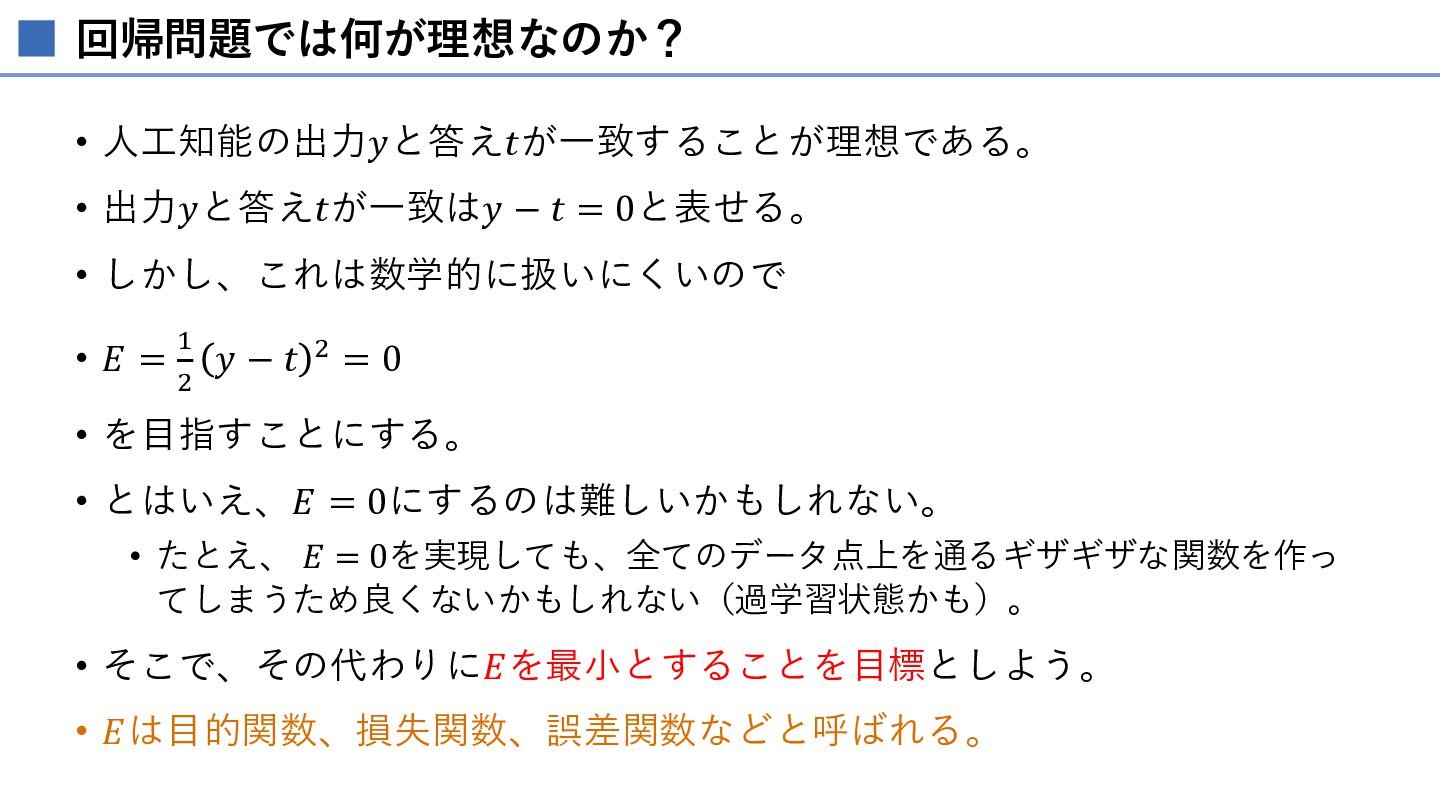
回帰問題では何が理想なのか? • 人工知能の出力𝑦と答え𝑡が一致することが 理想である。 𝑓 = (𝑦 − 𝑡)2 •
つまり、一致させることが目的となる。 • 出力𝑦と答え𝑡が一致は𝑦 − 𝑡 = 0と表せる。 • しかし、これは数学的に扱いにくいので •𝐸= 1 2 𝑦−𝑡 2 =0 • を目標にする。 • 𝑦 − 𝑡 2 とすることで出力と答えの差を大 きさで表せる。 𝑓 =𝑦−𝑡 差が大きくても小さくなる。
回帰問題では何が理想なのか? • とはいえ、実際は𝐸 = 0にするのは難しいかもしれない。 • たとえ、 𝐸 = 0を実現しても、全てのデータ点上を通るギザギザな関数を
作ってしまうため良くないかもしれない(これを過学習状態という)。 • そこで、その代わりに𝐸(出力、予測と答えの差)を最小とするこ とを目標としよう。 • 𝐸は誤差関数、損失関数などと呼ばれる。 • また、Eを最小にすることを目的とするため、目的関数とも言う。 • ただし、目的関数と誤差関数は同じとは限らない。 • 誤差関数以外の関数を目的関数にすることは可能である。
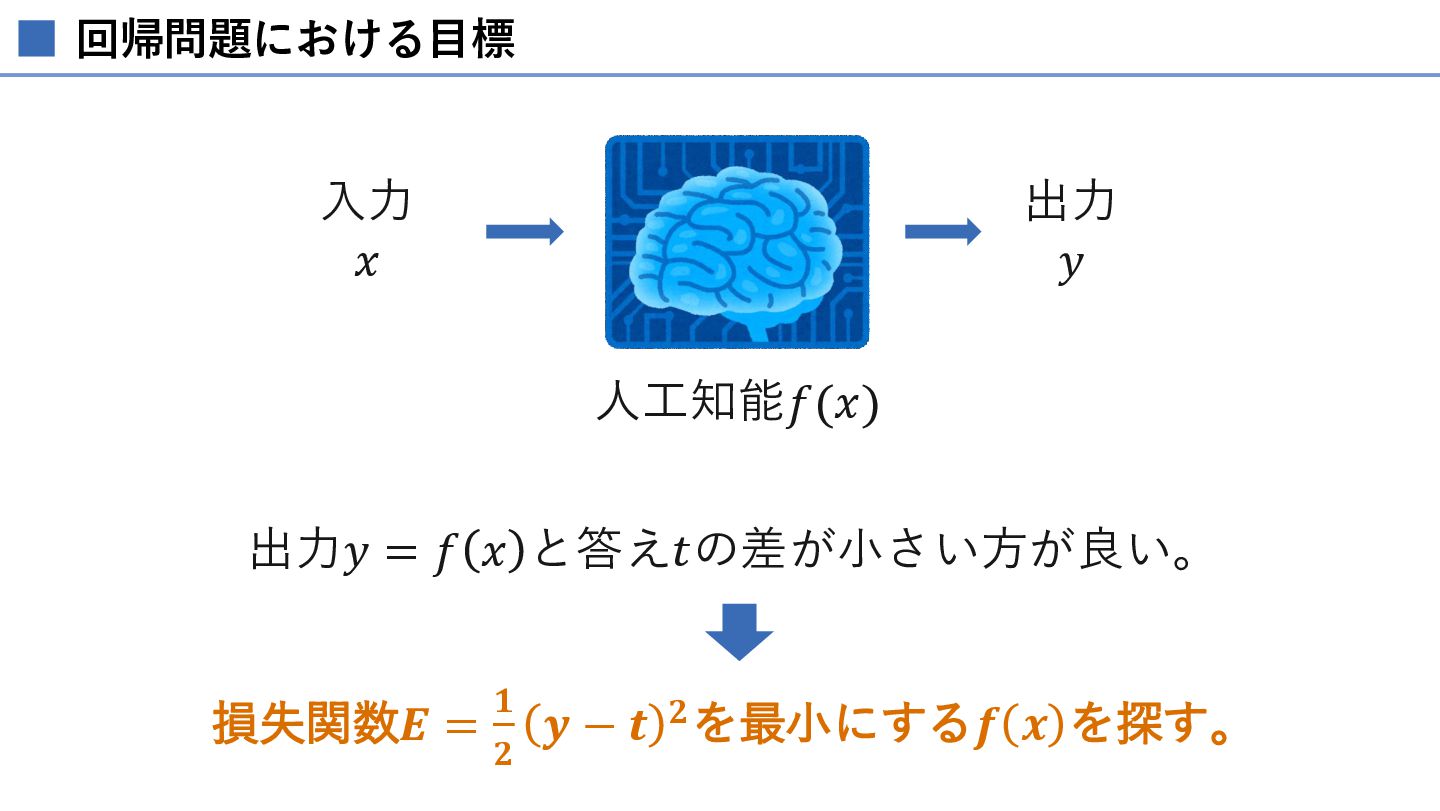
回帰問題における目標 入力 𝑥 出力 𝑦 人工知能𝑓(𝑥) 出力𝑦 = 𝑓 𝑥
と答え𝑡の差が小さい方が良い。 誤差関数𝑬 = 𝟏 𝟐 𝒚 − 𝒕 𝟐 を最小にする𝒇 𝒙 を探す。=学習
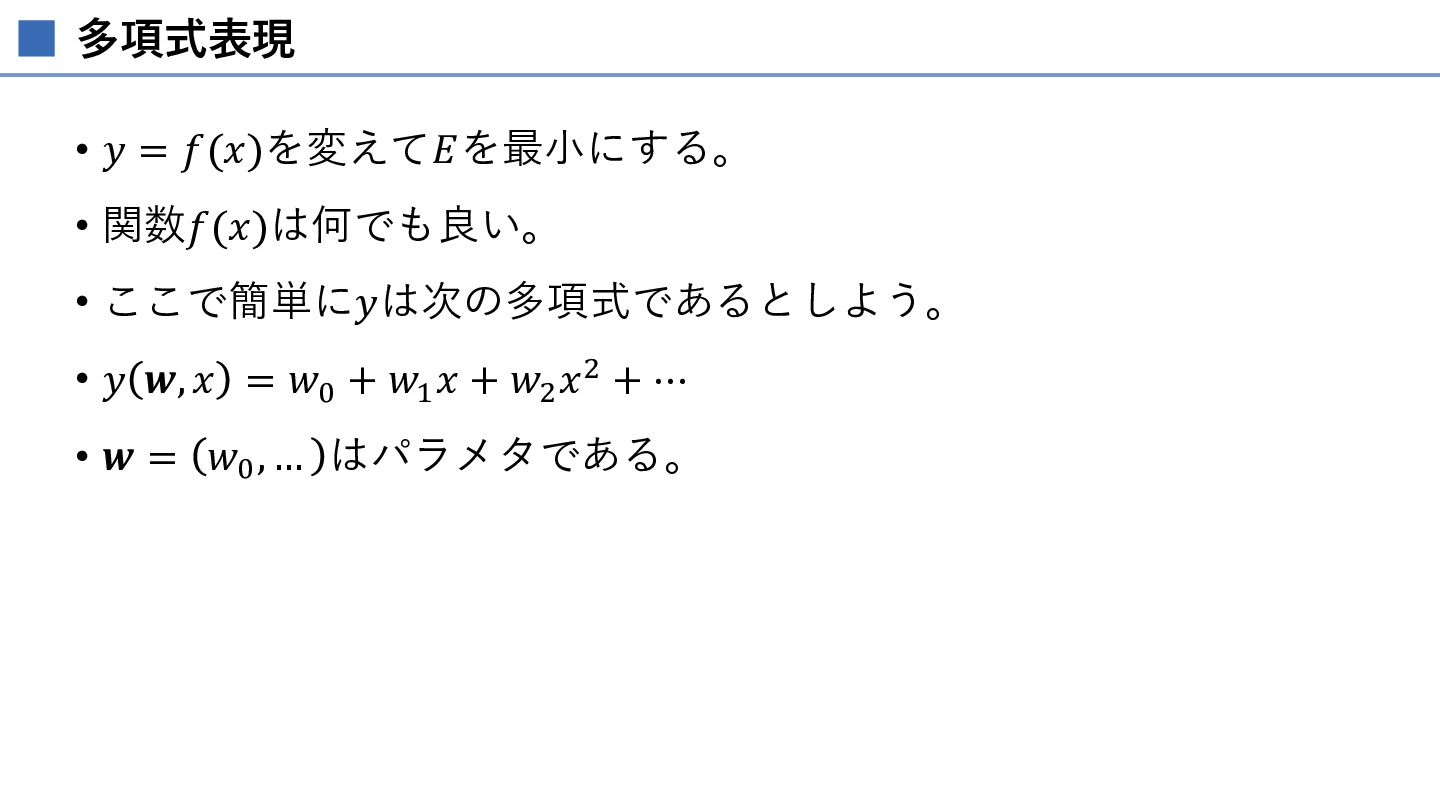
多項式表現 • 𝑦 = 𝑓(𝑥)を変えて𝐸を最小にする。 • 関数𝑓(𝑥)は何でも良い。 • ここで簡単に𝑦は次の多項式であるとしよう。 •
𝑦 𝒘, 𝑥 = 𝑤0 + 𝑤1 𝑥 + 𝑤2 𝑥 2 + ⋯ • 𝒘 = 𝑤0 , … はパラメタである。
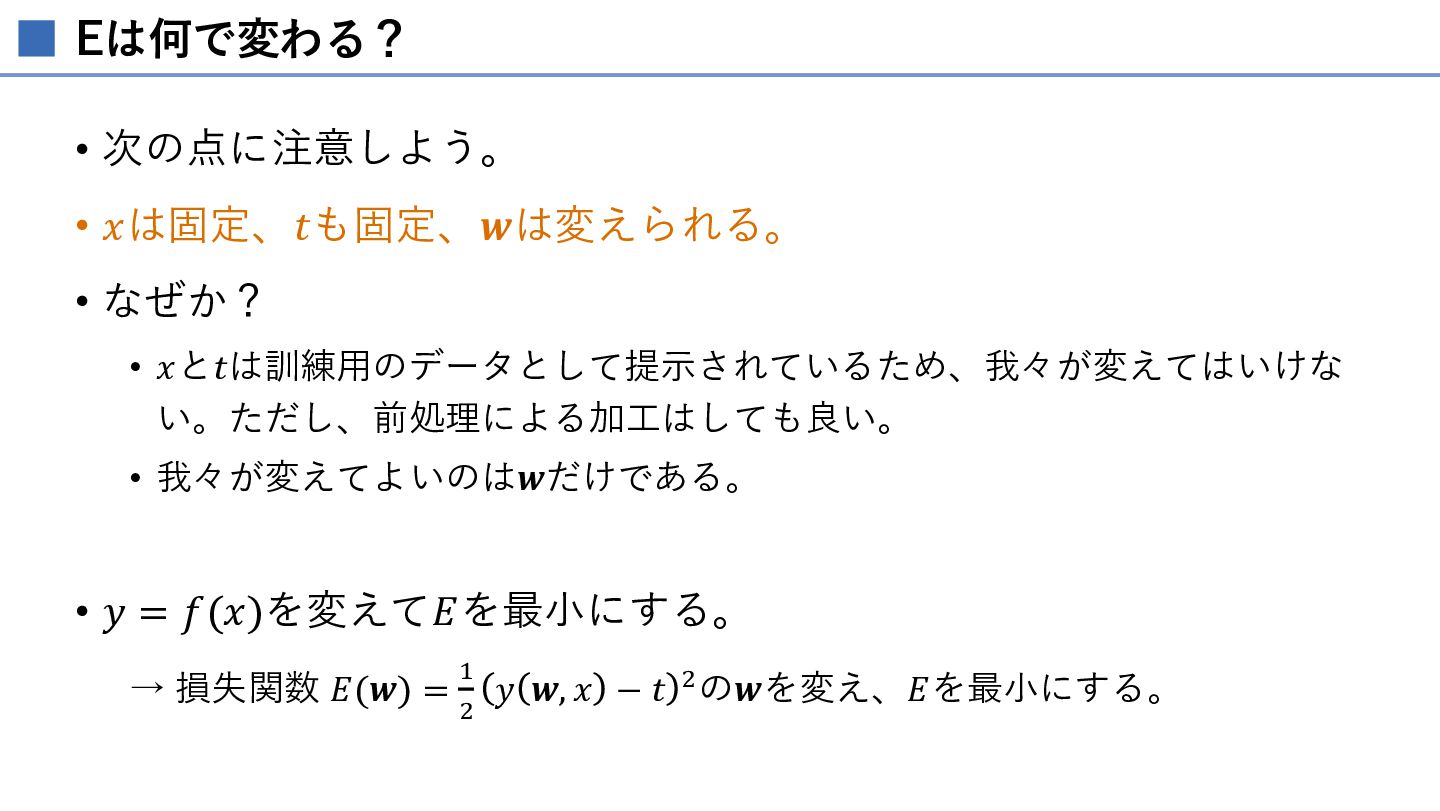
Eは何で変わる? • 次の点に注意しよう。 • 学習中は、𝑥も固定、𝑡も固定、𝒘は変えられる。 • なぜか? • 𝑥と𝑡は訓練データとして提示されているため、我々が変えてはいけない。 •
ただし、前処理による加工はしても良い。 • 我々が変えてよいのは𝒘だけである。 • 𝑦 𝒘, 𝑥 の𝒘を変えて誤差関数𝐸を最小にする。
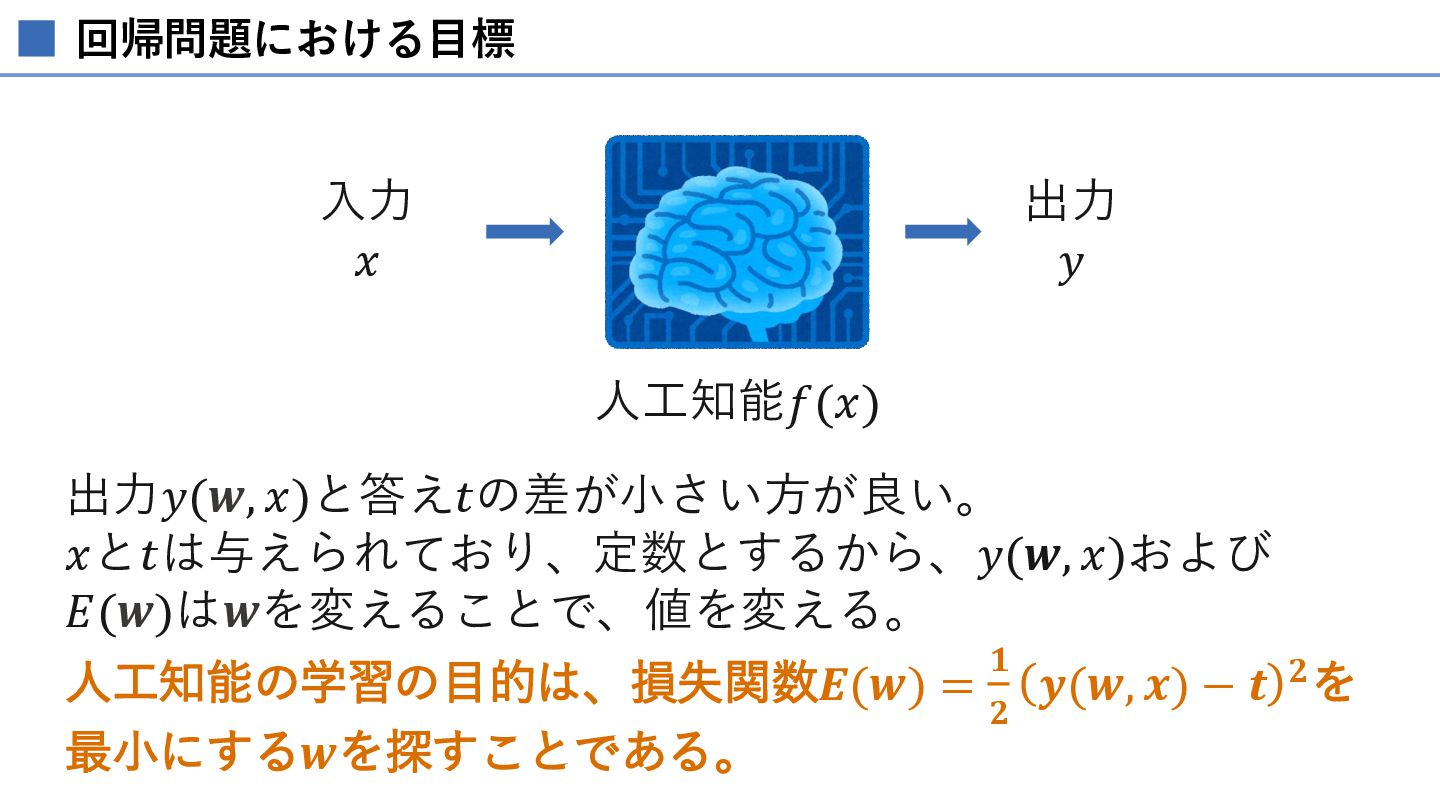
回帰問題における目標 入力 𝑥 出力 𝑦 人工知能𝑓(𝒘, 𝑥) • 出力𝑦(𝒘, 𝑥)と答え𝑡の差(誤差)が小さい方が良い。
• 𝑦(𝒘, 𝑥)の𝒘を変えることで、𝐸(𝒘)の最小化をめざす。 • 人工知能の学習の目的は、誤差関数𝑬(𝒘)を最小にする𝒘を 探すことである。
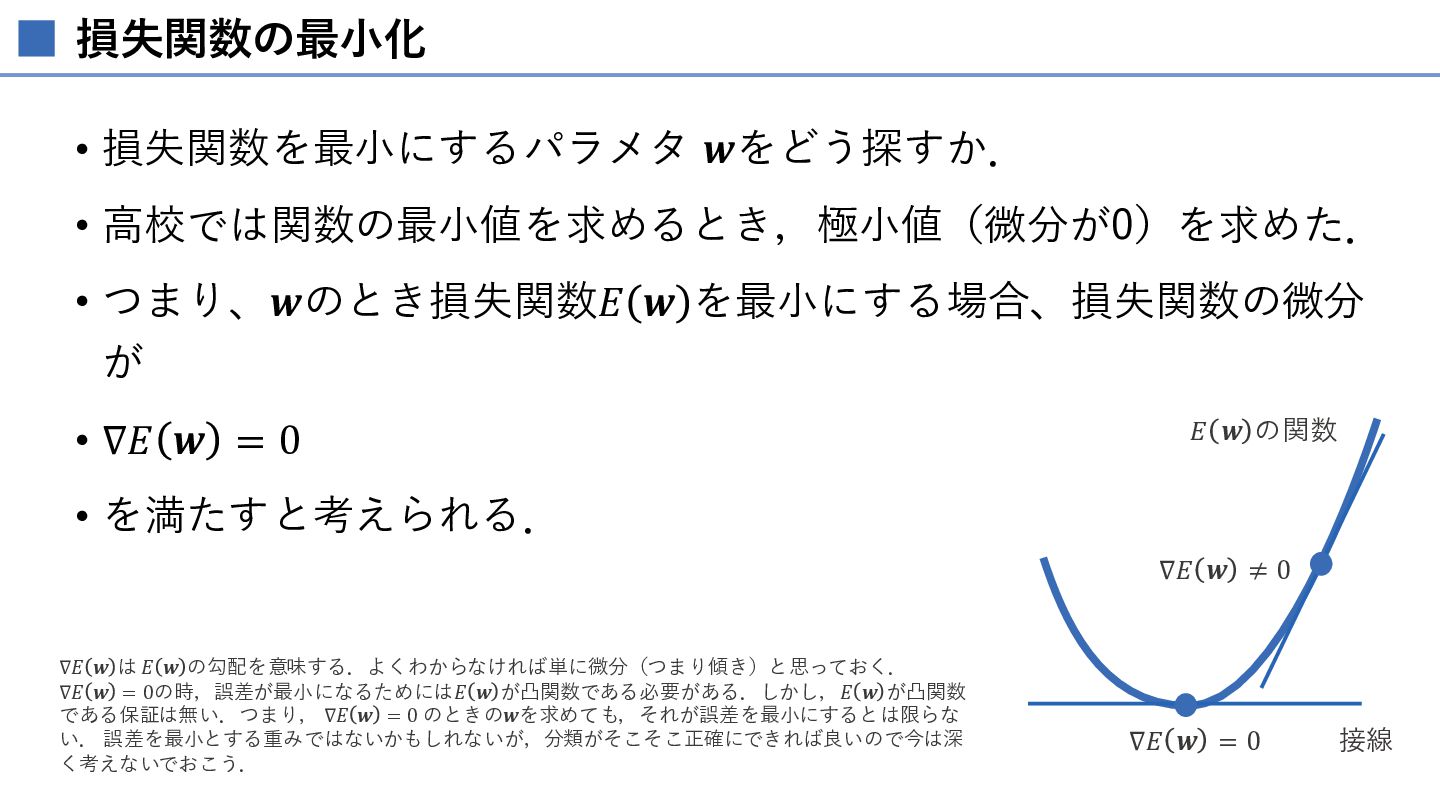
損失関数の最小化 • 誤差関数を最小にするパラメタ 𝒘をどう探すか. • 高校では関数の最小値を求めるとき,極小値(微分が0)を求めた. • つまり、𝒘のとき損失関数𝐸 𝒘 を最小にする場合、損失関数の微分
が 𝐸 𝒘 • ∇𝐸 𝒘 = 0 𝐸 𝒘 の関数 • を満たすと考えられる. ∇𝐸 𝒘 ≠ 0 ∇𝐸 𝒘 は 𝐸 𝒘 の勾配を意味する.よくわからなければ単に微分(つまり傾き)と思っておく. ∇𝐸 𝒘 = 0の時,誤差が最小になるためには𝐸 𝒘 が凸関数である必要がある.しかし,𝐸 𝒘 が凸関数 である保証は無い.つまり, ∇𝐸 𝒘 = 0 のときの𝒘を求めても,それが誤差を最小にするとは限らな い. 誤差を最小とする重みではないかもしれないが,分類がそこそこ正確にできれば良いので今は深 く考えないでおこう. ∇𝐸 𝒘 = 0 接線 𝒘
簡単にはwは見つからないか • 多項式フィッティングはデータが十分にあれば解析的に求められる。 • 解析的に求められるとは、∇𝐸 𝒘 = 0の方程式が解けるという意味である。 • 条件によっては方程式が解けないこともある。
• 人工ニューラルネットワークのような更に複雑な関数𝑓 𝒘, 𝑥 を用い るとに最適な𝒘を解析的に求められなくなる。 • 解析的に求められない場合は勾配降下法が用いられることがある。
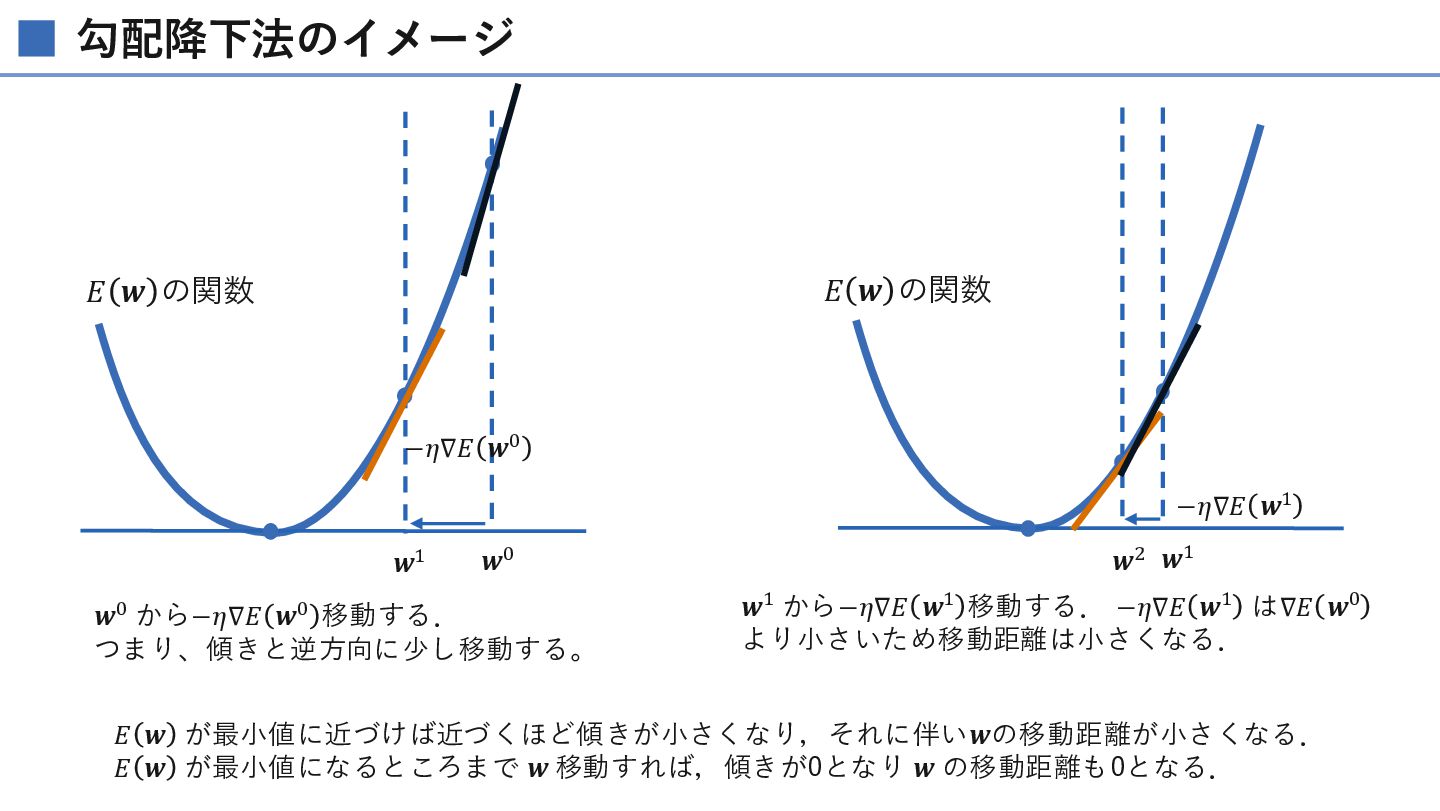
勾配降下法のイメージ 𝐸 𝒘 の関数 𝐸 𝒘 の関数 −𝜂∇𝐸 𝒘0 −𝜂∇𝐸
𝒘1 𝒘1 𝒘0 𝒘0 から−𝜂∇𝐸 𝒘0 移動する. つまり、傾きと逆方向に少し移動する。 𝒘2 𝒘1 𝒘1 から−𝜂∇𝐸 𝒘1 移動する. −𝜂∇𝐸 𝒘1 は∇𝐸 𝒘0 より小さいため移動距離は小さくなる. 𝐸 𝒘 が最小値に近づけば近づくほど傾きが小さくなり,それに伴い𝒘の移動距離が小さくなる. 𝐸 𝒘 が最小値になるところまで 𝒘 移動すれば,傾きが0となり 𝒘 の移動距離も0となる.
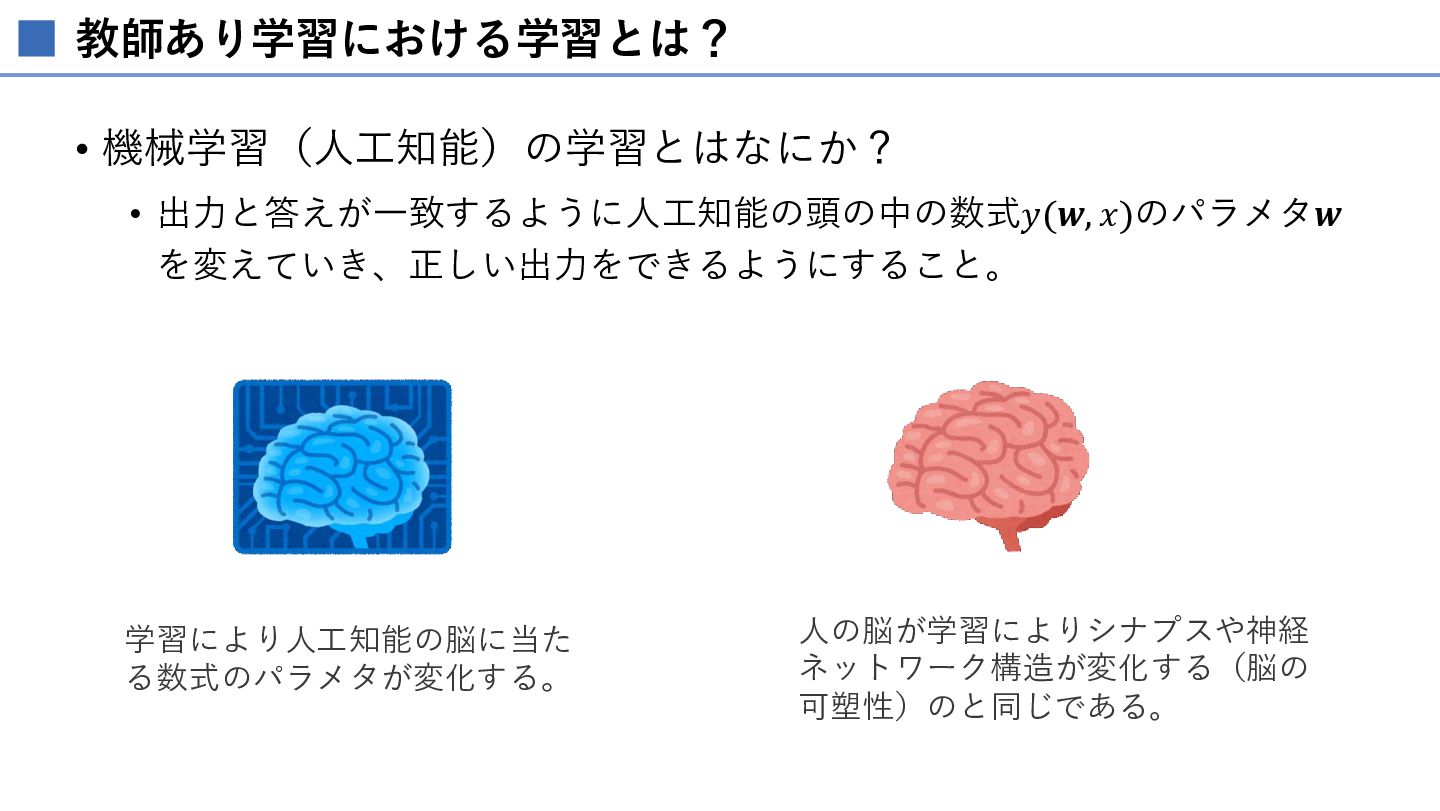
教師あり学習における学習とは? • 機械学習(人工知能)の学習とはなにか? • 出力と答えが一致するように人工知能の脳にあたる数式𝑦(𝒘, 𝑥)のパラメタ 𝒘を変えていき、答えに近い出力を出せるようにすること。 学習により人工知能の脳に当た る数式のパラメタが変化する。 脳が学習によりシナプスや神経ネッ
トワーク構造が変化する(脳の可塑 性)のと同じである。
教師なし学習
教師なし学習とは • 教師なし学習とは、答えを明示せず、入力のみから学習することで ある。 • 答えの代わりに、何らかの指標に基づいて学習する。 • 教師あり学習では誤差関数を指標として学習した。しかし、誤差関数は答 えを与えなければ計算できない。 •
教師なし学習では、入力を与えれば求まり、答えを必要としない指標を考 え、それを最小化(最大化)する。 目的関数
クラスタリング
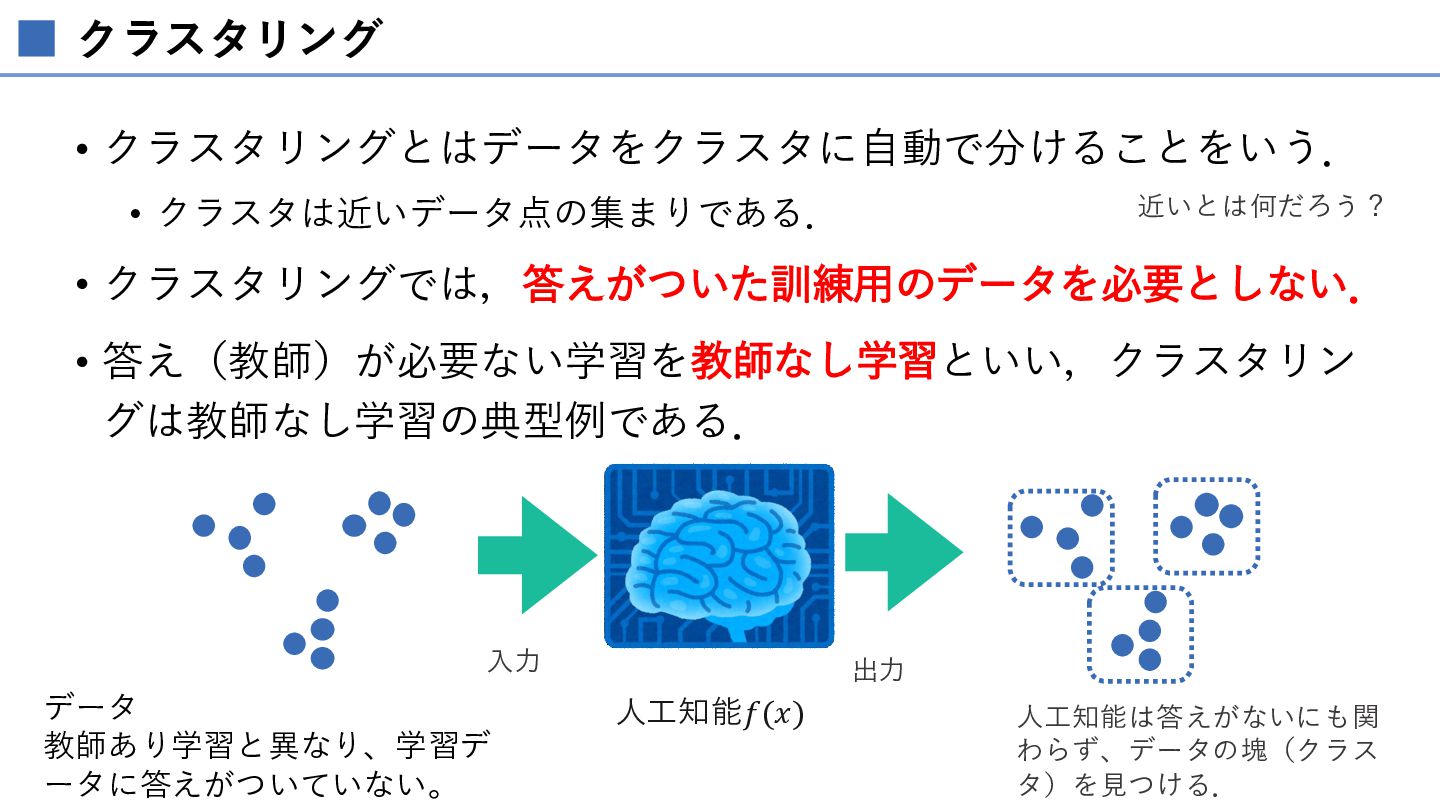
クラスタリング • クラスタリングとはデータをクラスタに自動で分けることをいう. 近いとは何だろう? • クラスタは近いデータ点の集まりである. • クラスタリングでは,答えがついた訓練用のデータを必要としない. • 答え(教師)が必要ない学習を教師なし学習といい,クラスタリン
グは教師なし学習の典型例である. 入力 データ 教師あり学習と異なり、学習デ ータに答えがついていない。 出力 人工知能𝑓(𝑥) 人工知能は答えがないにも関 わらず、データの塊(クラス タ)を見つける.
クラスタリング(k-means)の 具体的な方法
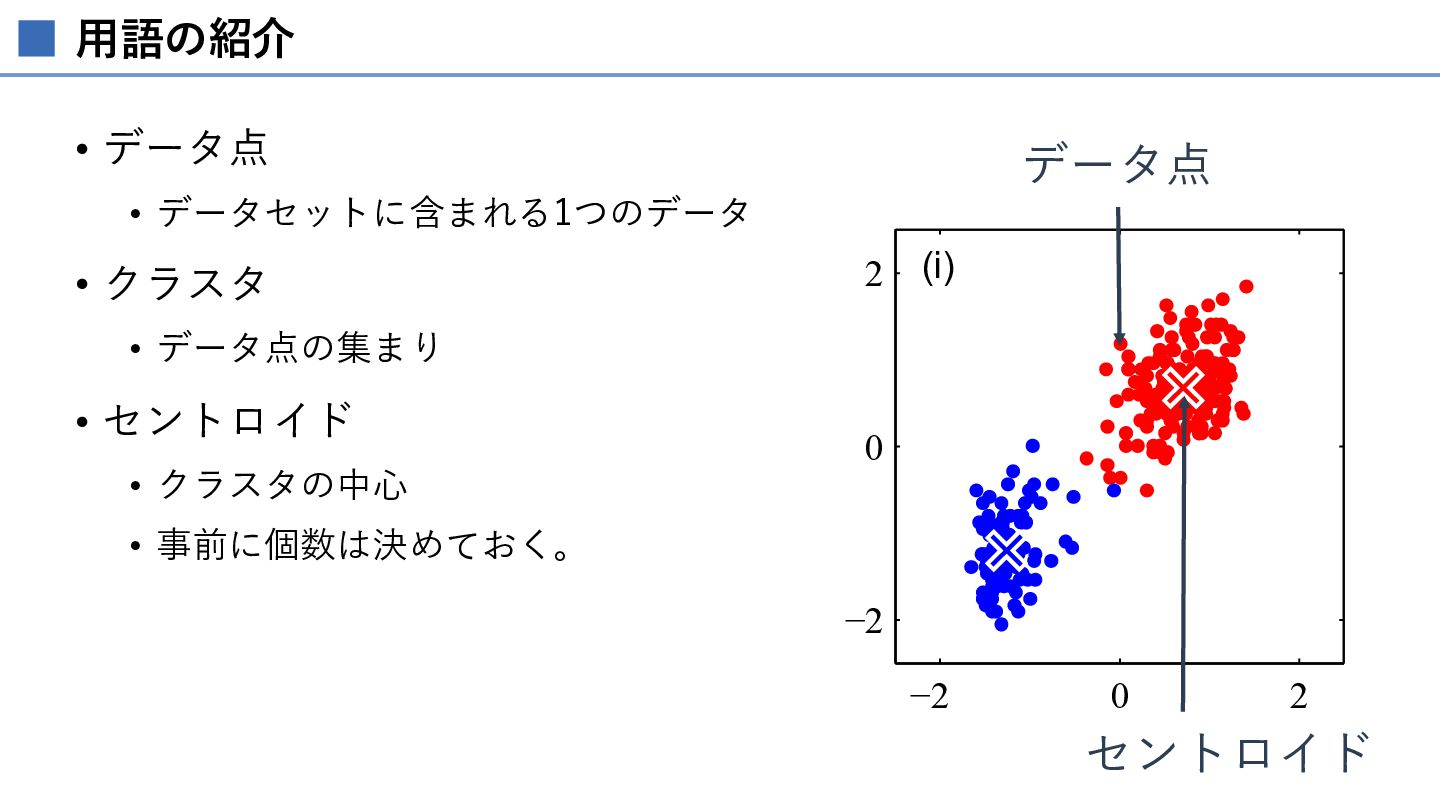
用語の紹介 • データ点 データ点 • データセットに含まれる1つのデータ • クラスタ 2 (i)
• データ点の集まり • セントロイド • クラスタの中心 0 • 事前に個数は決めておく。 −2 −2 0 2 セントロイド
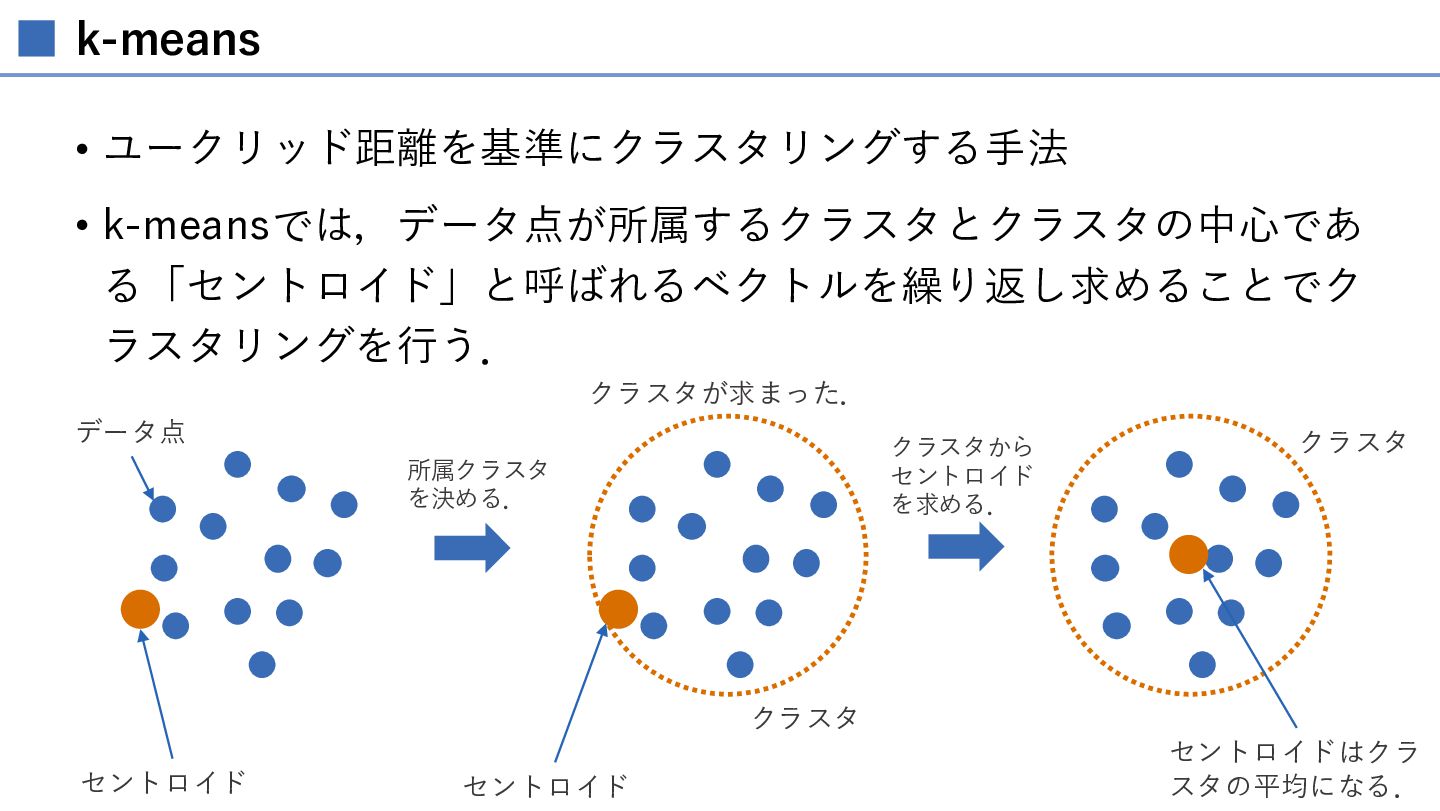
k-means • ユークリッド距離を基準にクラスタリングする手法 • k-meansでは,データ点が所属するクラスタとクラスタの中心であ る「セントロイド」と呼ばれるベクトルを繰り返し求めることでク ラスタリングを行う. クラスタが求まった. データ点 クラスタから
セントロイド を求める. 所属クラスタ を決める. クラスタ クラスタ セントロイド セントロイド セントロイドはクラ スタの平均になる.
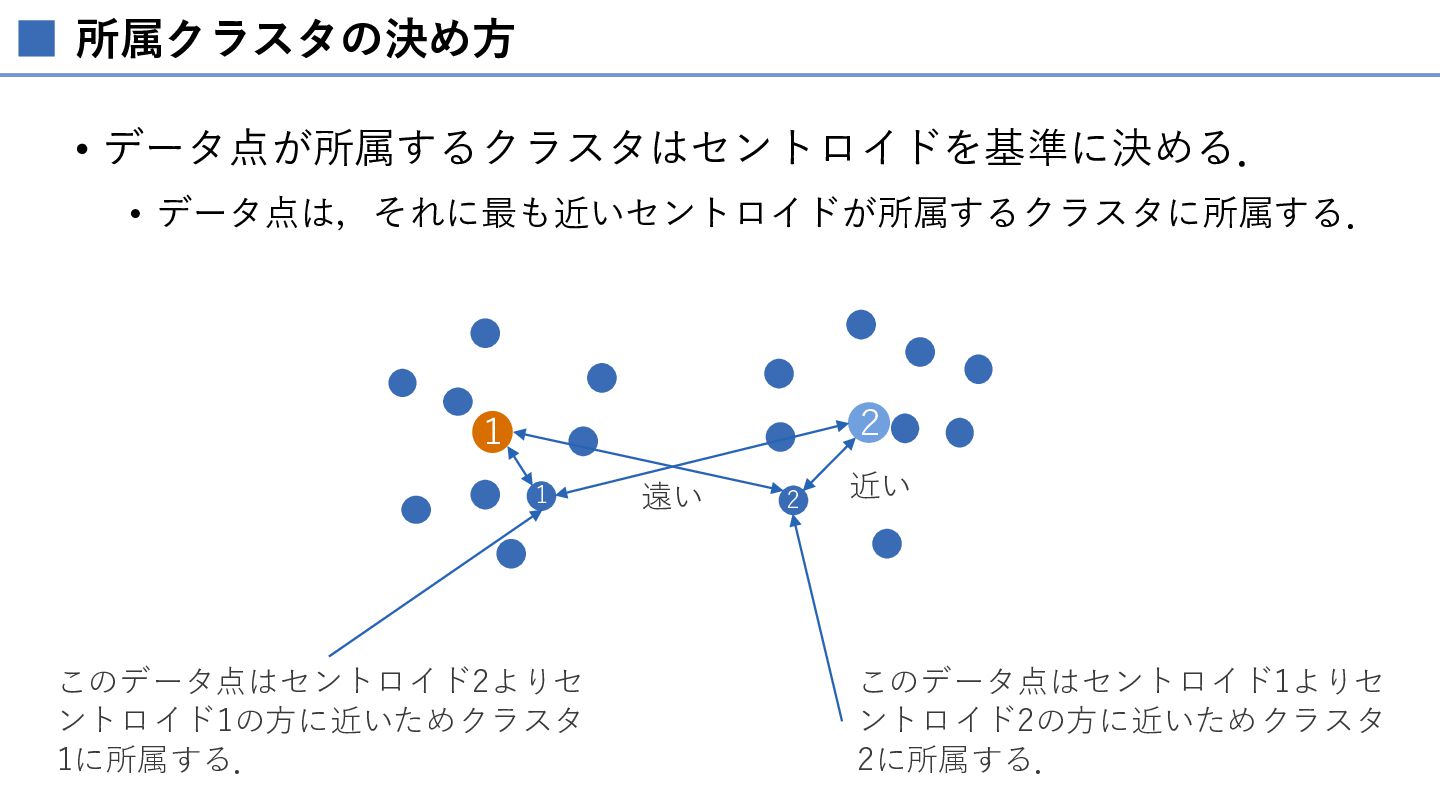
所属クラスタの決め方 • データ点が所属するクラスタはセントロイドを基準に決める. • データ点は,それに最も近いセントロイドが所属するクラスタに所属する. 2 1 1 このデータ点はセントロイド2よりセ ントロイド1の方に近いためクラスタ
1に所属する. 遠い 2 近い このデータ点はセントロイド1よりセ ントロイド2の方に近いためクラスタ 2に所属する.
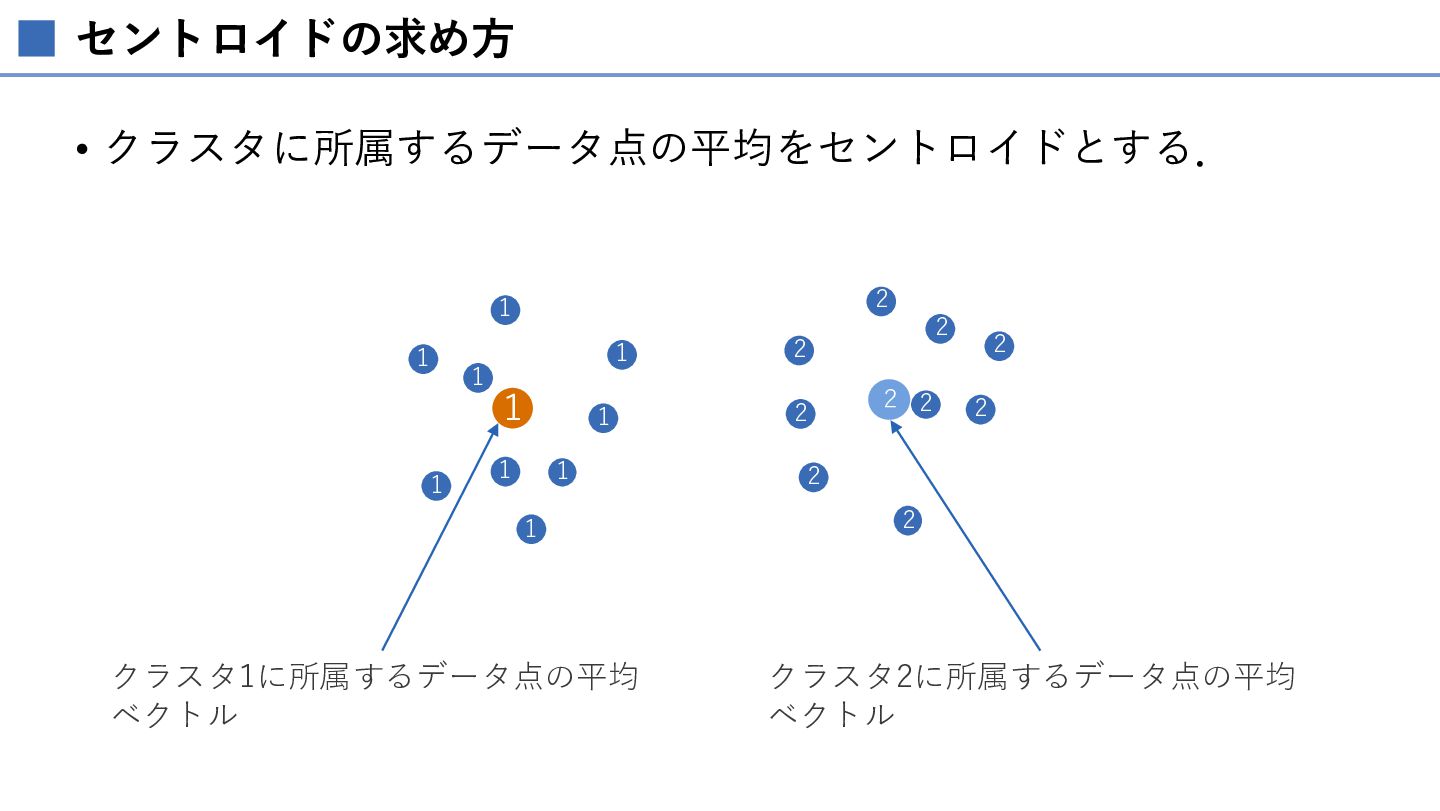
セントロイドの求め方 • クラスタに所属するデータ点の平均をセントロイドとする. 2 1 1 1 1 1 1
1 1 1 1 クラスタ1に所属するデータ点の平均 ベクトル 2 2 2 2 2 2 2 2 2 クラスタ2に所属するデータ点の平均 ベクトル
K-meansのアルゴリズム • K-meansでは次の手順でクラスタリングを行う. 1. セントロイドを初期化する. 2. 各データ点の所属クラスタを決める. 3. セントロイドを計算する. 4.
N回繰り返したら(所属クラスタの変更がなければ)終了.そう でなければ2へ.
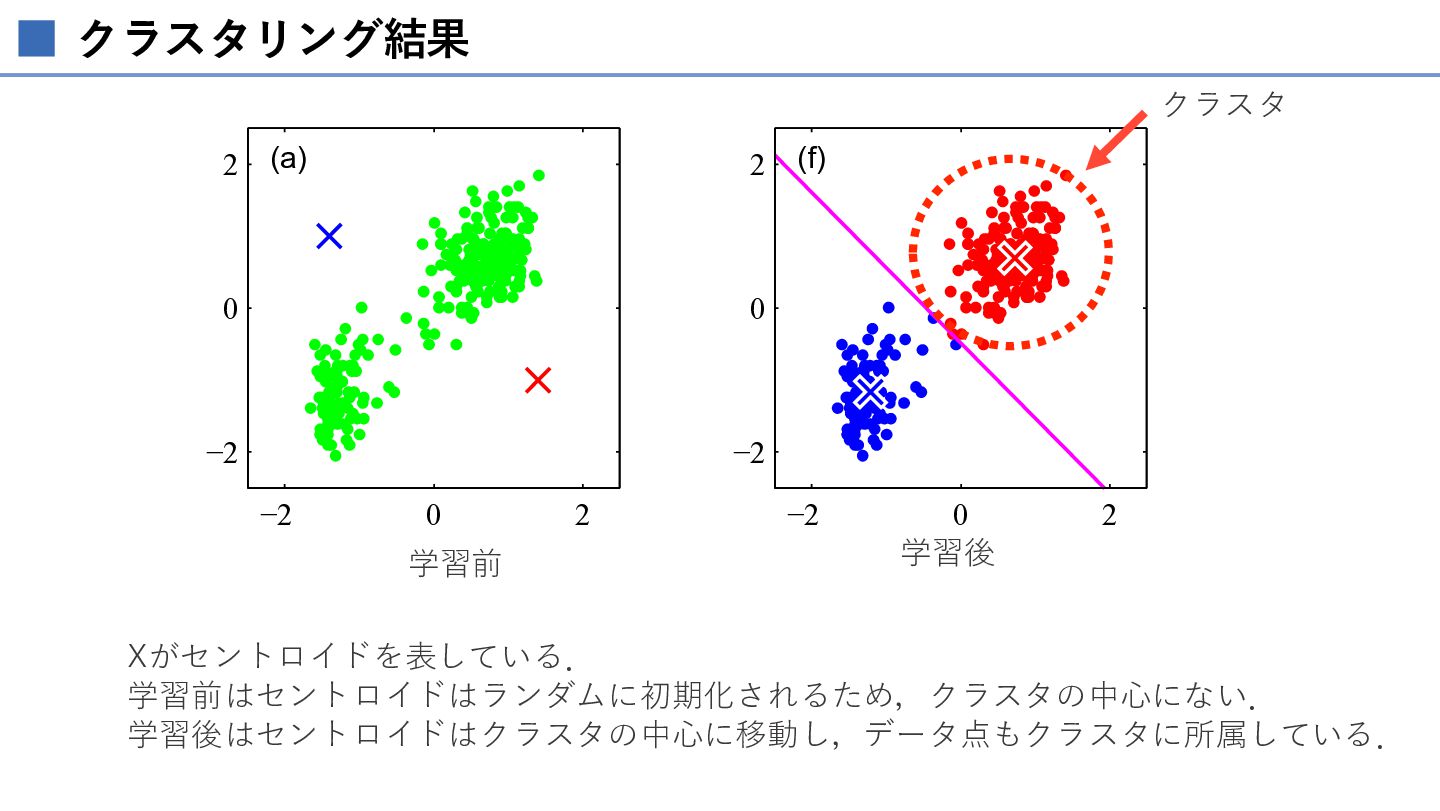
クラスタリング結果 クラスタ 2 (a) 2 0 0 −2 −2 −2
0 学習前 2 (f) −2 0 学習後 2 Xがセントロイドを表している. 学習前はセントロイドはランダムに初期化されるため,クラスタの中心にない. 学習後はセントロイドはクラスタの中心に移動し,データ点もクラスタに所属している.
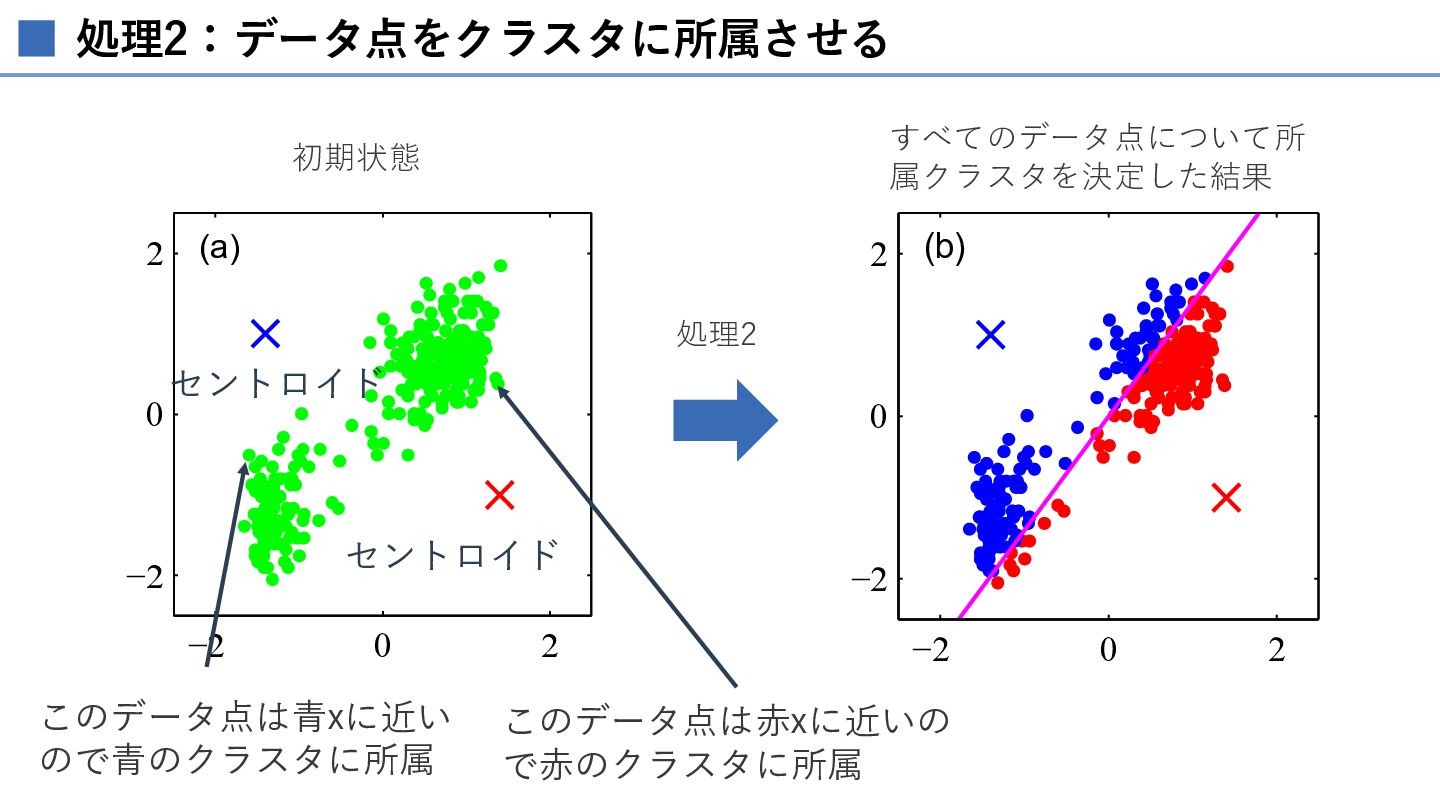
処理2:データ点をクラスタに所属させる すべてのデータ点について所 属クラスタを決定した結果 初期状態 2 (a) 2 (b) 処理2 0
セントロイド 0 セントロイド −2 −2 0 このデータ点は青xに近い ので青のクラスタに所属 2 −2 −2 このデータ点は赤xに近いの で赤のクラスタに所属 0 2
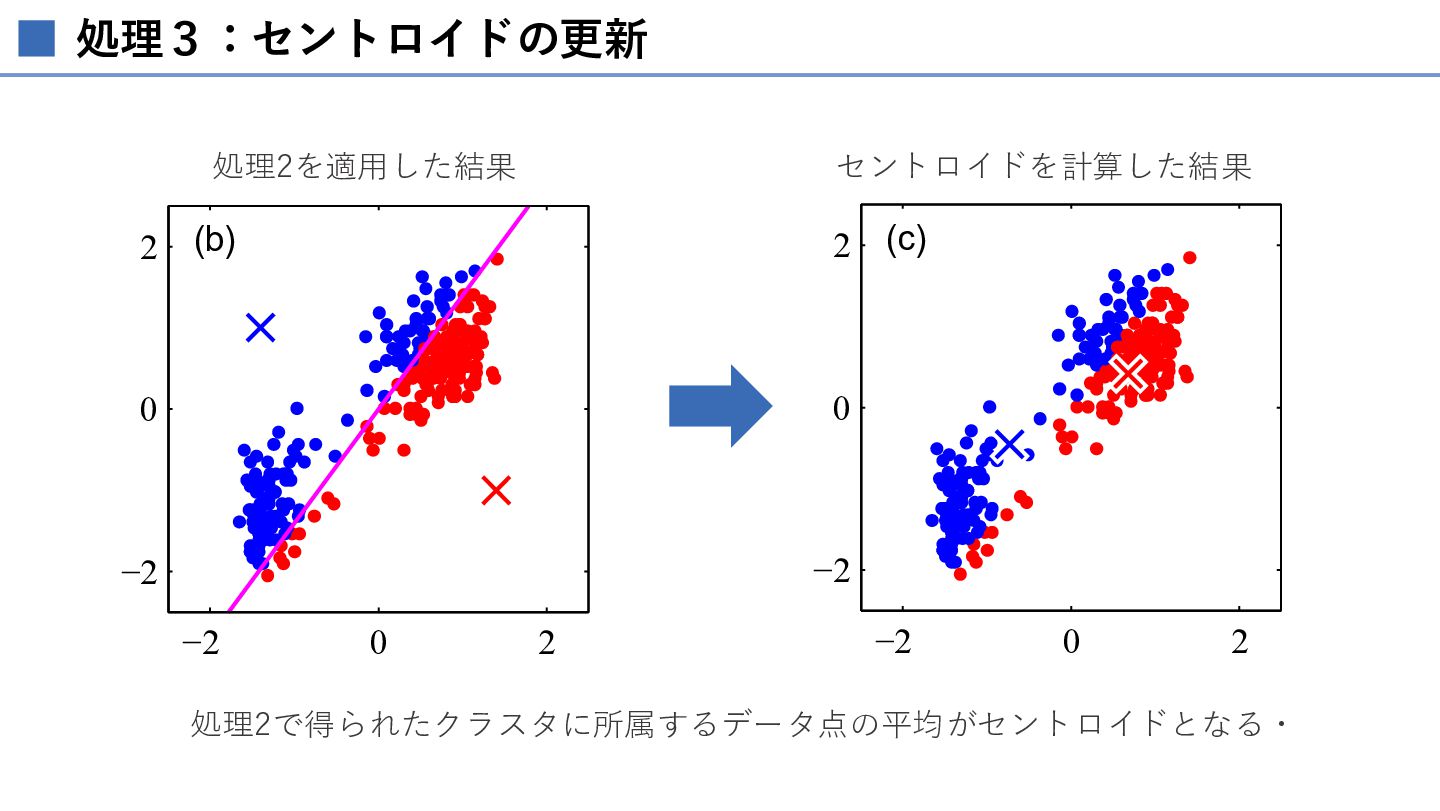
処理3:セントロイドの更新 2 処理2を適用した結果 セントロイドを計算した結果 (b) 2 0 0 −2 −2
−2 0 2 (c) −2 0 2 処理2で得られたクラスタに所属するデータ点の平均がセントロイドとなる・
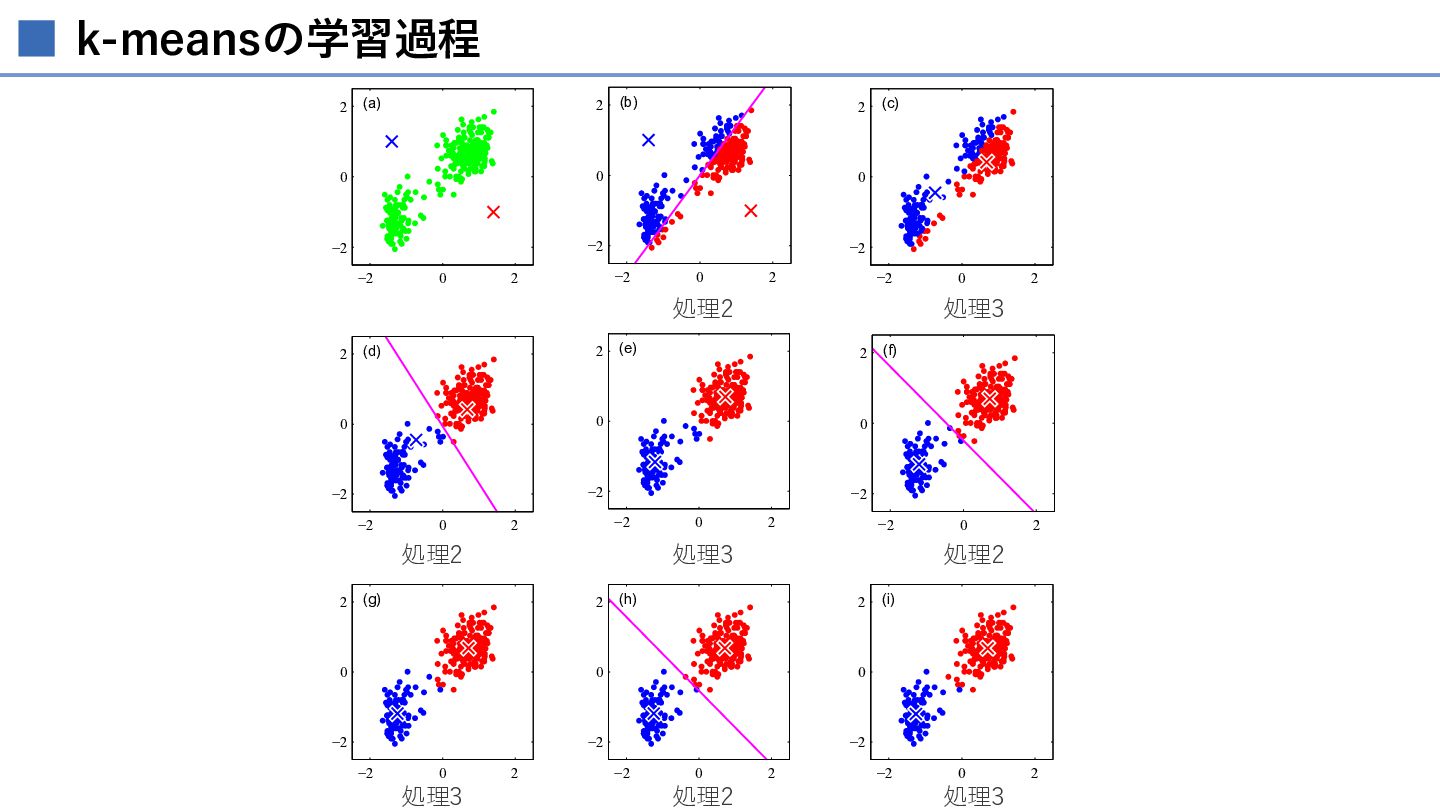
k-meansの学習過程 2 (a) 2 (b) 2 0 0 0 −2
−2 −2 −2 0 −2 2 0 2 (c) −2 処理2 2 (d) 2 0 0 −2 −2 −2 0 2 −2 0 2 −2 処理3 (g) 2 (h) 2 0 0 −2 −2 −2 0 処理3 2 −2 0 処理2 0 2 処理2 0 −2 (f) 0 処理2 2 2 処理3 (e) −2 2 0 2 (i) −2 0 処理3 2
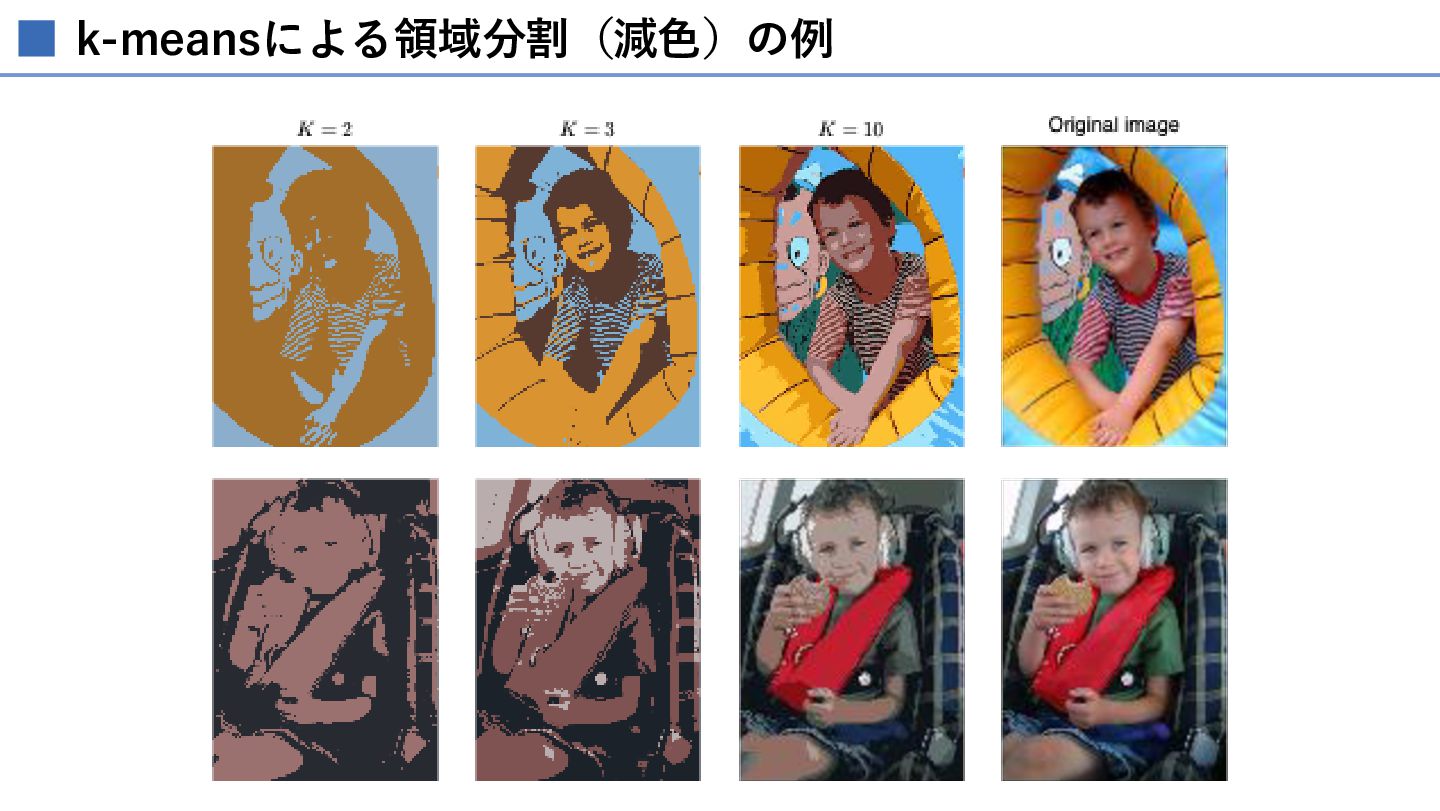
k-meansによる領域分割(減色)の例
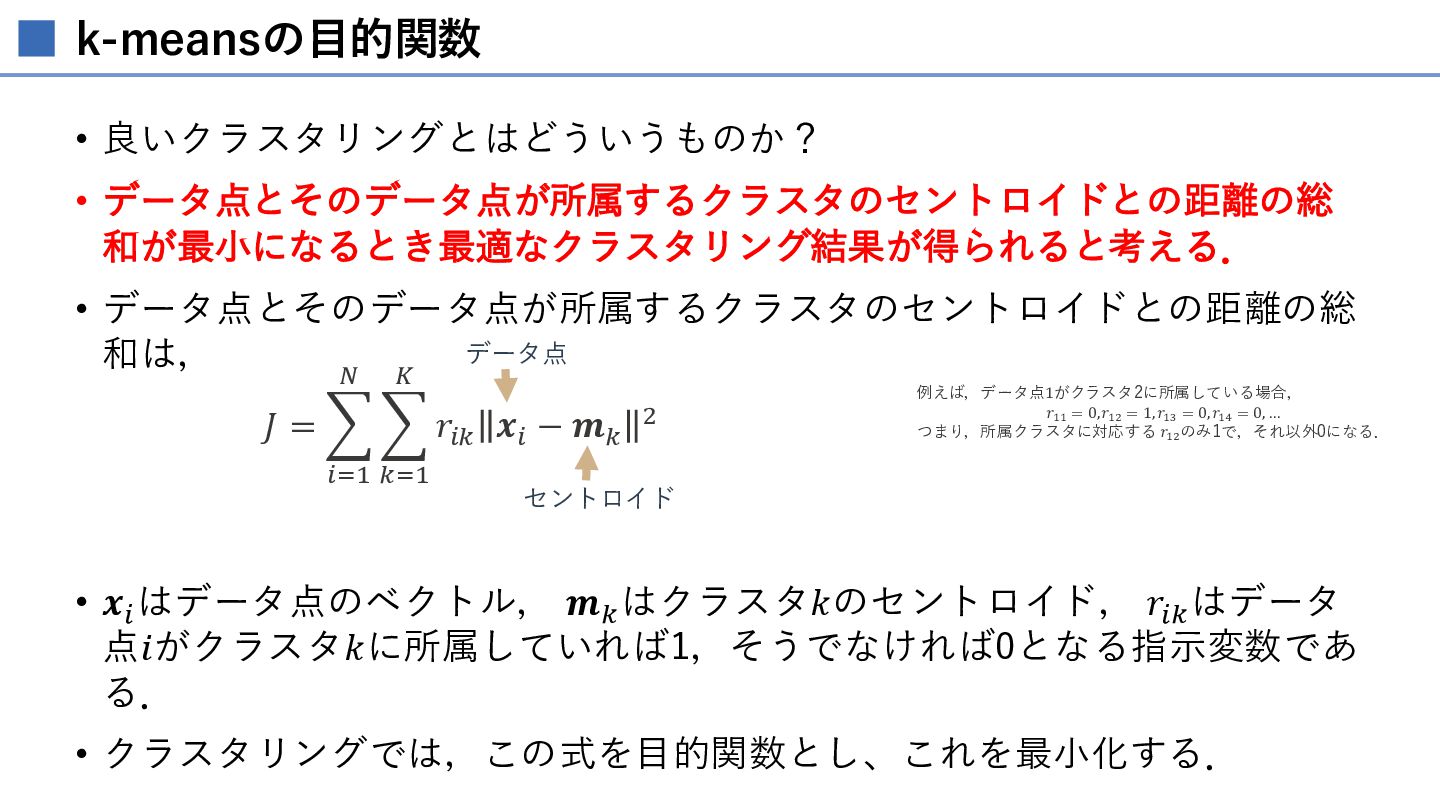
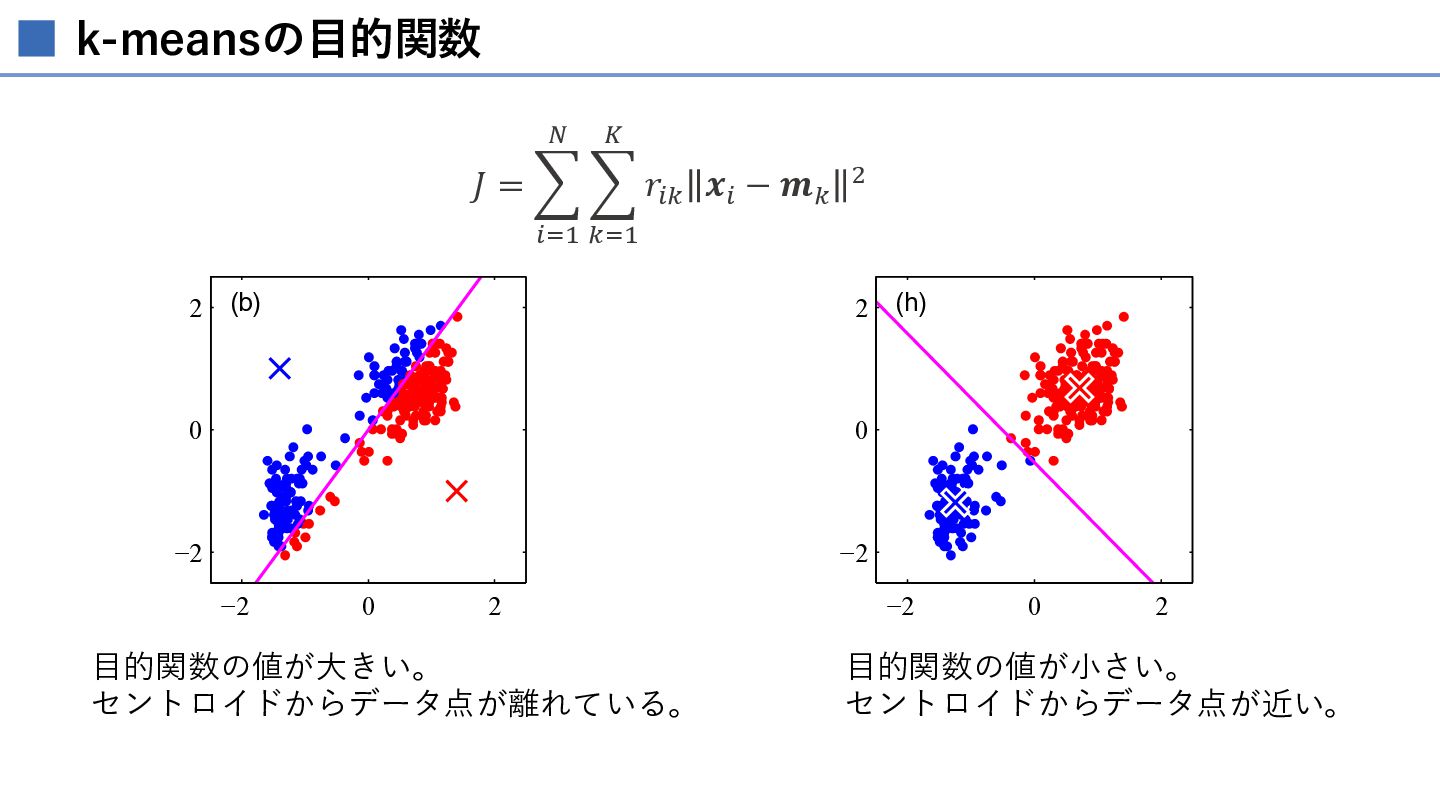
k-meansの目的関数 • 良いクラスタリングとはどういうものか? • データ点とそのデータ点が所属するクラスタのセントロイドとの距離の総 和が最小になるとき最適なクラスタリング結果が得られると考える. • データ点とそのデータ点が所属するクラスタのセントロイドとの距離の総 データ点 和は,
𝑁 𝐾 𝐽= 𝑟𝑖𝑘 𝒙𝑖 − 𝒎𝑘 𝑖=1 𝑘=1 2 例えば,データ点1がクラスタ2に所属している場合, 𝑟11 = 0, 𝑟12 = 1, 𝑟13 = 0, 𝑟14 = 0, … つまり,所属クラスタに対応する 𝑟12のみ1で,それ以外0になる. セントロイド • 𝒙𝑖 はデータ点のベクトル, 𝒎𝑘 はクラスタ𝑘のセントロイド, 𝑟𝑖𝑘 はデータ 点𝑖がクラスタ𝑘に所属していれば1,そうでなければ0となる指示変数であ る. • クラスタリングでは,この式を目的関数とし、これを最小化する.
k-meansの目的関数 𝑁 𝐾 𝑟𝑖𝑘 𝒙𝑖 − 𝒎𝑘 2 𝐽= 𝑖=1
𝑘=1 2 (b) 2 0 0 −2 −2 −2 0 2 目的関数の値が大きい。 セントロイドからデータ点が離れている。 (h) −2 0 2 目的関数の値が小さい。 セントロイドからデータ点が近い。
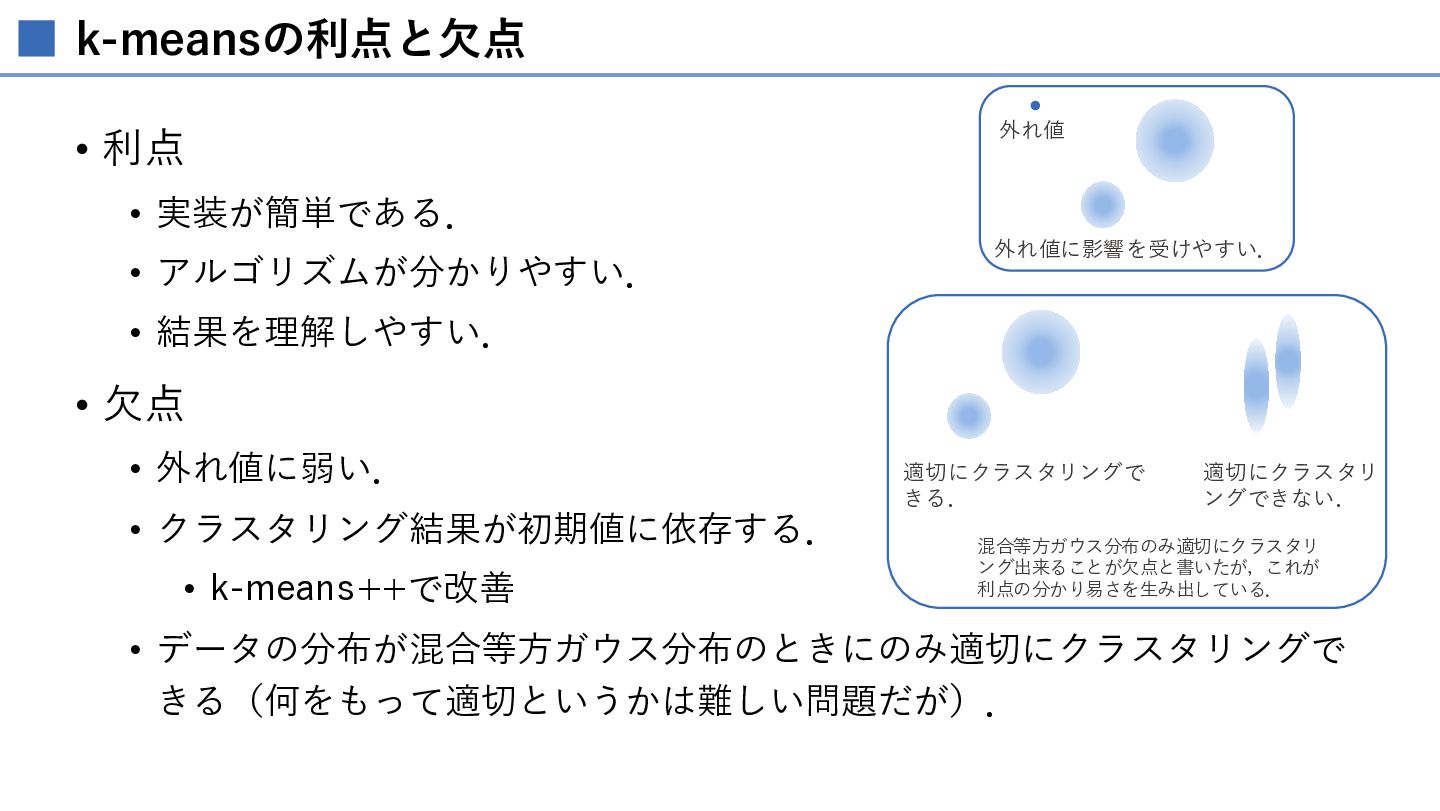
k-meansの利点と欠点 • 利点 外れ値 • 実装が簡単である. • アルゴリズムが分かりやすい. 外れ値に影響を受けやすい. •
結果を理解しやすい. • 欠点 • 外れ値に弱い. • クラスタリング結果が初期値に依存する. • k-means++で改善 適切にクラスタリングで きる. 適切にクラスタリ ングできない. 混合等方ガウス分布のみ適切にクラスタリ ング出来ることが欠点と書いたが,これが 利点の分かり易さを生み出している. • データの分布が混合等方ガウス分布のときにのみ適切にクラスタリングで きる(何をもって適切というかは難しい問題だが).
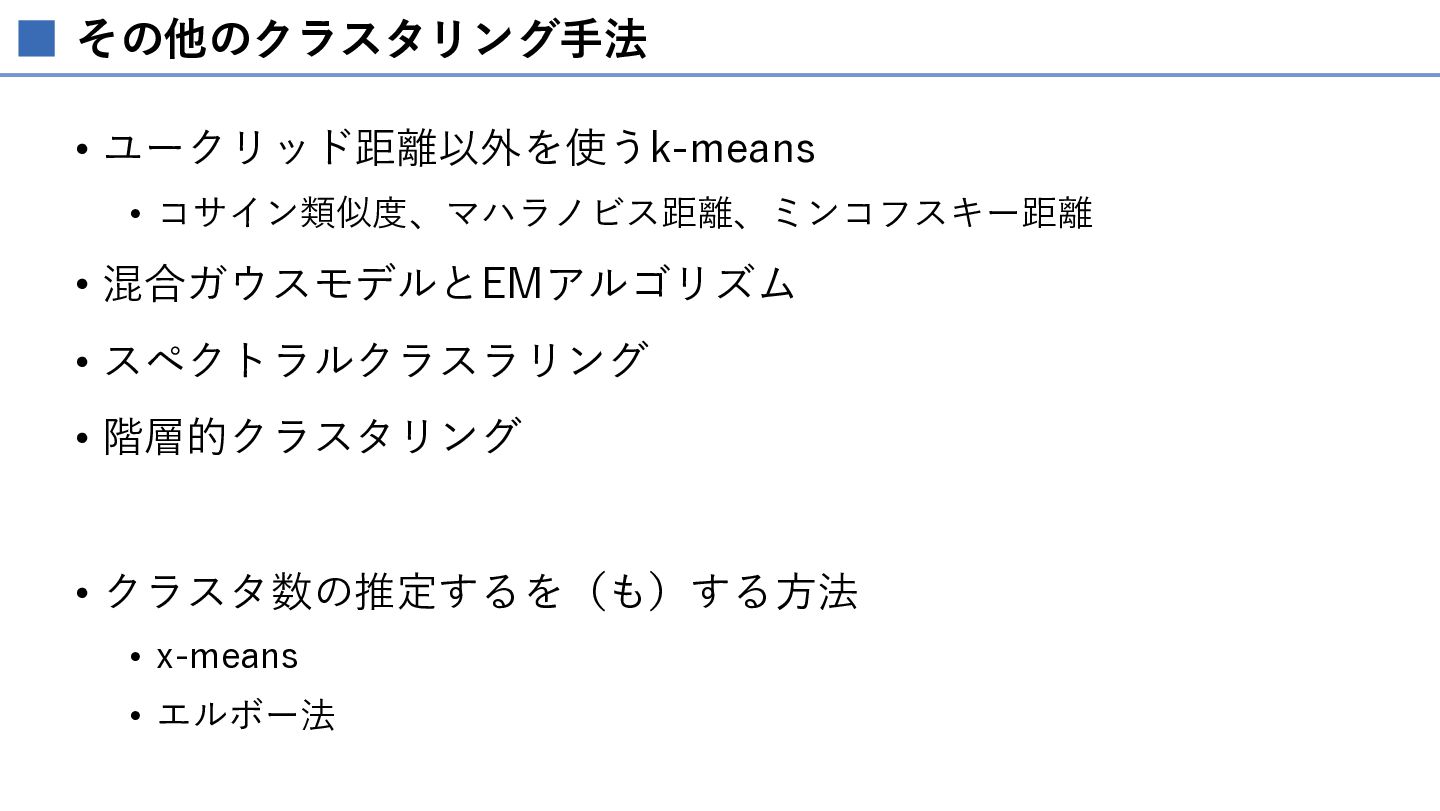
その他のクラスタリング手法 • ユークリッド距離以外を使うk-means • コサイン類似度、マハラノビス距離、ミンコフスキー距離 • 混合ガウスモデルとEMアルゴリズム • スペクトラルクラスラリング •
階層的クラスタリング • クラスタ数の推定するを(も)する方法 • x-means • エルボー法
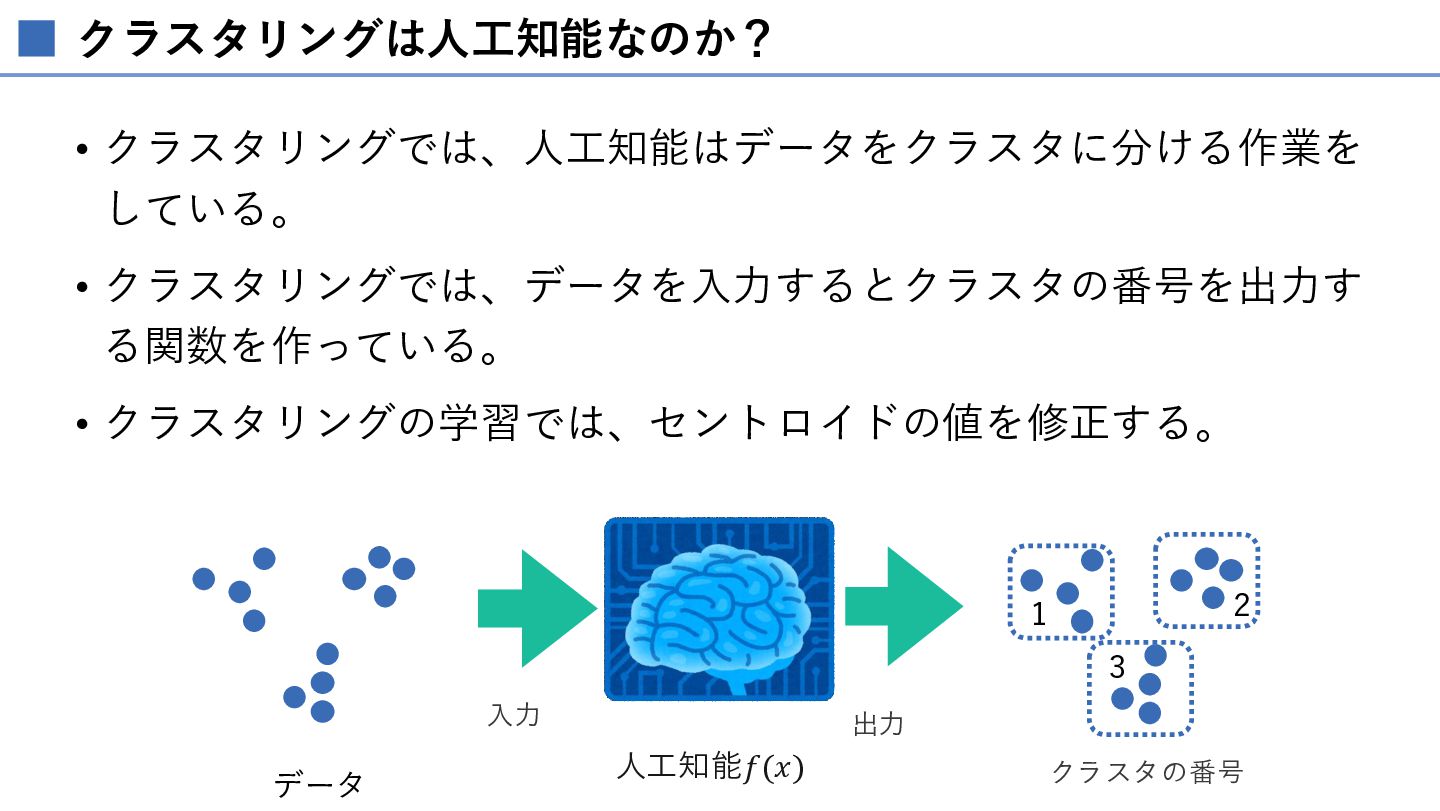
クラスタリングは人工知能なのか? • クラスタリングでは、人工知能はデータをクラスタに分ける作業を している。 • クラスタリングでは、データを入力するとクラスタの番号を出力す る関数を作っている。 • クラスタリングの学習では、セントロイドの値を修正する。 2
1 3 入力 データ 出力 人工知能𝑓(𝑥) クラスタの番号
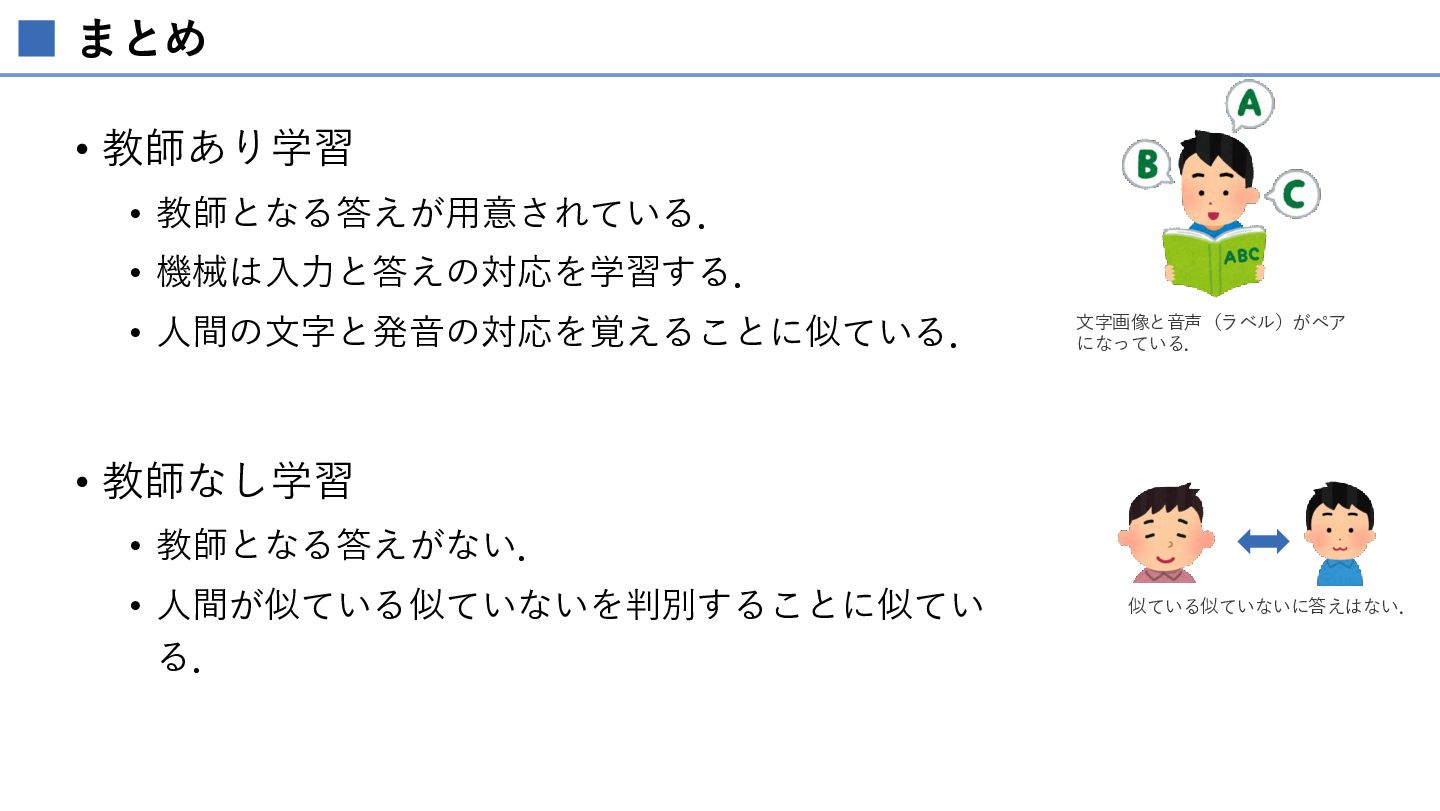
まとめ • 教師あり学習 • 教師となる答えが用意されている. • 機械は入力と答えの対応を学習する. • 人工知能の出力と答えを近づけるように、人工知 能の脳(数式)を変化させる。
文字画像と音声(ラベル)がペア になっている. • 人間の文字と発音の対応を覚えることに似ている. • 教師なし学習 • 教師となる答えがない. • 答えを必要としない指標に基づき学習する。 • 人間が似ている似ていないを判別することに似てい る. 似ている似ていないに答えはない.
出席レポート • 人工知能が「学習する」とは、人工知能の何が変わることなのか、 簡単に説明してください。


 kfujita
 adeputra13
 hiola
 signer
 drpoonamkc
 yatabe
 akiraasano
 yasslab
 3l4l5
 ainischool
 pawan_pharm
 echaille
 rashwhitman
 helmedeiros
 thoeni
 rasmusluckow
 bryan
 inesmontani
 helenjbeal
 soudai
 addyosmani
 62gerente
 gurzu
 iamctodd
 marcelosomers