Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
CVPR2026論文紹介_VLMにとって良いvision encoderとは何か?Reth...
Search
小林優斗
June 20, 2026
Research
270
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
CVPR2026論文紹介_VLMにとって良いvision encoderとは何か?Rethinking Model Selection in VLM Through the Lens of Gromov-Wasserstein Distance
小林優斗
June 20, 2026
More Decks by 小林優斗
See All by 小林優斗
ICCV2025参加報告_採択されやすいワークショップの選び方
kobayashi31
0
200
Other Decks in Research
See All in Research
Model Predictive Control for Uncertain Systems: Robust & Data-Driven Designs
kohlerjohannes
0
180
就労支援の現場での生成AI活用
enochan
0
160
Easy to Guess, Hard to Verify: Lessons from AIMO 3 for Olympiad-Level AI Mathematics
corochann
0
130
データサイエンティストの就労意識~2015 → 2026 一般(個人)会員アンケートより
datascientistsociety
PRO
0
1.1k
山中市政の総括:相反する二つの顔
sishi
0
230
ros2-perf-multihost: 分散システムにおける客観的なアーキテクチャ評価フレームワーク
takasehideki
0
300
Vers un système bovin allaitant multiperformant :leviers actionnés et trajectoire de réduction de l'empreinte carbone à travers 4 années d'expérimentation à FERM'INOV
institutdelelevage
PRO
0
100
Physical AIでモデリングはどう変わるか/How Physical AI Will Change Modeling
stktu
0
310
The Conductor Pattern -Multi-Granularity Feedback for Creative Agents-
shibuiwilliam
2
110
Language and AI
ayaniwa
0
330
Santé et fertilité des sols : ce que nous disent les pratiques dans les systèmes de polyculture-élevage
institutdelelevage
PRO
0
140
論文紹介:Doc-to-LoRA: Learning to Instantly Internalize Contexts
yukako_nakano
0
210
Featured
See All Featured
We Have a Design System, Now What?
morganepeng
55
8.4k
The Cost Of JavaScript in 2023
addyosmani
55
10k
Leading Effective Engineering Teams in the AI Era
addyosmani
9
2.8k
How to make the Groovebox
asonas
2
2.5k
Git: the NoSQL Database
bkeepers
PRO
433
67k
Paper Plane
katiecoart
PRO
5
54k
My Coaching Mixtape
mlcsv
0
360
Designing Powerful Visuals for Engaging Learning
tmiket
1
610
The agentic SEO stack - context over prompts
schlessera
0
970
How to Build an AI Search Optimization Roadmap - Criteria and Steps to Take #SEOIRL
aleyda
1
2.2k
Everyday Curiosity
cassininazir
0
360
Why Your Marketing Sucks and What You Can Do About It - Sophie Logan
marketingsoph
0
440
Transcript
VLMにとって 良いvision encoderとは何か? 小林優斗(名工大 玉木・丁研) 第64回 名古屋CV・PRML勉強会 CVPR2026論文紹介 Rethinking Model
Selection in VLM Through the Lens of Gromov-Wasserstein Distance Muyang Li, Yucheng Liu, Jianbo Ma, Elliot Osborne, Bo Han, Tongliang Liu
本紹介の概要 ◼背景知識の説明 • VLMとは • 標準のアーキテクチャ • Vision Encoder の重要性
◼CVPR2026の論文紹介 • Rethinking Model Selection in VLM Through the Lens of Gromov-Wasserstein Distance [Li+, CVPR2026] (ハイライト論文)
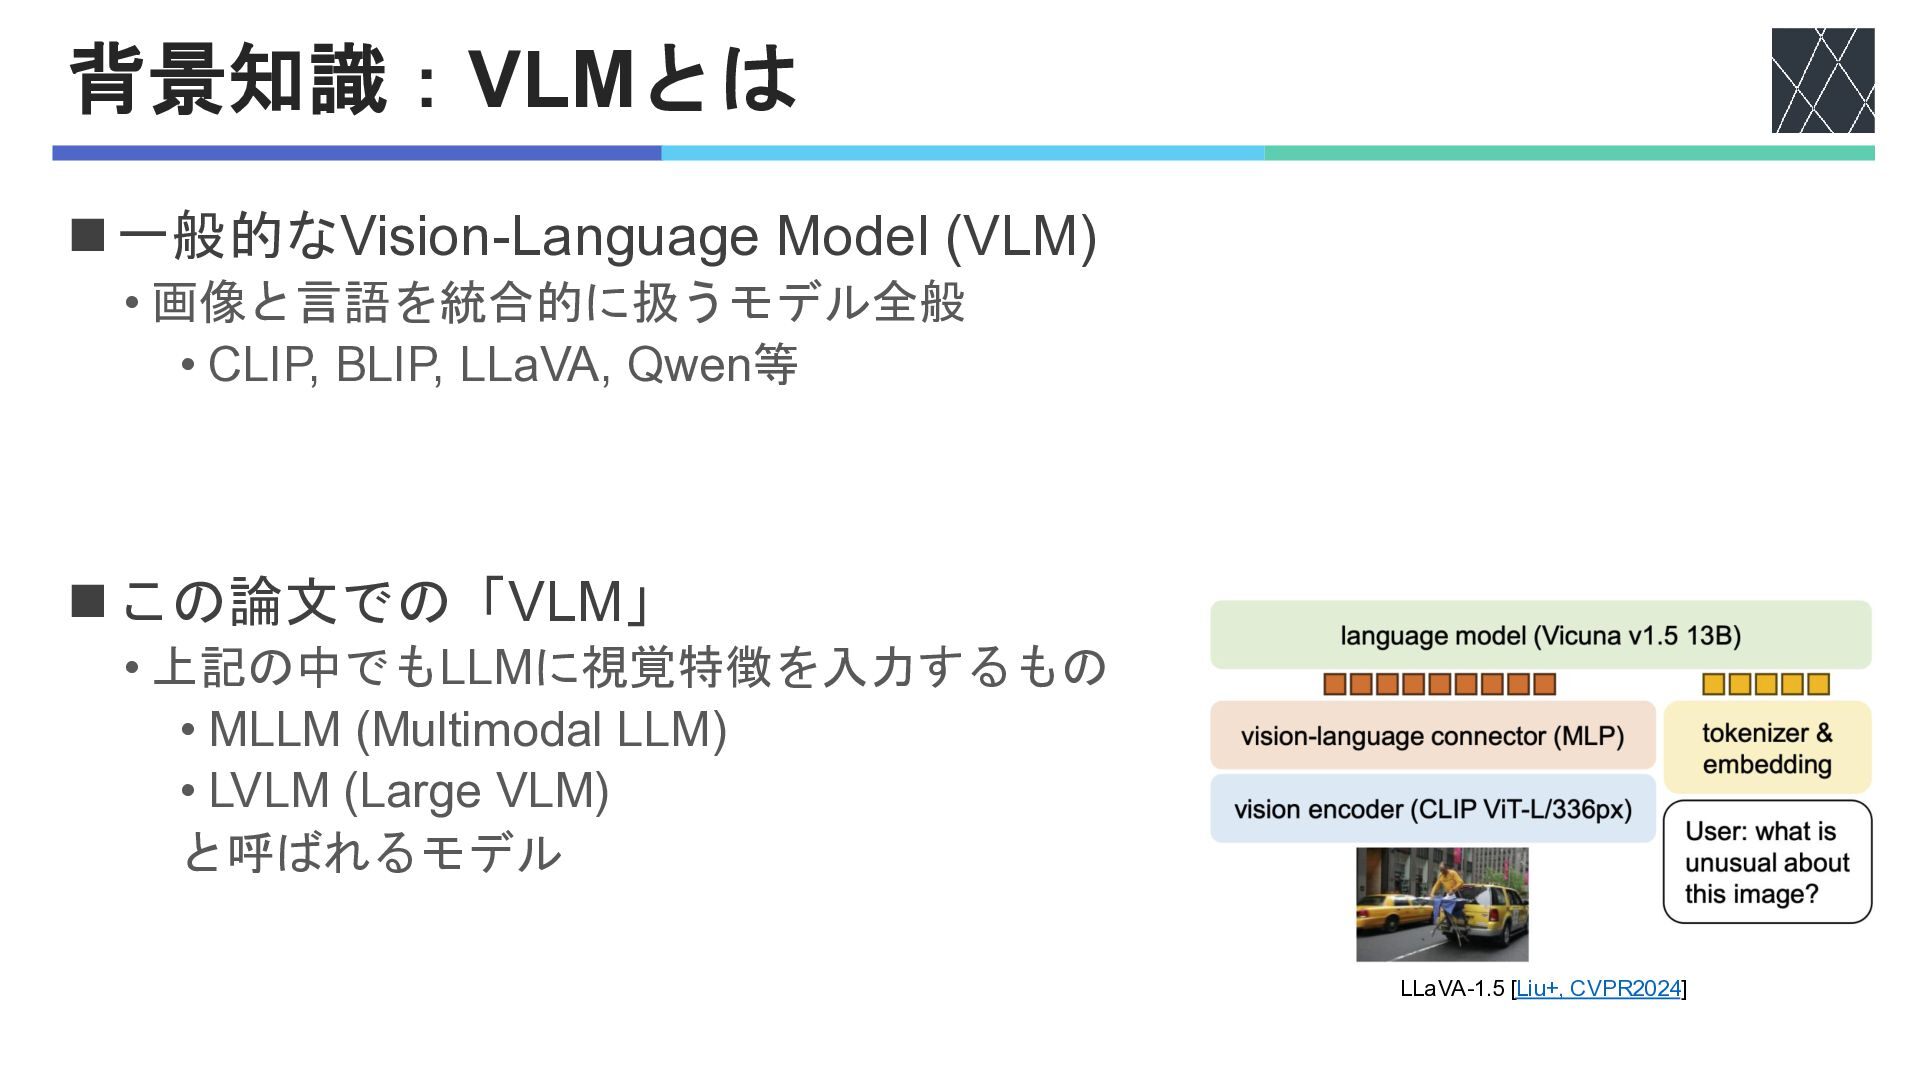
背景知識:VLMとは ◼一般的なVision-Language Model (VLM) • 画像と言語を統合的に扱うモデル全般 • CLIP, BLIP, LLaVA,
Qwen等 ◼この論文での「VLM」 • 上記の中でもLLMに視覚特徴を入力するもの • MLLM (Multimodal LLM) • LVLM (Large VLM) と呼ばれるモデル LLaVA-1.5 [Liu+, CVPR2024]
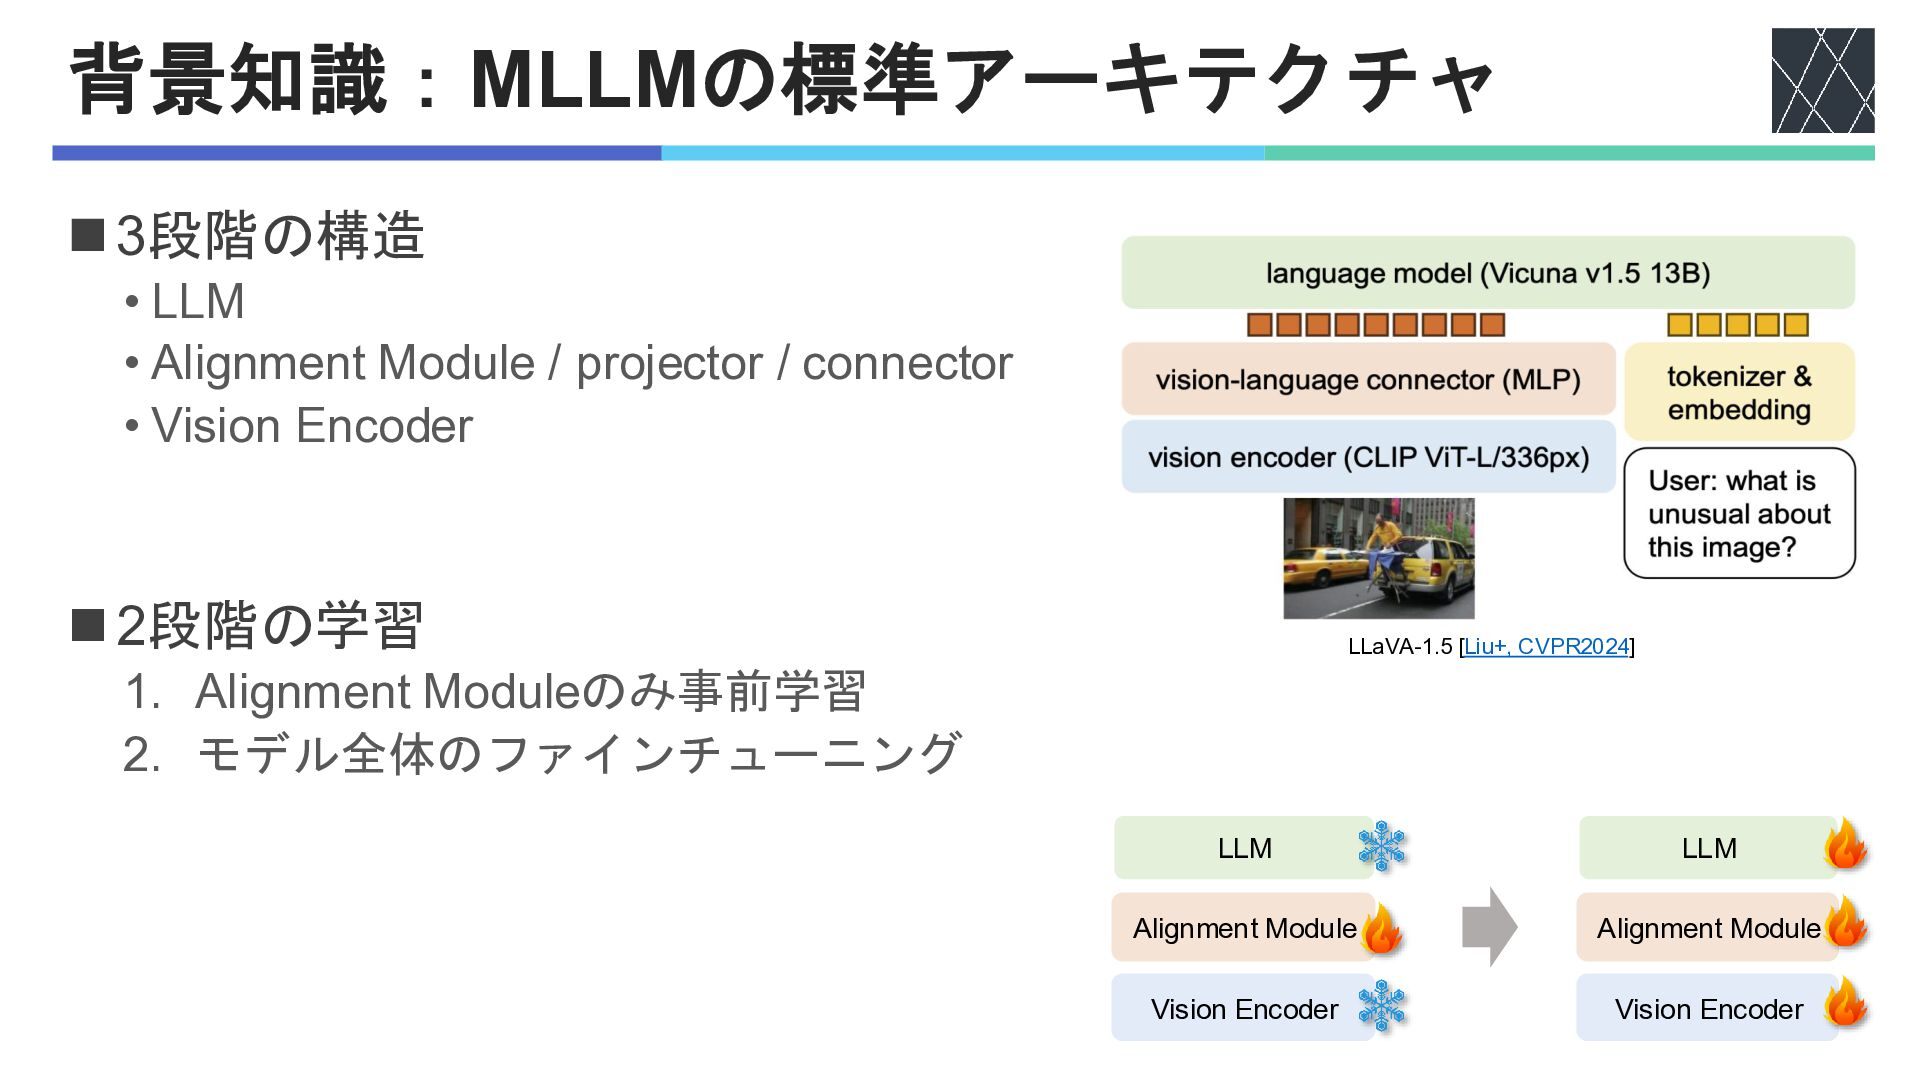
背景知識:MLLMの標準アーキテクチャ ◼3段階の構造 • LLM • Alignment Module / projector /
connector • Vision Encoder ◼2段階の学習 1. Alignment Moduleのみ事前学習 2. モデル全体のファインチューニング LLaVA-1.5 [Liu+, CVPR2024] Vision Encoder Alignment Module LLM Vision Encoder Alignment Module LLM
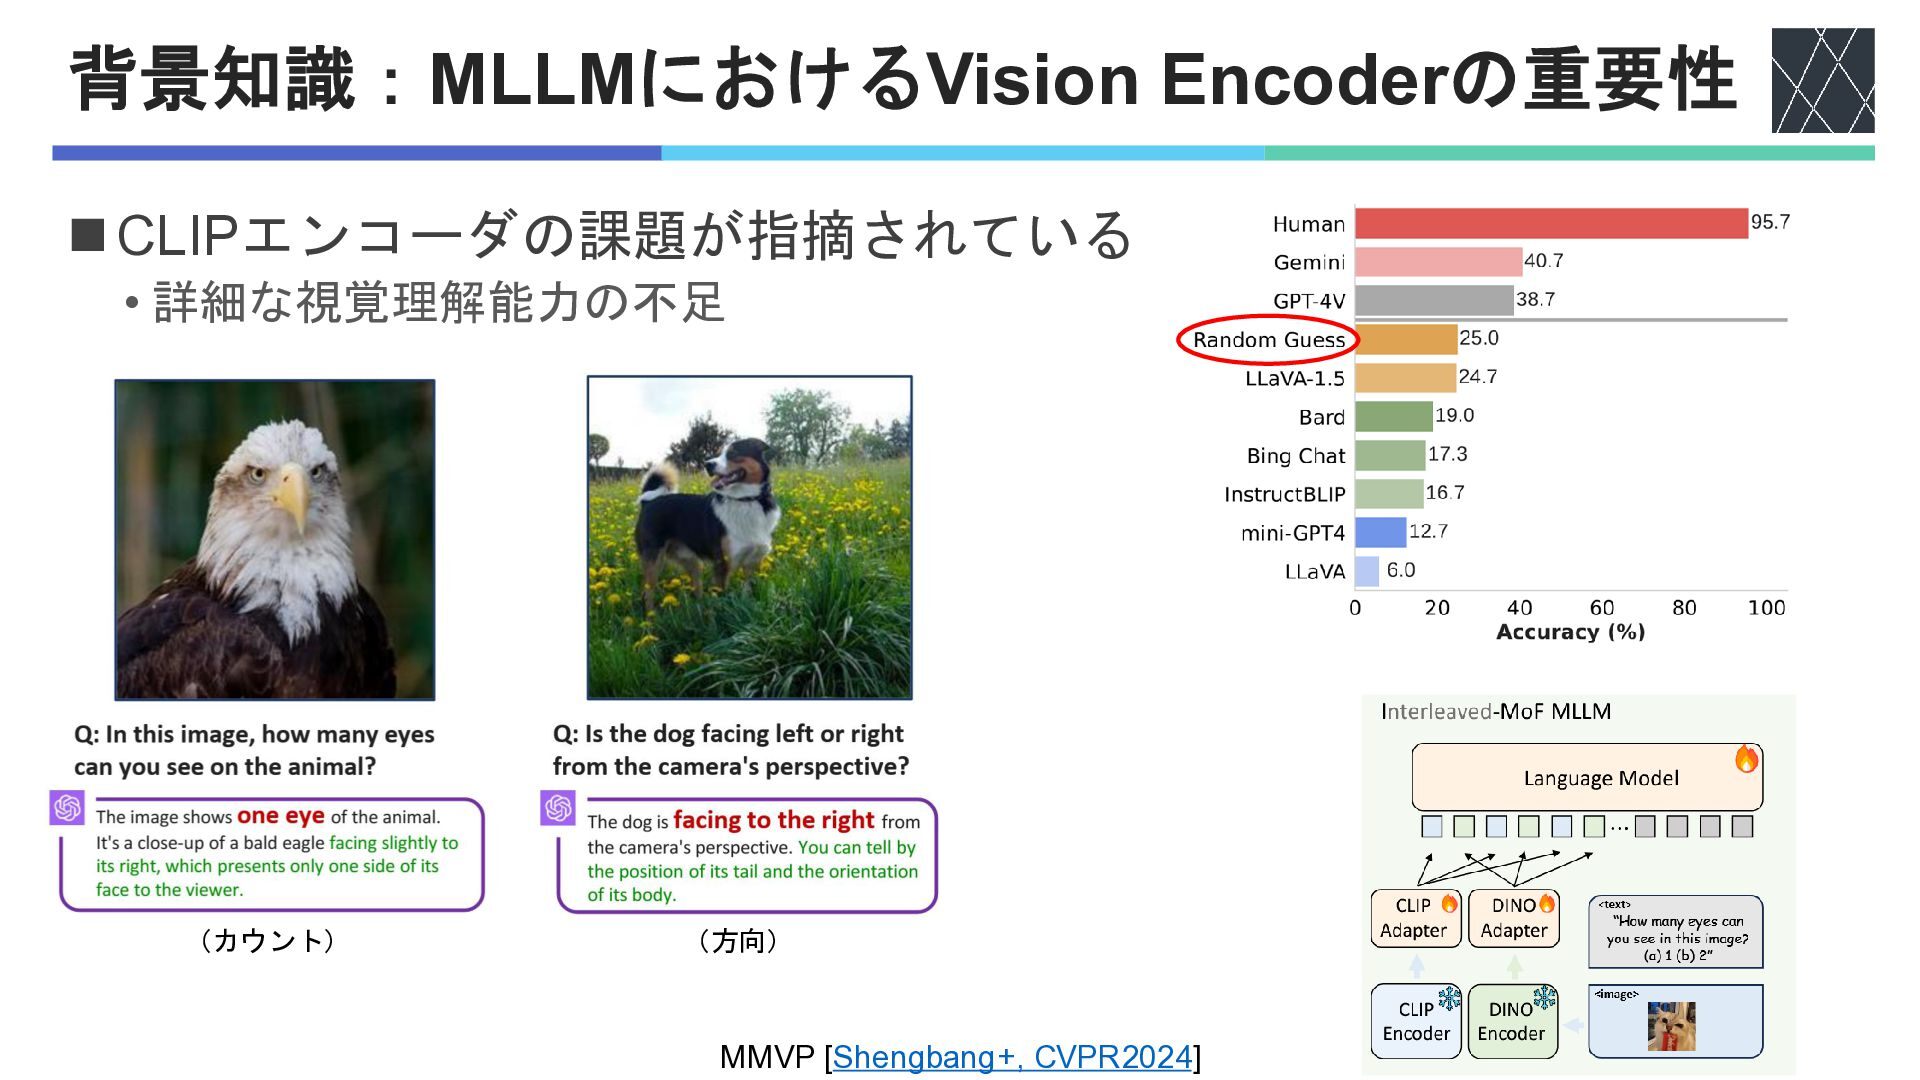
背景知識:MLLMにおけるVision Encoderの重要性 ◼CLIPエンコーダの課題が指摘されている • 詳細な視覚理解能力の不足 MMVP [Shengbang+, CVPR2024] (カウント) (方向)
Rethinking Model Selection in VLM Through the Lens of Gromov-Wasserstein
Distance Muyang Li, Yucheng Liu, Jianbo Ma, Elliot Osborne, Bo Han, Tongliang Liu CVPR2026
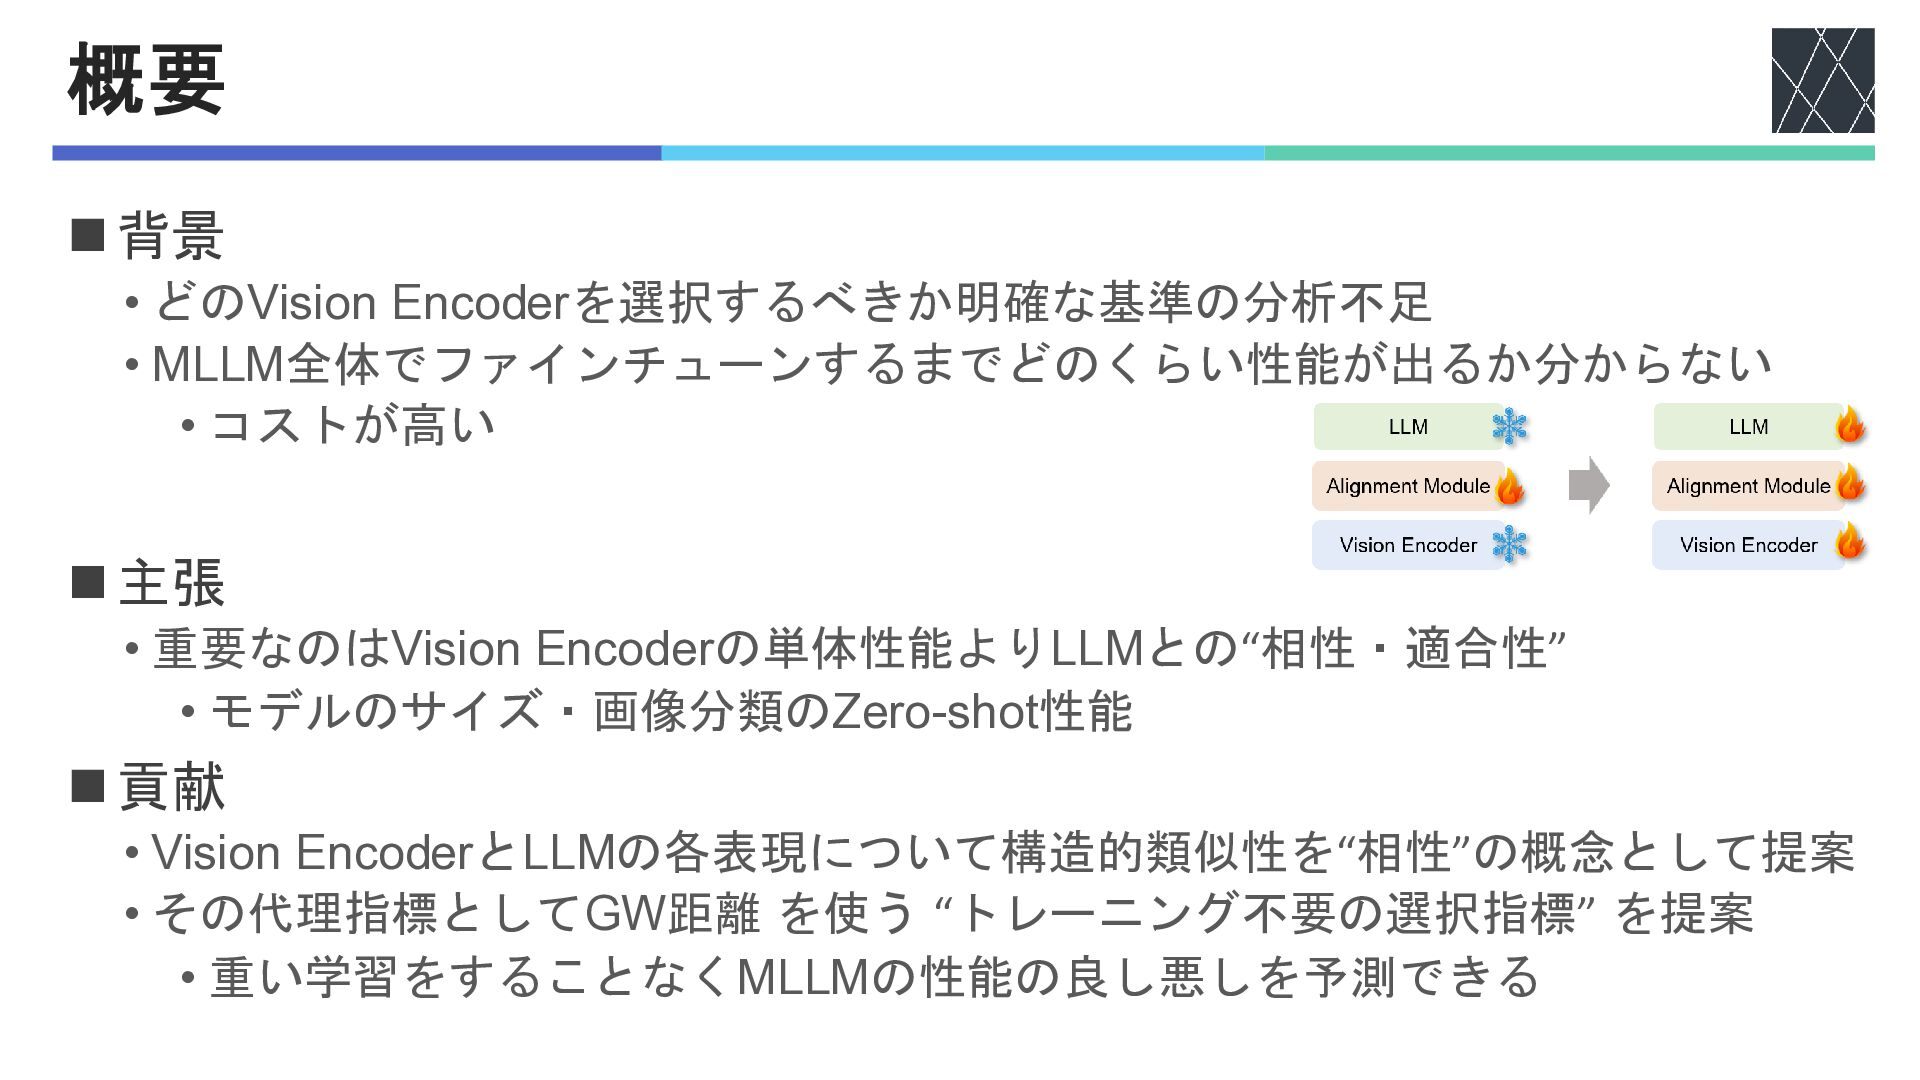
概要 ◼背景 • どのVision Encoderを選択するべきか明確な基準の分析不足 • MLLM全体でファインチューンするまでどのくらい性能が出るか分からない • コストが高い ◼主張
• 重要なのはVision Encoderの単体性能よりLLMとの“相性・適合性” • モデルのサイズ・画像分類のZero-shot性能 ◼貢献 • Vision EncoderとLLMの各表現について構造的類似性を“相性”の概念として提案 • その代理指標としてGW距離 を使う “トレーニング不要の選択指標” を提案 • 重い学習をすることなくMLLMの性能の良し悪しを予測できる
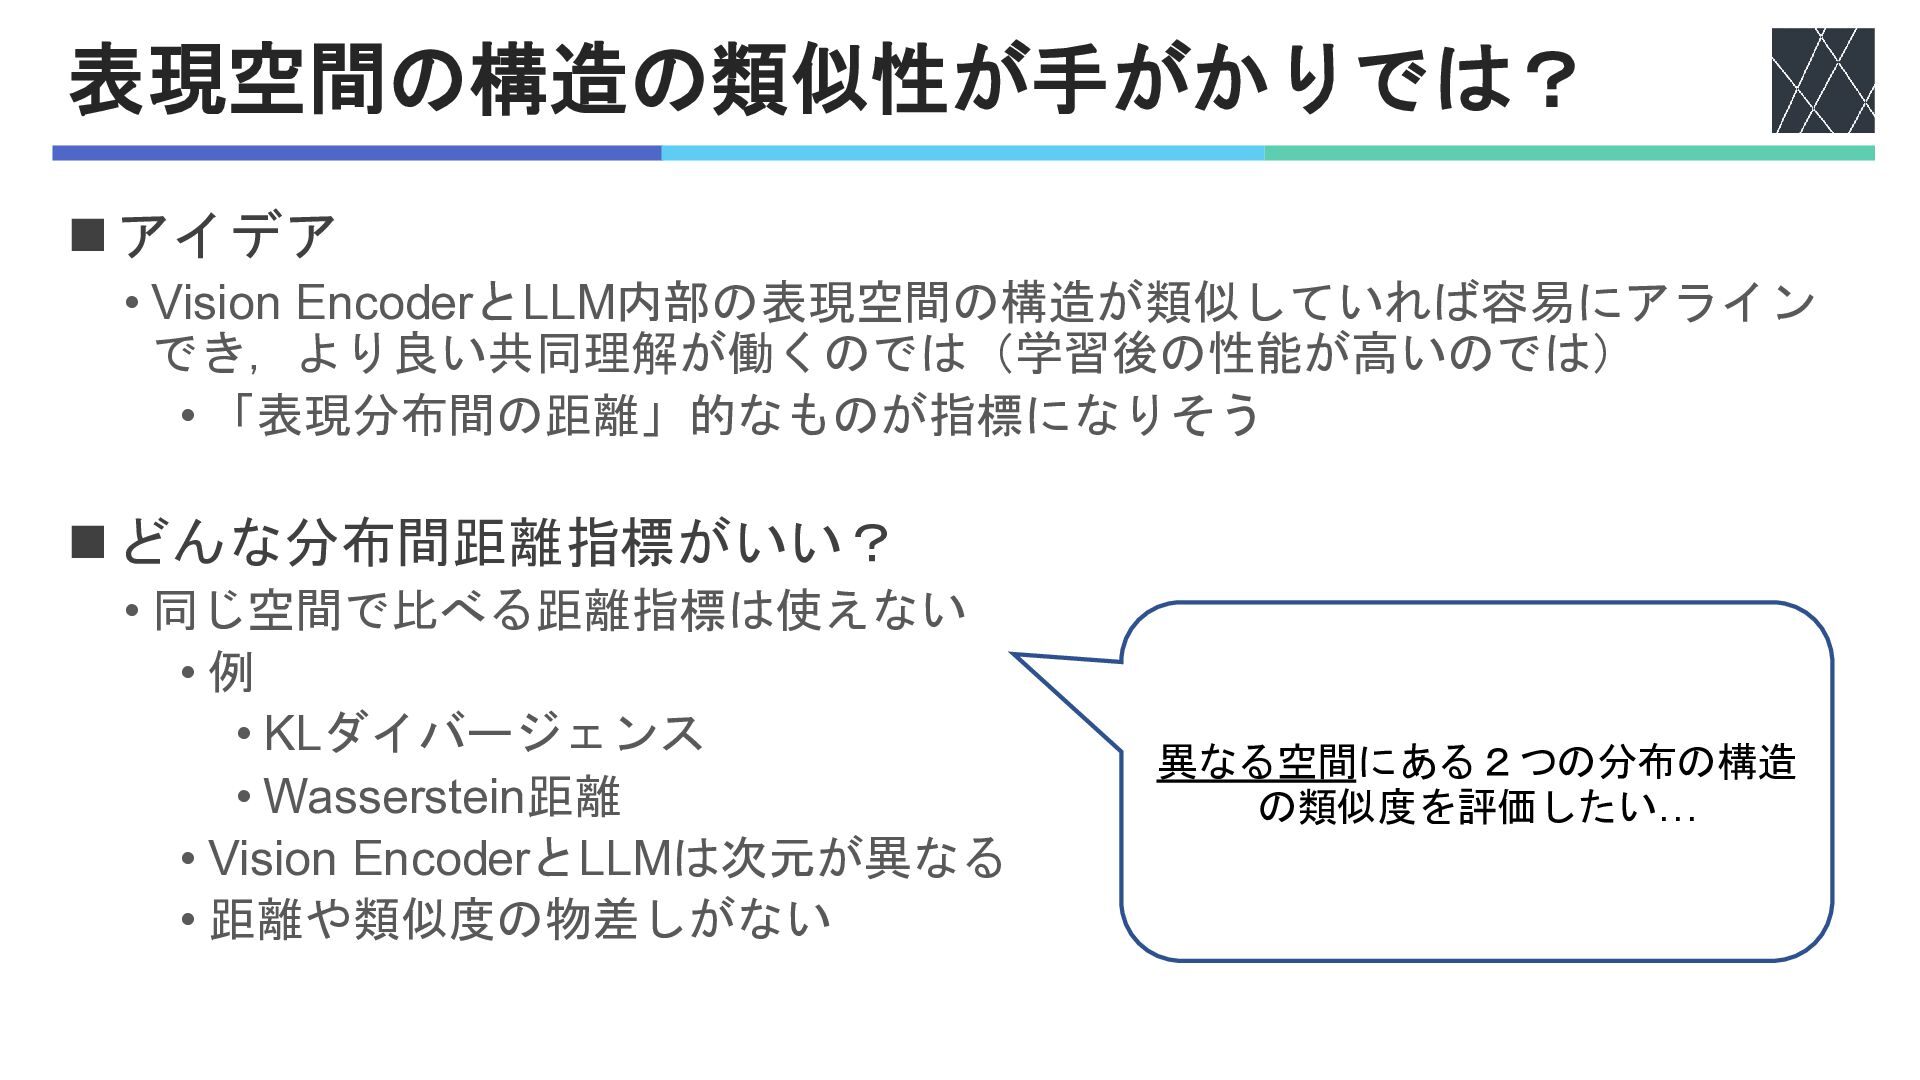
表現空間の構造の類似性が手がかりでは? ◼アイデア • Vision EncoderとLLM内部の表現空間の構造が類似していれば容易にアライン でき,より良い共同理解が働くのでは(学習後の性能が高いのでは) • 「表現分布間の距離」的なものが指標になりそう ◼どんな分布間距離指標がいい? •
同じ空間で比べる距離指標は使えない • 例 • KLダイバージェンス • Wasserstein距離 • Vision EncoderとLLMは次元が異なる • 距離や類似度の物差しがない 異なる空間にある2つの分布の構造 の類似度を評価したい…
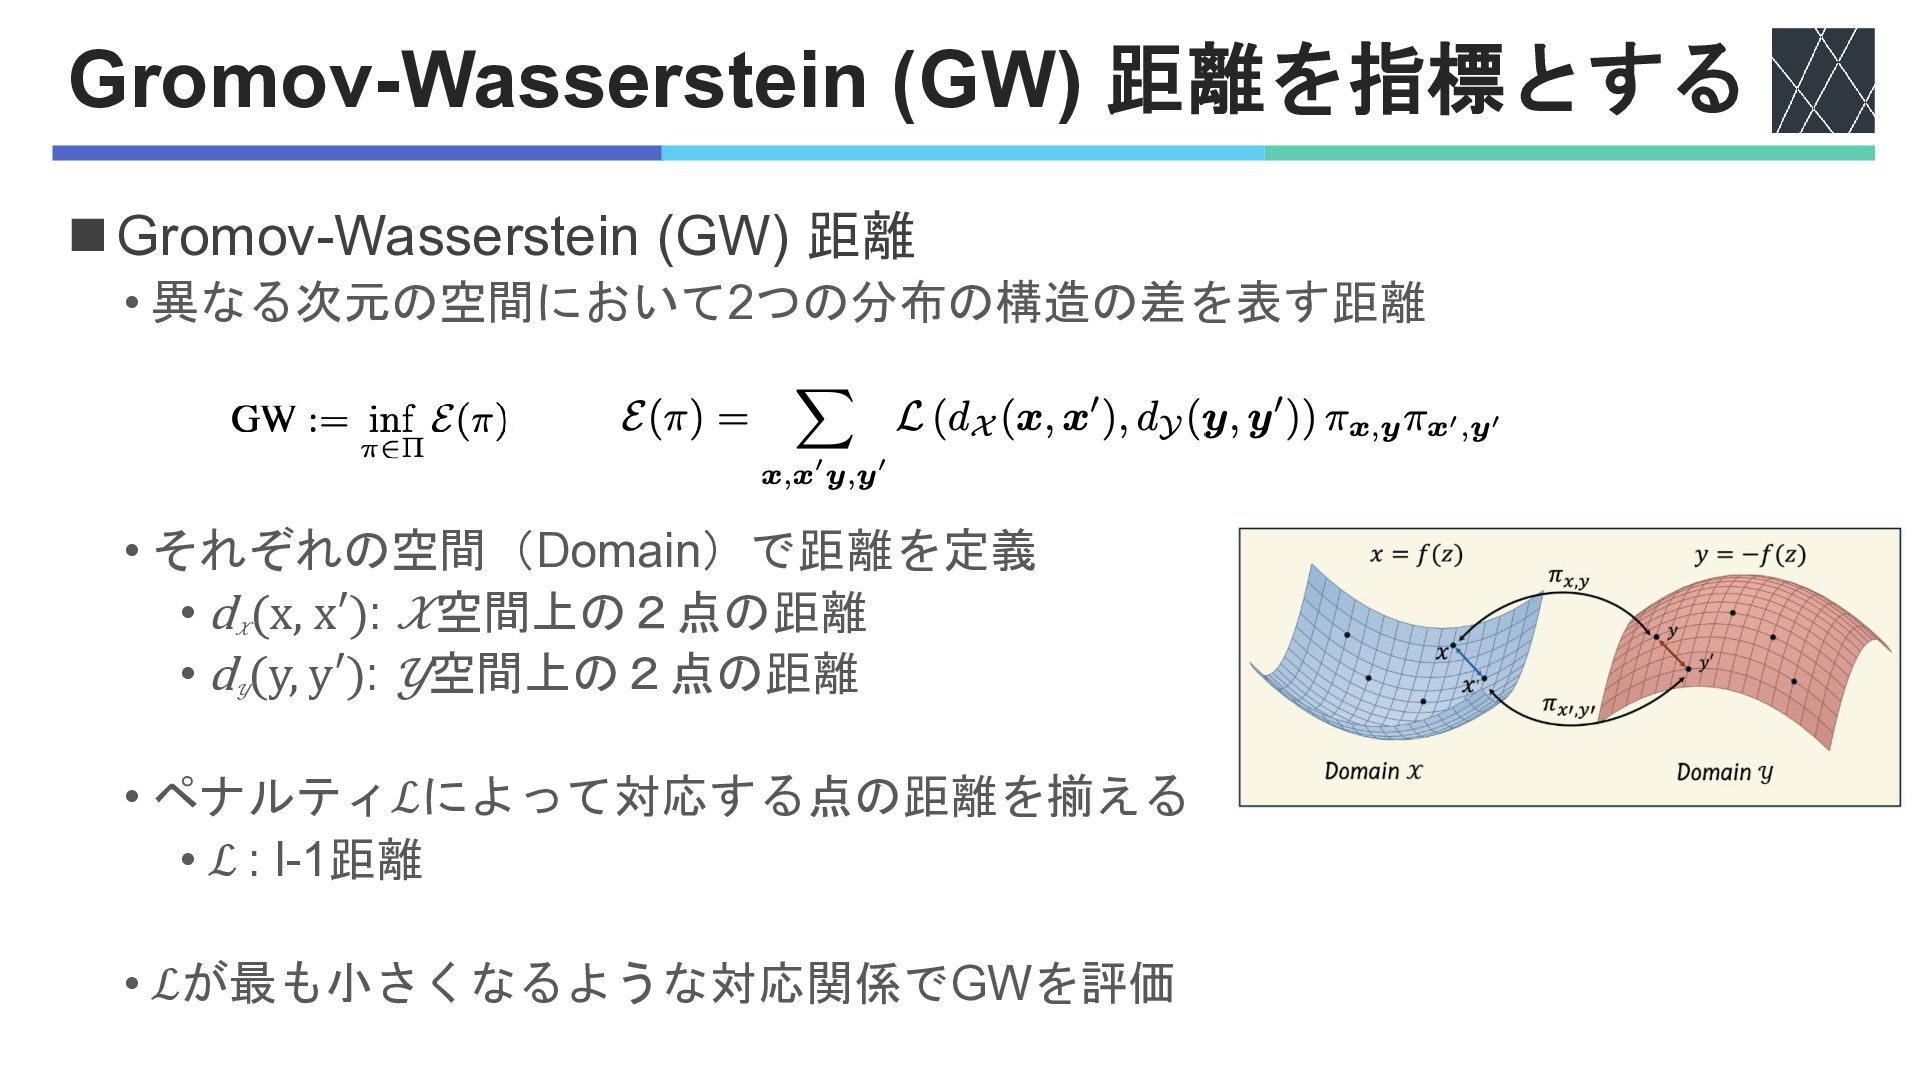
Gromov-Wasserstein (GW) 距離を指標とする ◼Gromov-Wasserstein (GW) 距離 • 異なる次元の空間において2つの分布の構造の差を表す距離 • それぞれの空間(Domain)で距離を定義
• d 𝒳 (x, x′): 𝒳空間上の2点の距離 • d 𝒴 (y, y′): 𝒴空間上の2点の距離 • ペナルティℒによって対応する点の距離を揃える • ℒ : l-1距離 • ℒが最も小さくなるような対応関係でGWを評価
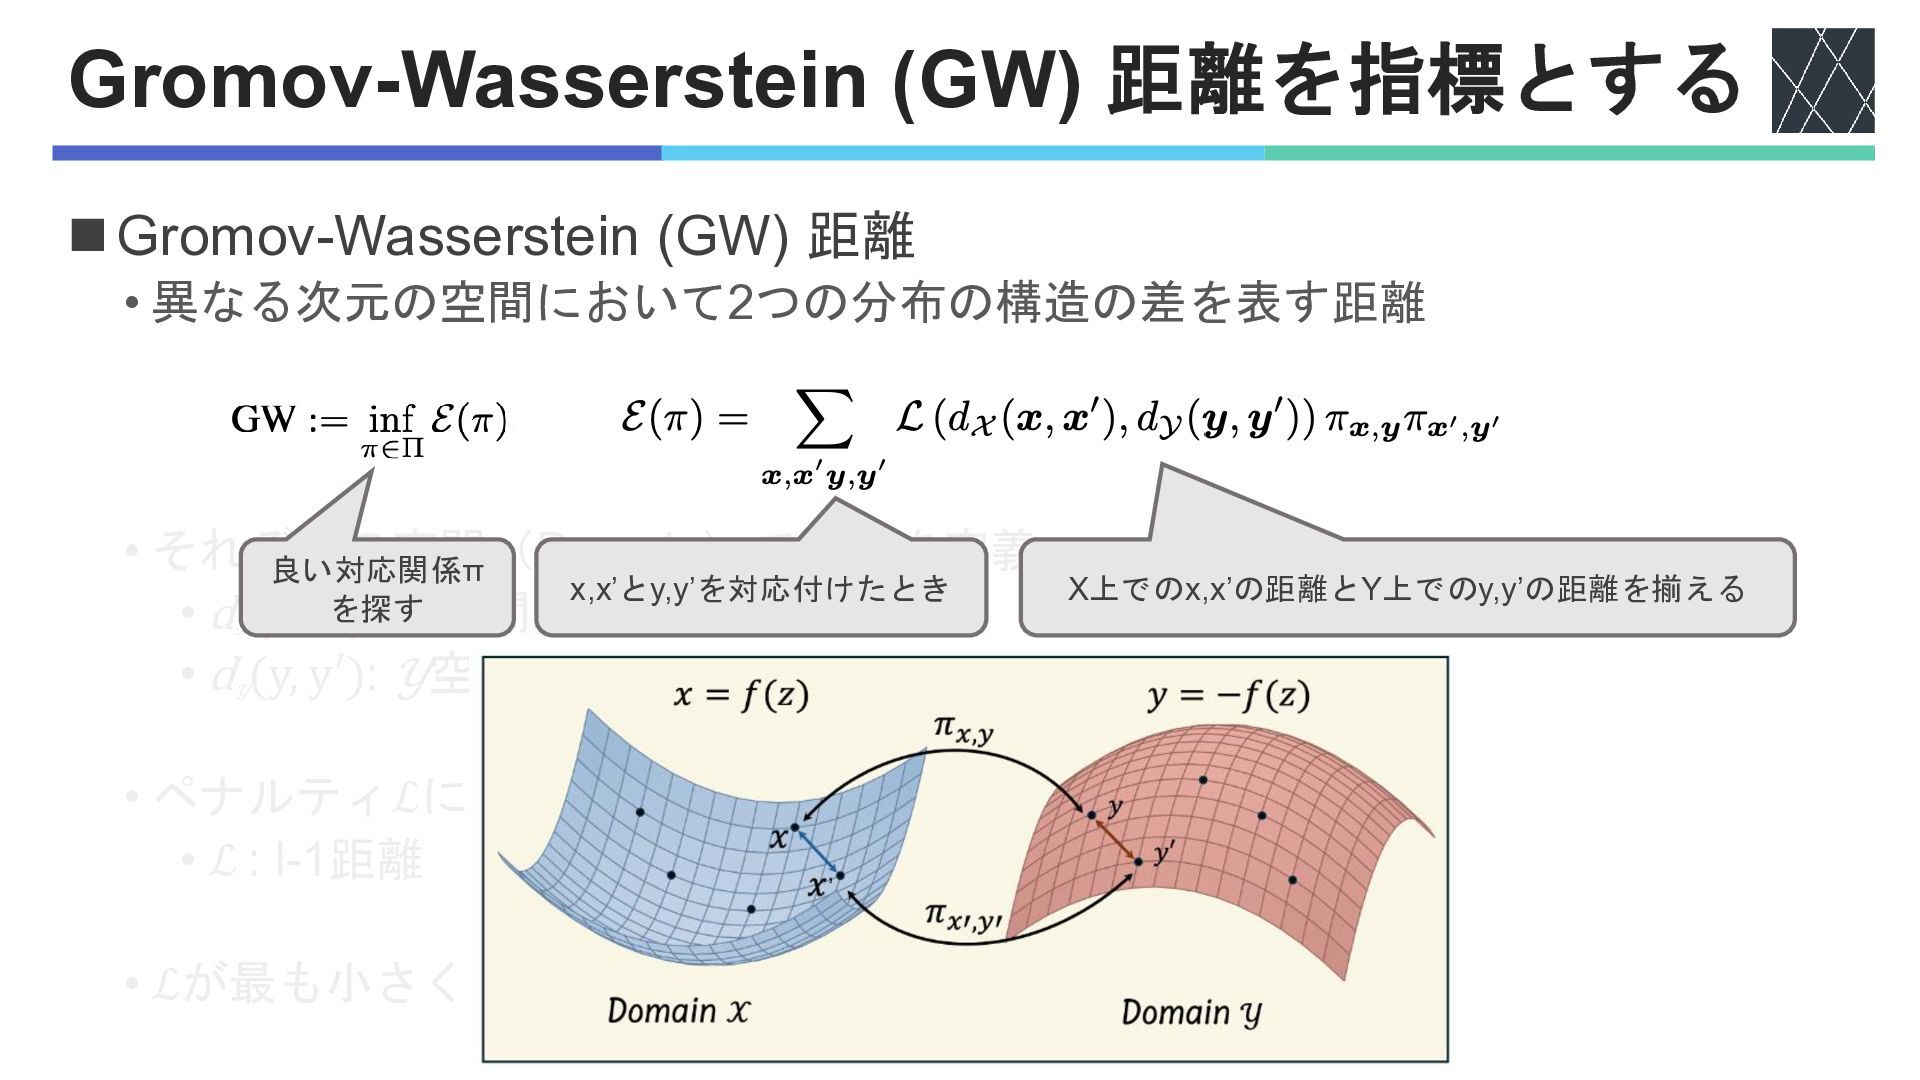
Gromov-Wasserstein (GW) 距離を指標とする ◼Gromov-Wasserstein (GW) 距離 • 異なる次元の空間において2つの分布の構造の差を表す距離 • それぞれの空間(Domain)で距離を定義
• d 𝒳 (x, x′): 𝒳空間上の2点の距離 • d 𝒴 (y, y′): 𝒴空間上の2点の距離 • ペナルティℒによって対応する点の距離を揃える • ℒ : l-1距離 • ℒが最も小さくなるような対応関係でGWを評価 良い対応関係π を探す X上でのx,x’の距離とY上でのy,y’の距離を揃える x,x’とy,y’を対応付けたとき
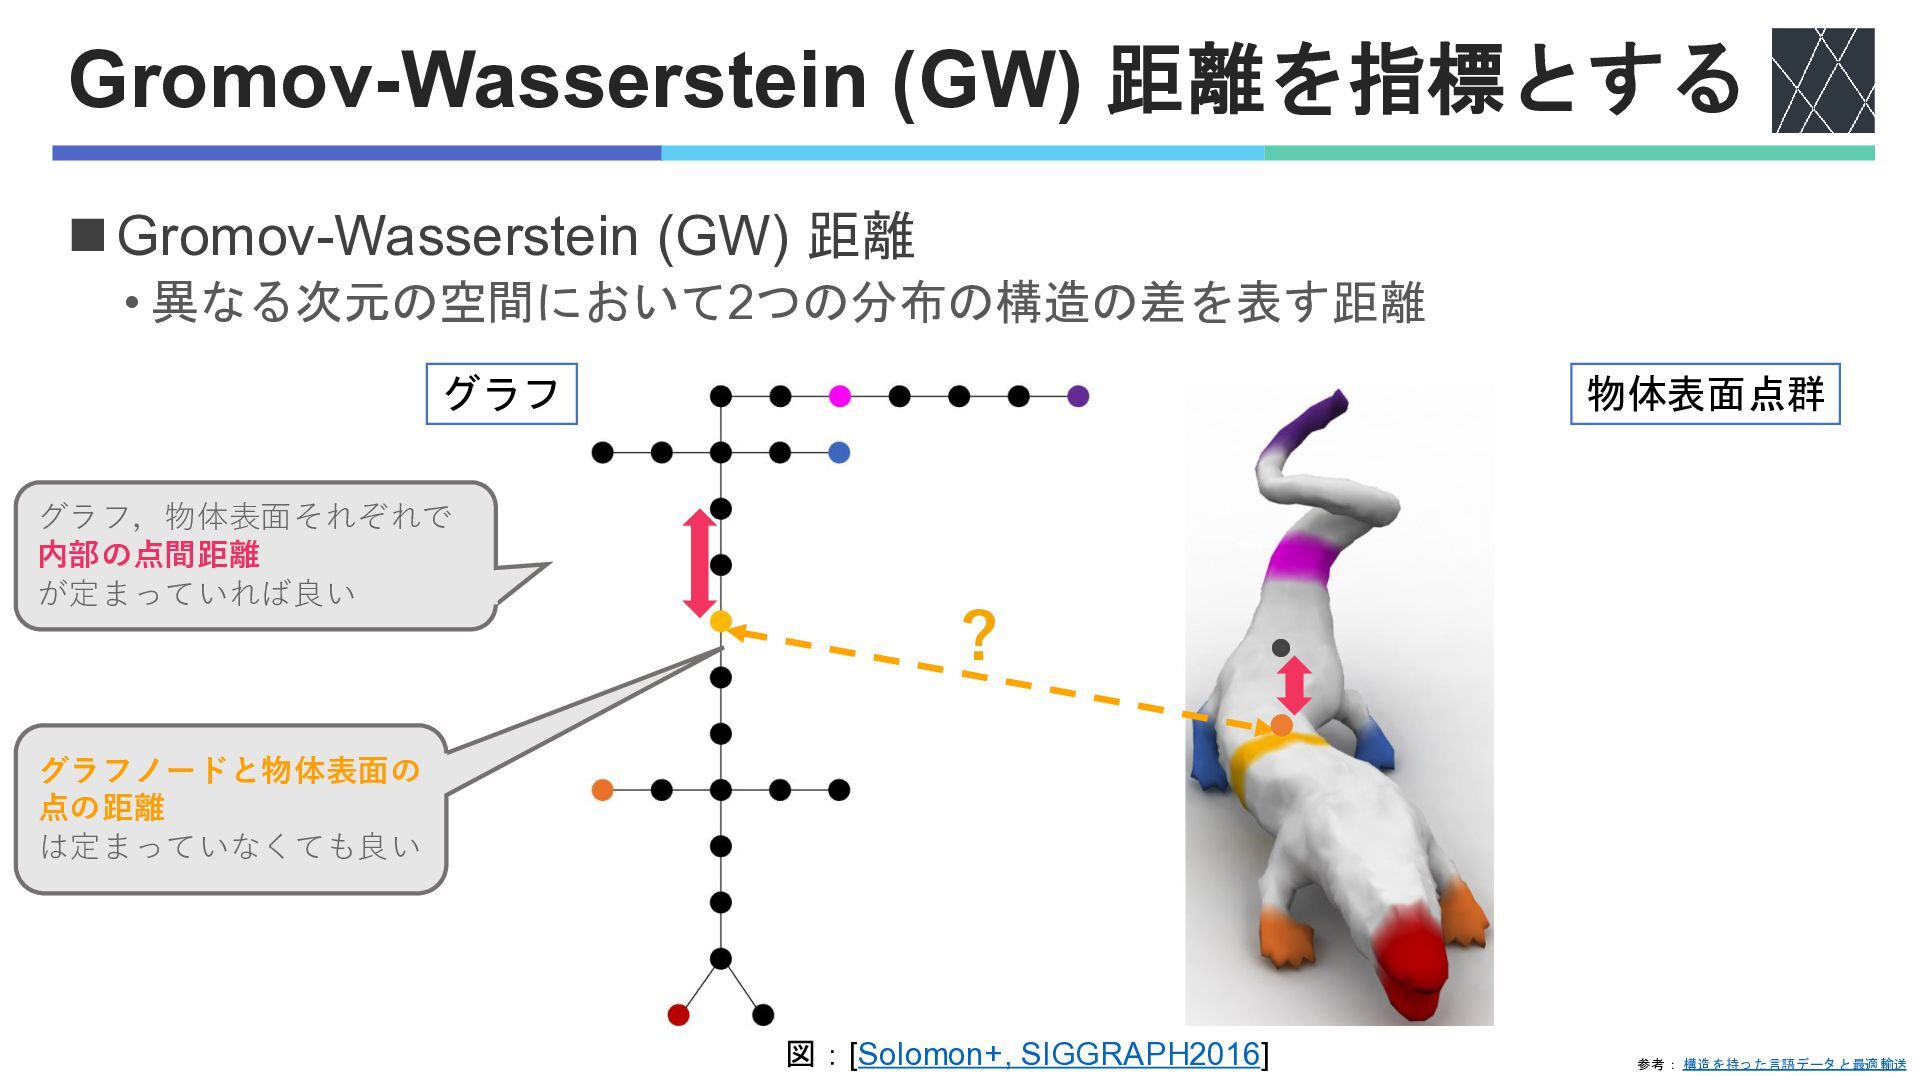
Gromov-Wasserstein (GW) 距離を指標とする ◼Gromov-Wasserstein (GW) 距離 • 異なる次元の空間において2つの分布の構造の差を表す距離 • それぞれの空間(Domain)で距離を定義
• d 𝒳 (x, x′): 𝒳空間上の2点の距離 • d 𝒴 (y, y′): 𝒴空間上の2点の距離 • ペナルティℒによって対応する点の距離を揃える • ℒ : l-1距離 • ℒが最も小さくなるような対応関係でGWを評価 良い対応関係π を探す X上でのx,x’の距離とY上でのy,y’の距離を揃える 物体表面点群 参考: 構造を持った言語データと最適輸送 x,x’とy,y’を対応付けたとき 図:[Solomon+, SIGGRAPH2016] ? グラフノードと物体表面の 点の距離 は定まっていなくても良い グラフ,物体表面それぞれで 内部の点間距離 が定まっていれば良い グラフ
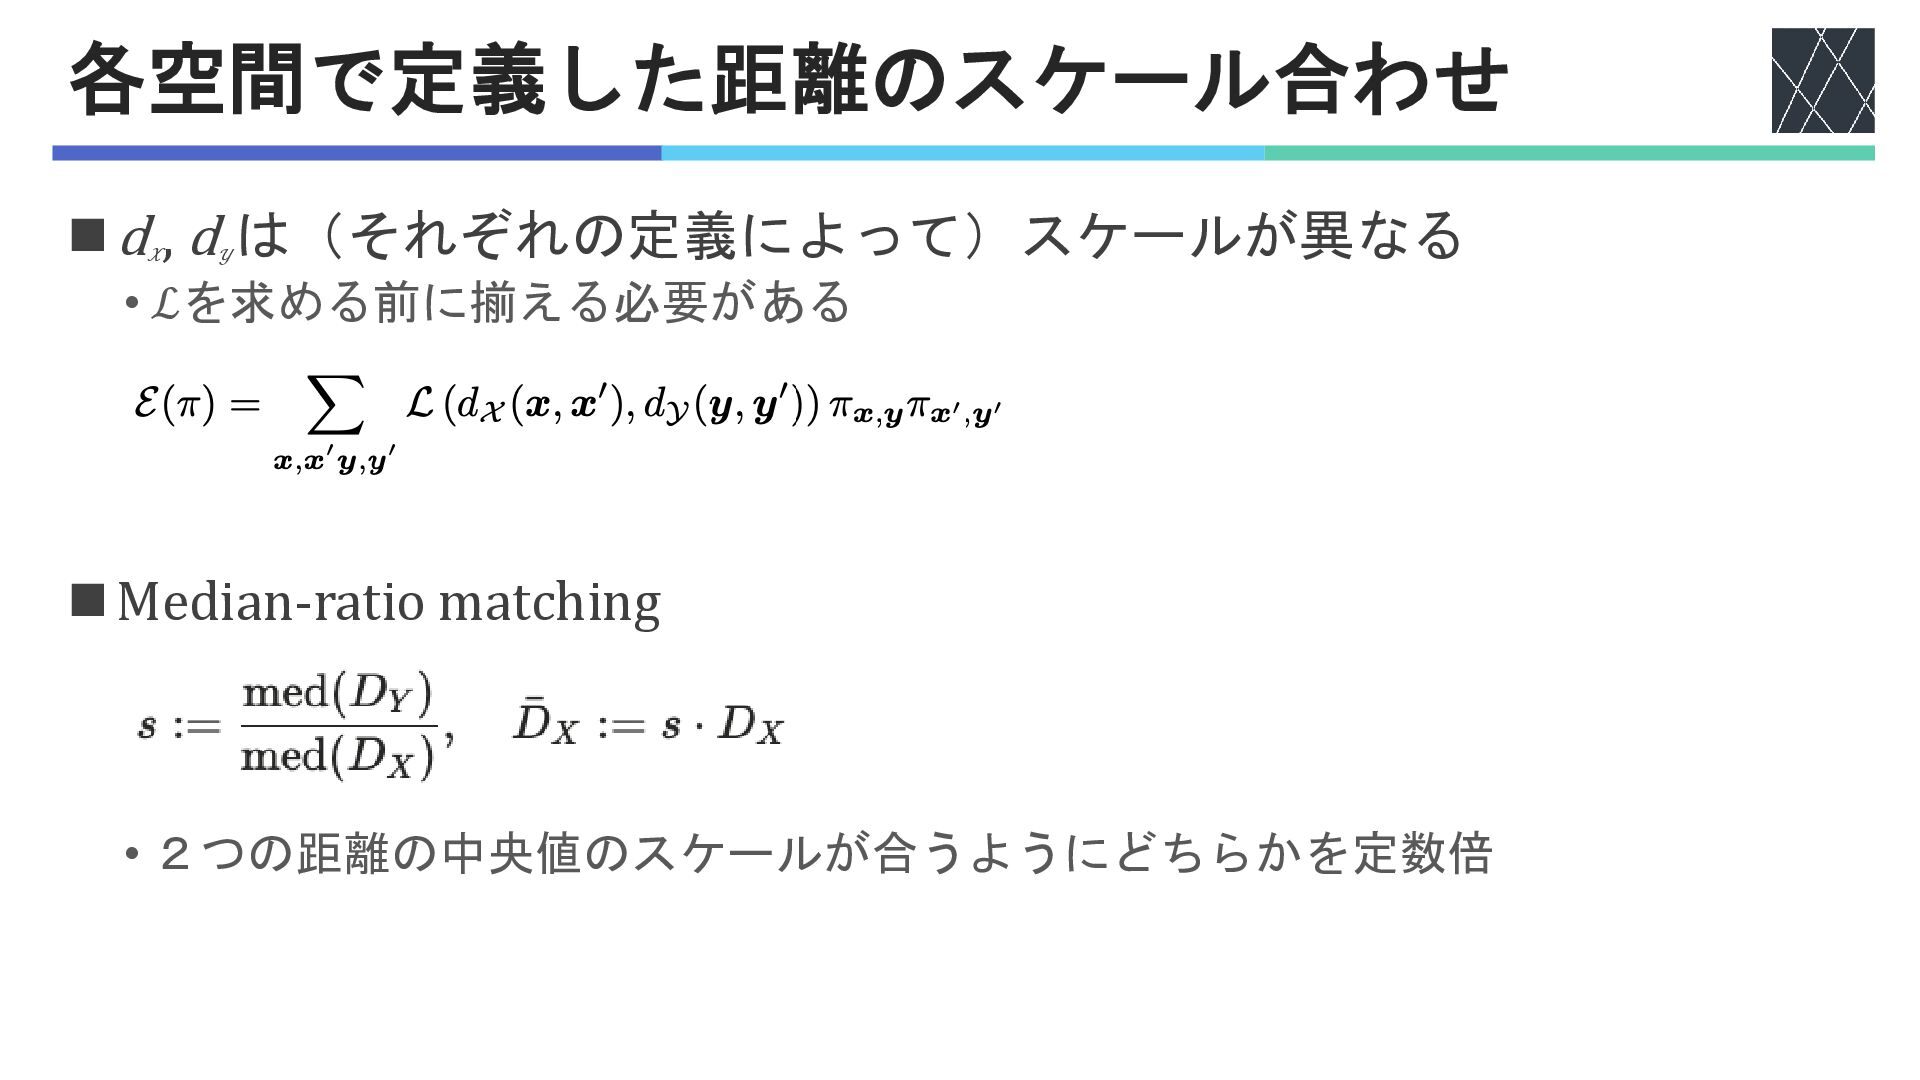
各空間で定義した距離のスケール合わせ ◼d 𝒳 , d 𝒴 は(それぞれの定義によって)スケールが異なる • ℒを求める前に揃える必要がある ◼Median-ratio
matching • 2つの距離の中央値のスケールが合うようにどちらかを定数倍
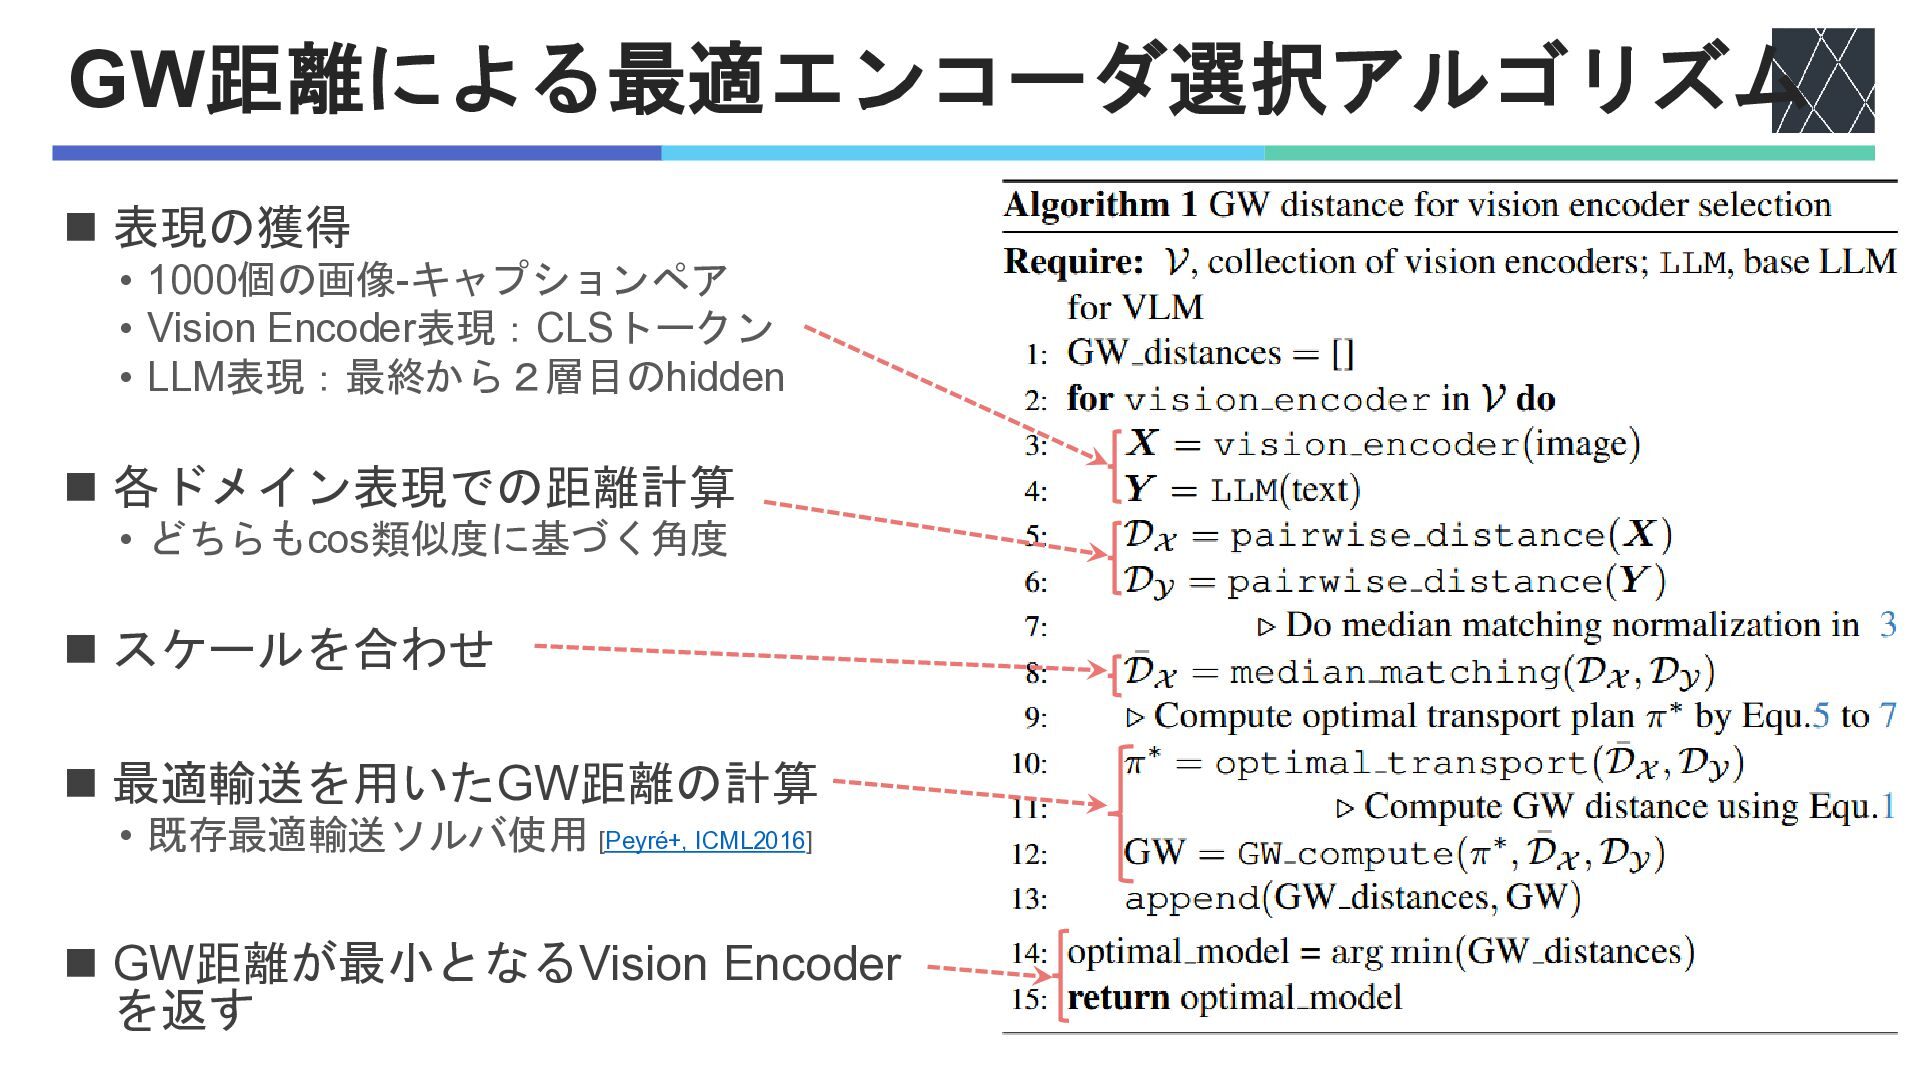
GW距離による最適エンコーダ選択アルゴリズム ◼ 表現の獲得 • 1000個の画像-キャプションペア • Vision Encoder表現:CLSトークン • LLM表現:最終から2層目のhidden
◼ 各ドメイン表現での距離計算 • どちらもcos類似度に基づく角度 ◼ スケールを合わせ ◼ 最適輸送を用いたGW距離の計算 • 既存最適輸送ソルバ使用 [Peyré+, ICML2016] ◼ GW距離が最小となるVision Encoder を返す
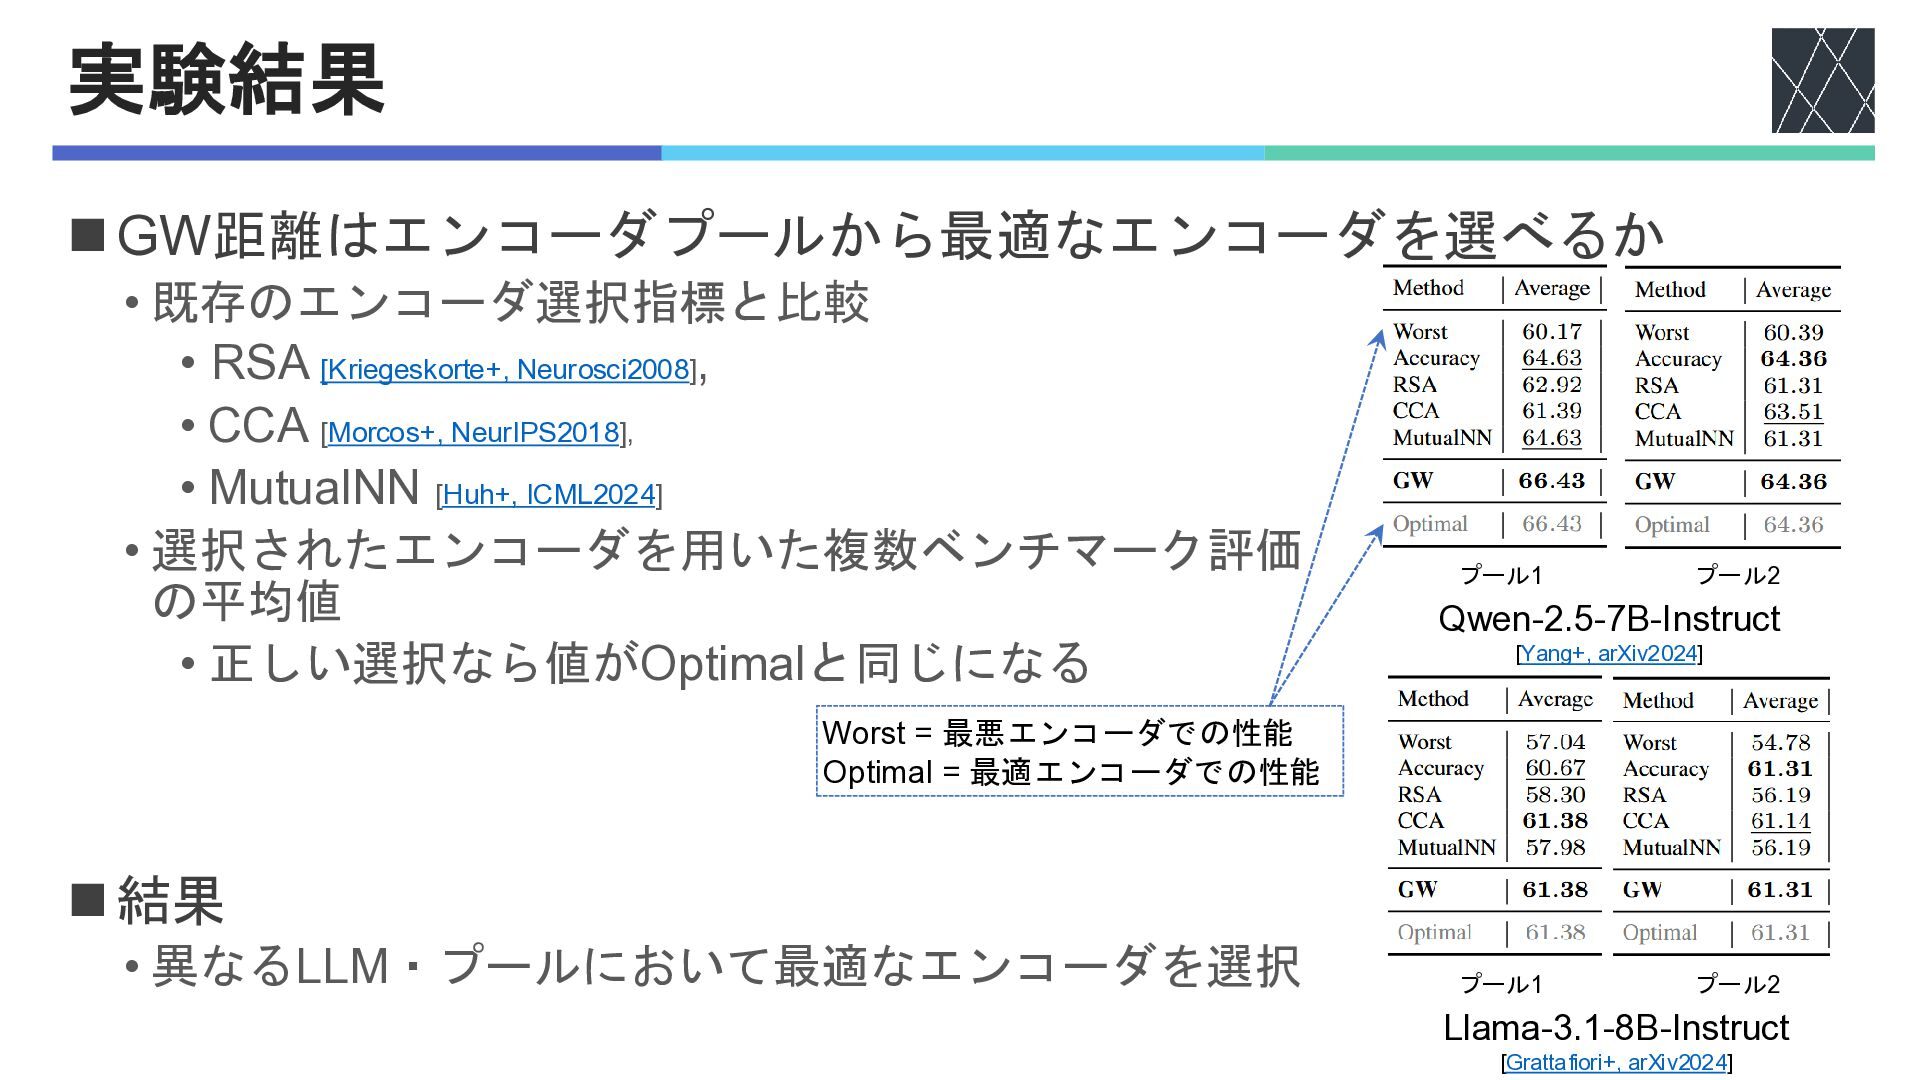
実験結果 ◼GW距離はエンコーダプールから最適なエンコーダを選べるか • 既存のエンコーダ選択指標と比較 • RSA [Kriegeskorte+, Neurosci2008], • CCA
[Morcos+, NeurIPS2018], • MutualNN [Huh+, ICML2024] • 選択されたエンコーダを用いた複数ベンチマーク評価 の平均値 • 正しい選択なら値がOptimalと同じになる ◼結果 • 異なるLLM・プールにおいて最適なエンコーダを選択 Qwen-2.5-7B-Instruct [Yang+, arXiv2024] Llama-3.1-8B-Instruct [Grattafiori+, arXiv2024] Worst = 最悪エンコーダでの性能 Optimal = 最適エンコーダでの性能 プール1 プール2 プール1 プール2
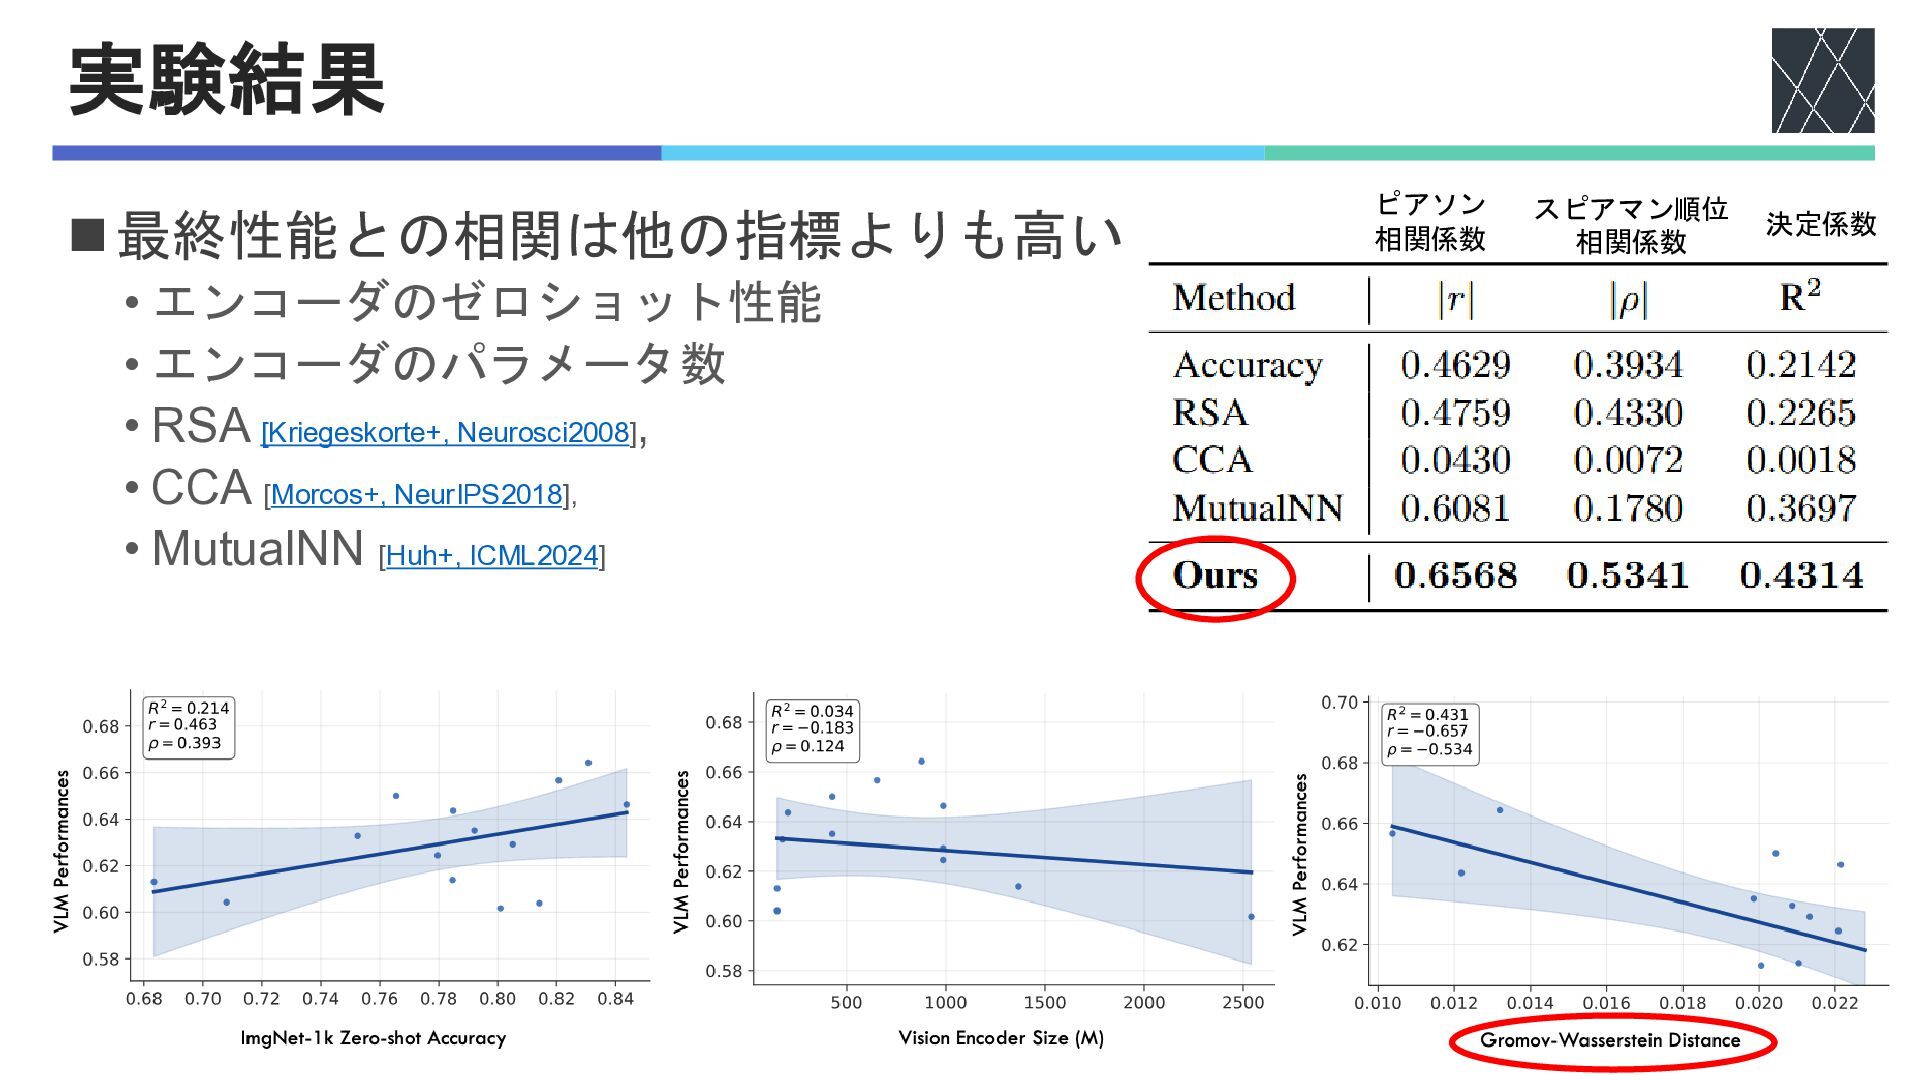
実験結果 ◼最終性能との相関は他の指標よりも高い • エンコーダのゼロショット性能 • エンコーダのパラメータ数 • RSA [Kriegeskorte+, Neurosci2008],
• CCA [Morcos+, NeurIPS2018], • MutualNN [Huh+, ICML2024] ピアソン 相関係数 スピアマン順位 相関係数 決定係数
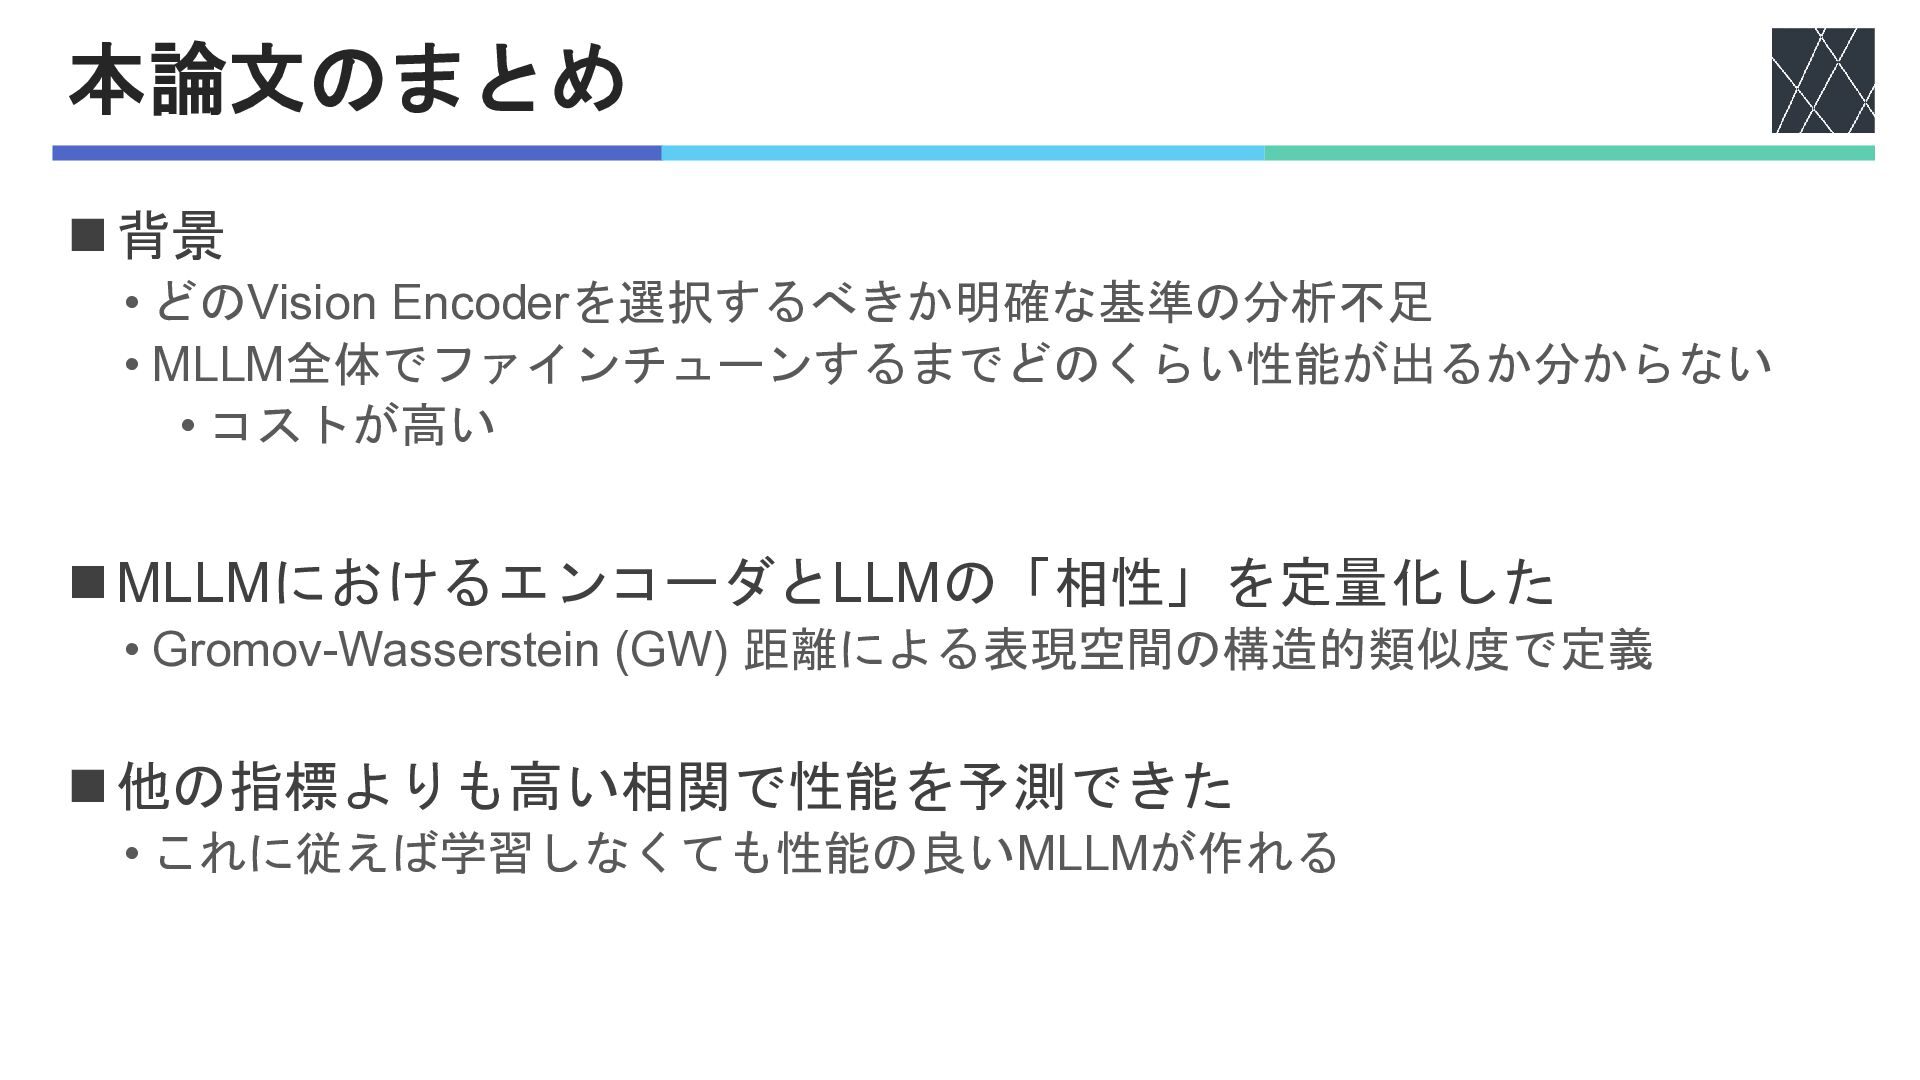
本論文のまとめ ◼背景 • どのVision Encoderを選択するべきか明確な基準の分析不足 • MLLM全体でファインチューンするまでどのくらい性能が出るか分からない • コストが高い ◼MLLMにおけるエンコーダとLLMの「相性」を定量化した
• Gromov-Wasserstein (GW) 距離による表現空間の構造的類似度で定義 ◼他の指標よりも高い相関で性能を予測できた • これに従えば学習しなくても性能の良いMLLMが作れる


 kobayashi31
 kohlerjohannes
 enochan
 corochann
 datascientistsociety
 sishi
 takasehideki
 institutdelelevage
 stktu
 shibuiwilliam
 ayaniwa
 yukako_nakano
 morganepeng
 addyosmani
 asonas
 bkeepers
 katiecoart
 mlcsv
 tmiket
 schlessera
 aleyda
 cassininazir
 marketingsoph