Share
Embed
Quora With BERT
ktr
November 05, 2019
Transcript
20 slides
-
自己紹介 • Webマーケティング系の会社でMLエンジニア の予定 ◦ 先週の金曜に入社したばかり ▪ 前職は情シス ▪
NLPを使ったSNSデータの解析 ◦ 人生初LT 2 @ktr_wtb 実務におけるTipsや、知見の共有、つよつよなトーク出来ません.... -
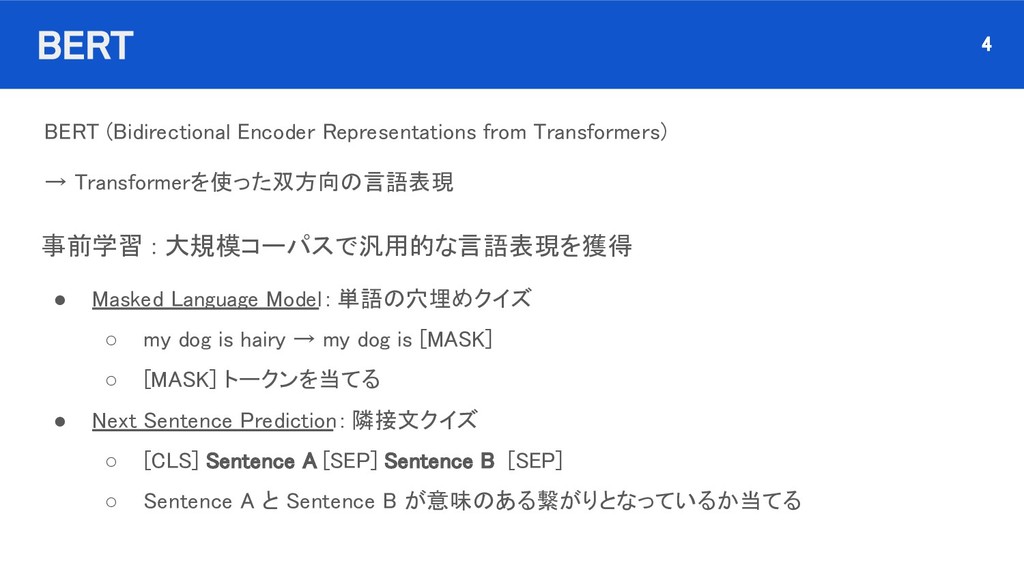
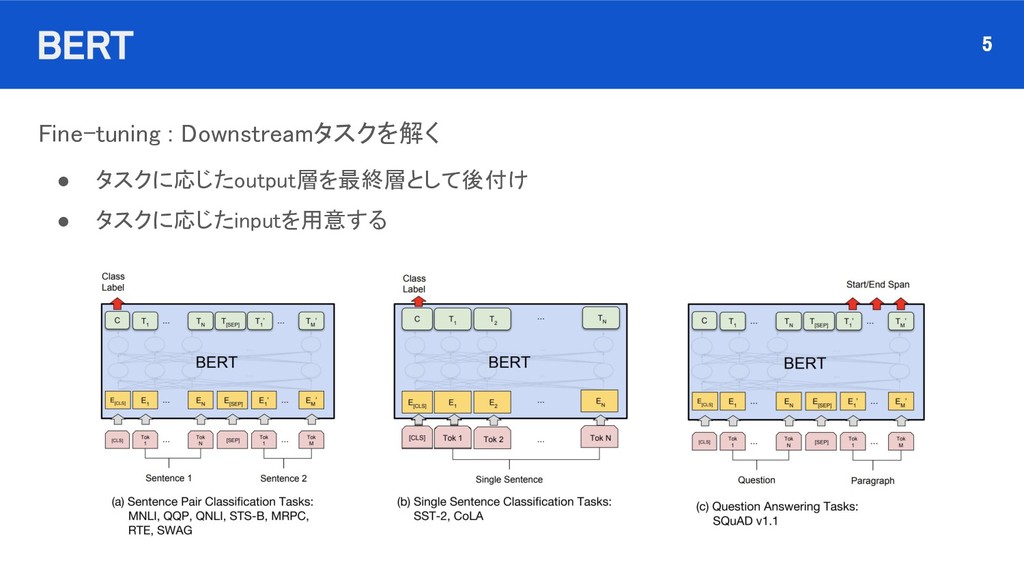
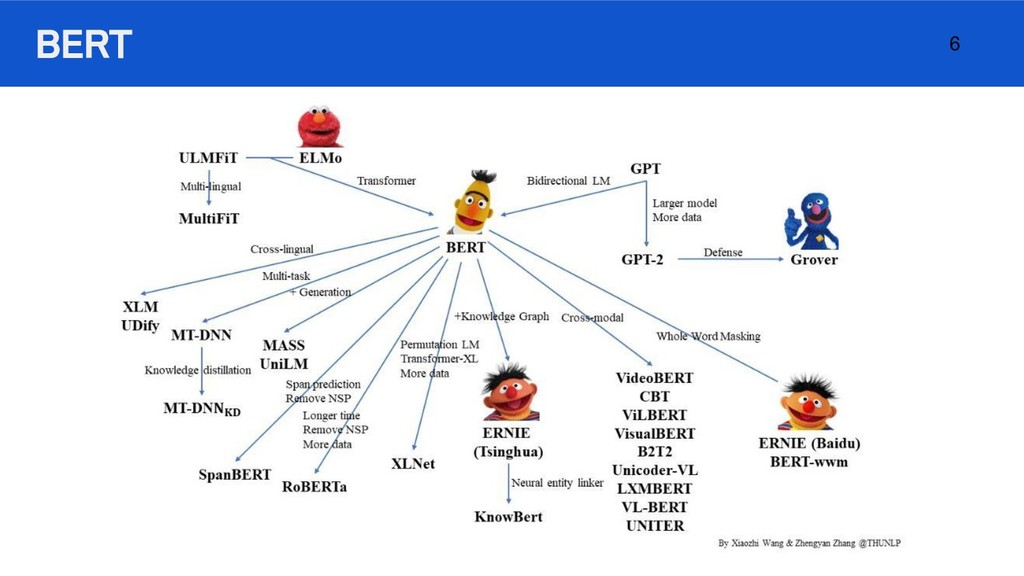
BERT BERT (Bidirectional Encoder Representations from Transformers) → Transformerを使った双方向の言語表現
4 • Masked Language Model : 単語の穴埋めクイズ ◦ my dog is hairy → my dog is [MASK] ◦ [MASK] トークンを当てる • Next Sentence Prediction : 隣接文クイズ ◦ [CLS] Sentence A [SEP] Sentence B [SEP] ◦ Sentence A と Sentence B が意味のある繋がりとなっているか当てる 事前学習 : 大規模コーパスで汎用的な言語表現を獲得 -
Quora Insincere Questions Classification • Kaggleで開催 2018/11/7 ~ 2019/2/14
• 4037 teams • BERT発表後の初のNLPコンペ ◦ ルールで用意されていたEmbeddingデータ以外の外部データの使用が禁止されていたの で、BERTは使用できなかった 8 -
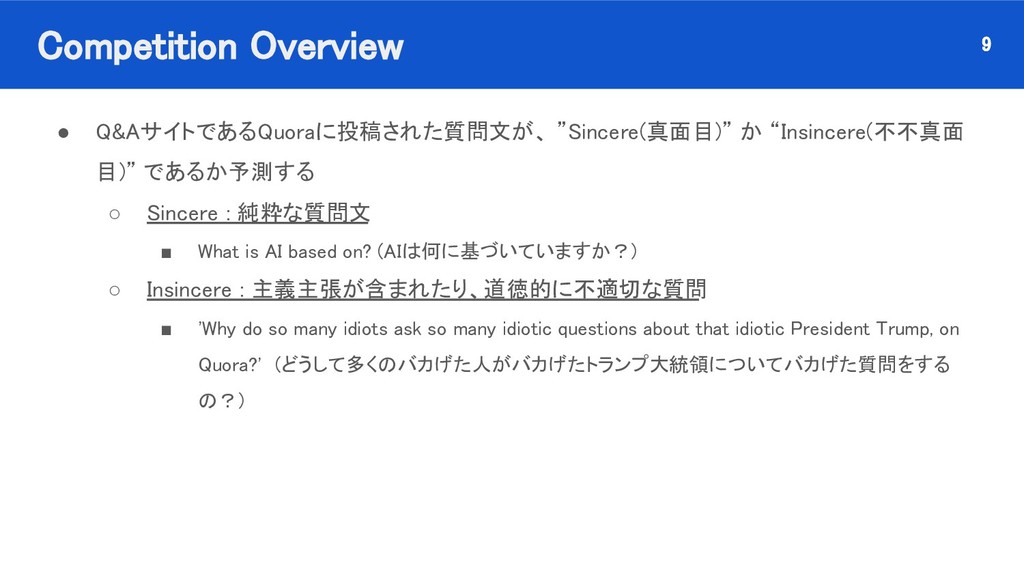
Competition Overview • Q&AサイトであるQuoraに投稿された質問文が、 ”Sincere(真面目)” か “Insincere(不不真面 目)” であるか予測する ◦
Sincere : 純粋な質問文 ▪ What is AI based on? (AIは何に基づいていますか?) ◦ Insincere : 主義主張が含まれたり、道徳的に不適切な質問 ▪ 'Why do so many idiots ask so many idiotic questions about that idiotic President Trump, on Quora?' (どうして多くのバカげた人がバカげたトランプ大統領についてバカげた質問をする の?) 9 -
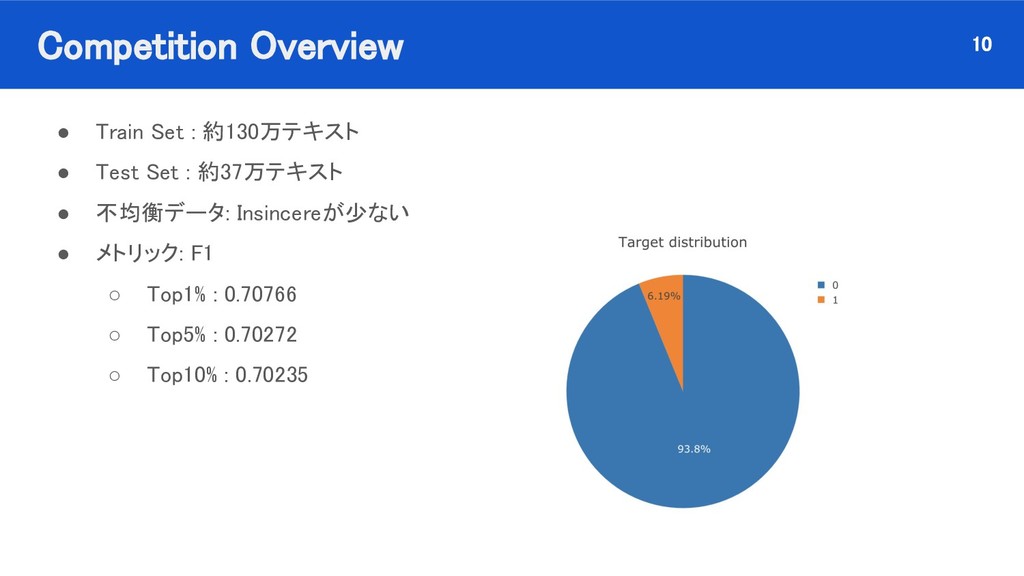
Competition Overview • Train Set : 約130万テキスト • Test Set
: 約37万テキスト • 不均衡データ: Insincereが少ない • メトリック: F1 ◦ Top1% : 0.70766 ◦ Top5% : 0.70272 ◦ Top10% : 0.70235 10 -
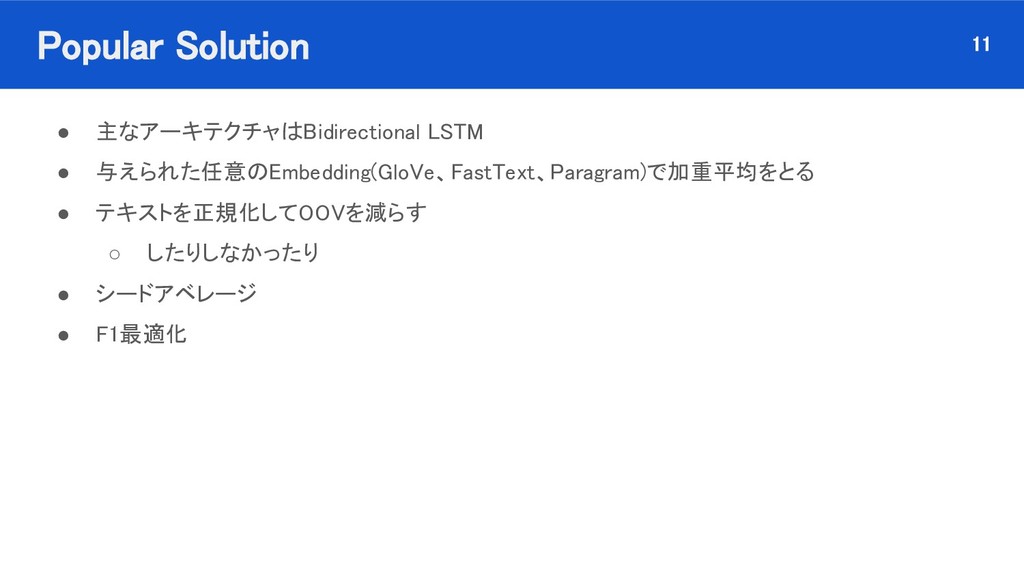
Popular Solution • 主なアーキテクチャはBidirectional LSTM • 与えられた任意のEmbedding(GloVe、FastText、Paragram)で加重平均をとる •
テキストを正規化してOOVを減らす ◦ したりしなかったり • シードアベレージ • F1最適化 11 -
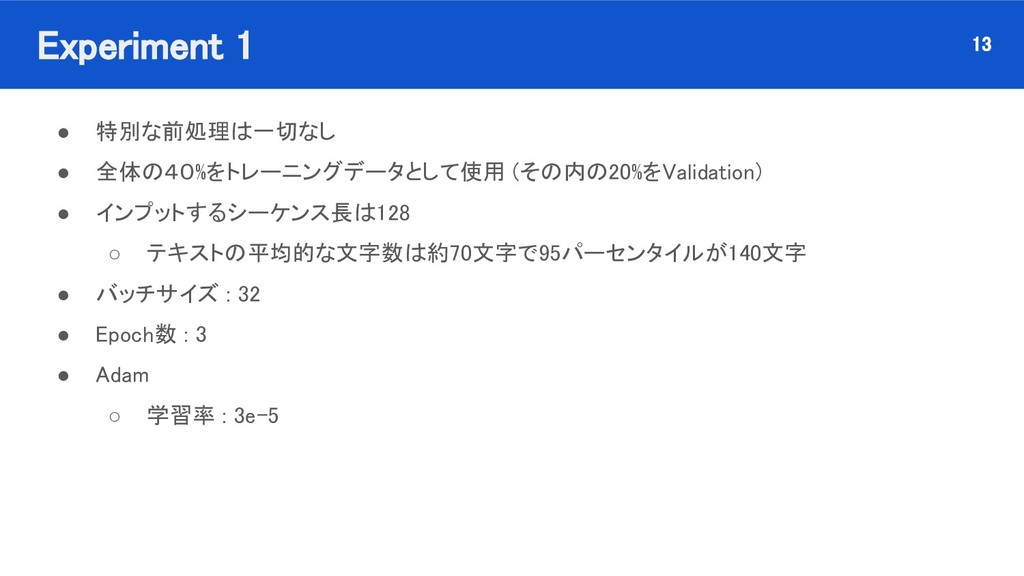
Experiment 1 • 特別な前処理は一切なし • 全体の40%をトレーニングデータとして使用 (その内の20%をValidation) • インプットするシーケンス長は128
◦ テキストの平均的な文字数は約70文字で95パーセンタイルが140文字 • バッチサイズ : 32 • Epoch数 : 3 • Adam ◦ 学習率 : 3e-5 13 -
Experiment 2 • 層ごとに学習率を変える [1] ◦ 下層は経験的に汎用的な表現を獲得していると考えられているので、それを忘却しない ように学習率を下げる ◦ ηk-1
= ξ x ηk ◦ ベースの学習率を2e-5、ξ=0.95 として段階的に下げる ◦ [2e-5, 0.95 x 2e-5, (0.95)^2 x 2e-5, …..] 15 [1] How to Fine-Tune BERT for Text Classification? ( https://arxiv.org/pdf/1905.05583.pdf) -
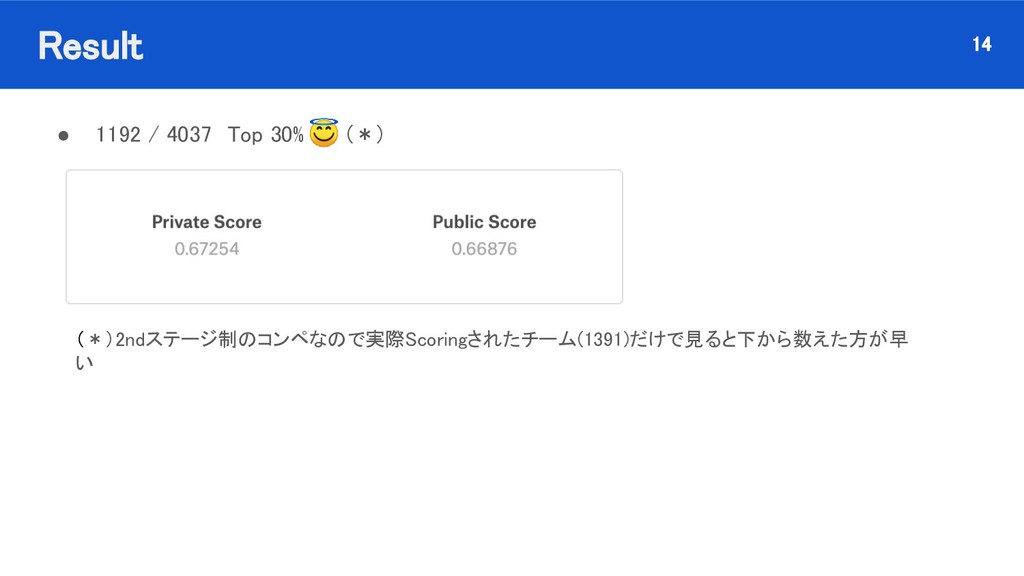
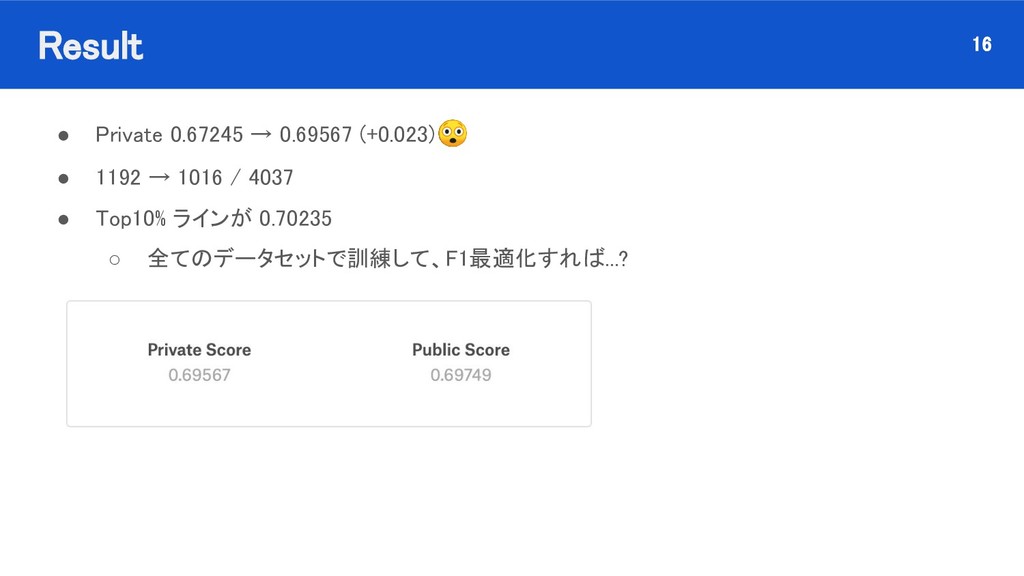
Result • Private 0.67245 → 0.69567 (+0.023) • 1192
→ 1016 / 4037 • Top10% ラインが 0.70235 ◦ 全てのデータセットで訓練して、F1最適化すれば...? 16 -
所感 ① • BERTなら特になにもしなくてもいいスコア出る? ◦ そんなことなかった ▪ データセットの問題かも
▪ 大文字の数や先頭が大文字など、メタ特徴量も効くかも ◦ Fine Tuning のやり方を工夫する [1] ▪ Within-Task Further Pre-Training : DownStream タスク内で事前学習を行う ▪ 学習率のスケジューリング • Slanted Triangular Learning Rates 18 -
所感 ② • リソース ◦ モデルのみで418MB、1batch 512シーケンスだと合計1237MB [2] ▪
1batch 829MBを使用。8batch位が限界 ◦ 訓練時間 KernelのP100で1epoch 1.5hくらい ▪ ColabのK80だと倍くらい掛かった ◦ 2ndの人は一層のBidirectional LSTM ▪ Kagglerがチューニングしたモデルはやっぱりすごいなあ 19 [2] https://krishansubudhi.github.io/deeplearning/2019/09/20/BertMemoryAnalysis.html