Upgrade to Pro — share decks privately, control downloads, hide ads and more …

[Track 1] 이슬라 소르나에서 공룡 기르기: 사내 멀티클라우드 IDP 이야기

Avatar for Lablup Inc. Lablup Inc.
October 16, 2026
8

[Track 1] 이슬라 소르나에서 공룡 기르기: 사내 멀티클라우드 IDP 이야기

사내 인프라에서 GPU 인스턴스를 하나 만드는 일은 단순히 클라우드 콘솔에서 버튼을 누르는 과정이 아닙니다. AWS, Azure, OpenStack, 베어메탈은 생애주기부터 차이가 존재하지만, 이를 사용자가 전부 알아야 할 필요는 없습니다. 그렇다고 전부 감추면 필요한 순간에 손을 쓸 수 없게 됩니다. 추상화를 어디까지 할 것인가는 개발 비용의 문제가 아니라, 플랫폼이 복잡해질수록 쓰기 어려워진다는 사용자 경험의 문제가 됩니다. 사내 멀티클라우드 IDP인 Isla Sorna를 만들며 그은 선들에 대한 이야기를 합니다.

Avatar for Lablup Inc.

Lablup Inc.

October 16, 2026

More Decks by Lablup Inc.

Transcript

  1. 이슬라 소르나에서 공룡 기르기: 사내 멀티클라우드 IDP 이야기 GPU·NPU 자원을

    한 플랫폼으로 묶으며 그은 선들 강시온 래블업 / Software Engineer
  2. 발표자 소개 강시온 Software Engineer · Lablup Inc. • AI

    인프라 플랫폼 Backend.AI를 만드는 회사에 재직 • 온프레미스 장비와 클라우드 장비를 관리 • 제품의 클라우드 전환을 담당
  3. 1 1부. 흩어진 자원을 묶어서 효율을 올린 이야기 2 2부.

    그 과정에서 부딪힌 질문, 어디까지 묶을 것인가 점유 현황이 안 보이던 노드들, 매번 40분씩 걸리던 준비, 놓치던 회수 정답이 없어 선을 그어야 했던 고민 세 가지
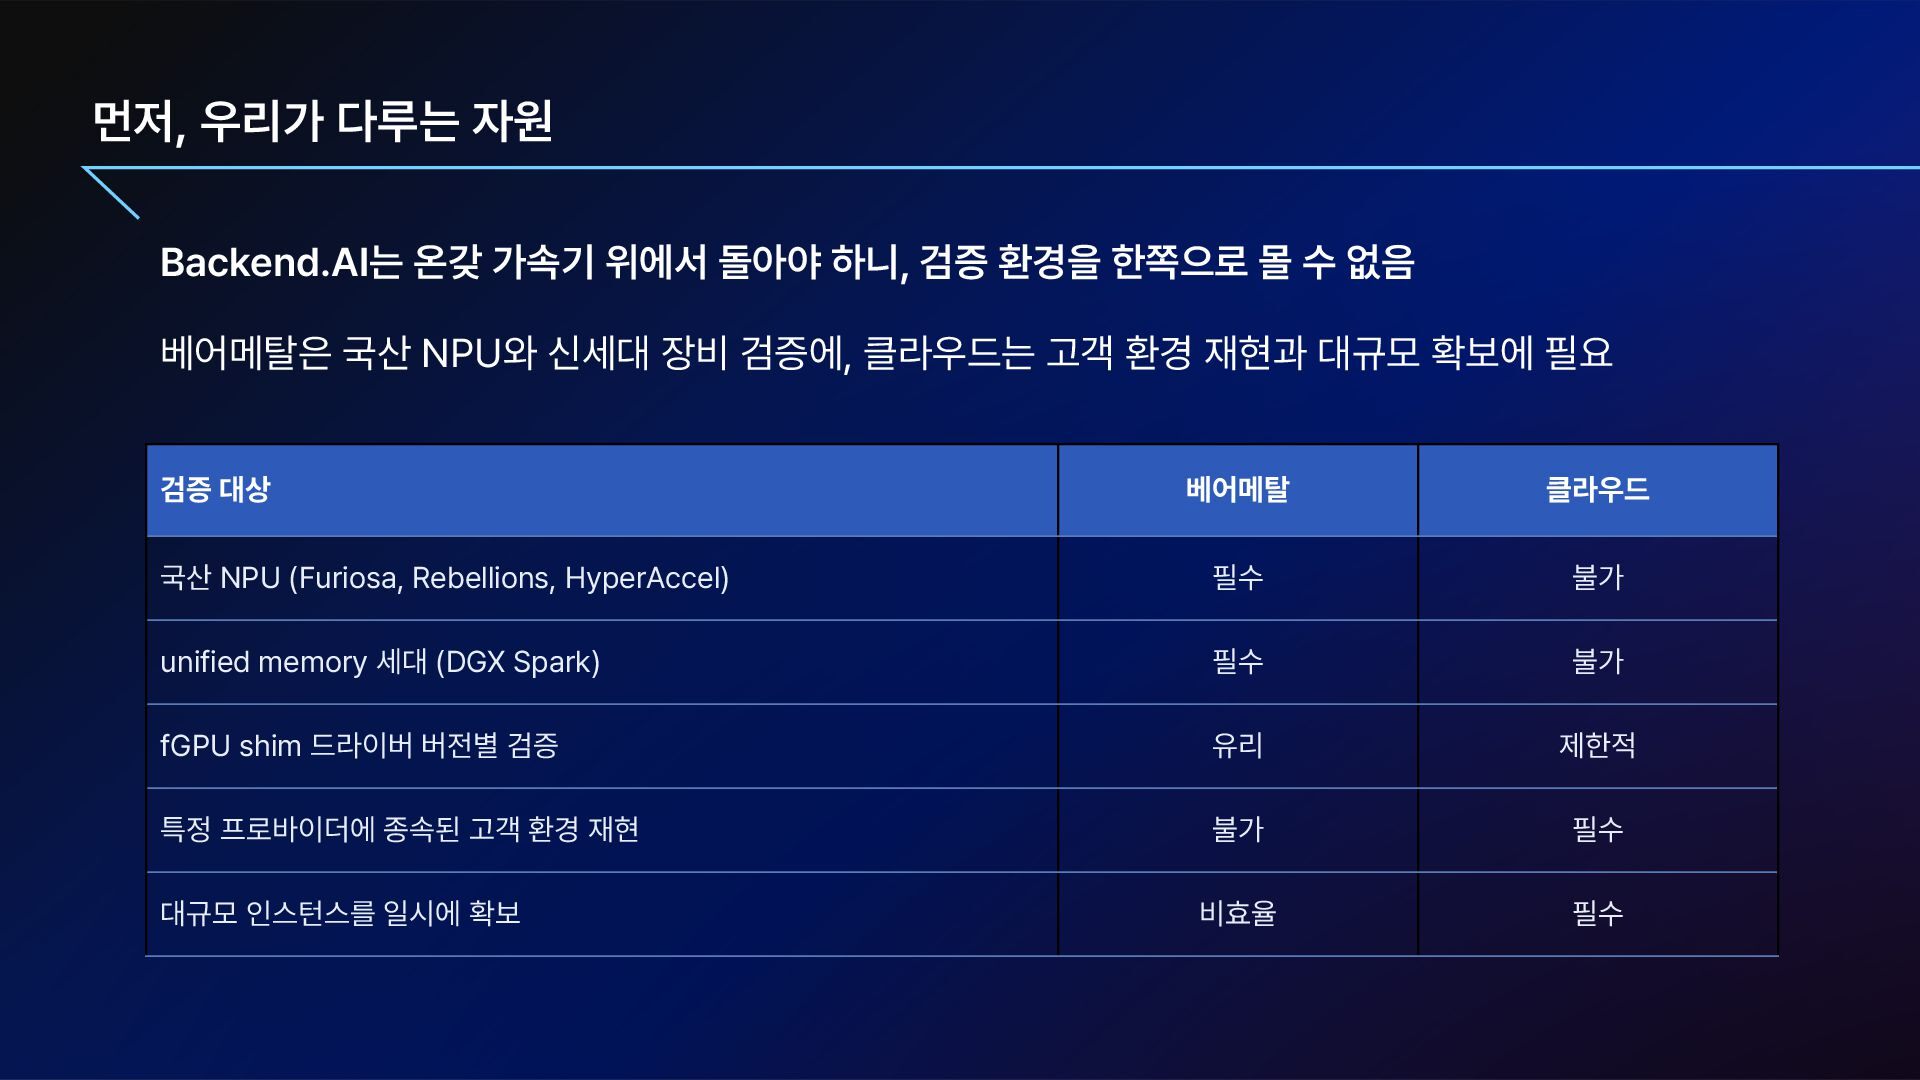
  4. 먼저, 우리가 다루는 자원 Backend.AI는 온갖 가속기 위에서 돌아야 하니,

    검증 환경을 한쪽으로 몰 수 없음 베어메탈은 국산 NPU와 신세대 장비 검증에, 클라우드는 고객 환경 재현과 대규모 확보에 필요 검증 대상 베어메탈 클라우드 국산 NPU Furiosa, Rebellions, HyperAccel 필수 불가 unified memory 세대 DGX Spark 필수 불가 fGPU shim 드라이버 버전별 검증 유리 제한적 특정 프로바이더에 종속된 고객 환경 재현 불가 필수 대규모 인스턴스를 일시에 확보 비효율 필수
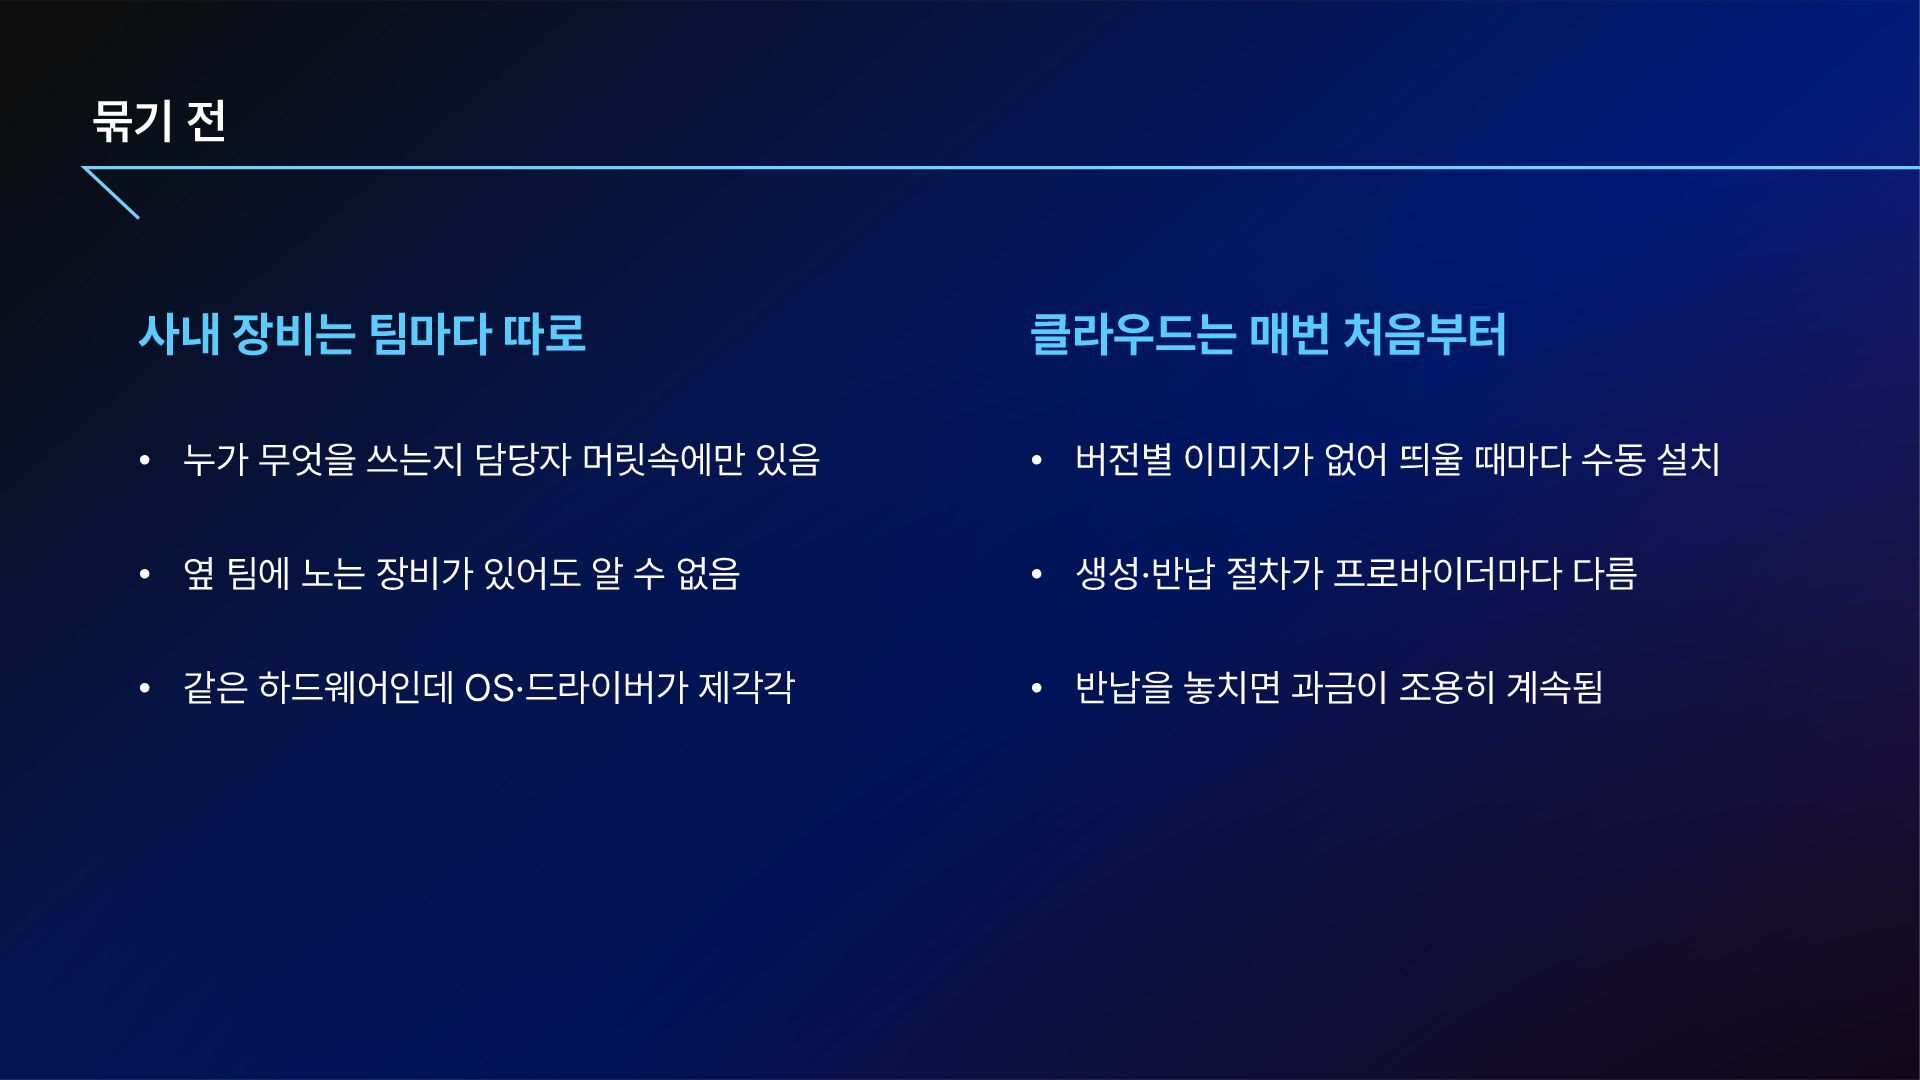
  5. 묶기 전 사내 장비는 팀마다 따로 클라우드는 매번 처음부터 •

    누가 무엇을 쓰는지 담당자 머릿속에만 있음 • 버전별 이미지가 없어 띄울 때마다 수동 설치 • 옆 팀에 노는 장비가 있어도 알 수 없음 • 생성·반납 절차가 프로바이더마다 다름 • 같은 하드웨어인데 OS·드라이버가 제각각 • 반납을 놓치면 과금이 조용히 계속됨
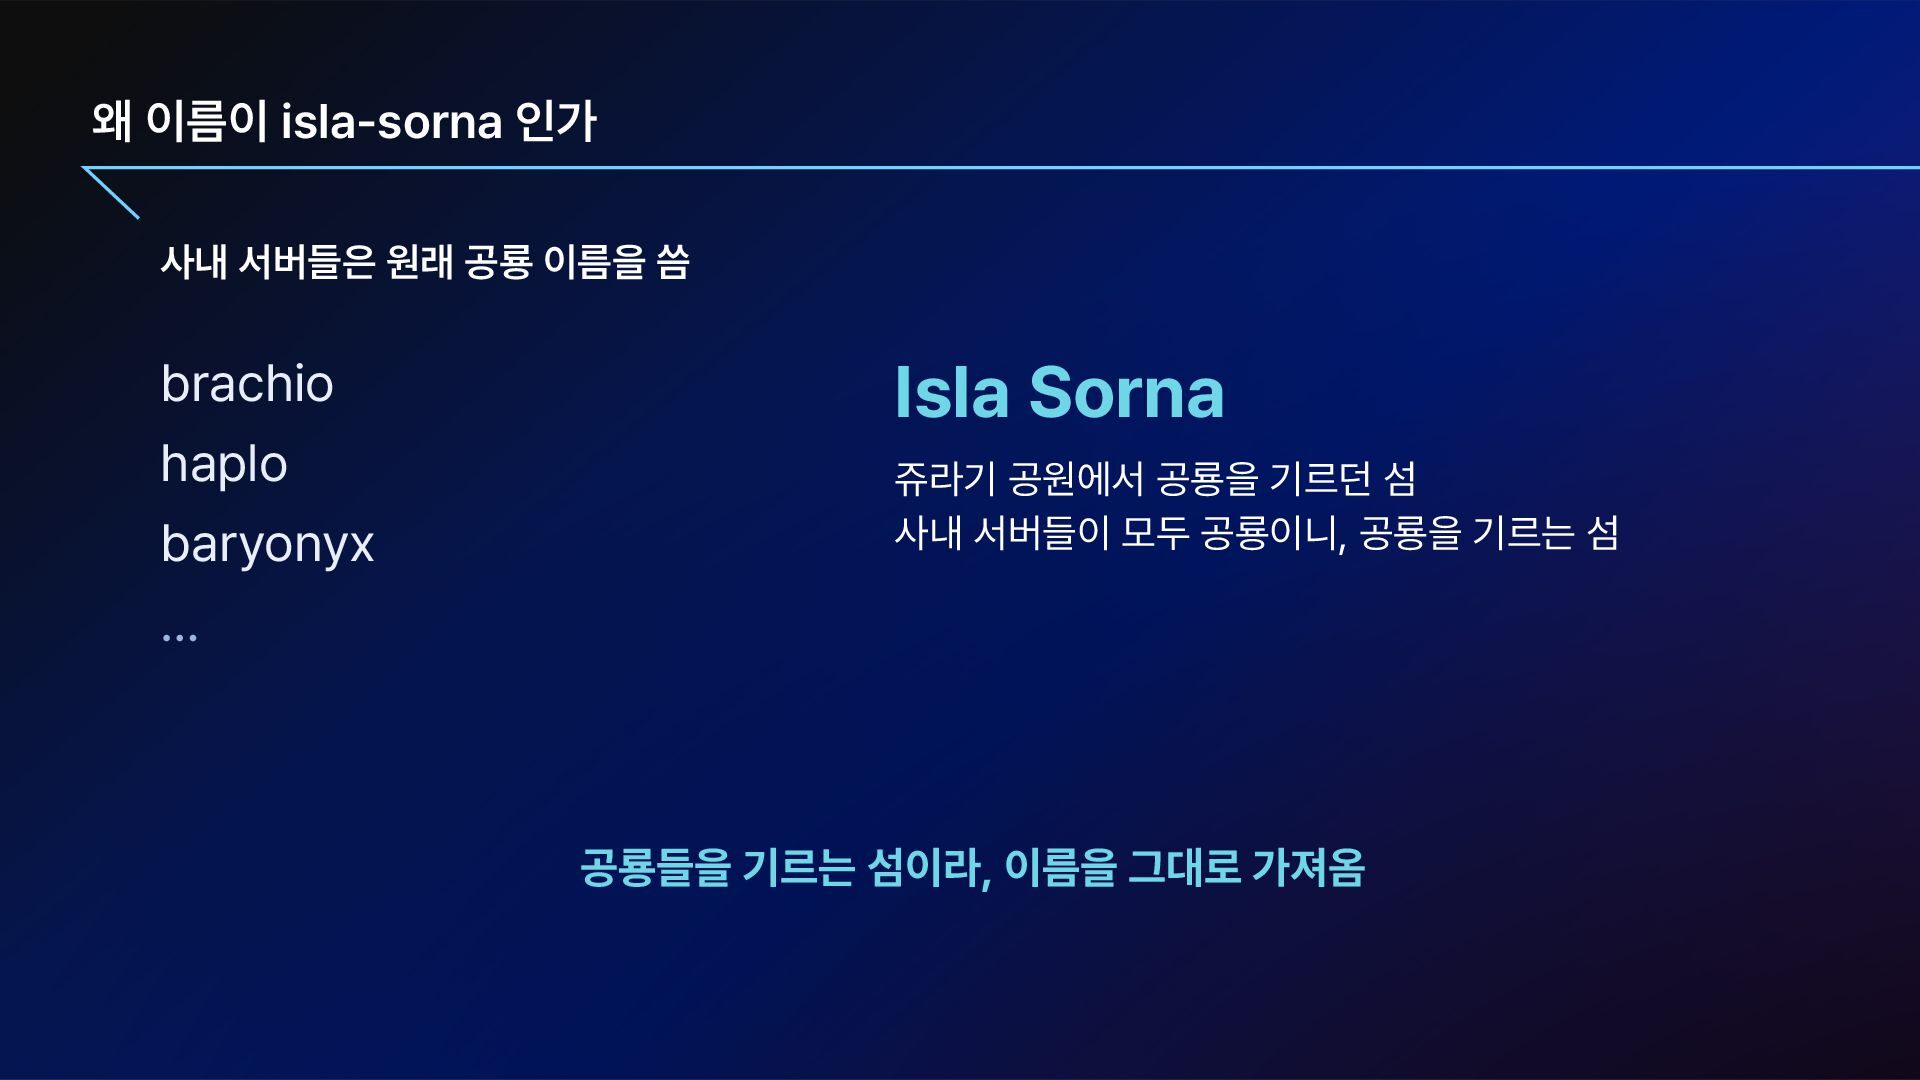
  6. 왜 이름이 isla sorna 인가 사내 서버들은 원래 공룡 이름을

    씀 brachio haplo baryonyx Isla Sorna 쥬라기 공원에서 공룡을 기르던 섬 사내 서버들이 모두 공룡이니, 공룡을 기르는 섬 … 공룡들을 기르는 섬이라, 이름을 그대로 가져옴
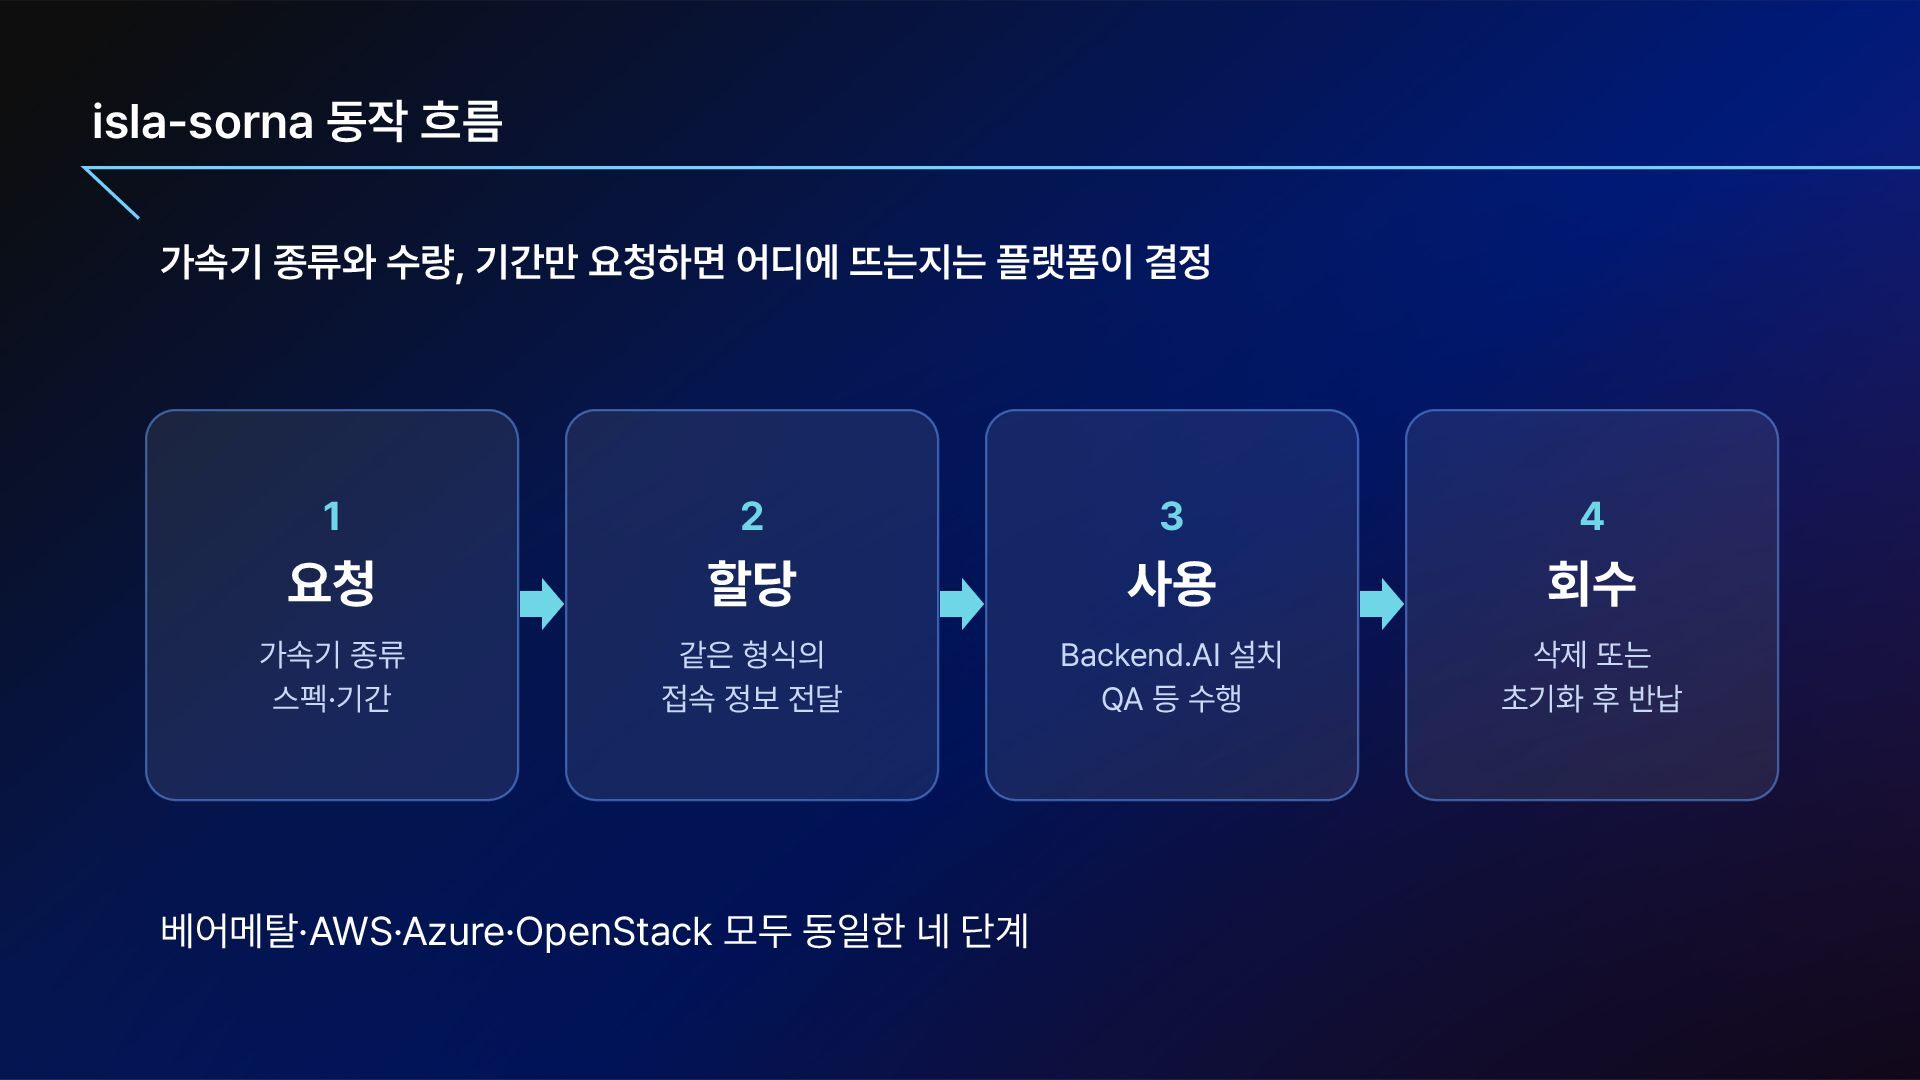
  7. isla sorna 동작 흐름 가속기 종류와 수량, 기간만 요청하면 어디에

    뜨는지는 플랫폼이 결정 1 2 3 4 요청 할당 사용 회수 가속기 종류 스펙·기간 같은 형식의 접속 정보 전달 Backend.AI 설치 QA 등 수행 삭제 또는 초기화 후 반납 베어메탈·AWS·Azure·OpenStack 모두 동일한 네 단계
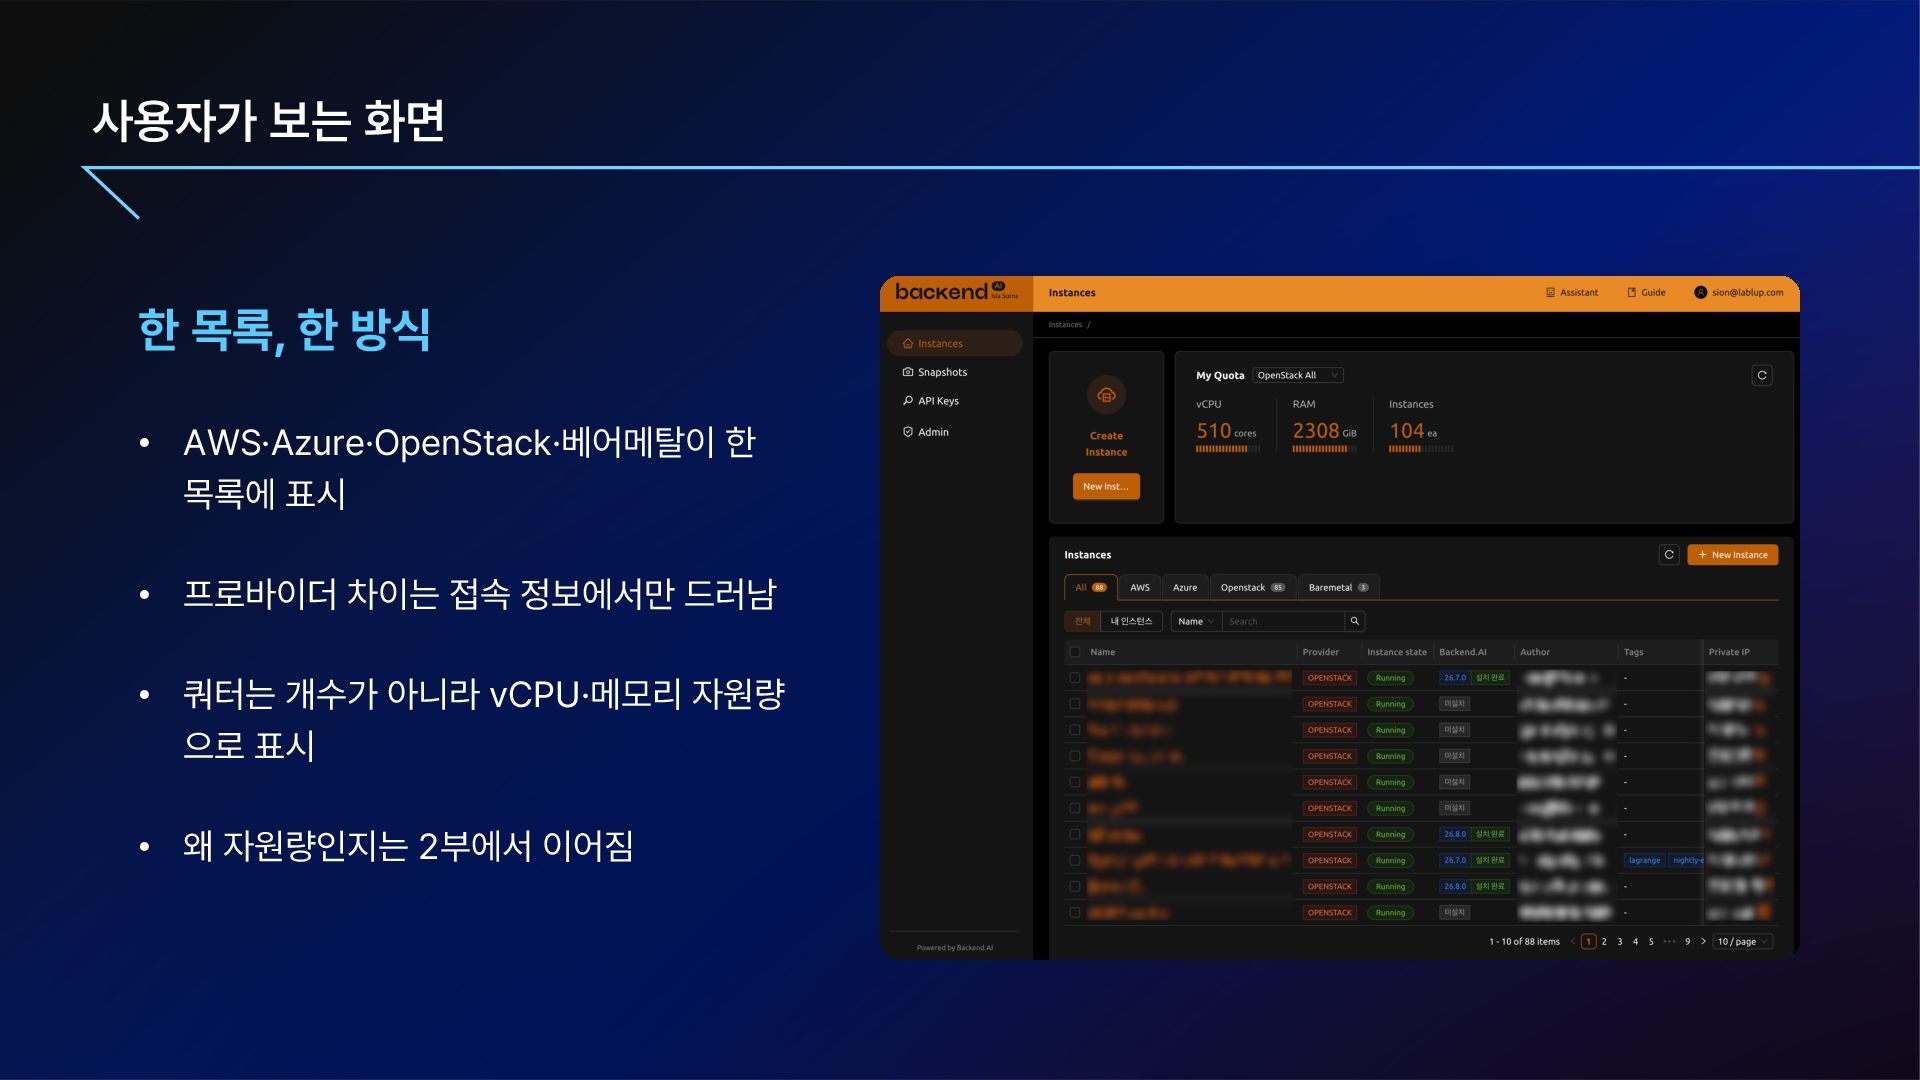
  8. 사용자가 보는 화면 한 목록, 한 방식 • AWS·Azure·OpenStack·베어메탈이 한

    목록에 표시 • 프로바이더 차이는 접속 정보에서만 드러남 • 쿼터는 개수가 아니라 vCPU·메모리 자원량 으로 표시 • 왜 자원량인지는 2부에서 이어짐
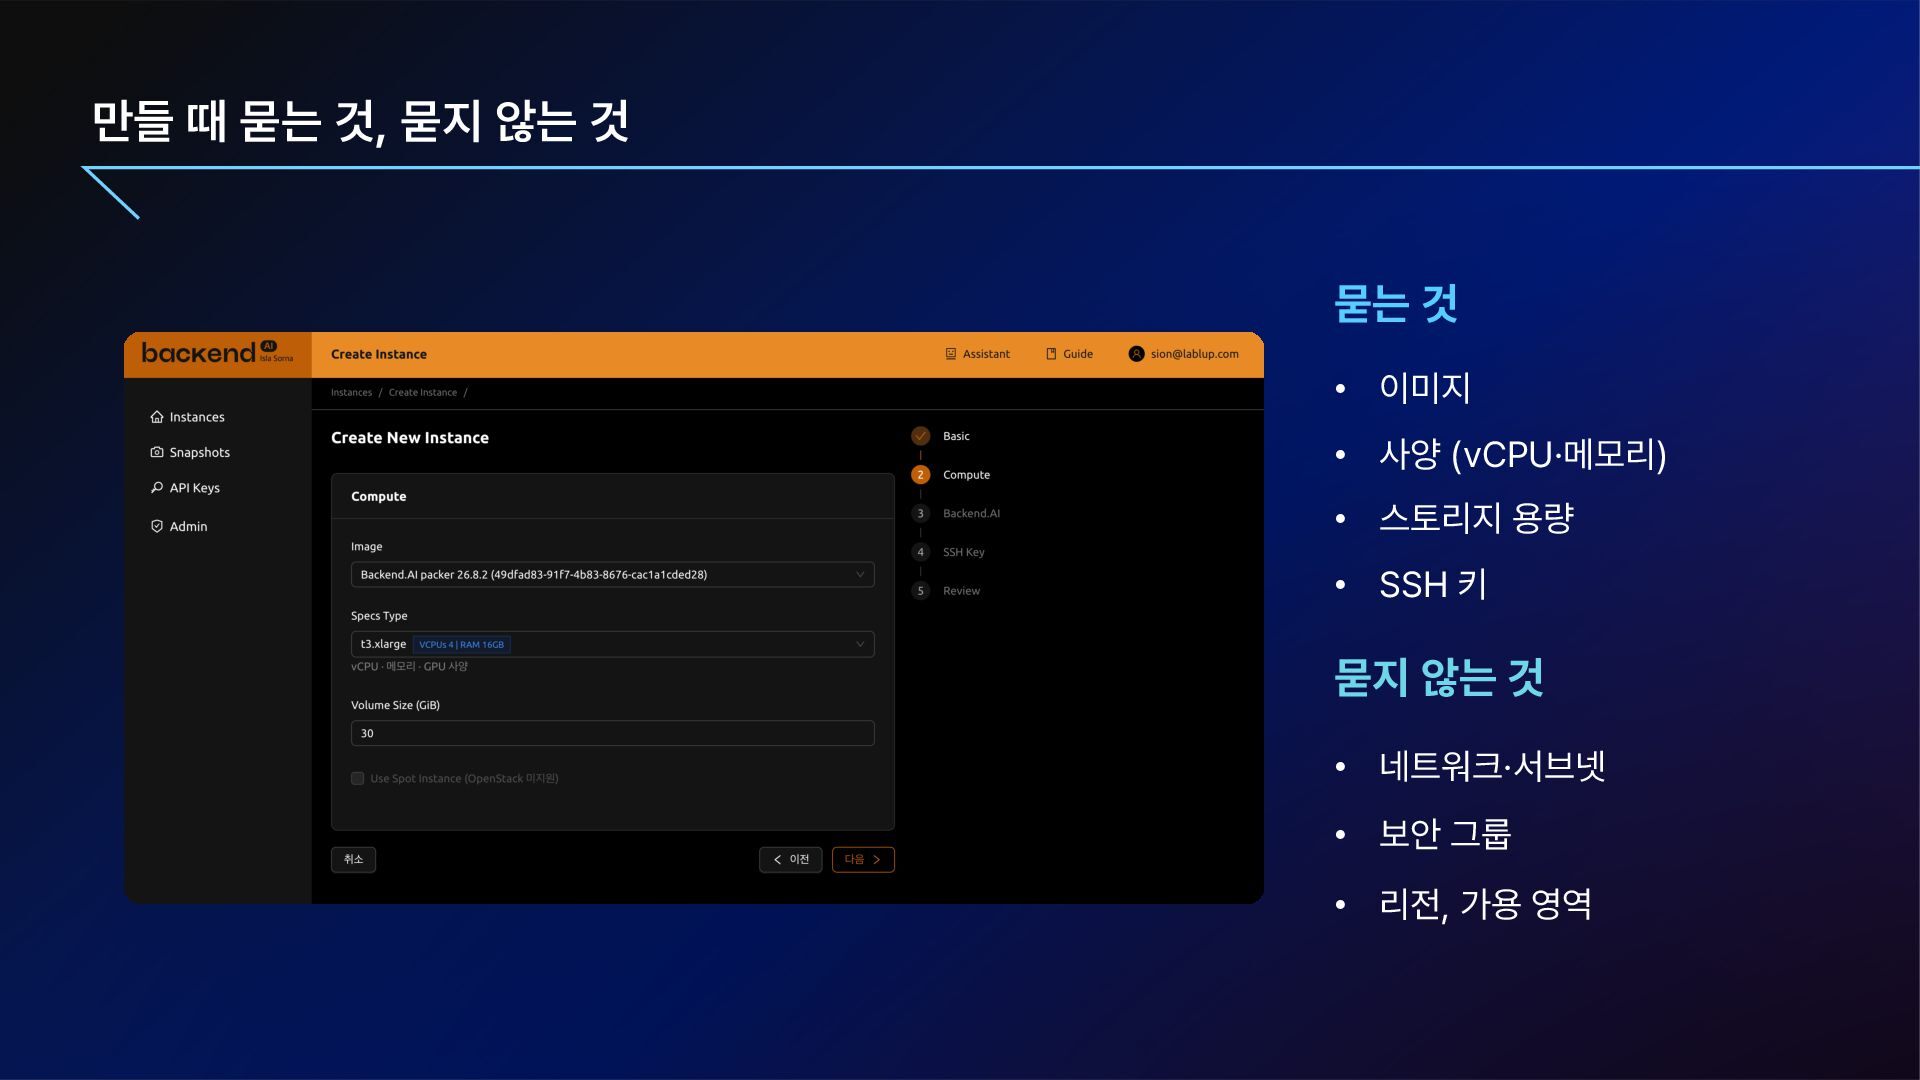
  9. 만들 때 묻는 것, 묻지 않는 것 묻는 것 •

    이미지 • 사양 vCPU·메모리 • 스토리지 용량 • SSH 키 묻지 않는 것 • 네트워크·서브넷 • 보안 그룹 • 리전, 가용 영역
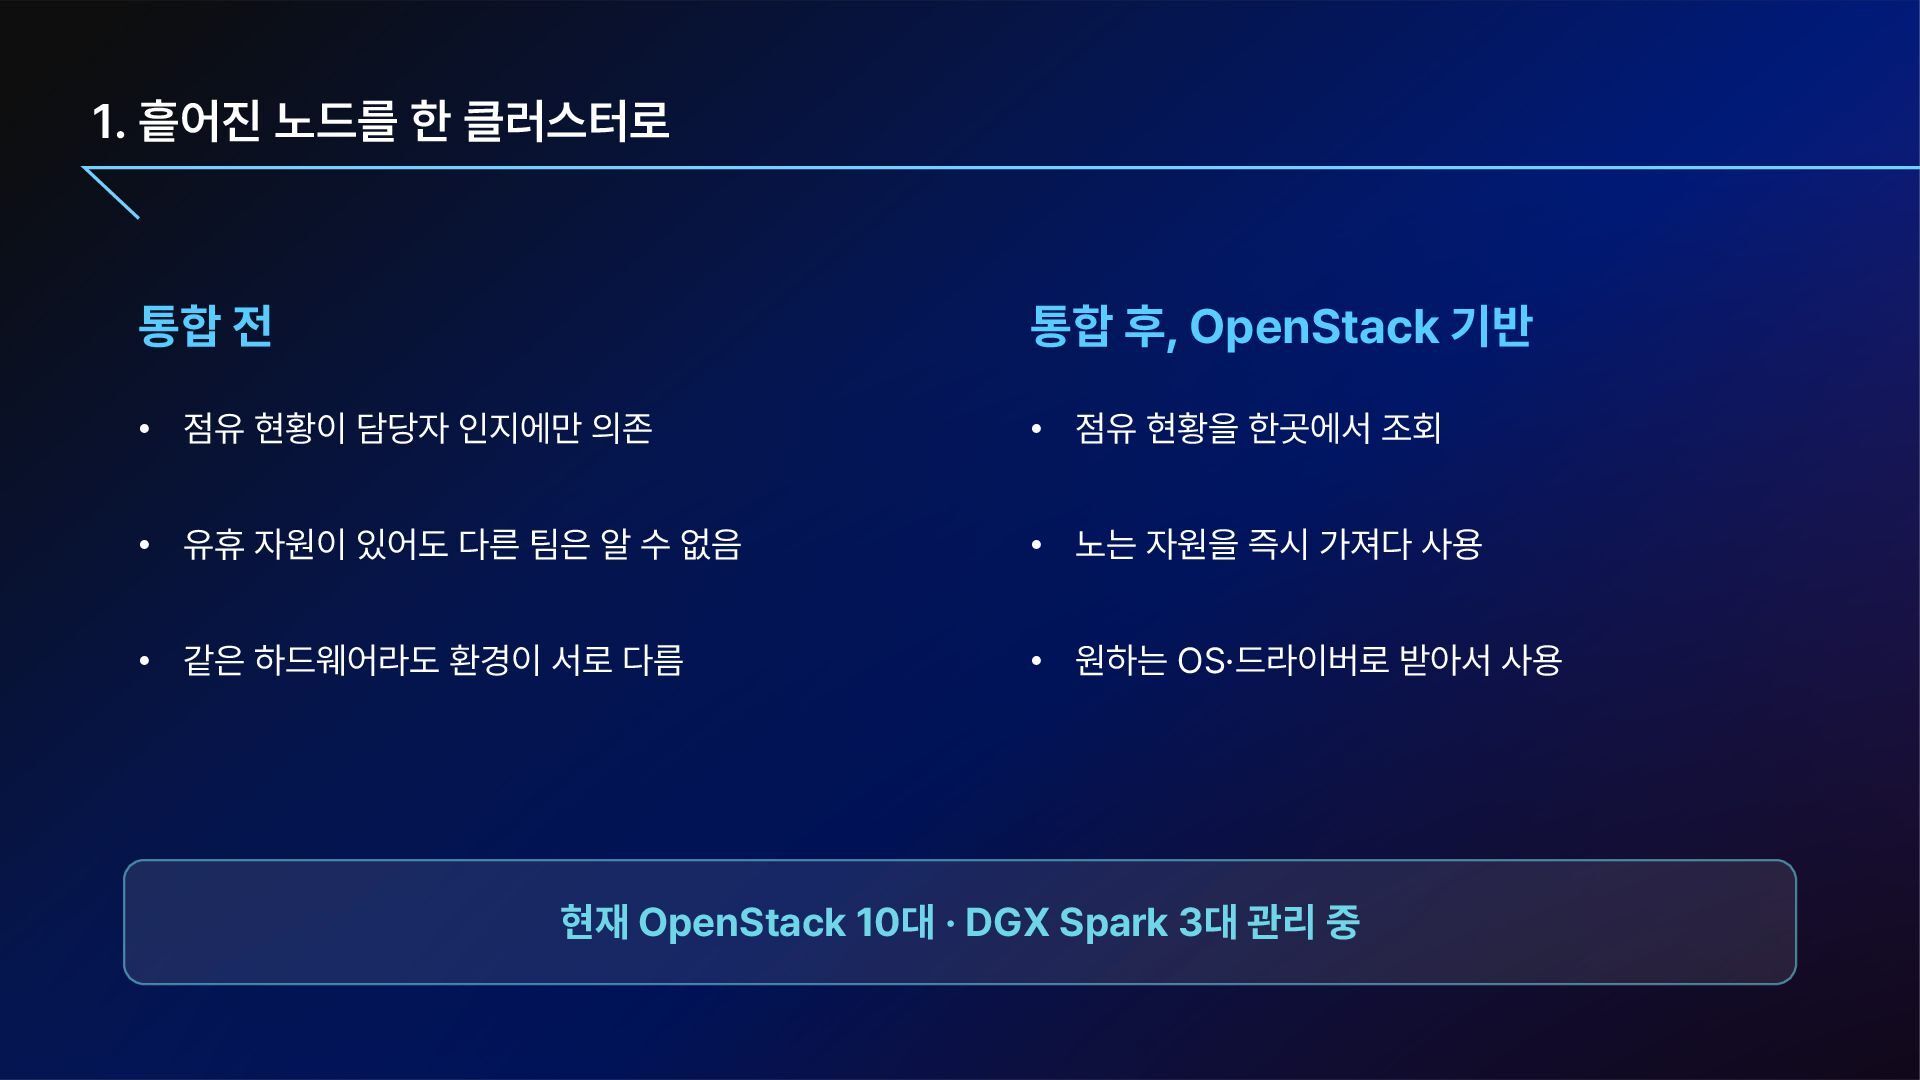
  10. 1. 흩어진 노드를 한 클러스터로 통합 전 통합 후, OpenStack

    기반 • 점유 현황이 담당자 인지에만 의존 • 점유 현황을 한곳에서 조회 • 유휴 자원이 있어도 다른 팀은 알 수 없음 • 노는 자원을 즉시 가져다 사용 • 같은 하드웨어라도 환경이 서로 다름 • 원하는 OS·드라이버로 받아서 사용 현재 OpenStack 10대 · DGX Spark 3대 관리 중
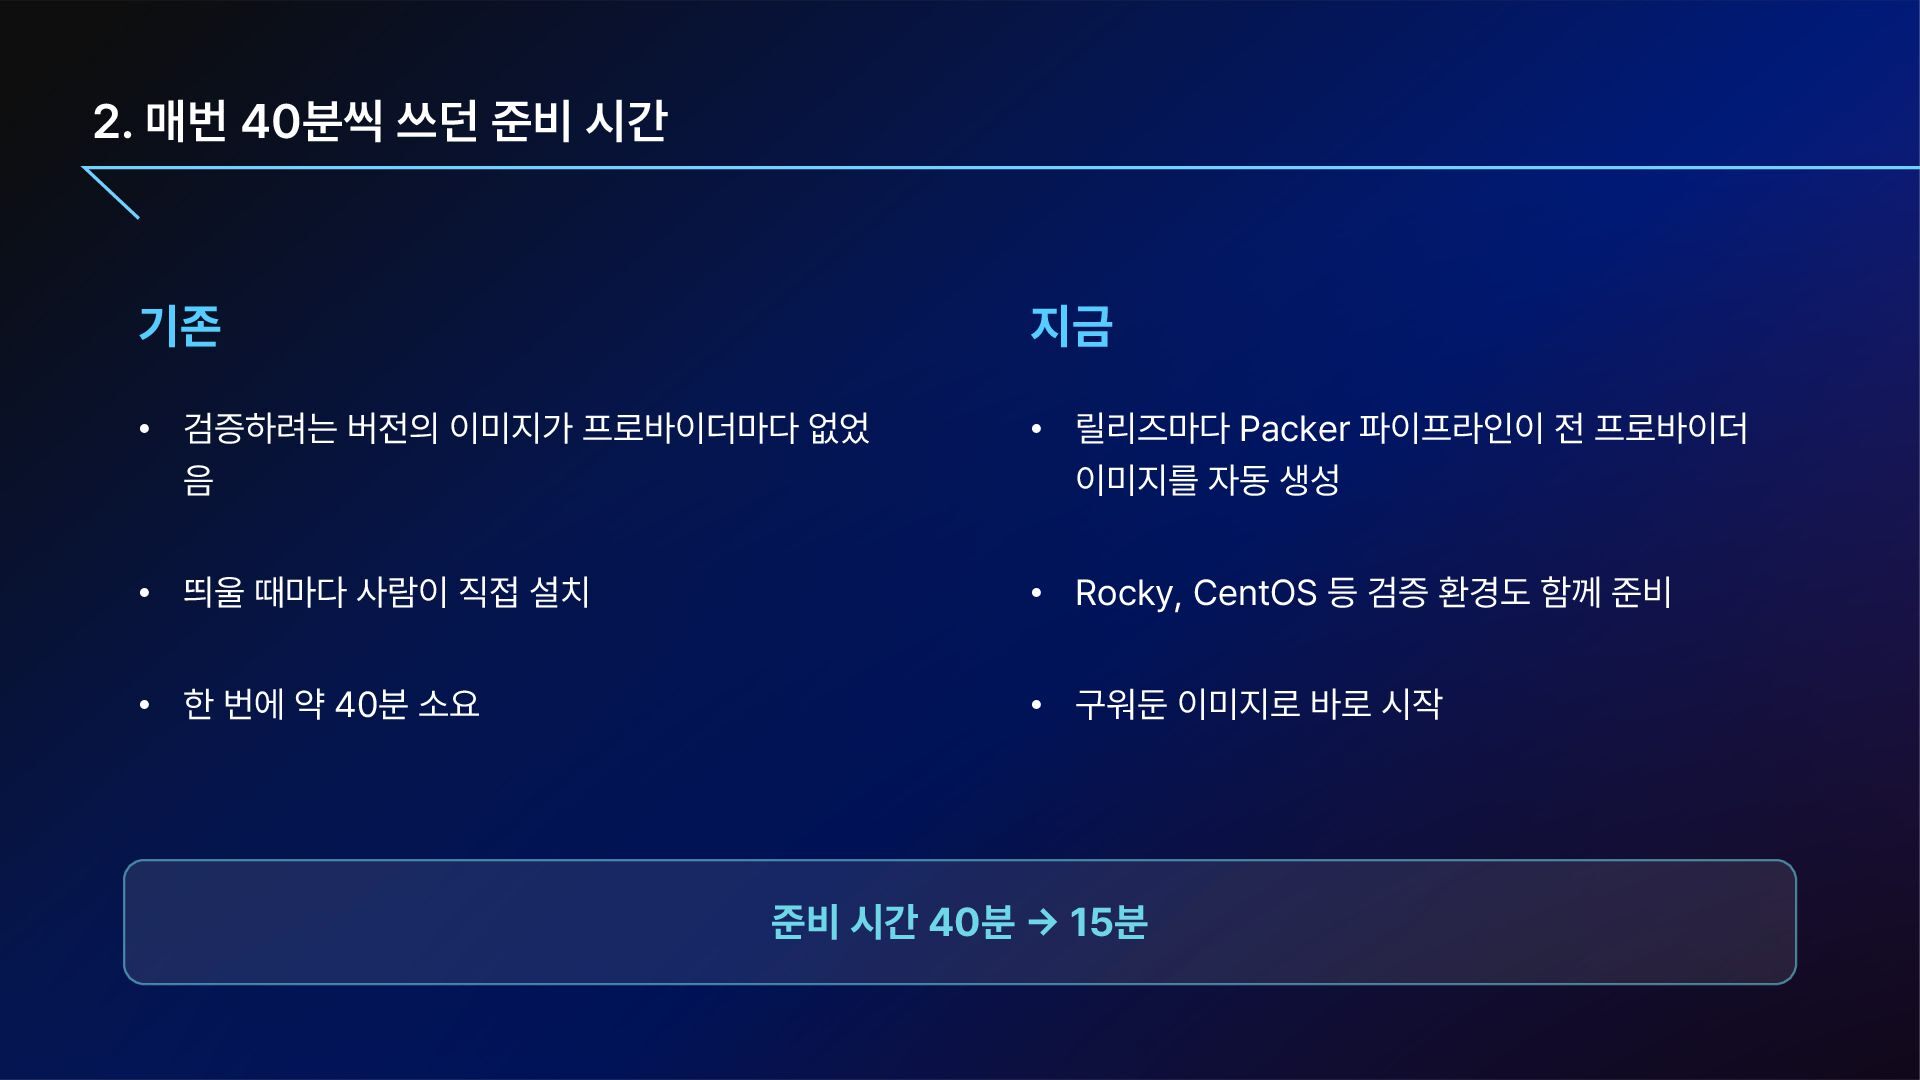
  11. 2. 매번 40분씩 쓰던 준비 시간 기존 지금 • 검증하려는

    버전의 이미지가 프로바이더마다 없었 음 • 릴리즈마다 Packer 파이프라인이 전 프로바이더 이미지를 자동 생성 • 띄울 때마다 사람이 직접 설치 • Rocky, CentOS 등 검증 환경도 함께 준비 • 한 번에 약 40분 소요 • 구워둔 이미지로 바로 시작 준비 시간 40분 15분
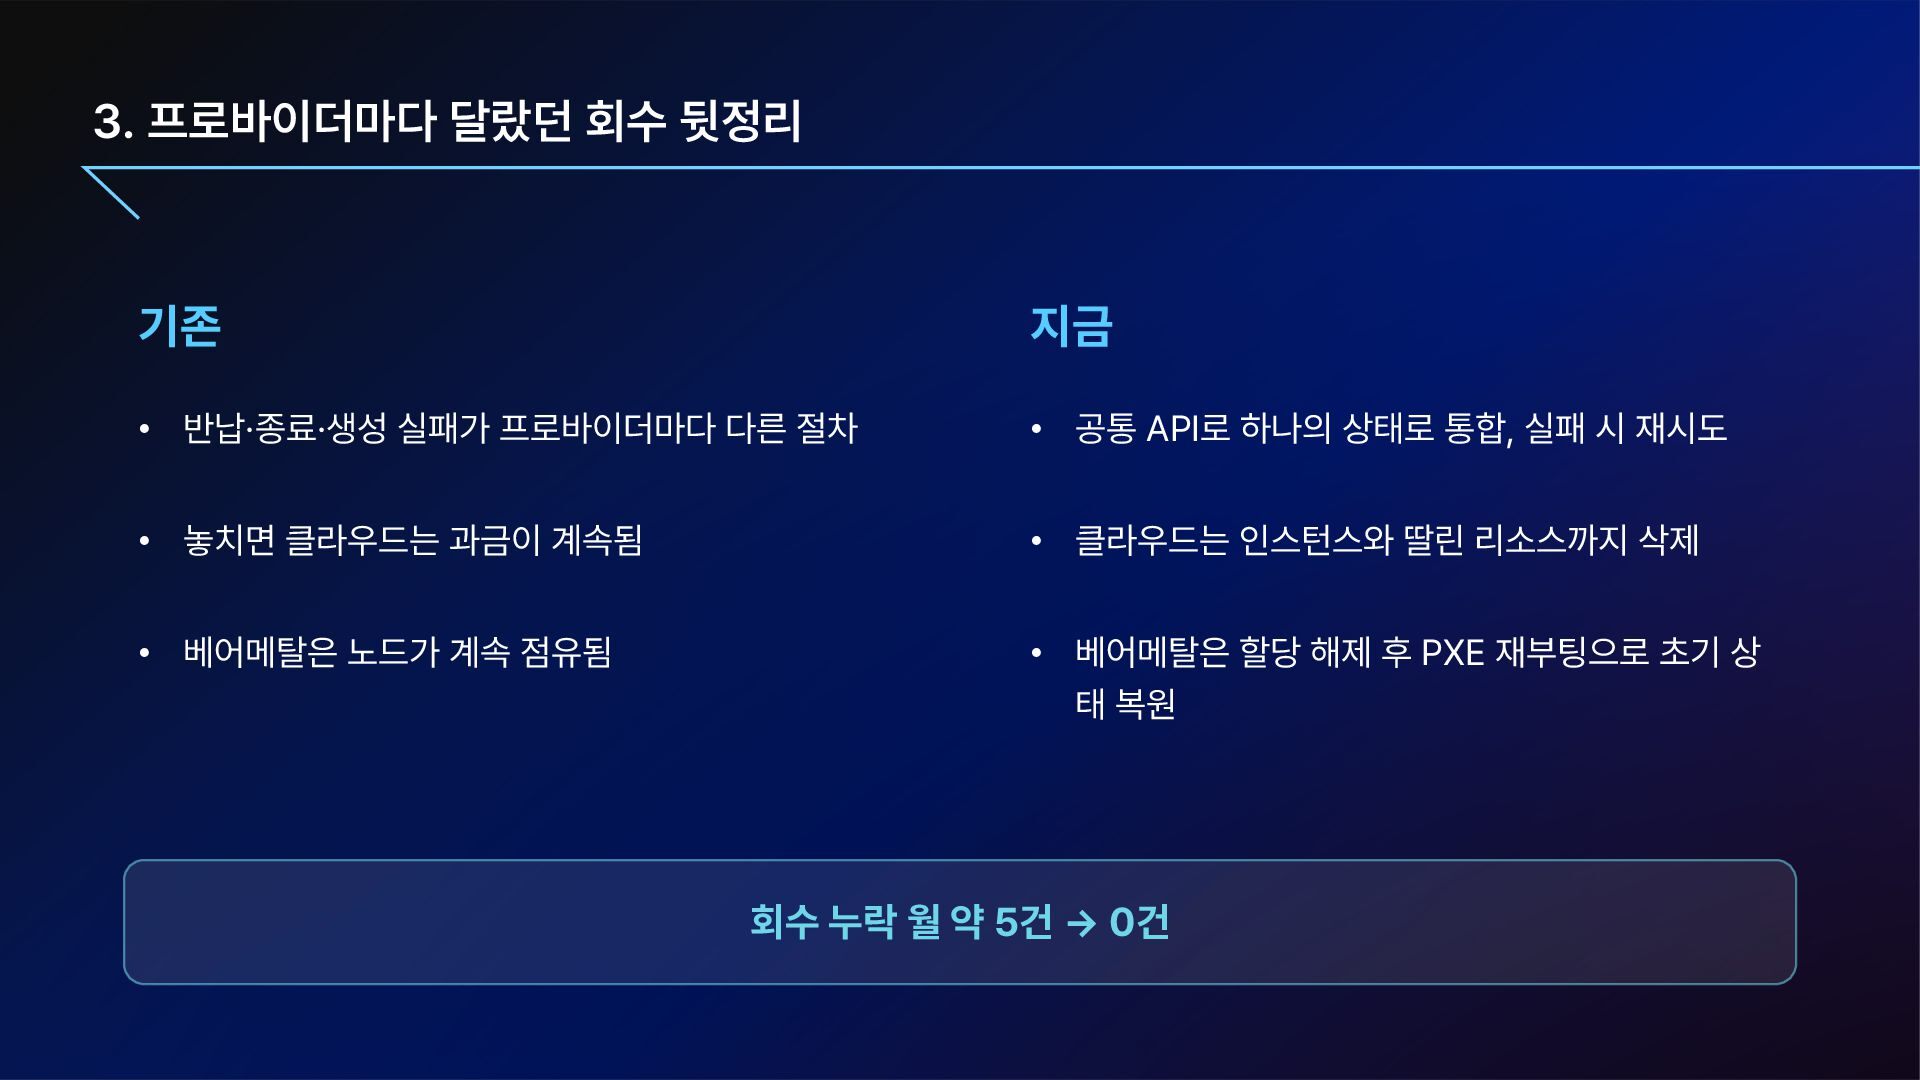
  12. 3. 프로바이더마다 달랐던 회수 뒷정리 기존 지금 • 반납·종료·생성 실패가

    프로바이더마다 다른 절차 • 공통 API로 하나의 상태로 통합, 실패 시 재시도 • 놓치면 클라우드는 과금이 계속됨 • 클라우드는 인스턴스와 딸린 리소스까지 삭제 • 베어메탈은 노드가 계속 점유됨 • 베어메탈은 할당 해제 후 PXE 재부팅으로 초기 상 태 복원 회수 누락 월 약 5건 0건
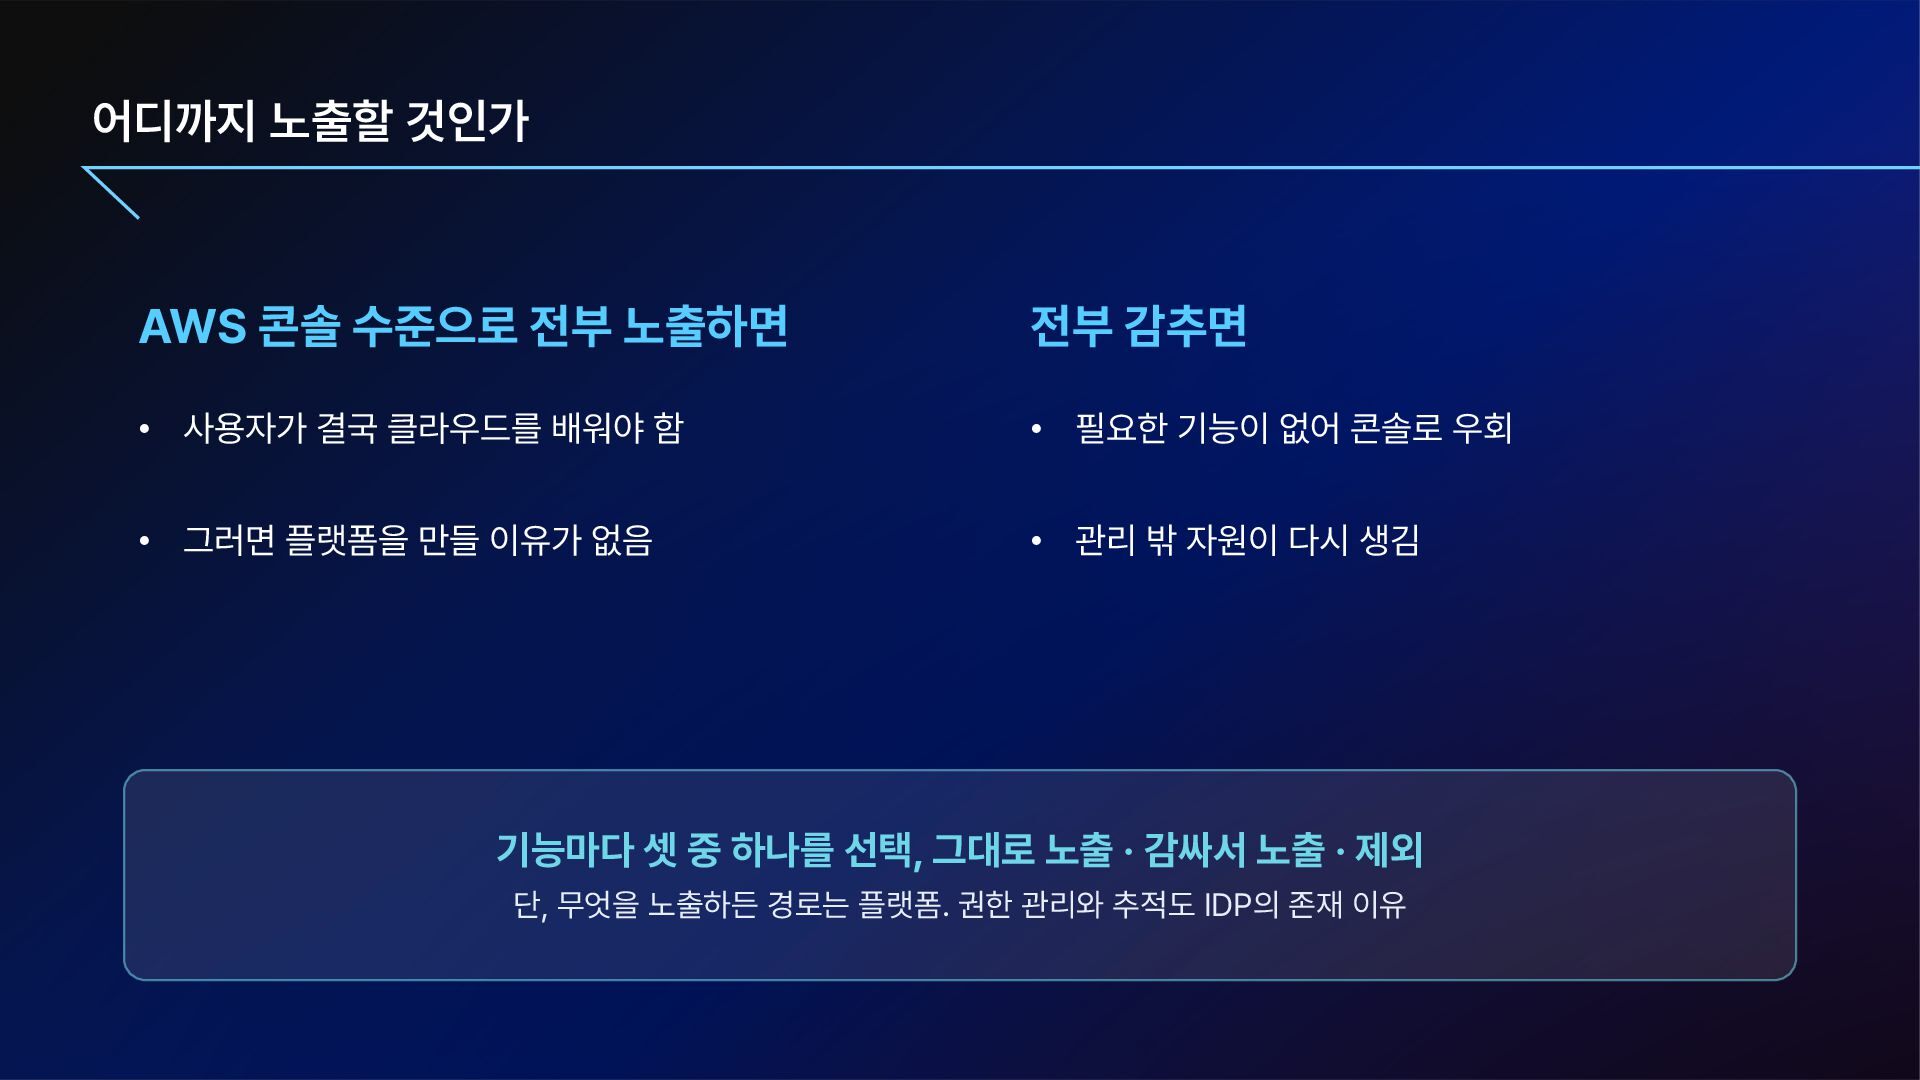
  13. 어디까지 노출할 것인가 AWS 콘솔 수준으로 전부 노출하면 전부 감추면

    • 사용자가 결국 클라우드를 배워야 함 • 필요한 기능이 없어 콘솔로 우회 • 그러면 플랫폼을 만들 이유가 없음 • 관리 밖 자원이 다시 생김 기능마다 셋 중 하나를 선택, 그대로 노출 · 감싸서 노출 · 제외 단, 무엇을 노출하든 경로는 플랫폼. 권한 관리와 추적도 IDP의 존재 이유
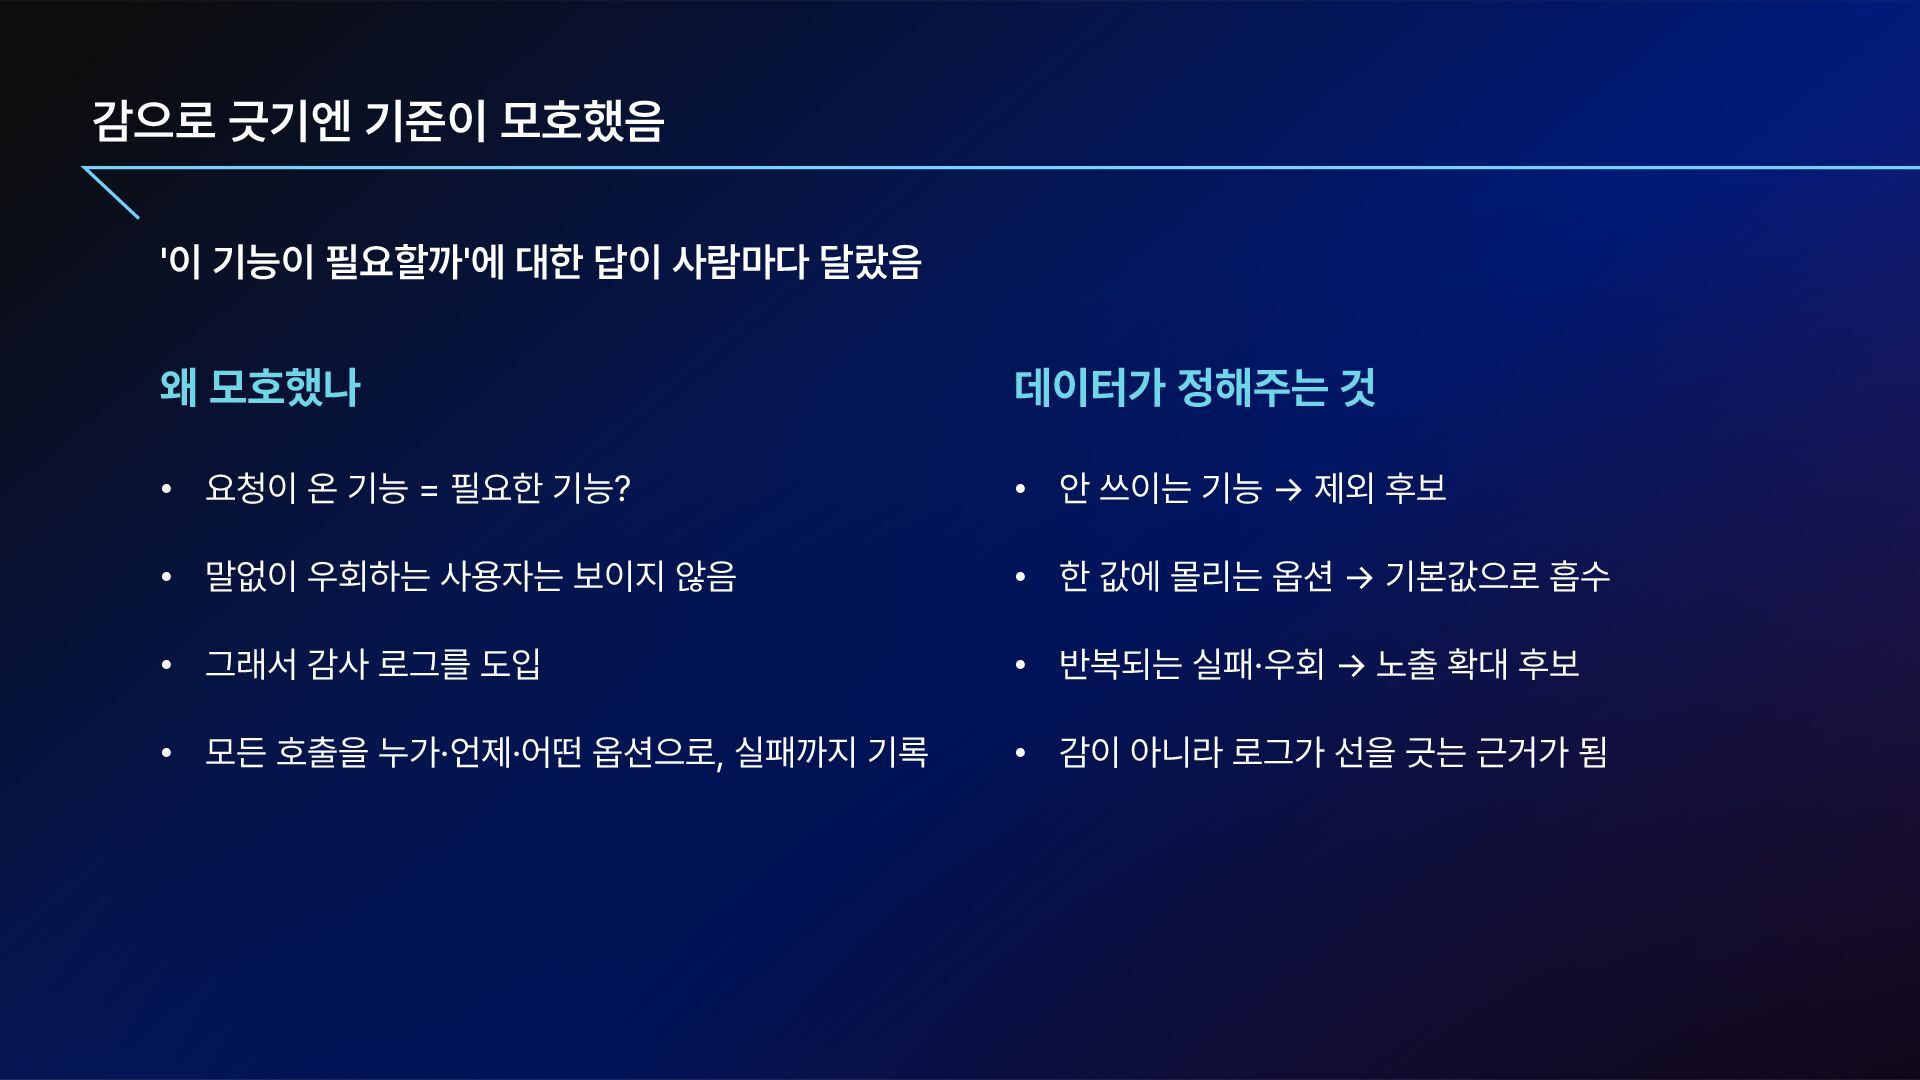
  14. 감으로 긋기엔 기준이 모호했음 이 기능이 필요할까 에 대한 답이

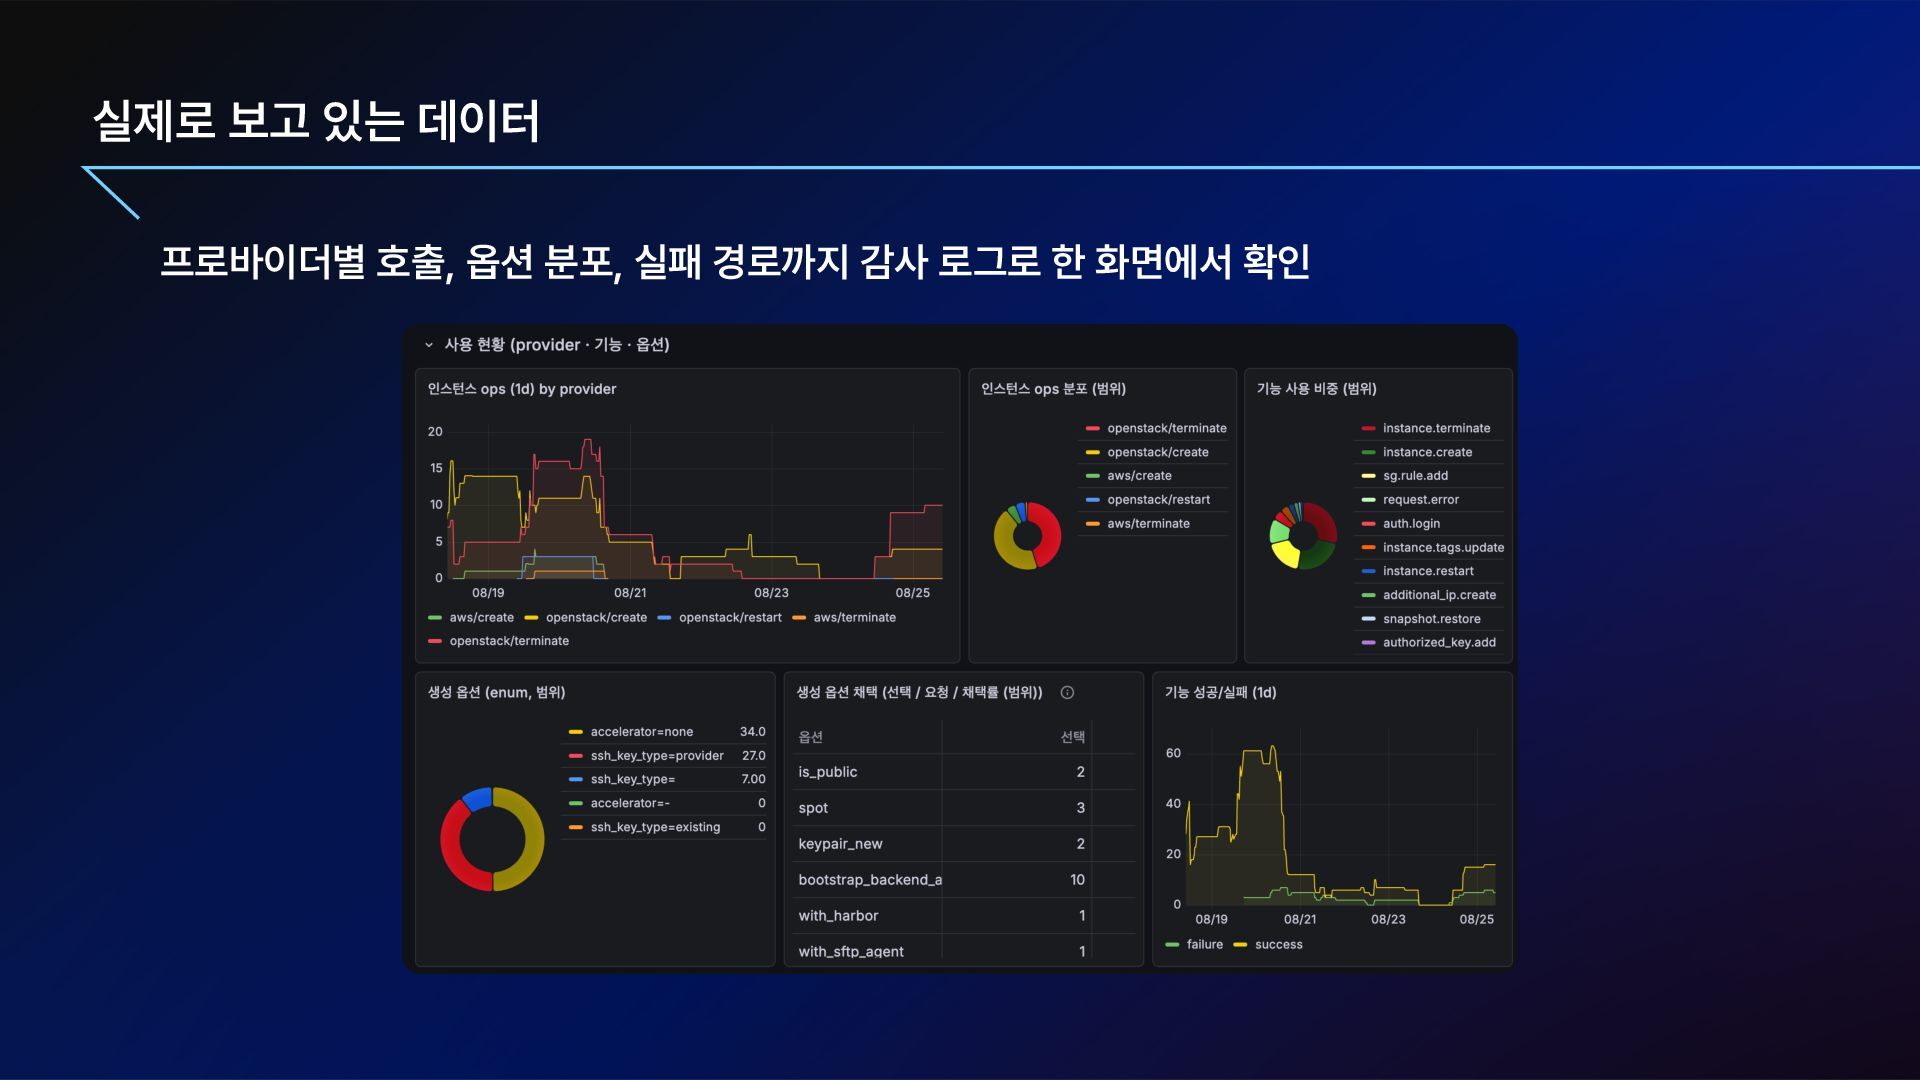
    사람마다 달랐음 왜 모호했나 • 요청이 온 기능 데이터가 정해주는 것 필요한 기능? • 안 쓰이는 기능 제외 후보 • 말없이 우회하는 사용자는 보이지 않음 • 한 값에 몰리는 옵션 기본값으로 흡수 • 그래서 감사 로그를 도입 • 반복되는 실패·우회 노출 확대 후보 • 모든 호출을 누가·언제·어떤 옵션으로, 실패까지 기록 • 감이 아니라 로그가 선을 긋는 근거가 됨
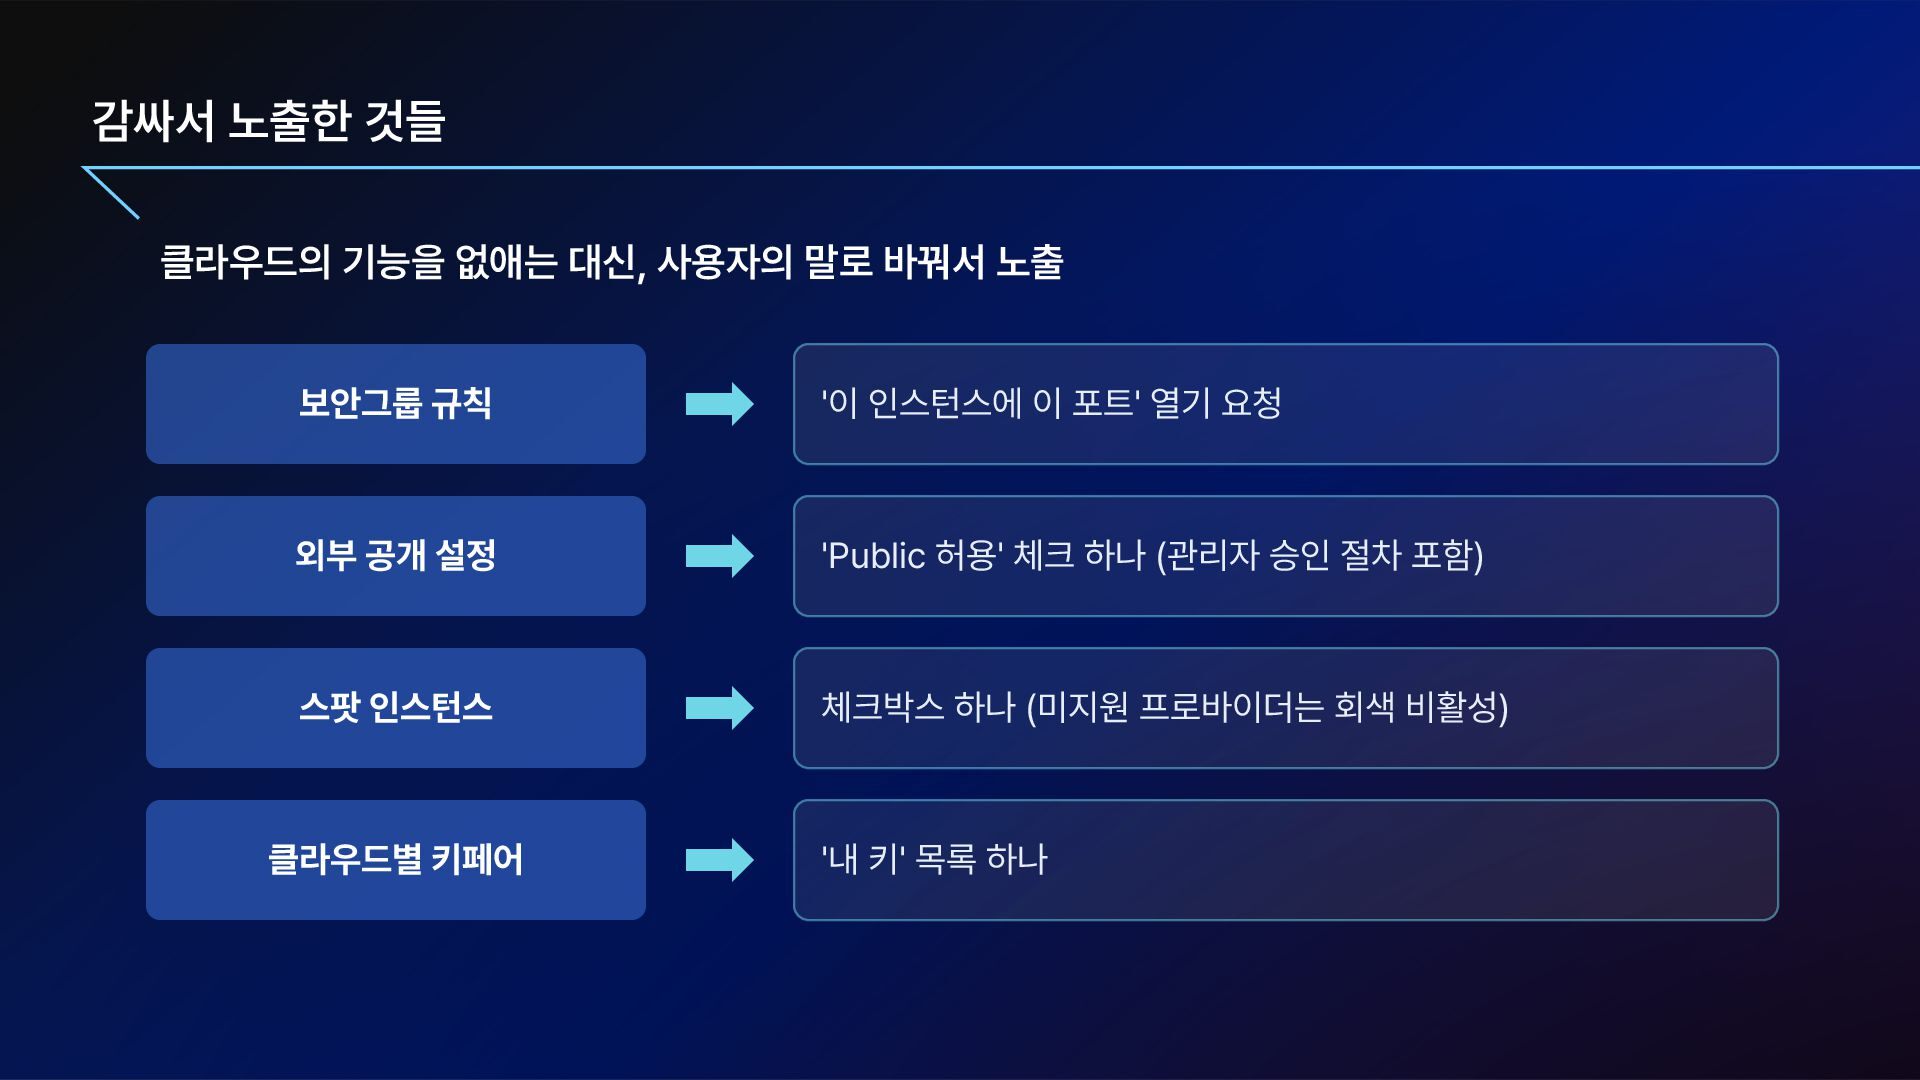
  15. 감싸서 노출한 것들 클라우드의 기능을 없애는 대신, 사용자의 말로 바꿔서

    노출 보안그룹 규칙 이 인스턴스에 이 포트 열기 요청 외부 공개 설정 Public 허용 체크 하나 관리자 승인 절차 포함 스팟 인스턴스 체크박스 하나 미지원 프로바이더는 회색 비활성 클라우드별 키페어 내 키 목록 하나
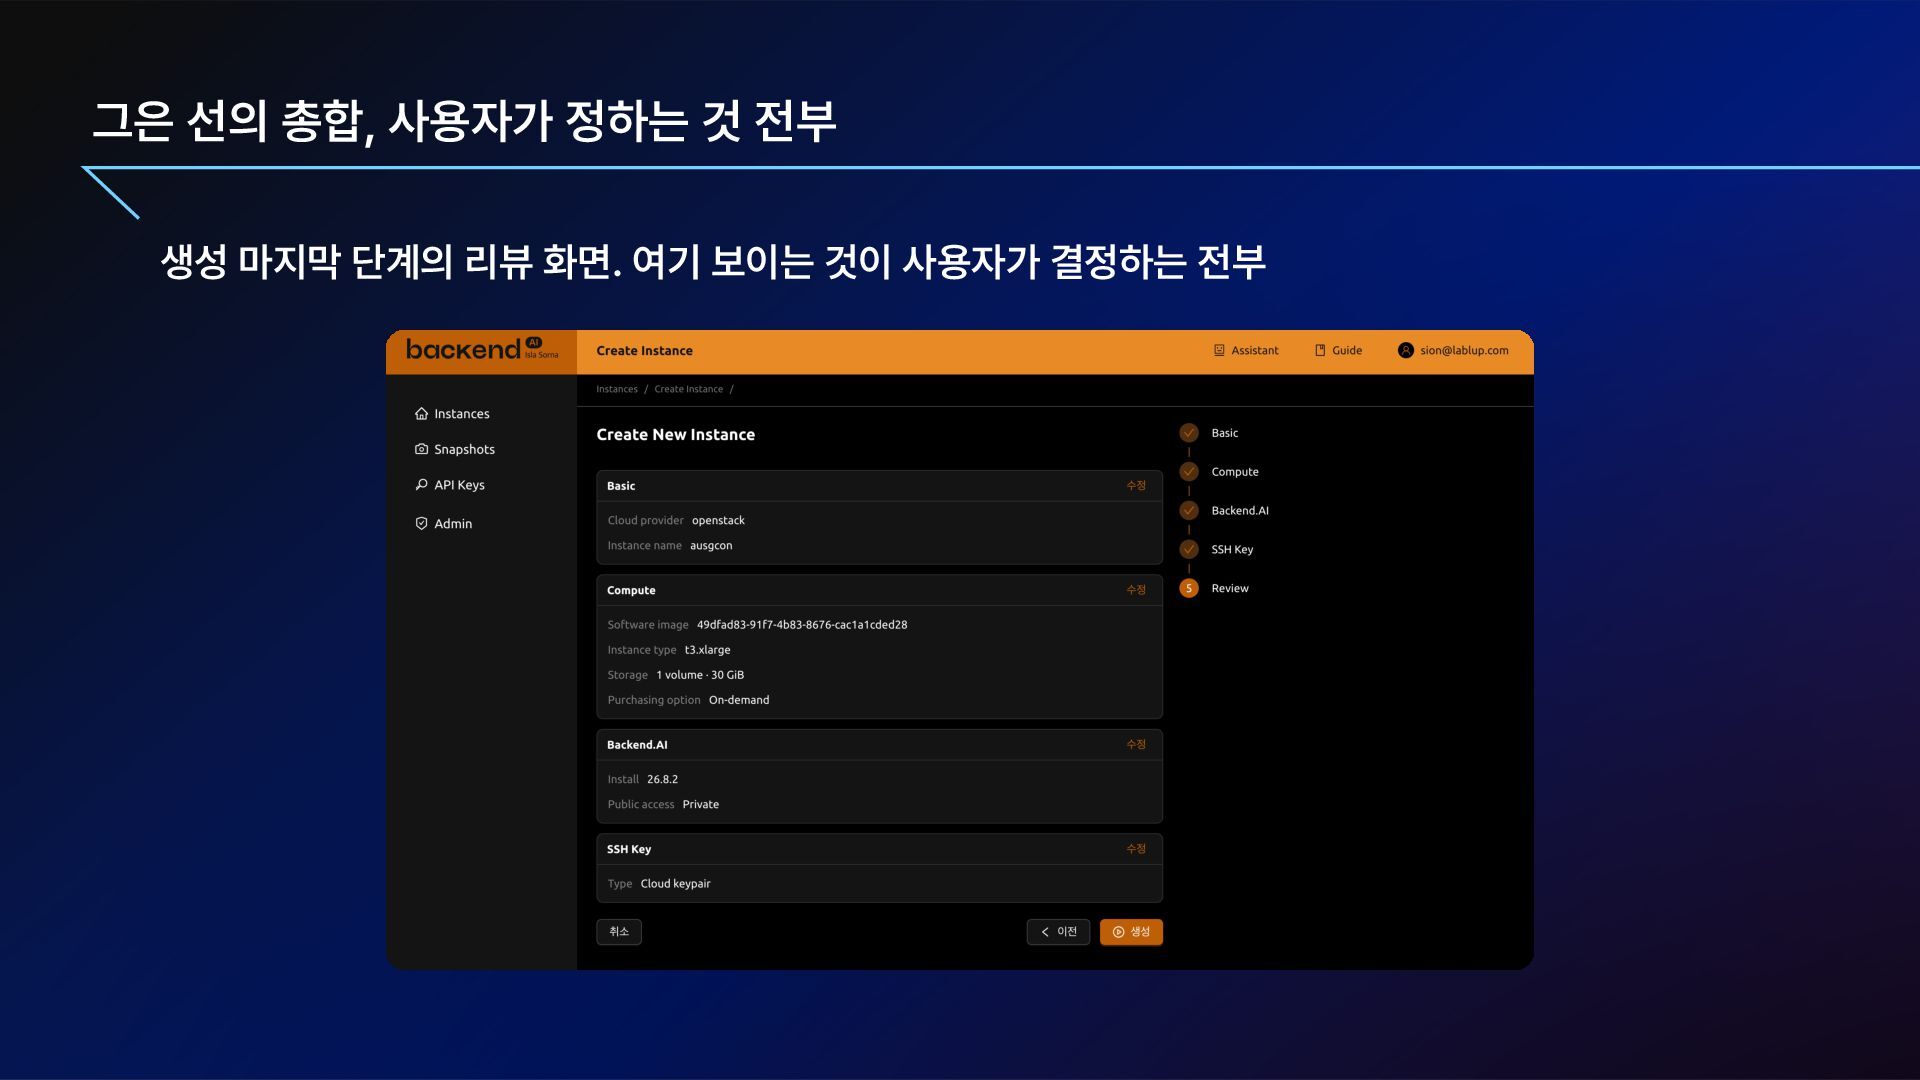
  16. 그은 선의 총합, 사용자가 정하는 것 전부 생성 마지막 단계의

    리뷰 화면. 여기 보이는 것이 사용자가 결정하는 전부
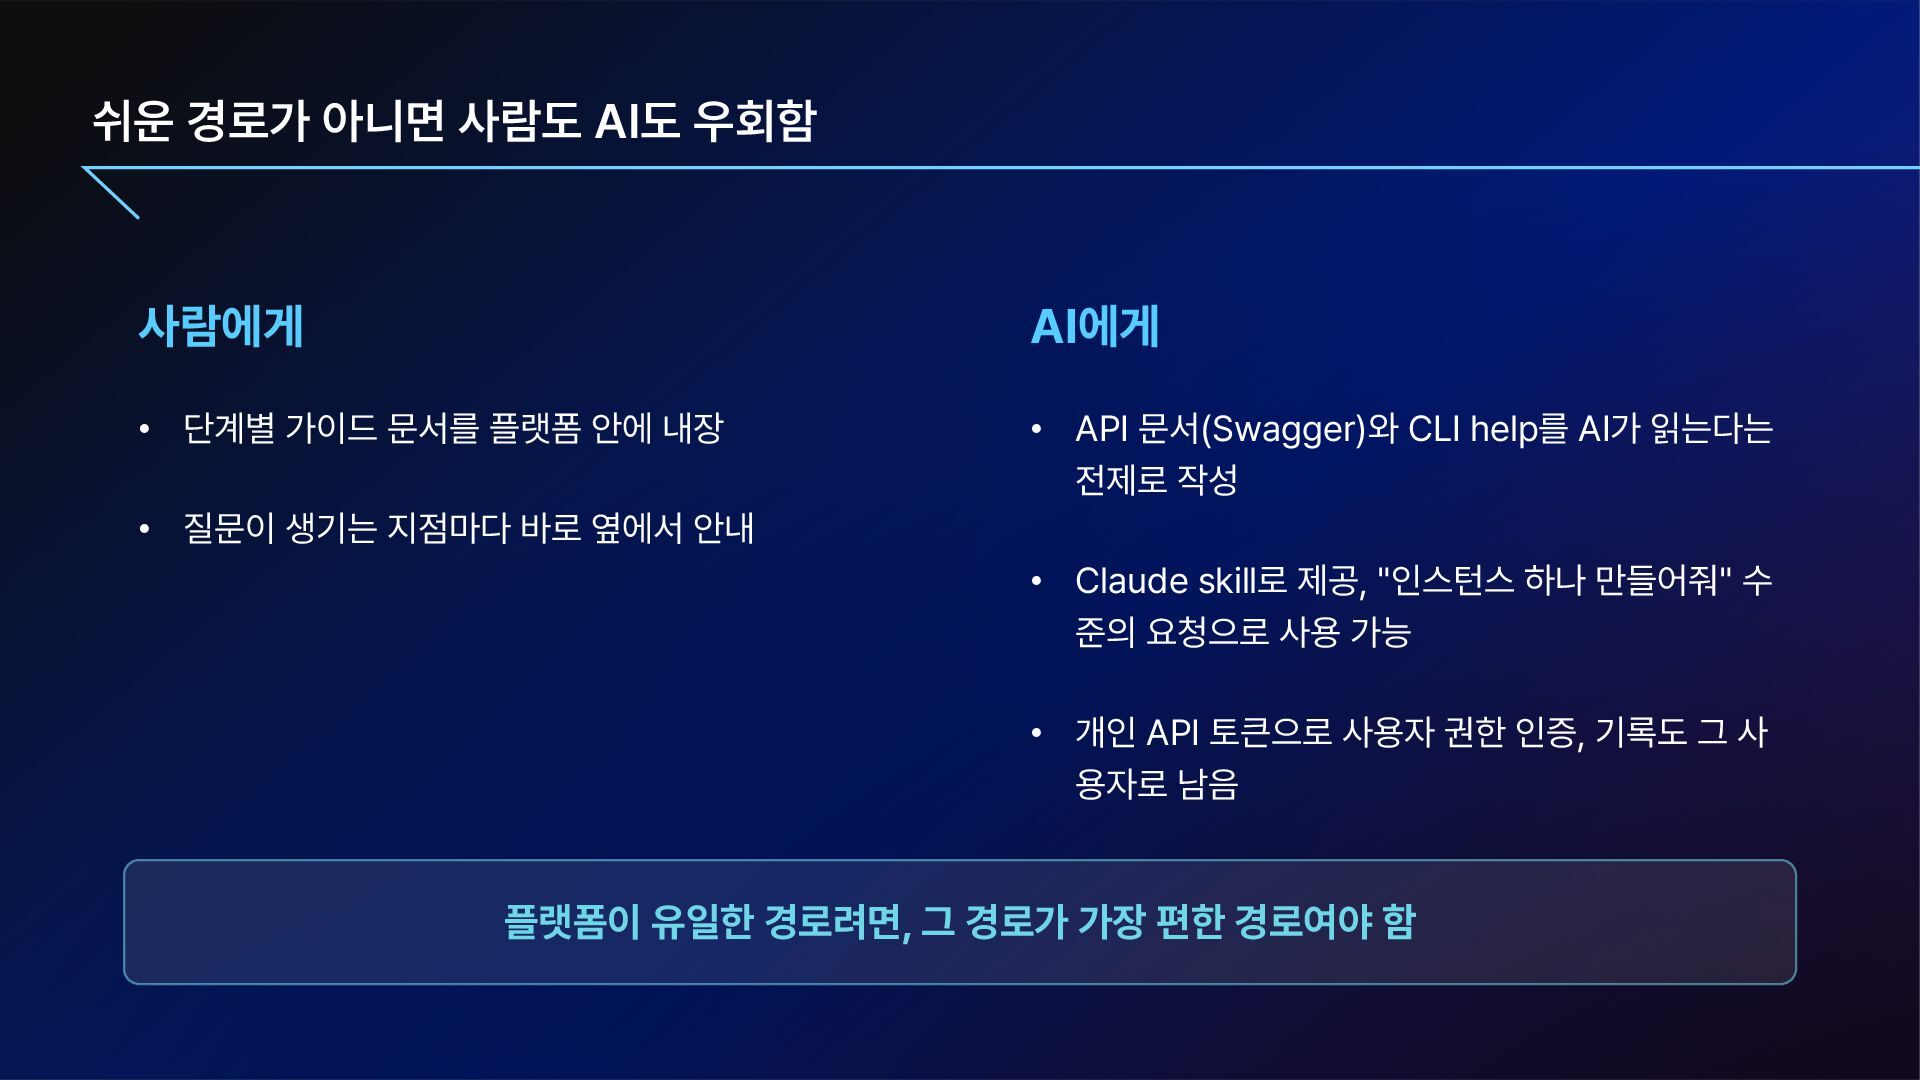
  17. 쉬운 경로가 아니면 사람도 AI도 우회함 사람에게 AI에게 • 단계별

    가이드 문서를 플랫폼 안에 내장 • API 문서 Swagger 와 CLI help를 AI가 읽는다는 전제로 작성 • 질문이 생기는 지점마다 바로 옆에서 안내 • Claude skill로 제공, 인스턴스 하나 만들어줘 수 준의 요청으로 사용 가능 • 개인 API 토큰으로 사용자 권한 인증, 기록도 그 사 용자로 남음 플랫폼이 유일한 경로려면, 그 경로가 가장 편한 경로여야 함
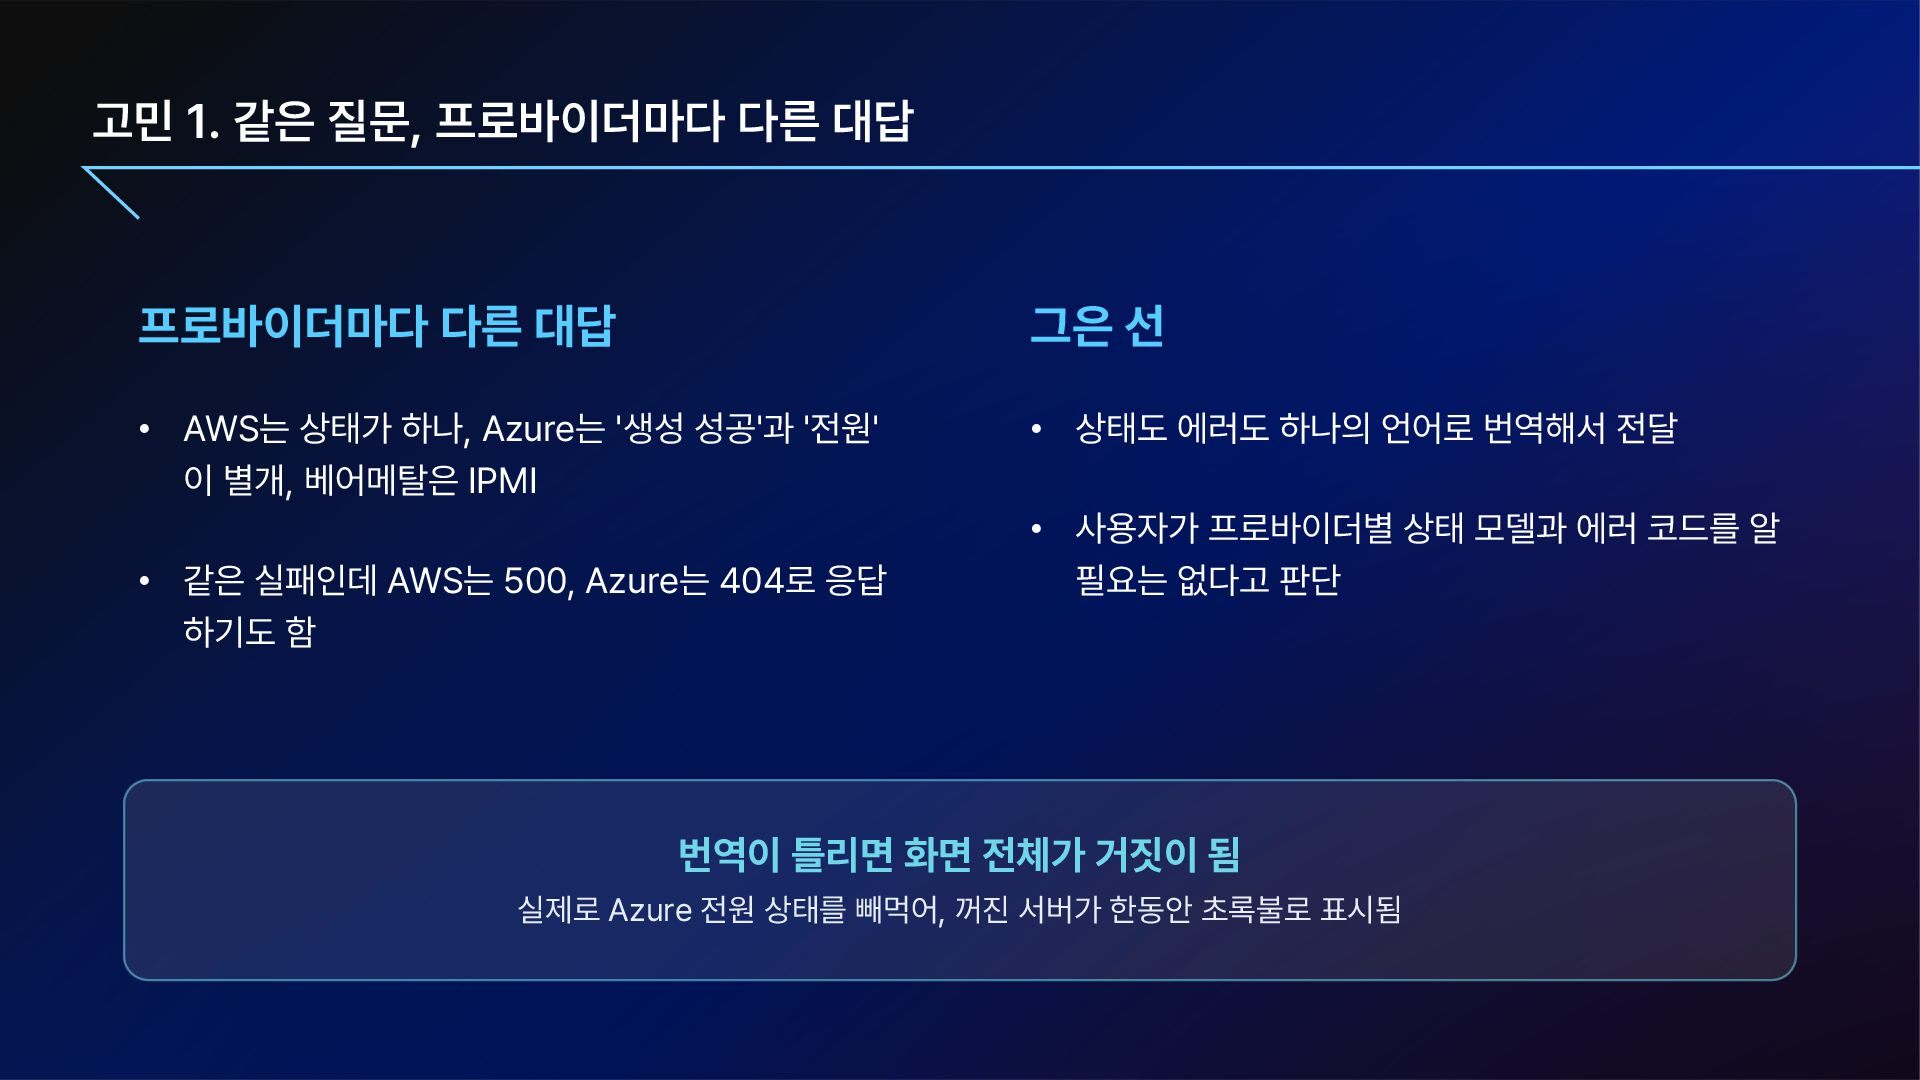
  18. 고민 1. 같은 질문, 프로바이더마다 다른 대답 프로바이더마다 다른 대답

    그은 선 • AWS는 상태가 하나, Azure는 생성 성공 과 전원 이 별개, 베어메탈은 IPMI • 상태도 에러도 하나의 언어로 번역해서 전달 • 같은 실패인데 AWS는 500, Azure는 404로 응답 하기도 함 • 사용자가 프로바이더별 상태 모델과 에러 코드를 알 필요는 없다고 판단 번역이 틀리면 화면 전체가 거짓이 됨 실제로 Azure 전원 상태를 빼먹어, 꺼진 서버가 한동안 초록불로 표시됨
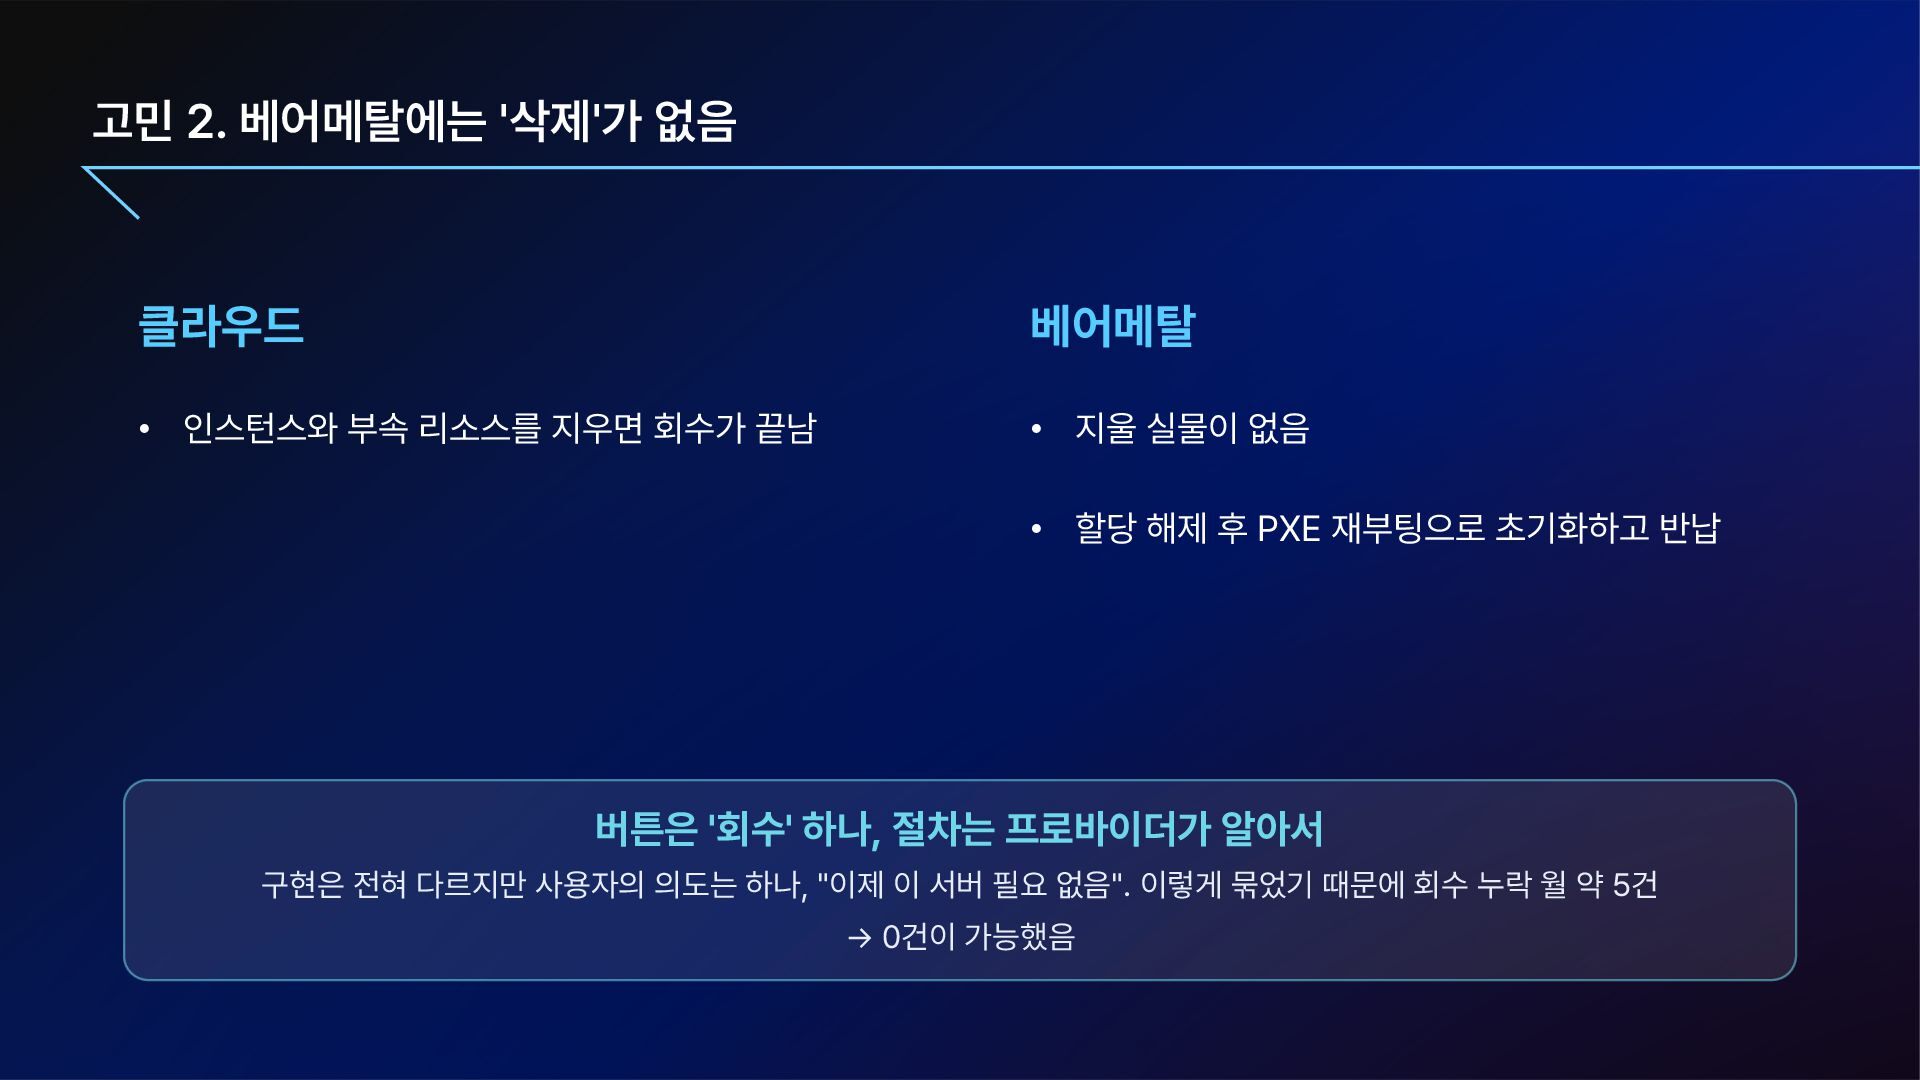
  19. 고민 2. 베어메탈에는 삭제 가 없음 클라우드 베어메탈 • 인스턴스와

    부속 리소스를 지우면 회수가 끝남 • 지울 실물이 없음 • 할당 해제 후 PXE 재부팅으로 초기화하고 반납 버튼은 회수 하나, 절차는 프로바이더가 알아서 구현은 전혀 다르지만 사용자의 의도는 하나, 이제 이 서버 필요 없음 . 이렇게 묶었기 때문에 회수 누락 월 약 5건 0건이 가능했음
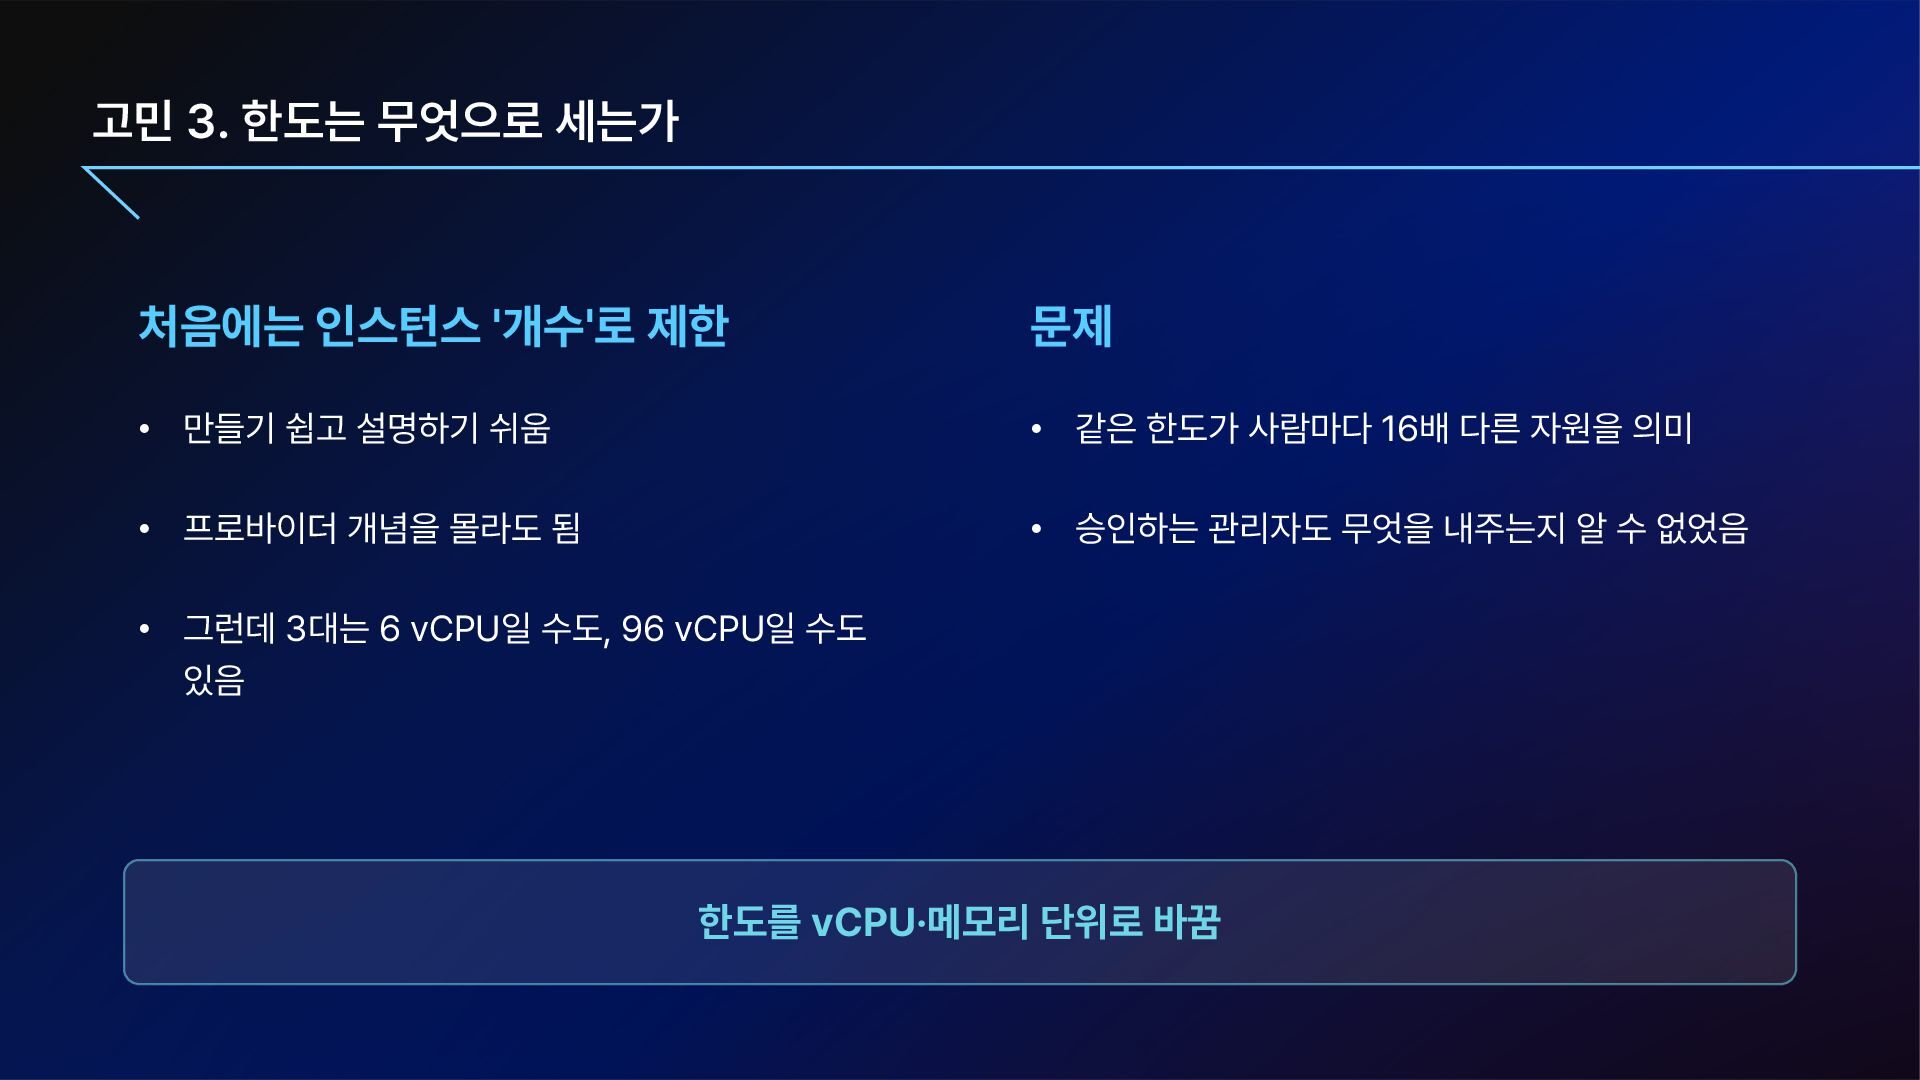
  20. 고민 3. 한도는 무엇으로 세는가 처음에는 인스턴스 개수 로 제한

    문제 • 만들기 쉽고 설명하기 쉬움 • 같은 한도가 사람마다 16배 다른 자원을 의미 • 프로바이더 개념을 몰라도 됨 • 승인하는 관리자도 무엇을 내주는지 알 수 없었음 • 그런데 3대는 6 vCPU일 수도, 96 vCPU일 수도 있음 한도를 vCPU·메모리 단위로 바꿈
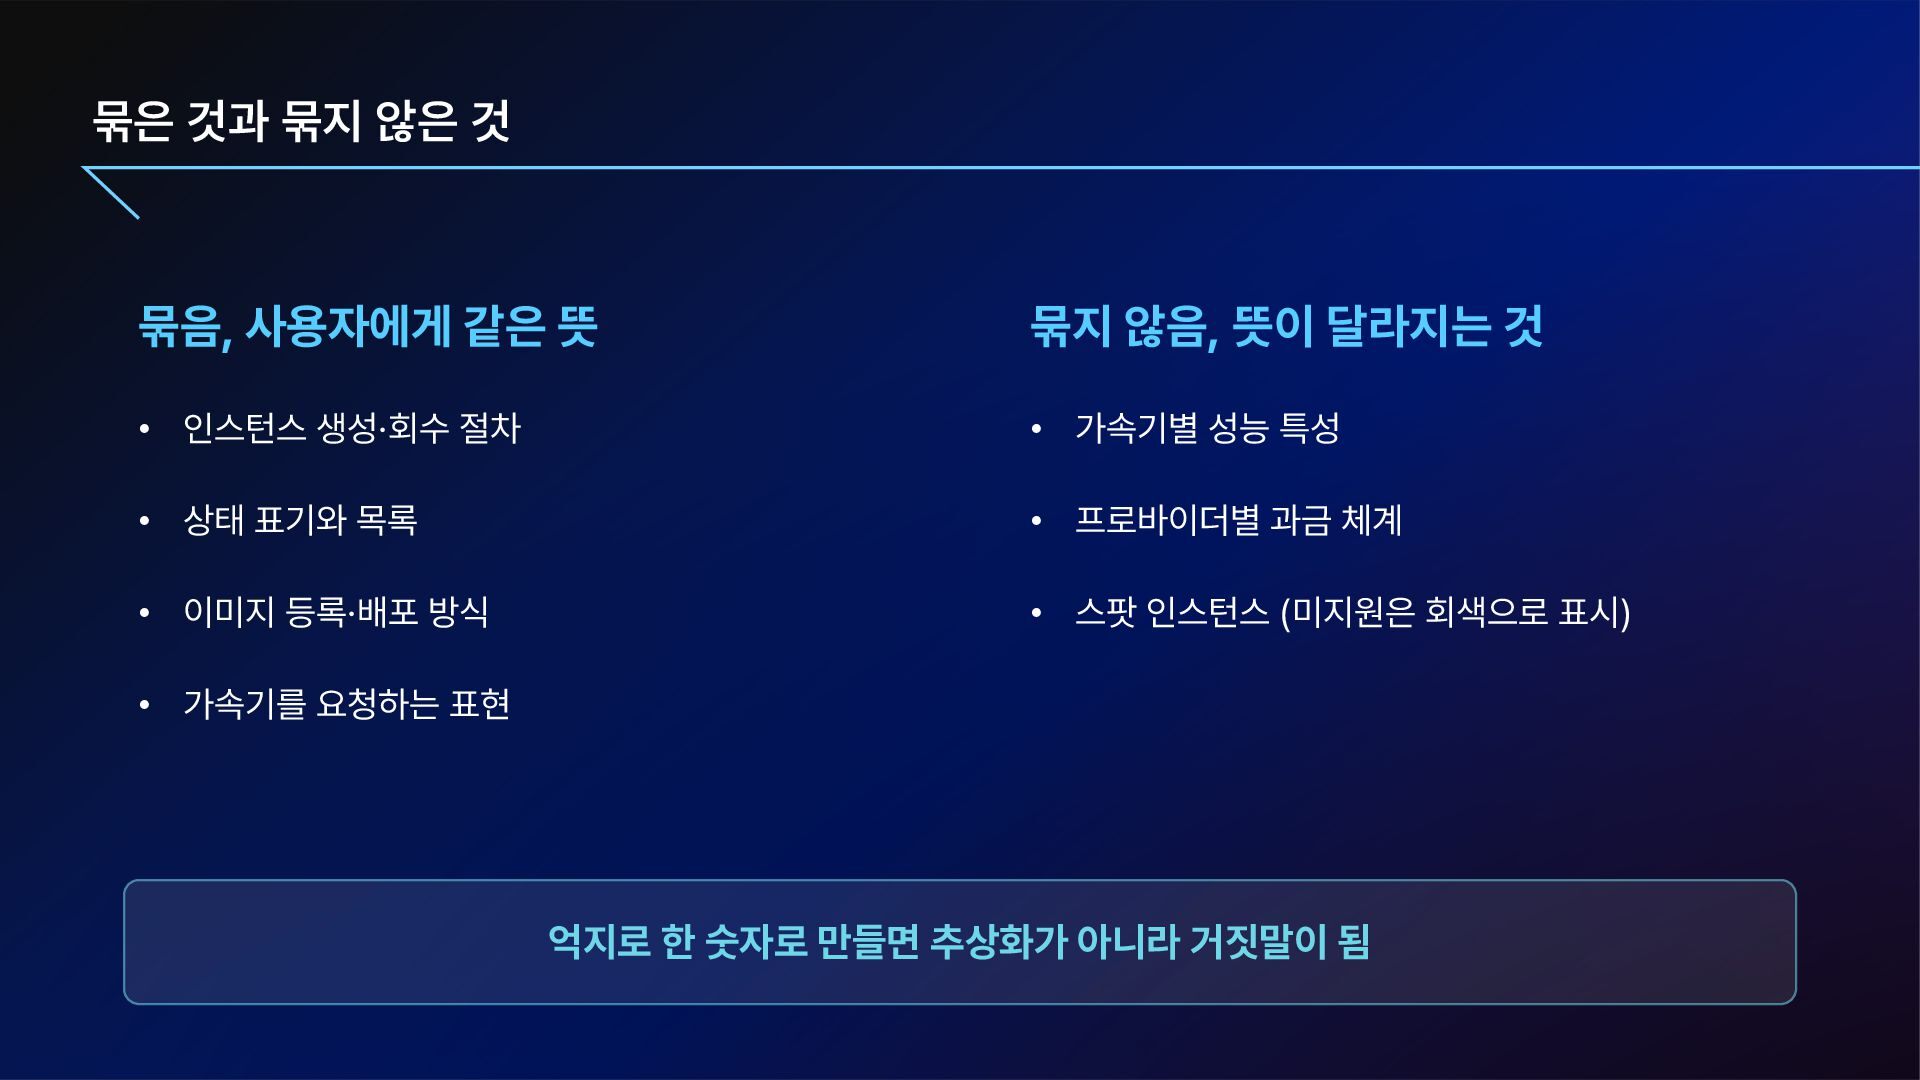
  21. 묶은 것과 묶지 않은 것 묶음, 사용자에게 같은 뜻 묶지

    않음, 뜻이 달라지는 것 • 인스턴스 생성·회수 절차 • 가속기별 성능 특성 • 상태 표기와 목록 • 프로바이더별 과금 체계 • 이미지 등록·배포 방식 • 스팟 인스턴스 미지원은 회색으로 표시 • 가속기를 요청하는 표현 억지로 한 숫자로 만들면 추상화가 아니라 거짓말이 됨
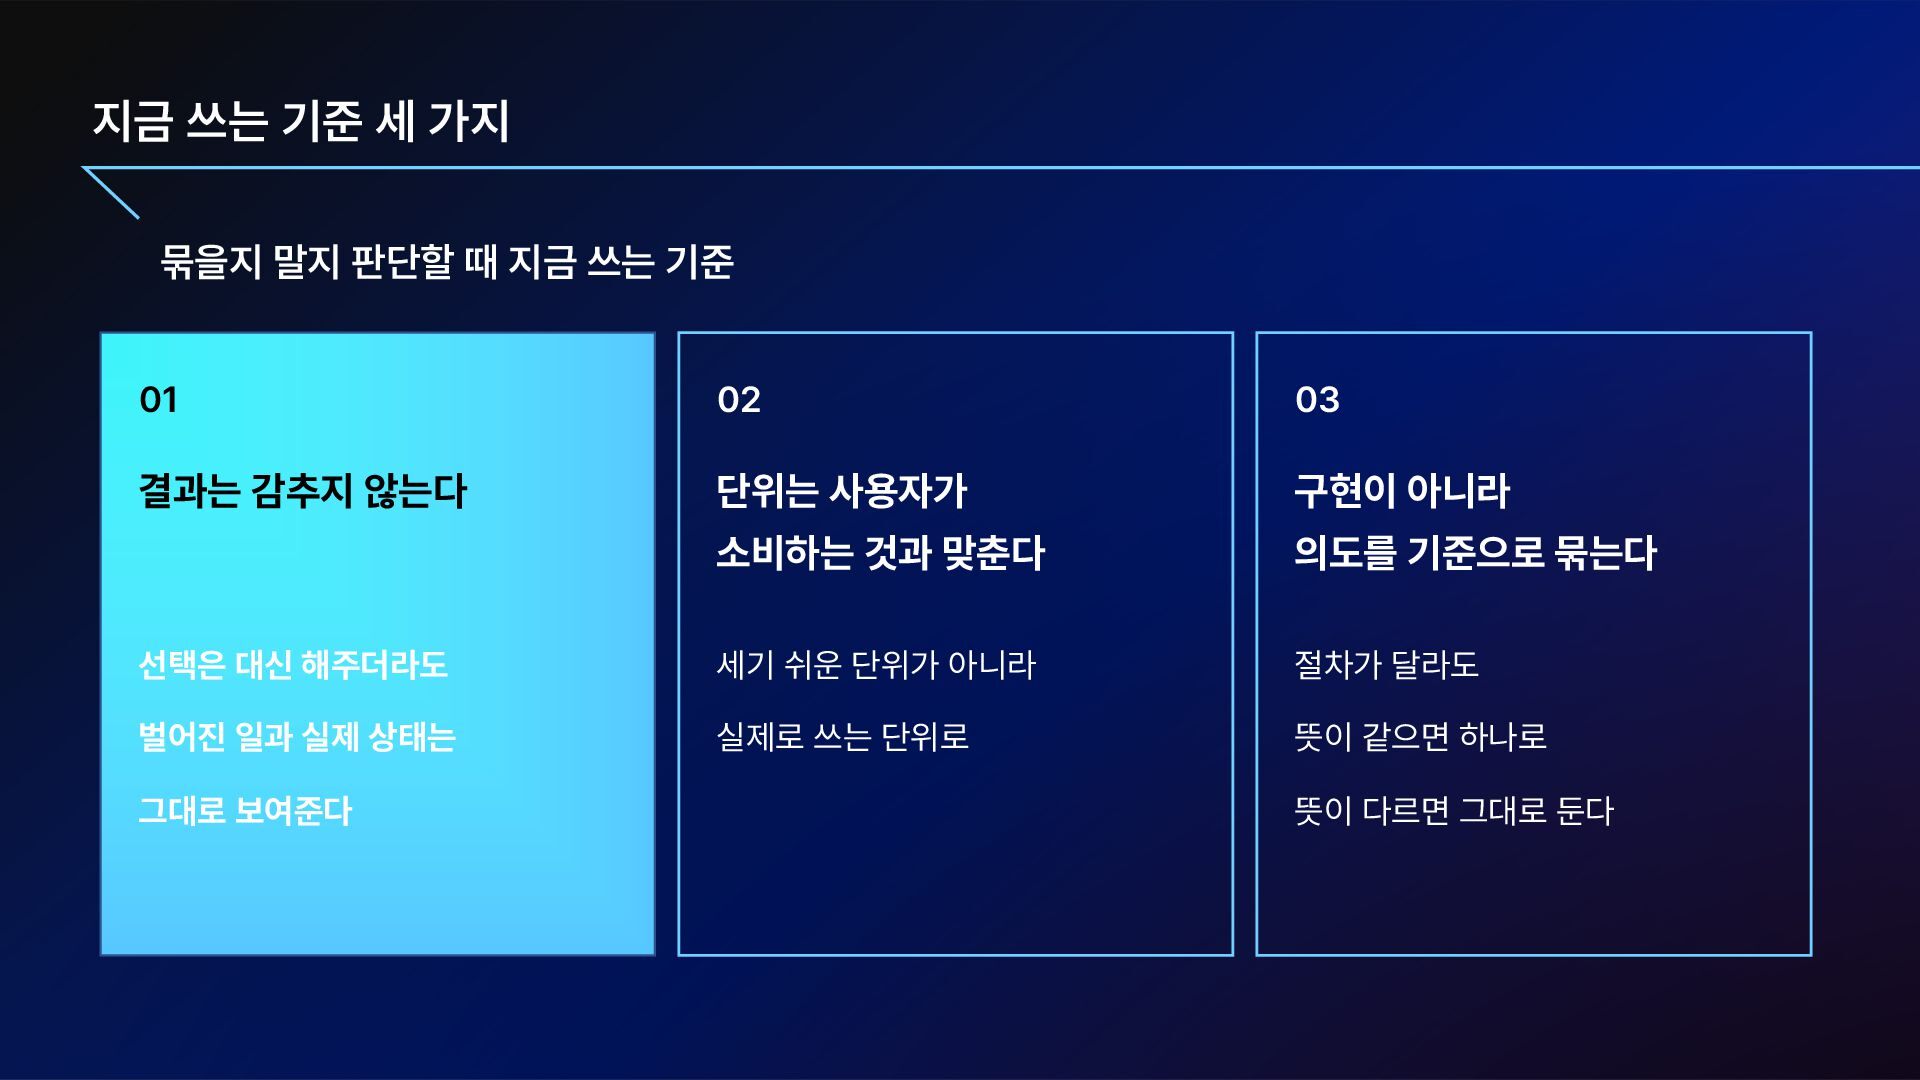
  22. 지금 쓰는 기준 세 가지 묶을지 말지 판단할 때 지금

    쓰는 기준 01 02 03 결과는 감추지 않는다 단위는 사용자가 구현이 아니라 소비하는 것과 맞춘다 의도를 기준으로 묶는다 선택은 대신 해주더라도 세기 쉬운 단위가 아니라 절차가 달라도 벌어진 일과 실제 상태는 실제로 쓰는 단위로 뜻이 같으면 하나로 그대로 보여준다 뜻이 다르면 그대로 둔다
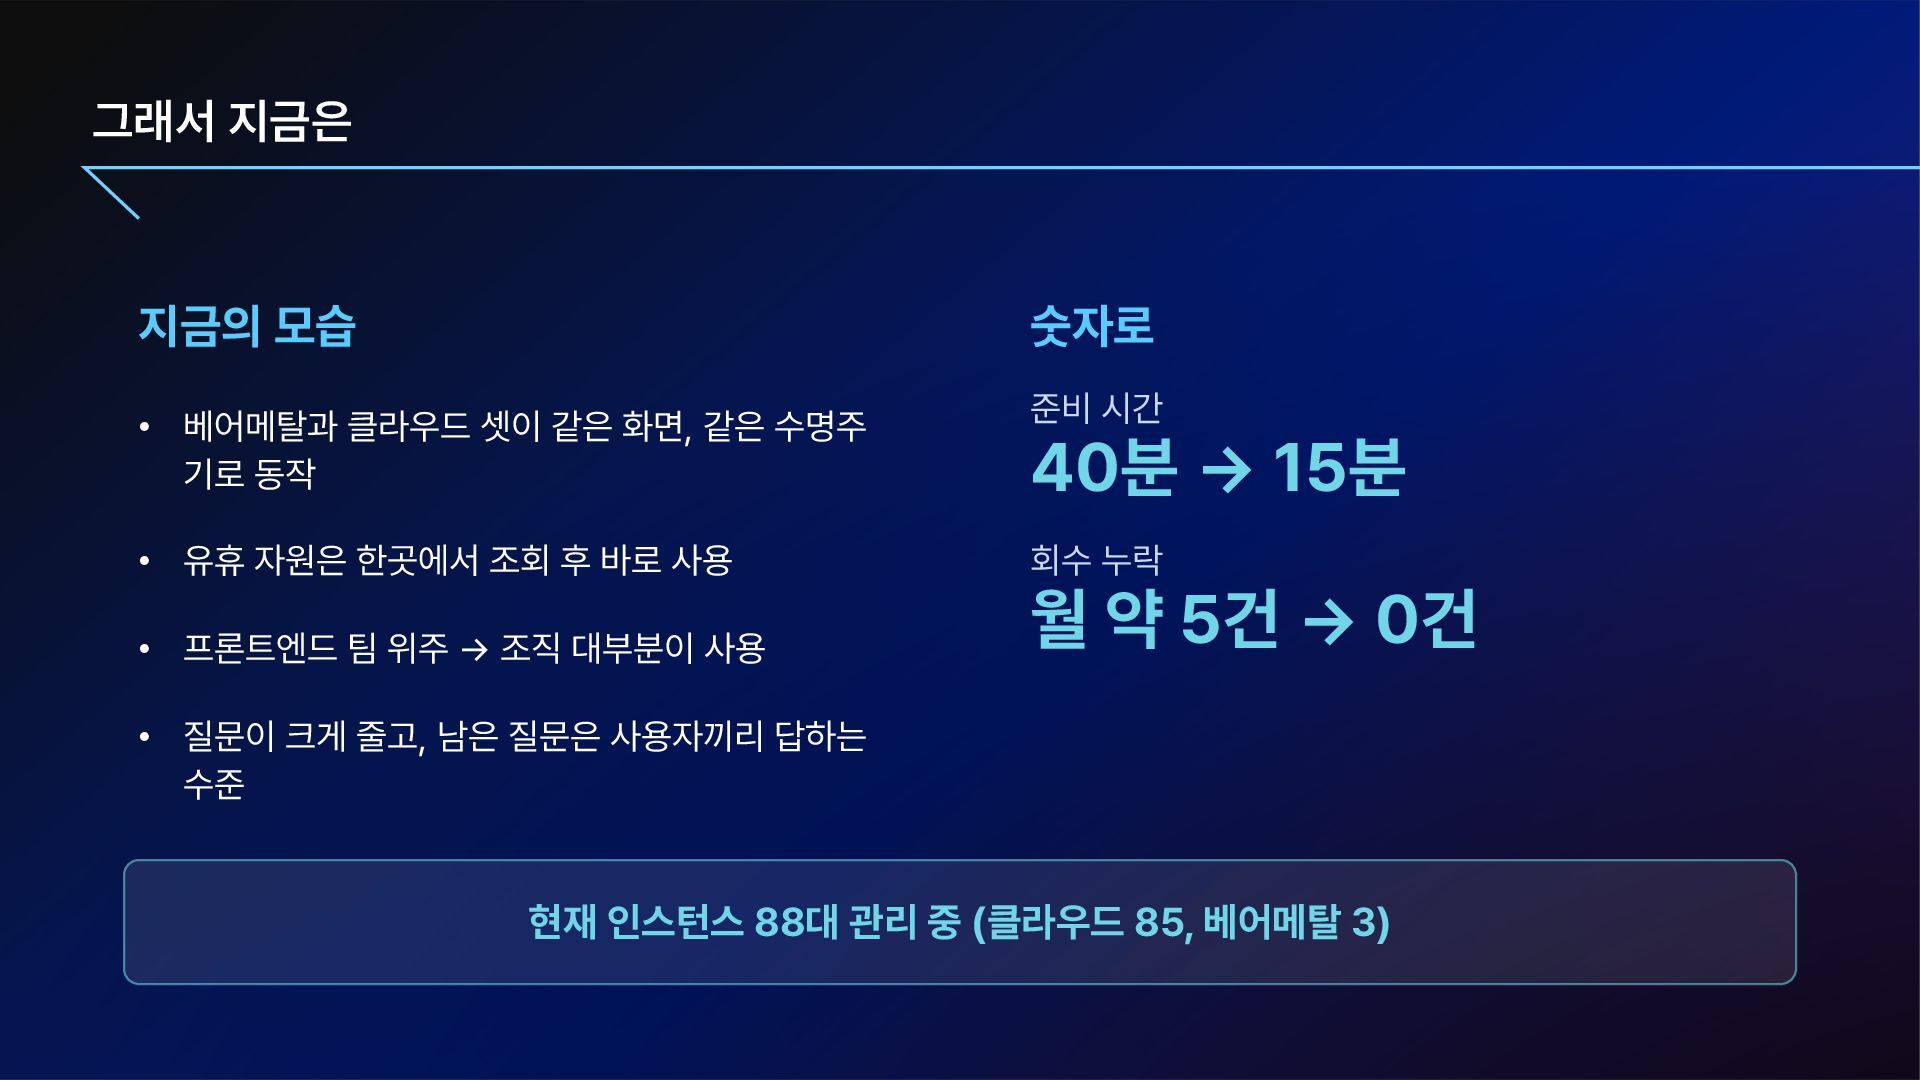
  23. 그래서 지금은 지금의 모습 숫자로 • 베어메탈과 클라우드 셋이 같은

    화면, 같은 수명주 기로 동작 • 유휴 자원은 한곳에서 조회 후 바로 사용 • 프론트엔드 팀 위주 조직 대부분이 사용 준비 시간 40분 회수 누락 15분 월 약 5건 0건 • 질문이 크게 줄고, 남은 질문은 사용자끼리 답하는 수준 현재 인스턴스 88대 관리 중 클라우드 85, 베어메탈 3
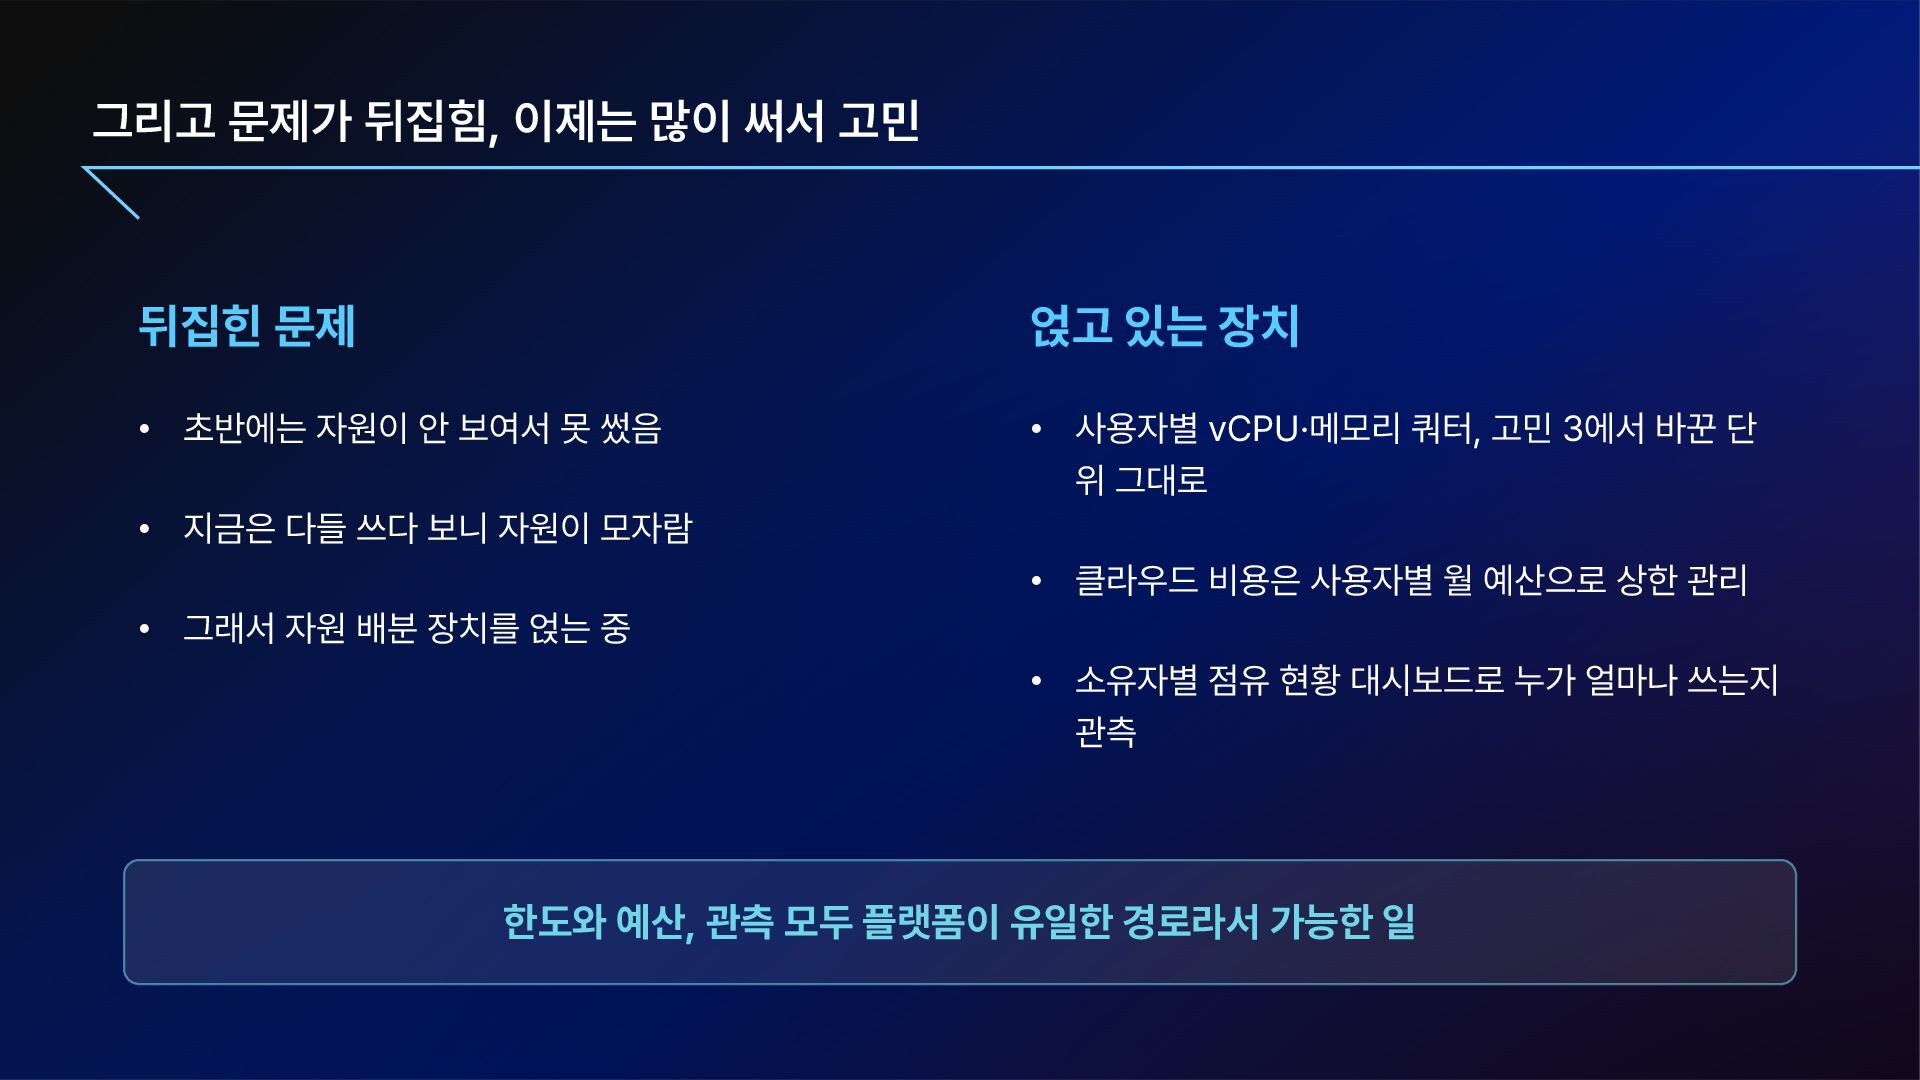
  24. 그리고 문제가 뒤집힘, 이제는 많이 써서 고민 뒤집힌 문제 얹고

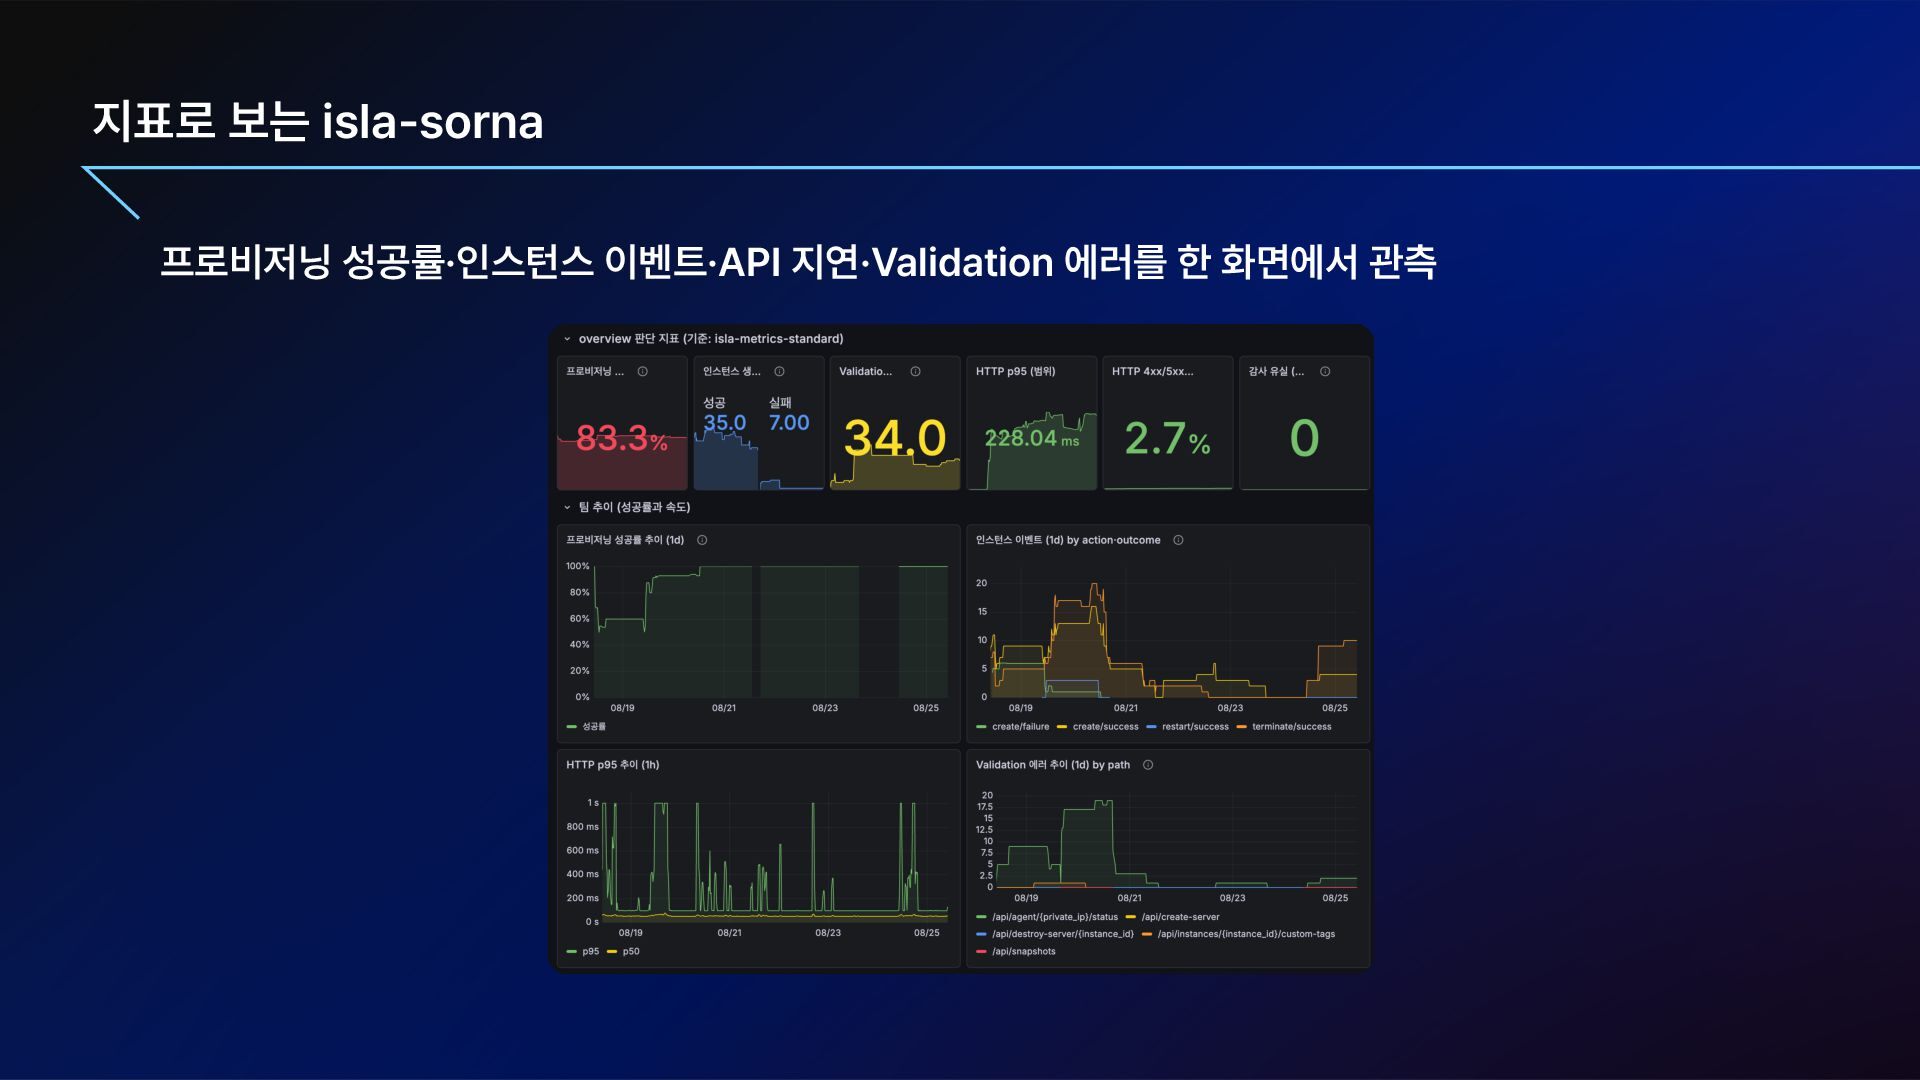
    있는 장치 • 초반에는 자원이 안 보여서 못 썼음 • 사용자별 vCPU·메모리 쿼터, 고민 3에서 바꾼 단 위 그대로 • 지금은 다들 쓰다 보니 자원이 모자람 • 클라우드 비용은 사용자별 월 예산으로 상한 관리 • 그래서 자원 배분 장치를 얹는 중 • 소유자별 점유 현황 대시보드로 누가 얼마나 쓰는지 관측 한도와 예산, 관측 모두 플랫폼이 유일한 경로라서 가능한 일
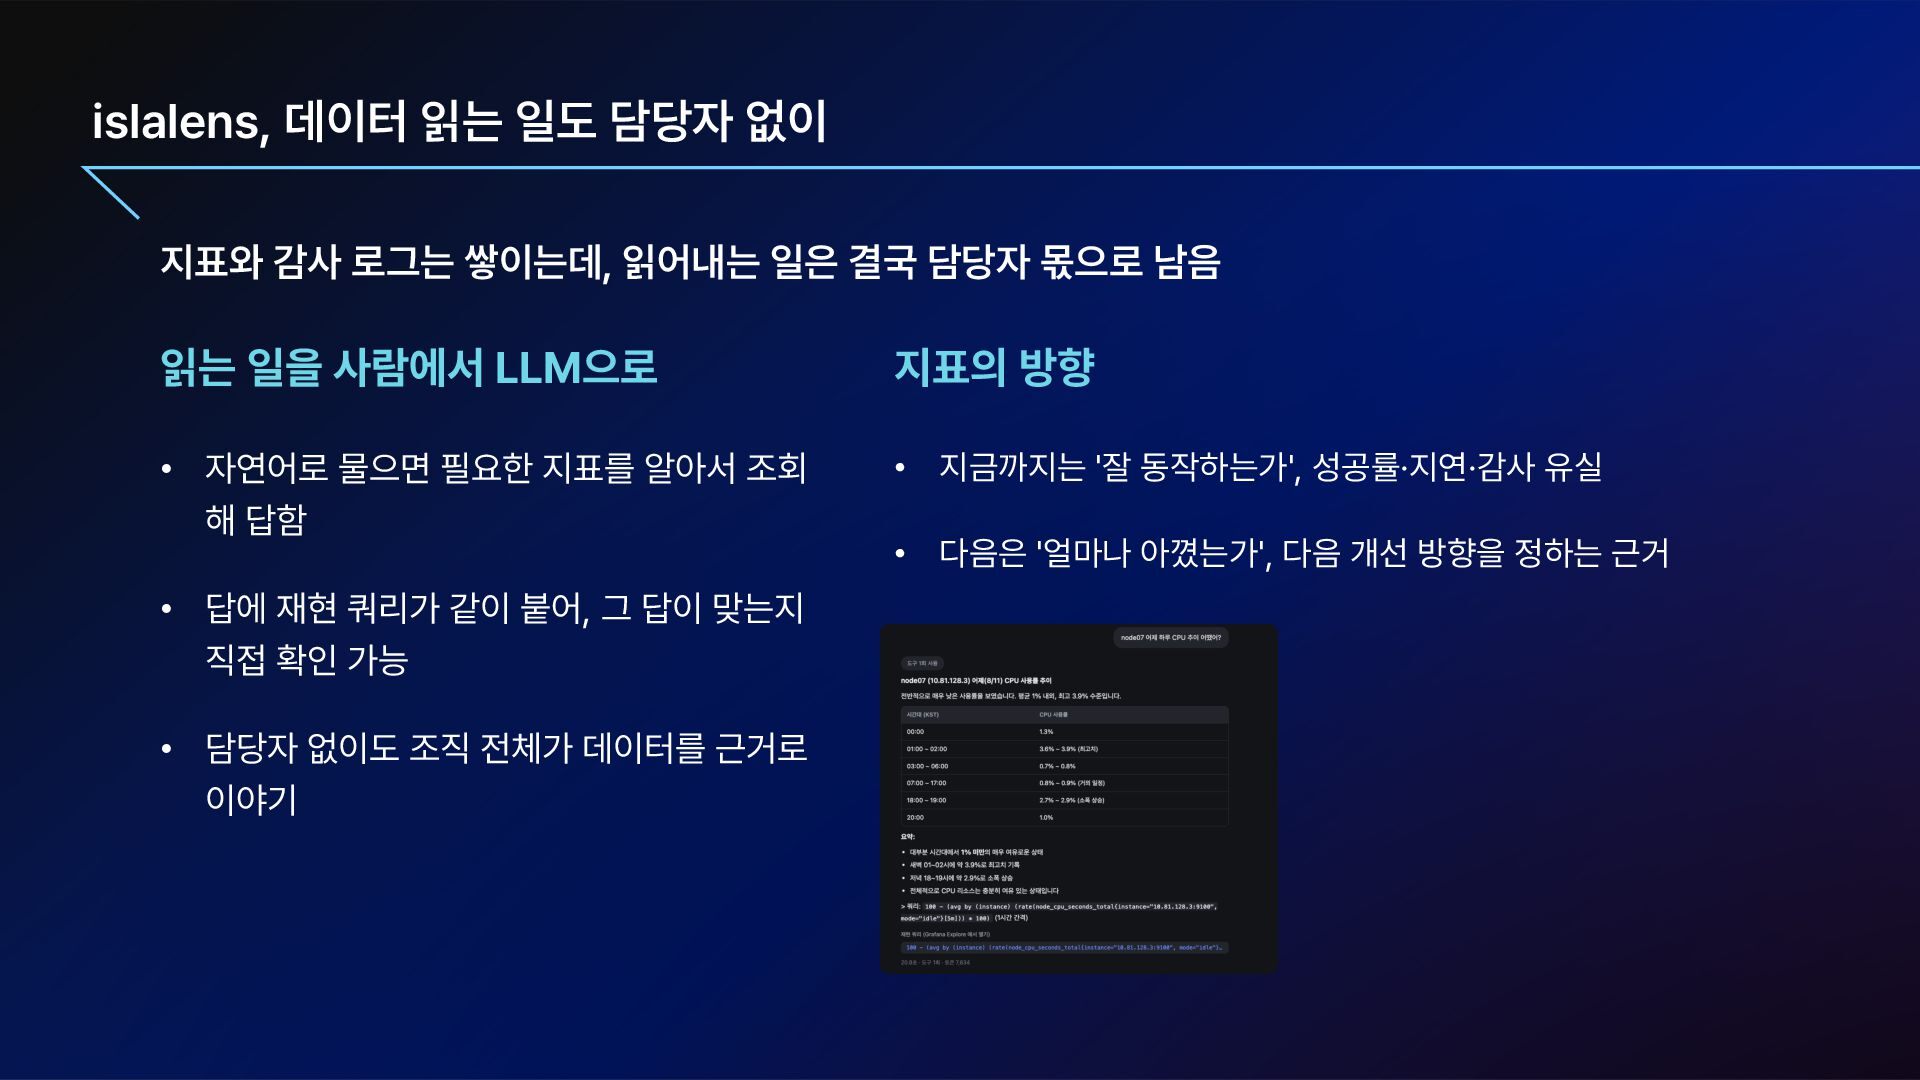
  25. islalens, 데이터 읽는 일도 담당자 없이 지표와 감사 로그는 쌓이는데,

    읽어내는 일은 결국 담당자 몫으로 남음 읽는 일을 사람에서 LLM으로 지표의 방향 • 자연어로 물으면 필요한 지표를 알아서 조회 해 답함 • 지금까지는 잘 동작하는가 , 성공률·지연·감사 유실 • 답에 재현 쿼리가 같이 붙어, 그 답이 맞는지 직접 확인 가능 • 담당자 없이도 조직 전체가 데이터를 근거로 이야기 • 다음은 얼마나 아꼈는가 , 다음 개선 방향을 정하는 근거
  26. 정리 네 인프라를 한 플랫폼으로 묶어 준비 시간과 회수 누락을

    줄임 고민 세 번을 지나며, 무엇을 묶고 무엇을 둘지 기준이 남음 남은 기준 세 가지 1. 결과는 감추지 않는다 2. 단위는 사용자가 소비하는 것과 맞춘다 3. 구현이 아니라 의도를 기준으로 묶는다
  27. Q A