Share
Embed
Transcript
27 slides
-
Xây dựng tự động corpus từ web Nguyễn Văn Hải
Pgs. Yamamoto Kazuhide Ptn.Xử Lý Ngôn Ngữ Tự Nhiên Trường Đại Học Khoa Học Kỹ Thuật Nagaoka -
Kế hoạch 1. Xây dựng crawler 2. Kiểm tra thông
tin ecoding 3. Phán đoán web tiếng Việt 4. Lấy ra các câu văn từ web 5. Tái kiểm tra corpus -
Crawler Robot, bot, spider, worn, ant Là phần
mềm tự động lấy dữ liệu từ web Chức năng của crawler: - lấy thông tin từ server - Trích xuất những thông tin cần thiết - Tìm link trong trang web và tự động truy cập -
Xây dựng crawler đơn giản 1. Chọn url khởi đầu
2. Sử dụng html protocol để lấy trang web 3. Trích xuất các link, lưu trong queue 4. Lặp lại bước 2, 3 -
Các vấn đề phát sinh 1. Thời gian giới hạn:
nếu sever không trả lời thì chương trình sẽ bị đóng bang 2. Nếu không lên kế hoạch truy cập 1 cách hợp lý, chương trình sẽ liên tục truy xuất 1 trang web, điều này sẽ trở thành tấn công Dos vì thế phải quản lý tần suất truy cập của 1 trang web, ví dụ 1request/1s hoặc ít hơn 3. Các link khác nhau nhưng cùng 1 trang web -
Các vấn đề phát sinh 4. Truy cập lại trang
web đã xử lý xong. Chương trình bị rơi vào vòng lặp vĩnh viễn vì thế phải xây dung phương pháp đánh dấu các link đã xử lý, đơn giản lưu lại url của 1 trang web đã xử lý, trước khi them vào queue 1 url mới thì so sánh các url đã xử lý trước. -
Quy định đối với crawler Việc sử dụng các
crawler truy cập websites thường gây nghẽn mạng, vì thế các trang web có quy định lưu dưới dạng robots.txt. Vd: User-Agent: Googlebot Disallow: /cgi-bin/ với googlebot thì không được truy cập vào /cgi-bin/. -
Mechanize Là module của python nhằm đơn giản các
thao tác với web và browser. 1.Browser Tạo ra các instance trong class Browser() import mechanize br = mechanize.browser() -
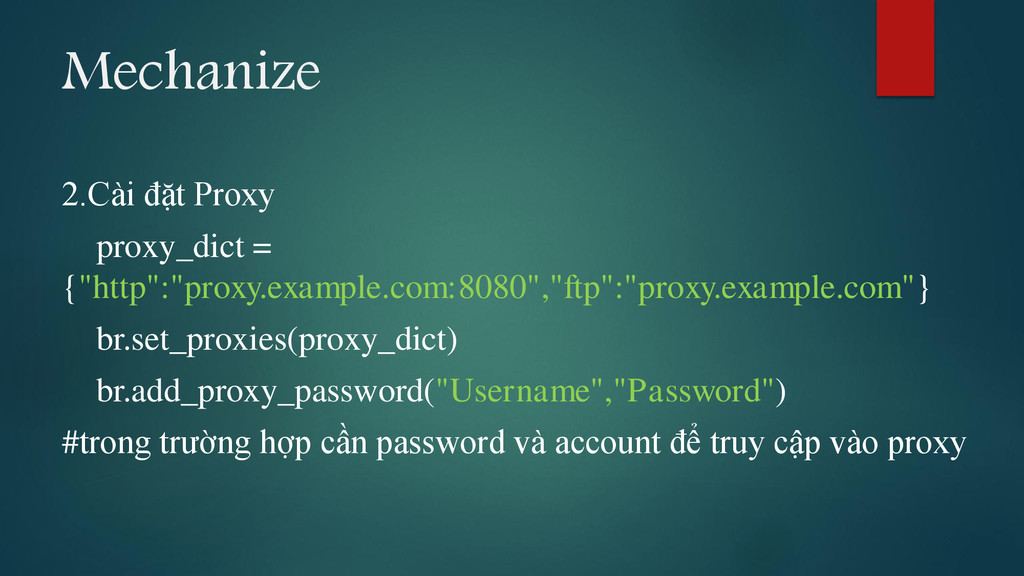
Mechanize 2.Cài đặt Proxy proxy_dict = {"http":"proxy.example.com:8080","ftp":"proxy.example.com"} br.set_proxies(proxy_dict) br.add_proxy_password("Username","Password") #trong
trường hợp cần password và account để truy cập vào proxy -
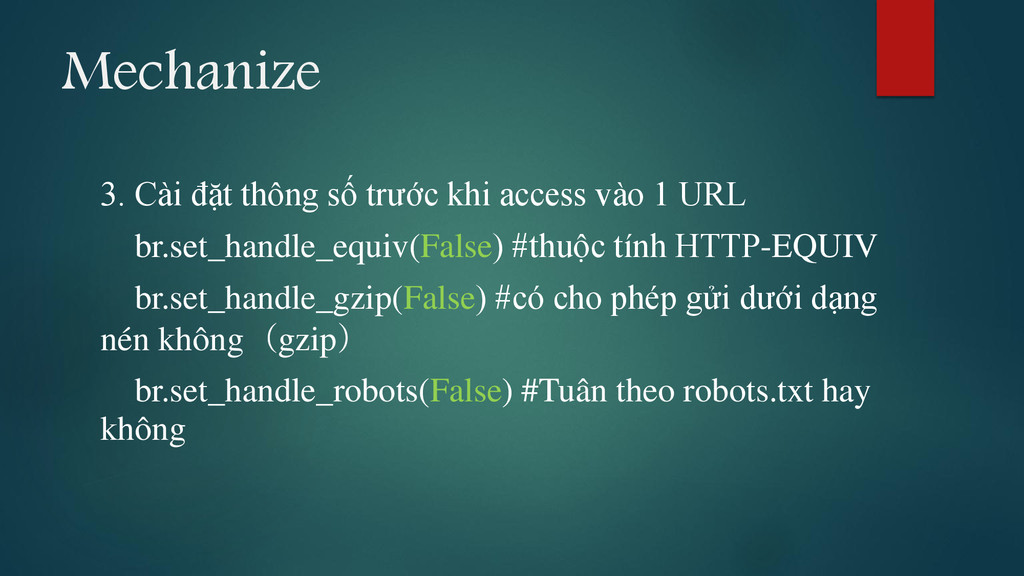
Mechanize 3. Cài đặt thông số trước khi access vào
1 URL br.set_handle_equiv(False) #thuộc tính HTTP-EQUIV br.set_handle_gzip(False) #có cho phép gửi dưới dạng nén không(gzip) br.set_handle_robots(False) #Tuân theo robots.txt hay không -
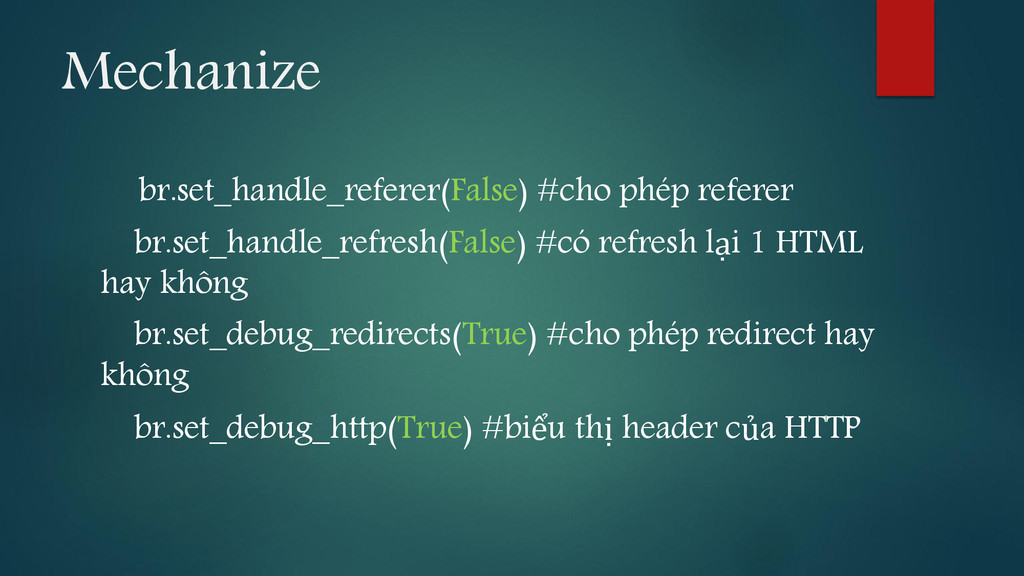
Mechanize br.set_handle_referer(False) #cho phép referer br.set_handle_refresh(False) #có refresh lại 1
HTML hay không br.set_debug_redirects(True) #cho phép redirect hay không br.set_debug_http(True) #biểu thị header của HTTP -
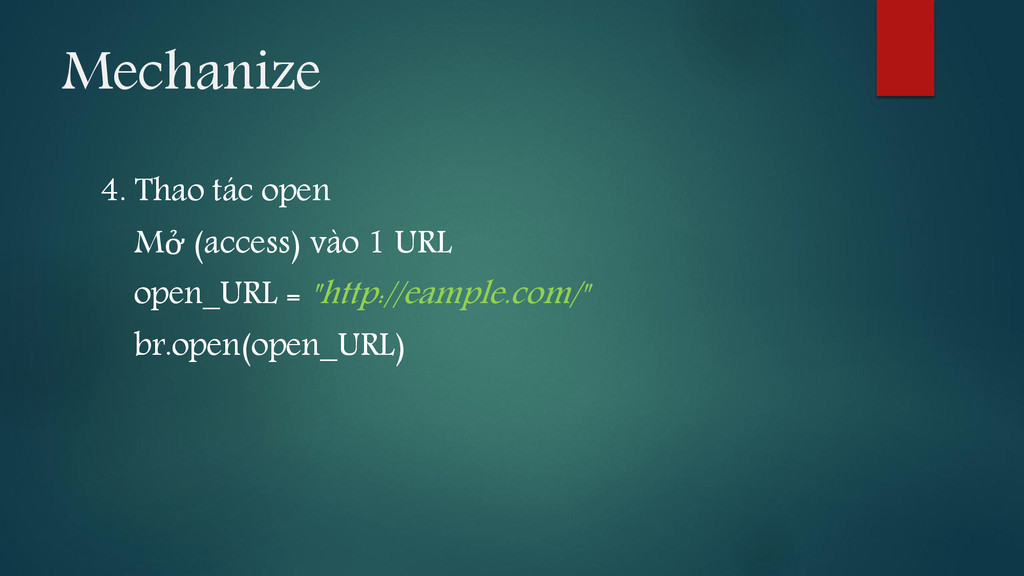
Mechanize 4. Thao tác open Mở (access) vào 1 URL
open_URL = "http://eample.com/" br.open(open_URL) -
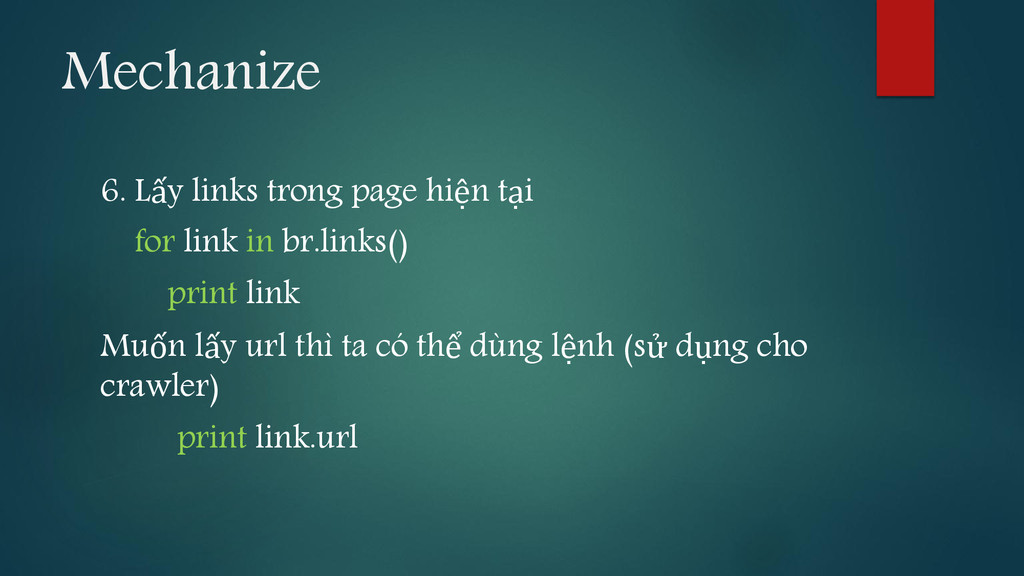
Mechanize 6. Lấy links trong page hiện tại for link
in br.links() print link Muốn lấy url thì ta có thể dùng lệnh (sử dụng cho crawler) print link.url -
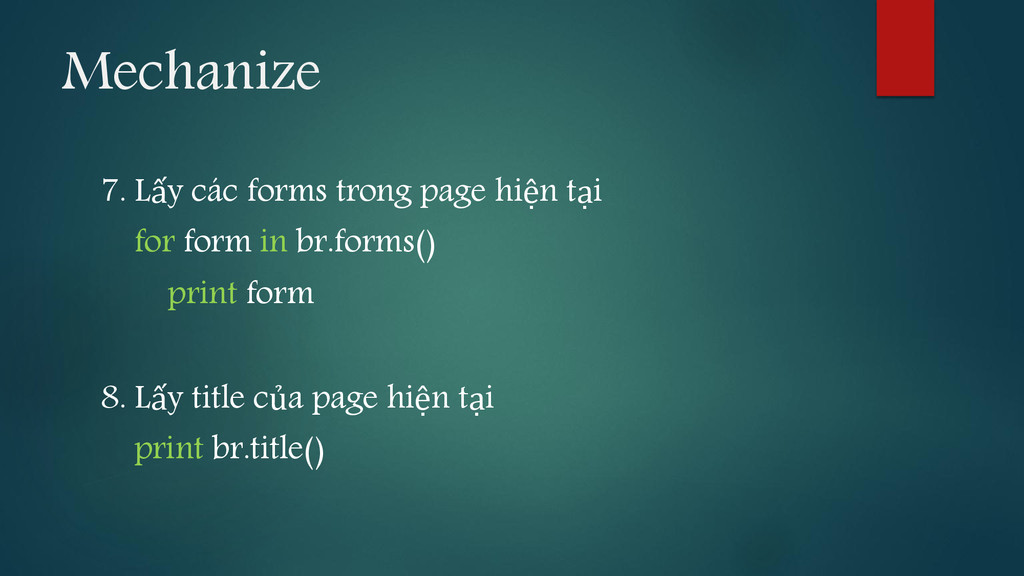
Mechanize 7. Lấy các forms trong page hiện tại for
form in br.forms() print form 8. Lấy title của page hiện tại print br.title() -
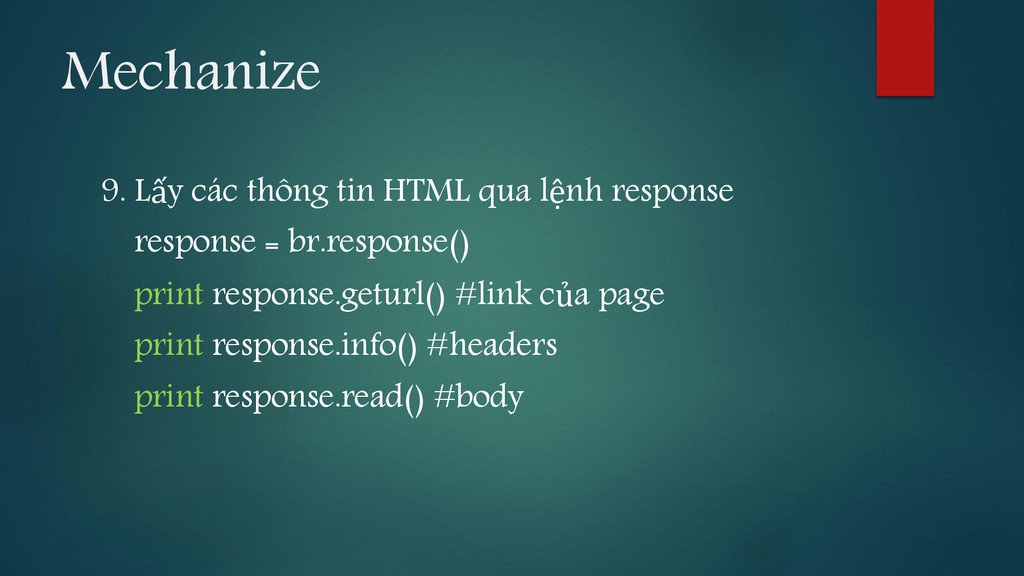
Mechanize 9. Lấy các thông tin HTML qua lệnh response
response = br.response() print response.geturl() #link của page print response.info() #headers print response.read() #body -
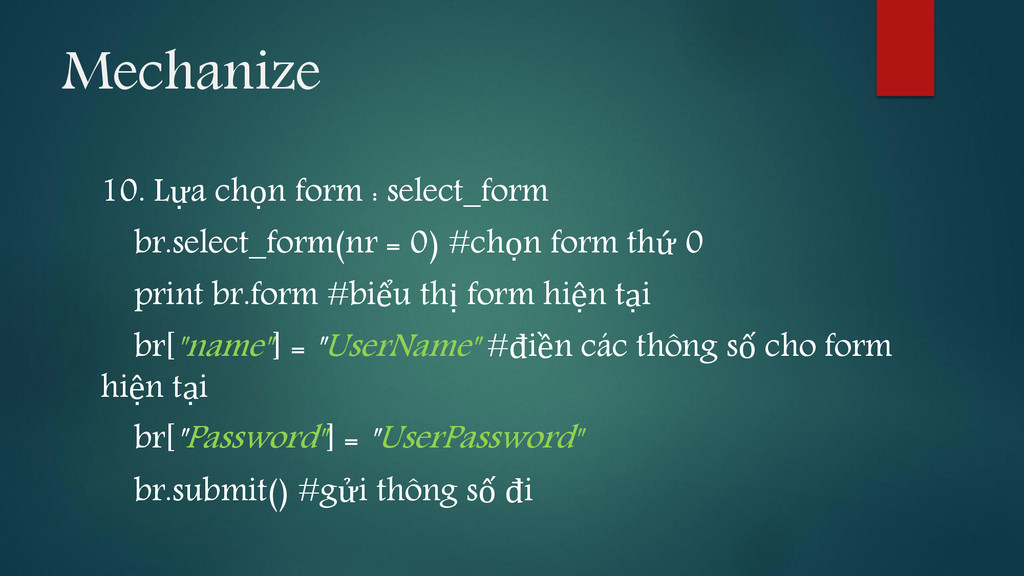
Mechanize 10. Lựa chọn form : select_form br.select_form(nr = 0)
#chọn form thứ 0 print br.form #biểu thị form hiện tại br["name"] = "UserName" #điền các thông số cho form hiện tại br["Password"] = "UserPassword" br.submit() #gửi thông số đi -
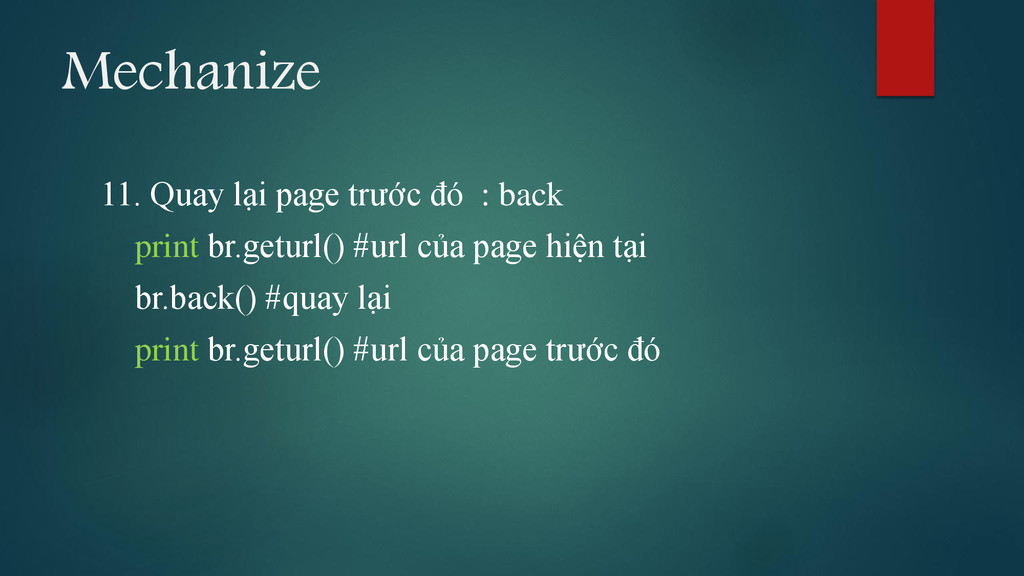
Mechanize 11. Quay lại page trước đó : back print
br.geturl() #url của page hiện tại br.back() #quay lại print br.geturl() #url của page trước đó -
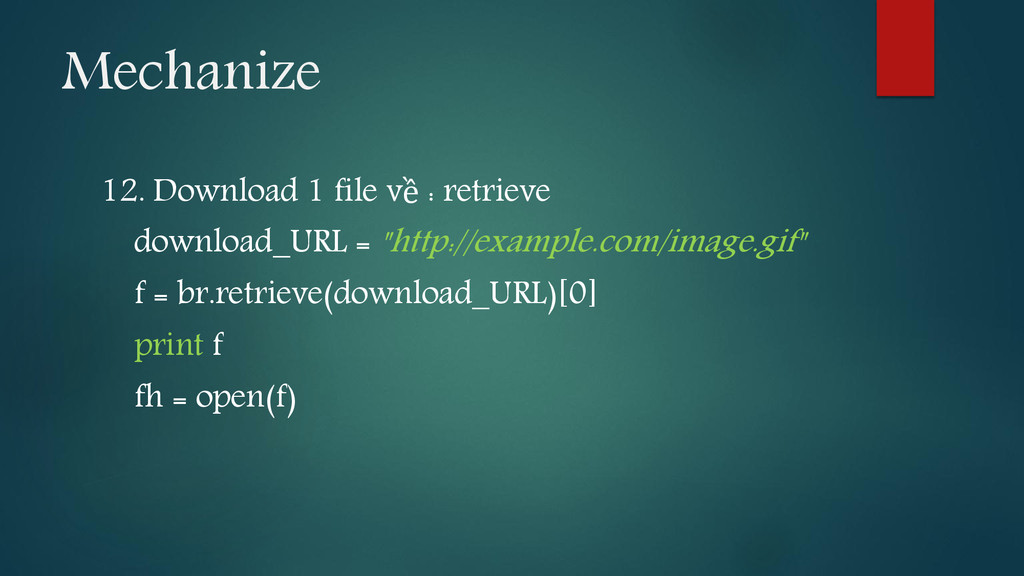
Mechanize 12. Download 1 file về : retrieve download_URL =
"http://example.com/image.gif" f = br.retrieve(download_URL)[0] print f fh = open(f) -
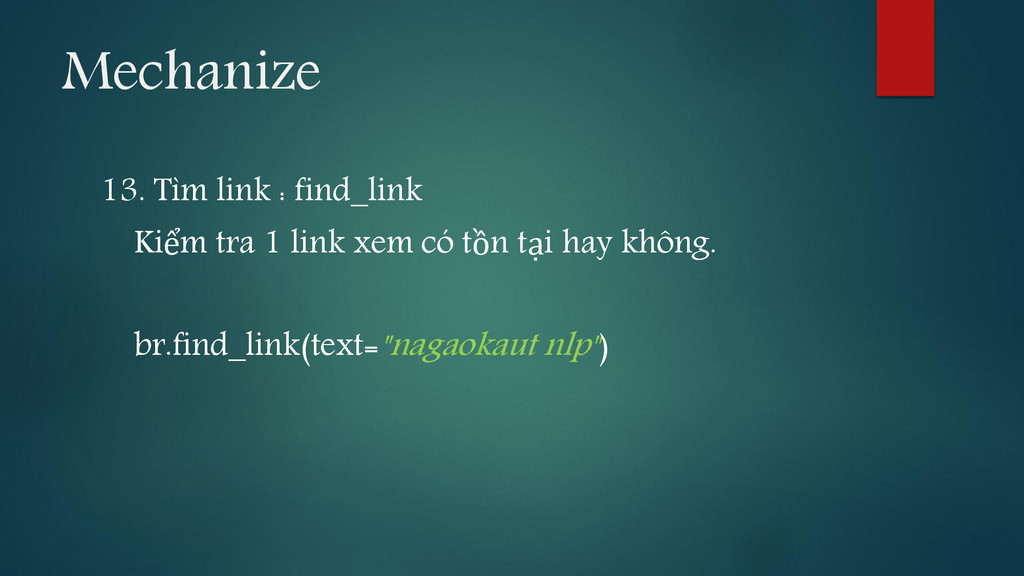
Mechanize 13. Tìm link : find_link Kiểm tra 1 link
xem có tồn tại hay không. br.find_link(text="nagaokaut nlp") -
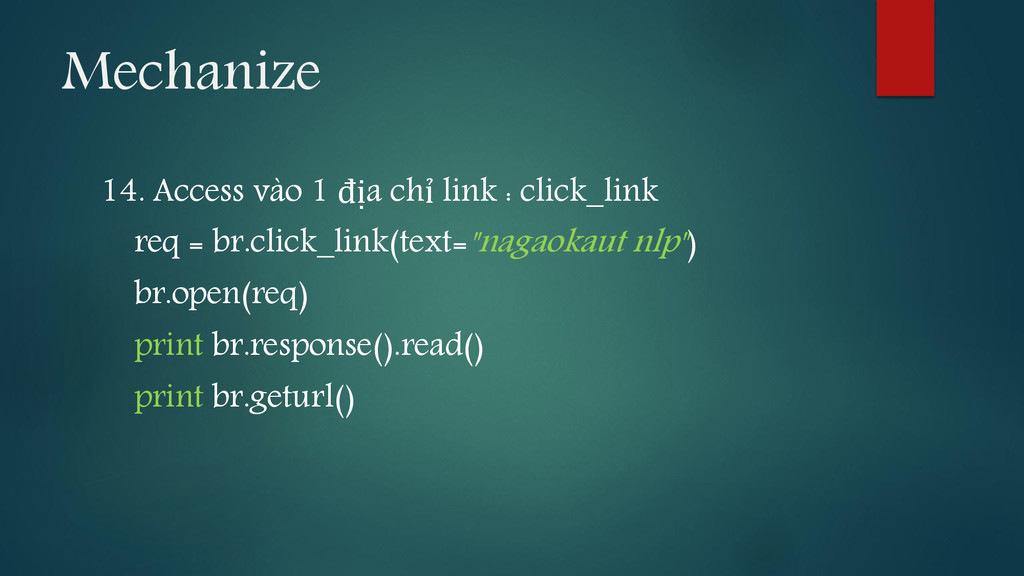
Mechanize 14. Access vào 1 địa chỉ link : click_link
req = br.click_link(text="nagaokaut nlp") br.open(req) print br.response().read() print br.geturl() -
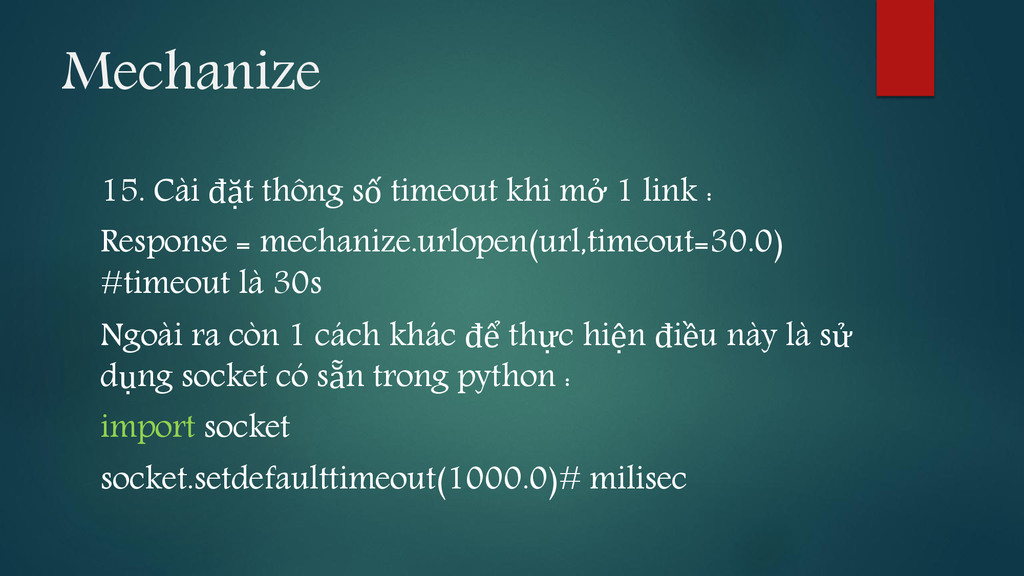
Mechanize 15. Cài đặt thông số timeout khi mở 1
link : Response = mechanize.urlopen(url,timeout=30.0) #timeout là 30s Ngoài ra còn 1 cách khác để thực hiện điều này là sử dụng socket có sẵn trong python : import socket socket.setdefaulttimeout(1000.0)# milisec -
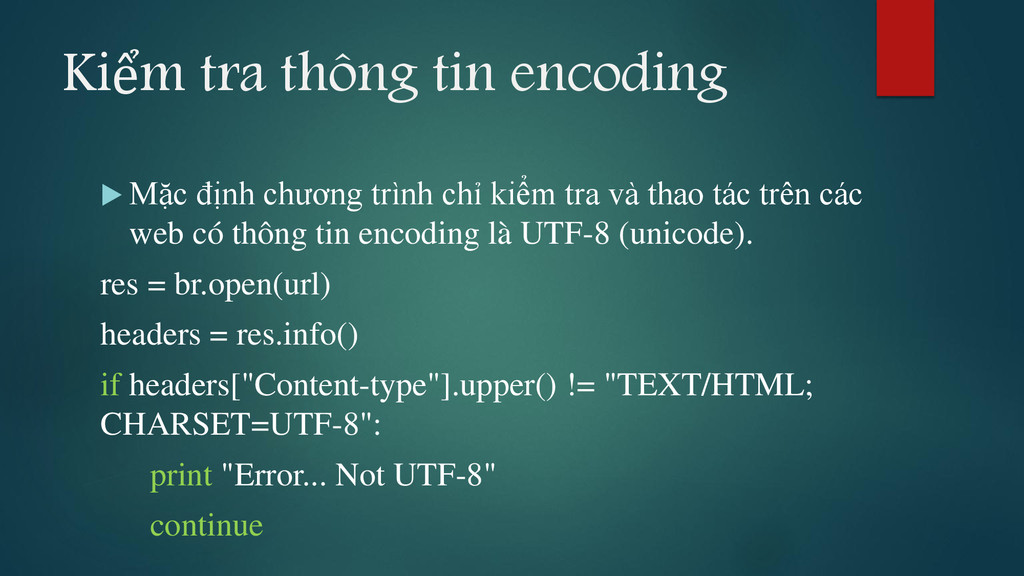
Kiểm tra thông tin encoding Mặc định chương trình
chỉ kiểm tra và thao tác trên các web có thông tin encoding là UTF-8 (unicode). res = br.open(url) headers = res.info() if headers["Content-type"].upper() != "TEXT/HTML; CHARSET=UTF-8": print "Error... Not UTF-8" continue -
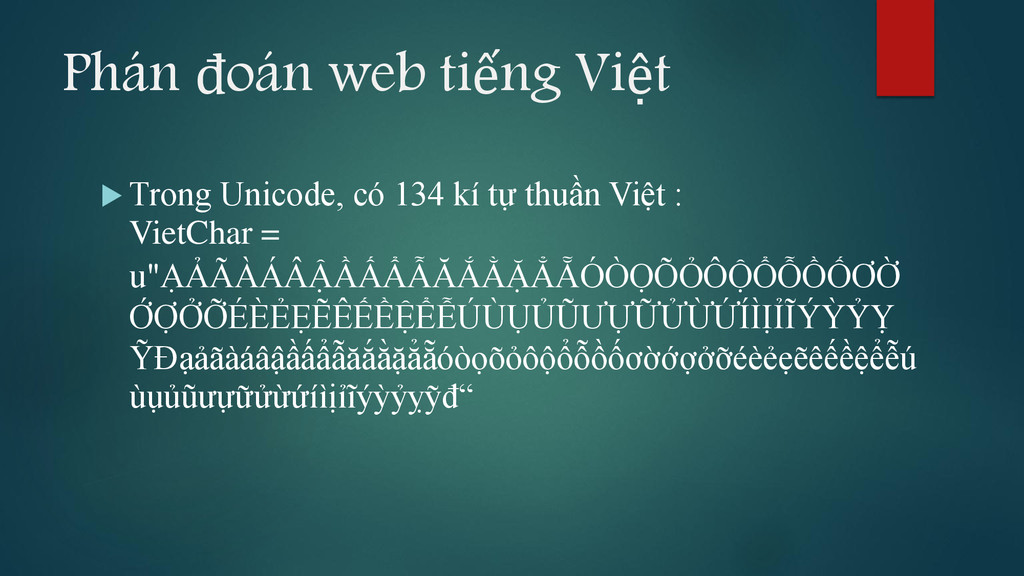
Phán đoán web tiếng Việt Trong Unicode, có 134
kí tự thuần Việt : VietChar = u"ẠẢÃÀÁÂẬẦẤẨẪĂẮẰẶẲẴÓÒỌÕỎÔỘỔỖỒỐƠỜ ỚỢỞỠÉÈẺẸẼÊẾỀỆỂỄÚÙỤỦŨƯỰỮỬỪỨÍÌỊỈĨÝỲỶỴ ỸĐạảãàáâậầấẩẫăắằặẳẵóòọõỏôộổỗồốơờớợởỡéèẻẹẽêếềệểễú ùụủũưựữửừứíìịỉĩýỳỷỵỹđ“ -
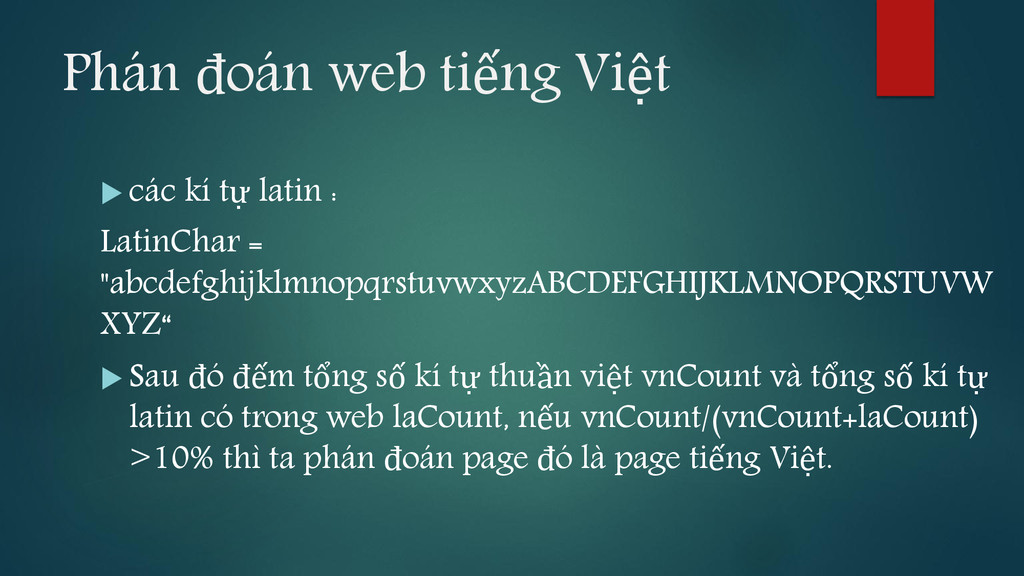
Phán đoán web tiếng Việt các kí tự latin
: LatinChar = "abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVW XYZ“ Sau đó đếm tổng số kí tự thuần việt vnCount và tổng số kí tự latin có trong web laCount, nếu vnCount/(vnCount+laCount) >10% thì ta phán đoán page đó là page tiếng Việt. -
Lấy các câu văn từ web Để lấy ra
được các câu văn từ Web, điều đầu tiên phải làm là loại bỏ các mã HTML không cần thiết. import nltk raw = unicode(nltk.clean_html(html),'utf8') -
Tách các câu văn tiếng Việt Trong 1 Web
tiếng Việt vẫn sẽ có các câu không phải tiếng Việt, ta sẽ xác định lại 1 lần nữa. Loại bỏ các câu văn trùng nhau. -
Tái kiểm tra corpus Chọn ngẫu nhiên trong corpus
ra 1000 câu văn để người kiểm tra.