Share
Embed
Transcript
67 slides
-
自己紹介 経歴 趣味 生命科学系学部卒 →バイオベンチャー企業 →コンサル企業 ・バーピージャンプ ・チャーハン作り 野望 データサイエンティスト・機械学習エンジニア
をバイオインフォ界隈に。 木本 直樹 (@_kimoton) -
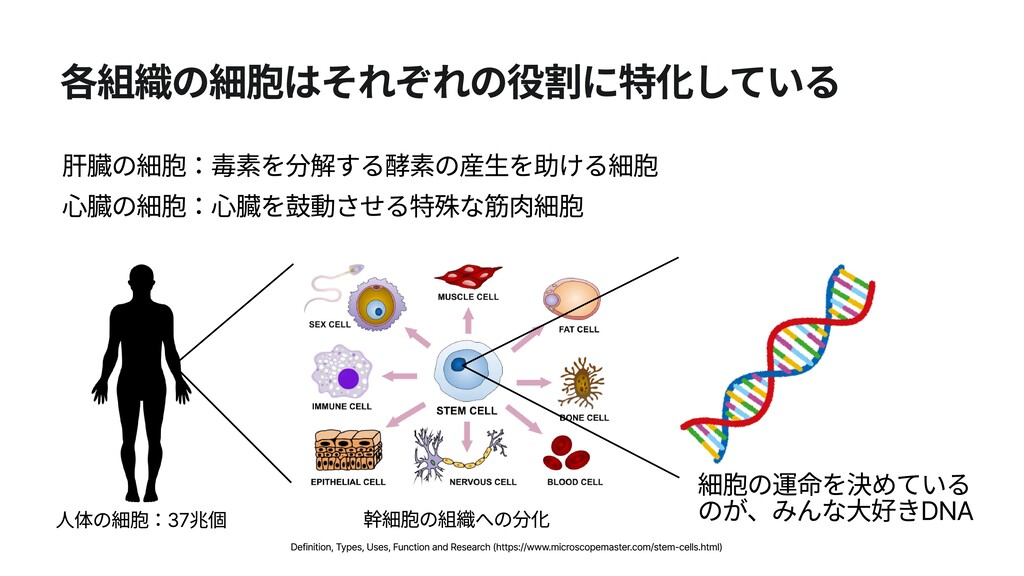
各組織の細胞はそれぞれの役割に特化している 肝臓の細胞:毒素を分解する酵素の産生を助ける細胞 心臓の細胞:心臓を鼓動させる特殊な筋肉細胞 細胞の運命を決めている のが、みんな大好きDNA 幹細胞の組織への分化 人体の細胞:37兆個 Definition, Types, Uses,
Function and Research (https://www.microscopemaster.com/stem-cells.html) -
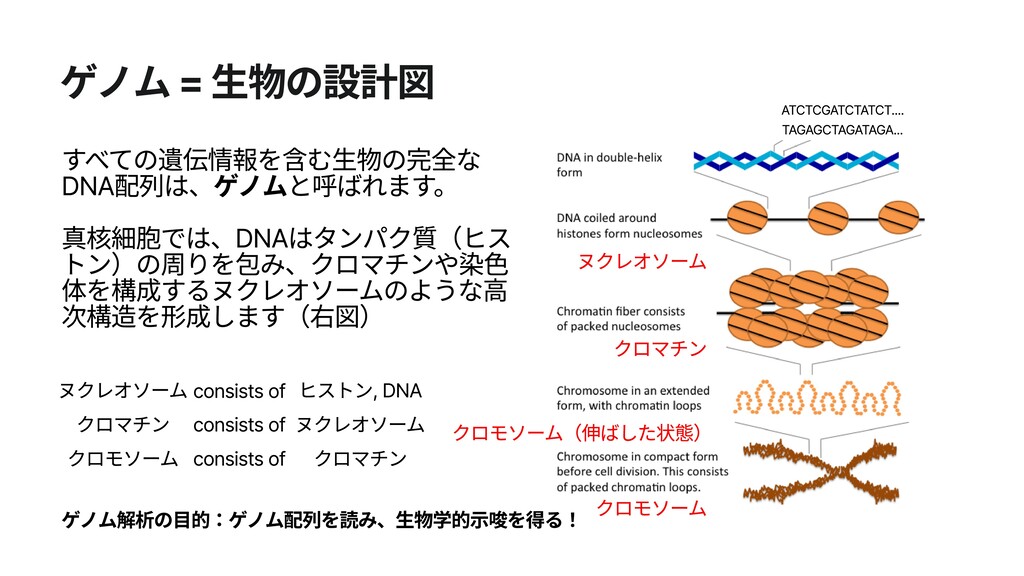
ゲノム = 生物の設計図 すべての遺伝情報を含む生物の完全な DNA配列は、ゲノムと呼ばれます。 真核細胞では、DNAはタンパク質(ヒス トン)の周りを包み、クロマチンや染色 体を構成するヌクレオソームのような高 次構造を形成します(右図) ヌクレオソーム
クロマチン クロマチン クロモソーム(伸ばした状態) クロモソーム consists of consists of ヌクレオソーム クロモソーム consists of クロマチン ゲノム解析の目的:ゲノム配列を読み、生物学的示唆を得る! ヌクレオソーム ヒストン, DNA ATCTCGATCTATCT.... TAGAGCTAGATAGA... -
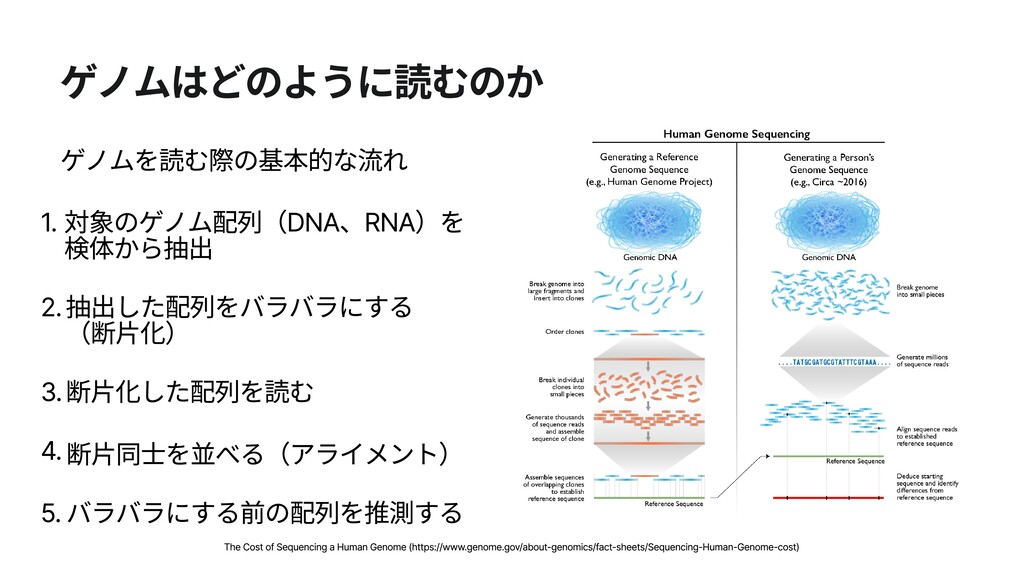
ゲノムはどのように読むのか ゲノムを読む際の基本的な流れ 1. 対象のゲノム配列(DNA、RNA)を 検体から抽出 2. 抽出した配列をバラバラにする (断片化) 3. 断片化した配列を読む
4.断片同士を並べる(アライメント) 5.バラバラにする前の配列を推測する The Cost of Sequencing a Human Genome (https://www.genome.gov/about-genomics/fact-sheets/Sequencing-Human-Genome-cost) -
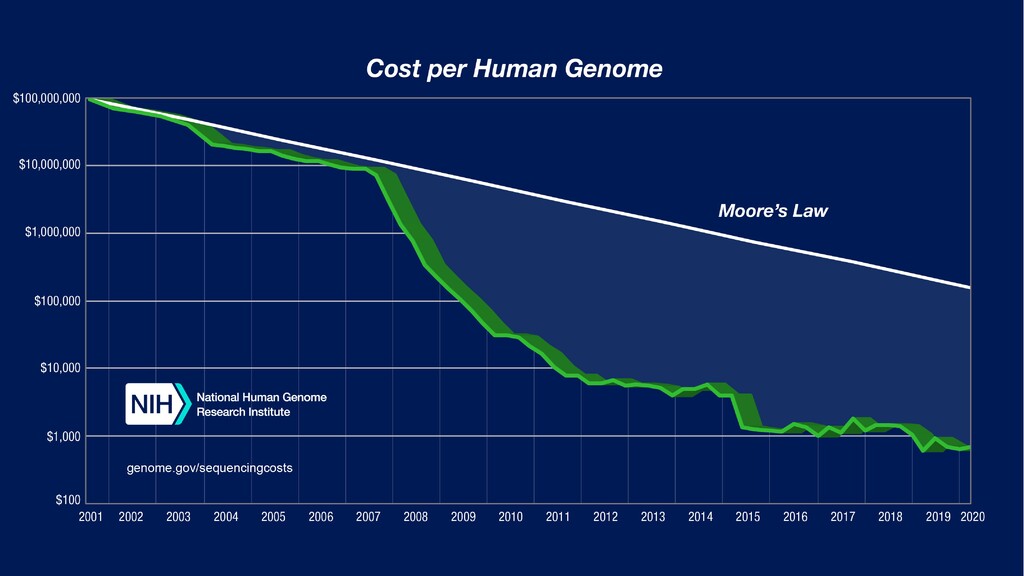
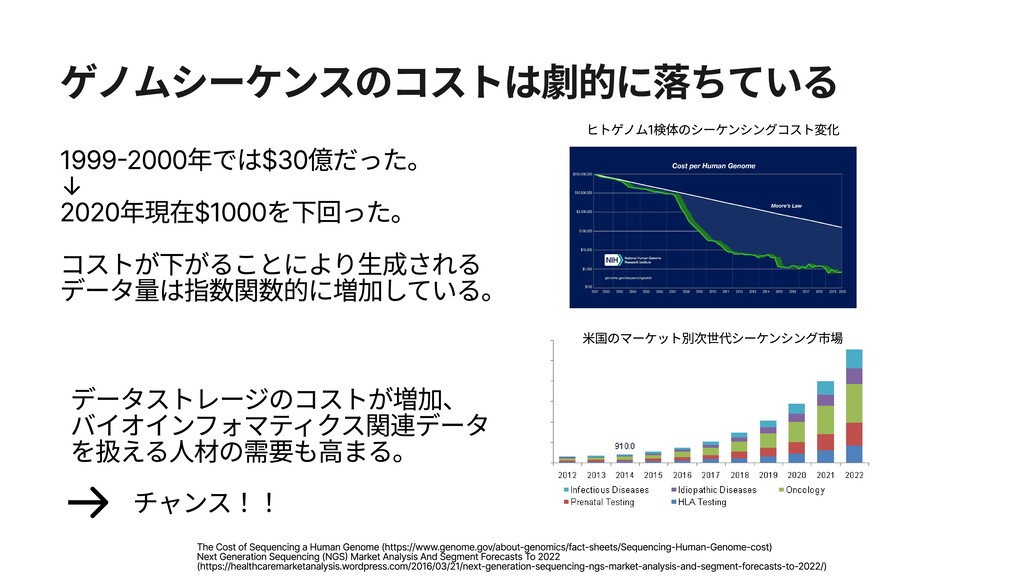
ゲノムシーケンスのコストは劇的に落ちている 1999-2000年では$30億だった。 ↓ 2020年現在$1000を下回った。 コストが下がることにより生成される データ量は指数関数的に増加している。 データストレージのコストが増加、 バイオインフォマティクス関連データ を扱える人材の需要も高まる。 チャンス!!
米国のマーケット別次世代シーケンシング市場 ヒトゲノム1検体のシーケンシングコスト変化 The Cost of Sequencing a Human Genome (https://www.genome.gov/about-genomics/fact-sheets/Sequencing-Human-Genome-cost) Next Generation Sequencing (NGS) Market Analysis And Segment Forecasts To 2022 (https://healthcaremarketanalysis.wordpress.com/2016/03/21/next-generation-sequencing-ngs-market-analysis-and-segment-forecasts-to-2022/) -
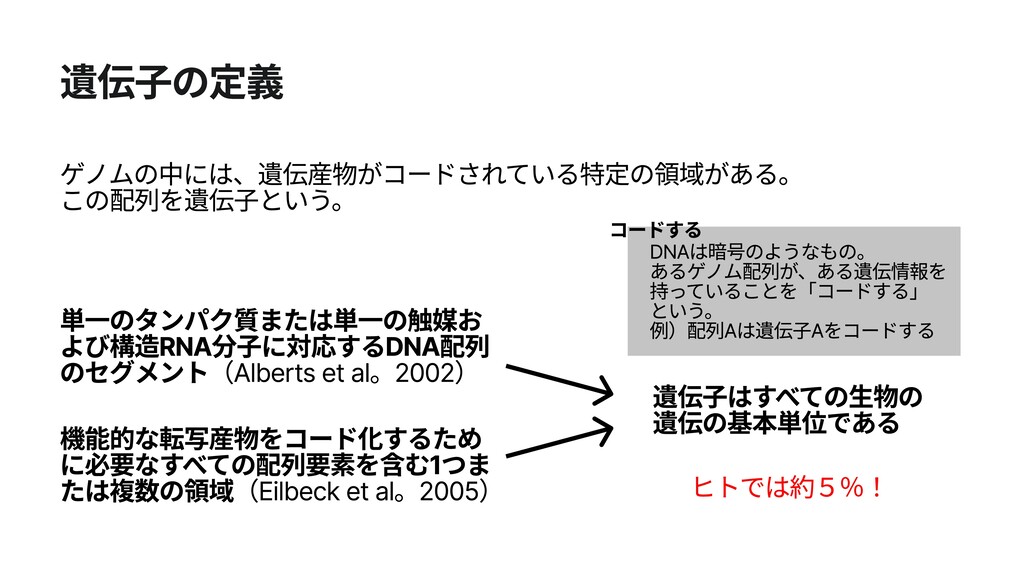
遺伝子の定義 機能的な転写産物をコード化するため に必要なすべての配列要素を含む1つま たは複数の領域(Eilbeck et al。2005) 単一のタンパク質または単一の触媒お よび構造RNA分子に対応するDNA配列 のセグメント(Alberts et
al。2002) 遺伝子はすべての生物の 遺伝の基本単位である ゲノムの中には、遺伝産物がコードされている特定の領域がある。 この配列を遺伝子という。 コードする DNAは暗号のようなもの。 あるゲノム配列が、ある遺伝情報を 持っていることを「コードする」 という。 例)配列Aは遺伝子Aをコードする ヒトでは約5%! -
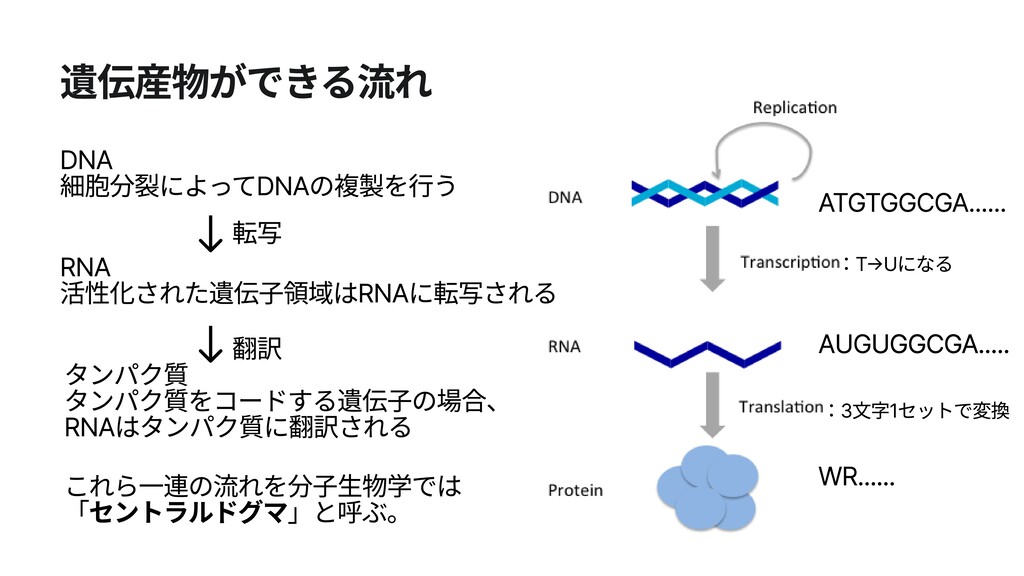
AUGUGGCGA..... . WR...... A TGTGGCGA...... AUGUGGCGA..... WR...... 遺伝産物ができる流れ DNA 細胞分裂によってDNAの複製を行う
RNA 活性化された遺伝子領域はRNAに転写される タンパク質 タンパク質をコードする遺伝子の場合、 RNAはタンパク質に翻訳される これら一連の流れを分子生物学では 「セントラルドグマ」と呼ぶ。 転写 翻訳 :3文字1セットで変換 :T→Uになる -
遺伝子がなぜ重要なのか 細胞の刺激に対する振る舞いはそれらが コードされている遺伝子及び機能分子の 活性により支配される。 遺伝子発現(制御)によって 生物に関する全てが決定される。 遺伝子がゲノム生物学の中心的な概念 遺伝子発現 単に発現ともいい、遺伝子の情報が 細胞における構造および機能(タン
パク質)に変換される過程を指す 遺伝子発現制御 細胞が特定の遺伝子産物(タンパ ク質やRNA)の合成を増加または 減少させるメカニズムのこと いっぱい作る? 作るの止める? -
1.1.3 How genes are controlled? The transcriptional and
the post-transcriptional regulation 遺伝子発現はどのように制御されるか。 転写及び転写後調節 -
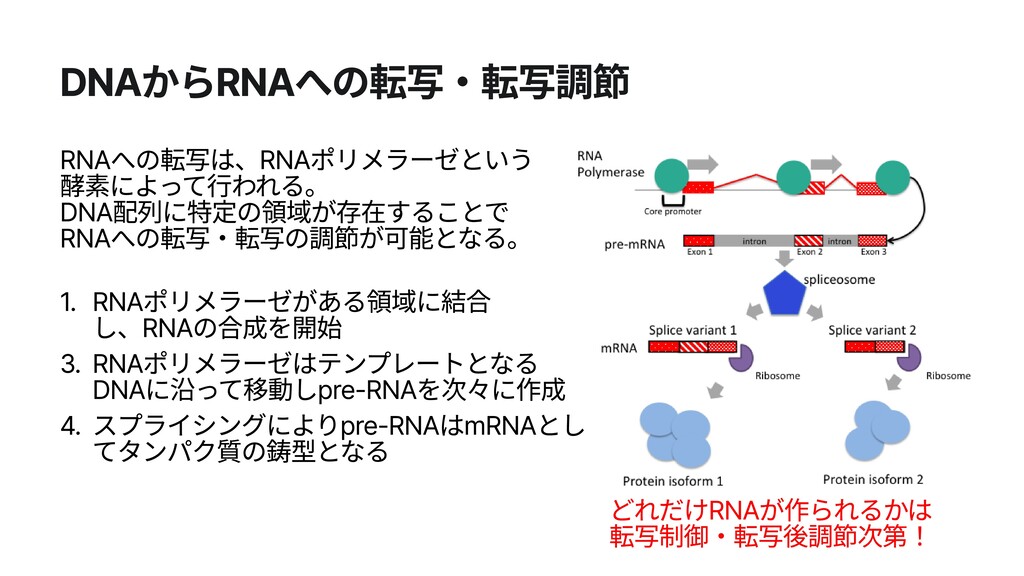
DNAからRNAへの転写・転写調節 1. 3. 4. RNAポリメラーゼがある領域に結合 し、RNAの合成を開始 RNAポリメラーゼはテンプレートとなる DNAに沿って移動しpre-RNAを次々に作成 スプライシングによりpre-RNAはmRNAとし てタンパク質の鋳型となる
RNAへの転写は、RNAポリメラーゼという 酵素によって行われる。 DNA配列に特定の領域が存在することで RNAへの転写・転写の調節が可能となる。 どれだけRNAが作られるかは 転写制御・転写後調節次第! -
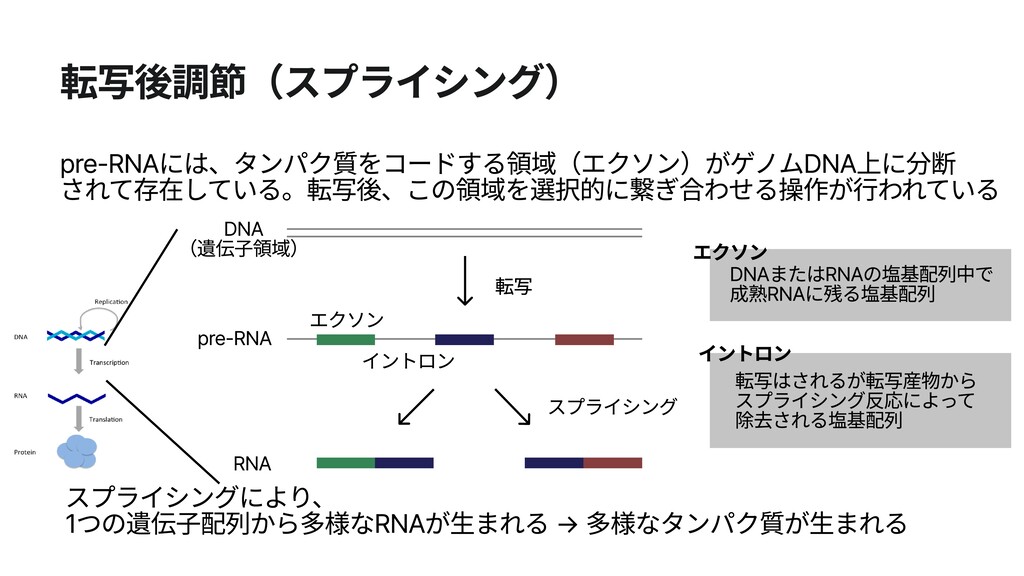
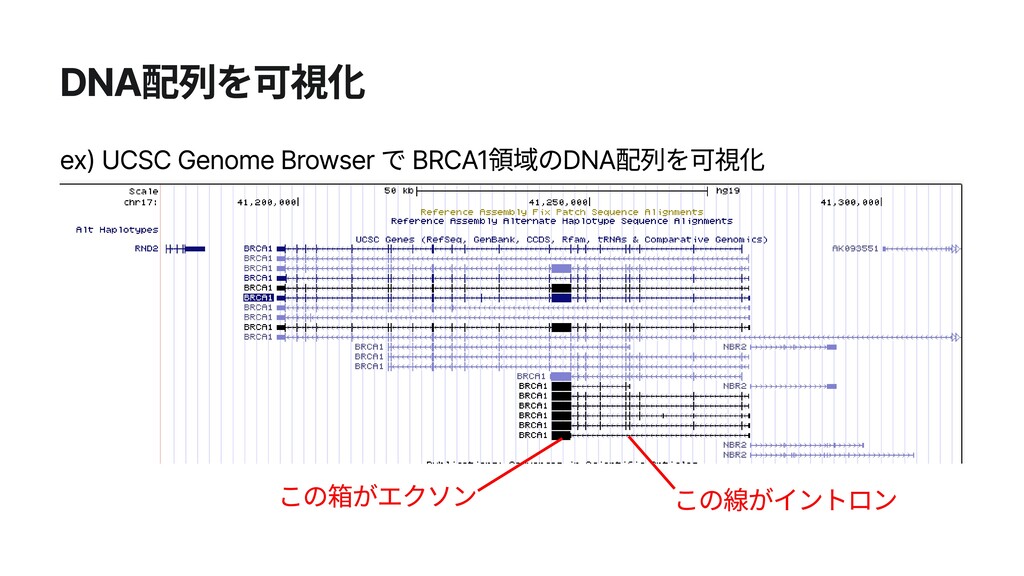
転写後調節(スプライシング) エクソン エクソン DNAまたはRNAの塩基配列中で 成熟RNAに残る塩基配列 DNA (遺伝子領域) 転写 転写 スプライシング
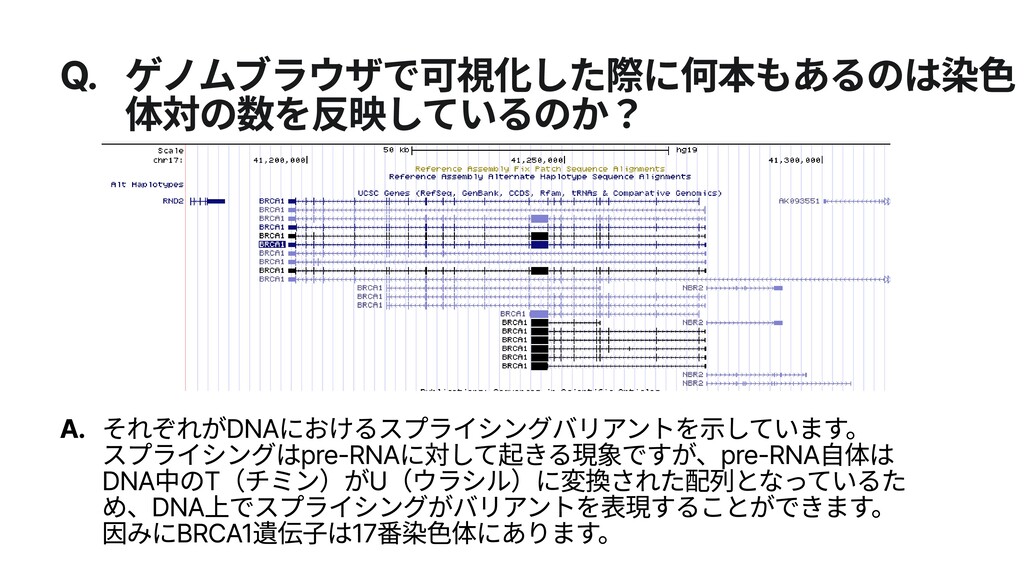
pre-RNA RNA イントロン 転写はされるが転写産物から スプライシング反応によって 除去される塩基配列 イントロン スプライシングにより、 1つの遺伝子配列から多様なRNAが生まれる → 多様なタンパク質が生まれる pre-RNAには、タンパク質をコードする領域(エクソン)がゲノムDNA上に分断 されて存在している。転写後、この領域を選択的に繋ぎ合わせる操作が行われている -
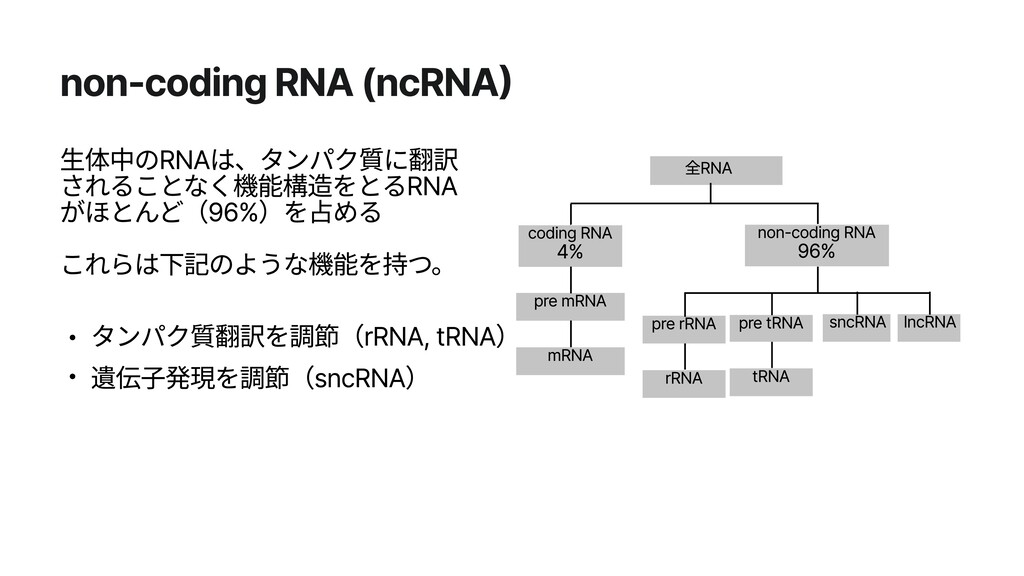
non-coding RNA (ncRNA) 生体中のRNAは、タンパク質に翻訳 されることなく機能構造をとるRNA がほとんど(96%)を占める これらは下記のような機能を持つ。 全RNA non-coding RNA
96% pre mRNA mRNA pre rRNA pre tRNA rRNA tRNA sncRNA lncRNA coding RNA 4% タンパク質翻訳を調節(rRNA, tRNA) 遺伝子発現を調節(sncRNA) ・ ・ -
1.1 まとめ ゲノムとはすべての遺伝情報を含む生物の完全なDNA配列を指す ・ 遺伝子とはゲノムの中でも遺伝産物がコードされている特定の領 域を指す ・ 遺伝子の発現によって生命の振る舞いは規定される → 遺伝子はゲノム生物学の中心的な概念
・ 生命はRNAへの転写を調節することにより遺伝子の発現量 (RNA・タンパク質の生成)を制御している ・ 遺伝子はあくまで文字列(A、T、G、C)の集合 ・ -
遺伝子発現調節のメカニズム 転写調節 ・転写因子による調節 ・エピジェネティックな調節 転写後調節 ・スプライシング ・キャップの形成・ポリアデニル化 AAAAAA スプライシング AAAAAA
pre-RNA mRNA DNAからpre-mRNAへの変換 pre-mRNAからmRNAへの変換 -
エピジェネティックな調節 エピジェネティック? 遺伝子発現調節に影響を与えるDNA配列以外の構造 (クロマチン構造、DNAメチル化等 ) i)DNA修飾 ・メチル化(CpG island等) ・ヒドロキシメチル化 ・ホルミル化
ii)ヒストン修飾 ・メチル化 ・アセチル化 ・リン酸化 ・ユビキチン化 エピジェネティクス|環境儀 No.59|国立環境研究所 (https://www.nies.go.jp/kanko/kankyogi/59/column2.html) ヒストンメチル化・アセチル化の例 -
スプライシング制御 ・スプライシングエンハンサー(ESE、ISE) スプライシングを促進する配列 ・スプライシングサイレンサー(ESS、ISS) スプライシングを抑制する配列 DNA 転写 スプライシング pre-RNA RNA
スプライシングを調節することにより、 タンパク質の多様性が生まれる。 -
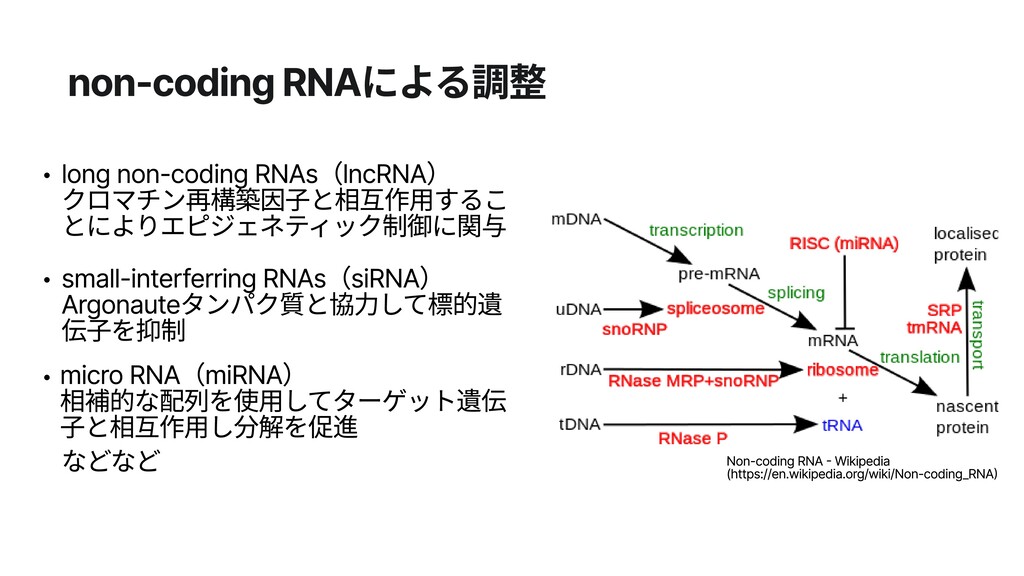
non-coding RNAによる調整 long non-coding RNAs(lncRNA) クロマチン再構築因子と相互作用するこ とによりエピジェネティック制御に関与 small-interferring RNAs(siRNA) Argonauteタンパク質と協力して標的遺
伝子を抑制 などなど micro RNA(miRNA) 相補的な配列を使用してターゲット遺伝 子と相互作用し分解を促進 Non-coding RNA - Wikipedia (https://en.wikipedia.org/wiki/Non-coding_RNA) ・ ・ ・ -
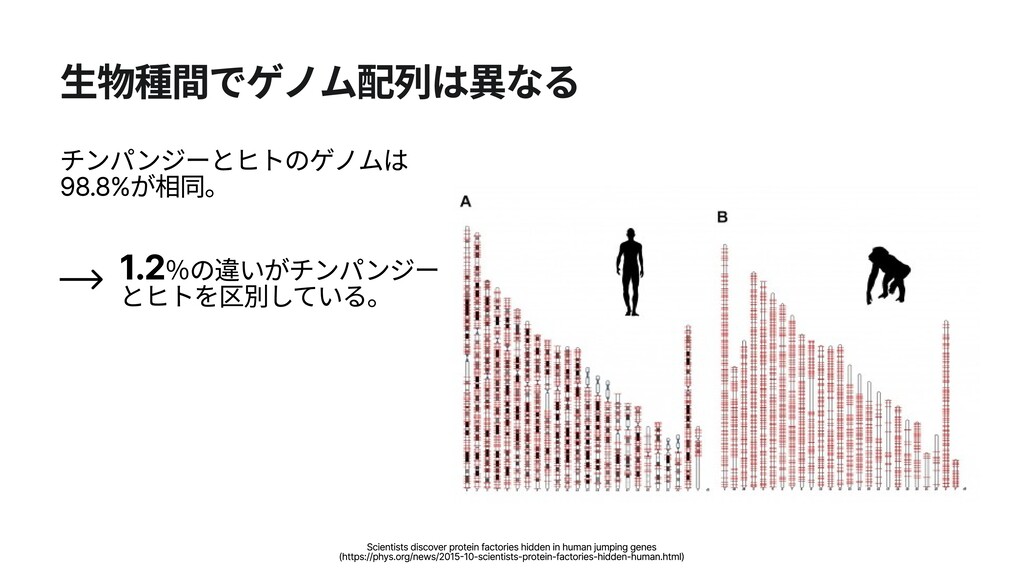
生物種間でゲノム配列は異なる チンパンジーとヒトのゲノムは 98.8%が相同。 1.2%の違いがチンパンジー とヒトを区別している。 Scientists discover protein factories hidden
in human jumping genes (https://phys.org/news/2015-10-scientists-protein-factories-hidden-human.html) -
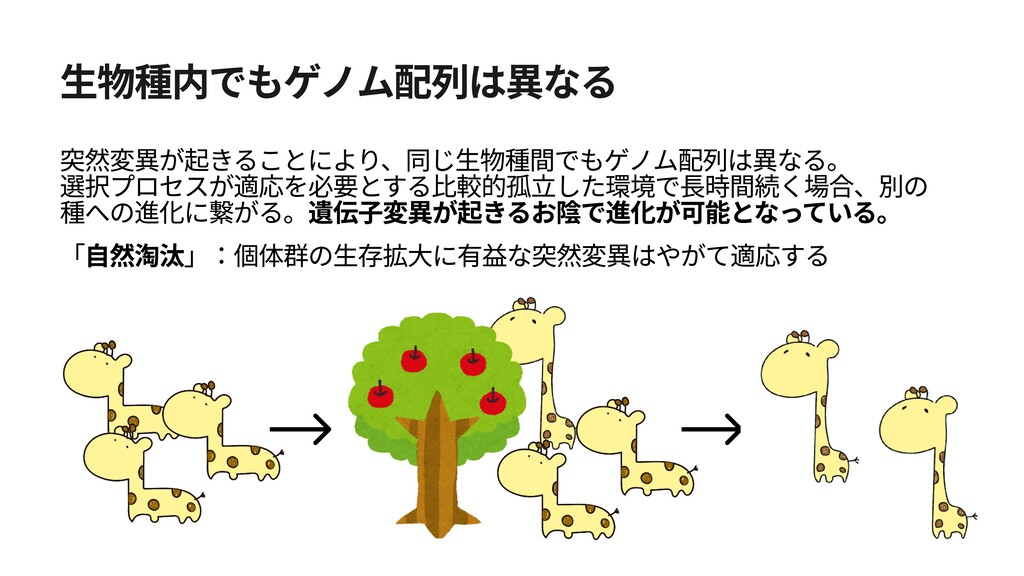
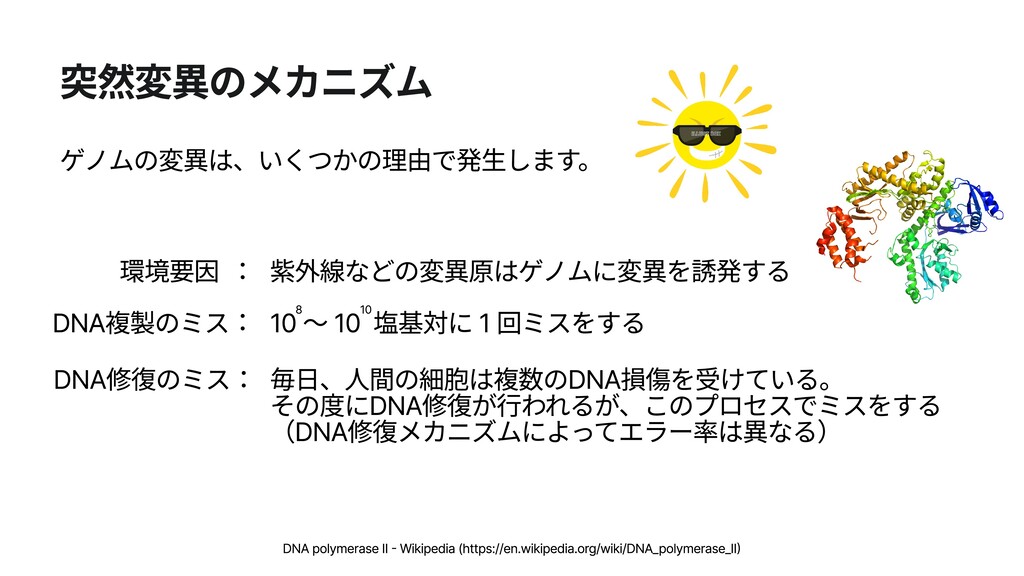
突然変異のメカニズム ゲノムの変異は、いくつかの理由で発生します。 DNA複製のミス : : 環境要因 : DNA修復のミス 10 ~
10 塩基対に 1 回ミスをする 10 8 紫外線などの変異原はゲノムに変異を誘発する 毎日、人間の細胞は複数のDNA損傷を受けている。 その度にDNA修復が行われるが、このプロセスでミスをする (DNA修復メカニズムによってエラー率は異なる) DNA polymerase II - Wikipedia (https://en.wikipedia.org/wiki/DNA_polymerase_II) -
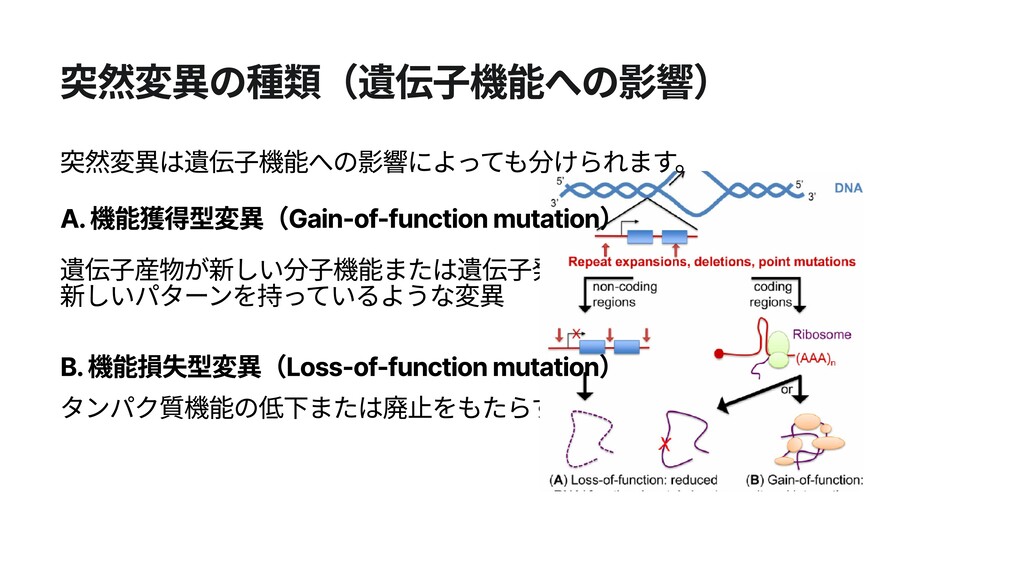
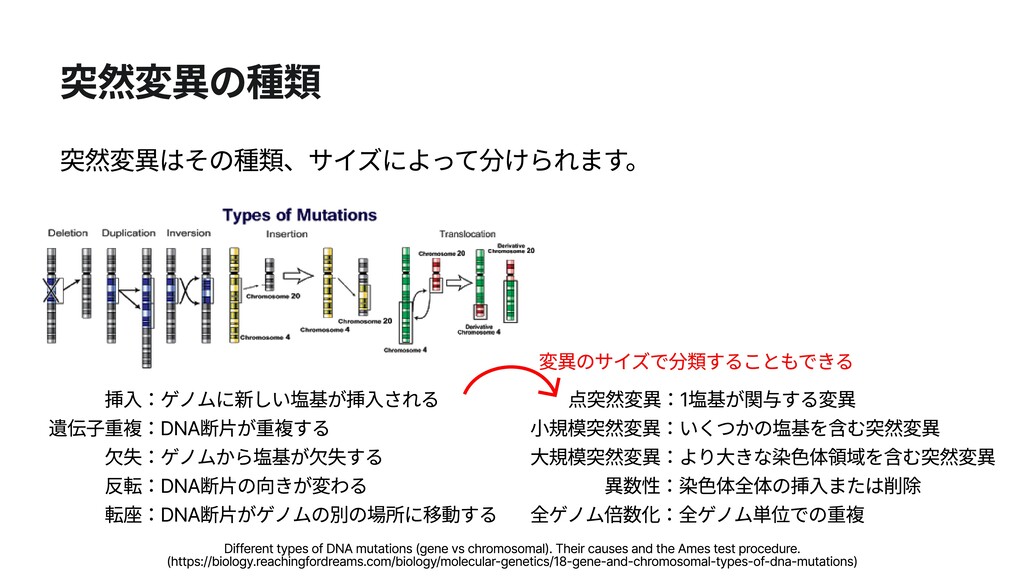
突然変異の種類 突然変異はその種類、サイズによって分けられます。 変異のサイズで分類することもできる 全ゲノム倍数化:全ゲノム単位での重複 点突然変異:1塩基が関与する変異 小規模突然変異:いくつかの塩基を含む突然変異 大規模突然変異:より大きな染色体領域を含む突然変異 異数性:染色体全体の挿入または削除 転座:DNA断片がゲノムの別の場所に移動する 挿入:ゲノムに新しい塩基が挿入される
遺伝子重複:DNA断片が重複する 欠失:ゲノムから塩基が欠失する 反転:DNA断片の向きが変わる Different types of DNA mutations (gene vs chromosomal). Their causes and the Ames test procedure. (https://biology.reachingfordreams.com/biology/molecular-genetics/18-gene-and-chromosomal-types-of-dna-mutations) -
ハイスループットとは…? 要するに、自動化、高速化により時間と経費が抑えられたハイテク評価系! > 時間と経費を節約するための高速化合物評価系。 何百万という化合物を 一つ一つ人の手でスクリーニングすれば,時間がかかるばかりでなく経 費が高くつく。化合物の評価系を単純化、ミニチュア化できる場合、ロ ボットを用いて自動的に高速で化合物を評価することで、時間と経費を 抑えられる。このようなハイテク評価系をハイスループットアッセイと いう。一方、単純化もしくはミニチュア化することができず、人の手に
よって行なう職人的な評価系をロースループットアッセイという。 バイオキーワード集|実験医学onlineより引用 -
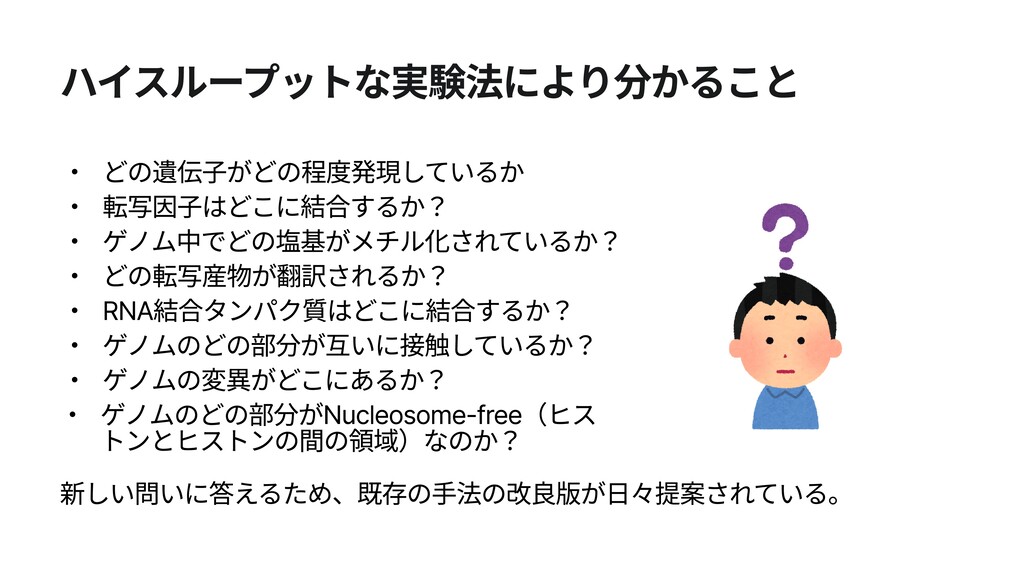
ハイスループットな実験法により分かること 新しい問いに答えるため、既存の手法の改良版が日々提案されている。 ・ どの遺伝子がどの程度発現しているか 転写因子はどこに結合するか? ・ ゲノム中でどの塩基がメチル化されているか? ・ どの転写産物が翻訳されるか? ・
RNA結合タンパク質はどこに結合するか? ・ ゲノムのどの部分が互いに接触しているか? ・ ゲノムの変異がどこにあるか? ・ ゲノムのどの部分がNucleosome-free(ヒス トンとヒストンの間の領域)なのか? ・ -
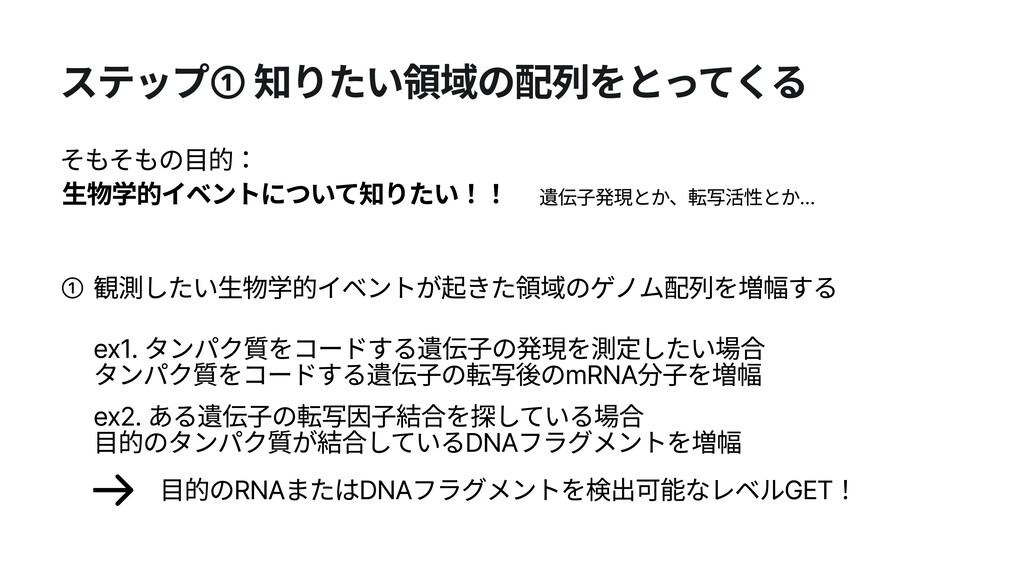
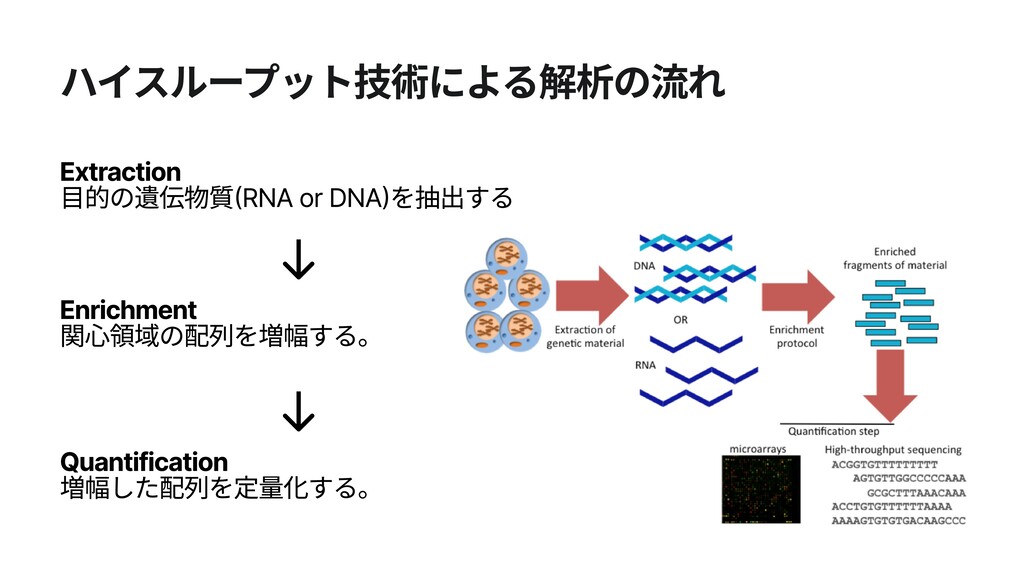
ex1. タンパク質をコードする遺伝子の発現を測定したい場合 タンパク質をコードする遺伝子の転写後のmRNA分子を増幅 遺伝子発現とか、転写活性とか… ex2. ある遺伝子の転写因子結合を探している場合 目的のタンパク質が結合しているDNAフラグメントを増幅 ステップ① 知りたい領域の配列をとってくる 生物学的イベントについて知りたい!!
そもそもの目的: 観測したい生物学的イベントが起きた領域のゲノム配列を増幅する ① 目的のRNAまたはDNAフラグメントを検出可能なレベルGET! -
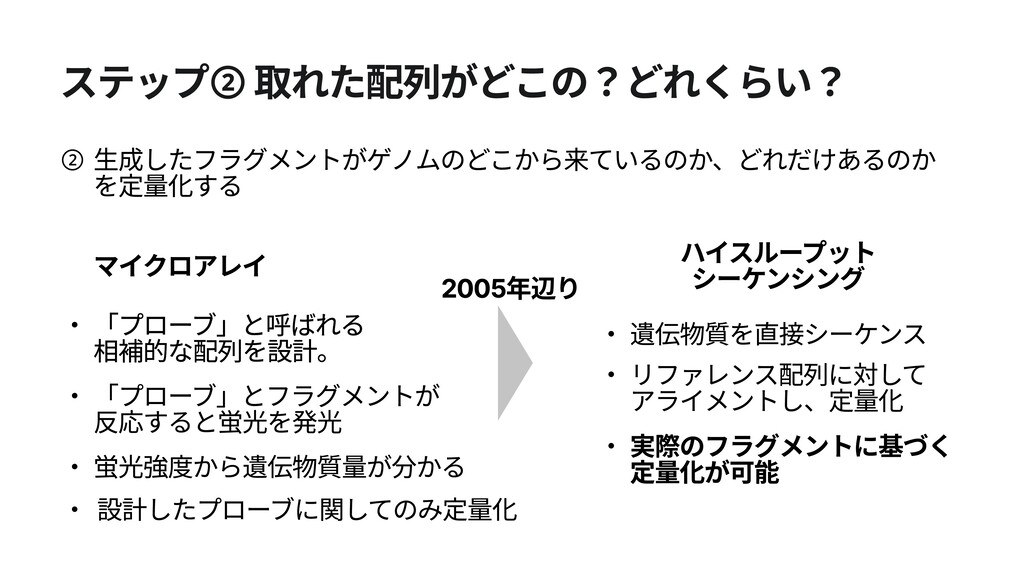
ステップ② 取れた配列がどこの?どれくらい? 生成したフラグメントがゲノムのどこから来ているのか、どれだけあるのか を定量化する ② マイクロアレイ ハイスループット シーケンシング 2005年辺り 「プローブ」と呼ばれる
相補的な配列を設計。 ・「プローブ」と呼ばれる 相補的な配列を設計。 ・ ・遺伝物質を直接シーケンス ・ ・リファレンス配列に対して アライメントし、定量化 ・ ・実際のフラグメントに基づく 定量化が可能 ・ 蛍光強度から遺伝物質量が分かる ・ 設計したプローブに関してのみ定量化 ・ 「プローブ」とフラグメントが 反応すると蛍光を発光 ・ -
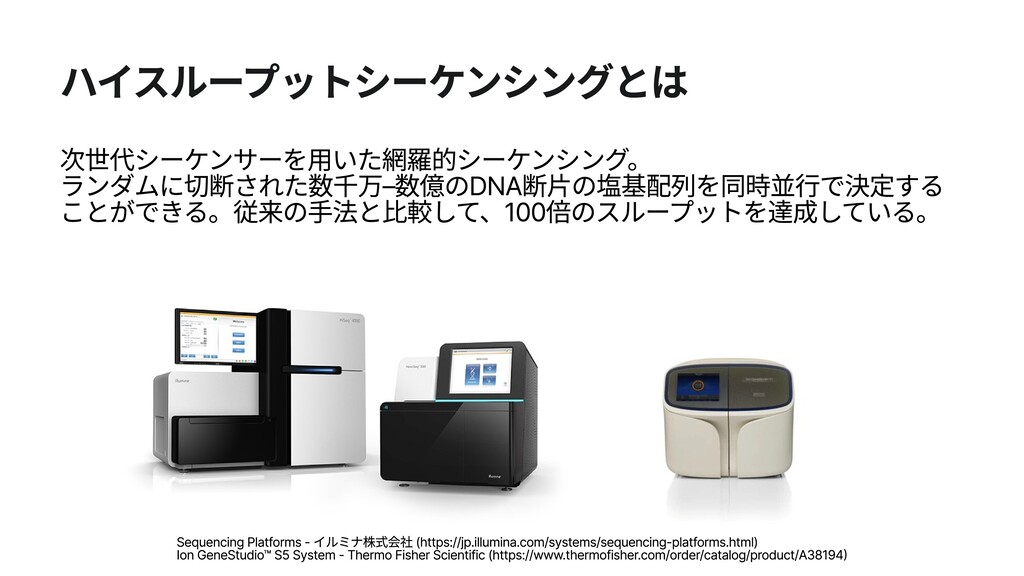
ハイスループットシーケンシングとは 次世代シーケンサーを用いた網羅的シーケンシング。 ランダムに切断された数千万–数億のDNA断片の塩基配列を同時並行で決定する ことができる。従来の手法と比較して、100倍のスループットを達成している。 Sequencing Platforms - イルミナ株式会社 (https://jp.illumina.com/systems/sequencing-platforms.html) Ion
GeneStudio™ S5 System - Thermo Fisher Scientific (https://www.thermofisher.com/order/catalog/product/A38194) -
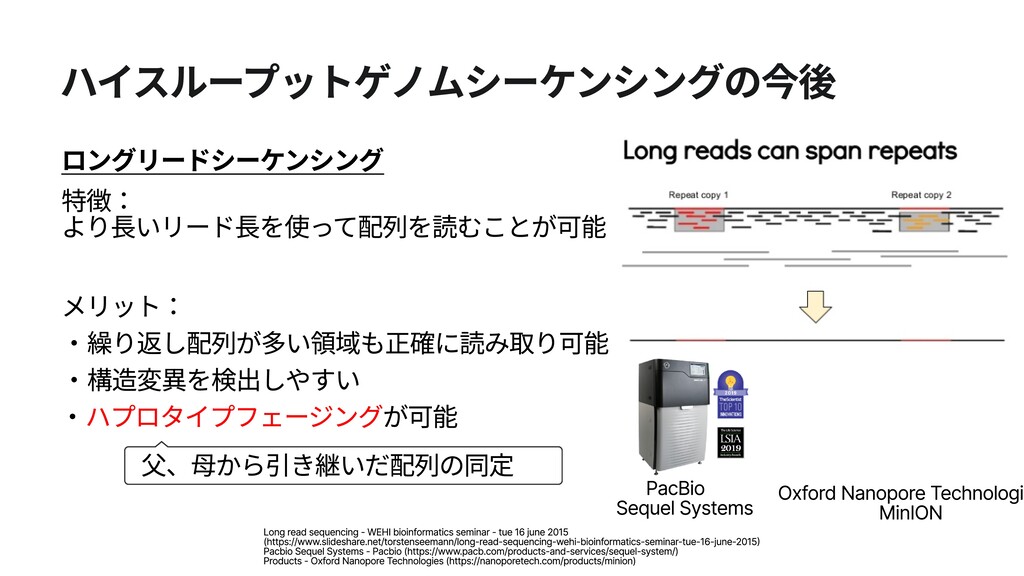
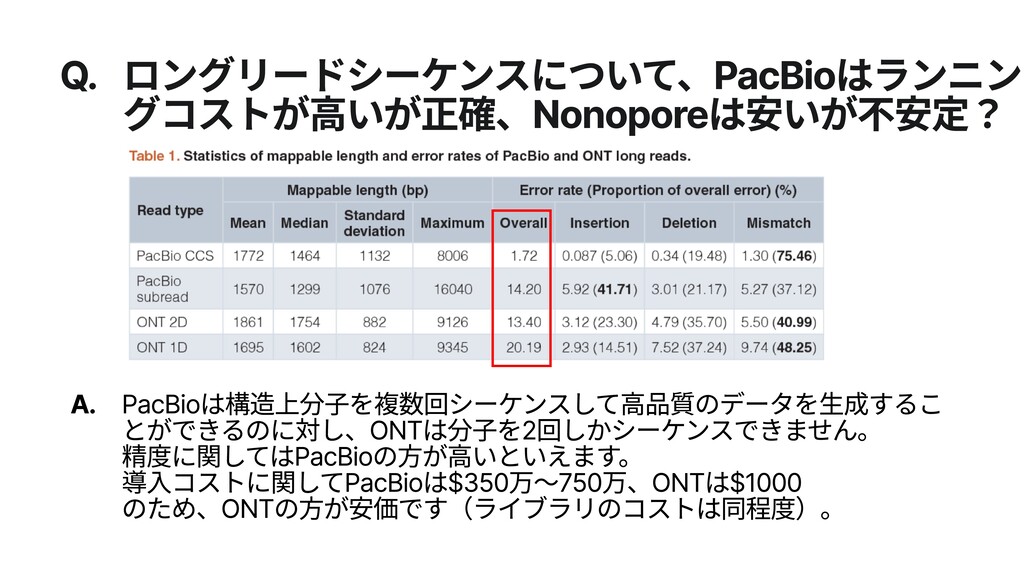
ハイスループットゲノムシーケンシングの今後 父、母から引き継いだ配列の同定 PacBio Sequel Systems Oxford Nanopore Technologie MinION Long
read sequencing - WEHI bioinformatics seminar - tue 16 june 2015 (https://www.slideshare.net/torstenseemann/long-read-sequencing-wehi-bioinformatics-seminar-tue-16-june-2015) Pacbio Sequel Systems - Pacbio (https://www.pacb.com/products-and-services/sequel-system/) Products - Oxford Nanopore Technologies (https://nanoporetech.com/products/minion) 特徴: より長いリード長を使って配列を読むことが可能 メリット: ロングリードシーケンシング 繰り返し配列が多い領域も正確に読み取り可能 ・ 構造変異を検出しやすい ・ が可能 ハプロタイプフェージング ・ -
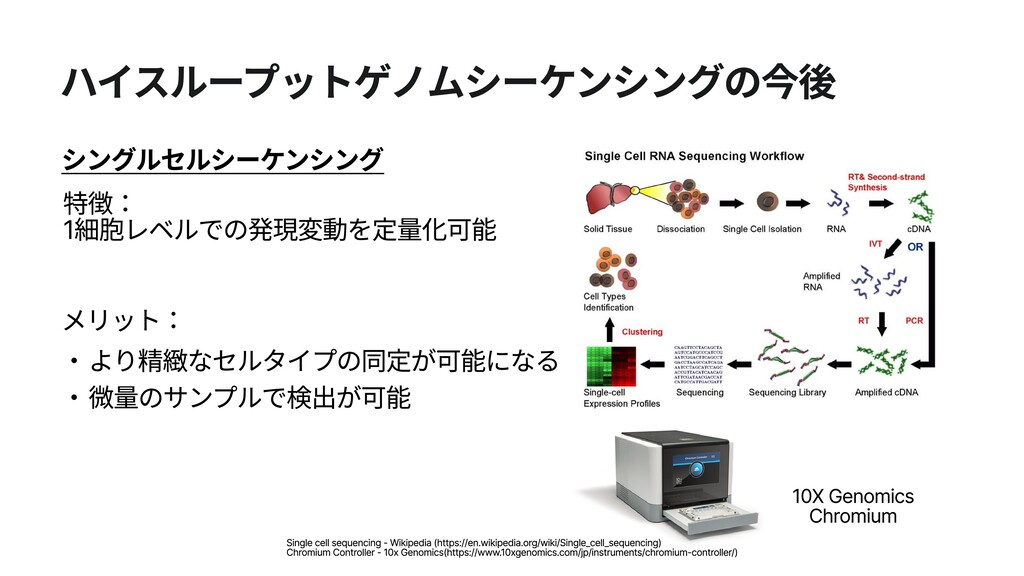
ハイスループットゲノムシーケンシングの今後 メリット: 特徴: 1細胞レベルでの発現変動を定量化可能 シングルセルシーケンシング 10X Genomics Chromium Single cell
sequencing - Wikipedia (https://en.wikipedia.org/wiki/Single_cell_sequencing) Chromium Controller - 10x Genomics(https://www.10xgenomics.com/jp/instruments/chromium-controller/) より精緻なセルタイプの同定が可能になる ・ 微量のサンプルで検出が可能 ・ -
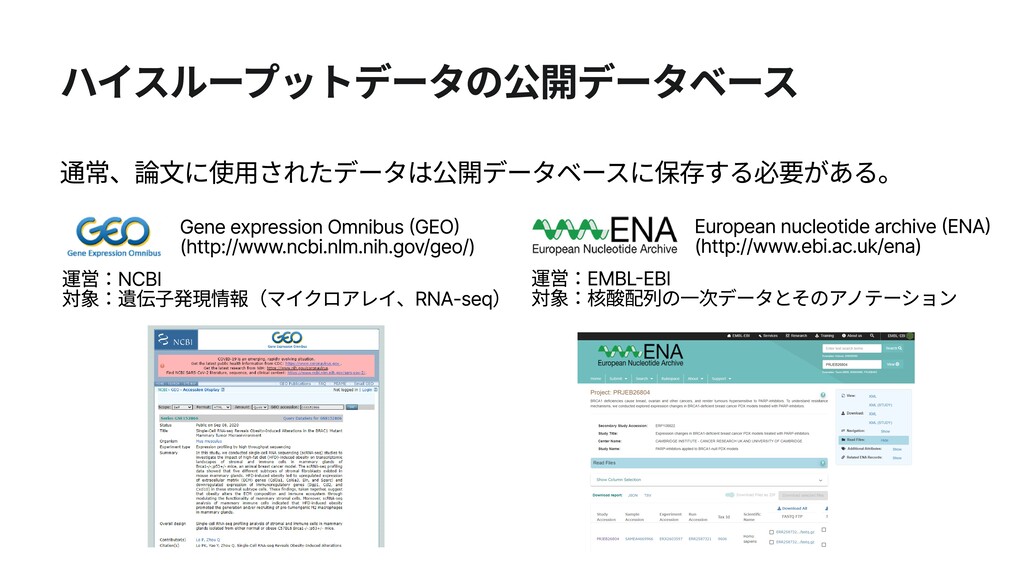
ハイスループットデータの公開データベース 通常、論文に使用されたデータは公開データベースに保存する必要がある。 Gene expression Omnibus (GEO) (http://www.ncbi.nlm.nih.gov/geo/) European nucleotide archive
(ENA) (http://www.ebi.ac.uk/ena) 運営:EMBL-EBI 対象:核酸配列の一次データとそのアノテーション 運営:NCBI 対象:遺伝子発現情報(マイクロアレイ、RNA-seq) -
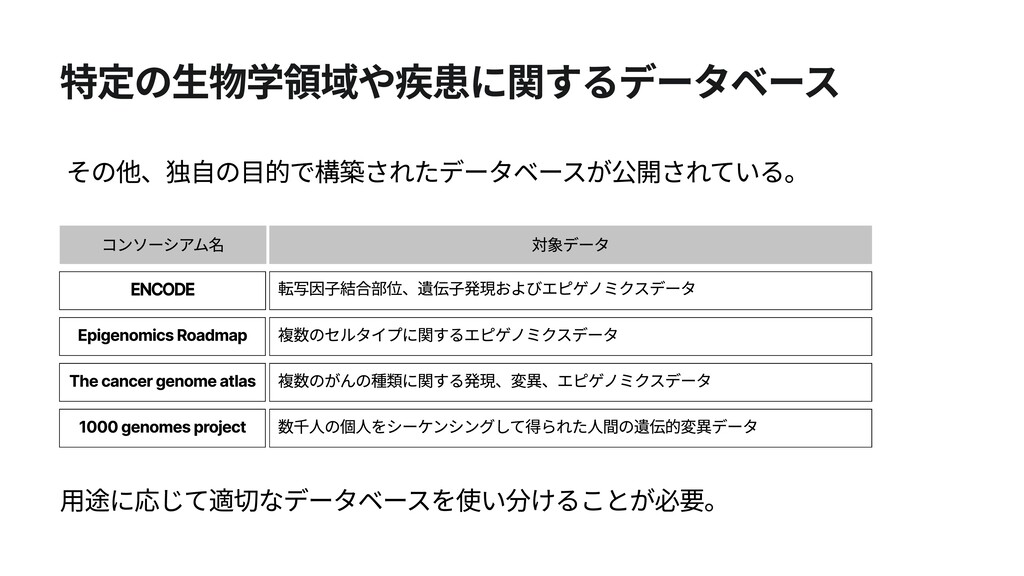
特定の生物学領域や疾患に関するデータベース その他、独自の目的で構築されたデータベースが公開されている。 用途に応じて適切なデータベースを使い分けることが必要。 コンソーシアム名 転写因子結合部位、遺伝子発現およびエピゲノミクスデータ 複数のセルタイプに関するエピゲノミクスデータ 対象データ ENCODE Epigenomics Roadmap
複数のがんの種類に関する発現、変異、エピゲノミクスデータ 数千人の個人をシーケンシングして得られた人間の遺伝的変異データ The cancer genome atlas 1000 genomes project -
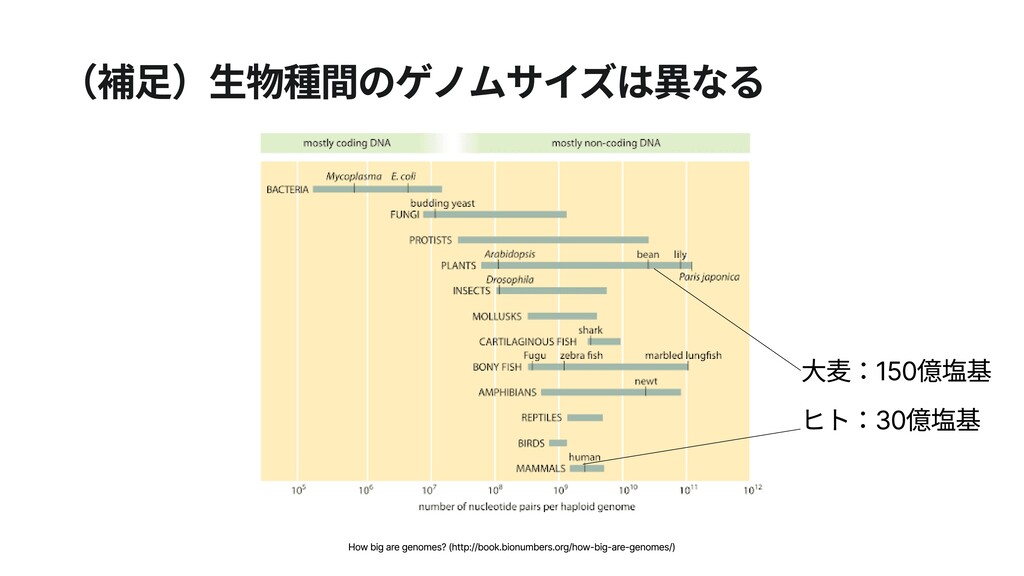
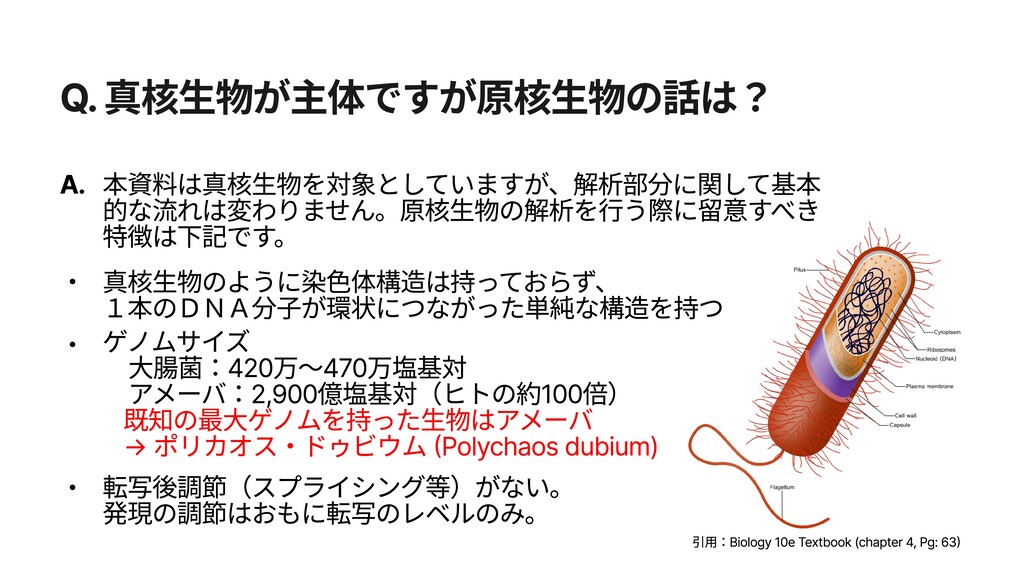
Q. 真核生物が主体ですが原核生物の話は? A. 転写後調節(スプライシング等)がない。 発現の調節はおもに転写のレベルのみ。 ゲノムサイズ 大腸菌:420万~470万塩基対 アメーバ:2,900億塩基対(ヒトの約100倍) 真核生物のように染色体構造は持っておらず、 1本のDNA分子が環状につながった単純な構造を持つ
・ ・ ・ 本資料は真核生物を対象としていますが、解析部分に関して基本 的な流れは変わりません。原核生物の解析を行う際に留意すべき 特徴は下記です。 既知の最大ゲノムを持った生物はアメーバ → ポリカオス・ドゥビウム (Polychaos dubium) 引用:Biology 10e Textbook (chapter 4, Pg: 63) -
Q. エンハンサーの中にスプライシングを促進するもの とそもそもの転写を促進する2種類(多種類)あるのか A. スプライシングエンハンサーはエクソン内に存在するスプライシングを指 示・促進する配列のことを指します(6塩基からなるDNA配列)。 一般的にエンハンサーというと、遺伝子の上流、下流あるいは遺伝子内に 存在し、転写因子が結合することで遺伝子発現を促進するような配列のこ とを指します 。
以上から、スプライシングエンハンサーは一般的なエンハンサーの定義か らは少し異なったものと捉えるのが正しいかもしれません。 -
Q. 今の技術だと繰り返し配列のエラー率はどれくらいに なりますか? A. アセンブリの際のエラー率は、繰り返し配列の量・長さに依ります 。 一般的に繰り返し配列はユニークな配列に対し、エラー率が高くなること が言われています 。 Repetitive
DNA and next-generation sequencing: computational challenges and solutions https://pubmed.ncbi.nlm.nih.gov/22124482 参考: -
Q. よく「ドラフトゲノム」という言葉を耳にするが、 これは不完全に決定、という意味か? A. 多くのゲノム配列は繰り返し配列などの解読が困難な部分が多くをを占め ており、ゲノムアセンブリによって染色体への対応付けを含む全ゲノムの 完全な配列を決定することは膨大な労力と時間がかかります 。 解読率が低く、配列が不連続であったり、正確に配列推定されていない概 要配列の状態でも、おおよその遺伝子情報は得ることができるため、この
ようなデータを用いて研究を行うことが可能となります 。 上記のような可能な範囲で全ゲノム配列を決定したリードのデータを「ド ラフトゲノム」と表現します 。