Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
【第5回】ゼロから始めるゲノム解析(Python編)
Search
Sponsored
·
SiteGround - Reliable hosting with speed, security, and support you can count on.
→
nkimoto
December 23, 2021
Technology
780
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
【第5回】ゼロから始めるゲノム解析(Python編)
2021/12/23 (木) 【第5回】ゼロから始めるゲノム解析(Python編) 資料
nkimoto
December 23, 2021
Transcript
18 slides
【第5回】ゼロから始めるゲノム解析 (Python編) Computing GC Content: Parsing FASTA and Analyzing Sequences
@kimoton
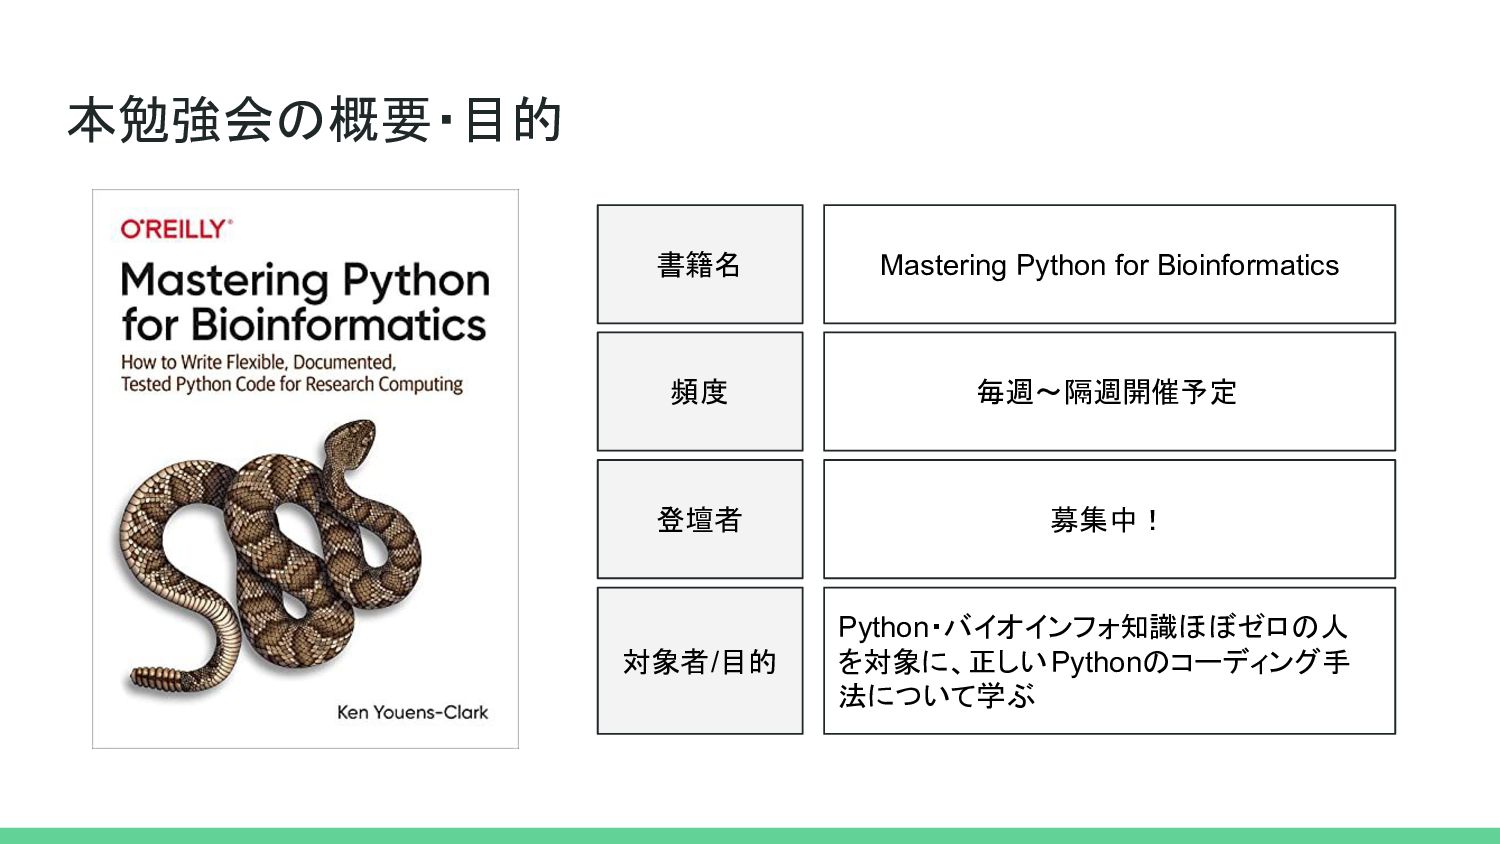
本勉強会の概要・目的 書籍名 対象者/目的 Mastering Python for Bioinformatics Python・バイオインフォ知識ほぼゼロの人 を対象に、正しいPythonのコーディング手 法について学ぶ
頻度 毎週〜隔週開催予定 登壇者 募集中!
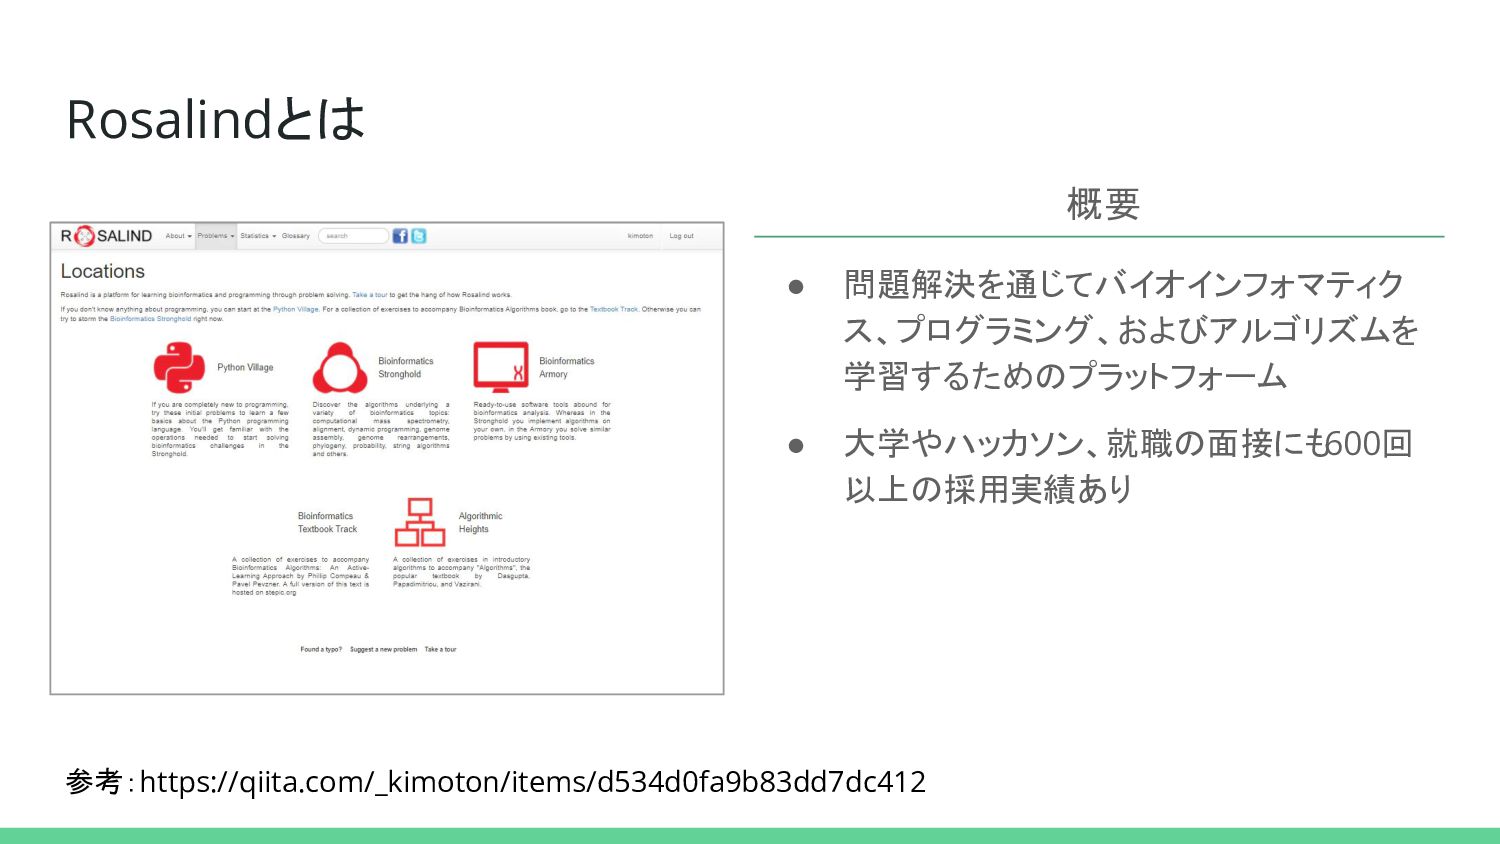
Rosalindとは • 問題解決を通じてバイオインフォマティク ス、プログラミング、およびアルゴリズムを 学習するためのプラットフォーム • 大学やハッカソン、就職の面接にも 600回 以上の採用実績あり 参考:https://qiita.com/_kimoton/items/d534d0fa9b83dd7dc412
概要
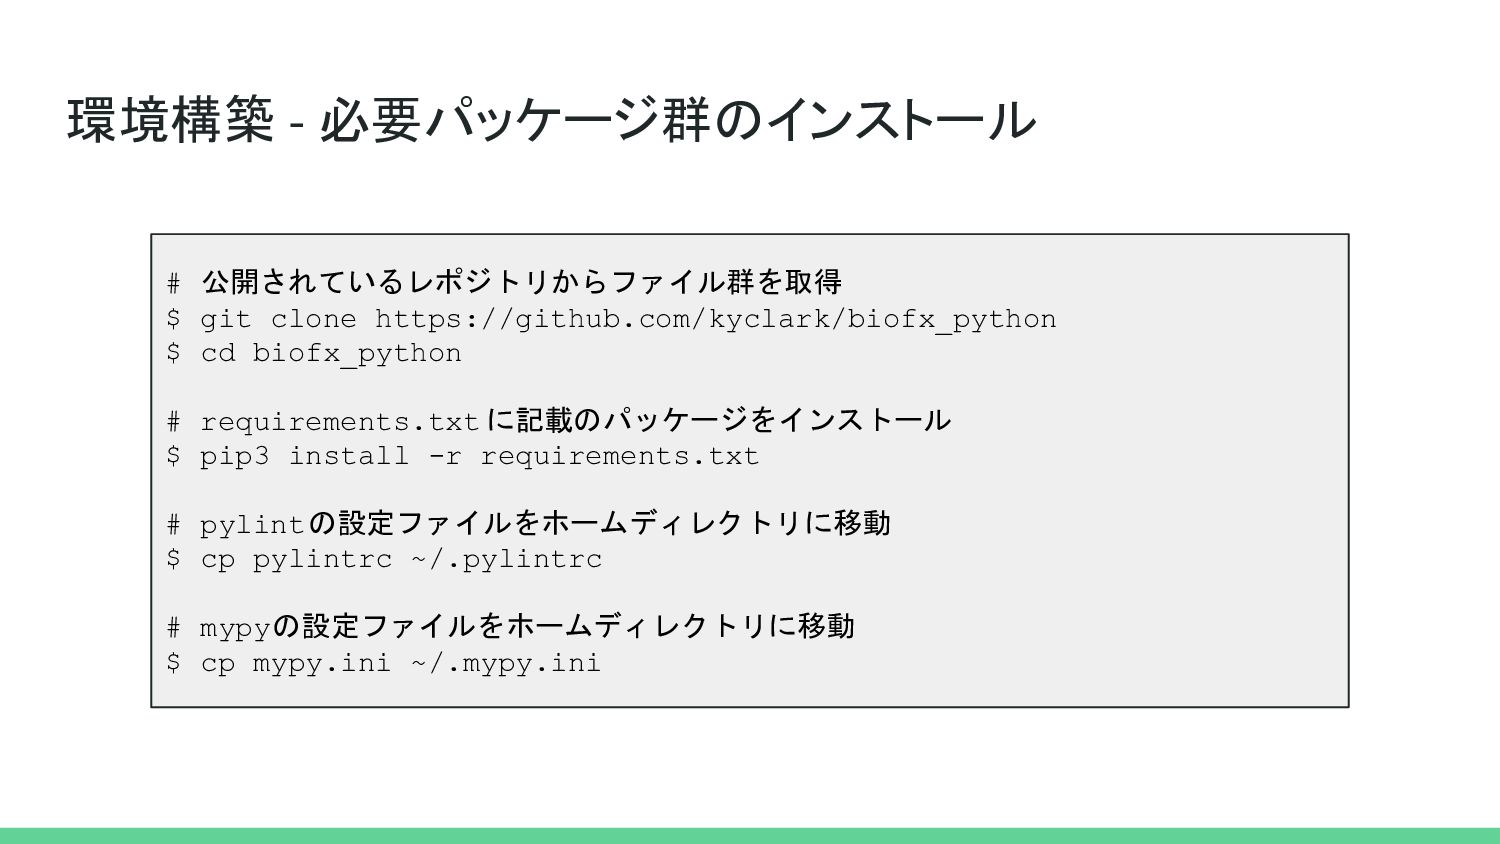
環境構築 - 必要パッケージ群のインストール # 公開されているレポジトリからファイル群を取得 $ git clone https://github.com/kyclark/biofx_python $
cd biofx_python # requirements.txt に記載のパッケージをインストール $ pip3 install -r requirements.txt # pylintの設定ファイルをホームディレクトリに移動 $ cp pylintrc ~/.pylintrc # mypyの設定ファイルをホームディレクトリに移動 $ cp mypy.ini ~/.mypy.ini
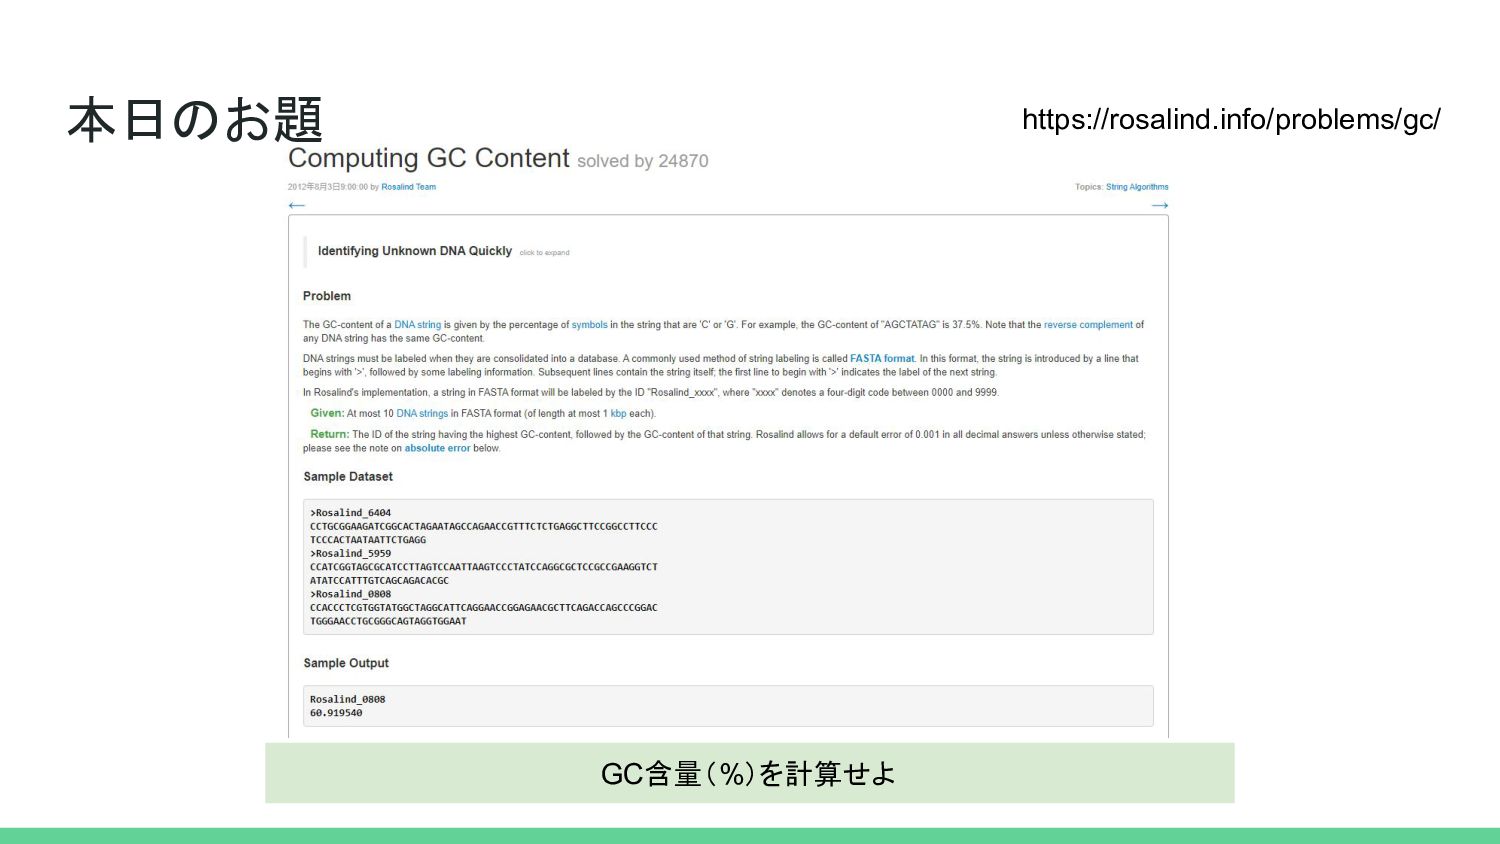
本日のお題 GC含量(%)を計算せよ https://rosalind.info/problems/gc/
本日学ぶこと • Bio.Seqモジュールを用いたFASTAファイルのパースの仕方 • 標準入力の受け取り方 • formatメソッドを用いた文字列フォーマットの仕方 • リスト内包表記、filter()関数、map()関数を用いたforループの書き換 え
• 正規表現を用いた文字列内のパターンカウント
前提知識編
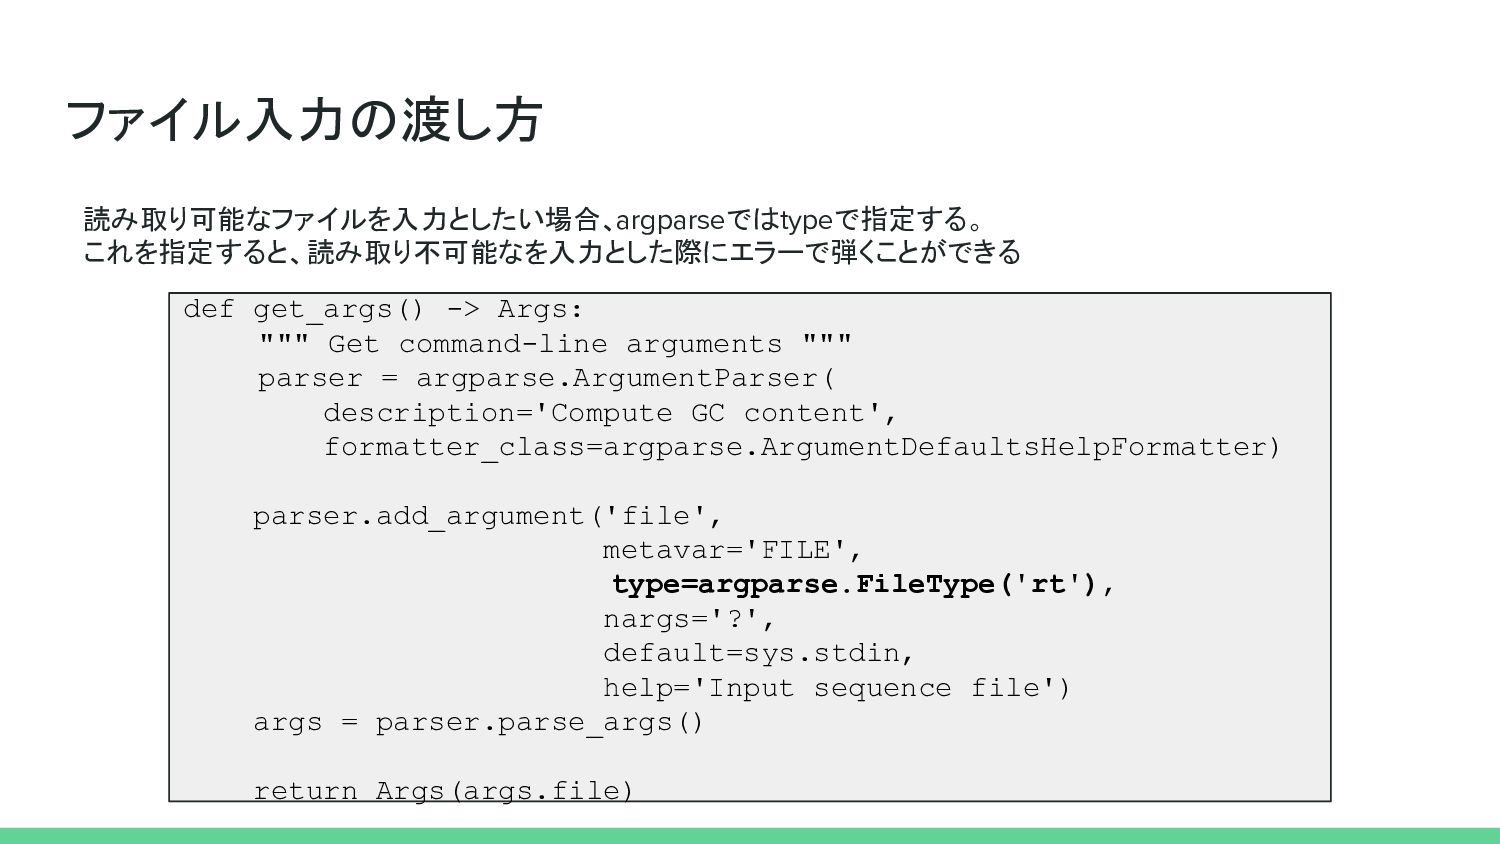
ファイル入力の渡し方 読み取り可能なファイルを入力としたい場合、argparseではtypeで指定する。 これを指定すると、読み取り不可能なを入力とした際にエラーで弾くことができる def get_args() -> Args: """ Get command-line
arguments """ parser = argparse.ArgumentParser( description='Compute GC content', formatter_class=argparse.ArgumentDefaultsHelpFormatter) parser.add_argument('file', metavar='FILE', type=argparse.FileType('rt'), nargs='?', default=sys.stdin, help='Input sequence file') args = parser.parse_args() return Args(args.file)
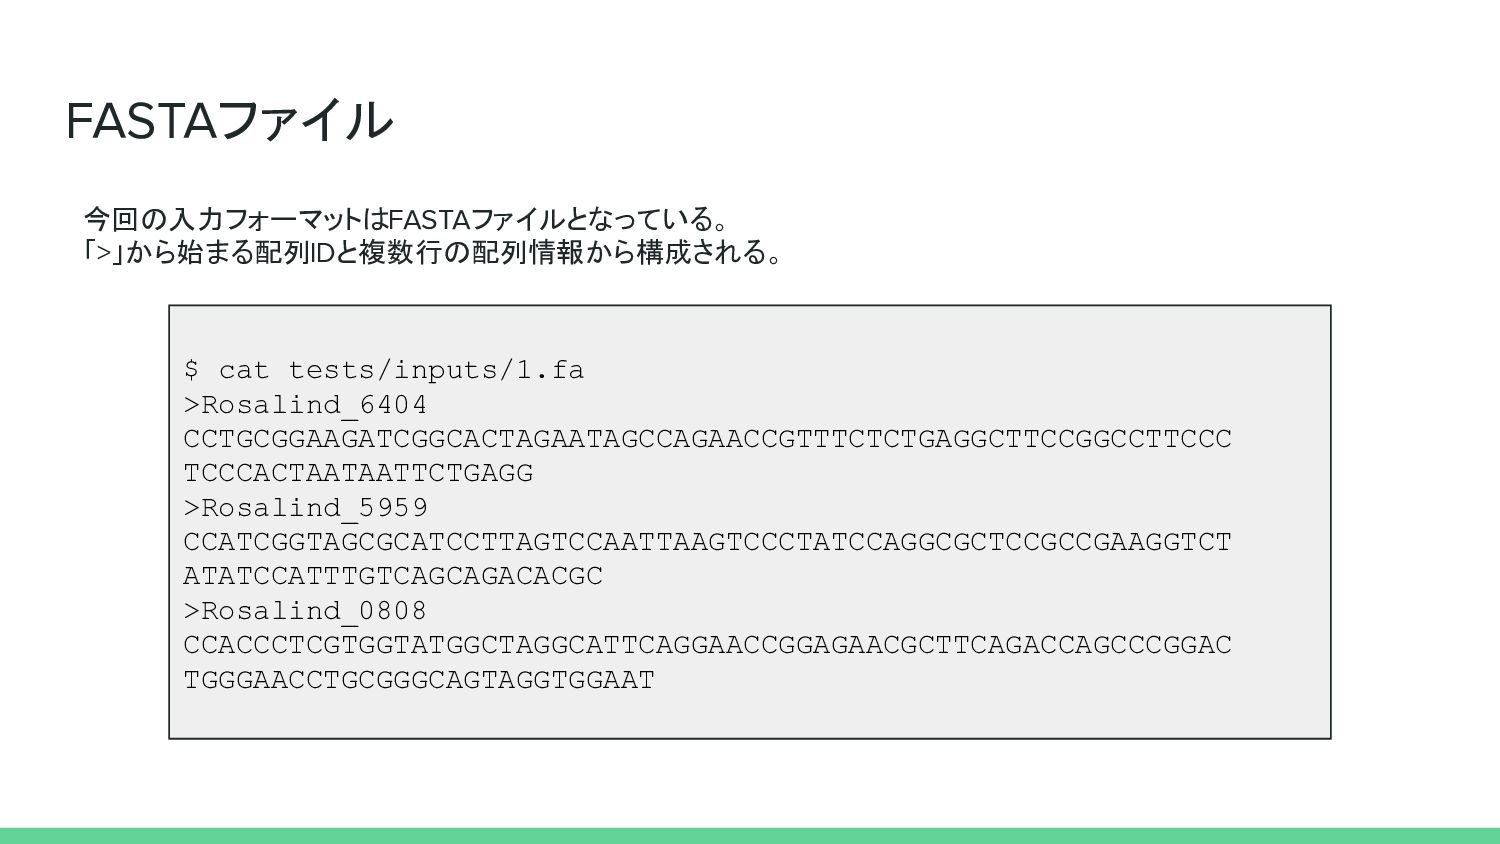
FASTAファイル 今回の入力フォーマットはFASTAファイルとなっている。 「>」から始まる配列IDと複数行の配列情報から構成される。 $ cat tests/inputs/1.fa >Rosalind_6404 CCTGCGGAAGATCGGCACTAGAATAGCCAGAACCGTTTCTCTGAGGCTTCCGGCCTTCCC TCCCACTAATAATTCTGAGG >Rosalind_5959
CCATCGGTAGCGCATCCTTAGTCCAATTAAGTCCCTATCCAGGCGCTCCGCCGAAGGTCT ATATCCATTTGTCAGCAGACACGC >Rosalind_0808 CCACCCTCGTGGTATGGCTAGGCATTCAGGAACCGGAGAACGCTTCAGACCAGCCCGGAC TGGGAACCTGCGGGCAGTAGGTGGAAT
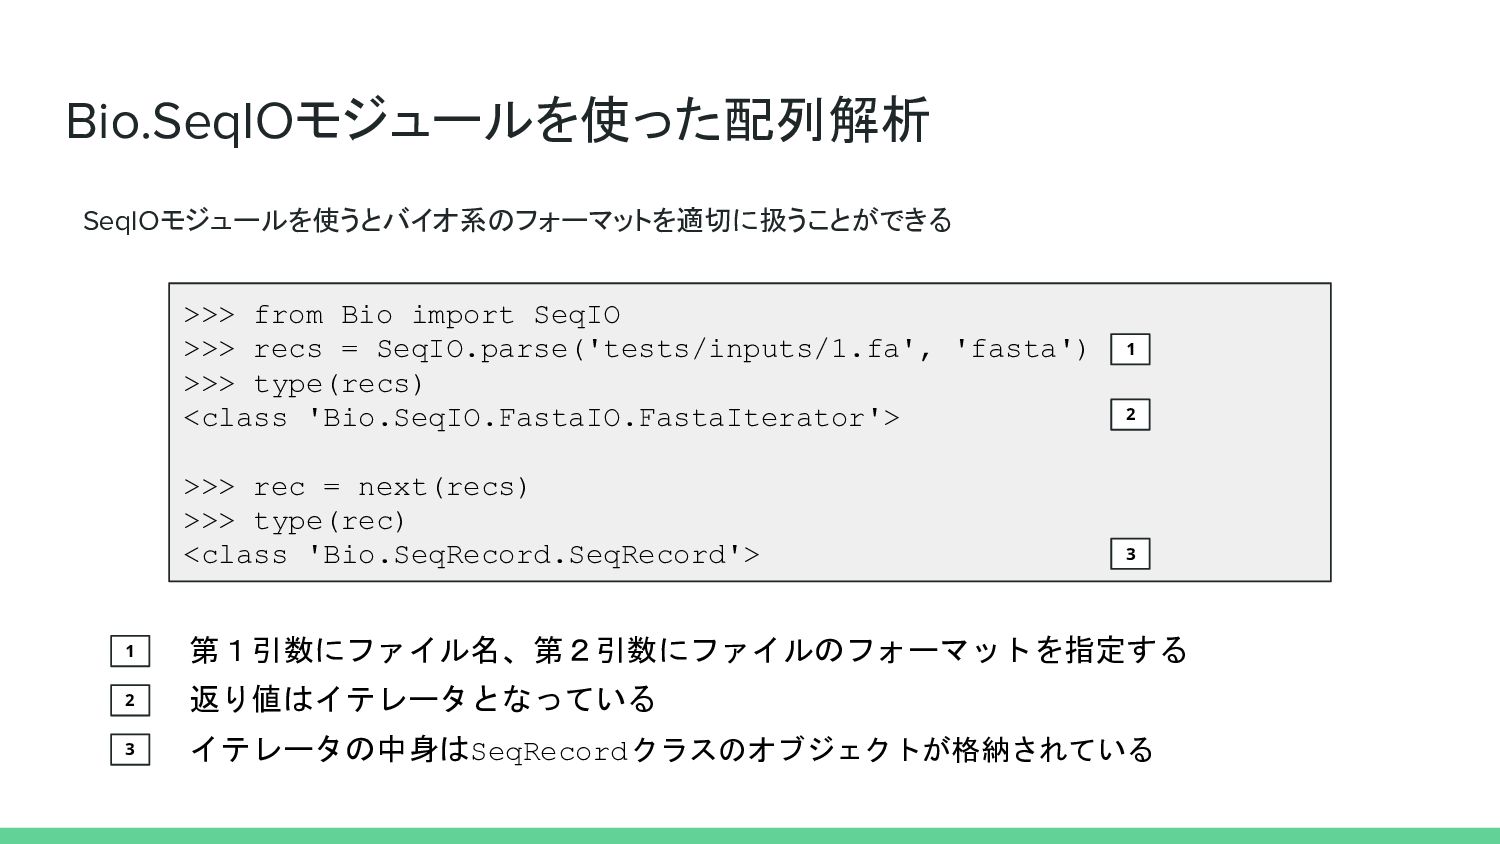
Bio.SeqIOモジュールを使った配列解析 SeqIOモジュールを使うとバイオ系のフォーマットを適切に扱うことができる >>> from Bio import SeqIO >>> recs =
SeqIO.parse('tests/inputs/1.fa', 'fasta') >>> type(recs) <class 'Bio.SeqIO.FastaIO.FastaIterator'> >>> rec = next(recs) >>> type(rec) <class 'Bio.SeqRecord.SeqRecord'> 1 1 第1引数にファイル名、第2引数にファイルのフォーマットを指定する 2 返り値はイテレータとなっている 2 3 3 イテレータの中身はSeqRecordクラスのオブジェクトが格納されている
SeqRecordクラス SeqIOモジュールで読み取ったデータはSeqRecordクラスのオブジェクトとして扱う >>> rec SeqRecord( seq=Seq('CCTGCGGAAGATCGGCACTAGAATAGCCAGAACCGTTTCTCTGAGGCTTCCGGC...AGG'), id='Rosalind_6404', name='Rosalind_6404', description='Rosalind_6404', dbxrefs=[]
) 1 1 seq属性には、FASTAファイルに含まれていた配列のSeqオブジェクトが格納され ている 2 id属性には、FASTAファイルに含まれていた配列IDが格納される 2 3 他にもnameやdescriptionといった情報が格納できる。 3
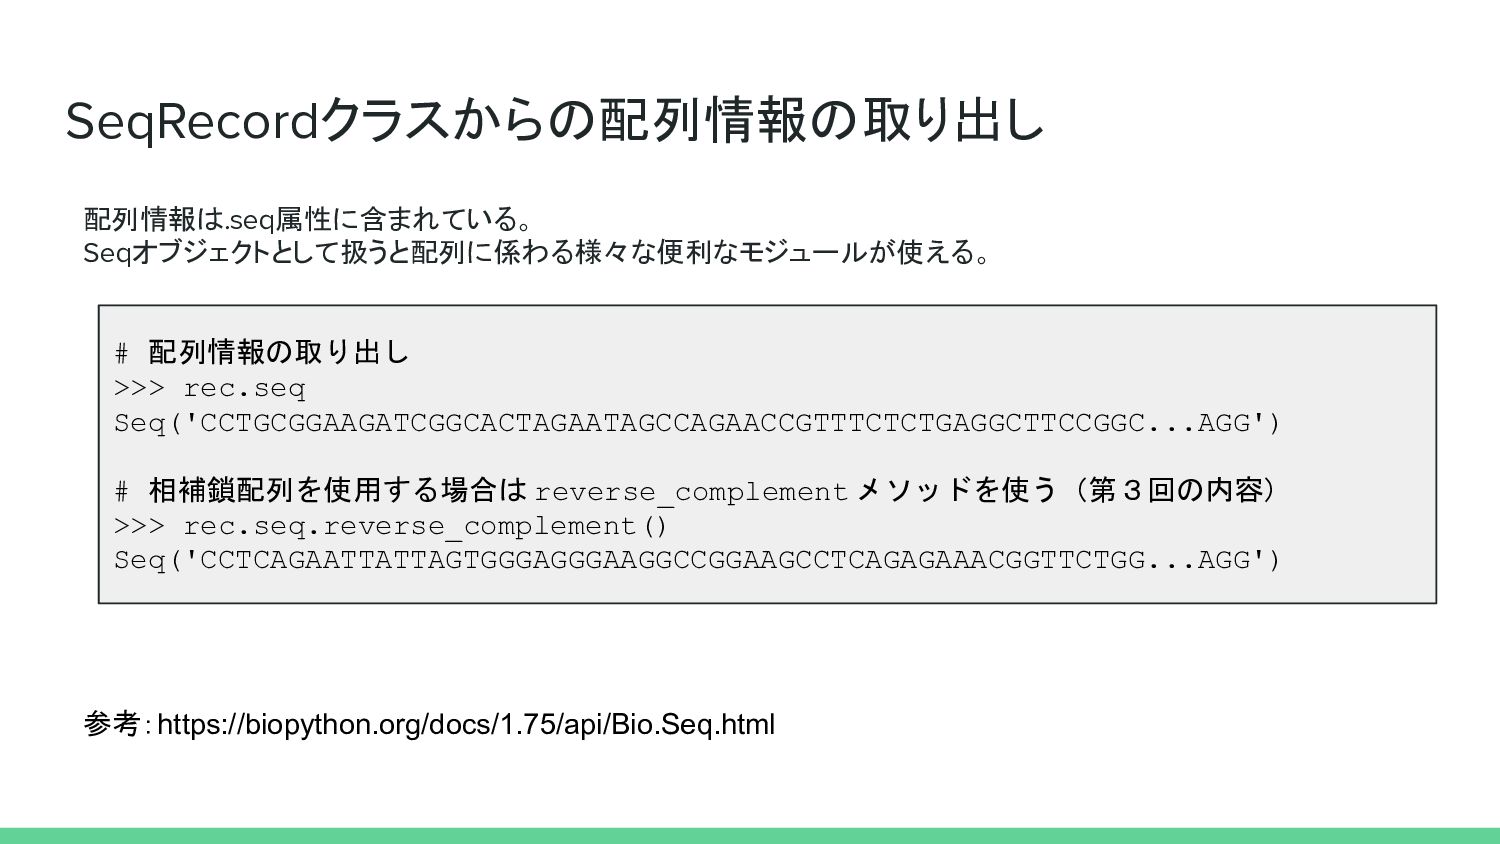
SeqRecordクラスからの配列情報の取り出し 配列情報は.seq属性に含まれている。 Seqオブジェクトとして扱うと配列に係わる様々な便利なモジュールが使える。 # 配列情報の取り出し >>> rec.seq Seq('CCTGCGGAAGATCGGCACTAGAATAGCCAGAACCGTTTCTCTGAGGCTTCCGGC...AGG') # 相補鎖配列を使用する場合は
reverse_complement メソッドを使う(第3回の内容) >>> rec.seq.reverse_complement() Seq('CCTCAGAATTATTAGTGGGAGGGAAGGCCGGAAGCCTCAGAGAAACGGTTCTGG...AGG') 参考:https://biopython.org/docs/1.75/api/Bio.Seq.html
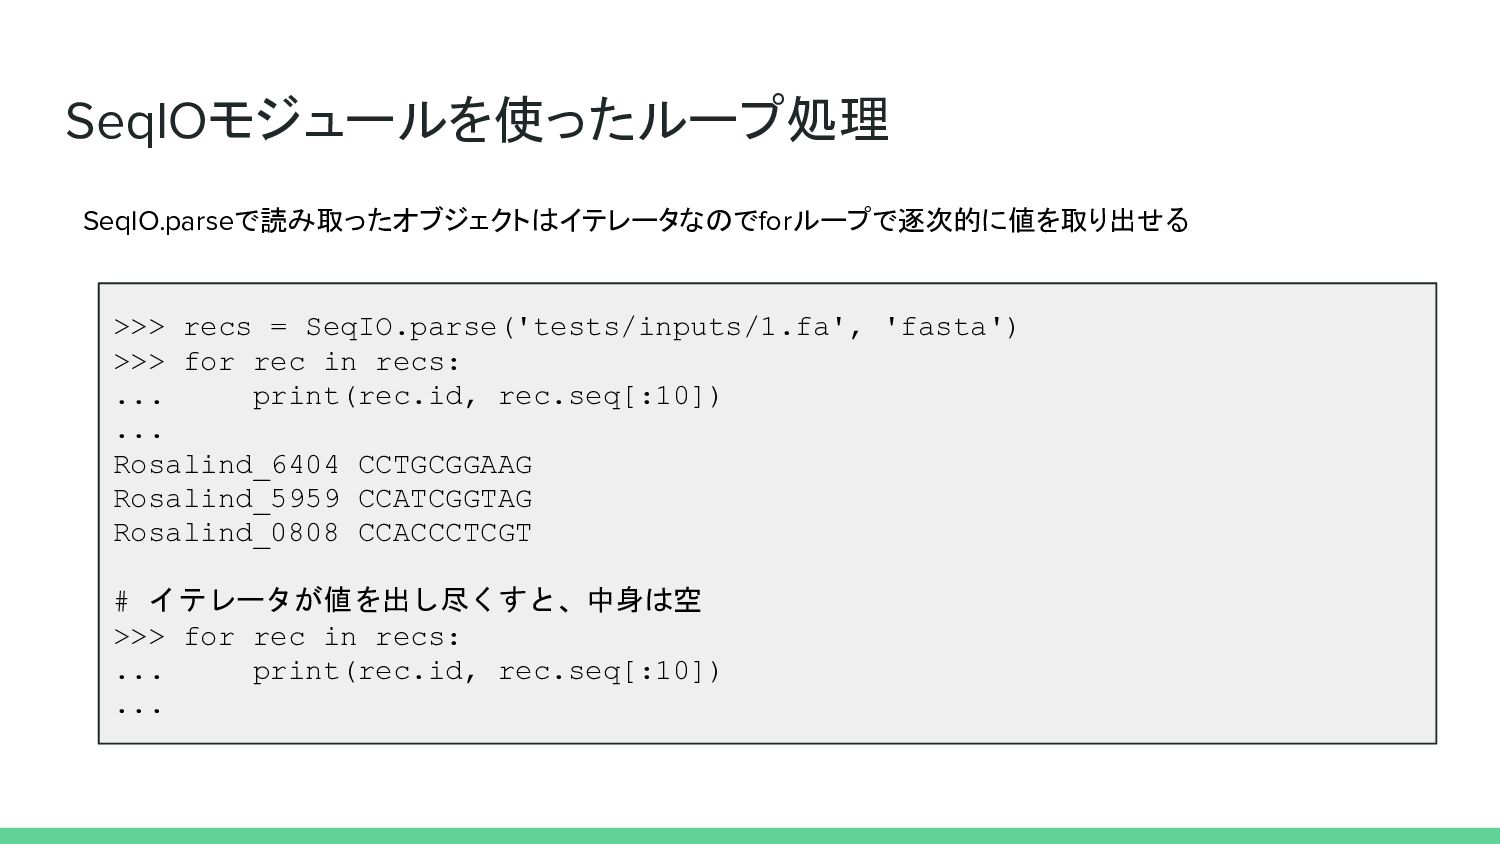
SeqIOモジュールを使ったループ処理 SeqIO.parseで読み取ったオブジェクトはイテレータなのでforループで逐次的に値を取り出せる >>> recs = SeqIO.parse('tests/inputs/1.fa', 'fasta') >>> for rec
in recs: ... print(rec.id, rec.seq[:10]) ... Rosalind_6404 CCTGCGGAAG Rosalind_5959 CCATCGGTAG Rosalind_0808 CCACCCTCGT # イテレータが値を出し尽くすと、中身は空 >>> for rec in recs: ... print(rec.id, rec.seq[:10]) ...
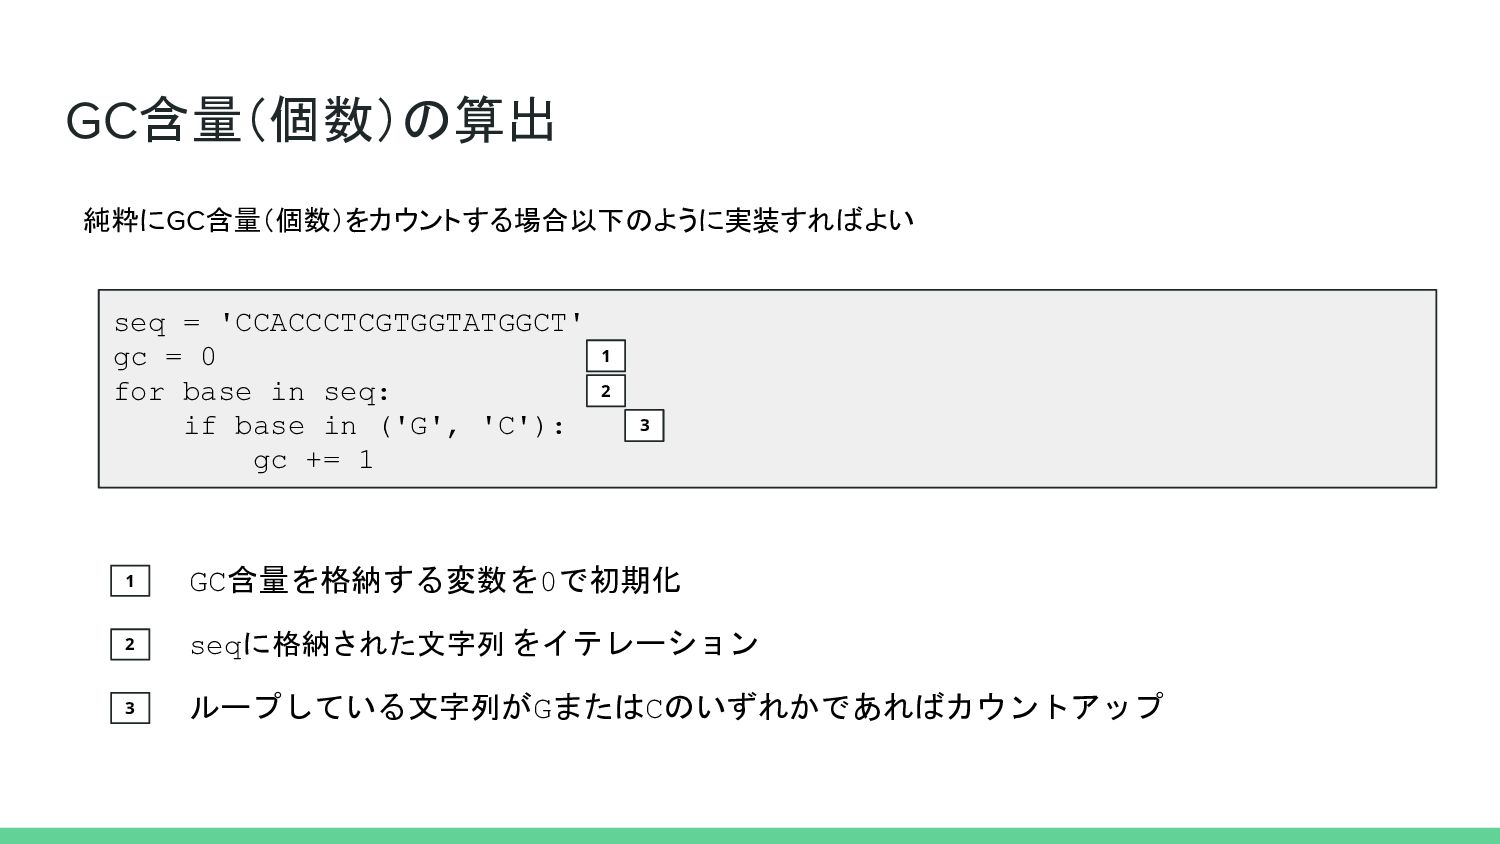
GC含量(個数)の算出 純粋にGC含量(個数)をカウントする場合以下のように実装すればよい seq = 'CCACCCTCGTGGTATGGCT' gc = 0 for base
in seq: if base in ('G', 'C'): gc += 1 1 1 GC含量を格納する変数を0で初期化 2 seqに格納された文字列 をイテレーション 3 ループしている文字列がGまたはCのいずれかであればカウントアップ 2 3
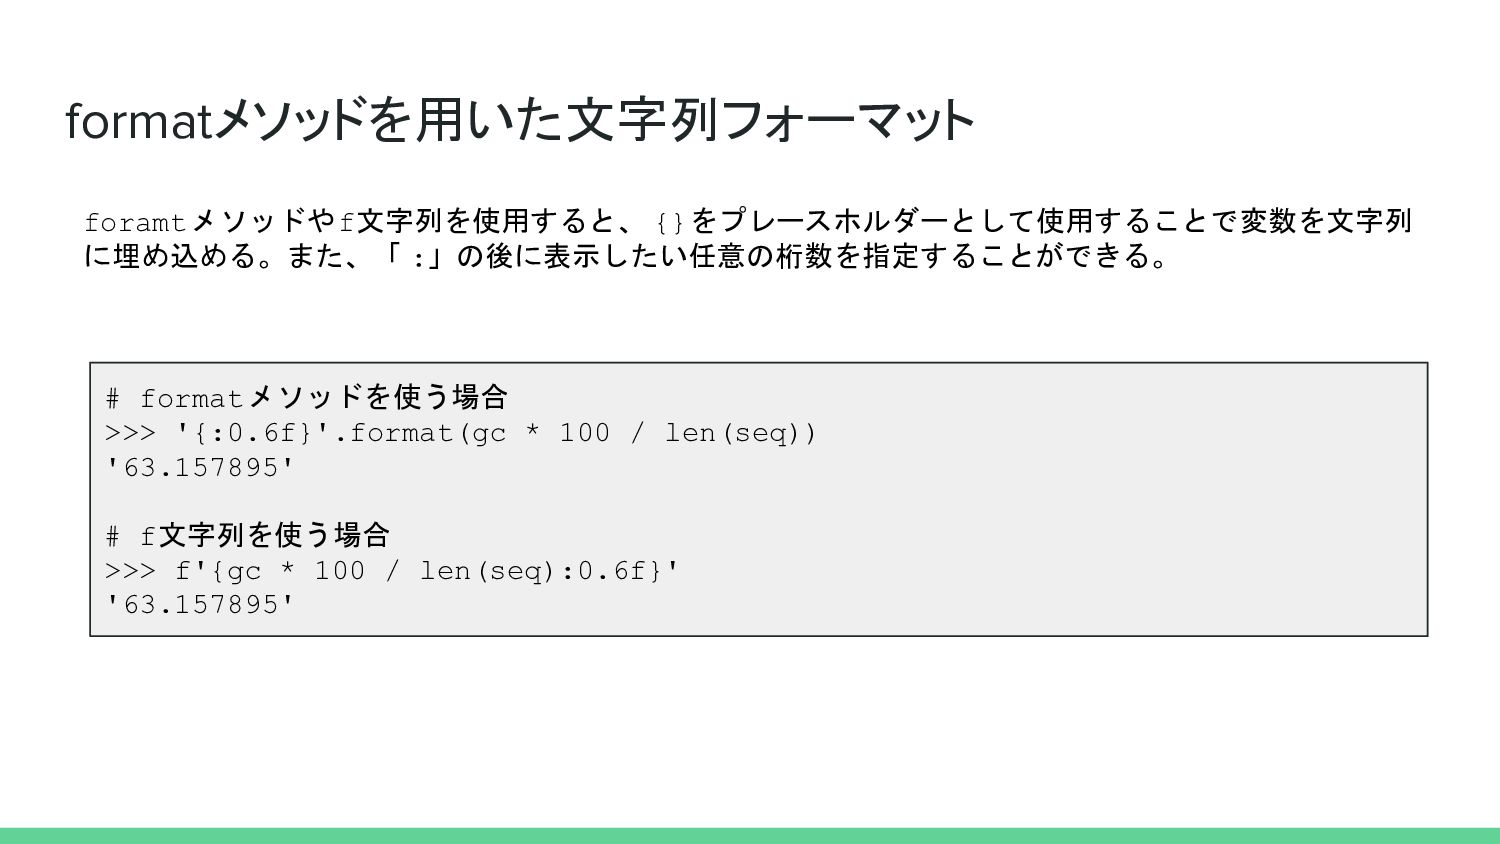
formatメソッドを用いた文字列フォーマット # formatメソッドを使う場合 >>> '{:0.6f}'.format(gc * 100 / len(seq)) '63.157895'
# f文字列を使う場合 >>> f'{gc * 100 / len(seq):0.6f}' '63.157895' foramtメソッドやf文字列を使用すると、 {}をプレースホルダーとして使用することで変数を文字列 に埋め込める。また、「 :」の後に表示したい任意の桁数を指定することができる。
解法編
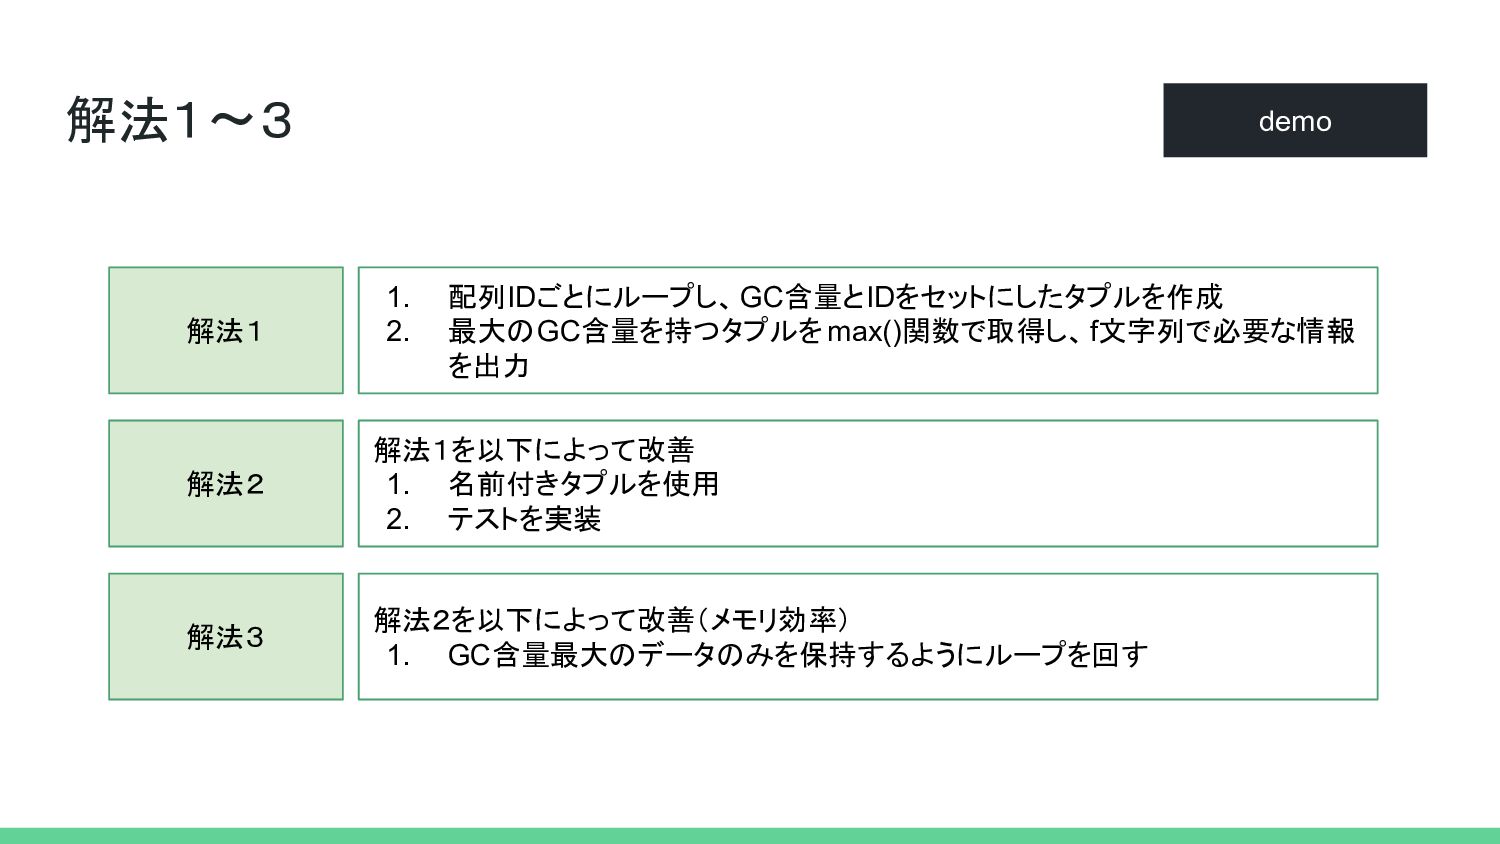
解法1~3 demo 解法1 1. 配列IDごとにループし、GC含量とIDをセットにしたタプルを作成 2. 最大のGC含量を持つタプルを max()関数で取得し、f文字列で必要な情報 を出力 解法2
解法1を以下によって改善 1. 名前付きタプルを使用 2. テストを実装 解法3 解法2を以下によって改善(メモリ効率) 1. GC含量最大のデータのみを保持するようにループを回す
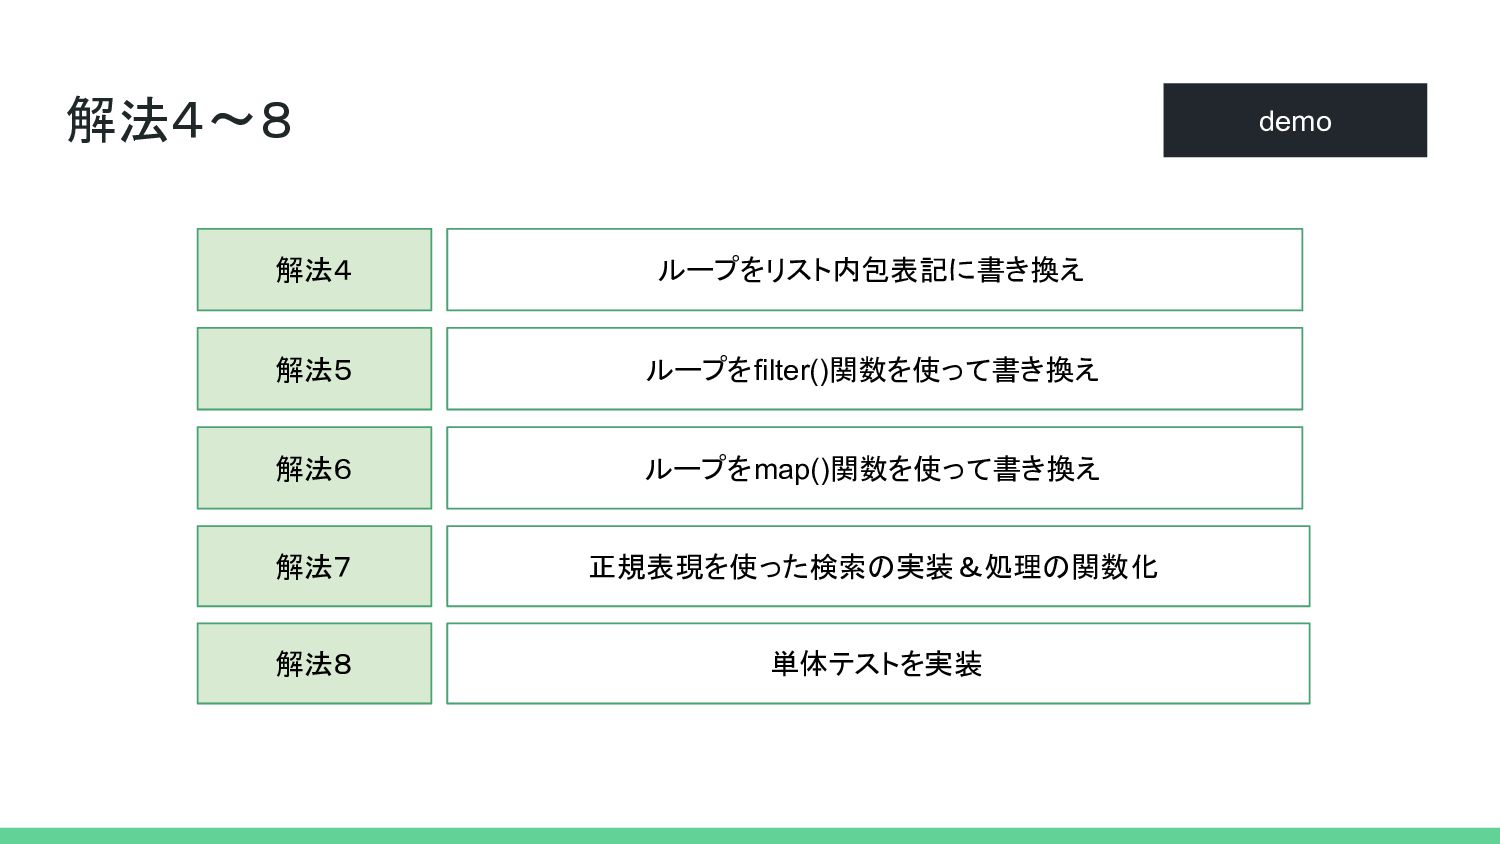
解法4~8 demo 解法4 ループをリスト内包表記に書き換え 解法5 ループをfilter()関数を使って書き換え 解法6 ループをmap()関数を使って書き換え 解法7 正規表現を使った検索の実装&処理の関数化
解法8 単体テストを実装
More Decks by nkimoto
See All by nkimoto
Location Restriction Sites: Using, Testing, and Sharing Code
nkimoto
0
390
Finding a Protein Motif: Fetching Data and Using Regular Expressions
nkimoto
0
370
Overlap Graphs: Sequence Assembly Using Shared K-mers
nkimoto
0
250
Computing GC Content: Parsing FASTA and Analyzing Sequences
nkimoto
0
340
【第3回】ゼロから始めるゲノム解析(Python編)
nkimoto
0
490
【第1回】ゼロから始めるゲノム解析(Python編).pdf
nkimoto
0
960
【第7回】ゼロから始めるゲノム解析.pdf
nkimoto
0
500
【第5回】ゼロから始めるゲノム解析(R編)
nkimoto
0
600
【第3回】ゼロから始めるゲノム解析(R編)
nkimoto
0
1.6k
Other Decks in Technology
See All in Technology
これからのデータエンジニアの役割について考える / Rethinking the Role of Data Engineers in the AI Era
okiyuki99
0
370
PostgreSQL オプティマイザ統計の秘密
nori_shinoda
1
460
Go初心者のクラウドエンジニアが、デプロイを通して旨味を知っていく話
ryudai
1
140
現場を動かすAIエージェント#2_製造業現場でのAI活用から見た、ハマる罠と実践知
kintotechdev
2
220
内製アプリとClaudeスキルのセキュリティチェック、 Backlogの課題で回しています。
ayaka_egaaa
0
170
Linuxネットワークスタック進化の軌跡: 過去10年の歩みと最新トレンド
orimanabu
1
280
2026-11-11 Tamachi.sre#7 PaCにインフラリソースの命を救われました。 / PaC saves the infra resource life
masasuzu
0
120
顧客合意を取りながら進めるAWSコスト削減の実践
optim
0
160
自治体AIコンタクトセンター、何をどこに任せる?~Amazon Connect Customer +Amazon Bedrockの実践知~ / 20261107 Satoshi Torano
shift_evolve
PRO
1
130
Frontier Teams — Amazon は AI で「開発のやり方」をどう変えたのか
kmotohas
0
150
AIエージェントの監視、思考を見るか行動を見るか / Monitoring AI Agents: Thoughts or Actions
yusukeshimizu
2
190
サボる子はいねぇがー!AgentCoreハーネスの脆弱性に学ぶ、エージェントの入力バリデーション
iwamot
PRO
5
320
Featured
See All Featured
Unsuck your backbone
ammeep
672
58k
AI Search: Implications for SEO and How to Move Forward - #ShenzhenSEOConference
aleyda
1
1.4k
GraphQLとの向き合い方2022年版
quramy
50
15k
Highjacked: Video Game Concept Design
rkendrick25
PRO
2
560
Keith and Marios Guide to Fast Websites
keithpitt
413
23k
What’s in a name? Adding method to the madness
productmarketing
PRO
24
4.2k
Writing Fast Ruby
sferik
630
63k
Discover your Explorer Soul
emna__ayadi
2
1.3k
Marketing to machines
jonoalderson
1
6k
Between Models and Reality
mayunak
4
570
Done Done
chrislema
187
17k
Breaking role norms: Why Content Design is so much more than writing copy - Taylor Woolridge
uxyall
2
520


 SiteGround - Reliable hosting with speed, security, and support you can count on.


 nkimoto
 okiyuki99
 nori_shinoda
 ryudai
 kintotechdev
 ayaka_egaaa
 orimanabu
 masasuzu
 optim
 shift_evolve
 kmotohas
 yusukeshimizu
 iwamot
 ammeep
 aleyda
 quramy
 rkendrick25
 keithpitt
 productmarketing
 sferik
 emna__ayadi
 jonoalderson
 mayunak
 chrislema
 uxyall