Share
Embed
Transcript
110 slides
-
Neste conjunto de transparências demonstraremos a importância do conceito de
base de um espaço vetorial. -
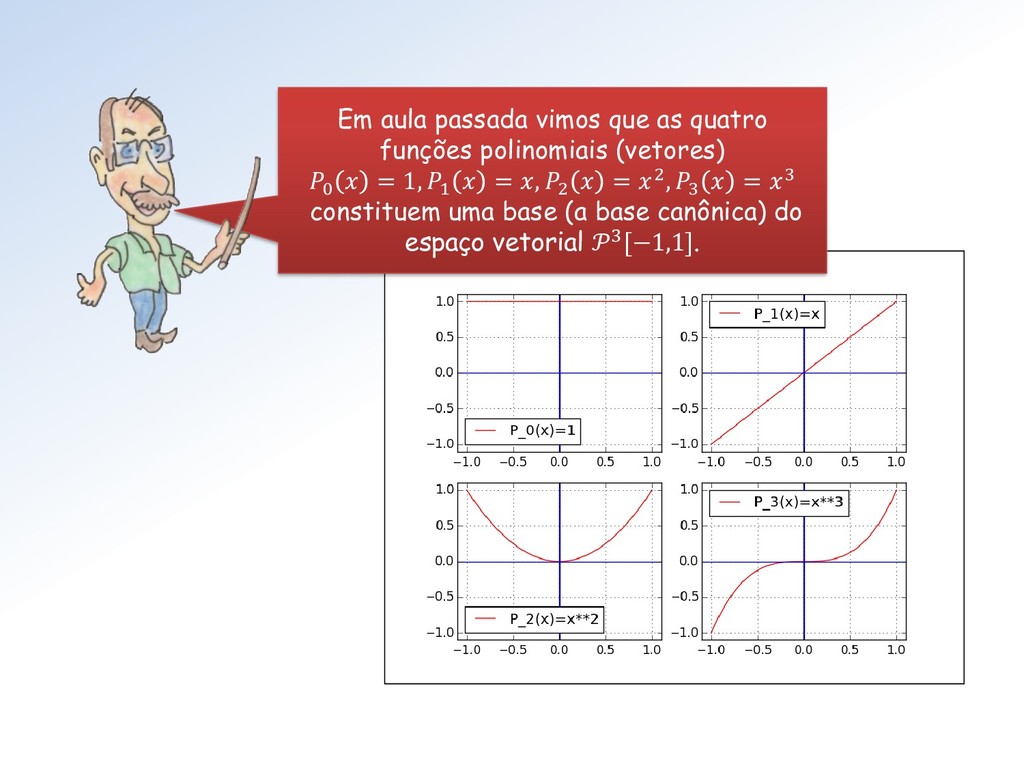
Em aula passada vimos que as quatro funções polinomiais (vetores)
0 = 1, 1 = , 2 = 2, 3 = 3 constituem uma base (a base canônica) do espaço vetorial 3[−1,1]. -
Uma outra base é a “base de Lagrange” Em ℙ1[,
], que tem dimensão 2, as funções básicas de Lagrange serão nomeadas 0 1 e 1 1 e são polinomiais de grau 1. -
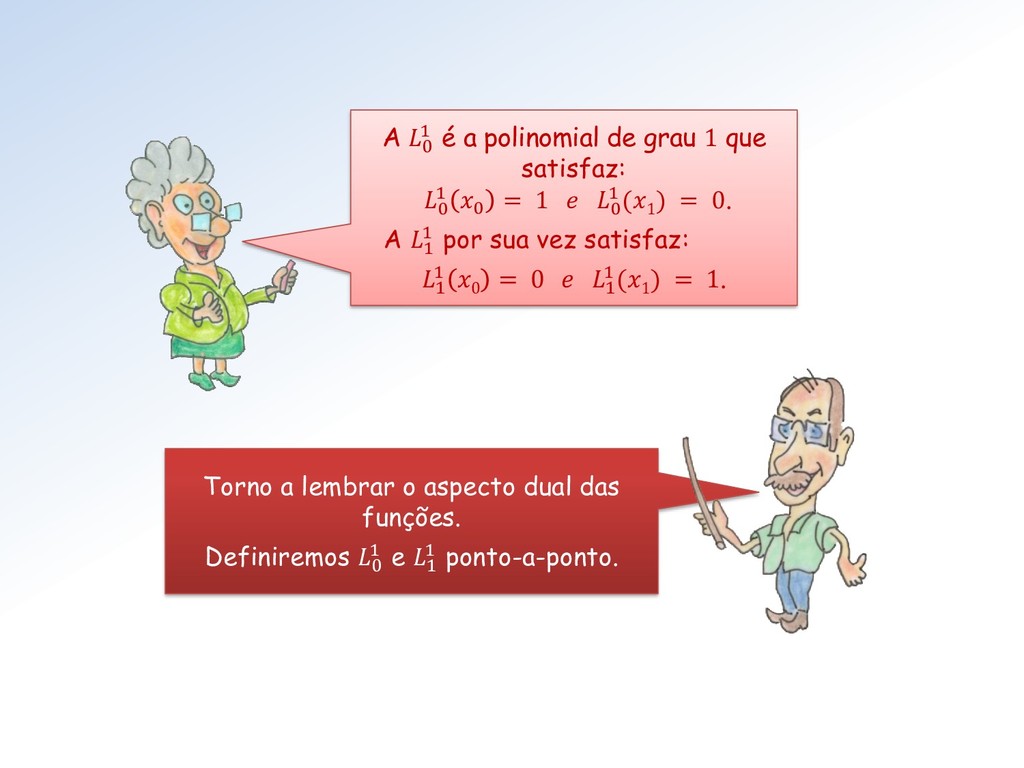
A 0 1 é a polinomial de grau 1 que
satisfaz: 0 1 0 = 1 0 1 ( 1 ) = 0. A 1 1 por sua vez satisfaz: 1 1 0 = 0 1 1( 1 ) = 1. Torno a lembrar o aspecto dual das funções. Definiremos 0 1 e 1 1 ponto-a-ponto. -
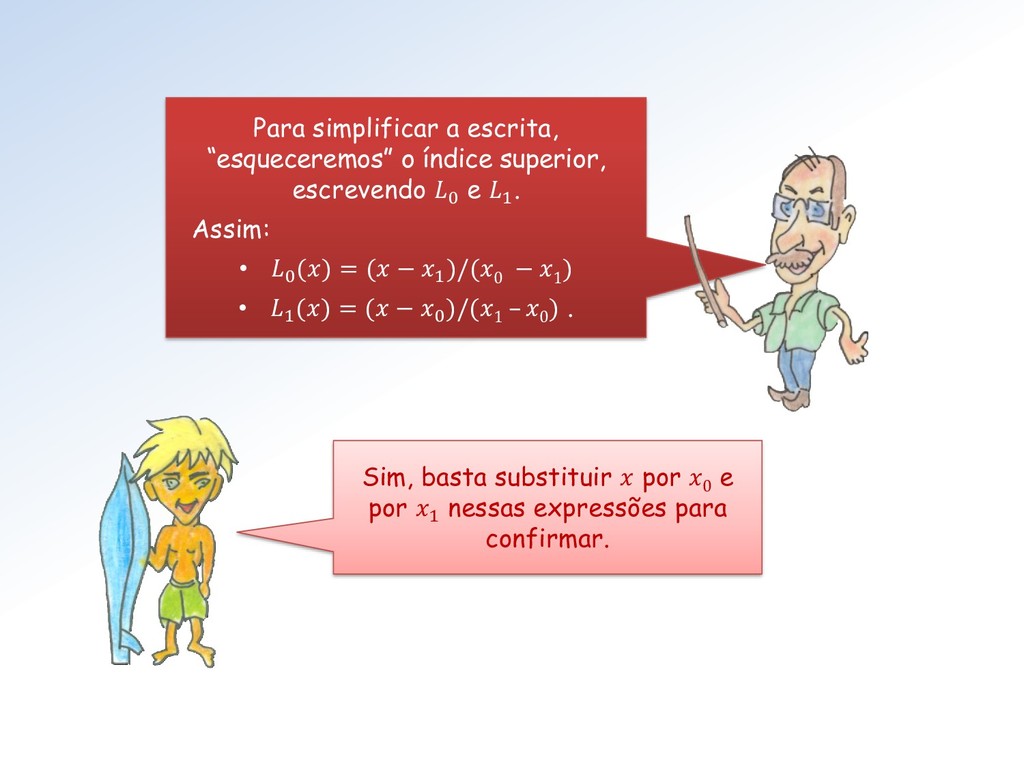
Para simplificar a escrita, “esqueceremos” o índice superior, escrevendo 0
e 1 . Assim: • 0 () = ( − 1 )/( 0 − 1 ) • 1 () = ( − 0 )/( 1 – 0 ) . Sim, basta substituir por 0 e por 1 nessas expressões para confirmar. -
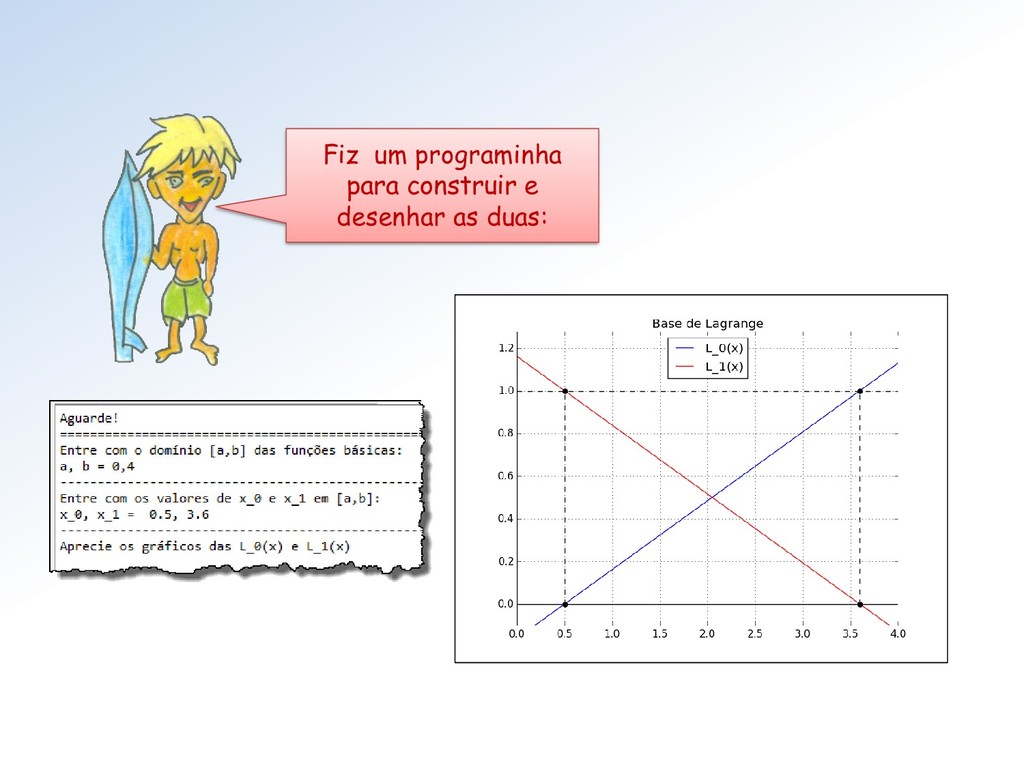
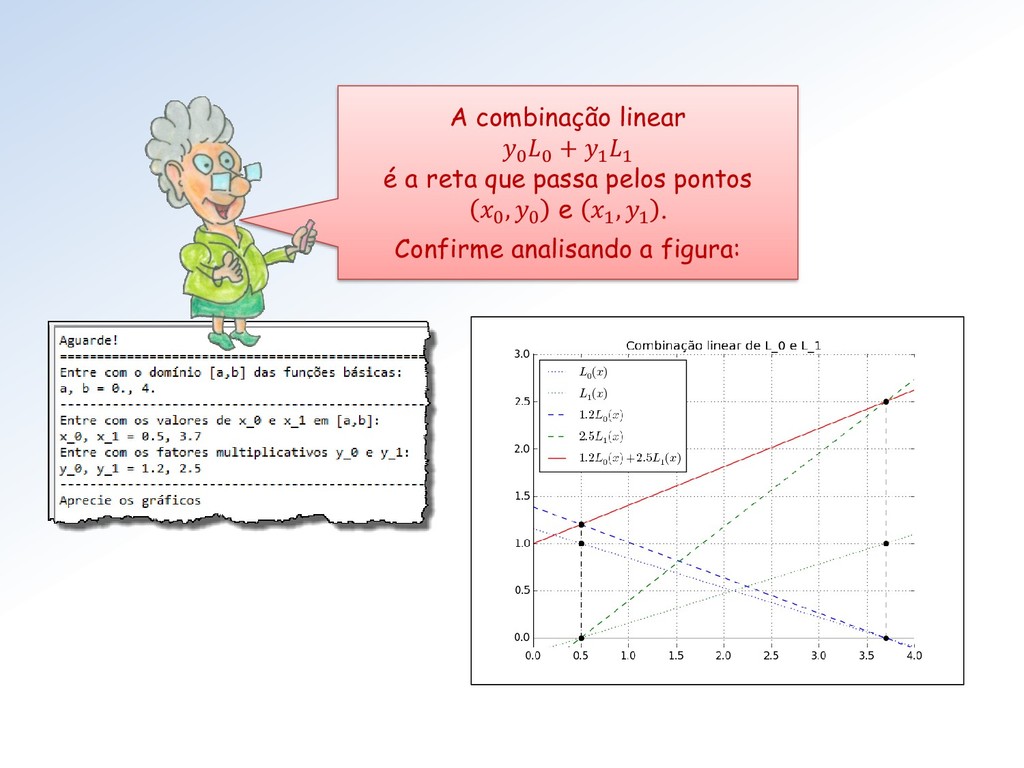
A combinação linear 0 0 + 1 1 é a
reta que passa pelos pontos 0 , 0 e 1 , 1 . Confirme analisando a figura: -
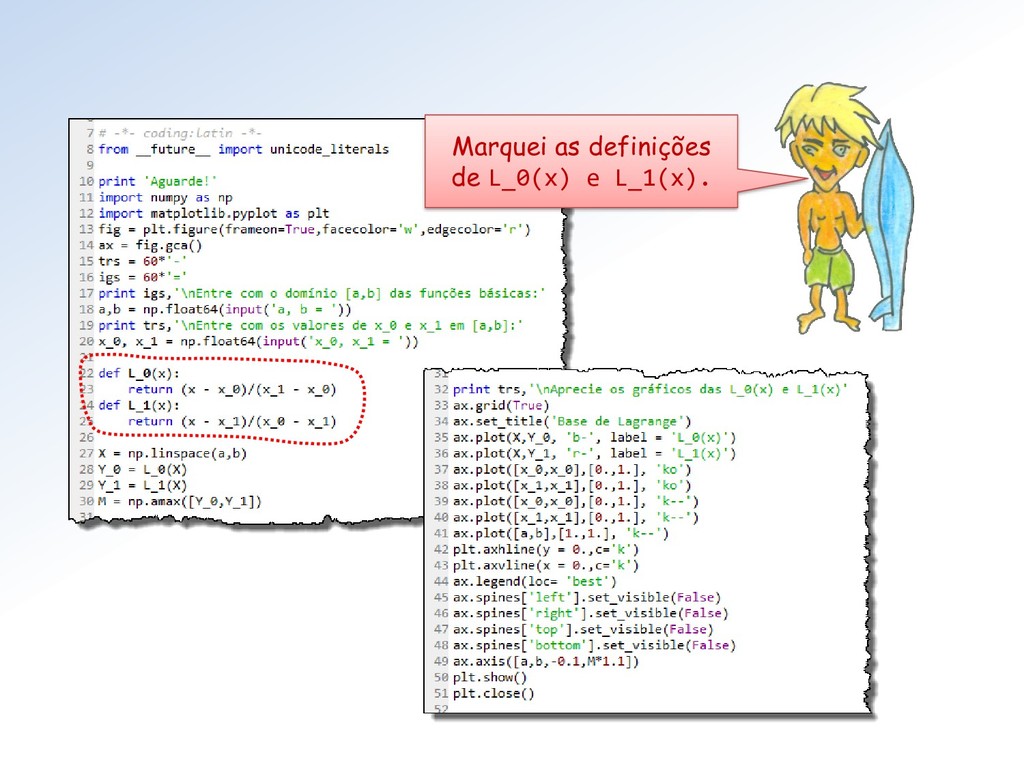
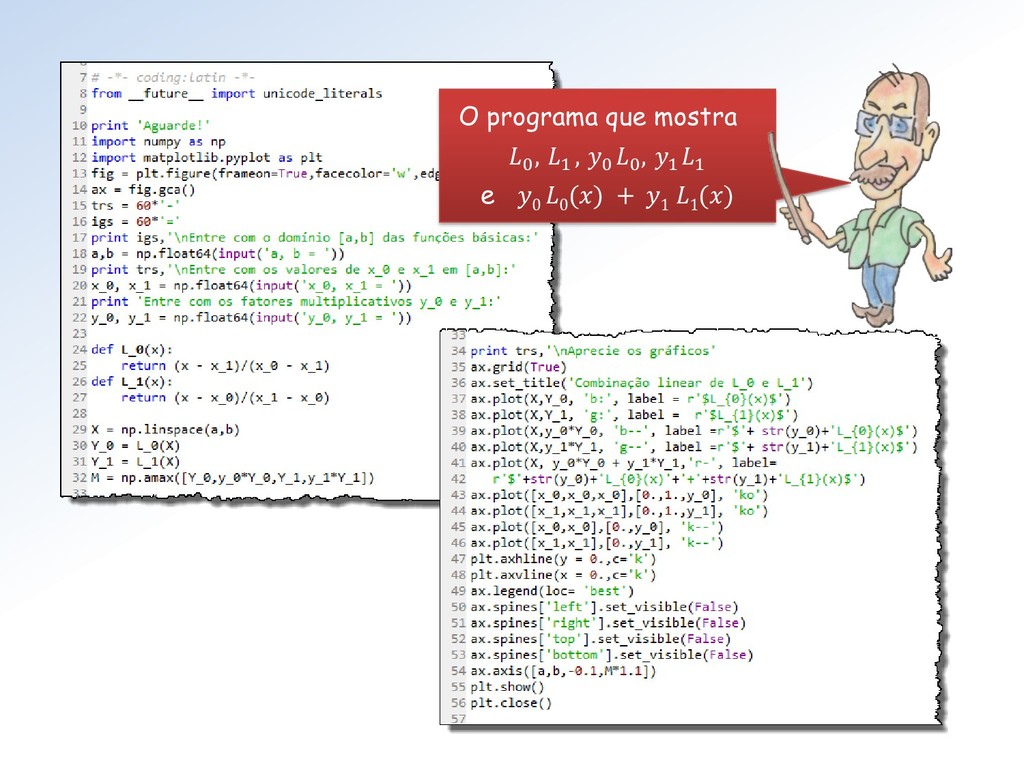
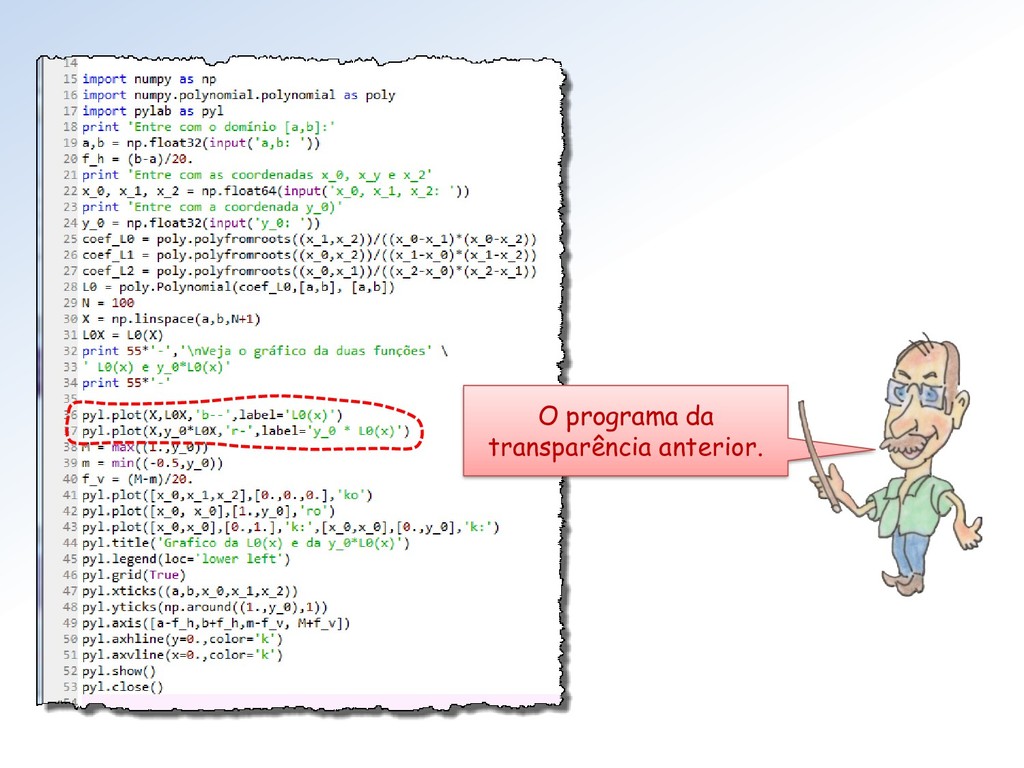
O programa que mostra 0 , 1 , 0 0
, 1 1 e 0 0 () + 1 1 () -
Bem, uma função polinomial de grau dois, responde tua pergunta.
Isto se os pontos já não estiverem alinhados. Mestra, qual a função que passa por três pontos dados? -
Em ℙ2[, ], que tem dimensão três, as funções básicas
(também) serão nomeadas 0 2 , 1 2 2 2(). Elas são polinomiais de grau 2. Elas são definidas pelas 9 condições: • 0 2 0 = 1, 0 2 1 = 0, 0 2( 2 ) = 0 • 1 2 0 = 0, 1 2 1 = 1, 1 2( 2 ) = 0 • 2 2 2 = 0, 2 2 1 = 0, 2 2( 2 ) = 1 -
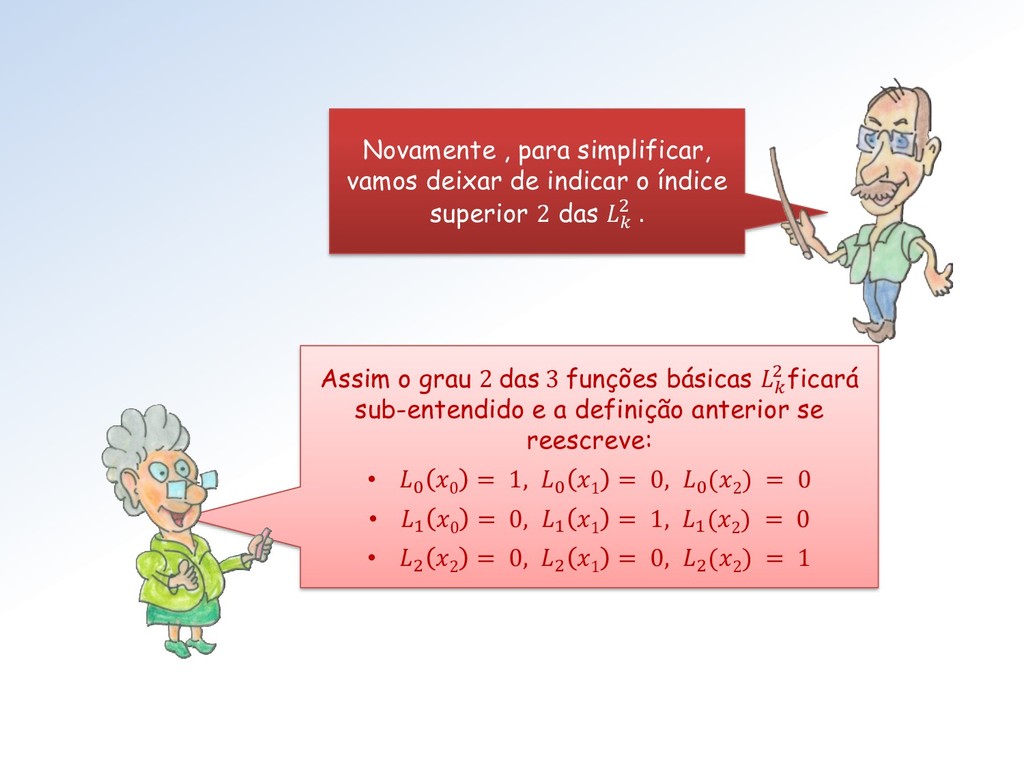
Assim o grau 2 das 3 funções básicas 2 ficará
sub-entendido e a definição anterior se reescreve: • 0 0 = 1, 0 1 = 0, 0 ( 2 ) = 0 • 1 0 = 0, 1 1 = 1, 1 ( 2 ) = 0 • 2 2 = 0, 2 1 = 0, 2 ( 2 ) = 1 Novamente , para simplificar, vamos deixar de indicar o índice superior 2 das 2 . -
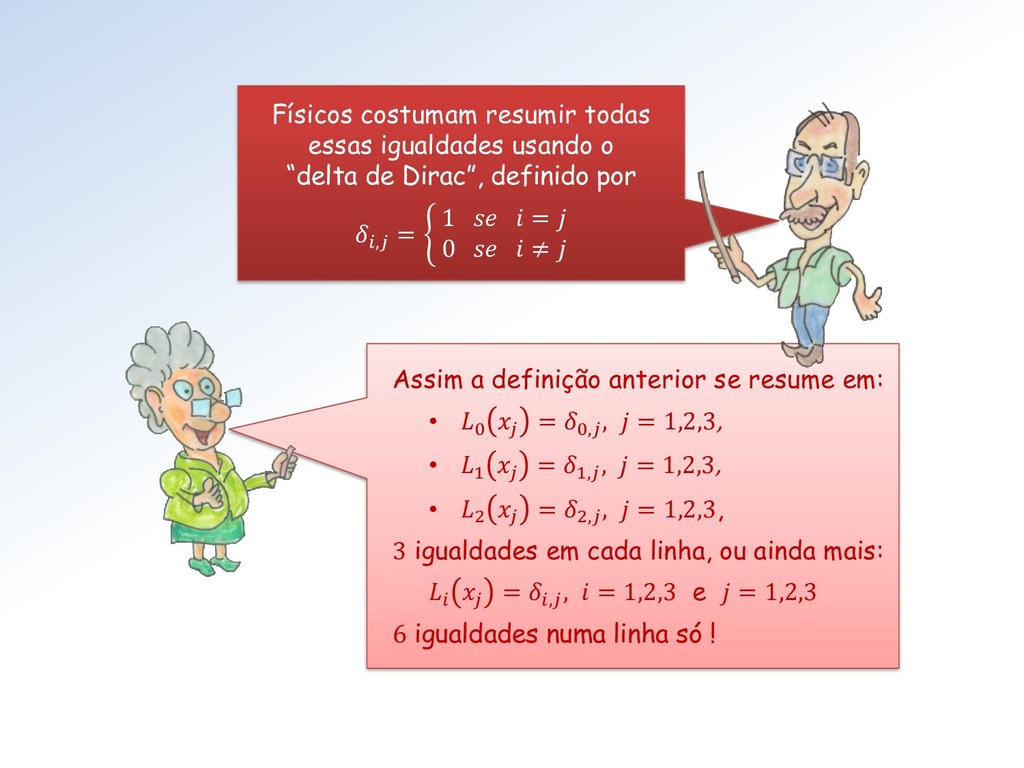
Assim a definição anterior se resume em: • 0 =
0, , = 1,2,3, • 1 = 1, , = 1,2,3, • 2 = 2, , = 1,2,3, 3 igualdades em cada linha, ou ainda mais: = , , = 1,2,3 e = 1,2,3 6 igualdades numa linha só ! Físicos costumam resumir todas essas igualdades usando o “delta de Dirac”, definido por , = ቊ 1 = 0 ≠ -
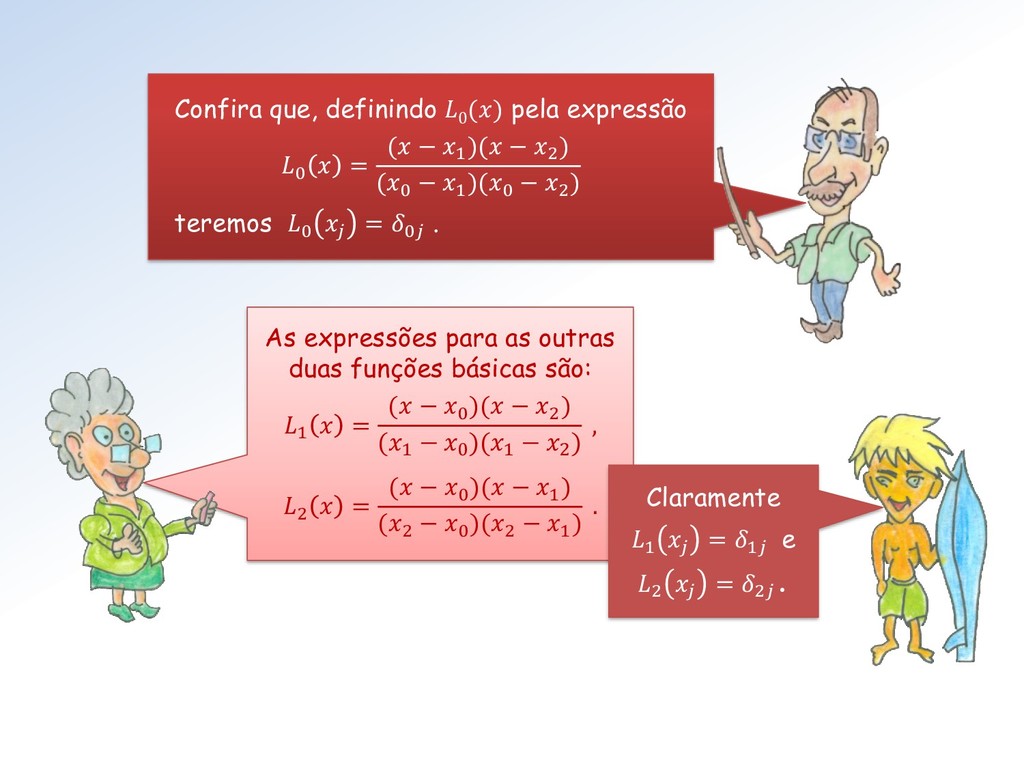
As expressões para as outras duas funções básicas são: 1
= ( − 0 )( − 2 ) (1 − 0 )(1 − 2 ) , 2 = ( − 0 )( − 1 ) (2 − 0 )(2 − 1 ) . Confira que, definindo 0 () pela expressão 0 = ( − 1 )( − 2 ) (0 − 1 )(0 − 2 ) teremos 0 = 0 . Claramente 1 = 1 e 2 = 2 . -
Este programa gera as polinomiais da base de Lagrange do
espaço das funções polinomiais de grau menor ou igual a 2. -
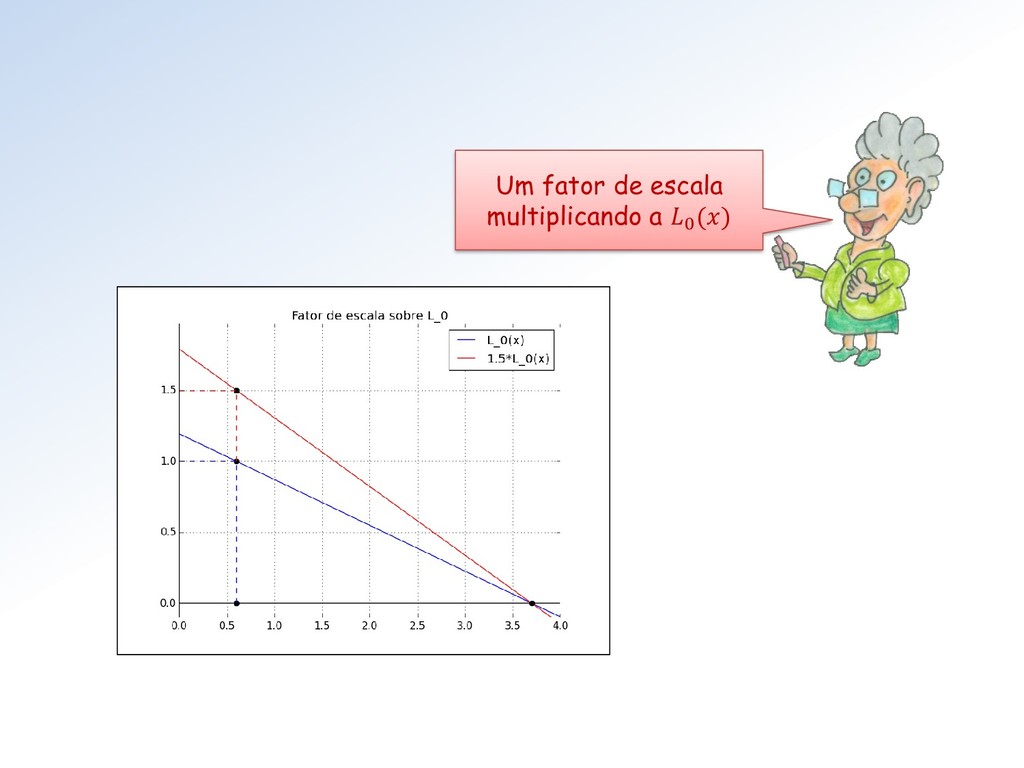
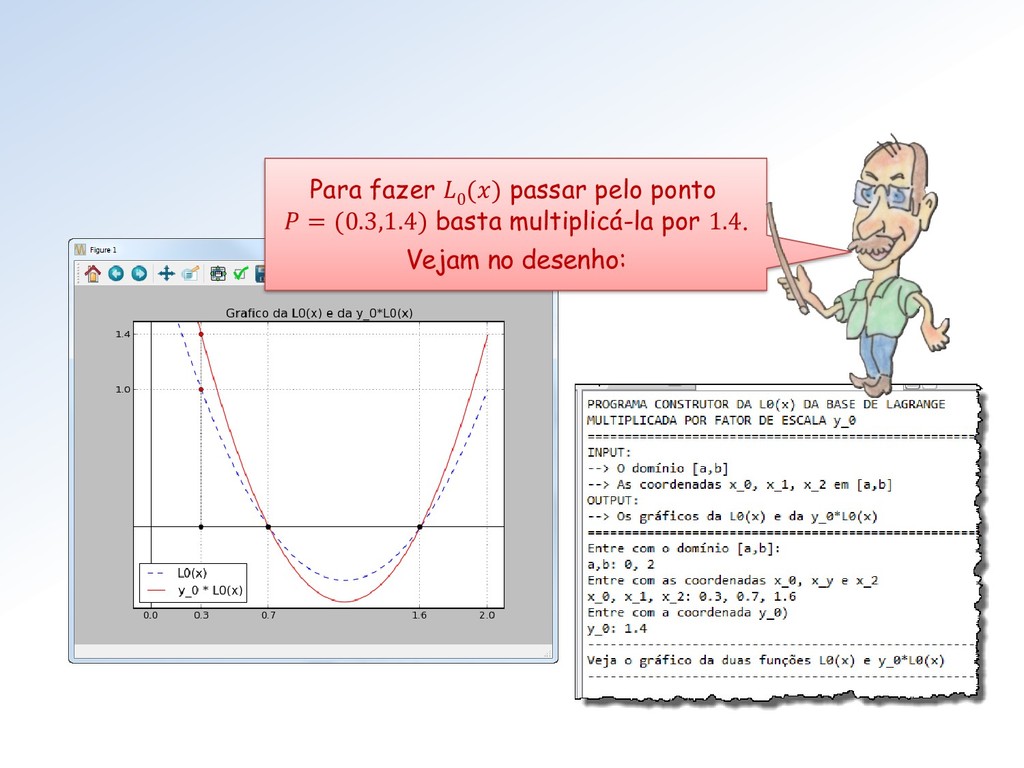
Para fazer 0 () passar pelo ponto = (0.3,1.4) basta
multiplicá-la por 1.4. Vejam no desenho: -
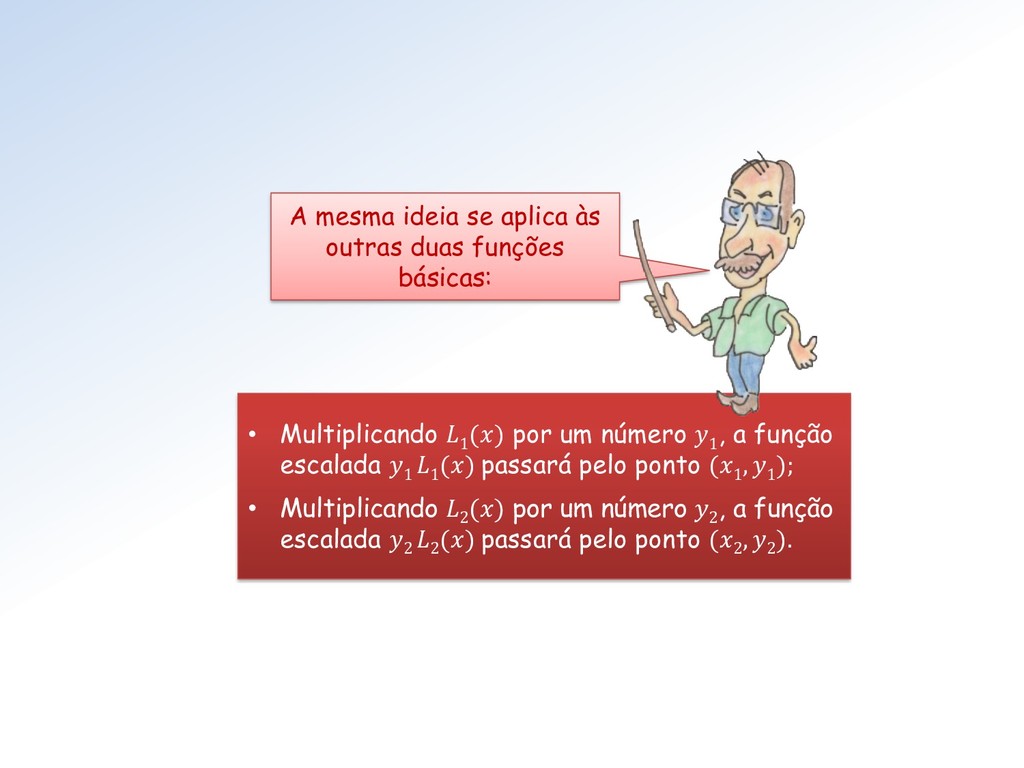
• Multiplicando 1 () por um número 1 , a
função escalada 1 1 () passará pelo ponto ( 1 , 1 ); • Multiplicando 2 () por um número 2 , a função escalada 2 2 () passará pelo ponto ( 2 , 2 ). A mesma ideia se aplica às outras duas funções básicas: -
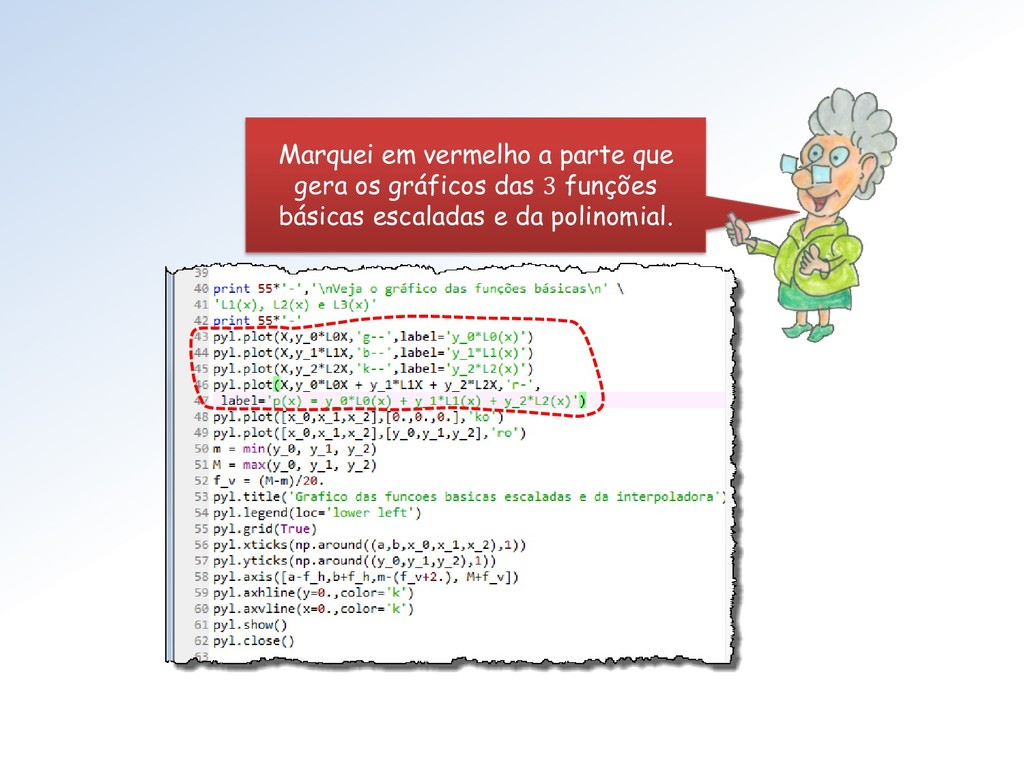
Este programa gera a polinomial de grau dois (≤ 2)
que passa pelos pontos ( 0 , 0 ), ( 1 , 1 ), ( 2 , 2 ) utilizando a base de Lagrange do espaço das funções polinomiais de grau ≤ 2. -
Marquei em vermelho a parte que gera os gráficos das
3 funções básicas escaladas e da polinomial. -
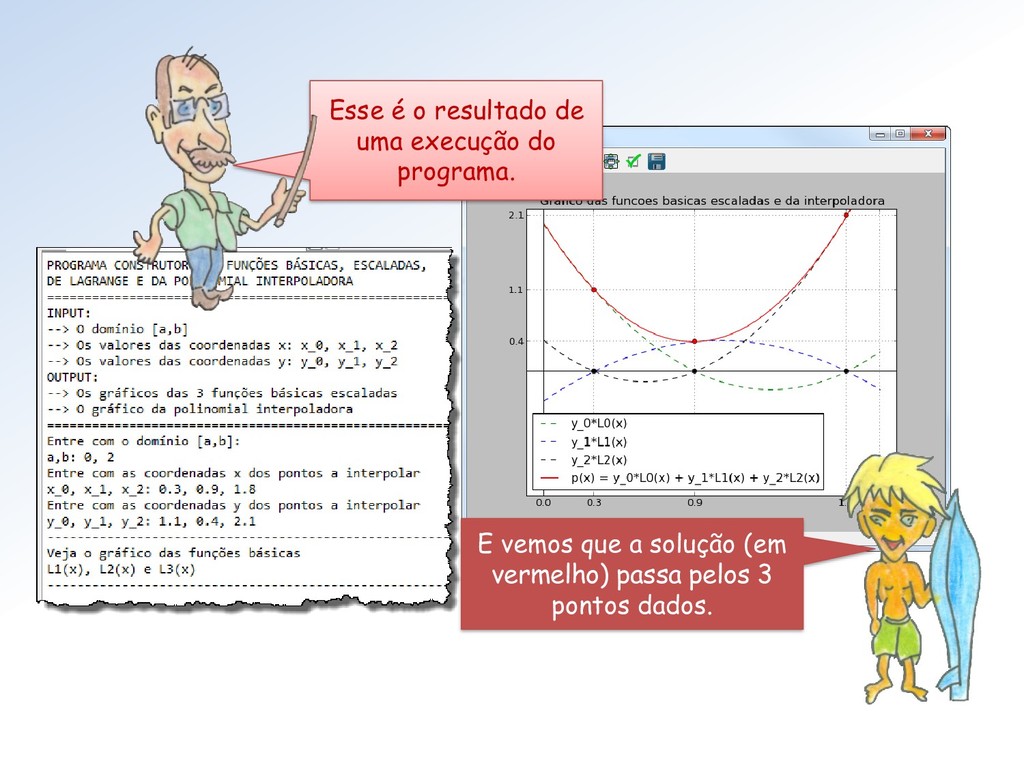
Esse é o resultado de uma execução do programa. E
vemos que a solução (em vermelho) passa pelos 3 pontos dados. -
Estas ideias tem sido usadas, a séculos, para aproximar funções
por retas e por parábolas. Vá ao apêndice passear um pouco pela história. -
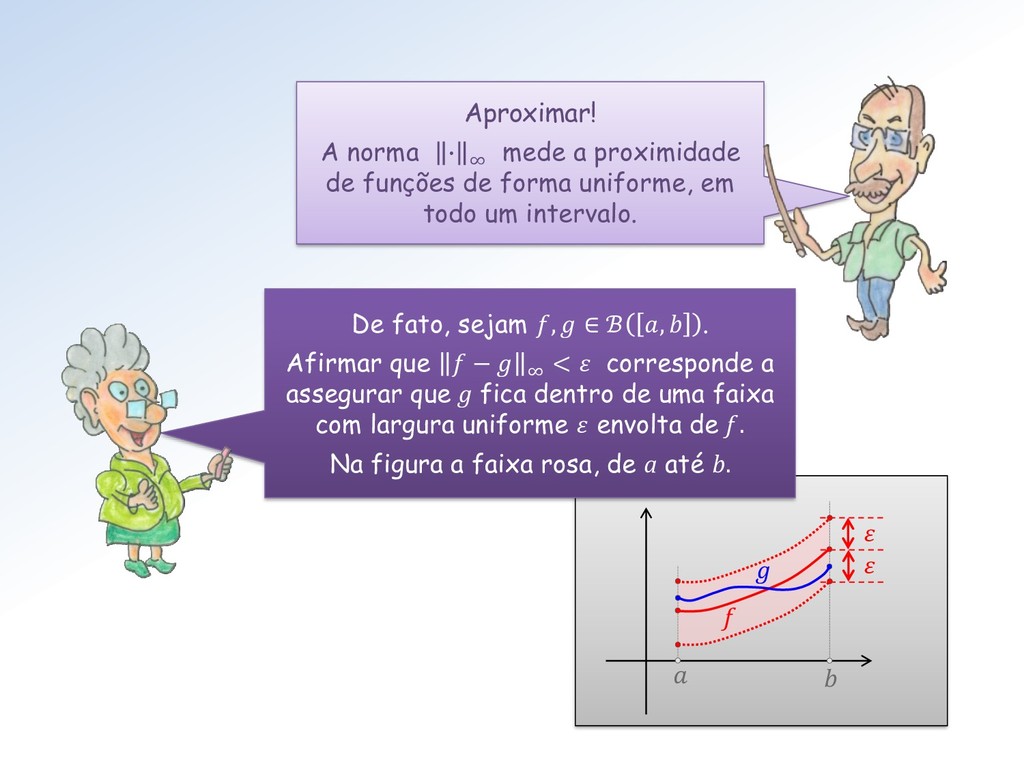
f Aproximar! A norma ∙ ∞ mede a proximidade de
funções de forma uniforme, em todo um intervalo. De fato, sejam , ∈ ℬ , . Afirmar que − ∞ < corresponde a assegurar que g fica dentro de uma faixa com largura uniforme envolta de f . Na figura a faixa rosa, de a até b. -
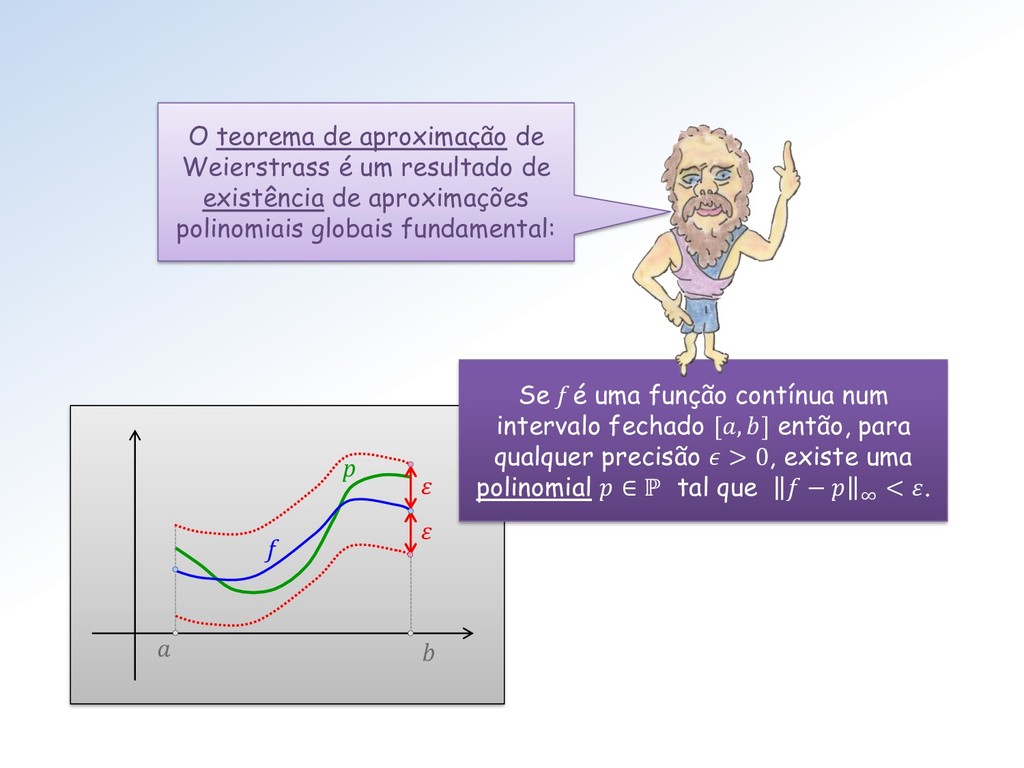
f p Se f é uma função contínua num intervalo
fechado [, ] então, para qualquer precisão > 0, existe uma polinomial ∈ ℙ tal que − ∞ < . O teorema de aproximação de Weierstrass é um resultado de existência de aproximações polinomiais globais fundamental: -
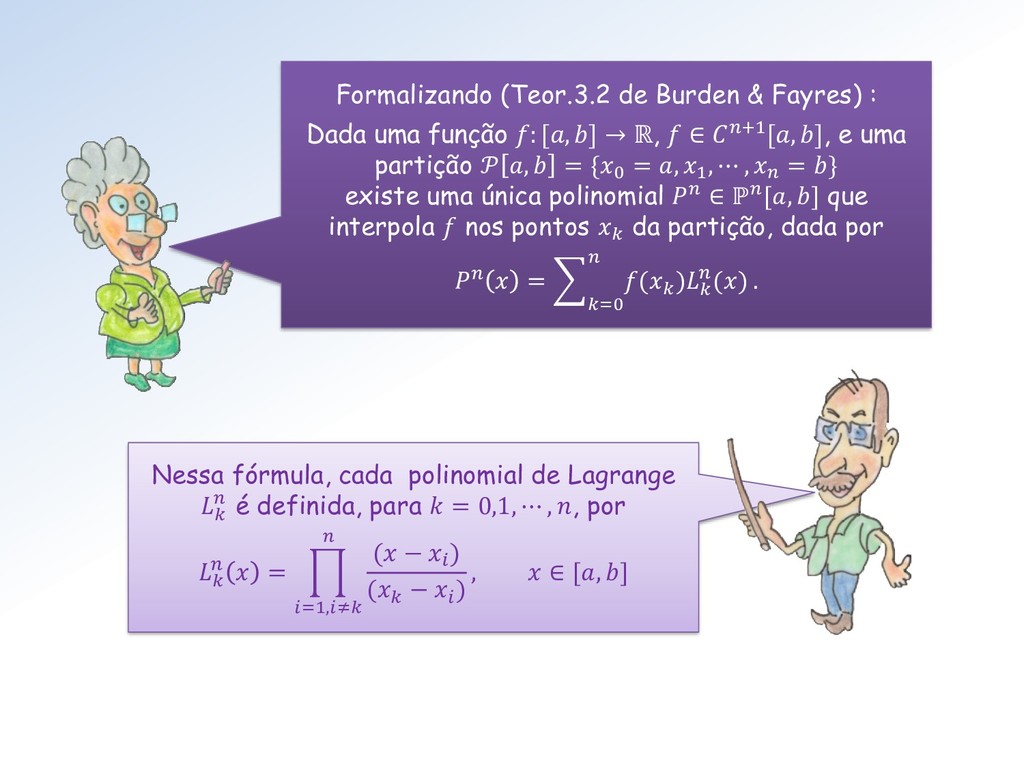
Nessa fórmula, cada polinomial de Lagrange é definida, para =
0,1, ⋯ , , por = ෑ =1,≠ ( − ) ( − ) , ∈ [, ] Formalizando (Teor.3.2 de Burden & Fayres) : Dada uma função : [, ] → ℝ, ∈ +1[, ], e uma partição , = {0 = , 1 , ⋯ , = } existe uma única polinomial ∈ ℙ[, ] que interpola nos pontos da partição, dada por = =0 ( ) () . -
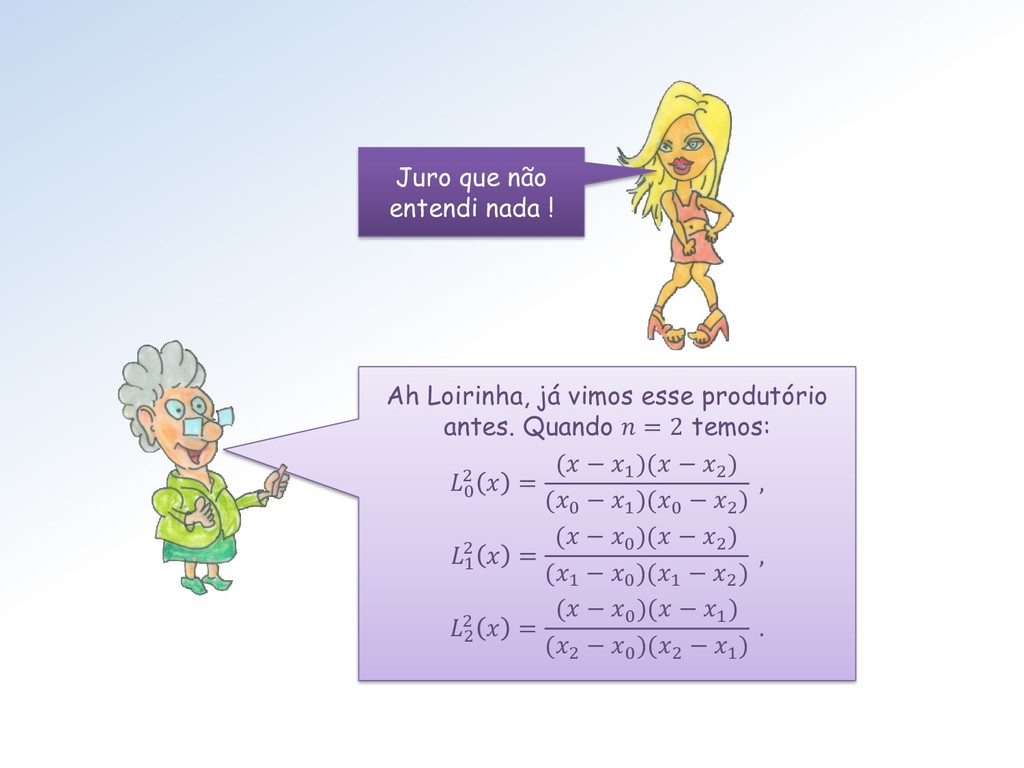
Ah Loirinha, já vimos esse produtório antes. Quando = 2
temos: 0 2 = ( − 1 )( − 2 ) (0 − 1 )(0 − 2 ) , 1 2 = ( − 0 )( − 2 ) (1 − 0 )(1 − 2 ) , 2 2 = ( − 0 )( − 1 ) (2 − 0 )(2 − 1 ) . Juro que não entendi nada ! -
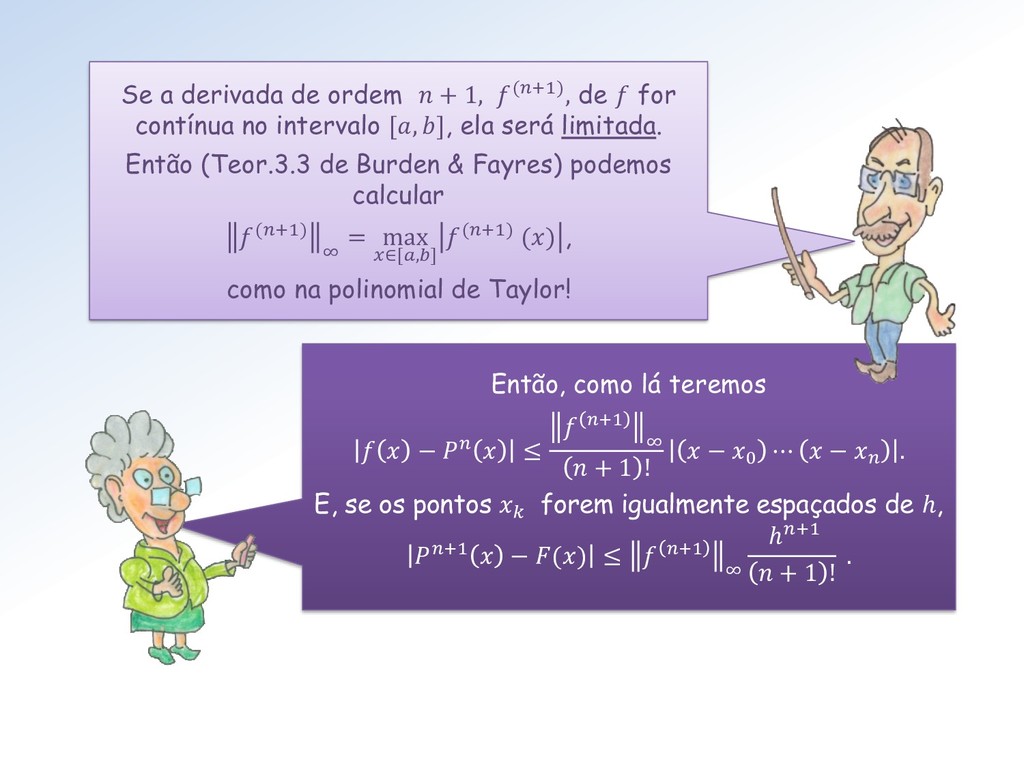
Então, como lá teremos − ≤ +1 ∞ + 1
! − 0 ⋯ − . E, se os pontos forem igualmente espaçados de ℎ, +1 − () ≤ +1 ∞ ℎ+1 + 1 ! . Se a derivada de ordem + 1, (+1), de for contínua no intervalo [, ], ela será limitada. Então (Teor.3.3 de Burden & Fayres) podemos calcular (+1) ∞ = max ∈[,] (+1) () , como na polinomial de Taylor! -
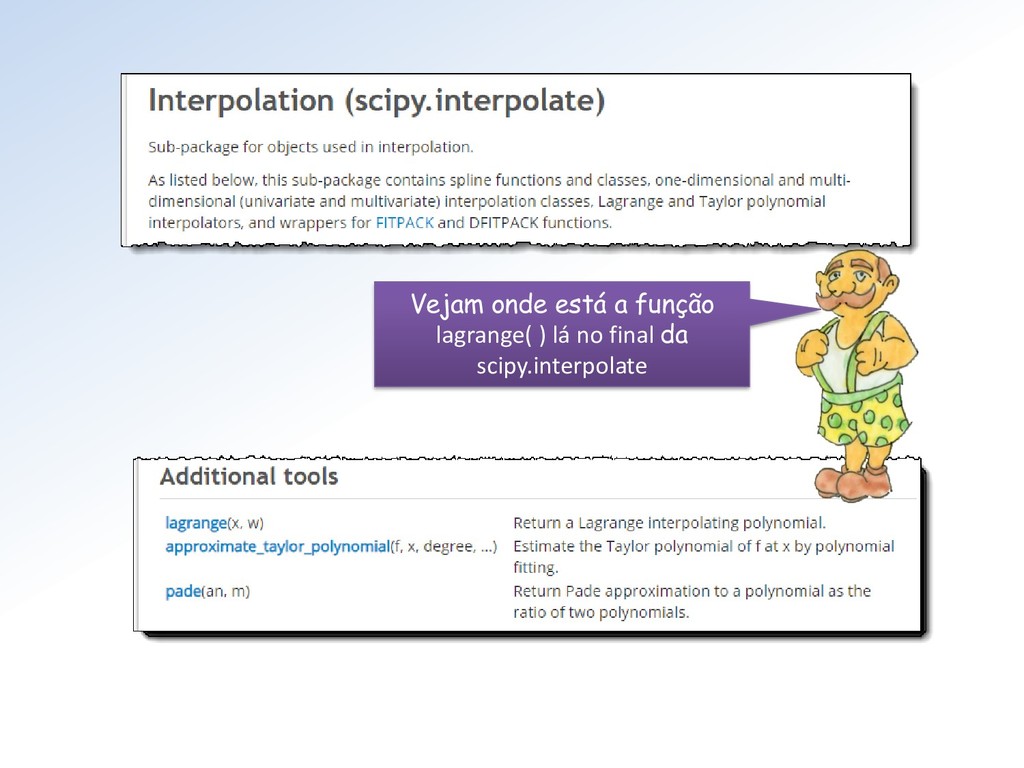
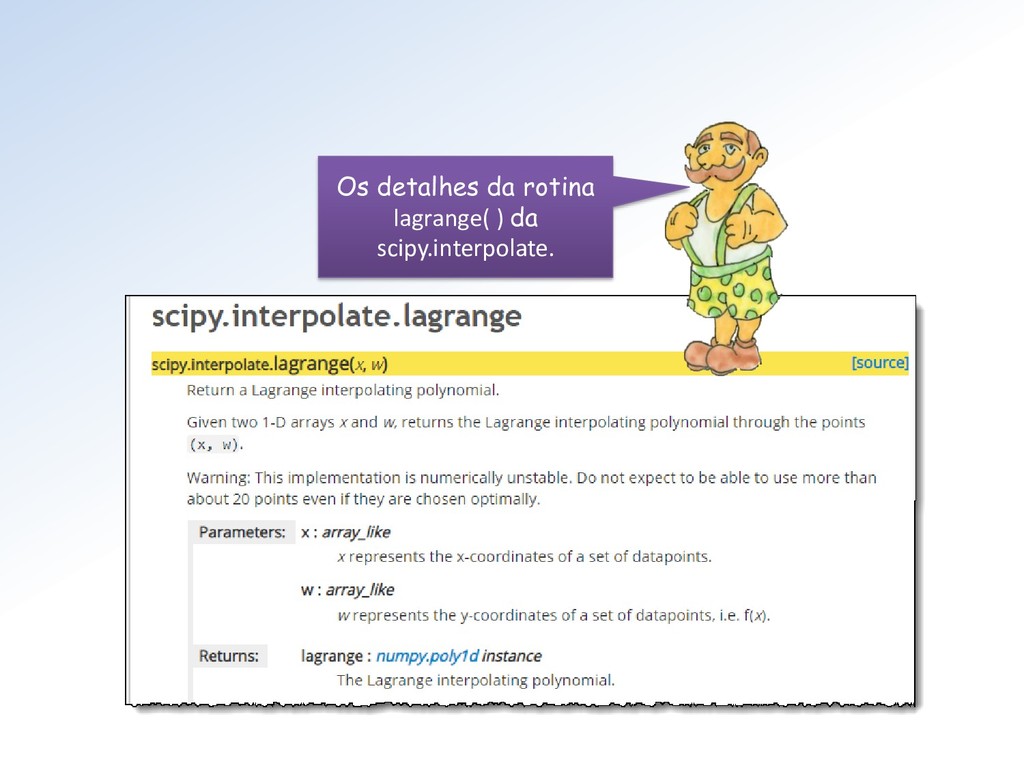
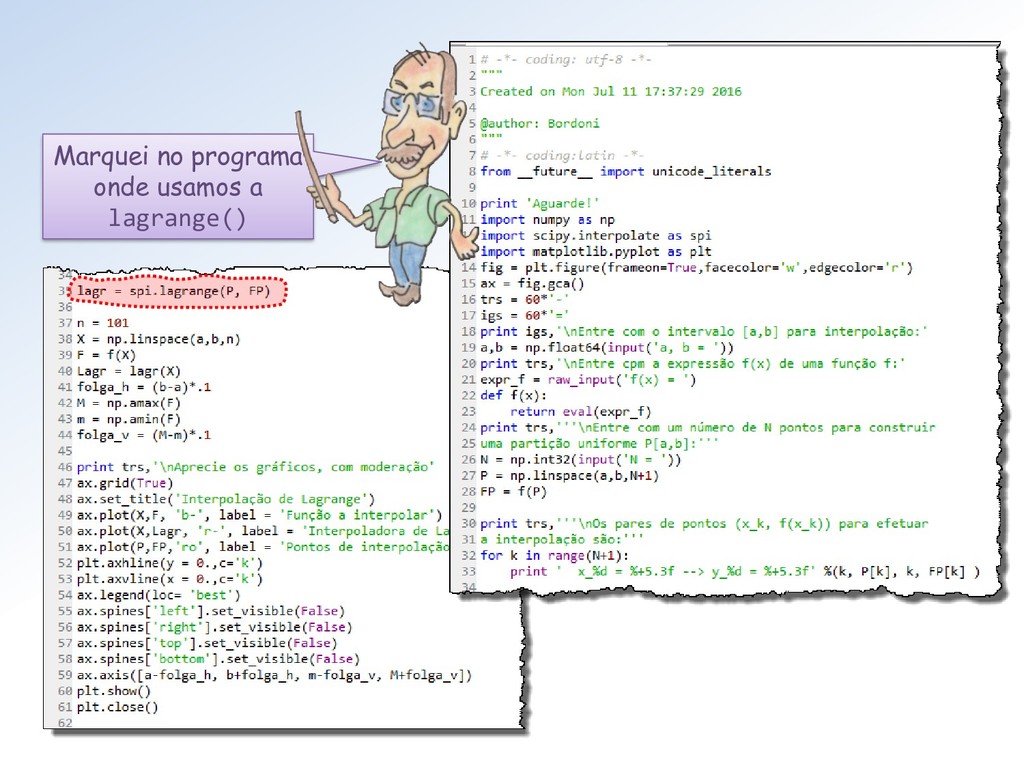
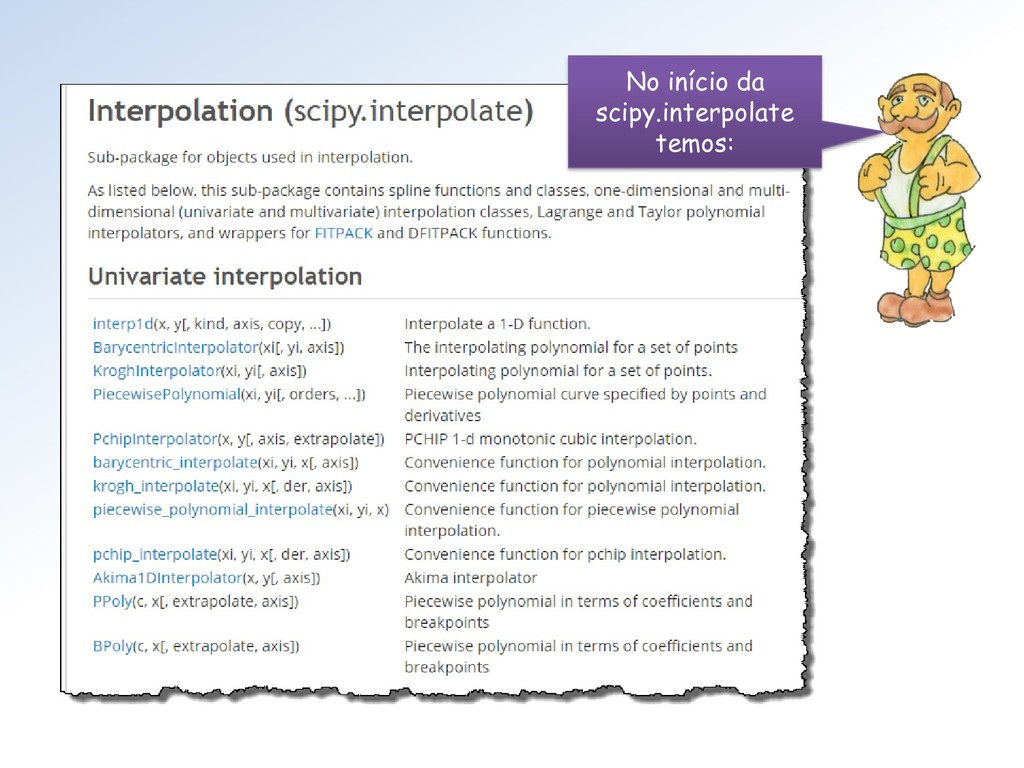
Vejam onde está a função lagrange( ) lá no final
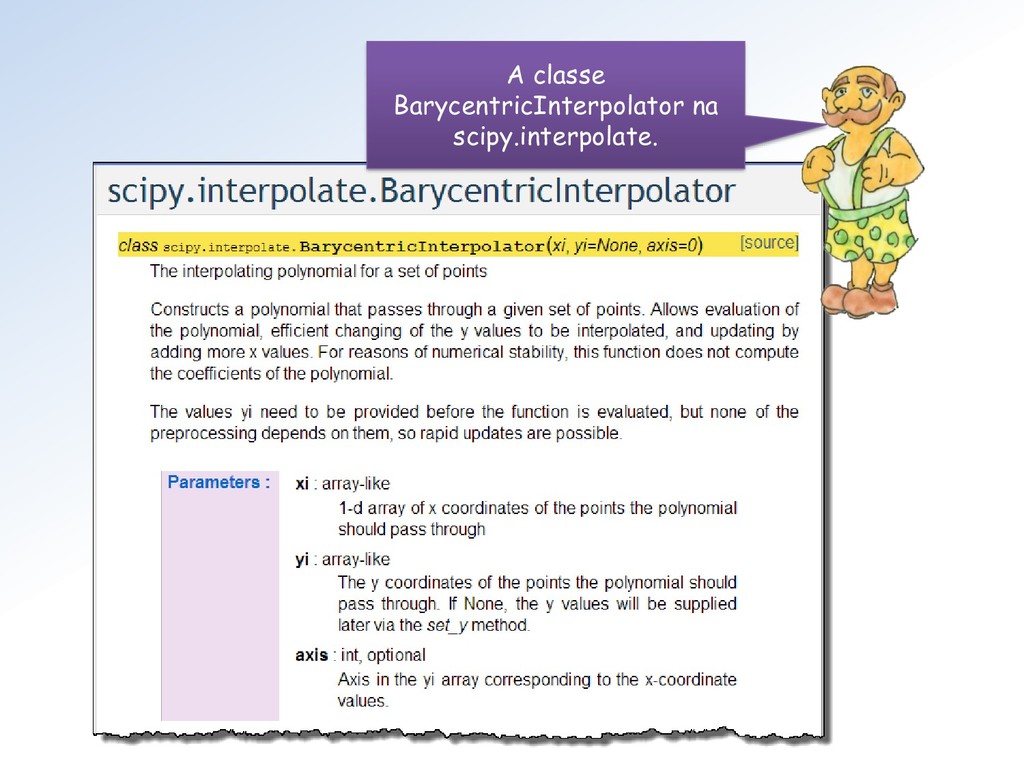
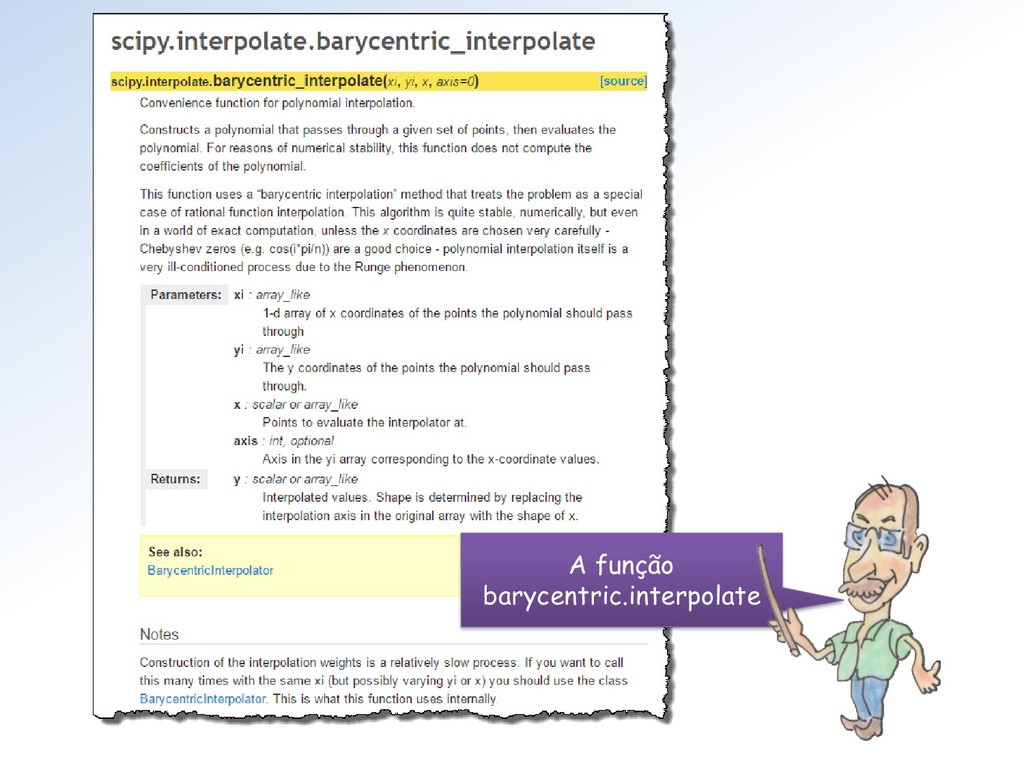
da scipy.interpolate -
• Recebe: 1. Um intervalo [, ], 2. A expressão
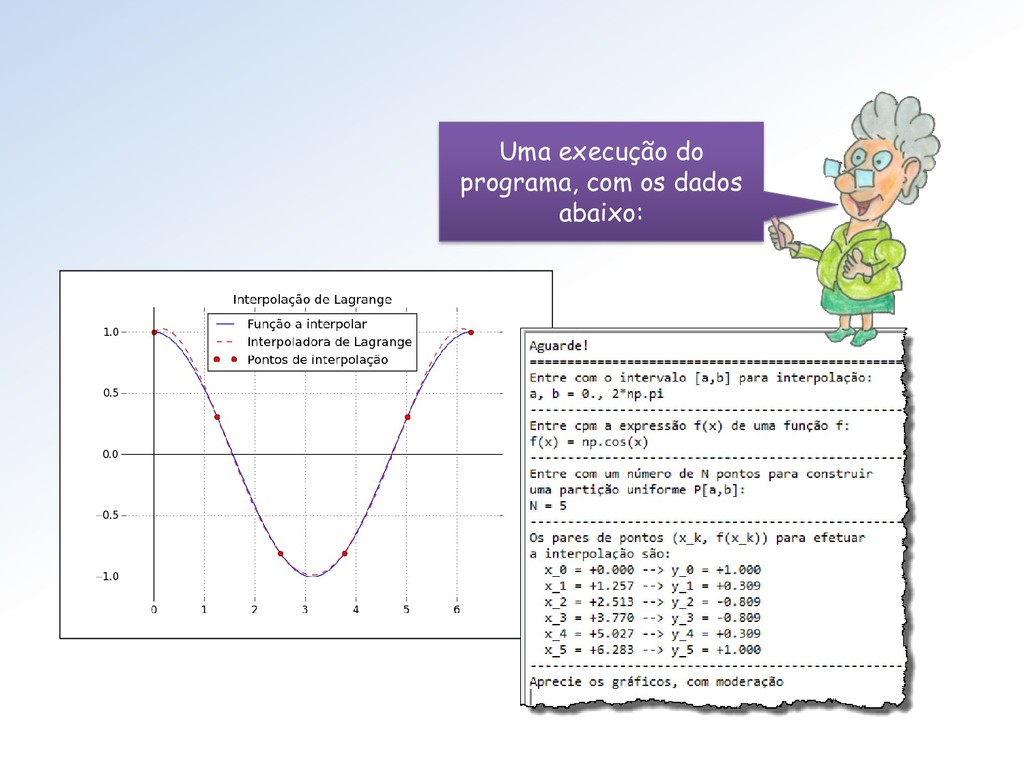
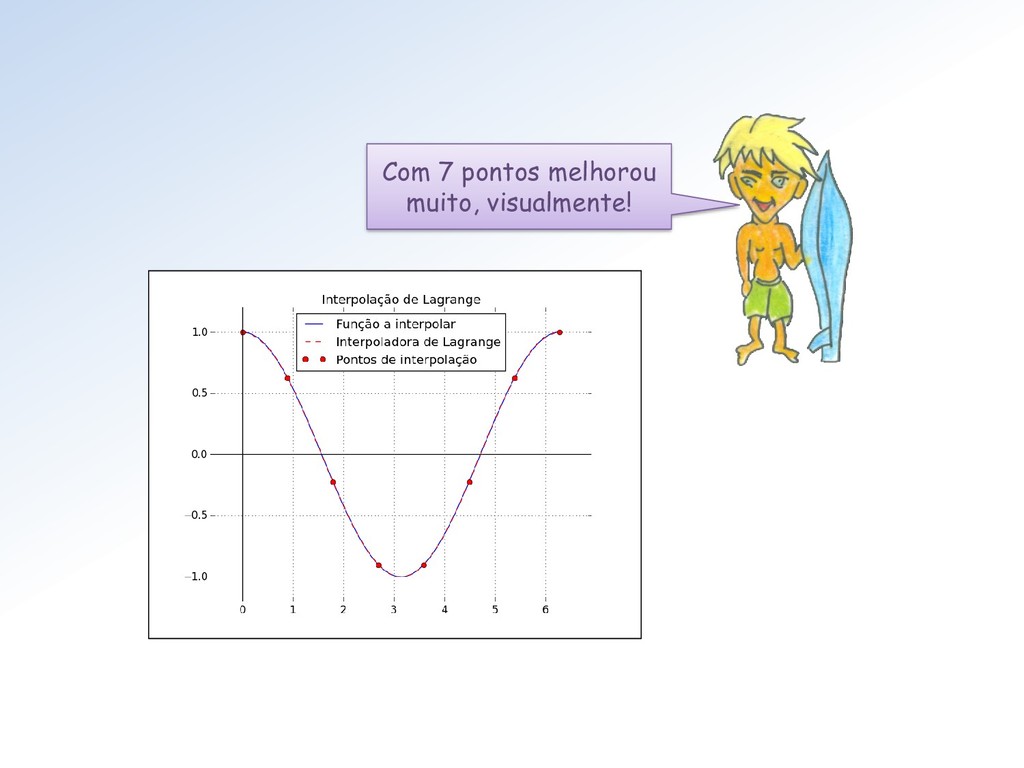
() de uma função, 3. Um número de pontos para criar uma partição uniforme de , . • Constrói a interpoladora de Lagrange da função usando a rotina lagrange() da SciPy. • E devolve: 1. Uma tabela dos pares dos pares , ( ) , 2. Os gráficos de e da interpoladora de Lagrange da função sobre a partição , . Faremos um programa que: -
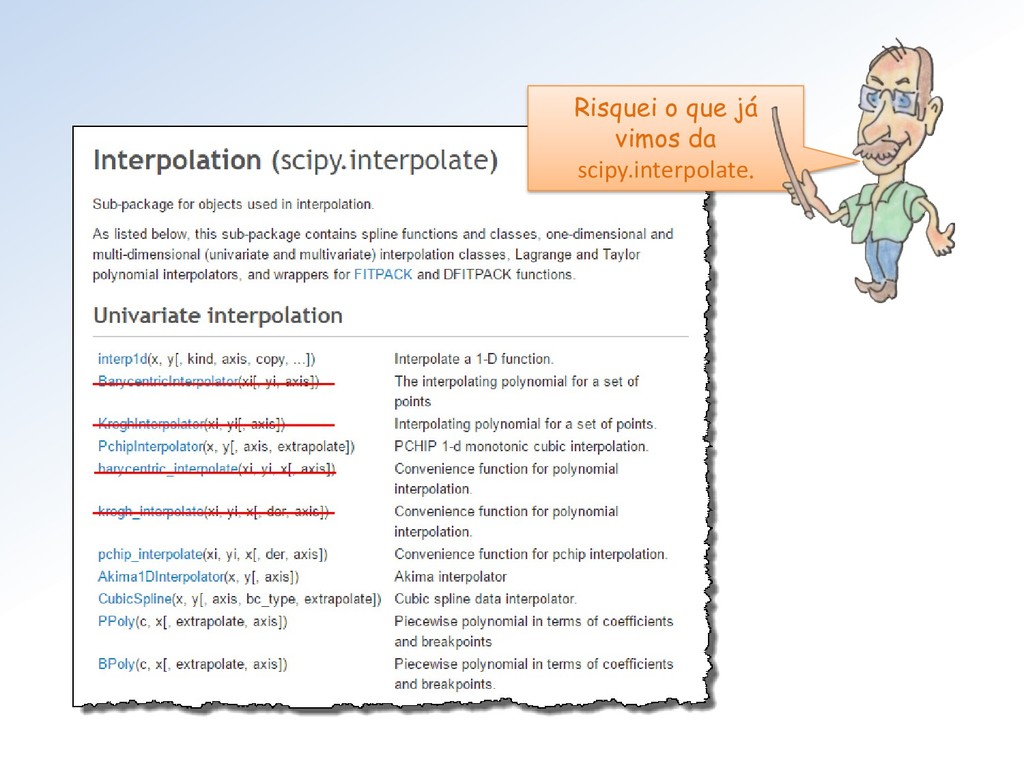
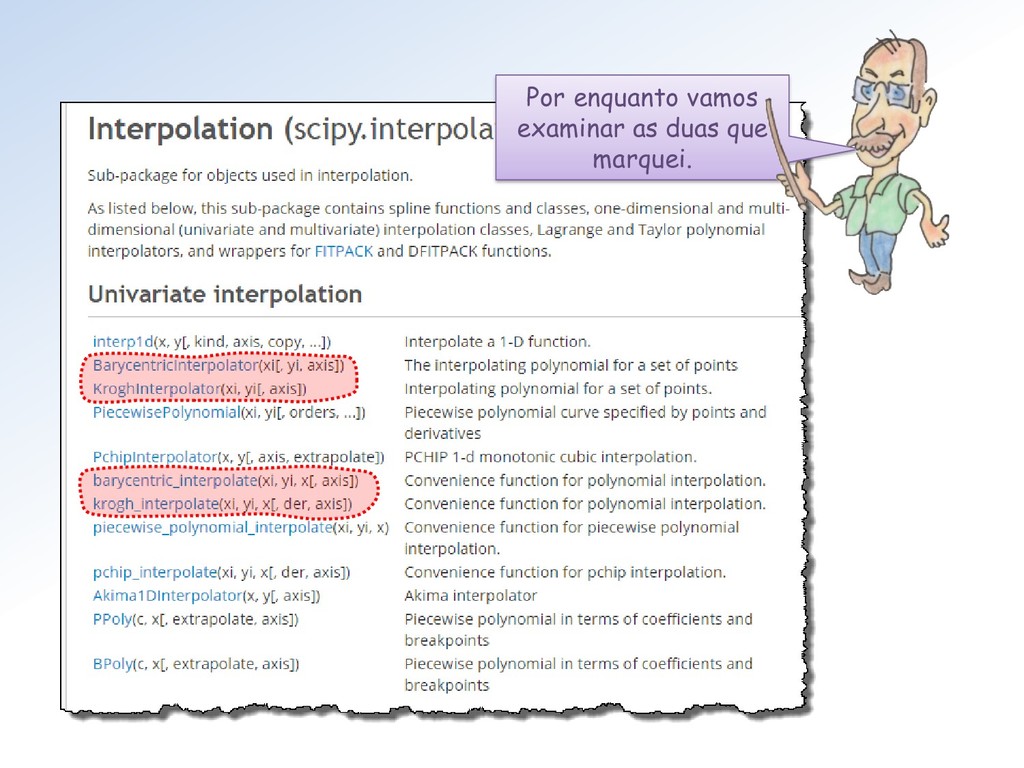
O pacote de interpolação da SciPy é grande. Precisaríamos de
várias aulas explorá-lo por completo. -
Mestres! Por que a interpolação de Lagrange só aparece lá
no final da scipy.interpolate e não no logo no início lista? Na verdade ela está escondida nas duas que o Mestre marcou! -
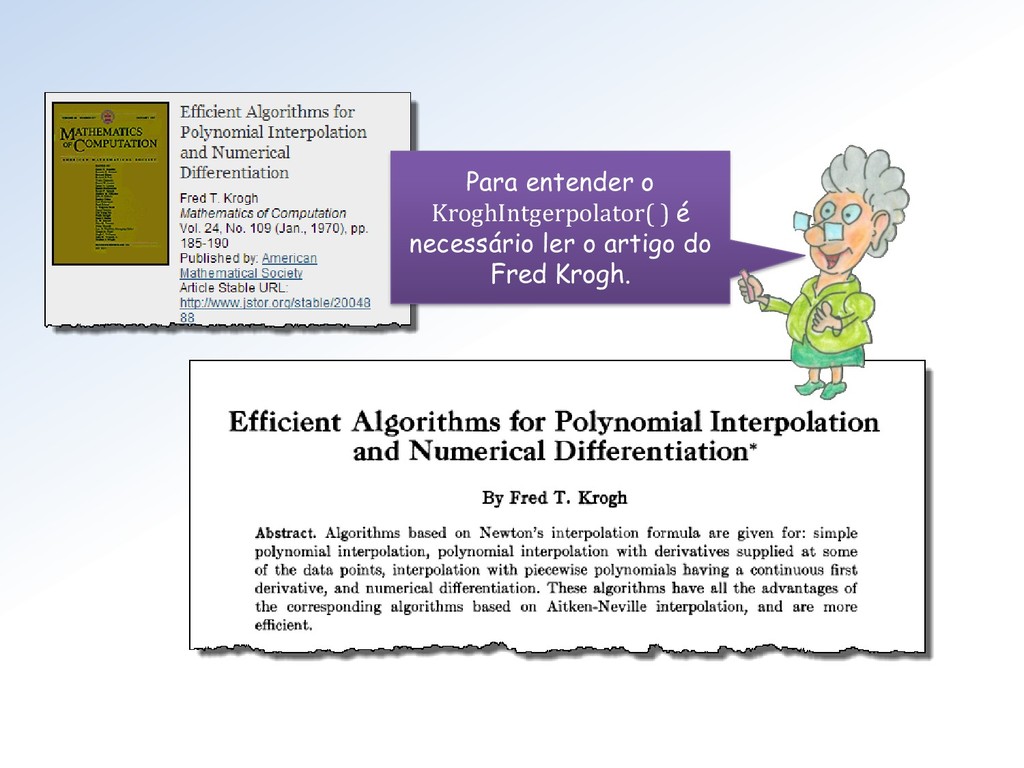
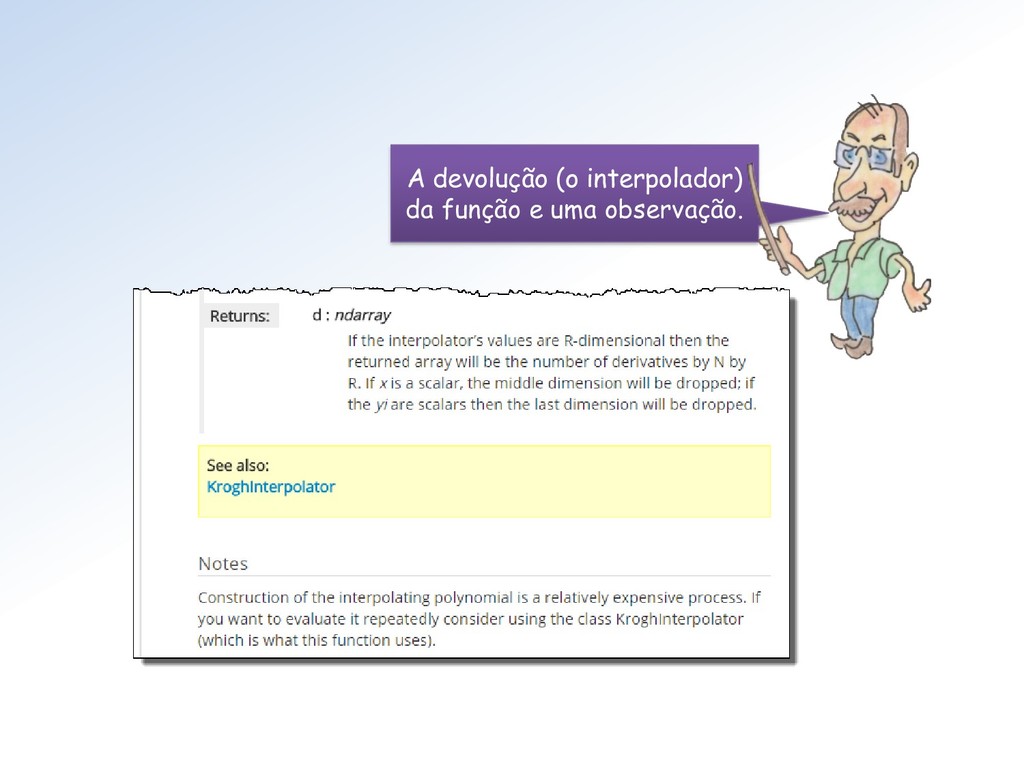
Não deixem de acessar e ler o artigo. Lá estão
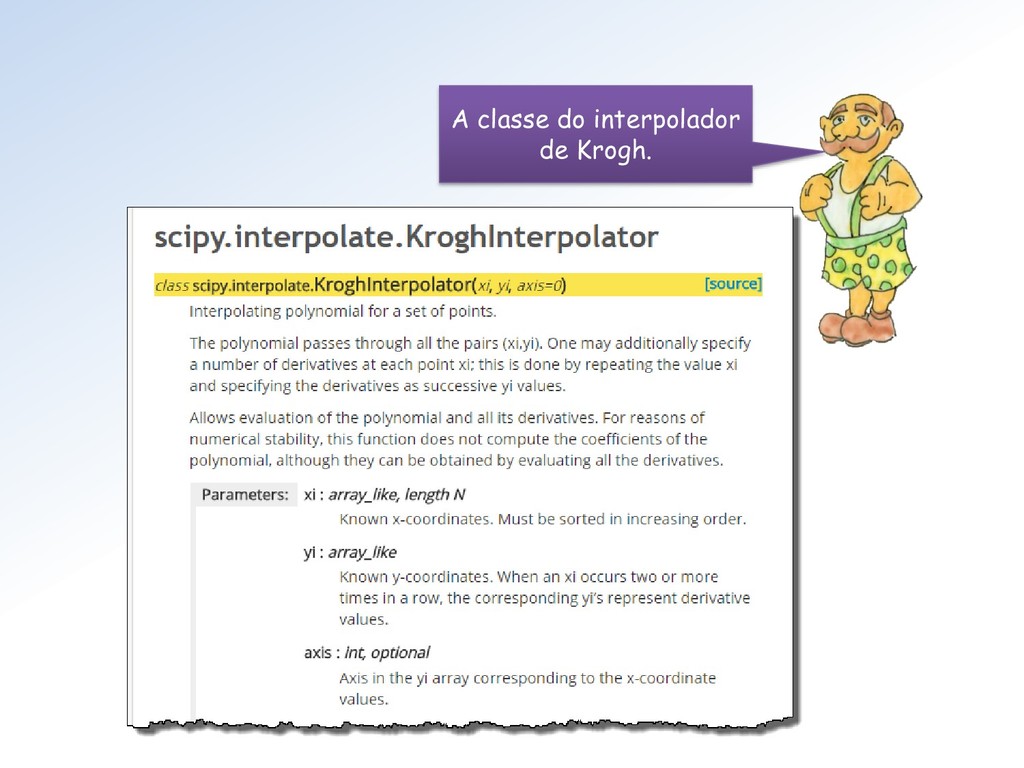
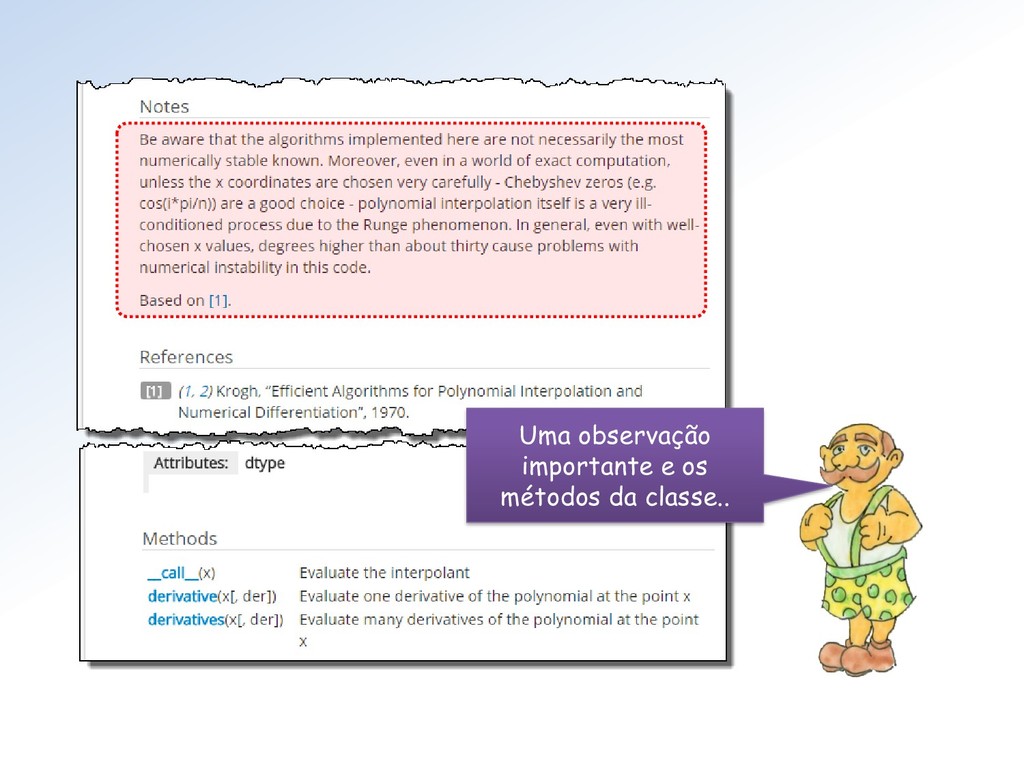
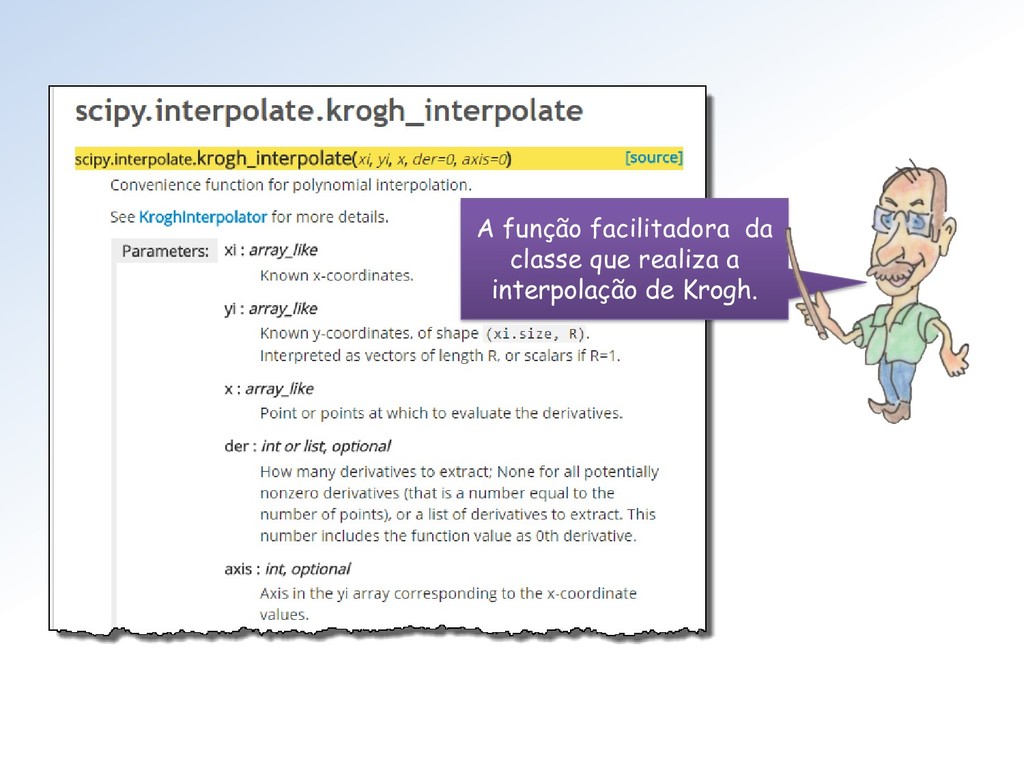
detalhados os algoritmos de Krogh empregados pela scipy.interpolate Inclusive o artigo compara número de operações com os algoritmos de Lagrange e Aitken/Neville, mostrando que os propostos por Krogh tem melhor performance. -
• = ( ) • , +1 = +1 −
+1− • , +1 , +2 = +1, +2 − , +1 +1− • , +1 , +2 , +3 = +1, +2 , +3 − , +1, +2 +1− • E assim por diante Os algoritmos de Krogh usam as fórmulas de diferenças divididas finitas (DDF) de Newton, definidas recursivamente por: Não entendi essas diferenças divididas! -
Repito, não entendi! Vai explicar ou não ?!...?! Morri de
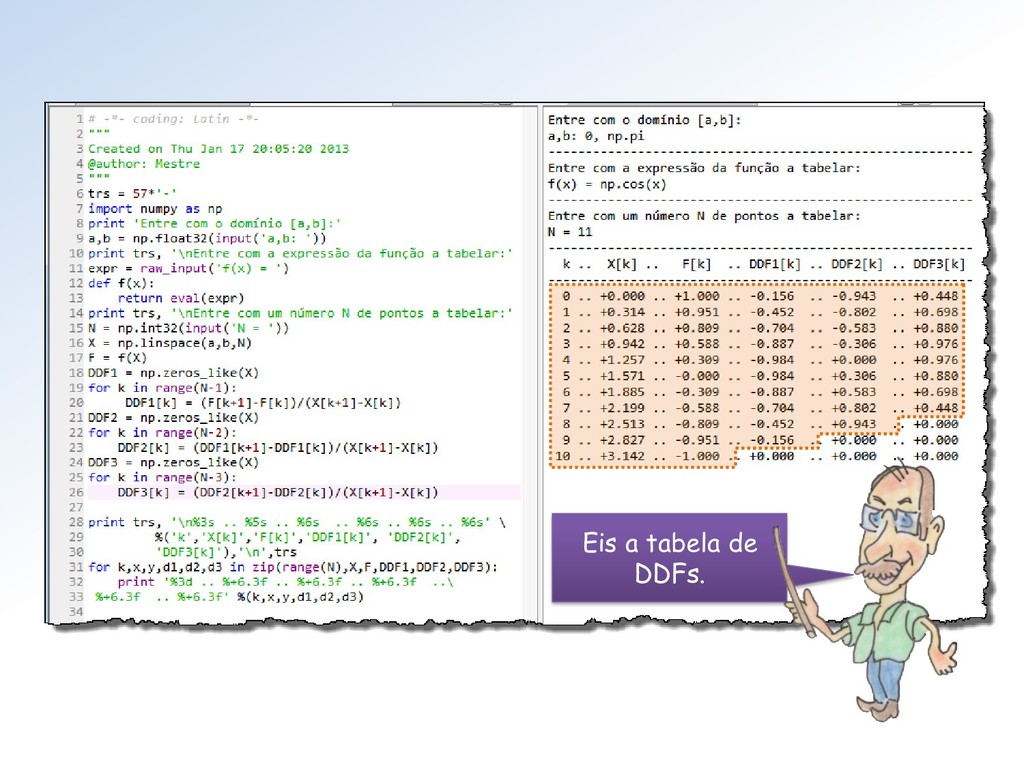
medo, meu Kruguinho querido! Mestre, faça um programa que constrói uma tabela de diferenças divididas finitas. -
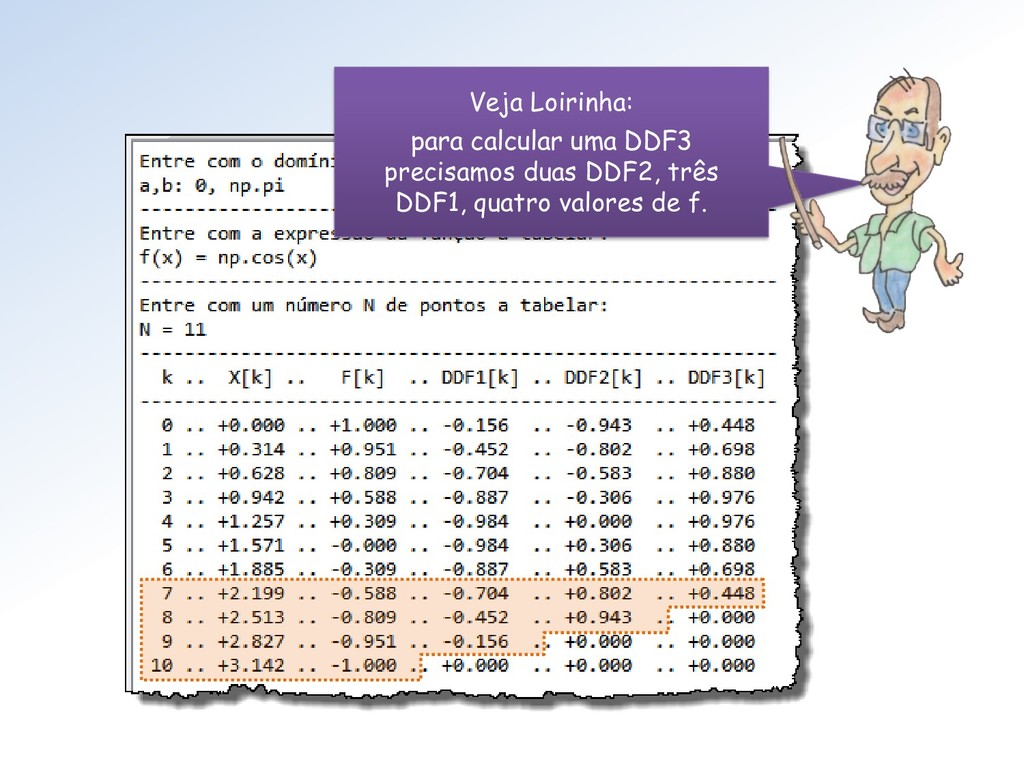
Mestra, por quê a escadaria no final da tabela ?
Devido à recursividade, minha filha! -
Veja Loirinha: para calcular uma DDF3 precisamos duas DDF2, três
DDF1, quatro valores de f. -
Uma colega que não foi aprovada em Cálculo Numérico no
período anterior disse que o professor exigia que essas tabelas de DDF fossem feitas à mão. Já ouvi falar dessa besteira. São mestres da idade da pedra. -
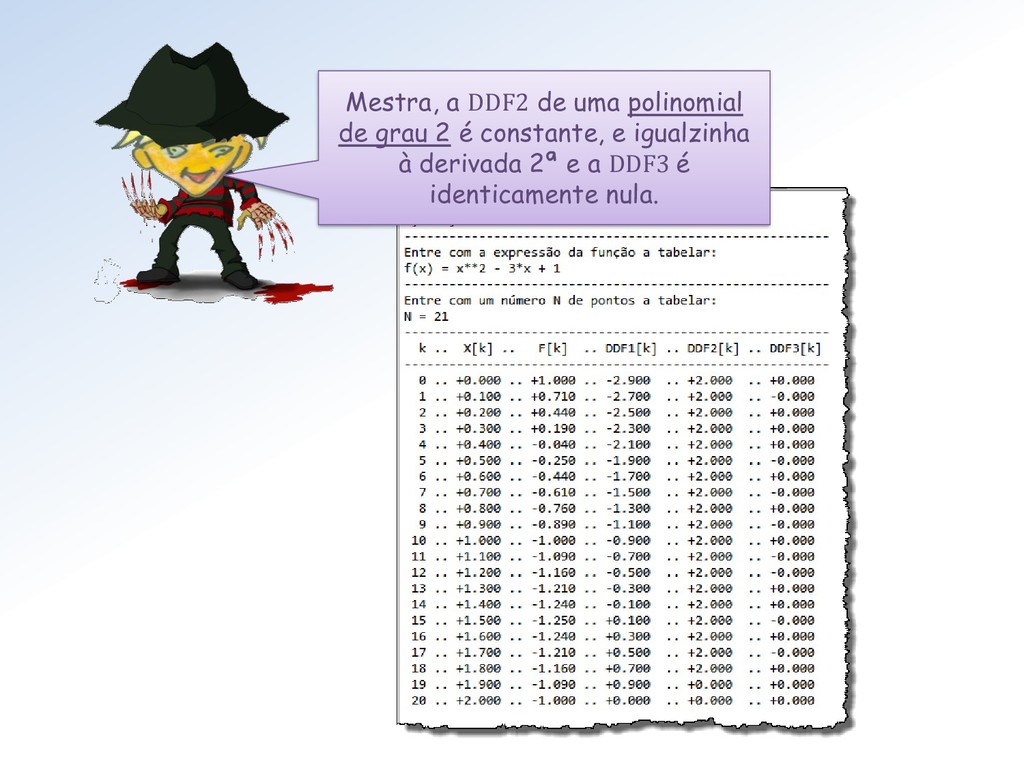
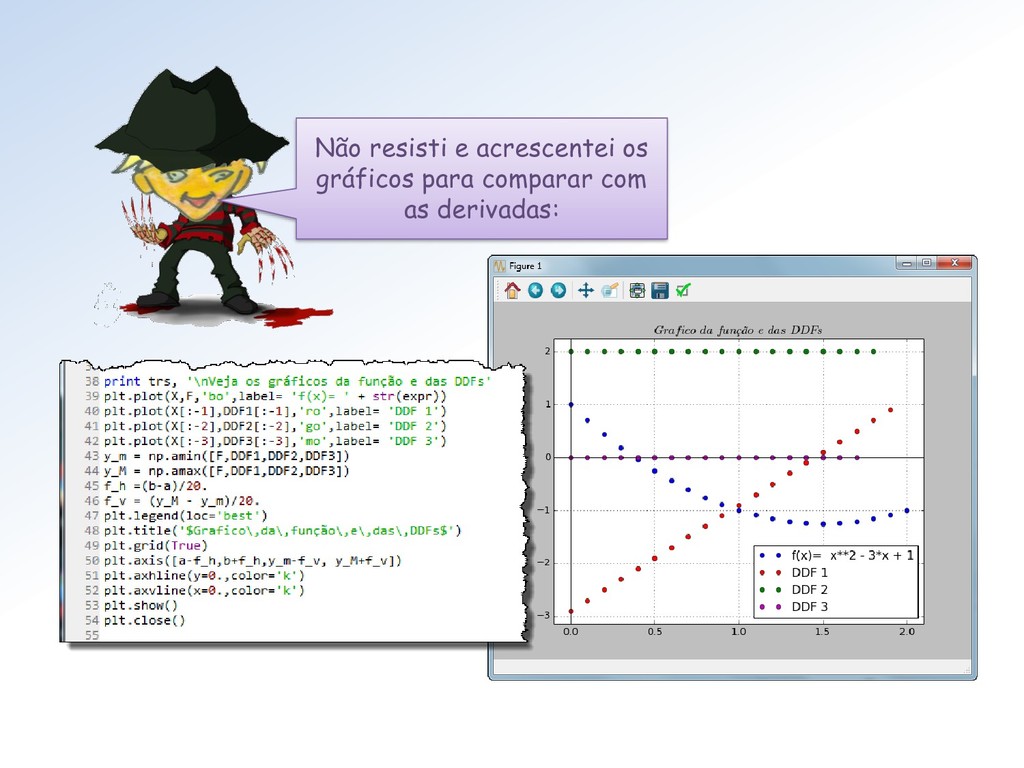
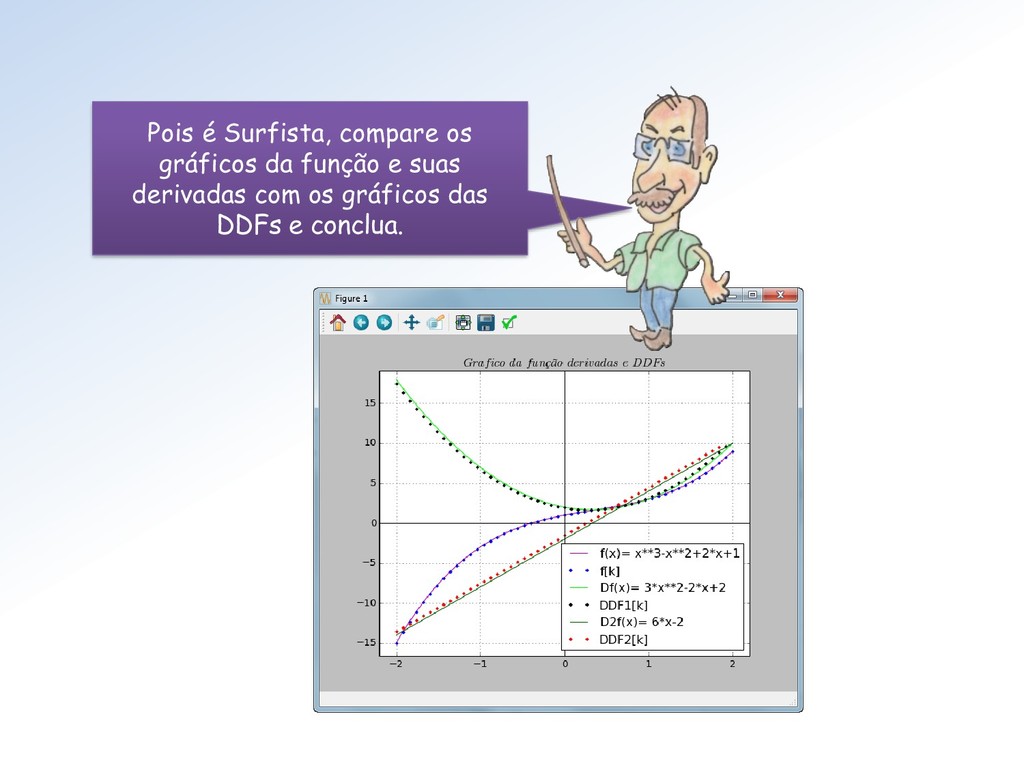
Mestra, a DDF2 de uma polinomial de grau 2 é
constante, e igualzinha à derivada 2ª e a DDF3 é identicamente nula. -
Pois é Surfista, compare os gráficos da função e suas
derivadas com os gráficos das DDFs e conclua. -
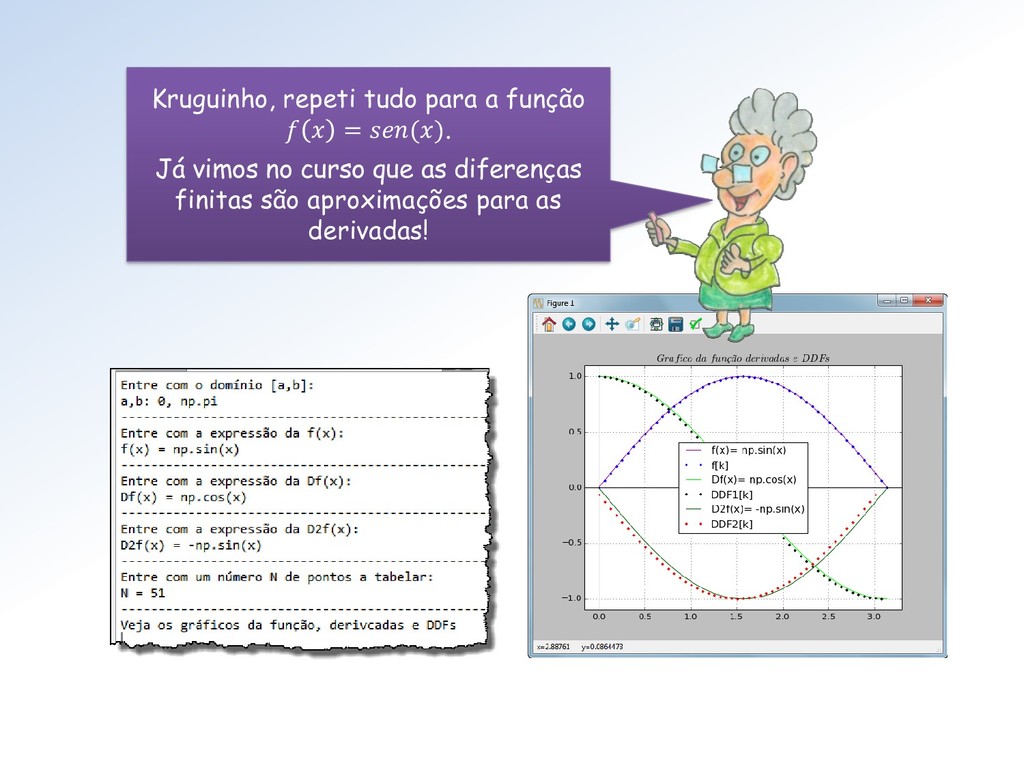
Kruguinho, repeti tudo para a função = (). Já vimos
no curso que as diferenças finitas são aproximações para as derivadas! -
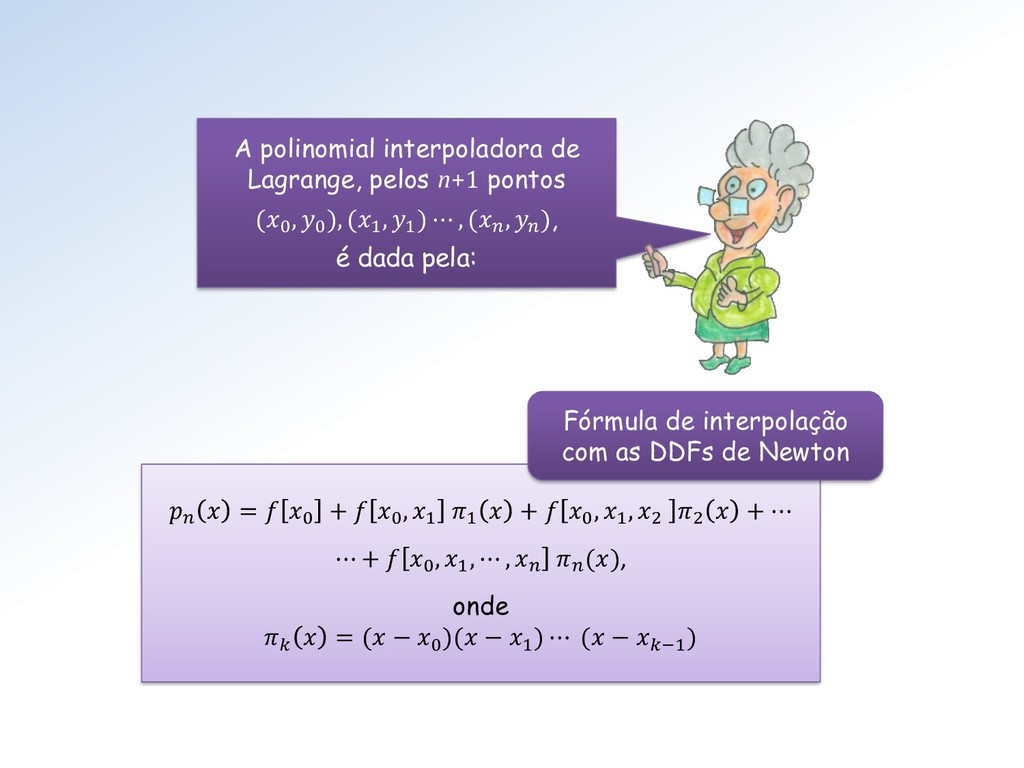
A polinomial interpoladora de Lagrange, pelos n+1 pontos (0 ,
0 ), (1 , 1 ) ⋯ , ( , ), é dada pela: = 0 + 0 , 1 1 + 0 , 1 , 2 2 + ⋯ ⋯ + 0 , 1 , ⋯ , (), onde = ( − 0 )( − 1 ) ⋯ ( − −1 ) Fórmula de interpolação com as DDFs de Newton -
Com alguma manipulação algébrica é possível mostrar que as fórmulas
de Newton e de Lagrange são iguais. Loirinha e Surfista, façam essas continhas para as interpoladoras de grau 1 e 2. -
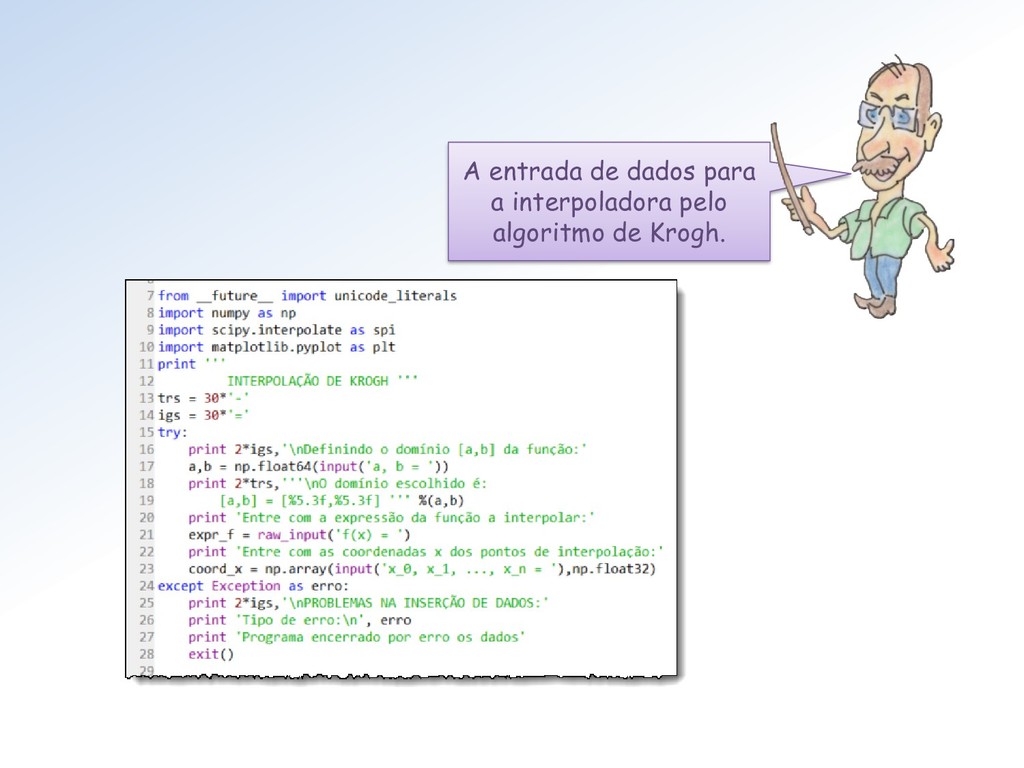
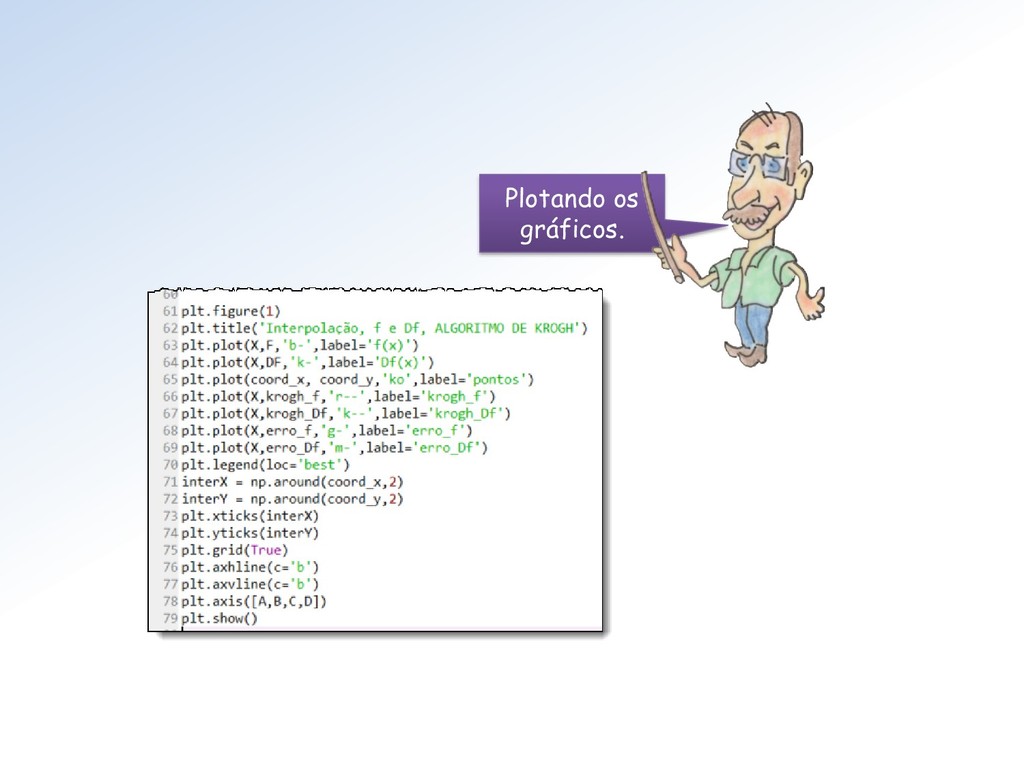
Um programa para interpolar uma função : [, ] →
ℝ e sua derivada usando o algoritmo de Krogh. -
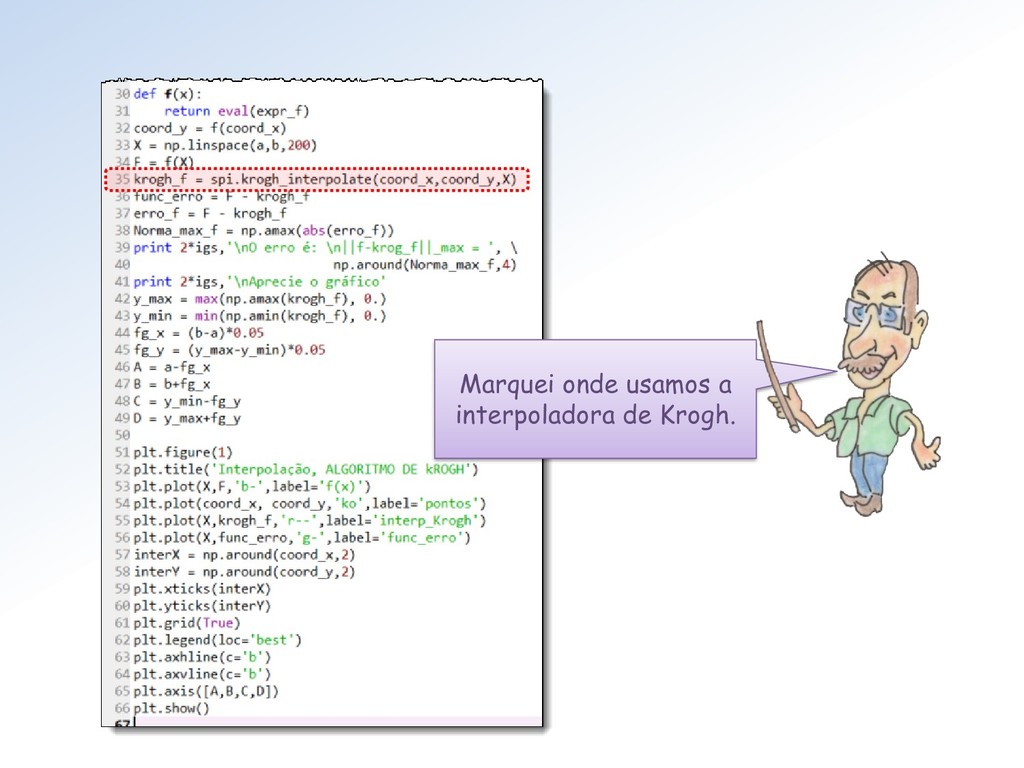
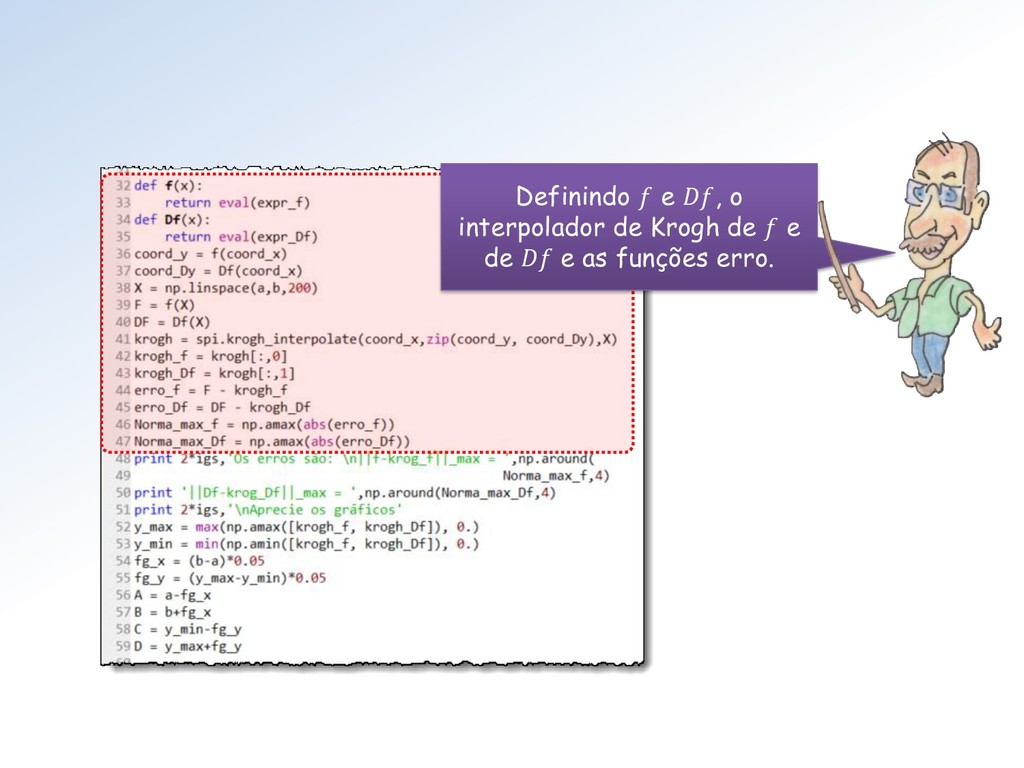
Definindo e , o interpolador de Krogh de e de
e as funções erro. -
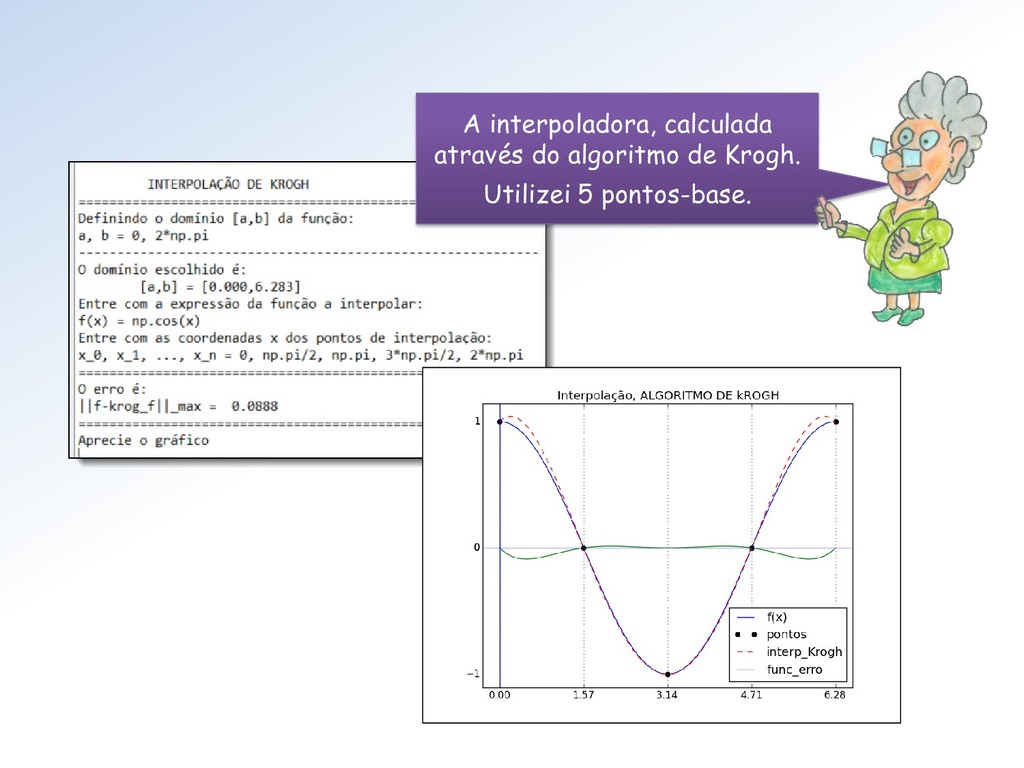
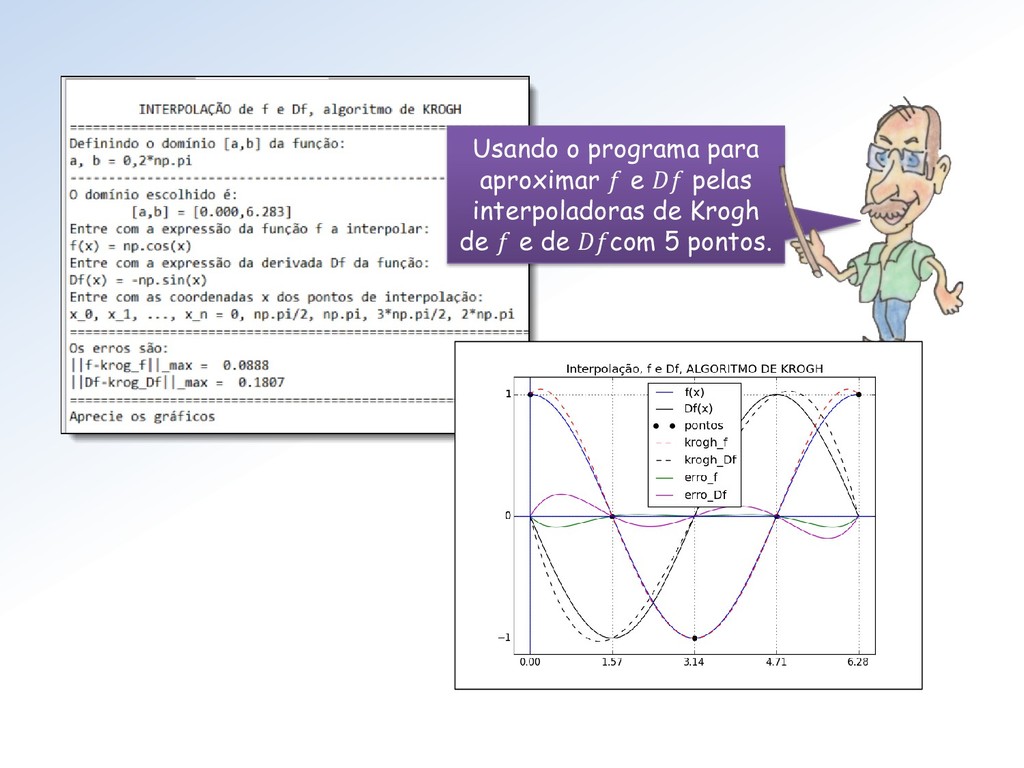
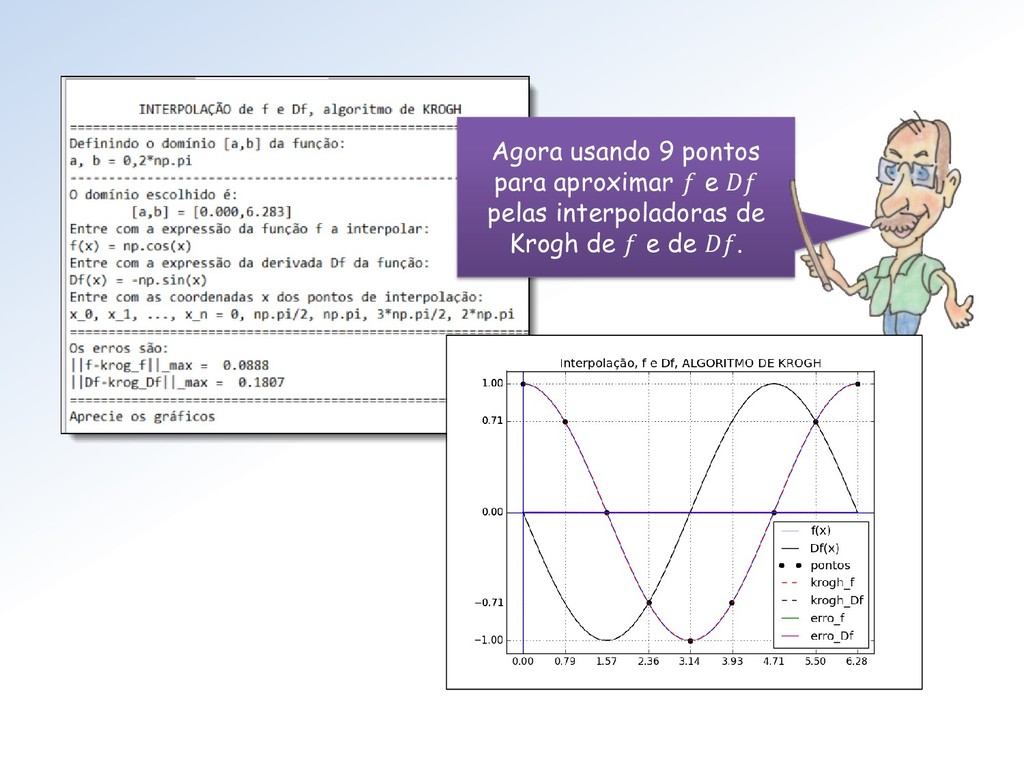
Usando o programa para aproximar e pelas interpoladoras de Krogh
de e de com 5 pontos. -
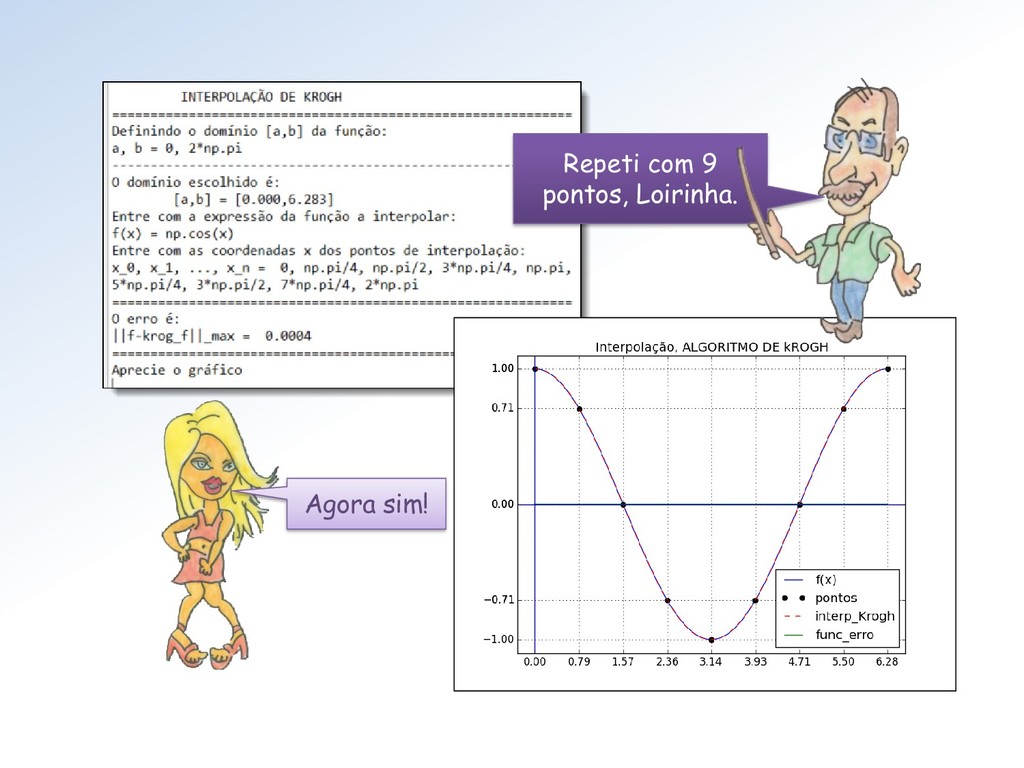
Agora usando 9 pontos para aproximar e pelas interpoladoras de
Krogh de e de . -
Eis um artigo de peso! Nele os autores recuperam conceitualmente
a interpolação de Lagrange com um algoritmo ótimo! -
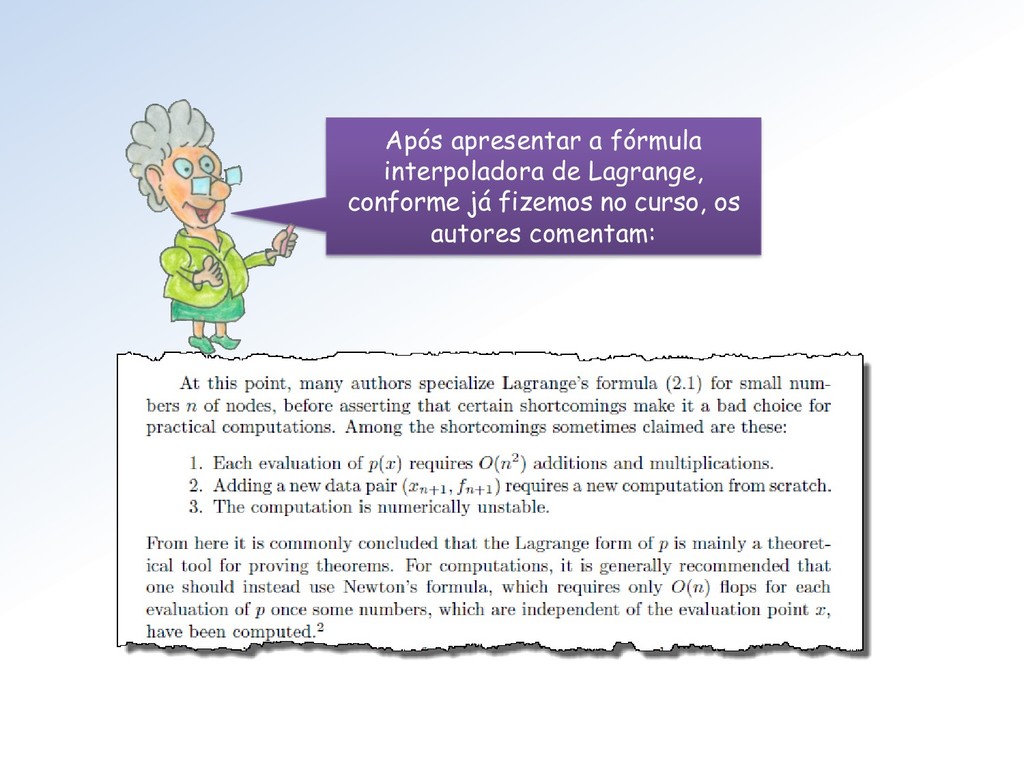
Após apresentar a fórmula interpoladora de Lagrange, conforme já fizemos
no curso, os autores comentam: -
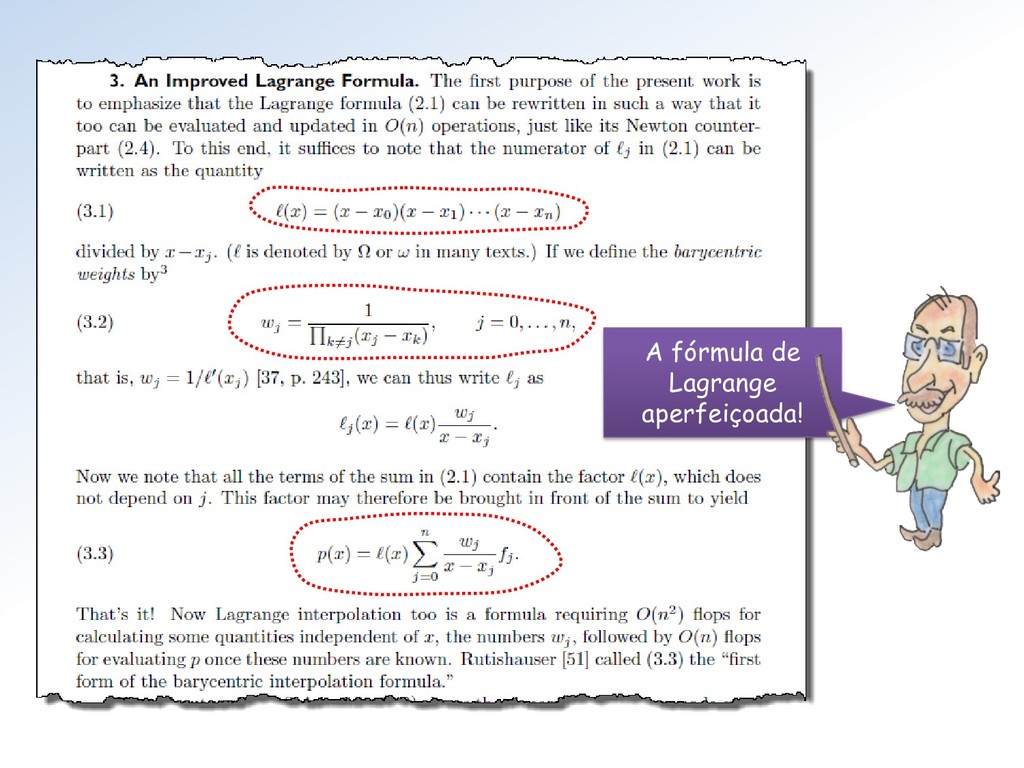
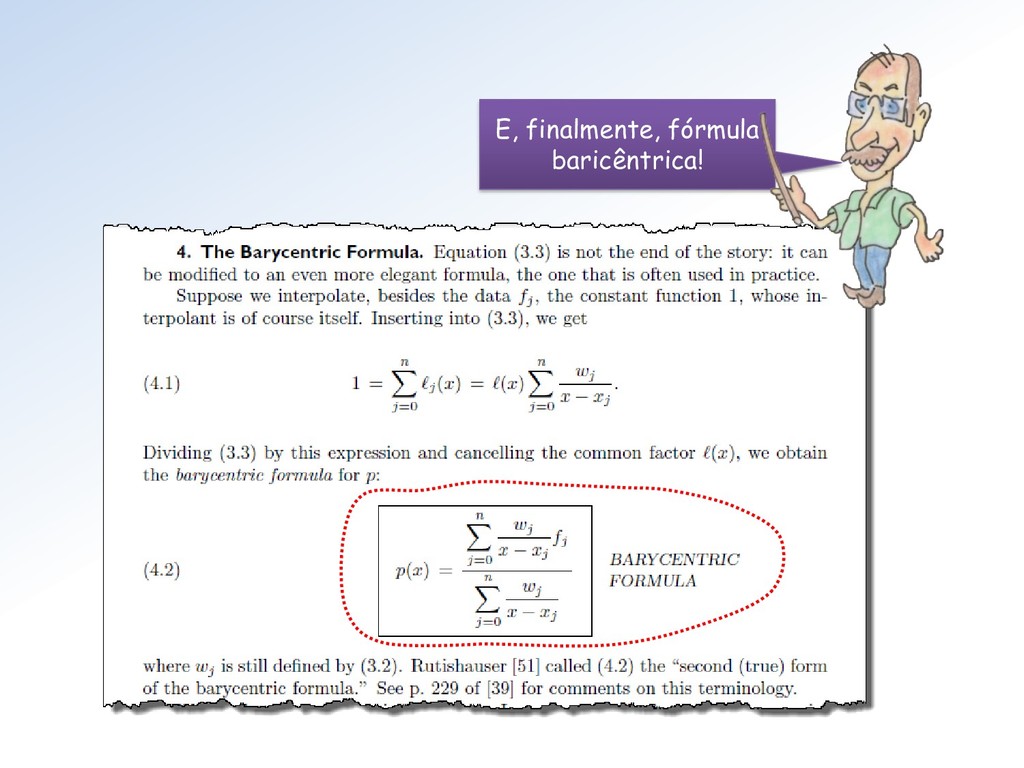
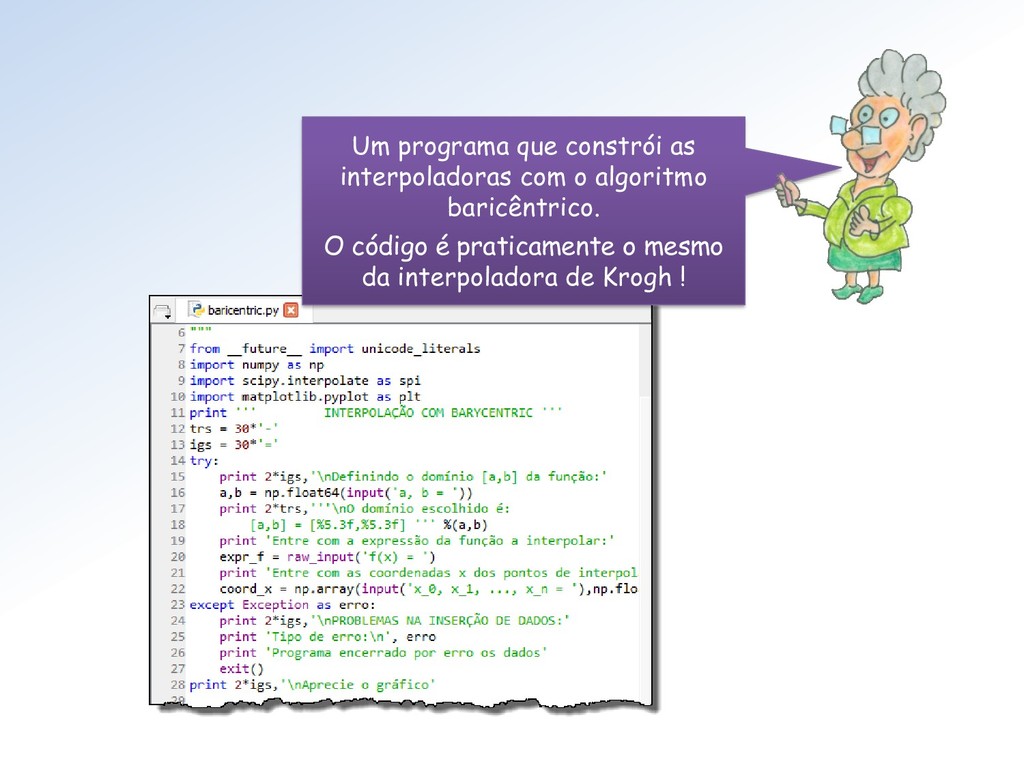
Um programa que constrói as interpoladoras com o algoritmo baricêntrico.
O código é praticamente o mesmo da interpoladora de Krogh ! -
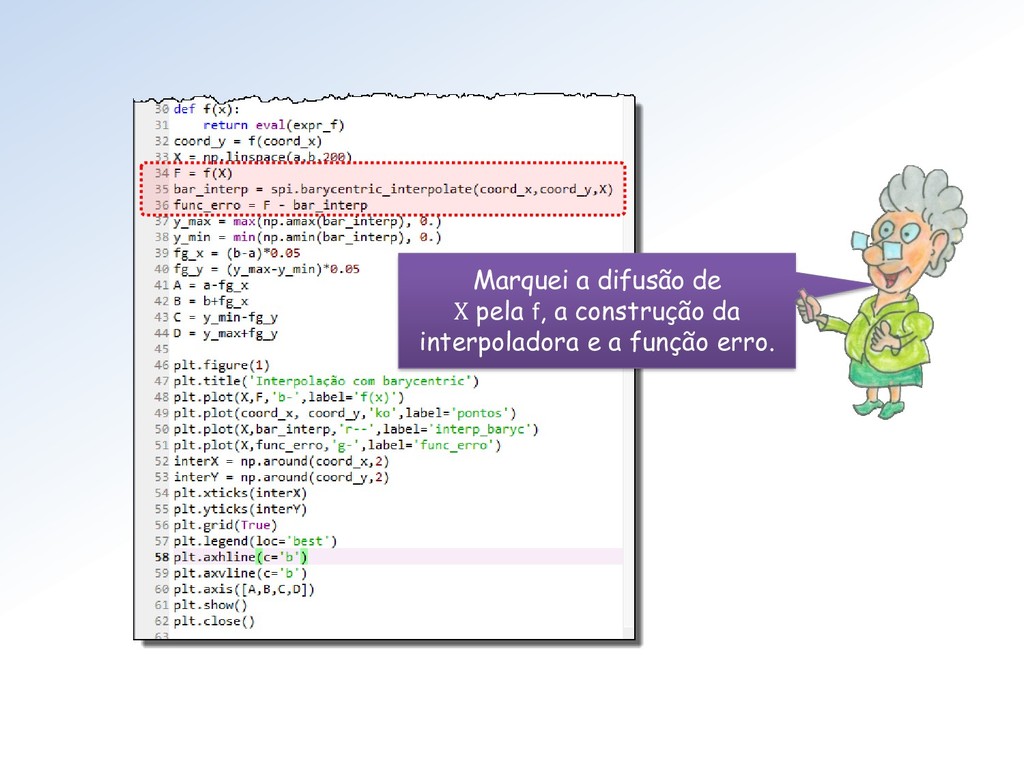
Marquei a difusão de X pela f, a construção da
interpoladora e a função erro. -
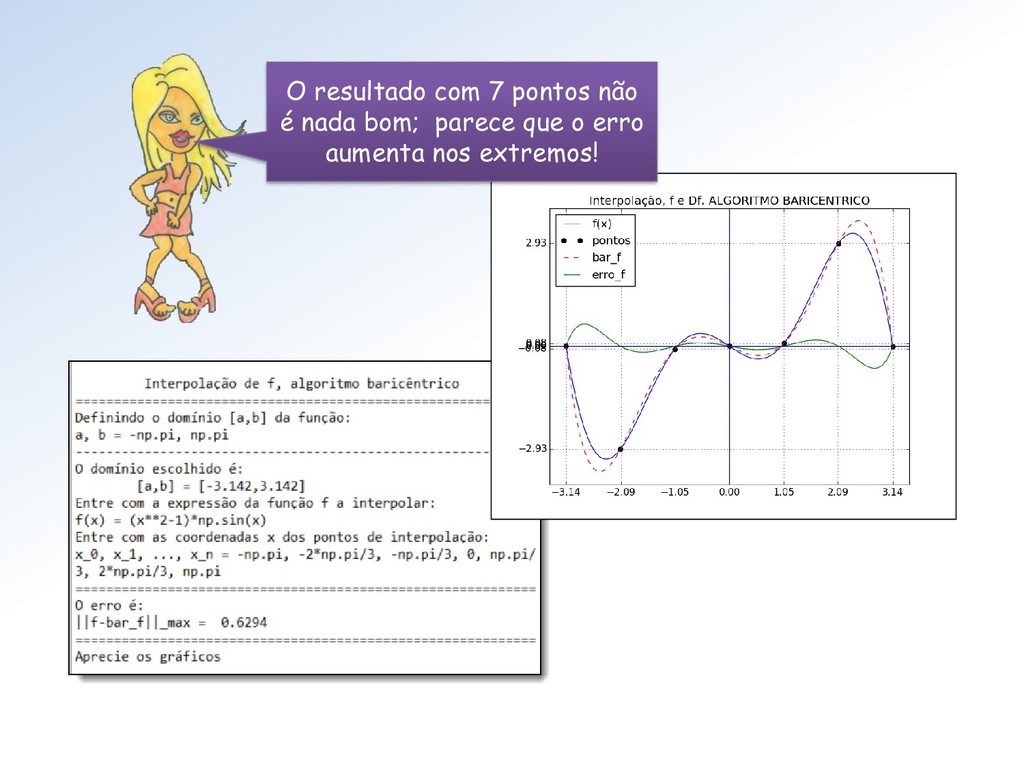
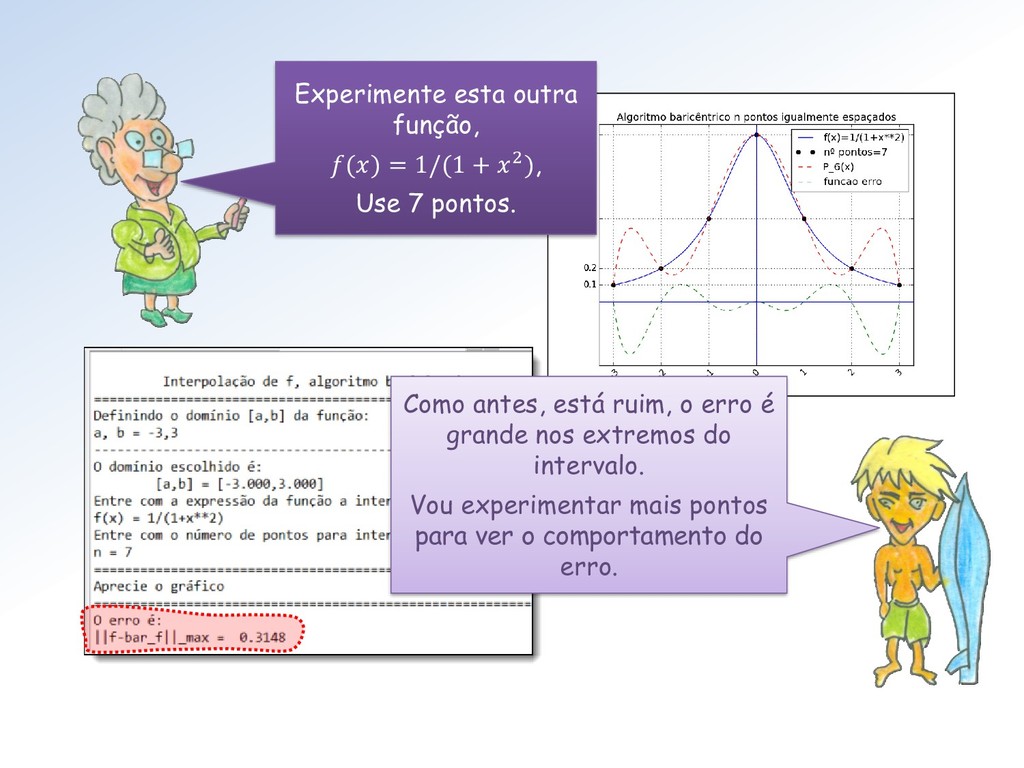
O resultado com 7 pontos não é nada bom; parece
que o erro aumenta nos extremos! -
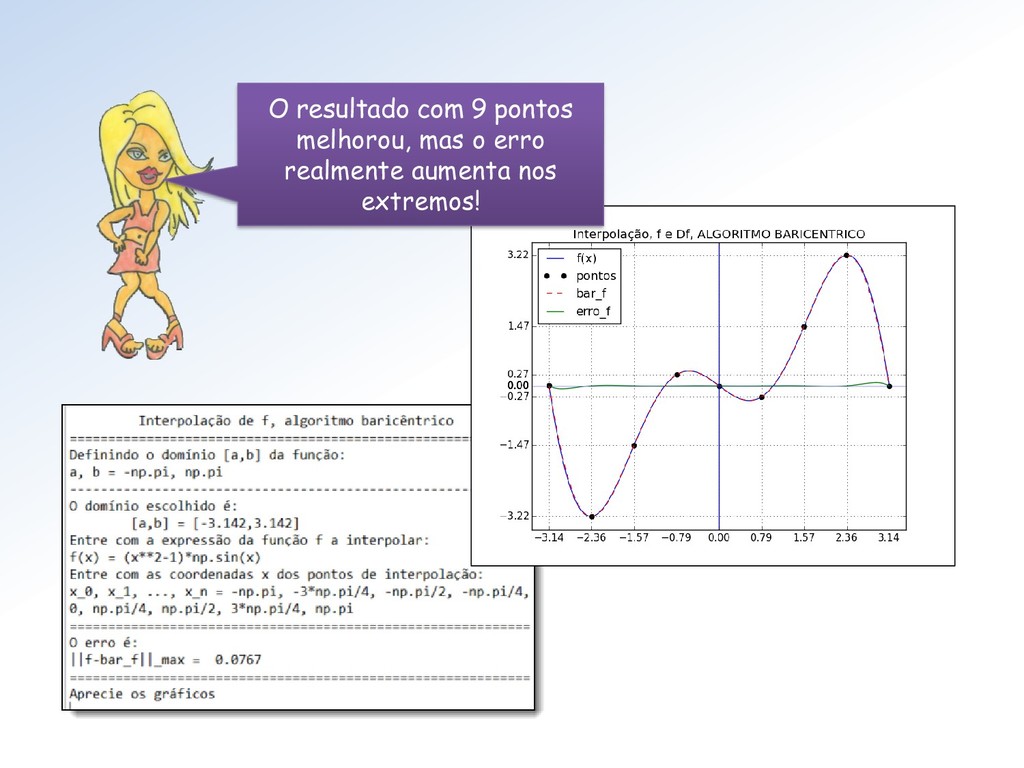
O resultado com 9 pontos melhorou, mas o erro realmente
aumenta nos extremos! -
Como antes, está ruim, o erro é grande nos extremos
do intervalo. Vou experimentar mais pontos para ver o comportamento do erro. Experimente esta outra função, () = 1/(1 + 2), Use 7 pontos. -
Com 9 melhorou no centro, mas o erro aumentou nos
estremos. Com 15 pontos o erro disparou! -
Loirinha, você tocou num ponto crucial. Para valores igualmente espaçados,
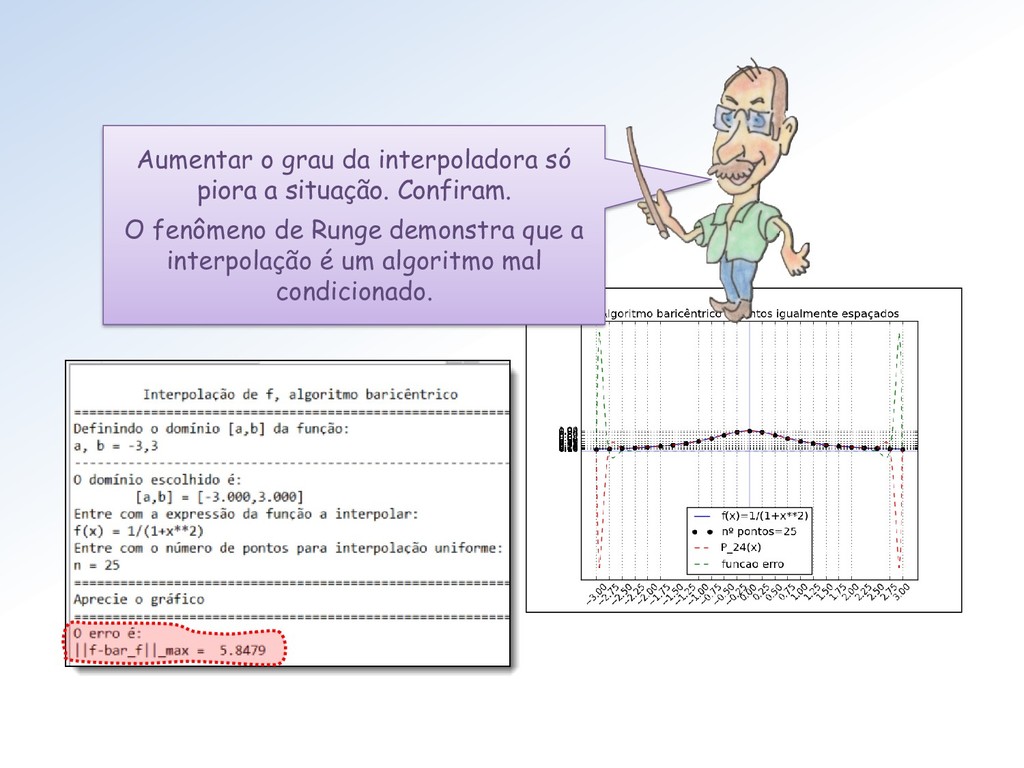
ao aumentarmos o grau da interpoladora, surge o fenômeno de Runge! Mestres, parece que aumentar o grau da polinomial interpoladora não melhora a precisão da interpolação. -
Aumentar o grau da interpoladora só piora a situação. Confiram.
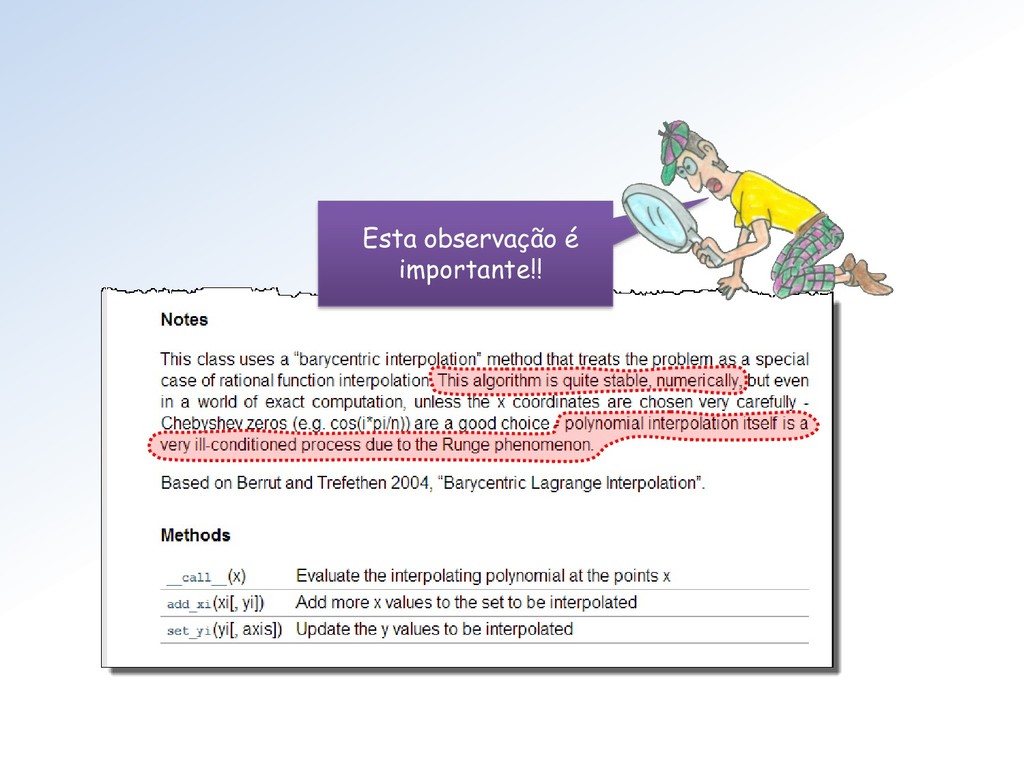
O fenômeno de Runge demonstra que a interpolação é um algoritmo mal condicionado. -
Com 31 pontos o erro é 18 vezes maior que
o valor da máximo da função Ele Ru(n)ge cada vez mais e vai devorar o Mestre! Pois é Surfista, mas para a função de Runge, = 1/(1 + 2), isto não acontece! -
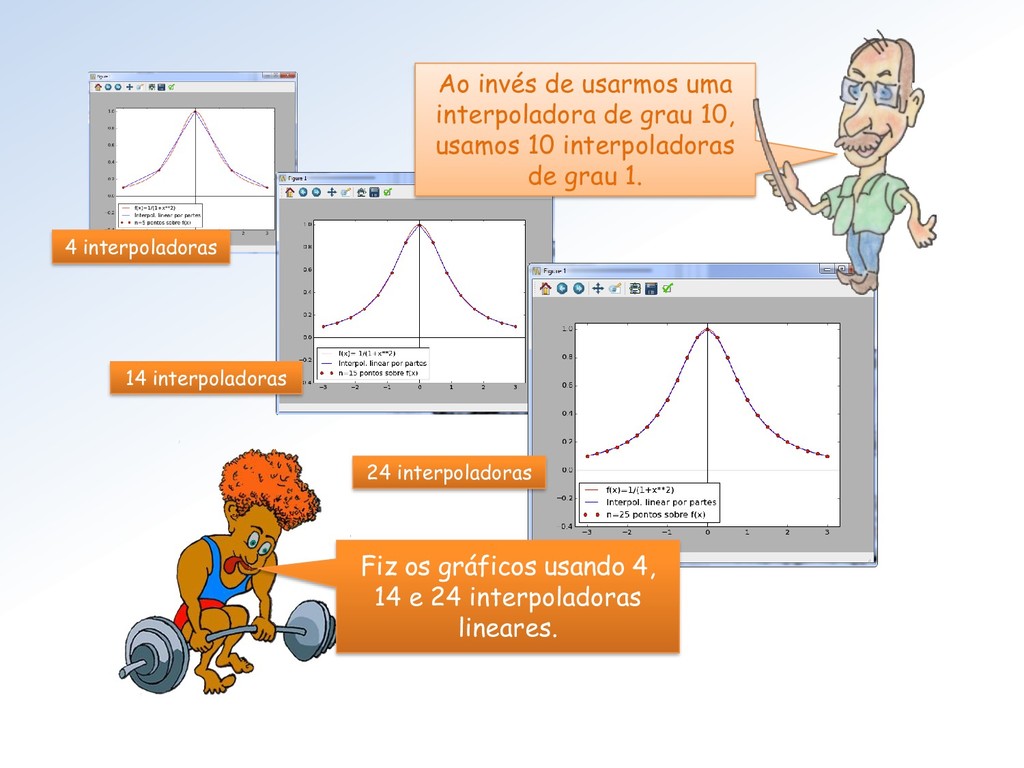
E aí Mestres, como faremos para matar esse leão? DIVIDIR
PARA CONQUISTAR! Um mantra na computação. -
4 interpoladoras 14 interpoladoras 24 interpoladoras Ao invés de usarmos
uma interpoladora de grau 10, usamos 10 interpoladoras de grau 1. Fiz os gráficos usando 4, 14 e 24 interpoladoras lineares. -
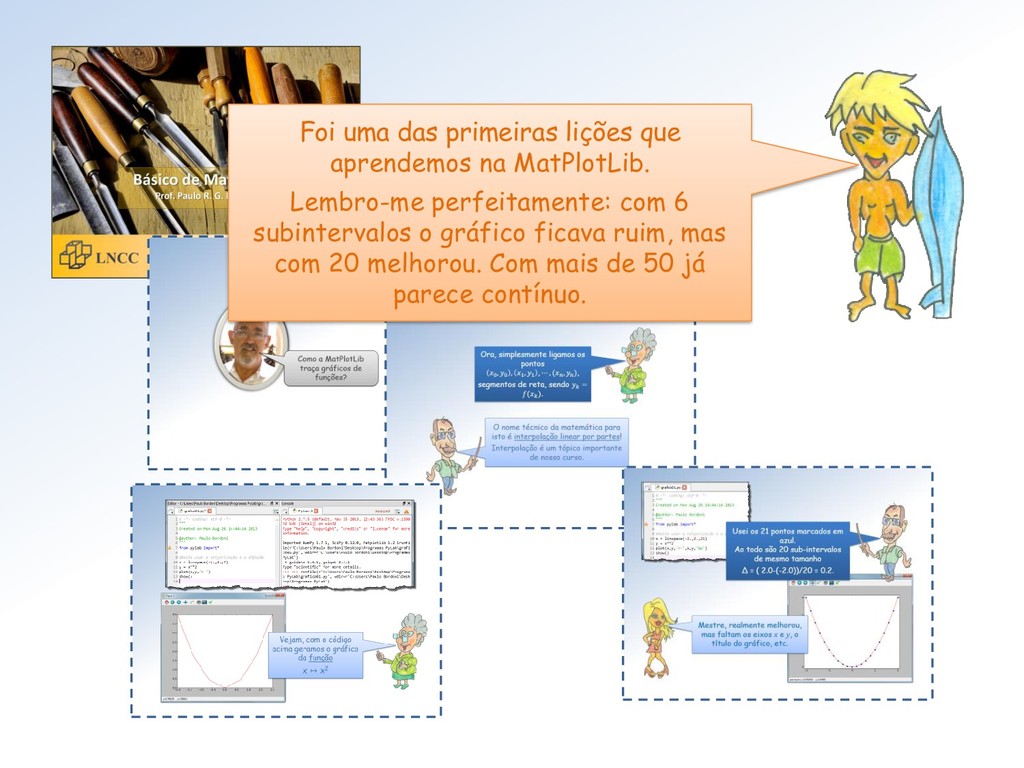
Foi uma das primeiras lições que aprendemos na MatPlotLib. Lembro-me
perfeitamente: com 6 subintervalos o gráfico ficava ruim, mas com 20 melhorou. Com mais de 50 já parece contínuo. -
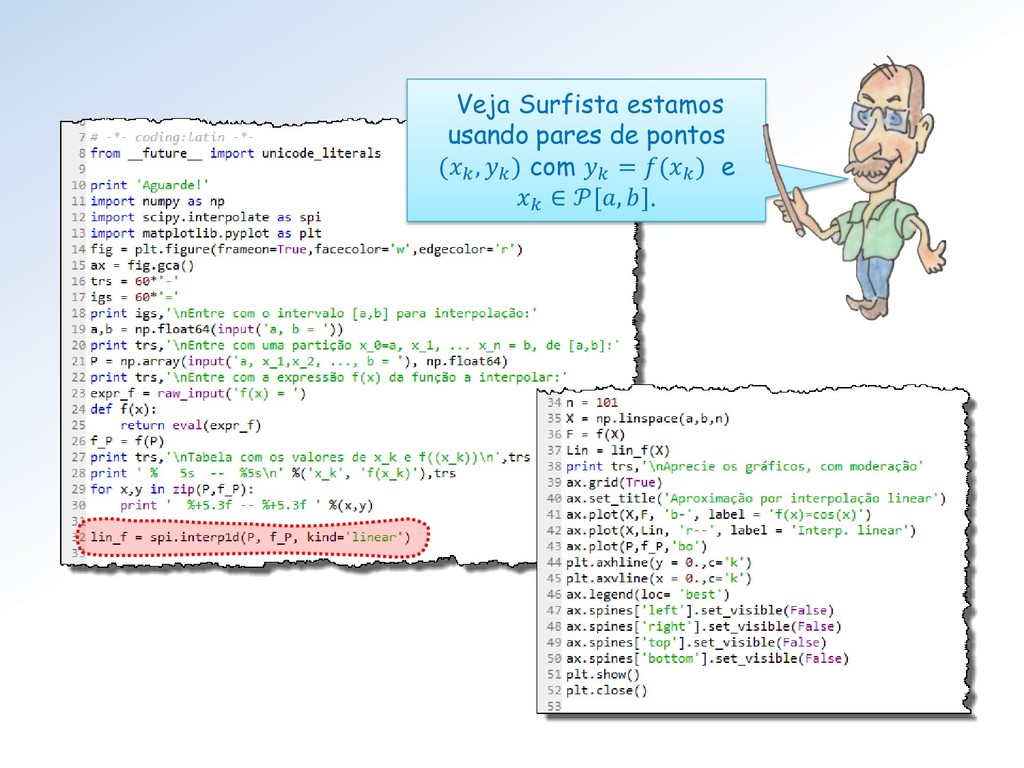
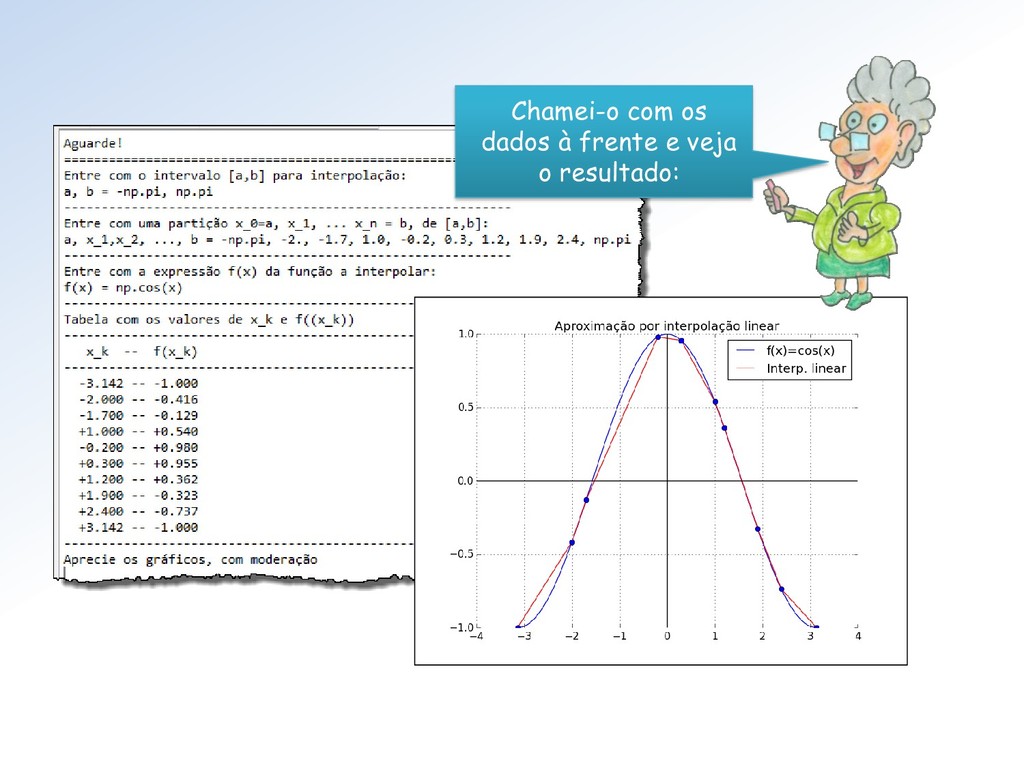
O programa: • Recebe: 1. Um intervalo [, ], 2.
A expressão de uma função : [, ] → ℝ, 3. Uma partição de , , 4. A opção por kind = ′linear′ para a interpoladora. • E devolve: 1. Uma tabela dos pares dos pares , ( ) , 2. Os gráficos de e da interpoladora linear por partes de Lagrange da função sobre a partição , . Agora faremos uma interpolação linear por partes de uma função : [, ] → ℝ. -
Veja Surfista estamos usando pares de pontos ( , )
com = ( ) e ∈ [, ]. -
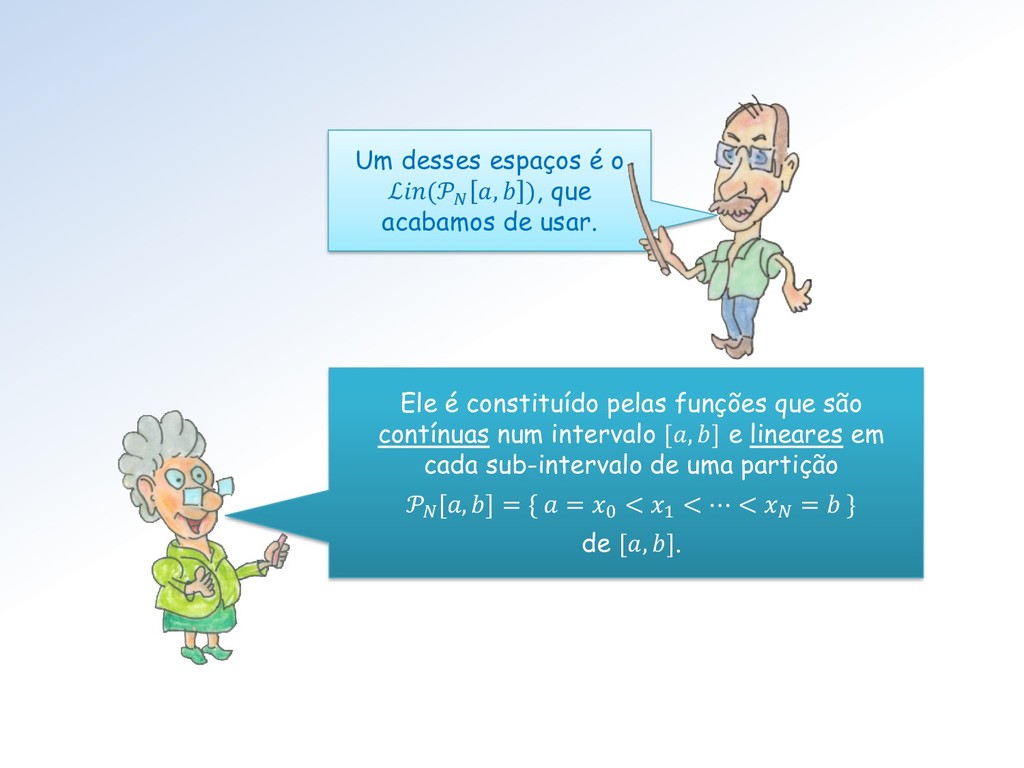
Um desses espaços é o ℒ( , ), que acabamos
de usar. Ele é constituído pelas funções que são contínuas num intervalo [, ] e lineares em cada sub-intervalo de uma partição [, ] = { = 0 < 1 < ⋯ < = } de [, ]. -
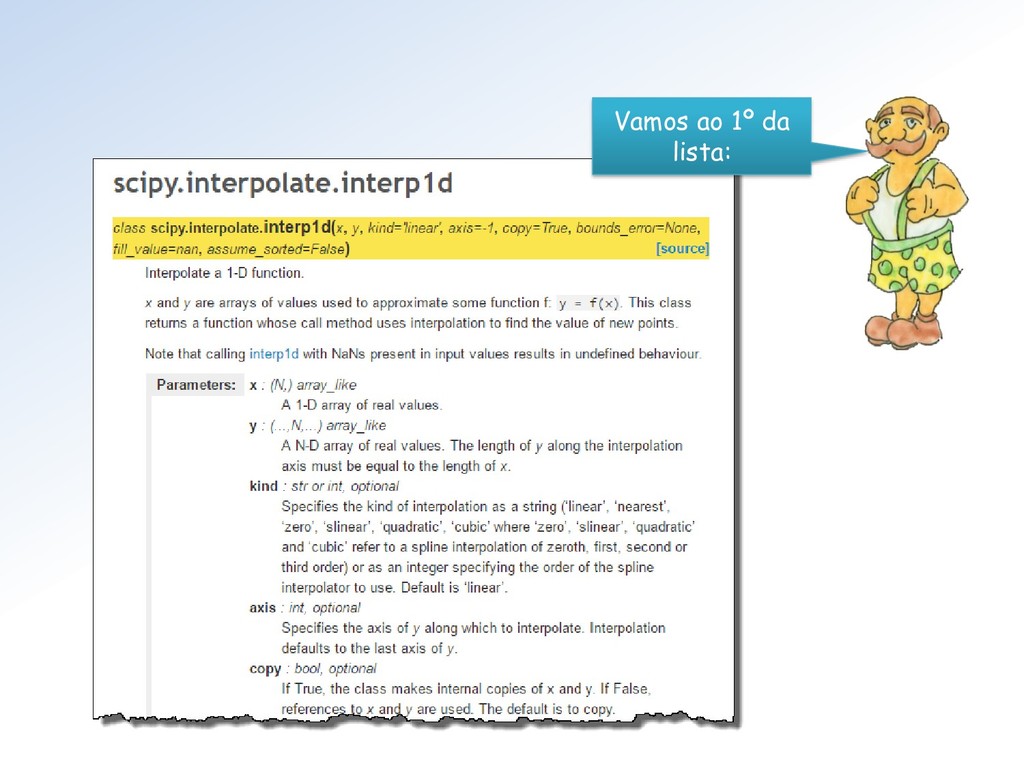
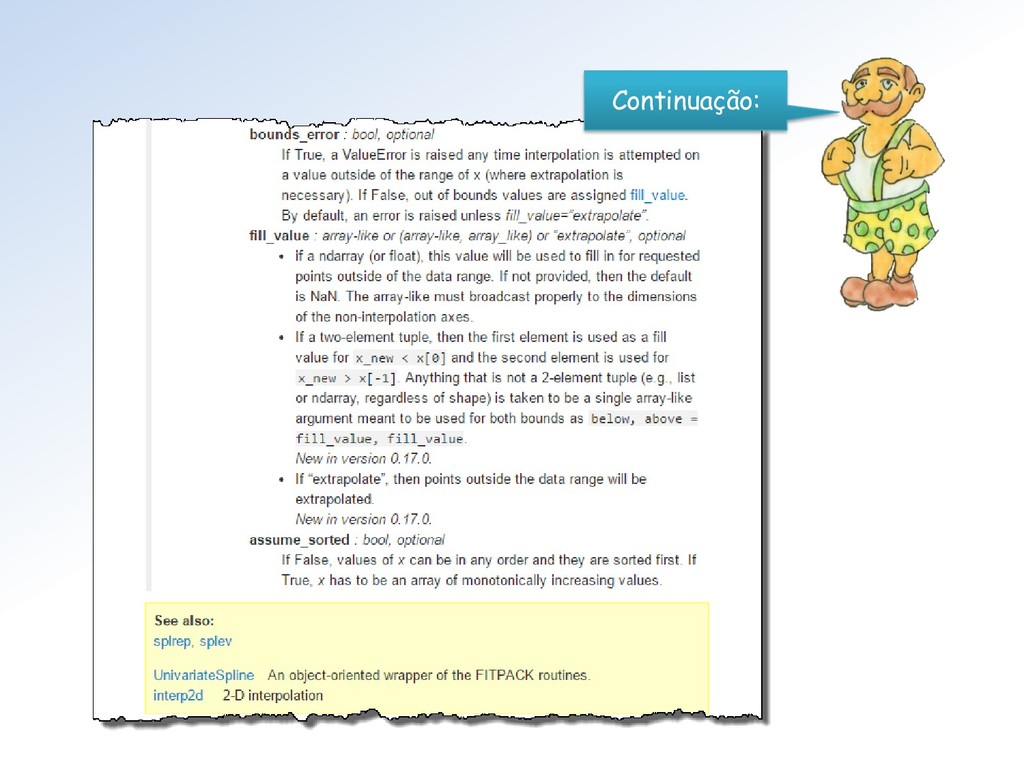
A rotina interp1d( ) do pacote scipy.interpolate permite construirmos facilmente
funções (vetores) desse subespaço. ℒ , é um subespaço de , . -
Todo espaco vetorial tem uma base, ao menos uma. Mostre-nos
uma base do ℒ( , ), Mestra. Ah, minha filha, uma delas é a minha coleção de chapéus de bruxa! -
Chapeus de bruxa, Mestra? Amei! Sim Loirinha. A base canônica
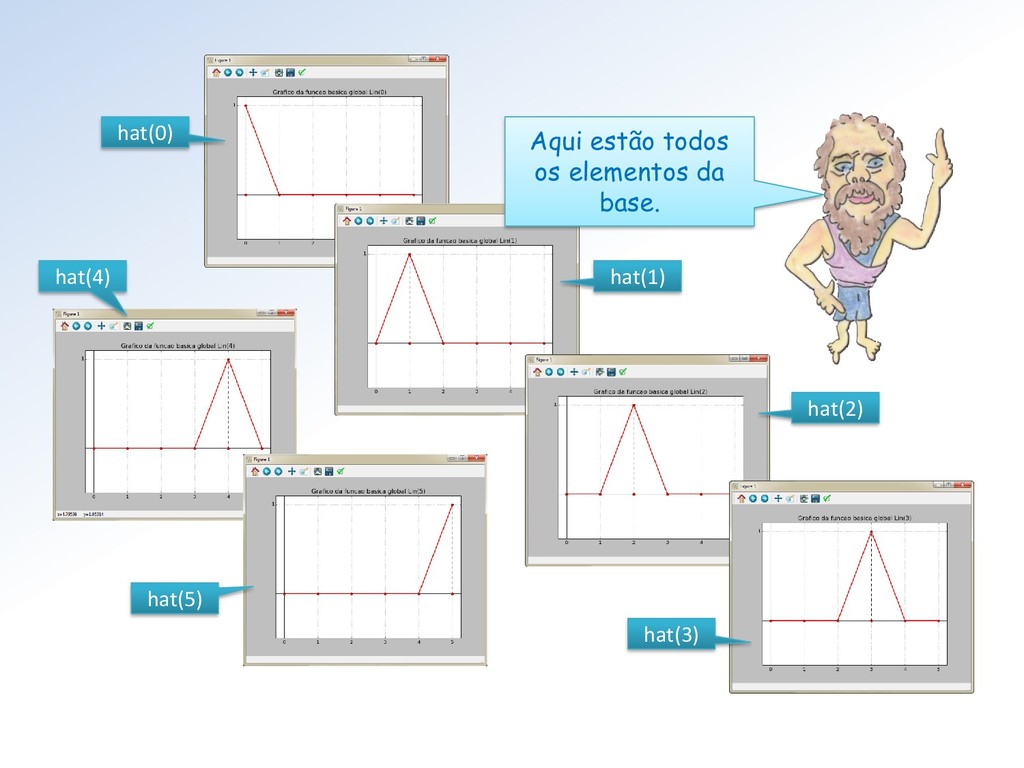
de ℒ( , ) é a coleção ℋ = {ℎ0 , ℎ1 , … , ℎ } constituída pelas N+1 “hat functions” que o Galileu vai te mostrar nas próximas transparências. -
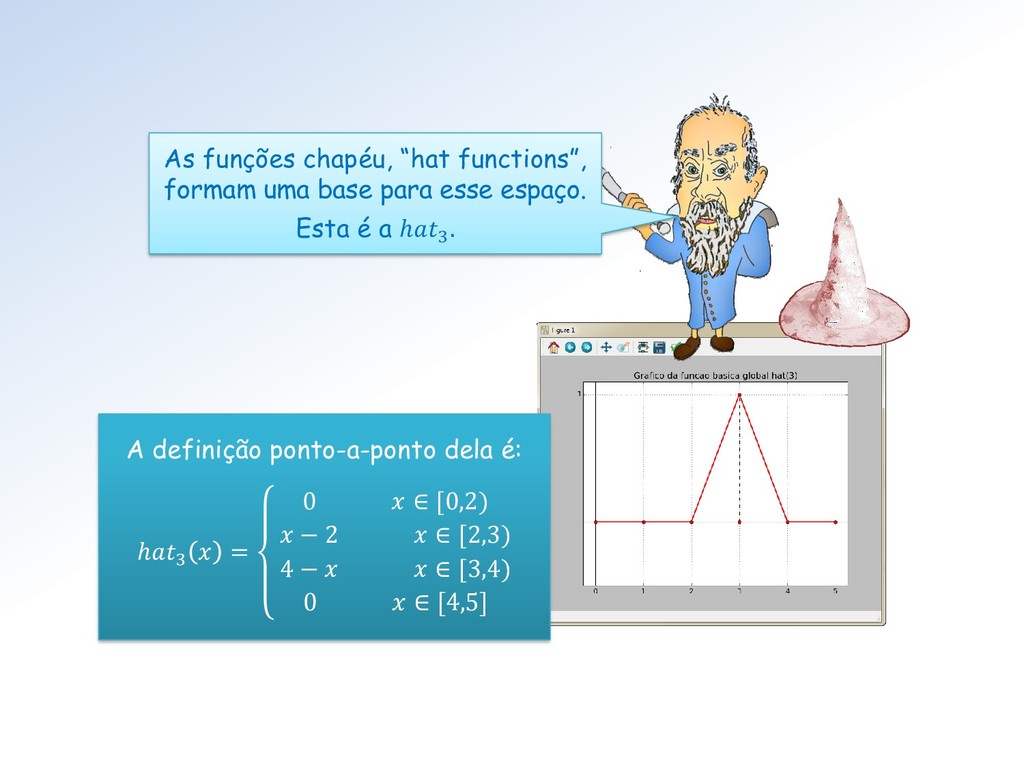
As funções chapéu, “hat functions”, formam uma base para esse
espaço. Esta é a ℎ3 . A definição ponto-a-ponto dela é: ℎ3 = 0 ∈ [0,2) − 2 ∈ [2,3) 4 − ∈ [3,4) 0 ∈ [4,5] -
Aqui estão todos os elementos da base. hat(0) hat(3) hat(2)
hat(1) hat(4) hat(5) -
Aspecto fundamental e importantíssimo: ℒ( , ) é um subespaço
de , de dimensão finita + 1. E a característica fundamental das funções básicas é que elas se anulam fora de dois subintervalos (i. é possuem suporte compacto). -
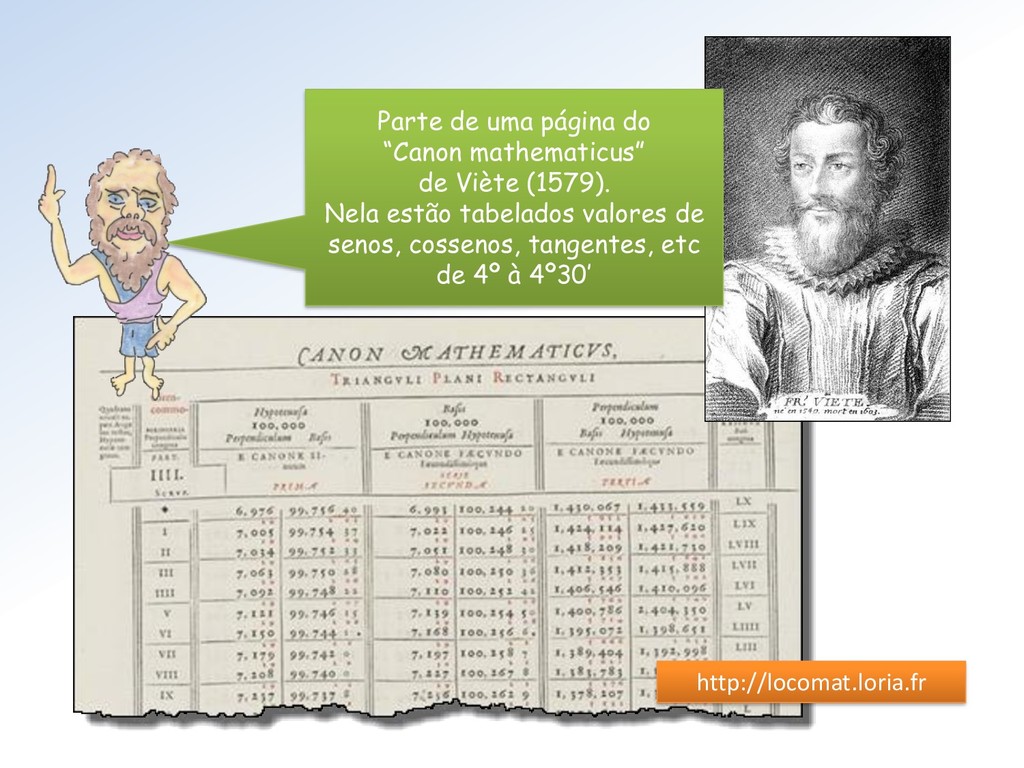
http://locomat.loria.fr Parte de uma página do “Canon mathematicus” de Viète
(1579). Nela estão tabelados valores de senos, cossenos, tangentes, etc de 4º à 4º30’ -
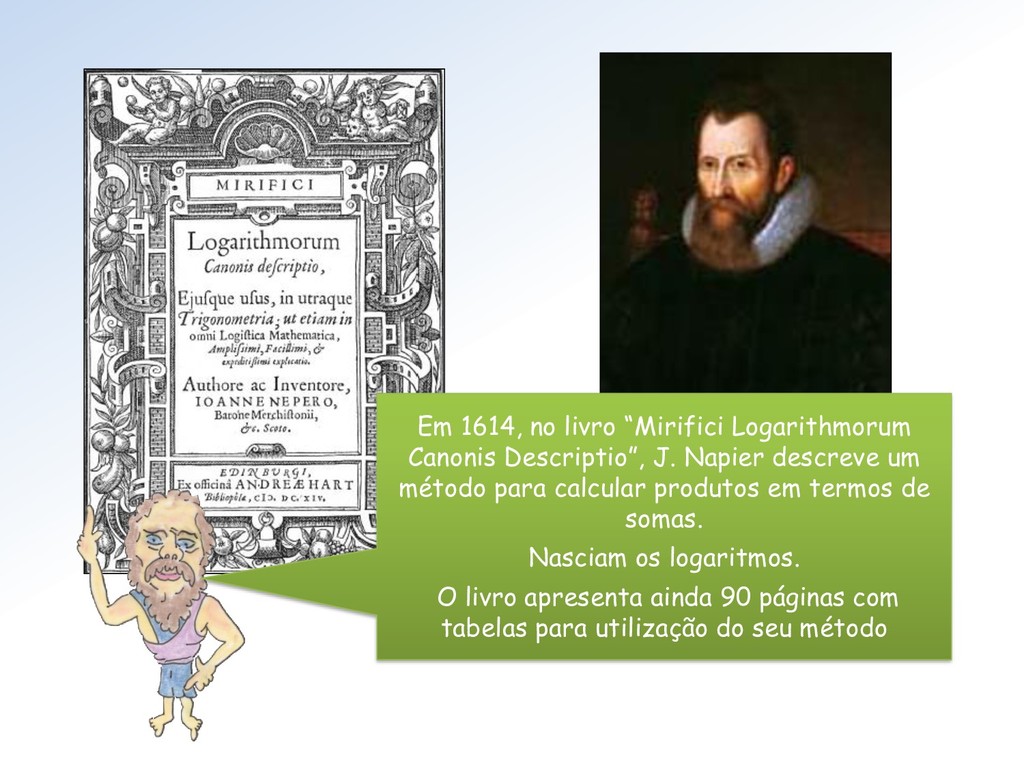
Em 1614, no livro “Mirifici Logarithmorum Canonis Descriptio”, J. Napier
descreve um método para calcular produtos em termos de somas. Nasciam os logaritmos. O livro apresenta ainda 90 páginas com tabelas para utilização do seu método -
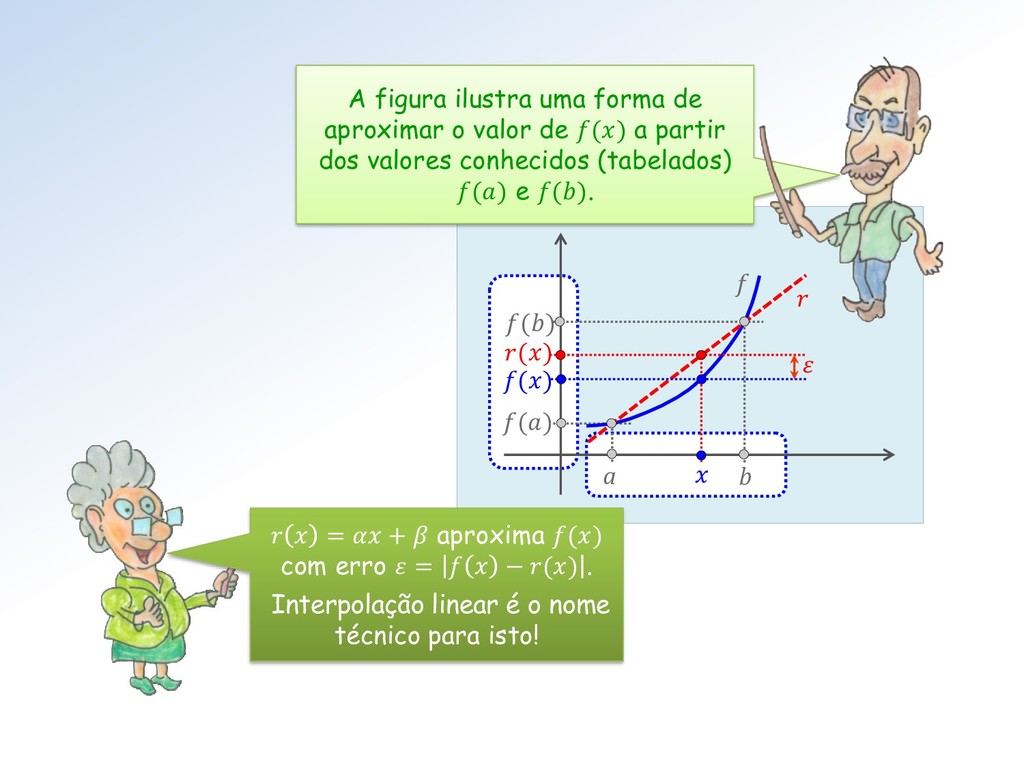
() () a b () () A figura ilustra uma
forma de aproximar o valor de () a partir dos valores conhecidos (tabelados) () e (). = + aproxima () com erro = − () . Interpolação linear é o nome técnico para isto! -
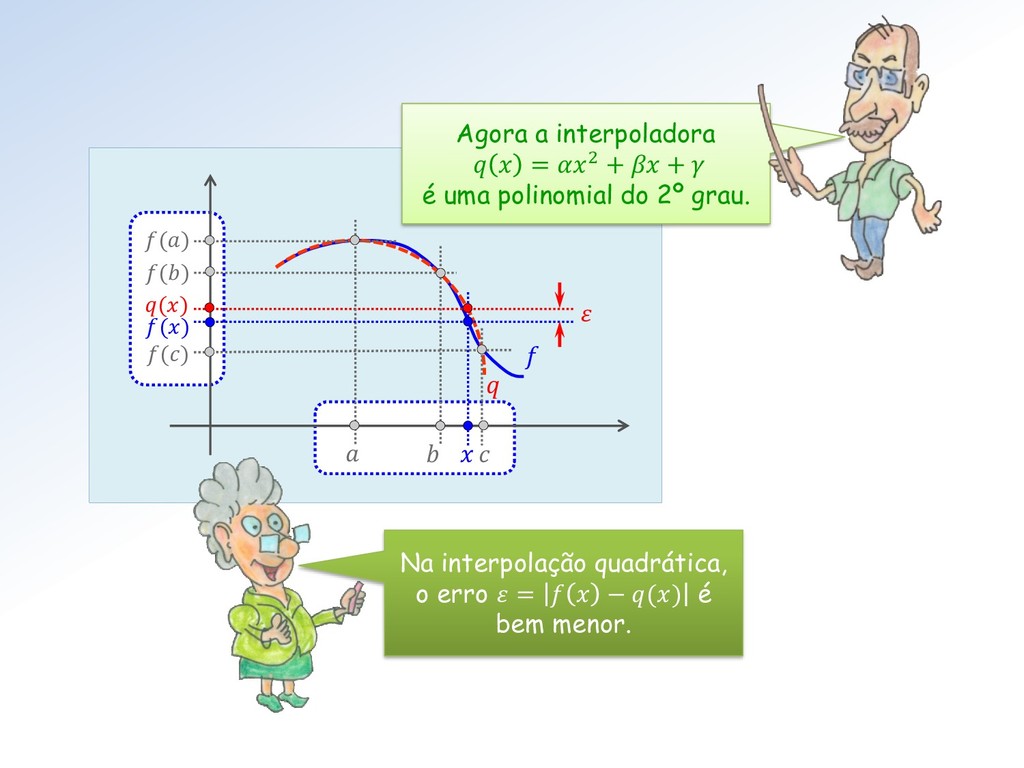
() () () () () Na interpolação quadrática, o erro
= − () é bem menor. Agora a interpoladora = 2 + + é uma polinomial do 2º grau. -
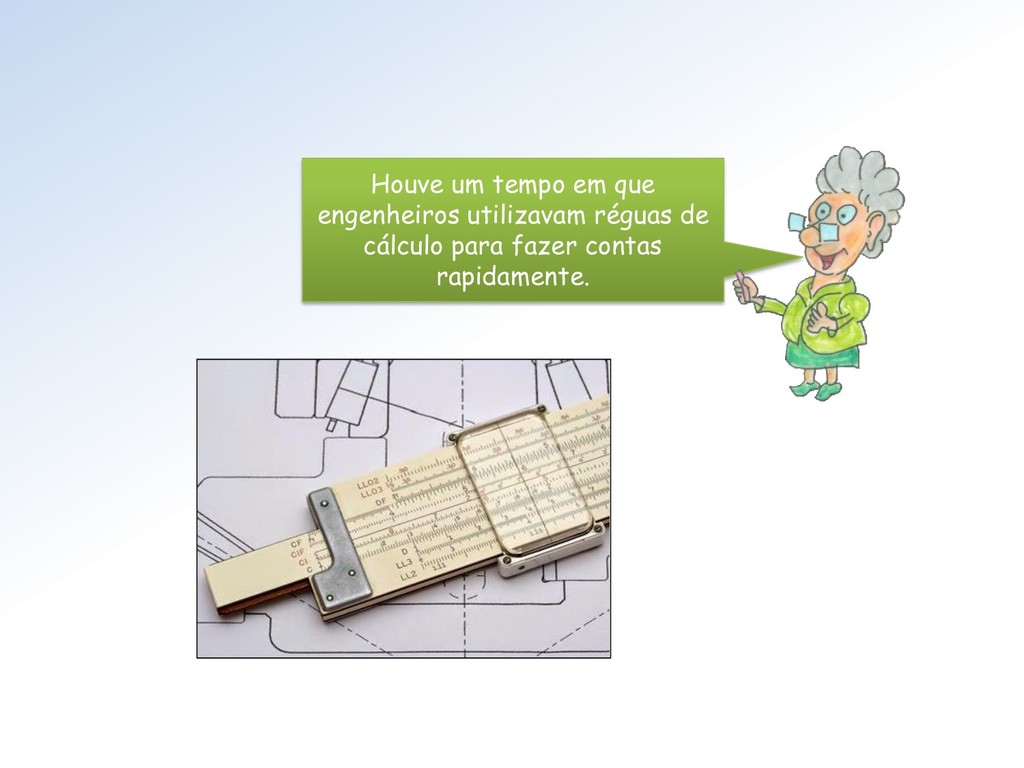
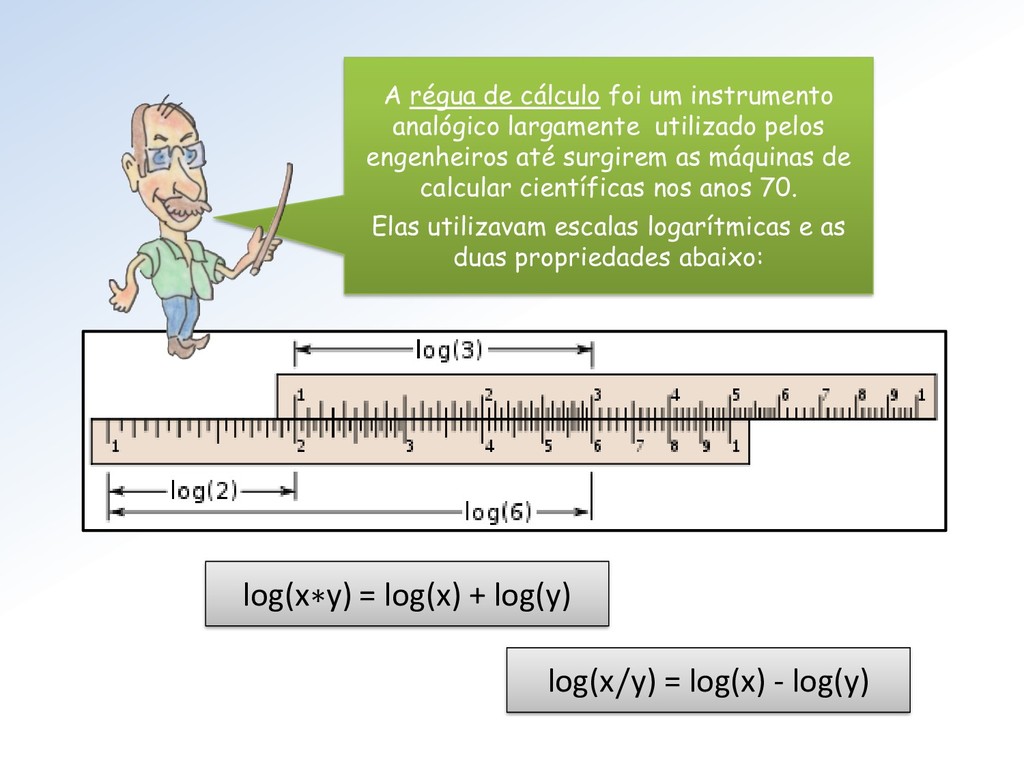
Houve um tempo em que engenheiros utilizavam réguas de cálculo
para fazer contas rapidamente. -
log(x∗y) = log(x) + log(y) log(x/y) = log(x) - log(y)
A régua de cálculo foi um instrumento analógico largamente utilizado pelos engenheiros até surgirem as máquinas de calcular científicas nos anos 70. Elas utilizavam escalas logarítmicas e as duas propriedades abaixo: