Upgrade to Pro — share decks privately, control downloads, hide ads and more …

潜在拡散モデルを用いたタンパク質変性領域(IDR)の粗視化MDレベルの高速なアンサンブル構造生...

Avatar for Rento Yabuki Rento Yabuki
September 27, 2026

潜在拡散モデルを用いたタンパク質変性領域(IDR)の粗視化MDレベルの高速なアンサンブル構造生成モデル STARLING (Nature 2026)

潜在拡散モデルを用いたタンパク質変性領域(IDR)の粗視化MDレベルの高速なアンサンブル構造生成モデルSTARLINGの紹介(Nature 2026)

Avatar for Rento Yabuki

Rento Yabuki

September 27, 2026

Other Decks in Science

Transcript

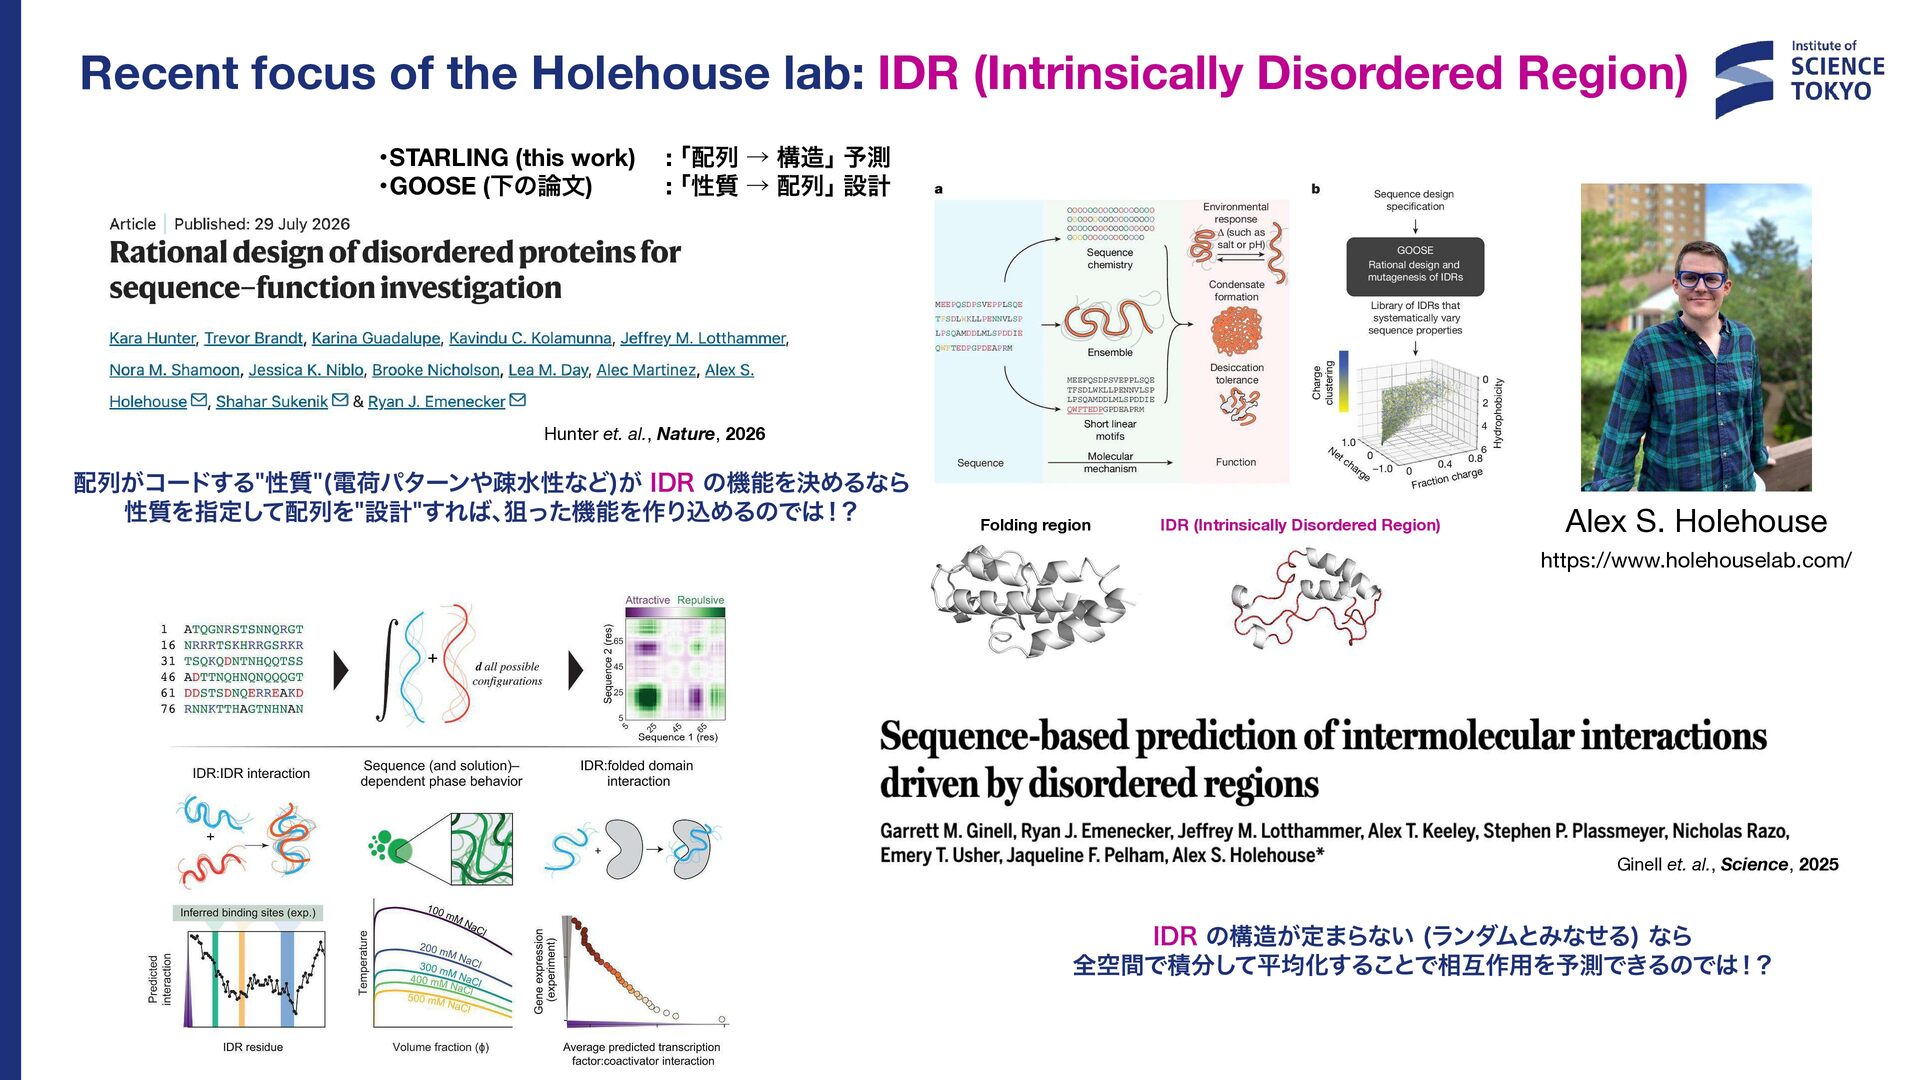
  1. Recent focus of the Holehouse lab: IDR (Intrinsically Disordered Region)

    ・STARLING (this work) ・GOOSE (下の論文) :「配列 → 構造」予測 :「性質 → 配列」設計 Hunter et. al., Nature, 2026 配列がコードする"性質"(電荷パターンや疎水性など)が IDR の機能を決めるなら 性質を指定して配列を"設計"すれば、狙った機能を作り込めるのでは!? Folding region IDR (Intrinsically Disordered Region) Alex S. Holehouse https://www.holehouselab.com/ Ginell et. al., Science, 2025 IDR の構造が定まらない (ランダムとみなせる) なら 全空間で積分して平均化することで相互作用を予測できるのでは!?
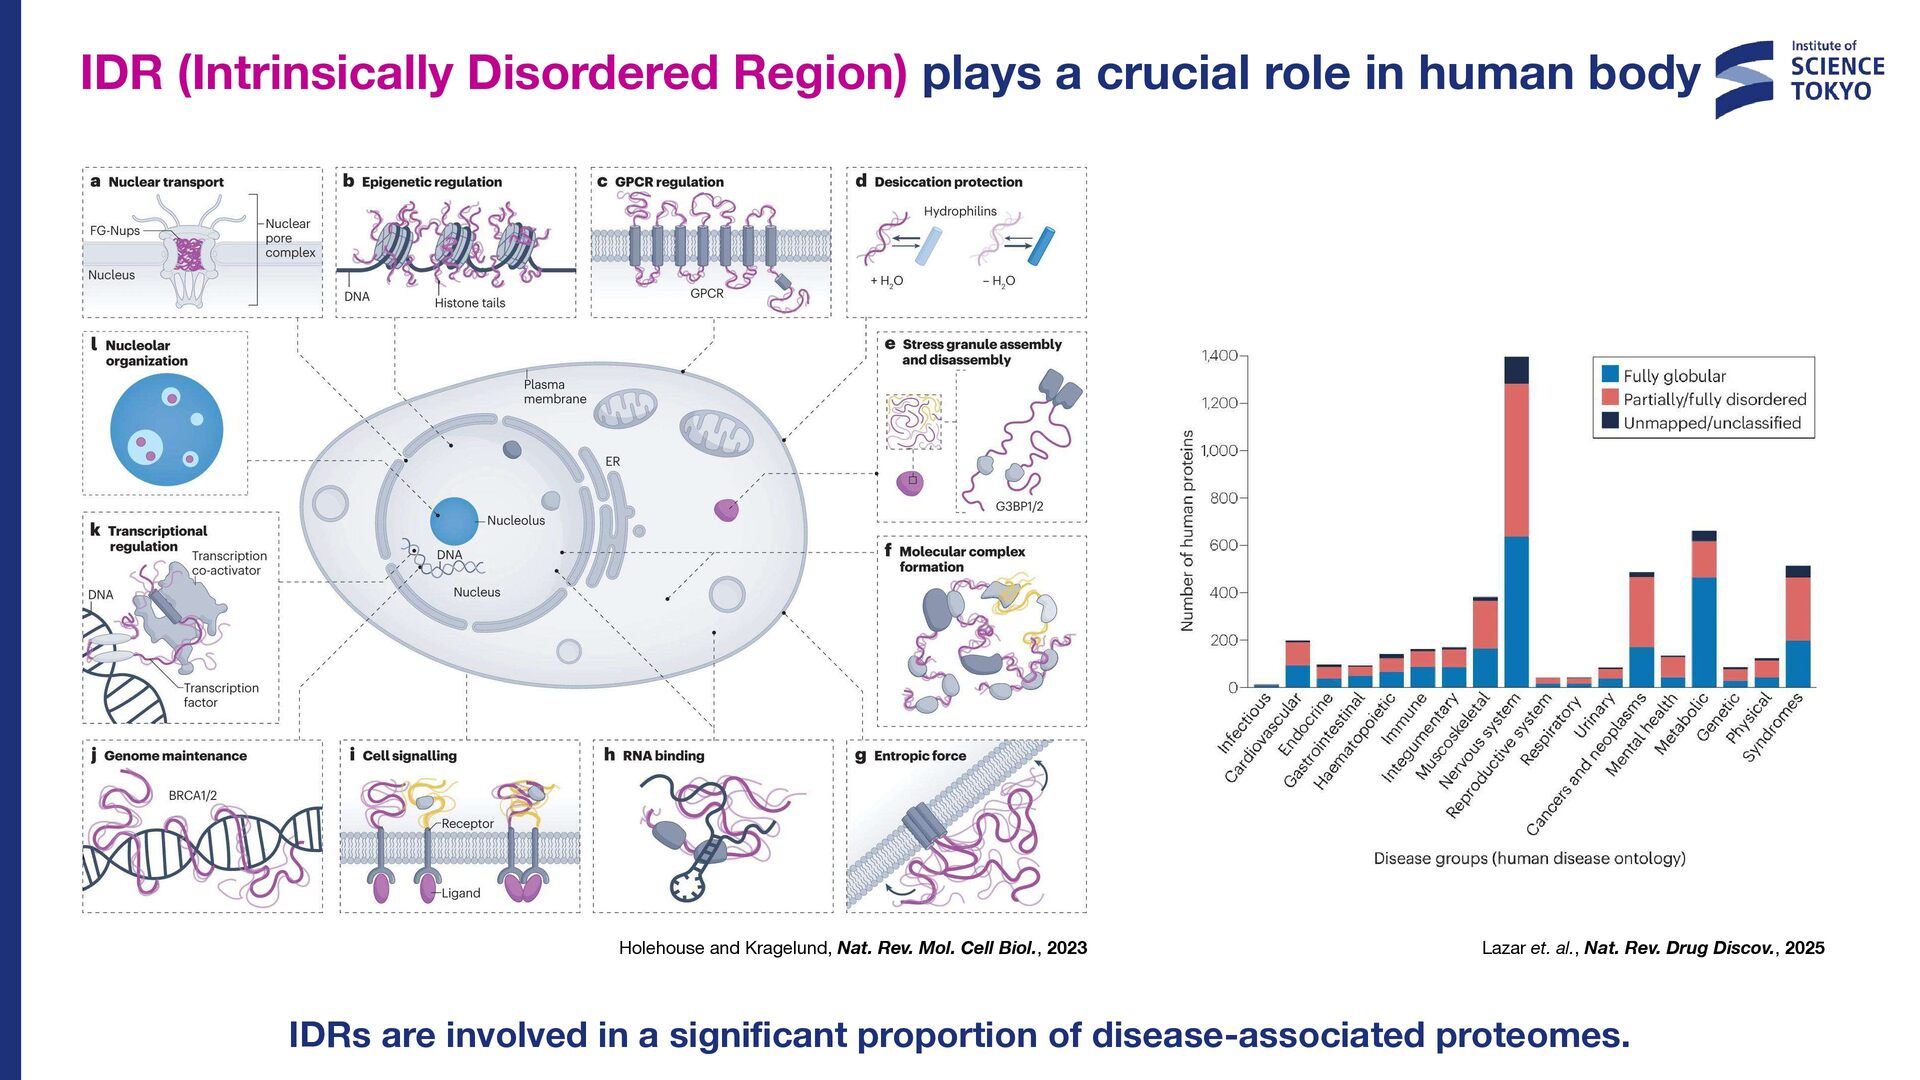
  2. IDR (Intrinsically Disordered Region) plays a crucial role in human

    body Holehouse and Kragelund, Nat. Rev. Mol. Cell Biol., 2023 Lazar et. al., Nat. Rev. Drug Discov., 2025 IDRs are involved in a significant proportion of disease-associated proteomes.
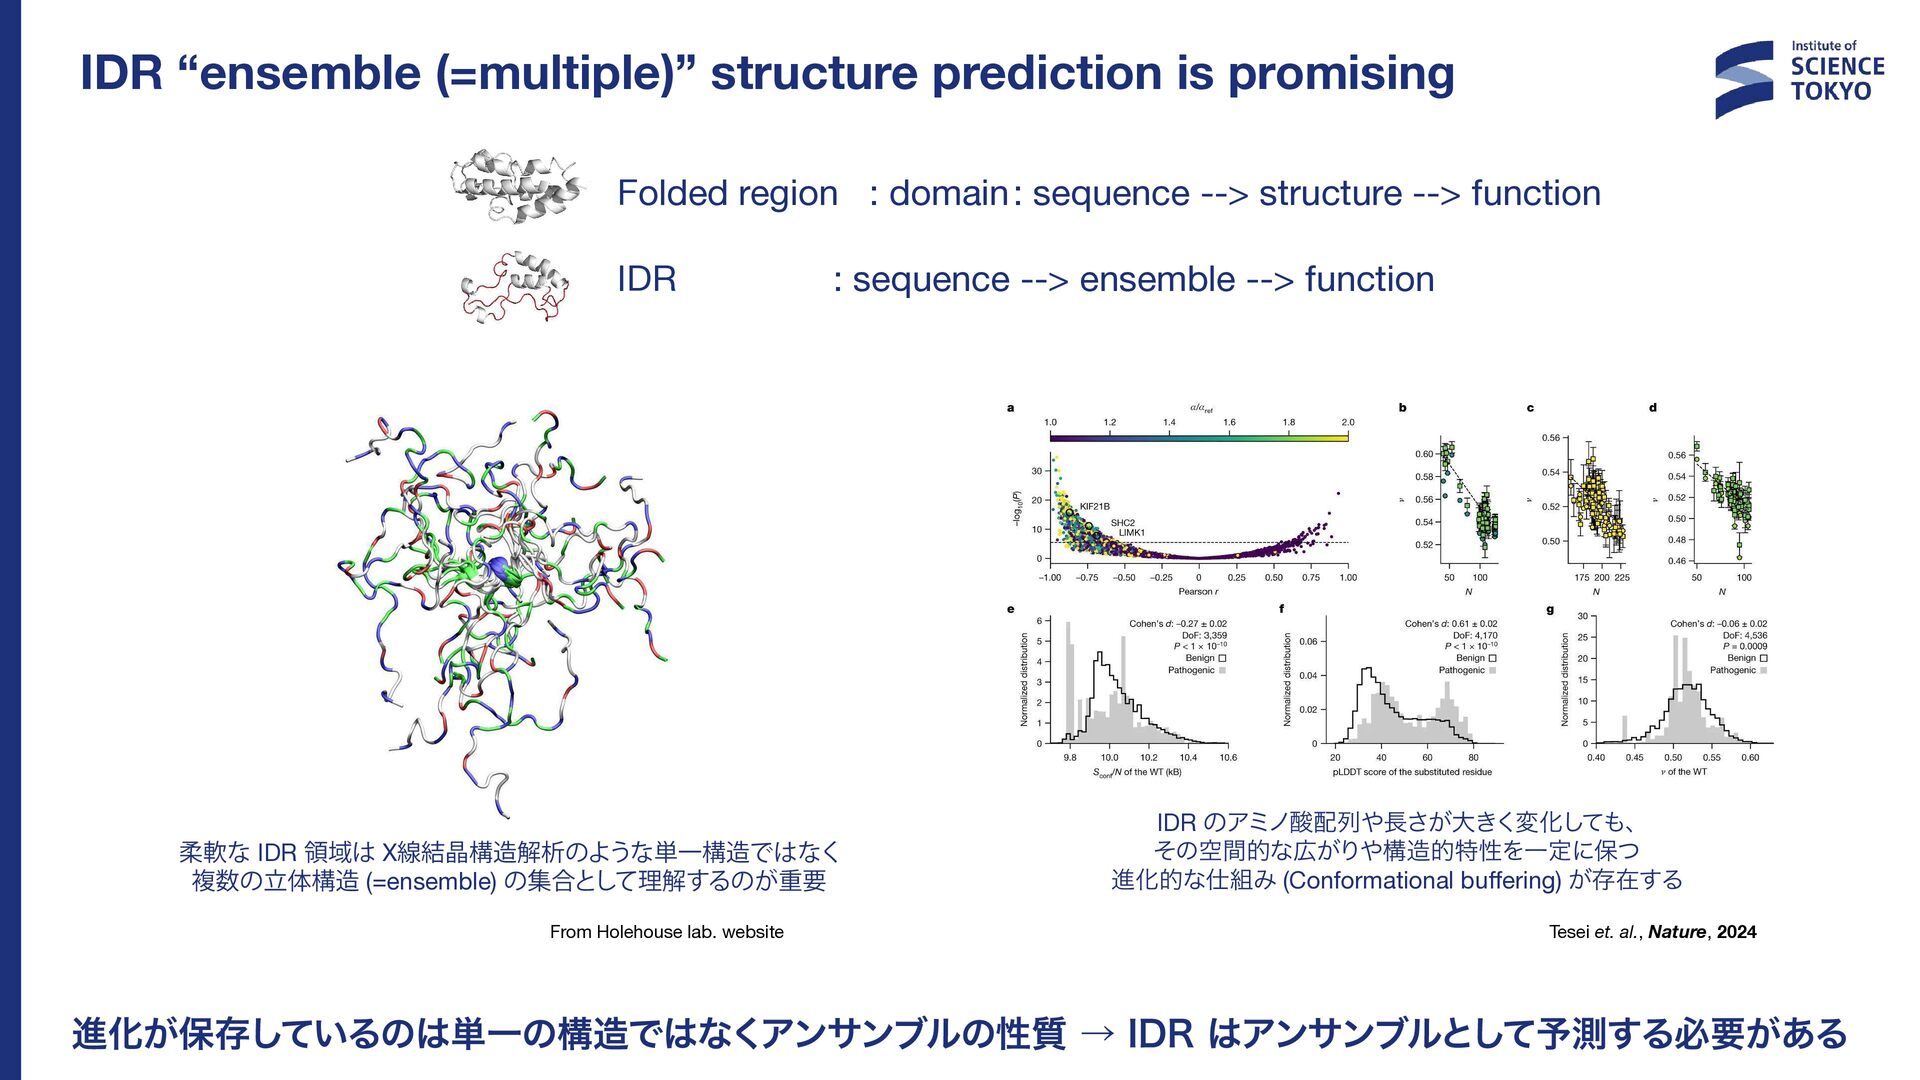
  3. IDR “ensemble (=multiple)” structure prediction is promising Folded region :

    domain : sequence --> structure --> function IDR : sequence --> ensemble --> function 柔軟な IDR 領域は X線結晶構造解析のような単一構造ではなく 複数の立体構造 (=ensemble) の集合として理解するのが重要 From Holehouse lab. website IDR のアミノ酸配列や長さが大きく変化しても、 その空間的な広がりや構造的特性を一定に保つ 進化的な仕組み (Conformational buffering) が存在する Tesei et. al., Nature, 2024 進化が保存しているのは単一の構造ではなくアンサンブルの性質 → IDR はアンサンブルとして予測する必要がある
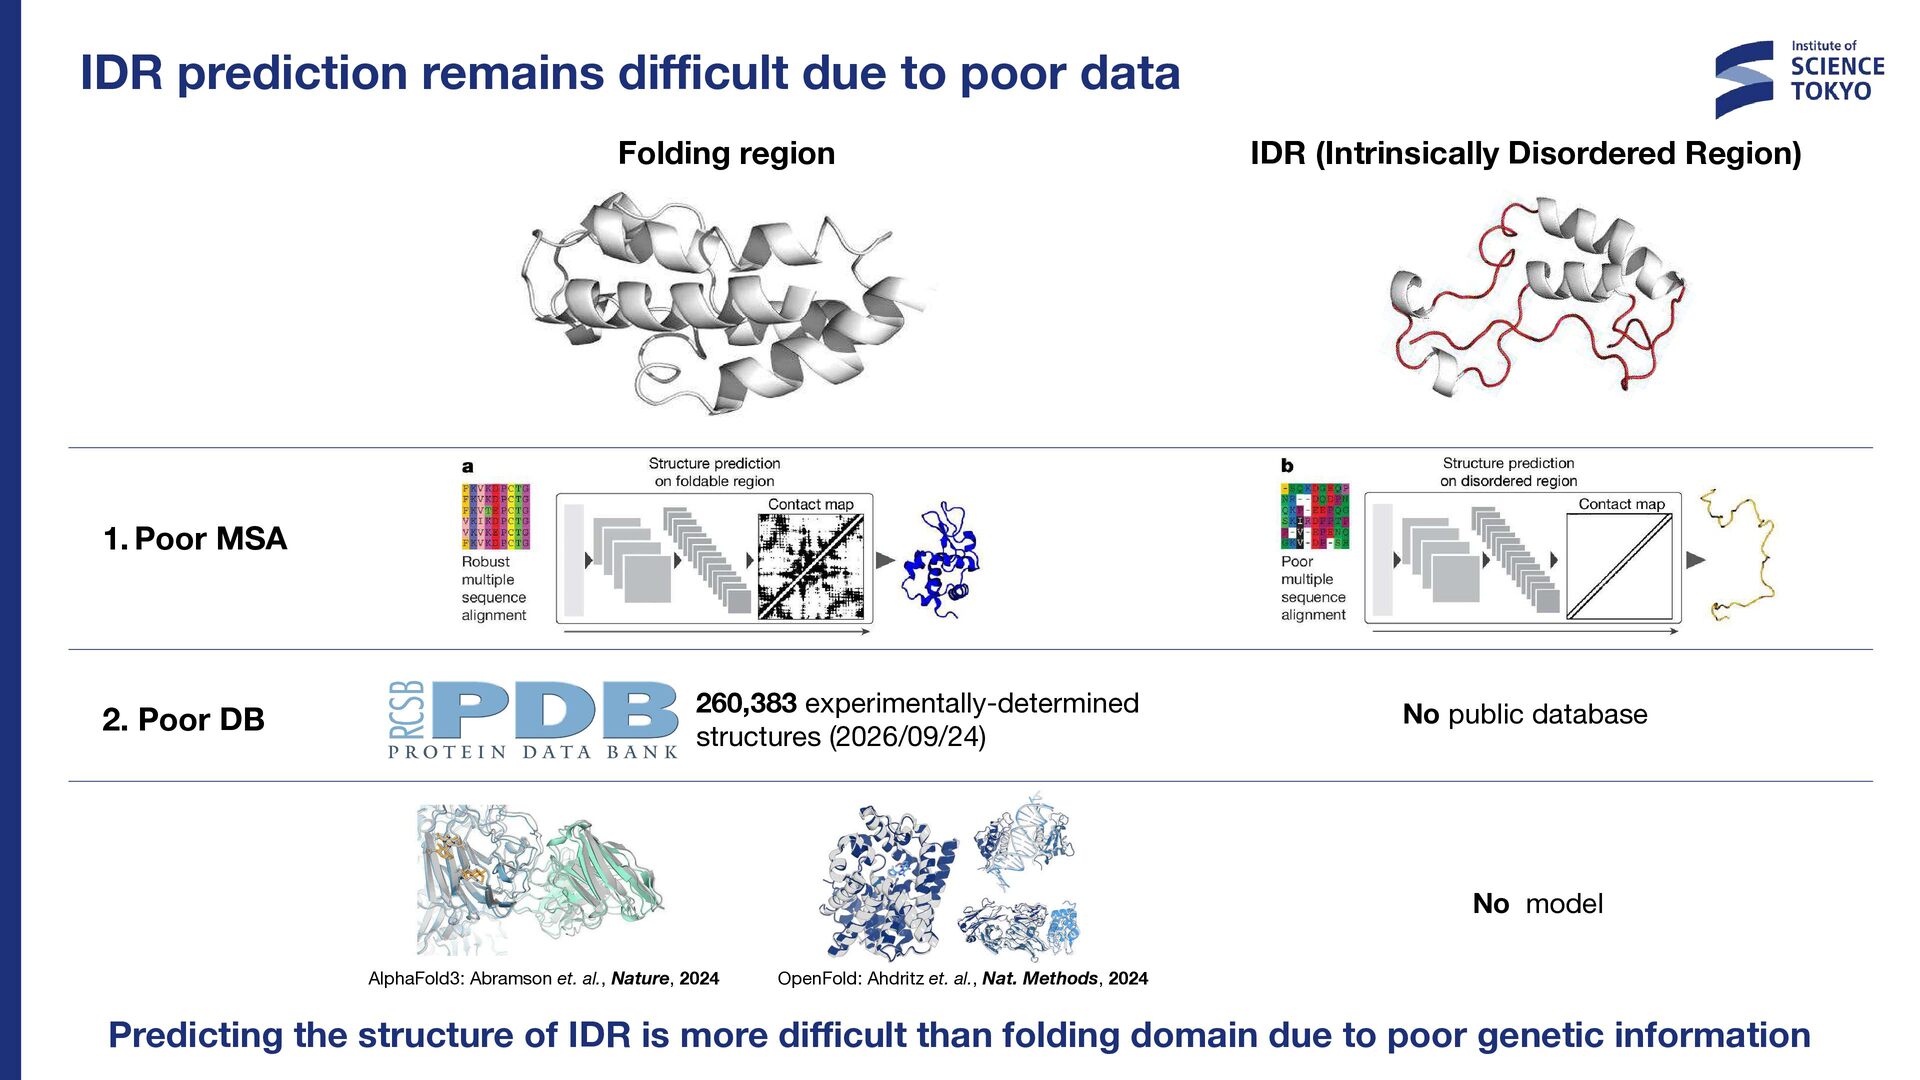
  4. IDR prediction remains difficult due to poor data Folding region

    IDR (Intrinsically Disordered Region) 1. Poor MSA 2. Poor DB 260,383 experimentally-determined structures (2026/09/24) No public database No model AlphaFold3: Abramson et. al., Nature, 2024 OpenFold: Ahdritz et. al., Nat. Methods, 2024 Predicting the structure of IDR is more difficult than folding domain due to poor genetic information
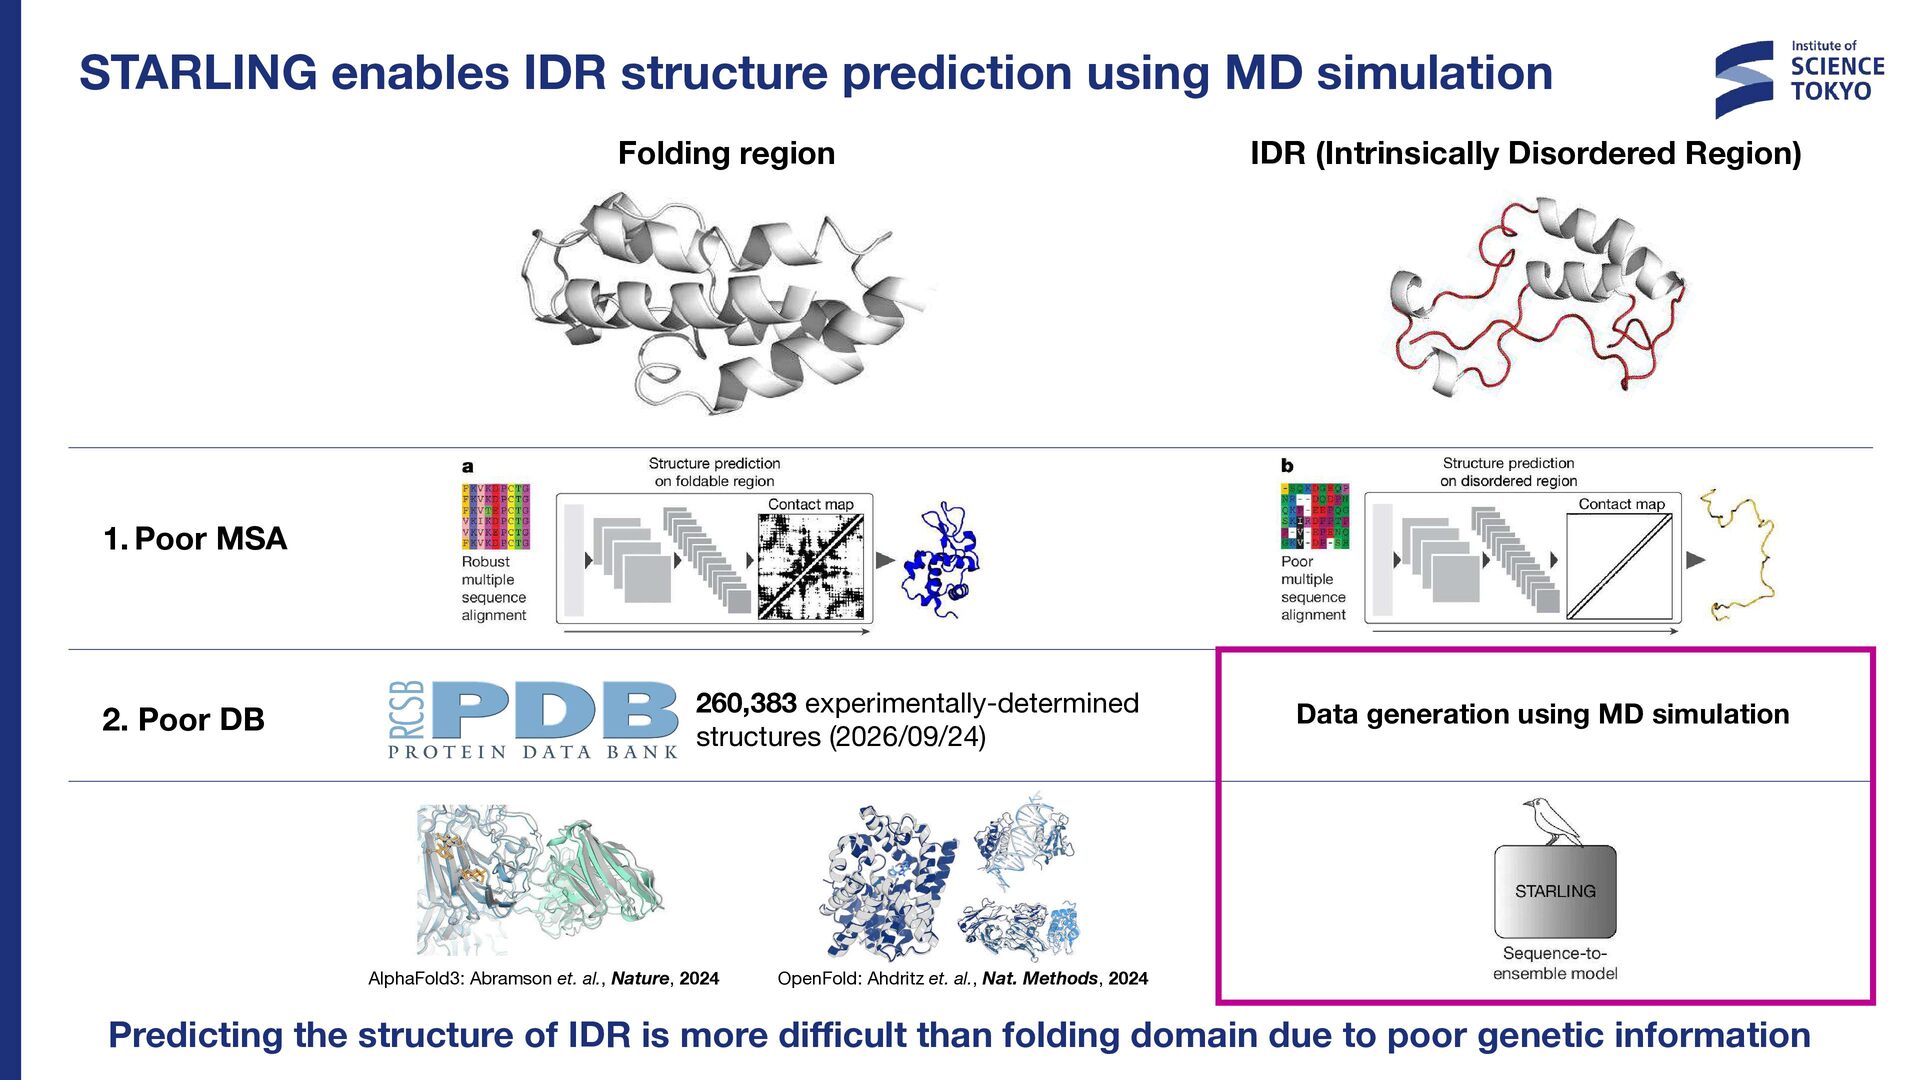
  5. STARLING enables IDR structure prediction using MD simulation Folding region

    IDR (Intrinsically Disordered Region) 1. Poor MSA 2. Poor DB 260,383 experimentally-determined structures (2026/09/24) AlphaFold3: Abramson et. al., Nature, 2024 Data generation using MD simulation OpenFold: Ahdritz et. al., Nat. Methods, 2024 Predicting the structure of IDR is more difficult than folding domain due to poor genetic information
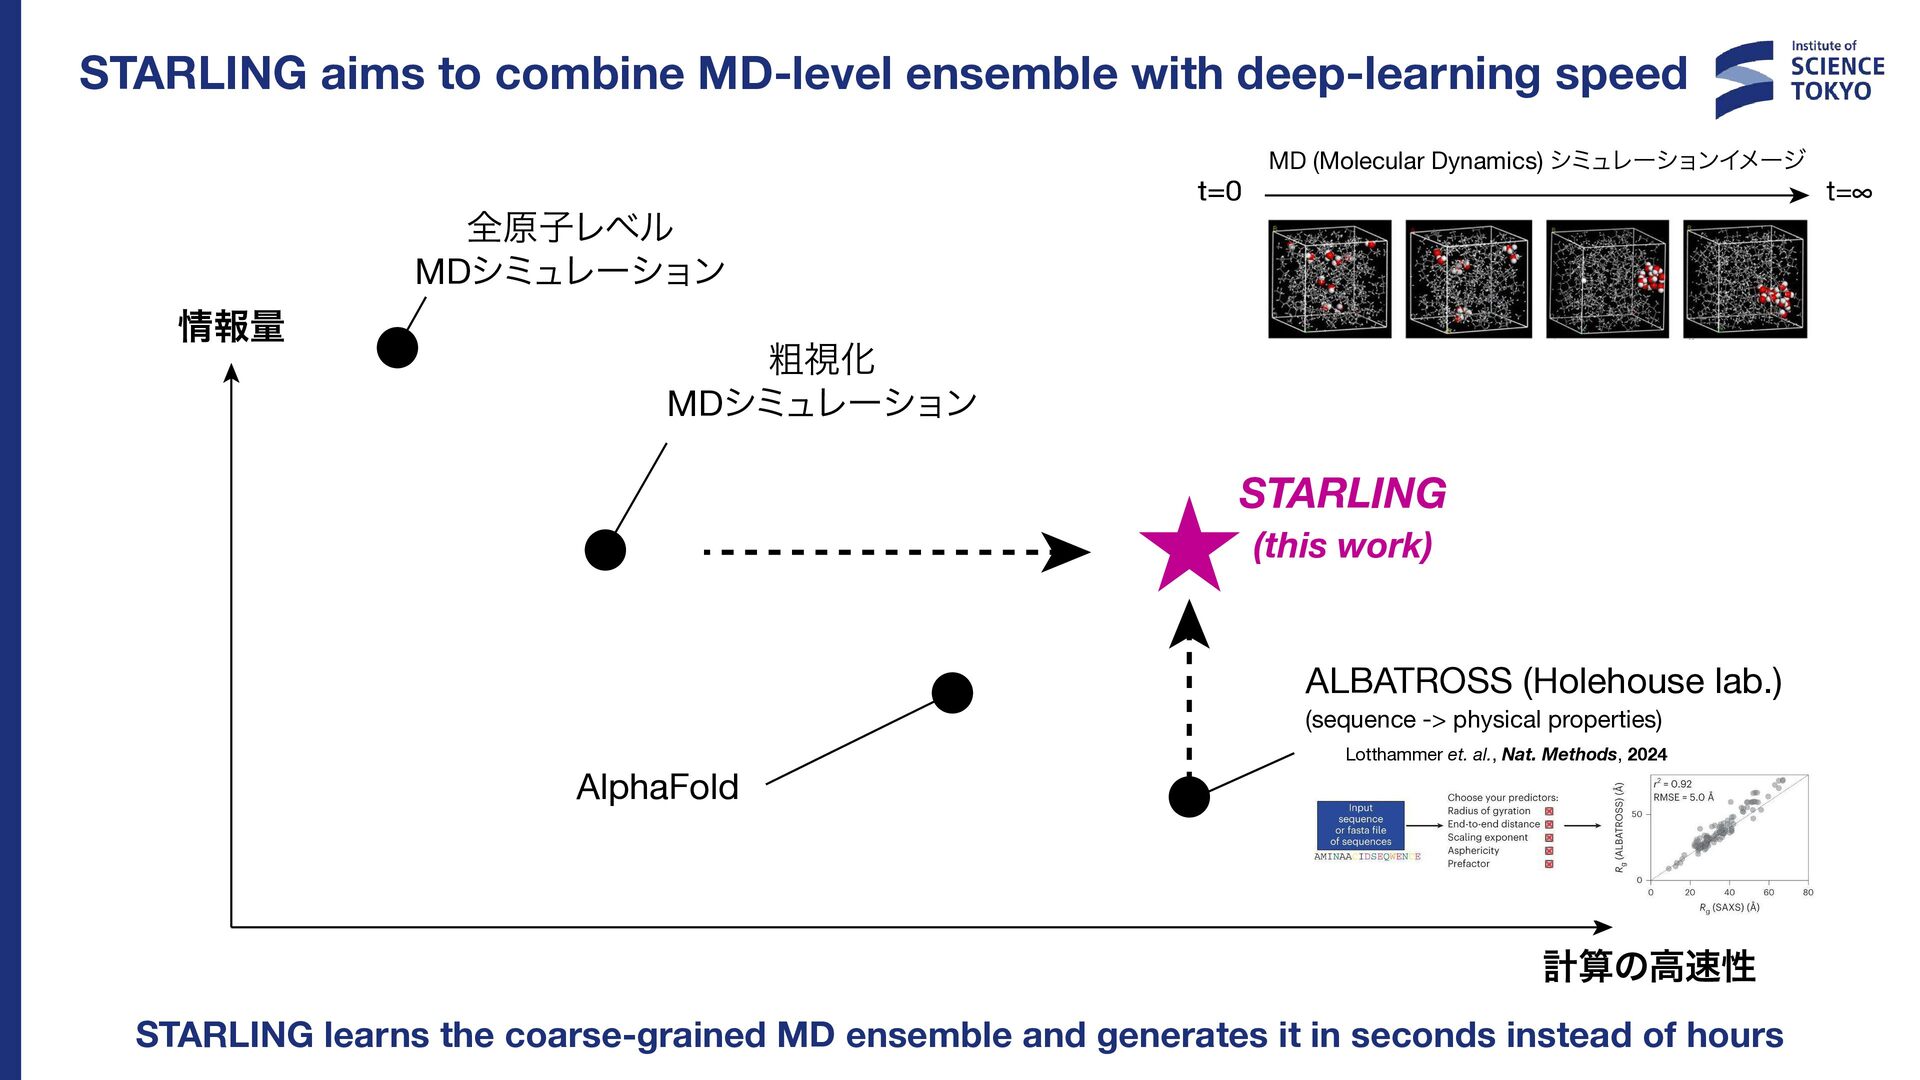
  6. STARLING aims to combine MD-level ensemble with deep-learning speed 情報量

    全原子レベル MDシミュレーション t=0 MD (Molecular Dynamics) シミュレーションイメージ 粗視化 MDシミュレーション STARLING (this work) ALBATROSS (Holehouse lab.) (sequence -> physical properties) AlphaFold Lotthammer et. al., Nat. Methods, 2024 計算の高速性 STARLING learns the coarse-grained MD ensemble and generates it in seconds instead of hours t=∞
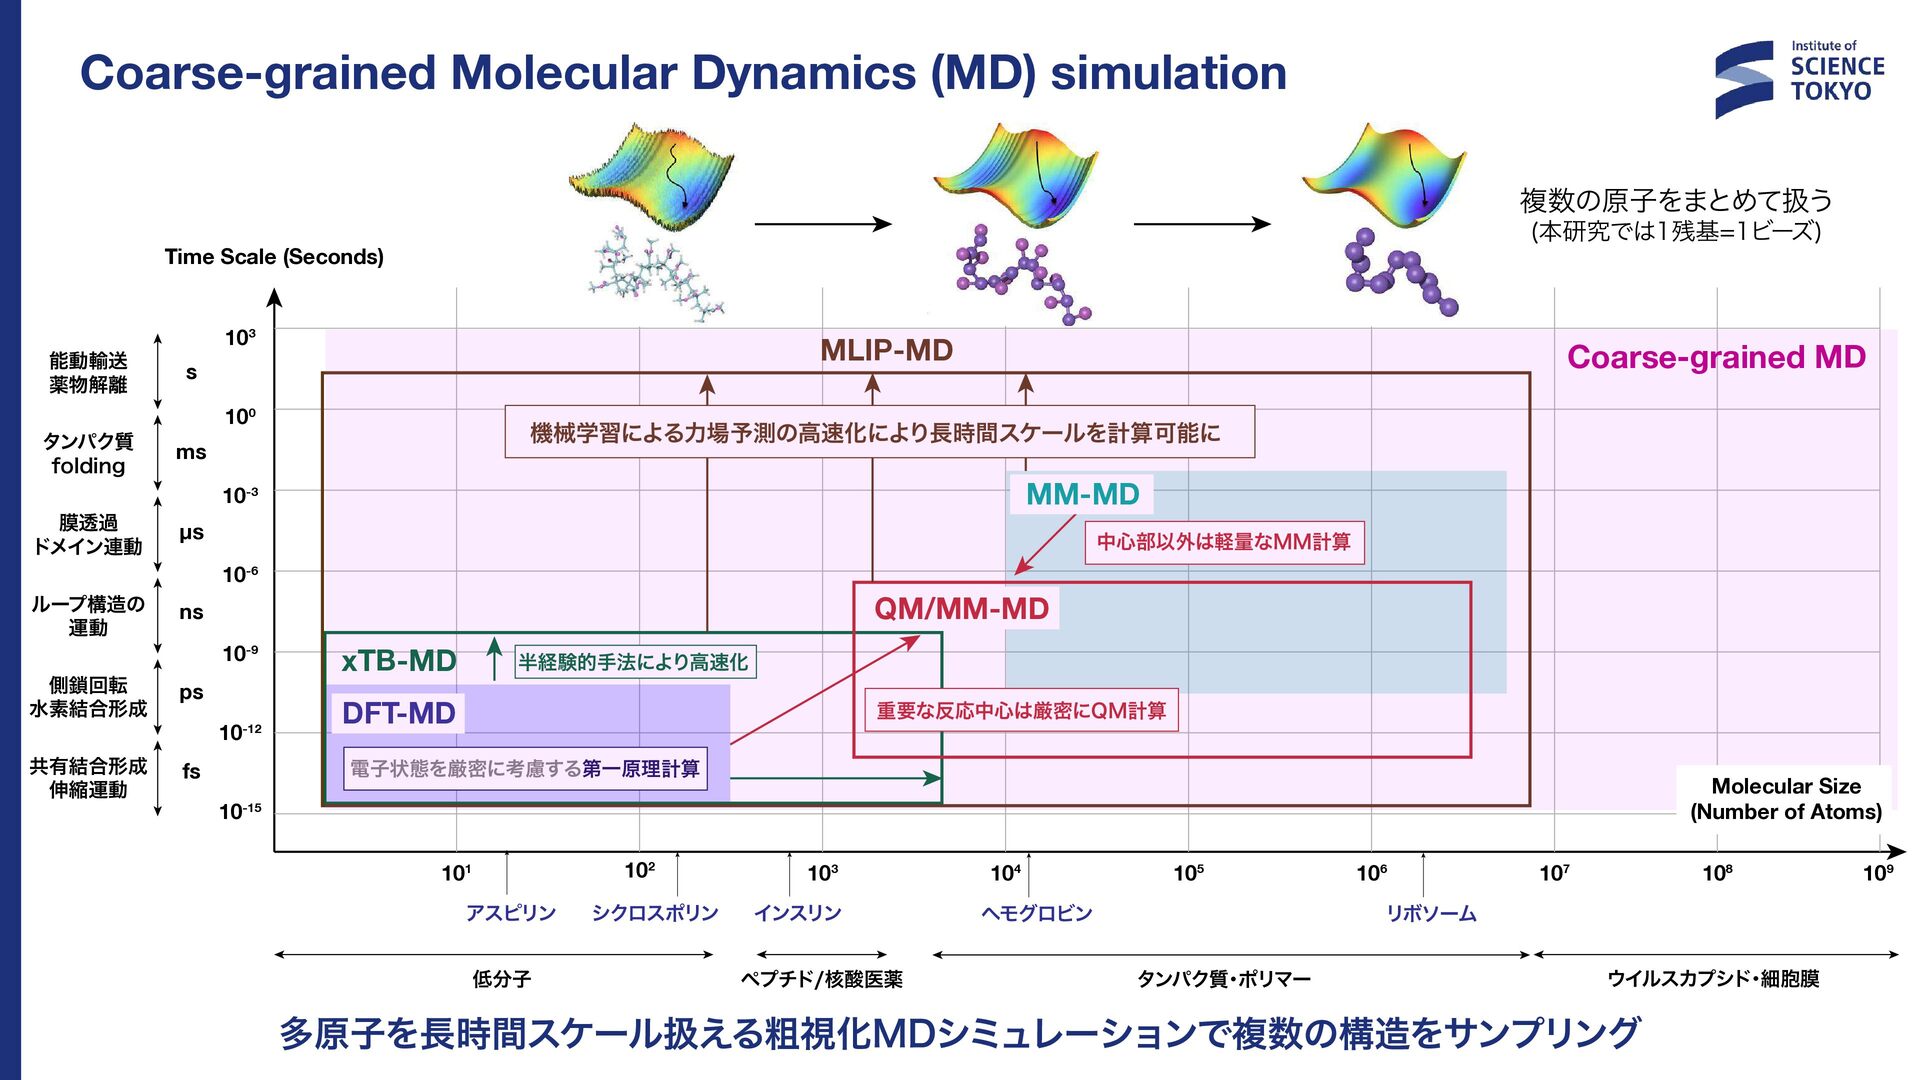
  7. Coarse-grained Molecular Dynamics (MD) simulation 複数の原子をまとめて扱う (本研究では1残基=1ビーズ) Time Scale (Seconds)

    能動輸送 薬物解離 s 103 MLIP-MD 100 タンパク質 folding ms 膜透過 ドメイン連動 μs ループ構造の 運動 ns Coarse-grained MD 機械学習による力場予測の高速化により長時間スケールを計算可能に MM-MD 10-3 中心部以外は軽量なMM計算 10-6 10-9 側鎖回転 水素結合形成 ps 共有結合形成 伸縮運動 fs 10-12 QM/MM-MD xTB-MD 半経験的手法により高速化 DFT-MD 重要な反応中心は厳密にQM計算 電子状態を厳密に考慮する第一原理計算 Molecular Size (Number of Atoms) 10-15 102 101 アスピリン 低分子 シクロスポリン 103 インスリン ペプチド/核酸医薬 104 105 106 107 108 リボソーム ヘモグロビン タンパク質・ポリマー ウイルスカプシド・細胞膜 多原子を長時間スケール扱える粗視化MDシミュレーションで複数の構造をサンプリング 109
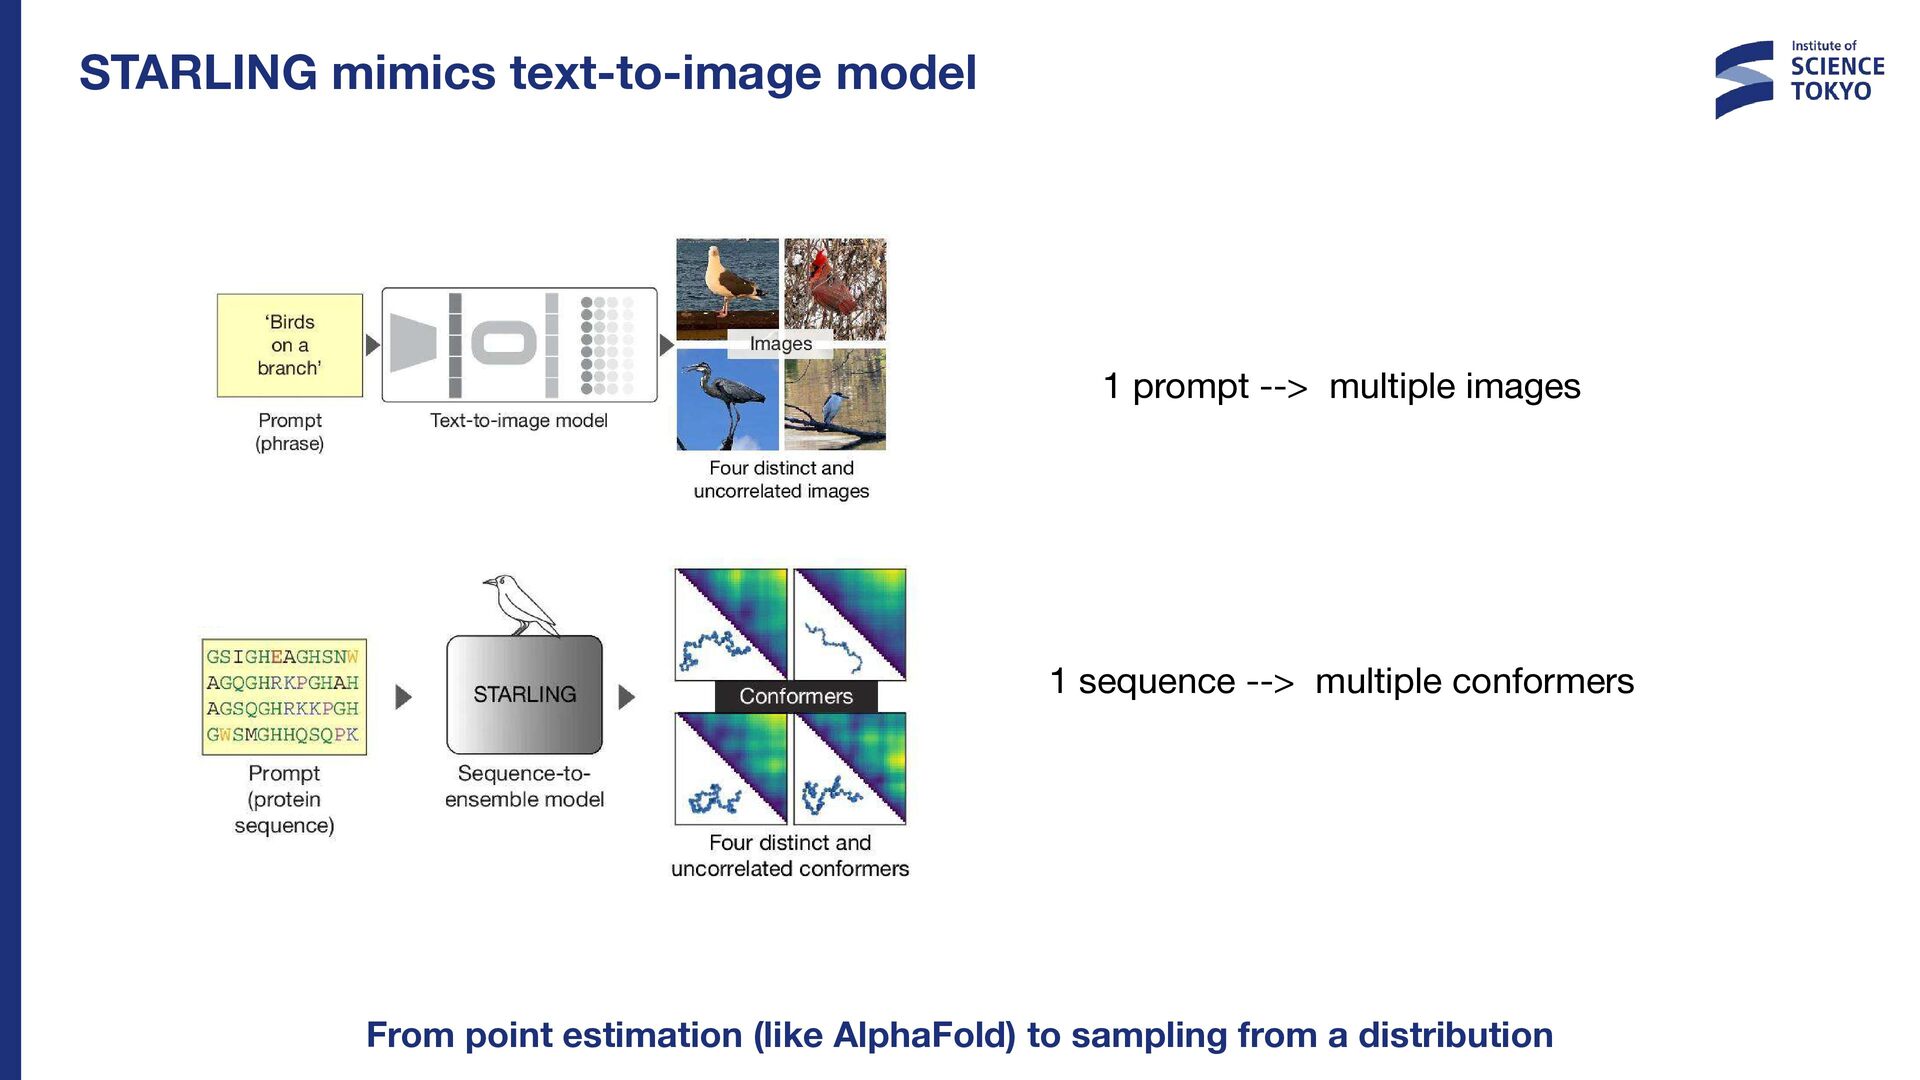
  8. STARLING mimics text-to-image model 1 prompt --> multiple images 1

    sequence --> multiple conformers From point estimation (like AlphaFold) to sampling from a distribution
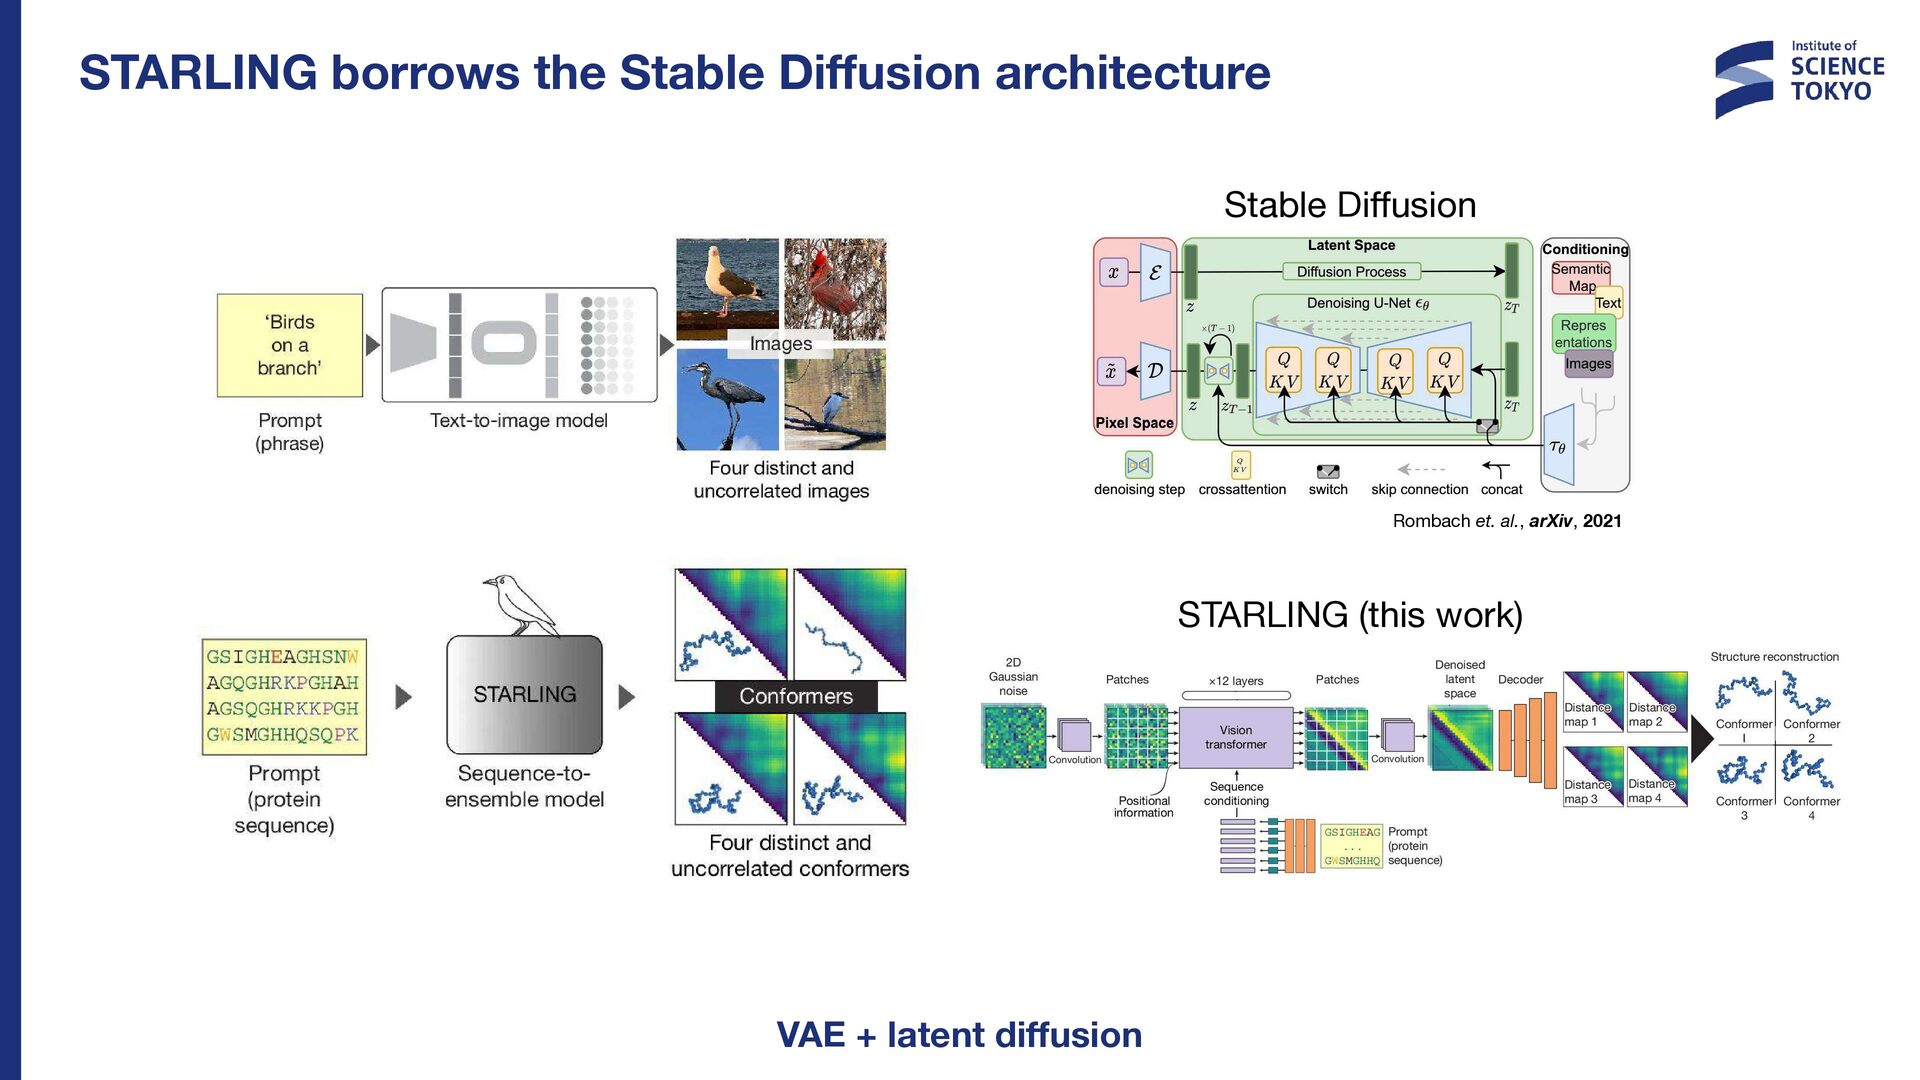
  9. STARLING borrows the Stable Diffusion architecture Stable Diffusion Rombach et.

    al., arXiv, 2021 STARLING (this work) VAE + latent diffusion
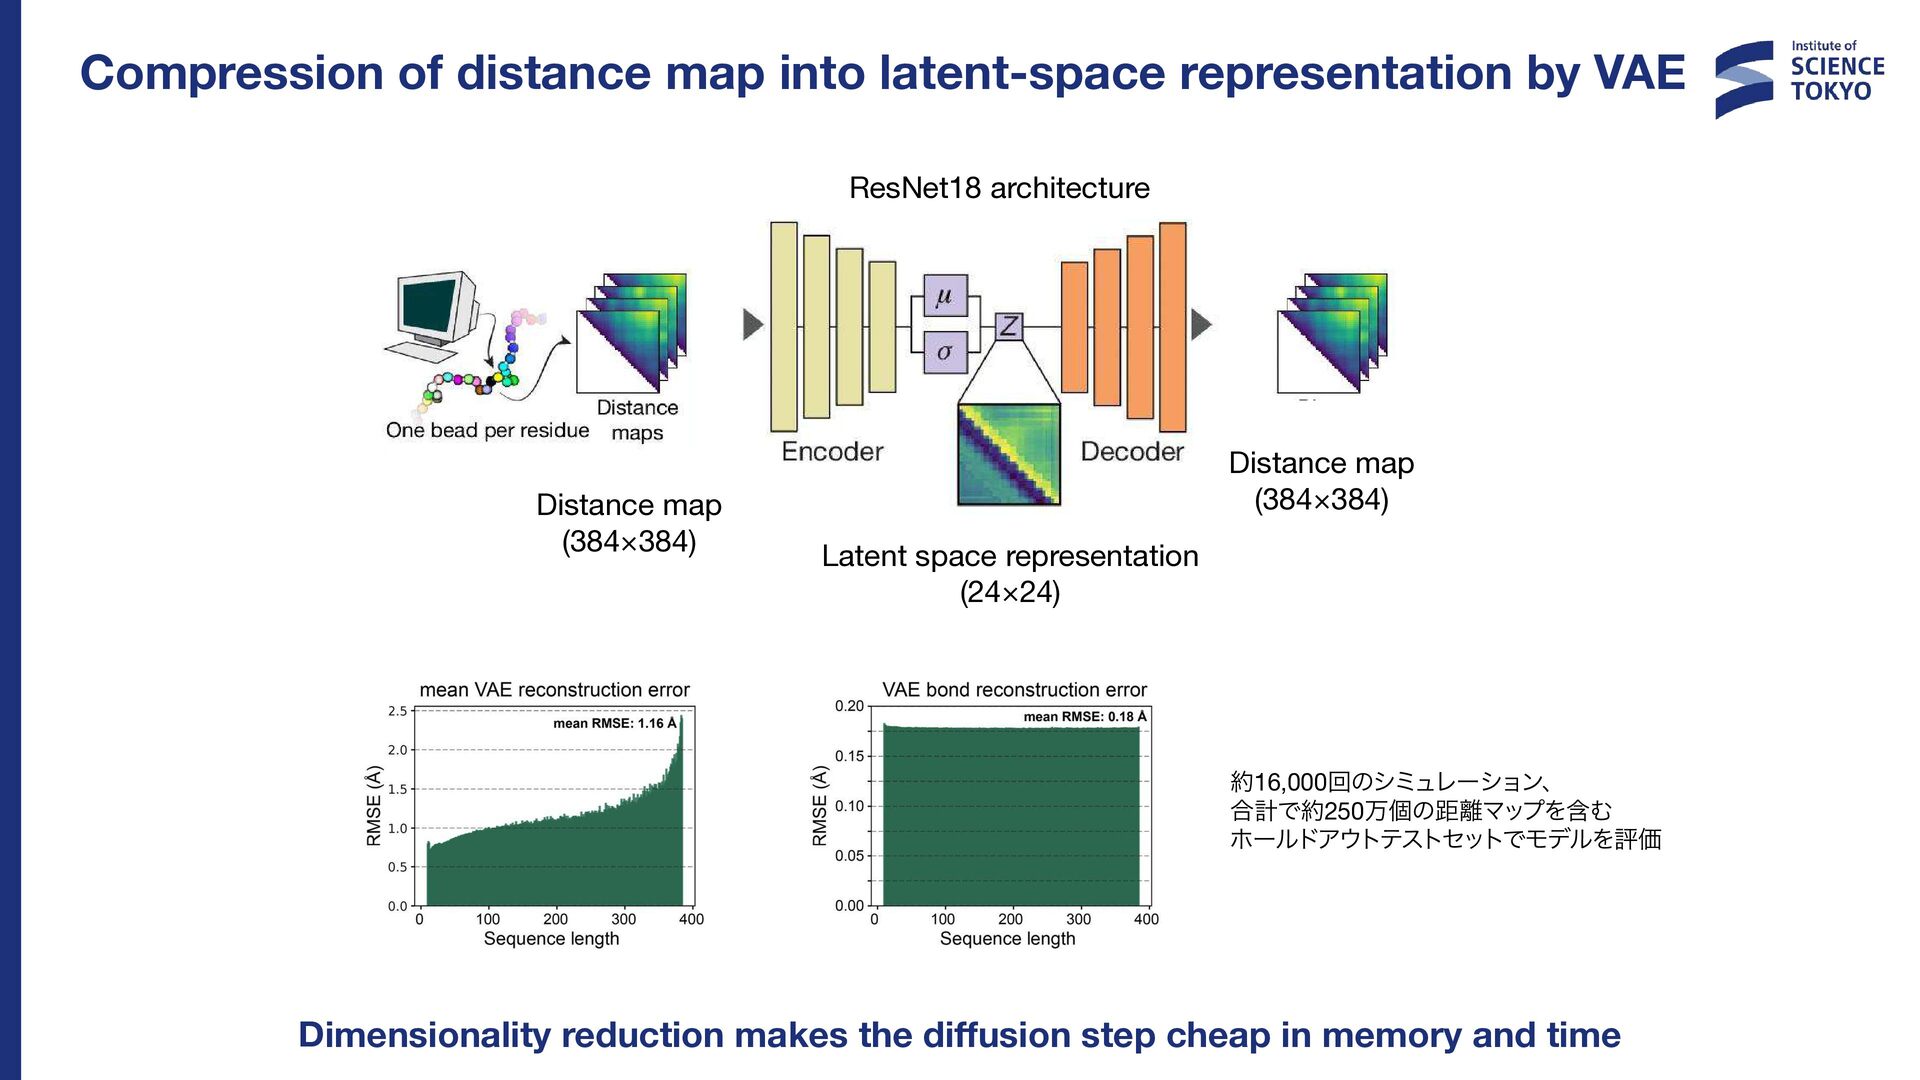
  10. Compression of distance map into latent-space representation by VAE ResNet18

    architecture Distance map (384×384) Distance map (384×384) Latent space representation (24×24) 約16,000回のシミュレーション、 合計で約250万個の距離マップを含む ホールドアウトテストセットでモデルを評価 Dimensionality reduction makes the diffusion step cheap in memory and time
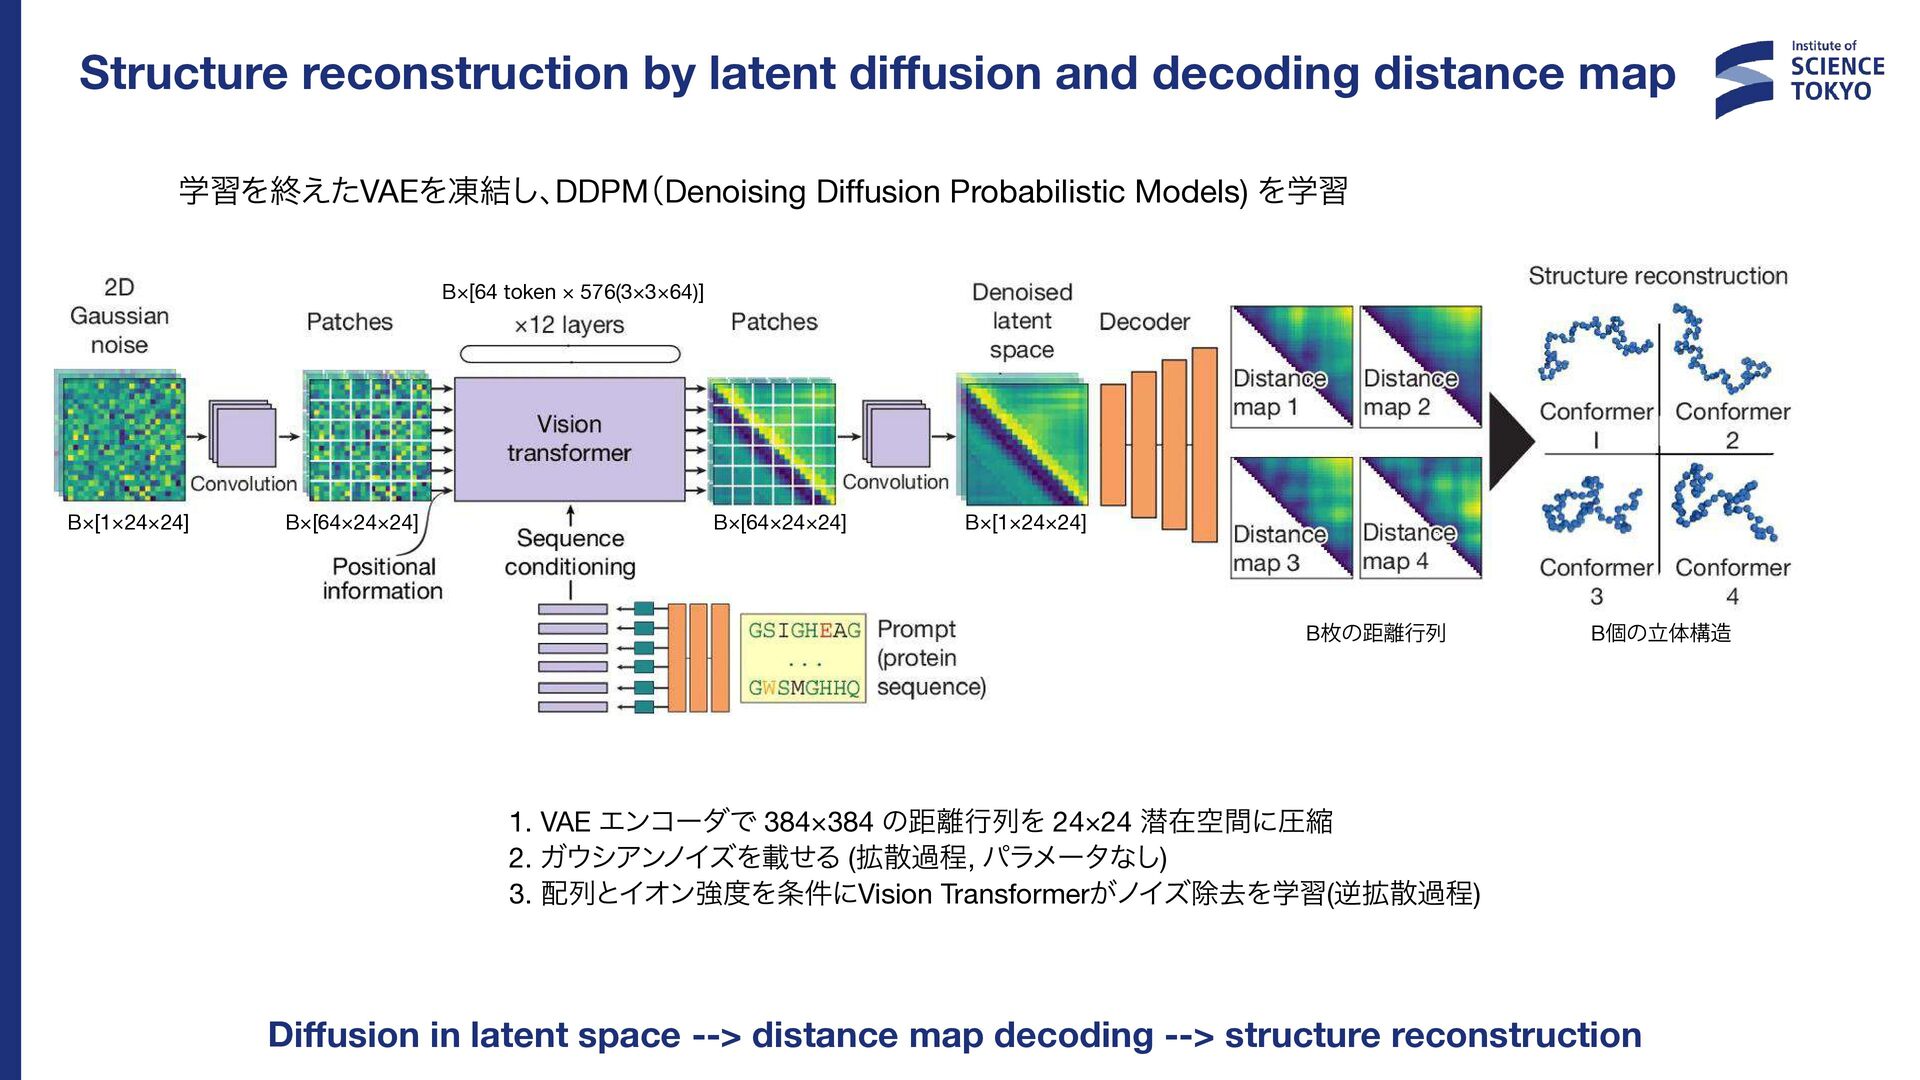
  11. Structure reconstruction by latent diffusion and decoding distance map 学習を終えたVAEを凍結し、DDPM(Denoising

    Diffusion Probabilistic Models) を学習 B×[64 token × 576(3×3×64)] B×[1×24×24] B×[64×24×24] B×[64×24×24] B×[1×24×24] B枚の距離行列 B個の立体構造 1. VAE エンコーダで 384×384 の距離行列を 24×24 潜在空間に圧縮 2. ガウシアンノイズを載せる (拡散過程, パラメータなし) 3. 配列とイオン強度を条件にVision Transformerがノイズ除去を学習(逆拡散過程) Diffusion in latent space --> distance map decoding --> structure reconstruction
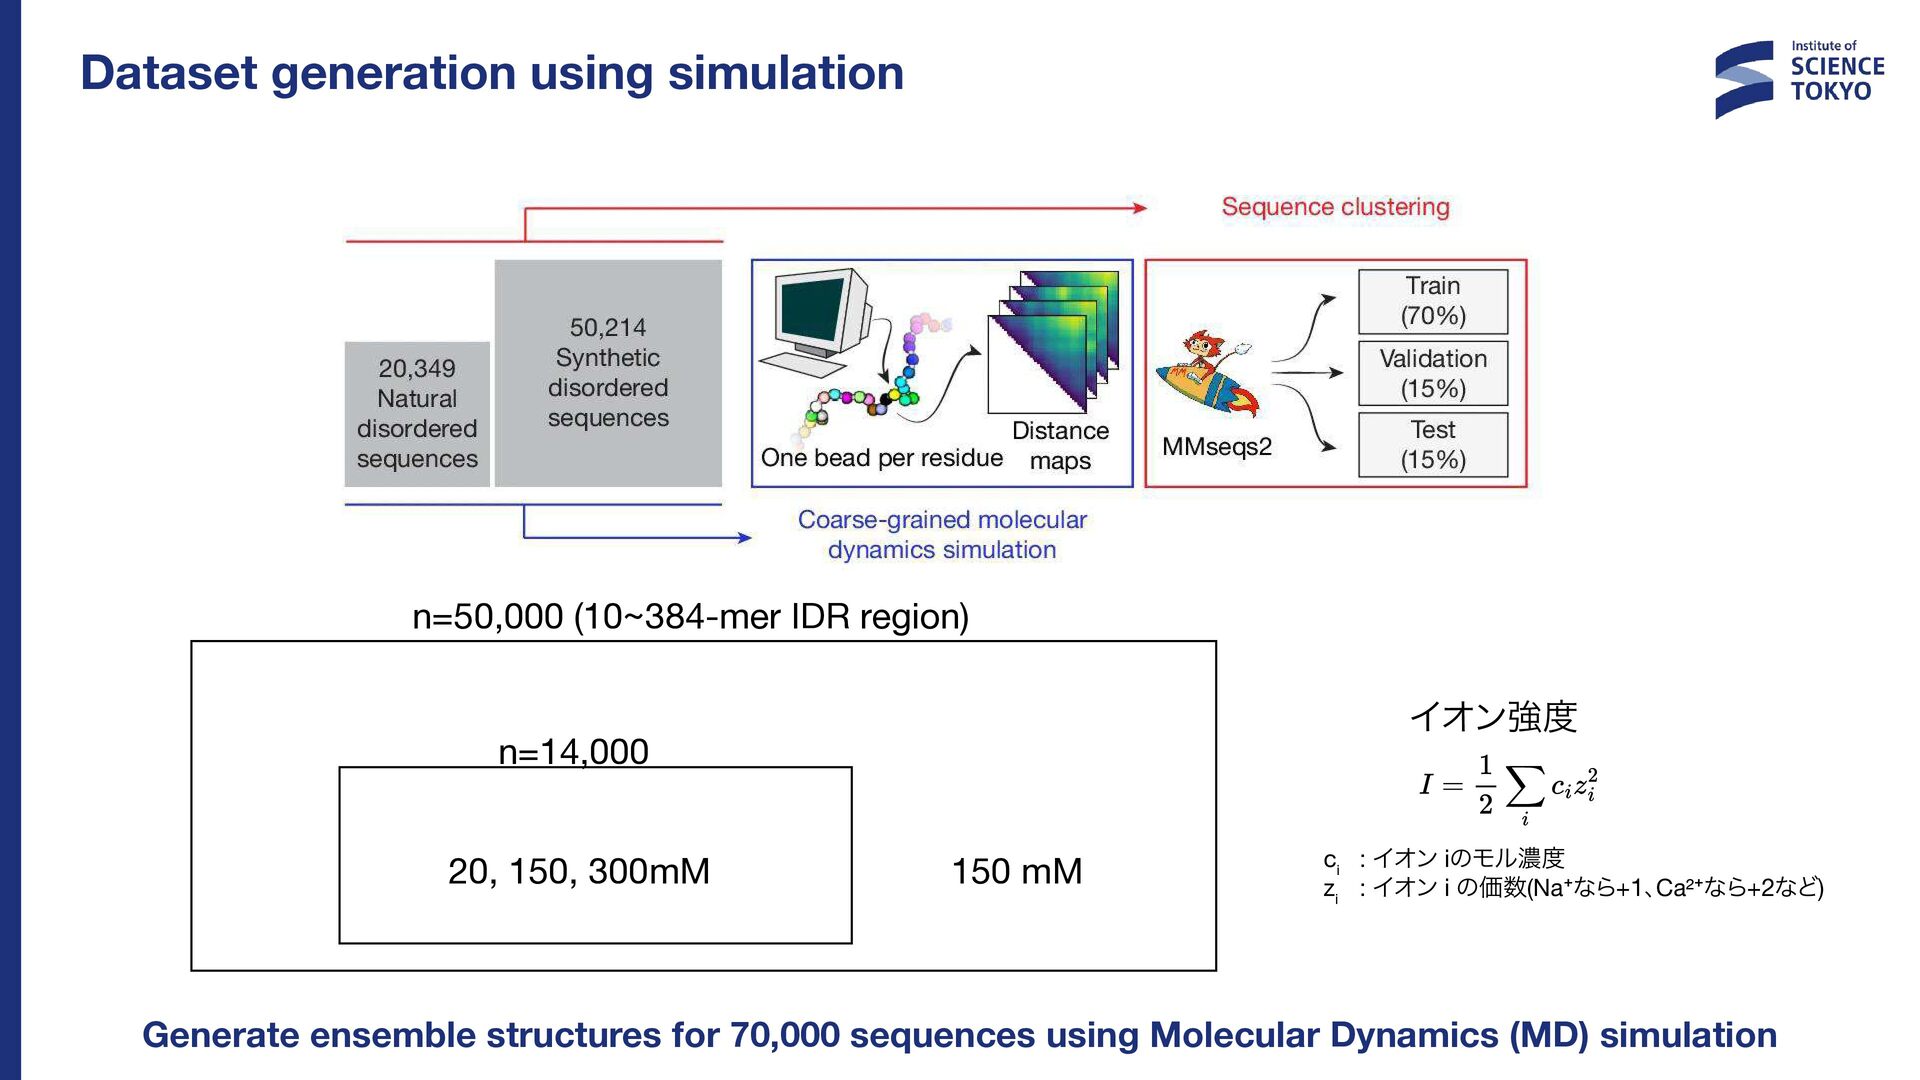
  12. Dataset generation using simulation n=50,000 (10~384-mer IDR region) イオン強度 n=14,000

    20, 150, 300mM 150 mM ci : イオン iのモル濃度 zi : イオン i の価数(Na⁺なら+1、 Ca²⁺なら+2など) Generate ensemble structures for 70,000 sequences using Molecular Dynamics (MD) simulation
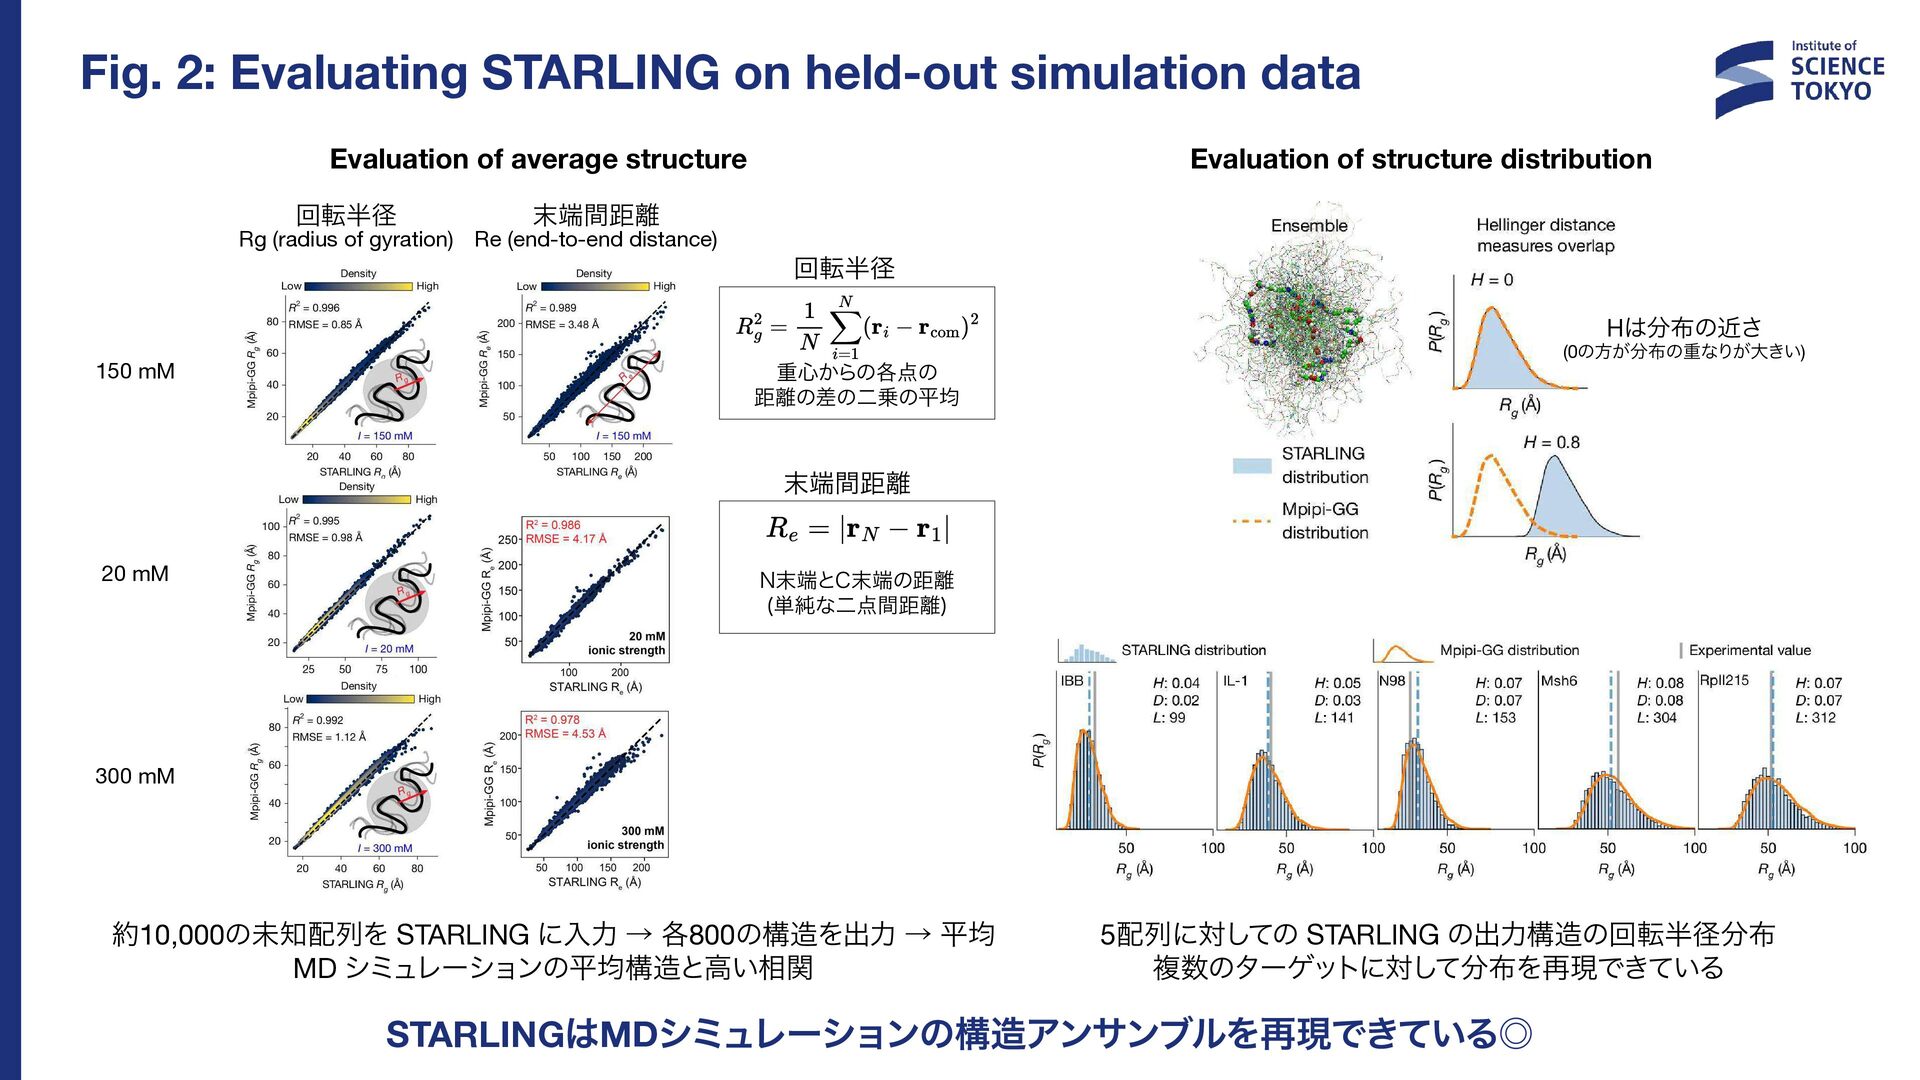
  13. Fig. 2: Evaluating STARLING on held-out simulation data Evaluation of

    average structure 回転半径 Evaluation of structure distribution 末端間距離 Rg (radius of gyration) Re (end-to-end distance) 回転半径 Hは分布の近さ 150 mM (0の方が分布の重なりが大きい) 重心からの各点の 距離の差の二乗の平均 末端間距離 20 mM N末端とC末端の距離 (単純な二点間距離) 300 mM 約10,000の未知配列を STARLING に入力 → 各800の構造を出力 → 平均 MD シミュレーションの平均構造と高い相関 5配列に対しての STARLING の出力構造の回転半径分布 複数のターゲットに対して分布を再現できている STARLINGはMDシミュレーションの構造アンサンブルを再現できている◎
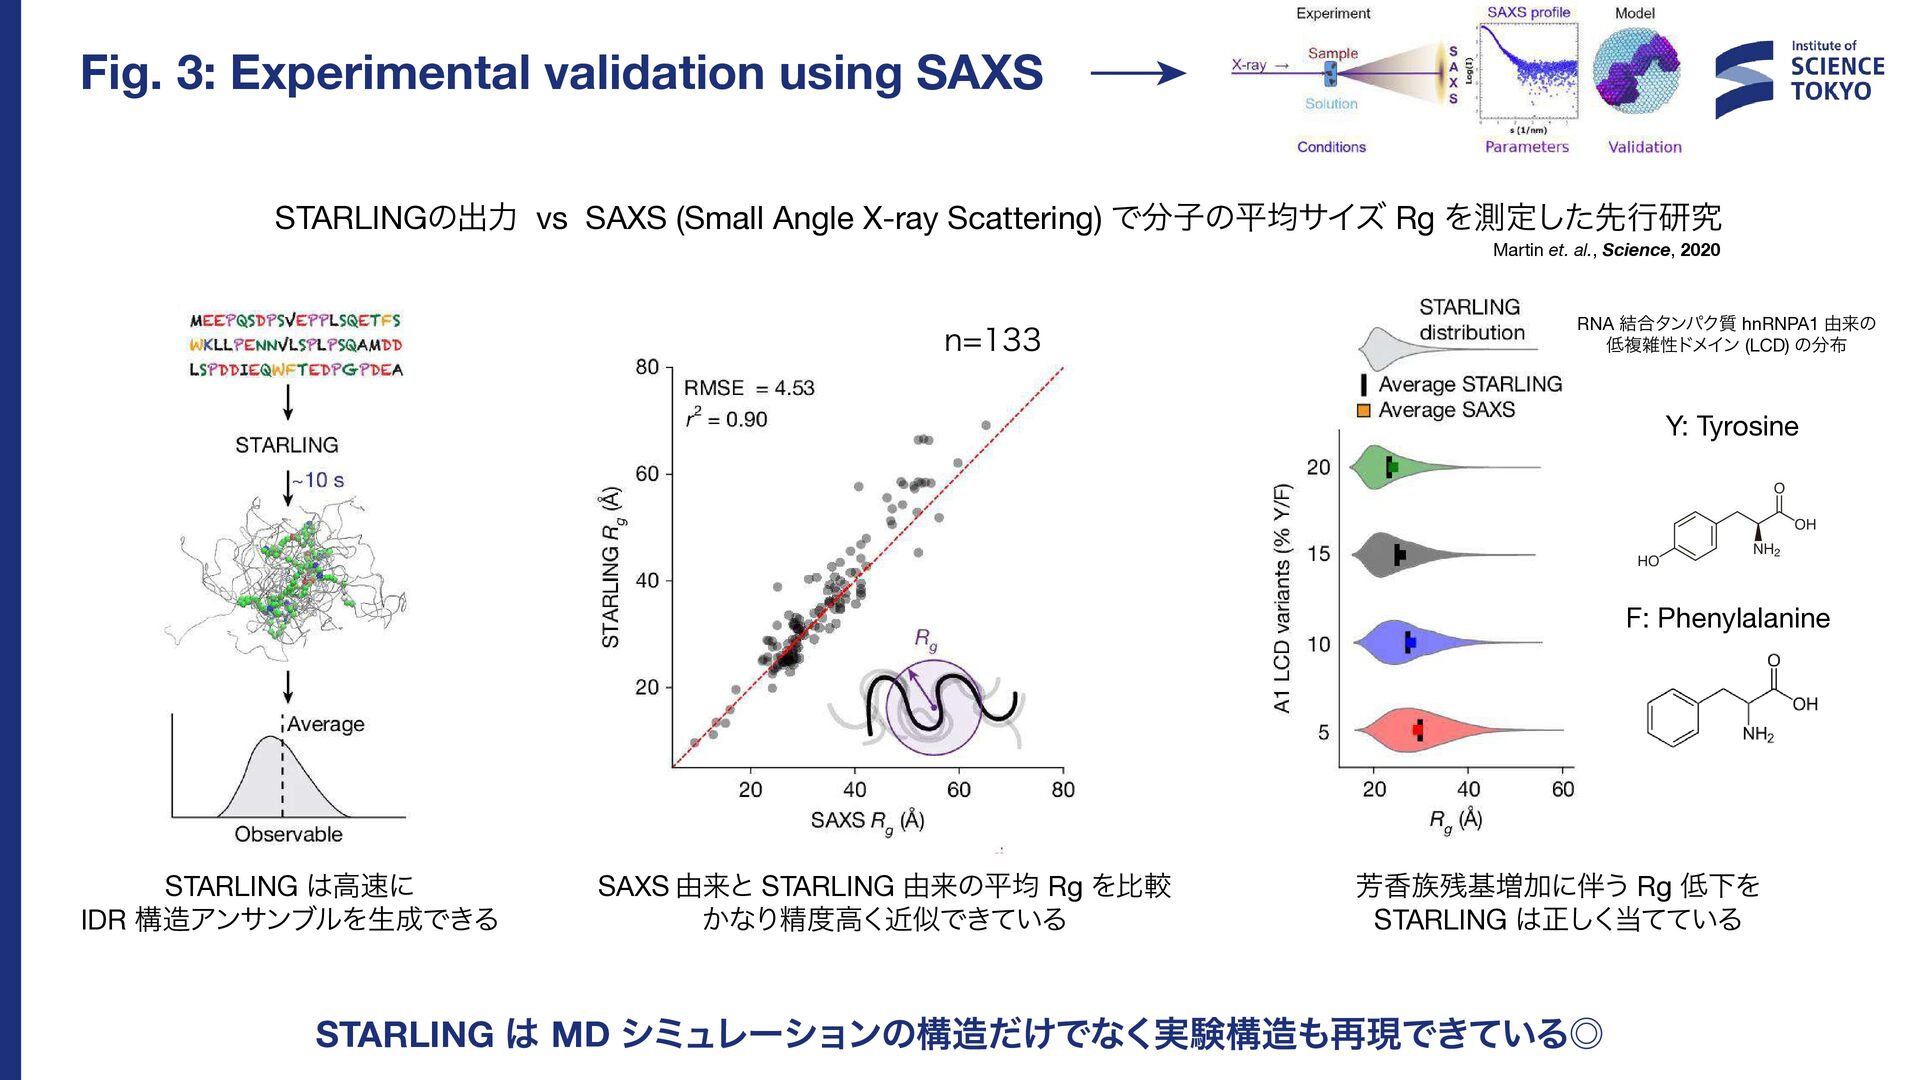
  14. Fig. 3: Experimental validation using SAXS STARLINGの出力 vs SAXS (Small

    Angle X-ray Scattering) で分子の平均サイズ Rg を測定した先行研究 Martin et. al., Science, 2020 n=133 RNA 結合タンパク質 hnRNPA1 由来の 低複雑性ドメイン (LCD) の分布 Y: Tyrosine F: Phenylalanine STARLING は高速に IDR 構造アンサンブルを生成できる SAXS 由来と STARLING 由来の平均 Rg を比較 かなり精度高く近似できている 芳香族残基増加に伴う Rg 低下を STARLING は正しく当てている STARLING は MD シミュレーションの構造だけでなく実験構造も再現できている◎
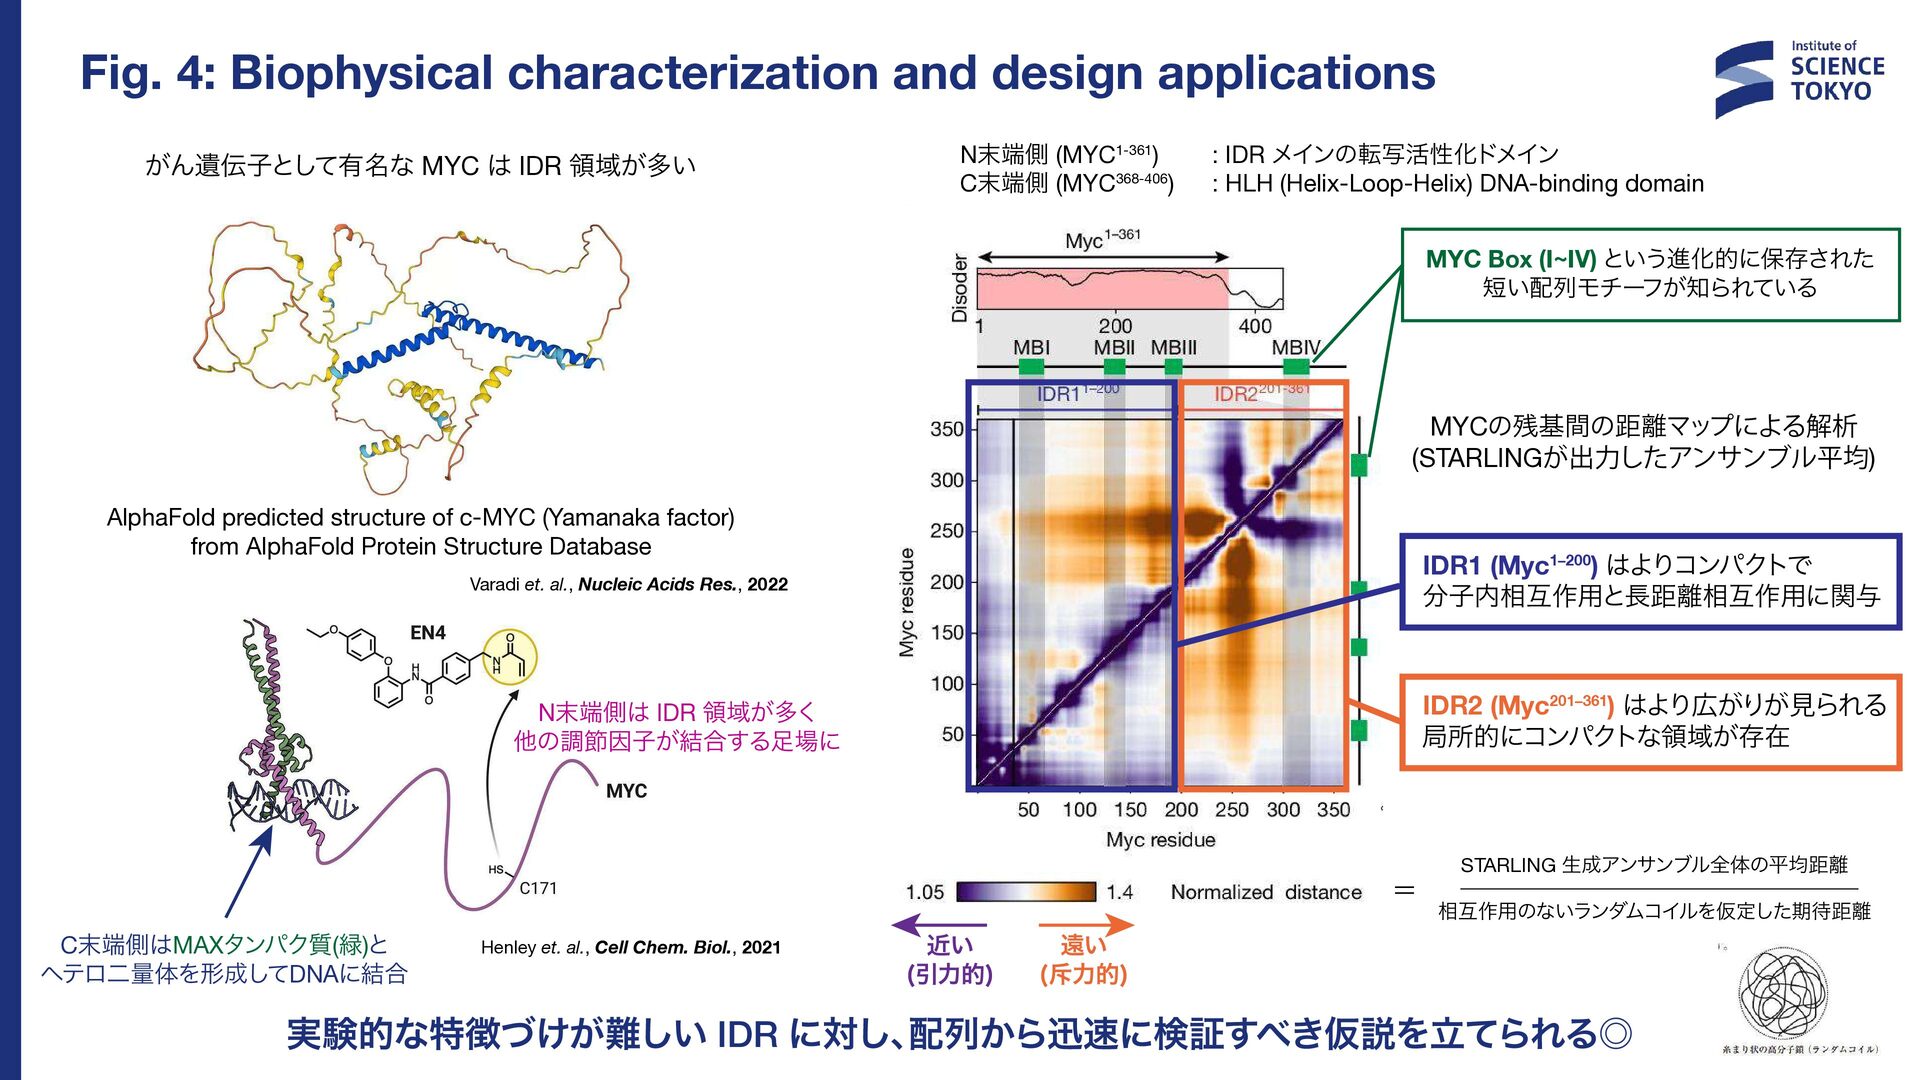
  15. Fig. 4: Biophysical characterization and design applications がん遺伝子として有名な MYC は

    IDR 領域が多い N末端側 (MYC1-361) C末端側 (MYC368-406) : IDR メインの転写活性化ドメイン : HLH (Helix-Loop-Helix) DNA-binding domain MYC Box (I~IV) という進化的に保存された 短い配列モチーフが知られている MYCの残基間の距離マップによる解析 (STARLINGが出力したアンサンブル平均) AlphaFold predicted structure of c-MYC (Yamanaka factor) from AlphaFold Protein Structure Database IDR1 (Myc1–200) はよりコンパクトで 分子内相互作用と長距離相互作用に関与 Varadi et. al., Nucleic Acids Res., 2022 IDR2 (Myc201–361) はより広がりが見られる 局所的にコンパクトな領域が存在 N末端側は IDR 領域が多く 他の調節因子が結合する足場に = C末端側はMAXタンパク質(緑)と ヘテロ二量体を形成してDNAに結合 Henley et. al., Cell Chem. Biol., 2021 近い (引力的) 遠い (斥力的) STARLING 生成アンサンブル全体の平均距離 相互作用のないランダムコイルを仮定した期待距離 実験的な特徴づけが難しい IDR に対し、配列から迅速に検証すべき仮説を立てられる◎
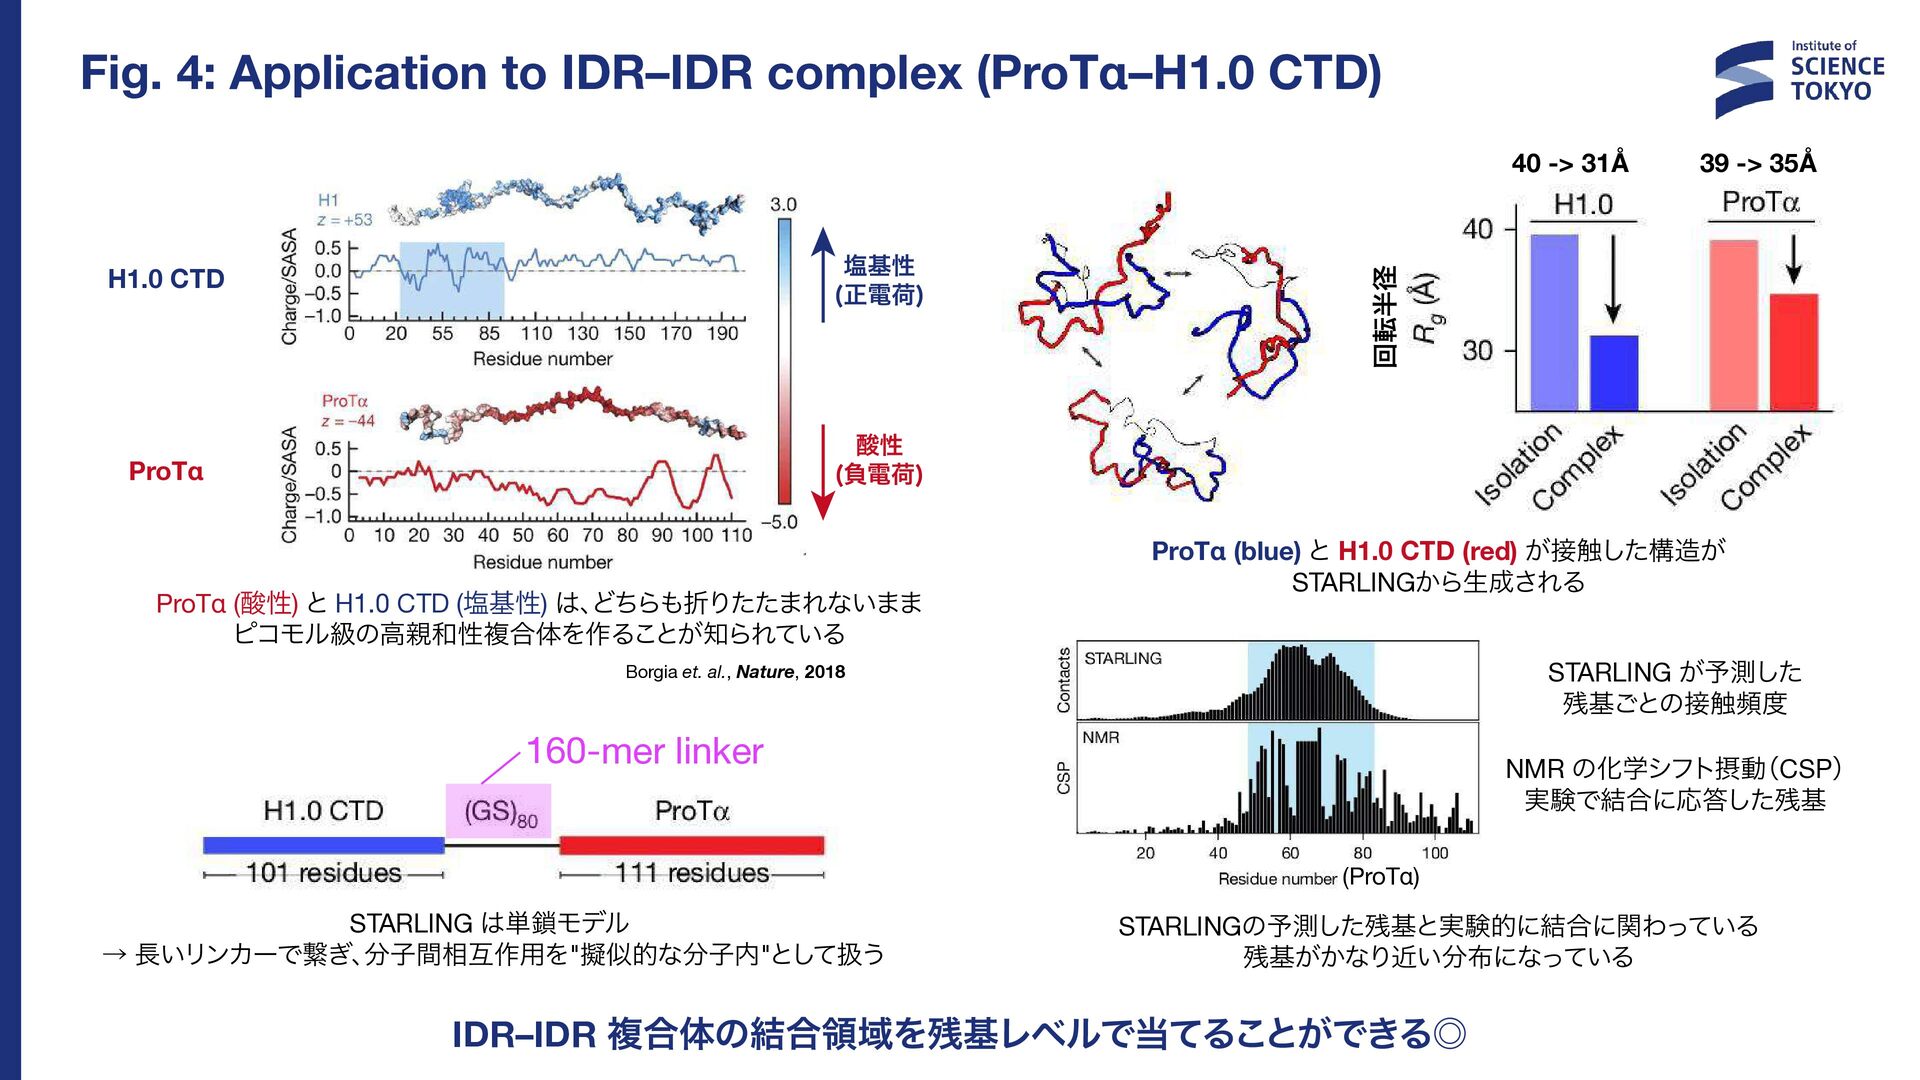
  16. Fig. 4: Application to IDR–IDR complex (ProTα–H1.0 CTD) 塩基性 (正電荷)

    H1.0 CTD 39 -> 35Å 回転半径 40 -> 31Å 酸性 (負電荷) ProTα ProTα (酸性) と H1.0 CTD (塩基性) は、 どちらも折りたたまれないまま ピコモル級の高親和性複合体を作ることが知られている ProTα (blue) と H1.0 CTD (red) が接触した構造が STARLINGから生成される STARLING が予測した 残基ごとの接触頻度 Borgia et. al., Nature, 2018 160-mer linker NMR の化学シフト摂動(CSP) 実験で結合に応答した残基 (ProTα) STARLING は単鎖モデル → 長いリンカーで繋ぎ、分子間相互作用を"擬似的な分子内"として扱う STARLINGの予測した残基と実験的に結合に関わっている 残基がかなり近い分布になっている IDR–IDR 複合体の結合領域を残基レベルで当てることができる◎
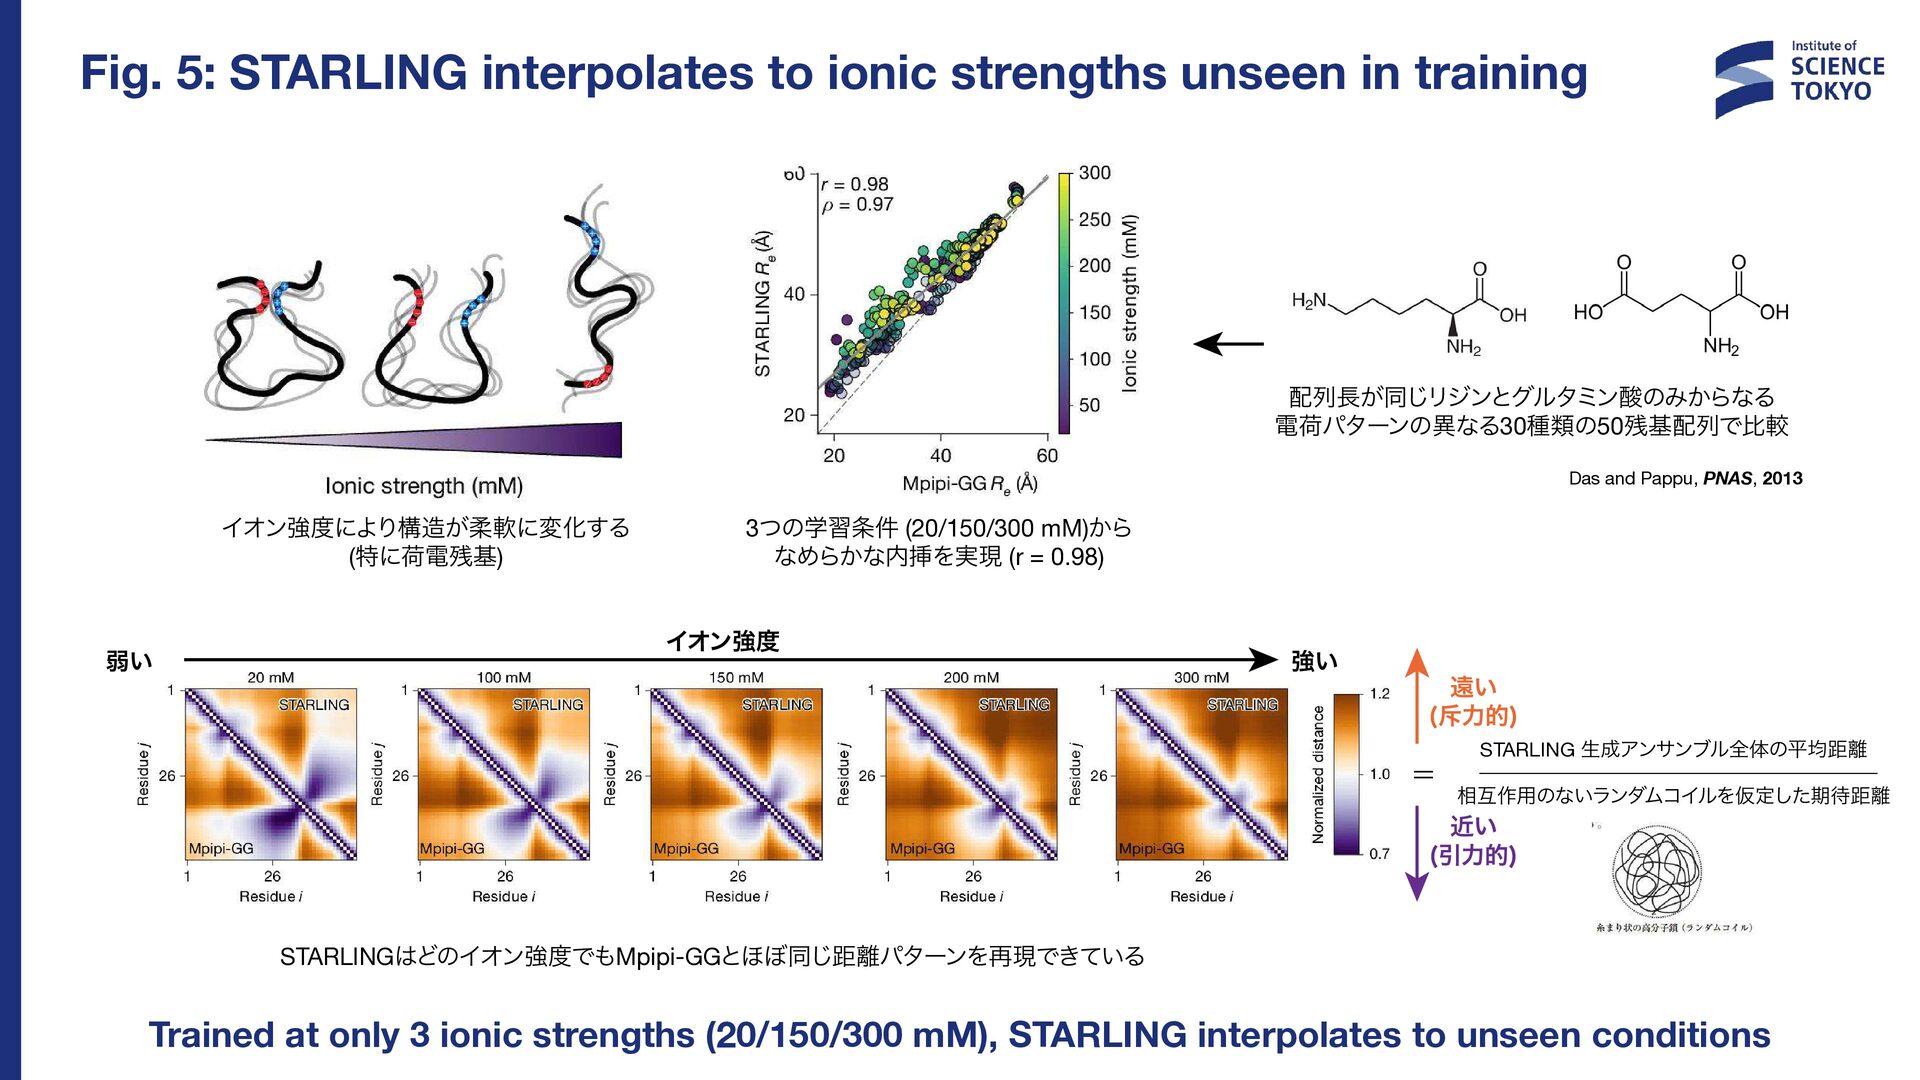
  17. Fig. 5: STARLING interpolates to ionic strengths unseen in training

    配列長が同じリジンとグルタミン酸のみからなる 電荷パターンの異なる30種類の50残基配列で比較 Das and Pappu, PNAS, 2013 イオン強度により構造が柔軟に変化する (特に荷電残基) 弱い 3つの学習条件 (20/150/300 mM)から なめらかな内挿を実現 (r = 0.98) イオン強度 強い 遠い (斥力的) = STARLING 生成アンサンブル全体の平均距離 相互作用のないランダムコイルを仮定した期待距離 近い (引力的) STARLINGはどのイオン強度でもMpipi-GGとほぼ同じ距離パターンを再現できている Trained at only 3 ionic strengths (20/150/300 mM), STARLING interpolates to unseen conditions
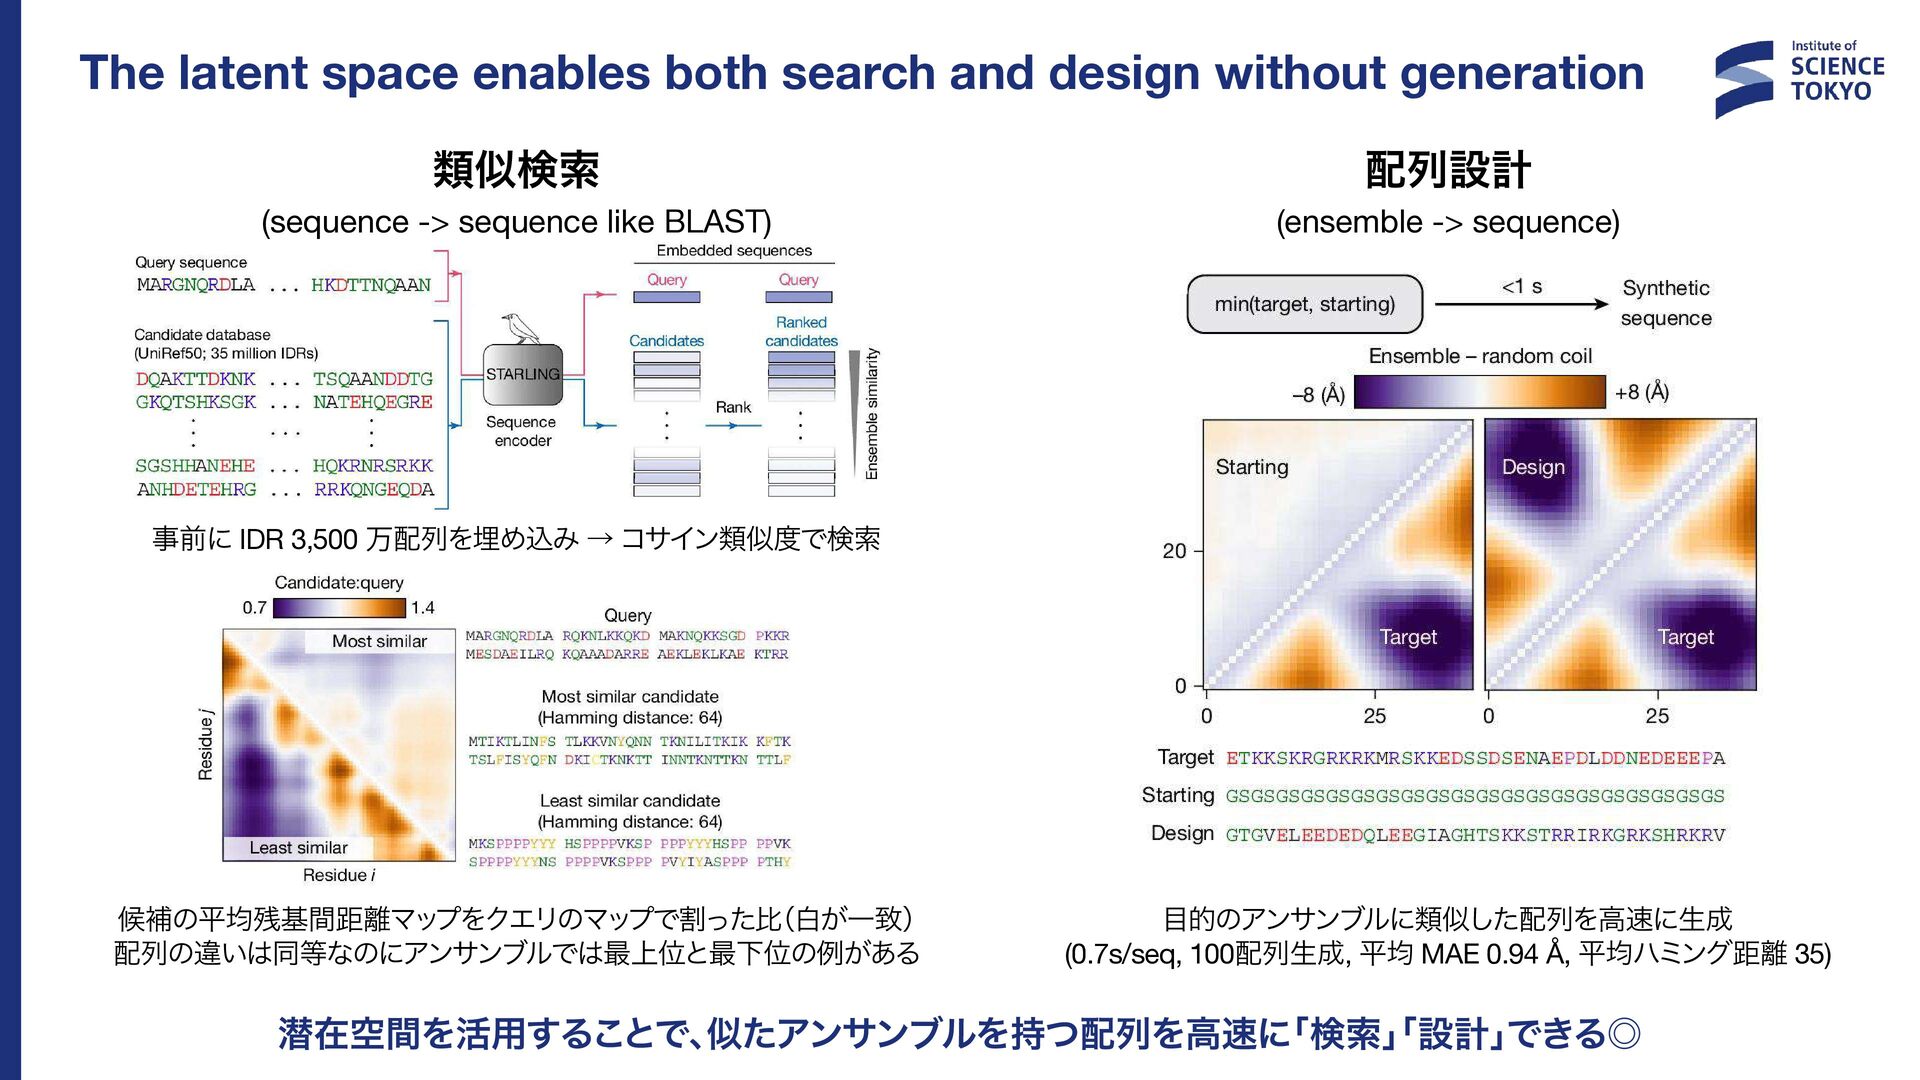
  18. The latent space enables both search and design without generation

    類似検索 (sequence -> sequence like BLAST) 配列設計 (ensemble -> sequence) 事前に IDR 3,500 万配列を埋め込み → コサイン類似度で検索 候補の平均残基間距離マップをクエリのマップで割った比 (白が一致) 配列の違いは同等なのにアンサンブルでは最上位と最下位の例がある 目的のアンサンブルに類似した配列を高速に生成 (0.7s/seq, 100配列生成, 平均 MAE 0.94 Å, 平均ハミング距離 35) 潜在空間を活用することで、似たアンサンブルを持つ配列を高速に 「検索」 「設計」 できる◎