Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
190821 不均衡 データとの戦い方(前処理編) うっちーさん
Search
Sponsored
·
SiteGround - Reliable hosting with speed, security, and support you can count on.
→
RPACommunity
August 21, 2019
Technology
580
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
190821 不均衡 データとの戦い方(前処理編) うっちーさん
RPACommunity
August 21, 2019
More Decks by RPACommunity
See All by RPACommunity
201023 Automation Anywhere「A2019」を触ってみた Ayy
rpabank
0
1.1k
201023 DX Suiteを触ってみた Ayy
rpabank
0
1.1k
201023 RPA超初心者がWinActorにチャレンジしてみた ユーコさん
rpabank
0
690
201023 PowerPlatform はじめの一歩 みさみささん
rpabank
0
690
201023 アシロボで実際に沼ってみた たまいさん
rpabank
0
750
201018 RPAの本質とトレンド Mitz
rpabank
0
560
201006 僕がいまRPAで伝えたいことのすべて いろはまるさん
rpabank
0
530
201006 UiPath MVP 2019-2020 はなっち!さん
rpabank
0
510
201006 今からでも間に合う!UiPathトーク一気に振り返り たまいさん
rpabank
0
470
Other Decks in Technology
See All in Technology
CTO Night|NotionのAIエージェントとFDE
kzkhykw1991
0
230
実践! SRE × AI - ABEMA における AIOps -
tetsuya28
8
3.1k
価値について
gree_tech
PRO
0
100
hackers_champloo_2026_tidb
makocchi
0
170
V8のArray.prototype.flatを最大約20倍速くするまでと、巨大OSSへの大規模コミットの道のり
riyaamemiya
0
310
Benchmarking Disaggregated Serving on vLLM + Dynamo with a Real Coding-Agent Workload
nttcom
1
200
⾮構造化データを価値に変える AI エージェント基盤とその組織
ivry_presentationmaterials
0
200
QA4AI 2026-Oct 生成AI時代の品質保証
tokuty
1
890
DevelopersIO 2026 知識の地図を描く ─ オントロジーとは何か?
ishikawa_satoru
1
1.7k
10年後、Engineering 行為を剥奪されるとして、わたしたちは、どう、何を創ればいいだろうか。 / If Engineering Is Taken Away in 10 Years, How and What Should We Create?
bitkey
PRO
1
200
オントロジーって 結局なにもの? AI エージェントに「意味」を渡す知識設計の話
greenmidori
0
230
アウトプット初心者、半年間のふりかえり
4o1sobblue
0
440
Featured
See All Featured
How Fast Is Fast Enough? [PerfNow 2025]
tammyeverts
3
940
Self-Hosted WebAssembly Runtime for Runtime-Neutral Checkpoint/Restore in Edge–Cloud Continuum
chikuwait
0
890
How to Align SEO within the Product Triangle To Get Buy-In & Support - #RIMC
aleyda
2
1.8k
RailsConf 2023
tenderlove
30
1.6k
A designer walks into a library…
pauljervisheath
211
25k
How To Stay Up To Date on Web Technology
chriscoyier
790
250k
B2B Lead Gen: Tactics, Traps & Triumph
marketingsoph
1
280
Google's AI Overviews - The New Search
badams
0
1.6k
We Are The Robots
honzajavorek
0
400
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
540
Sam Torres - BigQuery for SEOs
techseoconnect
PRO
0
580
Have SEOs Ruined the Internet? - User Awareness of SEO in 2025
akashhashmi
0
520
Transcript
不均衡データとの戦い方 (前処理編) うっちー@マクニカ 1
自己紹介 福岡県出身、学生時代を福岡で過ごす。 2008年 大学院を修了、専攻は応用数学。 その後、東京のソフトウェア会社に就職。 2017年 マクニカネットワーク株式会社に転職。
2019年3月まで「Splunk」Pre Sales 技術担当。 2019年4月より、現在の部署でAI関連の業務に勤しむ。 2019年7月G検定合格。 特技・趣味 お酒大好き。九州男児。 幼少期子役としてCM、舞台等に出演。 将棋好き。某将棋アプリで三段です。 Facebook: /masakatsu.uchida.5 2
いつもの 本資料の内容と発表での発言は個人の見解であり、 所属する組織の公式見解ではありません。 3
Agenda 不均衡データ 考え方編 不均衡データ 実践編 まとめ 4
不均衡データ 考え方編 5
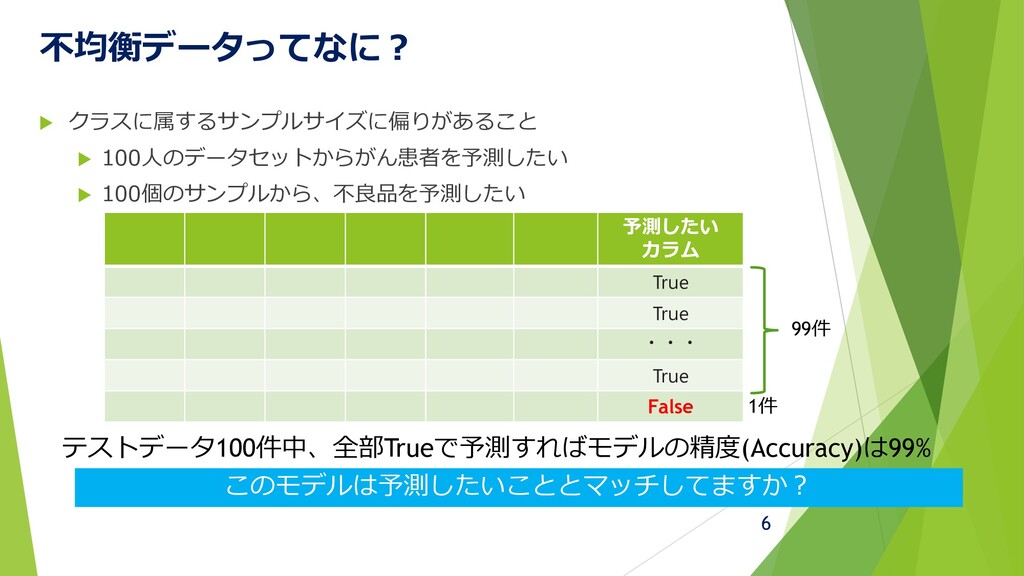
不均衡データってなに? クラスに属するサンプルサイズに偏りがあること 100人のデータセットからがん患者を予測したい 100個のサンプルから、不良品を予測したい 予測したい カラム True
True ・・・ True False 99件 1件 テストデータ100件中、全部Trueで予測すればモデルの精度(Accuracy)は99% このモデルは予測したいこととマッチしてますか? 6
本日のテーマ サンプルサイズが偏って いる事がわかったけど、 そう頻繁に起きるわけ じゃないし、困ったなあ 今あるデータだけを使って、モデルの改善を試みる方法をご紹介します 7
前提条件 今回のLTでは、教師あり学習の2値分類問題を対象とします。 データセットはテーブルデータを対象とします。 8
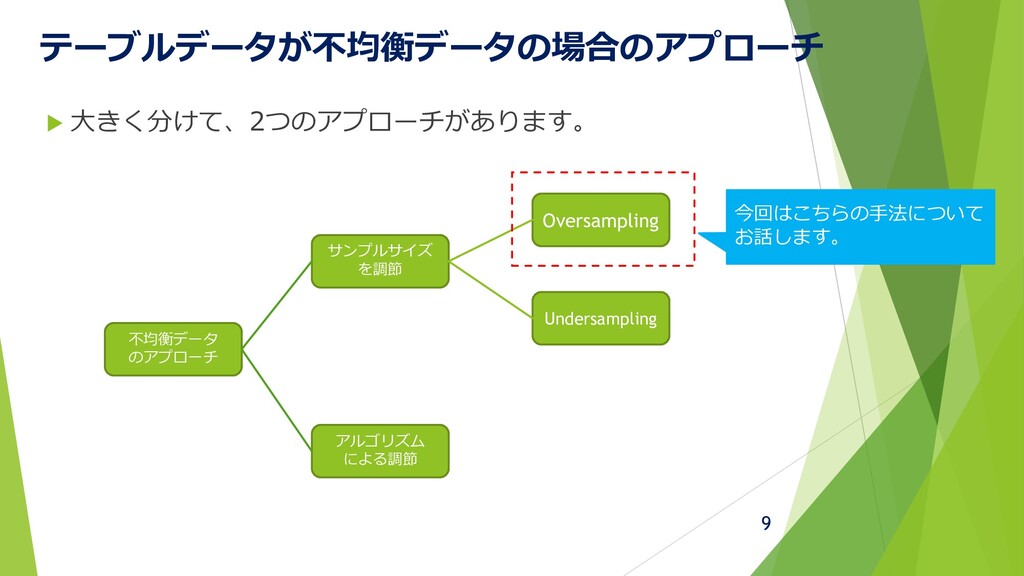
テーブルデータが不均衡データの場合のアプローチ 大きく分けて、2つのアプローチがあります。 不均衡データ のアプローチ サンプルサイズ を調節 アルゴリズム による調節 Oversampling
Undersampling 今回はこちらの手法について お話します。 9
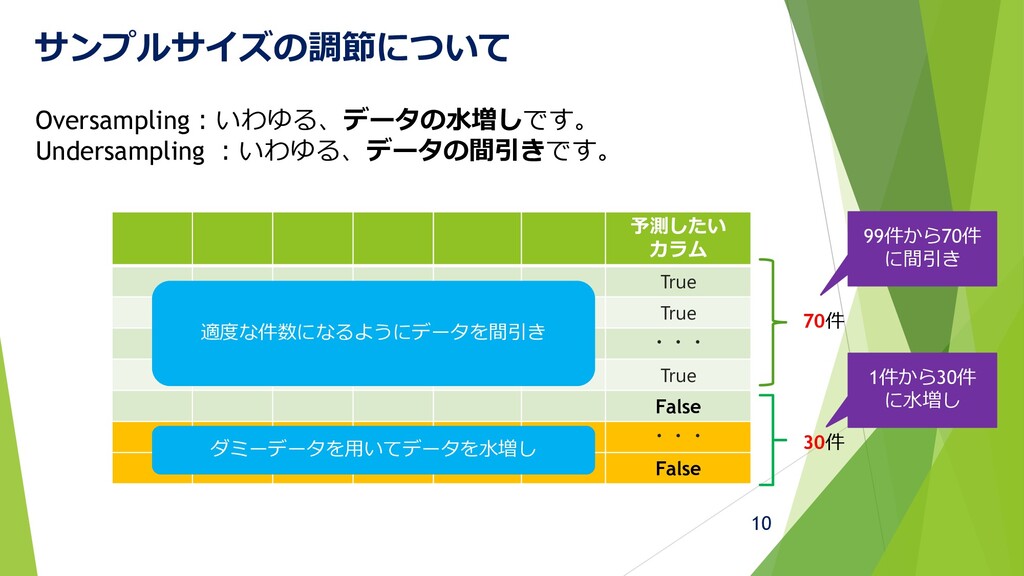
サンプルサイズの調節について Oversampling:いわゆる、データの水増しです。 Undersampling :いわゆる、データの間引きです。 予測したい カラム True True ・・・ True
False ・・・ False 70件 30件 ダミーデータを用いてデータを水増し 適度な件数になるようにデータを間引き 99件から70件 に間引き 1件から30件 に水増し 10
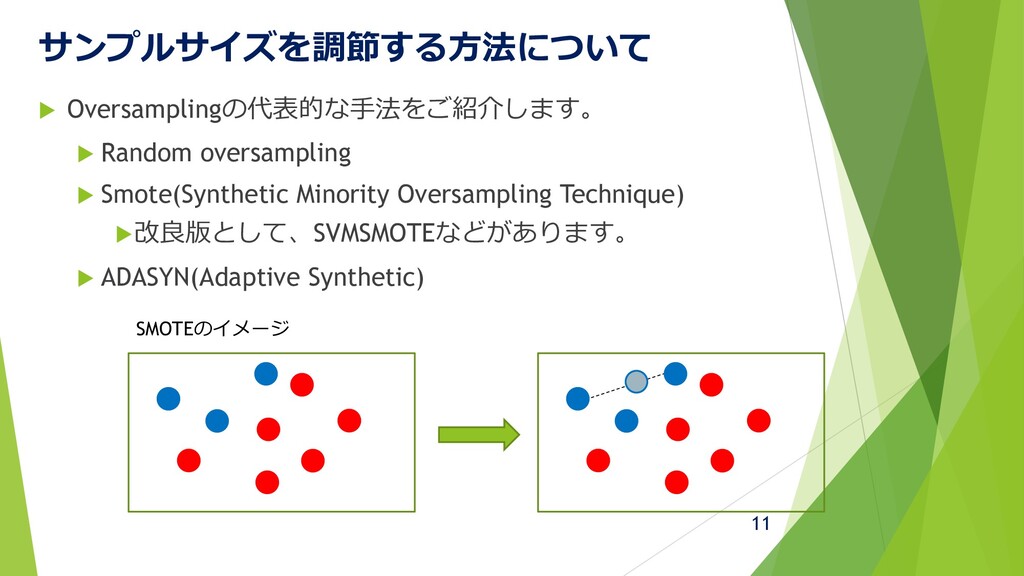
サンプルサイズを調節する方法について Oversamplingの代表的な手法をご紹介します。 Random oversampling Smote(Synthetic Minority Oversampling
Technique) 改良版として、SVMSMOTEなどがあります。 ADASYN(Adaptive Synthetic) SMOTEのイメージ 11
サンプルサイズを調節する際の注意事項について 1. Oversamplingによって過学習が発生する可能性がある問題 データ量が増えたことにより、過学習してしまうことがあります。 2. 精度があがるとは限らない問題 サンプルサイズを調整しても、モデル精度が改善しない場合があります。 12
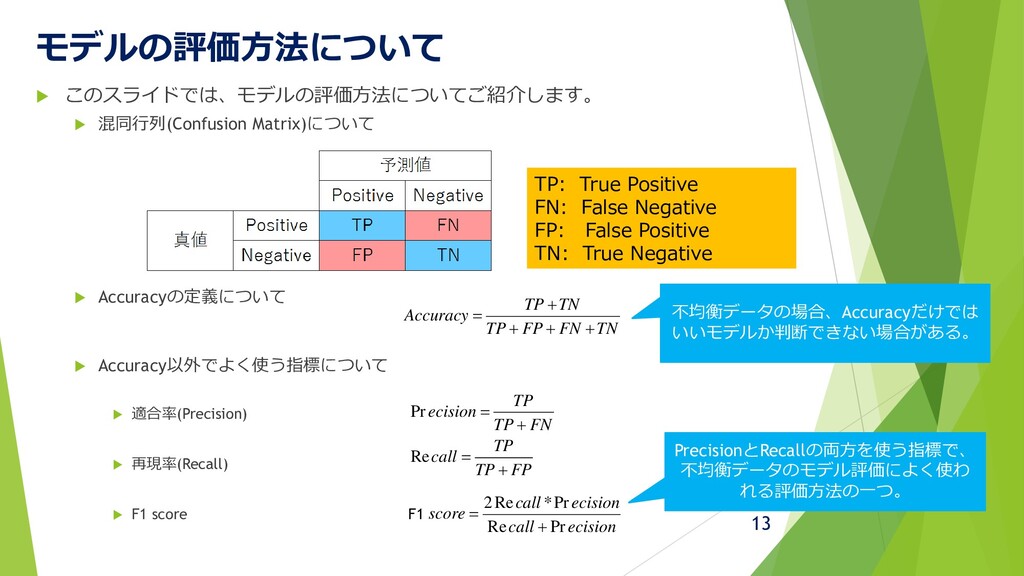
モデルの評価方法について このスライドでは、モデルの評価方法についてご紹介します。 混同行列(Confusion Matrix)について Accuracyの定義について Accuracy以外でよく使う指標について
適合率(Precision) 再現率(Recall) F1 score FP TP TP call + = Re ecision call ecision call score Pr Re Pr * Re 2 + = FN TP TP ecision + = Pr 13 TP: True Positive FN: False Negative FP: False Positive TN: True Negative TN FN FP TP TN TP Accuracy + + + + = F1 PrecisionとRecallの両方を使う指標で、 不均衡データのモデル評価によく使わ れる評価方法の一つ。 不均衡データの場合、Accuracyだけでは いいモデルか判断できない場合がある。
不均衡データ 実践編 14
この章の概要 不均衡データのデータセットを使って、下記パターンのモデルを作成し、 精度を比較することで、Oversamplingの効果について確認します。 Oversamplingを適用しない場合 Oversamplingを適用した場合 評価指標はAccuracy
と F1 scoreを利用します。 15
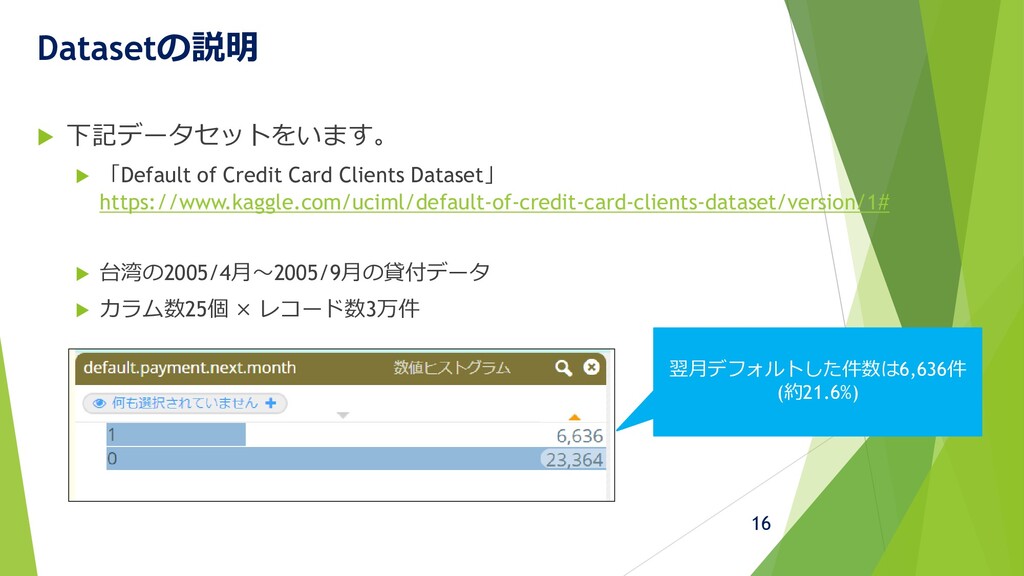
Datasetの説明 下記データセットをいます。 「Default of Credit Card Clients Dataset」
https://www.kaggle.com/uciml/default-of-credit-card-clients-dataset/version/1# 台湾の2005/4月~2005/9月の貸付データ カラム数25個 × レコード数3万件 翌月デフォルトした件数は6,636件 (約21.6%) 16
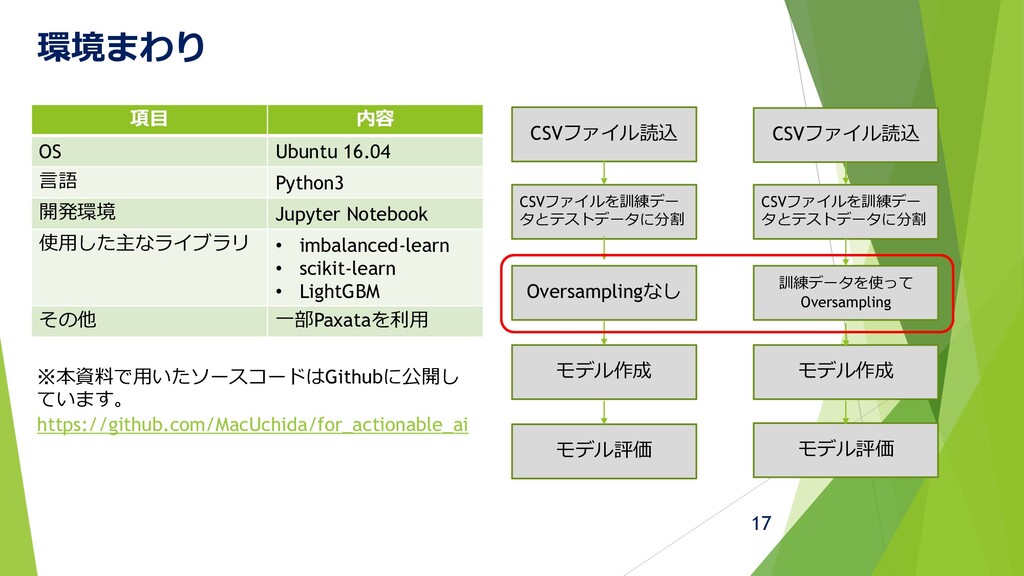
環境まわり CSVファイル読込 モデル作成 モデル作成 モデル評価 CSVファイルを訓練デー タとテストデータに分割 モデル評価 Oversamplingなし 訓練データを使って
Oversampling CSVファイル読込 CSVファイルを訓練デー タとテストデータに分割 ※本資料で用いたソースコードはGithubに公開し ています。 https://github.com/MacUchida/for_actionable_ai 17 項目 内容 OS Ubuntu 16.04 言語 Python3 開発環境 Jupyter Notebook 使用した主なライブラリ • imbalanced-learn • scikit-learn • LightGBM その他 一部Paxataを利用
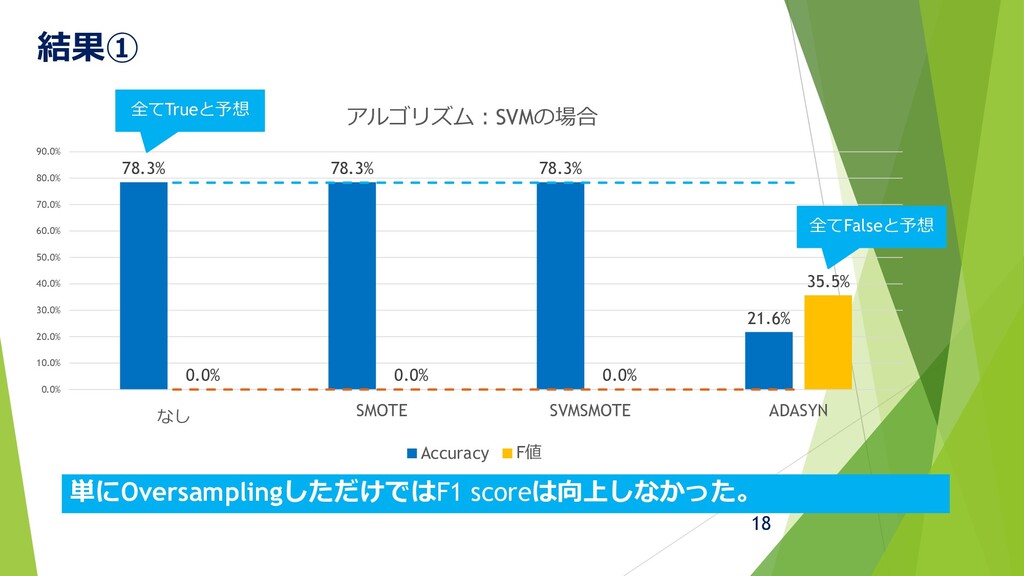
結果① 18 78.3% 78.3% 78.3% 21.6% 0.0% 0.0% 0.0% 35.5%
0.0% 10.0% 20.0% 30.0% 40.0% 50.0% 60.0% 70.0% 80.0% 90.0% なし SMOTE SVMSMOTE ADASYN アルゴリズム:SVMの場合 Accuracy F値 単にOversamplingしただけではF1 scoreは向上しなかった。 全てFalseと予想 全てTrueと予想
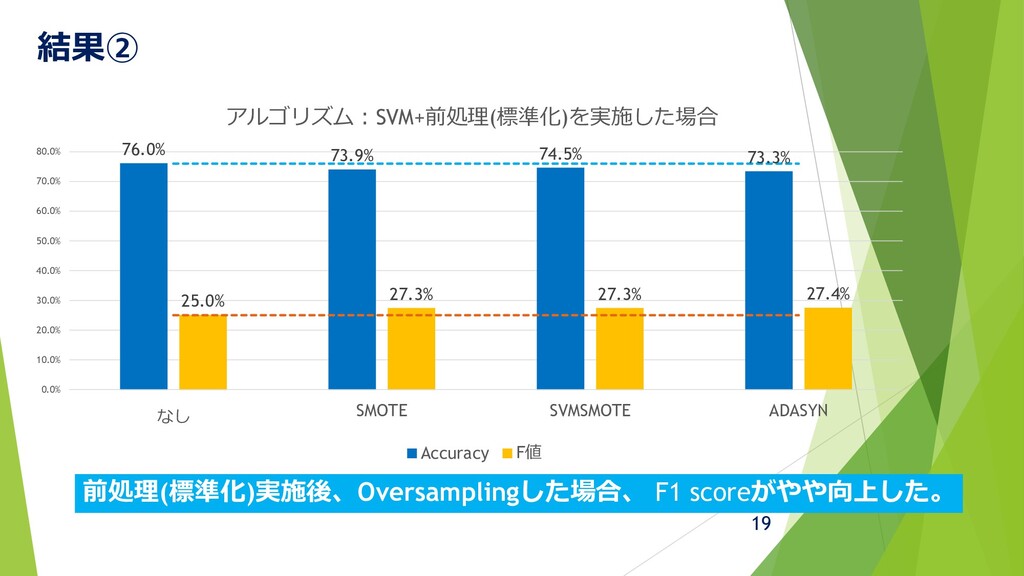
結果② 19 前処理(標準化)実施後、Oversamplingした場合、 F1 scoreがやや向上した。 76.0% 73.9% 74.5% 73.3% 25.0%
27.3% 27.3% 27.4% 0.0% 10.0% 20.0% 30.0% 40.0% 50.0% 60.0% 70.0% 80.0% なし SMOTE SVMSMOTE ADASYN アルゴリズム:SVM+前処理(標準化)を実施した場合 Accuracy F値
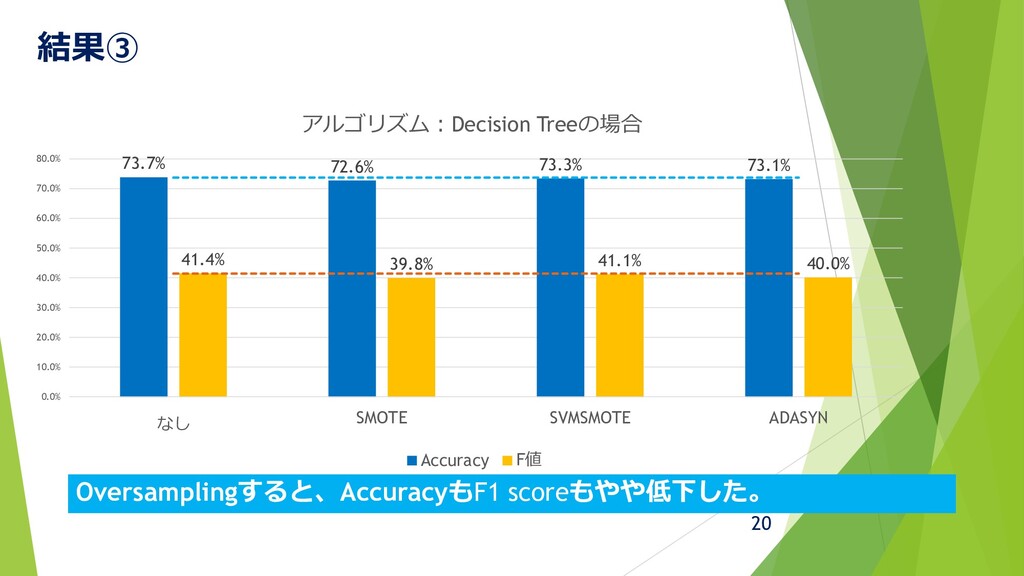
結果③ 20 73.7% 72.6% 73.3% 73.1% 41.4% 39.8% 41.1% 40.0%
0.0% 10.0% 20.0% 30.0% 40.0% 50.0% 60.0% 70.0% 80.0% なし SMOTE SVMSMOTE ADASYN アルゴリズム:Decision Treeの場合 Accuracy F値 Oversamplingすると、AccuracyもF1 scoreもやや低下した。
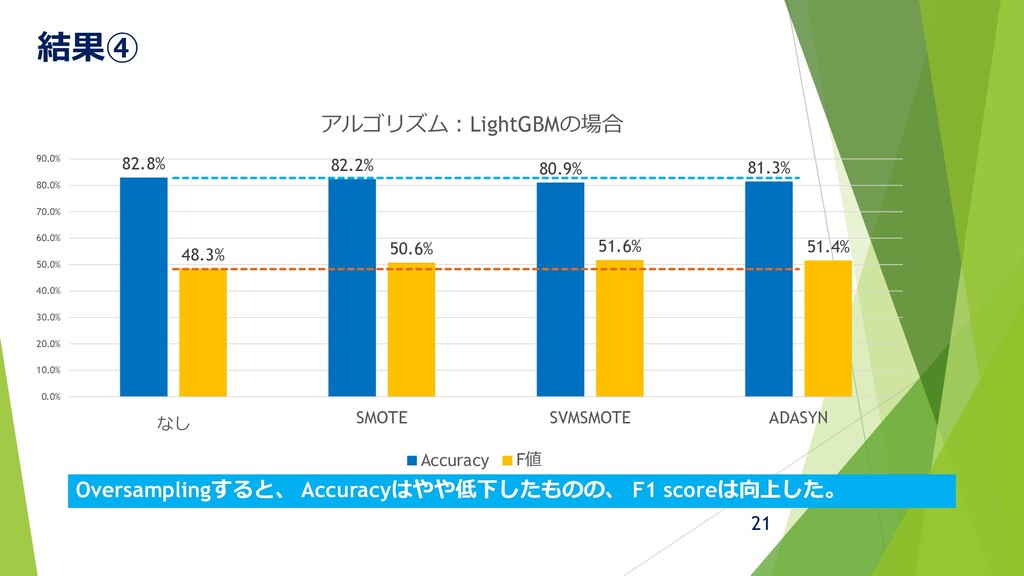
結果④ 21 82.8% 82.2% 80.9% 81.3% 48.3% 50.6% 51.6% 51.4%
0.0% 10.0% 20.0% 30.0% 40.0% 50.0% 60.0% 70.0% 80.0% 90.0% なし SMOTE SVMSMOTE ADASYN アルゴリズム:LightGBMの場合 Accuracy F値 Oversamplingすると、 Accuracyはやや低下したものの、 F1 scoreは向上した。
不均衡データ まとめ編 22
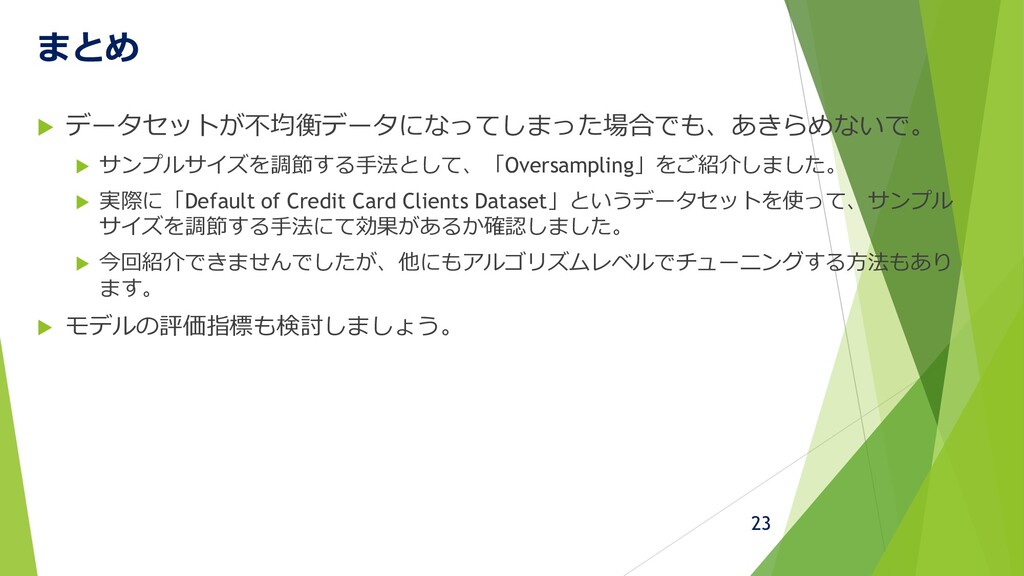
まとめ データセットが不均衡データになってしまった場合でも、あきらめないで。 サンプルサイズを調節する手法として、「Oversampling」をご紹介しました。 実際に「Default of Credit Card
Clients Dataset」というデータセットを使って、サンプル サイズを調節する手法にて効果があるか確認しました。 今回紹介できませんでしたが、他にもアルゴリズムレベルでチューニングする方法もあり ます。 モデルの評価指標も検討しましょう。 23
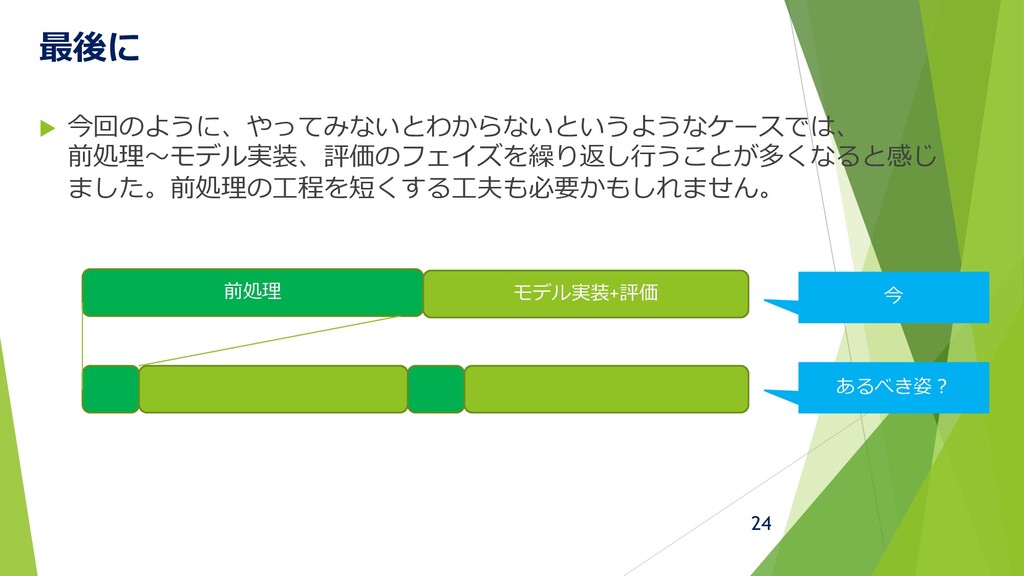
最後に 今回のように、やってみないとわからないというようなケースでは、 前処理~モデル実装、評価のフェイズを繰り返し行うことが多くなると感じ ました。前処理の工程を短くする工夫も必要かもしれません。 前処理 モデル実装+評価 今 あるべき姿? 24
25

 SiteGround - Reliable hosting with speed, security, and support you can count on.


 rpabank
 kzkhykw1991
 tetsuya28
 gree_tech
 makocchi
 riyaamemiya
 nttcom
 ivry_presentationmaterials
 tokuty
 ishikawa_satoru
 bitkey
 greenmidori
 4o1sobblue
 tammyeverts
 chikuwait
 aleyda
 tenderlove
 pauljervisheath
 chriscoyier
 marketingsoph
 badams
 honzajavorek
 jct
 techseoconnect
 akashhashmi