Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
文献紹介_201909_Sentence Mover’s Similarity_ Automa...
Search
T.Tada
September 24, 2019
Technology
180
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
文献紹介_201909_Sentence Mover’s Similarity_ Automatic Evaluation for Multi-Sentence Texts
T.Tada
September 24, 2019
More Decks by T.Tada
See All by T.Tada
文献紹介_202002_Is artificial data useful for biomedical Natural Language Processing algorithms?
tad
0
77
文献紹介_202001_A Novel System for Extractive Clinical Note Summarization using EHR Data
tad
0
200
文献紹介_201912_Publicly Available Clinical BERT Embeddings
tad
0
180
文献紹介_201911_EDA: Easy Data Augmentation Techniques for Boosting Performance on Text Classification Tasks
tad
0
230
文献紹介_201910_Do Neural NLP Models Know Numbers? Probing Numeracy in Embeddings
tad
0
110
文献紹介_201908_Medical Word Embeddings for Spanish_ Development and Evaluation
tad
0
73
文献紹介_201907_Is Word Segmentation Necessary for Deep Learning of Chinese Representations
tad
0
130
文献紹介_201906_Predicting Annotation Difficulty to Improve Task Routing and Model Performance for Biomedical Information Extraction
tad
0
120
文献紹介201905_Context-Aware Cross-Lingual Mapping
tad
0
120
Other Decks in Technology
See All in Technology
オントロジーって 結局なにもの? AI エージェントに「意味」を渡す知識設計の話
greenmidori
0
260
sue445's proposals 2026
sue445
0
130
AI × アーキテクト 第1・2章|生成AIの課題とアーキテクトの素養
daidaidai
1
230
Gemini Intelligence 入門 ― AppFunctions と Gemini Nano
takuroabe
0
350
コンテナ運用におけるネットワーク・コンテナコストの削減方法/How to Reduce Network and Container Costs in Container Operations
masakiokuda
2
390
契約で守るコンパウンドプロダクトのデザインシステム
yug1224
1
180
ガチで放置できるClaude Code実行環境の作り方.pdf
lamaglama39
4
7.5k
Conditional PED-ANOVA: Hyperparameter Importance in Hierarchical & Dynamic Search Spaces
pfn
PRO
0
150
dbt Semantic Layerで進めるenechainのデータ民主化
akizhou
1
220
Claude Code on Bedrock で統制をかける小ネタ集/claude-code-bedrock-governance-tips
emiki
1
410
初海外で注意すべきこと12選!!!安全快適なre:invent生活にするために
yuuuuuuu168
1
200
【データ横丁主催】AI エージェント時代のTranslytical Data Platform
shisyu_gaku
0
250
Featured
See All Featured
Bootstrapping a Software Product
garrettdimon
PRO
306
120k
The #1 spot is gone: here's how to win anyway
tamaranovitovic
4
1.2k
YesSQL, Process and Tooling at Scale
rocio
174
15k
How GitHub (no longer) Works
holman
316
150k
How to train your dragon (web standard)
notwaldorf
96
6.9k
What Being in a Rock Band Can Teach Us About Real World SEO
427marketing
0
1.1k
Discover your Explorer Soul
emna__ayadi
2
1.3k
Primal Persuasion: How to Engage the Brain for Learning That Lasts
tmiket
0
500
Agile Actions for Facilitating Distributed Teams - ADO2019
mkilby
0
310
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.8k
SEO Brein meetup: CTRL+C is not how to scale international SEO
lindahogenes
2
2.9k
Reality Check: Gamification 10 Years Later
codingconduct
0
2.3k
Transcript
- 文献紹介 2019 Sep 24 - Sentence Mover’s Similarity: Automatic
Evaluation for Multi-Sentence Texts 長岡技術科学大学 自然言語処理研究室 多田太郎
About the paper 2 Authors: Conference:
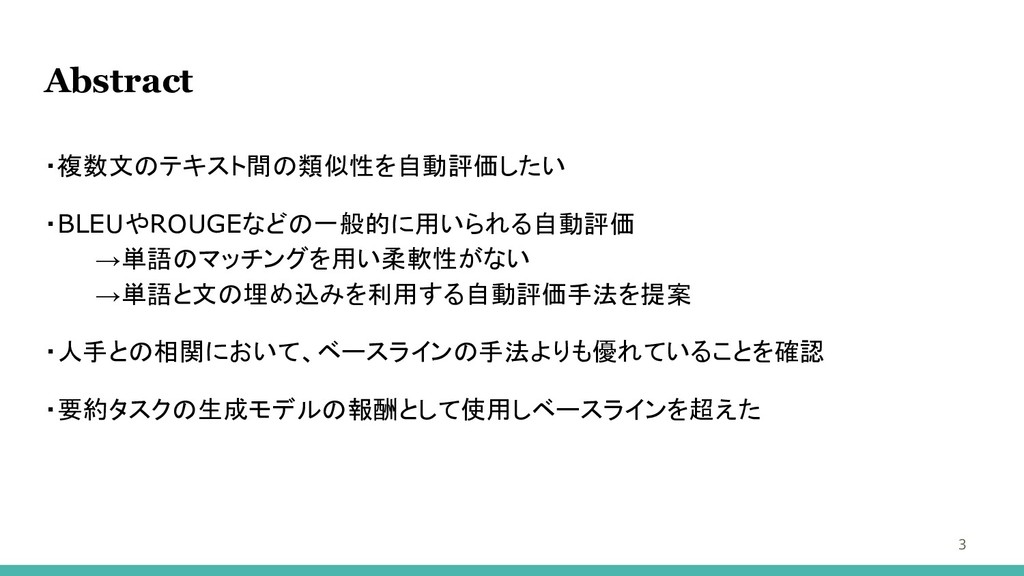
Abstract ・複数文のテキスト間の類似性を自動評価したい ・BLEUやROUGEなどの一般的に用いられる自動評価 →単語のマッチングを用い柔軟性がない →単語と文の埋め込みを利用する自動評価手法を提案 ・人手との相関において、ベースラインの手法よりも優れていることを確認 ・要約タスクの生成モデルの報酬として使用しベースラインを超えた 3
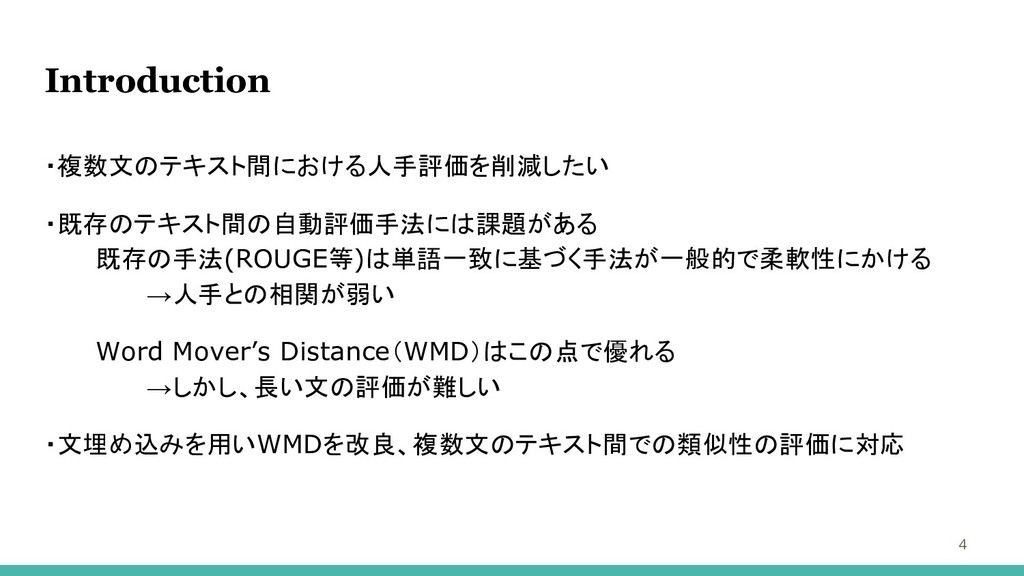
Introduction ・複数文のテキスト間における人手評価を削減したい ・既存のテキスト間の自動評価手法には課題がある 既存の手法(ROUGE等)は単語一致に基づく手法が一般的で柔軟性にかける →人手との相関が弱い Word Mover’s Distance(WMD)はこの点で優れる →しかし、長い文の評価が難しい ・文埋め込みを用いWMDを改良、複数文のテキスト間での類似性の評価に対応
4
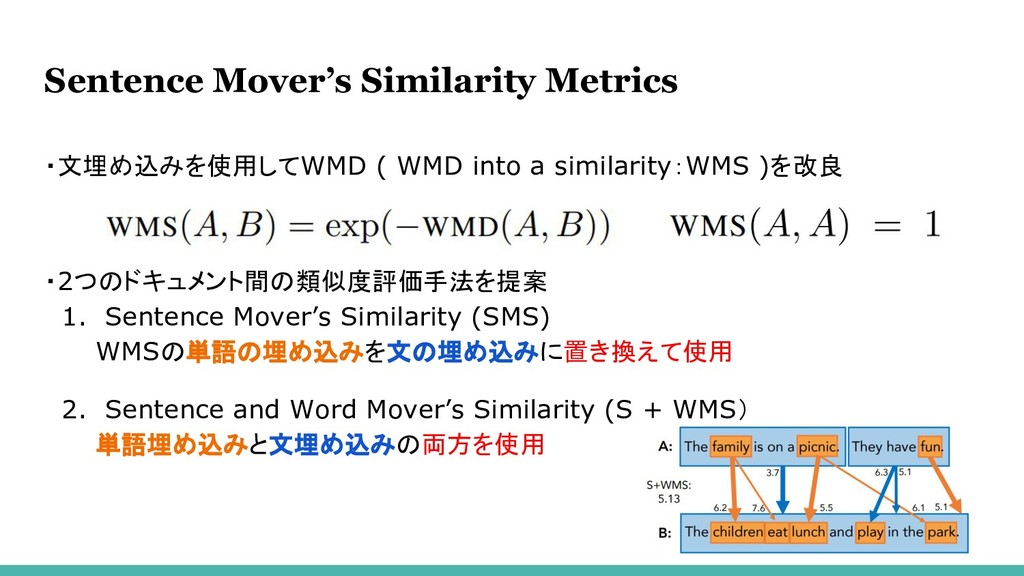
Sentence Mover’s Similarity Metrics ・文埋め込みを使用してWMD ( WMD into a similarity:WMS
)を改良 ・2つのドキュメント間の類似度評価手法を提案 1. Sentence Mover’s Similarity (SMS) WMSの単語の埋め込みを文の埋め込みに置き換えて使用 2. Sentence and Word Mover’s Similarity (S + WMS) 単語埋め込みと文埋め込みの両方を使用 5
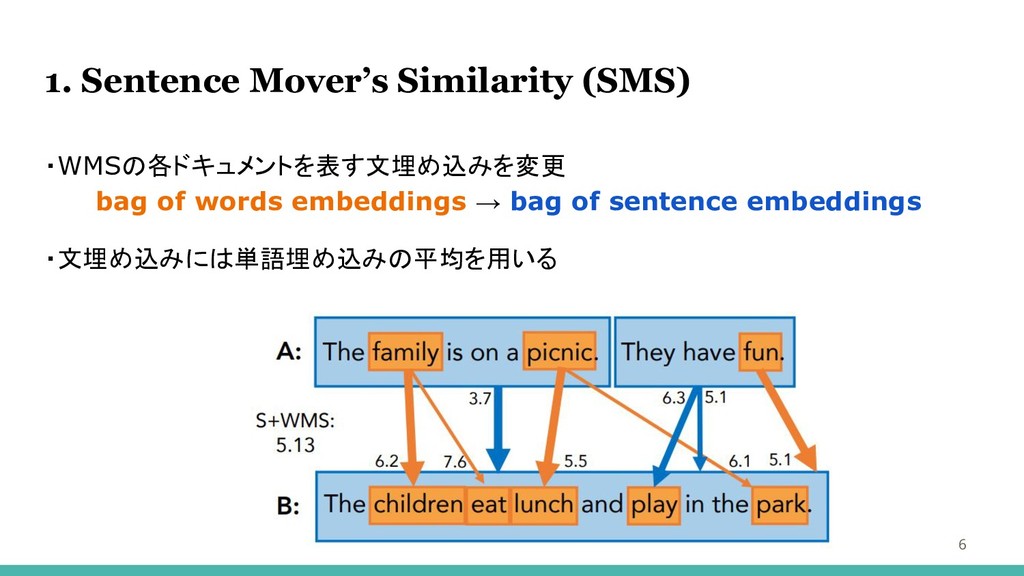
1. Sentence Mover’s Similarity (SMS) ・WMSの各ドキュメントを表す文埋め込みを変更 bag of words embeddings
→ bag of sentence embeddings ・文埋め込みには単語埋め込みの平均を用いる 6
2. Sentence and Word Mover’s Similarity (S + WMS) ・WMSとSMSを組み合わせ、各ドキュメントの単語と文の情報を使い距離を累積
bag of words embeddingsとbag of sentence embeddingsを併用 ・文の埋め込みは単語の埋め込みと同様に扱う 7
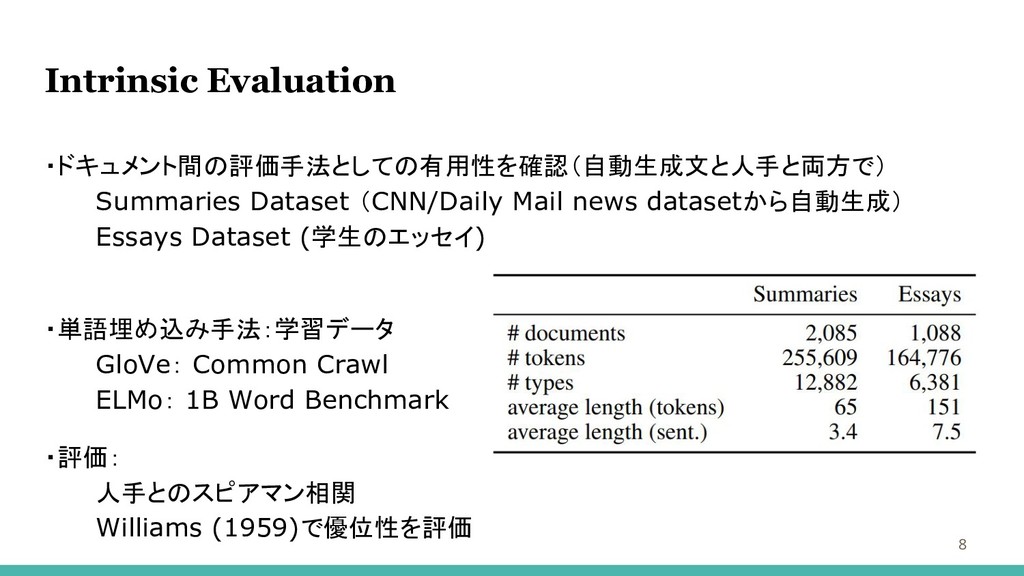
Intrinsic Evaluation ・ドキュメント間の評価手法としての有用性を確認(自動生成文と人手と両方で) Summaries Dataset (CNN/Daily Mail news datasetから自動生成) Essays
Dataset (学生のエッセイ) ・単語埋め込み手法:学習データ GloVe: Common Crawl ELMo: 1B Word Benchmark ・評価: 人手とのスピアマン相関 Williams (1959)で優位性を評価 8
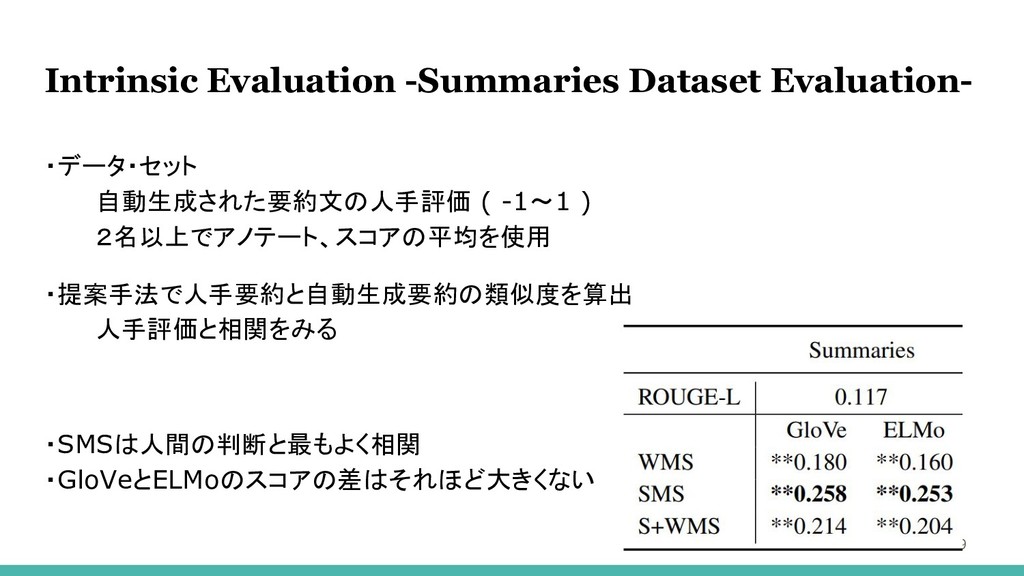
Intrinsic Evaluation -Summaries Dataset Evaluation- ・データ・セット 自動生成された要約文の人手評価 ( -1〜1 )
2名以上でアノテート、スコアの平均を使用 ・提案手法で人手要約と自動生成要約の類似度を算出 人手評価と相関をみる ・SMSは人間の判断と最もよく相関 ・GloVeとELMoのスコアの差はそれほど大きくない 9
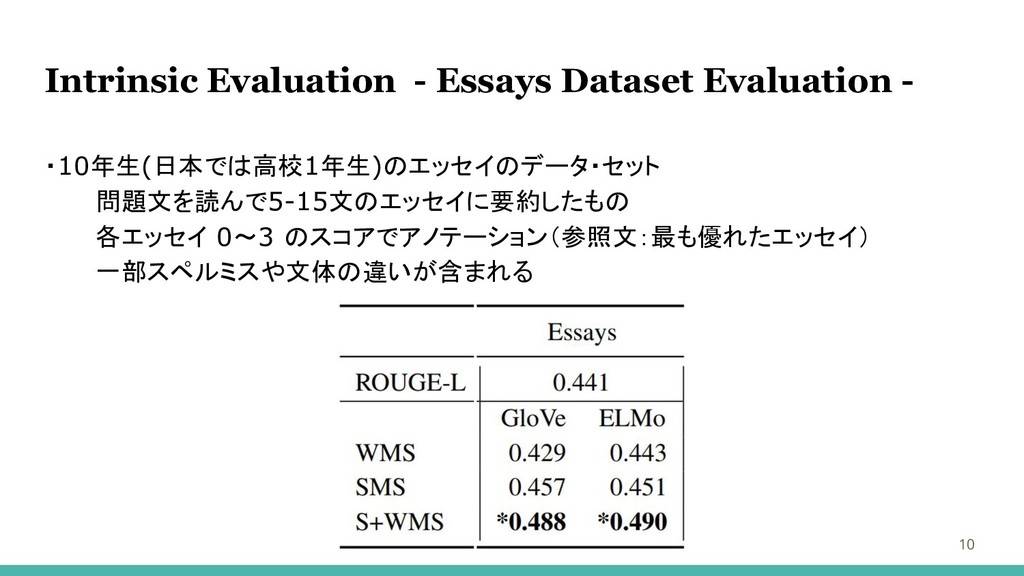
Intrinsic Evaluation - Essays Dataset Evaluation - ・10年生(日本では高校1年生)のエッセイのデータ・セット 問題文を読んで5-15文のエッセイに要約したもの 各エッセイ
0〜3 のスコアでアノテーション(参照文:最も優れたエッセイ) 一部スペルミスや文体の違いが含まれる 10
Extrinsic Evaluation テキスト生成モデルを学習する際の報酬として使用し評価 ・学習データ: CNN / Daily Mailデータセット ・モデル: エンコーダーデコーダーモデル、強化学習を使用
エンコーダ:2層 bidirectiona LSTM、デコーダ:2層 LSTM policy gradient 強化学習、評価手法を最大化するように学習等(詳細は論文参照) 11
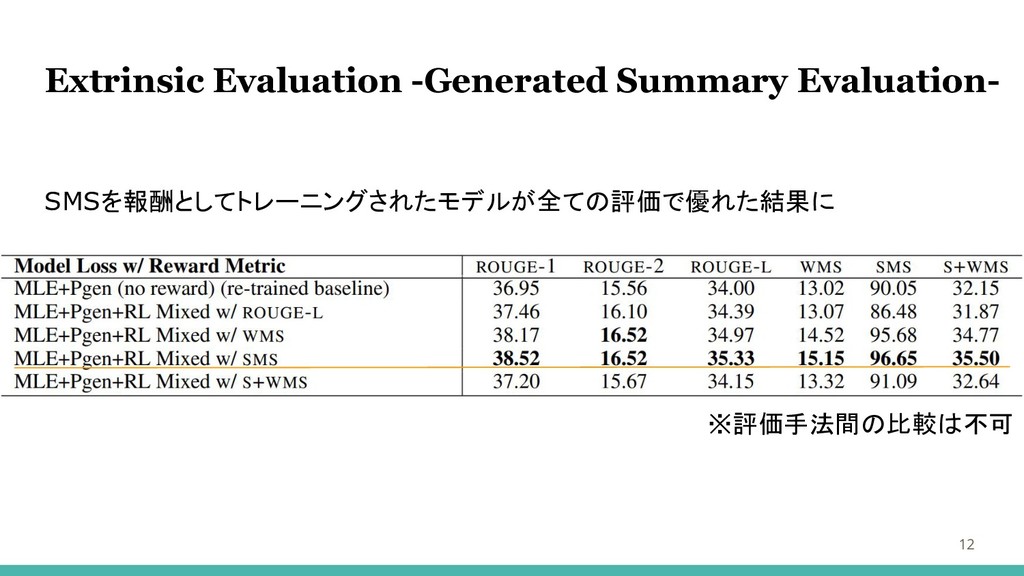
Extrinsic Evaluation -Generated Summary Evaluation- SMSを報酬としてトレーニングされたモデルが全ての評価で優れた結果に 12 ※評価手法間の比較は不可
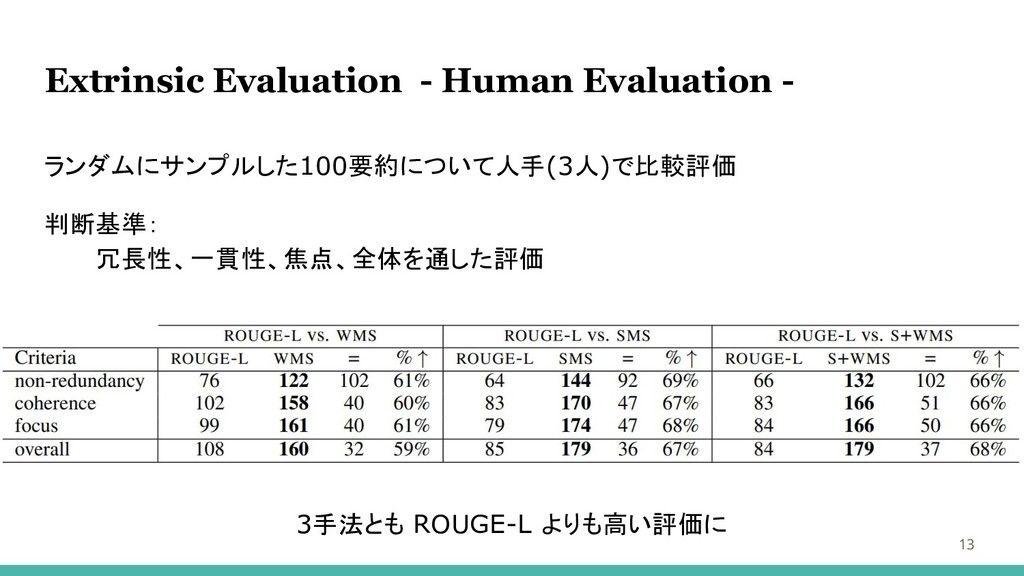
Extrinsic Evaluation - Human Evaluation - ランダムにサンプルした100要約について人手(3人)で比較評価 判断基準: 冗長性、一貫性、焦点、全体を通した評価 3手法とも
ROUGE-L よりも高い評価に 13
Conclusion ・複数文からなるドキュメントに対応した類似度の自動評価手法を提案 ・既存の手法と比較し人手との相関が向上 ・自動生成の報酬として用いた際にもベースラインを上回った ・コード(既存のWMD実装の拡張)とデータセットは公開 14
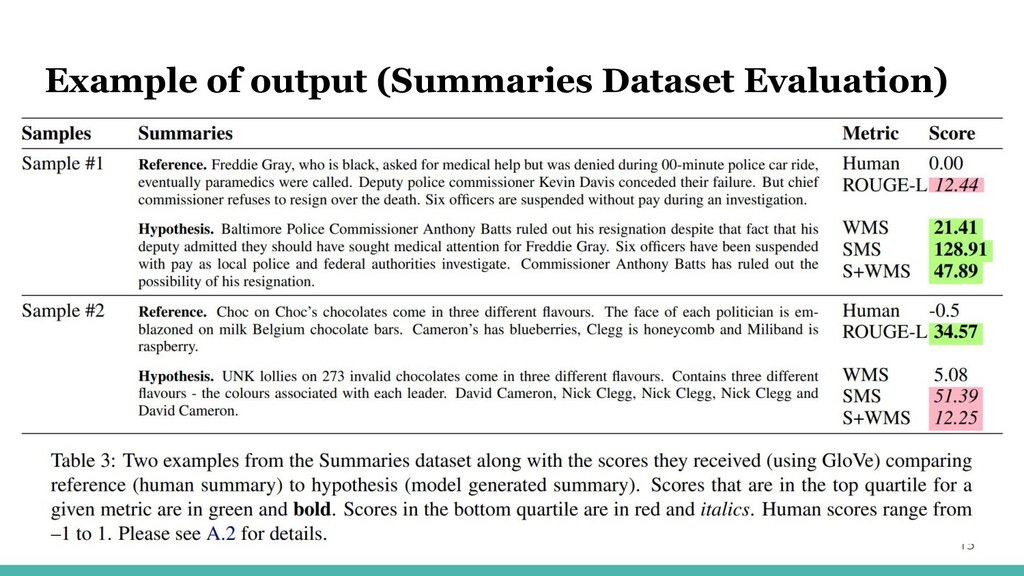
Example of output (Summaries Dataset Evaluation) 15
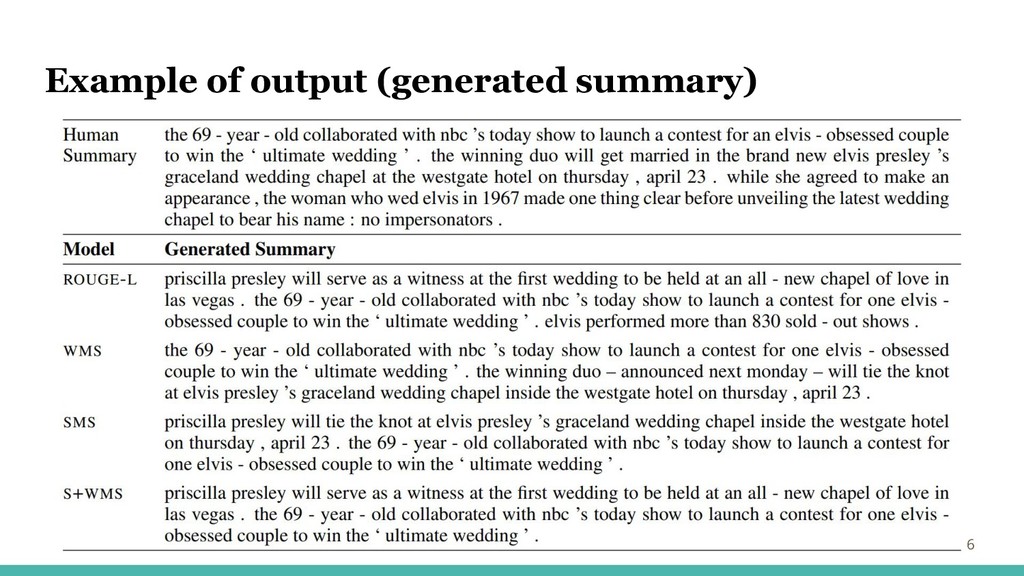
Example of output (generated summary) 16


 tad
 greenmidori
 sue445
 daidaidai
 takuroabe
 masakiokuda
 yug1224
 lamaglama39
 pfn
 akizhou
 emiki
 yuuuuuuu168
 shisyu_gaku
 garrettdimon
 tamaranovitovic
 rocio
 holman
 notwaldorf
 427marketing
 emna__ayadi
 tmiket
 mkilby
 inesmontani
 lindahogenes
 codingconduct