Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
文献紹介_201907_Is Word Segmentation Necessary for ...
Search
T.Tada
July 03, 2019
Technology
130
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
文献紹介_201907_Is Word Segmentation Necessary for Deep Learning of Chinese Representations
T.Tada
July 03, 2019
More Decks by T.Tada
See All by T.Tada
文献紹介_202002_Is artificial data useful for biomedical Natural Language Processing algorithms?
tad
0
77
文献紹介_202001_A Novel System for Extractive Clinical Note Summarization using EHR Data
tad
0
200
文献紹介_201912_Publicly Available Clinical BERT Embeddings
tad
0
180
文献紹介_201911_EDA: Easy Data Augmentation Techniques for Boosting Performance on Text Classification Tasks
tad
0
230
文献紹介_201910_Do Neural NLP Models Know Numbers? Probing Numeracy in Embeddings
tad
0
110
文献紹介_201909_Sentence Mover’s Similarity_ Automatic Evaluation for Multi-Sentence Texts
tad
0
170
文献紹介_201908_Medical Word Embeddings for Spanish_ Development and Evaluation
tad
0
73
文献紹介_201906_Predicting Annotation Difficulty to Improve Task Routing and Model Performance for Biomedical Information Extraction
tad
0
120
文献紹介201905_Context-Aware Cross-Lingual Mapping
tad
0
110
Other Decks in Technology
See All in Technology
AI感のないAWS構成図をAIエージェントに描かせたい!
sagochiko
2
480
生成AIを使って「人が」考える技術 ― AI時代の人機共想と実践ノウハウ|UNITT AC2026
ishiirikie
0
450
Mastering Agentic Development: Harness Engineering for Effective Coding Agents
konippi
3
660
AI coding 整合正規方法
philipz
0
580
顧客の成果創出とプロダクトの成長を 両立するためのFDE
sansantech
PRO
0
510
カンファレンスに参加した後の浮遊感とセルフケア
pauli
0
240
ボードゲームの遊び相手をFoundation Modelsで作る / iOSDC Japan 2026
genda
0
240
The seven pitfalls of AI (revised version)
ufried
0
120
Claude起点の仕様駆動開発
tanakaseiya
0
220
BedrockとLambdaで作る リアルタイム進行型推理ゲーム
kawametho
0
120
企業の現実世界をグラフで写し取る
sansantech
PRO
0
210
VS Code × GitHub Copilot での Fabric 開発
ryomaru0825
1
190
Featured
See All Featured
AI: The stuff that nobody shows you
jnunemaker
PRO
10
1.1k
エンジニアに許された特別な時間の終わり
watany
109
250k
Digital Ethics as a Driver of Design Innovation
axbom
PRO
1
440
First, design no harm
axbom
PRO
2
1.3k
RailsConf 2023
tenderlove
30
1.6k
Neural Spatial Audio Processing for Sound Field Analysis and Control
skoyamalab
0
530
Bootstrapping a Software Product
garrettdimon
PRO
306
120k
Balancing Empowerment & Direction
lara
6
1.3k
Applied NLP in the Age of Generative AI
inesmontani
PRO
4
2.5k
Reality Check: Gamification 10 Years Later
codingconduct
0
2.3k
Rails Girls Zürich Keynote
gr2m
96
14k
The Curious Case for Waylosing
cassininazir
1
540
Transcript
- 文献紹介 2019 Jul 3 - Is Word Segmentation Necessary
for Deep Learning of Chinese Representations? 長岡技術科学大学 自然言語処理研究室 多田太郎
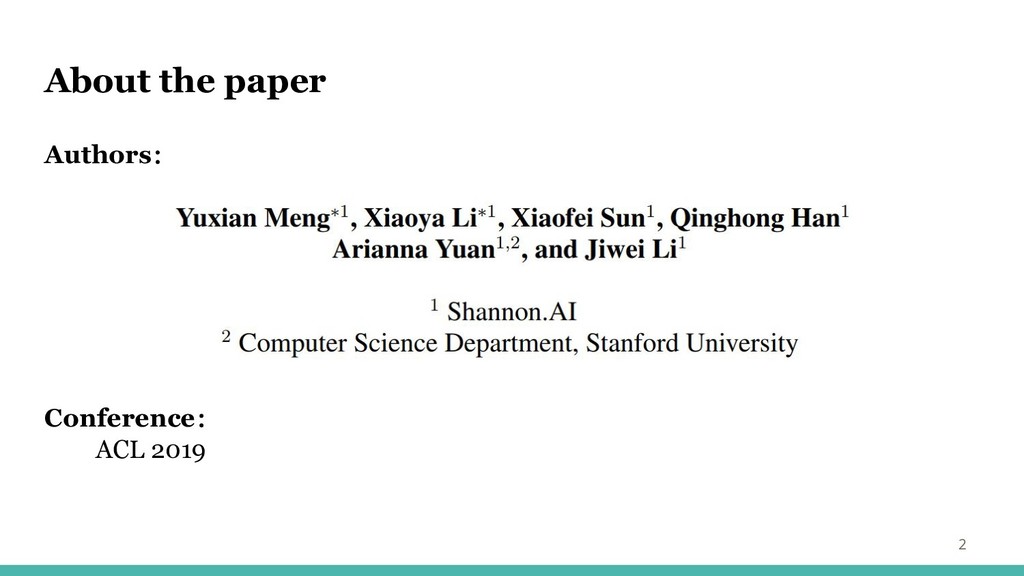
About the paper 2 Authors: Conference: ACL 2019
Abstract ・中国語のテキストの単語分割の必要性はあまり調べられていない ・中国語単語分割(CWS)が深層学習に基づく中国語NLPに必要であるか ・4つのエンドツーエンドのNLPベンチマークタスクで実験 ・文字ベースのモデルは一貫して単語ベースのモデルよりも優れていた 3
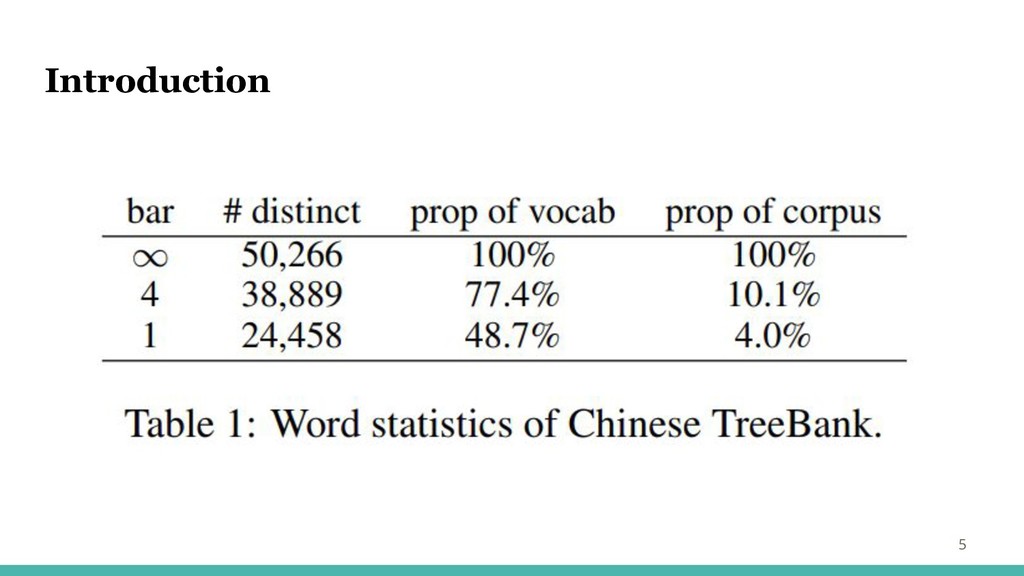
Introduction 4 ・中国語テキストでは前処理として単語分割を行なうのが一般的 ・単語ベースのモデルにはいくつかの基本的な欠点がある コーパス内の単語のスパース性が過剰適合につながる OOV単語の偏在はモデルの学習能力を制限する →単語の頻度が低いため、モデルでそれらの意味を完全に学習することは不可能 ・最先端の単語セグメンテーションの性能でも完全には程遠い その誤差は下流のNLPタスクに影響 →中国語の単語の境界が非常に曖昧なため
・単語ベースのモデルを文字ベースのモデルと比較し、有用性を検討
Introduction 5
・ディープラーニングベースの中国語NLPにおける単語分割の効果を評価 言語モデリング、機械翻訳、テキスト分類、文のマッチング/言い換え ・単語ベースのモデルと文字ベースのモデルを比較 グリッドサーチでハイパーパラメータを調整 (学習率、バッチサイズ、ドロップアウト率などの重要な項目) Experimental Results 6
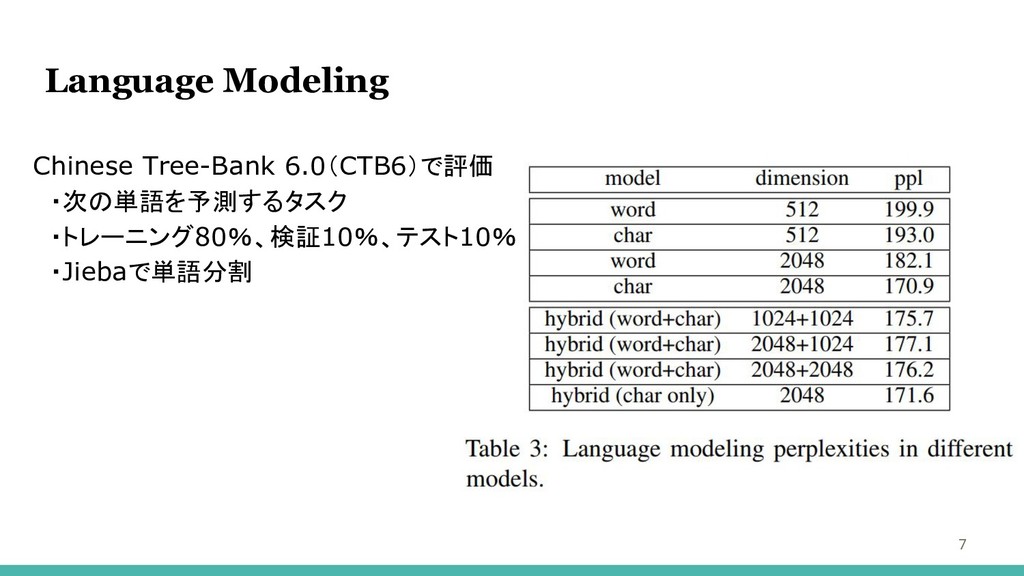
Chinese Tree-Bank 6.0(CT B6)で評価 ・次の単語を予測するタスク ・トレーニング80%、検証10%、テスト10% ・Jiebaで単語分割 Language Modeling 7
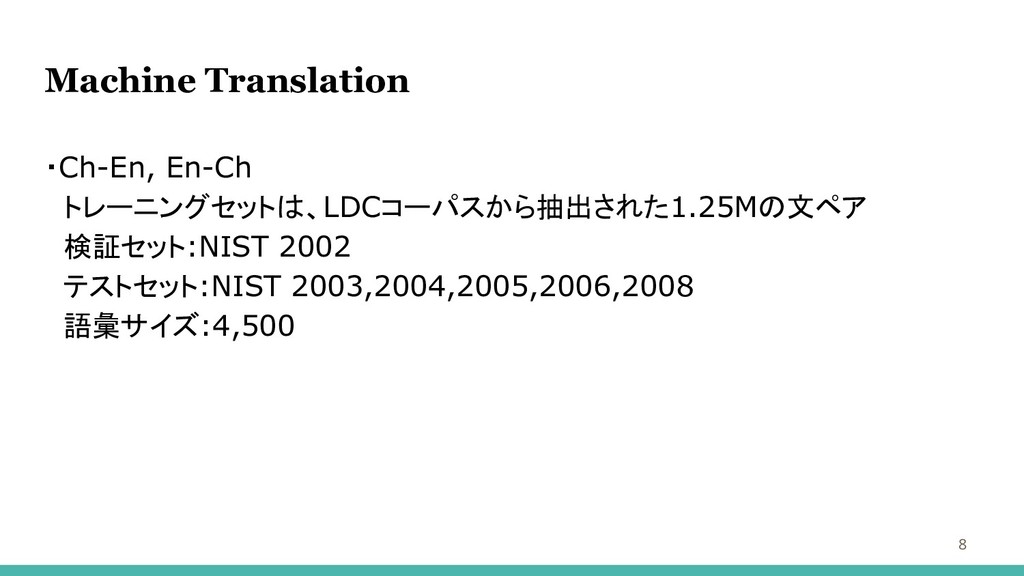
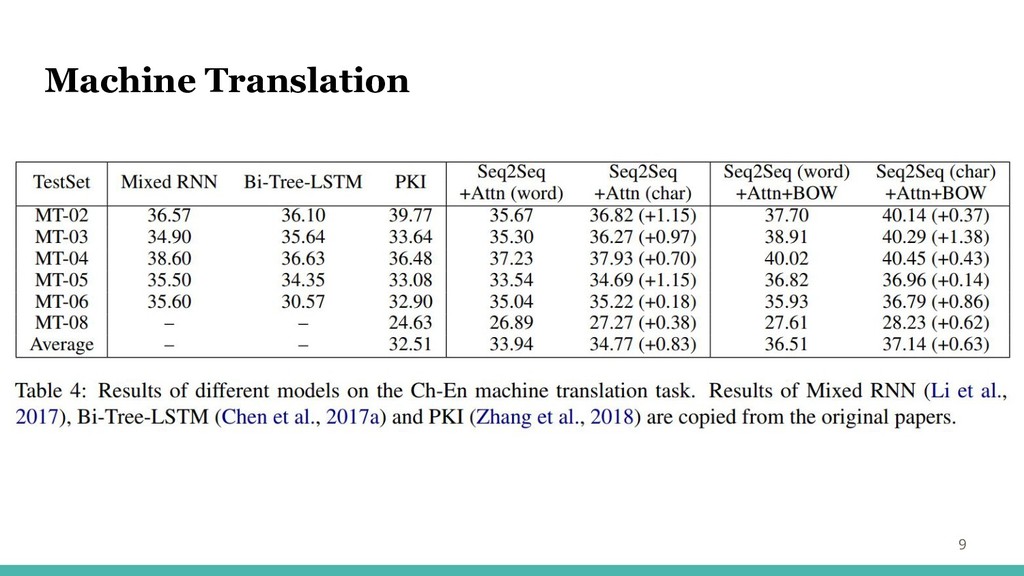
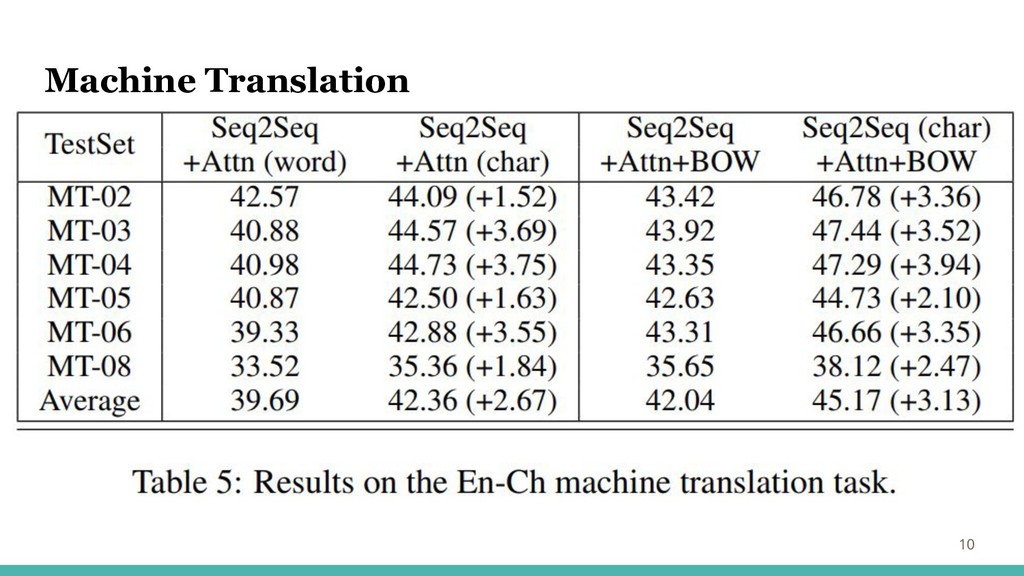
・Ch-En, En-Ch トレーニングセットは、LDCコーパスから抽出された1.25Mの文ペア 検証セット:NIST 2002 テストセット:NIST 2003,2004,2005,2006,2008 語彙サイズ:4,500 Machine Translation
8
・テ Machine Translation 9
・テ Machine Translation 10
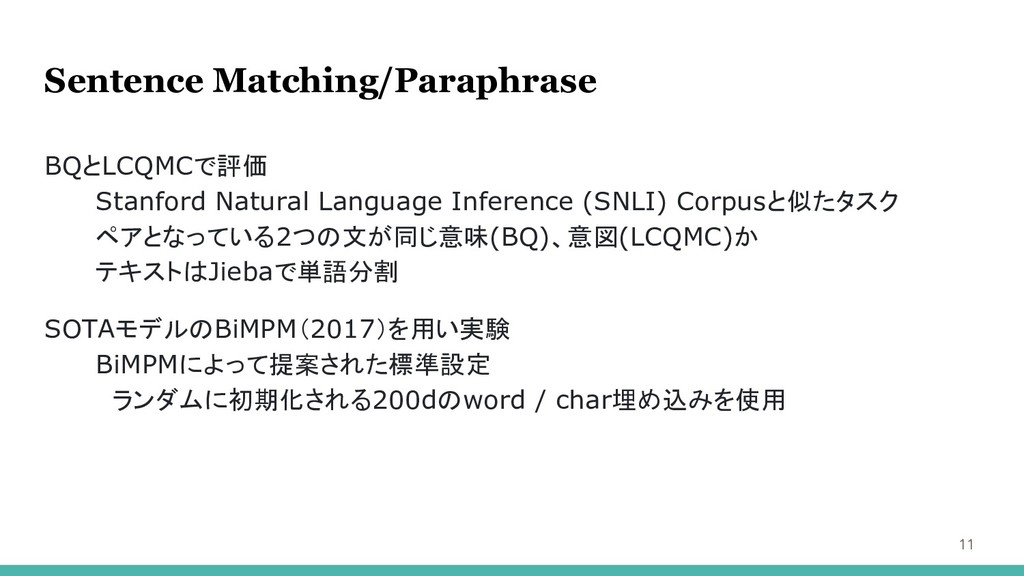
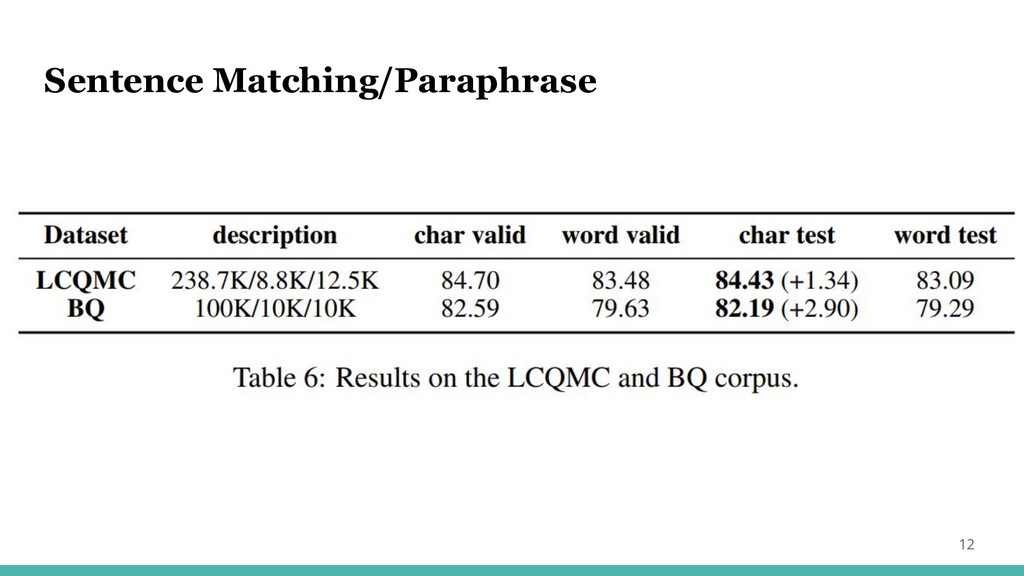
Sentence Matching/Paraphrase 11 BQとLCQMCで評価 Stanford Natural Language Inference (SNLI) Corpusと似たタスク
ペアとなっている2つの文が同じ意味(BQ)、意図(LCQMC)か テキストはJiebaで単語分割 SOTAモデルのBiMPM(2017)を用い実験 BiMPMによって提案された標準設定 ランダムに初期化される200dのword / char埋め込みを使用
Sentence Matching/Paraphrase 12
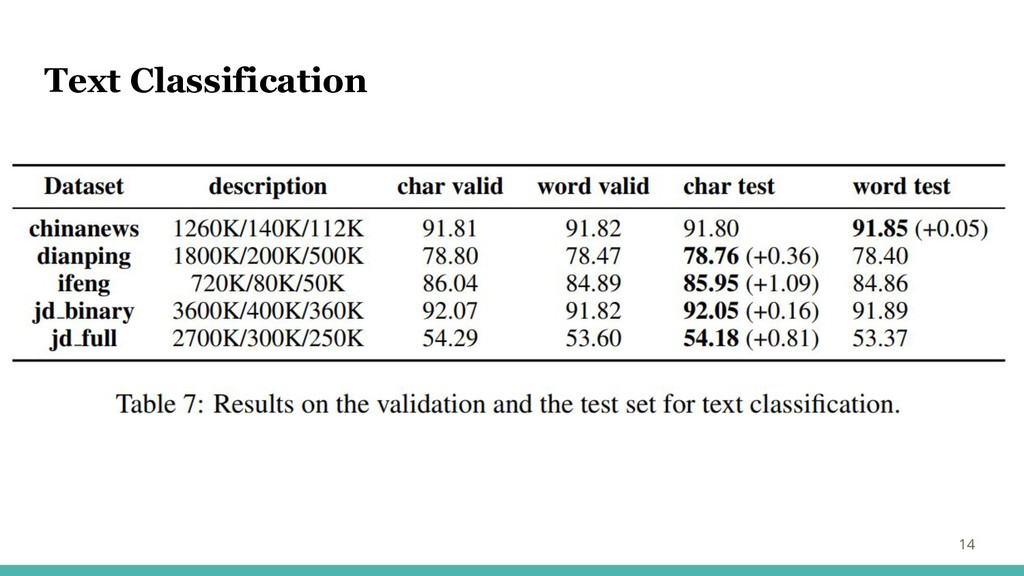
Text Classification 13 5つのデータ・セットで実験 ChinaNews:ニュース記事、7カテゴリ Ifeng:ニュース記事の最初の段落、5カテゴリ JD_Full:製品レビュー、5クラス JD_binary:製品レビュー、2クラス Dianping:レストランのレビュー、2クラス 単語ベースと文字ベースで双方向LSTMモデルをトレーニング
Text Classification 14 ・ト
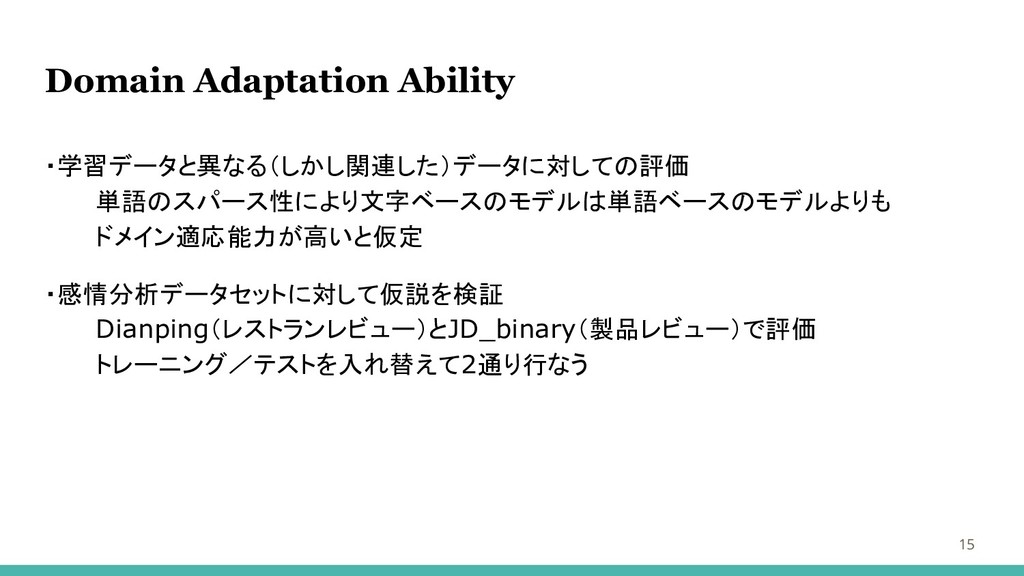
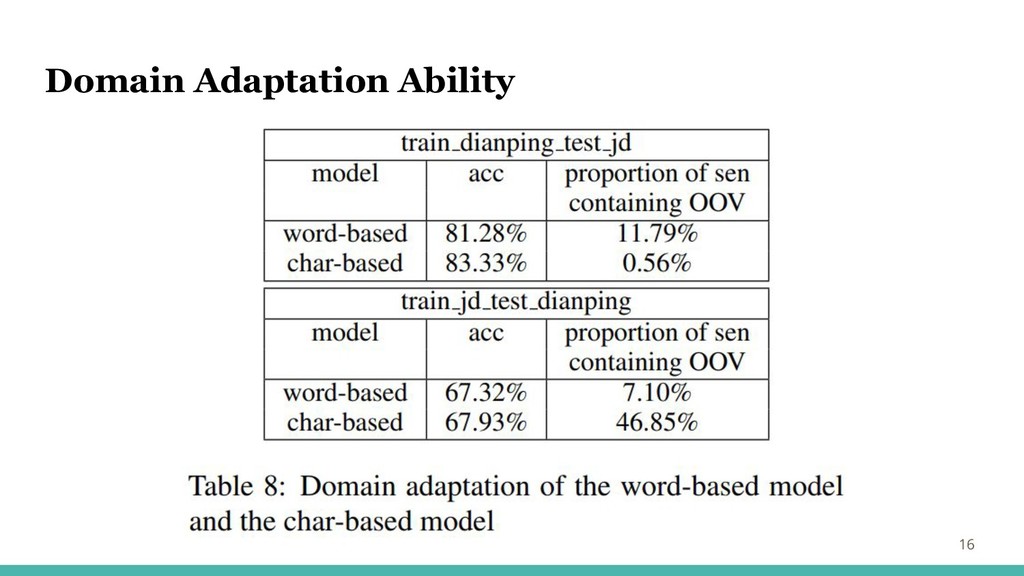
Domain Adaptation Ability 15 ・学習データと異なる(しかし関連した)データに対しての評価 単語のスパース性により文字ベースのモデルは単語ベースのモデルよりも ドメイン適応能力が高いと仮定 ・感情分析データセットに対して仮説を検証 Dianping(レストランレビュー)とJD_binary(製品レビュー)で評価 トレーニング/テストを入れ替えて2通り行なう
Domain Adaptation Ability 16
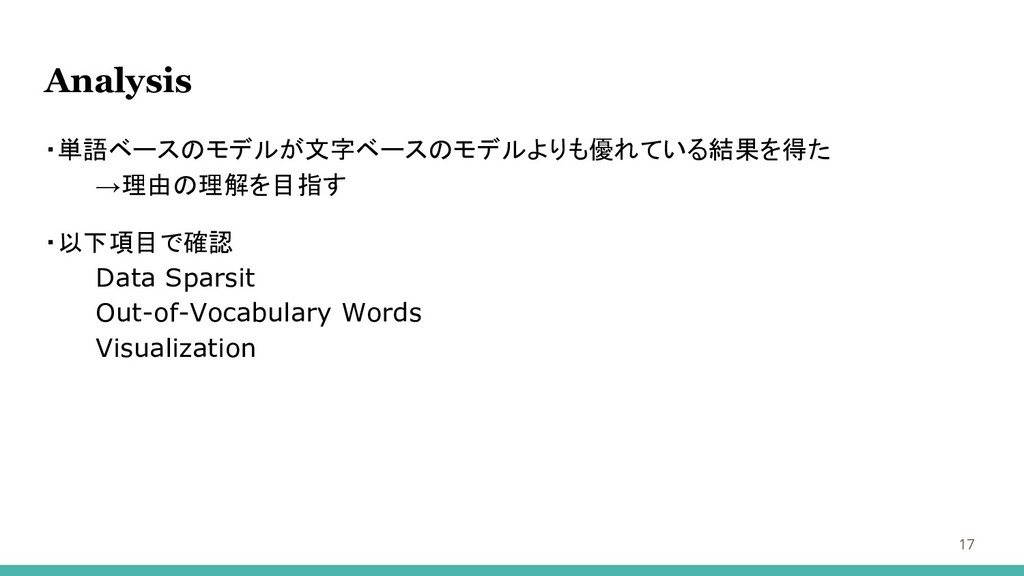
Analysis 17 ・単語ベースのモデルが文字ベースのモデルよりも優れている結果を得た →理由の理解を目指す ・以下項目で確認 Data Sparsit Out-of-Vocabulary Words Visualization
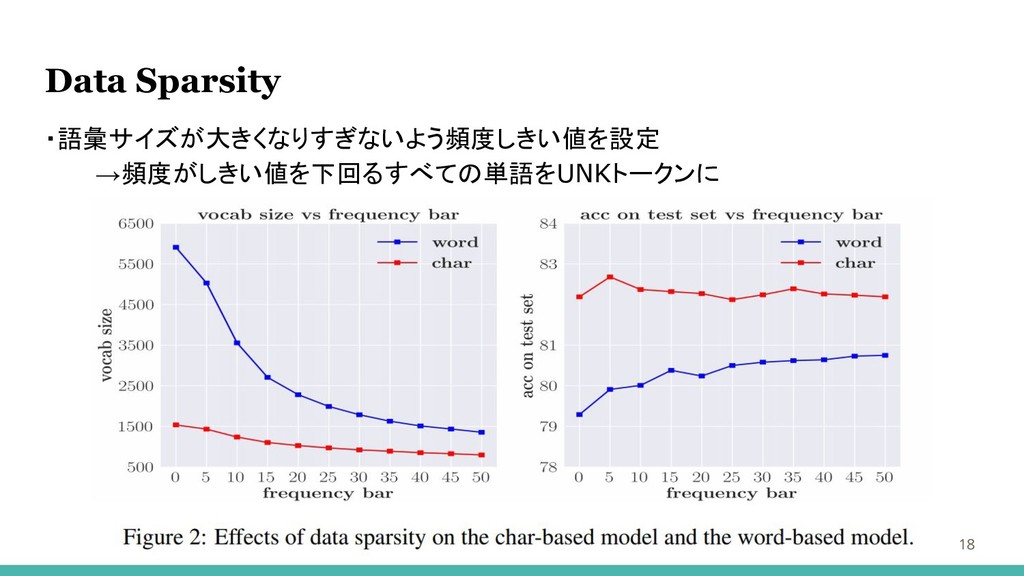
Data Sparsity 18 ・語彙サイズが大きくなりすぎないよう頻度しきい値を設定 →頻度がしきい値を下回るすべての単語をUNKトークンに
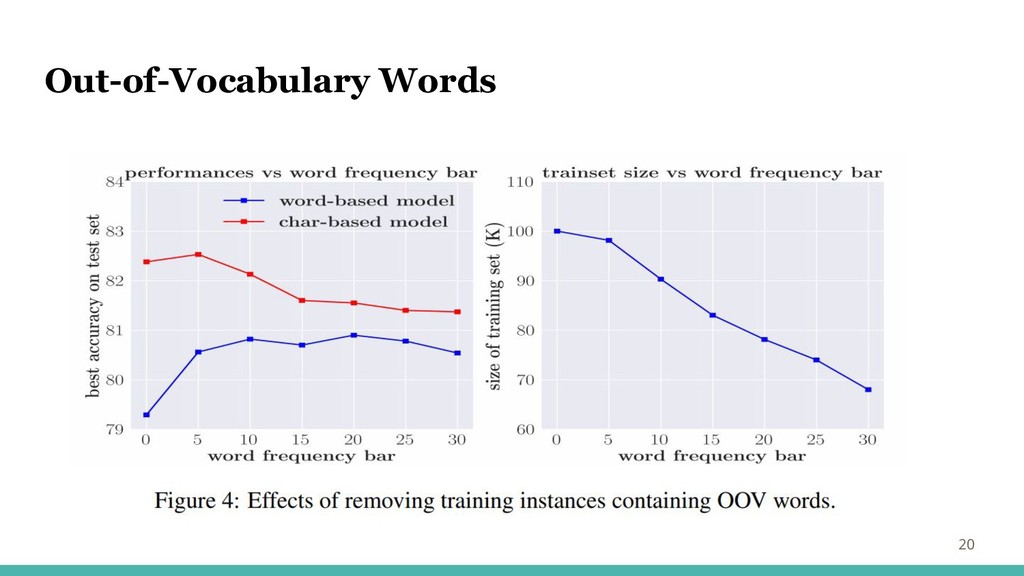
Out-of-Vocabulary Words 19 ・単語ベースのモデルの劣っている理由にOOVが考えられる →OOVの数を減らすことで、単語ベースと文字ベースのギャップを小さくできるのでは ・頻度しきい値を低く設定すると、データのスパース性の問題の悪化が予想される →異なる単語頻度のしきい値に対して、データ・セットから単語OOVを含む文を削除
Out-of-Vocabulary Words 20
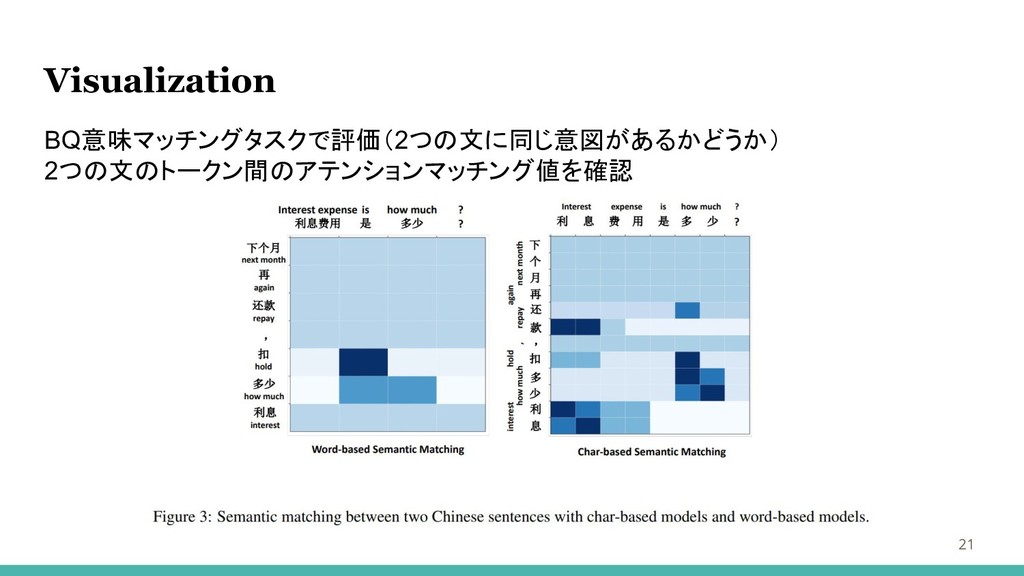
Visualization 21 BQ意味マッチングタスクで評価(2つの文に同じ意図があるかどうか) 2つの文のトークン間のアテンションマッチング値を確認
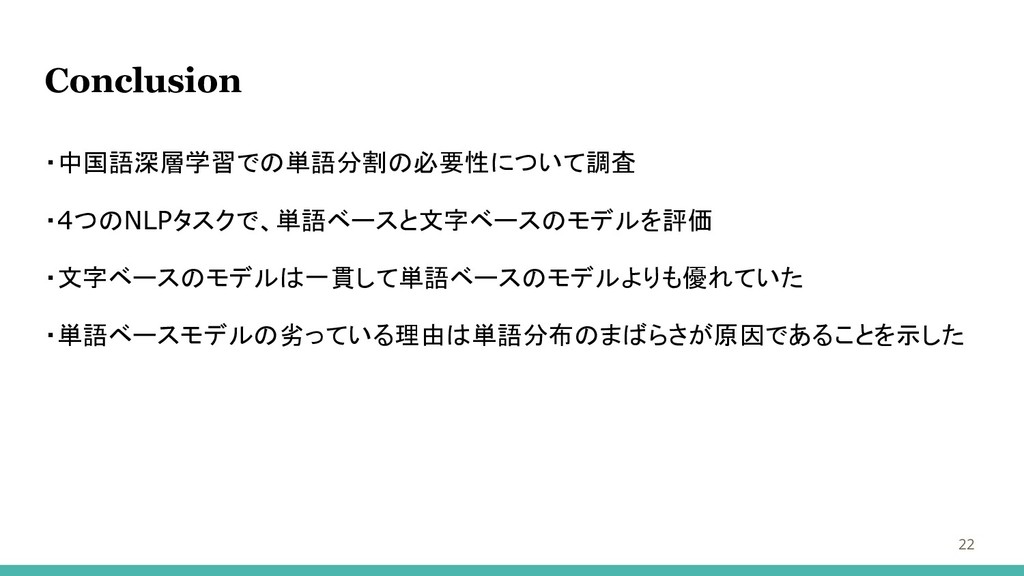
Conclusion 22 ・中国語深層学習での単語分割の必要性について調査 ・4つのNLPタスクで、単語ベースと文字ベースのモデルを評価 ・文字ベースのモデルは一貫して単語ベースのモデルよりも優れていた ・単語ベースモデルの劣っている理由は単語分布のまばらさが原因であることを示した
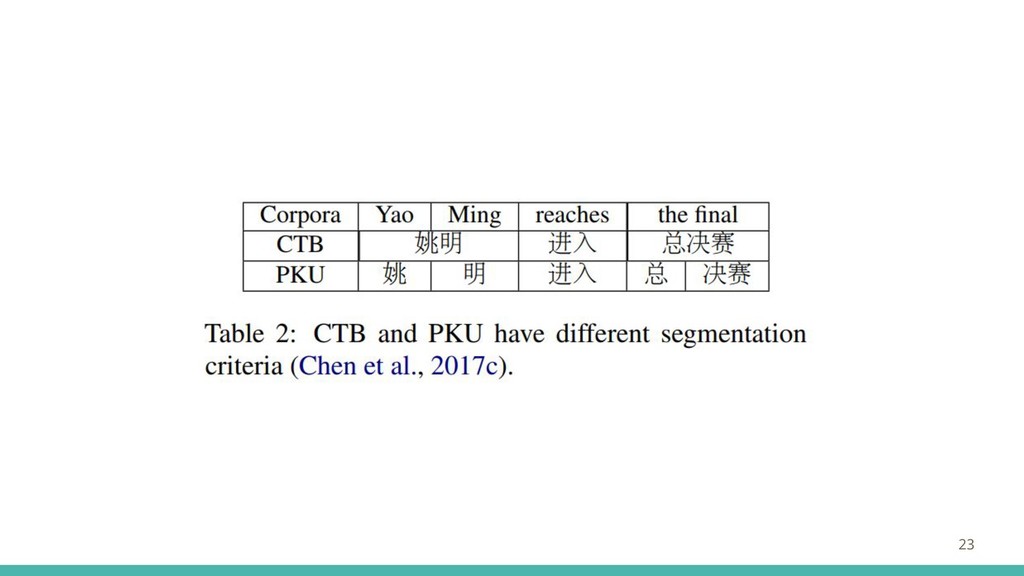
23
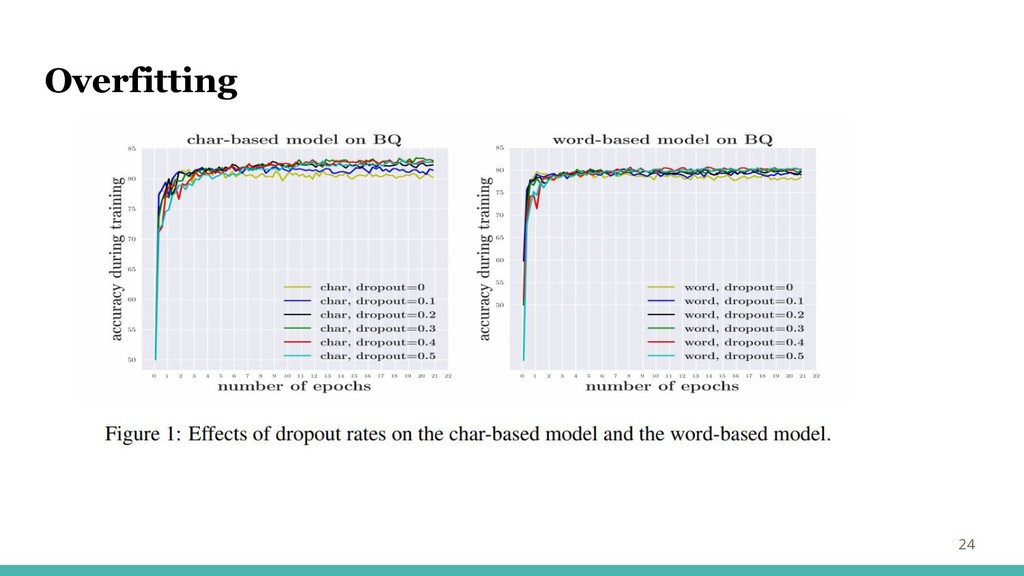
Overfitting 24


 tad
 sagochiko
 ishiirikie
 konippi
 philipz
 sansantech
 pauli
 genda
 ufried
 tanakaseiya
 kawametho
 ryomaru0825
 jnunemaker
 watany
 axbom
 tenderlove
 skoyamalab
 garrettdimon
 lara
 inesmontani
 codingconduct
 gr2m
 cassininazir