Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
文献紹介_201910_Do Neural NLP Models Know Numbers? ...
Search
T.Tada
October 28, 2019
Technology
110
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
文献紹介_201910_Do Neural NLP Models Know Numbers? Probing Numeracy in Embeddings
T.Tada
October 28, 2019
More Decks by T.Tada
See All by T.Tada
文献紹介_202002_Is artificial data useful for biomedical Natural Language Processing algorithms?
tad
0
77
文献紹介_202001_A Novel System for Extractive Clinical Note Summarization using EHR Data
tad
0
200
文献紹介_201912_Publicly Available Clinical BERT Embeddings
tad
0
180
文献紹介_201911_EDA: Easy Data Augmentation Techniques for Boosting Performance on Text Classification Tasks
tad
0
230
文献紹介_201909_Sentence Mover’s Similarity_ Automatic Evaluation for Multi-Sentence Texts
tad
0
180
文献紹介_201908_Medical Word Embeddings for Spanish_ Development and Evaluation
tad
0
73
文献紹介_201907_Is Word Segmentation Necessary for Deep Learning of Chinese Representations
tad
0
130
文献紹介_201906_Predicting Annotation Difficulty to Improve Task Routing and Model Performance for Biomedical Information Extraction
tad
0
120
文献紹介201905_Context-Aware Cross-Lingual Mapping
tad
0
120
Other Decks in Technology
See All in Technology
AI コーディングと人間の認知スループット / CTO Night & Day 2026 Morning Session / AI Coding and Human Cognitive Throughput
prog893
5
1.5k
freeeにおけるSoftware Factory
freee
PRO
0
320
From Developer Experience to Agentic Experience: The Next Evolution of APIs
benjagm
0
110
局所最適は悪ではない。壊れているのは指標です。量と質を同時に見る先行指標の設計
recruitengineers
PRO
2
430
Kiro Crewで「みのるん式」仕事術やってみた
minorun365
PRO
3
1k
ストレスなくAIと付き合いたい!こんなときどうしてる?
namiki64
4
670
Rustuna: Rustによる高速なOptuna実装
pfn
PRO
0
220
Tofu-Controller lightning talk @ Containerday 2026
gionn
0
190
macOS Golden Gate 時代のMac管理
tategami
0
130
Teaching Python with three kinds of AI
reuven
0
100
LLM-as-a-Judgeは本当に信頼できるのか――評価器を評価する話
taka_aki
3
1.1k
僕のハーネスを紹介します
watany
5
1.4k
Featured
See All Featured
The Web Performance Landscape in 2024 [PerfNow 2024]
tammyeverts
12
1.3k
Claude Code のすすめ
schroneko
67
230k
How to optimise 3,500 product descriptions for ecommerce in one day using ChatGPT
katarinadahlin
PRO
3
3.9k
Into the Great Unknown - MozCon
thekraken
41
2.8k
How to Get Subject Matter Experts Bought In and Actively Contributing to SEO & PR Initiatives.
livdayseo
0
230
How People are Using Generative and Agentic AI to Supercharge Their Products, Projects, Services and Value Streams Today
helenjbeal
2
370
No one is an island. Learnings from fostering a developers community.
thoeni
21
3.9k
Introduction to Domain-Driven Design and Collaborative software design
baasie
1
1k
Tell your own story through comics
letsgokoyo
1
1.1k
Noah Learner - AI + Me: how we built a GSC Bulk Export data pipeline
techseoconnect
PRO
0
460
世界の人気アプリ100個を分析して見えたペイウォール設計の心得
akihiro_kokubo
PRO
74
43k
Principles of Awesome APIs and How to Build Them.
keavy
128
18k
Transcript
- 文献紹介 2019 Oct. 28 - Do Neural NLP Models
Know Numbers? Probing Numeracy in Embeddings 長岡技術科学大学 自然言語処理研究室 多田太郎
About the paper 2 Authors: Conference: EMNLP2019 (https://arxiv.org/abs/1909.07940)
Abstract ・複雑な推論タスクでは、数字を理解して扱うことが重要 ・現在、ほとんどのNLPモデルは、テキスト内の数値を他のトークンと同じ方法で処理 ・数値推論が含まれるタスクのSOTAモデルを検証 →数値をどう扱うのが良いのか調査 3
Introduction ・既存のモデルは複雑な推論を行なうことができない(特に数値) ・最近のいくつかのデータ・セットには数値の比較やソート等を必要とする例が含まれる ・最初のステップとして数値の大小関係を理解する必要がある ex. 「23」が「twenty-two」より大きい値を表すこと ・既存のニューラルモデルがどのくらい、どのように数値について学習しているか調査 4
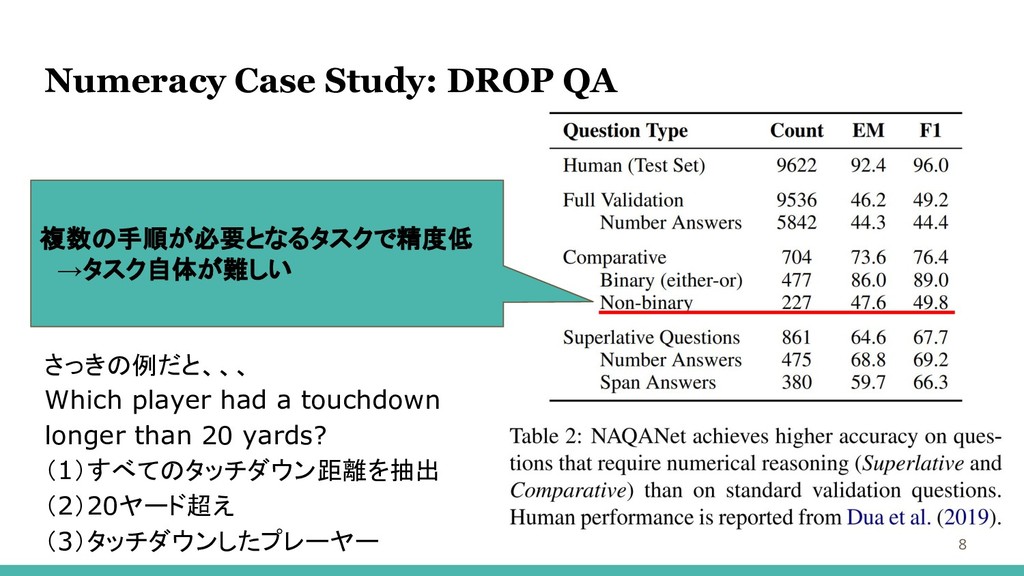
Numeracy Case Study: DROP QA 5 数値推論を必要とするタスクを用いて既存モデルを検証 ・DROP Dataset: カウント、ソート、加算などの数値推論が含まれる
・モデル: NAQANet (Dua et al., 2019) ※DROPのSOTAモデル 数値の大きさや、明示的な比較を実行するための補助コンポーネントは含まれていない 計算能力を必要とする質問、比較の質問と最上級を答える質問に焦点を当てる
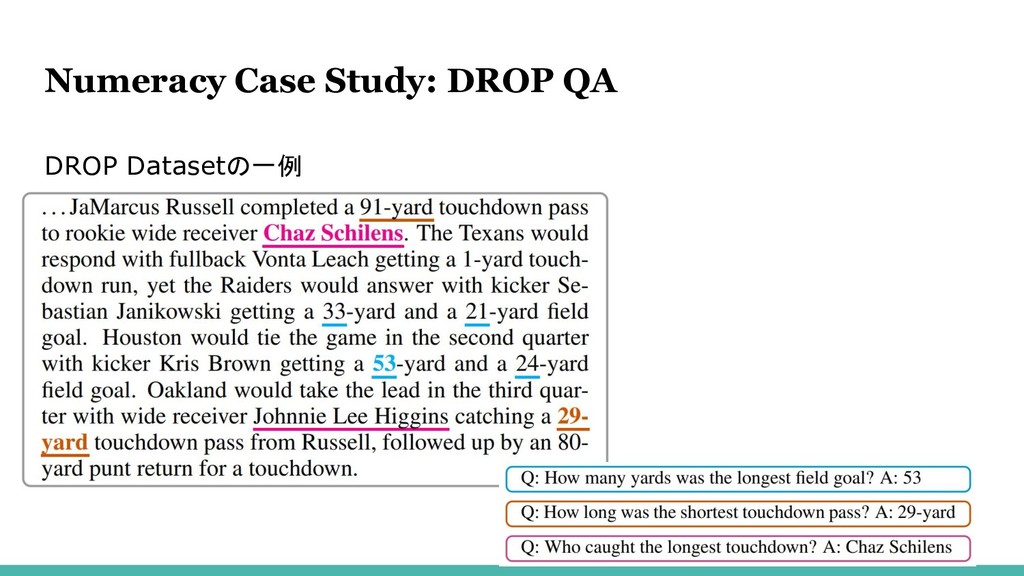
Numeracy Case Study: DROP QA 6 DROP Datasetの一例
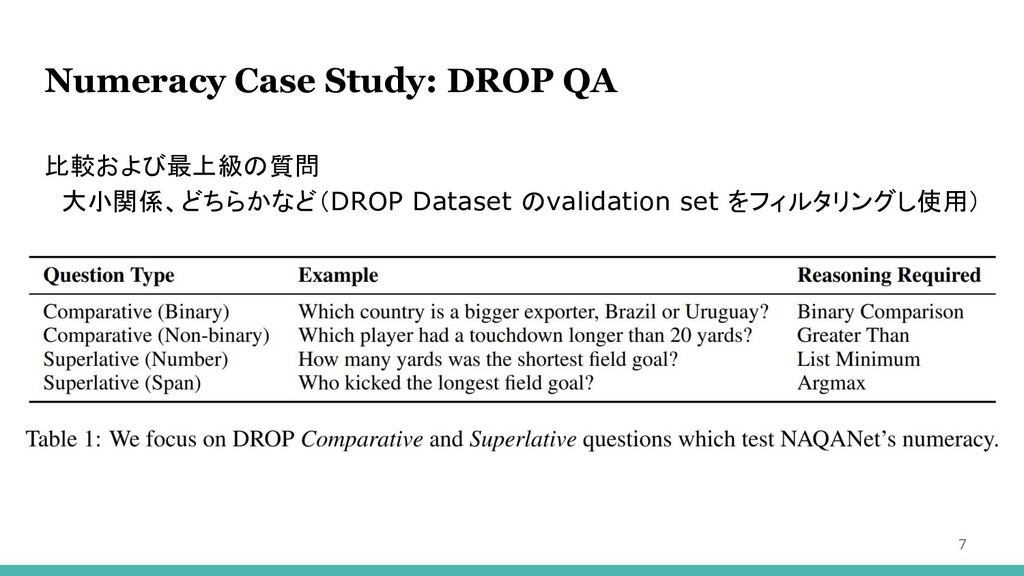
Numeracy Case Study: DROP QA 7 比較および最上級の質問 大小関係、どちらかなど(DROP Dataset のvalidation
set をフィルタリングし使用)
Numeracy Case Study: DROP QA 8 さっきの例だと、、、 Which player had
a touchdown longer than 20 yards? (1)すべてのタッチダウン距離を抽出 (2)20ヤード超え (3)タッチダウンしたプレーヤー 複数の手順が必要となるタスクで精度低 →タスク自体が難しい
Numeracy Case Study: DROP QA 9 NAQANetによって正しく回答された例(最上級の質問) 結構出来てる!!
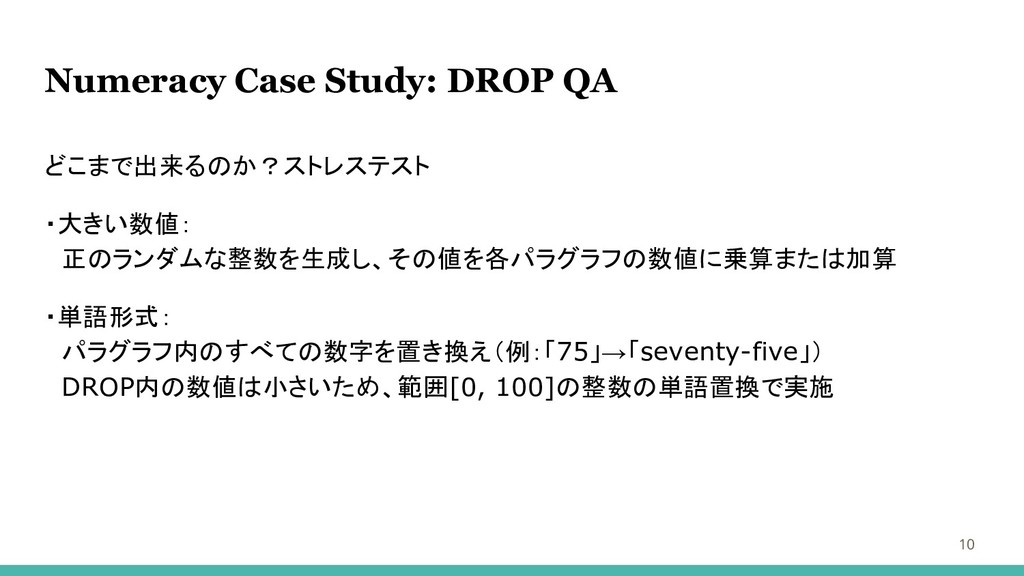
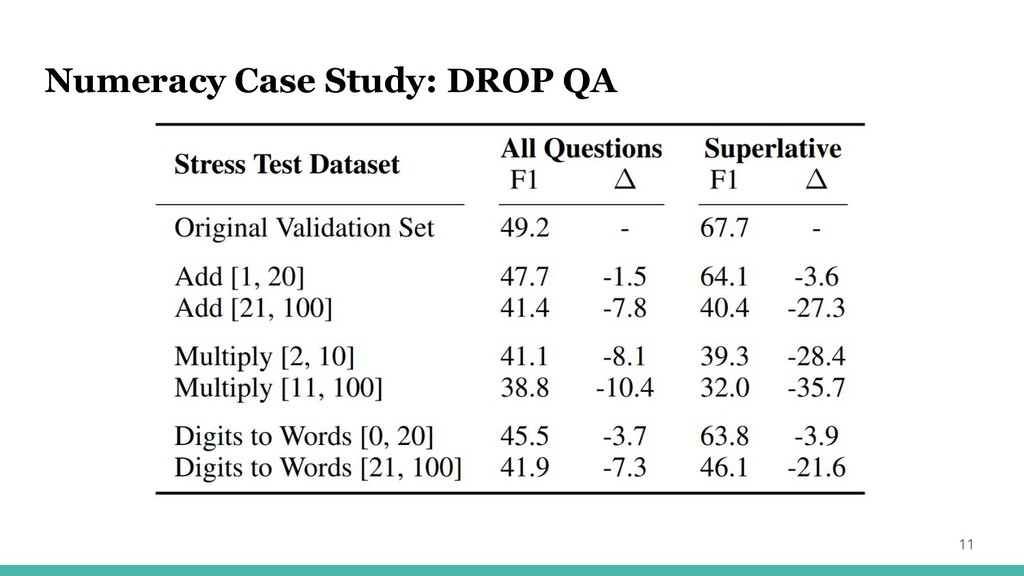
Numeracy Case Study: DROP QA 10 どこまで出来るのか?ストレステスト ・大きい数値: 正のランダムな整数を生成し、その値を各パラグラフの数値に乗算または加算 ・単語形式:
パラグラフ内のすべての数字を置き換え(例:「75」→「seventy-five」) DROP内の数値は小さいため、範囲[0, 100]の整数の単語置換で実施
Numeracy Case Study: DROP QA 11
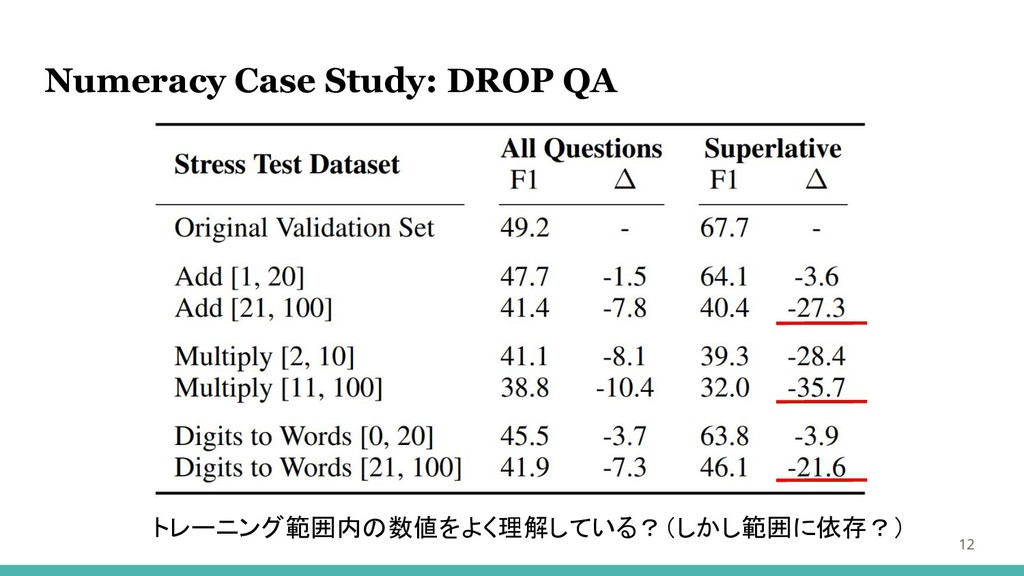
Numeracy Case Study: DROP QA 12 トレーニング範囲内の数値をよく理解している?(しかし範囲に依存?)
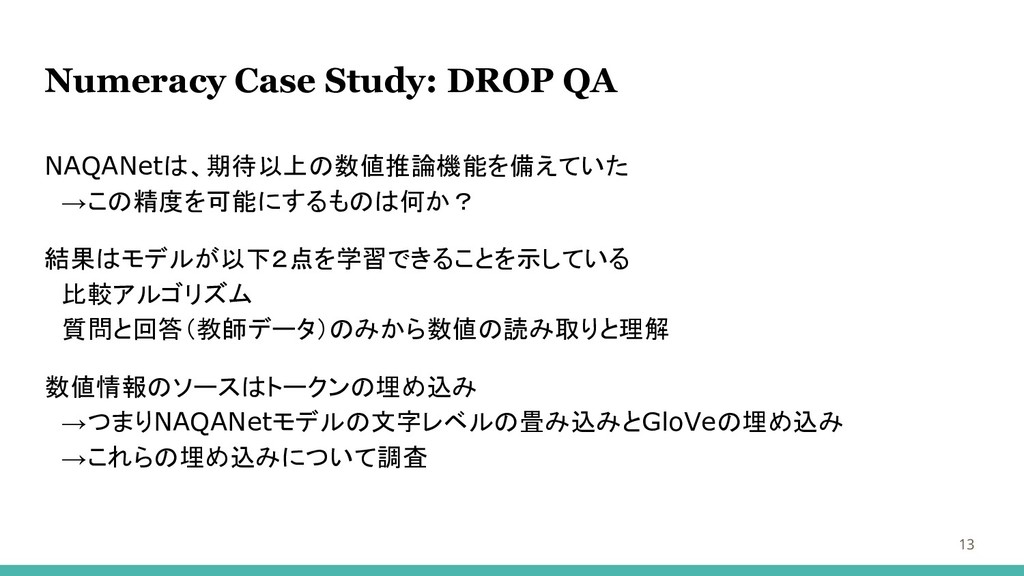
Numeracy Case Study: DROP QA 13 NAQANetは、期待以上の数値推論機能を備えていた →この精度を可能にするものは何か? 結果はモデルが以下2点を学習できることを示している 比較アルゴリズム
質問と回答(教師データ)のみから数値の読み取りと理解 数値情報のソースはトークンの埋め込み →つまりNAQANetモデルの文字レベルの畳み込みとGloVeの埋め込み →これらの埋め込みについて調査
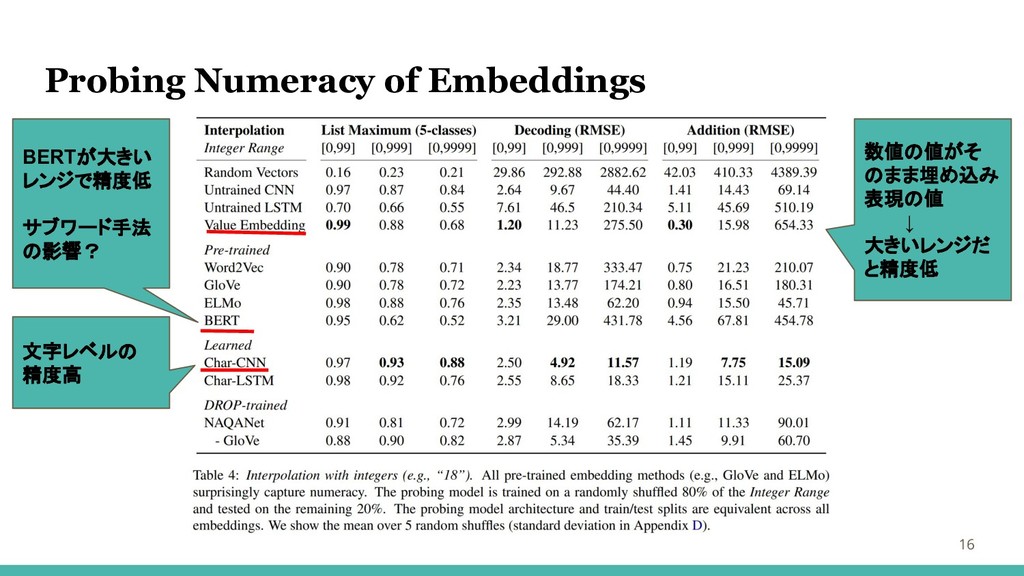
Probing Numeracy of Embeddings 14 数について評価するために3つのタスクを実施
Probing Numeracy of Embeddings 15 Training and Evaluation ・トレーニング範囲内の値での精度をみる ・最初に範囲を選択し(実験毎に範囲指定)、指定整数の範囲をシャッフル
・80%をトレーニングセット、20%をテストセットに分割
Probing Numeracy of Embeddings 16 文字レベルの 精度高 BERTが大きい レンジで精度低 サブワード手法
の影響? 数値の値がそ のまま埋め込み 表現の値 ↓ 大きいレンジだ と精度低
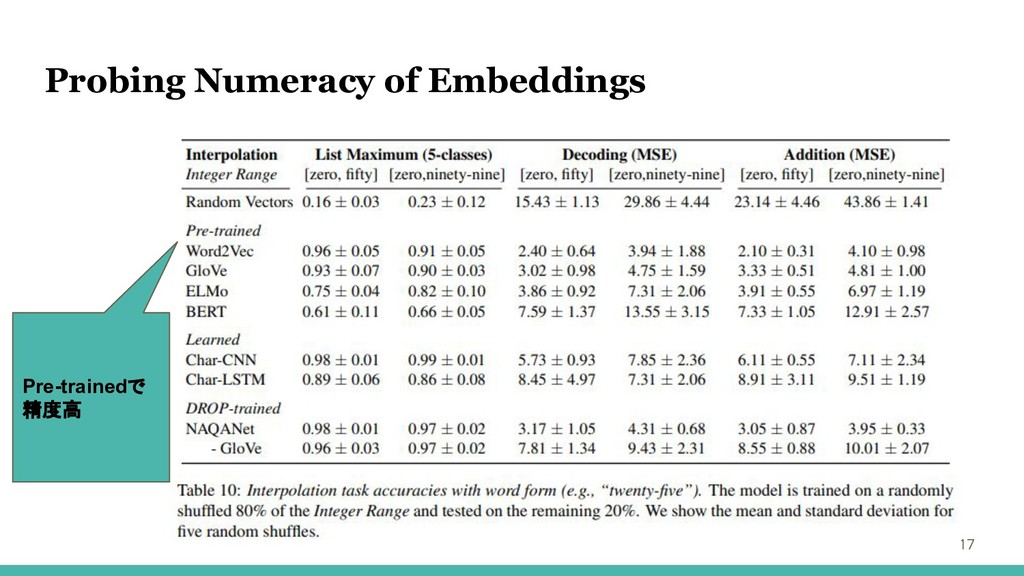
Probing Numeracy of Embeddings 17 Pre-trainedで 精度高
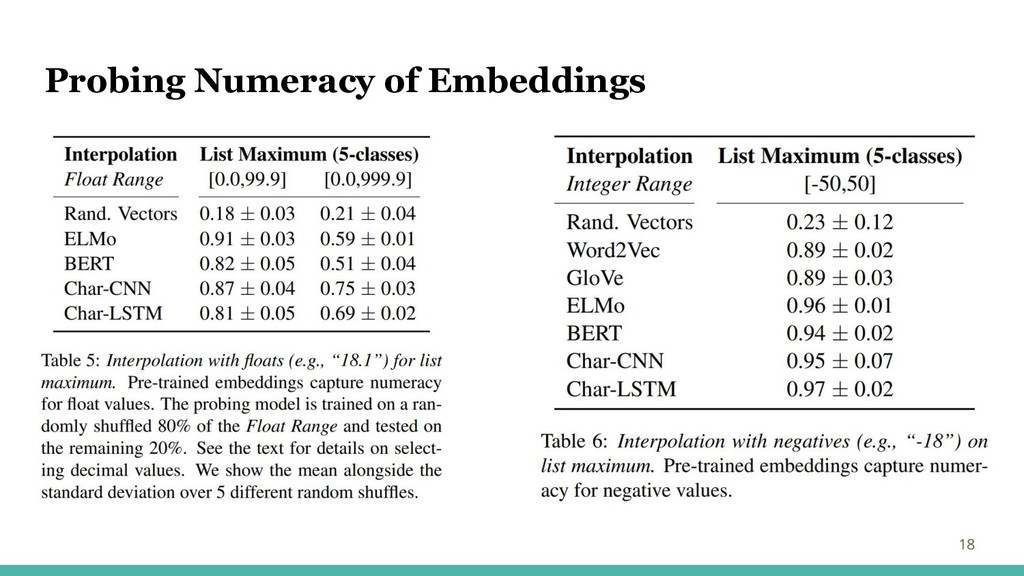
Probing Numeracy of Embeddings 18
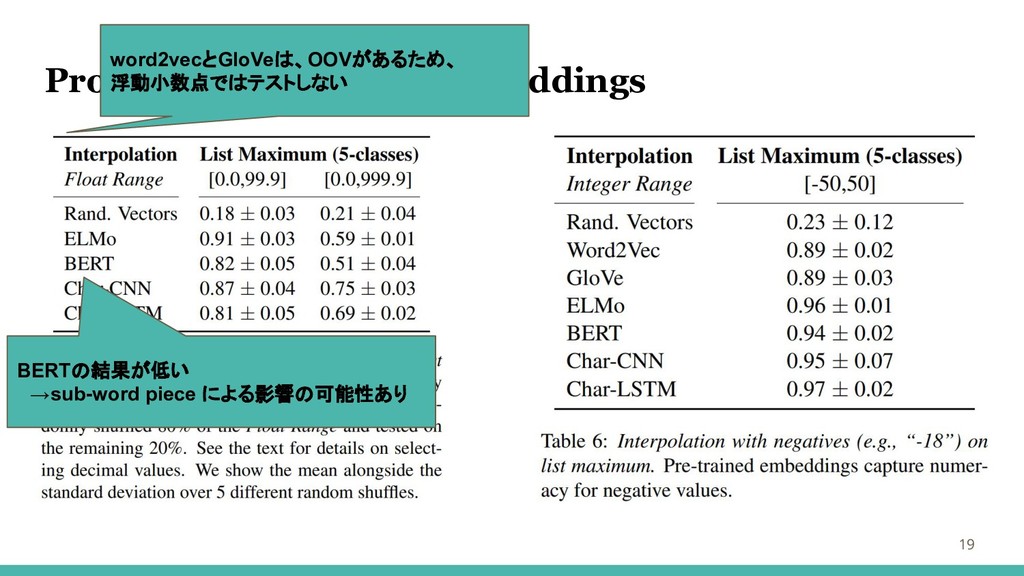
Probing Numeracy of Embeddings 19 BERTの結果が低い →sub-word piece による影響の可能性あり word2vecとGloVeは、OOVがあるため、
浮動小数点ではテストしない
Probing Numeracy of Embeddings 20 NAQANet の実験でトレーニング範囲外の値に苦労している結果がみられた →NAQANet 特性か、一般的な問題か? トレーニングの範囲外の値に対して実験を行い検証
冒頭のNAQANetでの 実験結果の解析
Probing Numeracy of Embeddings 21 トレーニングの範囲外の値でList Maximum トレーニング: [0,150] テスト:
[151,160], [151,180], [151,200] 全ての手法で、精度が下がる結果 特にトークンベクトルで大きく下がった
Probing Numeracy of Embeddings 22 トレーニングの範囲外の値でDecoding と Addition トレーニング:[-500,500](青) テスト:[2000、2000](赤)
どの埋め込み方法も範囲外の 値には対応出来ず
Probing Numeracy of Embeddings 23 トレーニングの範囲外の値でDecoding と Addition トレーニング:[-500,500](青) テスト:[2000、2000](赤)
どの埋め込み方法も範囲外の 値には対応出来ず Trask et al. (2018) でもモデルがトレーニング範囲外の値への対応が難しいこと に触れている →彼らはニューラルモデル自体に起因すると考察している
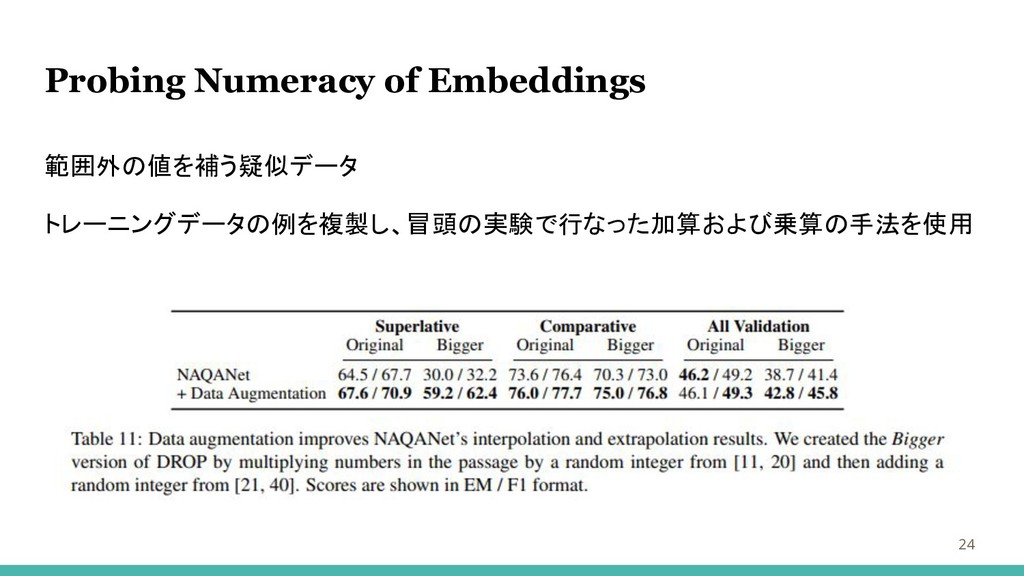
Probing Numeracy of Embeddings 24 範囲外の値を補う疑似データ トレーニングデータの例を複製し、冒頭の実験で行なった加算および乗算の手法を使用
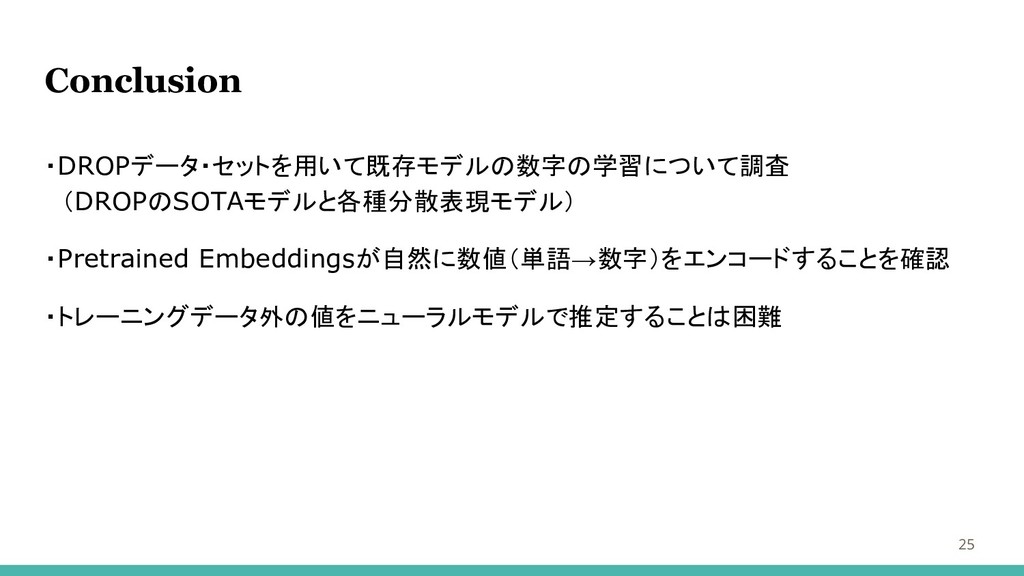
Conclusion 25 ・DROPデータ・セットを用いて既存モデルの数字の学習について調査 (DROPのSOTAモデルと各種分散表現モデル) ・Pretrained Embeddingsが自然に数値(単語→数字)をエンコードすることを確認 ・トレーニングデータ外の値をニューラルモデルで推定することは困難


 tad
 prog893
 freee
 benjagm
 recruitengineers
 minorun365
 namiki64
 pfn
 gionn
 tategami
 reuven
 taka_aki
 watany
 tammyeverts
 schroneko
 katarinadahlin
 thekraken
 livdayseo
 helenjbeal
 thoeni
 baasie
 letsgokoyo
 techseoconnect
 akihiro_kokubo
 keavy





 テスト:[2000、2000](赤)](https://files.speakerdeck.com/presentations/744c98975a80405c9d8aa33b37aea95f/slide_21.jpg)
 テスト:[2000、2000](赤)](https://files.speakerdeck.com/presentations/744c98975a80405c9d8aa33b37aea95f/slide_22.jpg)