Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
文献紹介_201912_Publicly Available Clinical BERT Em...
Search
T.Tada
December 16, 2019
Technology
180
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
文献紹介_201912_Publicly Available Clinical BERT Embeddings
T.Tada
December 16, 2019
More Decks by T.Tada
See All by T.Tada
文献紹介_202002_Is artificial data useful for biomedical Natural Language Processing algorithms?
tad
0
77
文献紹介_202001_A Novel System for Extractive Clinical Note Summarization using EHR Data
tad
0
200
文献紹介_201911_EDA: Easy Data Augmentation Techniques for Boosting Performance on Text Classification Tasks
tad
0
230
文献紹介_201910_Do Neural NLP Models Know Numbers? Probing Numeracy in Embeddings
tad
0
110
文献紹介_201909_Sentence Mover’s Similarity_ Automatic Evaluation for Multi-Sentence Texts
tad
0
170
文献紹介_201908_Medical Word Embeddings for Spanish_ Development and Evaluation
tad
0
73
文献紹介_201907_Is Word Segmentation Necessary for Deep Learning of Chinese Representations
tad
0
130
文献紹介_201906_Predicting Annotation Difficulty to Improve Task Routing and Model Performance for Biomedical Information Extraction
tad
0
120
文献紹介201905_Context-Aware Cross-Lingual Mapping
tad
0
110
Other Decks in Technology
See All in Technology
【データ横丁主催】AI Agentがコンテキストを使って仕事をした後、何が残るのか― 組織の経験を次の判断に引き継ぐ「Agent Memory」
shisyu_gaku
2
270
The kernel report
ennael
PRO
1
140
Making AI Agents Safe and Fast- Jev, Obsidian, and the Meta-Harness
x5gtrn
PRO
0
160
Swap and Memory Reclaim - Squeezing Out More RAM
ennael
PRO
1
1.4k
Mastering Agentic Development: Harness Engineering for Effective Coding Agents
konippi
3
660
Terraformを用いたJamf Pro構成のIaC, GitOps化への挑戦
yukun
0
120
KanaAI
shreyas1009
0
130
VS Code × GitHub Copilot での Fabric 開発
ryomaru0825
1
190
AI coding 整合正規方法
philipz
0
580
Coil3を内部実装から読み解く~キャッシュ戦略とAVIF画像の描画〜/nikkei-tech-talk50
nikkei_engineer_recruiting
0
180
HolmesGPTで始めるSREエージェント入門!プラットフォームの障害調査はAIにお任せ 〜
leveragestech
PRO
0
120
10年欲しかった音楽管理アプリを、AIと一緒に作りはじめた
judau
1
190
Featured
See All Featured
Claude Code のすすめ
schroneko
67
230k
Everyday Curiosity
cassininazir
0
330
Fight the Zombie Pattern Library - RWD Summit 2016
marcelosomers
234
18k
Build your cross-platform service in a week with App Engine
jlugia
234
19k
Impact Scores and Hybrid Strategies: The future of link building
tamaranovitovic
0
440
StorybookのUI Testing Handbookを読んだ
zakiyama
31
6.9k
Believing is Seeing
oripsolob
1
230
Code Reviewing Like a Champion
maltzj
528
40k
The Success of Rails: Ensuring Growth for the Next 100 Years
eileencodes
47
8.3k
SERP Conf. Vienna - Web Accessibility: Optimizing for Inclusivity and SEO
sarafernandez
2
1.6k
Designing Dashboards & Data Visualisations in Web Apps
destraynor
232
55k
Responsive Adventures: Dirty Tricks From The Dark Corners of Front-End
smashingmag
254
22k
Transcript
- 文献紹介 2019 Dec. 16 - Publicly Available Clinical BERT
Embeddings 長岡技術科学大学 自然言語処理研究室 多田太郎
About the paper 2 Authors: Conference:
・文脈を考慮した単語埋め込みモデル(ELMoやBERTなど)は、特定分野では 限定的にしか検討されていない ・臨床テキスト用のBERTモデルを調査および公開 一般的な臨床テキスト向けと退院サマリー向け ・提案モデルは、3つの臨床分野NLPタスクで精度高 3 Abstract
・ELMoやBERTなどの文脈を考慮した埋め込み表現はNLPで成功 ・臨床テキストは、一般テキストや非臨床的な生物医学テキストと異なる 臨床分野のBERTモデルの必要性 ・しかし、計算コストが膨大 学習済みモデルを構築し、公開 4 Introduction
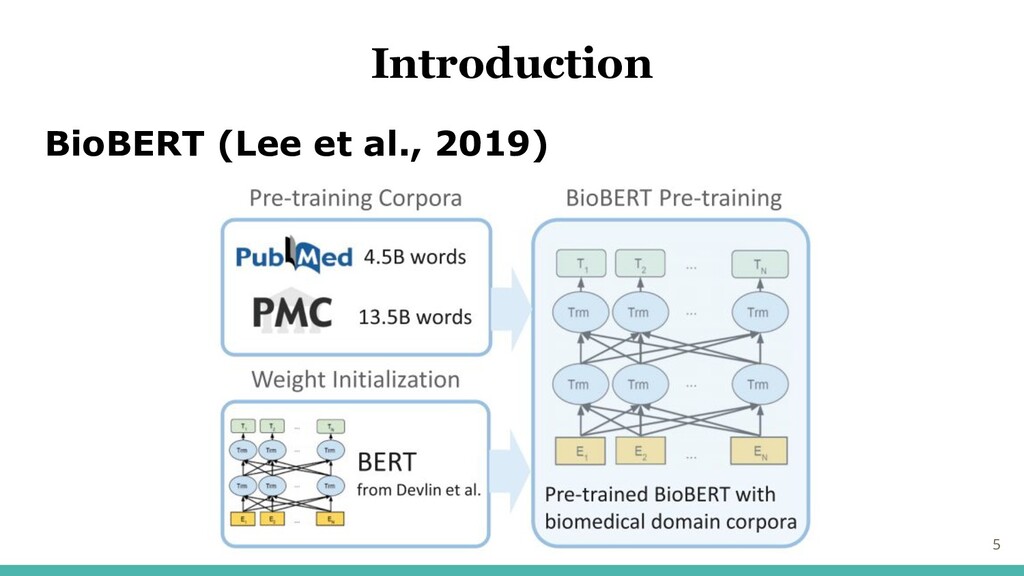
BioBERT (Lee et al., 2019) 5 Introduction
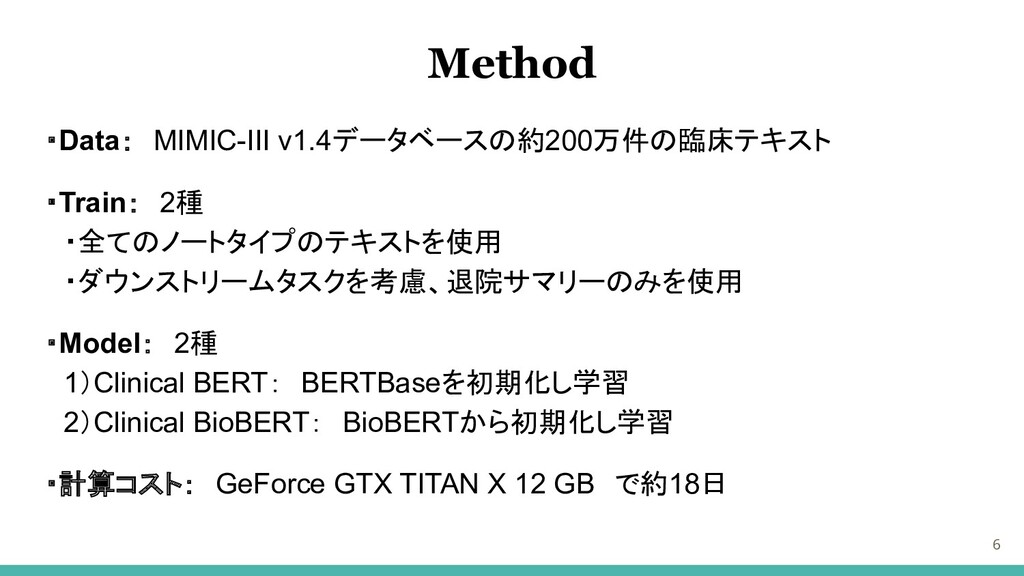
・Data: MIMIC-III v1.4データベースの約200万件の臨床テキスト ・Train: 2種 ・全てのノートタイプのテキストを使用 ・ダウンストリームタスクを考慮、退院サマリーのみを使用 ・Model: 2種 1)Clinical BERT: BERTBaseを初期化し学習 2)Clinical BioBERT: BioBERTから初期化し学習
・計算コスト: GeForce GTX TITAN X 12 GB で約18日 6 Method
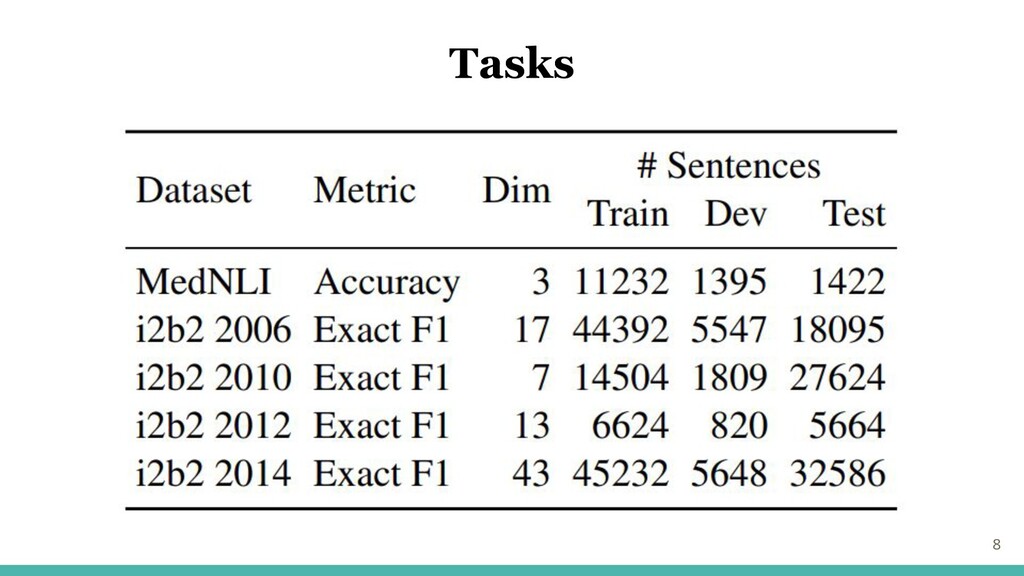
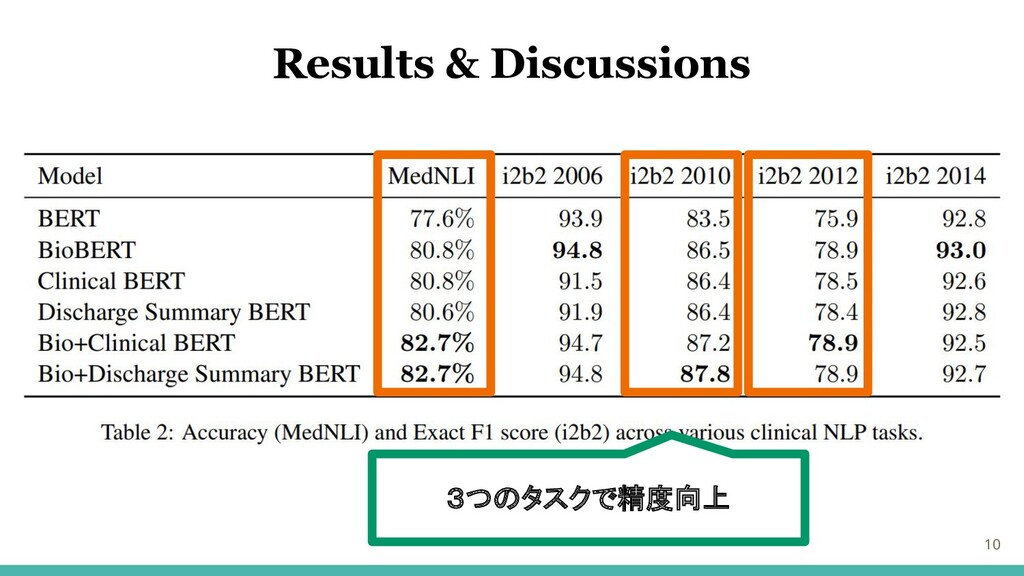
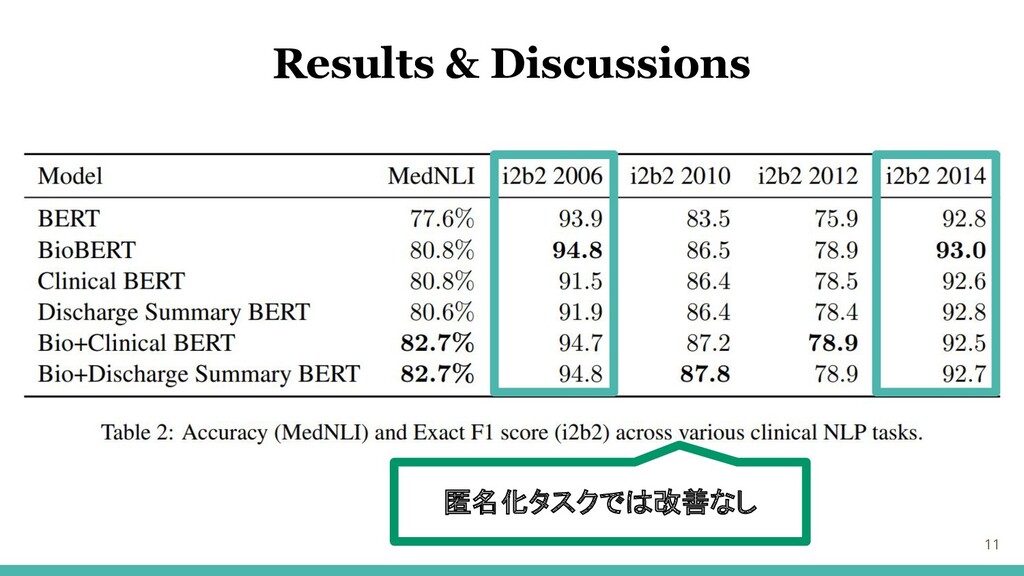
・5つのタスクで評価 MedNLI: 自然言語推論タスク 4つのi2b2のNERタスク 2006: 1B 匿名化タスク 2010: 概念抽出タスク 2012: エンティティ抽出チャレンジ 2014: 7A 匿名化チャレンジ ・最近傍の単語を確認 7 Tasks
8 Tasks
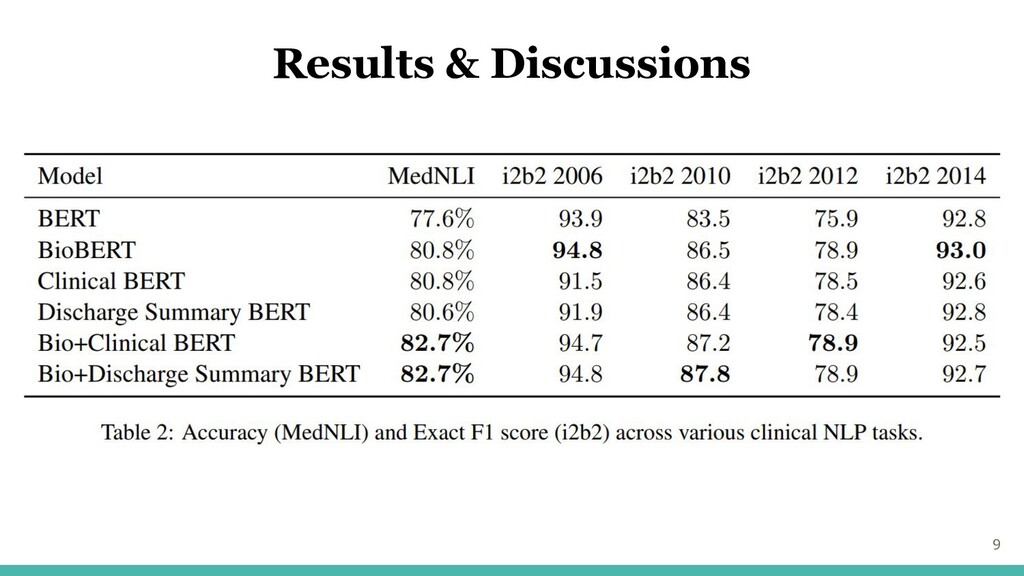
9 Results & Discussions
10 Results & Discussions 3つのタスクで精度向上
11 Results & Discussions 匿名化タスクでは改善なし
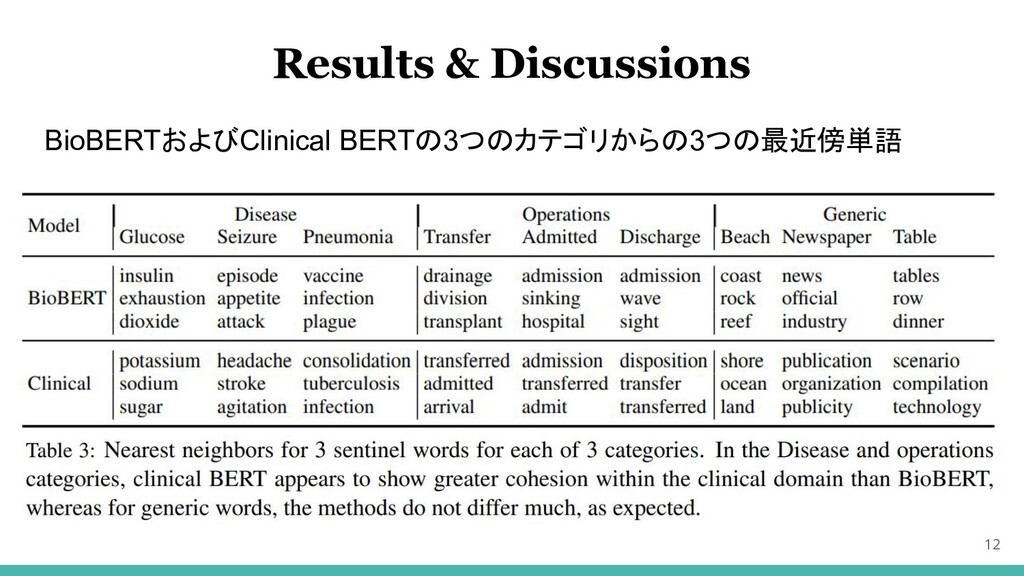
BioBERTおよびClinical BERTの3つのカテゴリからの3つの最近傍単語 12 Results & Discussions
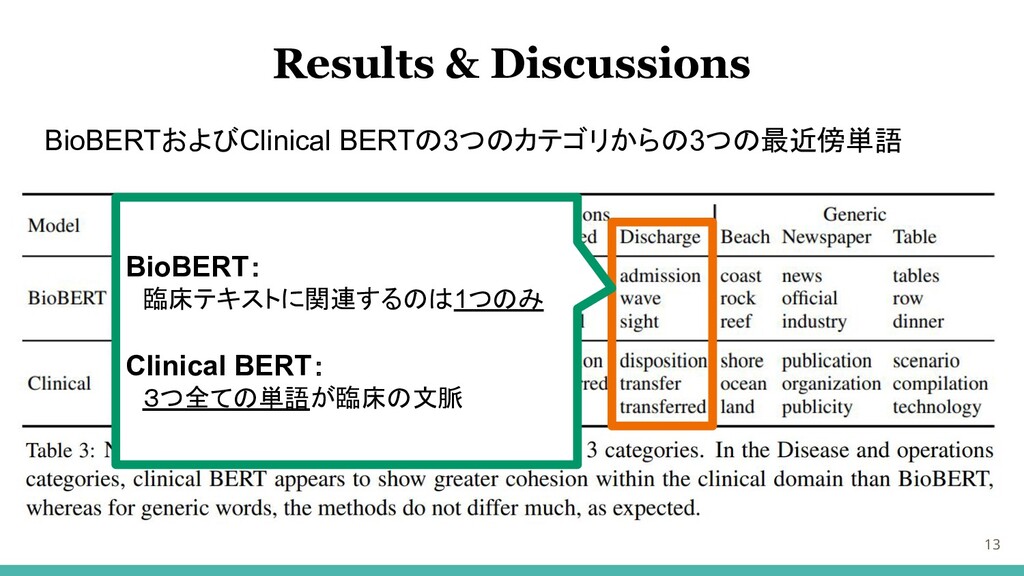
BioBERTおよびClinical BERTの3つのカテゴリからの3つの最近傍単語 13 Results & Discussions BioBERT: 臨床テキストに関連するのは1つのみ Clinical BERT:
3つ全ての単語が臨床の文脈
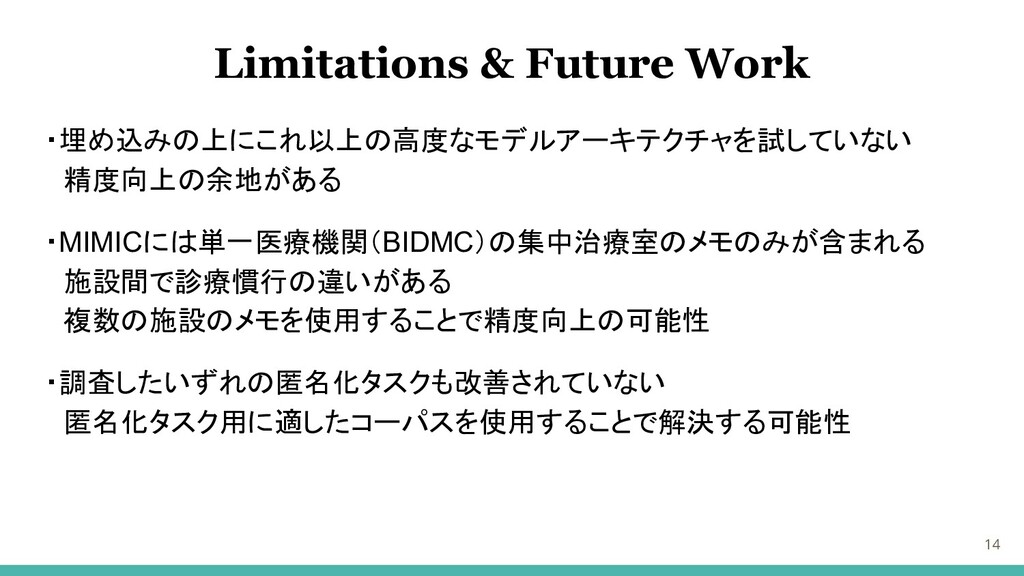
・埋め込みの上にこれ以上の高度なモデルアーキテクチャを試していない 精度向上の余地がある ・MIMICには単一医療機関(BIDMC)の集中治療室のメモのみが含まれる 施設間で診療慣行の違いがある 複数の施設のメモを使用することで精度向上の可能性 ・調査したいずれの匿名化タスクも改善されていない 匿名化タスク用に適したコーパスを使用することで解決する可能性 14 Limitations &
Future Work
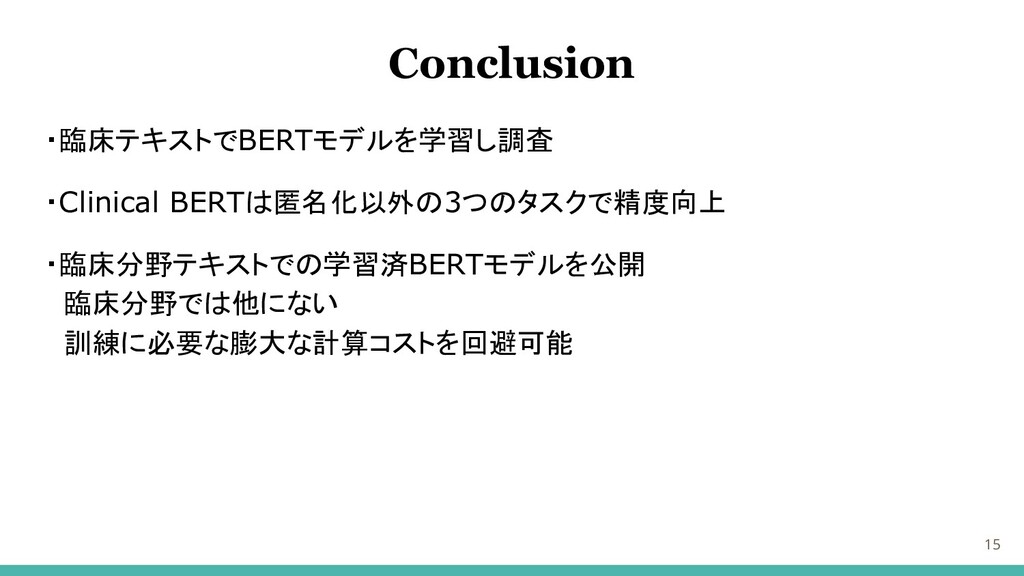
・臨床テキストでBERTモデルを学習し調査 ・Clinical BERTは匿名化以外の3つのタスクで精度向上 ・臨床分野テキストでの学習済BERTモデルを公開 臨床分野では他にない 訓練に必要な膨大な計算コストを回避可能 15 Conclusion
Appendix 16


 tad
 shisyu_gaku
 ennael
 x5gtrn
 konippi
 yukun
 shreyas1009
 ryomaru0825
 philipz
 nikkei_engineer_recruiting
 leveragestech
 judau
 schroneko
 cassininazir
 marcelosomers
 jlugia
 tamaranovitovic
 zakiyama
 oripsolob
 maltzj
 eileencodes
 sarafernandez
 destraynor
 smashingmag