Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
適応テンソル分解と主成分分析に基づく教師なし特徴抽出は、従来手法よりも生物学的に妥当な発現量差...
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Y-h. Taguchi
PRO
March 12, 2026
Science
80
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
適応テンソル分解と主成分分析に基づく教師なし特徴抽出は、従来手法よりも生物学的に妥当な発現量差のある遺伝子を選択する
SIGBIO84
https://www.ipsj.or.jp/kenkyukai/event/bio84.html
での講演スライドです。
Y-h. Taguchi
PRO
March 12, 2026
More Decks by Y-h. Taguchi
See All by Y-h. Taguchi
Tensor decomposition-based unsupervised feature extraction applied to bioinformatics and affinity with AI-based methodology
tagtag
PRO
0
45
知能とはなにか -ヒトとAIのあいだ-
tagtag
PRO
0
230
サンプル対応のない複数遺伝子発現プロファイルに対するテンソル分解型統合解析の要約
tagtag
PRO
0
260
AI(人工知能)の過去・現在・未来 ~AIは人類を越えるのか~
tagtag
PRO
0
170
presen_司法書士学員会.pdf
tagtag
PRO
1
120
生成AIと司法書士の未来.pdf
tagtag
PRO
0
190
データ駆動型ゲノム解析で迫る睡眠研究
tagtag
PRO
0
130
知能とはなにか -ヒトとAIのあいだ-
tagtag
PRO
0
120
Genomic Differentiation of Sleep and Anesthesia: The Role of RHO GTPase and Cortical Neurons
tagtag
PRO
0
78
Other Decks in Science
See All in Science
機械学習 - 授業概要
trycycle
PRO
0
660
機械学習 - pandas入門
trycycle
PRO
0
770
O(log n)-Approximation Algorithms for Bipartiteness Ratio
tasusu
0
260
データベース15: ビッグデータ時代のデータベース
trycycle
PRO
1
600
[TMLR 2026, Featured Certification] Double Bounded α-Divergence Optimization for Density Estimation
gkazunii
1
130
コーヒー豆様核 (Coffee-bean nuclei) における形態学的サブタイピングと精選・焙煎特性の同定
jagupath
PRO
0
190
白金鉱業Meetup Vol.25 【初学者向け発表枠】「で、この施策って効いてるの」に答える効果検証の基礎 ~ATE / ATT / CATE / LATEを現場の問いに翻訳する~
brainpadpr
1
320
Webinaire : Valorisez les résultats de vos projets européens avec EU-FarmBook
institutdelelevage
PRO
0
170
SAT ソルバーの仕組みと制約ソルバーへの応用
tsoh
3
650
GKE上でオセロの強化学習やってみた
akasan
0
110
生成AIが科学とRAにもたらしていること:メタサイエンスの視点から
rmaruy
0
140
1. CPC理論の展開と集合的知能モデル(JSAI2026 KS-27 集合的予測符号化と新たな知性の時代)
hayashiyus884
1
410
Featured
See All Featured
The agentic SEO stack - context over prompts
schlessera
0
970
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
580
Jess Joyce - The Pitfalls of Following Frameworks
techseoconnect
PRO
1
440
Music & Morning Musume
bryan
48
7.4k
4 Signs Your Business is Dying
shpigford
187
23k
How to Ace a Technical Interview
jacobian
280
24k
Believing is Seeing
oripsolob
1
240
Building a Modern Day E-commerce SEO Strategy
aleyda
45
9.2k
The Web Performance Landscape in 2024 [PerfNow 2024]
tammyeverts
12
1.3k
Organizational Design Perspectives: An Ontology of Organizational Design Elements
kimpetersen
PRO
1
840
How to make the Groovebox
asonas
2
2.5k
Why You Should Never Use an ORM
jnunemaker
PRO
61
10k
Transcript
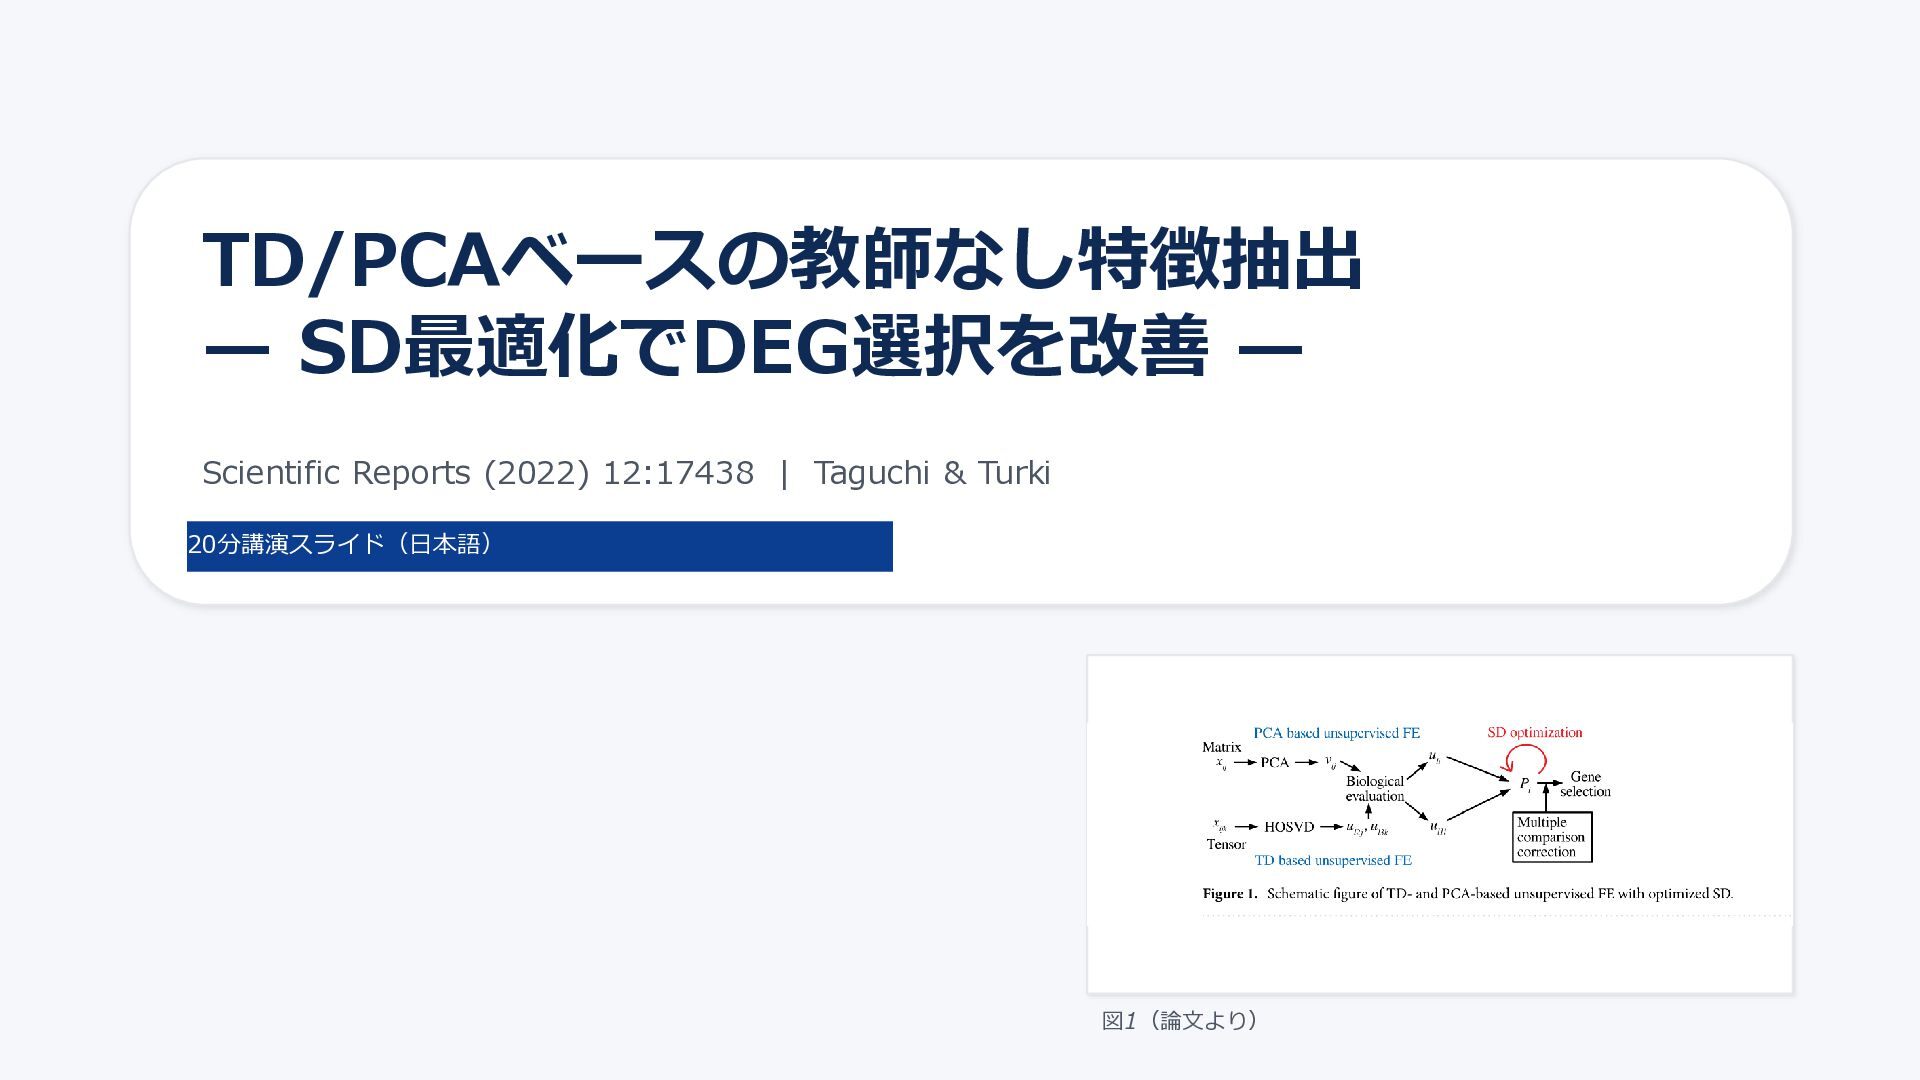
TD/PCAベースの教師なし特徴抽出 — SD最適化でDEG選択を改善 — Scientific Reports (2022) 12:17438 | Taguchi
& Turki 20分講演スライド(日本語) 図1(論文より)
本日の流れ 20分 アジェンダ 1. 背景:DEG選択の難しさ(large p, small n) 2. 方法:TD/PCAベース教師なし特徴抽出(FE)
3. 改良点:Gaussian仮定に合わせたSD最適化 4. 結果①:MAQC/SEQC(遺伝子数・分布の妥当性) 5. 結果②:SARS-CoV-2薬剤リポジショニング 6. 結果③:多臓器×多薬剤(生物学的妥当性) 7. まとめ Sci Rep (2022) 12:17438 | doi:10.1038/s41598-022-21474-z 2
背景:DEG選択は「large p, small n」問題 背景 なぜ難しい? • 遺伝子数pが非常に多く、サンプル数nが少な い •
多重検定補正で有意になりにくい • 既存法(例:DESeq2)は - 負の二項分布(NB) - 分散関係(dispersion relation) などの仮定に依存 論文の狙い TD/PCAベース教師なしFEは、 「PC/特異値ベクトルがGaussianに従う 」 という比較的シンプルな仮定でDEGを抽 出。 ただし従来版は: • P値のヒストグラムが帰無仮説とズレ る • 選ばれる遺伝子数が少なすぎる → SD(標準偏差)を最適化して改善す る。 Sci Rep (2022) 12:17438 | doi:10.1038/s41598-022-21474-z 3
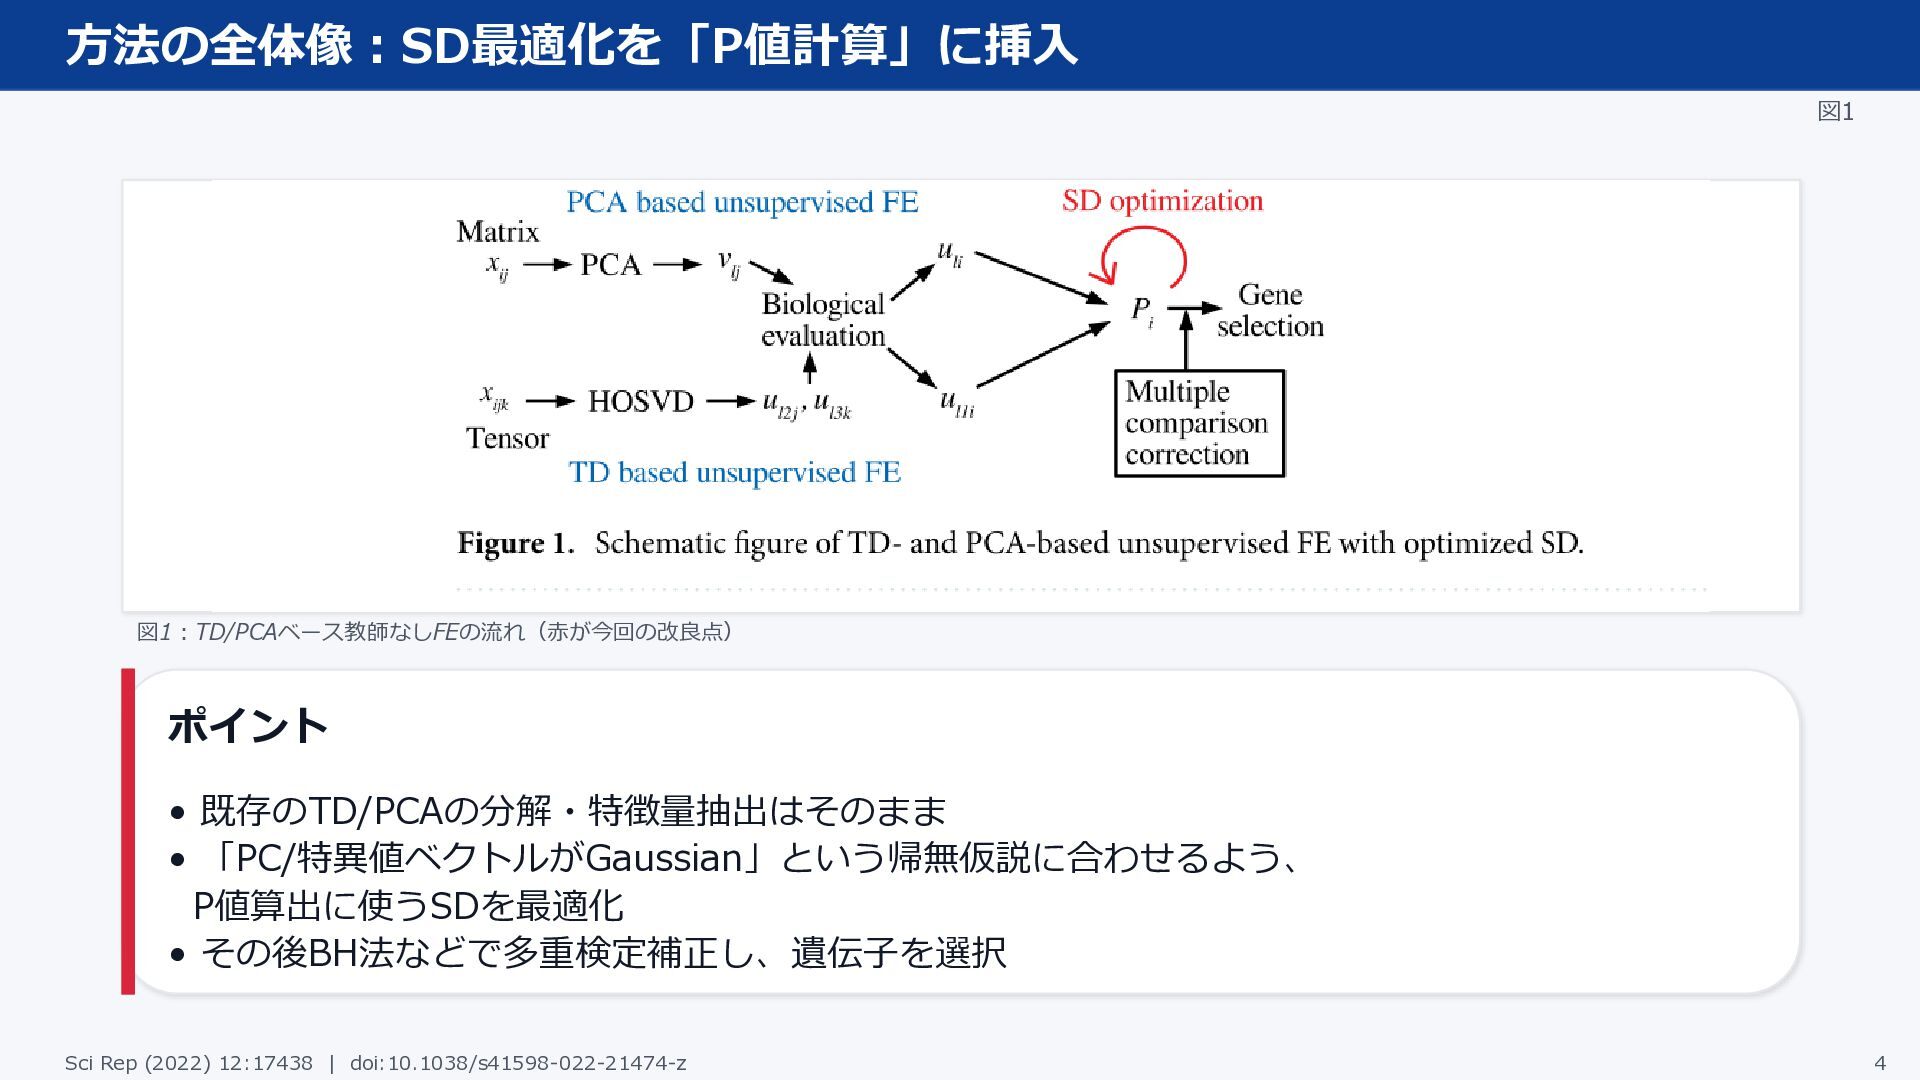
方法の全体像:SD最適化を「P値計算」に挿入 図1 図1:TD/PCAベース教師なしFEの流れ(赤が今回の改良点) ポイント • 既存のTD/PCAの分解・特徴量抽出はそのまま • 「PC/特異値ベクトルがGaussian」という帰無仮説に合わせるよう、 P値算出に使うSDを最適化 •
その後BH法などで多重検定補正し、遺伝子を選択 Sci Rep (2022) 12:17438 | doi:10.1038/s41598-022-21474-z 4
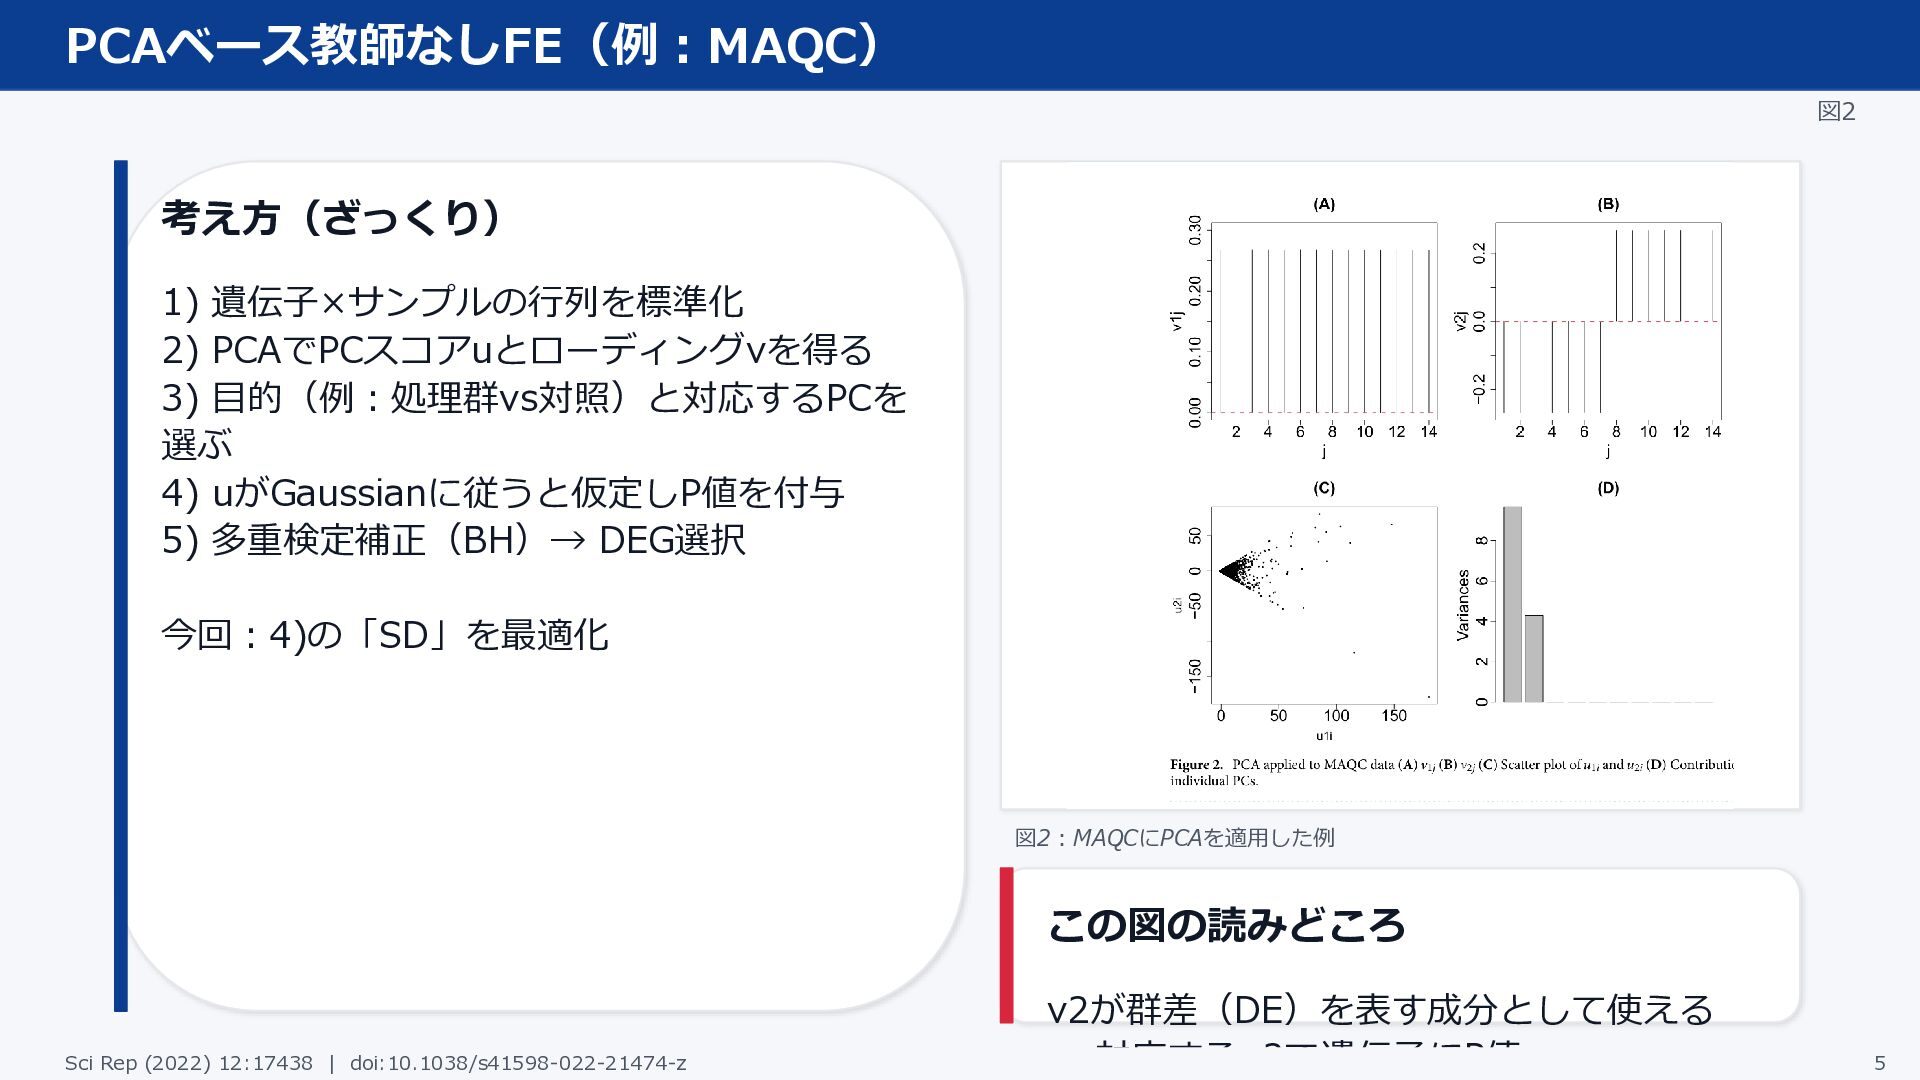
PCAベース教師なしFE(例:MAQC) 図2 考え方(ざっくり) 1) 遺伝子×サンプルの行列を標準化 2) PCAでPCスコアuとローディングvを得る 3) 目的(例:処理群vs対照)と対応するPCを 選ぶ
4) uがGaussianに従うと仮定しP値を付与 5) 多重検定補正(BH)→ DEG選択 今回:4)の「SD」を最適化 図2:MAQCにPCAを適用した例 この図の読みどころ v2が群差(DE)を表す成分として使える → 対応するu2で遺伝子にP値 Sci Rep (2022) 12:17438 | doi:10.1038/s41598-022-21474-z 5
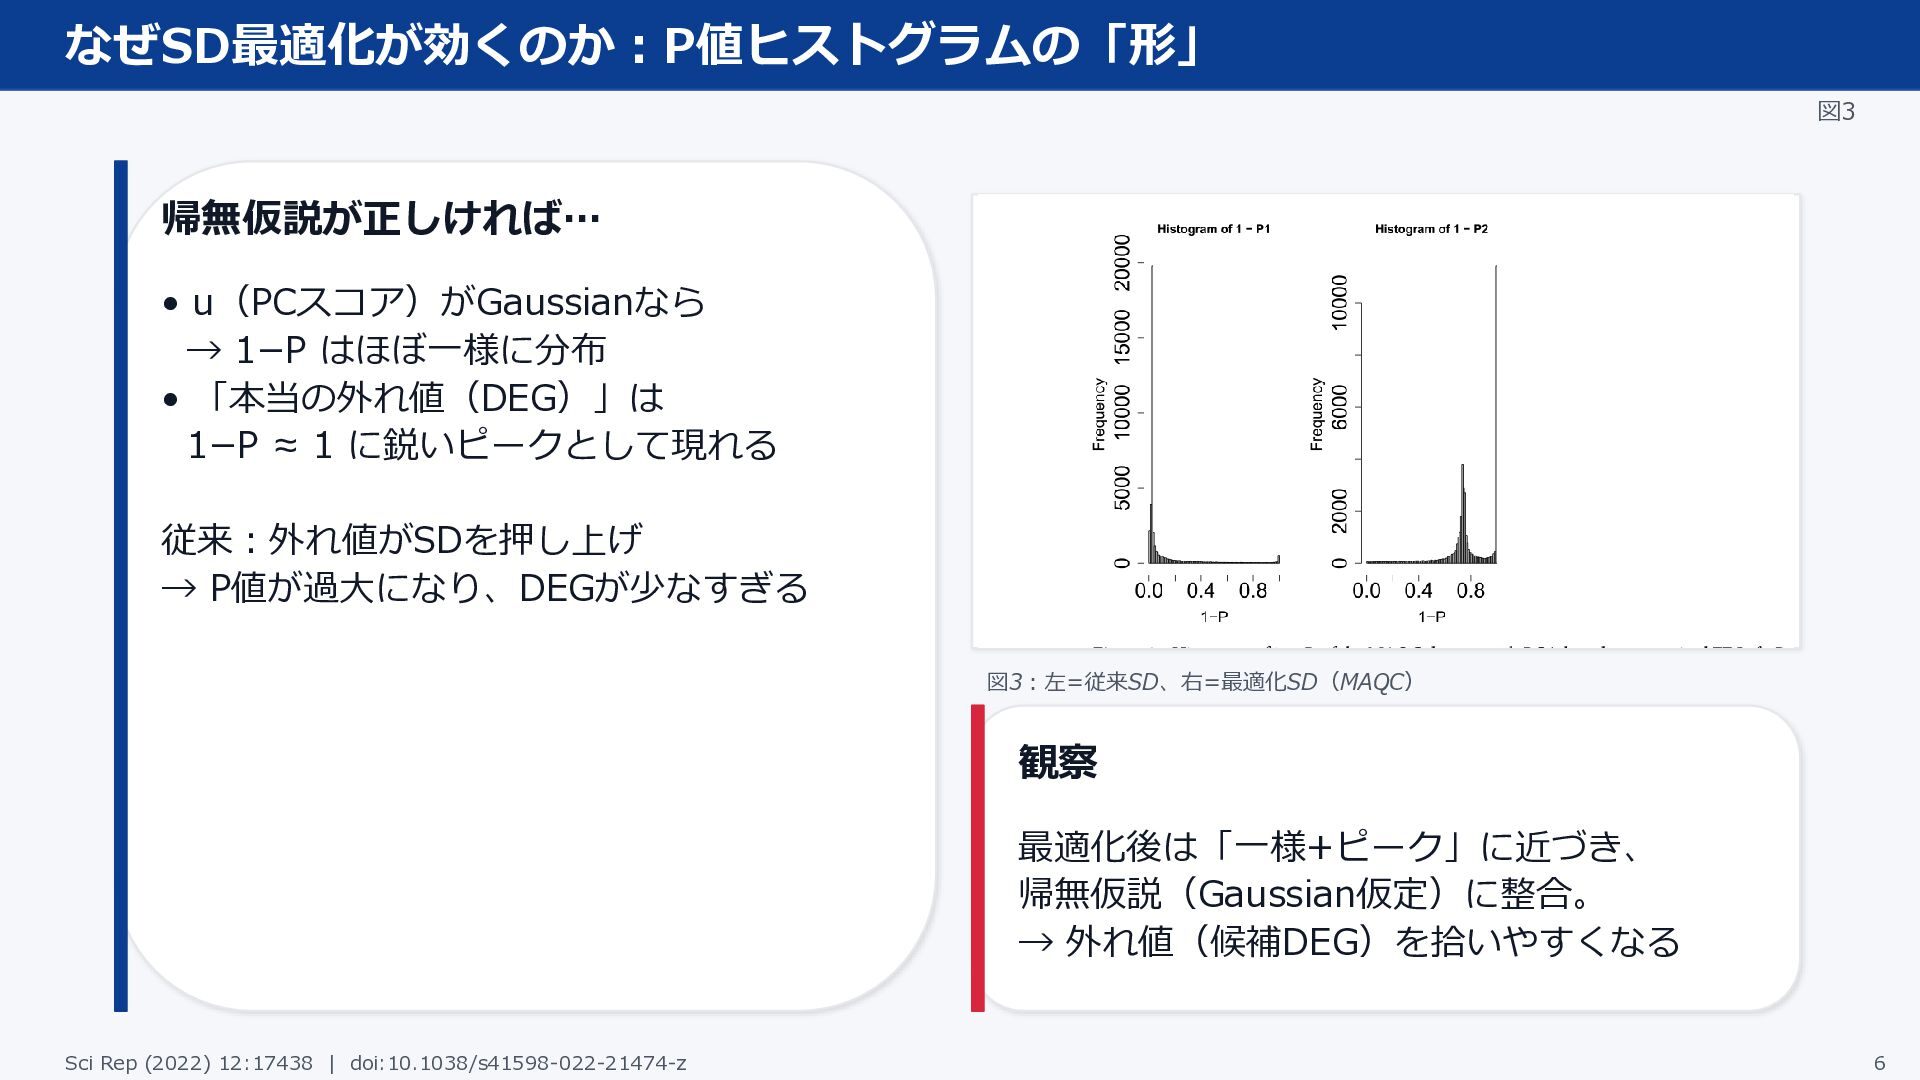
なぜSD最適化が効くのか:P値ヒストグラムの「形」 図3 帰無仮説が正しければ… • u(PCスコア)がGaussianなら → 1−P はほぼ一様に分布 • 「本当の外れ値(DEG)」は
1−P ≈ 1 に鋭いピークとして現れる 従来:外れ値がSDを押し上げ → P値が過大になり、DEGが少なすぎる 図3:左=従来SD、右=最適化SD(MAQC) 観察 最適化後は「一様+ピーク」に近づき、 帰無仮説(Gaussian仮定)に整合。 → 外れ値(候補DEG)を拾いやすくなる Sci Rep (2022) 12:17438 | doi:10.1038/s41598-022-21474-z 6
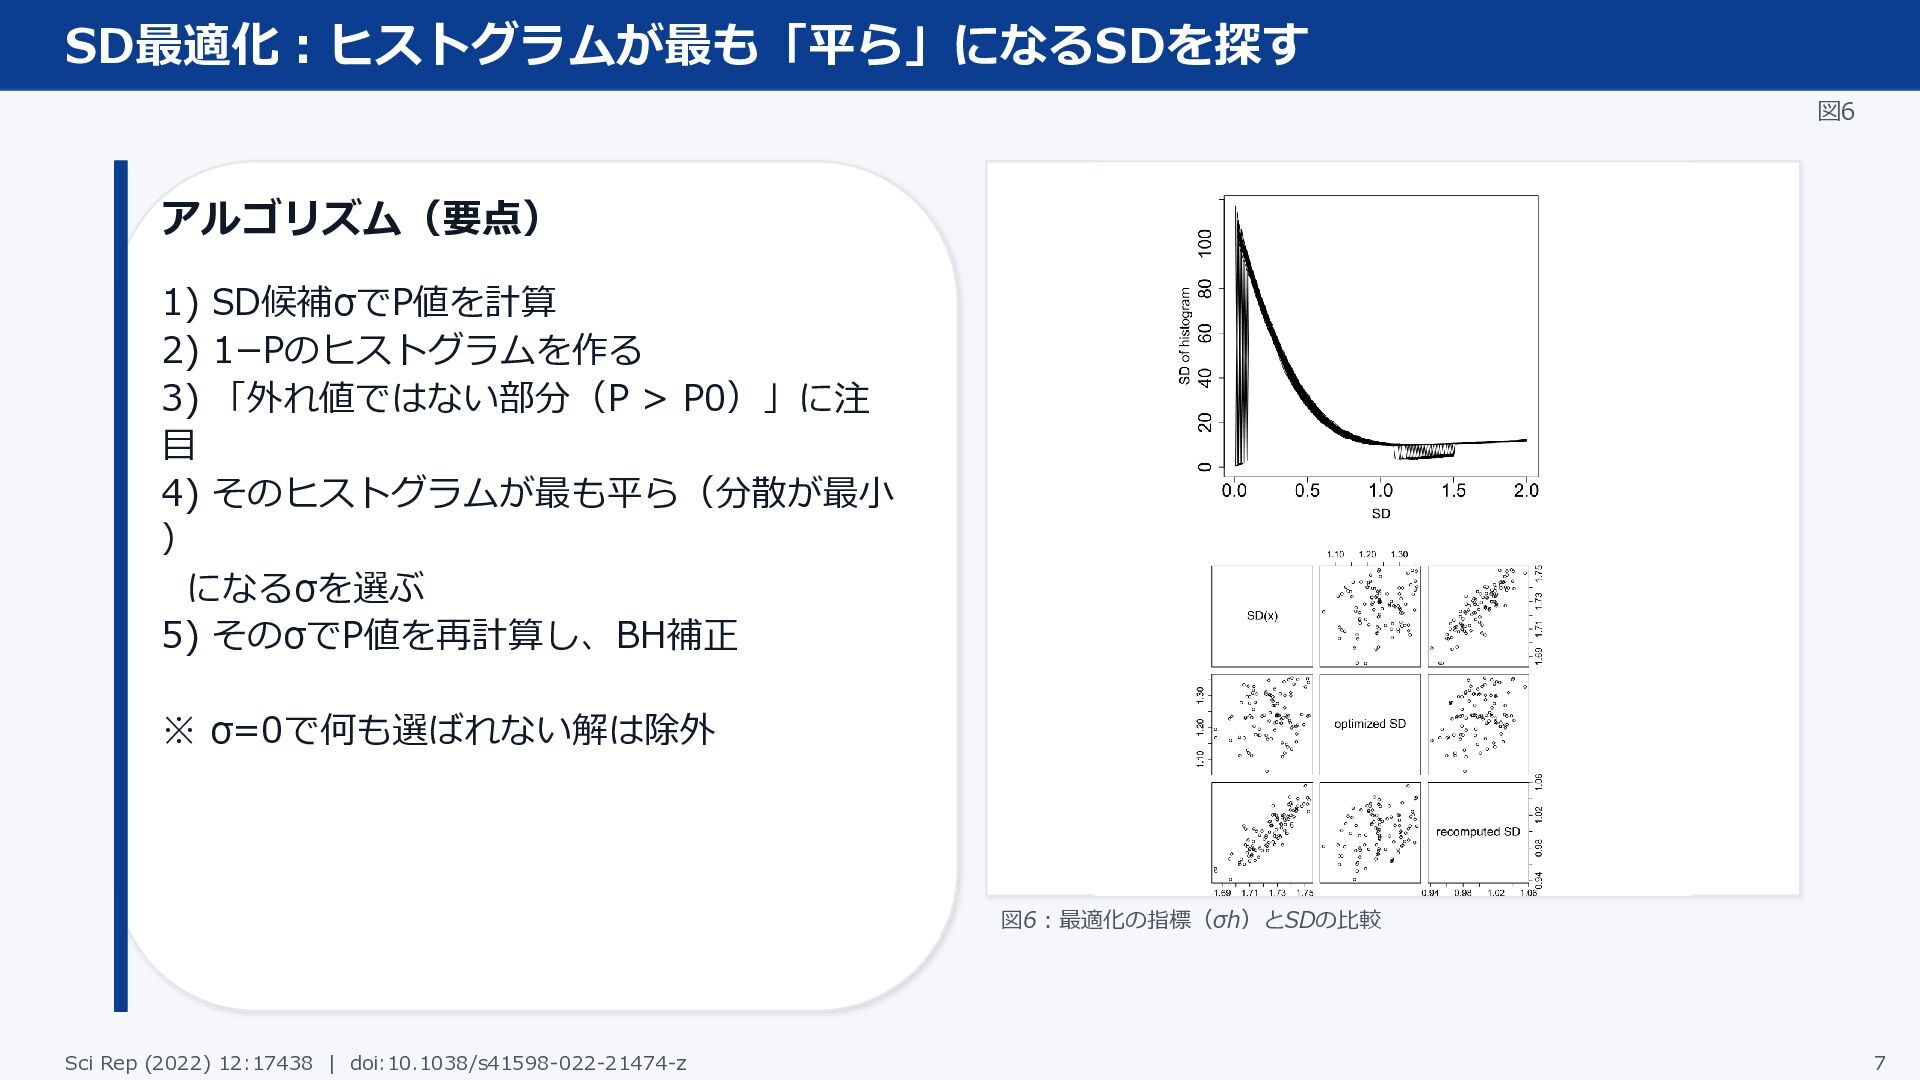
SD最適化:ヒストグラムが最も「平ら」になるSDを探す 図6 アルゴリズム(要点) 1) SD候補σでP値を計算 2) 1−Pのヒストグラムを作る 3) 「外れ値ではない部分(P >
P0)」に注 目 4) そのヒストグラムが最も平ら(分散が最小 ) になるσを選ぶ 5) そのσでP値を再計算し、BH補正 ※ σ=0で何も選ばれない解は除外 図6:最適化の指標(σh)とSDの比較 Sci Rep (2022) 12:17438 | doi:10.1038/s41598-022-21474-z 7
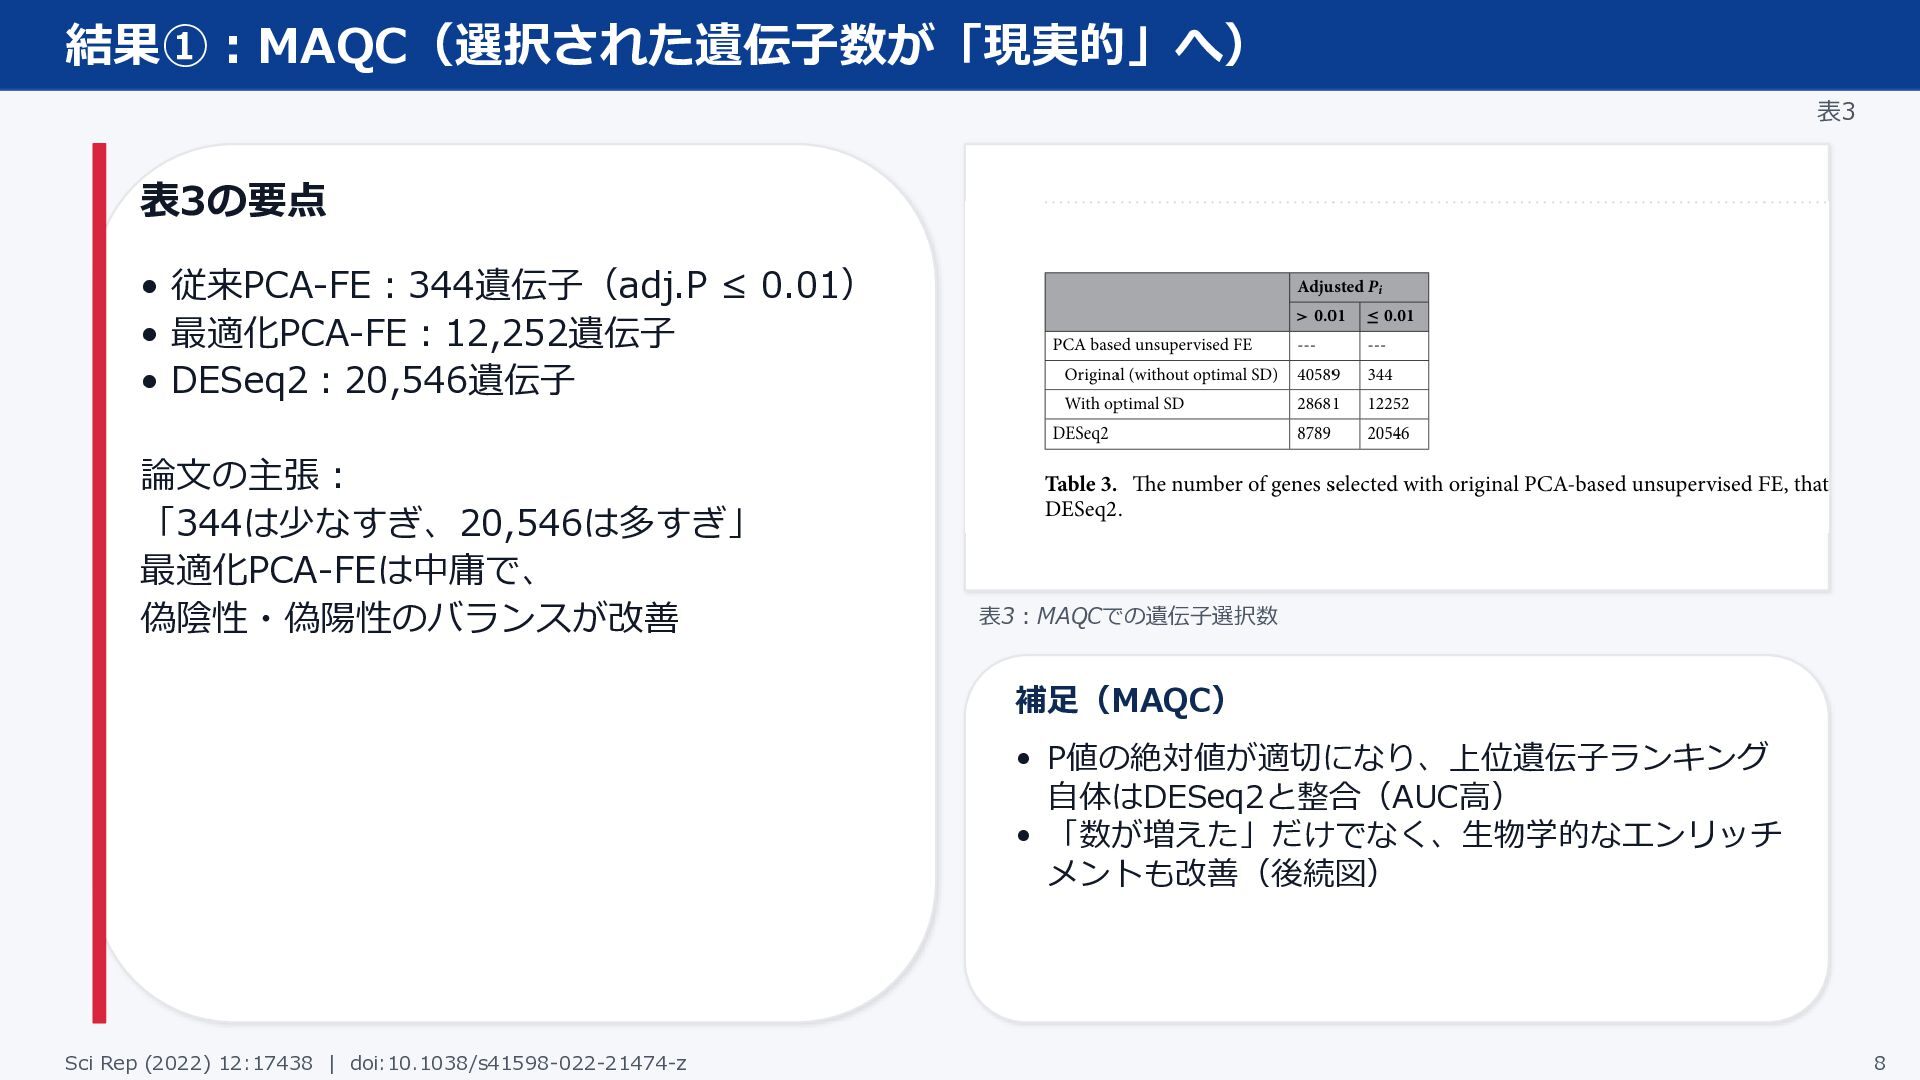
結果①:MAQC(選択された遺伝子数が「現実的」へ) 表3 表3の要点 • 従来PCA-FE:344遺伝子(adj.P ≤ 0.01) • 最適化PCA-FE:12,252遺伝子 •
DESeq2:20,546遺伝子 論文の主張: 「344は少なすぎ、20,546は多すぎ」 最適化PCA-FEは中庸で、 偽陰性・偽陽性のバランスが改善 表3:MAQCでの遺伝子選択数 補足(MAQC) • P値の絶対値が適切になり、上位遺伝子ランキング 自体はDESeq2と整合(AUC高) • 「数が増えた」だけでなく、生物学的なエンリッチ メントも改善(後続図) Sci Rep (2022) 12:17438 | doi:10.1038/s41598-022-21474-z 8
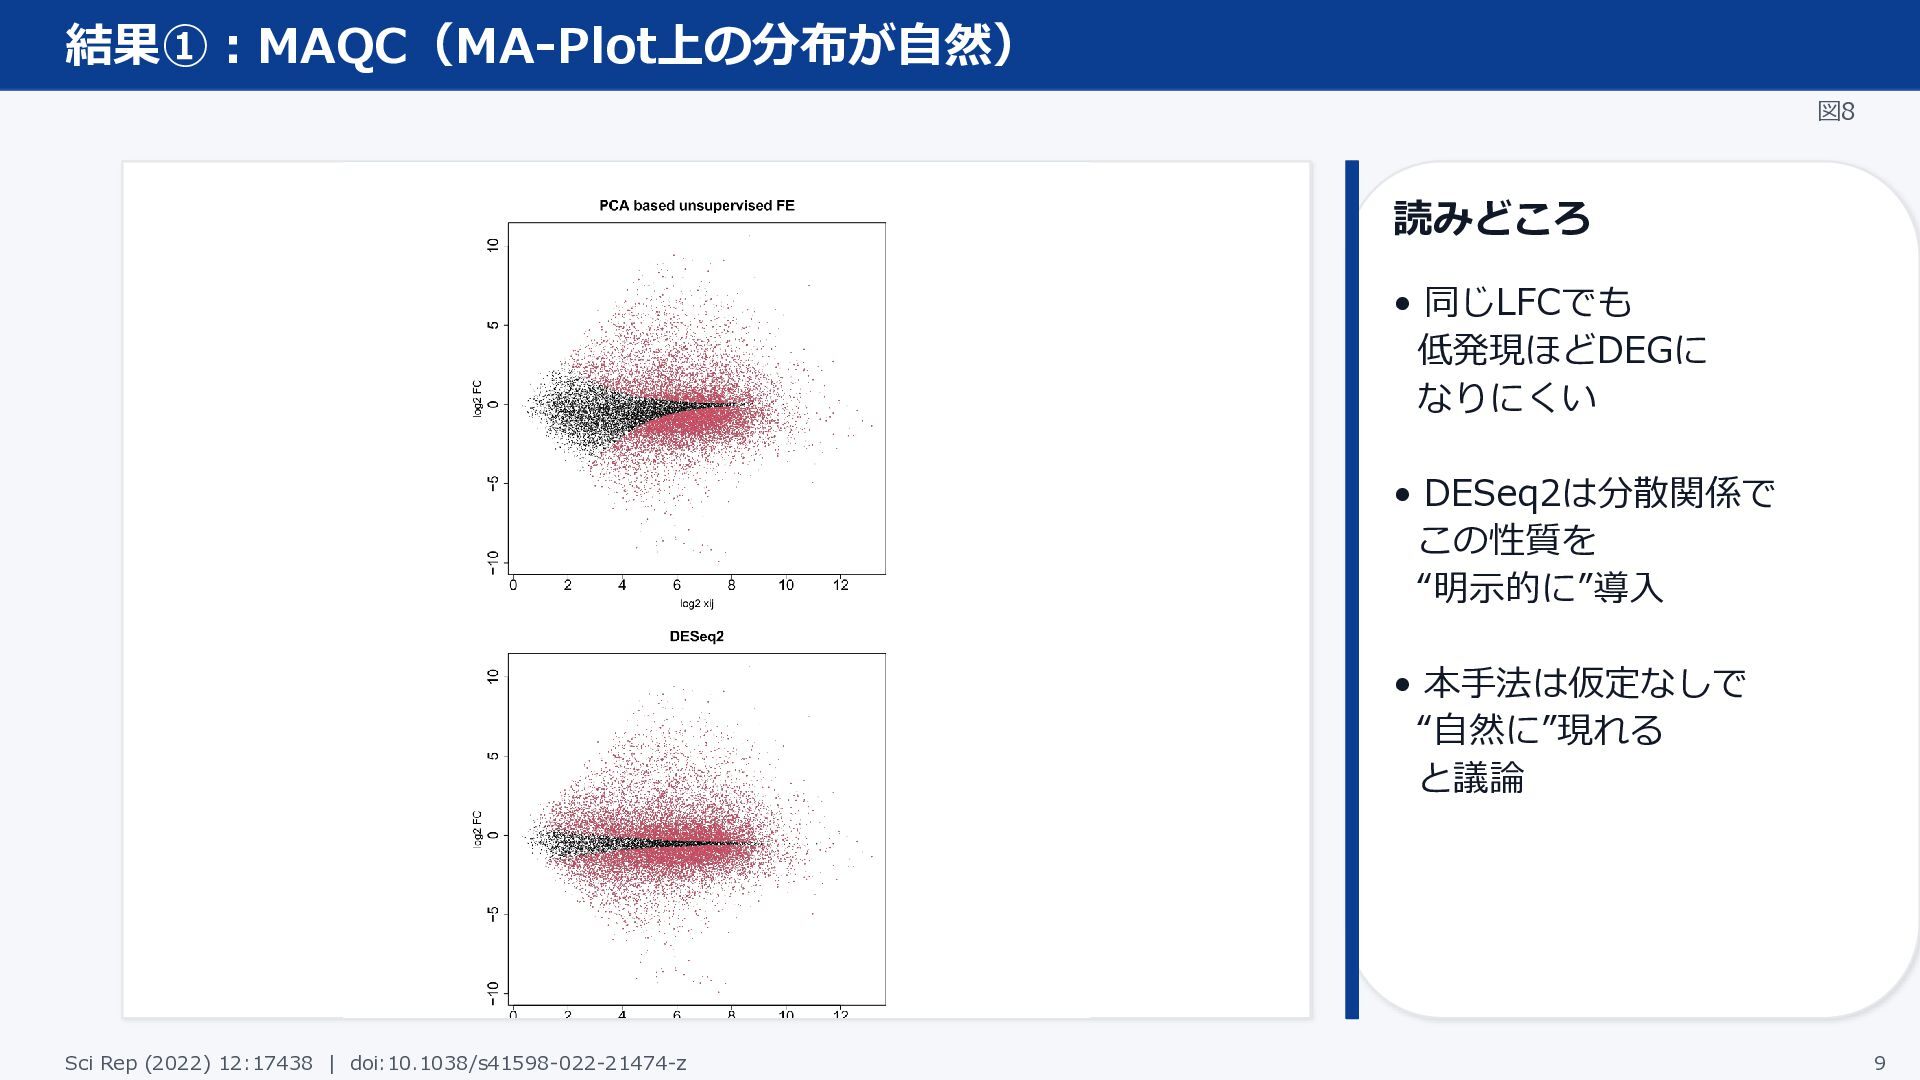
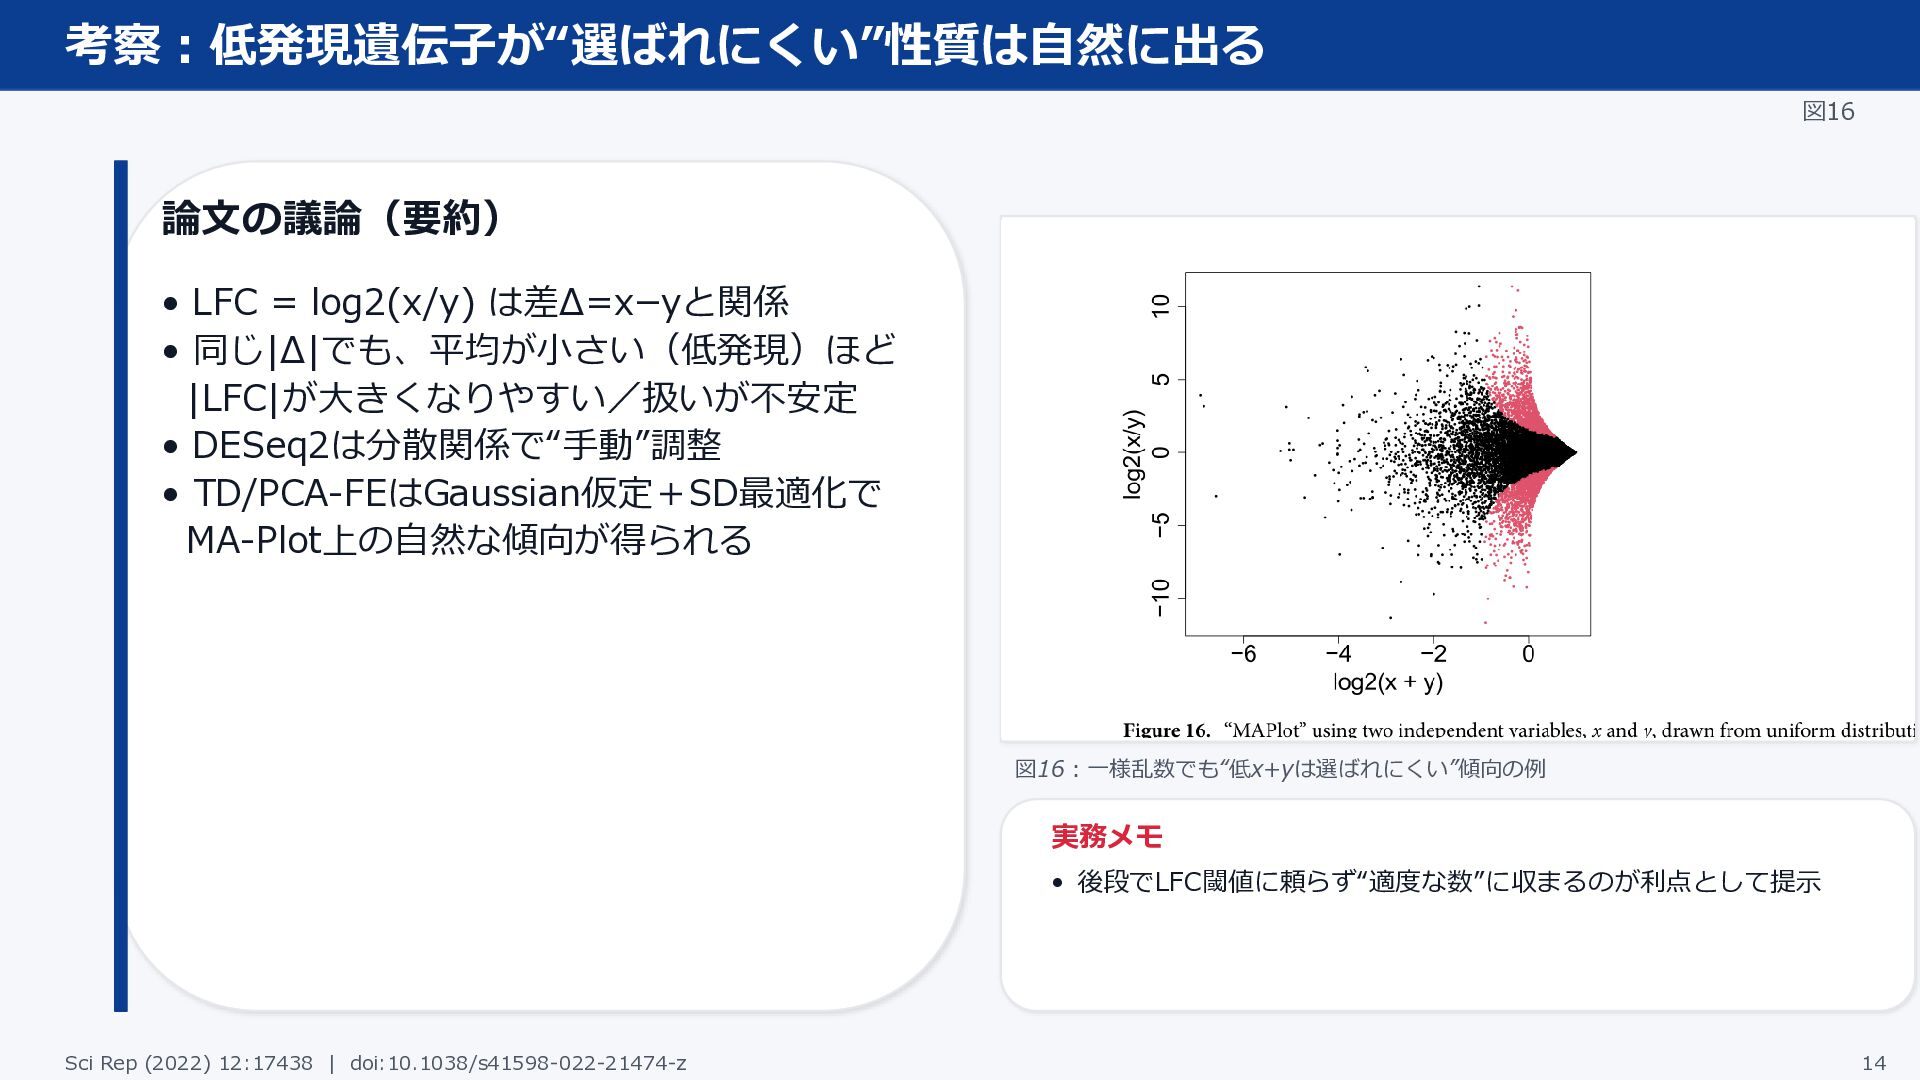
結果①:MAQC(MA-Plot上の分布が自然) 図8 読みどころ • 同じLFCでも 低発現ほどDEGに なりにくい • DESeq2は分散関係で この性質を
“明示的に”導入 • 本手法は仮定なしで “自然に”現れる と議論 Sci Rep (2022) 12:17438 | doi:10.1038/s41598-022-21474-z 9
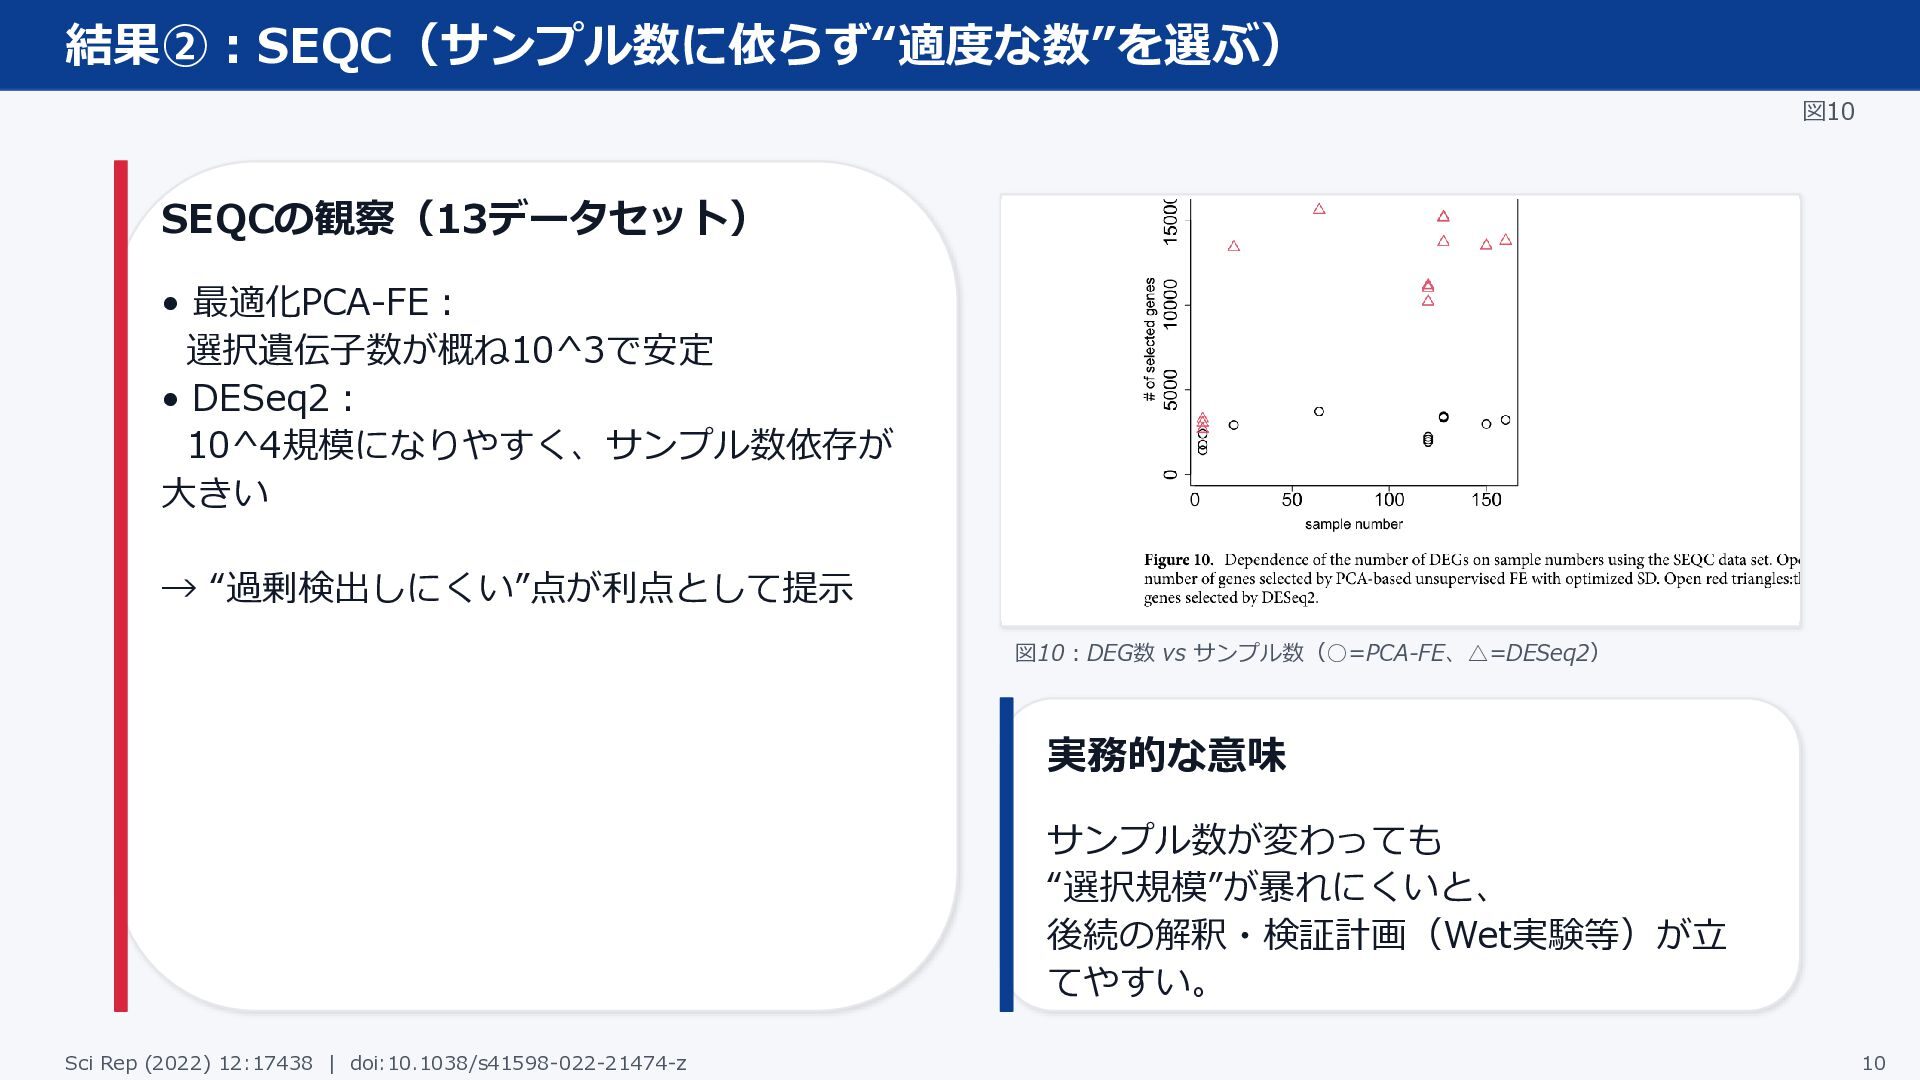
結果②:SEQC(サンプル数に依らず“適度な数”を選ぶ) 図10 SEQCの観察(13データセット) • 最適化PCA-FE: 選択遺伝子数が概ね10^3で安定 • DESeq2: 10^4規模になりやすく、サンプル数依存が 大きい
→ “過剰検出しにくい”点が利点として提示 図10:DEG数 vs サンプル数(◦=PCA-FE、△=DESeq2) 実務的な意味 サンプル数が変わっても “選択規模”が暴れにくいと、 後続の解釈・検証計画(Wet実験等)が立 てやすい。 Sci Rep (2022) 12:17438 | doi:10.1038/s41598-022-21474-z 10
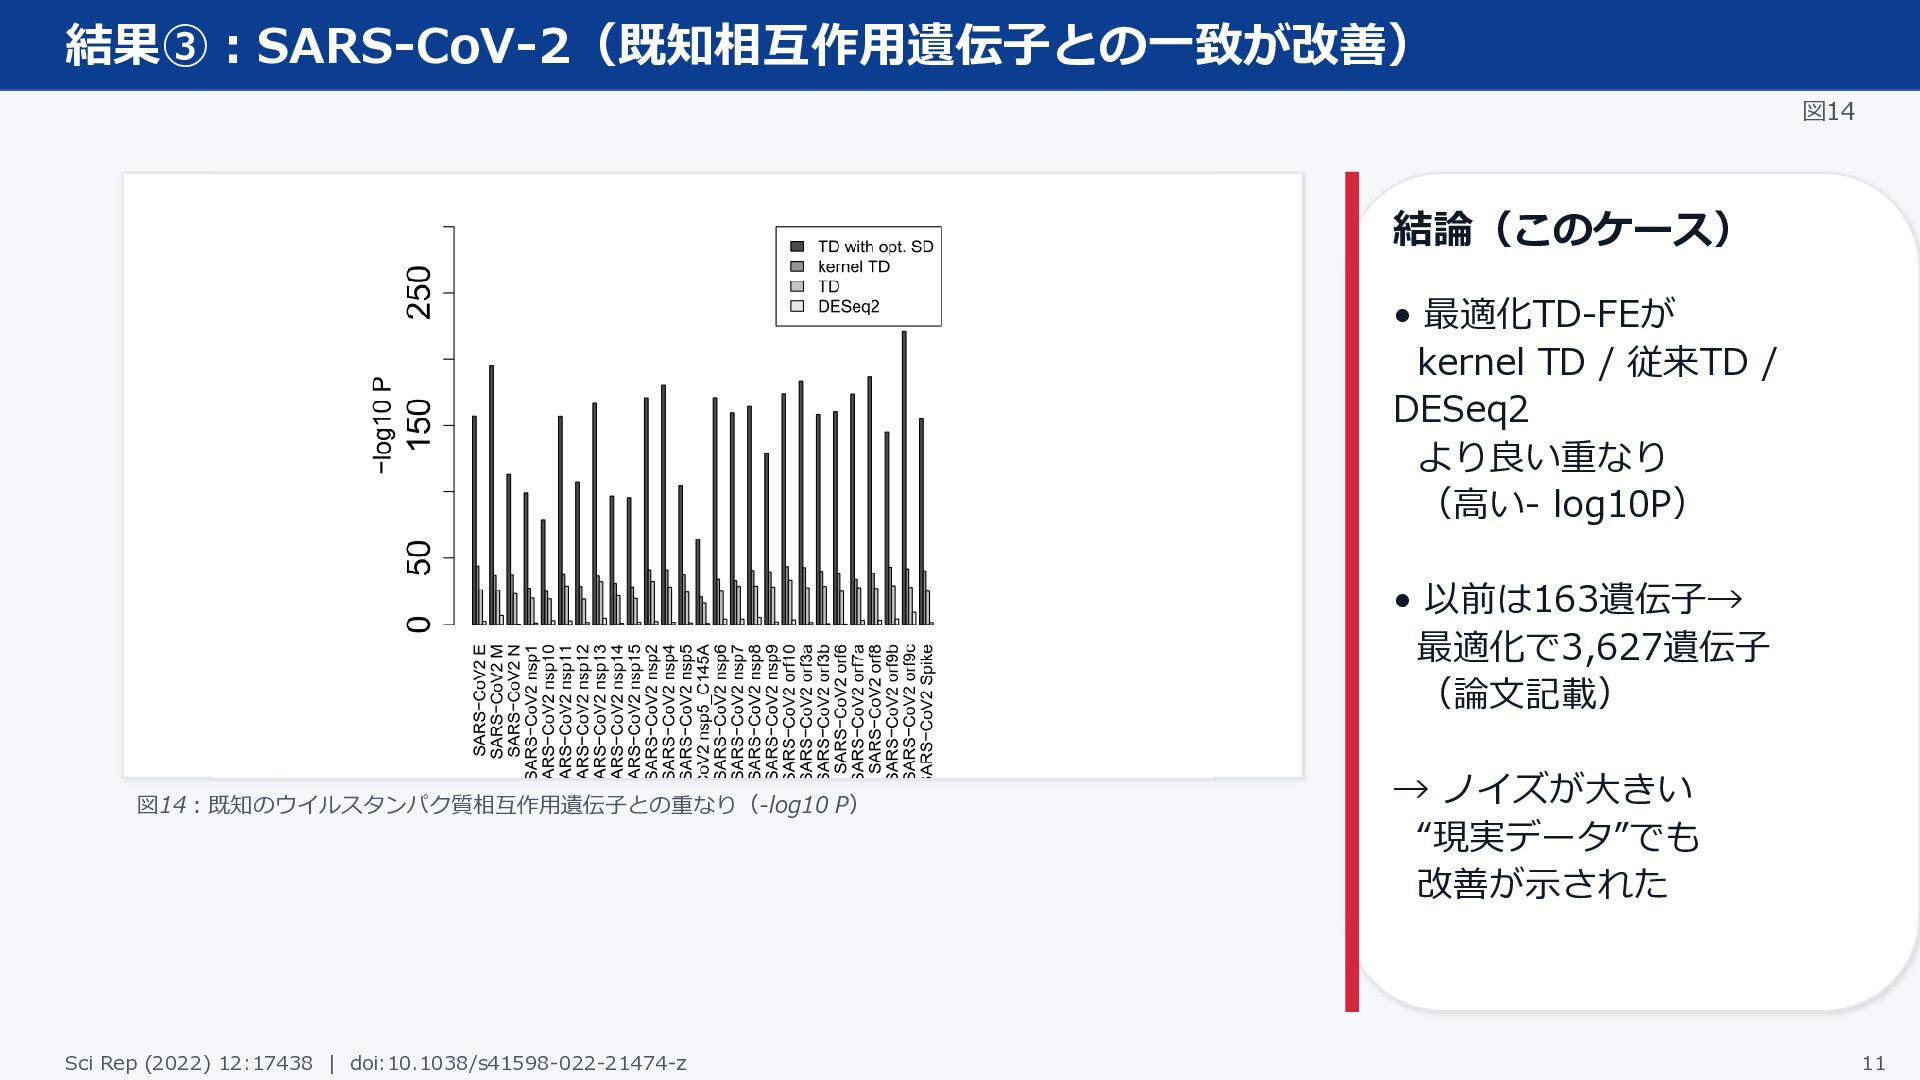
結果③:SARS-CoV-2(既知相互作用遺伝子との一致が改善) 図14 図14:既知のウイルスタンパク質相互作用遺伝子との重なり(-log10 P) 結論(このケース) • 最適化TD-FEが kernel TD /
従来TD / DESeq2 より良い重なり (高い- log10P) • 以前は163遺伝子→ 最適化で3,627遺伝子 (論文記載) → ノイズが大きい “現実データ”でも 改善が示された Sci Rep (2022) 12:17438 | doi:10.1038/s41598-022-21474-z 11
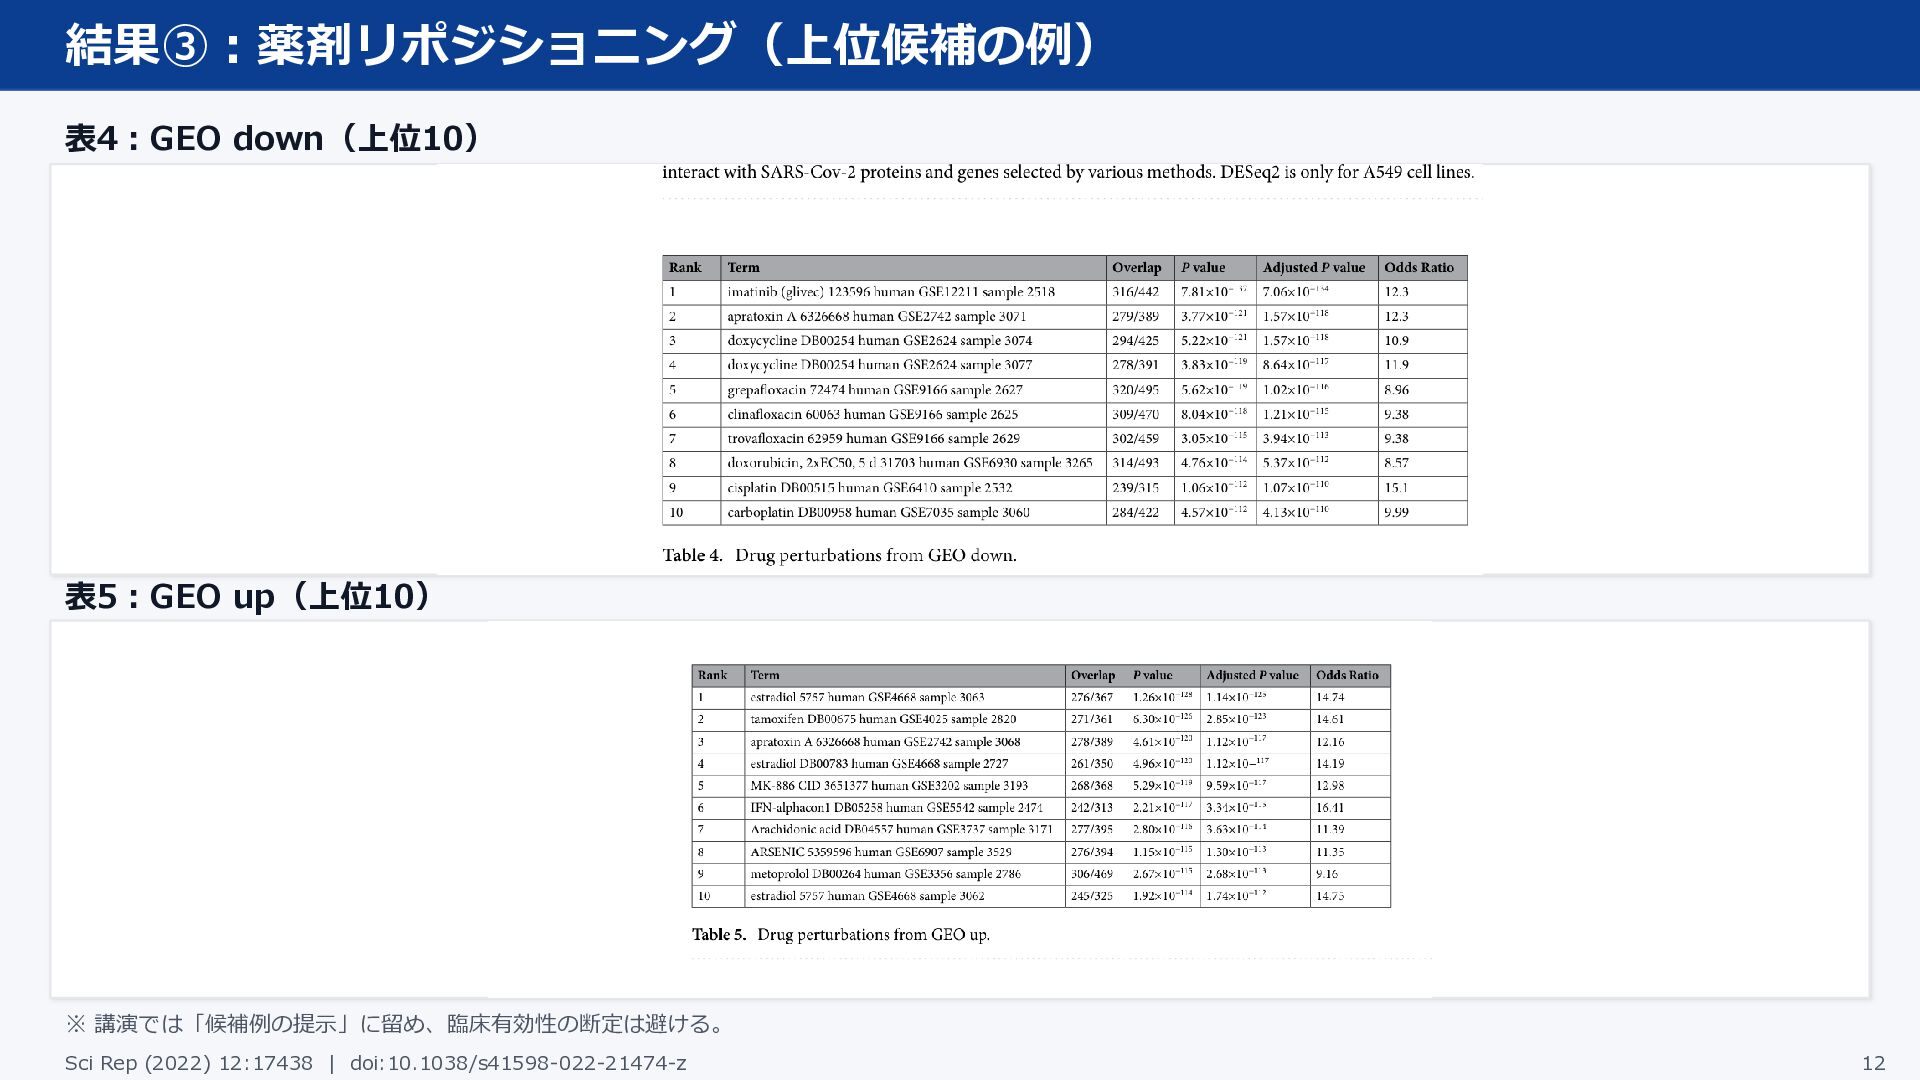
結果③:薬剤リポジショニング(上位候補の例) 表4:GEO down(上位10) 表5:GEO up(上位10) ※ 講演では「候補例の提示」に留め、臨床有効性の断定は避ける。 Sci Rep (2022)
12:17438 | doi:10.1038/s41598-022-21474-z 12
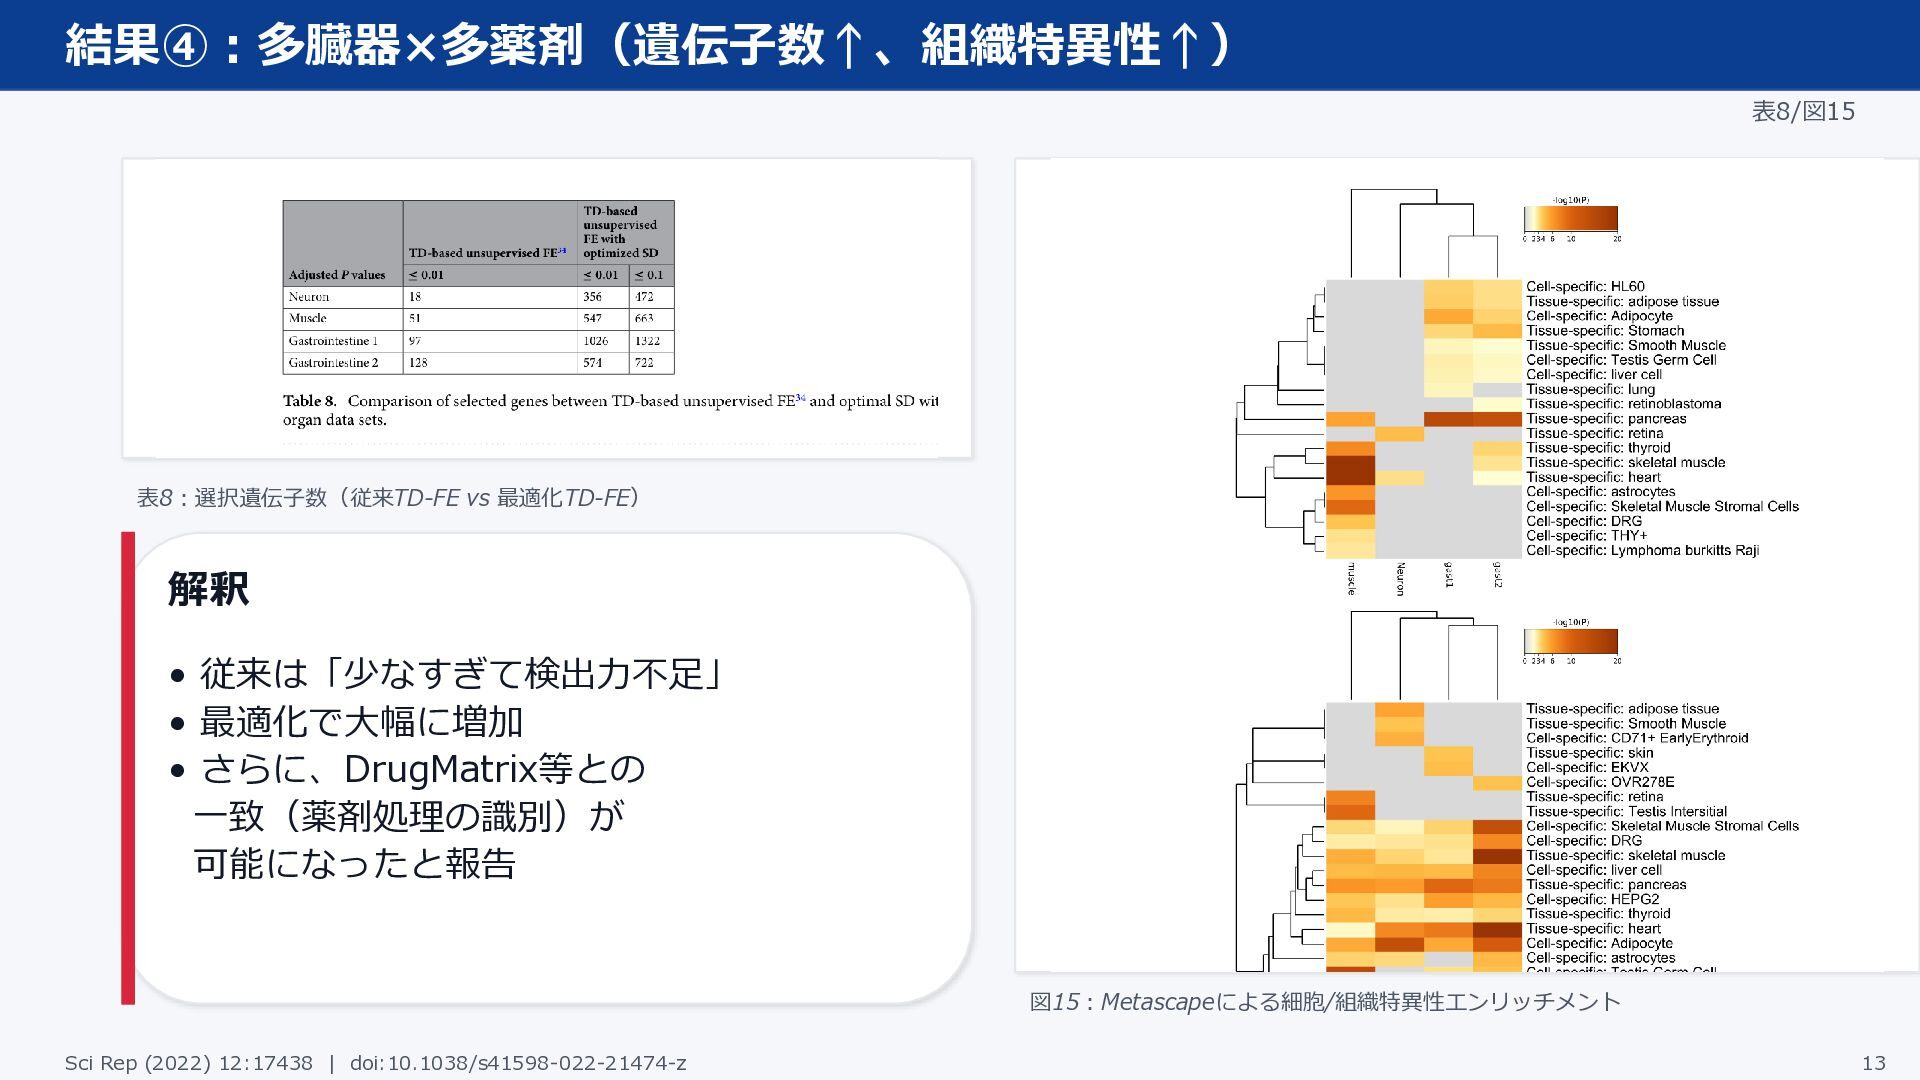
結果④:多臓器×多薬剤(遺伝子数↑、組織特異性↑) 表8/図15 表8:選択遺伝子数(従来TD-FE vs 最適化TD-FE) 解釈 • 従来は「少なすぎて検出力不足」 • 最適化で大幅に増加
• さらに、DrugMatrix等との 一致(薬剤処理の識別)が 可能になったと報告 図15:Metascapeによる細胞/組織特異性エンリッチメント Sci Rep (2022) 12:17438 | doi:10.1038/s41598-022-21474-z 13
考察:低発現遺伝子が“選ばれにくい”性質は自然に出る 図16 論文の議論(要約) • LFC = log2(x/y) は差Δ=x−yと関係 • 同じ|Δ|でも、平均が小さい(低発現)ほど
|LFC|が大きくなりやすい/扱いが不安定 • DESeq2は分散関係で“手動”調整 • TD/PCA-FEはGaussian仮定+SD最適化で MA-Plot上の自然な傾向が得られる 図16:一様乱数でも“低x+yは選ばれにくい”傾向の例 実務メモ • 後段でLFC閾値に頼らず“適度な数”に収まるのが利点として提示 Sci Rep (2022) 12:17438 | doi:10.1038/s41598-022-21474-z 14
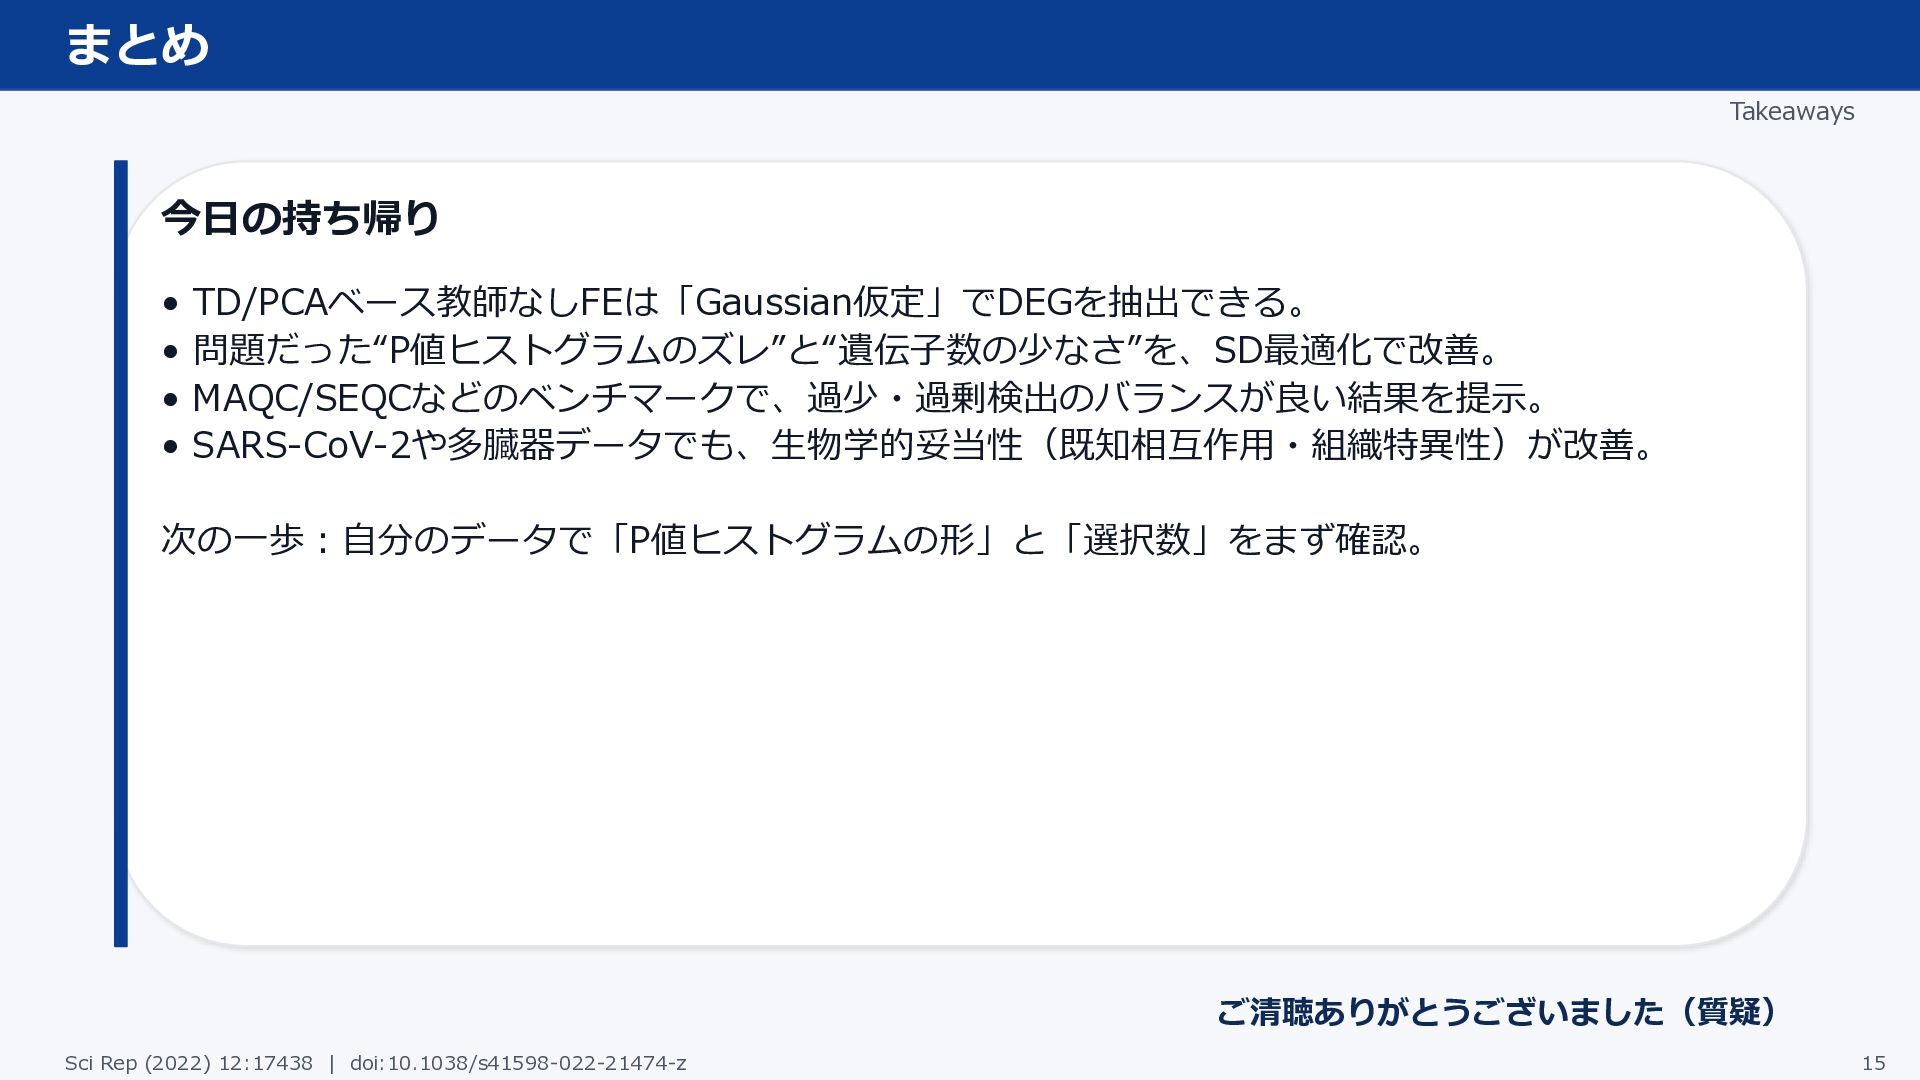
まとめ Takeaways 今日の持ち帰り • TD/PCAベース教師なしFEは「Gaussian仮定」でDEGを抽出できる。 • 問題だった“P値ヒストグラムのズレ”と“遺伝子数の少なさ”を、SD最適化で改善。 • MAQC/SEQCなどのベンチマークで、過少・過剰検出のバランスが良い結果を提示。 •
SARS-CoV-2や多臓器データでも、生物学的妥当性(既知相互作用・組織特異性)が改善。 次の一歩:自分のデータで「P値ヒストグラムの形」と「選択数」をまず確認。 ご清聴ありがとうございました(質疑) Sci Rep (2022) 12:17438 | doi:10.1038/s41598-022-21474-z 15


 tagtag
 trycycle
 tasusu
 gkazunii
 jagupath
 brainpadpr
 institutdelelevage
 tsoh
 akasan
 rmaruy
 hayashiyus884
 schlessera
 reverentgeek
 techseoconnect
 bryan
 shpigford
 jacobian
 oripsolob
 aleyda
 tammyeverts
 kimpetersen
 asonas
 jnunemaker