Databricks Free Edition講座 データサイエンス編
Sponsored
·
 Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→

Share
Embed

Transcript
136 slides
-
自己紹介 弥生 隆明 (やよい たかあき) シニア スペシャリスト ソリューションアーキテクト ▪ 2020年からデータブリックス
ジャパンにお いて、プレセールス、POCに従事 ▪ 生成AI、データエンジニアリング、 アプリが専門領域です。 ▪ 前職はコンサル、総合電機メーカー にてデータ分析・Webサービス構築 などに従事。インド赴任経験あり。 ▪ Databricks Certified (Data Engineer | Machine Learning) Professional, Generative AI Engineer Associate ▪ Qiitaでいろいろ書いています。 2 @taka_aki -
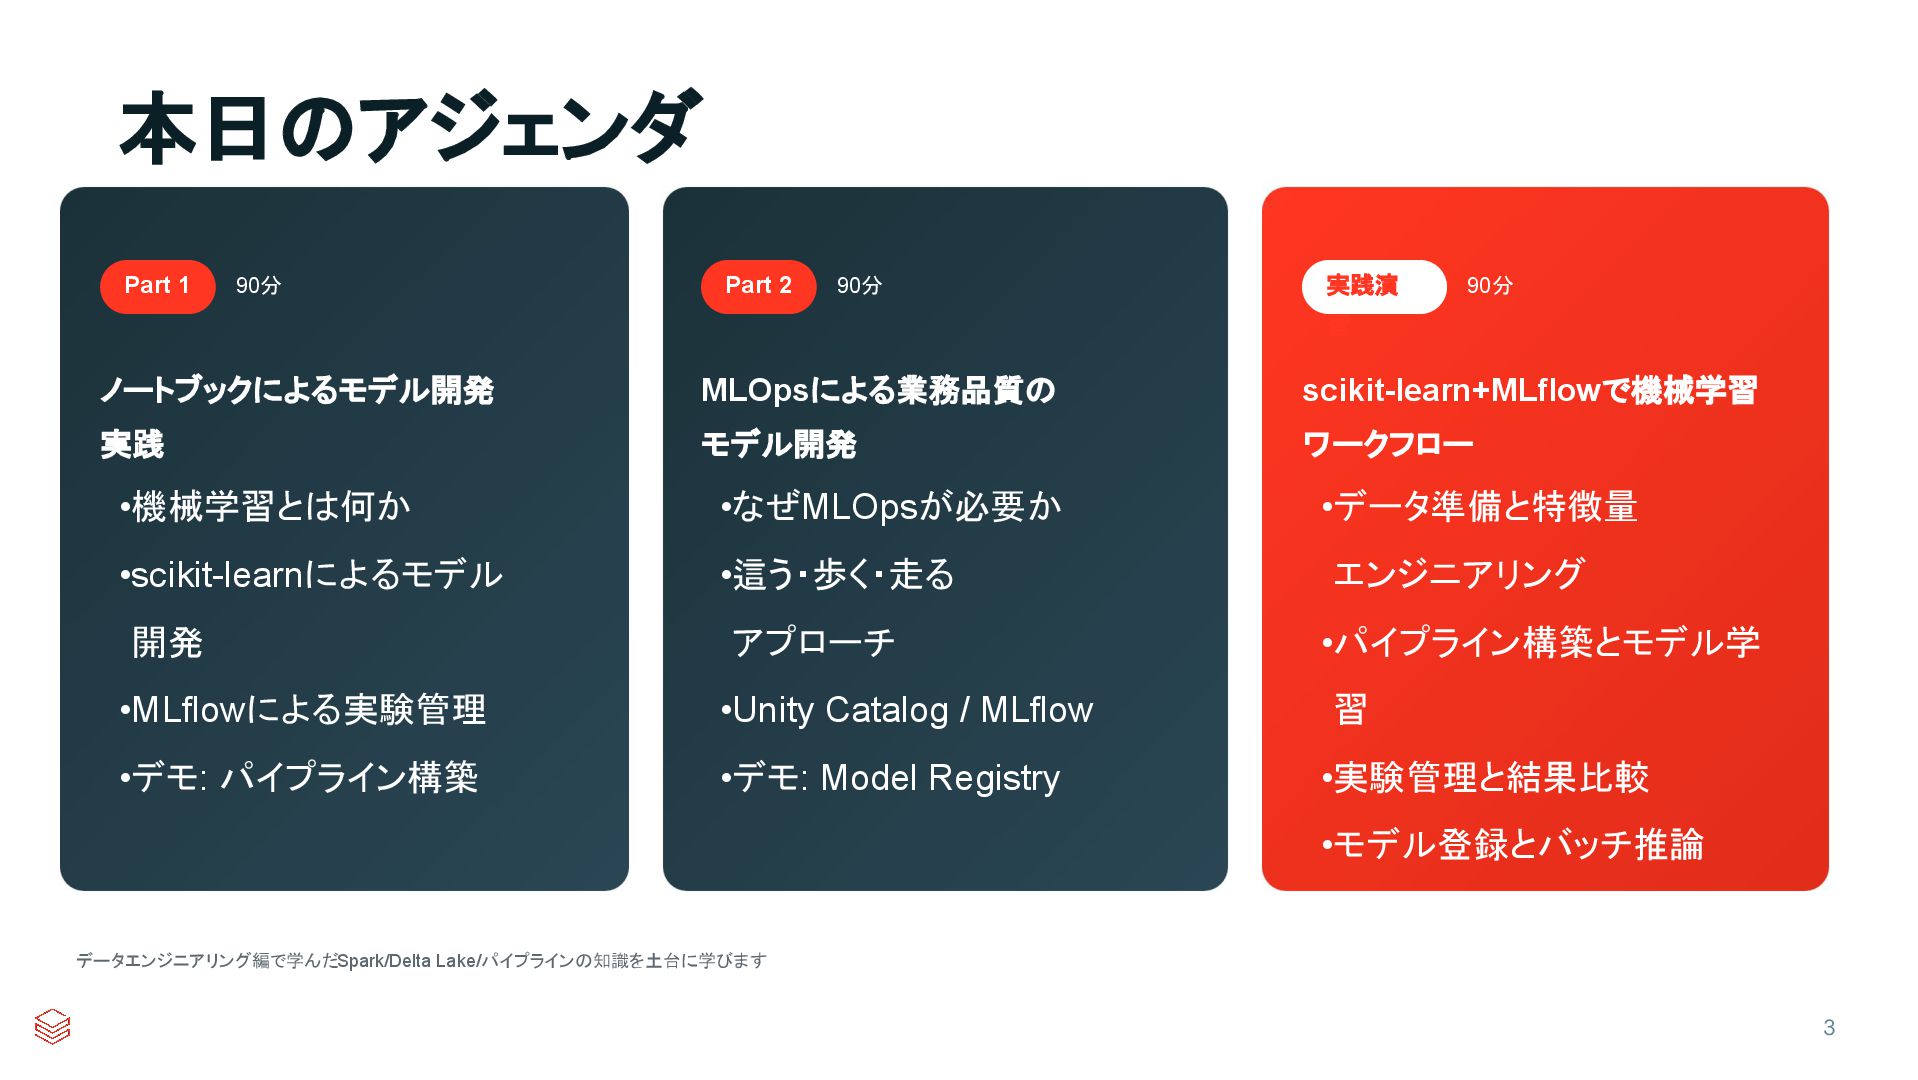
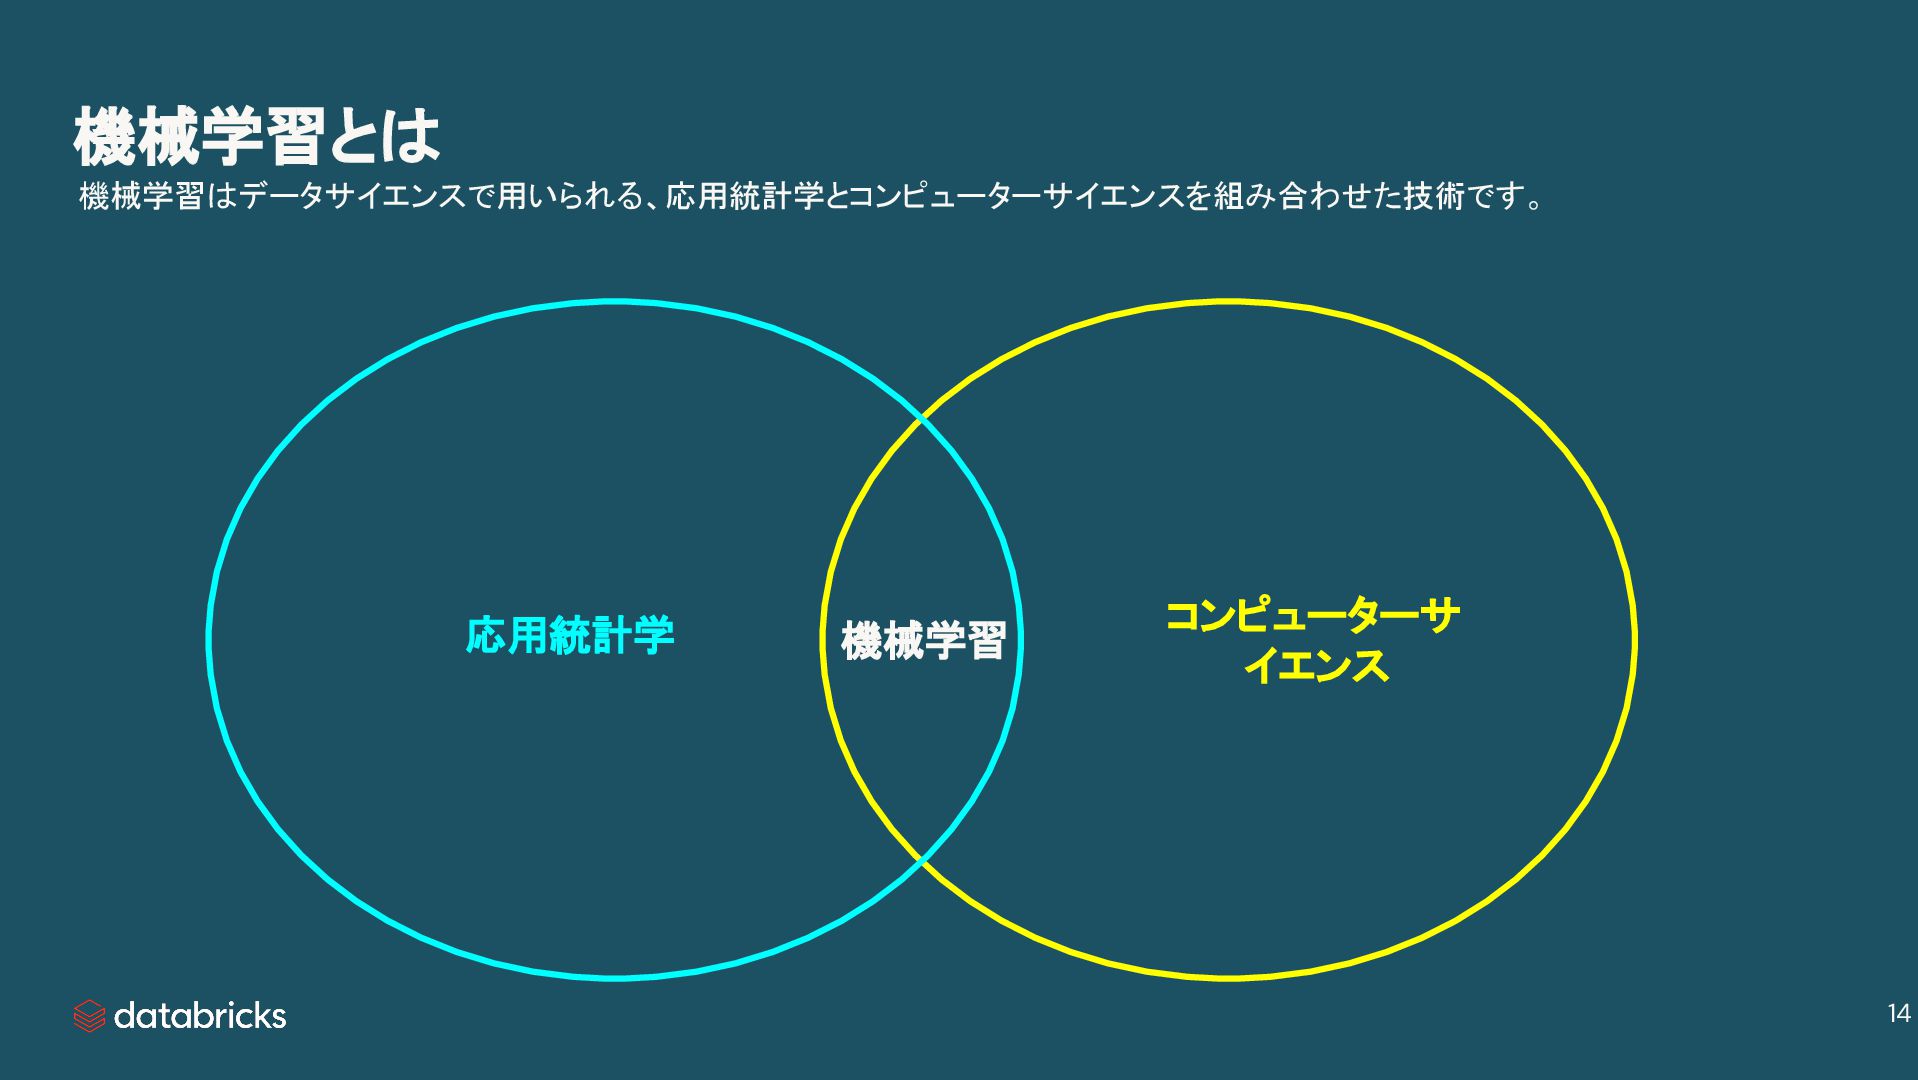
本日のアジェンダ 3 Part 1 90分 ノートブックによるモデル開発 実践 •機械学習とは何か •scikit-learnによるモデル 開発
•MLflowによる実験管理 •デモ: パイプライン構築 Part 2 90分 MLOpsによる業務品質の モデル開発 •なぜMLOpsが必要か •這う・歩く・走る アプローチ •Unity Catalog / MLflow •デモ: Model Registry 実践演 習 90分 scikit-learn+MLflowで機械学習 ワークフロー •データ準備と特徴量 エンジニアリング •パイプライン構築とモデル学 習 •実験管理と結果比較 •モデル登録とバッチ推論 データエンジニアリング編で学んだSpark/Delta Lake/パイプラインの知識を土台に学びます -
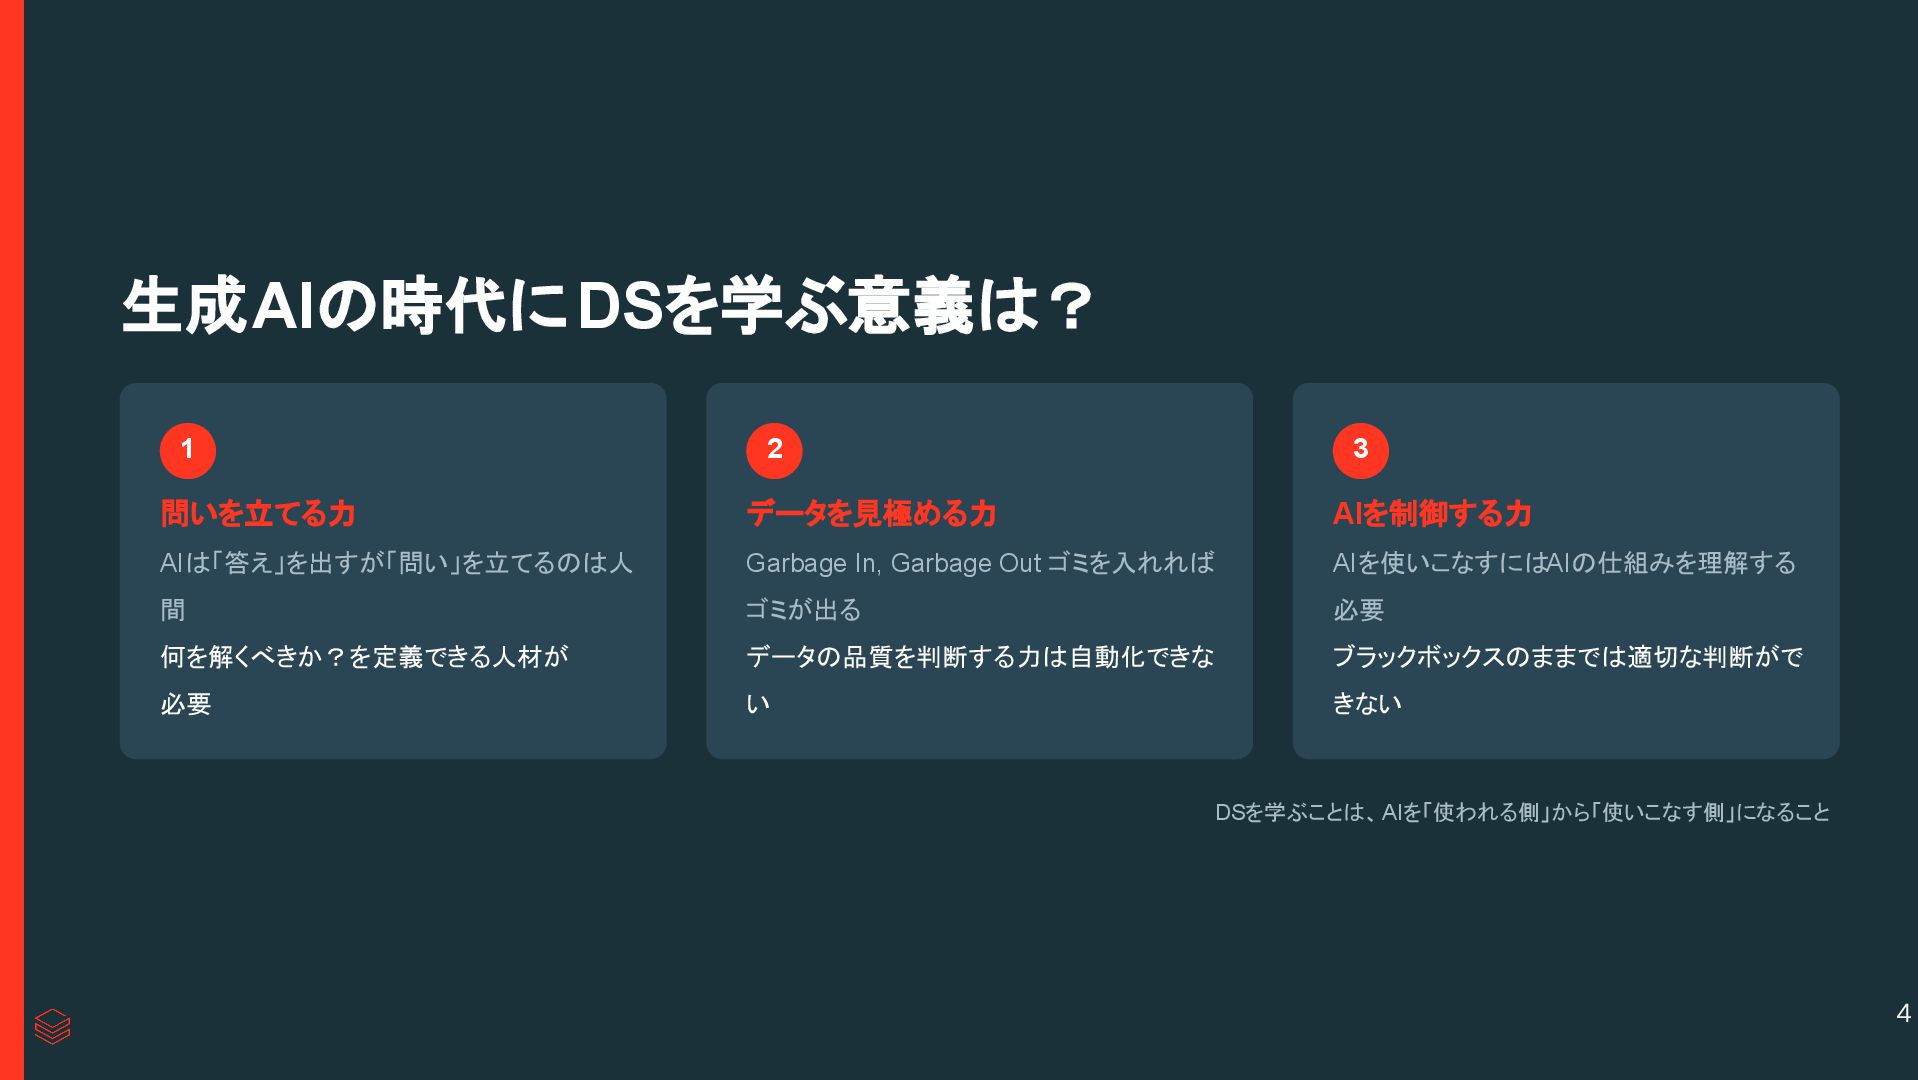
生成AIの時代にDSを学ぶ意義は? 1 問いを立てる力 AIは「答え」を出すが「問い」を立てるのは人 間 何を解くべきか?を定義できる人材が 必要 2 データを見極める力 Garbage
In, Garbage Out ゴミを入れれば ゴミが出る データの品質を判断する力は自動化できな い 3 AIを制御する力 AIを使いこなすにはAIの仕組みを理解する 必要 ブラックボックスのままでは適切な判断がで きない DSを学ぶことは、AIを「使われる側」から「使いこなす側」になること 4 -
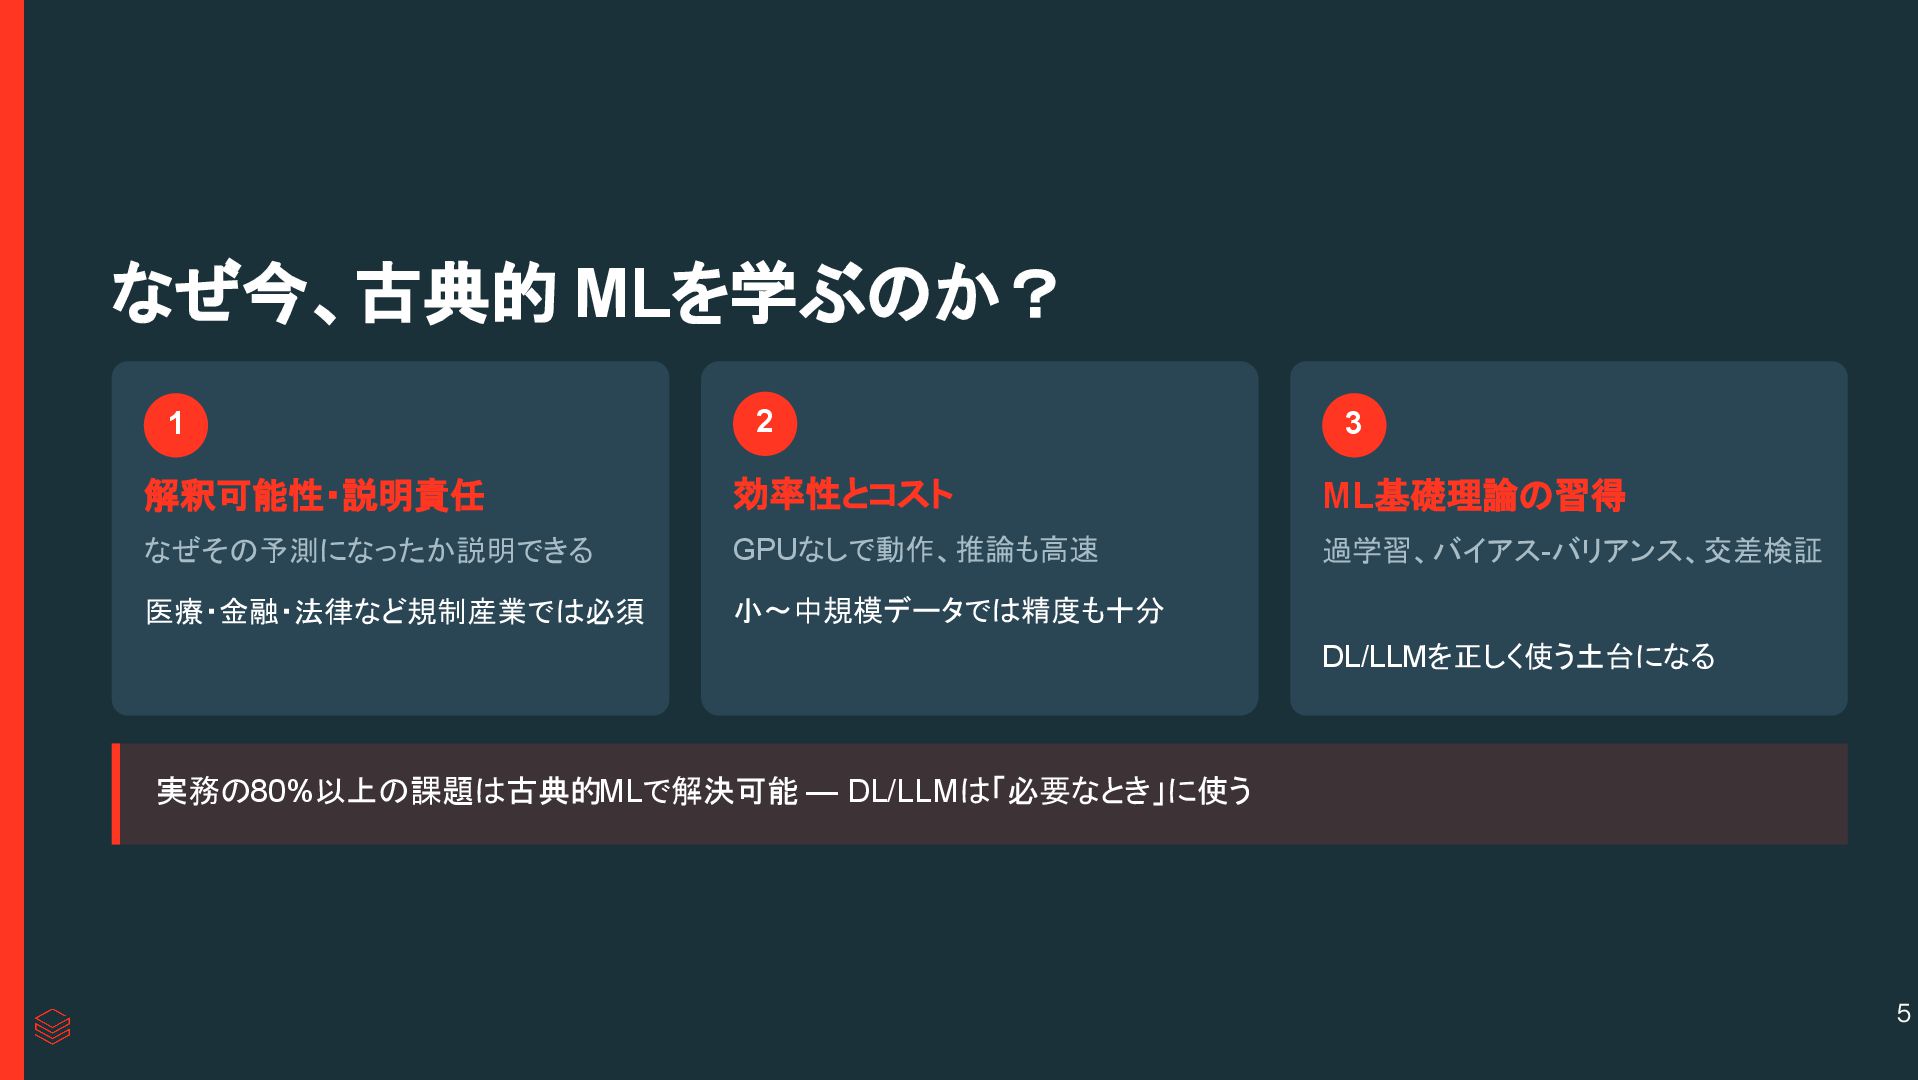
なぜ今、古典的 MLを学ぶのか? 1 解釈可能性・説明責任 なぜその予測になったか説明できる 医療・金融・法律など規制産業では必須 2 効率性とコスト GPUなしで動作、推論も高速 小〜中規模データでは精度も十分
3 ML基礎理論の習得 過学習、バイアス-バリアンス、交差検証 DL/LLMを正しく使う土台になる 実務の80%以上の課題は古典的MLで解決可能 — DL/LLMは「必要なとき」に使う 5 -
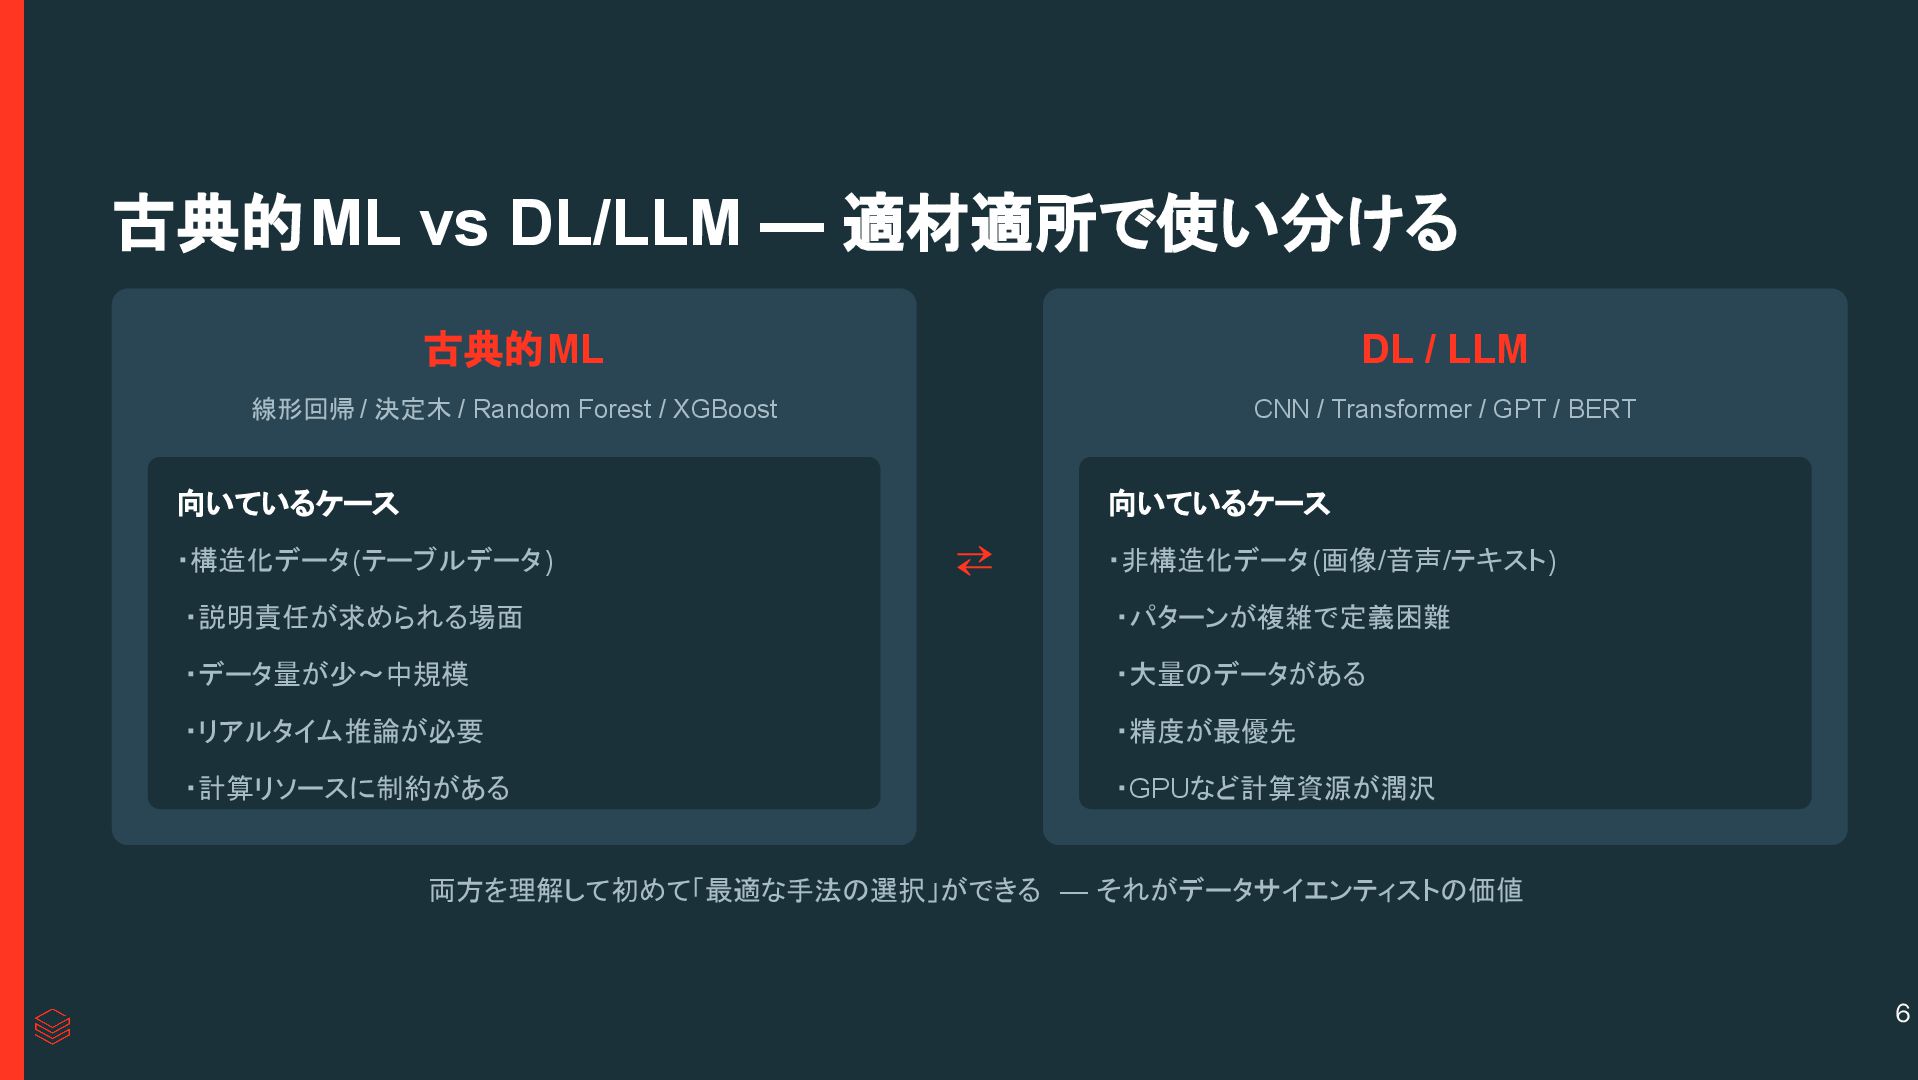
古典的ML vs DL/LLM — 適材適所で使い分ける 古典的ML 線形回帰 / 決定木 /
Random Forest / XGBoost 向いているケース ・構造化データ(テーブルデータ) ・説明責任が求められる場面 ・データ量が少〜中規模 ・リアルタイム推論が必要 ・計算リソースに制約がある ⇄ DL / LLM CNN / Transformer / GPT / BERT 向いているケース ・非構造化データ(画像/音声/テキスト) ・パターンが複雑で定義困難 ・大量のデータがある ・精度が最優先 ・GPUなど計算資源が潤沢 両方を理解して初めて「最適な手法の選択」ができる — それがデータサイエンティストの価値 6 -
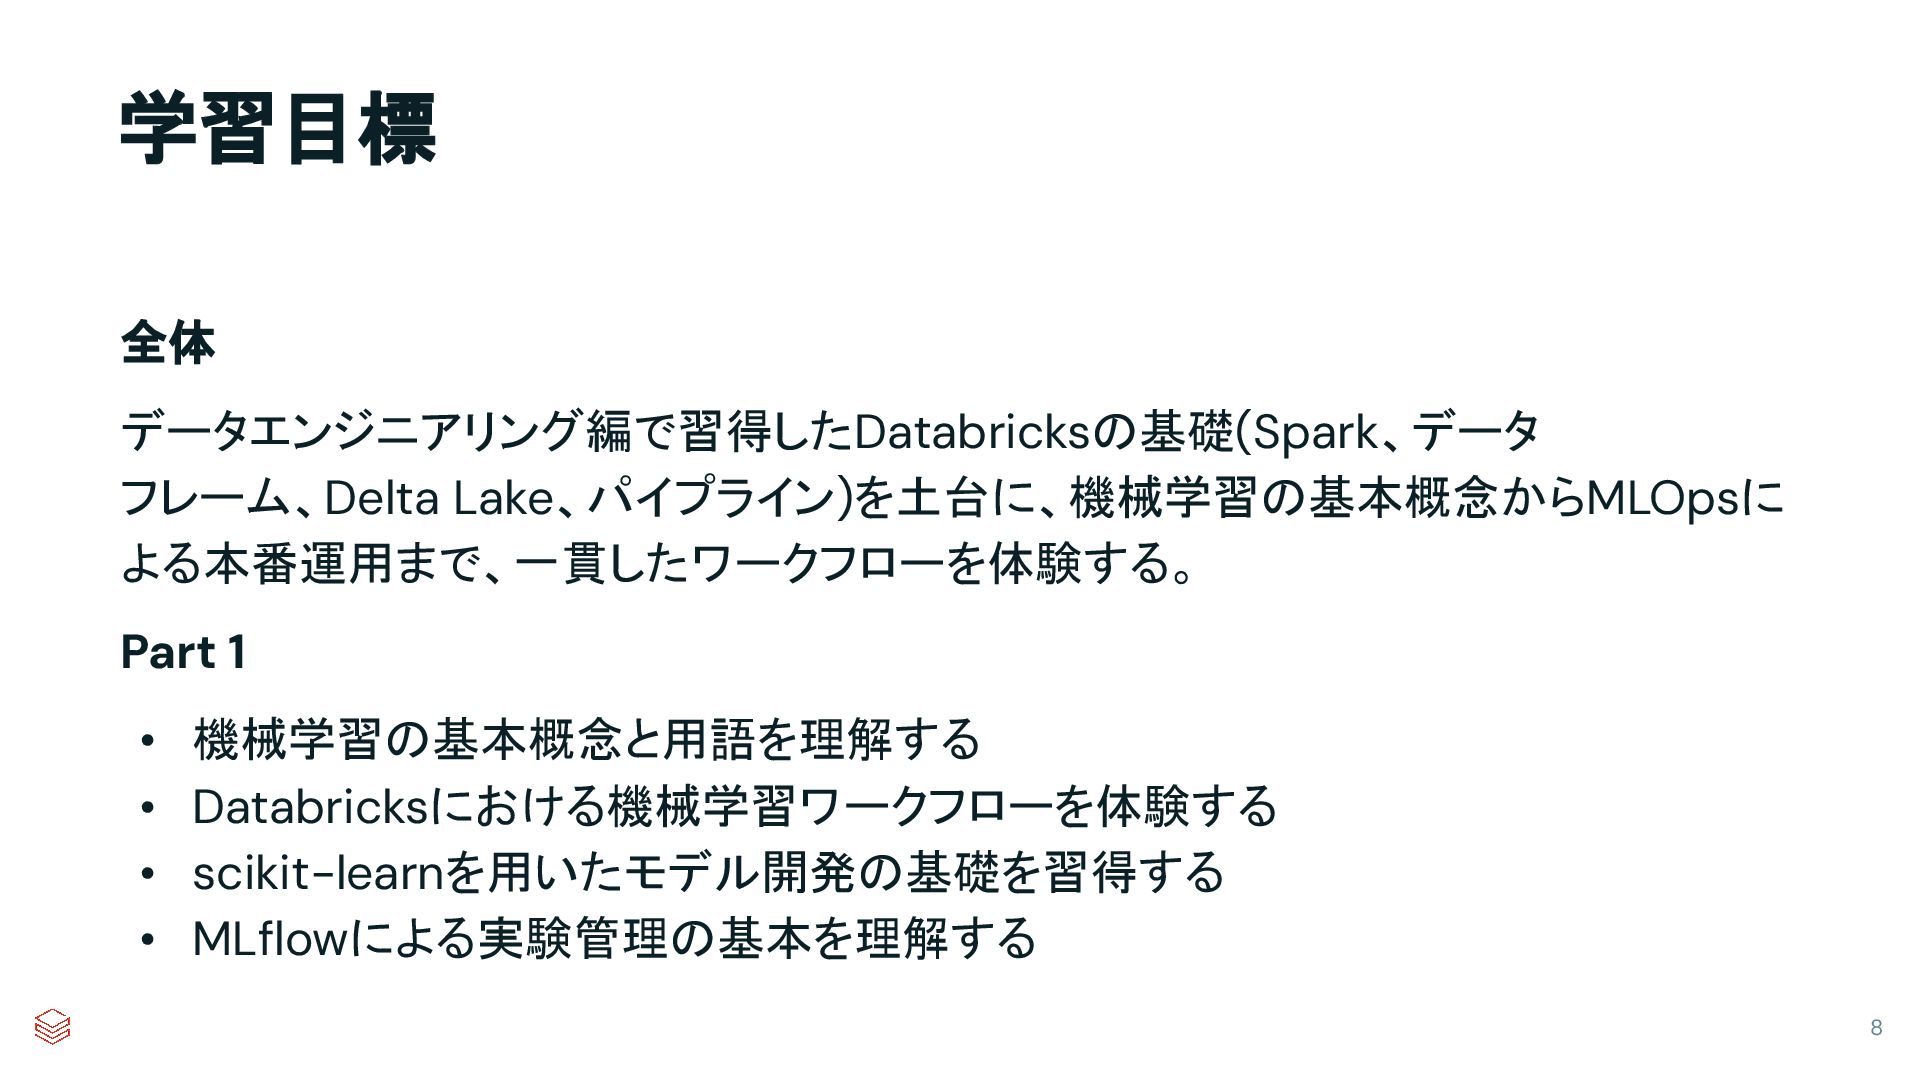
学習目標 8 全体 データエンジニアリング編で習得したDatabricksの基礎(Spark、データ フレーム、Delta Lake、パイプライン)を土台に、機械学習の基本概念からMLOpsに よる本番運用まで、一貫したワークフローを体験する。 Part 1 •
機械学習の基本概念と用語を理解する • Databricksにおける機械学習ワークフローを体験する • scikit-learnを用いたモデル開発の基礎を習得する • MLflowによる実験管理の基本を理解する -
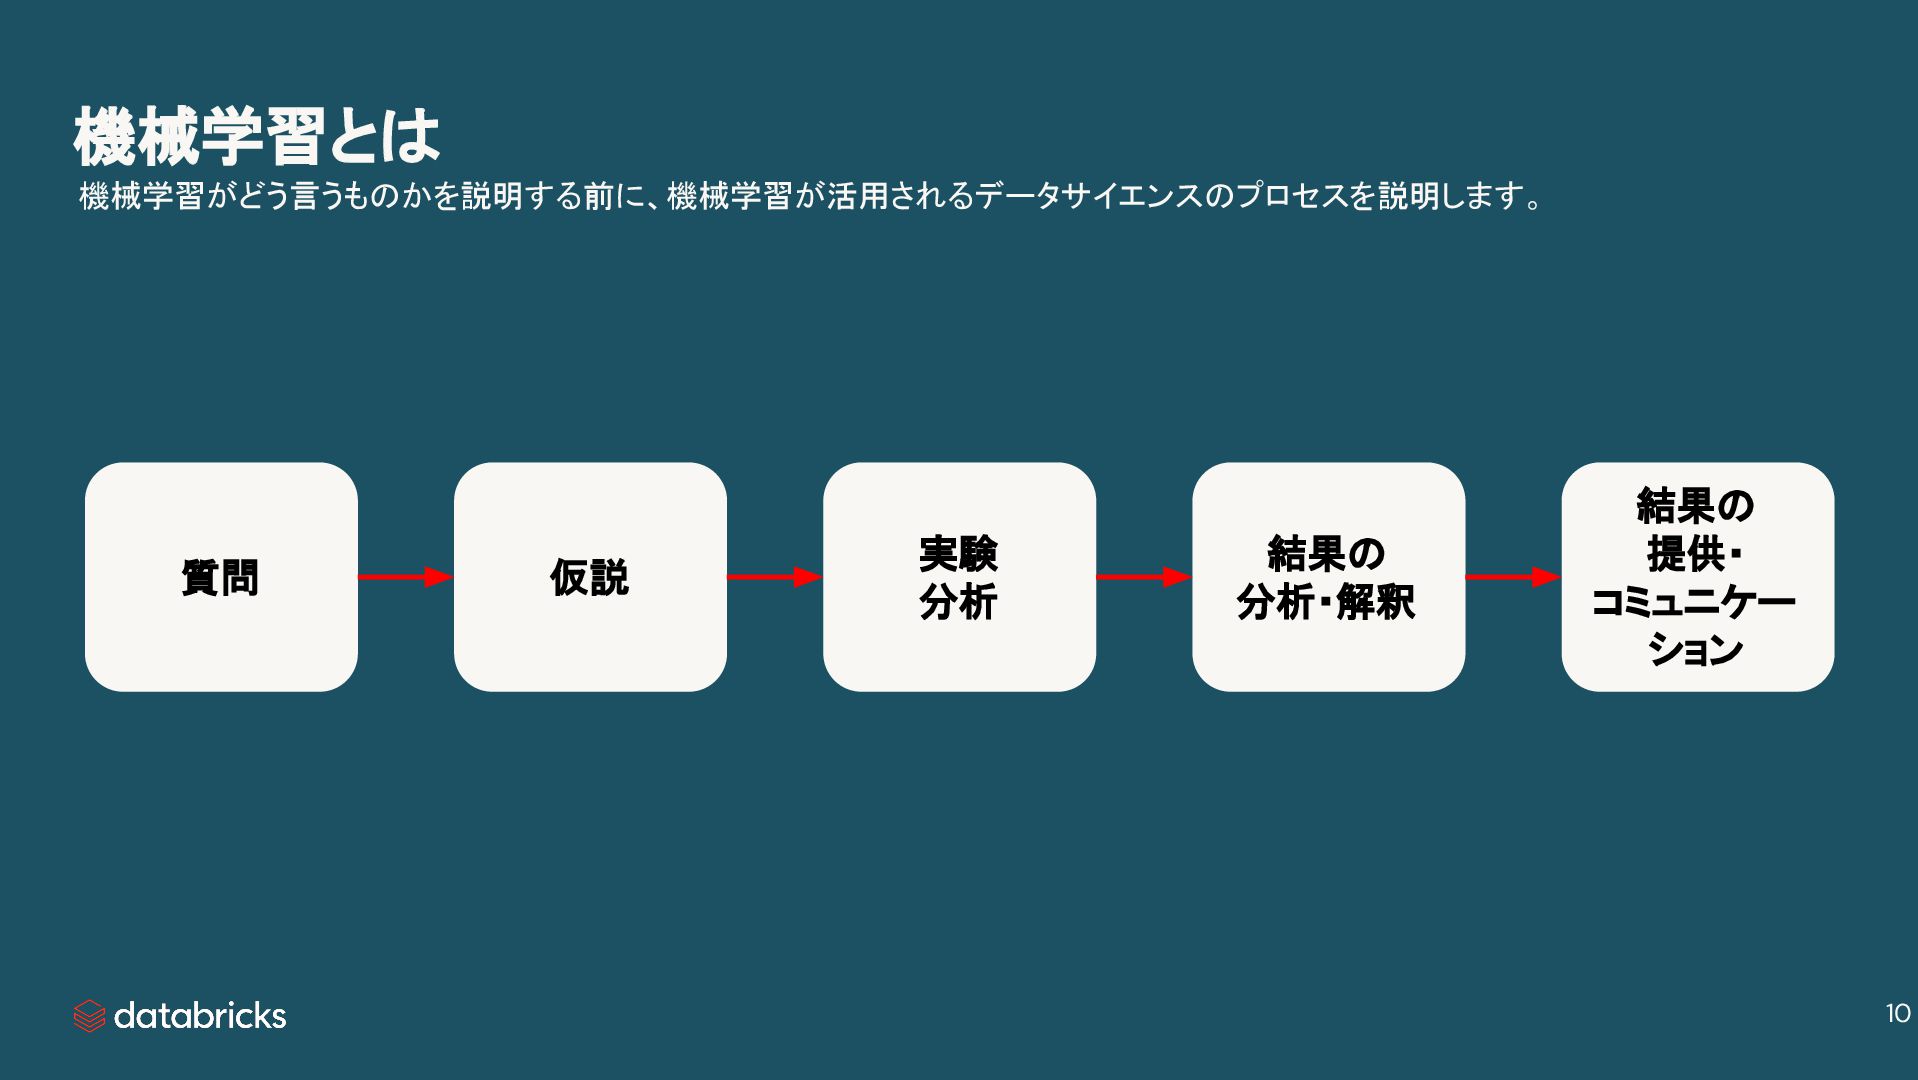
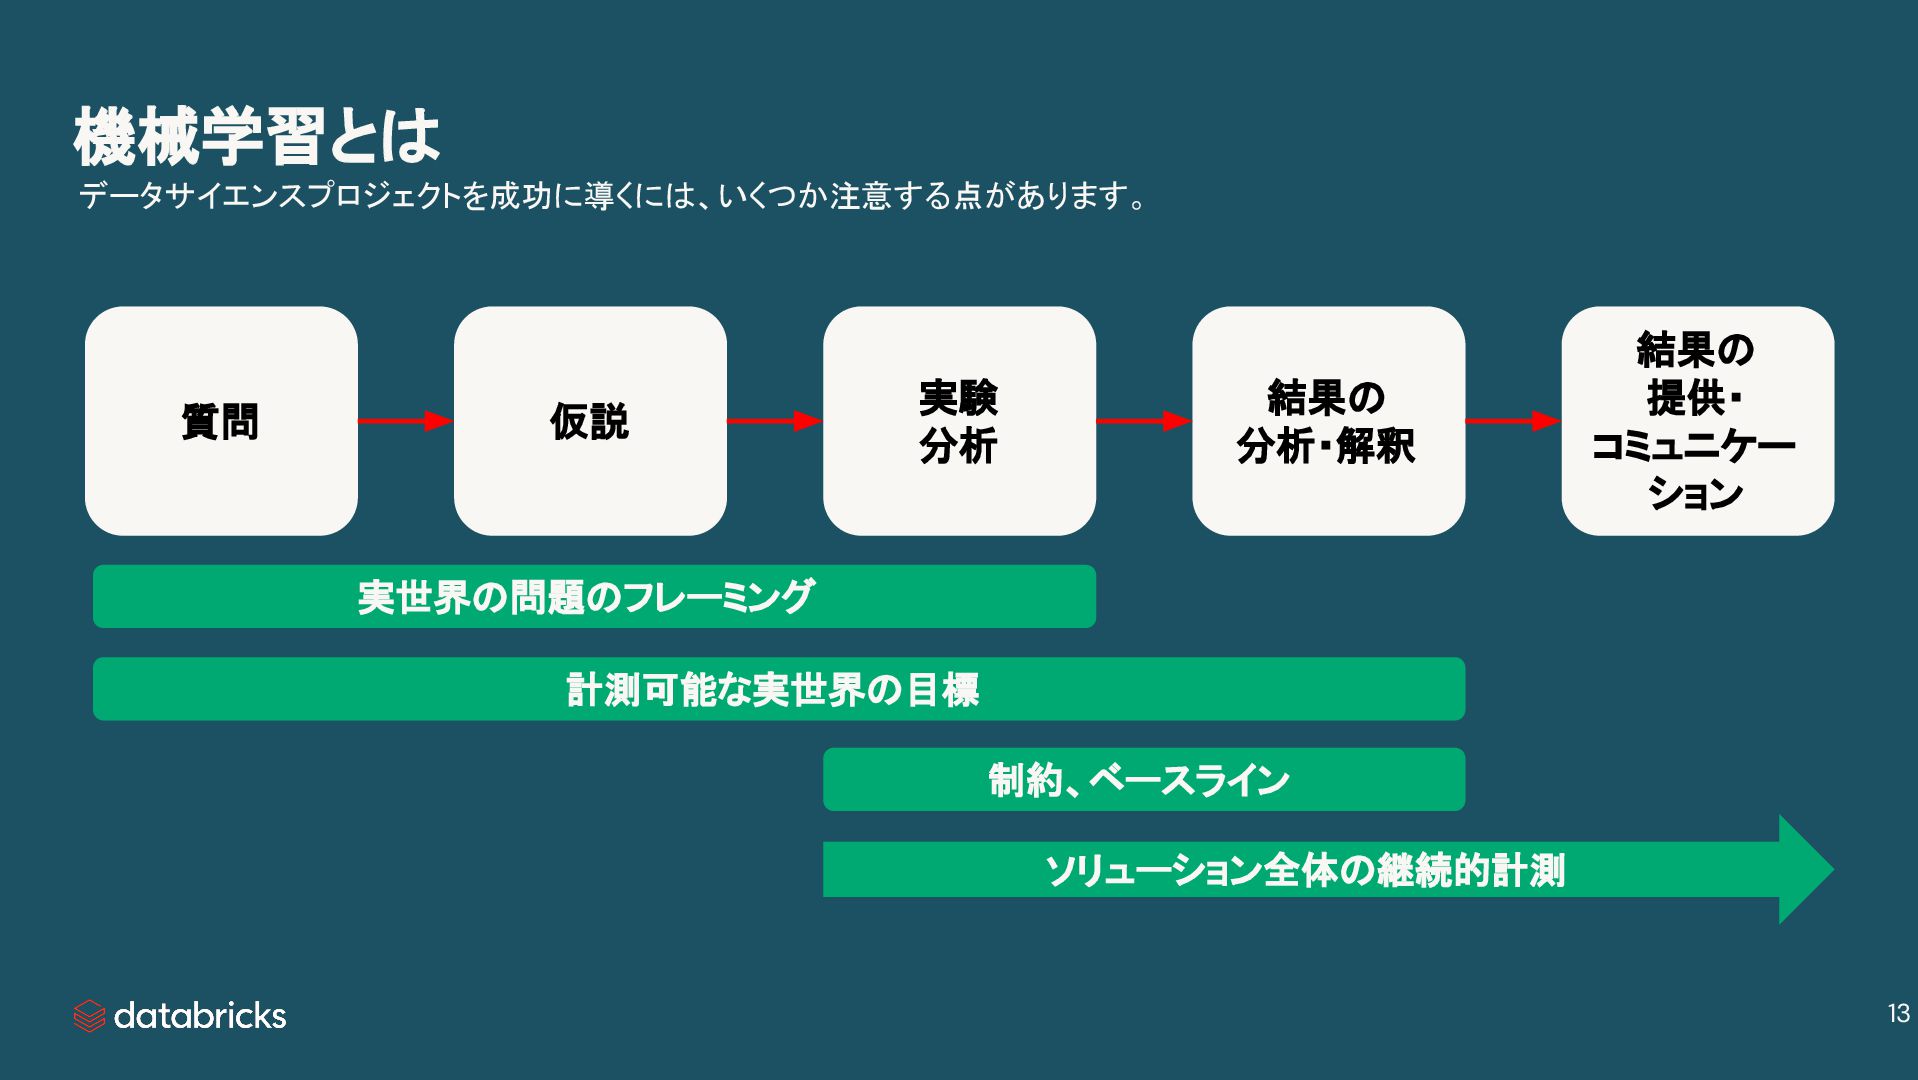
機械学習とは データサイエンスプロジェクトを成功に導くには、いくつか注意する点があります。 質問 仮説 実験 分析 結果の 分析・解釈 結果の 提供・
コミュニケー ション 実世界の問題のフレーミング 計測可能な実世界の目標 制約、ベースライン ソリューション全体の継続的計測 13 -
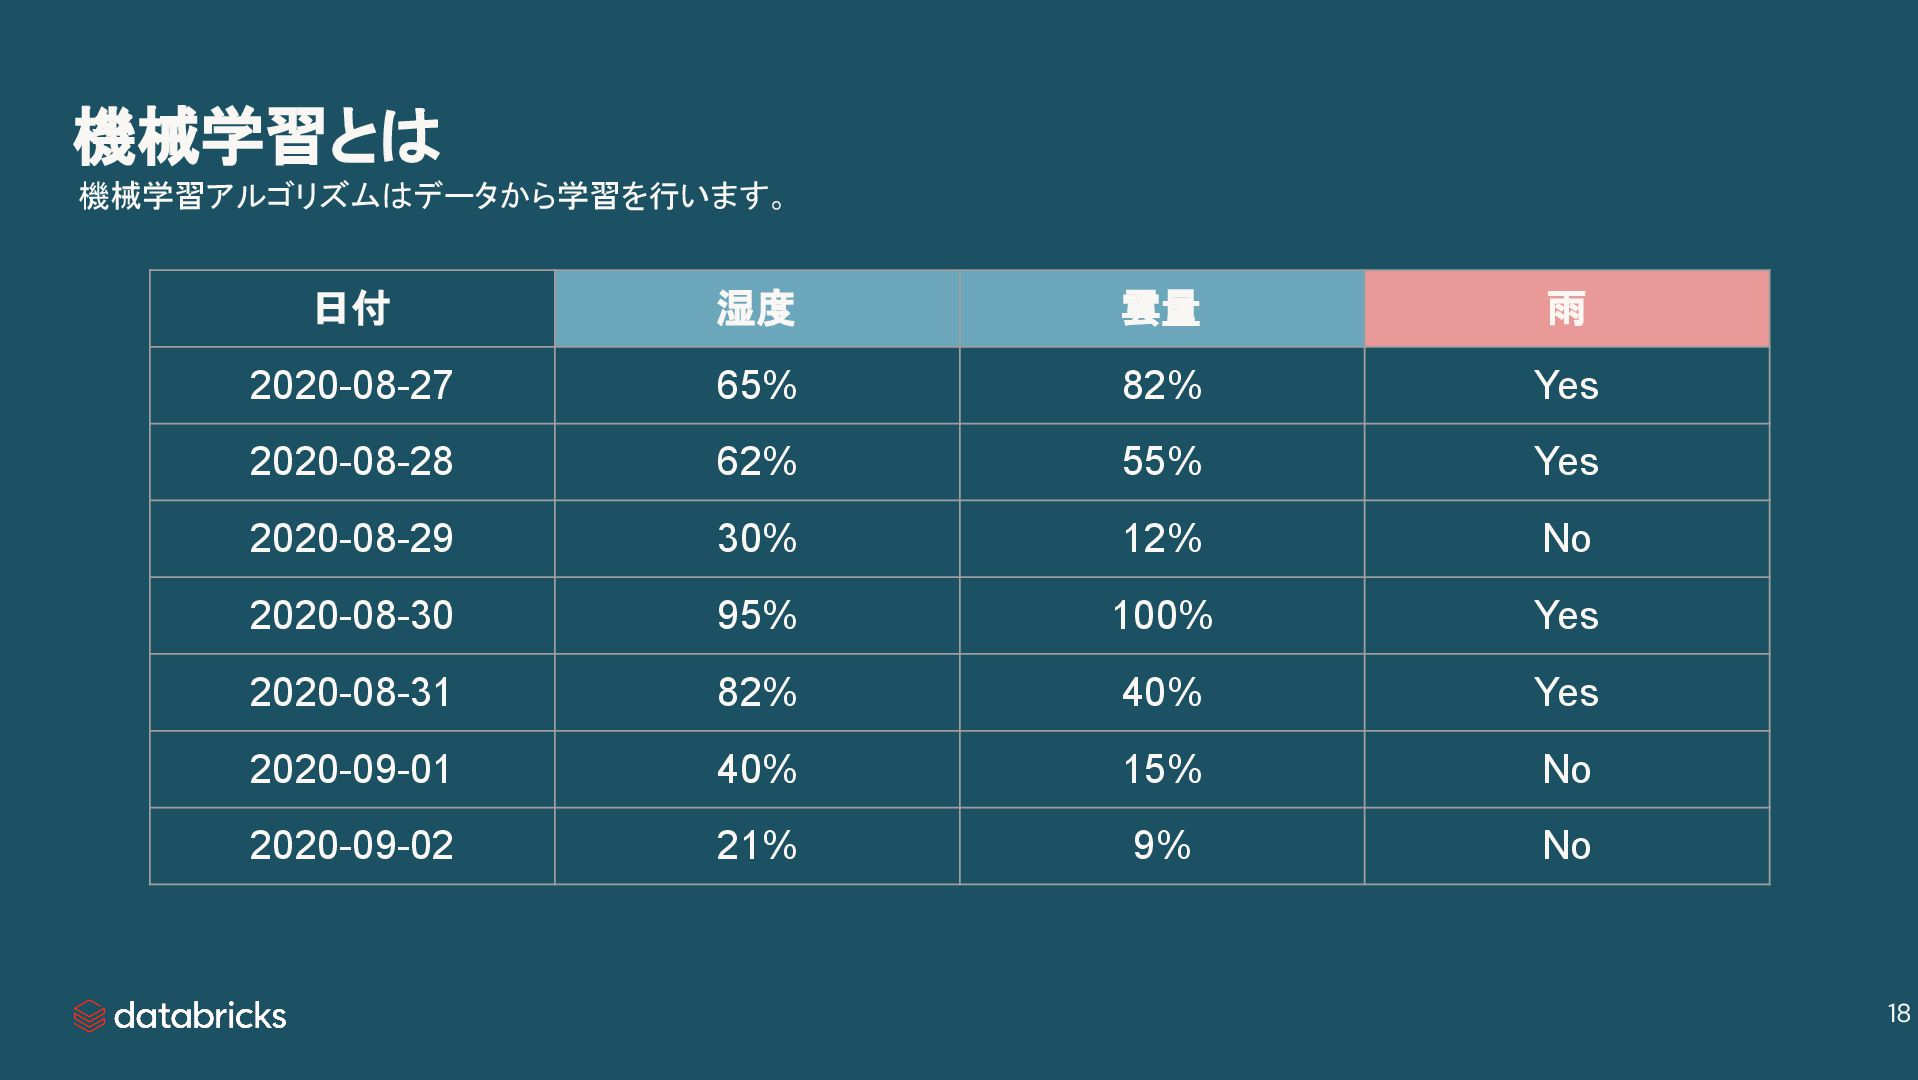
機械学習とは 機械学習アルゴリズムはデータから学習を行います。 日付 湿度 雲量 雨 2020-08-27 65% 82% Yes
2020-08-28 62% 55% Yes 2020-08-29 30% 12% No 2020-08-30 95% 100% Yes 2020-08-31 82% 40% Yes 2020-09-01 40% 15% No 2020-09-02 21% 9% No 18 -
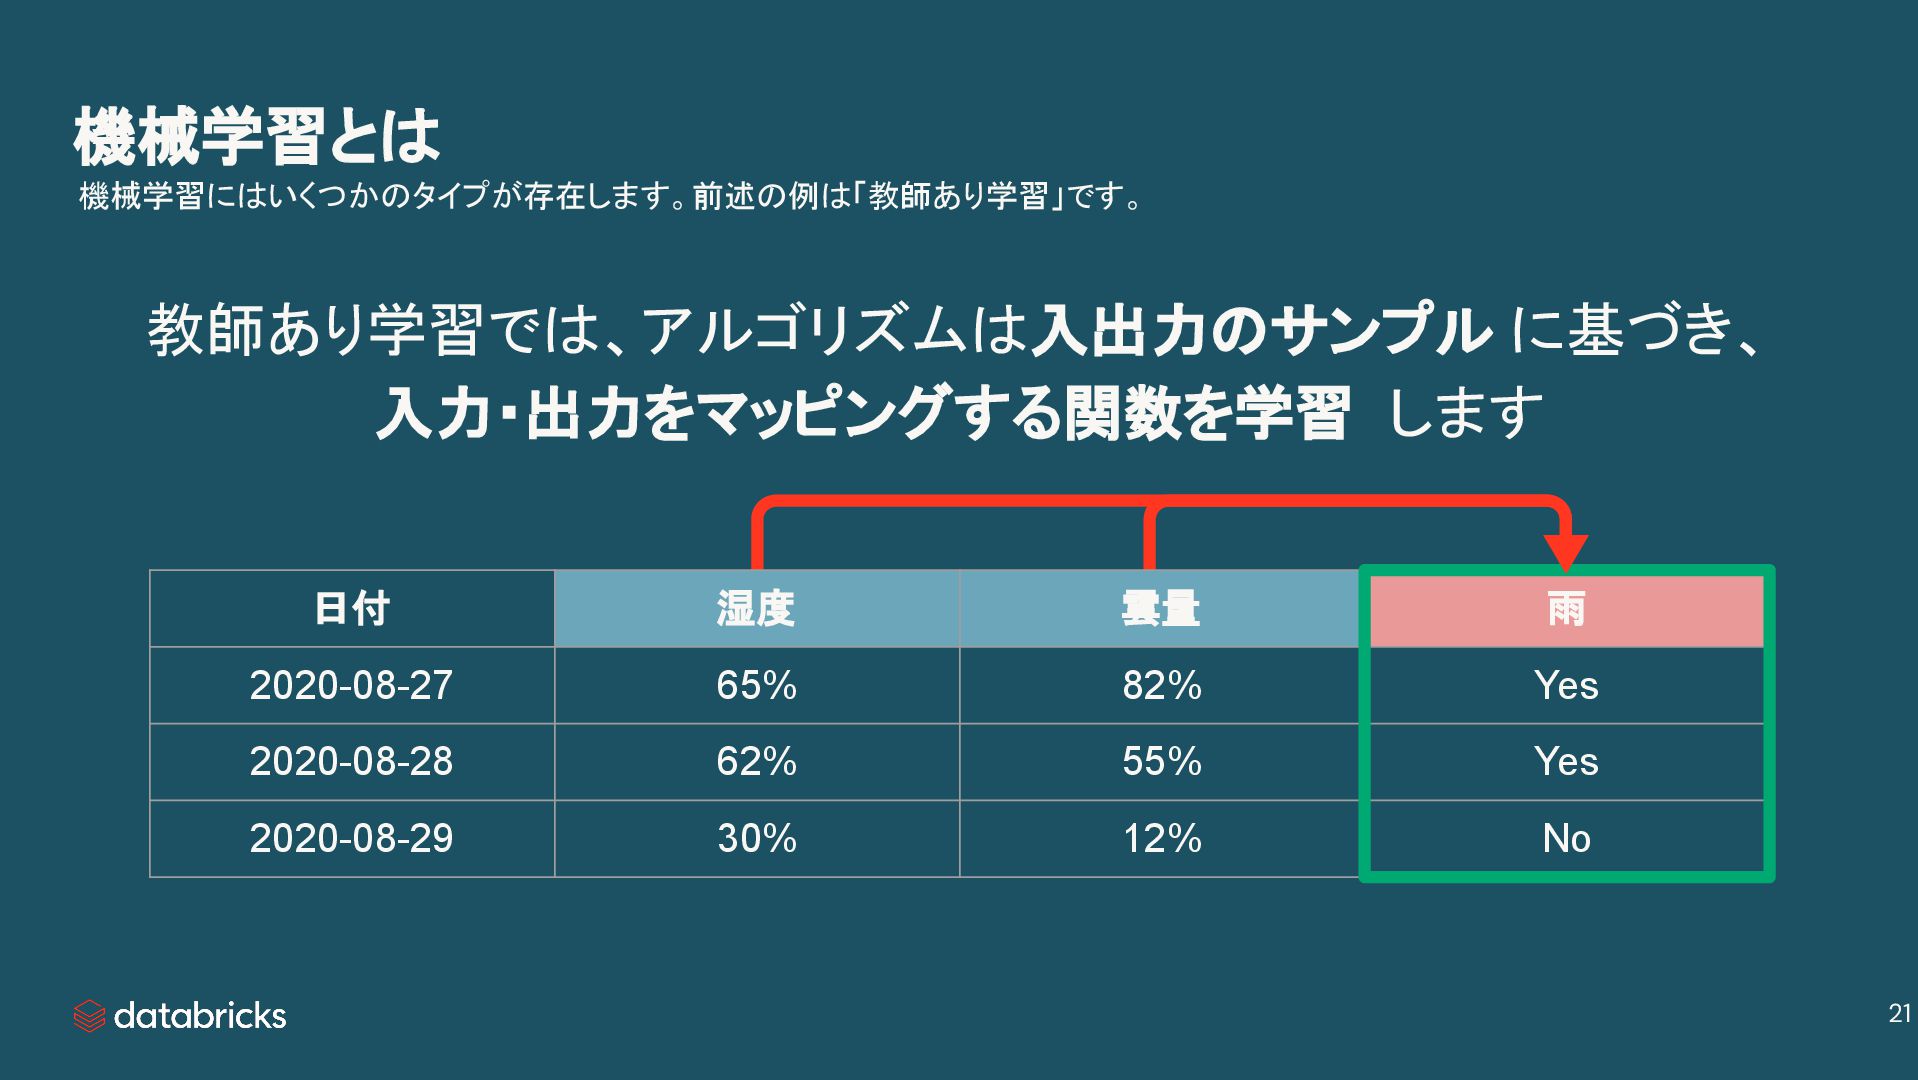
機械学習とは 機械学習にはいくつかのタイプが存在します。前述の例は「教師あり学習」です。 日付 湿度 雲量 雨 2020-08-27 65% 82% Yes
2020-08-28 62% 55% Yes 2020-08-29 30% 12% No 教師あり学習では、アルゴリズムは入出力のサンプル に基づき、 入力・出力をマッピングする関数を学習 します 21 -
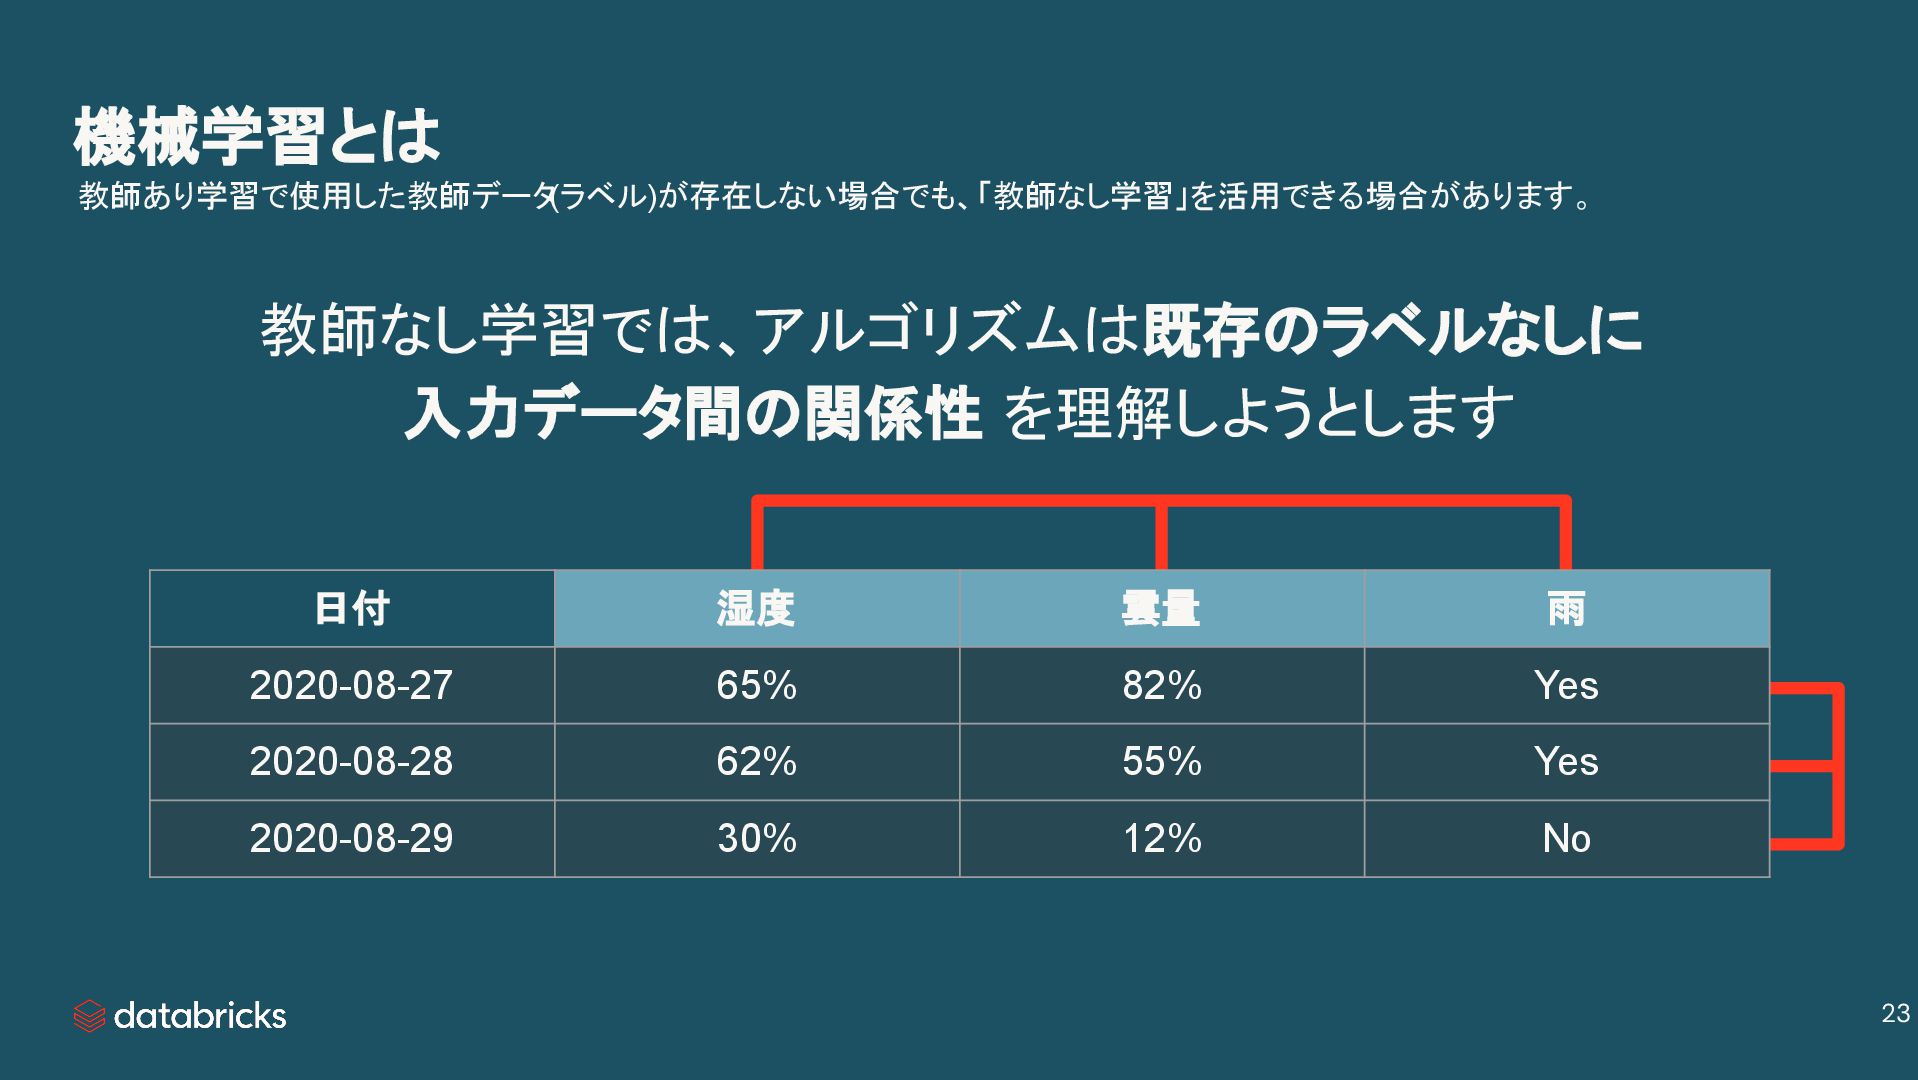
機械学習とは 教師あり学習で使用した教師データ (ラベル)が存在しない場合でも、「教師なし学習」を活用できる場合があります。 教師なし学習では、アルゴリズムは既存のラベルなしに 入力データ間の関係性 を理解しようとします 日付 湿度 雲量 雨
2020-08-27 65% 82% Yes 2020-08-28 62% 55% Yes 2020-08-29 30% 12% No 23 -
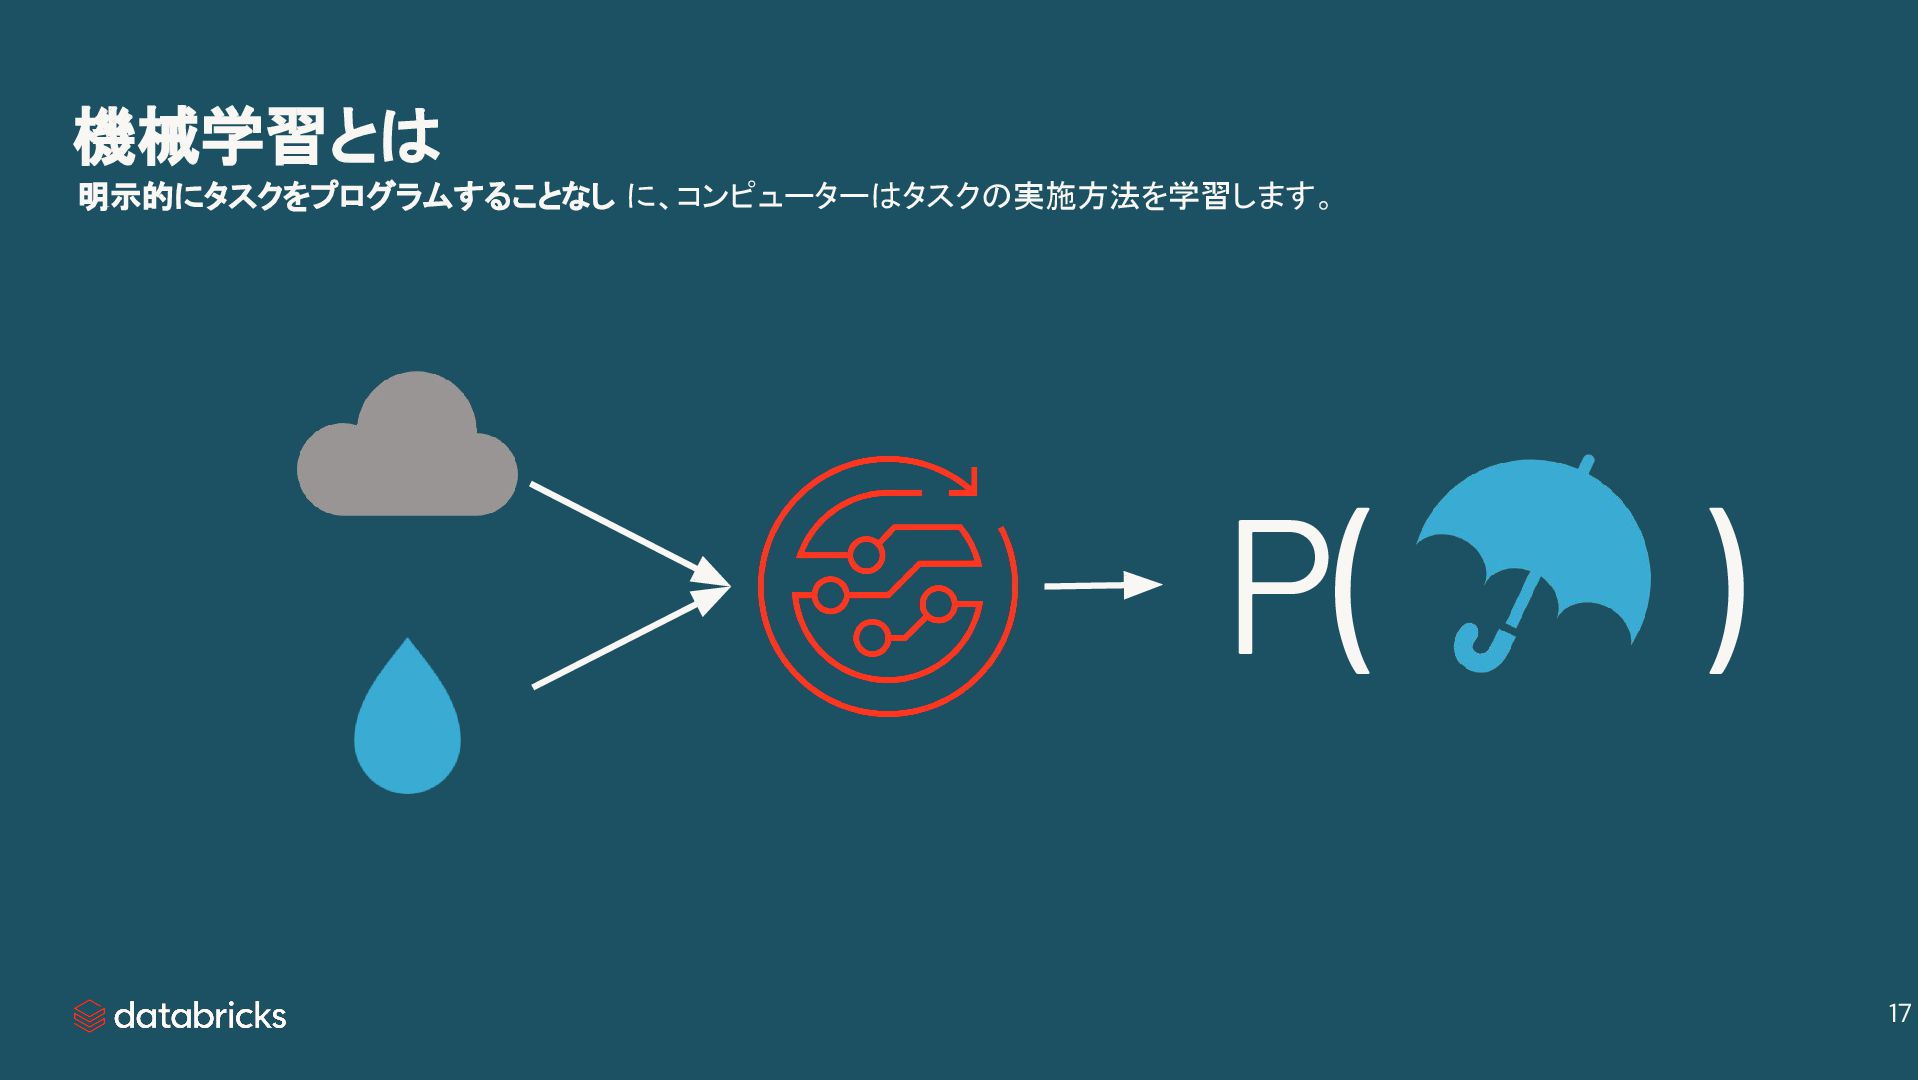
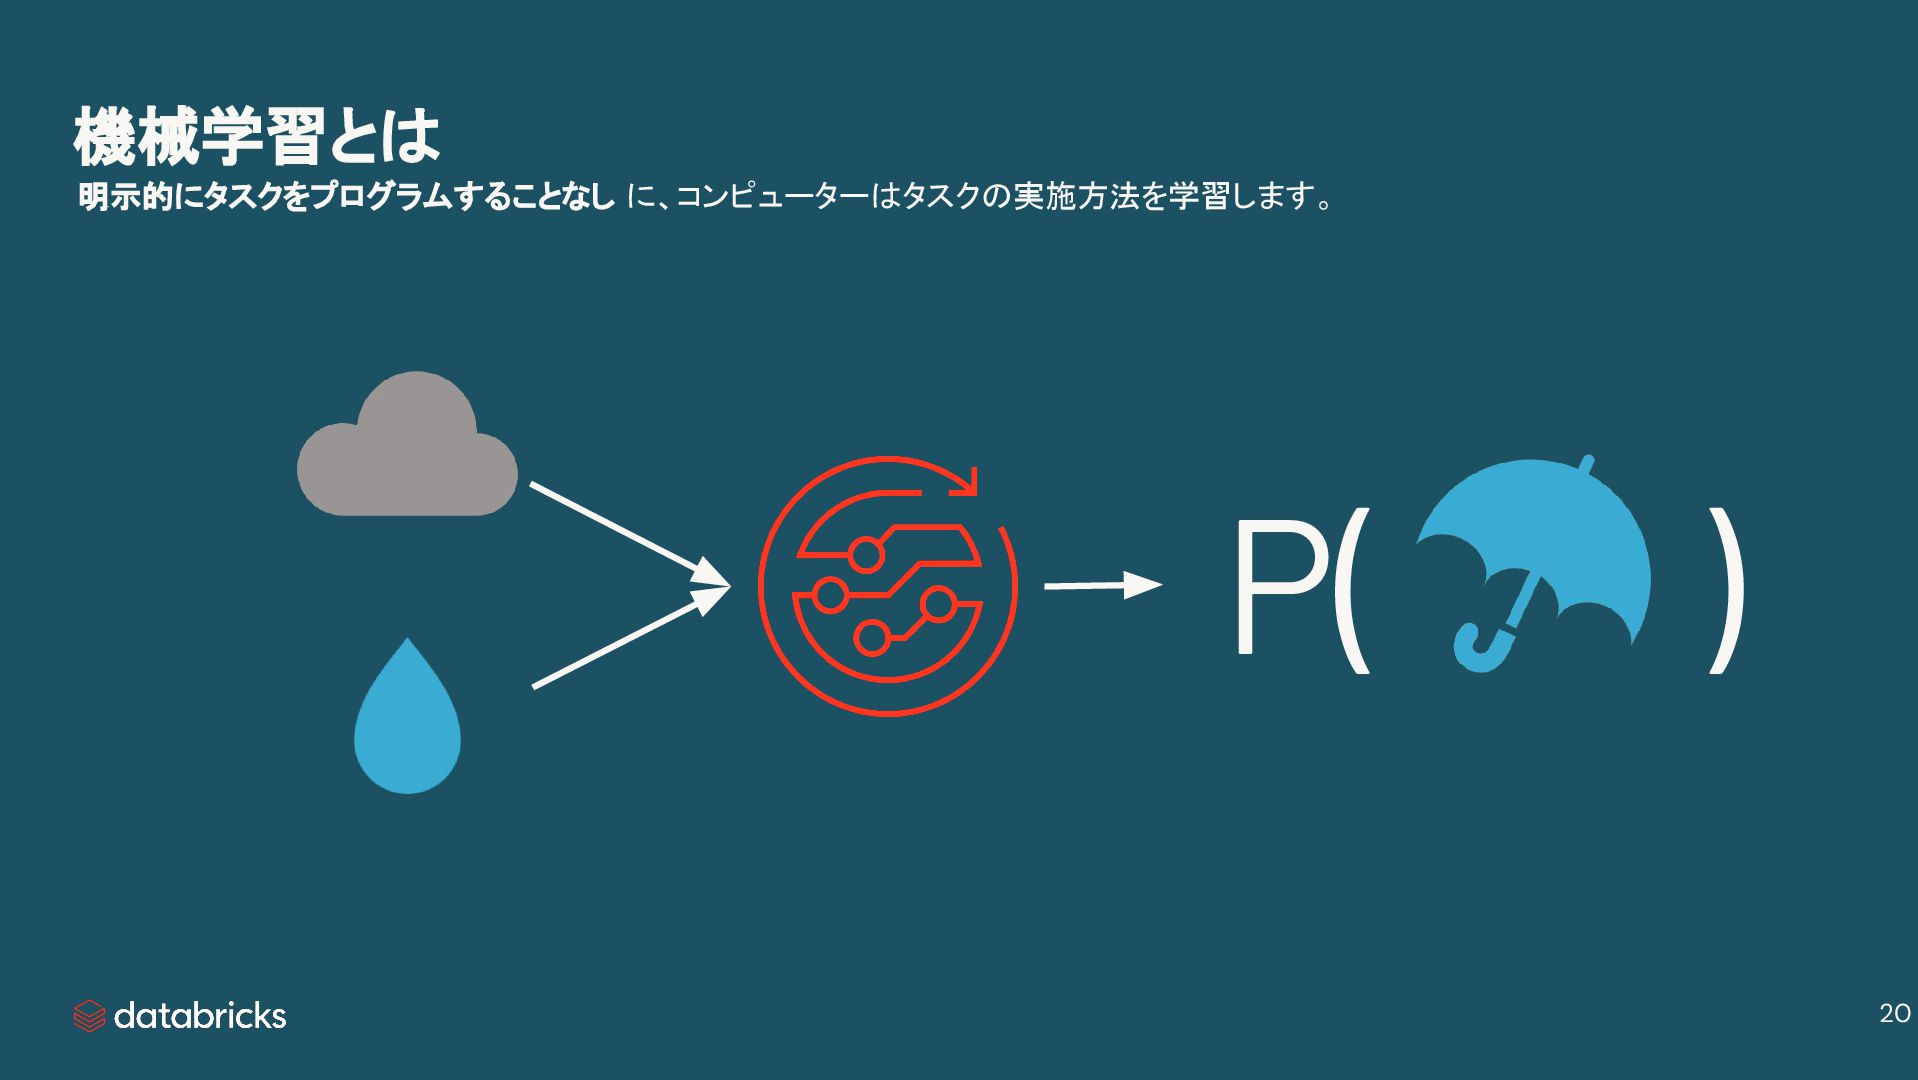
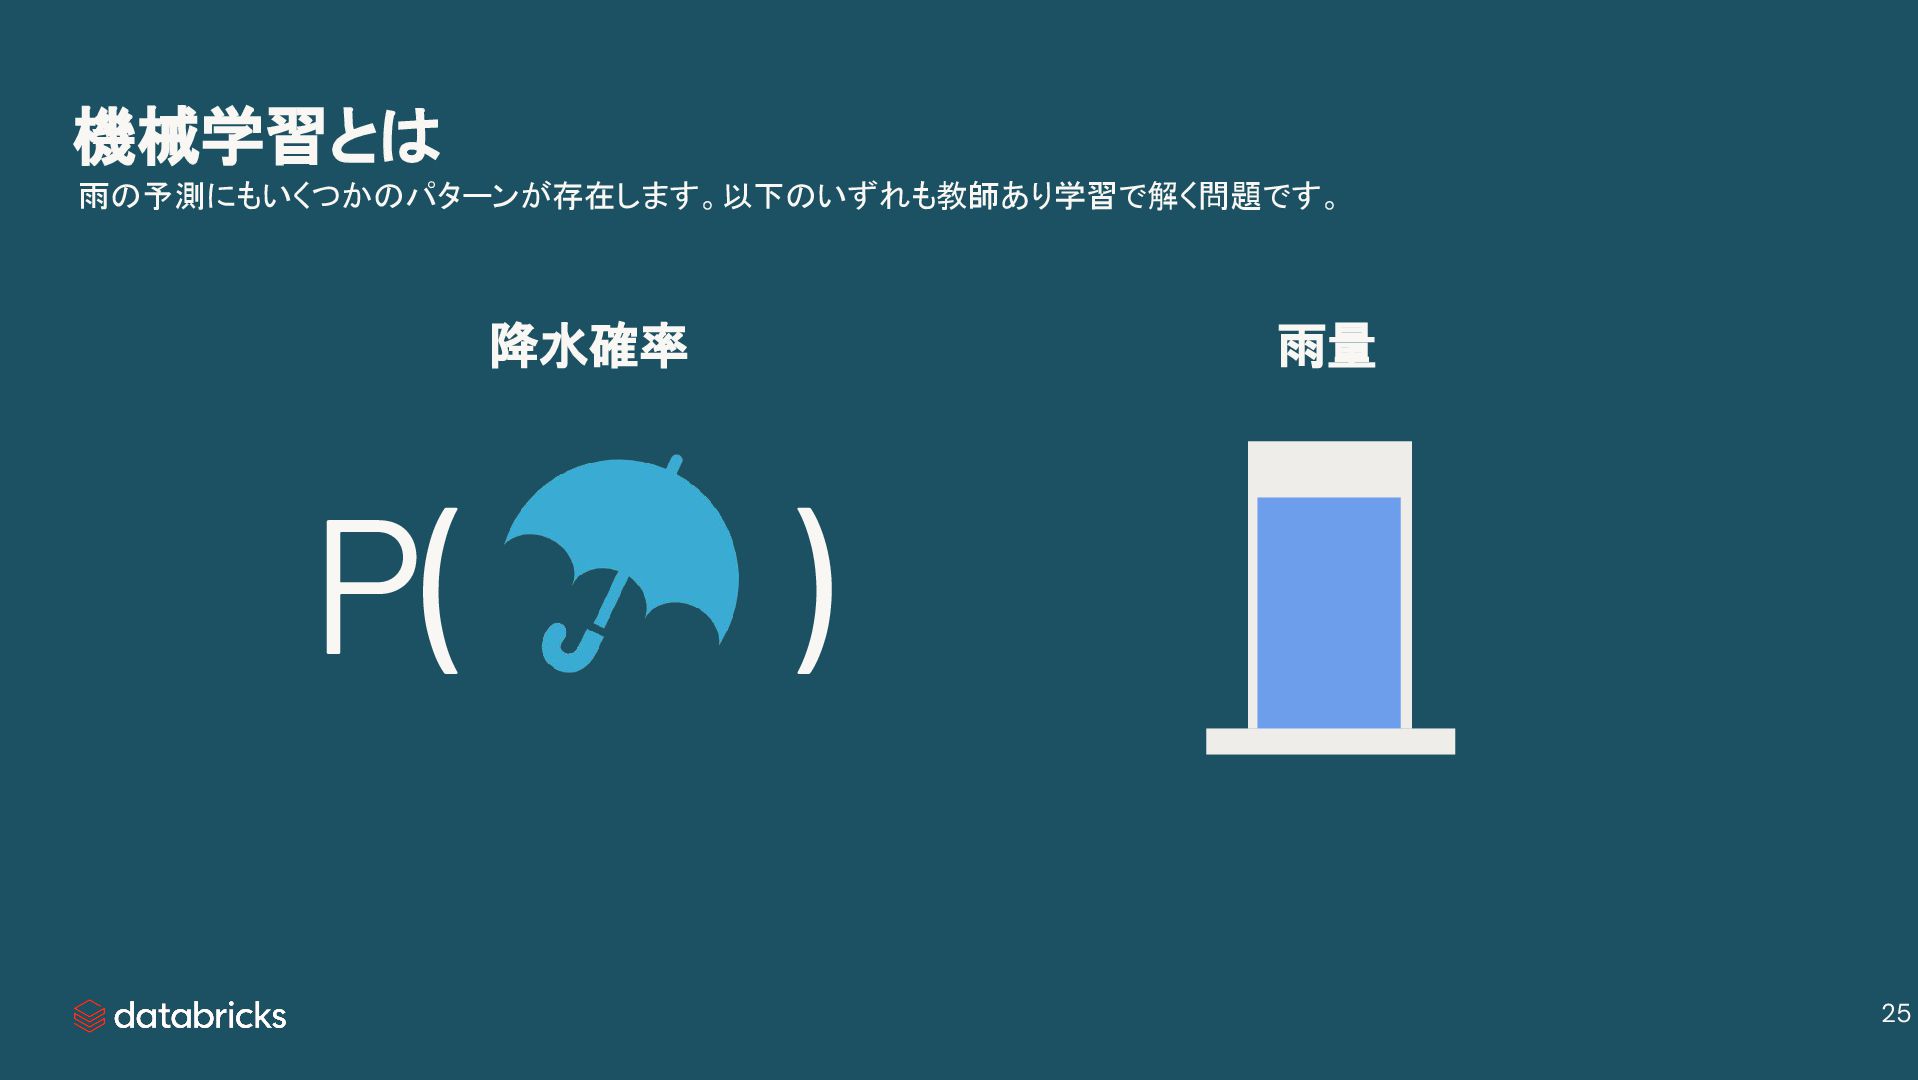
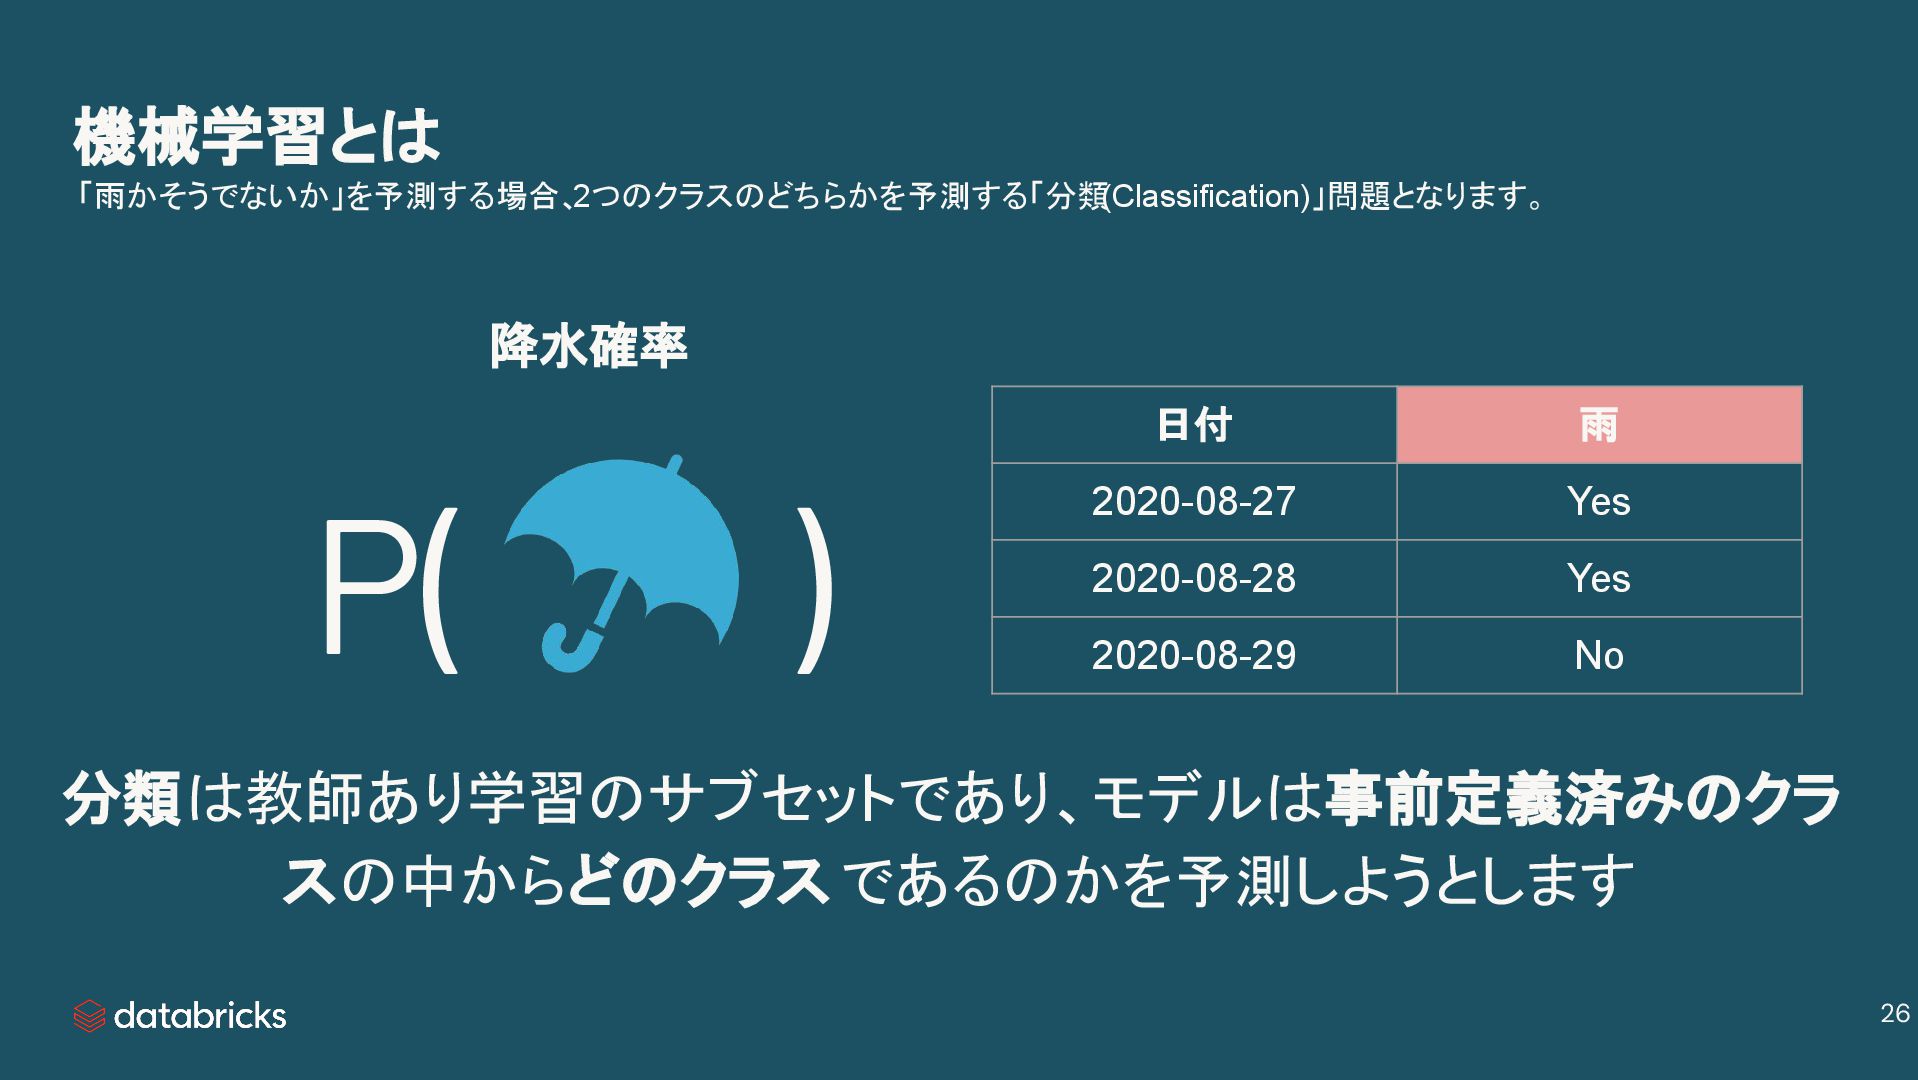
機械学習とは 「雨かそうでないか」を予測する場合、 2つのクラスのどちらかを予測する「分類 (Classification)」問題となります。 P( ) 降水確率 日付 雨 2020-08-27
Yes 2020-08-28 Yes 2020-08-29 No 分類は教師あり学習のサブセットであり、モデルは事前定義済みのクラ スの中からどのクラス であるのかを予測しようとします 26 -
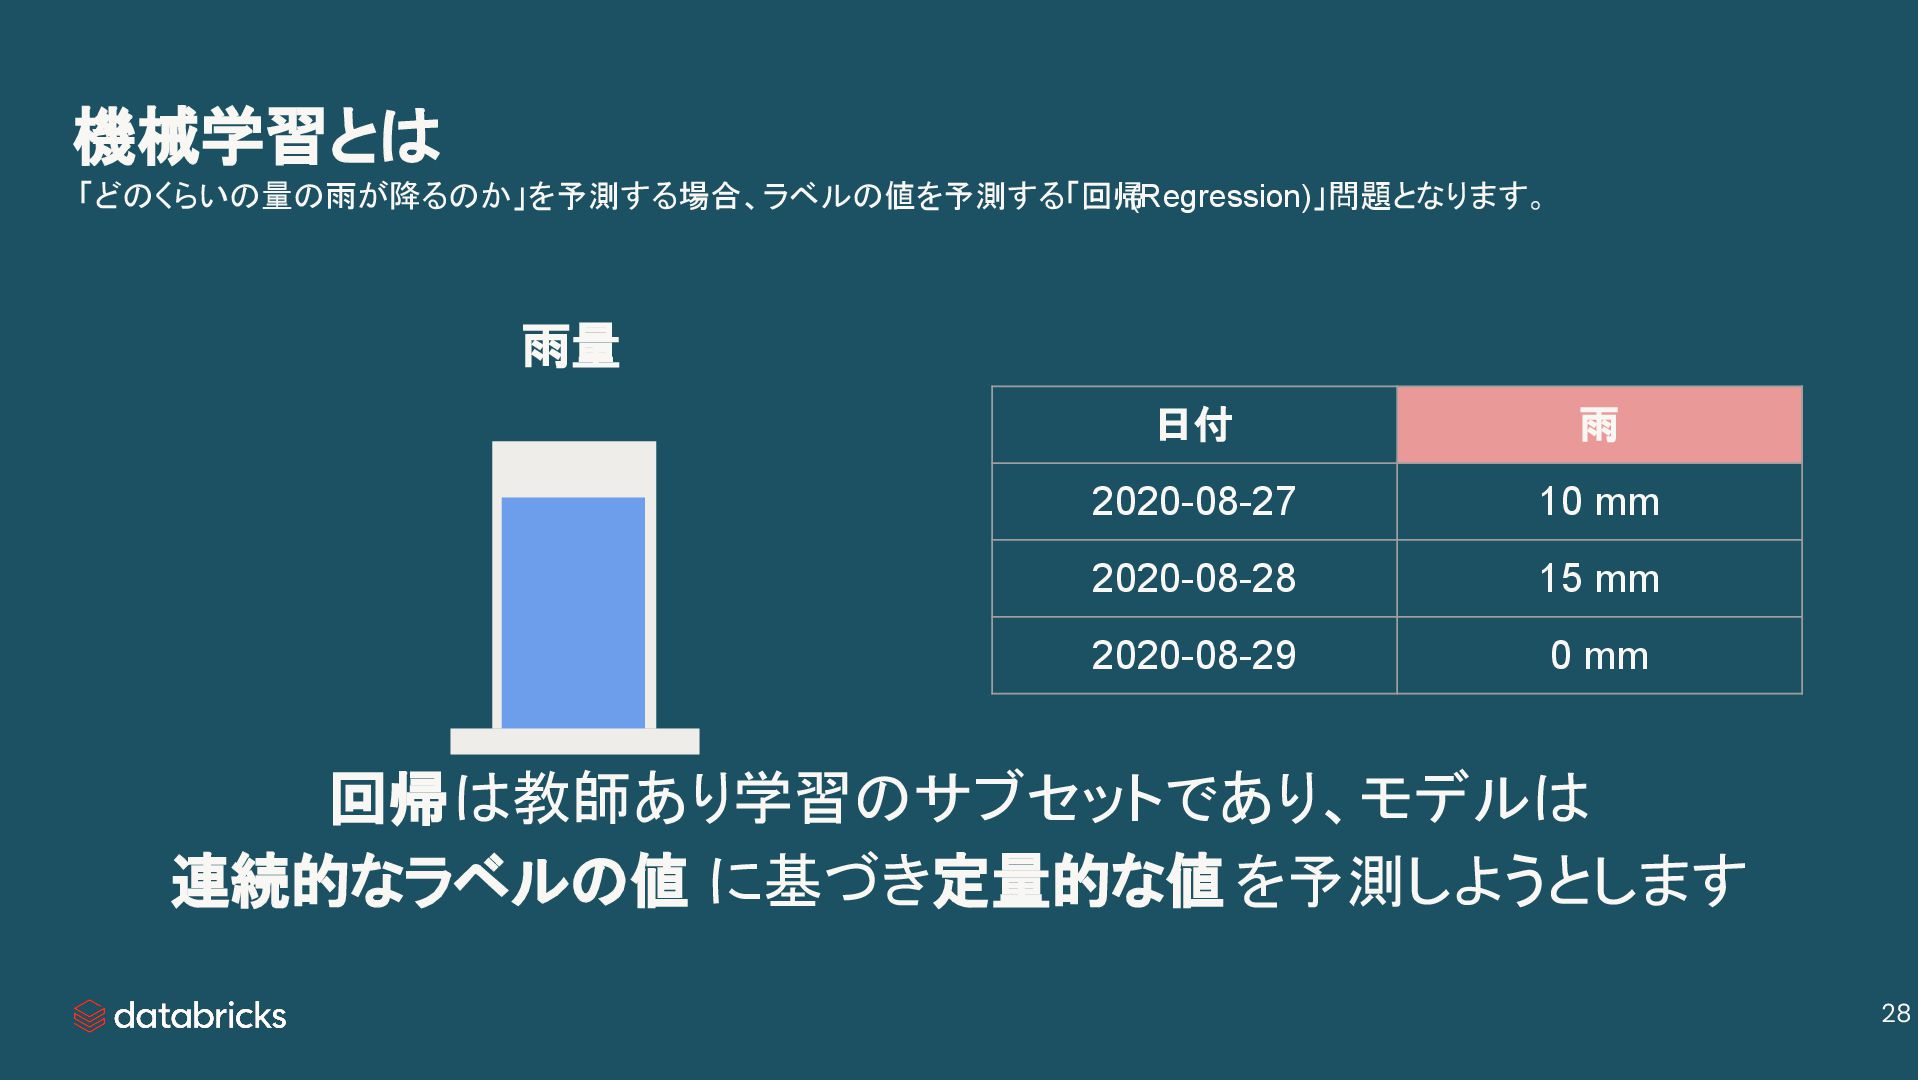
機械学習とは 「どのくらいの量の雨が降るのか」を予測する場合、ラベルの値を予測する「回帰 (Regression)」問題となります。 日付 雨 2020-08-27 10 mm 2020-08-28 15
mm 2020-08-29 0 mm 回帰は教師あり学習のサブセットであり、モデルは 連続的なラベルの値 に基づき定量的な値 を予測しようとします 雨量 28 -
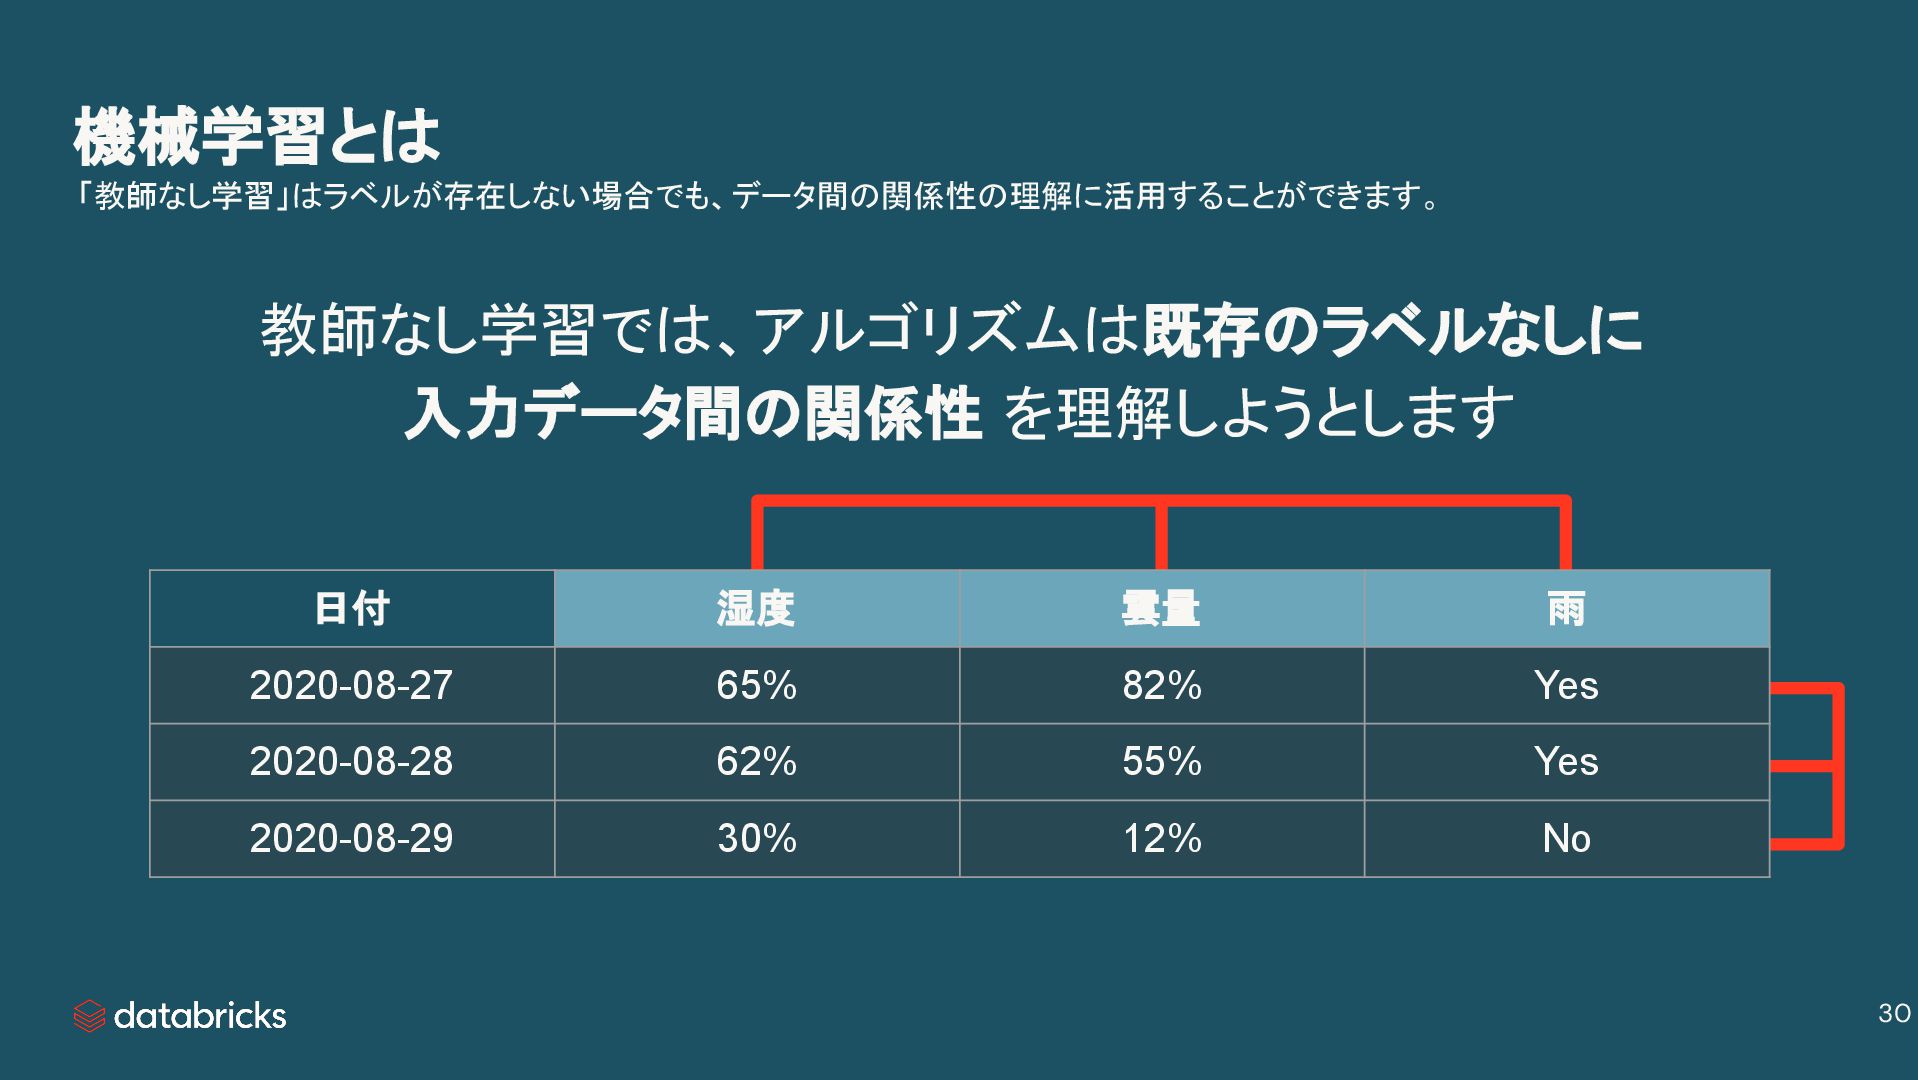
機械学習とは 「教師なし学習」はラベルが存在しない場合でも、データ間の関係性の理解に活用することができます。 教師なし学習では、アルゴリズムは既存のラベルなしに 入力データ間の関係性 を理解しようとします 日付 湿度 雲量 雨 2020-08-27
65% 82% Yes 2020-08-28 62% 55% Yes 2020-08-29 30% 12% No 30 -
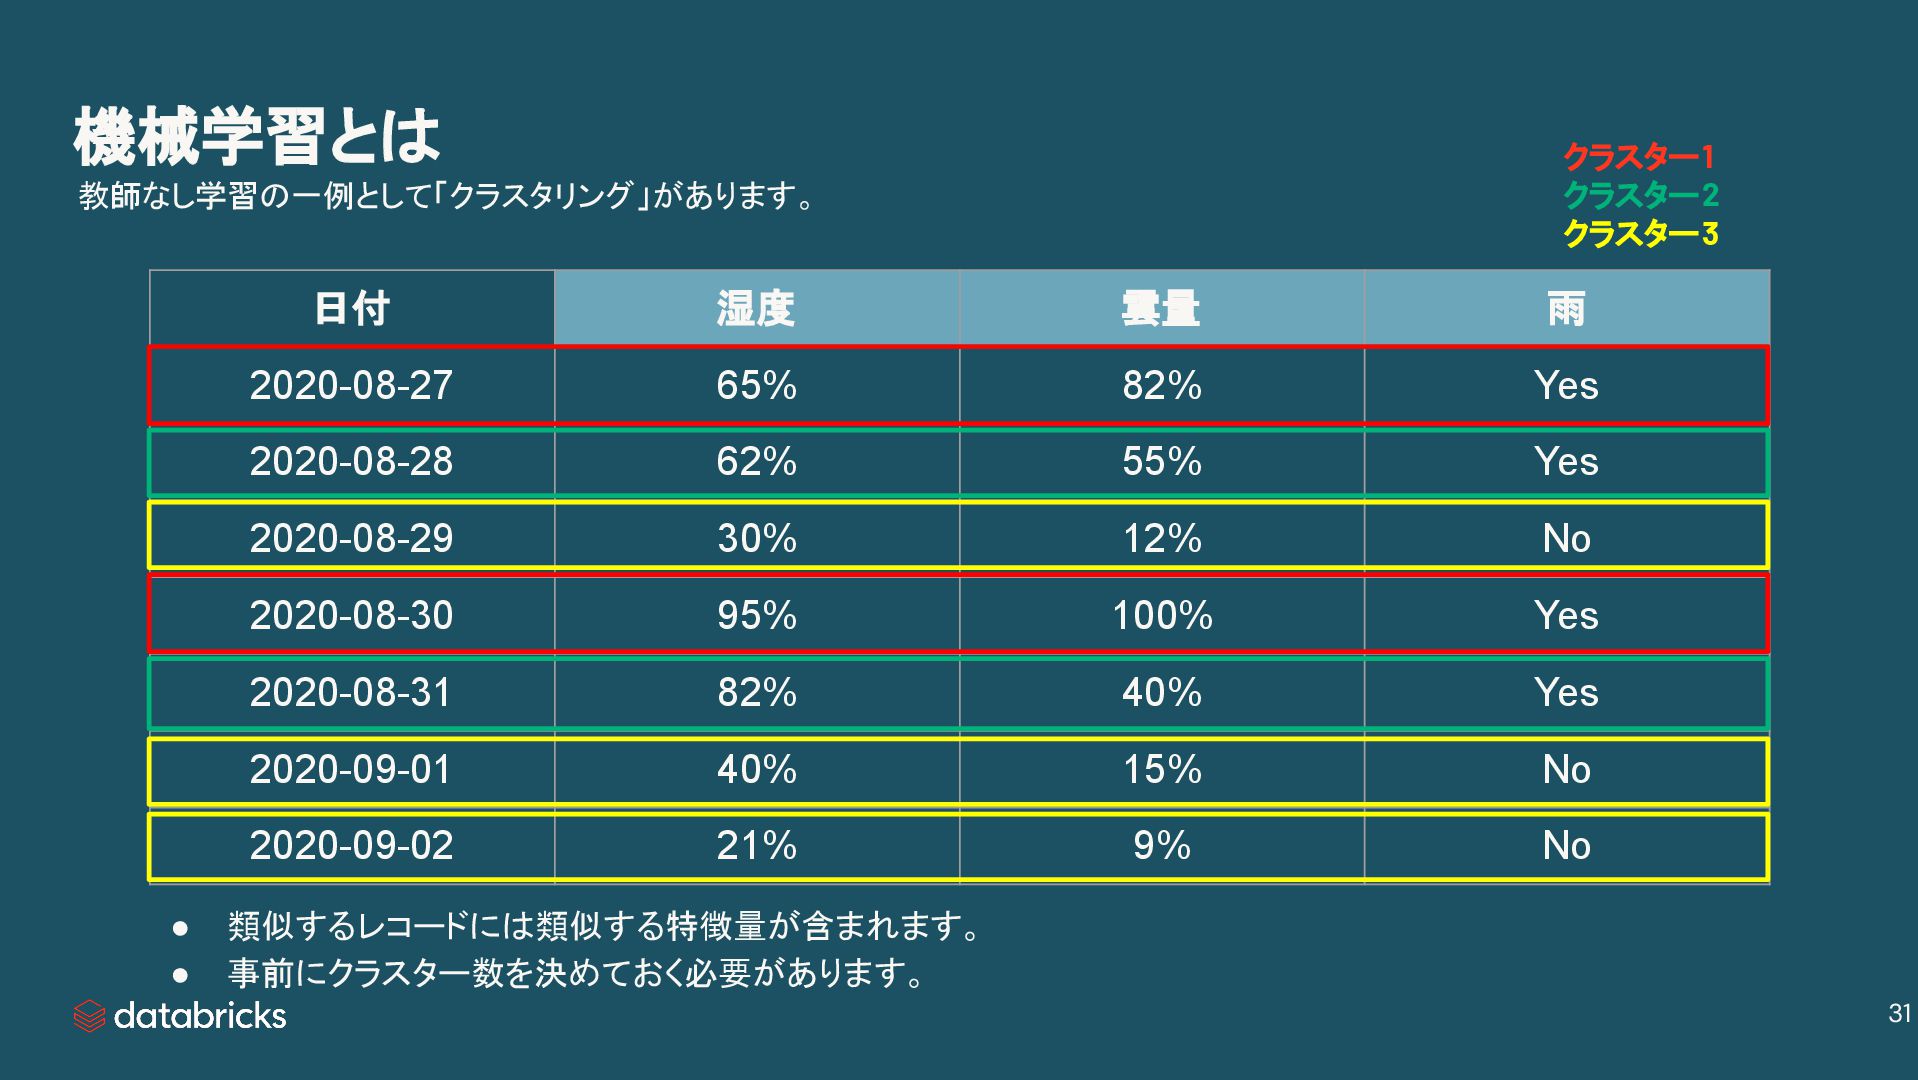
機械学習とは 教師なし学習の一例として「クラスタリング」があります。 日付 湿度 雲量 雨 2020-08-27 65% 82% Yes
2020-08-28 62% 55% Yes 2020-08-29 30% 12% No 2020-08-30 95% 100% Yes 2020-08-31 82% 40% Yes 2020-09-01 40% 15% No 2020-09-02 21% 9% No クラスター1 クラスター2 クラスター3 • 類似するレコードには類似する特徴量が含まれます。 • 事前にクラスター数を決めておく必要があります。 31 -
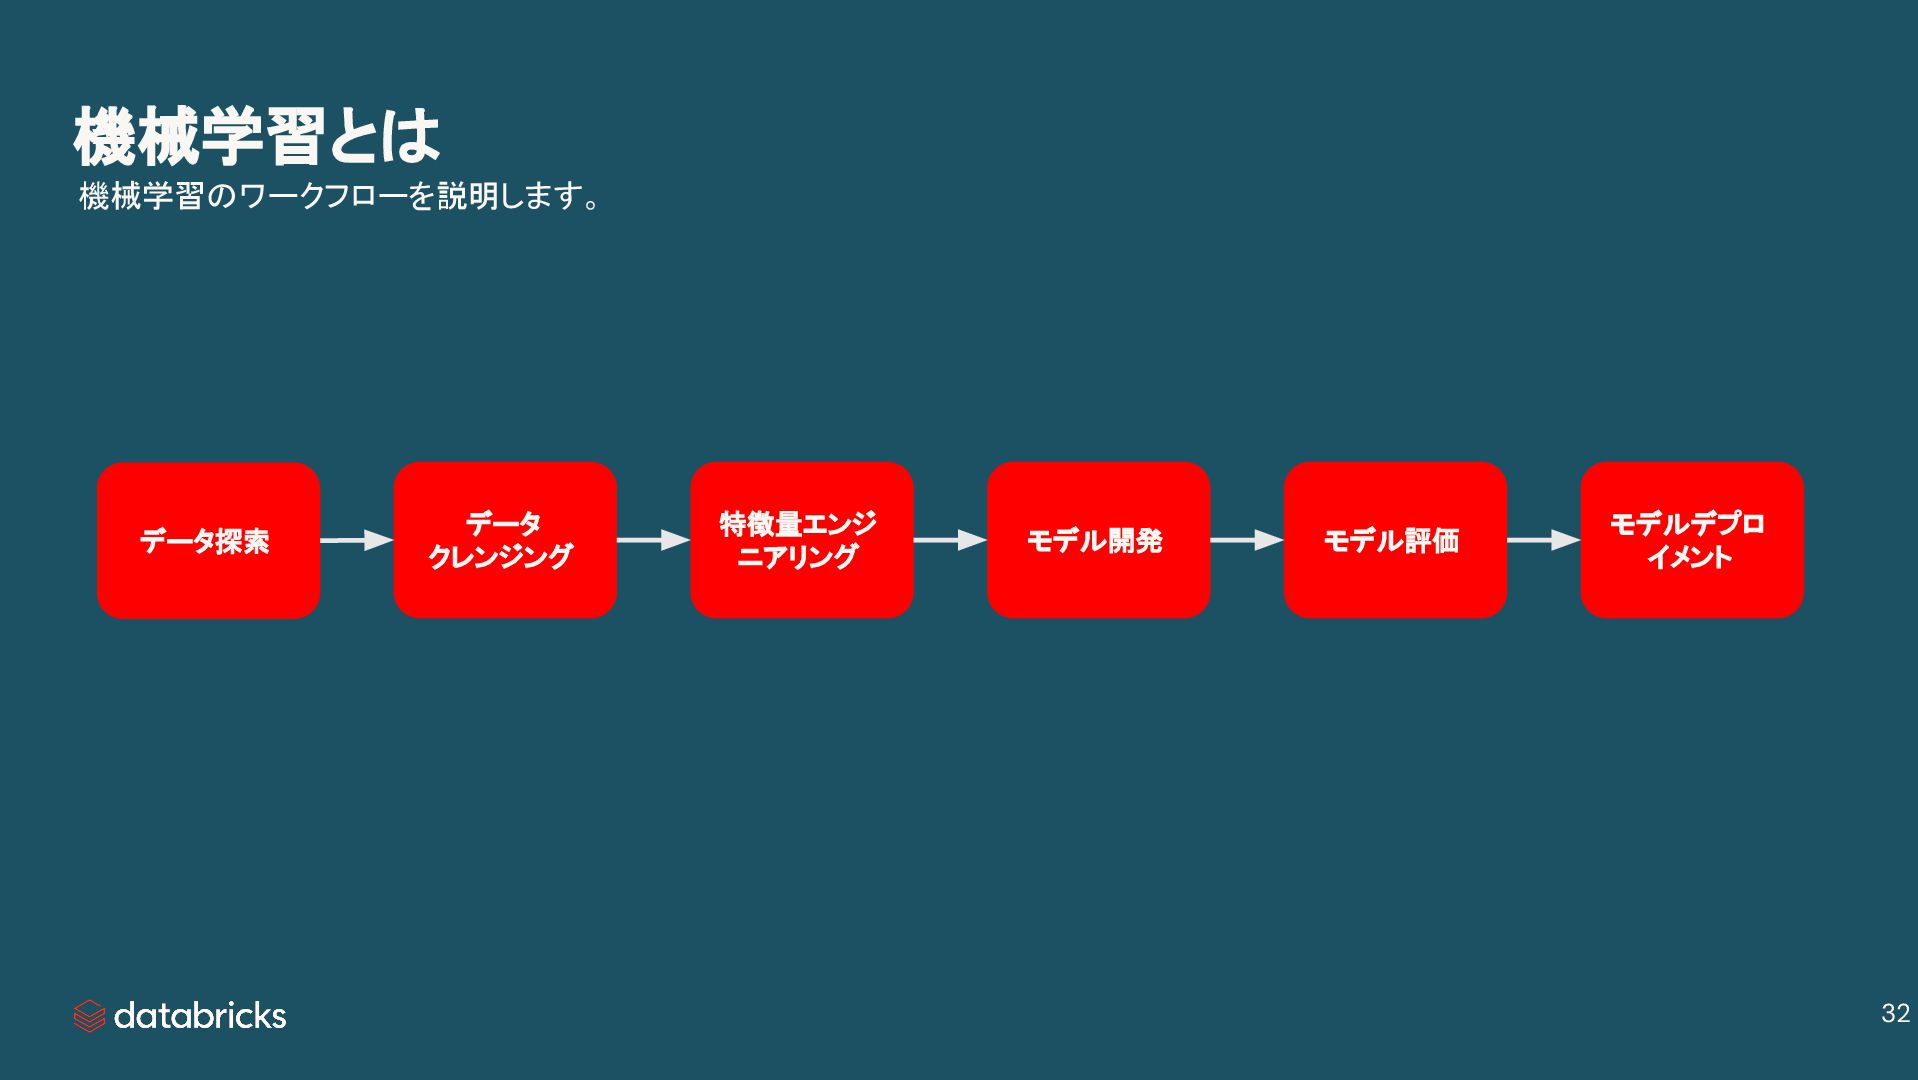
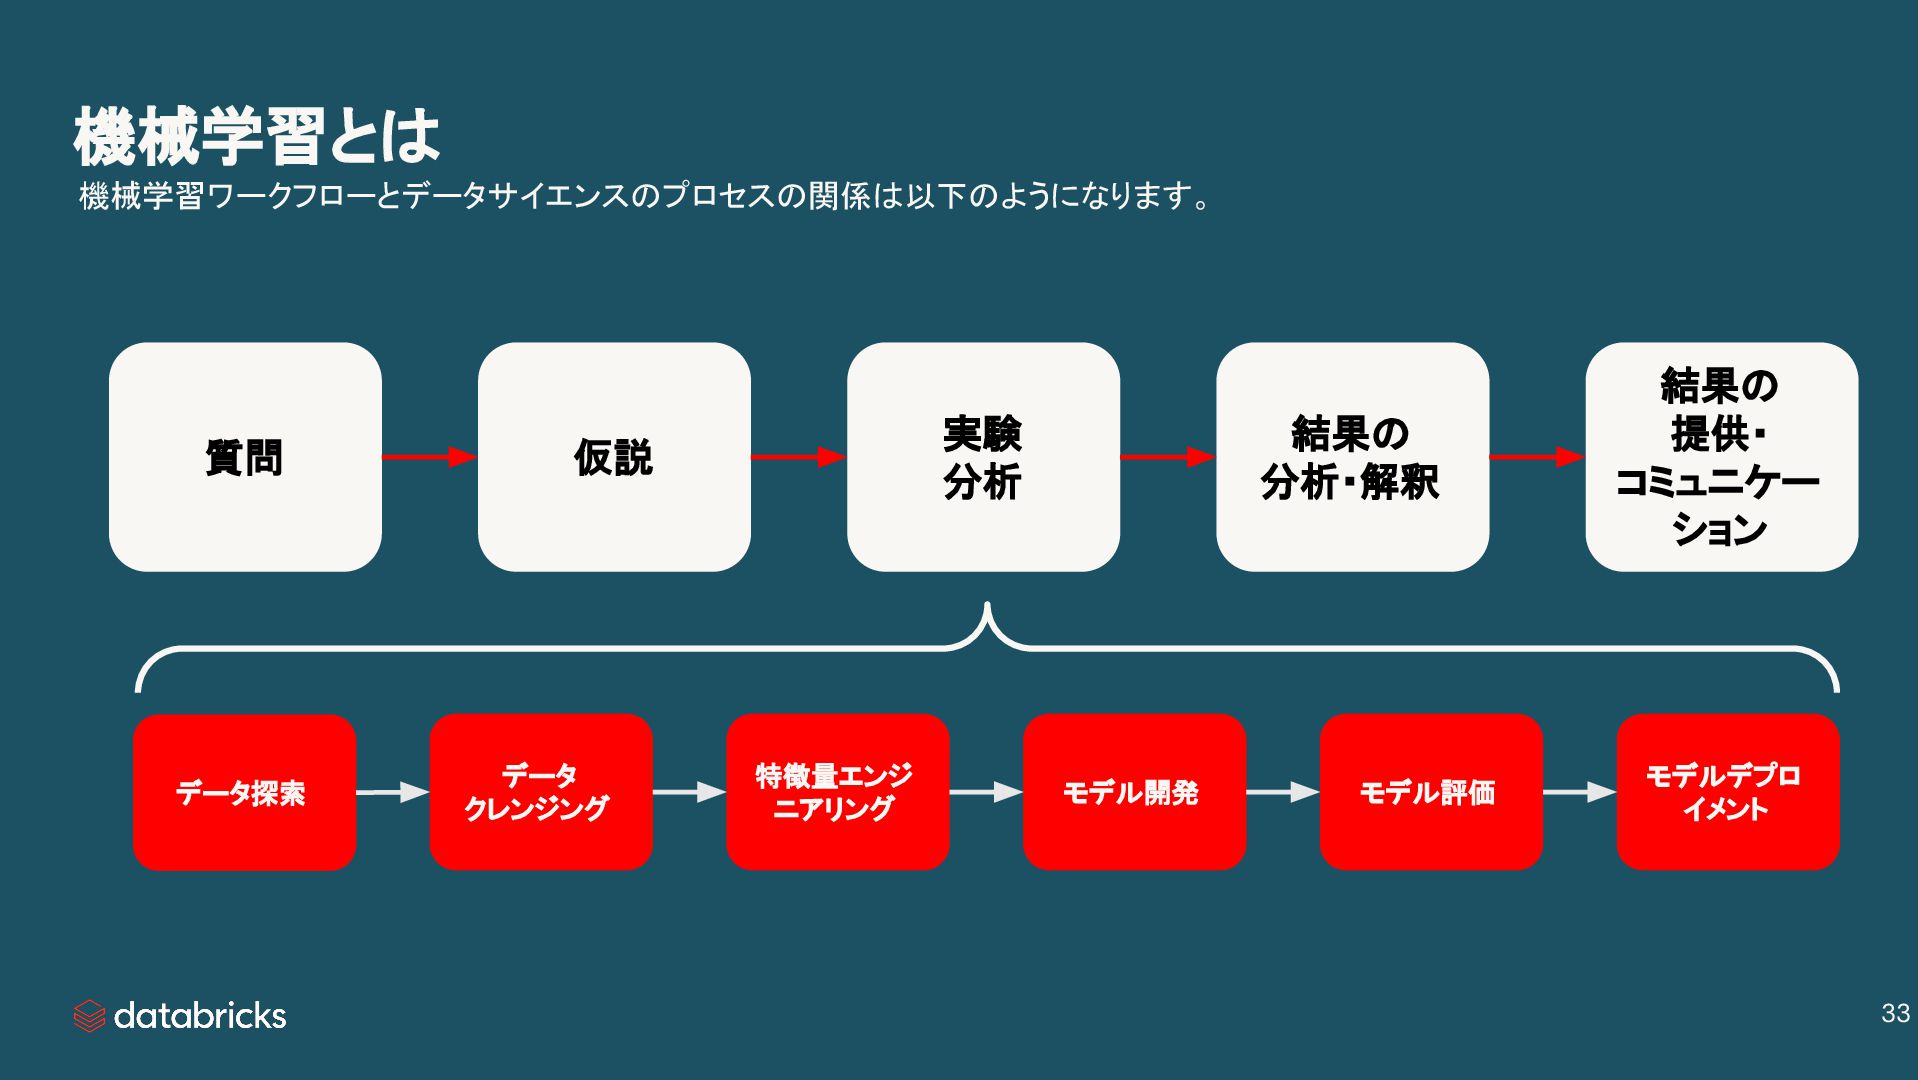
機械学習とは 機械学習ワークフローとデータサイエンスのプロセスの関係は以下のようになります。 データ探索 データ クレンジング 特徴量エンジ ニアリング モデル開発 モデル評価 モデルデプロ
イメント 質問 仮説 実験 分析 結果の 分析・解釈 結果の 提供・ コミュニケー ション 33 -
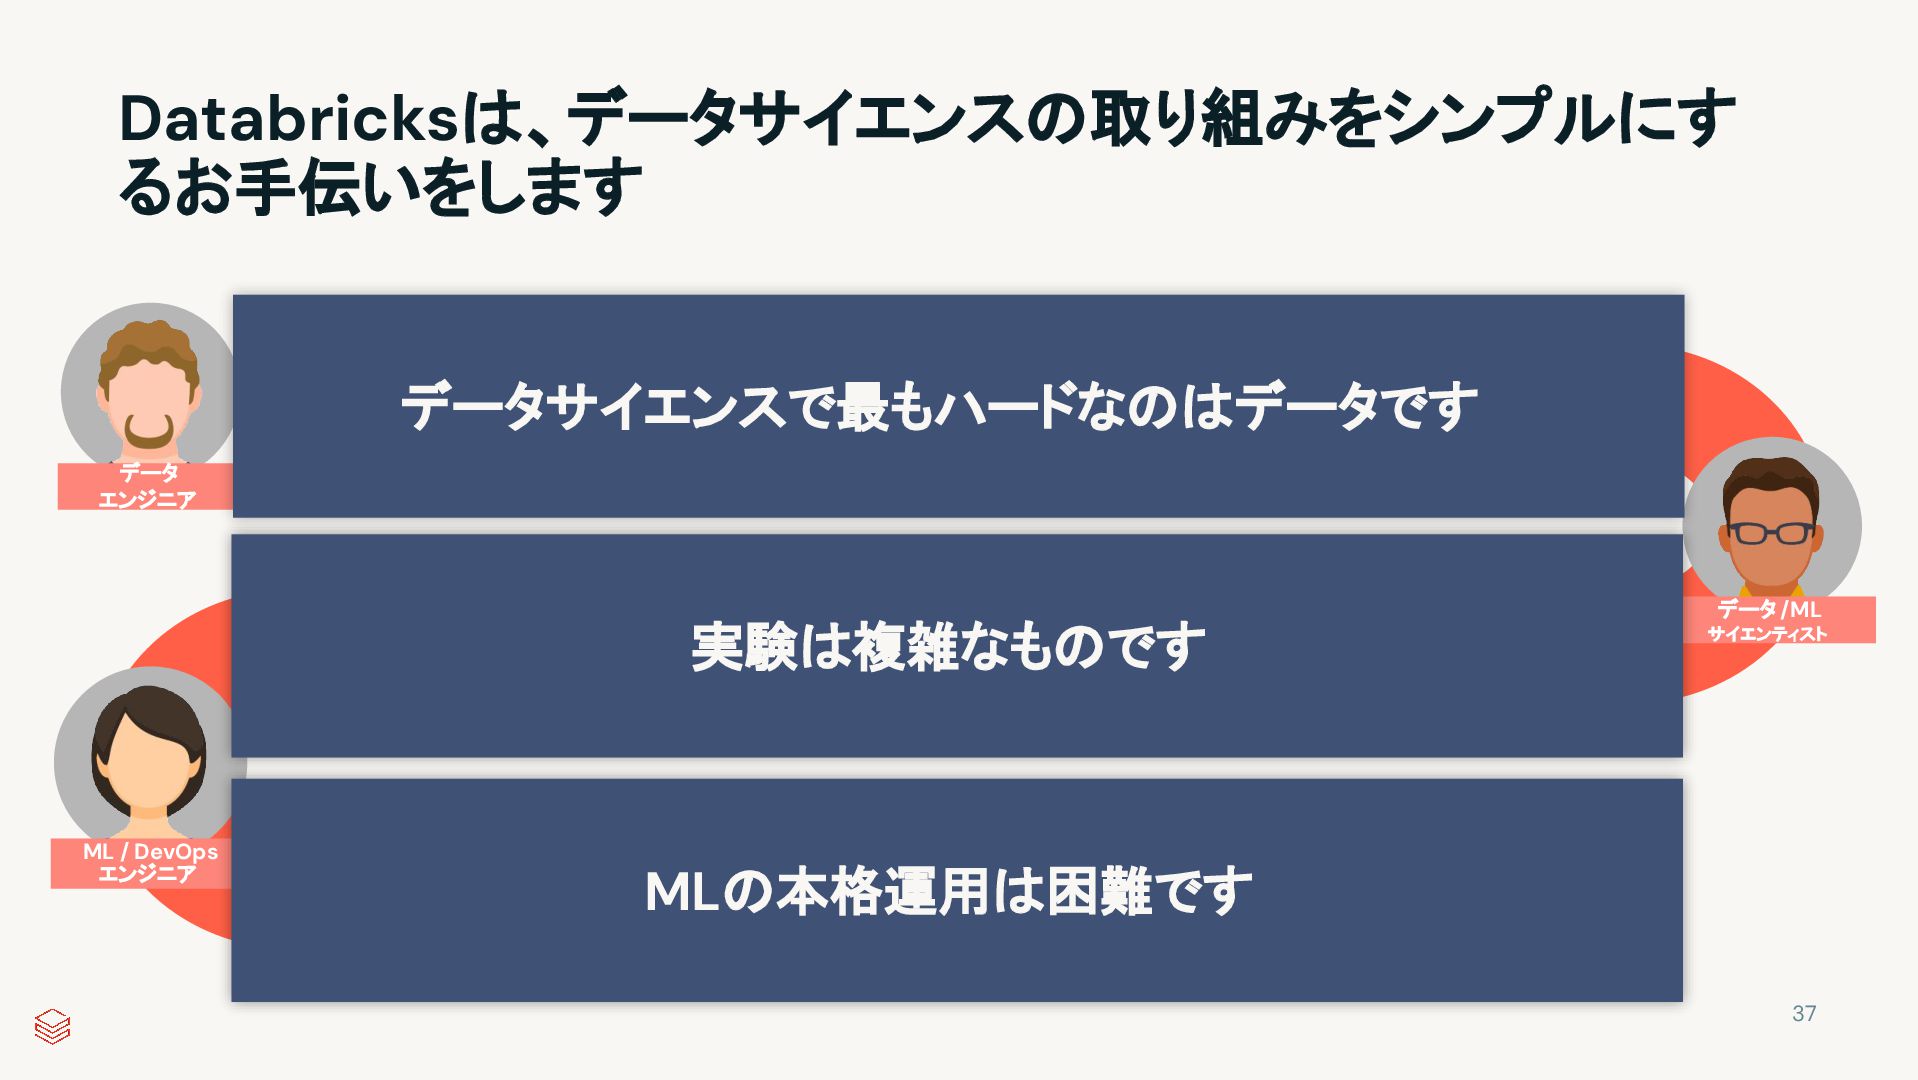
Databricksは、データサイエンスの取り組みをシンプルにす るお手伝いをします データアクセス 探索的データ分析 特徴量 エンジニアリング モデル チューニング モデル トレーニング
実験 トラッキング モデル管理 CI / CD モデル サービング モデル監視 維持 & ガバナンス ML / DevOps エンジニア データ エンジニア データ /ML サイエンティスト データサイエンスで最もハードなのはデータです 実験は複雑なものです MLの本格運用は困難です 37 -
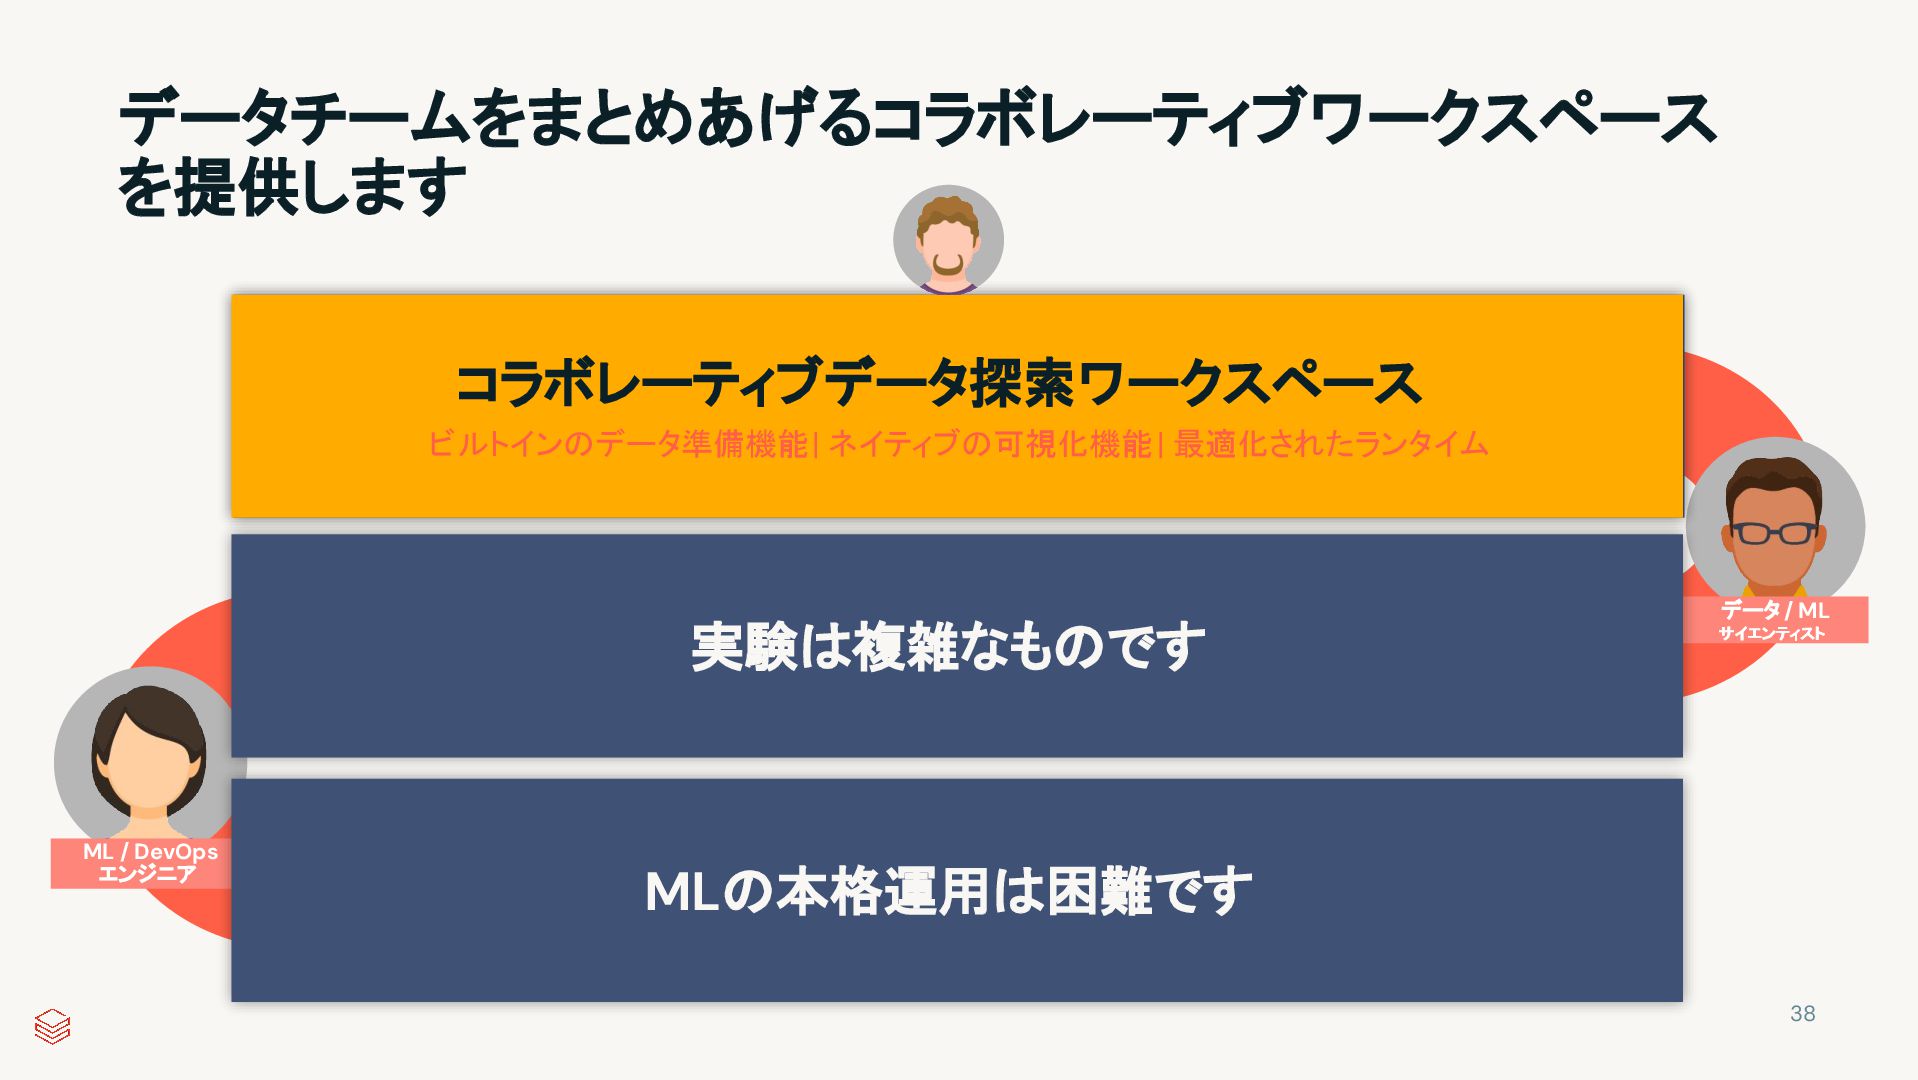
データチームをまとめあげるコラボレーティブワークスペース を提供します Data Access Exploratory Data Analysis Feature Engineering Model
Tuning Model Training Experiment Tracking Model Management CI / CD Model Serving Model Monitoring Maintenance & Governance < Data Engineers> < Data Scientists > < MLOps + DevOps > データ / ML サイエンティスト ML / DevOps エンジニア The hardest part of data science is data 実験は複雑なものです MLの本格運用は困難です コラボレーティブデータ探索ワークスペース ビルトインのデータ準備機能 | ネイティブの可視化機能 | 最適化されたランタイム 38 -
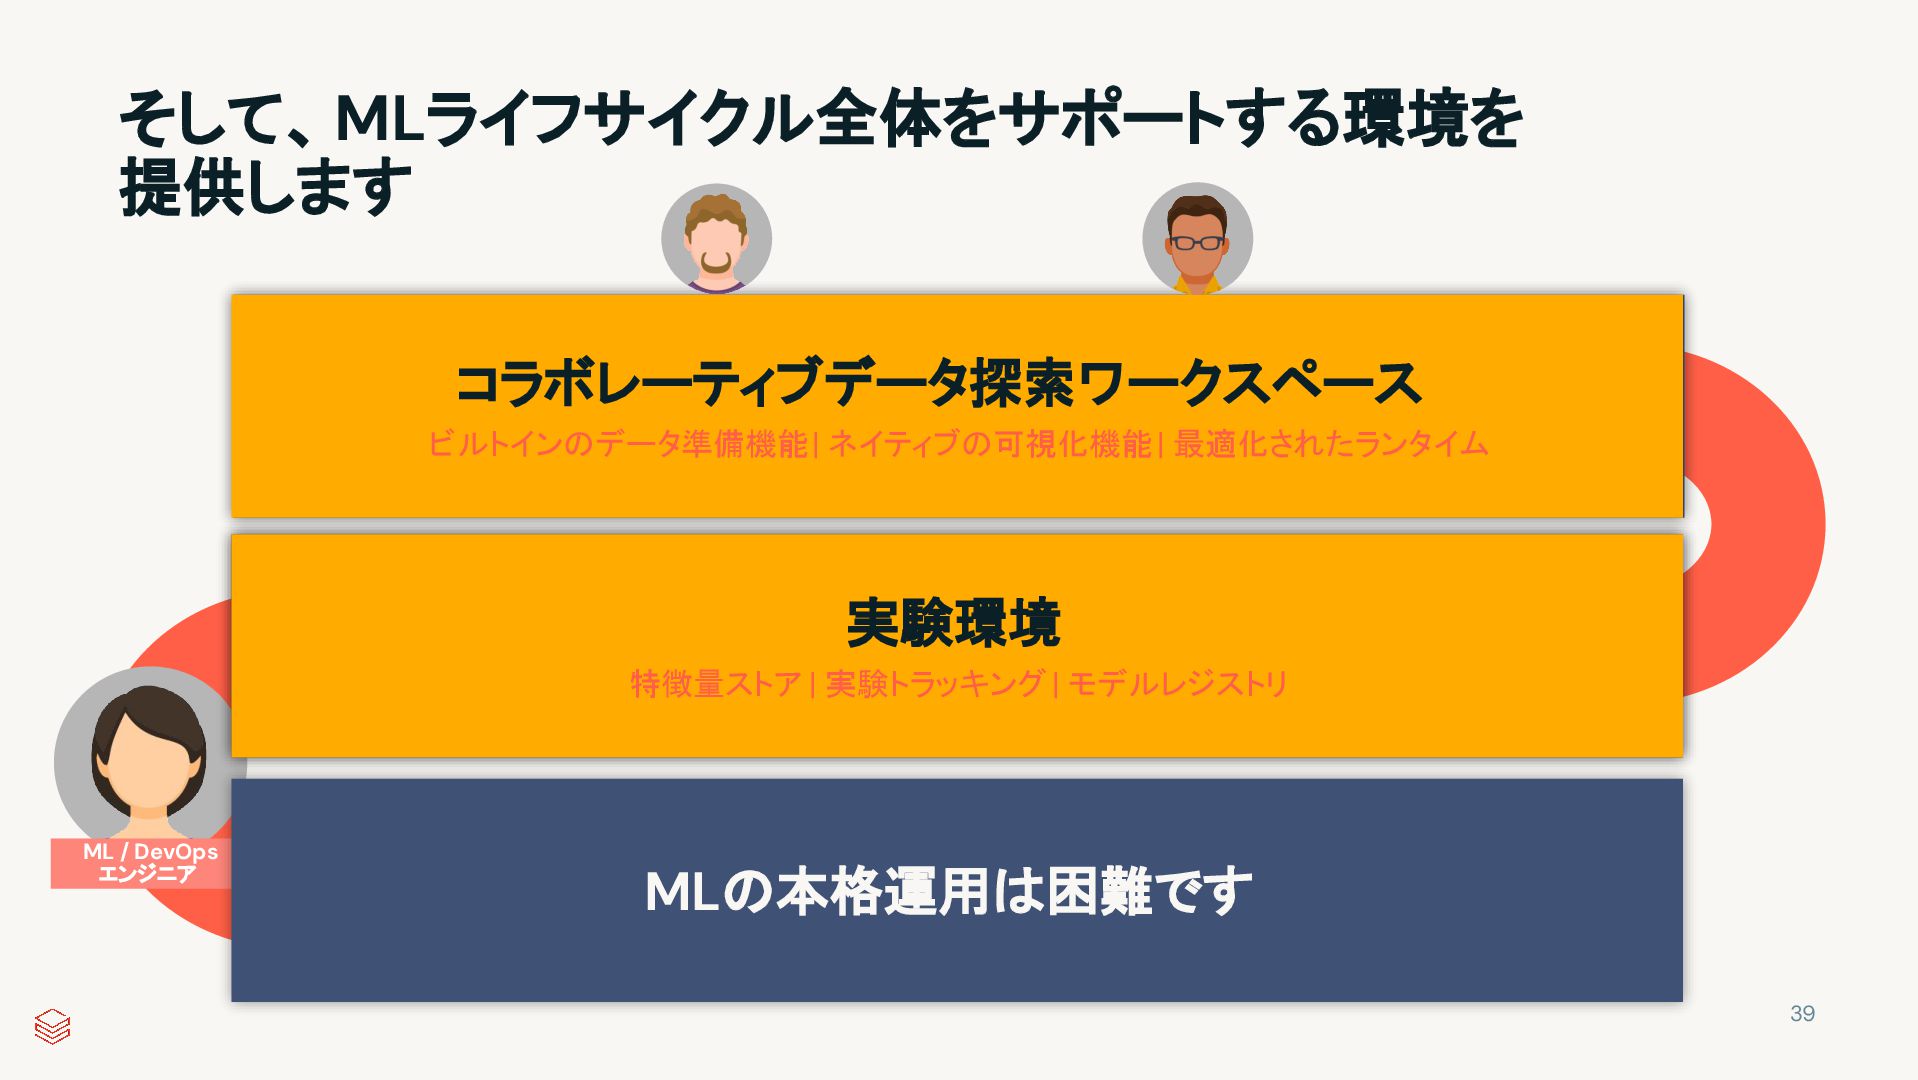
そして、MLライフサイクル全体をサポートする環境を 提供します Data Access Exploratory Data Analysis Feature Engineering Model
Tuning Model Training Experiment Tracking Model Management CI / CD Model Serving Model Monitoring Maintenance & Governance < Data Engineers> < Data Scientists > < MLOps + DevOps > ML / DevOps エンジニア The hardest part of data science is data Experimentation is complex MLの本格運用は困難です コラボレーティブデータ探索ワークスペース ビルトインのデータ準備機能 | ネイティブの可視化機能 | 最適化されたランタイム 実験環境 特徴量ストア | 実験トラッキング | モデルレジストリ 39 -
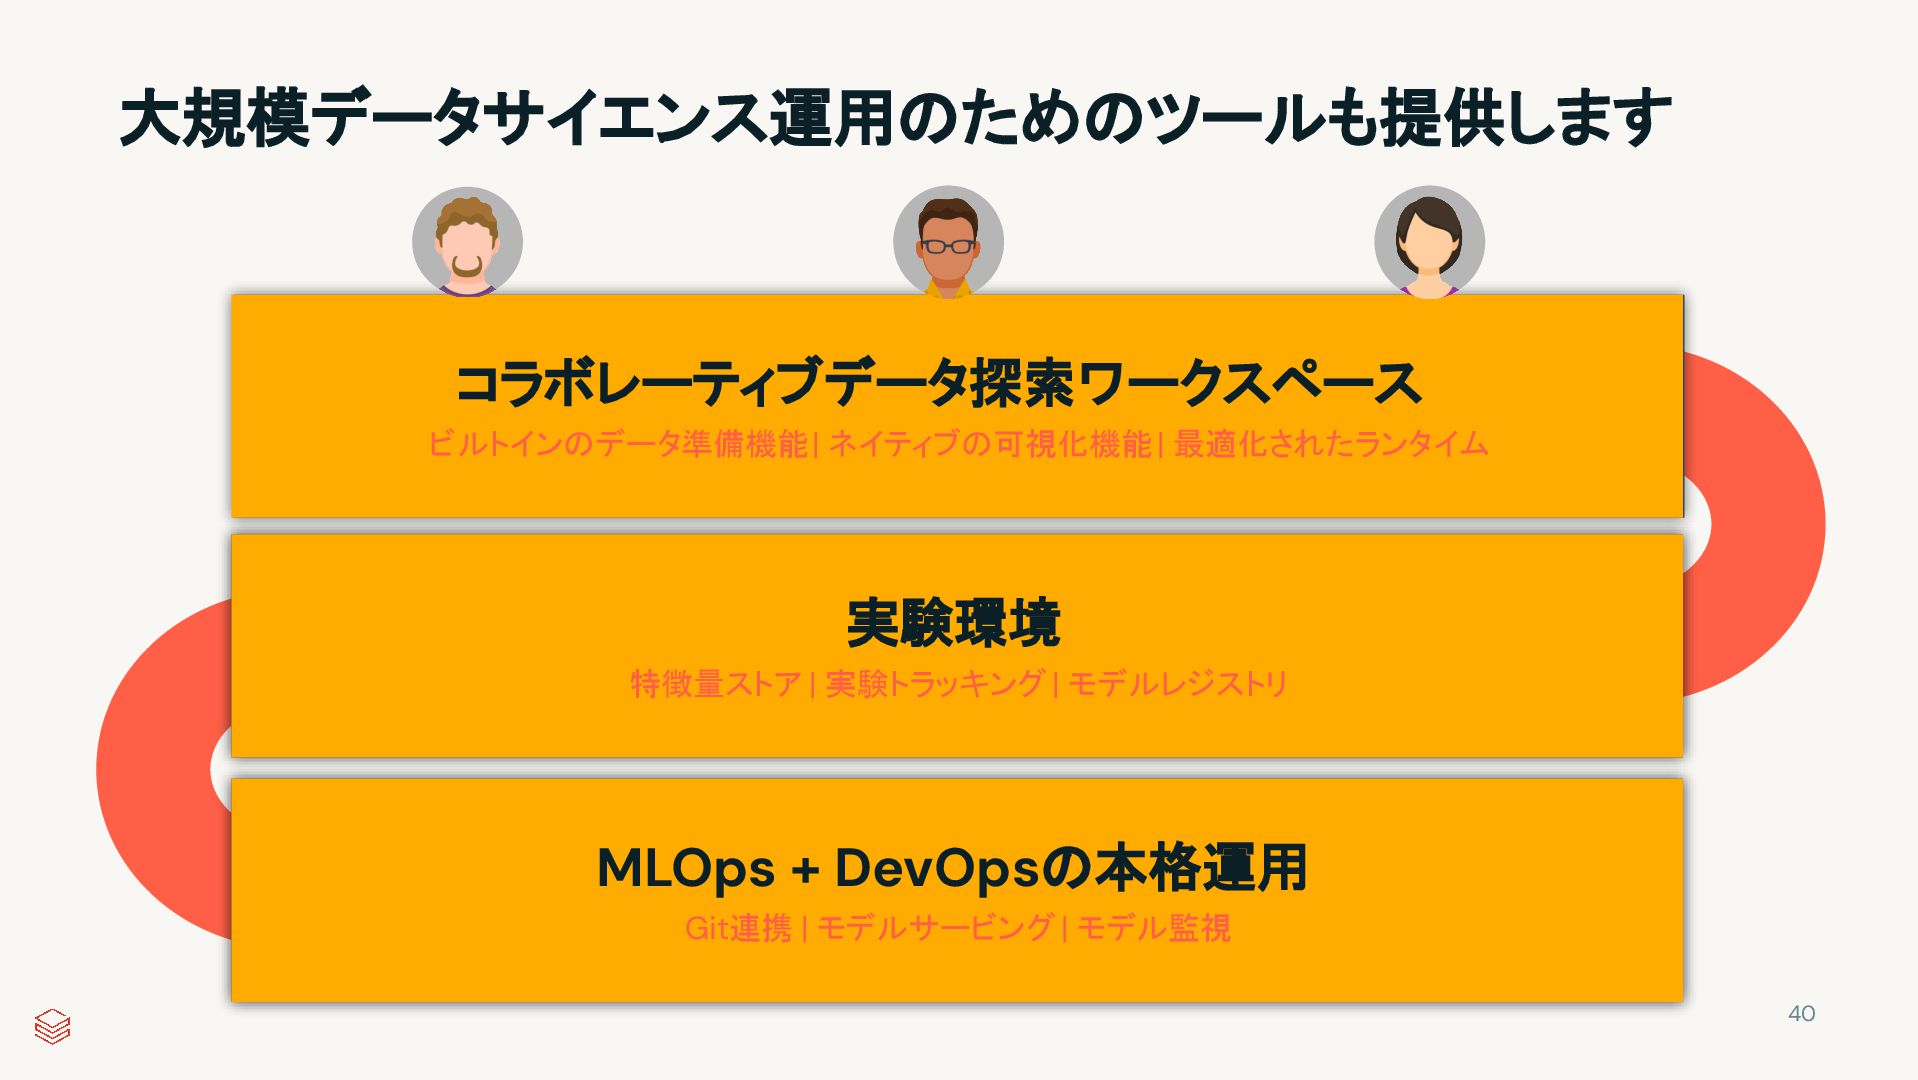
大規模データサイエンス運用のためのツールも提供します Data Access Exploratory Data Analysis Feature Engineering Model Tuning
Model Training Experiment Tracking Model Management CI / CD Model Serving Model Monitoring Maintenance & Governance < Data Engineers> < Data Scientists > < MLOps + DevOps > The hardest part of data science is data Experimentation is complex Productionizing ML is difficult コラボレーティブデータ探索ワークスペース ビルトインのデータ準備機能 | ネイティブの可視化機能 | 最適化されたランタイム 実験環境 特徴量ストア | 実験トラッキング | モデルレジストリ MLOps + DevOpsの本格運用 Git連携 | モデルサービング | モデル監視 40 -
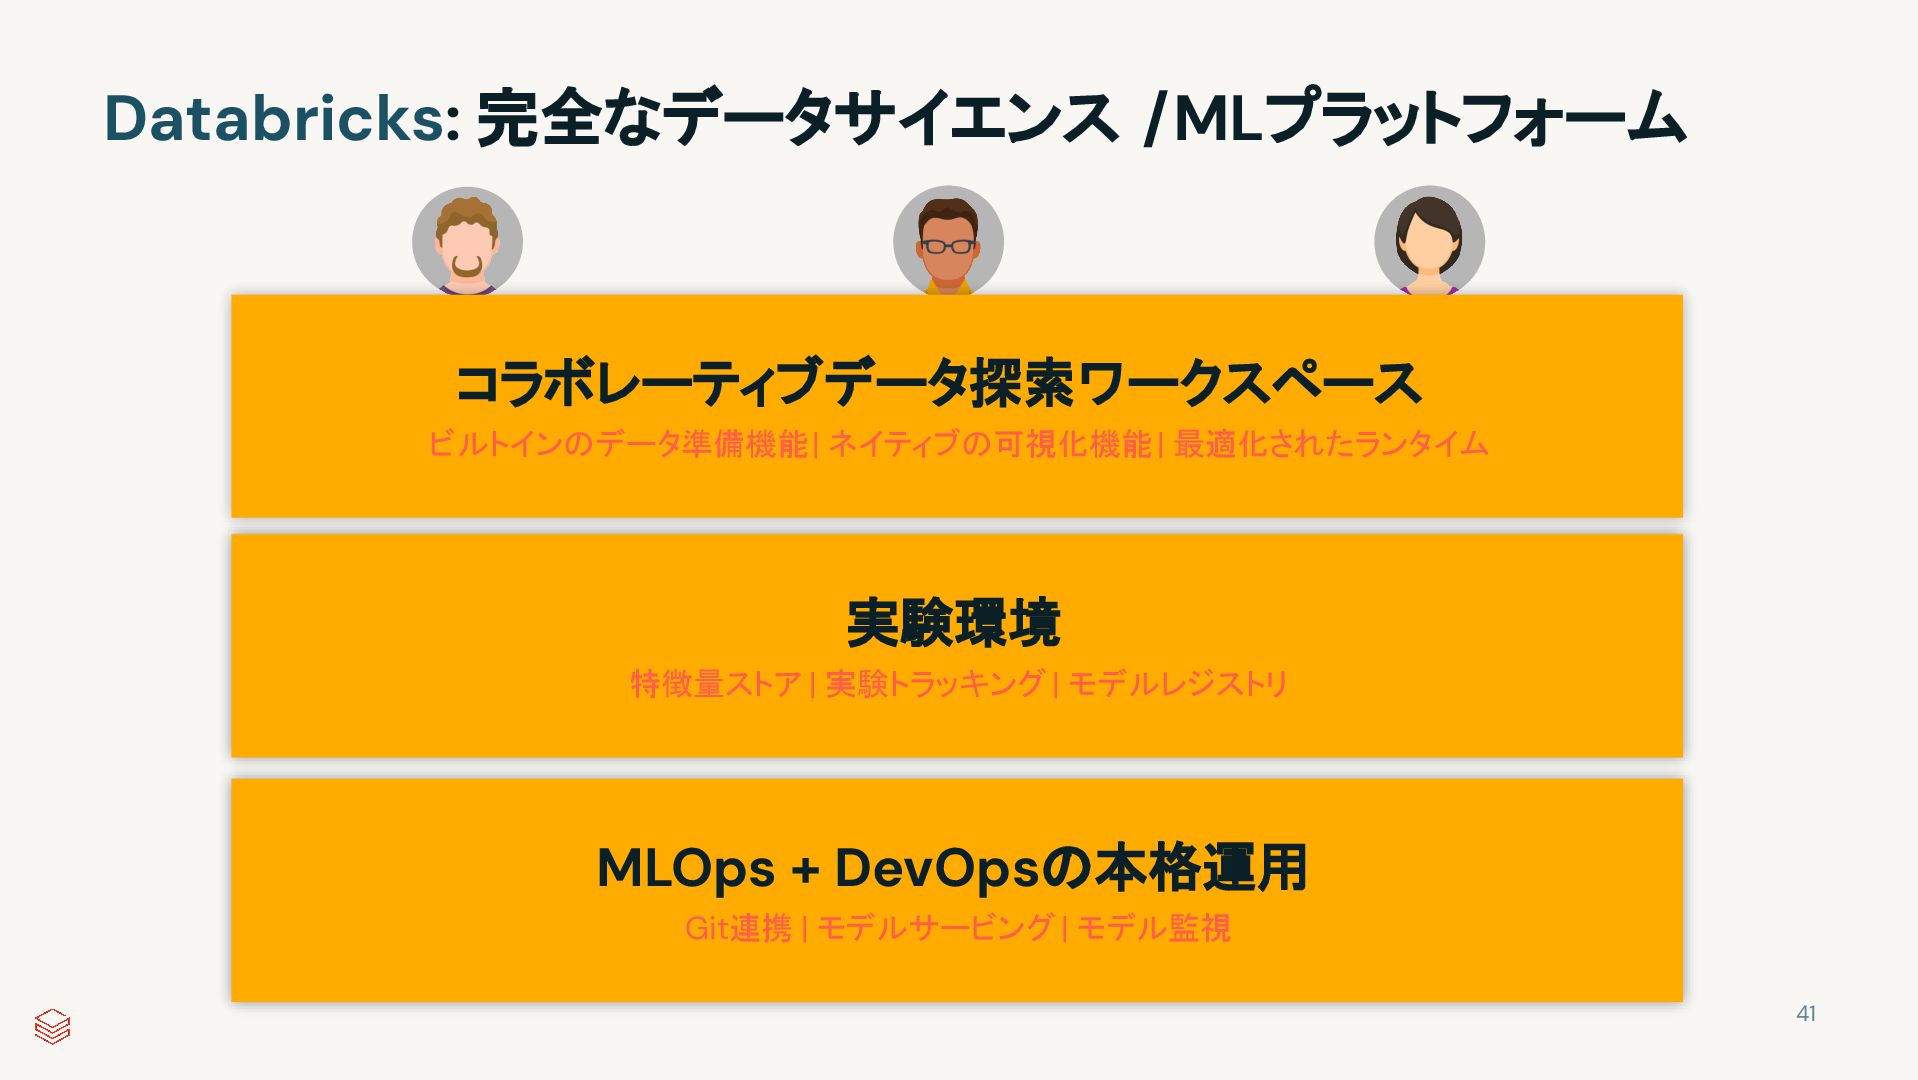
Databricks: 完全なデータサイエンス /MLプラットフォーム Exploratory Data Analysis Data Visualization Feature Selection
Model Tuning Model Training Experiment Tracking Model Management CI / CD Model Serving Model Monitoring Maintenance & Governance < Data Scientists > < DevOps > コラボレーティブデータ探索ワークスペース ビルトインのデータ準備機能 | ネイティブの可視化機能 | 最適化されたランタイム 実験環境 特徴量ストア | 実験トラッキング | モデルレジストリ MLOps + DevOpsの本格運用 Git連携 | モデルサービング | モデル監視 41 -
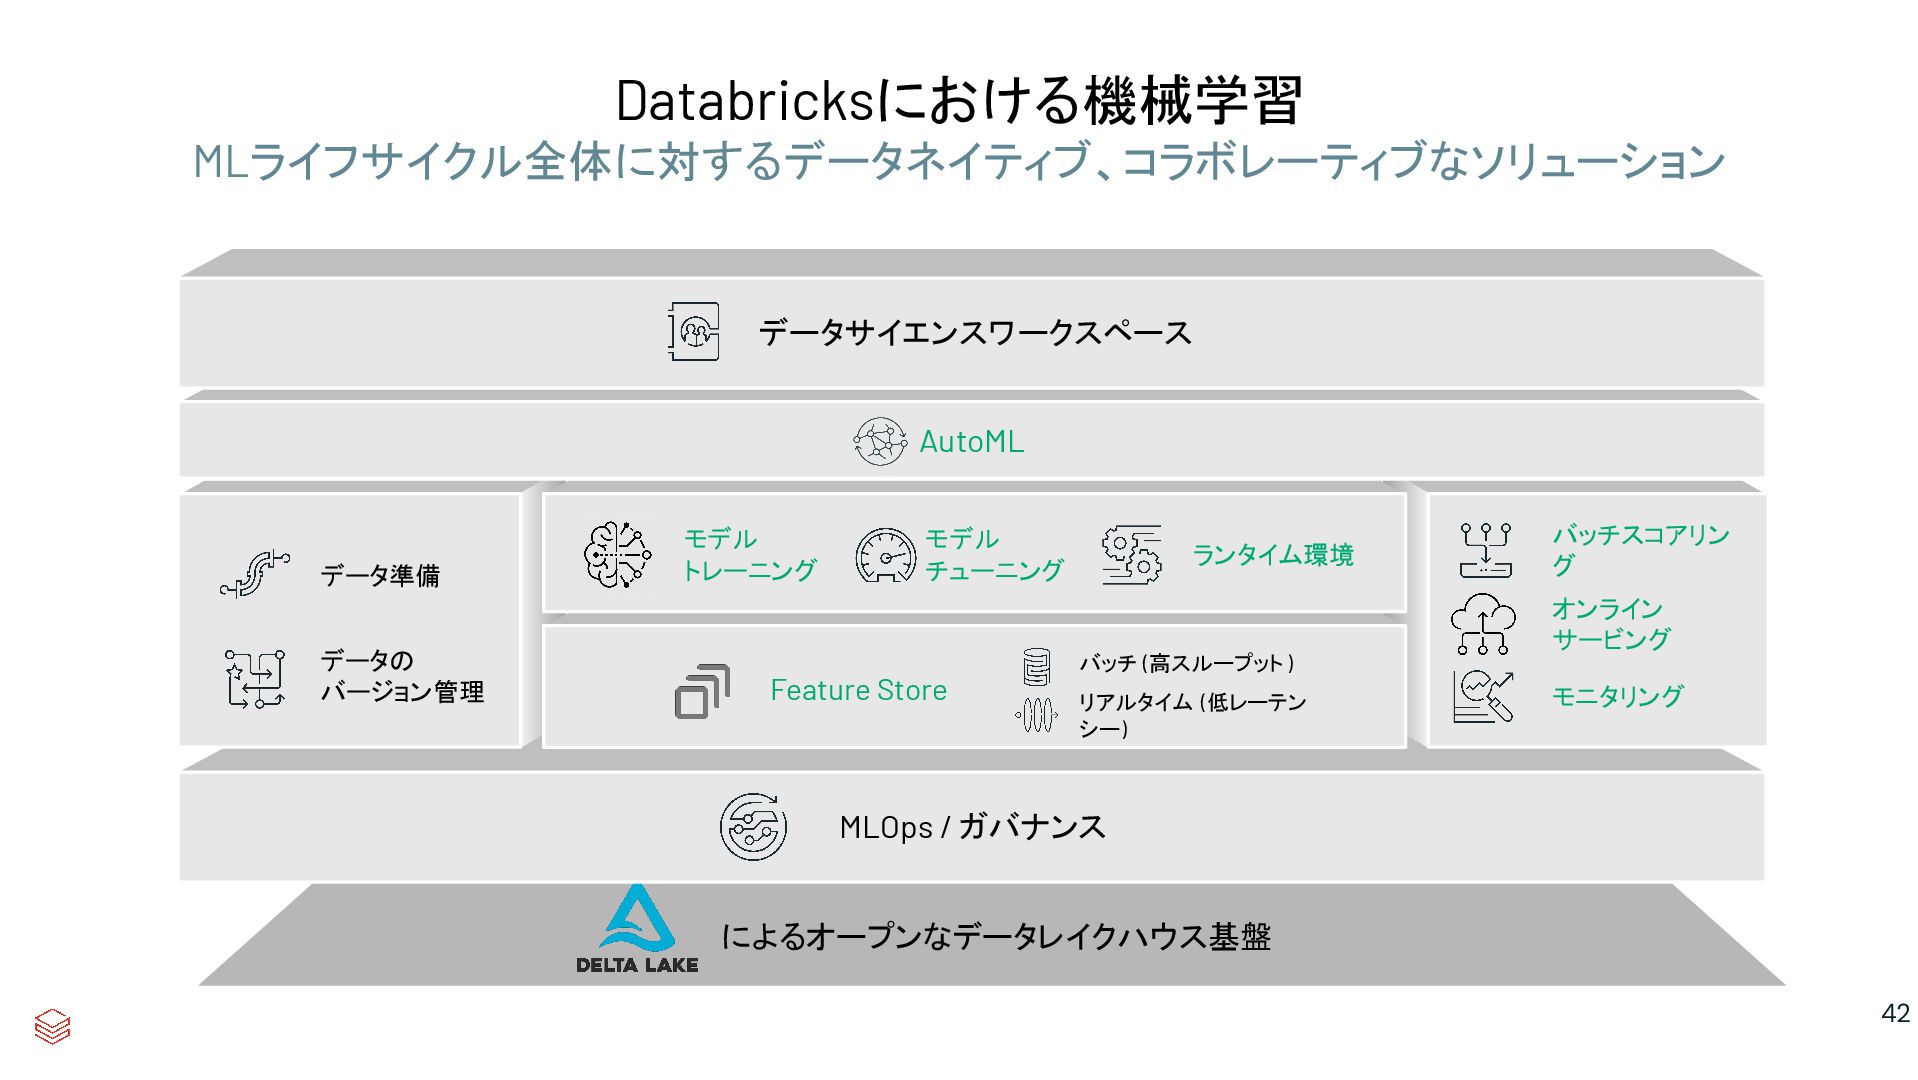
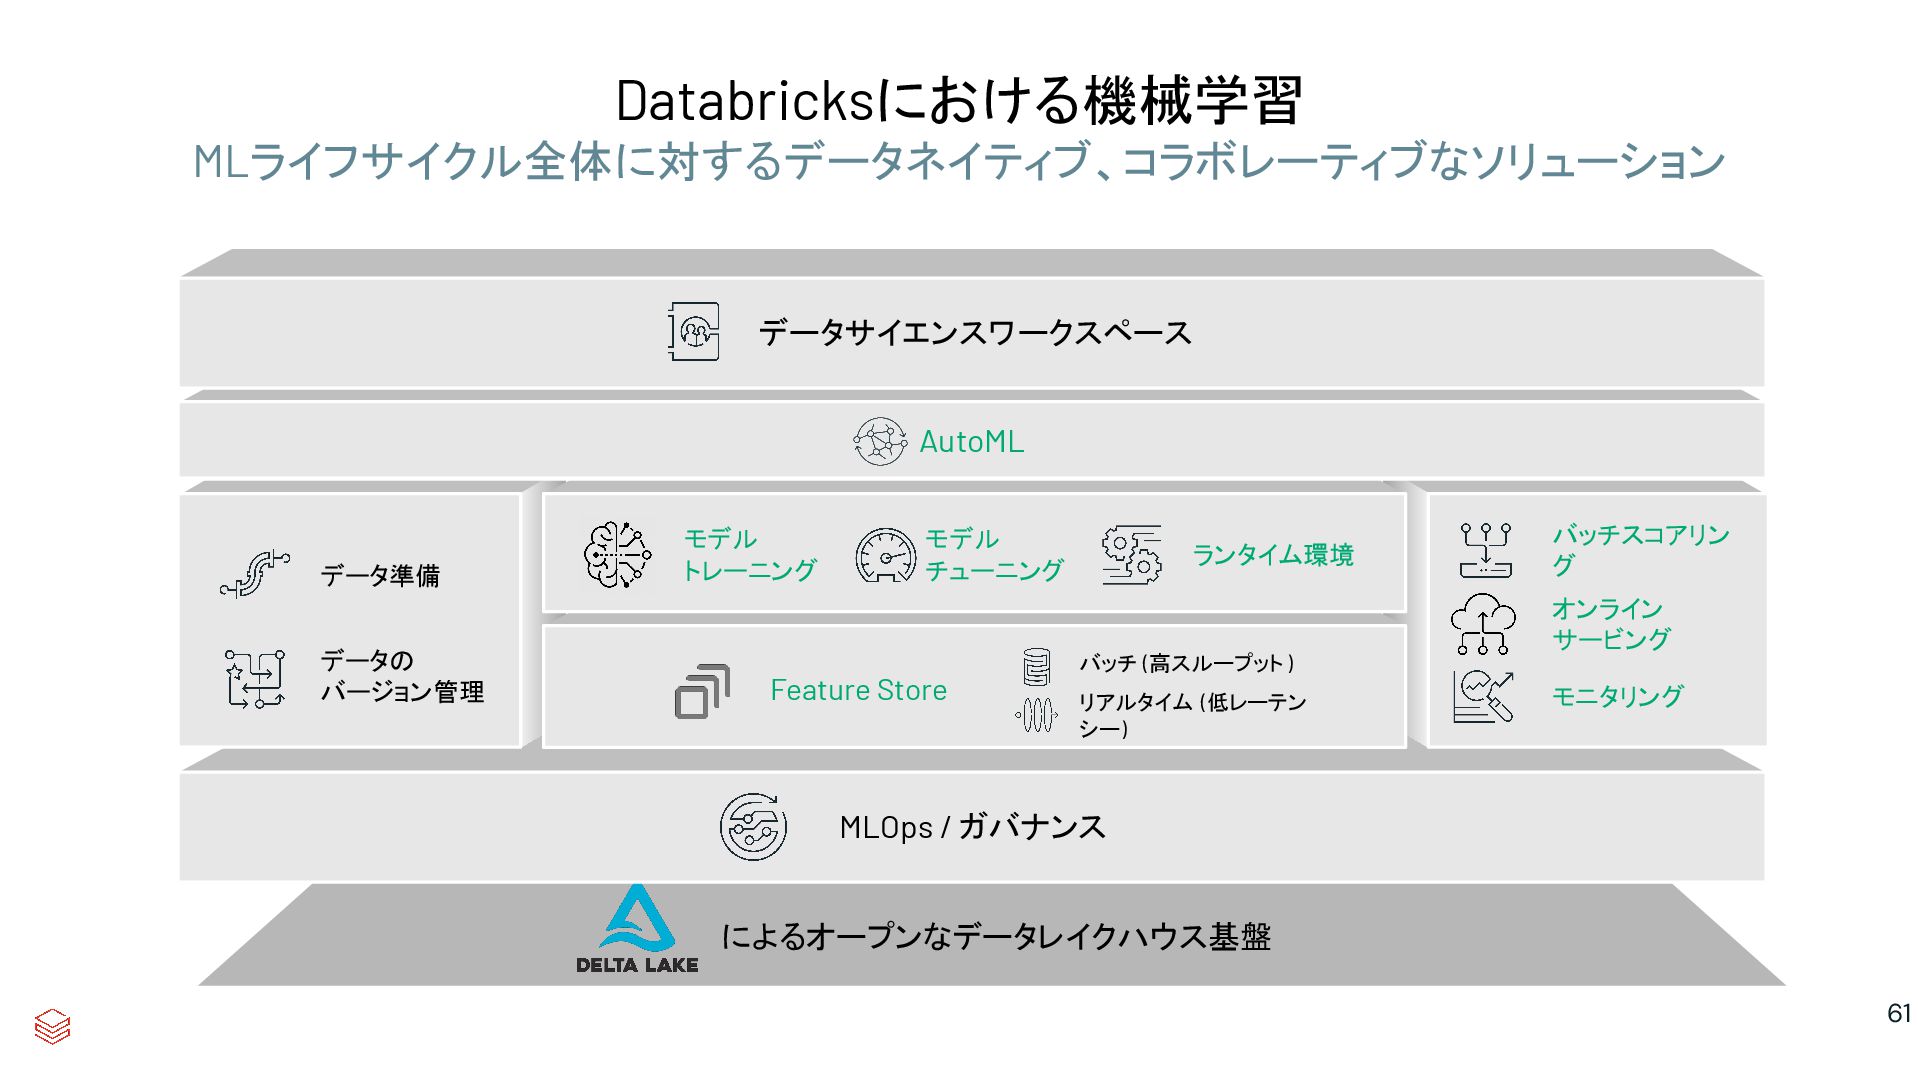
Databricksにおける機械学習 MLライフサイクル全体に対するデータネイティブ、コラボレーティブなソリューション によるオープンなデータレイクハウス基盤 MLOps / ガバナンス データ準備 データの バージョン管理 モニタリング
バッチスコアリン グ オンライン サービング モデル トレーニング モデル チューニング ランタイム環境 Feature Store バッチ (高スループット) リアルタイム (低レーテン シー) AutoML データサイエンスワークスペース 42 -
走る • プロダクションに移行 • CI/CDと開発プロセス の実装 • エンドツーエンドかつ部 門間の自動化と再現性 の確保
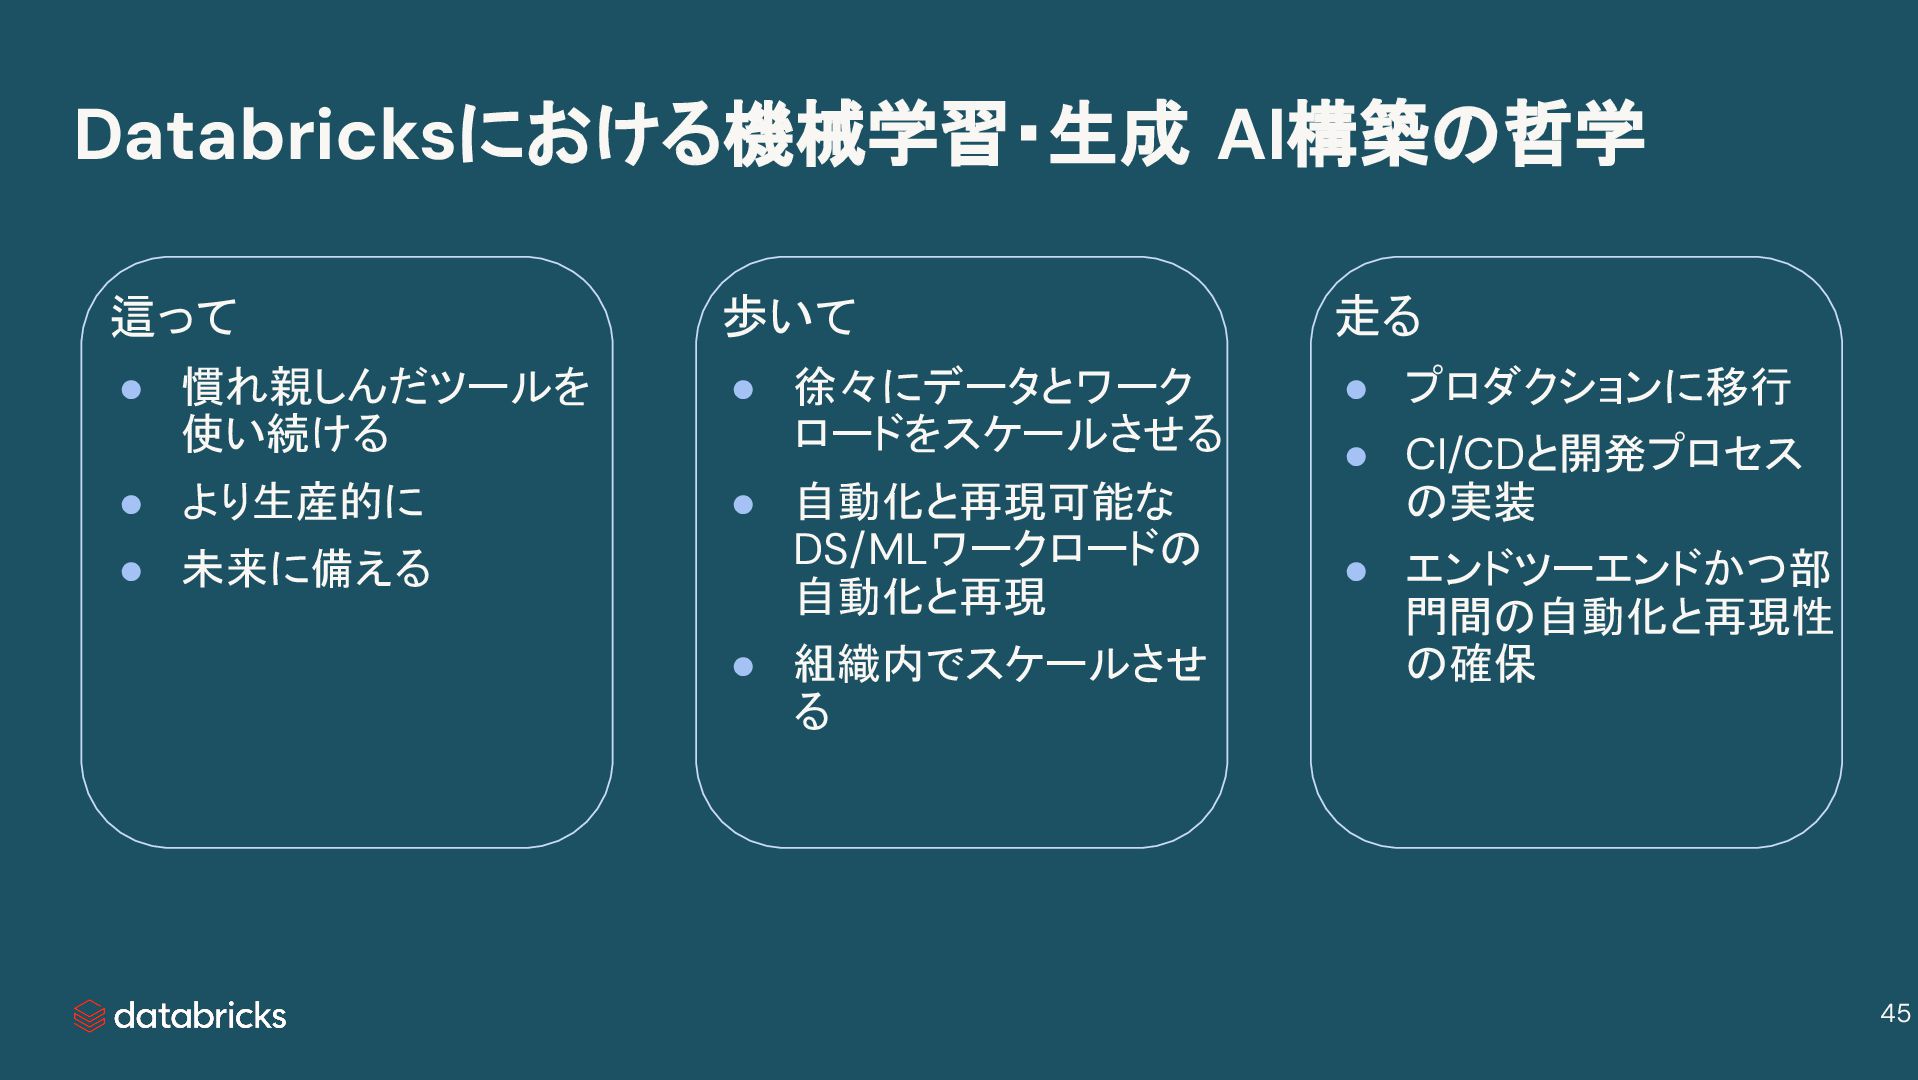
歩いて • 徐々にデータとワーク ロードをスケールさせる • 自動化と再現可能な DS/MLワークロードの 自動化と再現 • 組織内でスケールさせ る 這って • 慣れ親しんだツールを 使い続ける • より生産的に • 未来に備える Databricksにおける機械学習・生成 AI構築の哲学 45 -
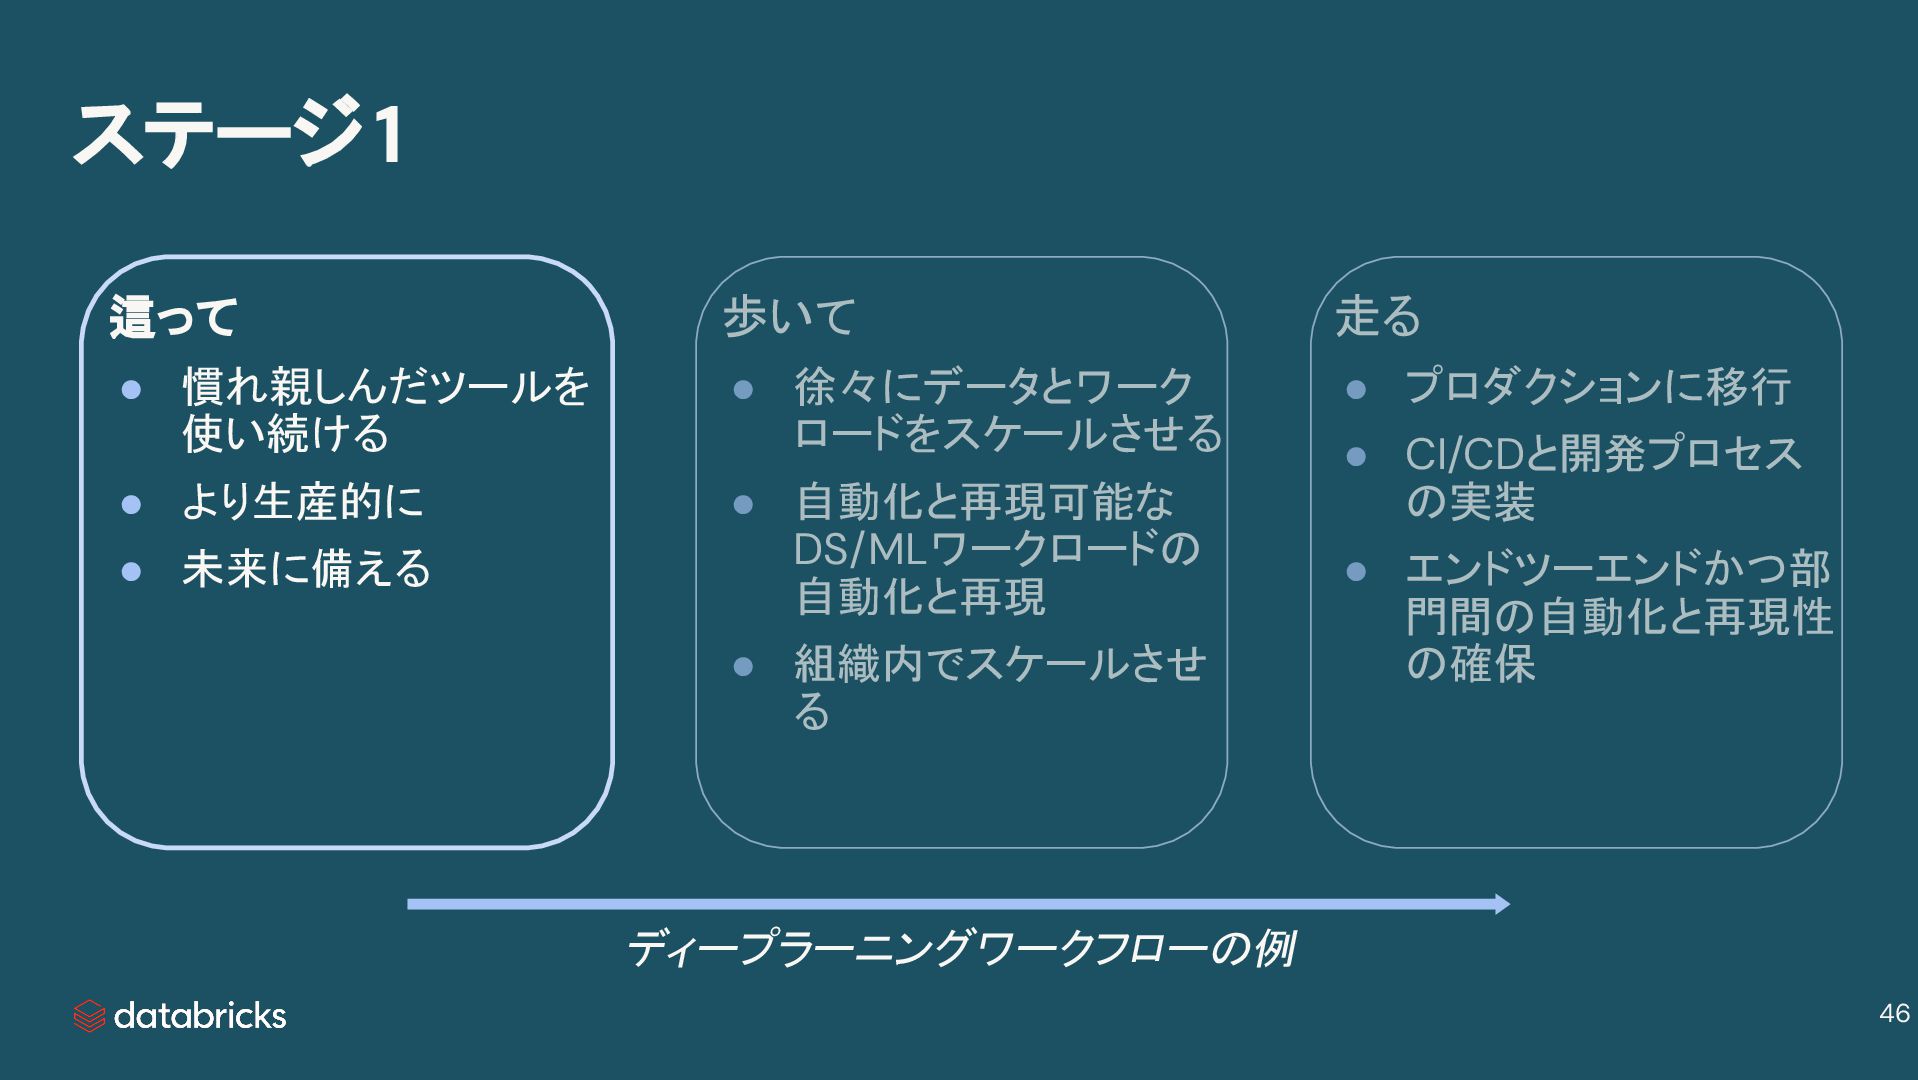
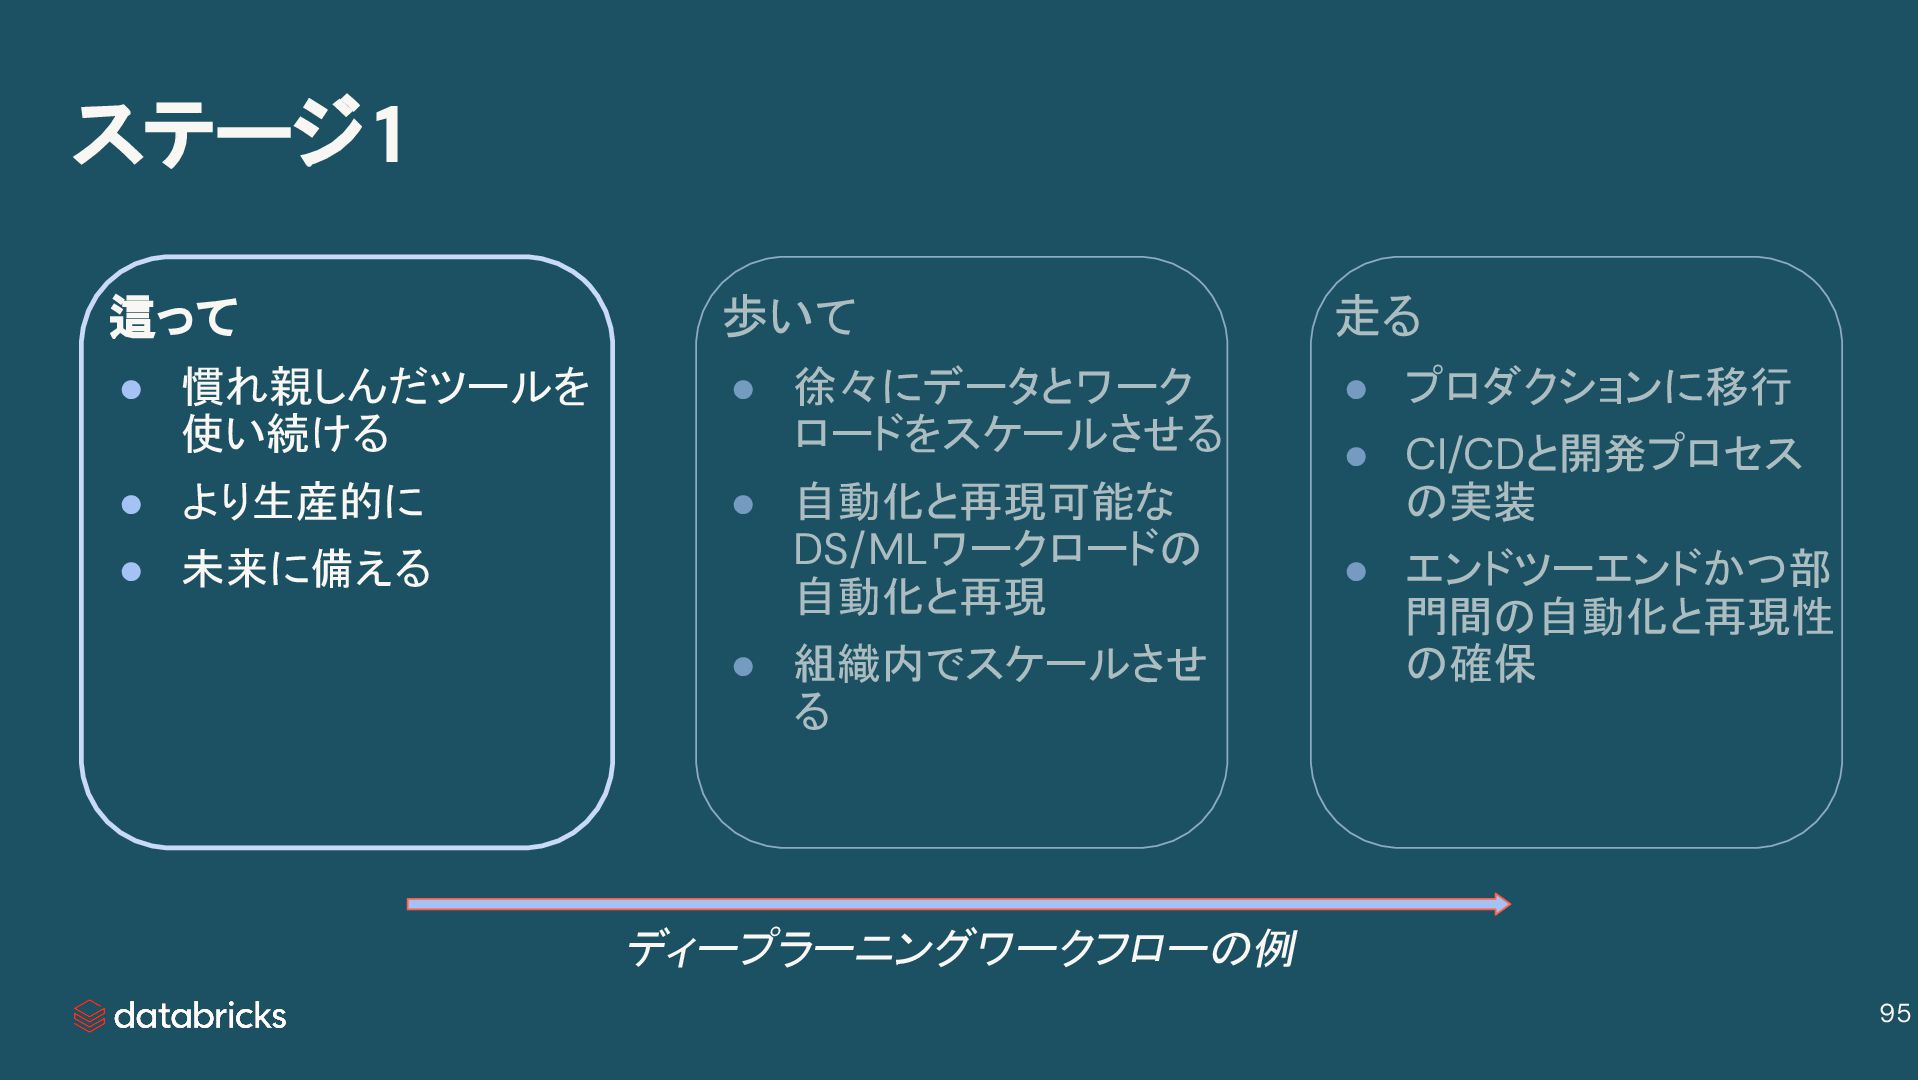
這って • 慣れ親しんだツールを 使い続ける • より生産的に • 未来に備える ステージ1 ディープラーニングワークフローの例
走る • プロダクションに移行 • CI/CDと開発プロセス の実装 • エンドツーエンドかつ部 門間の自動化と再現性 の確保 歩いて • 徐々にデータとワーク ロードをスケールさせる • 自動化と再現可能な DS/MLワークロードの 自動化と再現 • 組織内でスケールさせ る 46 -
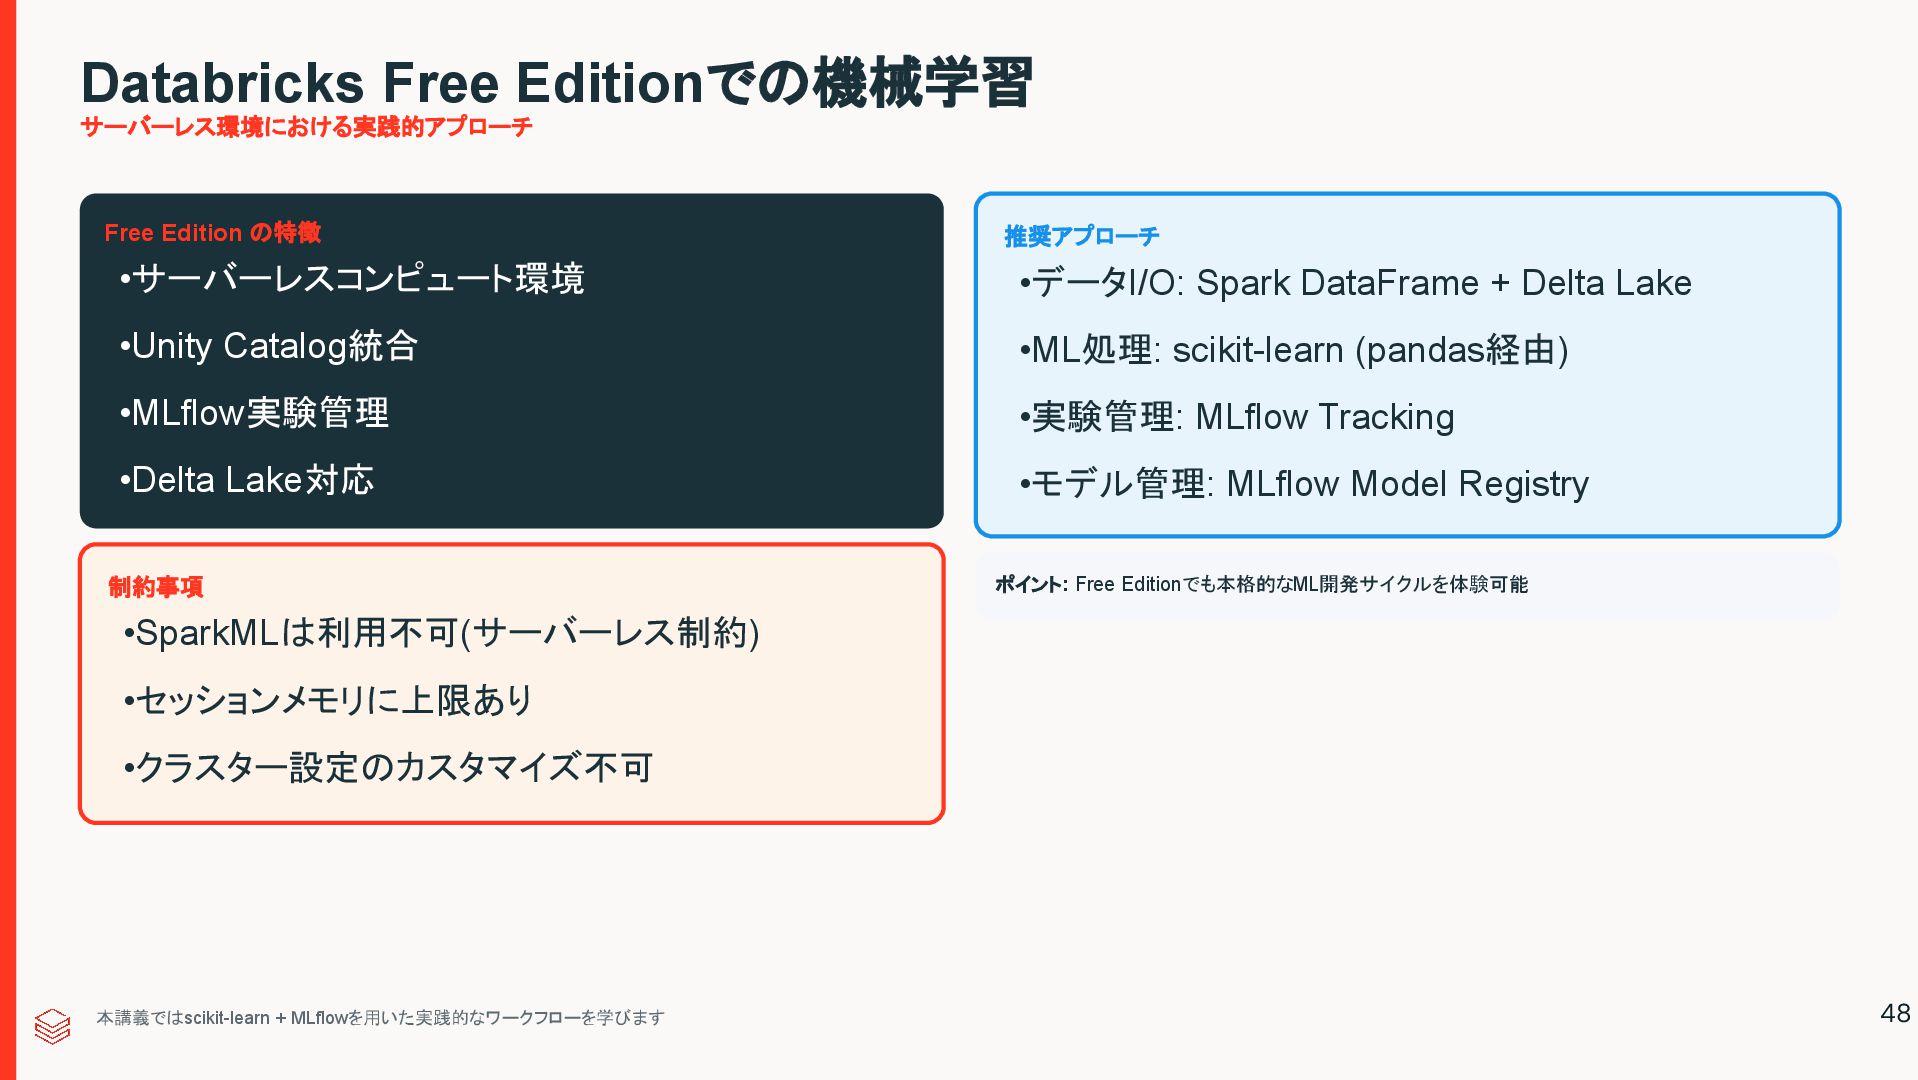
Databricks Free Editionでの機械学習 サーバーレス環境における実践的アプローチ Free Edition の特徴 •サーバーレスコンピュート環境 •Unity Catalog統合
•MLflow実験管理 •Delta Lake対応 制約事項 •SparkMLは利用不可(サーバーレス制約) •セッションメモリに上限あり •クラスター設定のカスタマイズ不可 推奨アプローチ •データI/O: Spark DataFrame + Delta Lake •ML処理: scikit-learn (pandas経由) •実験管理: MLflow Tracking •モデル管理: MLflow Model Registry ポイント: Free Editionでも本格的なML開発サイクルを体験可能 本講義ではscikit-learn + MLflowを用いた実践的なワークフローを学びます 48 -
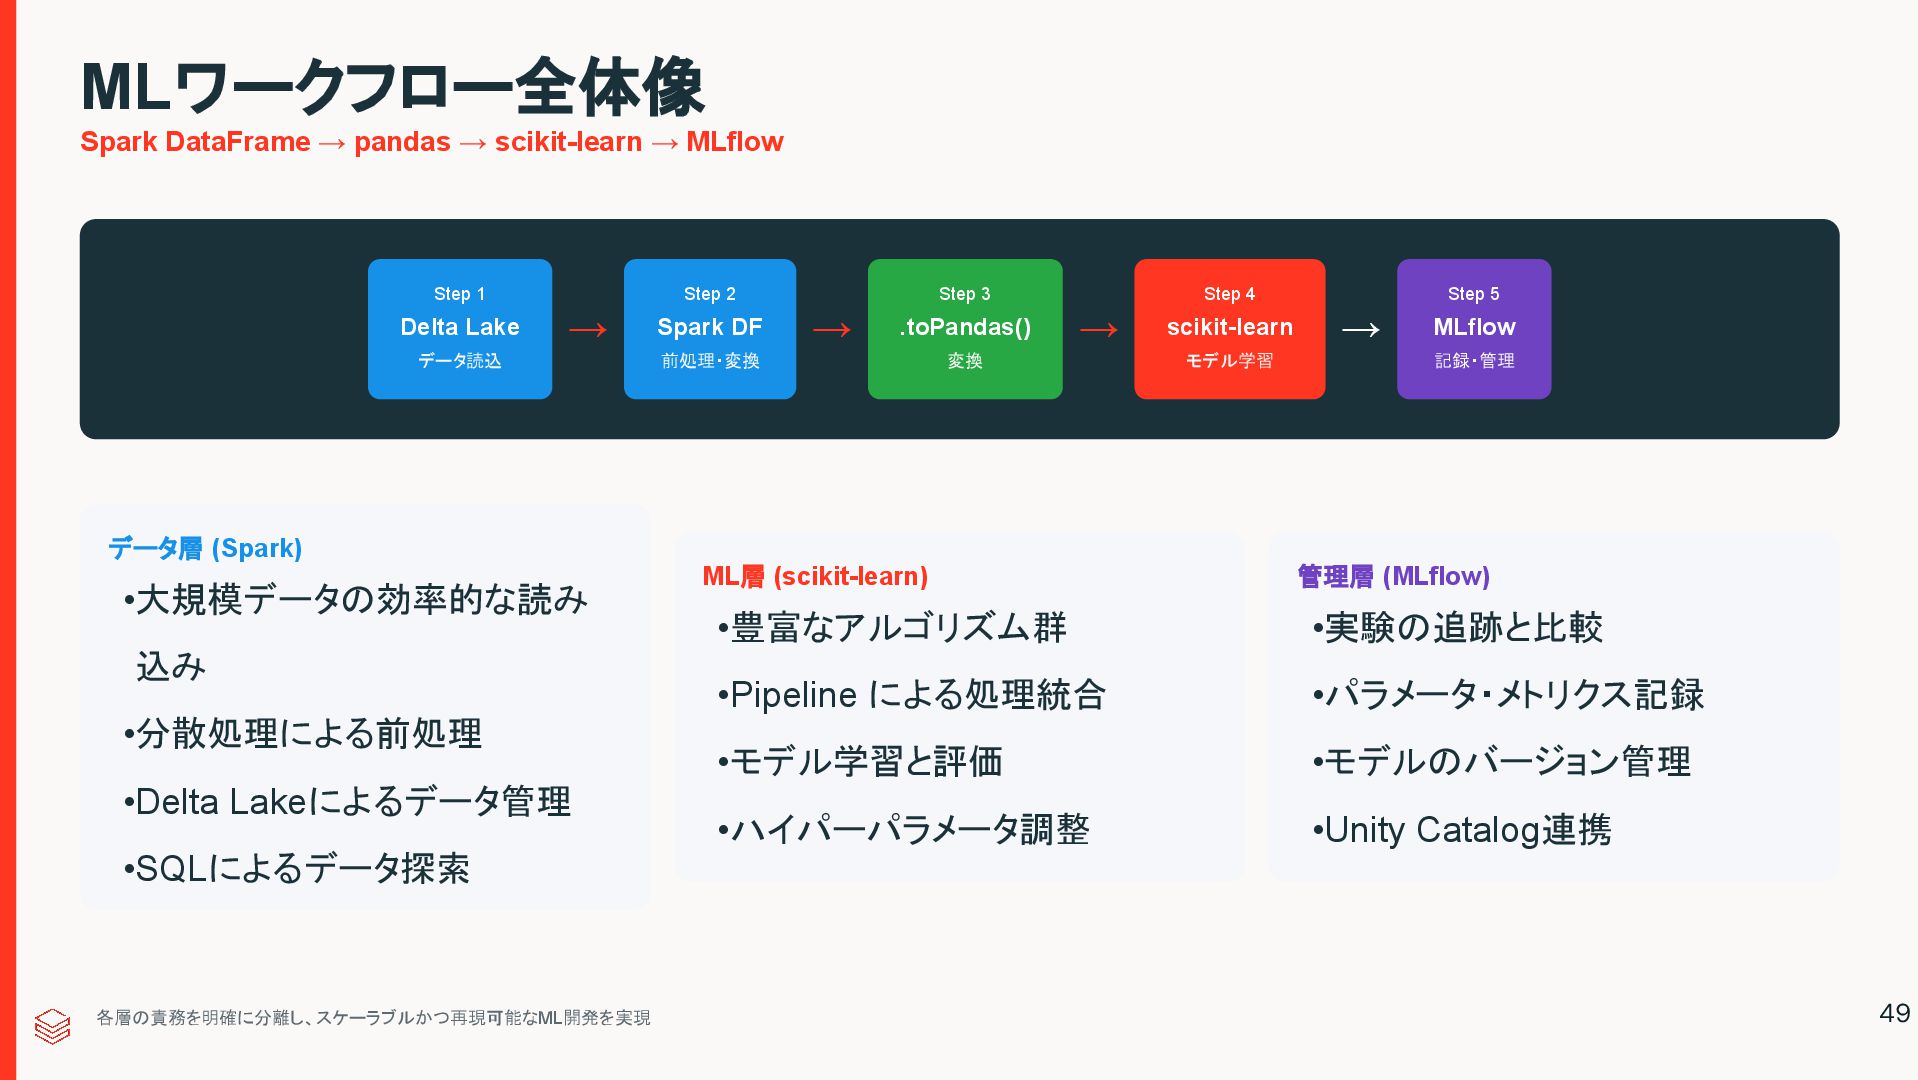
MLワークフロー全体像 Spark DataFrame → pandas → scikit-learn → MLflow Step
1 Delta Lake データ読込 → Step 2 Spark DF 前処理・変換 → Step 3 .toPandas() 変換 → Step 4 scikit-learn モデル学習 → Step 5 MLflow 記録・管理 データ層 (Spark) •大規模データの効率的な読み 込み •分散処理による前処理 •Delta Lakeによるデータ管理 •SQLによるデータ探索 ML層 (scikit-learn) •豊富なアルゴリズム群 •Pipeline による処理統合 •モデル学習と評価 •ハイパーパラメータ調整 管理層 (MLflow) •実験の追跡と比較 •パラメータ・メトリクス記録 •モデルのバージョン管理 •Unity Catalog連携 各層の責務を明確に分離し、スケーラブルかつ再現可能なML開発を実現 49 -
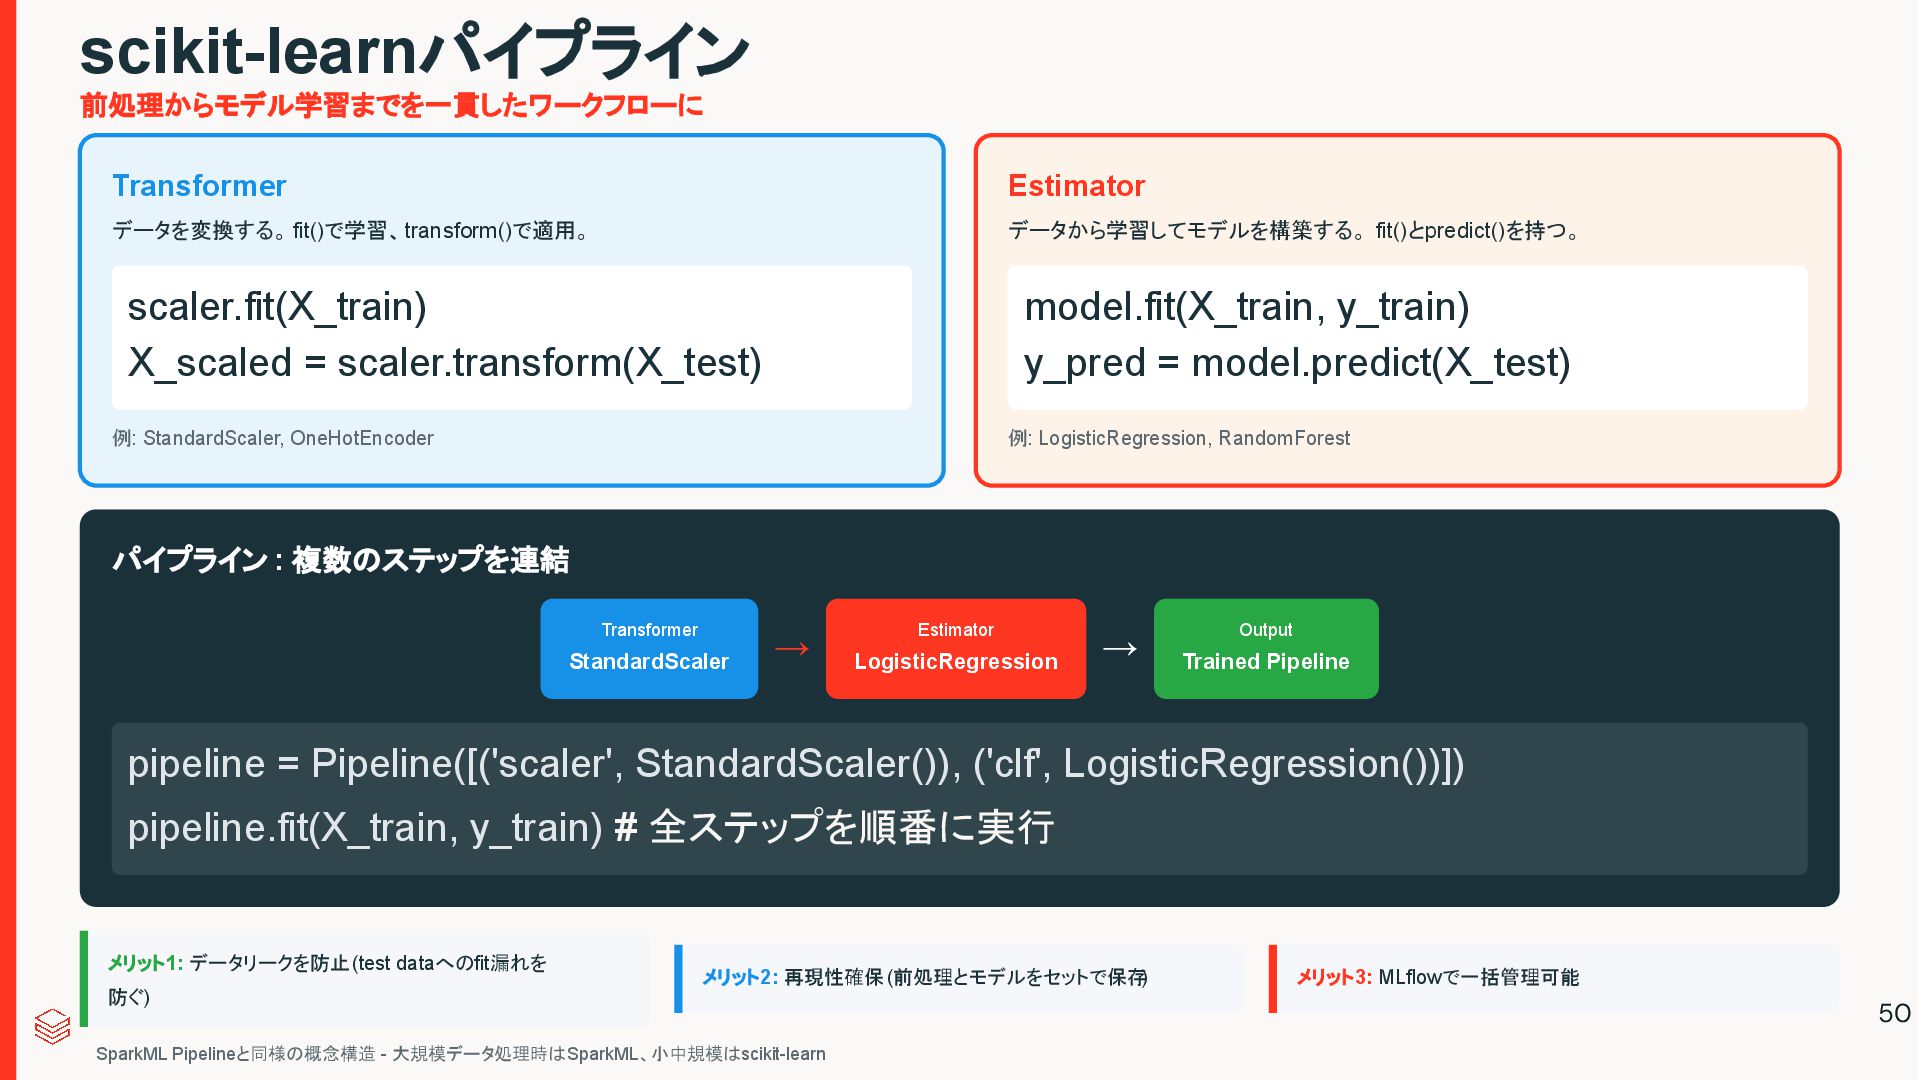
scikit-learnパイプライン 前処理からモデル学習までを一貫したワークフローに Transformer データを変換する。 fit()で学習、transform()で適用。 scaler.fit(X_train) X_scaled = scaler.transform(X_test) 例:
StandardScaler, OneHotEncoder Estimator データから学習してモデルを構築する。 fit()とpredict()を持つ。 model.fit(X_train, y_train) y_pred = model.predict(X_test) 例: LogisticRegression, RandomForest パイプライン : 複数のステップを連結 Transformer StandardScaler → Estimator LogisticRegression → Output Trained Pipeline pipeline = Pipeline([('scaler', StandardScaler()), ('clf', LogisticRegression())]) pipeline.fit(X_train, y_train) # 全ステップを順番に実行 メリット1: データリークを防止 (test dataへのfit漏れを 防ぐ) メリット2: 再現性確保 (前処理とモデルをセットで保存 ) メリット3: MLflowで一括管理可能 SparkML Pipelineと同様の概念構造 - 大規模データ処理時はSparkML、小中規模はscikit-learn 50 -
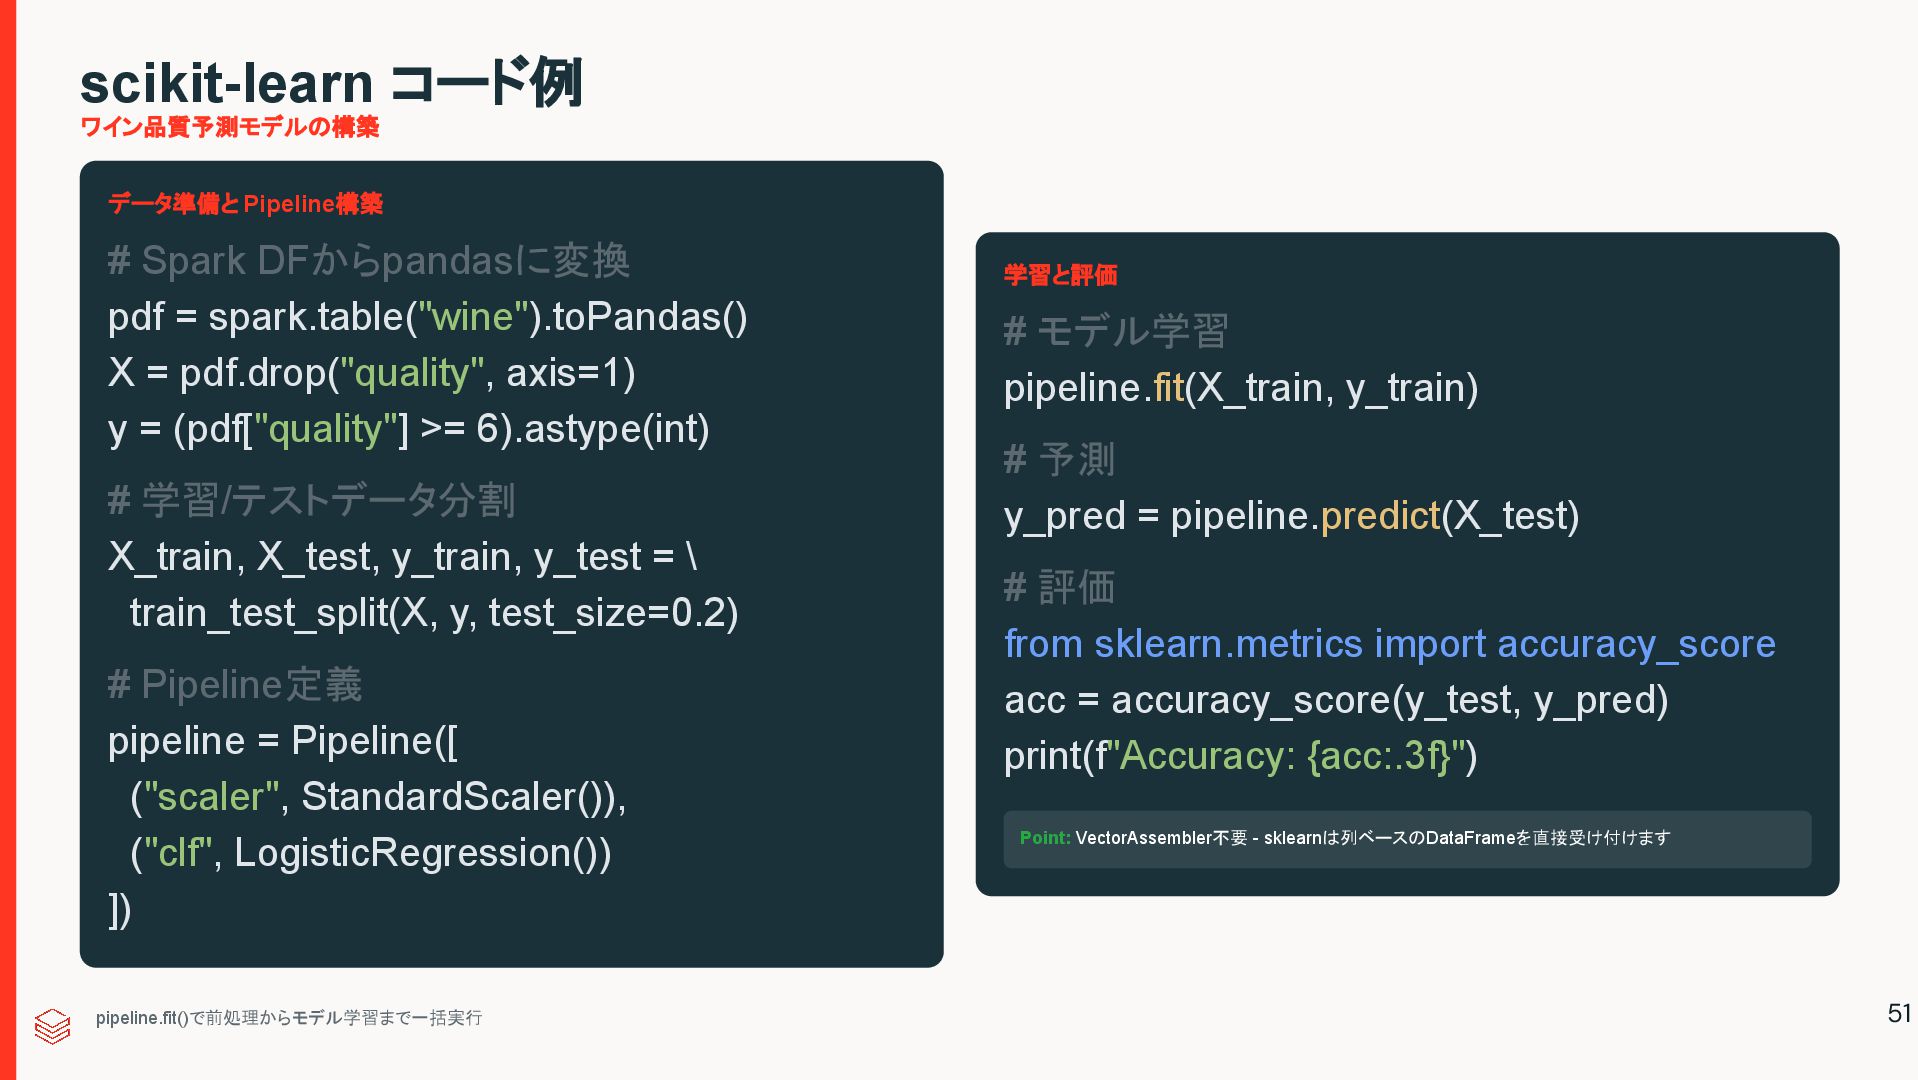
scikit-learn コード例 ワイン品質予測モデルの構築 データ準備と Pipeline構築 # Spark DFからpandasに変換 pdf =
spark.table("wine").toPandas() X = pdf.drop("quality", axis=1) y = (pdf["quality"] >= 6).astype(int) # 学習/テストデータ分割 X_train, X_test, y_train, y_test = \ train_test_split(X, y, test_size=0.2) # Pipeline定義 pipeline = Pipeline([ ("scaler", StandardScaler()), ("clf", LogisticRegression()) ]) 学習と評価 # モデル学習 pipeline.fit(X_train, y_train) # 予測 y_pred = pipeline.predict(X_test) # 評価 from sklearn.metrics import accuracy_score acc = accuracy_score(y_test, y_pred) print(f"Accuracy: {acc:.3f}") Point: VectorAssembler不要 - sklearnは列ベースのDataFrameを直接受け付けます pipeline.fit()で前処理からモデル学習まで一括実行 51 -
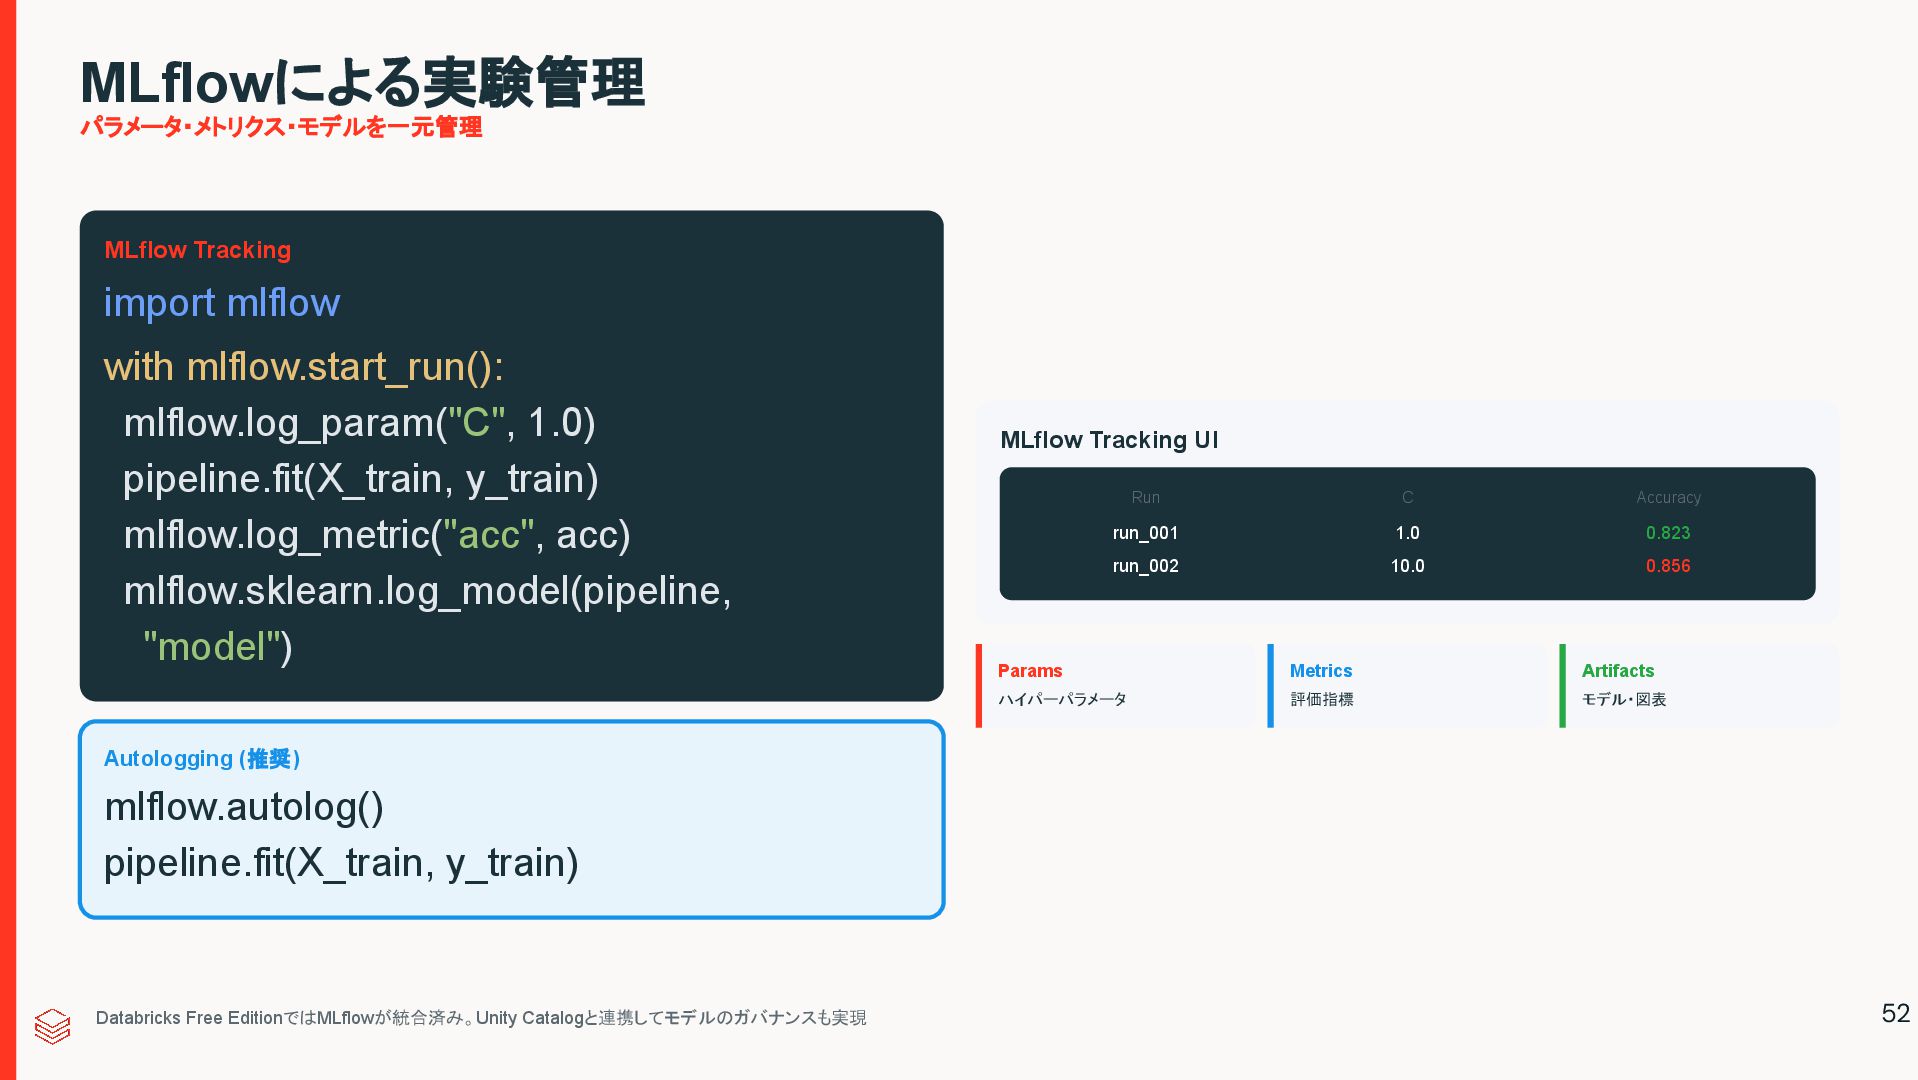
MLflowによる実験管理 パラメータ・メトリクス・モデルを一元管理 MLflow Tracking import mlflow with mlflow.start_run(): mlflow.log_param("C", 1.0)
pipeline.fit(X_train, y_train) mlflow.log_metric("acc", acc) mlflow.sklearn.log_model(pipeline, "model") Autologging (推奨) mlflow.autolog() pipeline.fit(X_train, y_train) MLflow Tracking UI Run C Accuracy run_001 1.0 0.823 run_002 10.0 0.856 Params ハイパーパラメータ Metrics 評価指標 Artifacts モデル・図表 Databricks Free EditionではMLflowが統合済み。Unity Catalogと連携してモデルのガバナンスも実現 52 -
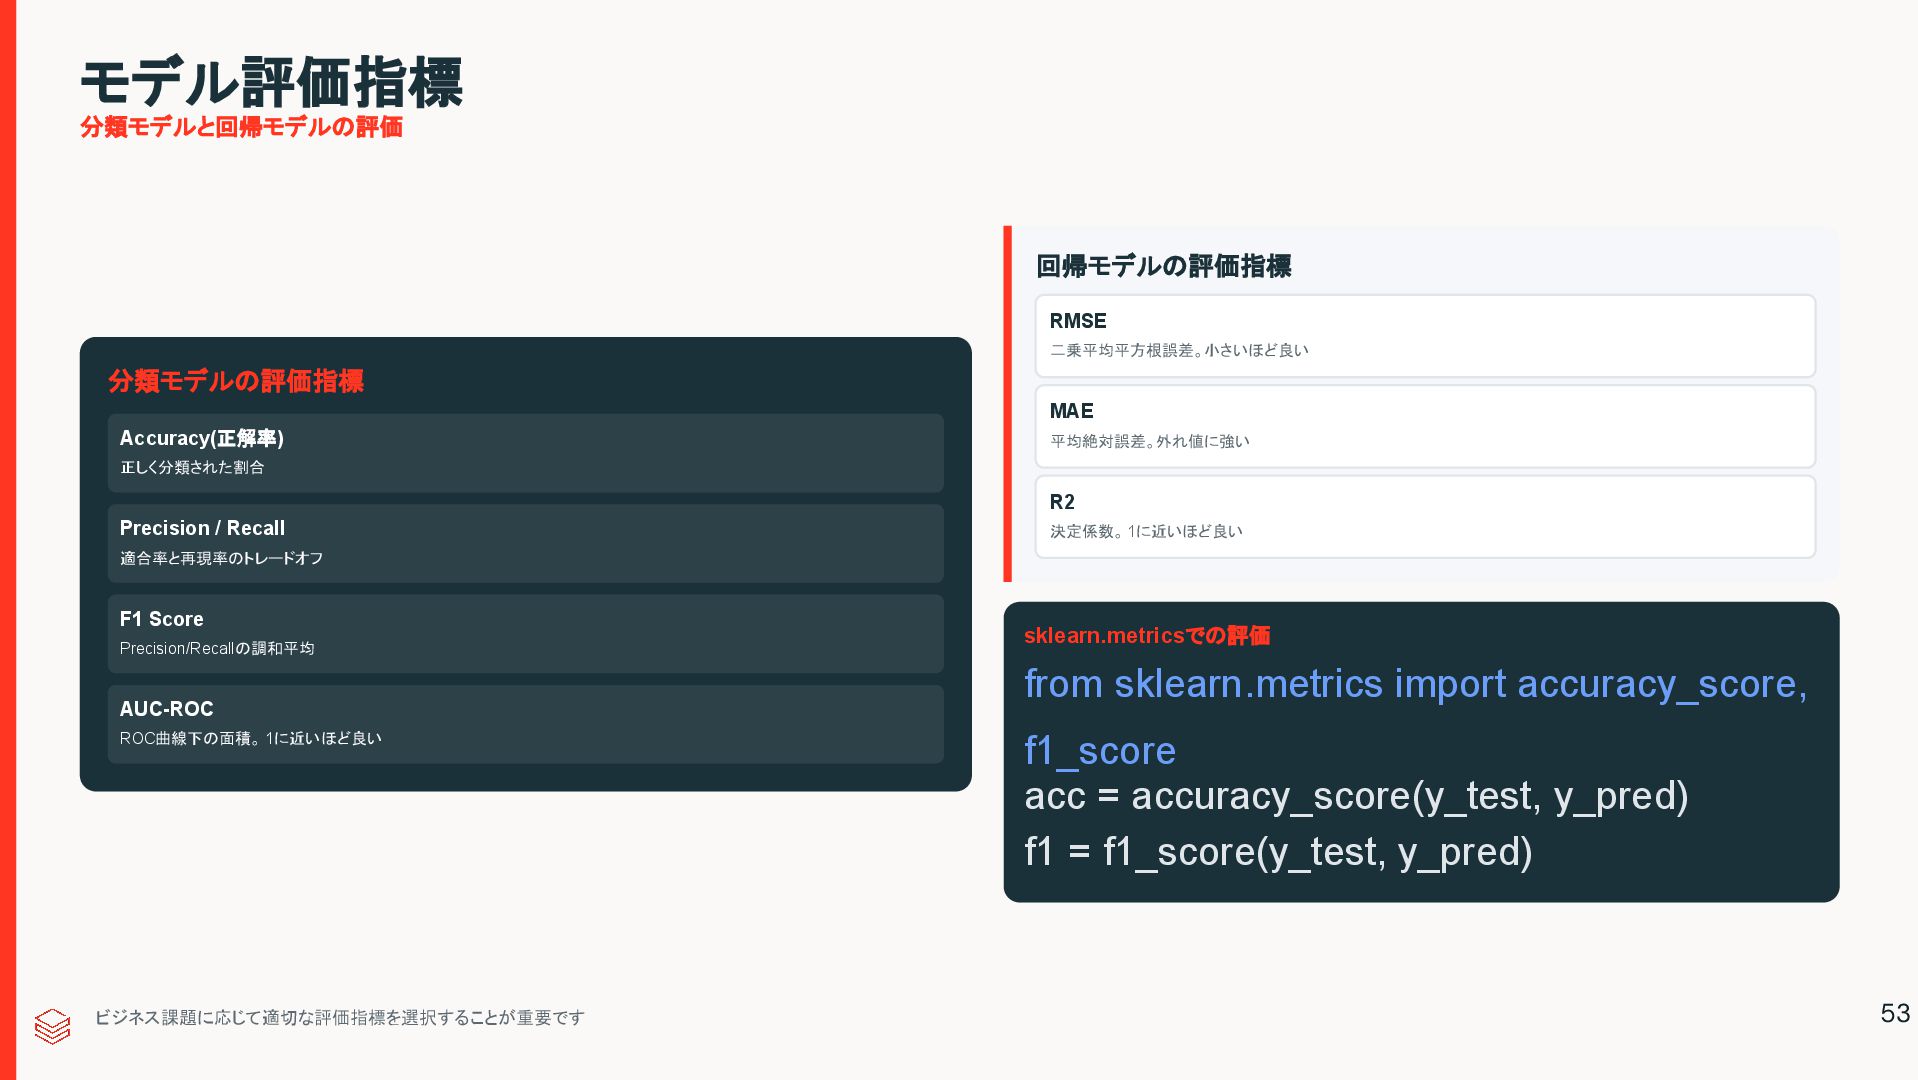
モデル評価指標 分類モデルと回帰モデルの評価 分類モデルの評価指標 Accuracy(正解率) 正しく分類された割合 Precision / Recall 適合率と再現率のトレードオフ F1
Score Precision/Recallの調和平均 AUC-ROC ROC曲線下の面積。 1に近いほど良い 回帰モデルの評価指標 RMSE 二乗平均平方根誤差。小さいほど良い MAE 平均絶対誤差。外れ値に強い R2 決定係数。1に近いほど良い sklearn.metricsでの評価 from sklearn.metrics import accuracy_score, f1_score acc = accuracy_score(y_test, y_pred) f1 = f1_score(y_test, y_pred) ビジネス課題に応じて適切な評価指標を選択することが重要です 53 -
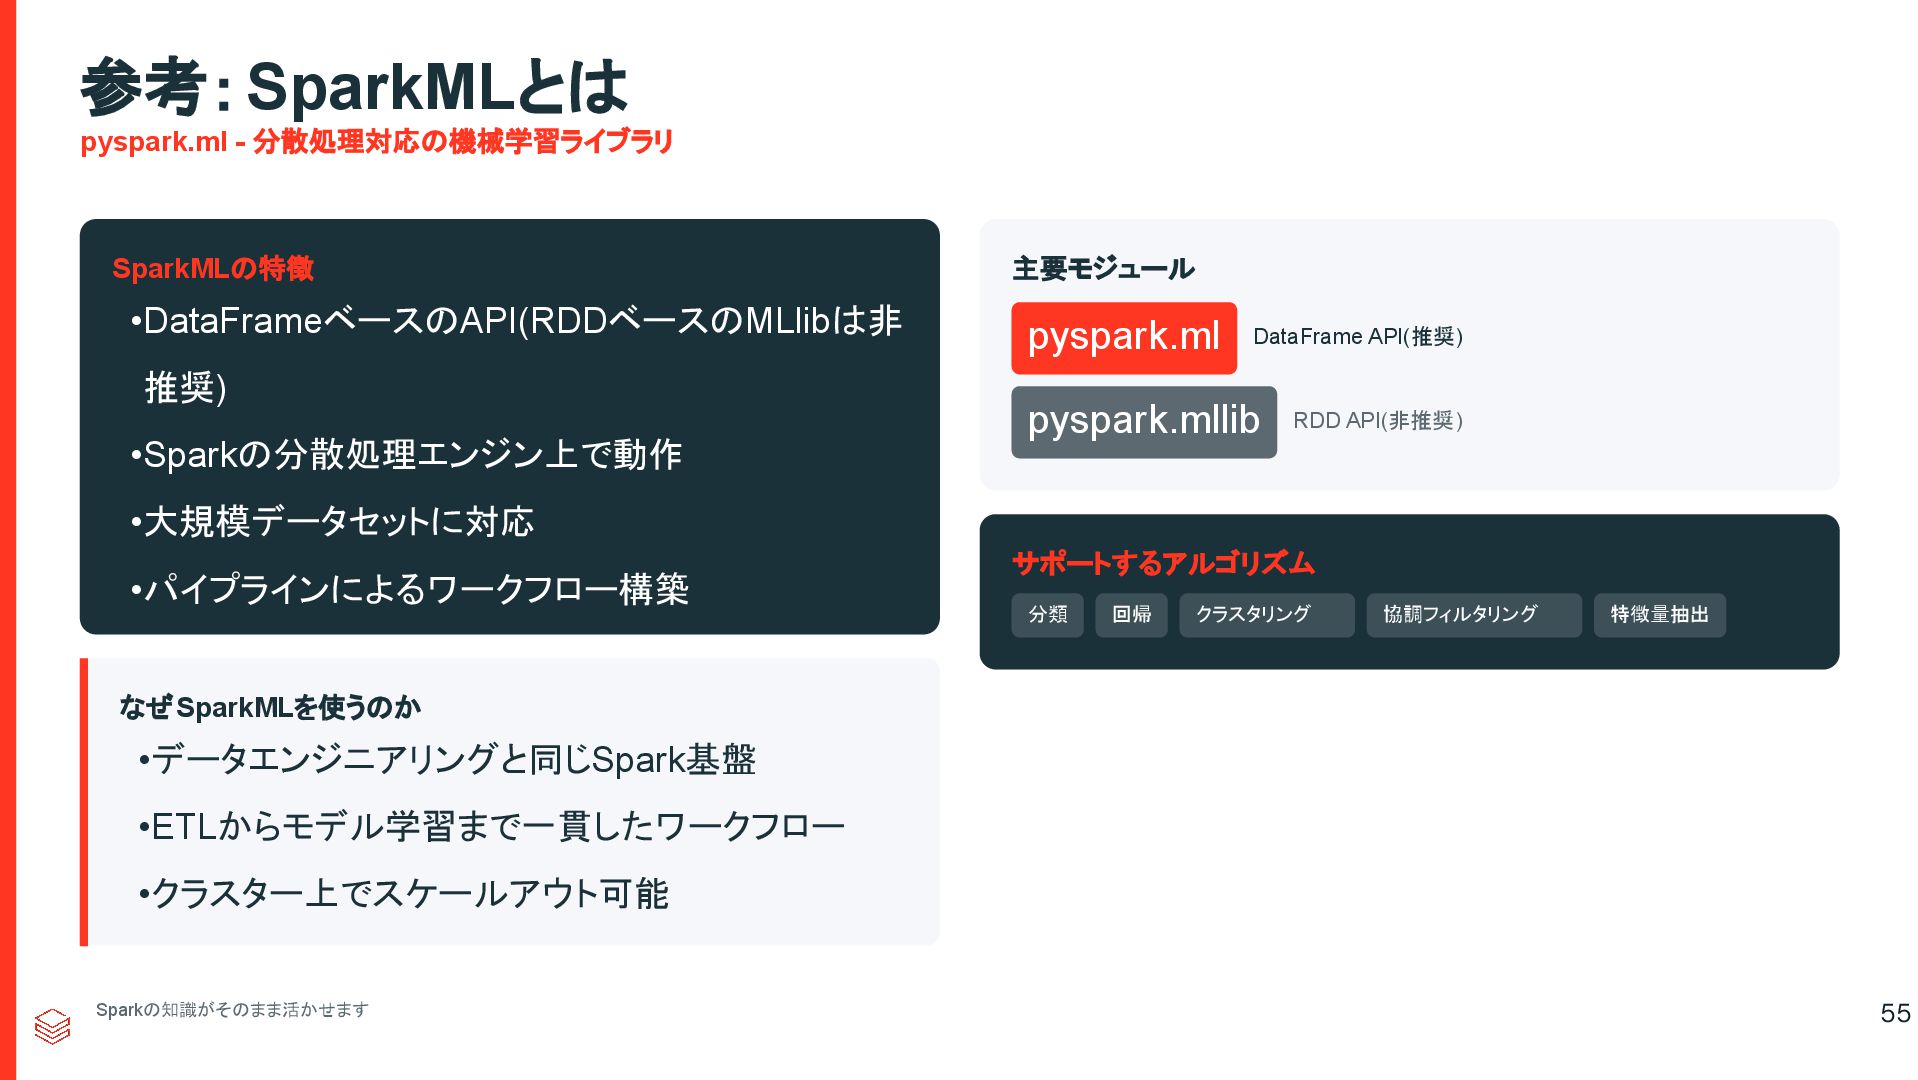
参考:SparkMLとは pyspark.ml - 分散処理対応の機械学習ライブラリ SparkMLの特徴 •DataFrameベースのAPI(RDDベースのMLlibは非 推奨) •Sparkの分散処理エンジン上で動作 •大規模データセットに対応 •パイプラインによるワークフロー構築
なぜSparkMLを使うのか •データエンジニアリングと同じSpark基盤 •ETLからモデル学習まで一貫したワークフロー •クラスター上でスケールアウト可能 主要モジュール pyspark.ml DataFrame API(推奨) pyspark.mllib RDD API(非推奨) サポートするアルゴリズム 分類 回帰 クラスタリング 協調フィルタリング 特徴量抽出 Sparkの知識がそのまま活かせます 55 -
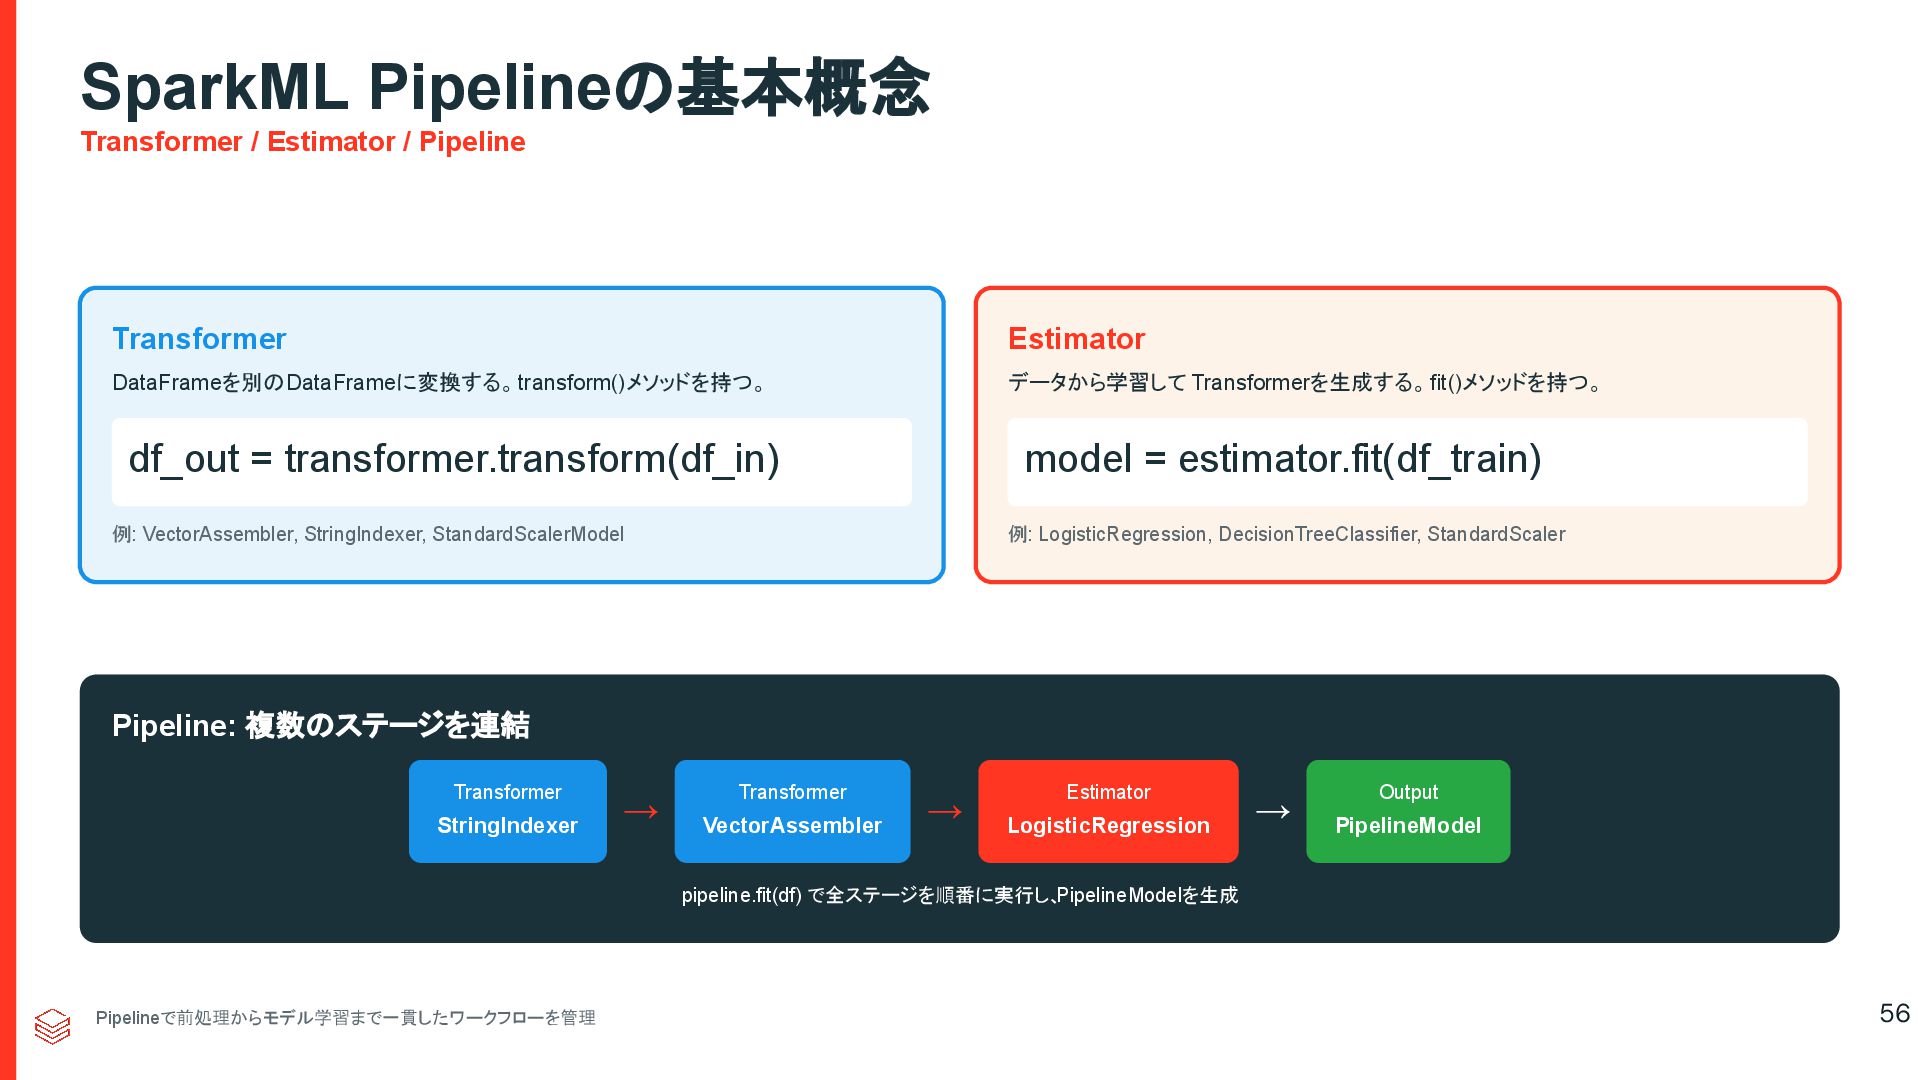
SparkML Pipelineの基本概念 Transformer / Estimator / Pipeline Transformer DataFrameを別のDataFrameに変換する。transform()メソッドを持つ。 df_out
= transformer.transform(df_in) 例: VectorAssembler, StringIndexer, StandardScalerModel Estimator データから学習して Transformerを生成する。fit()メソッドを持つ。 model = estimator.fit(df_train) 例: LogisticRegression, DecisionTreeClassifier, StandardScaler Pipeline: 複数のステージを連結 Transformer StringIndexer → Transformer VectorAssembler → Estimator LogisticRegression → Output PipelineModel pipeline.fit(df) で全ステージを順番に実行し、 PipelineModelを生成 Pipelineで前処理からモデル学習まで一貫したワークフローを管理 56 -
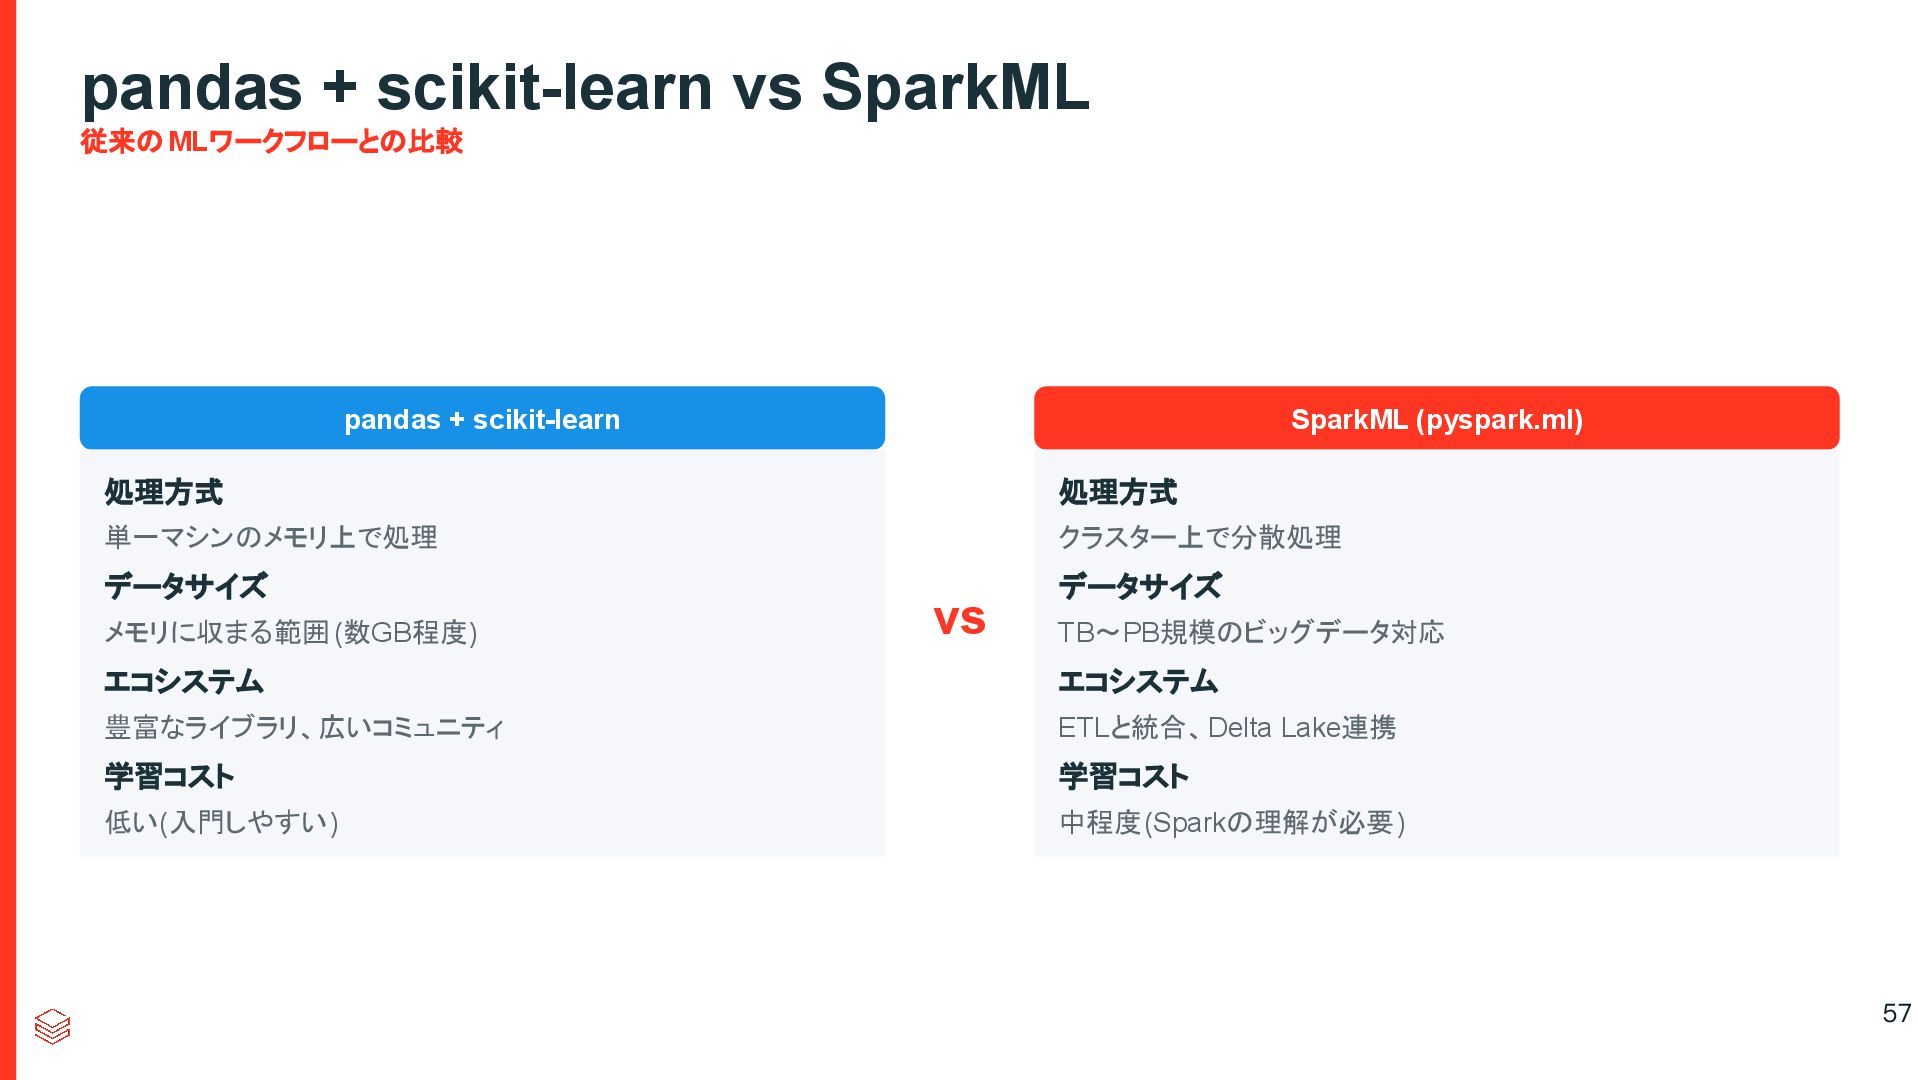
pandas + scikit-learn vs SparkML 従来のMLワークフローとの比較 pandas + scikit-learn 処理方式
単一マシンのメモリ上で処理 データサイズ メモリに収まる範囲(数GB程度) エコシステム 豊富なライブラリ、広いコミュニティ 学習コスト 低い(入門しやすい) vs SparkML (pyspark.ml) 処理方式 クラスター上で分散処理 データサイズ TB〜PB規模のビッグデータ対応 エコシステム ETLと統合、Delta Lake連携 学習コスト 中程度(Sparkの理解が必要) 57 -
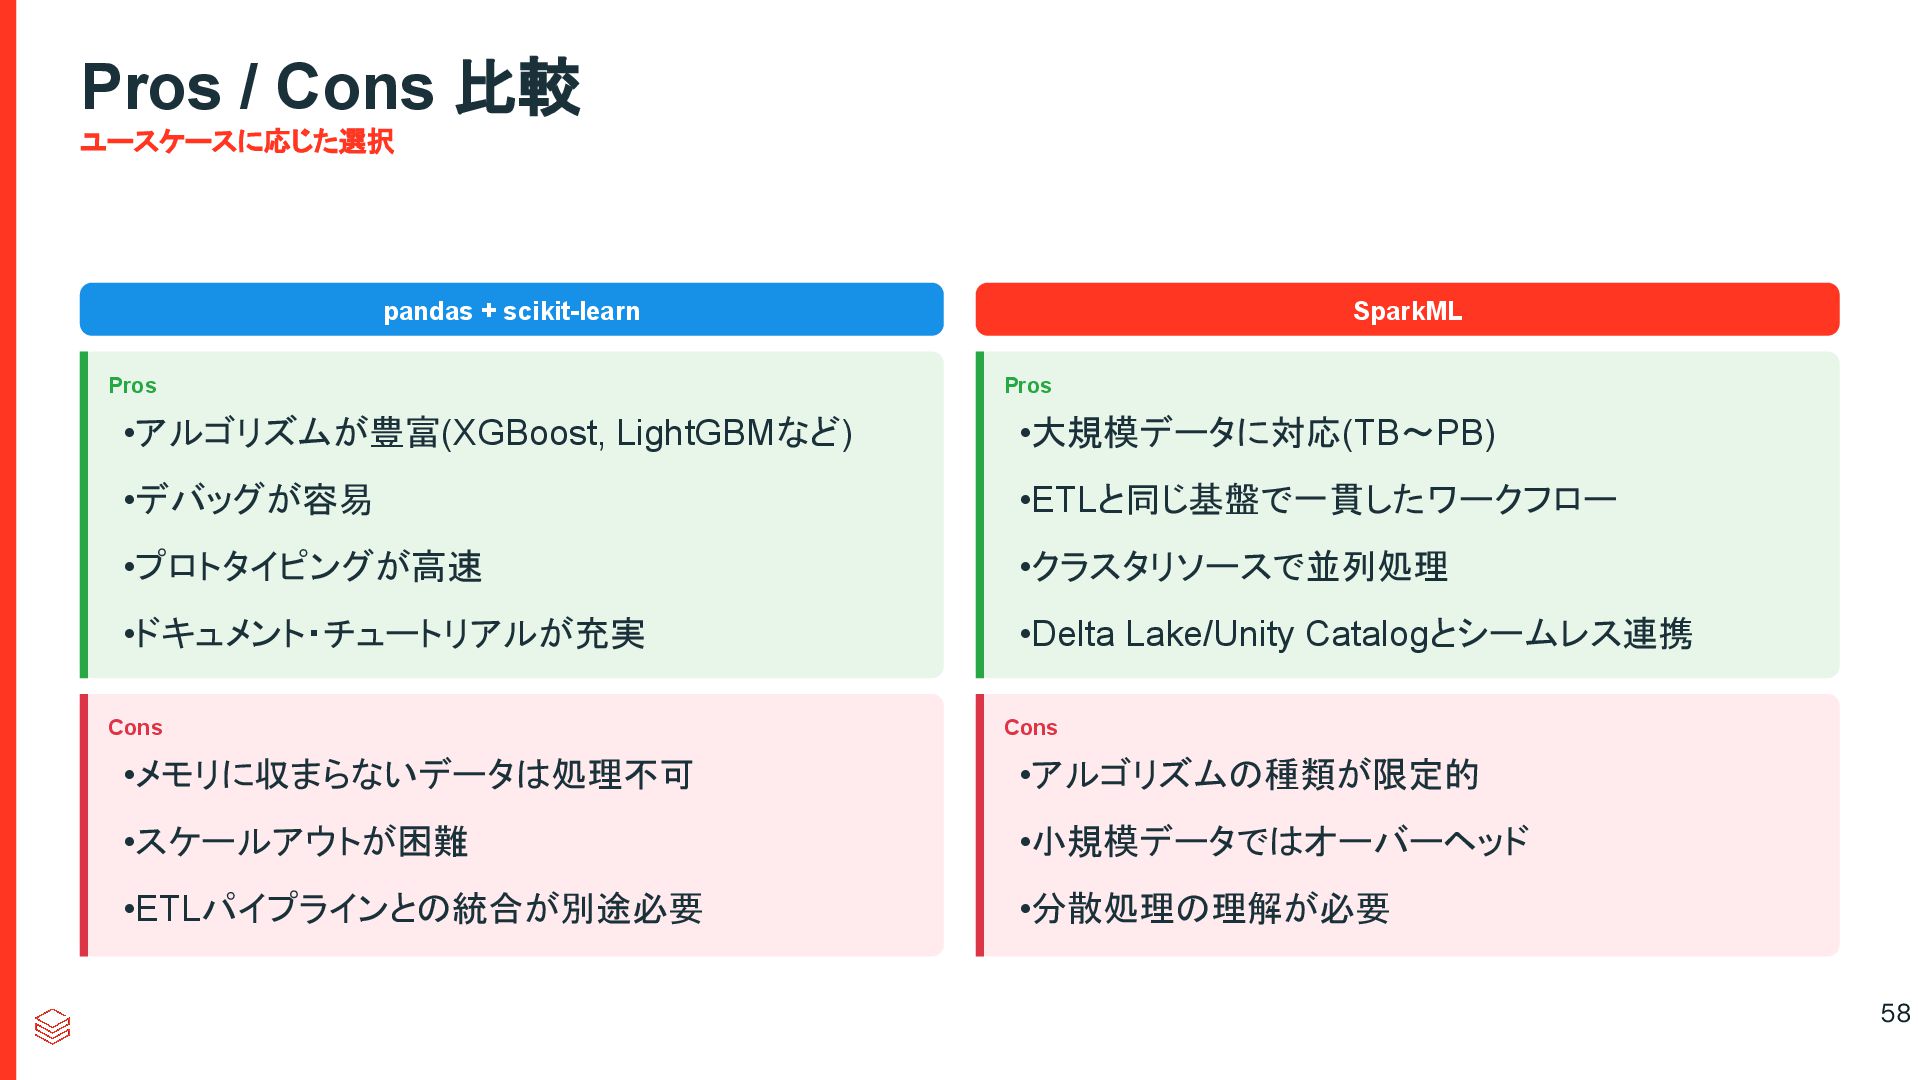
Pros / Cons 比較 ユースケースに応じた選択 pandas + scikit-learn Pros •アルゴリズムが豊富(XGBoost,
LightGBMなど) •デバッグが容易 •プロトタイピングが高速 •ドキュメント・チュートリアルが充実 Cons •メモリに収まらないデータは処理不可 •スケールアウトが困難 •ETLパイプラインとの統合が別途必要 SparkML Pros •大規模データに対応(TB〜PB) •ETLと同じ基盤で一貫したワークフロー •クラスタリソースで並列処理 •Delta Lake/Unity Catalogとシームレス連携 Cons •アルゴリズムの種類が限定的 •小規模データではオーバーヘッド •分散処理の理解が必要 58 -
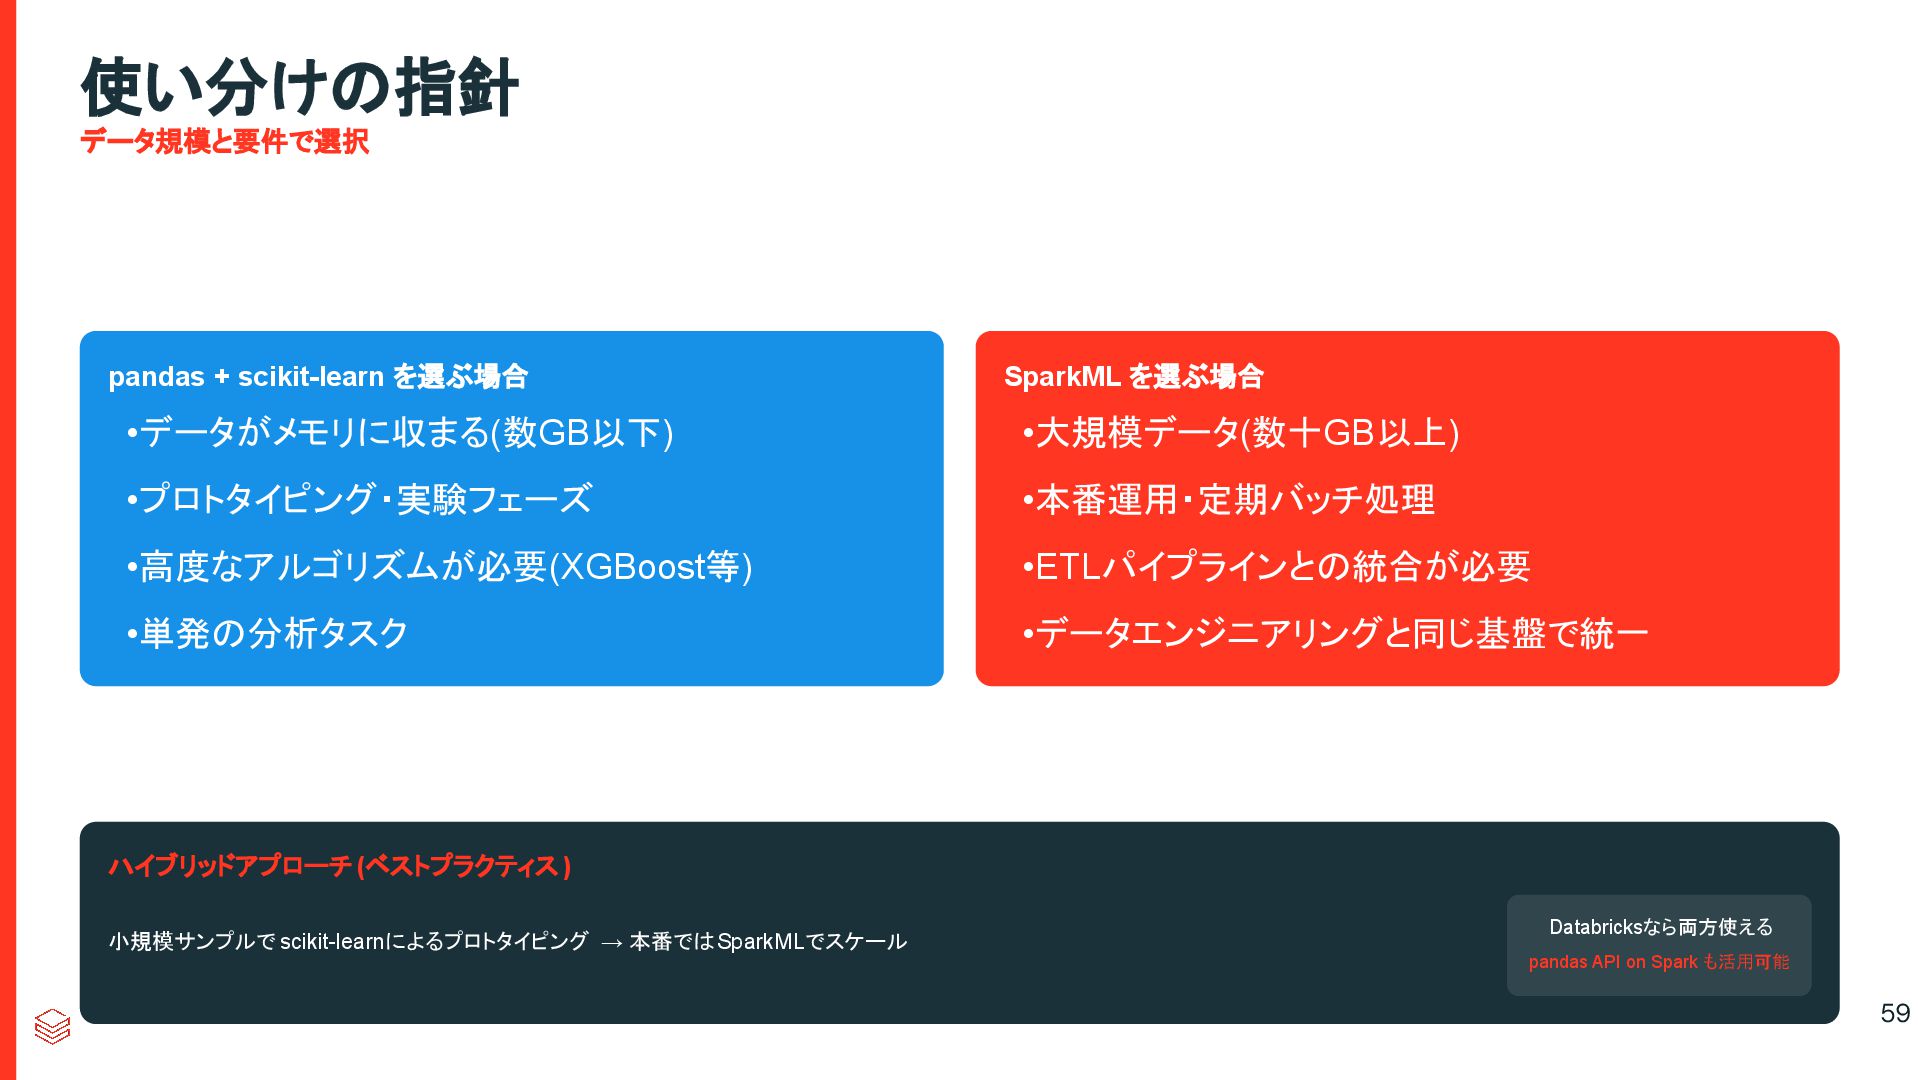
使い分けの指針 データ規模と要件で選択 pandas + scikit-learn を選ぶ場合 •データがメモリに収まる(数GB以下) •プロトタイピング・実験フェーズ •高度なアルゴリズムが必要(XGBoost等) •単発の分析タスク
SparkML を選ぶ場合 •大規模データ(数十GB以上) •本番運用・定期バッチ処理 •ETLパイプラインとの統合が必要 •データエンジニアリングと同じ基盤で統一 ハイブリッドアプローチ (ベストプラクティス) 小規模サンプルで scikit-learnによるプロトタイピング → 本番ではSparkMLでスケール Databricksなら両方使える pandas API on Spark も活用可能 59 -
Databricksにおける機械学習 MLライフサイクル全体に対するデータネイティブ、コラボレーティブなソリューション によるオープンなデータレイクハウス基盤 MLOps / ガバナンス データ準備 データの バージョン管理 モニタリング
バッチスコアリン グ オンライン サービング モデル トレーニング モデル チューニング ランタイム環境 Feature Store バッチ (高スループット) リアルタイム (低レーテン シー) AutoML データサイエンスワークスペース 61 -
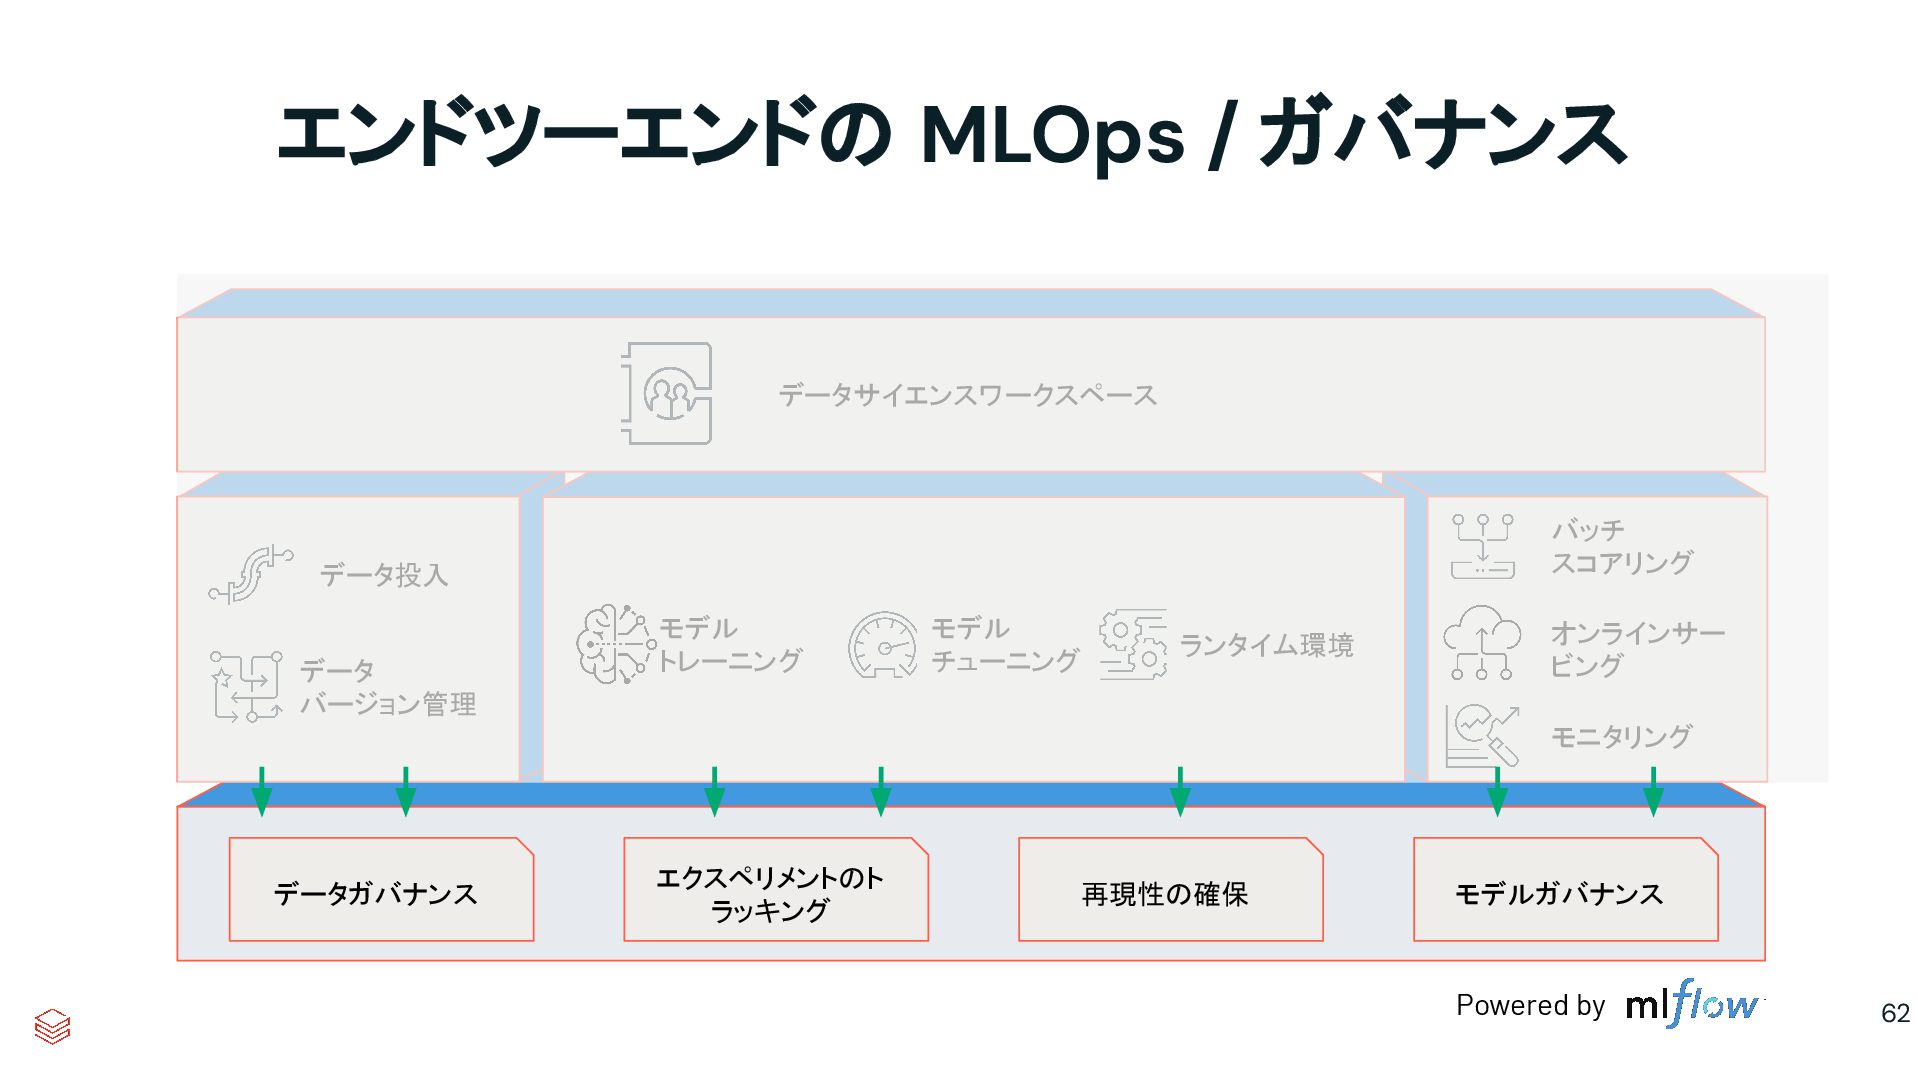
エンドツーエンドの MLOps / ガバナンス データサイエンスワークスペース データ投入 データ バージョン管理 モデル トレーニング
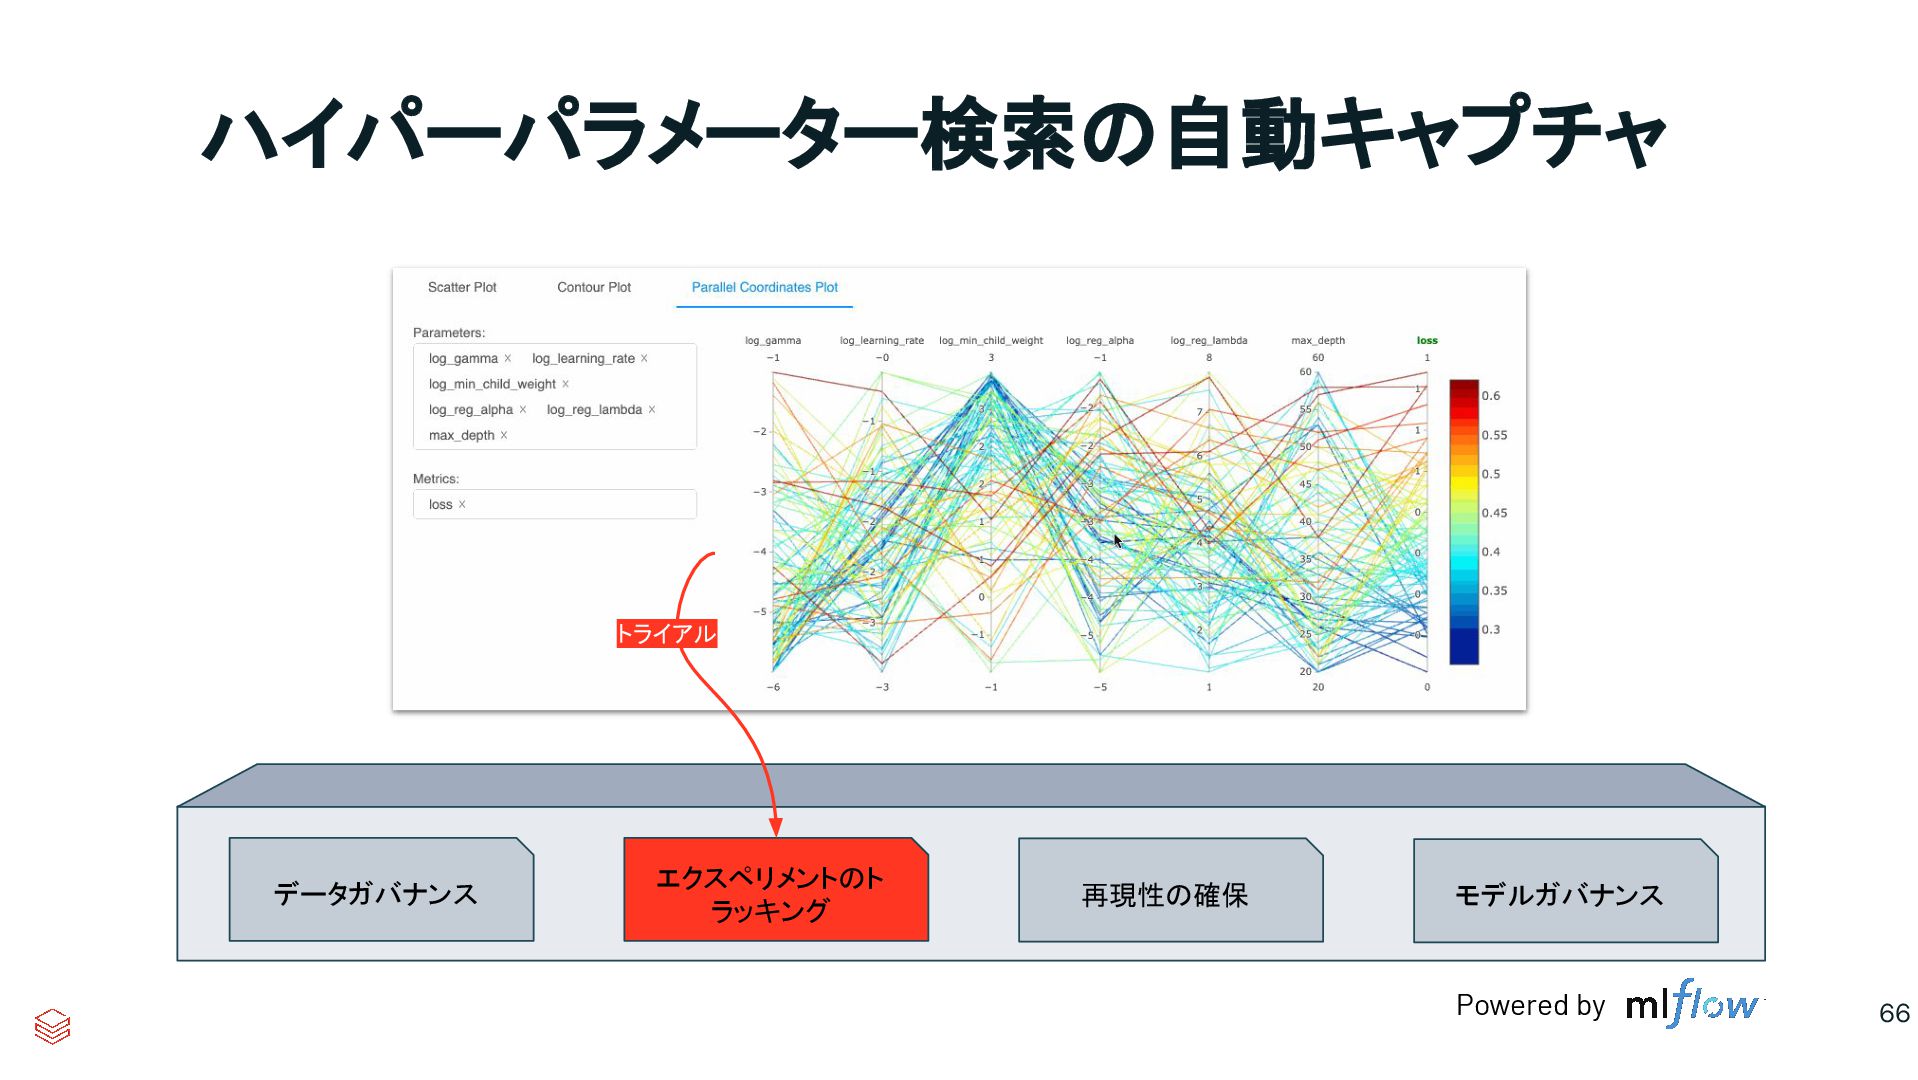
モデル チューニング ランタイム環境 モニタリング バッチ スコアリング オンラインサー ビング データガバナンス エクスペリメントのト ラッキング 再現性の確保 モデルガバナンス Powered by 62 -
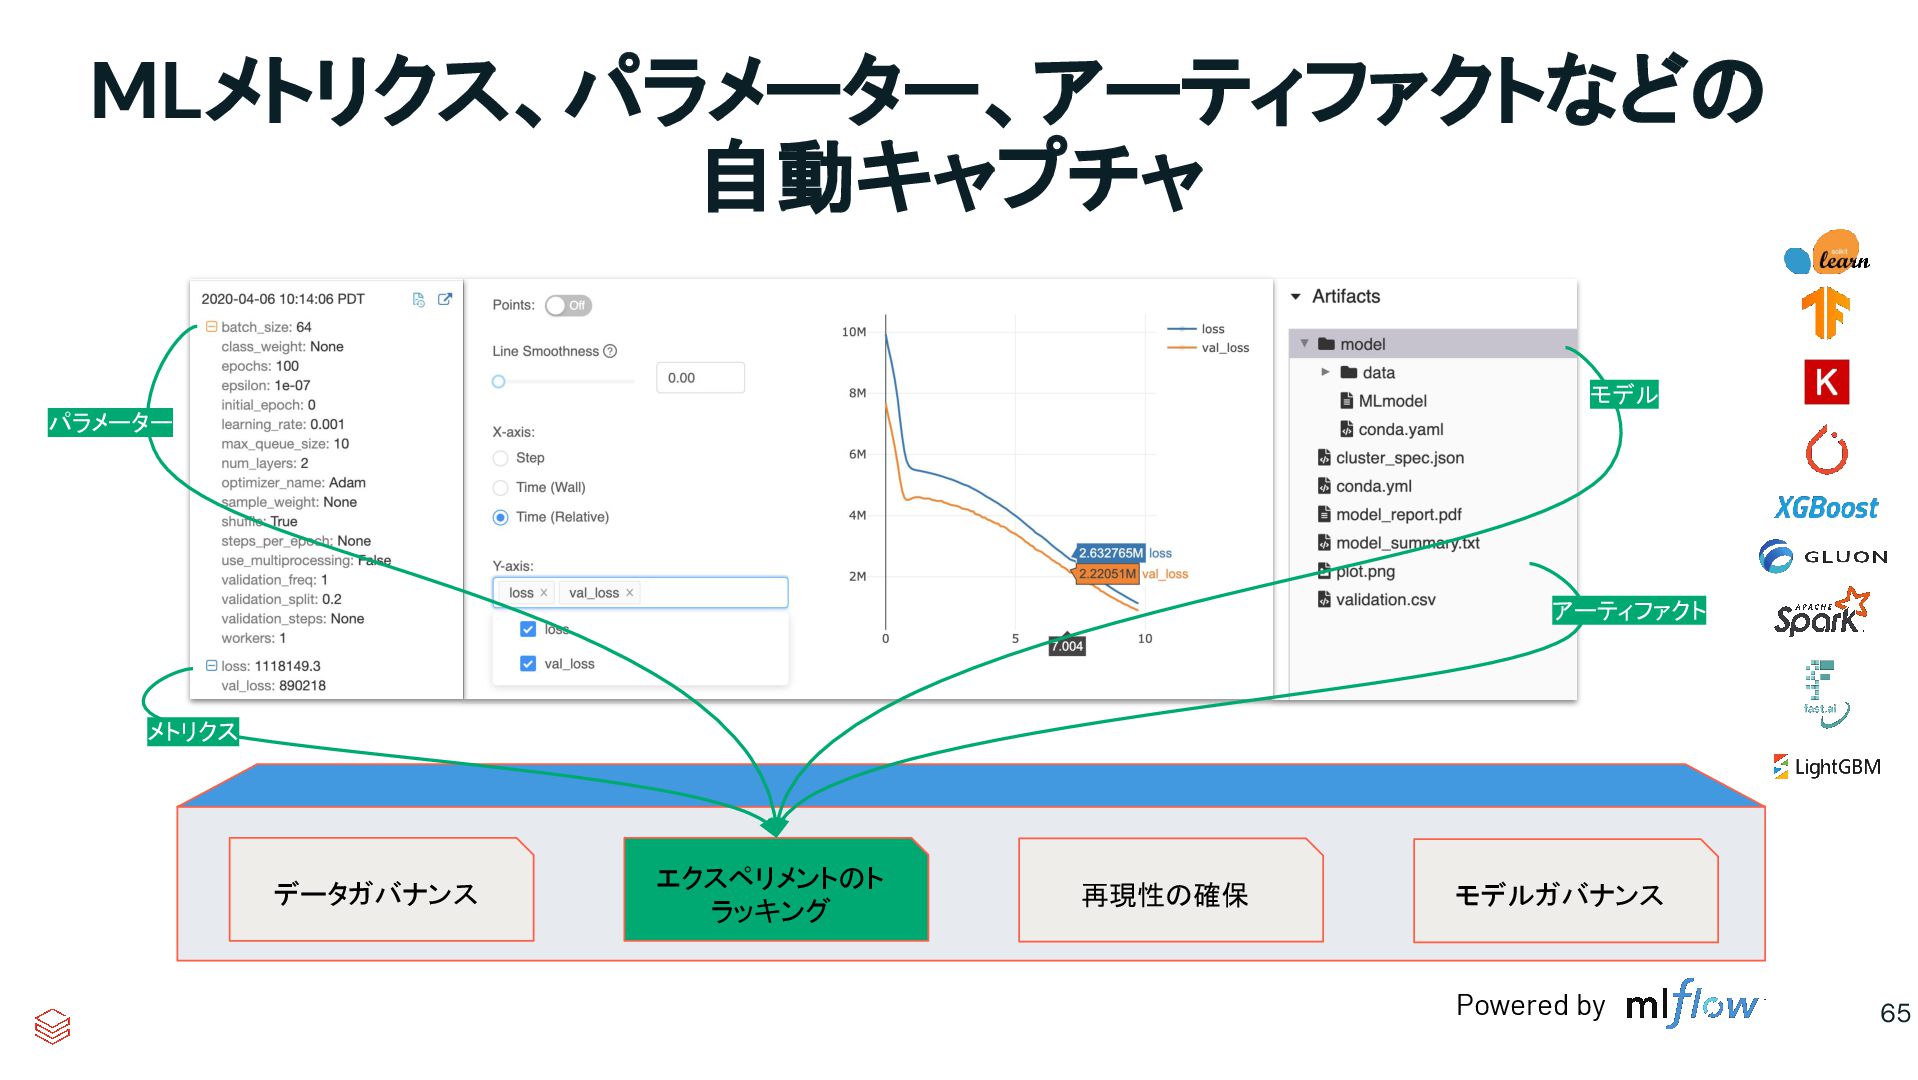
Powered by データガバナンス エクスペリメントのト ラッキング 再現性の確保 モデルガバナンス パラメーター メトリクス モデル
アーティファクト MLメトリクス、パラメーター、アーティファクトなどの 自動キャプチャ 65 -
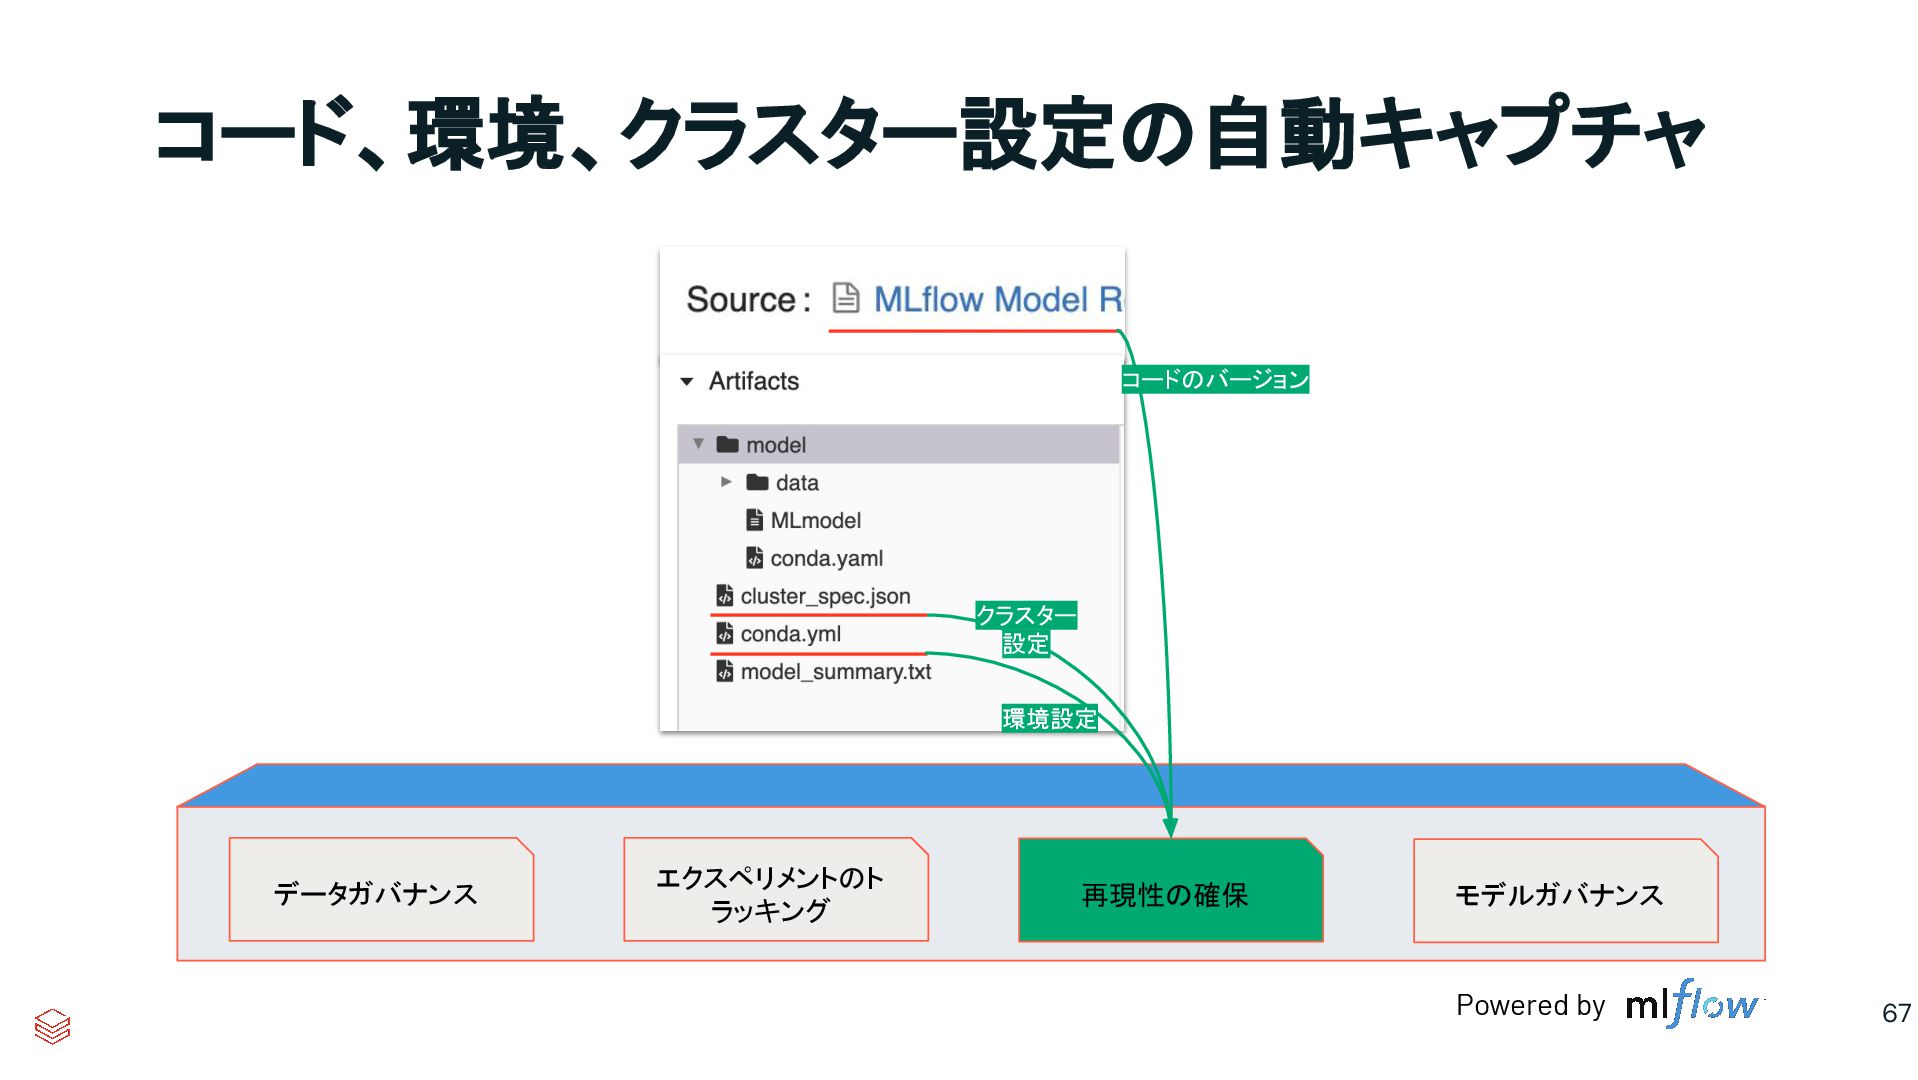
Powered by データガバナンス エクスペリメントのト ラッキング 再現性の確保 モデルガバナンス コードのバージョン クラスター 設定
環境設定 コード、環境、クラスター設定の自動キャプチャ 67 -
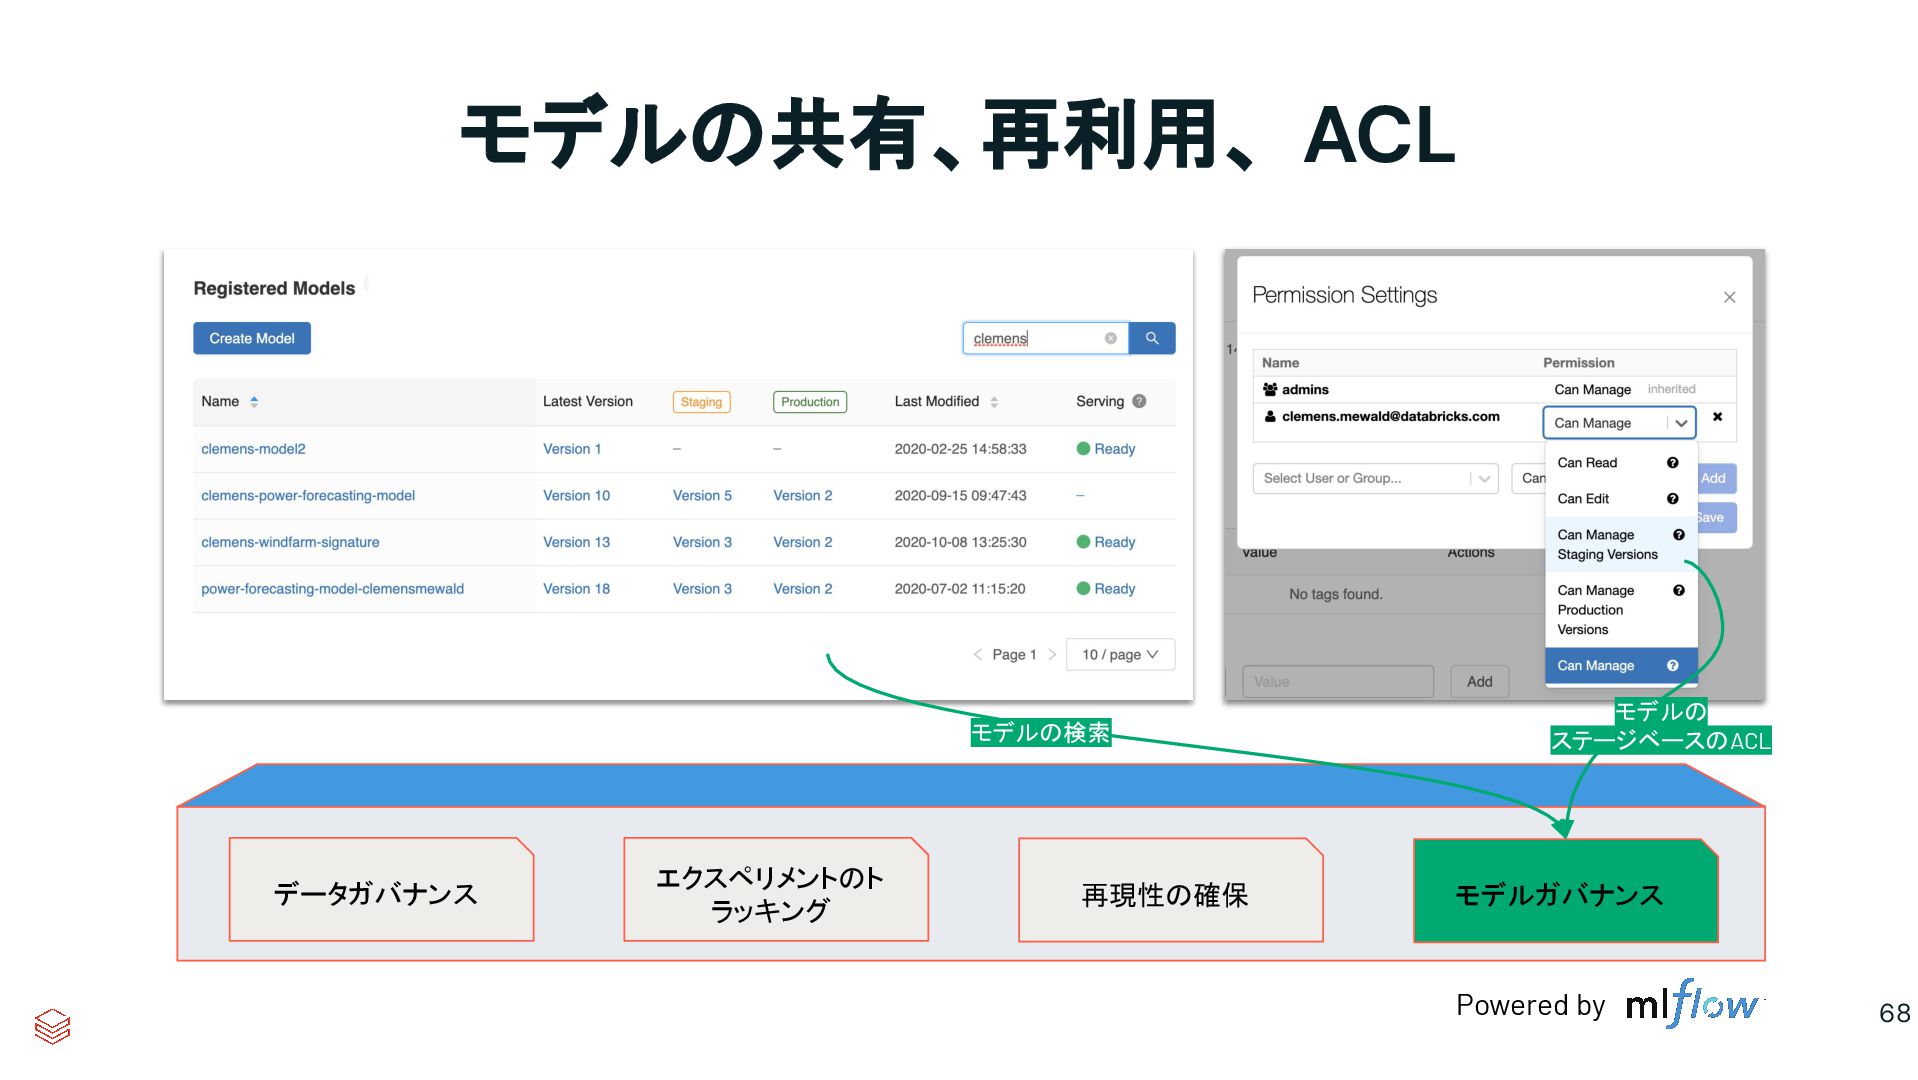
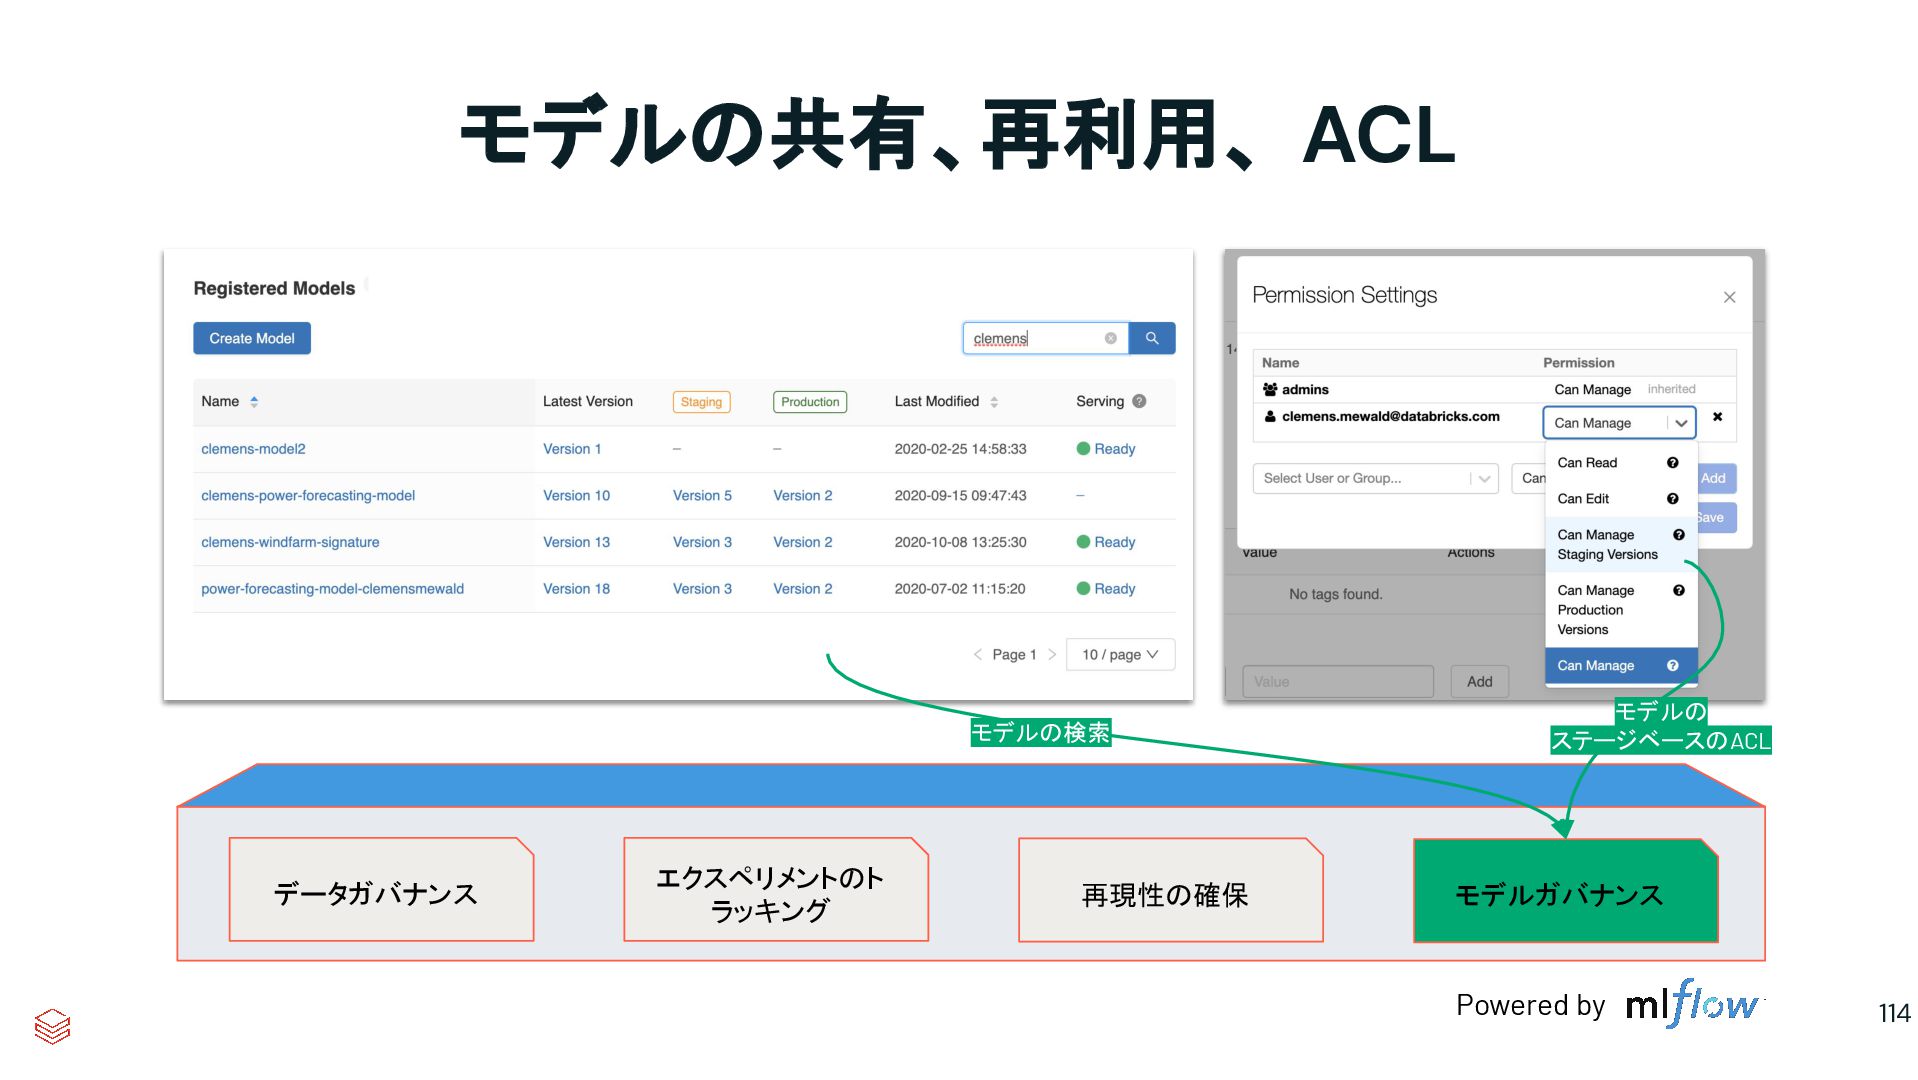
Powered by データガバナンス エクスペリメントのト ラッキング 再現性の確保 モデルガバナンス モデルの検索 モデルの ステージベースのACL
モデルの共有、再利用、 ACL 68 -
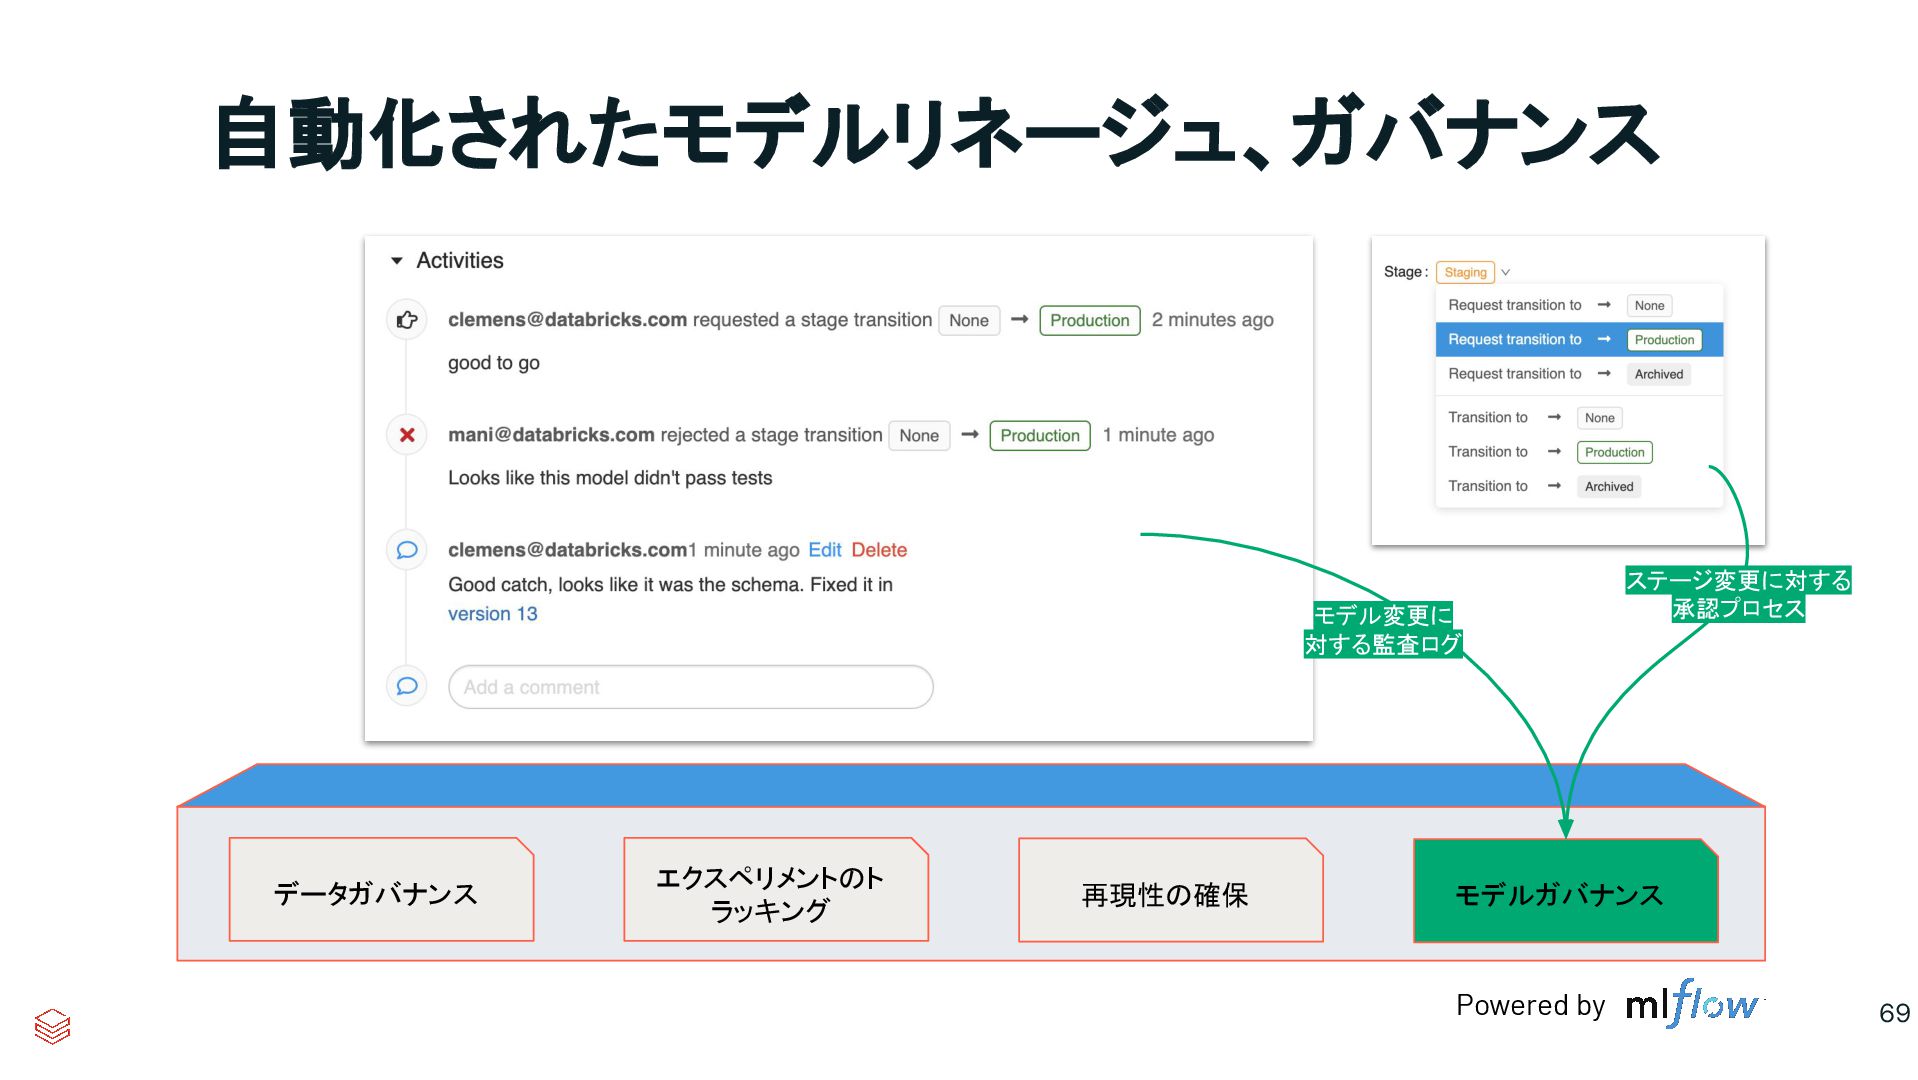
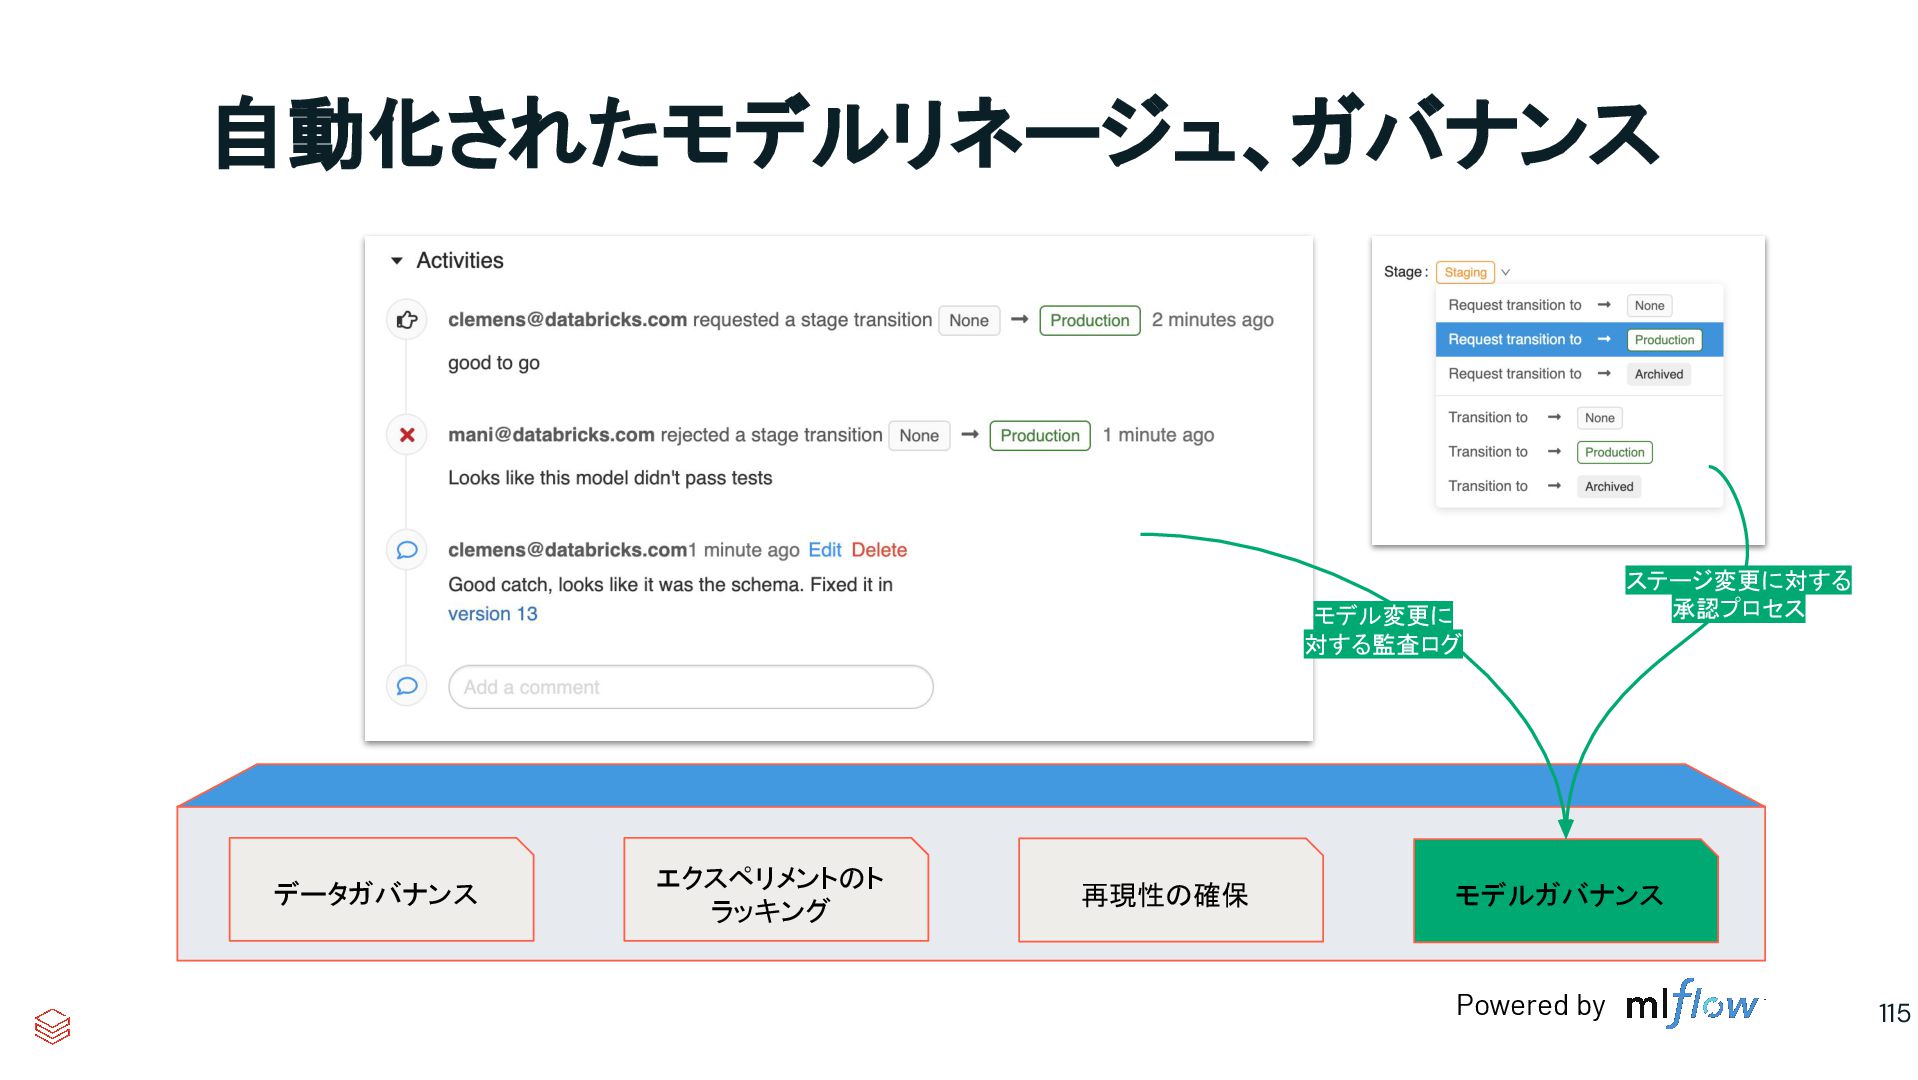
Powered by データガバナンス エクスペリメントのト ラッキング 再現性の確保 モデルガバナンス ステージ変更に対する 承認プロセス モデル変更に
対する監査ログ 自動化されたモデルリネージュ、ガバナンス 69 -
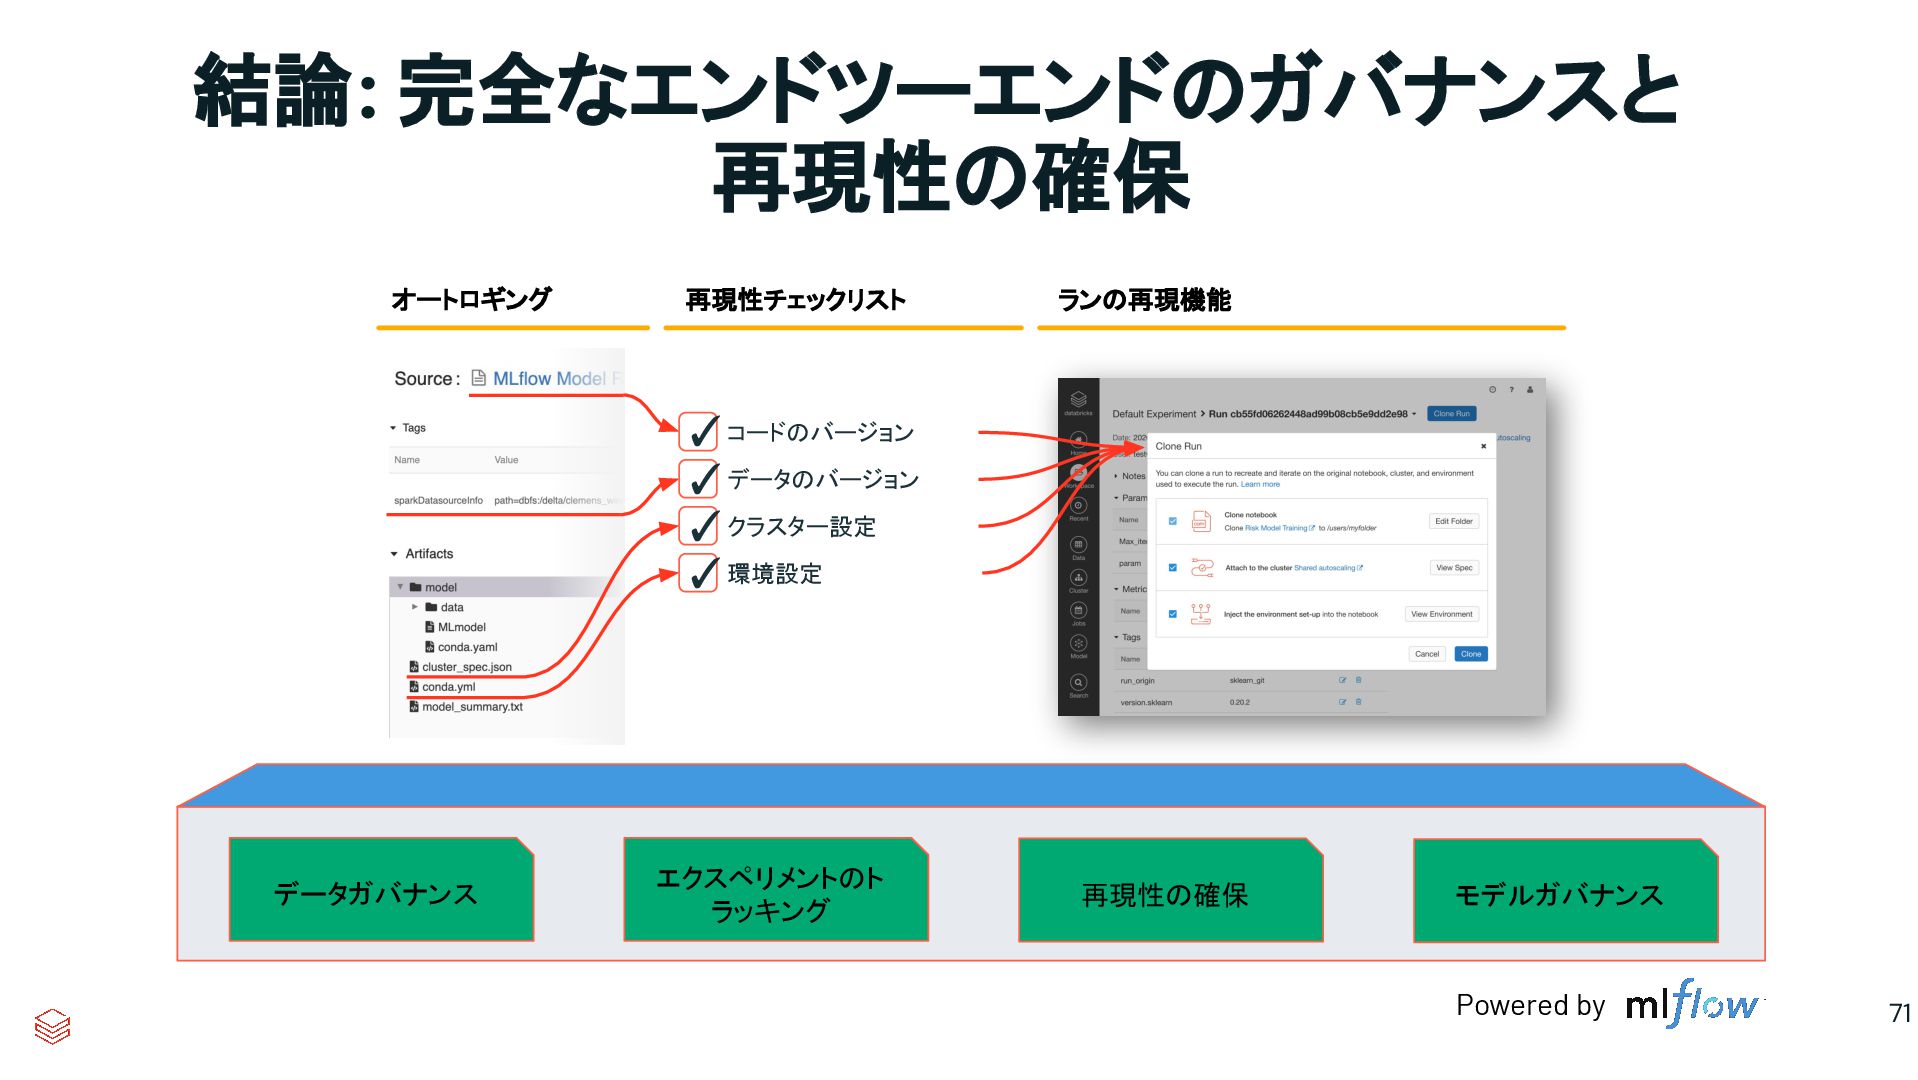
コードのバージョン データのバージョン クラスター設定 環境設定 オートロギング 再現性チェックリスト ランの再現機能 データガバナンス エクスペリメントのト ラッキング
再現性の確保 モデルガバナンス Powered by ✓ ✓ ✓ ✓ 結論: 完全なエンドツーエンドのガバナンスと 再現性の確保 71 -
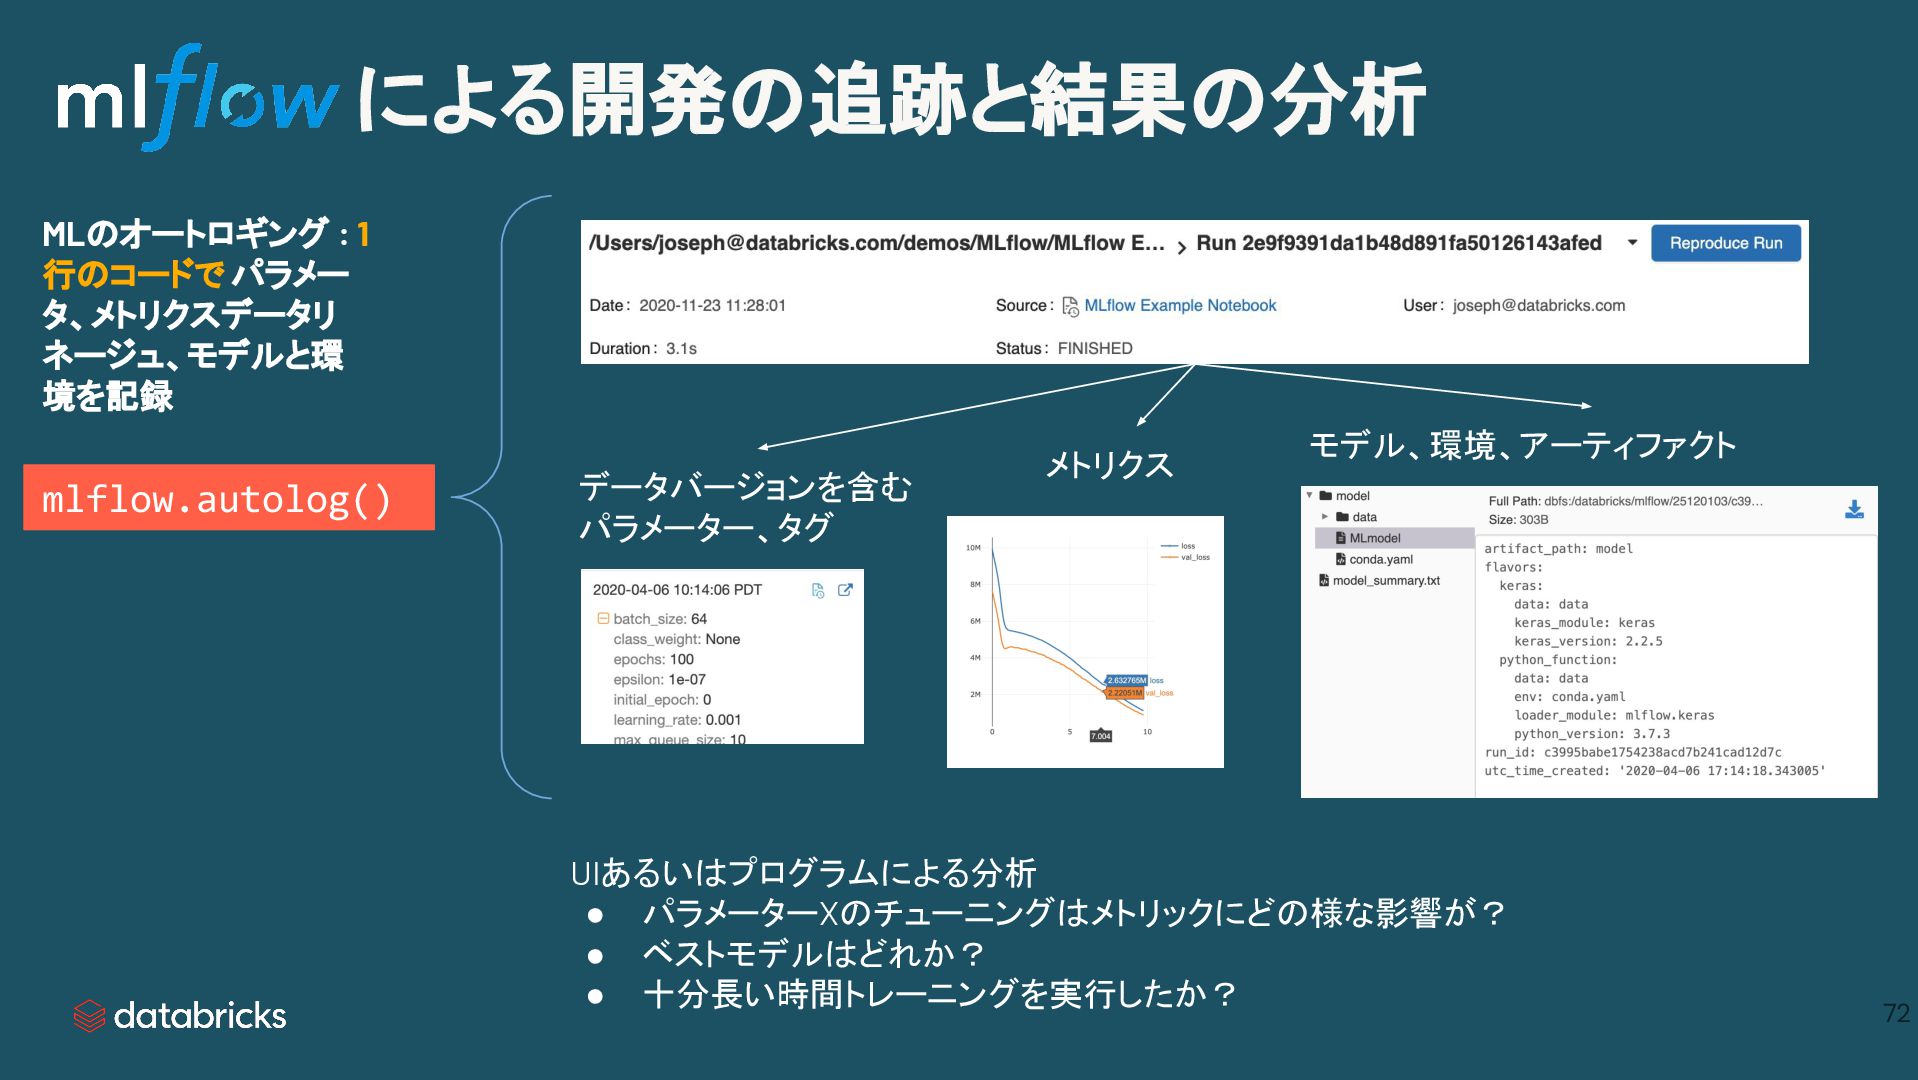
MLのオートロギング : 1 行のコードで パラメー タ、メトリクスデータリ ネージュ、モデルと環 境を記録 mlflow.autolog() による開発の追跡と結果の分析
UIあるいはプログラムによる分析 • パラメーターXのチューニングはメトリックにどの様な影響が? • ベストモデルはどれか? • 十分長い時間トレーニングを実行したか? データバージョンを含む パラメーター、タグ モデル、環境、アーティファクト メトリクス 72 -
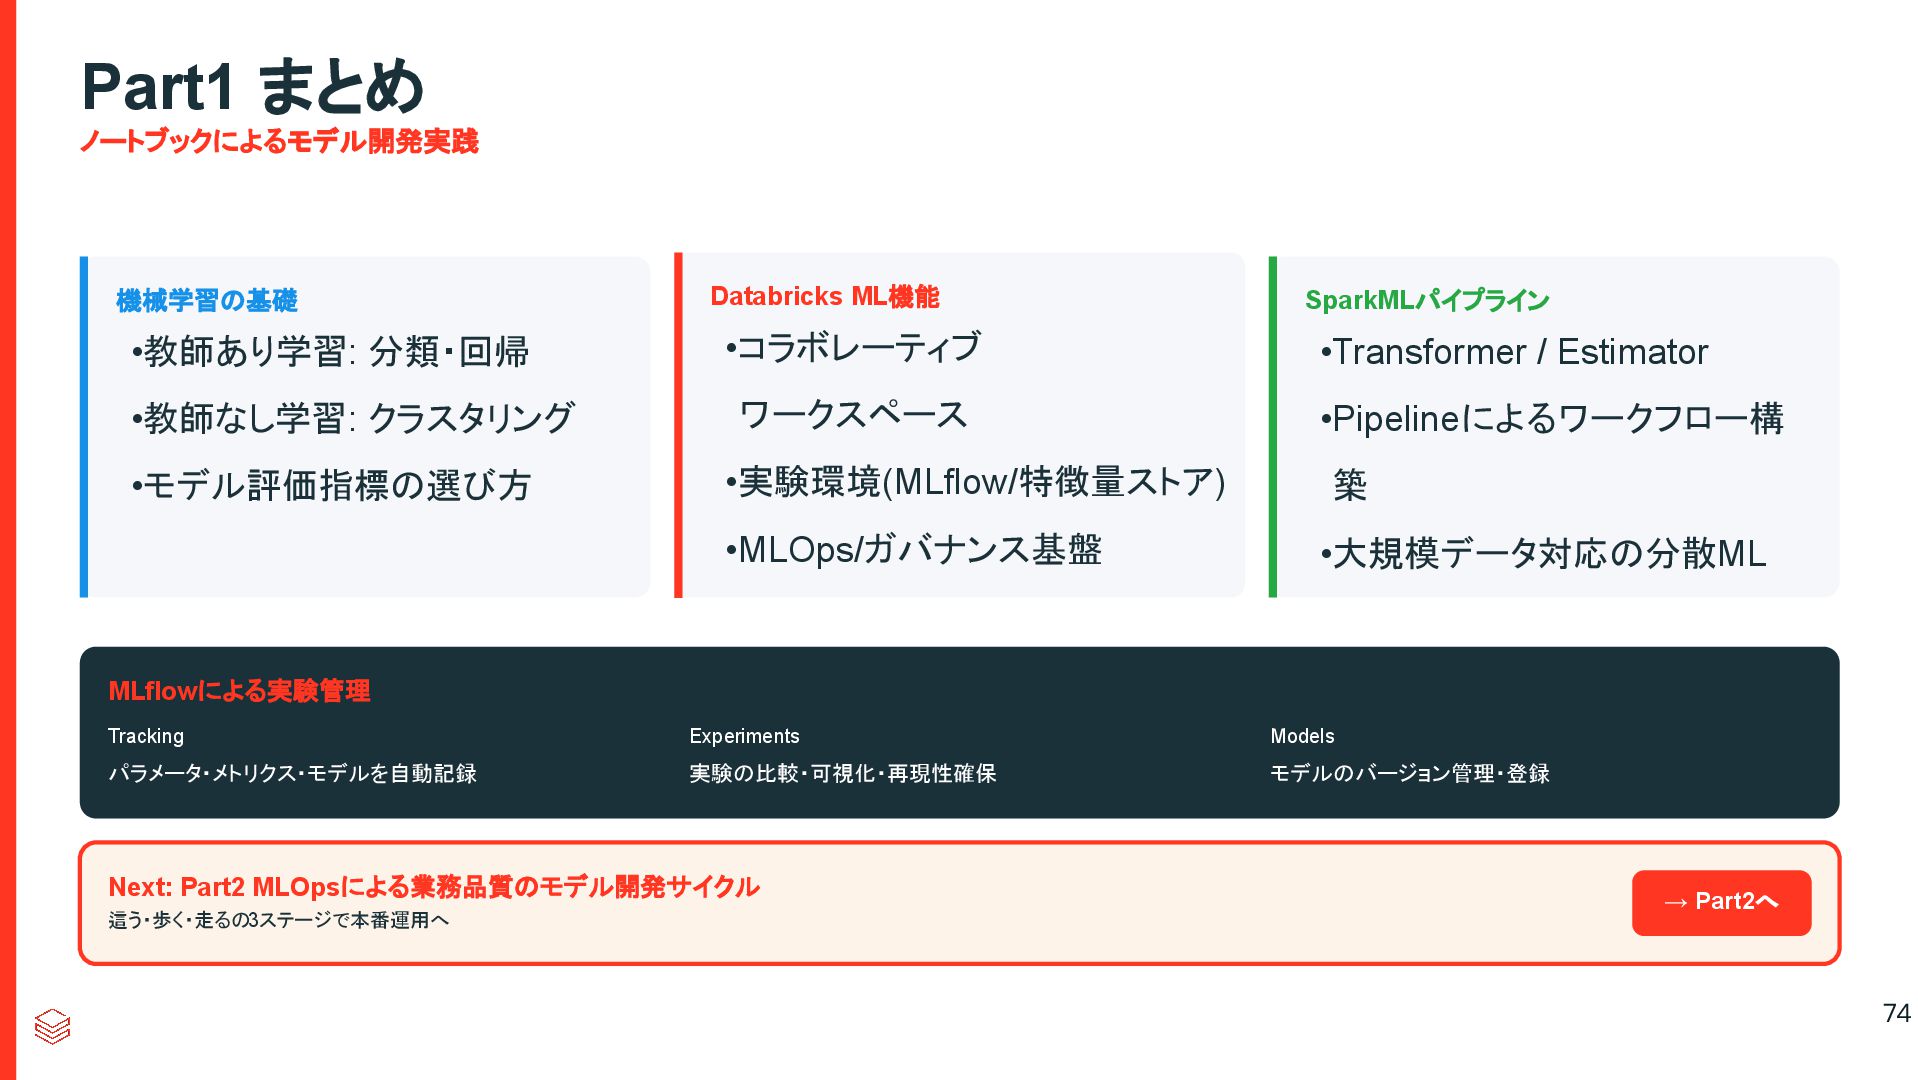
Part1 まとめ ノートブックによるモデル開発実践 機械学習の基礎 •教師あり学習: 分類・回帰 •教師なし学習: クラスタリング •モデル評価指標の選び方 Databricks
ML機能 •コラボレーティブ ワークスペース •実験環境(MLflow/特徴量ストア) •MLOps/ガバナンス基盤 SparkMLパイプライン •Transformer / Estimator •Pipelineによるワークフロー構 築 •大規模データ対応の分散ML MLflowによる実験管理 Tracking パラメータ・メトリクス・モデルを自動記録 Experiments 実験の比較・可視化・再現性確保 Models モデルのバージョン管理・登録 Next: Part2 MLOpsによる業務品質のモデル開発サイクル 這う・歩く・走るの3ステージで本番運用へ → Part2へ 74 -
学習目標 76 全体 データエンジニアリング編で習得したDatabricksの基礎(Spark、データ フレーム、Delta Lake、パイプライン)を土台に、機械学習の基本概念からMLOpsに よる本番運用まで、一貫したワークフローを体験する。 Part 2 •
MLOpsの必要性と概念を理解する • 「這う・歩く・走る」アプローチの実践方法を学ぶ • Unity Catalog、MLflow、Feature Storeの役割を理解する • モデルのデプロイメントとモニタリングの基礎を習得する -
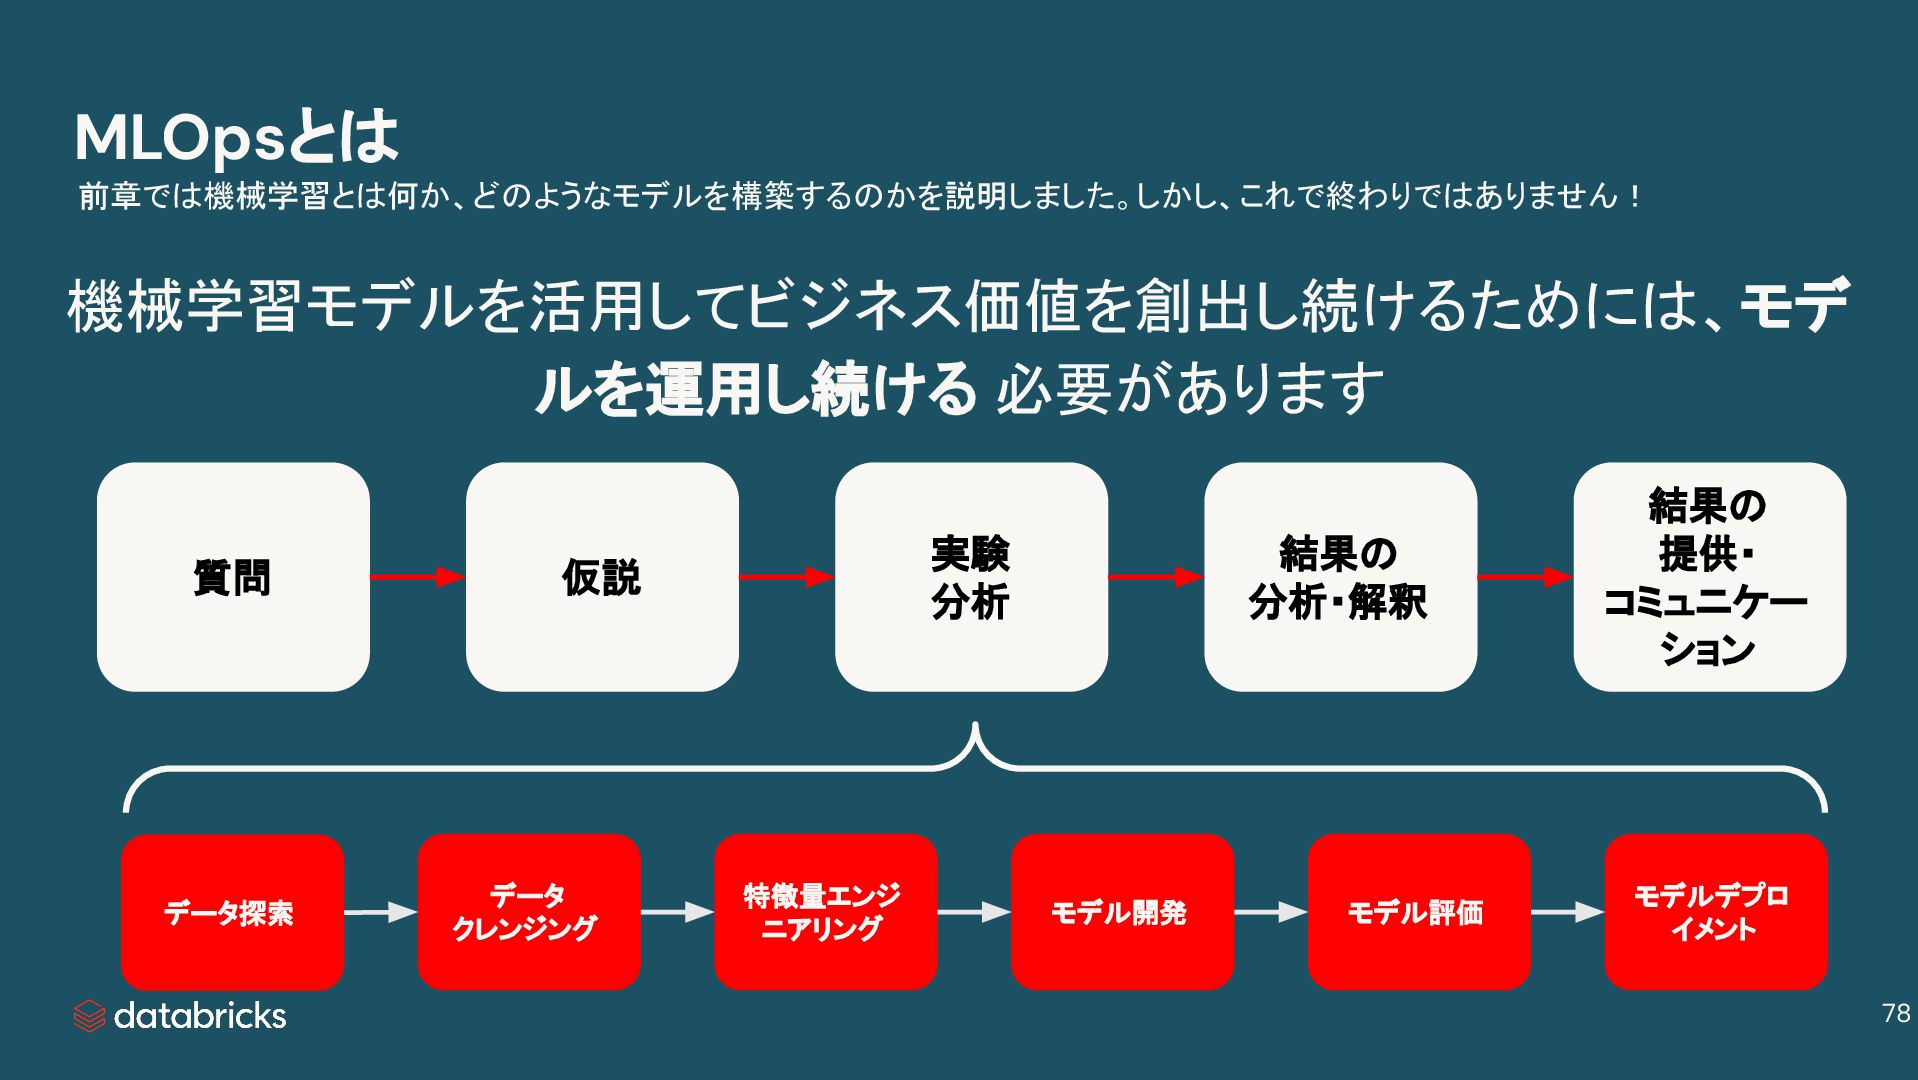
MLOpsとは 前章では機械学習とは何か、どのようなモデルを構築するのかを説明しました。しかし、これで終わりではありません! データ探索 データ クレンジング 特徴量エンジ ニアリング モデル開発 モデル評価 モデルデプロ
イメント 質問 仮説 実験 分析 結果の 分析・解釈 結果の 提供・ コミュニケー ション 機械学習モデルを活用してビジネス価値を創出し続けるためには、モデ ルを運用し続ける 必要があります 78 -
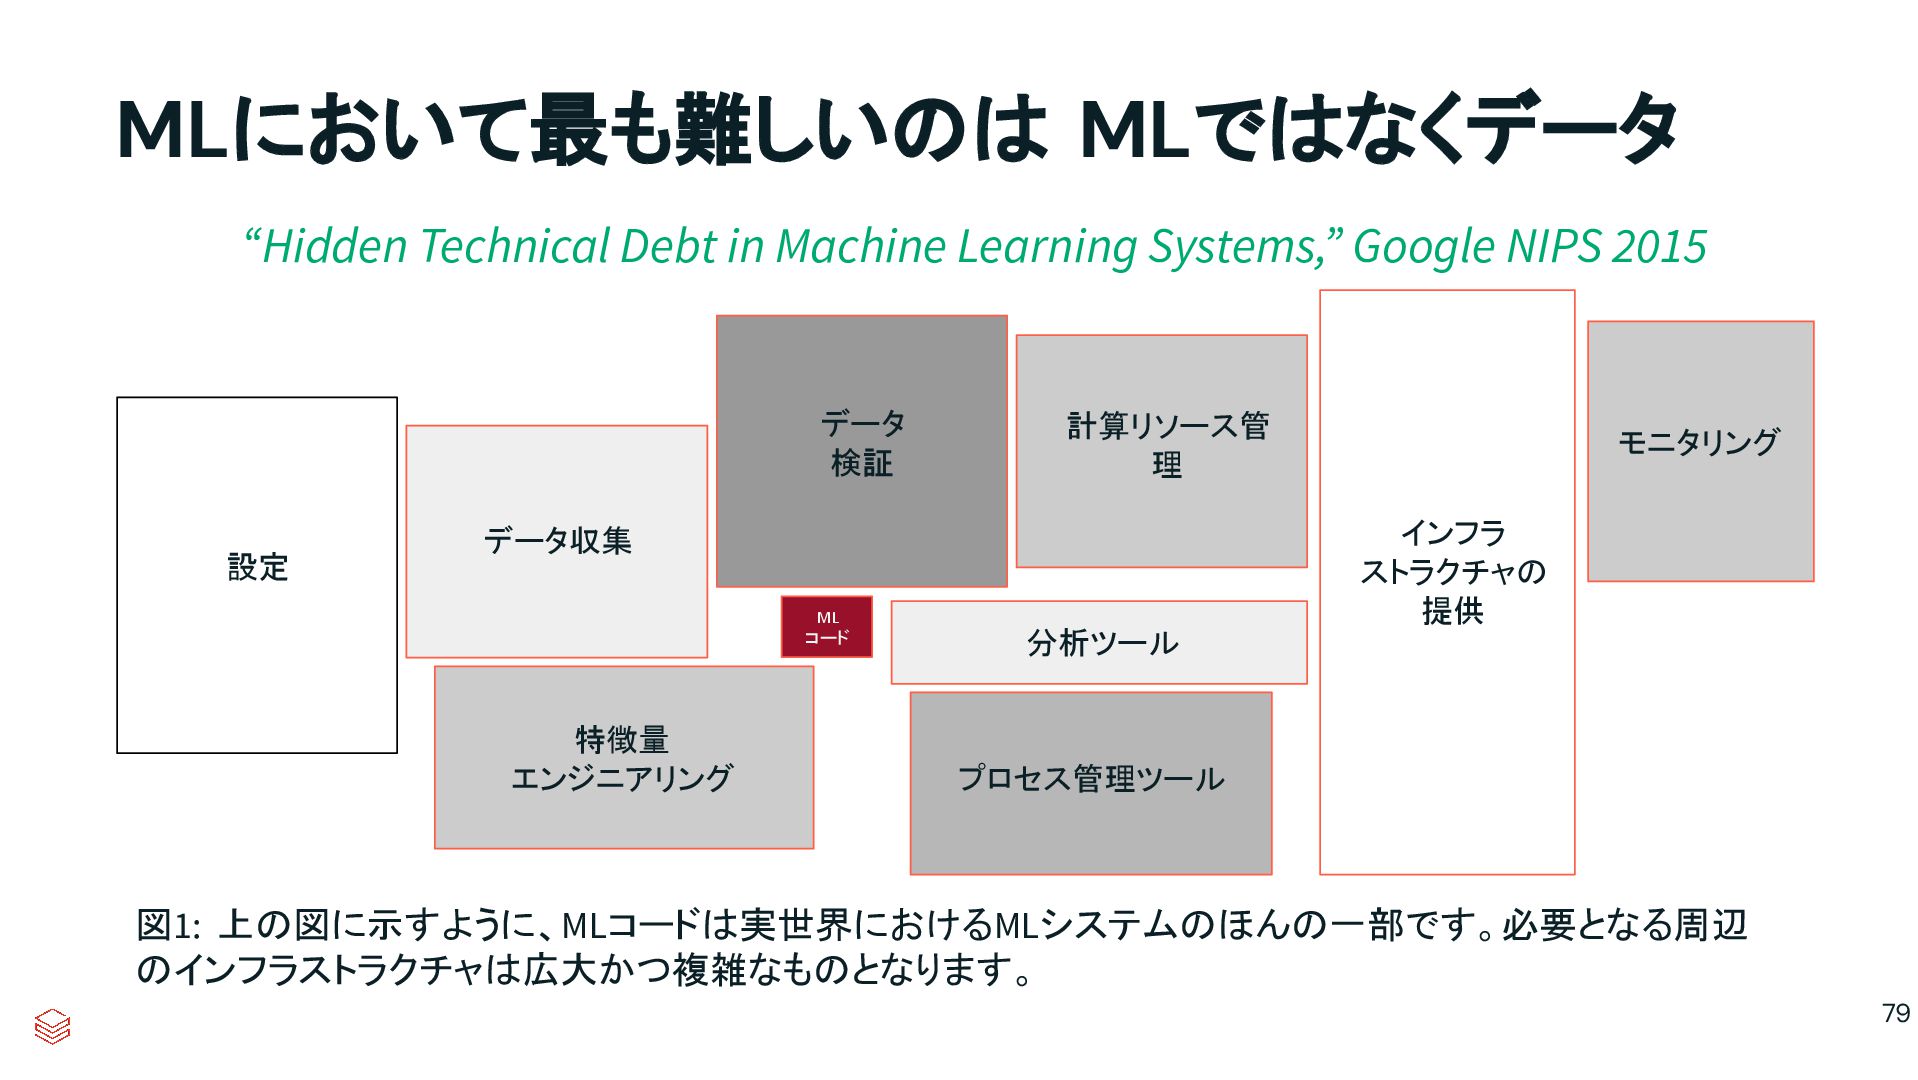
ML コード 設定 データ収集 データ 検証 特徴量 エンジニアリング 計算リソース管 理
分析ツール プロセス管理ツール インフラ ストラクチャの 提供 モニタリング “Hidden Technical Debt in Machine Learning Systems,” Google NIPS 2015 図1: 上の図に示すように、MLコードは実世界におけるMLシステムのほんの一部です。必要となる周辺 のインフラストラクチャは広大かつ複雑なものとなります。 MLにおいて最も難しいのは MLではなくデータ 79 -
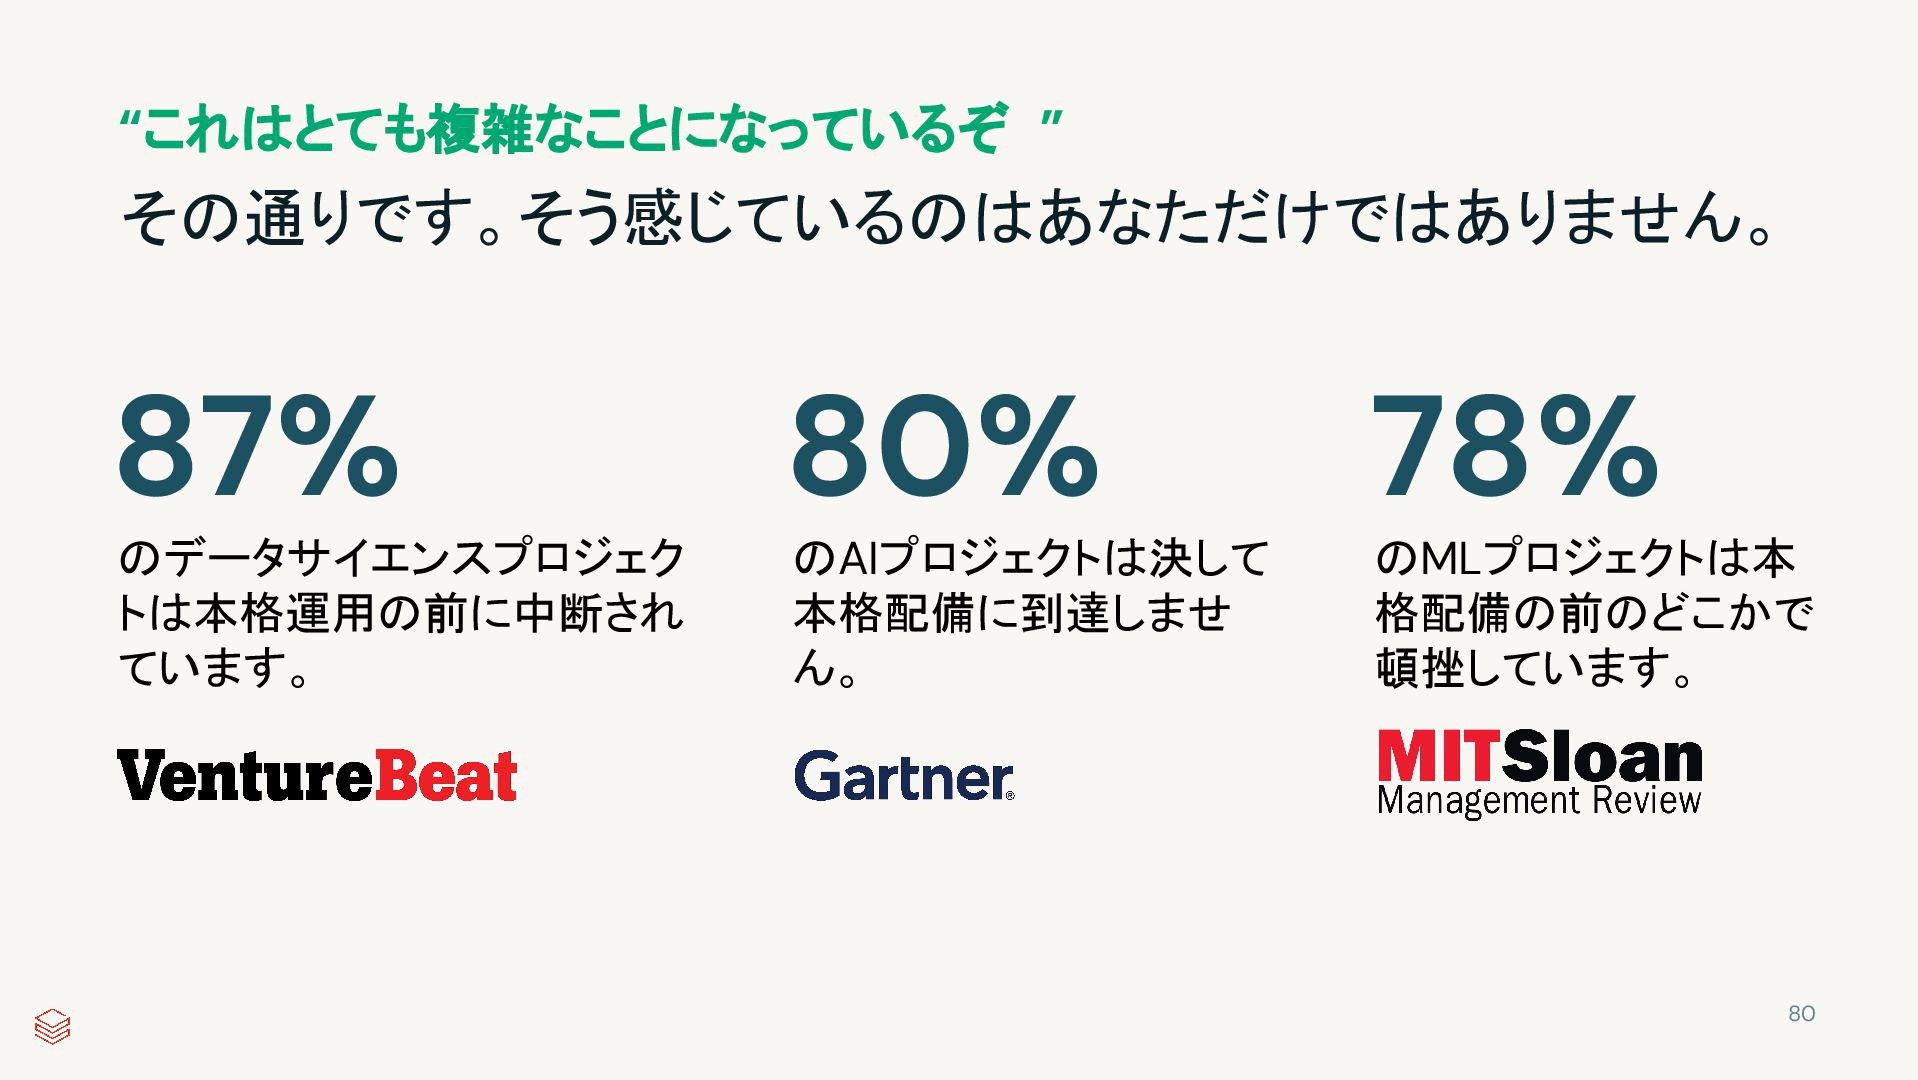
“これはとても複雑なことになっているぞ ” のデータサイエンスプロジェク トは本格運用の前に中断され ています。 のAIプロジェクトは決して 本格配備に到達しませ ん。 のMLプロジェクトは本 格配備の前のどこかで
頓挫しています。 その通りです。そう感じているのはあなただけではありません。 87% 80% 78% 80 -
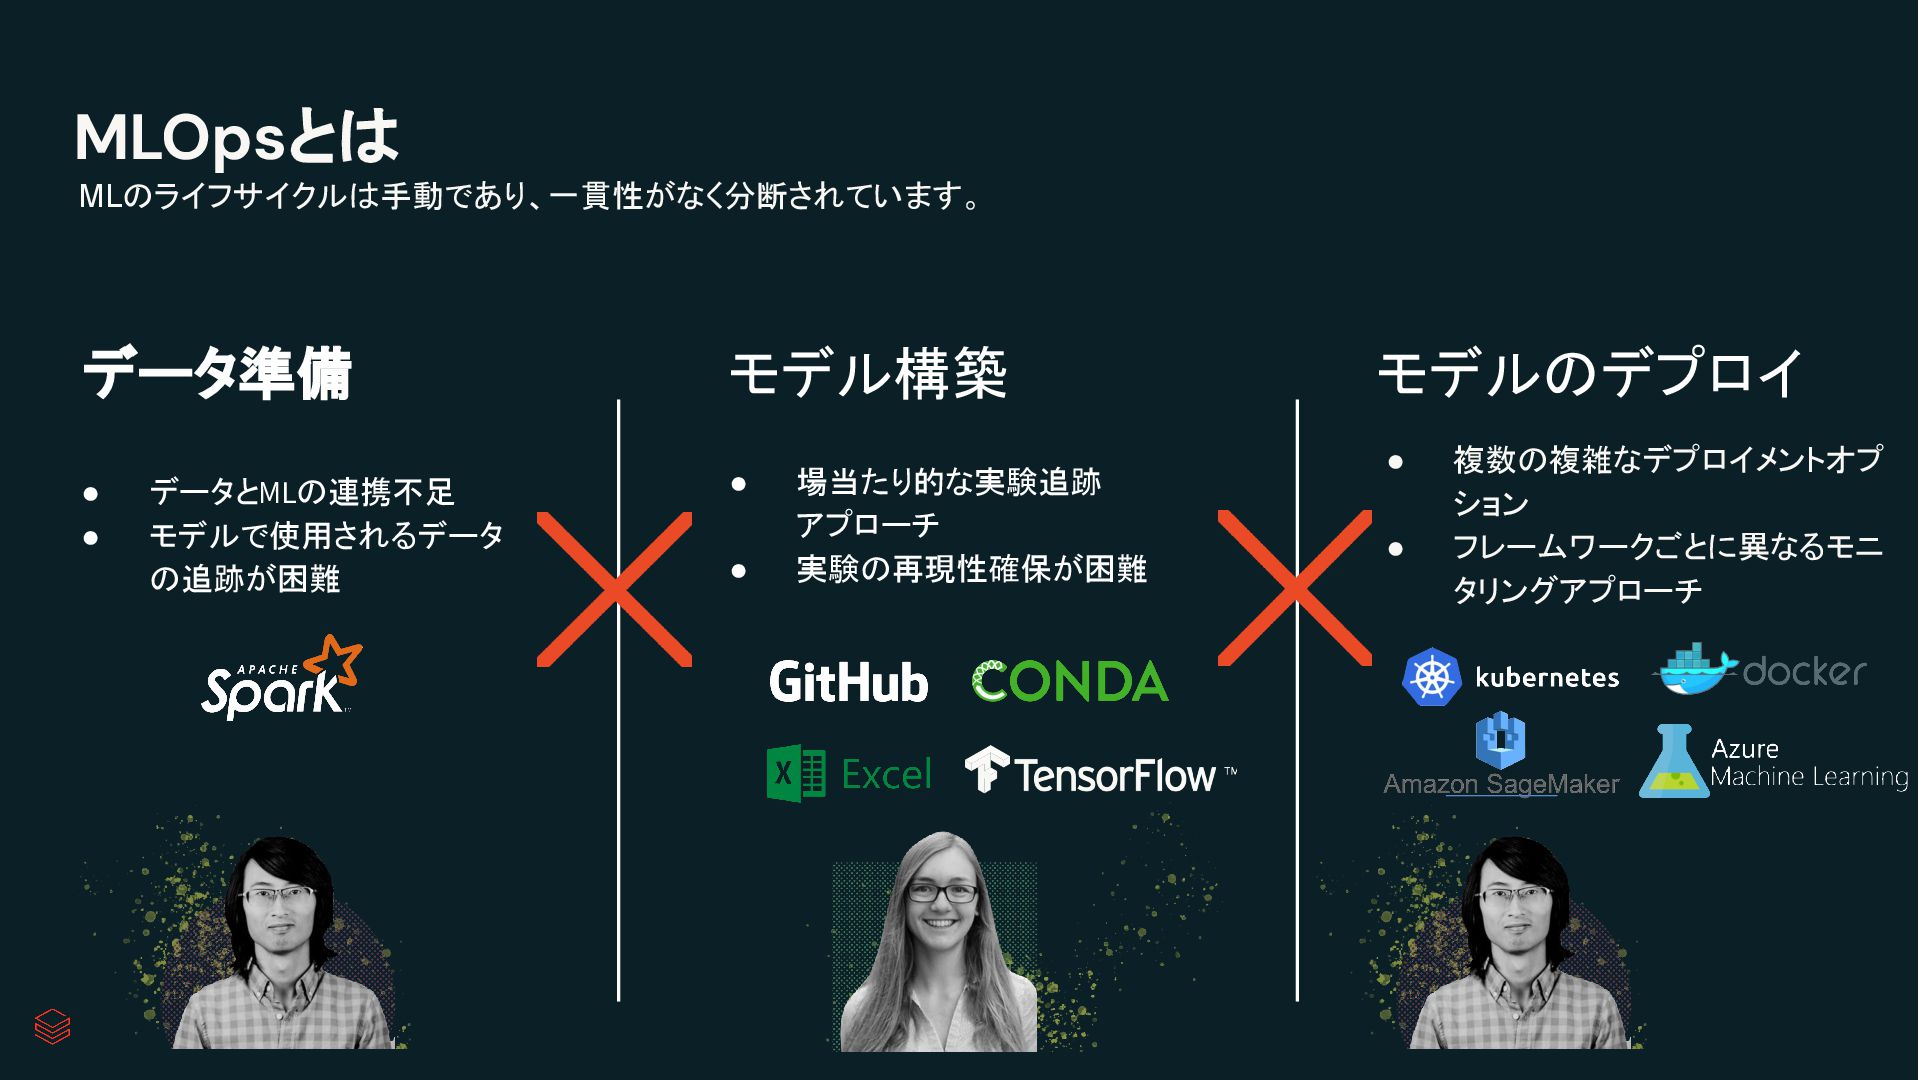
• 場当たり的な実験追跡 アプローチ • 実験の再現性確保が困難 データ準備 • 複数の複雑なデプロイメントオプ ション •
フレームワークごとに異なるモニ タリングアプローチ モデル構築 モデルのデプロイ • データとMLの連携不足 • モデルで使用されるデータ の追跡が困難 MLOpsとは MLのライフサイクルは手動であり、一貫性がなく分断されています。 82 -
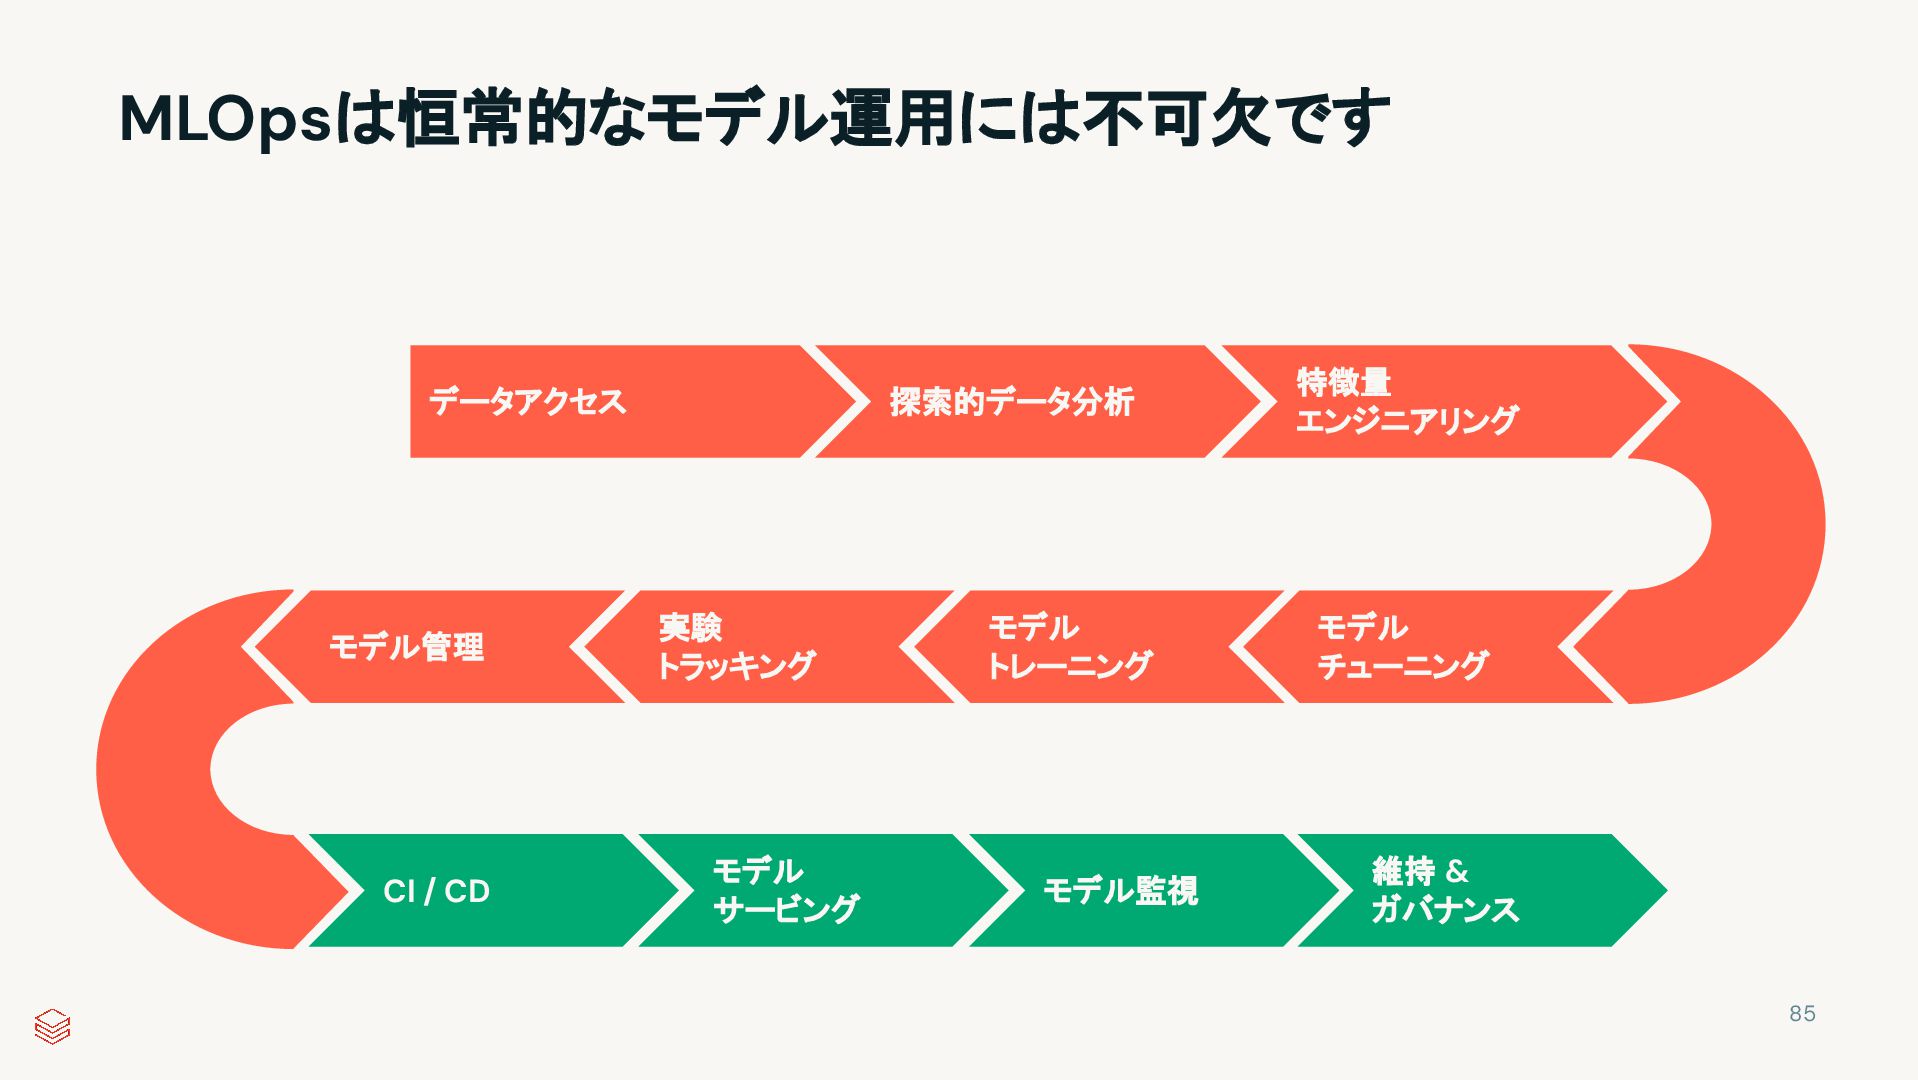
MLOpsは恒常的なモデル運用には不可欠です データアクセス 探索的データ分析 特徴量 エンジニアリング モデル チューニング モデル トレーニング 実験
トラッキング モデル管理 CI / CD モデル サービング モデル監視 維持 & ガバナンス 85 -
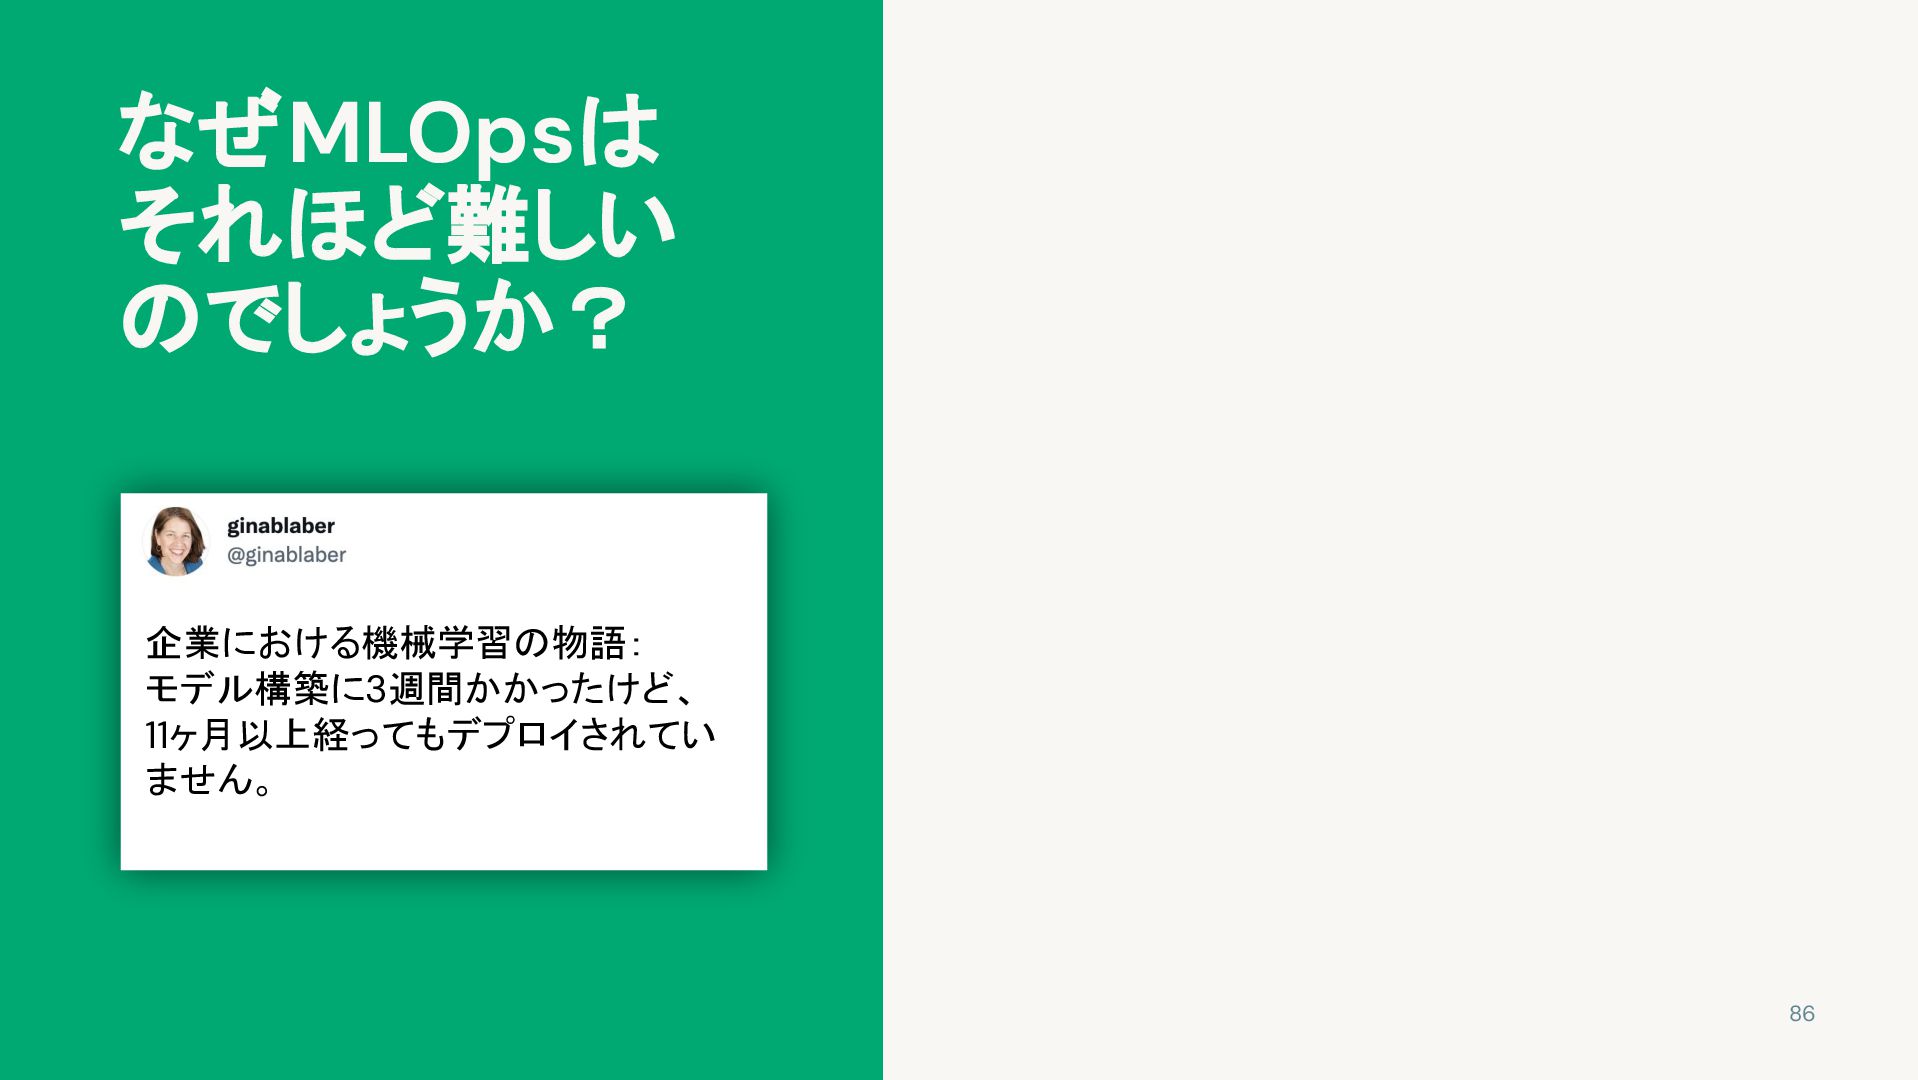
なぜMLOpsは それほど難しい のでしょうか? The story of enterprise Machine Learning: “It
took me 3 weeks to develop the model. It’s been >11 months, and it’s still not deployed.” @DineshNirmallBM #StrataData #strataconf 10:19 AM - Mar 7, 2018 • TweetDeck 企業における機械学習の物語: モデル構築に3週間かかったけど、 11ヶ月以上経ってもデプロイされてい ません。 86 -
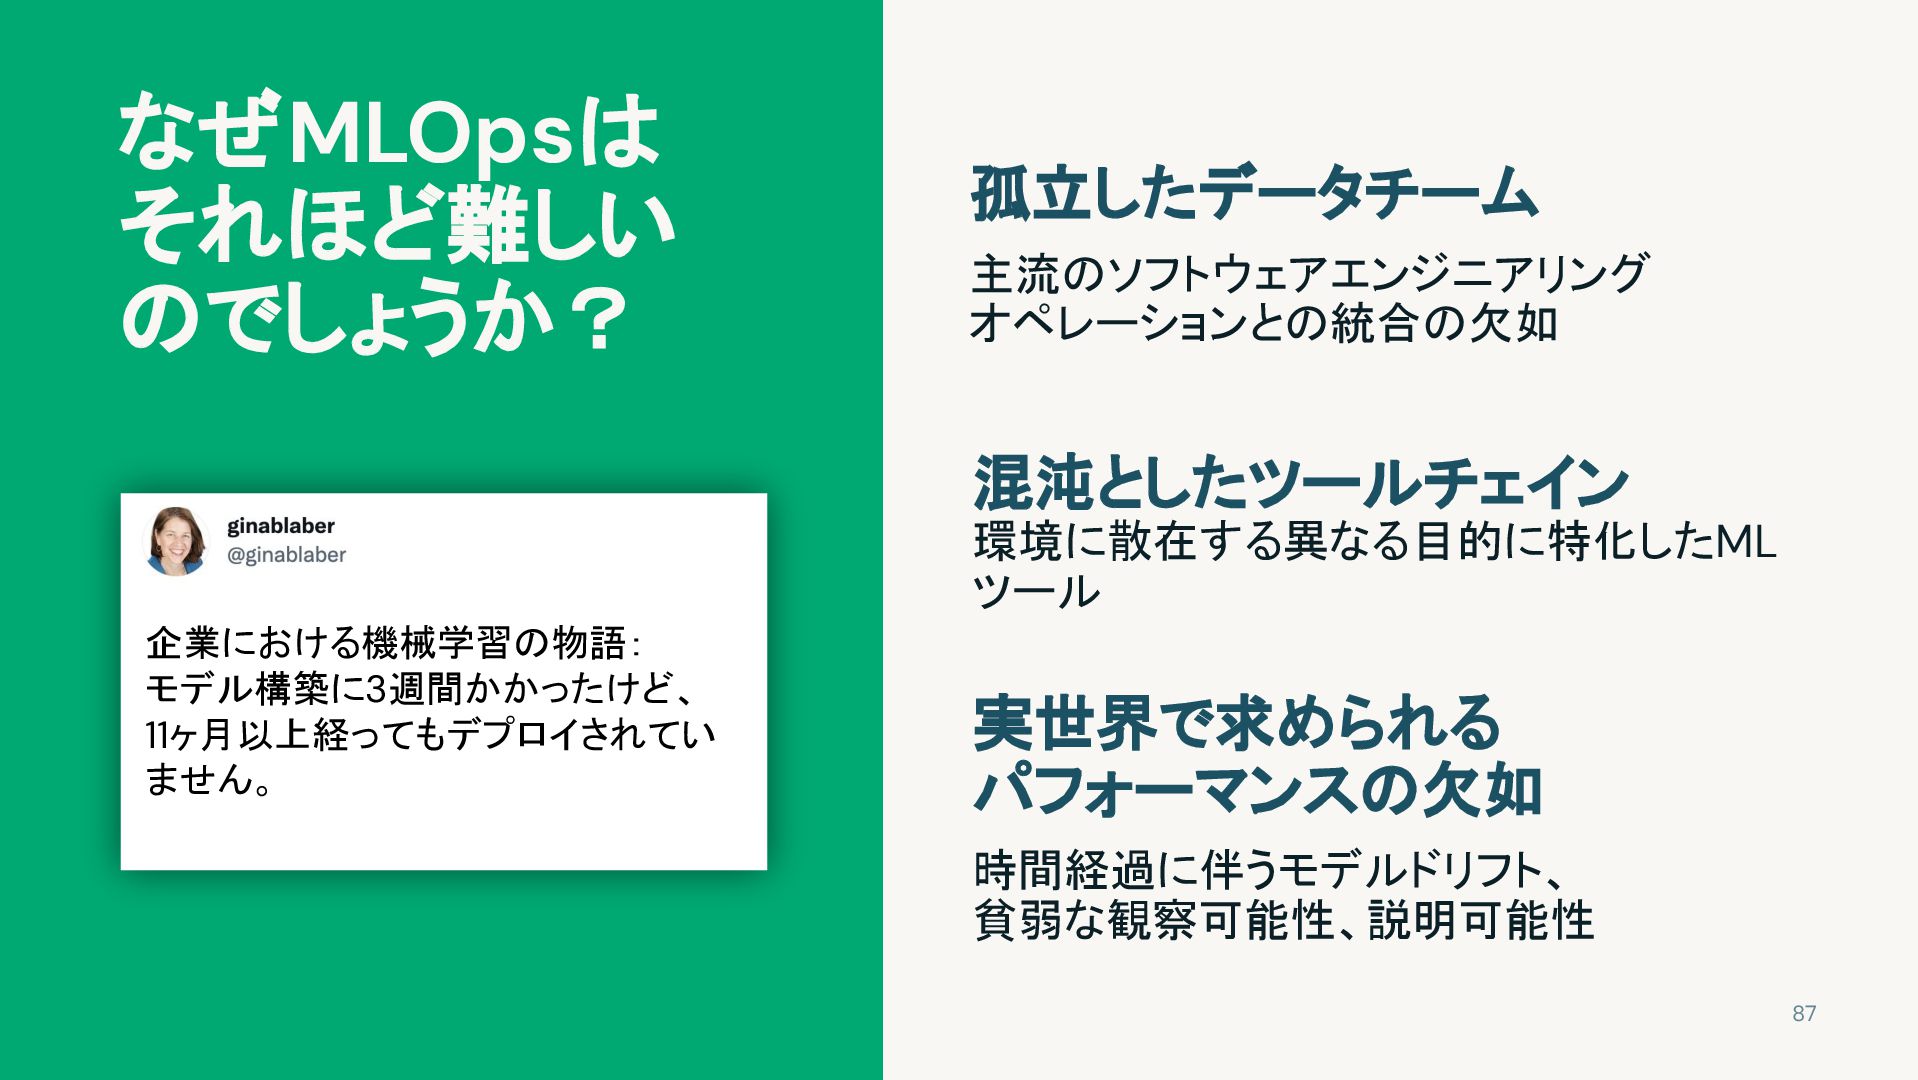
孤立したデータチーム 主流のソフトウェアエンジニアリング オペレーションとの統合の欠如 The story of enterprise Machine Learning: “It
took me 3 weeks to develop the model. It’s been >11 months, and it’s still not deployed.” @DineshNirmallBM #StrataData #strataconf 10:19 AM - Mar 7, 2018 • TweetDeck 混沌としたツールチェイン 環境に散在する異なる目的に特化したML ツール 実世界で求められる パフォーマンスの欠如 時間経過に伴うモデルドリフト、 貧弱な観察可能性、説明可能性 企業における機械学習の物語: モデル構築に3週間かかったけど、 11ヶ月以上経ってもデプロイされてい ません。 なぜMLOpsは それほど難しい のでしょうか? 87 -
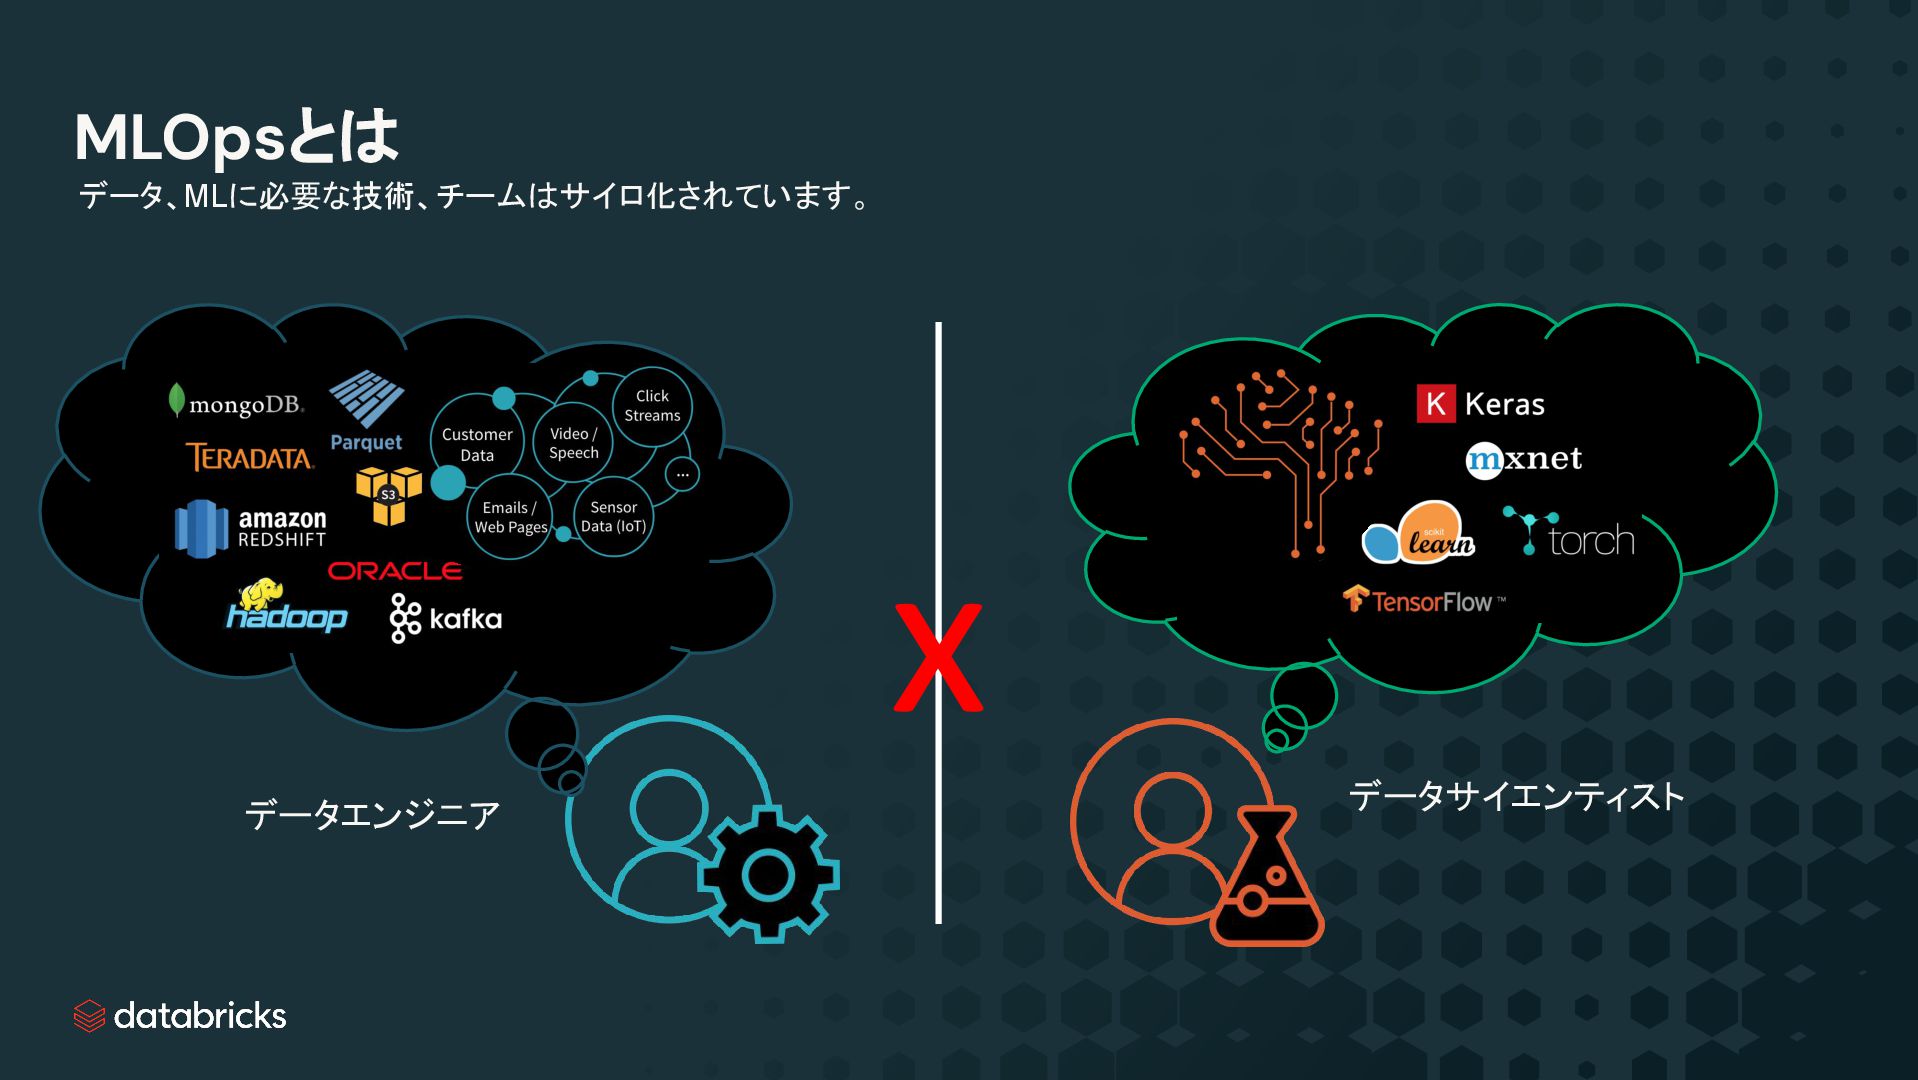
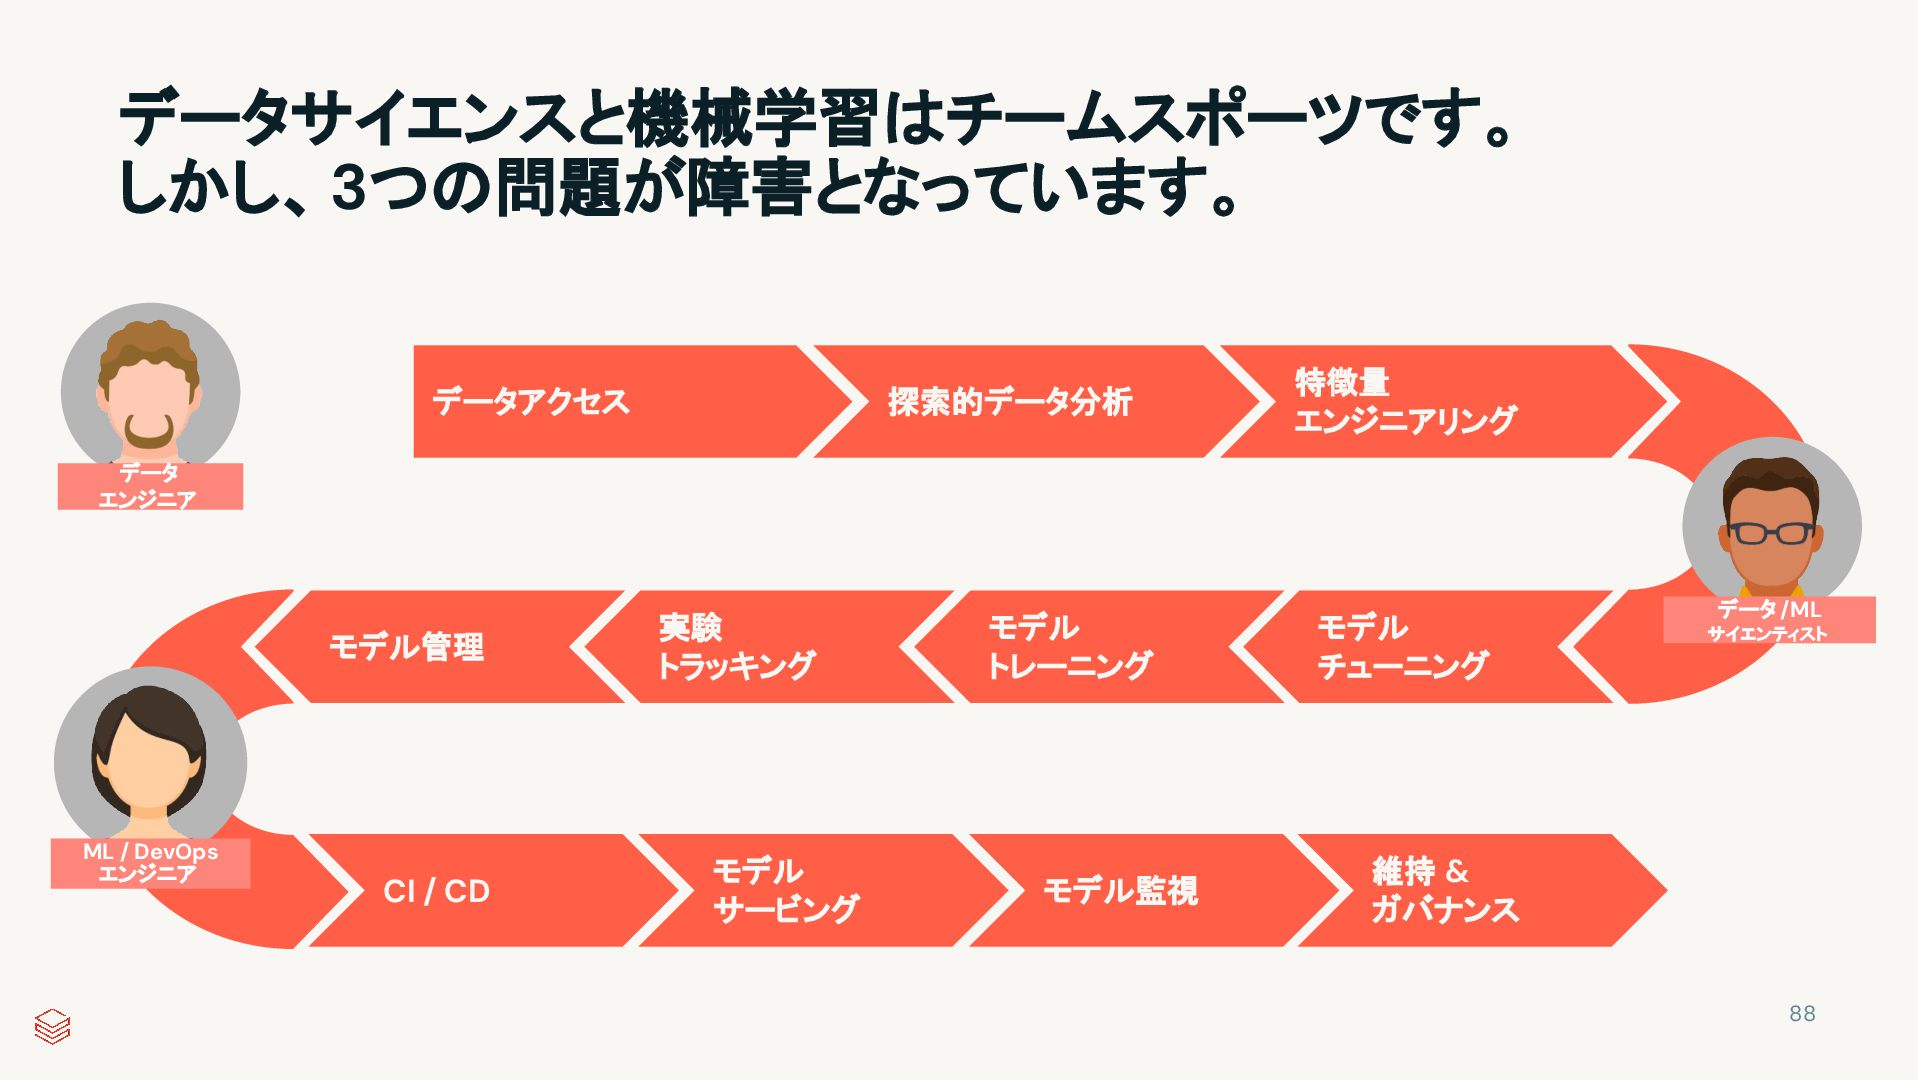
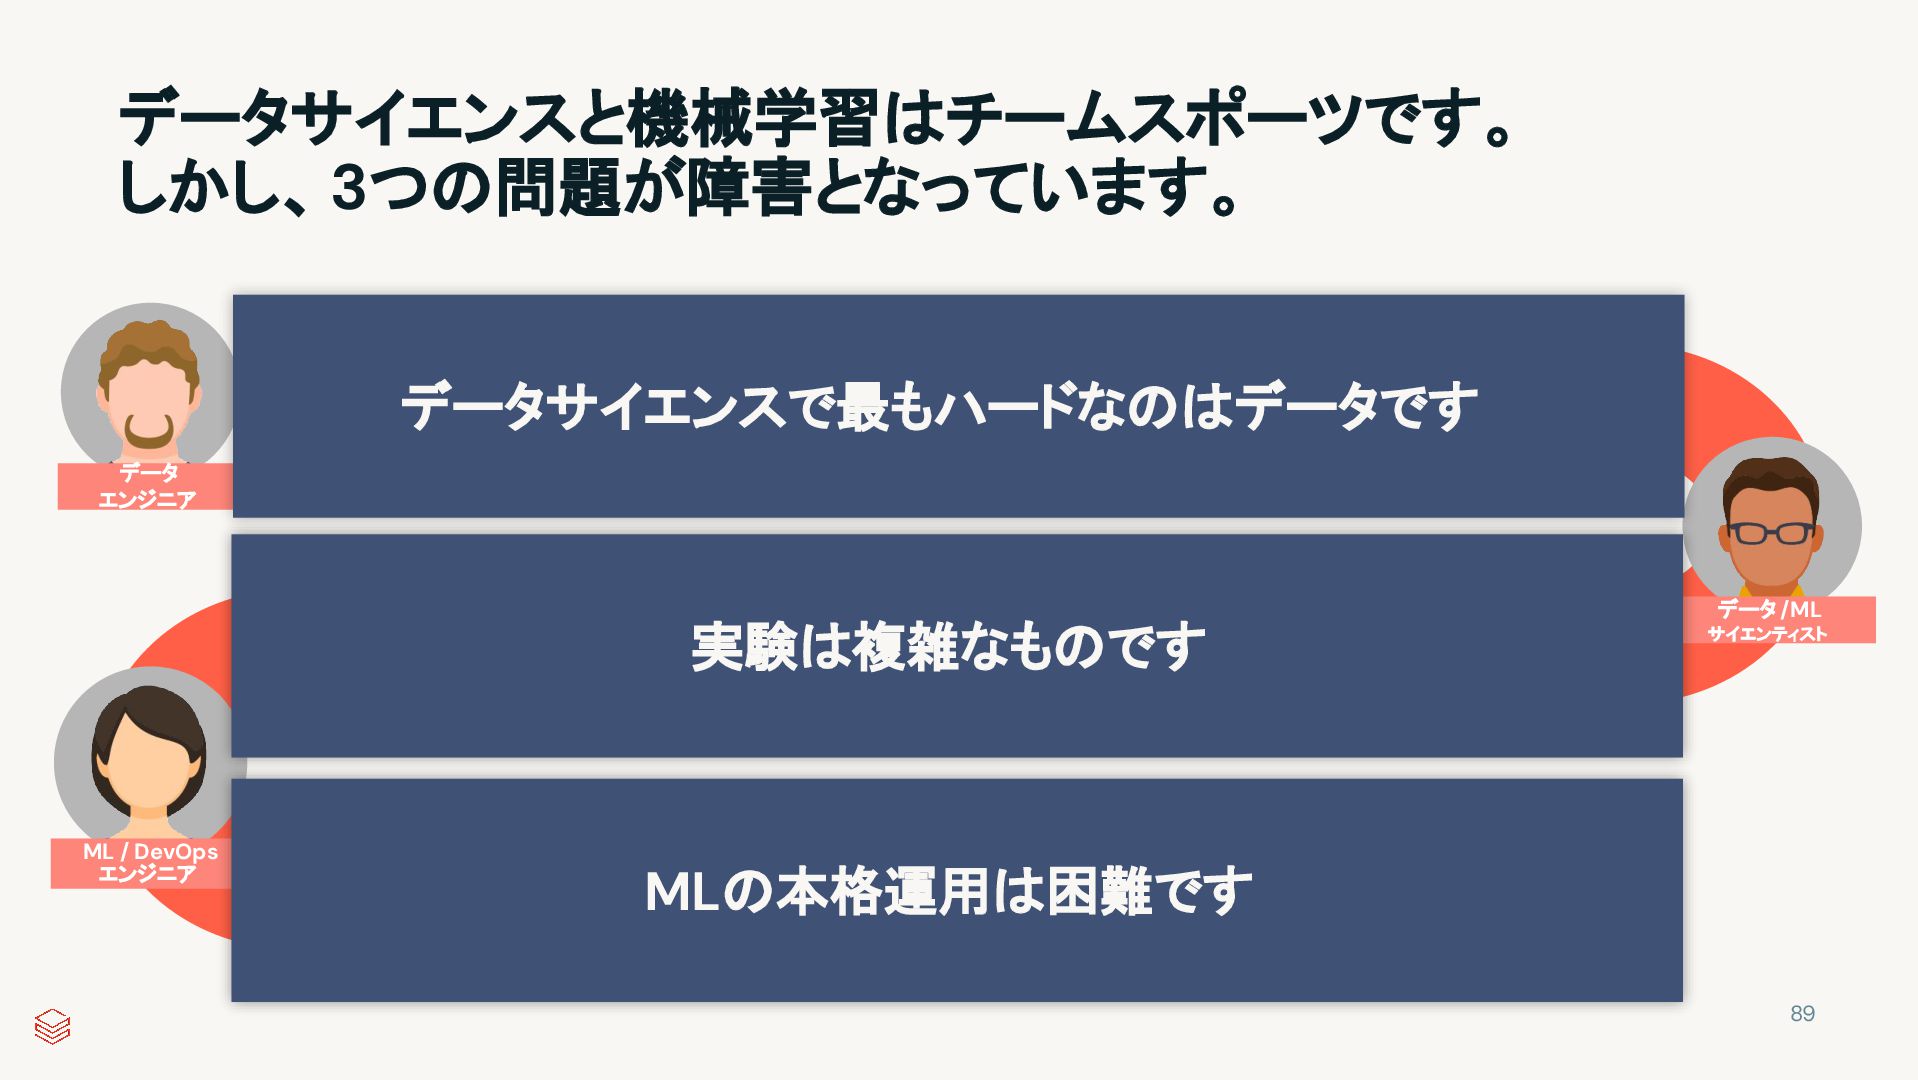
データサイエンスと機械学習はチームスポーツです。 しかし、3つの問題が障害となっています。 データアクセス 探索的データ分析 特徴量 エンジニアリング モデル チューニング モデル トレーニング
実験 トラッキング モデル管理 CI / CD モデル サービング モデル監視 維持 & ガバナンス ML / DevOps エンジニア データ エンジニア データ /ML サイエンティスト 88 -
データサイエンスと機械学習はチームスポーツです。 しかし、3つの問題が障害となっています。 データアクセス 探索的データ分析 特徴量 エンジニアリング モデル チューニング モデル トレーニング
実験 トラッキング モデル管理 CI / CD モデル サービング モデル監視 維持 & ガバナンス ML / DevOps エンジニア データ エンジニア データ /ML サイエンティスト データサイエンスで最もハードなのはデータです 実験は複雑なものです MLの本格運用は困難です 89 -
MLOpsとは MLOpsにおいては共通的な課題が存在しています。 ▪ サイロ化 ▪ MLプロセスのそれぞれが異なる部門に依存しています。 ▪ 再現性の確保 ▪ MLの実験を再現可能、監査可能にするのが困難です。
▪ MLの結果は常に使用されたデータのバージョンに依存します。 既存MLモデルのメンテナンスは面倒で時間を浪費するものです! 90 -
MLOpsとは MLOpsでは以下のゴールを達成する必要があります。 • チームスポーツです!DE、DS、Opsメンバーが協働する必要があります。 • エンドツーエンドのMLライフサイクルの自動化 • 再現性のあるMLパイプラインの構築 ◦ コードのバージョン管理
(モデル、データ処理) - Azure DevOps, Github, ... ◦ 設定のバージョン管理 (モデル、デプロイ) - Terraform, ... ◦ データのバージョン管理 - Delta, ... • モデルトレーニング、デプロイのための再利用可能なソフトウェア環境 • モデルの追跡、パッケージ、デプロイ • エンドツーエンドのMLライフサイクルのデータガバナンス • 運用、ML関連の課題に対するMLアプリケーションのモニタリング • MLライフサイクルにおけるイベントの通知、アラート 91 -
MLOpsとは MLOpsでは以下のゴールを達成する必要があります。 • データとモデルのテスト・検証を追加することで、継続的インテグレーション (CI) はコードのテスト・検証を拡張します。 • 継続的デリバリー (CD) は、新たなMLモデル予測サービスを自動でデプロイ
するMLトレーニングパイプラインのデリバリーに関するものです • 継続的トレーニング (CT) は、再デプロイのためにMLモデルを自動で再ト レーニングを行います。 • 継続的モニタリング (CM) は、ビジネスメトリクスに関係するプロダクション データ、モデルパフォーマンスのモニタリングに関するものです。 92 -
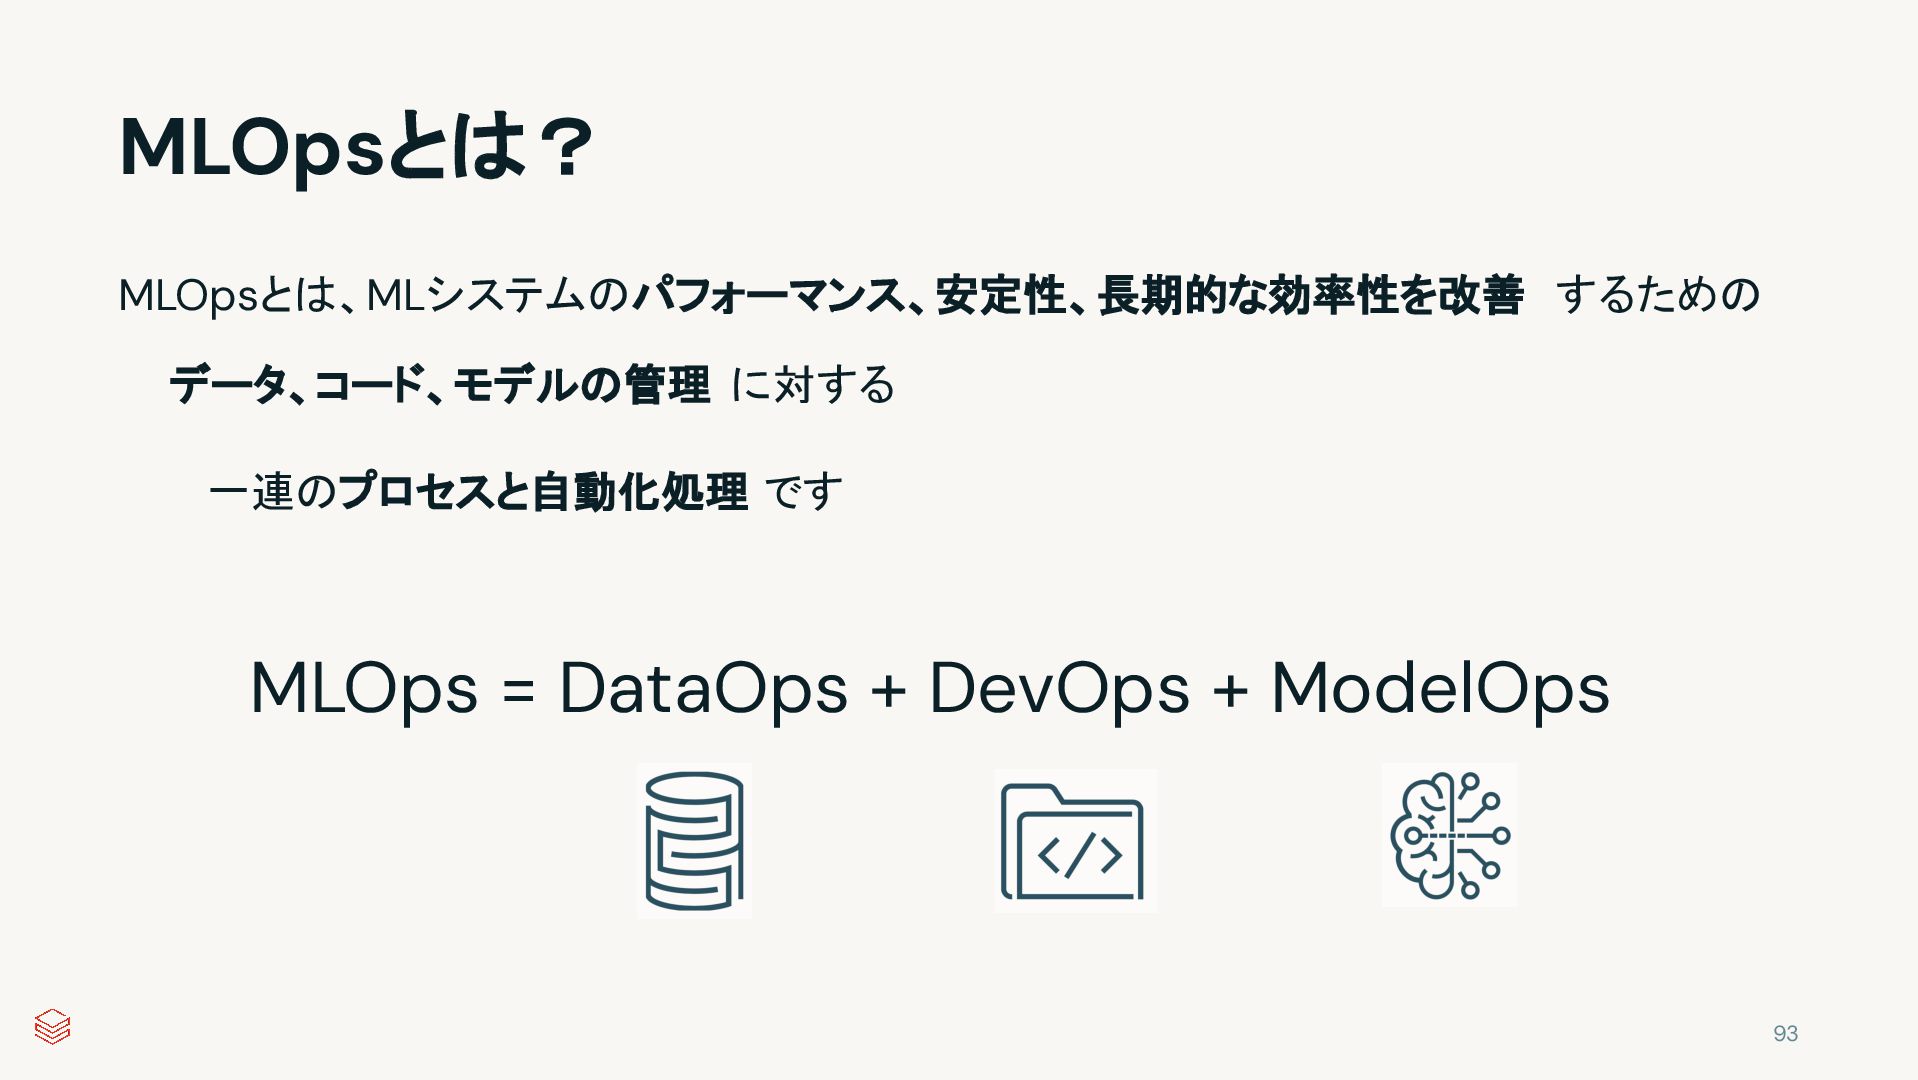
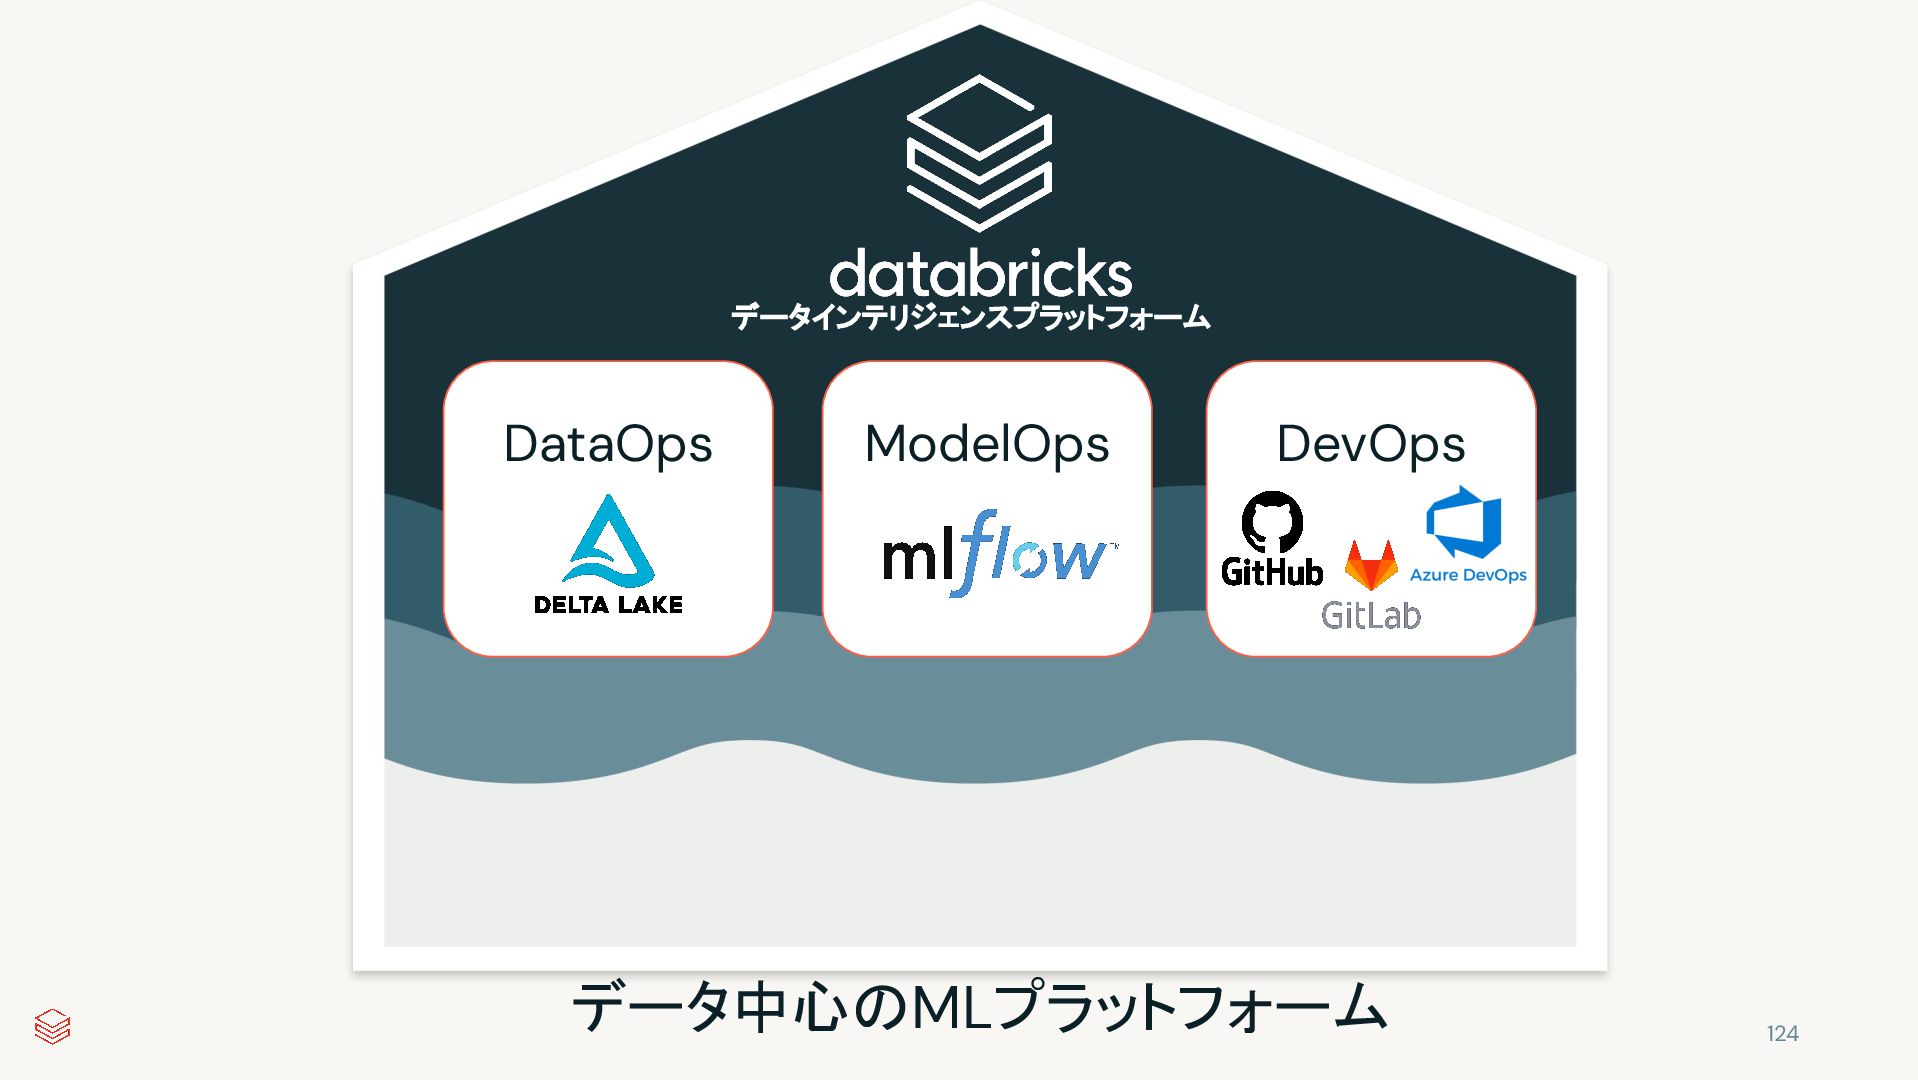
MLOpsとは、MLシステムのパフォーマンス、安定性、長期的な効率性を改善 するための MLOpsとは? 93 データ、コード、モデルの管理 に対する 一連のプロセスと自動化処理 です MLOps =
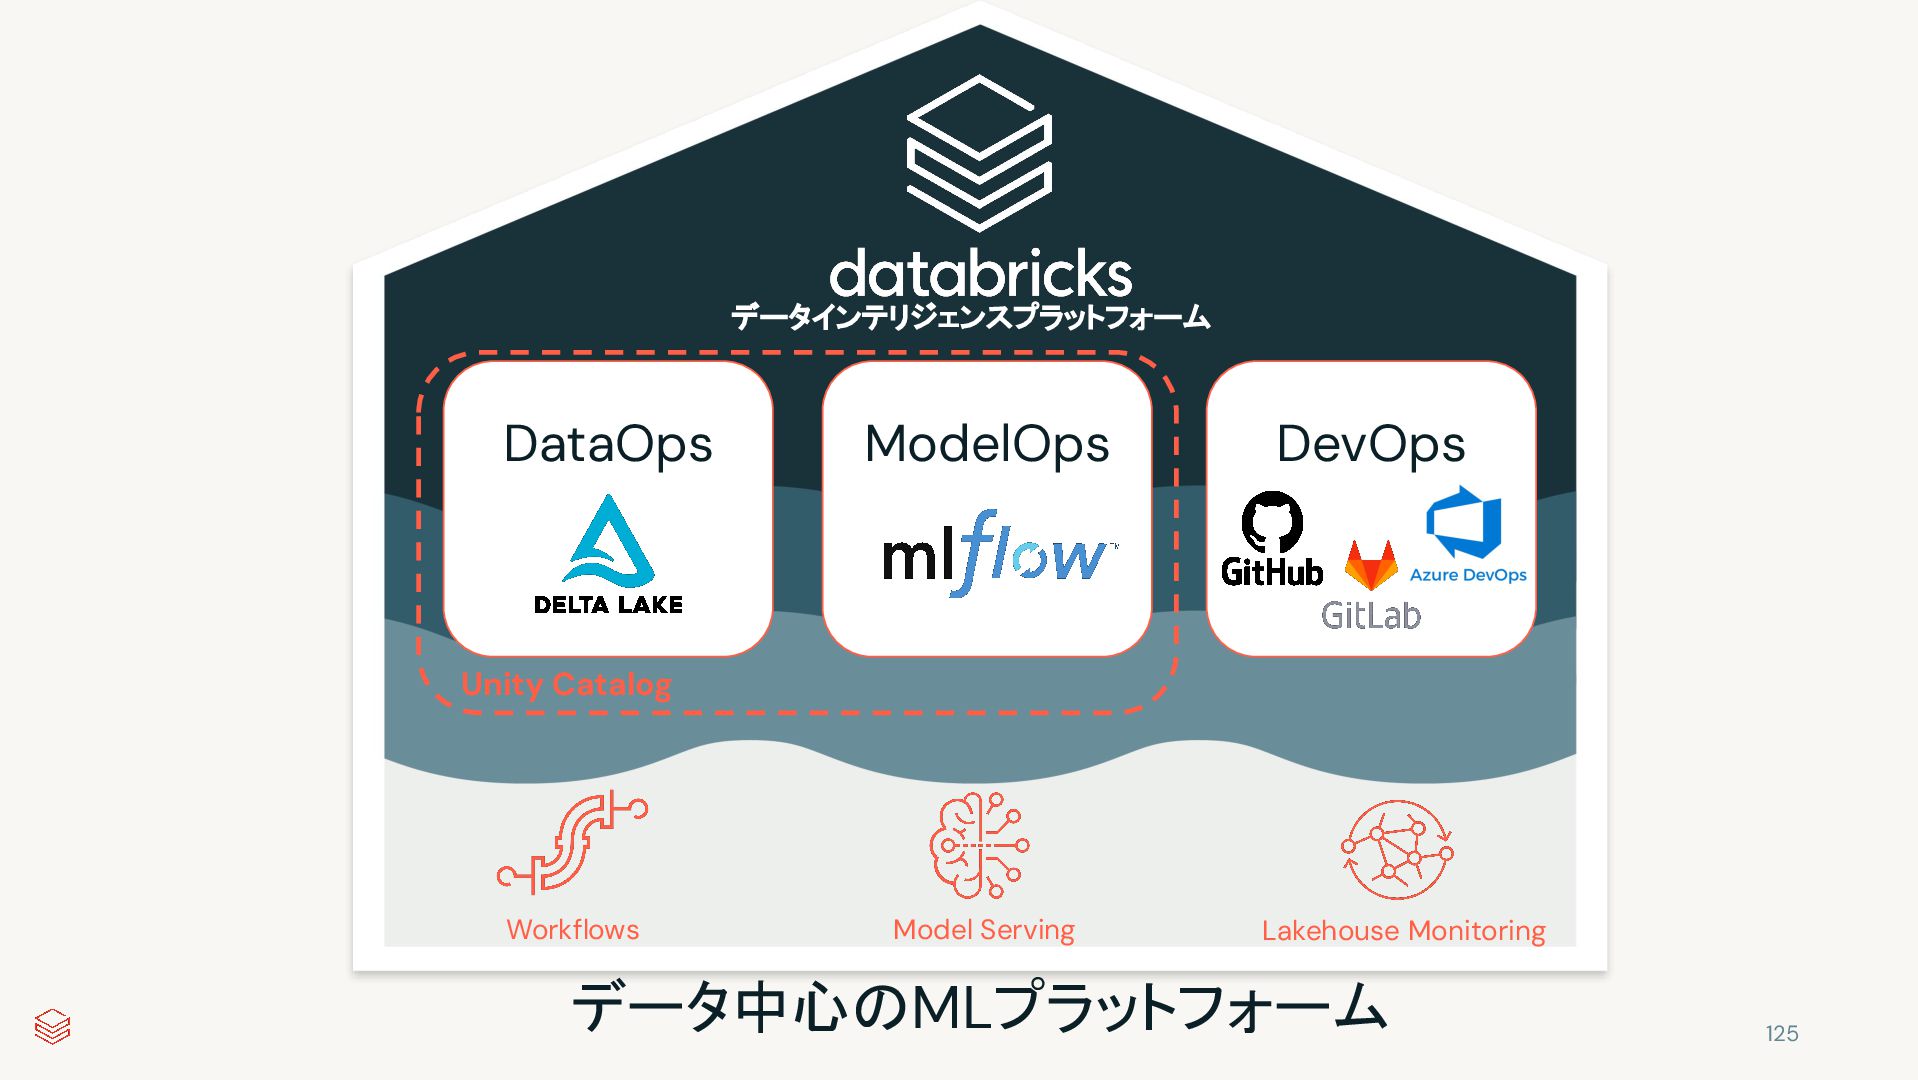
DataOps + DevOps + ModelOps -
這って • 慣れ親しんだツールを 使い続ける • より生産的に • 未来に備える ステージ1 ディープラーニングワークフローの例
走る • プロダクションに移行 • CI/CDと開発プロセス の実装 • エンドツーエンドかつ部 門間の自動化と再現性 の確保 歩いて • 徐々にデータとワーク ロードをスケールさせる • 自動化と再現可能な DS/MLワークロードの 自動化と再現 • 組織内でスケールさせ る 95 -
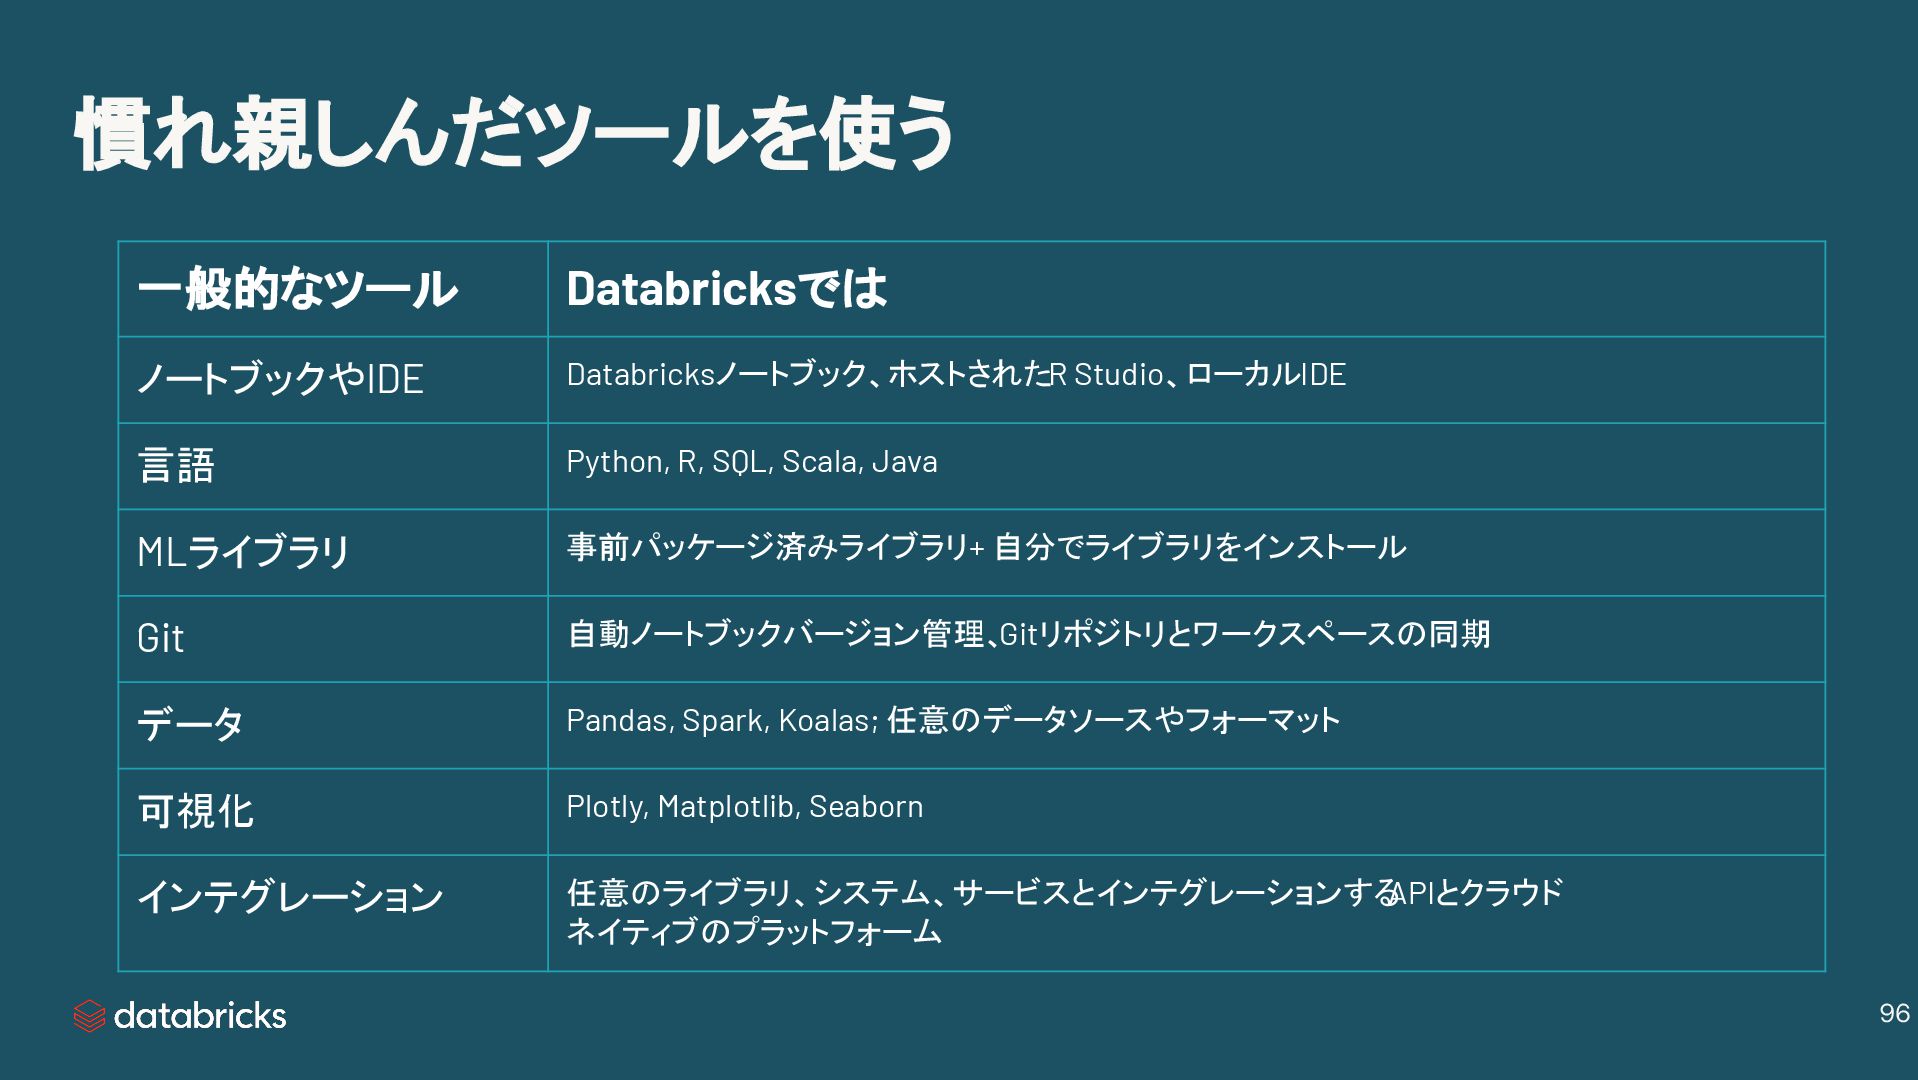
慣れ親しんだツールを使う 一般的なツール Databricksでは ノートブックやIDE Databricksノートブック、ホストされたR Studio、ローカルIDE 言語 Python, R, SQL,
Scala, Java MLライブラリ 事前パッケージ済みライブラリ + 自分でライブラリをインストール Git 自動ノートブックバージョン管理、 Gitリポジトリとワークスペースの同期 データ Pandas, Spark, Koalas; 任意のデータソースやフォーマット 可視化 Plotly, Matplotlib, Seaborn インテグレーション 任意のライブラリ、システム、サービスとインテグレーションする APIとクラウド ネイティブのプラットフォーム 96 -
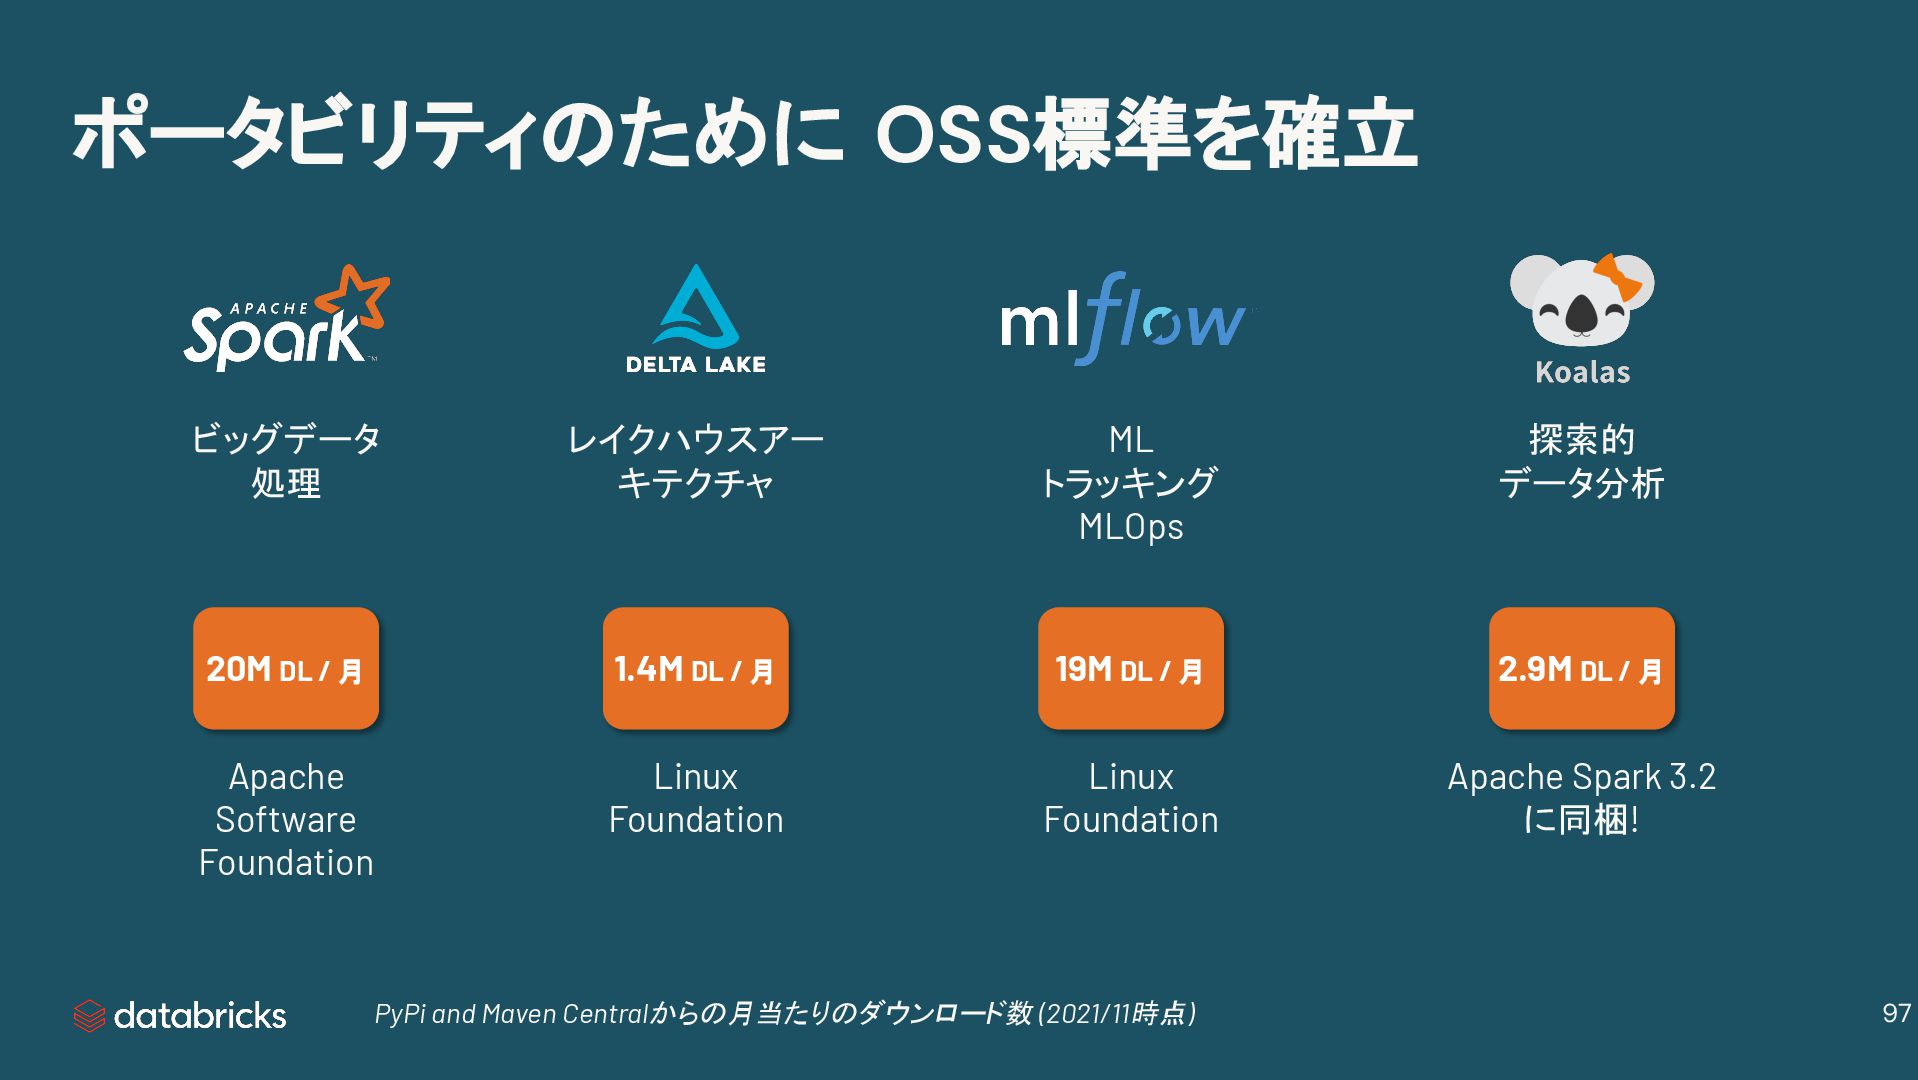
ポータビリティのために OSS標準を確立 ビッグデータ 処理 レイクハウスアー キテクチャ ML トラッキング MLOps 探索的
データ分析 Apache Software Foundation Linux Foundation Linux Foundation Apache Spark 3.2 に同梱! 20M DL / 月 19M DL / 月 PyPi and Maven Centralからの月当たりのダウンロード数 (2021/11時点) 1.4M DL / 月 2.9M DL / 月 97 -
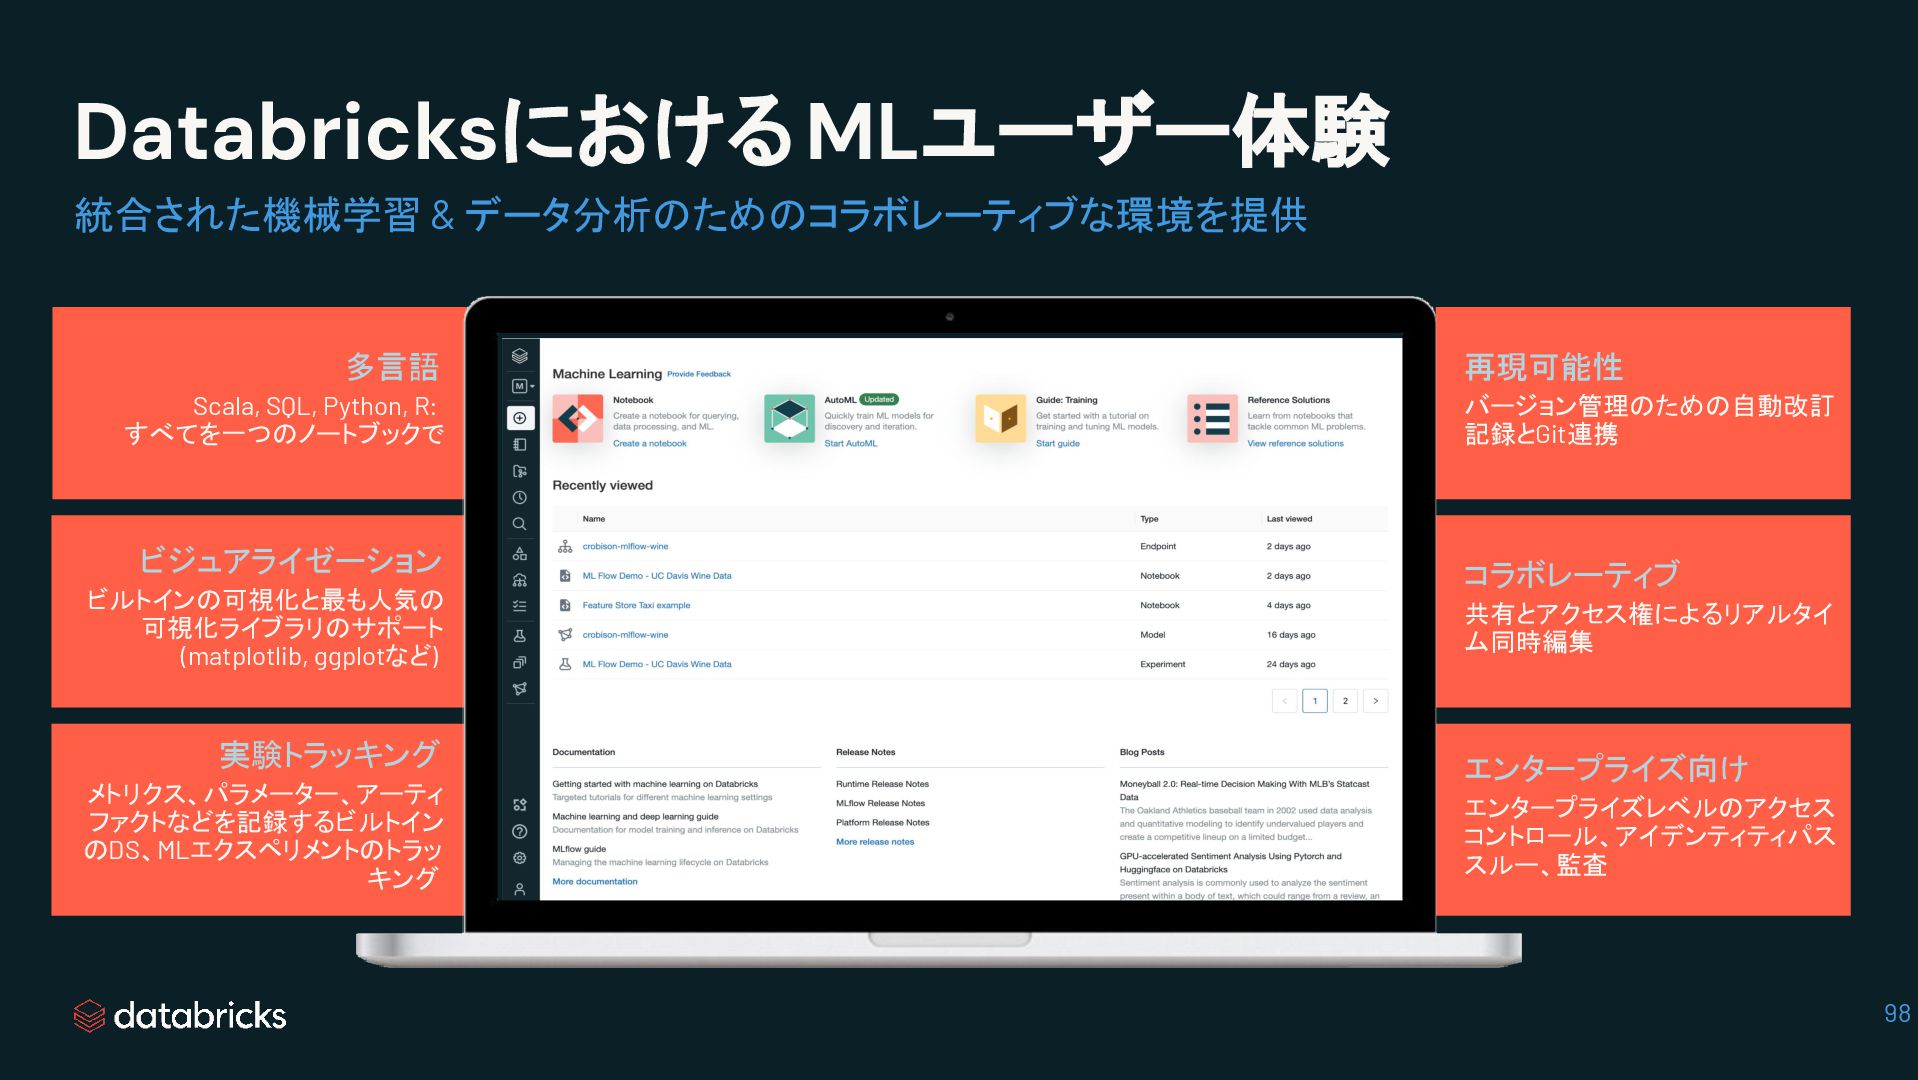
エンタープライズ向け エンタープライズレベルのアクセス コントロール、アイデンティティパス スルー、監査 コラボレーティブ 共有とアクセス権によるリアルタイ ム同時編集 再現可能性 バージョン管理のための自動改訂 記録とGit連携
ビジュアライゼーション ビルトインの可視化と最も人気の 可視化ライブラリのサポート (matplotlib, ggplotなど) 実験トラッキング メトリクス、パラメーター、アーティ ファクトなどを記録するビルトイン のDS、MLエクスペリメントのトラッ キング 多言語 Scala, SQL, Python, R: すべてを一つのノートブックで DatabricksにおけるMLユーザー体験 統合された機械学習 & データ分析のためのコラボレーティブな環境を提供 98 -
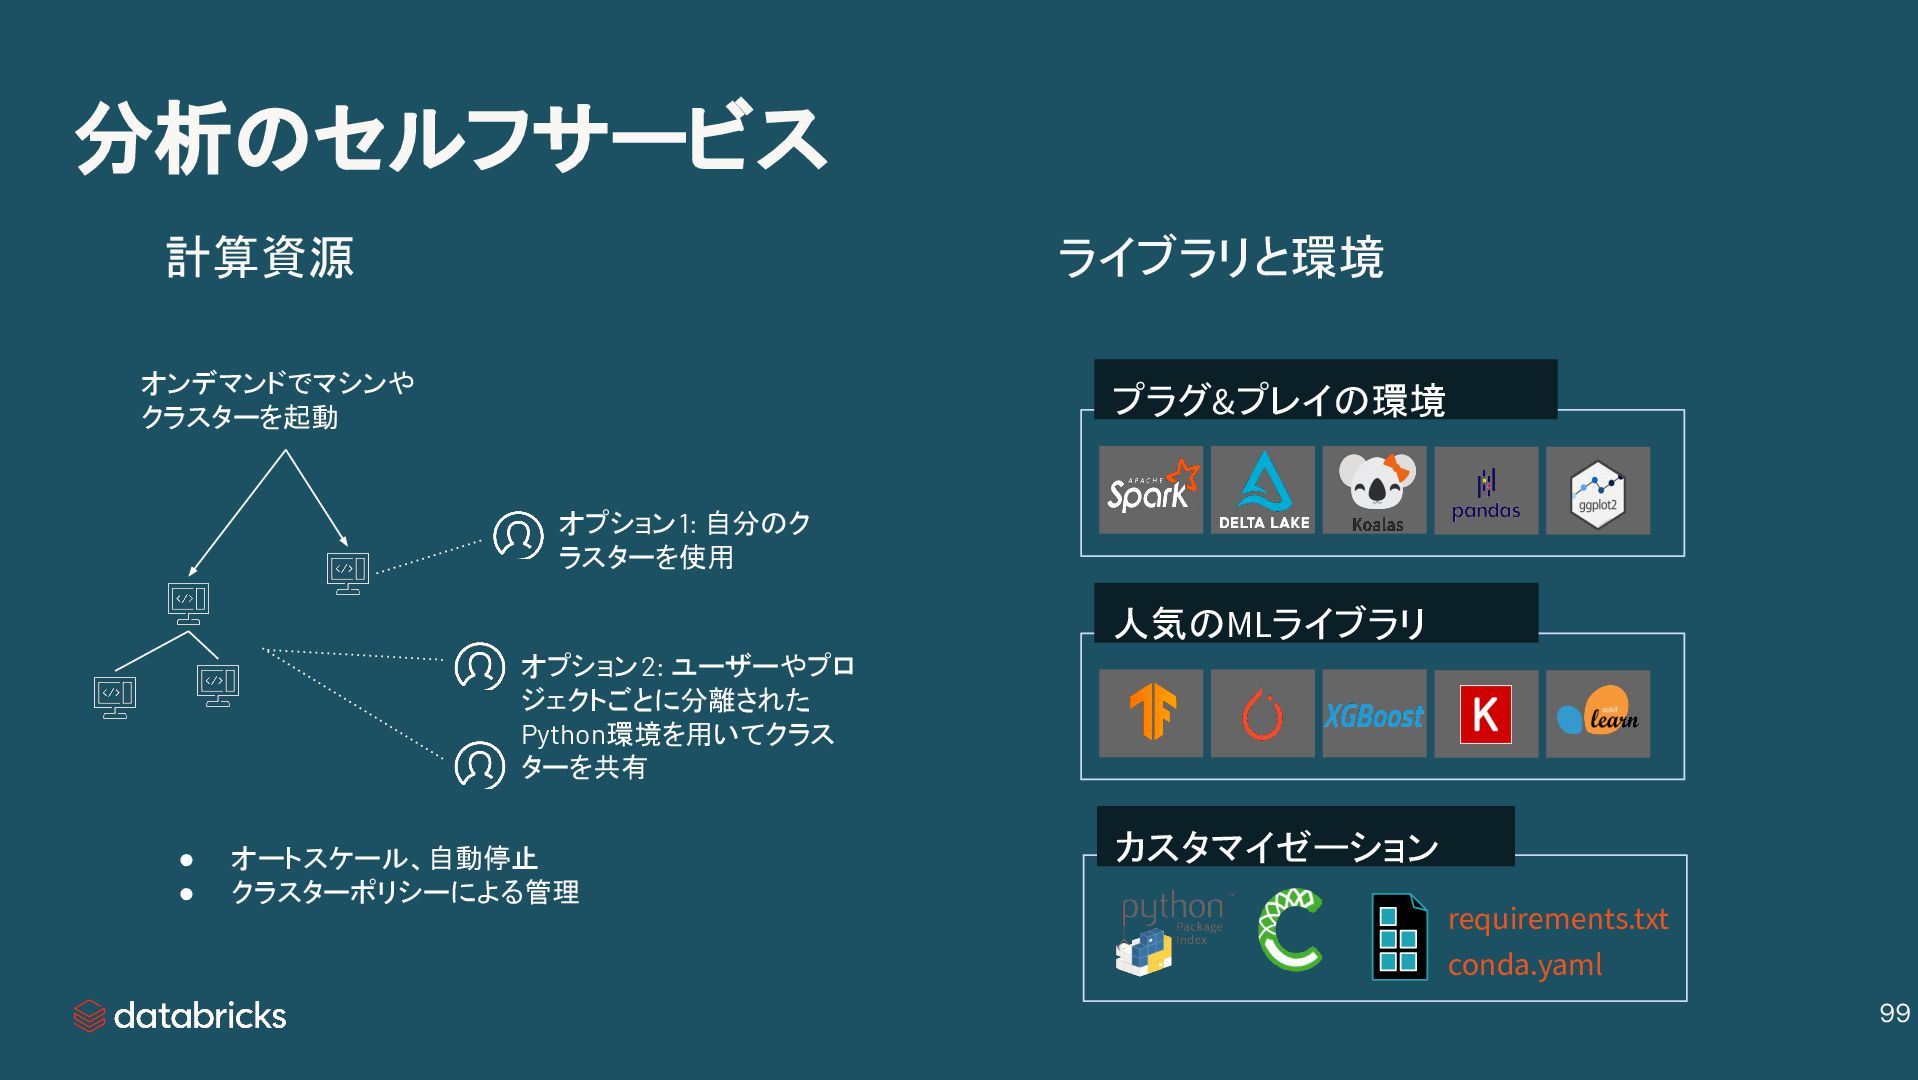
分析のセルフサービス 計算資源 ライブラリと環境 人気のMLライブラリ プラグ&プレイの環境 requirements.txt conda.yaml カスタマイゼーション オンデマンドでマシンや クラスターを起動
• オートスケール、自動停止 • クラスターポリシーによる管理 オプション2: ユーザーやプロ ジェクトごとに分離された Python環境を用いてクラス ターを共有 オプション1: 自分のク ラスターを使用 99 -
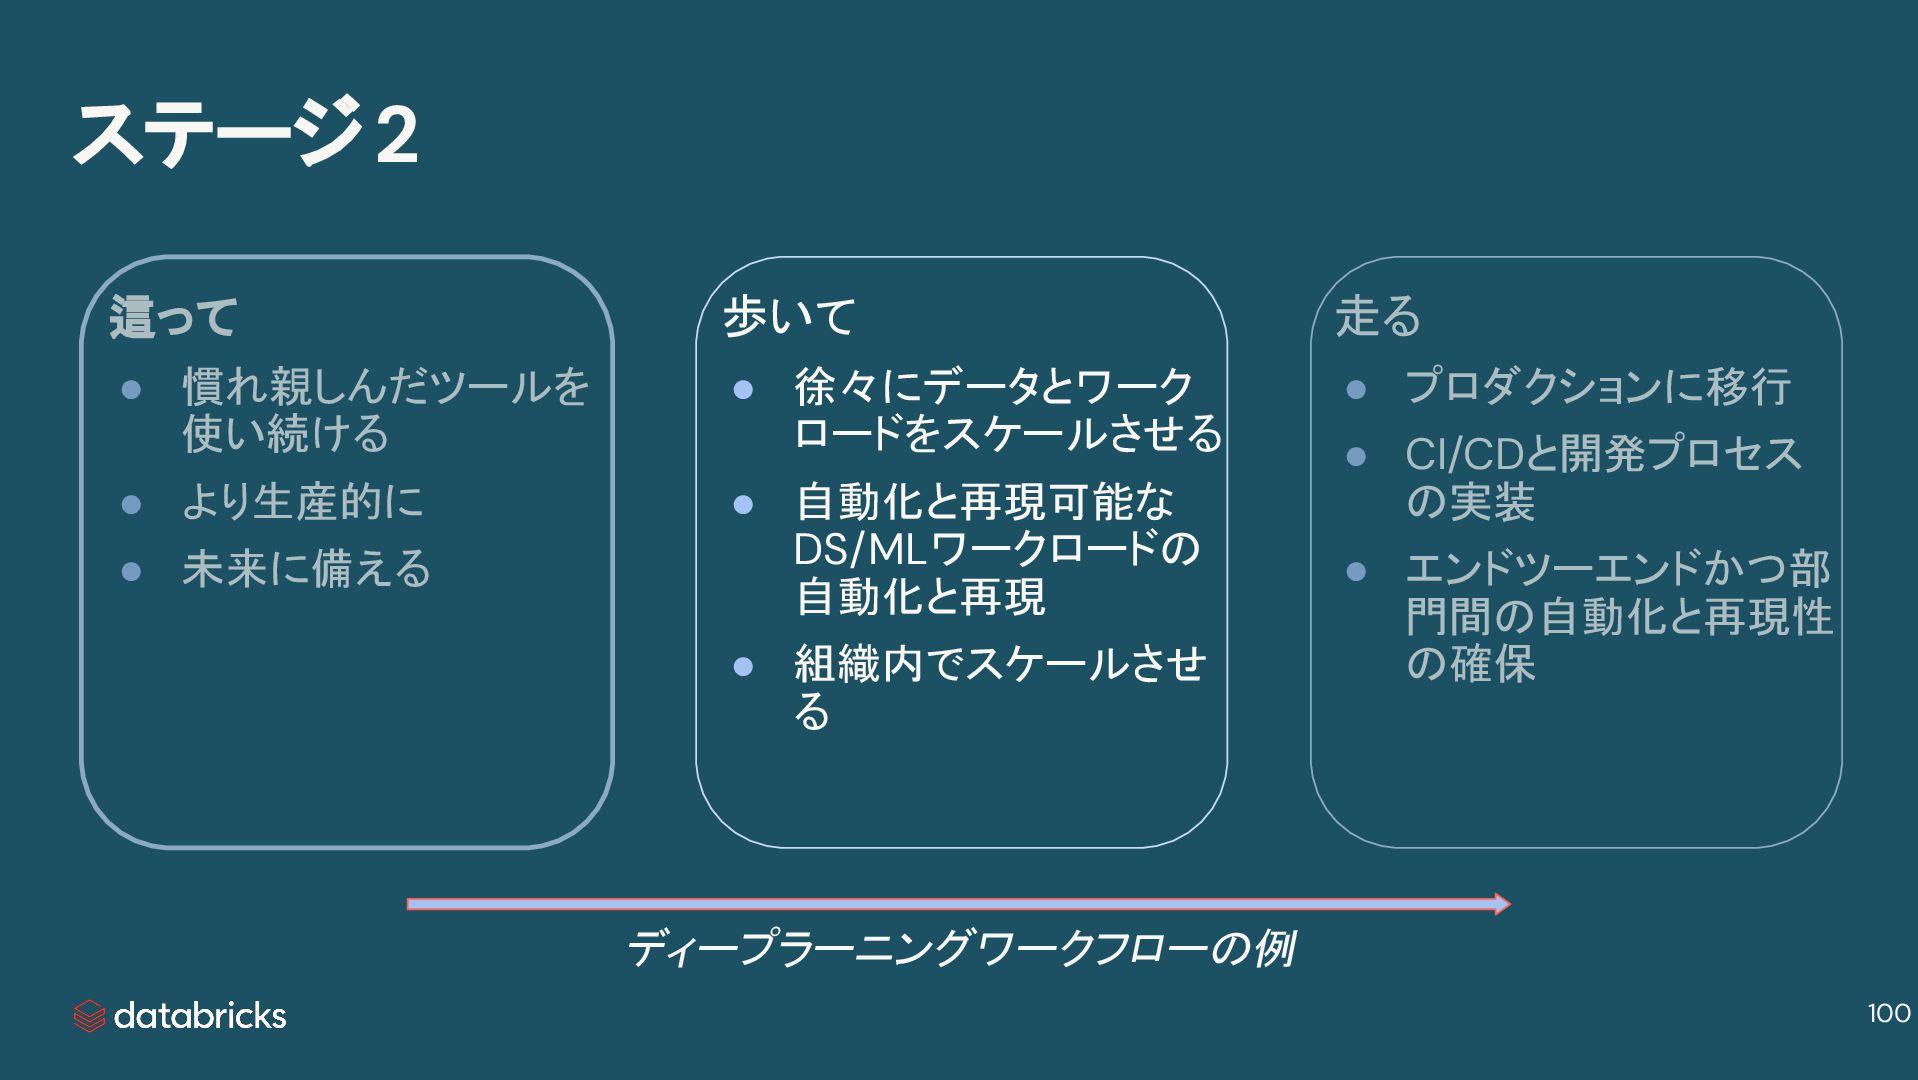
ステージ2 這って • 慣れ親しんだツールを 使い続ける • より生産的に • 未来に備える ディープラーニングワークフローの例
走る • プロダクションに移行 • CI/CDと開発プロセス の実装 • エンドツーエンドかつ部 門間の自動化と再現性 の確保 歩いて • 徐々にデータとワーク ロードをスケールさせる • 自動化と再現可能な DS/MLワークロードの 自動化と再現 • 組織内でスケールさせ る 100 -
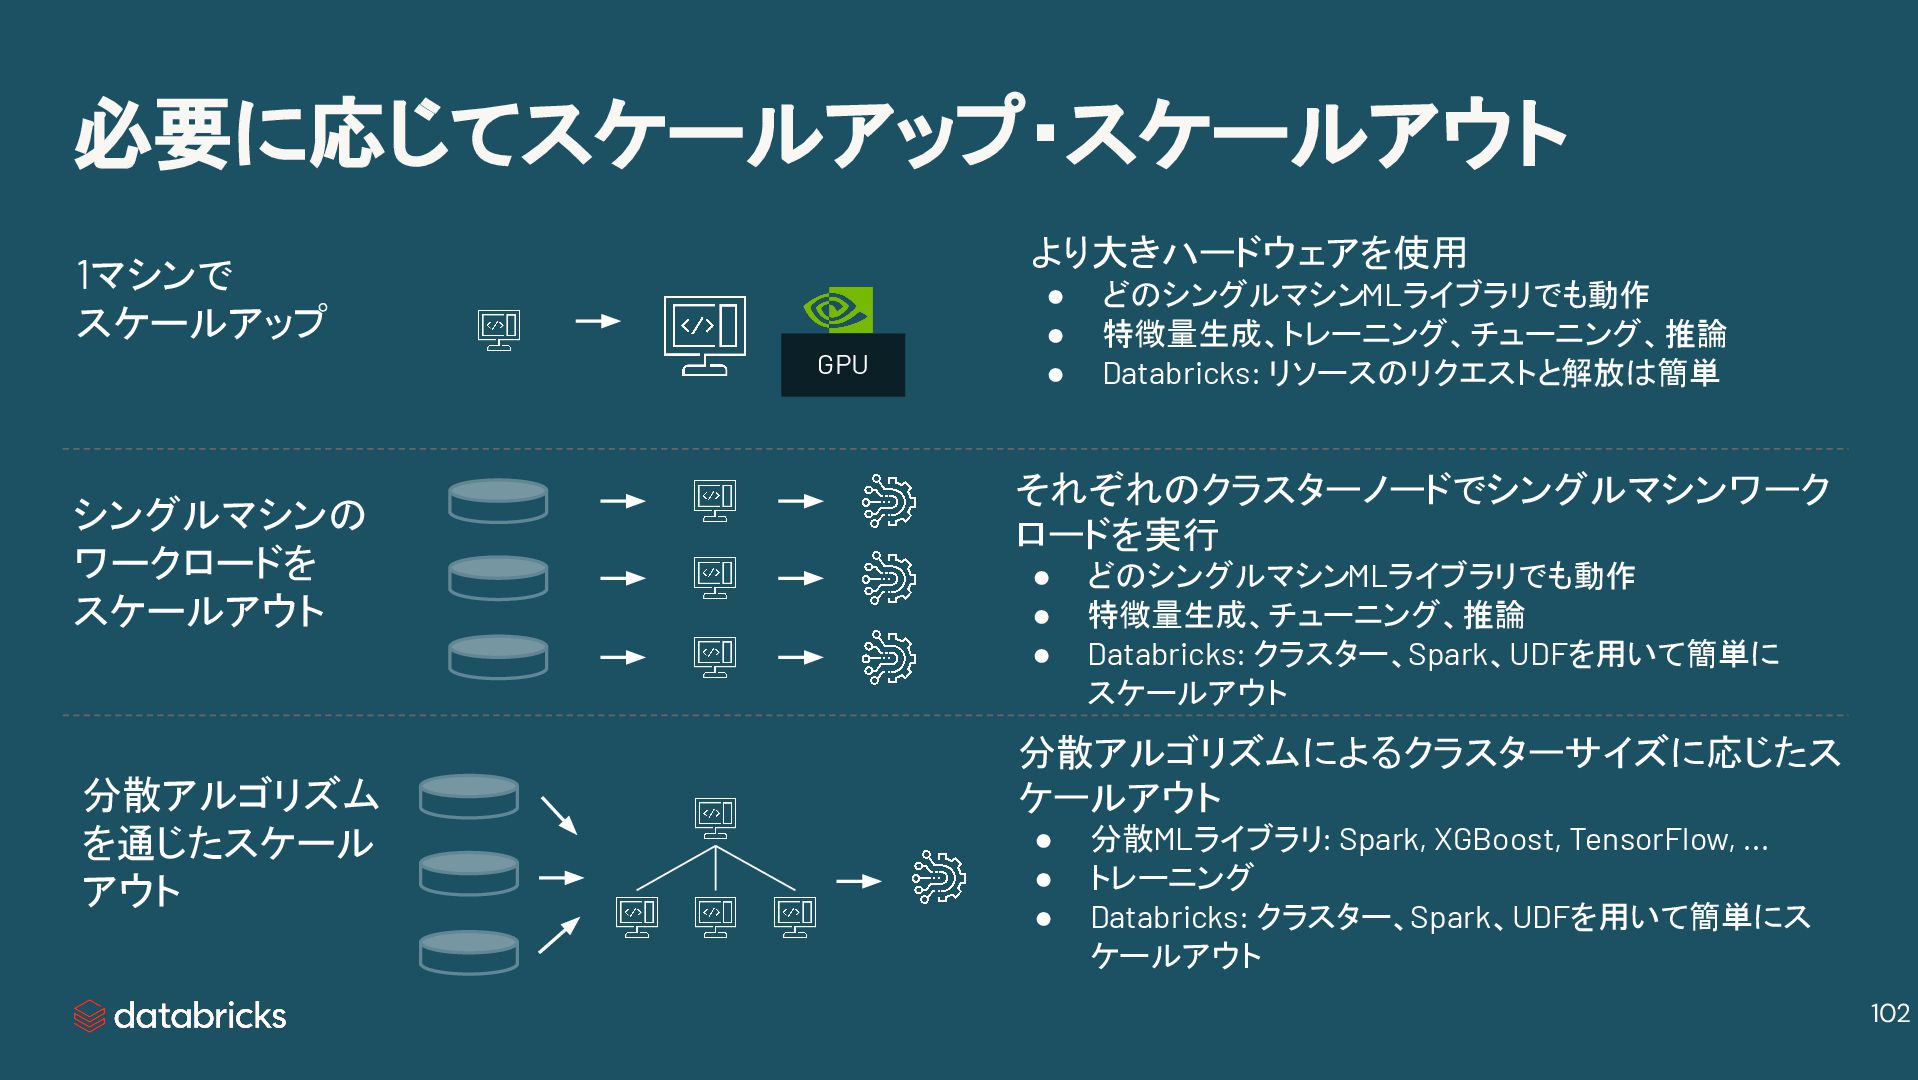
より大きハードウェアを使用 • どのシングルマシンMLライブラリでも動作 • 特徴量生成、トレーニング、チューニング、推論 • Databricks: リソースのリクエストと解放は簡単 必要に応じてスケールアップ・スケールアウト 1マシンで
スケールアップ シングルマシンの ワークロードを スケールアウト それぞれのクラスターノードでシングルマシンワーク ロードを実行 • どのシングルマシンMLライブラリでも動作 • 特徴量生成、チューニング、推論 • Databricks: クラスター、Spark、UDFを用いて簡単に スケールアウト 分散アルゴリズムによるクラスターサイズに応じたス ケールアウト • 分散MLライブラリ: Spark, XGBoost, TensorFlow, ... • トレーニング • Databricks: クラスター、Spark、UDFを用いて簡単にス ケールアウト 分散アルゴリズム を通じたスケール アウト GPU 102 -
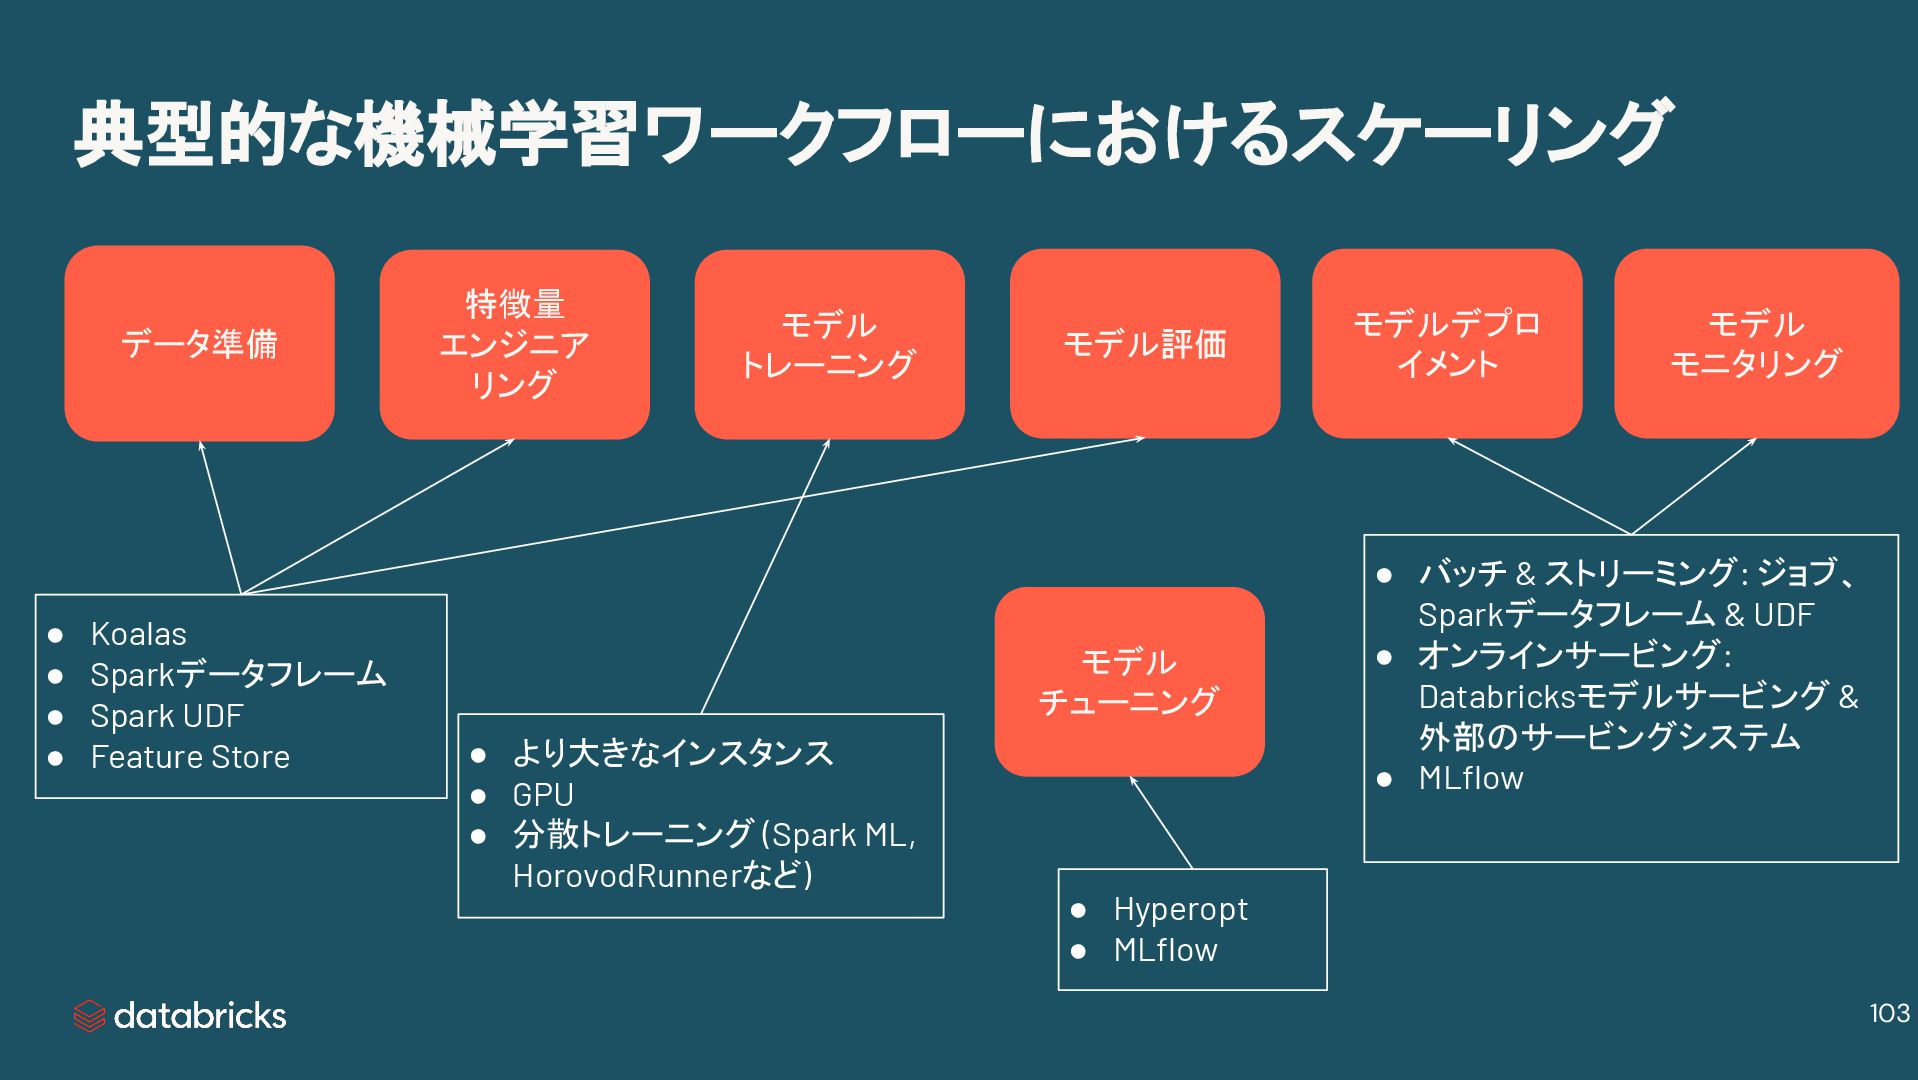
データ準備 特徴量 エンジニア リング モデル トレーニング モデル評価 モデルデプロ イメント モデル
チューニング モデル モニタリング • Koalas • Sparkデータフレーム • Spark UDF • Feature Store • より大きなインスタンス • GPU • 分散トレーニング (Spark ML, HorovodRunnerなど) • Hyperopt • MLflow • バッチ & ストリーミング: ジョブ、 Sparkデータフレーム & UDF • オンラインサービング: Databricksモデルサービング & 外部のサービングシステム • MLflow 典型的な機械学習ワークフローにおけるスケーリング 103 -
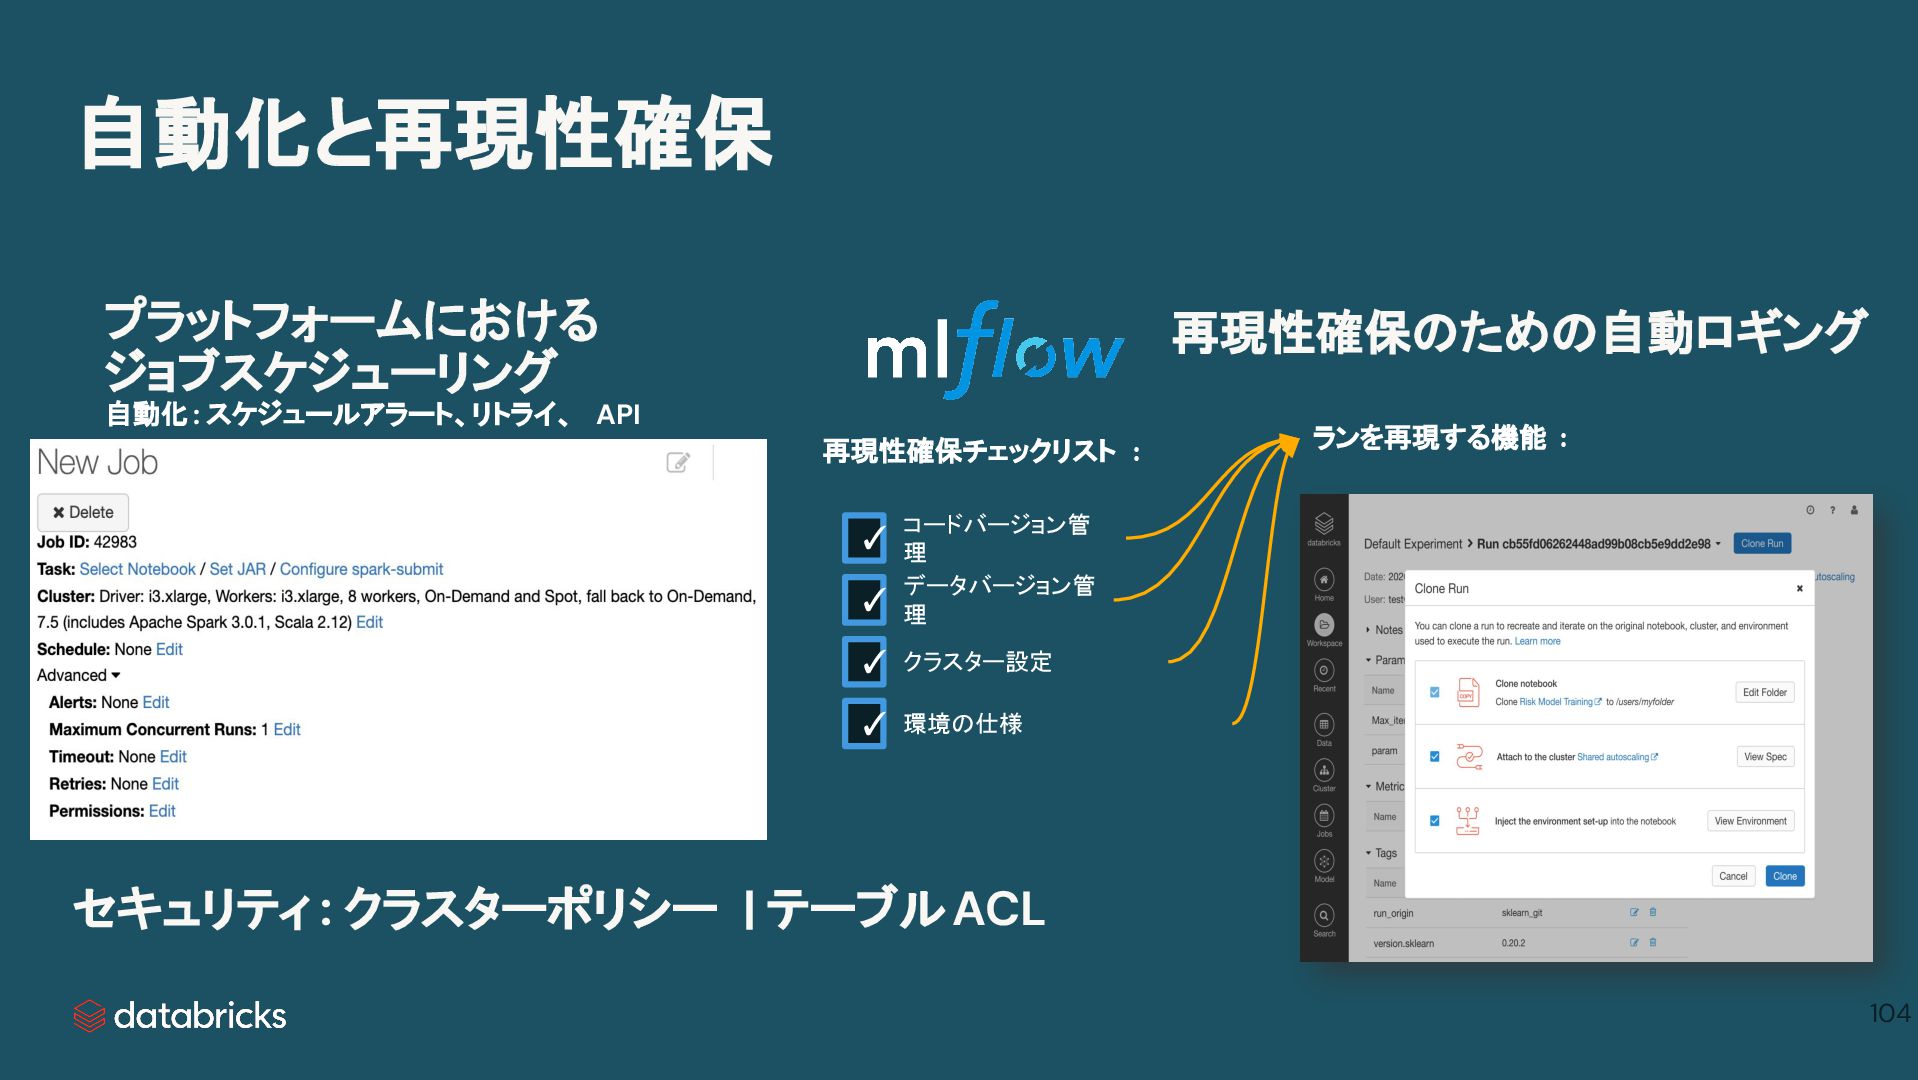
再現性確保のための自動ロギング ランを再現する機能 : ✓ ✓ ✓ ✓ コードバージョン管 理 データバージョン管
理 クラスター設定 環境の仕様 再現性確保チェックリスト : プラットフォームにおける ジョブスケジューリング 自動化: スケジュールアラート、リトライ、 API セキュリティ : クラスターポリシー | テーブルACL 自動化と再現性確保 104 -
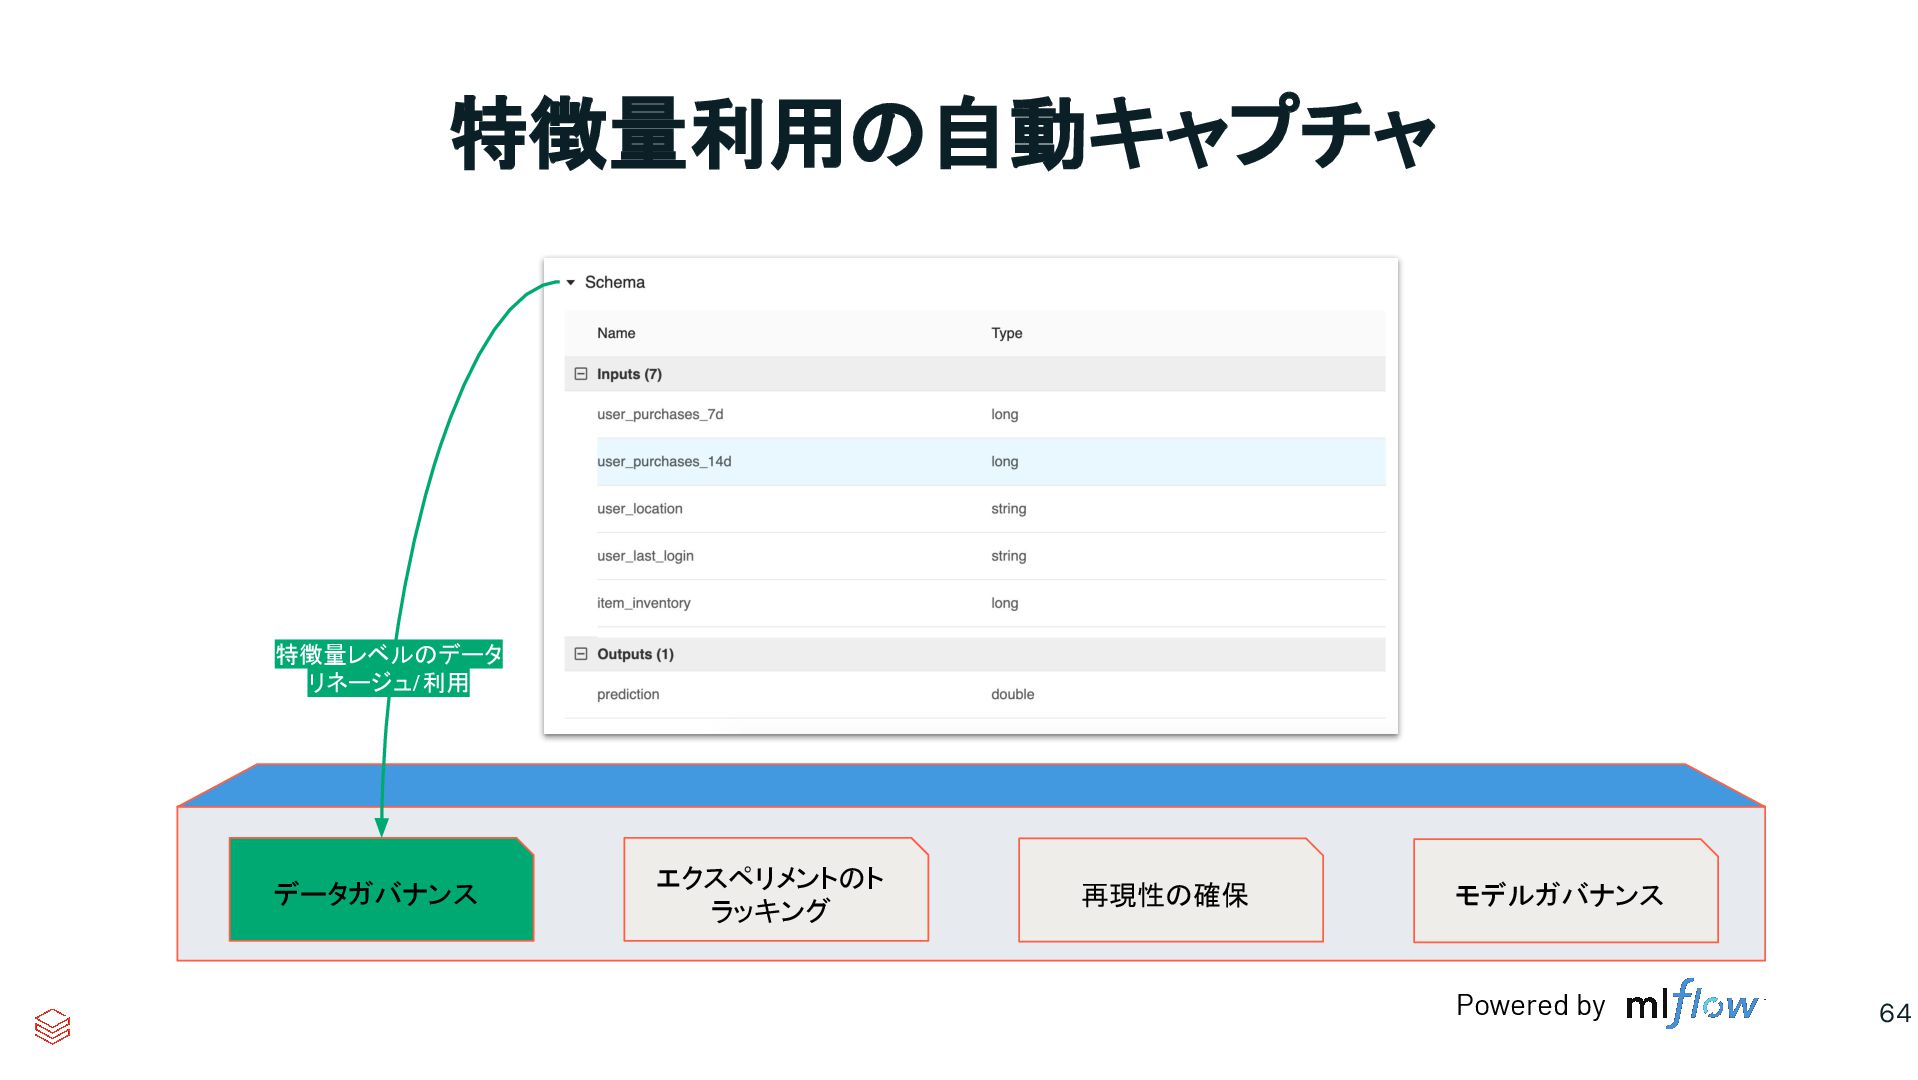
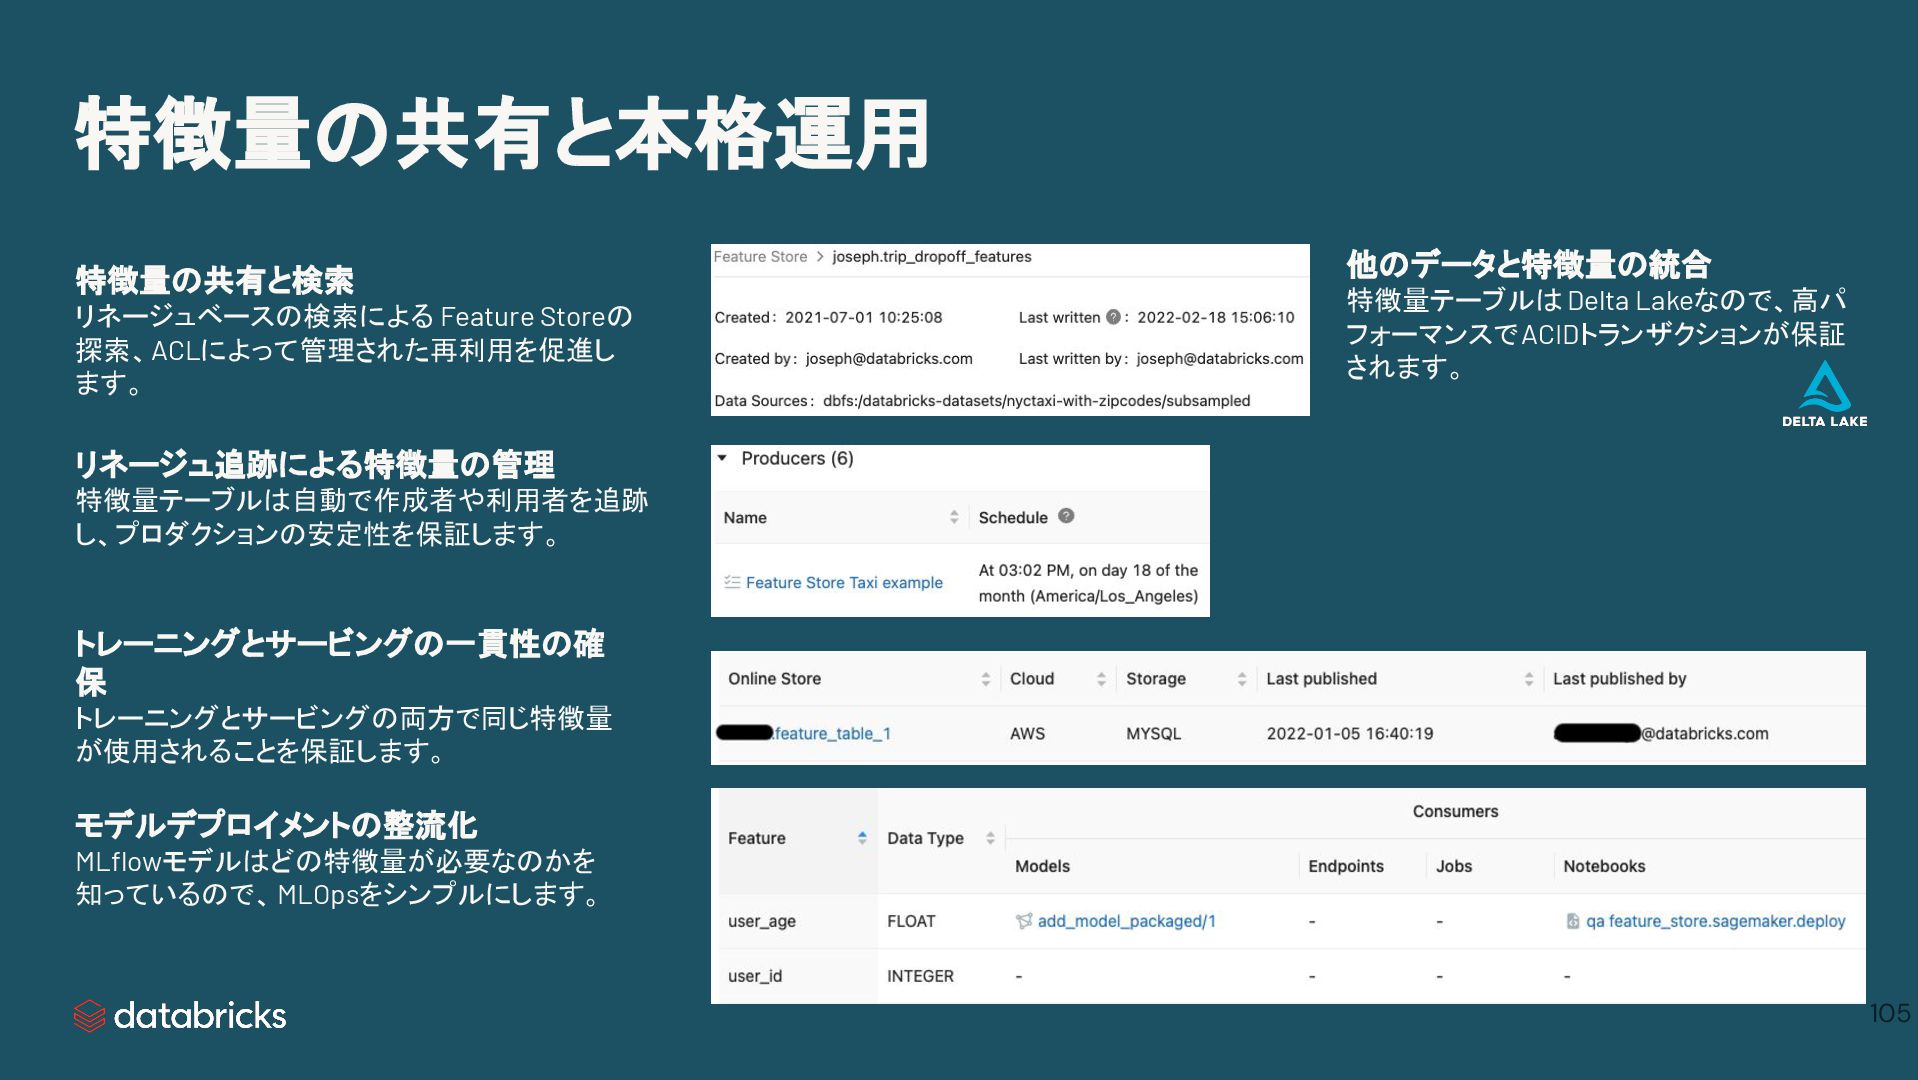
特徴量の共有と本格運用 特徴量の共有と検索 リネージュベースの検索による Feature Storeの 探索、ACLによって管理された再利用を促進し ます。 トレーニングとサービングの一貫性の確 保 トレーニングとサービングの両方で同じ特徴量
が使用されることを保証します。 モデルデプロイメントの整流化 MLflowモデルはどの特徴量が必要なのかを 知っているので、MLOpsをシンプルにします。 他のデータと特徴量の統合 特徴量テーブルはDelta Lakeなので、高パ フォーマンスでACIDトランザクションが保証 されます。 リネージュ追跡による特徴量の管理 特徴量テーブルは自動で作成者や利用者を追跡 し、プロダクションの安定性を保証します。 105 -
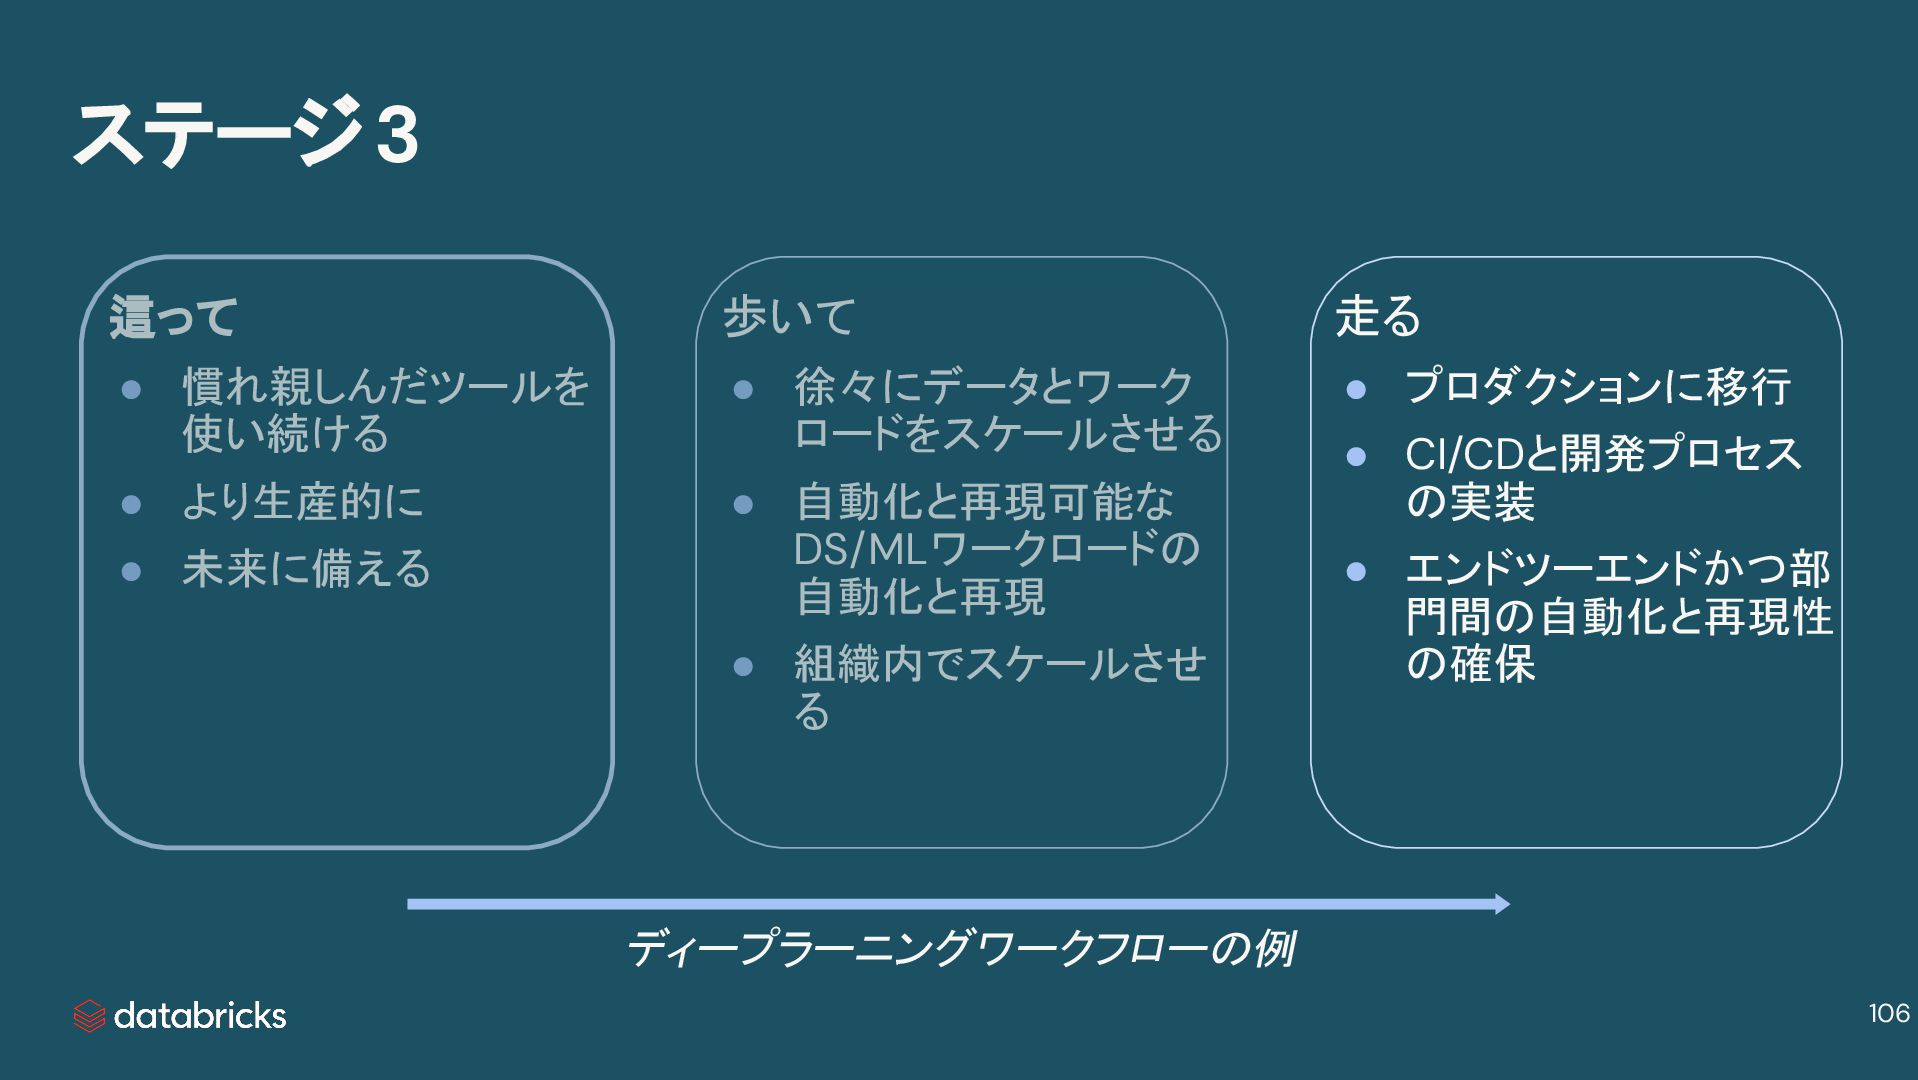
ステージ3 這って • 慣れ親しんだツールを 使い続ける • より生産的に • 未来に備える ディープラーニングワークフローの例
走る • プロダクションに移行 • CI/CDと開発プロセス の実装 • エンドツーエンドかつ部 門間の自動化と再現性 の確保 歩いて • 徐々にデータとワーク ロードをスケールさせる • 自動化と再現可能な DS/MLワークロードの 自動化と再現 • 組織内でスケールさせ る 106 -
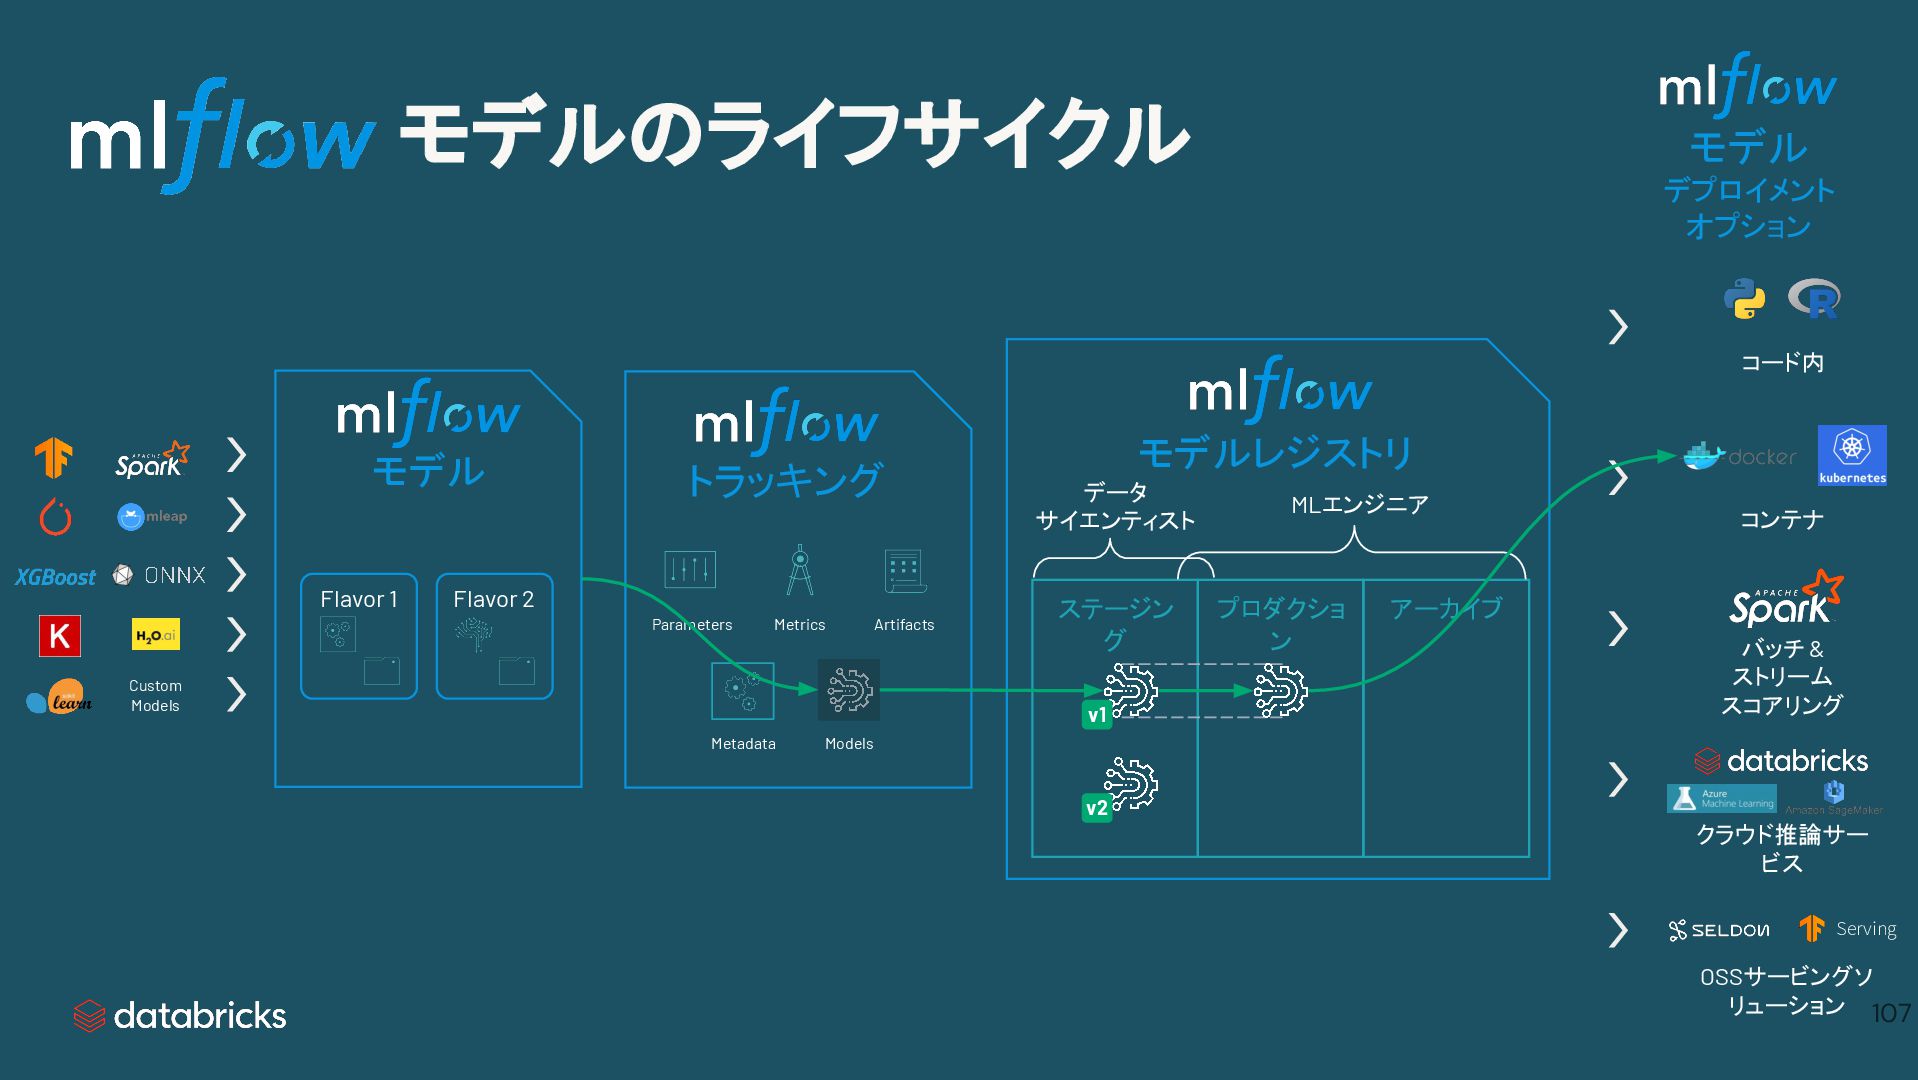
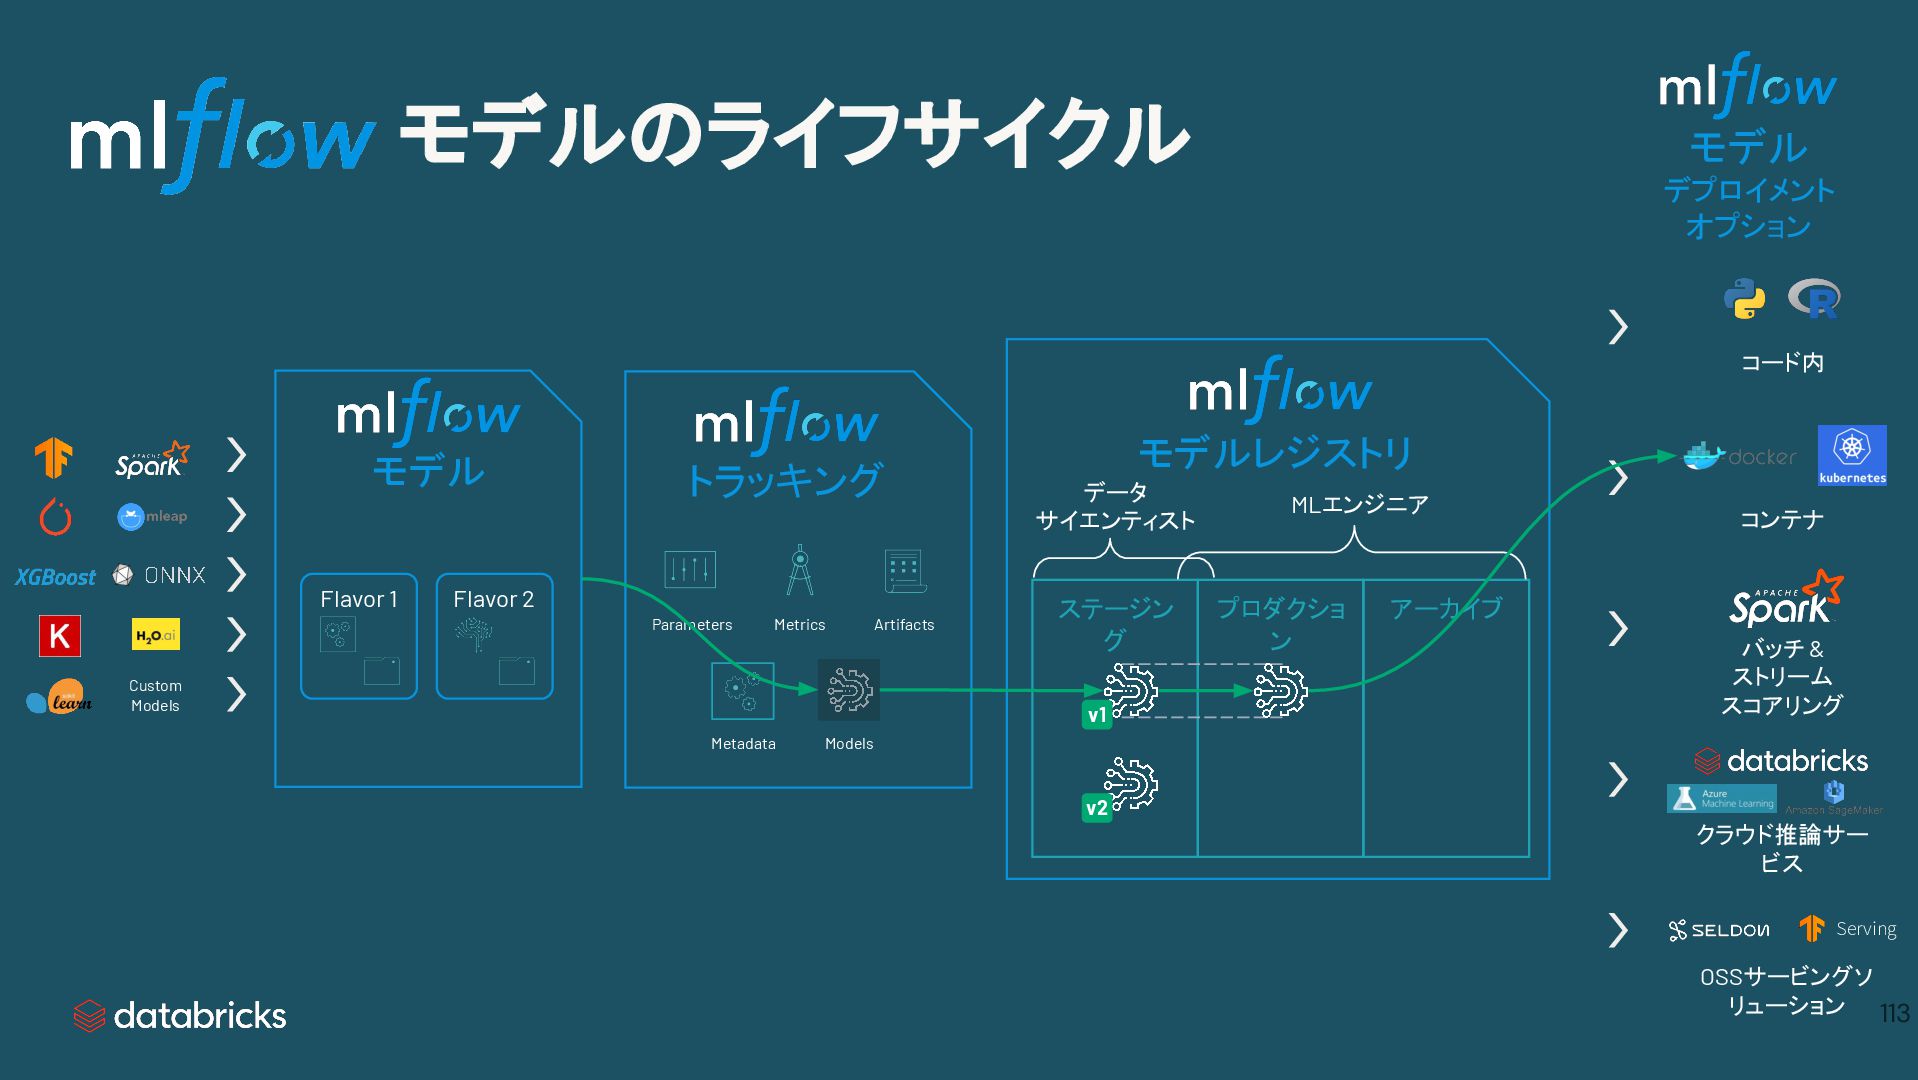
モデルのライフサイクル ステージン グ プロダクショ ン アーカイブ データ サイエンティスト MLエンジニア v1
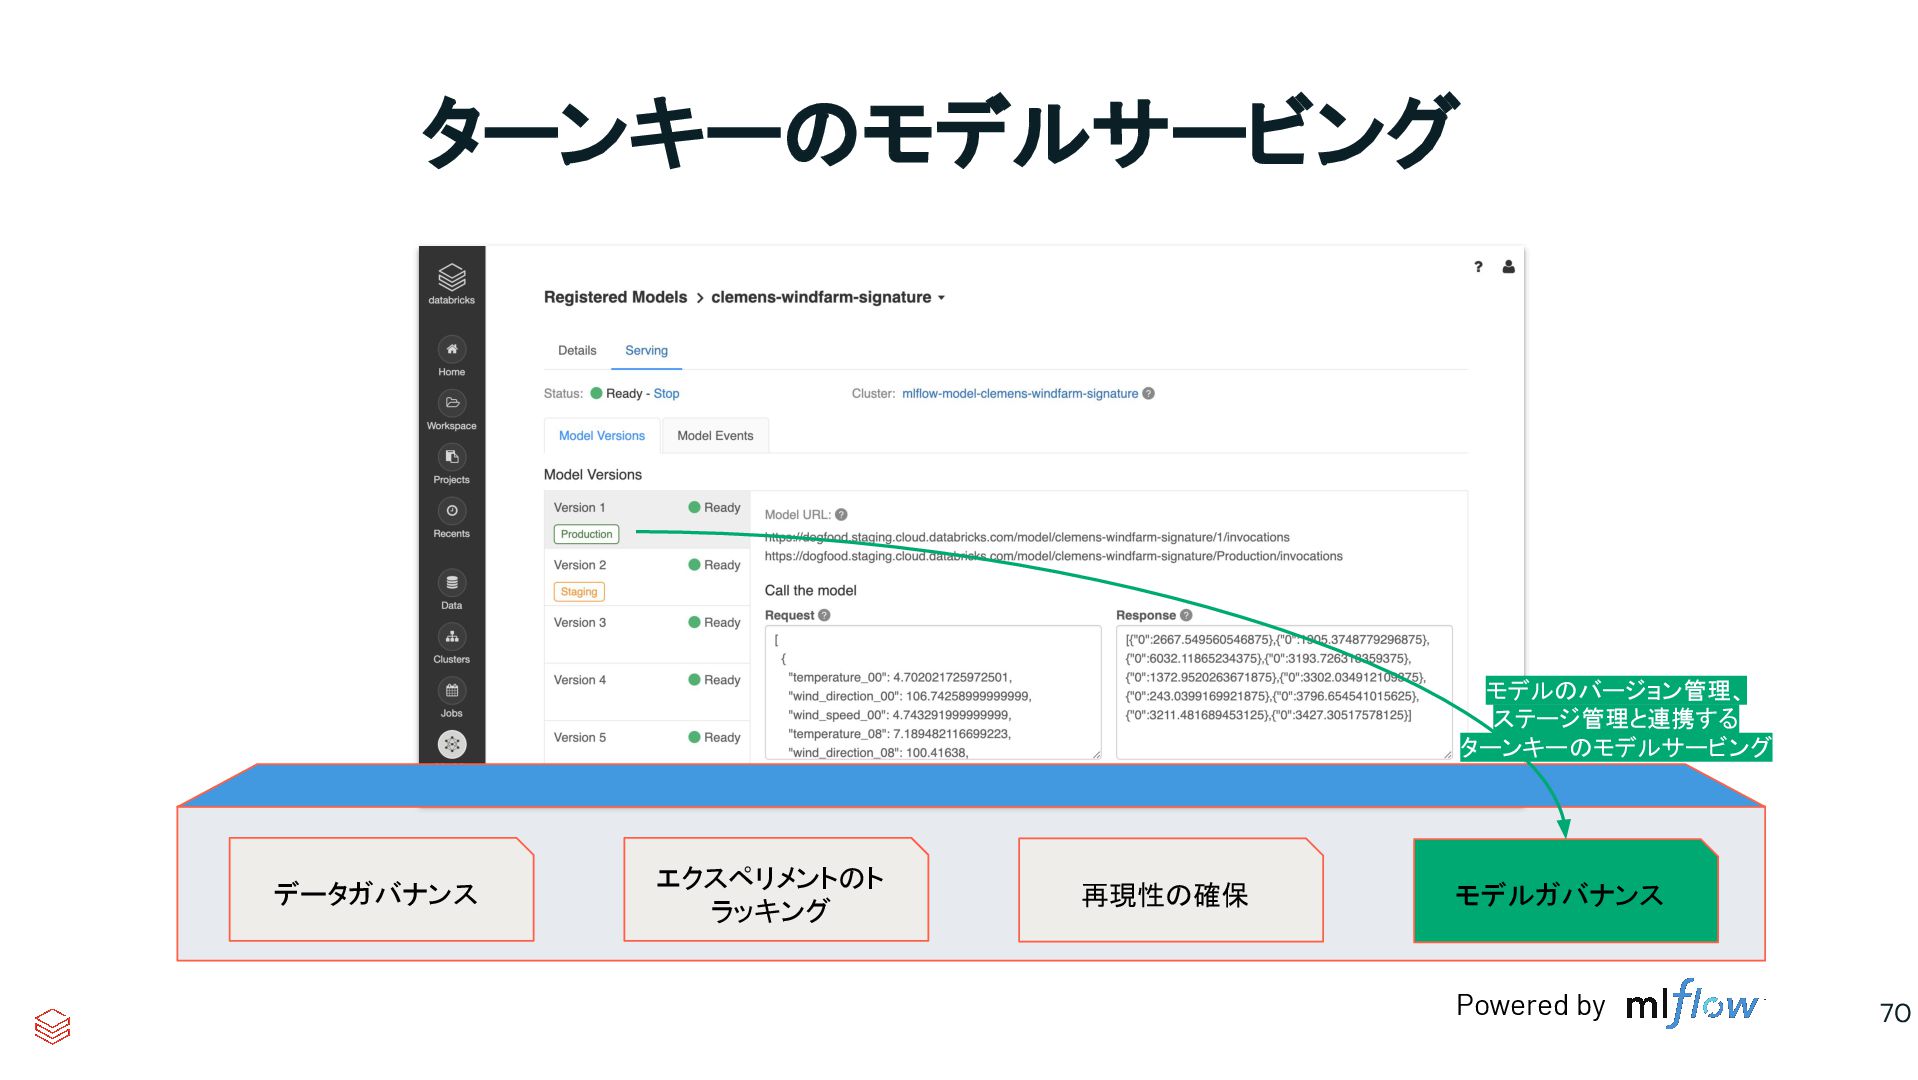
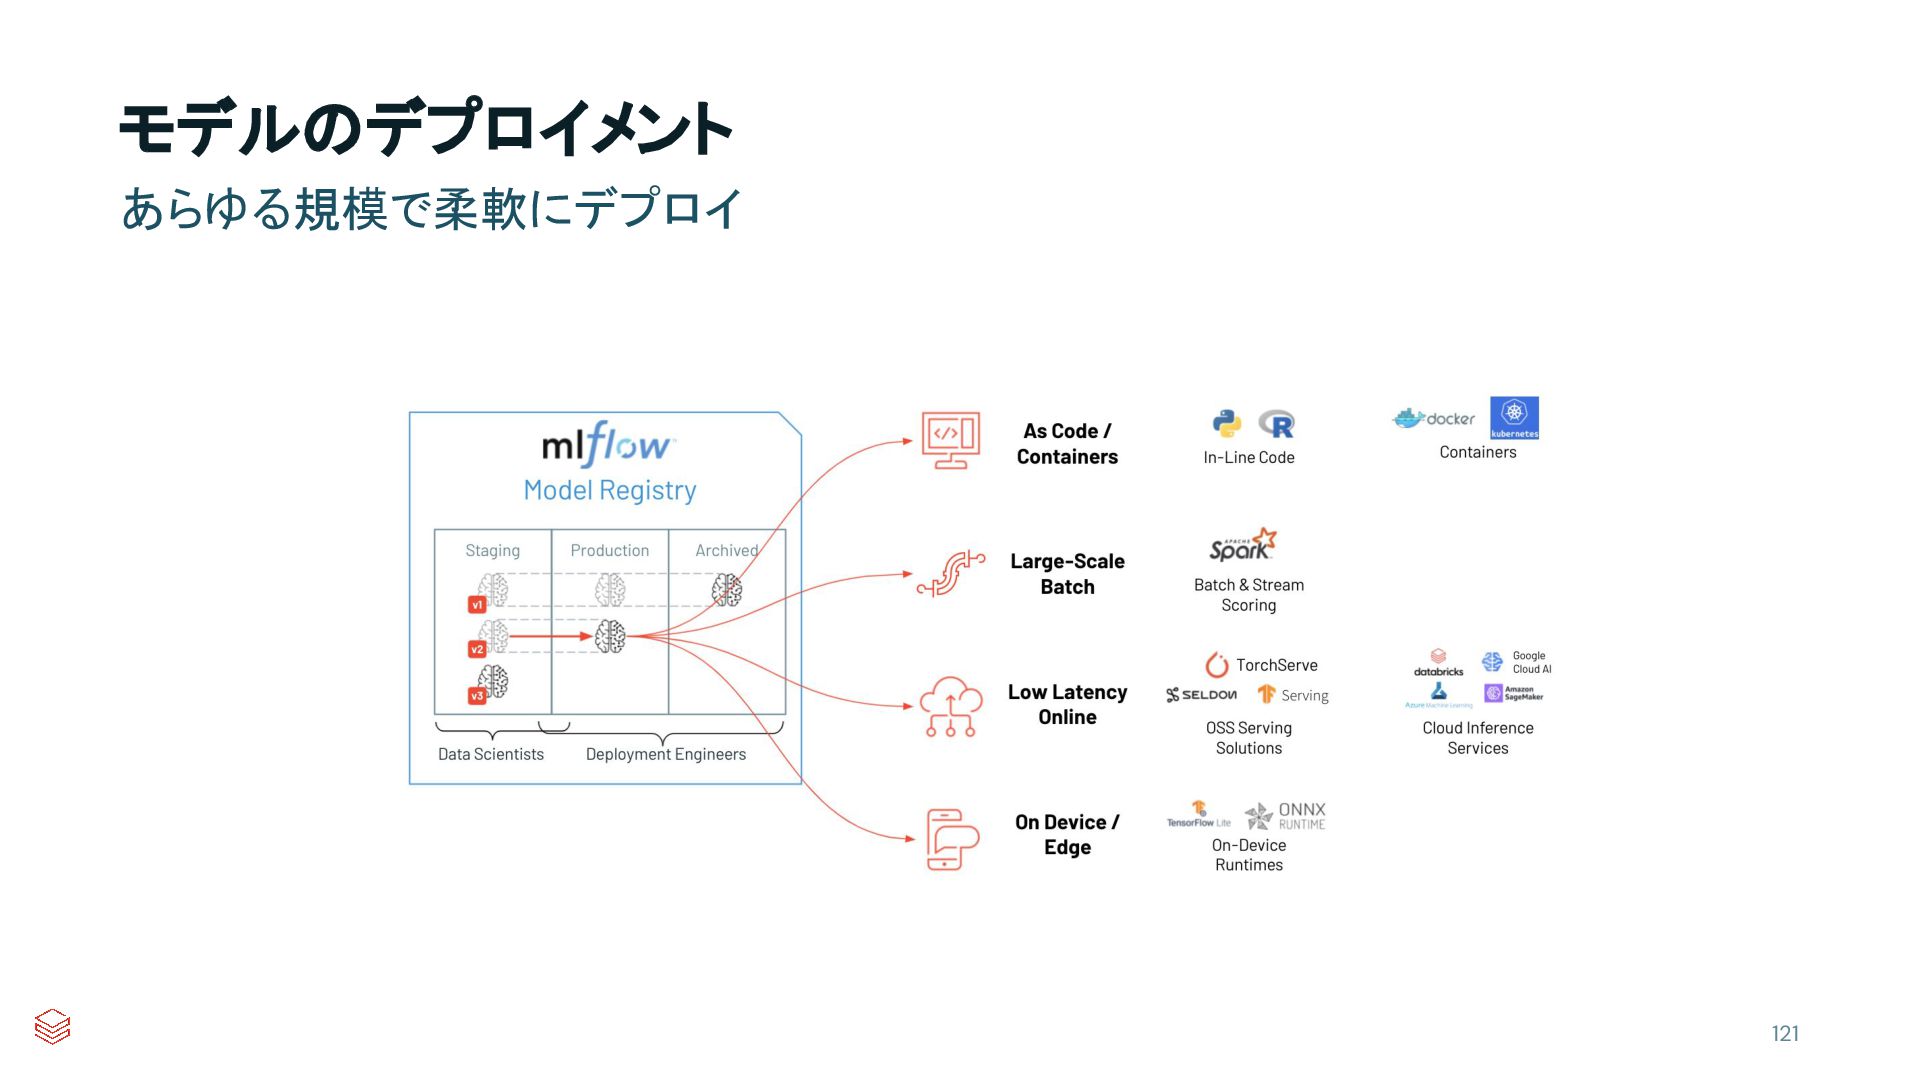
v2 モデル トラッキング Flavor 2 Flavor 1 モデルレジストリ Custom Models コード内 コンテナ バッチ & ストリーム スコアリング クラウド推論サー ビス OSSサービングソ リューション Serving Parameters Metrics Artifacts Models Metadata モデル デプロイメント オプション 107 -
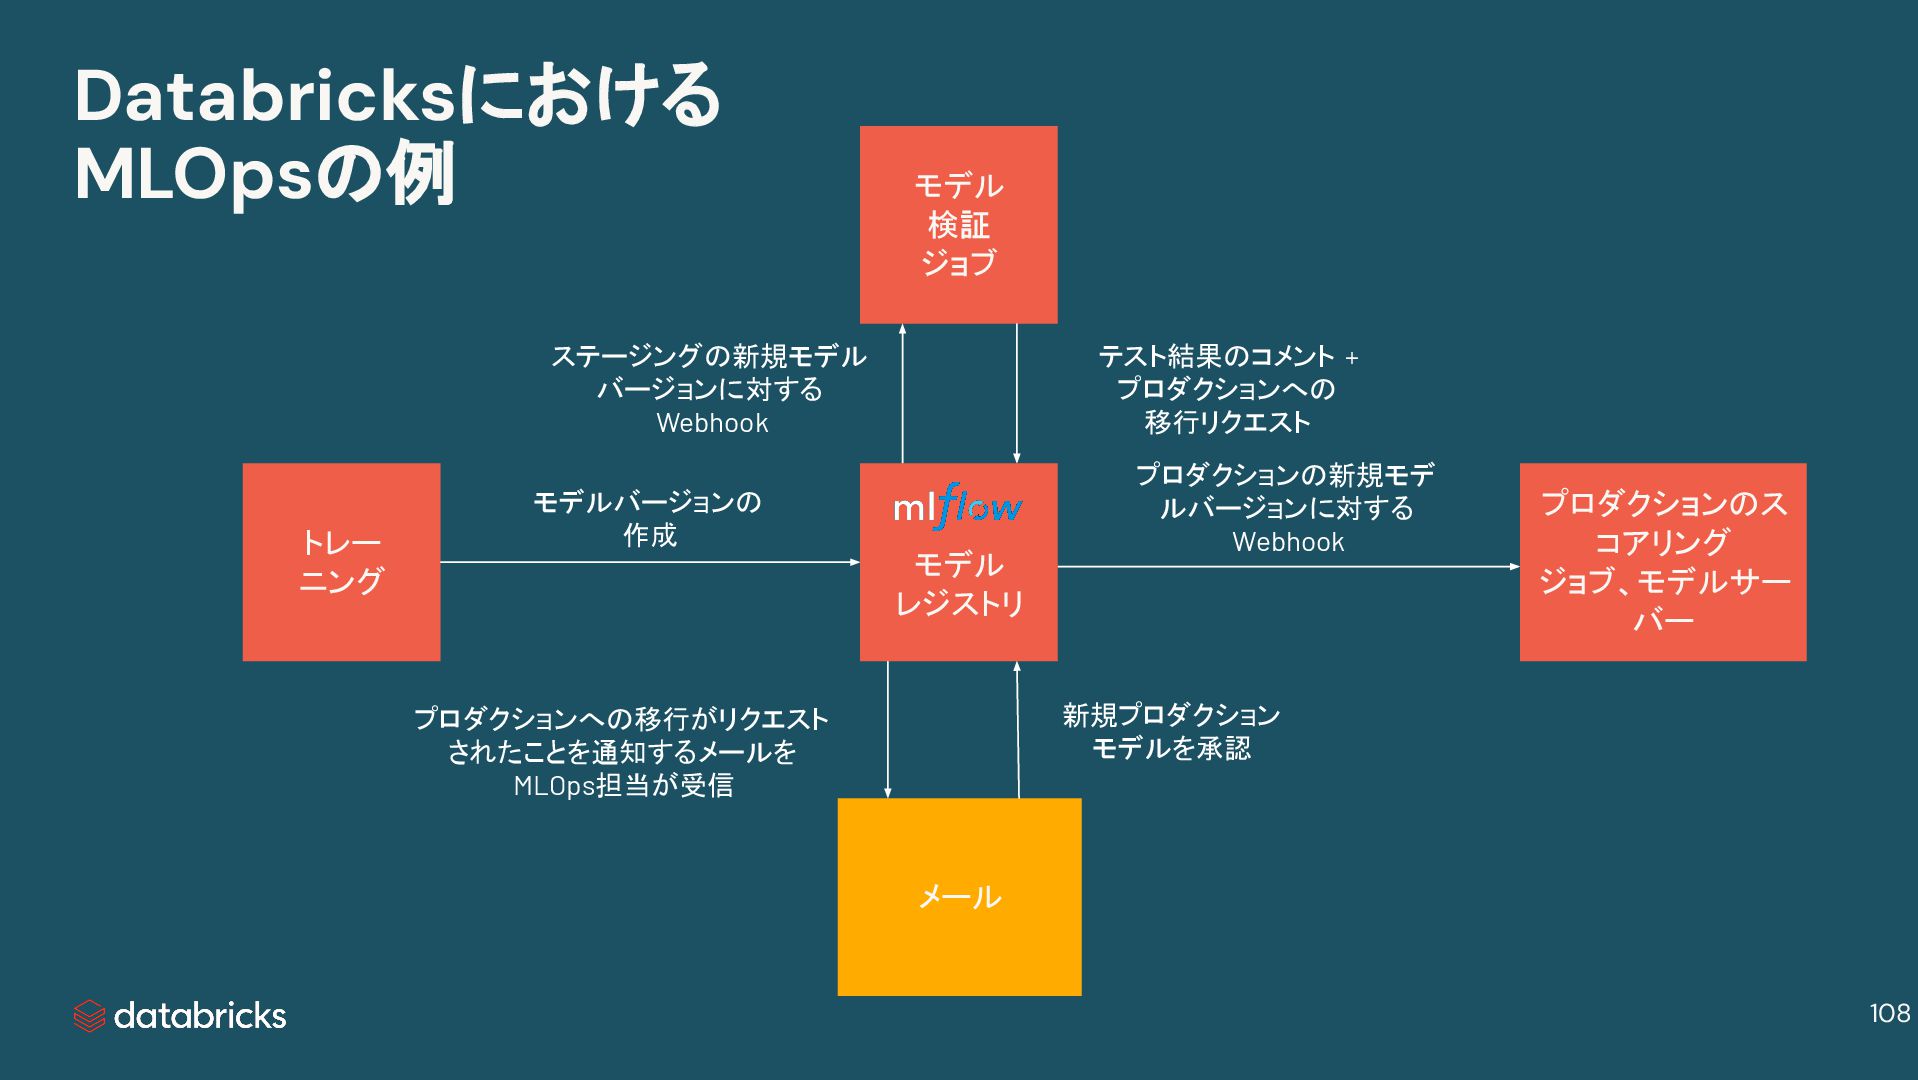
Databricksにおける MLOpsの例 トレー ニング モデル 検証 ジョブ プロダクションのス コアリング ジョブ、モデルサー
バー メール モデルバージョンの 作成 ステージングの新規モデル バージョンに対する Webhook テスト結果のコメント + プロダクションへの 移行リクエスト プロダクションの新規モデ ルバージョンに対する Webhook プロダクションへの移行がリクエスト されたことを通知するメールを MLOps担当が受信 新規プロダクション モデルを承認 モデル レジストリ 108 -
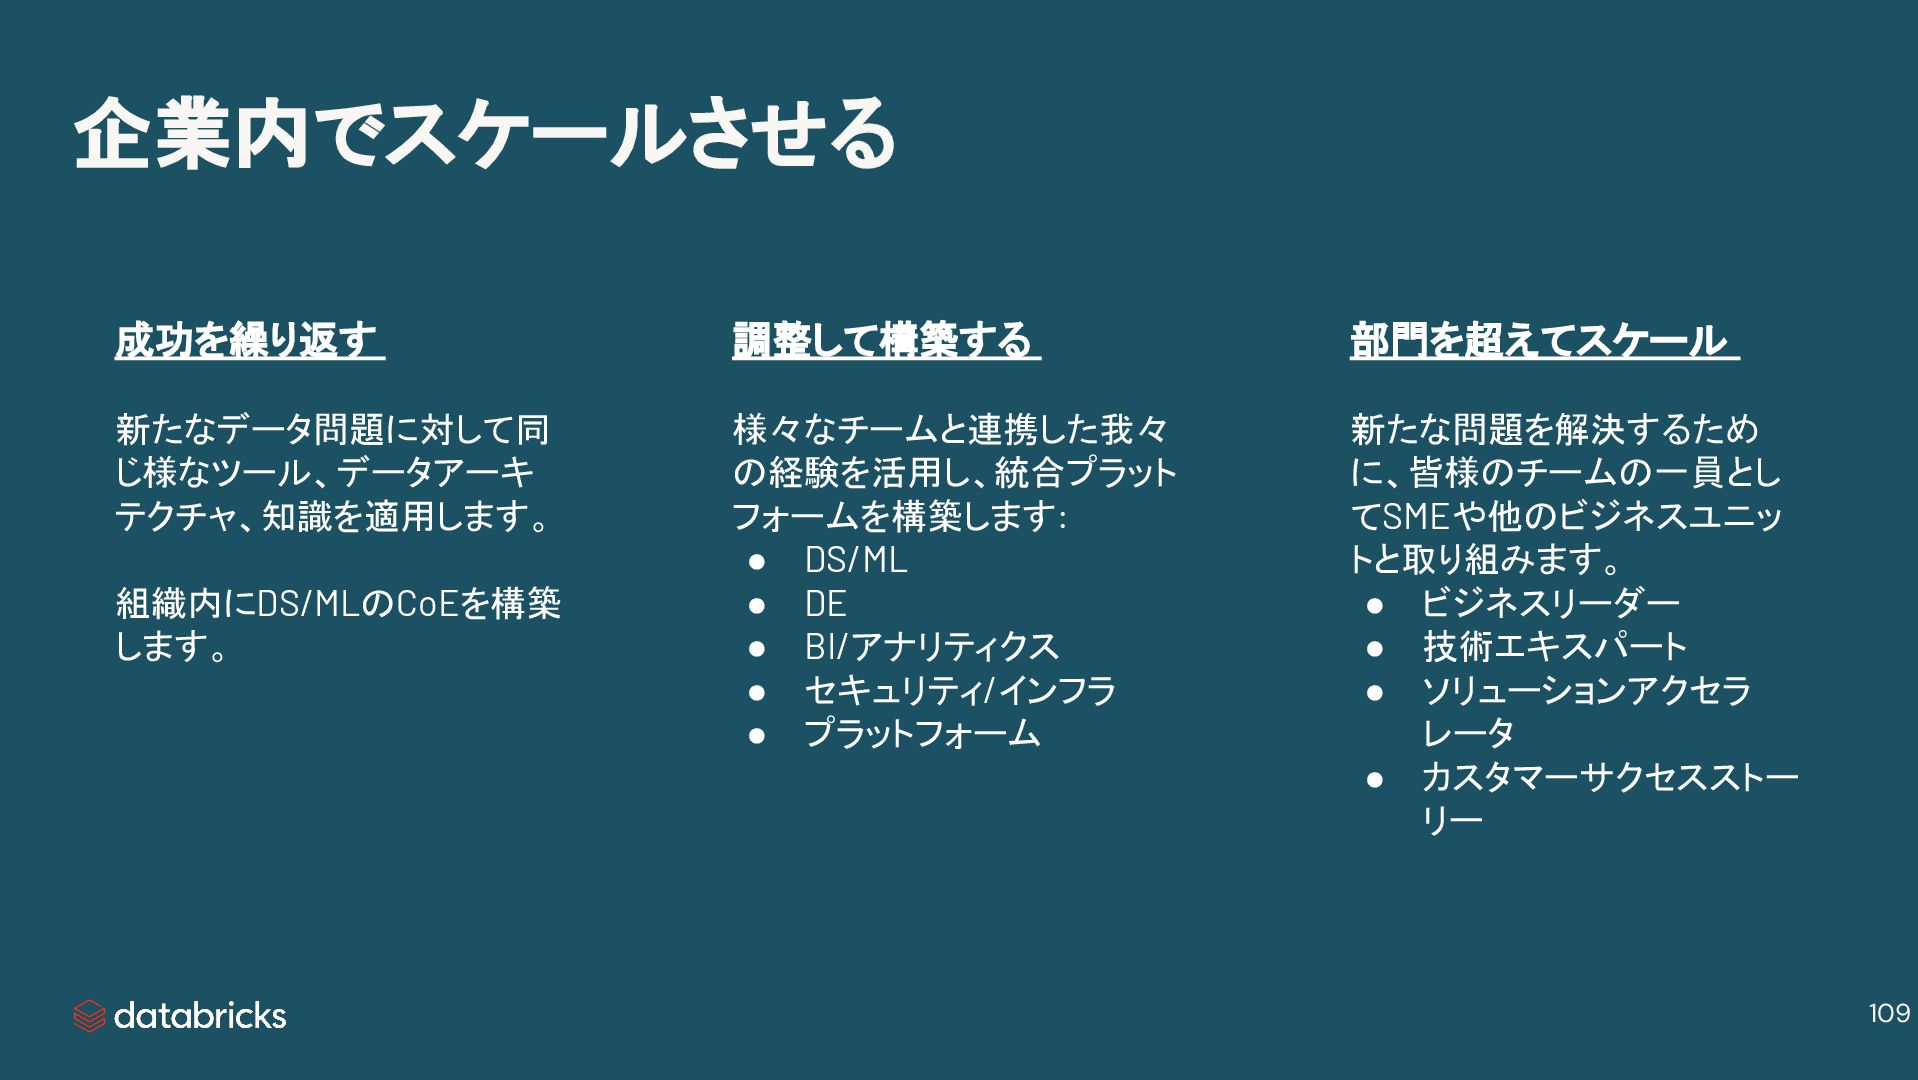
部門を超えてスケール 新たな問題を解決するため に、皆様のチームの一員とし てSMEや他のビジネスユニッ トと取り組みます。 • ビジネスリーダー • 技術エキスパート •
ソリューションアクセラ レータ • カスタマーサクセスストー リー 調整して構築する 様々なチームと連携した我々 の経験を活用し、統合プラット フォームを構築します: • DS/ML • DE • BI/アナリティクス • セキュリティ/インフラ • プラットフォーム 成功を繰り返す 新たなデータ問題に対して同 じ様なツール、データアーキ テクチャ、知識を適用します。 組織内にDS/MLのCoEを構築 します。 企業内でスケールさせる 109 -
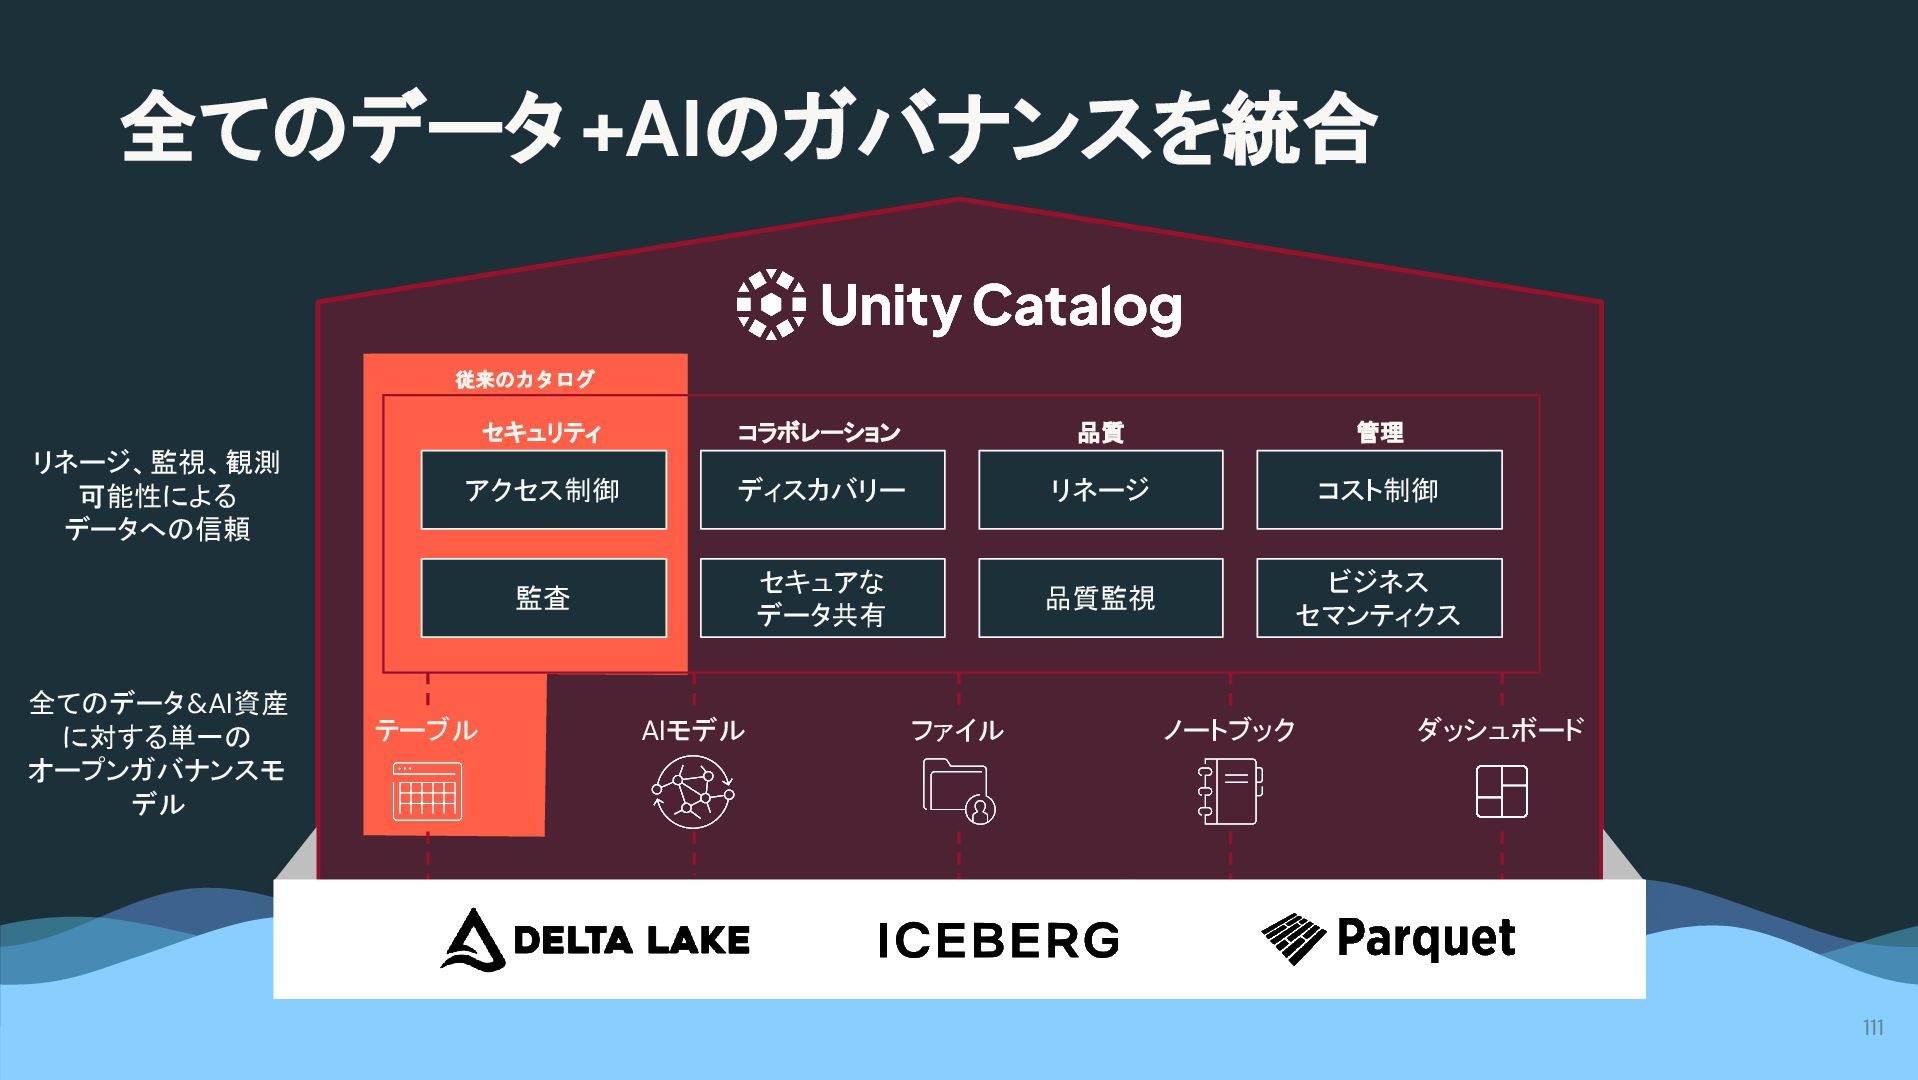
従来のカタログ 全てのデータ +AIのガバナンスを統合 テーブル AIモデル ファイル ノートブック ダッシュボード 全てのデータ&AI資産 に対する単一の
オープンガバナンスモ デル リネージ、監視、観測 可能性による データへの信頼 アクセス制御 ディスカバリー リネージ 監査 セキュアな データ共有 品質監視 コスト制御 ビジネス セマンティクス セキュリティ コラボレーション 品質 管理 111 -
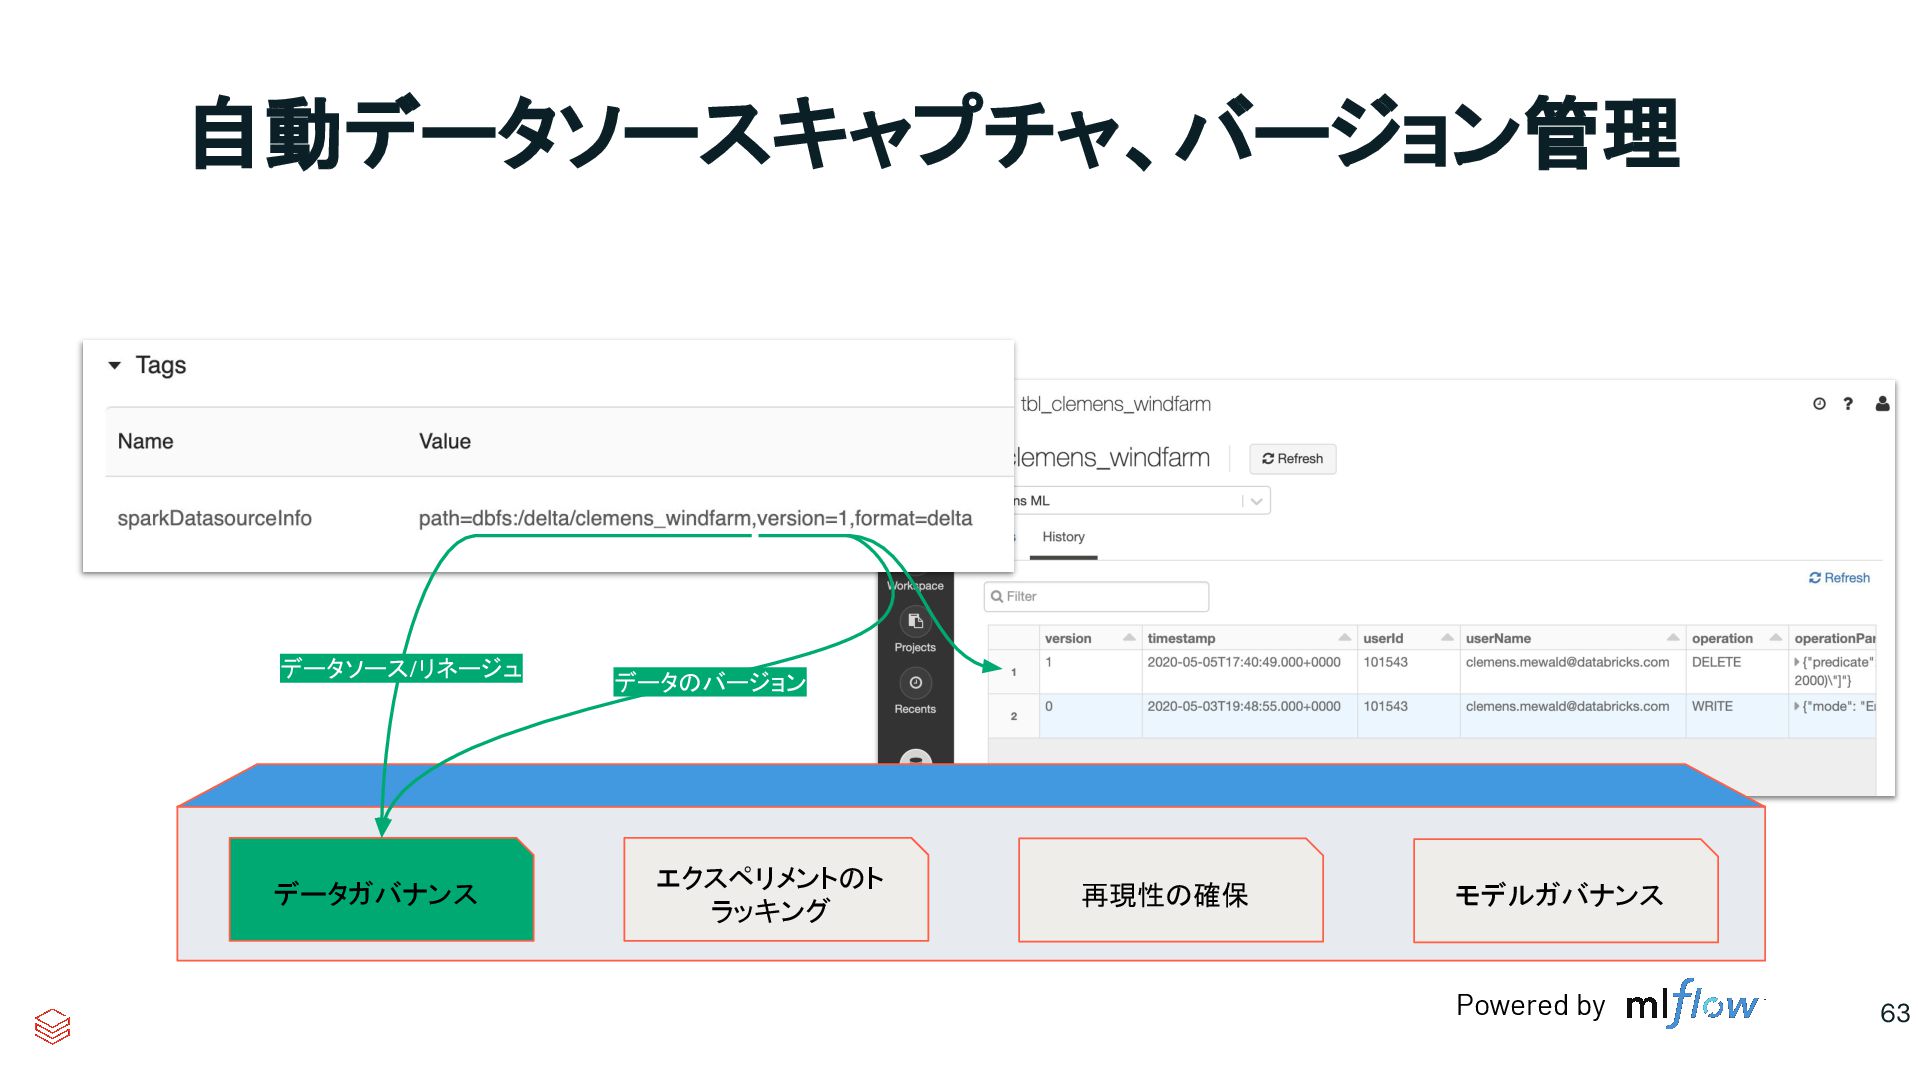
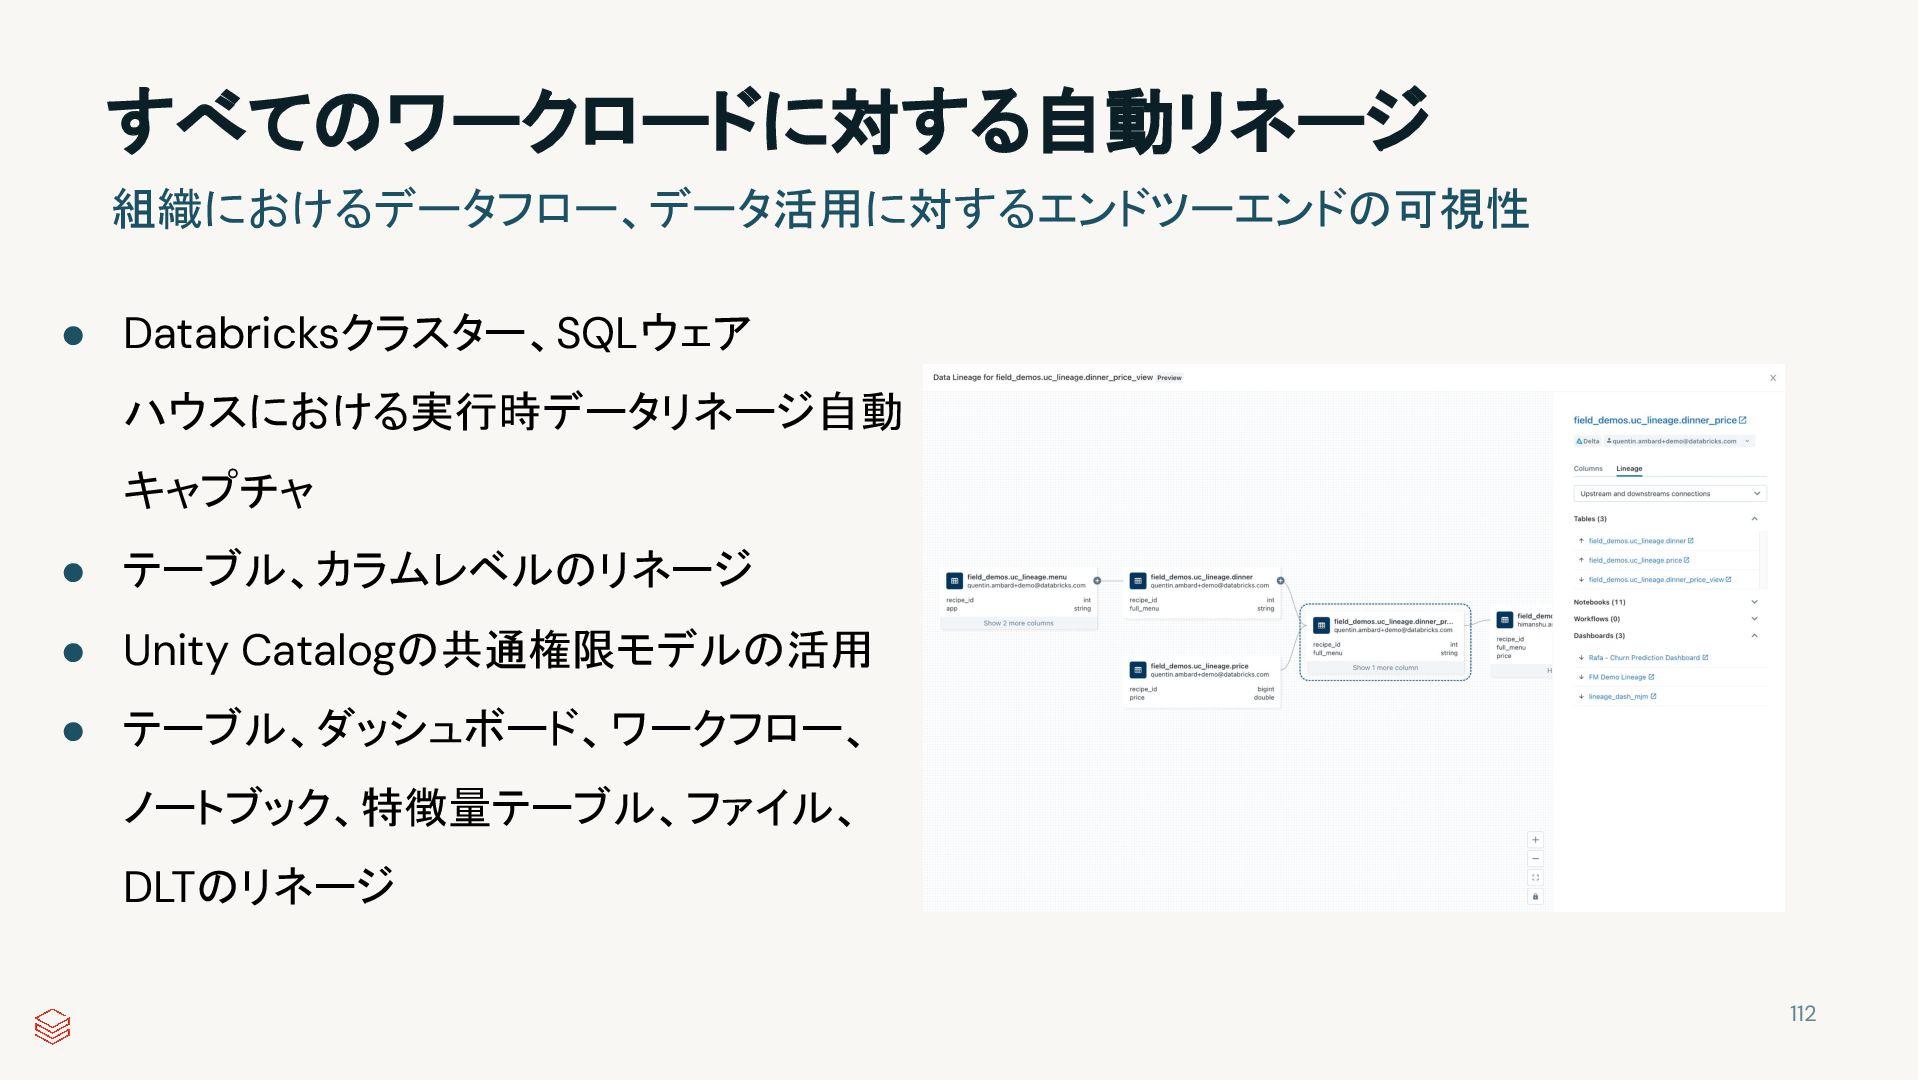
112 すべてのワークロードに対する自動リネージ • Databricksクラスター、SQLウェア ハウスにおける実行時データリネージ自動 キャプチャ • テーブル、カラムレベルのリネージ • Unity
Catalogの共通権限モデルの活用 • テーブル、ダッシュボード、ワークフロー、 ノートブック、特徴量テーブル、ファイル、 DLTのリネージ 組織におけるデータフロー、データ活用に対するエンドツーエンドの可視性 -
モデルのライフサイクル ステージン グ プロダクショ ン アーカイブ データ サイエンティスト MLエンジニア v1
v2 モデル トラッキング Flavor 2 Flavor 1 モデルレジストリ Custom Models コード内 コンテナ バッチ & ストリーム スコアリング クラウド推論サー ビス OSSサービングソ リューション Serving Parameters Metrics Artifacts Models Metadata モデル デプロイメント オプション 113 -
Powered by データガバナンス エクスペリメントのト ラッキング 再現性の確保 モデルガバナンス モデルの検索 モデルの ステージベースのACL
モデルの共有、再利用、 ACL 114 -
Powered by データガバナンス エクスペリメントのト ラッキング 再現性の確保 モデルガバナンス ステージ変更に対する 承認プロセス モデル変更に
対する監査ログ 自動化されたモデルリネージュ、ガバナンス 115 -
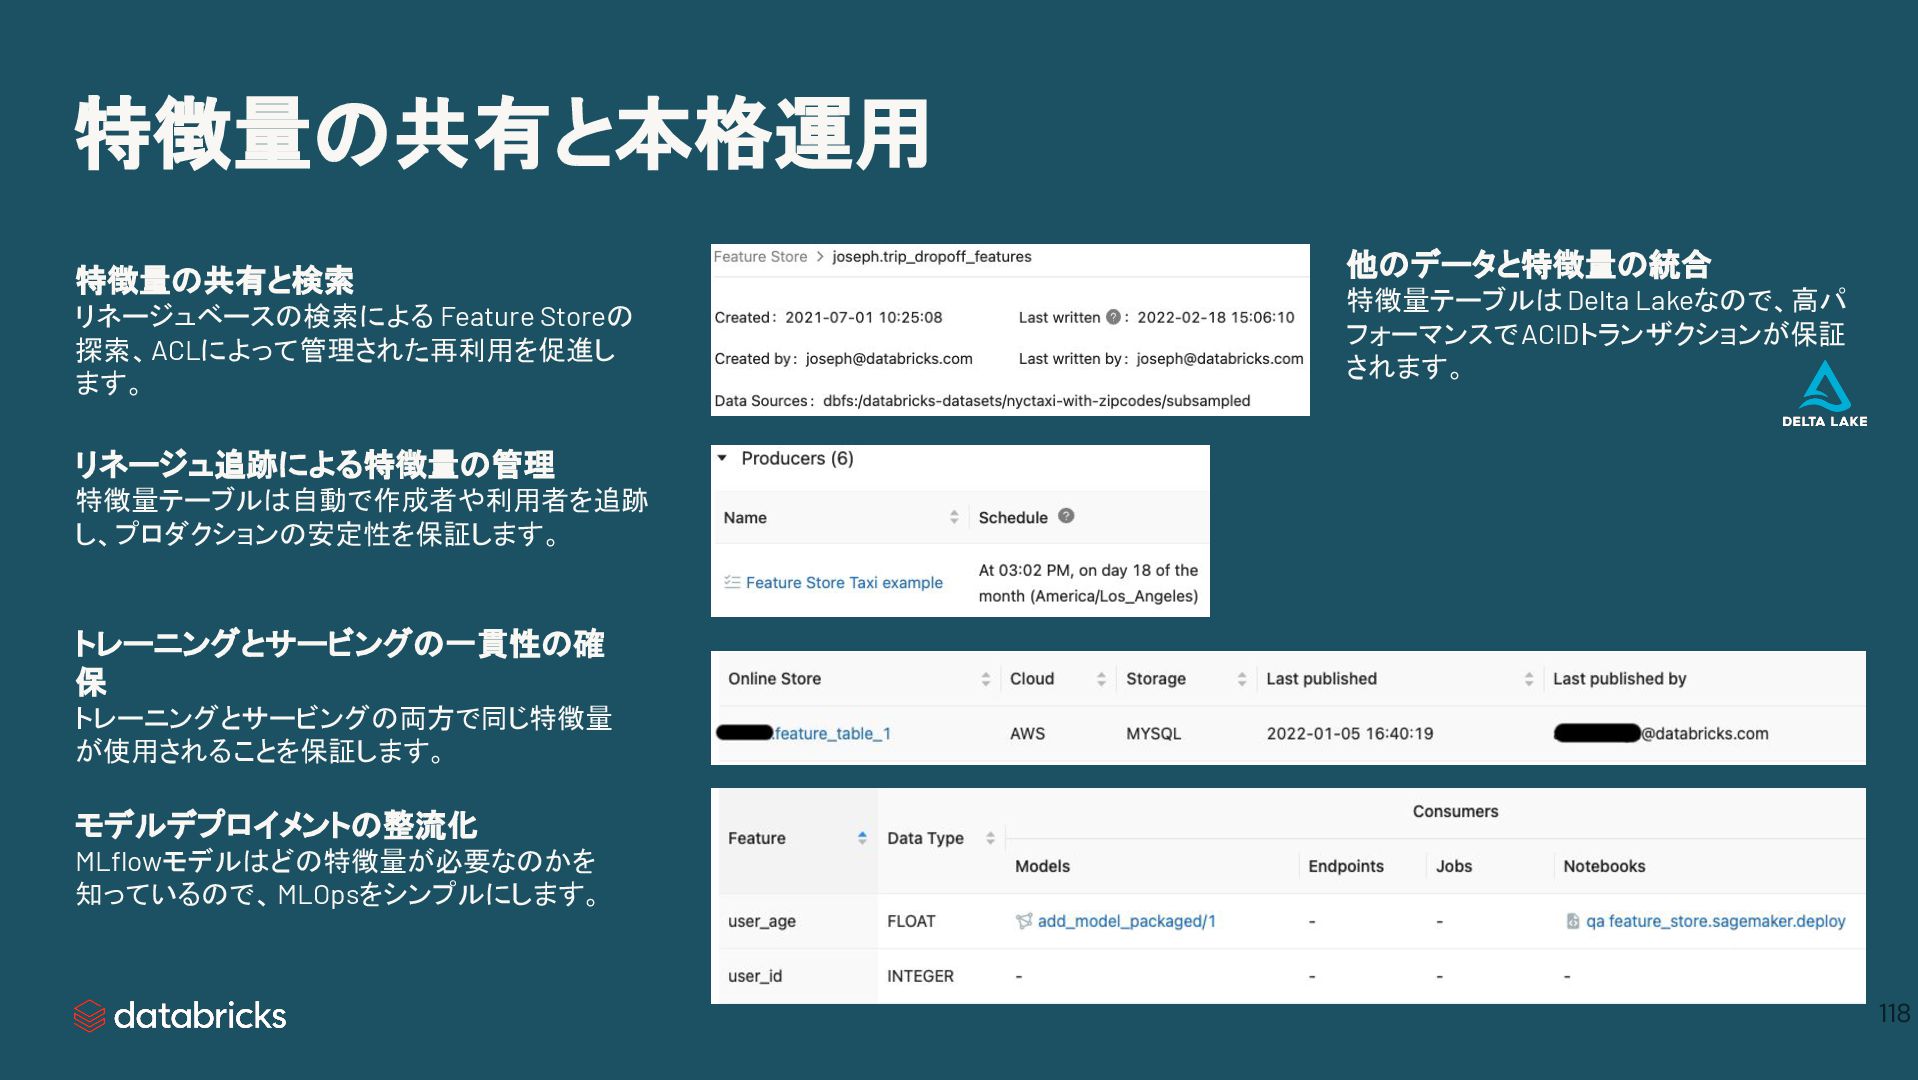
特徴量の共有と本格運用 特徴量の共有と検索 リネージュベースの検索による Feature Storeの 探索、ACLによって管理された再利用を促進し ます。 トレーニングとサービングの一貫性の確 保 トレーニングとサービングの両方で同じ特徴量
が使用されることを保証します。 モデルデプロイメントの整流化 MLflowモデルはどの特徴量が必要なのかを 知っているので、MLOpsをシンプルにします。 他のデータと特徴量の統合 特徴量テーブルはDelta Lakeなので、高パ フォーマンスでACIDトランザクションが保証 されます。 リネージュ追跡による特徴量の管理 特徴量テーブルは自動で作成者や利用者を追跡 し、プロダクションの安定性を保証します。 118 -
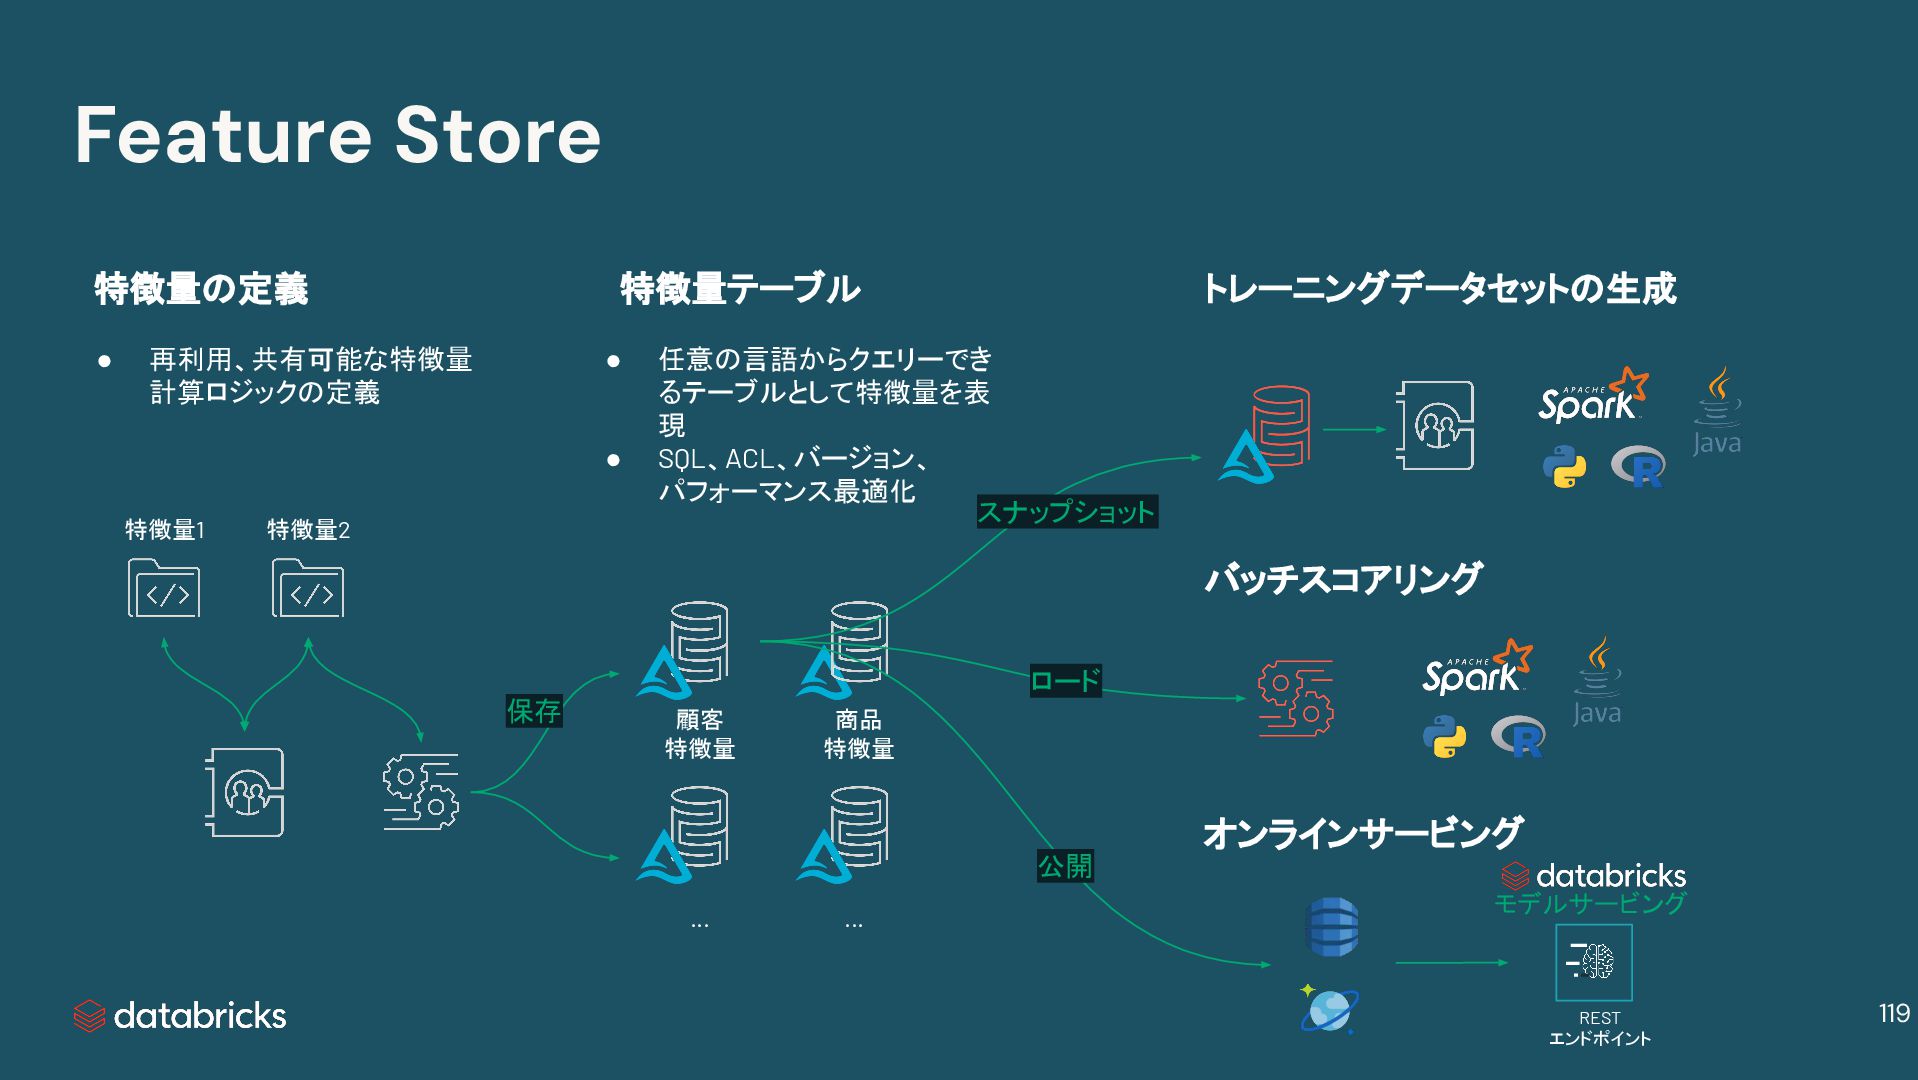
特徴量の定義 特徴量テーブル トレーニングデータセットの生成 バッチスコアリング オンラインサービング 特徴量1 特徴量2 • 再利用、共有可能な特徴量 計算ロジックの定義
顧客 特徴量 商品 特徴量 ... ... • 任意の言語からクエリーでき るテーブルとして特徴量を表 現 • SQL、ACL、バージョン、 パフォーマンス最適化 保存 REST エンドポイント モデルサービング スナップショット ロード 公開 Feature Store 119 -
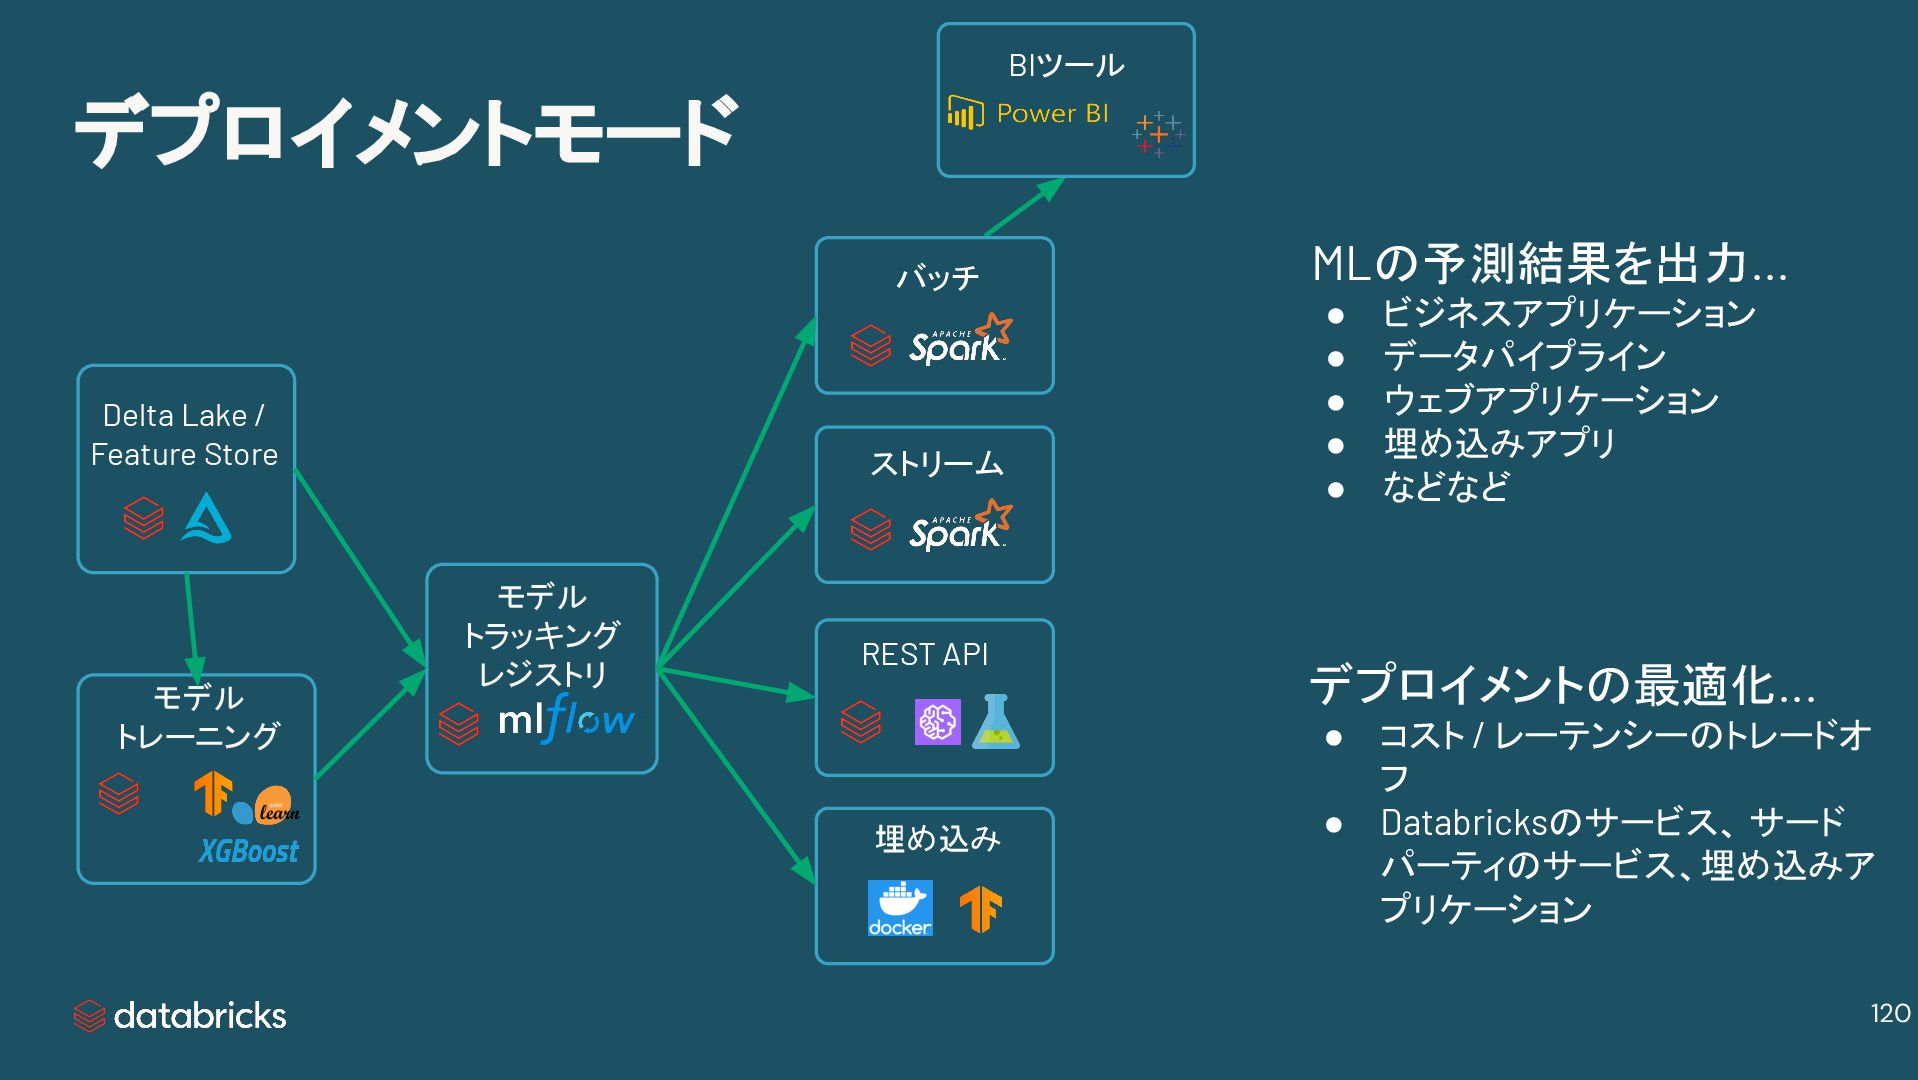
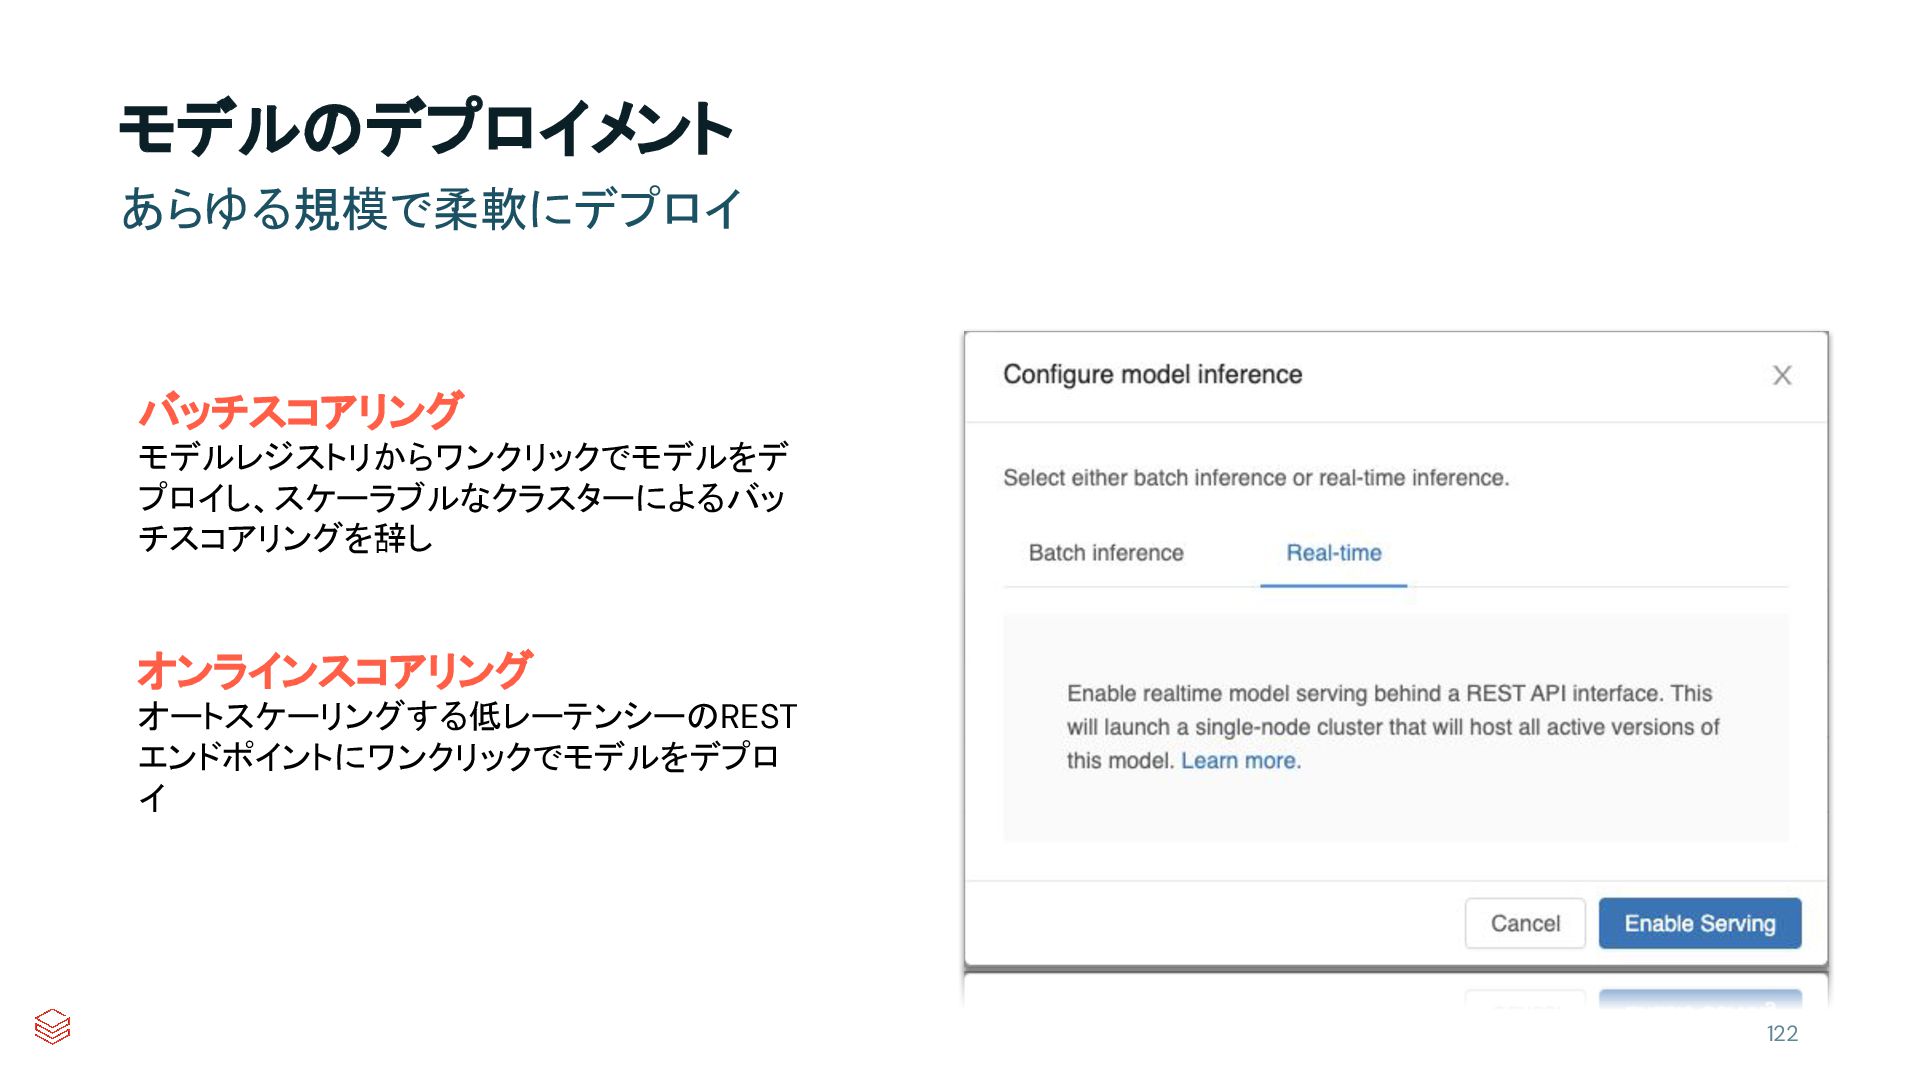
デプロイメントモード モデル トレーニング バッチ モデル トラッキング レジストリ ストリーム REST API
埋め込み Delta Lake / Feature Store BIツール MLの予測結果を出力... • ビジネスアプリケーション • データパイプライン • ウェブアプリケーション • 埋め込みアプリ • などなど デプロイメントの最適化... • コスト / レーテンシーのトレードオ フ • Databricksのサービス、 サード パーティのサービス、埋め込みア プリケーション 120 -
125 データインテリジェンスプラットフォーム ModelOps DataOps DevOps データ中心のMLプラットフォーム Unity Catalog Workflows Model
Serving Lakehouse Monitoring -
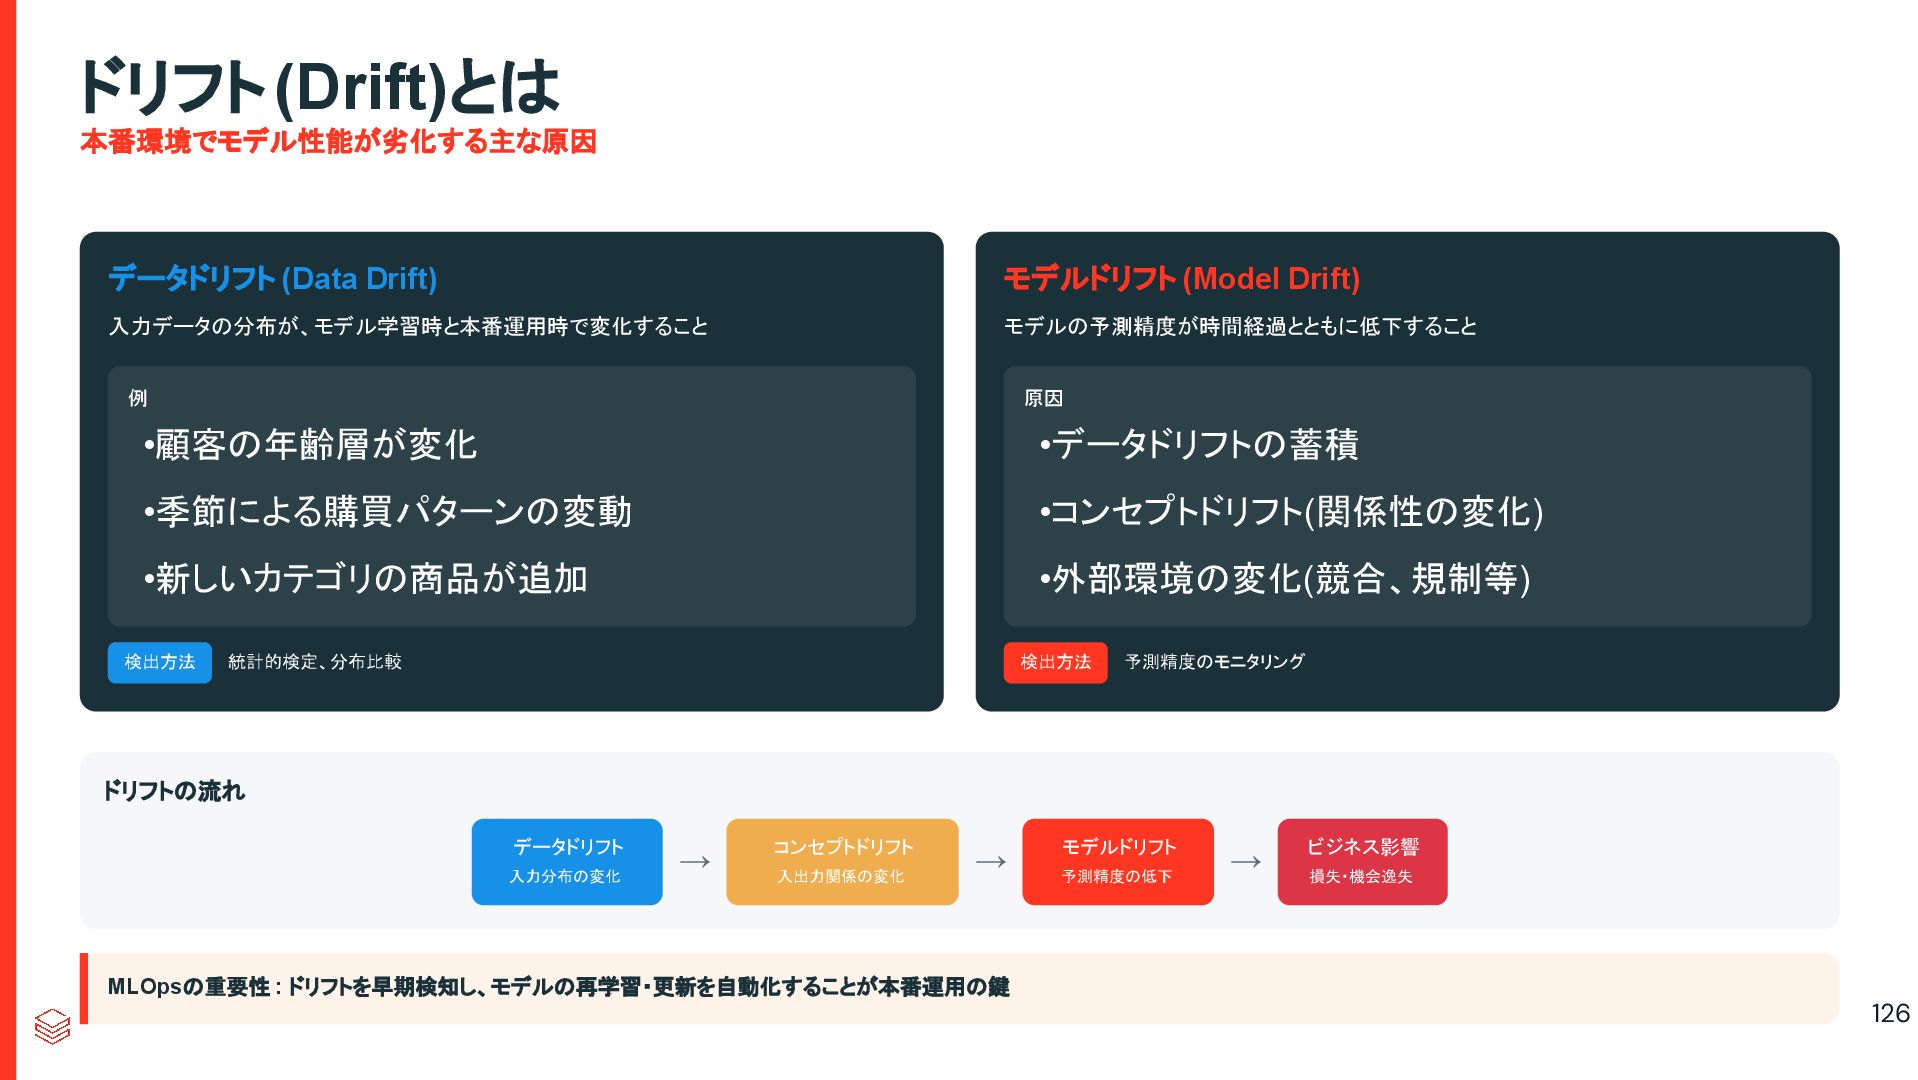
ドリフト(Drift)とは 本番環境でモデル性能が劣化する主な原因 データドリフト (Data Drift) 入力データの分布が、モデル学習時と本番運用時で変化すること 例 •顧客の年齢層が変化 •季節による購買パターンの変動 •新しいカテゴリの商品が追加
検出方法 統計的検定、分布比較 モデルドリフト (Model Drift) モデルの予測精度が時間経過とともに低下すること 原因 •データドリフトの蓄積 •コンセプトドリフト(関係性の変化) •外部環境の変化(競合、規制等) 検出方法 予測精度のモニタリング ドリフトの流れ データドリフト 入力分布の変化 → コンセプトドリフト 入出力関係の変化 → モデルドリフト 予測精度の低下 → ビジネス影響 損失・機会逸失 MLOpsの重要性 : ドリフトを早期検知し、モデルの再学習・更新を自動化することが本番運用の鍵 126 -
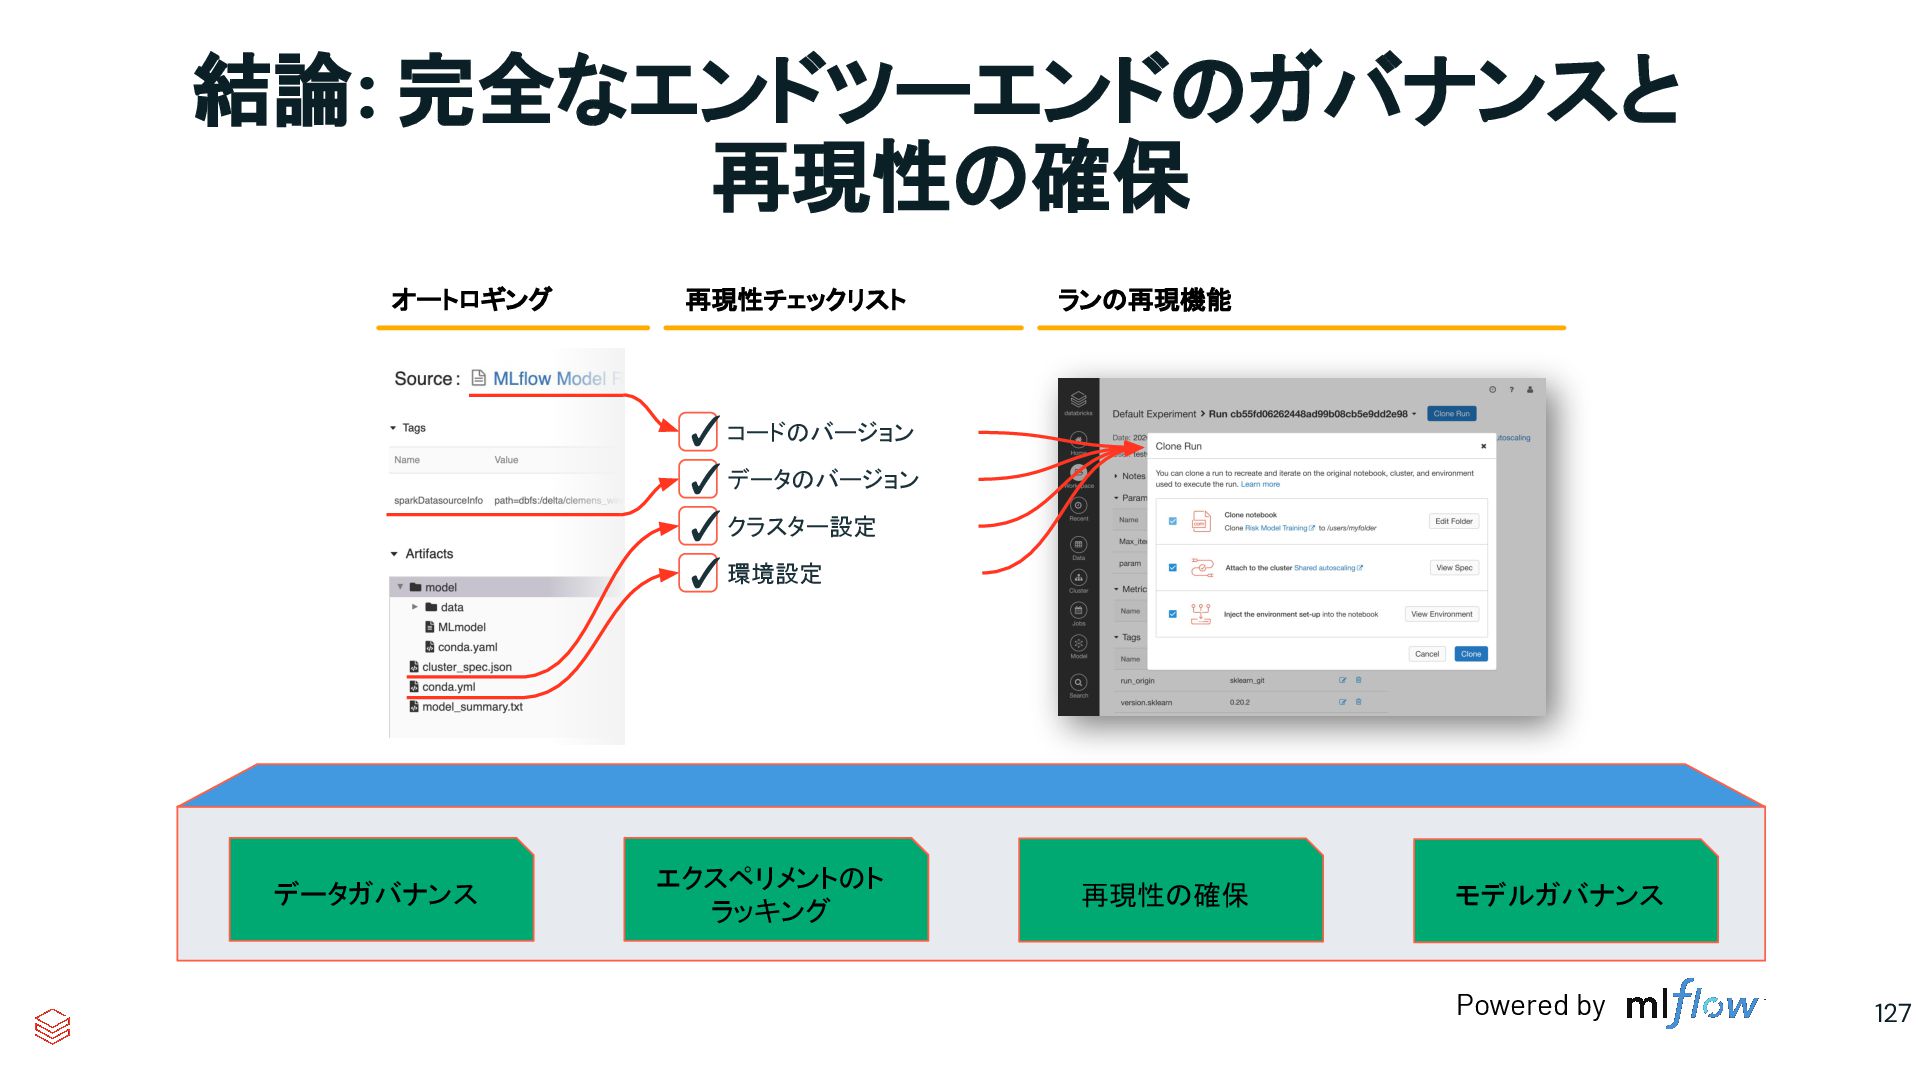
コードのバージョン データのバージョン クラスター設定 環境設定 オートロギング 再現性チェックリスト ランの再現機能 データガバナンス エクスペリメントのト ラッキング
再現性の確保 モデルガバナンス Powered by ✓ ✓ ✓ ✓ 結論: 完全なエンドツーエンドのガバナンスと 再現性の確保 127 -
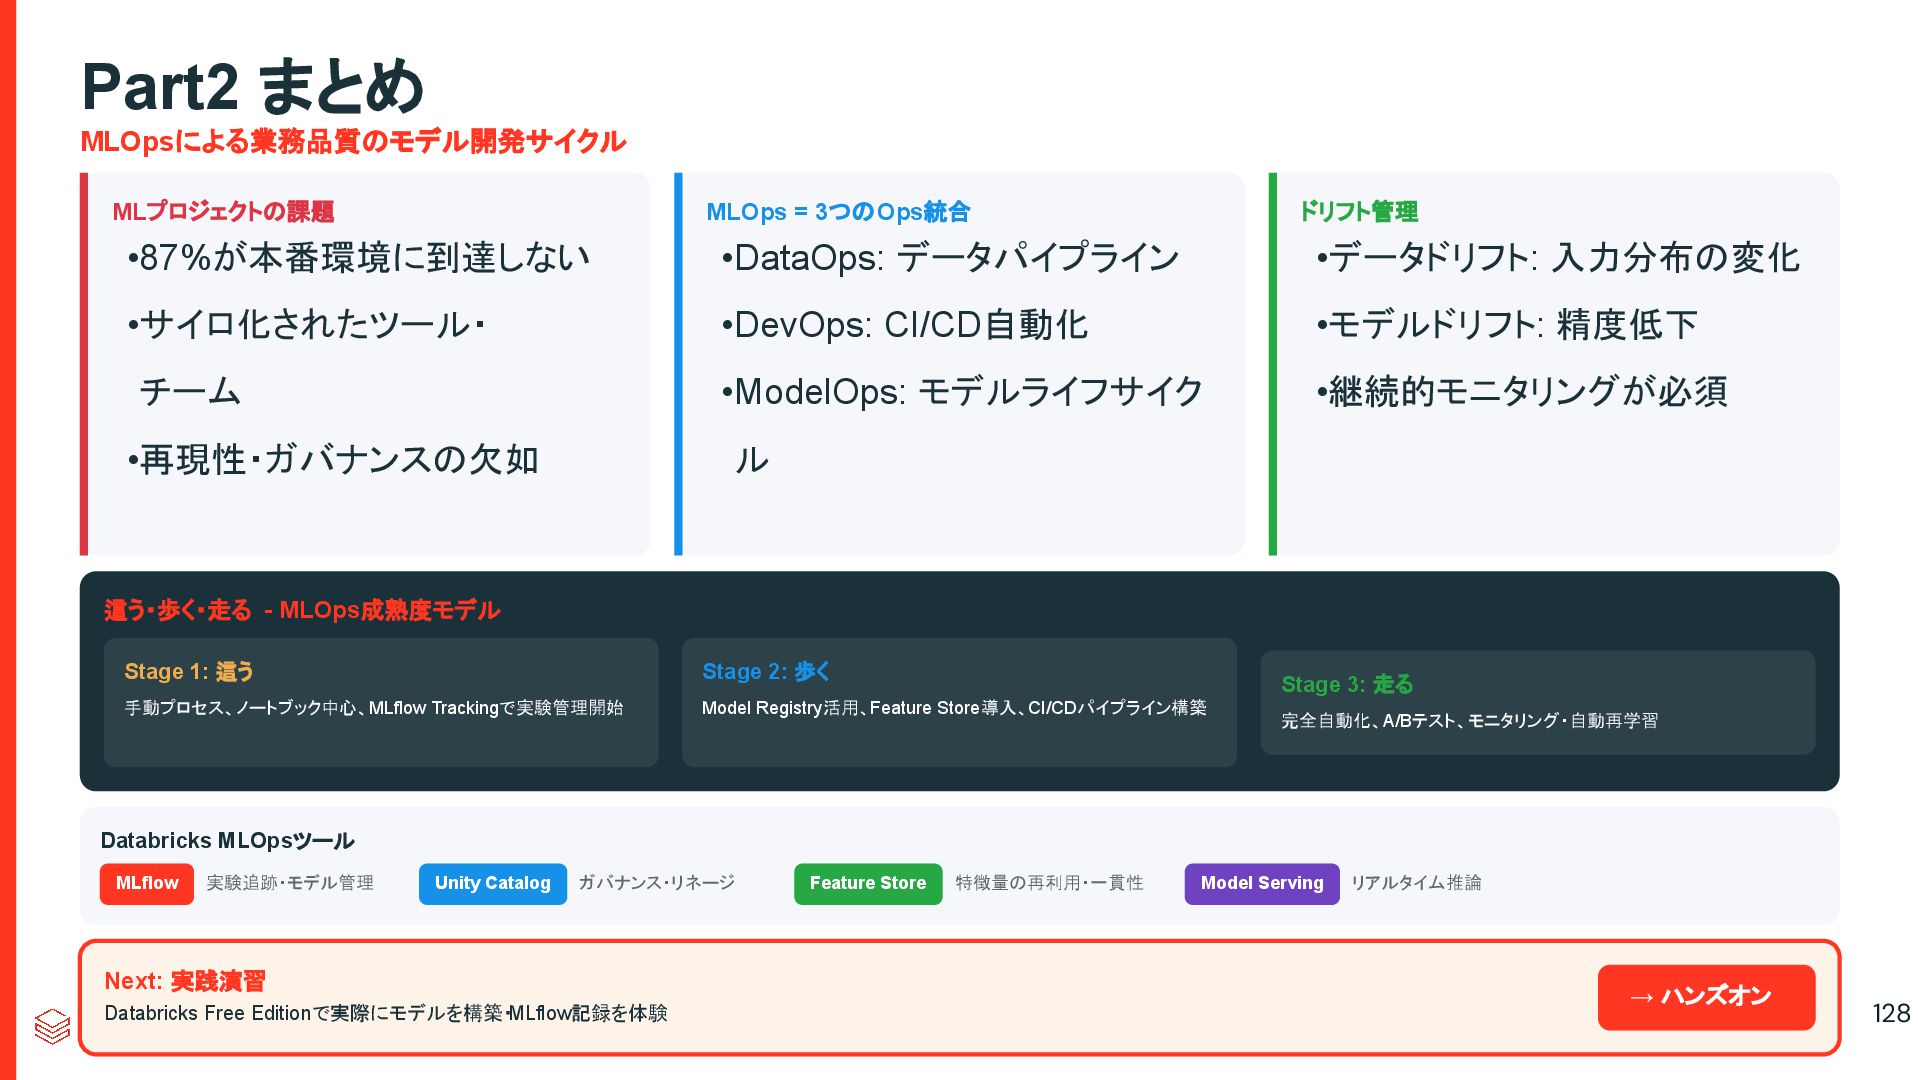
Part2 まとめ MLOpsによる業務品質のモデル開発サイクル MLプロジェクトの課題 •87%が本番環境に到達しない •サイロ化されたツール・ チーム •再現性・ガバナンスの欠如 MLOps =
3つのOps統合 •DataOps: データパイプライン •DevOps: CI/CD自動化 •ModelOps: モデルライフサイク ル ドリフト管理 •データドリフト: 入力分布の変化 •モデルドリフト: 精度低下 •継続的モニタリングが必須 這う・歩く・走る - MLOps成熟度モデル Stage 1: 這う 手動プロセス、ノートブック中心、MLflow Trackingで実験管理開始 Stage 2: 歩く Model Registry活用、Feature Store導入、CI/CDパイプライン構築 Stage 3: 走る 完全自動化、A/Bテスト、モニタリング・自動再学習 Databricks MLOpsツール MLflow 実験追跡・モデル管理 Unity Catalog ガバナンス・リネージ Feature Store 特徴量の再利用・一貫性 Model Serving リアルタイム推論 Next: 実践演習 Databricks Free Editionで実際にモデルを構築・ MLflow記録を体験 → ハンズオン 128 -
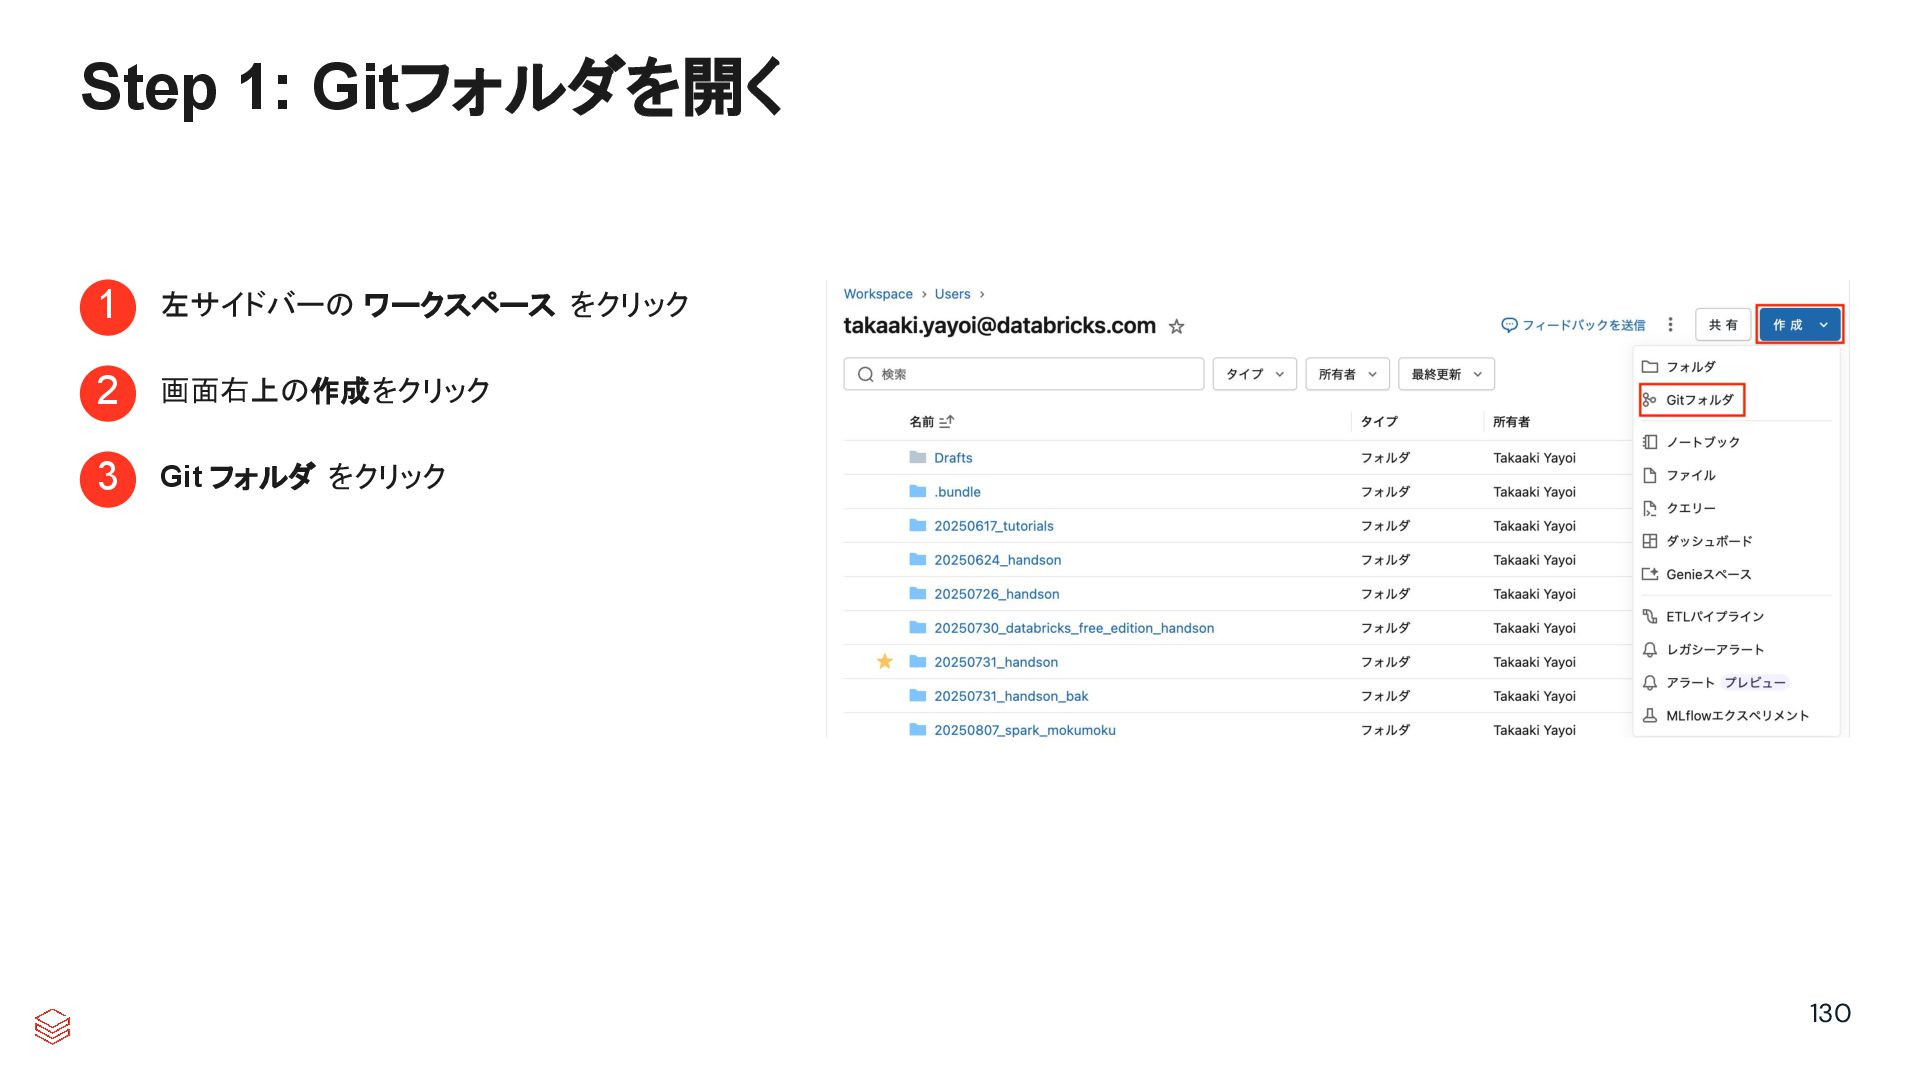
Step 1: Gitフォルダを開く 1 左サイドバーの ワークスペース をクリック 2 画面右上の作成をクリック 3
Git フォルダ をクリック 130 -
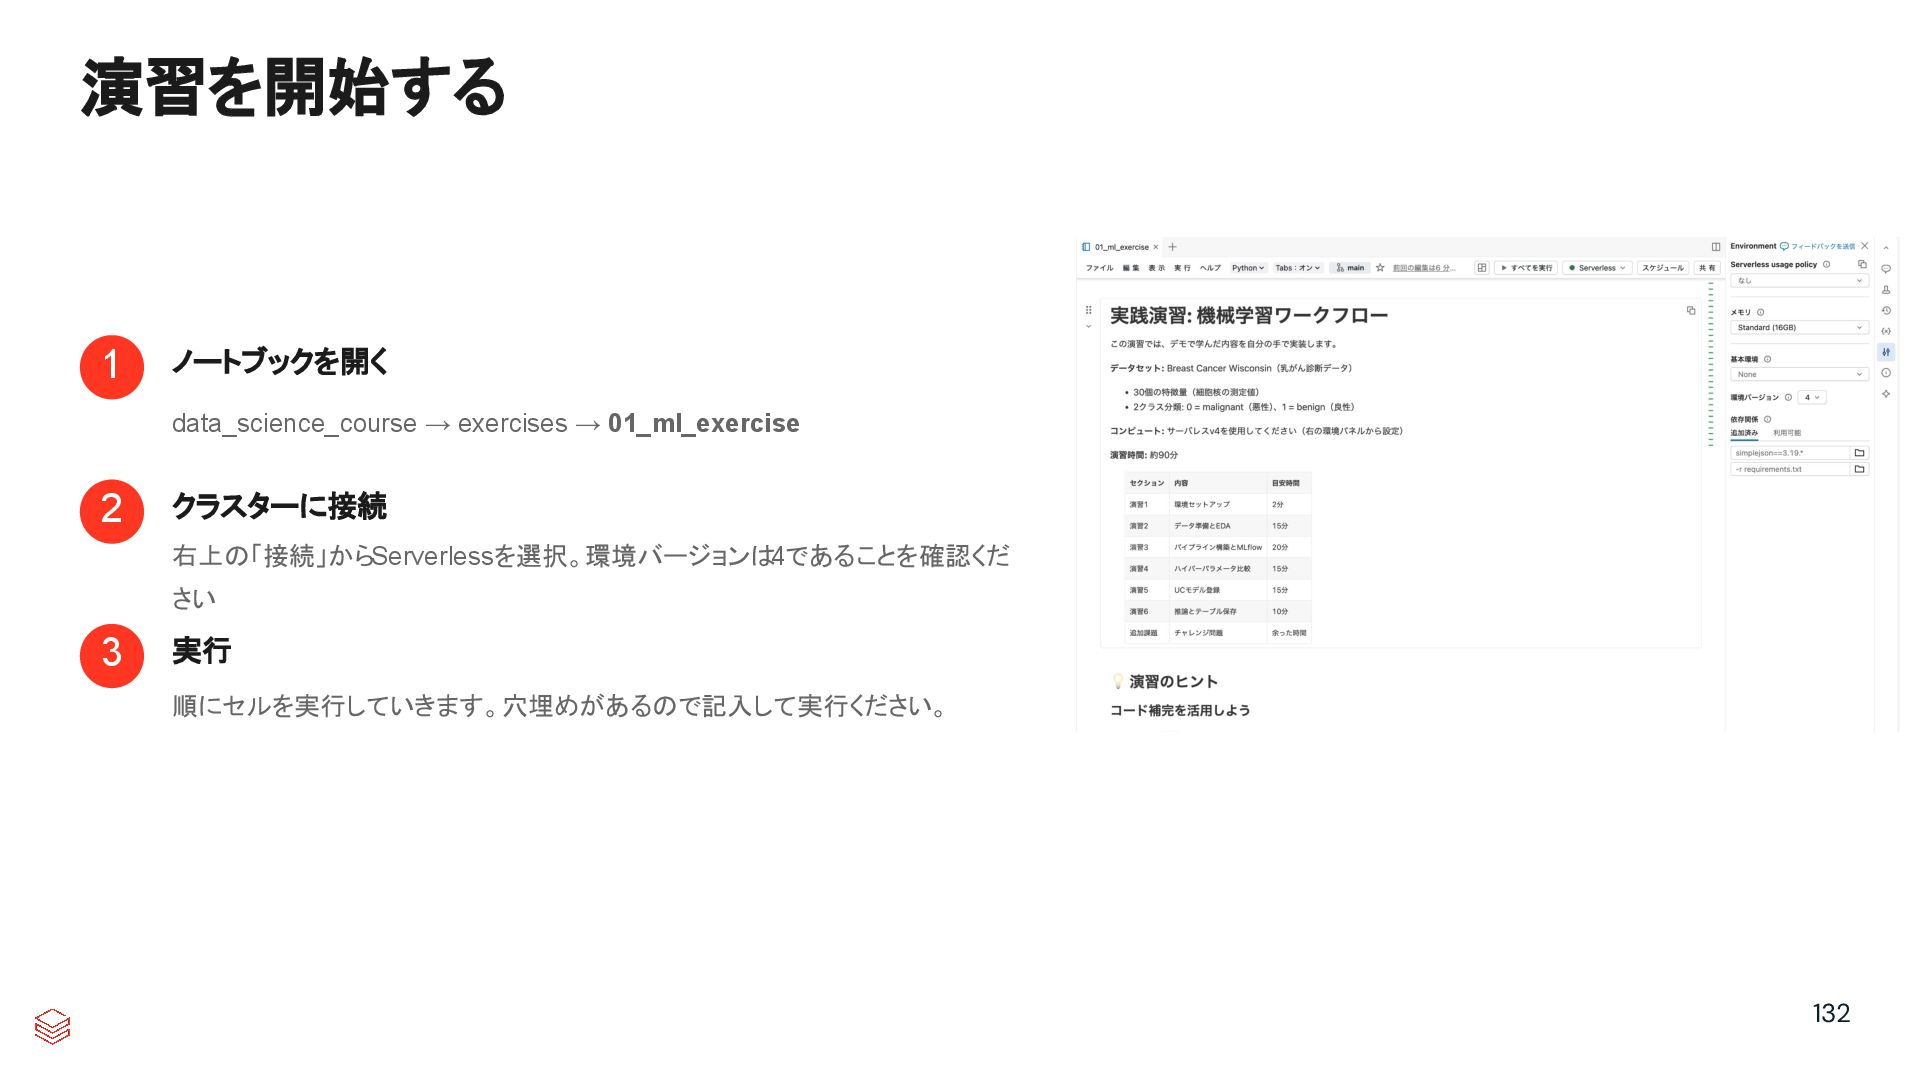
演習を開始する 1 ノートブックを開く data_science_course → exercises → 01_ml_exercise 2 クラスターに接続
右上の「接続」からServerlessを選択。環境バージョンは 4であることを確認くだ さい 3 実行 順にセルを実行していきます。穴埋めがあるので記入して実行ください。 132 -
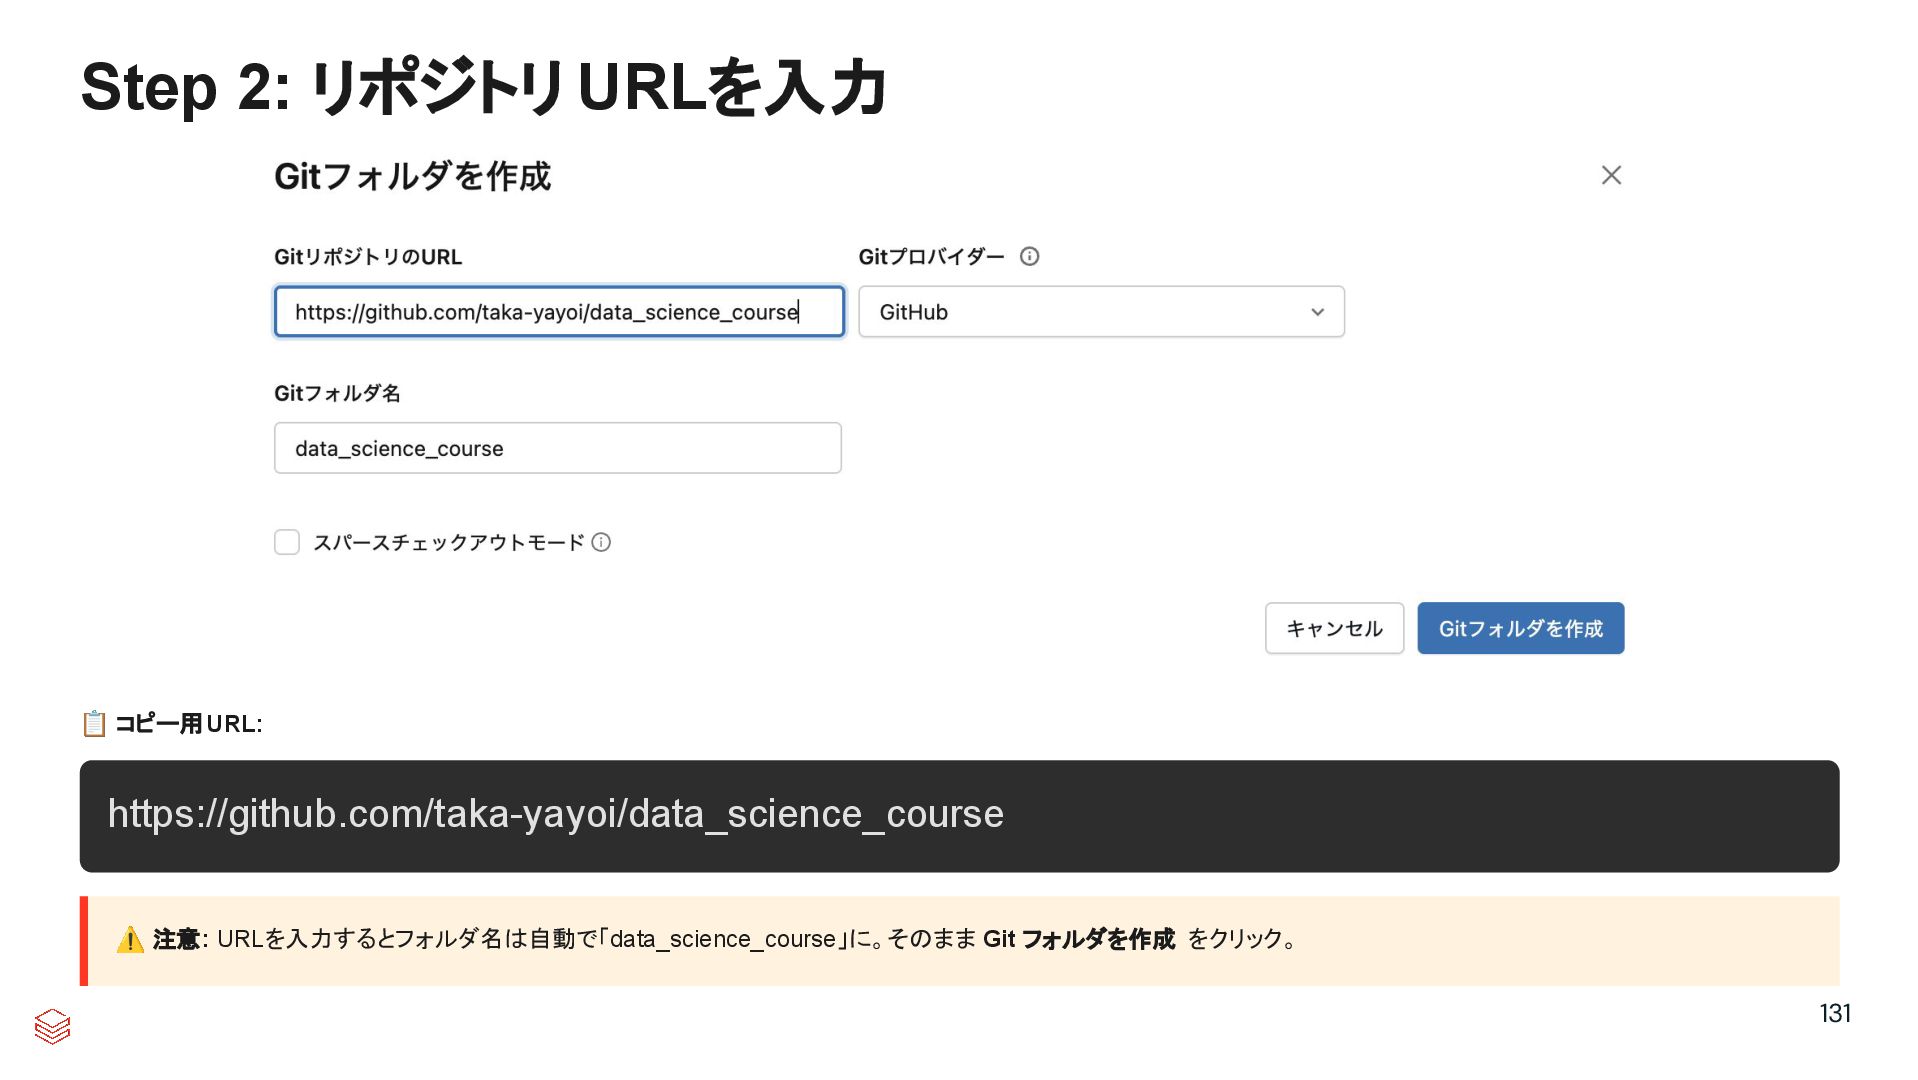
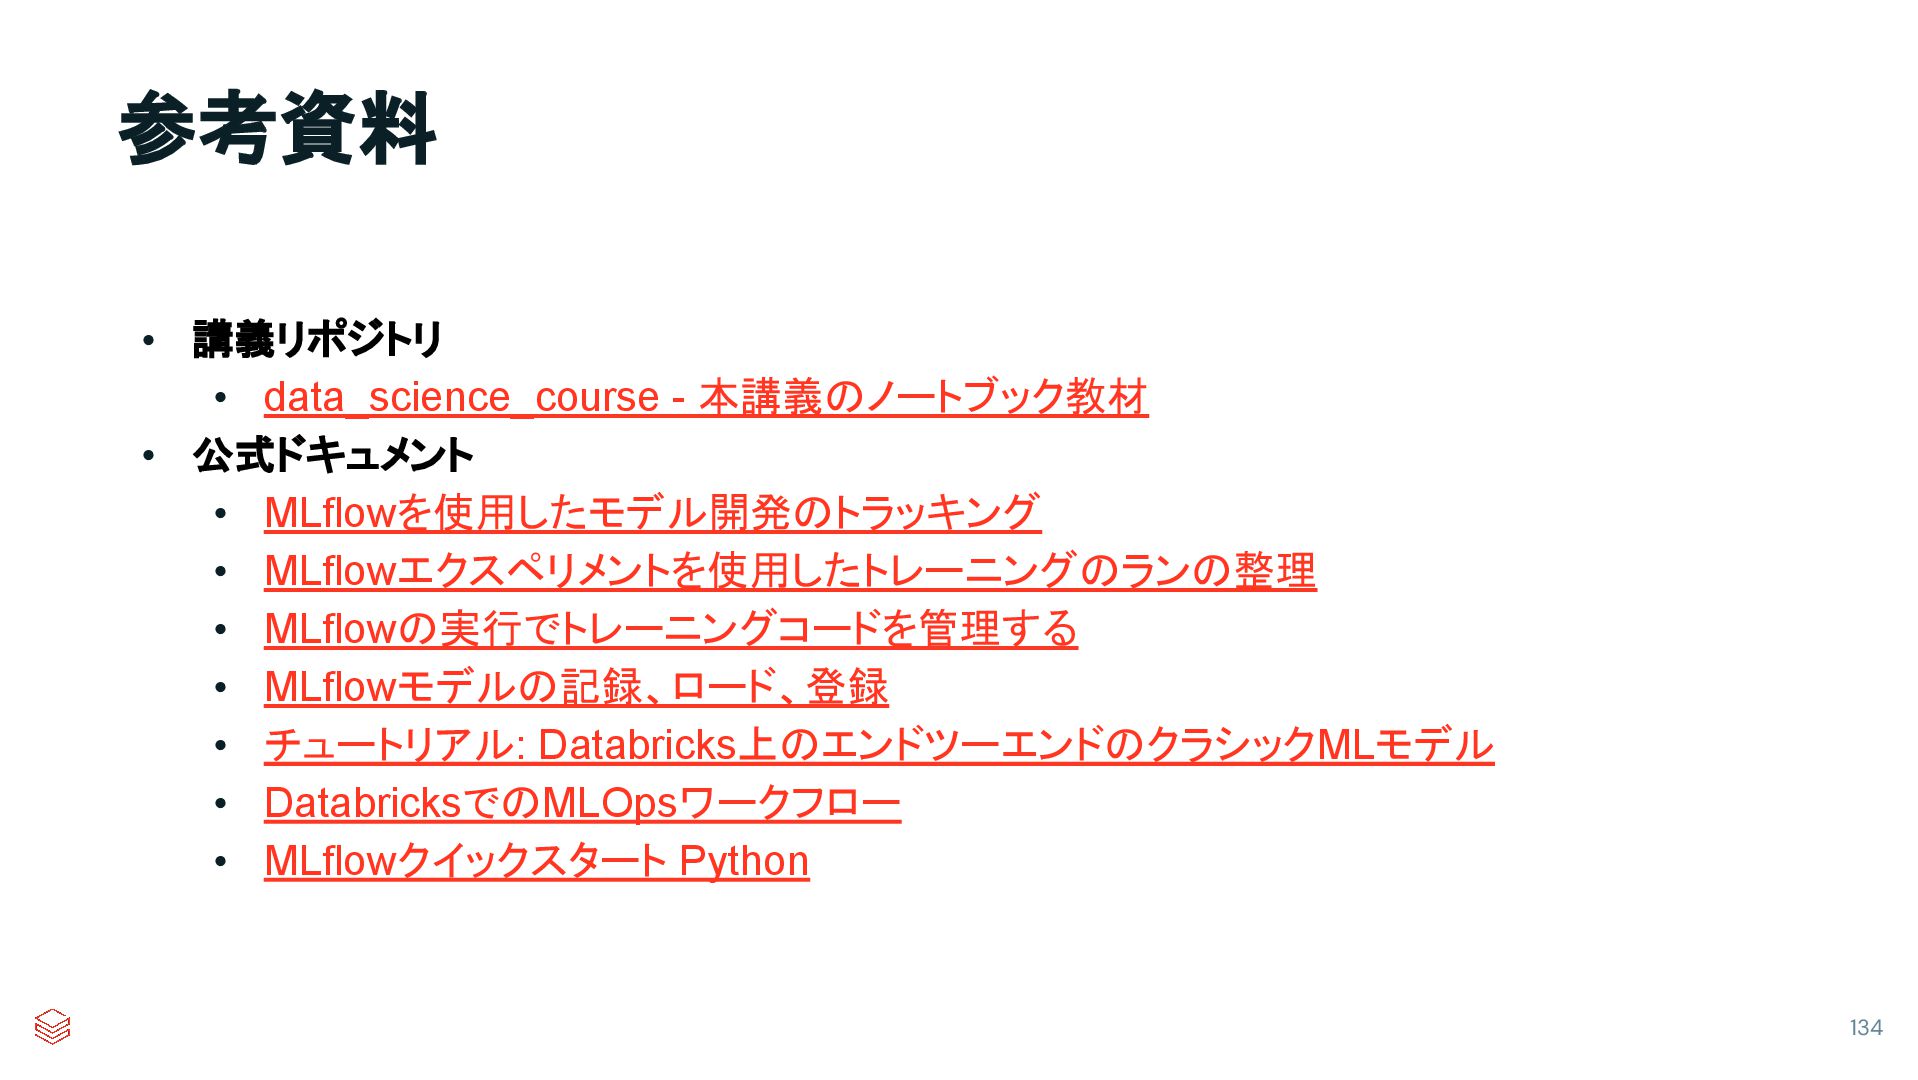
参考資料 134 • 講義リポジトリ • data_science_course - 本講義のノートブック教材 • 公式ドキュメント
• MLflowを使用したモデル開発のトラッキング • MLflowエクスペリメントを使用したトレーニングのランの整理 • MLflowの実行でトレーニングコードを管理する • MLflowモデルの記録、ロード、登録 • チュートリアル: Databricks上のエンドツーエンドのクラシックMLモデル • DatabricksでのMLOpsワークフロー • MLflowクイックスタート Python -
参考資料 135 • Qiita記事(機械学習・ MLflow基礎) • [2024年版] Databricksにおける機械学習モデル構築のエンドツーエンドのサンプル • MLflowのご紹介:オープンソース機械学習プラットフォーム
• Databricksにおける機械学習トレーニングのトラッキング • Databricksの機械学習モデルの自動ロギング • Delta LakeとMLflowによる機械学習の本格運用 • Qiita記事(モデルレジストリ・モデル管理 ) • Unity Catalogにおけるモデルライフサイクルの管理 • Unity Catalogでの機械学習モデル管理が捗りそうな件 • DatabricksにおけるMLflowモデルレジストリ • Databricksにおける機械学習モデルの管理 • Databricksにおけるモデルサービング
 taka_aki
 harutiro
 sergicalsix
 sansantech
 masasuzu
 knwoop
 wind111
 kintotechdev
 oidfj
 sioncojp
 yappli_developers
 sat
 michielstock
 quramy
 rmw
 lemiorhan
 mclloyd
 tammyeverts
 jlugia
 ivargrimstad
 palkan
 aemeredith
 morganepeng