Databricks Free Edition講座 データエンジニアリング編
Sponsored
·
 SiteGround - Reliable hosting with speed, security, and support you can count on.
→
SiteGround - Reliable hosting with speed, security, and support you can count on.
→

Share
Embed

Transcript
109 slides
-
自己紹介 弥生 隆明 (やよい たかあき) シニア スペシャリスト ソリューションアーキテクト ▪ 2020年からデータブリックス
ジャパンにお いて、プレセールス、POCに従事 ▪ 生成AI、データエンジニアリング、 アプリが専門領域です。 ▪ 前職はコンサル、総合電機メーカー にてデータ分析・Webサービス構築 などに従事。インド赴任経験あり。 ▪ Databricks Certified (Data Engineer | Machine Learning) Professional, Generative AI Engineer Associate ▪ Qiitaでいろいろ書いています。 2 @taka_aki -
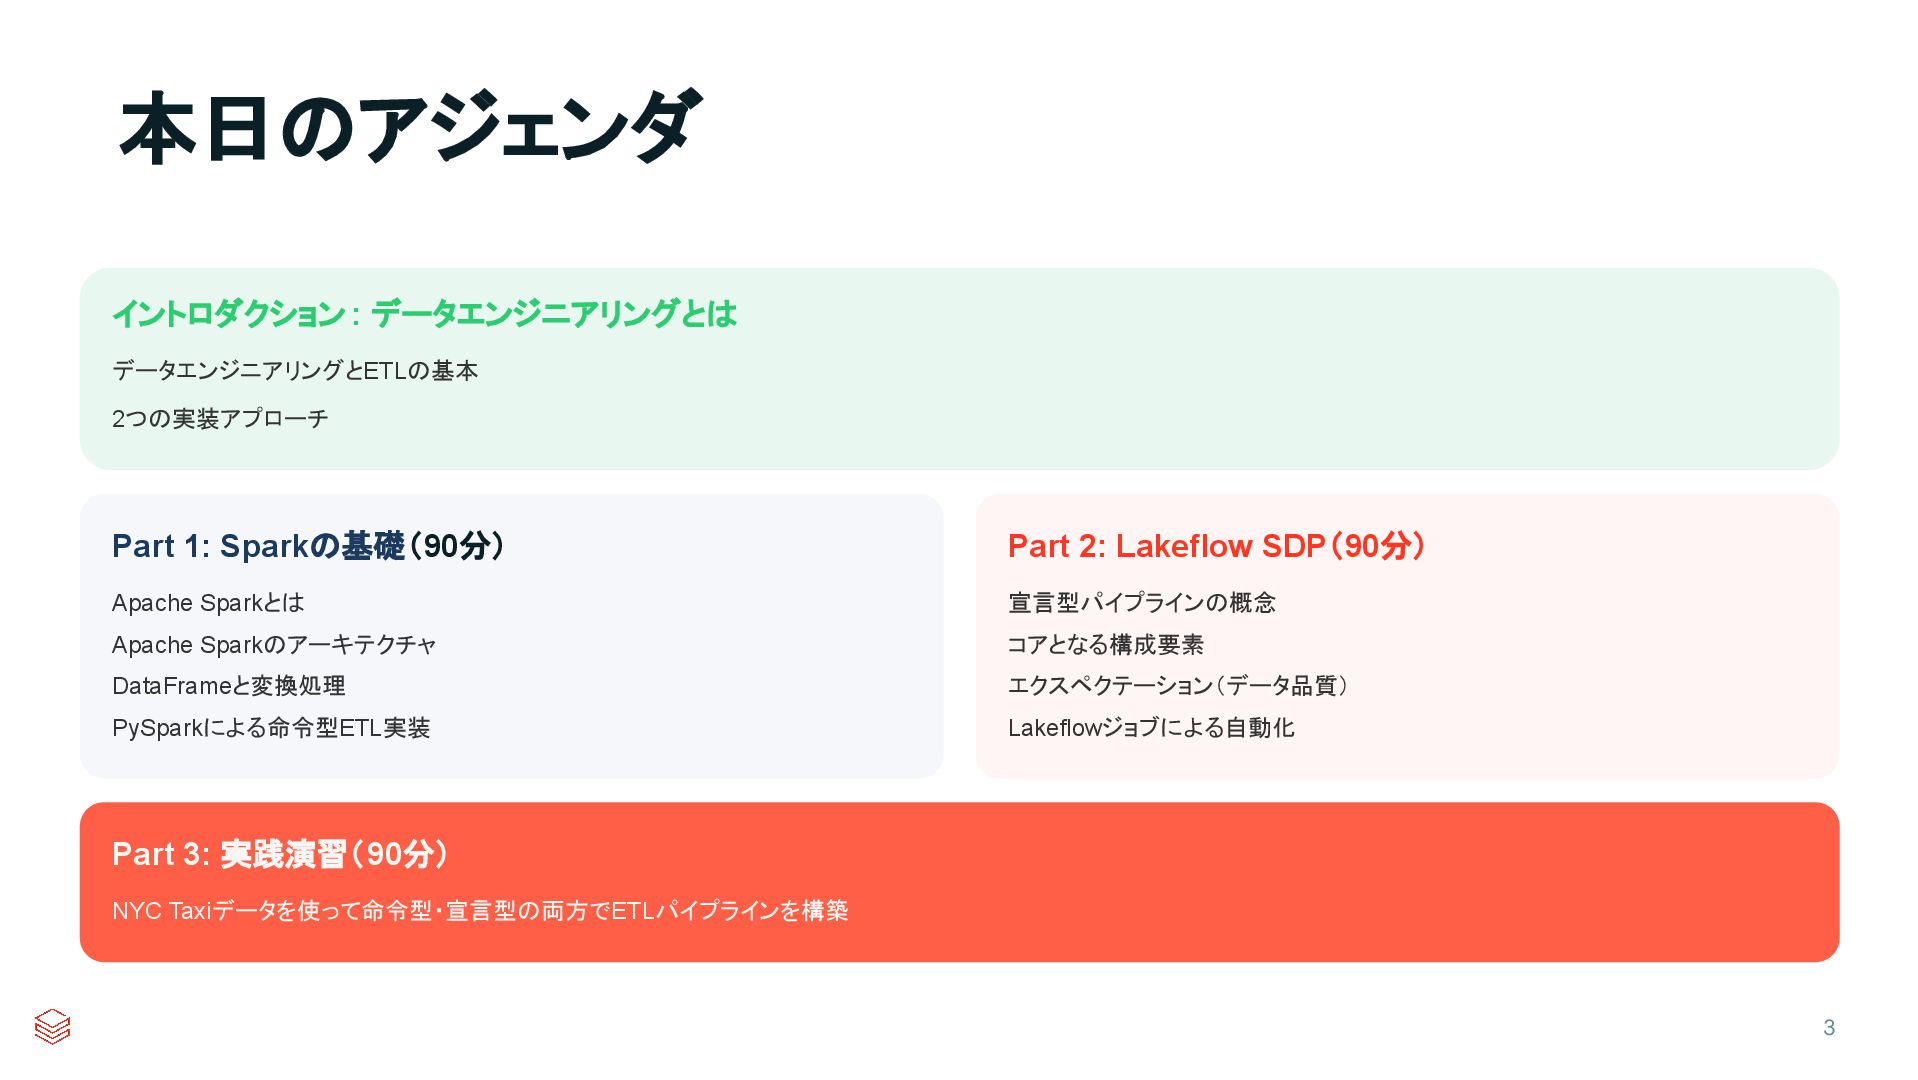
Part 1: Sparkの基礎(90分) Apache Sparkとは Apache Sparkのアーキテクチャ DataFrameと変換処理 PySparkによる命令型ETL実装 Part
2: Lakeflow SDP(90分) 宣言型パイプラインの概念 コアとなる構成要素 エクスペクテーション(データ品質) Lakeflowジョブによる自動化 Part 3: 実践演習(90分) NYC Taxiデータを使って命令型・宣言型の両方でETLパイプラインを構築 本日のアジェンダ イントロダクション : データエンジニアリングとは 2つの実装アプローチ データエンジニアリングとETLの基本 3 -
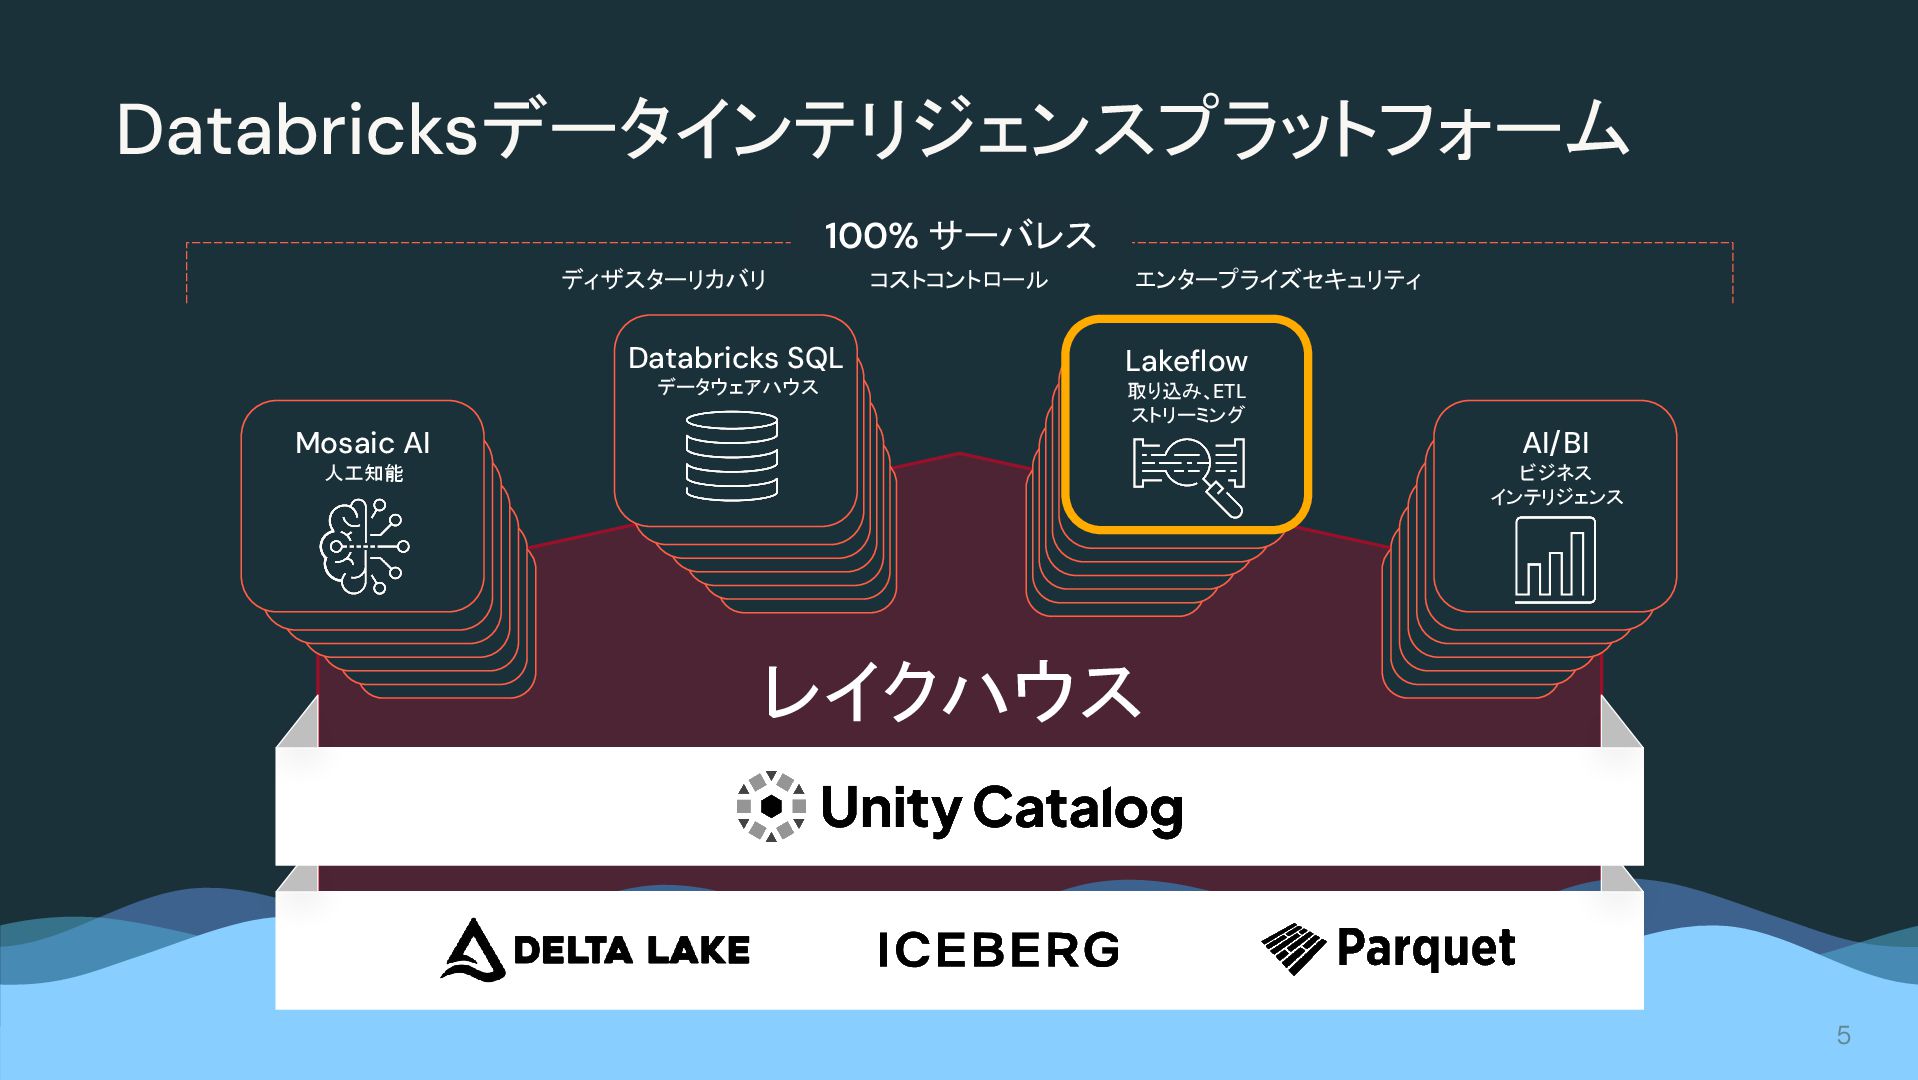
ディザスターリカバリ コストコントロール エンタープライズセキュリティ 100% サーバレス レイクハウス AI/BI ビジネス インテリジェンス Databricks
SQL データウェアハウス Lakeflow 取り込み、ETL ストリーミング Mosaic AI 人工知能 Databricksデータインテリジェンスプラットフォーム 5 -
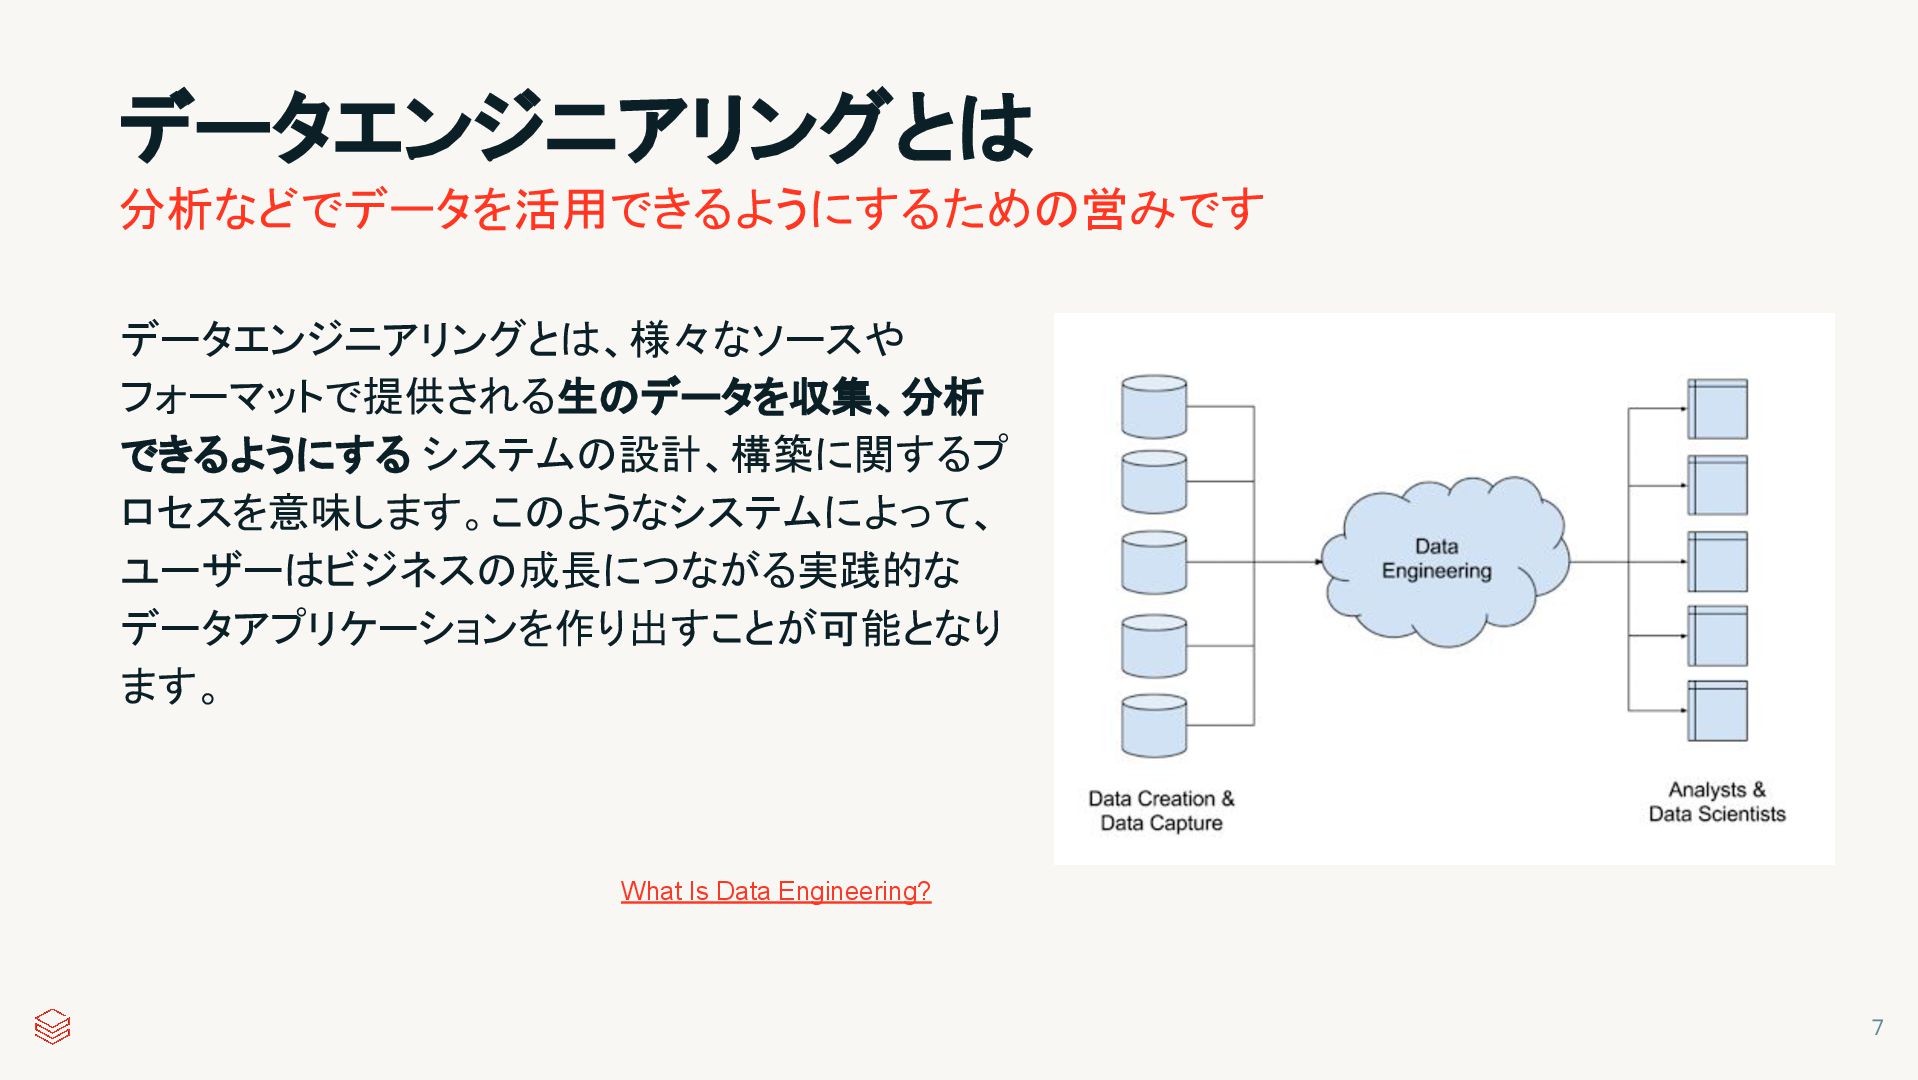
データエンジニアリングとは データエンジニアリングとは、様々なソースや フォーマットで提供される生のデータを収集、分析 できるようにする システムの設計、構築に関するプ ロセスを意味します。このようなシステムによって、 ユーザーはビジネスの成長につながる実践的な データアプリケーションを作り出すことが可能となり ます。 7
What Is Data Engineering? 分析などでデータを活用できるようにするための営みです -
データエンジニアリングとは 企業の規模に関係なく、すべての企業が重要なビジネス上の質問に回答するために調査 する必要がある膨大な量の様々なデータを所有 しています。データエンジニアリングは、 アナリスト、データサイエンティスト、エグゼクティブのようなデータ利用者がすべてのデータを信 頼しながら、クイックかつセキュアに調査できるようにするためのプロセスをサポートすることを目 的としています。 データが様々なテクノロジーによって管理され、多様な構造で格納 されているため、 データアナリストは課題に直面にしています。さらに、分析で使用するツールはデータが同じテク
ノロジーで管理され、同じ構造で格納されていることを前提としています。 What Is Data Engineering? 8 なぜ、データエンジニアリングが重要なのでしょうか? -
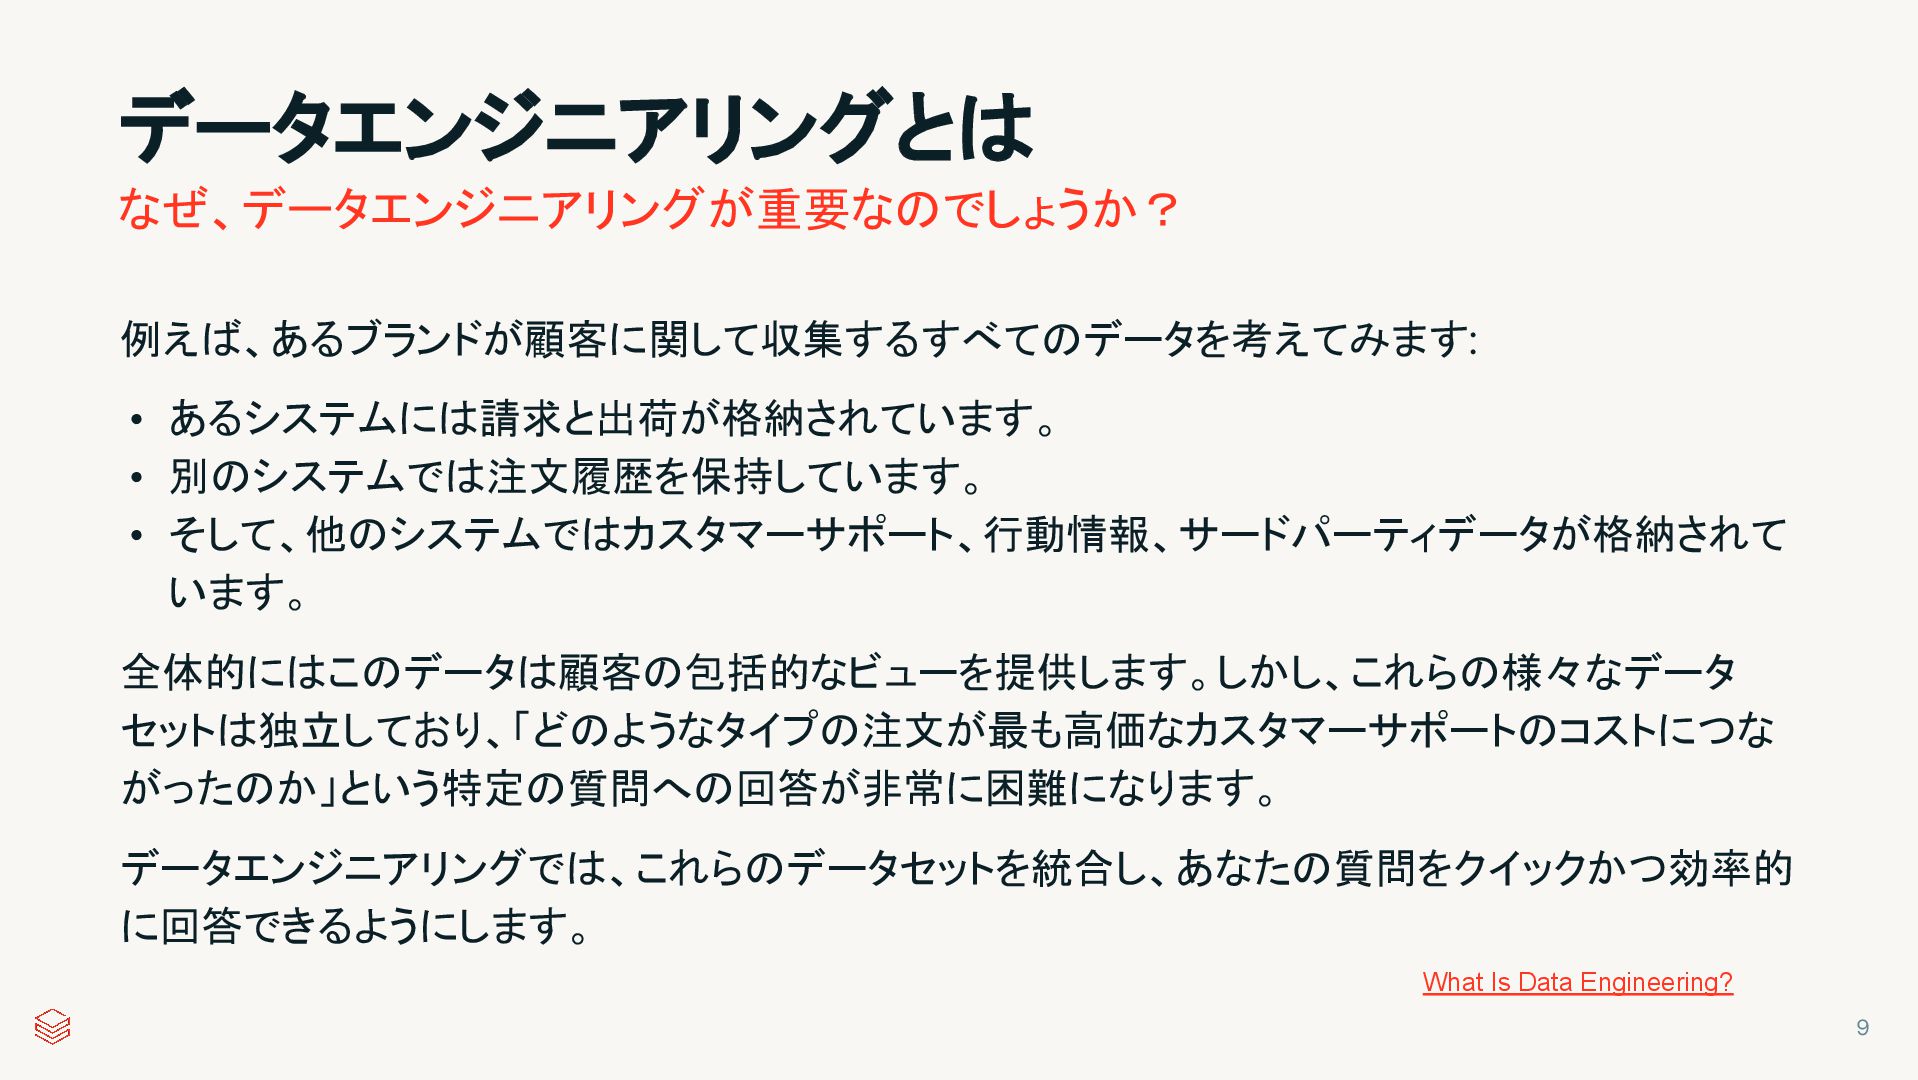
データエンジニアリングとは 例えば、あるブランドが顧客に関して収集するすべてのデータを考えてみます: • あるシステムには請求と出荷が格納されています。 • 別のシステムでは注文履歴を保持しています。 • そして、他のシステムではカスタマーサポート、行動情報、サードパーティデータが格納されて います。 全体的にはこのデータは顧客の包括的なビューを提供します。しかし、これらの様々なデータ
セットは独立しており、「どのようなタイプの注文が最も高価なカスタマーサポートのコストにつな がったのか」という特定の質問への回答が非常に困難になります。 データエンジニアリングでは、これらのデータセットを統合し、あなたの質問をクイックかつ効率的 に回答できるようにします。 What Is Data Engineering? 9 なぜ、データエンジニアリングが重要なのでしょうか? -
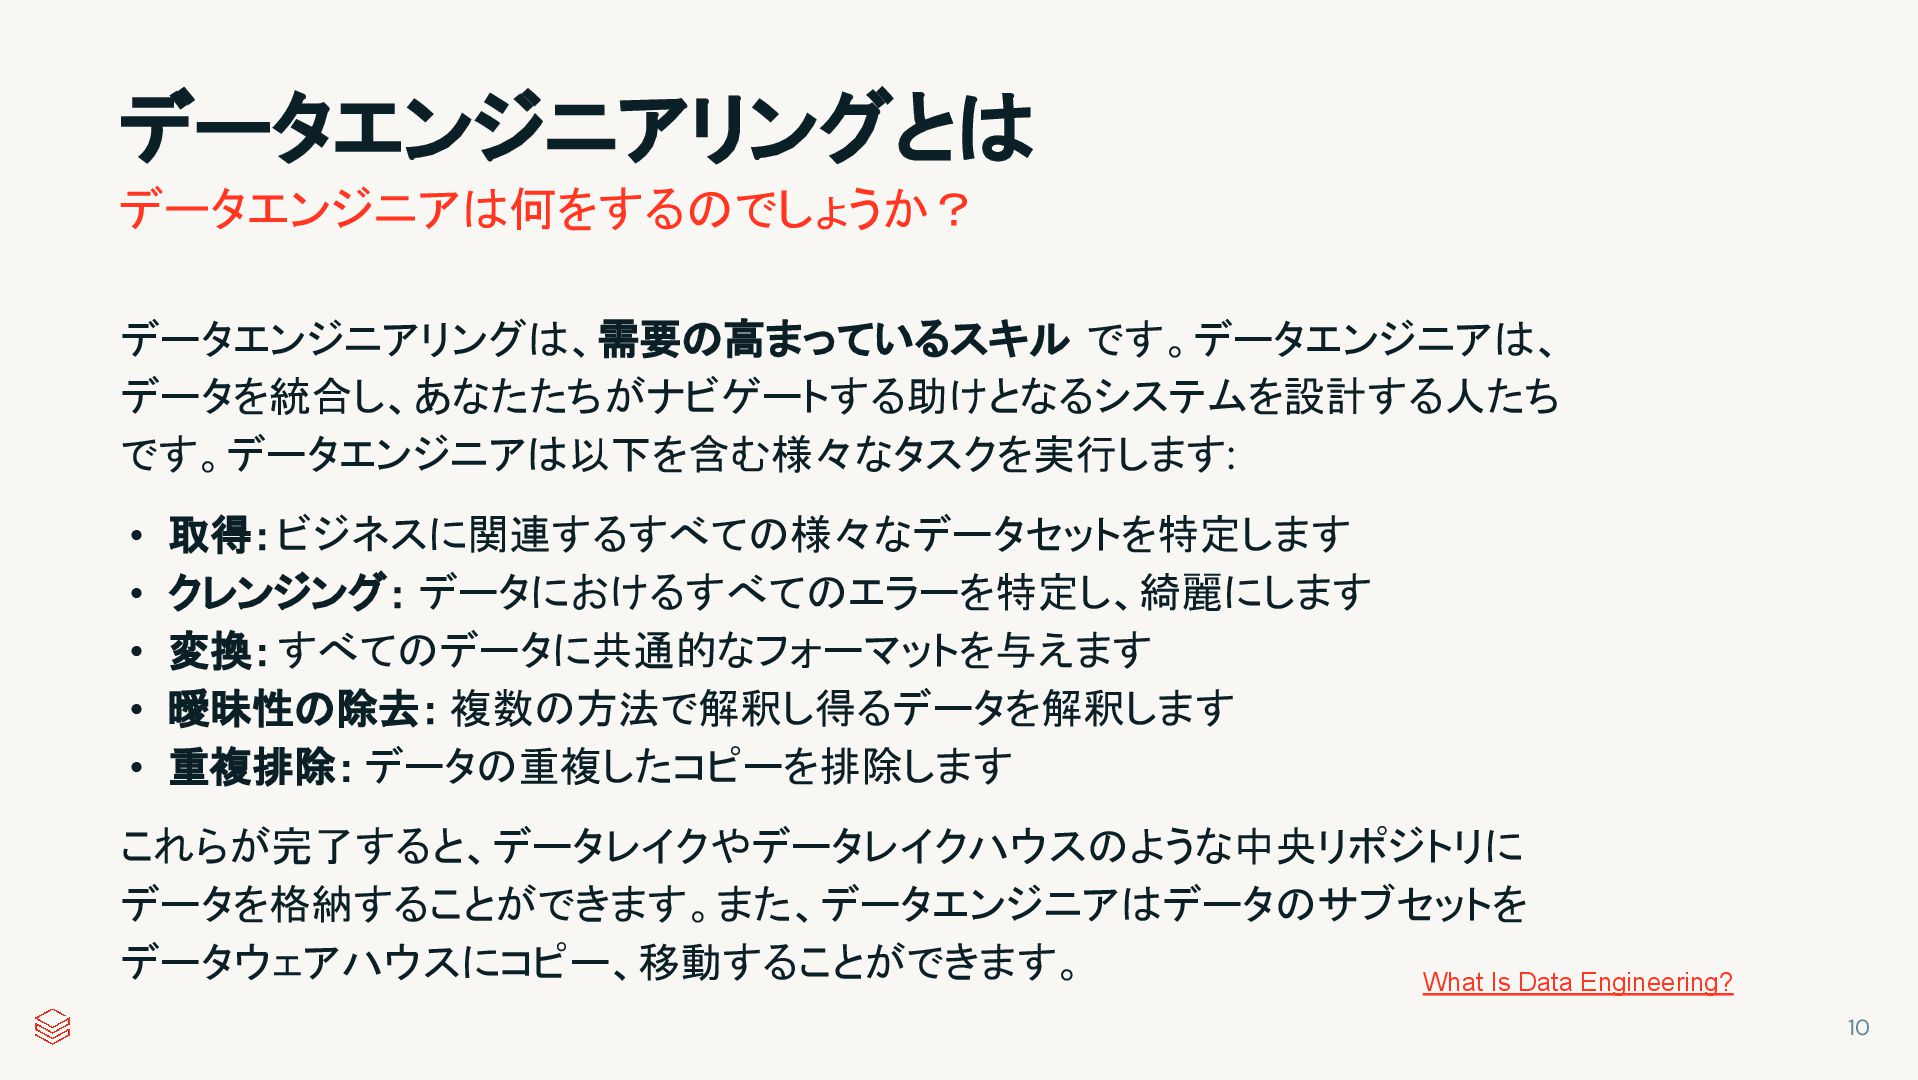
データエンジニアリングとは データエンジニアリングは、需要の高まっているスキル です。データエンジニアは、 データを統合し、あなたたちがナビゲートする助けとなるシステムを設計する人たち です。データエンジニアは以下を含む様々なタスクを実行します: • 取得:ビジネスに関連するすべての様々なデータセットを特定します • クレンジング: データにおけるすべてのエラーを特定し、綺麗にします
• 変換:すべてのデータに共通的なフォーマットを与えます • 曖昧性の除去: 複数の方法で解釈し得るデータを解釈します • 重複排除: データの重複したコピーを排除します これらが完了すると、データレイクやデータレイクハウスのような中央リポジトリに データを格納することができます。また、データエンジニアはデータのサブセットを データウェアハウスにコピー、移動することができます。 What Is Data Engineering? 10 データエンジニアは何をするのでしょうか? -
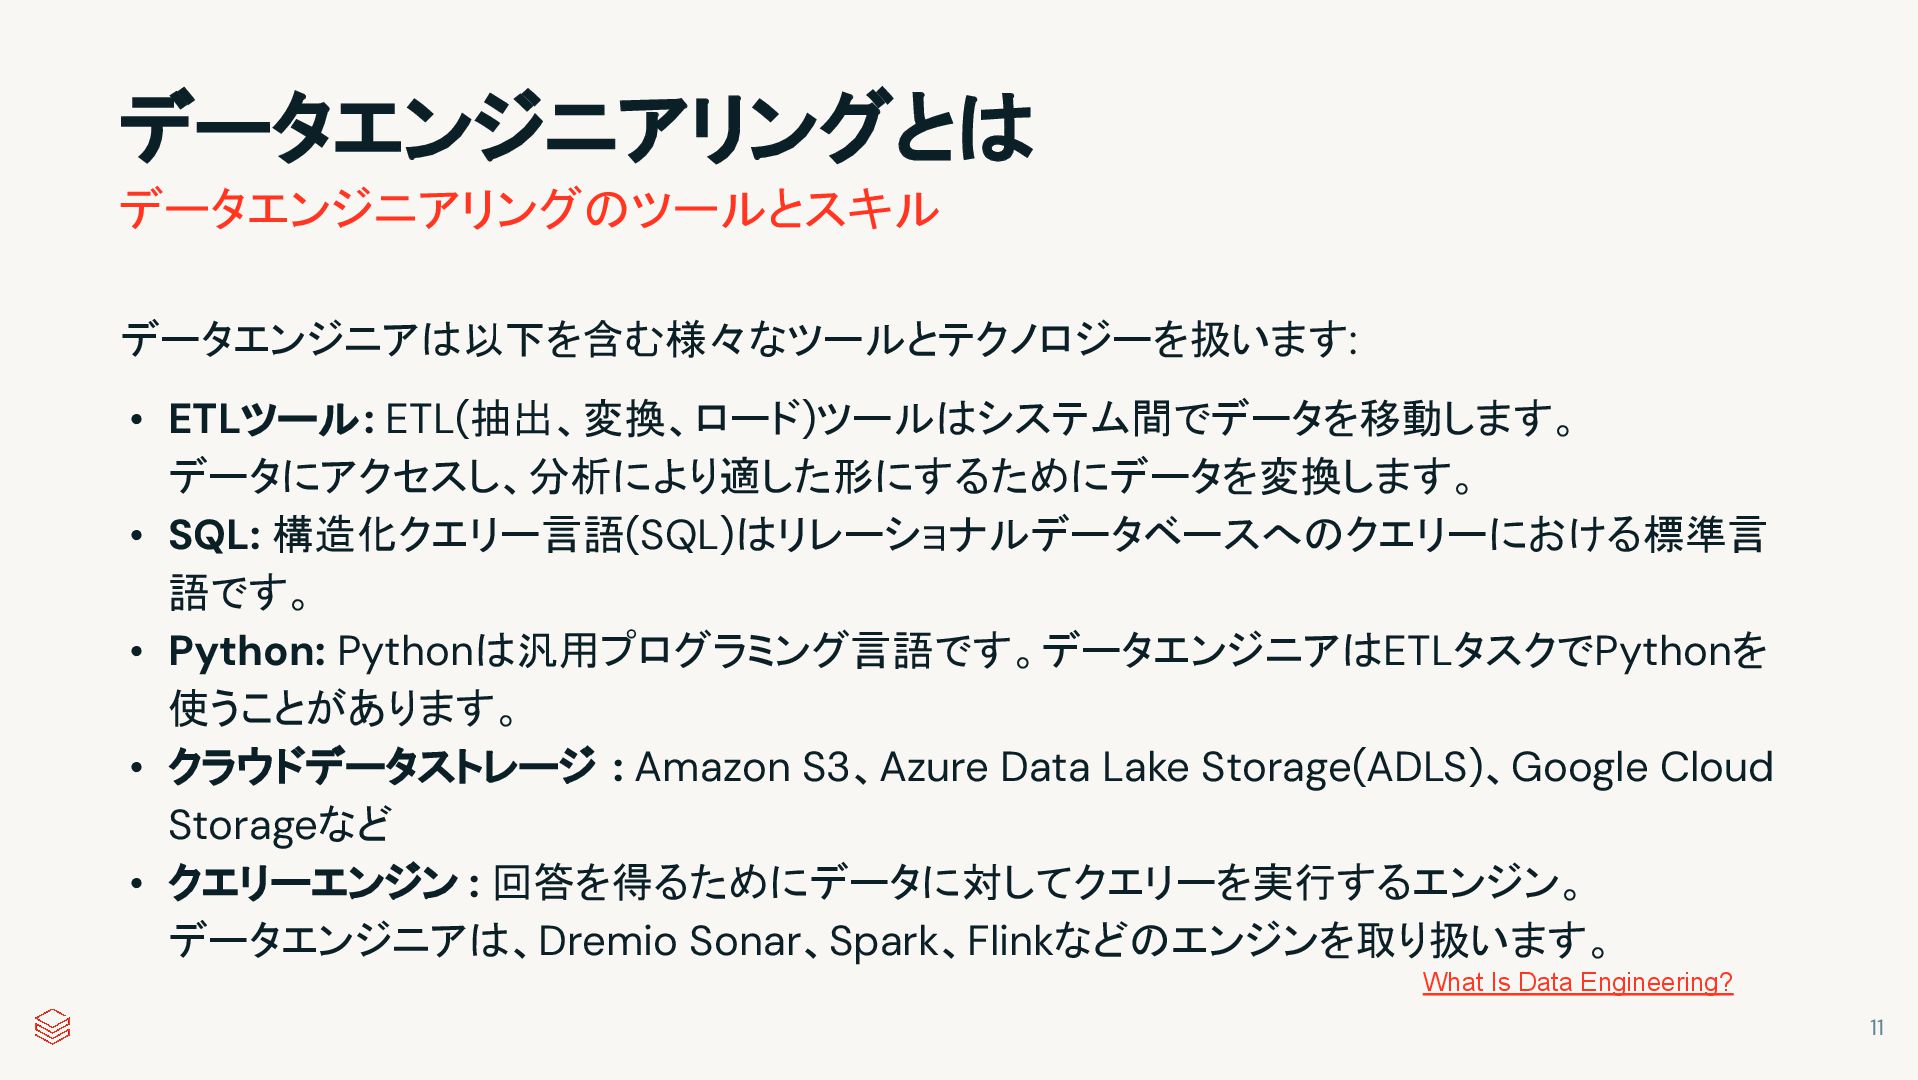
データエンジニアリングとは データエンジニアは以下を含む様々なツールとテクノロジーを扱います: • ETLツール: ETL(抽出、変換、ロード)ツールはシステム間でデータを移動します。 データにアクセスし、分析により適した形にするためにデータを変換します。 • SQL: 構造化クエリー言語(SQL)はリレーショナルデータベースへのクエリーにおける標準言 語です。
• Python: Pythonは汎用プログラミング言語です。データエンジニアはETLタスクでPythonを 使うことがあります。 • クラウドデータストレージ : Amazon S3、Azure Data Lake Storage(ADLS)、Google Cloud Storageなど • クエリーエンジン : 回答を得るためにデータに対してクエリーを実行するエンジン。 データエンジニアは、Dremio Sonar、Spark、Flinkなどのエンジンを取り扱います。 11 What Is Data Engineering? データエンジニアリングのツールとスキル -
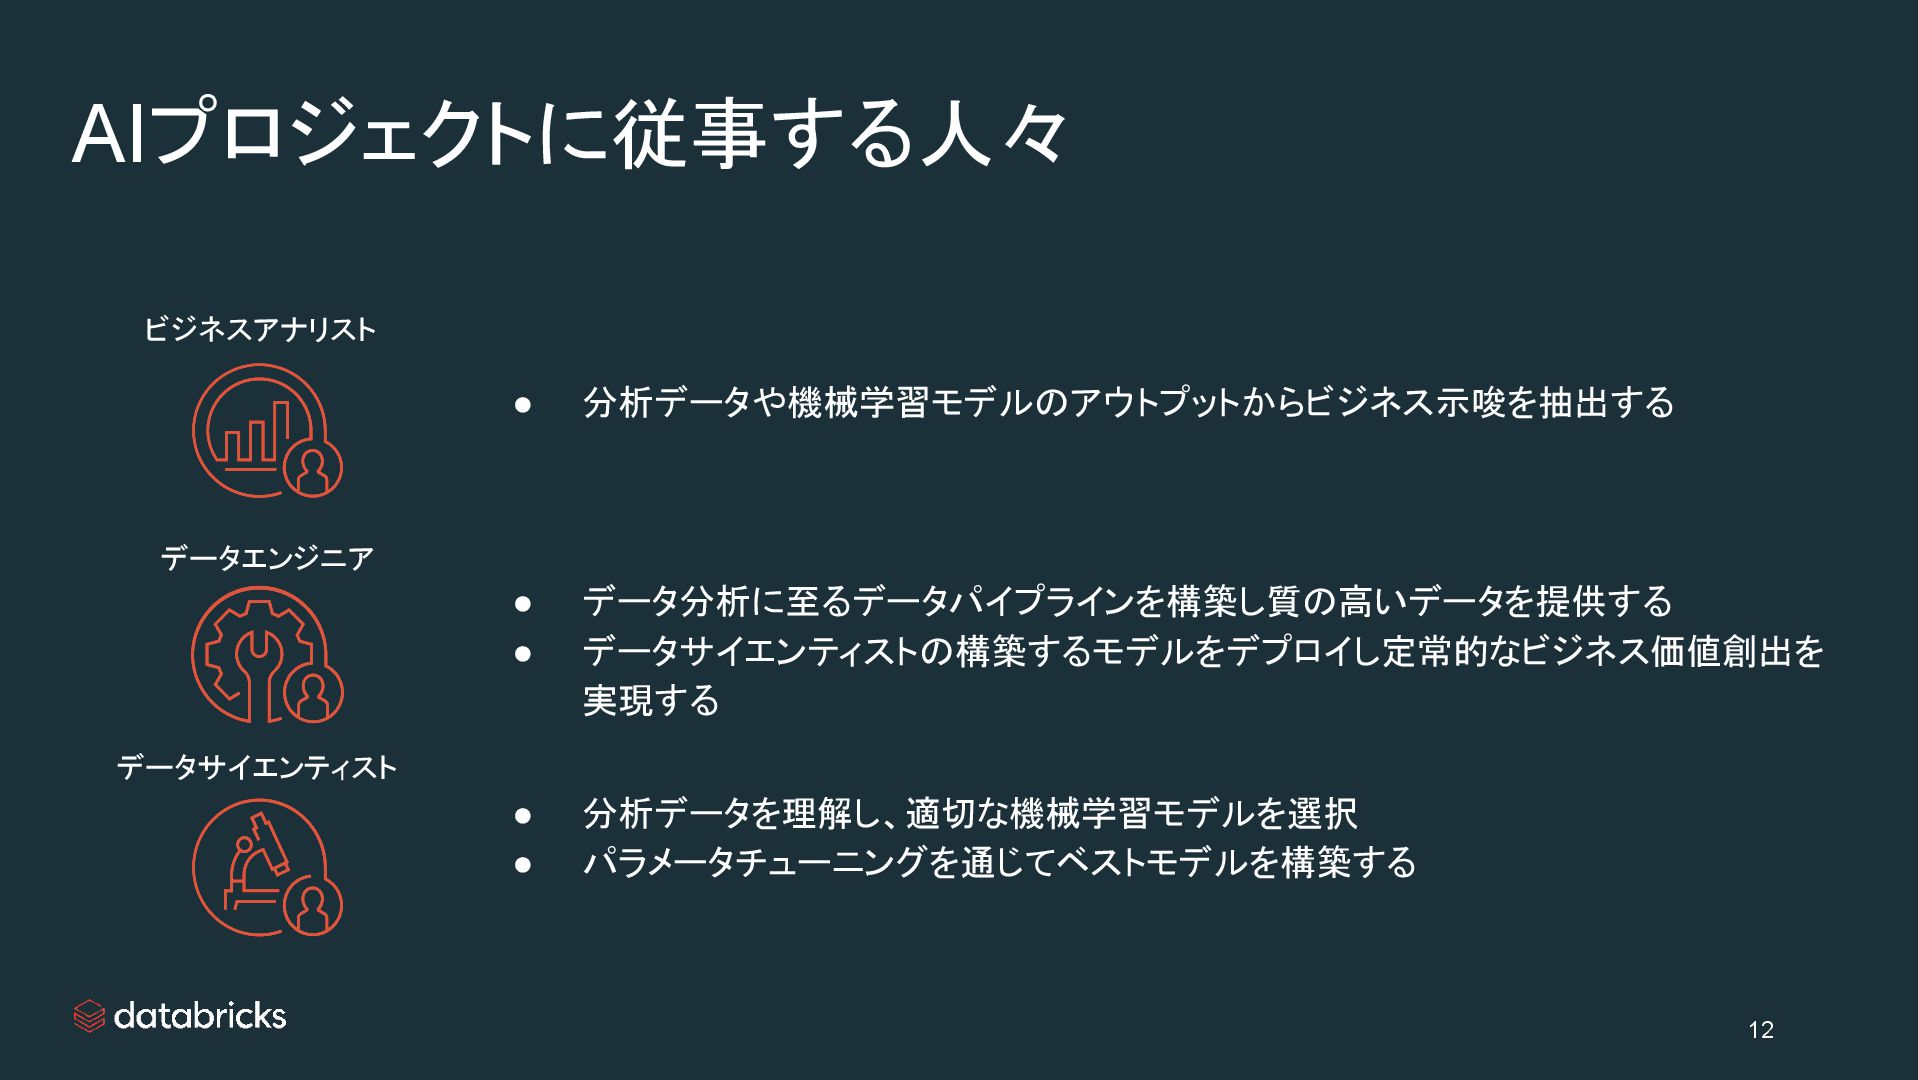
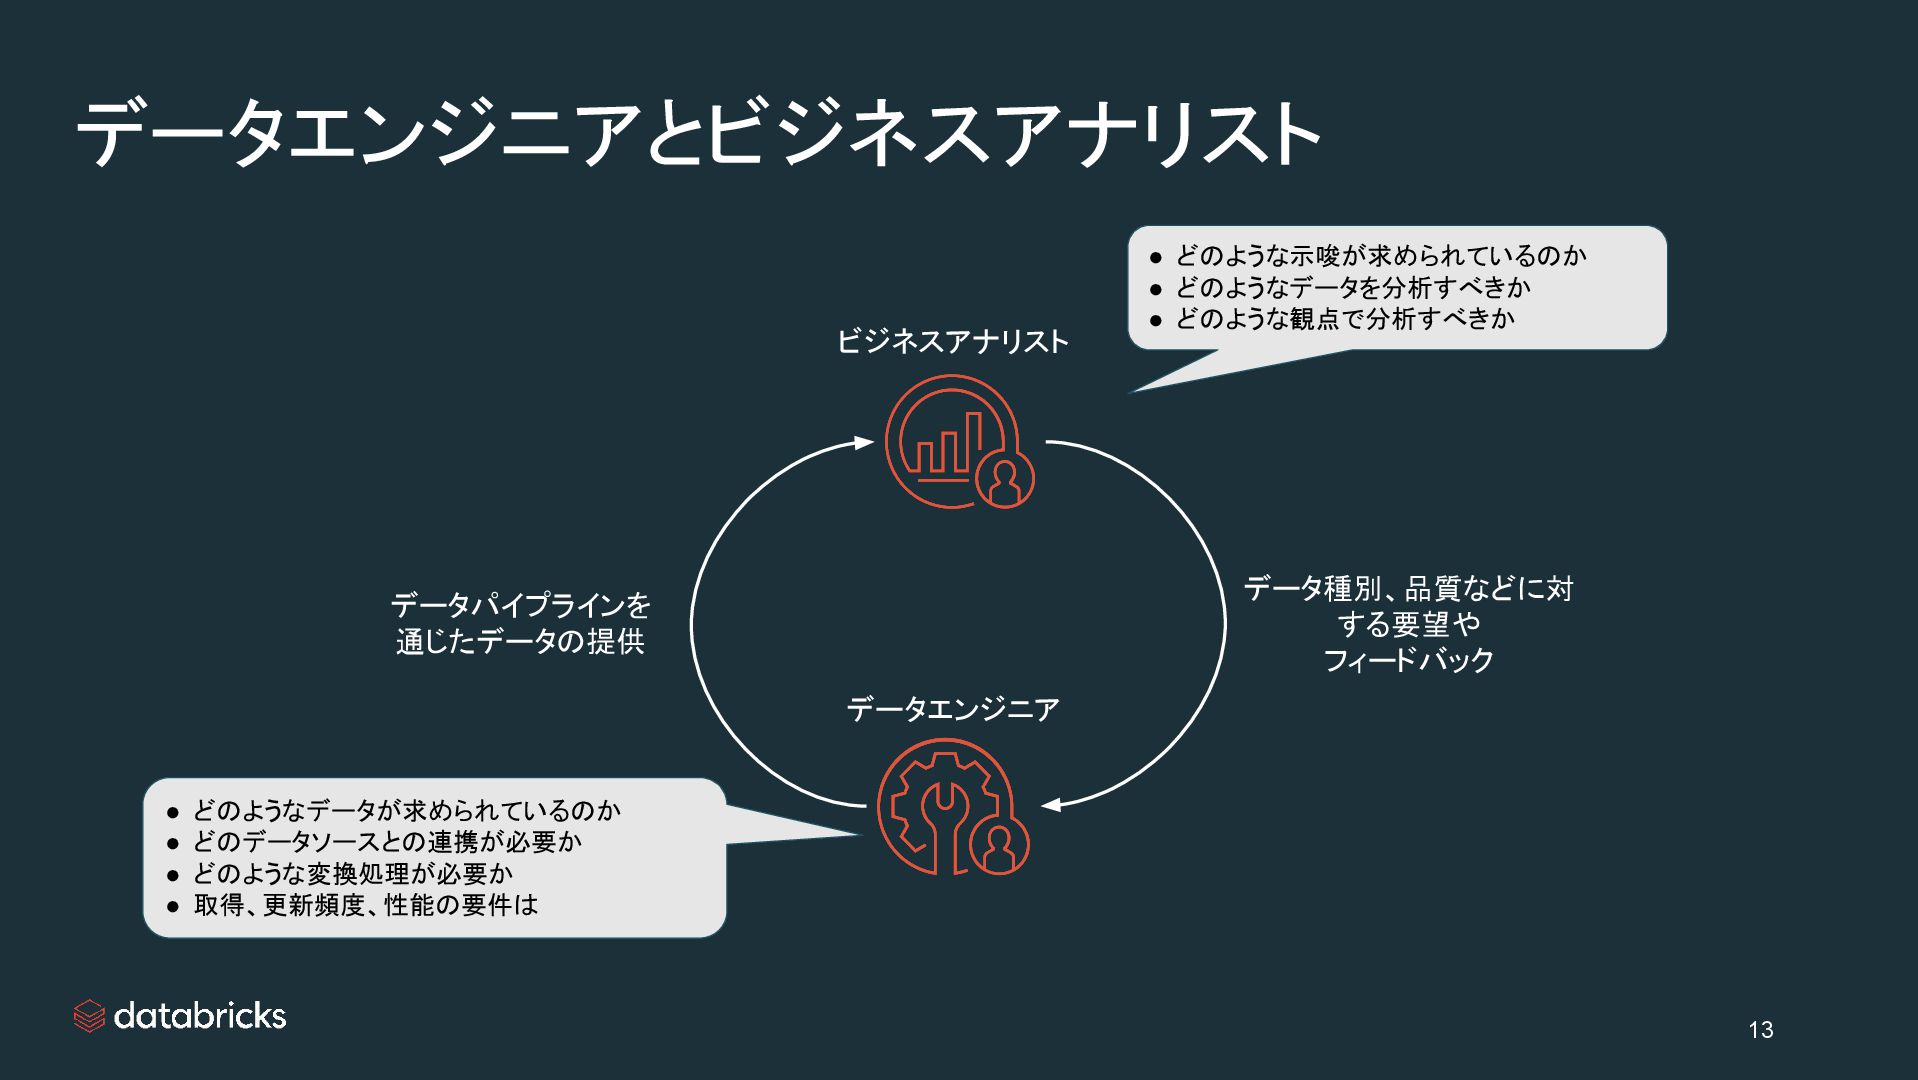
AIプロジェクトに従事する人々 12 ビジネスアナリスト データエンジニア データサイエンティスト • 分析データや機械学習モデルのアウトプットからビジネス示唆を抽出する • データ分析に至るデータパイプラインを構築し質の高いデータを提供する •
データサイエンティストの構築するモデルをデプロイし定常的なビジネス価値創出を 実現する • 分析データを理解し、適切な機械学習モデルを選択 • パラメータチューニングを通じてベストモデルを構築する -
13 ビジネスアナリスト データエンジニア • どのような示唆が求められているのか • どのようなデータを分析すべきか • どのような観点で分析すべきか •
どのようなデータが求められているのか • どのデータソースとの連携が必要か • どのような変換処理が必要か • 取得、更新頻度、性能の要件は データパイプラインを 通じたデータの提供 データ種別、品質などに対 する要望や フィードバック データエンジニアとビジネスアナリスト -
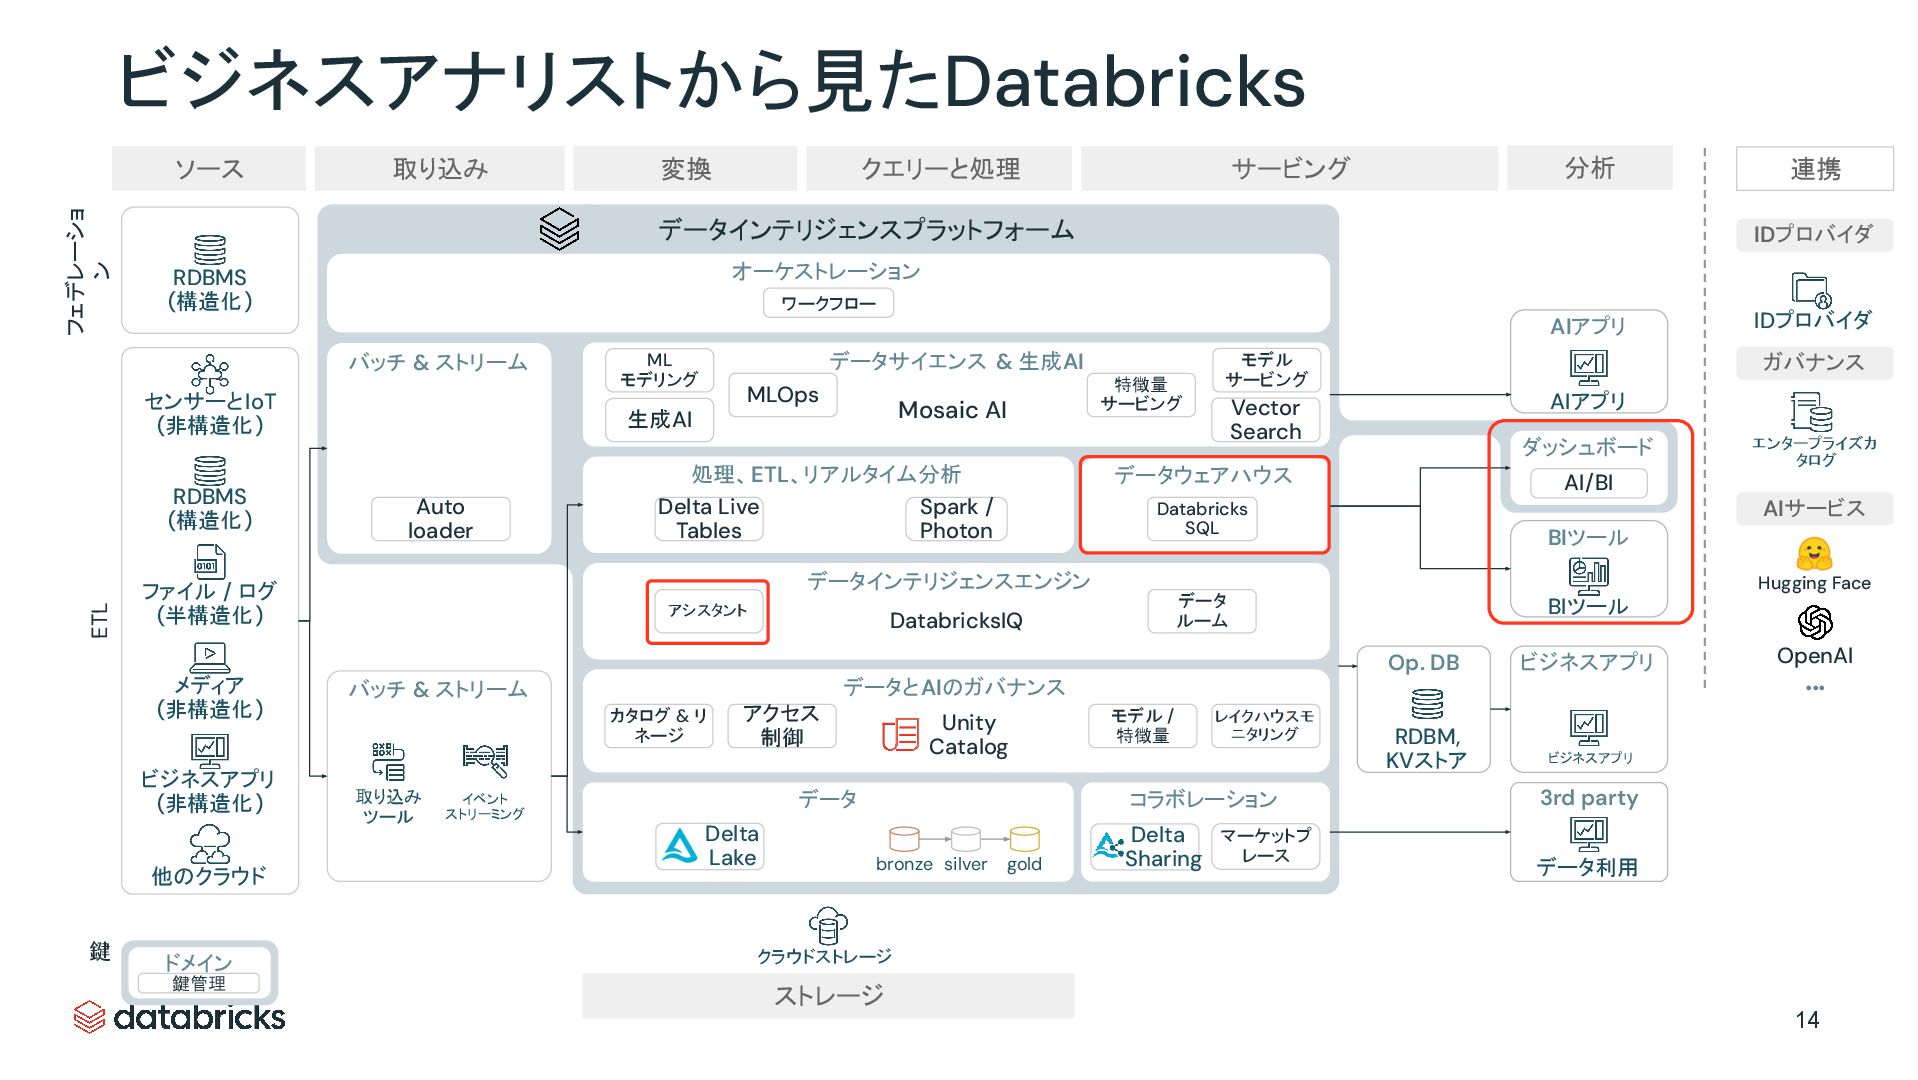
BIツール Op. DB バッチ & ストリーム データ コラボレーション ビジネスアナリストから見たDatabricks ストレージ
データサイエンス & 生成AI 処理、ETL、リアルタイム分析 オーケストレーション データとAIのガバナンス バッチ & ストリーム データウェアハウス データインテリジェンスエンジン データインテリジェンスプラットフォーム フェデレーショ ン ETL AIアプリ 3rd party ビジネスアプリ 連携 取り込み 変換 分析 ソース サービング クエリーと処理 ダッシュボード Spark / Photon Delta Live Tables Databricks SQL ワークフロー Auto loader マーケットプ レース アシスタント データ ルーム AI/BI レイクハウスモ ニタリング Hugging Face OpenAI IDプロバイダ ガバナンス AIサービス モデル サービング Vector Search ML モデリング Mosaic AI カタログ & リ ネージ アクセス 制御 Unity Catalog MLOps 生成AI 特徴量 サービング … ドメイン 鍵管理 鍵 モデル / 特徴量 DatabricksIQ センサーとIoT (非構造化) RDBMS (構造化) ビジネスアプリ (非構造化) メディア (非構造化) 他のクラウド ビジネスアプリ ファイル / ログ (半構造化) IDプロバイダ エンタープライズカ タログ クラウドストレージ AIアプリ RDBMS (構造化) 取り込み ツール イベント ストリーミング RDBM, KVストア データ利用 BIツール Delta Lake Delta Sharing bronze silver gold 14 -
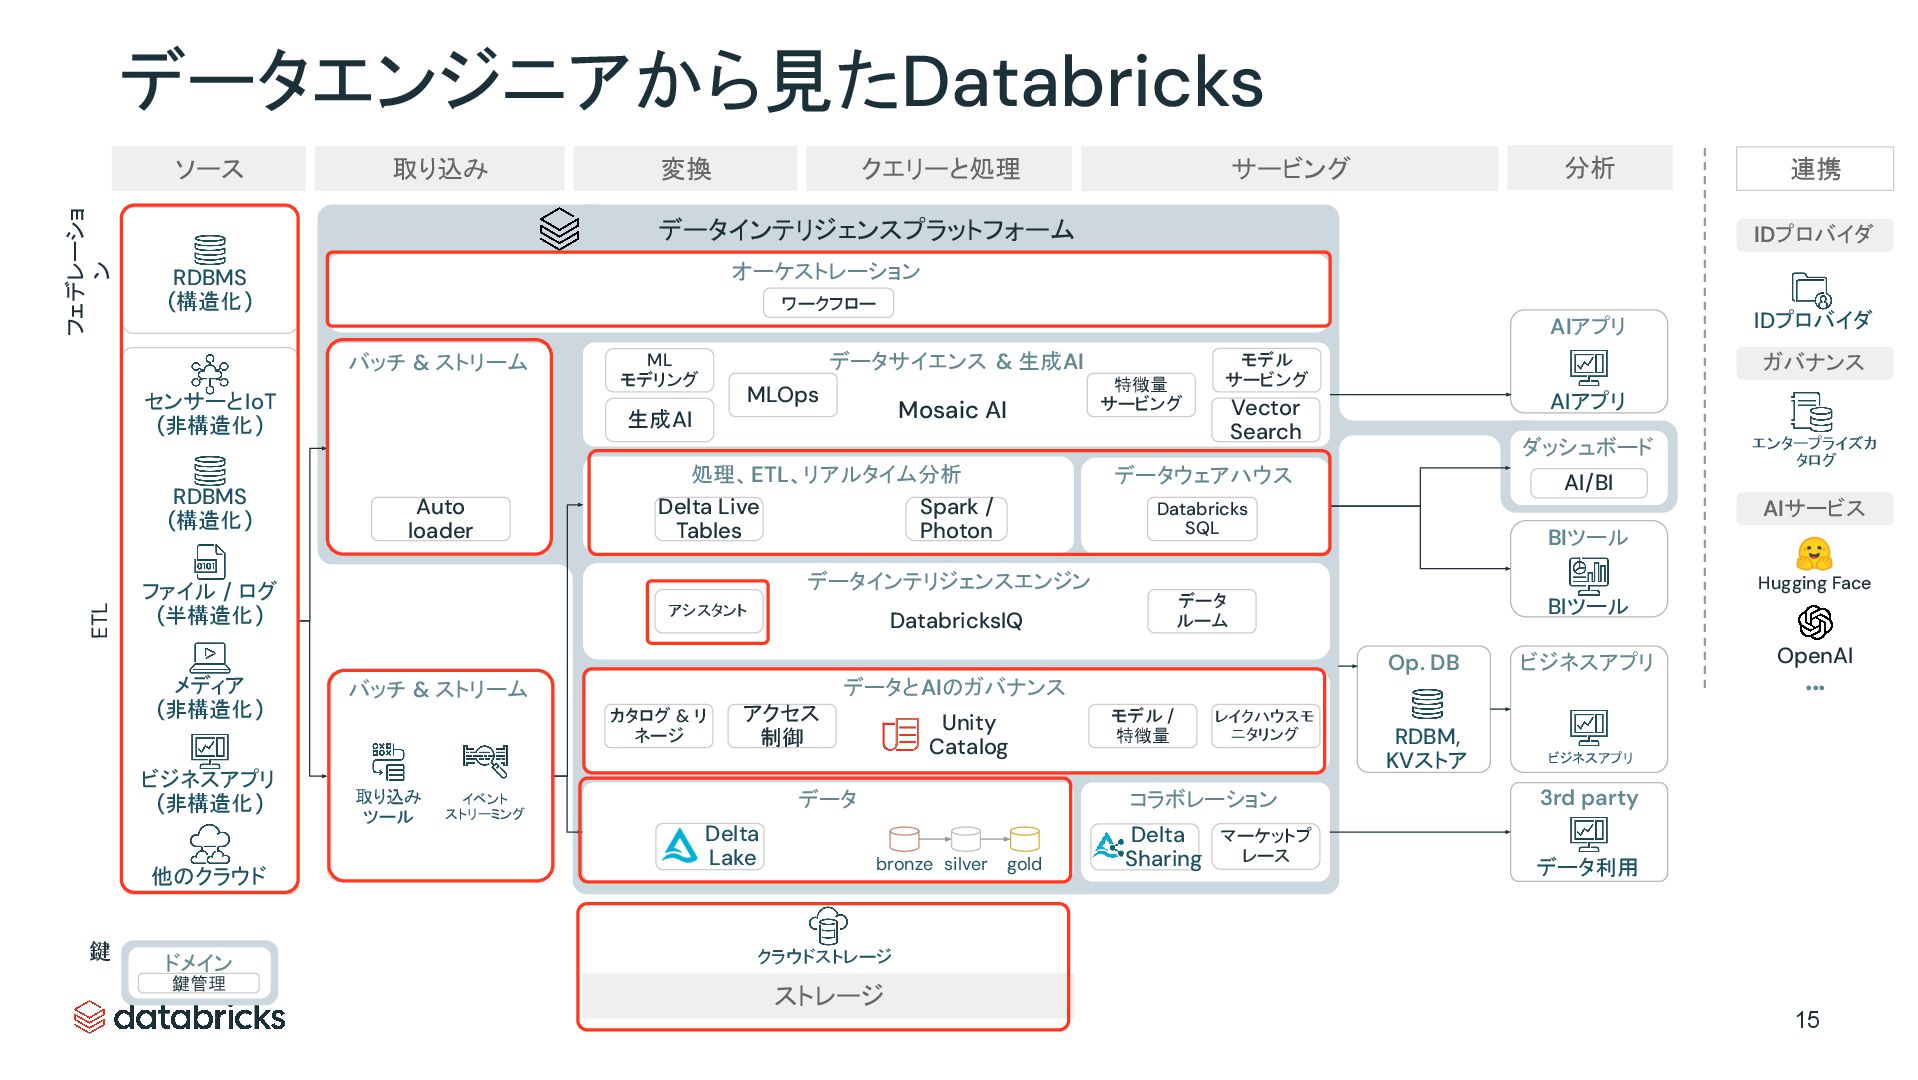
BIツール Op. DB バッチ & ストリーム データ コラボレーション データエンジニアから見たDatabricks ストレージ
データサイエンス & 生成AI 処理、ETL、リアルタイム分析 オーケストレーション データとAIのガバナンス バッチ & ストリーム データウェアハウス データインテリジェンスエンジン データインテリジェンスプラットフォーム フェデレーショ ン ETL AIアプリ 3rd party ビジネスアプリ 連携 取り込み 変換 分析 ソース サービング クエリーと処理 ダッシュボード Spark / Photon Delta Live Tables Databricks SQL ワークフロー Auto loader マーケットプ レース アシスタント データ ルーム AI/BI レイクハウスモ ニタリング Hugging Face OpenAI IDプロバイダ ガバナンス AIサービス モデル サービング Vector Search ML モデリング Mosaic AI カタログ & リ ネージ アクセス 制御 Unity Catalog MLOps 生成AI 特徴量 サービング … ドメイン 鍵管理 鍵 モデル / 特徴量 DatabricksIQ センサーとIoT (非構造化) RDBMS (構造化) ビジネスアプリ (非構造化) メディア (非構造化) 他のクラウド ビジネスアプリ ファイル / ログ (半構造化) IDプロバイダ エンタープライズカ タログ クラウドストレージ AIアプリ RDBMS (構造化) 取り込み ツール イベント ストリーミング RDBM, KVストア データ利用 BIツール Delta Lake Delta Sharing bronze silver gold 15 -
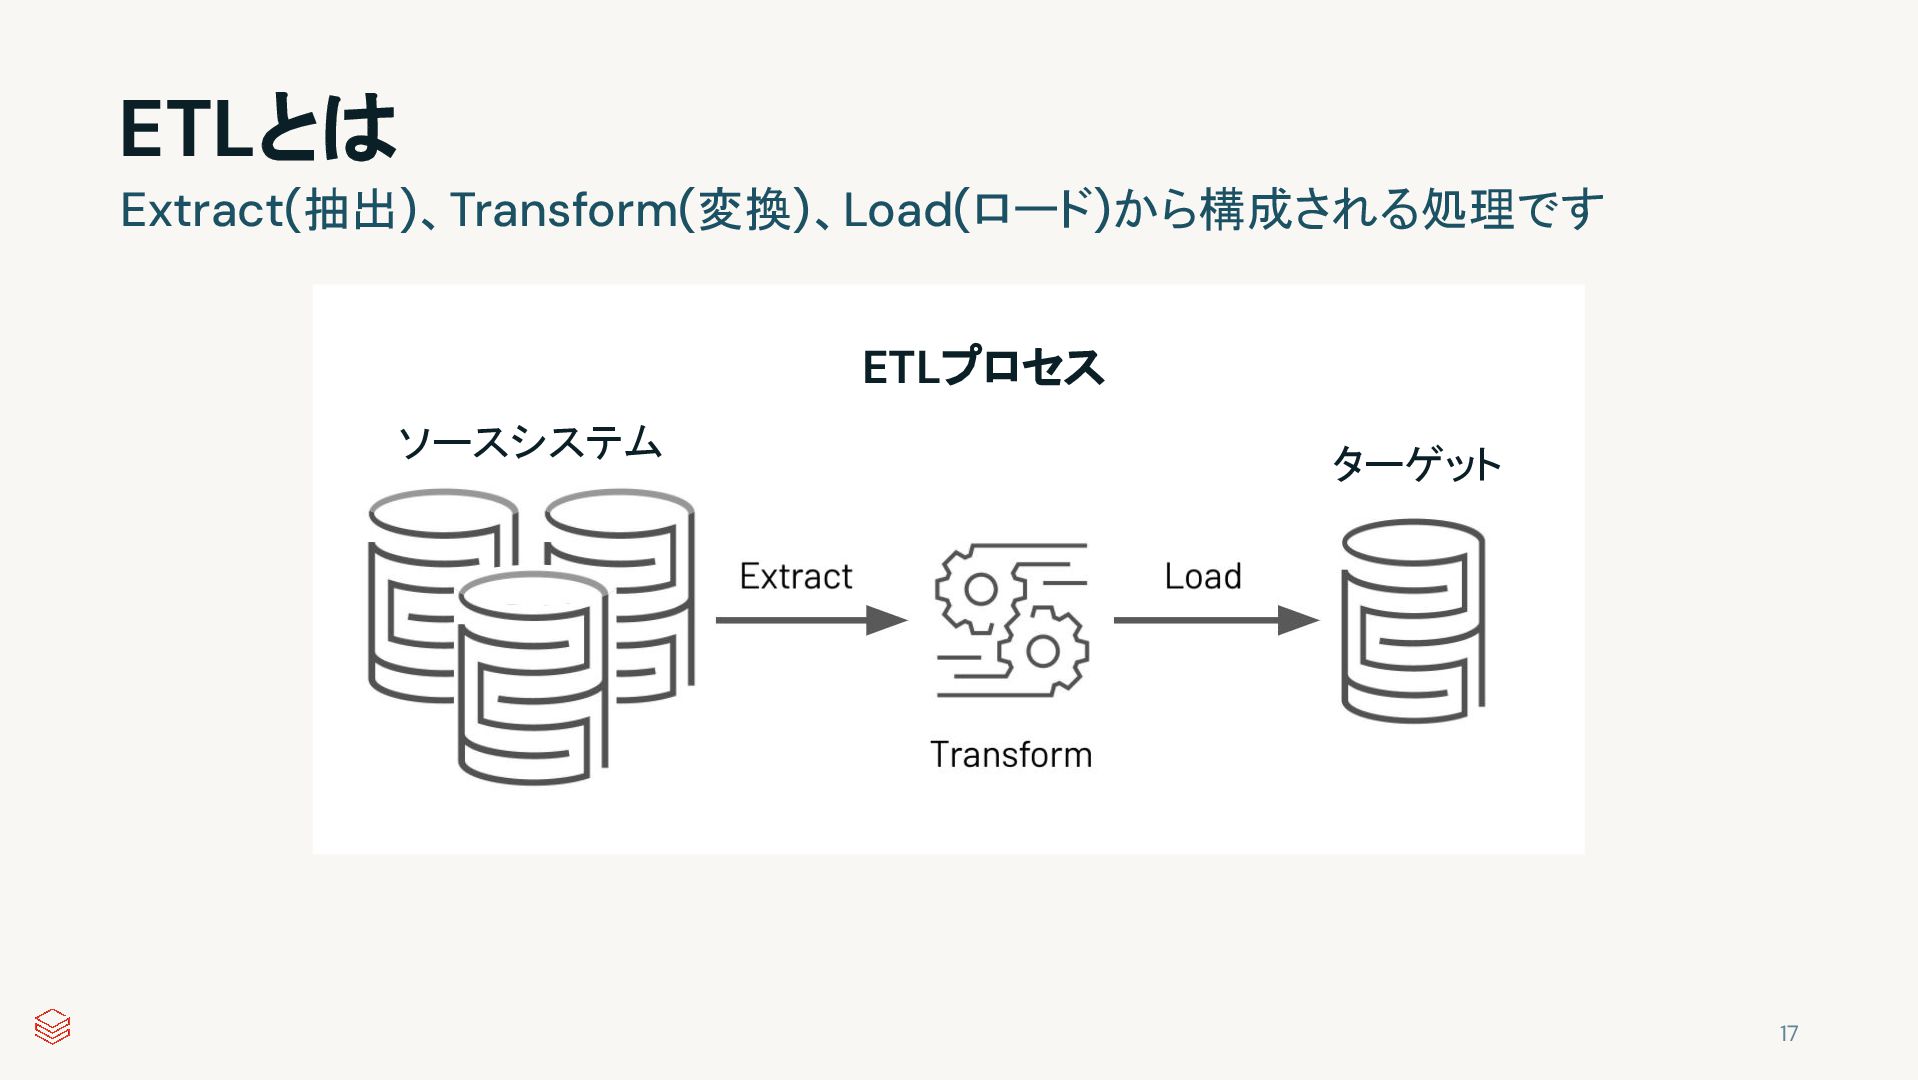
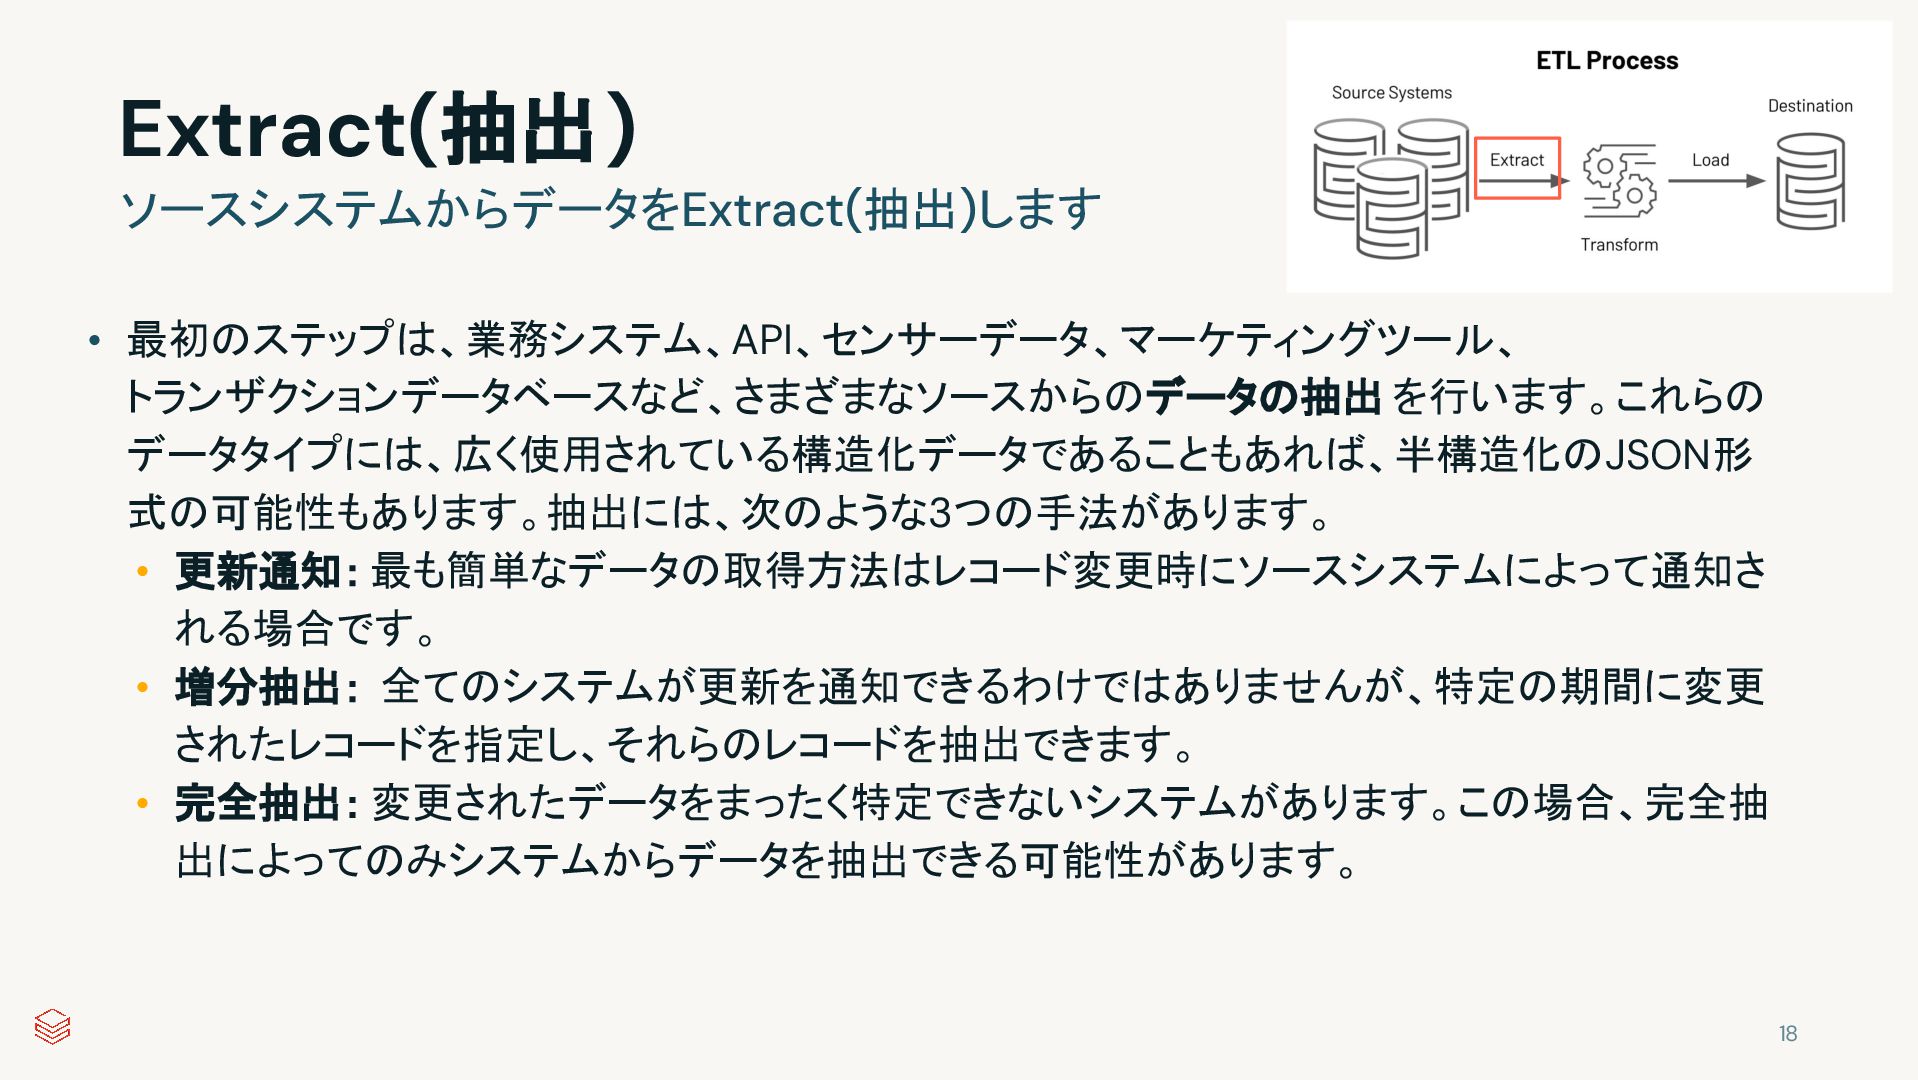
Extract(抽出) ソースシステムからデータをExtract(抽出)します 18 • 最初のステップは、業務システム、API、センサーデータ、マーケティングツール、 トランザクションデータベースなど、さまざまなソースからのデータの抽出 を行います。これらの データタイプには、広く使用されている構造化データであることもあれば、半構造化のJSON形 式の可能性もあります。抽出には、次のような3つの手法があります。 •
更新通知: 最も簡単なデータの取得方法はレコード変更時にソースシステムによって通知さ れる場合です。 • 増分抽出: 全てのシステムが更新を通知できるわけではありませんが、特定の期間に変更 されたレコードを指定し、それらのレコードを抽出できます。 • 完全抽出: 変更されたデータをまったく特定できないシステムがあります。この場合、完全抽 出によってのみシステムからデータを抽出できる可能性があります。 -
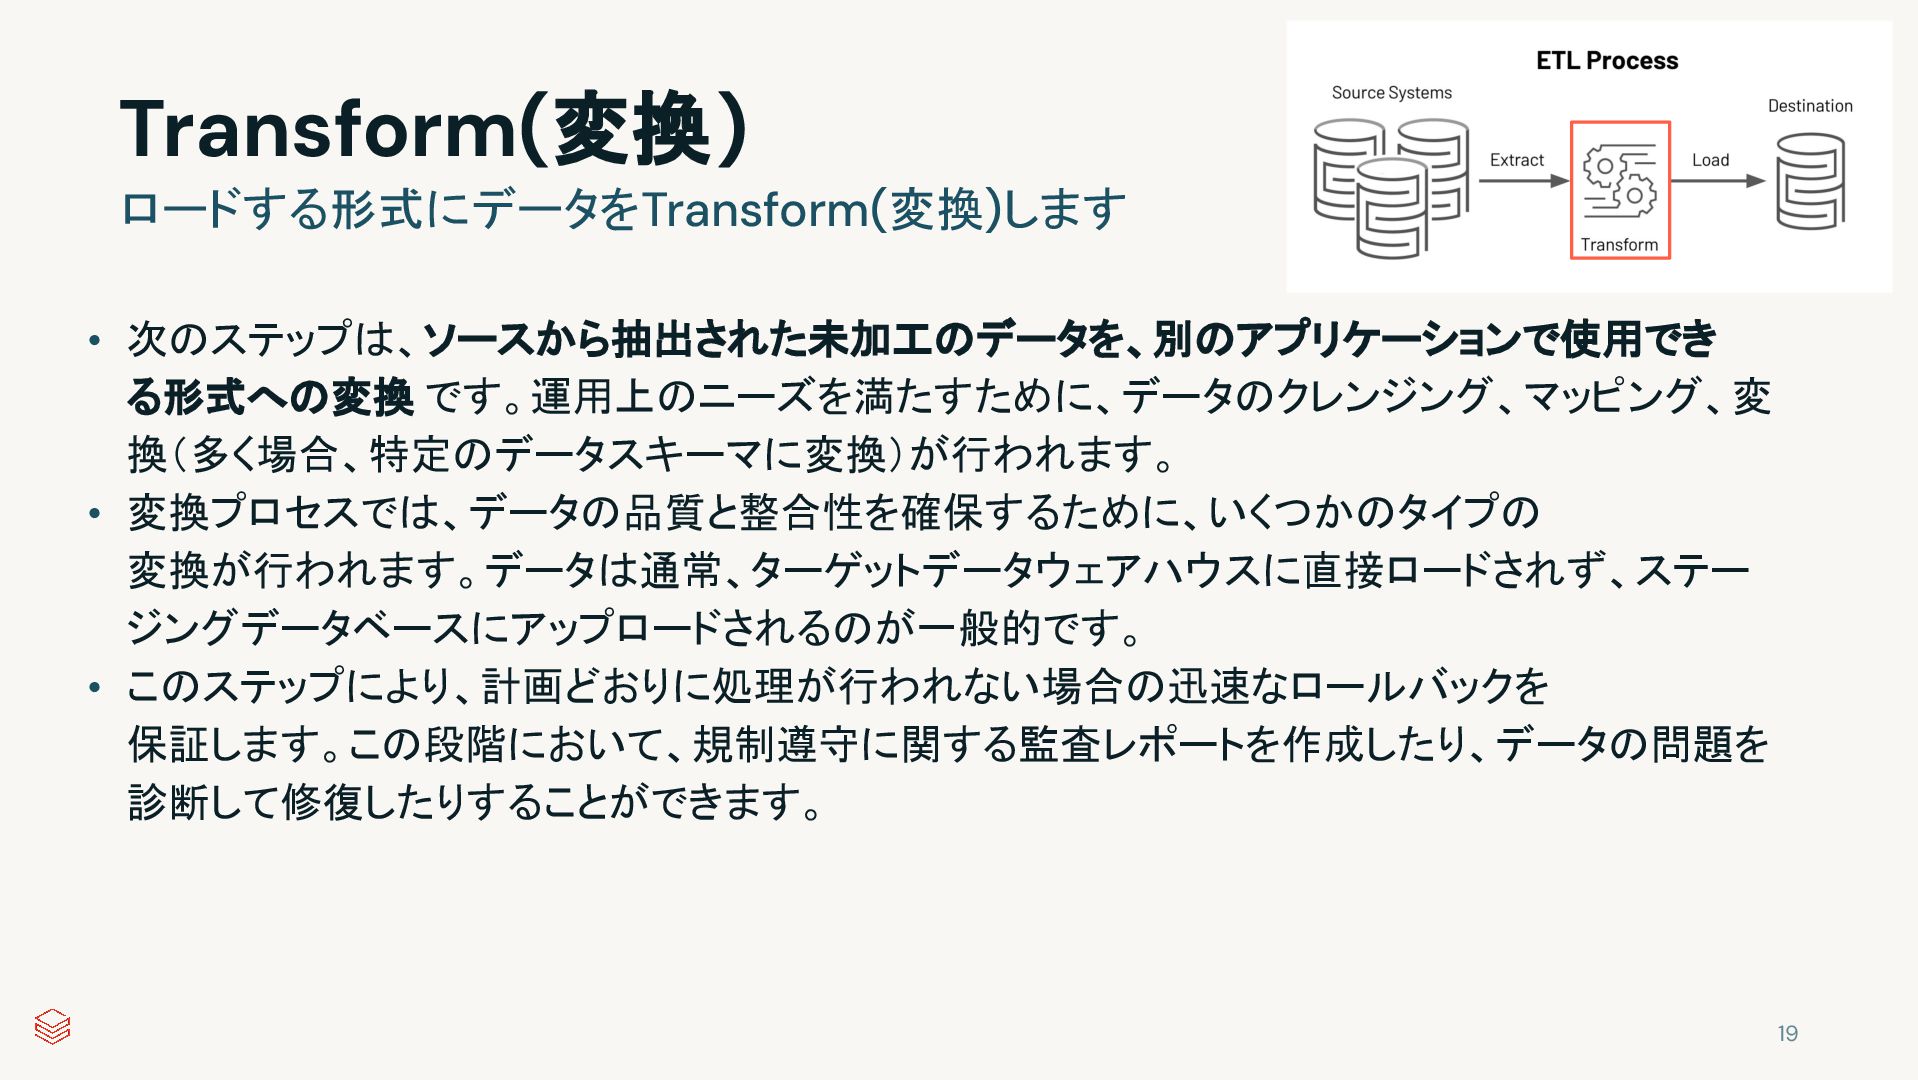
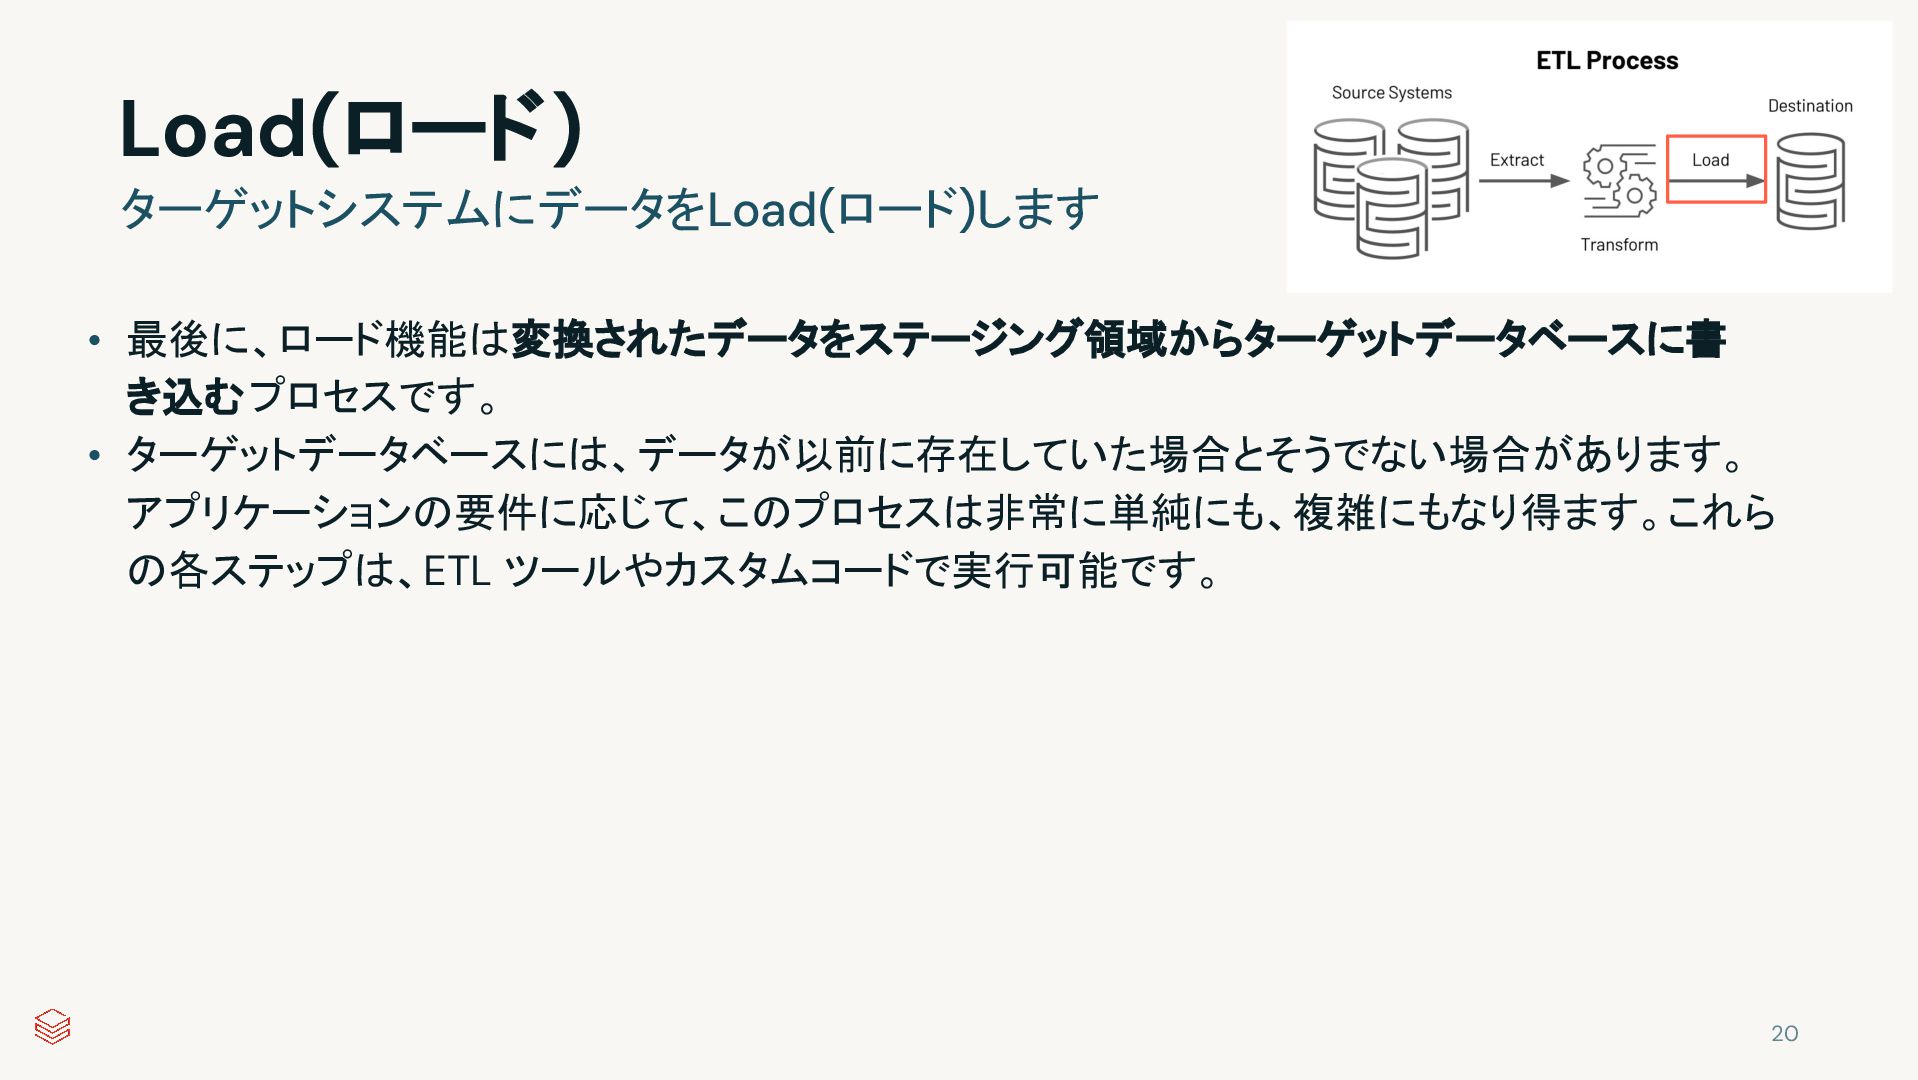
Transform(変換) ロードする形式にデータをTransform(変換)します 19 • 次のステップは、ソースから抽出された未加工のデータを、別のアプリケーションで使用でき る形式への変換 です。運用上のニーズを満たすために、データのクレンジング、マッピング、変 換(多く場合、特定のデータスキーマに変換)が行われます。 • 変換プロセスでは、データの品質と整合性を確保するために、いくつかのタイプの
変換が行われます。データは通常、ターゲットデータウェアハウスに直接ロードされず、ステー ジングデータベースにアップロードされるのが一般的です。 • このステップにより、計画どおりに処理が行われない場合の迅速なロールバックを 保証します。この段階において、規制遵守に関する監査レポートを作成したり、データの問題を 診断して修復したりすることができます。 -
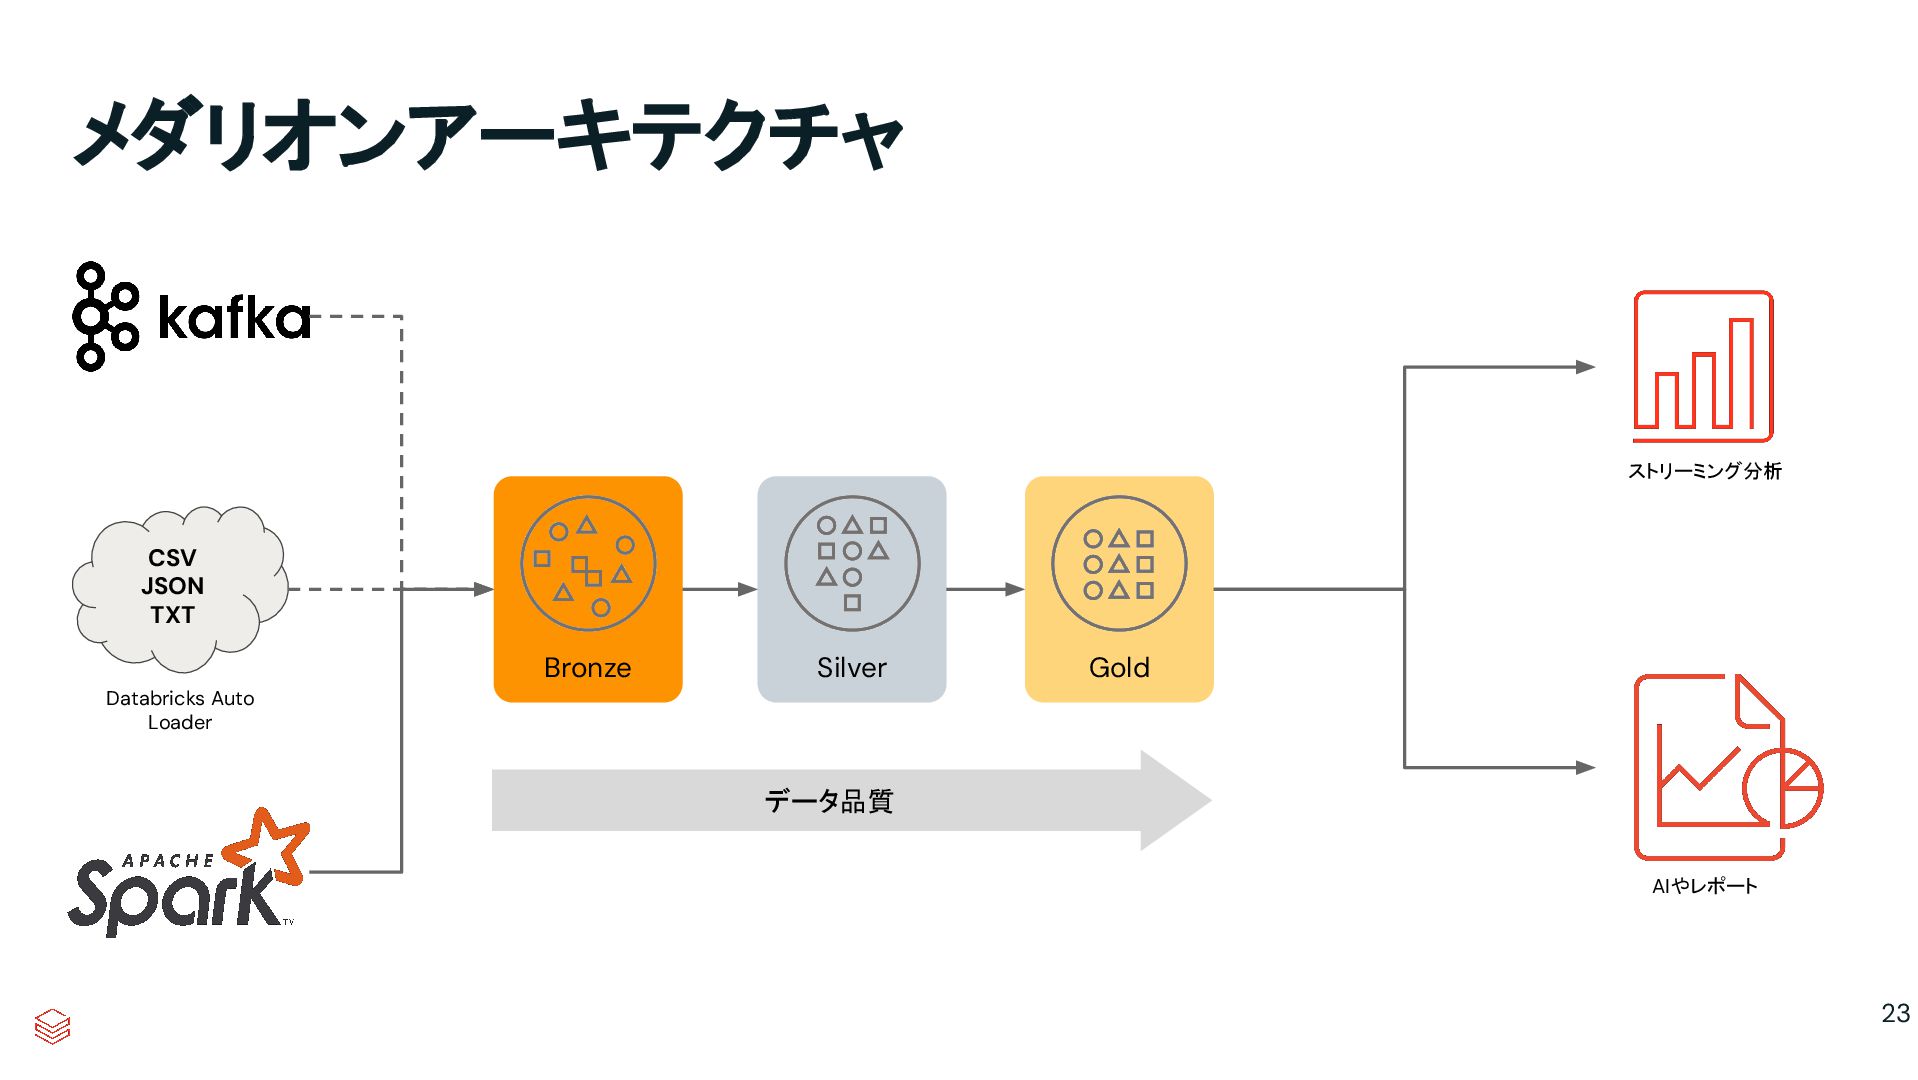
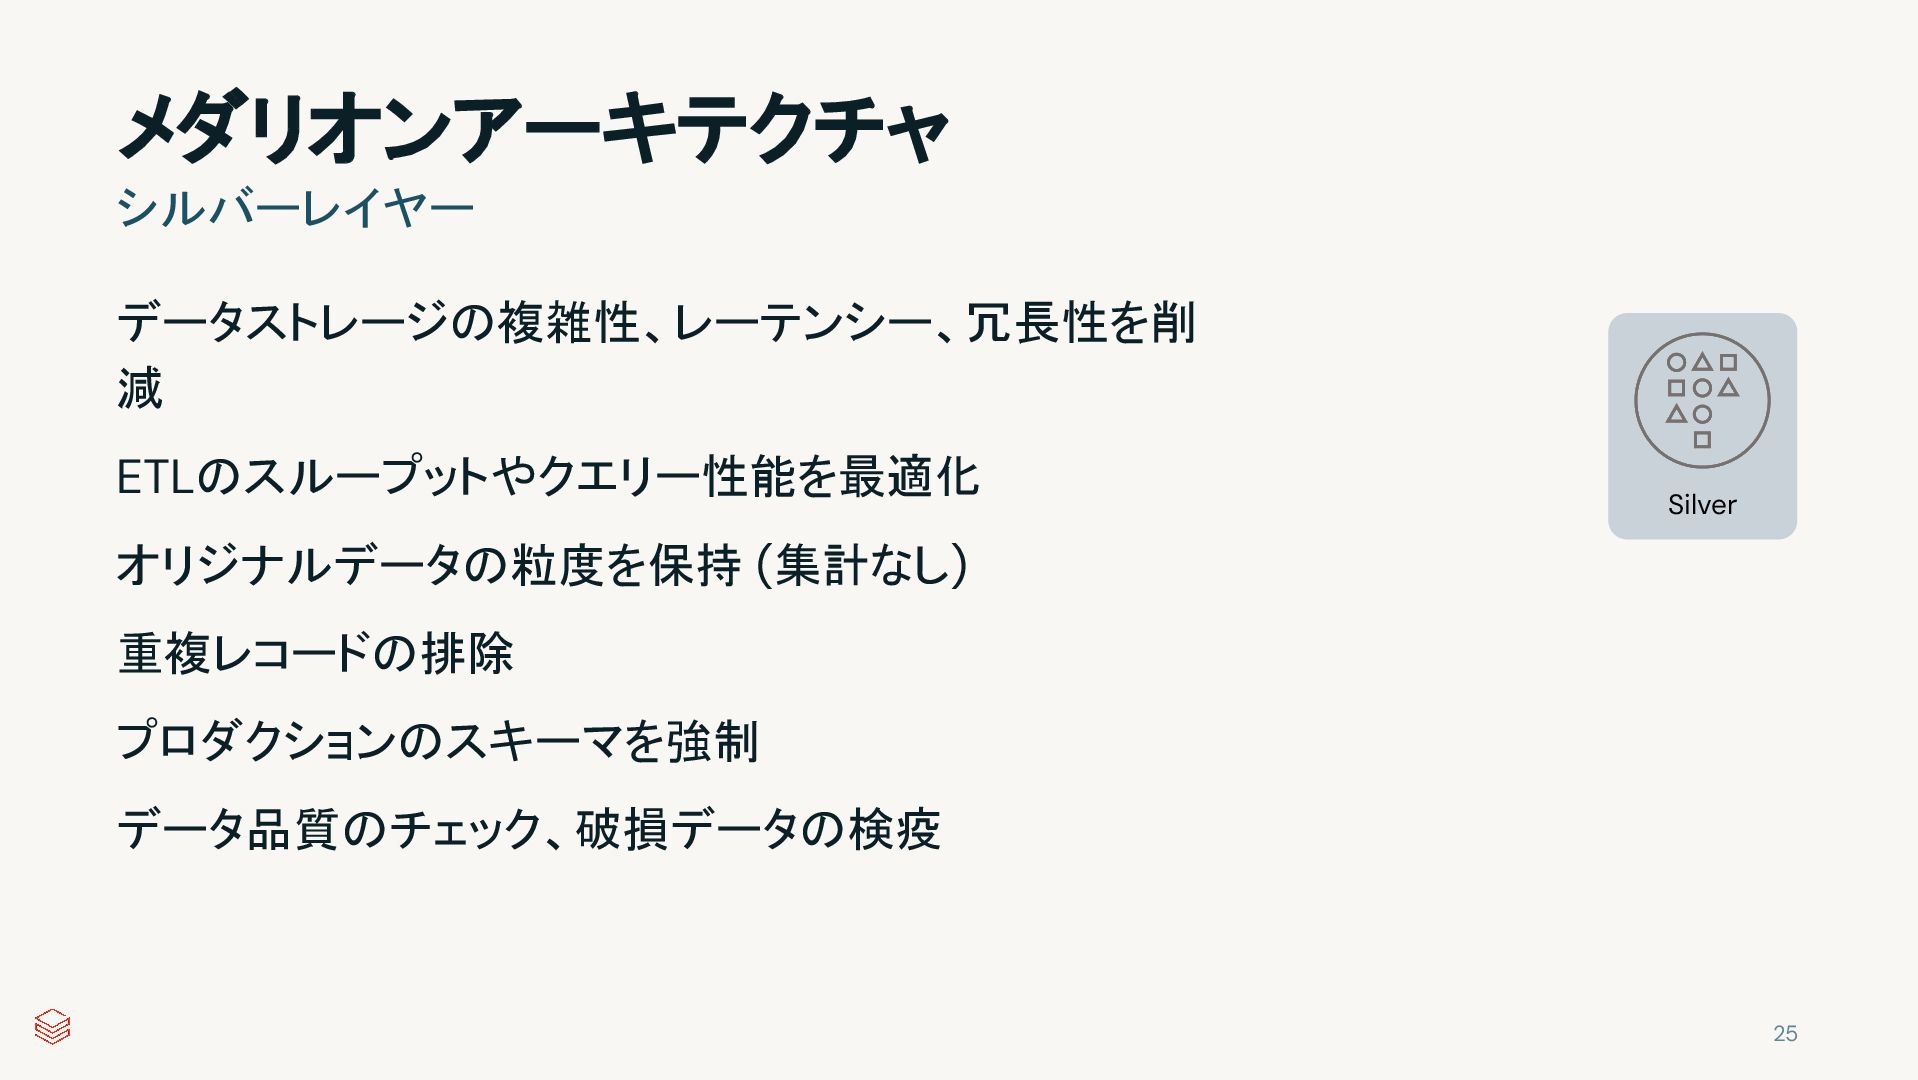
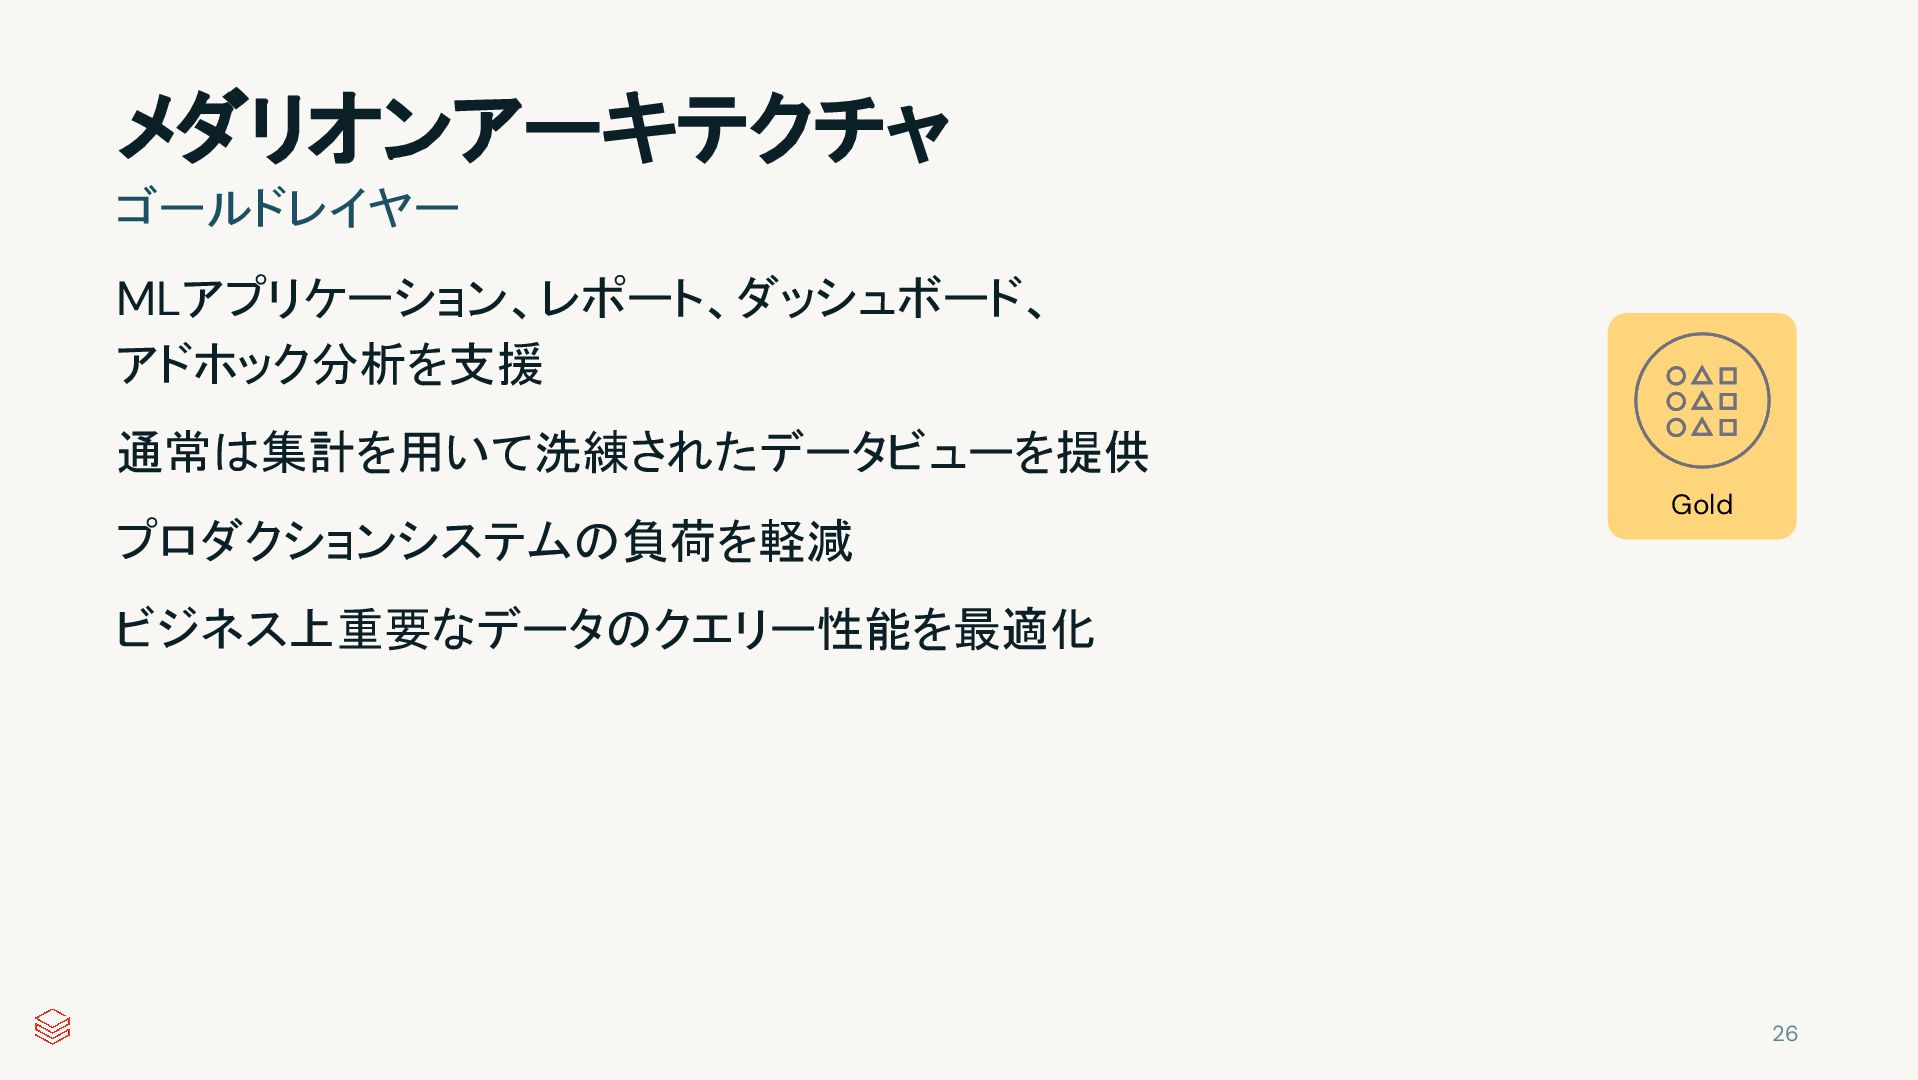
メダリオンアーキテクチャとは ETLパイプラインを設計・構築する際の整理学です 22 • メダリオンアーキテクチャは、レイクハウスに格納されているデータの品質を示す一連のデータ レイヤーを表現します。 • 企業のデータプロダクトに対して信頼できる唯一の情報源(single source of
truth)を構築する ために、Databricksではマルチレイヤーのアプローチを取ることをお勧めしています。 • このアーキテクチャは、公立的な分析に最適化されたレイアウトでデータ格納される前の検証、 変換を行う複数のレイヤーをデータが追加する際の、原子性、一貫性、分離性、耐久性を保証 します。ブロンズ(生)、シルバー(検証済み)、ゴールド(拡張済み)と いう用語はそれぞれのレイヤーにおけるデータの品質を表現しています。 22 メダリオンアーキテクチャ (medallion architecture) | Databricks -
メダリオンアーキテクチャ CSV JSON TXT Bronze Silver Gold AIやレポート ストリーミング分析 データ品質
Databricks Auto Loader 23 -
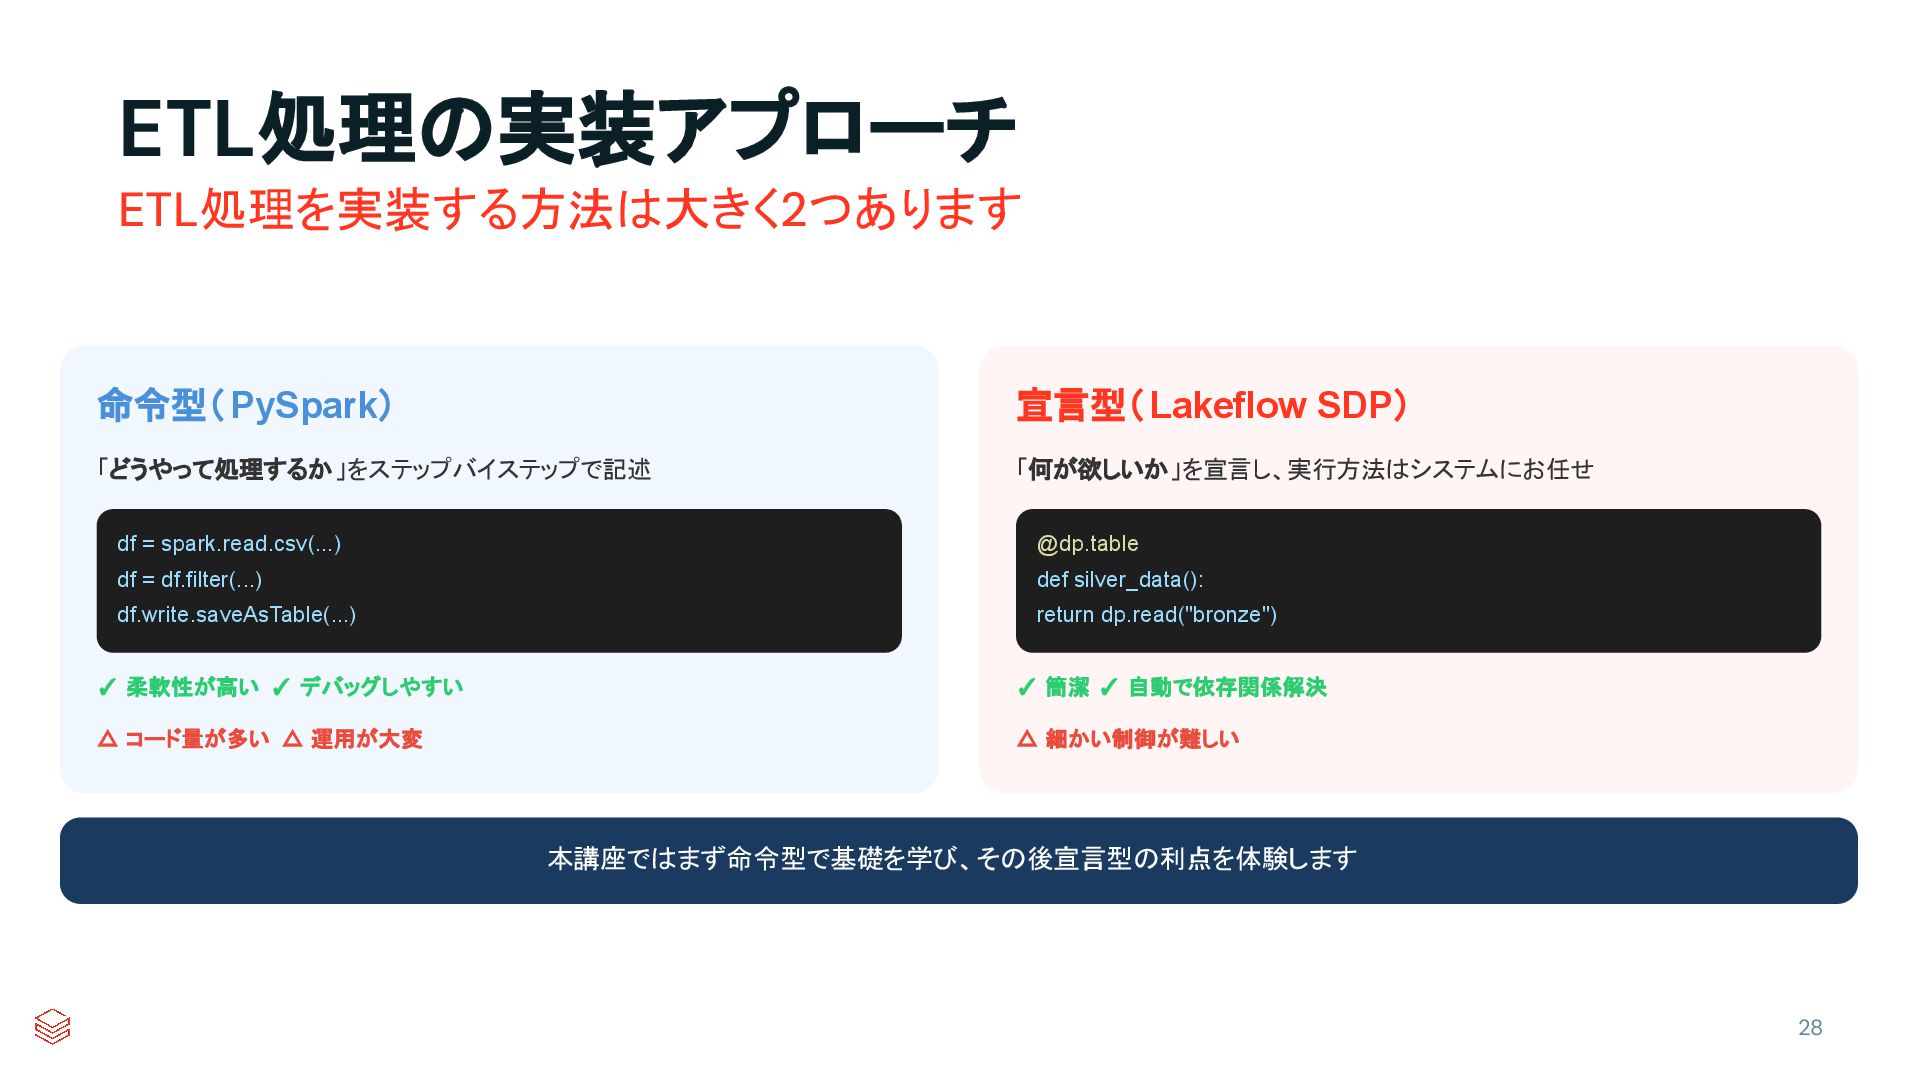
ETL処理の実装アプローチ 28 ETL処理を実装する方法は大きく2つあります 命令型(PySpark) 「どうやって処理するか」をステップバイステップで記述 df = spark.read.csv(...) df =
df.filter(...) df.write.saveAsTable(...) ✓ 柔軟性が高い ✓ デバッグしやすい △ コード量が多い △ 運用が大変 宣言型(Lakeflow SDP) 「何が欲しいか」を宣言し、実行方法はシステムにお任せ @dp.table def silver_data(): return dp.read("bronze") ✓ 簡潔 ✓ 自動で依存関係解決 △ 細かい制御が難しい 本講座ではまず命令型で基礎を学び、その後宣言型の利点を体験します -
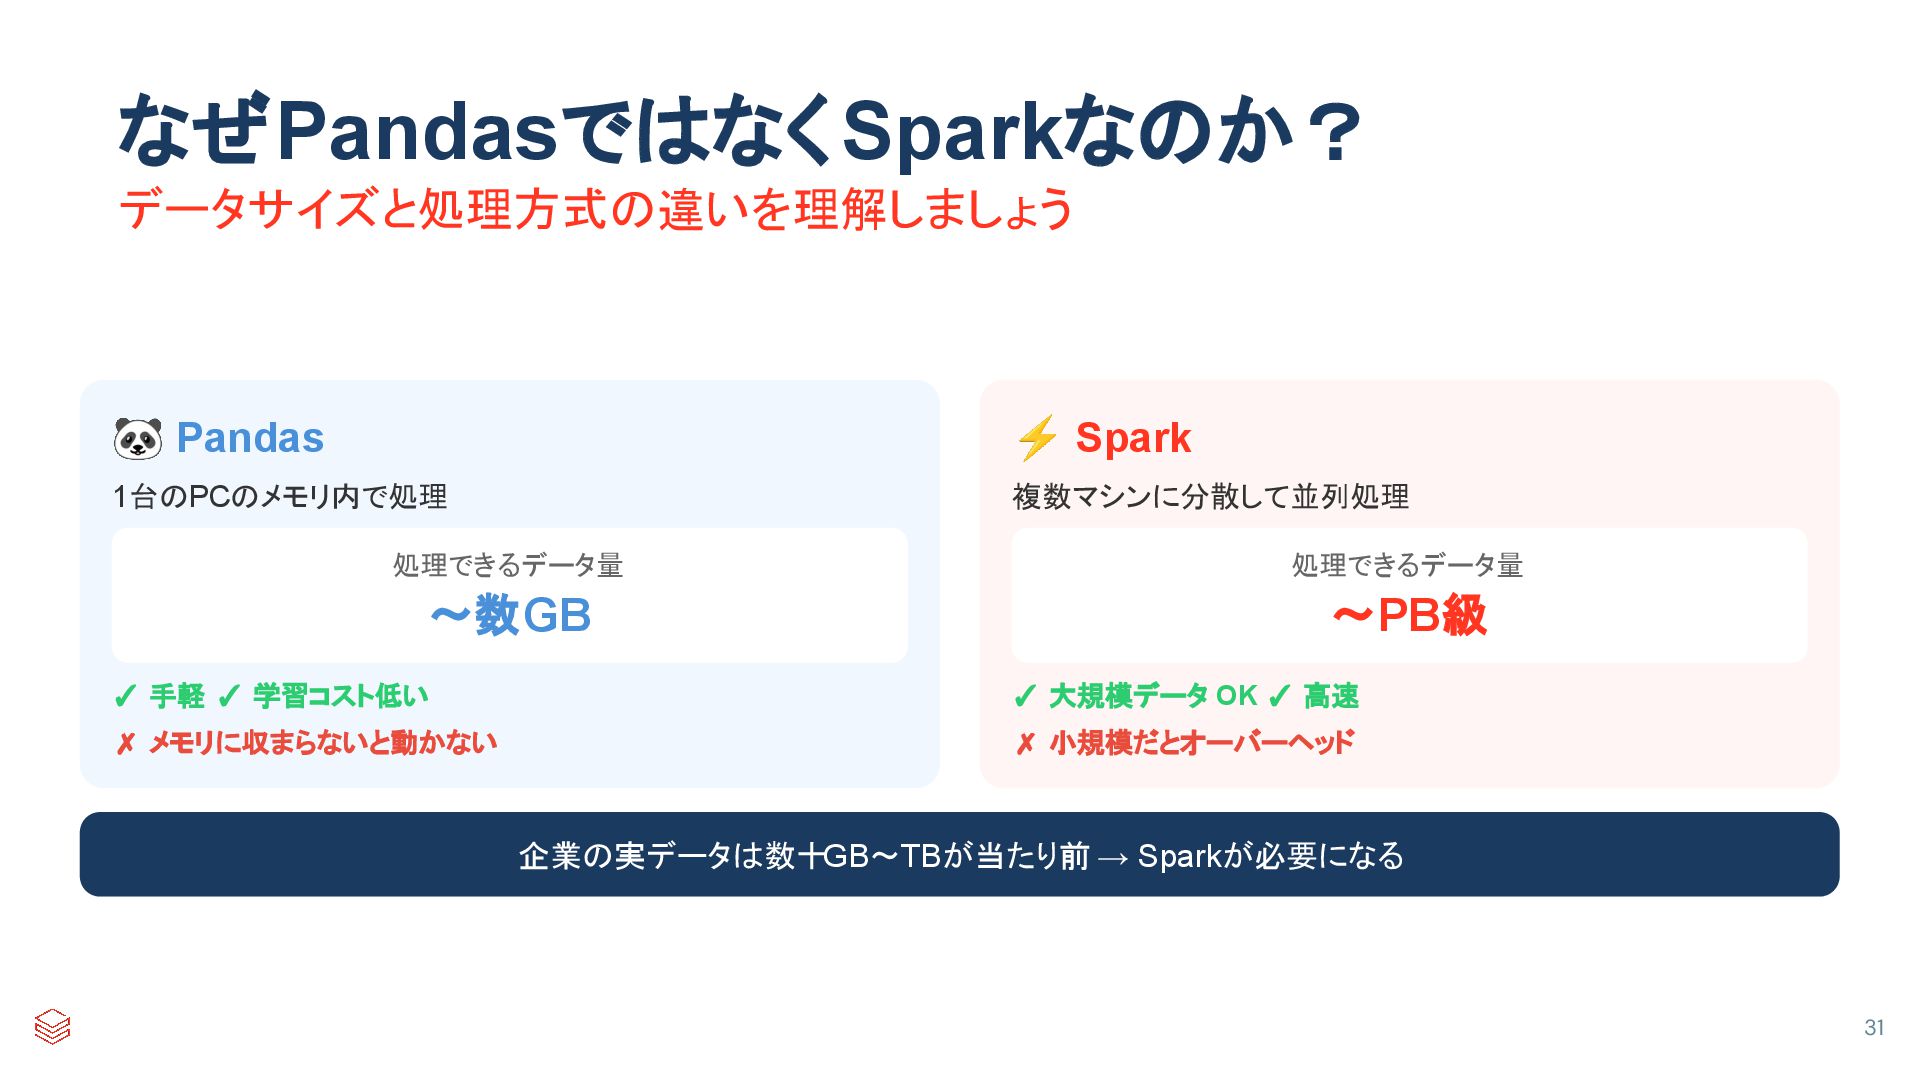
🐼 Pandas 1台のPCのメモリ内で処理 処理できるデータ量 〜数GB ✓ 手軽 ✓ 学習コスト低い ✗
メモリに収まらないと動かない ⚡ Spark 複数マシンに分散して並列処理 処理できるデータ量 〜PB級 ✓ 大規模データ OK ✓ 高速 ✗ 小規模だとオーバーヘッド 企業の実データは数十GB〜TBが当たり前 → Sparkが必要になる なぜPandasではなくSparkなのか? 31 データサイズと処理方式の違いを理解しましょう -
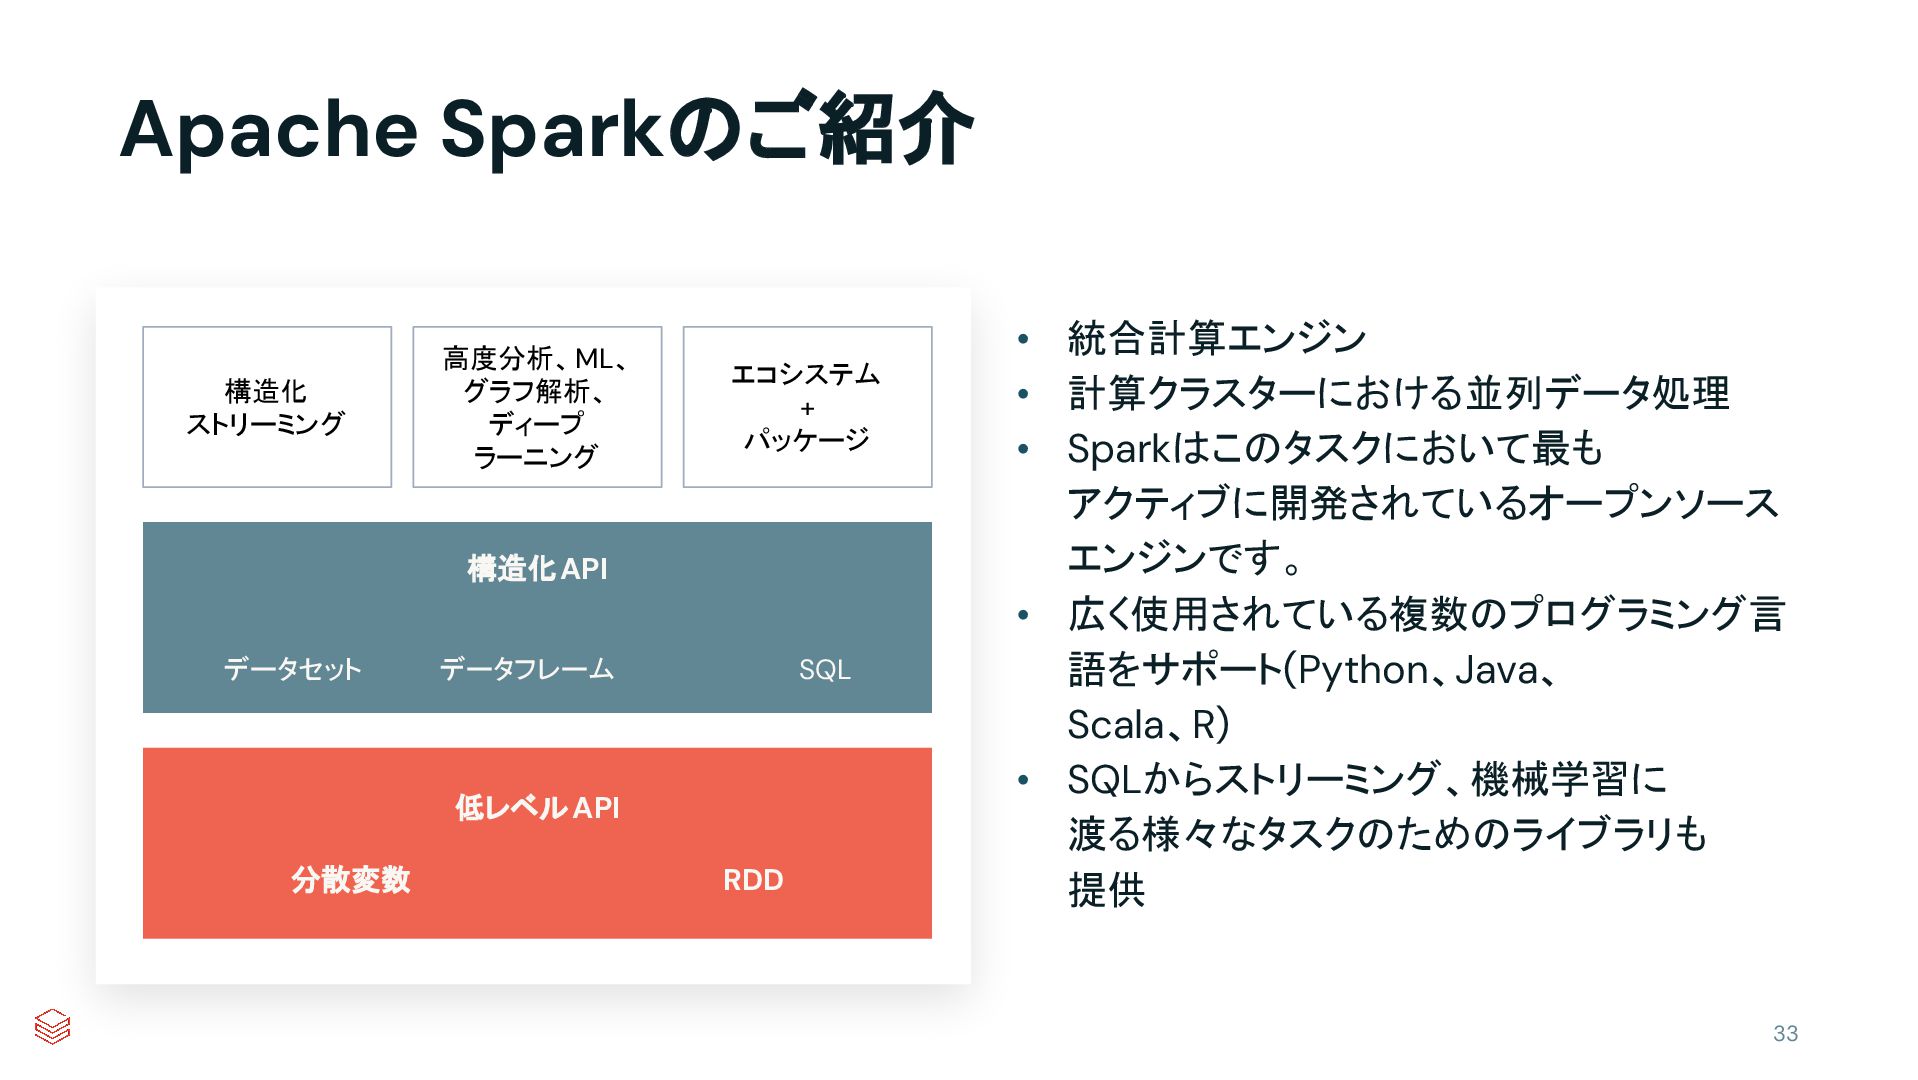
Apache Sparkのご紹介 • 統合計算エンジン • 計算クラスターにおける並列データ処理 • Sparkはこのタスクにおいて最も アクティブに開発されているオープンソース エンジンです。
• 広く使用されている複数のプログラミング言 語をサポート(Python、Java、 Scala、R) • SQLからストリーミング、機械学習に 渡る様々なタスクのためのライブラリも 提供 33 構造化 ストリーミング 構造化API データセット データフレーム SQL 高度分析、ML、 グラフ解析、 ディープ ラーニング エコシステム + パッケージ 低レベルAPI 分散変数 RDD -
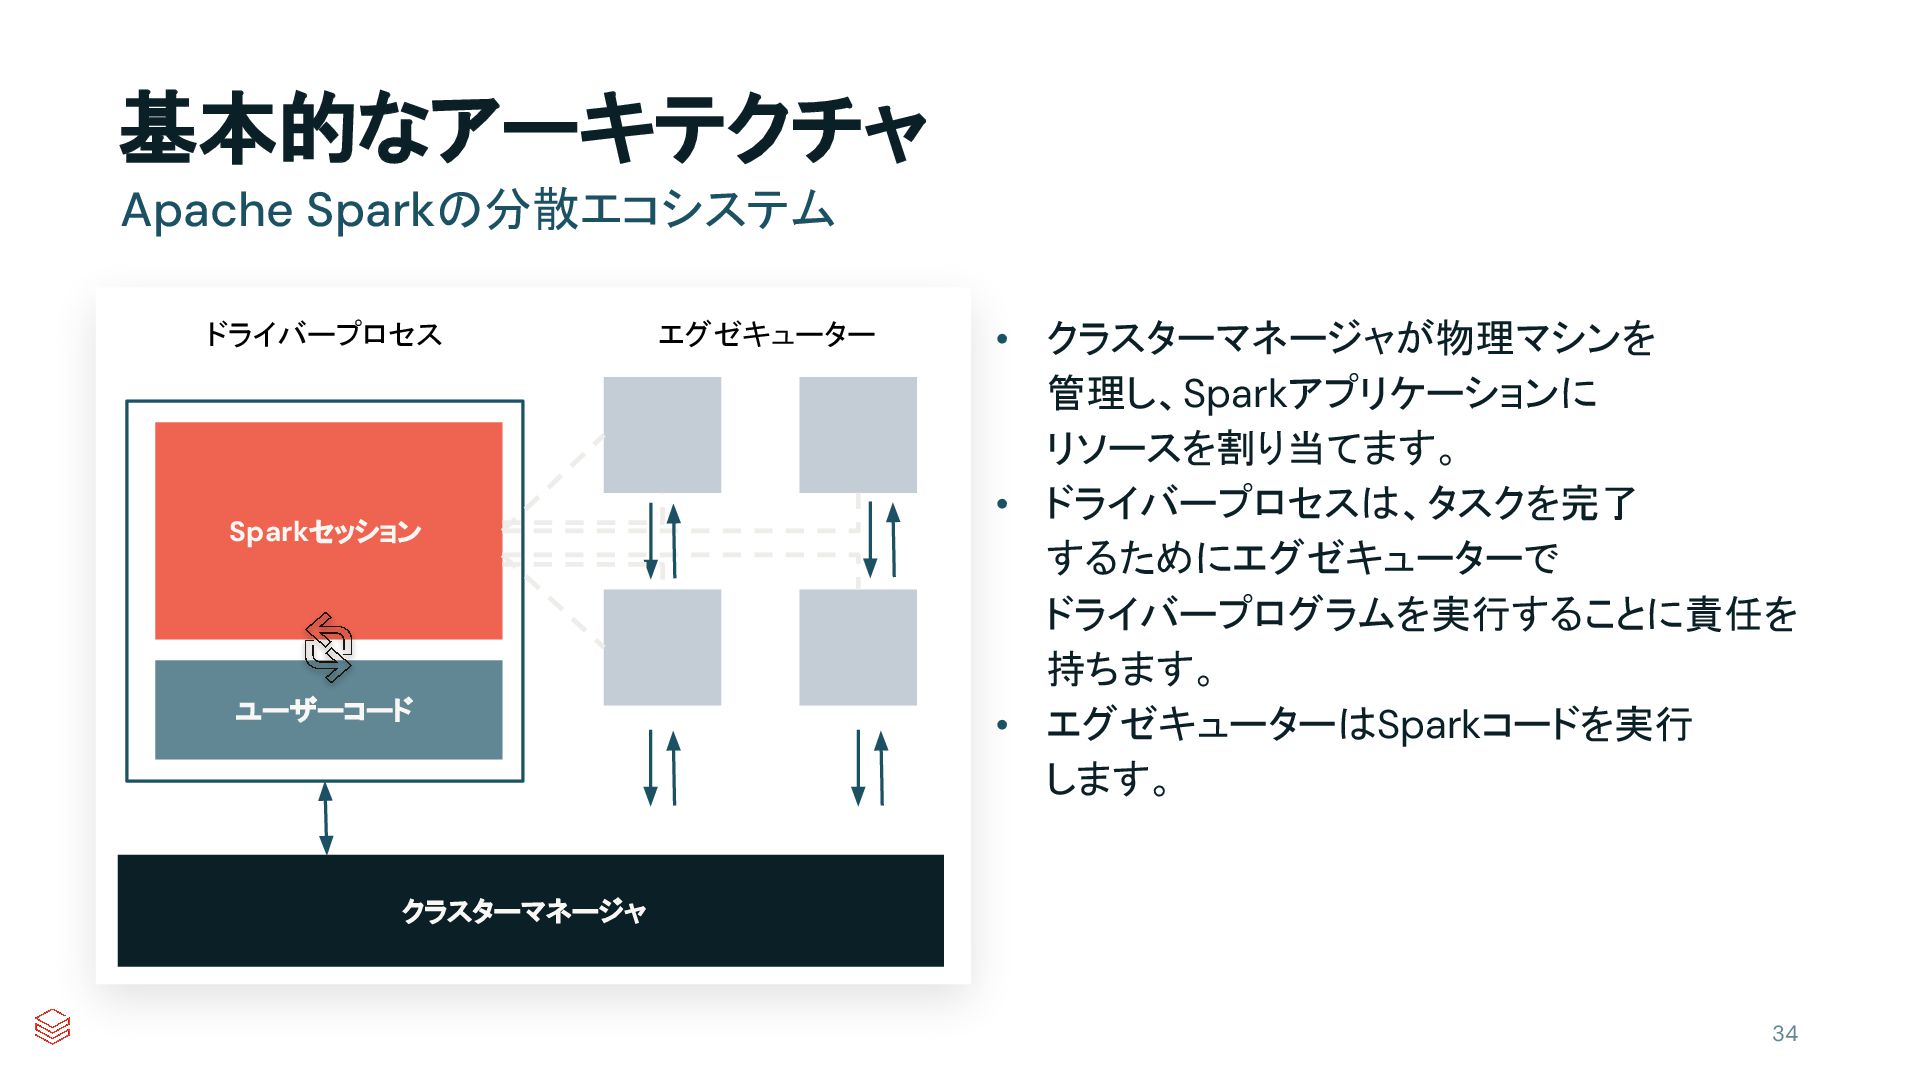
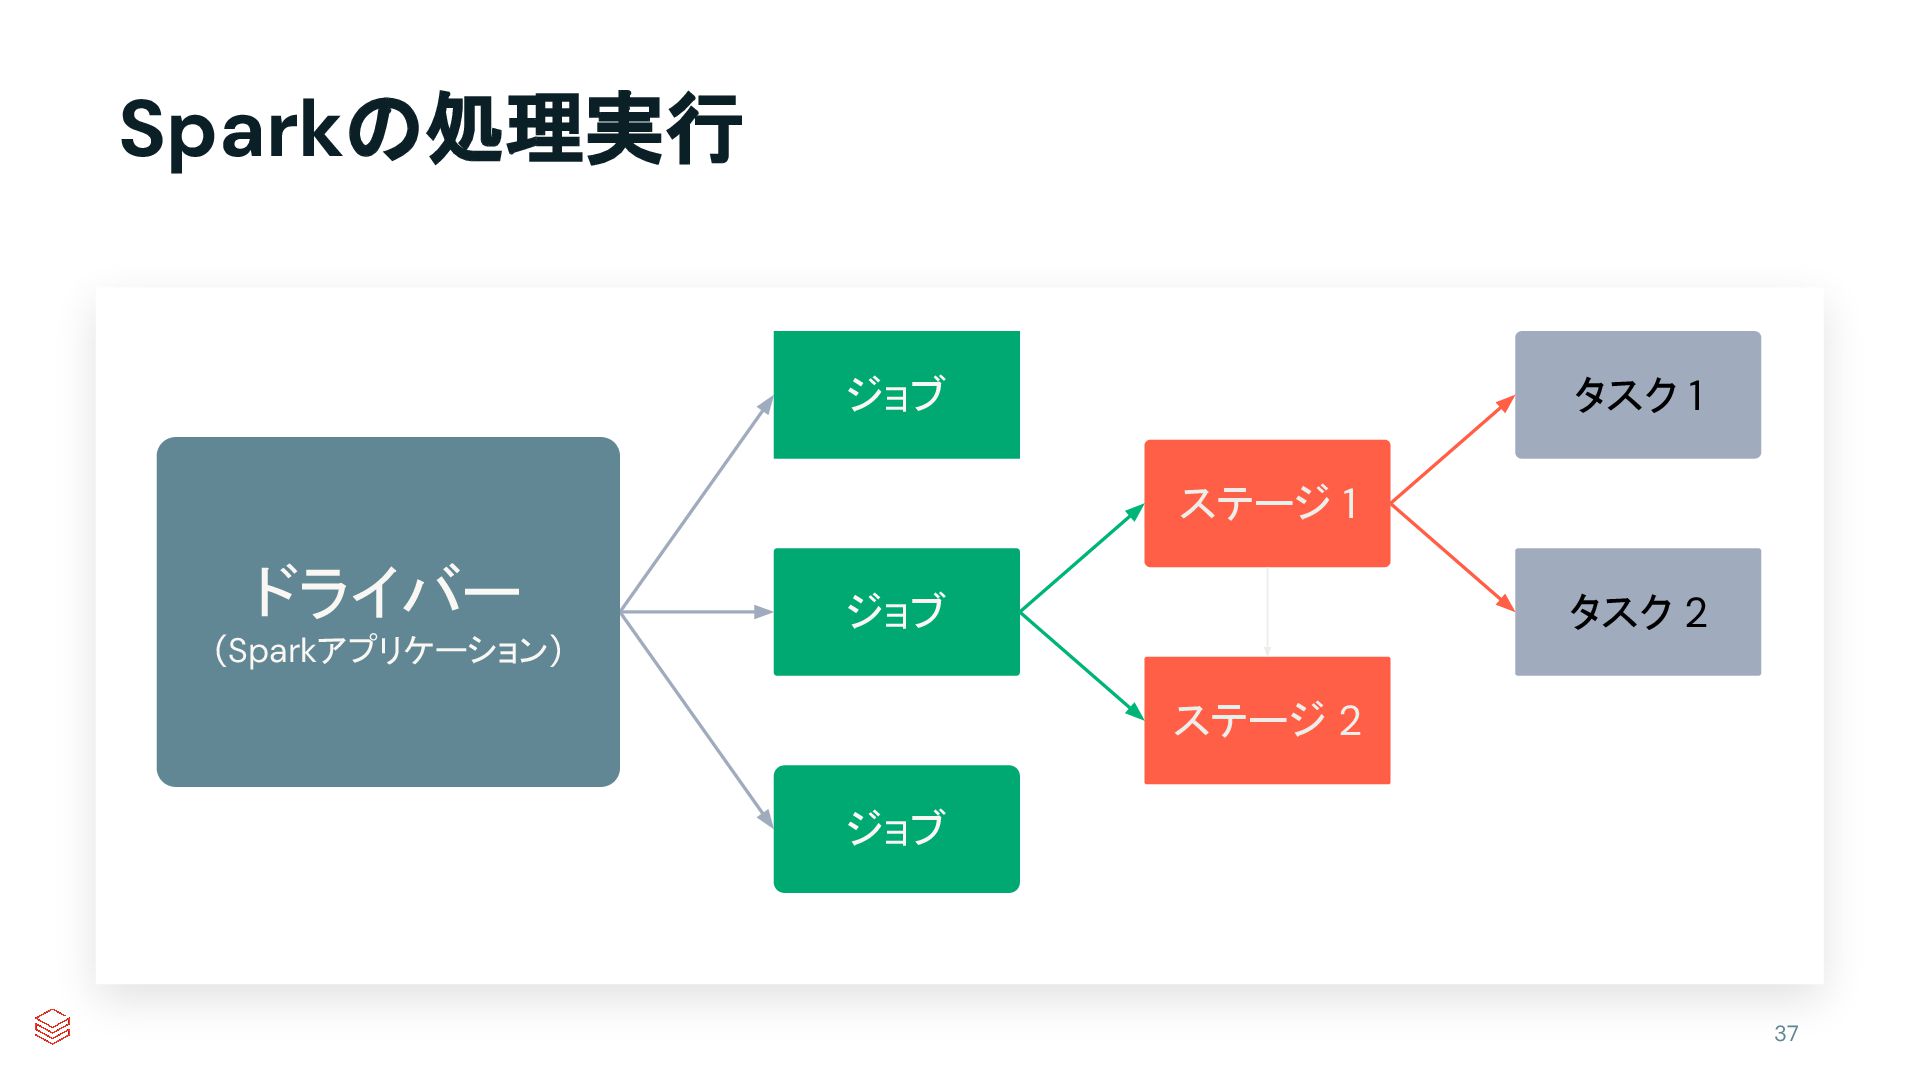
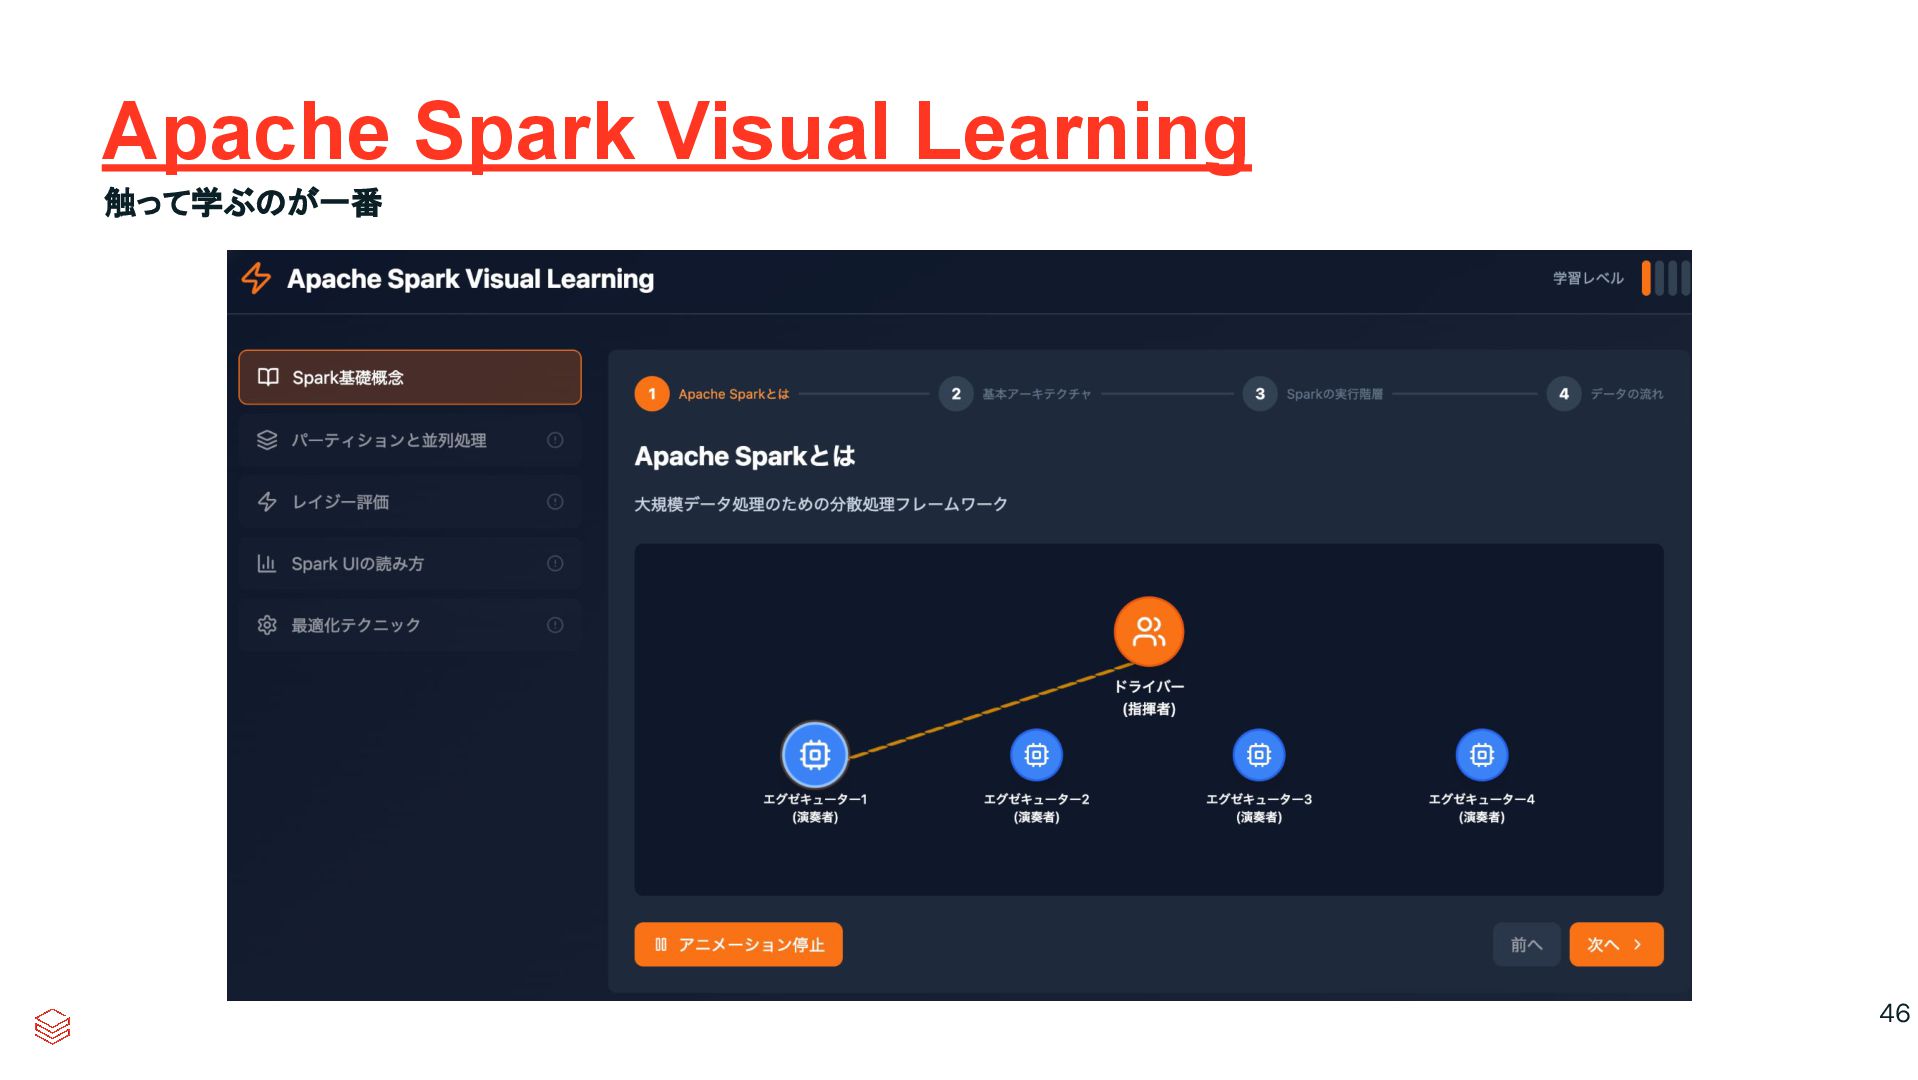
基本的なアーキテクチャ • クラスターマネージャが物理マシンを 管理し、Sparkアプリケーションに リソースを割り当てます。 • ドライバープロセスは、タスクを完了 するためにエグゼキューターで ドライバープログラムを実行することに責任を 持ちます。
• エグゼキューターはSparkコードを実行 します。 Apache Sparkの分散エコシステム クラスターマネージャ 34 Sparkセッション ユーザーコード ドライバープロセス エグゼキューター -
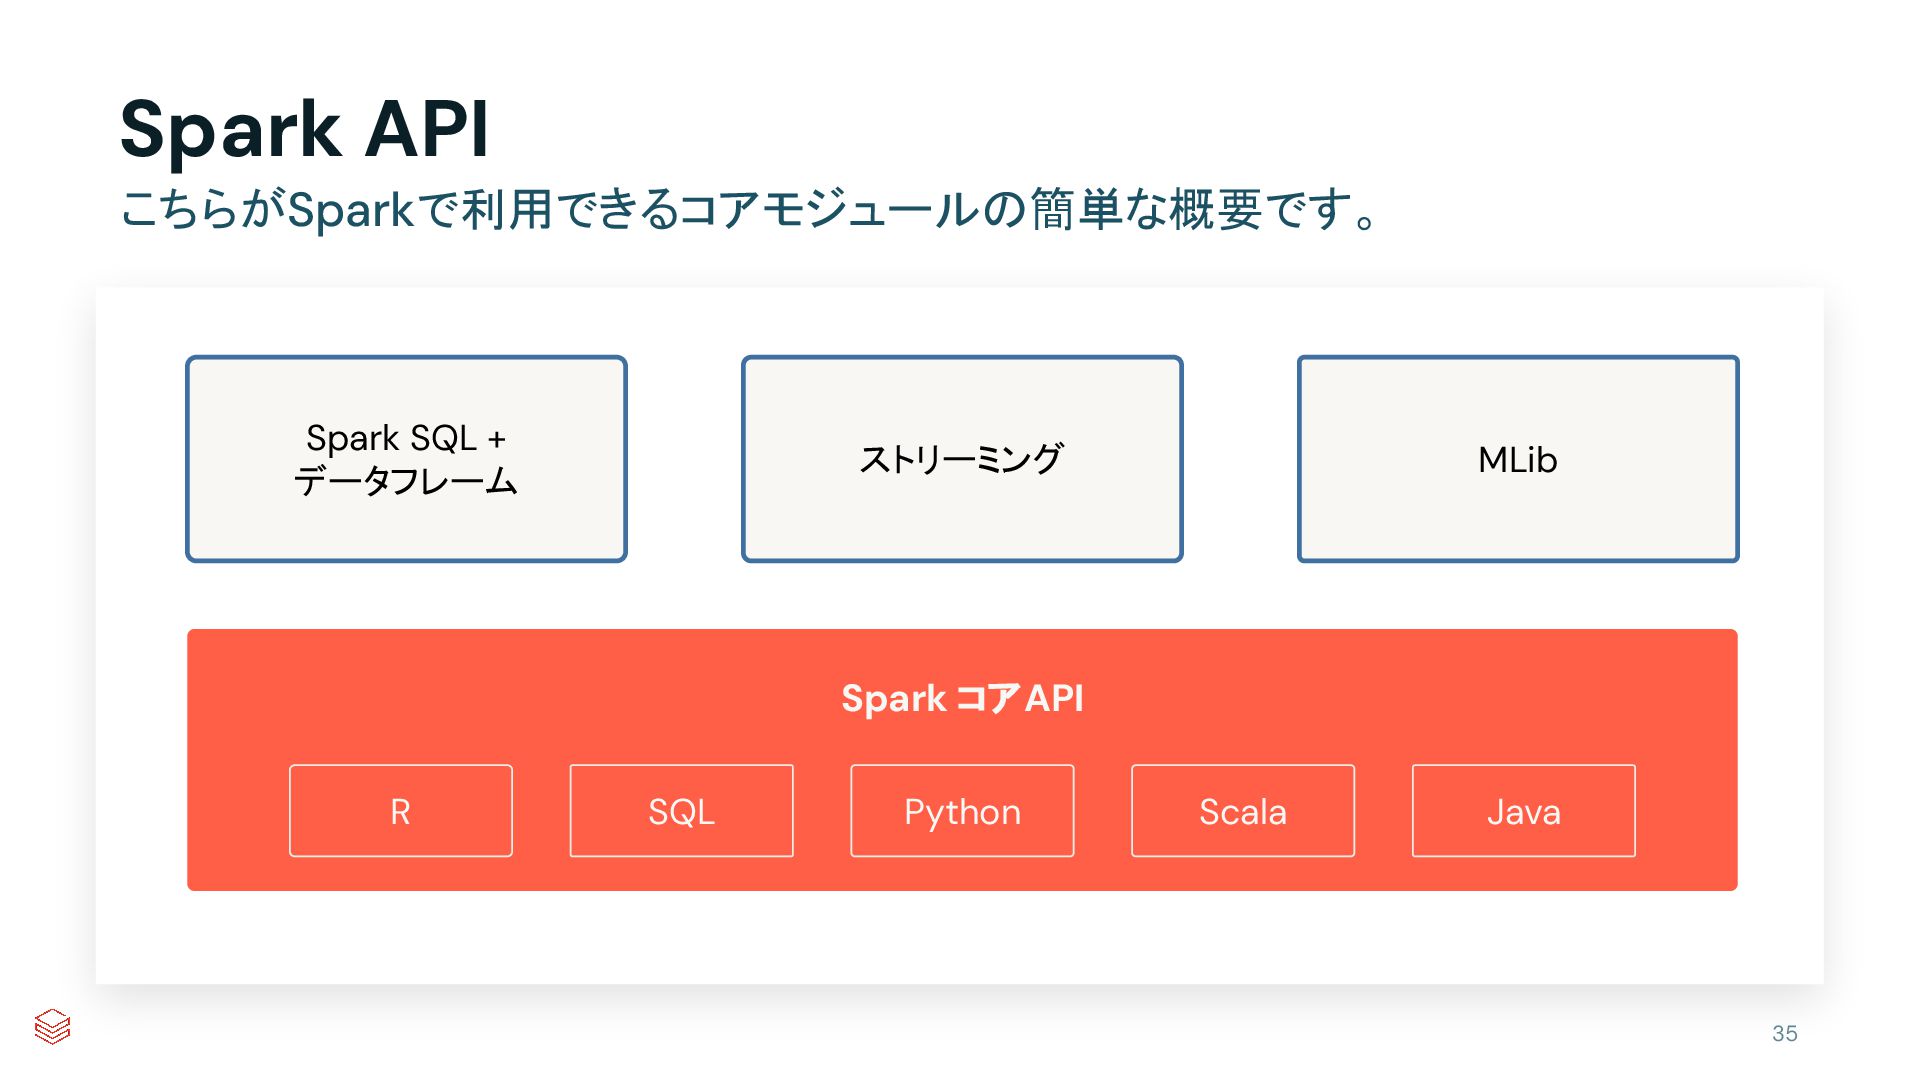
Spark API こちらがSparkで利用できるコアモジュールの簡単な概要です。 35 Spark SQL + データフレーム ストリーミング MLib
SQL Python Scala Java R Spark コアAPI -
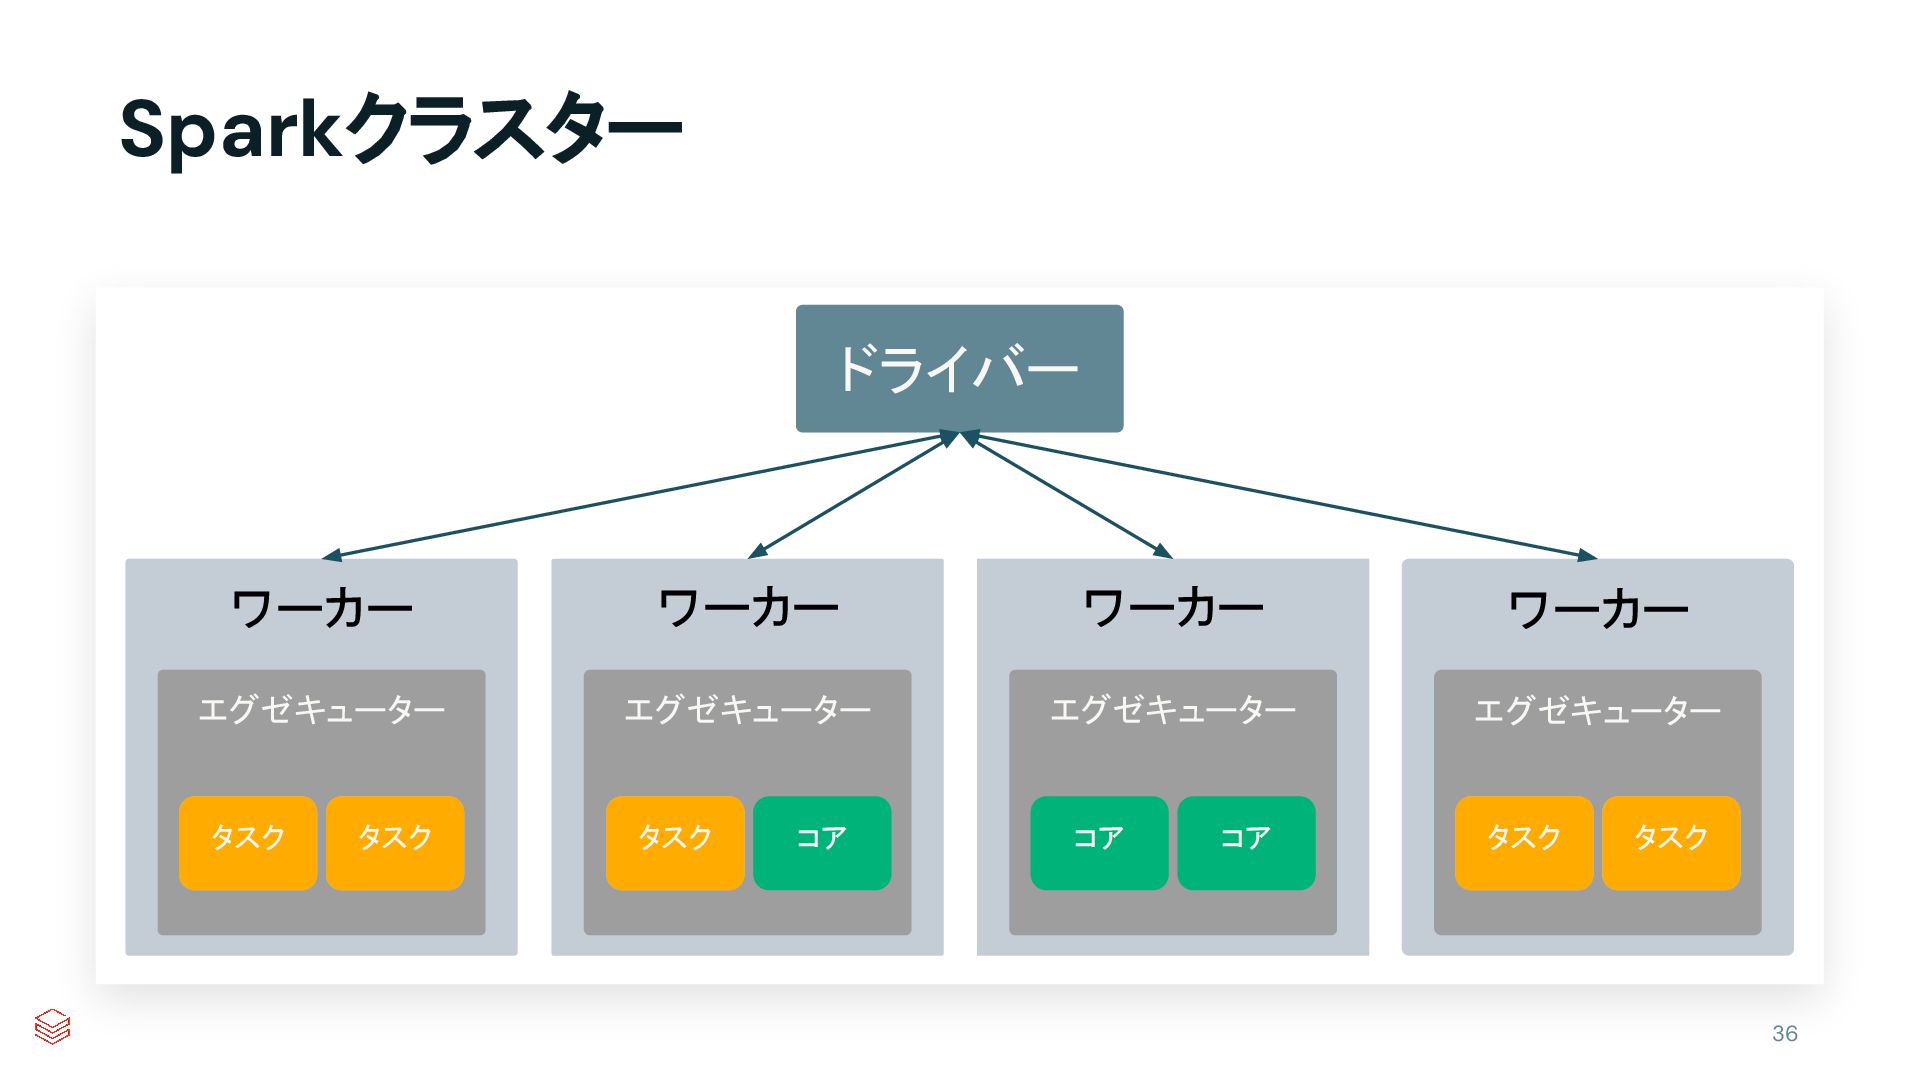
ワーカー ワーカー ワーカー ワーカー ドライバー エグゼキューター エグゼキューター エグゼキューター エグゼキューター Core
Core Core コア コア コア Core Core Sparkクラスター タスク タスク タスク タスク タスク 36 -
Sparkの処理実行 ジョブ ジョブ ジョブ ステージ 1 ステージ 2 タスク 1
タスク 2 37 ドライバー (Sparkアプリケーション) -
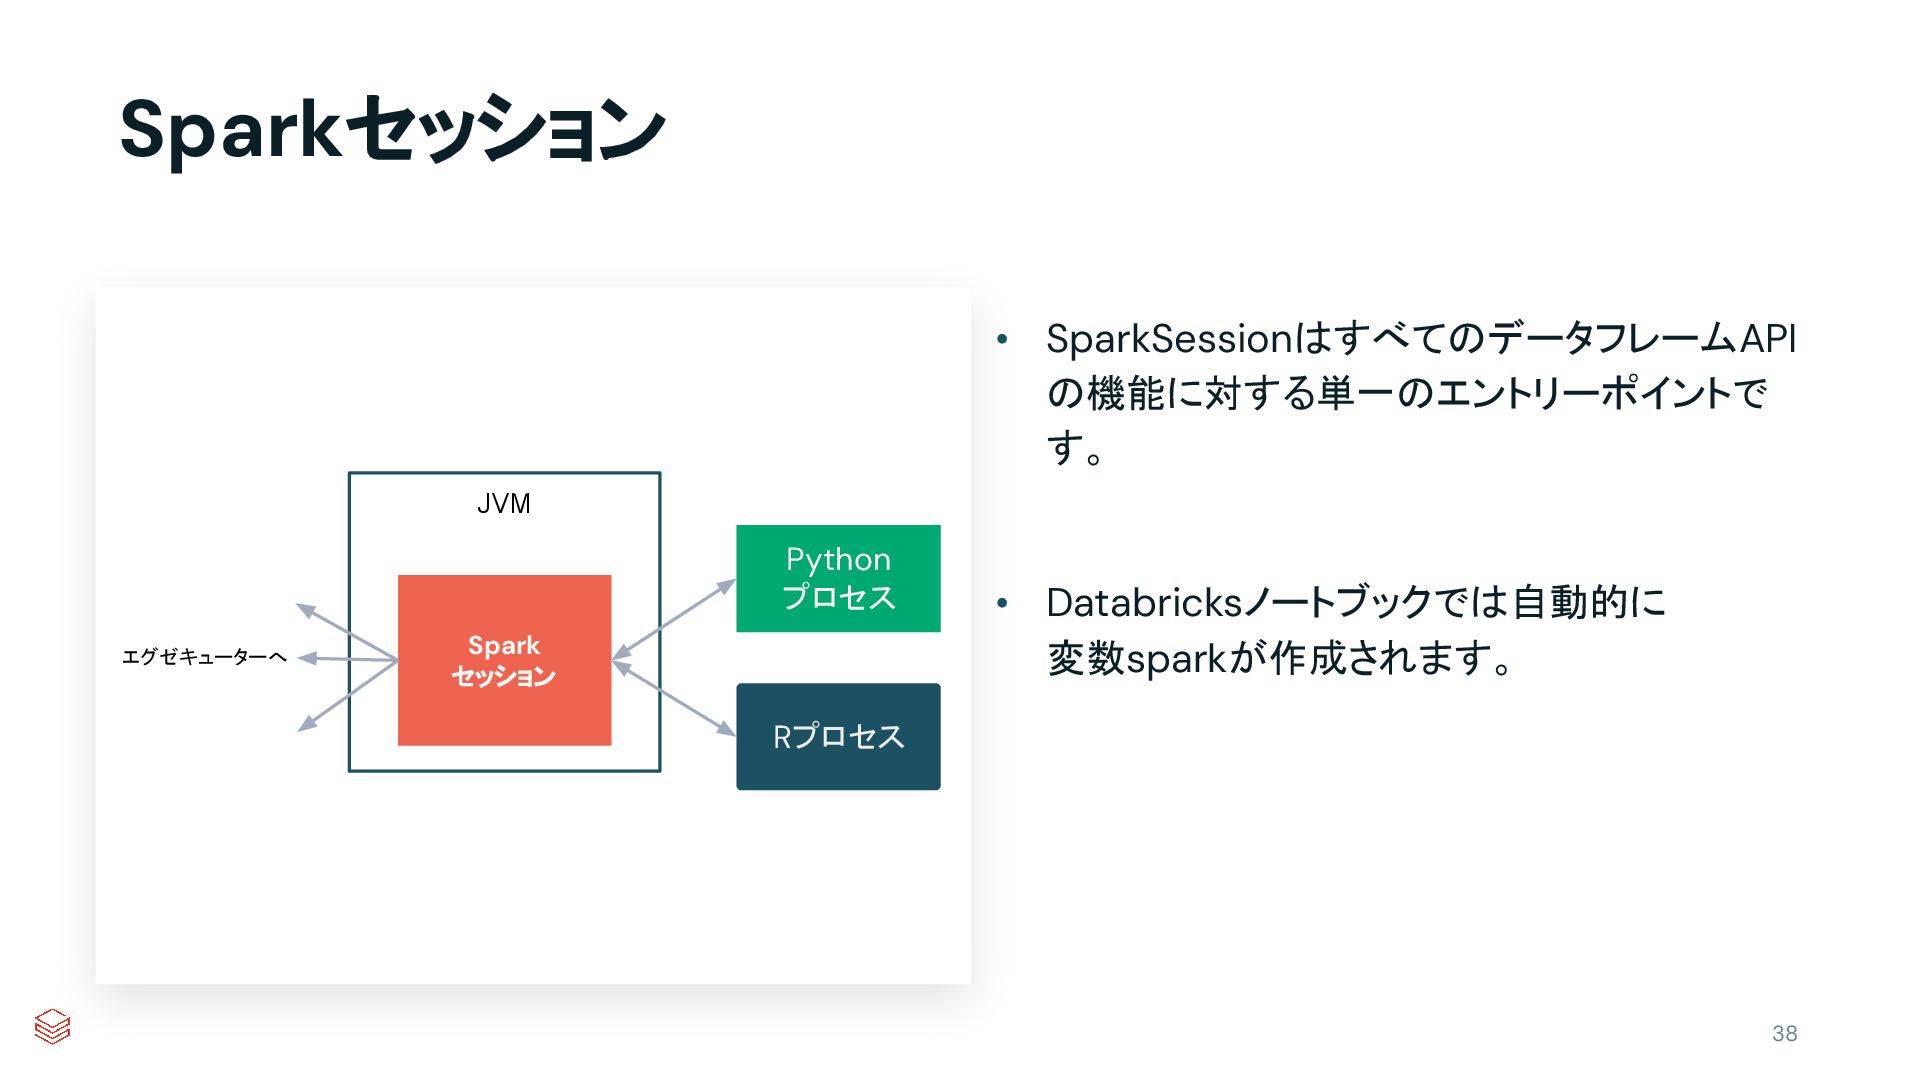
Sparkセッション • SparkSessionはすべてのデータフレームAPI の機能に対する単一のエントリーポイントで す。 • Databricksノートブックでは自動的に 変数sparkが作成されます。 38 JVM
Spark セッション Python プロセス Rプロセス エグゼキューターへ -
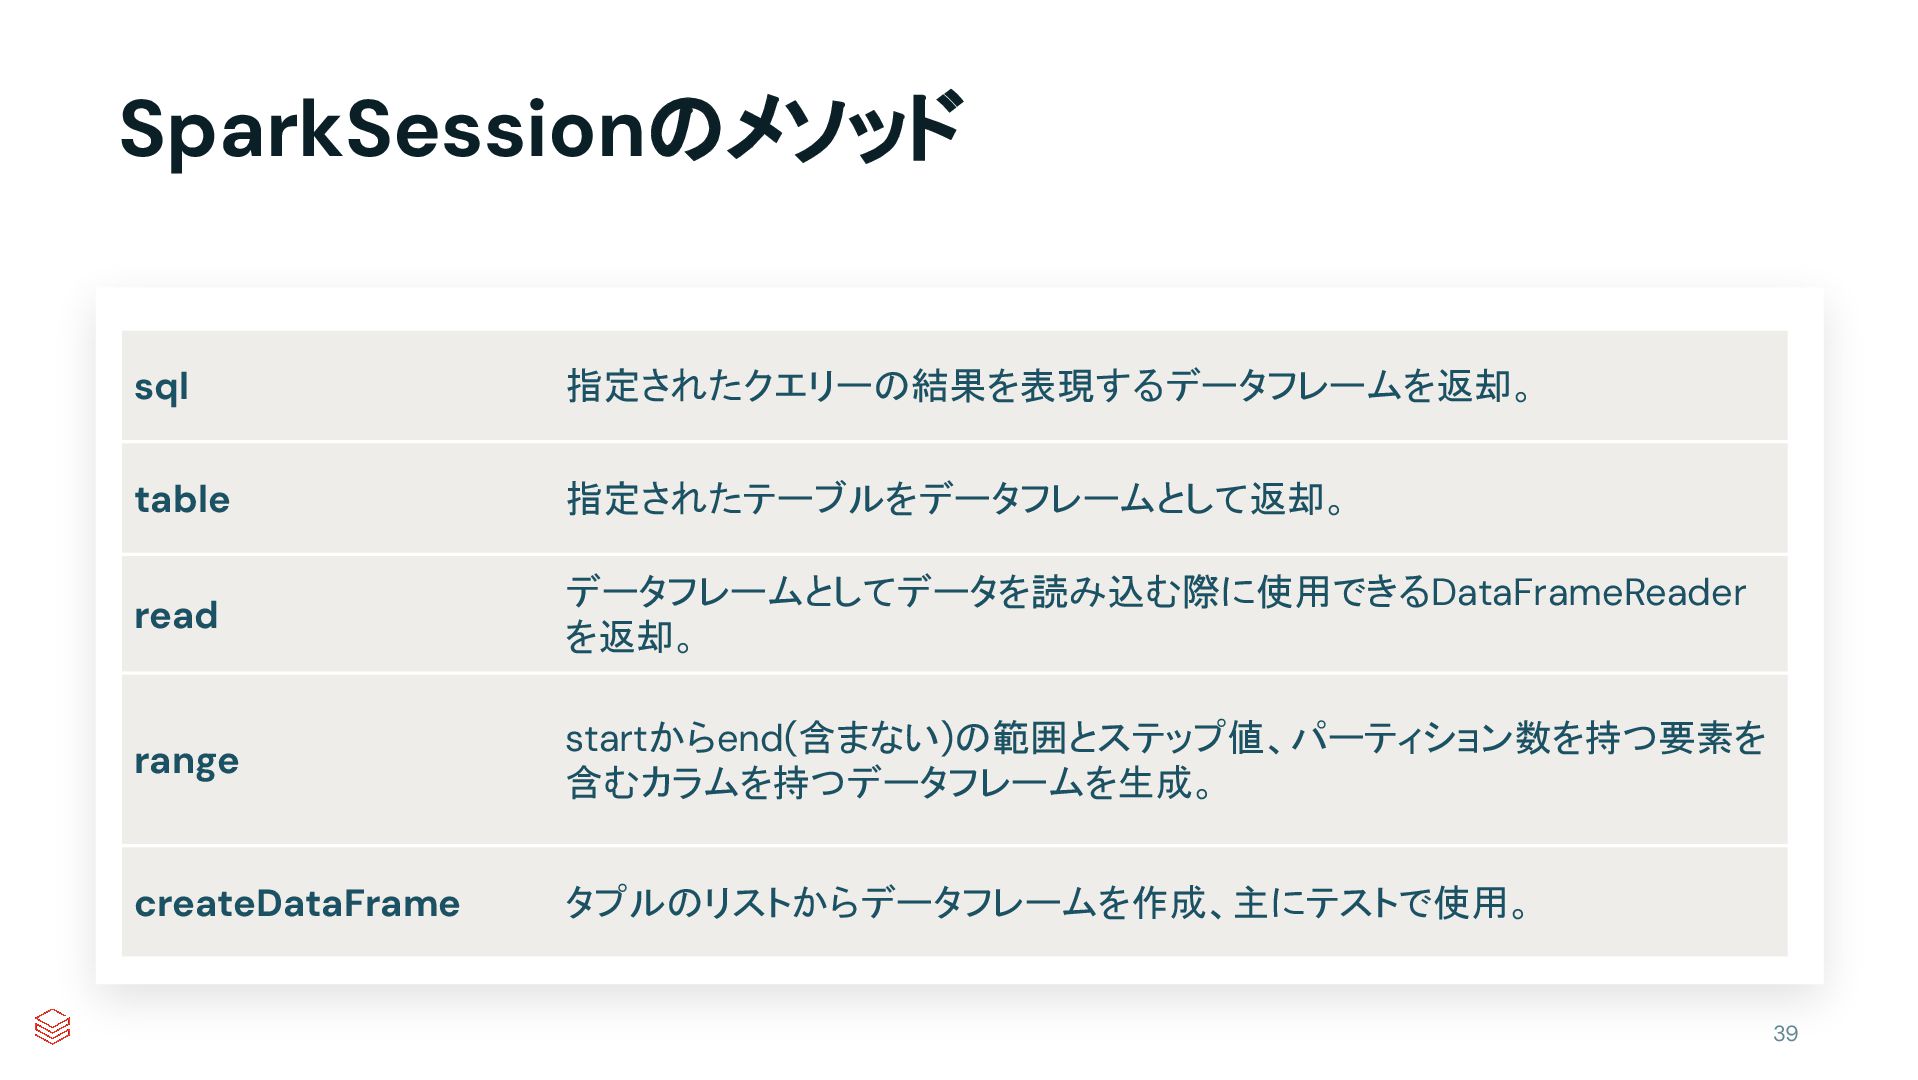
SparkSessionのメソッド 39 sql 指定されたクエリーの結果を表現するデータフレームを返却。 table 指定されたテーブルをデータフレームとして返却。 read データフレームとしてデータを読み込む際に使用できるDataFrameReader を返却。 range
startからend(含まない)の範囲とステップ値、パーティション数を持つ要素を 含むカラムを持つデータフレームを生成。 createDataFrame タプルのリストからデータフレームを作成、主にテストで使用。 -
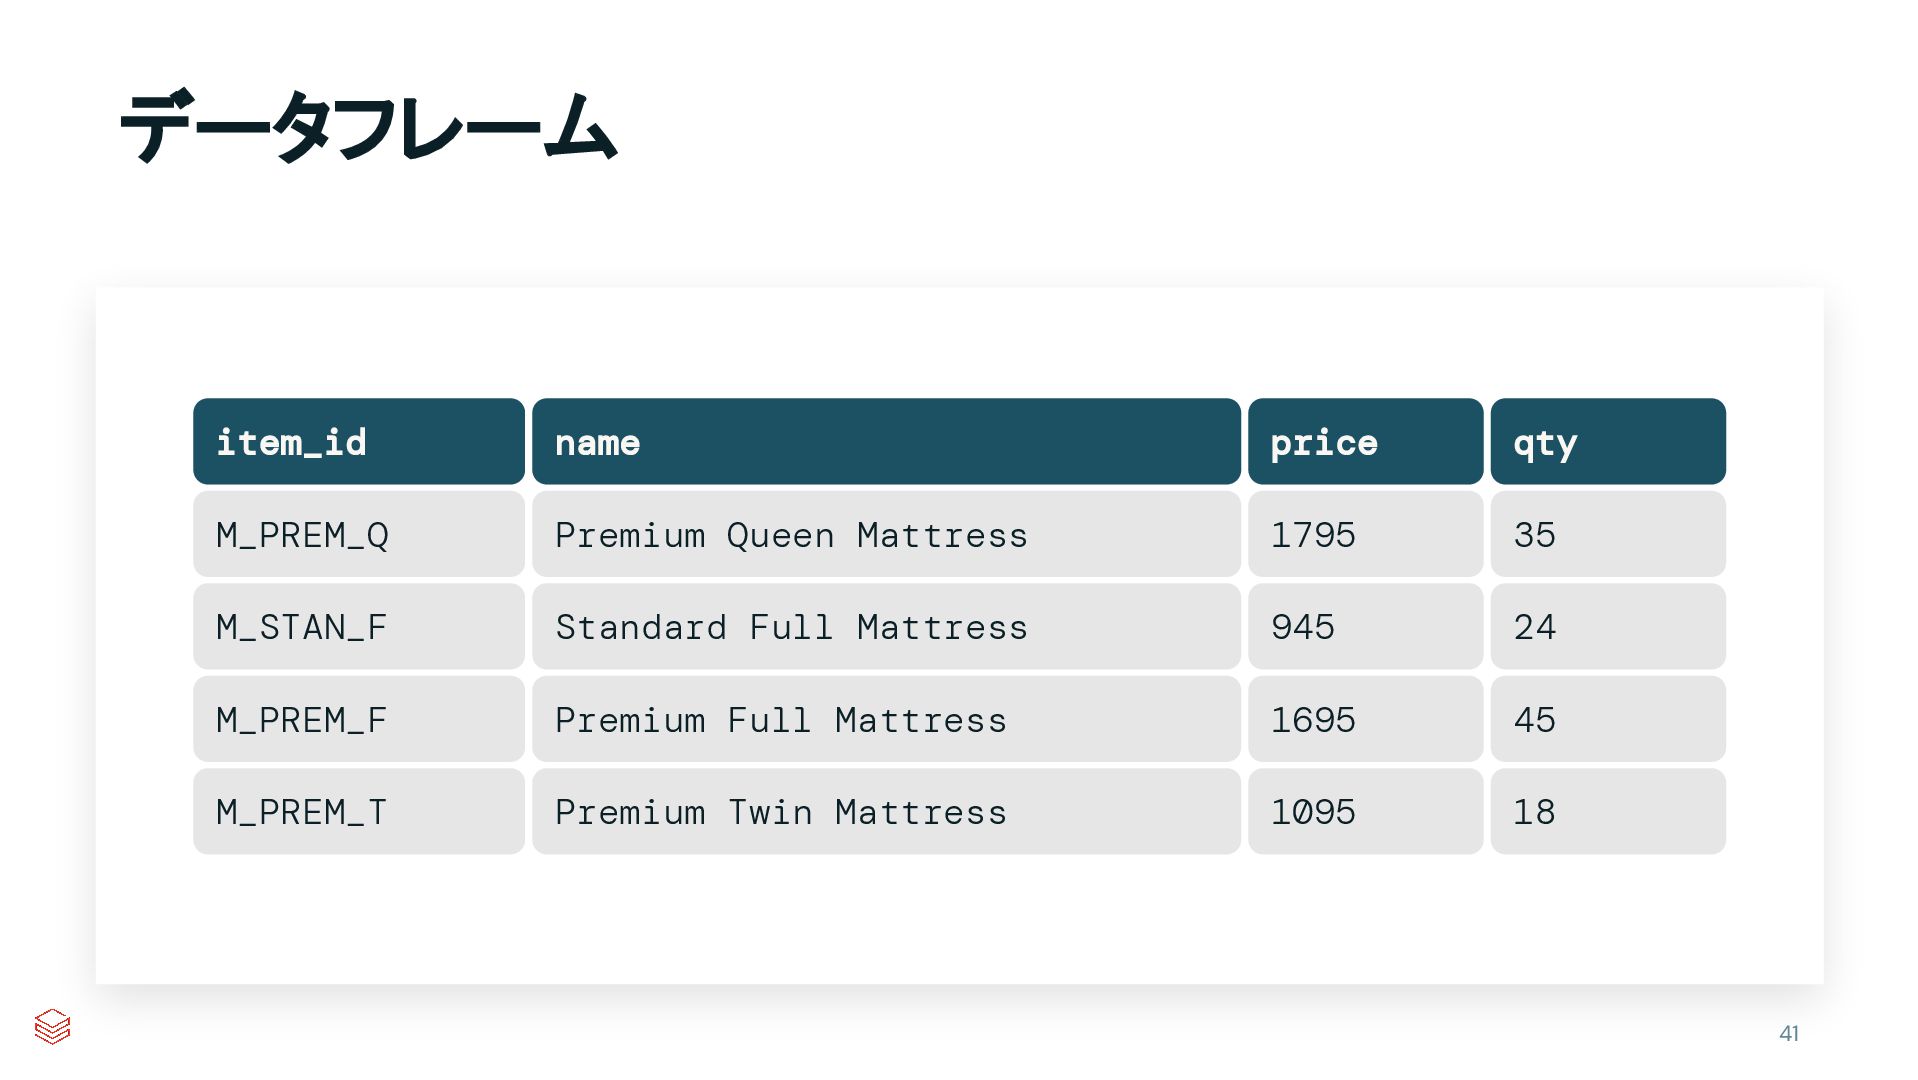
データフレーム 41 item_id name price M_PREM_Q Premium Queen Mattress 1795
M_STAN_F Standard Full Mattress 945 M_PREM_F Premium Full Mattress 1695 M_PREM_T Premium Twin Mattress 1095 qty 35 24 45 18 -
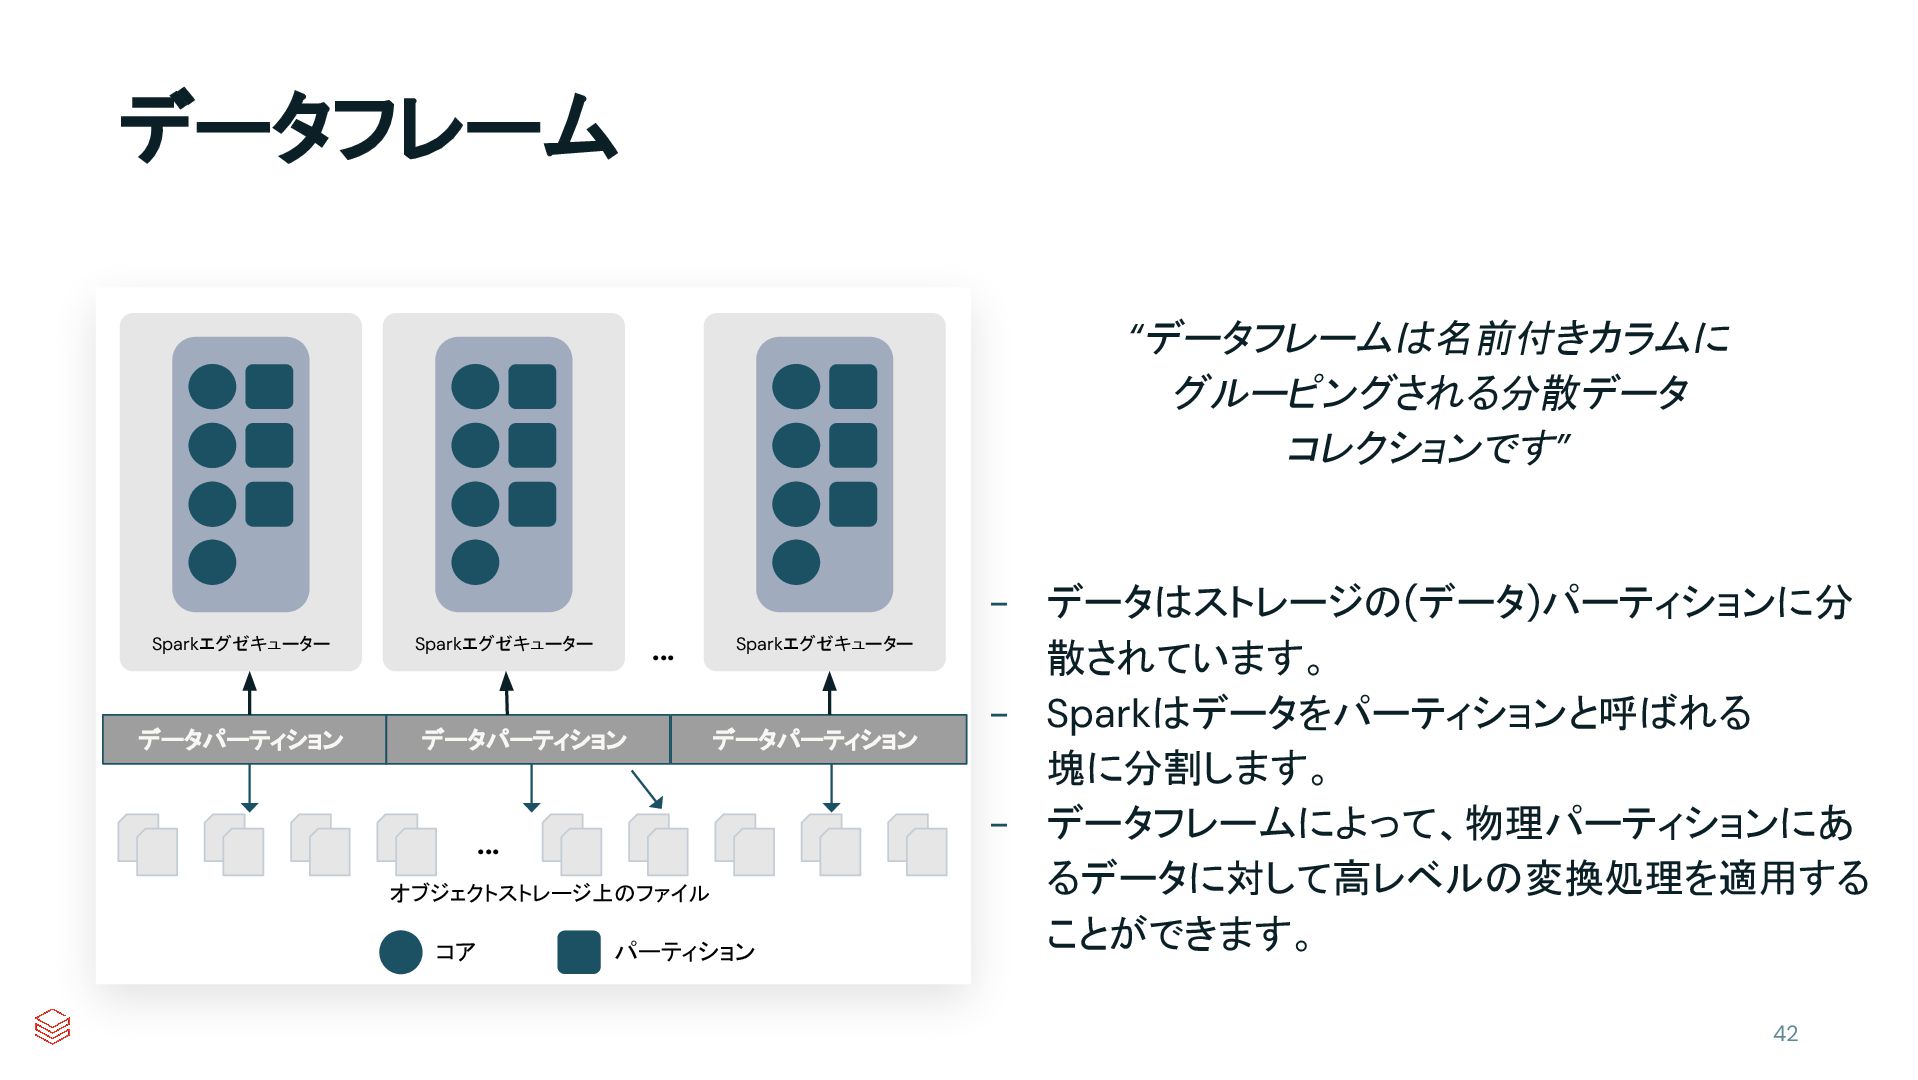
データフレーム “データフレームは名前付きカラムに グルーピングされる分散データ コレクションです” - データはストレージの(データ)パーティションに分 散されています。 - Sparkはデータをパーティションと呼ばれる 塊に分割します。
- データフレームによって、物理パーティションにあ るデータに対して高レベルの変換処理を適用する ことができます。 42 オブジェクトストレージ上のファイル データパーティション データパーティション データパーティション Sparkエグゼキューター Sparkエグゼキューター Sparkエグゼキューター ... コア パーティション ... -
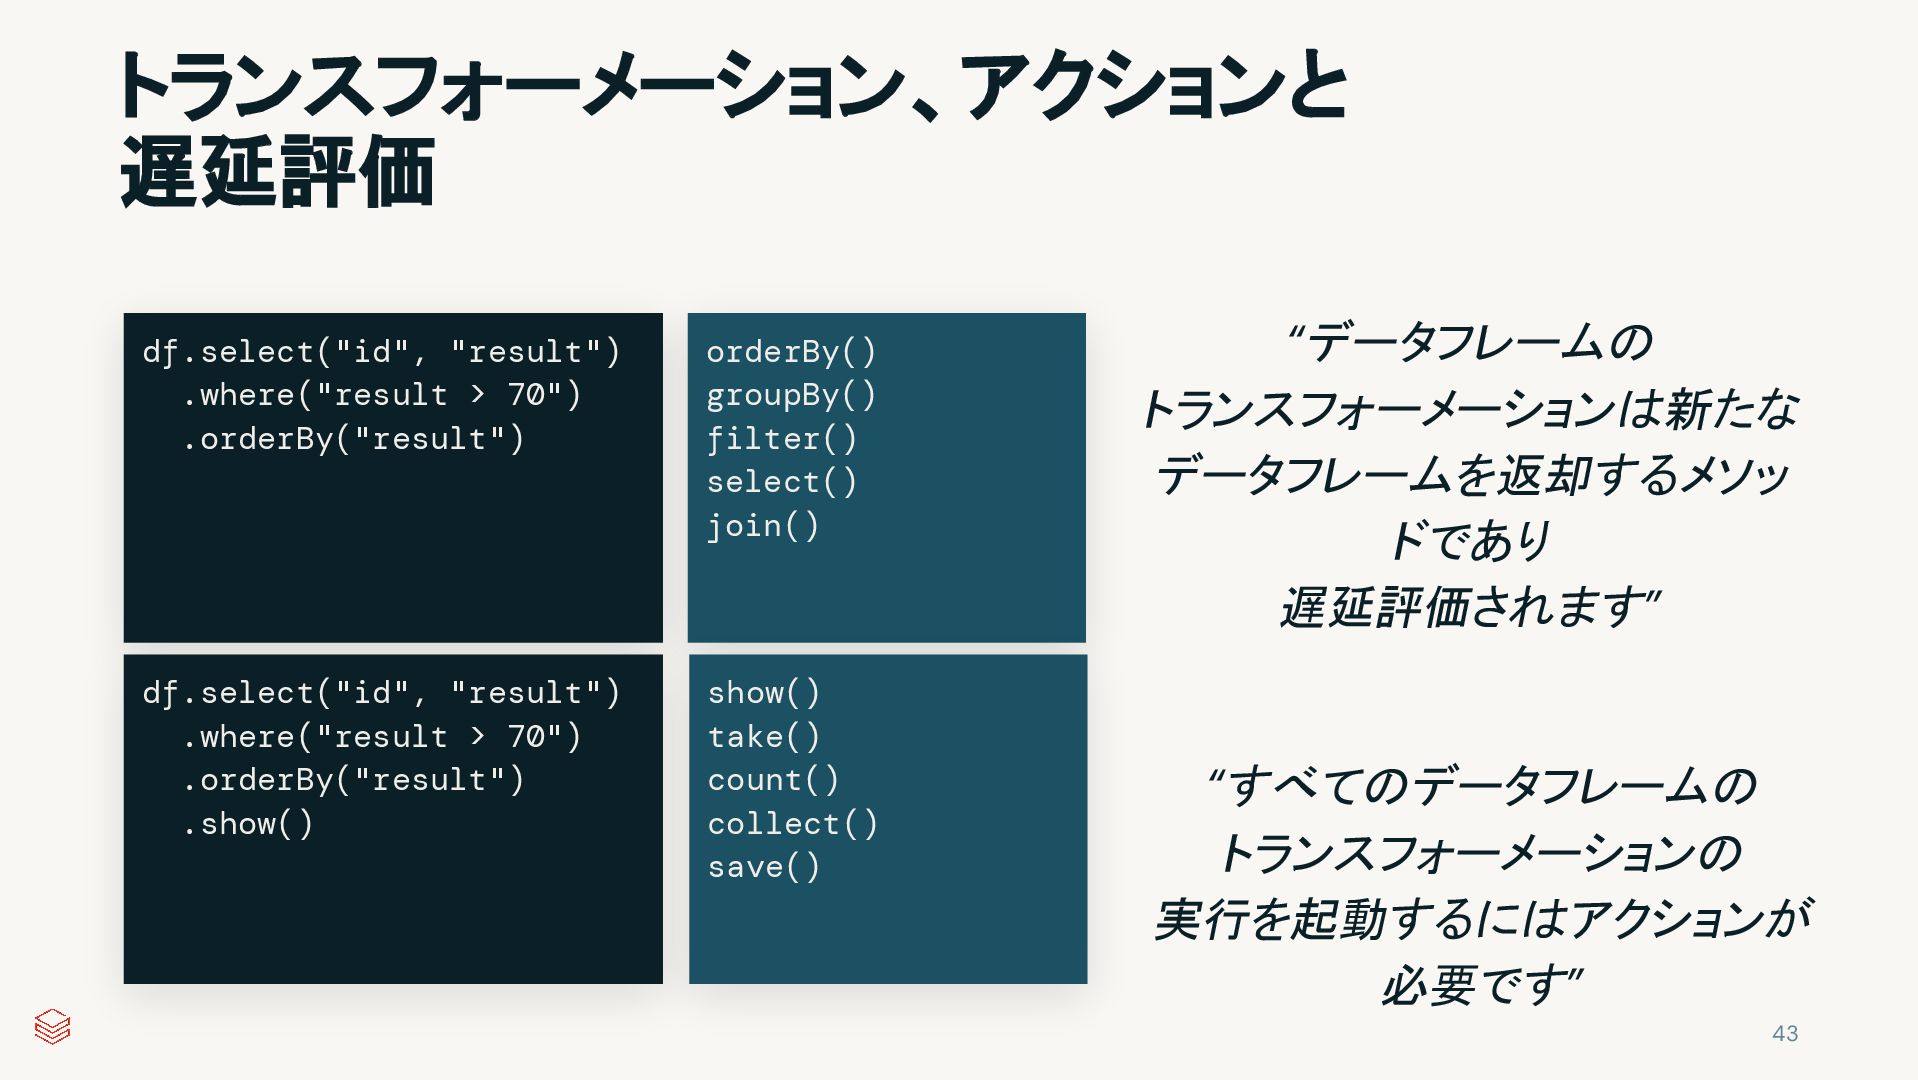
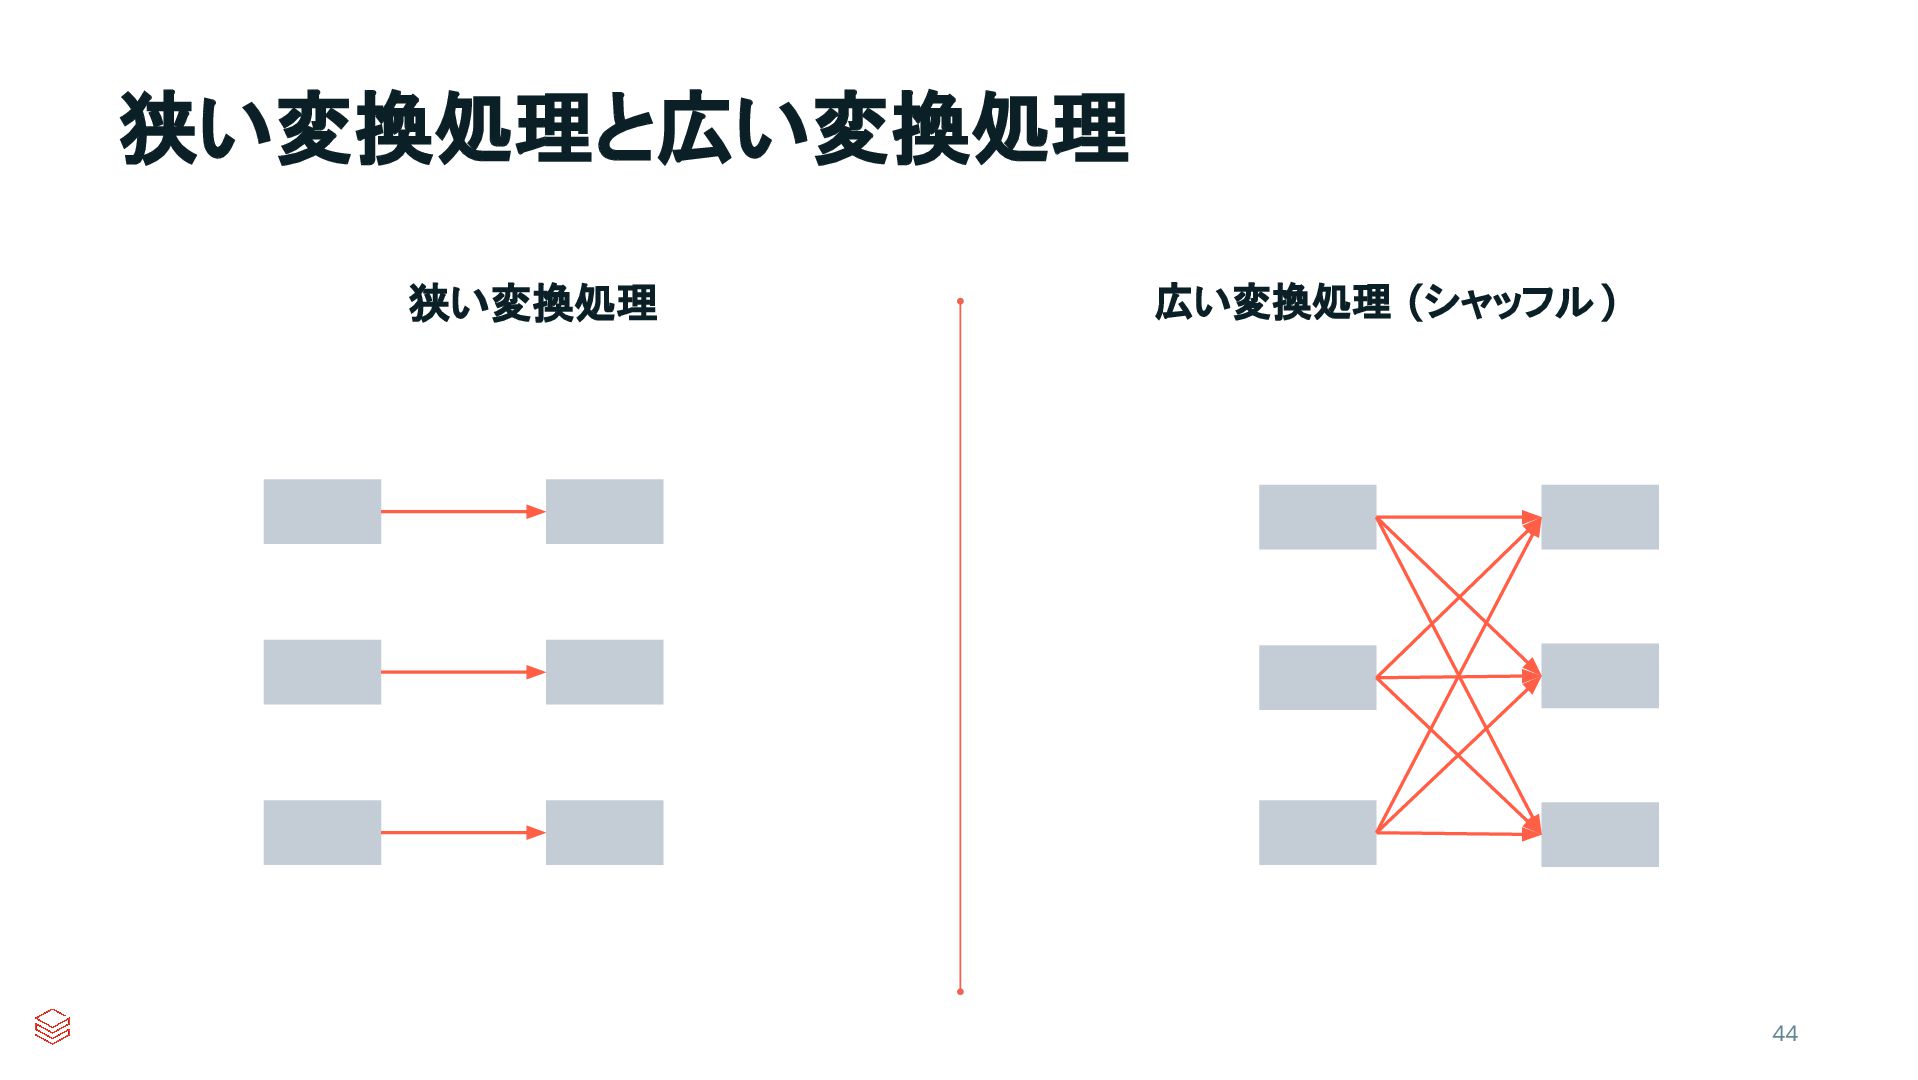
トランスフォーメーション、アクションと 遅延評価 “データフレームの トランスフォーメーションは新たな データフレームを返却するメソッ ドであり 遅延評価されます” 43 “すべてのデータフレームの トランスフォーメーションの
実行を起動するにはアクションが 必要です” df.select("id", "result") .where("result > 70") .orderBy("result") df.select("id", "result") .where("result > 70") .orderBy("result") .show() orderBy() groupBy() filter() select() join() show() take() count() collect() save() -
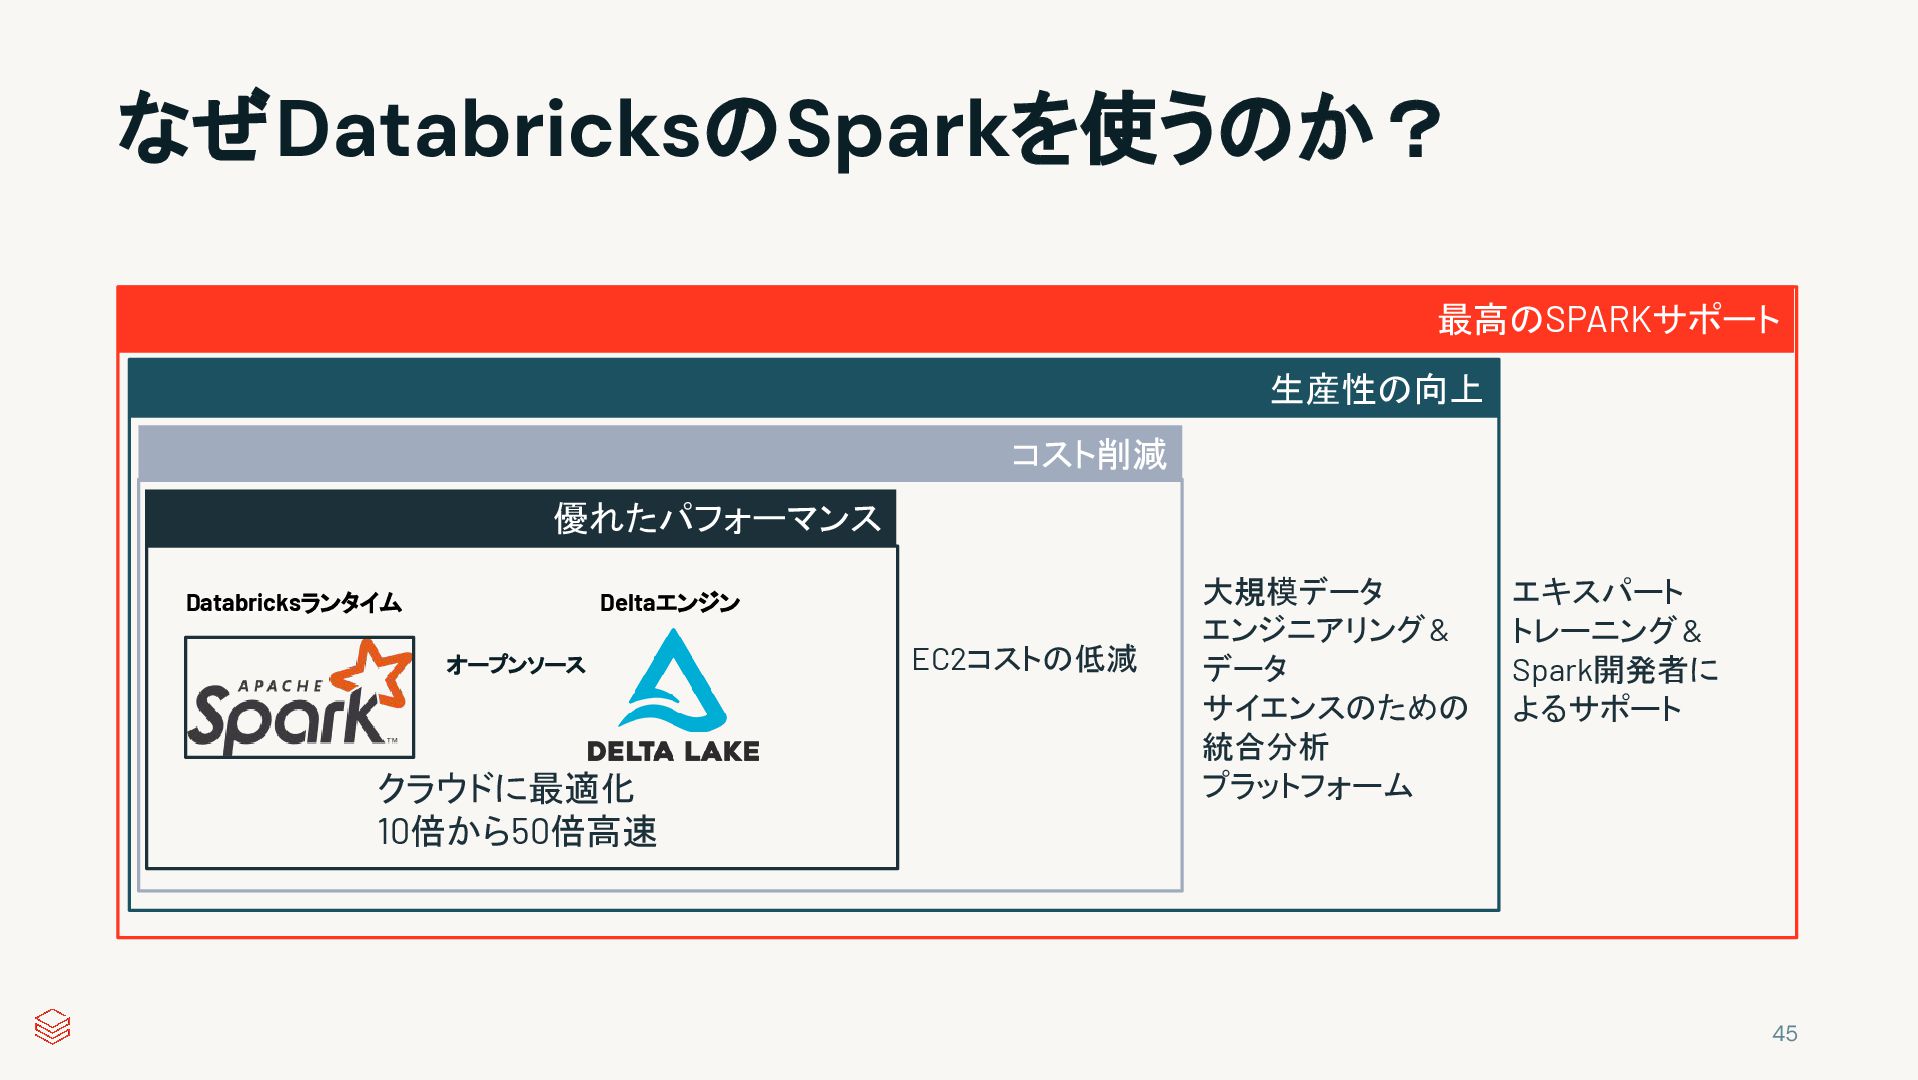
なぜDatabricksのSparkを使うのか? 45 EC2コストの低減 オープンソース 生産性の向上 大規模データ エンジニアリング & データ サイエンスのための
統合分析 プラットフォーム コスト削減 最高のSPARKサポート エキスパート トレーニング & Spark開発者に よるサポート 優れたパフォーマンス クラウドに最適化 10倍から50倍高速 Databricksランタイム Deltaエンジン -
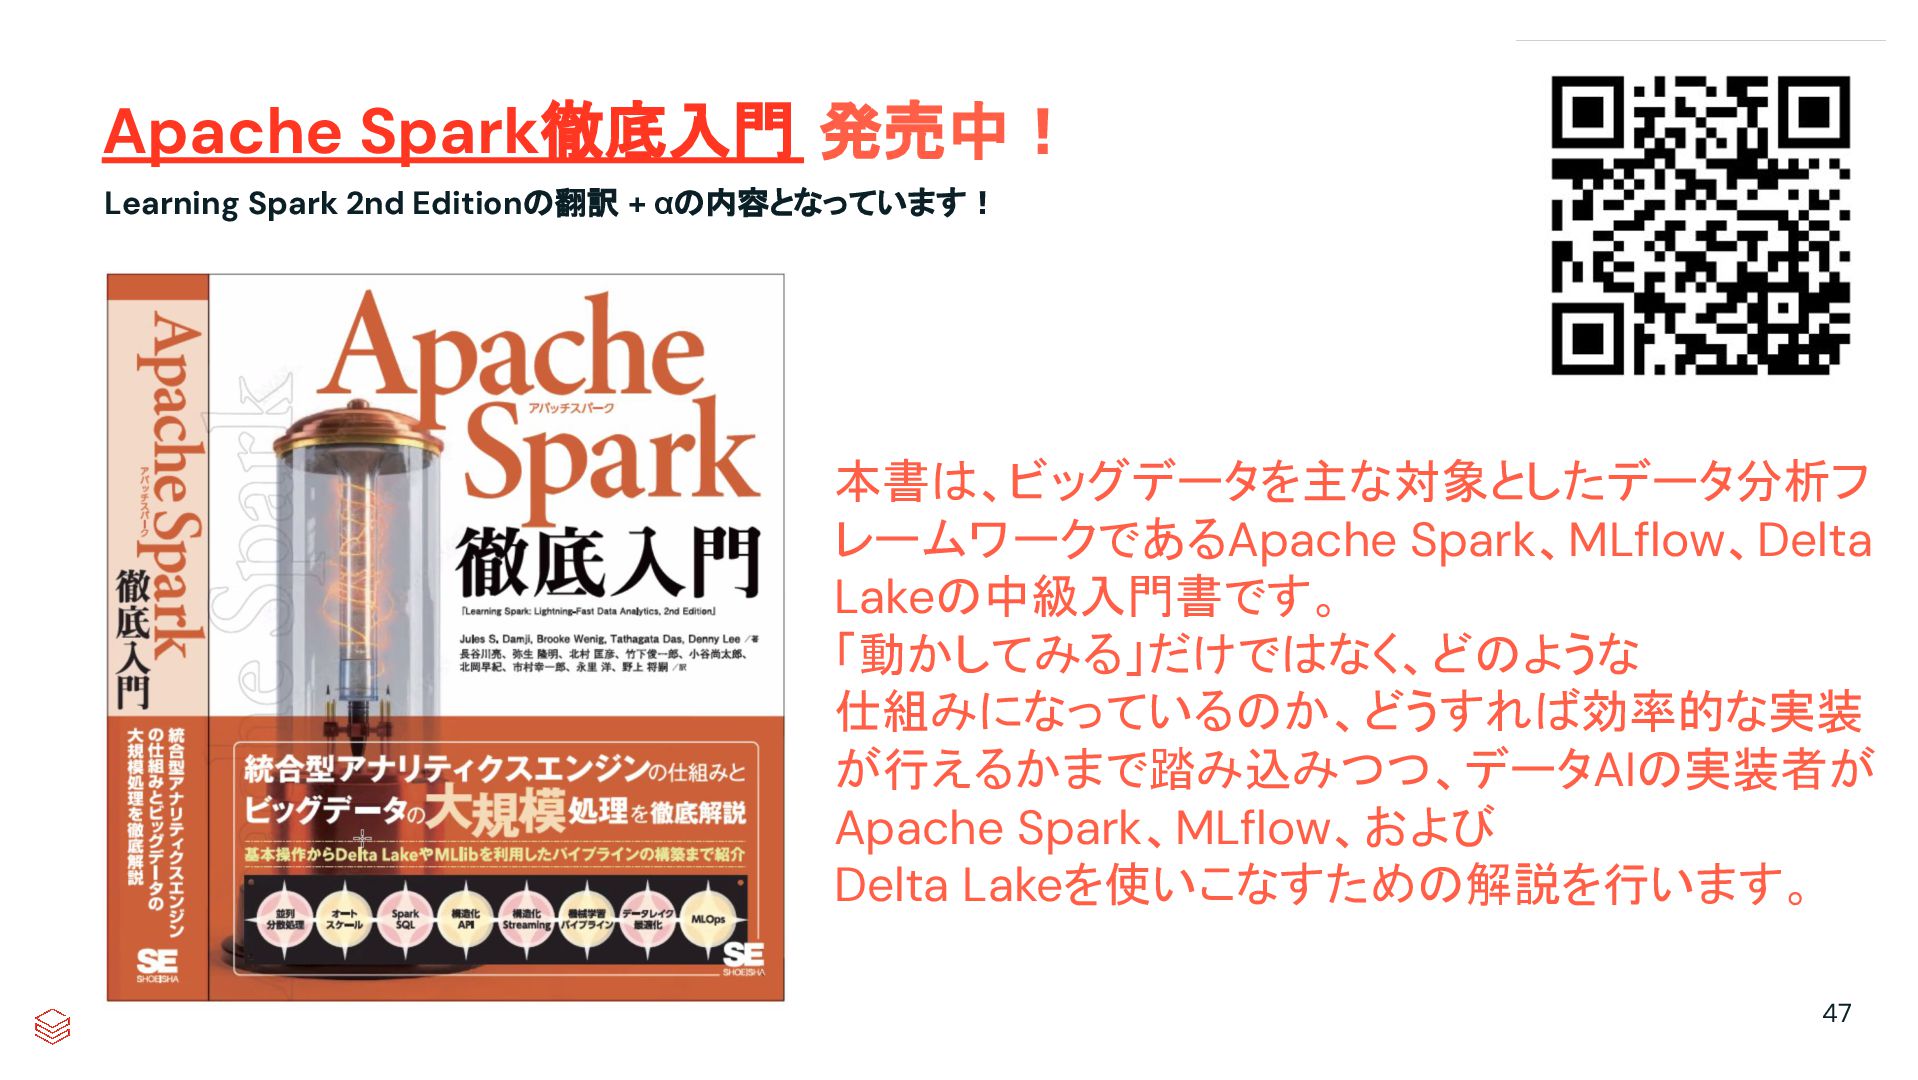
Apache Spark徹底入門 発売中! Learning Spark 2nd Editionの翻訳 + αの内容となっています! 本書は、ビッグデータを主な対象としたデータ分析フ
レームワークであるApache Spark、MLflow、Delta Lakeの中級入門書です。 「動かしてみる」だけではなく、どのような 仕組みになっているのか、どうすれば効率的な実装 が行えるかまで踏み込みつつ、データAIの実装者が Apache Spark、MLflow、および Delta Lakeを使いこなすための解説を行います。 47 -
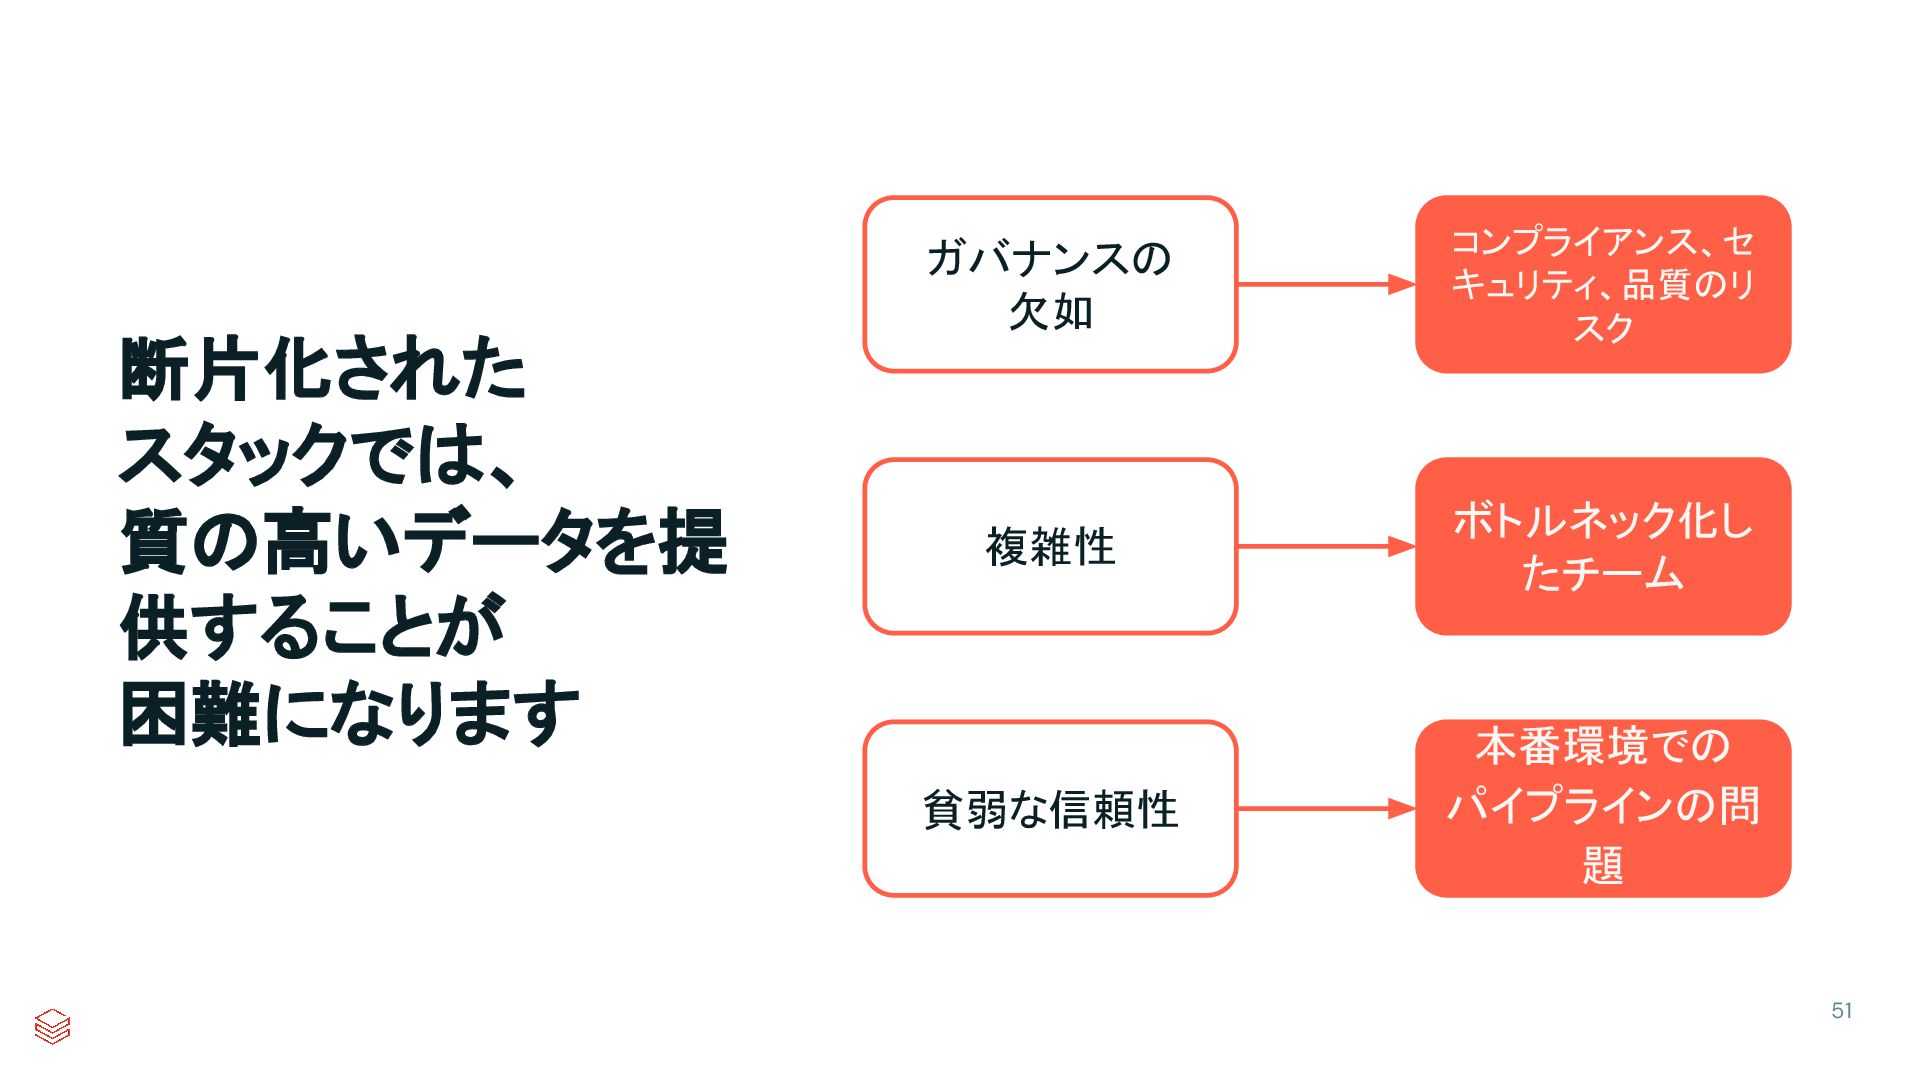
断片化された スタックでは、 質の高いデータを提 供することが 困難になります ガバナンスの 欠如 複雑性 貧弱な信頼性 コンプライアンス、セ
キュリティ、品質のリ スク ボトルネック化し たチーム 本番環境での パイプラインの問 題 51 -
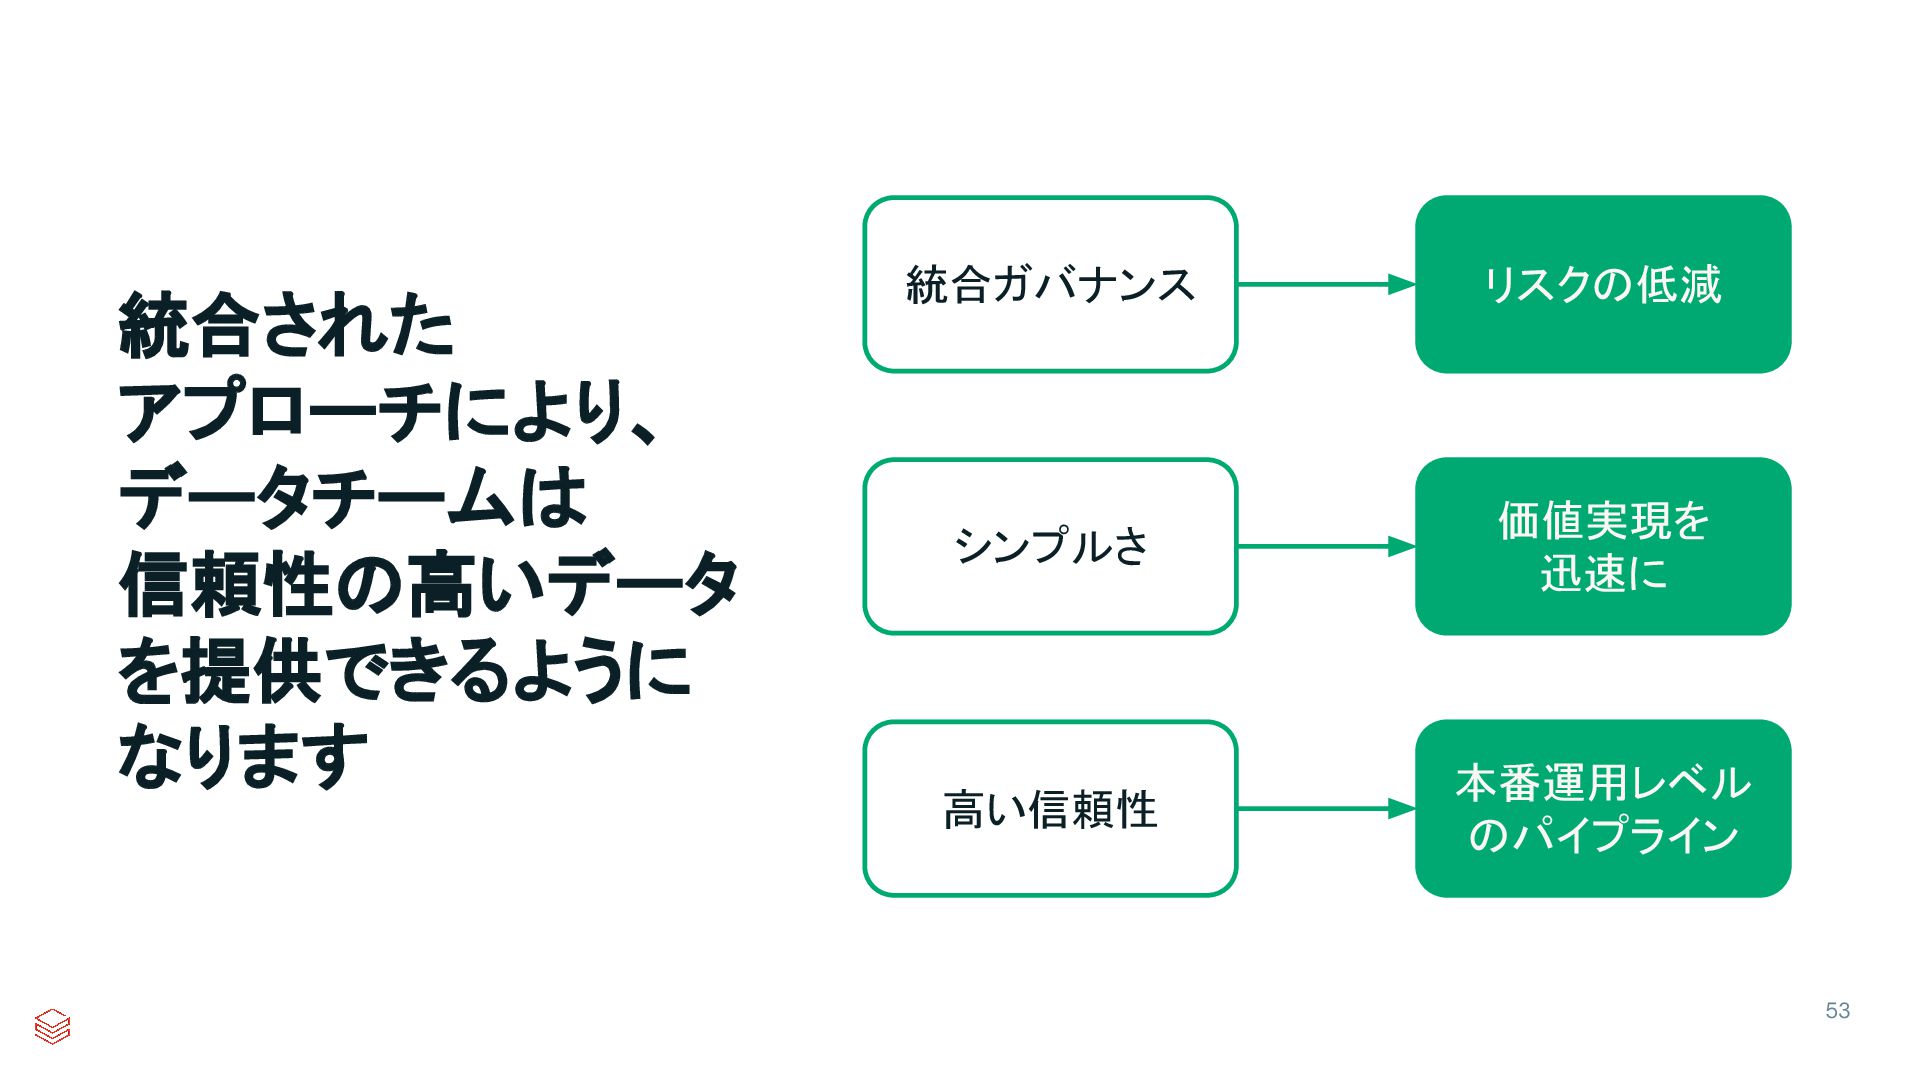
統合された アプローチにより、 データチームは 信頼性の高いデータ を提供できるように なります 統合ガバナンス シンプルさ 高い信頼性 リスクの低減
価値実現を 迅速に 本番運用レベル のパイプライン 53 -
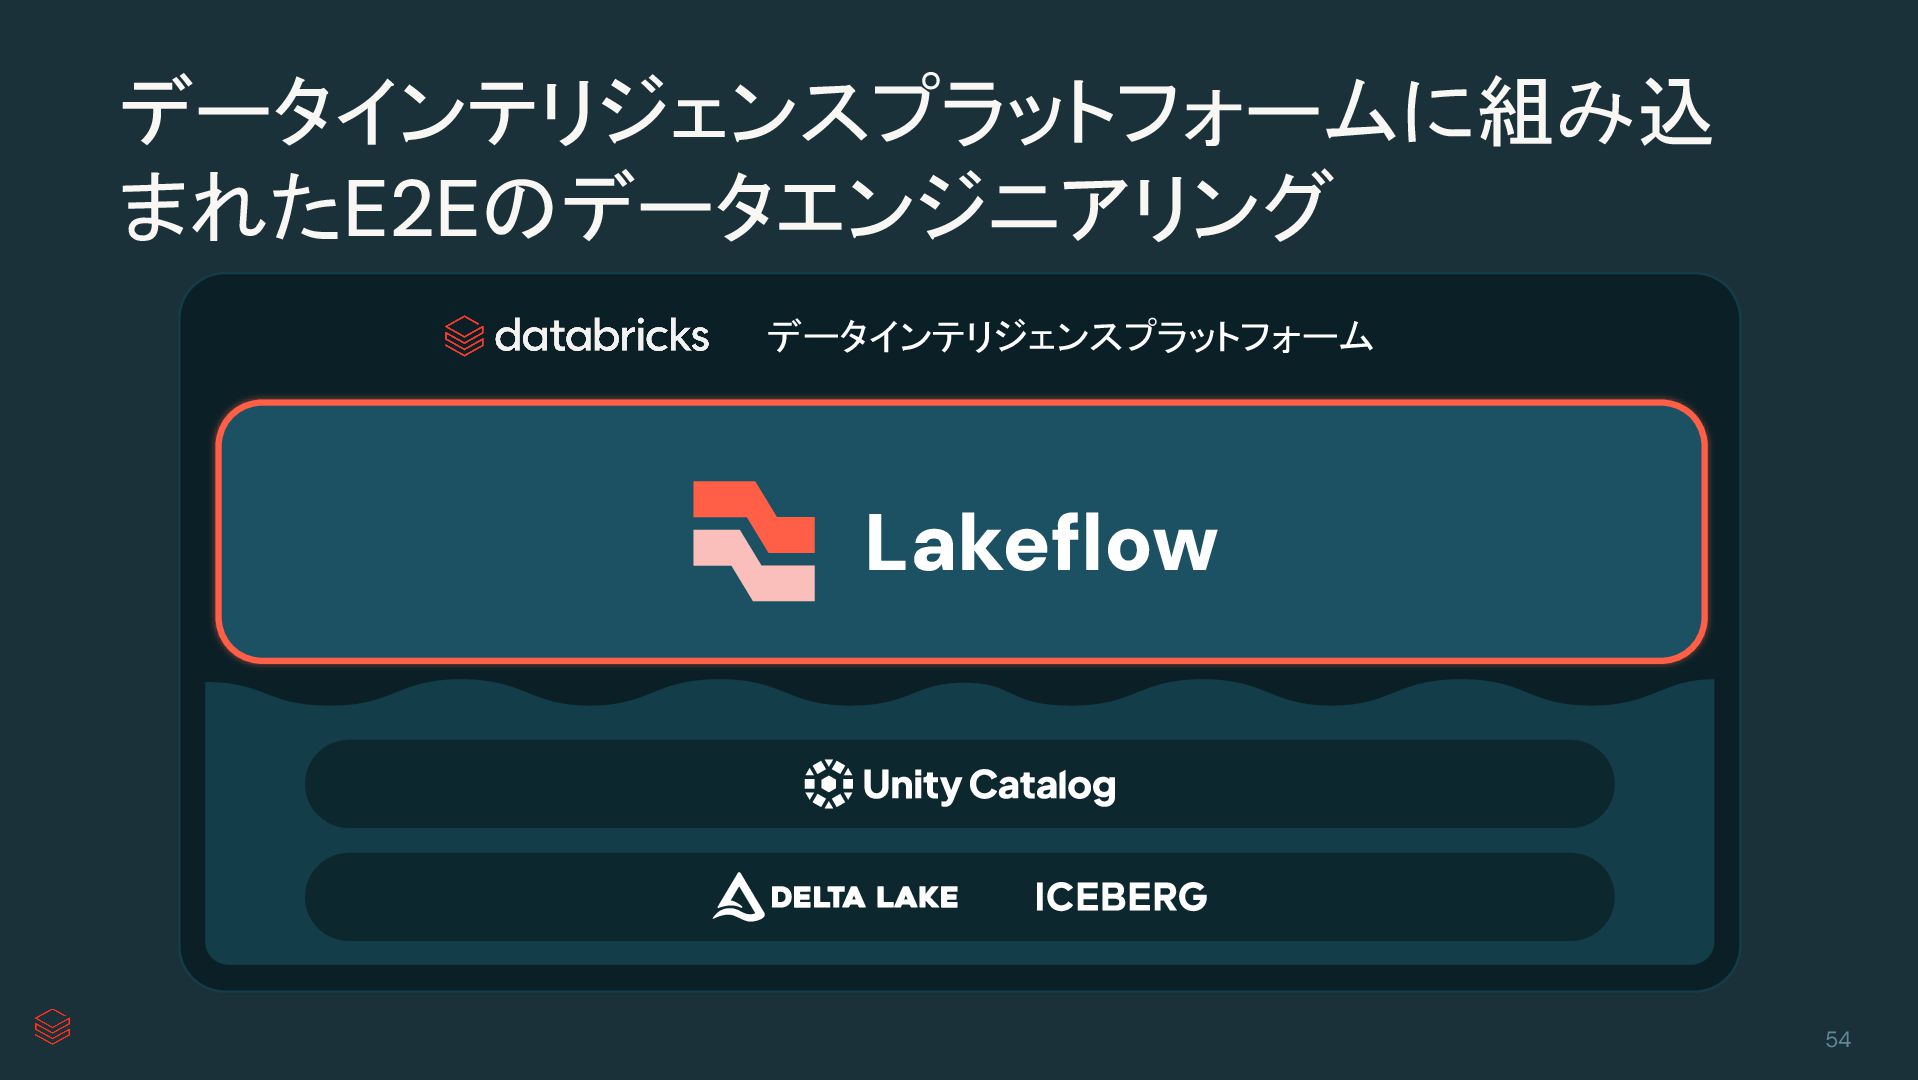
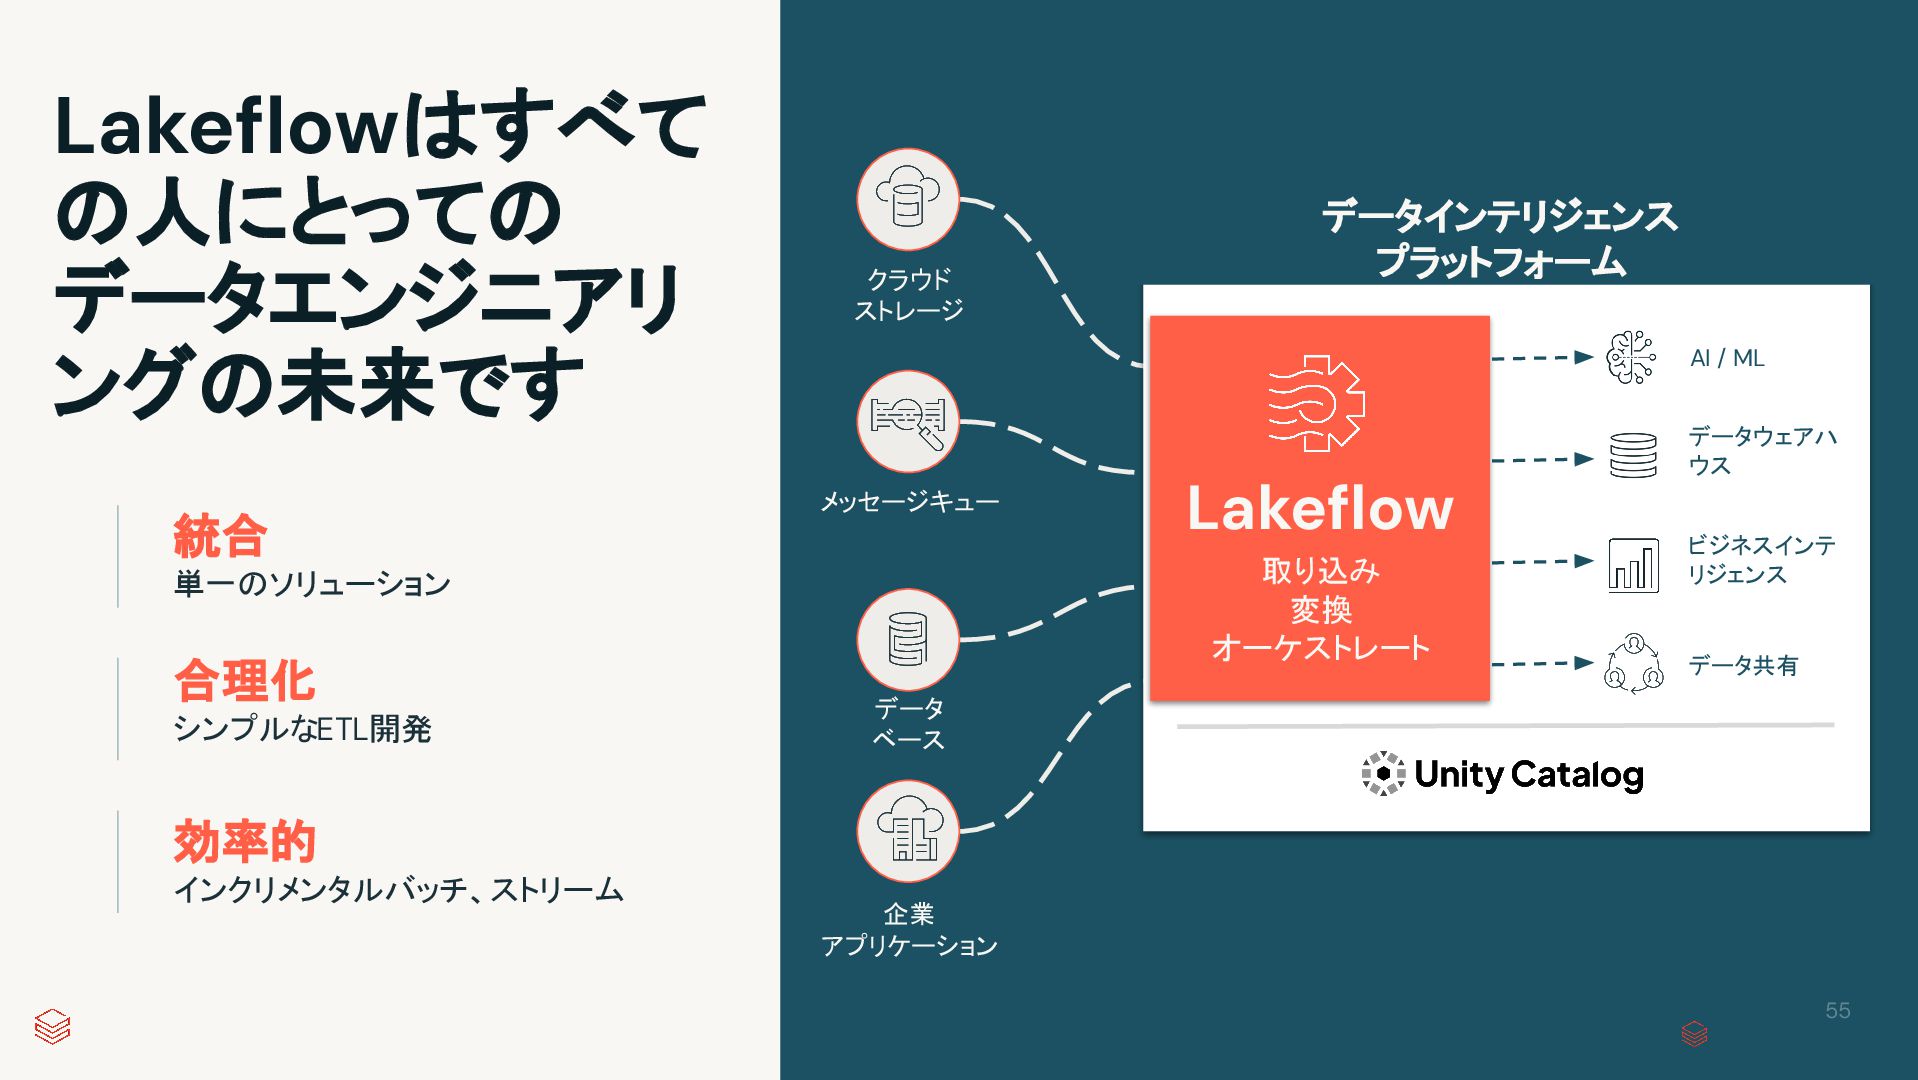
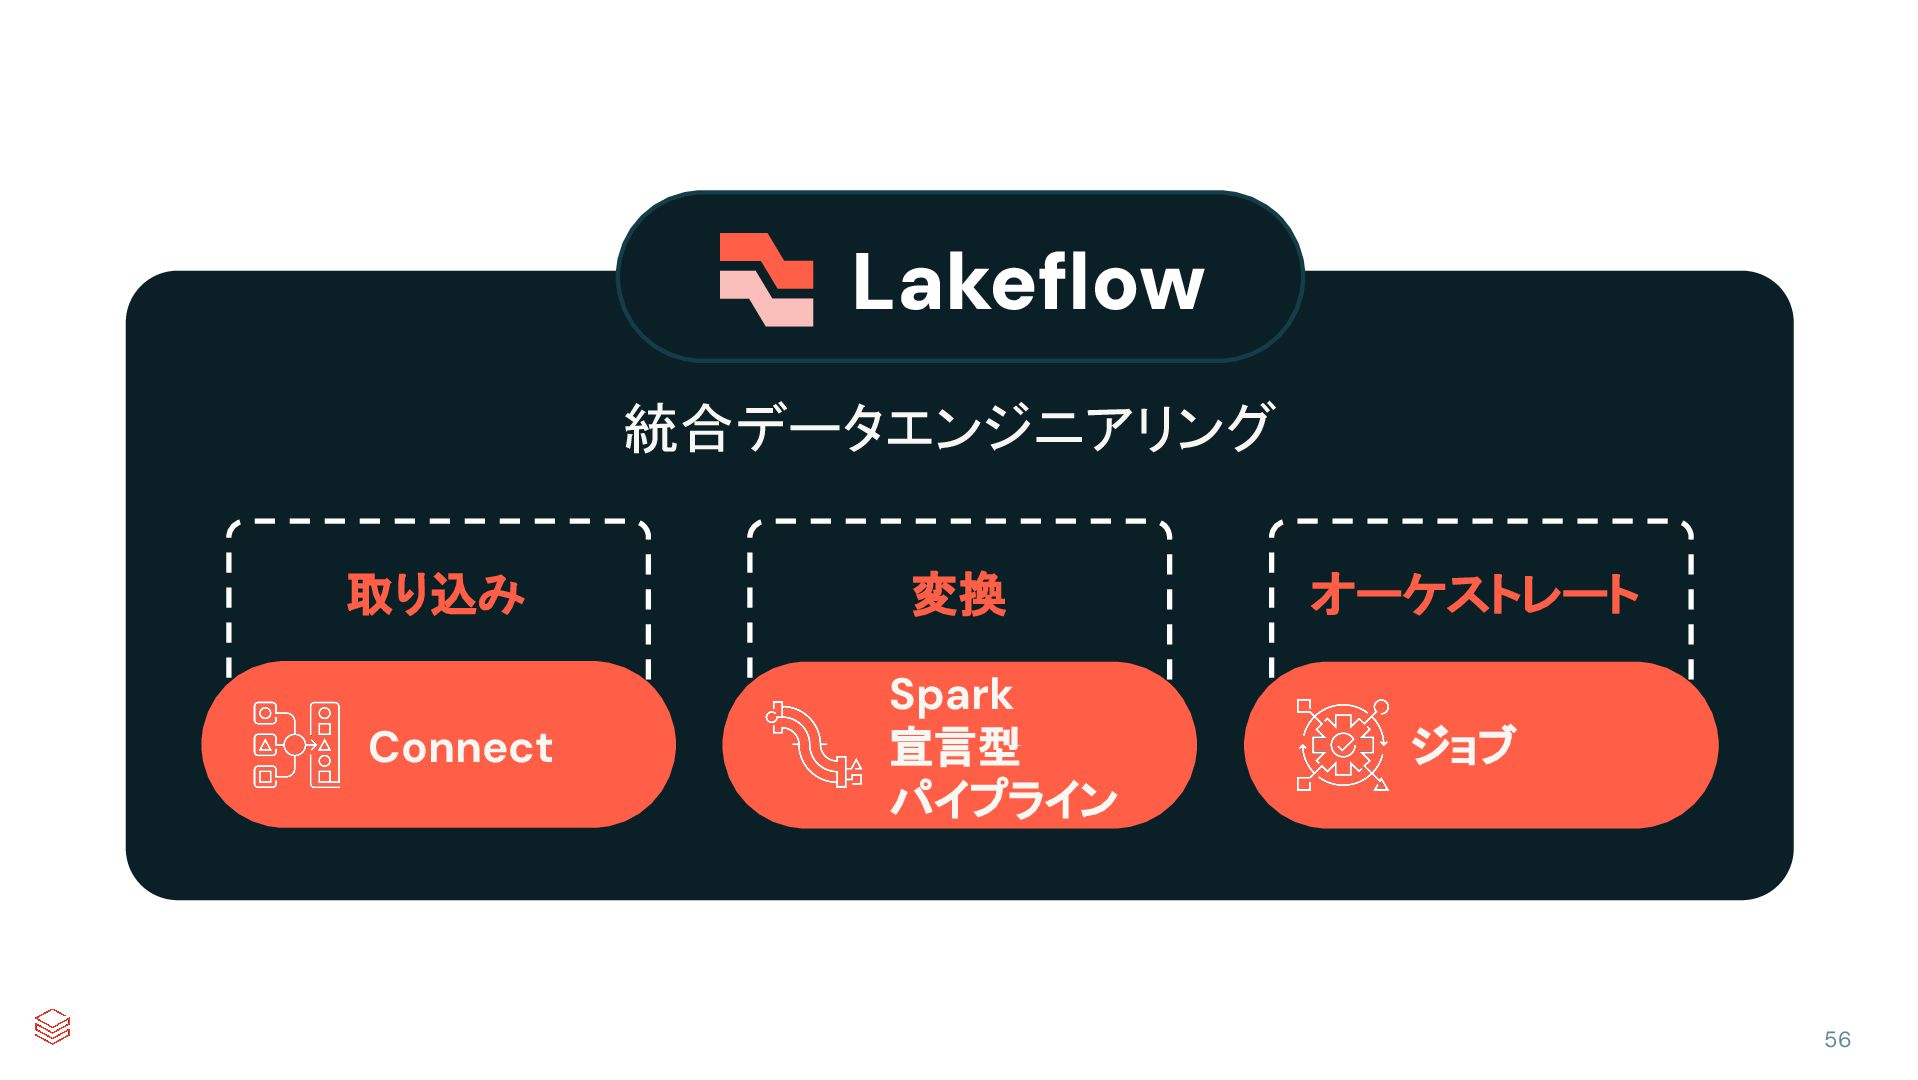
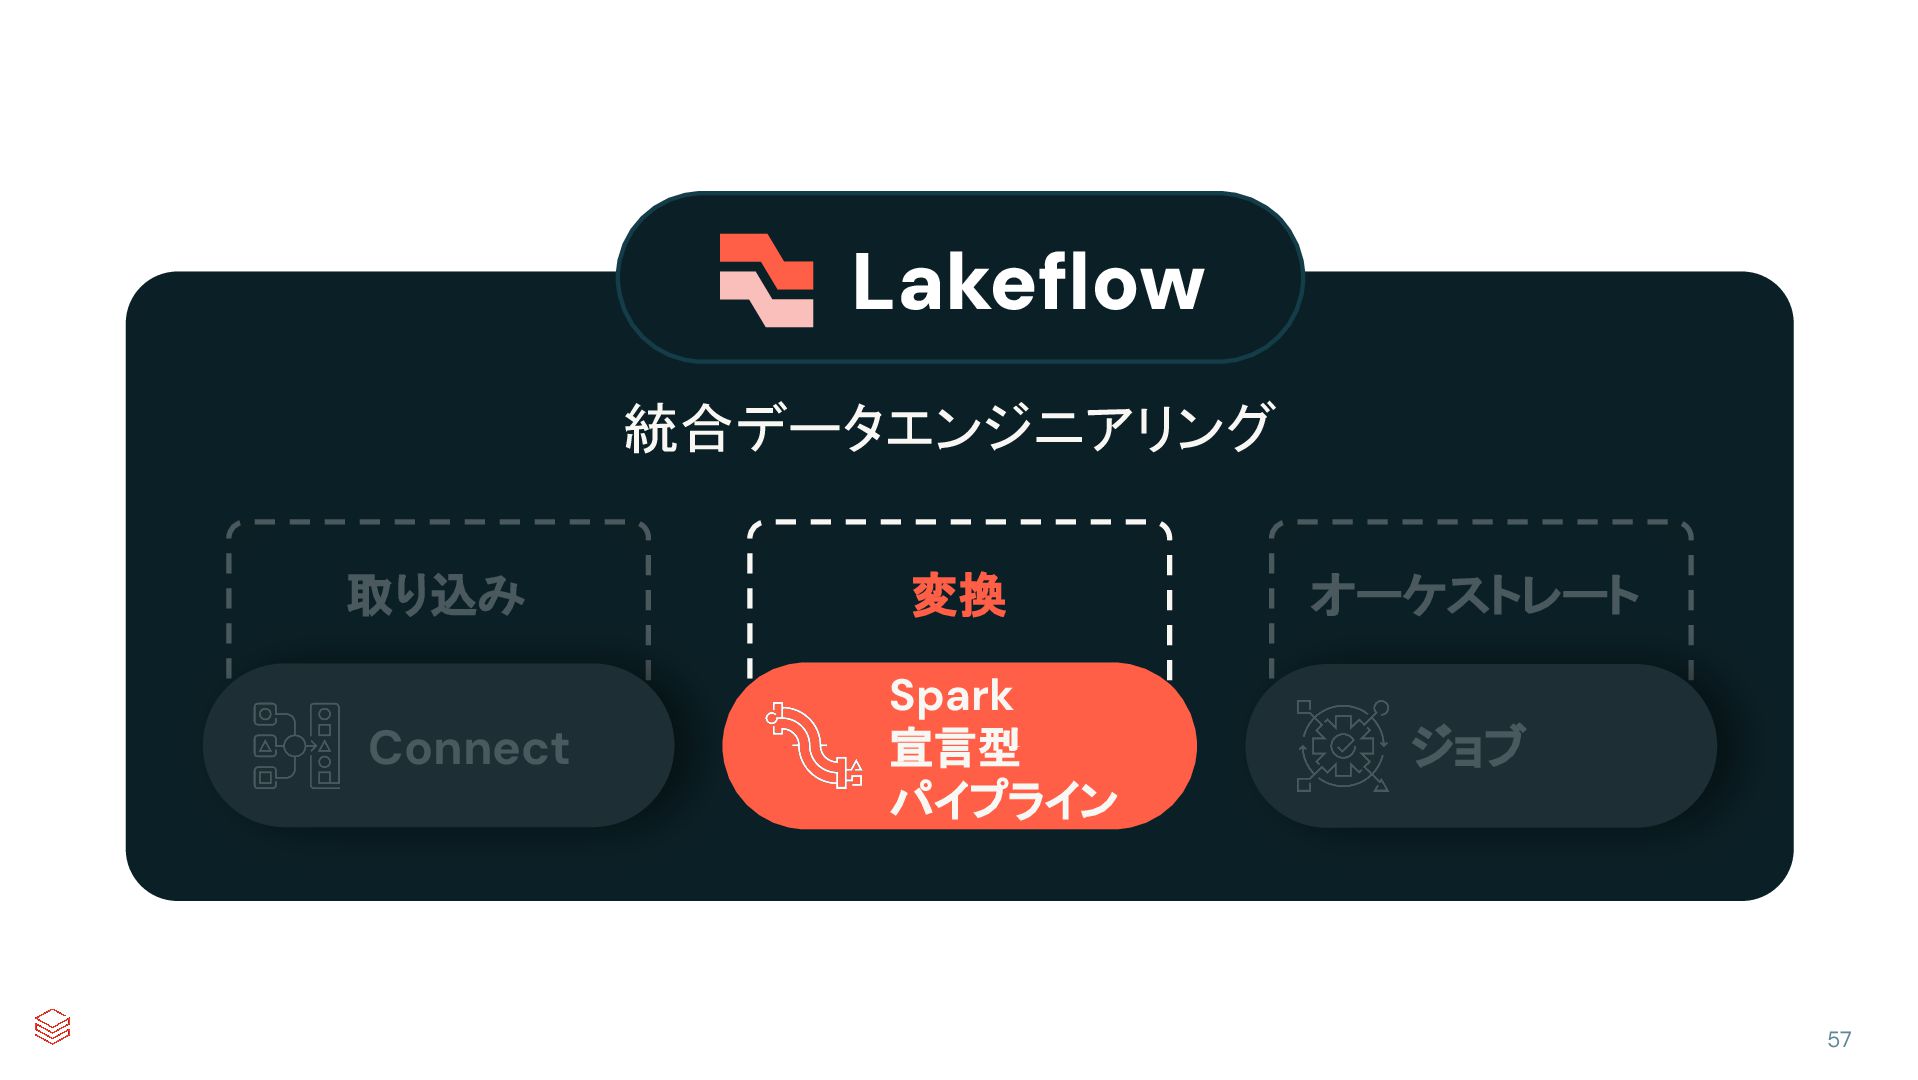
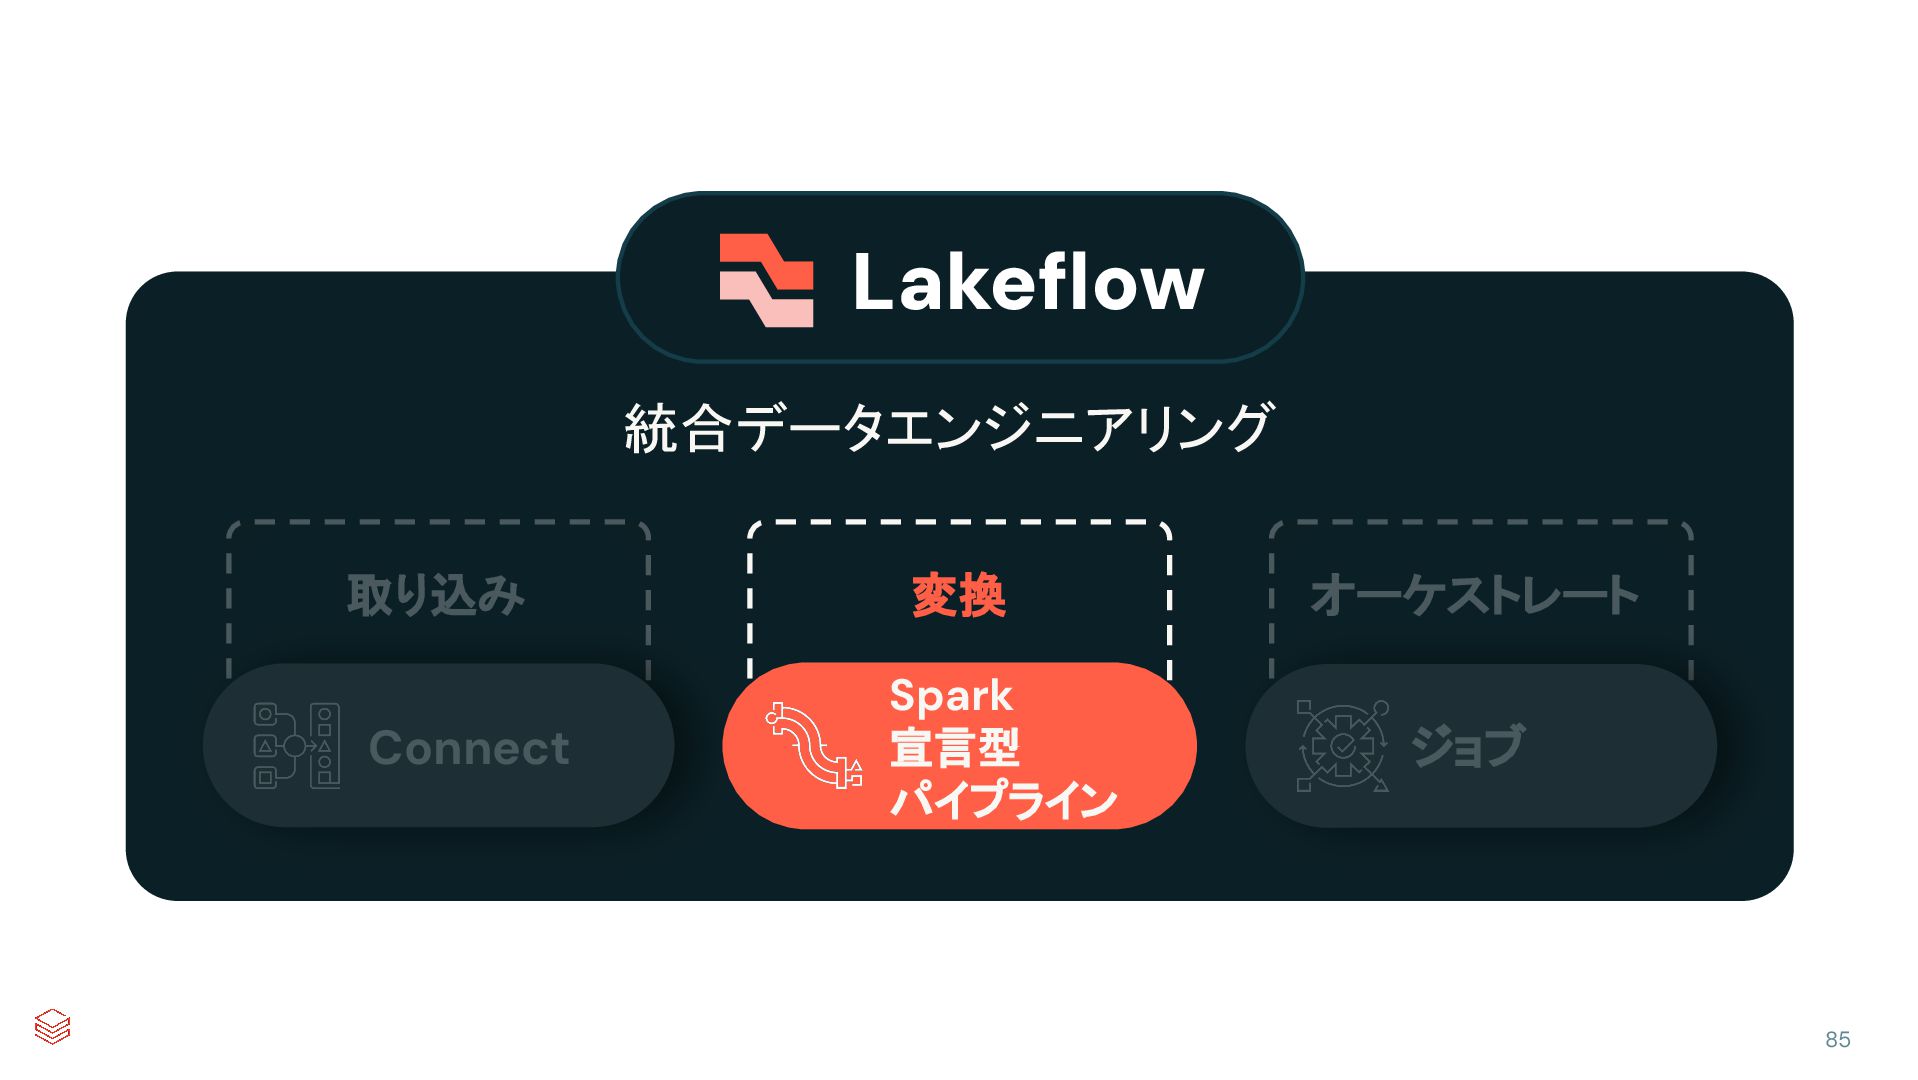
統合 単一のソリューション 合理化 シンプルなETL開発 効率的 インクリメンタルバッチ、ストリーム Lakeflow 取り込み 変換 オーケストレート
クラウド ストレージ メッセージキュー データ ベース 企業 アプリケーション データインテリジェンス プラットフォーム データウェアハ ウス ビジネスインテ リジェンス AI / ML データ共有 Lakeflowはすべて の人にとっての データエンジニアリ ングの未来です 55 -
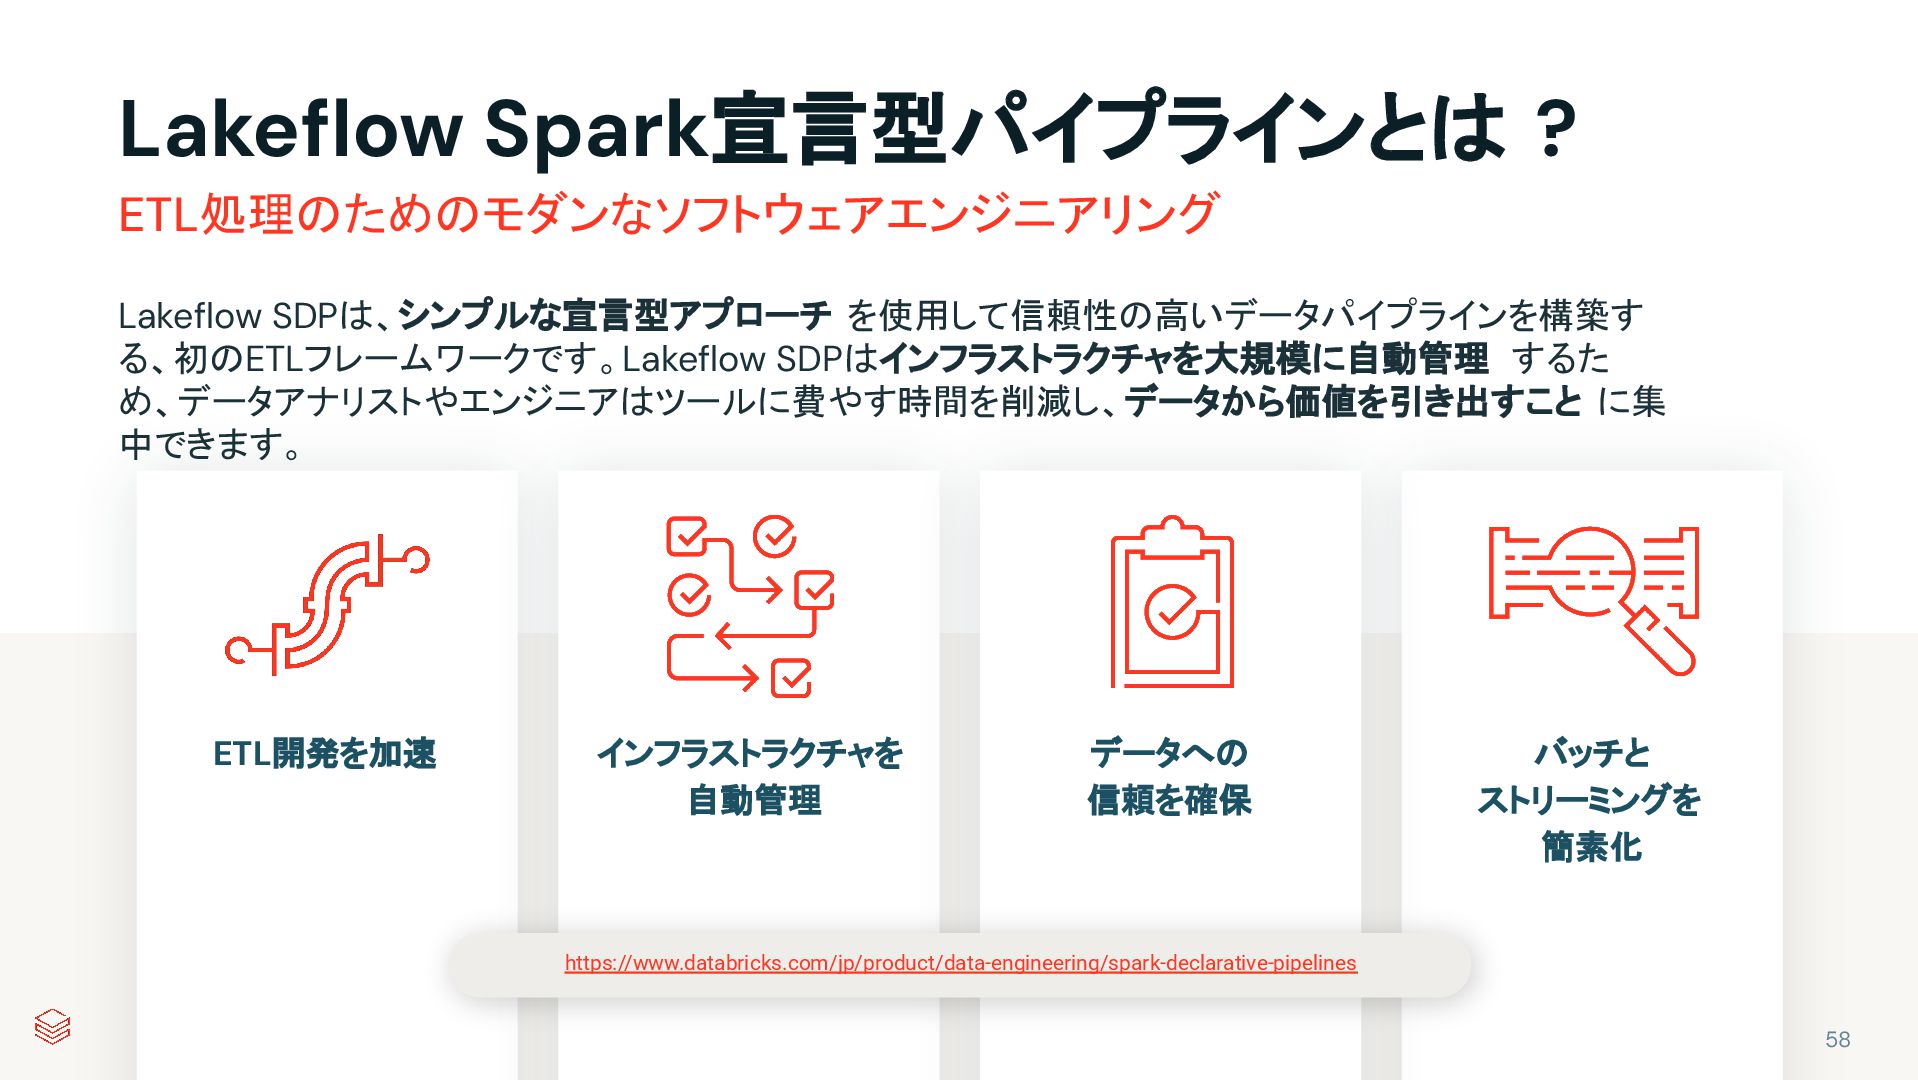
Lakeflow Spark宣言型パイプラインとは ? ETL処理のためのモダンなソフトウェアエンジニアリング Lakeflow SDPは、シンプルな宣言型アプローチ を使用して信頼性の高いデータパイプラインを構築す る、初のETLフレームワークです。Lakeflow SDPはインフラストラクチャを大規模に自動管理 するた
め、データアナリストやエンジニアはツールに費やす時間を削減し、データから価値を引き出すこと に集 中できます。 ETL開発を加速 インフラストラクチャを 自動管理 データへの 信頼を確保 バッチと ストリーミングを 簡素化 https://www.databricks.com/jp/product/data-engineering/spark-declarative-pipelines 58 -
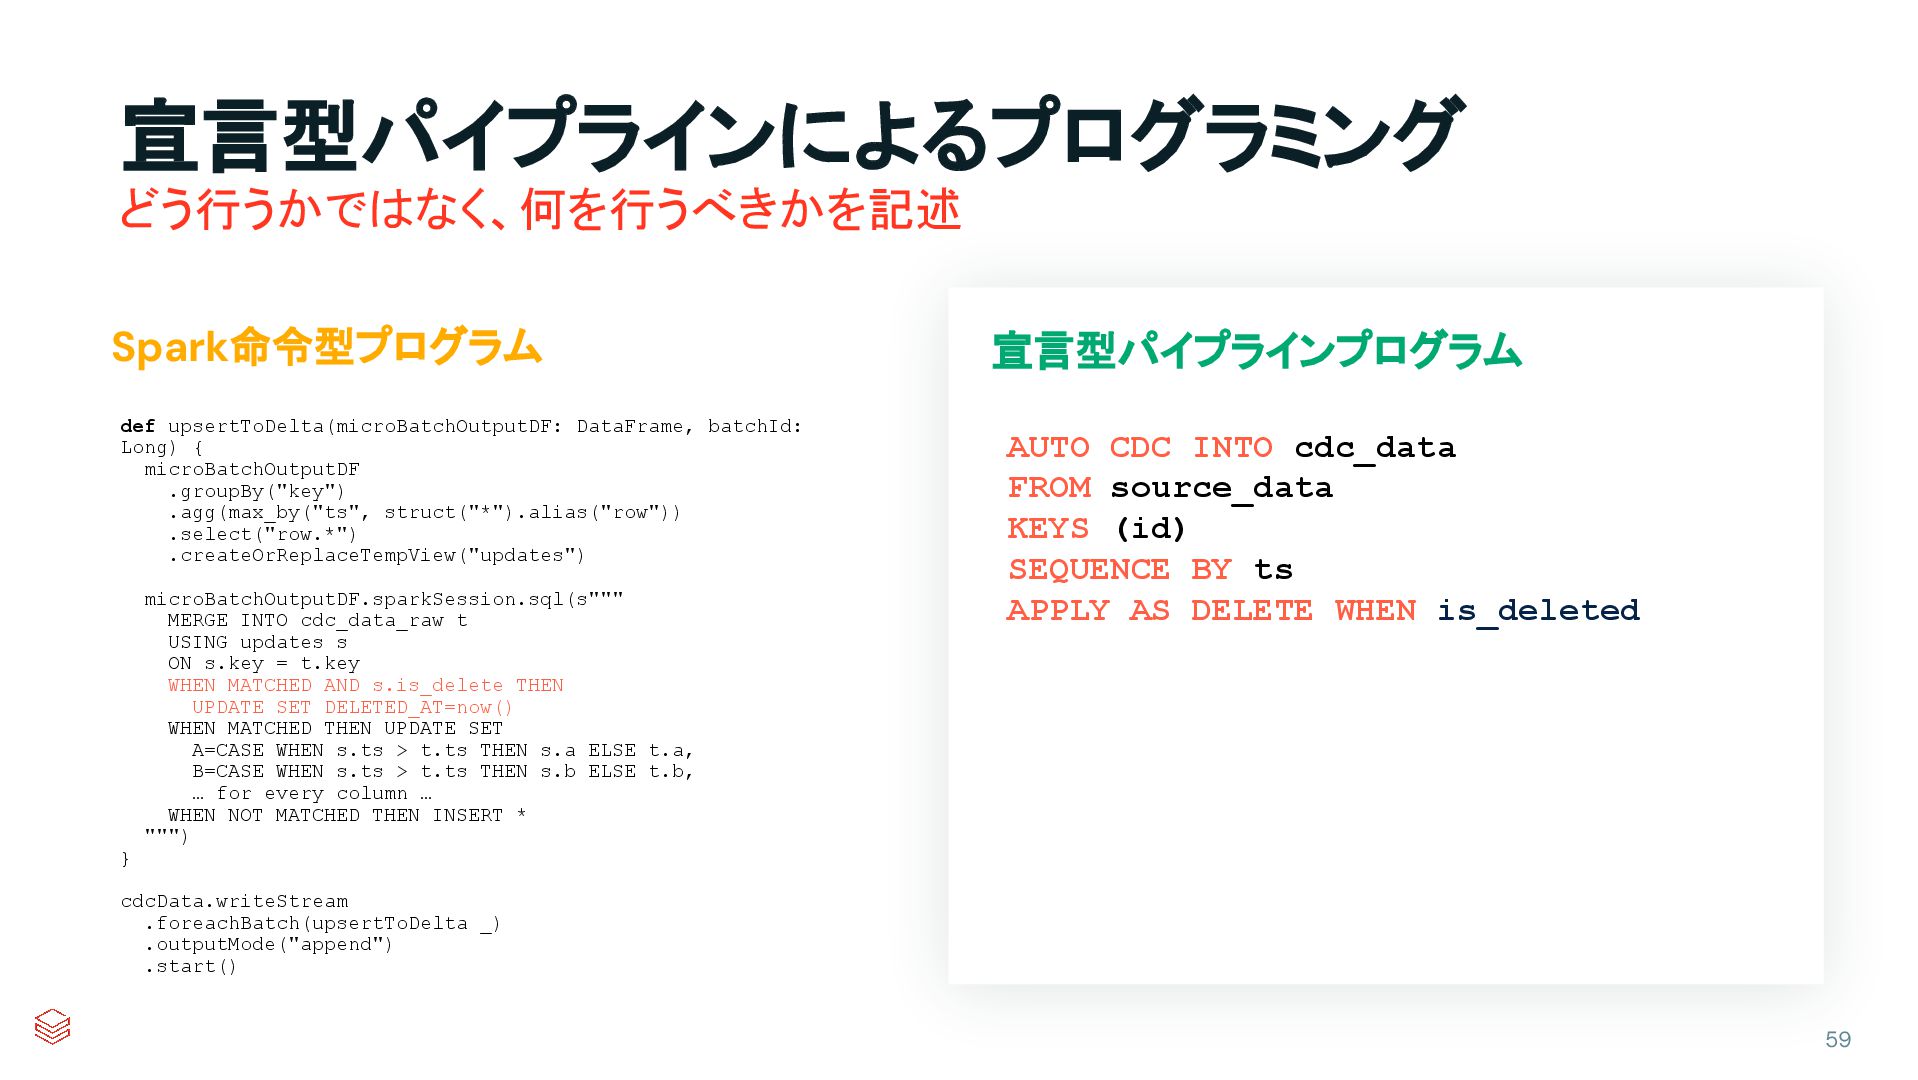
宣言型パイプラインによるプログラミング どう行うかではなく、何を行うべきかを記述 宣言型パイプラインプログラム def upsertToDelta(microBatchOutputDF: DataFrame, batchId: Long) { microBatchOutputDF
.groupBy("key") .agg(max_by("ts", struct("*").alias("row")) .select("row.*") .createOrReplaceTempView("updates") microBatchOutputDF.sparkSession.sql(s""" MERGE INTO cdc_data_raw t USING updates s ON s.key = t.key WHEN MATCHED AND s.is_delete THEN UPDATE SET DELETED_AT=now() WHEN MATCHED THEN UPDATE SET A=CASE WHEN s.ts > t.ts THEN s.a ELSE t.a, B=CASE WHEN s.ts > t.ts THEN s.b ELSE t.b, … for every column … WHEN NOT MATCHED THEN INSERT * """) } cdcData.writeStream .foreachBatch(upsertToDelta _) .outputMode("append") .start() AUTO CDC INTO cdc_data FROM source_data KEYS (id) SEQUENCE BY ts APPLY AS DELETE WHEN is_deleted Spark命令型プログラム 59 -
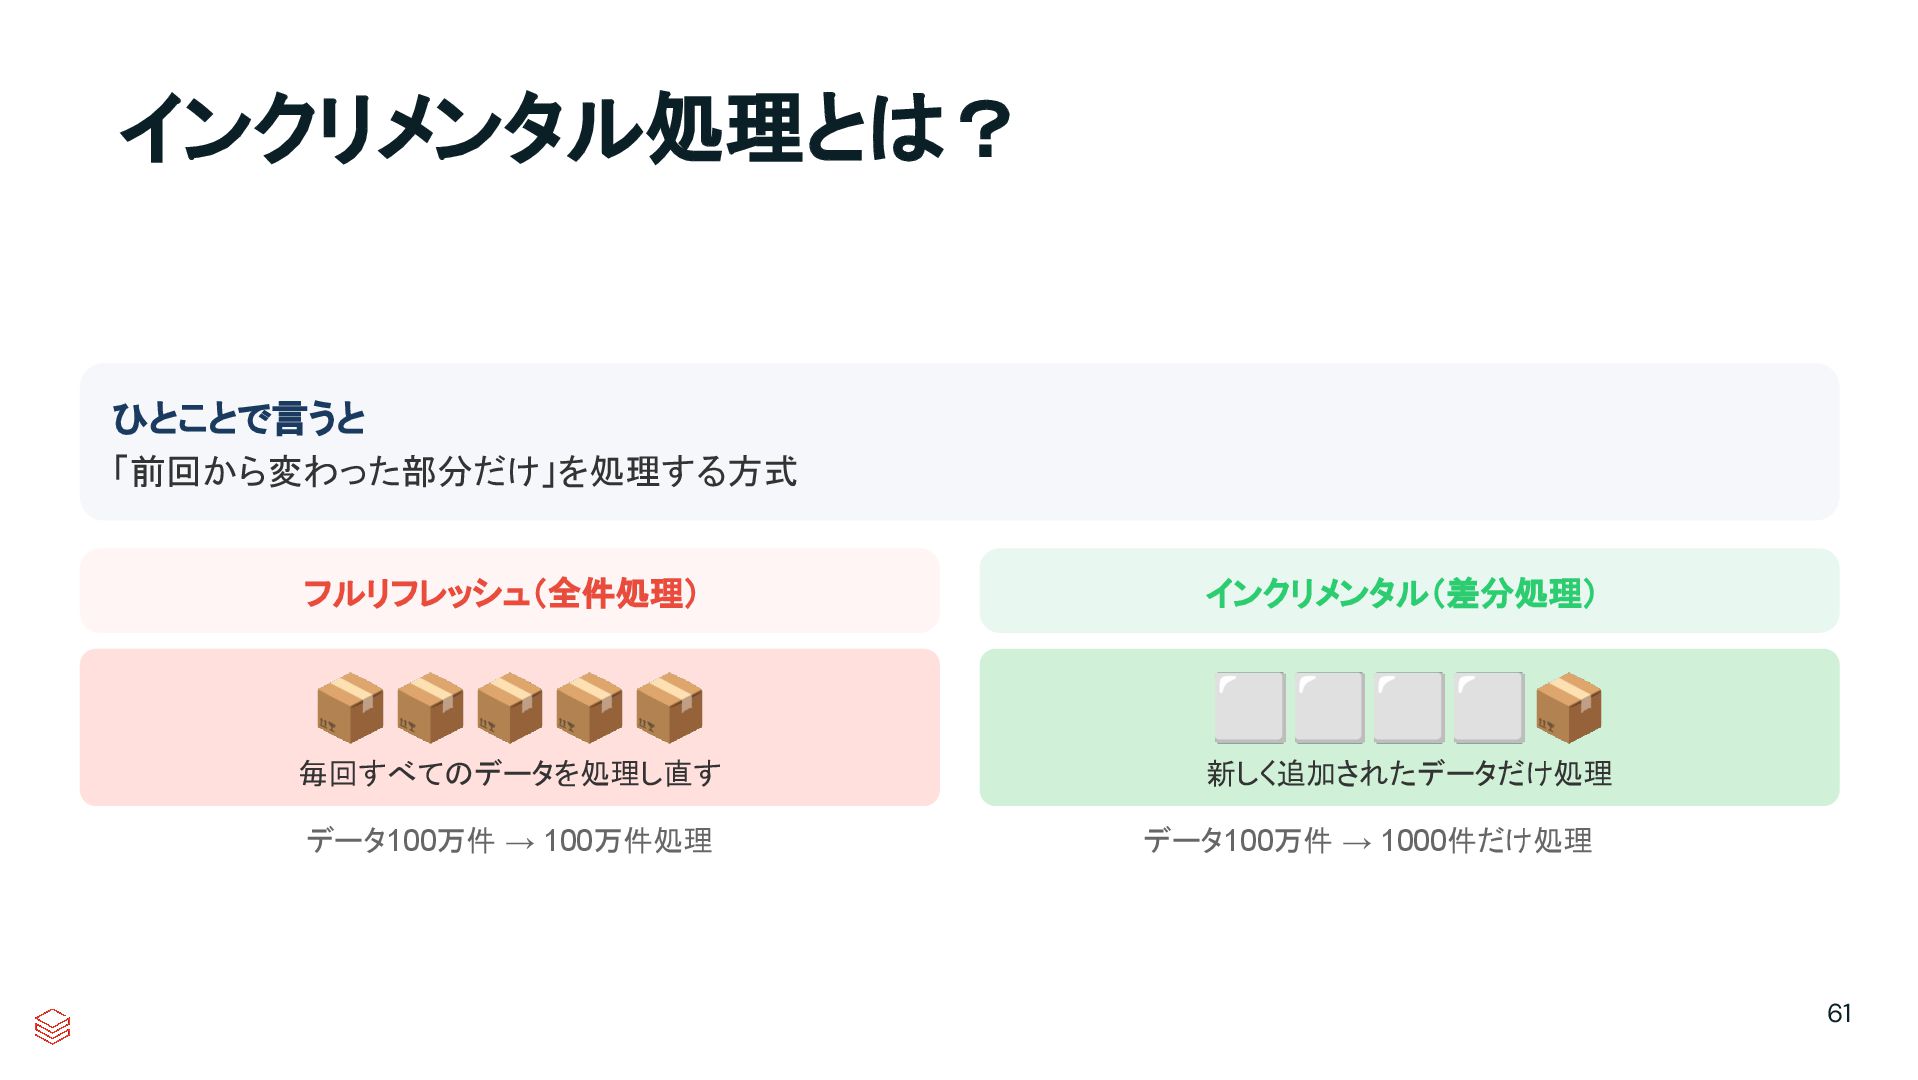
ひとことで言うと 「前回から変わった部分だけ」を処理する方式 フルリフレッシュ(全件処理) 📦📦📦📦📦 毎回すべてのデータを処理し直す データ100万件 → 100万件処理 インクリメンタル(差分処理) ⬜⬜⬜⬜📦
新しく追加されたデータだけ処理 データ100万件 → 1000件だけ処理 インクリメンタル処理とは? 61 -
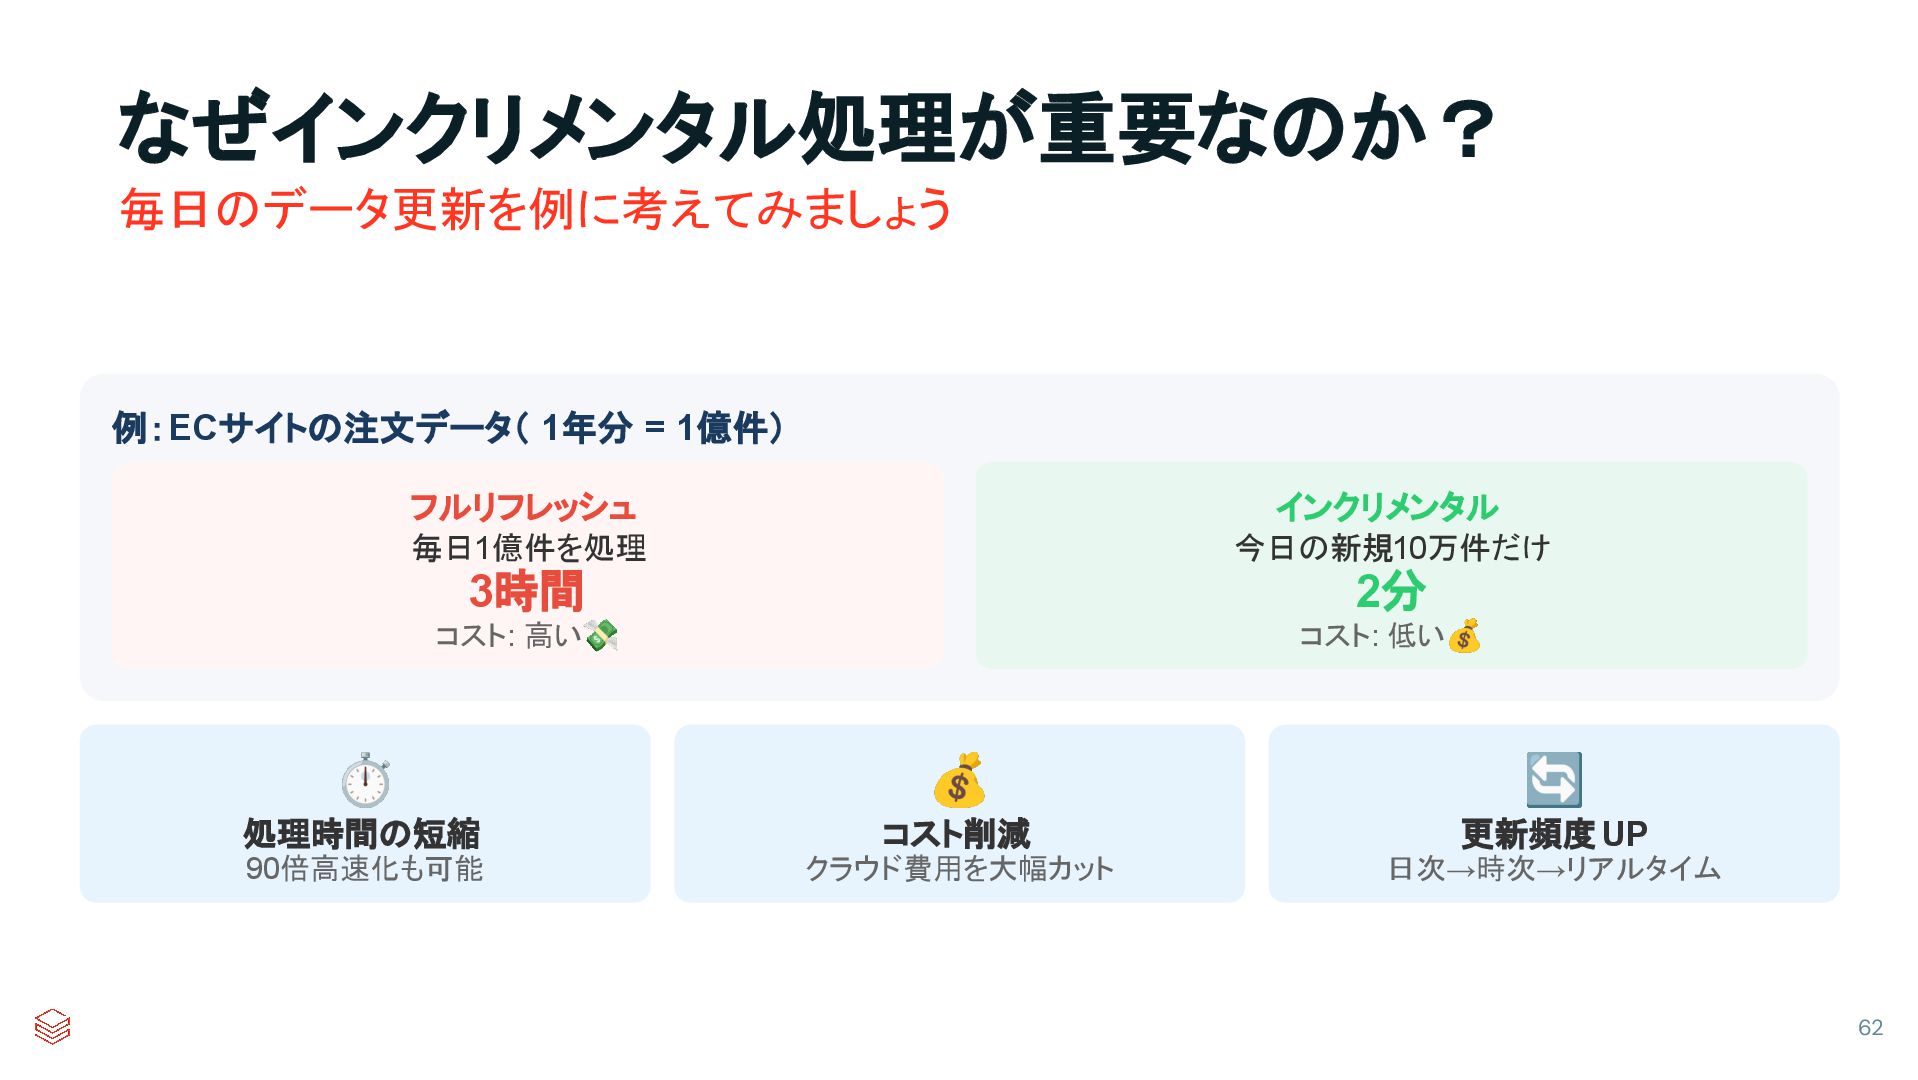
例:ECサイトの注文データ( 1年分 = 1億件) フルリフレッシュ 毎日1億件を処理 3時間 コスト: 高い💸 インクリメンタル
今日の新規10万件だけ 2分 コスト: 低い💰 ⏱ 処理時間の短縮 90倍高速化も可能 💰 コスト削減 クラウド費用を大幅カット 🔄 更新頻度UP 日次→時次→リアルタイム なぜインクリメンタル処理が重要なのか? 62 毎日のデータ更新を例に考えてみましょう -
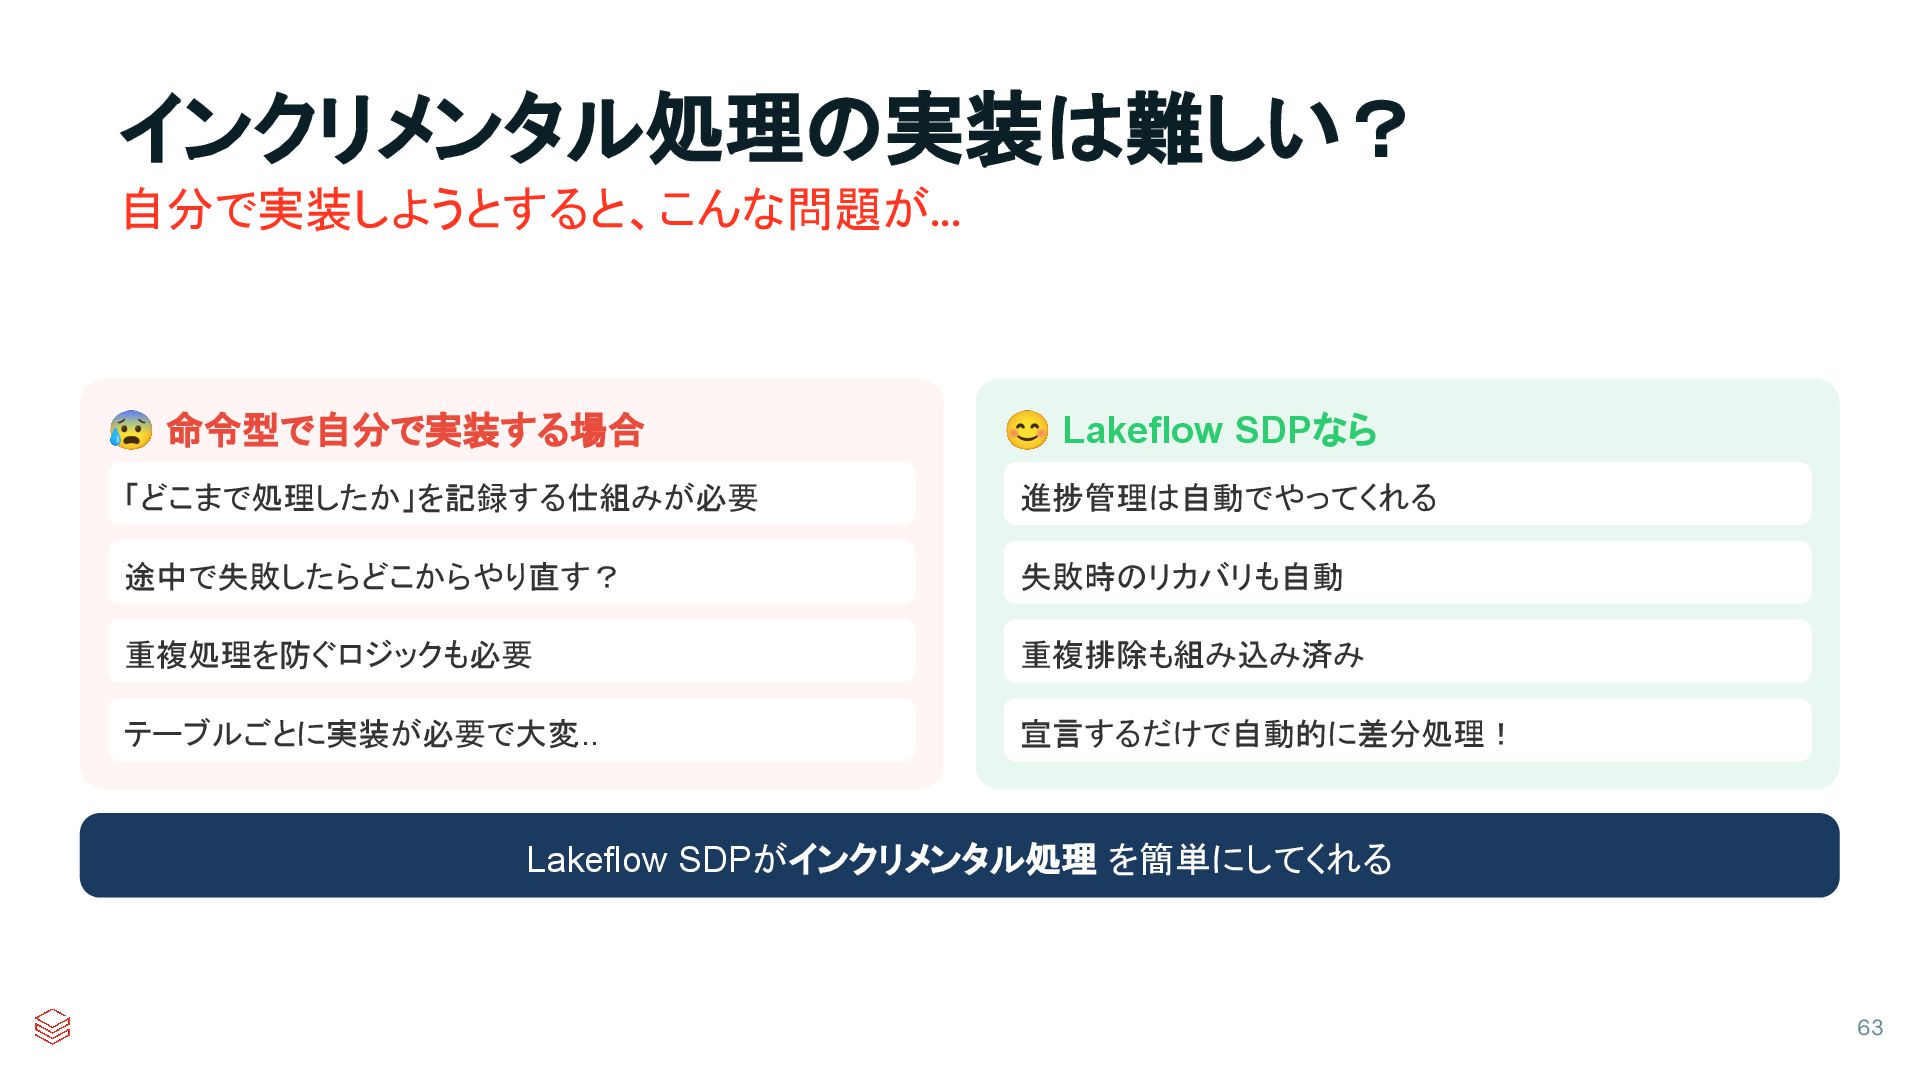
😰 命令型で自分で実装する場合 「どこまで処理したか」を記録する仕組みが必要 途中で失敗したらどこからやり直す? 重複処理を防ぐロジックも必要 テーブルごとに実装が必要で大変 ... 😊 Lakeflow SDPなら
進捗管理は自動でやってくれる 失敗時のリカバリも自動 重複排除も組み込み済み 宣言するだけで自動的に差分処理! Lakeflow SDPがインクリメンタル処理 を簡単にしてくれる インクリメンタル処理の実装は難しい? 63 自分で実装しようとすると、こんな問題が... -
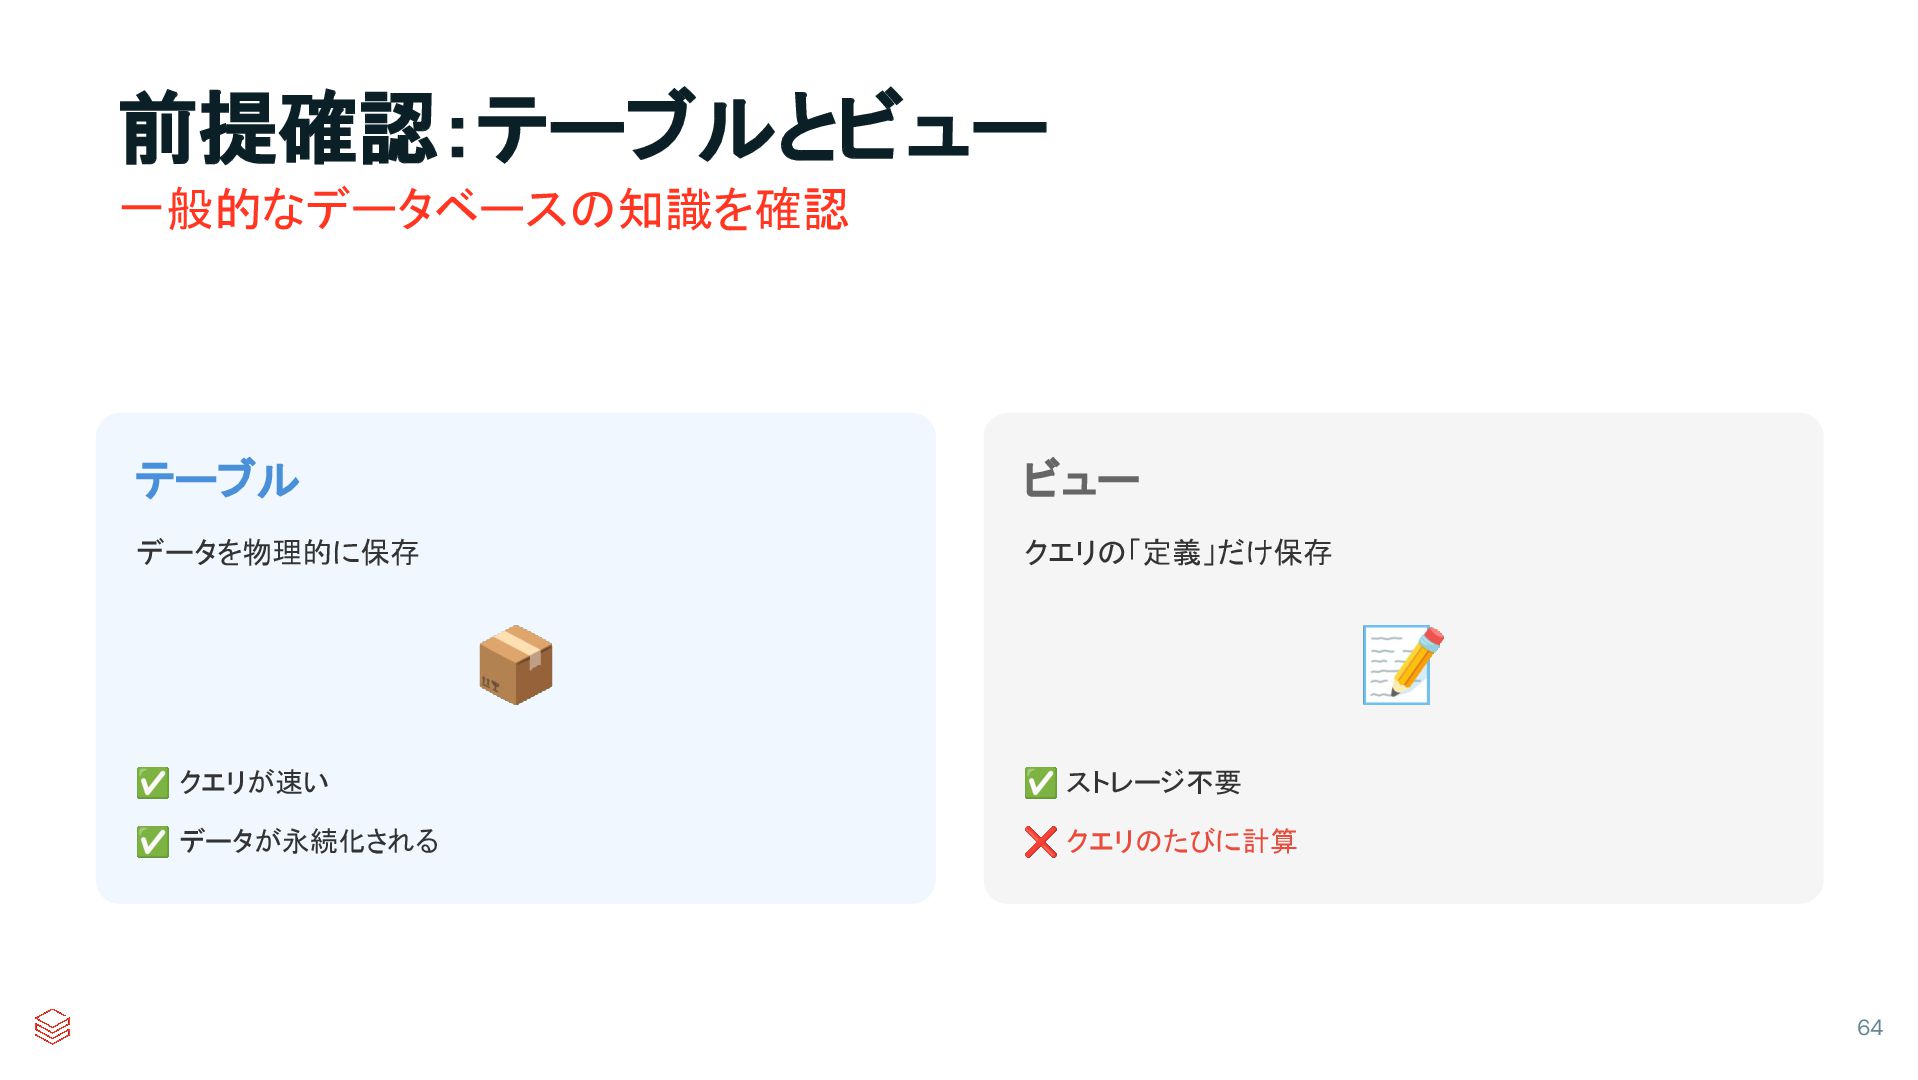
テーブル データを物理的に保存 📦 ✅ クエリが速い ✅ データが永続化される ビュー クエリの「定義」だけ保存 📝
✅ ストレージ不要 ❌ クエリのたびに計算 前提確認:テーブルとビュー 64 一般的なデータベースの知識を確認 -
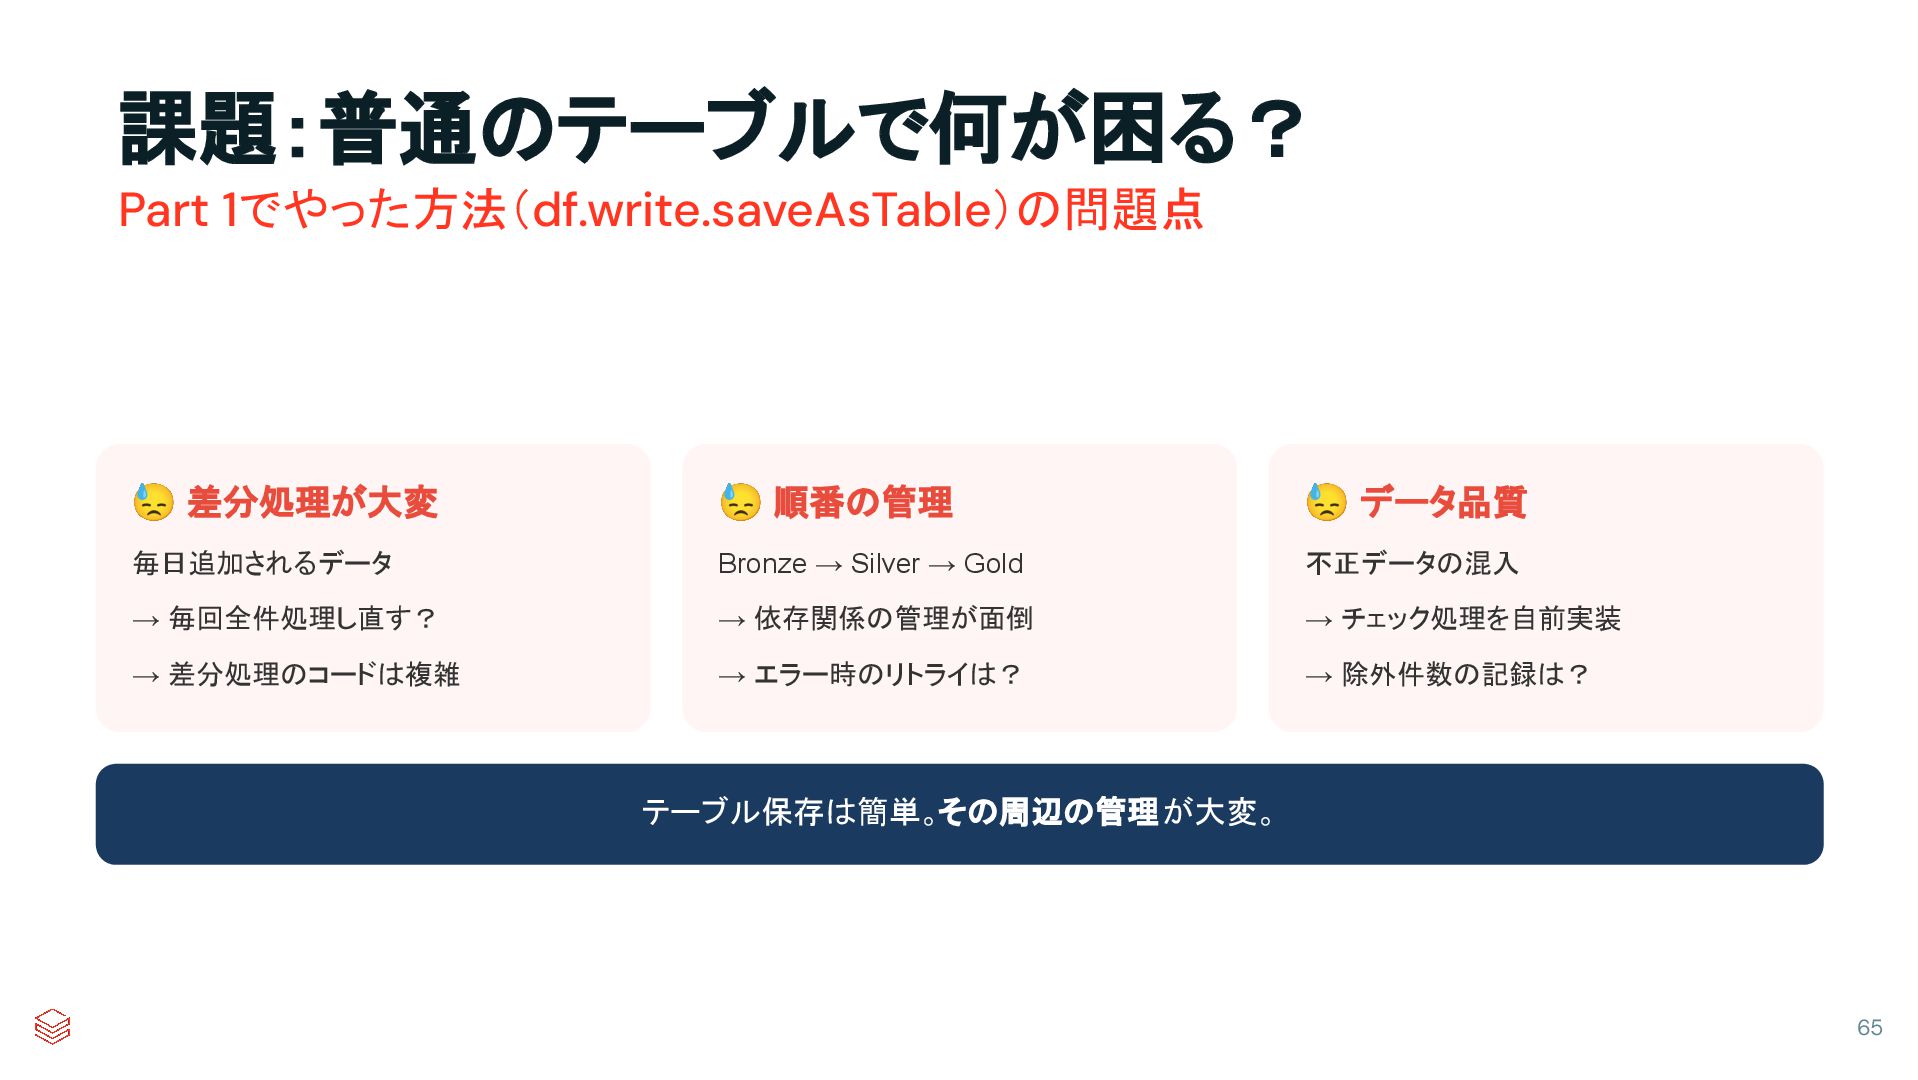
😓 差分処理が大変 毎日追加されるデータ → 毎回全件処理し直す? → 差分処理のコードは複雑 😓 順番の管理 Bronze
→ Silver → Gold → 依存関係の管理が面倒 → エラー時のリトライは? 😓 データ品質 不正データの混入 → チェック処理を自前実装 → 除外件数の記録は? テーブル保存は簡単。その周辺の管理が大変。 課題:普通のテーブルで何が困る? 65 Part 1でやった方法(df.write.saveAsTable)の問題点 -
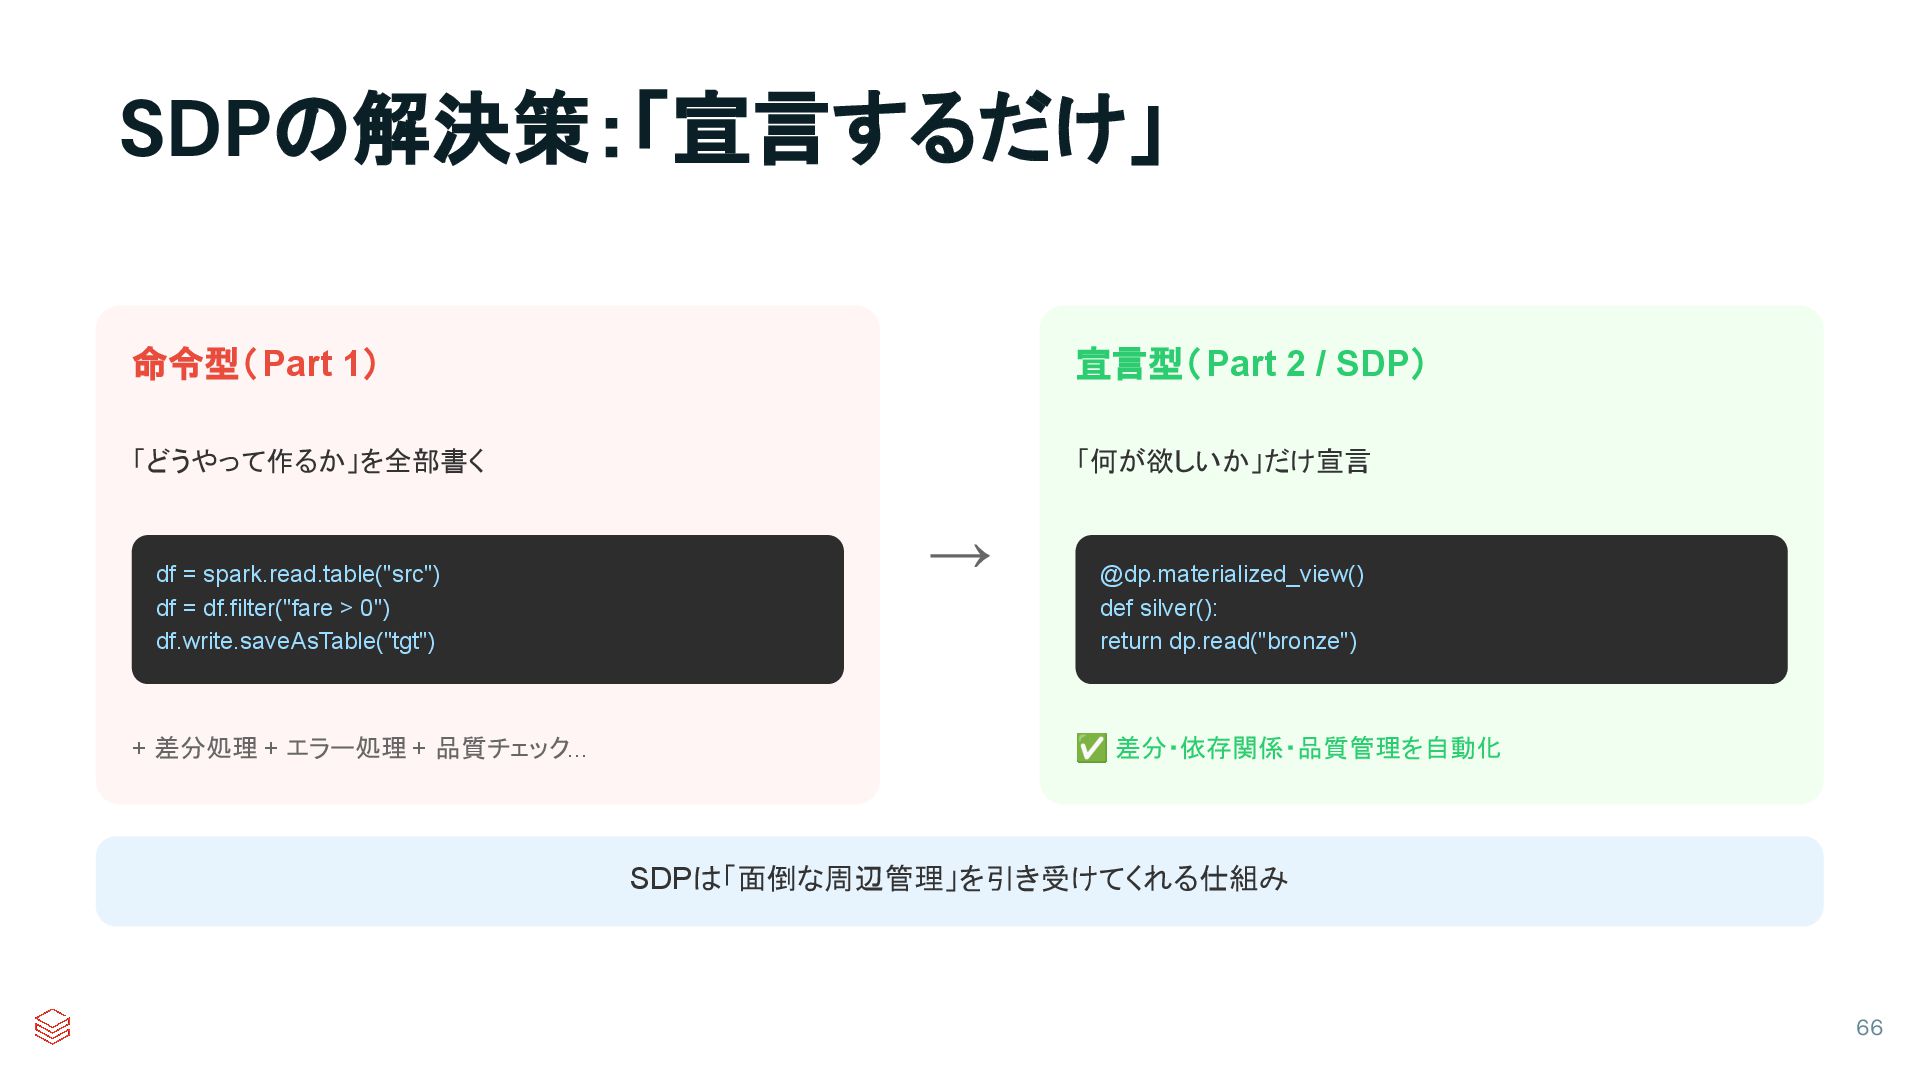
命令型(Part 1) 「どうやって作るか」を全部書く df = spark.read.table("src") df = df.filter("fare >
0") df.write.saveAsTable("tgt") + 差分処理 + エラー処理 + 品質チェック... → 宣言型(Part 2 / SDP) 「何が欲しいか」だけ宣言 @dp.materialized_view() def silver(): return dp.read("bronze") ✅ 差分・依存関係・品質管理を自動化 SDPは「面倒な周辺管理」を引き受けてくれる仕組み SDPの解決策:「宣言するだけ」 66 -
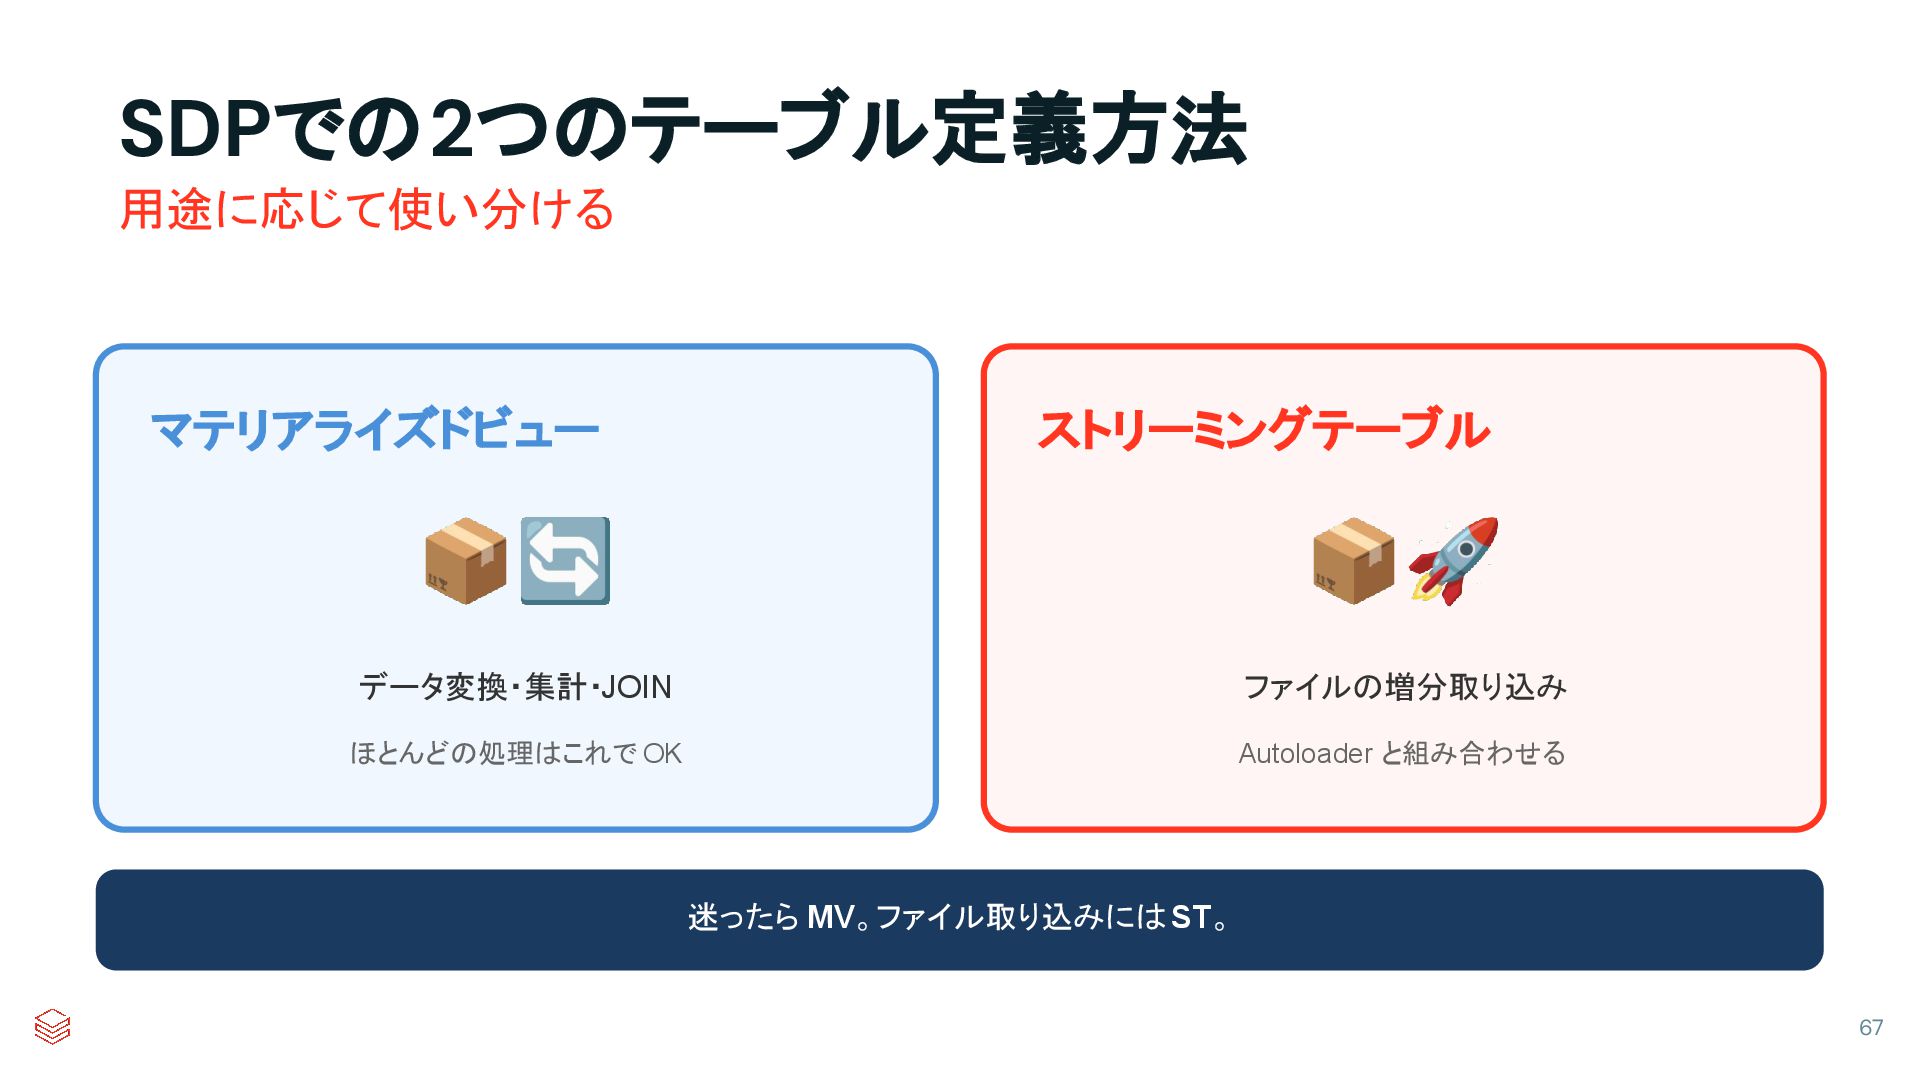
マテリアライズドビュー 📦🔄 データ変換・集計・JOIN ほとんどの処理はこれで OK ストリーミングテーブル 📦🚀 ファイルの増分取り込み Autoloader と組み合わせる
迷ったら MV。ファイル取り込みには ST。 SDPでの2つのテーブル定義方法 67 用途に応じて使い分ける -
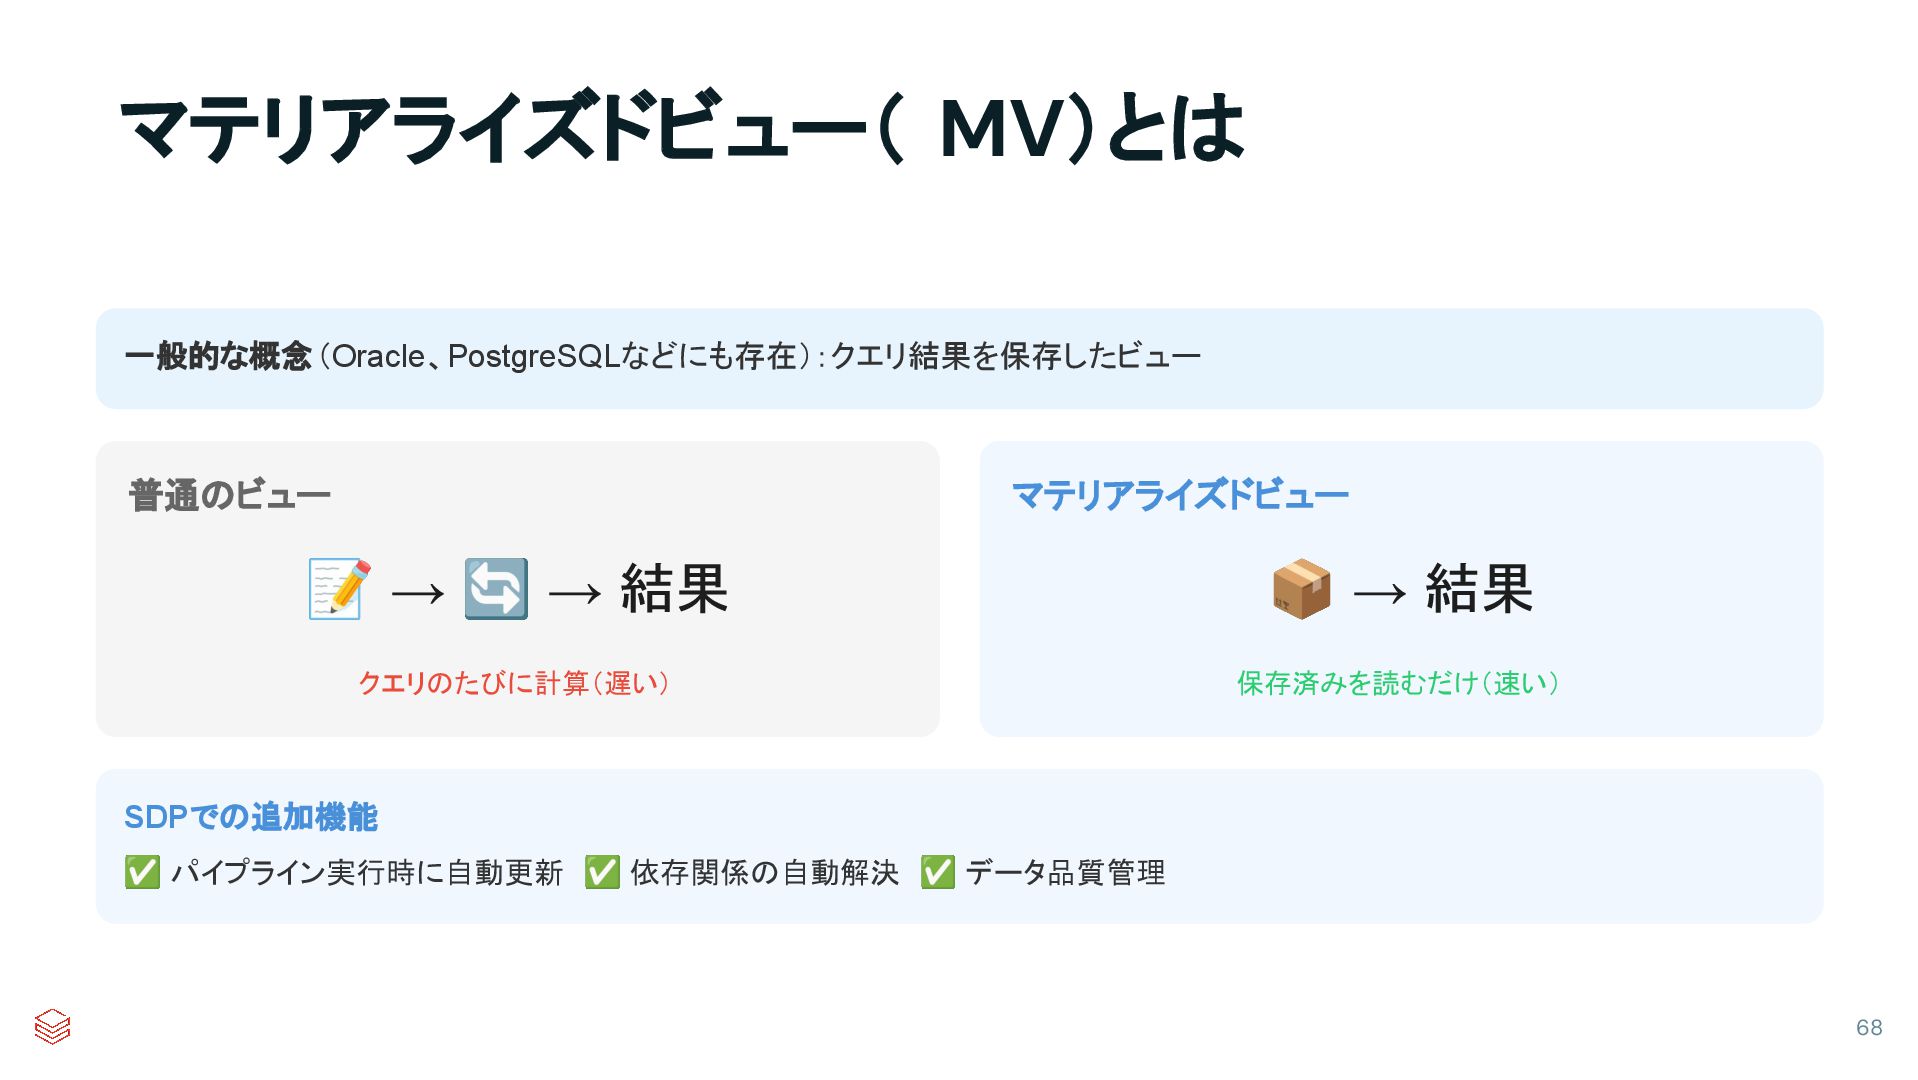
一般的な概念(Oracle、PostgreSQLなどにも存在):クエリ結果を保存したビュー 普通のビュー 📝 → 🔄 → 結果 クエリのたびに計算(遅い) マテリアライズドビュー 📦
→ 結果 保存済みを読むだけ(速い) SDPでの追加機能 ✅ パイプライン実行時に自動更新 ✅ 依存関係の自動解決 ✅ データ品質管理 マテリアライズドビュー( MV)とは 68 -
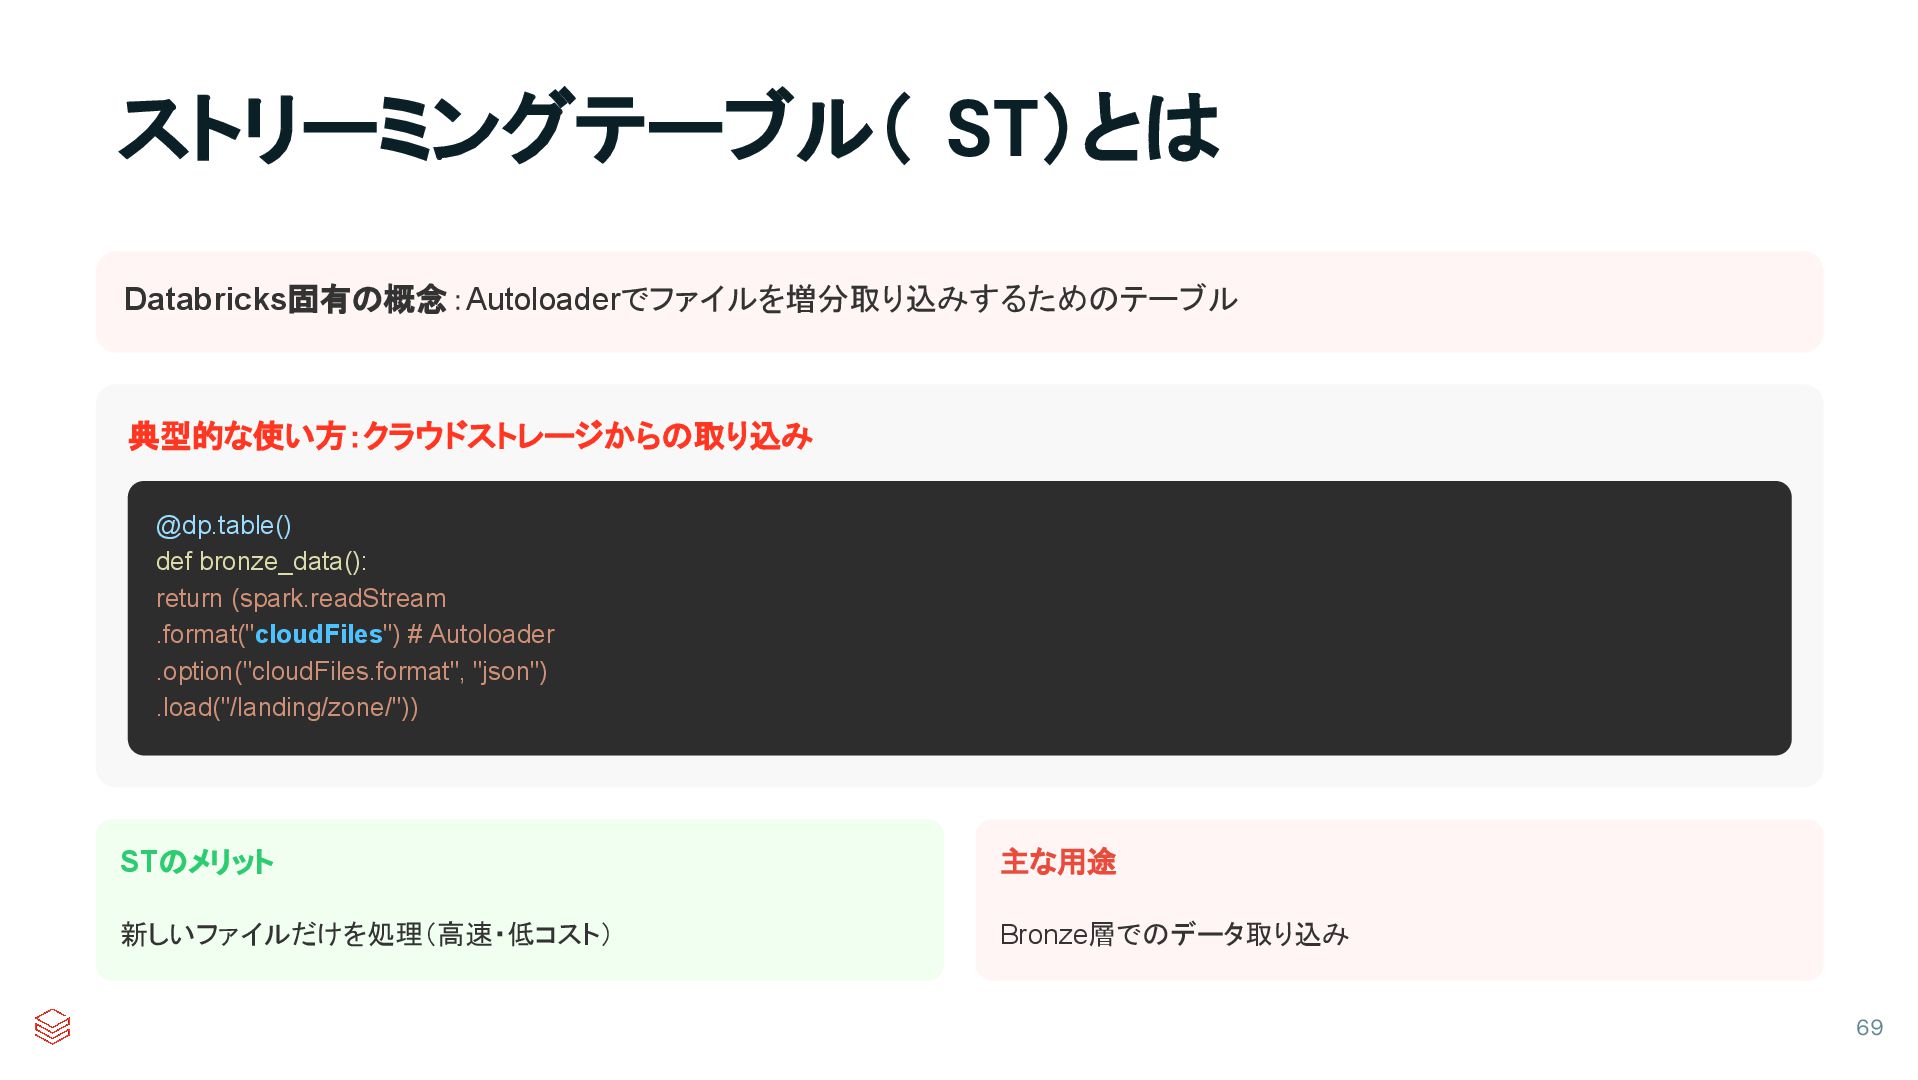
Databricks固有の概念:Autoloaderでファイルを増分取り込みするためのテーブル 典型的な使い方:クラウドストレージからの取り込み @dp.table() def bronze_data(): return (spark.readStream .format("cloudFiles") # Autoloader
.option("cloudFiles.format", "json") .load("/landing/zone/")) STのメリット 新しいファイルだけを処理(高速・低コスト) 主な用途 Bronze層でのデータ取り込み ストリーミングテーブル( ST)とは 69 -
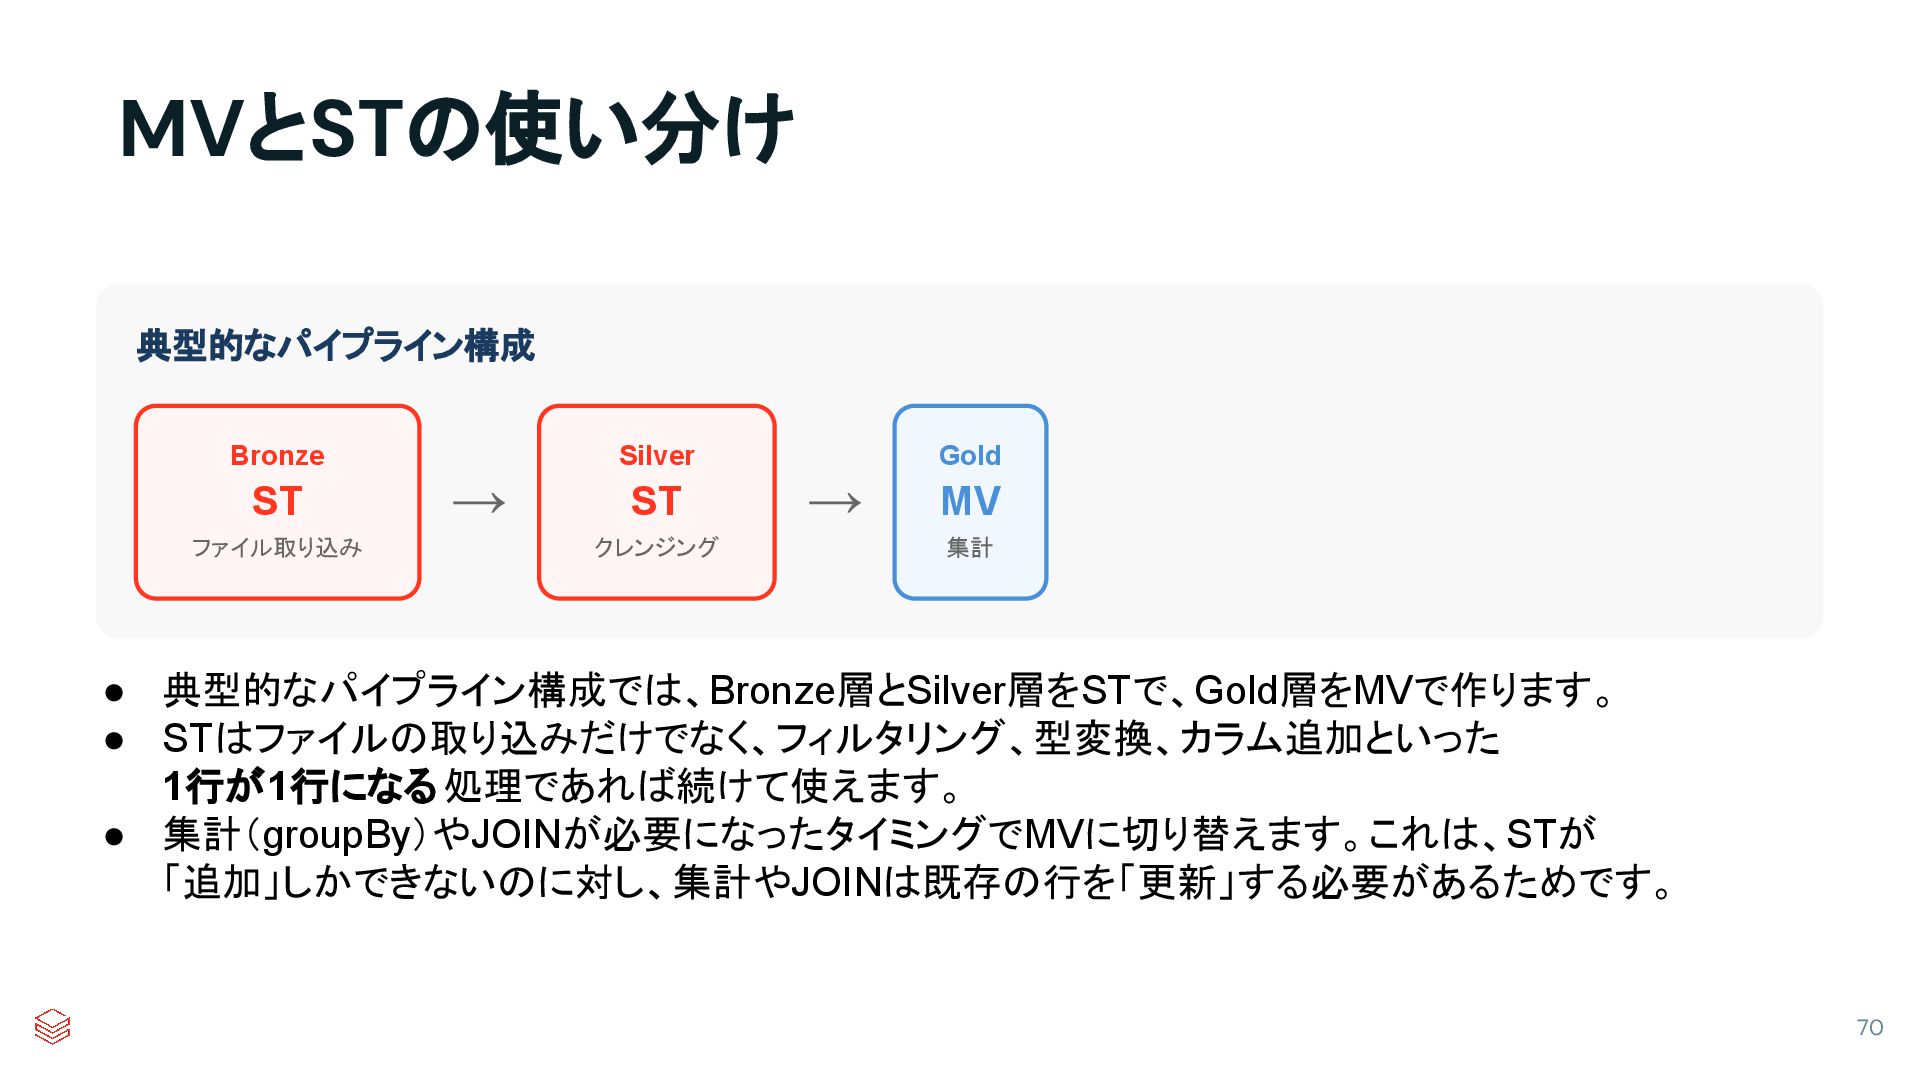
典型的なパイプライン構成 Bronze ST ファイル取り込み → Silver → クレンジング ST Gold
MV 集計 MVとSTの使い分け 70 • 典型的なパイプライン構成では、Bronze層とSilver層をSTで、Gold層をMVで作ります。 • STはファイルの取り込みだけでなく、フィルタリング、型変換、カラム追加といった 1行が1行になる処理であれば続けて使えます。 • 集計(groupBy)やJOINが必要になったタイミングでMVに切り替えます。これは、STが 「追加」しかできないのに対し、集計やJOINは既存の行を「更新」する必要があるためです。 -
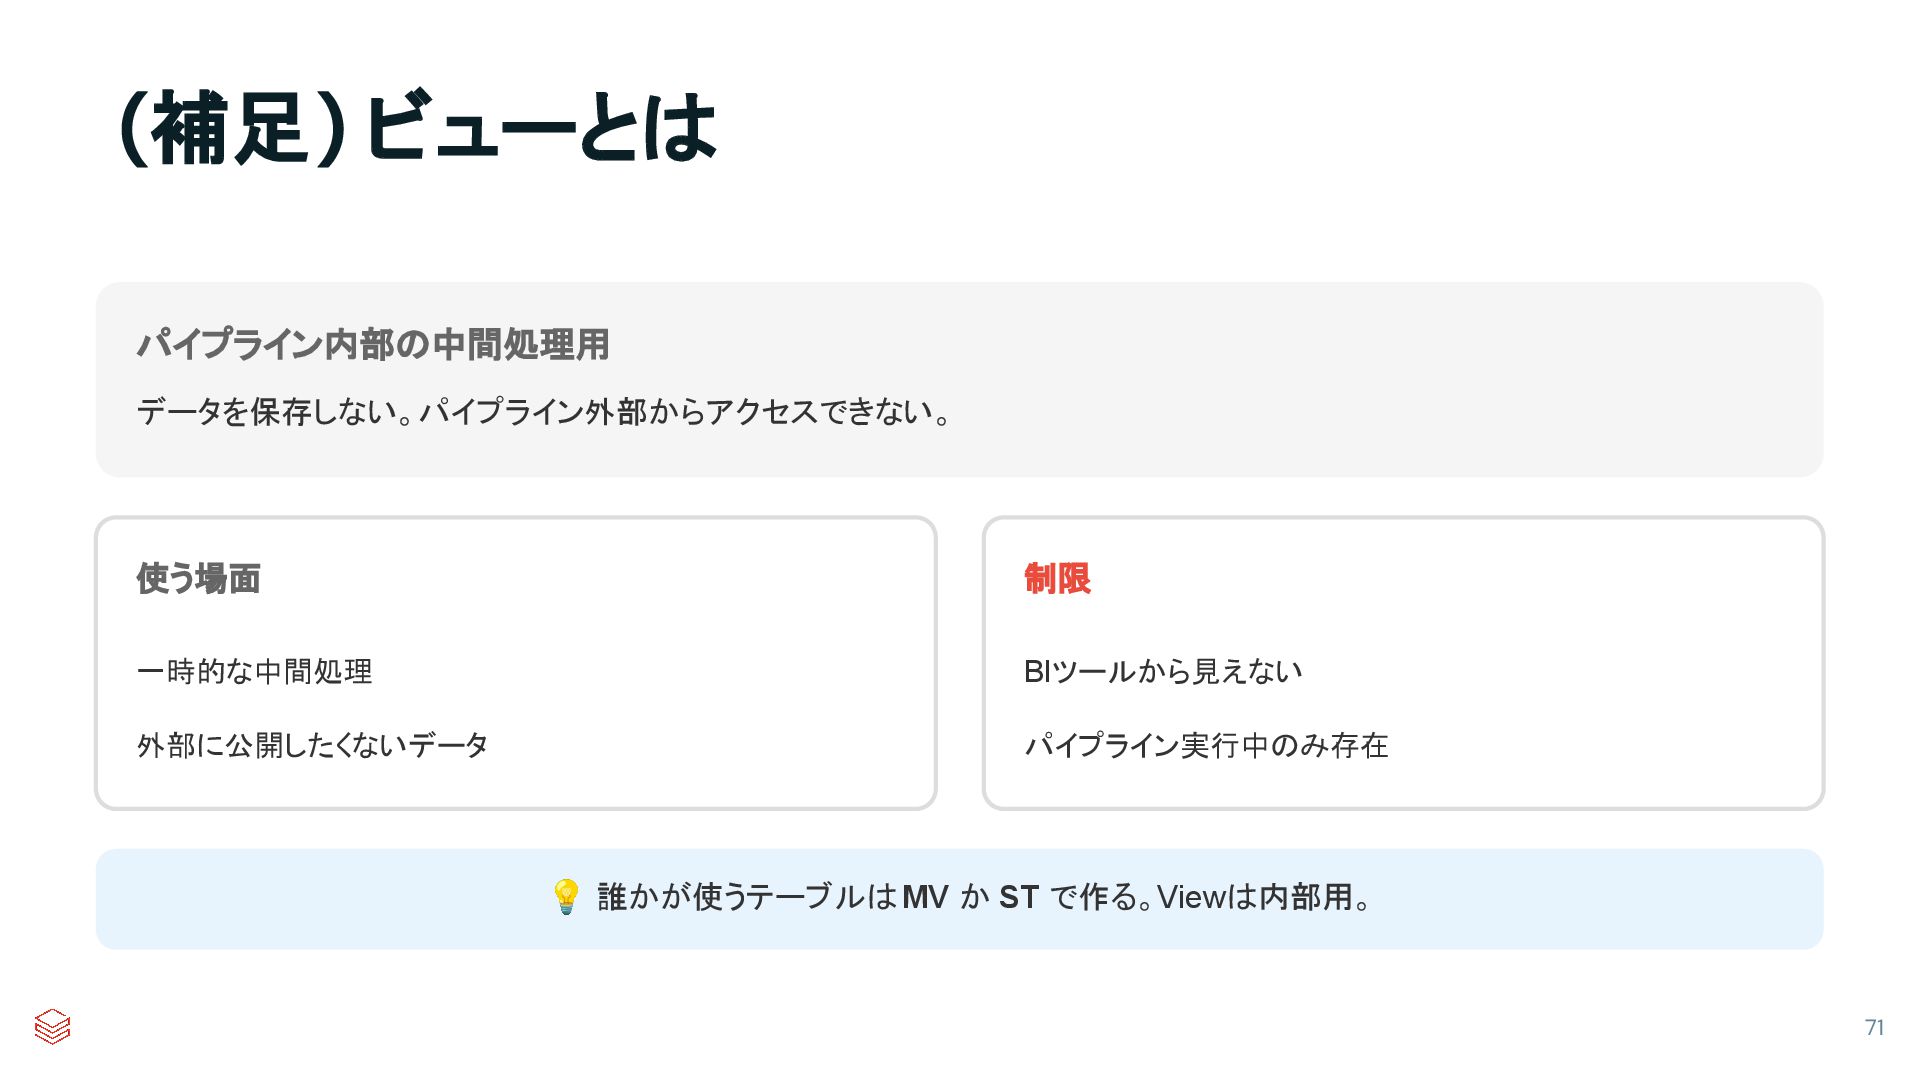
パイプライン内部の中間処理用 データを保存しない。パイプライン外部からアクセスできない。 使う場面 一時的な中間処理 外部に公開したくないデータ 制限 BIツールから見えない パイプライン実行中のみ存在 💡 誰かが使うテーブルは
MV か ST で作る。Viewは内部用。 (補足) ビューとは 71 -
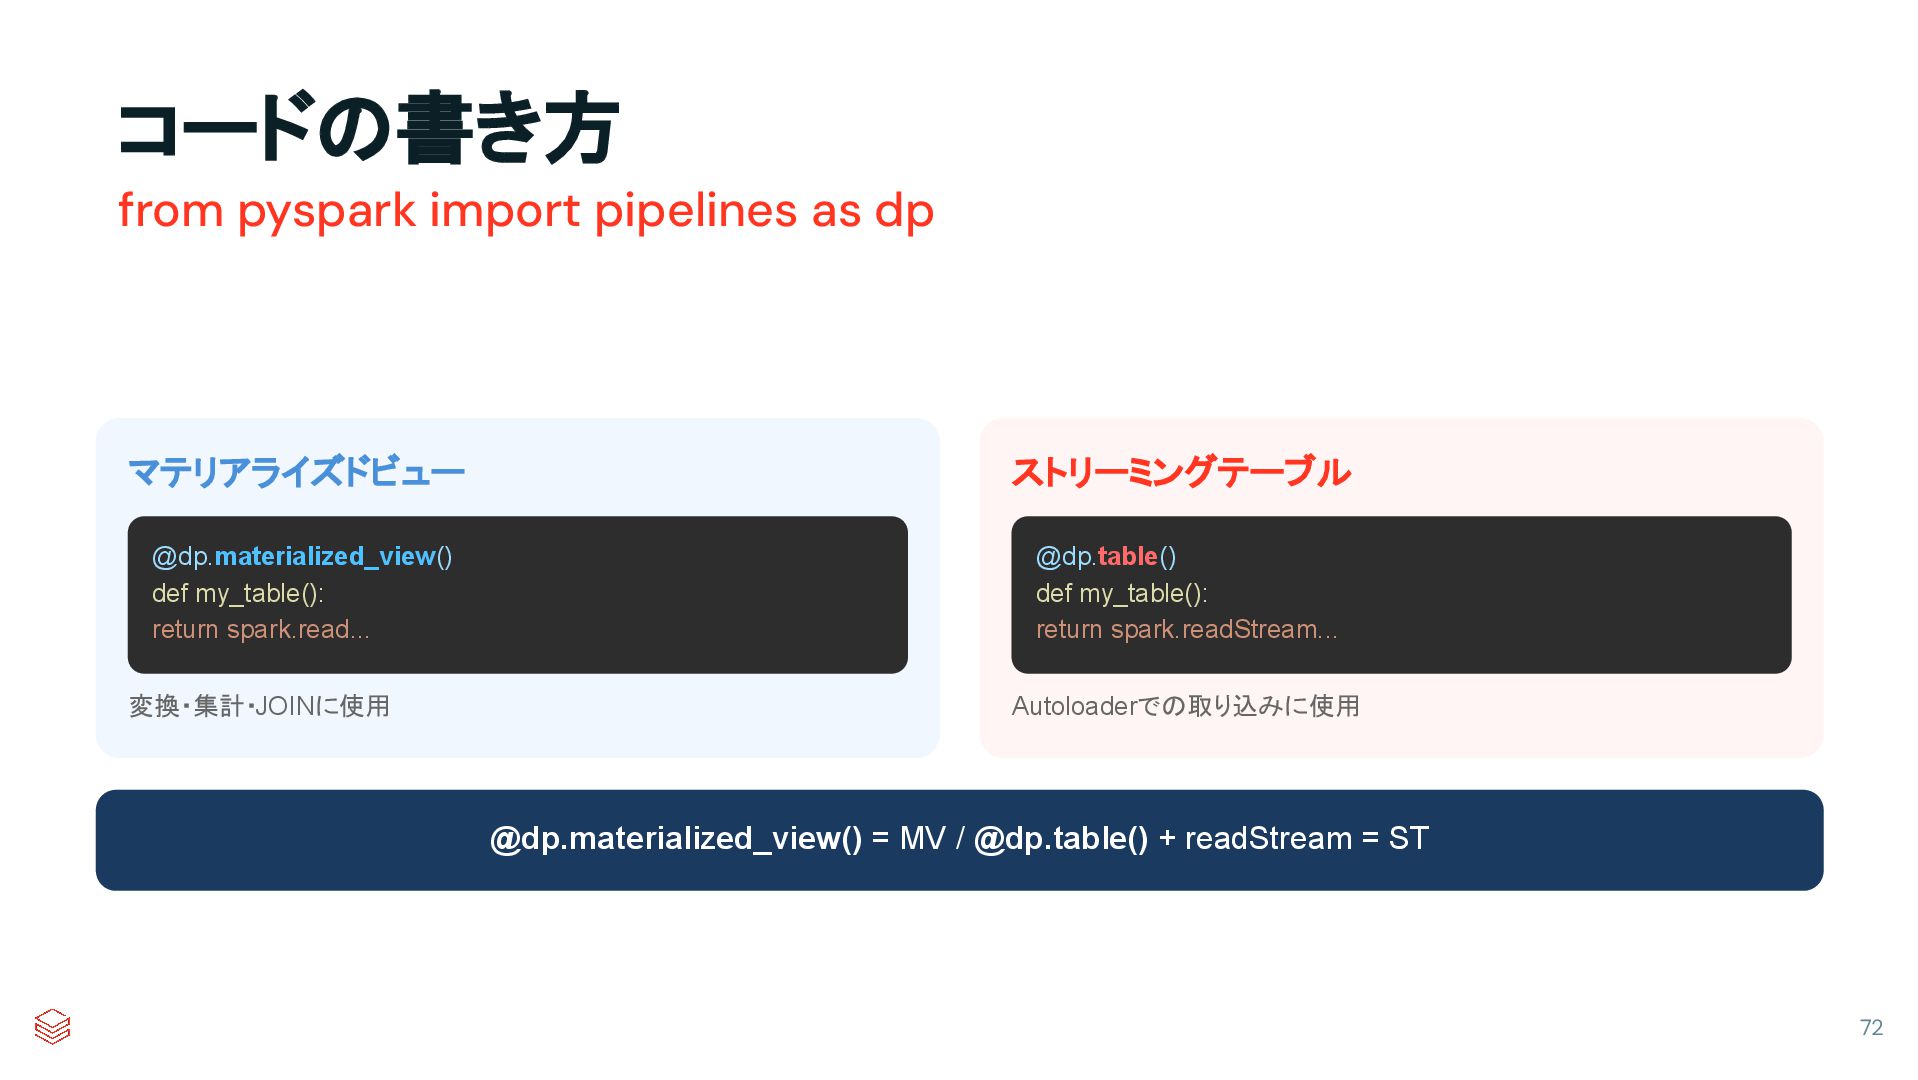
マテリアライズドビュー @dp.materialized_view() def my_table(): return spark.read... 変換・集計・JOINに使用 ストリーミングテーブル @dp.table() def
my_table(): return spark.readStream... Autoloaderでの取り込みに使用 @dp.materialized_view() = MV / @dp.table() + readStream = ST コードの書き方 72 from pyspark import pipelines as dp -
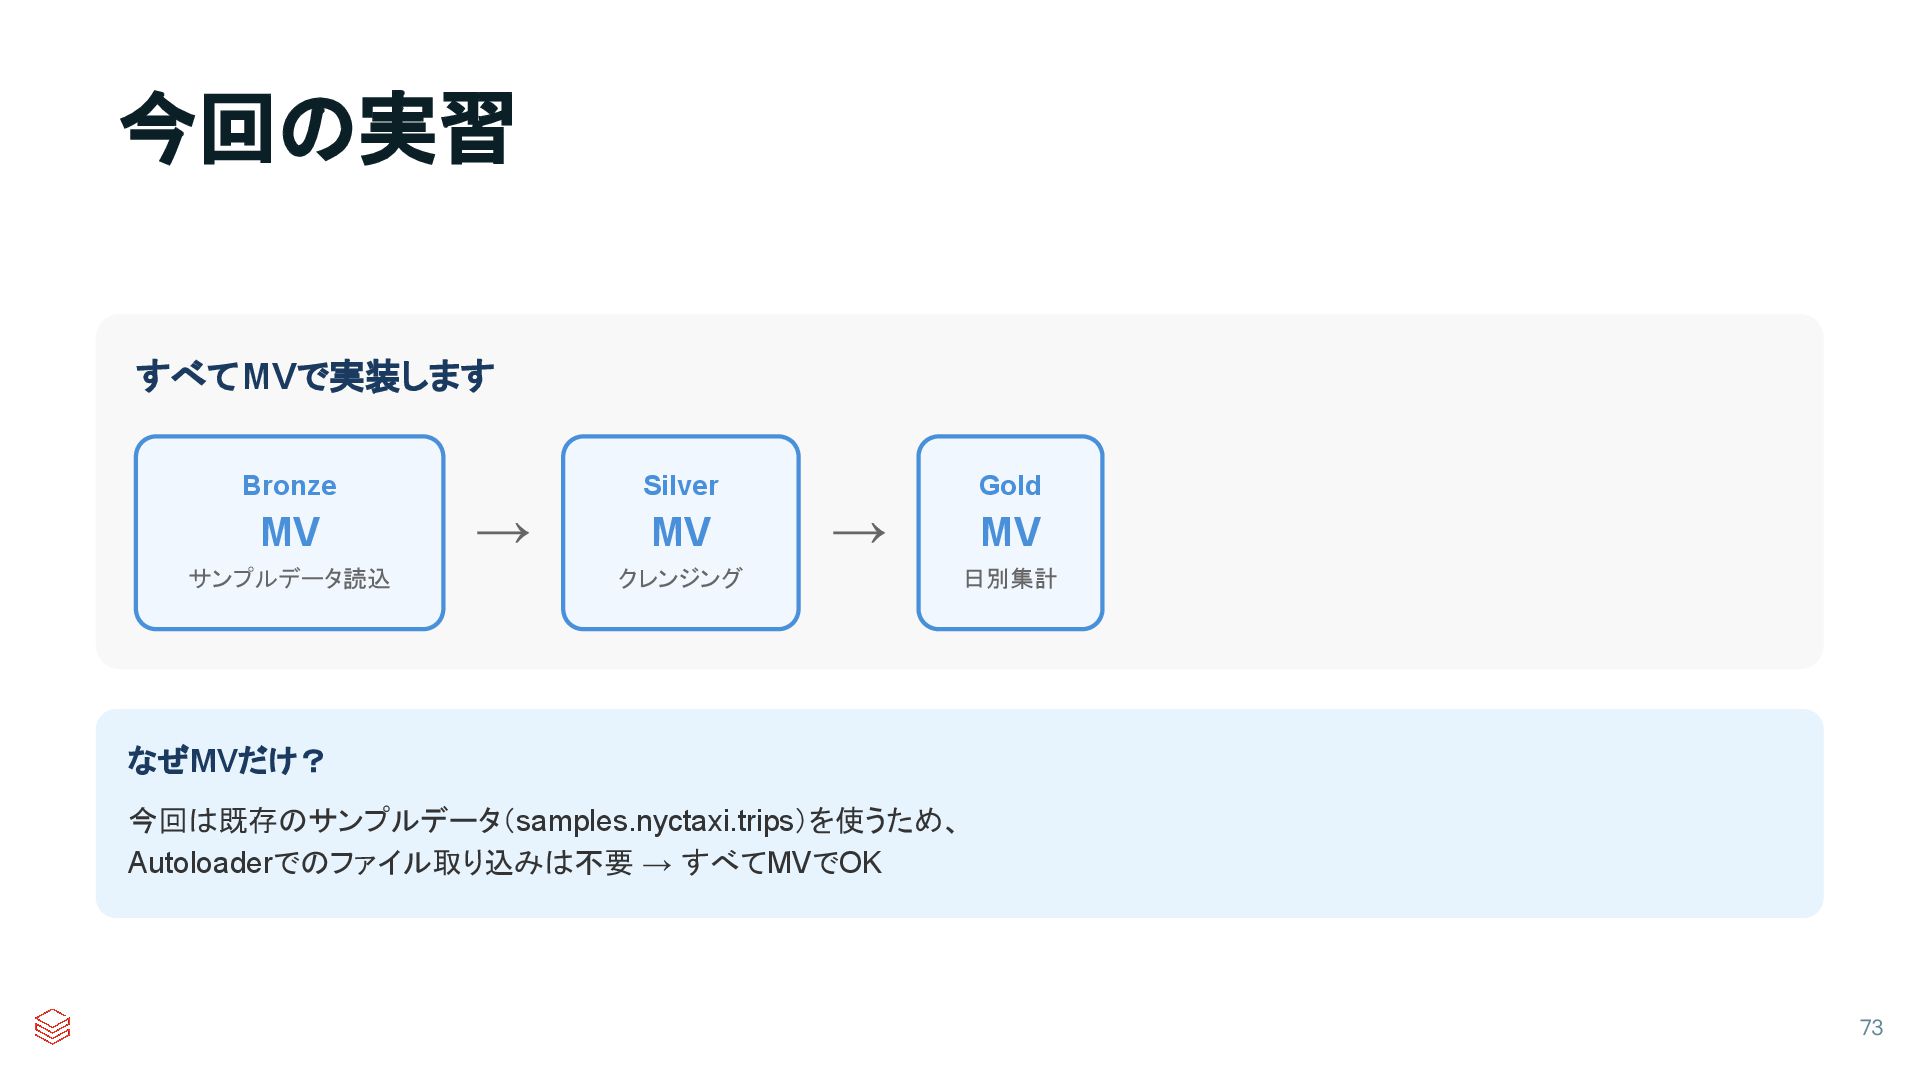
すべてMVで実装します Bronze MV サンプルデータ読込 → Silver MV クレンジング → Gold
MV 日別集計 なぜMVだけ? 今回は既存のサンプルデータ(samples.nyctaxi.trips)を使うため、 Autoloaderでのファイル取り込みは不要 → すべてMVでOK 今回の実習 73 -
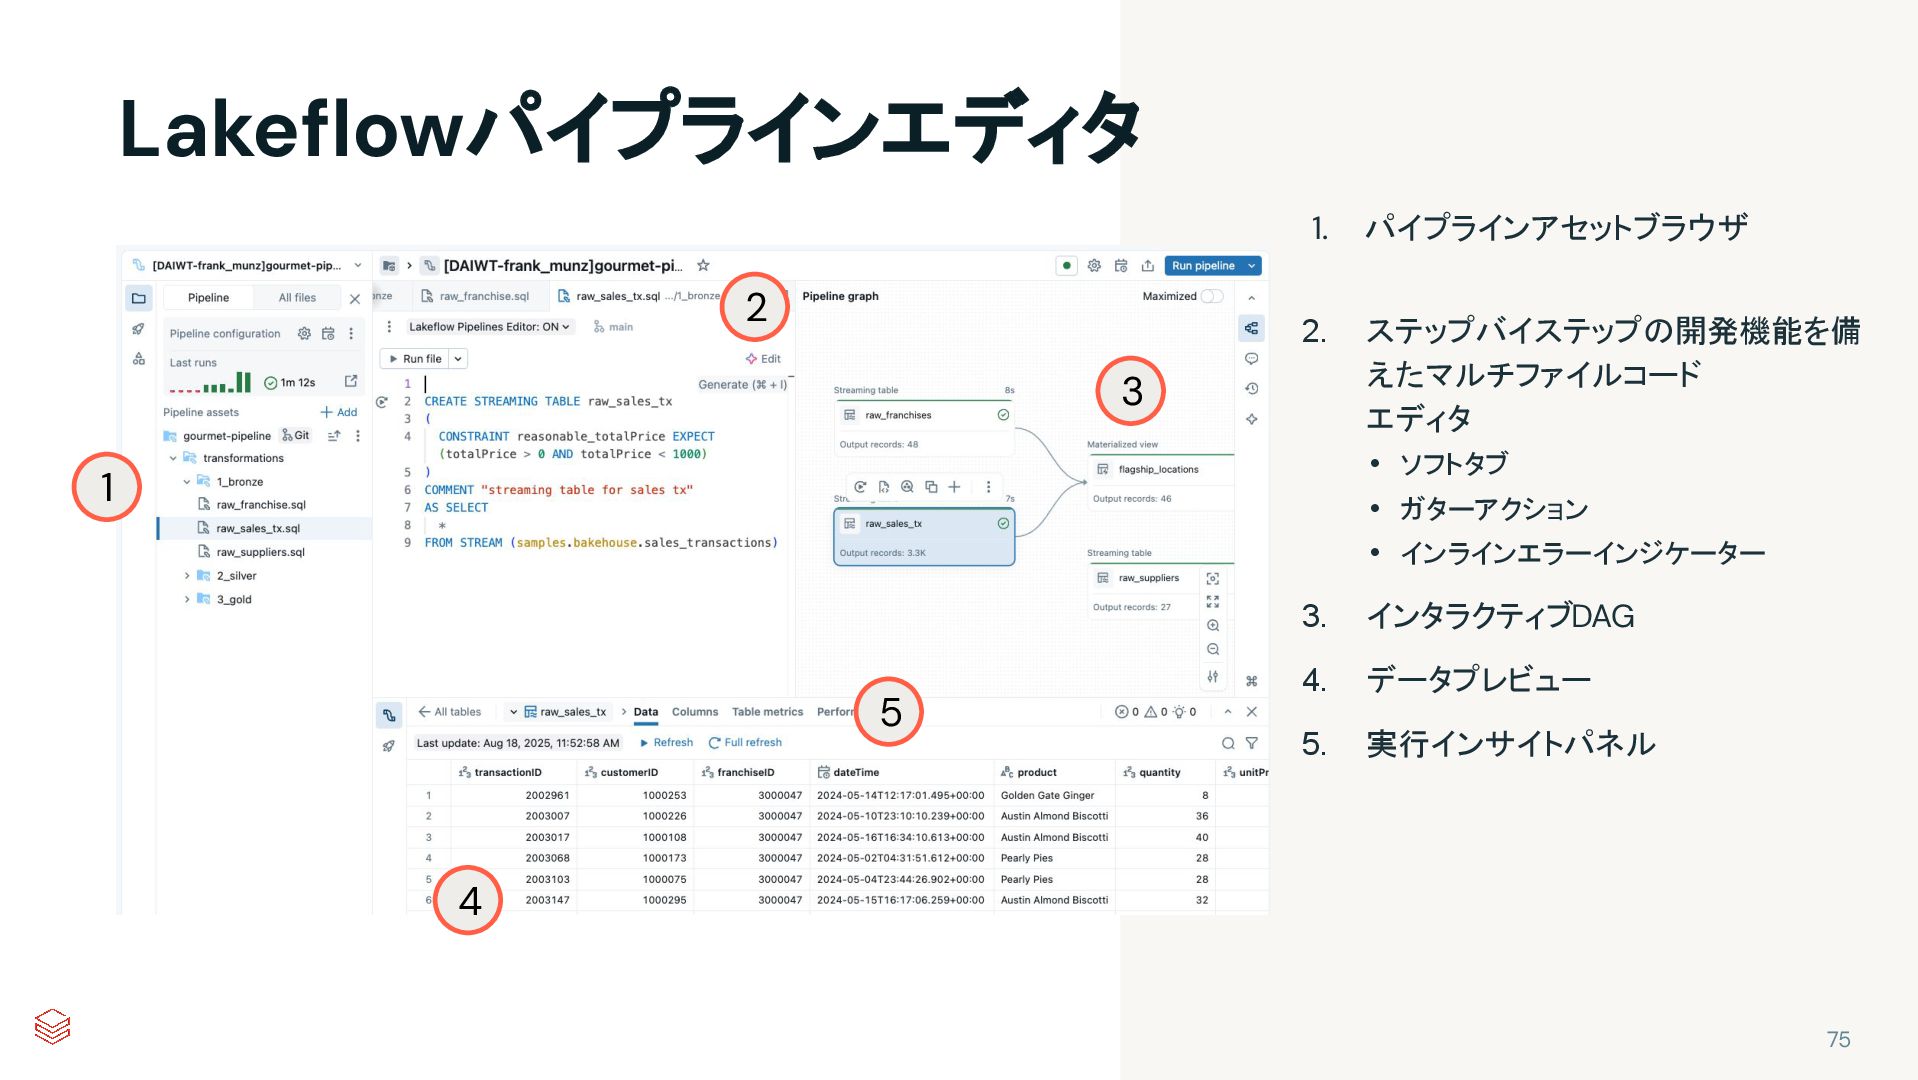
Lakeflowパイプラインエディタ 1. パイプラインアセットブラウザ 2. ステップバイステップの開発機能を備 えたマルチファイルコード エディタ • ソフトタブ •
ガターアクション • インラインエラーインジケーター 3. インタラクティブDAG 4. データプレビュー 5. 実行インサイトパネル 1 2 3 4 5 75 -
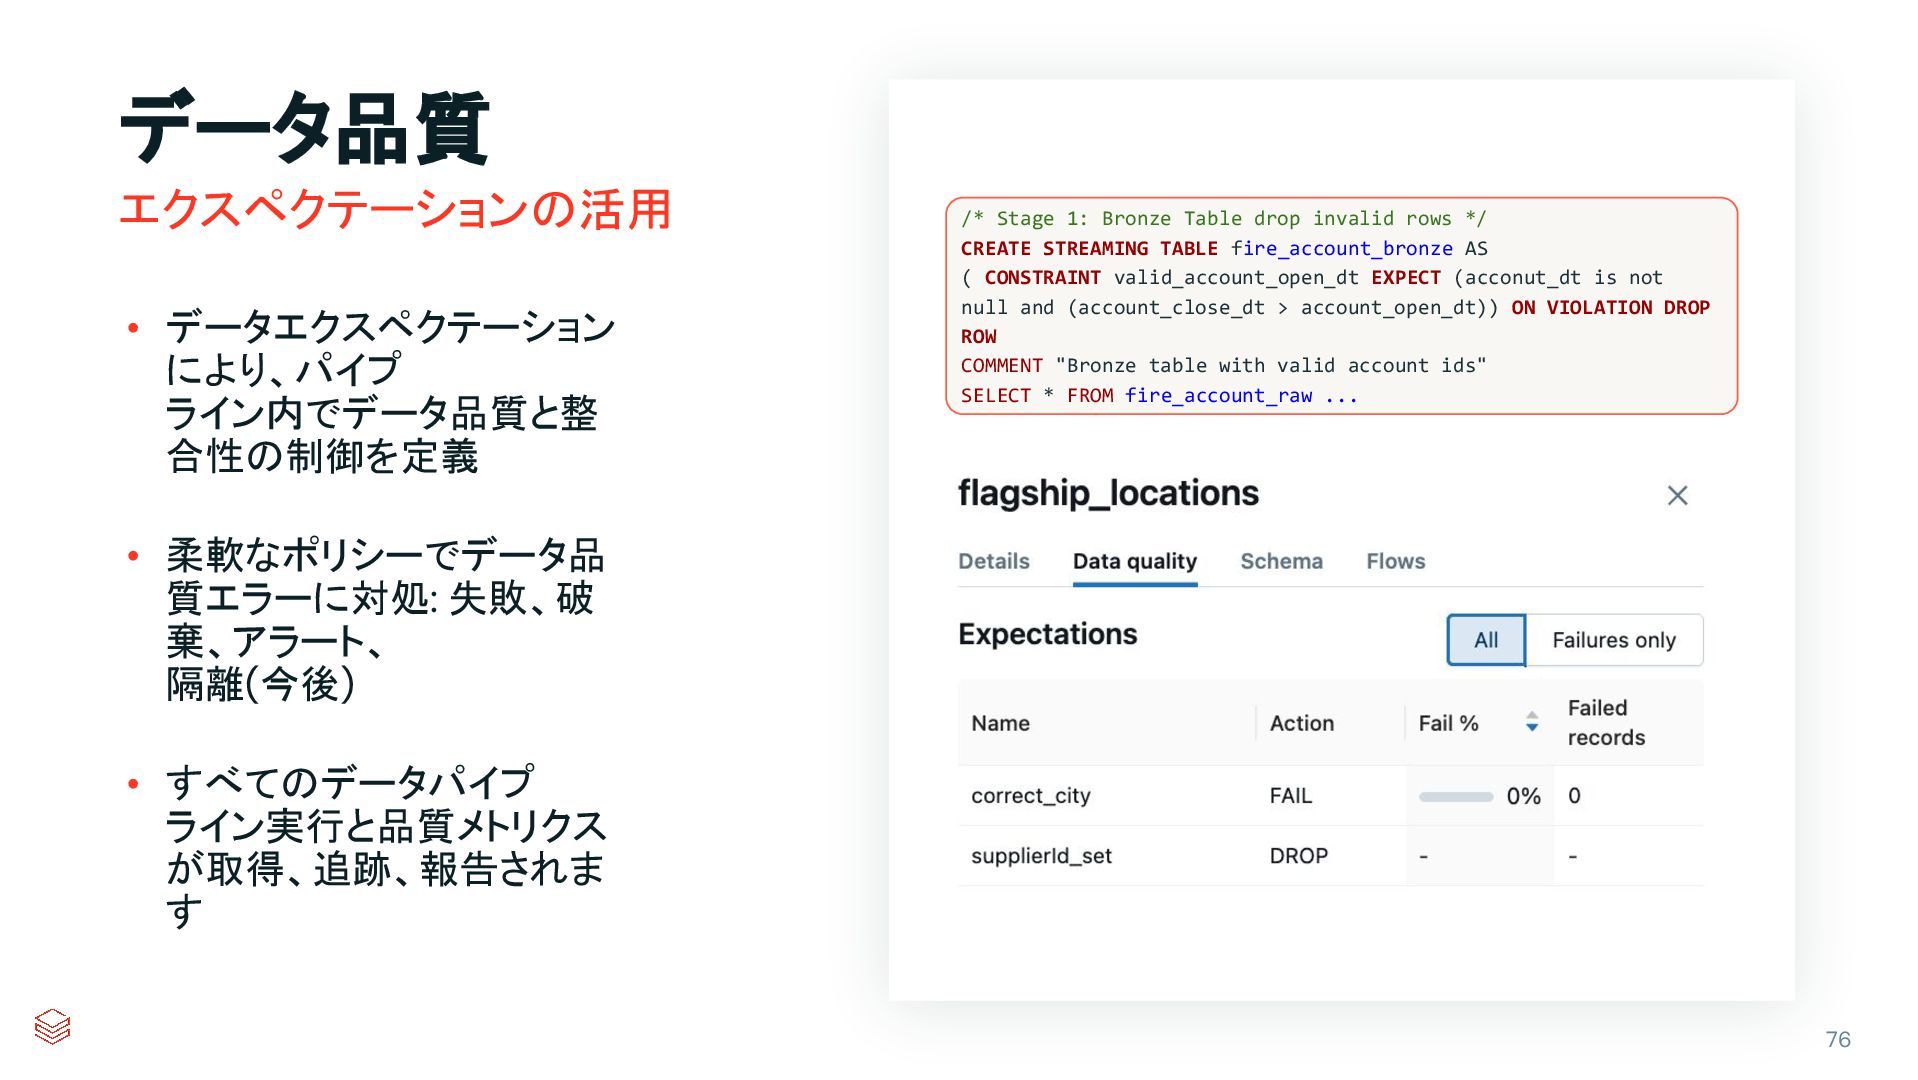
データ品質 エクスペクテーションの活用 • データエクスペクテーション により、パイプ ライン内でデータ品質と整 合性の制御を定義 • 柔軟なポリシーでデータ品 質エラーに対処:
失敗、破 棄、アラート、 隔離(今後) • すべてのデータパイプ ライン実行と品質メトリクス が取得、追跡、報告されま す /* Stage 1: Bronze Table drop invalid rows */ CREATE STREAMING TABLE fire_account_bronze AS ( CONSTRAINT valid_account_open_dt EXPECT (acconut_dt is not null and (account_close_dt > account_open_dt)) ON VIOLATION DROP ROW COMMENT "Bronze table with valid account ids" SELECT * FROM fire_account_raw ... 76 -
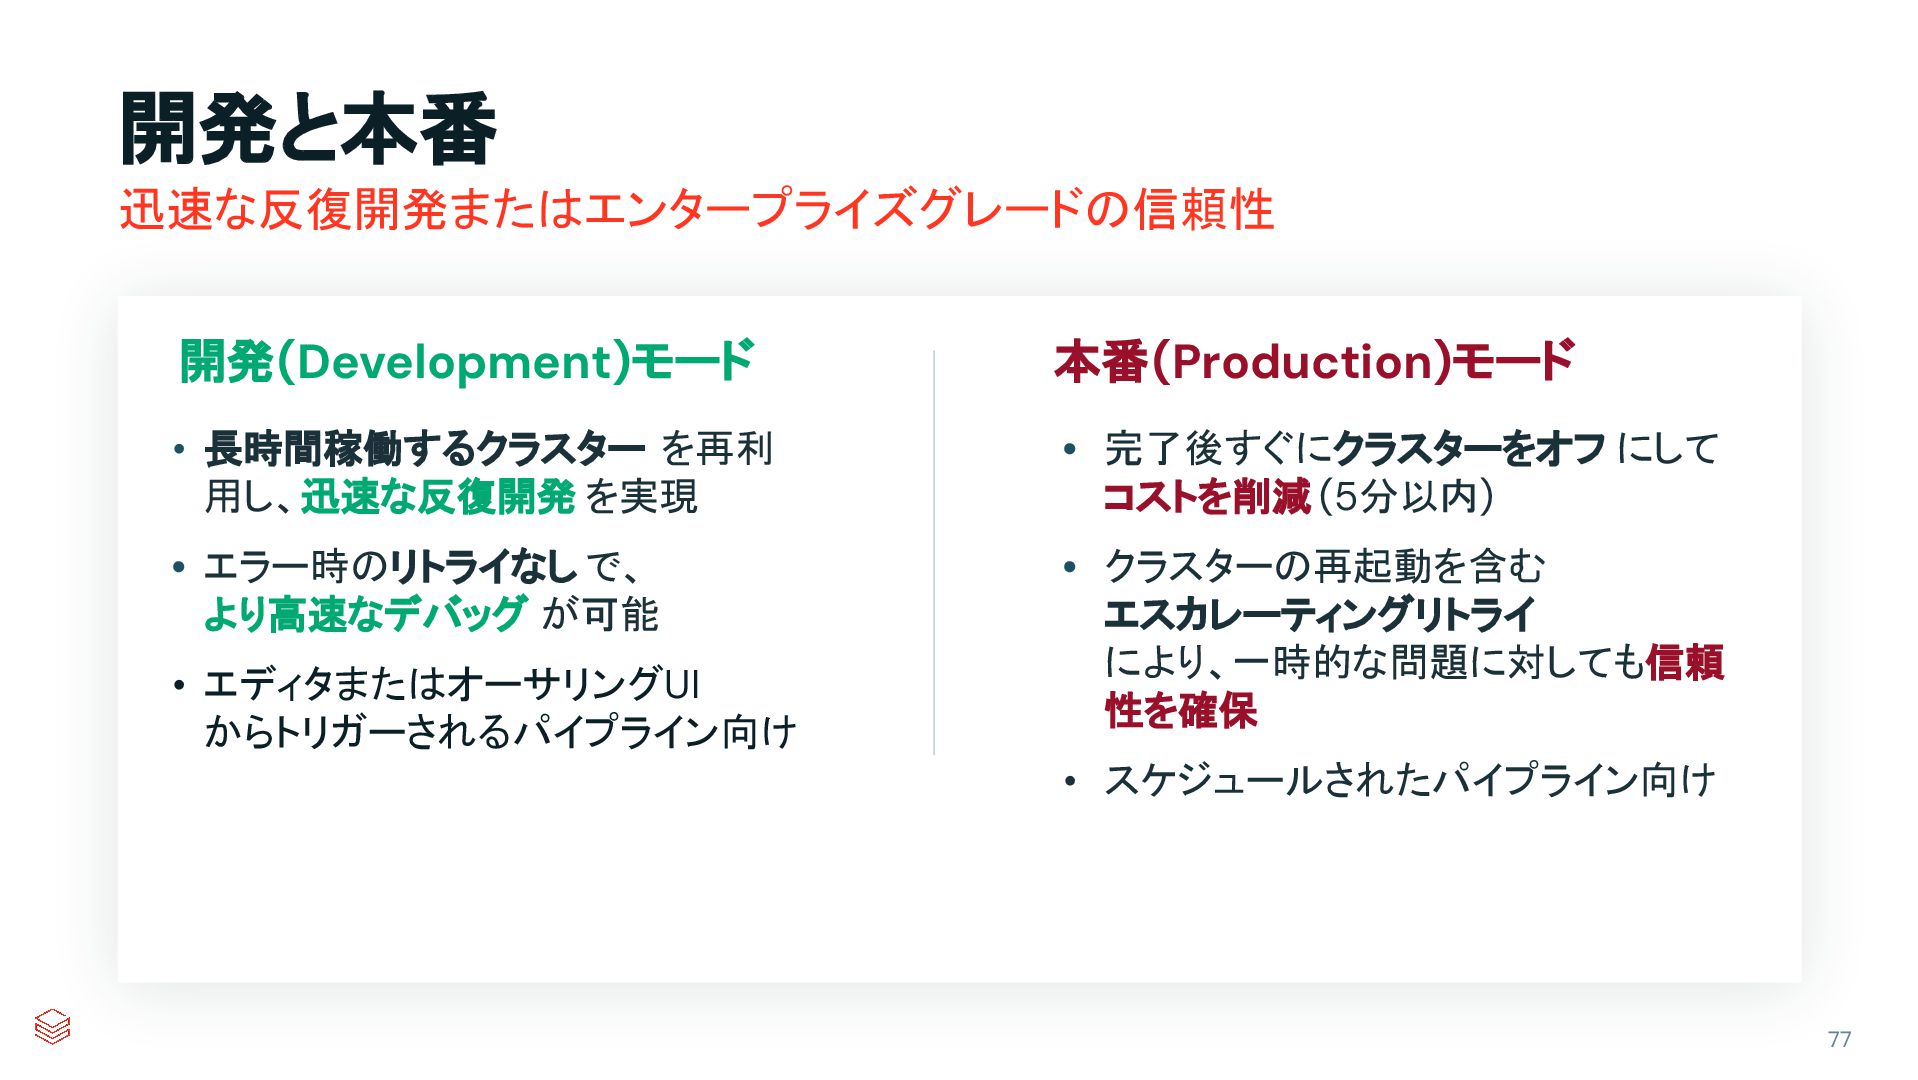
開発と本番 迅速な反復開発またはエンタープライズグレードの信頼性 開発(Development)モード • 長時間稼働するクラスター を再利 用し、迅速な反復開発 を実現 • エラー時のリトライなし
で、 より高速なデバッグ が可能 • エディタまたはオーサリングUI からトリガーされるパイプライン向け • 完了後すぐにクラスターをオフ にして コストを削減 (5分以内) • クラスターの再起動を含む エスカレーティングリトライ により、一時的な問題に対しても信頼 性を確保 • スケジュールされたパイプライン向け 本番(Production)モード 77 -
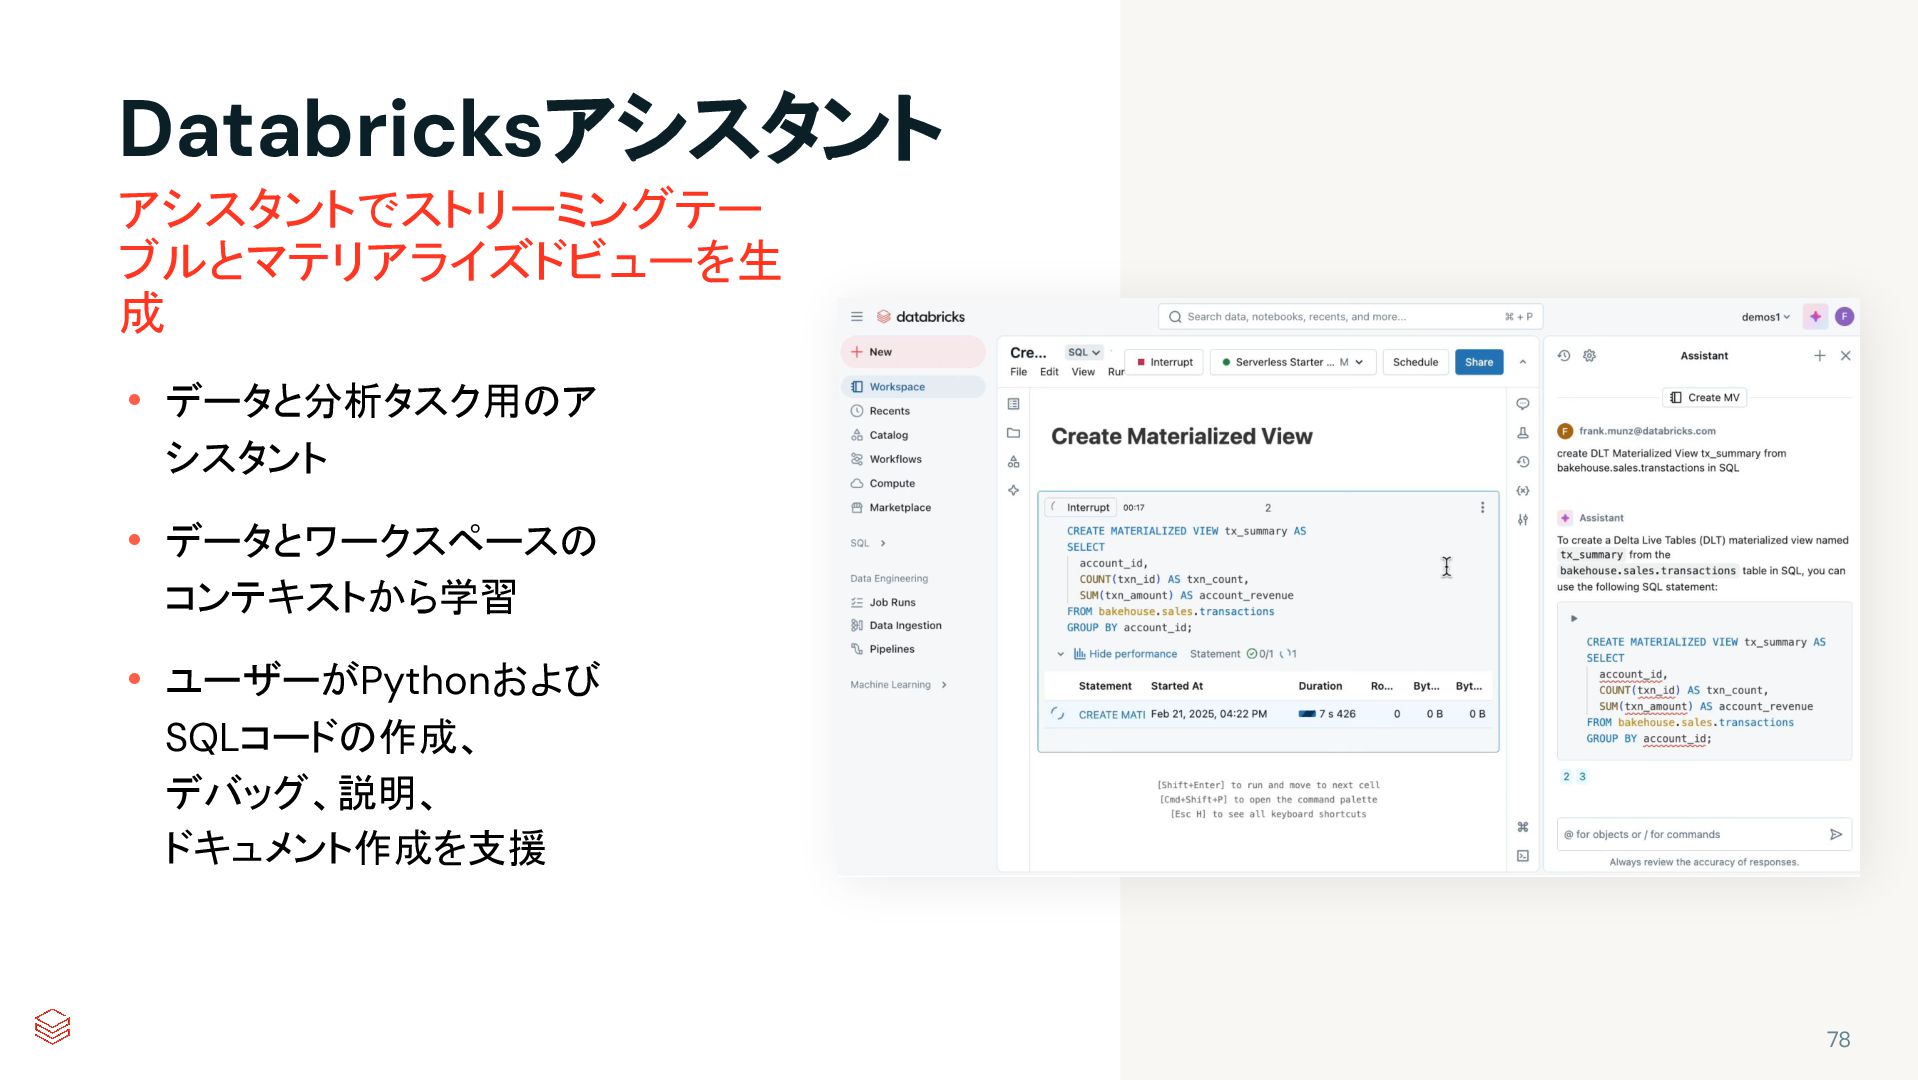
Databricksアシスタント アシスタントでストリーミングテー ブルとマテリアライズドビューを生 成 • データと分析タスク用のア シスタント • データとワークスペースの コンテキストから学習
• ユーザーがPythonおよび SQLコードの作成、 デバッグ、説明、 ドキュメント作成を支援 78 -
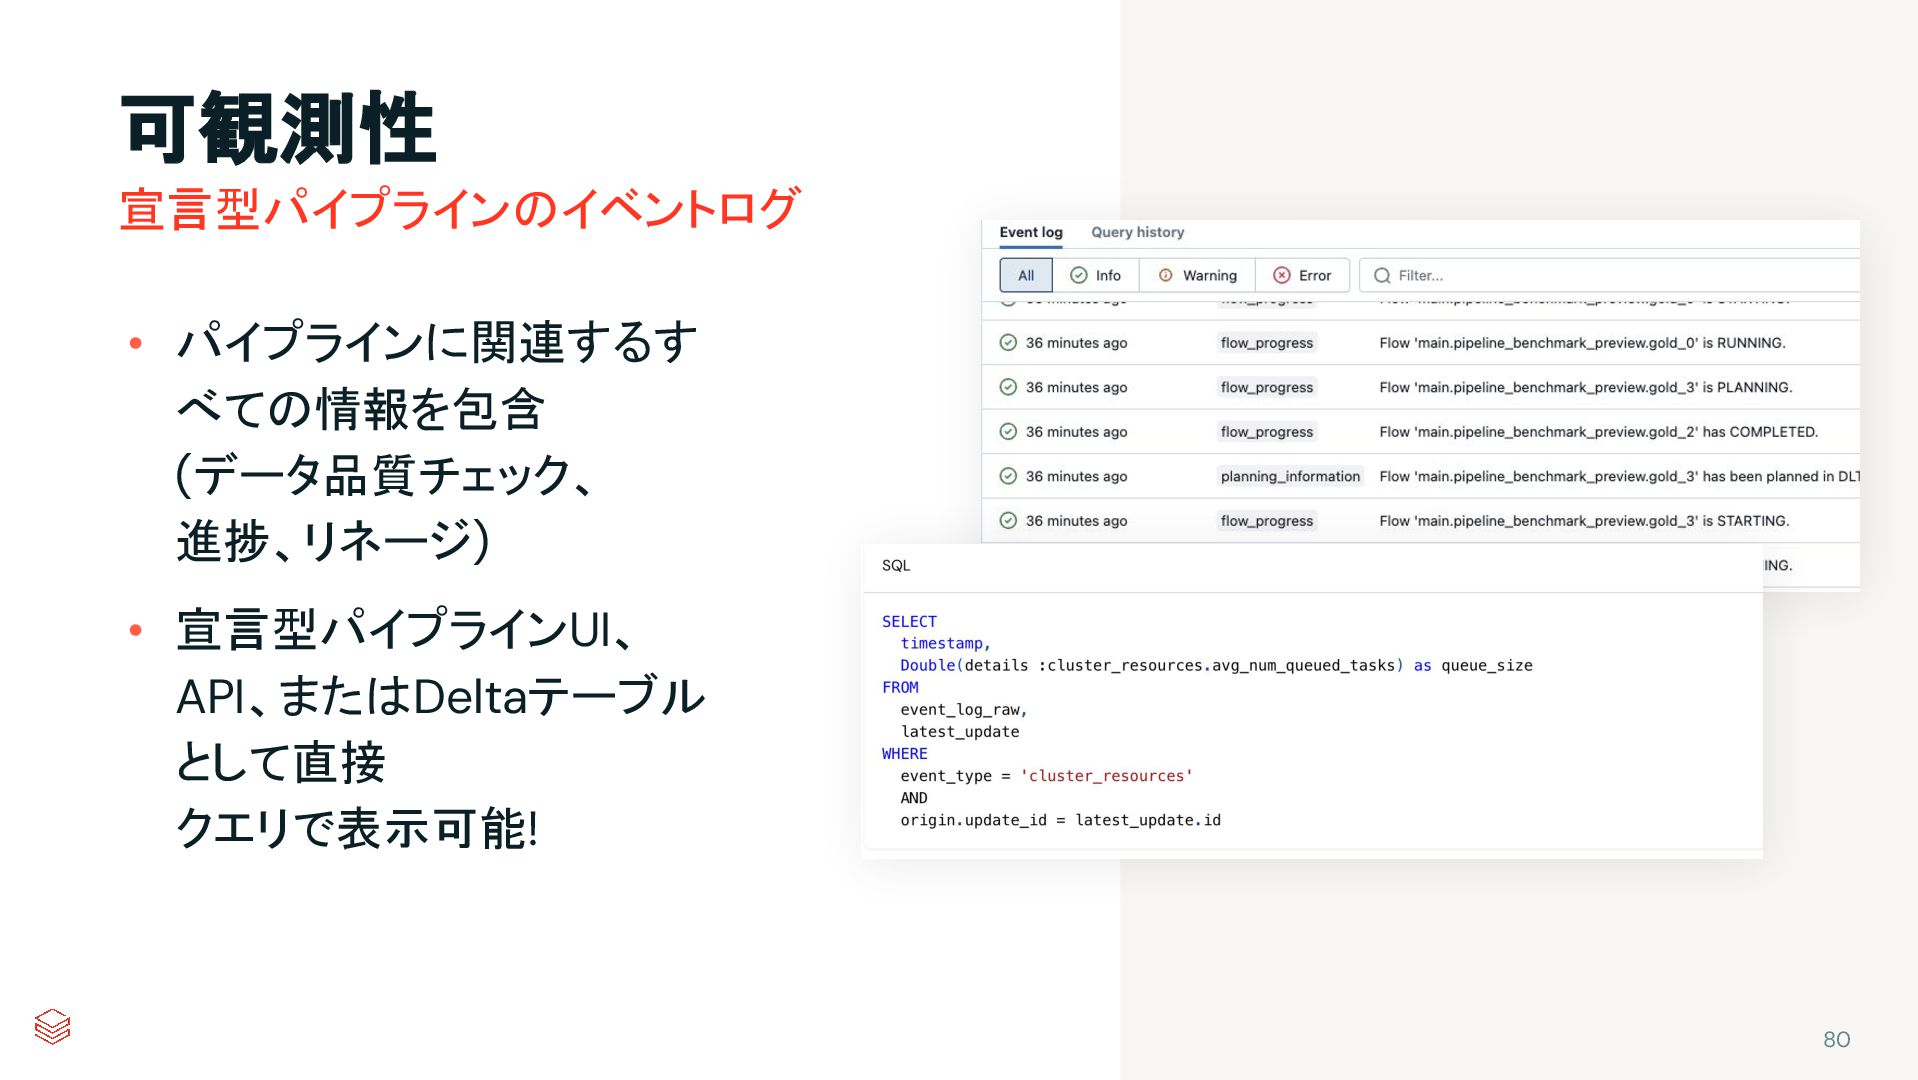
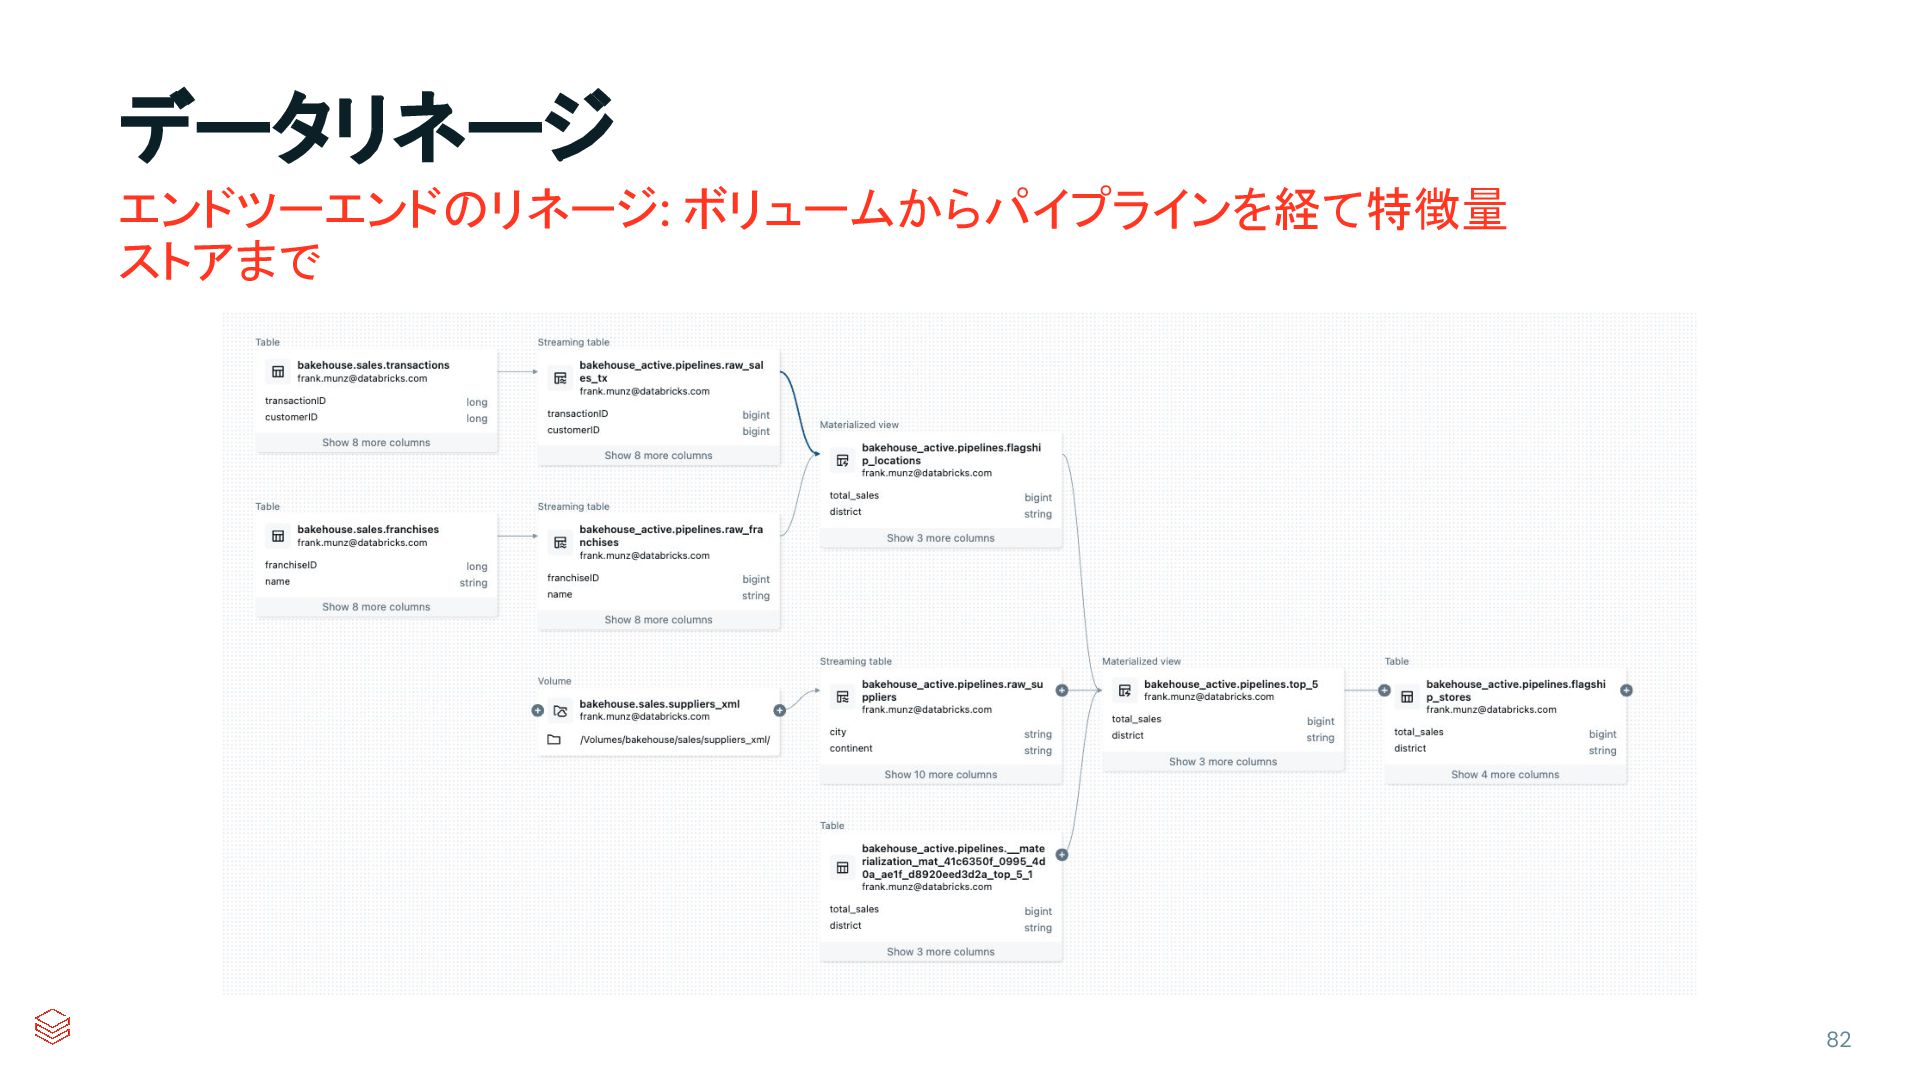
可観測性 • パイプラインに関連するす べての情報を包含 (データ品質チェック、 進捗、リネージ) • 宣言型パイプラインUI、 API、またはDeltaテーブル として直接
クエリで表示可能! 宣言型パイプラインのイベントログ 80 -
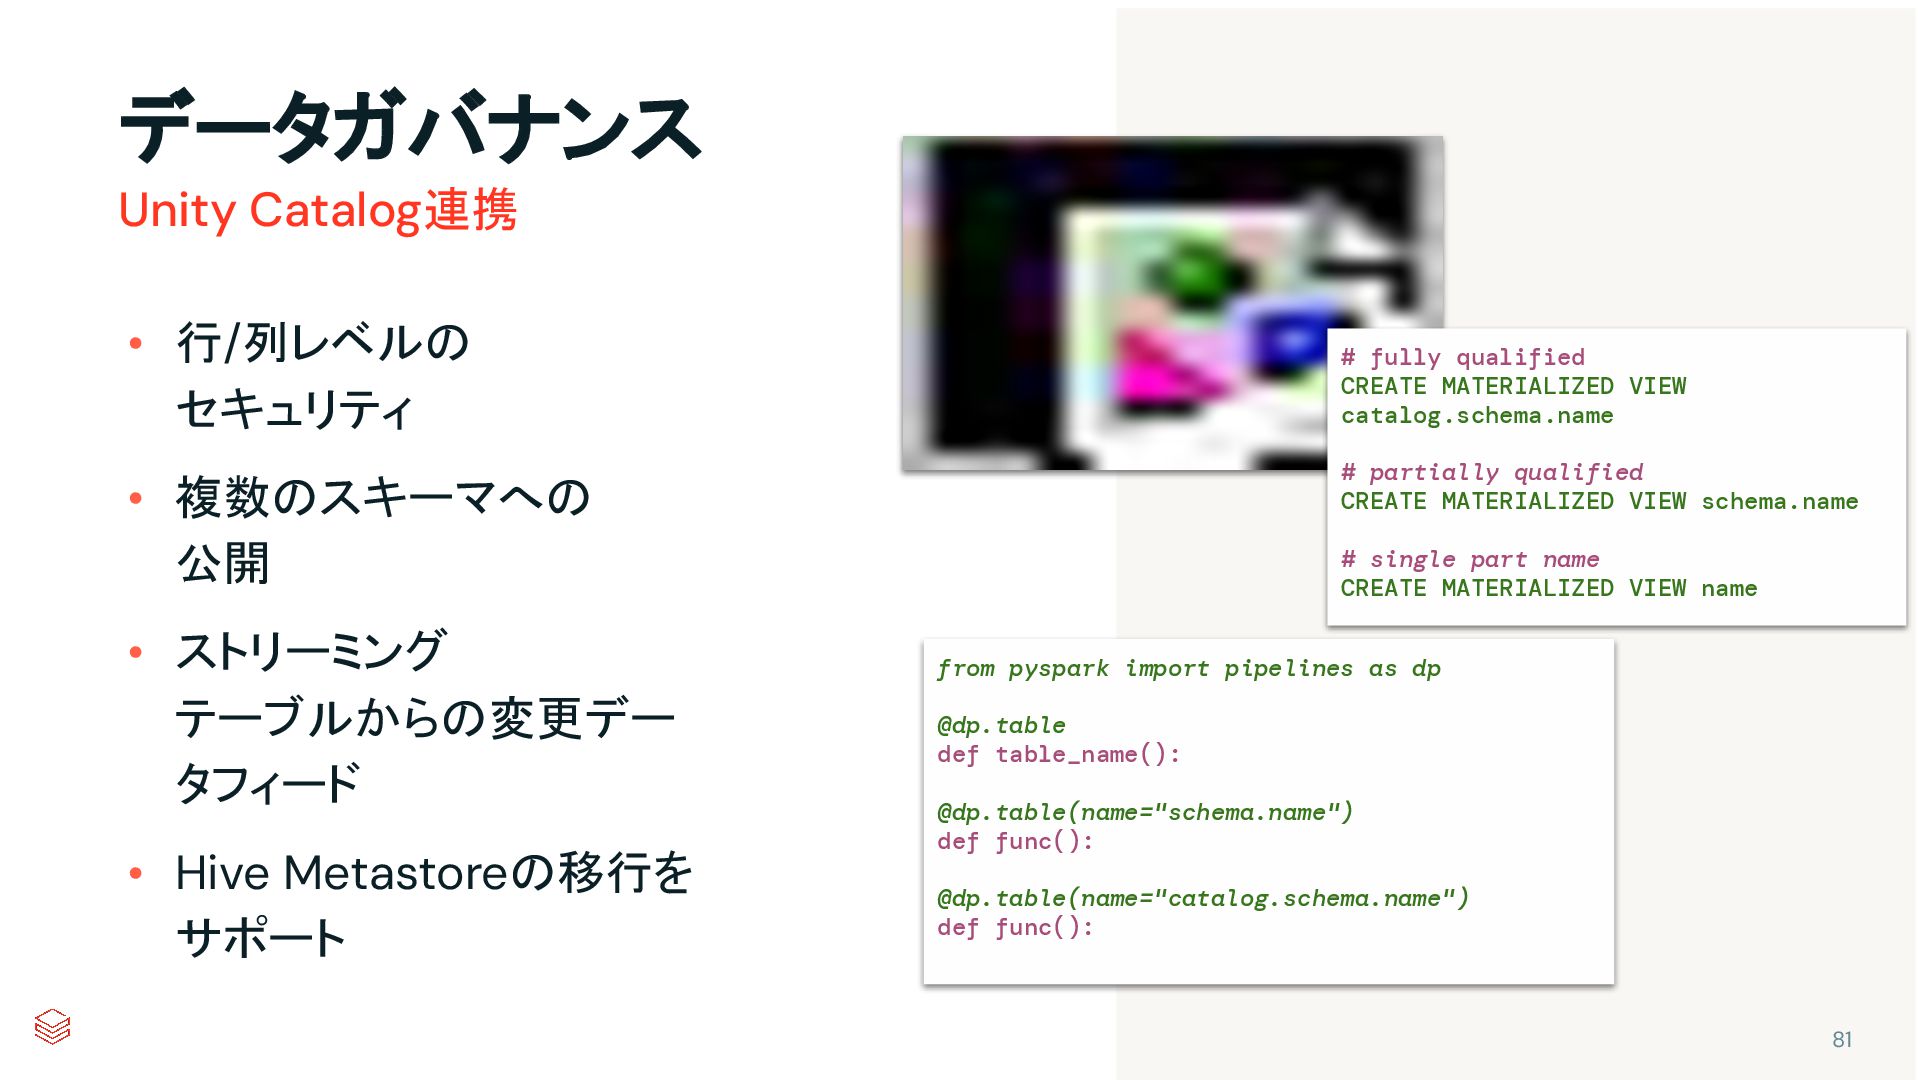
データガバナンス • 行/列レベルの セキュリティ • 複数のスキーマへの 公開 • ストリーミング テーブルからの変更デー
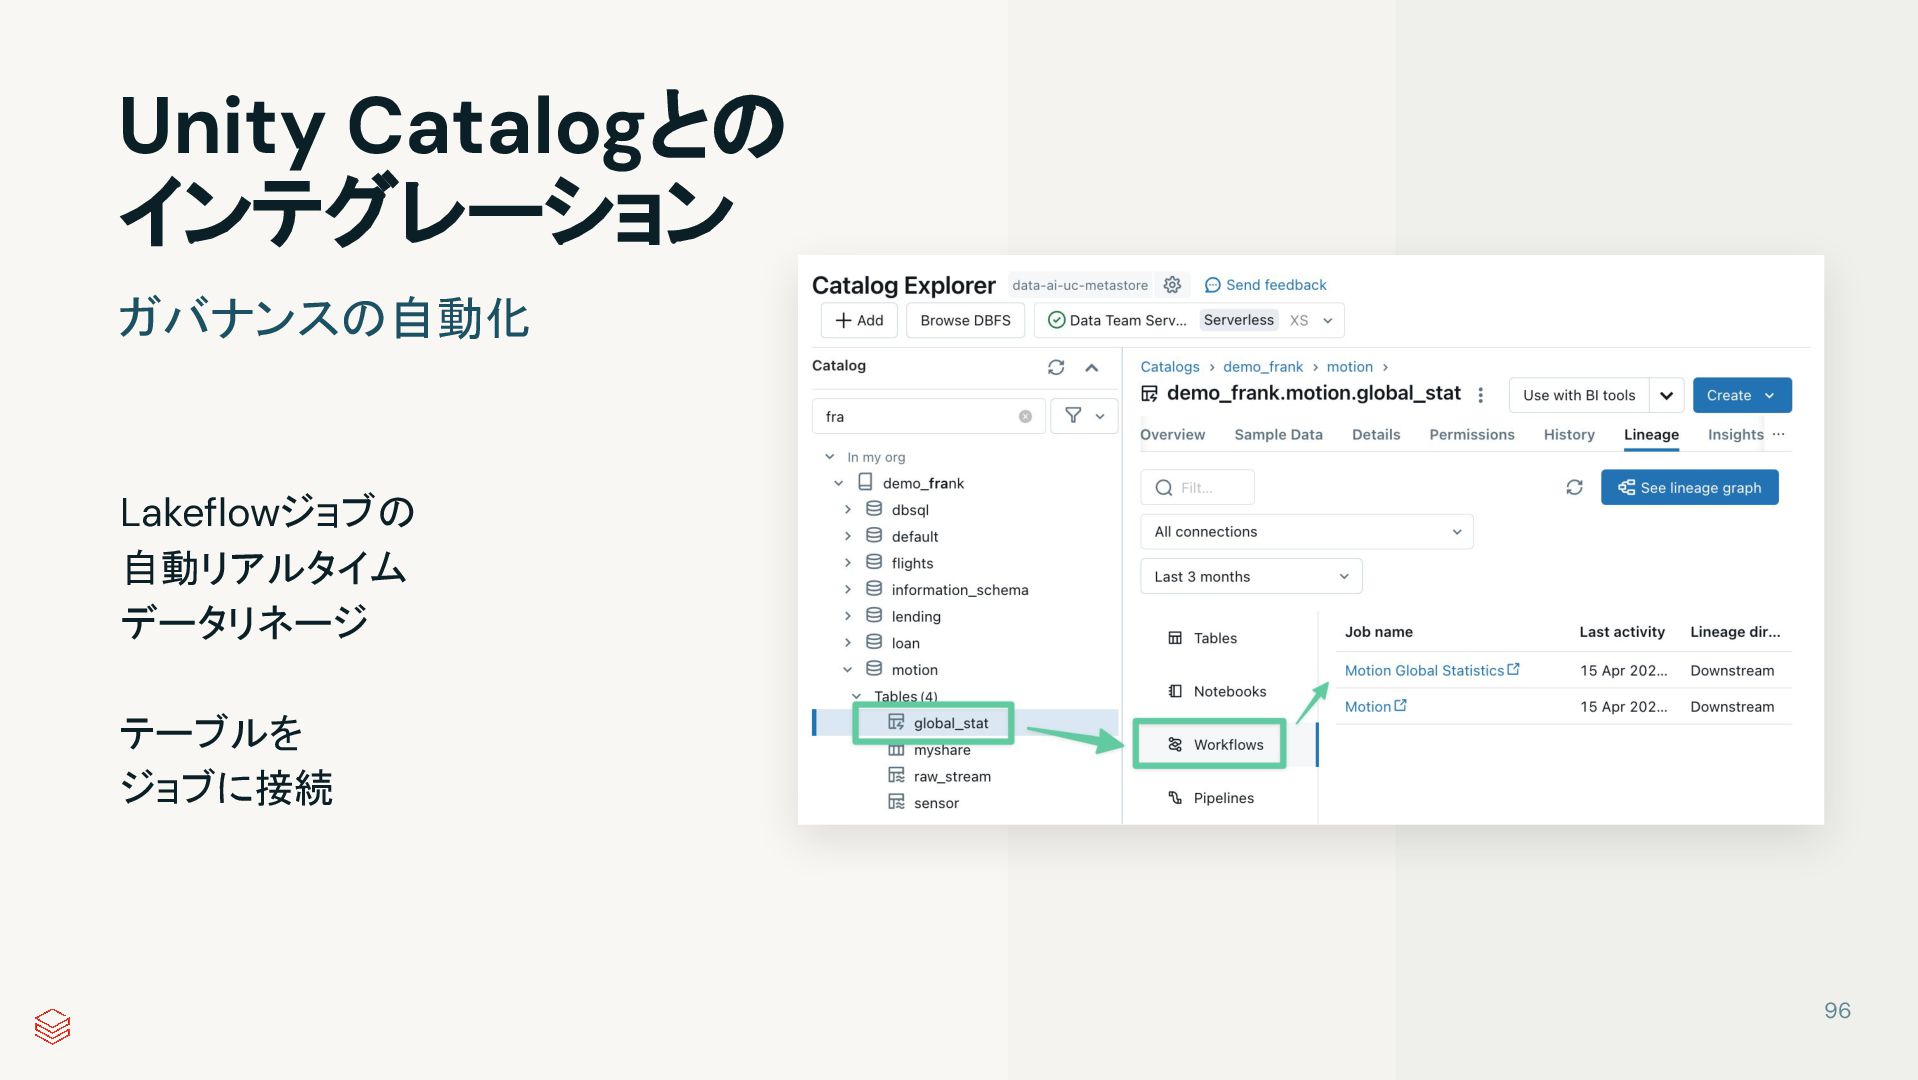
タフィード • Hive Metastoreの移行を サポート Unity Catalog連携 # fully qualified CREATE MATERIALIZED VIEW catalog.schema.name # partially qualified CREATE MATERIALIZED VIEW schema.name # single part name CREATE MATERIALIZED VIEW name from pyspark import pipelines as dp @dp.table def table_name(): @dp.table(name="schema.name") def func(): @dp.table(name="catalog.schema.name") def func(): 81 -
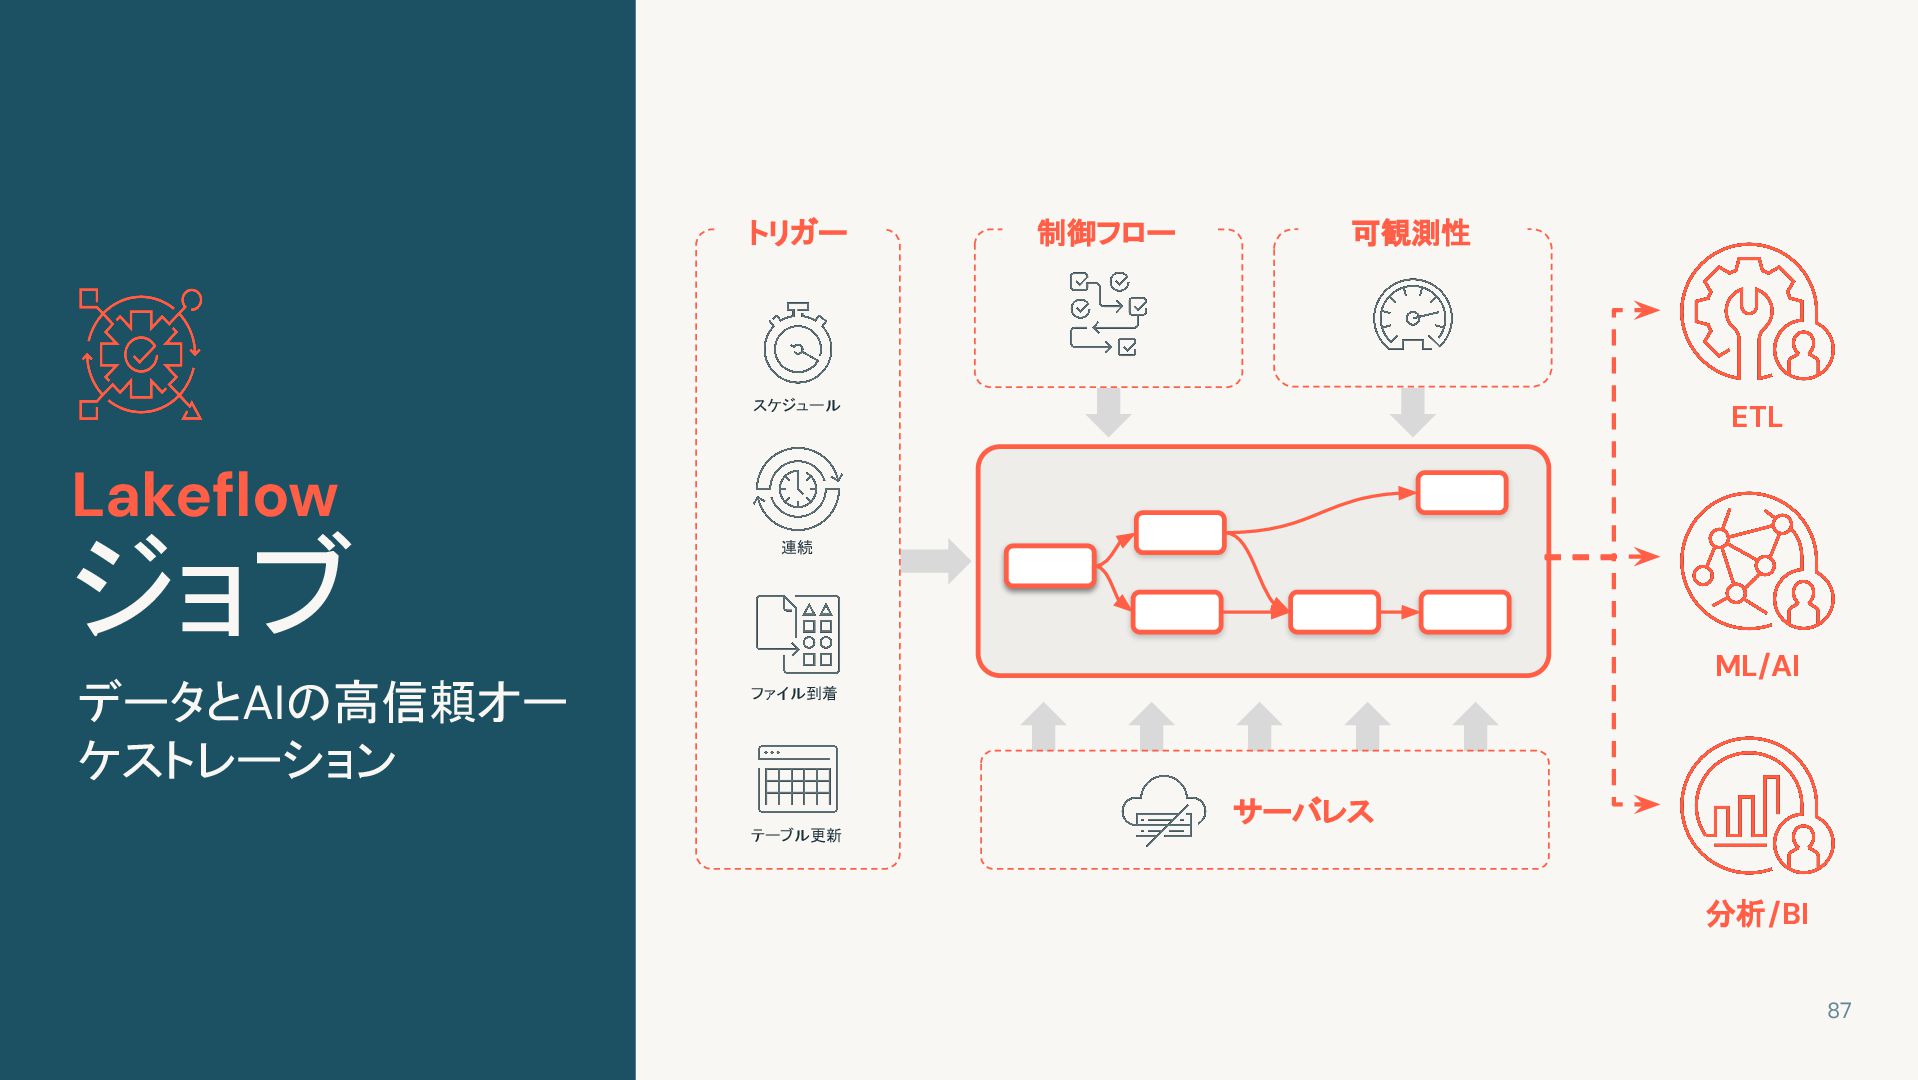
サーバレス Lakeflow ジョブ データとAIの高信頼オー ケストレーション スケジュール 連続 ファイル到着 テーブル更新 トリガー
可観測性 制御フロー ETL ML/AI 分析/BI 87 -
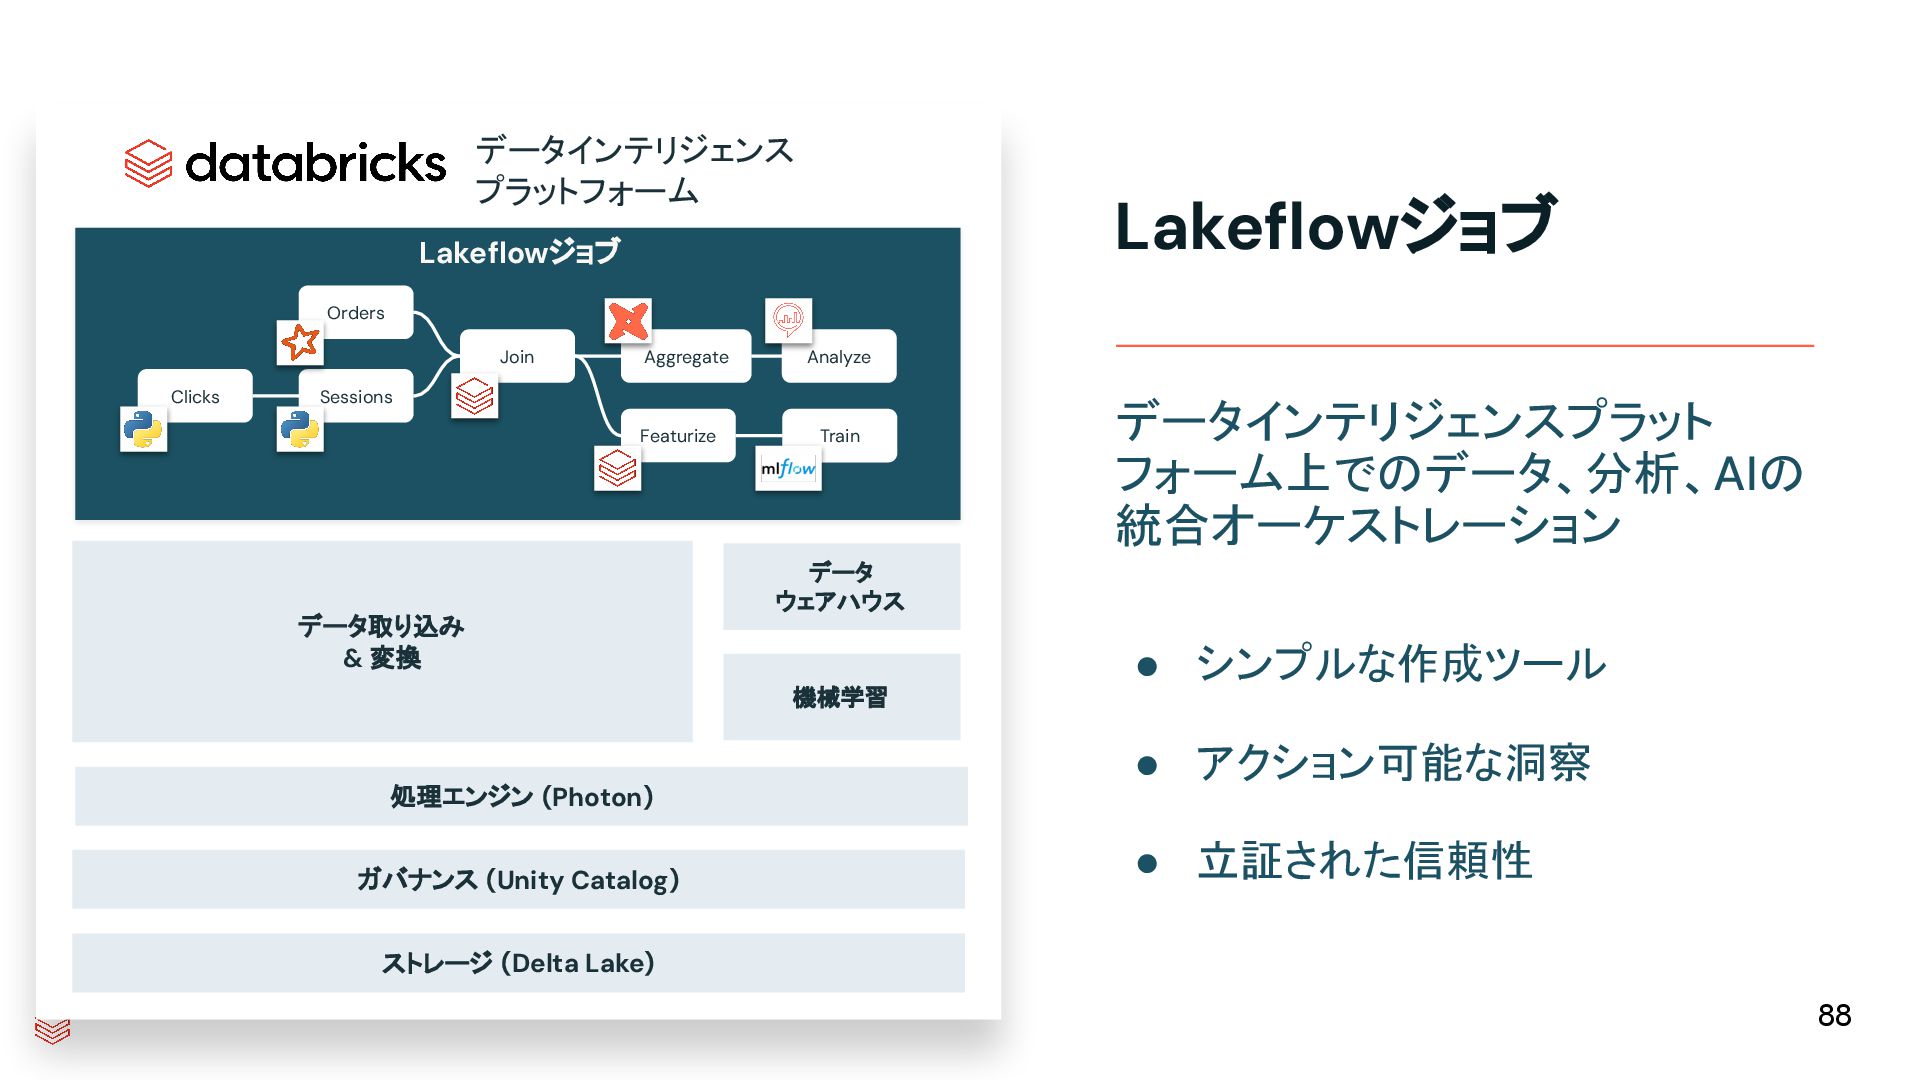
Lakeflowジョブ データインテリジェンスプラット フォーム上でのデータ、分析、AIの 統合オーケストレーション • シンプルな作成ツール • アクション可能な洞察 • 立証された信頼性
データインテリジェンス プラットフォーム データ取り込み & 変換 処理エンジン (Photon) ガバナンス (Unity Catalog) ストレージ (Delta Lake) データ ウェアハウス 機械学習 Lakeflowジョブ Sessions Clicks Join Featurize Aggregate Analyze Train Orders 88 -
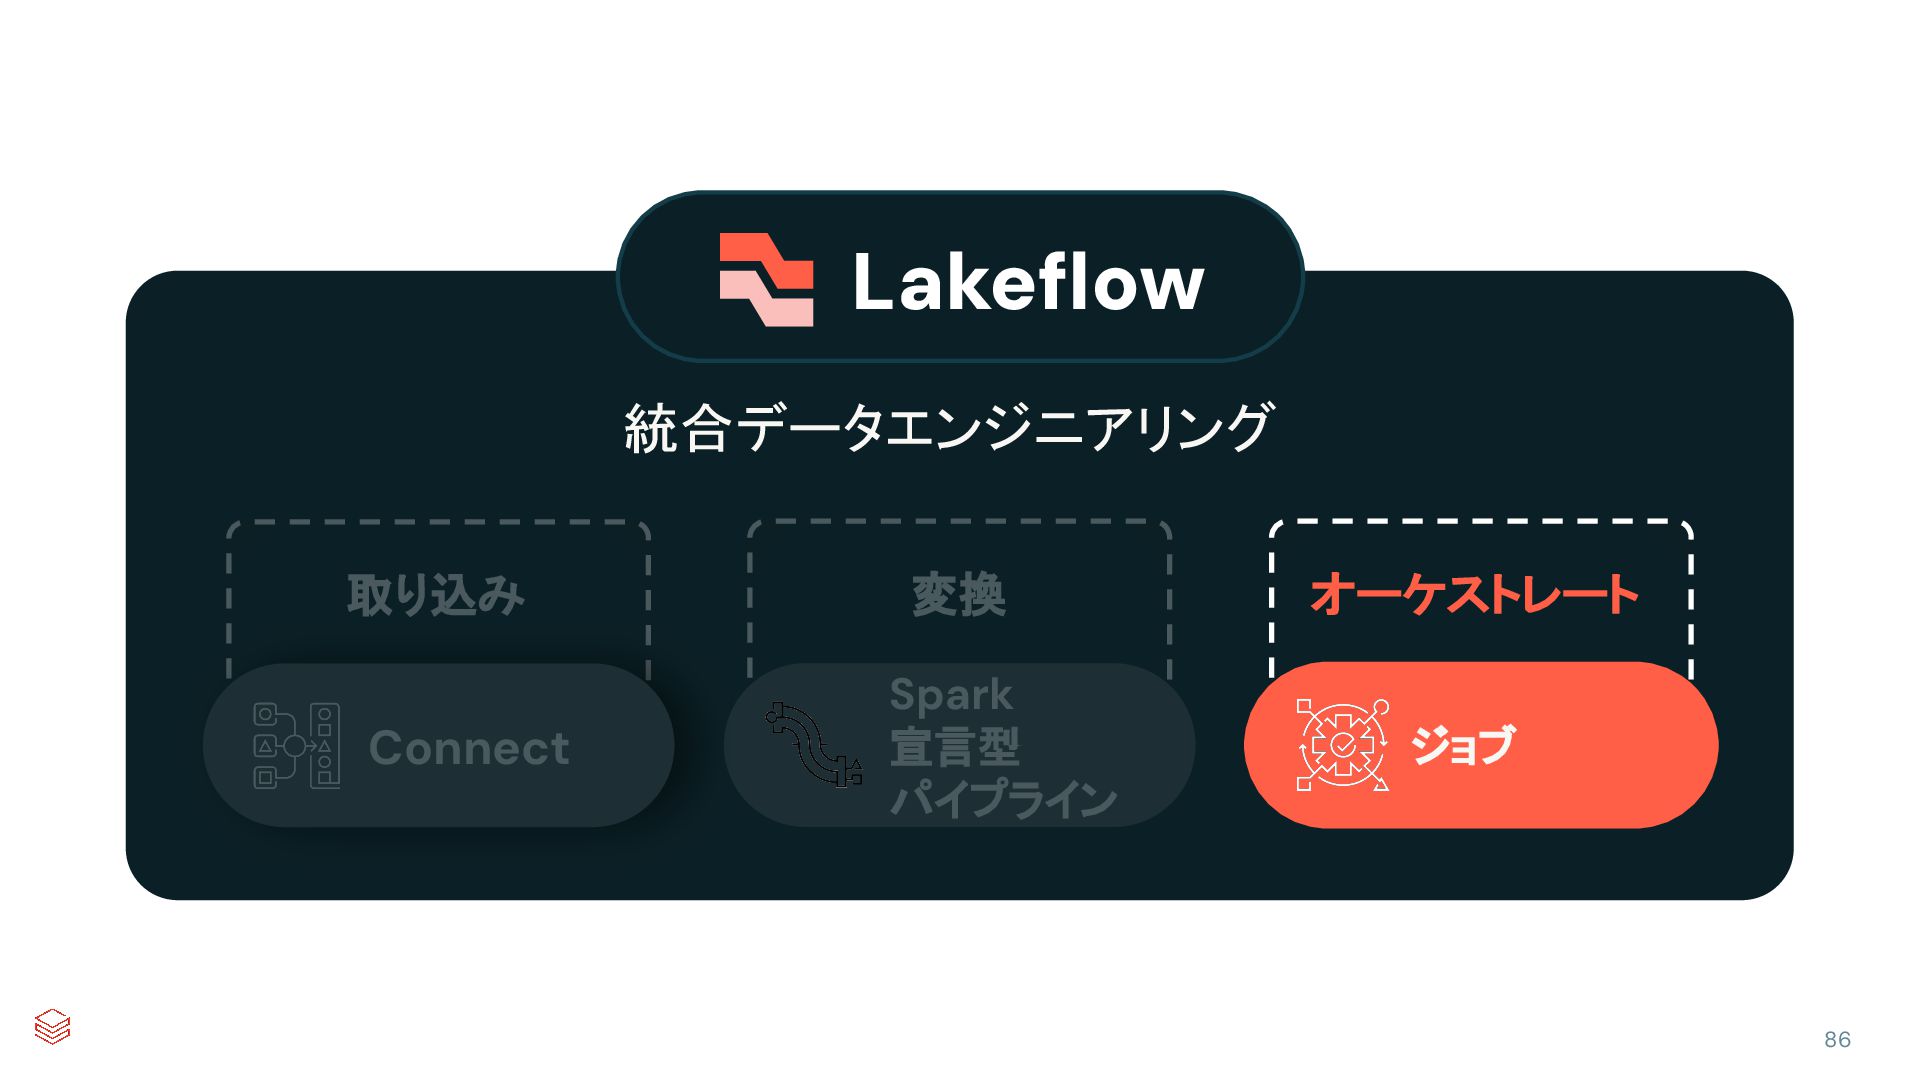
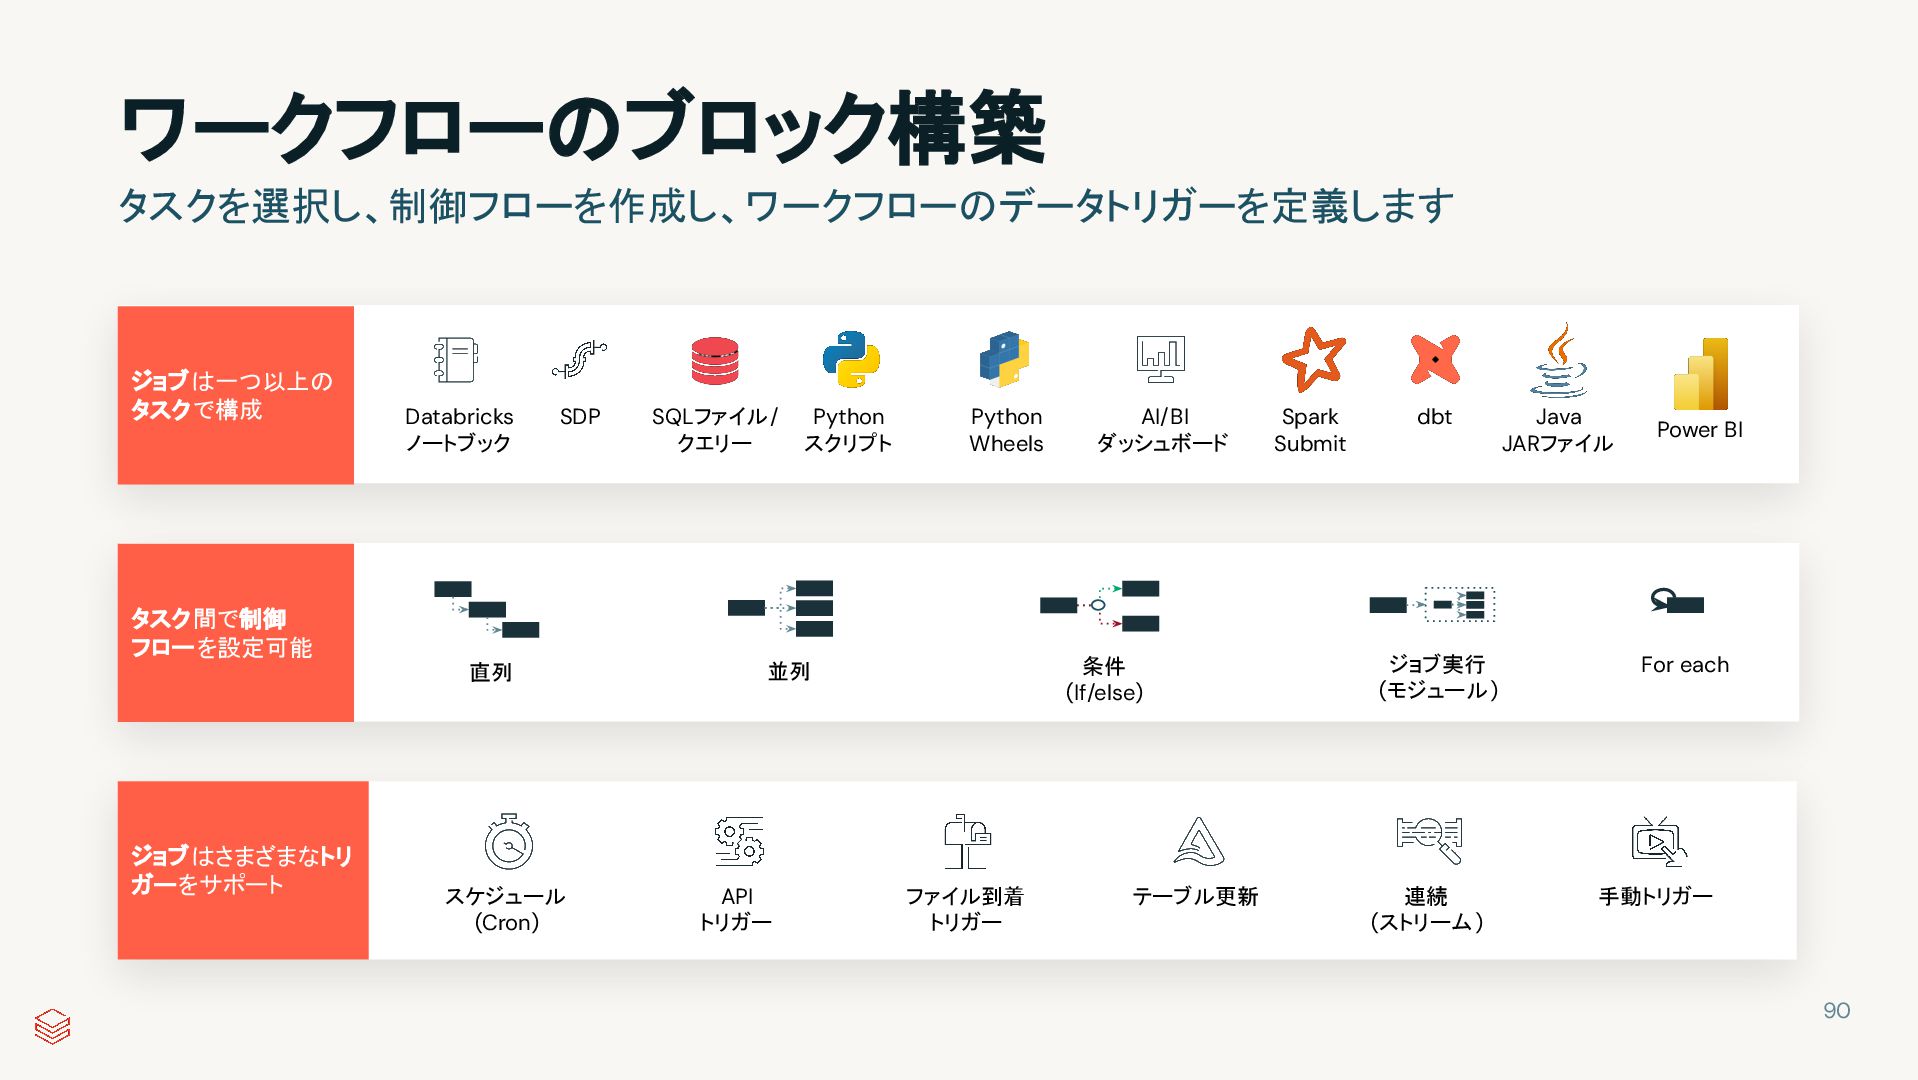
ワークフローのブロック構築 タスクを選択し、制御フローを作成し、ワークフローのデータトリガーを定義します Databricks ノートブック Python スクリプト Python Wheels SQLファイル/ クエリー
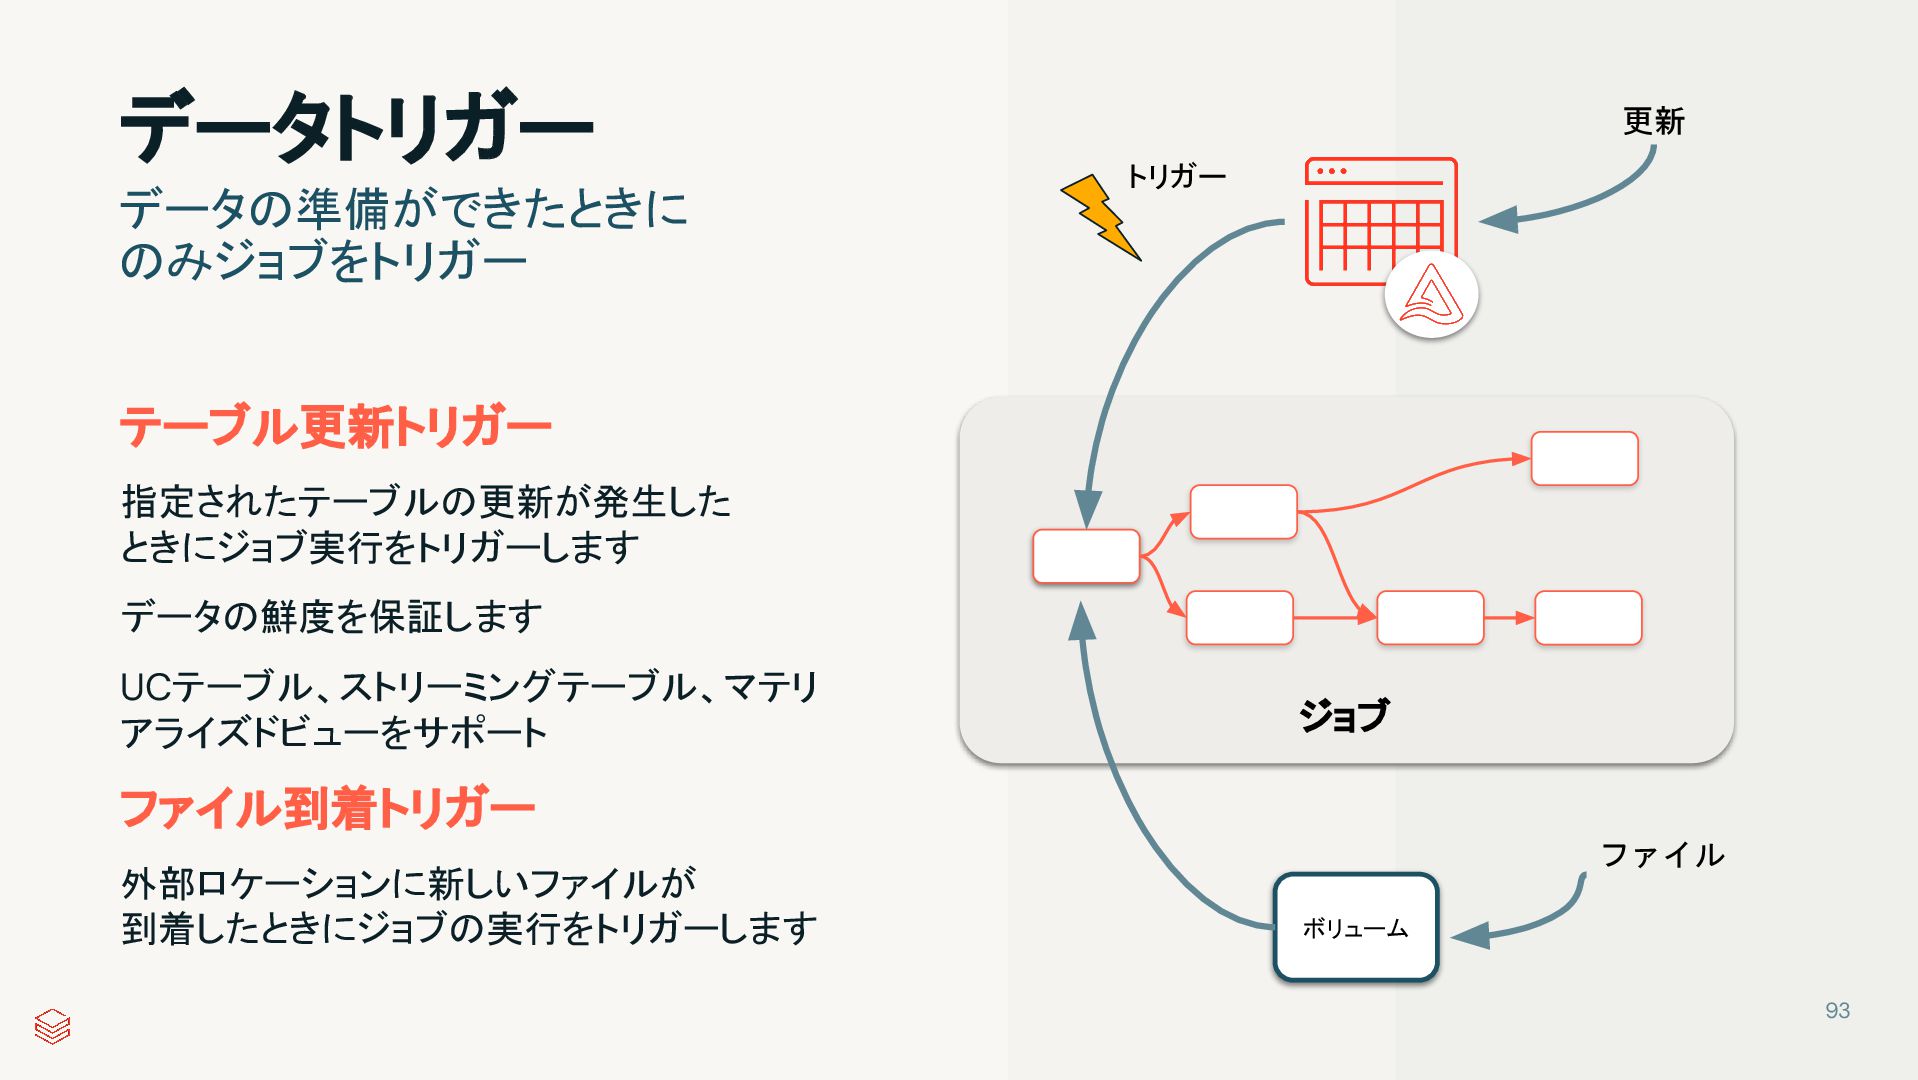
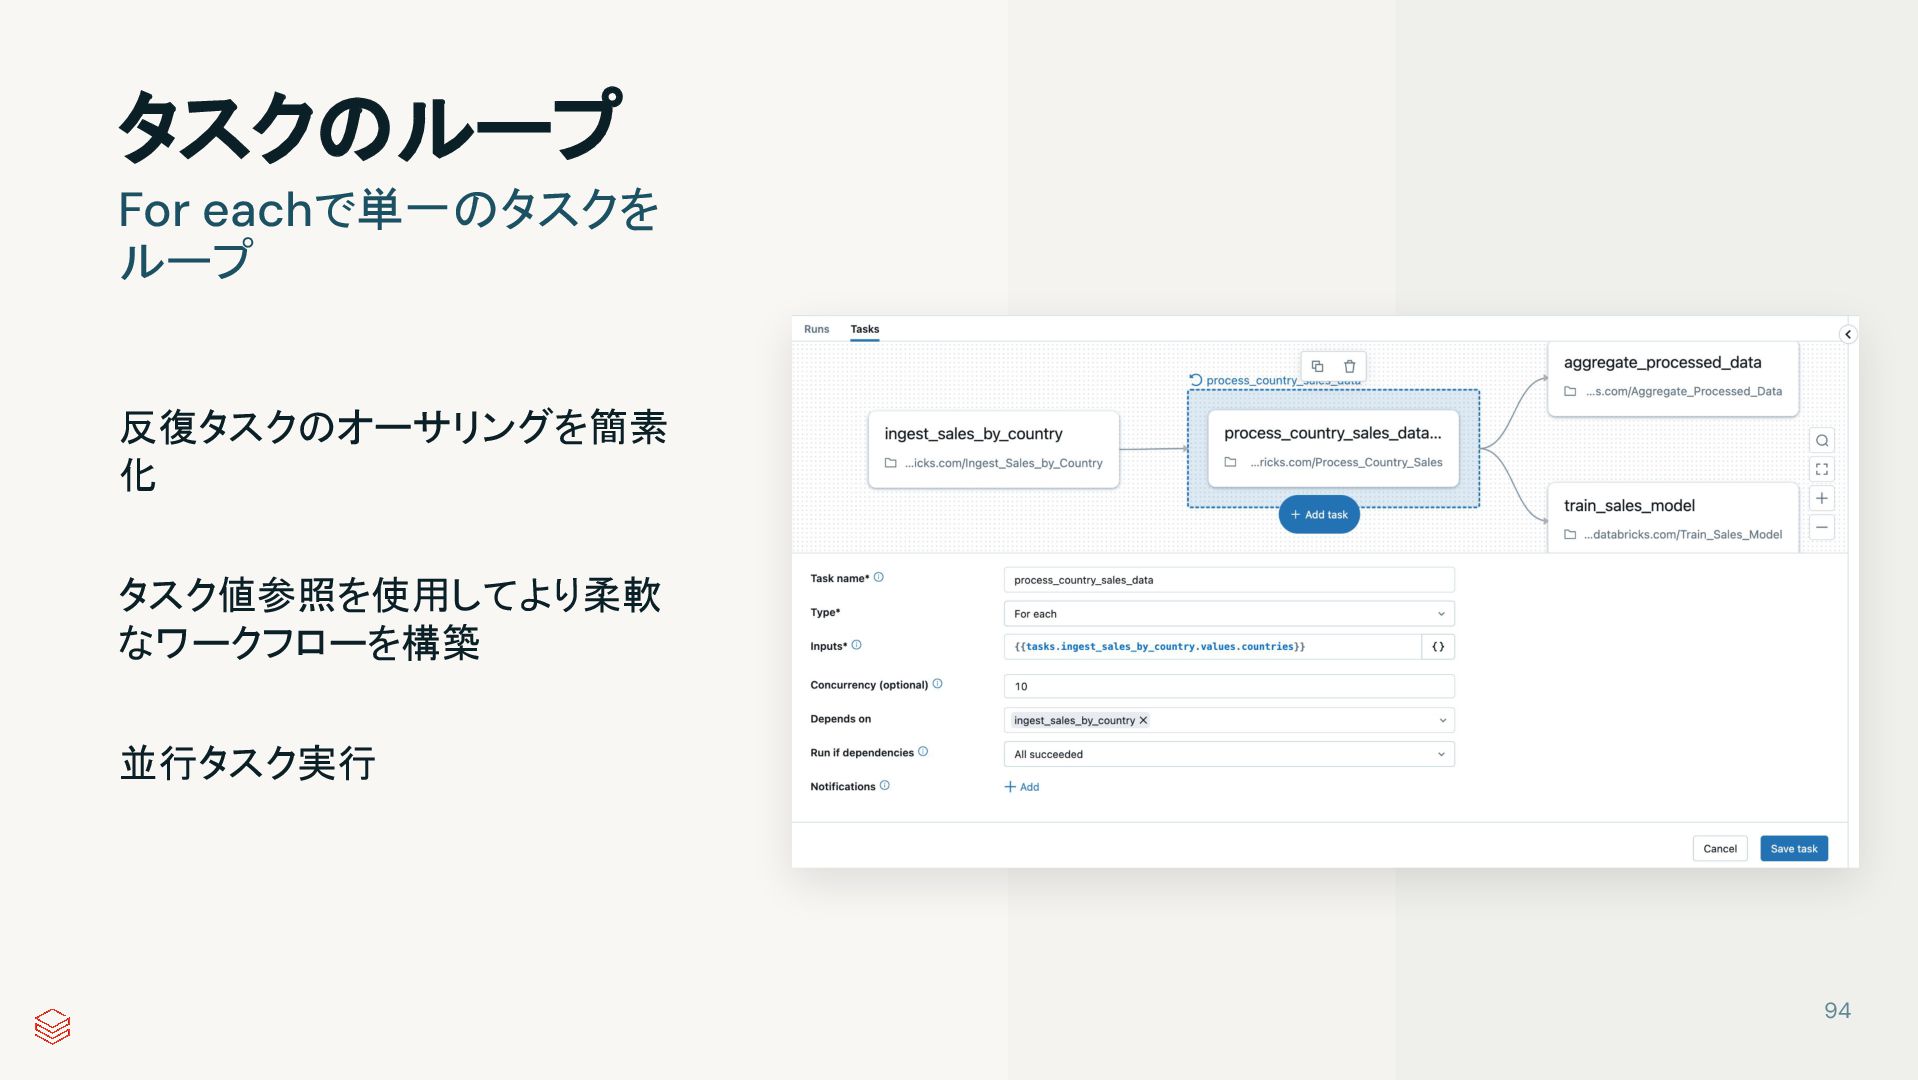
SDP dbt Java JARファイル Spark Submit ジョブは一つ以上の タスクで構成 タスク間で制御 フローを設定可能 ジョブはさまざまなトリ ガーをサポート AI/BI ダッシュボード 手動トリガー スケジュール (Cron) API トリガー ファイル到着 トリガー テーブル更新 連続 (ストリーム) Power BI 直列 並列 条件 (If/else) ジョブ実行 (モジュール) For each 90 -
データトリガー テーブル更新トリガー 指定されたテーブルの更新が発生した ときにジョブ実行をトリガーします データの鮮度を保証します UCテーブル、ストリーミングテーブル、マテリ アライズドビューをサポート ファイル到着トリガー 外部ロケーションに新しいファイルが 到着したときにジョブの実行をトリガーします
データの準備ができたときに のみジョブをトリガー 更新 ジョブ トリガー ボリューム ファイル 93 -
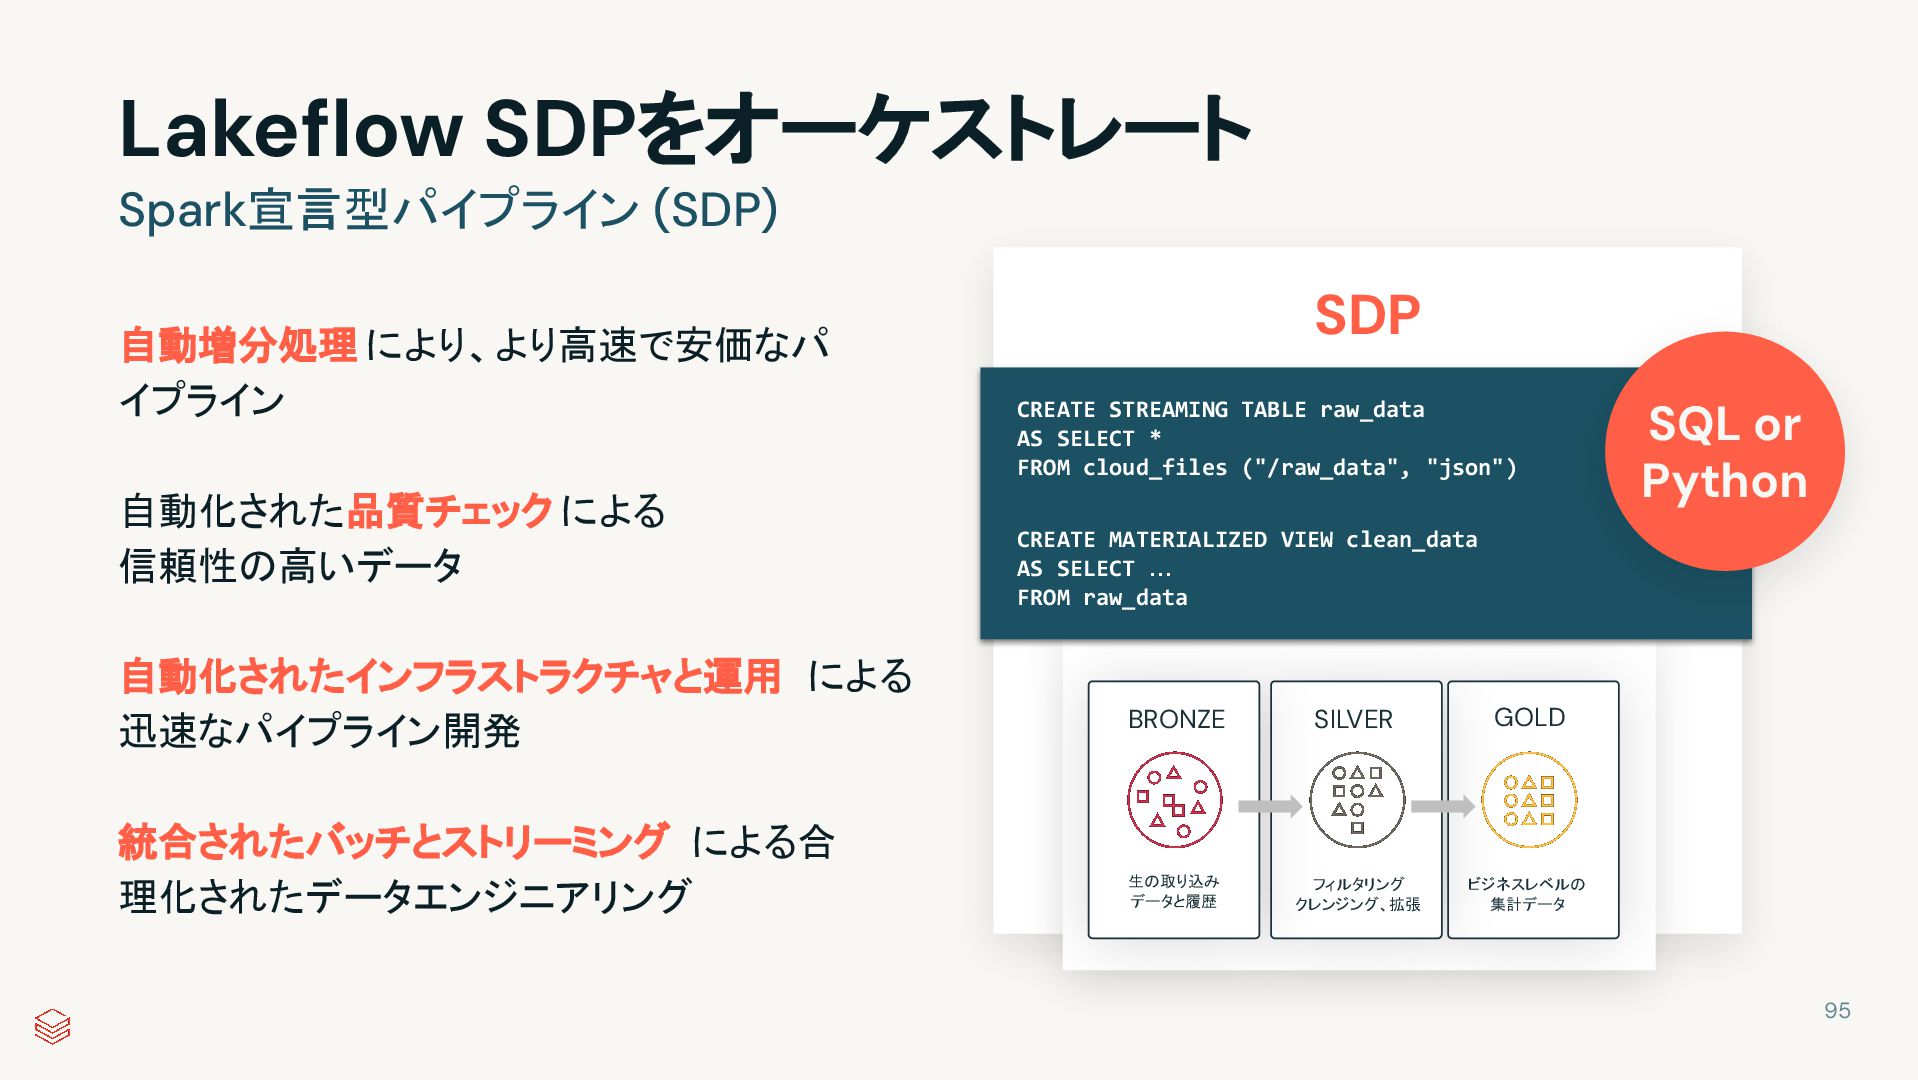
Lakeflow SDPをオーケストレート Spark宣言型パイプライン (SDP) SDP 自動増分処理 により、より高速で安価なパ イプライン 自動化された品質チェック による
信頼性の高いデータ 統合されたバッチとストリーミング による合 理化されたデータエンジニアリング 自動化されたインフラストラクチャと運用 による 迅速なパイプライン開発 生の取り込み データと履歴 BRONZE フィルタリング クレンジング、拡張 SILVER ビジネスレベルの 集計データ GOLD CREATE STREAMING TABLE raw_data AS SELECT * FROM cloud_files ("/raw_data", "json") CREATE MATERIALIZED VIEW clean_data AS SELECT … FROM raw_data SQL or Python 95 -
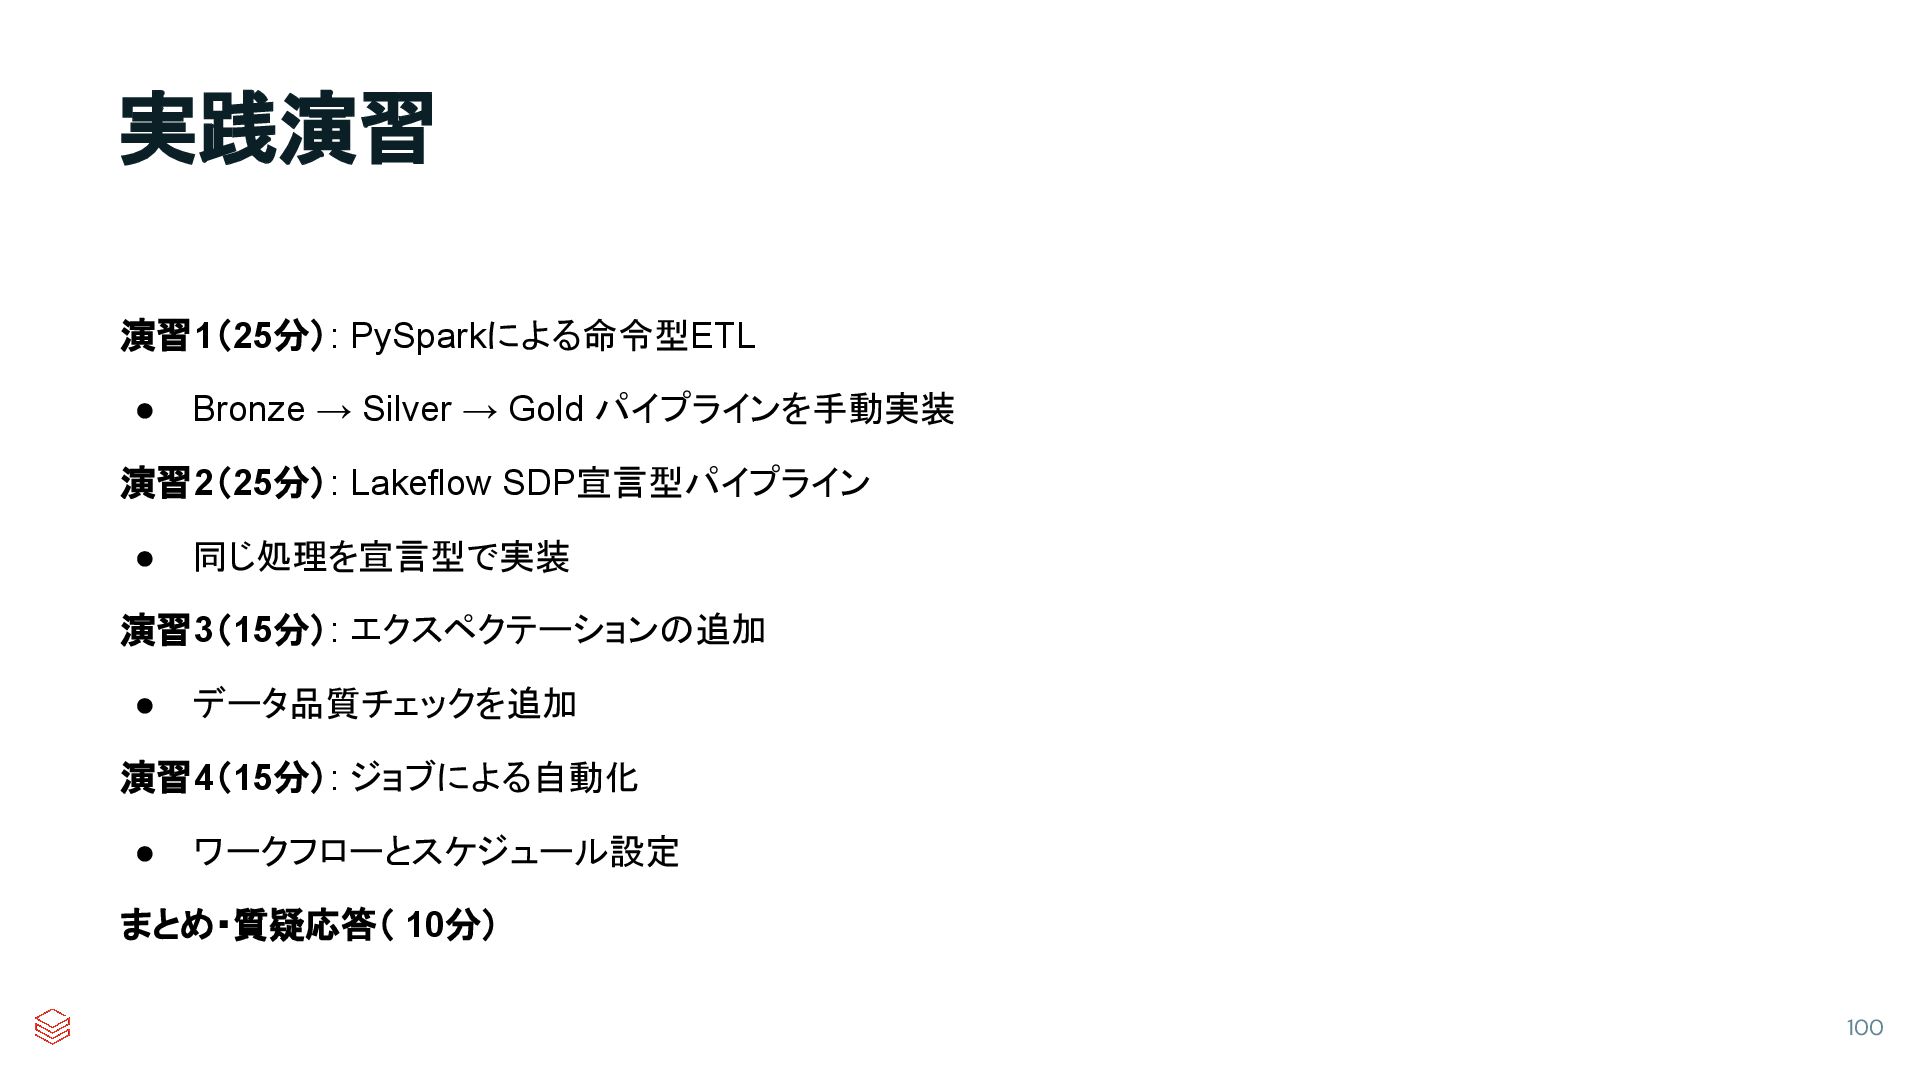
実践演習 100 演習1(25分): PySparkによる命令型ETL • Bronze → Silver → Gold
パイプラインを手動実装 演習2(25分): Lakeflow SDP宣言型パイプライン • 同じ処理を宣言型で実装 演習3(15分): エクスペクテーションの追加 • データ品質チェックを追加 演習4(15分): ジョブによる自動化 • ワークフローとスケジュール設定 まとめ・質疑応答( 10分) -
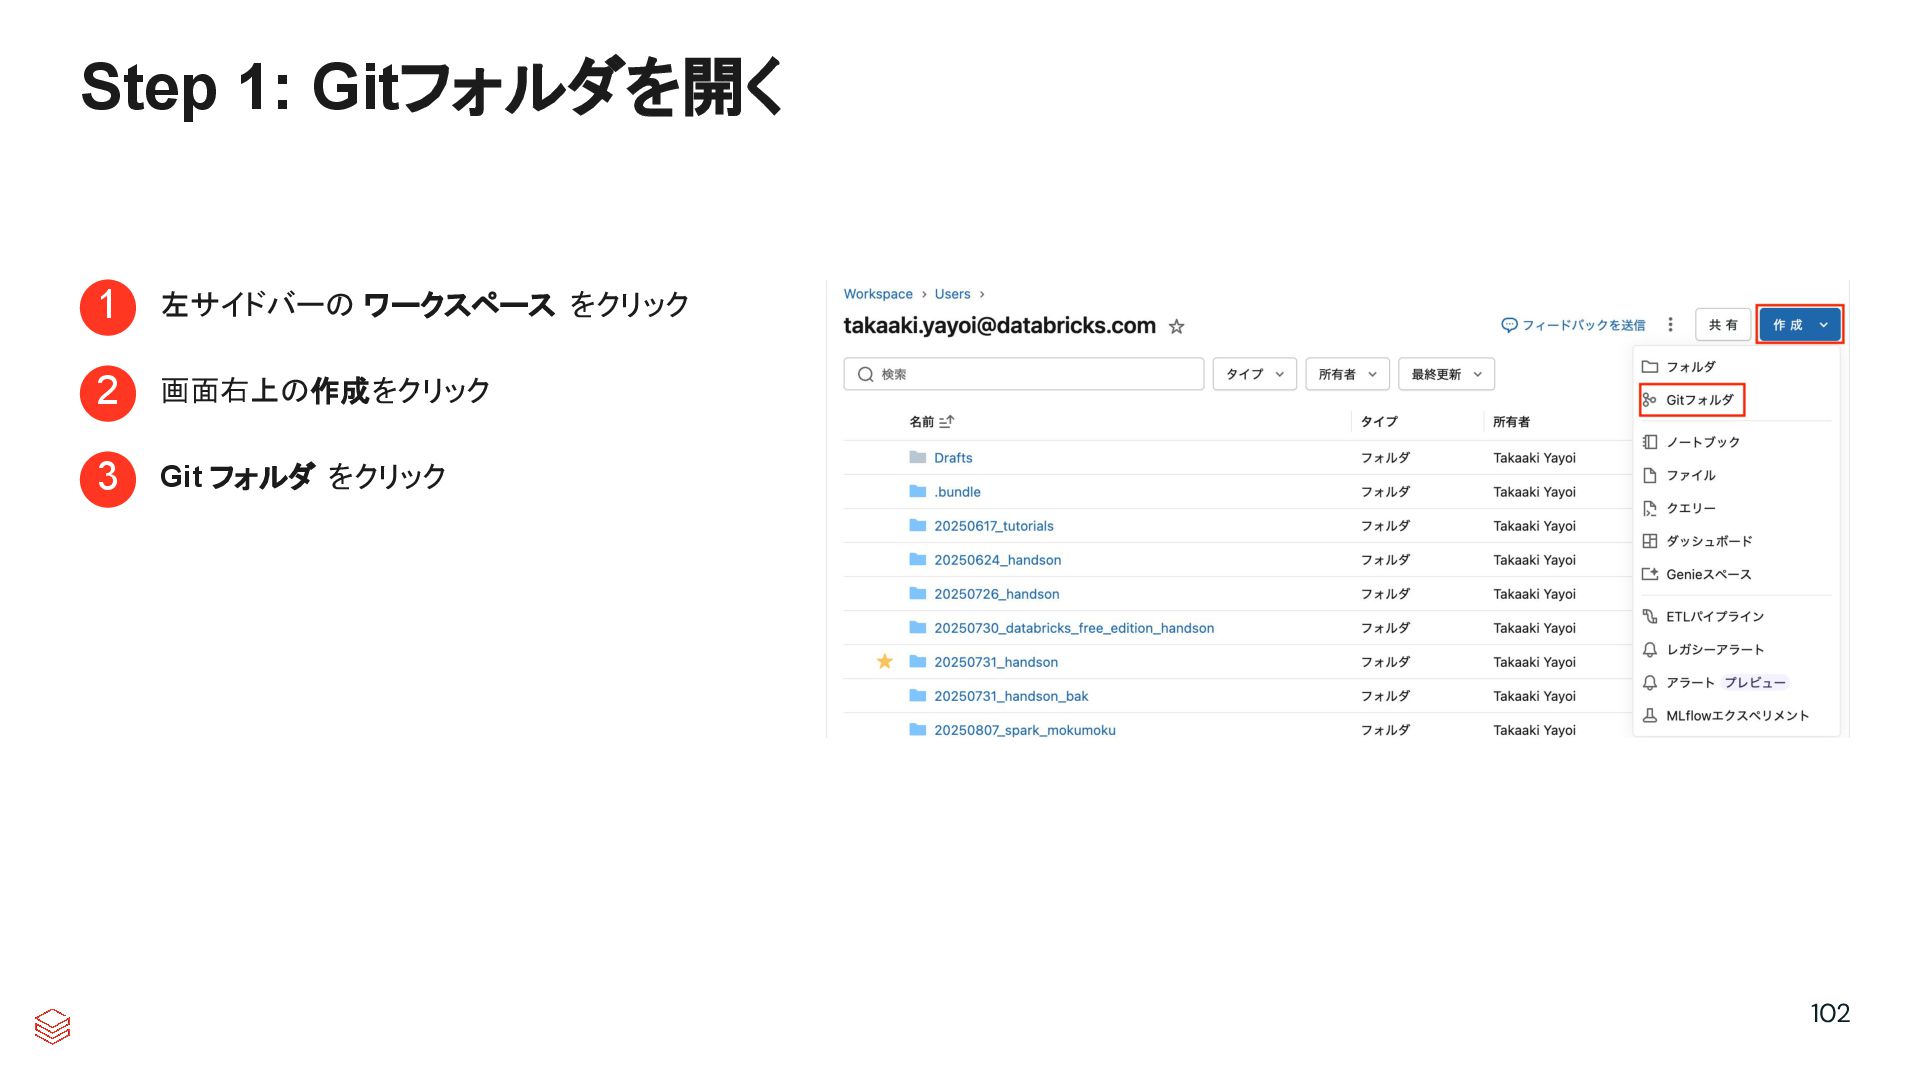
Step 1: Gitフォルダを開く 1 左サイドバーの ワークスペース をクリック 2 画面右上の作成をクリック 3
Git フォルダ をクリック 102 -
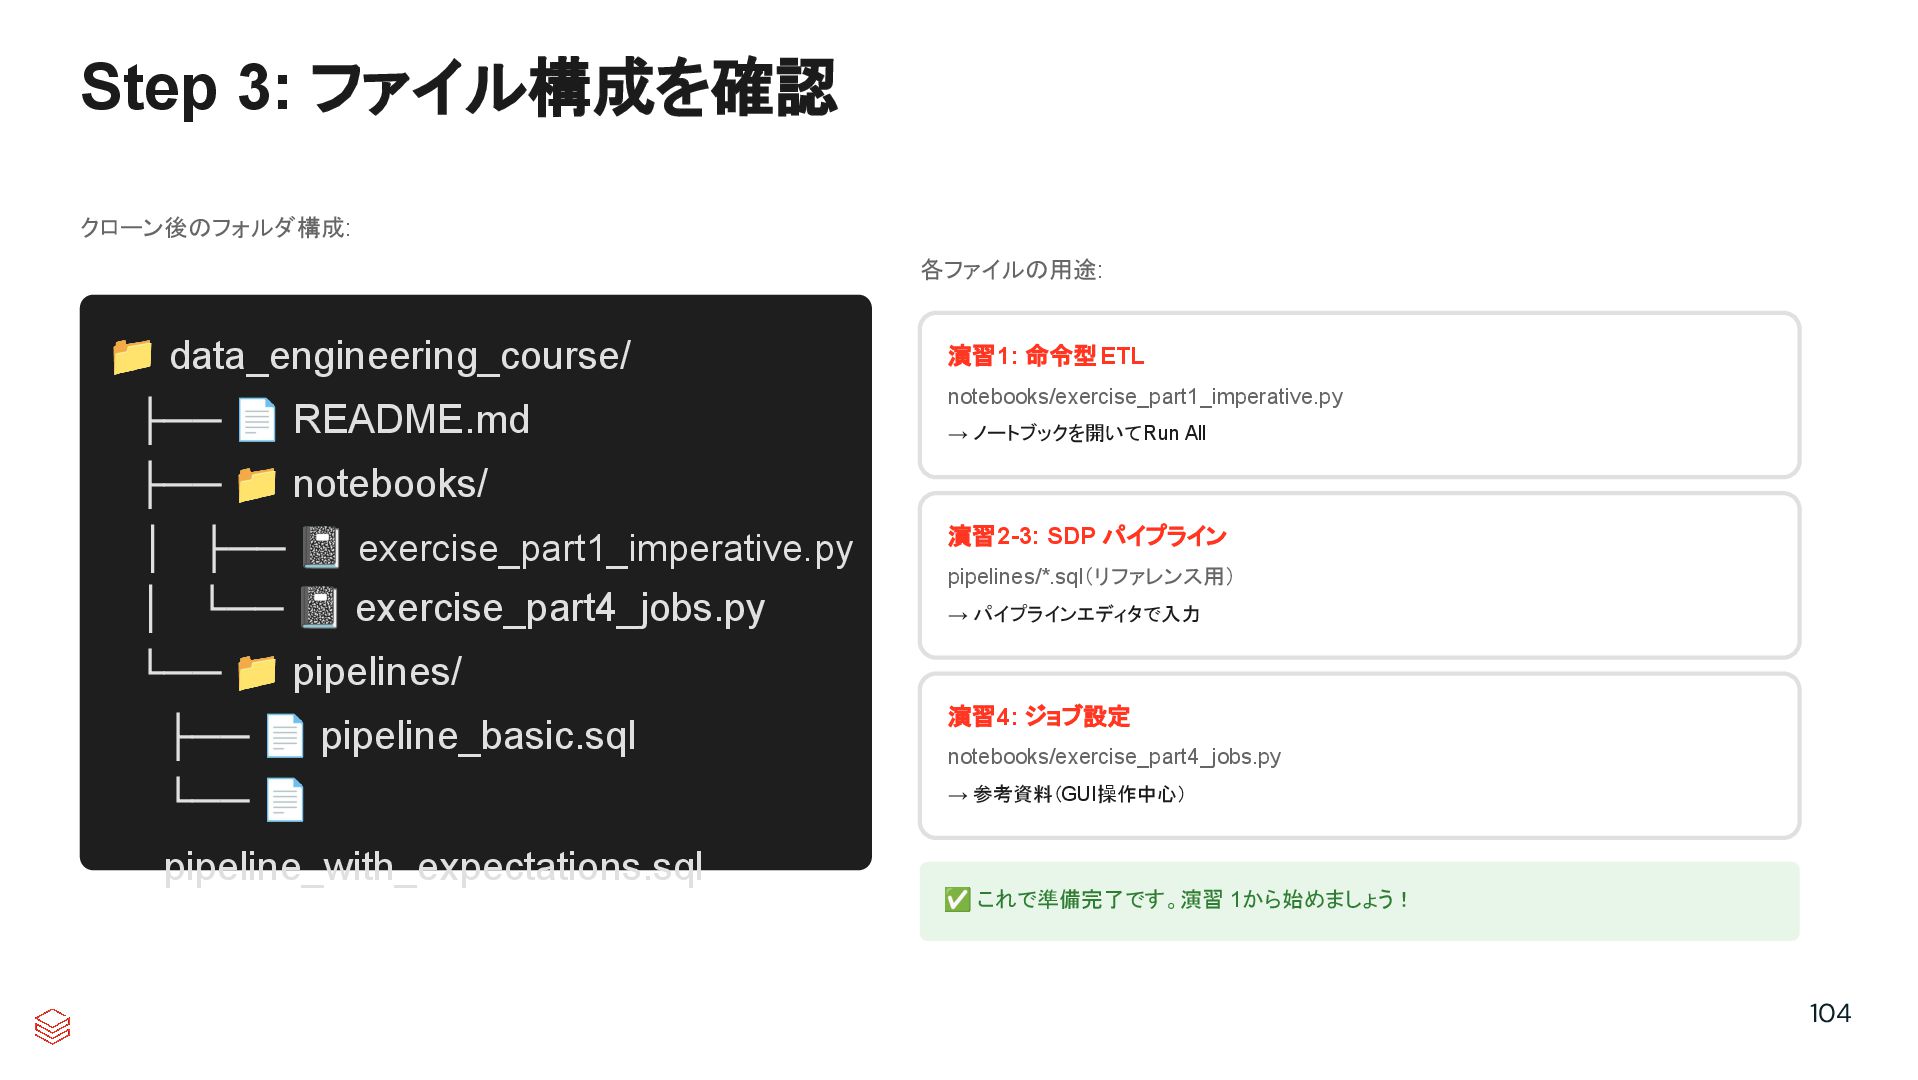
Step 3: ファイル構成を確認 クローン後のフォルダ構成: 📁 data_engineering_course/ ├── 📄 README.md ├──
📁 notebooks/ │ ├── 📓 exercise_part1_imperative.py │ └── 📓 exercise_part4_jobs.py └── 📁 pipelines/ ├── 📄 pipeline_basic.sql └── 📄 pipeline_with_expectations.sql 各ファイルの用途: 演習1: 命令型ETL notebooks/exercise_part1_imperative.py → ノートブックを開いて Run All 演習2-3: SDP パイプライン pipelines/*.sql(リファレンス用) → パイプラインエディタで入力 演習4: ジョブ設定 notebooks/exercise_part4_jobs.py → 参考資料(GUI操作中心) ✅ これで準備完了です。演習 1から始めましょう! 104 -
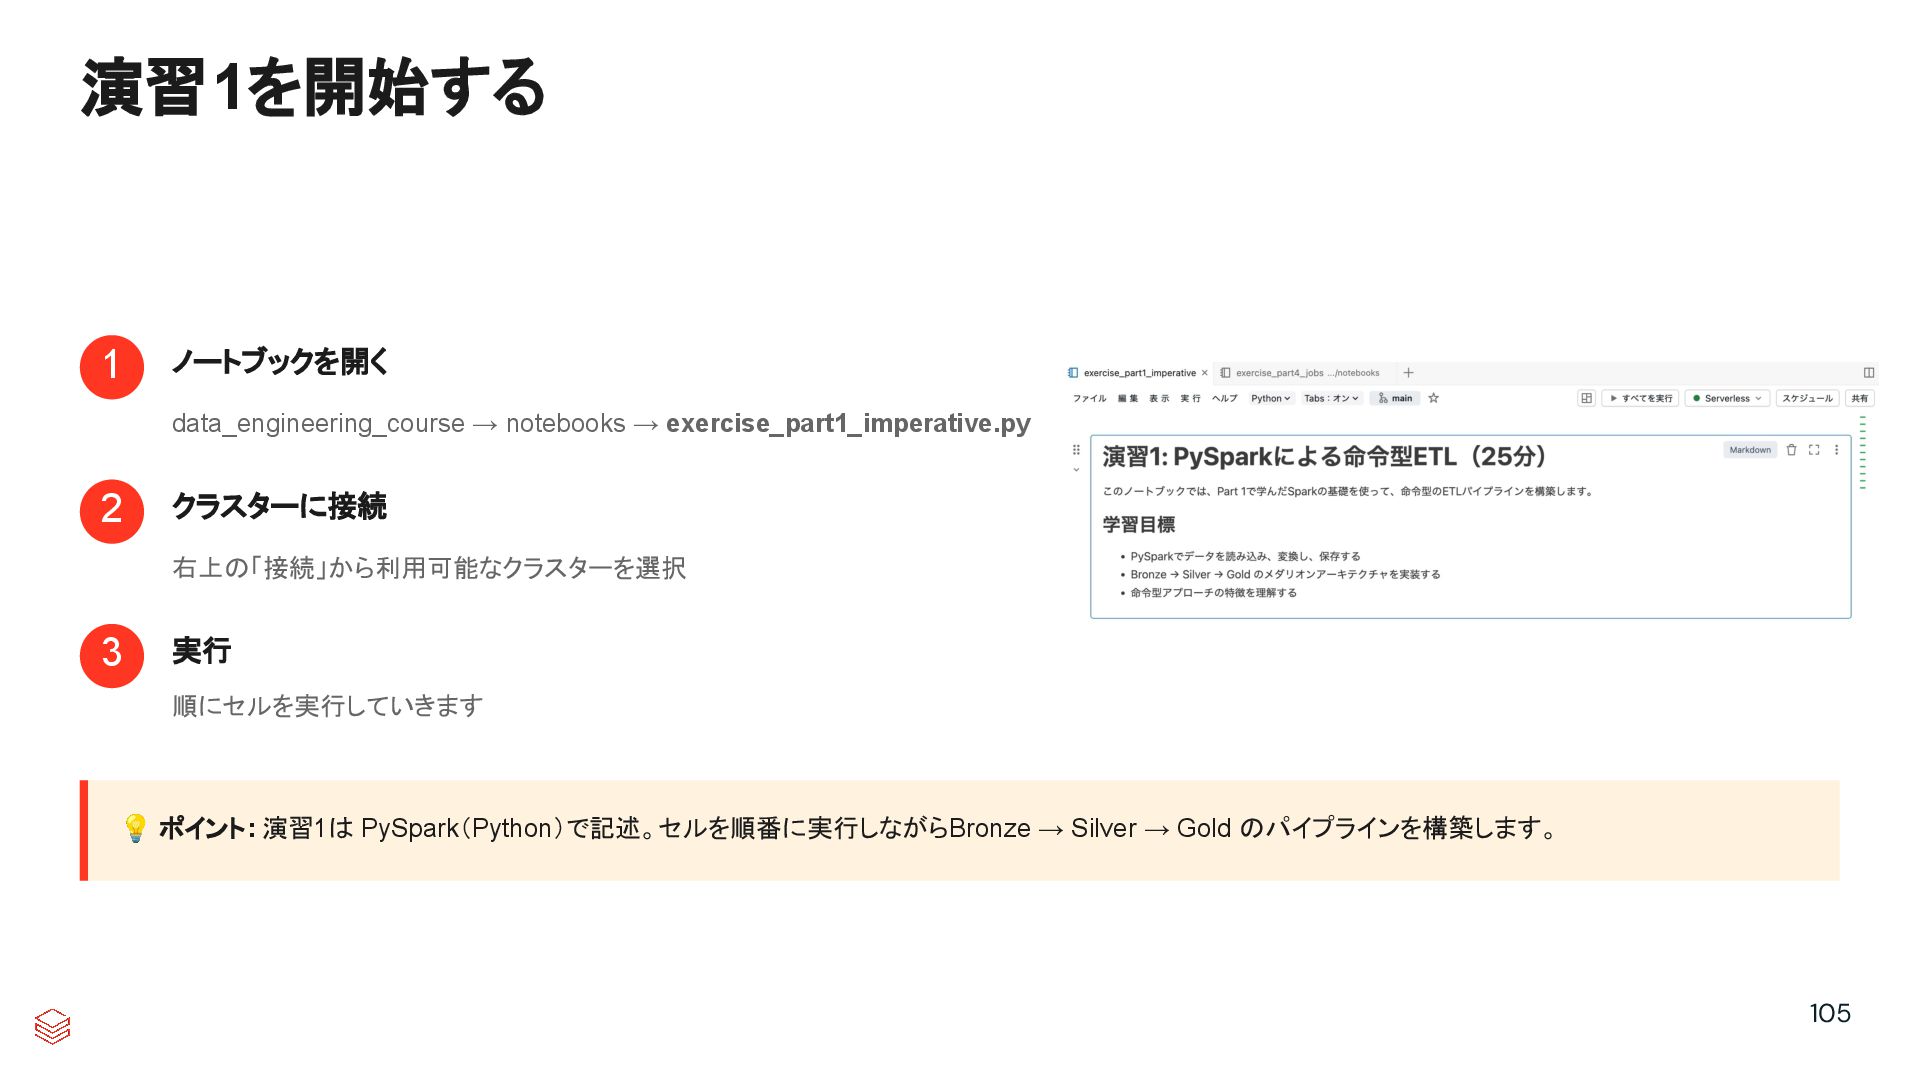
演習1を開始する 1 ノートブックを開く data_engineering_course → notebooks → exercise_part1_imperative.py 2 クラスターに接続
右上の「接続」から利用可能なクラスターを選択 3 実行 順にセルを実行していきます 💡 ポイント: 演習1は PySpark(Python)で記述。セルを順番に実行しながら Bronze → Silver → Gold のパイプラインを構築します。 105 -
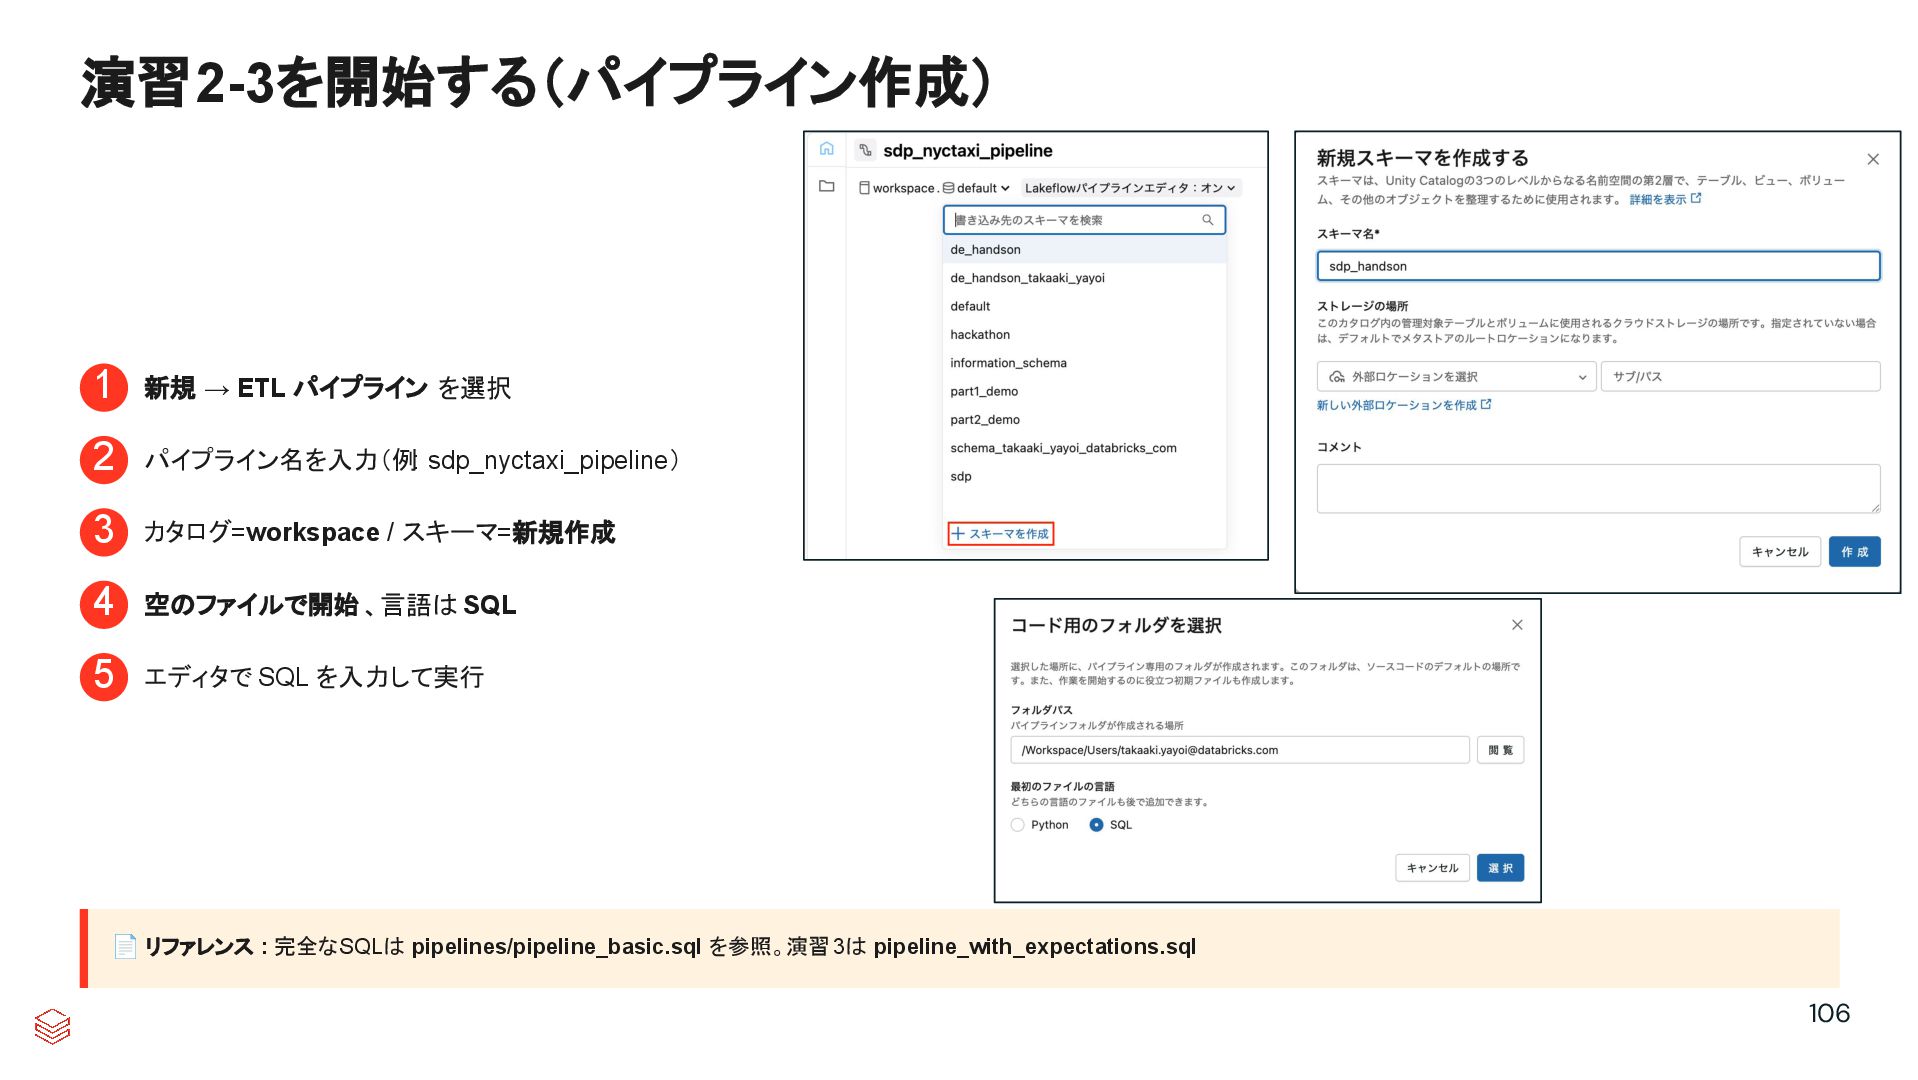
演習2-3を開始する(パイプライン作成) 1 新規 → ETL パイプライン を選択 2 パイプライン名を入力(例 :
sdp_nyctaxi_pipeline) 3 カタログ=workspace / スキーマ=新規作成 4 空のファイルで開始、言語は SQL 5 エディタで SQL を入力して実行 📄 リファレンス : 完全なSQLは pipelines/pipeline_basic.sql を参照。演習3は pipeline_with_expectations.sql 106 -
参考資料 108 • 実習のノートブック • Lakeflow SDP入門:基礎から実践まで #Databricks - Qiita
• はじめてのDatabricks #Databricks - Qiita • Databricks記事のまとめページ(その1) #Databricks - Qiita • Databricksドキュメント | Databricks on AWS • Databricks によるデータエンジニアリング | Databricks on AWS • Lakeflow Spark宣言型パイプライン | Databricks on AWS • ハンズオンで学ぶ Databricks - Databricksにおけるデータエンジニアリング - Speaker Deck • Databricksにおけるビジネスアナリストからデータエンジニアへの転換 #Databricks_AI_BI - Qiita • Apache Spark徹底入門
 taka_aki
 amarelo_n24
 tnir
 jcabot
 littlehands
 silmin_
 raksulrecruiting
 munenick
 okiyuki99
 maguroalternative
 shotashiratori
 hatahata021
 orimanabu
 akashhashmi
 skipperchong
 cassininazir
 lara
 philnash
 jcasabona
 marktimemedia
 aleyda
 lynnandtonic
 thoeni
 honzajavorek
 samlambert