Share
Embed

Transcript
79 slides
-
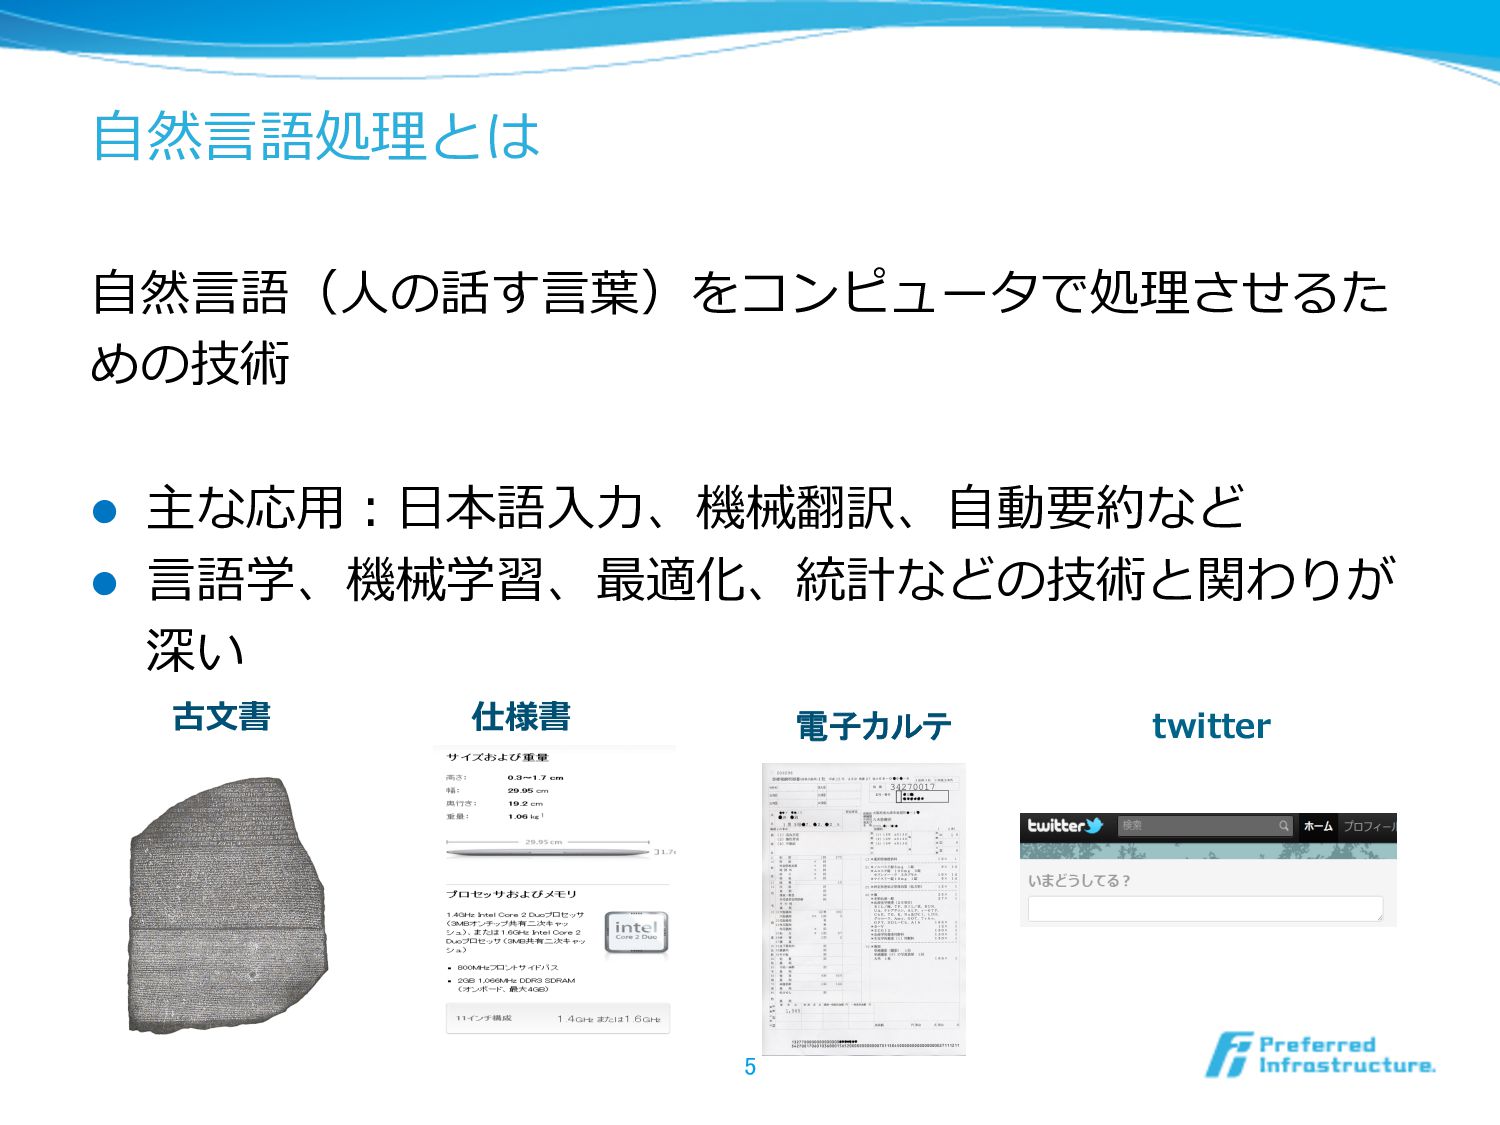
⾃自⼰己紹介 海野 裕也 l -2008 東⼤大情報理理⼯工修⼠士 l ⾃自然⾔言語処理理 l 2008-2011
⽇日本アイ・ビー・エム(株)東京基礎研 l テキストマイニング、⾃自然⾔言語処理理の研究開発 l 2011- (株)プリファードインフラストラクチャー l ⾃自然⾔言語処理理、情報検索索、機械学習、テキストマイニングなど の研究開発 l 研究開発系案件の担当、コンサルティング NLP若若⼿手の会共同委員⻑⾧長(2014-) 2 -
会社紹介 Preferred Infrastructure, Inc. (PFI) l 設⽴立立: 2006年年3⽉月 l 場所:
東京都⽂文京区本郷 l 従業員数: 36 l ミッション: Bring cutting-‐‑‒edge research advances to the real world. -
⾃自然⾔言語処理理の⽅方向性は⼤大きく分けると2つ? l ⾔言葉葉の構造を明らかにすること l ランダムなアルファベット列列と、正しい⽂文の間には ⼤大きな壁がある l 同じ意味を表す複数の表現と、同じ表現に対する複 数の意味解釈が存在する l
⾔言葉葉から情報を得ること l ⾃自然⾔言語のデータから、意味のある情報を取り出す l 取り出した情報をいかに活⽤用するか 6 -
具体的な研究課題 l ⾔言葉葉の構造を明らかにする研究 l 形態素解析、構⽂文解析、述語項構造解析、意味役割 付与、照応解析、共参照解析、曖昧性解消、談話解 析、⽂文⽣生成、⾃自動要約、機械翻訳 l ⾔言葉葉から情報を得る研究 l
情報抽出、関係抽出、知識識処理理、情報検索索、テキス トマイニング、質問応答 7 PFI含め、企業の研究はこちらが多い印象 -
⾃自然⾔言語データを取り巻く問題 l 多様化 l 様々なデータ源 l 多⾔言語 l 書き⾔言葉葉・話し⾔言葉葉・ネットスラング l
⼤大規模化 l インターネット、WWWの発達 l ネットニュース、掲⽰示板やBlog l SNSなどのカジュアルなテキストデータの爆発 10 -
利利⽤用事例例はどんどん多様化 実社会の中でNLPがどのように使われているのかを紹介す る l 医療療・ヘルスケア l 製造 l EC l
⽂文献・特許 l 社内情報 l SNS解析 l 広告 11 -
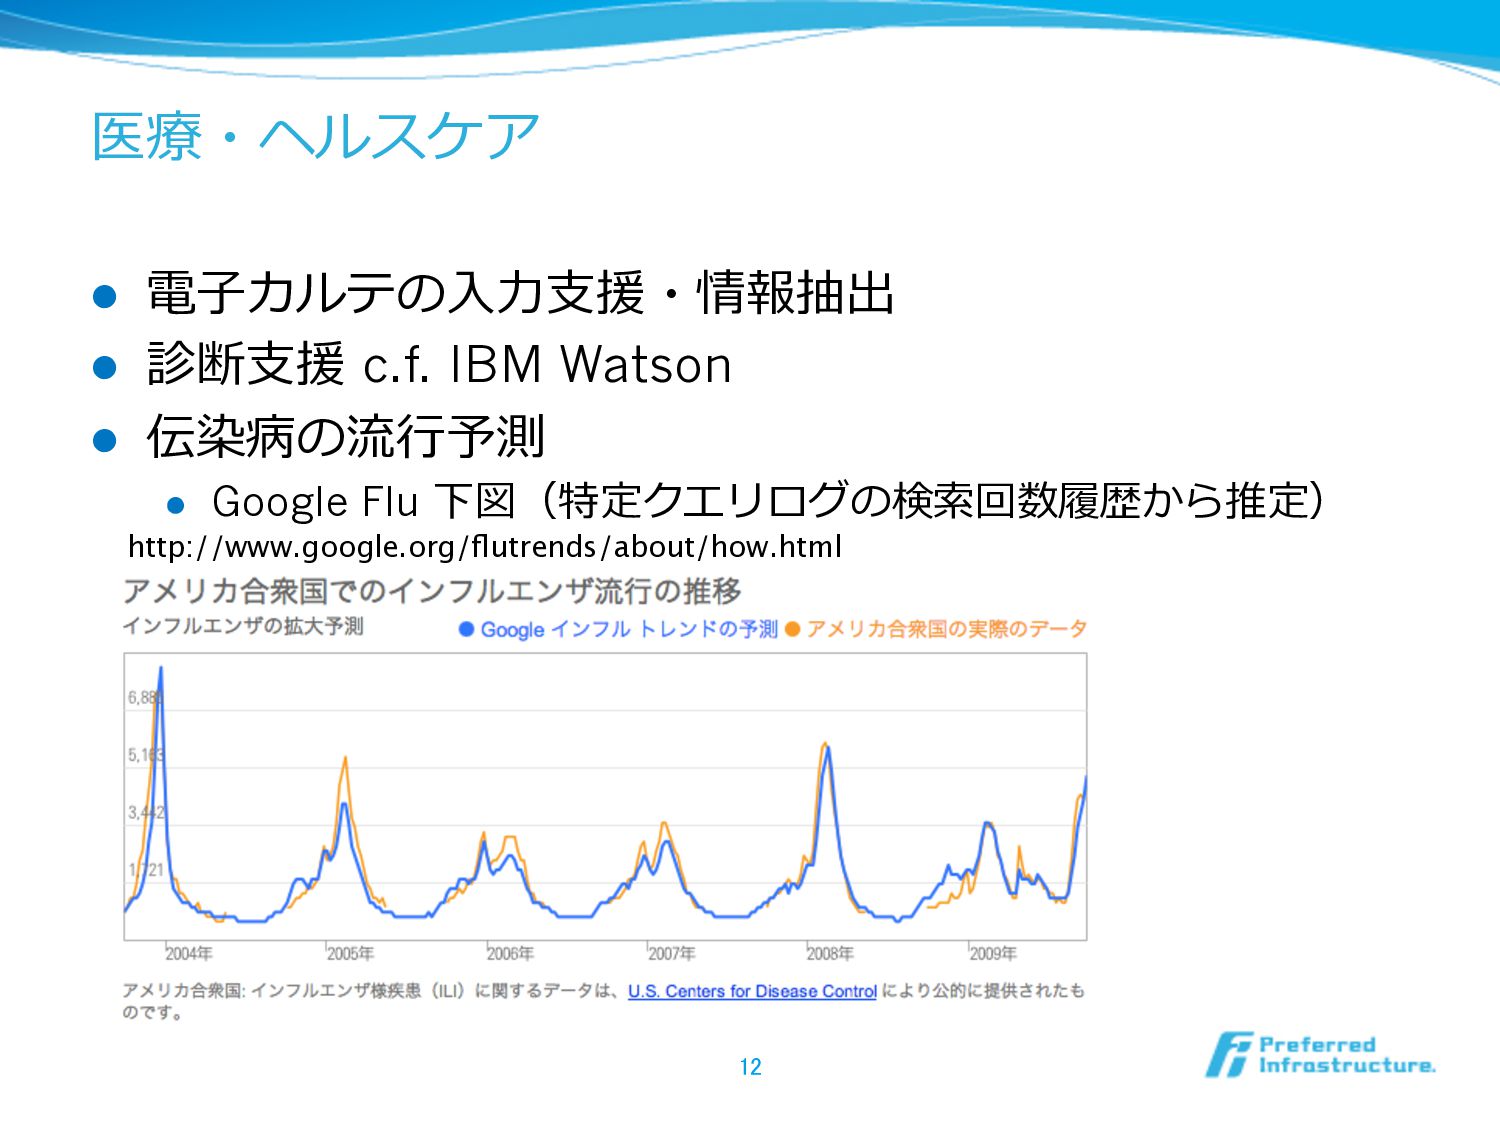
医療療・ヘルスケア l 電⼦子カルテの⼊入⼒力力⽀支援・情報抽出 l 診断⽀支援 c.f. IBM Watson l 伝染病の流流⾏行行予測
l Google Flu 下図(特定クエリログの検索索回数履履歴から推定) 12 http://www.google.org/flutrends/about/how.html -
EC l 楽天、Amazonなど⼤大量量の商品を扱うサイトが利利⽤用する 検索索 l ECサイトの多くは、外部検索索エンジン(Googleなど)から直接 来た後に商品を絞り込むために利利⽤用する場合が多い l ECサイトによって⾃自作・チューニングしている場合も多い l
各ECサイトの検索索エンジンを考察してみるのは⾯面⽩白い 楽天、Amazon、ZOZOTOWN など l 必要なNLP技術 l クエリ拡張(製品名などはそのままヒットしない) l 商品属性の抽出(製品名、原材料料、⾊色、キャッチコピー) l 名寄せ この商品とこの商品は同じ?バージョン違い? l レコメンド l 商品情報の⽂文章から、お薦めできるかどうかを分析する -
⽂文献・特許 l 研究機関やコンサルタントが⽂文献や特許を調査する際に 利利⽤用 l 漏漏れは許されない.関連結果を全て調べる.数千件⾒見見る場合も l 概念念が似たキーワード、⽂文書を分析し漏漏れ無く取得したい l 「iPS細胞」で検索索したら、それに関係しそうな概念念も全て調べ
る必要がある l 各企業、政府が今どのような⽅方針をとっているのかも調べたい →⾦金金融業界などでの利利⽤用も多い l 誰が⾔言っているのか、影響はどのくらいかの分析も重要 l 情報フィルタリングと同じように、クエリを仕掛けてお いて、新しい情報が⼿手に⼊入ったらすぐアラートを⾶飛ばす 仕組みも -
⼈人材・⼈人事 l ⽂文書と組織のマッチング l 情報と⼈人のマッチングを⾔言語情報を介して⾏行行い、情報を共有す べき⼈人に⾃自動的に必要な情報をpushする l 組織変更更があった時に、どの⽂文書(情報)をどの組織に割り当 てるのかの設定を⼈人⼿手で⾏行行うのは⾮非常に困難だが、それを⾃自動 で⾏行行う
l ⼈人事への応⽤用 l その⼈人の持っているスキルと,そのレベルをレジュメなどを元に ⾃自動推定し、その結果を検索索などで利利⽤用できるようにする l レジュメを⽂文書分類する.正解データはクラウドソーシング で作る l 転職斡旋会社や、⼤大企業の⼈人事などで使われる l linkedinなどで⼤大規模な適⽤用例例をみることができる -
社内情報 l 業務⽂文書解析 l メール、議事録、掲⽰示板、契約書、設計書、部品書 l 例例:ミーティングの場所、出席者、議題などを⾃自動抽出 過去の関連⽂文書を全て⾒見見つける l エンタープライズ検索索
l 国内市場は100億円程度度だが、近年年ビッグデータ解析の流流⾏行行と ともにデータベース市場、BI市場と融合してきつつある l ビッグデータ解析の要素技術として重要であり、世界最⼤大⼿手は 皆買収された.Fast(MS)、Autonomy (HP)、 Endeca(Oracle) l ⽂文書の⾃自動分類(タグ付)、整理理、組織名や⼈人名、製品 名の抽出、そして、それらの名寄せが利利⽤用される l ⽂文書分類、固有表現抽出、照応解析 -
SNS解析 l SNSの⼤大流流⾏行行 l SNSのメディアとしての影響⼒力力が強くなった l SNS上での情報の解析、影響の解析のニーズが⾼高まる l 広告業界や⼀一般消費者向け企業が強い興味を⽰示す l
全世界で使われることによる、多⾔言語化の影響が⼤大きい l 技術的にはBlog解析と類似 l Blog解析は2000年年代中頃にブーム l 例例:ブログウォッチャー(2004-) l 話題の追跡、プロフィールの解析、友⼈人関係の解析など、テー マは⾮非常に似ている 18 -
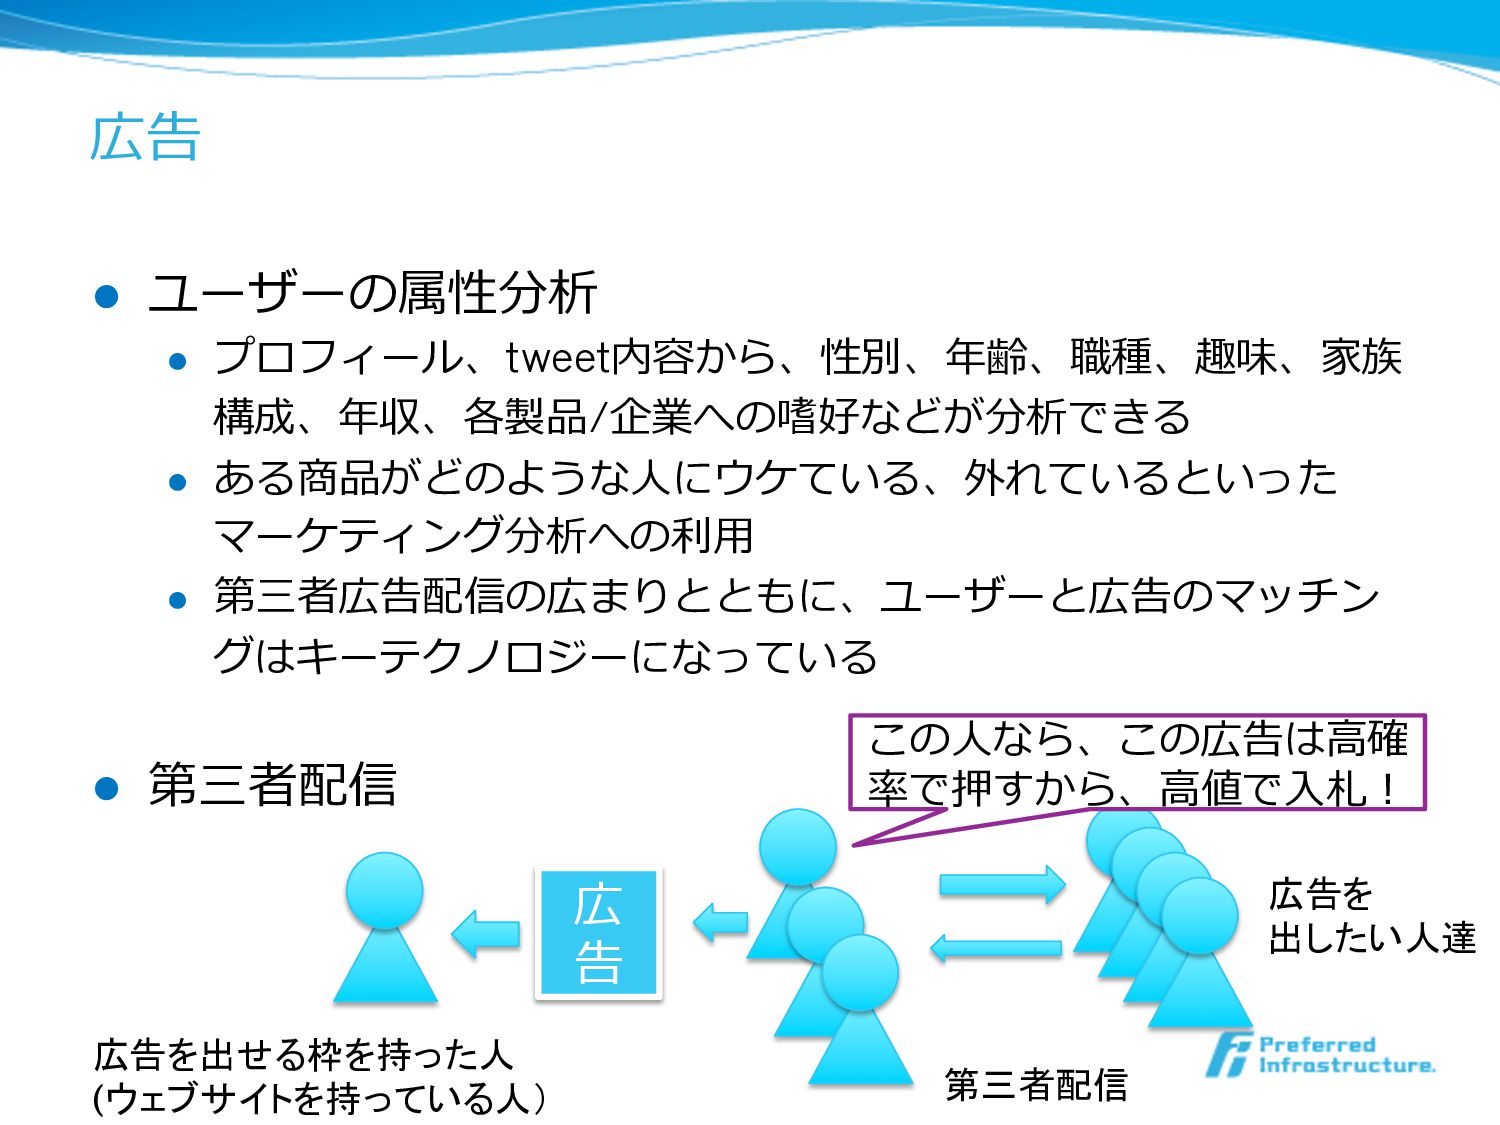
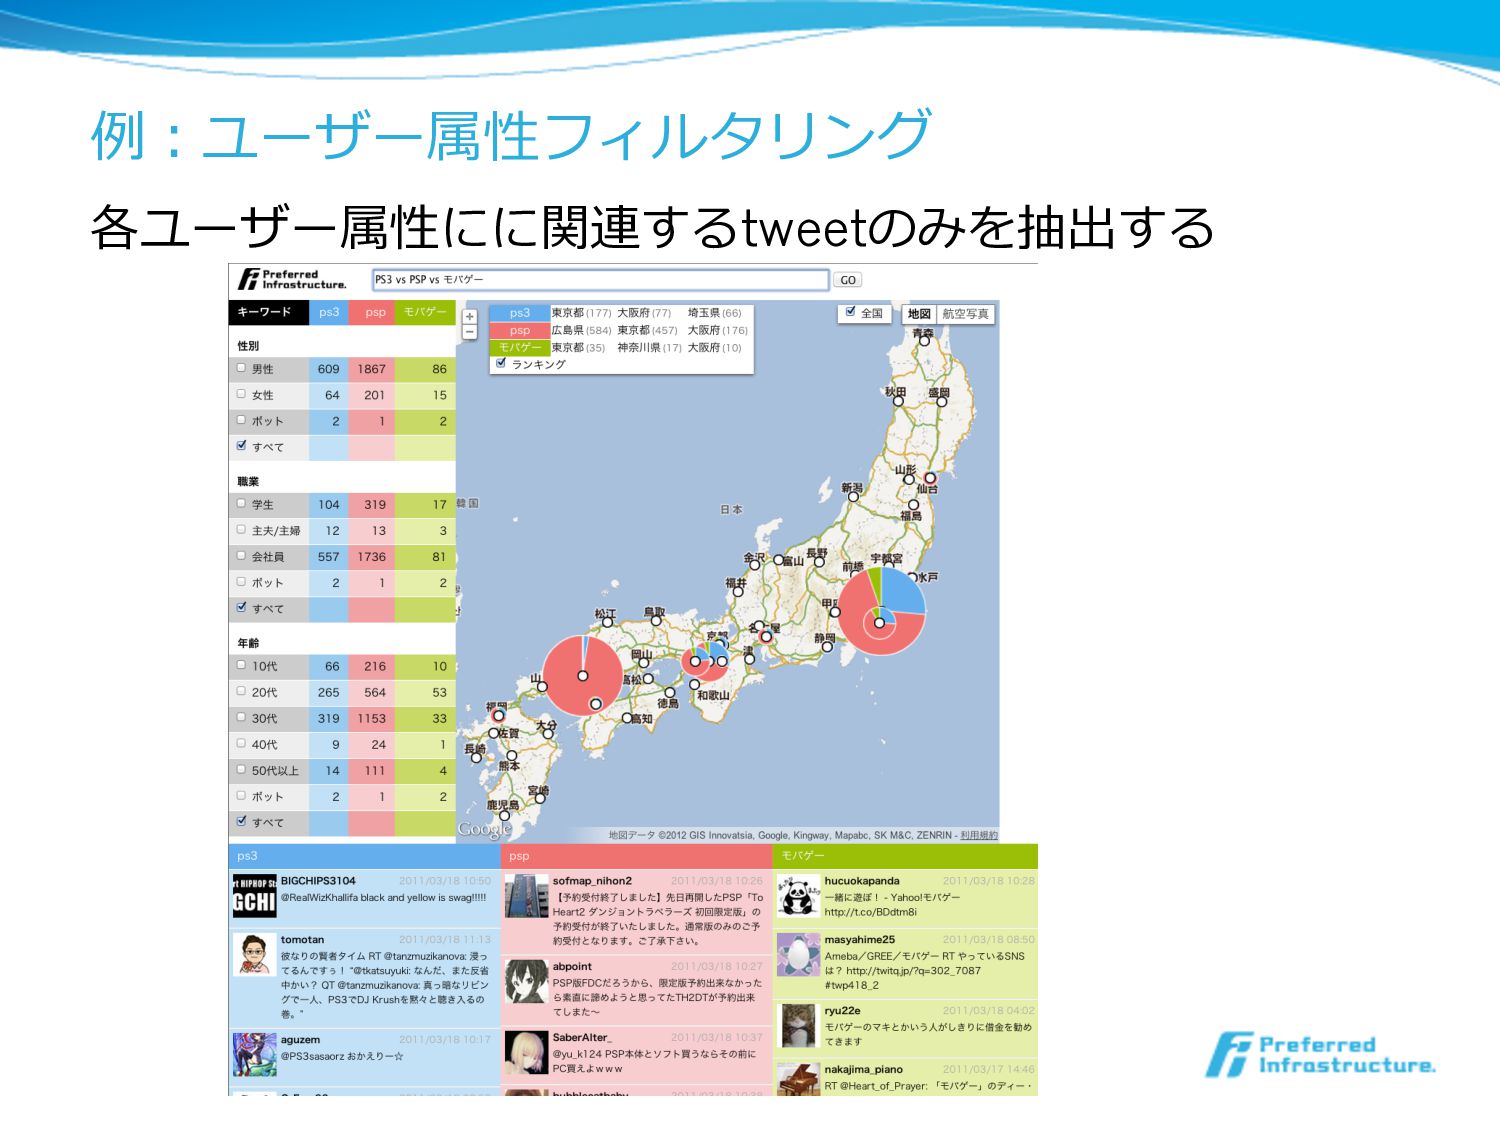
広告 l ユーザーの属性分析 l プロフィール、tweet内容から、性別、年年齢、職種、趣味、家族 構成、年年収、各製品/企業への嗜好などが分析できる l ある商品がどのような⼈人にウケている、外れているといった マーケティング分析への利利⽤用 l
第三者広告配信の広まりとともに、ユーザーと広告のマッチン グはキーテクノロジーになっている l 第三者配信 広告を 出したい人達 広告を出せる枠を持った人 (ウェブサイトを持っている人) 広 告 この⼈人なら、この広告は⾼高確 率率率で押すから、⾼高値で⼊入札! 第三者配信 -
⼀一⾔言で⾔言語処理理と⾔言っても適⽤用⽅方法は様々 l 業種によって異異なる要求 l 検出漏漏れがないことが重要な場合と、間違いが少ないことが重 要な場合 l かっちりした⽂文書から、⾛走り書きの⽂文書まで l 情報を⾒見見つける、整理理する、最適化する・・
l 1つの技術だけでは解決しないことも多い l 検索索、類似⽂文書、情報抽出、etc. l 可視化、UI、時系列列解析、統計分析など異異なる技術との組み合 わせが必要な場合もある 21 -
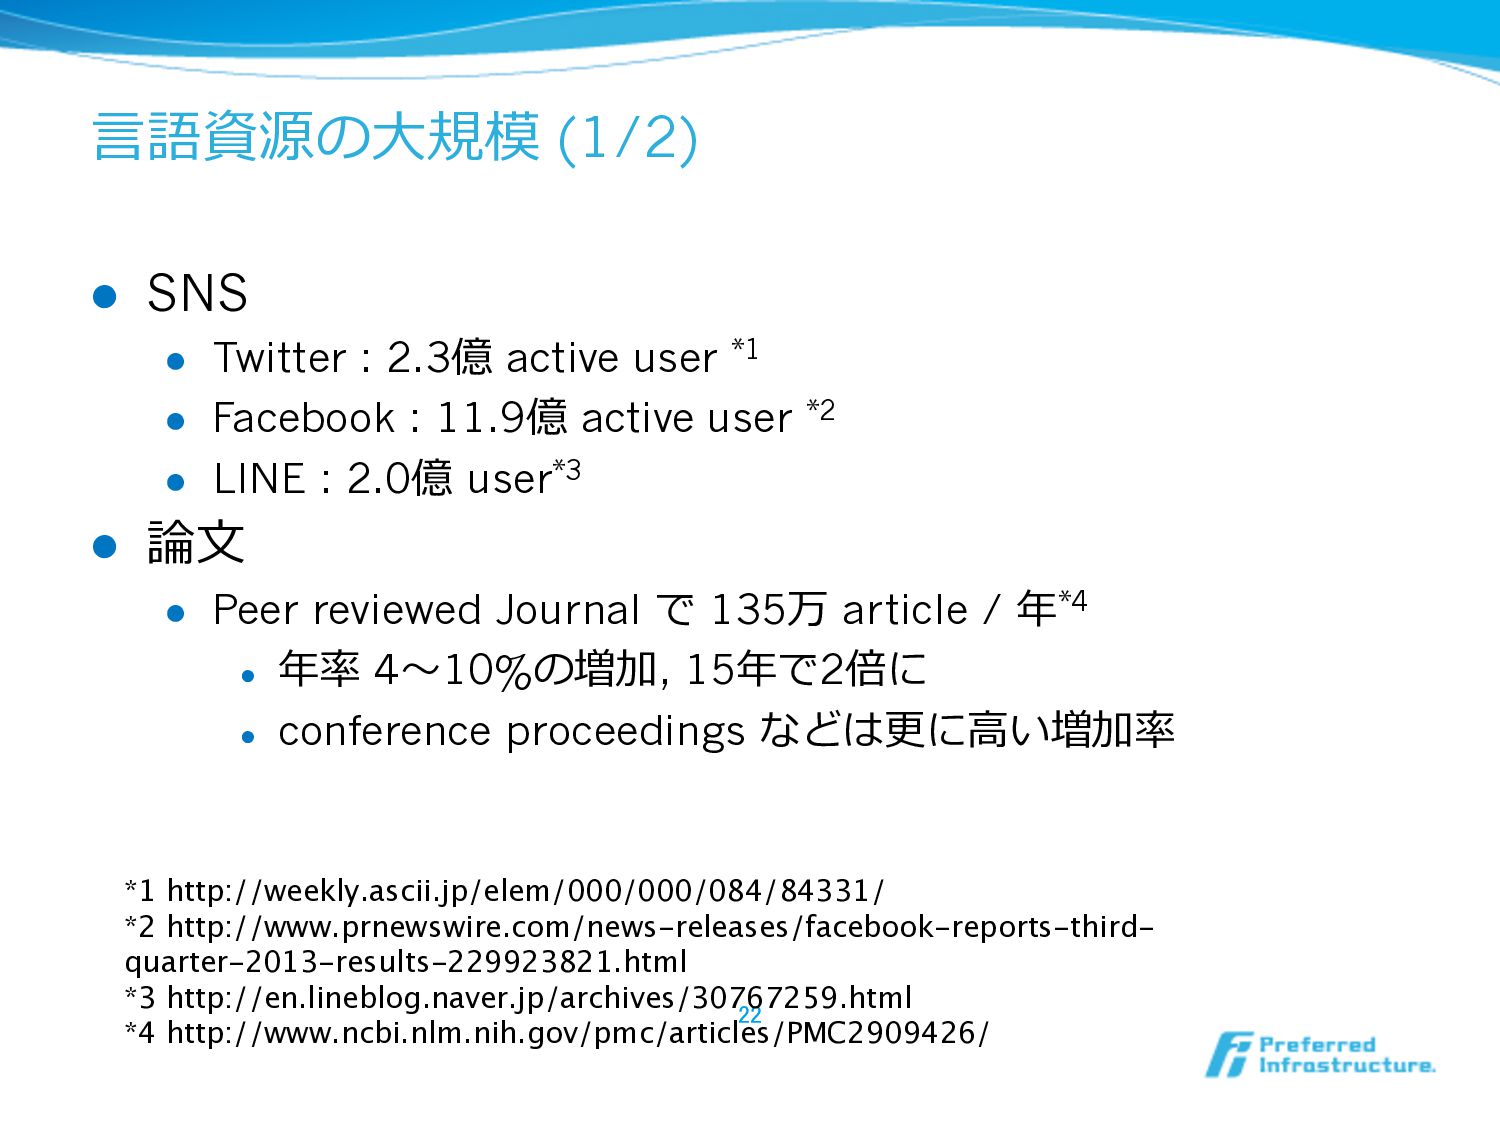
⾔言語資源の⼤大規模 (1/2) l SNS l Twitter : 2.3億 active user
*1 l Facebook : 11.9億 active user *2 l LINE : 2.0億 user*3 l 論論⽂文 l Peer reviewed Journal で 135万 article / 年年*4 l 年年率率率 4〜~10%の増加, 15年年で2倍に l conference proceedings などは更更に⾼高い増加率率率 22 *1 http://weekly.ascii.jp/elem/000/000/084/84331/ *2 http://www.prnewswire.com/news-releases/facebook-reports-third- quarter-2013-results-229923821.html *3 http://en.lineblog.naver.jp/archives/30767259.html *4 http://www.ncbi.nlm.nih.gov/pmc/articles/PMC2909426/ -
⾔言語資源の⼤大規模 (2/2) l 専⾨門家すら全ての情報に触れることは困難 l 関連する領領域も急速に拡⼤大している l SNS, 電⼦子ジャーナルなど情報発信能⼒力力は急激に増えた が、⼈人の処理理能⼒力力は急激に増えないのでアシストツール
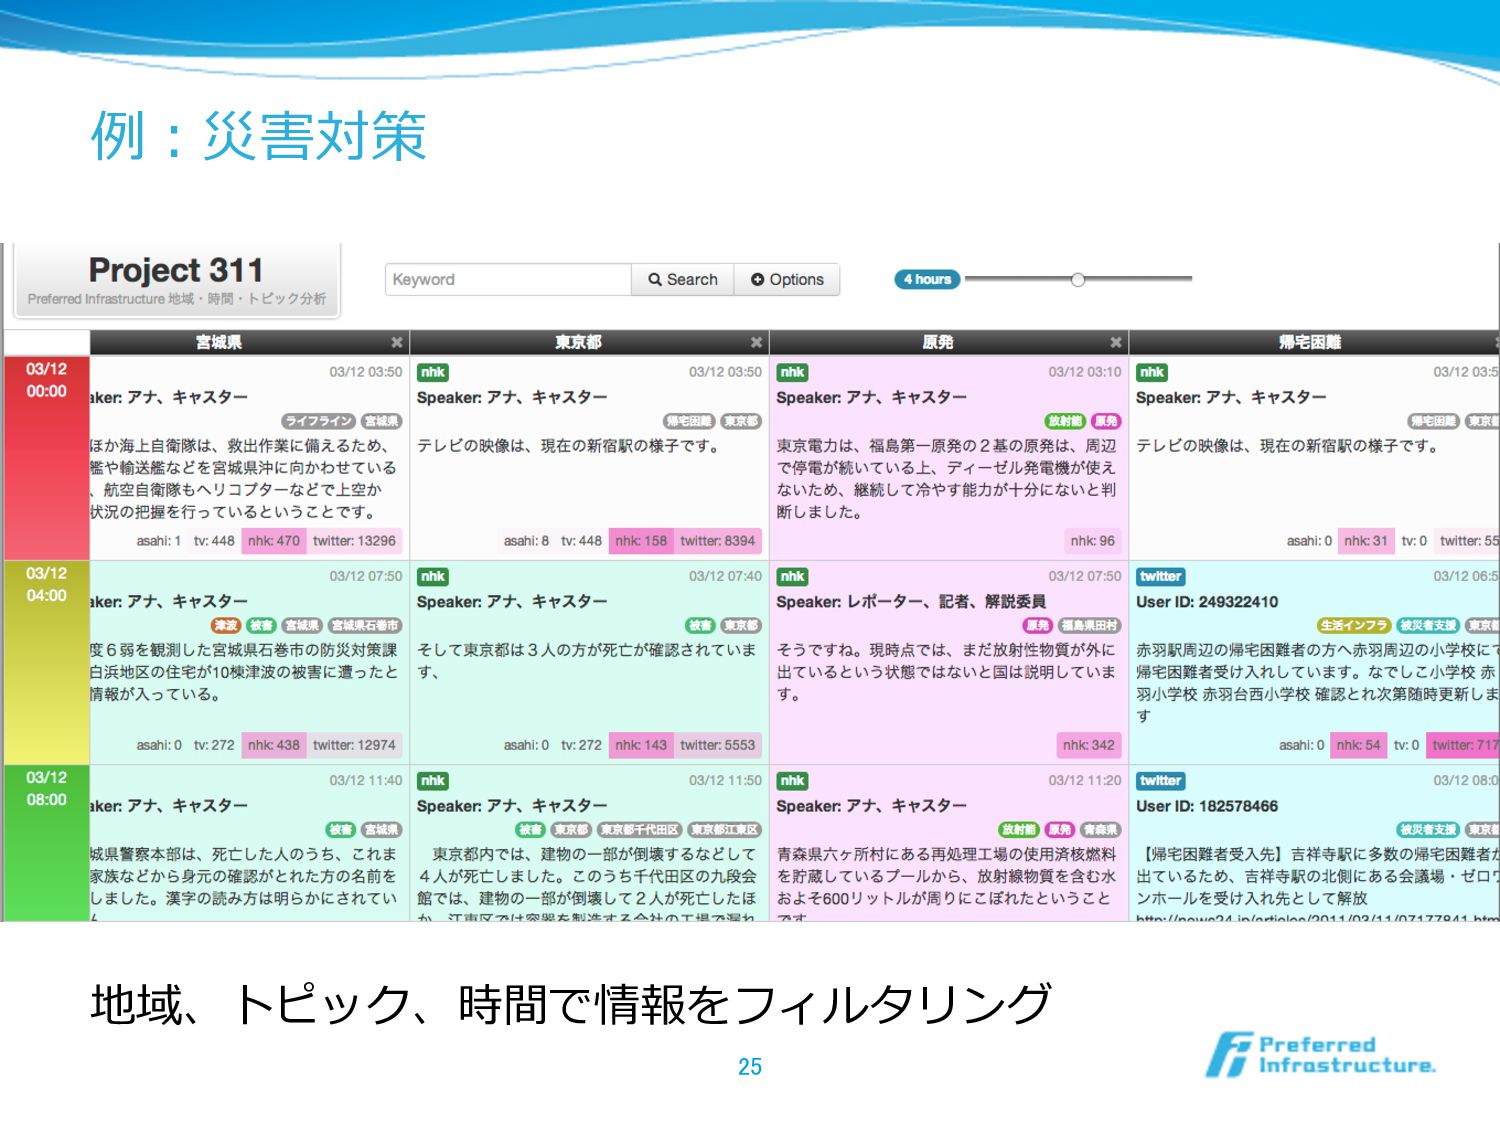
が必須 l ⼤大量量の情報から必要な情報のみを集める l 情報フィルタリングツール l 情報要約ツール l SNSを中⼼心に情報はリアルタイムで発⽣生する l 秒間数千〜~万, これらの結果に反応できるか 23 -
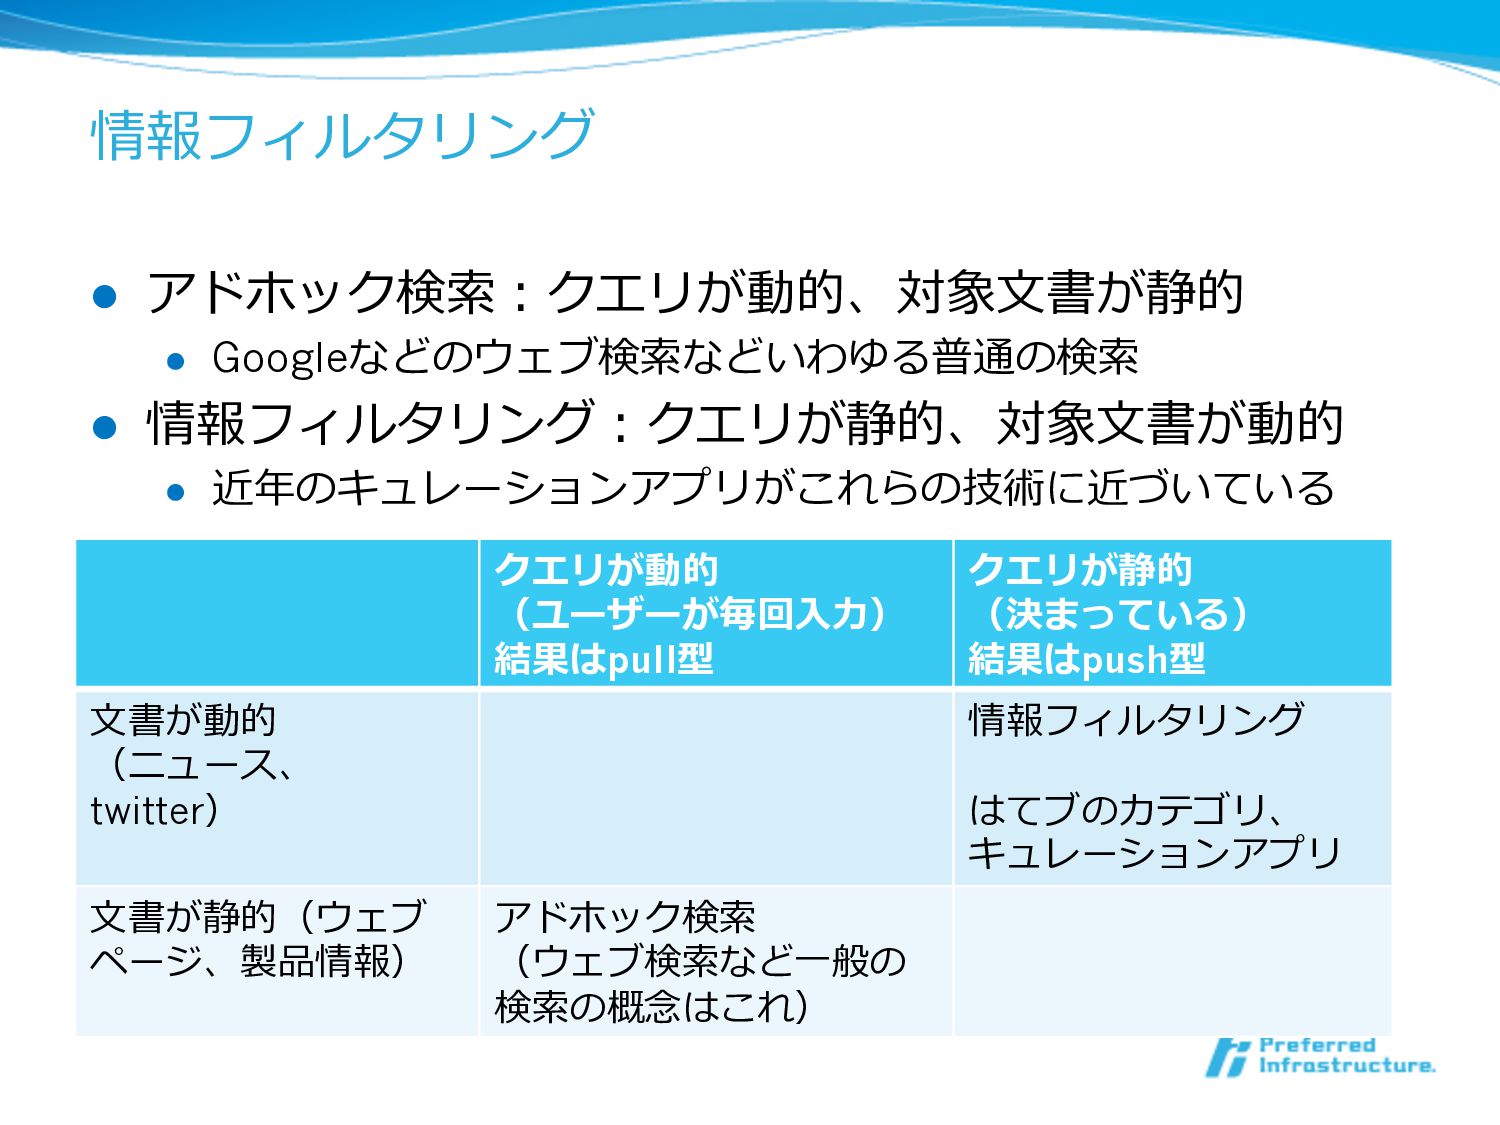
情報フィルタリング l アドホック検索索:クエリが動的、対象⽂文書が静的 l Googleなどのウェブ検索索などいわゆる普通の検索索 l 情報フィルタリング:クエリが静的、対象⽂文書が動的 l 近年年のキュレーションアプリがこれらの技術に近づいている クエリが動的
(ユーザーが毎回⼊入⼒力力) 結果はpull型 クエリが静的 (決まっている) 結果はpush型 ⽂文書が動的 (ニュース、 twitter) 情報フィルタリング はてブのカテゴリ、 キュレーションアプリ ⽂文書が静的(ウェブ ページ、製品情報) アドホック検索索 (ウェブ検索索など⼀一般の 検索索の概念念はこれ) -
データの変化まとめ l 適応領領域の増⼤大とデータの多様化 l ⾃自然⾔言語のデータはあらゆるビジネス領領域で利利⽤用されている l あらゆる領領域で、これらのデータ分析のニーズは⾼高まっている l 対象領領域ごとにデータの違いのみならず、要求⽔水準や必要な技 術もまるで異異なる
l データの⼤大規模化とフィルタリング技術 l ⼤大規模化、多様化が急速に進んでいて、⼈人間の処理理能⼒力力を上 回ってきている l 情報を取捨選別する仕組みが必要とされている 27 -
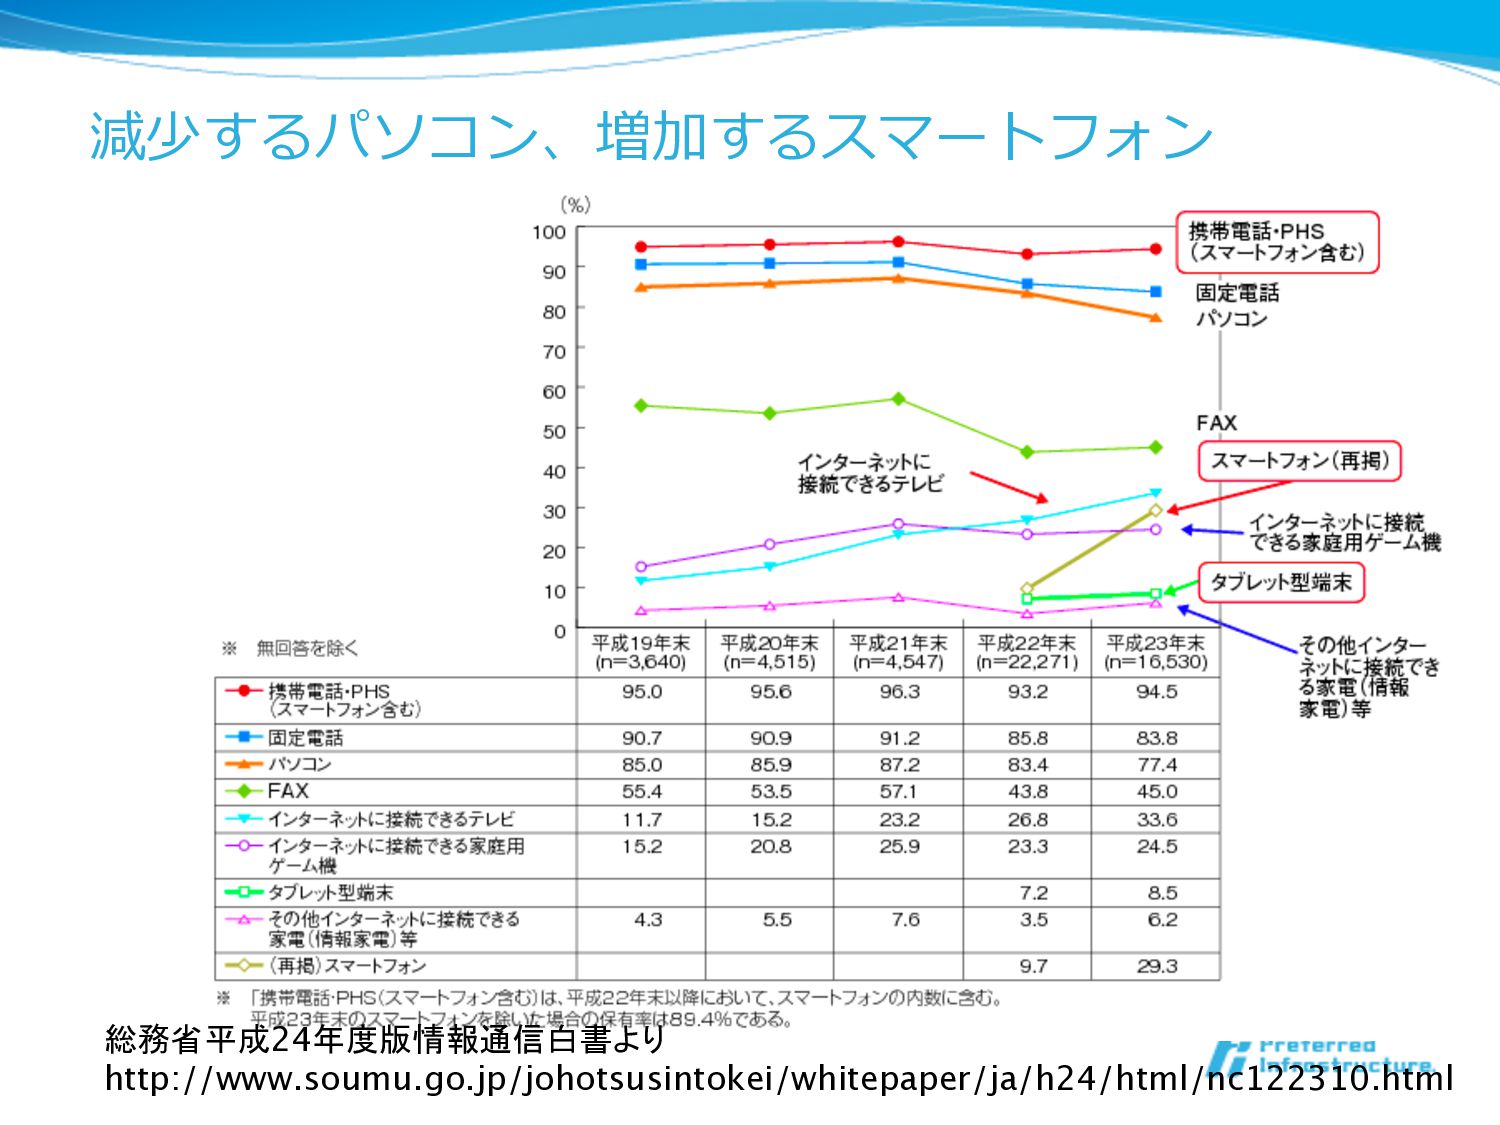
スマートフォン時代にブレークした技術(1/2) l 予測⼊入⼒力力 l 1970年年代にはアイデアがあったが、PC向けには普及しなかっ た l 携帯電話の普及に合わせて⽬目にするようになり、今では当たり 前に l
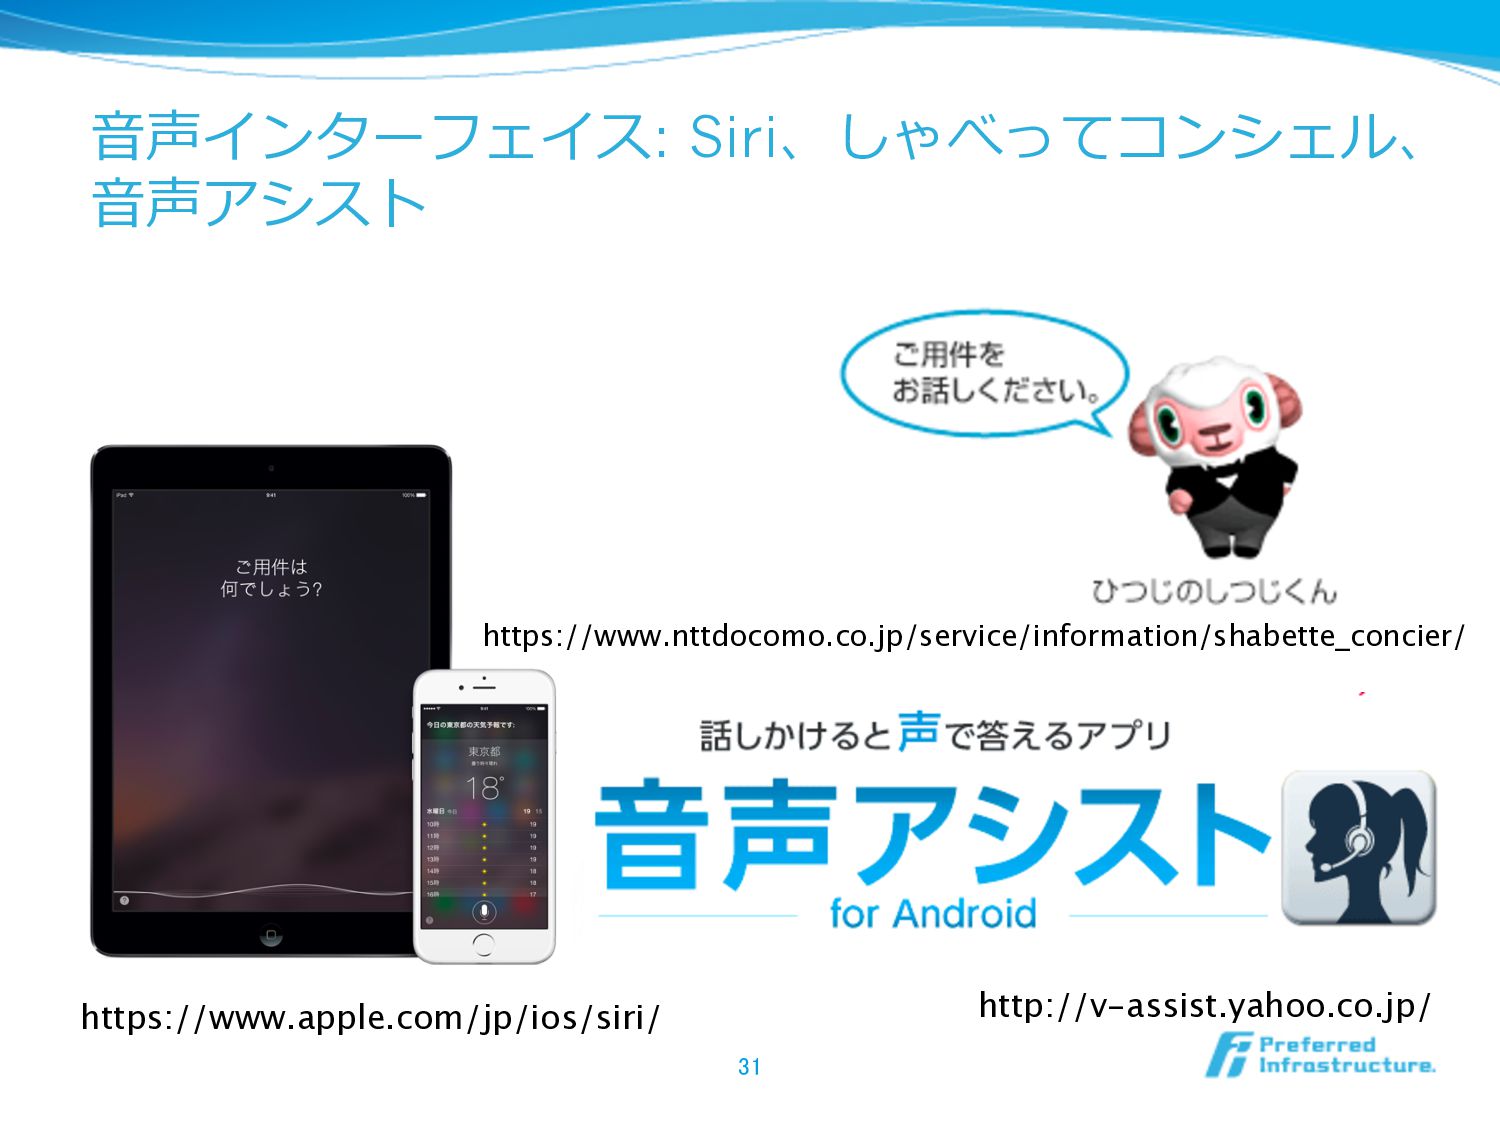
⾳音声⼊入⼒力力 l ⾳音声⼊入⼒力力ソフトは2000年年前後に⼀一⻫斉に発売されたが、結局キー ボードを置き換えなかった l ところが、スマホからの⾳音声検索索や⾳音声インターフェースに なって花開く 33 -
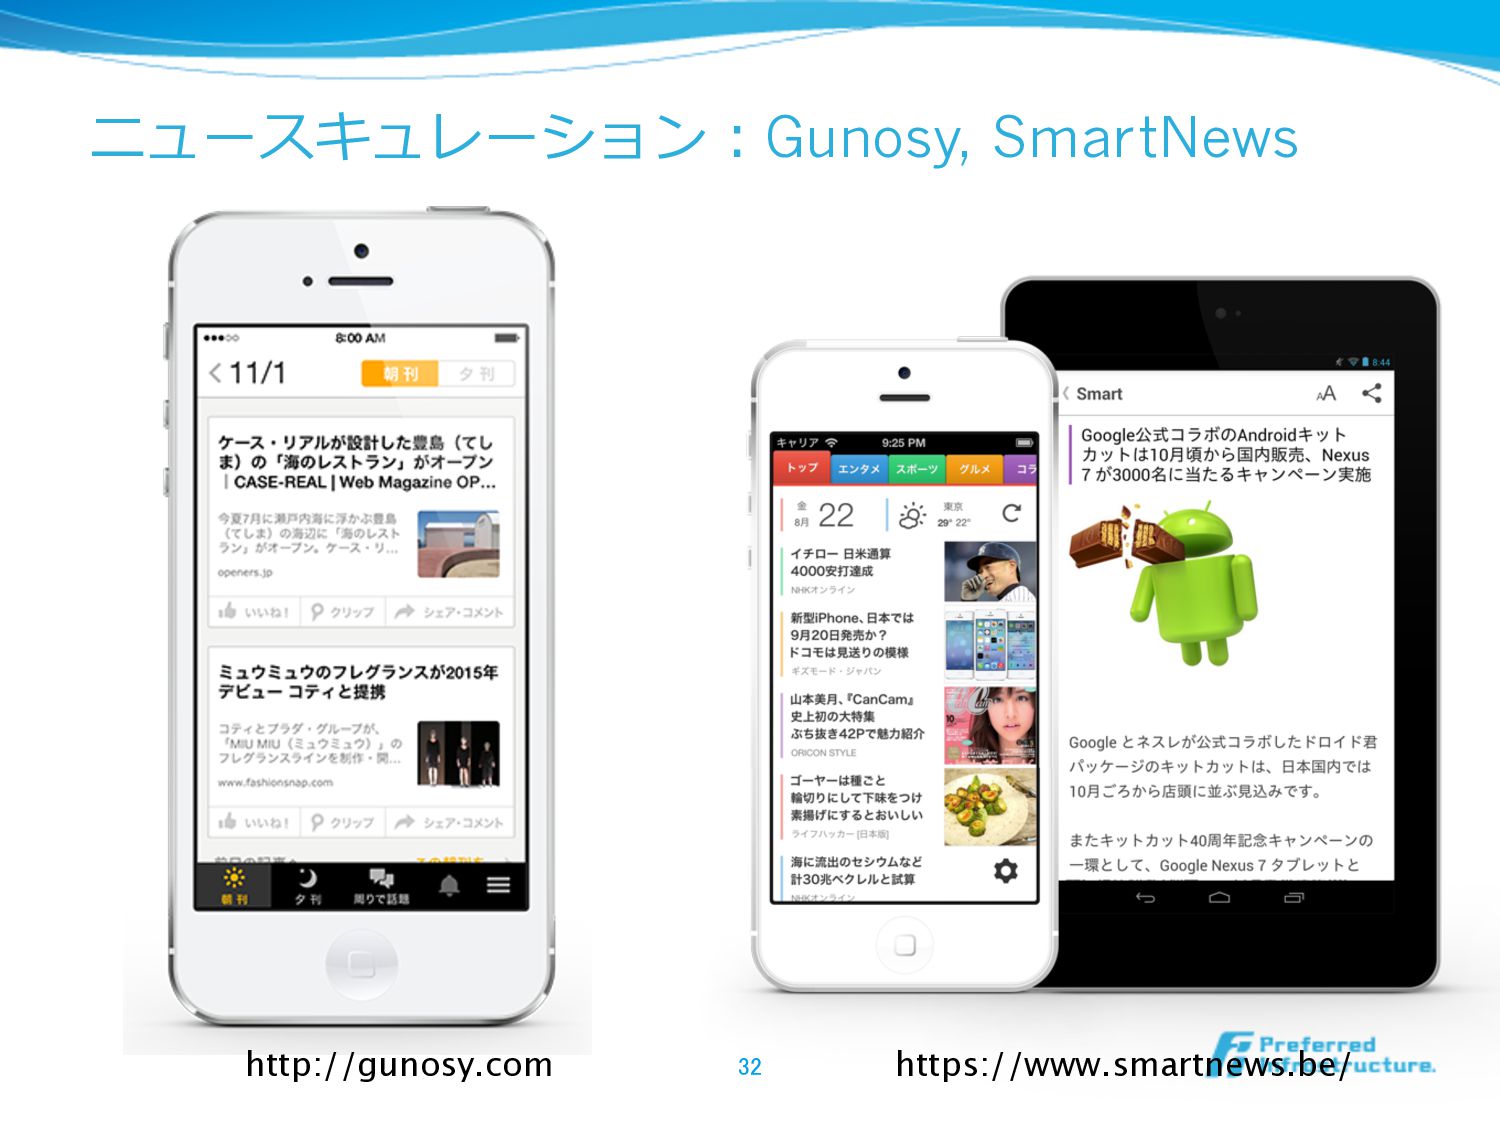
スマートフォン時代にブレークした技術(2/2) l 情報収集技術 l RSSリーダーをはじめ、情報収集アプリは2000年年台前半には存 在した l ⼤大々的に普及するようになったのはつい最近 l 機械翻訳(これから?)
l 機械翻訳ソフトは2000年年前後に⼀一⻫斉に発売されたが、結局普及 しなかった l ⼗十分な翻訳リソースの得られない旅⾏行行シーンなどで役に⽴立立つは ず 34 -
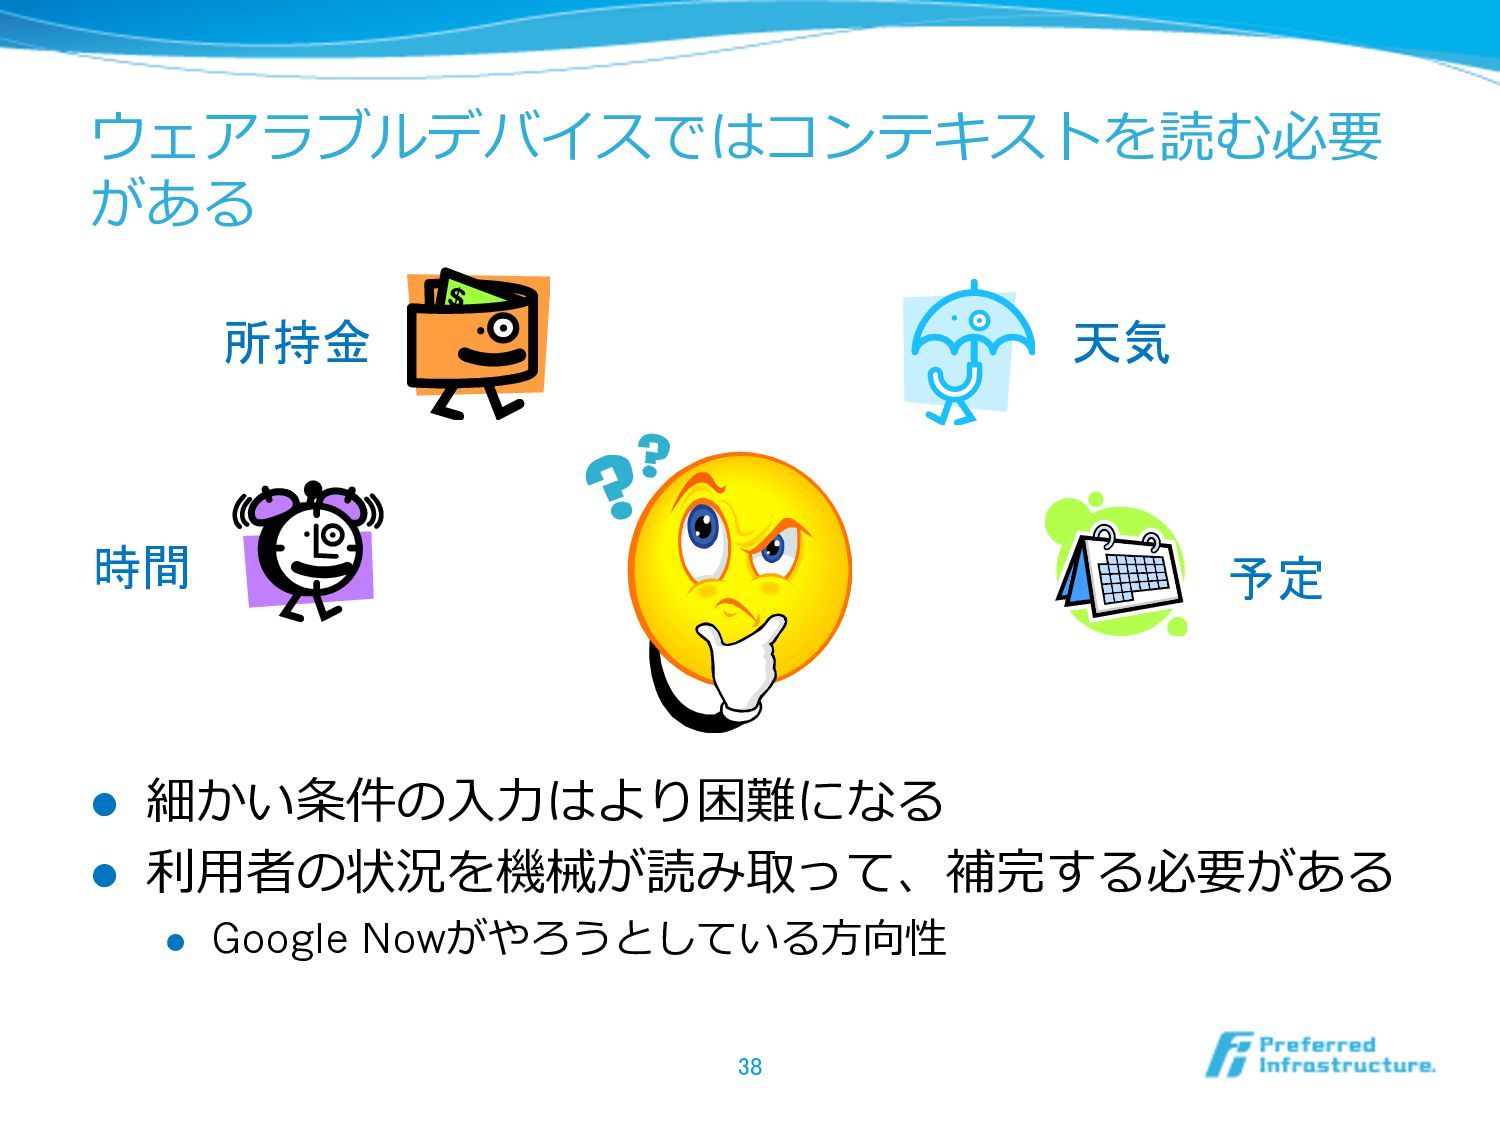
変化にあったソフトウェアの必要性 l 不不⾃自由な⼊入出⼒力力をサポートできるか? l キーボードやマウスのようなデバイスは使えない l ⼤大画⾯面で⼤大量量の情報を提⽰示することはできない l いつでも持っていることを活かせるか? l
秒単位で通知する必要の情報を提供できる l どこにいても情報にアクセスできる 36 -
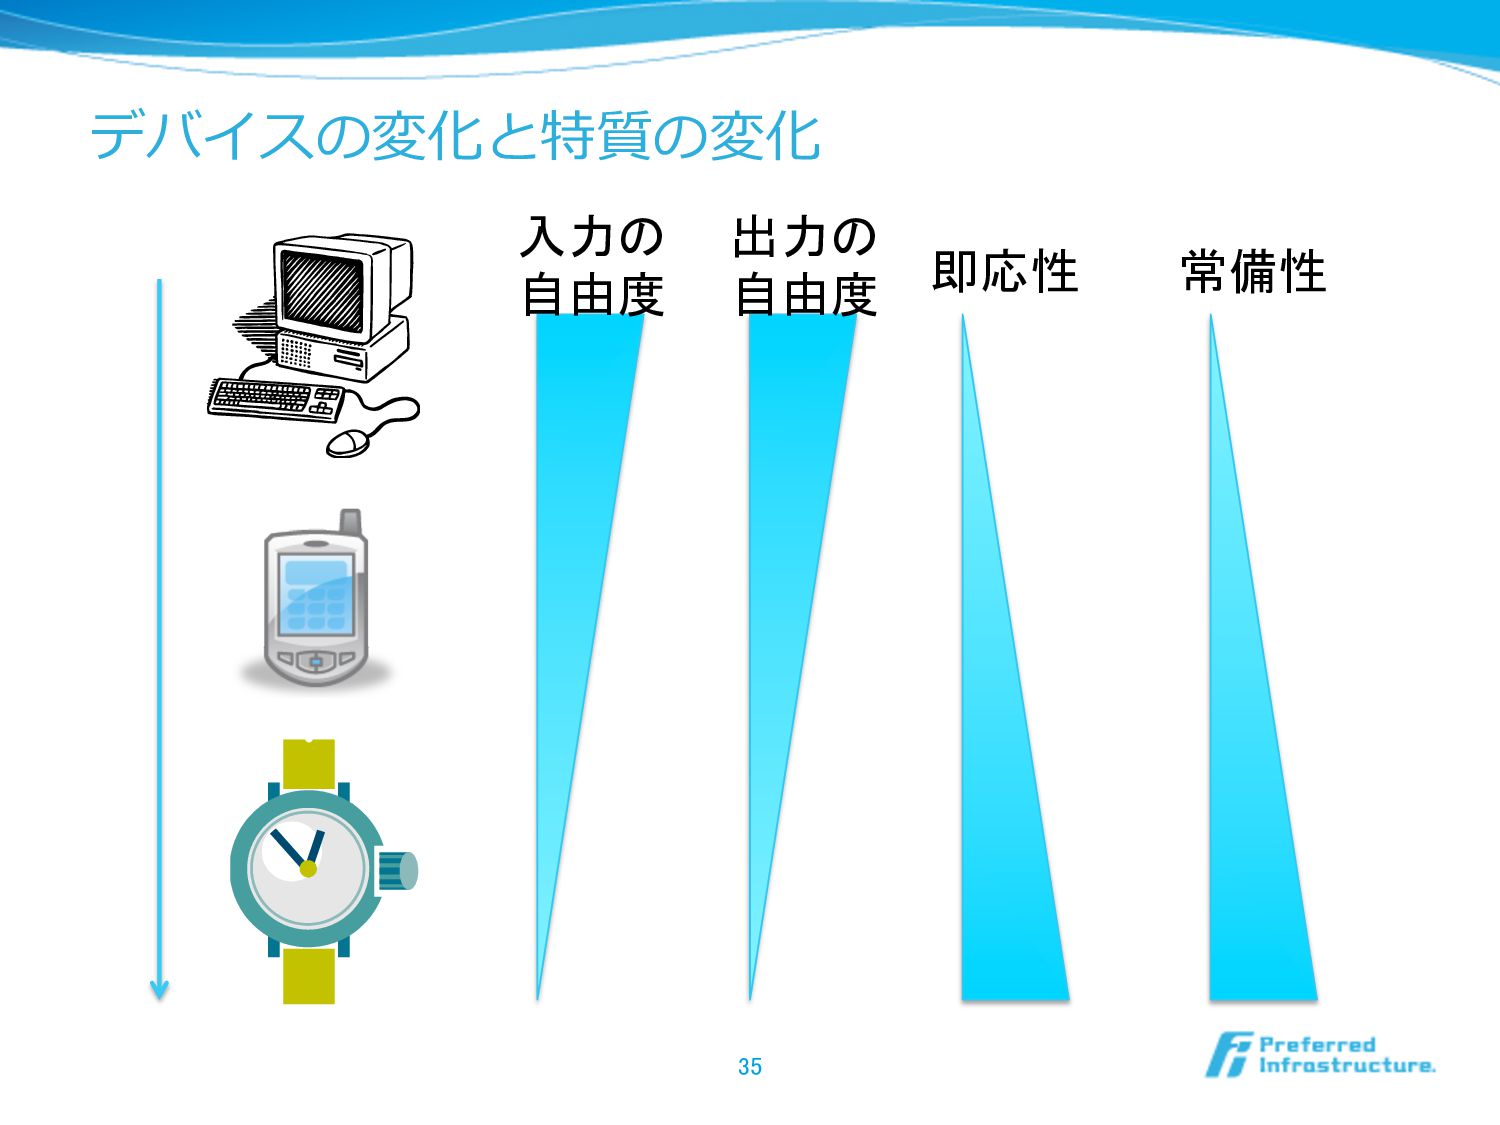
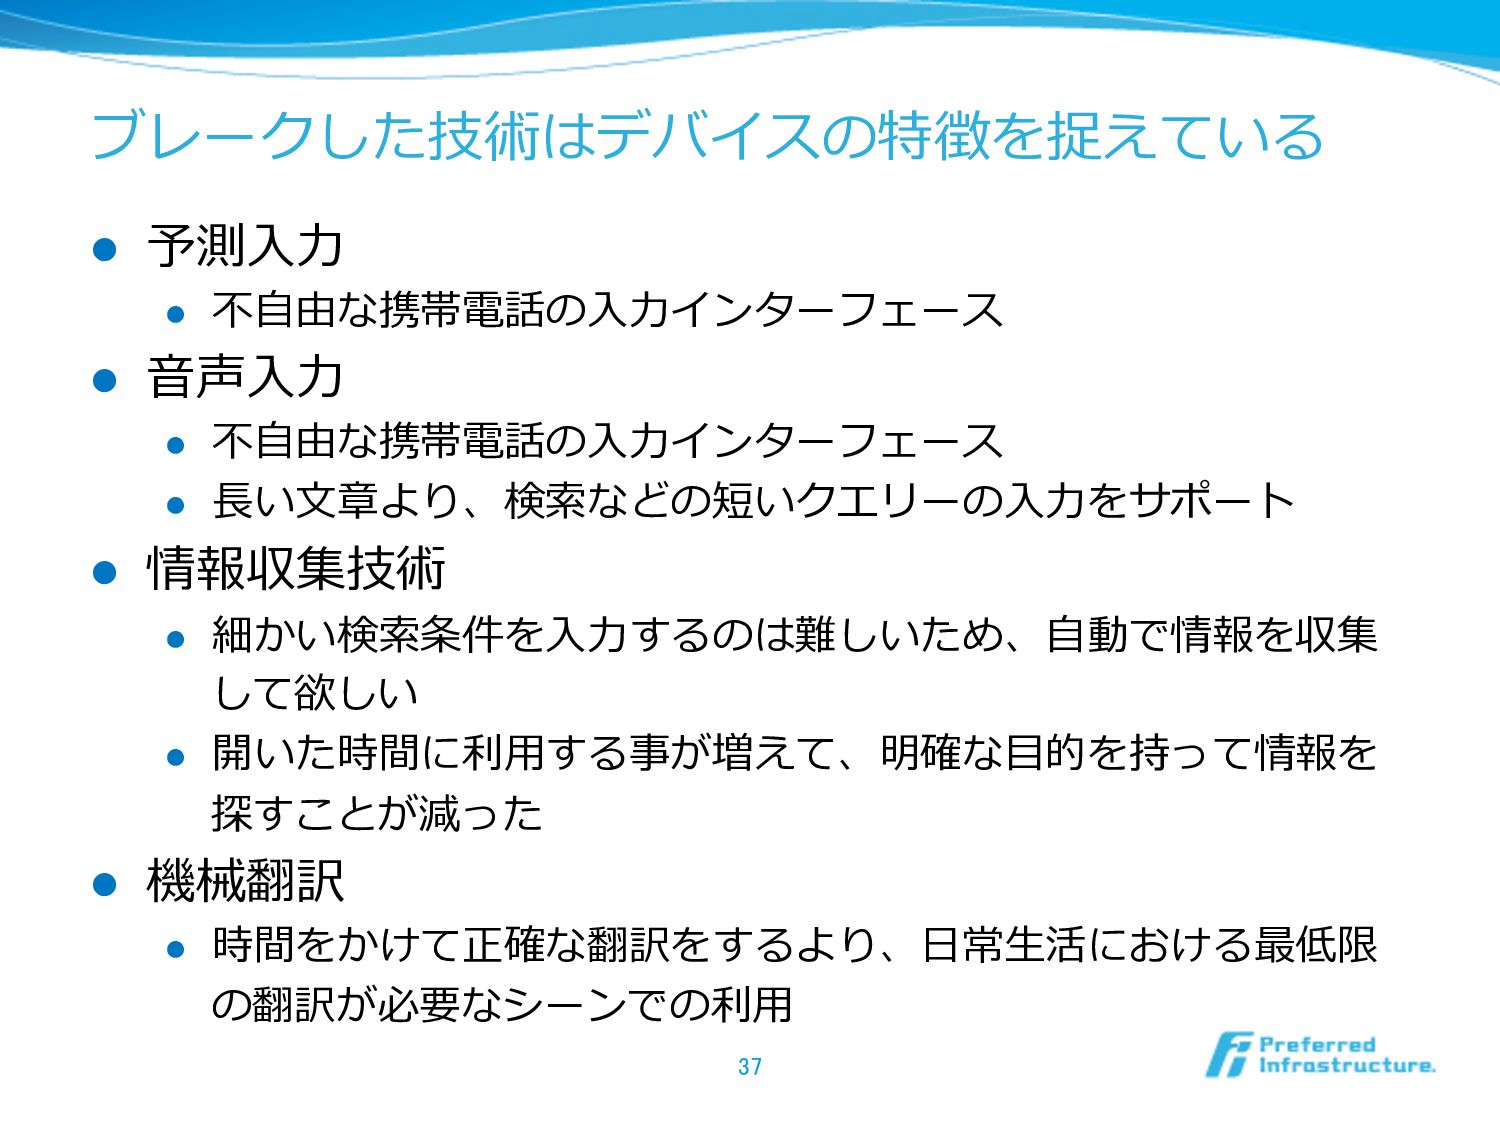
ブレークした技術はデバイスの特徴を捉えている l 予測⼊入⼒力力 l 不不⾃自由な携帯電話の⼊入⼒力力インターフェース l ⾳音声⼊入⼒力力 l 不不⾃自由な携帯電話の⼊入⼒力力インターフェース l
⻑⾧長い⽂文章より、検索索などの短いクエリーの⼊入⼒力力をサポート l 情報収集技術 l 細かい検索索条件を⼊入⼒力力するのは難しいため、⾃自動で情報を収集 して欲しい l 開いた時間に利利⽤用する事が増えて、明確な⽬目的を持って情報を 探すことが減った l 機械翻訳 l 時間をかけて正確な翻訳をするより、⽇日常⽣生活における最低限 の翻訳が必要なシーンでの利利⽤用 37 -
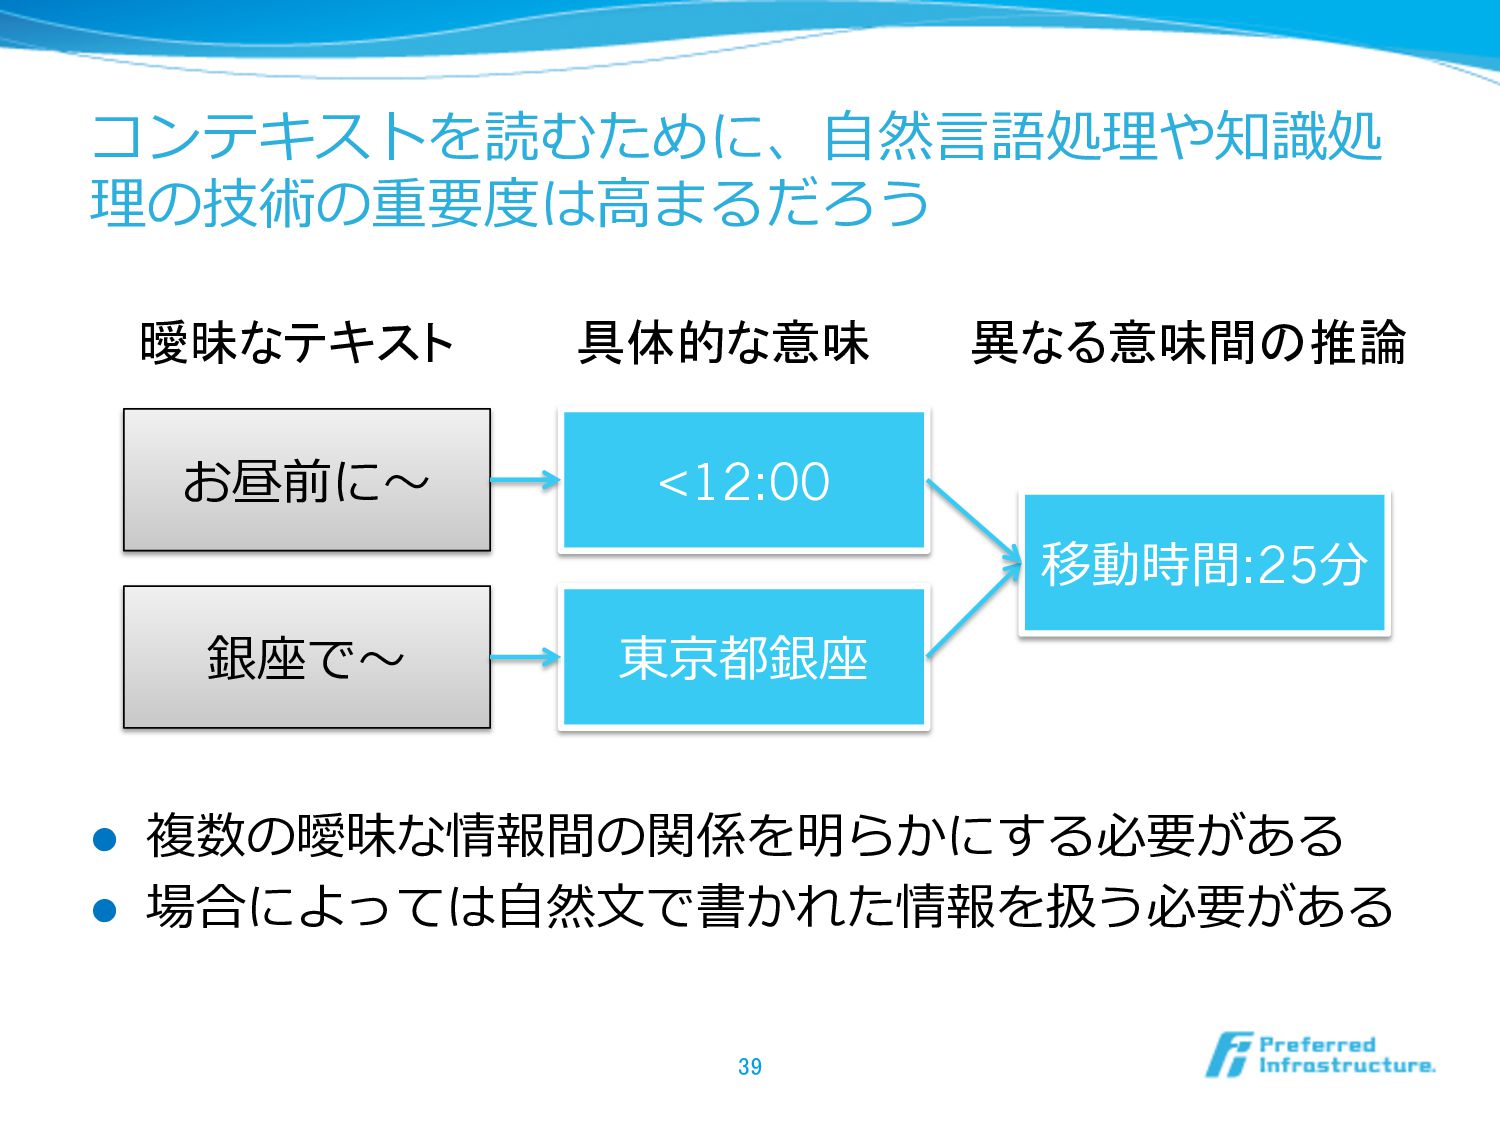
コンテキストを読むために、⾃自然⾔言語処理理や知識識処 理理の技術の重要度度は⾼高まるだろう l 複数の曖昧な情報間の関係を明らかにする必要がある l 場合によっては⾃自然⽂文で書かれた情報を扱う必要がある 39 お昼前に〜~ <12:00 銀座で〜~
東京都銀座 曖昧なテキスト 具体的な意味 異なる意味間の推論 移動時間:25分 -
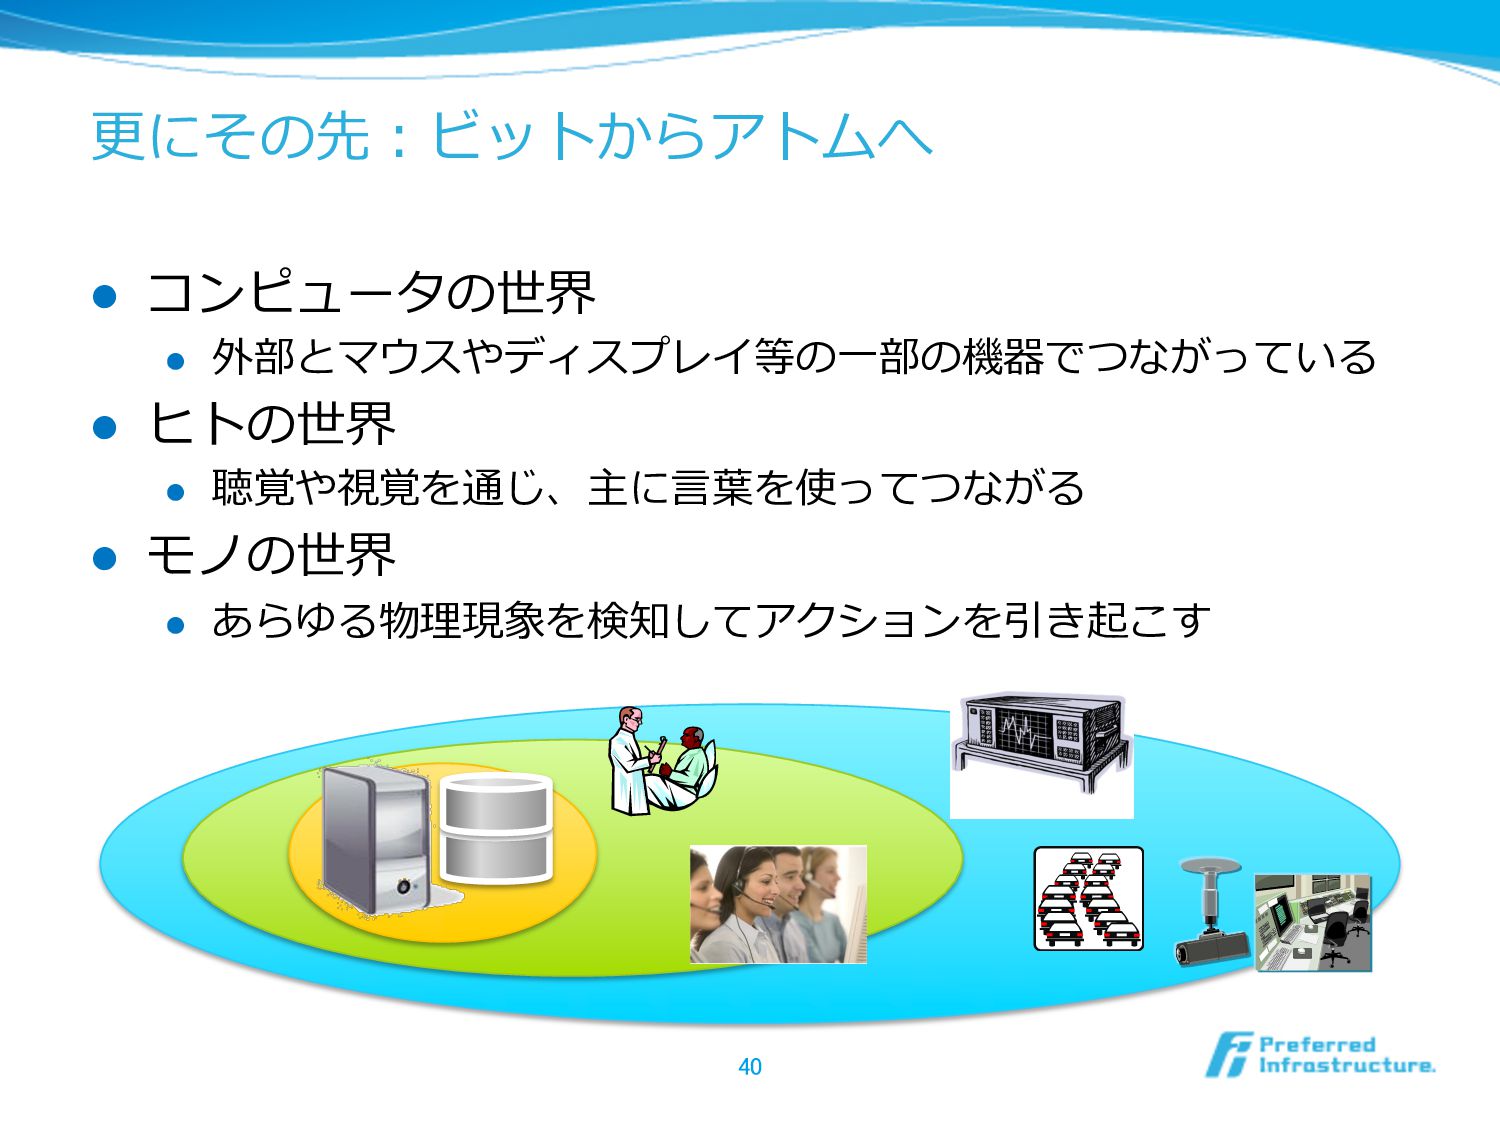
更更にその先:ビットからアトムへ l コンピュータの世界 l 外部とマウスやディスプレイ等の⼀一部の機器でつながっている l ヒトの世界 l 聴覚や視覚を通じ、主に⾔言葉葉を使ってつながる l
モノの世界 l あらゆる物理理現象を検知してアクションを引き起こす 40 -
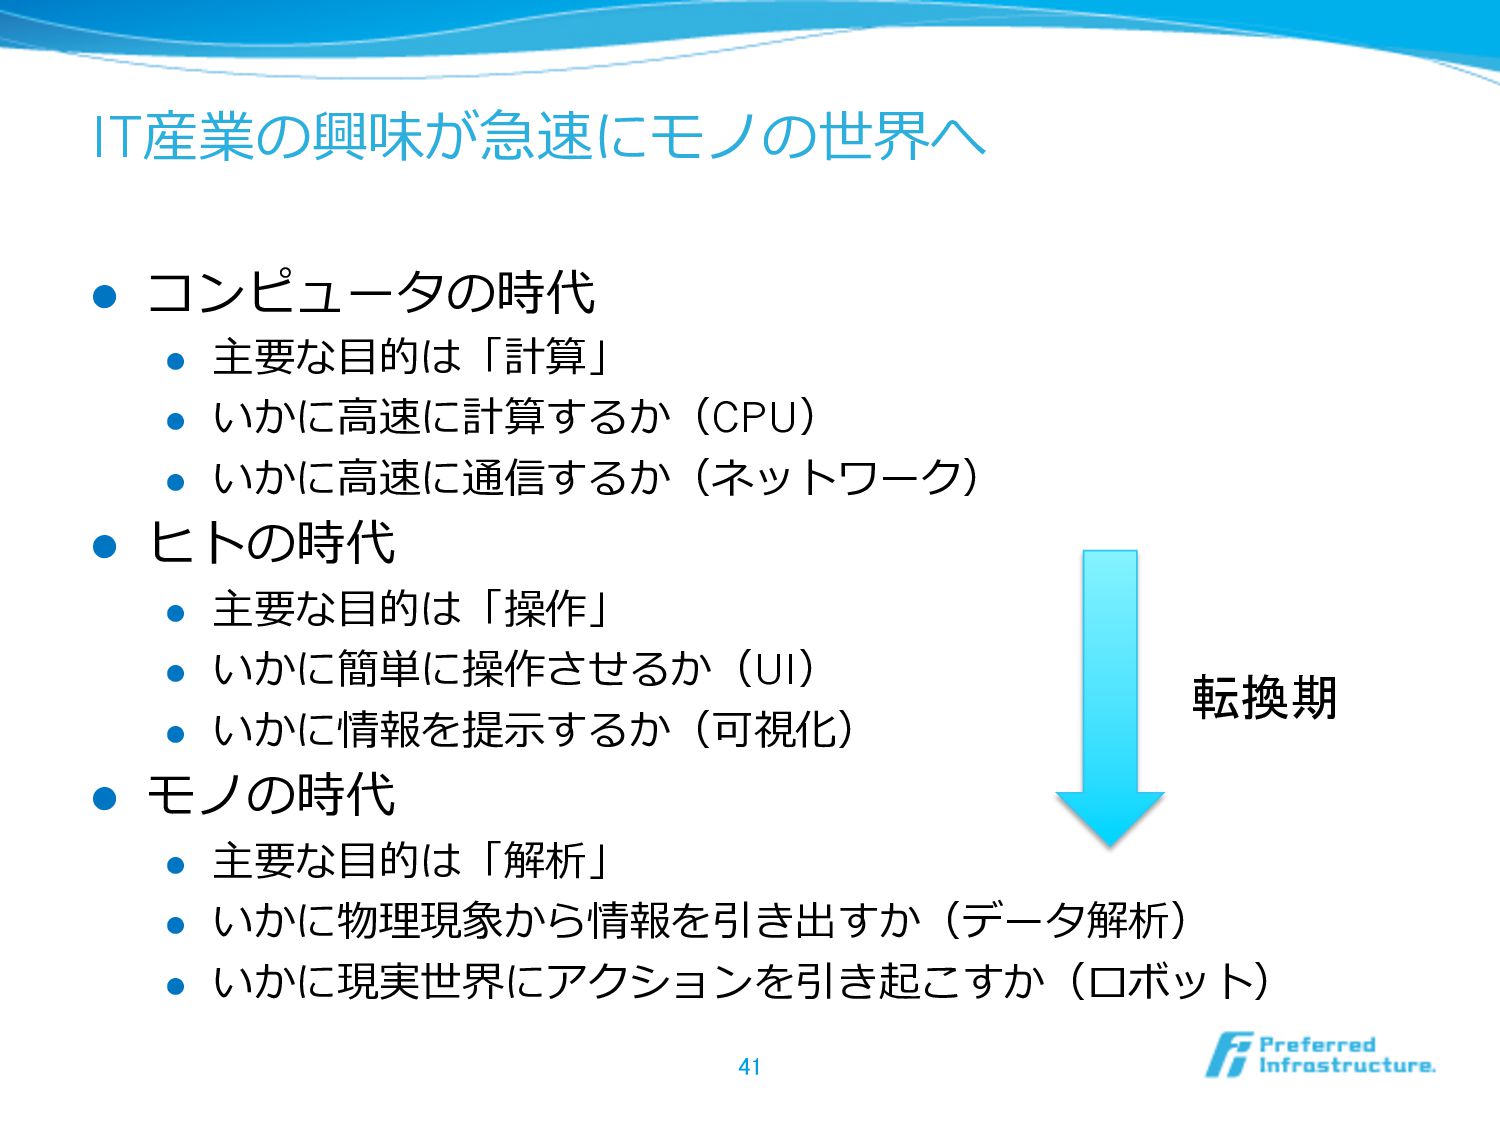
IT産業の興味が急速にモノの世界へ l コンピュータの時代 l 主要な⽬目的は「計算」 l いかに⾼高速に計算するか(CPU) l いかに⾼高速に通信するか(ネットワーク) l
ヒトの時代 l 主要な⽬目的は「操作」 l いかに簡単に操作させるか(UI) l いかに情報を提⽰示するか(可視化) l モノの時代 l 主要な⽬目的は「解析」 l いかに物理理現象から情報を引き出すか(データ解析) l いかに現実世界にアクションを引き起こすか(ロボット) 41 転換期 -
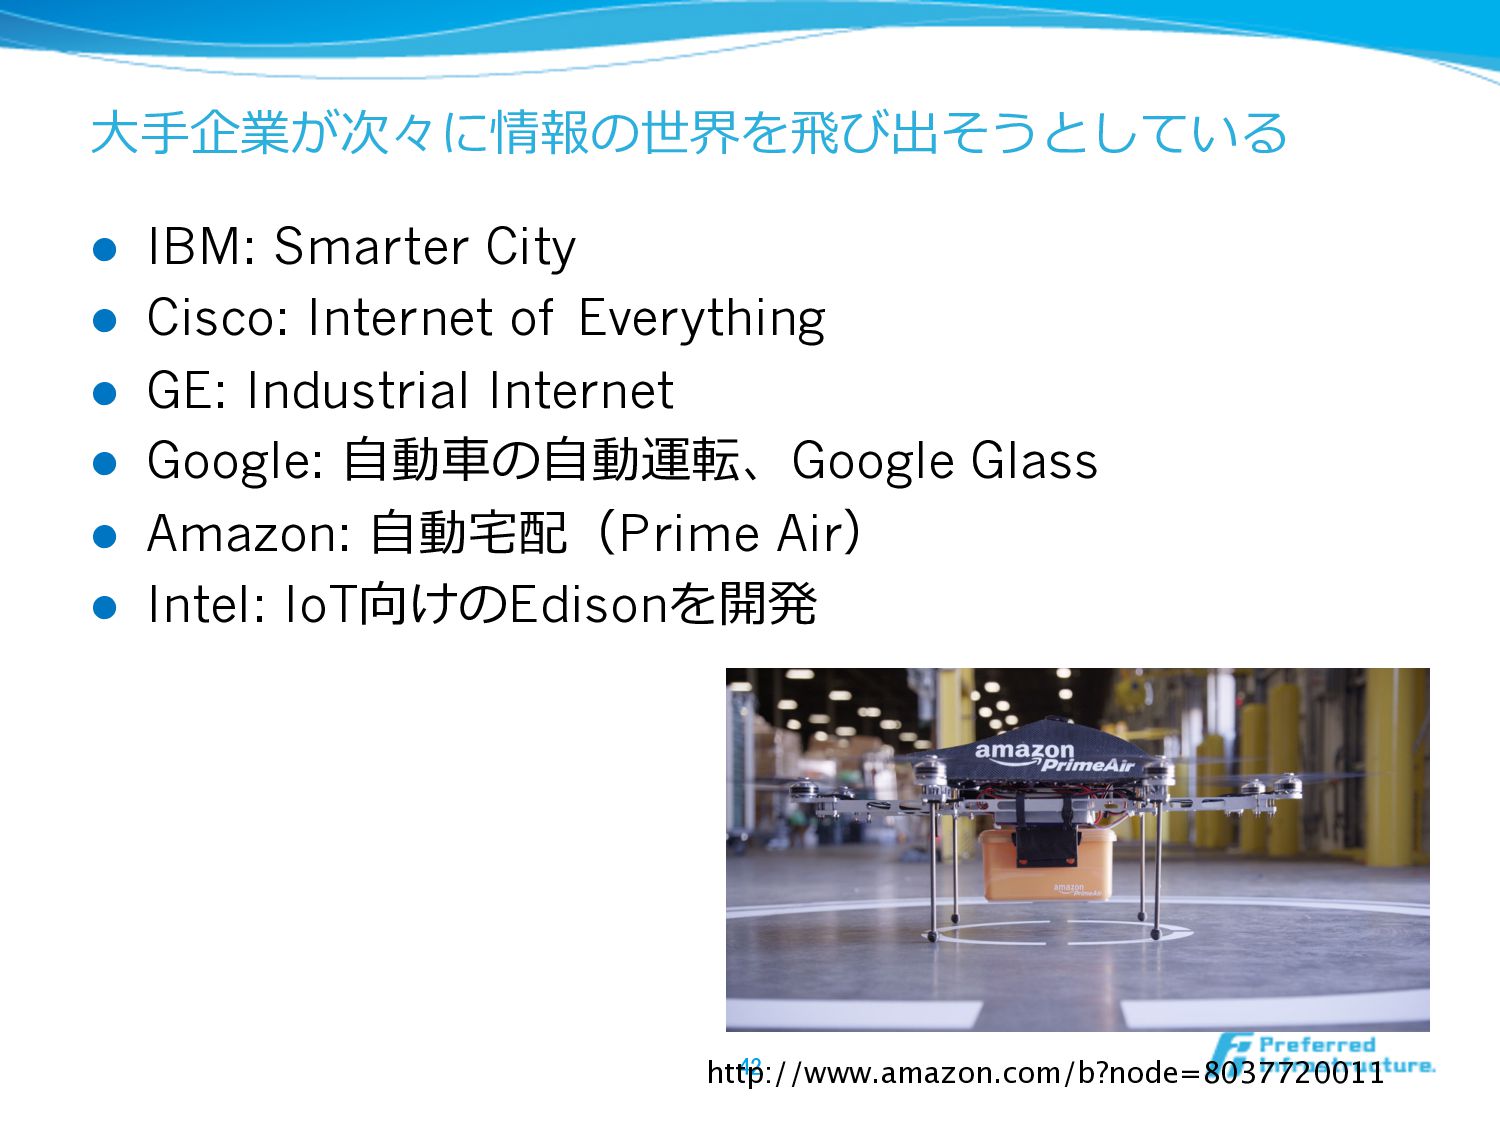
⼤大⼿手企業が次々に情報の世界を⾶飛び出そうとしている l IBM: Smarter City l Cisco: Internet of Everything
l GE: Industrial Internet l Google: ⾃自動⾞車車の⾃自動運転、Google Glass l Amazon: ⾃自動宅宅配(Prime Air) l Intel: IoT向けのEdisonを開発 42 http://www.amazon.com/b?node=8037720011 -
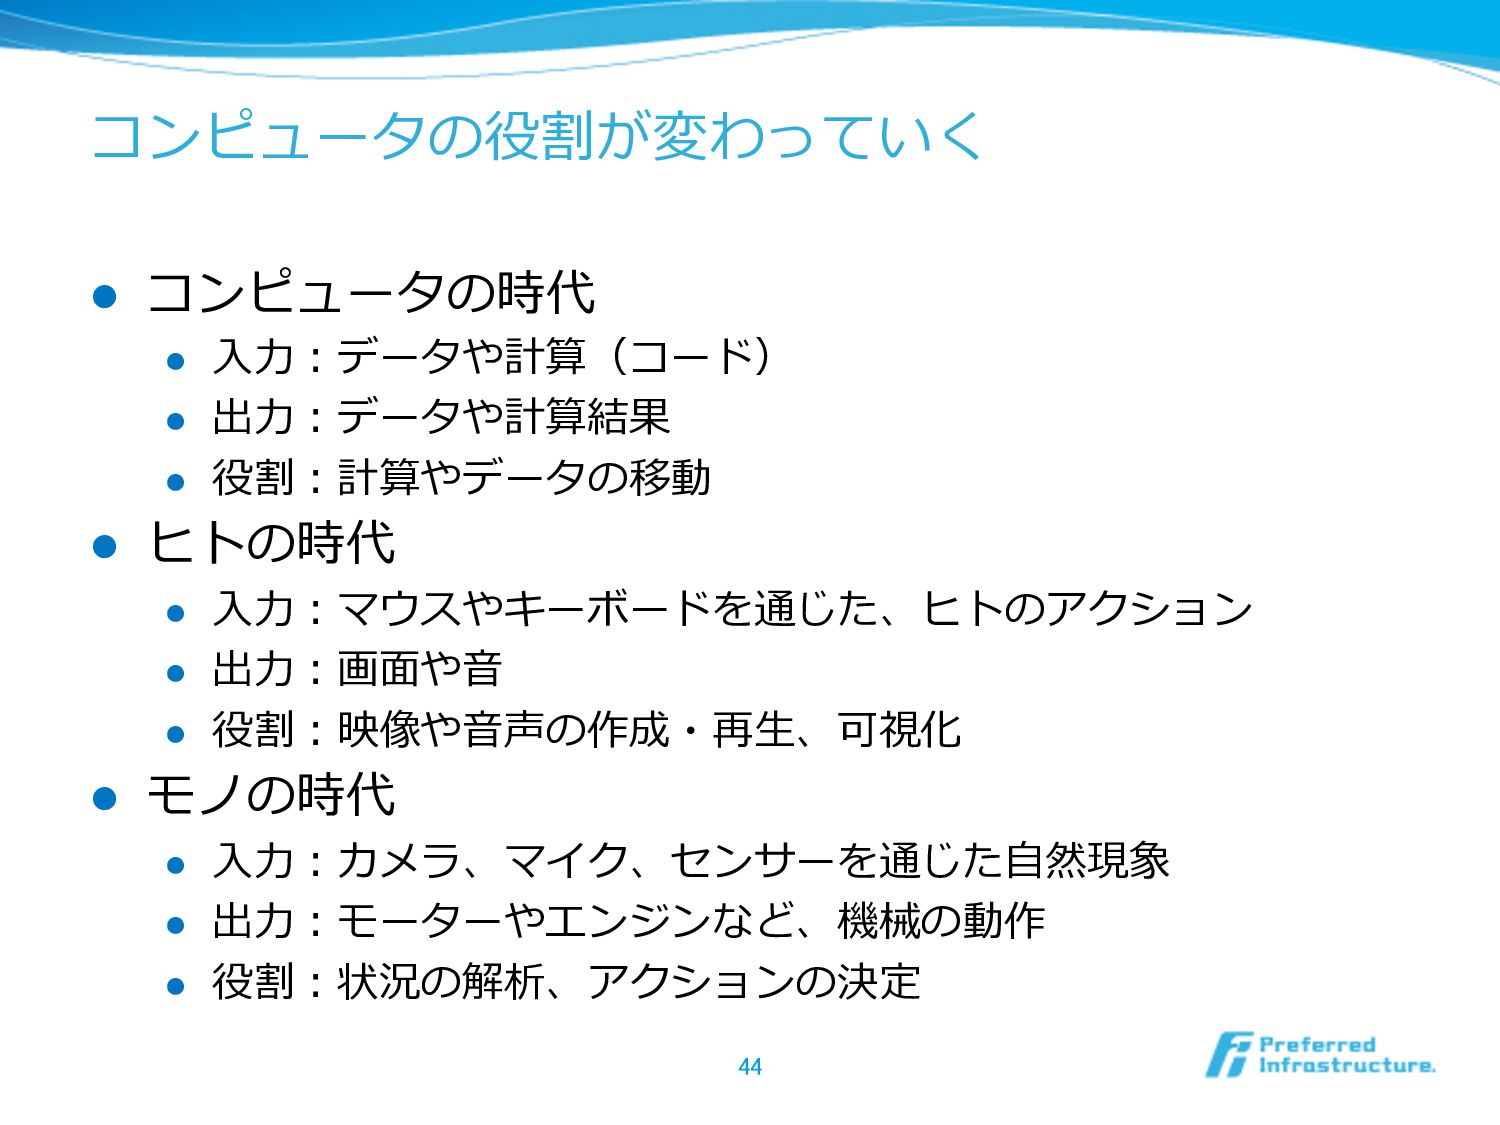
コンピュータの役割が変わっていく l コンピュータの時代 l ⼊入⼒力力:データや計算(コード) l 出⼒力力:データや計算結果 l 役割:計算やデータの移動 l
ヒトの時代 l ⼊入⼒力力:マウスやキーボードを通じた、ヒトのアクション l 出⼒力力:画⾯面や⾳音 l 役割:映像や⾳音声の作成・再⽣生、可視化 l モノの時代 l ⼊入⼒力力:カメラ、マイク、センサーを通じた⾃自然現象 l 出⼒力力:モーターやエンジンなど、機械の動作 l 役割:状況の解析、アクションの決定 44 -
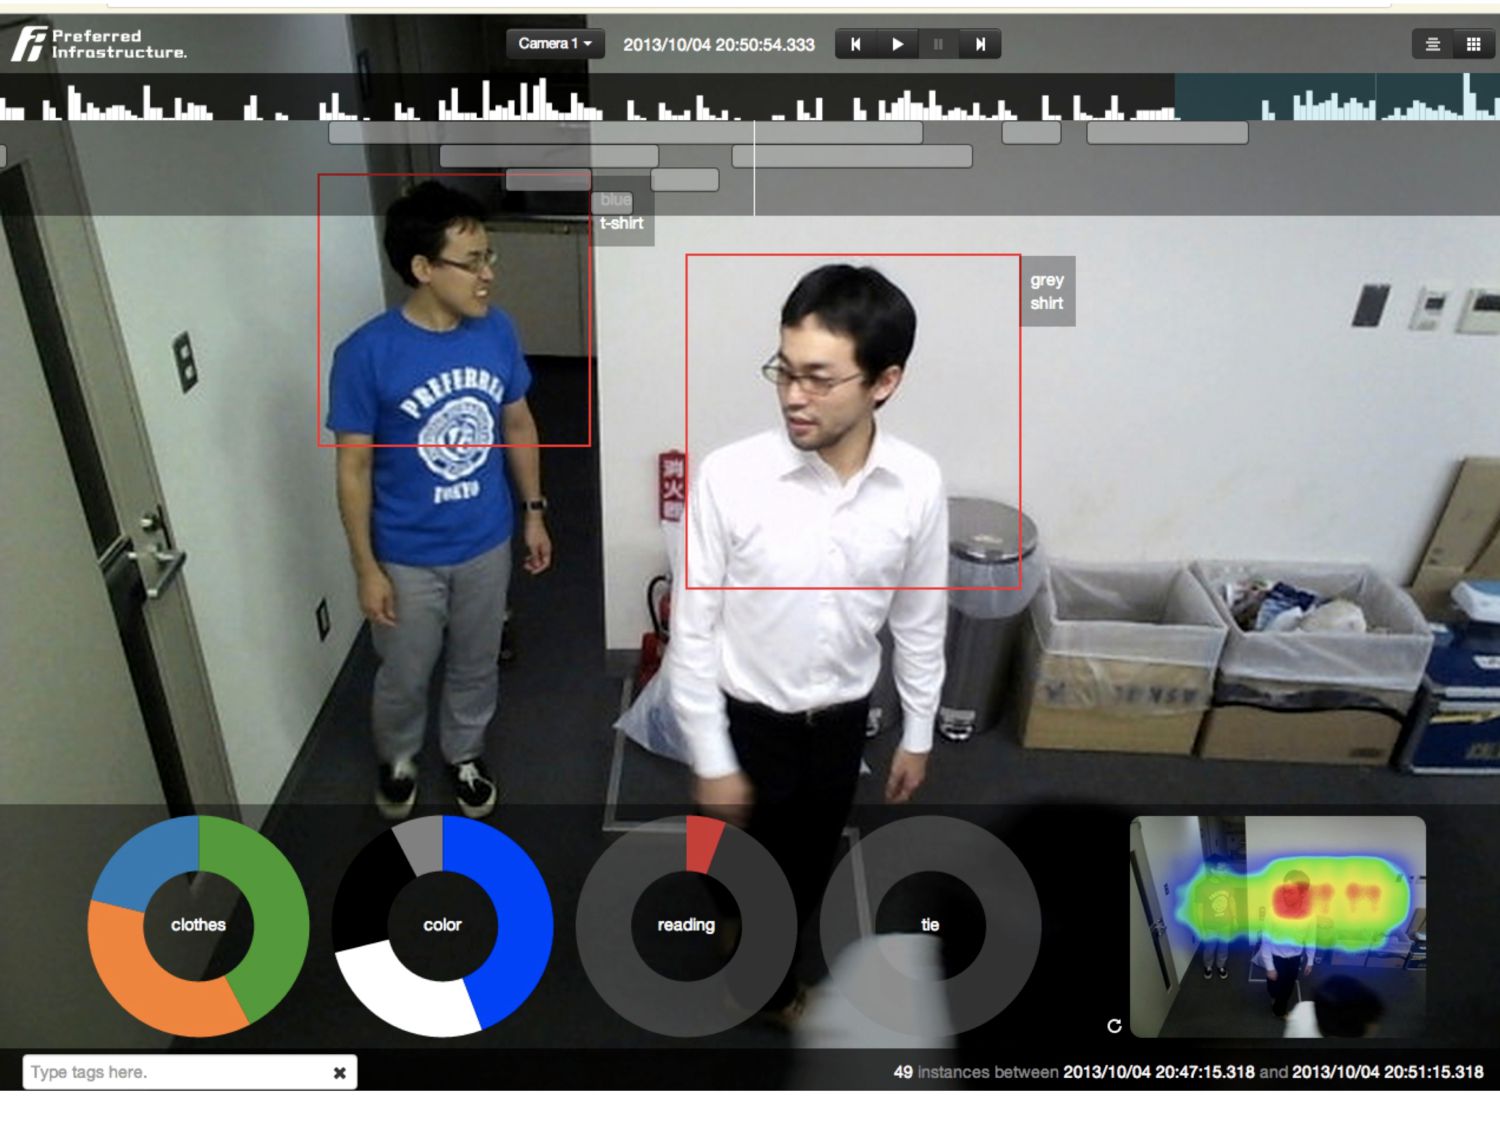
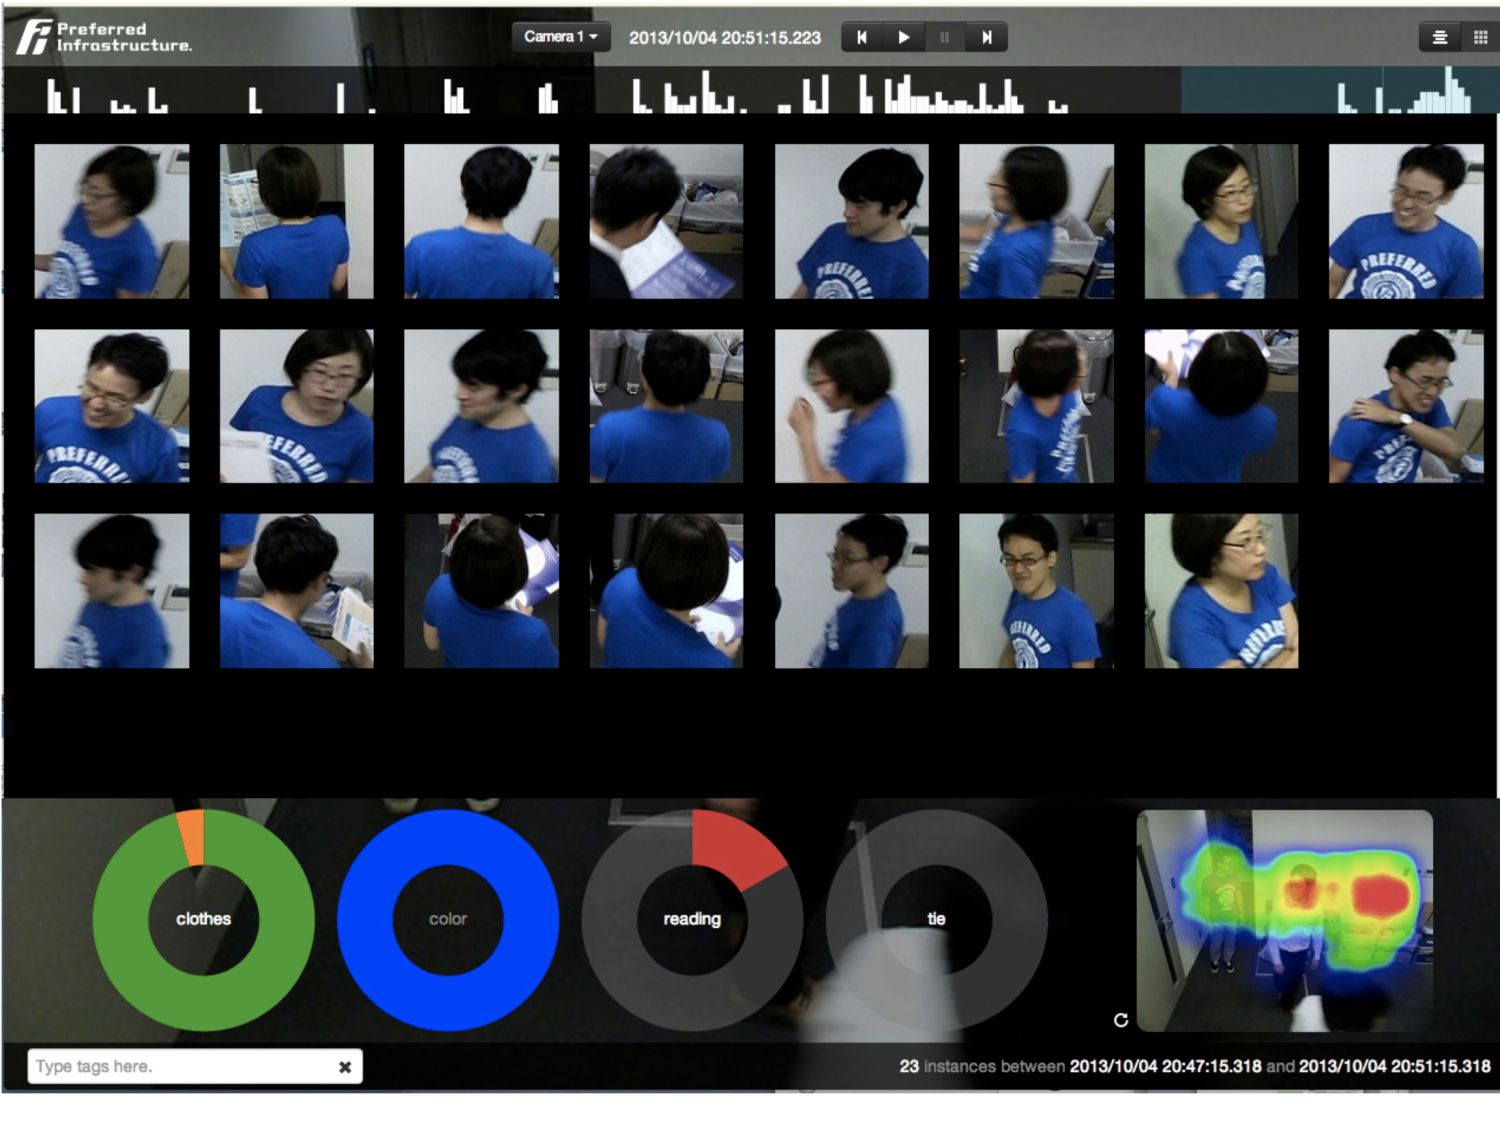
インターフェースとしての⾃自然⾔言語 l コトバは⼈人間に情報を伝える重要なツール l センサーの⽣生データは⼈人間には読めない l ⾳音声の波形データは、⽂文字におこして初めて理理解できる l 映像情報のままでは検索索もままならない l
ヒトの存在する限り重要性は変わらない l ⼈人間とのインターフェースとして必要性がなくなることはない l 逆にヒトが排除されて⾃自動化されていく領領域では、コトバの重 要度度が下がる可能性もある 48 -
デバイスの変化・まとめ l デバイスの変化に合わせて技術の重要度度は変わる l スマートフォンの出現で花開いた技術は沢⼭山ある l デバイスに合ったプロダクトが必要 l 徐々にモノ同⼠士がやりとりする世界に変化する l
テキストから、⾳音声や映像、センサーの⽣生データ l ⽬目的も、ヒトによる分析から、機械による⾃自動化が⽬目的になる だろう l テキストは⼈人間とのインターフェースとしての重要性は 依然として変わらない 49 -
⾃自然⾔言語処理理は外の技術を輸⼊入しやすい l 機械学習 l 1993: 統計的機械翻訳 [Brown+93] l 1996: 最⼤大エントロピー法
[Berger+96] l 2001: 条件付き確率率率場 [Lafferty+01] l ベイズ統計 l 2003: Latent Dirichlet Allocation [Blei+03] l 2006: Pitman-Yor language model [Teh06] l 最適化 l 2006: 整数線形計画法 [Clarke+06][Riedel+06] l 2010: 双対分解 [Koo+10][Rush+10] l 深層学習 l 2003: Neural language model [Bengio+03] l 2010: Recurrent Neural Network [Mikolov+10] l 2012: Skipgram Model (word2vec) [Mikolov+13] 52 -
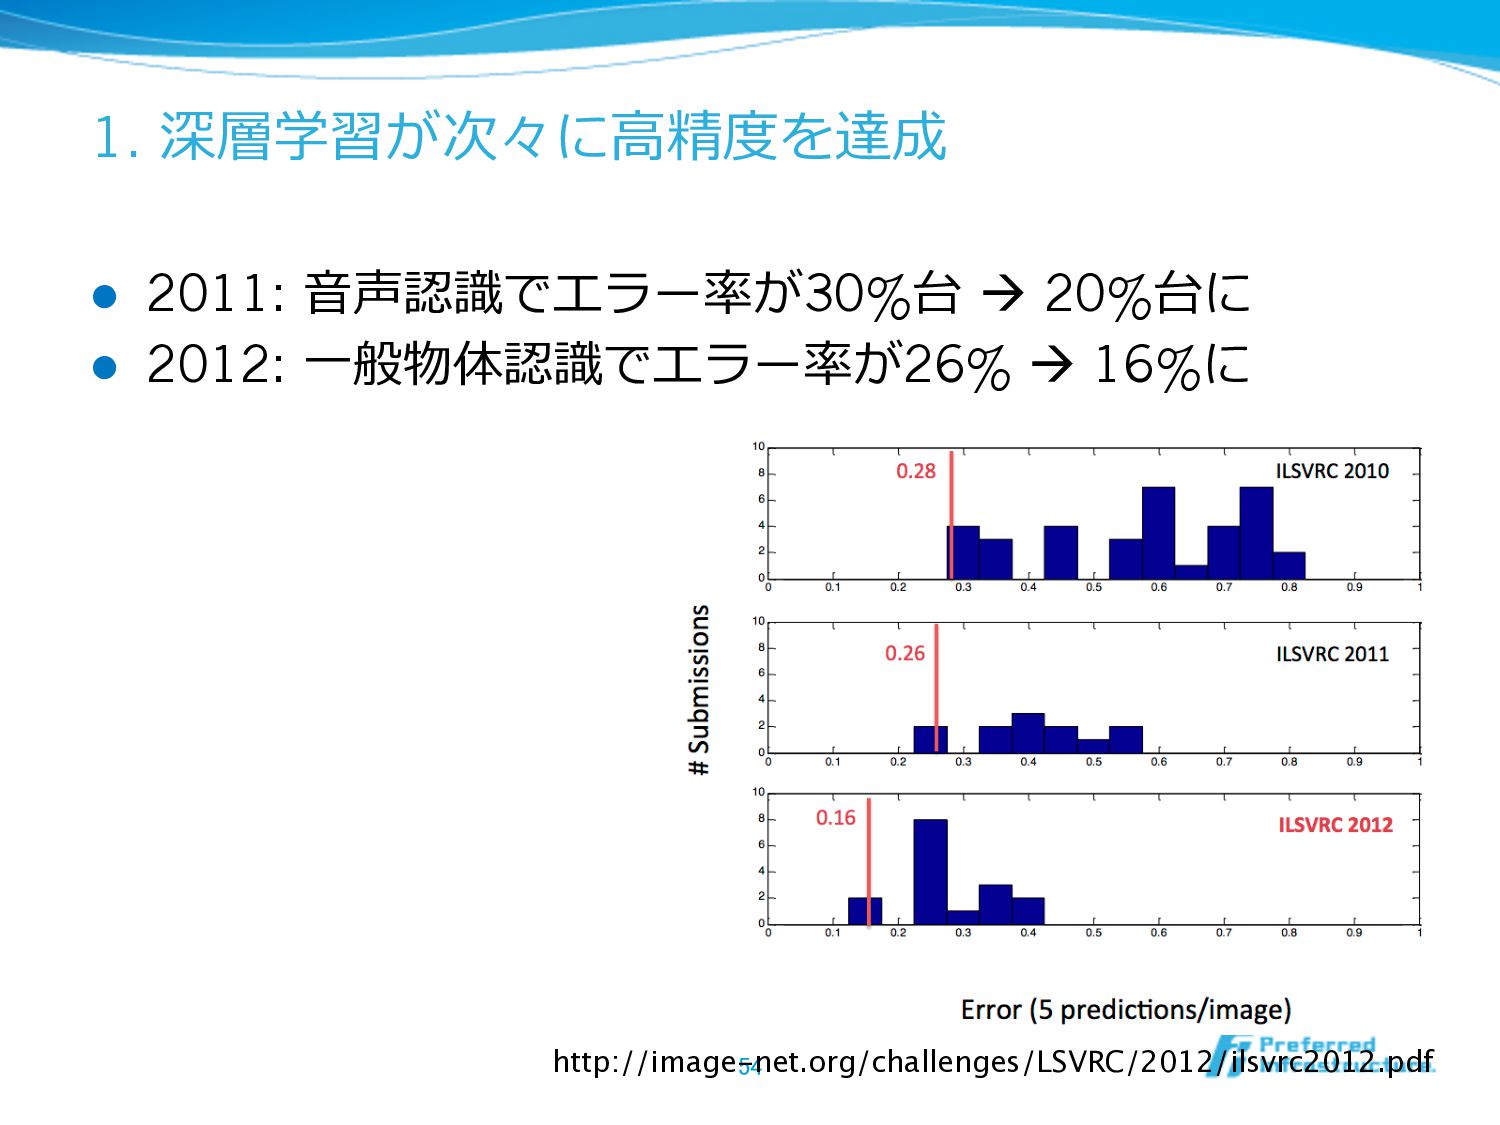
1. 深層学習が次々に⾼高精度度を達成 l 2011: ⾳音声認識識でエラー率率率が30%台 à 20%台に l 2012: ⼀一般物体認識識でエラー率率率が26%
à 16%に 54 http://image-net.org/challenges/LSVRC/2012/ilsvrc2012.pdf -
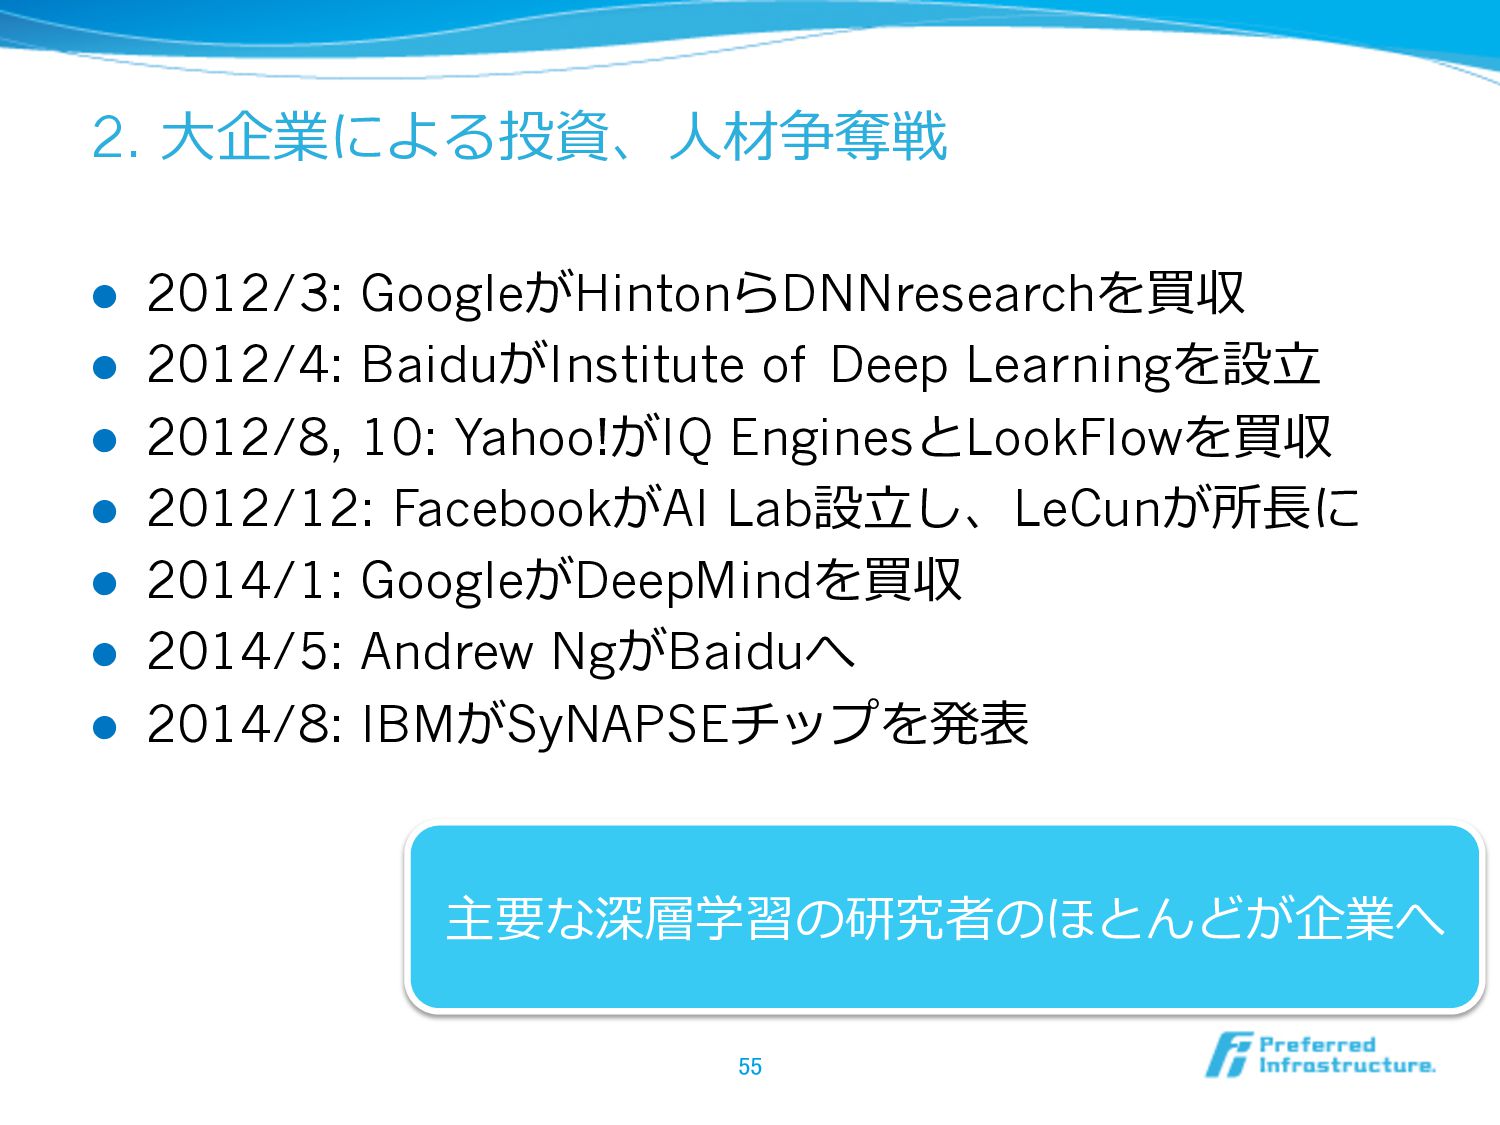
2. ⼤大企業による投資、⼈人材争奪戦 l 2012/3: GoogleがHintonらDNNresearchを買収 l 2012/4: BaiduがInstitute of Deep
Learningを設⽴立立 l 2012/8, 10: Yahoo!がIQ EnginesとLookFlowを買収 l 2012/12: FacebookがAI Lab設⽴立立し、LeCunが所⻑⾧長に l 2014/1: GoogleがDeepMindを買収 l 2014/5: Andrew NgがBaiduへ l 2014/8: IBMがSyNAPSEチップを発表 55 主要な深層学習の研究者のほとんどが企業へ -
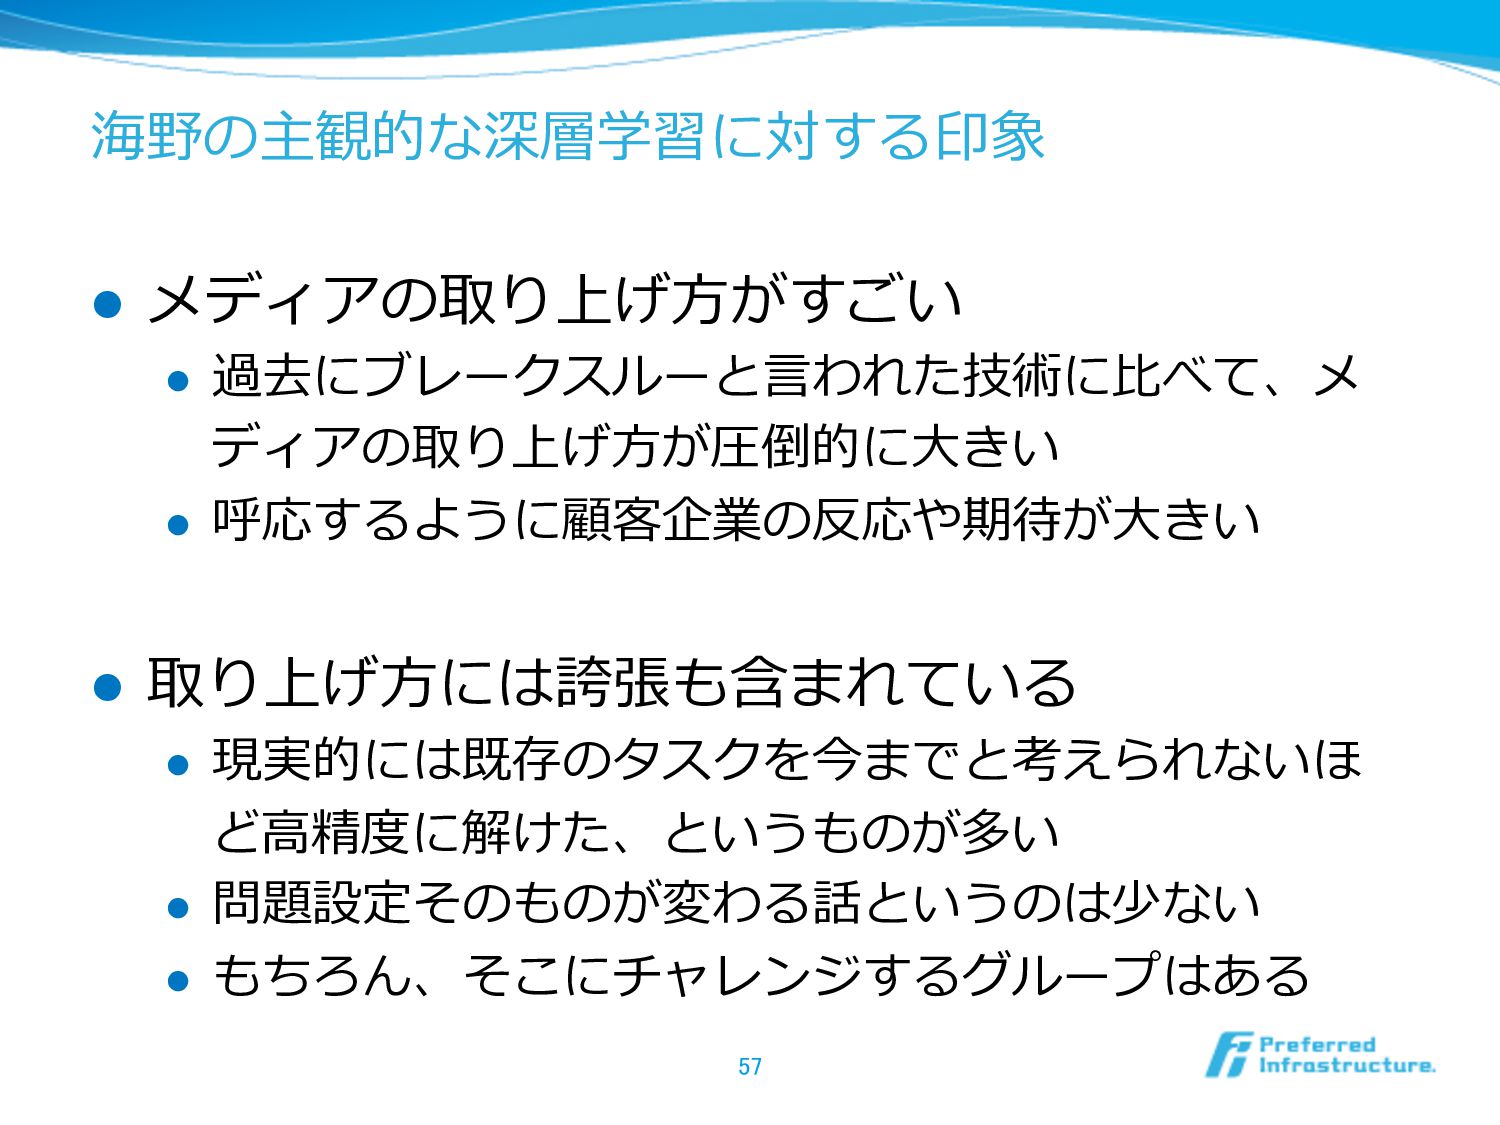
海野の主観的な深層学習に対する印象 l メディアの取り上げ⽅方がすごい l 過去にブレークスルーと⾔言われた技術に⽐比べて、メ ディアの取り上げ⽅方が圧倒的に⼤大きい l 呼応するように顧客企業の反応や期待が⼤大きい l 取り上げ⽅方には誇張も含まれている
l 現実的には既存のタスクを今までと考えられないほ ど⾼高精度度に解けた、というものが多い l 問題設定そのものが変わる話というのは少ない l もちろん、そこにチャレンジするグループはある 57 -
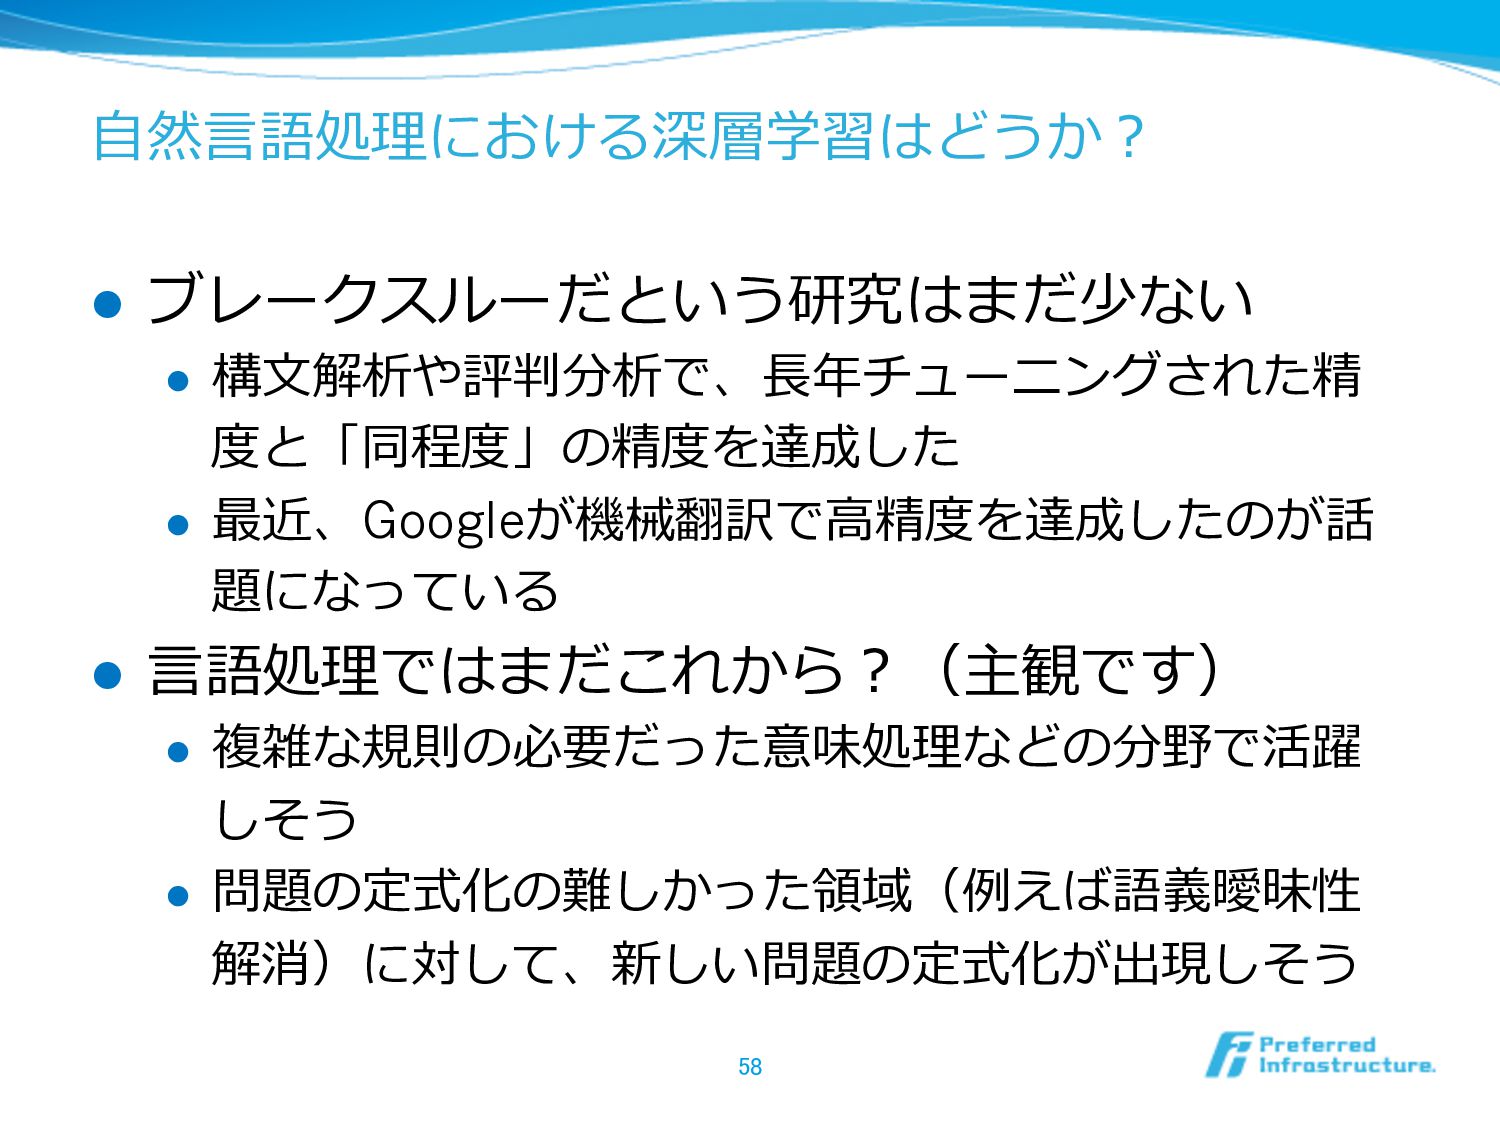
⾃自然⾔言語処理理における深層学習はどうか? l ブレークスルーだという研究はまだ少ない l 構⽂文解析や評判分析で、⻑⾧長年年チューニングされた精 度度と「同程度度」の精度度を達成した l 最近、Googleが機械翻訳で⾼高精度度を達成したのが話 題になっている l
⾔言語処理理ではまだこれから?(主観です) l 複雑な規則の必要だった意味処理理などの分野で活躍 しそう l 問題の定式化の難しかった領領域(例例えば語義曖昧性 解消)に対して、新しい問題の定式化が出現しそう 58 -
Neural Network Language Model (NNLM) [Bengio +03] l Nグラム⾔言語モデルを NN化
l 連続N-1⽂文字から、次 の⽂文字を当てる確率率率モ デルのニューラルネッ トを構築する 59 -
Recurrent Neural Network Language Model (RNNLM) [Mikolov+10] l t-1⽂文字読んだときの「状態」 をベクトル化して、t⽂文字⽬目を
その「状態」から当てる l NNLMでは直前N⽂文字のベクトル から次を当てていた l 直前までの⽂文脈情報が埋め込 まれている雰囲気 l http://rnnlm.org 60 ⽂文字、単語 時刻 t-‐‑‒1 の隠れ層 隠れ層 次の⼊入⼒力力 の予測 コピー -
Skip-gramモデル (word2vec) [Mikolov+13] l 周辺単語を予測するモデル l 周辺単語から予測するモデル (CBOW)も提案している l Analogical
reasoningの精度度が 劇的に向上 l 実装(word2vec)が公開され て⼀一気に話題に 61 -
意味の合成を⾏行行列列で表現する (MV-RNN) [Socher +12] l 各単語にはベクトルと⾏行行列列が対応する l 修飾されると、お互いの⾏行行列列を相⼿手のベクトルに掛けて、 さらに⾮非線形な変換 f
を段階的に⾏行行う l Rootまで繰り返すと⽂文の表現ベクトルが得られる 62 -
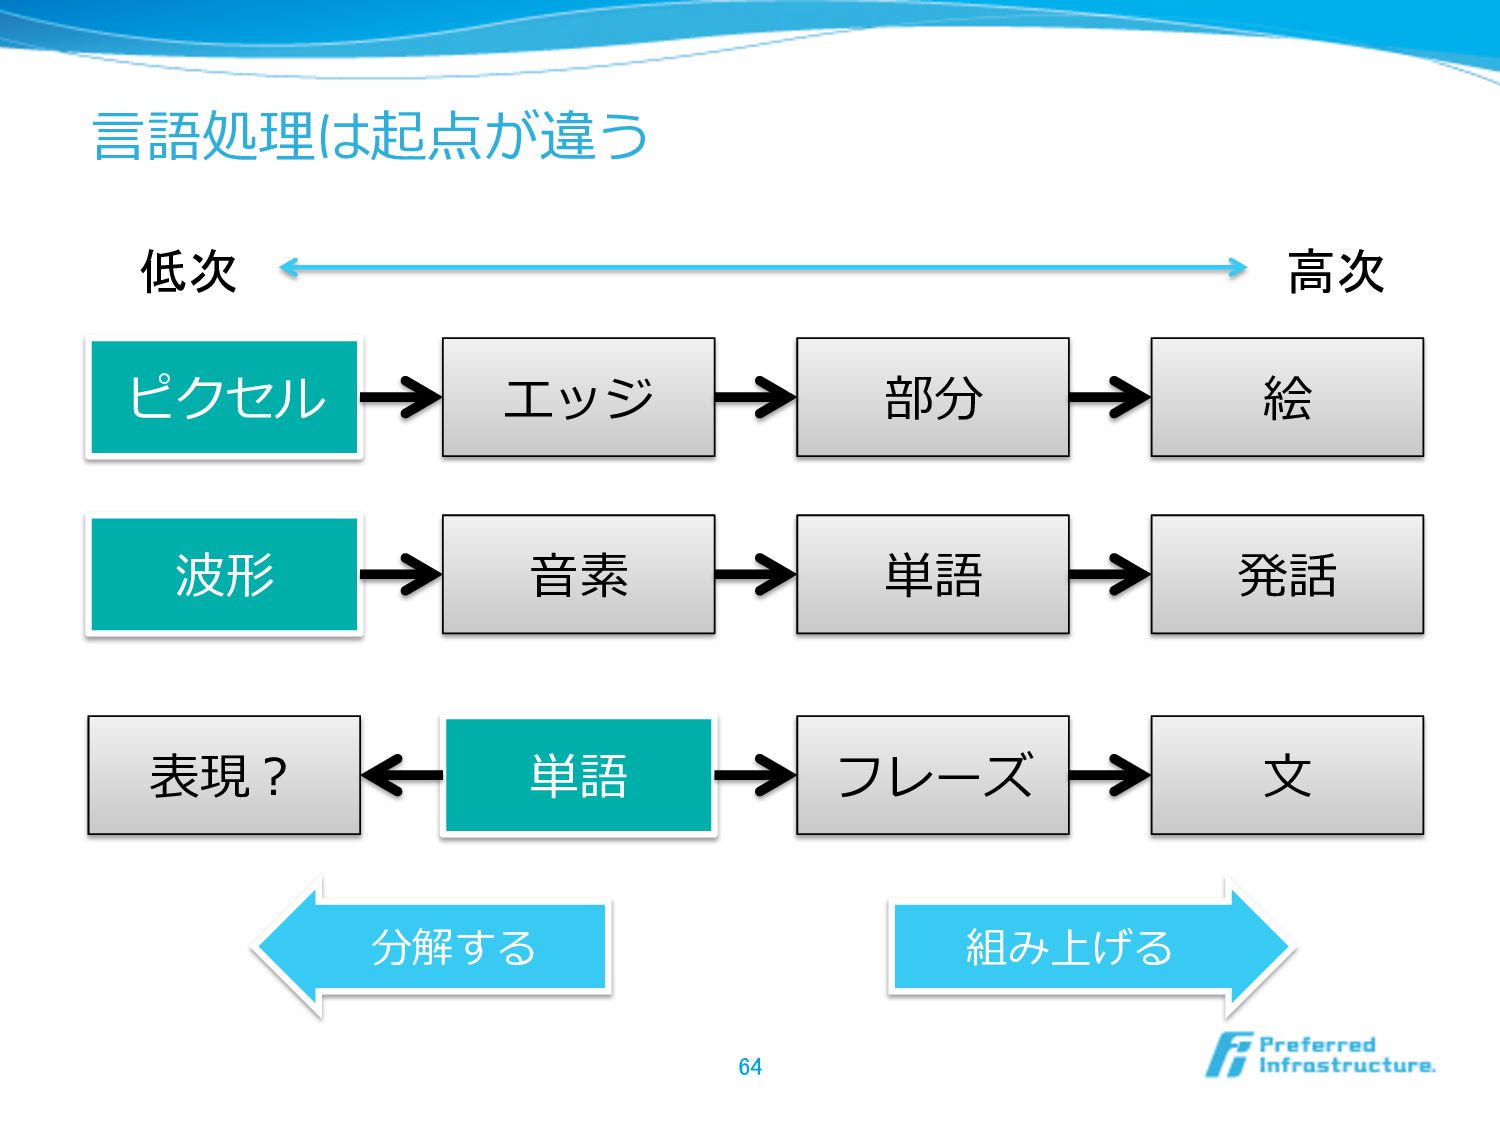
⾔言語処理理は起点が違う 64 低次 高次 ピクセル エッジ 部分 絵 波形 ⾳音素
単語 発話 組み上げる 分解する 表現? 単語 フレーズ ⽂文 -
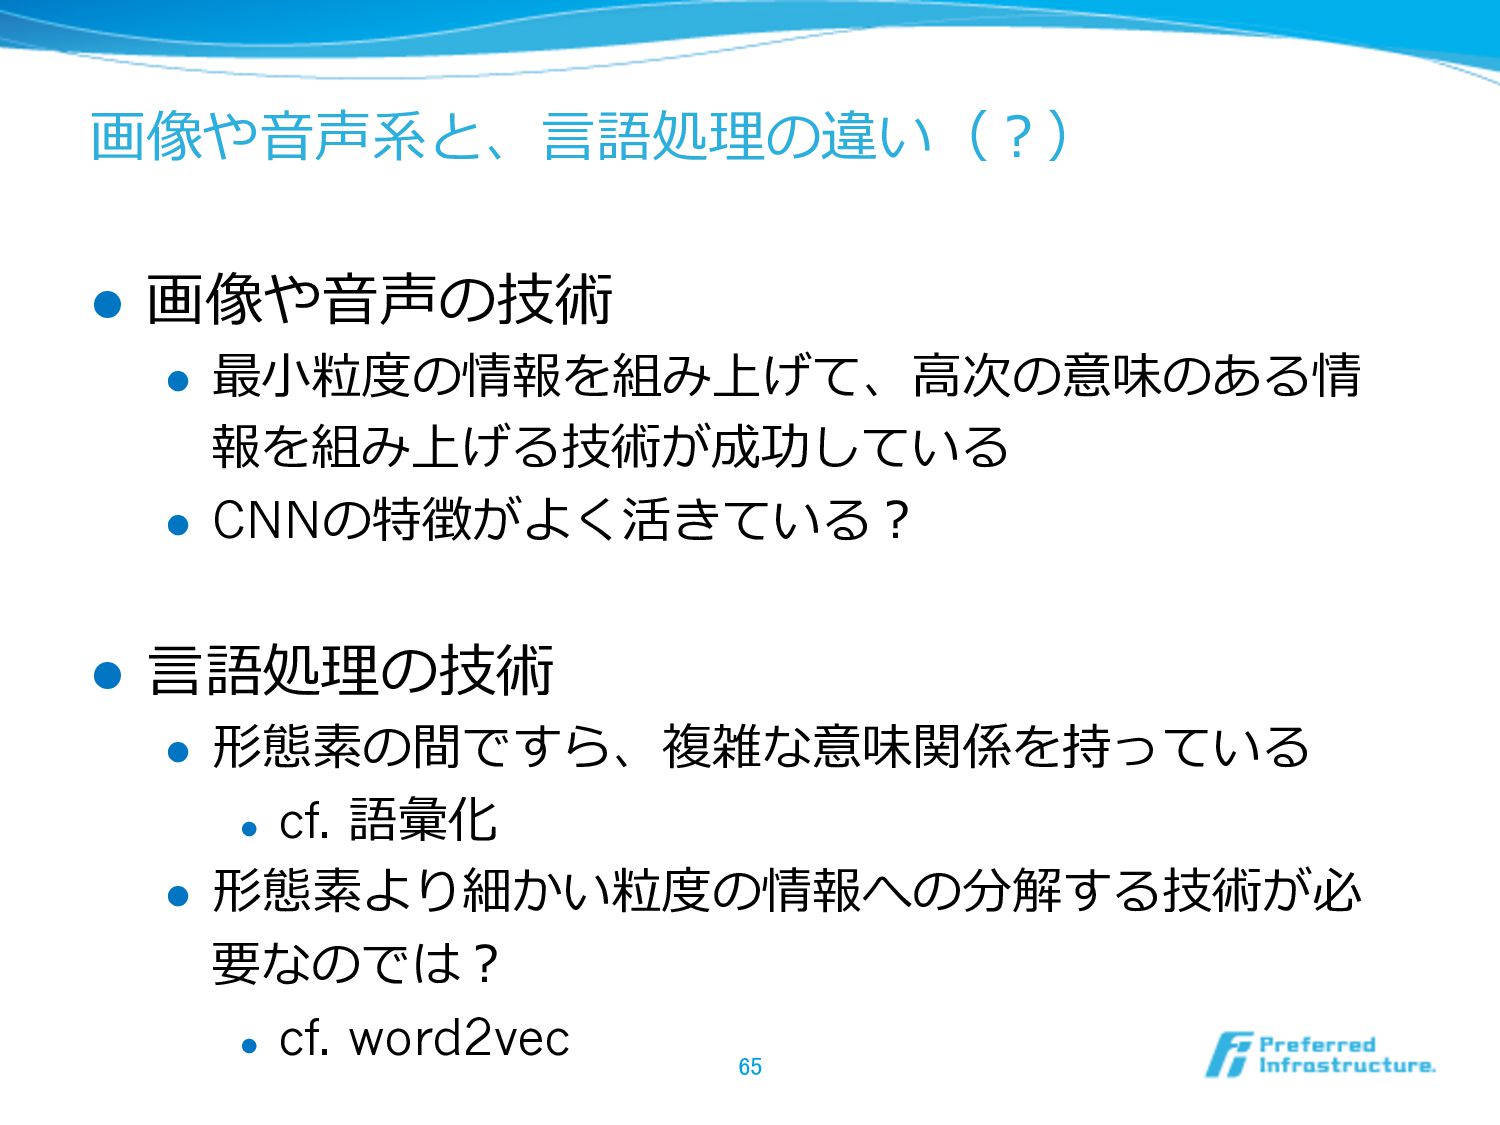
画像や⾳音声系と、⾔言語処理理の違い(?) l 画像や⾳音声の技術 l 最⼩小粒粒度度の情報を組み上げて、⾼高次の意味のある情 報を組み上げる技術が成功している l CNNの特徴がよく活きている? l ⾔言語処理理の技術
l 形態素の間ですら、複雑な意味関係を持っている l cf. 語彙化 l 形態素より細かい粒粒度度の情報への分解する技術が必 要なのでは? l cf. word2vec 65 -
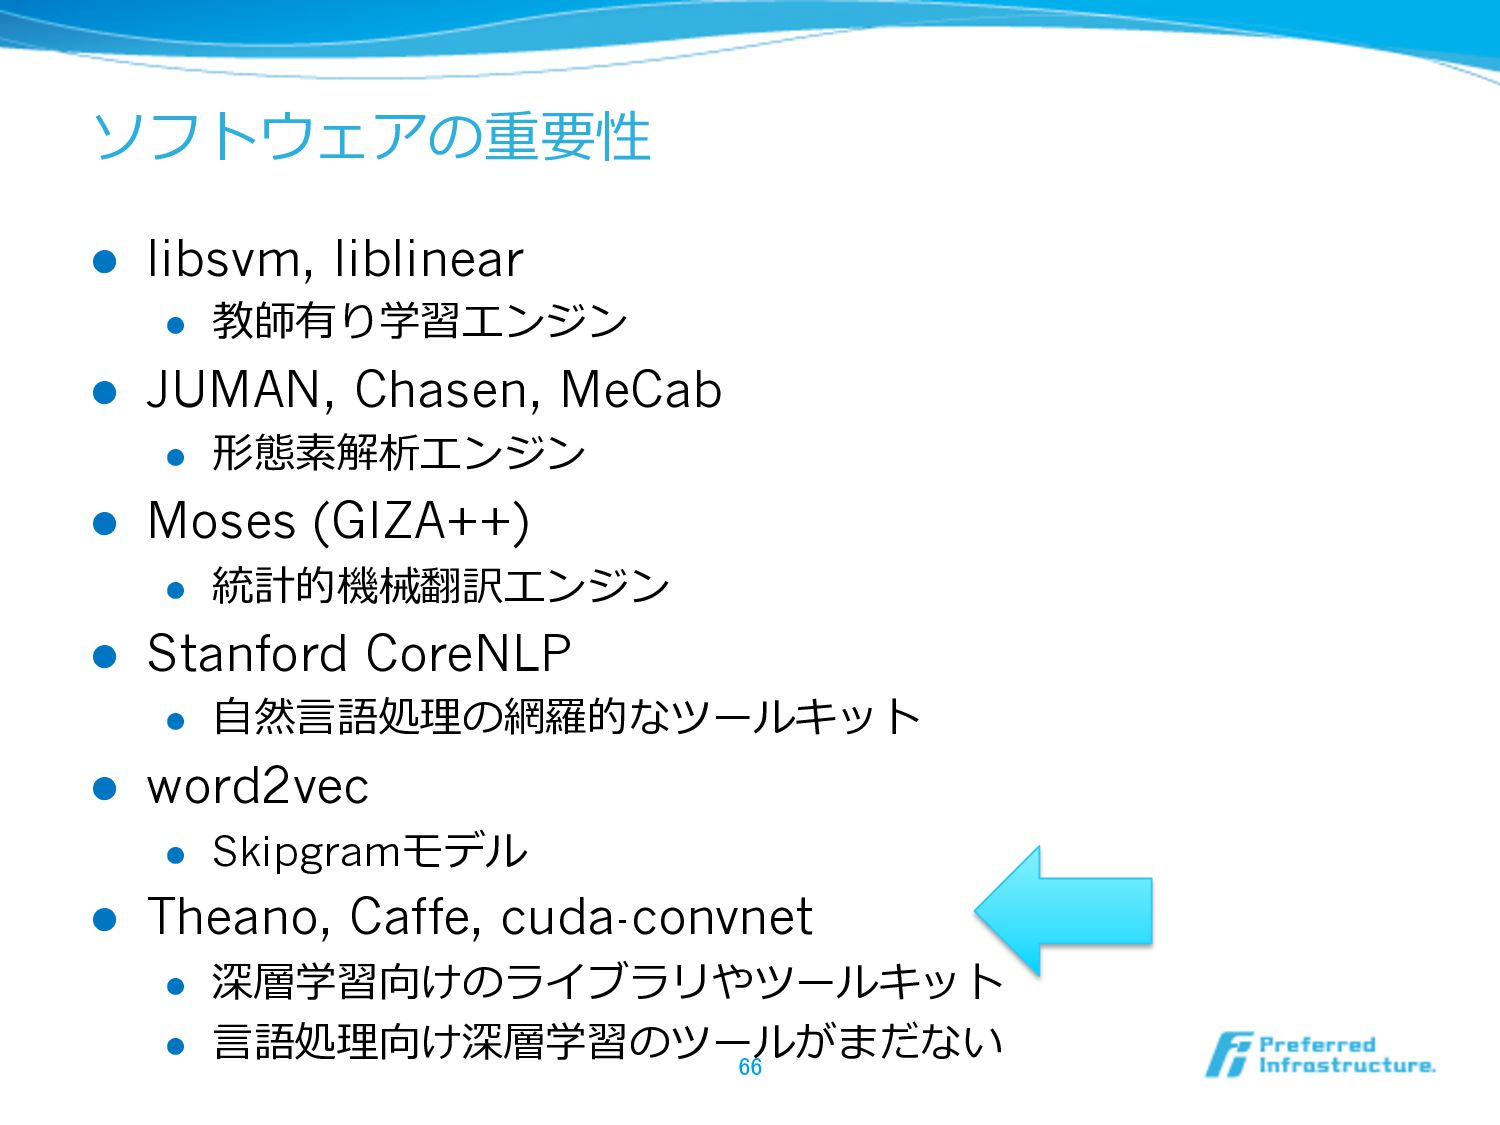
ソフトウェアの重要性 l libsvm, liblinear l 教師有り学習エンジン l JUMAN, Chasen, MeCab
l 形態素解析エンジン l Moses (GIZA++) l 統計的機械翻訳エンジン l Stanford CoreNLP l ⾃自然⾔言語処理理の網羅羅的なツールキット l word2vec l Skipgramモデル l Theano, Caffe, cuda-convnet l 深層学習向けのライブラリやツールキット l ⾔言語処理理向け深層学習のツールがまだない 66 -
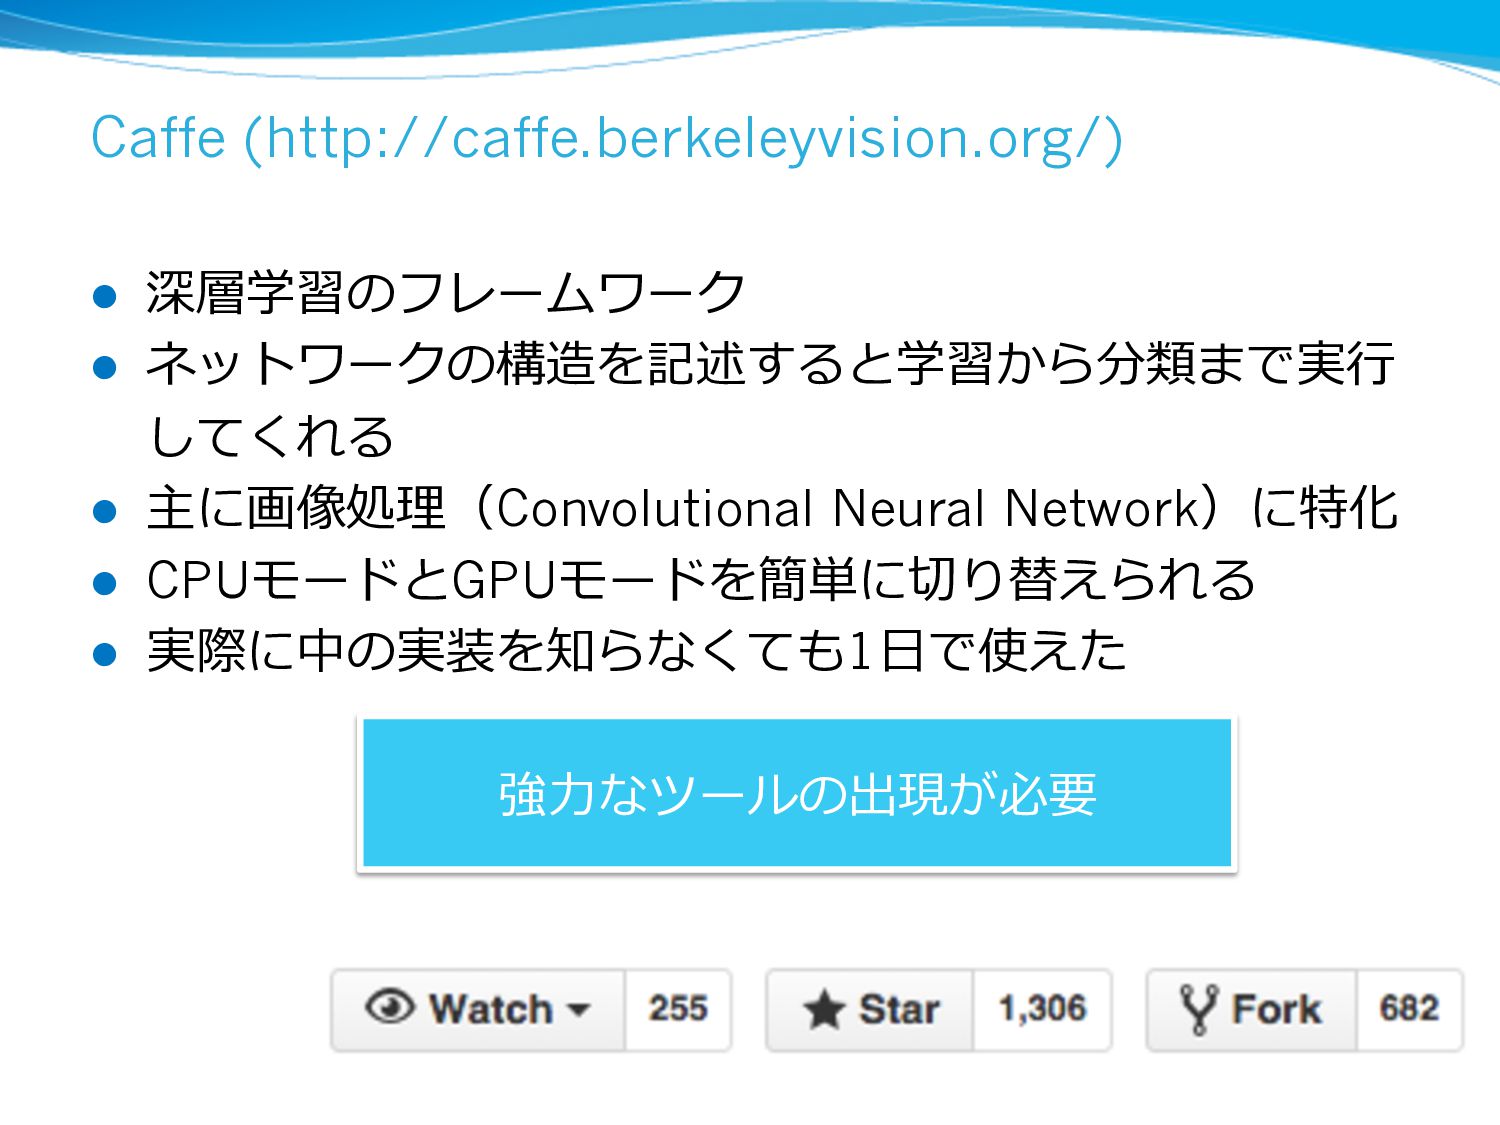
Caffe (http://caffe.berkeleyvision.org/) l 深層学習のフレームワーク l ネットワークの構造を記述すると学習から分類まで実⾏行行 してくれる l 主に画像処理理(Convolutional Neural
Network)に特化 l CPUモードとGPUモードを簡単に切切り替えられる l 実際に中の実装を知らなくても1⽇日で使えた 67 強⼒力力なツールの出現が必要 -
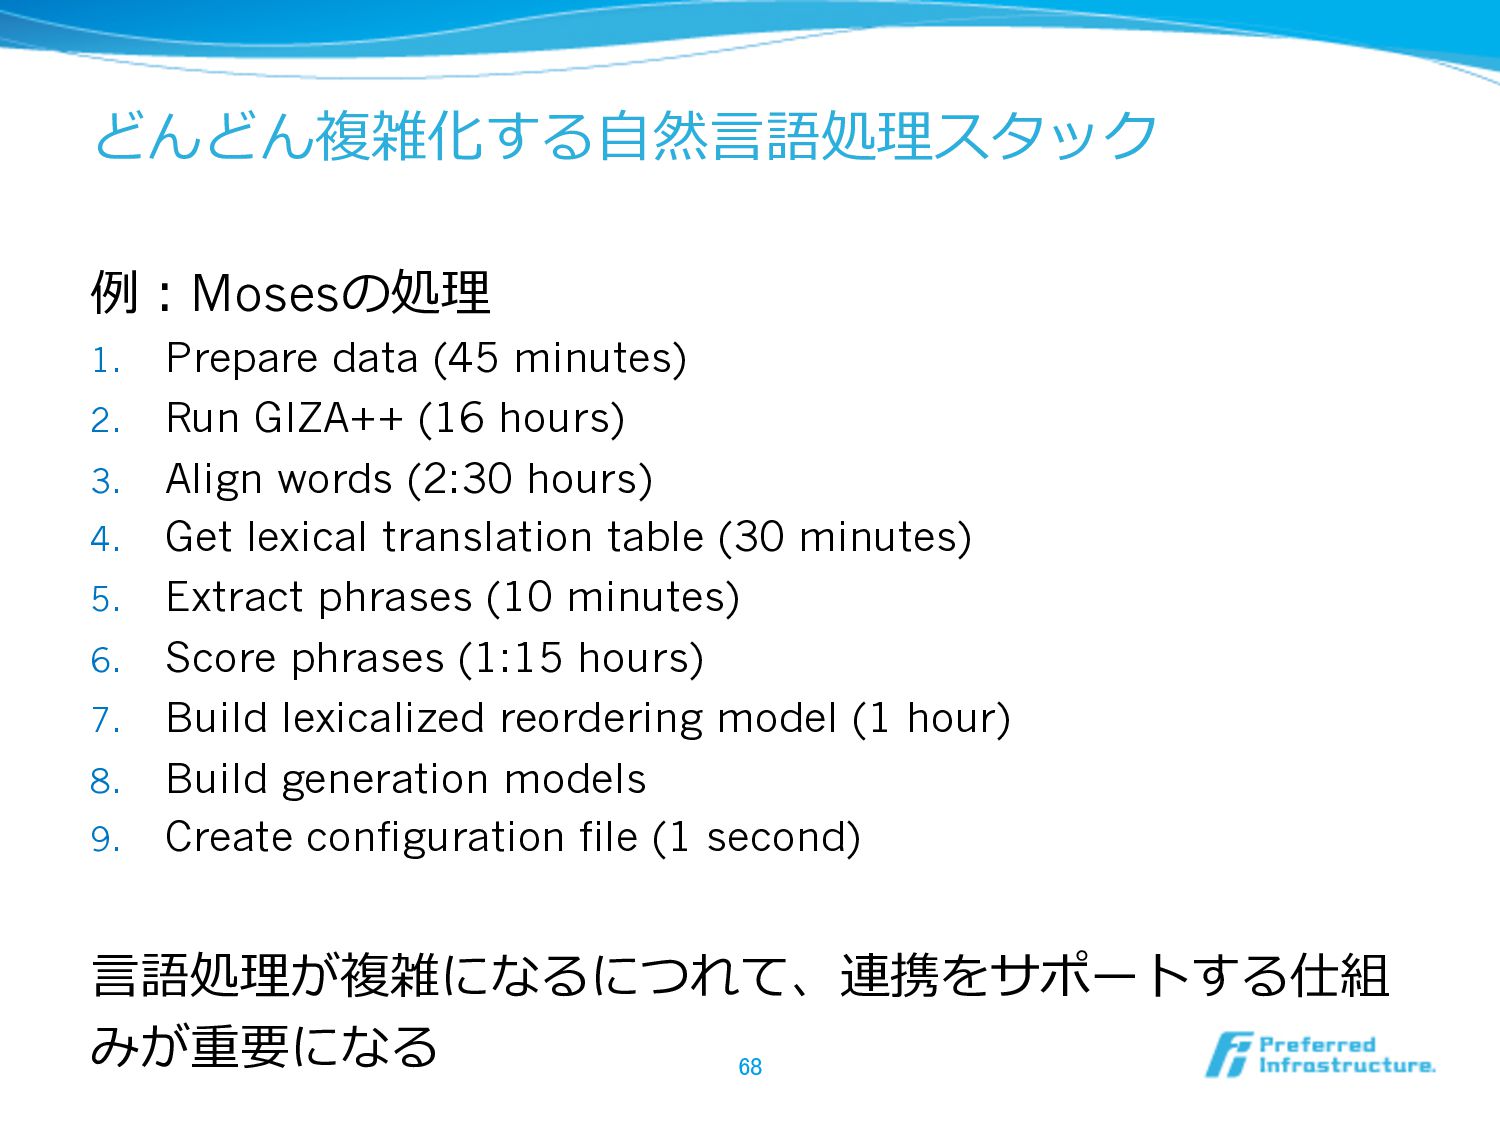
どんどん複雑化する⾃自然⾔言語処理理スタック 例例:Mosesの処理理 1. Prepare data (45 minutes) 2. Run GIZA++
(16 hours) 3. Align words (2:30 hours) 4. Get lexical translation table (30 minutes) 5. Extract phrases (10 minutes) 6. Score phrases (1:15 hours) 7. Build lexicalized reordering model (1 hour) 8. Build generation models 9. Create configuration file (1 second) ⾔言語処理理が複雑になるにつれて、連携をサポートする仕組 みが重要になる 68 -
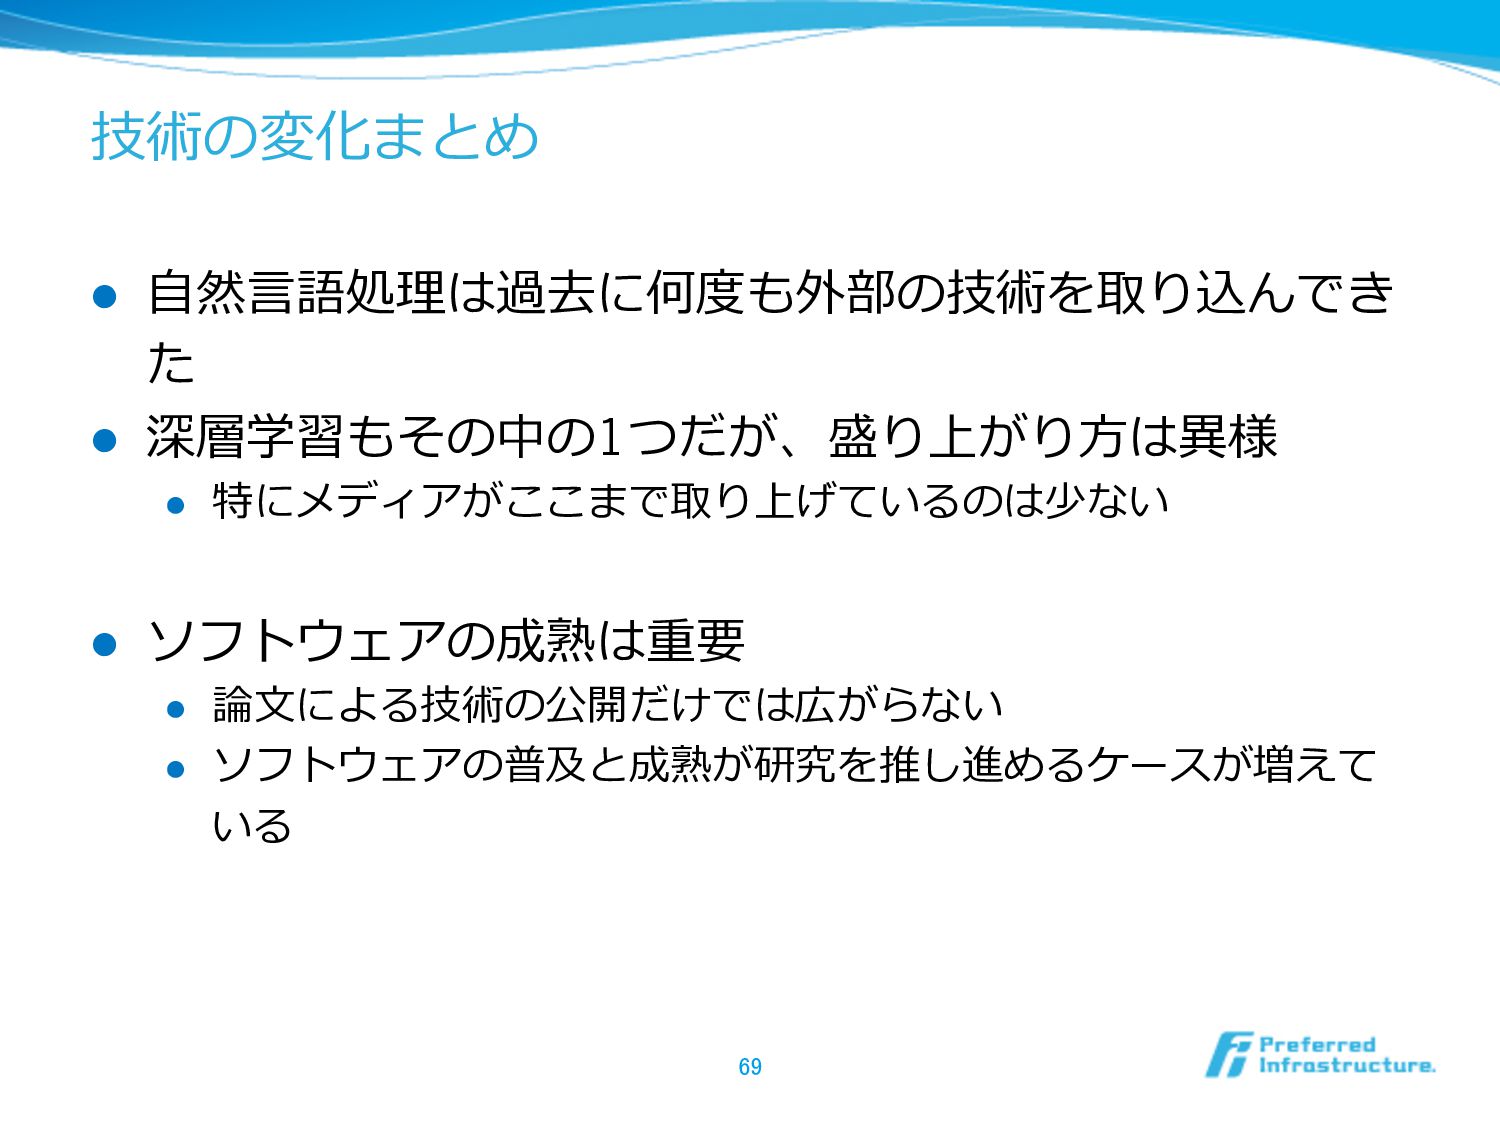
技術の変化まとめ l ⾃自然⾔言語処理理は過去に何度度も外部の技術を取り込んでき た l 深層学習もその中の1つだが、盛り上がり⽅方は異異様 l 特にメディアがここまで取り上げているのは少ない l ソフトウェアの成熟は重要
l 論論⽂文による技術の公開だけでは広がらない l ソフトウェアの普及と成熟が研究を推し進めるケースが増えて いる 69 -
Xappyはタイミングを逃したのか? l 情報源の増⼤大 l ⼤大量量のネットニュース、Blog、記事 l TwitterやFacebookを始めとしたSNSの普及 l いつでも情報を取得できる環境 l
ネットワークの進化:常時接続、4G l デバイスの進化:スマートフォン、タブレット l 情報整理理のための技術 l ⾃自然⾔言語処理理、機械学習、統計、etc. l GUIなどのツール群 73 タイミングと技術がマッチ -
全体のまとめ l データは多様化、⼤大規模化 l 様々な業種で活⽤用されると同時にデータは多様化 l データ量量も⼤大規模化、データのフィルタリングがキー l デバイスの変化に合わせた技術が必要 l
PCからスマホ、ウェアラブルへ、デバイスは変化している l 利利⽤用シーンの変化を意識識すると新しい可能性が⾒見見える l モノ同⼠士が判断する世界に変化しようとしている l 深層学習の本領領が発揮するのはこれから? l ⾔言語処理理に新しい技術が投⼊入されるのはいつもどおり l ここまで注⽬目と期待が集まるんは過去10年年ない l ⾔言語処理理で⼤大きな成果が出るならこれから 74 -
参考⽂文献 (1/4) l [Brown+93] Peter F . Brown, Vincent J.
Della Pietra, Stephen A. Della Pietra, Robert L. Mercer. The mathematics of statistical machine translation: parameter estimation. Computational Linguistics Vol. 19 (2), 1993. l [Berger+96] Adam L. Berger, Vincent J. Della Pietra, Stephen A. Della Pietra. A Maximum Entropy Approach to Natural Language Processing. Computational Linguistics, Vol. 22 (1), 1996. l [Lafferty+01] John Lafferty, Andrew McCallum, Fernando C. N. Pereira. Conditional Random Fields: Probabilistic Models for Segmenting and Labeling Sequence Data. ICML2001. 76 -
参考⽂文献 (2/4) l [Blei+03] David M. Blei, Andrew Y. Ng,
Michael I. Jordan. Latent Dirichlet Allocation. JMLR Vol. 3, 2003. l [Teh06] Yee Whye Teh. A Hierarchical Bayesian Language Model based on Pitman-Yor Processes. ACL 2006. l [Clarke+06] James Clarke, Mirella Lapata. Constraint-Based Sentence Compression: An Integer Programming Approach. COLING/ACL 2006. l [Riedel+06] Sebastian Riedel, James Clarke. Incremental Integer Linear Programming for Non-projective Dependency Parsing. COLING/ACL 2006. 77 -
参考⽂文献 (3/4) l [Koo+10] Terry Koo, Alexander M. Rush, Michael
Collins, Tommi Jaakkola, David Sontag. Dual Decomposition for Parsing with Non-Projective Head Automata. EMNLP 2010. l [Rush+10] Alexander M. Rush, David Sontag, Michael Collins, Tommi Jaakkola. On Dual Decomposition and Linear Programming Relaxations for Natural Language Processing. EMNLP 2010. l [Bengio+03] Yoshua Bengio, Réjean Ducharme, Pascal Vincent, Christian Jauvin. A Neural Probabilistic Language Model. JMLR, 2003. 78 -
参考⽂文献 (4/4) l [Mikolov+10] Tomas Mikolov, Martin Karafiat, Lukas Burget,
Jan "Honza" Cernocky, Sanjeev Khudanpur. Recurrent neural network based language model. Interspeech, 2010. l [Mikolov+13] Tomas Mikolov, Kai Chen, Greg Corrado, Jeffrey Dean. Efficient Estimation of Word Representations in Vector Space. CoRR, 2013. l [Socher+12] Richard Socher, Brody Huval, Christopher D. Manning, Andrew Y. Ng. Semantic Compositionality through Recursive Matrix-Vector Spaces. EMNLP2012. l [Kalchbrenner+14] Nal Kalchbrenner, Edward Grefenstette, Phil Blunsom. A Convolutional Neural Network for Modelling Sentences. ACL2014. 79
 unnonouno
 riyaamemiya
 murachiakira
 inariku
 nobitabashi
 oidfj
 gotok365
 yappli_developers
 sioncojp
 wadayusuke
 ayaka_egaaa
 oracle4engineer
 miu_crescent
 cassininazir
 thirion
 danielanewman
 reverentgeek
 tmiket
 davidcarrasco
 bcantrill
 addyosmani
 palkan
 afnizarnur
 marcelosomers