Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
自分で立ててみるLLMサービス
Search
世良泰明
October 05, 2026
Technology
23
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
自分で立ててみるLLMサービス
2026/10/5 さくらの夕べ 地域コミュニティナイト - 小江戸らぐ & LOCAL編 -
世良泰明
October 05, 2026
More Decks by 世良泰明
See All by 世良泰明
ホームラボ紹介
y_sera15
0
300
Serendie Design Systemを使ってWebアプリケーションを開発してみた
y_sera15
0
170
Kubernetesの公式ドキュメントを翻訳してみた
y_sera15
0
82
ラズパイ奮闘記 その1
y_sera15
0
82
metrics-serverをセキュアなTLSでデプロイしてみた
y_sera15
0
720
EKS勉強会
y_sera15
1
190
自宅k8s構築日記 冬休み編
y_sera15
0
330
自宅k8sクラスター構築日記
y_sera15
0
280
EKSを動かしてみた話
y_sera15
0
130
Other Decks in Technology
See All in Technology
ファミコンでPHPを動かす / PHP on the Famicom side b
tomzoh
0
110
AIは爆速なのに、私が詰まっていた話 ― 音声入力と鳴くマスコットでボトルネックを削る
yama3133
0
470
[2026 Oracle Technical Deep Dive] オンプレミスDBのCloud移行アプローチ:移行計画に基づくメソッドとツールの選択 (2026年9月17日開催)
oracle4engineer
PRO
0
110
メルカリにおけるAI時代の高速プロトタイピング基盤「Arca」
ryotarai
18
14k
[2026 Oracle Technical Deep Dive] エンタープライズAIエージェントを支えるOCIソリューション。ラインナップと特徴を理解しよう! (2026年9月17日開催)
oracle4engineer
PRO
0
310
覗いてみよう 関数型ビジュアル言語×2Dグラフィックスの世界
yohyamasaki
0
170
全社共通データ基盤をつくる。ソニーのDatabricks活用とデータガバナンス設計の裏側
sony
0
300
KanaAI
shreyas1009
0
140
AI駆動開発、viviONの1年 ── うまくいったこと・いかなかったこと
vivion
0
140
1万名の社員が使う認証基盤で どう信頼性を担保するか?
kairim0
0
180
【データ横丁主催】AI Agentがコンテキストを使って仕事をした後、何が残るのか― 組織の経験を次の判断に引き継ぐ「Agent Memory」
shisyu_gaku
2
320
自律型 AI をセキュアに実装!Gemini と MIG で作る動的コード実行環境
recruitengineers
PRO
1
130
Featured
See All Featured
Redefining SEO in the New Era of Traffic Generation
szymonslowik
1
460
Digital Projects Gone Horribly Wrong (And the UX Pros Who Still Save the Day) - Dean Schuster
uxyall
1
3.2k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
520
Balancing Empowerment & Direction
lara
6
1.3k
Reflections from 52 weeks, 52 projects
jeffersonlam
356
21k
Heart Work Chapter 1 - Part 1
lfama
PRO
10
36k
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
1
2k
Speed Design
sergeychernyshev
33
2.1k
Optimizing for Happiness
mojombo
378
71k
Neural Spatial Audio Processing for Sound Field Analysis and Control
skoyamalab
0
540
GraphQLの誤解/rethinking-graphql
sonatard
75
12k
Building Adaptive Systems
keathley
44
3.2k
Transcript
自分で触って立ててみるLLMサービス 2026/10/5 さくらの夕べ 地域コミュニティナイト - 小江戸らぐ&LOCAL編 世良泰明
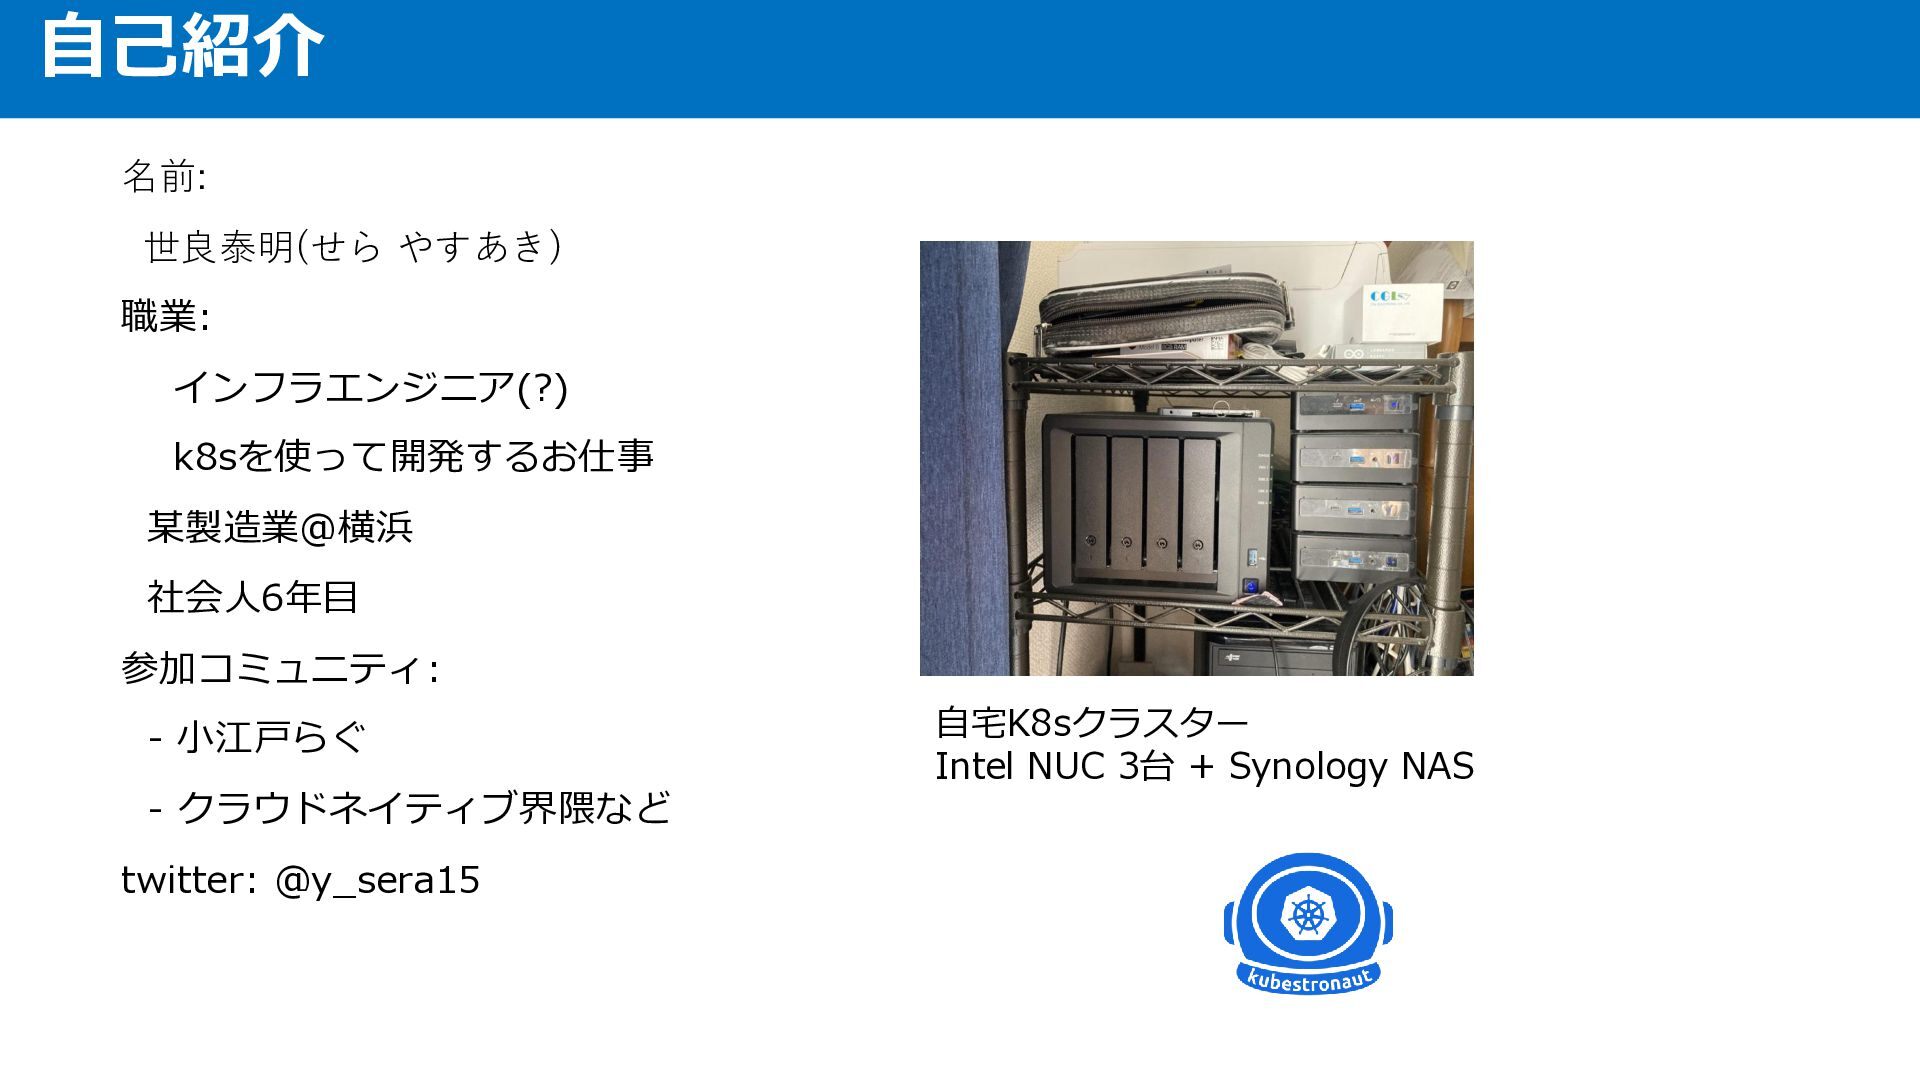
自己紹介 名前: 世良泰明(せら やすあき) 職業: インフラエンジニア(?) k8sを使って開発するお仕事 某製造業@横浜 社会人6年目 参加コミュニティ:
- 小江戸らぐ - クラウドネイティブ界隈など twitter: @y_sera15 自宅K8sクラスター Intel NUC 3台 + Synology NAS
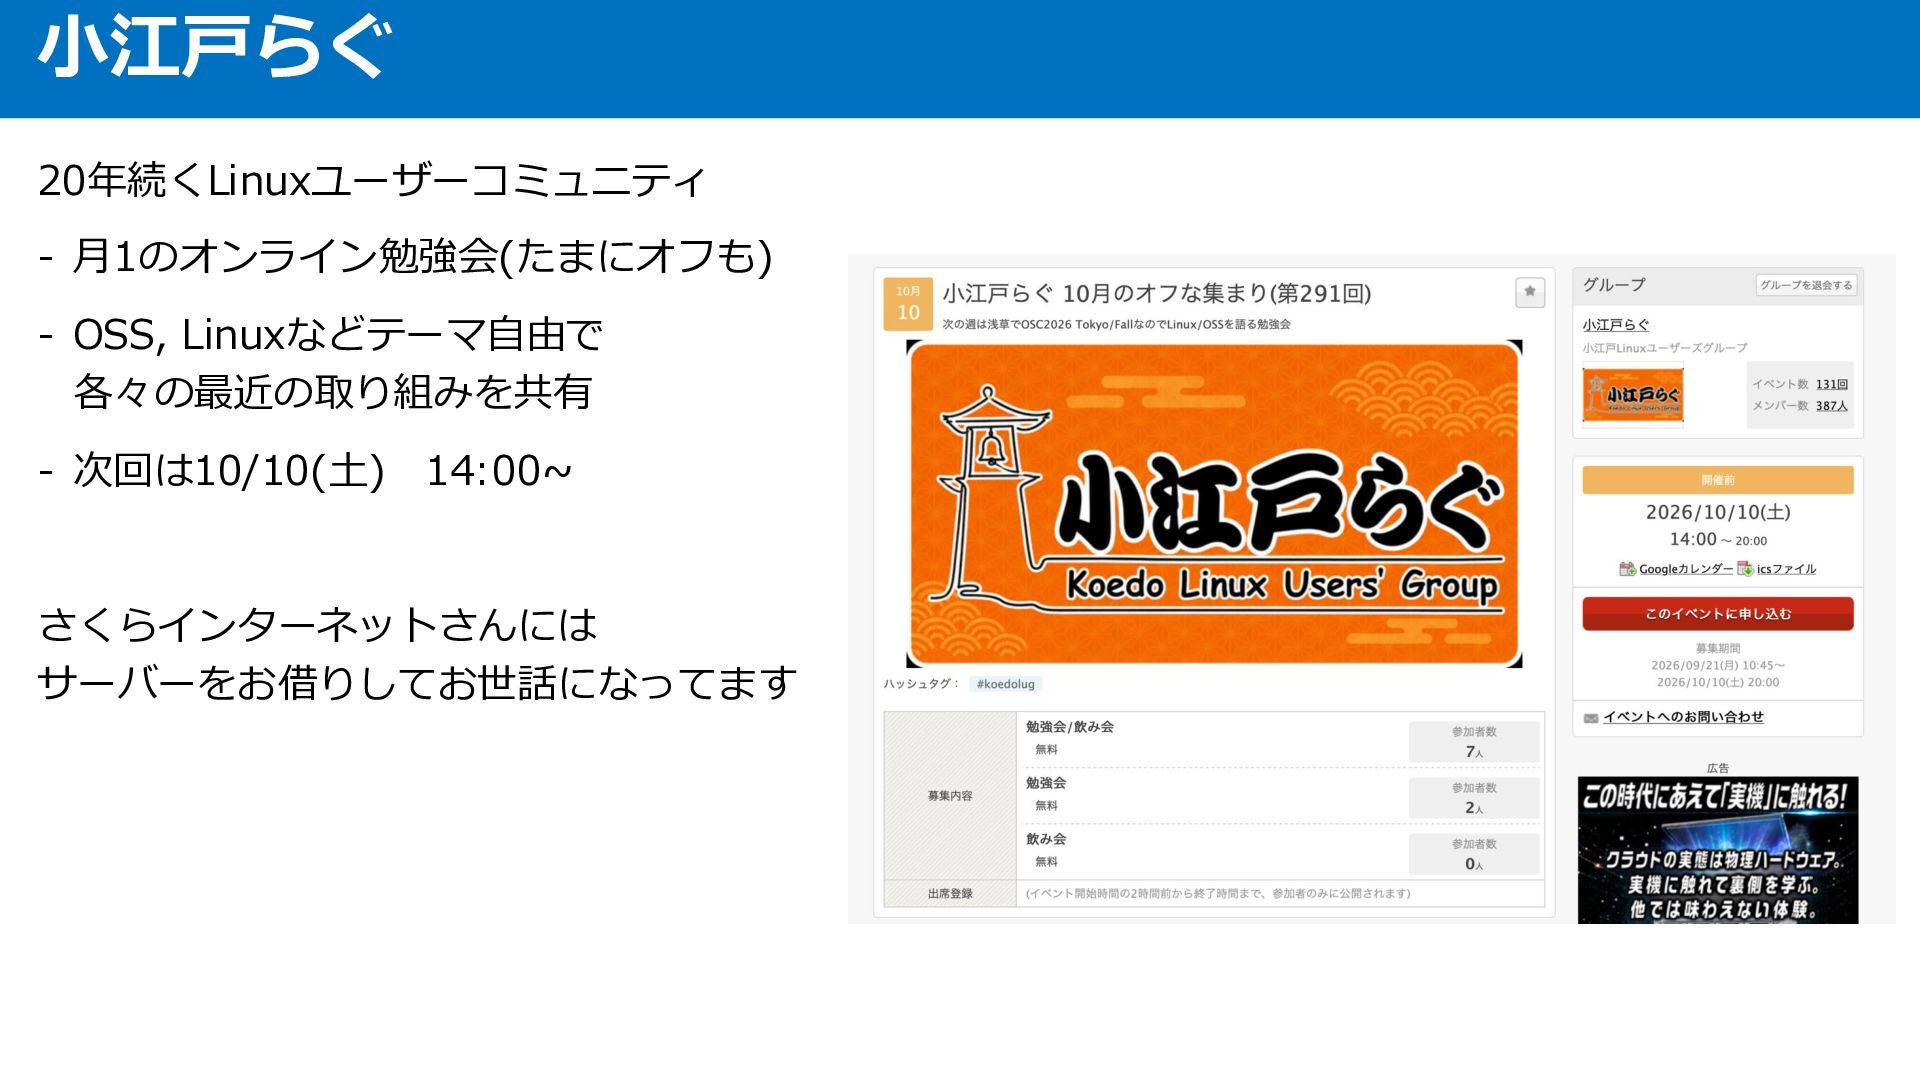
小江戸らぐ 20年続くLinuxユーザーコミュニティ - 月1のオンライン勉強会(たまにオフも) - OSS, Linuxなどテーマ自由で 各々の最近の取り組みを共有 - 次回は10/10(土)
14:00~ さくらインターネットさんには サーバーをお借りしてお世話になってます
今日のお話 • LLMを自分で動かしてみるお話 • AIサービスについて • 構成要素 • 高火力DOKを使ったAIコーディングの仕組み構築
質問 みなさん、AI使ってますか? - Chat GPT - Google Gemini - Github
Copilot - Claude Code - jev - dots などなど...
質問 みなさん、AI使ってますか? - Chat GPT - Google Gemini - Github
Copilot - Claude Code - jev - dots などなど... これらはあくまで「サービス」なので、エンジニアなら中の仕組みは知っておきたい
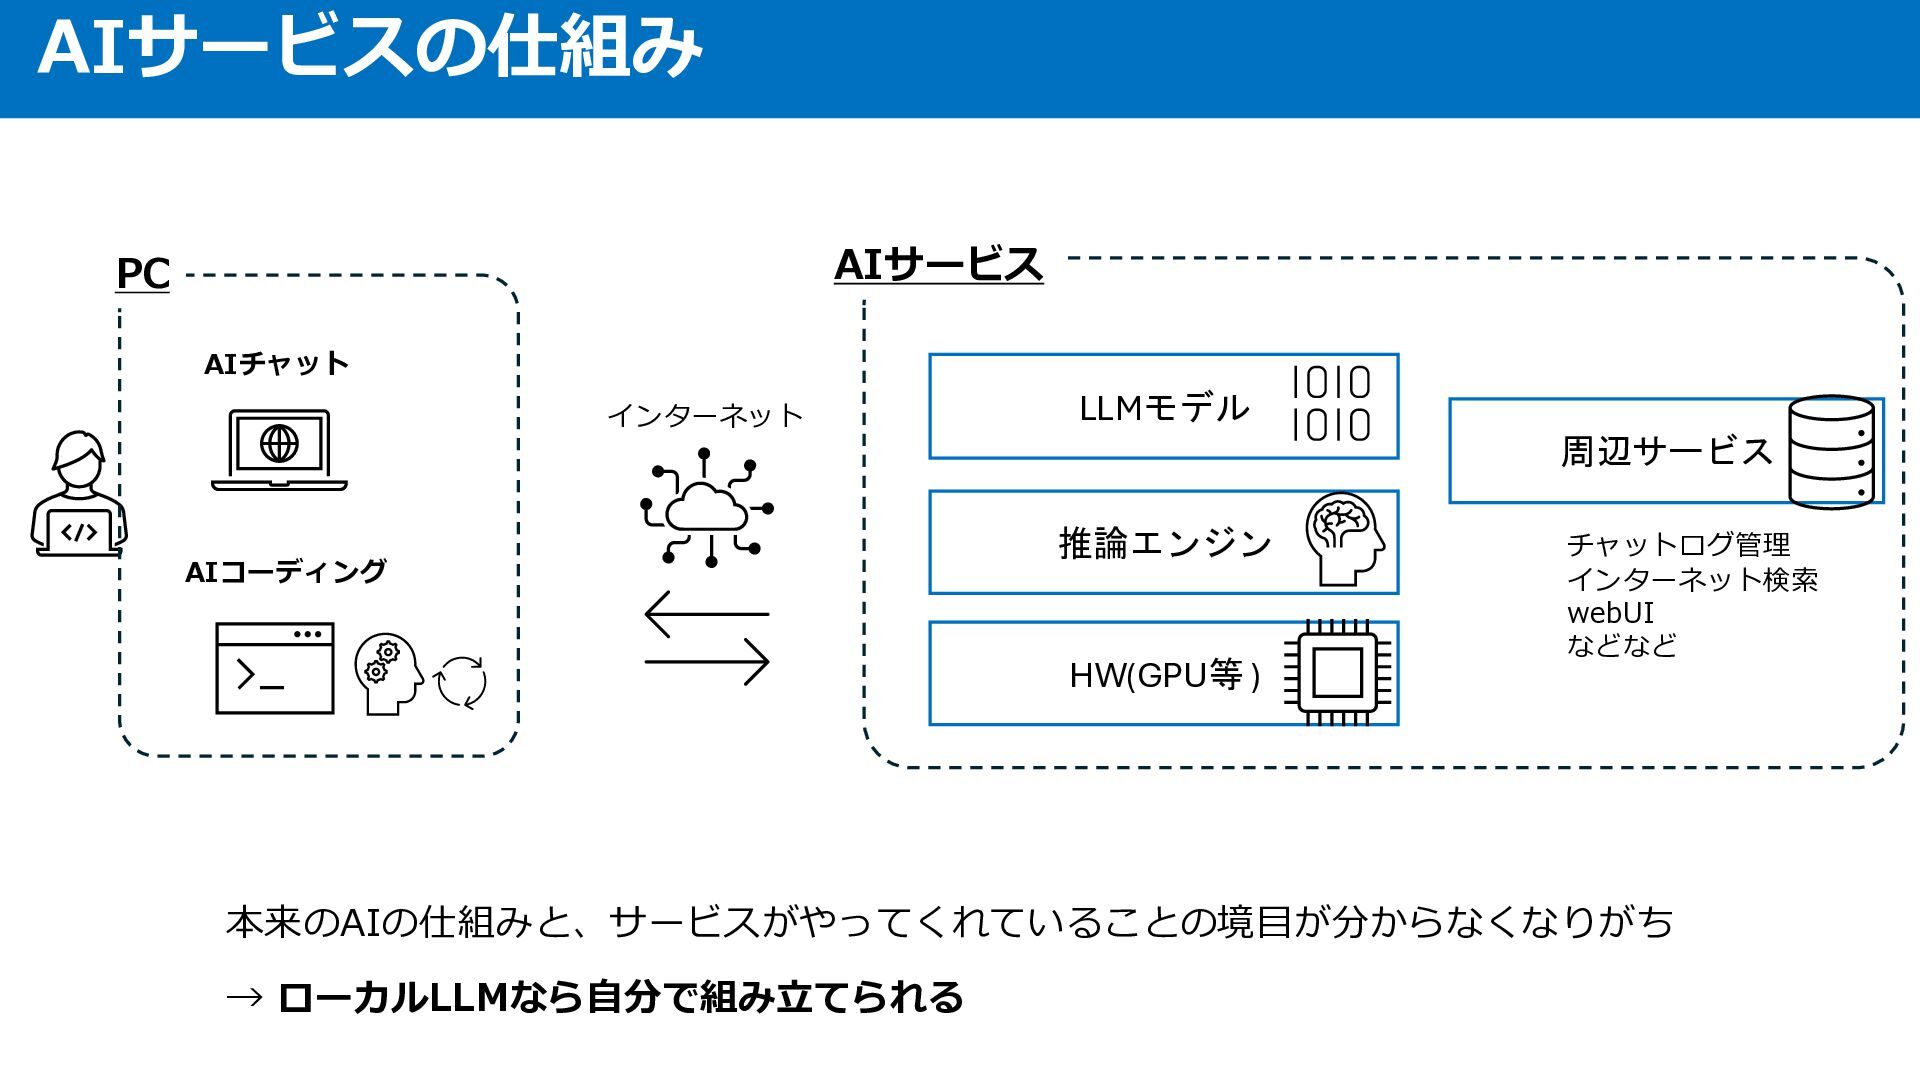
AIサービスの仕組み AIサービス PC AIチャット インターネット LLMモデル 周辺サービス AIコーディング 推論エンジン HW(GPU等
) チャットログ管理 インターネット検索 webUI などなど 本来のAIの仕組みと、サービスがやってくれていることの境目が分からなくなりがち → ローカルLLMなら自分で組み立てられる
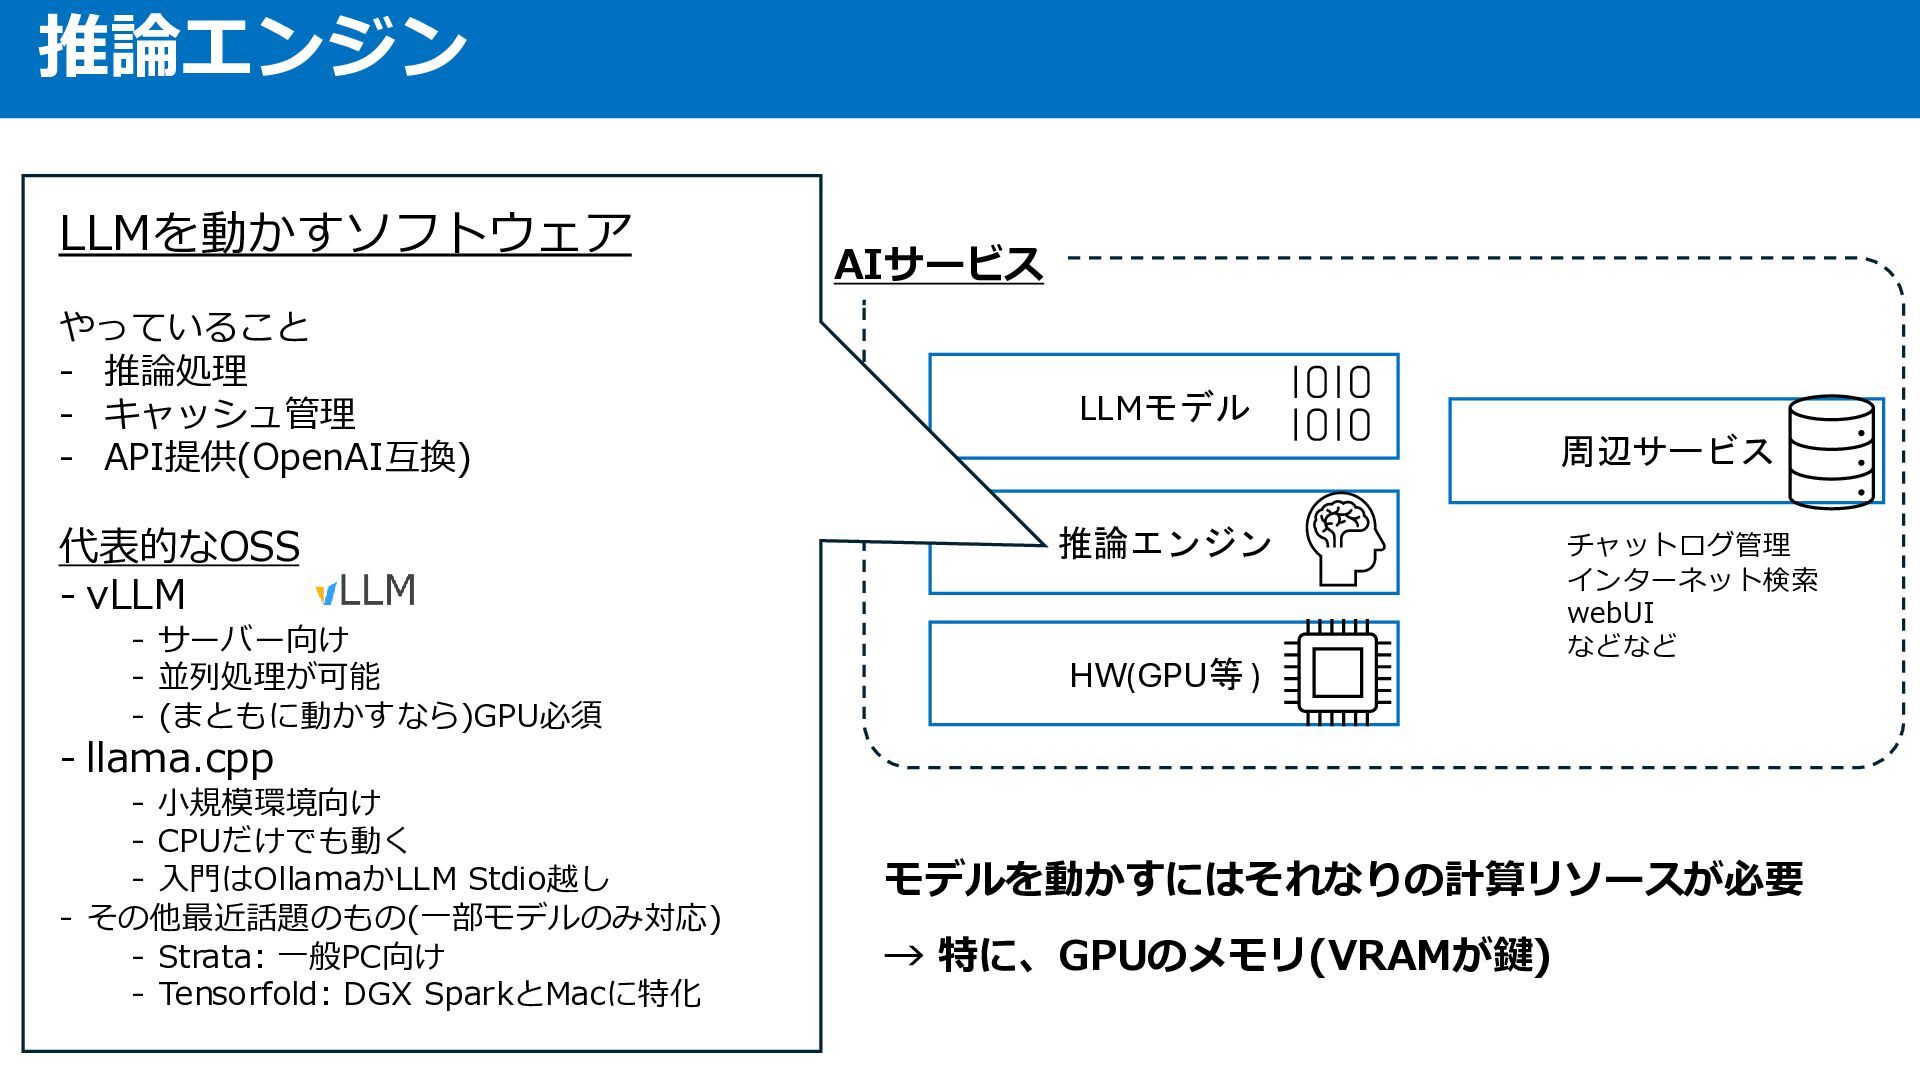
推論エンジン LLMを動かすソフトウェア PC やっていること AIチャット - 推論処理 - キャッシュ管理 -
API提供(OpenAI互換) インターネット 代表的なOSS AIコーディング - vLLM - サーバー向け - 並列処理が可能 - (まともに動かすなら)GPU必須 AIサービス LLMモデル 周辺サービス 推論エンジン HW(GPU等 ) チャットログ管理 インターネット検索 webUI などなど - llama.cpp - 小規模環境向け - CPUだけでも動く - 入門はOllamaかLLM Stdio越し - その他最近話題のもの(一部モデルのみ対応) - Strata: 一般PC向け - Tensorfold: DGX SparkとMacに特化 モデルを動かすにはそれなりの計算リソースが必要 → 特に、GPUのメモリ(VRAMが鍵)
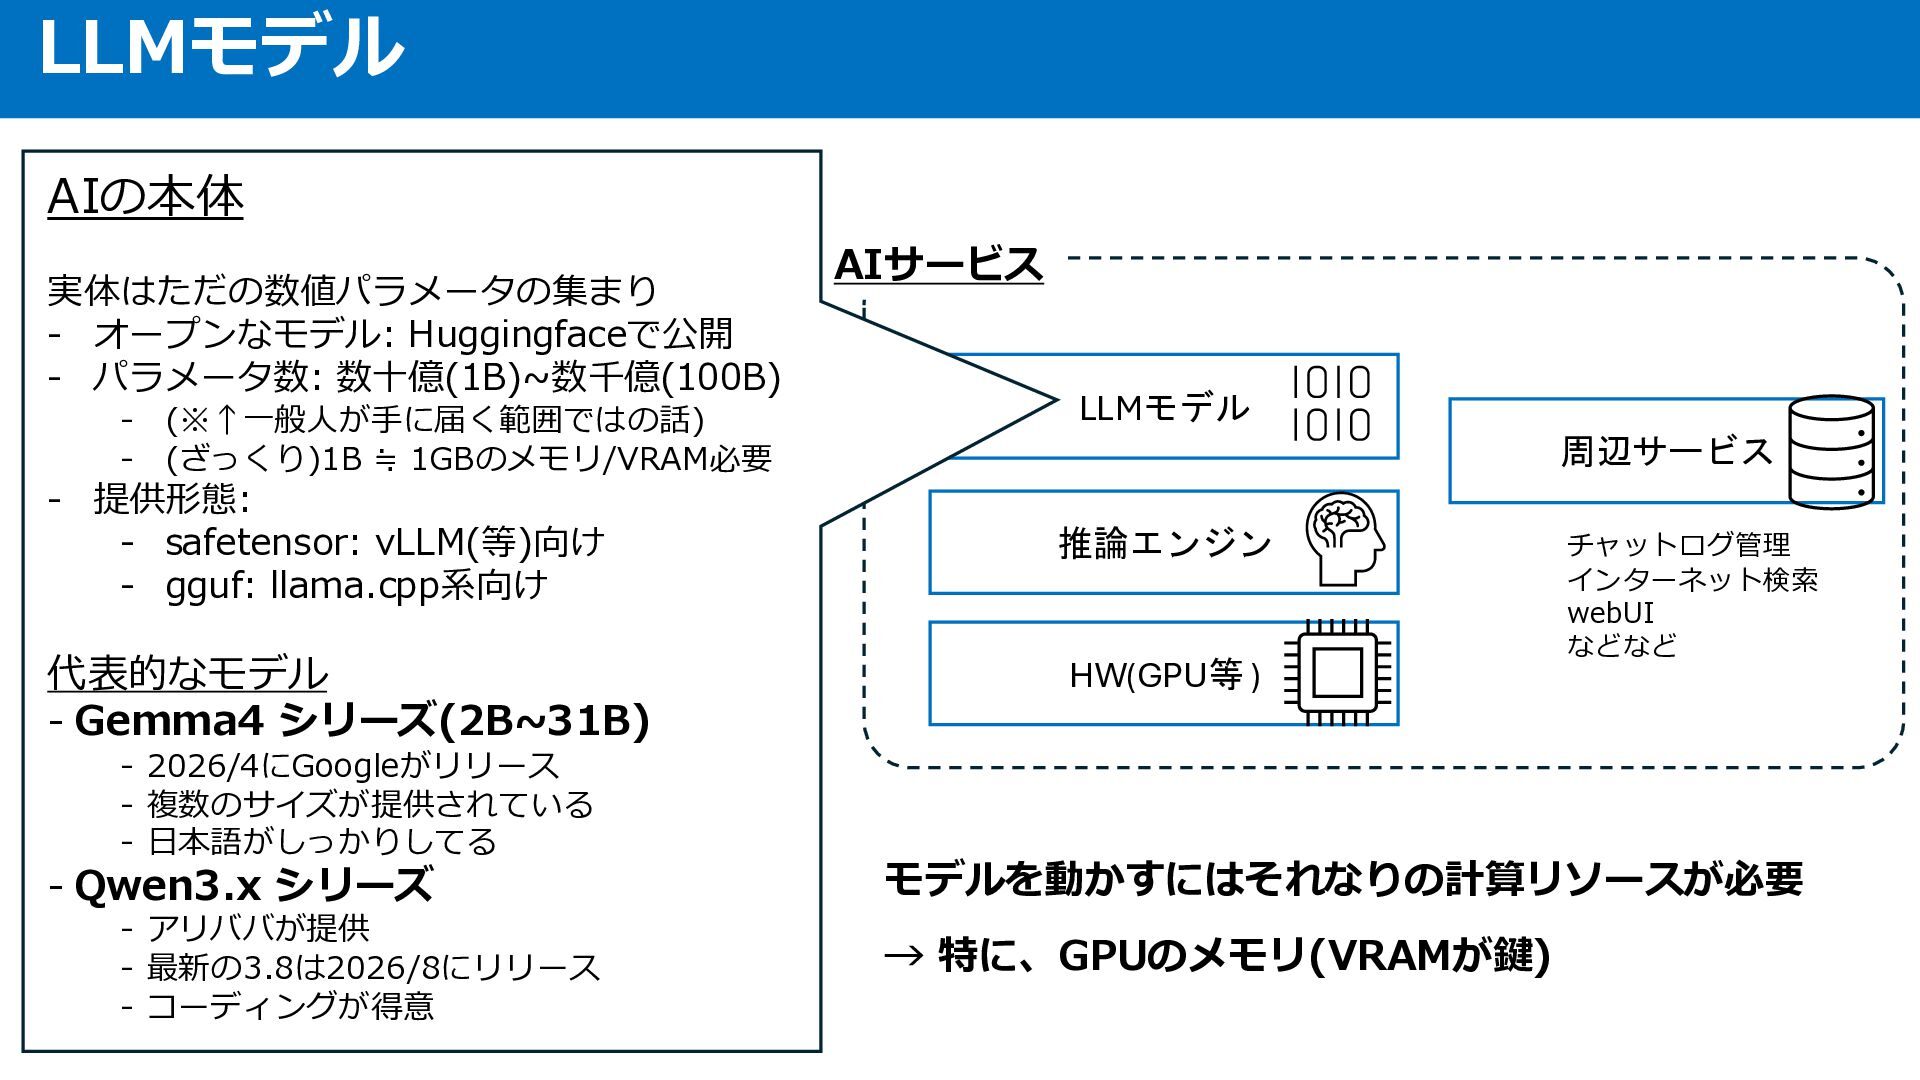
LLMモデル AIの本体 PC 実体はただの数値パラメータの集まり - オープンなモデル: Huggingfaceで公開 AIチャット - パラメータ数:
数十億(1B)~数千億(100B) インターネット - (※↑一般人が手に届く範囲ではの話) - (ざっくり)1B ≒ 1GBのメモリ/VRAM必要 AIサービス LLMモデル 周辺サービス - 提供形態: - safetensor: vLLM(等)向け AIコーディング - gguf: llama.cpp系向け 推論エンジン 代表的なモデル - Gemma4 シリーズ(2B~31B) HW(GPU等 ) - 2026/4にGoogleがリリース - 複数のサイズが提供されている - 日本語がしっかりしてる - Qwen3.x シリーズ - アリババが提供 - 最新の3.8は2026/8にリリース - コーディングが得意 チャットログ管理 インターネット検索 webUI などなど モデルを動かすにはそれなりの計算リソースが必要 → 特に、GPUのメモリ(VRAMが鍵)
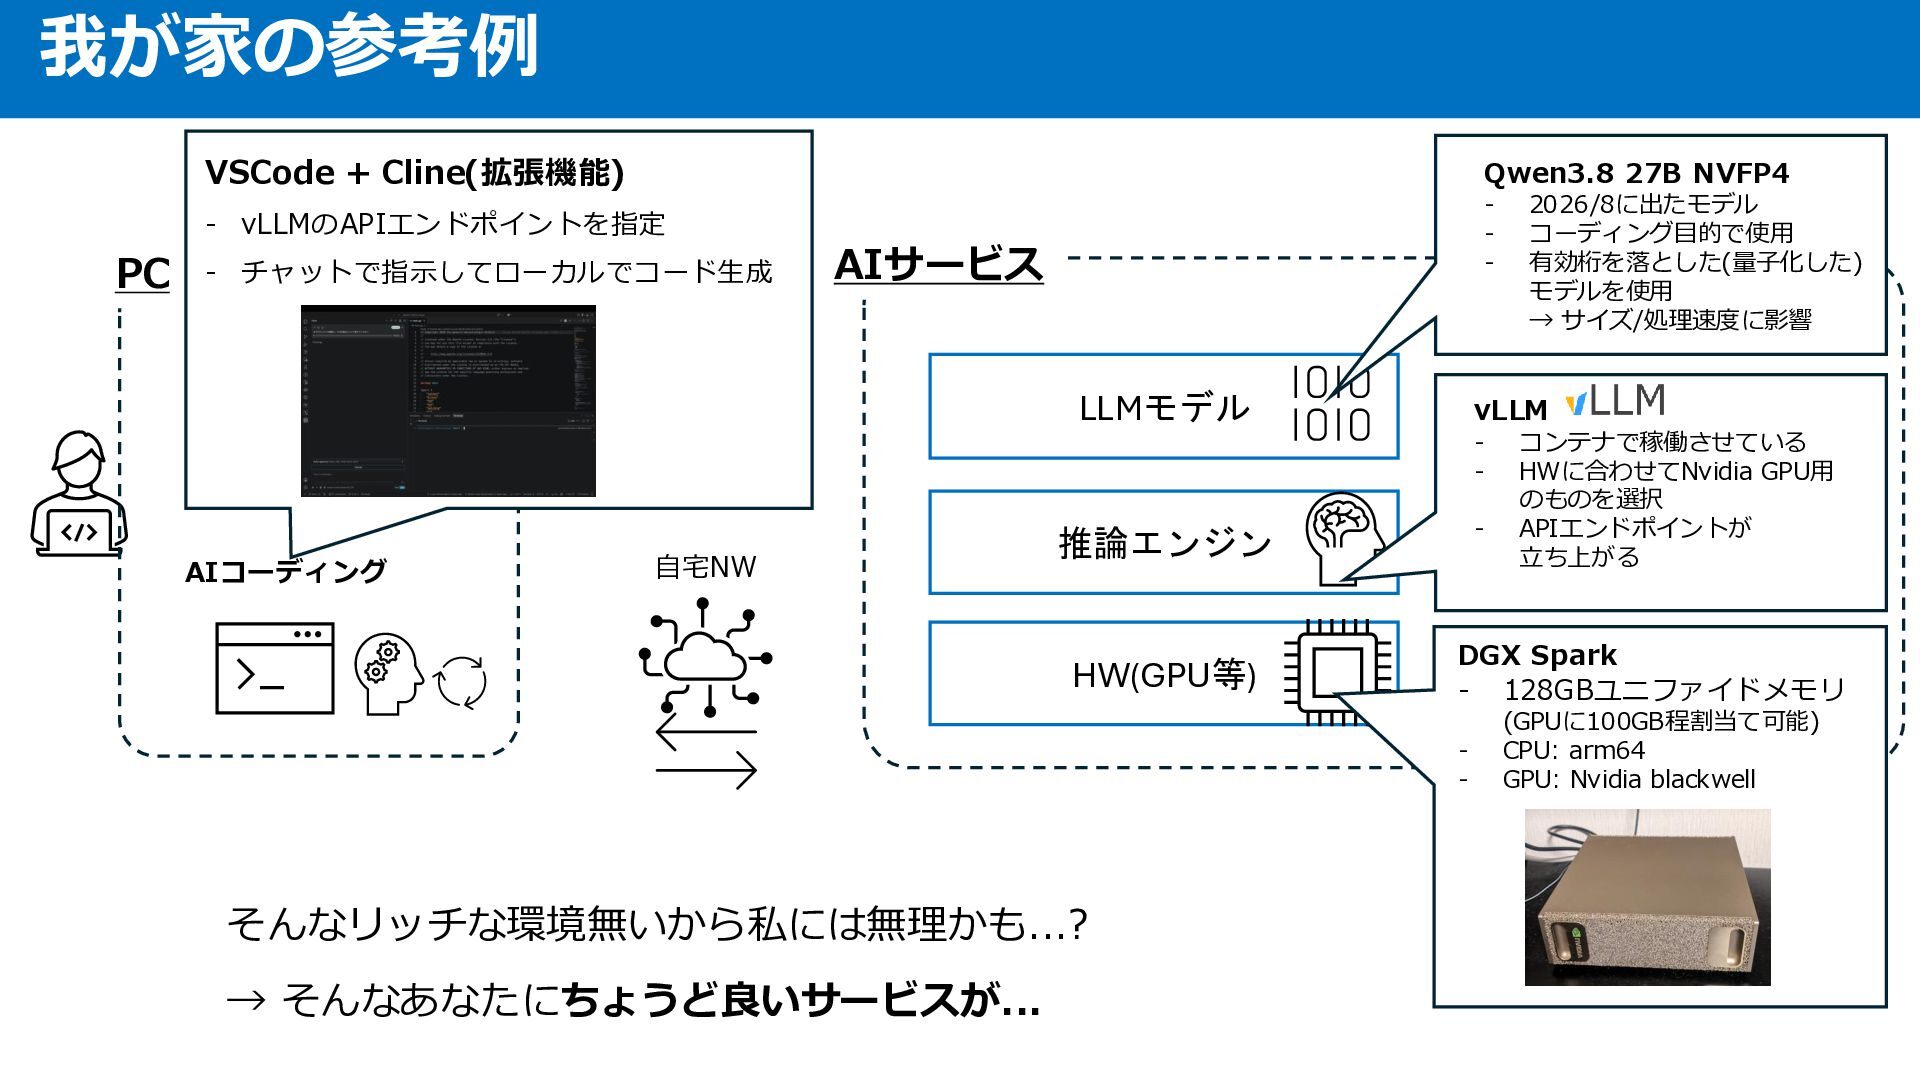
我が家の参考例 VSCode + Cline(拡張機能) Qwen3.8 27B NVFP4 - vLLMのAPIエンドポイントを指定 PC
- チャットで指示してローカルでコード生成 - AIサービス LLMモデル AIコーディング 自宅NW vLLM - 推論エンジン HW(GPU等) → そんなあなたにちょうど良いサービスが... コンテナで稼働させている HWに合わせてNvidia GPU用 のものを選択 APIエンドポイントが 立ち上がる DGX Spark - 128GBユニファイドメモリ - そんなリッチな環境無いから私には無理かも...? 2026/8に出たモデル コーディング目的で使用 有効桁を落とした(量子化した) モデルを使用 → サイズ/処理速度に影響 (GPUに100GB程割当て可能) CPU: arm64 GPU: Nvidia blackwell
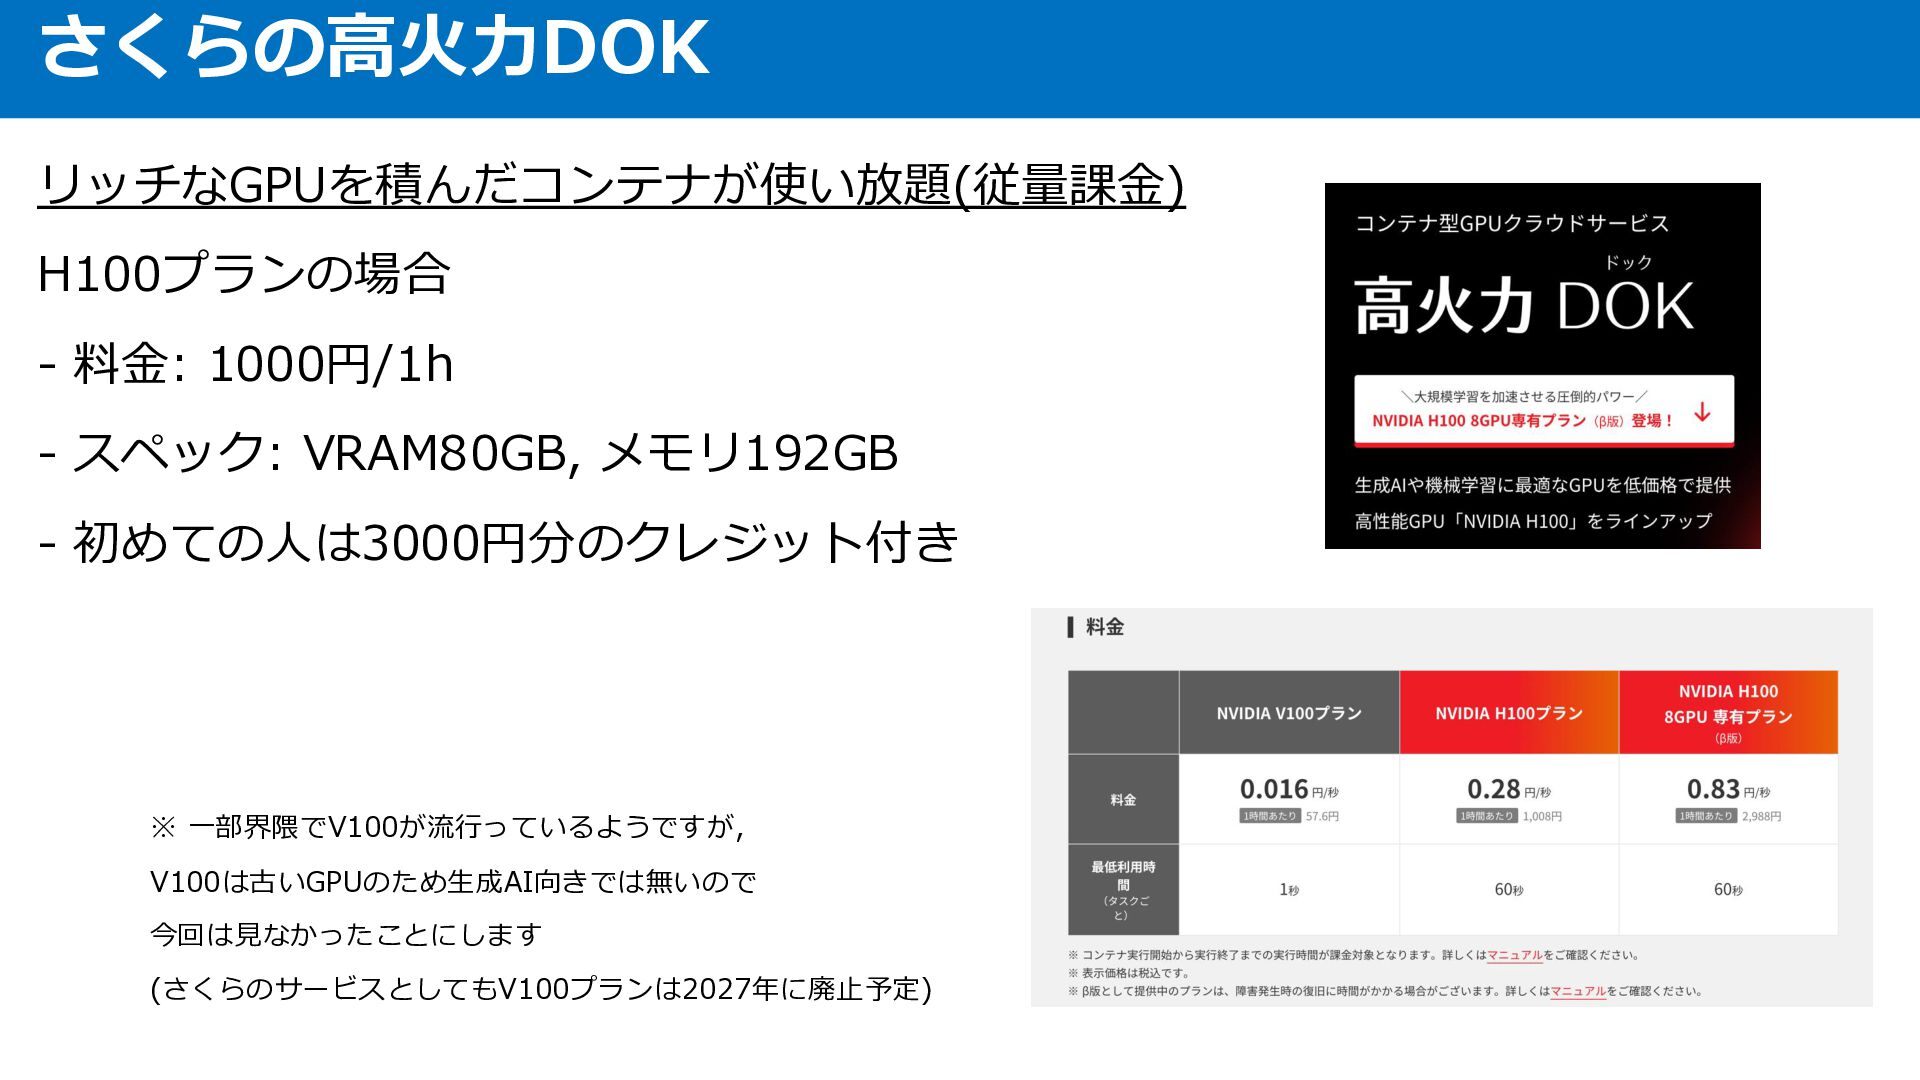
さくらの高火力DOK リッチなGPUを積んだコンテナが使い放題(従量課金) H100プランの場合 - 料金: 1000円/1h - スペック: VRAM80GB, メモリ192GB
- 初めての人は3000円分のクレジット付き ※ 一部界隈でV100が流行っているようですが, V100は古いGPUのため生成AI向きでは無いので 今回は見なかったことにします (さくらのサービスとしてもV100プランは2027年に廃止予定)
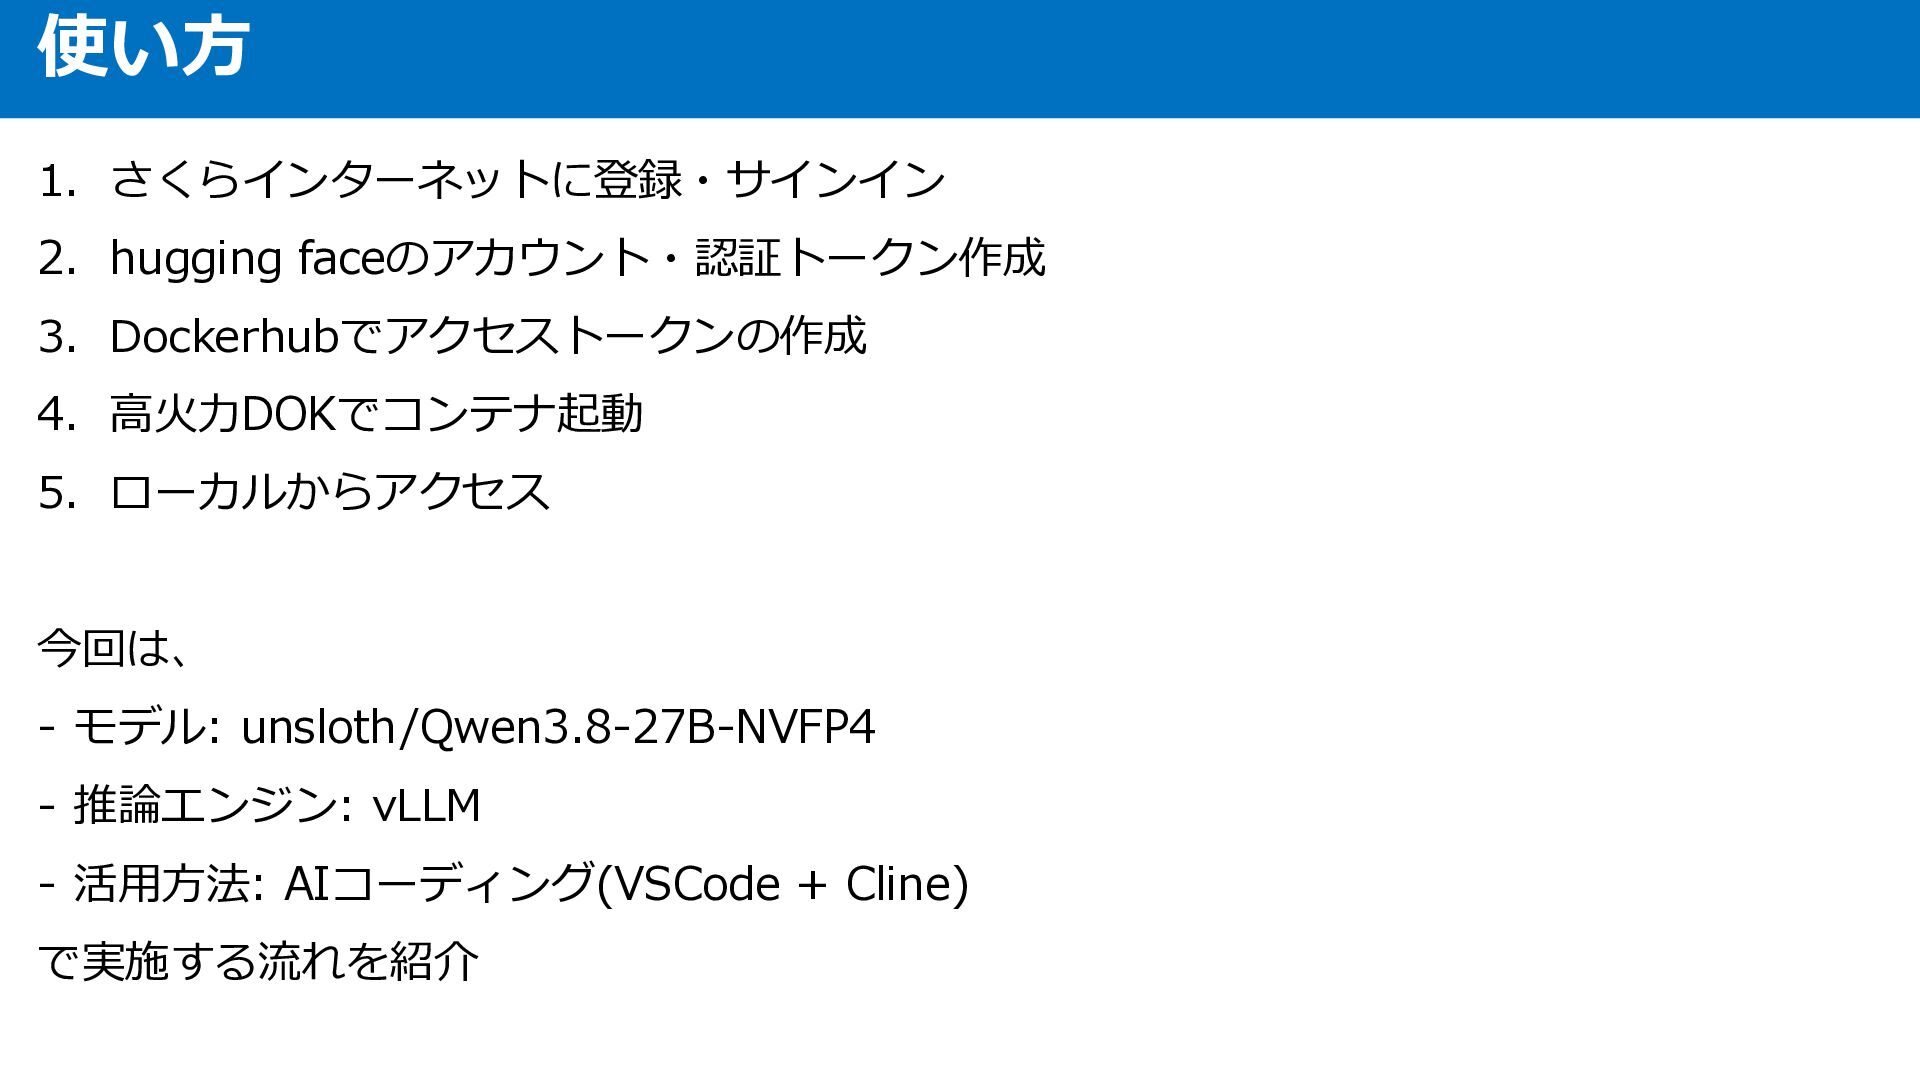
使い方 1. さくらインターネットに登録・サインイン 2. hugging faceのアカウント・認証トークン作成 3. Dockerhubでアクセストークンの作成 4. 高火力DOKでコンテナ起動
5. ローカルからアクセス 今回は、 - モデル: unsloth/Qwen3.8-27B-NVFP4 - 推論エンジン: vLLM - 活用方法: AIコーディング(VSCode + Cline) で実施する流れを紹介
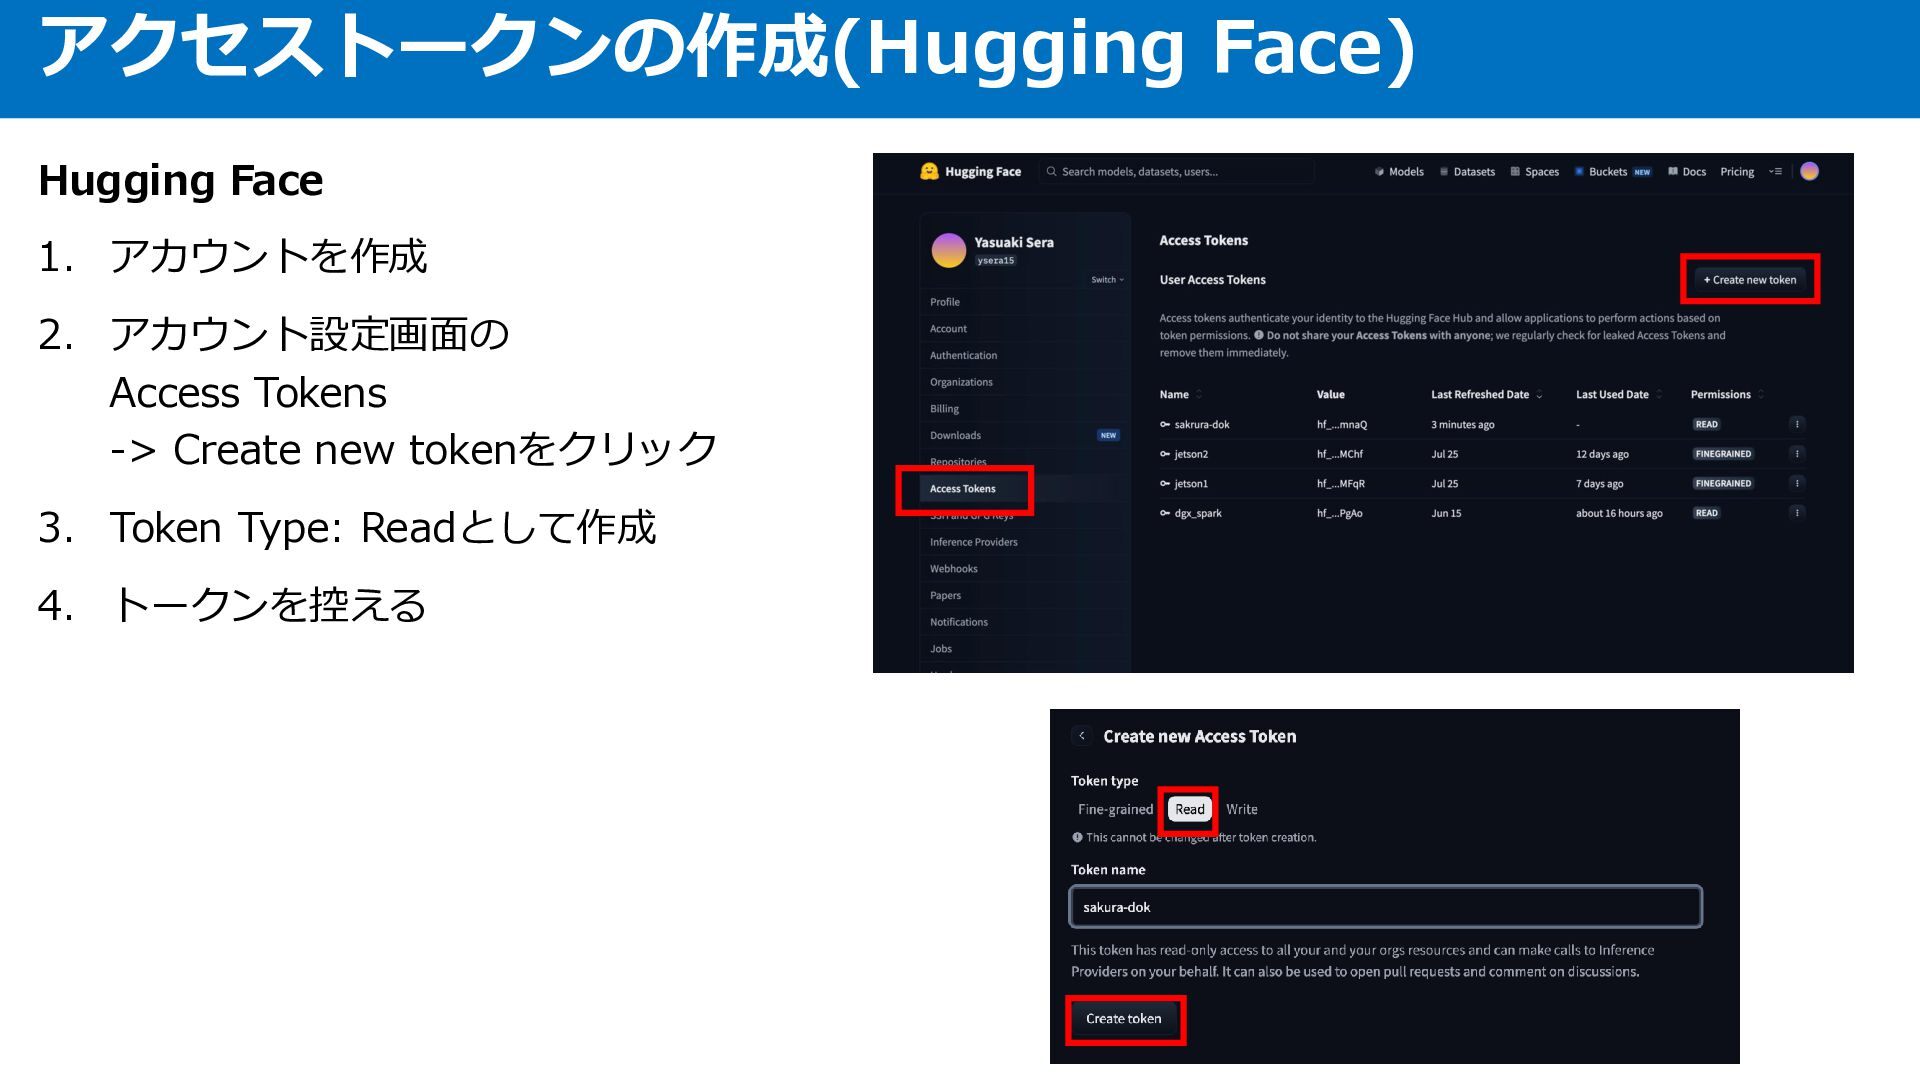
アクセストークンの作成(Hugging Face) Hugging Face 1. アカウントを作成 2. アカウント設定画面の Access Tokens
-> Create new tokenをクリック 3. Token Type: Readとして作成 4. トークンを控える
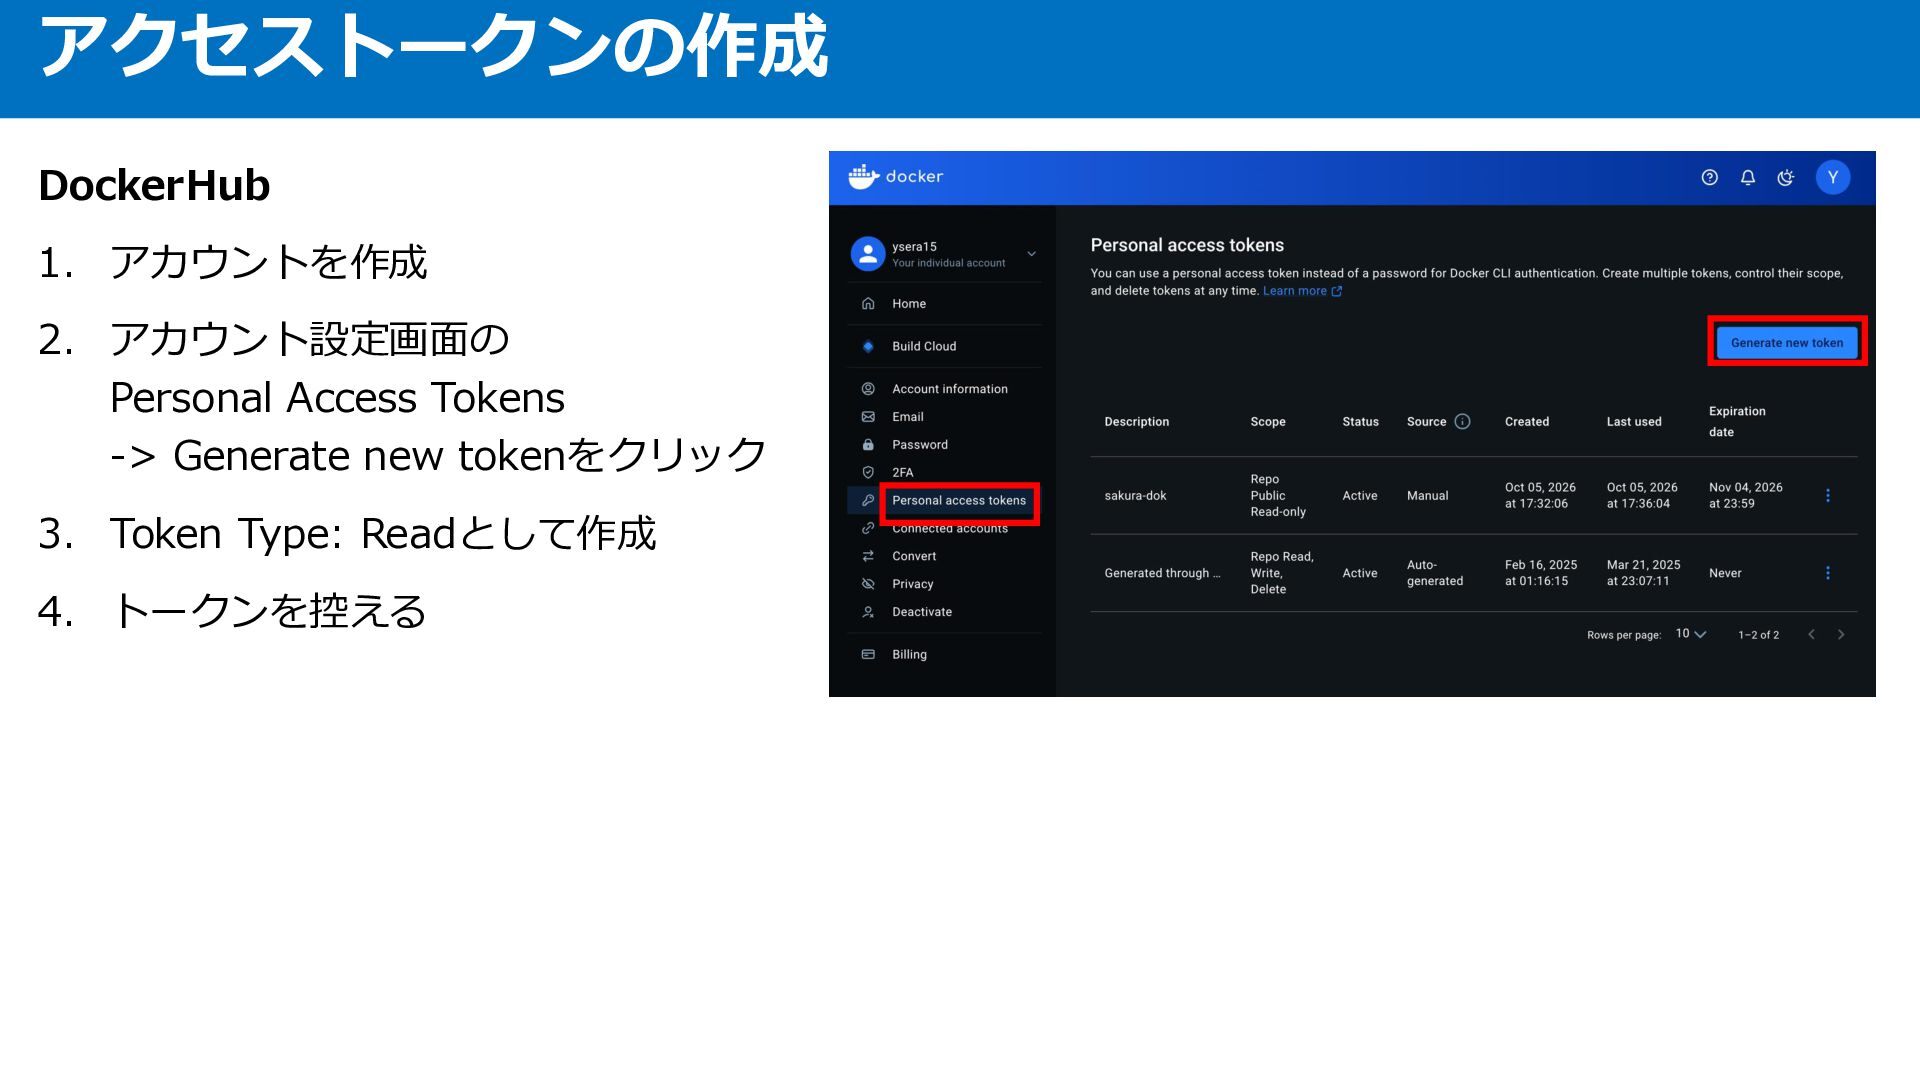
アクセストークンの作成 DockerHub 1. アカウントを作成 2. アカウント設定画面の Personal Access Tokens ->
Generate new tokenをクリック 3. Token Type: Readとして作成 4. トークンを控える
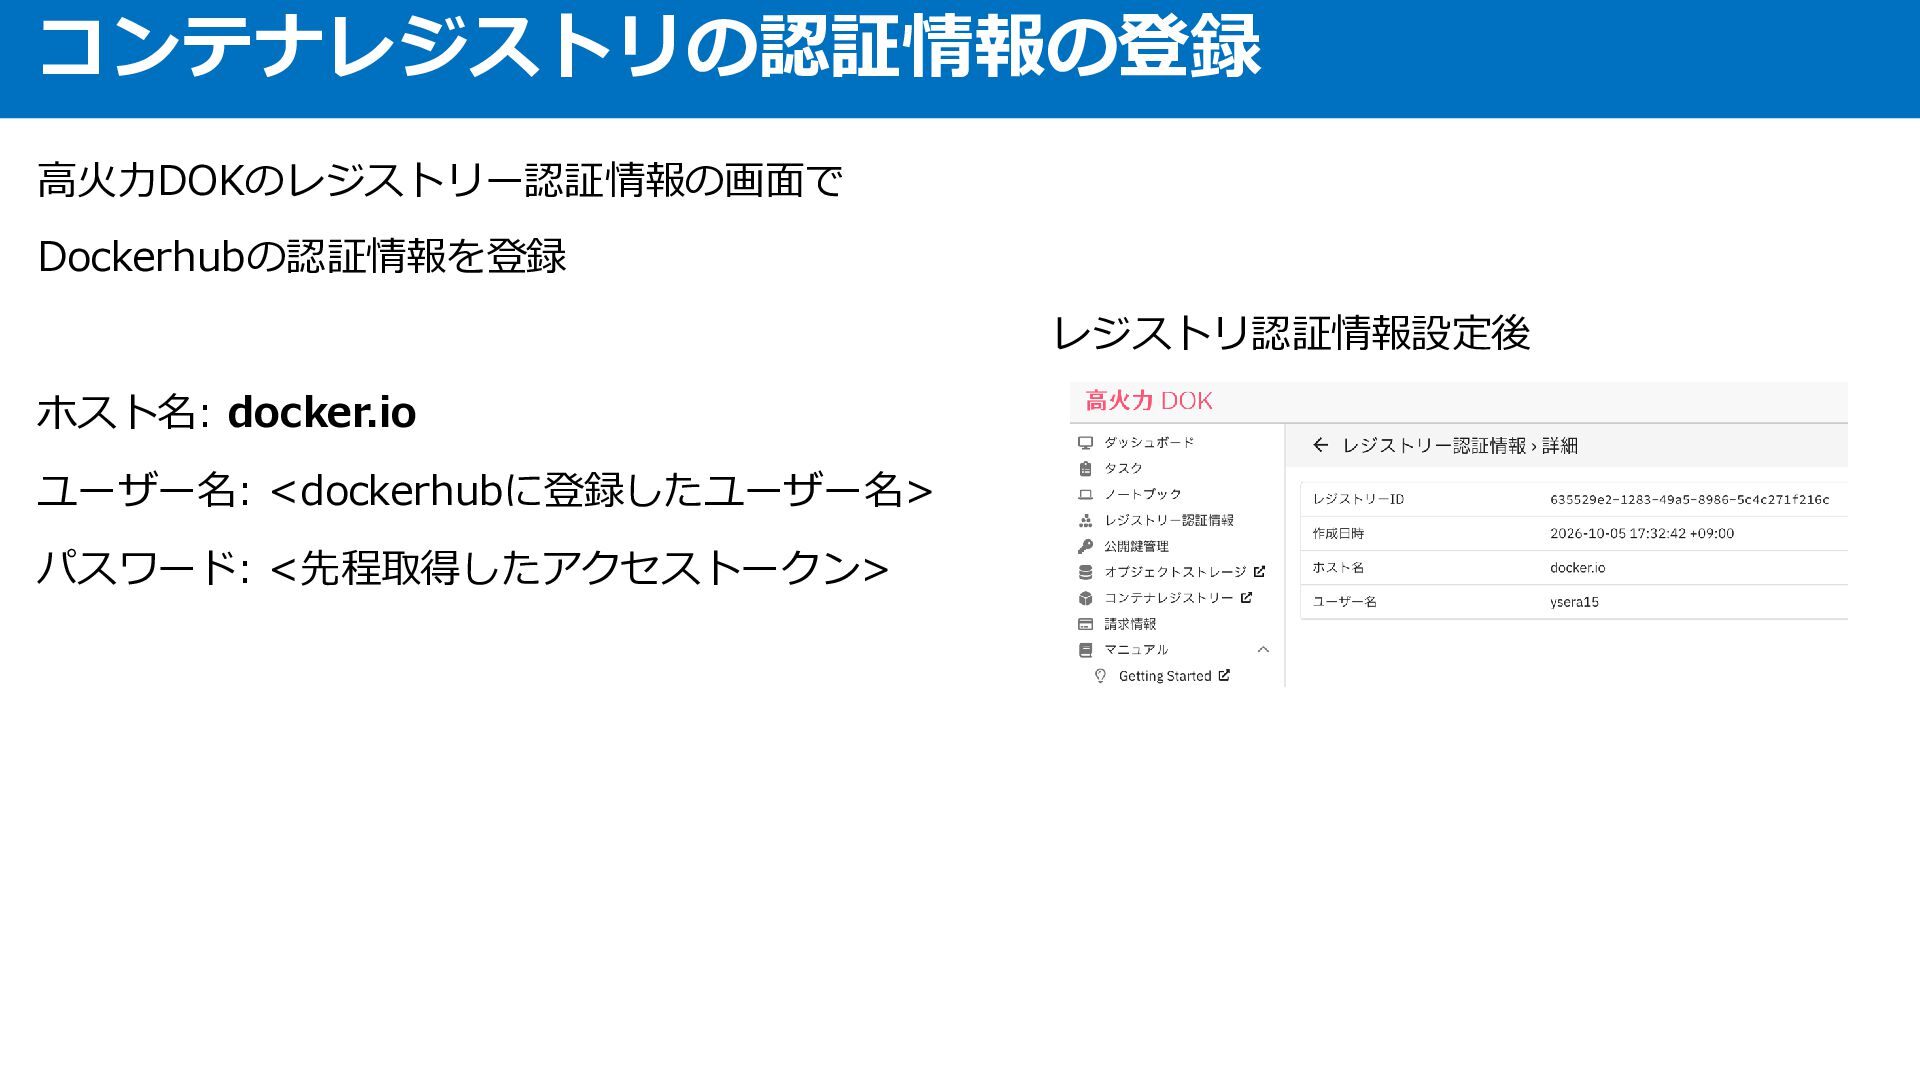
コンテナレジストリの認証情報の登録 高火力DOKのレジストリー認証情報の画面で Dockerhubの認証情報を登録 レジストリ認証情報設定後 ホスト名: docker.io ユーザー名: <dockerhubに登録したユーザー名> パスワード: <先程取得したアクセストークン>
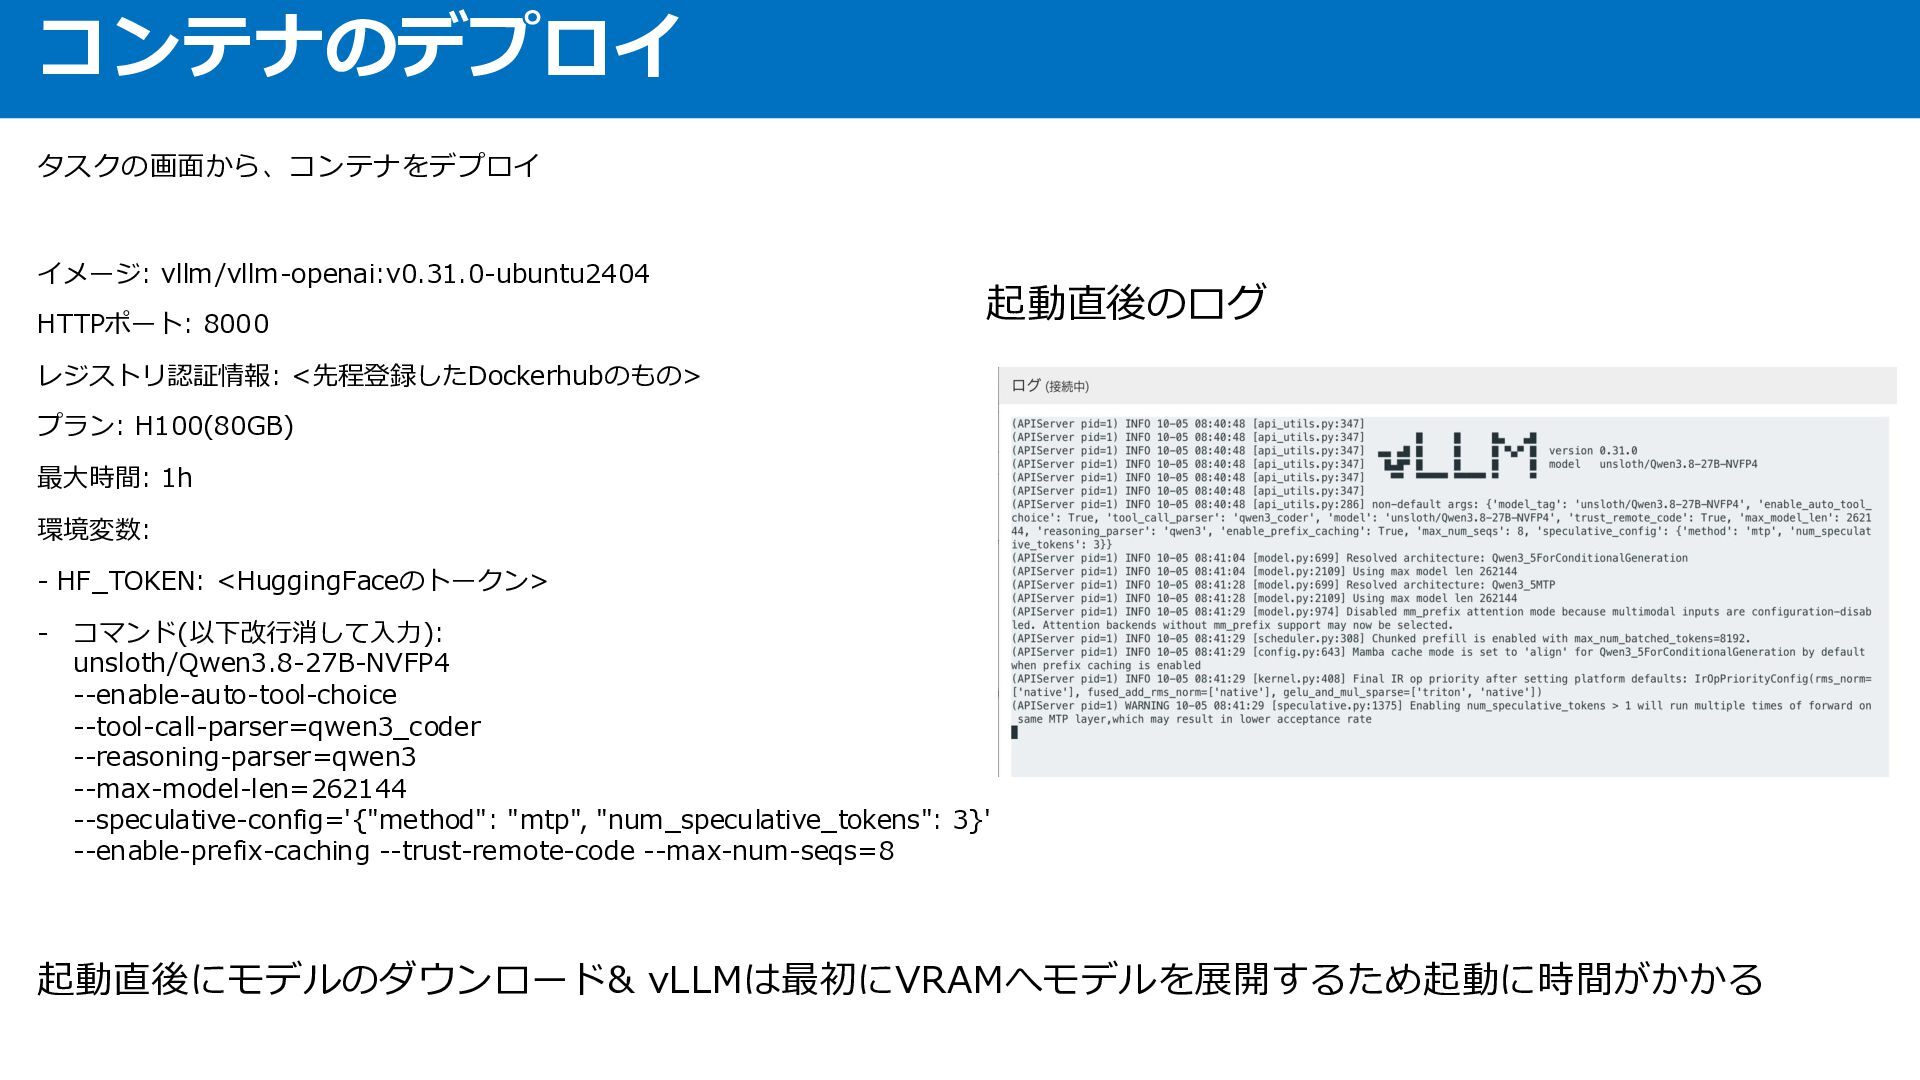
コンテナのデプロイ タスクの画面から、コンテナをデプロイ イメージ: vllm/vllm-openai:v0.31.0-ubuntu2404 HTTPポート: 8000 起動直後のログ レジストリ認証情報: <先程登録したDockerhubのもの> プラン:
H100(80GB) 最大時間: 1h 環境変数: - HF_TOKEN: <HuggingFaceのトークン> - コマンド(以下改行消して入力): unsloth/Qwen3.8-27B-NVFP4 --enable-auto-tool-choice --tool-call-parser=qwen3_coder --reasoning-parser=qwen3 --max-model-len=262144 --speculative-config='{"method": "mtp", "num_speculative_tokens": 3}' --enable-prefix-caching --trust-remote-code --max-num-seqs=8 起動直後にモデルのダウンロード& vLLMは最初にVRAMへモデルを展開するため起動に時間がかかる
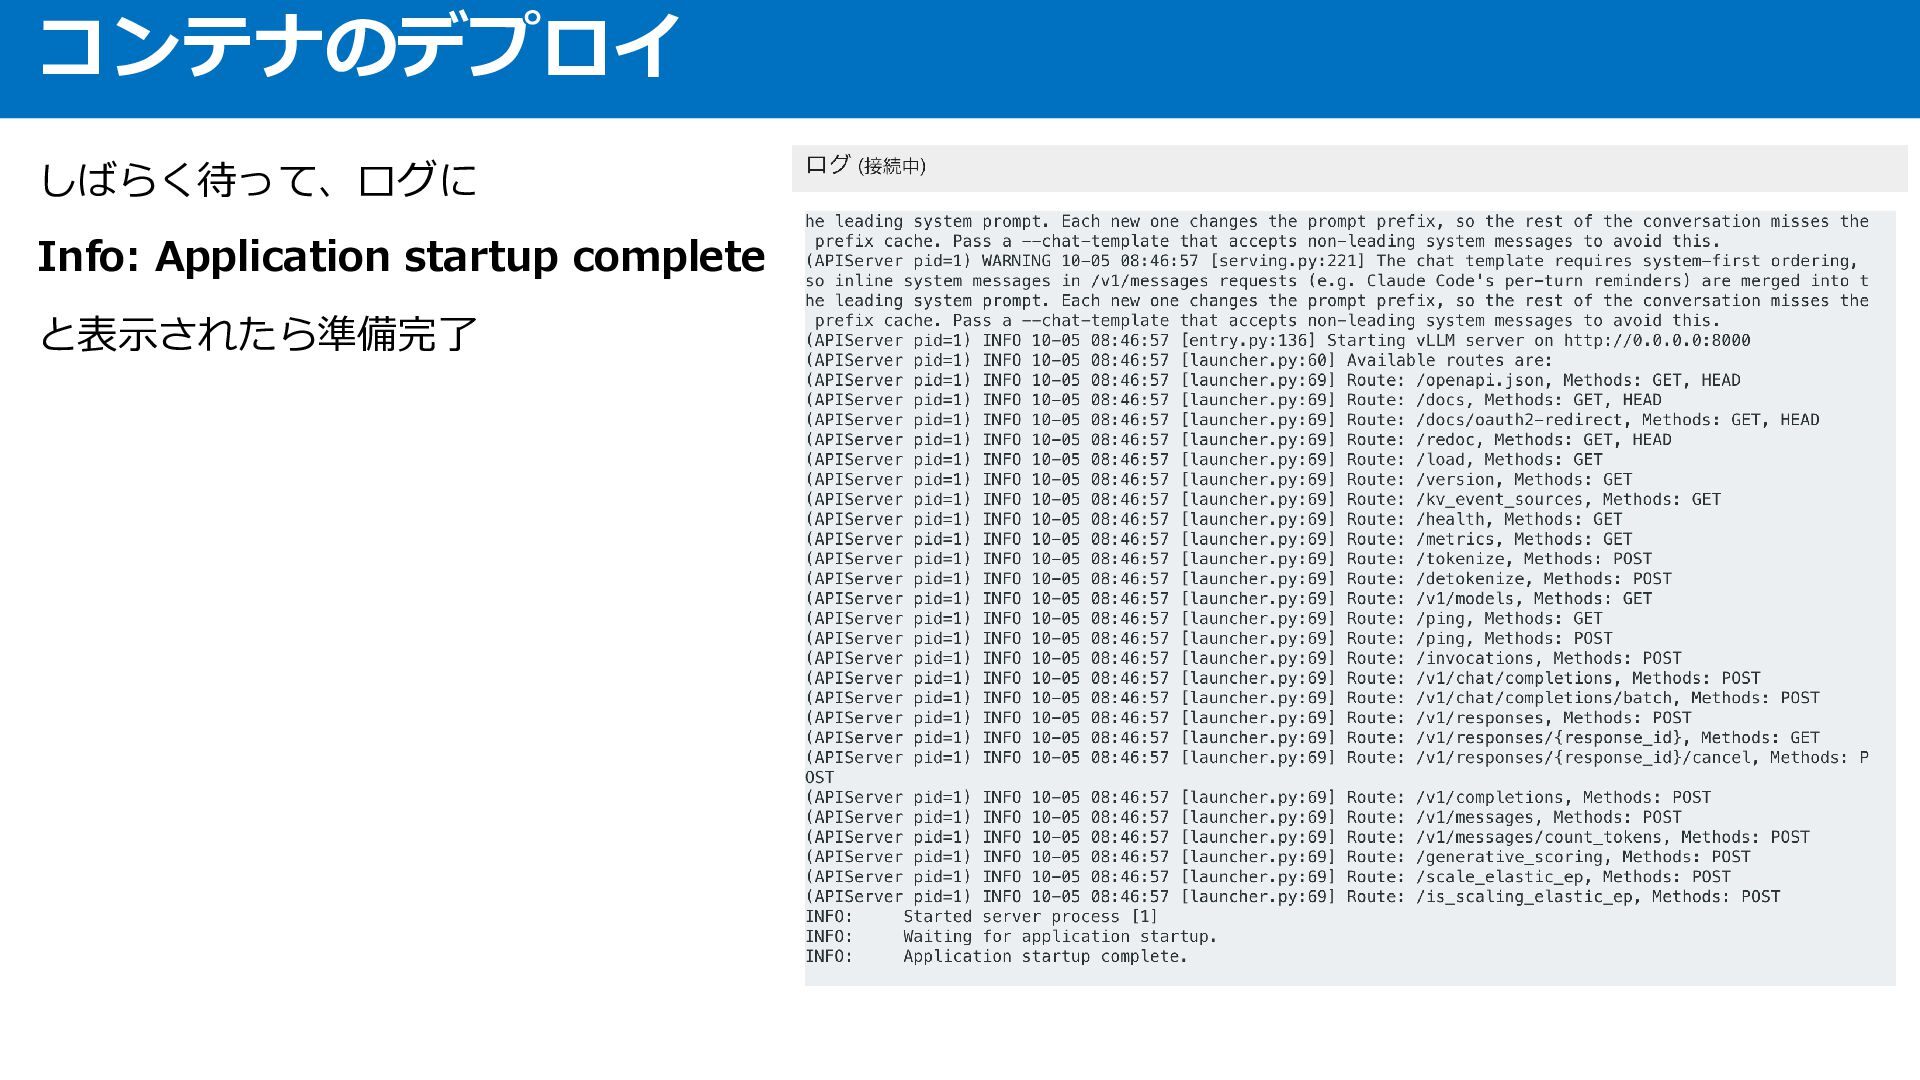
コンテナのデプロイ しばらく待って、ログに Info: Application startup complete と表示されたら準備完了
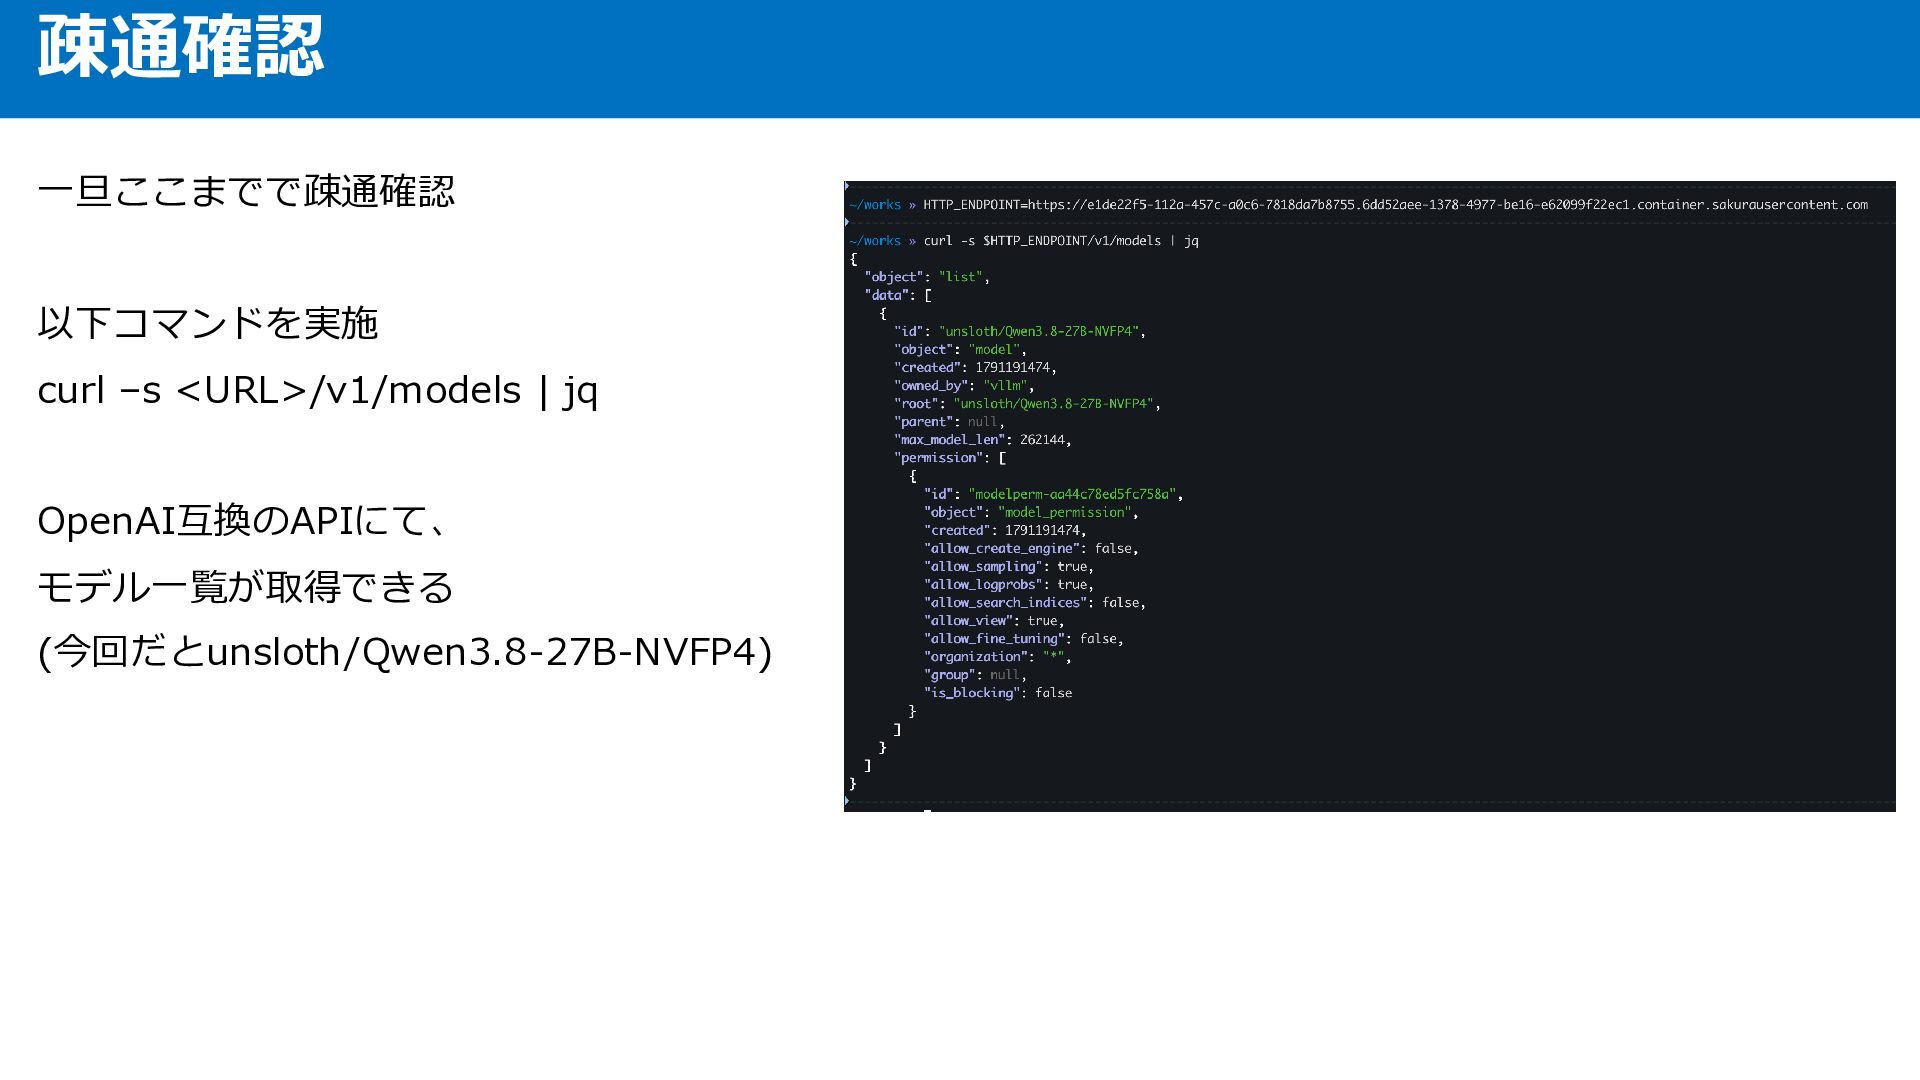
疎通確認 一旦ここまでで疎通確認 以下コマンドを実施 curl –s <URL>/v1/models | jq OpenAI互換のAPIにて、 モデル一覧が取得できる
(今回だとunsloth/Qwen3.8-27B-NVFP4)
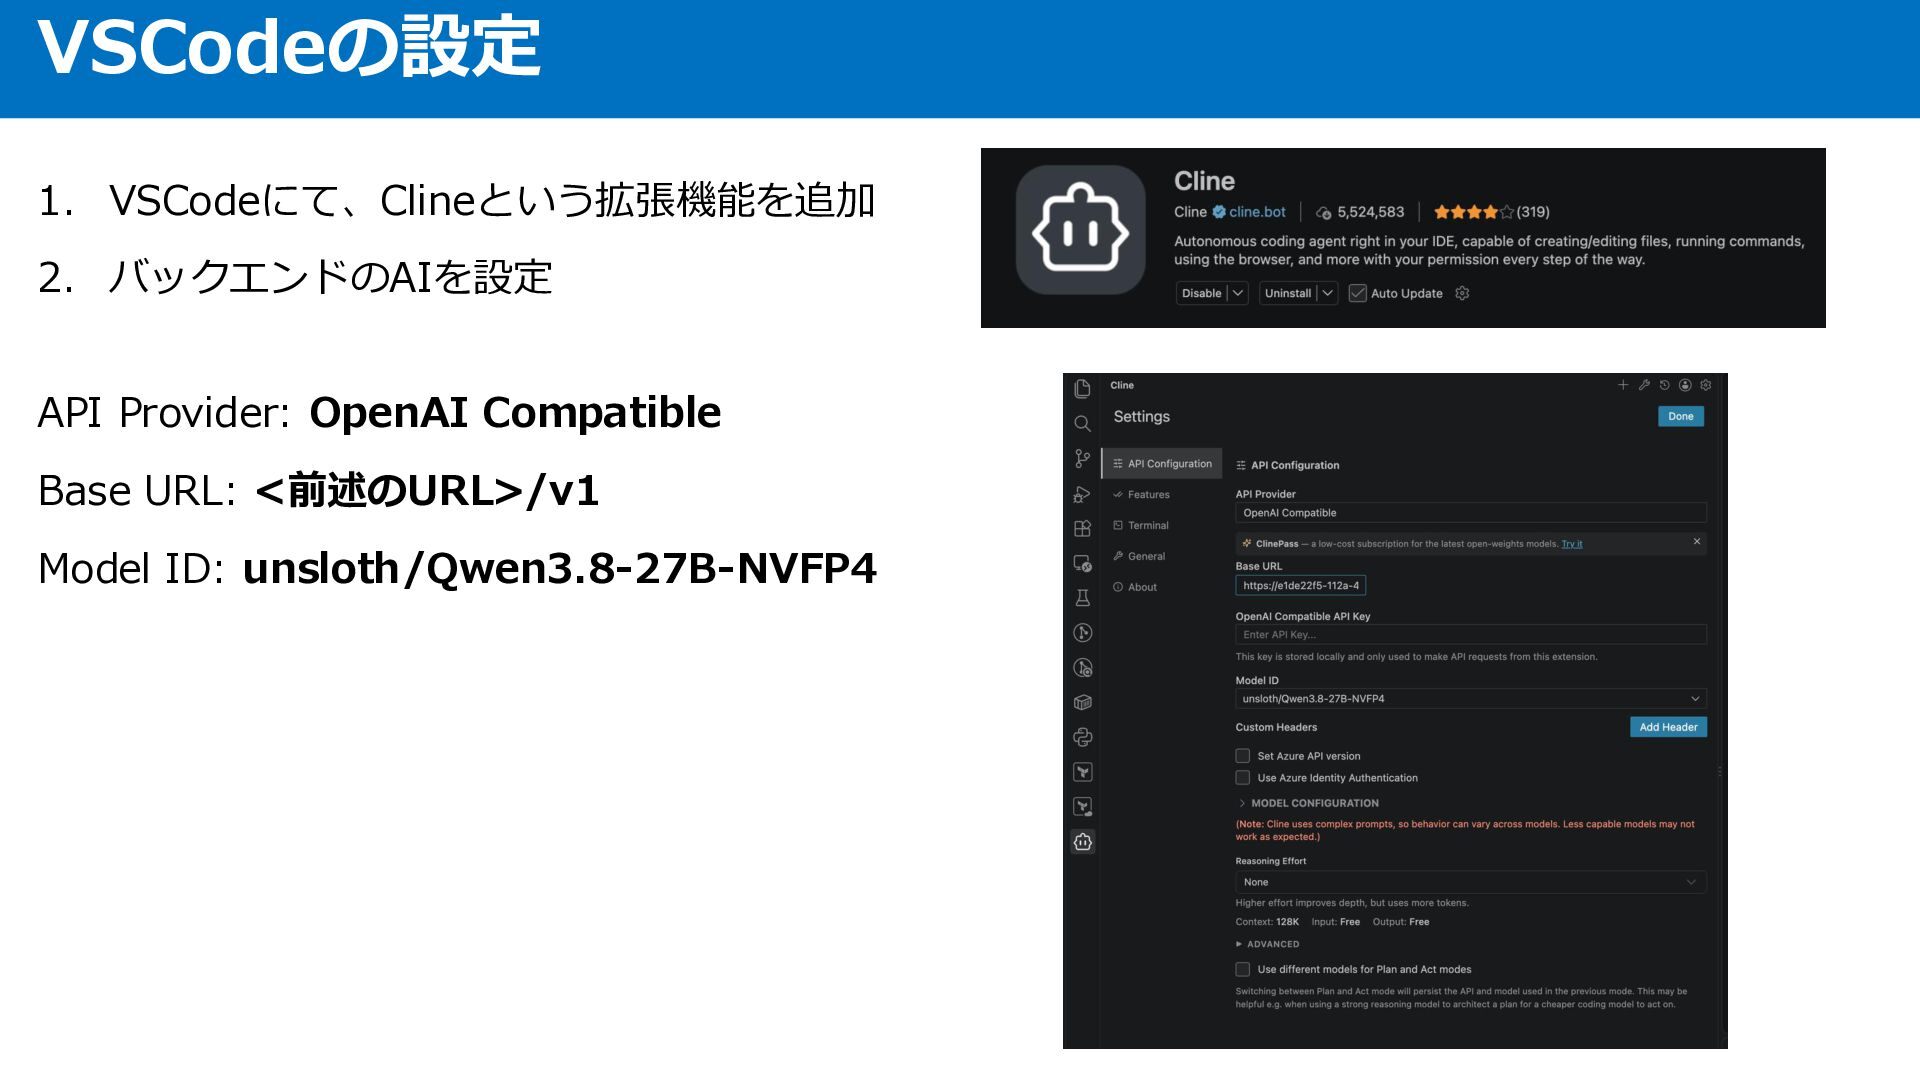
VSCodeの設定 1. VSCodeにて、Clineという拡張機能を追加 2. バックエンドのAIを設定 API Provider: OpenAI Compatible Base
URL: <前述のURL>/v1 Model ID: unsloth/Qwen3.8-27B-NVFP4
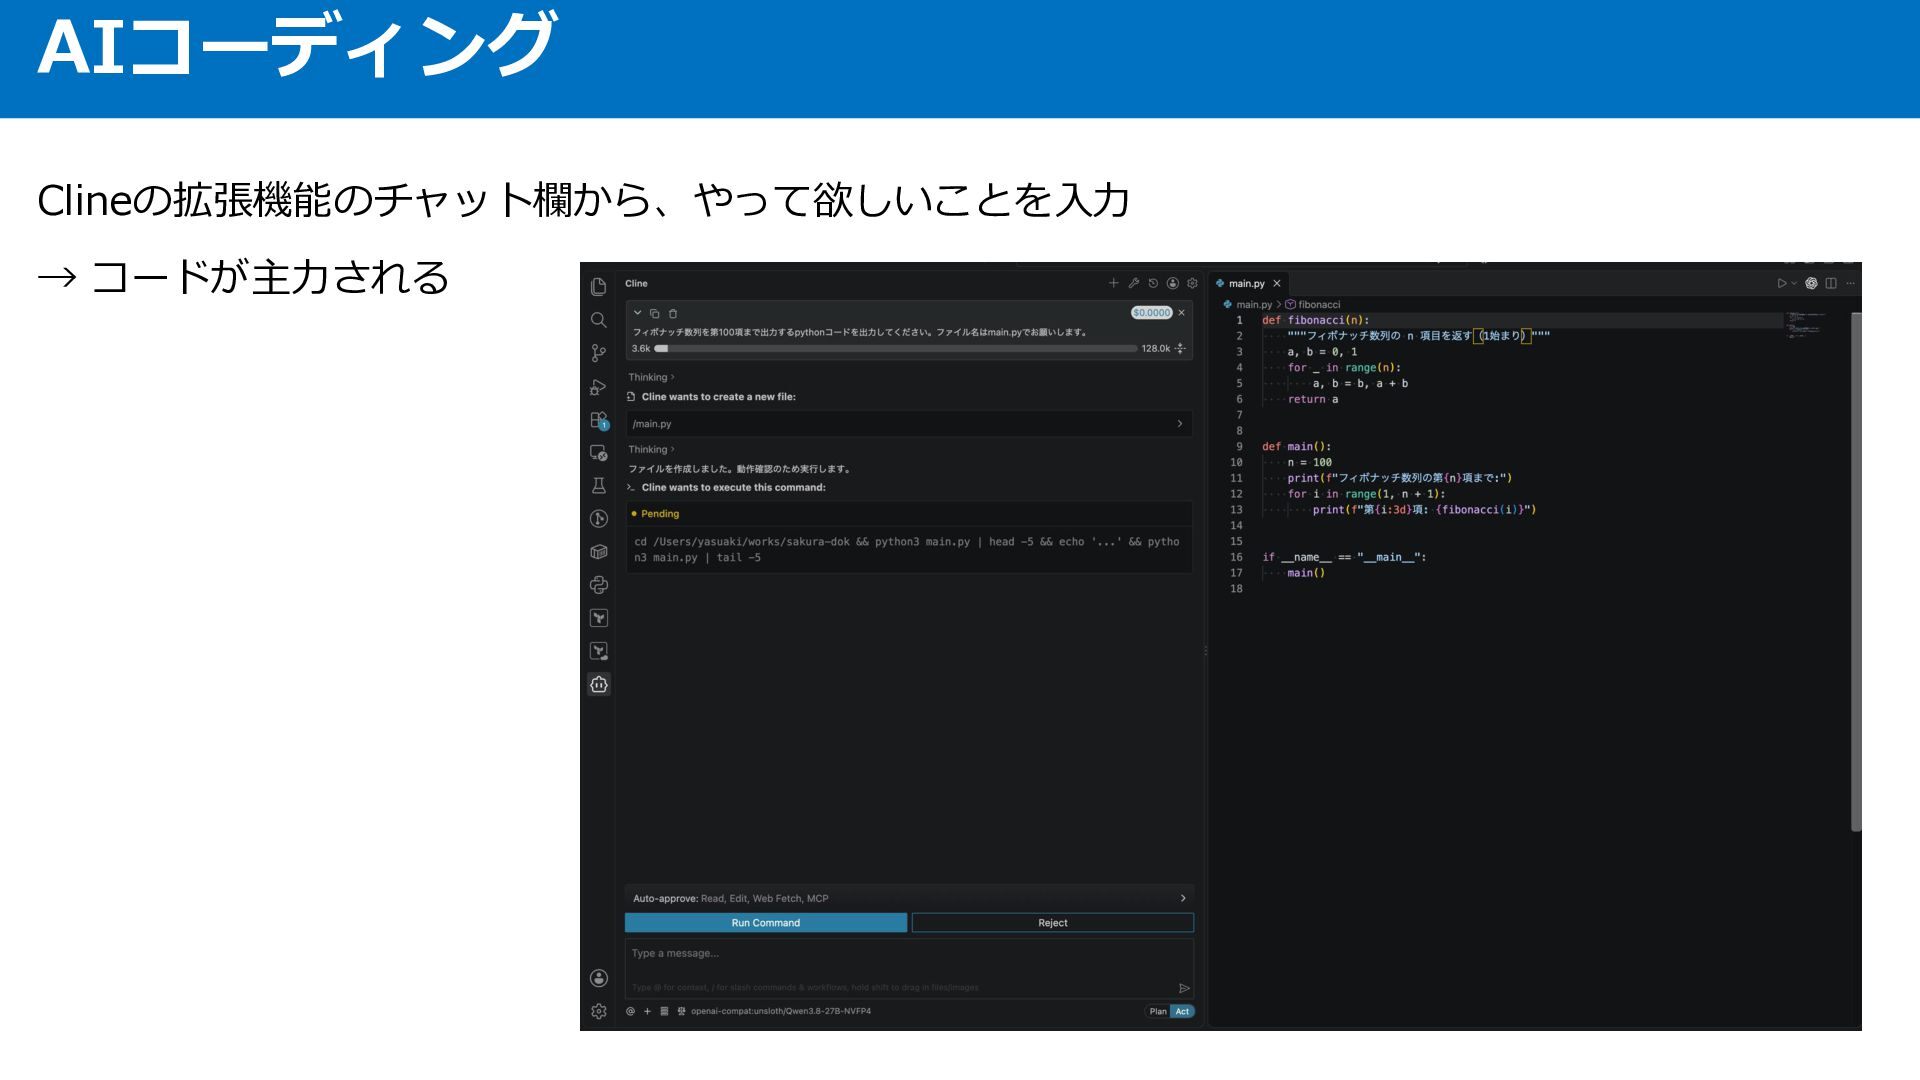
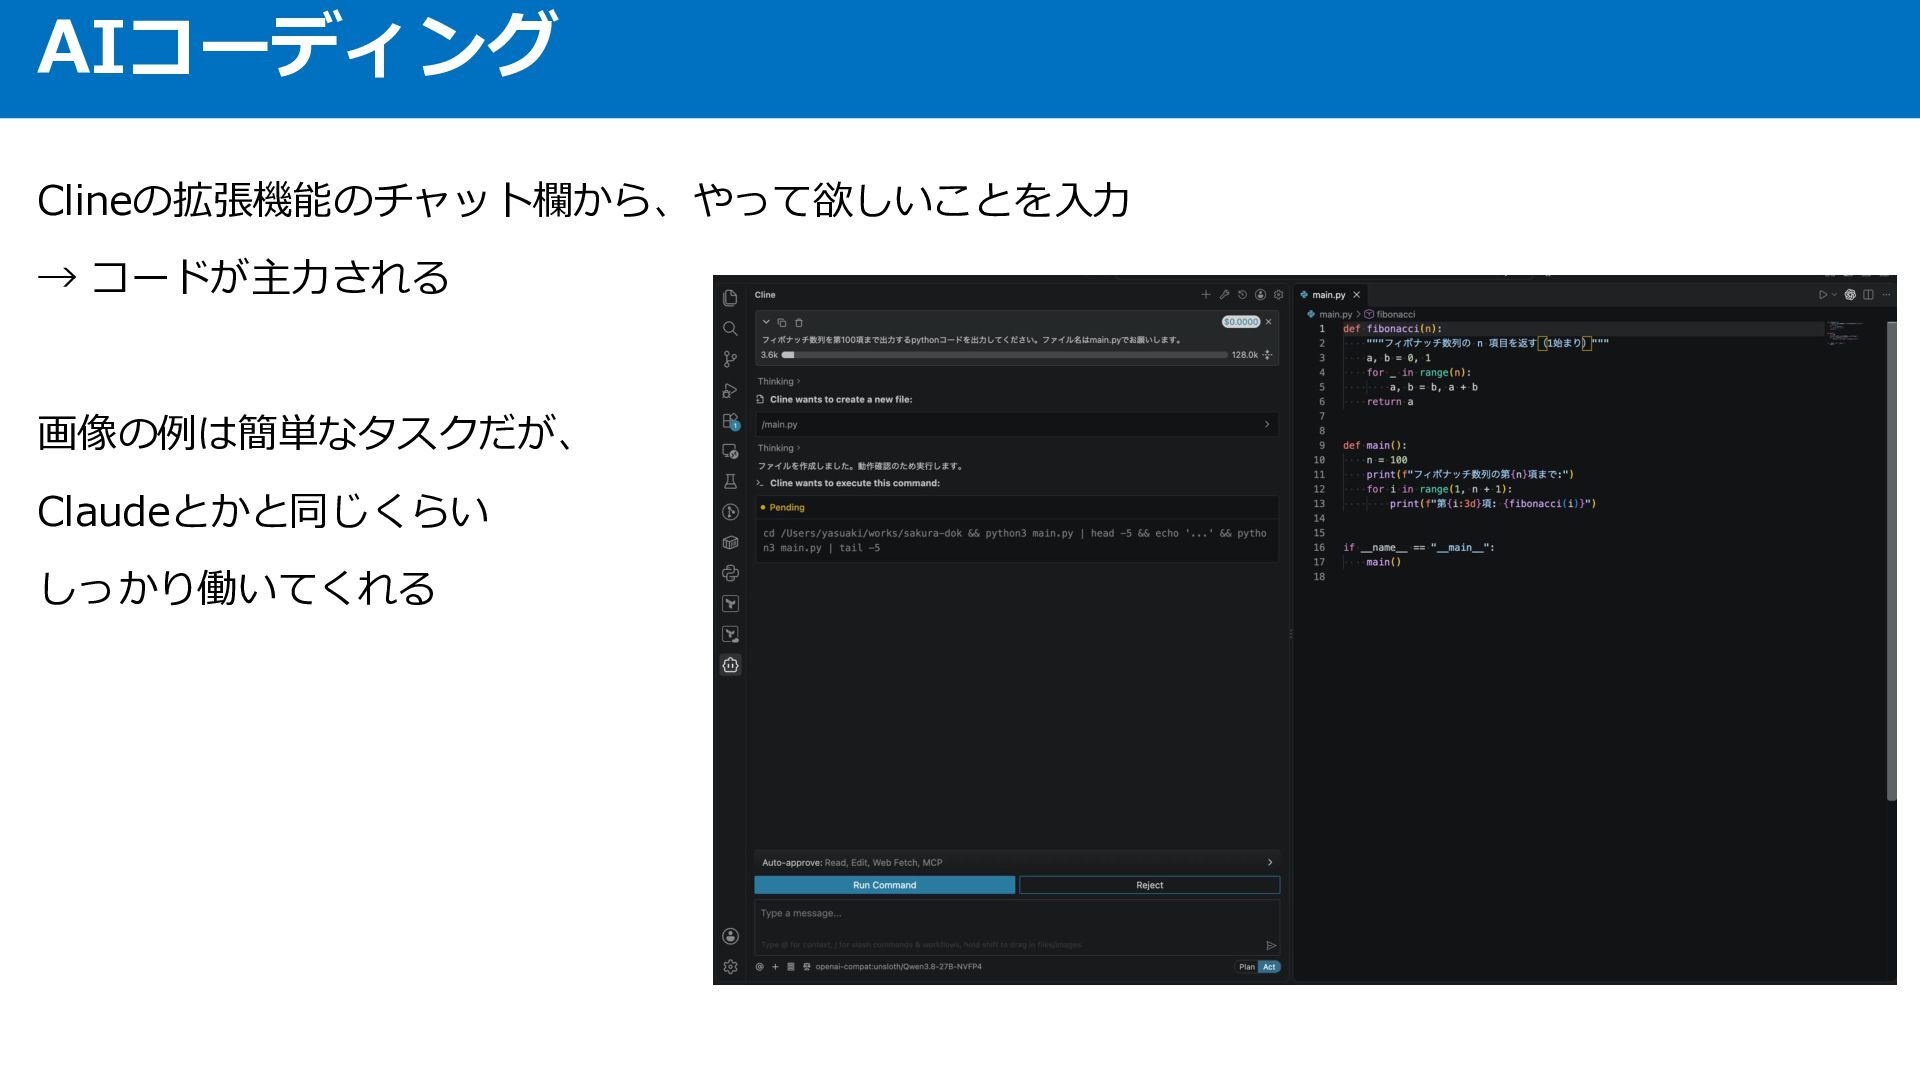
AIコーディング Clineの拡張機能のチャット欄から、やって欲しいことを入力 → コードが主力される
AIコーディング Clineの拡張機能のチャット欄から、やって欲しいことを入力 → コードが主力される 画像の例は簡単なタスクだが、 Claudeとかと同じくらい しっかり働いてくれる
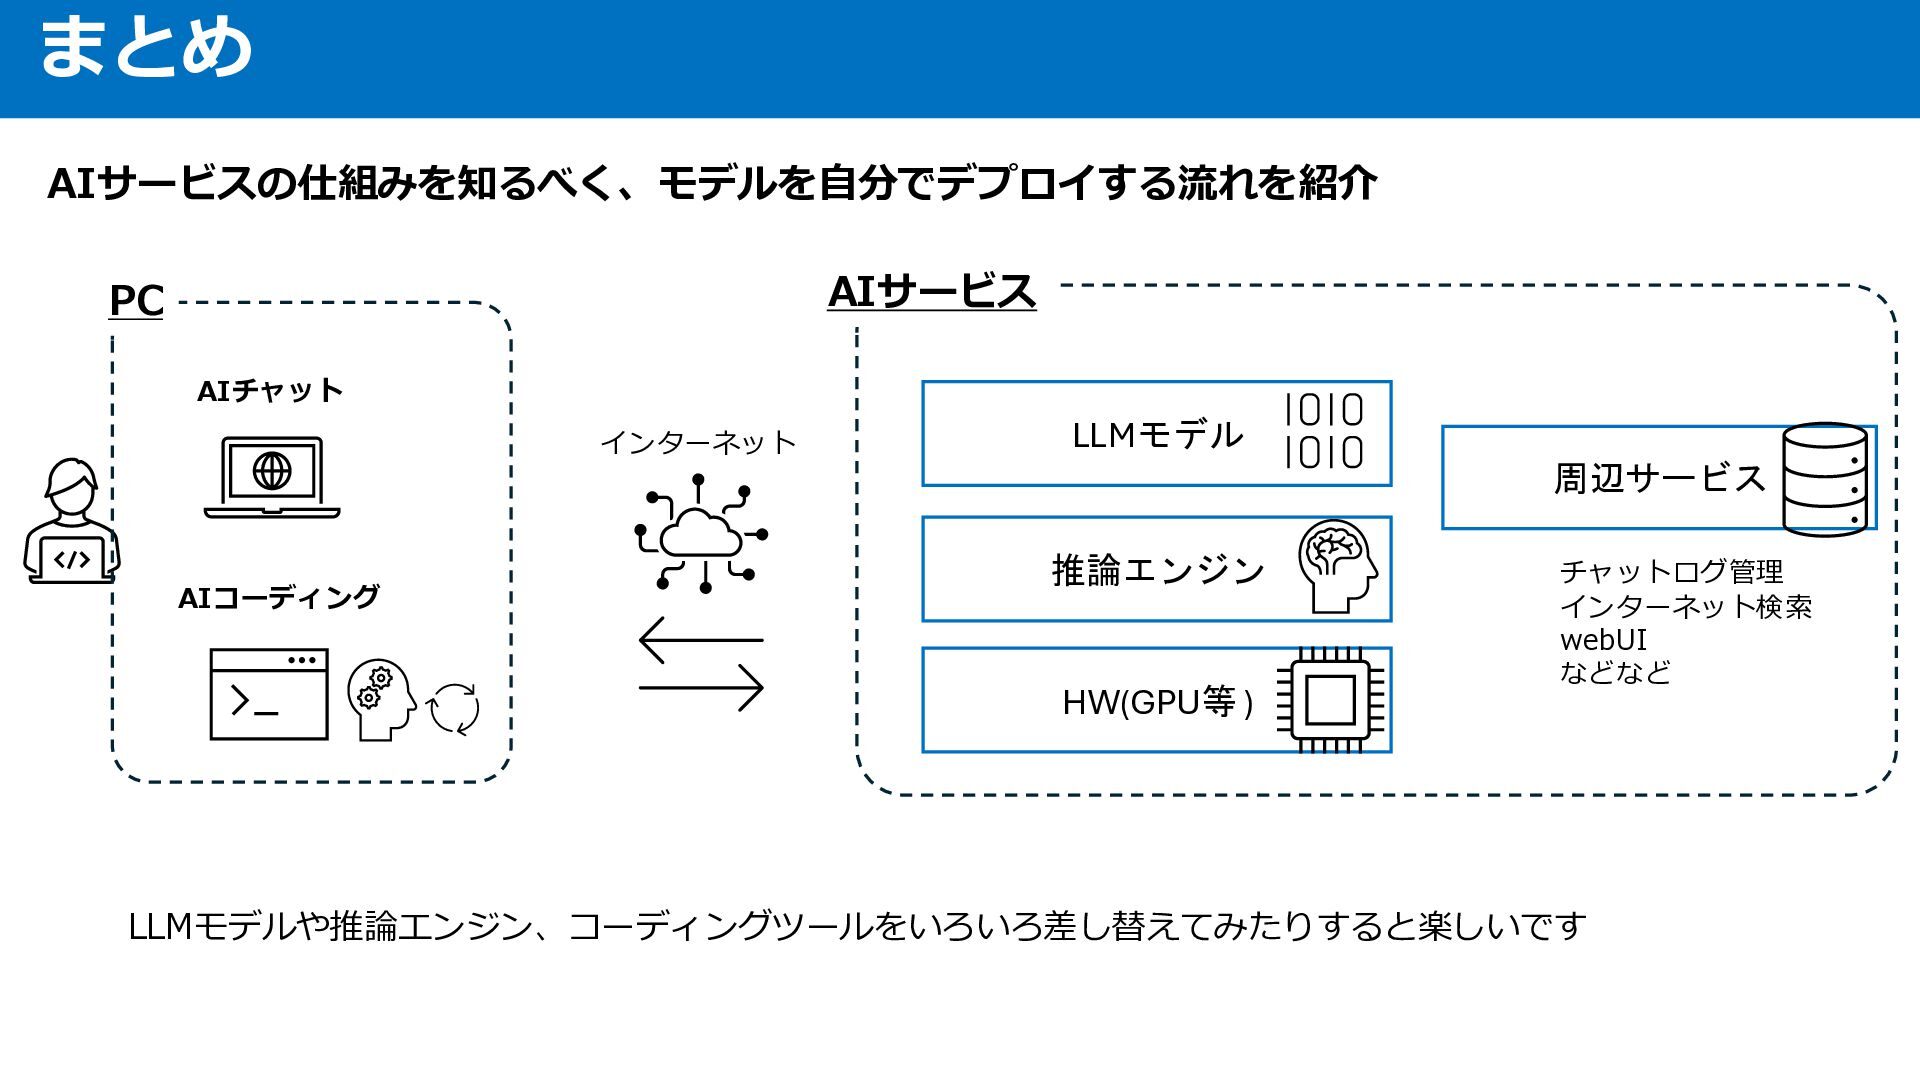
まとめ AIサービスの仕組みを知るべく、モデルを自分でデプロイする流れを紹介 AIサービス PC AIチャット インターネット LLMモデル 周辺サービス AIコーディング 推論エンジン
HW(GPU等 ) チャットログ管理 インターネット検索 webUI などなど LLMモデルや推論エンジン、コーディングツールをいろいろ差し替えてみたりすると楽しいです


 y_sera15
 tomzoh
 yama3133
 oracle4engineer
 ryotarai
 yohyamasaki
 sony
 shreyas1009
 vivion
 kairim0
 shisyu_gaku
 recruitengineers
 szymonslowik
 uxyall
 jct
 lara
 jeffersonlam
 lfama
 joshbly
 sergeychernyshev
 mojombo
 skoyamalab
 sonatard
 keathley