Share
Embed
Transcript
30 slides
-
www.albert2005.co.jp/ 本社 〒169-0074 東京都新宿区北新宿2-21-1 新宿フロントタワー15F TEL: 03-5937-1610 FAX: 03-5937-1612 東海⽀社
〒451-6008 愛知県名古屋市⻄区⽜島町6-1 名古屋ルーセントタワー8F TEL: 052-433-3701 FAX: 052-433-3702 正則化による変数選択の解説と応⽤例の紹介 2020 年 9 ⽉ 8 ⽇ 第三回 Data Science Cafe ビジネス推進本部 製造・⾃動⾞部 ⾃動⾞セクション アナリスト ⼤⽊ 俊幸 -
⽬次 I. 変数選択としての正則化法 1. 変数選択概論 2. 正則化法の導⼊ 3. 正則化法の例 II.
IIG Lasso の提案と紹介 1. 課題設定 2. IIGLasso 3. 数値実験 © 2020 ALBERT Inc. 2 -
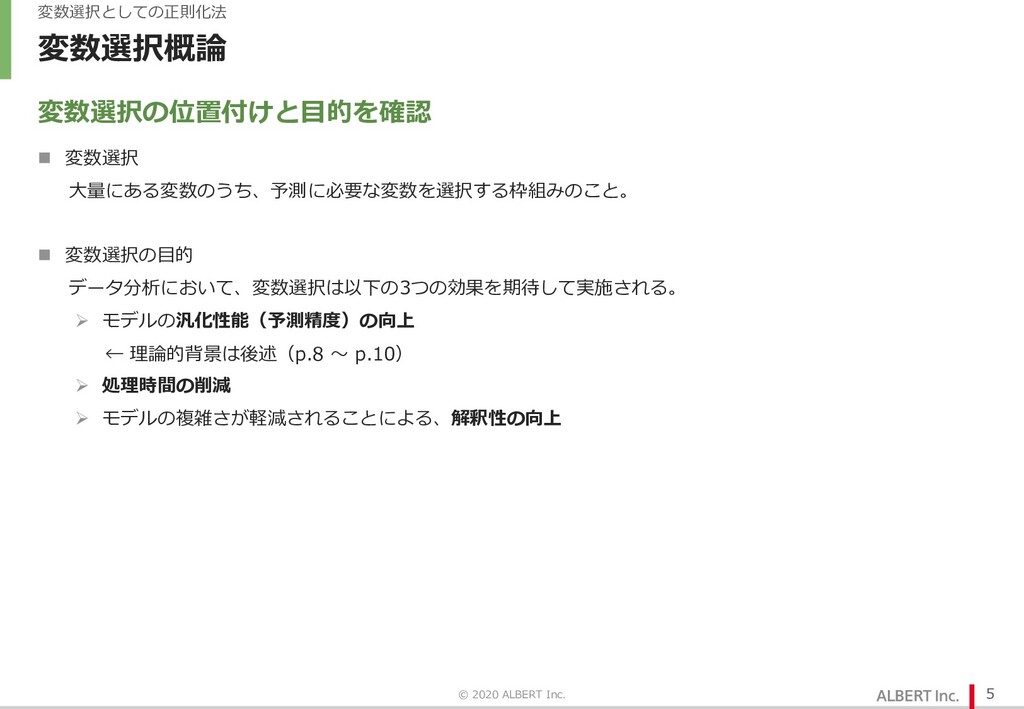
変数選択概論 n 変数選択 ⼤量にある変数のうち、予測に必要な変数を選択する枠組みのこと。 n 変数選択の⽬的 データ分析において、変数選択は以下の3つの効果を期待して実施される。 Ø モデルの汎化性能(予測精度)の向上 ←
理論的背景は後述(p.8 〜 p.10) Ø 処理時間の削減 Ø モデルの複雑さが軽減されることによる、解釈性の向上 © 2020 ALBERT Inc. 5 変数選択としての正則化法 変数選択の位置付けと⽬的を確認 -
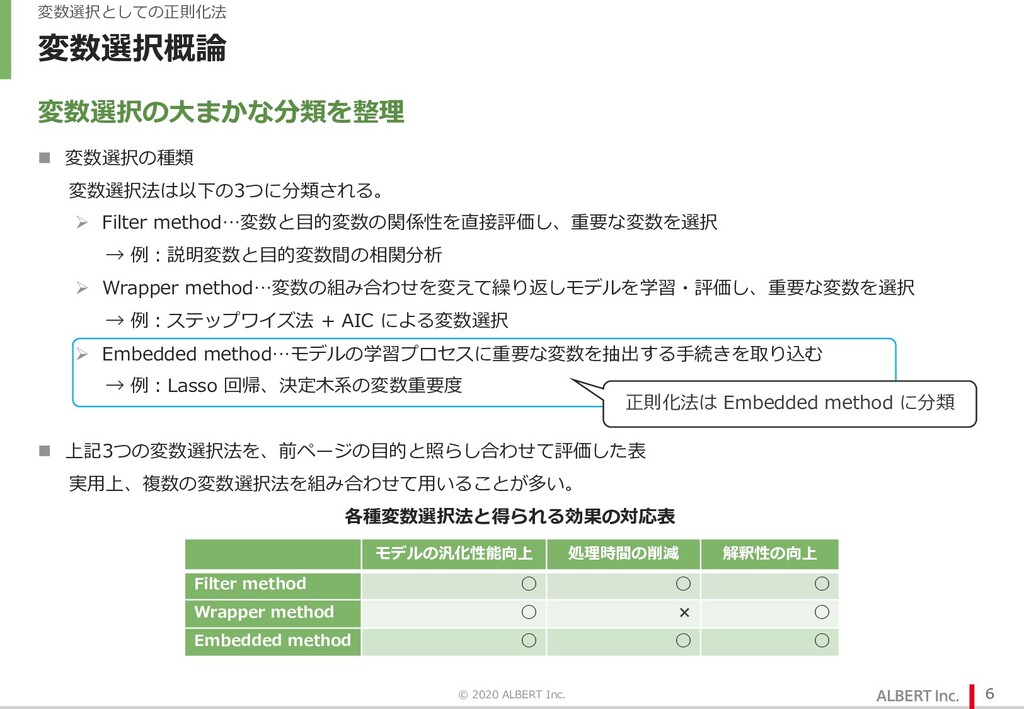
変数選択概論 n 変数選択の種類 変数選択法は以下の3つに分類される。 Ø Filter method…変数と⽬的変数の関係性を直接評価し、重要な変数を選択 → 例︓説明変数と⽬的変数間の相関分析 Ø
Wrapper method…変数の組み合わせを変えて繰り返しモデルを学習・評価し、重要な変数を選択 → 例︓ステップワイズ法 + AIC による変数選択 Ø Embedded method…モデルの学習プロセスに重要な変数を抽出する⼿続きを取り込む → 例︓Lasso 回帰、決定⽊系の変数重要度 n 上記3つの変数選択法を、前ページの⽬的と照らし合わせて評価した表 実⽤上、複数の変数選択法を組み合わせて⽤いることが多い。 © 2020 ALBERT Inc. 6 変数選択としての正則化法 変数選択の⼤まかな分類を整理 正則化法は Embedded method に分類 モデルの汎化性能向上 処理時間の削減 解釈性の向上 Filter method ◯ ◯ ◯ Wrapper method ◯ × ◯ Embedded method ◯ ◯ ◯ 各種変数選択法と得られる効果の対応表 -
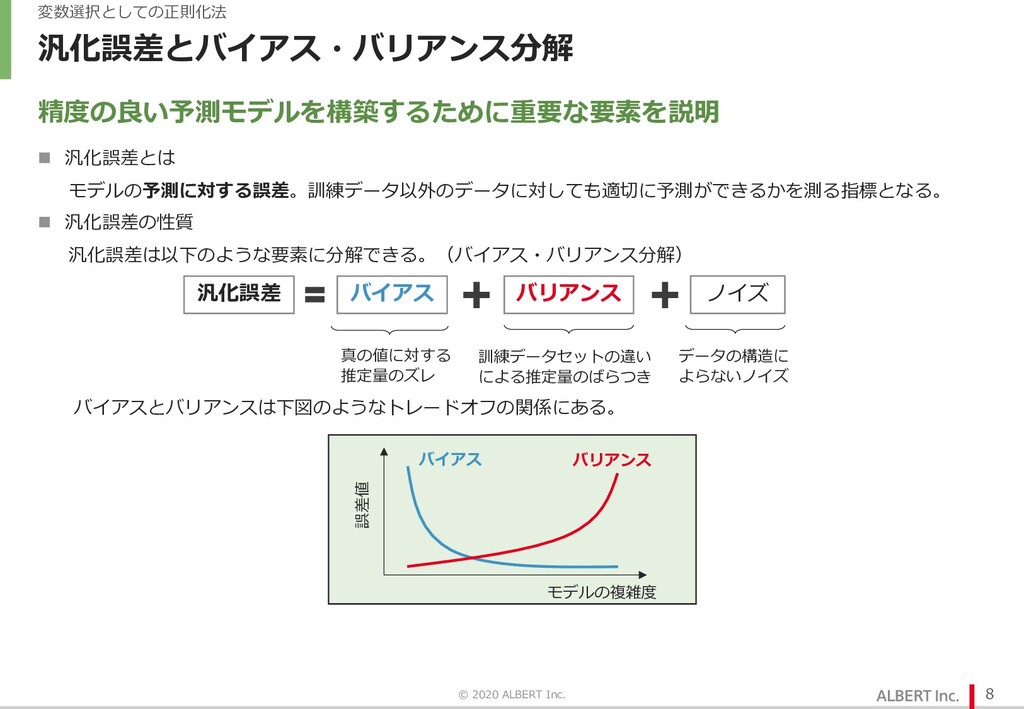
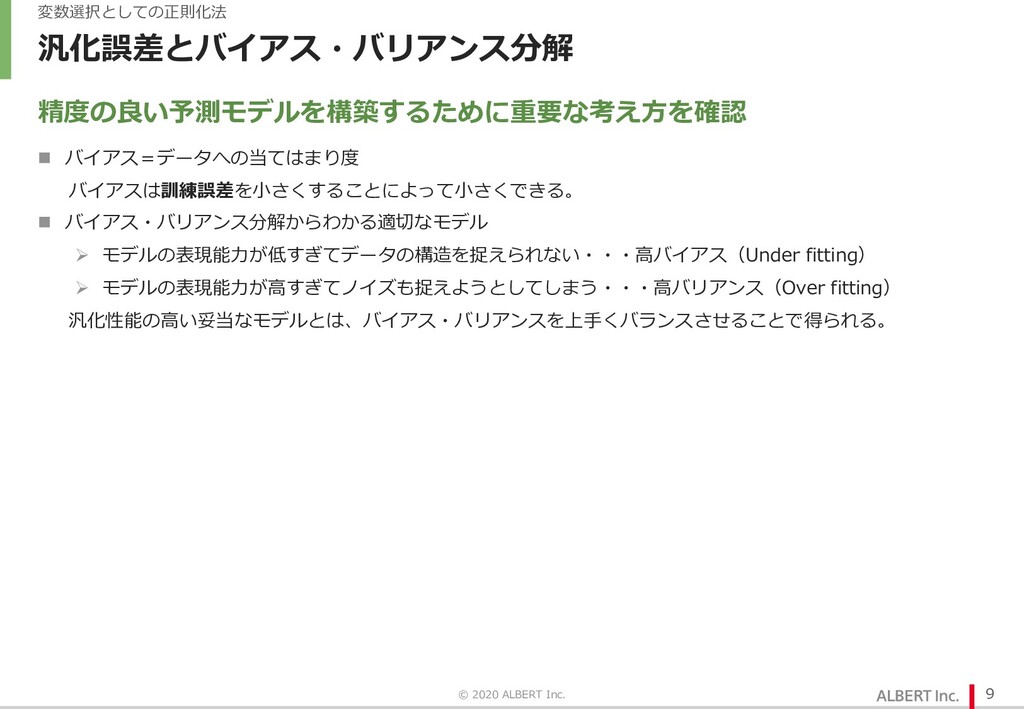
汎化誤差とバイアス・バリアンス分解 n 汎化誤差とは モデルの予測に対する誤差。訓練データ以外のデータに対しても適切に予測ができるかを測る指標となる。 n 汎化誤差の性質 汎化誤差は以下のような要素に分解できる。(バイアス・バリアンス分解) バイアスとバリアンスは下図のようなトレードオフの関係にある。 © 2020
ALBERT Inc. 8 変数選択としての正則化法 精度の良い予測モデルを構築するために重要な要素を説明 バイアス バリアンス ノイズ 汎化誤差 真の値に対する 推定量のズレ 訓練データセットの違い による推定量のばらつき データの構造に よらないノイズ モデルの複雑度 誤差値 バイアス バリアンス -
汎化誤差とバイアス・バリアンス分解 n バイアス=データへの当てはまり度 バイアスは訓練誤差を⼩さくすることによって⼩さくできる。 n バイアス・バリアンス分解からわかる適切なモデル Ø モデルの表現能⼒が低すぎてデータの構造を捉えられない・・・⾼バイアス(Under fitting) Ø
モデルの表現能⼒が⾼すぎてノイズも捉えようとしてしまう・・・⾼バリアンス(Over fitting) 汎化性能の⾼い妥当なモデルとは、バイアス・バリアンスを上⼿くバランスさせることで得られる。 © 2020 ALBERT Inc. 9 変数選択としての正則化法 精度の良い予測モデルを構築するために重要な考え⽅を確認 -
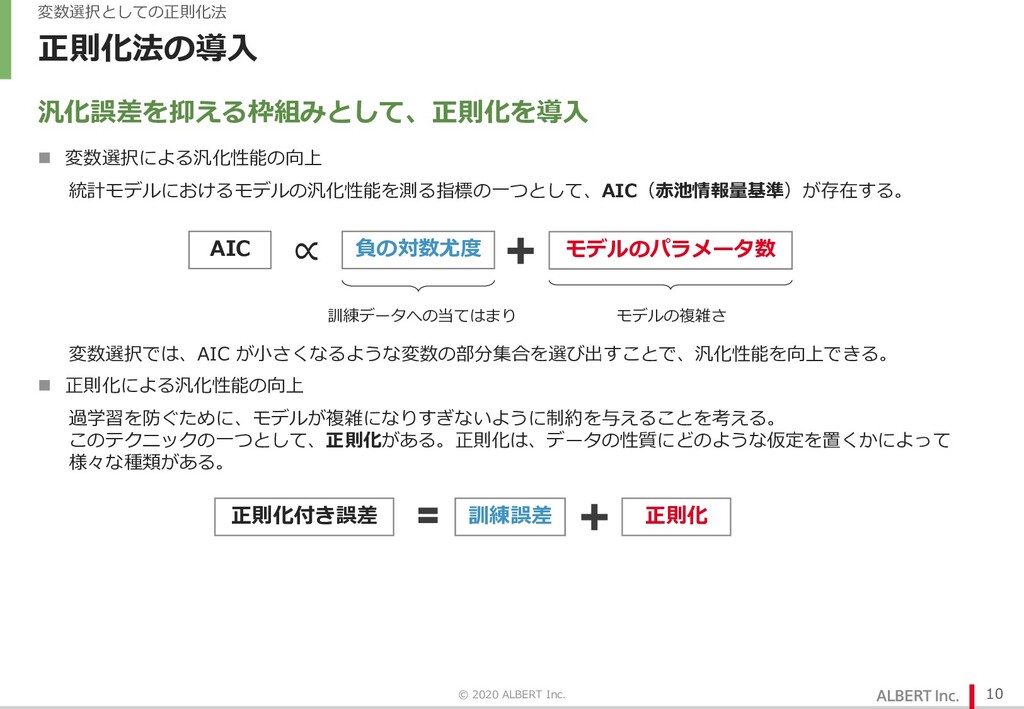
正則化法の導⼊ n 変数選択による汎化性能の向上 統計モデルにおけるモデルの汎化性能を測る指標の⼀つとして、AIC(⾚池情報量基準)が存在する。 変数選択では、AIC が⼩さくなるような変数の部分集合を選び出すことで、汎化性能を向上できる。 n 正則化による汎化性能の向上 過学習を防ぐために、モデルが複雑になりすぎないように制約を与えることを考える。 このテクニックの⼀つとして、正則化がある。正則化は、データの性質にどのような仮定を置くかによって
様々な種類がある。 © 2020 ALBERT Inc. 10 変数選択としての正則化法 汎化誤差を抑える枠組みとして、正則化を導⼊ 負の対数尤度 モデルのパラメータ数 AIC ∝ 訓練データへの当てはまり モデルの複雑さ 正則化付き誤差 訓練誤差 正則化 -
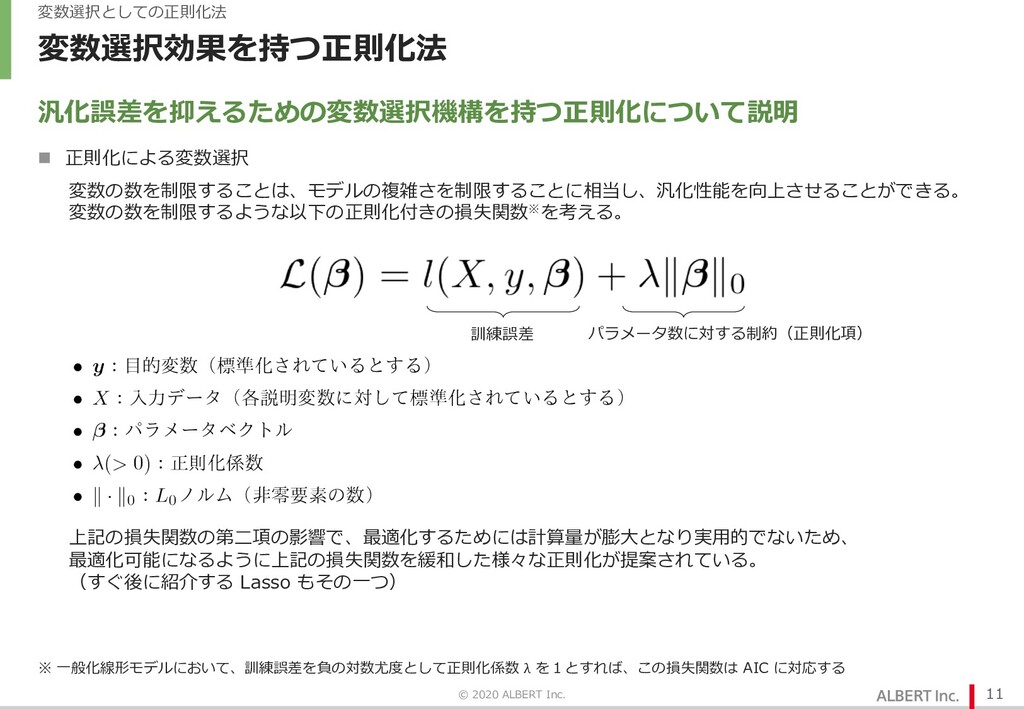
変数選択効果を持つ正則化法 n 正則化による変数選択 変数の数を制限することは、モデルの複雑さを制限することに相当し、汎化性能を向上させることができる。 変数の数を制限するような以下の正則化付きの損失関数※を考える。 上記の損失関数の第⼆項の影響で、最適化するためには計算量が膨⼤となり実⽤的でないため、 最適化可能になるように上記の損失関数を緩和した様々な正則化が提案されている。 (すぐ後に紹介する Lasso もその⼀つ)
© 2020 ALBERT Inc. 11 変数選択としての正則化法 ※ ⼀般化線形モデルにおいて、訓練誤差を負の対数尤度として正則化係数 λ を1とすれば、この損失関数は AIC に対応する 汎化誤差を抑えるための変数選択機構を持つ正則化について説明 訓練誤差 パラメータ数に対する制約(正則化項) -
Lasso(Least Absolute Shrinkage and Selection Operator)[1] n Lasso とは 予測に寄与しない変数の係数は⾃動的に0と推定(スパース推定)する、変数選択機能を持った正則化法。
n 線形回帰における定式化 損失関数は以下のようになる。 © 2020 ALBERT Inc. 13 変数選択としての正則化法 多くの派⽣形を持つ正則化法の代表例 -
Group Lasso[2] n Group Lasso※ とは あらかじめ変数をグルーピングすることで、変数をグループ単位で取捨選択する⼿法。 n 線形回帰における定式化 損失関数は以下のようになる。
© 2020 ALBERT Inc. 14 変数選択としての正則化法 ※ 簡単のため、ここではグループ間に重複する変数がない場合のみ扱う。 変数をグループ単位で取捨選択可能な正則化法 -
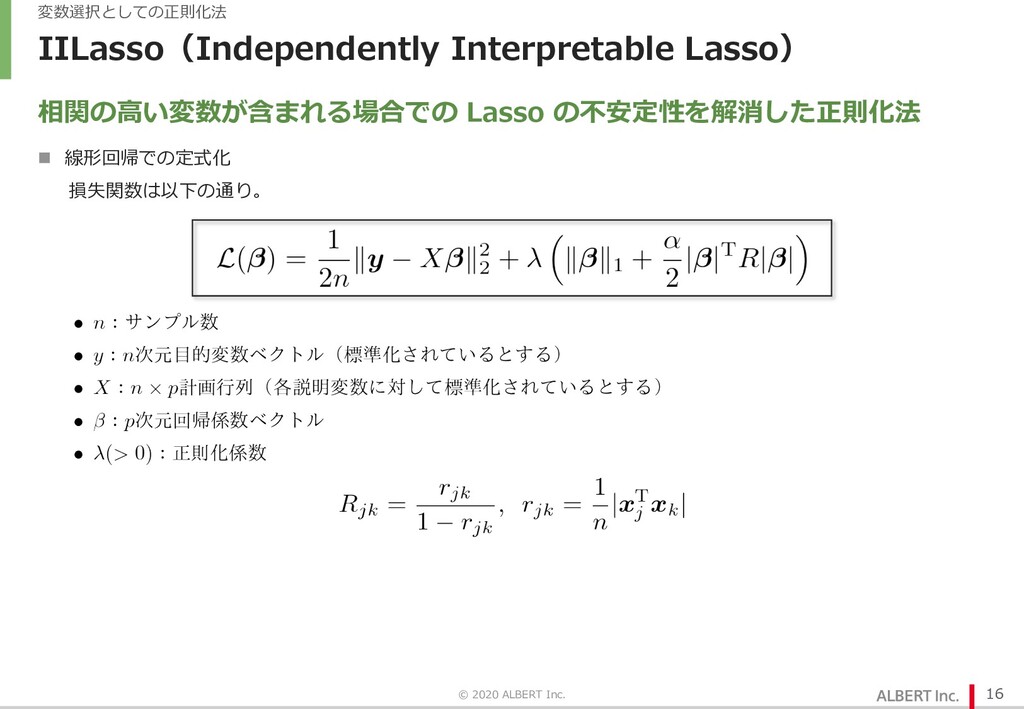
IILasso(Independently Interpretable Lasso)[3] n IILasso とは 変数間の相関が⾮常に⾼い場合に⽚⽅の変数を落とすことで、精度が不安定になったり、 解釈性が低下するという Lasso の持つ弱点を解決した⼿法。
© 2020 ALBERT Inc. 15 変数選択としての正則化法 相関の⾼い変数が含まれる場合での Lasso の不安定性を解消した正則化法 Lassoの弱点を表す図︓[3]より引⽤ Lasso に説明変数の相関に強さに応じた ペナルティを付与する項を付与することで回避。 (A)と(B)どちらも同じ予測を与えるが、 Lassoでは(B)が選ばれる。 → 解釈性しづらいモデルが選ばれてしまう。 -
IILasso(Independently Interpretable Lasso) n 線形回帰での定式化 損失関数は以下の通り。 © 2020 ALBERT Inc.
16 変数選択としての正則化法 相関の⾼い変数が含まれる場合での Lasso の不安定性を解消した正則化法 -
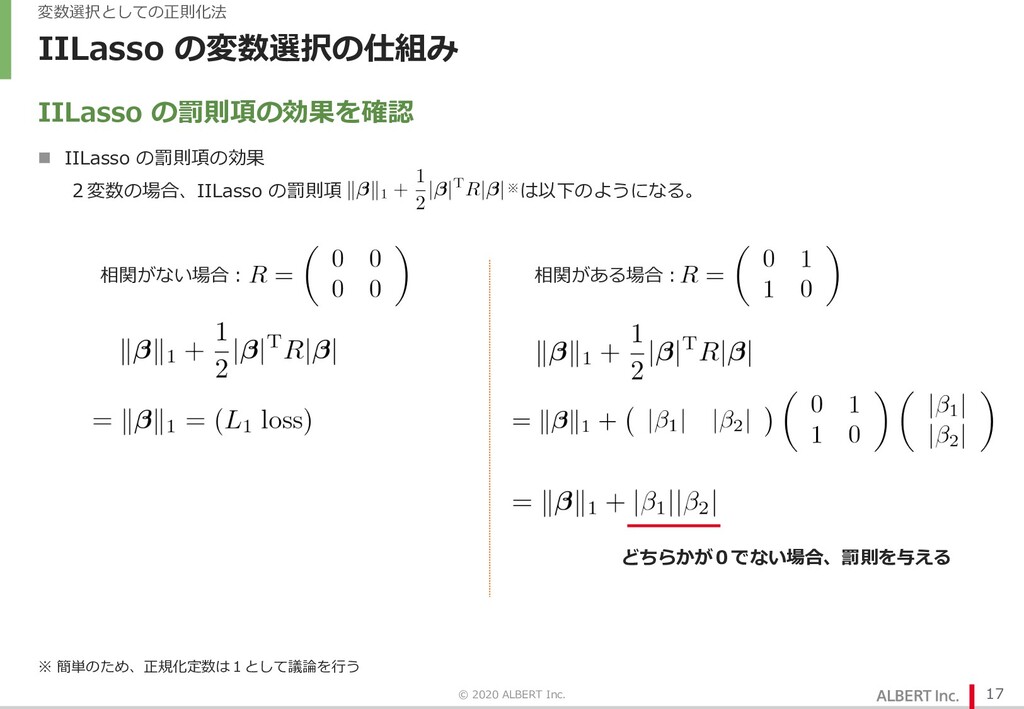
IILasso の変数選択の仕組み n IILasso の罰則項の効果 2変数の場合、IILasso の罰則項 ※は以下のようになる。 © 2020
ALBERT Inc. 17 変数選択としての正則化法 ※ 簡単のため、正規化定数は1として議論を⾏う IILasso の罰則項の効果を確認 相関がない場合︓ 相関がある場合︓ どちらかが0でない場合、罰則を与える -
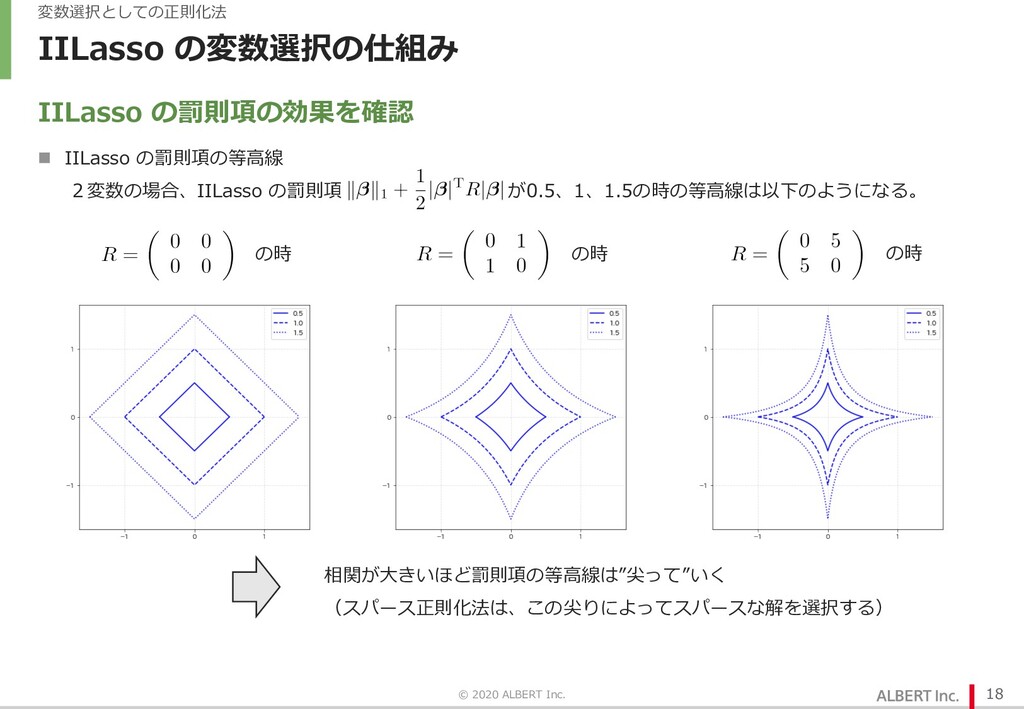
IILasso の変数選択の仕組み n IILasso の罰則項の等⾼線 2変数の場合、IILasso の罰則項 が0.5、1、1.5の時の等⾼線は以下のようになる。 © 2020
ALBERT Inc. 18 変数選択としての正則化法 IILasso の罰則項の効果を確認 の時 の時 の時 相関が⼤きいほど罰則項の等⾼線は”尖って”いく (スパース正則化法は、この尖りによってスパースな解を選択する) -
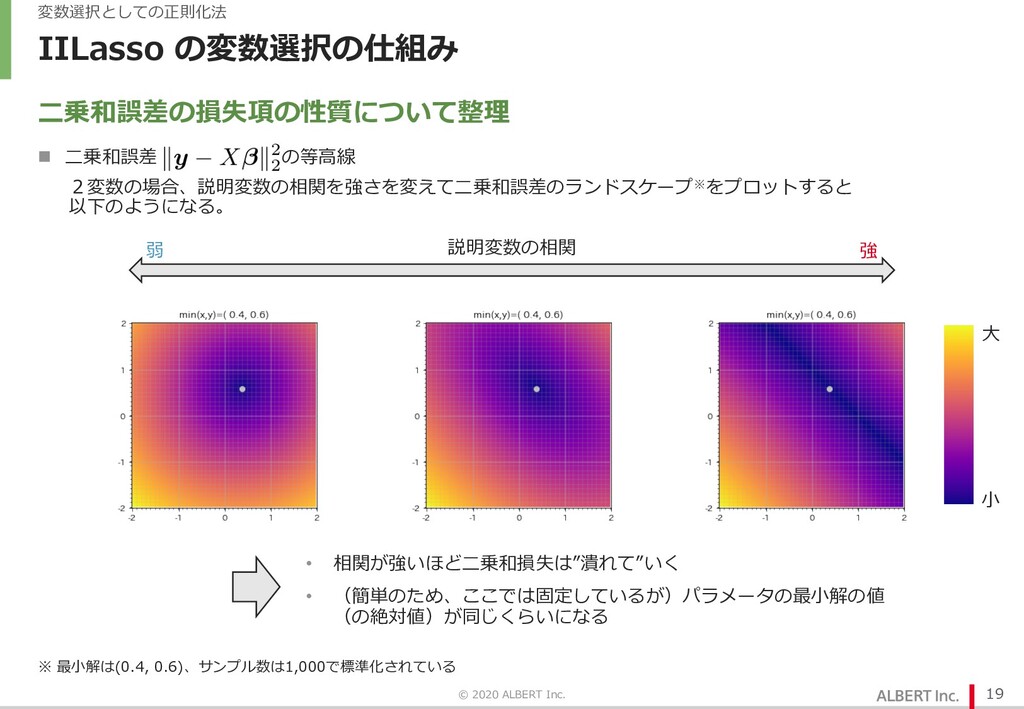
IILasso の変数選択の仕組み n ⼆乗和誤差 の等⾼線 2変数の場合、説明変数の相関を強さを変えて⼆乗和誤差のランドスケープ※をプロットすると 以下のようになる。 © 2020 ALBERT
Inc. 19 変数選択としての正則化法 ※ 最⼩解は(0.4, 0.6)、サンプル数は1,000で標準化されている ⼆乗和誤差の損失項の性質について整理 • 相関が強いほど⼆乗和損失は”潰れて”いく • (簡単のため、ここでは固定しているが)パラメータの最⼩解の値 (の絶対値)が同じくらいになる 説明変数の相関 強 弱 ⼤ ⼩ -
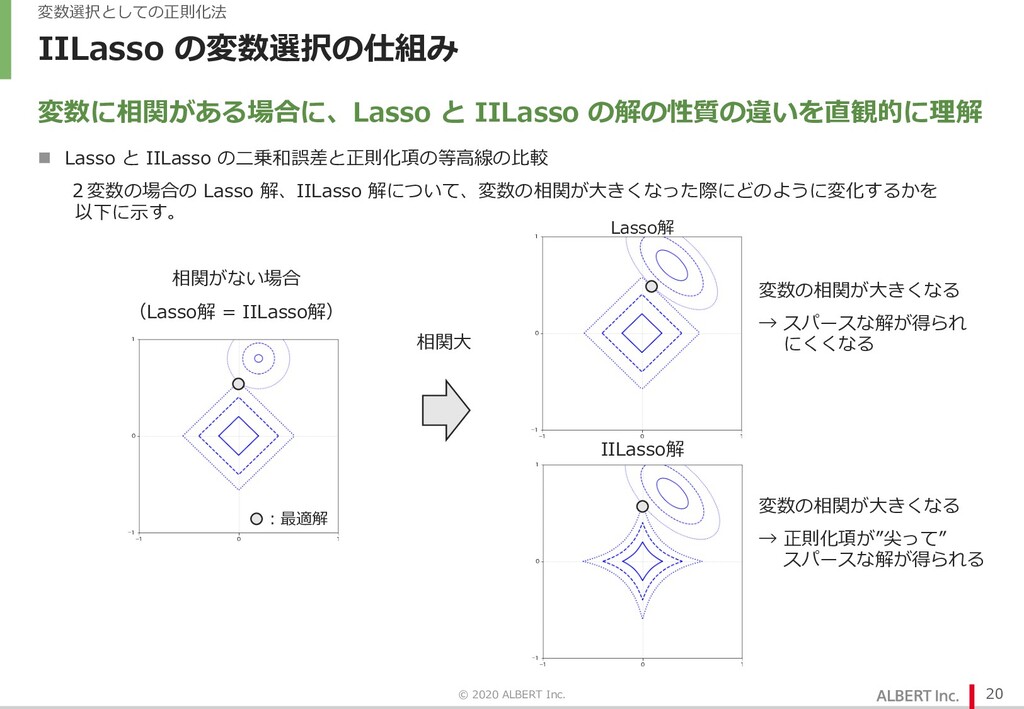
IILasso の変数選択の仕組み n Lasso と IILasso の⼆乗和誤差と正則化項の等⾼線の⽐較 2変数の場合の Lasso 解、IILasso
解について、変数の相関が⼤きくなった際にどのように変化するかを 以下に⽰す。 © 2020 ALBERT Inc. 20 変数選択としての正則化法 変数に相関がある場合に、Lasso と IILasso の解の性質の違いを直観的に理解 相関⼤ 相関がない場合 (Lasso解 = IILasso解) Lasso解 IILasso解 ︓最適解 変数の相関が⼤きくなる → スパースな解が得られ にくくなる 変数の相関が⼤きくなる → 正則化項が”尖って” スパースな解が得られる -
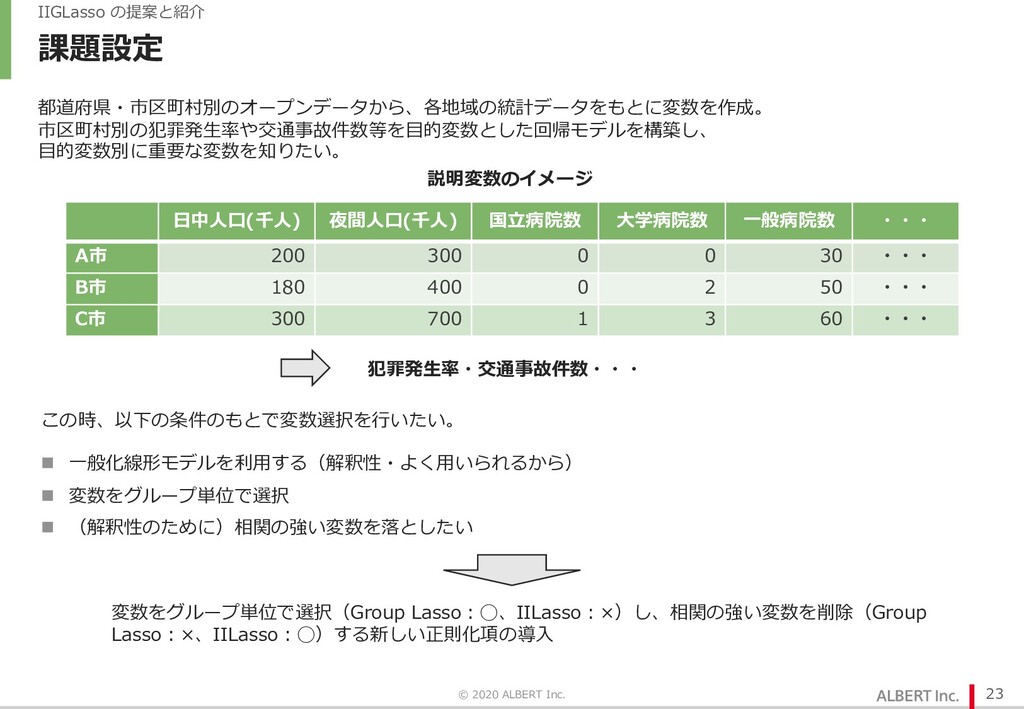
課題設定 © 2020 ALBERT Inc. 23 IIGLasso の提案と紹介 都道府県・市区町村別のオープンデータから、各地域の統計データをもとに変数を作成。 市区町村別の犯罪発⽣率や交通事故件数等を⽬的変数とした回帰モデルを構築し、
⽬的変数別に重要な変数を知りたい。 n ⼀般化線形モデルを利⽤する(解釈性・よく⽤いられるから) n 変数をグループ単位で選択 n (解釈性のために)相関の強い変数を落としたい この時、以下の条件のもとで変数選択を⾏いたい。 ⽇中⼈⼝(千⼈) 夜間⼈⼝(千⼈) 国⽴病院数 ⼤学病院数 ⼀般病院数 ・・・ A市 200 300 0 0 30 ・・・ B市 180 400 0 2 50 ・・・ C市 300 700 1 3 60 ・・・ 説明変数のイメージ 犯罪発⽣率・交通事故件数・・・ 変数をグループ単位で選択(Group Lasso︓◯、IILasso︓×)し、相関の強い変数を削除(Group Lasso︓×、IILasso︓◯)する新しい正則化項の導⼊ -
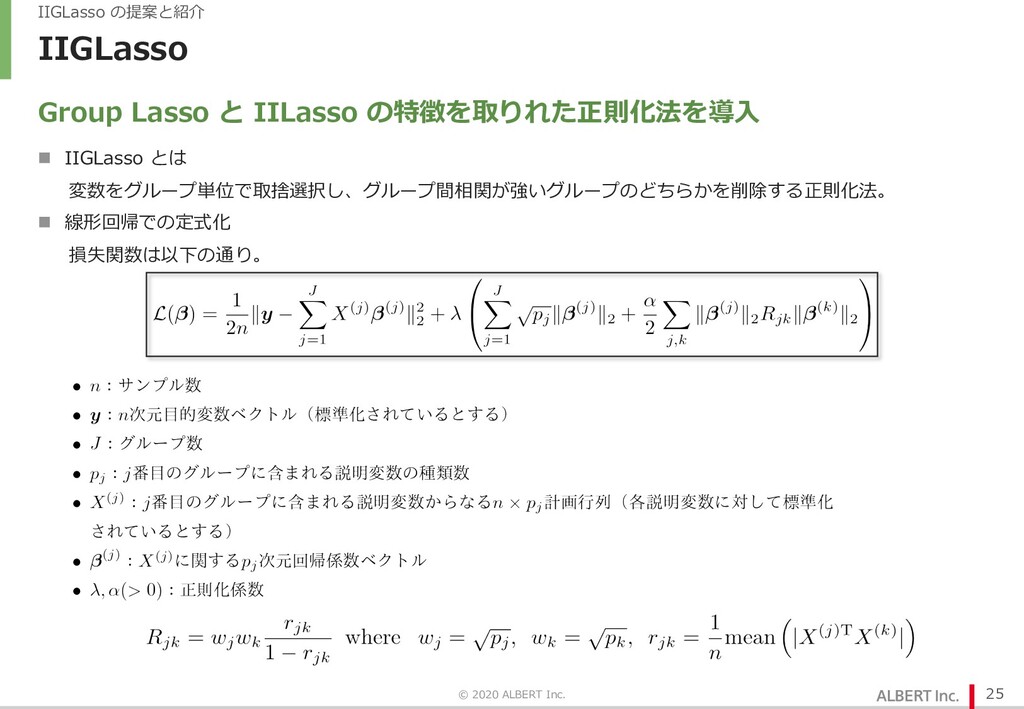
IIGLasso n IIGLasso とは 変数をグループ単位で取捨選択し、グループ間相関が強いグループのどちらかを削除する正則化法。 n 線形回帰での定式化 損失関数は以下の通り。 © 2020
ALBERT Inc. 25 IIGLasso の提案と紹介 Group Lasso と IILasso の特徴を取りれた正則化法を導⼊ -
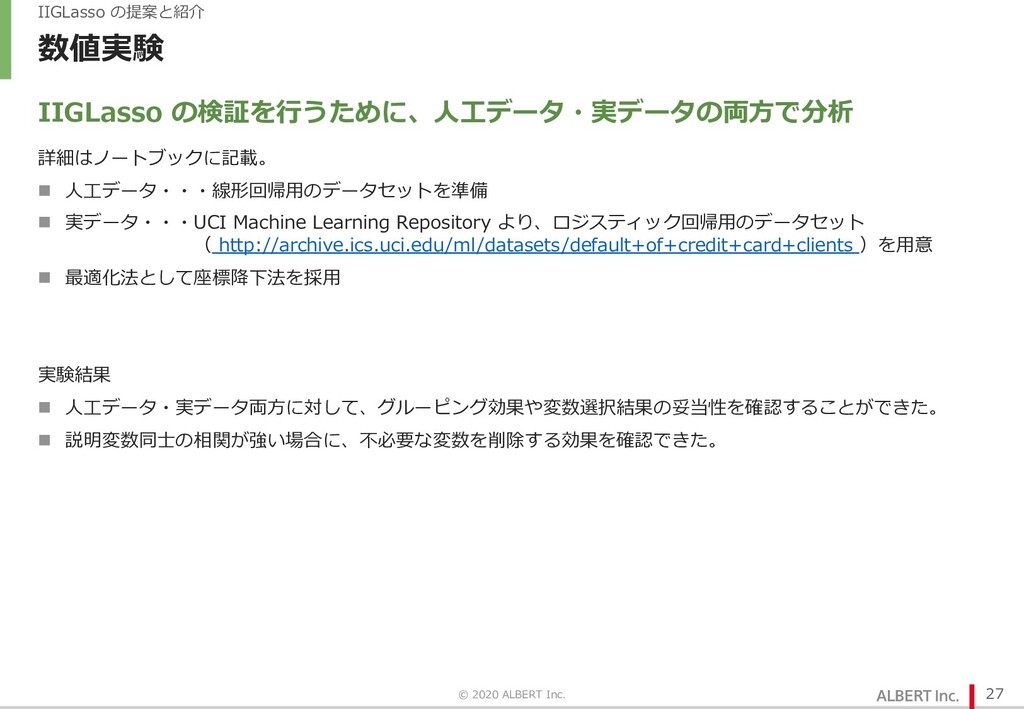
数値実験 詳細はノートブックに記載。 n ⼈⼯データ・・・線形回帰⽤のデータセットを準備 n 実データ・・・UCI Machine Learning Repository より、ロジスティック回帰⽤のデータセット
( http://archive.ics.uci.edu/ml/datasets/default+of+credit+card+clients )を⽤意 n 最適化法として座標降下法を採⽤ 実験結果 n ⼈⼯データ・実データ両⽅に対して、グルーピング効果や変数選択結果の妥当性を確認することができた。 n 説明変数同⼠の相関が強い場合に、不必要な変数を削除する効果を確認できた。 © 2020 ALBERT Inc. 27 IIGLasso の提案と紹介 IIGLasso の検証を⾏うために、⼈⼯データ・実データの両⽅で分析 -
まとめ © 2020 ALBERT Inc. 28 n 変数選択と正則化について簡単に解説し、変数選択法としての正則化法を紹介。 n 実案件における課題から新しい正則化法を提案して、実装・検証を⾏った。
今後の課題として以下が挙げられる。 Ø 理論的な解析 Ø 相関のペナルティ項のチューニング Ø 処理の⾼速化 Ø 他の⼀般化回帰モデルへの拡張 -
参考⽂献 © 2020 ALBERT Inc. 29 [1]︓Robert Tibshirani, “Regression Shrinkage
and Selection via the Lasso.” Journal of the Royal Statistical Society. Series B (1996) [2]︓M. Yuan et al, “Model selection and estimation in regression with grouped variables”, J.R. Statist. Soc. B. (2006) [3]︓M. Takada et al, “Independently Interpretable Lasso: A new Regularrizer for sparse Regression with uncorrelated variables”, AISTATS proceedings (2017)