Share
Embed
Transcript
14 slides
-
1 Copyright 2022 NTT CORPORATION 自己紹介 安藤 厚志 (あんどう あつし)
• 略歴 – 2013.3 名古屋大学大学院 情報科学研究科 博士前期課程 修了 – 2013.4- 日本電信電話株式会社入社、現職 – 2021.9 名古屋大学大学院 情報学研究科 博士(情報学) • 研究分野: 非言語・パラ言語情報の認識 – 感情認識、意図分類、話者認識・話者ダイアライゼーション • 学術活動 – 2018- 日本音響学会 学生・若手フォーラム 委員 – 2019- 音声研究委員会 専門委員 -
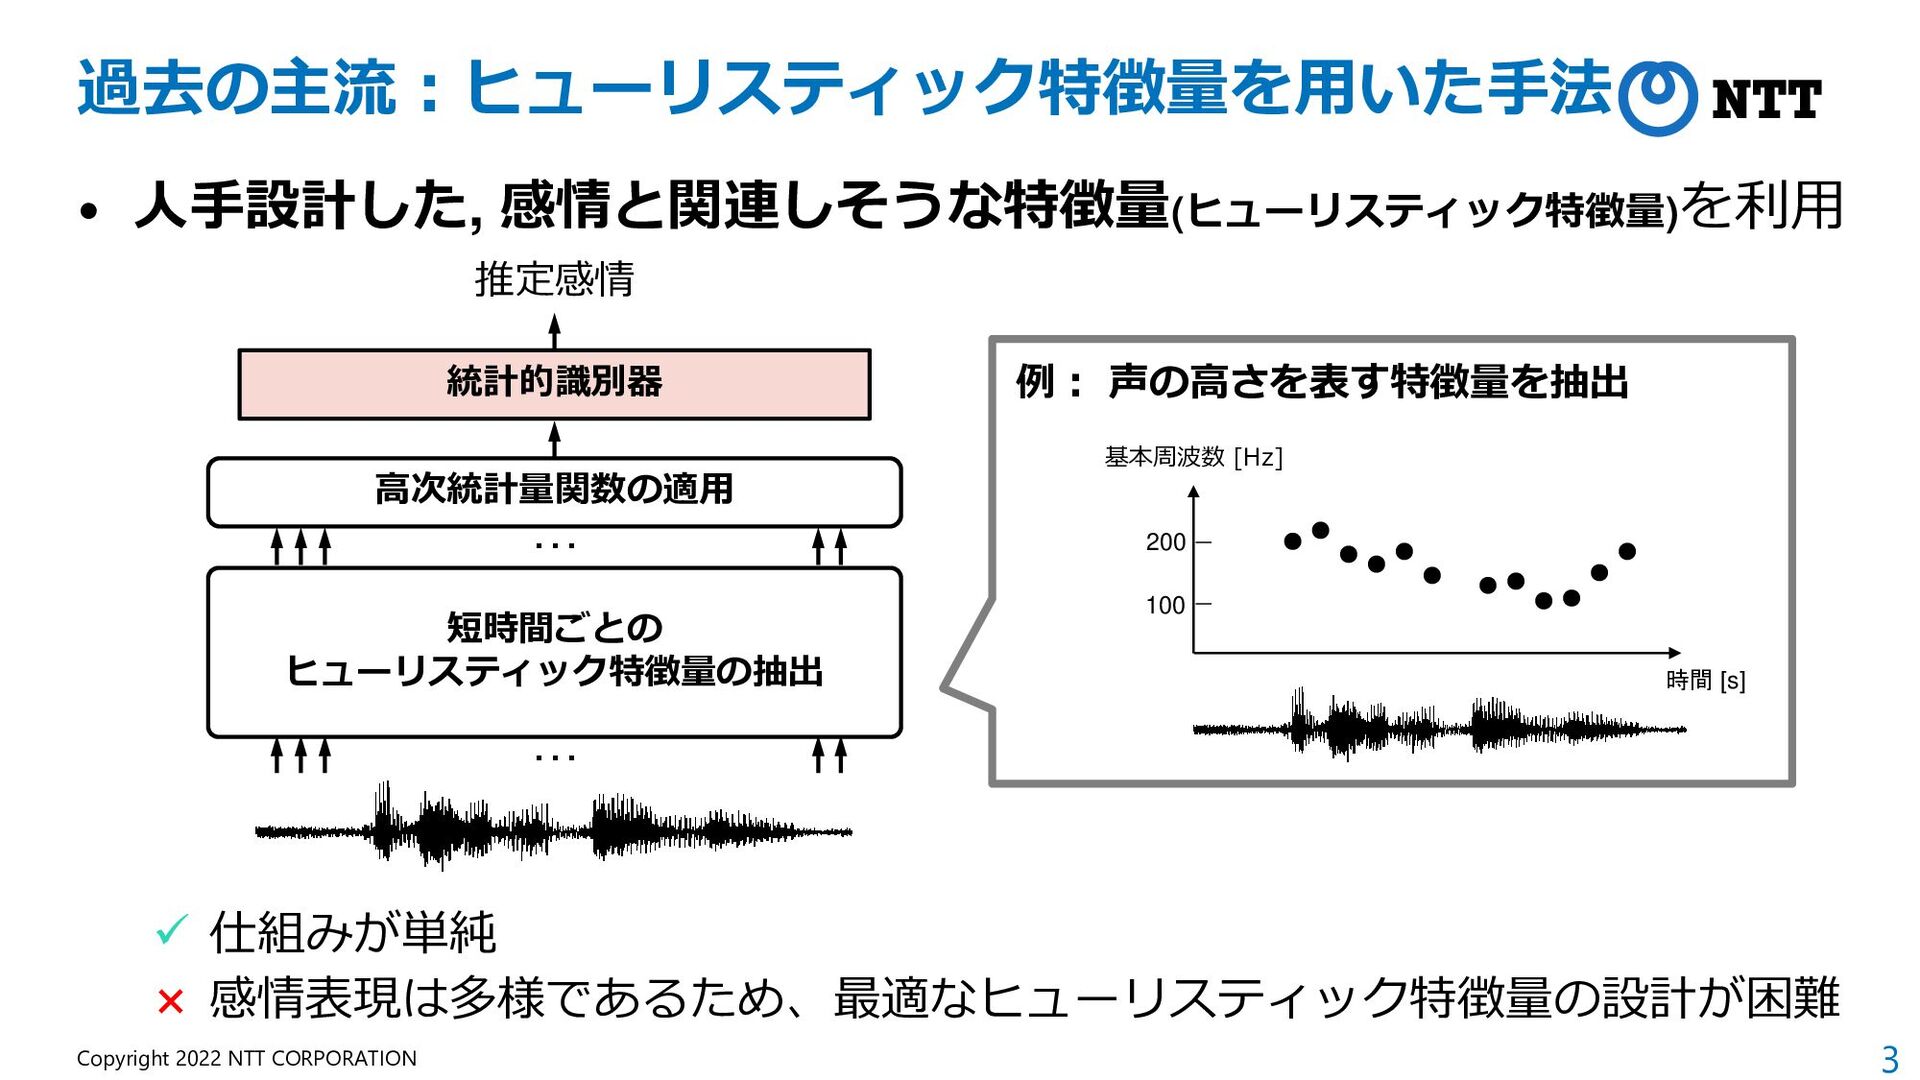
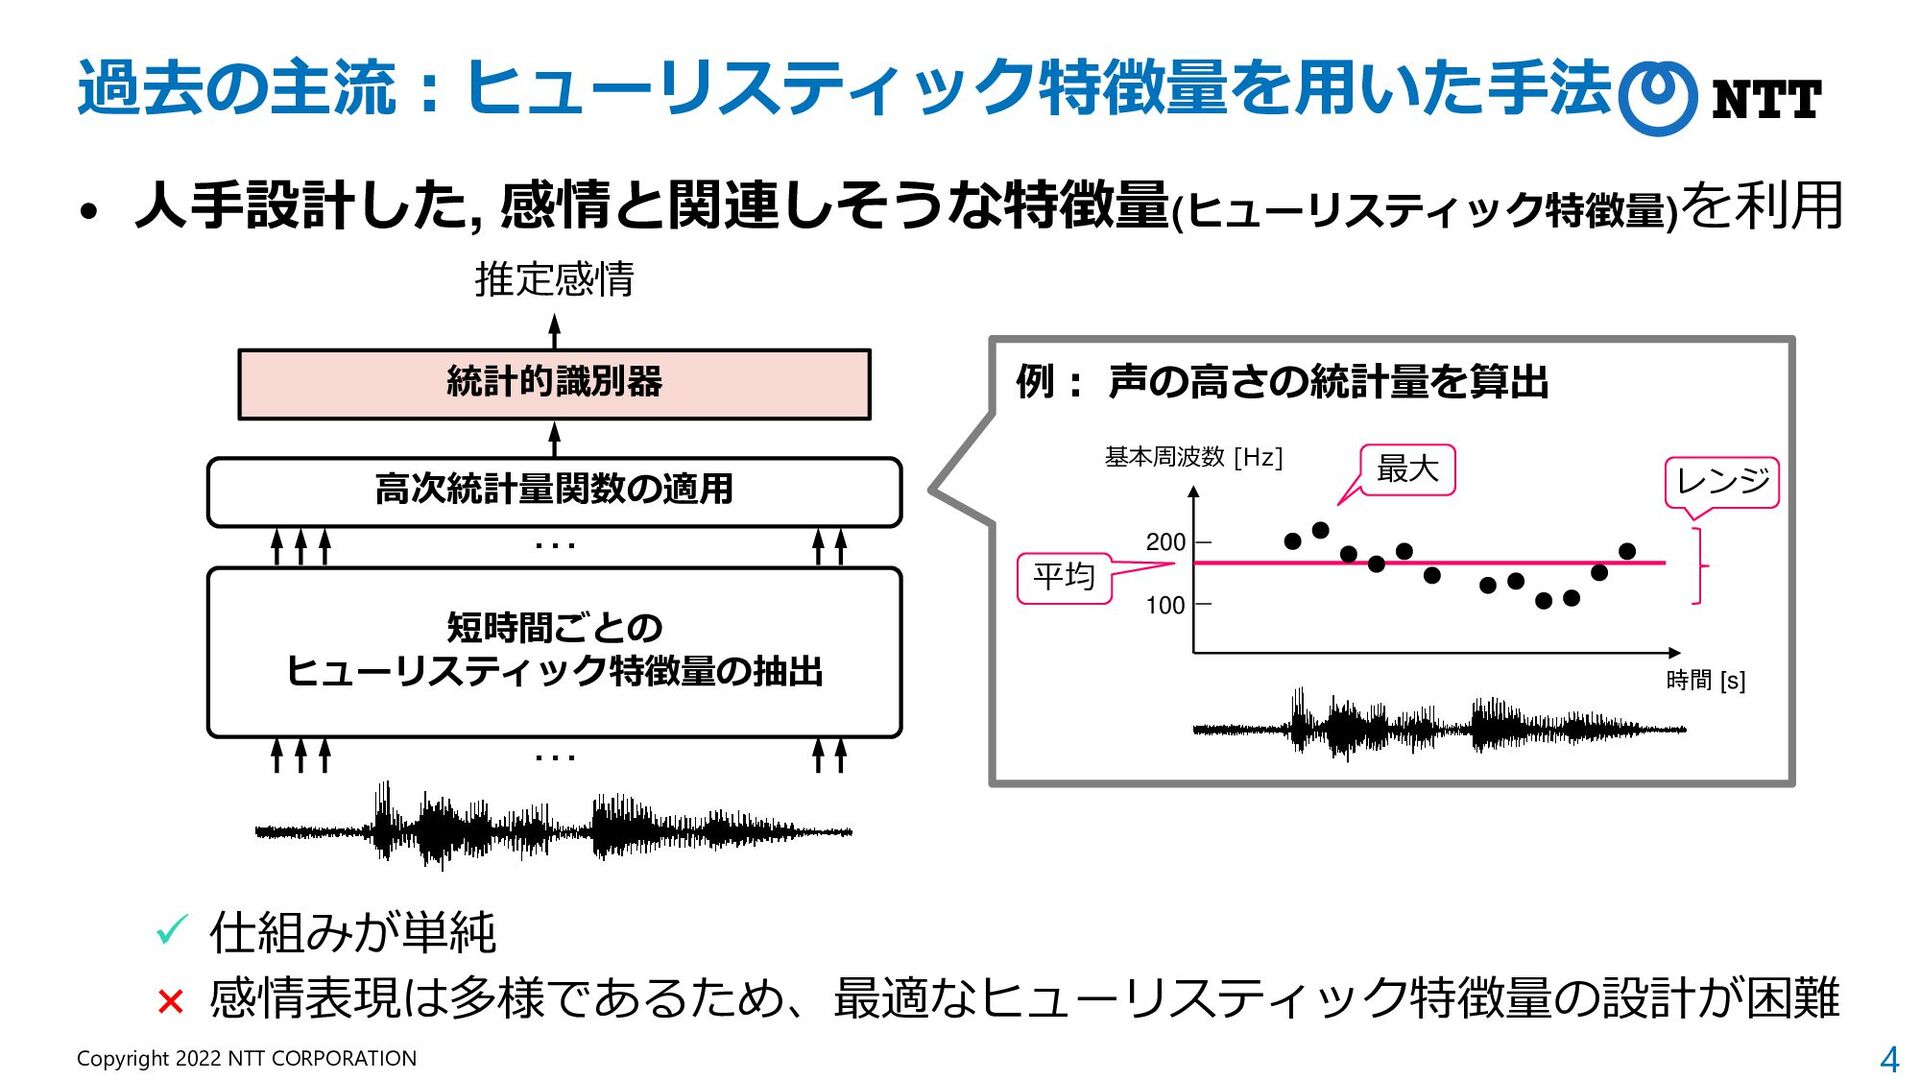
3 Copyright 2022 NTT CORPORATION 過去の主流:ヒューリスティック特徴量を用いた手法 • 人手設計した, 感情と関連しそうな特徴量(ヒューリスティック特徴量) を利用
仕組みが単純 × 感情表現は多様であるため、最適なヒューリスティック特徴量の設計が困難 時間 [s] 100 200 例: 声の高さを表す特徴量を抽出 基本周波数 [Hz] 統計的識別器 … 推定感情 … 短時間ごとの ヒューリスティック特徴量の抽出 高次統計量関数の適用 -
4 Copyright 2022 NTT CORPORATION 過去の主流:ヒューリスティック特徴量を用いた手法 • 人手設計した, 感情と関連しそうな特徴量(ヒューリスティック特徴量) を利用
仕組みが単純 × 感情表現は多様であるため、最適なヒューリスティック特徴量の設計が困難 V 時間 [s] 100 200 例: 声の高さの統計量を算出 基本周波数 [Hz] 統計的識別器 … 推定感情 … 短時間ごとの ヒューリスティック特徴量の抽出 高次統計量関数の適用 平均 最大 レンジ -
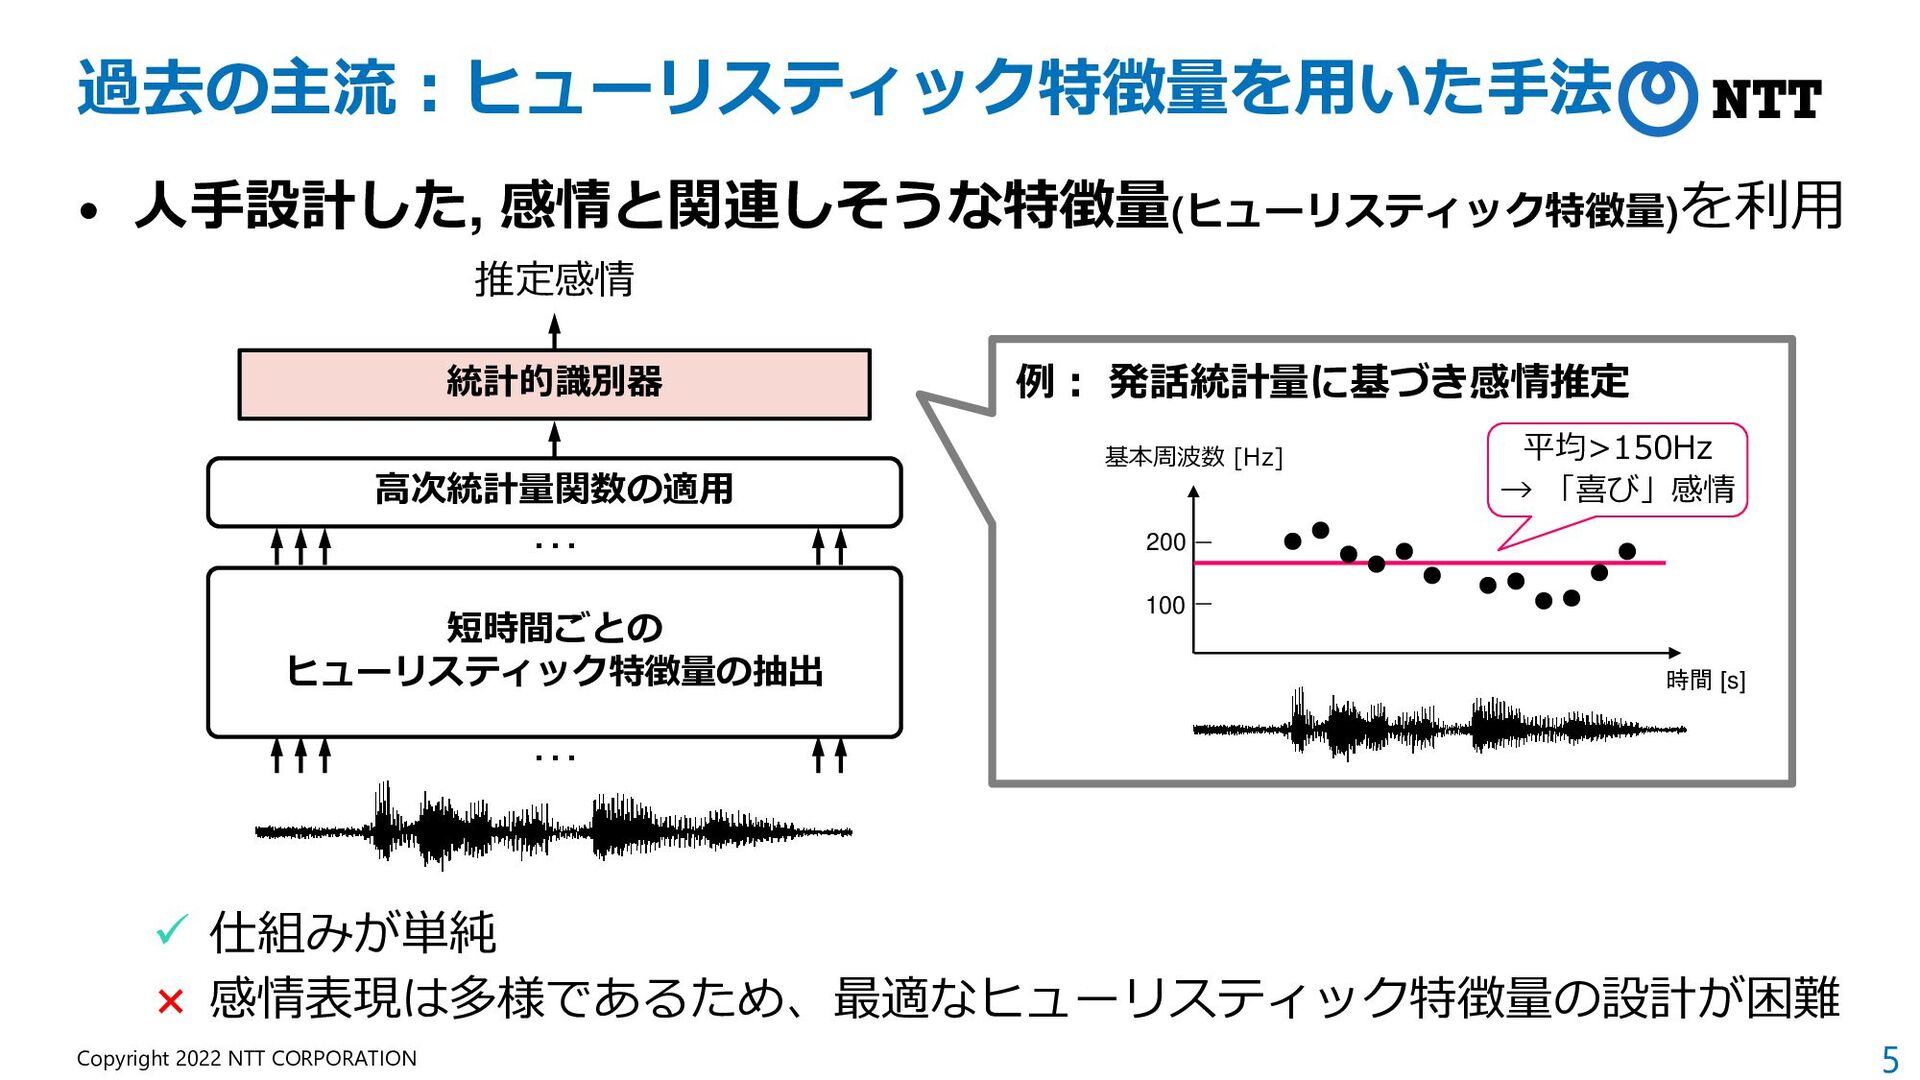
5 Copyright 2022 NTT CORPORATION 過去の主流:ヒューリスティック特徴量を用いた手法 • 人手設計した, 感情と関連しそうな特徴量(ヒューリスティック特徴量) を利用
仕組みが単純 × 感情表現は多様であるため、最適なヒューリスティック特徴量の設計が困難 V 時間 [s] 100 200 例: 発話統計量に基づき感情推定 基本周波数 [Hz] 統計的識別器 … 推定感情 … 短時間ごとの ヒューリスティック特徴量の抽出 高次統計量関数の適用 平均>150Hz → 「喜び」感情 -
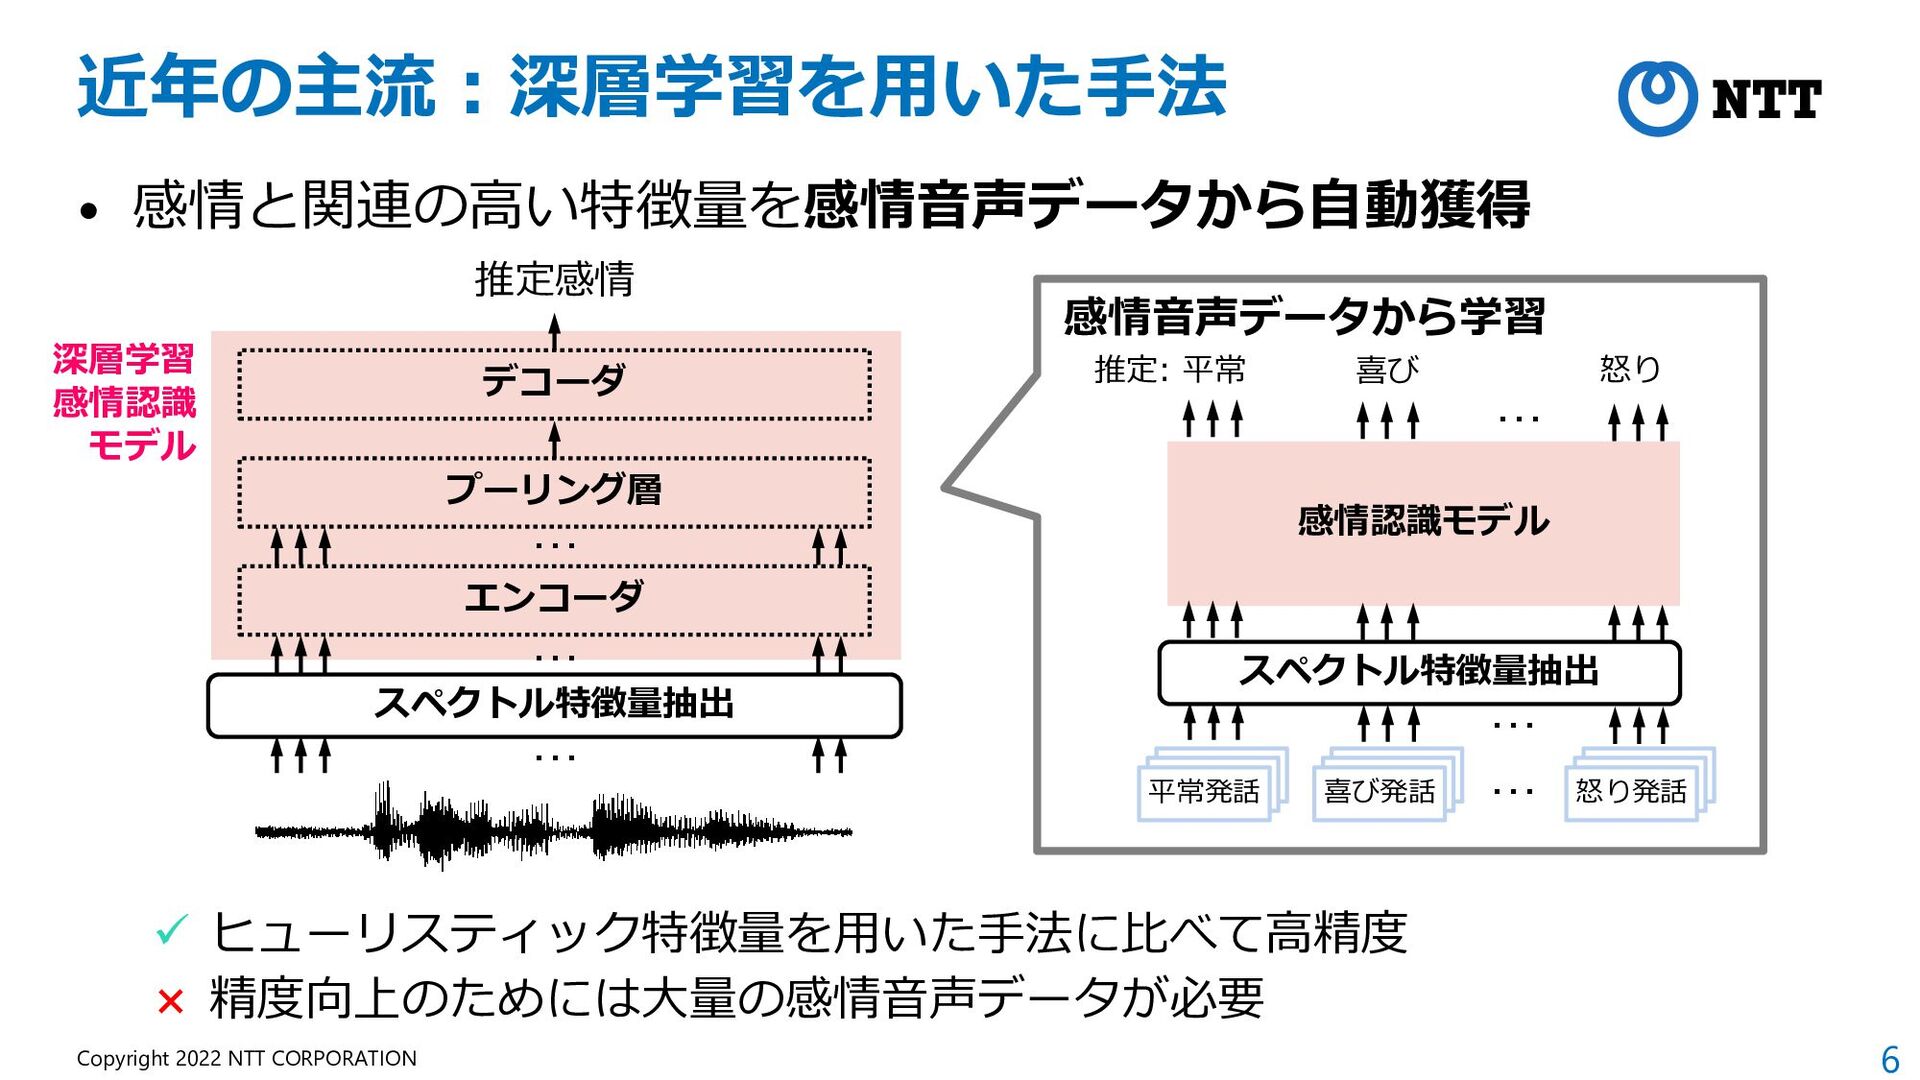
6 Copyright 2022 NTT CORPORATION • 感情と関連の高い特徴量を感情音声データから自動獲得 ヒューリスティック特徴量を用いた手法に比べて高精度 ×
精度向上のためには大量の感情音声データが必要 V 感情音声データから学習 近年の主流:深層学習を用いた手法 エンコーダ プーリング層 デコーダ … … 推定感情 … スペクトル特徴量抽出 深層学習 感情認識 モデル 感情認識モデル … スペクトル特徴量抽出 … … 平常発話 喜び発話 怒り発話 推定: 平常 喜び 怒り … -
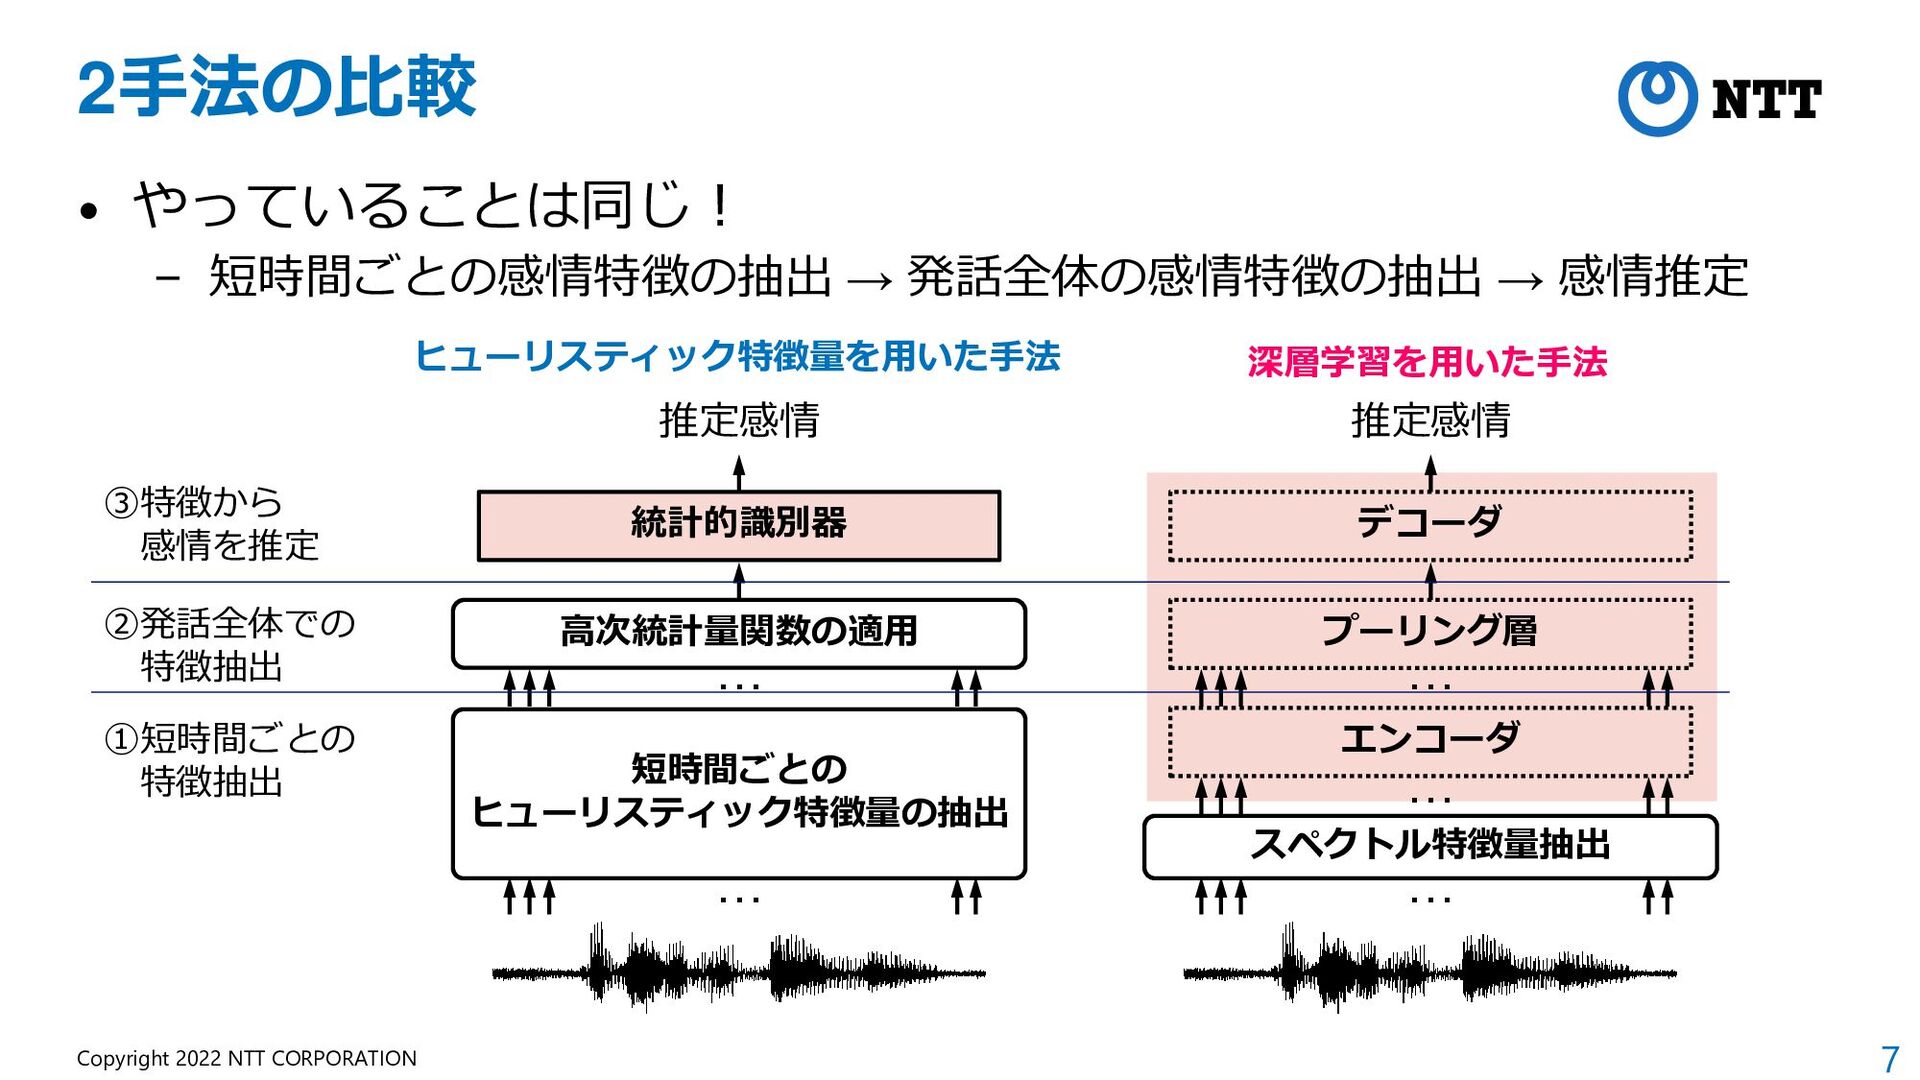
7 Copyright 2022 NTT CORPORATION 2手法の比較 • やっていることは同じ! – 短時間ごとの感情特徴の抽出
→ 発話全体の感情特徴の抽出 → 感情推定 統計的識別器 … 推定感情 … 短時間ごとの ヒューリスティック特徴量の抽出 高次統計量関数の適用 エンコーダ プーリング層 デコーダ … … 推定感情 … スペクトル特徴量抽出 ヒューリスティック特徴量を用いた手法 深層学習を用いた手法 ①短時間ごとの 特徴抽出 ②発話全体での 特徴抽出 ③特徴から 感情を推定 -
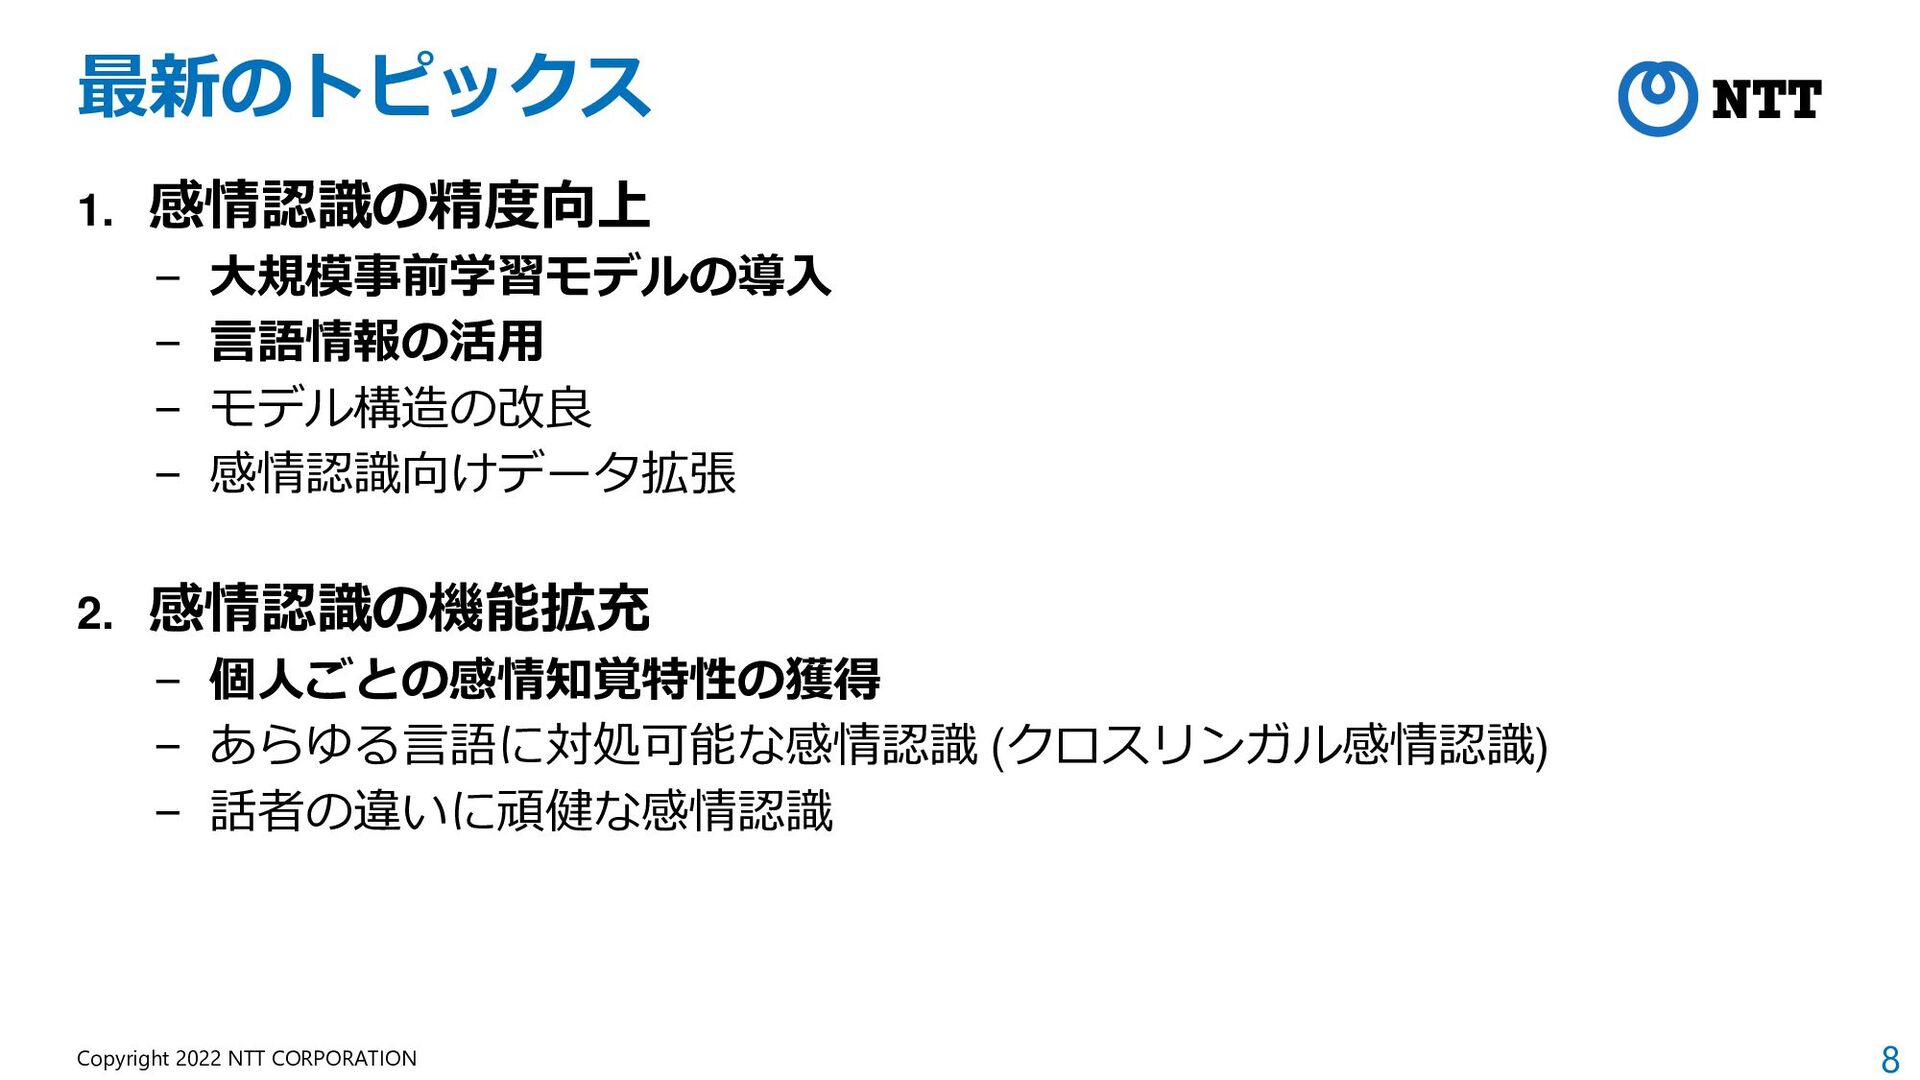
8 Copyright 2022 NTT CORPORATION 最新のトピックス 1. 感情認識の精度向上 – 大規模事前学習モデルの導入
– 言語情報の活用 – モデル構造の改良 – 感情認識向けデータ拡張 2. 感情認識の機能拡充 – 個人ごとの感情知覚特性の獲得 – あらゆる言語に対処可能な感情認識 (クロスリンガル感情認識) – 話者の違いに頑健な感情認識 -
9 Copyright 2022 NTT CORPORATION • 別タスクで学習した深層学習モデルの一部を利用 [Lu+, 20] –
自己教師あり学習(Self-Supervised Learning: SSL)モデルの利用が盛ん [Macary+, 21][Shor+, 22] 精度向上:大規模事前学習モデルの導入 エンコーダ 別タスク用デコーダ … … 推論結果 (例: 音声認識結果) エンコーダ プーリング層 デコーダ … … 推定感情 … -
10 Copyright 2022 NTT CORPORATION 精度向上:言語情報の活用 • 話し方の情報に加えて、単語の情報を考慮 [Siriwardhana+, 20]
[Shon+, 21] デコーダ 音声エンコーダ プーリング層 … … 推定感情 音声認識 テキストエンコーダ プーリング層 … … えー 微妙 … だけど -
11 Copyright 2022 NTT CORPORATION 多機能化:個人ごとの感情知覚特性の獲得 • 「この人ならこの感情を感じるはず」を再現 [Chou+,20][Ando+,21] エンコーダ
プーリング層 デコーダ … … 聞き手の知覚感情の推定値 入力音声 聞き手の 情報 … -
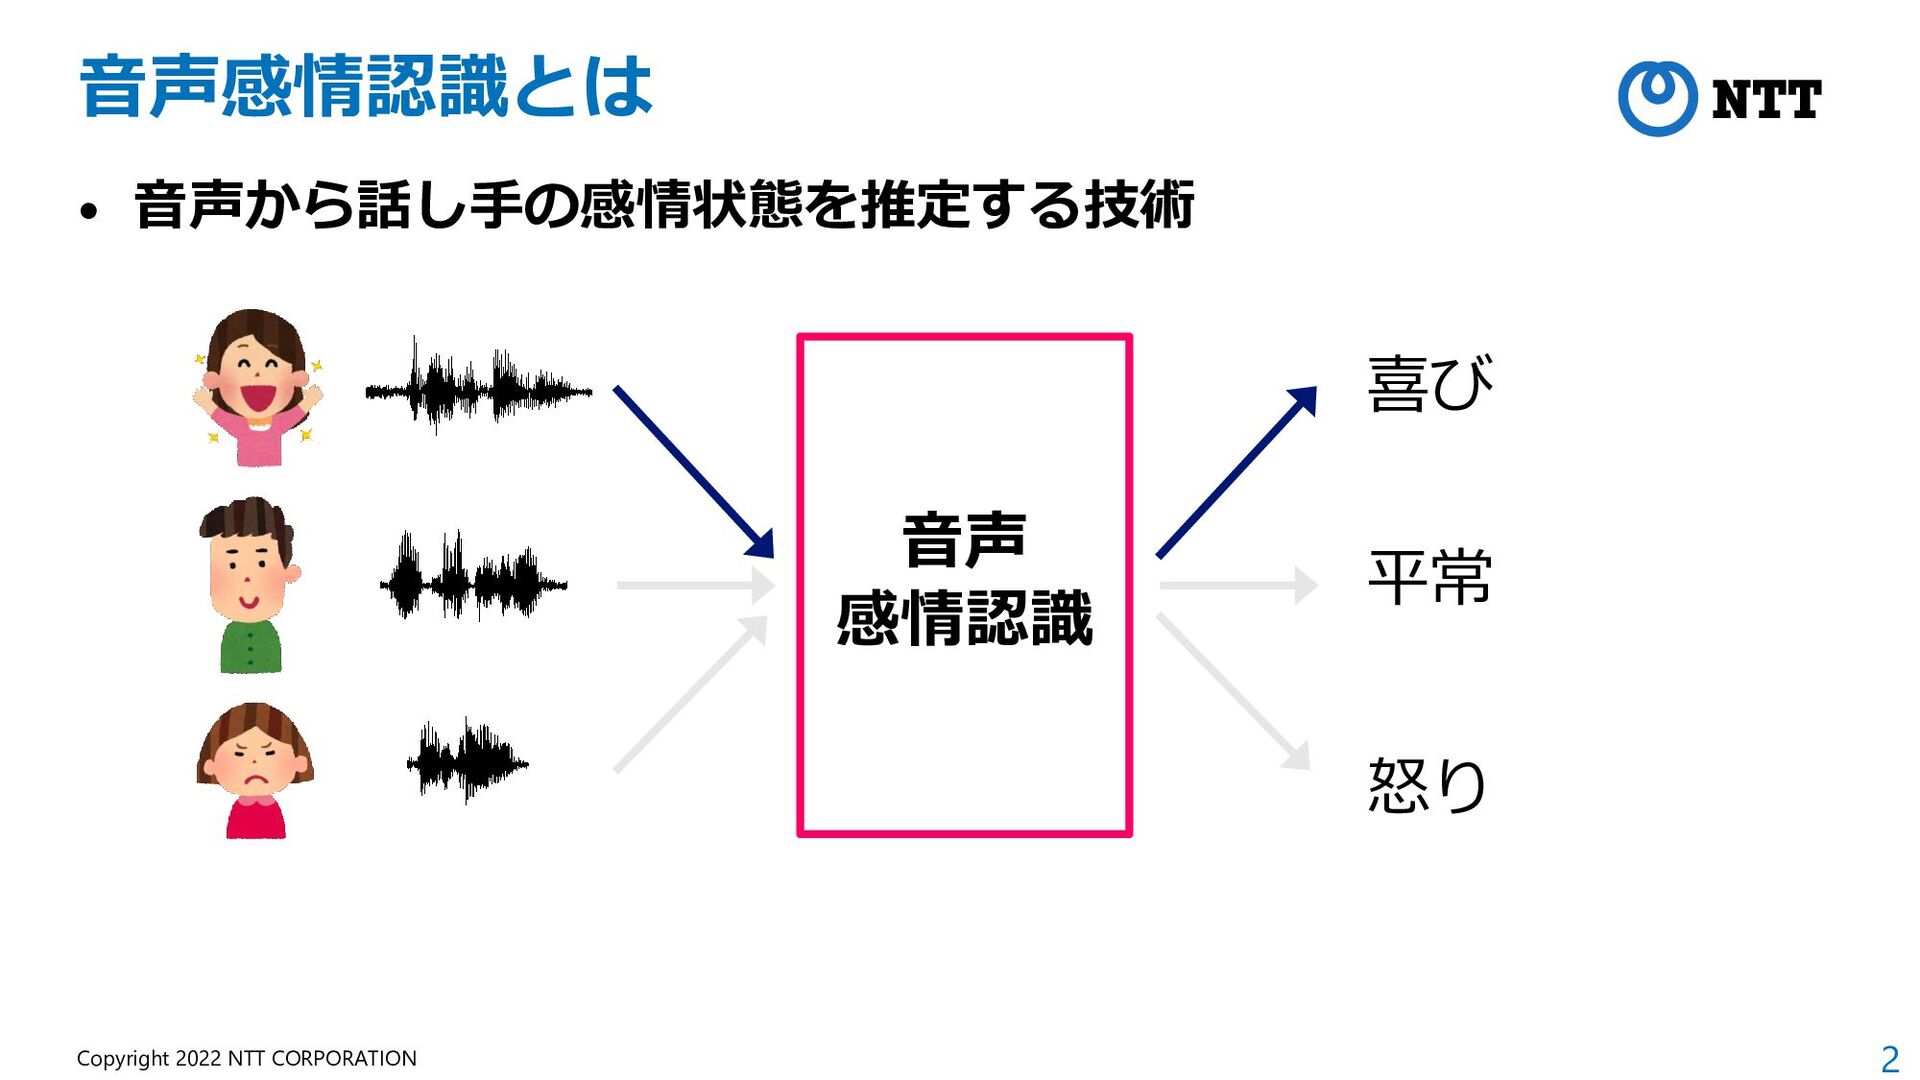
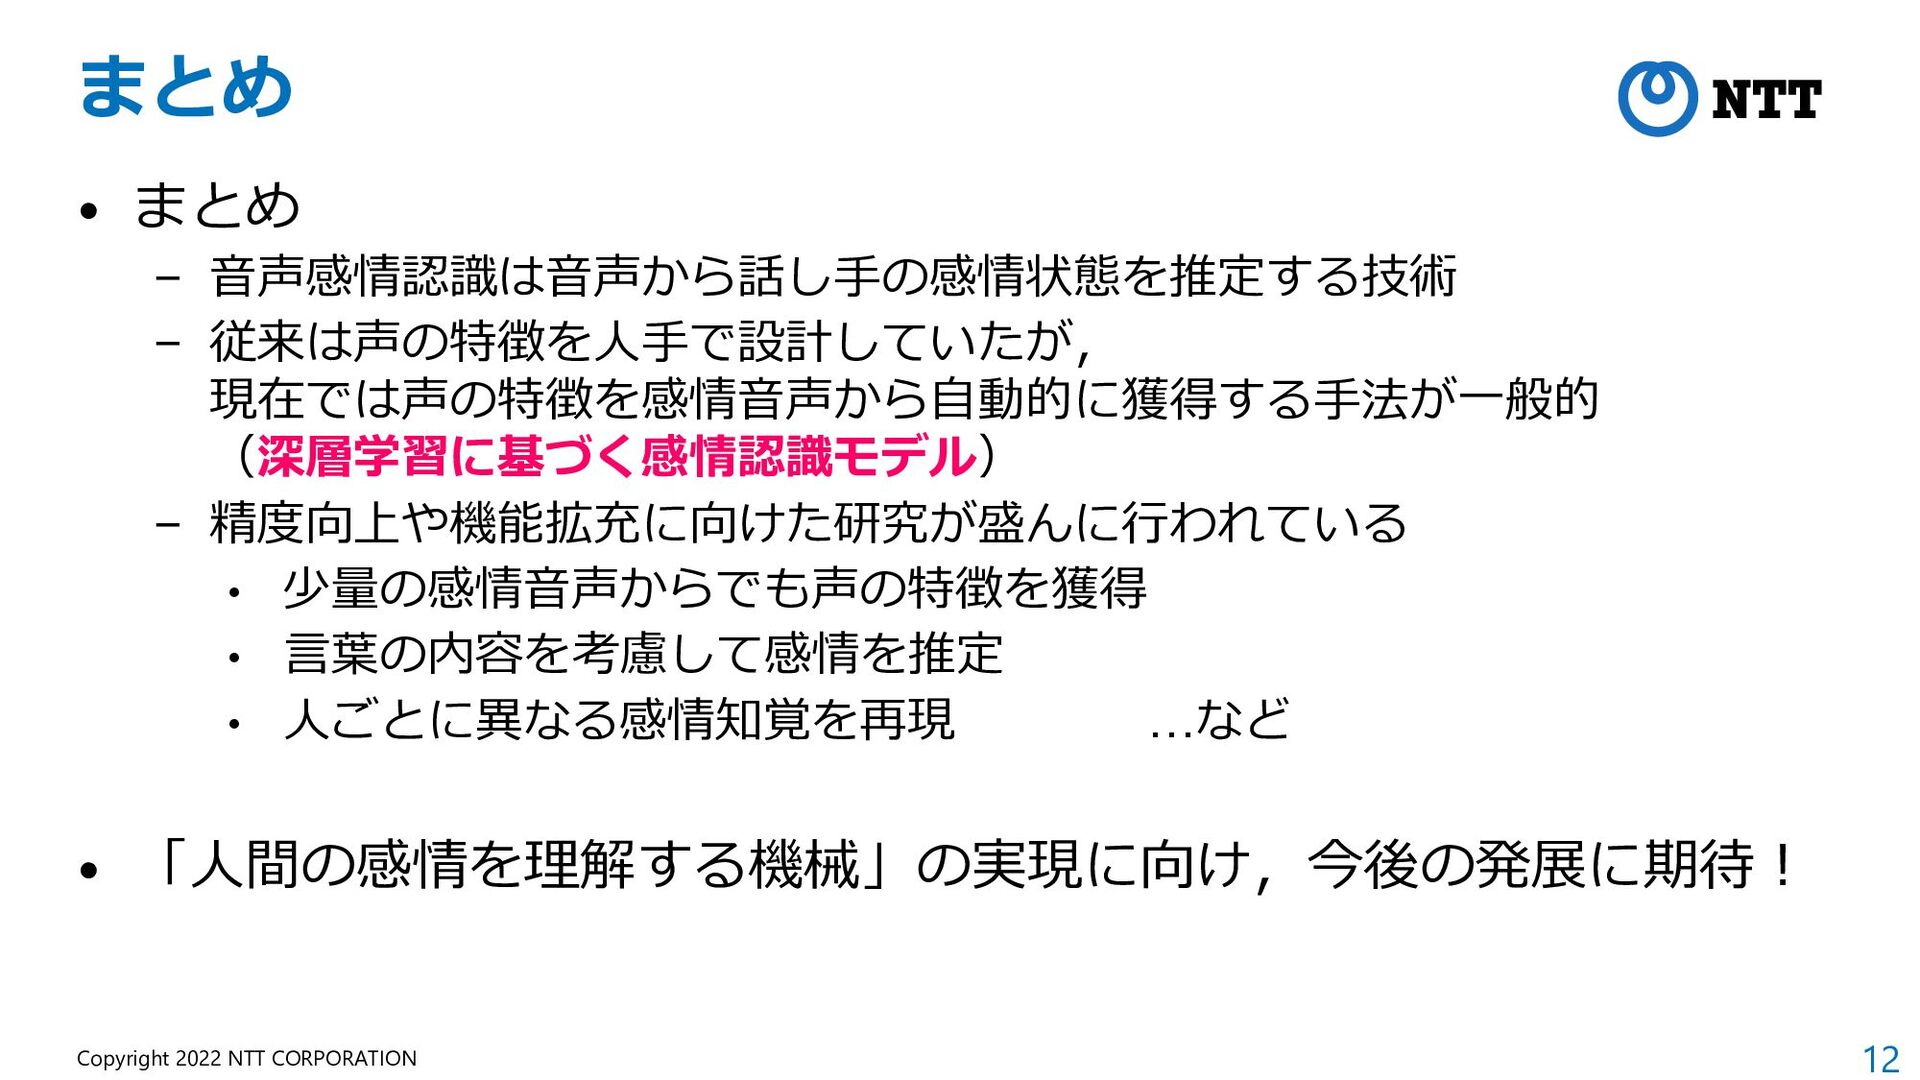
12 Copyright 2022 NTT CORPORATION まとめ • まとめ – 音声感情認識は音声から話し手の感情状態を推定する技術
– 従来は声の特徴を人手で設計していたが, 現在では声の特徴を感情音声から自動的に獲得する手法が一般的 (深層学習に基づく感情認識モデル) – 精度向上や機能拡充に向けた研究が盛んに行われている • 少量の感情音声からでも声の特徴を獲得 • 言葉の内容を考慮して感情を推定 • 人ごとに異なる感情知覚を再現 …など • 「人間の感情を理解する機械」の実現に向け,今後の発展に期待! -
13 Copyright 2022 NTT CORPORATION 参考文献 • [Lu+, 20] Z.
Lu, L. Cao, Y. Zhang, C. C. Chiu, and J. Fan, “Speech sentiment analysis via pre-trained features from end-to-end ASR models,” in Proc. of ICASSP, 2020, pp. 7149–7153. • [Macary+, 21] M. Macary, M. Tahon, Y. Est`eve, and A. Rousseau, “On the use of self-supervised pre- trained acoustic and linguistic features for continuous speech emotion recognition,” in Proc. of SLT, 2021, pp. 373–380. • [Shor+, 22] J. Shor, A. Jansen, W. Han, D. Park, and Y. Zhang, “Universal paralinguistic speech representations using self-supervised conformers,” in Proc. of ICASSP, 2022, pp. 3169–3173. • [Siriwardhana+, 20] S. Siriwardhana, A. Reis, R. Weerasekera, and S. Nanayakkara, “Jointly fine- tuning ”BERT-like” self supervised models to improve multimodal speech emotion recognition,” in Proc. of INTERSPEECH, 2020, pp. 3755–3759. • [Shon+, 21] S. Shon, P. Brusco, J. Pan, K. J. Han, and S. Watanabe, “Leveraging pre-trained language model for speech sentiment analysis,” in Proc. of INTERSPEECH, 2021, pp. 3420–3424. • [Chou+, 20] H. C. Chou and C. C. Lee, “Learning to recognize per-rater’s emotion perception using co-rater training strategy with soft and hard labels,” in Proc. of INTERSPEECH, 2020, pp. 4108–4112. • [Ando+ 21] A. Ando, T. Mori, S. Kobashikawa, and T. Toda, “Speech emotion recognition based on listener- dependent emotion perception models,” APSIPA Transactions on Signal and Information Processing, vol. 10, 2021.