Share
Embed
SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images
本資料はSatAI.challengeのサーベイメンバーと共に作成したものです。
SatAI.challengeは、リモートセンシング技術にAIを適用した論文の調査や、より俯瞰した技術トレンドの調査や国際学会のメタサーベイを行う研究グループです。speakerdeckではSatAI.challenge内での勉強会で使用した資料をWeb上で共有しています。
https://x.com/sataichallenge
紹介する論文は「SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images」です。この研究では、
リモートセンシングで利用されるOpen-Vocabulary Semantic Segmentation(OVSS) のCLIPベースの手法の特徴量マップの解像度を小さくしすぎている点に着目し、その特徴マップを高解像度化するSimFeatUpという手法を提案します。その他にも、OVSSの性能を向上するために、Transformerモデルの[class]トークンに由来するグローバルバイアスの低減手法も提案しています。多くのSemantic segmentation datasetでの実験により、特徴量マップの高解像度化がOVSSの性能向上に寄与することを示します。
SatAI.challenge
July 27, 2025
Transcript
20 slides
-
中村凌 1 第15回 SatAI.challenge勉強会 SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for
Remote Sensing Images [ CVPR 2025 ] -
中村 凌 株式会社天地人 / SatAI.challenge 主宰 / cvpaper.challenge HQ •
株式会社天地人データサイエンティスト (2024/04 - 現在) • SatAI.challenge 主宰(2024/09 - 現在) • cvpaper.challenge HQ(2021/1 - 現在 ) • MIRU メンターシッププログラム( 2024/09 - 現在) • 福岡大学大学院 理学研究科 応用数学専攻 博士課程(2021/04 - 2024/03) • 産業技術総合研究所 コンピュータビジョンチーム RA(2021/05 - 2024/03) • 福岡大学大学院 理学研究科 応用数学専攻 修士課程(2019/04 - 2021/03) 自己紹介 Twitter LinkedIn 2 これまでの個人的な活動 • 研究効率化Tips (ViEW2021招待講演) • 国際会議への論文採択実績(IROS / ICCV 2023, ICASSP / ECCV2024) • CCCS,W2021/2022 GC PC(登録者800名超え) • SSII2023オーディエンス賞受賞 • SatAI.challenge運営(国際論文の日本語資料・動画のアーカイブ化) -
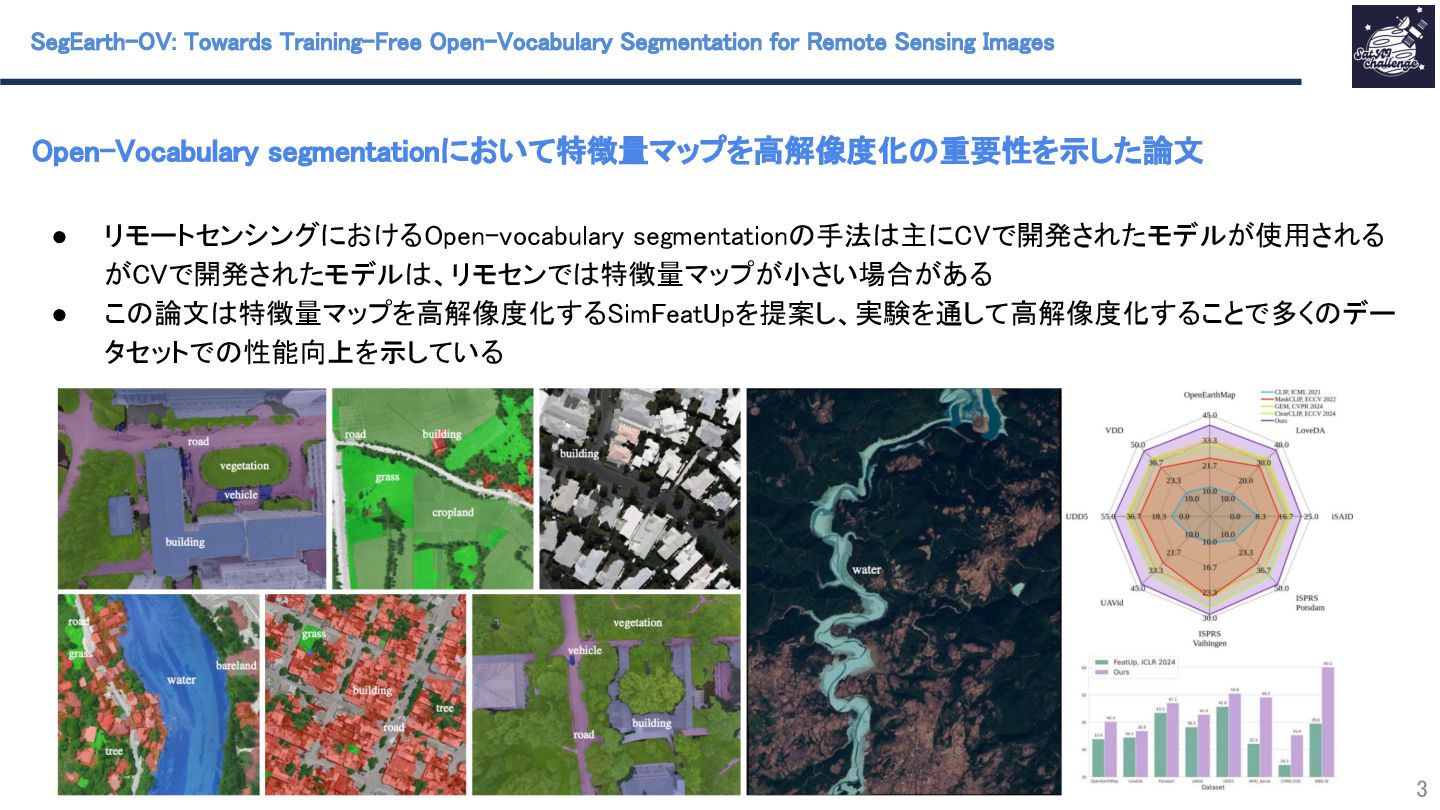
Open-Vocabulary segmentationにおいて特徴量マップを高解像度化の重要性を示した論文 3 • リモートセンシングにおけるOpen-vocabulary segmentationの手法は主にCVで開発されたモデルが使用される がCVで開発されたモデルは、リモセンでは特徴量マップが小さい場合がある •
この論文は特徴量マップを高解像度化するSimFeatUpを提案し、実験を通して高解像度化することで多くのデー タセットでの性能向上を示している SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images -
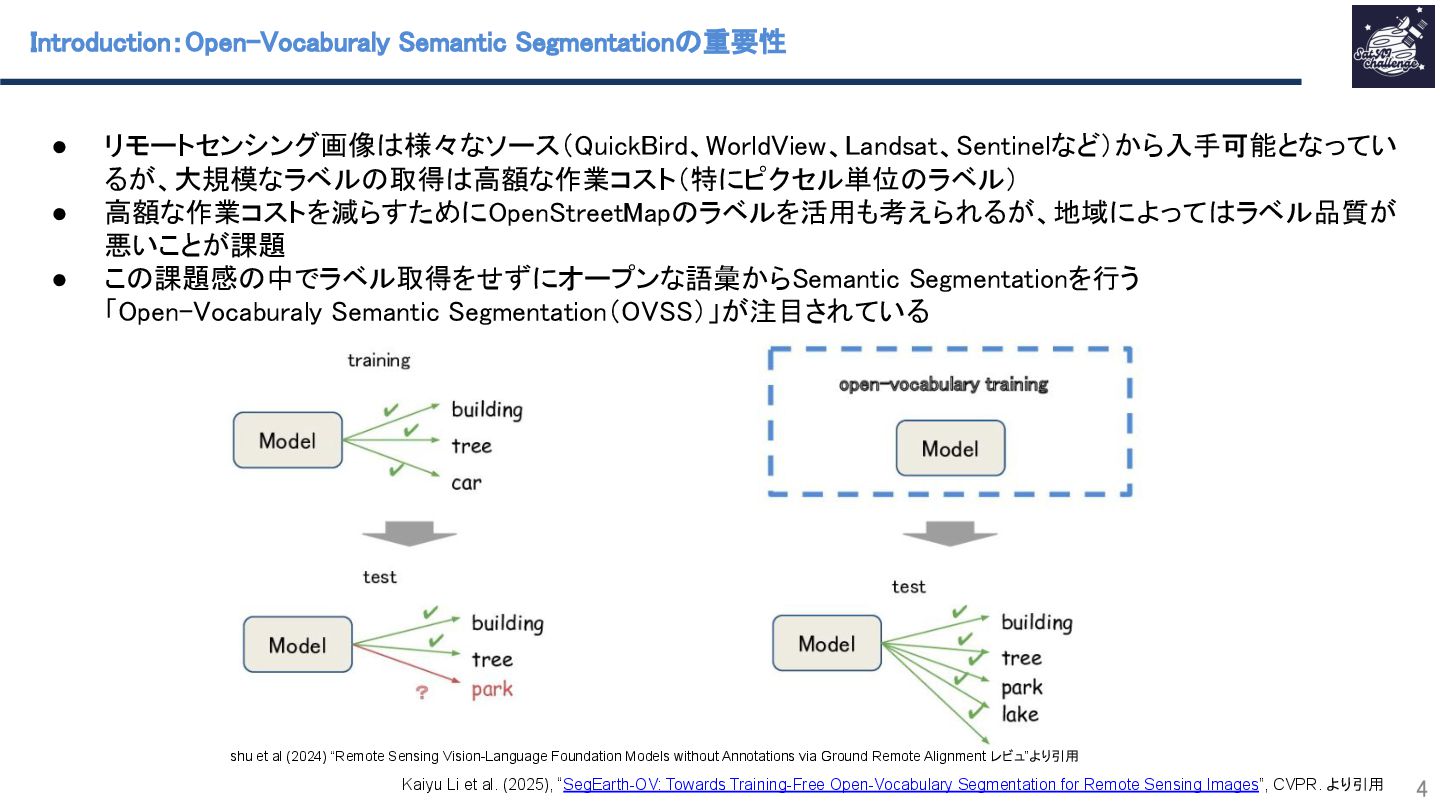
Introduction:Open-Vocaburaly Semantic Segmentationの重要性 4 Kaiyu Li et al. (2025),
“SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images”, CVPR. より引用 • リモートセンシング画像は様々なソース(QuickBird、WorldView、Landsat、Sentinelなど)から入手可能となってい るが、大規模なラベルの取得は高額な作業コスト(特にピクセル単位のラベル) • 高額な作業コストを減らすためにOpenStreetMapのラベルを活用も考えられるが、地域によってはラベル品質が 悪いことが課題 • この課題感の中でラベル取得をせずにオープンな語彙からSemantic Segmentationを行う 「Open-Vocaburaly Semantic Segmentation(OVSS)」が注目されている shu et al (2024) “Remote Sensing Vision-Language Foundation Models without Annotations via Ground Remote Alignment レビュ”より引用 -
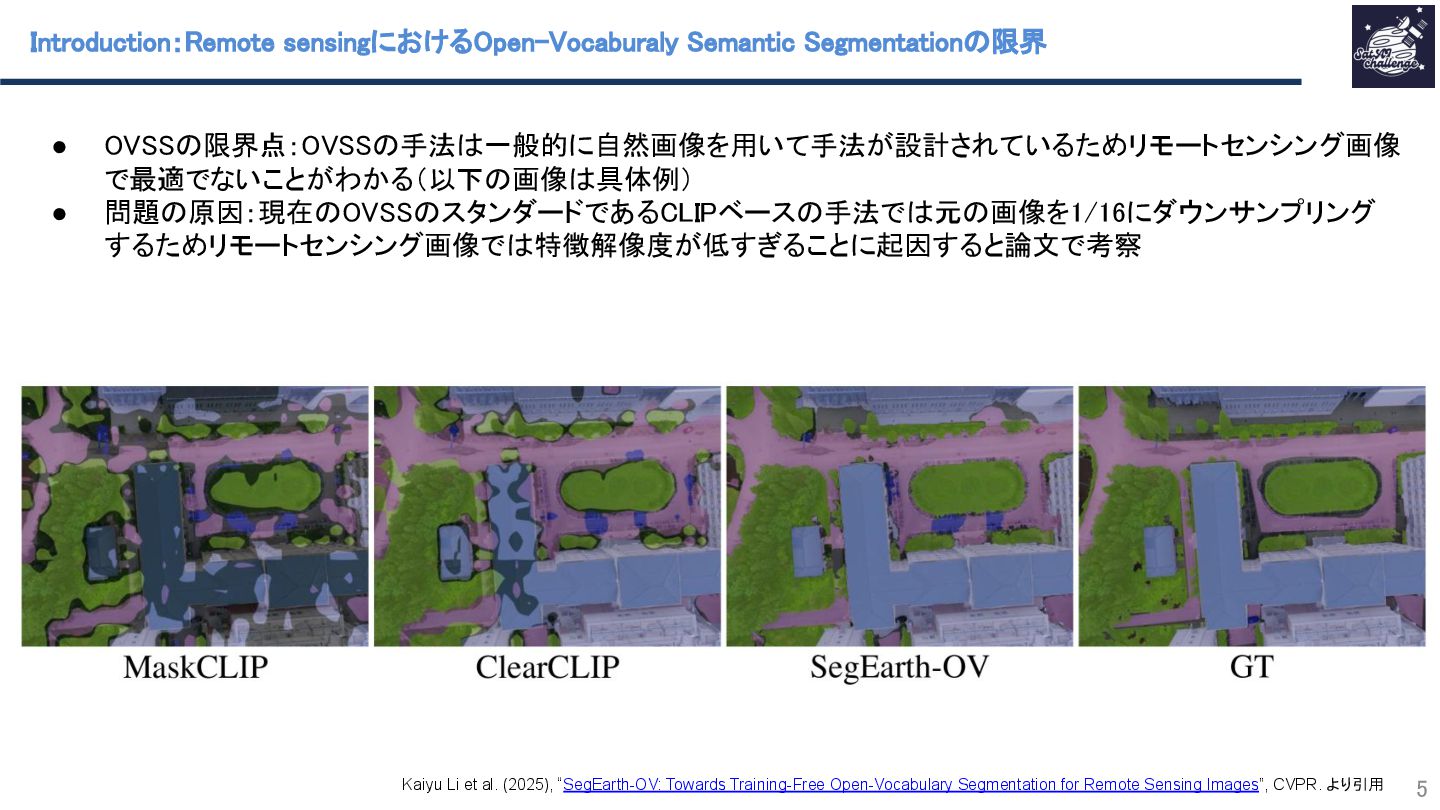
Introduction:Remote sensingにおけるOpen-Vocaburaly Semantic Segmentationの限界 5 • OVSSの限界点:OVSSの手法は一般的に自然画像を用いて手法が設計されているためリモートセンシング画像 で最適でないことがわかる(以下の画像は具体例)
• 問題の原因:現在のOVSSのスタンダードであるCLIPベースの手法では元の画像を1/16にダウンサンプリング するためリモートセンシング画像では特徴解像度が低すぎることに起因すると論文で考察 Kaiyu Li et al. (2025), “SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images”, CVPR. より引用 -
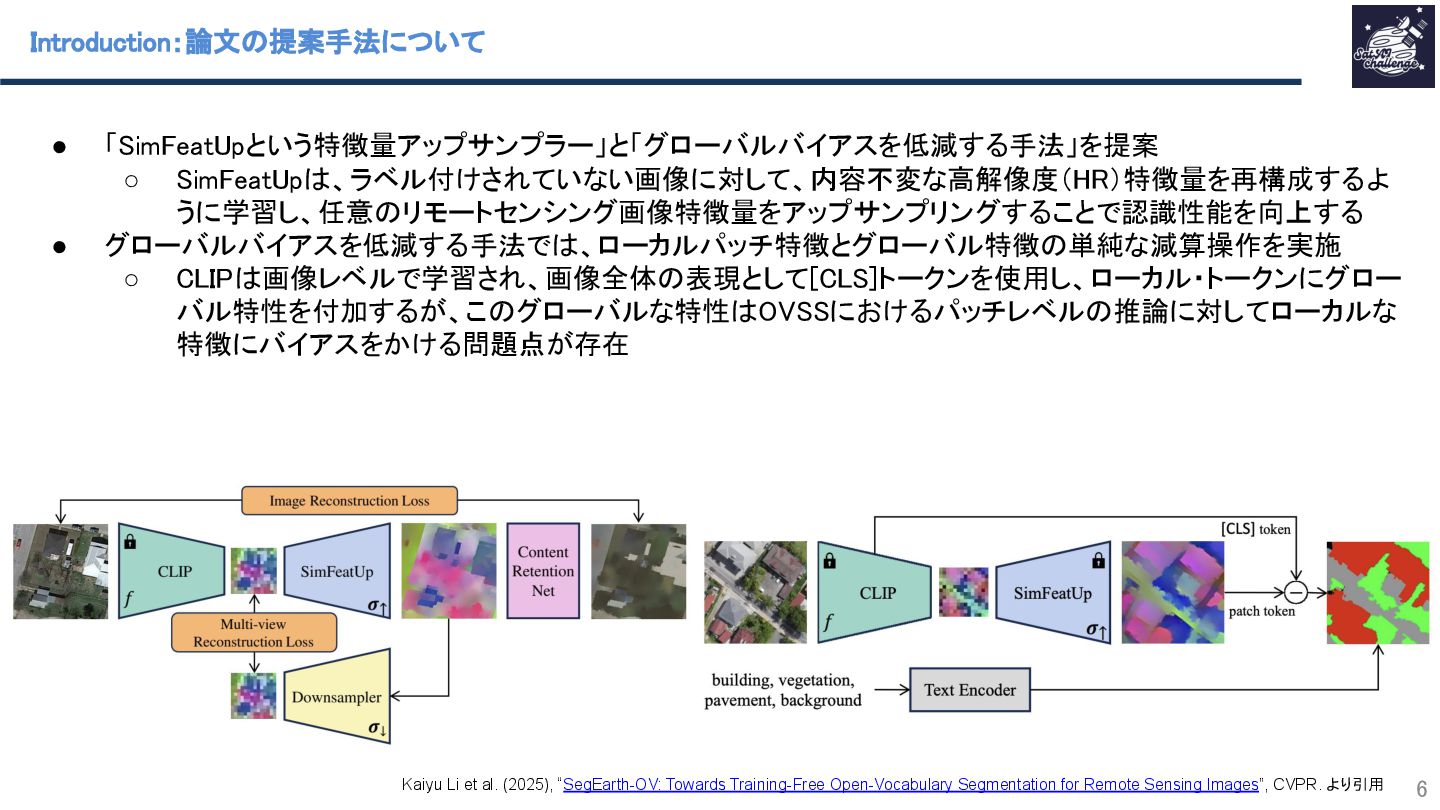
• 「SimFeatUpという特徴量アップサンプラー」と「グローバルバイアスを低減する手法」を提案 ◦ SimFeatUpは、ラベル付けされていない画像に対して、内容不変な高解像度(HR)特徴量を再構成するよ うに学習し、任意のリモートセンシング画像特徴量をアップサンプリングすることで認識性能を向上する • グローバルバイアスを低減する手法では、ローカルパッチ特徴とグローバル特徴の単純な減算操作を実施
◦ CLIPは画像レベルで学習され、画像全体の表現として[CLS]トークンを使用し、ローカル・トークンにグロー バル特性を付加するが、このグローバルな特性はOVSSにおけるパッチレベルの推論に対してローカルな 特徴にバイアスをかける問題点が存在 Introduction:論文の提案手法について 6 Kaiyu Li et al. (2025), “SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images”, CVPR. より引用 -
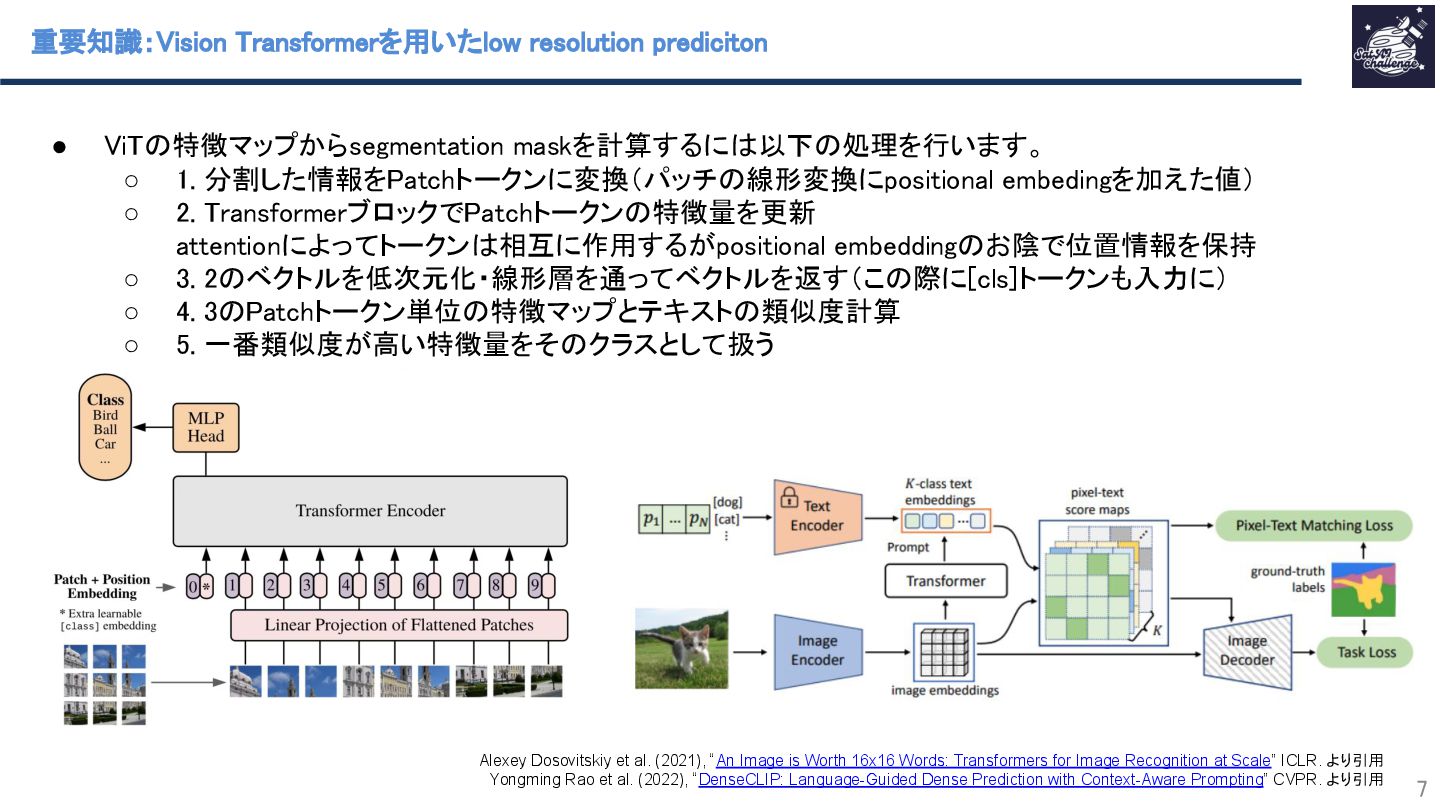
重要知識:Vision Transformerを用いたlow resolution prediciton 7 • ViTの特徴マップからsegmentation maskを計算するには以下の処理を行います。
◦ 1. 分割した情報をPatchトークンに変換(パッチの線形変換にpositional embedingを加えた値) ◦ 2. TransformerブロックでPatchトークンの特徴量を更新 attentionによってトークンは相互に作用するがpositional embeddingのお陰で位置情報を保持 ◦ 3. 2のベクトルを低次元化・線形層を通ってベクトルを返す(この際に[cls]トークンも入力に) ◦ 4. 3のPatchトークン単位の特徴マップとテキストの類似度計算 ◦ 5. 一番類似度が高い特徴量をそのクラスとして扱う Alexey Dosovitskiy et al. (2021), “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale” ICLR. より引用 Yongming Rao et al. (2022), “DenseCLIP: Language-Guided Dense Prediction with Context-Aware Prompting” CVPR. より引用 -
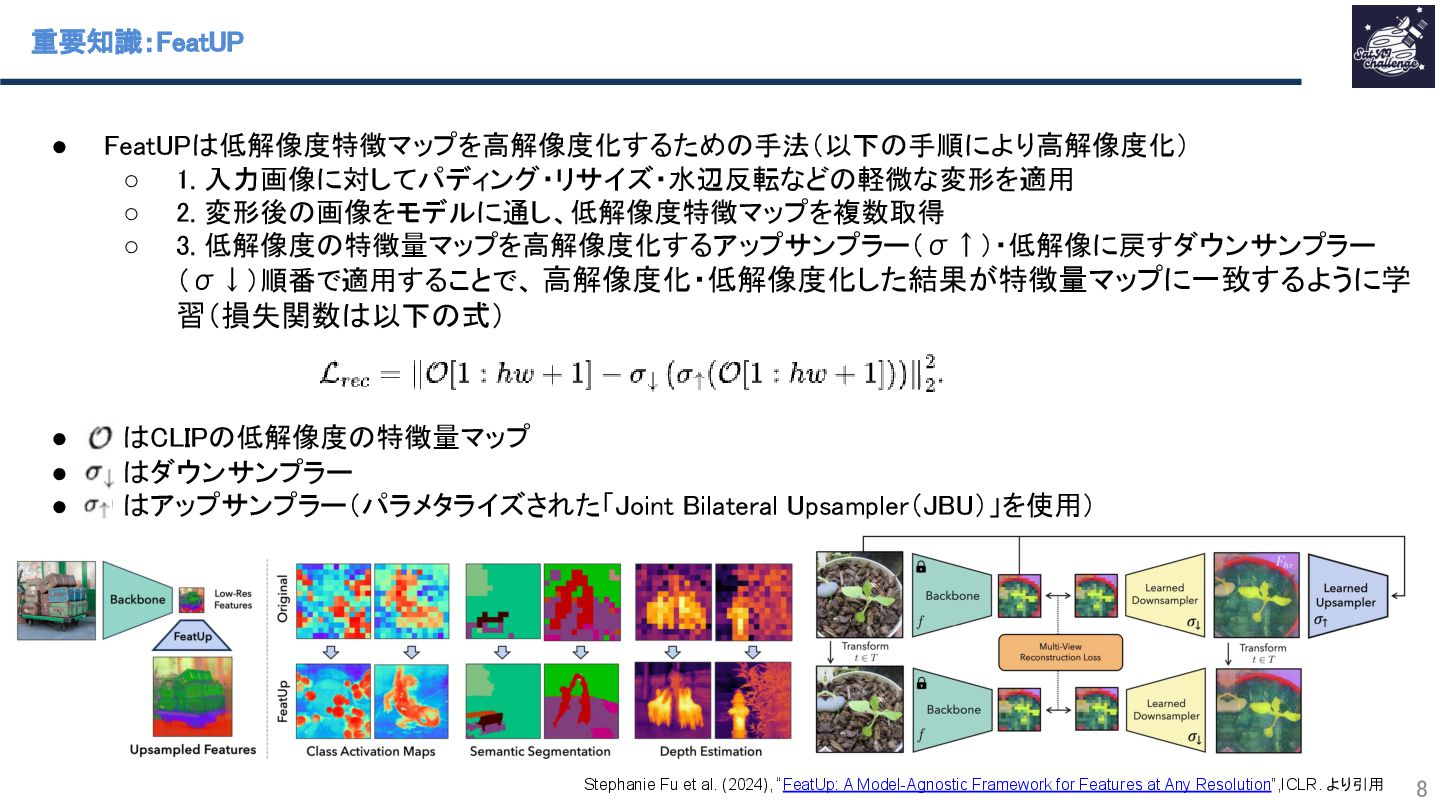
重要知識:FeatUP 8 • FeatUPは低解像度特徴マップを高解像度化するための手法(以下の手順により高解像度化) ◦ 1. 入力画像に対してパディング・リサイズ・水辺反転などの軽微な変形を適用
◦ 2. 変形後の画像をモデルに通し、低解像度特徴マップを複数取得 ◦ 3. 低解像度の特徴量マップを高解像度化するアップサンプラー(σ↑)・低解像に戻すダウンサンプラー (σ↓)順番で適用することで、 高解像度化・低解像度化した結果が特徴量マップに一致するように学 習(損失関数は以下の式) • はCLIPの低解像度の特徴量マップ • はダウンサンプラー • はアップサンプラー(パラメタライズされた「Joint Bilateral Upsampler(JBU)」を使用) Stephanie Fu et al. (2024), “FeatUp: A Model-Agnostic Framework for Features at Any Resolution”,ICLR. より引用 -
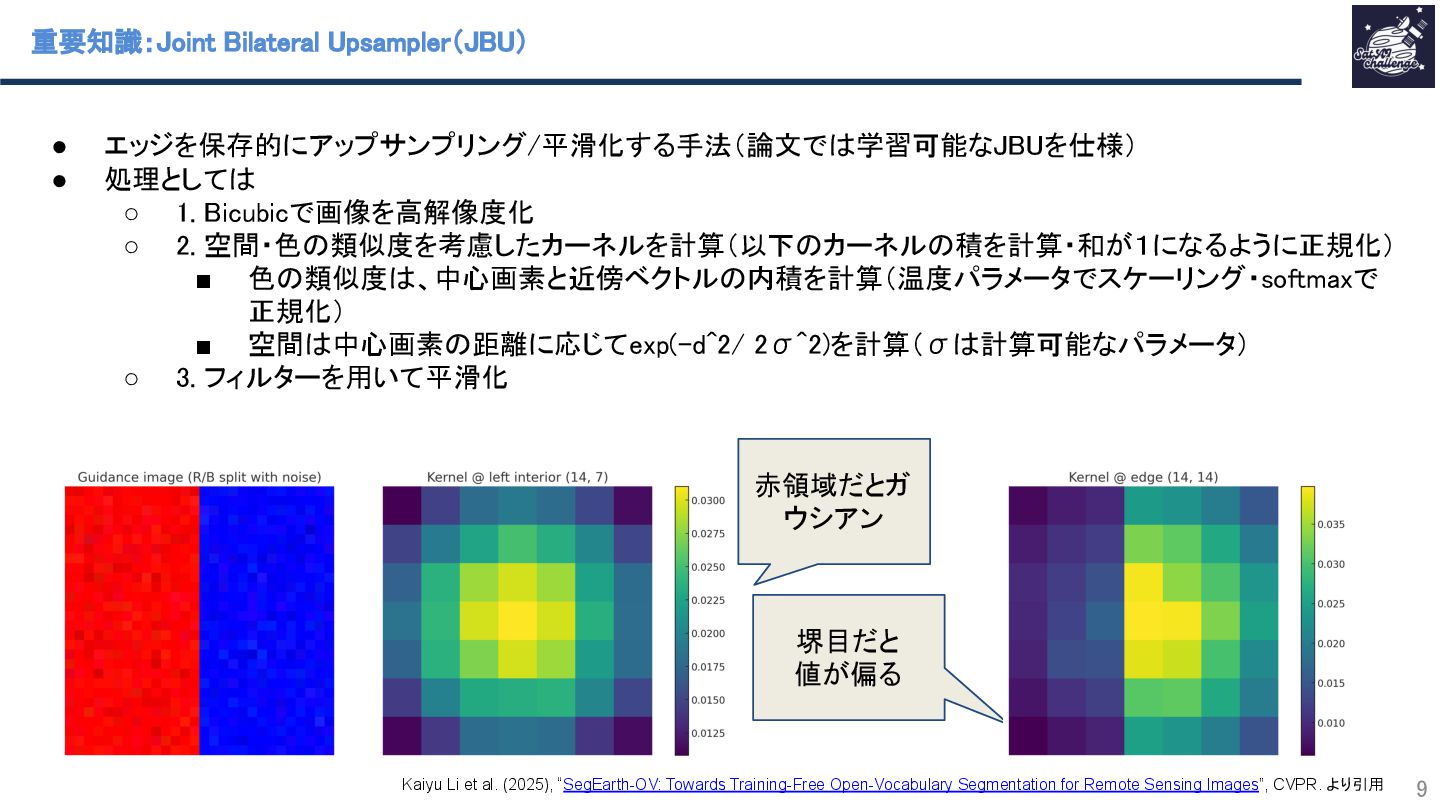
堺目だと 値が偏る • エッジを保存的にアップサンプリング/平滑化する手法(論文では学習可能なJBUを仕様) • 処理としては ◦ 1. Bicubicで画像を高解像度化
◦ 2. 空間・色の類似度を考慮したカーネルを計算(以下のカーネルの積を計算・和が1になるように正規化) ▪ 色の類似度は、中心画素と近傍ベクトルの内積を計算(温度パラメータでスケーリング・softmaxで 正規化) ▪ 空間は中心画素の距離に応じてexp(-d^2/ 2σ^2)を計算(σは計算可能なパラメータ) ◦ 3. フィルターを用いて平滑化 重要知識:Joint Bilateral Upsampler(JBU) 9 Kaiyu Li et al. (2025), “SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images”, CVPR. より引用 赤領域だとガ ウシアン -
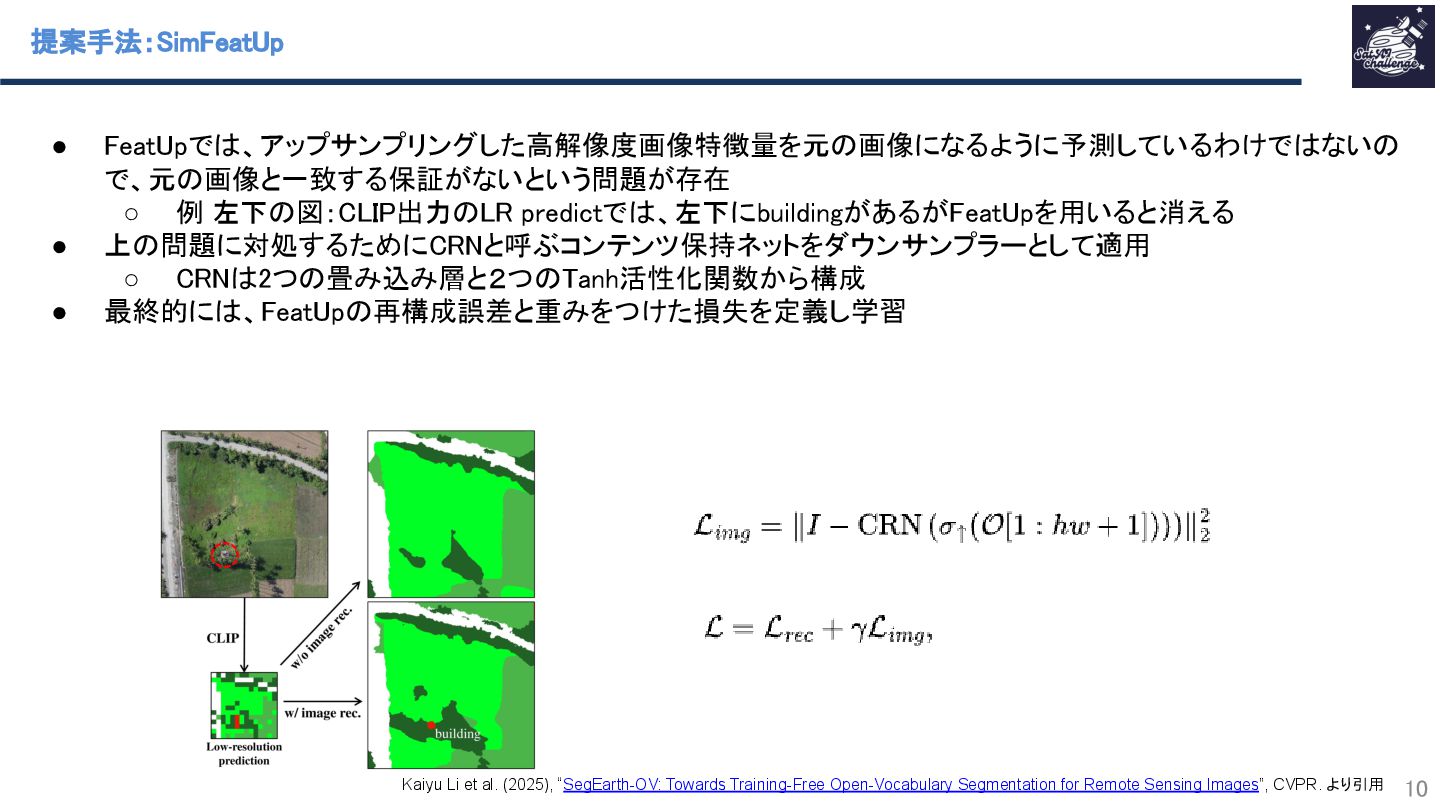
• FeatUpでは、アップサンプリングした高解像度画像特徴量を元の画像になるように予測しているわけではないの で、元の画像と一致する保証がないという問題が存在 ◦ 例 左下の図:CLIP出力のLR predictでは、左下にbuildingがあるがFeatUpを用いると消える •
上の問題に対処するためにCRNと呼ぶコンテンツ保持ネットをダウンサンプラーとして適用 ◦ CRNは2つの畳み込み層と2つのTanh活性化関数から構成 • 最終的には、FeatUpの再構成誤差と重みをつけた損失を定義し学習 提案手法:SimFeatUp 10 Kaiyu Li et al. (2025), “SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images”, CVPR. より引用 -
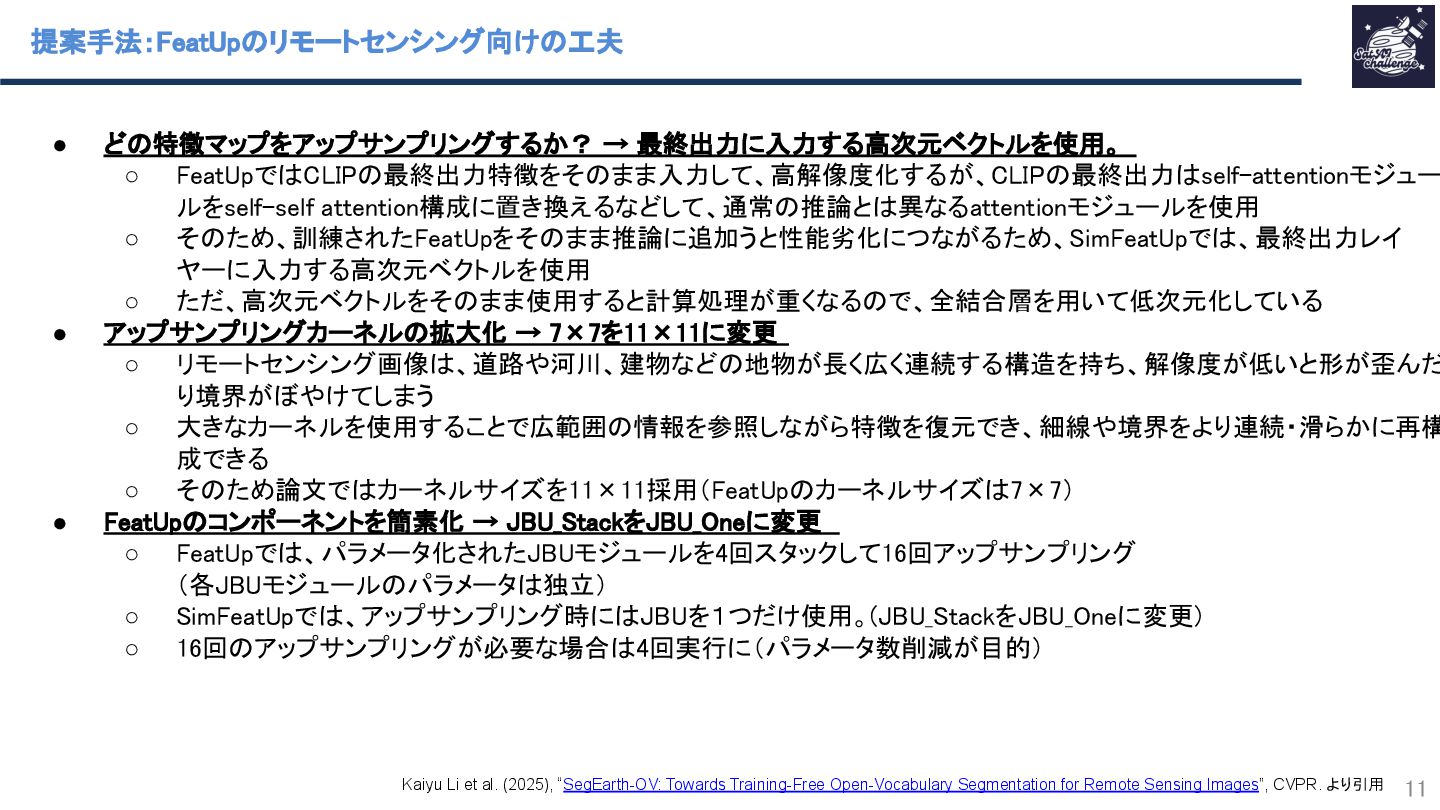
• どの特徴マップをアップサンプリングするか? → 最終出力に入力する高次元ベクトルを使用。 ◦ FeatUpではCLIPの最終出力特徴をそのまま入力して、高解像度化するが、CLIPの最終出力はself-attentionモジュー ルをself-self attention構成に置き換えるなどして、通常の推論とは異なるattentionモジュールを使用
◦ そのため、訓練されたFeatUpをそのまま推論に追加うと性能劣化につながるため、SimFeatUpでは、最終出力レイ ヤーに入力する高次元ベクトルを使用 ◦ ただ、高次元ベクトルをそのまま使用すると計算処理が重くなるので、全結合層を用いて低次元化している • アップサンプリングカーネルの拡大化 → 7×7を11×11に変更 ◦ リモートセンシング画像は、道路や河川、建物などの地物が長く広く連続する構造を持ち、解像度が低いと形が歪んだ り境界がぼやけてしまう ◦ 大きなカーネルを使用することで広範囲の情報を参照しながら特徴を復元でき、細線や境界をより連続・滑らかに再構 成できる ◦ そのため論文ではカーネルサイズを11×11採用(FeatUpのカーネルサイズは7×7) • FeatUpのコンポーネントを簡素化 → JBU_StackをJBU_Oneに変更 ◦ FeatUpでは、パラメータ化されたJBUモジュールを4回スタックして16回アップサンプリング (各JBUモジュールのパラメータは独立) ◦ SimFeatUpでは、アップサンプリング時にはJBUを1つだけ使用。(JBU_StackをJBU_Oneに変更) ◦ 16回のアップサンプリングが必要な場合は4回実行に(パラメータ数削減が目的) 提案手法:FeatUpのリモートセンシング向けの工夫 11 Kaiyu Li et al. (2025), “SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images”, CVPR. より引用 -
• CLIPの学習フェーズ:画像全体のグローバル情報を含む[CLS]トークンが、対照学習によってマルチモーダル 空間へのテキスト埋め込みと最適化 • OVSS推論フェーズ:パッチトークンが使用され、推論とギャップが発生 提案手法:グローバルバイアスの緩和 12
Kaiyu Li et al. (2025), “SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images”, CVPR. より引用 • 右の図では、[CLS]トークンとテキスト埋め込みとの類似度を計 算 • グローバルバイアスの影響で、buildingと認識 • グローバルバイアスの影響を減らすためにグローバルバイアス の一部を「減算」する方法を提案(以下の式) • はCLIPエンコーダの出力 • はCLIPエンコーダの[CLS]の出力 • は強度係数(実験では0.3を使用) -
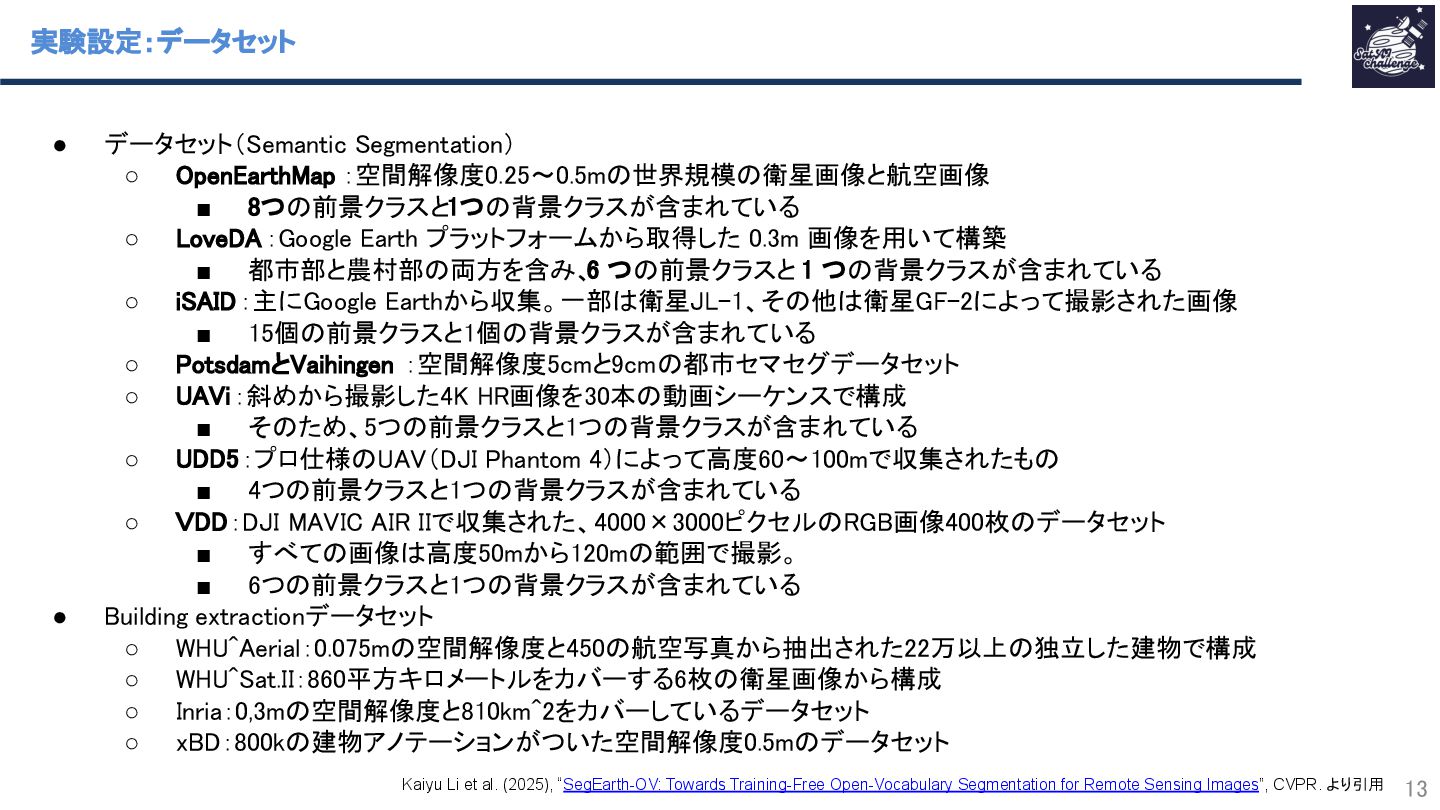
実験設定:データセット • データセット(Semantic Segmentation) ◦ OpenEarthMap :空間解像度0.25~0.5mの世界規模の衛星画像と航空画像
▪ 8つの前景クラスと1つの背景クラスが含まれている ◦ LoveDA:Google Earth プラットフォームから取得した 0.3m 画像を用いて構築 ▪ 都市部と農村部の両方を含み、 6 つの前景クラスと 1 つの背景クラスが含まれている ◦ iSAID:主にGoogle Earthから収集。一部は衛星JL-1、その他は衛星GF-2によって撮影された画像 ▪ 15個の前景クラスと1個の背景クラスが含まれている ◦ PotsdamとVaihingen :空間解像度5cmと9cmの都市セマセグデータセット ◦ UAVi:斜めから撮影した4K HR画像を30本の動画シーケンスで構成 ▪ そのため、5つの前景クラスと1つの背景クラスが含まれている ◦ UDD5:プロ仕様のUAV(DJI Phantom 4)によって高度60~100mで収集されたもの ▪ 4つの前景クラスと1つの背景クラスが含まれている ◦ VDD:DJI MAVIC AIR IIで収集された、4000×3000ピクセルのRGB画像400枚のデータセット ▪ すべての画像は高度50mから120mの範囲で撮影。 ▪ 6つの前景クラスと1つの背景クラスが含まれている • Building extractionデータセット ◦ WHU^Aerial:0.075mの空間解像度と450の航空写真から抽出された22万以上の独立した建物で構成 ◦ WHU^Sat.II:860平方キロメートルをカバーする6枚の衛星画像から構成 ◦ Inria:0,3mの空間解像度と810km^2をカバーしているデータセット ◦ xBD:800kの建物アノテーションがついた空間解像度0.5mのデータセット 13 Kaiyu Li et al. (2025), “SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images”, CVPR. より引用 -
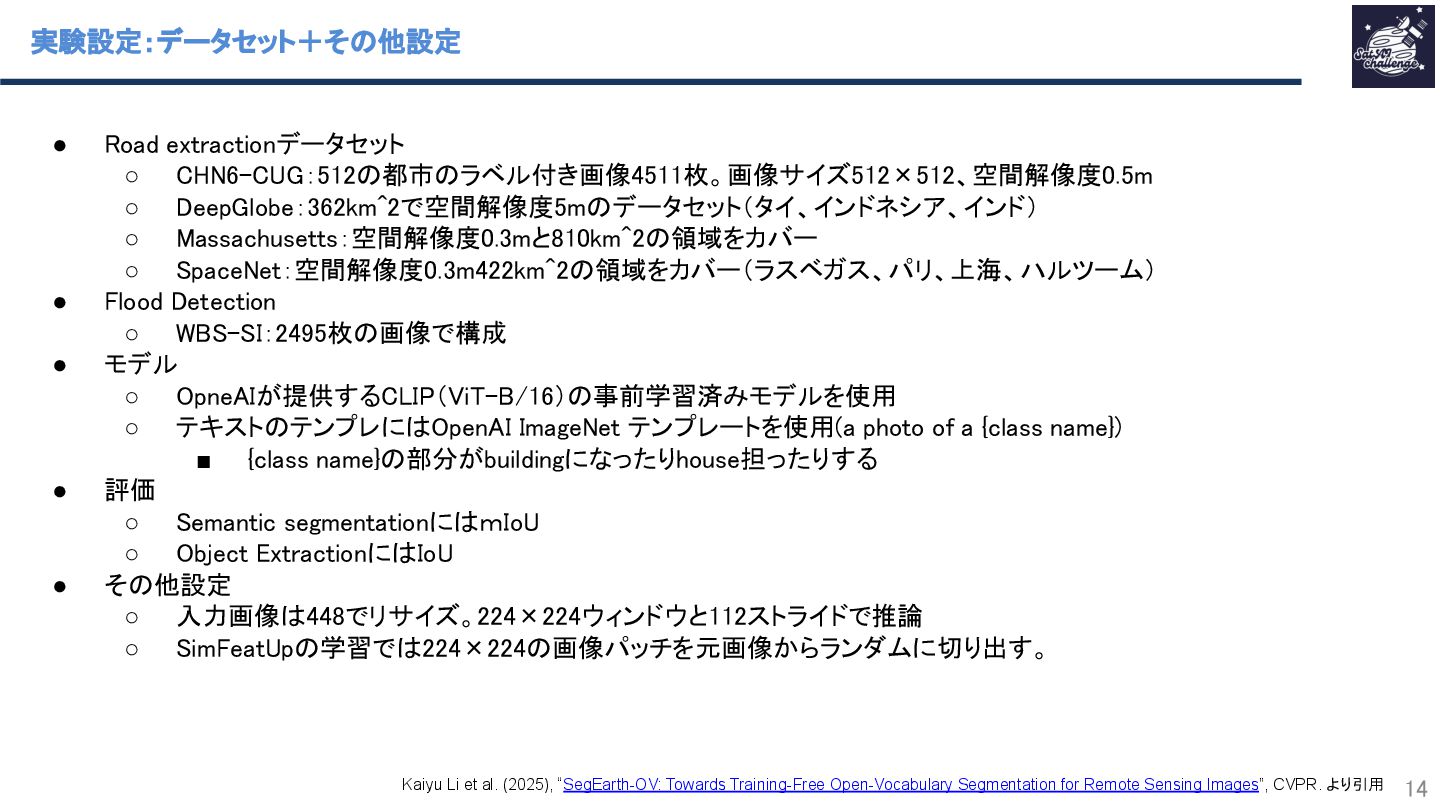
実験設定:データセット+その他設定 • Road extractionデータセット ◦ CHN6-CUG:512の都市のラベル付き画像4511枚。画像サイズ512×512、空間解像度0.5m ◦
DeepGlobe:362km^2で空間解像度5mのデータセット(タイ、インドネシア、インド) ◦ Massachusetts:空間解像度0.3mと810km^2の領域をカバー ◦ SpaceNet:空間解像度0.3m422km^2の領域をカバー(ラスベガス、パリ、上海、ハルツーム) • Flood Detection ◦ WBS-SI:2495枚の画像で構成 • モデル ◦ OpneAIが提供するCLIP(ViT-B/16)の事前学習済みモデルを使用 ◦ テキストのテンプレにはOpenAI ImageNet テンプレートを使用(a photo of a {class name}) ▪ {class name}の部分がbuildingになったりhouse担ったりする • 評価 ◦ Semantic segmentationにはmIoU ◦ Object ExtractionにはIoU • その他設定 ◦ 入力画像は448でリサイズ。224×224ウィンドウと112ストライドで推論 ◦ SimFeatUpの学習では224×224の画像パッチを元画像からランダムに切り出す。 14 Kaiyu Li et al. (2025), “SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images”, CVPR. より引用 -
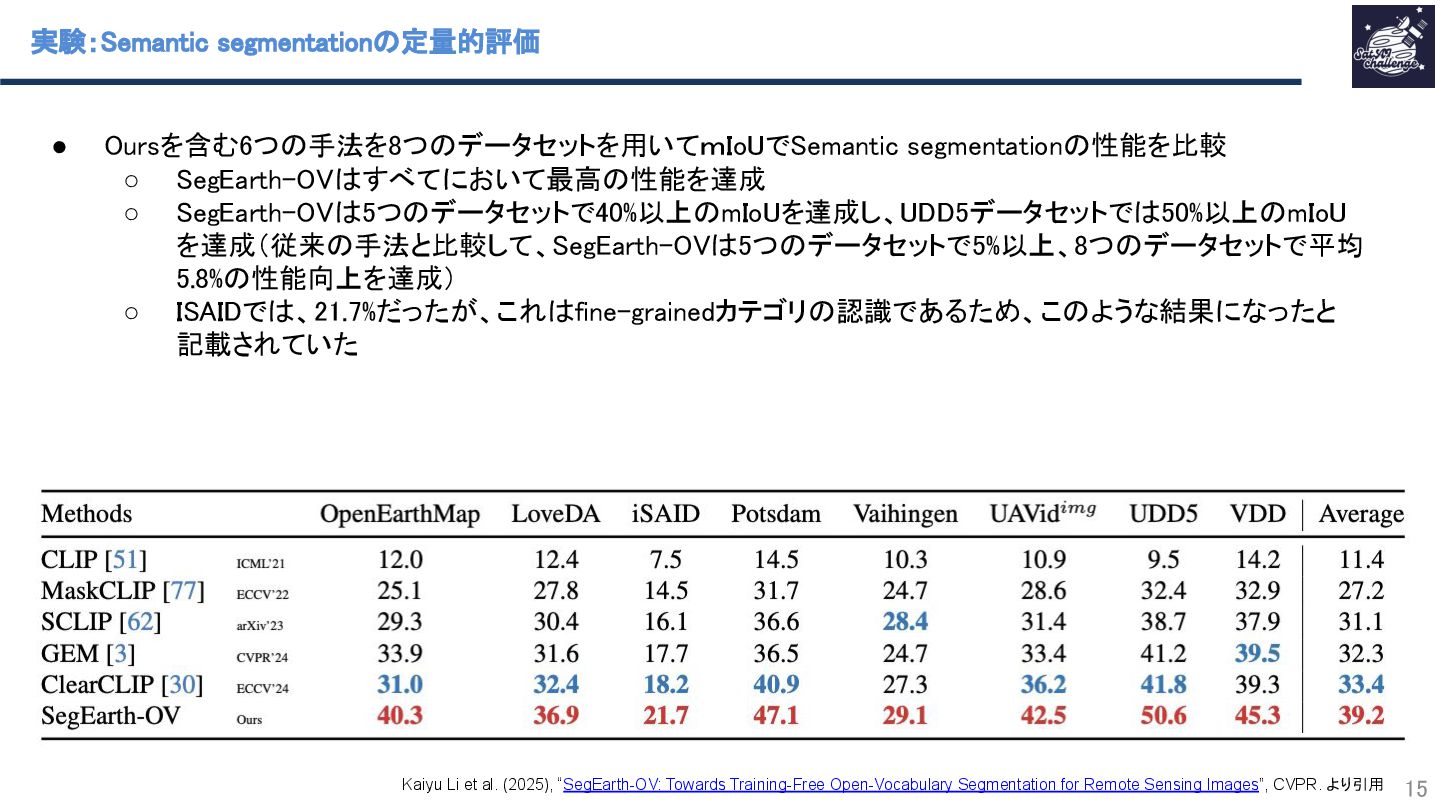
実験:Semantic segmentationの定量的評価 15 • Oursを含む6つの手法を8つのデータセットを用いてmIoUでSemantic segmentationの性能を比較 ◦ SegEarth-OVはすべてにおいて最高の性能を達成
◦ SegEarth-OVは5つのデータセットで40%以上のmIoUを達成し、UDD5データセットでは50%以上のmIoU を達成(従来の手法と比較して、SegEarth-OVは5つのデータセットで5%以上、8つのデータセットで平均 5.8%の性能向上を達成) ◦ ISAIDでは、21.7%だったが、これはfine-grainedカテゴリの認識であるため、このような結果になったと 記載されていた Kaiyu Li et al. (2025), “SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images”, CVPR. より引用 -
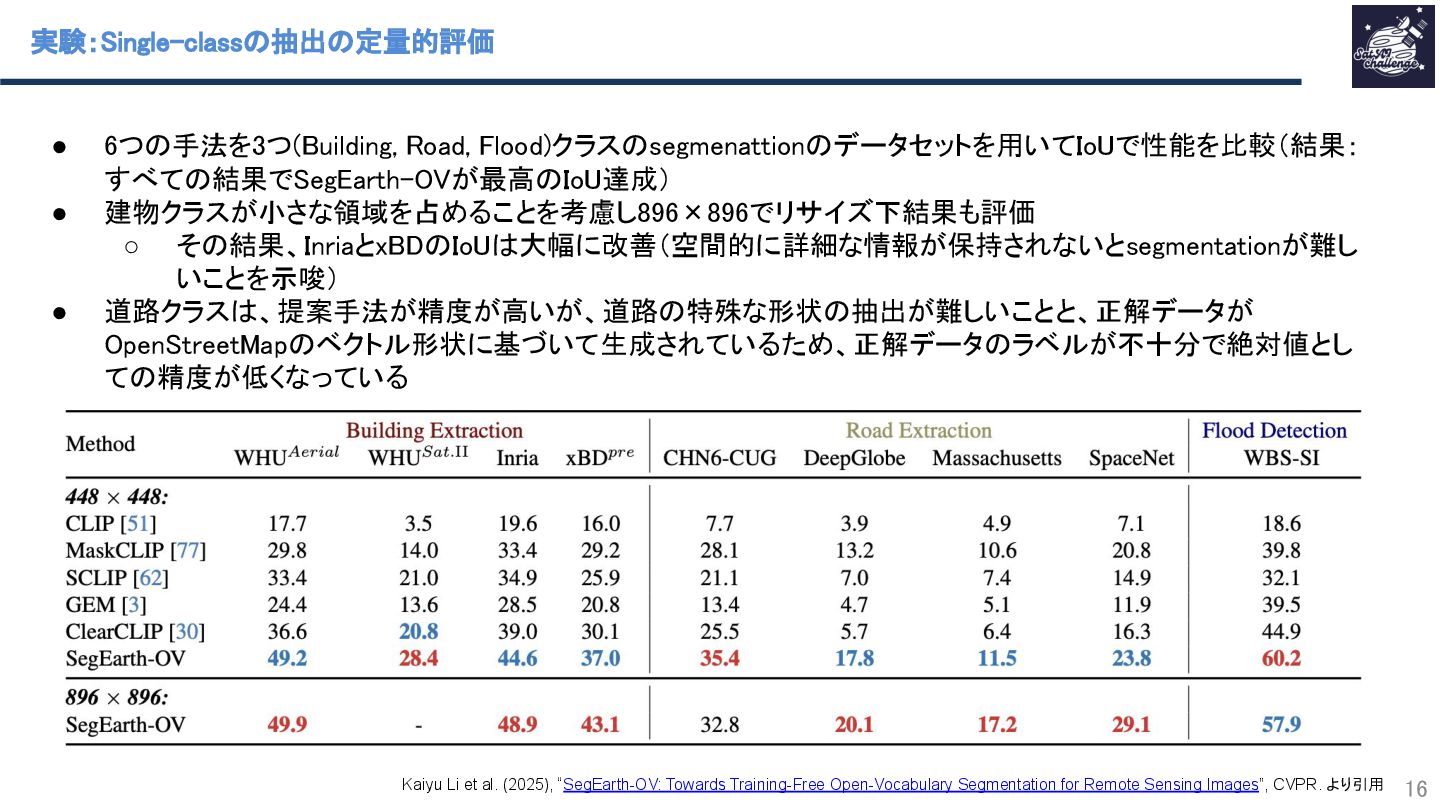
• 6つの手法を3つ(Building, Road, Flood)クラスのsegmenattionのデータセットを用いてIoUで性能を比較(結果: すべての結果でSegEarth-OVが最高のIoU達成) • 建物クラスが小さな領域を占めることを考慮し896×896でリサイズ下結果も評価 ◦
その結果、InriaとxBDのIoUは大幅に改善(空間的に詳細な情報が保持されないとsegmentationが難し いことを示唆) • 道路クラスは、提案手法が精度が高いが、道路の特殊な形状の抽出が難しいことと、正解データが OpenStreetMapのベクトル形状に基づいて生成されているため、正解データのラベルが不十分で絶対値とし ての精度が低くなっている 実験:Single-classの抽出の定量的評価 16 Kaiyu Li et al. (2025), “SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images”, CVPR. より引用 -
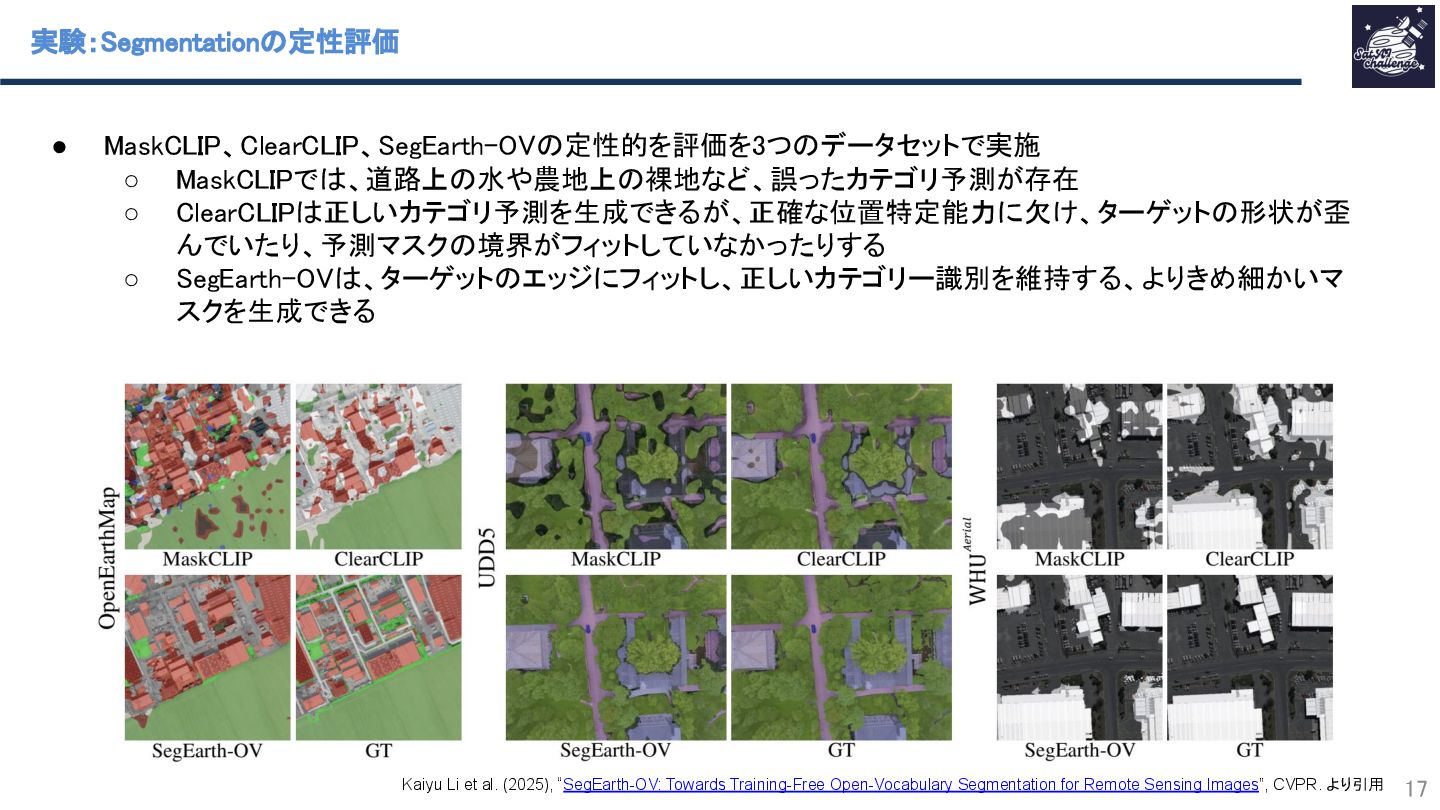
実験:Segmentationの定性評価 17 • MaskCLIP、ClearCLIP、SegEarth-OVの定性的を評価を3つのデータセットで実施 ◦ MaskCLIPでは、道路上の水や農地上の裸地など、誤ったカテゴリ予測が存在 ◦
ClearCLIPは正しいカテゴリ予測を生成できるが、正確な位置特定能力に欠け、ターゲットの形状が歪 んでいたり、予測マスクの境界がフィットしていなかったりする ◦ SegEarth-OVは、ターゲットのエッジにフィットし、正しいカテゴリー識別を維持する、よりきめ細かいマ スクを生成できる Kaiyu Li et al. (2025), “SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images”, CVPR. より引用 -
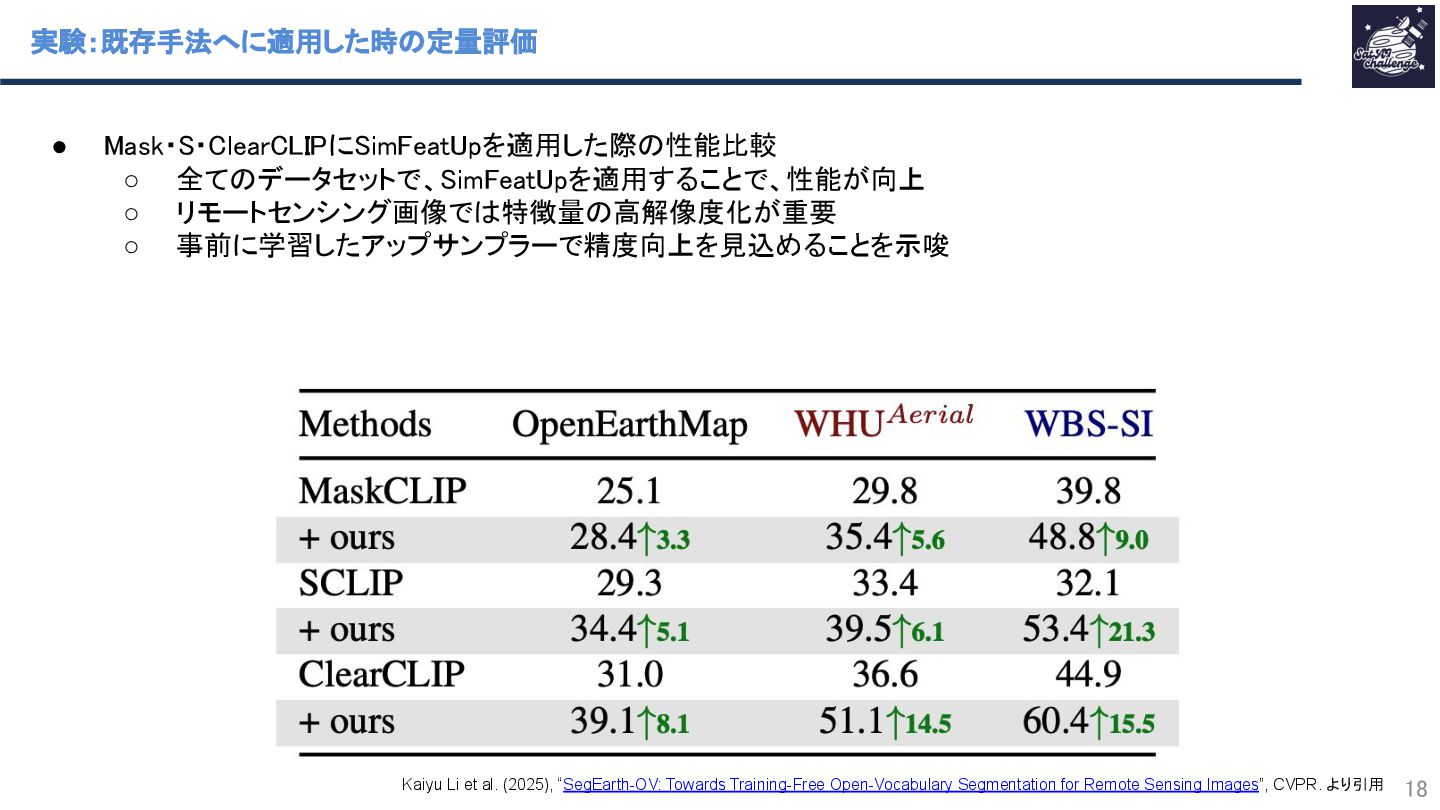
実験:既存手法へに適用した時の定量評価 18 • Mask・S・ClearCLIPにSimFeatUpを適用した際の性能比較 ◦ 全てのデータセットで、SimFeatUpを適用することで、性能が向上 ◦
リモートセンシング画像では特徴量の高解像度化が重要 ◦ 事前に学習したアップサンプラーで精度向上を見込めることを示唆 Kaiyu Li et al. (2025), “SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images”, CVPR. より引用 -
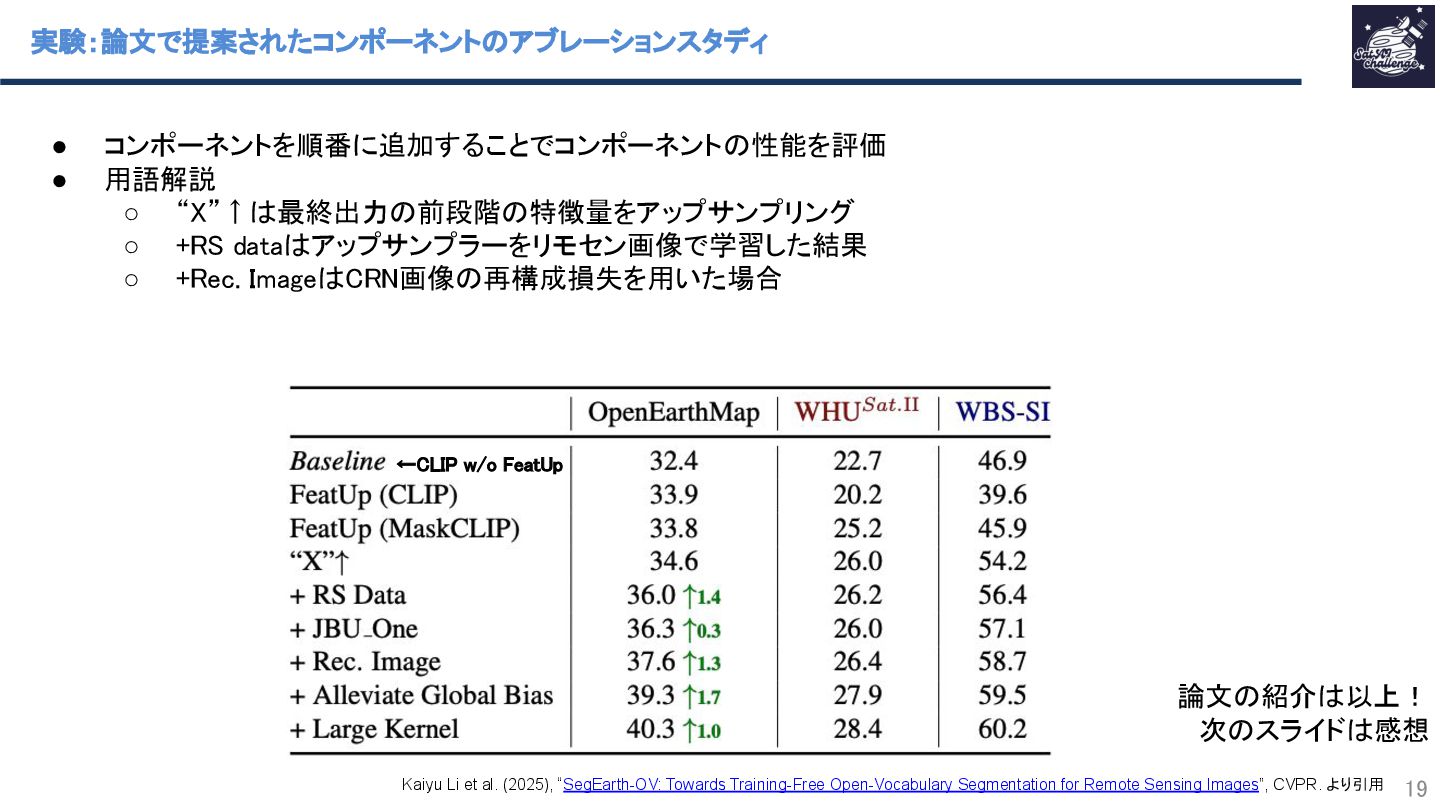
実験:論文で提案されたコンポーネントのアブレーションスタディ 19 • コンポーネントを順番に追加することでコンポーネントの性能を評価 • 用語解説 ◦ “X”↑は最終出力の前段階の特徴量をアップサンプリング
◦ +RS dataはアップサンプラーをリモセン画像で学習した結果 ◦ +Rec. ImageはCRN画像の再構成損失を用いた場合 ←CLIP w/o FeatUp 論文の紹介は以上! 次のスライドは感想 Kaiyu Li et al. (2025), “SegEarth-OV: Towards Training-Free Open-Vocabulary Segmentation for Remote Sensing Images”, CVPR. より引用 -
論文を読んだ後の感想 20 • モデルの構造の理解の重要さに気づけた気がします ◦ コードを見ることで、正規化などのあえて言語化してない、処理を上手くいくための小さな工夫が行わ れていることに気づけました
◦ モデルの処理の深い理解を得るためには実際にコードを読み、イメージできないコードを動かしてみる ことが重要 ◦ コードを動かす、必要な情報を抜き出すはLLMでできるようになってるので、深めるスピードも向上して いるように感じます • 衛星画像の高解像度特徴マップが重要であるということは、CVから輸入したモデル構造がリモートセンシン グに適してない可能性が浮上したと思います(プーリング処理は代表的な例なのかもしれません) ◦ この領域に関する興味はリモートセンシング研究者よりはCV研究者のほうが高いため、リモセン画像 を扱うCV研究者がどんどん改善してくれることに期待 • 一方、モデルの改善にも頭打ちが来るので、「入力側を高解像度化して認識性能を上げる(空間の情報を増 やすか)」か「地上のデータを組み合わせて認識性能(別のモダリティの情報を増やすか)」側の研究の重要 性も増したと考えています ◦ 性能向上に合わせて扱う情報が増えるので、計算処理が早い方法の検討も併せて重要になりそう