Share
Embed
baseballrによるMLBデータの抽出と階層ベイズモデルによる打率の推定 / TokyoR118
第118回R勉強会@東京(#TokyoR)の発表資料です。
https://tokyor.connpass.com/event/357734/
森下光之助
June 21, 2025
Transcript
42 slides
-
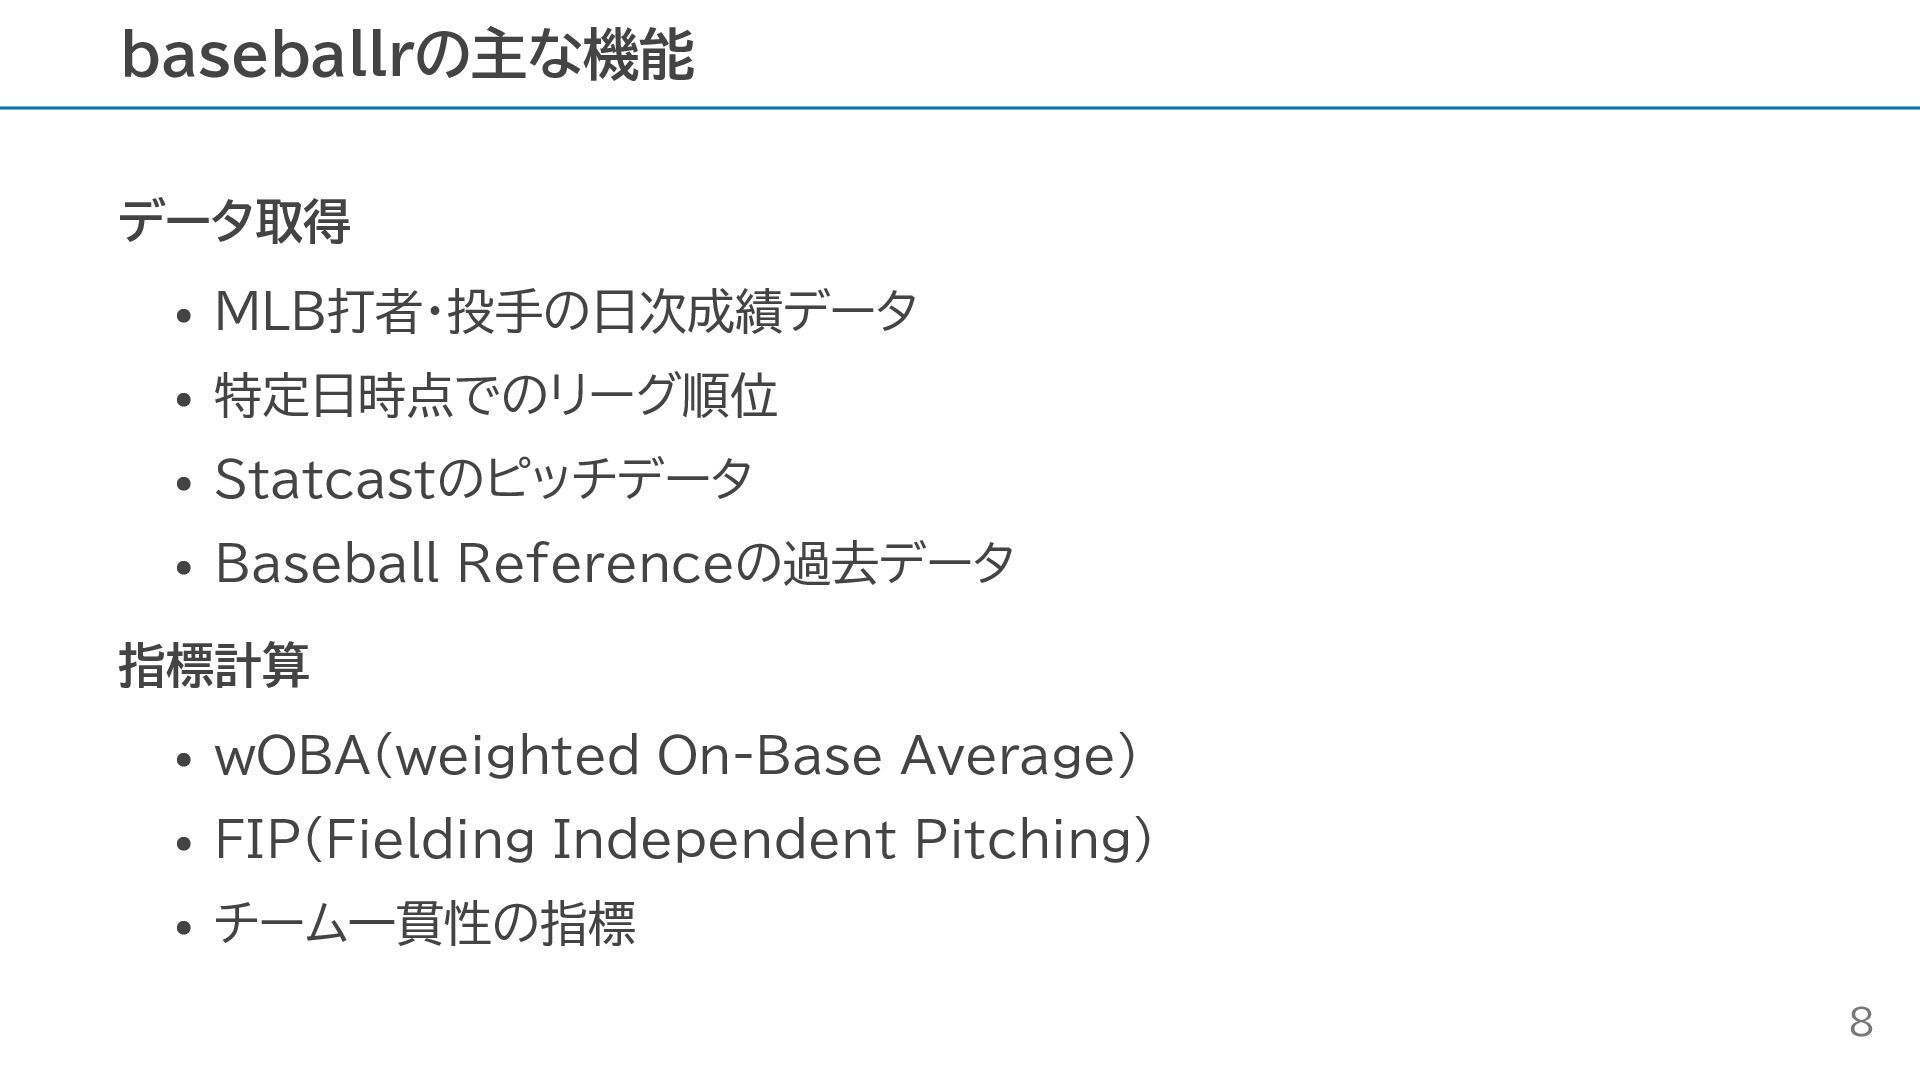
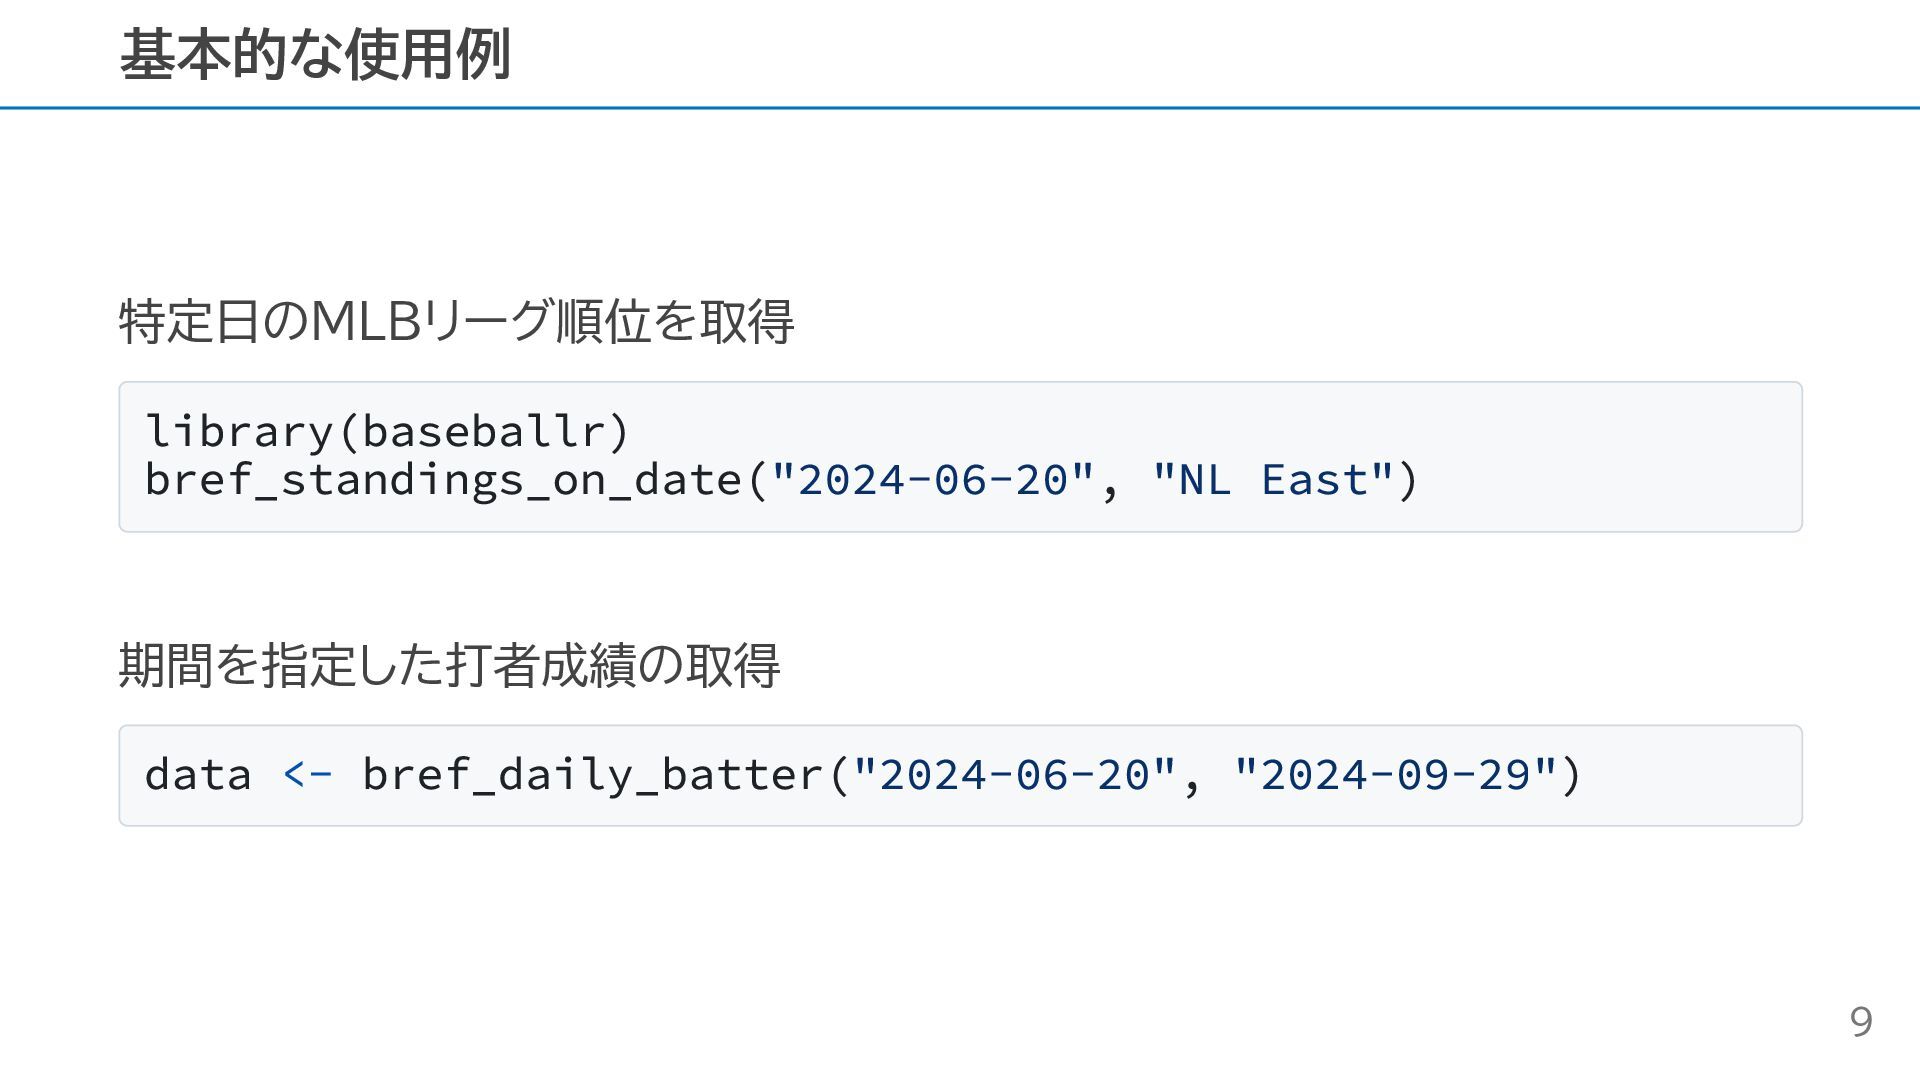
データ取得 MLB打者・投手の日次成績データ 特定日時点でのリーグ順位 Statcastのピッチデータ Baseball Referenceの過去データ 指標計算 wOBA(weighted On-Base Average)
FIP(Fielding Independent Pitching) チーム一貫性の指標 baseballrの主な機能 8 -
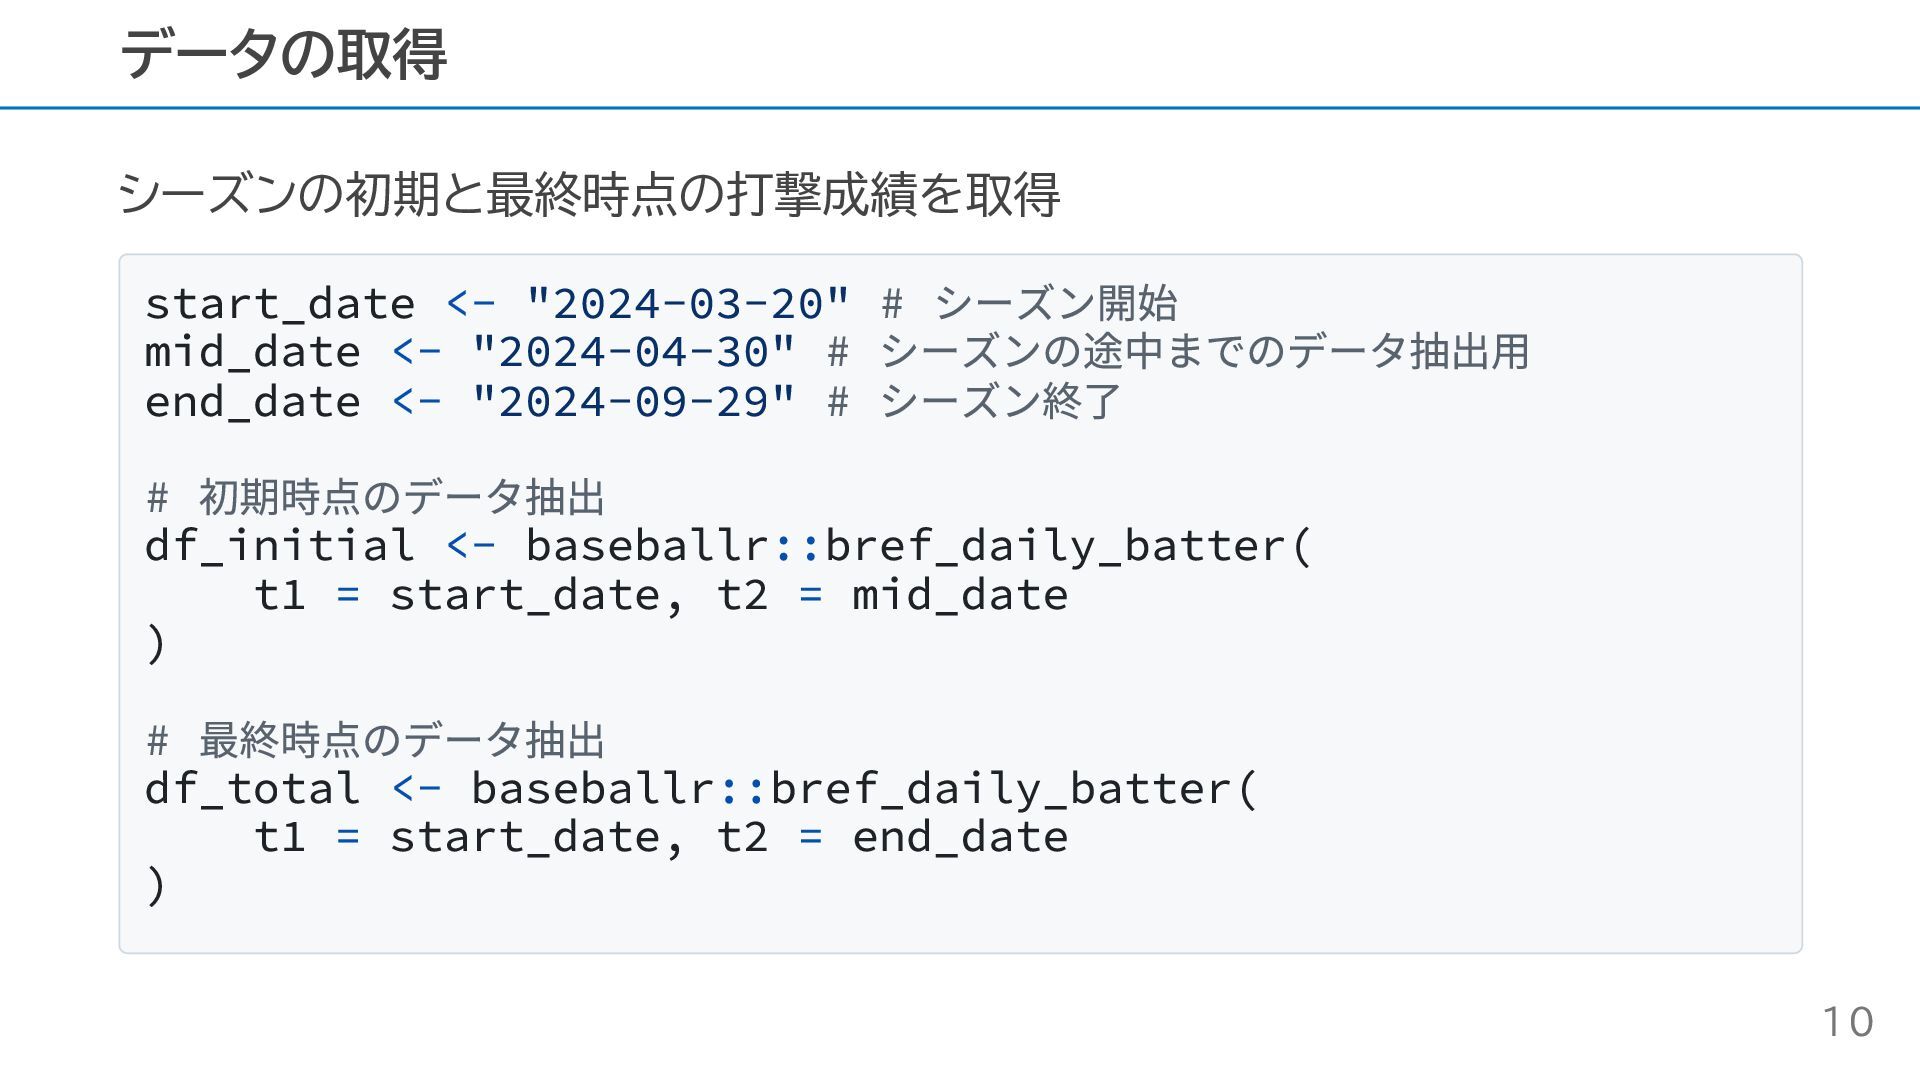
シーズンの初期と最終時点の打撃成績を取得 start_date <- "2024-03-20" # シーズン開始 mid_date <- "2024-04-30" #
シーズンの途中までのデータ抽出用 end_date <- "2024-09-29" # シーズン終了 # 初期時点のデータ抽出 df_initial <- baseballr::bref_daily_batter( t1 = start_date, t2 = mid_date ) # 最終時点のデータ抽出 df_total <- baseballr::bref_daily_batter( t1 = start_date, t2 = end_date ) データの取得 10 -
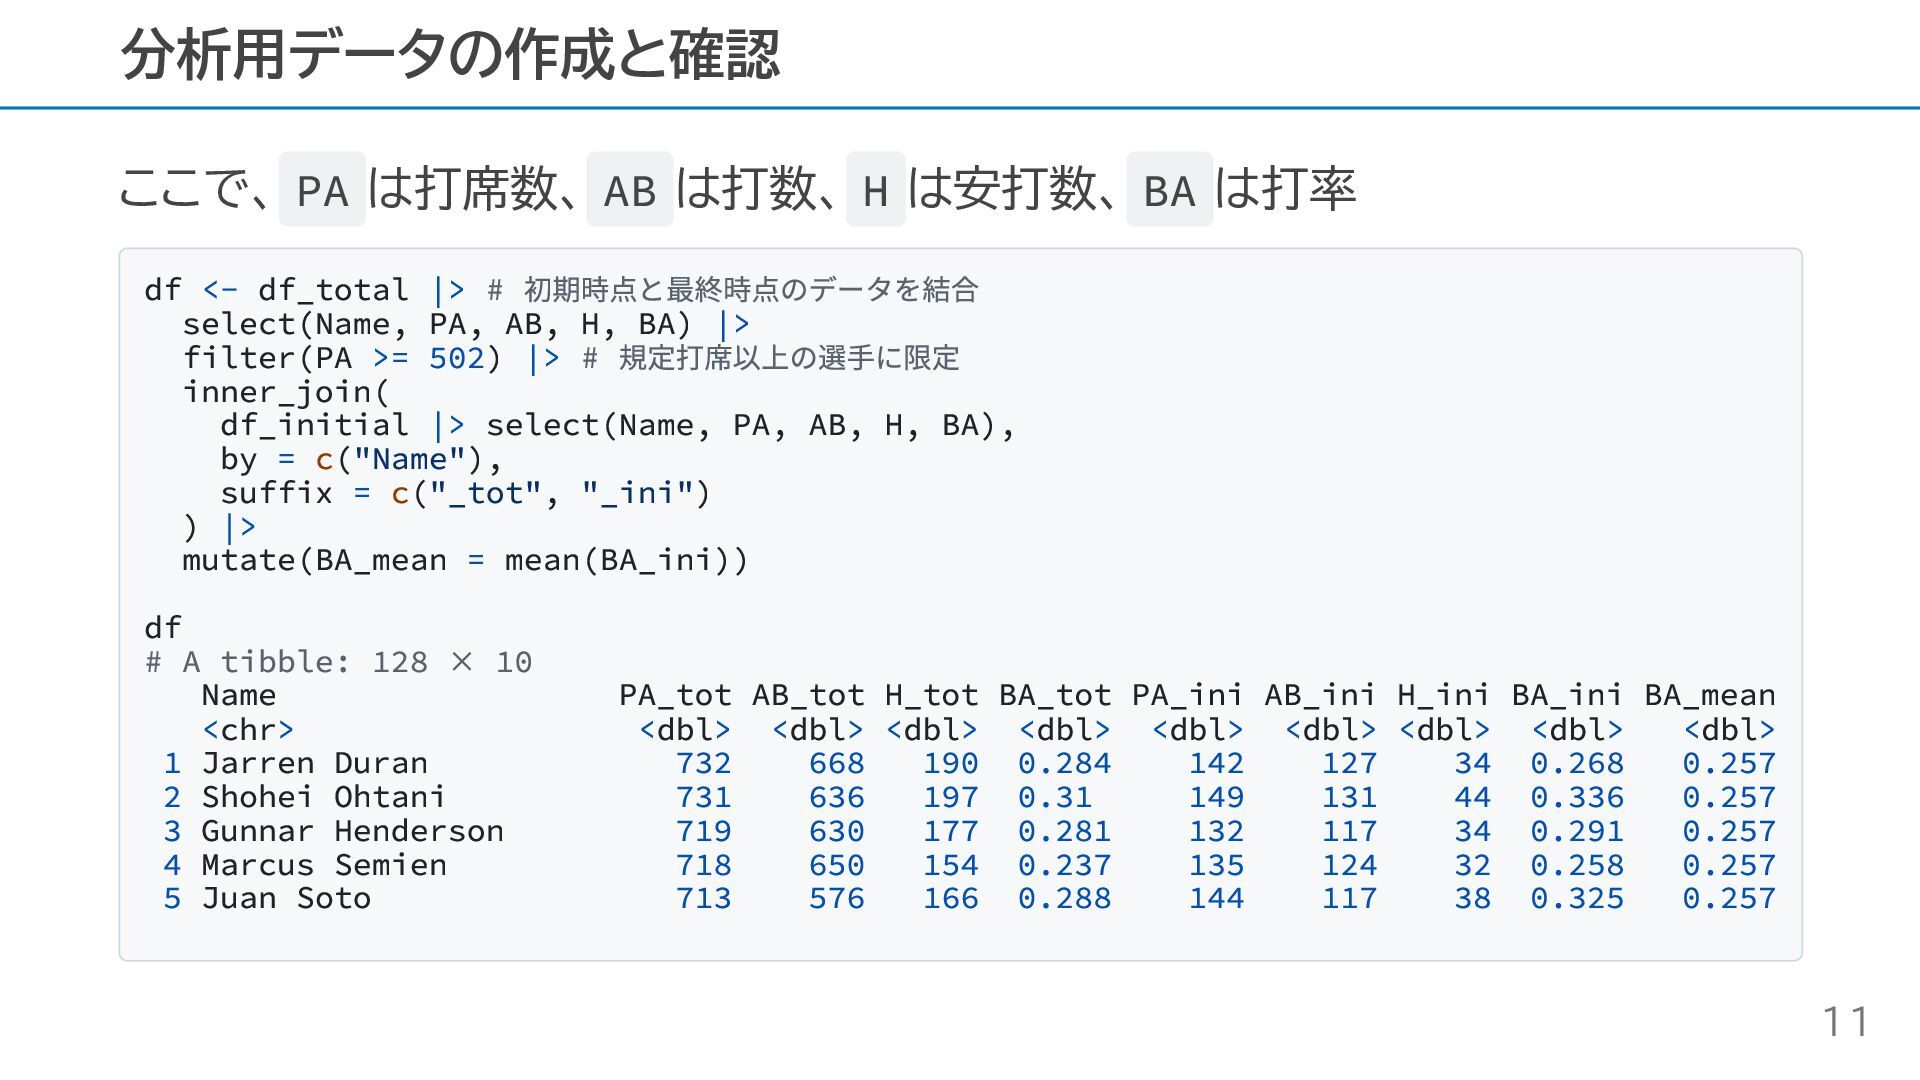
ここで、 PA は打席数、 AB は打数、 H は安打数、 BA は打率 df
<- df_total |> # 初期時点と最終時点のデータを結合 select(Name, PA, AB, H, BA) |> filter(PA >= 502) |> # 規定打席以上の選手に限定 inner_join( df_initial |> select(Name, PA, AB, H, BA), by = c("Name"), suffix = c("_tot", "_ini") ) |> mutate(BA_mean = mean(BA_ini)) df # A tibble: 128 × 10 Name PA_tot AB_tot H_tot BA_tot PA_ini AB_ini H_ini BA_ini BA_mean <chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> 1 Jarren Duran 732 668 190 0.284 142 127 34 0.268 0.257 2 Shohei Ohtani 731 636 197 0.31 149 131 44 0.336 0.257 3 Gunnar Henderson 719 630 177 0.281 132 117 34 0.291 0.257 4 Marcus Semien 718 650 154 0.237 135 124 32 0.258 0.257 5 Juan Soto 713 576 166 0.288 144 117 38 0.325 0.257 分析用データの作成と確認 11 -
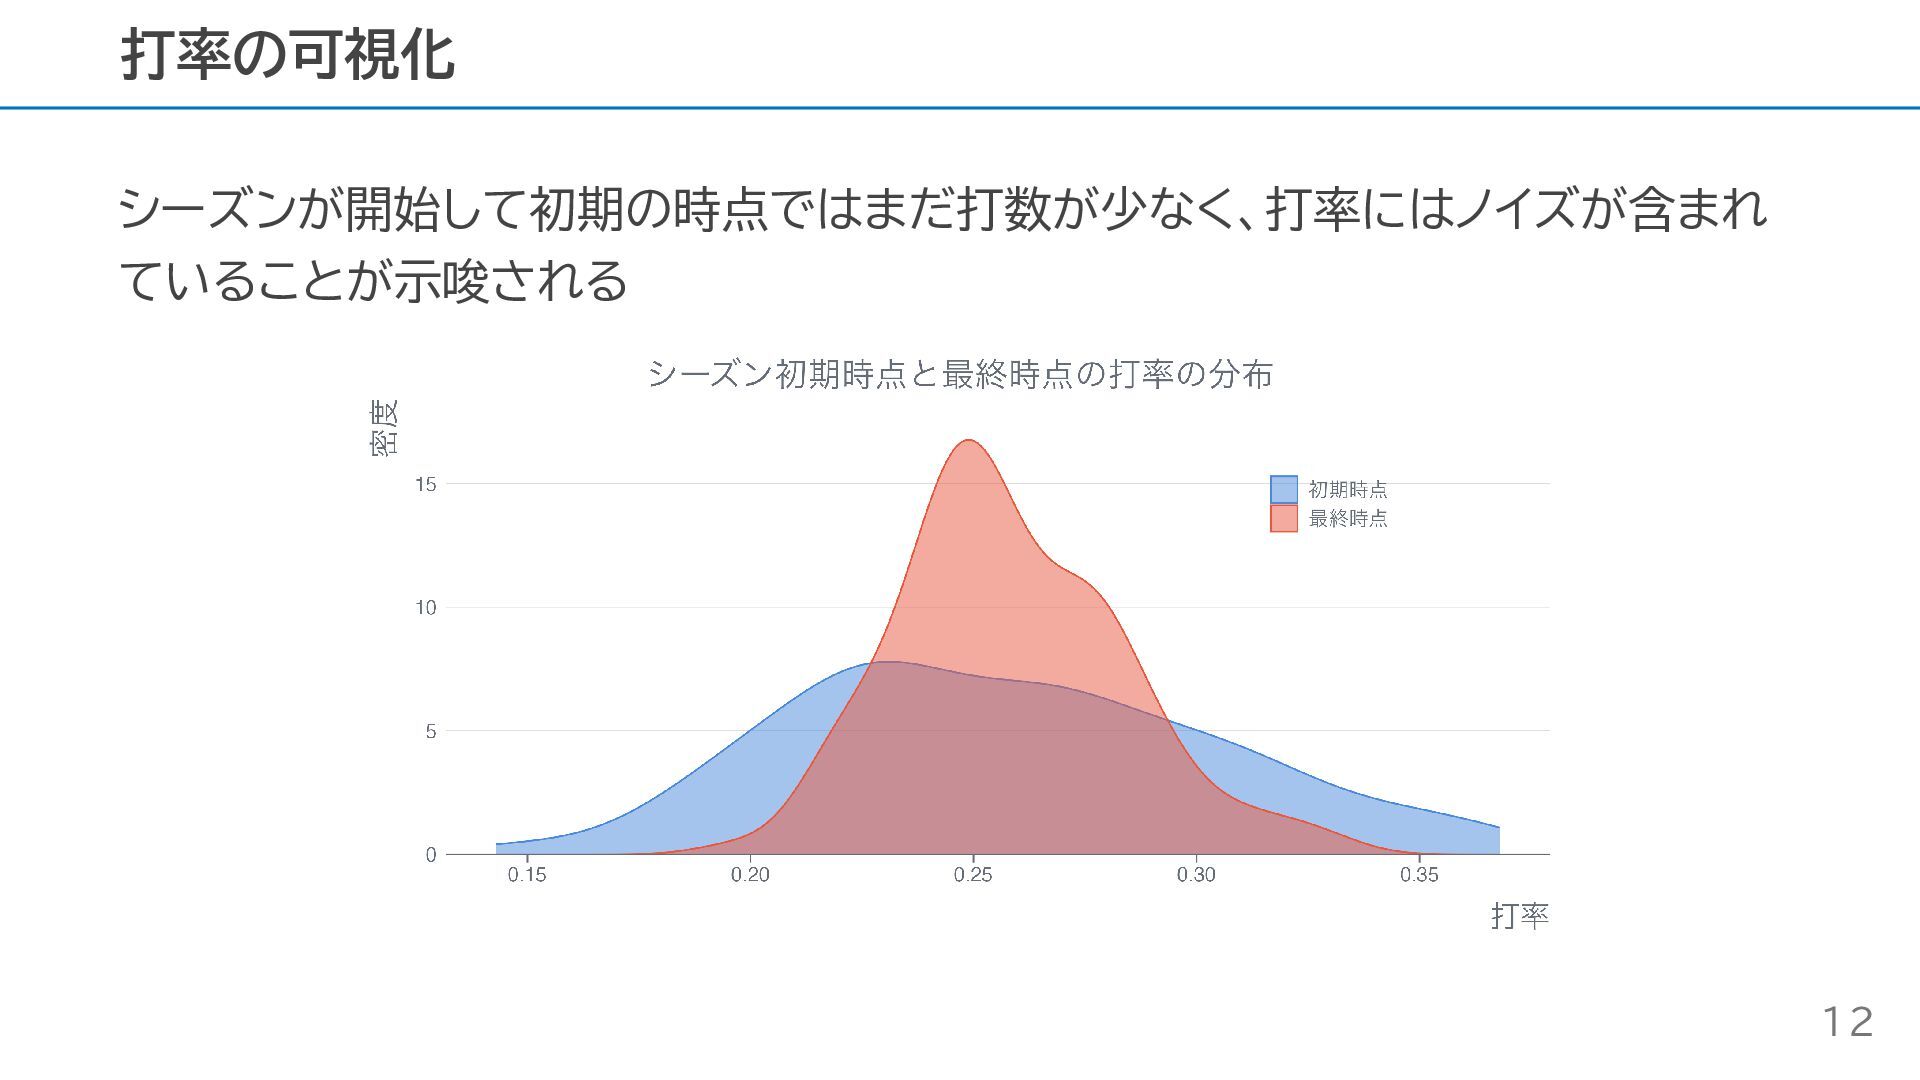
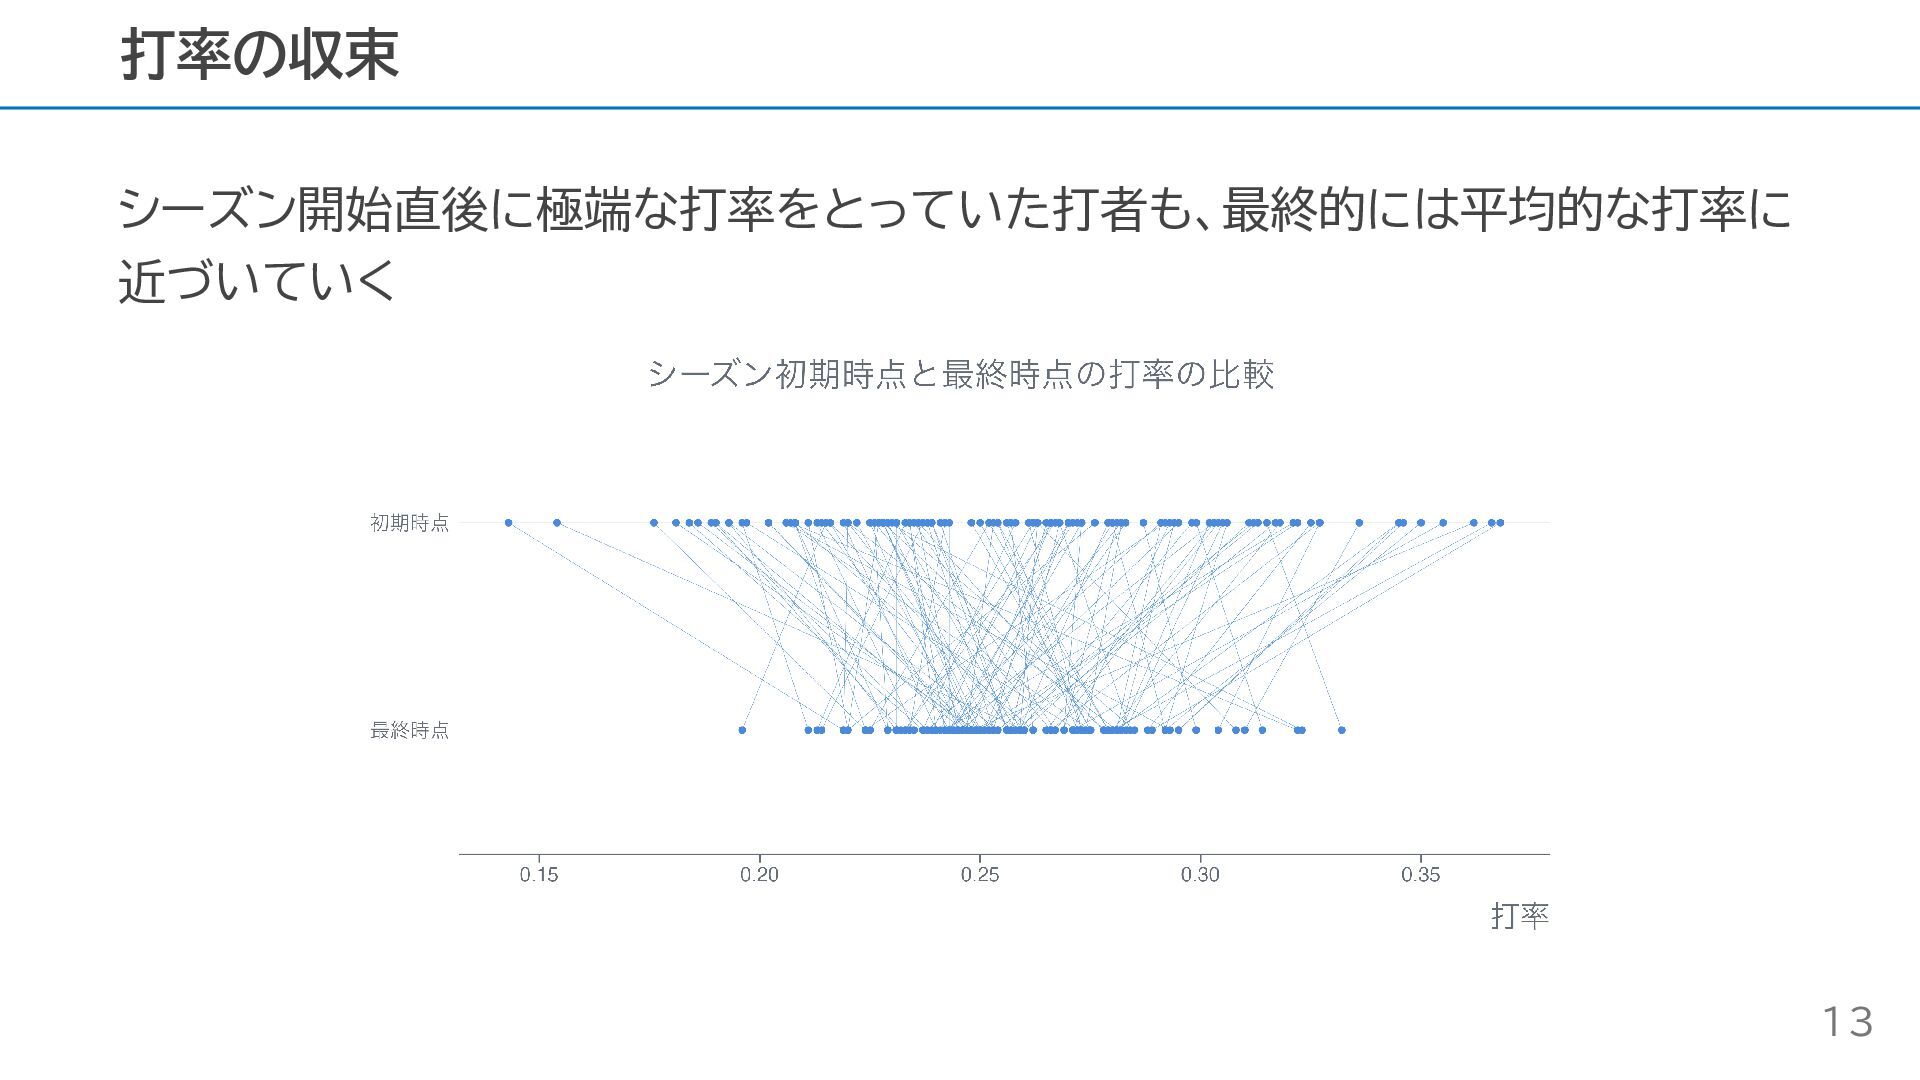
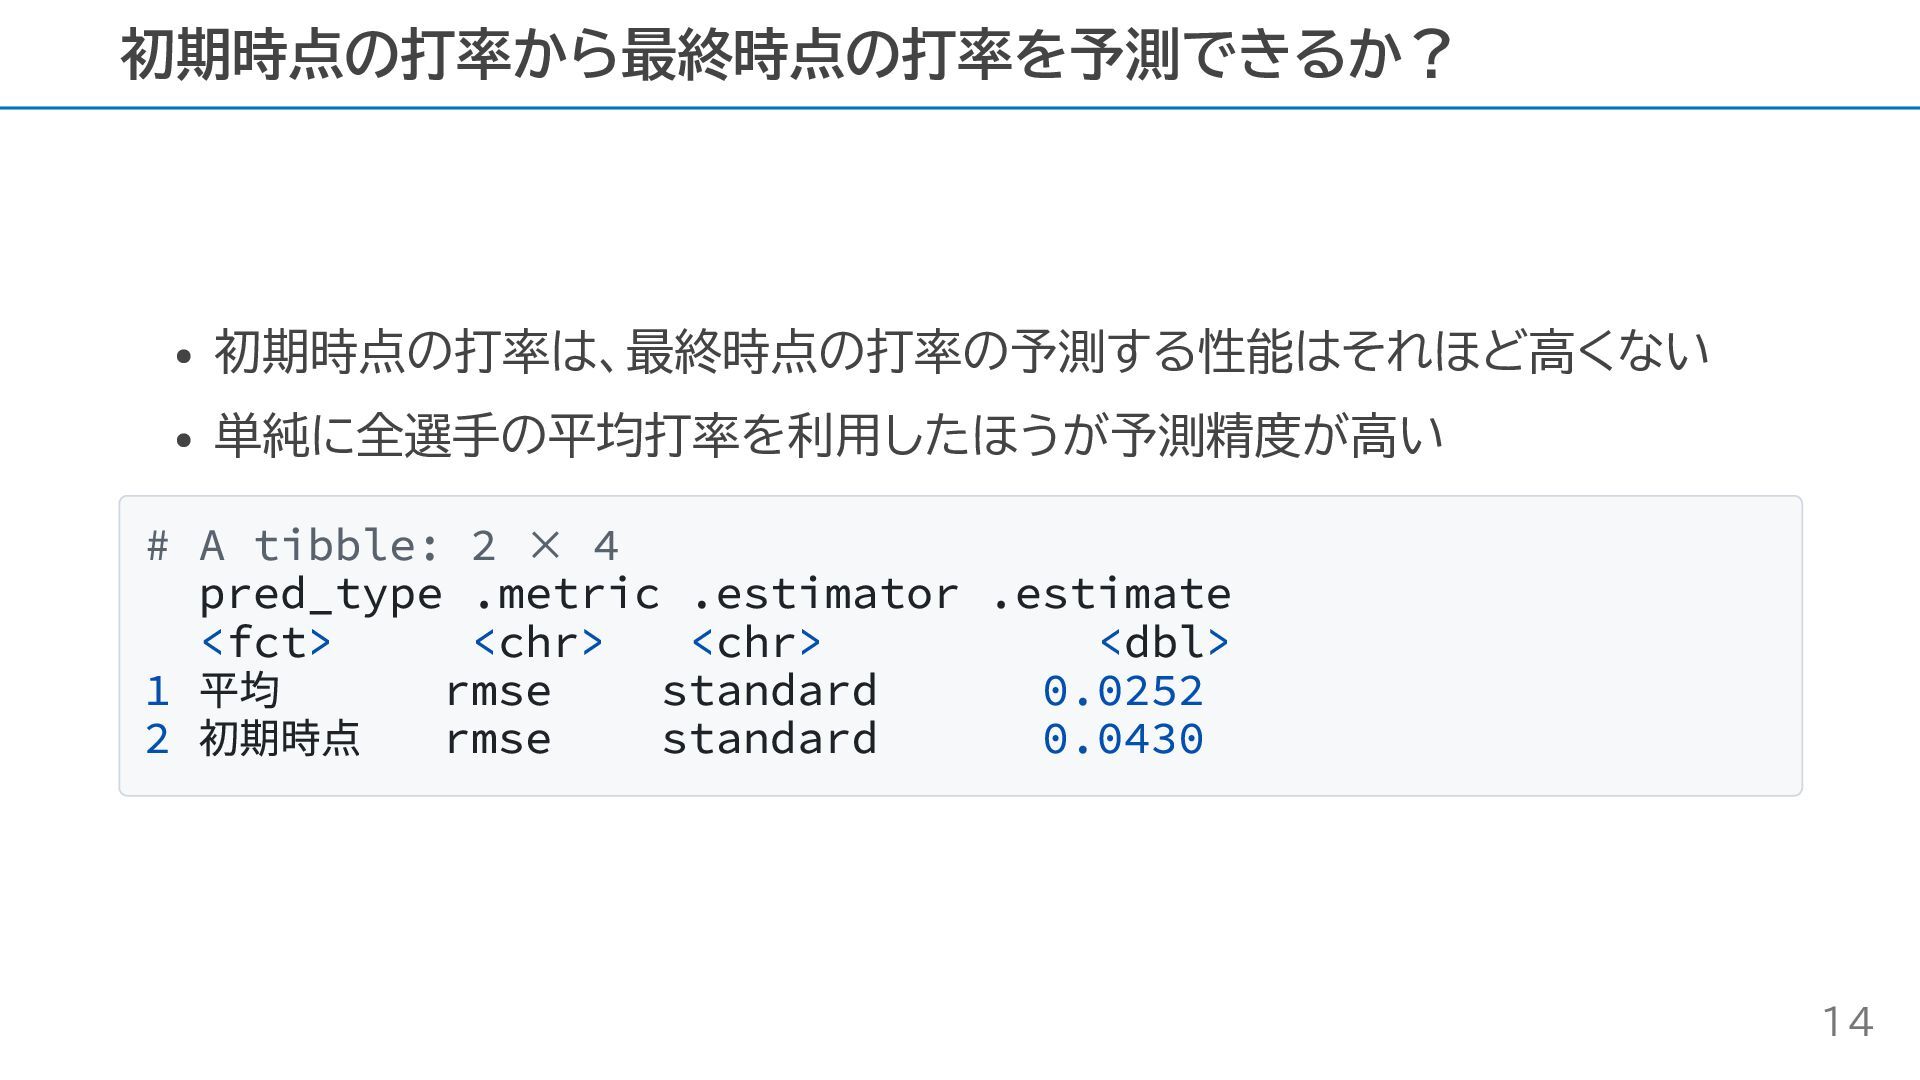
初期時点の打率は、最終時点の打率の予測する性能はそれほど高くない 単純に全選手の平均打率を利用したほうが予測精度が高い # A tibble: 2 × 4 pred_type .metric
.estimator .estimate <fct> <chr> <chr> <dbl> 1 平均 rmse standard 0.0252 2 初期時点 rmse standard 0.0430 初期時点の打率から最終時点の打率を予測できるか? 14 -
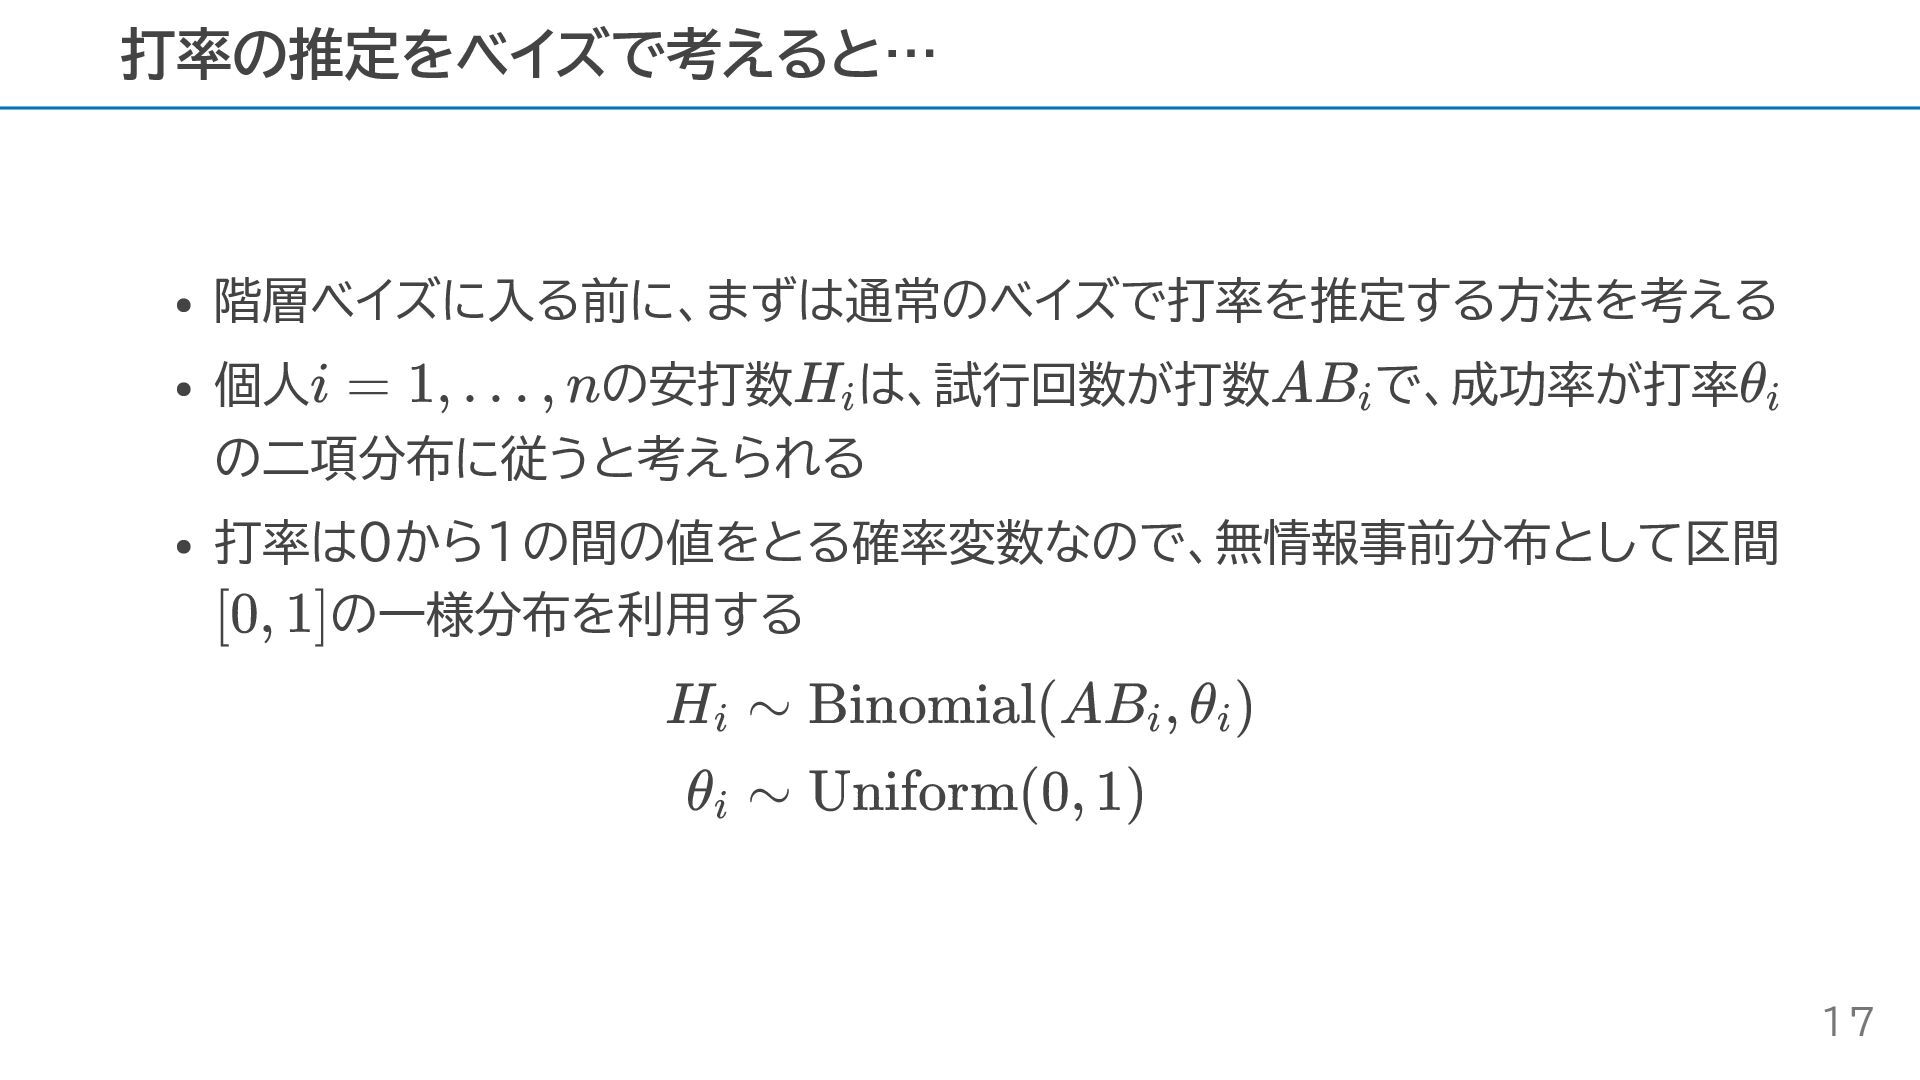
階層ベイズに入る前に、まずは通常のベイズで打率を推定する方法を考える 個人 の安打数 は、試行回数が打数 で、成功率が打率 の二項分布に従うと考えられる 打率は0から1の間の値をとる確率変数なので、無情報事前分布として区間 の一様分布を利用する
H i θ i ∼ Binomial(AB , θ ) i i ∼ Uniform(0, 1) 打率の推定をベイズで考えると… i = 1, … , n H i AB i θ i [0, 1] 17 -
前述のモデルをStanで記述すると以下のようになる data { int<lower=0> N; int<lower=0> AB[N]; int<lower=0> H[N]; }
parameters { vector<lower=0, upper=1>[N] theta; } model { H ~ binomial(AB, theta); theta ~ uniform(0, 1); } Stanコード 18 -
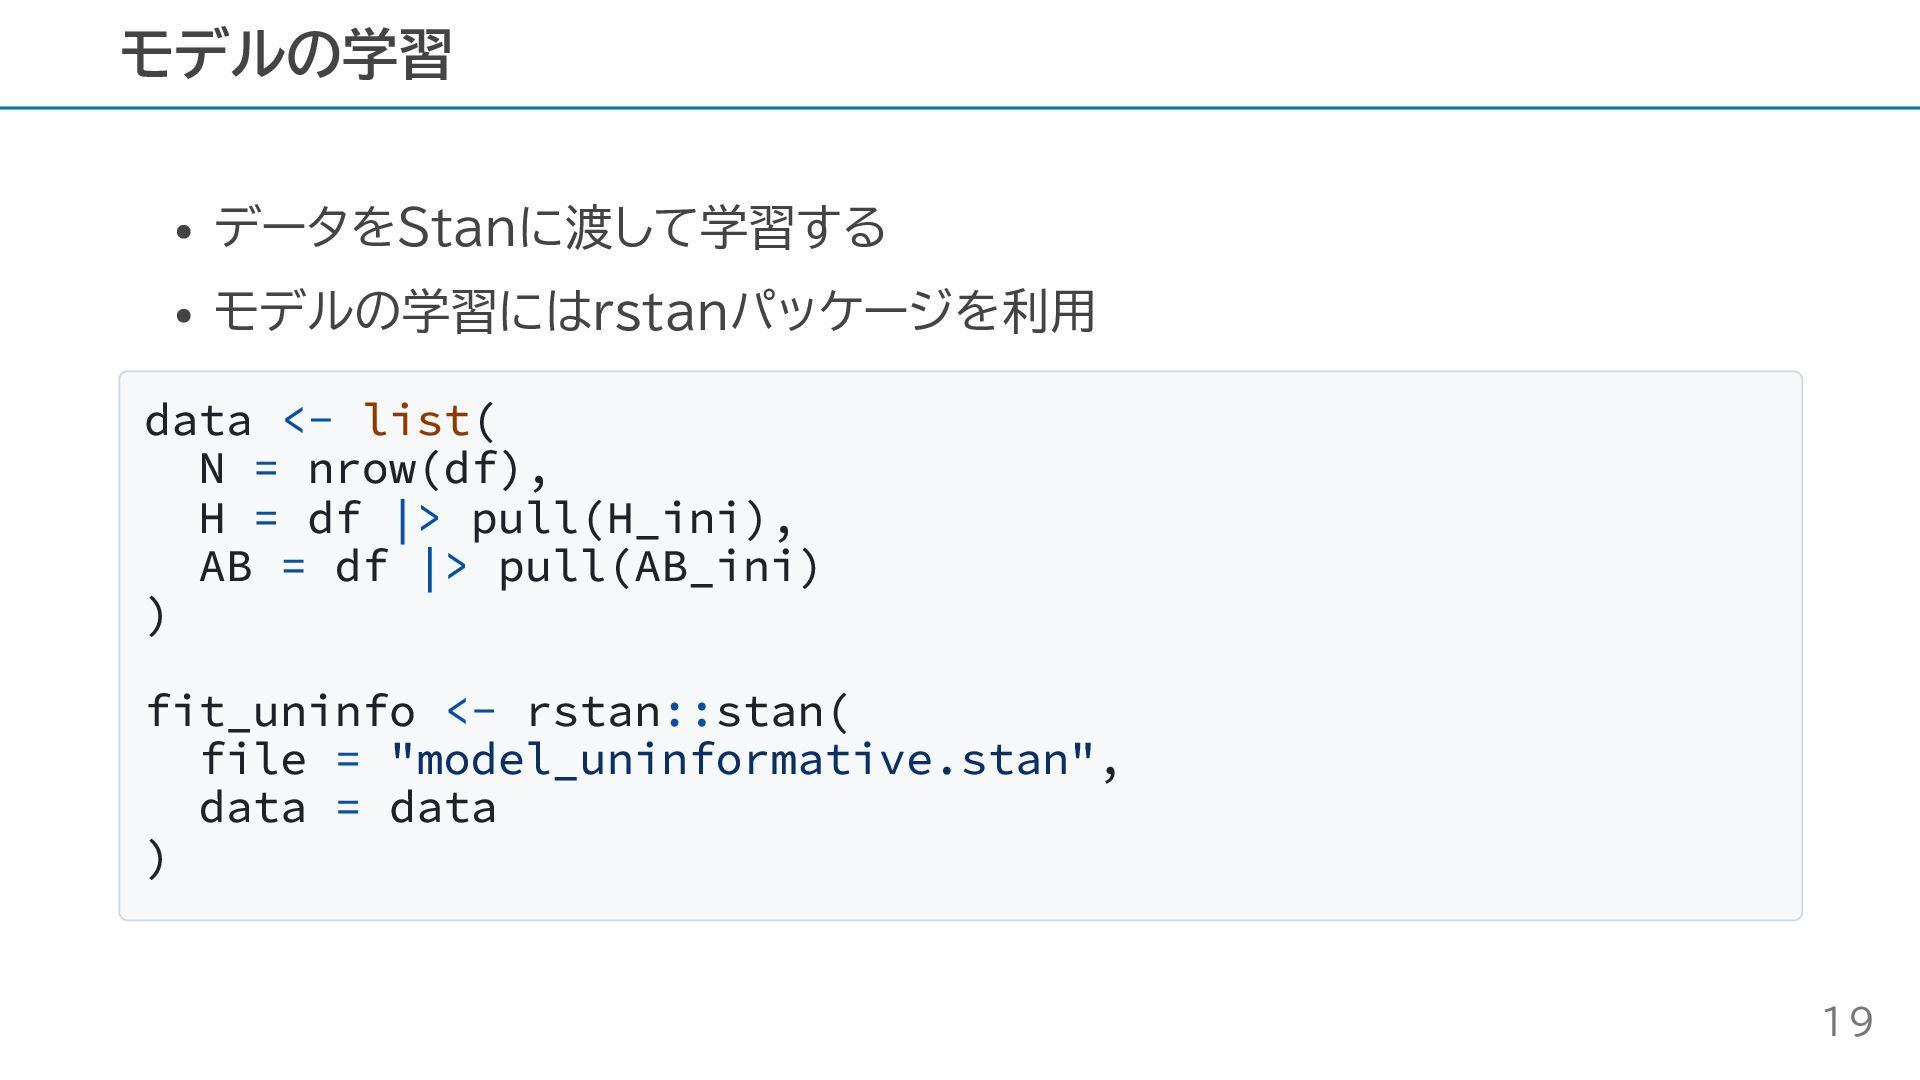
データをStanに渡して学習する モデルの学習にはrstanパッケージを利用 data <- list( N = nrow(df), H =
df |> pull(H_ini), AB = df |> pull(AB_ini) ) fit_uninfo <- rstan::stan( file = "model_uninformative.stan", data = data ) モデルの学習 19 -
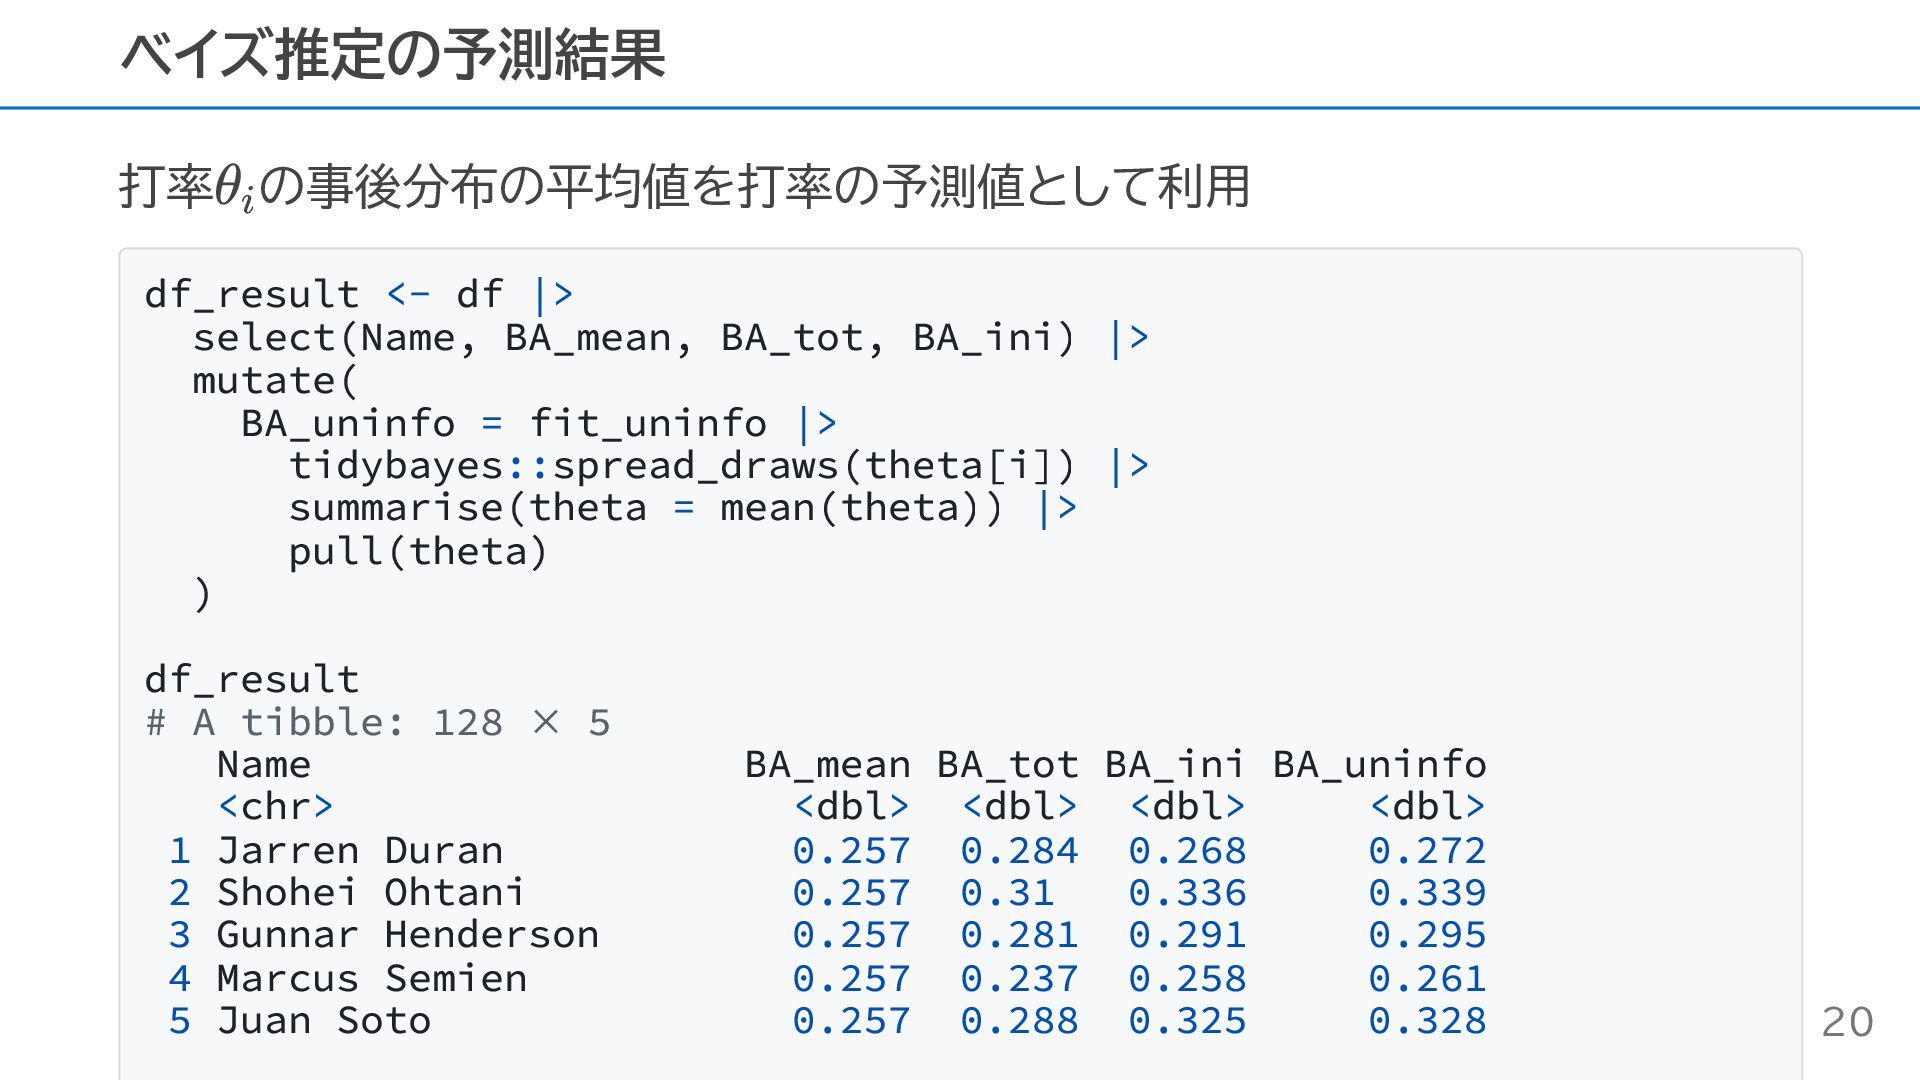
打率 の事後分布の平均値を打率の予測値として利用 df_result <- df |> select(Name, BA_mean, BA_tot, BA_ini)
|> mutate( BA_uninfo = fit_uninfo |> tidybayes::spread_draws(theta[i]) |> summarise(theta = mean(theta)) |> pull(theta) ) df_result # A tibble: 128 × 5 Name BA_mean BA_tot BA_ini BA_uninfo <chr> <dbl> <dbl> <dbl> <dbl> 1 Jarren Duran 0.257 0.284 0.268 0.272 2 Shohei Ohtani 0.257 0.31 0.336 0.339 3 Gunnar Henderson 0.257 0.281 0.291 0.295 4 Marcus Semien 0.257 0.237 0.258 0.261 5 Juan Soto 0.257 0.288 0.325 0.328 ベイズ推定の予測結果 θ i 20 -
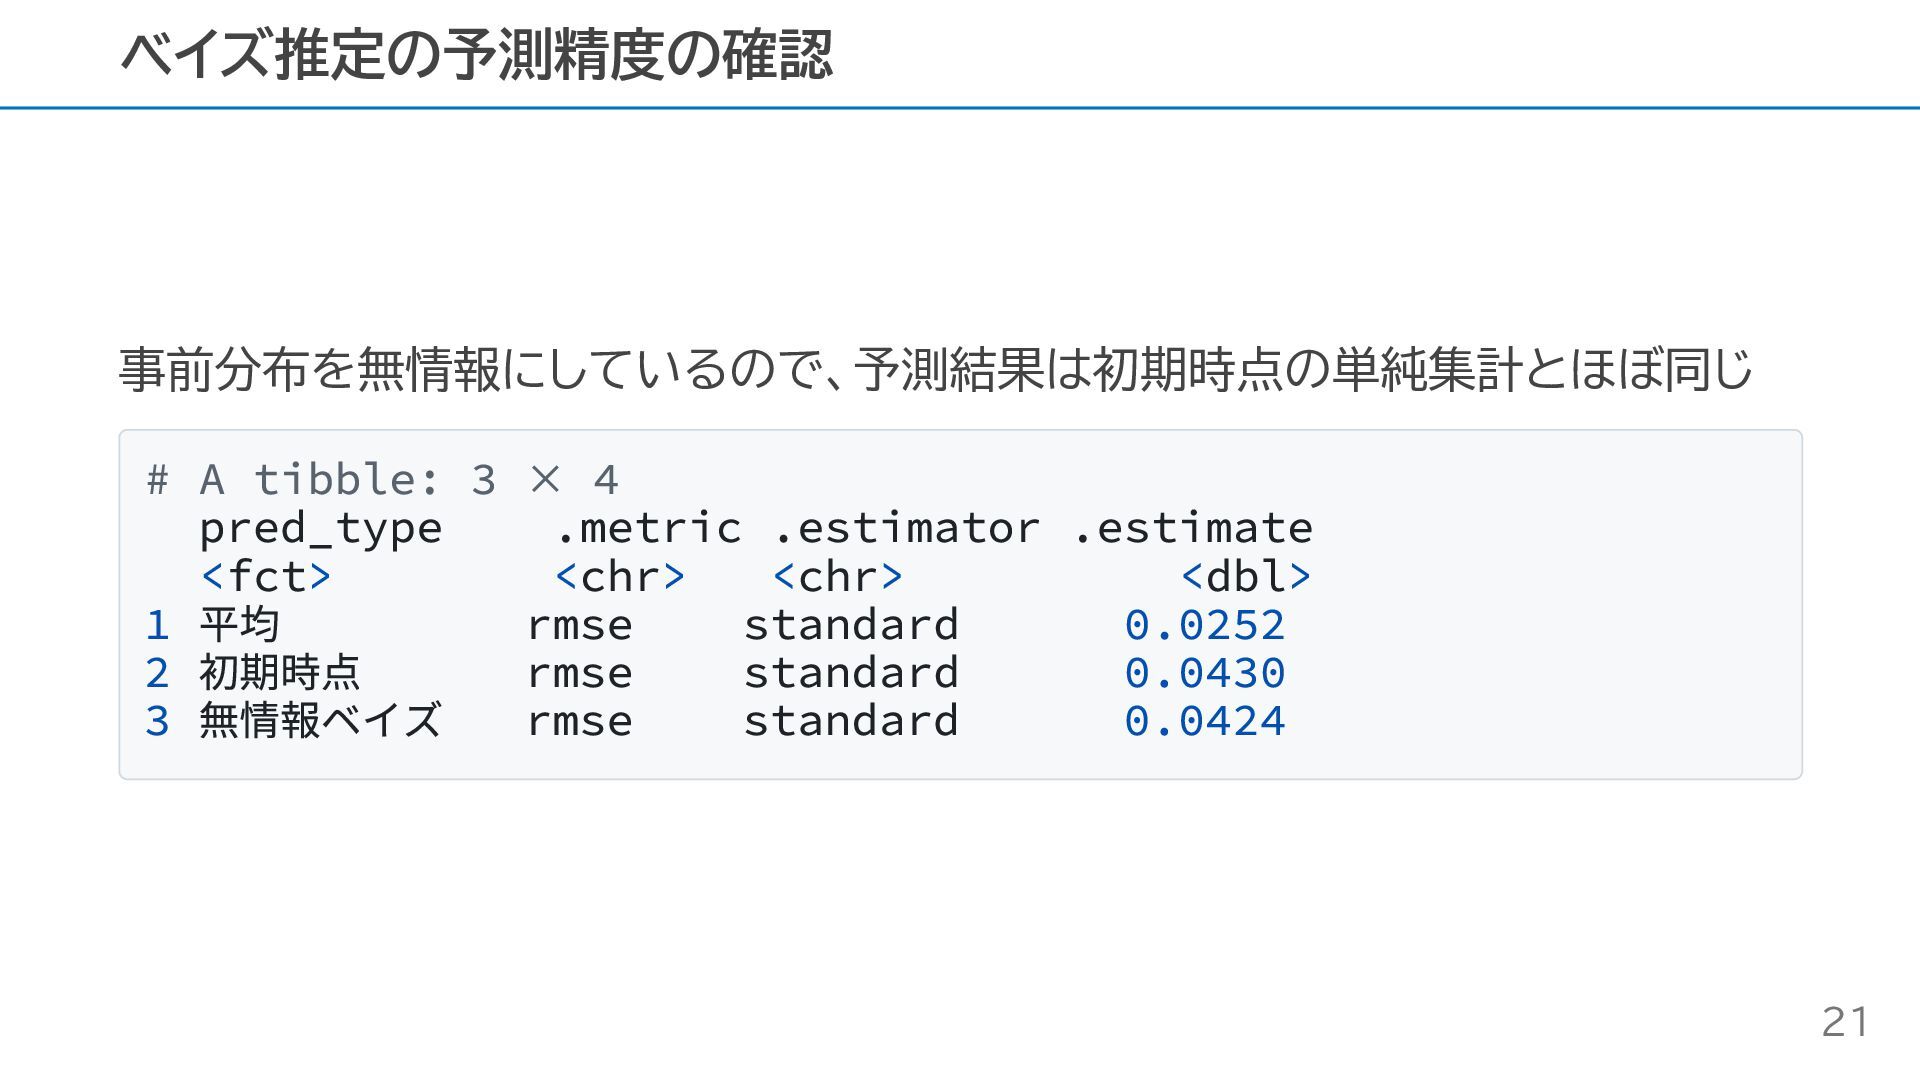
事前分布を無情報にしているので、予測結果は初期時点の単純集計とほぼ同じ # A tibble: 3 × 4 pred_type .metric .estimator
.estimate <fct> <chr> <chr> <dbl> 1 平均 rmse standard 0.0252 2 初期時点 rmse standard 0.0430 3 無情報ベイズ rmse standard 0.0424 ベイズ推定の予測精度の確認 21 -
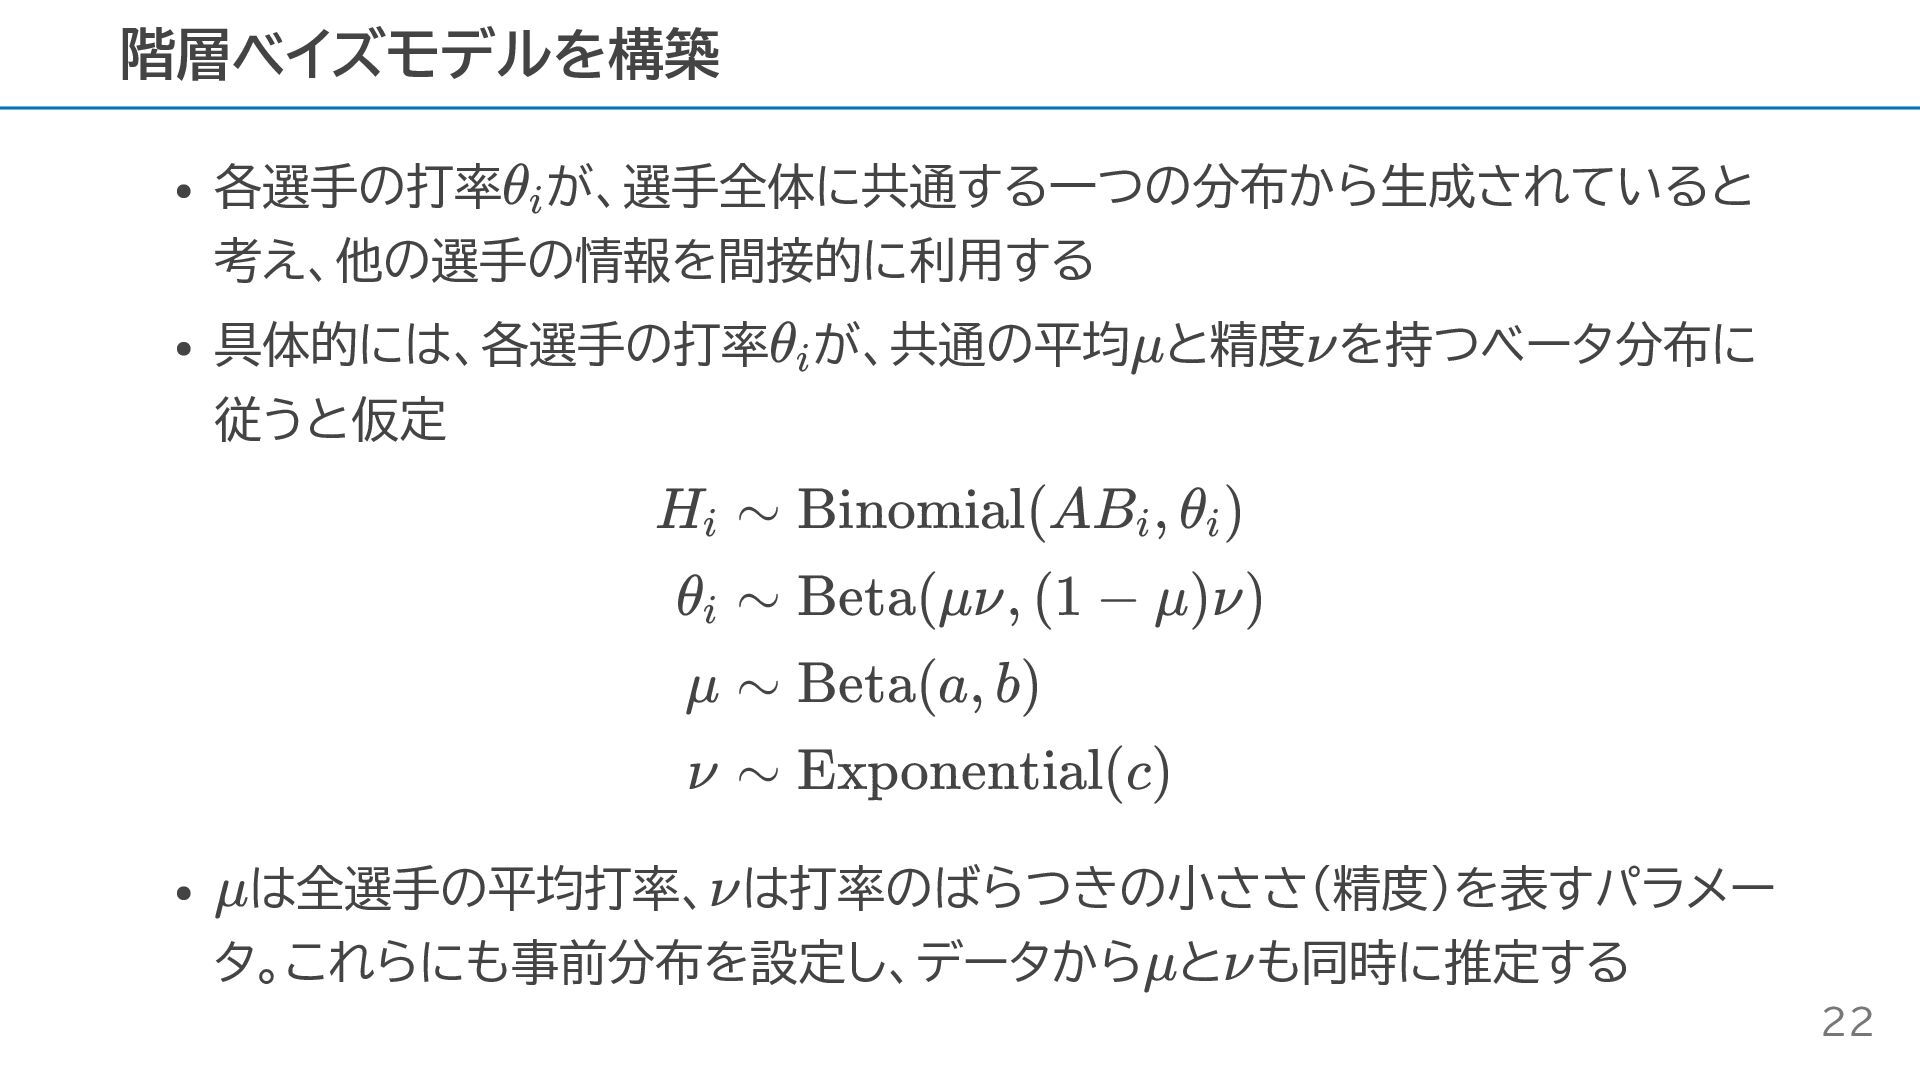
各選手の打率 が、選手全体に共通する一つの分布から生成されていると 考え、他の選手の情報を間接的に利用する 具体的には、各選手の打率 が、共通の平均 と精度 を持つベータ分布に 従うと仮定
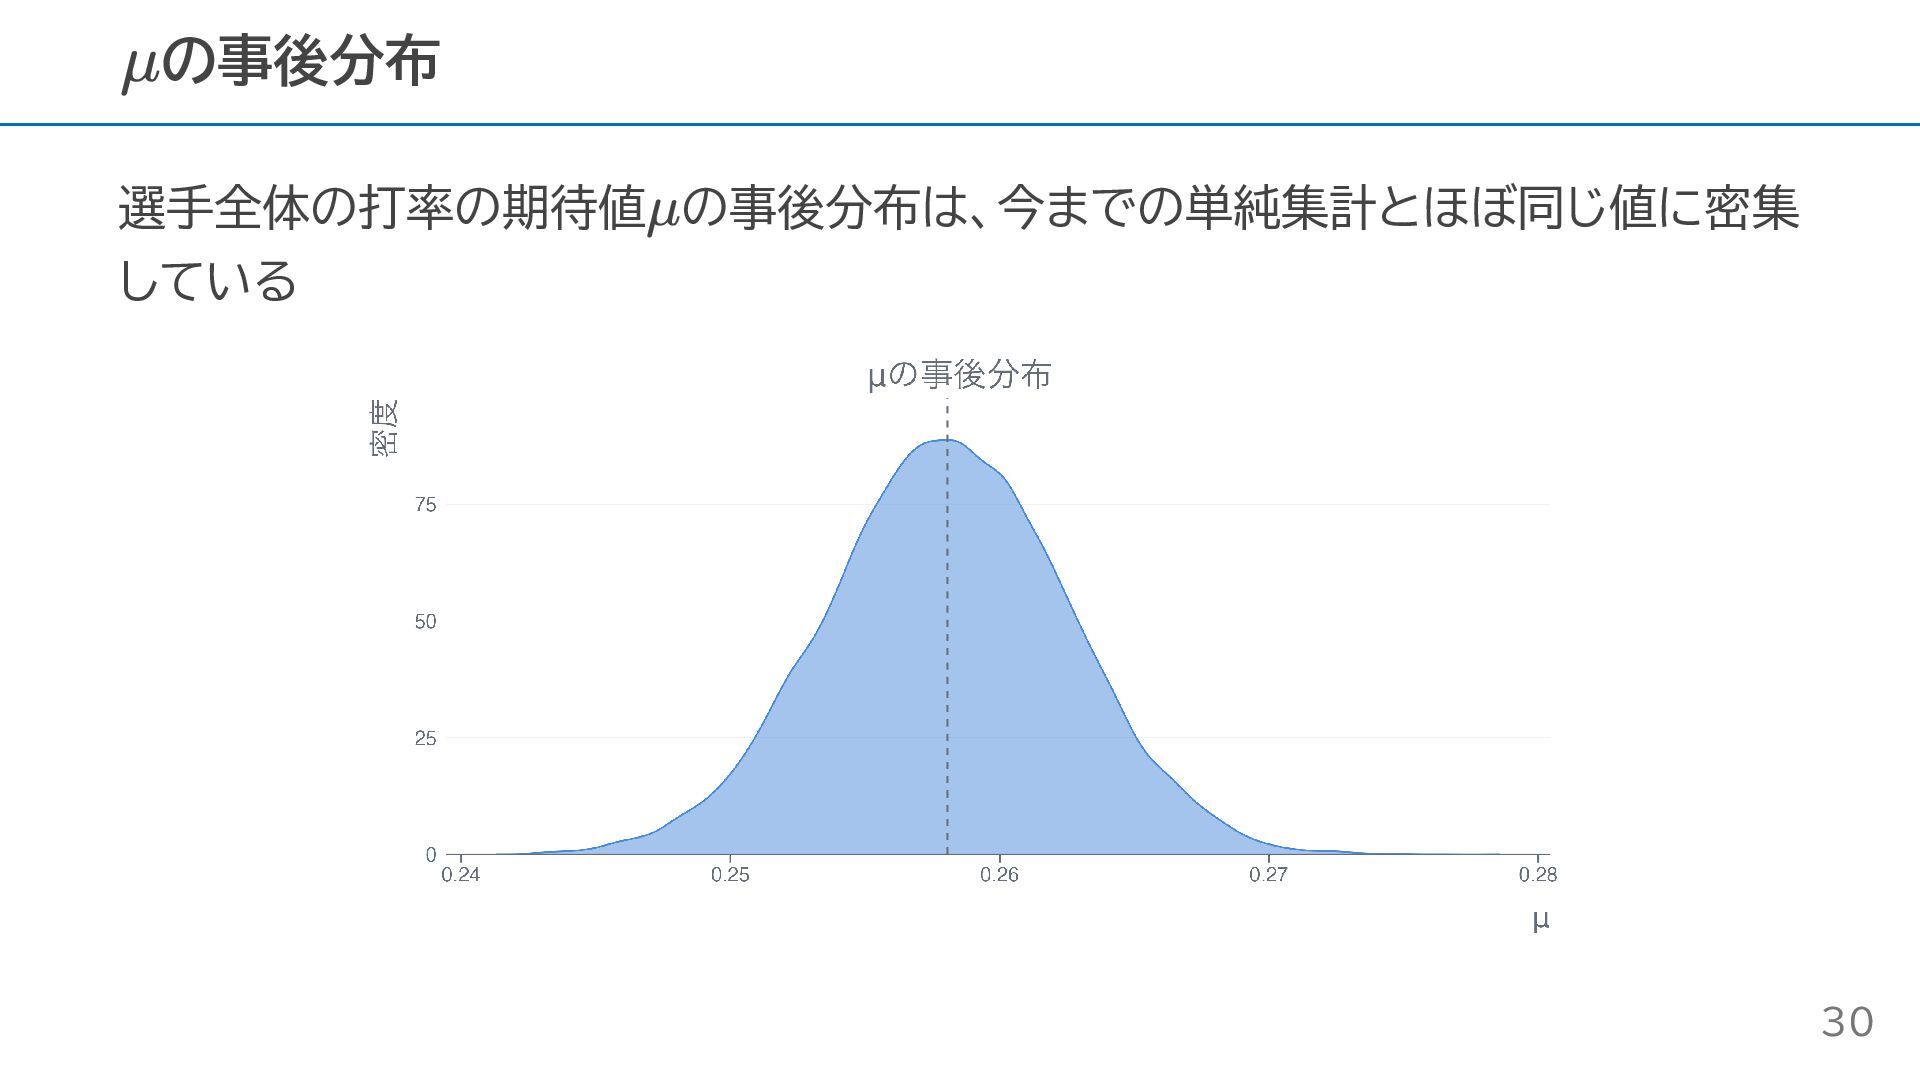
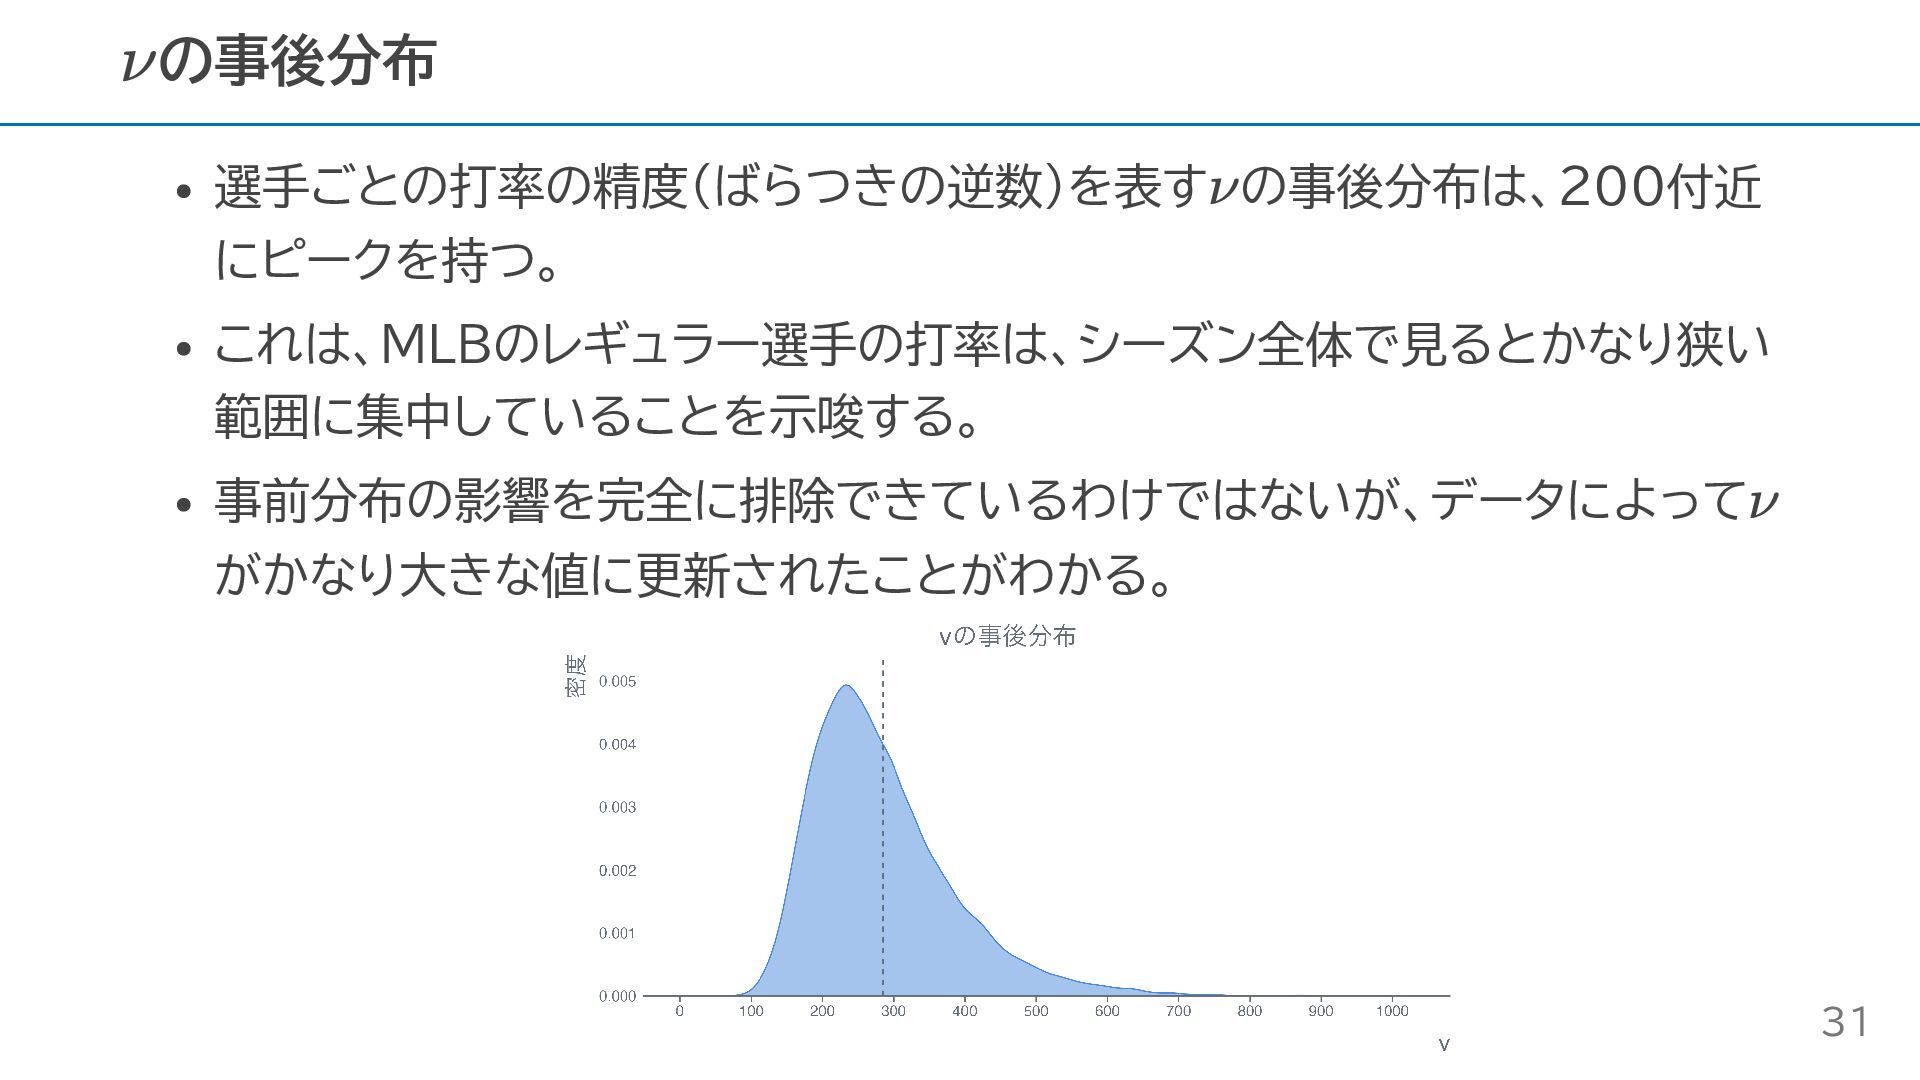
H i θ i μ ν ∼ Binomial(AB , θ ) i i ∼ Beta(μν, (1 − μ)ν) ∼ Beta(a, b) ∼ Exponential(c) は全選手の平均打率、 は打率のばらつきの小ささ(精度)を表すパラメー タ。これらにも事前分布を設定し、データから と も同時に推定する 階層ベイズモデルを構築 θ i θ i μ ν μ ν μ ν 22 -
data { int<lower=0> N; int<lower=0> AB[N]; int<lower=0> H[N]; } parameters
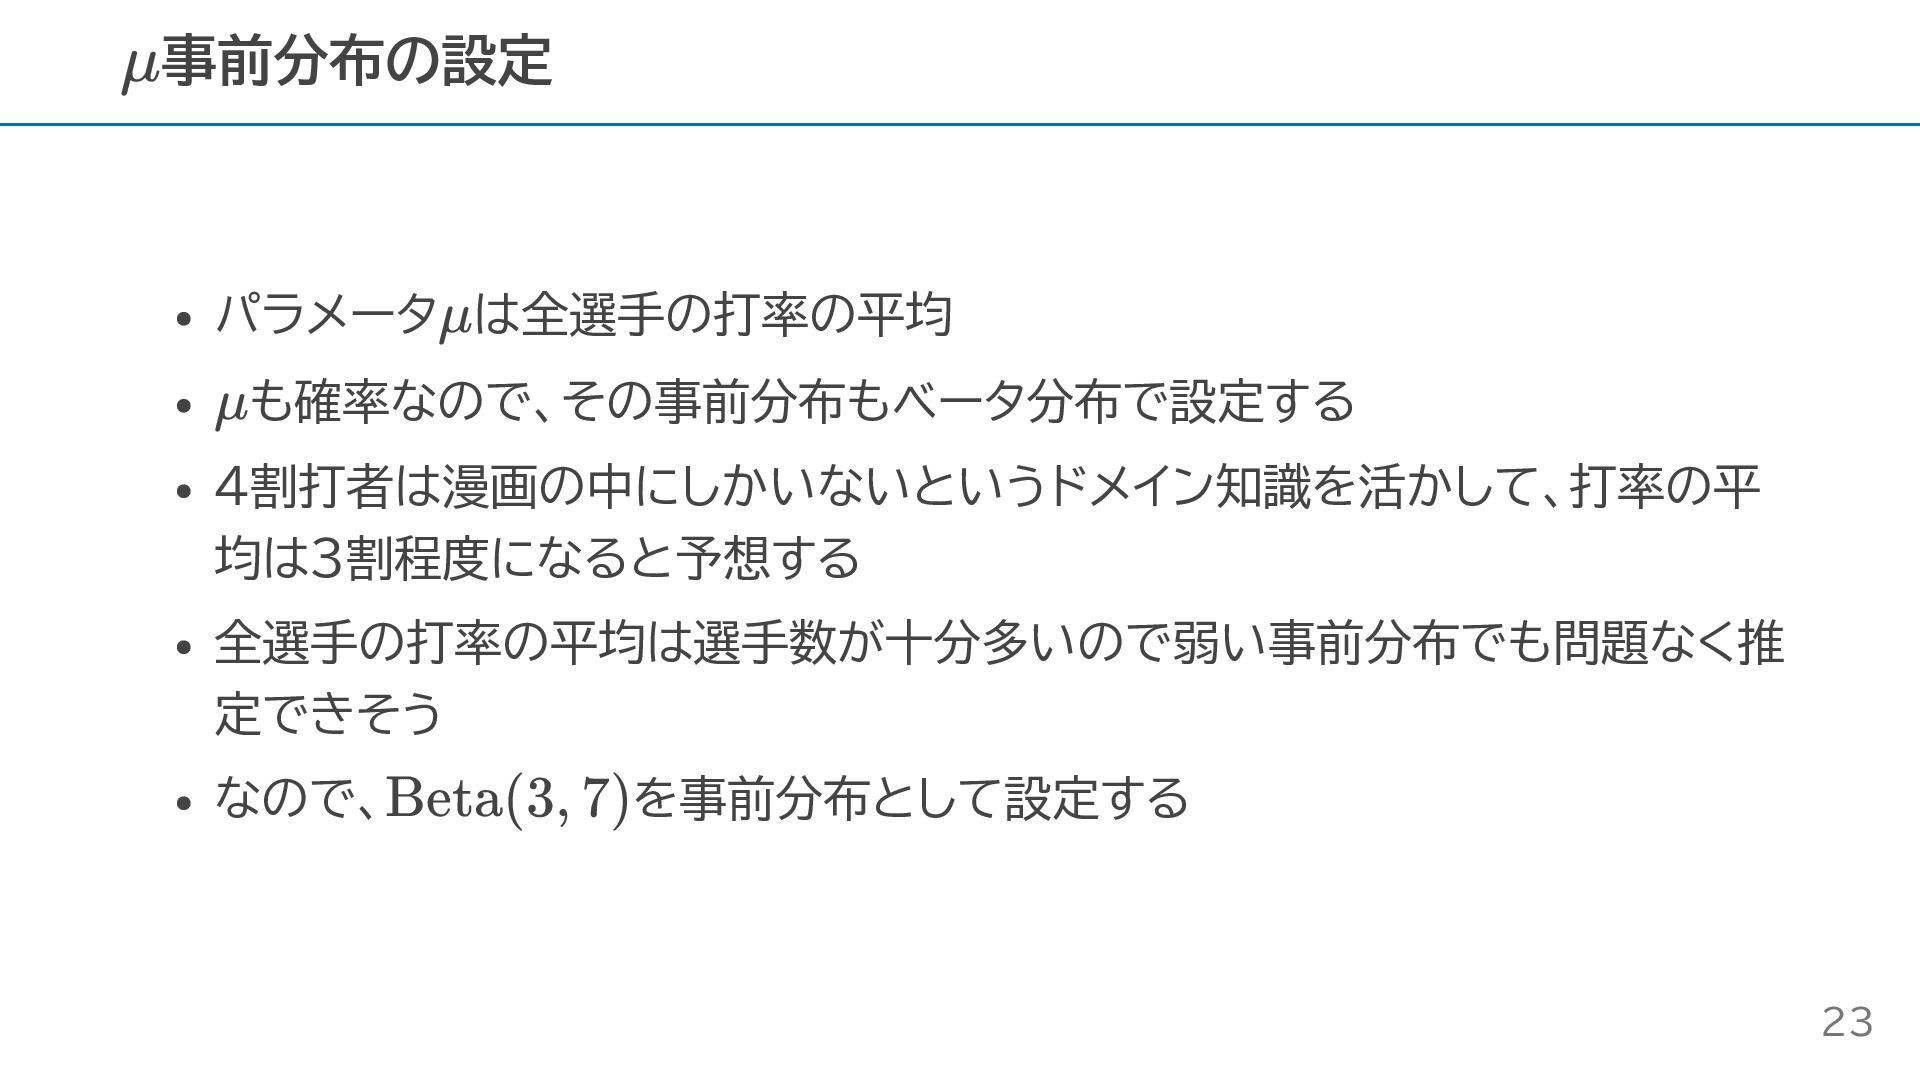
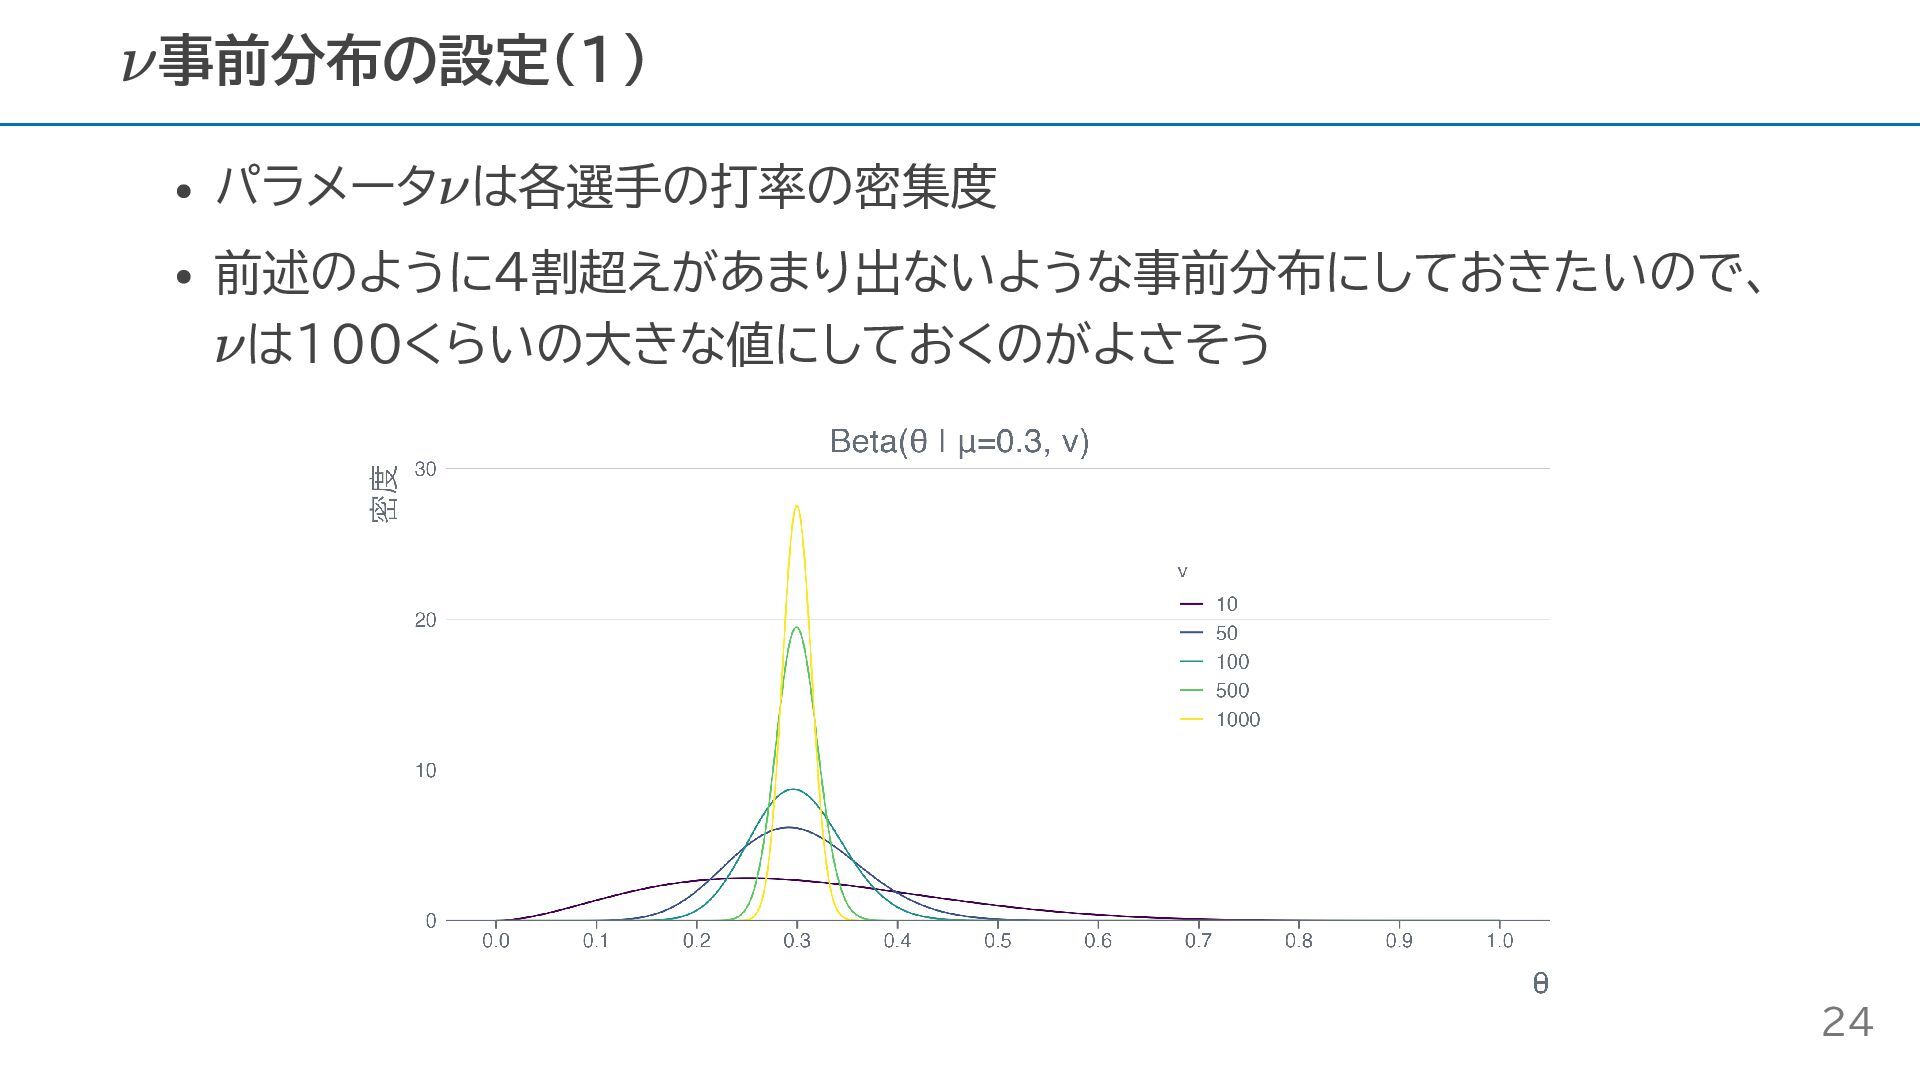
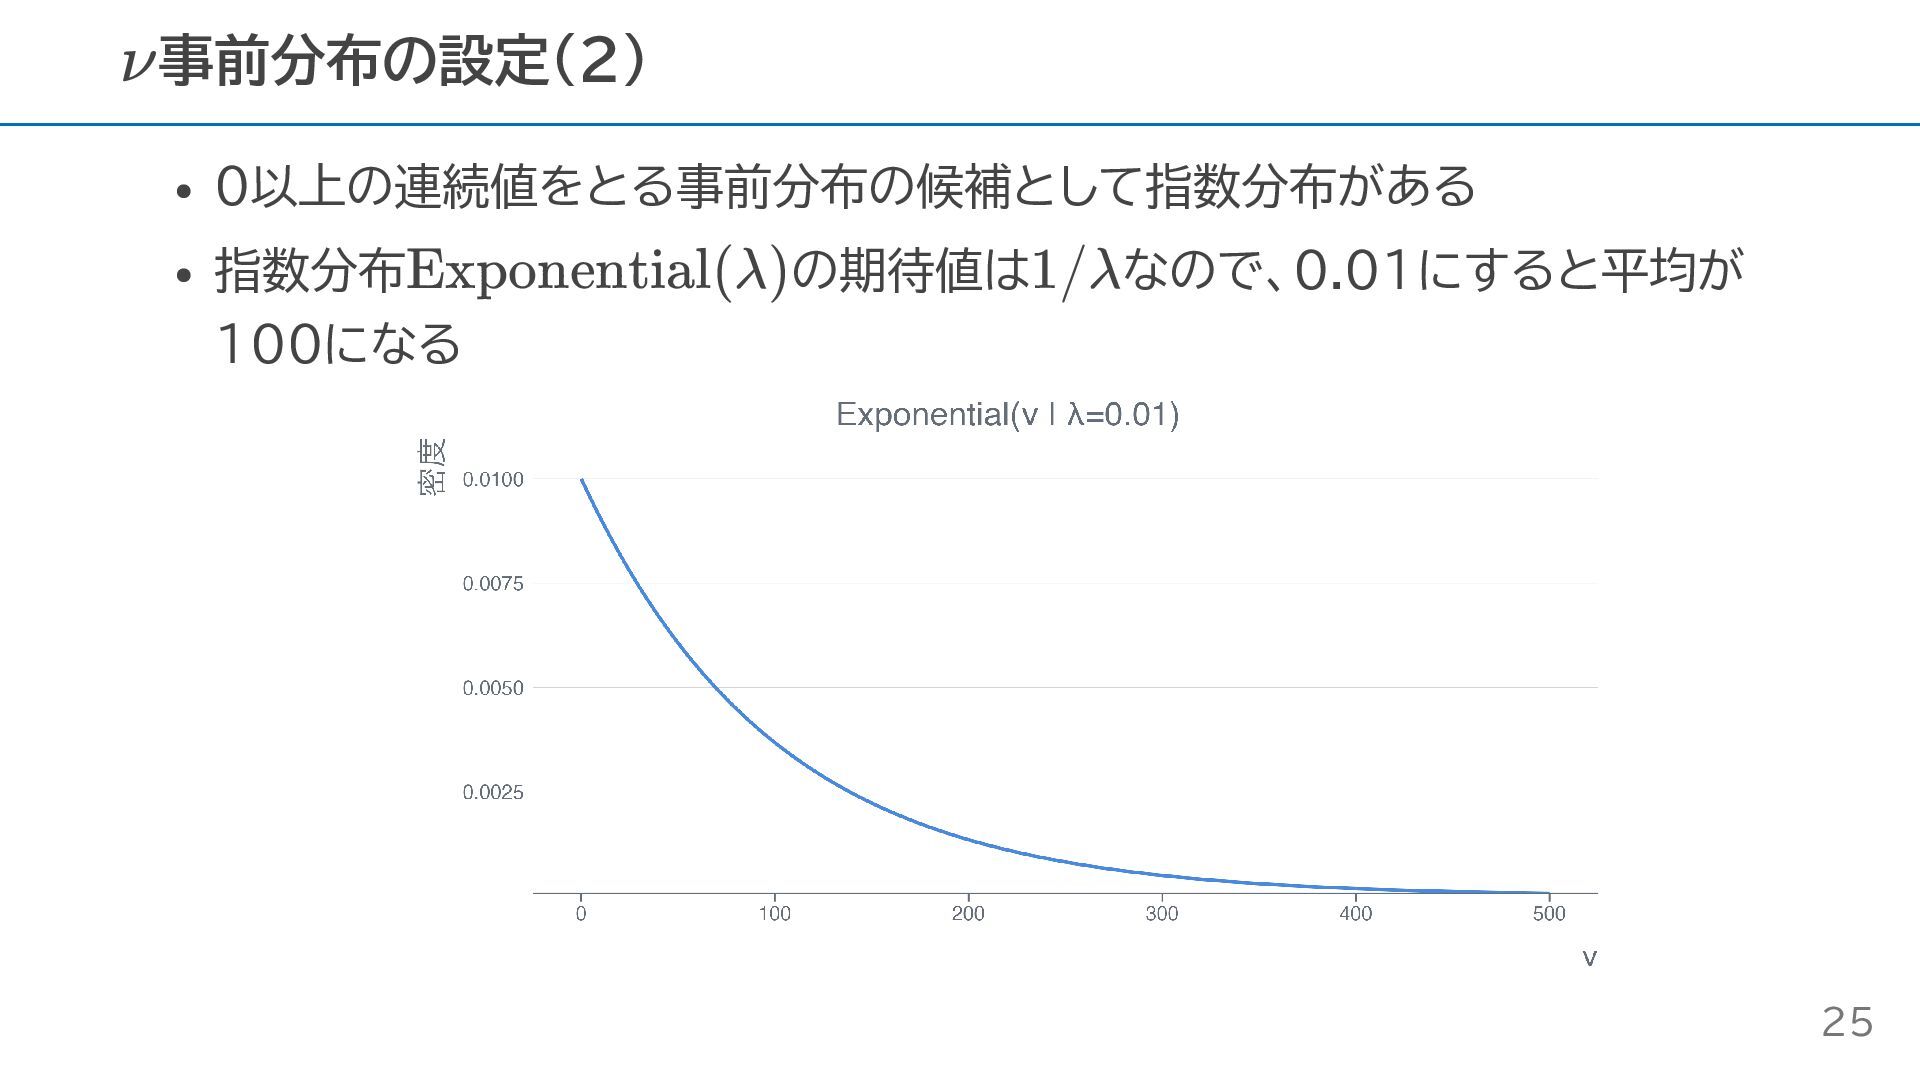
{ real<lower=0, upper=1> mu; real<lower=0, upper=10> nu; vector<lower=0, upper=1>[N] theta; } model { H ~ binomial(AB, theta); // nuはスケール調整されているため、100倍して元のスケールに戻して使用 theta ~ beta(100 * mu * nu, 100 * (1 - mu) * nu); mu ~ beta(3, 7); nu ~ exponential(1); } Stanコード 26 -
df_result <- df_result |> mutate( BA_hier = fit_hier |> tidybayes::spread_draws(theta[i])
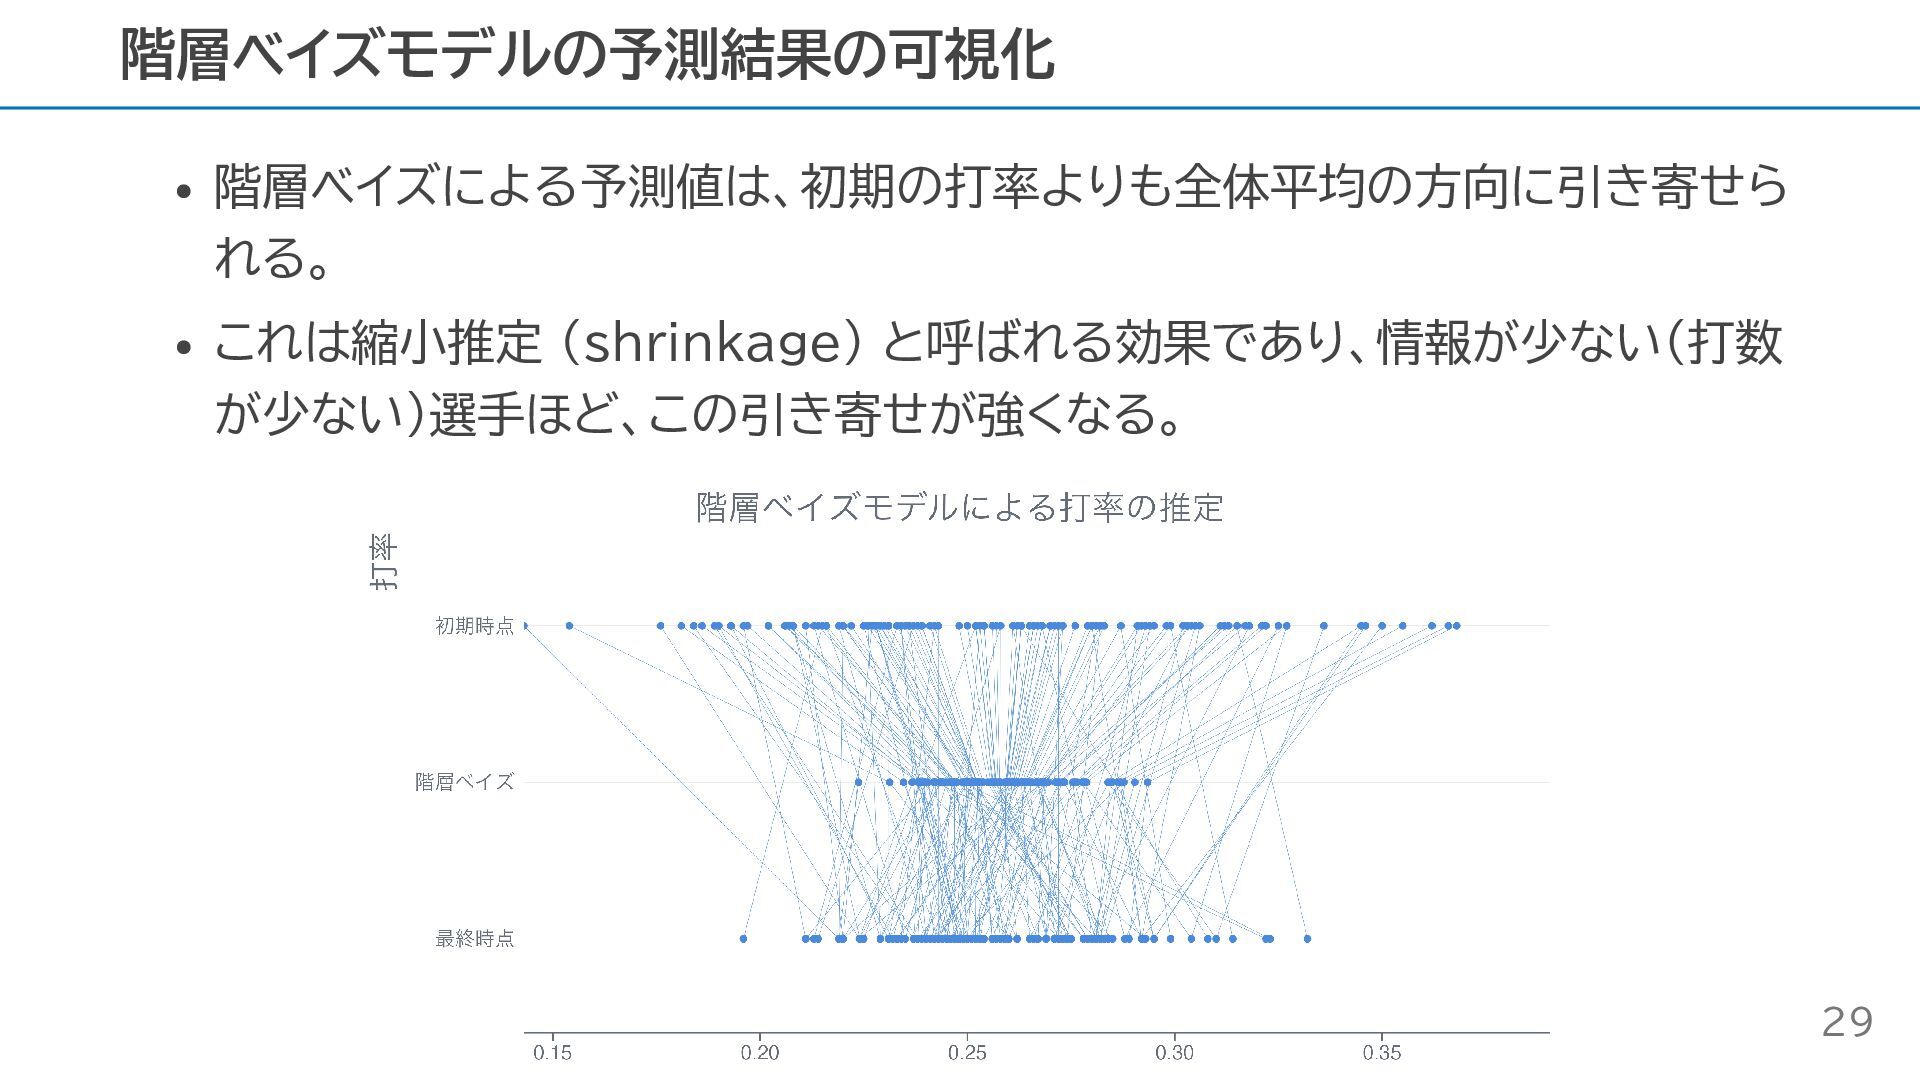
|> summarise(theta = mean(theta)) |> pull(theta) ) df_result # A tibble: 128 × 6 Name BA_mean BA_tot BA_ini BA_uninfo BA_hier <chr> <dbl> <dbl> <dbl> <dbl> <dbl> 1 Jarren Duran 0.257 0.284 0.268 0.272 0.261 2 Shohei Ohtani 0.257 0.31 0.336 0.339 0.284 3 Gunnar Henderson 0.257 0.281 0.291 0.295 0.268 4 Marcus Semien 0.257 0.237 0.258 0.261 0.258 5 Juan Soto 0.257 0.288 0.325 0.328 0.278 階層ベイズモデルの予測結果 27 -
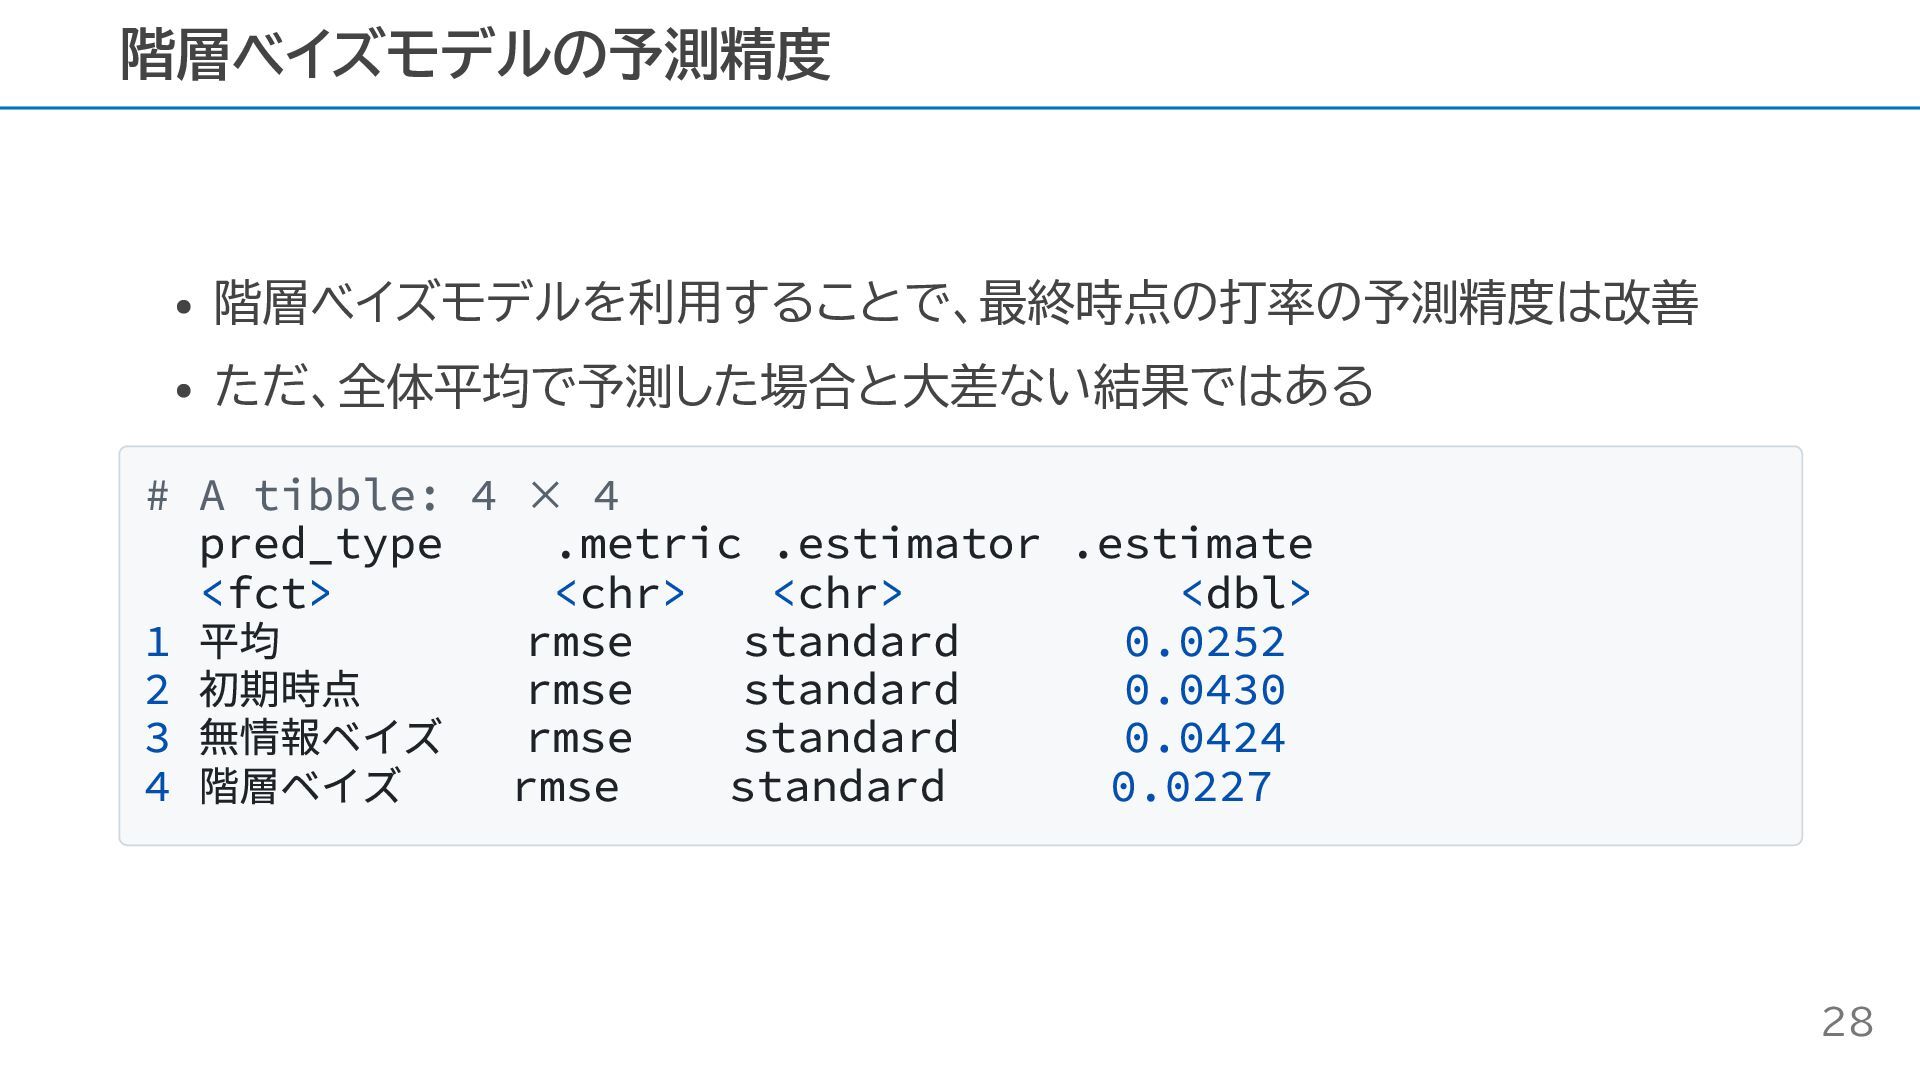
階層ベイズモデルを利用することで、最終時点の打率の予測精度は改善 ただ、全体平均で予測した場合と大差ない結果ではある # A tibble: 4 × 4 pred_type .metric
.estimator .estimate <fct> <chr> <chr> <dbl> 1 平均 rmse standard 0.0252 2 初期時点 rmse standard 0.0430 3 無情報ベイズ rmse standard 0.0424 4 階層ベイズ rmse standard 0.0227 階層ベイズモデルの予測精度 28 -
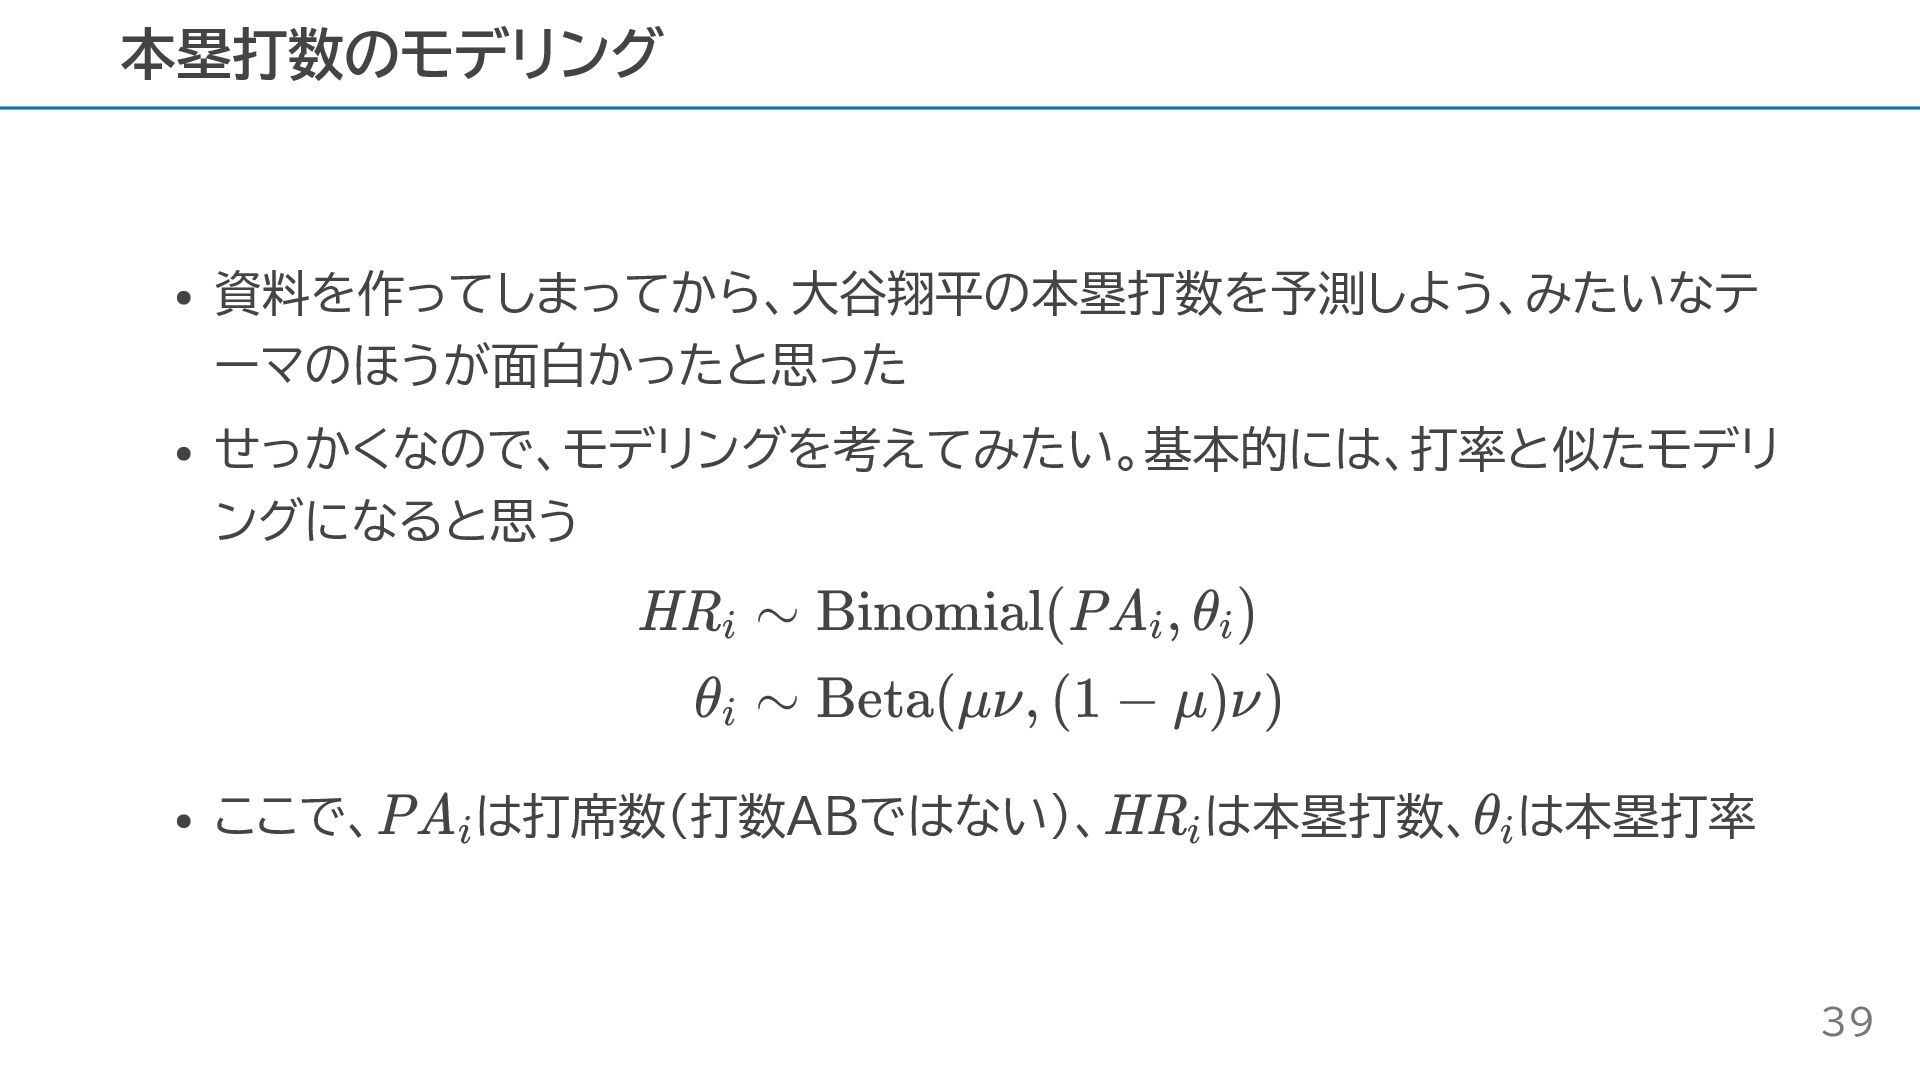
資料を作ってしまってから、大谷翔平の本塁打数を予測しよう、みたいなテ ーマのほうが面白かったと思った せっかくなので、モデリングを考えてみたい。基本的には、打率と似たモデリ ングになると思う HR i θ
i ∼ Binomial(PA , θ ) i i ∼ Beta(μν, (1 − μ)ν) ここで、 は打席数(打数ABではない)、 は本塁打数、 は本塁打率 本塁打数のモデリング PA i HR i θ i 39 -
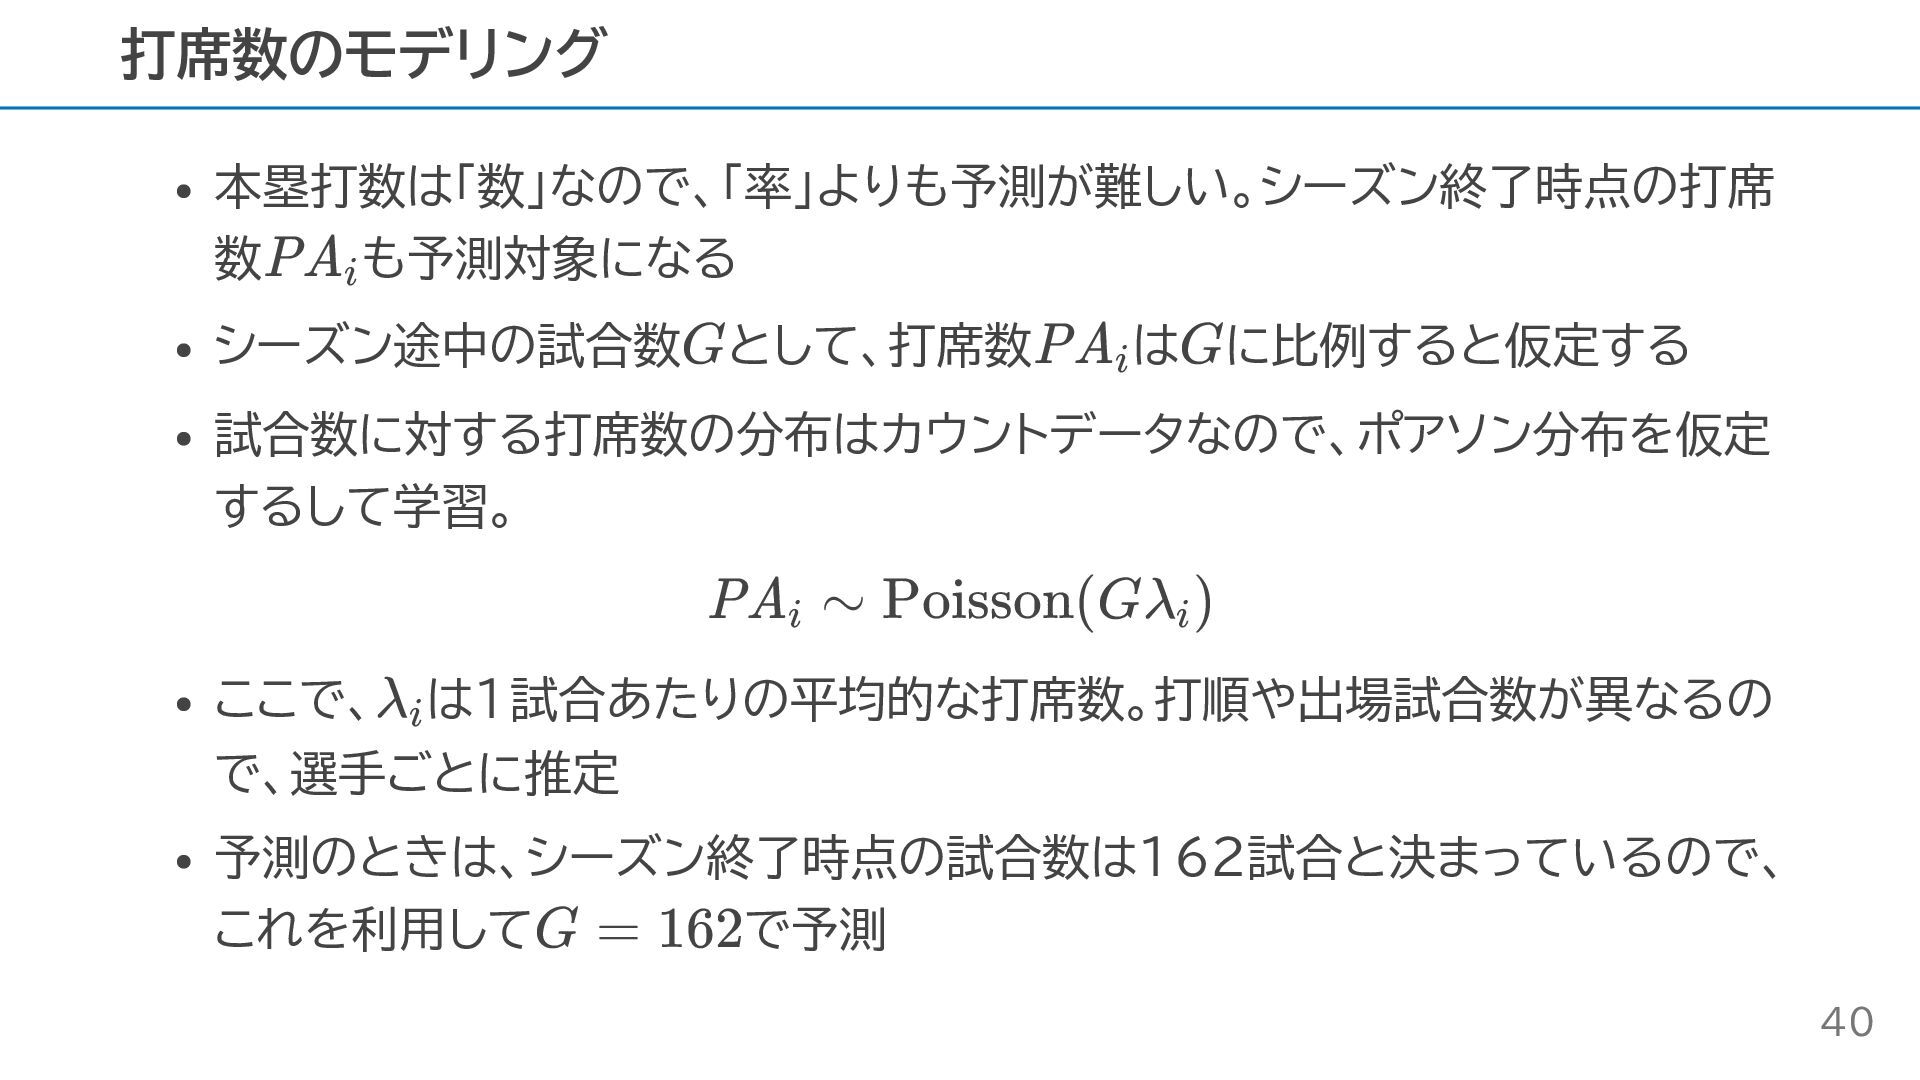
本塁打数は「数」なので、「率」よりも予測が難しい。シーズン終了時点の打席 数 も予測対象になる シーズン途中の試合数 として、打席数 は に比例すると仮定する 試合数に対する打席数の分布はカウントデータなので、ポアソン分布を仮定 するして学習。 PA
∼ i Poisson(Gλ ) i ここで、 は1試合あたりの平均的な打席数。打順や出場試合数が異なるの で、選手ごとに推定 予測のときは、シーズン終了時点の試合数は162試合と決まっているので、 これを利用して で予測 打席数のモデリング PA i G PA i G λ i G = 162 40 -
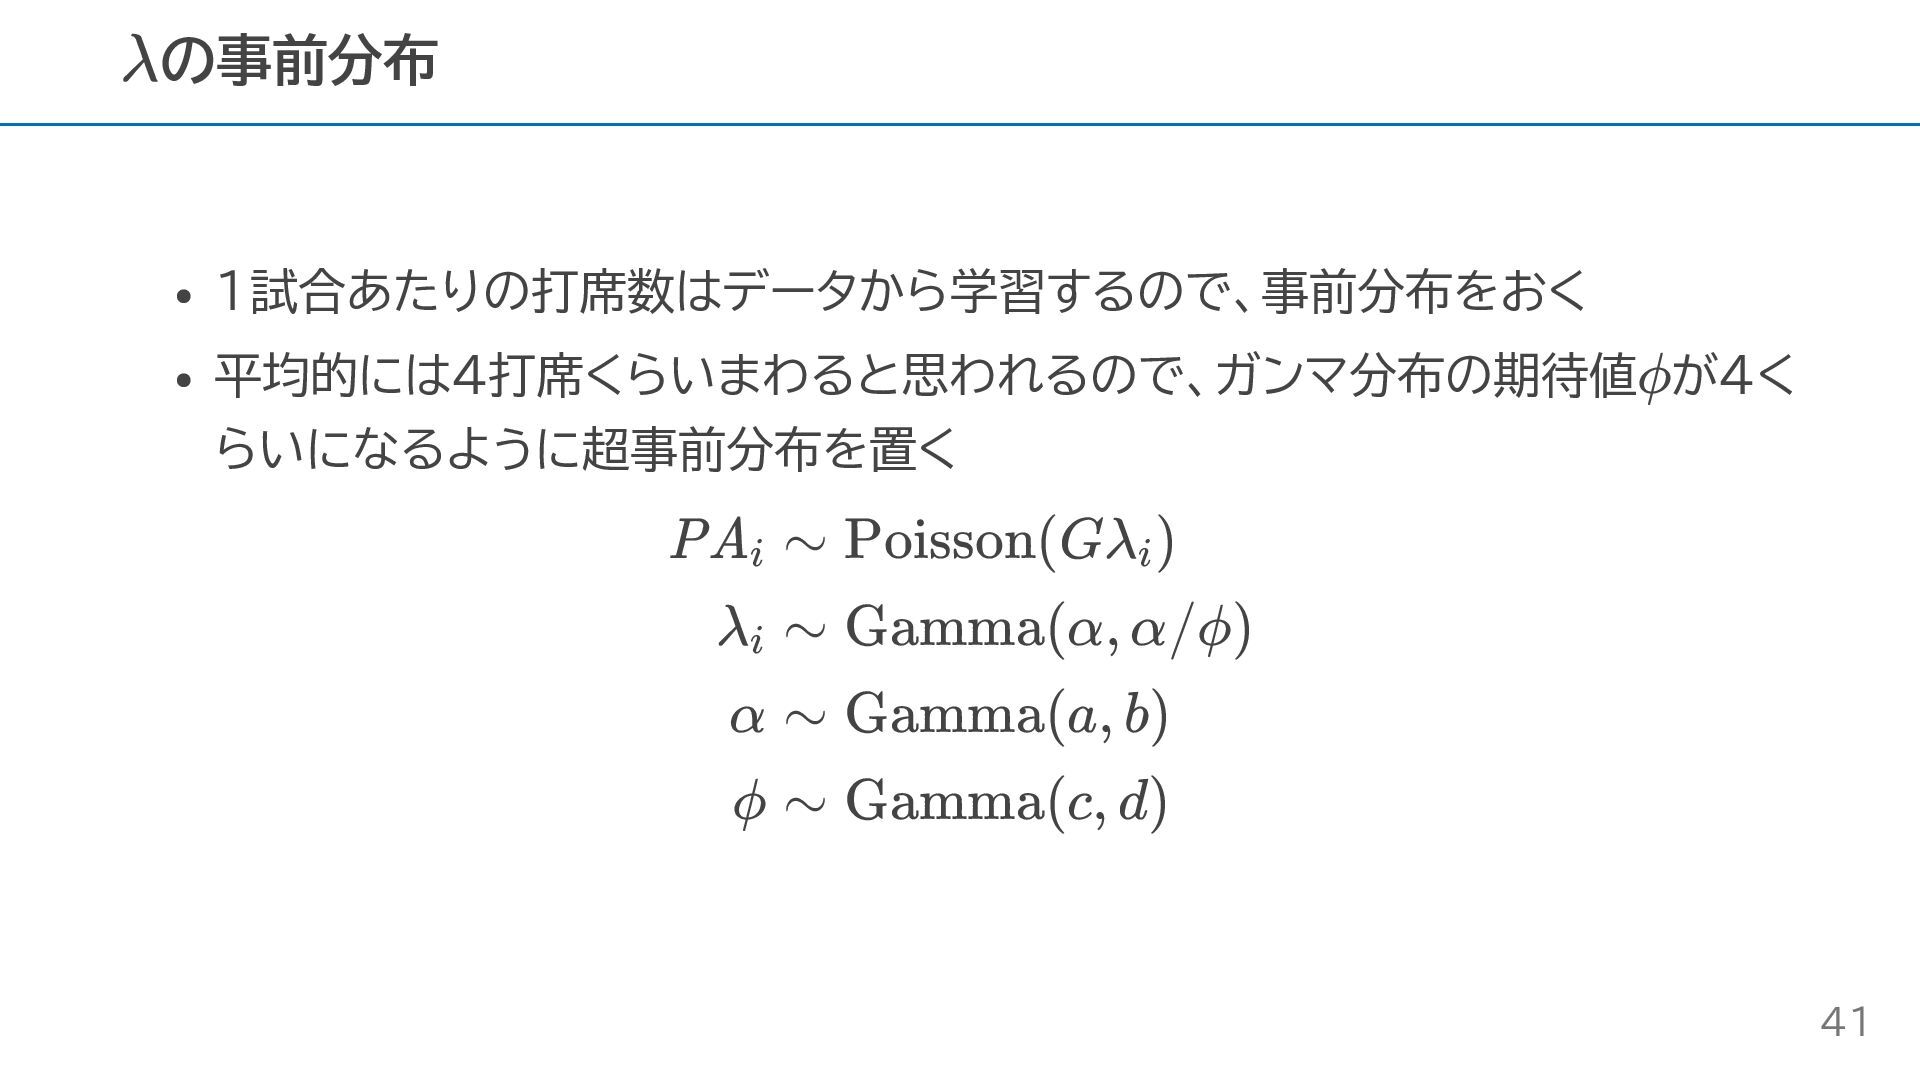
1試合あたりの打席数はデータから学習するので、事前分布をおく 平均的には4打席くらいまわると思われるので、ガンマ分布の期待値 が4く らいになるように超事前分布を置く PA i λ
i α ϕ ∼ Poisson(Gλ ) i ∼ Gamma(α, α/ϕ) ∼ Gamma(a, b) ∼ Gamma(c, d) の事前分布 λ ϕ 41