Share
Embed
2020EMNLP読み会_Identifying-Elements-Essential-for-BERT's-Multilinguality
Ikumi Yamashita
November 10, 2020
Transcript
21 slides
-
Overview • Multilingual BERT の multilinguality を担保するために必要な要素につい ての研究 • 複数の設定での実験から,
multilinguality のために必要な要素を明らかに した Ø パラメータの制限 Ø special tokenの共有 Ø position embedding の共有 Ø 訓練時のトークンの置換 1 -
Related works • Multilingual BERT がどのように multilinguality を獲得しているのかは現 在も議論が続いている Ø
語彙の共有は必要不可⽋ではないが⾔語の構造の情報が重要 [K et al., 2020, Artetxe et al., 2020] Ø ⾔語間でのパラメータの共有が重要 [Conneau et al., 2020] ü これらを踏まえて新たな観点から実験・分析を⾏う 2 -
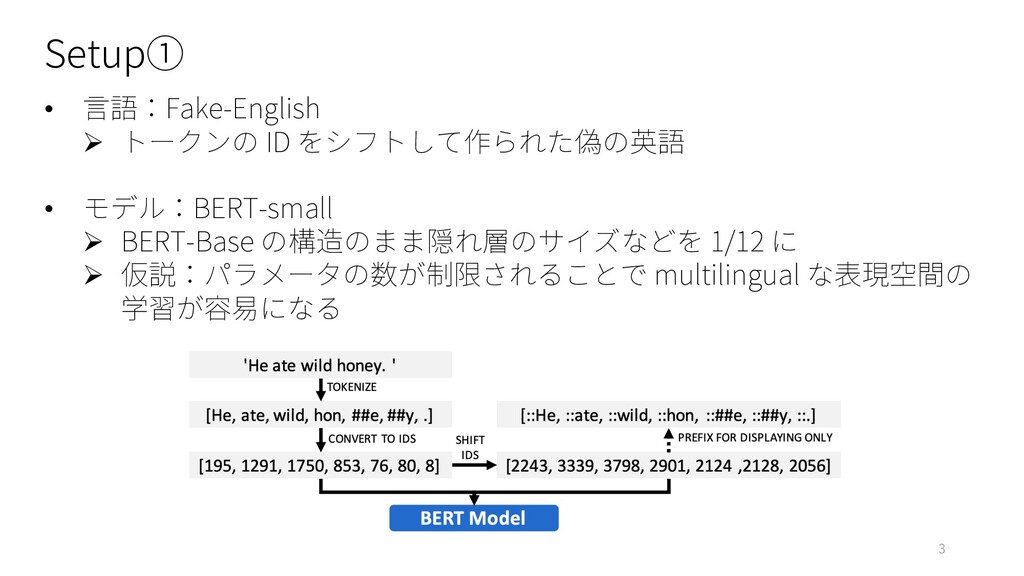
3 Setup① • ⾔語:Fake-English Ø トークンの ID をシフトして作られた偽の英語 • モデル:BERT-small
Ø BERT-Base の構造のまま隠れ層のサイズなどを 1/12 に Ø 仮説:パラメータの数が制限されることで multilingual な表現空間の 学習が容易になる -
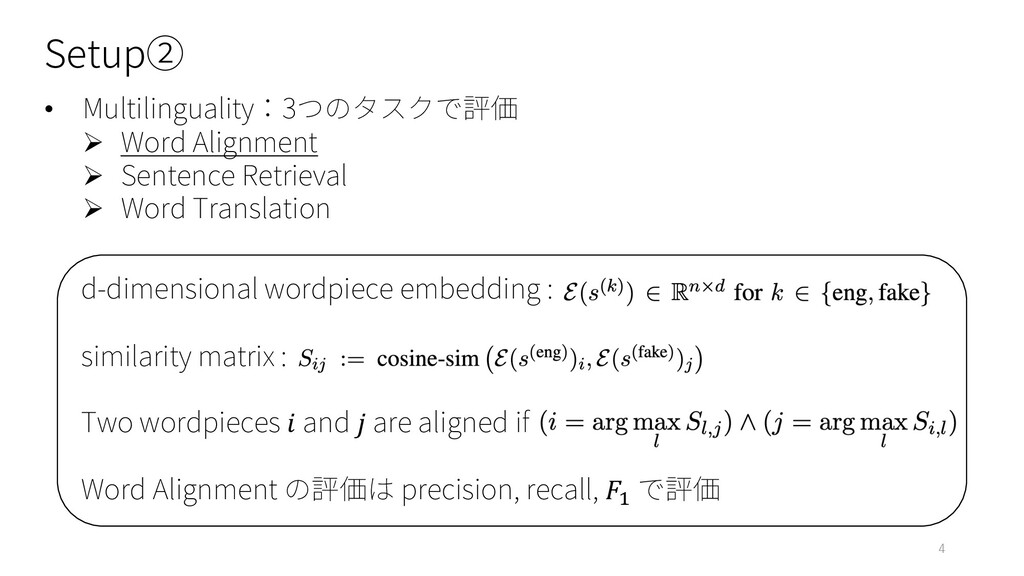
Setup② • Multilinguality:3つのタスクで評価 Ø Word Alignment Ø Sentence Retrieval Ø
Word Translation 4 d-dimensional wordpiece embedding : similarity matrix : Two wordpieces and are aligned if Word Alignment の評価は precision, recall, ! で評価 -
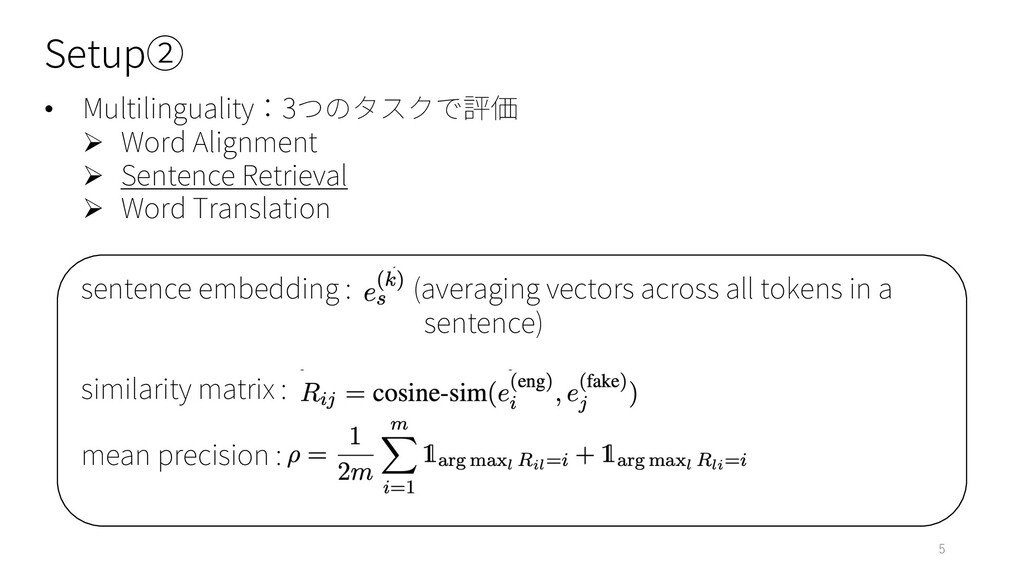
Setup② • Multilinguality:3つのタスクで評価 Ø Word Alignment Ø Sentence Retrieval Ø
Word Translation 5 sentence embedding : (averaging vectors across all tokens in a sentence) similarity matrix : mean precision : -
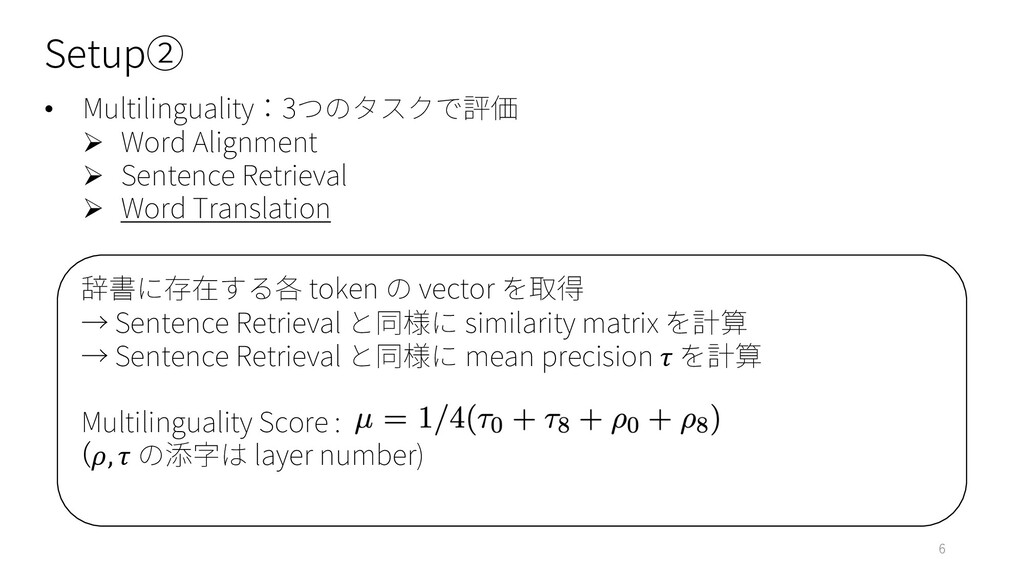
Setup② • Multilinguality:3つのタスクで評価 Ø Word Alignment Ø Sentence Retrieval Ø
Word Translation 6 辞書に存在する各 token の vector を取得 → Sentence Retrieval と同様に similarity matrix を計算 → Sentence Retrieval と同様に mean precision を計算 Multilinguality Score : (, の添字は layer number) -
Setup③ • Model Fit Ø Multilinguality とは別に BERT の学習がうまく⾏っているかを判別する 指標が必要
Ø MLM Perplexity で評価: 15% の確率でランダムに選択された token を [MASK] に置き換えて測 定 7 -
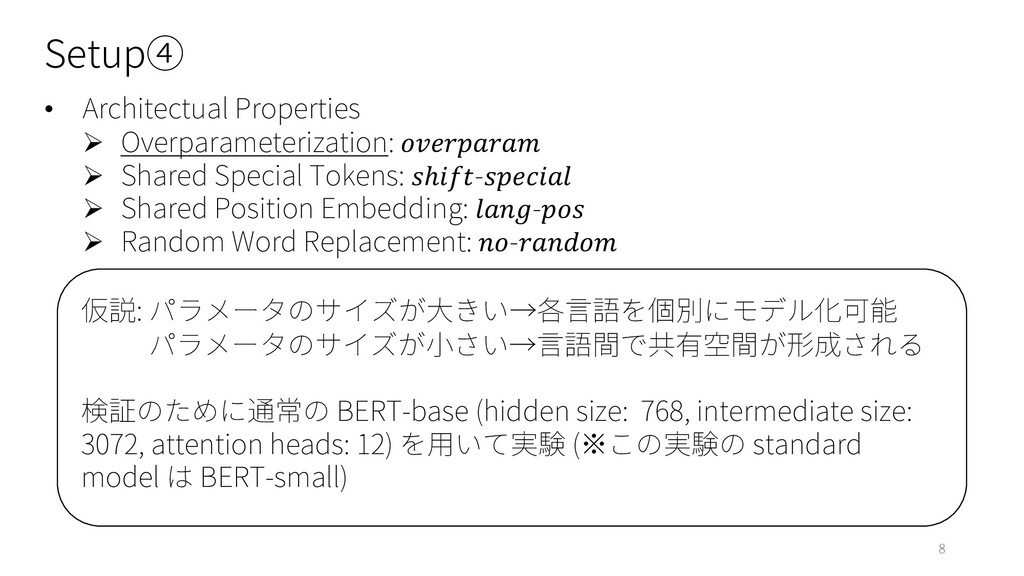
Setup④ • Architectual Properties Ø Overparameterization: Ø Shared Special Tokens:
ℎ- Ø Shared Position Embedding: - Ø Random Word Replacement: - 8 仮説: パラメータのサイズが⼤きい→各⾔語を個別にモデル化可能 パラメータのサイズが⼩さい→⾔語間で共有空間が形成される 検証のために通常の BERT-base (hidden size: 768, intermediate size: 3072, attention heads: 12) を⽤いて実験 (※この実験の standard model は BERT-small) -
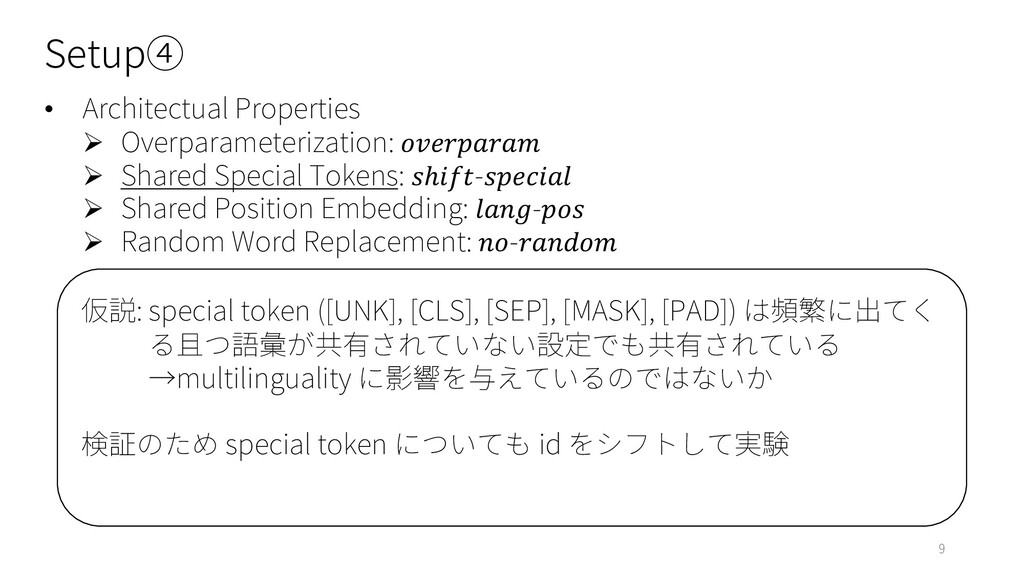
Setup④ • Architectual Properties Ø Overparameterization: Ø Shared Special Tokens:
ℎ- Ø Shared Position Embedding: - Ø Random Word Replacement: - 9 仮説: special token ([UNK], [CLS], [SEP], [MASK], [PAD]) は頻繁に出てく る且つ語彙が共有されていない設定でも共有されている →multilinguality に影響を与えているのではないか 検証のため special token についても id をシフトして実験 -
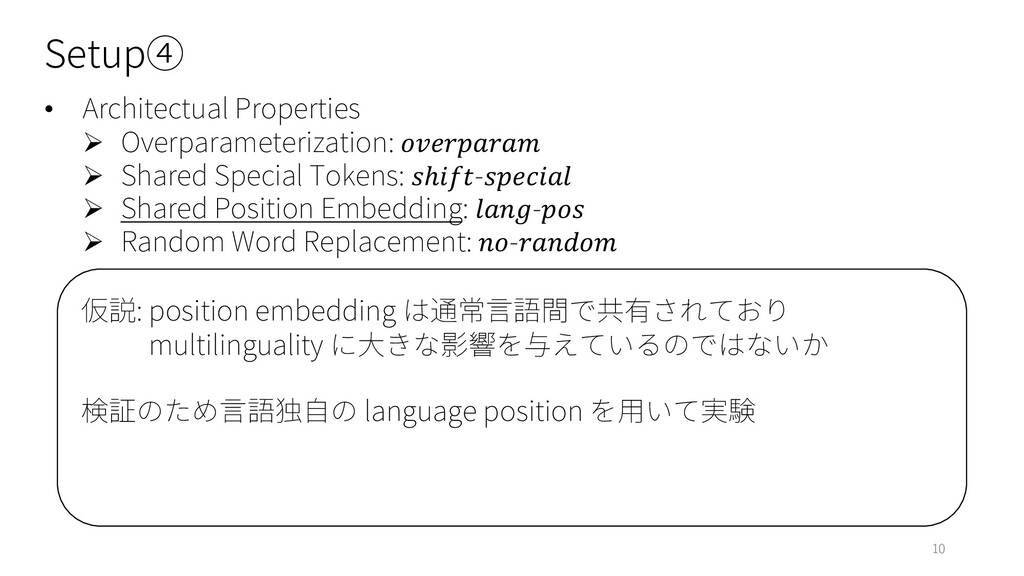
Setup④ • Architectual Properties Ø Overparameterization: Ø Shared Special Tokens:
ℎ- Ø Shared Position Embedding: - Ø Random Word Replacement: - 10 仮説: position embedding は通常⾔語間で共有されており multilinguality に⼤きな影響を与えているのではないか 検証のため⾔語独⾃の language position を⽤いて実験 -
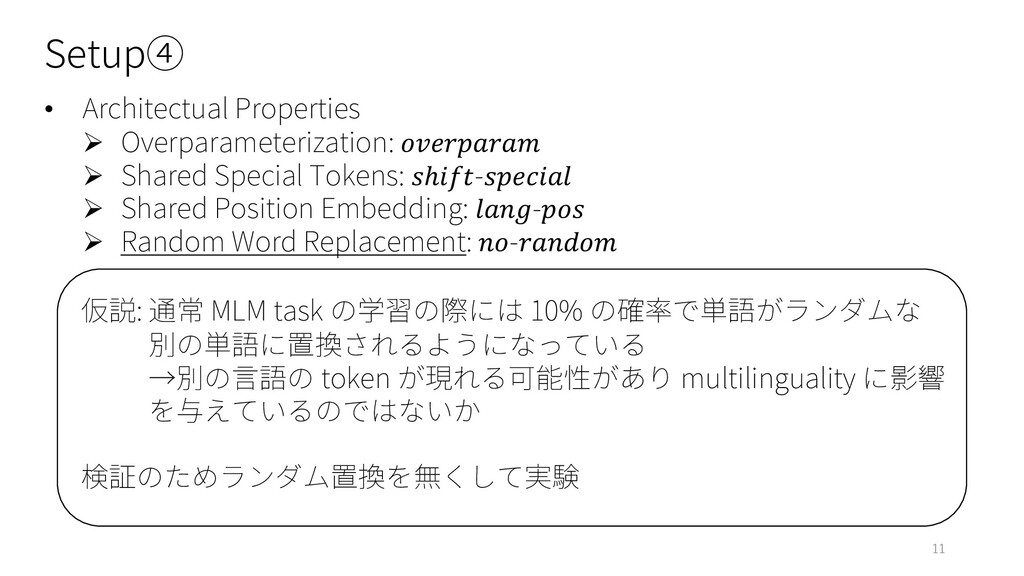
Setup④ • Architectual Properties Ø Overparameterization: Ø Shared Special Tokens:
ℎ- Ø Shared Position Embedding: - Ø Random Word Replacement: - 11 仮説: 通常 MLM task の学習の際には 10% の確率で単語がランダムな 別の単語に置換されるようになっている →別の⾔語の token が現れる可能性があり multilinguality に影響 を与えているのではないか 検証のためランダム置換を無くして実験 -
Setup⑤ • Linguistic Properties Ø Inverted Word Order: - Ø
Comparability of Corpora: - 12 先⾏研究: ⾔語の語順は multilinguality にある程度の影響を及ぼすが、 クリティカルなものではない 極端な事例である inversion で検証 (※読み取る順番が変わるが、n-gram などの⾔語構造は変わらない) -
Setup⑤ • Linguistic Properties Ø Inverted Word Order: - Ø
Comparability of Corpora: - 13 仮説: ⾔語の構造的類似性に学習データのドメインが寄与している (パラレルコーパスは異なるドメインのデータ⼆つよりも構造が 類似している可能性が⾼い) 検証のため聖書を半分に分け、⽚⽅をEnglish もう⽚⽅を Fake- English のコーパスとして使⽤ -
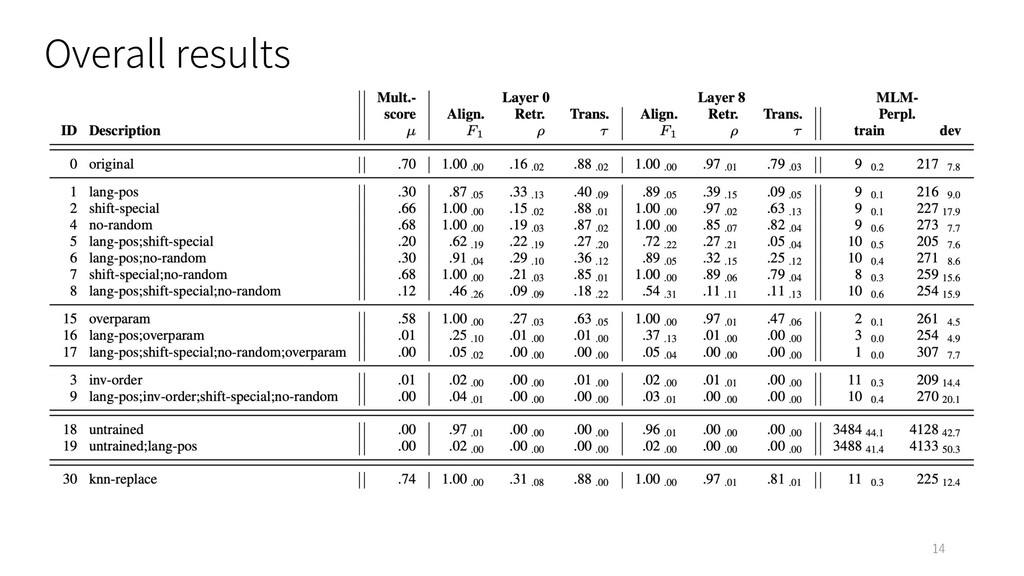
Results of architectural properties • lang-pos, shift-special, no-random はそれぞれ multilinguality
を下げる (lang-pos が最も影響が⼤きい, 三つ組み合わせることで⼤きく下がる) • multilinguality に関わらず MLM ppl は安定して低い • lang-pos, shift-special, no-random によって⾔語を分離し, overparam で パラメータを増やすことで multilingual ではない BERT の学習が⾏われて いる →multilinguality のためには4つのアーキテクチャが全て必要 15 -
Results of linguistic properties • inversion をすることで multilinguality はほぼ完全に失われる Ø
語順を逆転することで position 0 の English と position の Fake- English の対応を学習する必要が出てくる Ø しかし は⽂⻑であり定まらないため学習が難しい Ø 絶対位置よりも相対位置のほうが multilinguality のためには良い? 16 -
Results of corpus comparability • parallel ではないデータを学習に⽤いることで multilinguality は⼤きく下 がる
→ ⾔語間で comparable なデータを⽤いることで multilinguality をあげ ることができる 17 -
Multilinguality during training • multilinguality の上昇はモデルの性能の上昇が⽌まってから始まっている • パラメータが少ない場合は効率的に使う必要があるため, multilinguality が早く上昇する
• generalization と multilinguality は trade-off の関係にある可能性がある 18 -
Improving multilinguality • ここまでの実験から multilinguality を改善するための⼿段の⼀つとして, 学習時の単語の置換に他⾔語の意味の似た単語で置換する option を追加 •
fastText と VecMap を使い学習データ中の token を cross-lingual な共 通空間にマッピング • 共通空間の中から knn で置換する単語を探索 (knn-replace) 19 -
Conclusion • Multilingual BERT の multilinguality について重要な要素の分析 Ø position embedding
の共有 Ø special token の共有 Ø Masked token のランダム置換 Ø 限られたサイズのパラメータ • multilinguality には語順が影響している • comparable な学習データが multilinguality に寄与している 20