Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
2020ACL読み会_FastBERT:-a-Self-distilling-BERT-wit...
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Ikumi Yamashita
August 06, 2020
Technology
180
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
2020ACL読み会_FastBERT:-a-Self-distilling-BERT-with-Adaptive-Inference-Time
Ikumi Yamashita
August 06, 2020
More Decks by Ikumi Yamashita
See All by Ikumi Yamashita
2021論文紹介_When-Do-You-Need-Billions-of-Words-of-Pretraining-Data?
ikumi193
0
200
2021EACL/NAACL論文紹介_Multilingual-LAMA-Investigating-Knowledge-in-Multilingual-Pretrained-Language-Models
ikumi193
0
76
2021論文紹介_CANINE:-Pre-training-an-Efficient-Tokenization-Free-Encoder-for-Language-Representation
ikumi193
0
340
2020COLING読み会_Linguistic-Profiling-of-a-Neural-Language-Model
ikumi193
0
120
2020EMNLP読み会_Identifying-Elements-Essential-for-BERT's-Multilinguality
ikumi193
0
150
2020論文紹介_Finding-Universal-Grammatical-Relations-in-Multilingual-BERT
ikumi193
0
310
2019EMNLP読み会_Unicoder_A_Universal_Language_Encoder_by_Pre-training_with_Multiple_Cross-lingual_Tasks
ikumi193
0
80
2019論文読み会_Language-Modeling-with-Shared-Grammar
ikumi193
0
240
2019ACL読み会_Choosing-Transfer-Languages-for-Cross-Lingual-Learning
ikumi193
0
72
Other Decks in Technology
See All in Technology
Claude起点の仕様駆動開発
tanakaseiya
0
400
メルペイ 会計システム概要と歴史
mewuto
0
190
LLM機能を自作して分かるSnowflake Cortex AIの強み
nayuts
0
310
購入ドメインでの課題と取り組み
ykagano
0
150
IR Today: Theory, Practice, and Agents
dtunkelang
0
350
雪かき部 #7 もう怖くない!SELECT文!
foursue
0
280
FinTech 1-2 : Overview of FinTech
ks91
PRO
0
150
予測不能な実行エージェントを安全にサクッと試せるサンドボックス環境の話
sansantech
PRO
0
130
いちAWSエンジニアのAI活用を振り返る #devio2026 / devio osaka 2026 kawahara
masahirokawahara
2
390
BedrockとLambdaで作る リアルタイム進行型推理ゲーム
kawametho
0
190
ai_cording_with_k8s_knowledge.pdf
mochizuki875
1
300
AI駆動開発の時代になったのでトヨタ生産方式から見直す
terurou
0
3.2k
Featured
See All Featured
Why Your Marketing Sucks and What You Can Do About It - Sophie Logan
marketingsoph
0
420
Google's AI Overviews - The New Search
badams
0
1.6k
Ecommerce SEO: The Keys for Success Now & Beyond - #SERPConf2024
aleyda
1
2.2k
Marketing to machines
jonoalderson
1
5.9k
How to Get Subject Matter Experts Bought In and Actively Contributing to SEO & PR Initiatives.
livdayseo
0
210
Keith and Marios Guide to Fast Websites
keithpitt
413
23k
I Don’t Have Time: Getting Over the Fear to Launch Your Podcast
jcasabona
35
2.9k
AI Search: Implications for SEO and How to Move Forward - #ShenzhenSEOConference
aleyda
1
1.4k
Context Engineering - Making Every Token Count
addyosmani
9
1.2k
Designing for Performance
lara
611
70k
Leo the Paperboy
mayatellez
10
2.4k
The Cult of Friendly URLs
andyhume
79
7k
Transcript
紹介者:⼭下郁海 (TMU M1 ⼩町研究室) 2020/08/06 @ ACL2020 読み会
Abstract • 速度をチューニング可能な BERT ベースのモデル FastBERT を提案 • 推論時の速度を柔軟に変更可能 (adaptive
inference) であり、冗⻑な計算 を減らしている • 学習時には knowledge distillation の考え⽅をもとにした独⾃の⼿法 self- distillation を⽤いている 1
Introduction • 近年⼤きな成功を収めている pre-trained モデルは計算コストが⾼く推論 も遅いため実⽤的ではない Ø この問題解決のために Knowledge Distillation
などの⼿法が提案され ている (DistillBERT など) • 多くの NLP のデータセットには様々な難易度のデータが含まれている ü 使⽤する層の数を動的に減らすことのできる FastBERT を提案 ü 学習時の self-distillation と推論時の adaptive inference という⼆つの新し い考え⽅を⽤いて推論速度の向上を図った 2
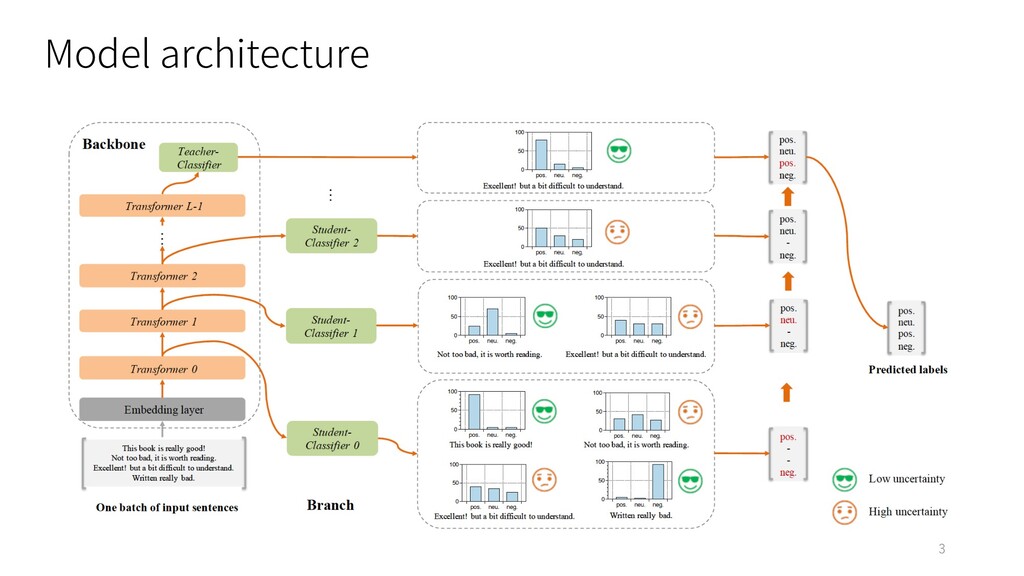
3 Model architecture
Model training 1. Backbone Pre-training • BERT モデルの事前学習 • BERT
ベースのモデルならなんでもいい (RoBERTa, ERNIE など) 2. Fine-tuning for backbone • 最終層の教師分類器の学習 3. Self-distillation for branch • 各層の分類器の学習 • 教師分類器からの self-distillation を⾏なっている 4
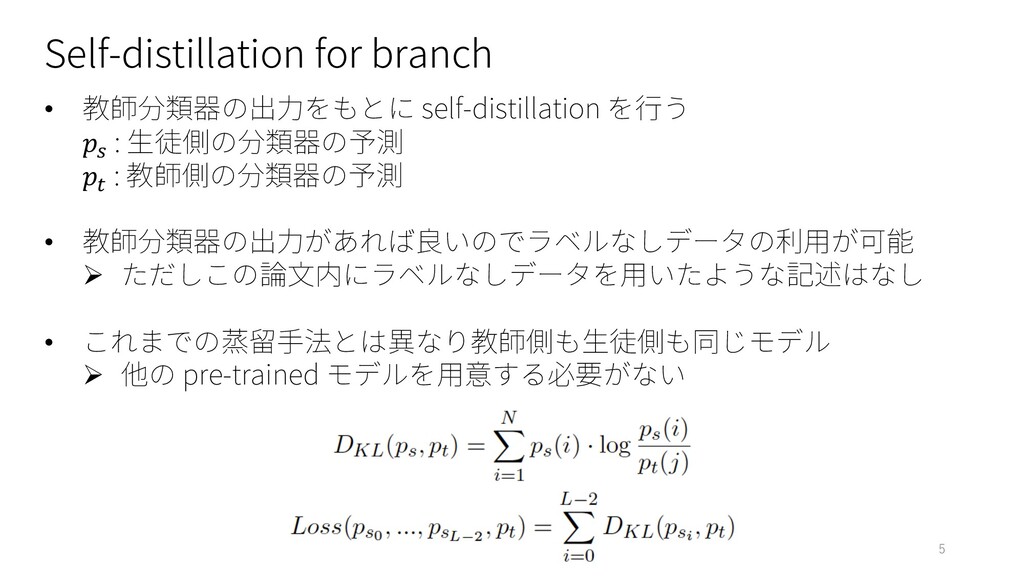
Self-distillation for branch • 教師分類器の出⼒をもとに self-distillation を⾏う ! : ⽣徒側の分類器の予測
" : 教師側の分類器の予測 • 教師分類器の出⼒があれば良いのでラベルなしデータの利⽤が可能 Ø ただしこの論⽂内にラベルなしデータを⽤いたような記述はなし • これまでの蒸留⼿法とは異なり教師側も⽣徒側も同じモデル Ø 他の pre-trained モデルを⽤意する必要がない 5
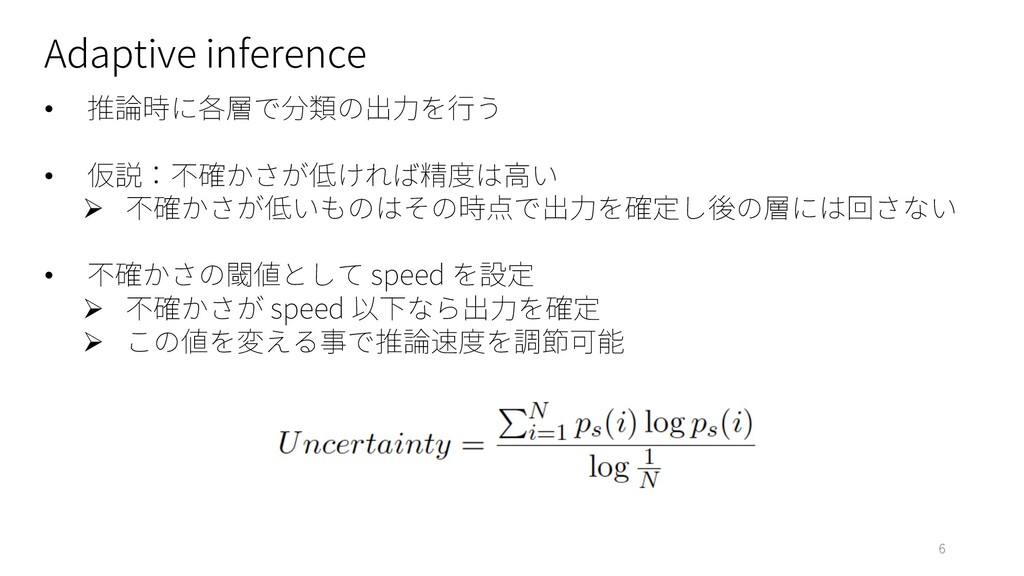
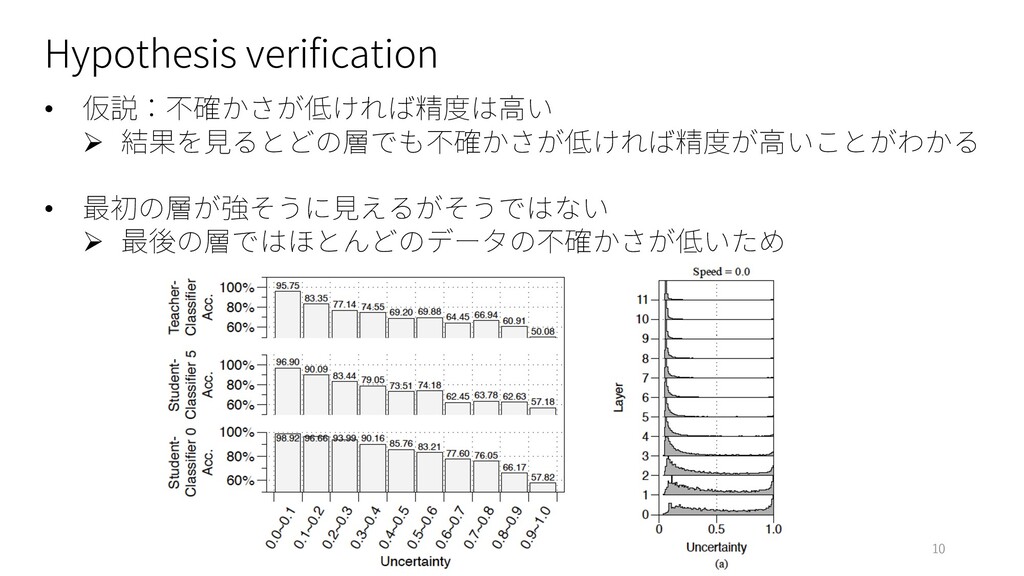
Adaptive inference • 推論時に各層で分類の出⼒を⾏う • 仮説:不確かさが低ければ精度は⾼い Ø 不確かさが低いものはその時点で出⼒を確定し後の層には回さない • 不確かさの閾値として
speed を設定 Ø 不確かさが speed 以下なら出⼒を確定 Ø この値を変える事で推論速度を調節可能 6
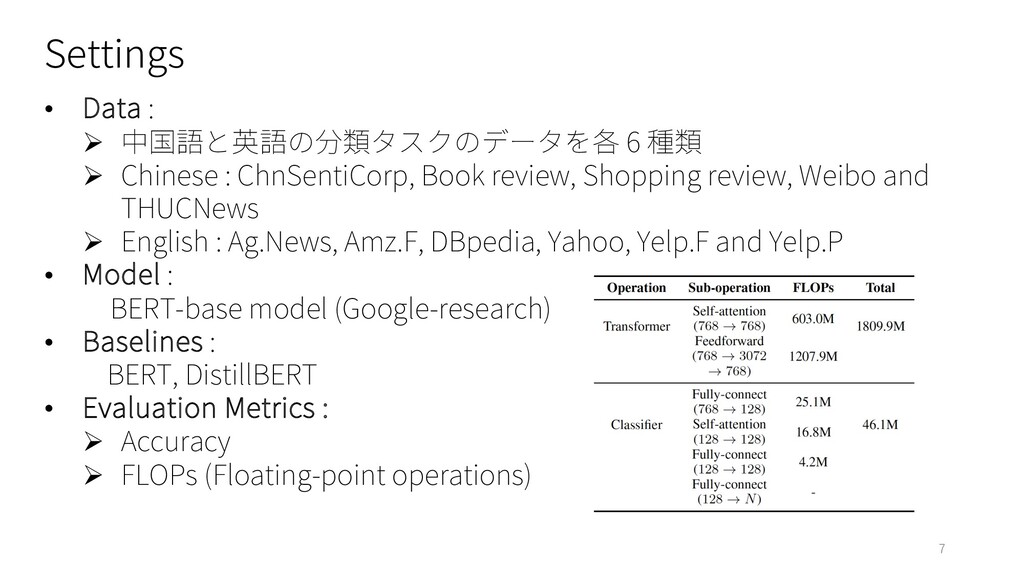
Settings • Data : Ø 中国語と英語の分類タスクのデータを各 6 種類 Ø Chinese
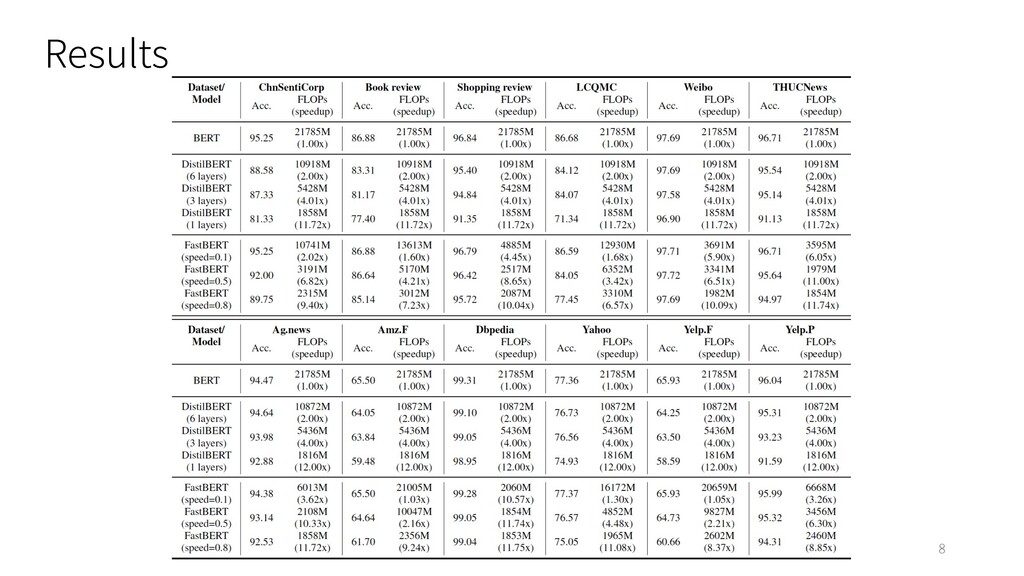
: ChnSentiCorp, Book review, Shopping review, Weibo and THUCNews Ø English : Ag.News, Amz.F, DBpedia, Yahoo, Yelp.F and Yelp.P • Model : BERT-base model (Google-research) • Baselines : BERT, DistillBERT • Evaluation Metrics : Ø Accuracy Ø FLOPs (Floating-point operations) 7
Results 8
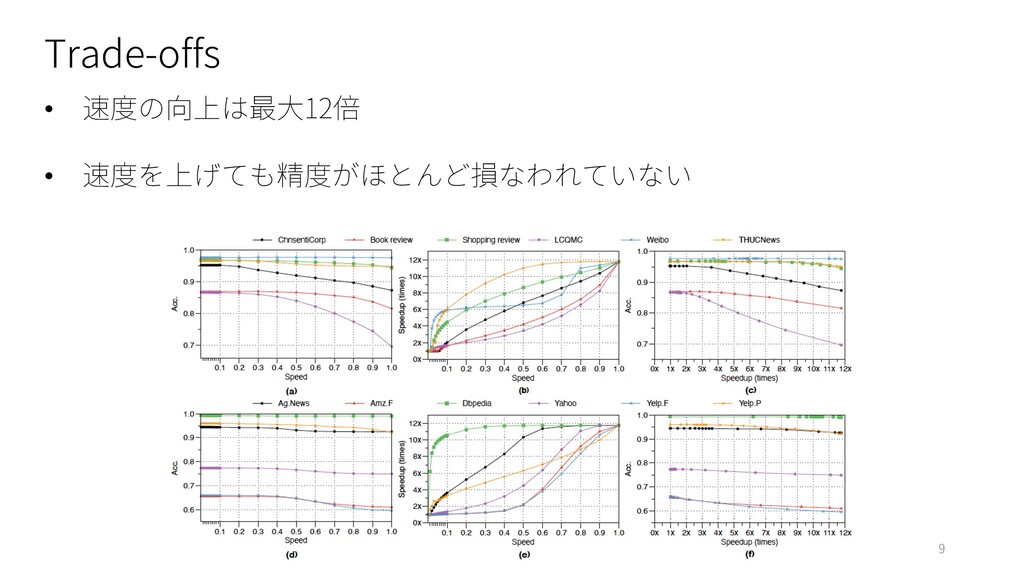
Trade-offs • 速度の向上は最⼤12倍 • 速度を上げても精度がほとんど損なわれていない 9
Hypothesis verification • 仮説:不確かさが低ければ精度は⾼い Ø 結果を⾒るとどの層でも不確かさが低ければ精度が⾼いことがわかる • 最初の層が強そうに⾒えるがそうではない Ø 最後の層ではほとんどのデータの不確かさが低いため
10
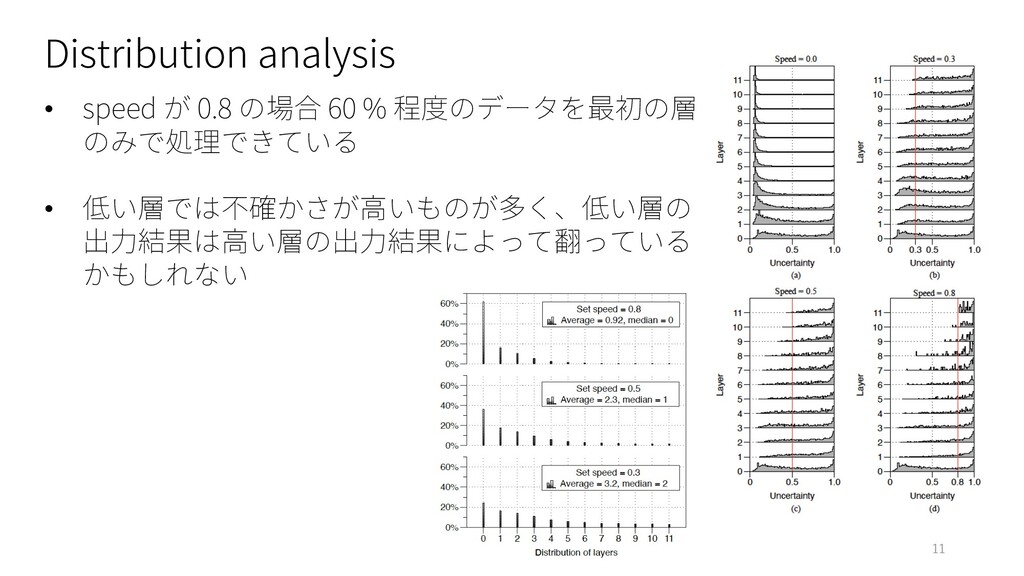
Distribution analysis • speed が 0.8 の場合 60 % 程度のデータを最初の層
のみで処理できている • 低い層では不確かさが⾼いものが多く、低い層の 出⼒結果は⾼い層の出⼒結果によって翻っている かもしれない 11
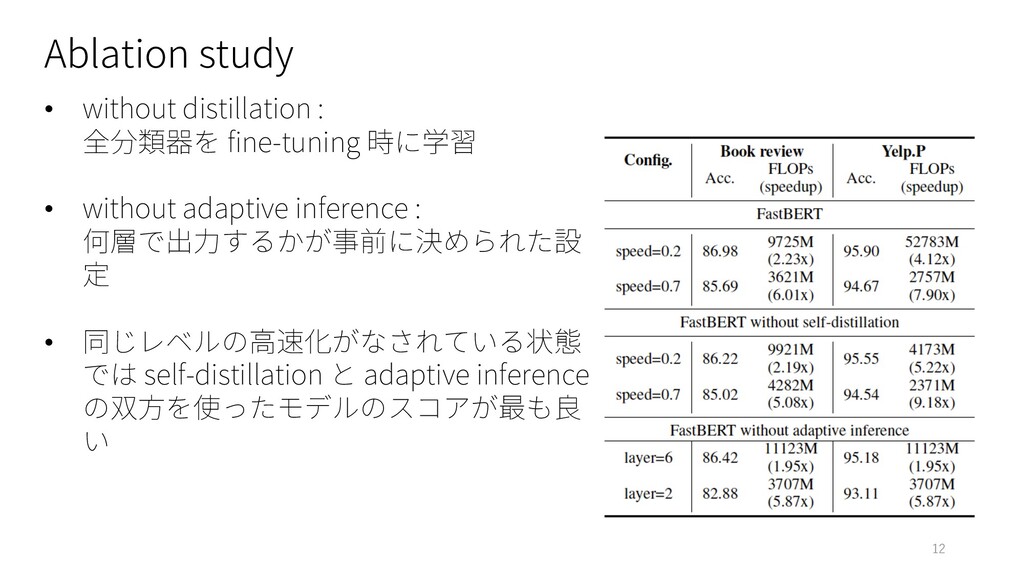
Ablation study • without distillation : 全分類器を fine-tuning 時に学習 •
without adaptive inference : 何層で出⼒するかが事前に決められた設 定 • 同じレベルの⾼速化がなされている状態 では self-distillation と adaptive inference の双⽅を使ったモデルのスコアが最も良 い 12
Conclusion • スピードをコントロールして速度を上げられる実⽤的な BERT である FastBERT を提案 • self-distillation と
adaptive inference の⼆つの新しい⼿法を導⼊ • 結果的に精度を損なわずに速度を上げる(コントロールする)実⽤的な モデルの学習が可能になった 13


 ikumi193
 tanakaseiya
 mewuto
 nayuts
 ykagano
 dtunkelang
 foursue
 ks91
 sansantech
 masahirokawahara
 kawametho
 mochizuki875
 terurou
 marketingsoph
 badams
 aleyda
 jonoalderson
 livdayseo
 keithpitt
 jcasabona
 addyosmani
 lara
 mayatellez
 andyhume