Share
Embed
Transcript
16 slides
-
Background • 近年の NLP は⼤規模なデータで事前学習を⾏ったモデルが中⼼ Ø しかし,⼤規模なデータでの学習で⼩規模なデータでは得られないどん な知識を学習しているかは明らかになってはいない • ⼤規模な事前学習のデータに関する幾つかの
research question が存在 Ø ⼤規模なデータから何を学習しているのか? Ø ⼤規模 LM にとって⼗分なデータ量は? Ø データを増やしていくとどのような能⼒が向上するのか? -
Overview • 事前学習のデータ量に関する複数の疑問に答えるために,事前学習データの サイズが異なる複数のモデルに対して 5 種類の⼿法を⽤いて分析 • 結果として以下のことを⽰した Ø 構⽂や意味的知識の学習にはそれほど多くのデータを必要としていない
Ø ⼀⽅で,⾔語理解に関する下流タスクを解くためにははるかに多くの データが必要 Ø ⾔語理解のタスクには構⽂や意味的知識が必要不可⽋な⼀⽅で,近年の ⼤規模モデルの性能向上の理由がそれ以外の未知の知識の学習によるも のである可能性 -
Approach • 5 つのデータサイズ (1M, 10M, 100M, 1B, 30B) で学習された
RoBERTa モデル を使⽤ • それぞれのモデルに対して 5 つの⼿法を適⽤し性能を確認 Ø Classifier probing Ø Minimum Description Length (MDL) probing Ø BLiMP Ø LAMA Ø SuperGLUE -
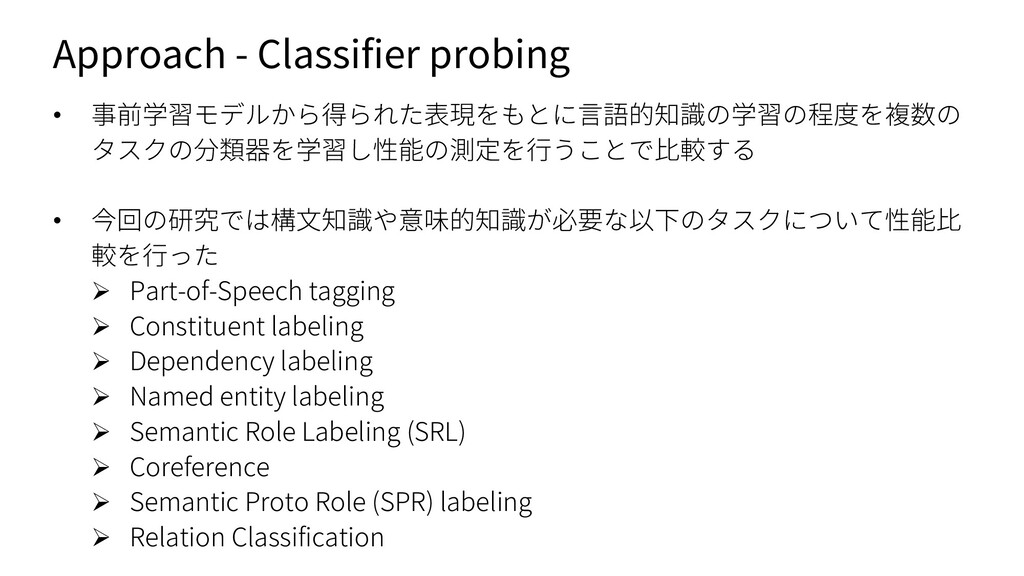
Approach - Classifier probing • 事前学習モデルから得られた表現をもとに⾔語的知識の学習の程度を複数の タスクの分類器を学習し性能の測定を⾏うことで⽐較する • 今回の研究では構⽂知識や意味的知識が必要な以下のタスクについて性能⽐ 較を⾏った
Ø Part-of-Speech tagging Ø Constituent labeling Ø Dependency labeling Ø Named entity labeling Ø Semantic Role Labeling (SRL) Ø Coreference Ø Semantic Proto Role (SPR) labeling Ø Relation Classification -
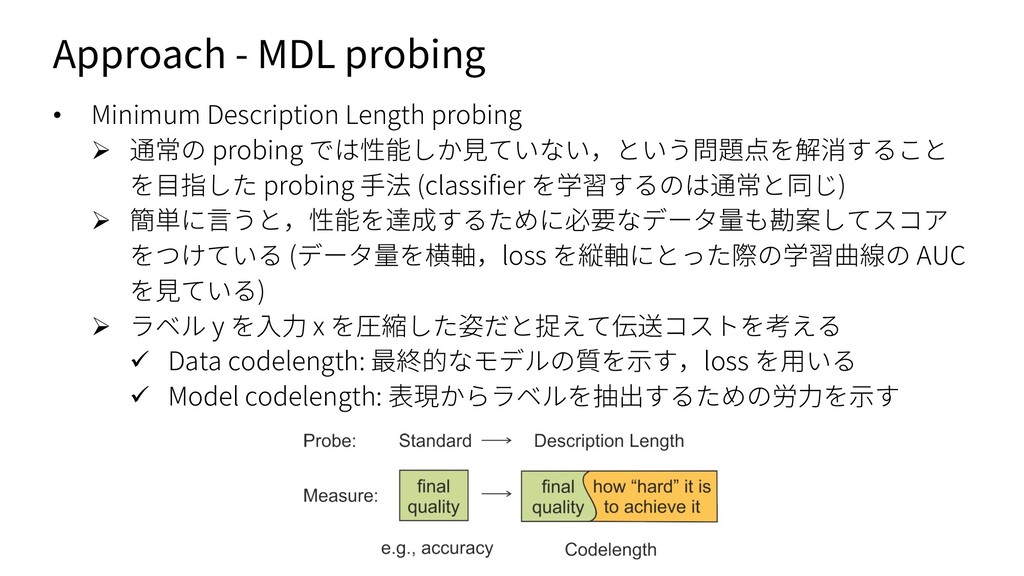
Approach - MDL probing • Minimum Description Length probing Ø
通常の probing では性能しか⾒ていない,という問題点を解消すること を⽬指した probing ⼿法 (classifier を学習するのは通常と同じ) Ø 簡単に⾔うと,性能を達成するために必要なデータ量も勘案してスコア をつけている (データ量を横軸,loss を縦軸にとった際の学習曲線の AUC を⾒ている) Ø ラベル y を⼊⼒ x を圧縮した姿だと捉えて伝送コストを考える ü Data codelength: 最終的なモデルの質を⽰す,loss を⽤いる ü Model codelength: 表現からラベルを抽出するための労⼒を⽰す -
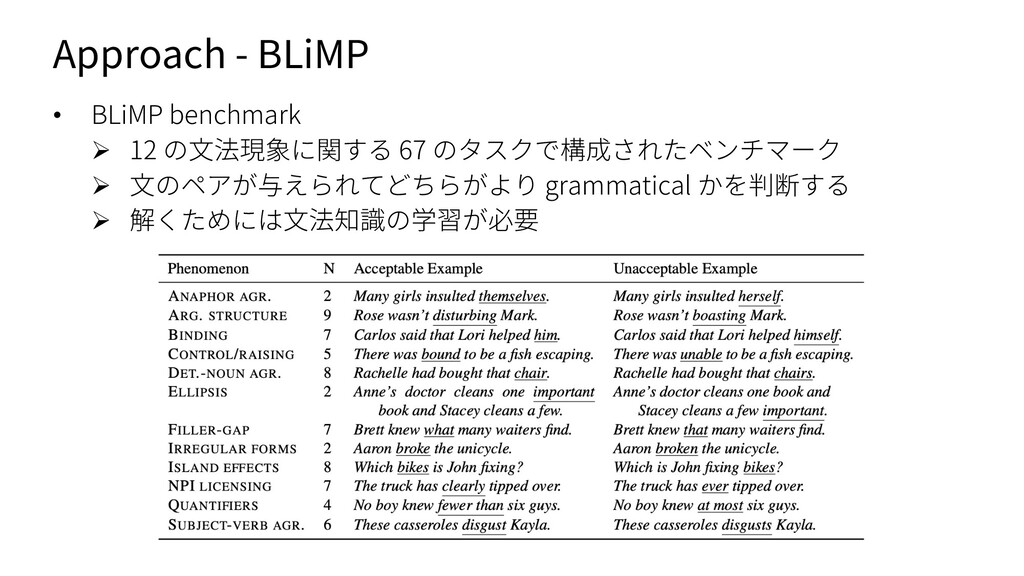
Approach - BLiMP • BLiMP benchmark Ø 12 の⽂法現象に関する 67
のタスクで構成されたベンチマーク Ø ⽂のペアが与えられてどちらがより grammatical かを判断する Ø 解くためには⽂法知識の学習が必要 -
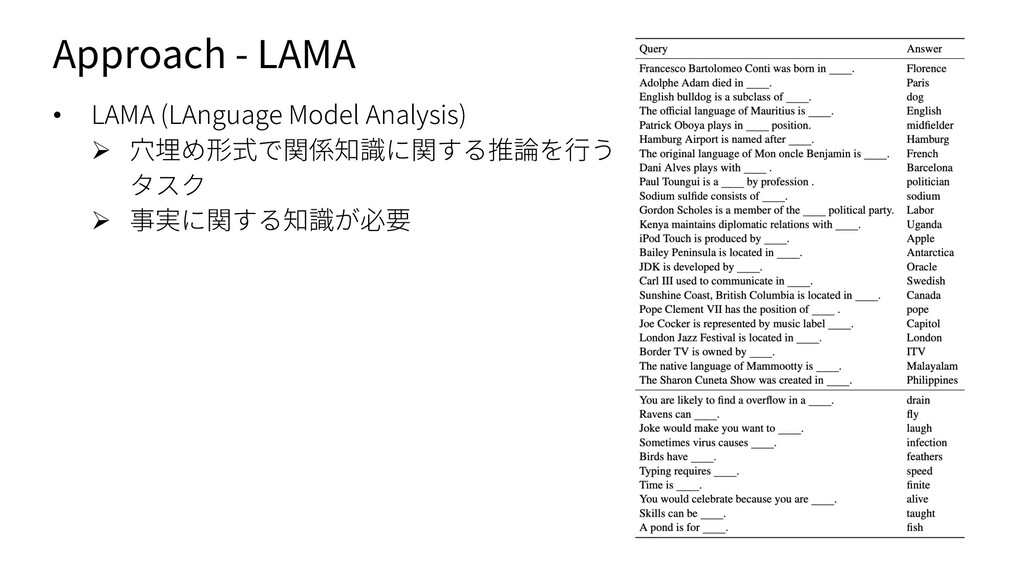
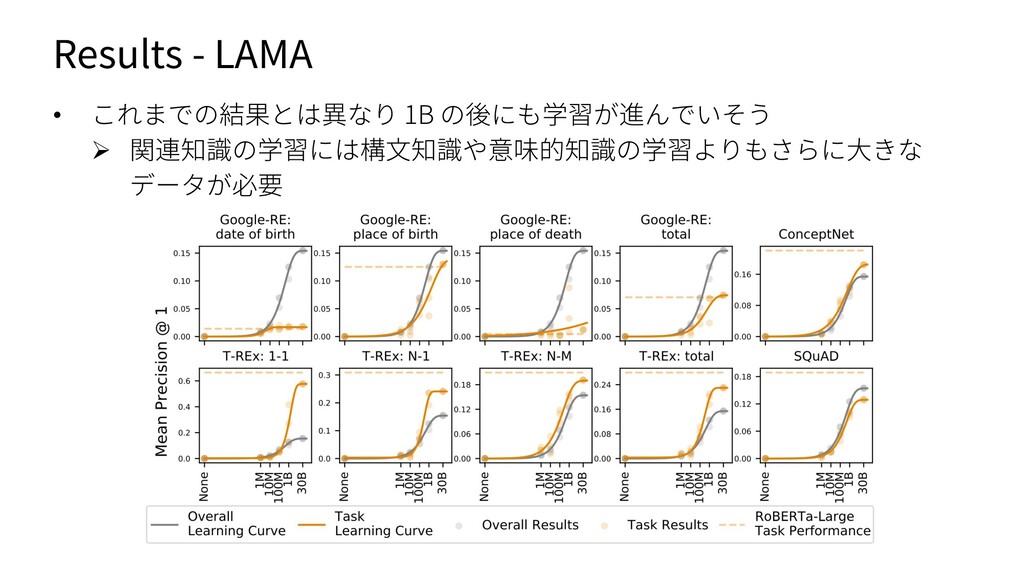
Approach - LAMA • LAMA (LAnguage Model Analysis) Ø ⽳埋め形式で関係知識に関する推論を⾏う
タスク Ø 事実に関する知識が必要 -
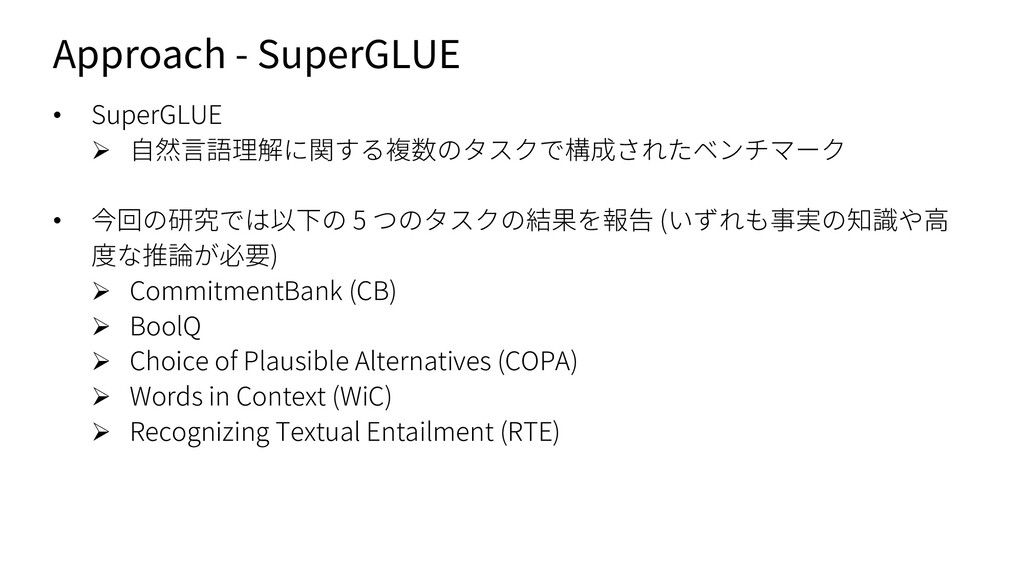
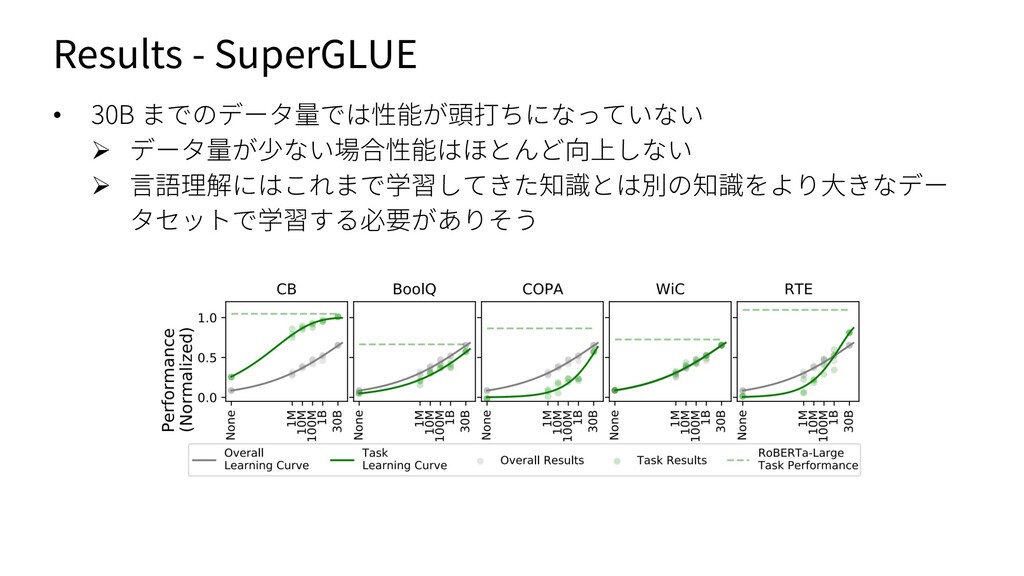
Approach - SuperGLUE • SuperGLUE Ø ⾃然⾔語理解に関する複数のタスクで構成されたベンチマーク • 今回の研究では以下の 5
つのタスクの結果を報告 (いずれも事実の知識や⾼ 度な推論が必要) Ø CommitmentBank (CB) Ø BoolQ Ø Choice of Plausible Alternatives (COPA) Ø Words in Context (WiC) Ø Recognizing Textual Entailment (RTE) -
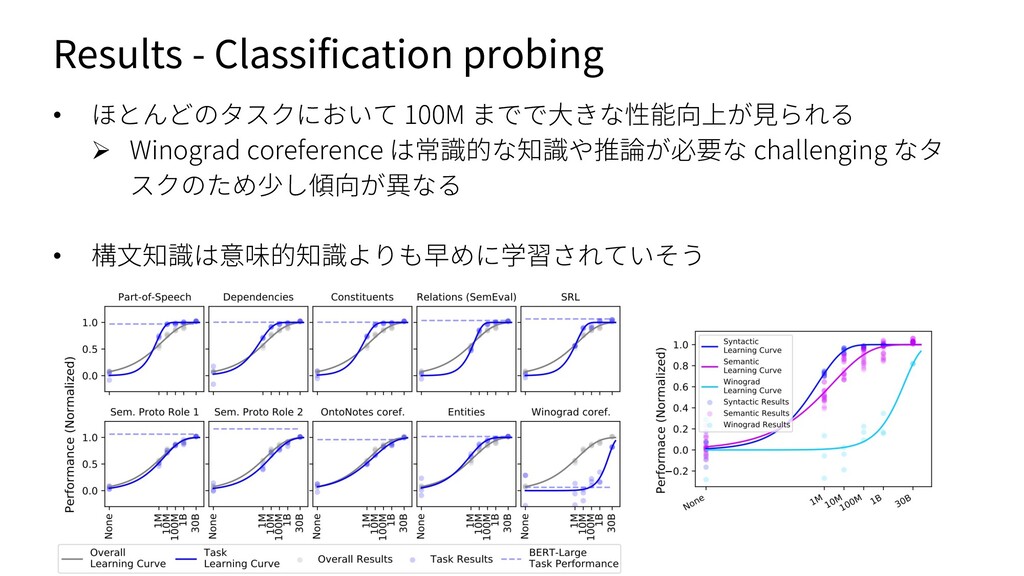
Results - Classification probing • ほとんどのタスクにおいて 100M までで⼤きな性能向上が⾒られる Ø Winograd
coreference は常識的な知識や推論が必要な challenging なタ スクのため少し傾向が異なる • 構⽂知識は意味的知識よりも早めに学習されていそう -
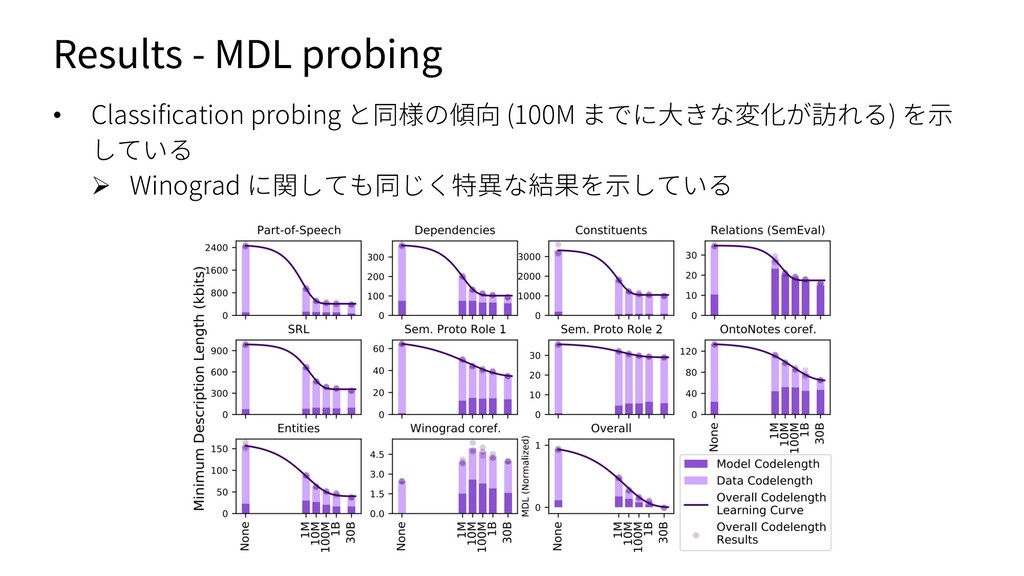
Results - MDL probing • Classification probing と同様の傾向 (100M までに⼤きな変化が訪れる)
を⽰ している Ø Winograd に関しても同じく特異な結果を⽰している -
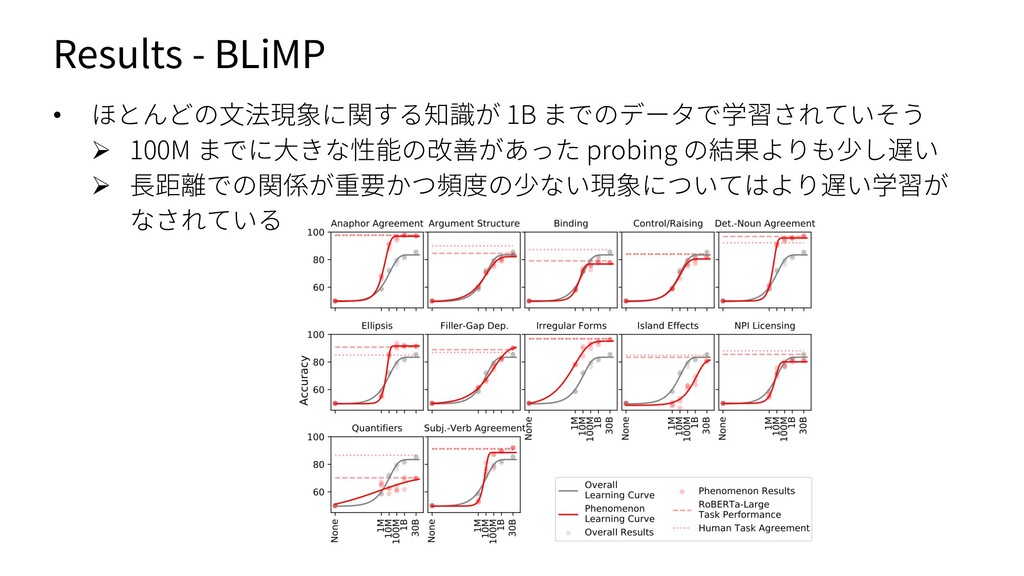
Results - BLiMP • ほとんどの⽂法現象に関する知識が 1B までのデータで学習されていそう Ø 100M までに⼤きな性能の改善があった
probing の結果よりも少し遅い Ø ⻑距離での関係が重要かつ頻度の少ない現象についてはより遅い学習が なされている -
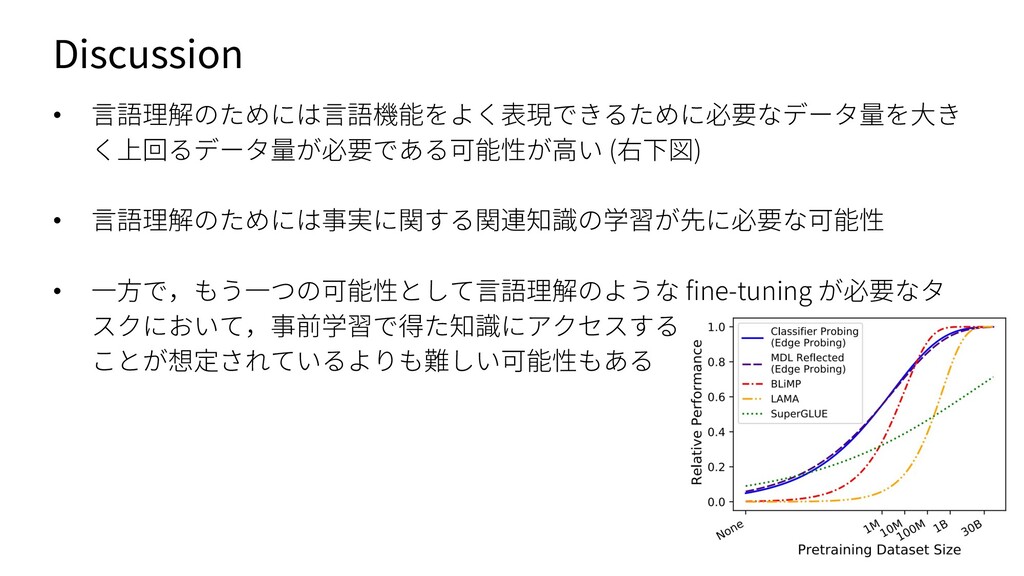
Discussion • ⾔語理解のためには⾔語機能をよく表現できるために必要なデータ量を⼤き く上回るデータ量が必要である可能性が⾼い (右下図) • ⾔語理解のためには事実に関する関連知識の学習が先に必要な可能性 • ⼀⽅で,もう⼀つの可能性として⾔語理解のような fine-tuning
が必要なタ スクにおいて,事前学習で得た知識にアクセスする ことが想定されているよりも難しい可能性もある -
Conclusion • 複数のデータサイズで事前学習された RoBERTa に対して分析を⾏った Ø 構⽂知識や意味的知識の学習は⽐較的少ないデータでも⼗分のようであ ることを⽰した Ø ⼀⽅で,事実に基づく知識を学習するためにはより⼤きなデータサイズ
が必要であることも⽰した Ø ⾔語理解に関してはさらに多い 30B 以上のデータサイズにおいてデータ を増やせば性能が向上するが,⾔語知識とは別の知識を学習しているの ではないかと考えられる Ø どのようなデータがどのようなタスクに必要なのかを知ることはより データ効率の良いモデルを得るための⾜掛かりになるはず