Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
2019ACL読み会_Choosing-Transfer-Languages-for-Cros...
Search
Ikumi Yamashita
November 18, 2019
Technology
72
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
2019ACL読み会_Choosing-Transfer-Languages-for-Cross-Lingual-Learning
Ikumi Yamashita
November 18, 2019
More Decks by Ikumi Yamashita
See All by Ikumi Yamashita
2021論文紹介_When-Do-You-Need-Billions-of-Words-of-Pretraining-Data?
ikumi193
0
200
2021EACL/NAACL論文紹介_Multilingual-LAMA-Investigating-Knowledge-in-Multilingual-Pretrained-Language-Models
ikumi193
0
76
2021論文紹介_CANINE:-Pre-training-an-Efficient-Tokenization-Free-Encoder-for-Language-Representation
ikumi193
0
340
2020COLING読み会_Linguistic-Profiling-of-a-Neural-Language-Model
ikumi193
0
120
2020EMNLP読み会_Identifying-Elements-Essential-for-BERT's-Multilinguality
ikumi193
0
150
2020ACL読み会_FastBERT:-a-Self-distilling-BERT-with-Adaptive-Inference-Time
ikumi193
0
180
2020論文紹介_Finding-Universal-Grammatical-Relations-in-Multilingual-BERT
ikumi193
0
310
2019EMNLP読み会_Unicoder_A_Universal_Language_Encoder_by_Pre-training_with_Multiple_Cross-lingual_Tasks
ikumi193
0
80
2019論文読み会_Language-Modeling-with-Shared-Grammar
ikumi193
0
240
Other Decks in Technology
See All in Technology
1万名の社員が使う認証基盤で どう信頼性を担保するか?
kairim0
0
210
予測不能な実行エージェントを安全にサクッと試せるサンドボックス環境の話
sansantech
PRO
0
130
FactoryBotアンチパターン / factory_bot anti-patterns
toshimaru
0
140
SDDの運用にめげずに向き合った話
sansantech
PRO
1
130
Incremental HTTP
kazuho
5
2.1k
LocalStack を使ったサーバーレスアプリケーション開発 / Serverless Development with LocalStack
kakakakakku
0
250
自主式軟體工廠
philipz
0
230
Meet AgentCore Identity Consent Portal
hironobuiga
3
190
スキルを作る、その前に!複数人で使われるスキルを 作るためのプロセス
junkifurukawa
2
340
「とりあえず動く」の先へ。 AI時代のチーム開発と内部設計/2026-slsdays
slsops
0
150
Claude Code本は、どのように執筆チームで書かれたか
oikon48
0
250
【データ横丁主催】AI Agentがコンテキストを使って仕事をした後、何が残るのか― 組織の経験を次の判断に引き継ぐ「Agent Memory」
shisyu_gaku
2
330
Featured
See All Featured
A Guide to Academic Writing Using Generative AI - A Workshop
ks91
PRO
1
510
Amusing Abliteration
ianozsvald
1
330
B2B Lead Gen: Tactics, Traps & Triumph
marketingsoph
0
260
Easily Structure & Communicate Ideas using Wireframe
afnizarnur
194
17k
Reflections from 52 weeks, 52 projects
jeffersonlam
356
21k
My Coaching Mixtape
mlcsv
0
340
The Invisible Side of Design
smashingmag
301
52k
Faster Mobile Websites
deanohume
310
32k
Bootstrapping a Software Product
garrettdimon
PRO
306
120k
Fashionably flexible responsive web design (full day workshop)
malarkey
409
67k
16th Malabo Montpellier Forum Presentation
akademiya2063
PRO
0
400
Agile that works and the tools we love
rasmusluckow
331
22k
Transcript
Choosing Transfer Languages for Cross-Lingual Learning Yu-Hsiang Lin, Chian-Yu Chen,
Jean Lee, Zirui Li, Yuyan Zhang, Mengzhou Xia, Shruti Rijhwani, Junxian He, Zhisong Zhang, Xuezhe Ma, Antonios Anastasopoulos, Patrick Littell, Graham Neubig ACL2019 2019/11/18 ACL2019読み会 紹介者:⼭下郁海
Overview • Cross-Lingual Transfer において最適な転移元の⾔語を選ぶためのフレーム ワーク -"/( 3"/, を提案 •
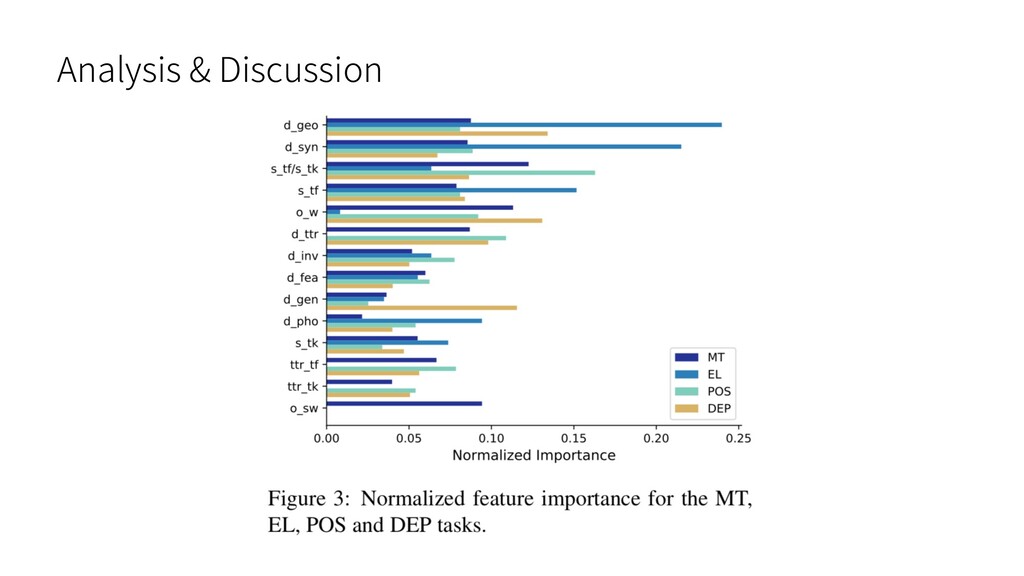
Machine Translation, Entity Linking, POS tagging, Dependency Parsing の4つ のタスクにおいて従来の転移元⾔語の選択⽅法よりも良い転移元⾔語を選択 できることを⽰した • 複数の素性でモデルを学習し、転移元⾔語の選択にどういった素性が強く影 響しているのかの分析を⾏った
Previous works 従来の転移元⾔語の選択⽅法 • 同じ語族の⾔語から選ぶ → 単⼀の語族の⾔語全てが同じ特性を持つとは限らない • タスクに重要な⾔語特性が類似したものから選ぶ (例
: Parsing task における語順が類似したもの) → どの⾔語特性が転移の際に重要であるかは⾃明ではない
-"/( 3"/, 特定の NLP タスクにおけるタスク⾔語と転移元⾔語の集合が与えられたとき、 スコアを⾼くするような転移元⾔語を選ぶランキングタスクとして定義 タスク⾔語と転移元⾔語のペアから複数の素性を抽出 → モデルを学習
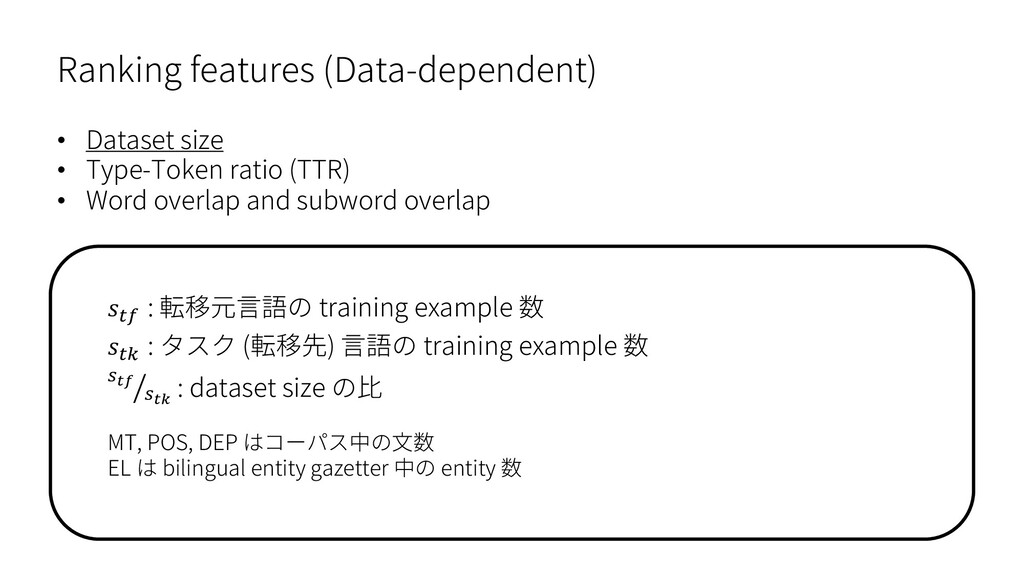
Ranking features (Data-dependent) • Dataset size • Type-Token ratio (TTR)
• Word overlap and subword overlap "# : 転移元⾔語の training example 数 "$ : タスク (転移先) ⾔語の training example 数 % &'( &') : dataset size の⽐ MT, POS, DEP はコーパス中の⽂数 EL は bilingual entity gazetter 中の entity 数
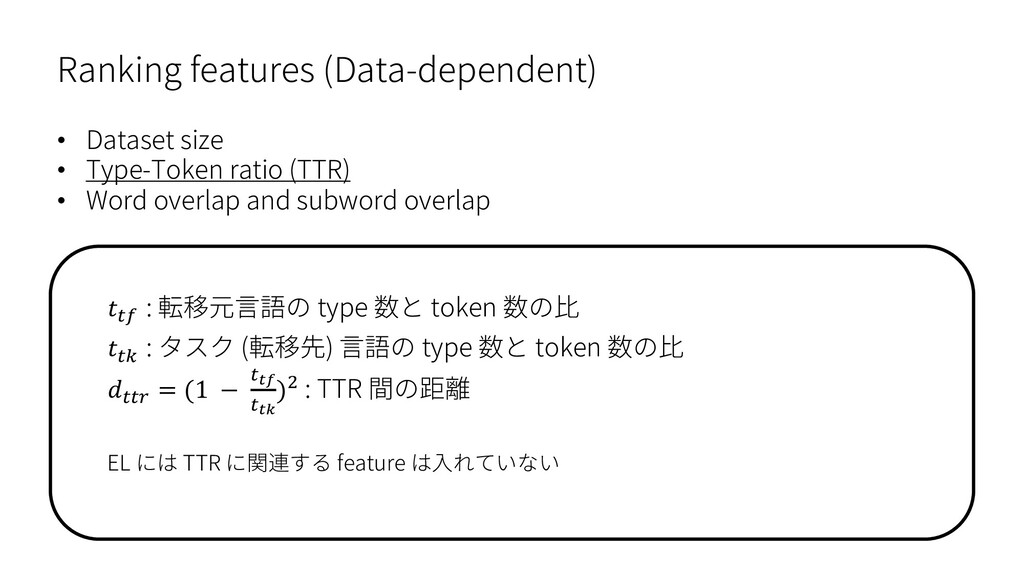
Ranking features (Data-dependent) • Dataset size • Type-Token ratio (TTR)
• Word overlap and subword overlap "# : 転移元⾔語の type 数と token 数の⽐ "$ : タスク (転移先) ⾔語の type 数と token 数の⽐ "", = (1 − "'( "') )2 : TTR 間の距離 EL には TTR に関連する feature は⼊れていない
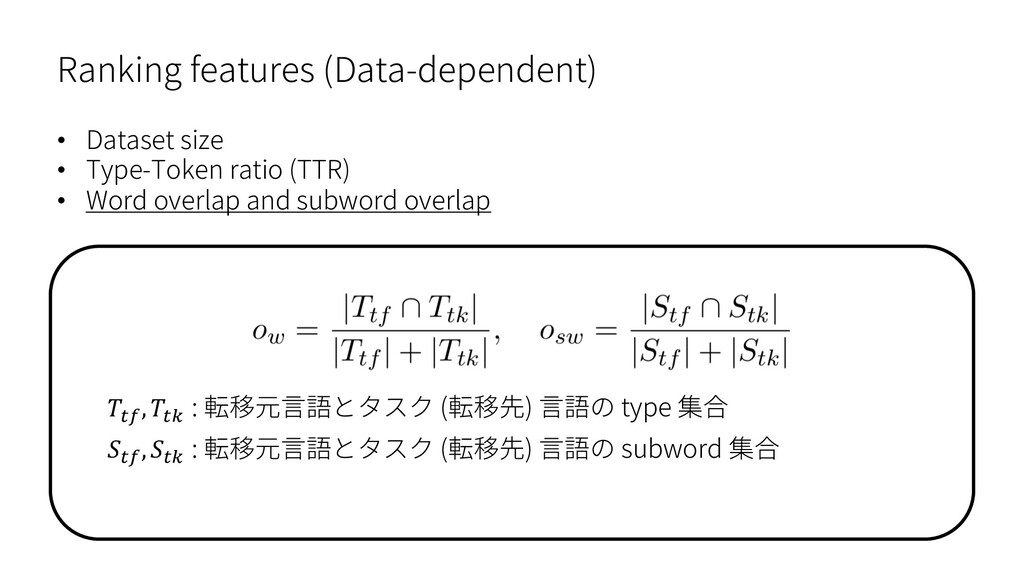
Ranking features (Data-dependent) • Dataset size • Type-Token ratio (TTR)
• Word overlap and subword overlap "# , "$ : 転移元⾔語とタスク (転移先) ⾔語の type 集合 "#, "$ : 転移元⾔語とタスク (転移先) ⾔語の subword 集合
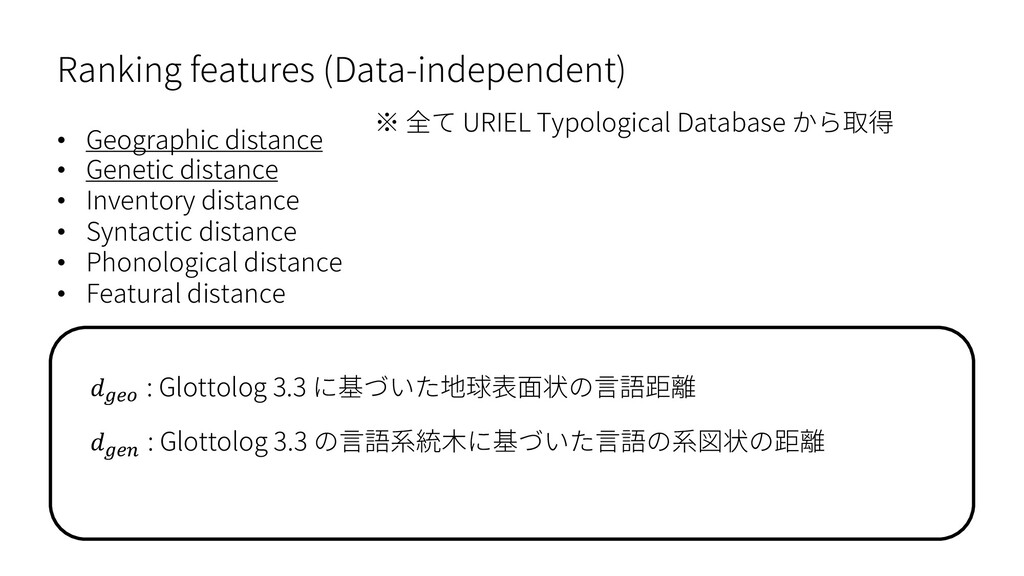
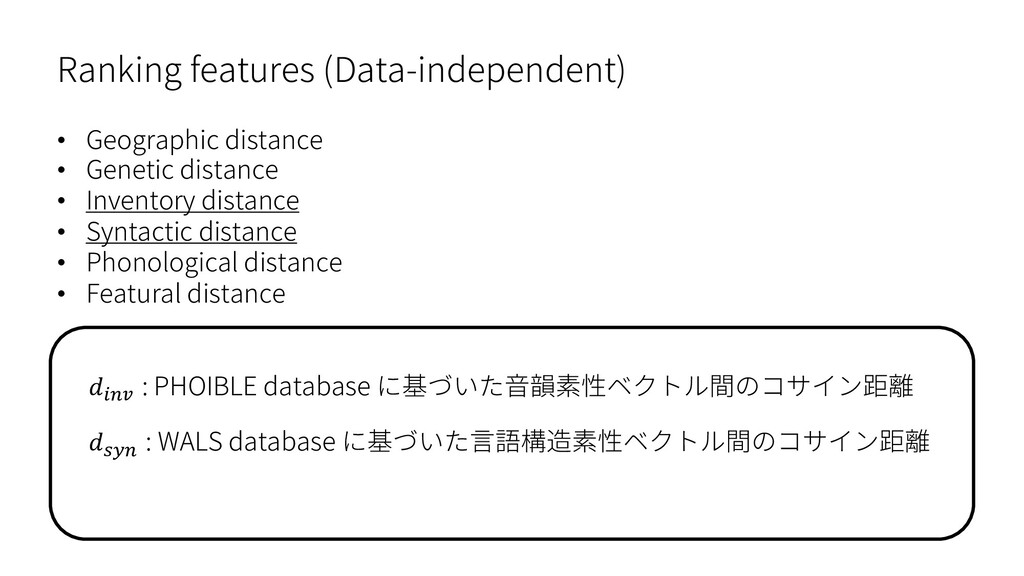
Ranking features (Data-independent) • Geographic distance • Genetic distance •
Inventory distance • Syntactic distance • Phonological distance • Featural distance ※ 全て URIEL Typological Database から取得 678 : Glottolog 3.3 に基づいた地球表⾯状の⾔語距離 679 : Glottolog 3.3 の⾔語系統⽊に基づいた⾔語の系図状の距離
Ranking features (Data-independent) • Geographic distance • Genetic distance •
Inventory distance • Syntactic distance • Phonological distance • Featural distance :9; : PHOIBLE database に基づいた⾳韻素性ベクトル間のコサイン距離 &<9 : WALS database に基づいた⾔語構造素性ベクトル間のコサイン距離
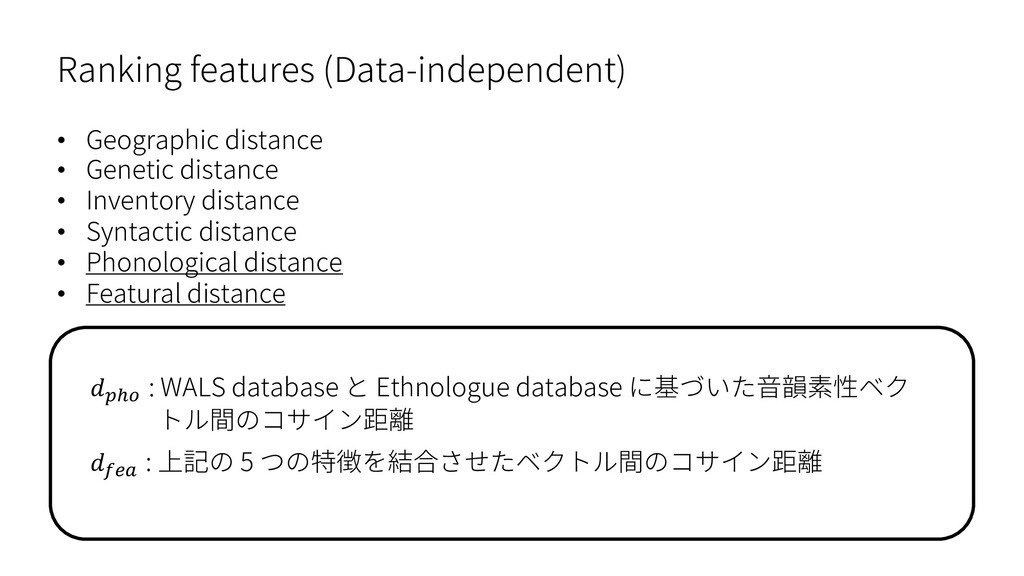
Ranking features (Data-independent) • Geographic distance • Genetic distance •
Inventory distance • Syntactic distance • Phonological distance • Featural distance =>8 : WALS database と Ethnologue database に基づいた⾳韻素性ベク トル間のコサイン距離 #7? : 上記の 5 つの特徴を結合させたベクトル間のコサイン距離
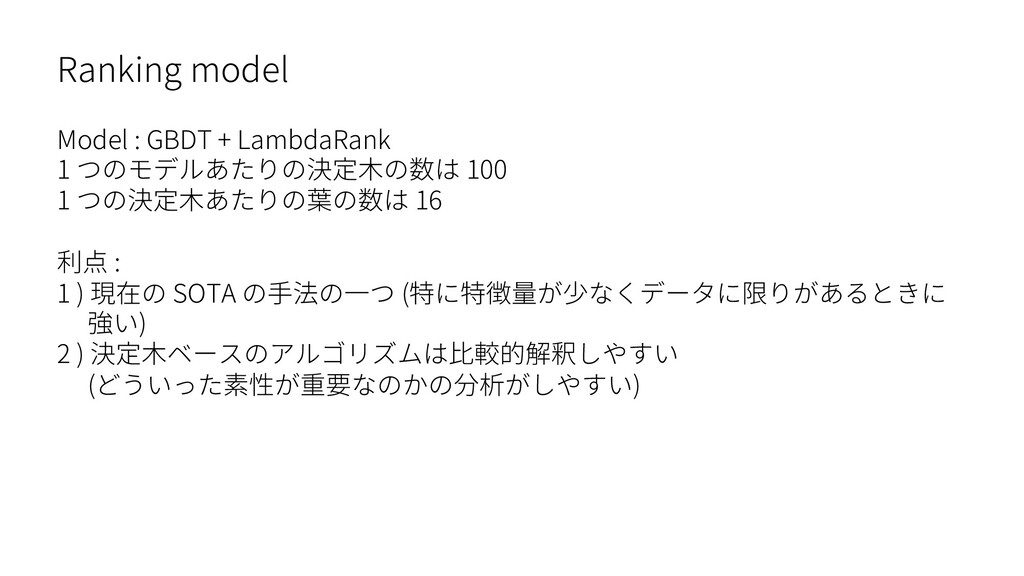
Ranking model Model : GBDT + LambdaRank 1 つのモデルあたりの決定⽊の数は 100
1 つの決定⽊あたりの葉の数は 16 利点 : 1 ) 現在の SOTA の⼿法の⼀つ (特に特徴量が少なくデータに限りがあるときに 強い) 2 ) 決定⽊ベースのアルゴリズムは⽐較的解釈しやすい (どういった素性が重要なのかの分析がしやすい)
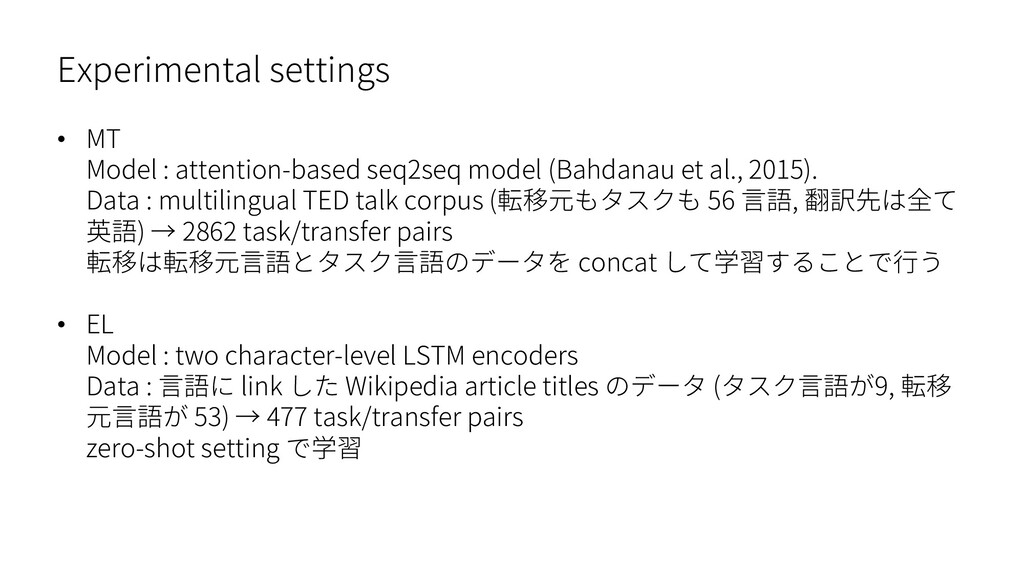
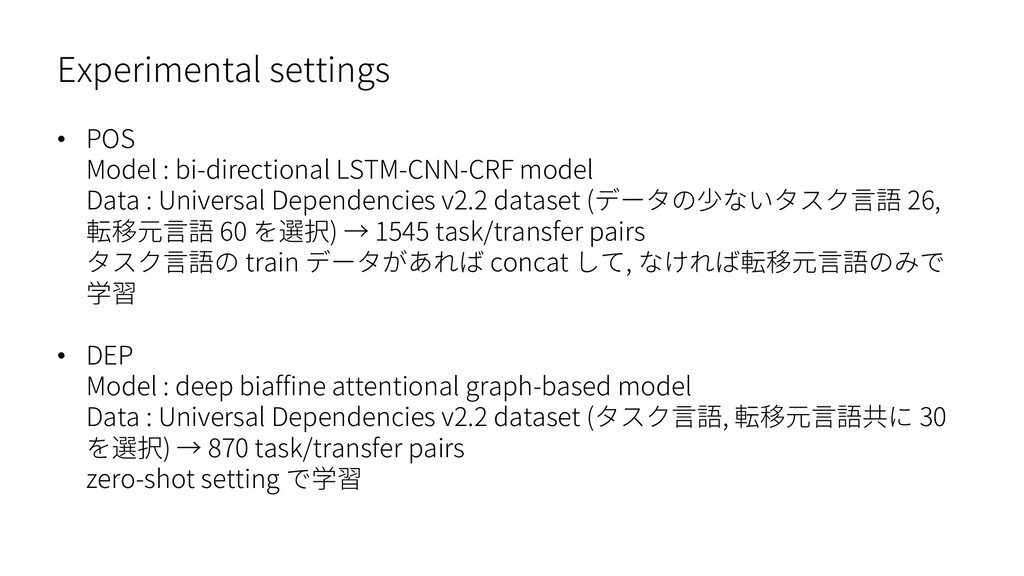
Experimental settings • MT Model : attention-based seq2seq model (Bahdanau
et al., 2015). Data : multilingual TED talk corpus (転移元もタスクも 56 ⾔語, 翻訳先は全て 英語) → 2862 task/transfer pairs 転移は転移元⾔語とタスク⾔語のデータを concat して学習することで⾏う • EL Model : two character-level LSTM encoders Data : ⾔語に link した Wikipedia article titles のデータ (タスク⾔語が9, 転移 元⾔語が 53) → 477 task/transfer pairs zero-shot setting で学習
Experimental settings • POS Model : bi-directional LSTM-CNN-CRF model Data
: Universal Dependencies v2.2 dataset (データの少ないタスク⾔語 26, 転移元⾔語 60 を選択) → 1545 task/transfer pairs タスク⾔語の train データがあれば concat して, なければ転移元⾔語のみで 学習 • DEP Model : deep biaffine attentional graph-based model Data : Universal Dependencies v2.2 dataset (タスク⾔語, 転移元⾔語共に 30 を選択) → 870 task/transfer pairs zero-shot setting で学習
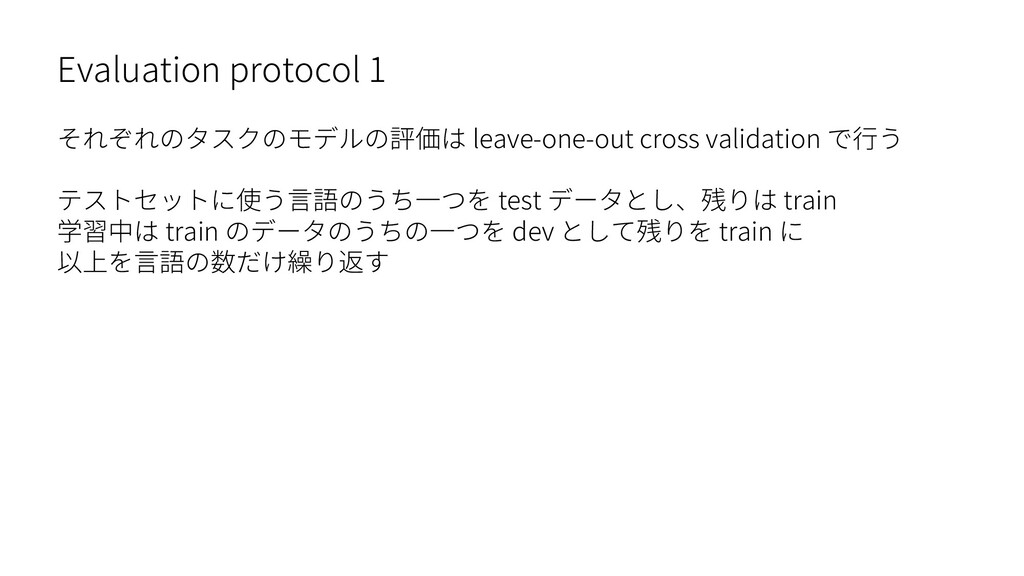
Evaluation protocol 1 それぞれのタスクのモデルの評価は leave-one-out cross validation で⾏う テストセットに使う⾔語のうち⼀つを test
データとし、残りは train 学習中は train のデータのうちの⼀つを dev として残りを train に 以上を⾔語の数だけ繰り返す
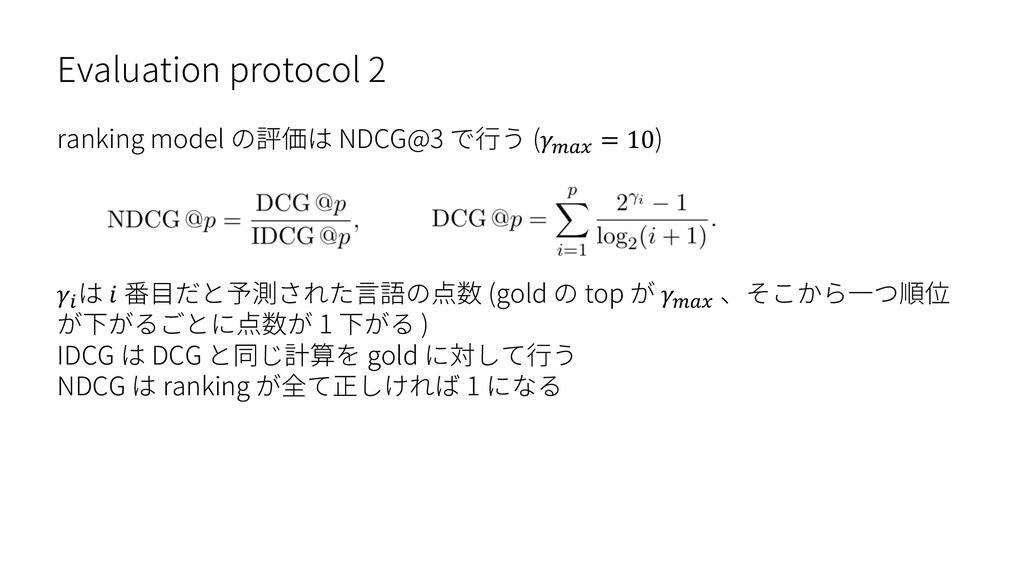
Evaluation protocol 2 ranking model の評価は NDCG@3 で⾏う (A?B =
10) : は 番⽬だと予測された⾔語の点数 (gold の top が A?B 、そこから⼀つ順位 が下がるごとに点数が 1 下がる ) IDCG は DCG と同じ計算を gold に対して⾏う NDCG は ranking が全て正しければ 1 になる
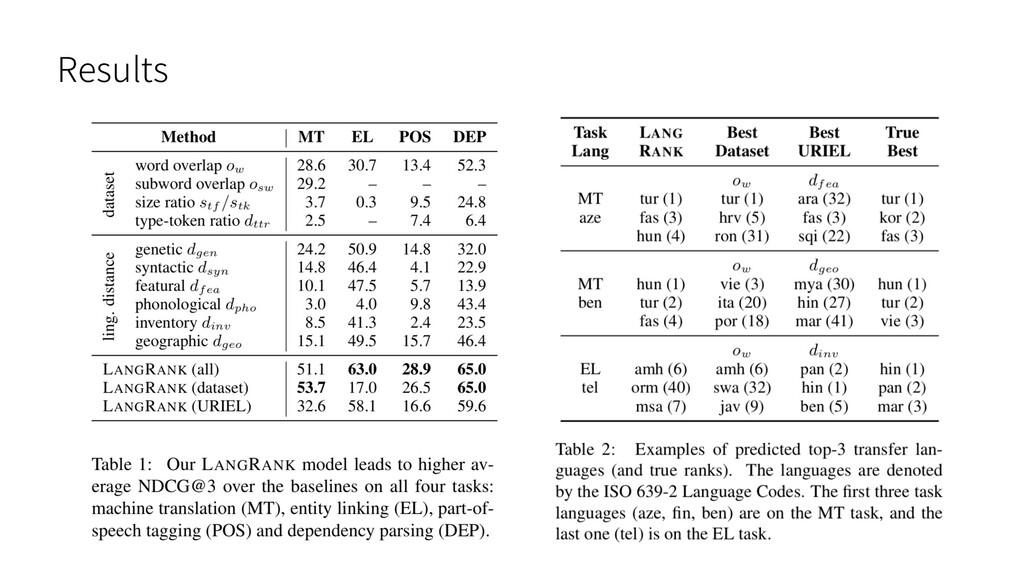
Results
Analysis & Discussion
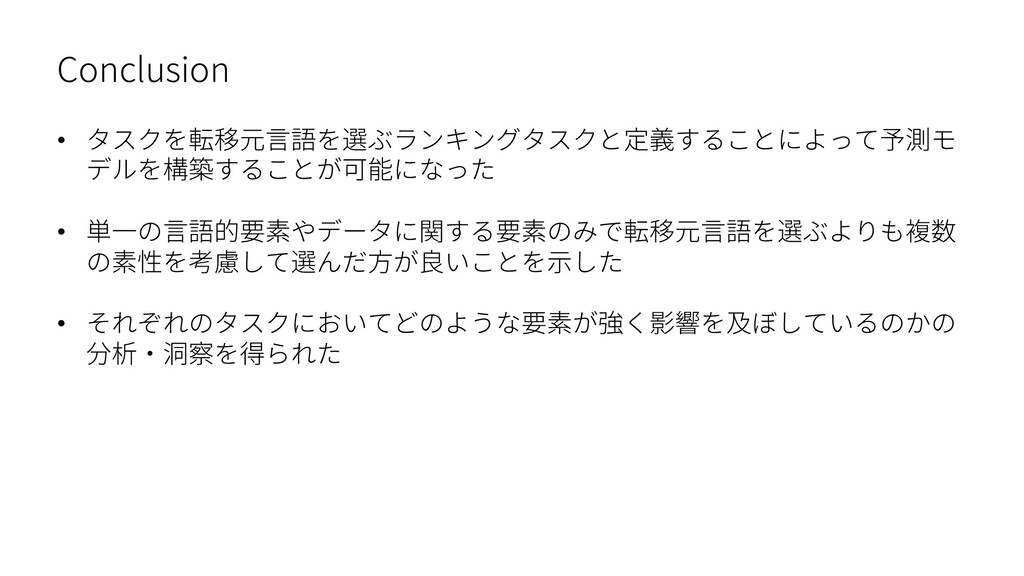
Conclusion • タスクを転移元⾔語を選ぶランキングタスクと定義することによって予測モ デルを構築することが可能になった • 単⼀の⾔語的要素やデータに関する要素のみで転移元⾔語を選ぶよりも複数 の素性を考慮して選んだ⽅が良いことを⽰した • それぞれのタスクにおいてどのような要素が強く影響を及ぼしているのかの 分析・洞察を得られた


 ikumi193
 kairim0
 sansantech
 toshimaru
 kazuho
 kakakakakku
 philipz
 hironobuiga
 junkifurukawa
 slsops
 oikon48
 shisyu_gaku
 ks91
 ianozsvald
 marketingsoph
 afnizarnur
 jeffersonlam
 mlcsv
 smashingmag
 deanohume
 garrettdimon
 malarkey
 akademiya2063
 rasmusluckow