Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
2020COLING読み会_Linguistic-Profiling-of-a-Neural-...
Search
Ikumi Yamashita
January 19, 2021
Technology
120
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
2020COLING読み会_Linguistic-Profiling-of-a-Neural-Language-Model
Ikumi Yamashita
January 19, 2021
More Decks by Ikumi Yamashita
See All by Ikumi Yamashita
2021論文紹介_When-Do-You-Need-Billions-of-Words-of-Pretraining-Data?
ikumi193
0
200
2021EACL/NAACL論文紹介_Multilingual-LAMA-Investigating-Knowledge-in-Multilingual-Pretrained-Language-Models
ikumi193
0
76
2021論文紹介_CANINE:-Pre-training-an-Efficient-Tokenization-Free-Encoder-for-Language-Representation
ikumi193
0
340
2020EMNLP読み会_Identifying-Elements-Essential-for-BERT's-Multilinguality
ikumi193
0
150
2020ACL読み会_FastBERT:-a-Self-distilling-BERT-with-Adaptive-Inference-Time
ikumi193
0
180
2020論文紹介_Finding-Universal-Grammatical-Relations-in-Multilingual-BERT
ikumi193
0
310
2019EMNLP読み会_Unicoder_A_Universal_Language_Encoder_by_Pre-training_with_Multiple_Cross-lingual_Tasks
ikumi193
0
80
2019論文読み会_Language-Modeling-with-Shared-Grammar
ikumi193
0
240
2019ACL読み会_Choosing-Transfer-Languages-for-Cross-Lingual-Learning
ikumi193
0
72
Other Decks in Technology
See All in Technology
Claude Code本は、どのように執筆チームで書かれたか
oikon48
0
250
オンラインゲームのシステム全体像 - コロプラ 2026年度 新卒研修
colopl
0
840
IR Today: Theory, Practice, and Agents
dtunkelang
0
350
OpenSharing について熱く語る 〜AI アセットの共有について〜
kameitomohiro
0
230
【データ横丁主催】AI Agentがコンテキストを使って仕事をした後、何が残るのか― 組織の経験を次の判断に引き継ぐ「Agent Memory」
shisyu_gaku
2
330
[2026-09-30]ロックンロールは鳴り止まないっ - 信頼性かまってちゃん - 「データ駆動を投げ捨ててまで。」追いかける信頼性改善に向けた取り組みの話
tosite
0
210
カンファレンスに参加した後の浮遊感とセルフケア
pauli
0
310
「とりあえず動く」の先へ。 AI時代のチーム開発と内部設計/2026-slsdays
slsops
0
150
Snapshot Testing in Practice: Predictable and Reliable SwiftUI Views
fespinoza
0
140
実体験から学ぶ分析エージェントの開発と運⽤
recruitengineers
PRO
1
320
BedrockとLambdaで作る リアルタイム進行型推理ゲーム
kawametho
0
190
購入ドメインでの課題と取り組み
ykagano
0
150
Featured
See All Featured
Building Experiences: Design Systems, User Experience, and Full Site Editing
marktimemedia
1
620
Sharpening the Axe: The Primacy of Toolmaking
bcantrill
46
3k
Typedesign – Prime Four
hannesfritz
42
3.2k
Test your architecture with Archunit
thirion
2
2.4k
Lightning talk: Run Django tests with GitHub Actions
sabderemane
0
290
Information Architects: The Missing Link in Design Systems
soysaucechin
1
1.2k
[Rails World 2023 - Day 1 Closing Keynote] - The Magic of Rails
eileencodes
38
3k
Efficient Content Optimization with Google Search Console & Apps Script
katarinadahlin
PRO
1
910
Speed Design
sergeychernyshev
33
2.1k
JavaScript: Past, Present, and Future - NDC Porto 2020
reverentgeek
52
6.1k
Visualization
eitanlees
153
17k
Groundhog Day: Seeking Process in Gaming for Health
codingconduct
0
390
Transcript
紹介者:⼭下郁海 (TMU M1 ⼩町研究室) 2020/01/19 @ COLING2020 読み会 1
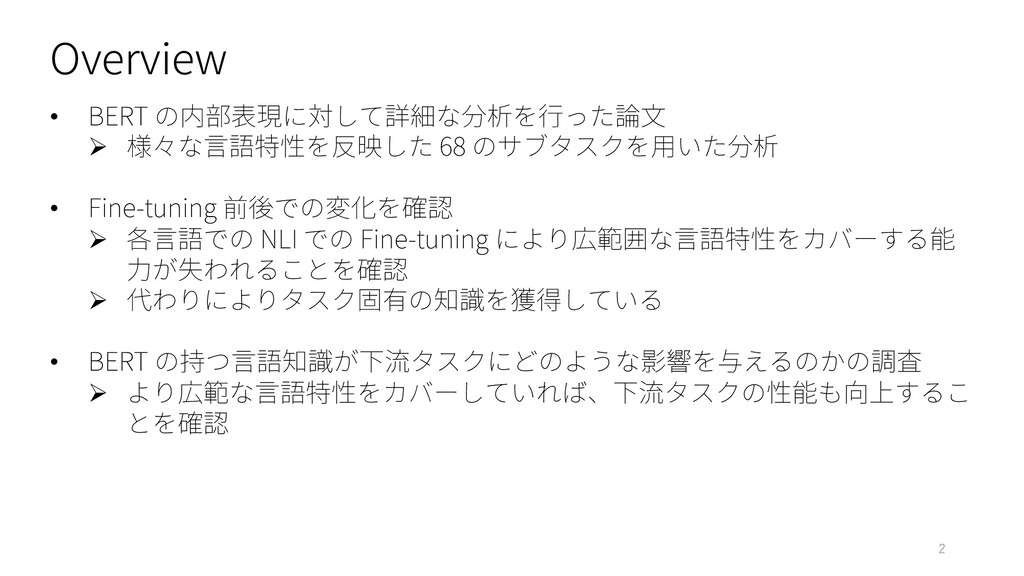
• BERT の内部表現に対して詳細な分析を⾏った論⽂ Ø 様々な⾔語特性を反映した 68 のサブタスクを⽤いた分析 • Fine-tuning 前後での変化を確認
Ø 各⾔語での NLI での Fine-tuning により広範囲な⾔語特性をカバーする能 ⼒が失われることを確認 Ø 代わりによりタスク固有の知識を獲得している • BERT の持つ⾔語知識が下流タスクにどのような影響を与えるのかの調査 Ø より広範な⾔語特性をカバーしていれば、下流タスクの性能も向上するこ とを確認 Overview 2
Settings 3
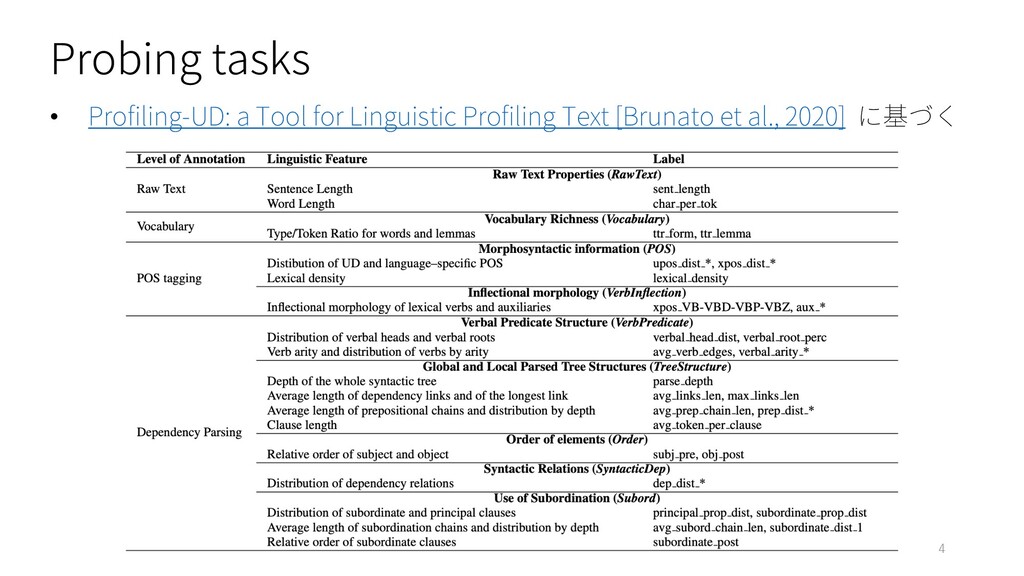
Probing tasks • Profiling-UD: a Tool for Linguistic Profiling Text
[Brunato et al., 2020] に基づく 4
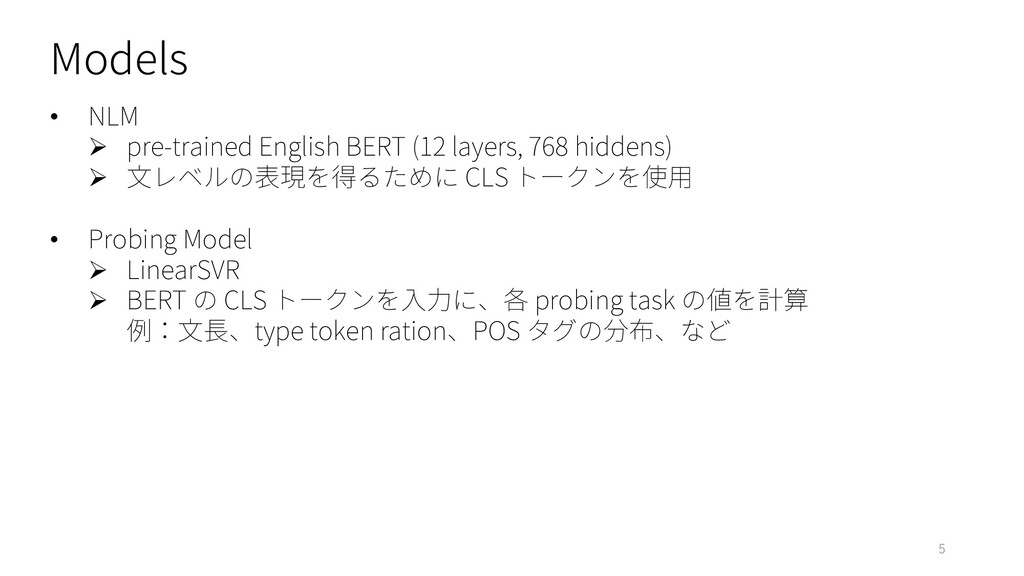
Models • NLM Ø pre-trained English BERT (12 layers, 768
hiddens) Ø ⽂レベルの表現を得るために CLS トークンを使⽤ • Probing Model Ø LinearSVR Ø BERT の CLS トークンを⼊⼒に、各 probing task の値を計算 例:⽂⻑、type token ration、POS タグの分布、など 5
Profiling BERT 6
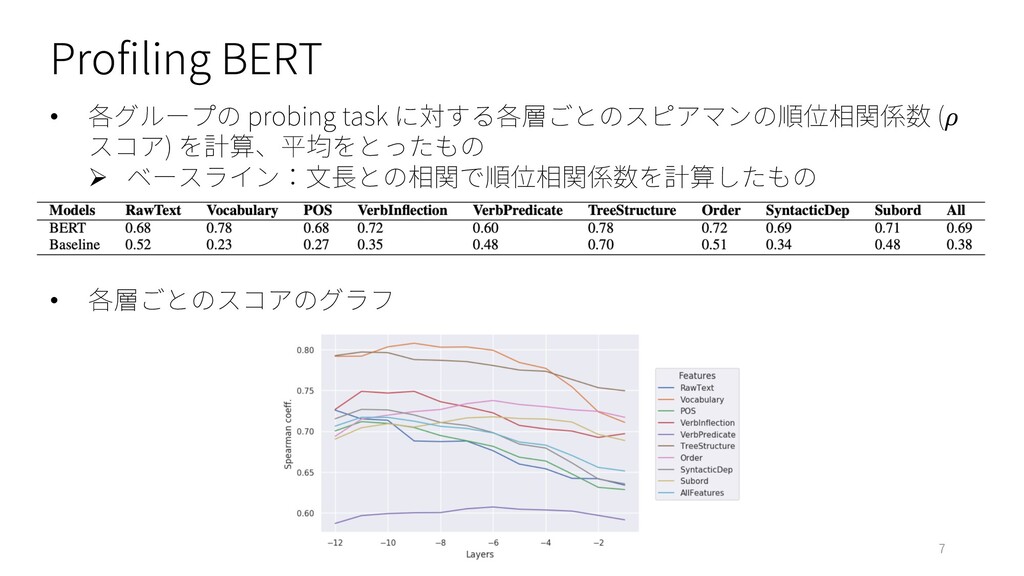
Profiling BERT • 各グループの probing task に対する各層ごとのスピアマンの順位相関係数 ( スコア) を計算、平均をとったもの
Ø ベースライン:⽂⻑との相関で順位相関係数を計算したもの • 各層ごとのスコアのグラフ 7
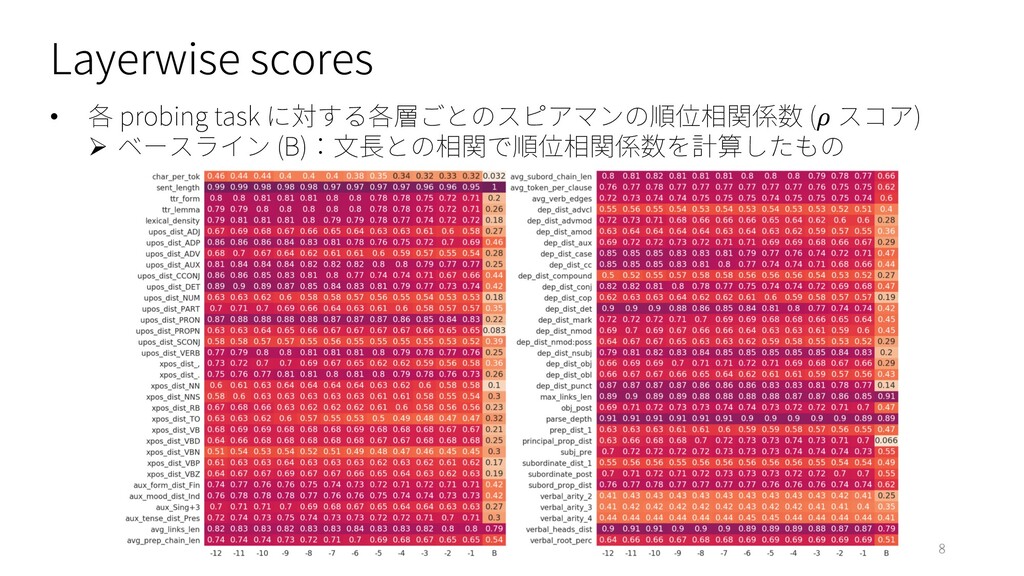
Layerwise scores • 各 probing task に対する各層ごとのスピアマンの順位相関係数 ( スコア) Ø
ベースライン (B):⽂⻑との相関で順位相関係数を計算したもの 8
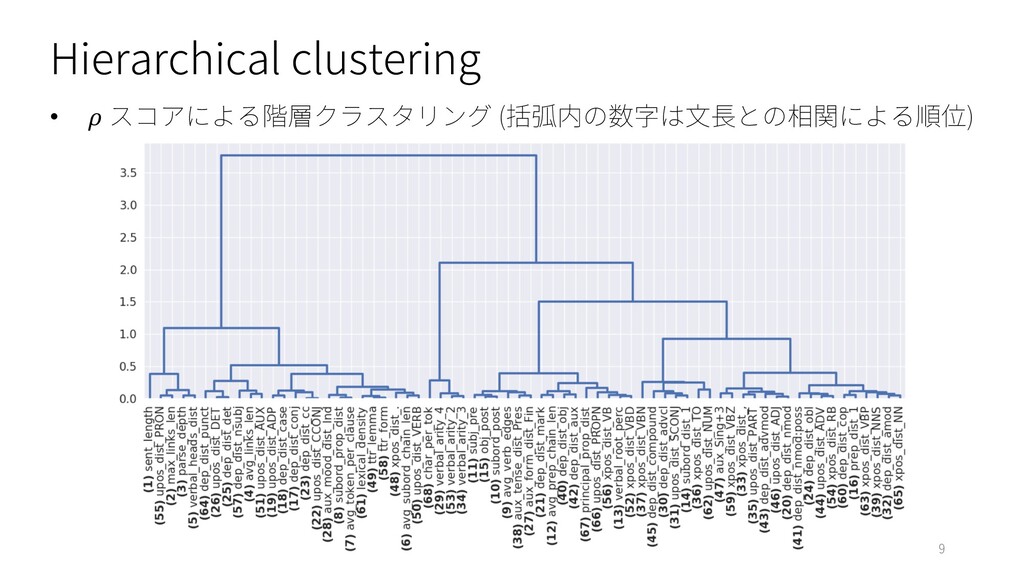
Hierarchical clustering • スコアによる階層クラスタリング (括弧内の数字は⽂⻑との相関による順位) 9
Impact of fine-tuning 10
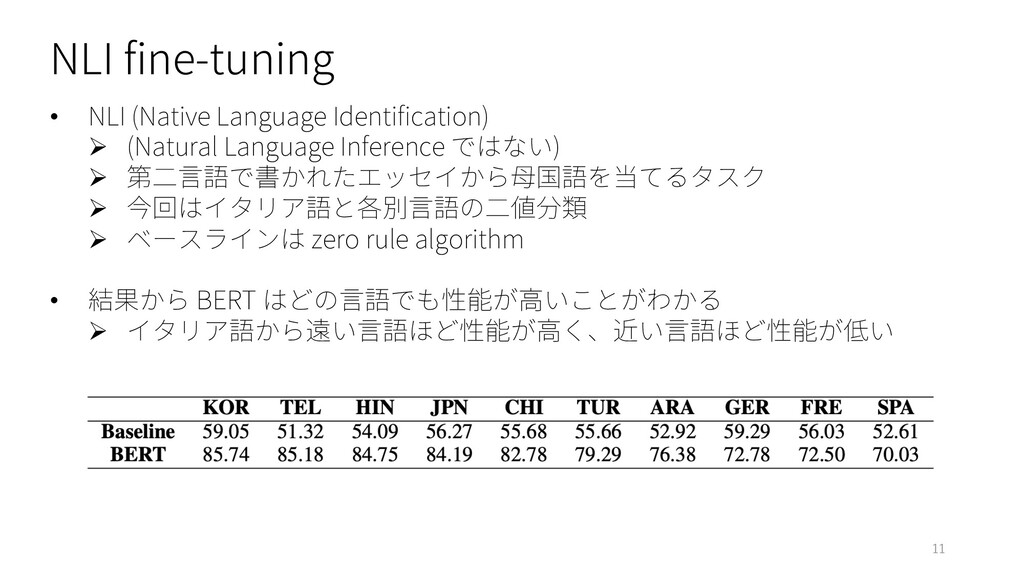
NLI fine-tuning • NLI (Native Language Identification) Ø (Natural Language
Inference ではない) Ø 第⼆⾔語で書かれたエッセイから⺟国語を当てるタスク Ø 今回はイタリア語と各別⾔語の⼆値分類 Ø ベースラインは zero rule algorithm • 結果から BERT はどの⾔語でも性能が⾼いことがわかる Ø イタリア語から遠い⾔語ほど性能が⾼く、近い⾔語ほど性能が低い 11
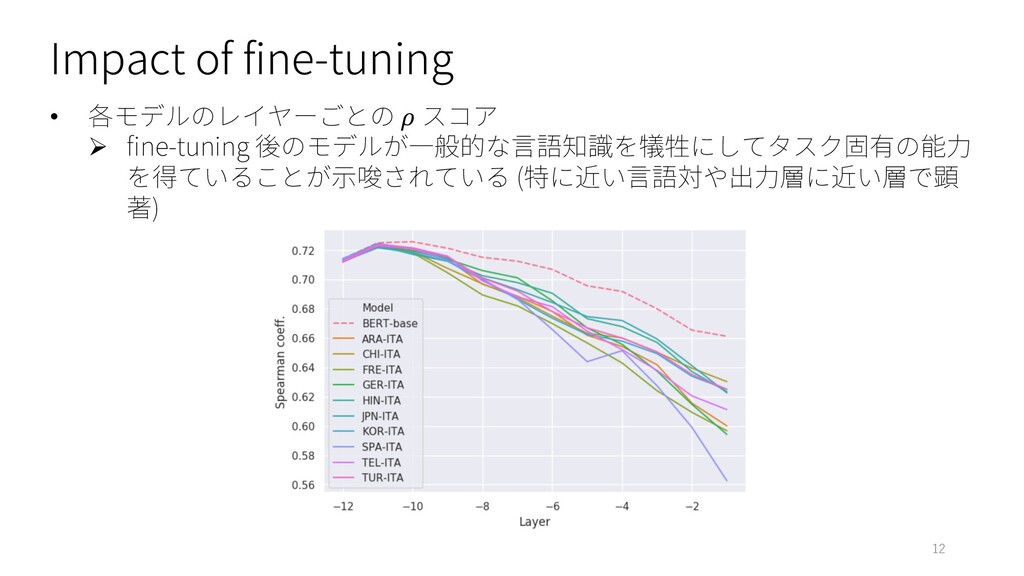
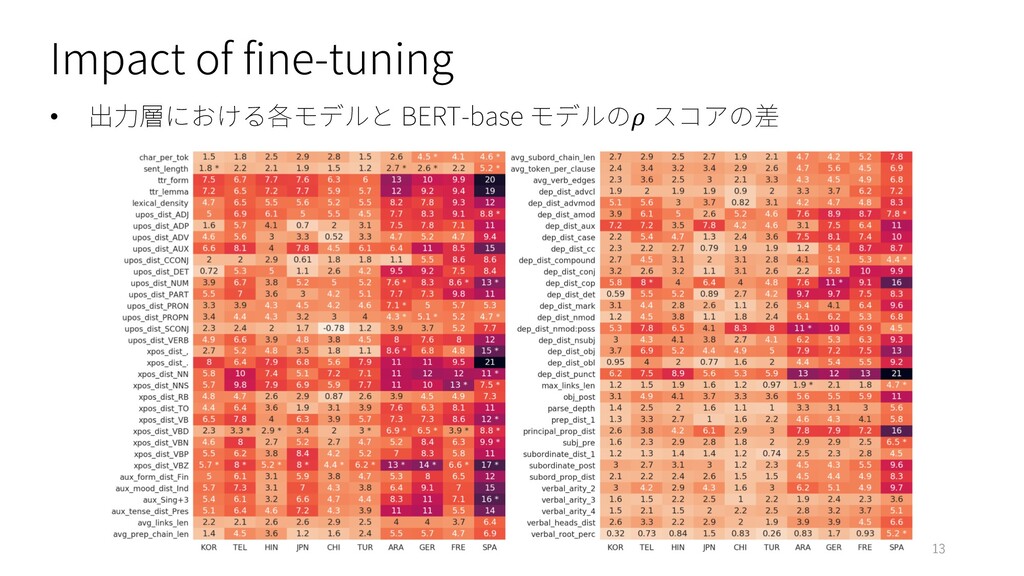
Impact of fine-tuning • 各モデルのレイヤーごとの スコア Ø fine-tuning 後のモデルが⼀般的な⾔語知識を犠牲にしてタスク固有の能⼒ を得ていることが⽰唆されている
(特に近い⾔語対や出⼒層に近い層で顕 著) 12
Impact of fine-tuning • 出⼒層における各モデルと BERT-base モデルの スコアの差 13
Are BERT’s linguistic knowledge useful for downstream task? 14
Are linguistic features useful? • NLI のデータを正しく分類できたセットと正しく分類できなかったセットに 分割、各⽂に対して probing task
を実⾏ Ø 各セットにおいて probing task の予測値と実際の値の誤差を Wilcoxon Rank-sum test を⽤いて同⼀の分布であるか判定 → ⼤きく異なる分布であ ることを確認 Ø これは正しく分類できた⽂とできなかった⽂に対する BERT の能⼒が異な ることを⽰唆している 15
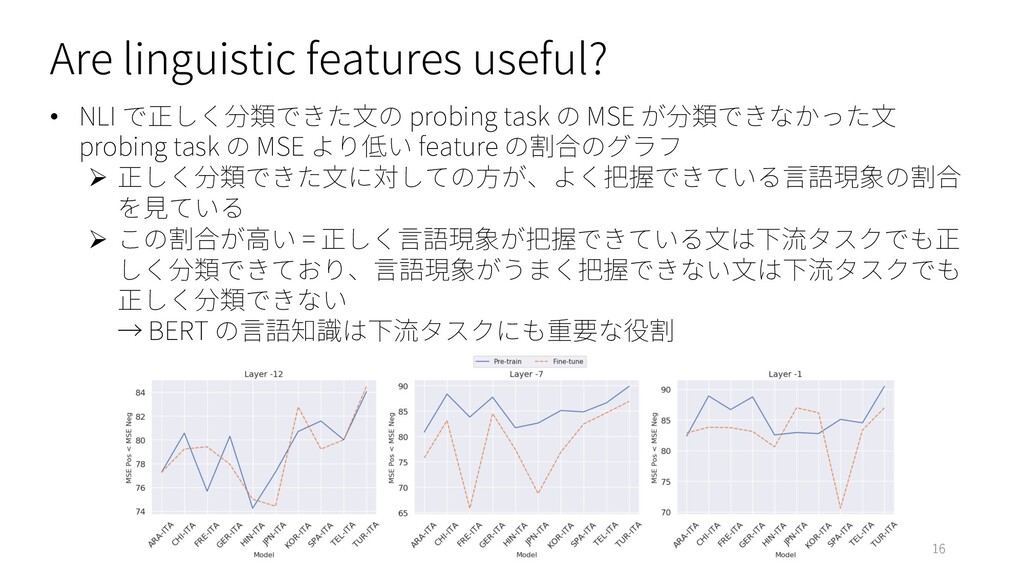
Are linguistic features useful? • NLI で正しく分類できた⽂の probing task の
MSE が分類できなかった⽂ probing task の MSE より低い feature の割合のグラフ Ø 正しく分類できた⽂に対しての⽅が、よく把握できている⾔語現象の割合 を⾒ている Ø この割合が⾼い = 正しく⾔語現象が把握できている⽂は下流タスクでも正 しく分類できており、⾔語現象がうまく把握できない⽂は下流タスクでも 正しく分類できない → BERT の⾔語知識は下流タスクにも重要な役割 16
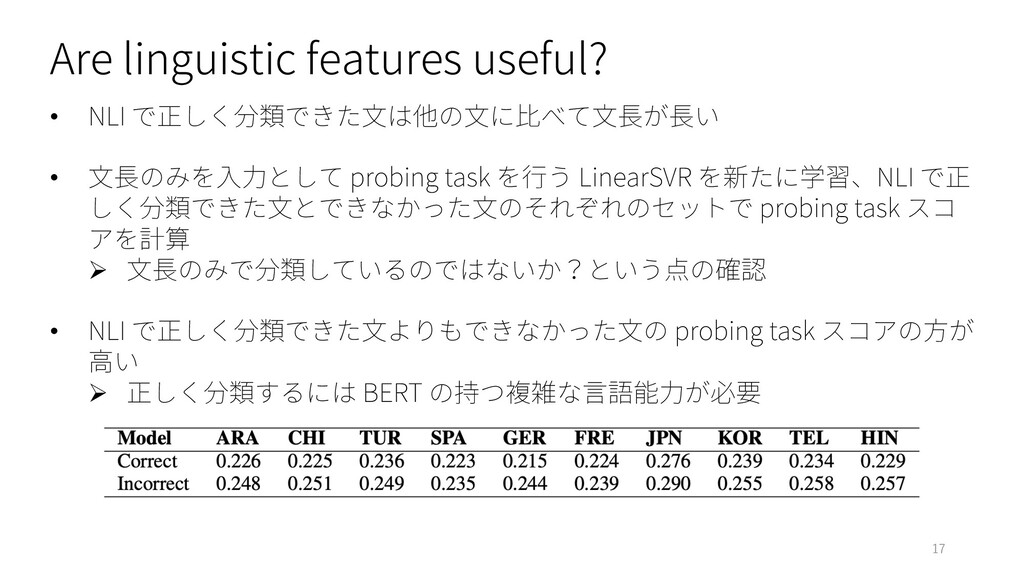
Are linguistic features useful? • NLI で正しく分類できた⽂は他の⽂に⽐べて⽂⻑が⻑い • ⽂⻑のみを⼊⼒として probing
task を⾏う LinearSVR を新たに学習、NLI で正 しく分類できた⽂とできなかった⽂のそれぞれのセットで probing task スコ アを計算 Ø ⽂⻑のみで分類しているのではないか?という点の確認 • NLI で正しく分類できた⽂よりもできなかった⽂の probing task スコアの⽅が ⾼い Ø 正しく分類するには BERT の持つ複雑な⾔語能⼒が必要 17
Conclusion • BERT に対して probing task を⽤いて詳細な分析を実⾏ Ø BERT が広範な⾔語知識を獲得していることを確認
• fine-tuning 前後で⽐較することによって、元々持っていた⾔語知識の多くを 失い、代わりにタスク固有の知識を持つことを確認 • BERT の持つ⾔語知識が下流タスクを解く上で重要な役割を果たしていること を確認 Ø 特定の⽂に対して BERT の持つ⾔語知識が優れていれば、下流タスクの性 能も良い可能性 18


 ikumi193
 oikon48
 colopl
 dtunkelang
 kameitomohiro
 shisyu_gaku
 tosite
 pauli
 slsops
 fespinoza
 recruitengineers
 kawametho
 ykagano
 marktimemedia
 bcantrill
 hannesfritz
 thirion
 sabderemane
 soysaucechin
 eileencodes
 katarinadahlin
 sergeychernyshev
 reverentgeek
 eitanlees
 codingconduct