Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Multi-task Learning for Multilingual Neural Mac...
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Hiroto Tamura
July 06, 2021
Research
66
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Multi-task Learning for Multilingual Neural Machine Translation
2021/06/24 論文紹介
EMNLP2020 (
https://aclanthology.org/2020.emnlp-main.75/
)
Hiroto Tamura
July 06, 2021
More Decks by Hiroto Tamura
See All by Hiroto Tamura
E2E-VLP: End-to-End Vision-Language Pre-training Enhanced by Visual Learning
jinlafan
0
140
Vokenization: Improving Language Understanding with Contextualized, Visual-Grounded Supervision
jinlafan
0
110
Bilingual Subword Segmentation for Neural Machine Translation
jinlafan
0
130
TMU Japanese-English Multimodal Machine Translation System for WAT 2020
jinlafan
0
150
Other Decks in Research
See All in Research
量子サマースクール2026「量子計算機アーキテクチャ分野の概観」
youten622
1
960
最先端NLP勉強会2026 論文紹介:Reasoning with Sampling: Your Base Model is Smarter Than You Think (ICLR 2026 paper)
kogoro
4
670
データサイエンティストの就労意識~2015 → 2026 一般(個人)会員アンケートより
datascientistsociety
PRO
0
990
論文紹介:Doc-to-LoRA: Learning to Instantly Internalize Contexts
yukako_nakano
0
190
【中間報告】国会議員の立法・政策実務を支える環境を巡る現状と課題
polipoli
0
690
完全自律LLMエージェントでDIVER OSINT CTF 2026に挑戦してみた
analokmaus
0
750
Ghost in the 7‑Zip: The Shadow of Residential Proxies Creeping into Your Life
nttcom
0
2.2k
J-STAGEの現況と全文XML登載必須化について
xspa2012
0
300
Apache Gravitinoで実現する Icebergカタログ統合とアクセスの一元化
matsumooon
0
580
2025年度秋葉原ウォーカブルプロジェクト調査報告 「アキバらしいウォーカブル」とは何か
izumiyama_lab
1
240
モデル評価を効率的にする方法
ftakahashi
0
190
[最先端NLP勉強会2026] Checklists Are Better Than Reward Models For Aligning Language Models
nzw0301
1
330
Featured
See All Featured
Collaborative Software Design: How to facilitate domain modelling decisions
baasie
1
340
SEO Brein meetup: CTRL+C is not how to scale international SEO
lindahogenes
2
2.9k
Navigating Weather and Climate Data
rabernat
0
550
The Language of Interfaces
destraynor
162
27k
Automating Front-end Workflow
addyosmani
1369
210k
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
2
930
Distributed Sagas: A Protocol for Coordinating Microservices
caitiem20
333
23k
16th Malabo Montpellier Forum Presentation
akademiya2063
PRO
0
400
Claude Code のすすめ
schroneko
67
230k
The World Runs on Bad Software
bkeepers
PRO
72
12k
The SEO Collaboration Effect
kristinabergwall1
1
590
Everyday Curiosity
cassininazir
0
350
Transcript
EMNLP 2020 ⽥村弘⼈, 6/21 1
Introduction 現在の multilingual MT は複数⾔語対の対訳データで訓練 • 単⾔語データの multilingual MT への活⽤はあまり研究されていない
• 逆翻訳するには多くの⾔語対で訓練必要→multilingual MT では⼤変 ⾃⼰教師有りの事前学習⼿法 • Catastrophic forgetting • Pre-training + fine-tuning の2段階 • 新しい⾔語や単⾔語データを⼊れる際の柔軟性が低い (from scratch) 提案⼿法 • Multilingual MT において単⾔語データを活⽤する新たなマルチタスク学習法 (MTL) を提案 • masked language modeling (MLM) + denoising auto-encoding (DAE) + MT • 新たなスケジューリング⼿法 (データとノイズ) を提案 • dynamic temperature-based sampling, dynamic noising ratio • High-resource, low-resource どちらでも性能向上 • NLU タスクに転移学習しても SOTA モデル (XLM-Roberta) 以上の性能 2
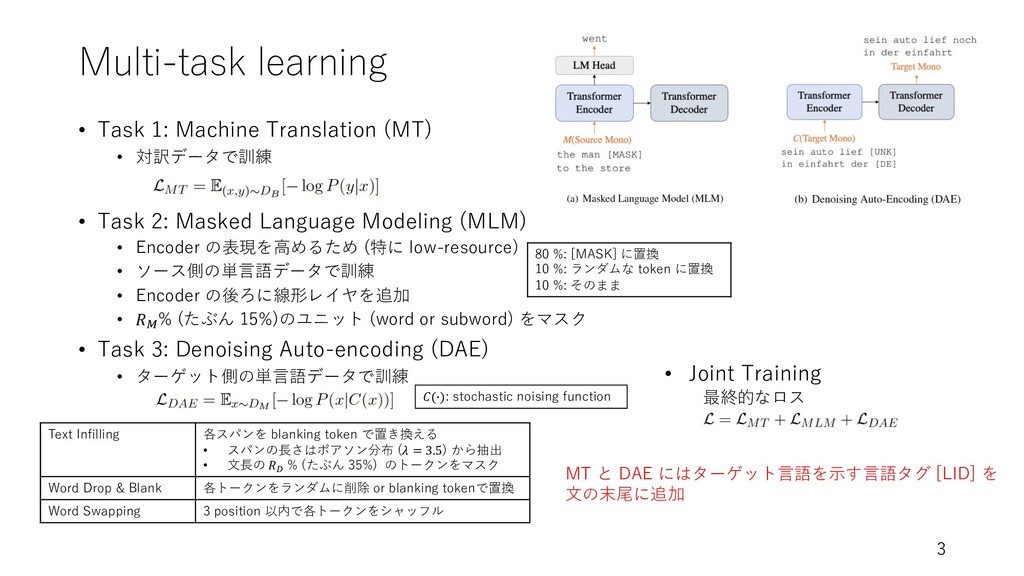
Multi-task learning • Task 1: Machine Translation (MT) • 対訳データで訓練
• Task 2: Masked Language Modeling (MLM) • Encoder の表現を⾼めるため (特に low-resource) • ソース側の単⾔語データで訓練 • Encoder の後ろに線形レイヤを追加 • 𝑅! % (たぶん 15%)のユニット (word or subword) をマスク • Task 3: Denoising Auto-encoding (DAE) • ターゲット側の単⾔語データで訓練 3 Text Infilling 各スパンを blanking token で置き換える • スパンの⻑さはポアソン分布 (𝜆 = 3.5) から抽出 • ⽂⻑の 𝑅! % (たぶん 35%) のトークンをマスク Word Drop & Blank 各トークンをランダムに削除 or blanking tokenで置換 Word Swapping 3 position 以内で各トークンをシャッフル 80 %: [MASK] に置換 10 %: ランダムな token に置換 10 %: そのまま MT と DAE にはターゲット⾔語を⽰す⾔語タグ [LID] を ⽂の末尾に追加 • Joint Training 最終的なロス 𝐶(*): stochastic noising function
Task Scheduling: Sampling • Temperature-based Sampling [Arivazhagan et al., 2019]
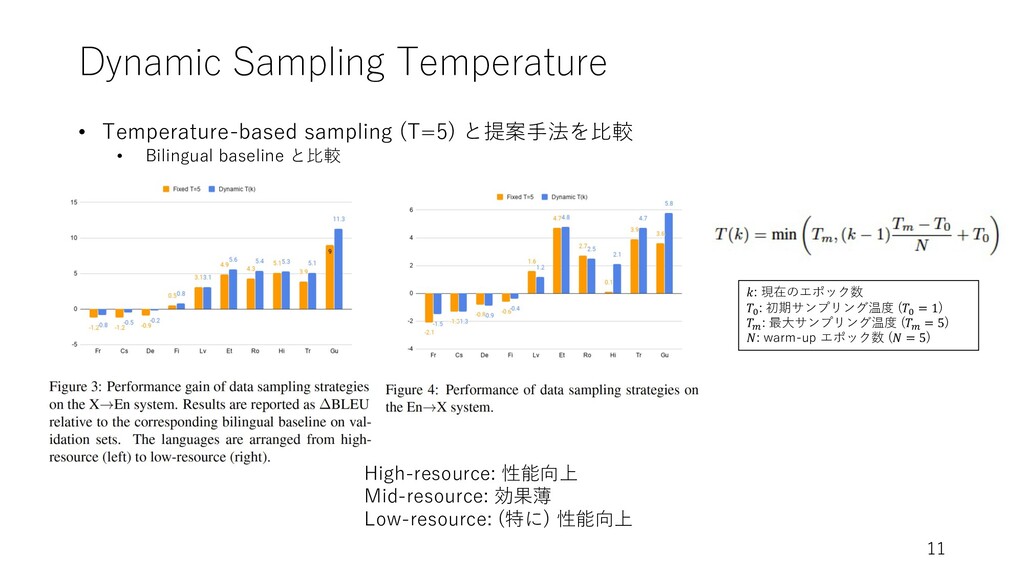
• データセットが⾔語によって不均衡→low-resource の性能に悪影響 • それぞれの⽂ペアを ,! ∑" ," # $ の確率に従ってサンプリング. • Low-resource では性能向上.high-resource な⾔語では性能の低下. Ø High-resource なデータで⼗分に訓練される前に収束している? [Bapna and Firat, 2019] • Dynamic Data Sampling • 最初は high-resource,徐々に low-resource な⾔語をサンプリング 4 𝑙: ⾔語ペア 𝐷" : 𝑙 の対訳コーパス 𝑇: サンプリング温度 (ハイパラ) 𝑘: 現在のエポック数 𝑇# : 初期サンプリング温度 (𝑇# = 1) 𝑇$ : 最⼤サンプリング温度 (𝑇$ = 5) 𝑁: warm-up エポック数 (𝑁 = 5) 1. warm-up ステップ中は線形に温度を増加 (徐々に low-resource な⾔語をサンプリング) 2. warm-up ステップ後は 𝑇% で⼀定 (⼀定の分布でサンプリング) [Arivazhagan et al., 2019]
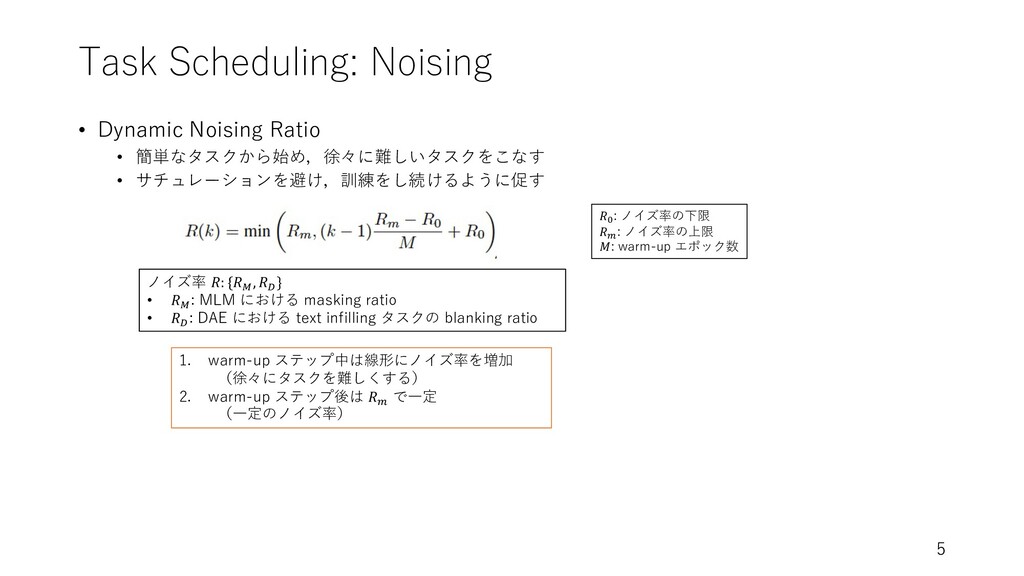
Task Scheduling: Noising • Dynamic Noising Ratio • 簡単なタスクから始め,徐々に難しいタスクをこなす •
サチュレーションを避け,訓練をし続けるように促す 5 𝑅# : ノイズ率の下限 𝑅$ : ノイズ率の上限 𝑀: warm-up エポック数 ノイズ率 𝑅: {𝑅& , 𝑅' } • 𝑅& : MLM における masking ratio • 𝑅' : DAE における text infilling タスクの blanking ratio 1. warm-up ステップ中は線形にノイズ率を増加 (徐々にタスクを難しくする) 2. warm-up ステップ後は 𝑅% で⼀定 (⼀定のノイズ率)
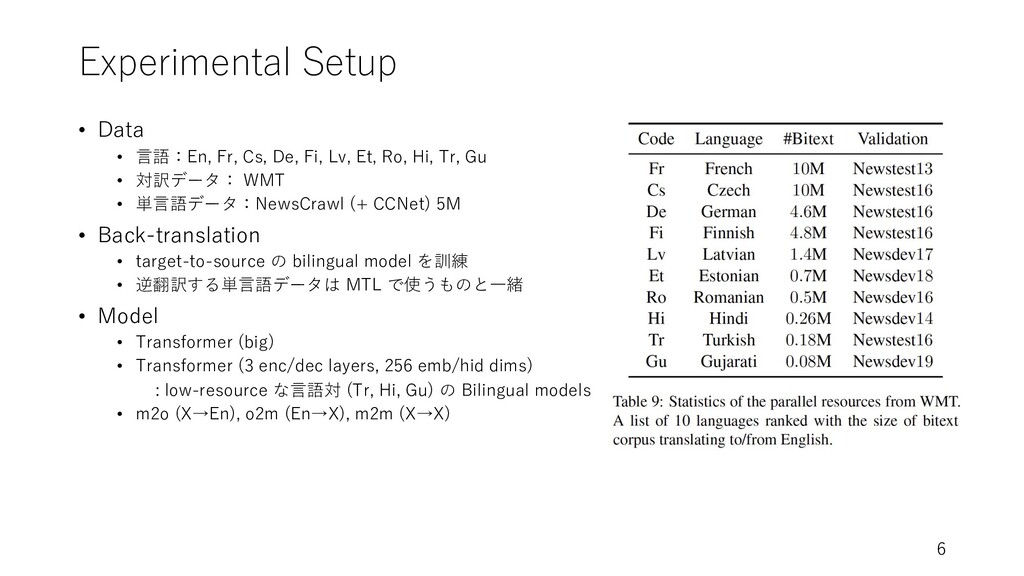
Experimental Setup • Data • ⾔語:En, Fr, Cs, De, Fi,
Lv, Et, Ro, Hi, Tr, Gu • 対訳データ: WMT • 単⾔語データ:NewsCrawl (+ CCNet) 5M • Back-translation • target-to-source の bilingual model を訓練 • 逆翻訳する単⾔語データは MTL で使うものと⼀緒 • Model • Transformer (big) • Transformer (3 enc/dec layers, 256 emb/hid dims) : low-resource な⾔語対 (Tr, Hi, Gu) の Bilingual models • m2o (X→En), o2m (En→X), m2m (X→X) 6
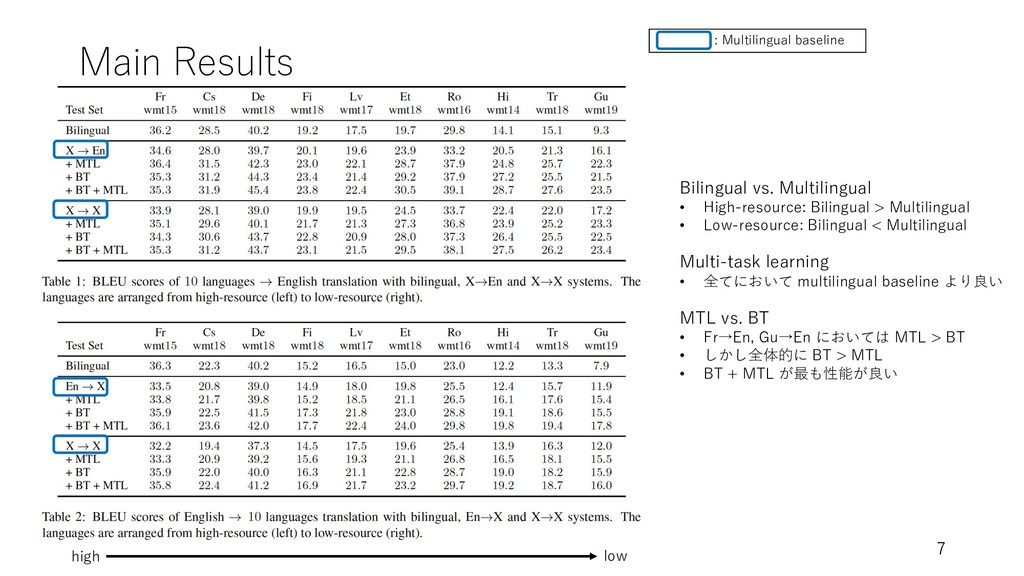
Main Results 7 Bilingual vs. Multilingual • High-resource: Bilingual >
Multilingual • Low-resource: Bilingual < Multilingual Multi-task learning • 全てにおいて multilingual baseline より良い MTL vs. BT • Fr→En, Gu→En においては MTL > BT • しかし全体的に BT > MTL • BT + MTL が最も性能が良い : Multilingual baseline high low
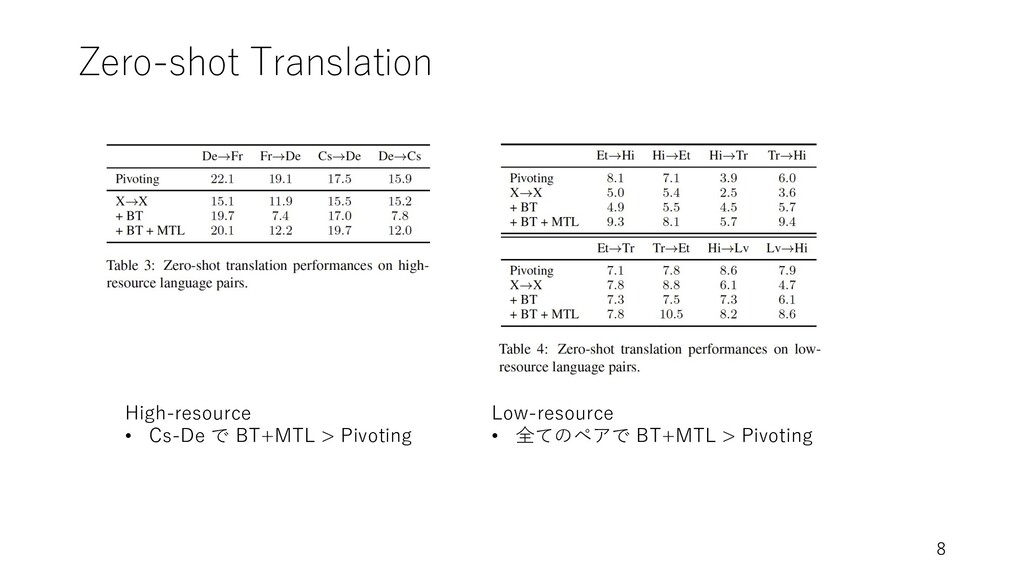
Zero-shot Translation 8 High-resource • Cs-De で BT+MTL > Pivoting
Low-resource • 全てのペアで BT+MTL > Pivoting
MTL vs. Pre-training • MTL と mBART[Liu et al., 2020]
を⽐較 • CC25 で事前訓練済みの mBART(公式のやつ)をMTL と同じ対訳データで fine-tuning 9 全ての⾔語ペアで MTL > mBART • NMT においては self-supervised+MT タスクを joint で 学習する⽅が pre-training+fine-tuning よりも良い 効率的 • mBART は事前学習に En: 55B, Fr: 10B tokens • MTL は En: 100M, Fr: 100M tokens
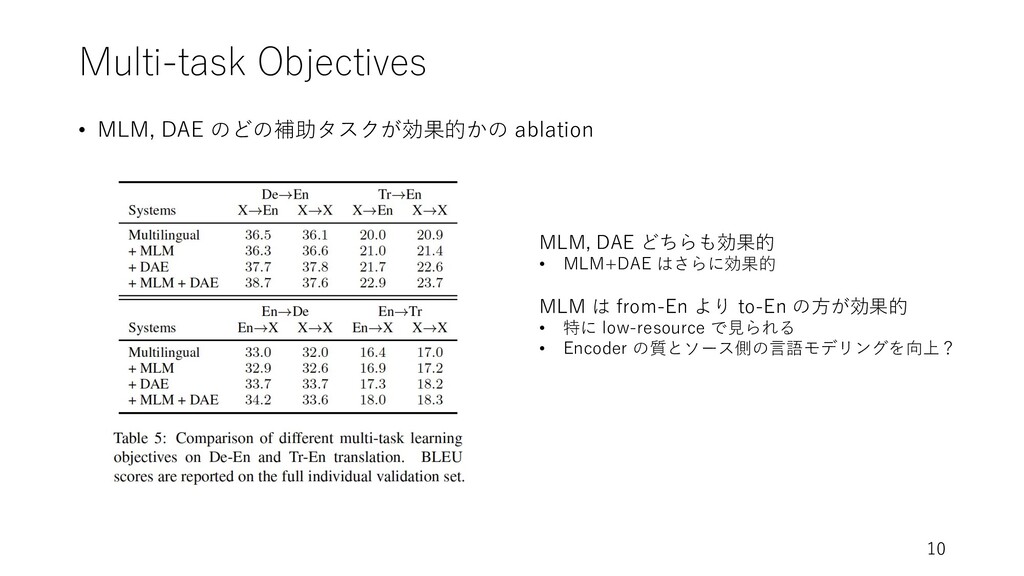
Multi-task Objectives • MLM, DAE のどの補助タスクが効果的かの ablation 10 MLM, DAE
どちらも効果的 • MLM+DAE はさらに効果的 MLM は from-En より to-En の⽅が効果的 • 特に low-resource で⾒られる • Encoder の質とソース側の⾔語モデリングを向上?
Dynamic Sampling Temperature 11 𝑘: 現在のエポック数 𝑇# : 初期サンプリング温度 (𝑇#
= 1) 𝑇$ : 最⼤サンプリング温度 (𝑇$ = 5) 𝑁: warm-up エポック数 (𝑁 = 5) High-resource: 性能向上 Mid-resource: 効果薄 Low-resource: (特に) 性能向上 • Temperature-based sampling (T=5) と提案⼿法を⽐較 • Bilingual baseline と⽐較
Noising Scheme • MLM (token-level or word-level ?) と DAE
(span-level or word-level ?) のノイズの違い を⽐較 • Multilingual baseline と⽐較 12 MLM • word-level > token-level DAE • span-level > word-level
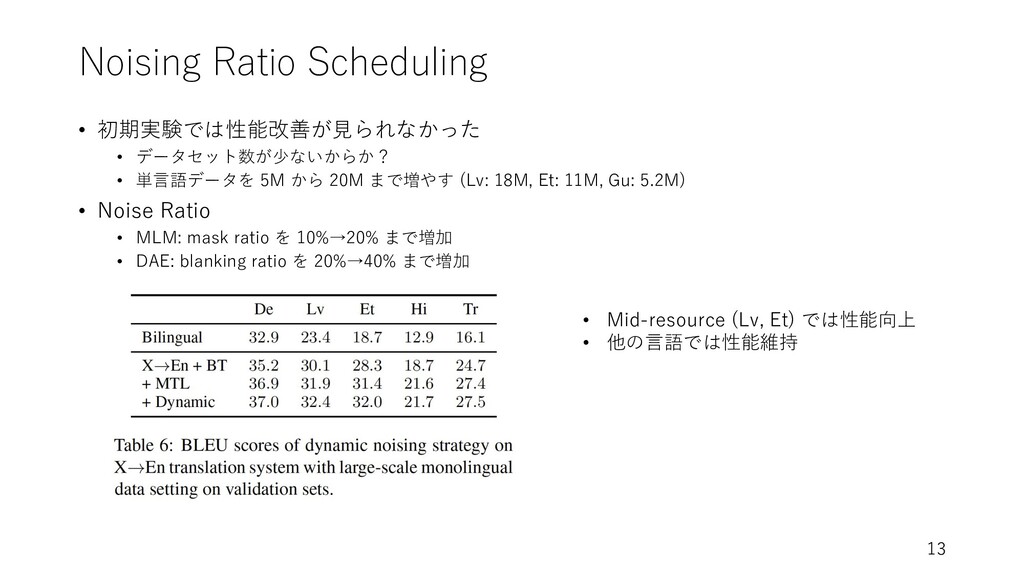
Noising Ratio Scheduling • 初期実験では性能改善が⾒られなかった • データセット数が少ないからか? • 単⾔語データを 5M
から 20M まで増やす (Lv: 18M, Et: 11M, Gu: 5.2M) • Noise Ratio • MLM: mask ratio を 10%→20% まで増加 • DAE: blanking ratio を 20%→40% まで増加 13 • Mid-resource (Lv, Et) では性能向上 • 他の⾔語では性能維持
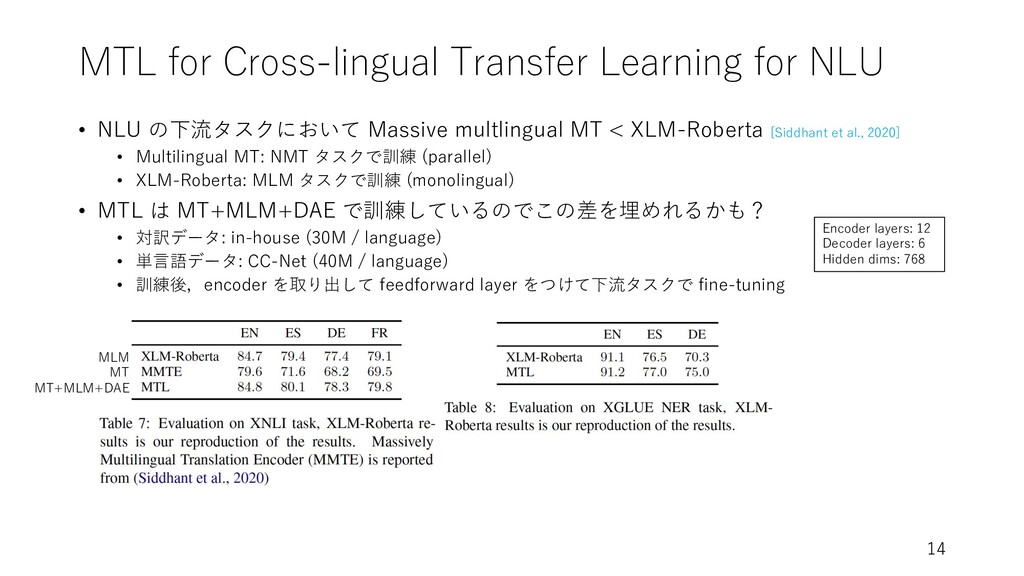
MTL for Cross-lingual Transfer Learning for NLU • NLU の下流タスクにおいて
Massive multlingual MT < XLM-Roberta [Siddhant et al., 2020] • Multilingual MT: NMT タスクで訓練 (parallel) • XLM-Roberta: MLM タスクで訓練 (monolingual) • MTL は MT+MLM+DAE で訓練しているのでこの差を埋めれるかも? • 対訳データ: in-house (30M / language) • 単⾔語データ: CC-Net (40M / language) • 訓練後,encoder を取り出して feedforward layer をつけて下流タスクで fine-tuning 14 MLM MT MT+MLM+DAE Encoder layers: 12 Decoder layers: 6 Hidden dims: 768
Conclusion • joint で学習するMTL (MT+MLM+DAE) フレームワークを提案 • low-resource, high-resource でも性能向上
• データのサンプリングとノイズの強度に対してのスケジューリング⼿法を提案 • 特に sampling scheduling が効果的 • NMT においては MTL > pre-training+fine-tuning であることを⽰した • NLU タスクにおいても効果を⽰した 15


 jinlafan
 youten622
 kogoro
 datascientistsociety
 yukako_nakano
 polipoli
 analokmaus
 nttcom
 xspa2012
 matsumooon
 izumiyama_lab
 ftakahashi
 nzw0301
 baasie
 lindahogenes
 rabernat
 destraynor
 addyosmani
 nmsamuel
 caitiem20
 akademiya2063
 schroneko
 bkeepers
 kristinabergwall1
 cassininazir