Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
[Journal club] OccamNets: Mitigating Dataset Bi...
Search
Sponsored
·
SiteGround - Reliable hosting with speed, security, and support you can count on.
→
Semantic Machine Intelligence Lab., Keio Univ.
PRO
July 28, 2023
Technology
44
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
[Journal club] OccamNets: Mitigating Dataset Bias by Favoring Simpler Hypotheses
Semantic Machine Intelligence Lab., Keio Univ.
PRO
July 28, 2023
More Decks by Semantic Machine Intelligence Lab., Keio Univ.
See All by Semantic Machine Intelligence Lab., Keio Univ.
[EMNLP26] RIGEL: Self-Distilled Score Adaptation for Image and Video Captioning Evaluation
keio_smilab
PRO
0
64
[RSJ26] Building a VLA Model Based on Self-Distilled Classification
keio_smilab
PRO
0
210
[RSJ26] AnoleVLA: Lightweight Vision-Language-Action Model with Deep State Space Models for Mobile Manipulation
keio_smilab
PRO
0
180
[RSJ26] NarrativeFlow: Flow-Based Vision-Language-Action Model Using Robot Velocity Fields
keio_smilab
PRO
0
250
[RSJ26] Flow as Flow: Modeling Robot Velocity Fields as Probability Velocity Fields
keio_smilab
PRO
1
240
[RSJ26] Hierarchy-Aware Multimodal Retrieval-Augmented Generation for Embodied Question Answering
keio_smilab
PRO
1
200
[MIRU26] Open-Vocabulary Intention-Guided Object Detection in Diverse Scenes
keio_smilab
PRO
0
250
[Journal club] Evo-1: Lightweight Vision-Language-Action Model with Preserved Semantic Alignment
keio_smilab
PRO
0
74
[MIRU26] To What Extent Does MLLM-as-a-Judge Exhibit Cross-Model Preference Bias?
keio_smilab
PRO
0
330
Other Decks in Technology
See All in Technology
FinOps Agentが生んだ技術負債:コスト自動調査の落とし穴と解消までの道のり
oasis1994liveforever
1
120
事業成長とデータ活用を止めないためのマネジメントへ挑戦
hiracky16
0
400
DWH の限界突破! AI エージェント向け爆速リアルタイムデータ基盤 ClickHouse
jozono
1
490
AI駆動で「他アプリの音を加工できる」アプリを作った
satomasahiro2005
0
170
「Docker Desktop不要の時代」は 来たのか?
ueponx
0
820
Temporal 最高!でも改めて「日付」について調べたら人類の負債すぎる件
riyaamemiya
0
180
JAWSUG TOHOKU 青森支部 「LoGoチャット」のAWS移行で 乗り越えたこと
taketakekaho
0
340
コンテナ運用におけるネットワーク・コンテナコストの削減方法/How to Reduce Network and Container Costs in Container Operations
masakiokuda
1
280
Active Record Connection Adaptersにおける長年の課題に再び取り組む
yahonda
0
200
Webの常識が通じないHTMLメールのダークモード
teamlab
PRO
0
130
Browser Spec: Testing Hotwire with Ruby
takahashim
1
130
ソフトウェア ファクトリー - 再現性のあるソフトウェアの工場づくり / Software factory
iktakahiro
6
5k
Featured
See All Featured
Everyday Curiosity
cassininazir
0
360
DevOps and Value Stream Thinking: Enabling flow, efficiency and business value
helenjbeal
2
410
How to audit for AI Accessibility on your Front & Back End
davetheseo
0
600
How to Grow Your eCommerce with AI & Automation
katarinadahlin
PRO
2
330
10 Git Anti Patterns You Should be Aware of
lemiorhan
PRO
659
62k
I Don’t Have Time: Getting Over the Fear to Launch Your Podcast
jcasabona
35
2.9k
Crafting Experiences
bethany
1
380
How to Talk to Developers About Accessibility
jct
2
580
Building Better People: How to give real-time feedback that sticks.
wjessup
371
20k
The World Runs on Bad Software
bkeepers
PRO
72
12k
Why You Should Never Use an ORM
jnunemaker
PRO
61
10k
16th Malabo Montpellier Forum Presentation
akademiya2063
PRO
0
410
Transcript
𝑅𝑜𝑏𝑖𝑘 𝑆ℎ𝑟𝑒𝑠𝑡ℎ𝑎1, 𝐾𝑢𝑠ℎ𝑎𝑙 𝐾𝑎𝑓𝑙𝑒2, 𝑎𝑛𝑑 𝐶ℎ𝑟𝑖𝑠𝑡𝑜𝑝ℎ𝑒𝑟 𝐾𝑎𝑛𝑎𝑛1.3 1𝑅𝑜𝑐ℎ𝑒𝑠𝑡𝑒𝑟 𝐼𝑛𝑠𝑡𝑖𝑡𝑢𝑡𝑒 𝑜𝑓
𝑇𝑒𝑐ℎ𝑛𝑜𝑙𝑜𝑔𝑦, 2𝐴𝑑𝑜𝑏𝑒 𝑅𝑒𝑠𝑒𝑎𝑟𝑐ℎ, 3𝑈𝑛𝑖𝑣𝑒𝑟𝑠𝑖𝑡𝑦 𝑜𝑓 𝑅𝑜𝑐ℎ𝑒𝑠𝑡𝑒𝑟 ECCV 2022 OccamNets: Mitigating Dataset Bias by Favoring Simpler Hypotheses 慶應義塾大学 杉浦孔明研究室 平野慎之助
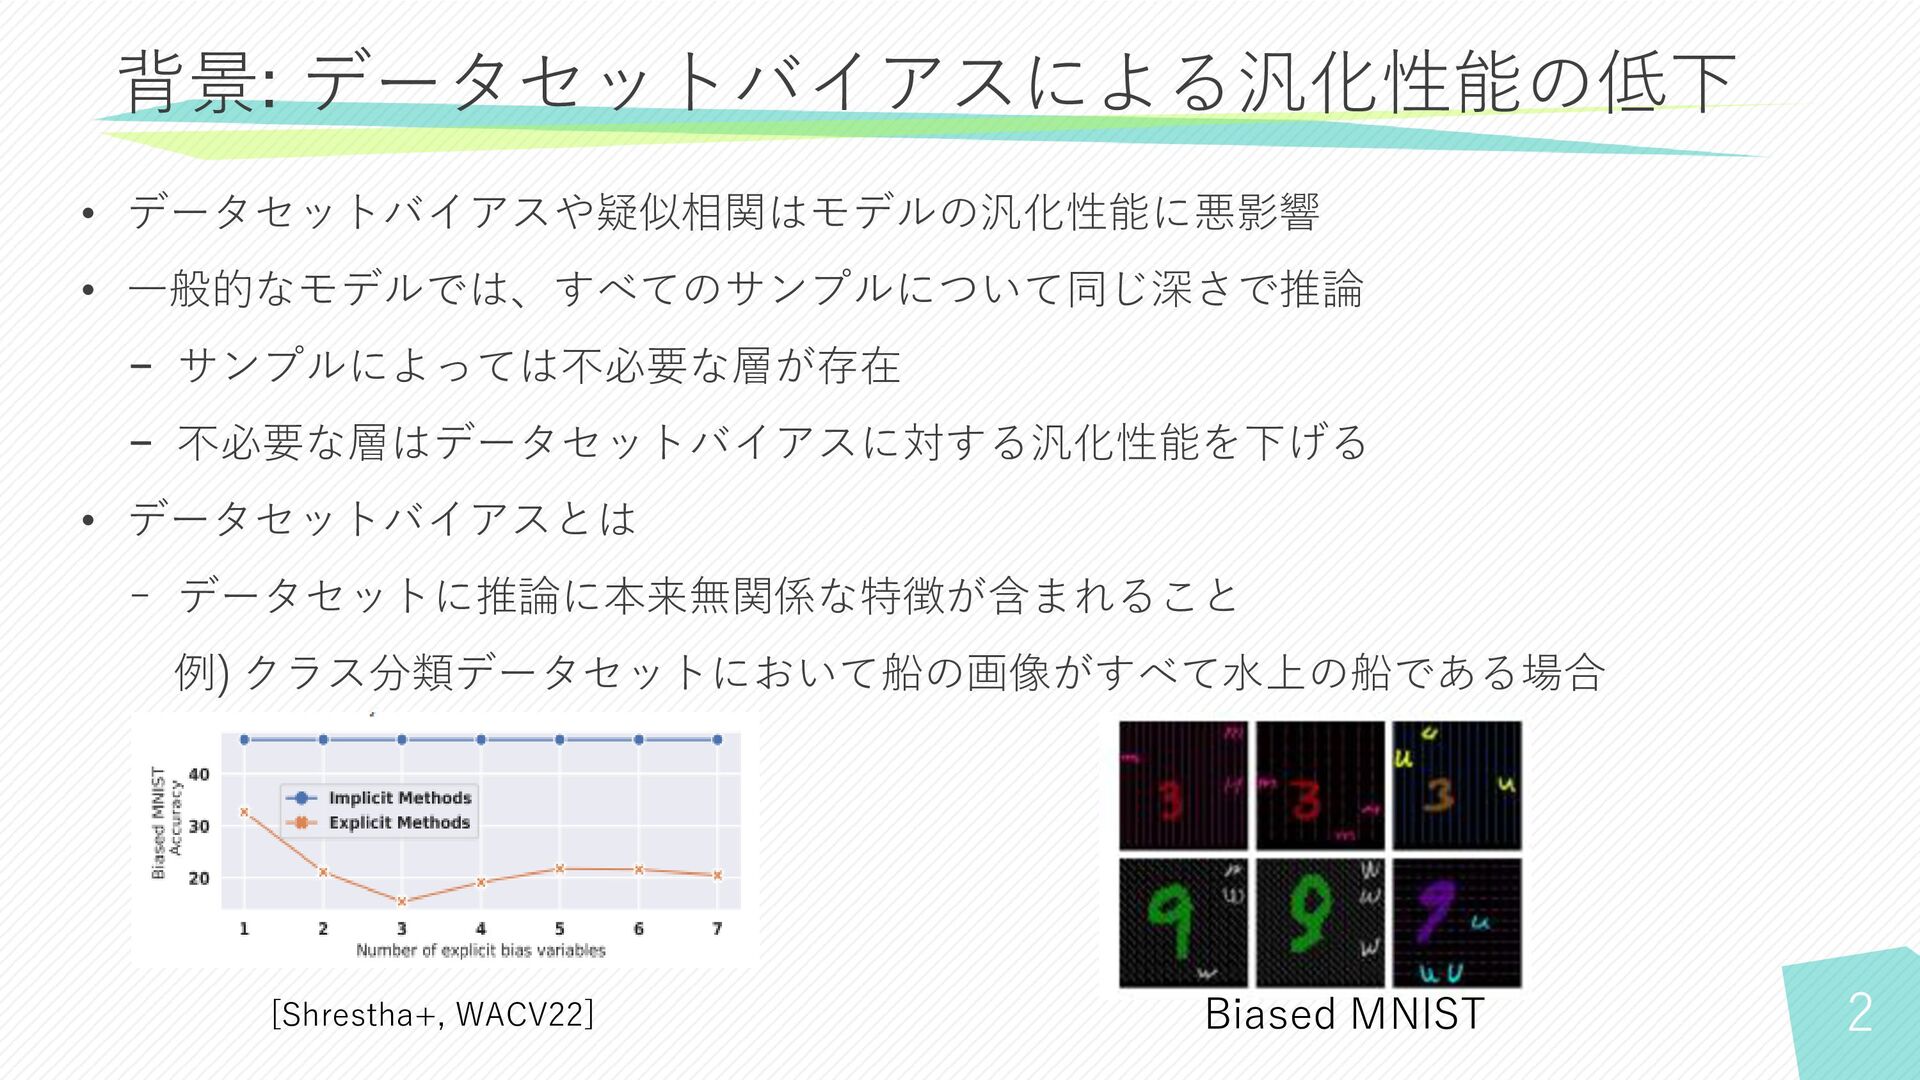
2 • データセットバイアスや疑似相関はモデルの汎化性能に悪影響 • 一般的なモデルでは、すべてのサンプルについて同じ深さで推論 − サンプルによっては不必要な層が存在 − 不必要な層はデータセットバイアスに対する汎化性能を下げる •
データセットバイアスとは − データセットに推論に本来無関係な特徴が含まれること 例) クラス分類データセットにおいて船の画像がすべて水上の船である場合 背景: データセットバイアスによる汎化性能の低下 Biased MNIST [Shrestha+, WACV22]
3 関連研究: 既存手法 特徴や問題等 [Kim+, CVPR19] 正則化と敵対的ネットワークを用いたモデルによりデータセット バイアスに対応 データセットバイアスの要因がわかっている必要がある [Wolczyk+,
NeurIPS21] 難度の低いサンプルについて早期終了を行うことで推論時間を削減 データセットバイアスに対応できていない [Kim+, CVPR19] [Wolczyk+, NeurIPS21]
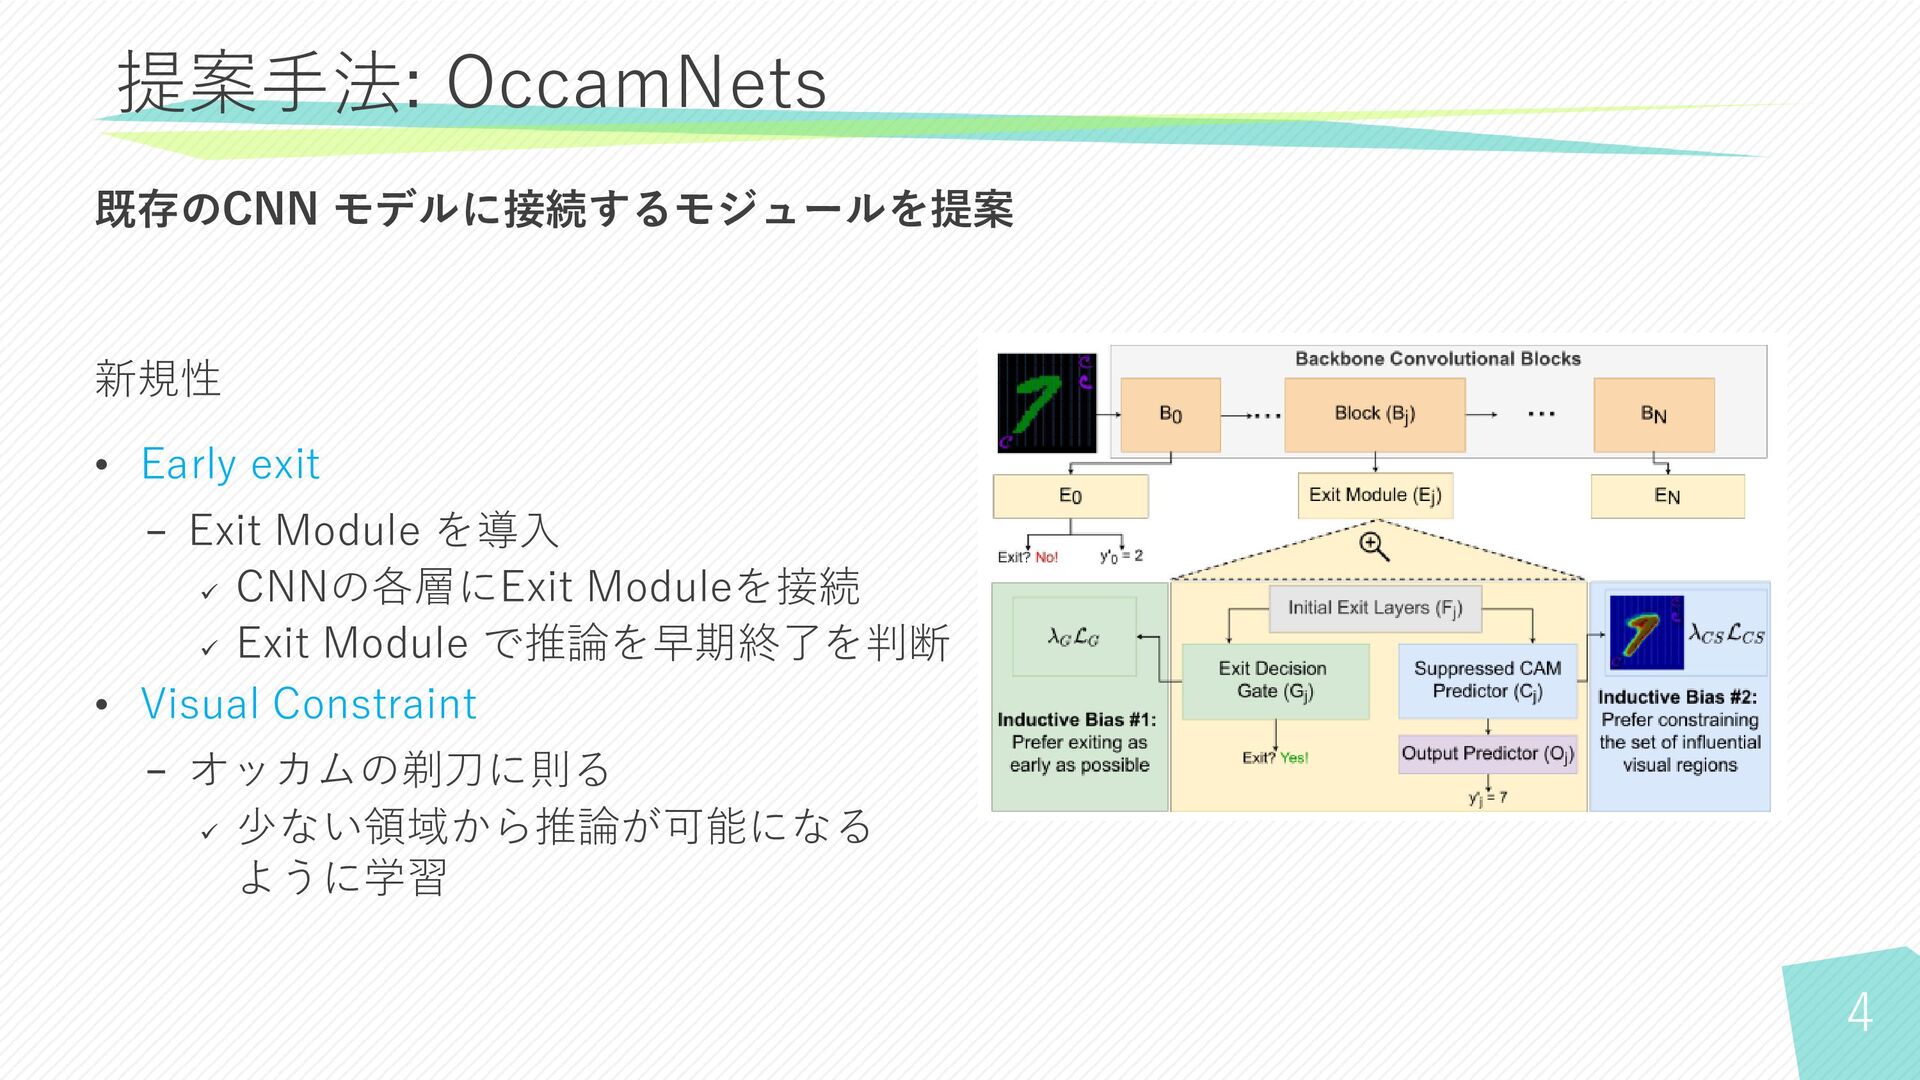
4 提案手法: OccamNets 既存のCNN モデルに接続するモジュールを提案 新規性 • Early exit −
Exit Module を導入 ✓ CNNの各層にExit Moduleを接続 ✓ Exit Module で推論を早期終了を判断 • Visual Constraint − オッカムの剃刀に則る ✓ 少ない領域から推論が可能になる ように学習
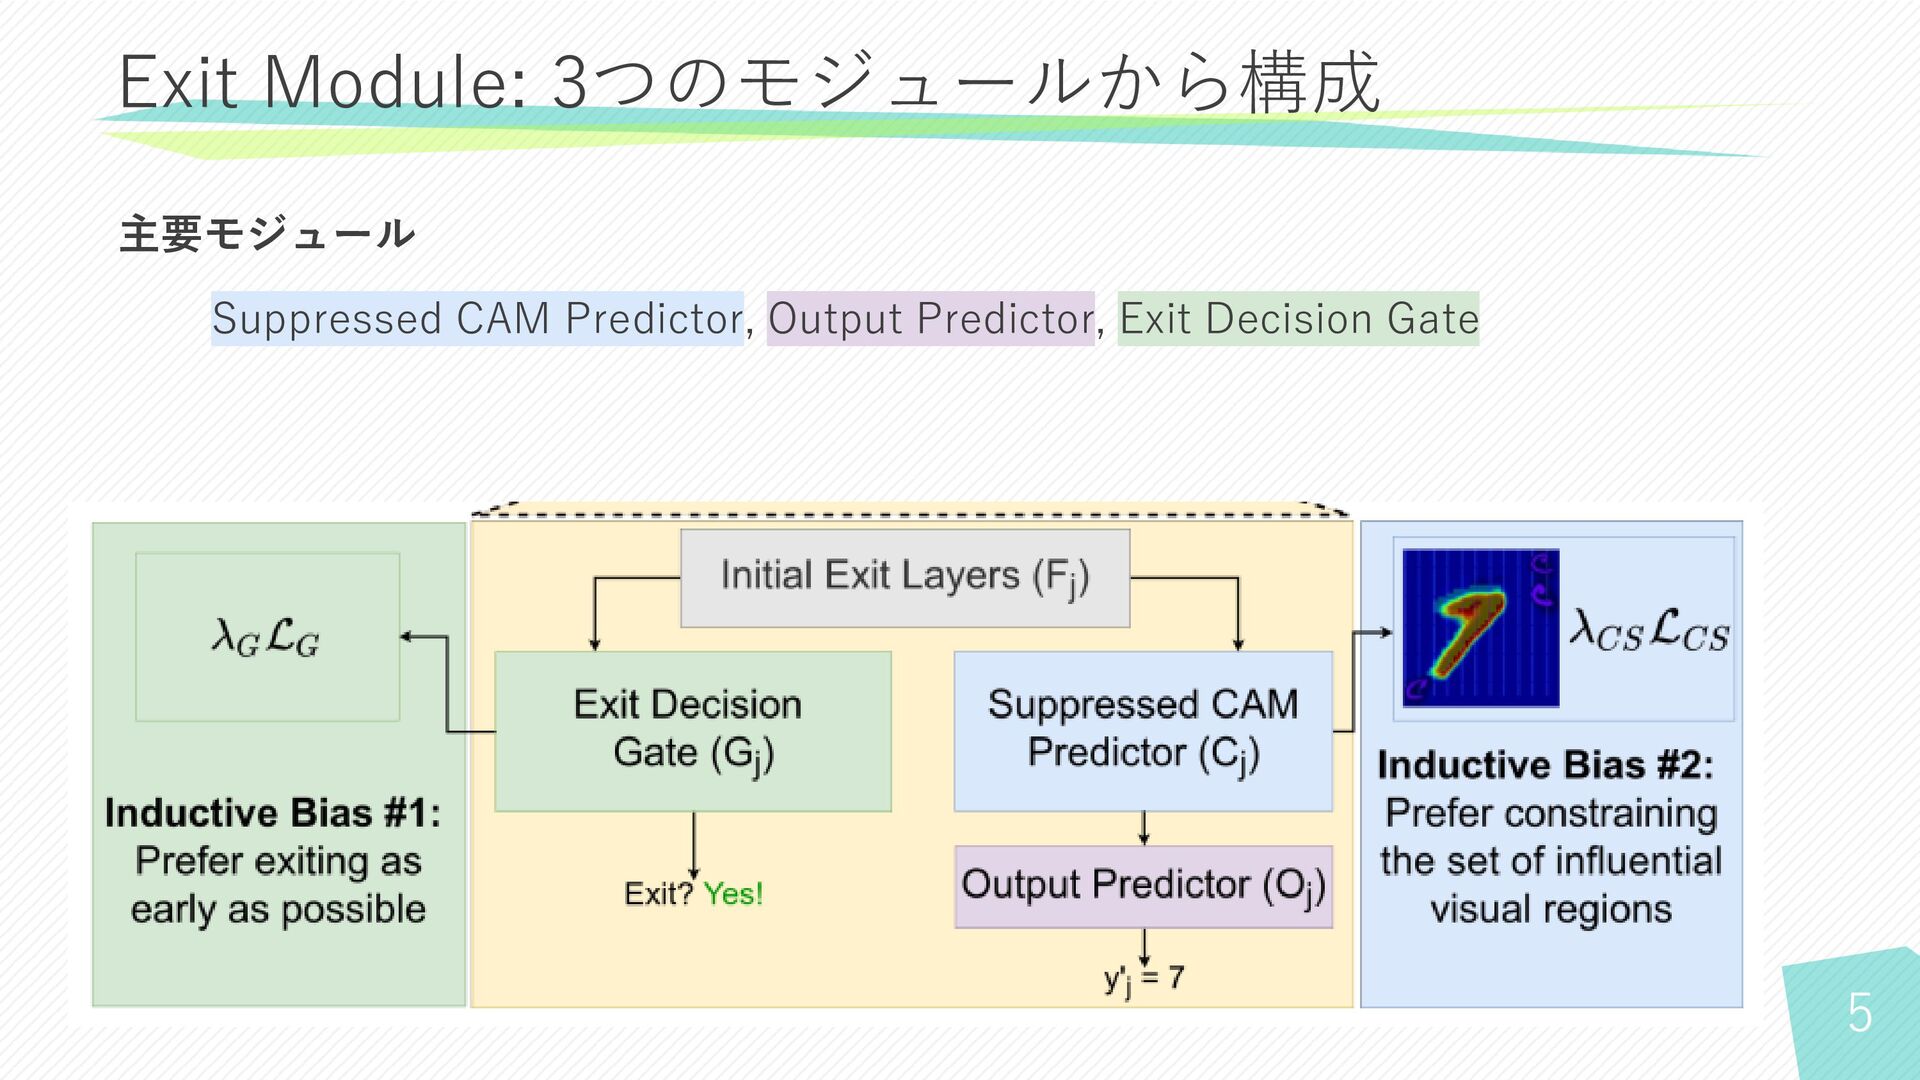
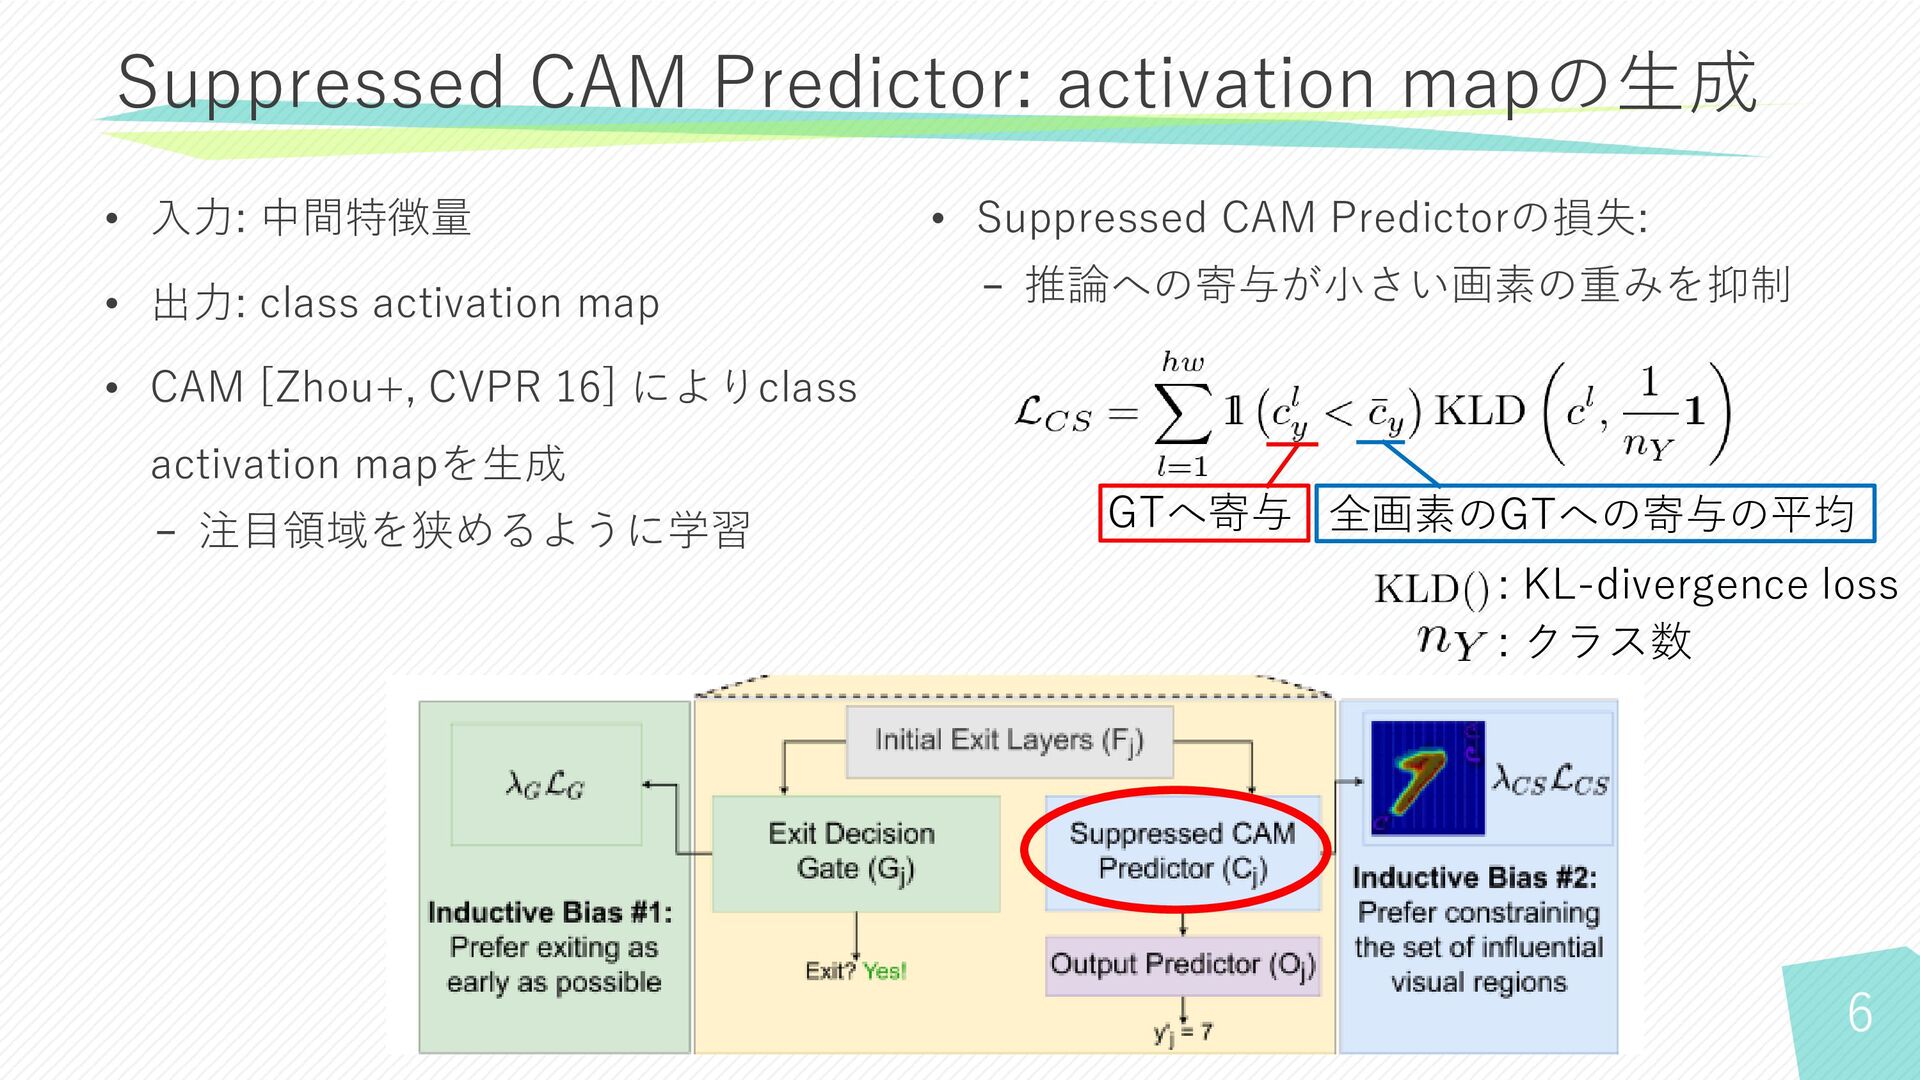
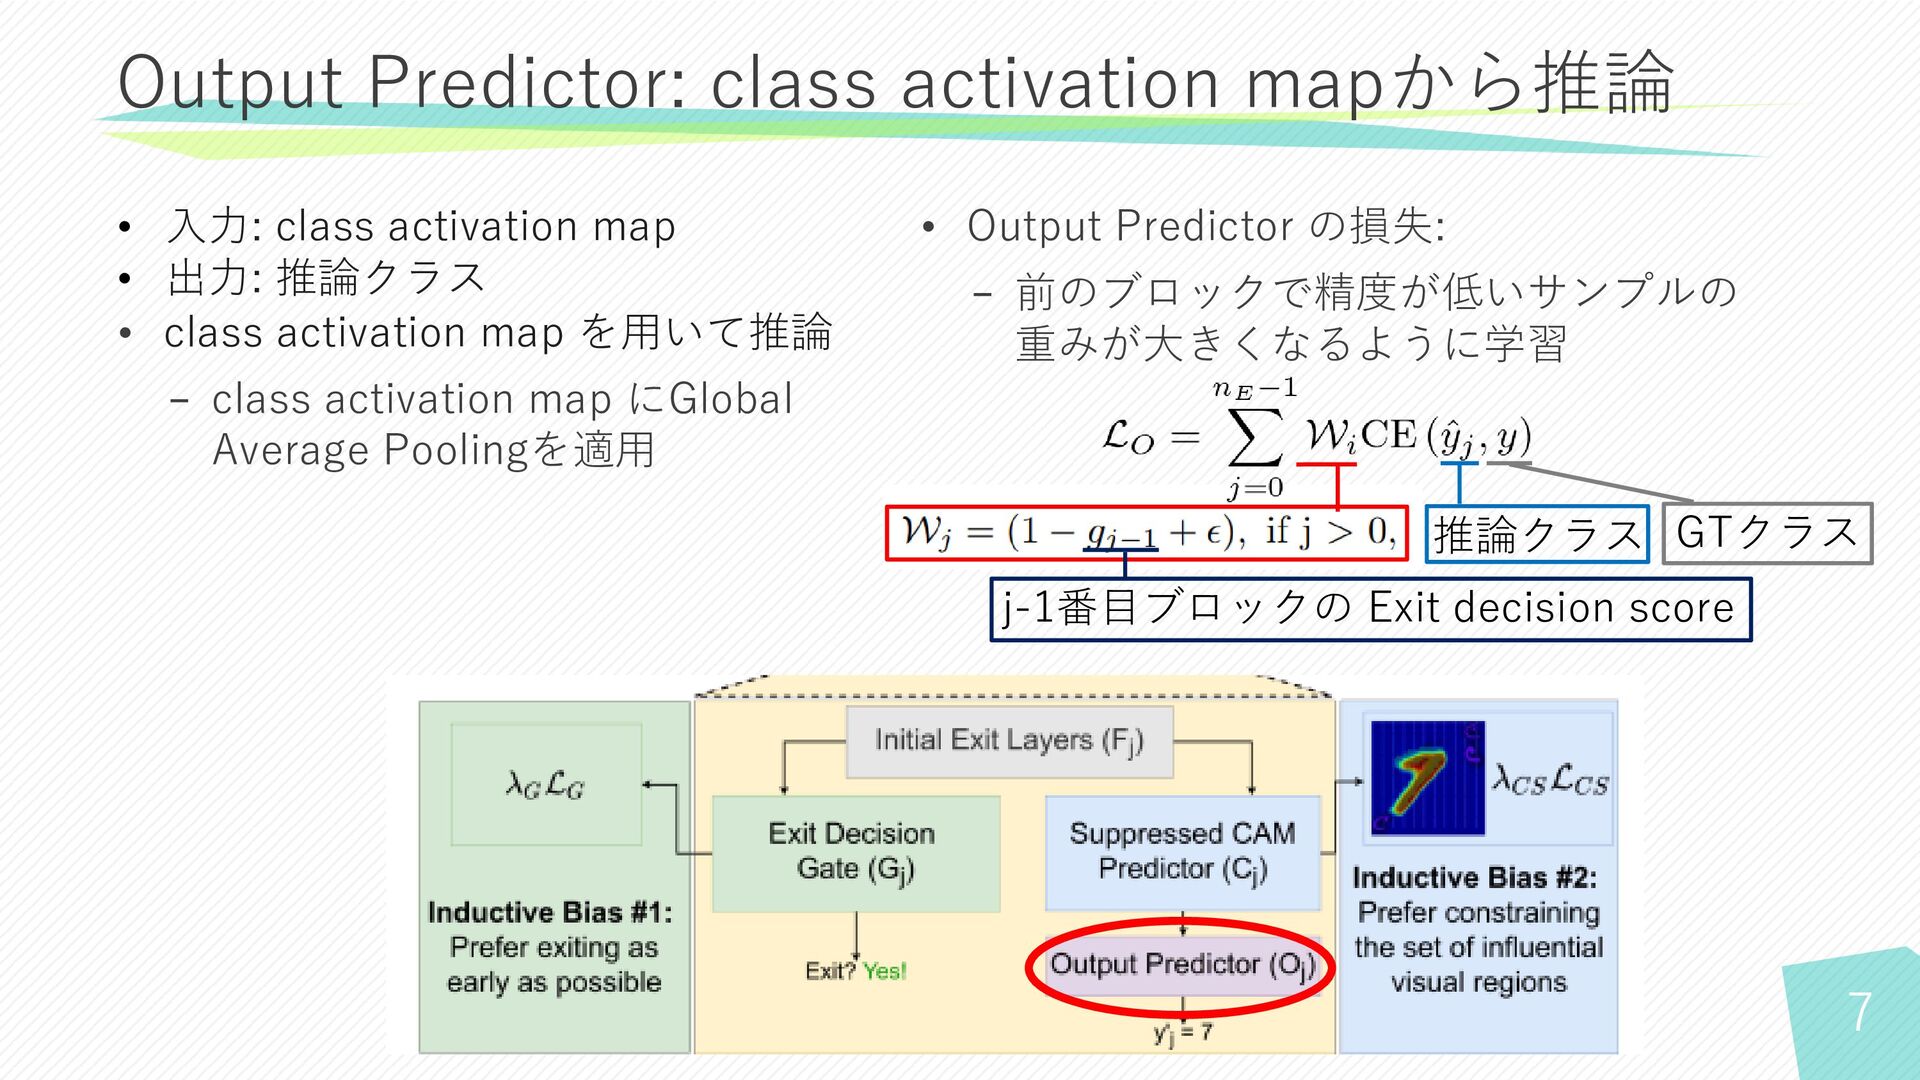
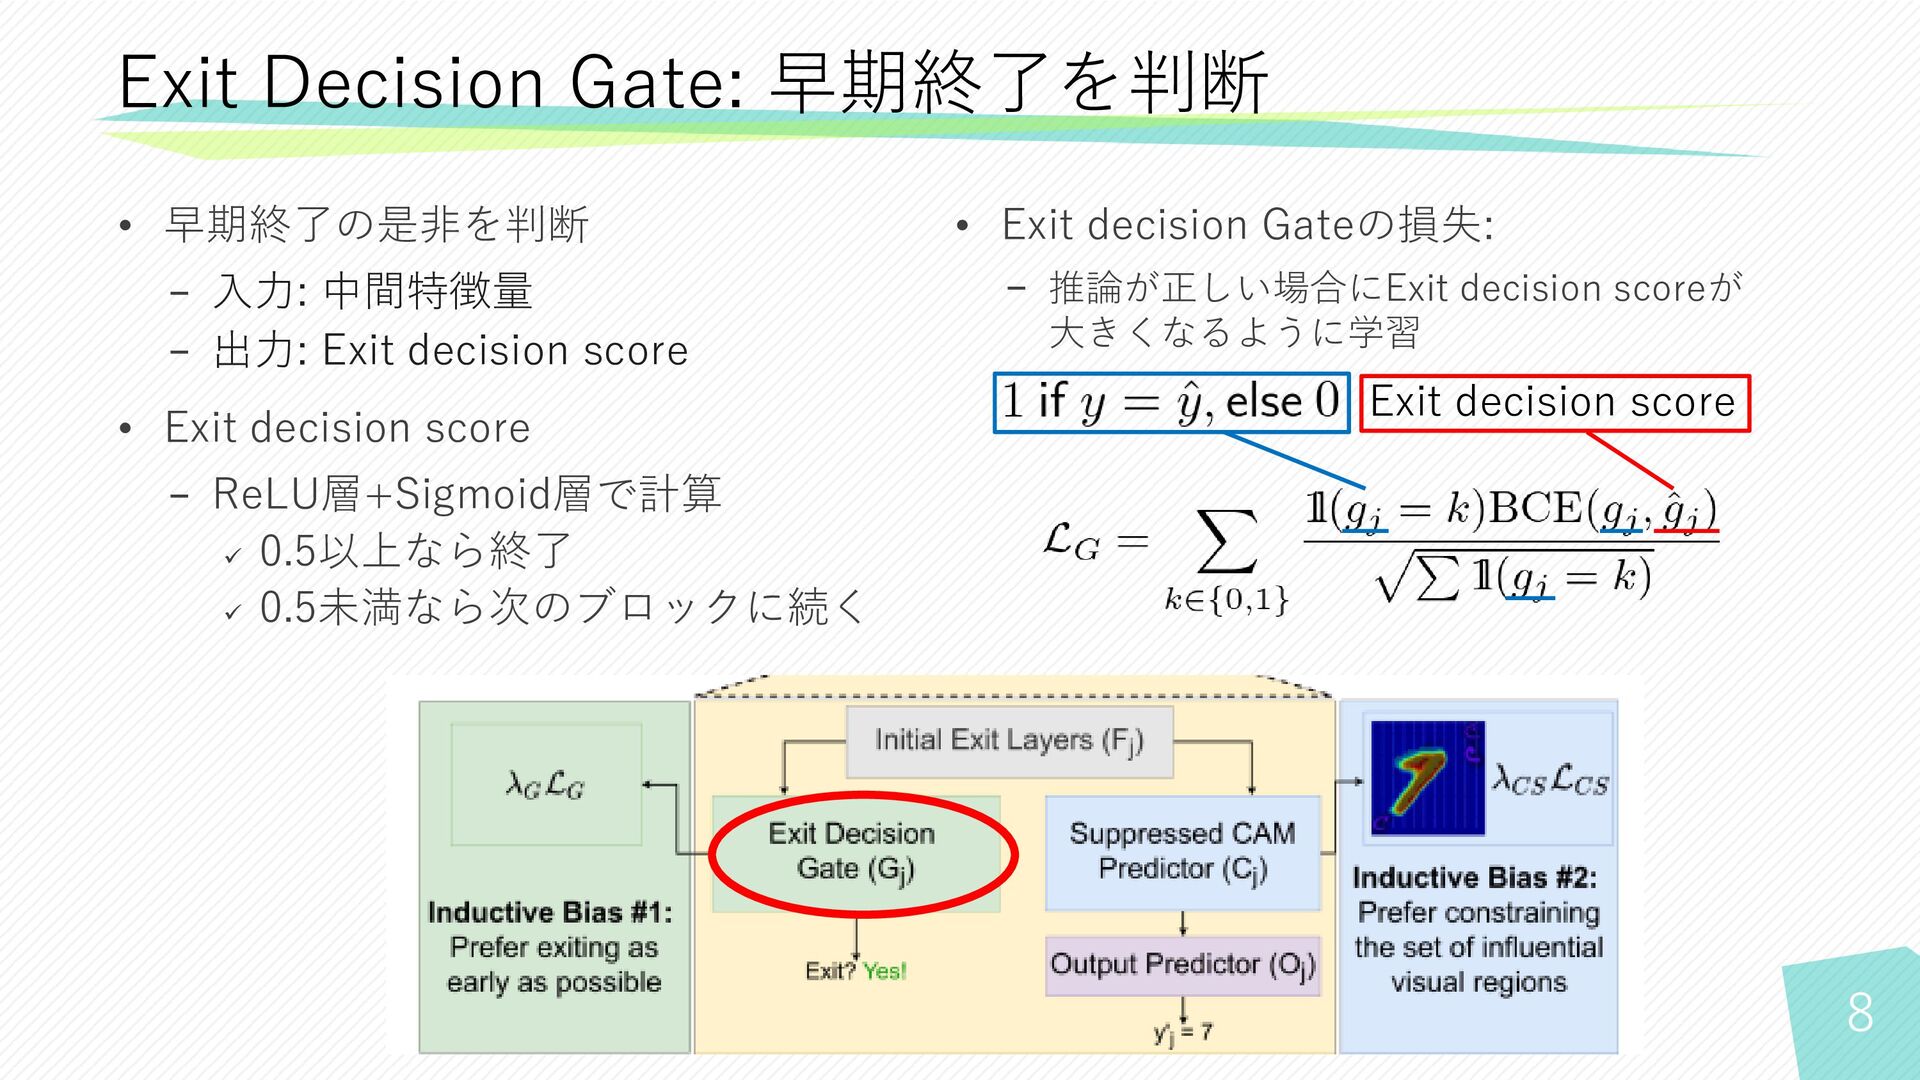
5 主要モジュール Suppressed CAM Predictor, Output Predictor, Exit Decision Gate
Exit Module: 3つのモジュールから構成
6 Suppressed CAM Predictor: activation mapの生成 GTへ寄与 全画素のGTへの寄与の平均 : KL-divergence
loss • 入力: 中間特徴量 • 出力: class activation map • CAM [Zhou+, CVPR 16] によりclass activation mapを生成 − 注目領域を狭めるように学習 • Suppressed CAM Predictorの損失: − 推論への寄与が小さい画素の重みを抑制 : クラス数
7 • class activation map を用いて推論 − class activation map
にGlobal Average Poolingを適用 Output Predictor: class activation mapから推論 • 入力: class activation map • 出力: 推論クラス • Output Predictor の損失: − 前のブロックで精度が低いサンプルの 重みが大きくなるように学習 j-1番目ブロックの Exit decision score 推論クラス GTクラス
8 • 早期終了の是非を判断 − 入力: 中間特徴量 − 出力: Exit decision
score • Exit decision score − ReLU層+Sigmoid層で計算 ✓ 0.5以上なら終了 ✓ 0.5未満なら次のブロックに続く Exit Decision Gate: 早期終了を判断 Exit decision score • Exit decision Gateの損失: − 推論が正しい場合にExit decision scoreが 大きくなるように学習
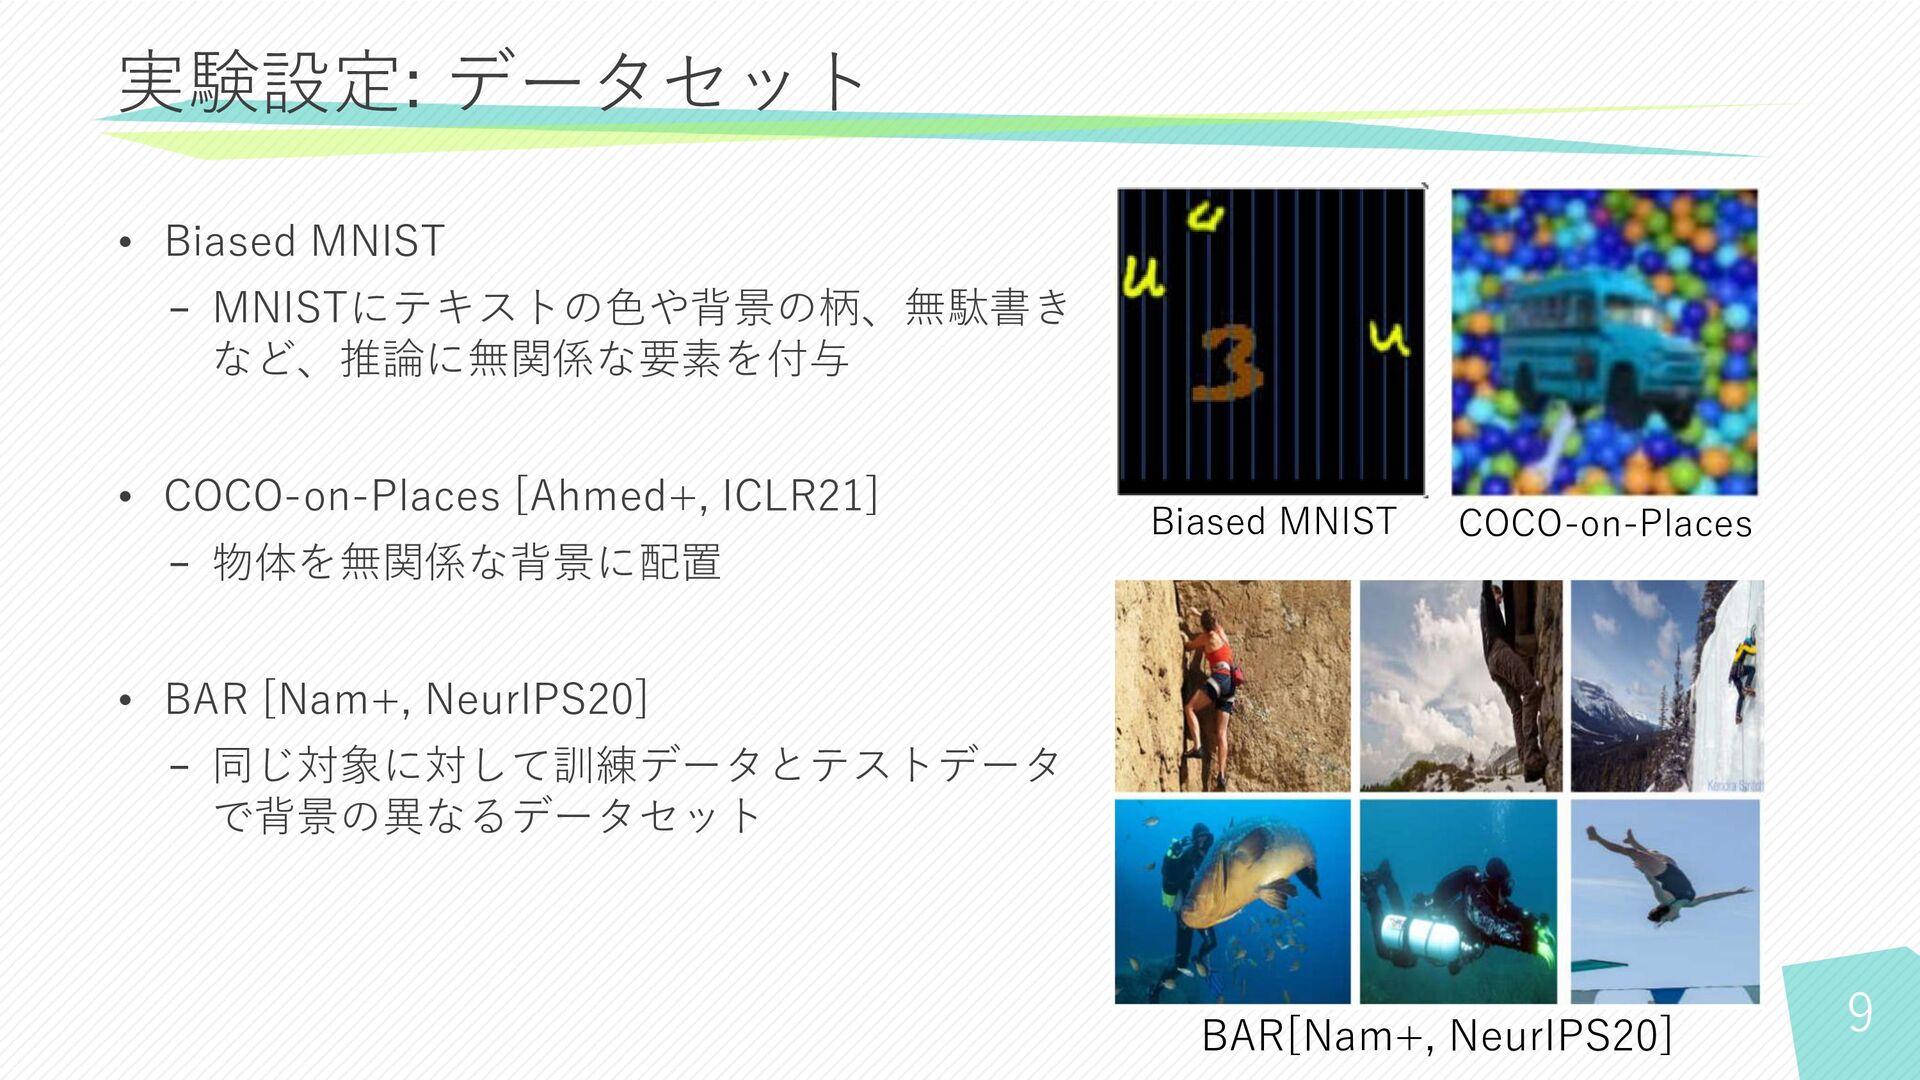
9 • Biased MNIST − MNISTにテキストの色や背景の柄、無駄書き など、推論に無関係な要素を付与 • COCO-on-Places [Ahmed+,
ICLR21] − 物体を無関係な背景に配置 • BAR [Nam+, NeurIPS20] − 同じ対象に対して訓練データとテストデータ で背景の異なるデータセット 実験設定: データセット Biased MNIST COCO-on-Places BAR[Nam+, NeurIPS20]
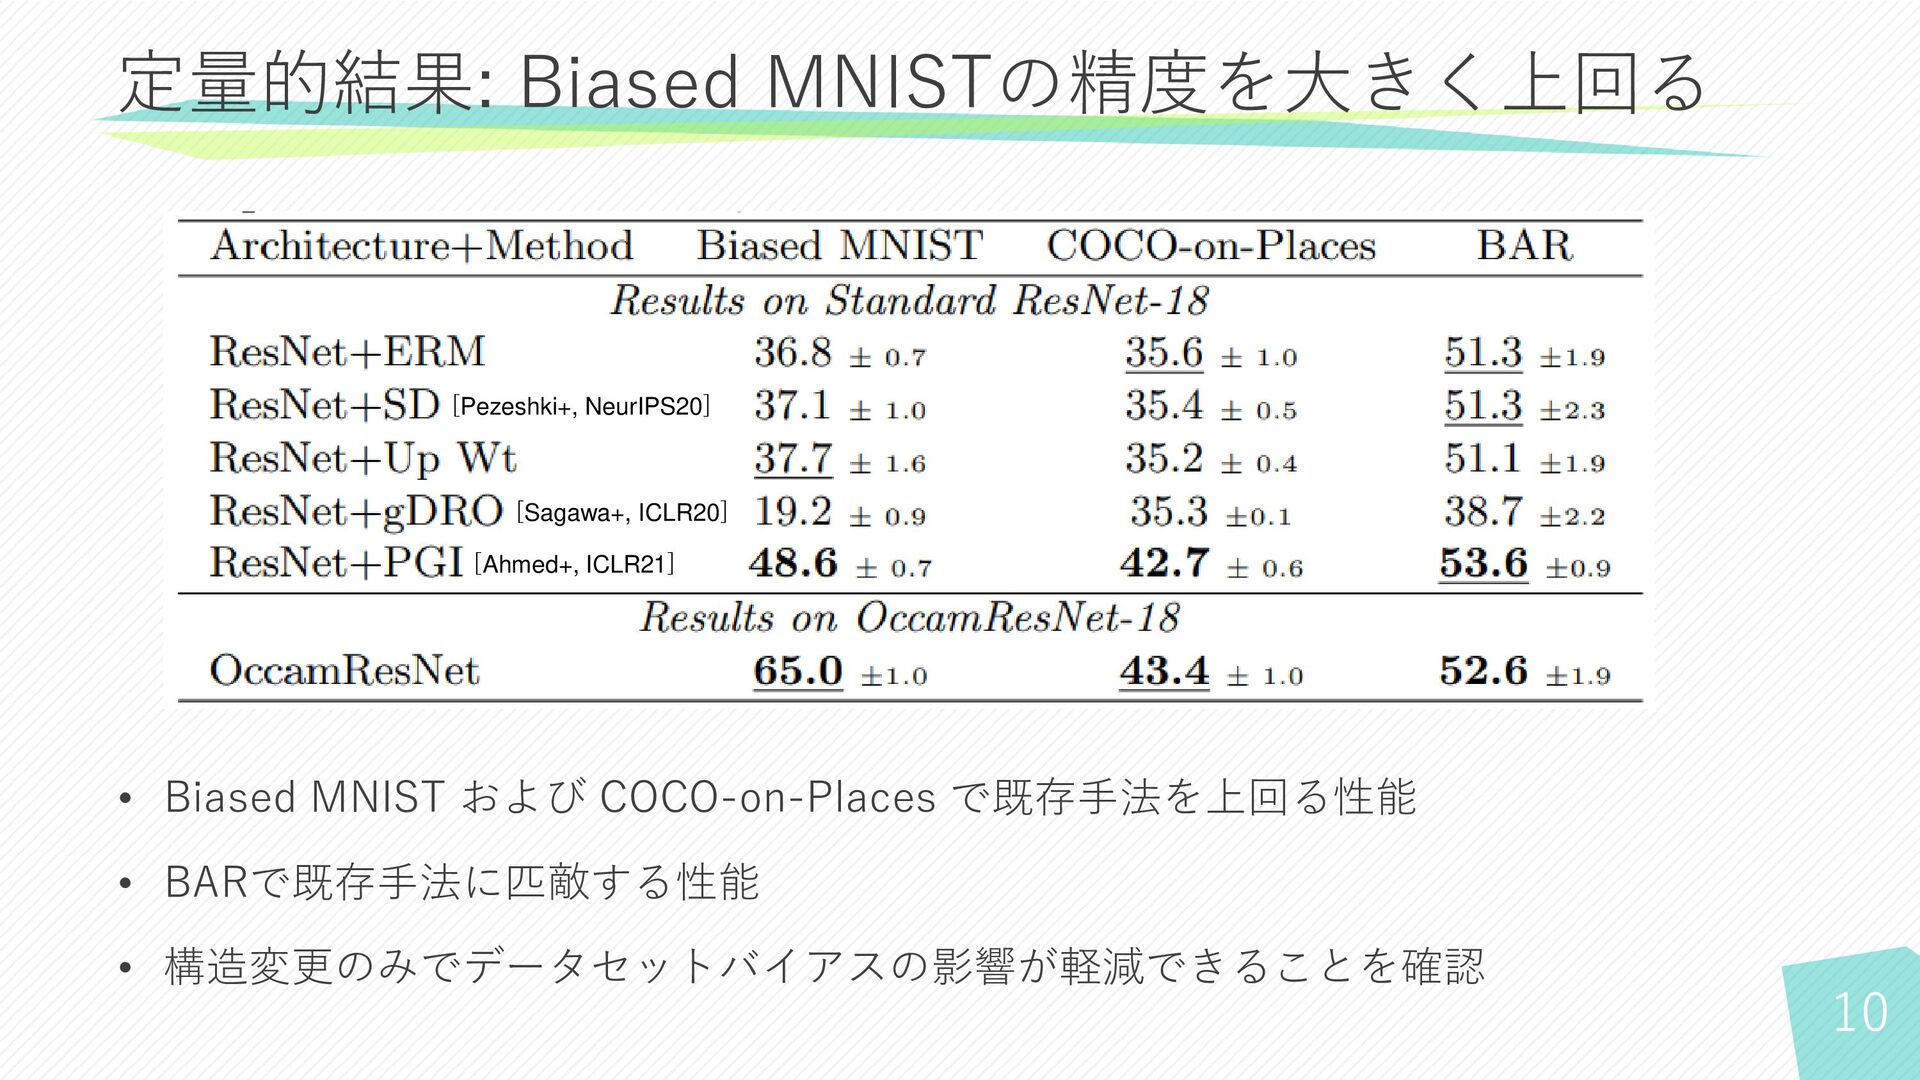
10 定量的結果: Biased MNISTの精度を大きく上回る • Biased MNIST および COCO-on-Places で既存手法を上回る性能
• BARで既存手法に匹敵する性能 • 構造変更のみでデータセットバイアスの影響が軽減できることを確認 [Pezeshki+, NeurIPS20] [Sagawa+, ICLR20] [Ahmed+, ICLR21]
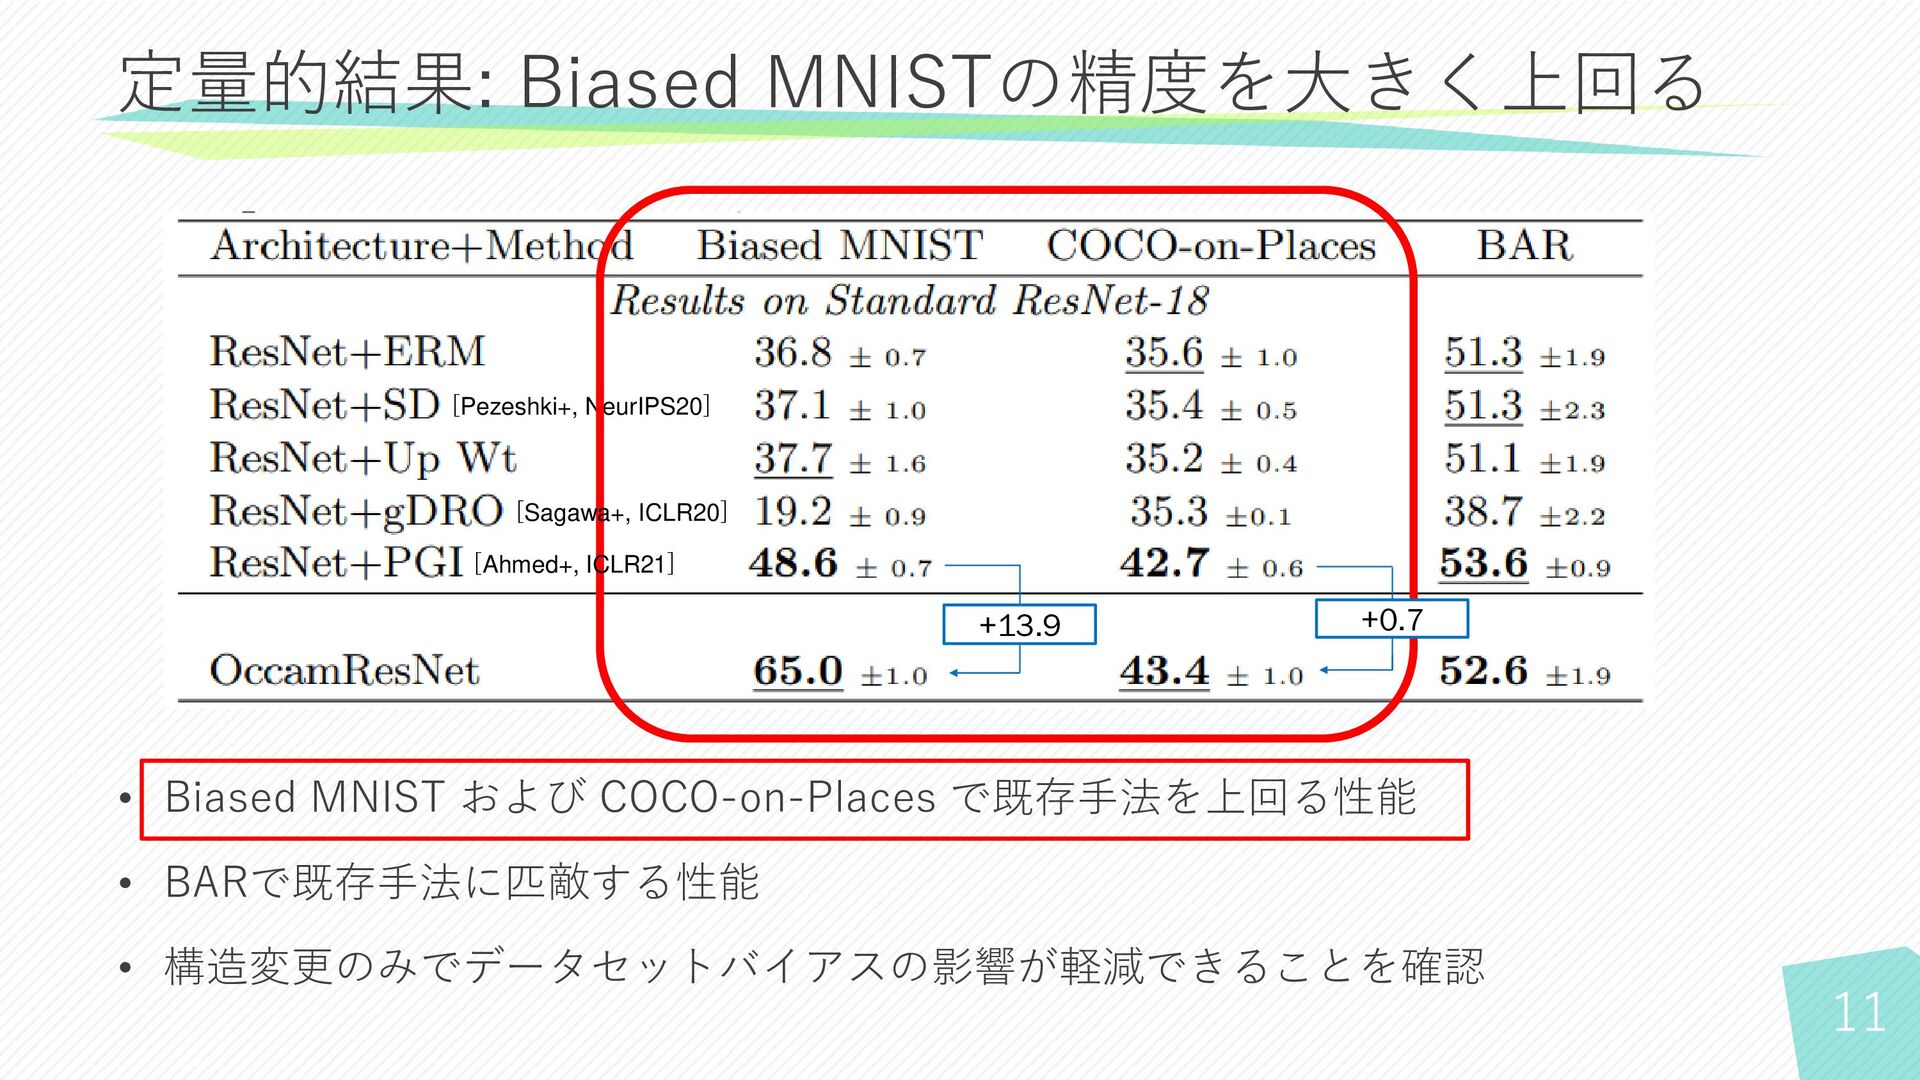
11 定量的結果: Biased MNISTの精度を大きく上回る • Biased MNIST および COCO-on-Places で既存手法を上回る性能
• BARで既存手法に匹敵する性能 • 構造変更のみでデータセットバイアスの影響が軽減できることを確認 [Pezeshki+, NeurIPS20] Shrestha [Sagawa+, ICLR20] [Ahmed+, ICLR21] +13.9 +0.7
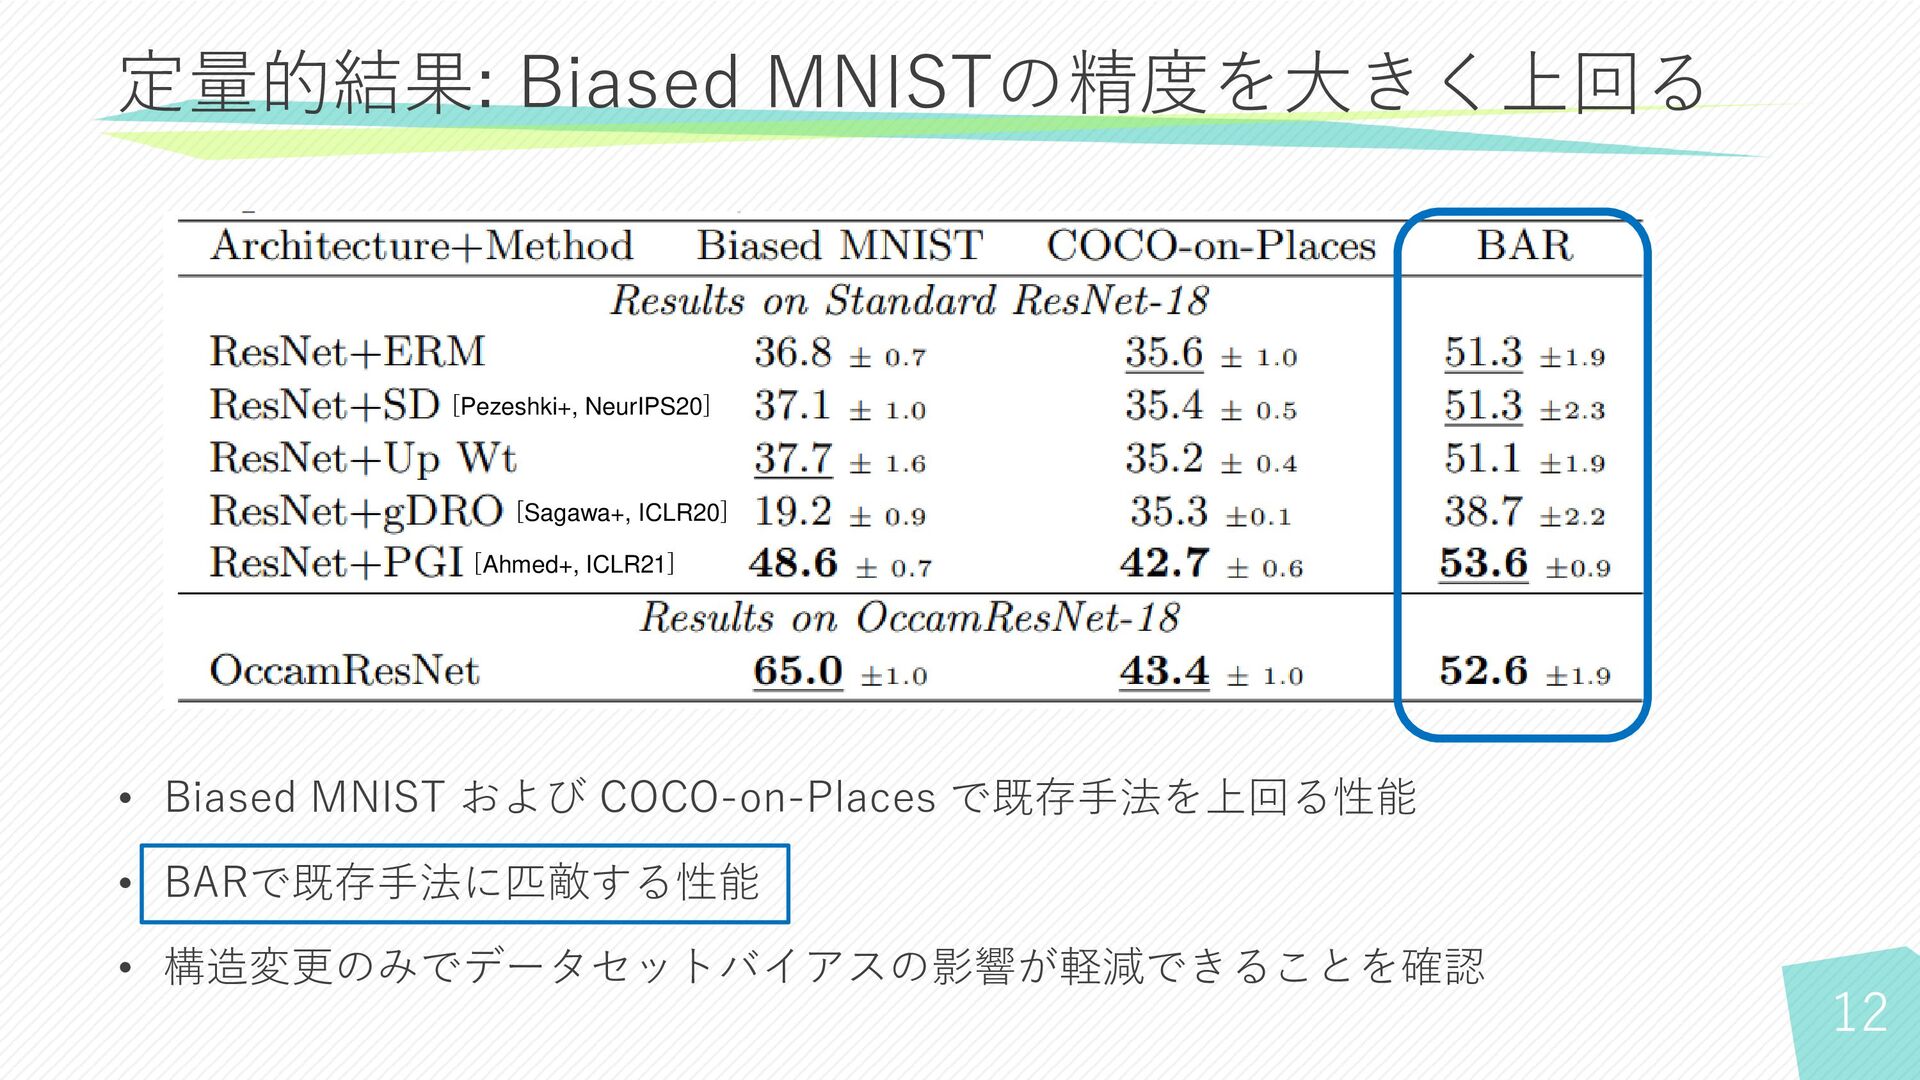
12 定量的結果: Biased MNISTの精度を大きく上回る • Biased MNIST および COCO-on-Places で既存手法を上回る性能
• BARで既存手法に匹敵する性能 • 構造変更のみでデータセットバイアスの影響が軽減できることを確認 [Pezeshki+, NeurIPS20] [Sagawa+, ICLR20] [Ahmed+, ICLR21]
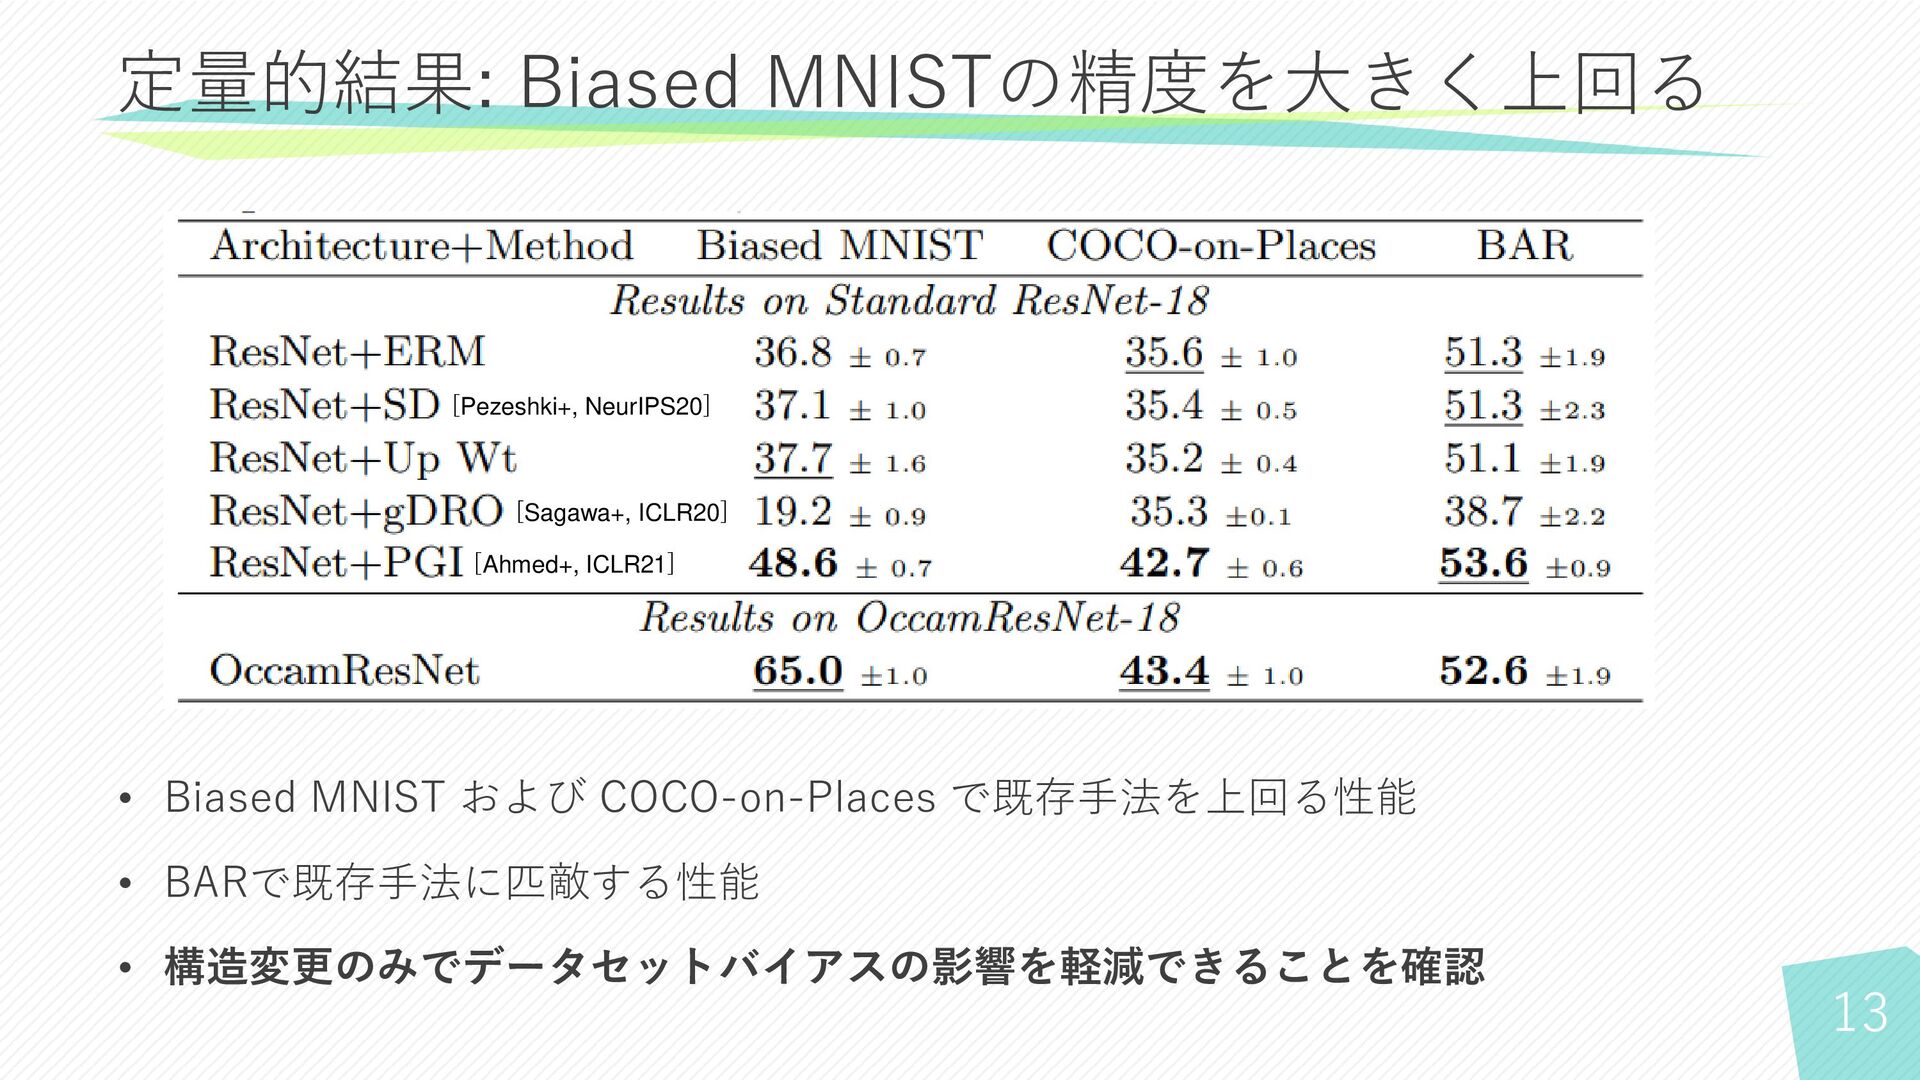
13 定量的結果: Biased MNISTの精度を大きく上回る • Biased MNIST および COCO-on-Places で既存手法を上回る性能
• BARで既存手法に匹敵する性能 • 構造変更のみでデータセットバイアスの影響を軽減できることを確認 [Pezeshki+, NeurIPS20] [Sagawa+, ICLR20] [Ahmed+, ICLR21]
14 • 既存手法にGrad-CAM [Selvaraju+, ICCV 17] を適用し、注目領域を可視化 定性的結果: 適切な領域に注目
15 • 既存手法にGrad-CAM [Selvaraju+, ICCV 17] を適用し、注目領域を可視化 定性的結果: 適切な領域に注目 無駄書き付近に注目
16 • 既存手法にGrad-CAM [Selvaraju+, ICCV 17] を適用し、注目領域を可視化 定性的結果: 適切な領域に注目 適切な領域に注目
17 • 既存手法にGrad-CAM [Selvaraju+, ICCV 17] を適用し、注目領域を可視化 定性的結果: 適切な領域に注目 注目箇所が不適切
注目領域が広すぎる
18 • 既存手法にGrad-CAM [Selvaraju+, ICCV 17] を適用し、注目領域を可視化 定性的結果: 適切な領域に注目 適切な限られた領域に注目
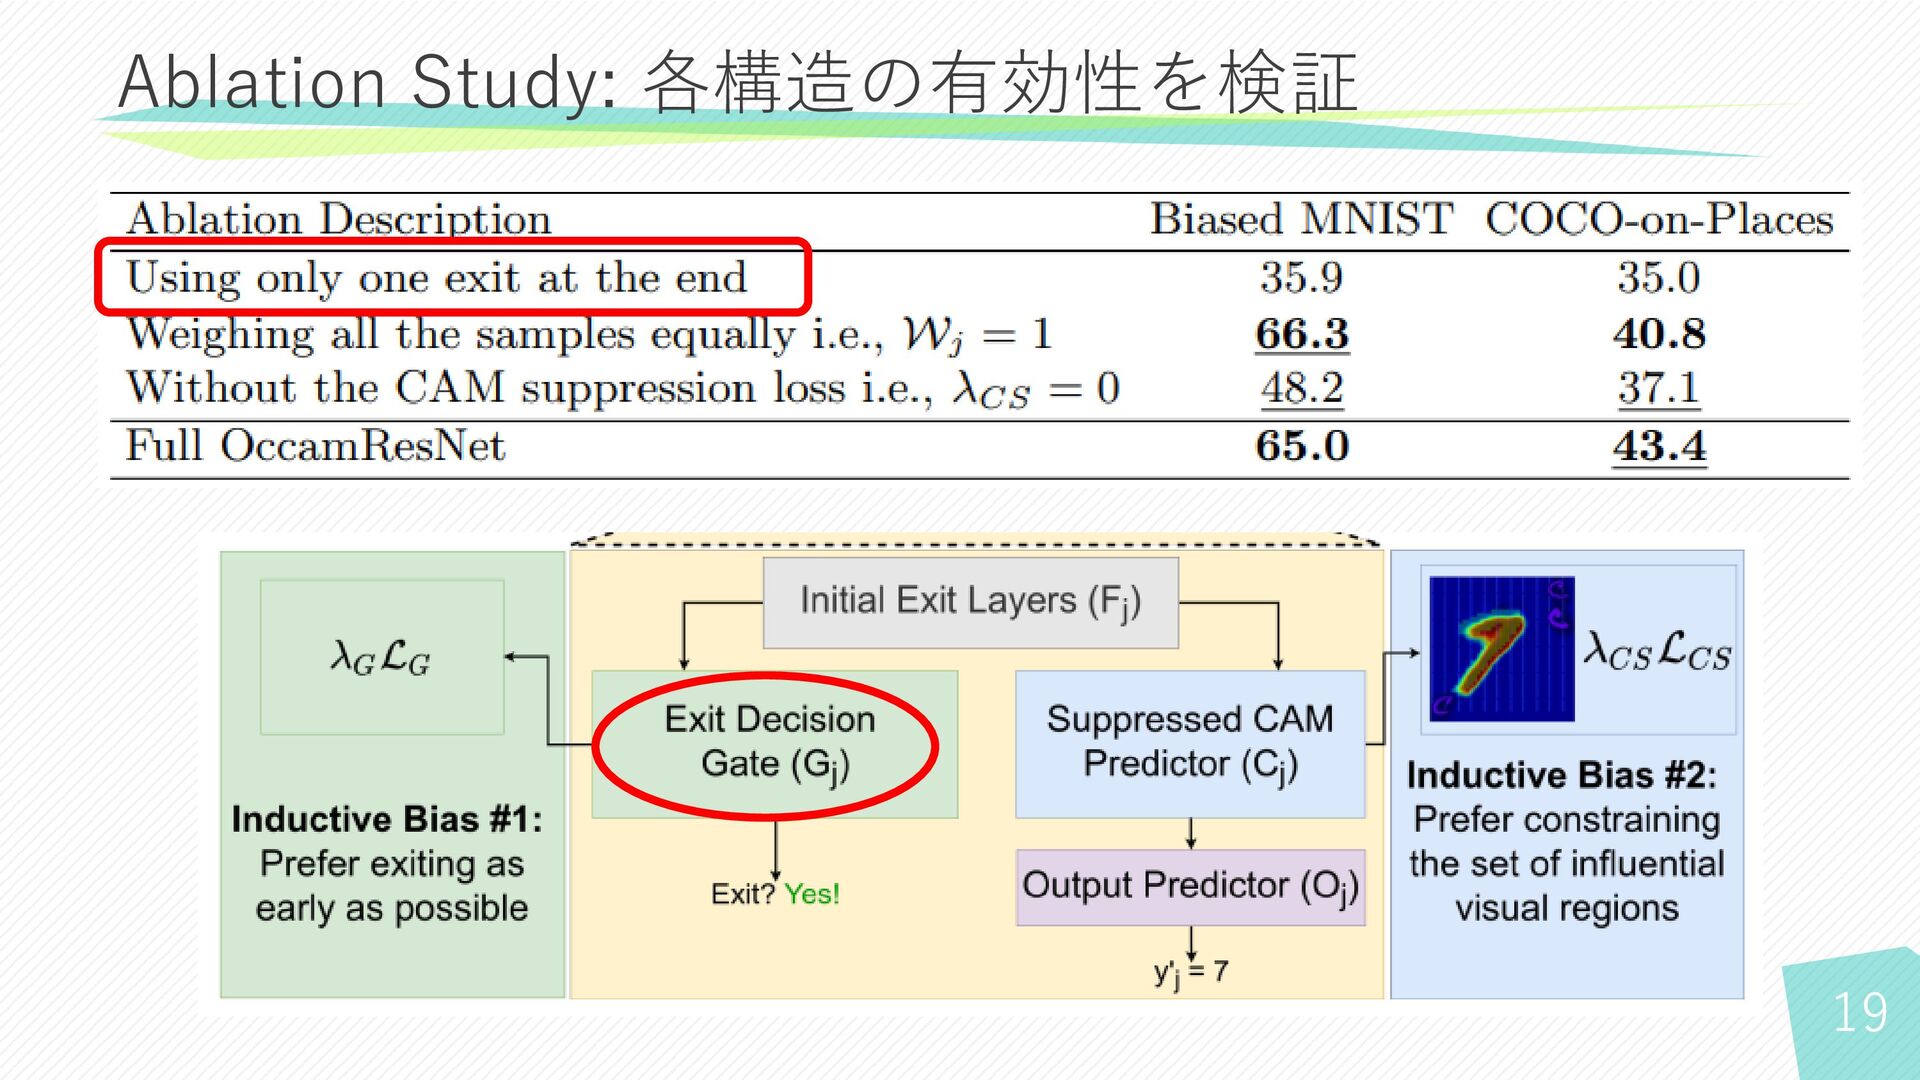
19 Ablation Study: 各構造の有効性を検証
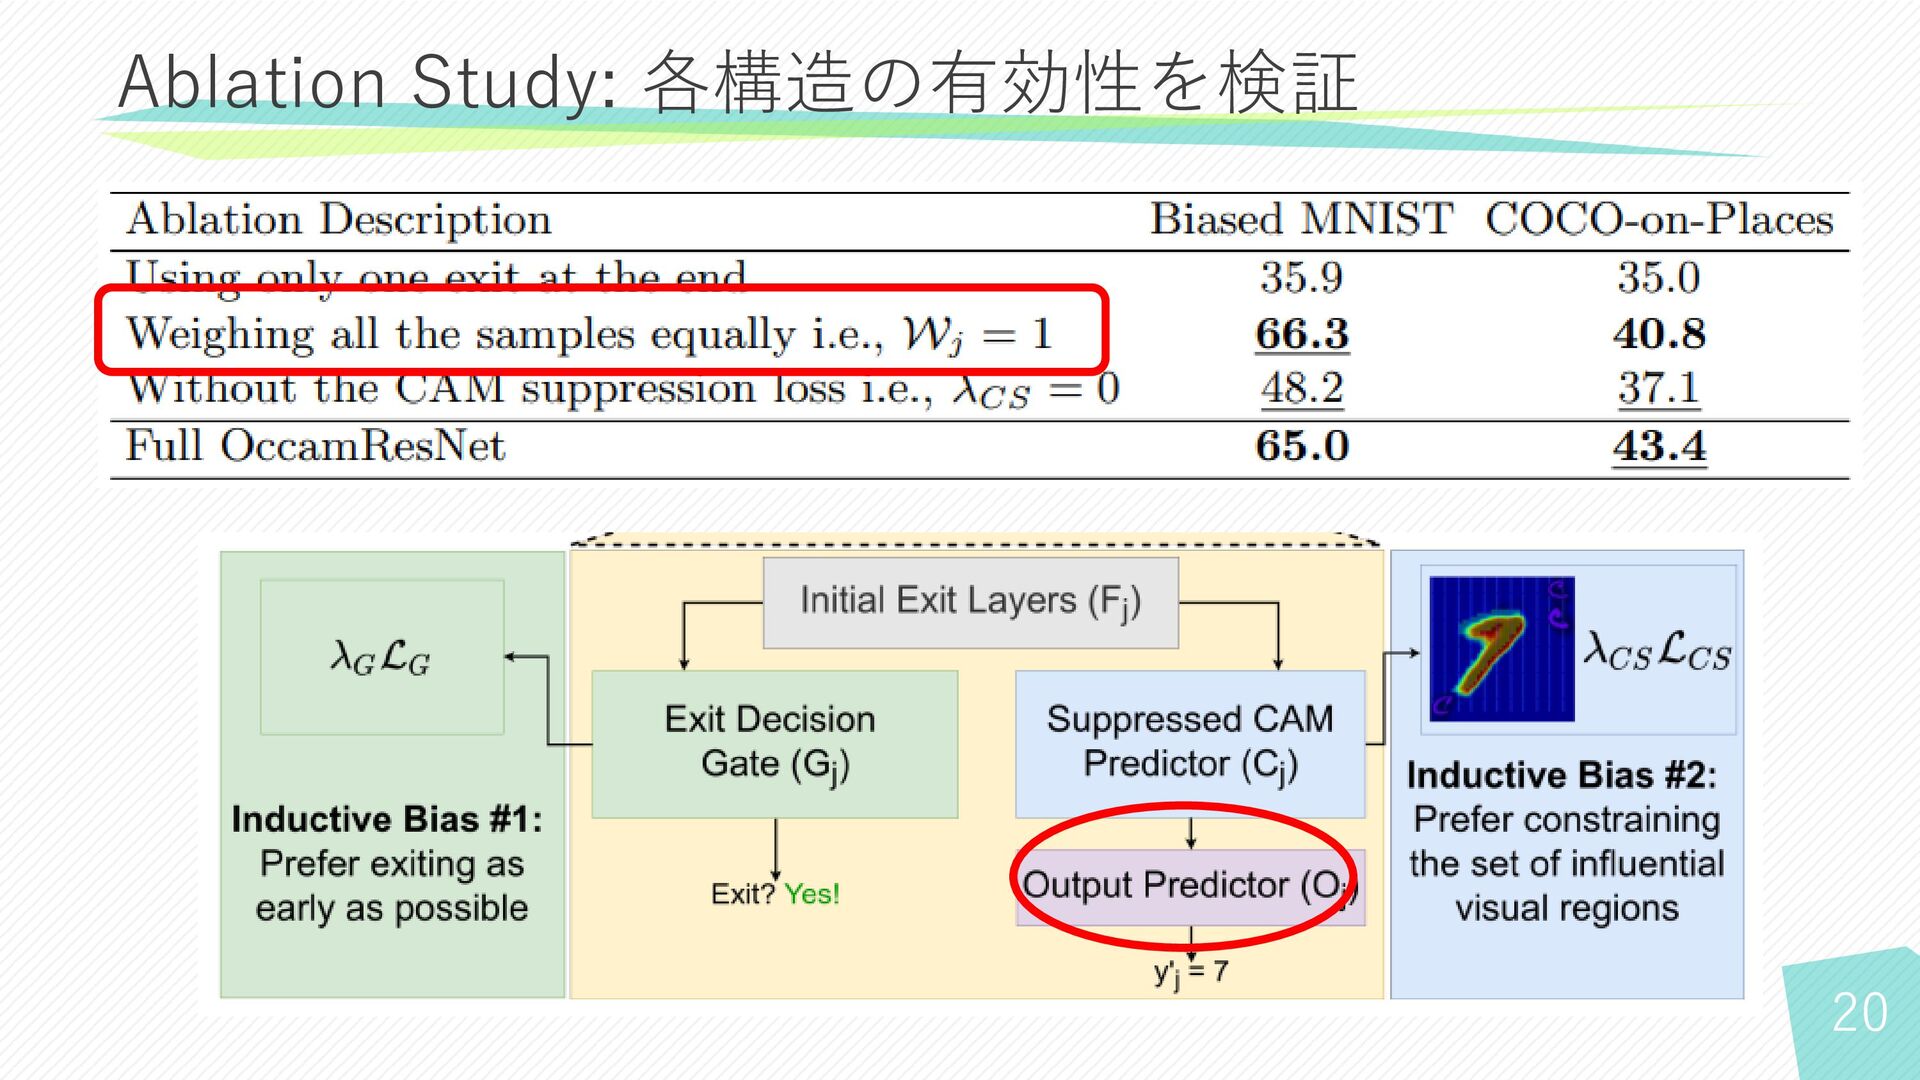
20 Ablation Study: 各構造の有効性を検証
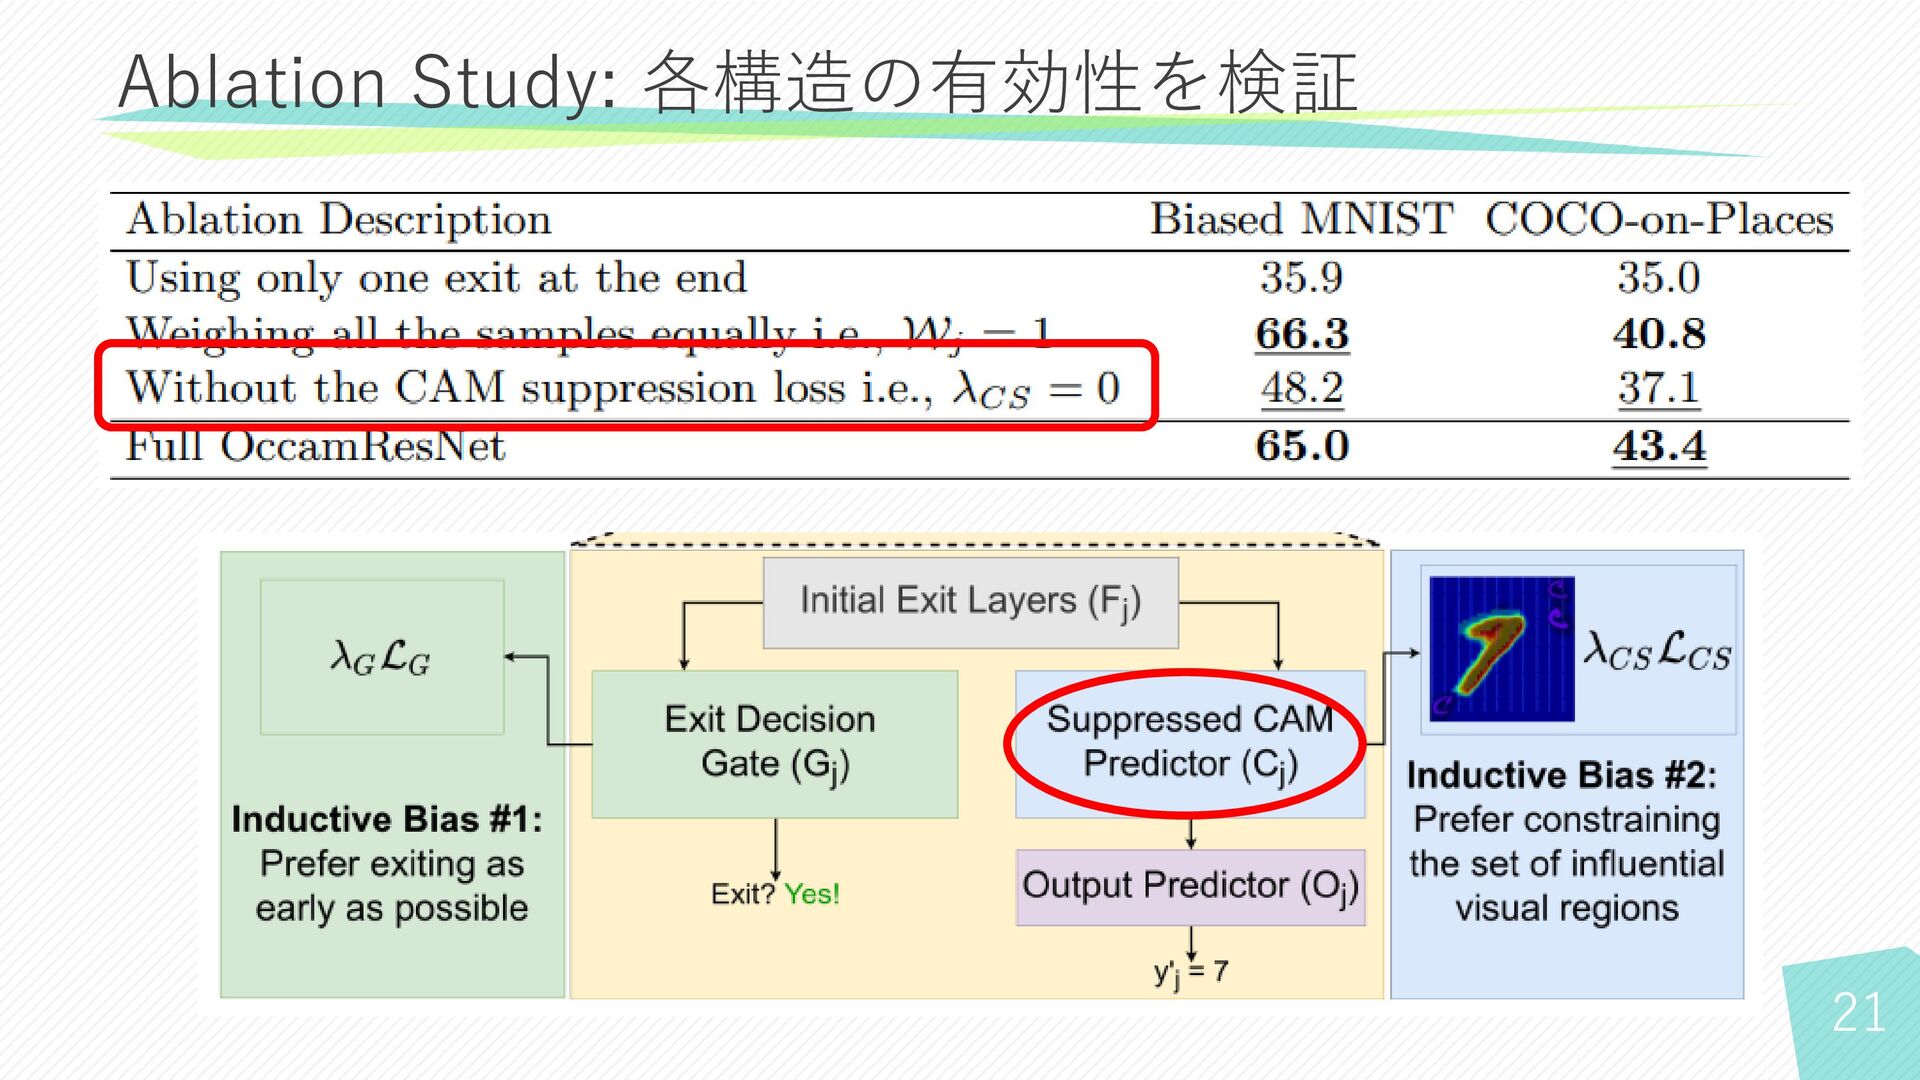
21 Ablation Study: 各構造の有効性を検証
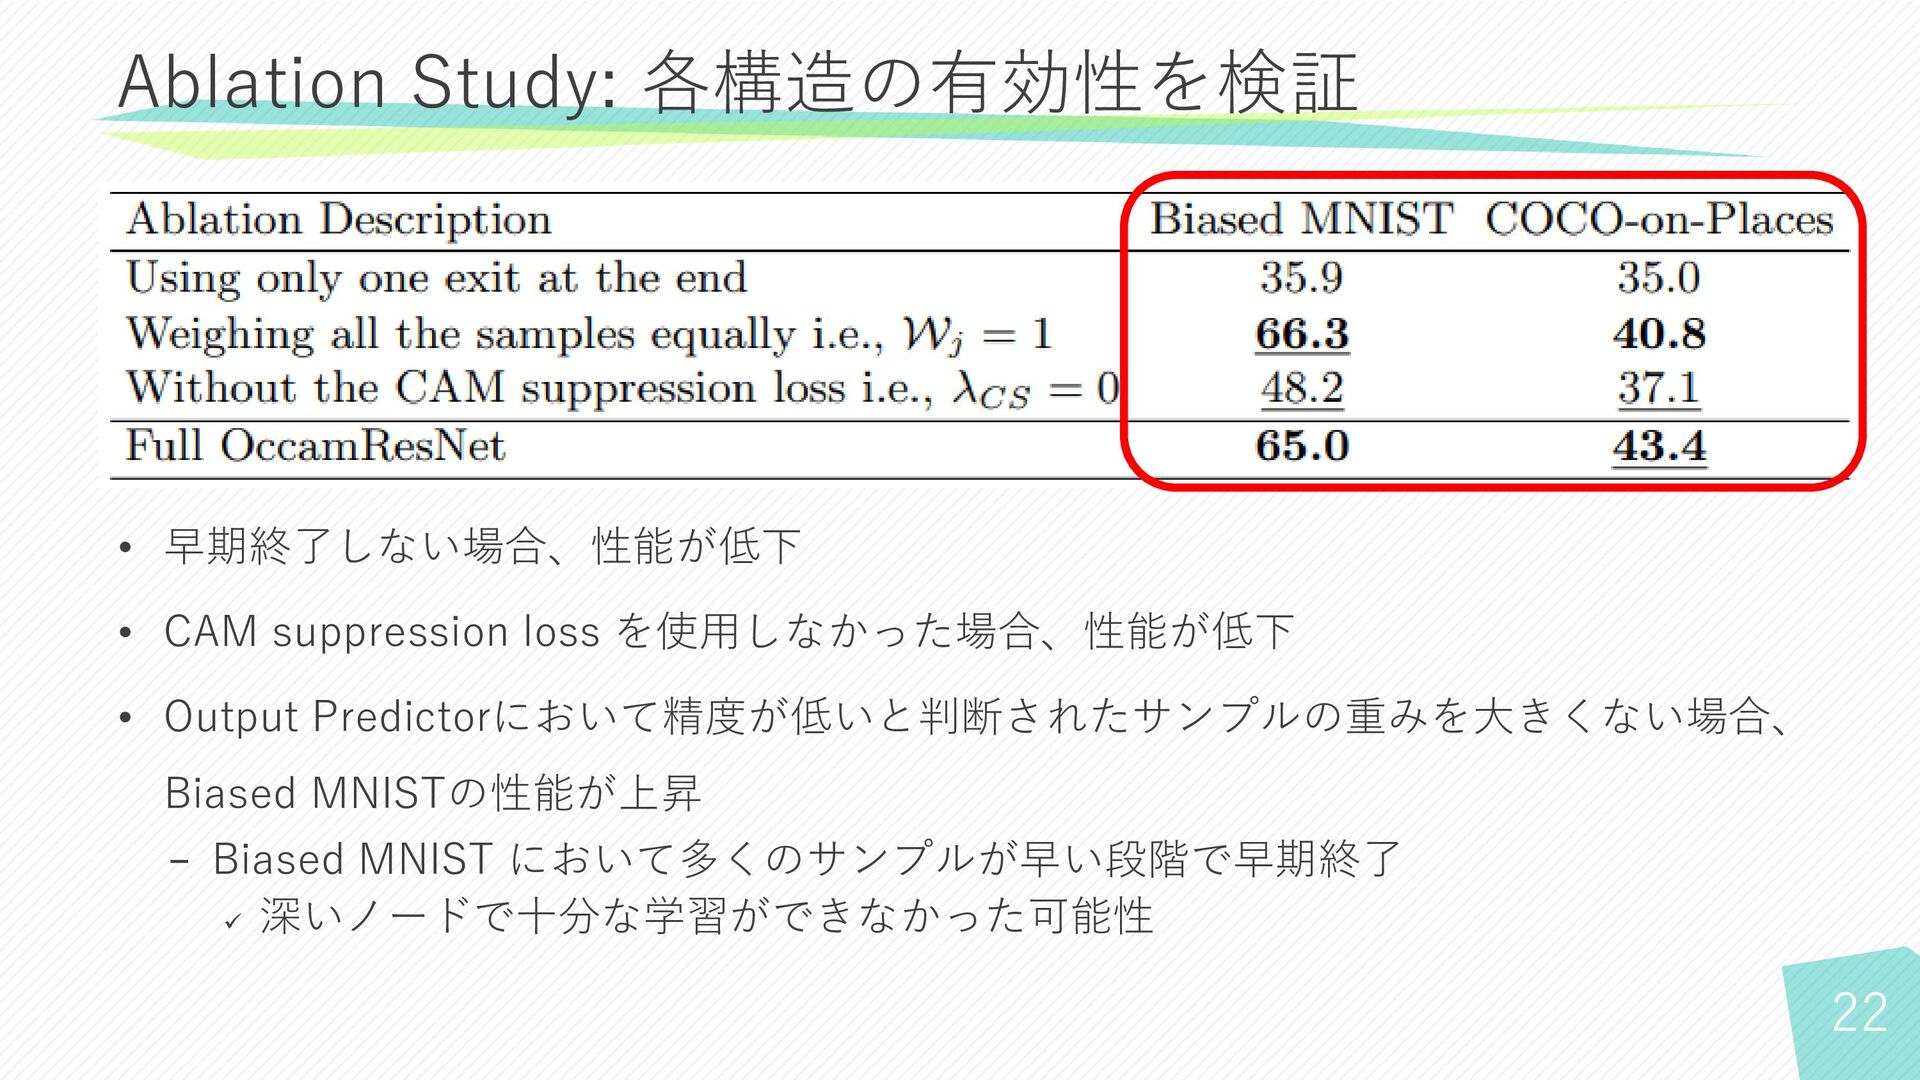
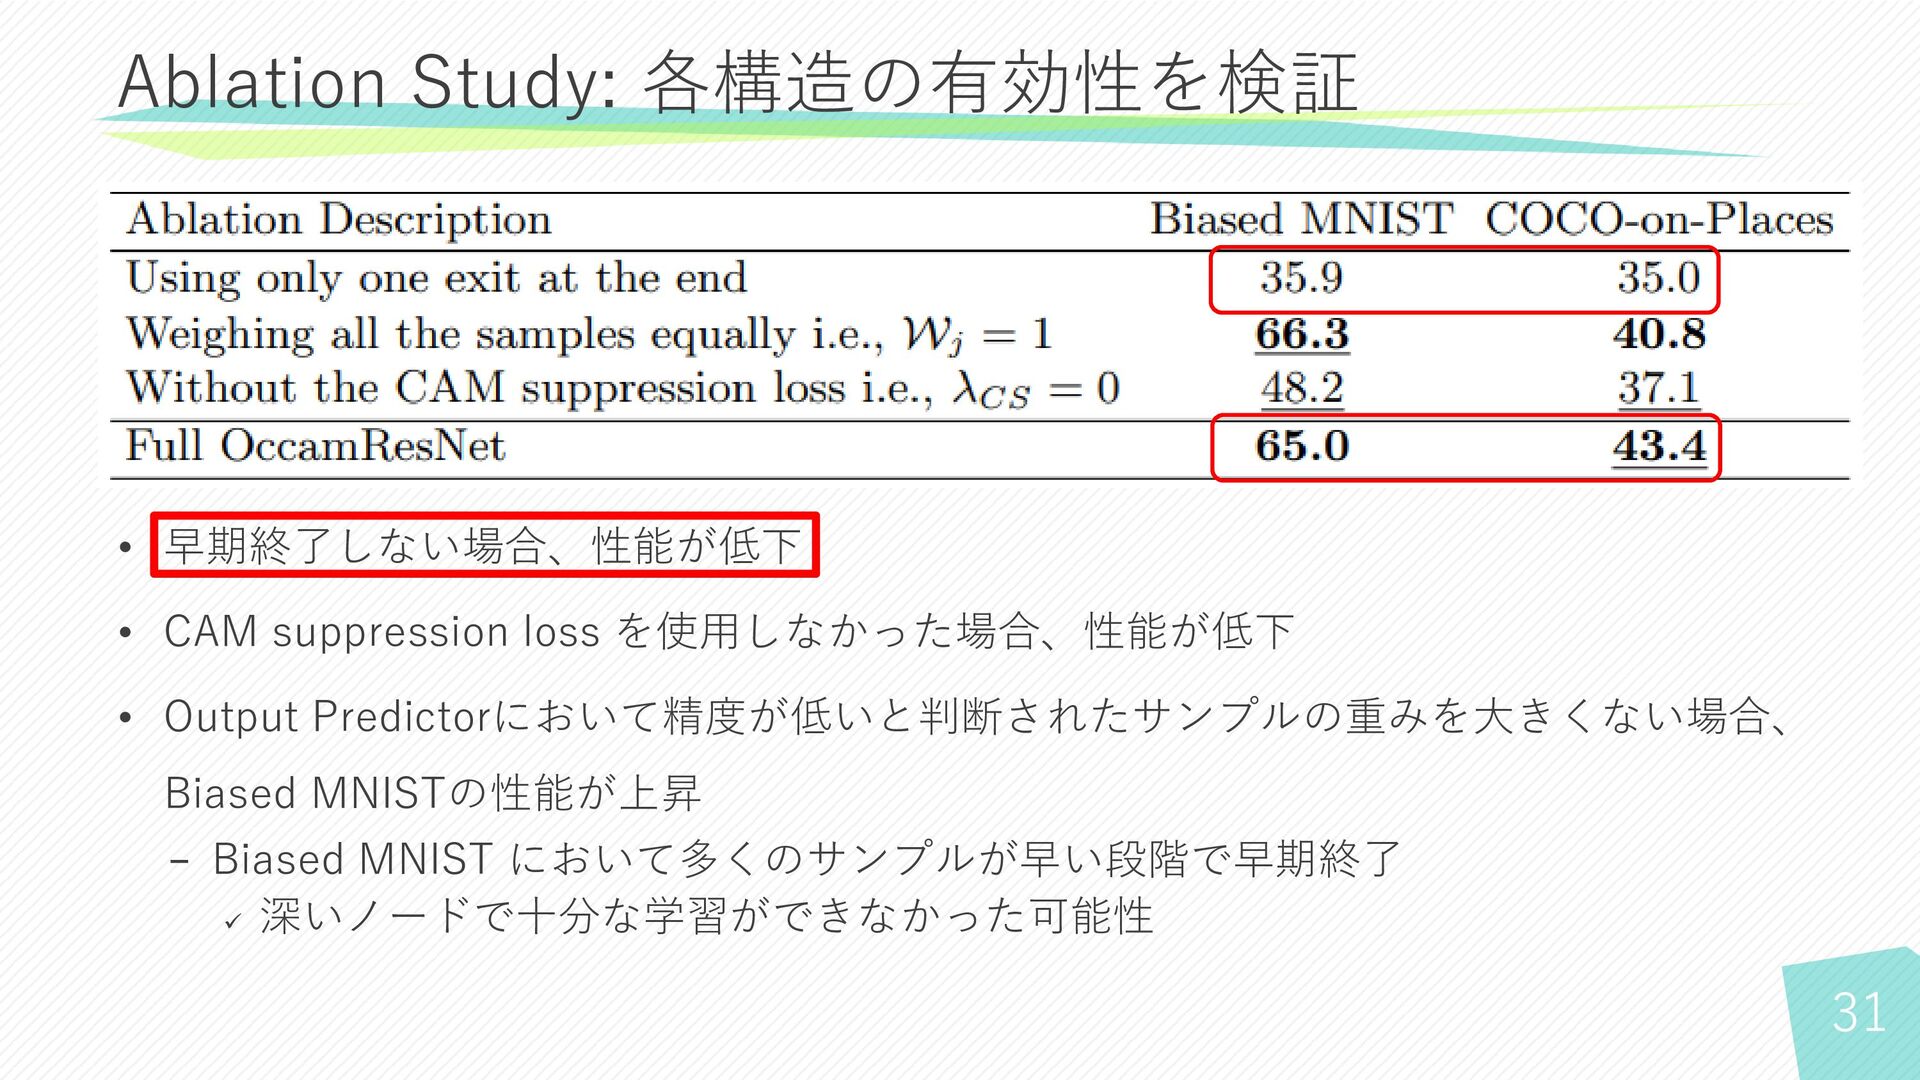
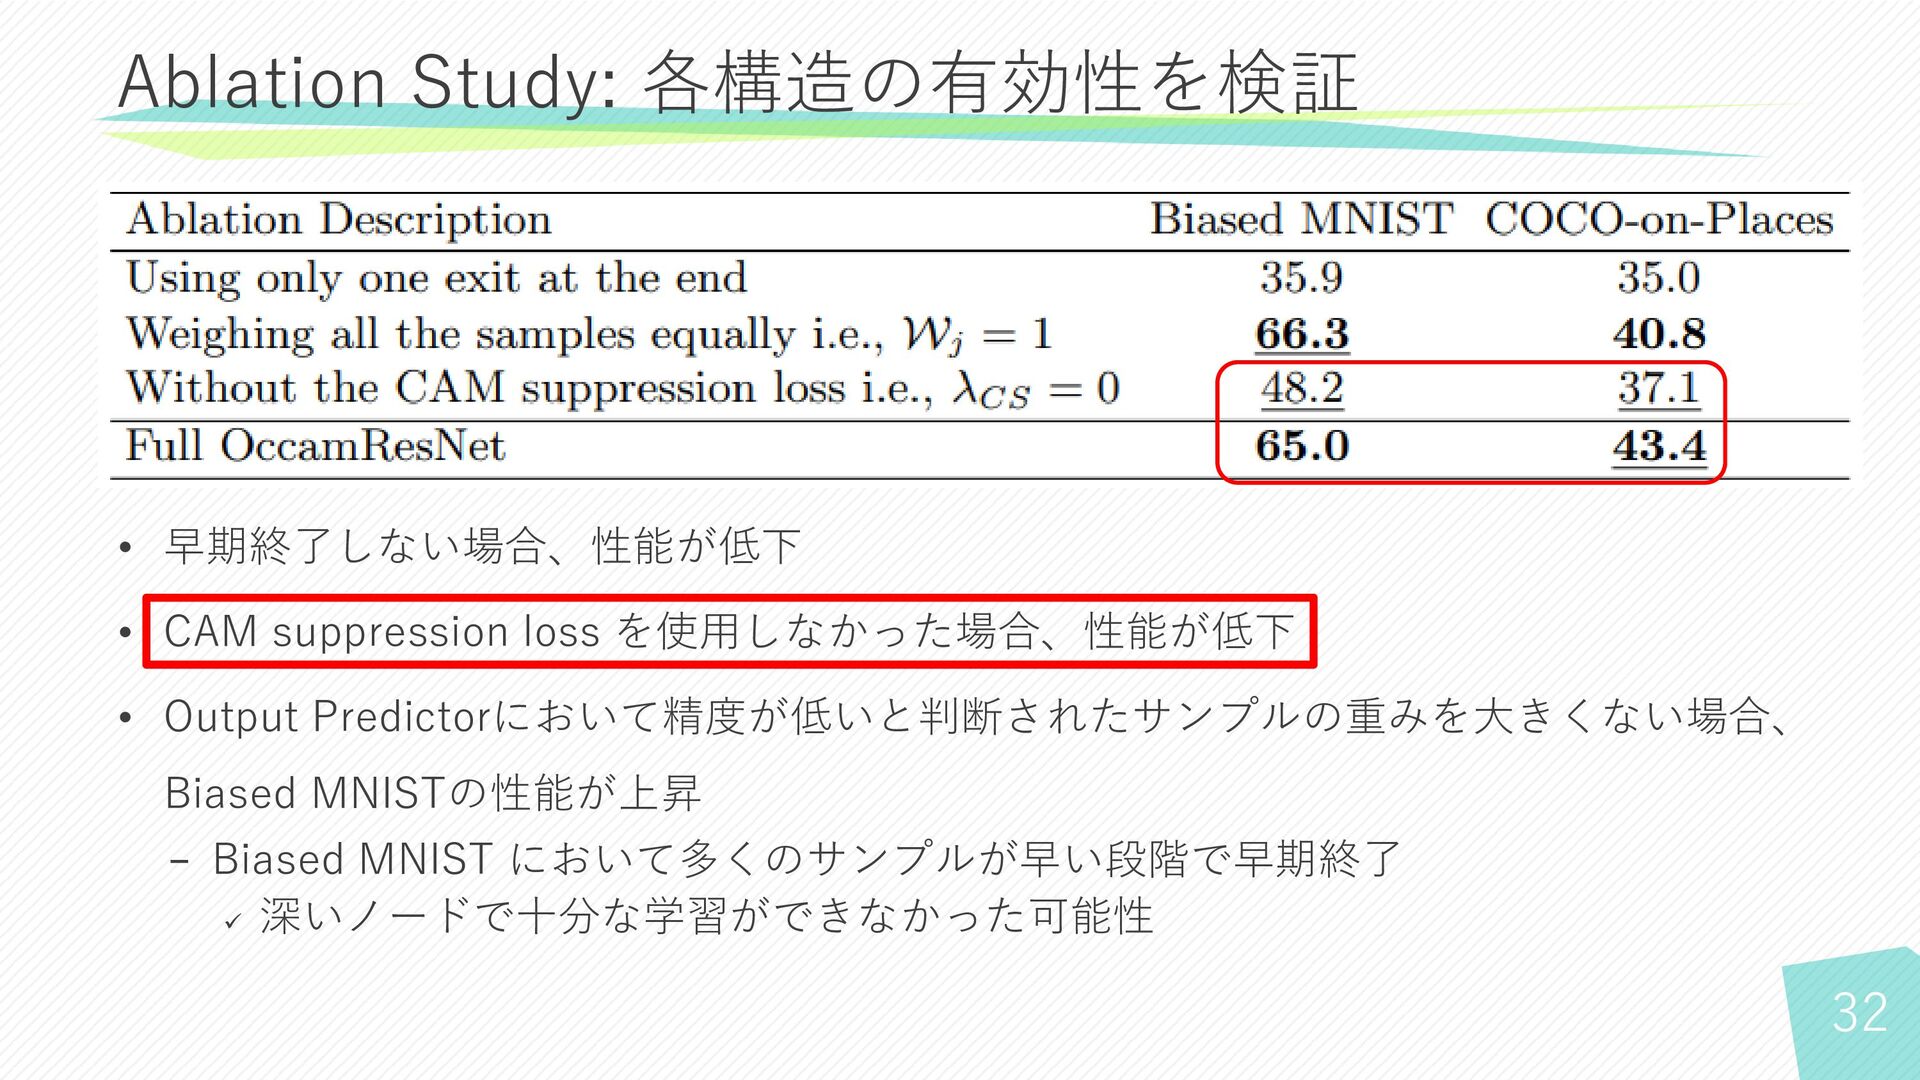
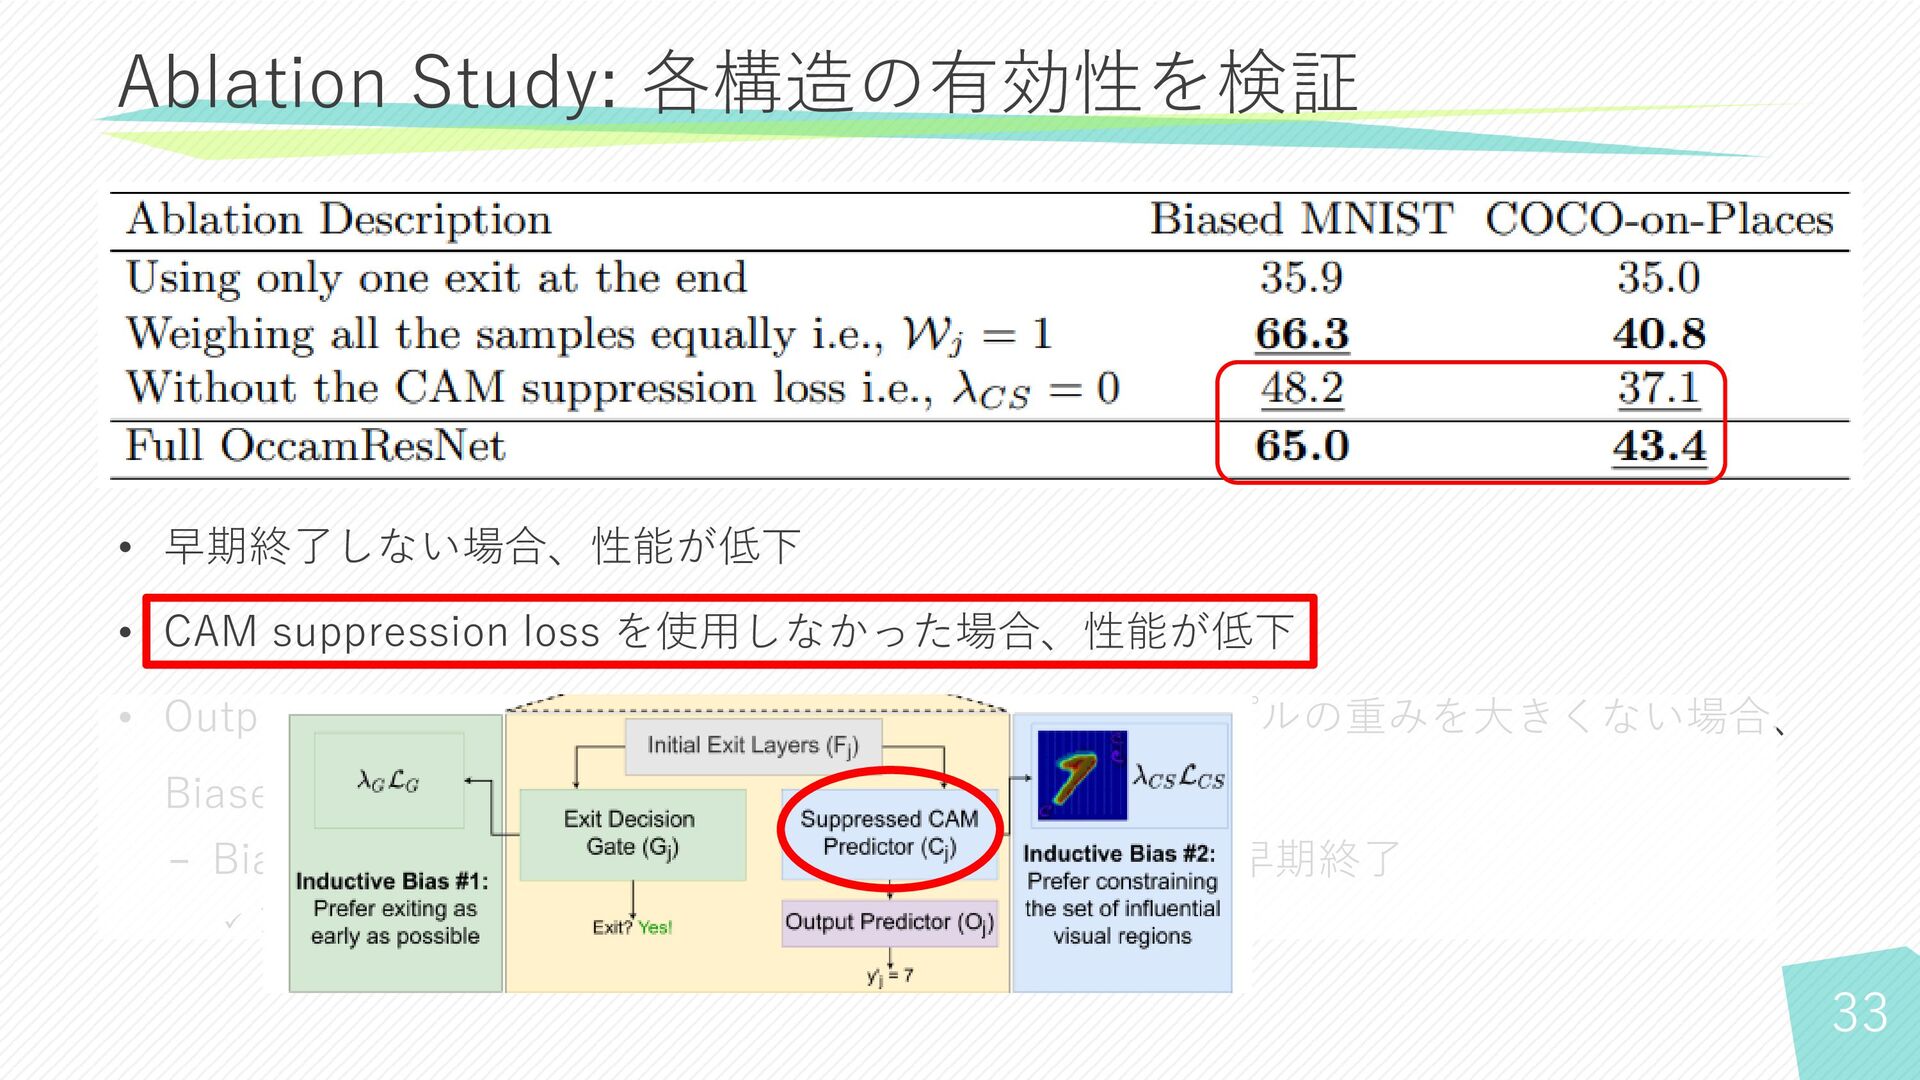
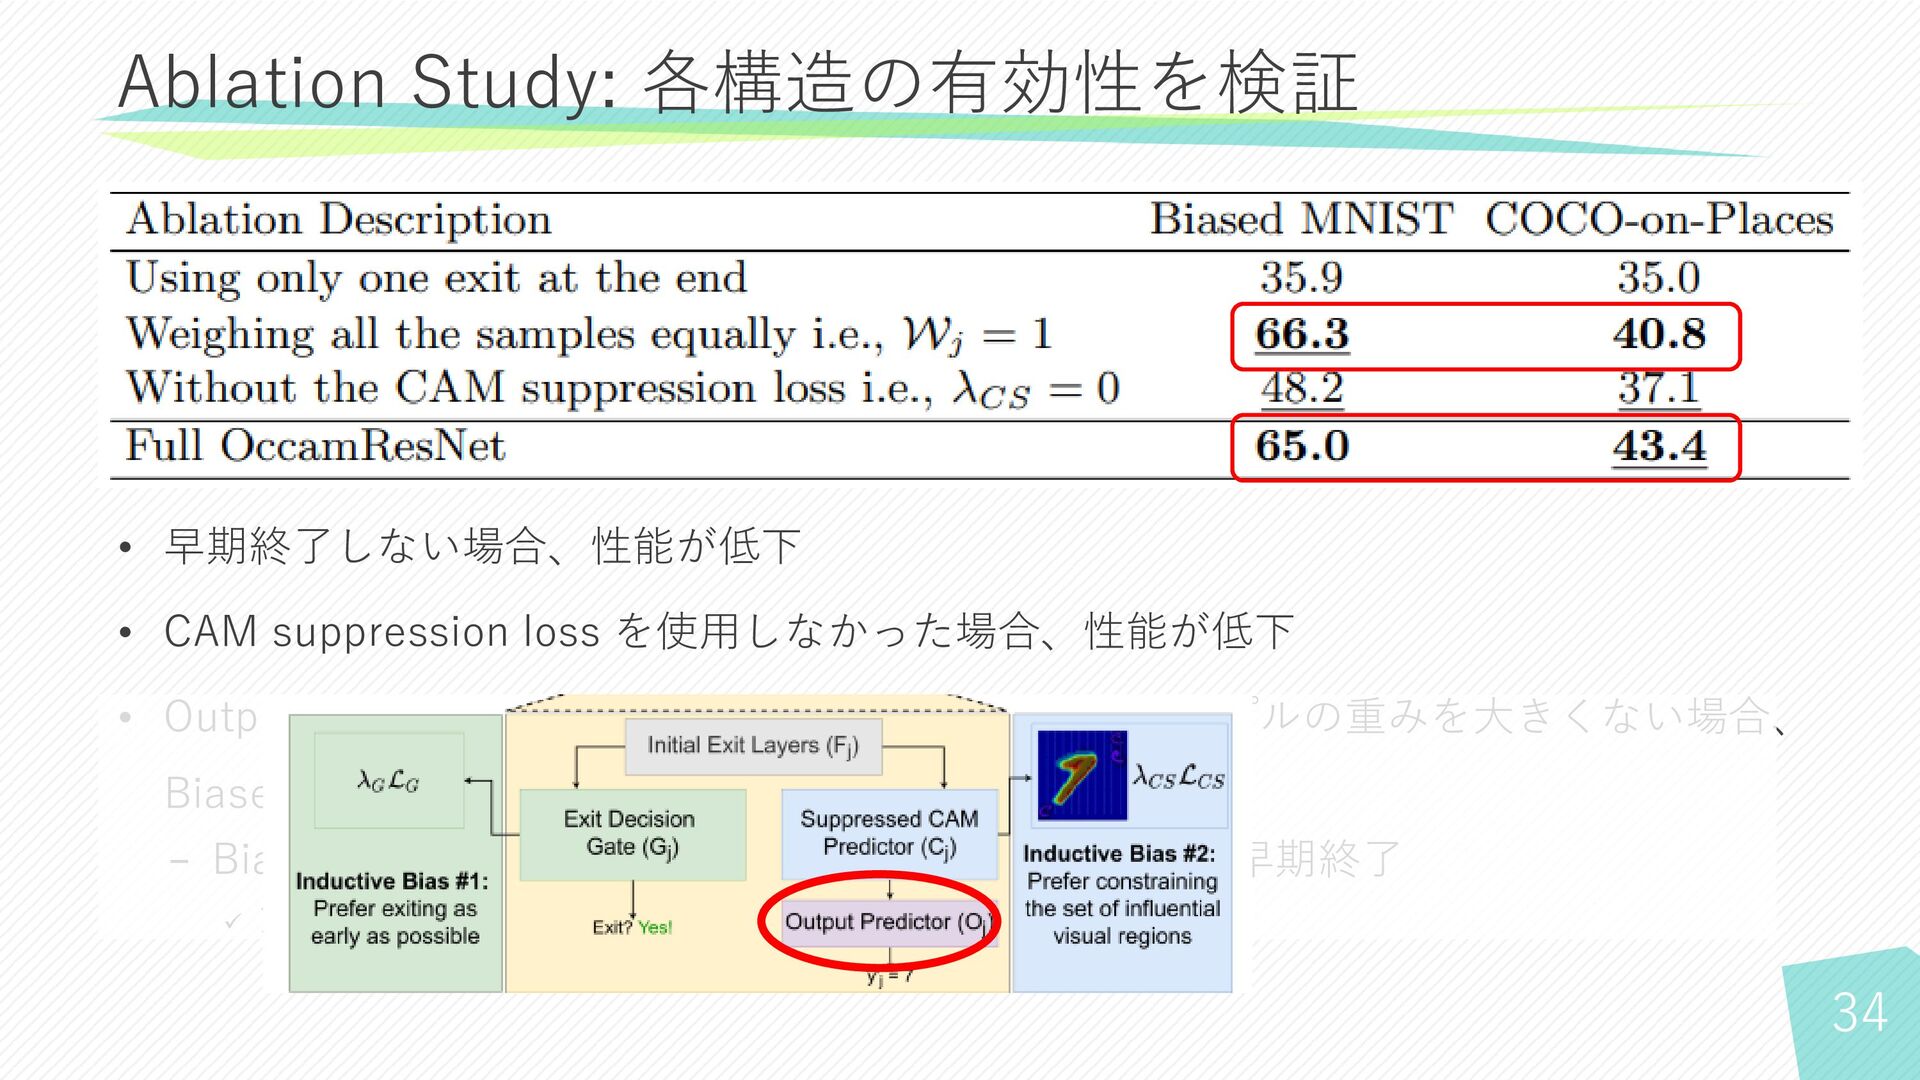
22 Ablation Study: 各構造の有効性を検証 • 早期終了しない場合、性能が低下 • CAM suppression loss
を使用しなかった場合、性能が低下 • Output Predictorにおいて精度が低いと判断されたサンプルの重みを大きくない場合、 Biased MNISTの性能が上昇 − Biased MNIST において多くのサンプルが早い段階で早期終了 ✓ 深いノードで十分な学習ができなかった可能性
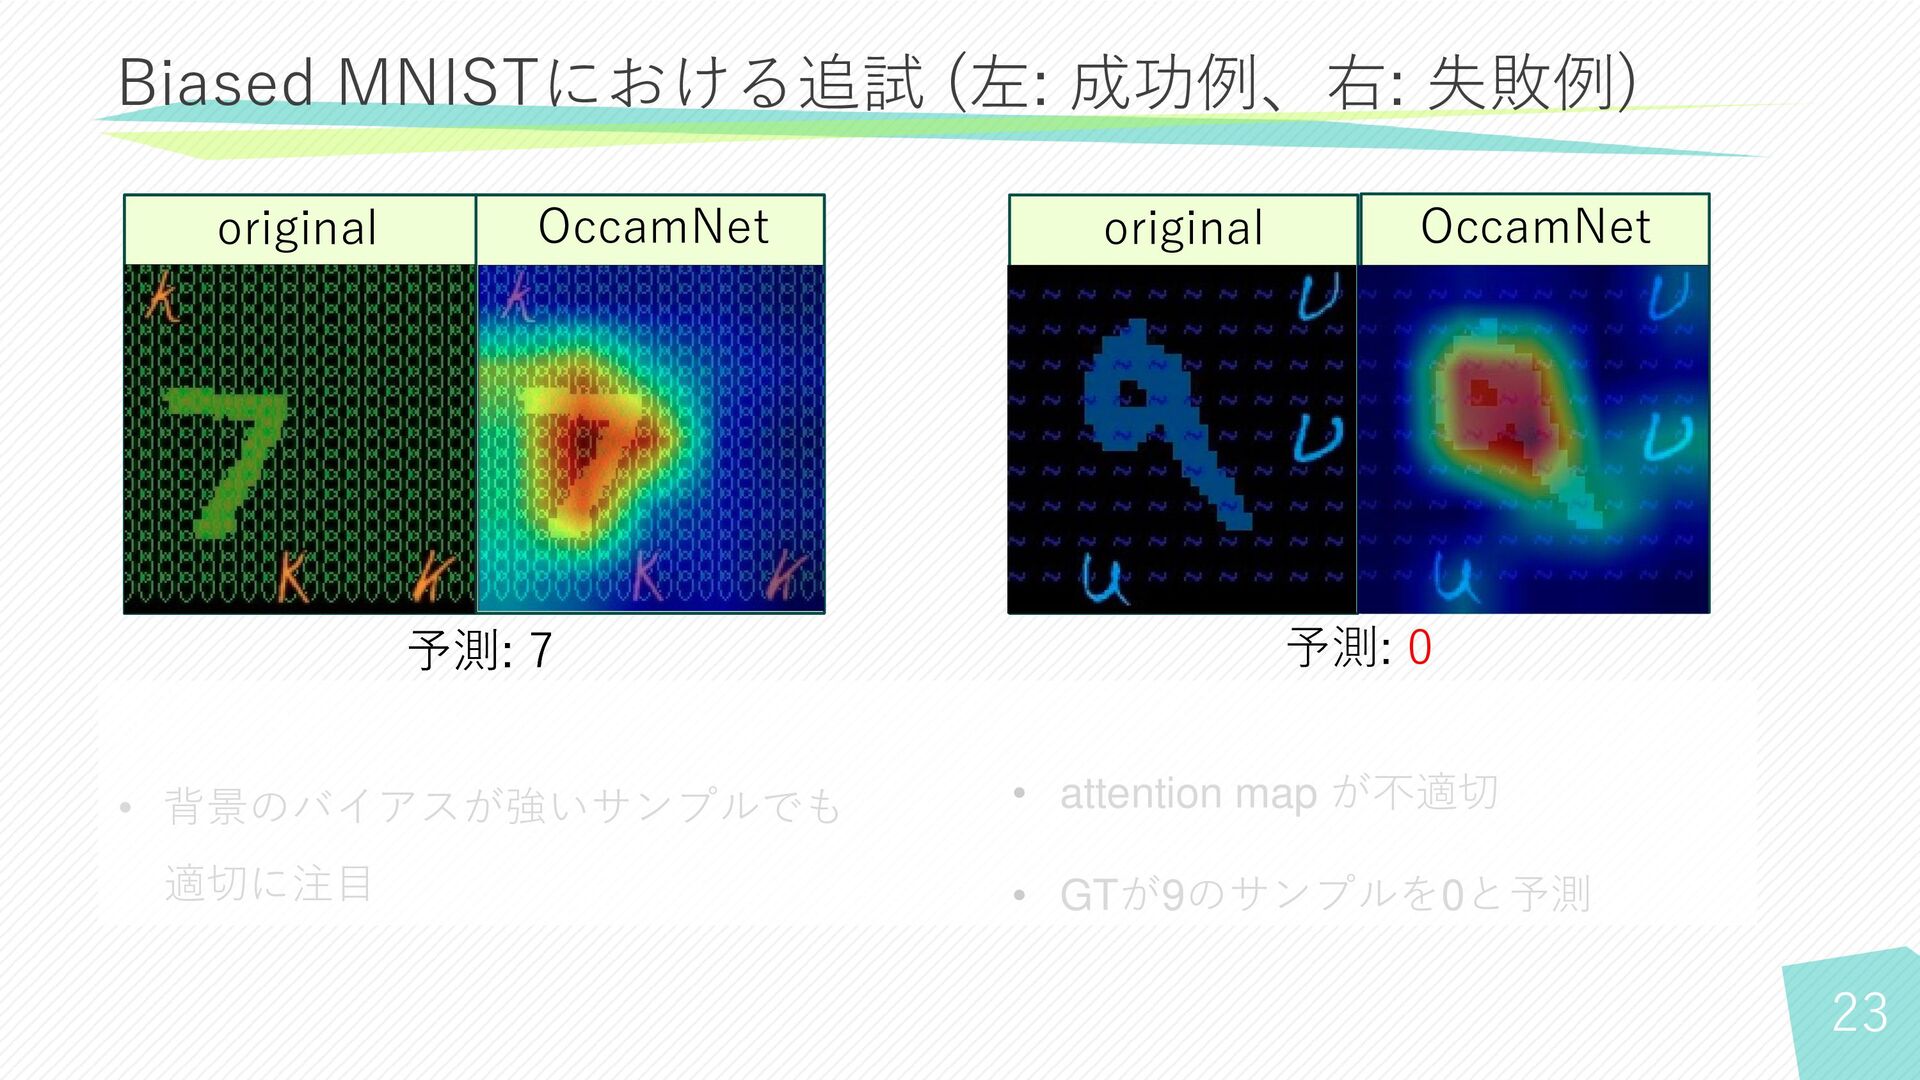
23 • attention map が不適切 • GTが9のサンプルを0と予測 • 背景のバイアスが強いサンプルでも 適切に注目
Biased MNISTにおける追試 (左: 成功例、右: 失敗例) original OccamNet 予測: 0 OccamNet original 予測: 7 original OccamNet 予測: 7
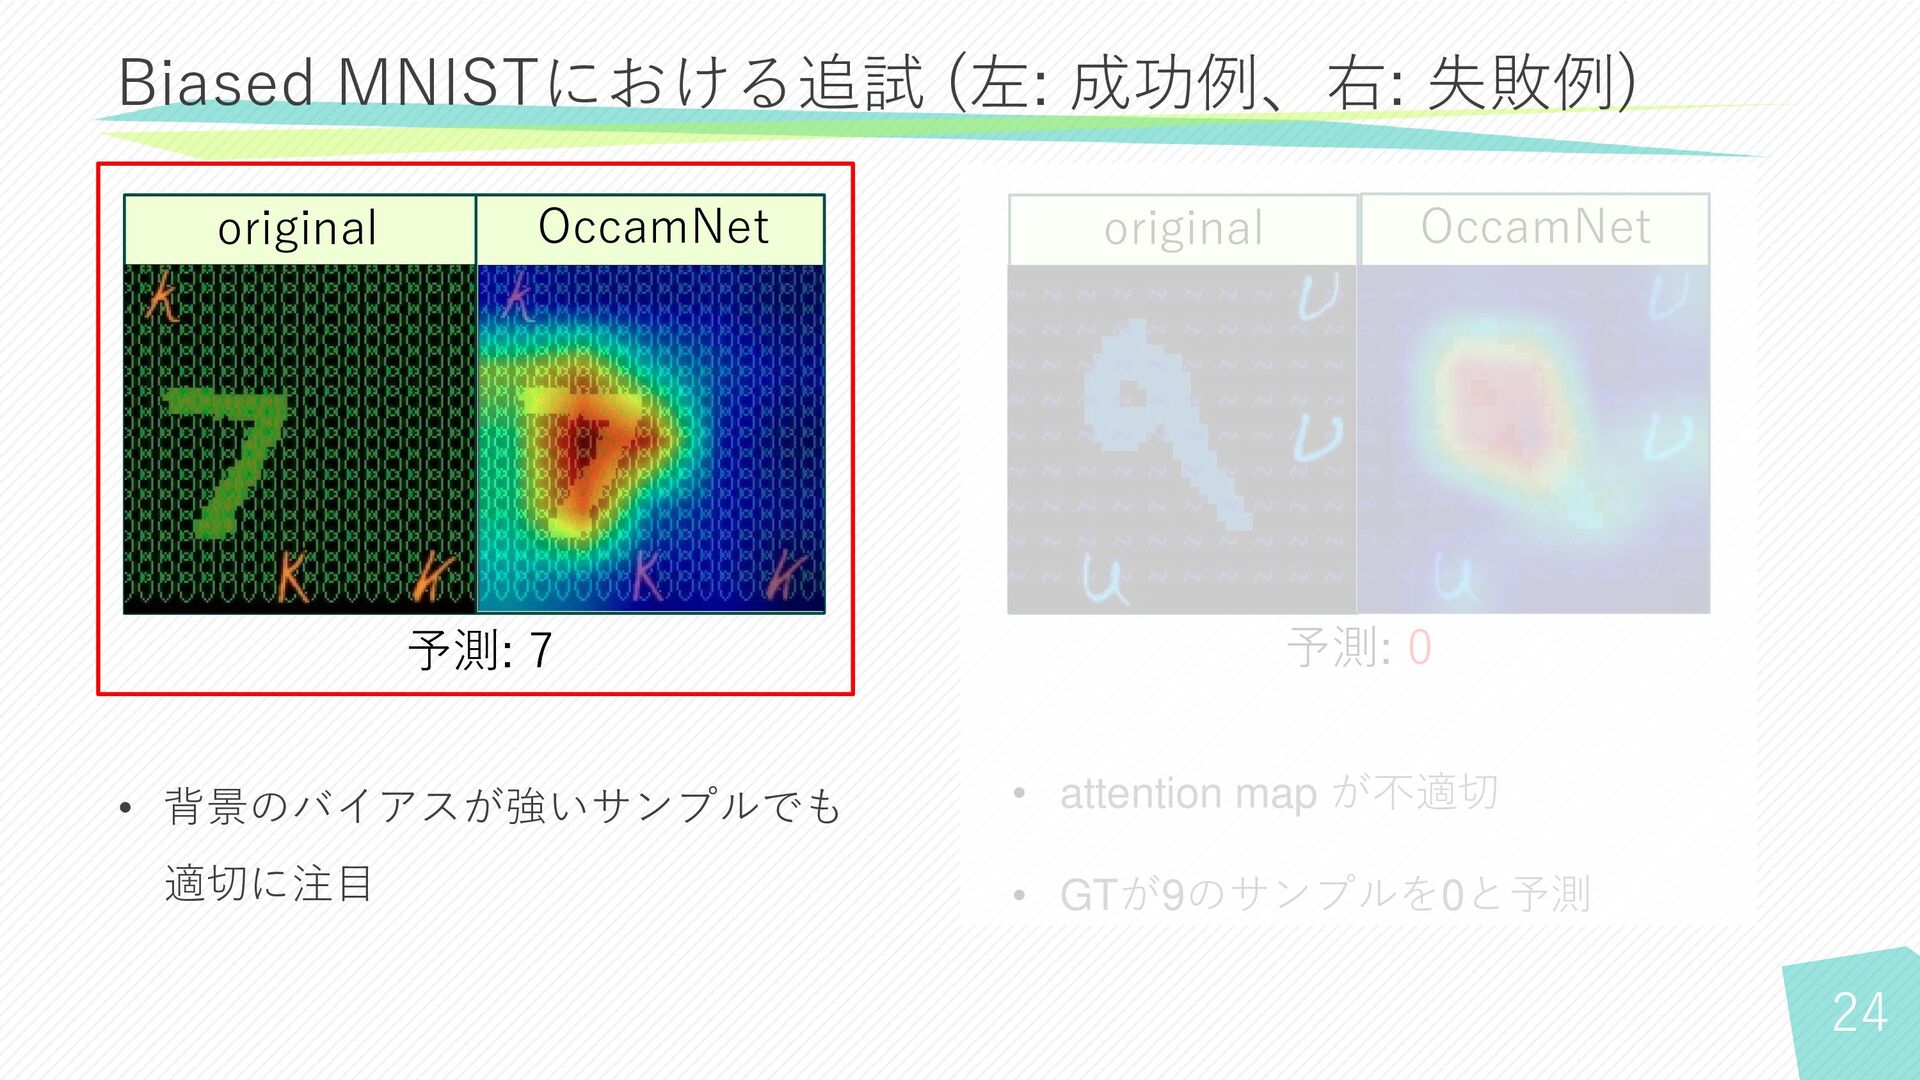
24 • attention map が不適切 • GTが9のサンプルを0と予測 • 背景のバイアスが強いサンプルでも 適切に注目
Biased MNISTにおける追試 (左: 成功例、右: 失敗例) original OccamNet 予測: 0 OccamNet original 予測: 7 original OccamNet 予測: 7
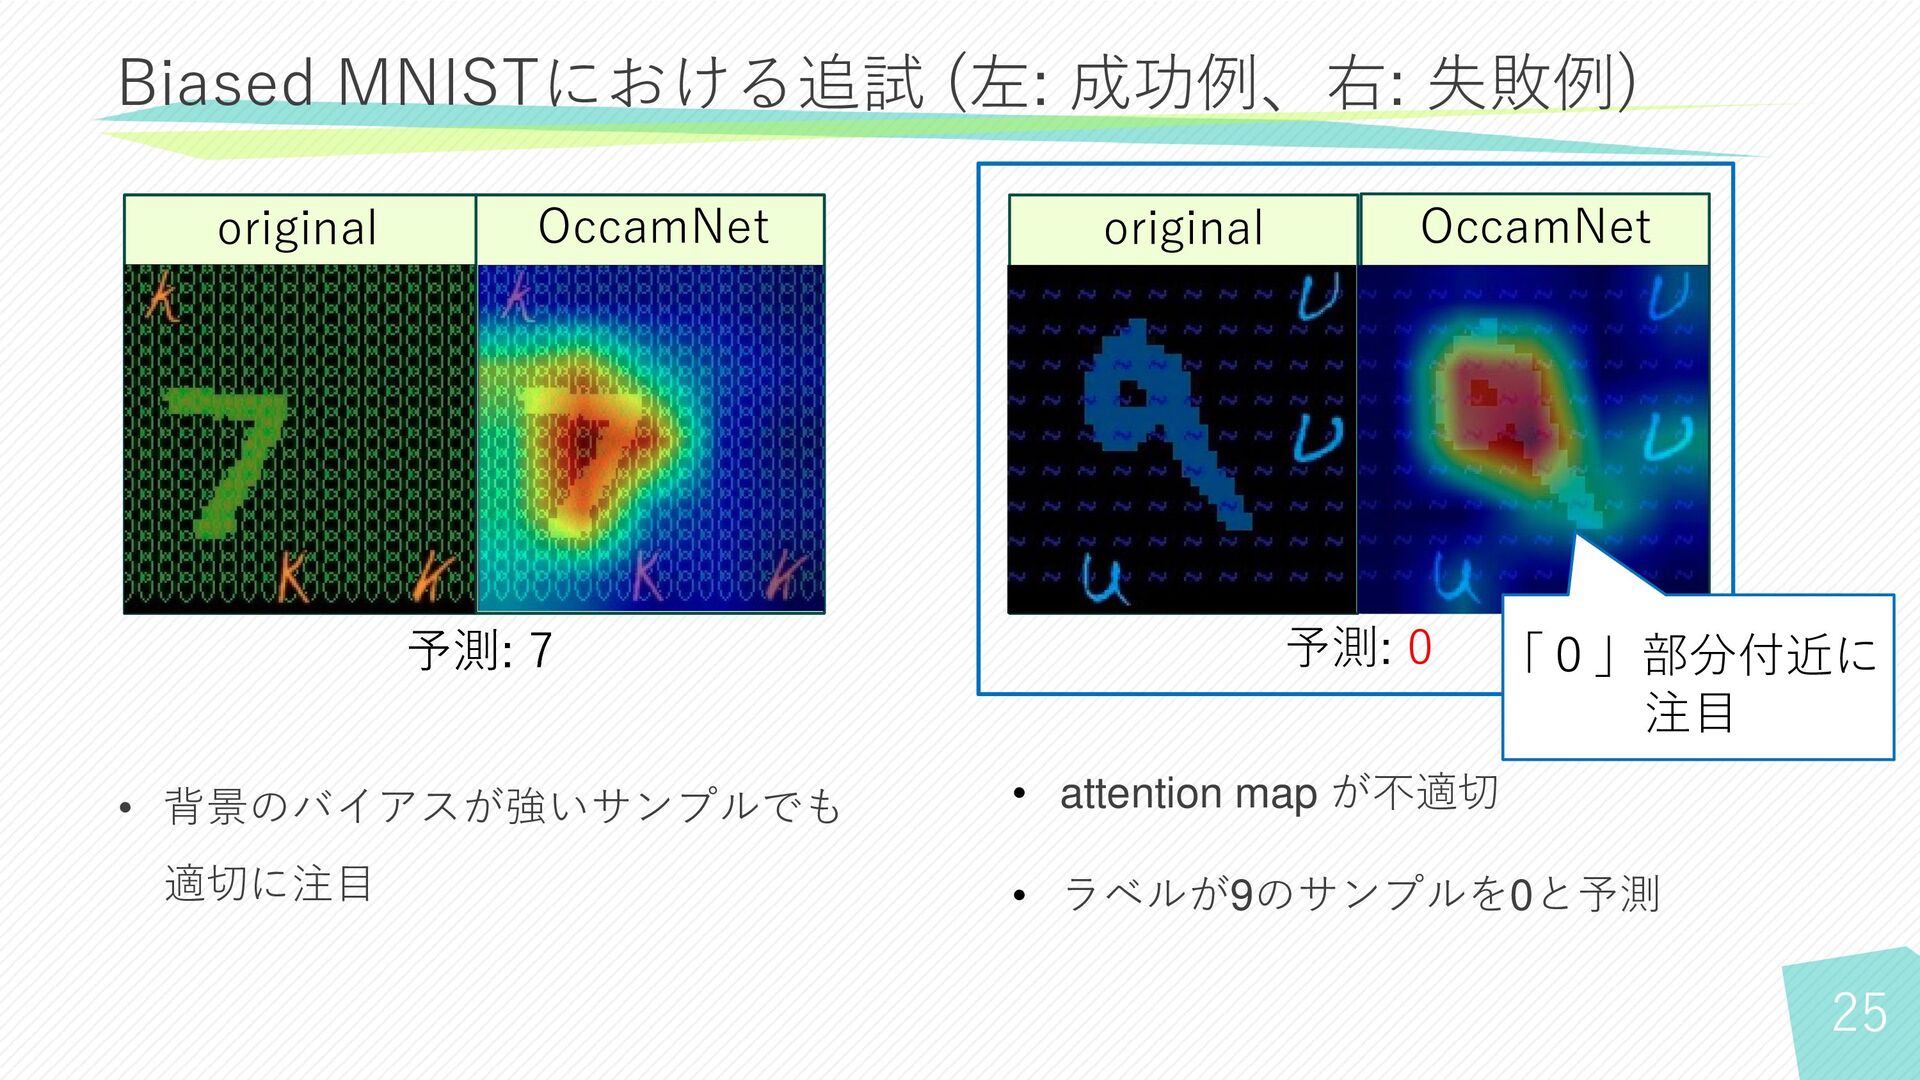
25 • attention map が不適切 • ラベルが9のサンプルを0と予測 • 背景のバイアスが強いサンプルでも 適切に注目
Biased MNISTにおける追試 (左: 成功例、右: 失敗例) original OccamNet 予測: 0 OccamNet original 予測: 7 original OccamNet 予測: 7 「0」部分付近に 注目
26 • 背景: − データセットバイアスや疑似相関が汎化性能に悪影響を与えることがある • 提案手法:OccamNets − サンプルごとに層の早期終了を行う ✓
各層で推論が不十分と判断されたサンプルのみ次の層に進む • 結果: − バイアスのあるデータセットで既存手法を上回る性能 − 既存手法と組み合わせることで性能がより向上 まとめ
27 Appendix
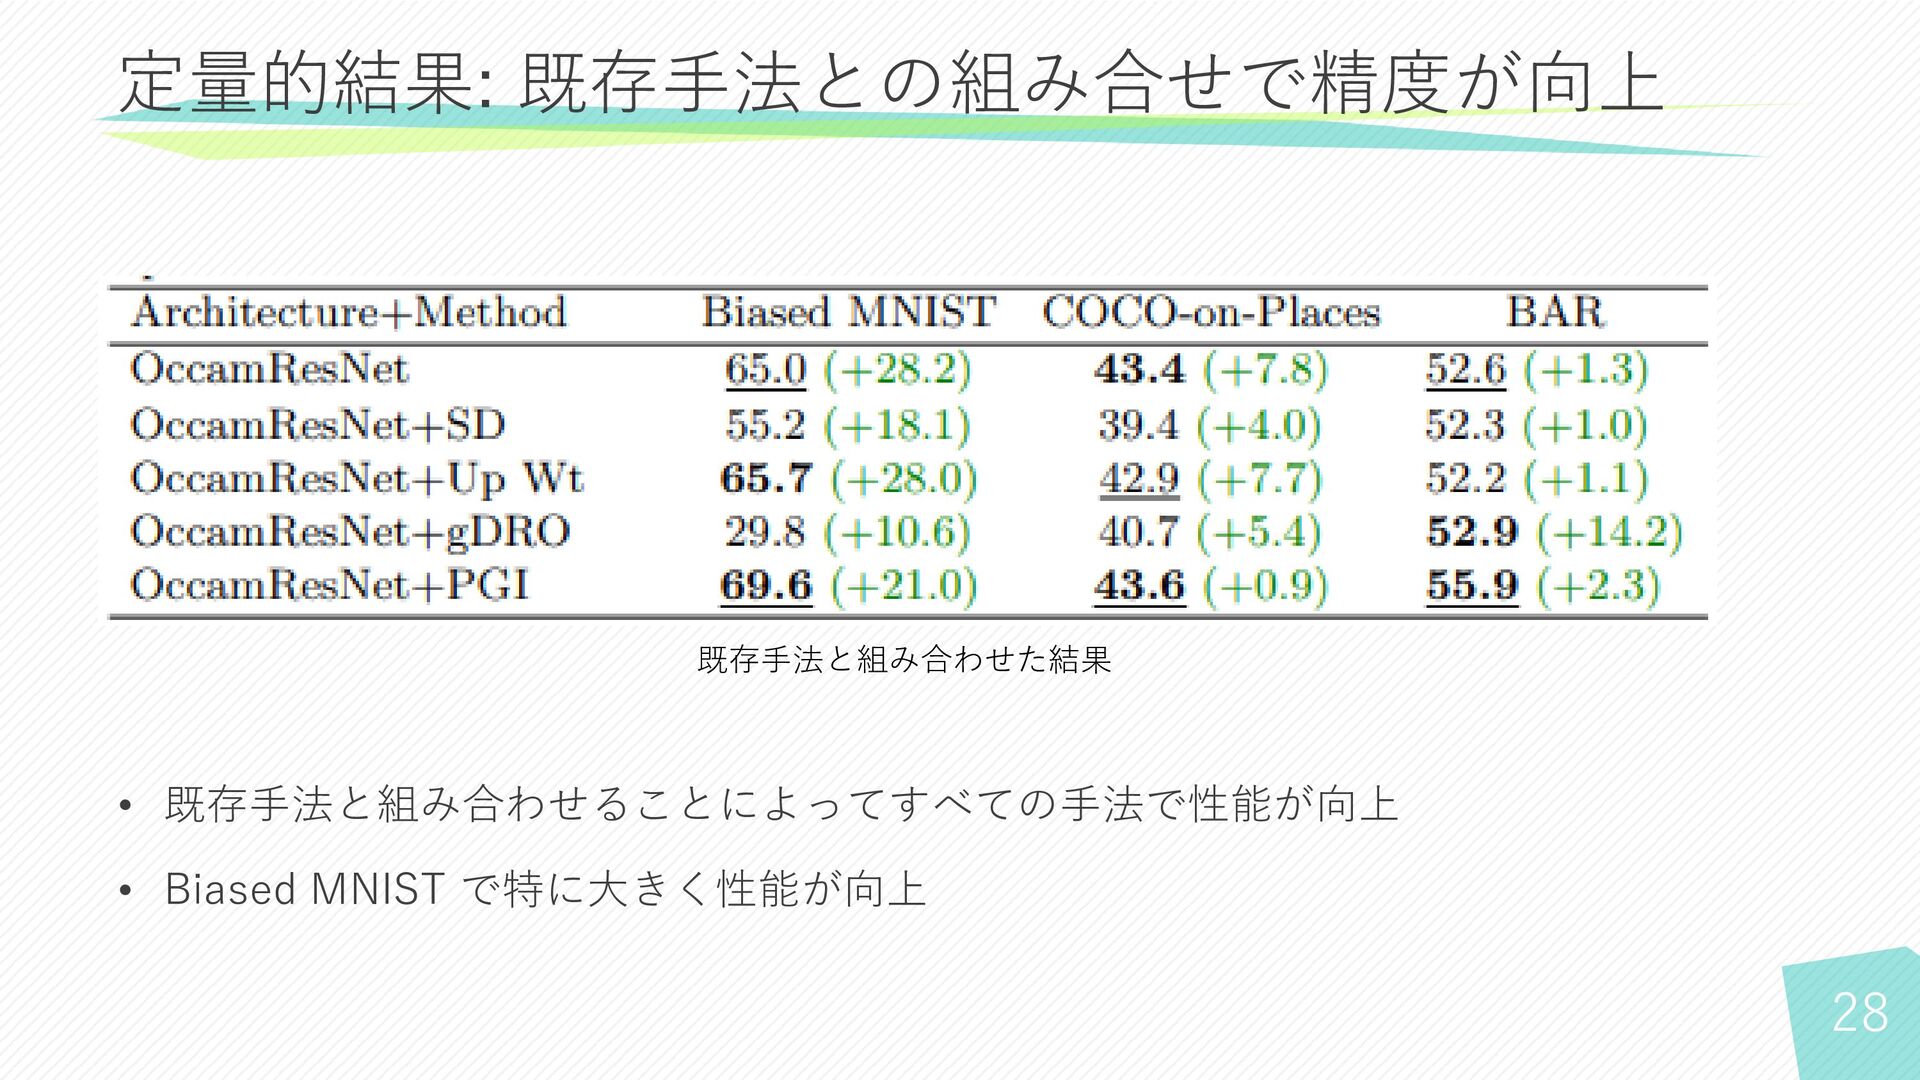
28 • 既存手法と組み合わせることによってすべての手法で性能が向上 • Biased MNIST で特に大きく性能が向上 定量的結果: 既存手法との組み合せで精度が向上 既存手法と組み合わせた結果
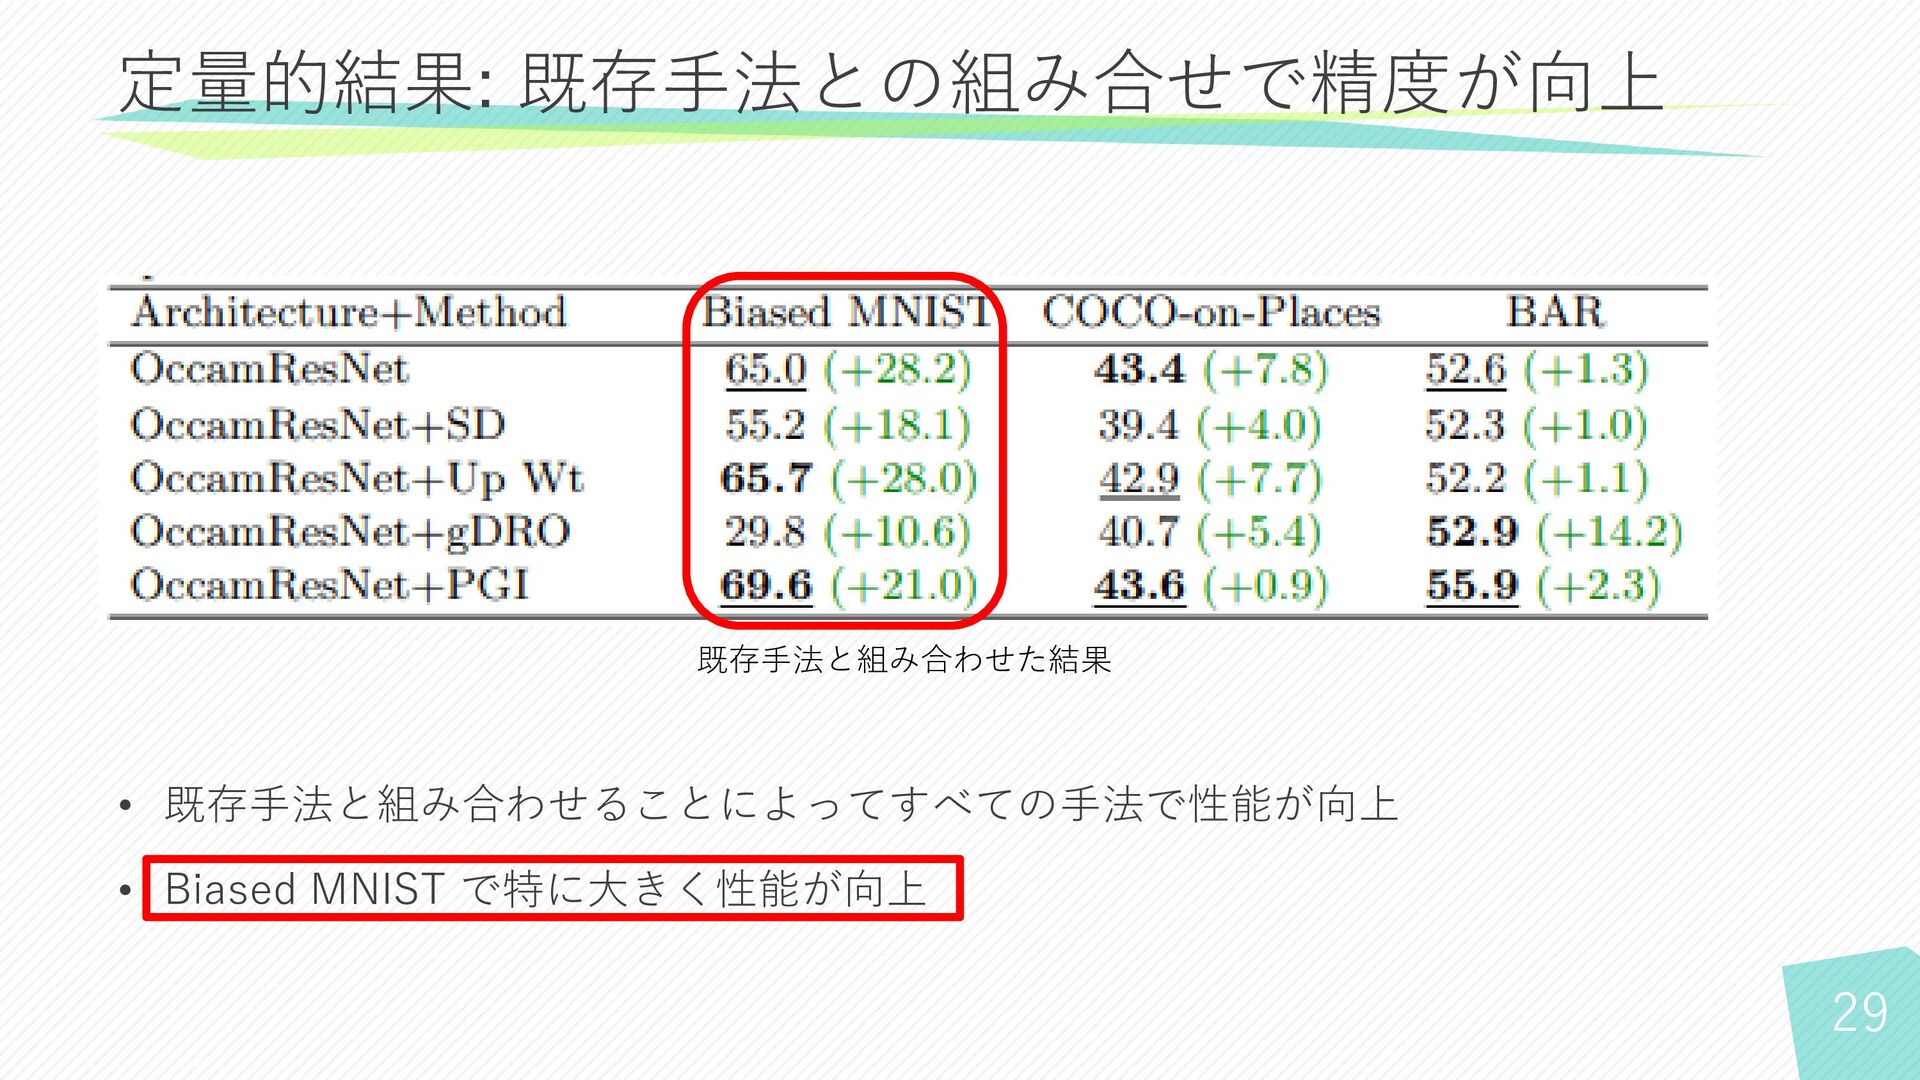
29 • 既存手法と組み合わせることによってすべての手法で性能が向上 • Biased MNIST で特に大きく性能が向上 定量的結果: 既存手法との組み合せで精度が向上 既存手法と組み合わせた結果
Robik Shrestha
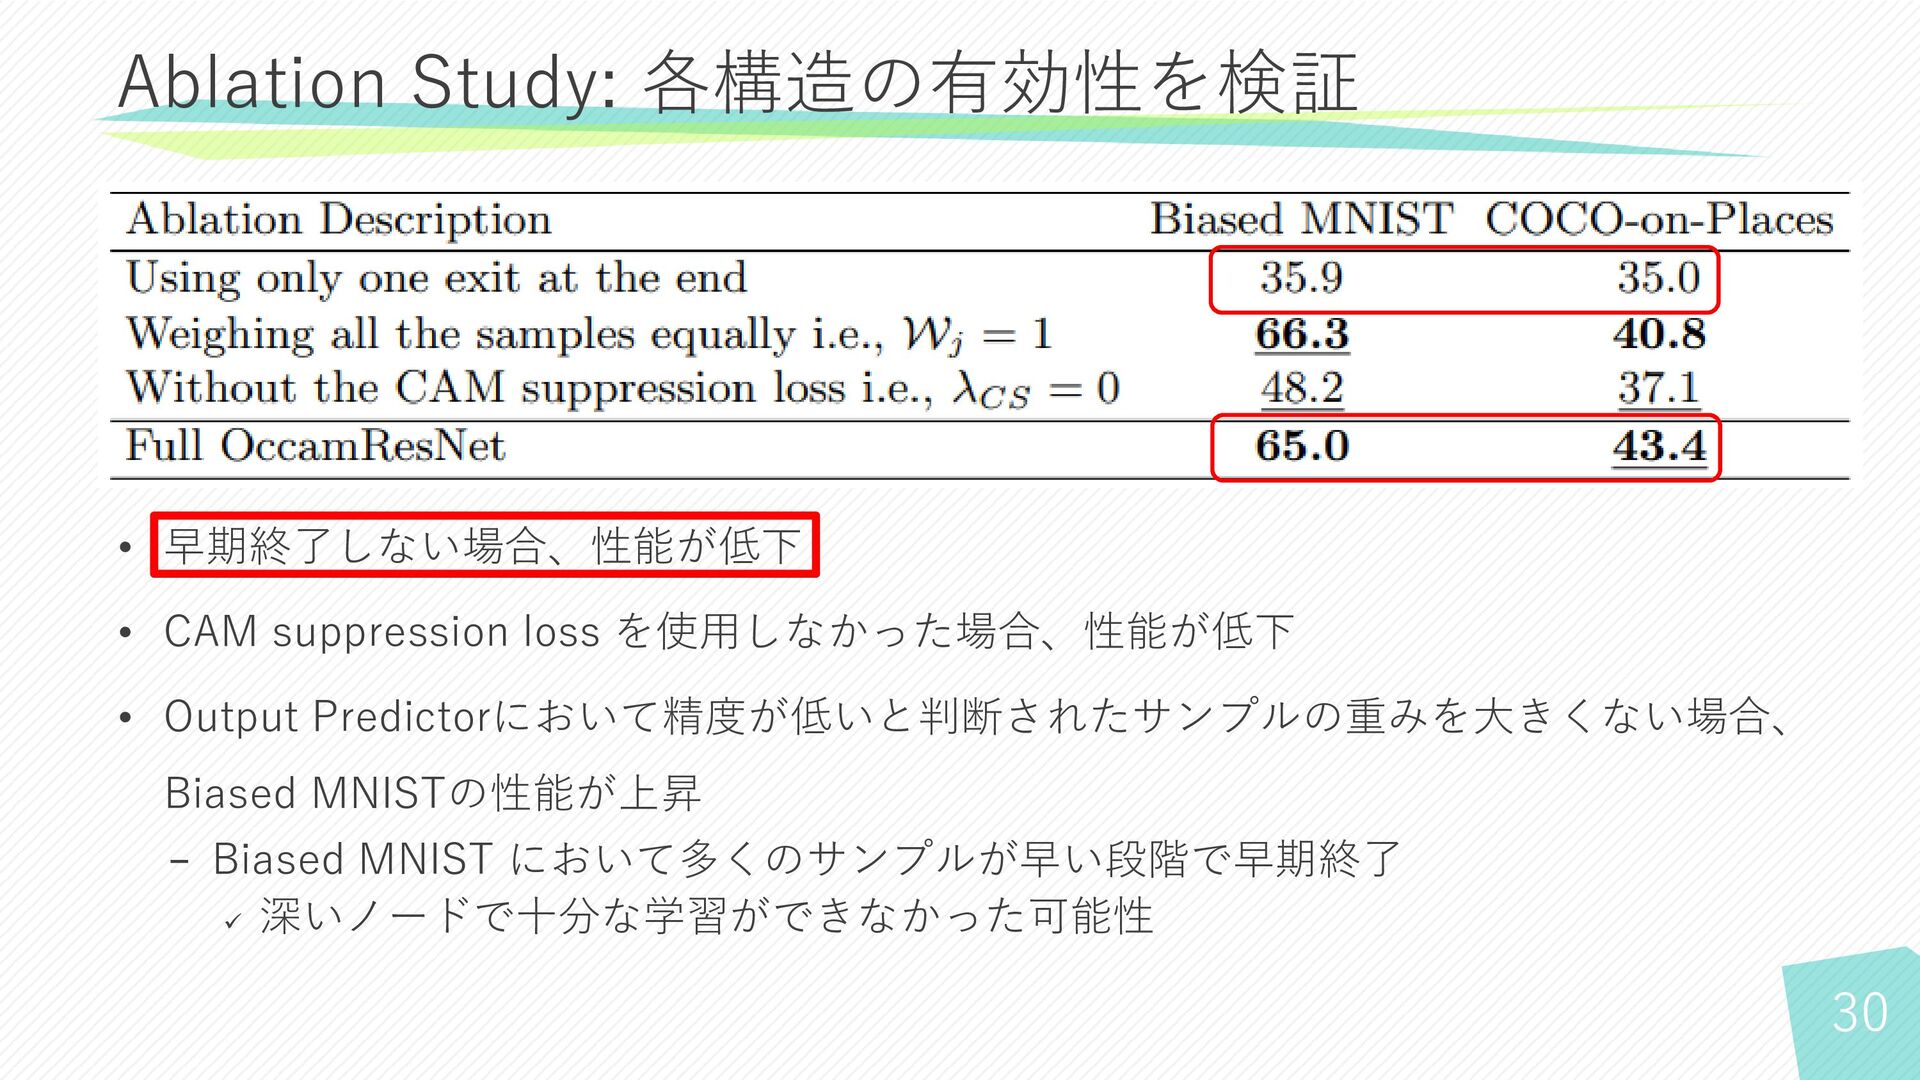
30 • 早期終了しない場合、性能が低下 • CAM suppression loss を使用しなかった場合、性能が低下 • Output
Predictorにおいて精度が低いと判断されたサンプルの重みを大きくない場合、 Biased MNISTの性能が上昇 − Biased MNIST において多くのサンプルが早い段階で早期終了 ✓ 深いノードで十分な学習ができなかった可能性 Ablation Study: 各構造の有効性を検証
31 • 早期終了しない場合、性能が低下 • CAM suppression loss を使用しなかった場合、性能が低下 • Output
Predictorにおいて精度が低いと判断されたサンプルの重みを大きくない場合、 Biased MNISTの性能が上昇 − Biased MNIST において多くのサンプルが早い段階で早期終了 ✓ 深いノードで十分な学習ができなかった可能性 Ablation Study: 各構造の有効性を検証
32 • 早期終了しない場合、性能が低下 • CAM suppression loss を使用しなかった場合、性能が低下 • Output
Predictorにおいて精度が低いと判断されたサンプルの重みを大きくない場合、 Biased MNISTの性能が上昇 − Biased MNIST において多くのサンプルが早い段階で早期終了 ✓ 深いノードで十分な学習ができなかった可能性 Ablation Study: 各構造の有効性を検証
33 • 早期終了しない場合、性能が低下 • CAM suppression loss を使用しなかった場合、性能が低下 • Output
Predictorにおいて精度が低いと判断されたサンプルの重みを大きくない場合、 Biased MNISTの精度が上昇 − Biased MNIST において多くのサンプルが早い段階で早期終了 ✓ 深いノードで十分な学習ができなかった可能性 Ablation Study: 各構造の有効性を検証
34 • 早期終了しない場合、性能が低下 • CAM suppression loss を使用しなかった場合、性能が低下 • Output
Predictorにおいて精度が低いと判断されたサンプルの重みを大きくない場合、 Biased MNISTの精度が上昇 − Biased MNIST において多くのサンプルが早い段階で早期終了 ✓ 深いノードで十分な学習ができなかった可能性 Ablation Study: 各構造の有効性を検証
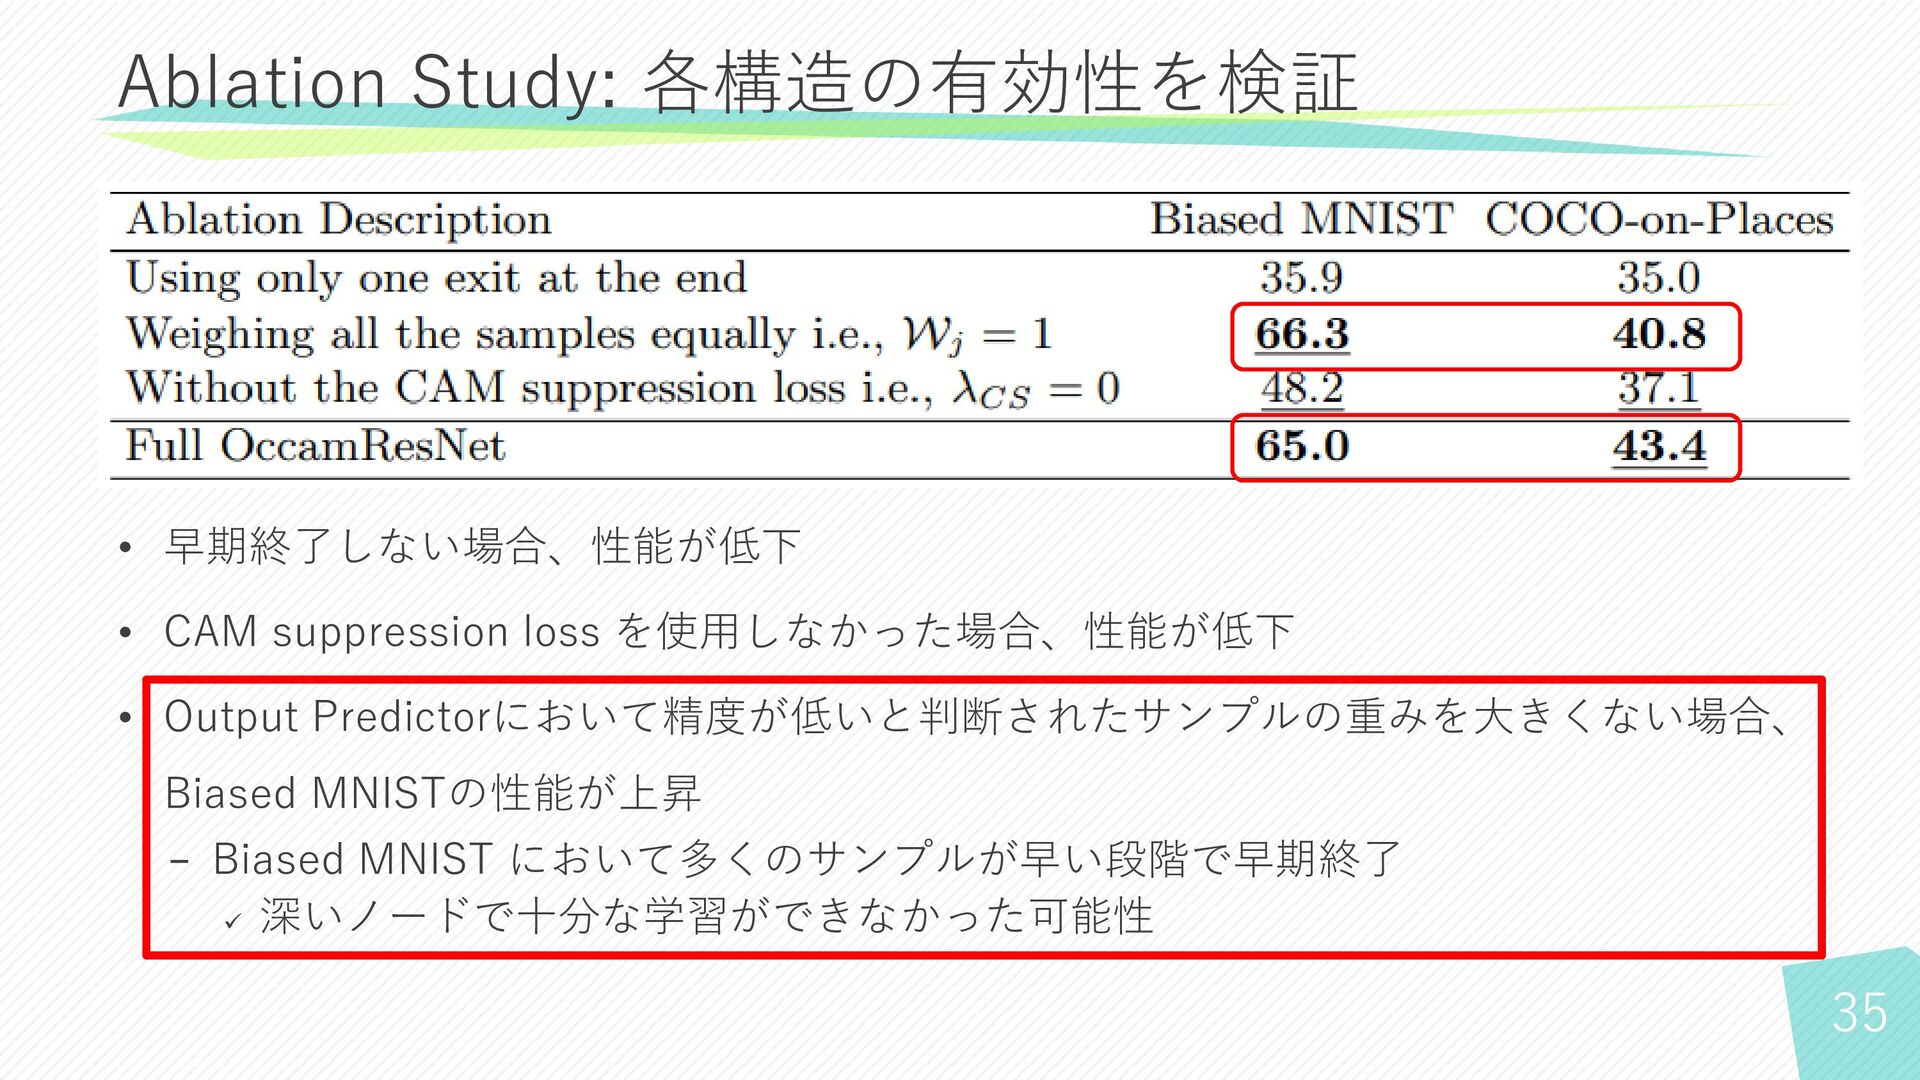
35 • 早期終了しない場合、性能が低下 • CAM suppression loss を使用しなかった場合、性能が低下 • Output
Predictorにおいて精度が低いと判断されたサンプルの重みを大きくない場合、 Biased MNISTの性能が上昇 − Biased MNIST において多くのサンプルが早い段階で早期終了 ✓ 深いノードで十分な学習ができなかった可能性 Ablation Study: 各構造の有効性を検証
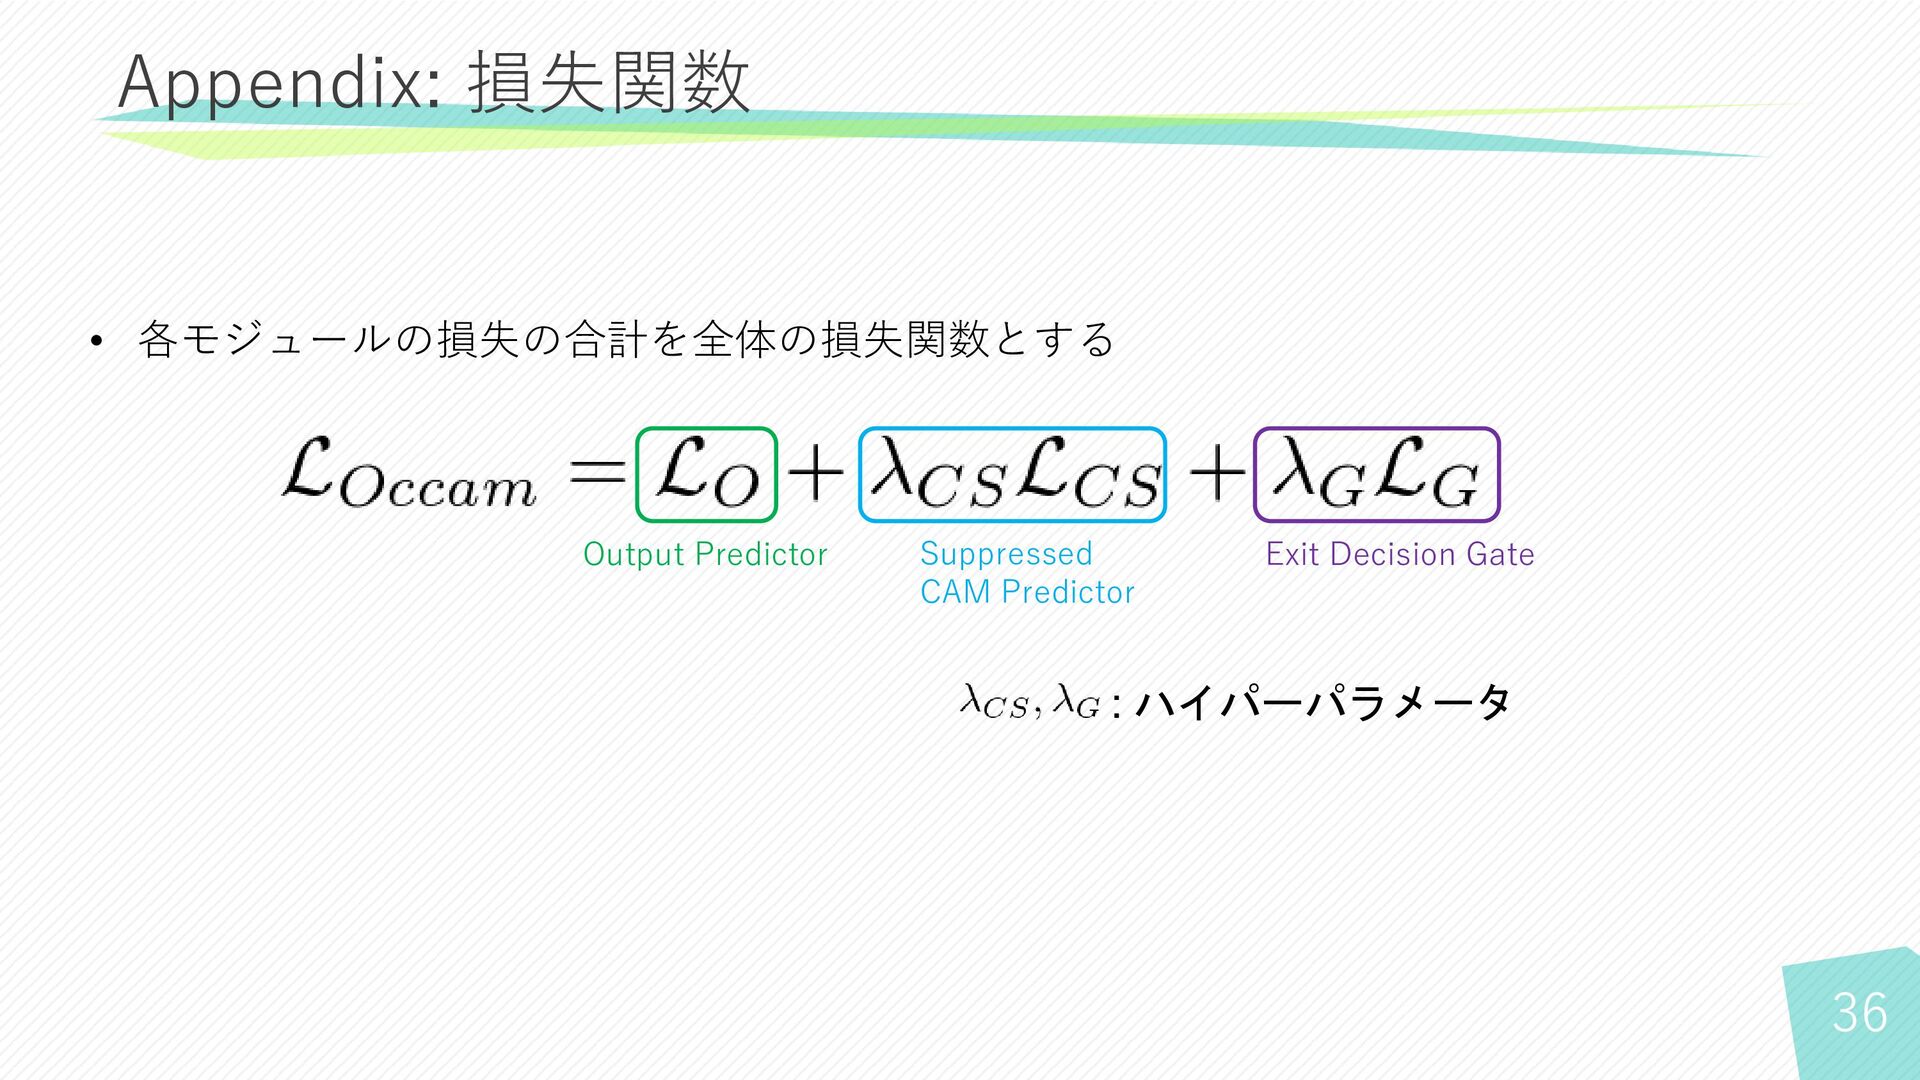
36 Appendix: 損失関数 Output Predictor Suppressed CAM Predictor Exit Decision
Gate • 各モジュールの損失の合計を全体の損失関数とする : ハイパーパラメータ

 SiteGround - Reliable hosting with speed, security, and support you can count on.


 keio_smilab
 oasis1994liveforever
 hiracky16
 jozono
 satomasahiro2005
 ueponx
 riyaamemiya
 taketakekaho
 masakiokuda
 yahonda
 teamlab
 takahashim
 iktakahiro
 cassininazir
 helenjbeal
 davetheseo
 katarinadahlin
 lemiorhan
 jcasabona
 bethany
 jct
 wjessup
 bkeepers
 jnunemaker
 akademiya2063