Share
Embed
[RSJ25] Everyday Object Manipulation Based on Scene Text-Aware Multimodal Retrieval
Semantic Machine Intelligence Lab., Keio Univ. PRO
August 31, 2025
Transcript
14 slides
-
背景:自然言語指示による実世界での物体検索・操作 2 自然言語指示を扱うロボティクス手法 ▪ π0 ,[Goko+, CoRL24] ▪ 生活支援ロボットによる物体操作 ▪
公共空間での物体検索 ▪ 例:ショッピングモール ▪ シーンテキストの利用により,物体を明確に指定可能 ×10 “Can you pass me the remote control next to the towel?” ×10 “Move the coke.” ×8 画像内の物体に記載された文字情報 ▪ Banana Nut Crunch, Post, Selects, … -
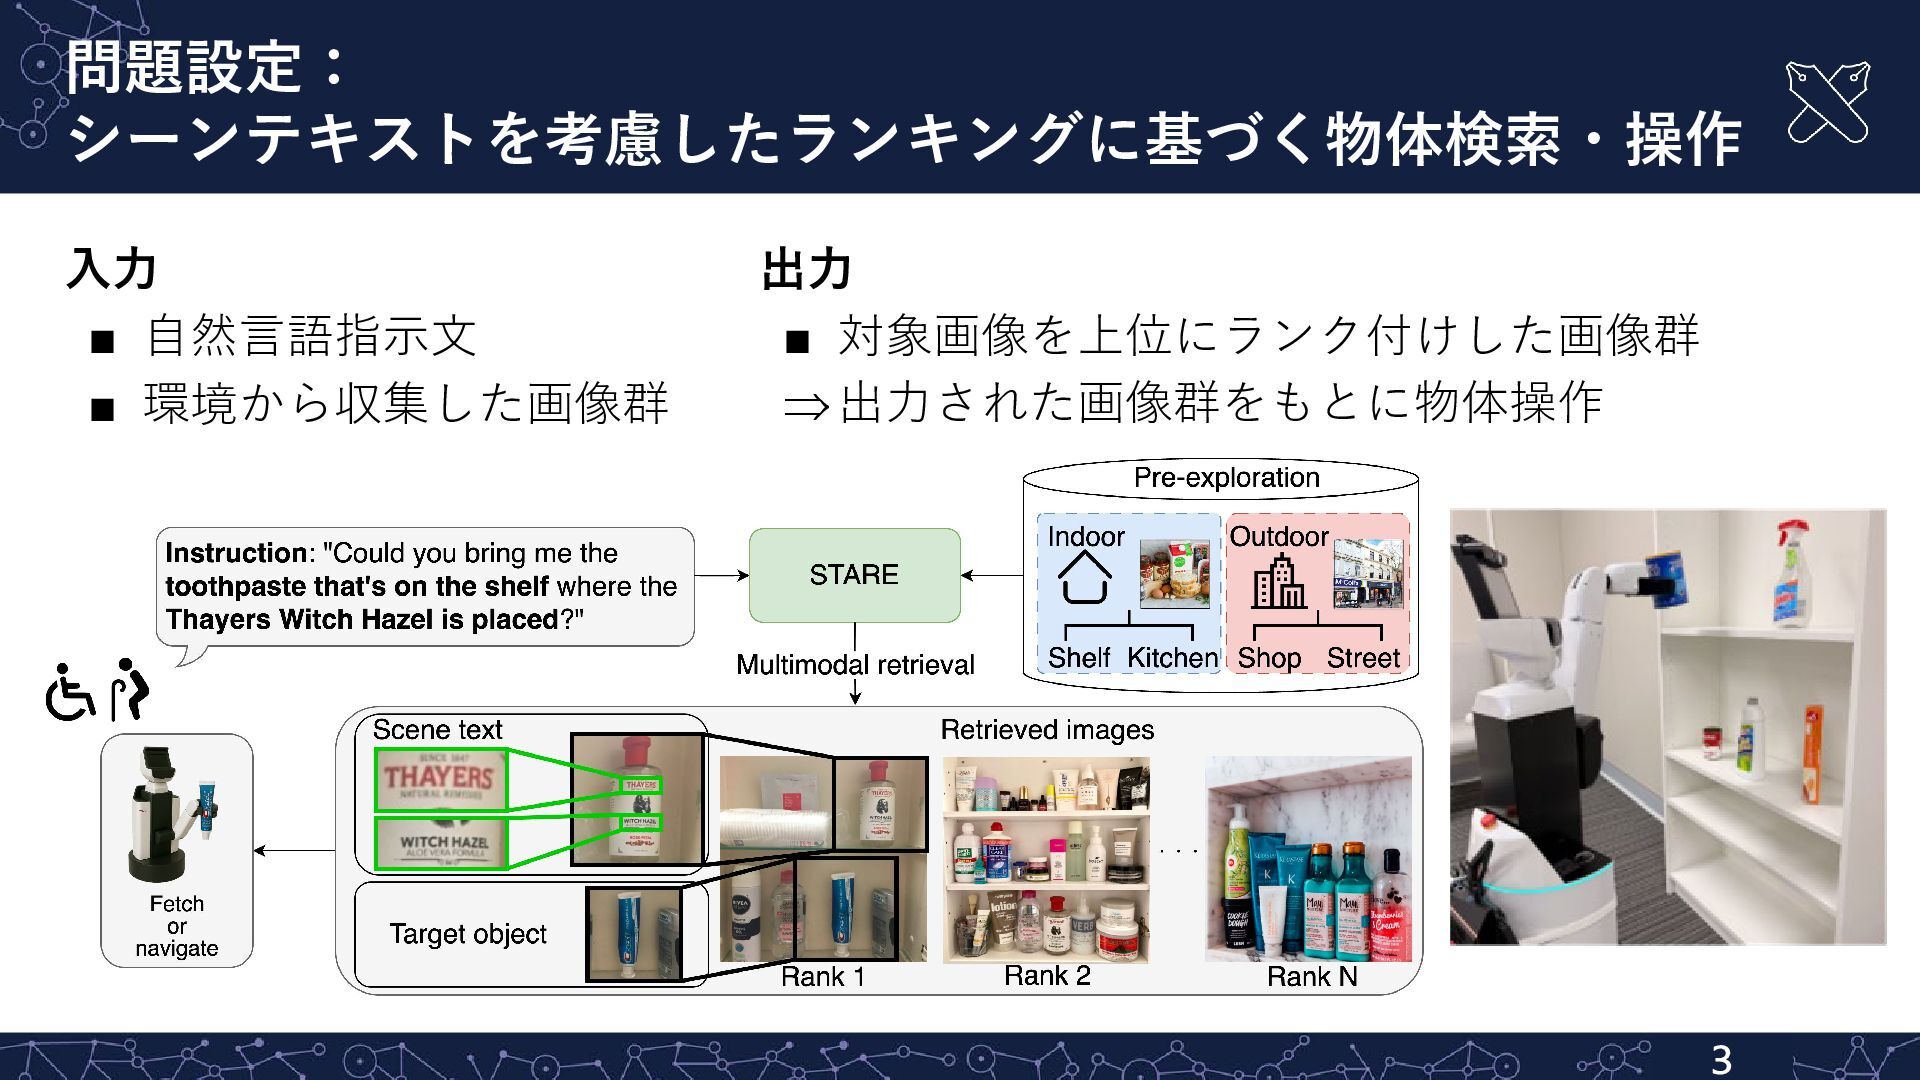
問題設定: シーンテキストを考慮したランキングに基づく物体検索・操作 3 入力 ▪ 自然言語指示文 ▪ 環境から収集した画像群 出力 ▪
対象画像を上位にランク付けした画像群 ⇒出力された画像群をもとに物体操作 -
関連研究:シーンテキストの活用が不十分 4 手法 概要 CLIP [Radford+, ICML21] BEiT-3 [Wang+, CVPR23]
大規模な画像・テキストペアで学習されたモデル Embodied RAG [Xie+, 24] NavRAG [Wang+, ACL25 Findings] RAGを実世界ロボット環境での検索とQAに応用 NLMap-SayCan [Chen+, ICRA23] RelaX-Former [Yashima+, RA-L25] 自然言語指示に基づく物体検索・操作 BEiT-3 RelaX-Former -
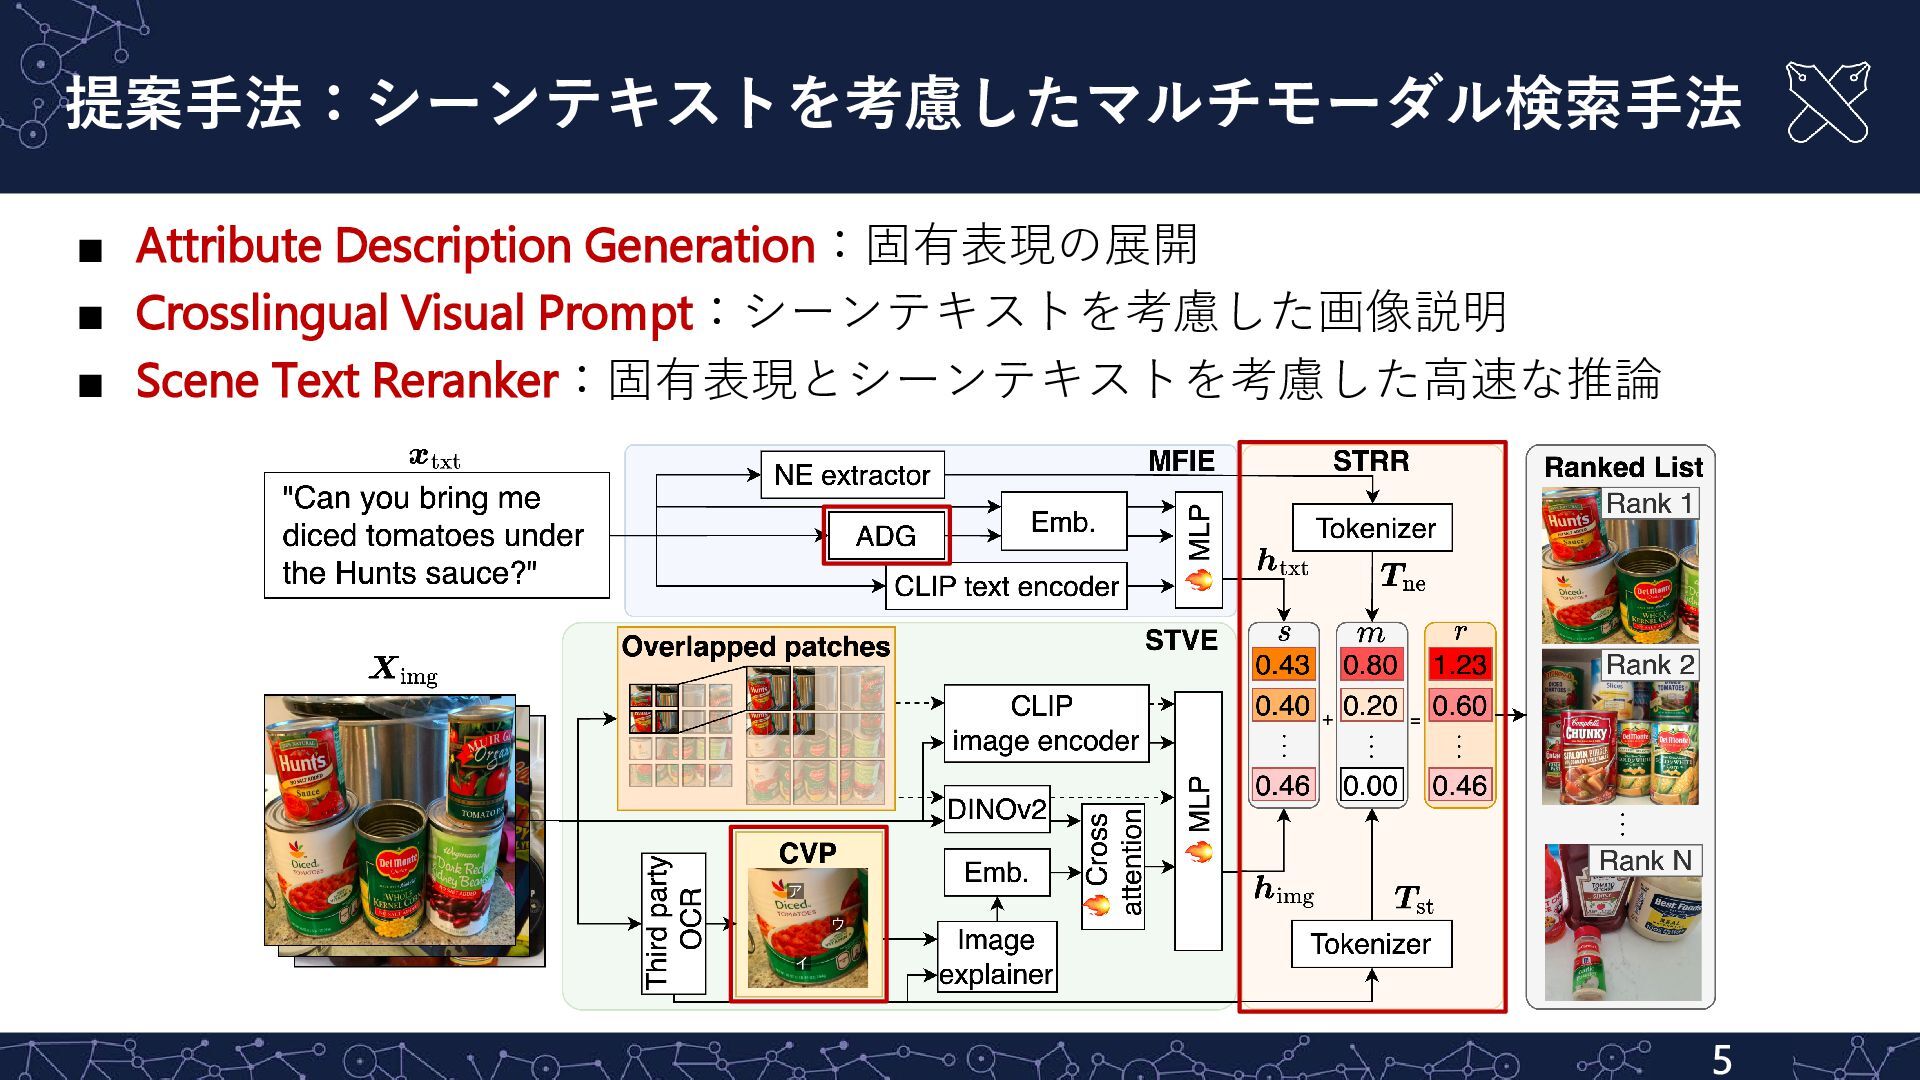
提案手法:シーンテキストを考慮したマルチモーダル検索手法 5 ▪ Attribute Description Generation:固有表現の展開 ▪ Crosslingual Visual Prompt:シーンテキストを考慮した画像説明
▪ Scene Text Reranker:固有表現とシーンテキストを考慮した高速な推論 -
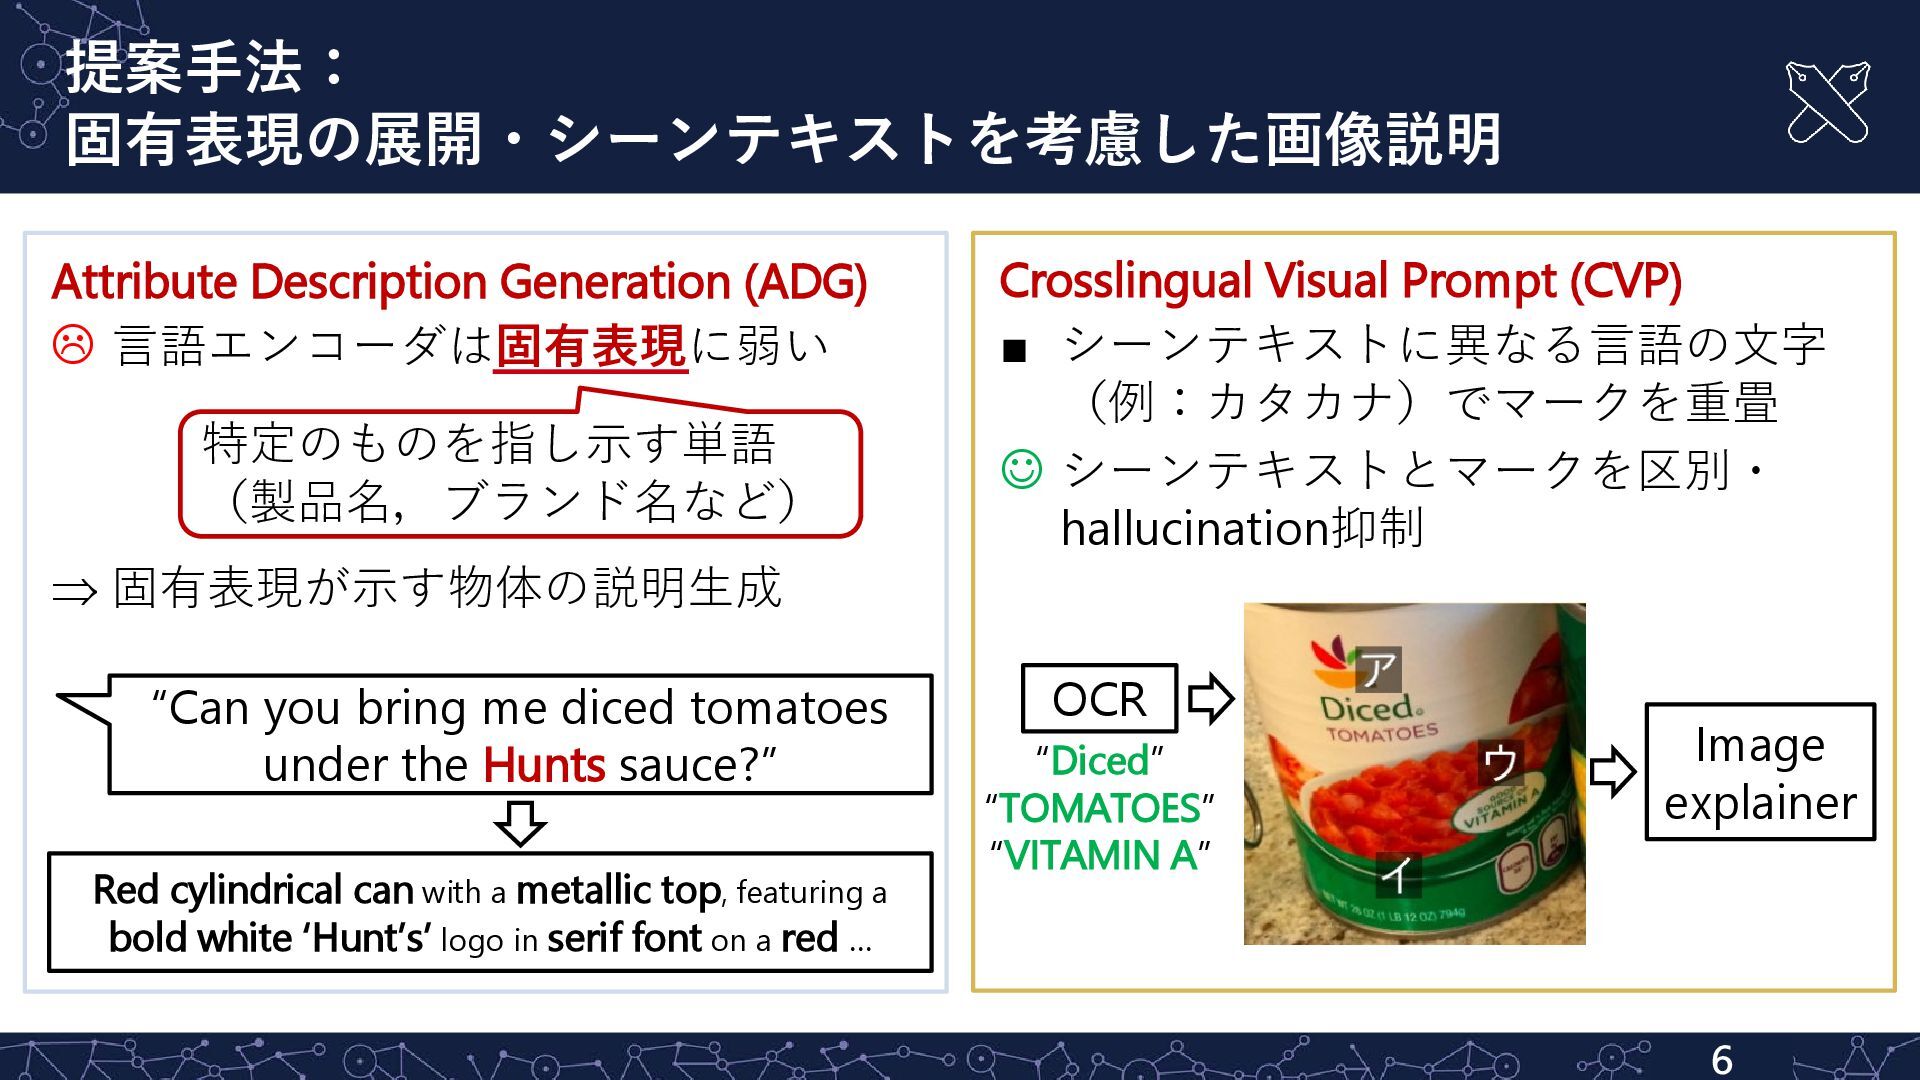
提案手法: 固有表現の展開・シーンテキストを考慮した画像説明 6 Attribute Description Generation (ADG) 言語エンコーダは固有表現に弱い ⇒
固有表現が示す物体の説明生成 Crosslingual Visual Prompt (CVP) ▪ シーンテキストに異なる言語の文字 (例:カタカナ)でマークを重畳 シーンテキストとマークを区別・ hallucination抑制 Image explainer OCR “Diced” “TOMATOES” “VITAMIN A” “Can you bring me diced tomatoes under the Hunts sauce?” Red cylindrical can with a metallic top, featuring a bold white ‘Hunt’s’ logo in serif font on a red … 特定のものを指し示す単語 (製品名,ブランド名など) -
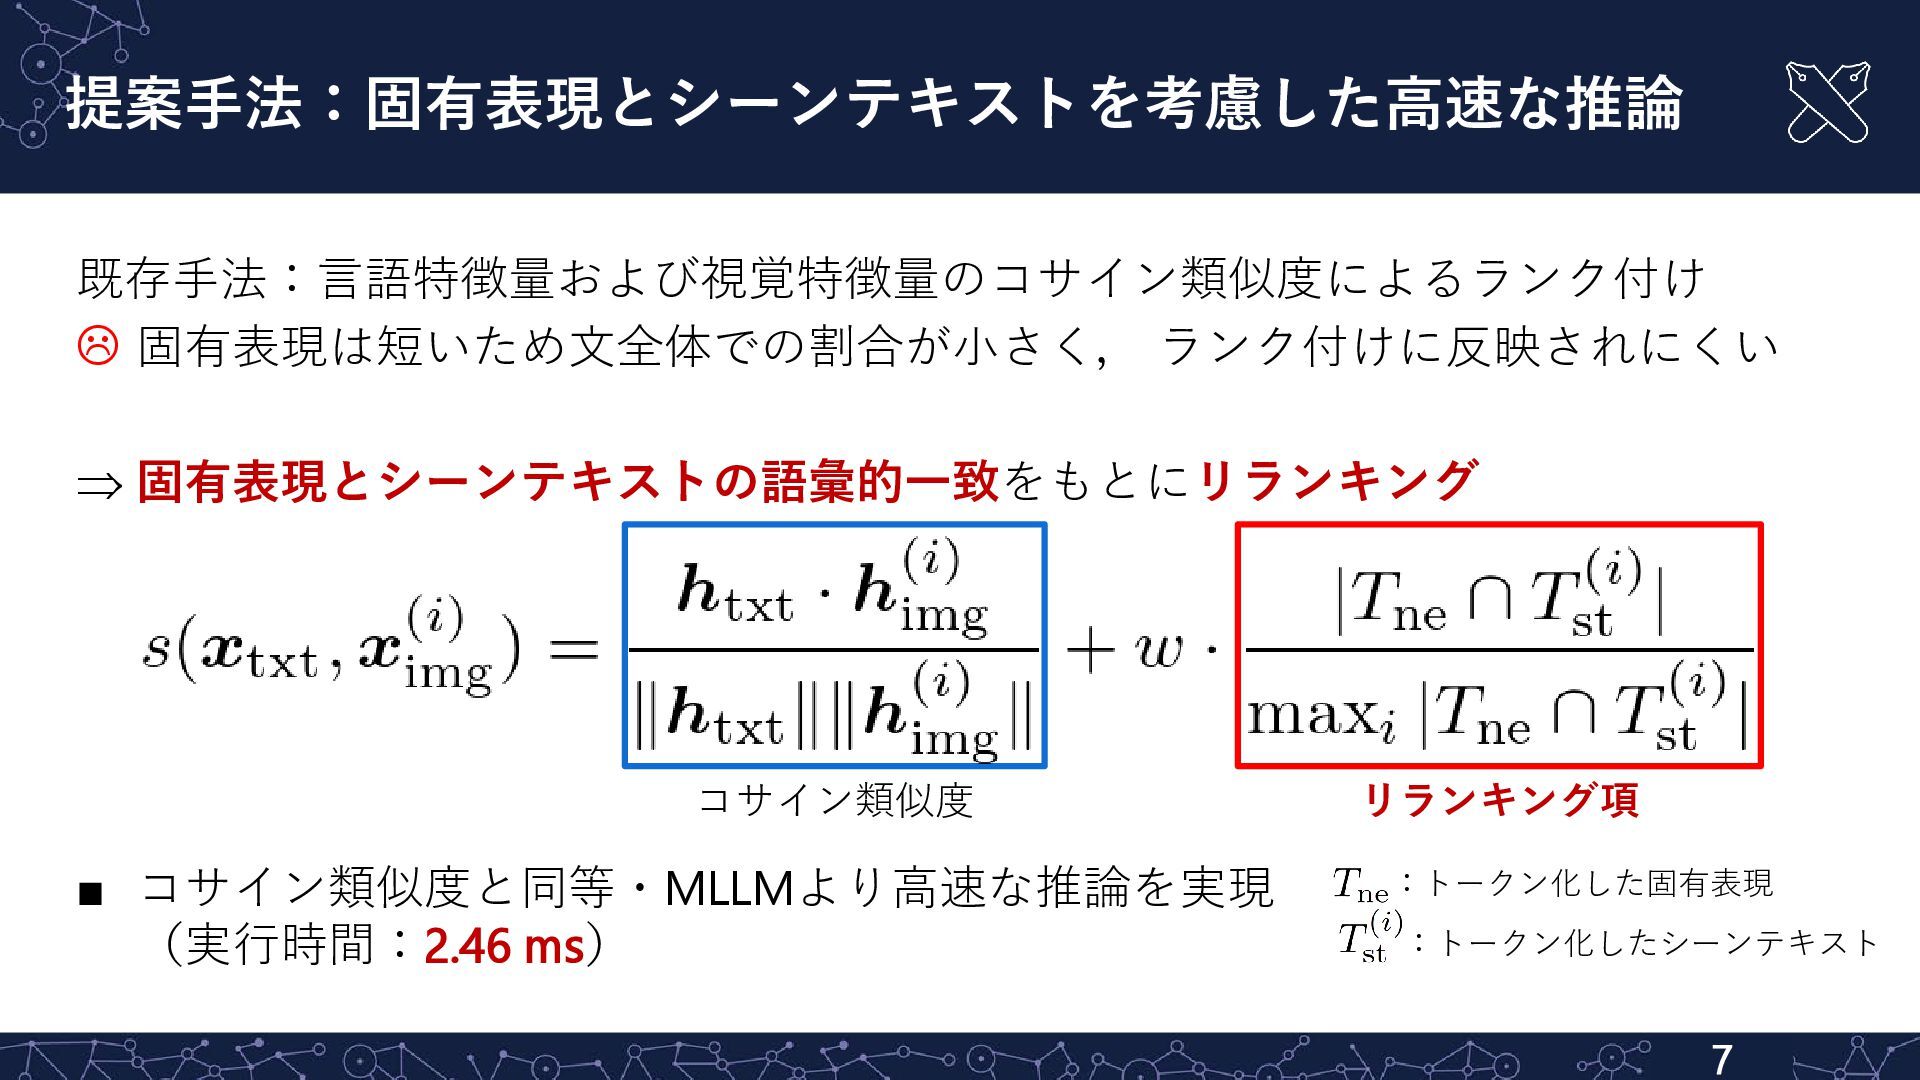
既存手法:言語特徴量および視覚特徴量のコサイン類似度によるランク付け 固有表現は短いため文全体での割合が小さく, ランク付けに反映されにくい ⇒ 固有表現とシーンテキストの語彙的一致をもとにリランキング ▪ コサイン類似度と同等・MLLMより高速な推論を実現 (実行時間:2.46 ms)
提案手法:固有表現とシーンテキストを考慮した高速な推論 7 :トークン化した固有表現 :トークン化したシーンテキスト コサイン類似度 リランキング項 -
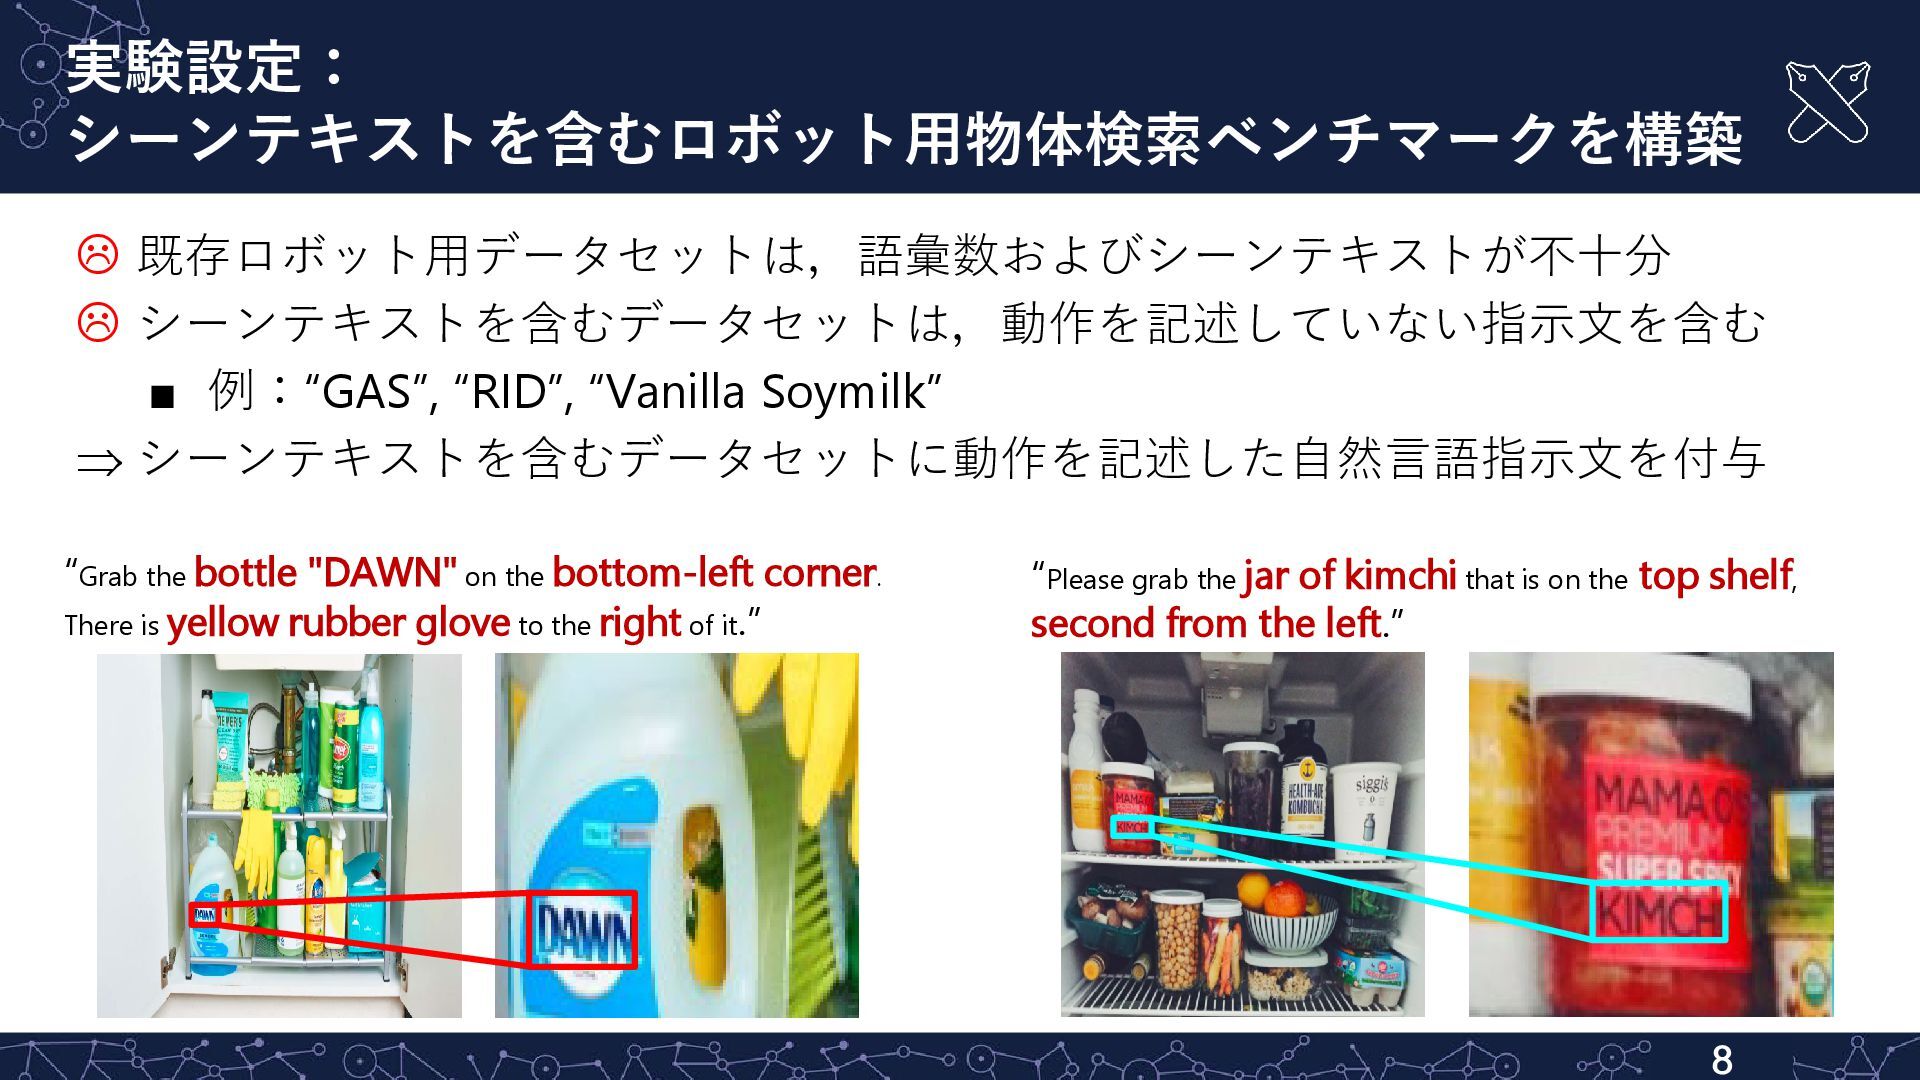
実験設定: シーンテキストを含むロボット用物体検索ベンチマークを構築 8 既存ロボット用データセットは,語彙数およびシーンテキストが不十分 シーンテキストを含むデータセットは,動作を記述していない指示文を含む ▪ 例:“GAS”, “RID”,
“Vanilla Soymilk” ⇒ シーンテキストを含むデータセットに動作を記述した自然言語指示文を付与 “Grab the bottle "DAWN" on the bottom-left corner. There is yellow rubber glove to the right of it.” “Please grab the jar of kimchi that is on the top shelf, second from the left.” -
定量的結果: シーンテキストの有無を問わずベースライン手法を上回った [%] 手法 GoGetIt (RefText) GoGetIt (Instruction) TextCaps-test LTRRIE
[Kaneda+, RA-L24] R@5↑ R@10↑ R@5↑ R@10↑ R@5↑ R@10↑ R@5↑ R@10↑ 提案手法 91.1 95.0 88.5 92.6 93.3 96.1 72.1 87.1 CLIP (fine-tuned) [Radford+, ICML21] 63.5 74.1 73.9 83.9 82.0 90.1 56.8 72.3 BEiT-3 [Wang+, CVPR23] 54.4 65.3 63.7 79.5 76.5 84.8 59.9 76.6 RelaX-Former [Yashima+, RA-L25] - - - - 62.3 73.7 66.6 81.7 9 +20.9 +8.7 +6.0 +5.4 -
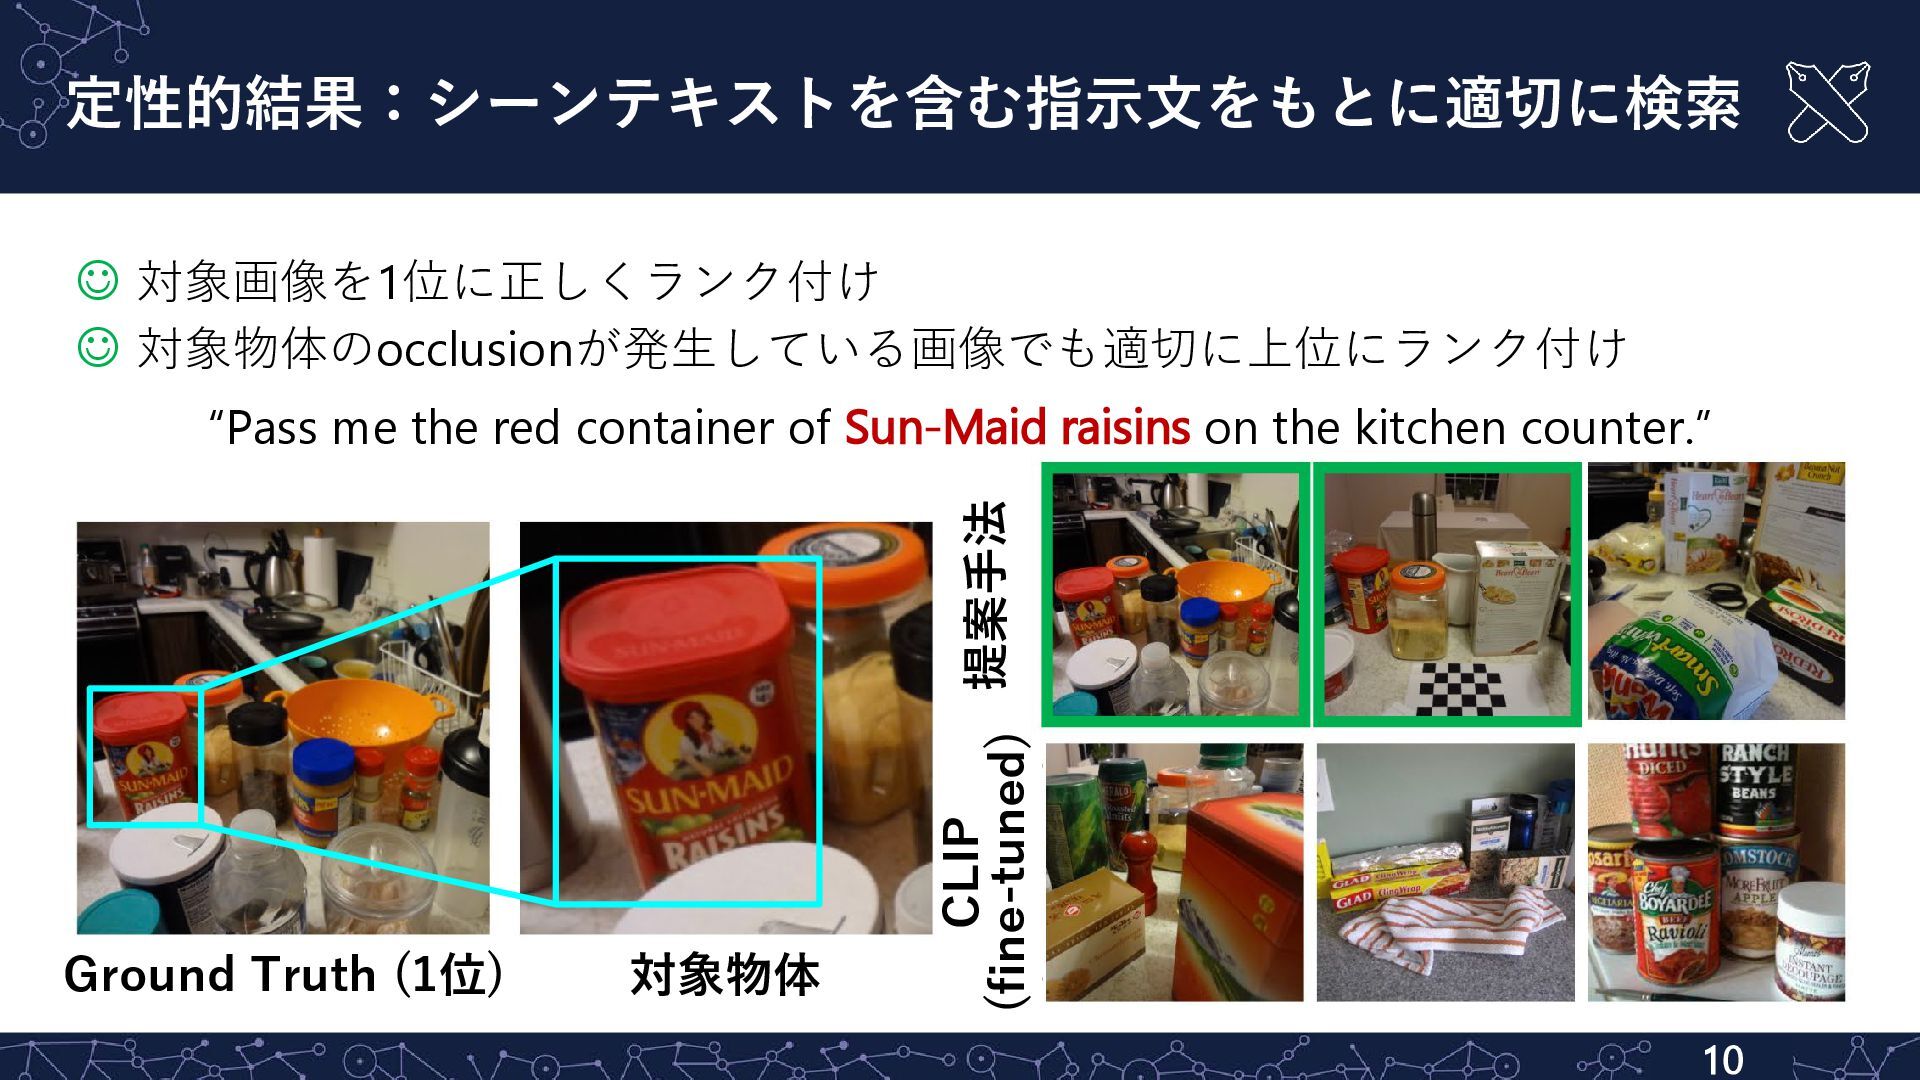
定性的結果:シーンテキストを含む指示文をもとに適切に検索 10 “Pass me the red container of Sun-Maid raisins
on the kitchen counter.” 提案手法 CLIP (fine-tuned) 対象物体 Ground Truth (1位) 対象画像を1位に正しくランク付け 対象物体のocclusionが発生している画像でも適切に上位にランク付け -
実機実験-設定:物体検索・操作へのゼロショット転移 11 ▪ 物体:YCB [Calli+, RAM15] (10種類)+ラベル付き日常物体(13種類) ▪ 試行回数:100エピソード ▪
評価尺度:Recall@5(検索) ▪ 成功率(把持) -
実機実験-定量・定性的結果: ベースライン⼿法を上回るゼロショット転移性能 手法 [%] R@5↑ SR↑ 提案手法 88 80 CLIP
(fine-tuned) [Radford+, ICML21] 74 65 BEiT-3 [Wang+, CVPR23] 66 62 12 +14 +15 シーンテキストを含む指示文をもとに 適切に対象物体の検索と把持を実行 “Take the spray bottle labeled windex.” Rank 1 Rank 2 Windex -
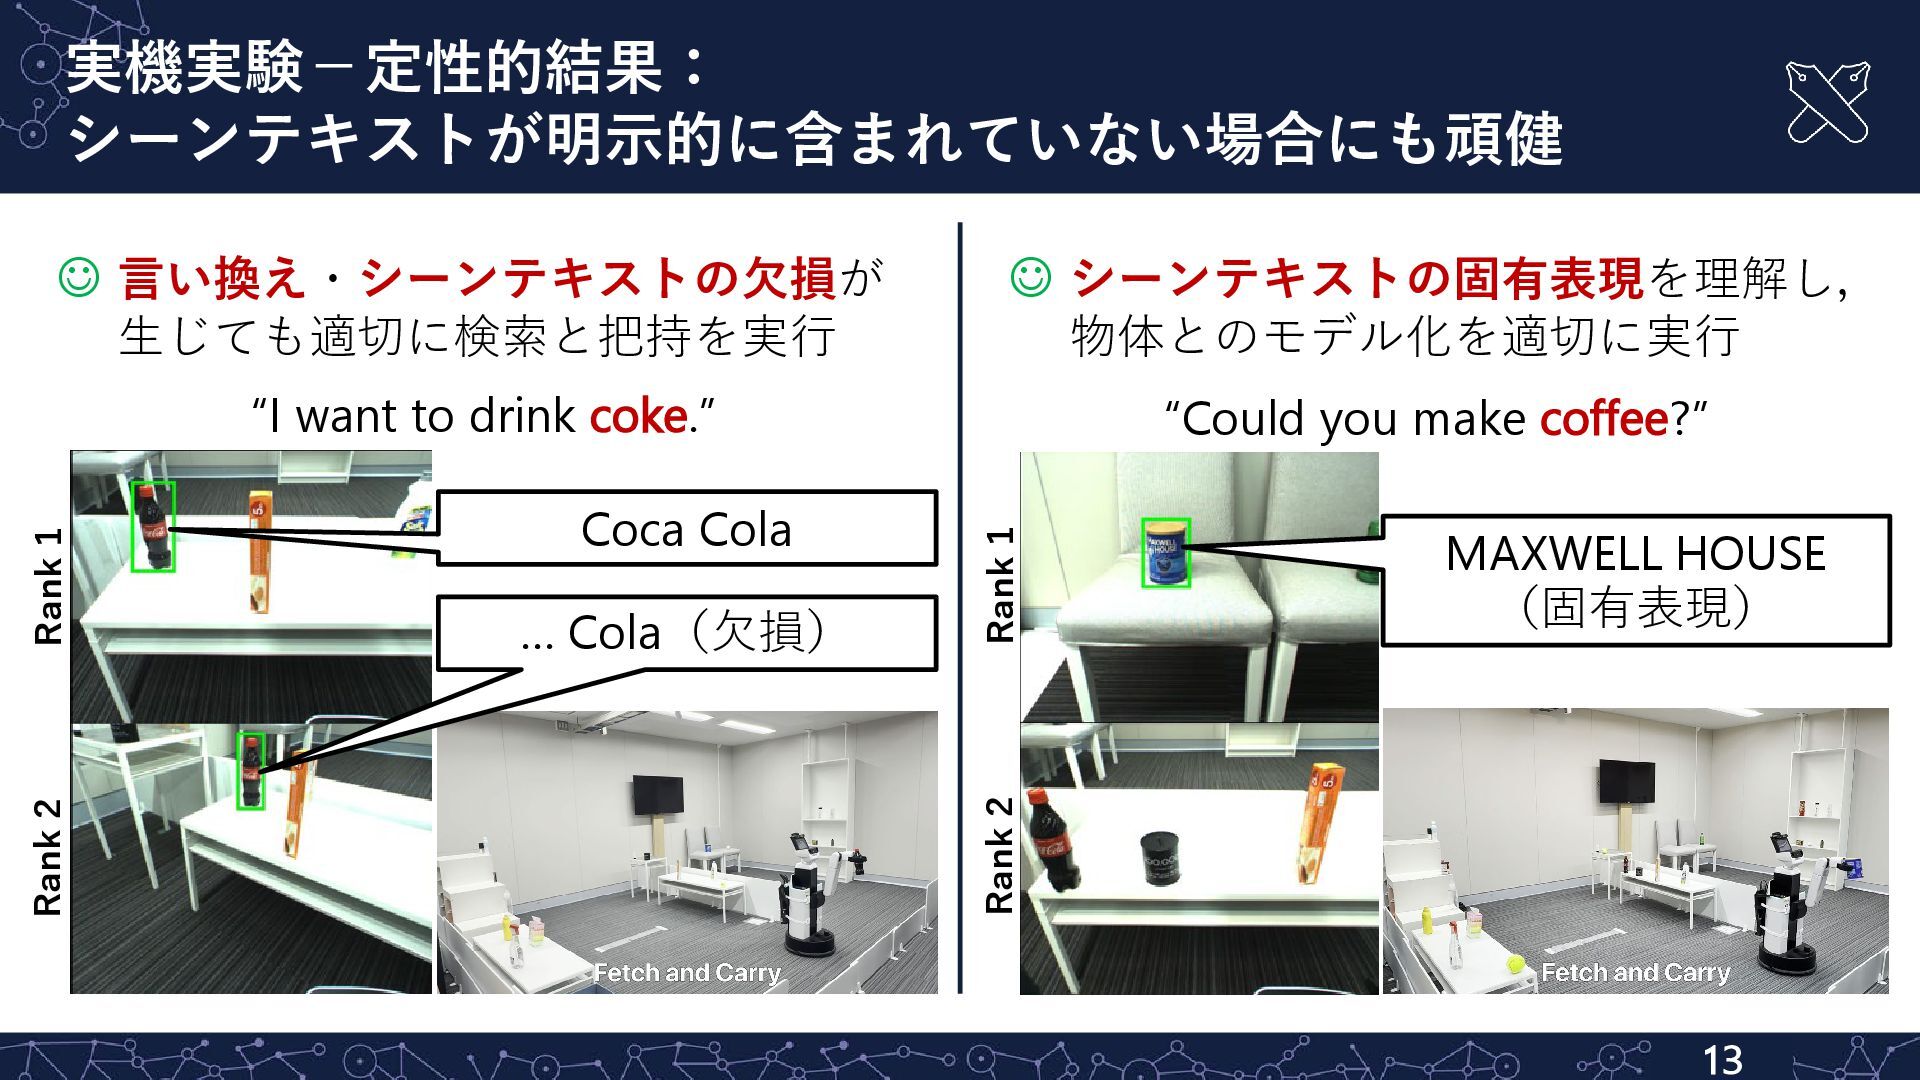
実機実験-定性的結果: シーンテキストが明示的に含まれていない場合にも頑健 13 シーンテキストの固有表現を理解し, 物体とのモデル化を適切に実行 “Could you make coffee?”
言い換え・シーンテキストの欠損が 生じても適切に検索と把持を実行 “I want to drink coke.” Rank 1 Rank 2 Coca Cola … Cola(欠損) Rank 1 Rank 2 MAXWELL HOUSE (固有表現) -
まとめ 14 背景 ▪ シーンテキストを考慮したマルチモーダル検索 新規性 ▪ 固有表現の展開 ▪ シーンテキストを考慮した画像説明
▪ 固有表現とシーンテキストを考慮した 高速な推論 実験結果 ▪ 複数ベンチマークおよび実機実験において ベースライン手法を上回った