Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
インデックスのパフォーマンス調べてみた
Search
matumoto
October 15, 2022
Technology
130
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
インデックスのパフォーマンス調べてみた
2022/10月に行われた大LTでの発表資料です
イベントページはこちら
https://zli.connpass.com/event/261496/
matumoto
October 15, 2022
More Decks by matumoto
See All by matumoto
Go標準パッケージのI/O処理をながめる
matumoto
0
530
testingを眺める
matumoto
1
230
sync/v2 プロポーザルの 背景と sync.Pool について
matumoto
0
850
Goトランザクション処理
matumoto
1
100
いまいちどスライスの 挙動を見直してみる
matumoto
0
440
Go1.22のリリース予定の機能を見る
matumoto
0
100
GoのUnderlying typeについて
matumoto
0
250
Typed-nilについて
matumoto
0
410
GoのType Setsという概念
matumoto
0
69
Other Decks in Technology
See All in Technology
AIエージェント統制はAPIから——押さえるべき5つの要素
nagix
0
120
IBC 2026 動画技術関連レポート / IBC 2026 Report
cyberagentdevelopers
PRO
2
120
AIに任せられるFlutterコードベースを作る 〜仕様をコードで表し、ハーネスで守る〜
myohei
1
630
推論基盤と Scale-Up Interconnect の現状と制約から俯瞰する技術動向
markunet
2
800
AI時代のエンジニアの情報発信〜個人の発信を組織の力に変える〜
ryo_kawamata
1
7.2k
生き様としてのSRE
hokkai7go
1
160
これだけは抑えておきたい!後悔しない re:Invent の過ごし方 / AWS re:Invent 2026 prestudy
kinunori
2
690
20261031_IoTLT_vol140_kitazaki_v1.pdf
kitazaki
0
170
FinOpsを導入してマルチプロダクトのコスト最適化を実現する
kworkdev
PRO
0
120
AI Agent 時代のデータ基盤: ClickHouse で実現する 超高速分析とコスト削減の両立
jozono
0
130
リアクションエンジニア ― 小さなリアクションから、話しかけやすい組織をつくる ―
ryuguyana
1
120
E2Eってつらくないですか?E2Eの管理コストを下げる手段とその実践
akaboshinit
6
3k
Featured
See All Featured
YesSQL, Process and Tooling at Scale
rocio
174
15k
Keith and Marios Guide to Fast Websites
keithpitt
413
23k
Collaborative Software Design: How to facilitate domain modelling decisions
baasie
1
360
How to audit for AI Accessibility on your Front & Back End
davetheseo
0
620
Abbi's Birthday
coloredviolet
4
11k
Building a Modern Day E-commerce SEO Strategy
aleyda
45
9.3k
Building an army of robots
kneath
307
47k
Accessibility Awareness
sabderemane
1
290
The Power of CSS Pseudo Elements
geoffreycrofte
82
6.6k
Unsuck your backbone
ammeep
672
58k
WENDY [Excerpt]
tessaabrams
14
40k
RailsConf & Balkan Ruby 2019: The Past, Present, and Future of Rails at GitHub
eileencodes
141
35k
Transcript
インデックスの パフォーマンス 調べてみた matumoto
自己紹介 • ハンドルネーム:matumoto • 本名:松本響輝 • 学年:28期 • 趣味:イカᔦꙬᔨ •
やってきた技術: ◦ ゲーム作り ◦ フロントエンド ◦ AtCoder 水💧 • Twitter:@matumoto_1234
インデックスについて
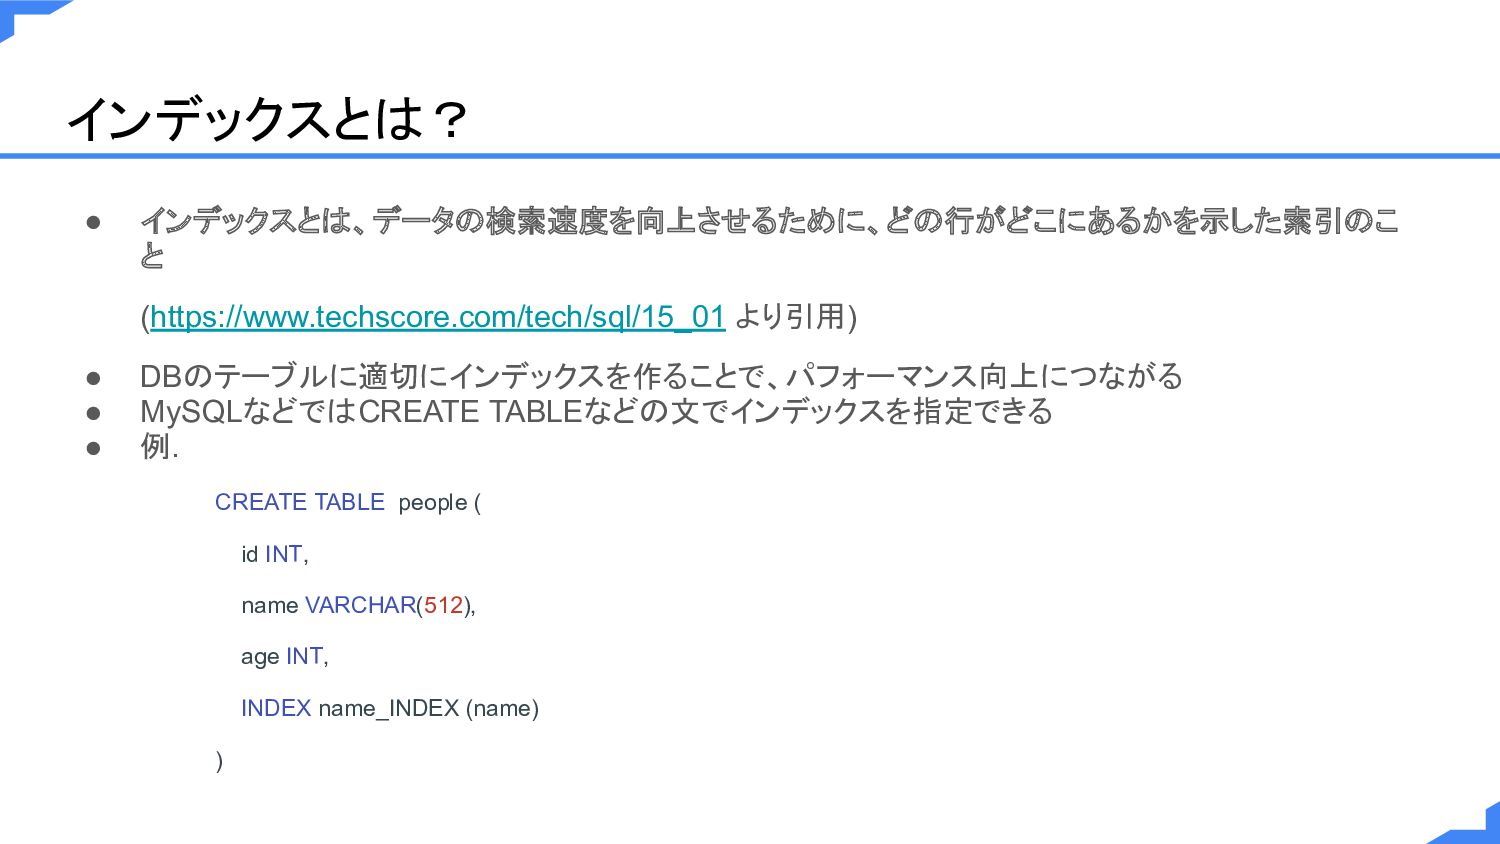
インデックスとは? • インデックスとは、データの検索速度を向上させるために、どの行がどこにあるかを示した索引のこ と (https://www.techscore.com/tech/sql/15_01 より引用) • DBのテーブルに適切にインデックスを作ることで、パフォーマンス向上につながる • MySQLなどではCREATE
TABLEなどの文でインデックスを指定できる • 例. CREATE TABLE people ( id INT, name VARCHAR(512), age INT, INDEX name_INDEX (name) )
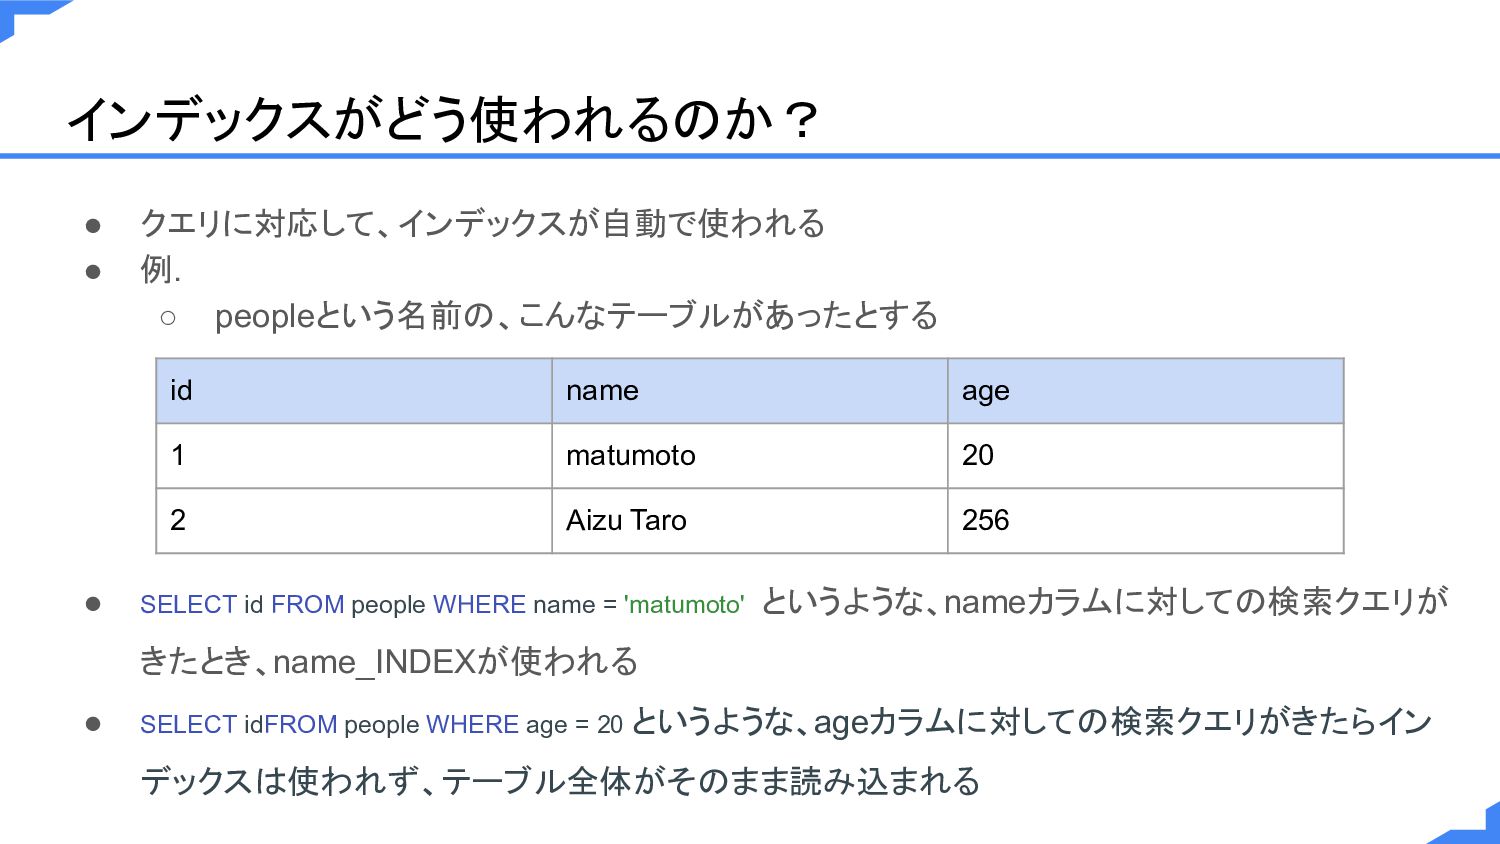
インデックスがどう使われるのか? • クエリに対応して、インデックスが自動で使われる • 例. ◦ peopleという名前の、こんなテーブルがあったとする id name age
1 matumoto 20 2 Aizu Taro 256 • SELECT id FROM people WHERE name = 'matumoto' というような、nameカラムに対しての検索クエリが きたとき、name_INDEXが使われる • SELECT idFROM people WHERE age = 20 というような、ageカラムに対しての検索クエリがきたらイン デックスは使われず、テーブル全体がそのまま読み込まれる
インデックスのパフォーマンス • インデックスは基本的に、ユニーク(重複がない)なもののほうがパフォーマンスが良い ◦ 例. PRIMARY KEYに基づくインデックスやUNIQUE制約のついたインデックスなど →なぜパフォーマンスが良いのか?(本題) →後述
インデックスの内部構造
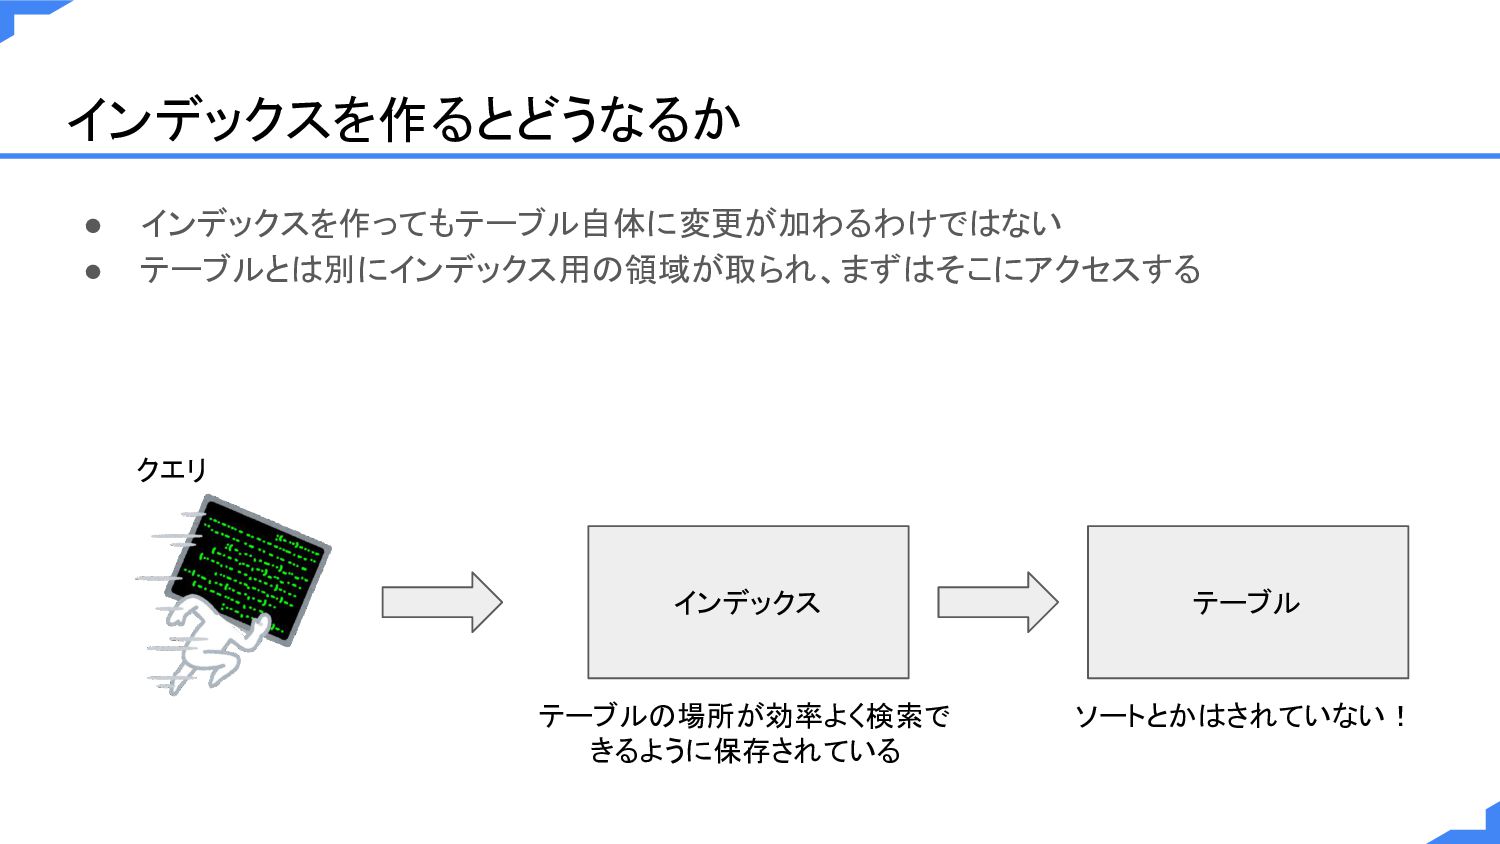
インデックスを作るとどうなるか • インデックスを作ってもテーブル自体に変更が加わるわけではない • テーブルとは別にインデックス用の領域が取られ、まずはそこにアクセスする テーブル インデックス クエリ ソートとかはされていない! テーブルの場所が効率よく検索で
きるように保存されている
インデックスはどうなっているか • B-treeというようなデータ構造がよく使われている ◦ 厳密にはB+treeや、B*treeという改良版が使われることが多い
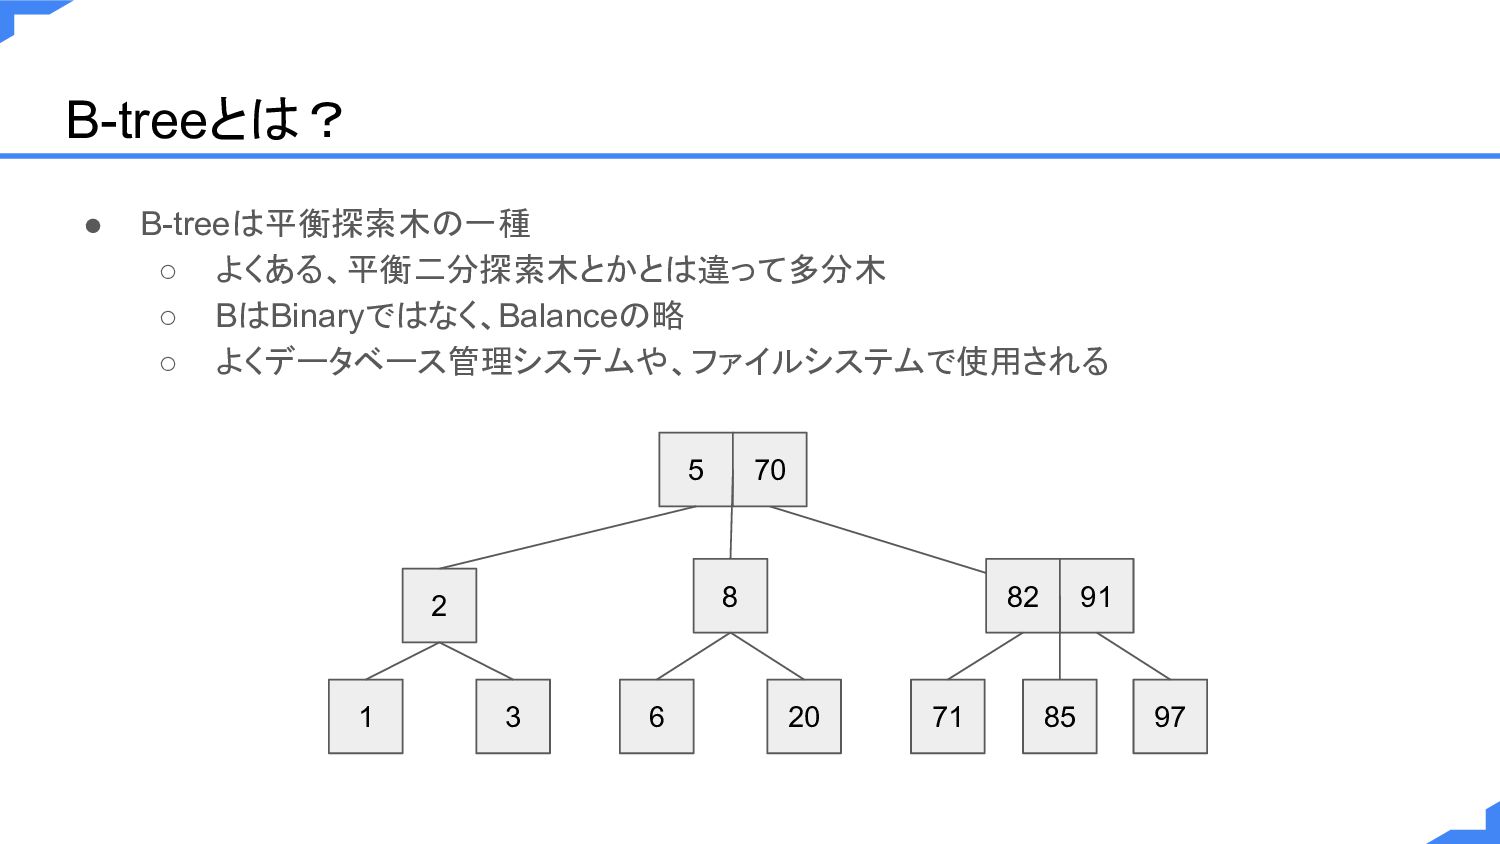
B-treeとは? • B-treeは平衡探索木の一種 ◦ よくある、平衡二分探索木とかとは違って多分木 ◦ BはBinaryではなく、Balanceの略 ◦ よくデータベース管理システムや、ファイルシステムで使用される 5
70 2 1 3 8 6 20 82 91 71 85 97
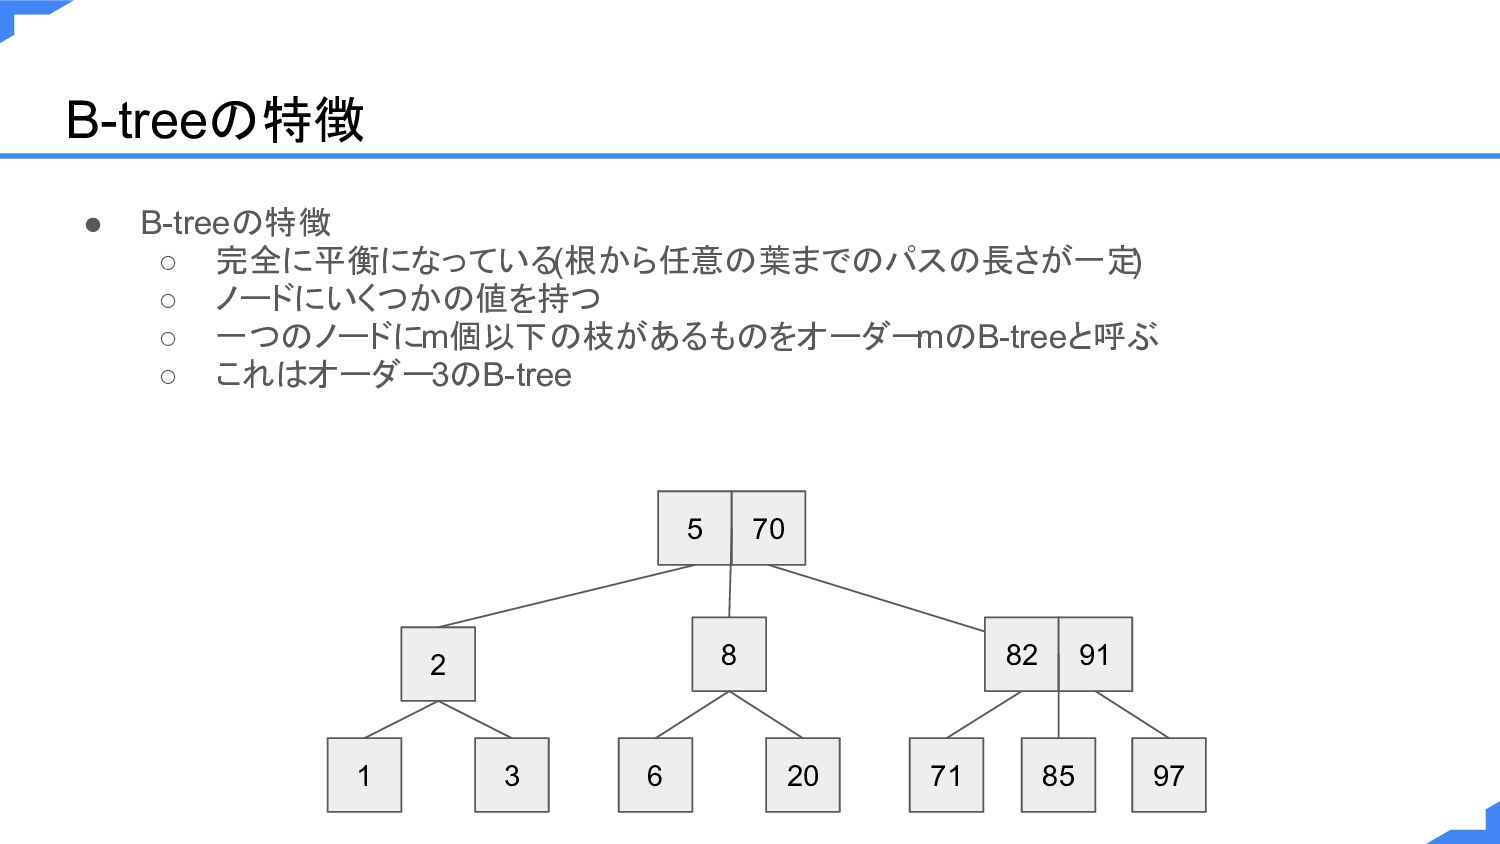
B-treeの特徴 • B-treeの特徴 ◦ 完全に平衡になっている(根から任意の葉までのパスの長さが一定 ) ◦ ノードにいくつかの値を持つ ◦ 一つのノードにm個以下の枝があるものをオーダー
mのB-treeと呼ぶ ◦ これはオーダー3のB-tree 5 70 2 1 3 8 6 20 82 91 71 85 97
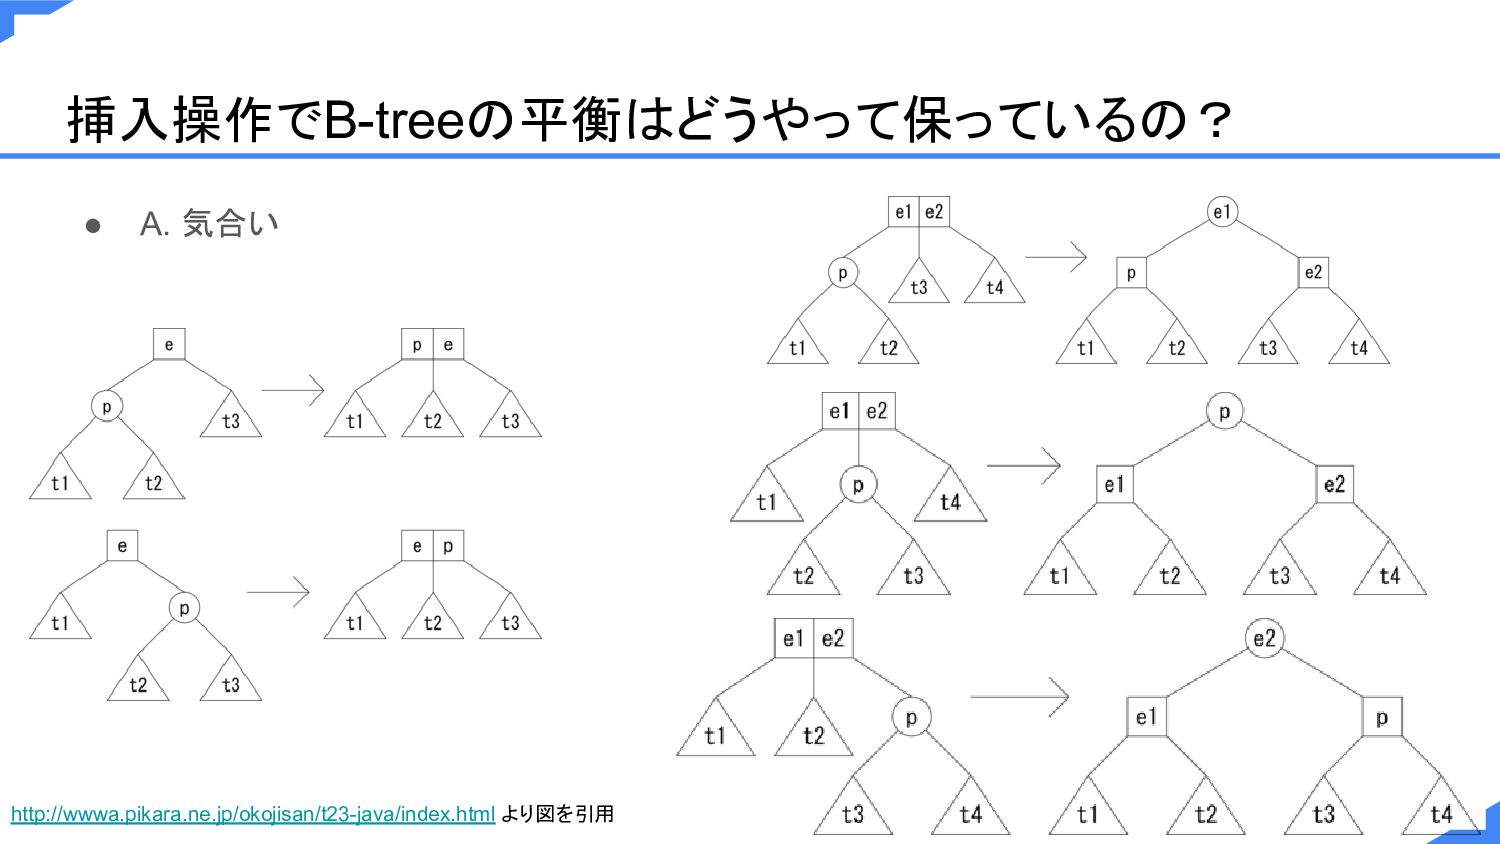
挿入操作でB-treeの平衡はどうやって保っているの? • A. 気合い http://wwwa.pikara.ne.jp/okojisan/t23-java/index.html より図を引用
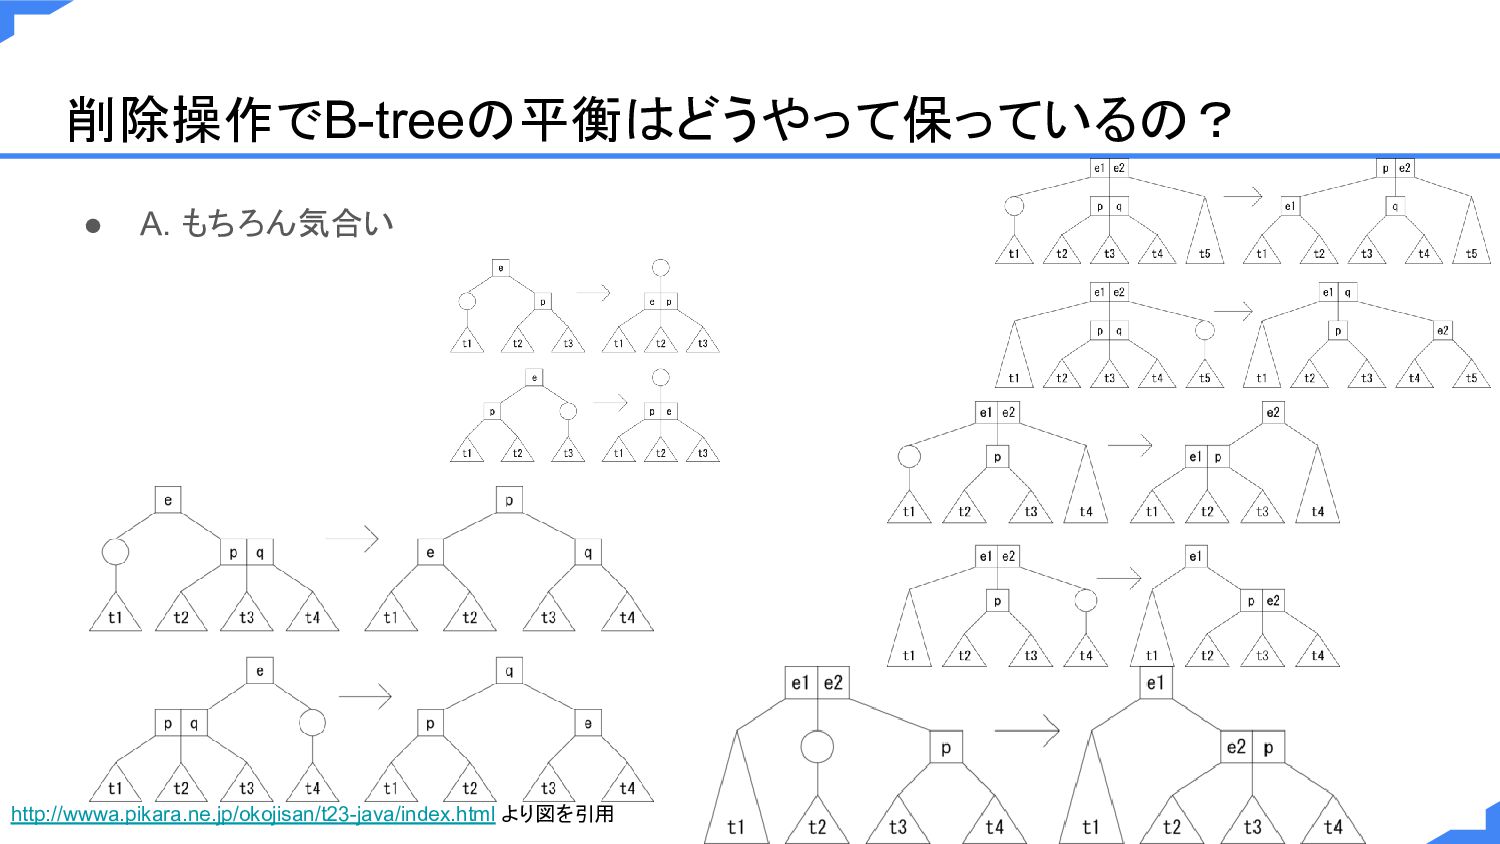
削除操作でB-treeの平衡はどうやって保っているの? • A. もちろん気合い http://wwwa.pikara.ne.jp/okojisan/t23-java/index.html より図を引用
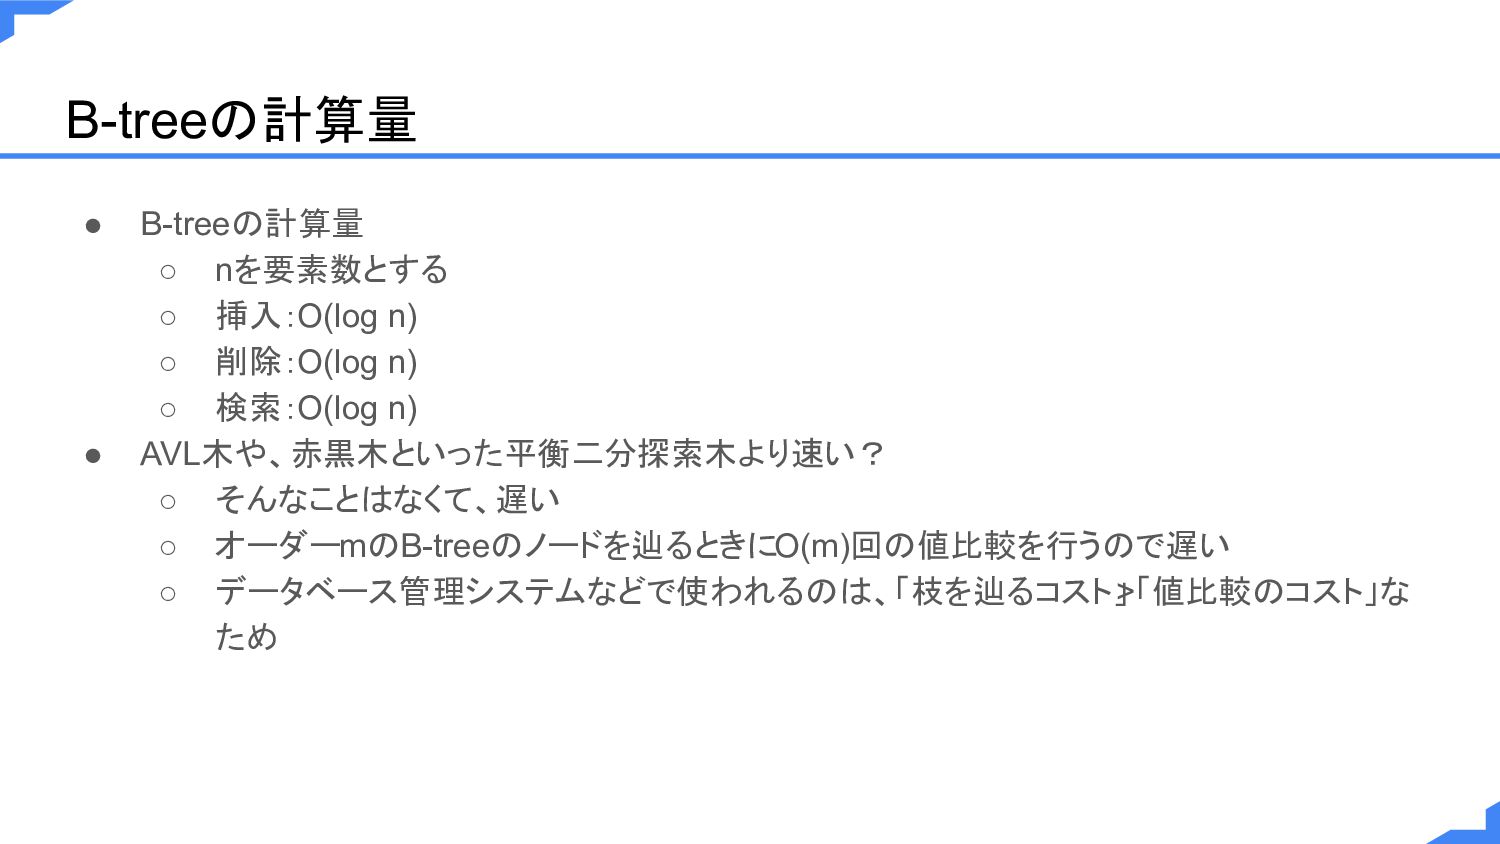
B-treeの計算量 • B-treeの計算量 ◦ nを要素数とする ◦ 挿入:O(log n) ◦ 削除:O(log
n) ◦ 検索:O(log n) • AVL木や、赤黒木といった平衡二分探索木より速い? ◦ そんなことはなくて、遅い ◦ オーダーmのB-treeのノードを辿るときにO(m)回の値比較を行うので遅い ◦ データベース管理システムなどで使われるのは、「枝を辿るコスト」 >「値比較のコスト」な ため
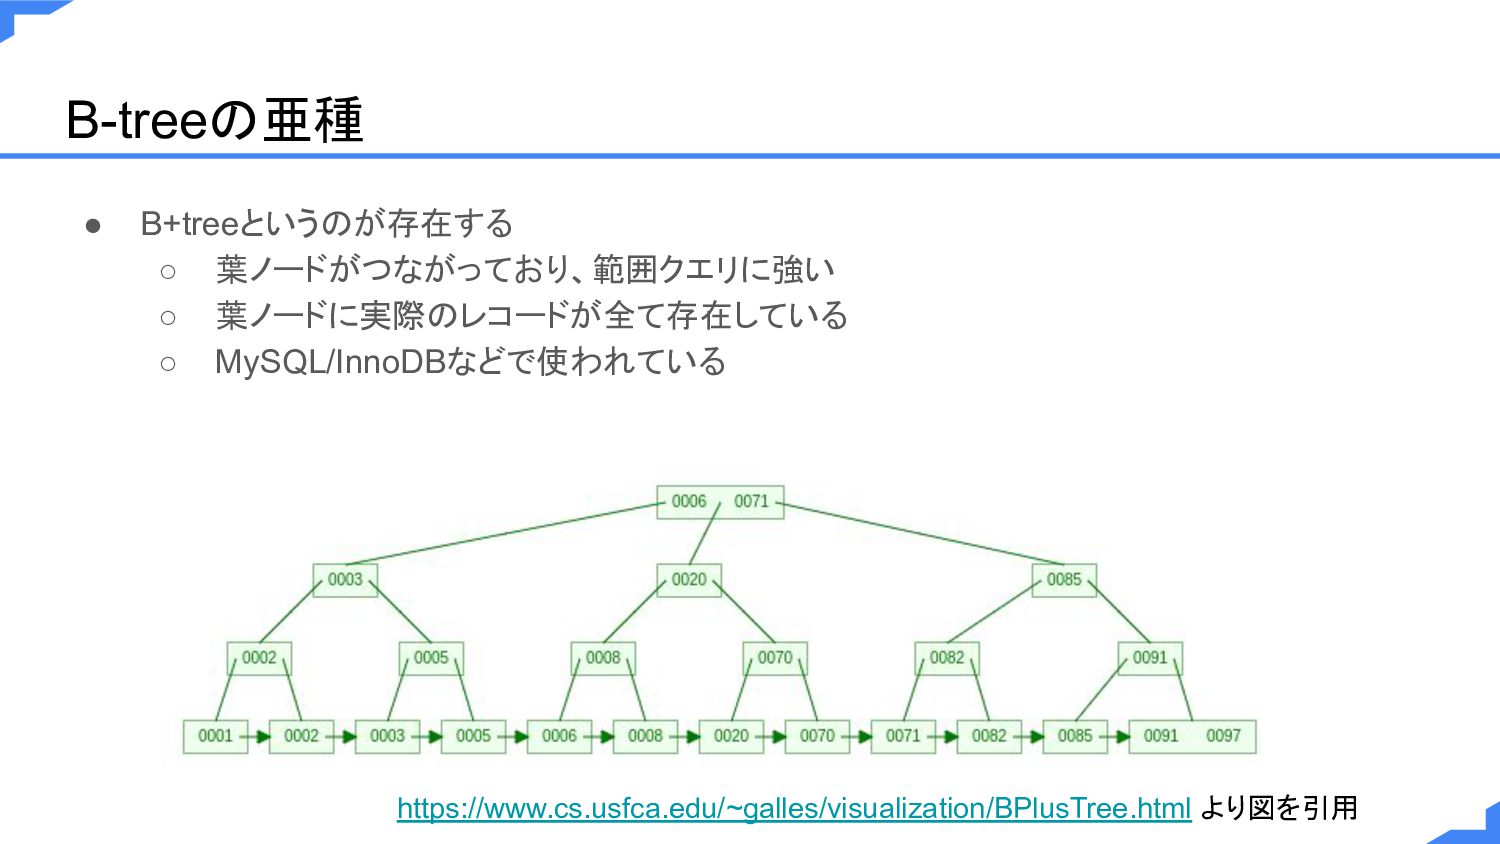
B-treeの亜種 • B+treeというのが存在する ◦ 葉ノードがつながっており、範囲クエリに強い ◦ 葉ノードに実際のレコードが全て存在している ◦ MySQL/InnoDBなどで使われている https://www.cs.usfca.edu/~galles/visualization/BPlusTree.html
より図を引用
インデックスの パフォーマンス
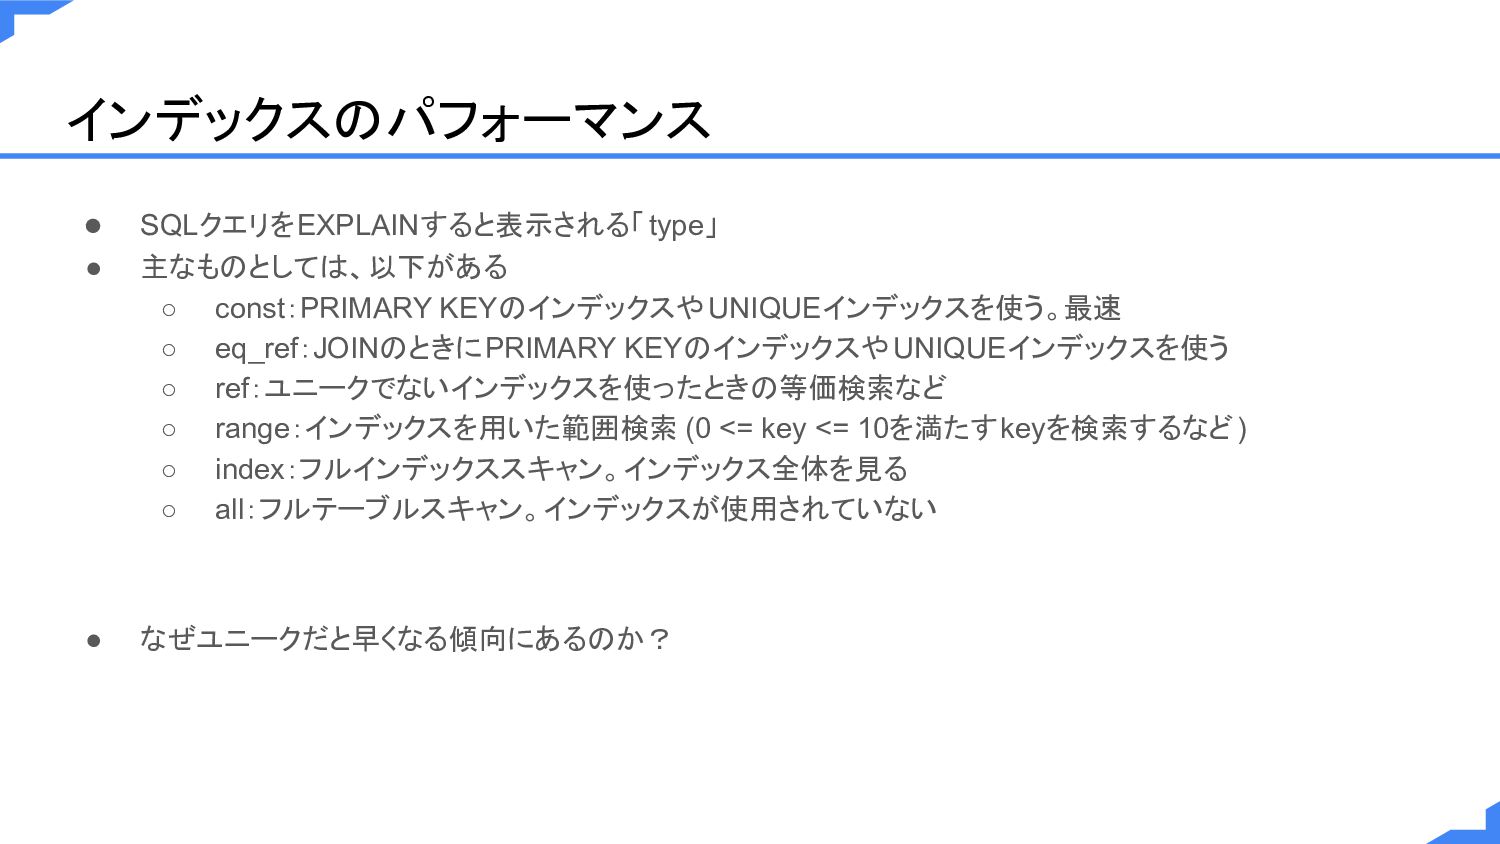
インデックスのパフォーマンス • SQLクエリをEXPLAINすると表示される「type」 • 主なものとしては、以下がある ◦ const:PRIMARY KEYのインデックスやUNIQUEインデックスを使う。最速 ◦ eq_ref:JOINのときにPRIMARY
KEYのインデックスやUNIQUEインデックスを使う ◦ ref:ユニークでないインデックスを使ったときの等価検索など ◦ range:インデックスを用いた範囲検索 (0 <= key <= 10を満たすkeyを検索するなど) ◦ index:フルインデックススキャン。インデックス全体を見る ◦ all:フルテーブルスキャン。インデックスが使用されていない • なぜユニークだと早くなる傾向にあるのか?
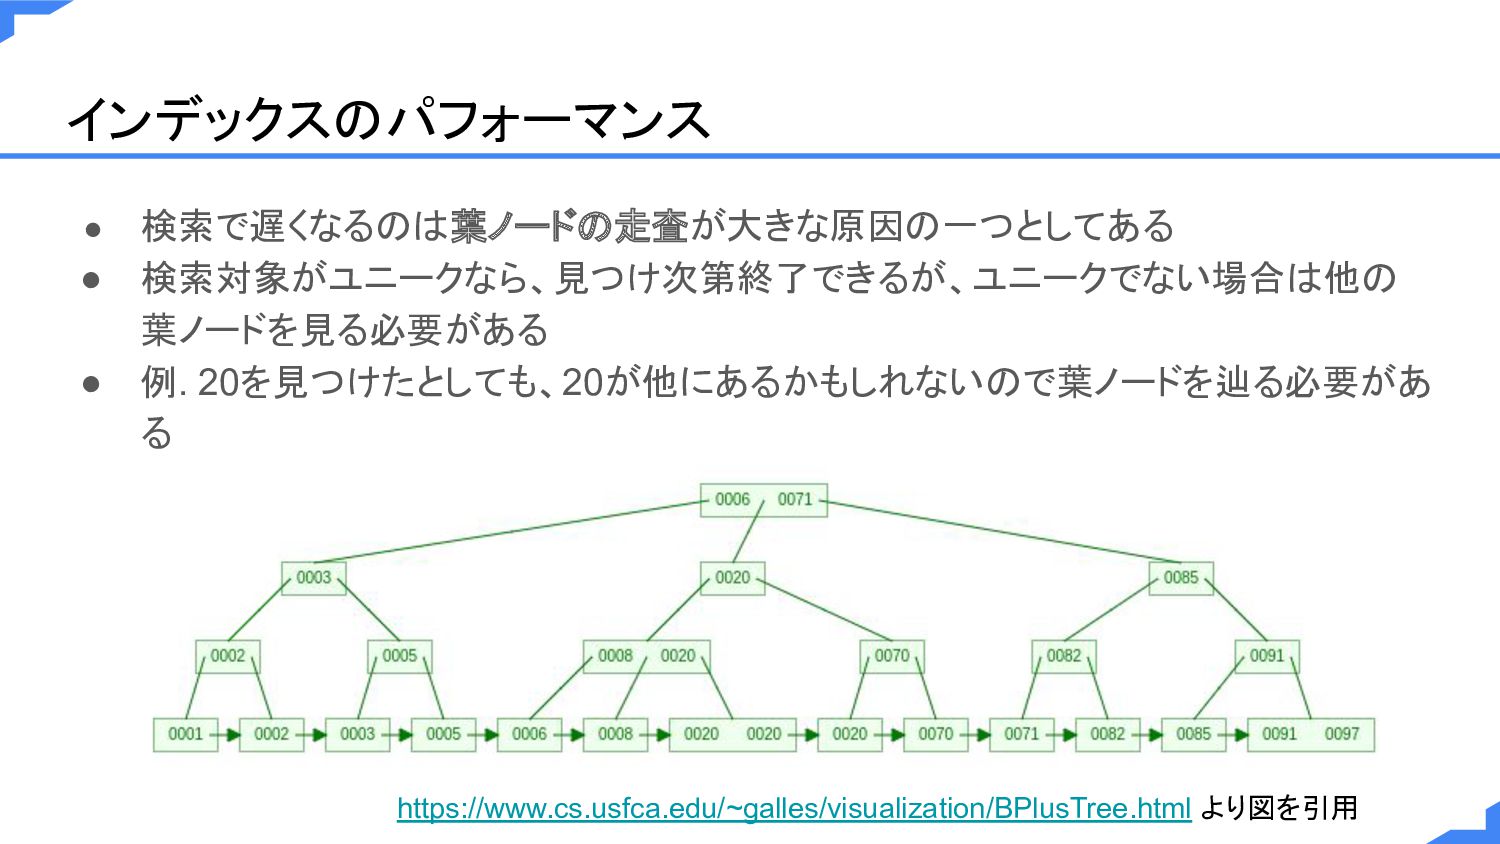
インデックスのパフォーマンス • 検索で遅くなるのは葉ノードの走査が大きな原因の一つとしてある • 検索対象がユニークなら、見つけ次第終了できるが、ユニークでない場合は他の 葉ノードを見る必要がある • 例. 20を見つけたとしても、20が他にあるかもしれないので葉ノードを辿る必要があ る
https://www.cs.usfca.edu/~galles/visualization/BPlusTree.html より図を引用
まとめ
まとめ • インデックスの内部構造はB-treeがベースになっていることが多くて、計算量は だ いたい O(log n) ◦ 範囲クエリでk個の要素がみつかるときは、 O(log
n + k) 程度
ご静聴ありがとうございました


 matumoto
 nagix
 cyberagentdevelopers
 myohei
 markunet
 ryo_kawamata
 hokkai7go
 kinunori
 kitazaki
 kworkdev
 jozono
 ryuguyana
 akaboshinit
 rocio
 keithpitt
 baasie
 davetheseo
 coloredviolet
 aleyda
 kneath
 sabderemane
 geoffreycrofte
 ammeep
 tessaabrams
 eileencodes