Share
Embed
その専用ベクトルDB、本当に要りますか?
『検索ピラミッド』――grepから専用DBまで、登るべき階段の見極め方
小薗井 康志|ITmedia オルタナティブ・ブログ「生涯ITエンジニアでいこう。」
osonoi
November 17, 2026
Transcript
15 slides
-
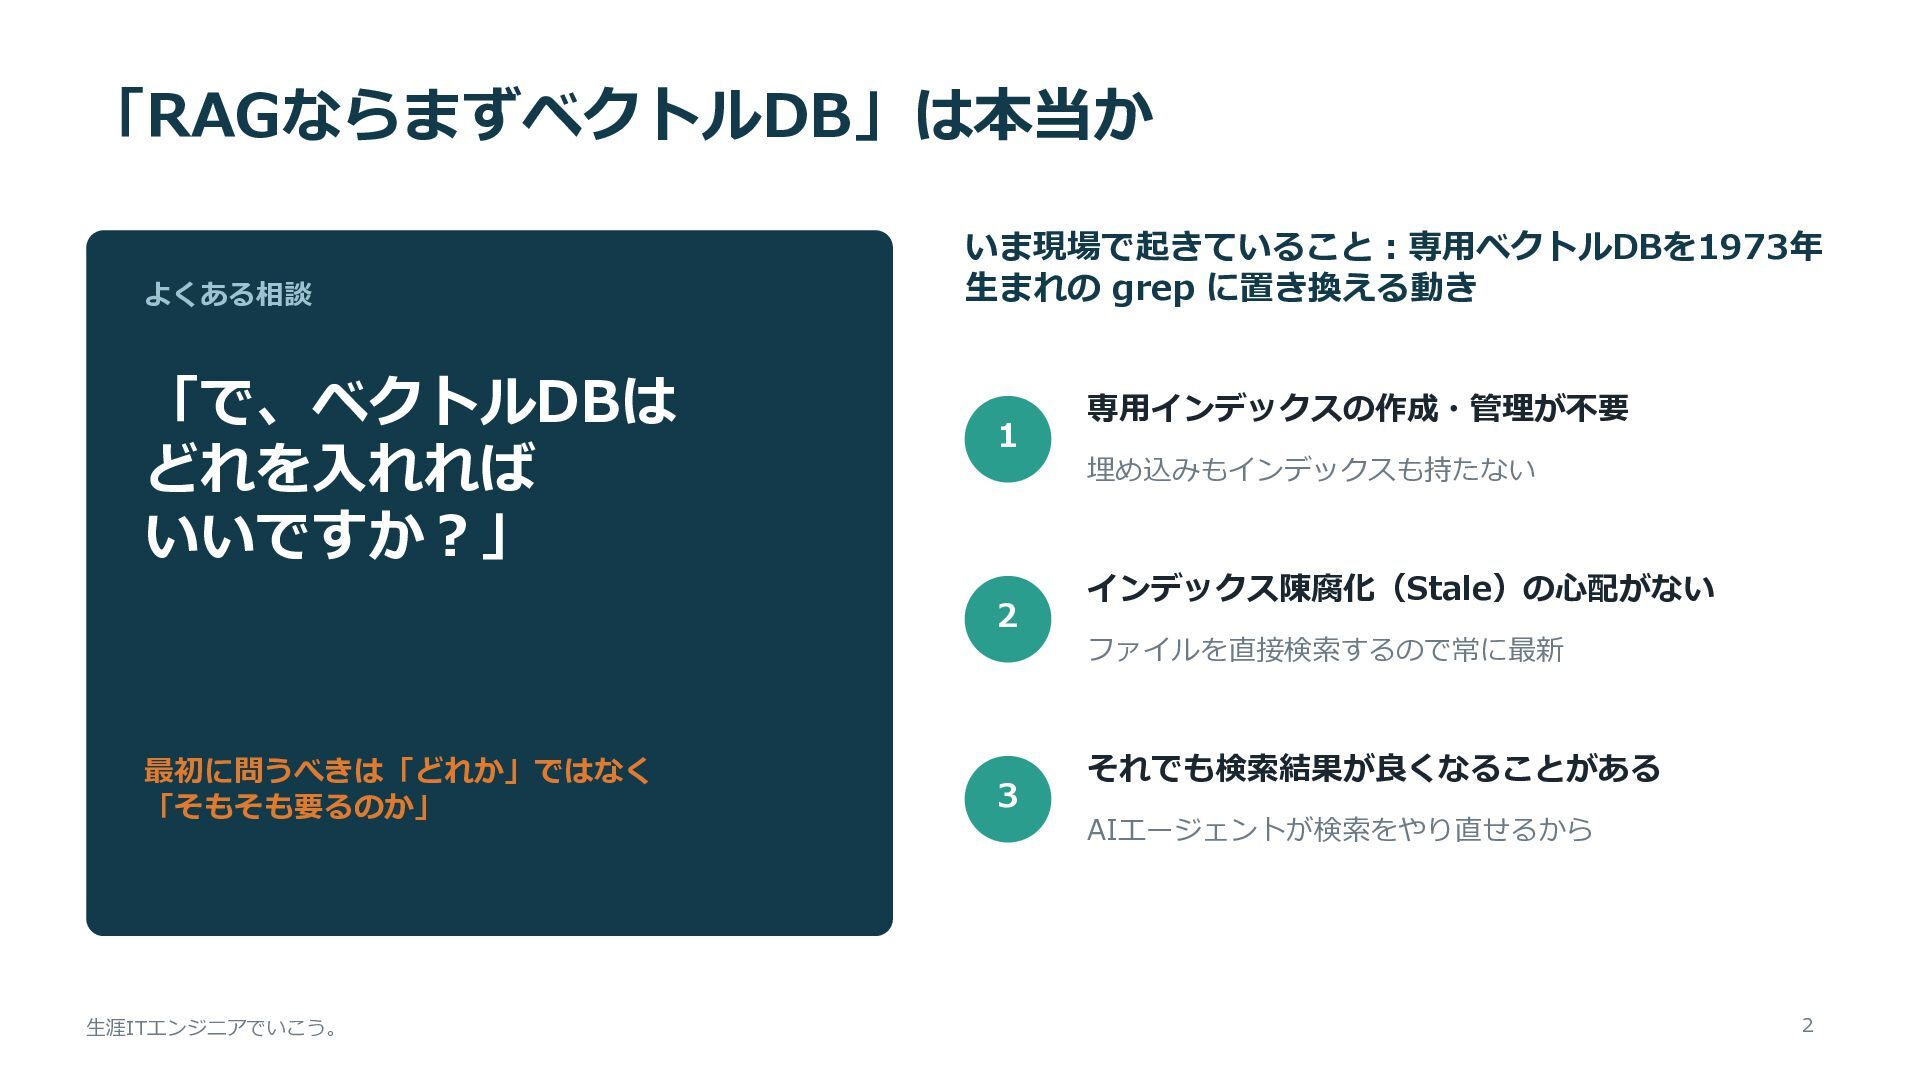
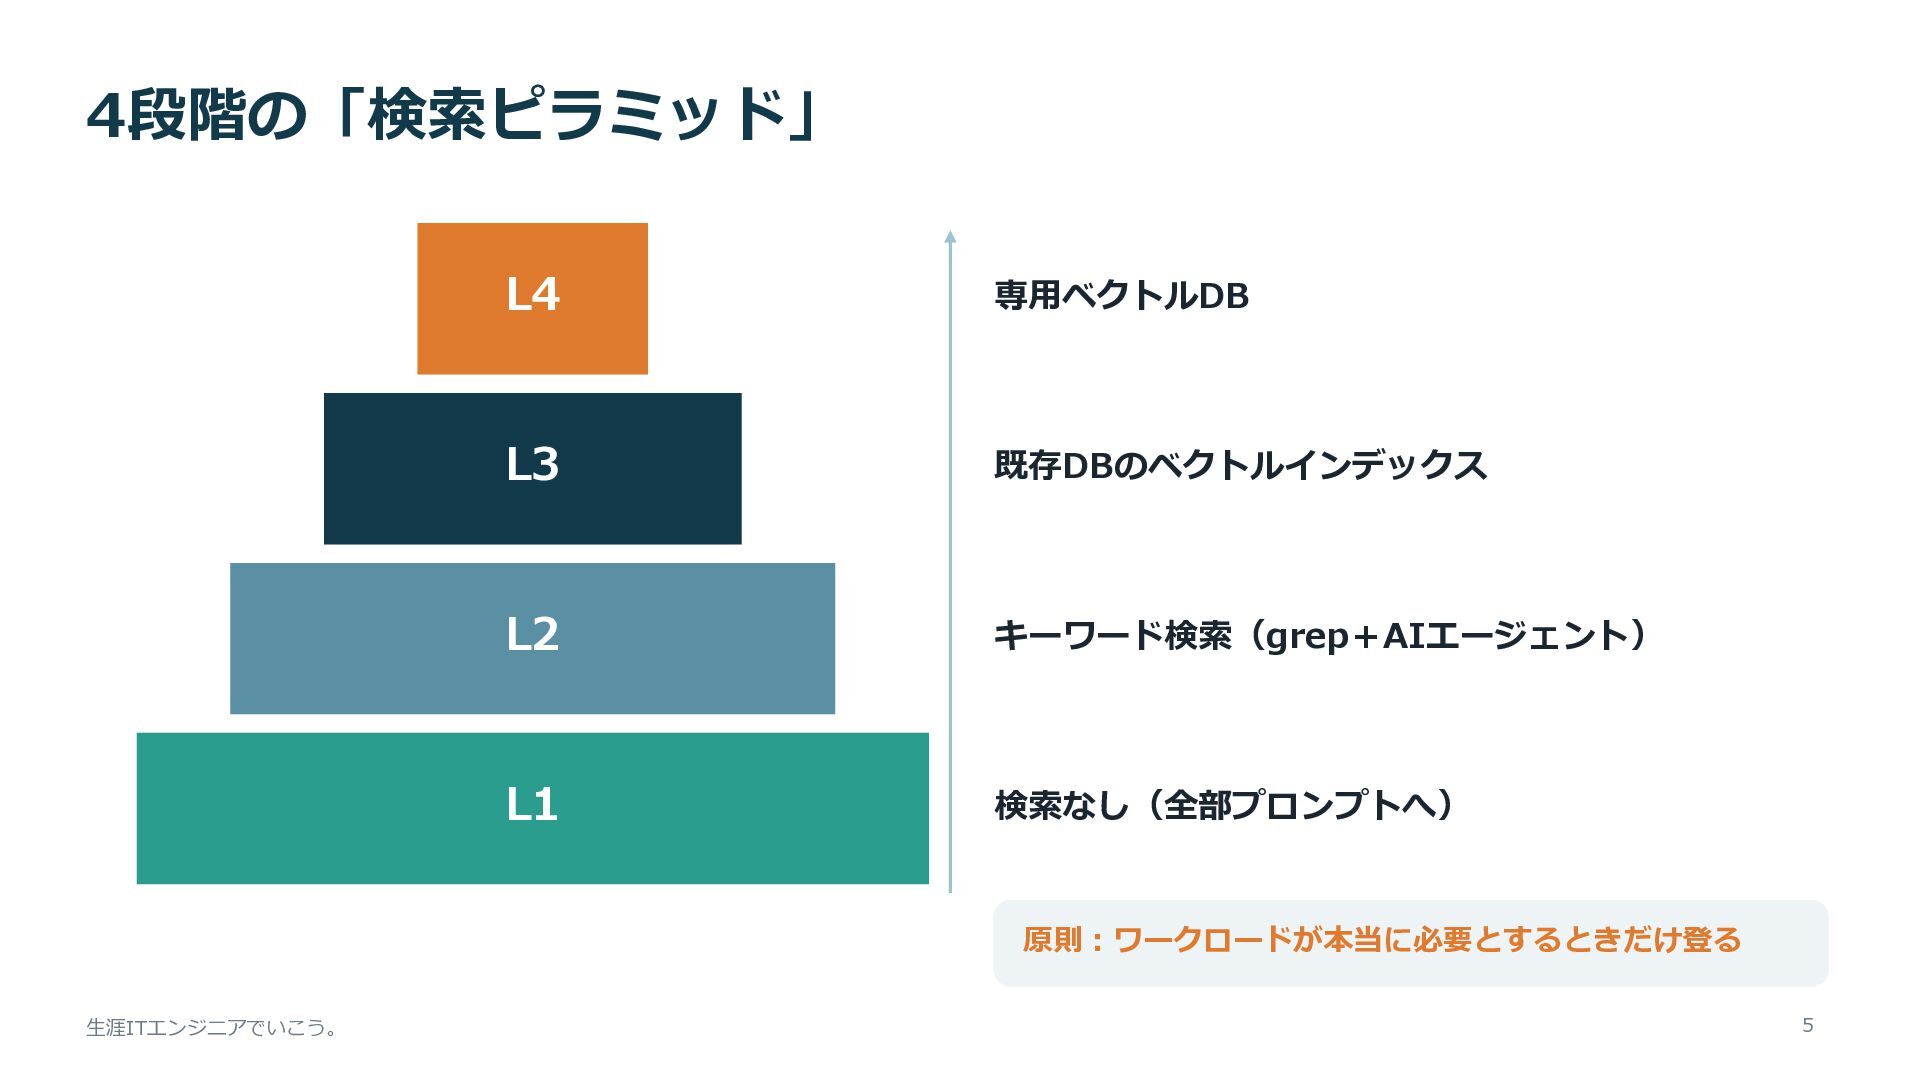
「RAGならまずベクトルDB」は本当か よくある相談 「で、ベクトルDBは どれを入れれば いいですか?」 いま現場で起きていること:専用ベクトルDBを1973年 生まれの grep に置き換える動き 1
2 最初に問うべきは「どれか」ではなく 「そもそも要るのか」 生涯ITエンジニアでいこう。 3 専用インデックスの作成・管理が不要 埋め込みもインデックスも持たない インデックス陳腐化(Stale)の心配がない ファイルを直接検索するので常に最新 それでも検索結果が良くなることがある AIエージェントが検索をやり直せるから 2 -
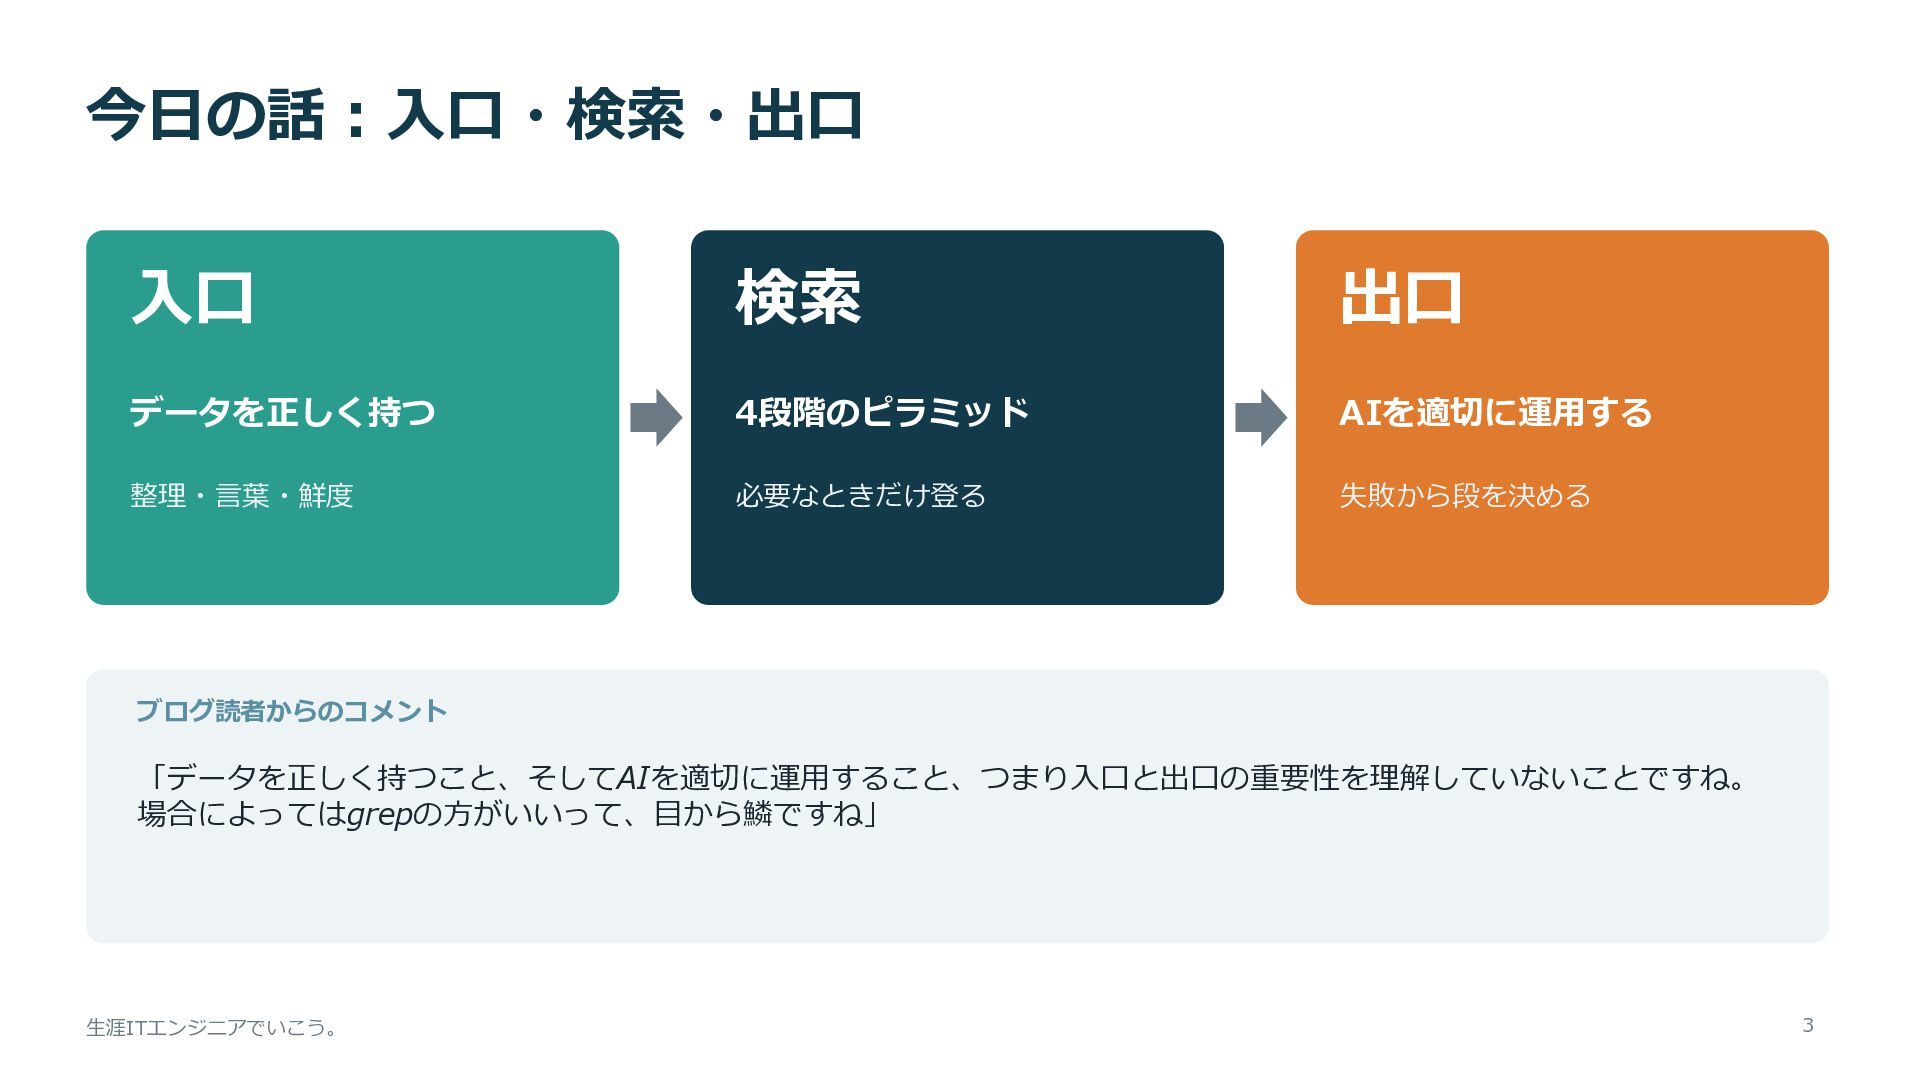
今日の話:入口・検索・出口 入口 検索 出口 データを正しく持つ 4段階のピラミッド AIを適切に運用する 整理・言葉・鮮度 必要なときだけ登る 失敗から段を決める
ブログ読者からのコメント 「データを正しく持つこと、そしてAIを適切に運用すること、つまり入口と出口の重要性を理解していないことですね。 場合によってはgrepの方がいいって、目から鱗ですね」 生涯ITエンジニアでいこう。 3 -
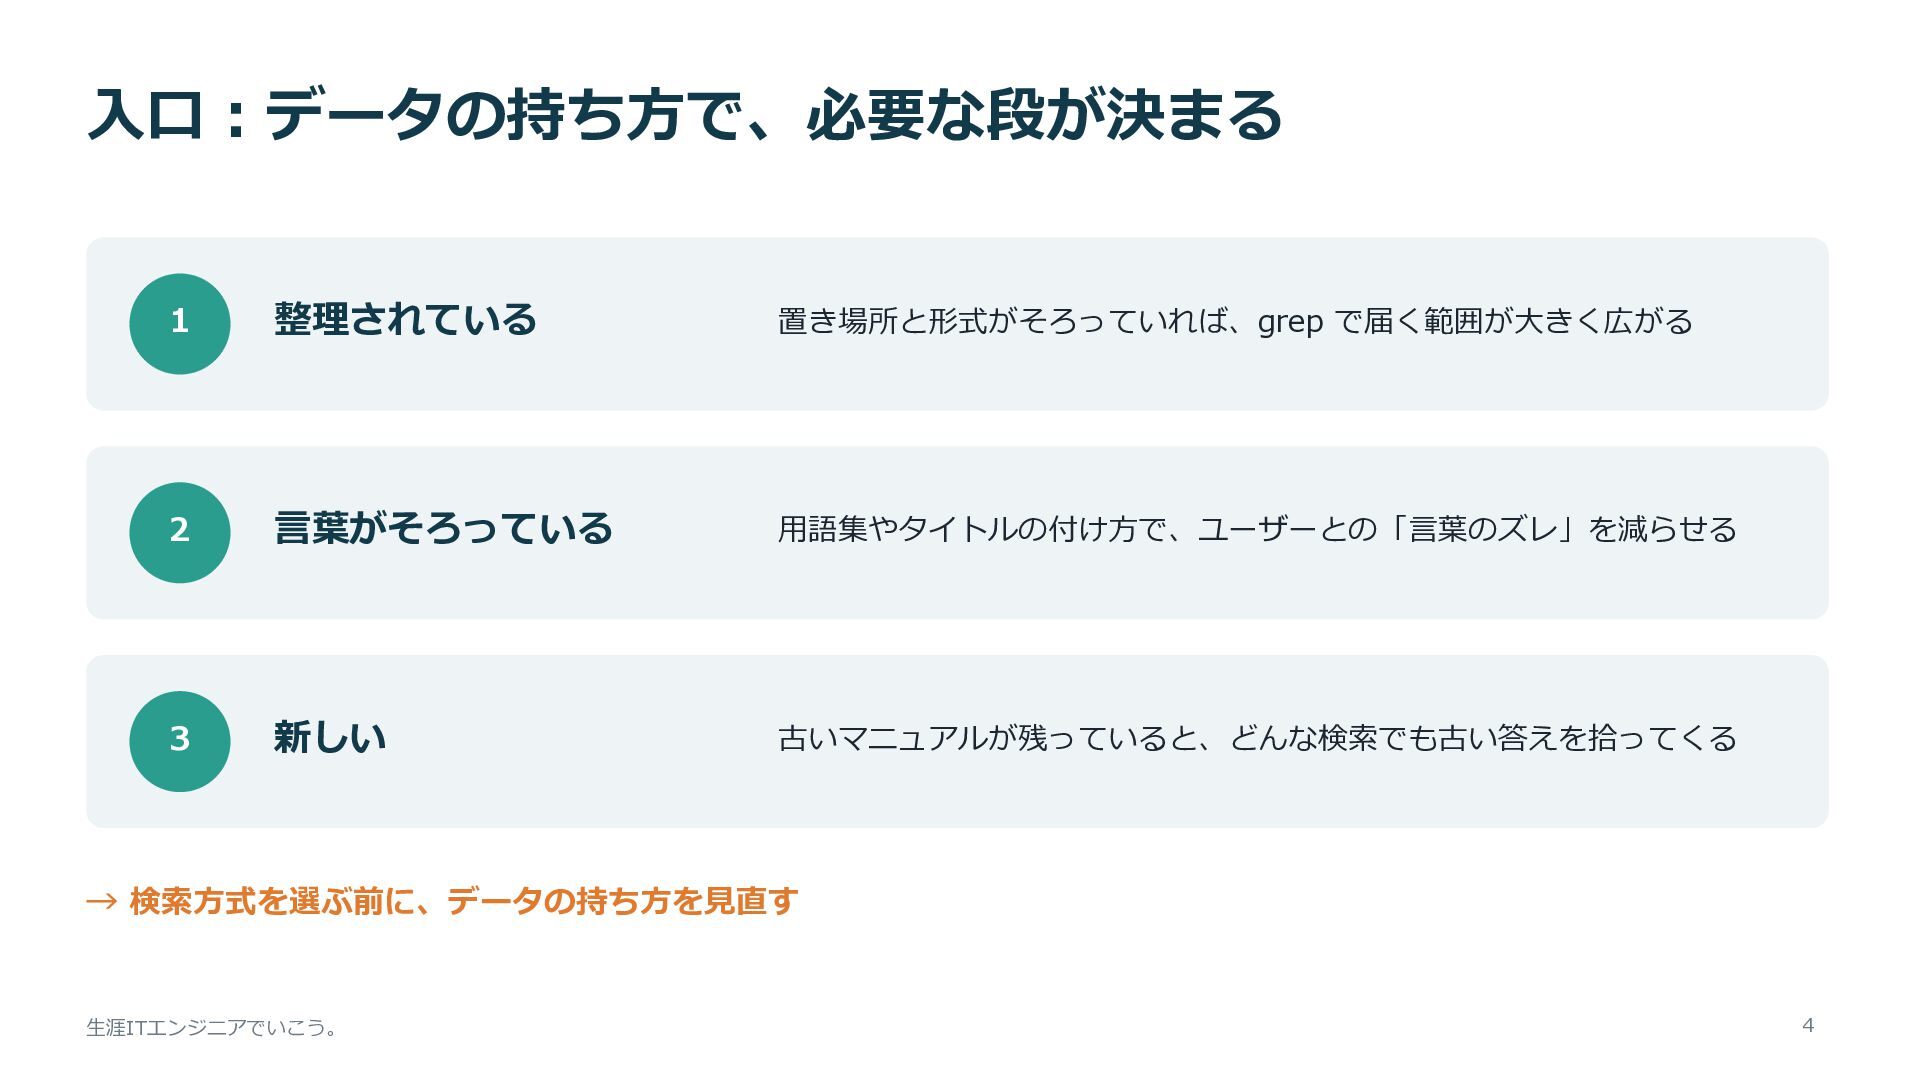
入口:データの持ち方で、必要な段が決まる 1 整理されている 置き場所と形式がそろっていれば、grep で届く範囲が大きく広がる 2 言葉がそろっている 用語集やタイトルの付け方で、ユーザーとの「言葉のズレ」を減らせる 3 新しい
古いマニュアルが残っていると、どんな検索でも古い答えを拾ってくる → 検索方式を選ぶ前に、データの持ち方を見直す 生涯ITエンジニアでいこう。 4 -
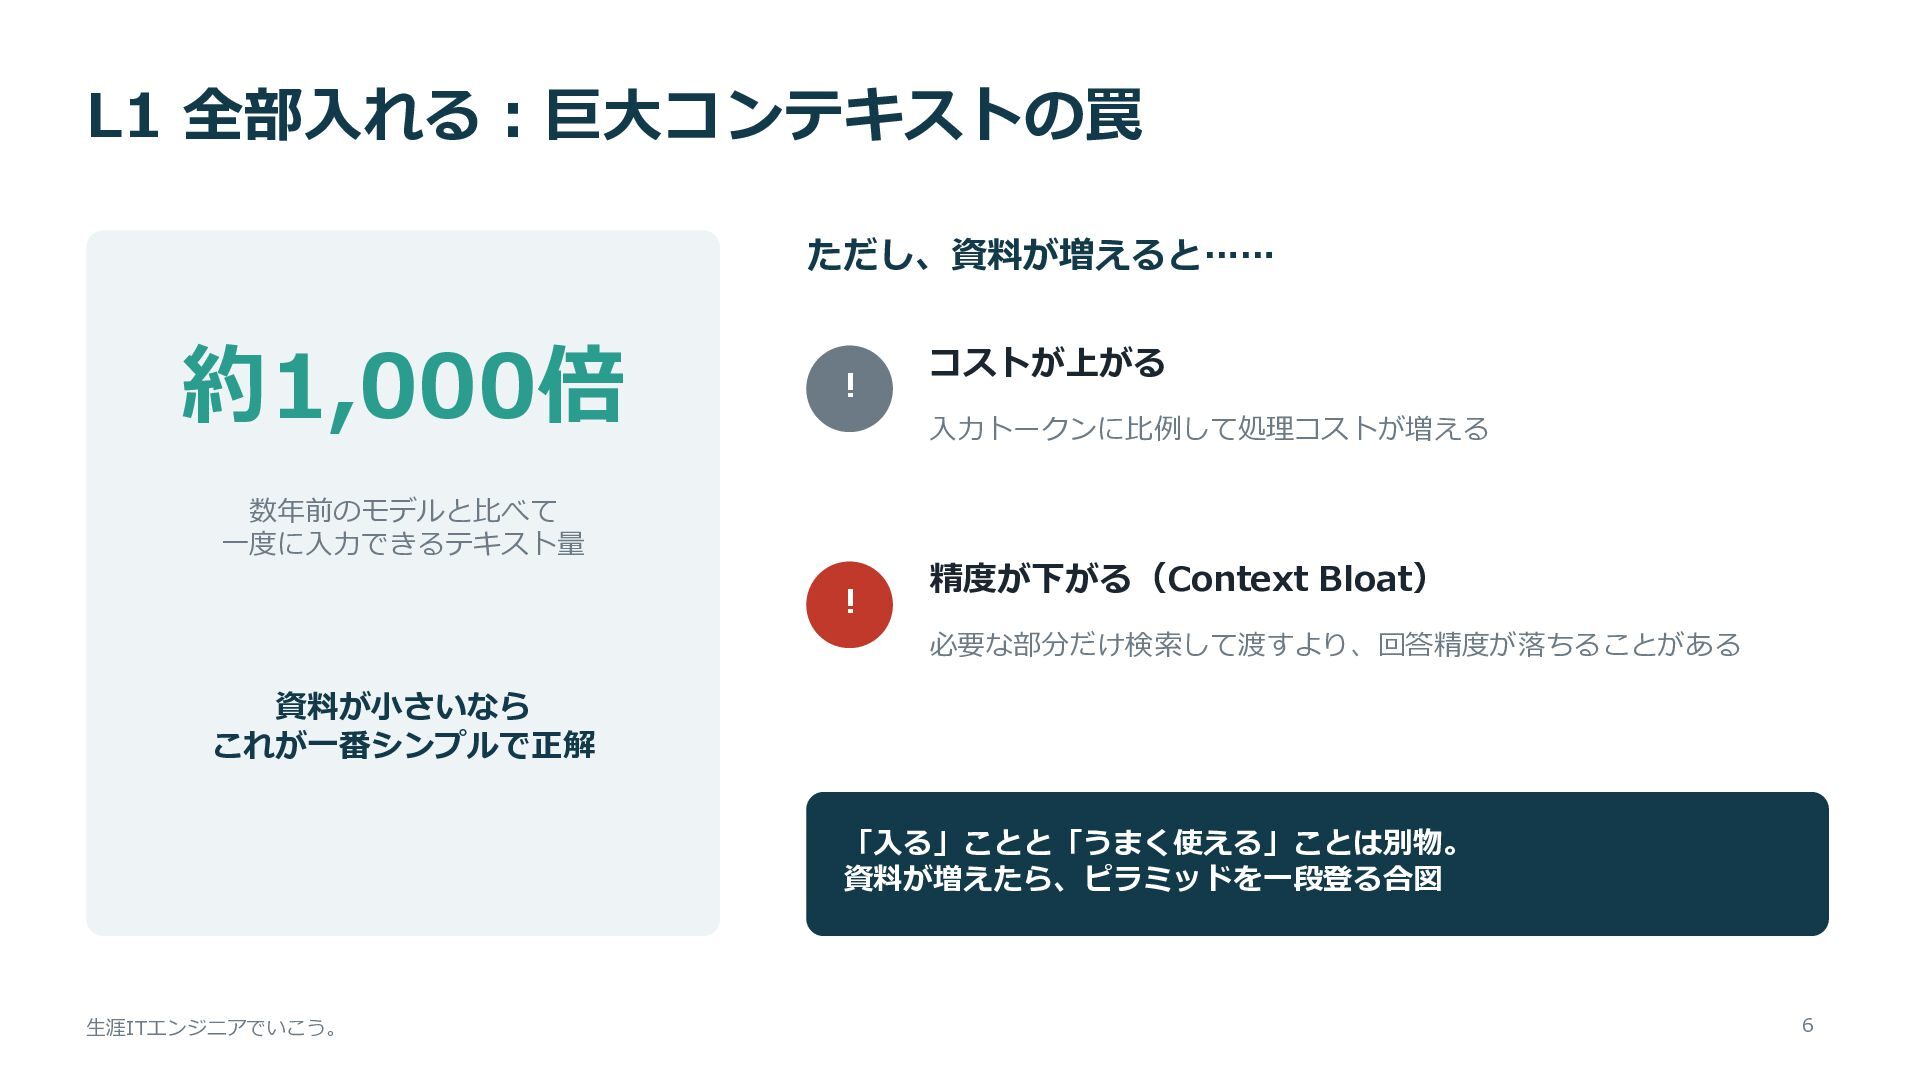
L1 全部入れる:巨大コンテキストの罠 ただし、資料が増えると…… 約1,000倍 ! コストが上がる 入力トークンに比例して処理コストが増える 数年前のモデルと比べて 一度に入力できるテキスト量 !
精度が下がる(Context Bloat) 必要な部分だけ検索して渡すより、回答精度が落ちることがある 資料が小さいなら これが一番シンプルで正解 「入る」ことと「うまく使える」ことは別物。 資料が増えたら、ピラミッドを一段登る合図 生涯ITエンジニアでいこう。 6 -
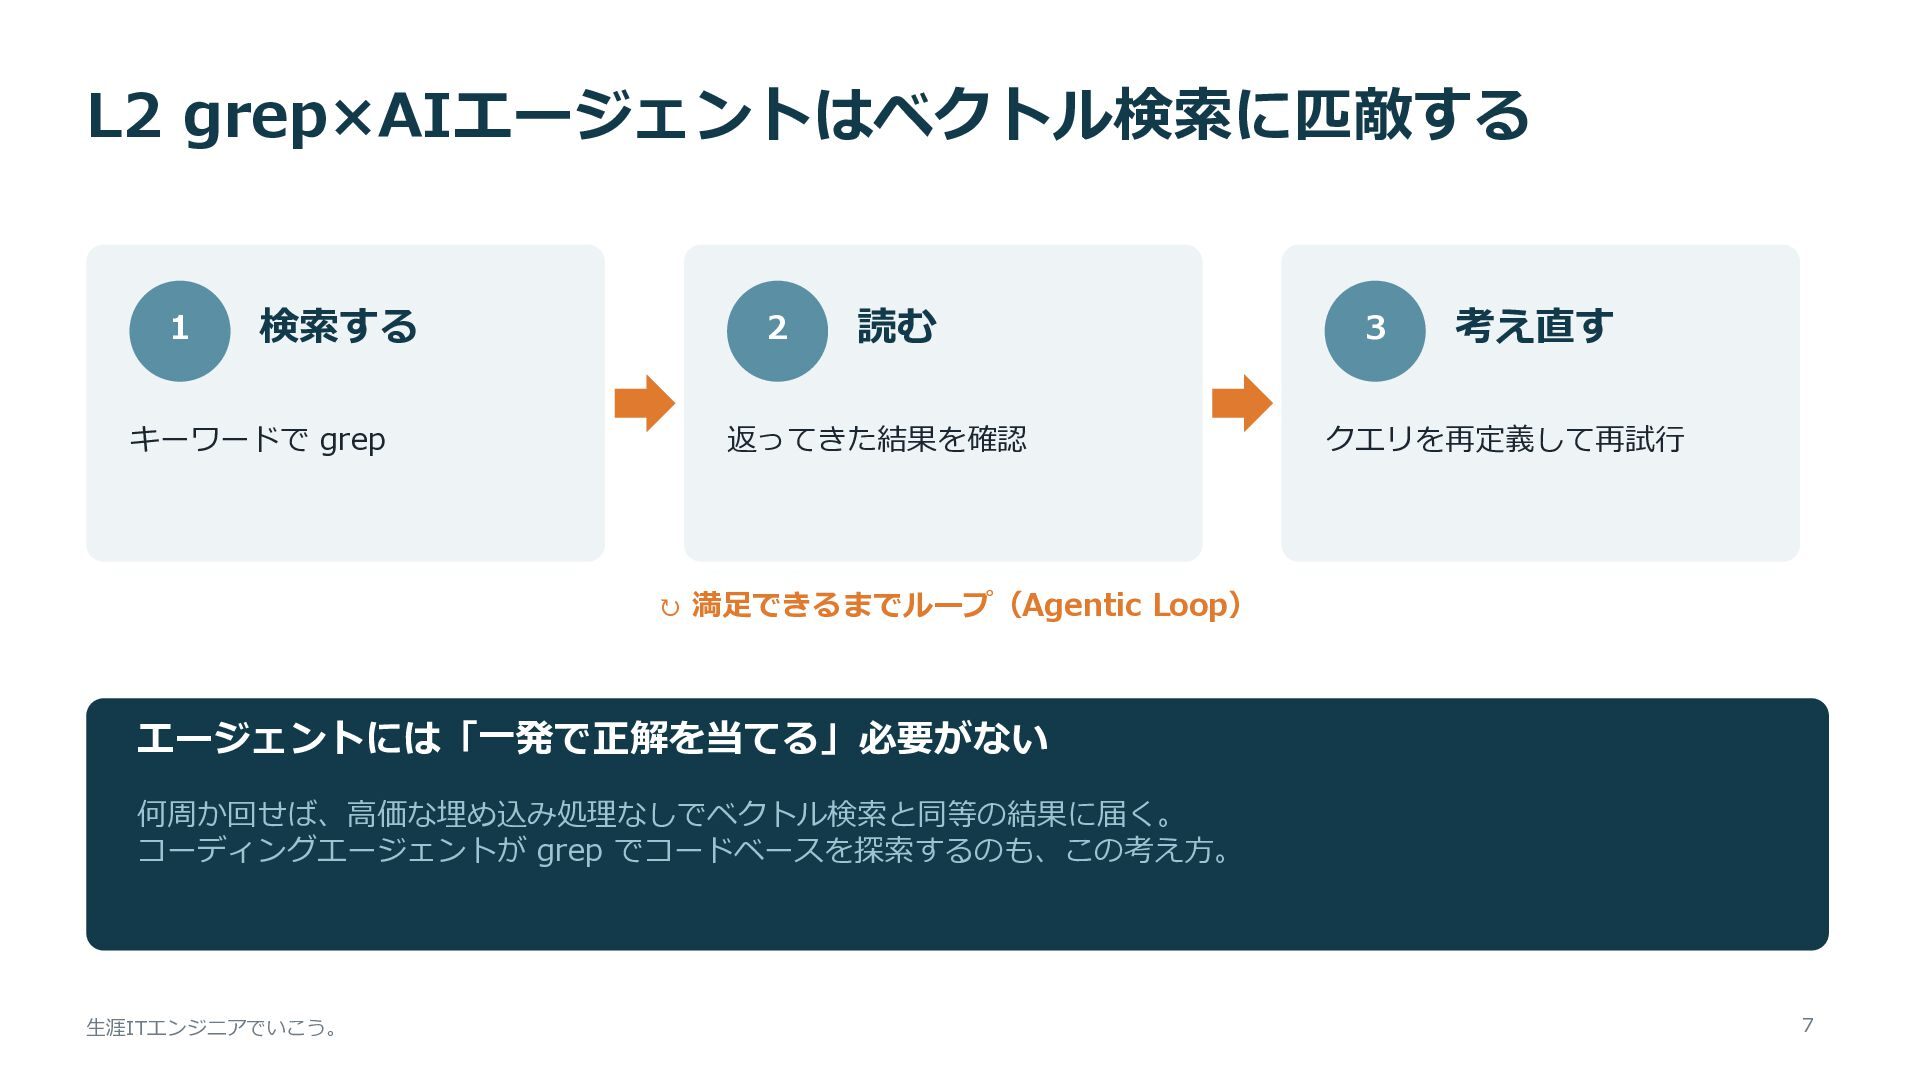
L2 grep×AIエージェントはベクトル検索に匹敵する 1 検索する キーワードで grep 2 読む 返ってきた結果を確認 3
考え直す クエリを再定義して再試行 ↻ 満足できるまでループ(Agentic Loop) エージェントには「一発で正解を当てる」必要がない 何周か回せば、高価な埋め込み処理なしでベクトル検索と同等の結果に届く。 コーディングエージェントが grep でコードベースを探索するのも、この考え方。 生涯ITエンジニアでいこう。 7 -
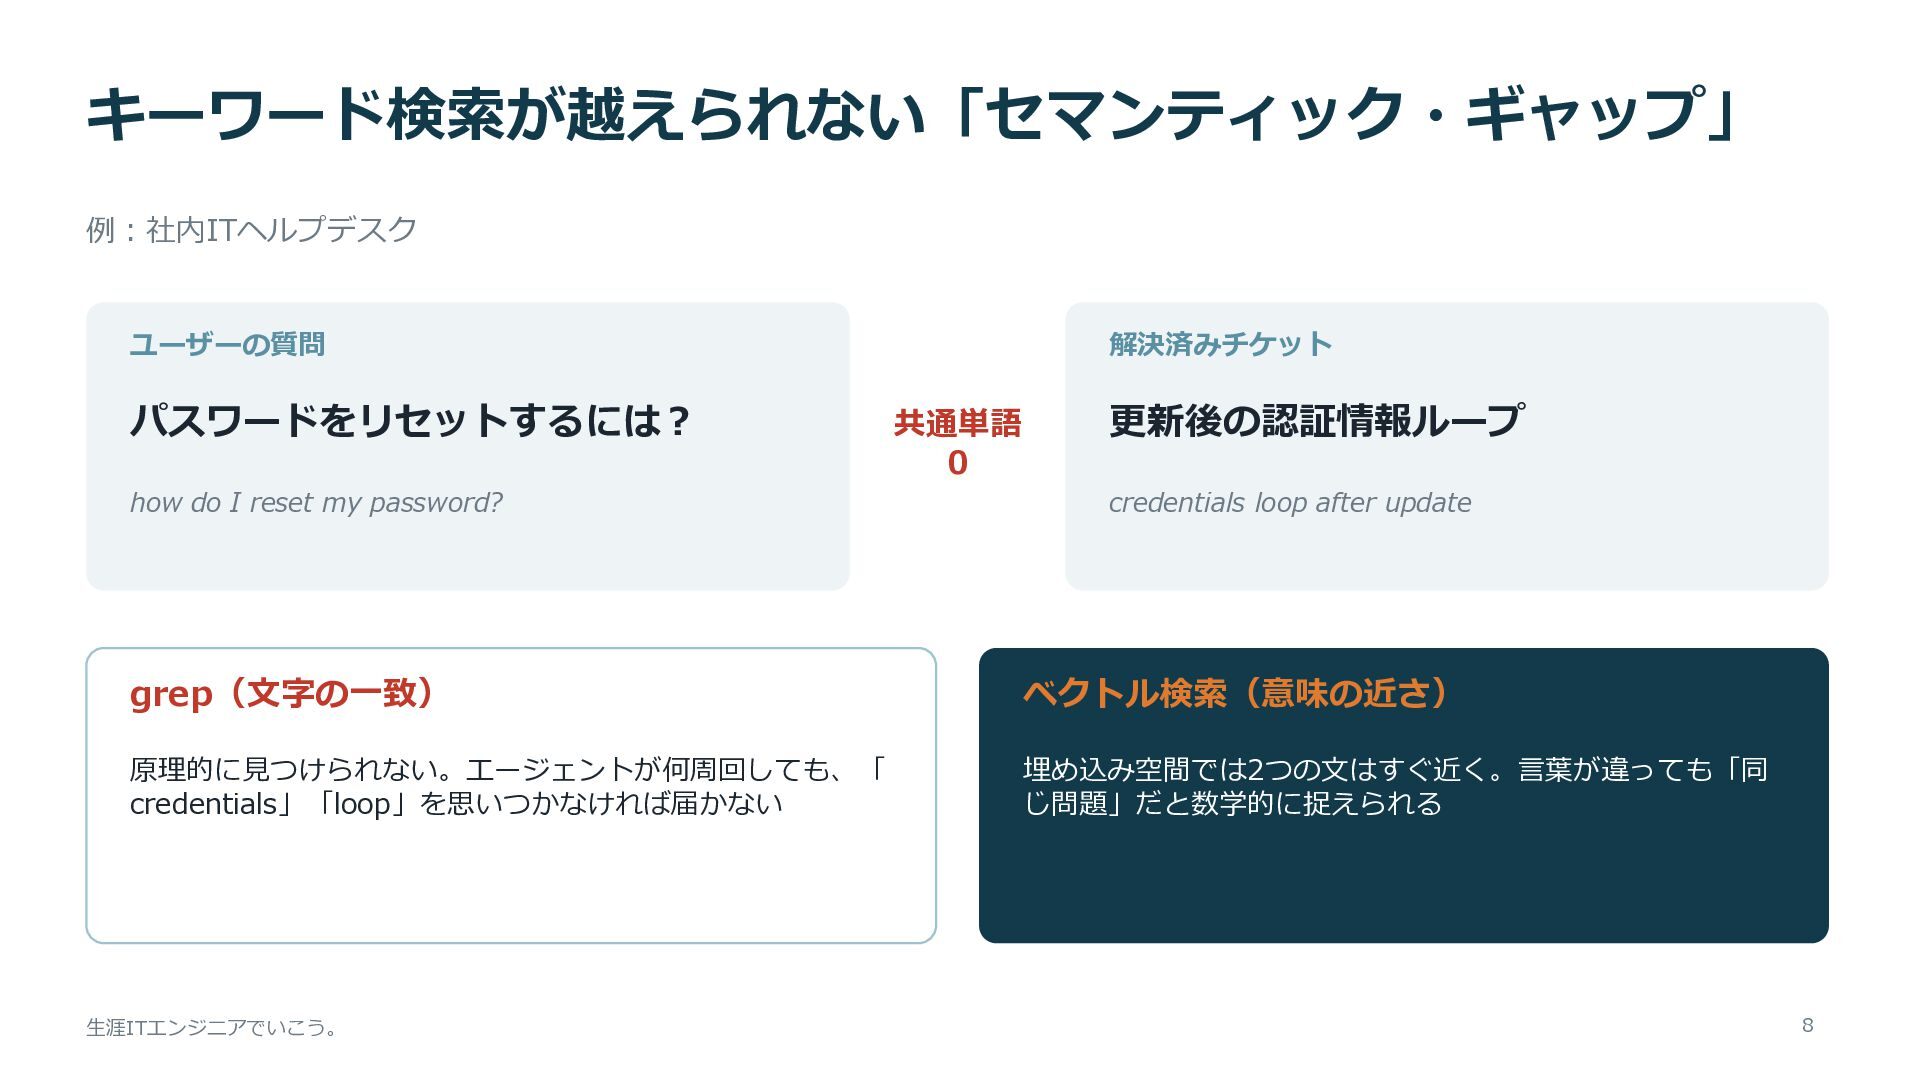
キーワード検索が越えられない「セマンティック・ギャップ」 例:社内ITヘルプデスク ユーザーの質問 パスワードをリセットするには? how do I reset my password?
解決済みチケット 共通単語 0 更新後の認証情報ループ credentials loop after update grep(文字の一致) ベクトル検索(意味の近さ) 原理的に見つけられない。エージェントが何周回しても、「 credentials」「loop」を思いつかなければ届かない 埋め込み空間では2つの文はすぐ近く。言葉が違っても「同 じ問題」だと数学的に捉えられる 生涯ITエンジニアでいこう。 8 -
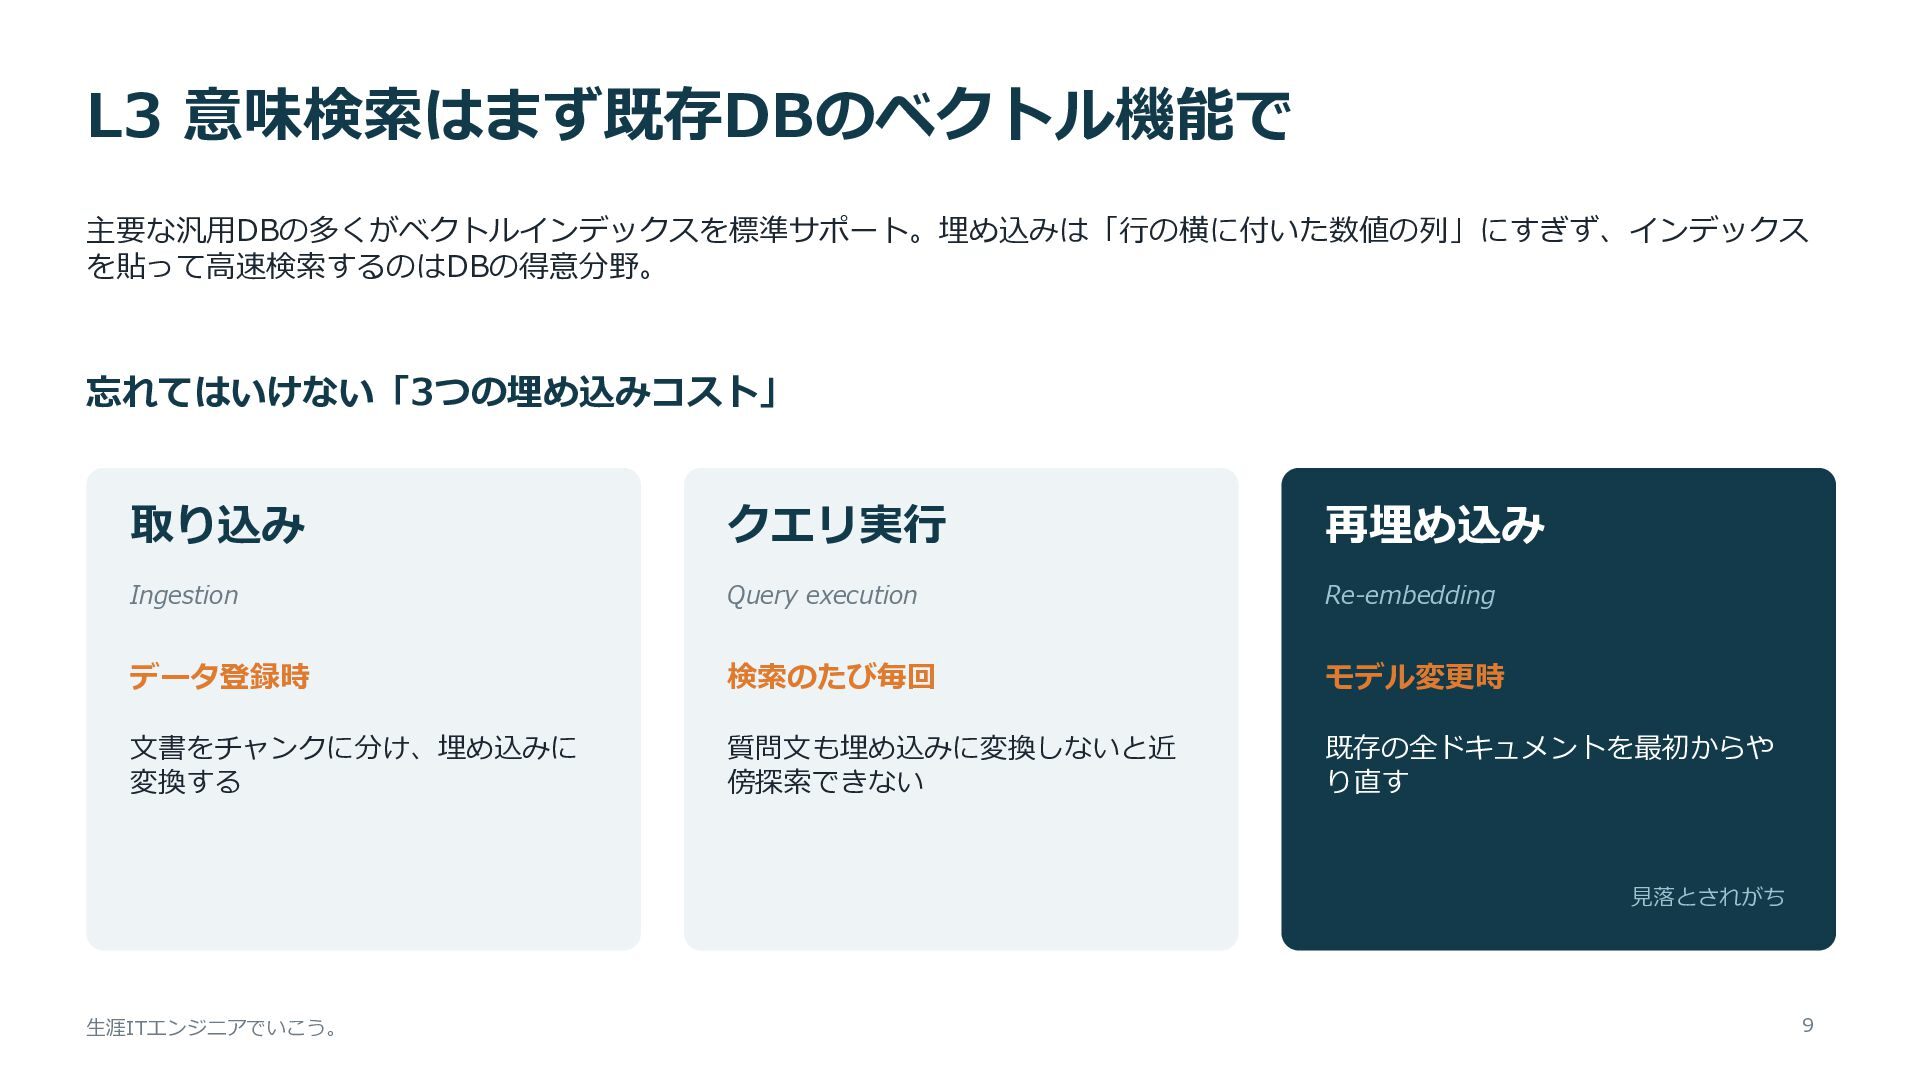
L3 意味検索はまず既存DBのベクトル機能で 主要な汎用DBの多くがベクトルインデックスを標準サポート。埋め込みは「行の横に付いた数値の列」にすぎず、インデックス を貼って高速検索するのはDBの得意分野。 忘れてはいけない「3つの埋め込みコスト」 取り込み クエリ実行 再埋め込み Ingestion Query
execution Re-embedding データ登録時 検索のたび毎回 モデル変更時 文書をチャンクに分け、埋め込みに 変換する 質問文も埋め込みに変換しないと近 傍探索できない 既存の全ドキュメントを最初からや り直す 見落とされがち 生涯ITエンジニアでいこう。 9 -
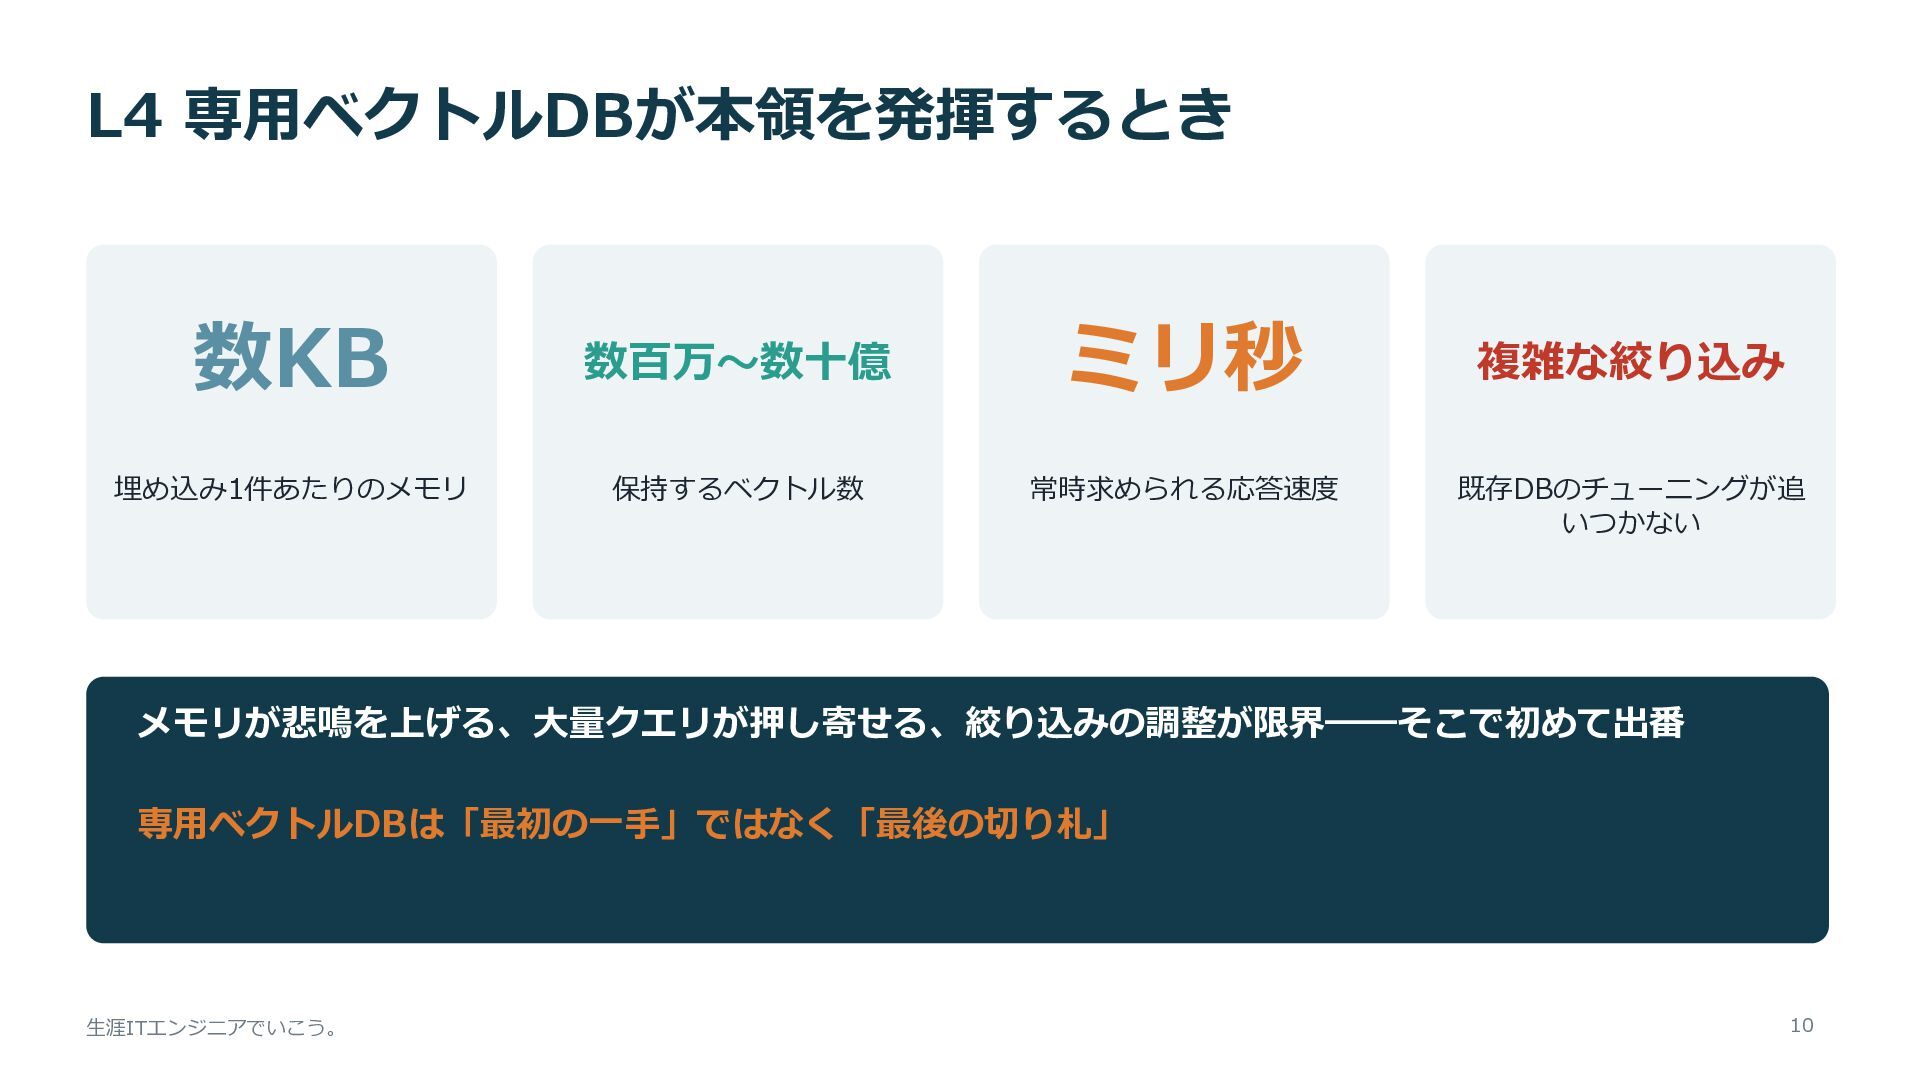
L4 専用ベクトルDBが本領を発揮するとき 数KB 数百万〜数十億 ミリ秒 埋め込み1件あたりのメモリ 保持するベクトル数 常時求められる応答速度 複雑な絞り込み 既存DBのチューニングが追
いつかない メモリが悲鳴を上げる、大量クエリが押し寄せる、絞り込みの調整が限界――そこで初めて出番 専用ベクトルDBは「最初の一手」ではなく「最後の切り札」 生涯ITエンジニアでいこう。 10 -
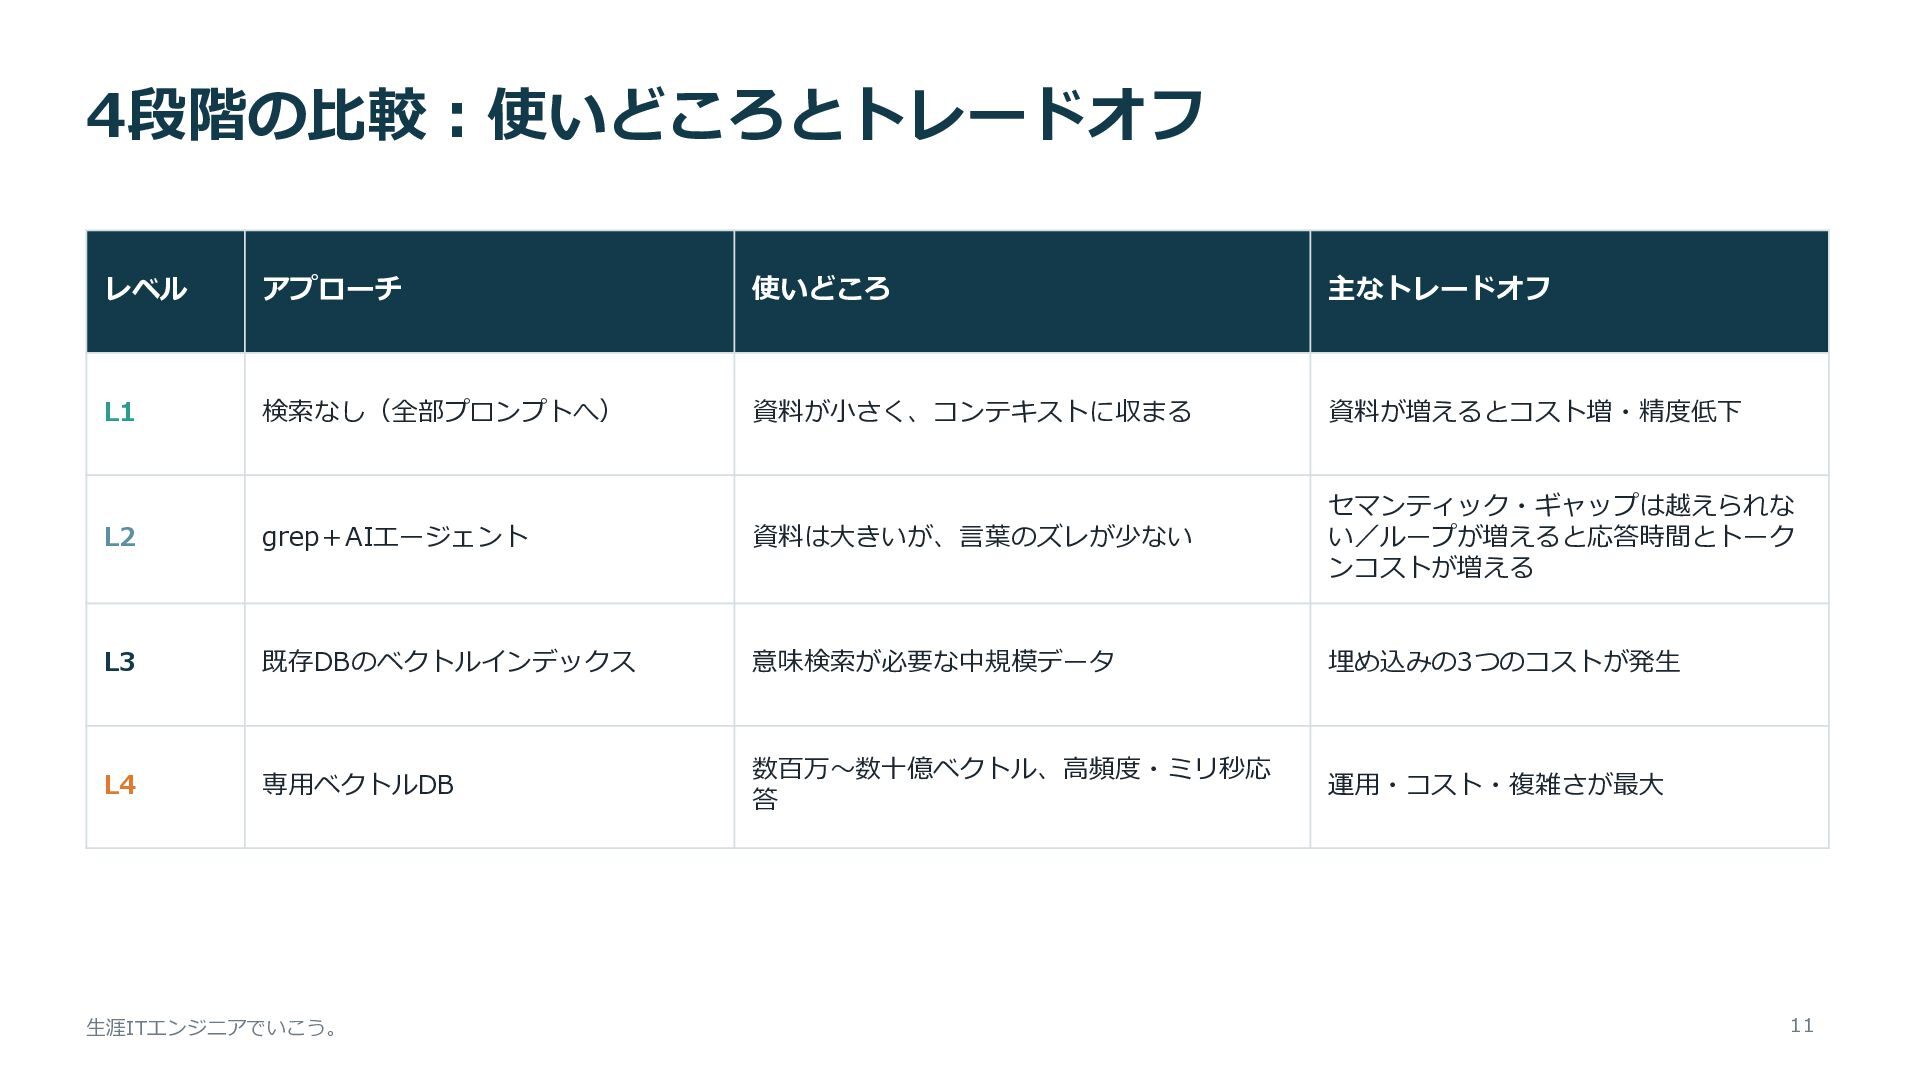
4段階の比較:使いどころとトレードオフ レベル アプローチ 使いどころ 主なトレードオフ L1 検索なし(全部プロンプトへ) 資料が小さく、コンテキストに収まる 資料が増えるとコスト増・精度低下 L2
grep+AIエージェント 資料は大きいが、言葉のズレが少ない セマンティック・ギャップは越えられな い/ループが増えると応答時間とトーク ンコストが増える L3 既存DBのベクトルインデックス 意味検索が必要な中規模データ 埋め込みの3つのコストが発生 L4 専用ベクトルDB 数百万〜数十億ベクトル、高頻度・ミリ秒応 答 運用・コスト・複雑さが最大 生涯ITエンジニアでいこう。 11 -
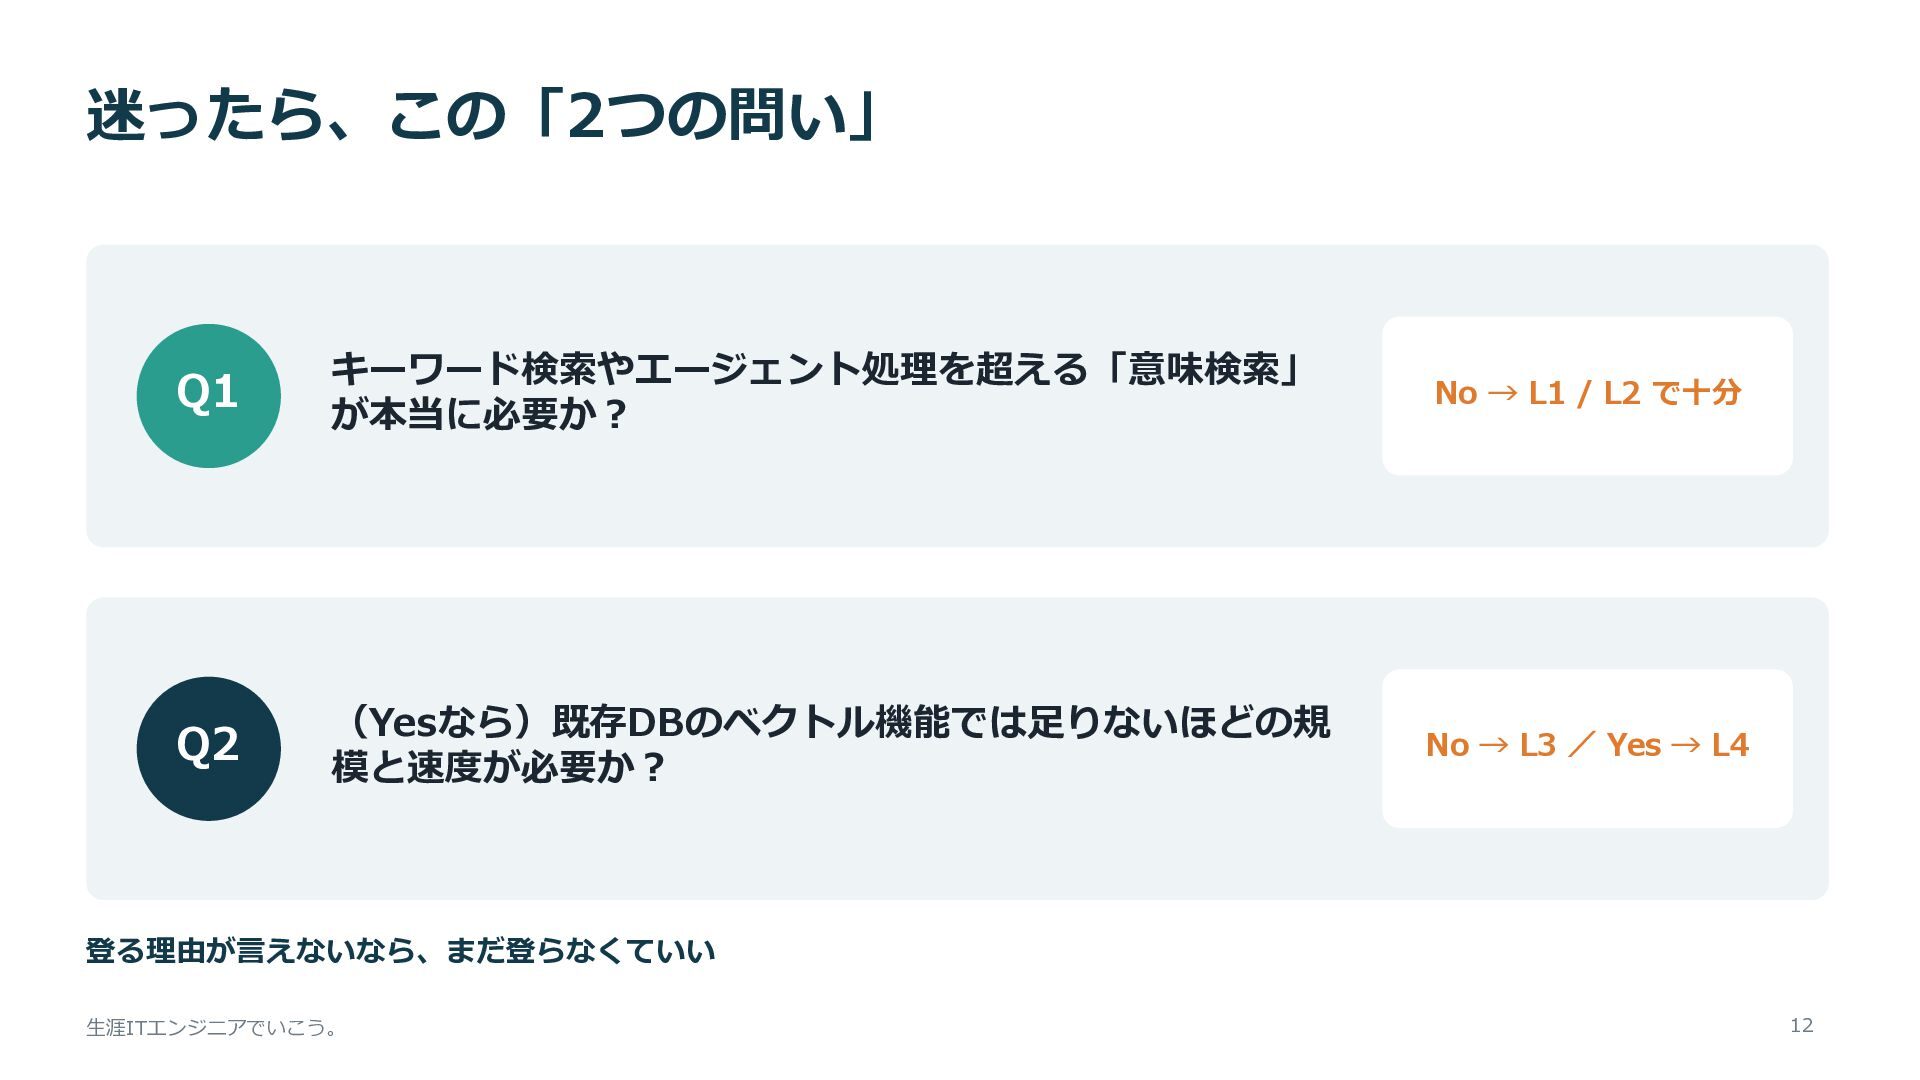
迷ったら、この「2つの問い」 Q1 キーワード検索やエージェント処理を超える「意味検索」 が本当に必要か? No → L1 / L2 で十分
Q2 (Yesなら)既存DBのベクトル機能では足りないほどの規 模と速度が必要か? No → L3 / Yes → L4 登る理由が言えないなら、まだ登らなくていい 生涯ITエンジニアでいこう。 12 -
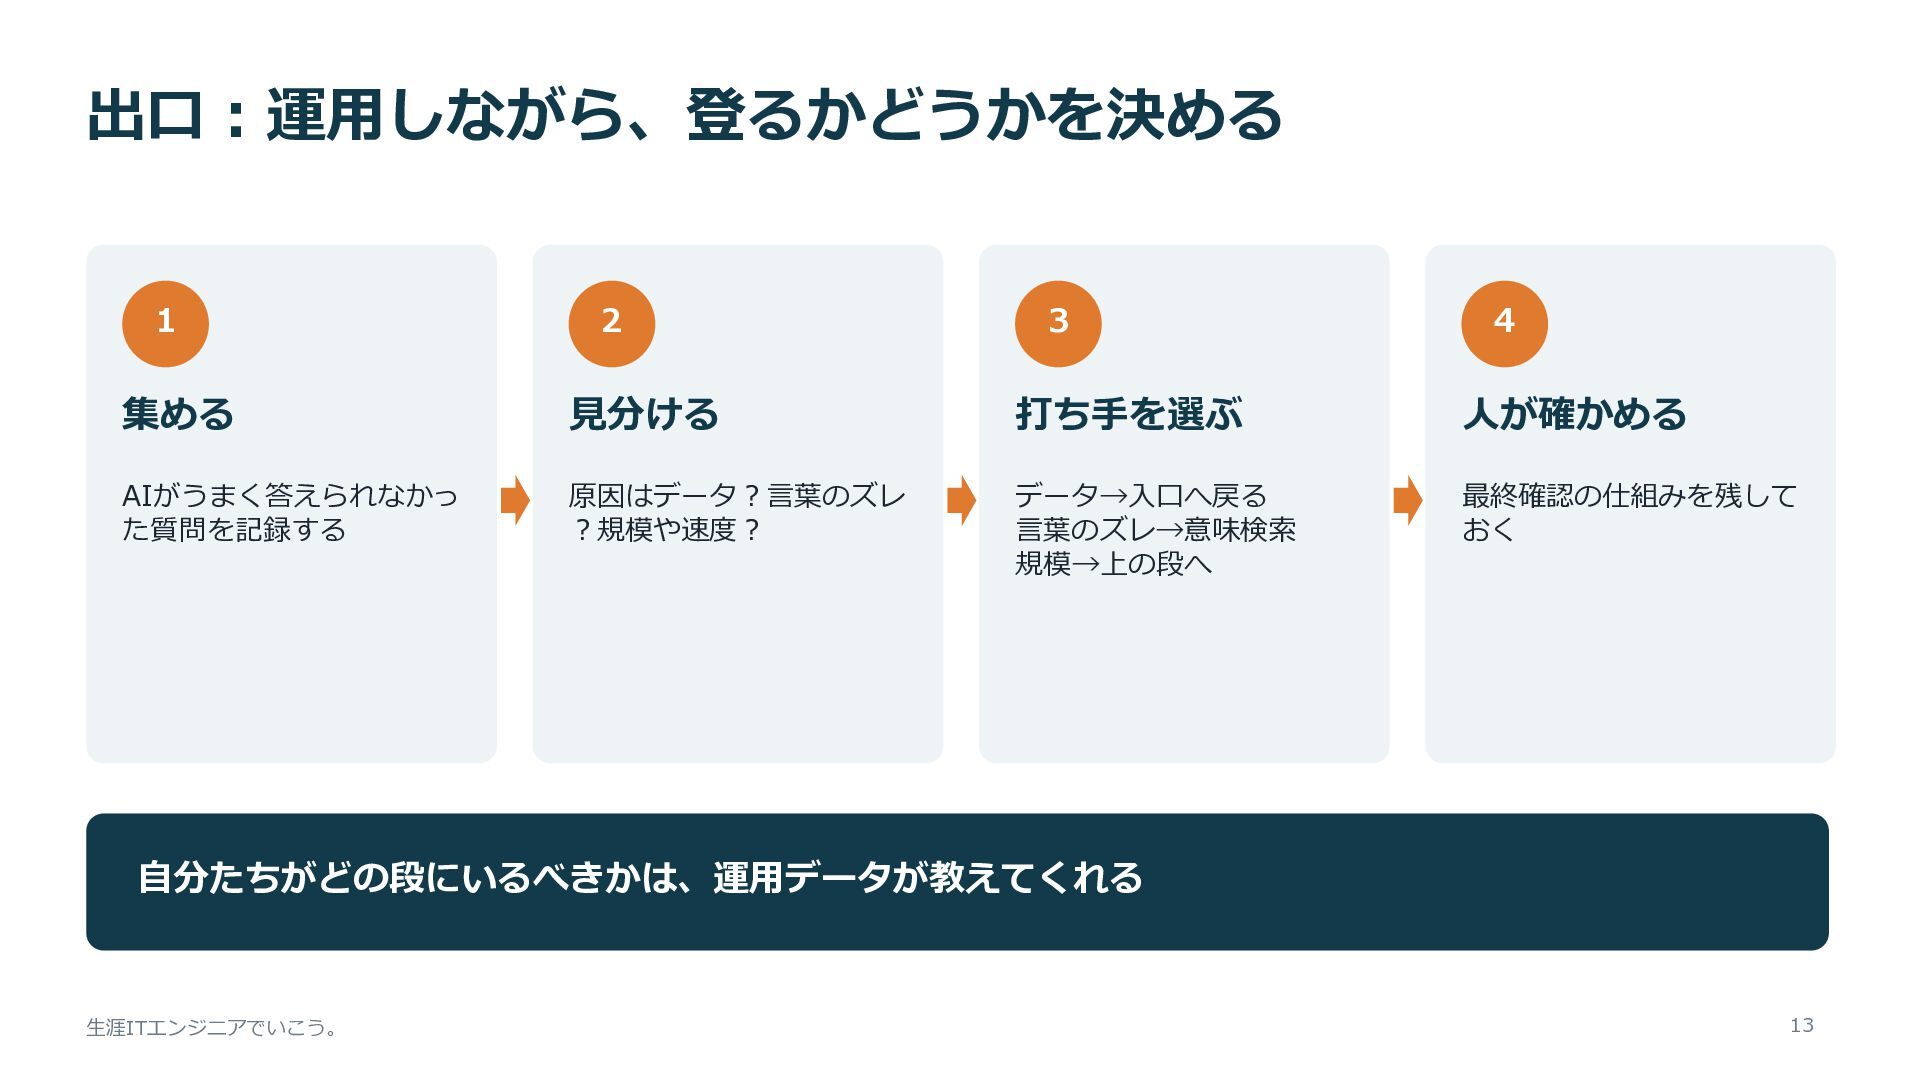
出口:運用しながら、登るかどうかを決める 1 2 3 4 集める 見分ける 打ち手を選ぶ 人が確かめる AIがうまく答えられなかっ
た質問を記録する 原因はデータ?言葉のズレ ?規模や速度? データ→入口へ戻る 言葉のズレ→意味検索 規模→上の段へ 最終確認の仕組みを残して おく 自分たちがどの段にいるべきかは、運用データが教えてくれる 生涯ITエンジニアでいこう。 13 -
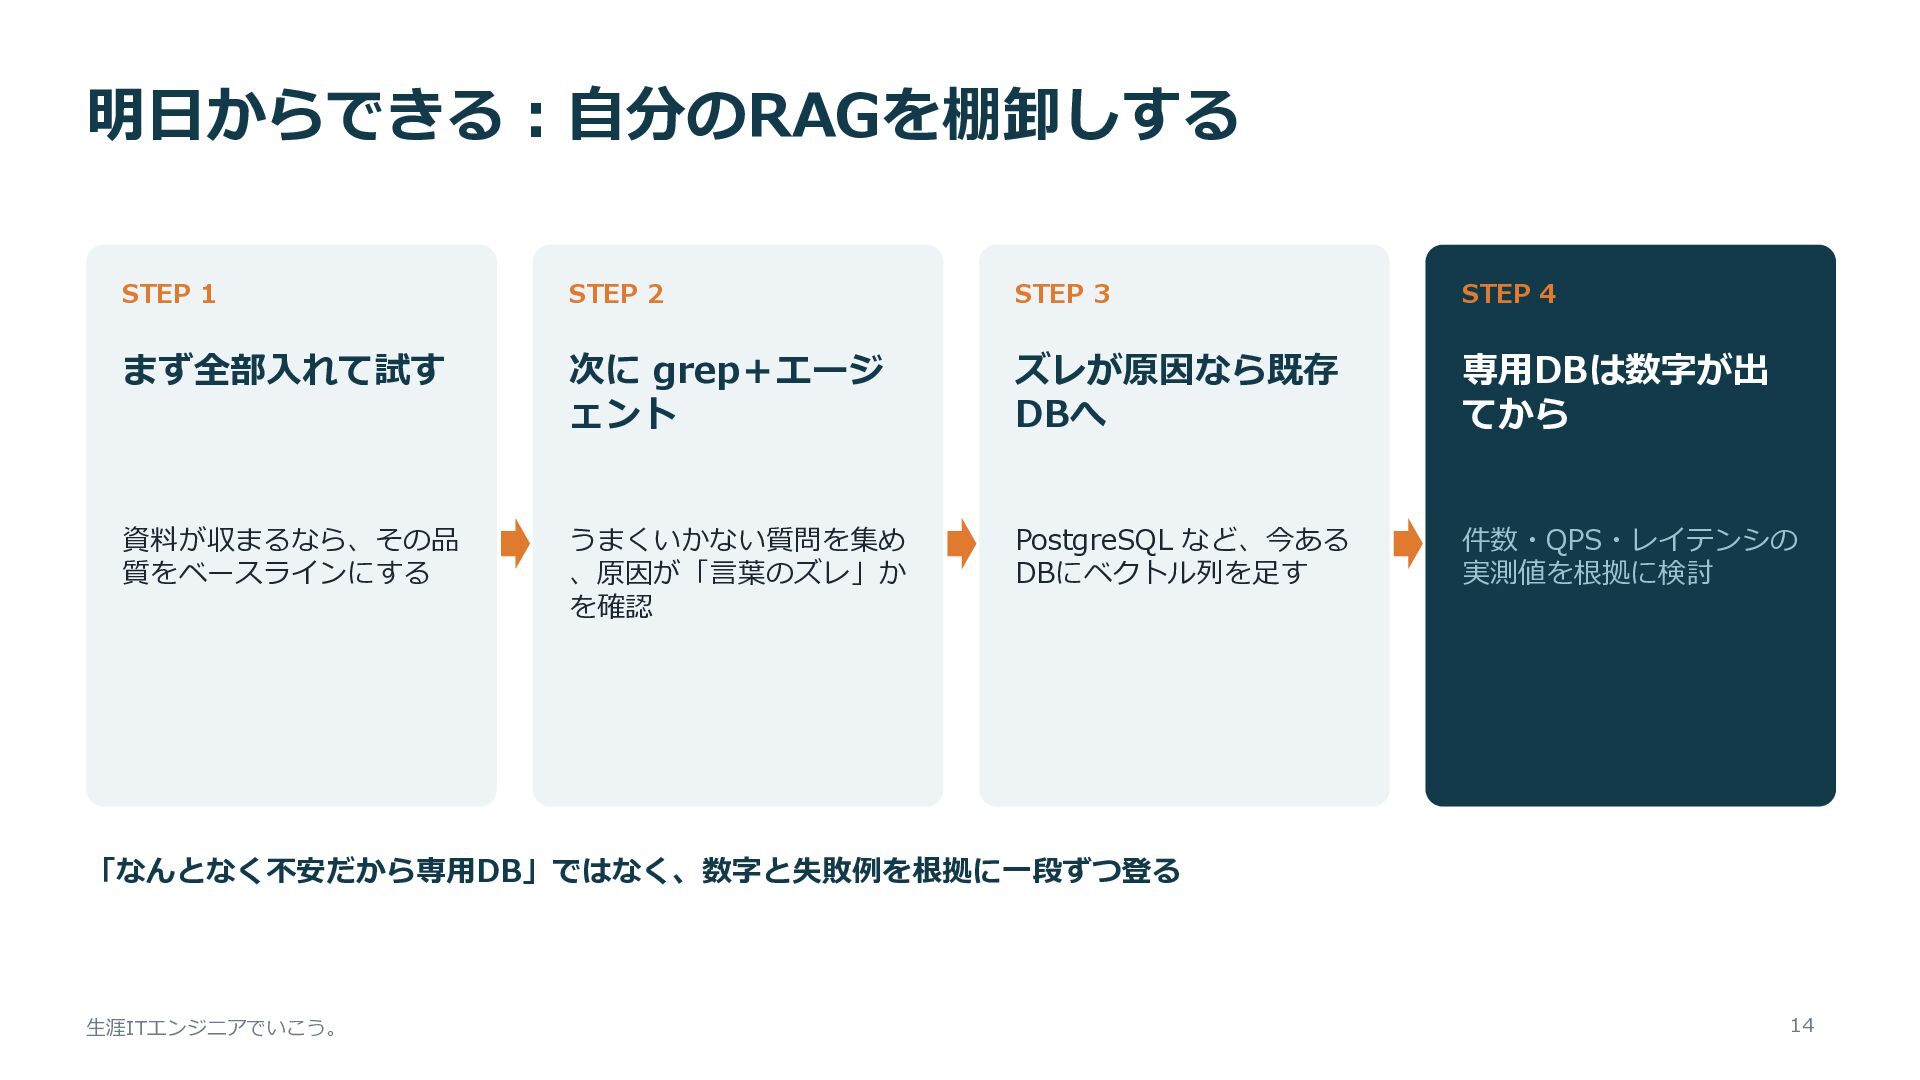
明日からできる:自分のRAGを棚卸しする STEP 1 STEP 2 STEP 3 STEP 4 まず全部入れて試す
次に grep+エージ ェント ズレが原因なら既存 DBへ 専用DBは数字が出 てから 資料が収まるなら、その品 質をベースラインにする うまくいかない質問を集め 、原因が「言葉のズレ」か を確認 PostgreSQL など、今ある DBにベクトル列を足す 件数・QPS・レイテンシの 実測値を根拠に検討 「なんとなく不安だから専用DB」ではなく、数字と失敗例を根拠に一段ずつ登る 生涯ITエンジニアでいこう。 14