Music Is Just Wiggly Air
Sponsored
·
 Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→

Share
Embed
Music Is Just Wiggly Air
Apache Beam Summit 2020
Digital signal processing (DSP) has been made easy with the help of many Python libraries, allowing engineers and researchers to quickly and effortlessly analyze audio, images, and video. However, scaling these algorithms and models to process millions of files has not been equally as seamless. At Spotify, we’re trying to address scaling DSP over our catalog of over 50 million songs. This talk will discuss the challenges we’ve encountered while building the infrastructure needed to support audio processing at scale. I’ll discuss the how we’ve leveraged Apache Beam for streaming data pipelines and the tooling we’ve built on top of Beam to support our heavy resource requirements.

Lynn Root
November 10, 2021
Transcript
141 slides
-
music is just wiggly air Lynn Root | Staff Engineer
| @roguelynn building infrastructure to support audio research -
— Audio intelligence research at Spotify advances the state of
the art in understanding music at scale to enhance how it is created, identified and consumed. research.spotify.com -
— Audio intelligence research at Spotify advances the state of
the art in understanding music at scale to enhance how it is created, identified and consumed. research.spotify.com -
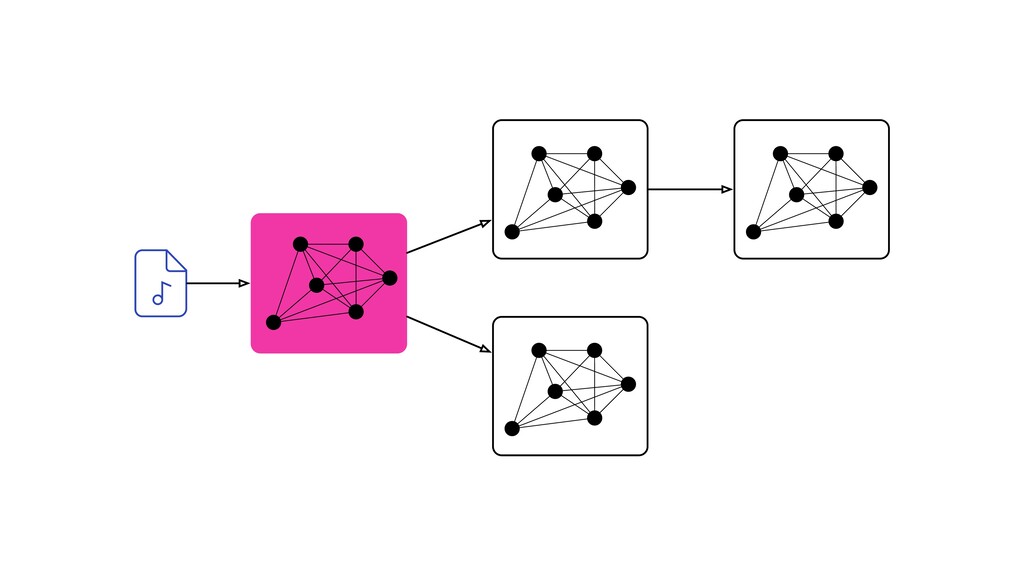
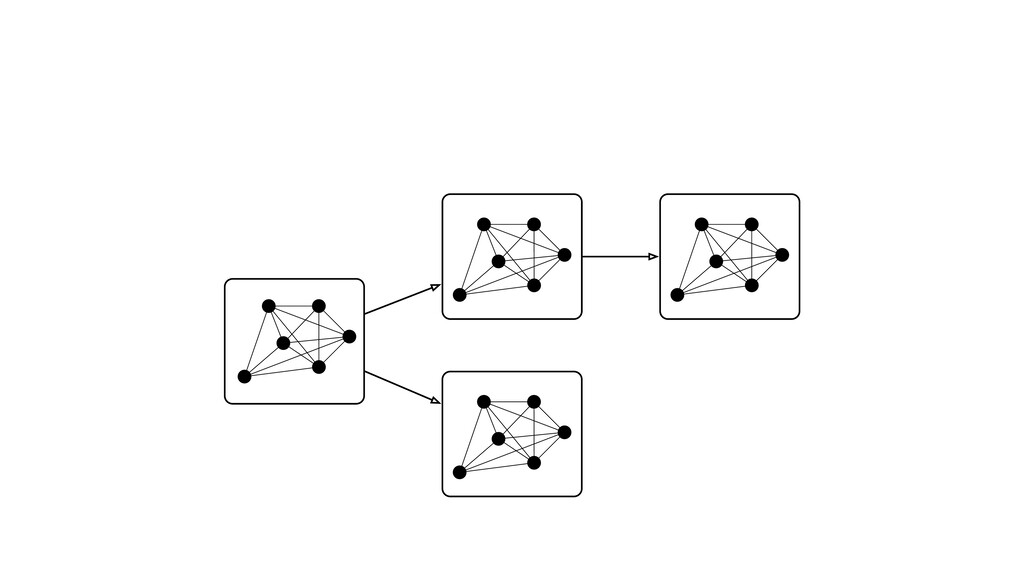
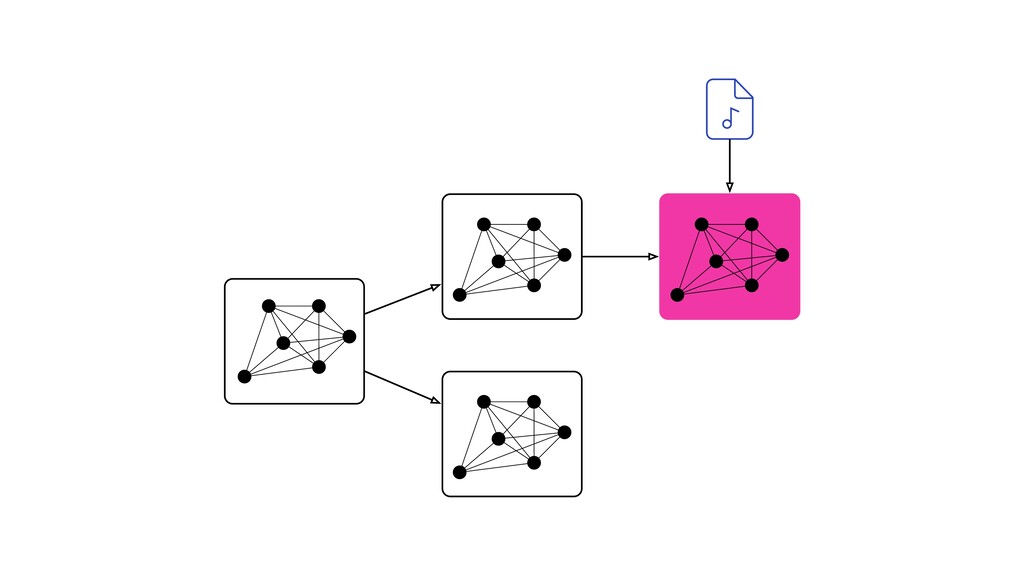
— summary Top-down & bottom-up Python Custom environment Avoid duplicate
work Streaming Scalability -
— Apache Beam Google Cloud PubSub Apache Beam on Google
Cloud Dataflow + -
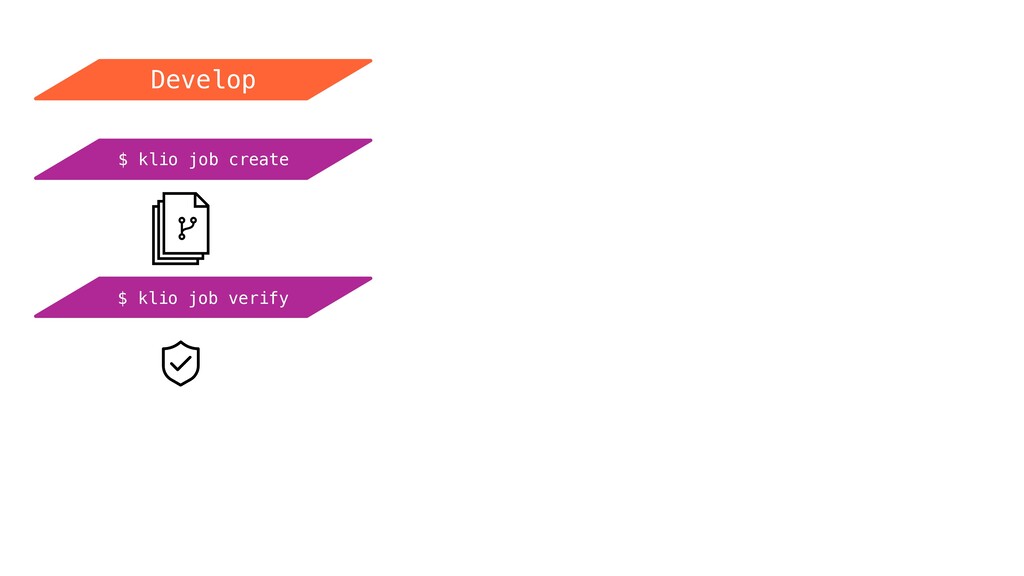
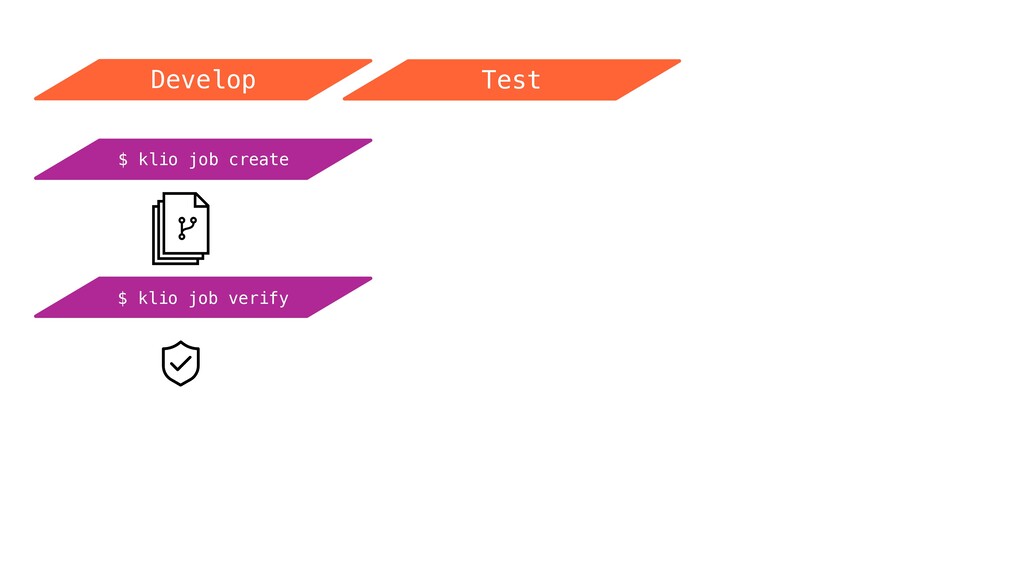
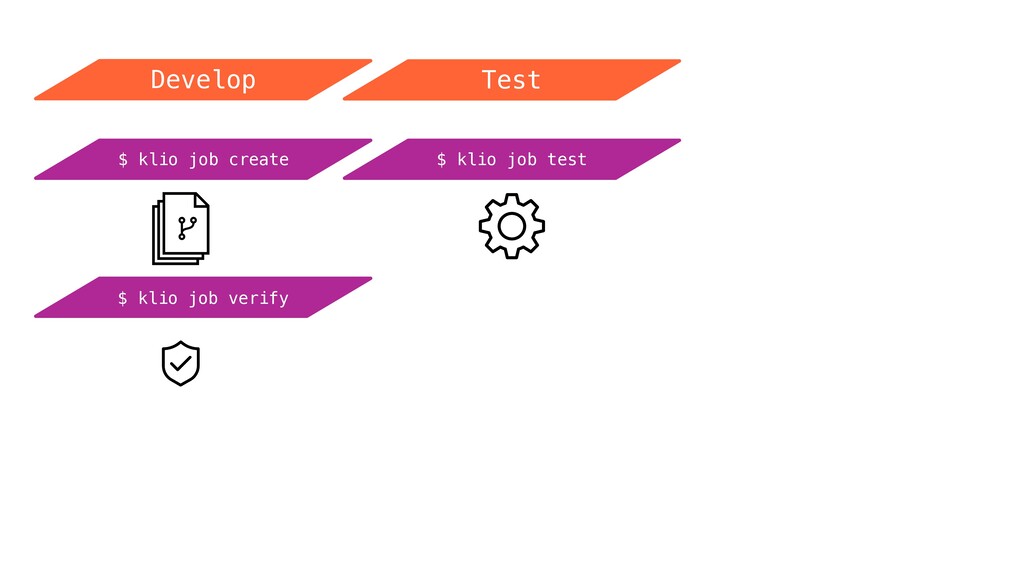
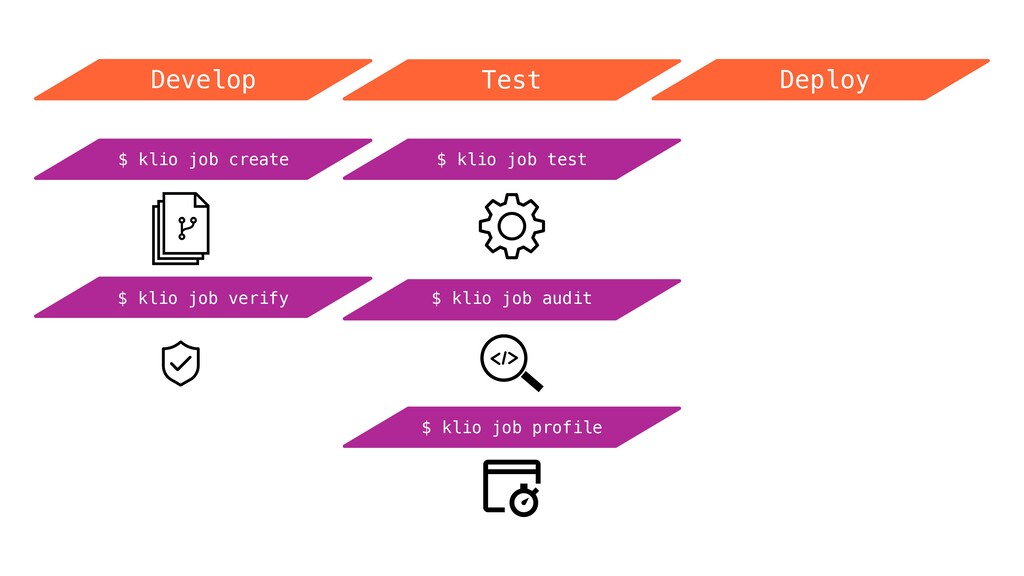
$ klio job create $ klio job test Develop Test
$ klio job verify -
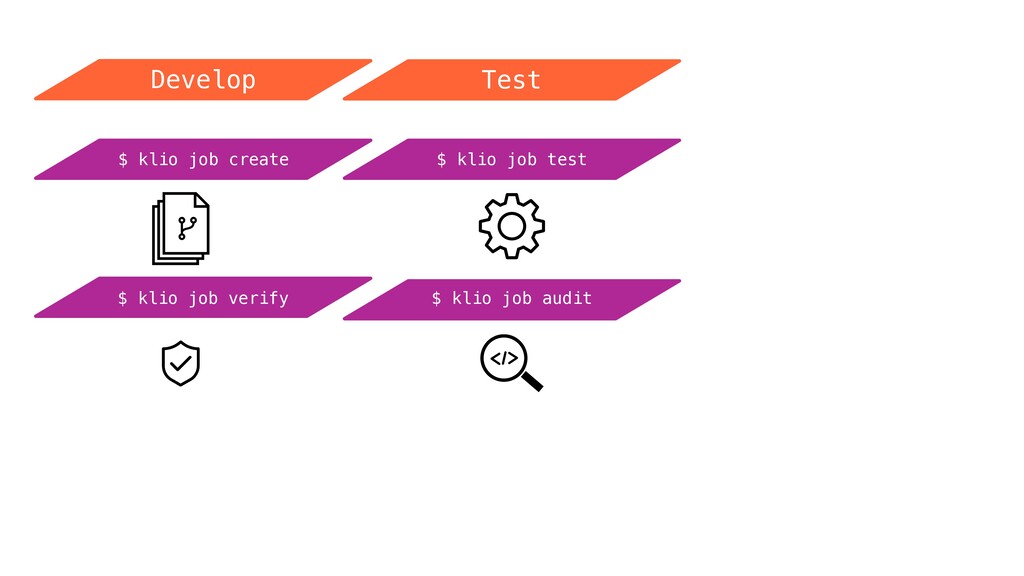
$ klio job create $ klio job test Develop Test
$ klio job verify $ klio job audit -
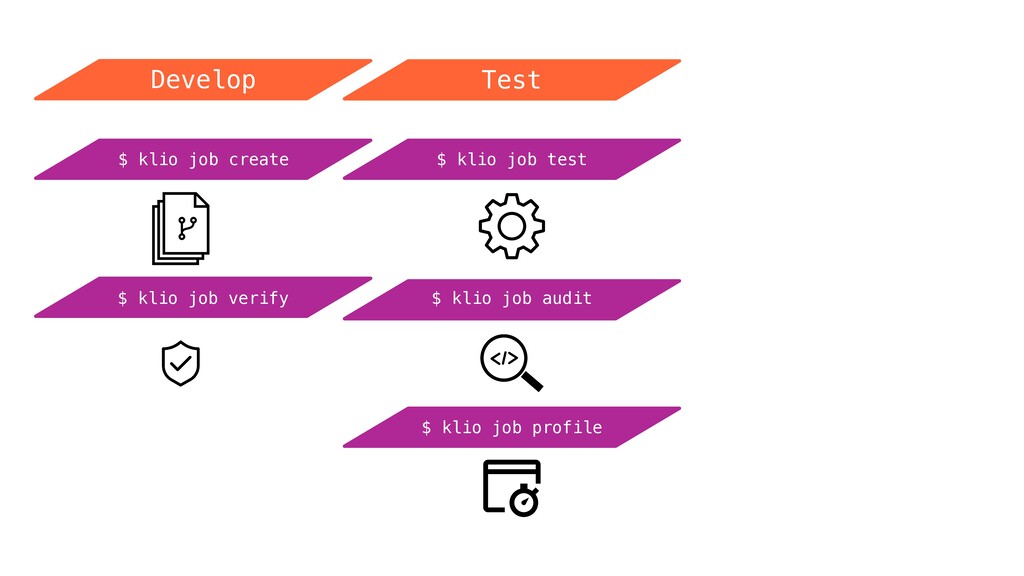
$ klio job create $ klio job test Develop Test
$ klio job verify $ klio job audit $ klio job profile -
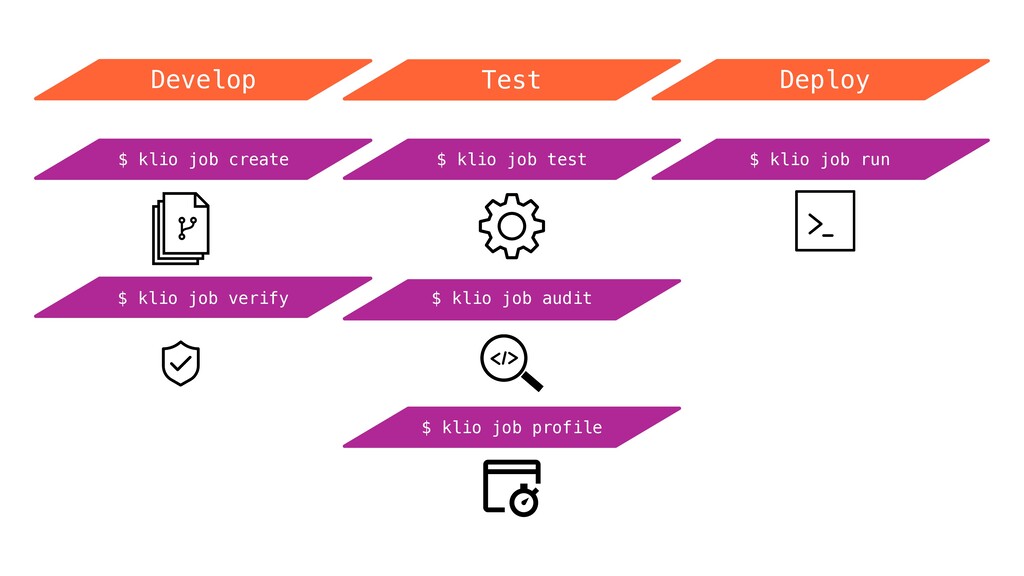
$ klio job create $ klio job test Develop Test
Deploy $ klio job verify $ klio job audit $ klio job profile -
$ klio job create $ klio job run $ klio
job test Develop Test Deploy $ klio job verify $ klio job audit $ klio job profile -
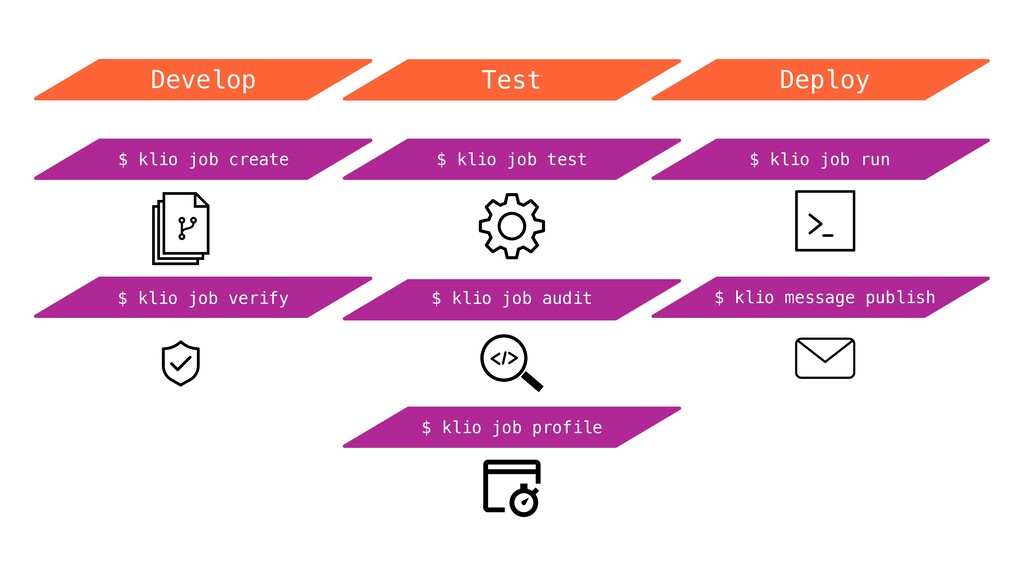
$ klio job create $ klio job run $ klio
message publish $ klio job test Develop Test Deploy $ klio job verify $ klio job audit $ klio job profile -
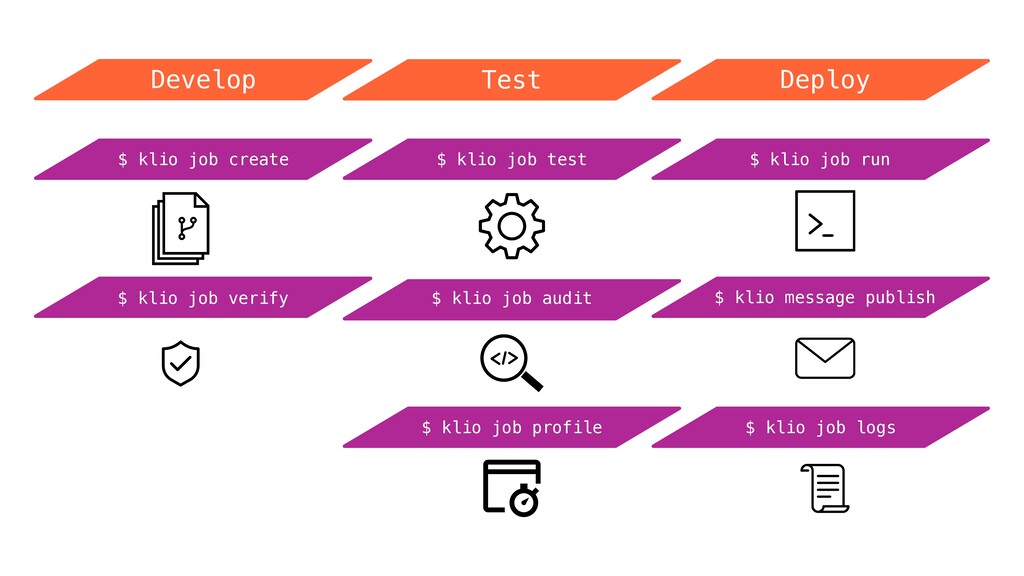
$ klio job create $ klio job run $ klio
message publish $ klio job test Develop Test Deploy $ klio job verify $ klio job audit $ klio job profile $ klio job logs -
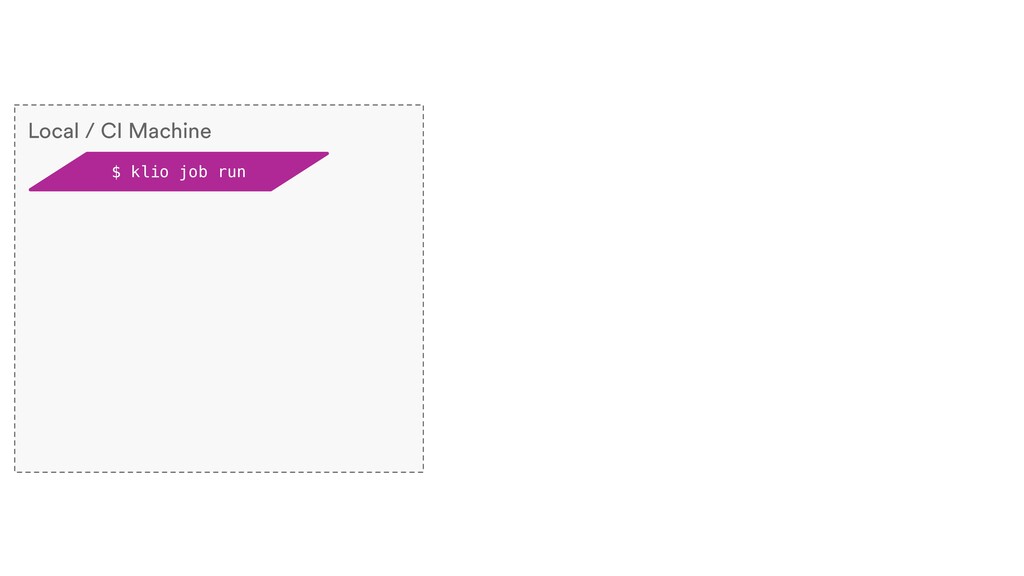
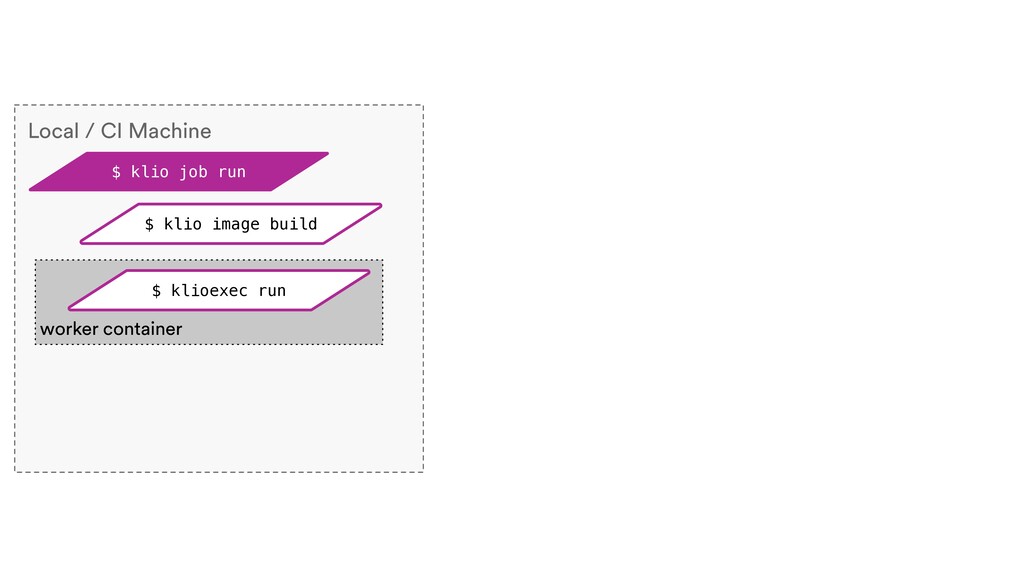
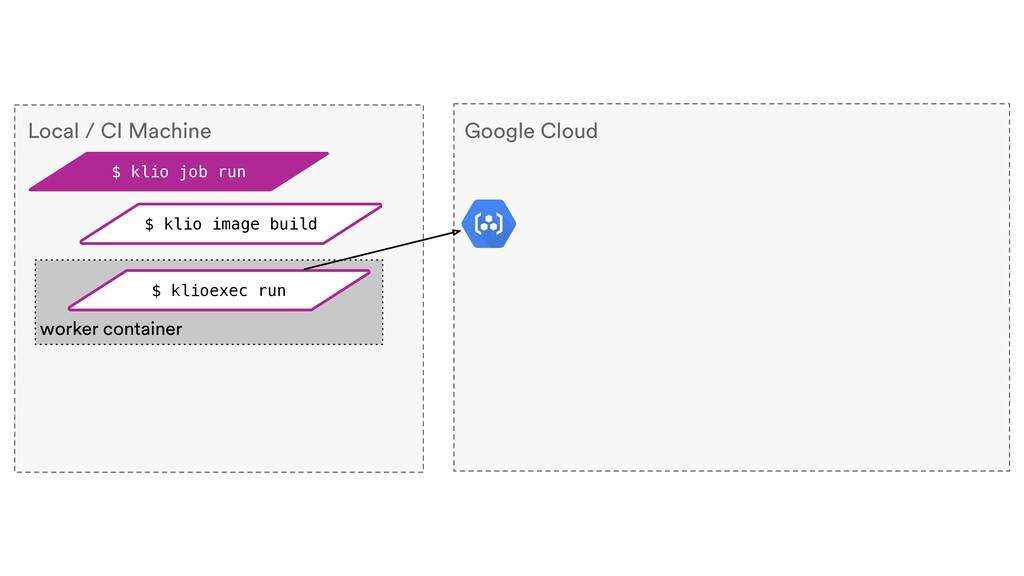
$ klio job run $ klio image build Local /
CI Machine -
$ klio job run $ klio image build $ klioexec
run Local / CI Machine worker container -
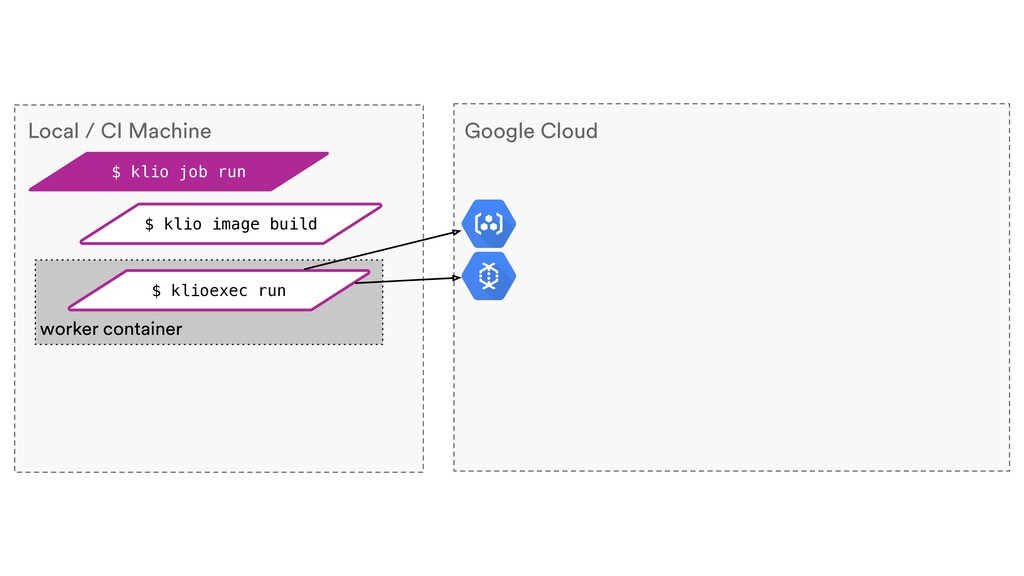
$ klio job run $ klio image build $ klioexec
run Local / CI Machine Google Cloud worker container -
$ klio job run $ klio image build $ klioexec
run Local / CI Machine Google Cloud worker container -
$ klio job run $ klio image build $ klioexec
run Local / CI Machine Google Cloud worker container -
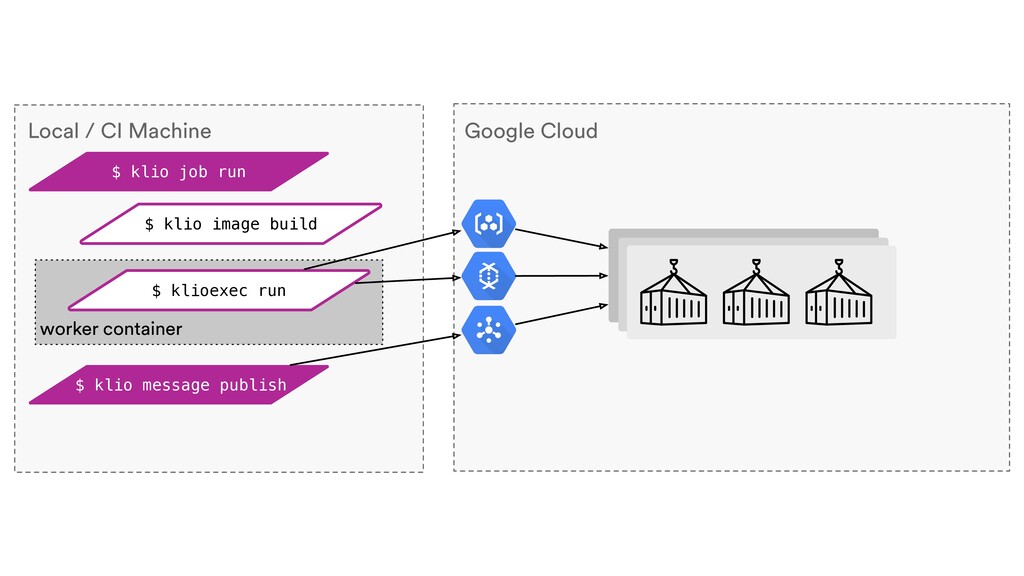
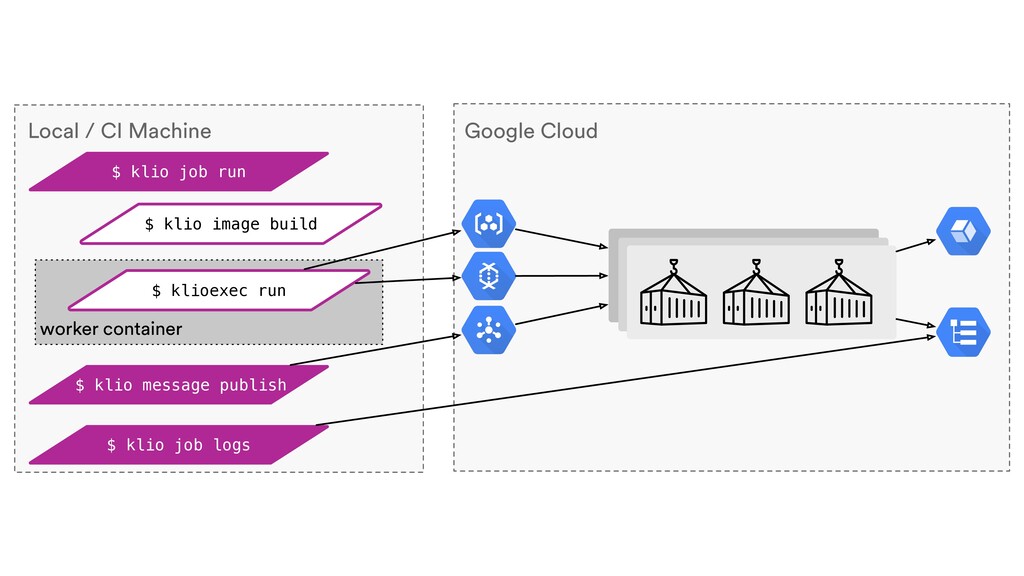
$ klio job run $ klio message publish $ klio
image build $ klioexec run Local / CI Machine Google Cloud worker container -
$ klio job run $ klio message publish $ klio
image build $ klioexec run Local / CI Machine Google Cloud worker container -
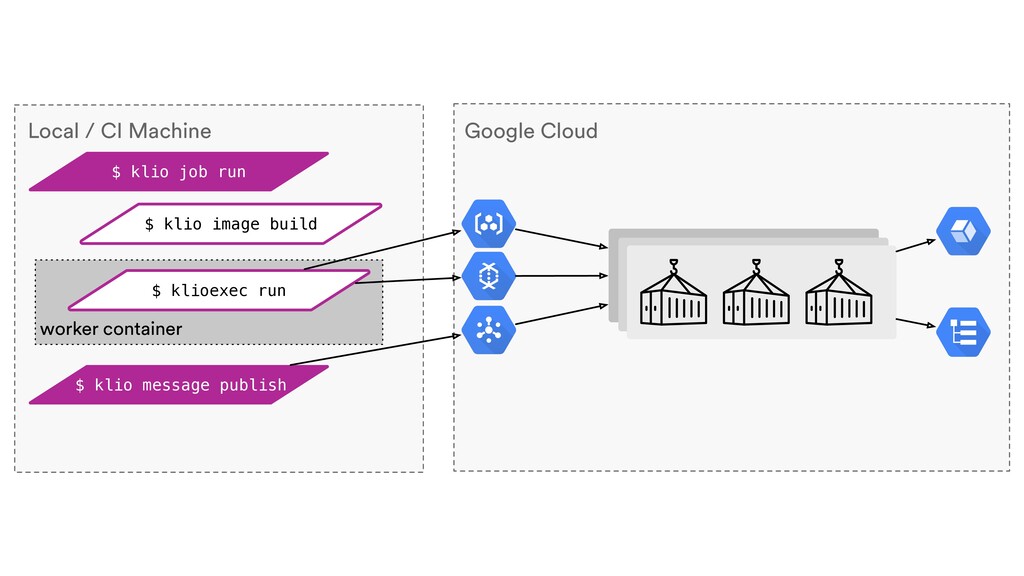
$ klio job run $ klio message publish $ klio
image build $ klioexec run Local / CI Machine Google Cloud worker container $ klio job logs -
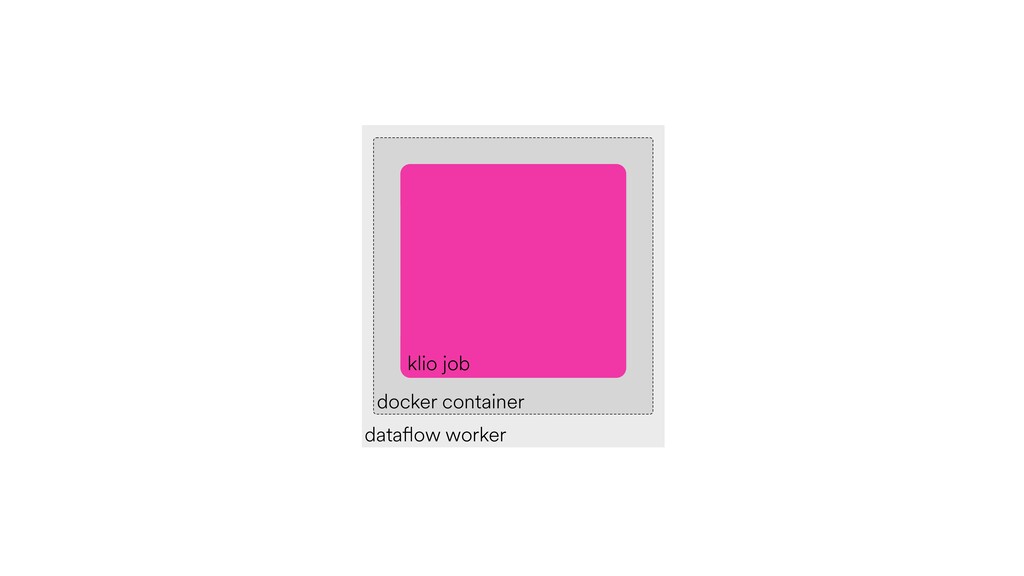
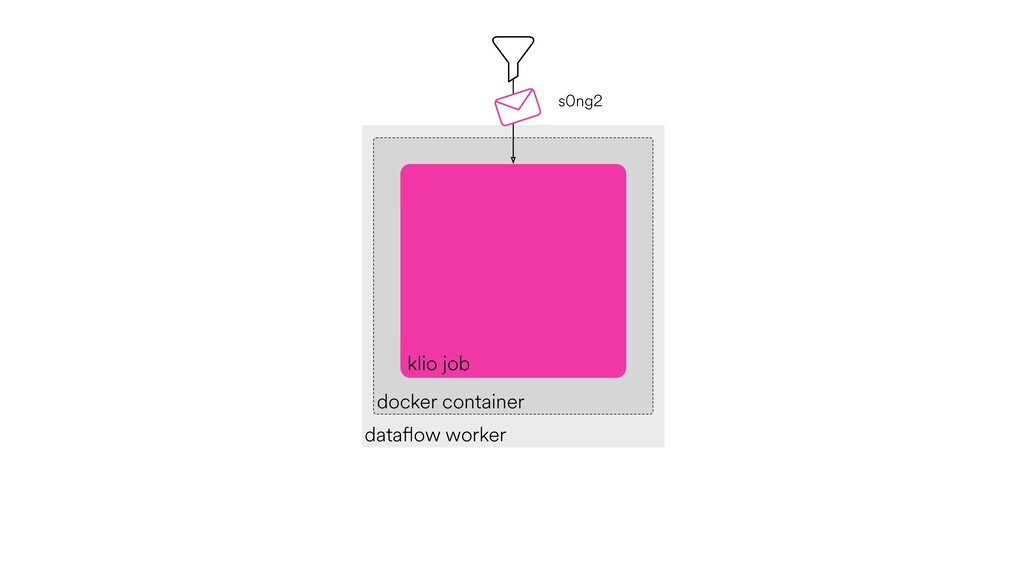
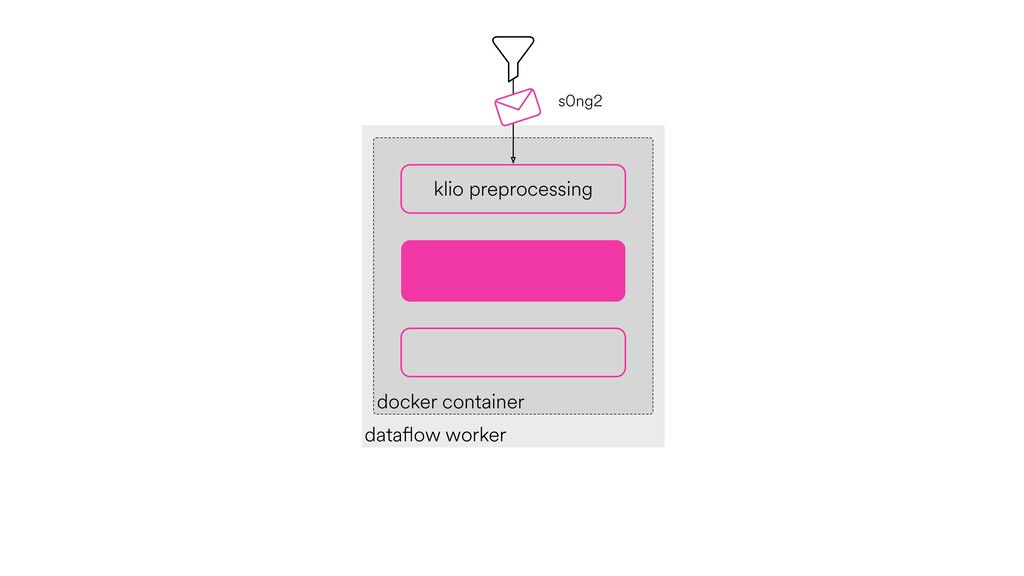
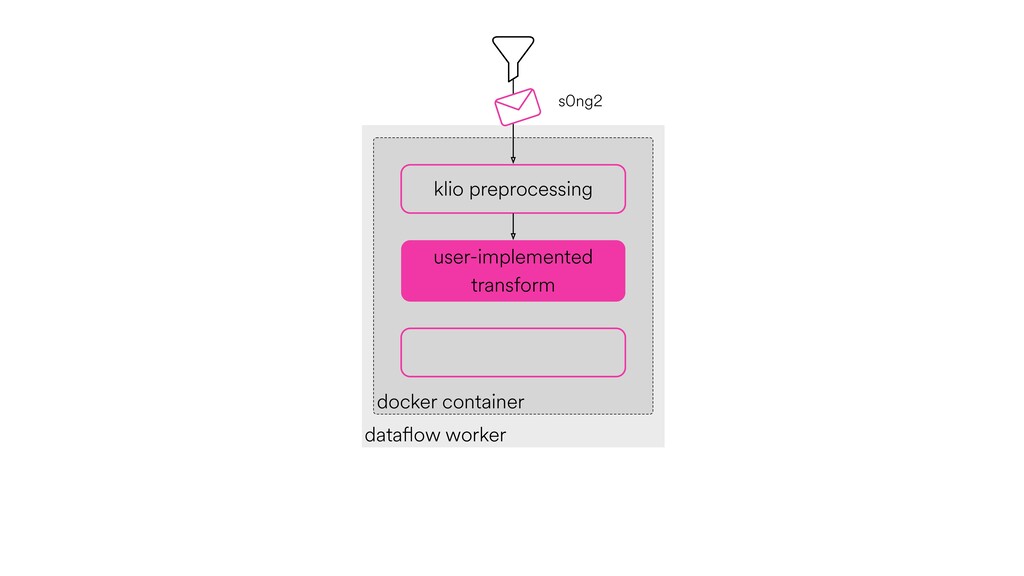
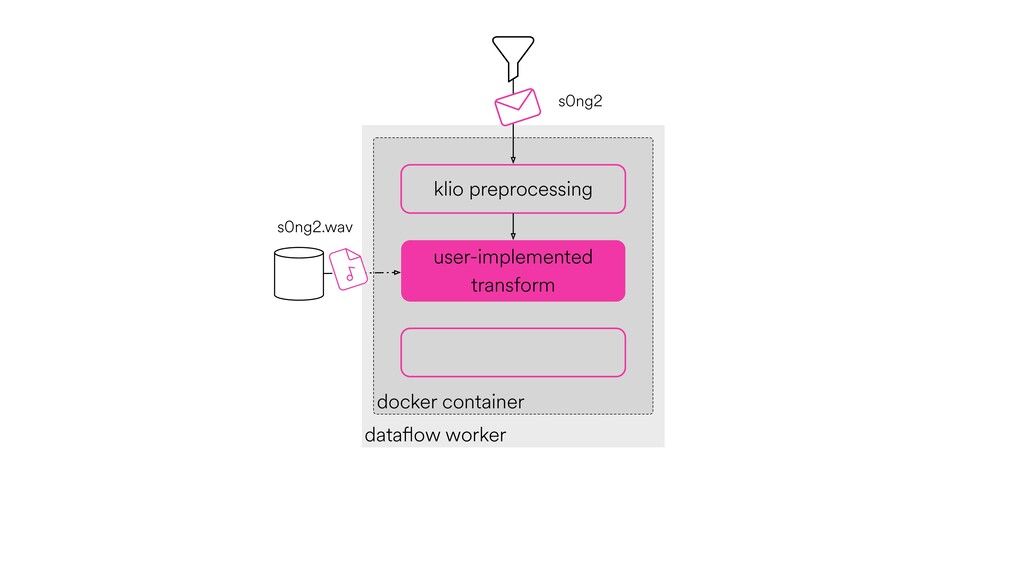
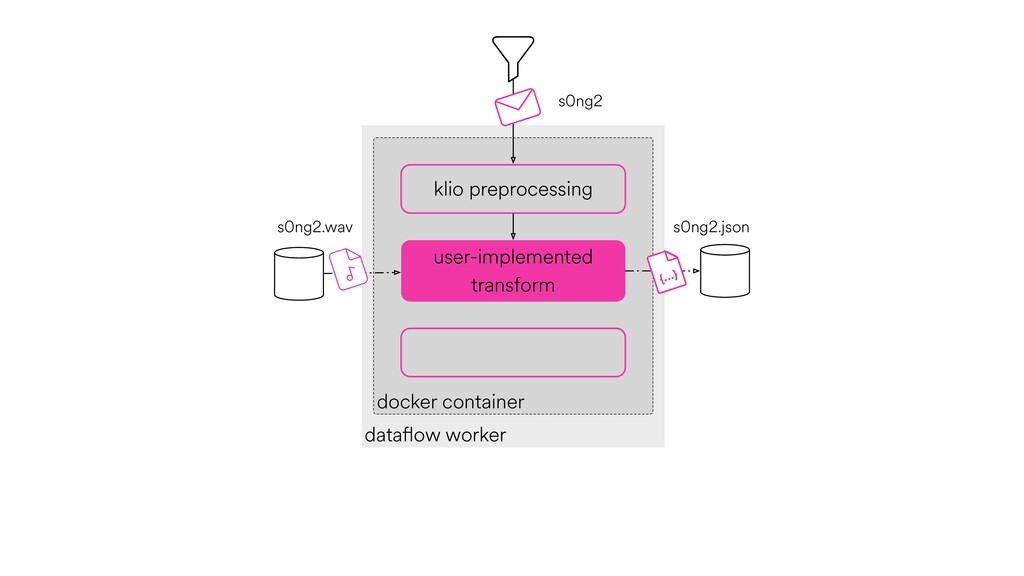
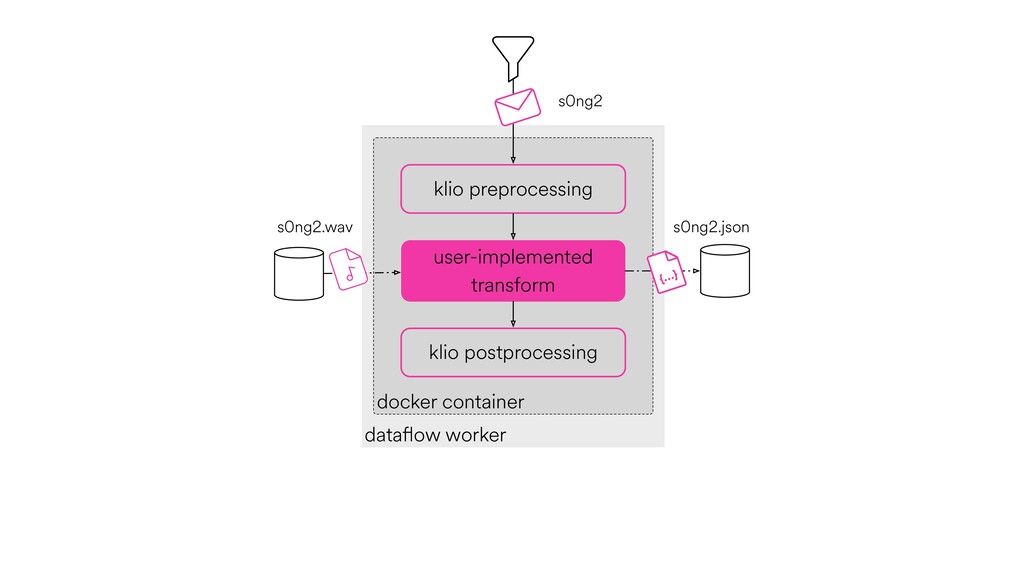
docker container data ow worker klio preprocessing user-implemented transform s0ng2
s0ng2.wav s0ng2.json -
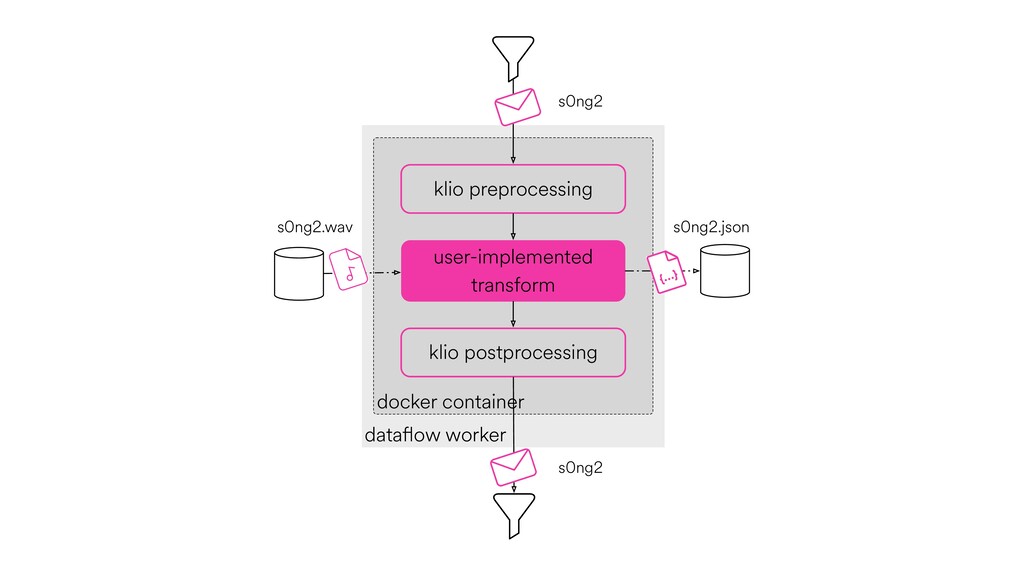
docker container data ow worker klio preprocessing user-implemented transform klio
postprocessing s0ng2 s0ng2.wav s0ng2.json -
docker container data ow worker klio preprocessing user-implemented transform klio
postprocessing s0ng2 s0ng2.wav s0ng2.json s0ng2 -
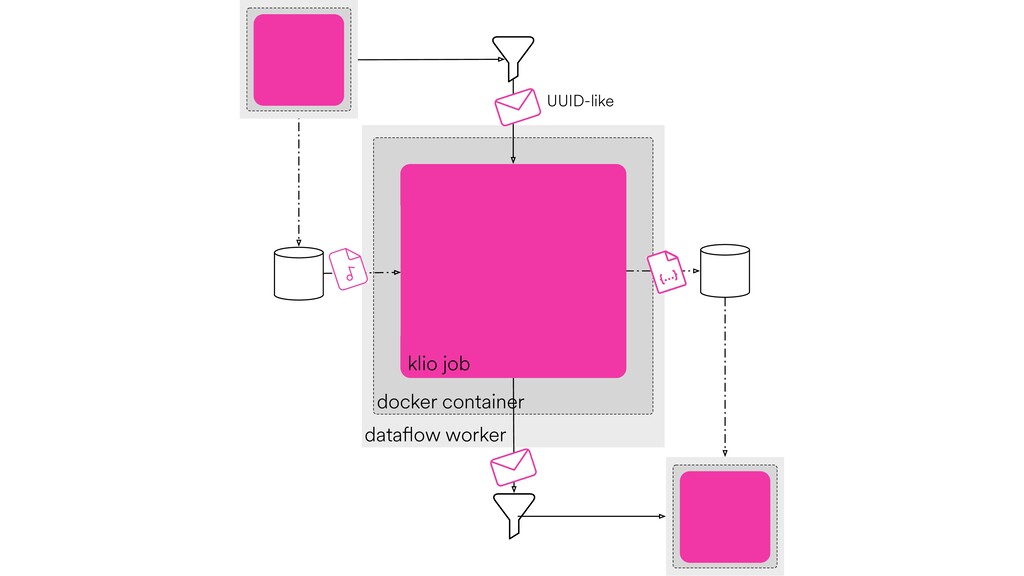
docker container data ow worker klio preprocessing user-implemented transform klio
postprocessing UUID-like klio job -
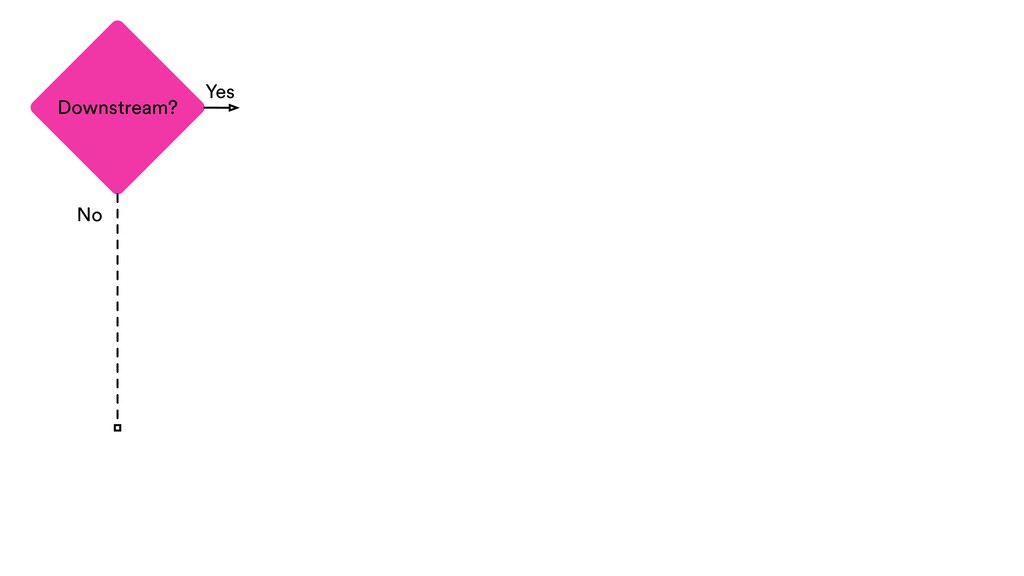
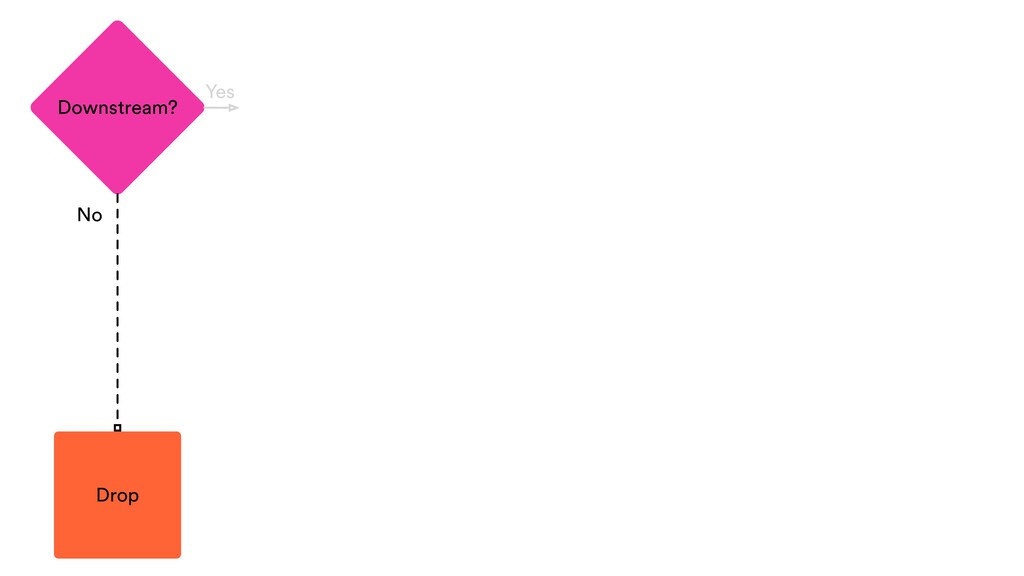
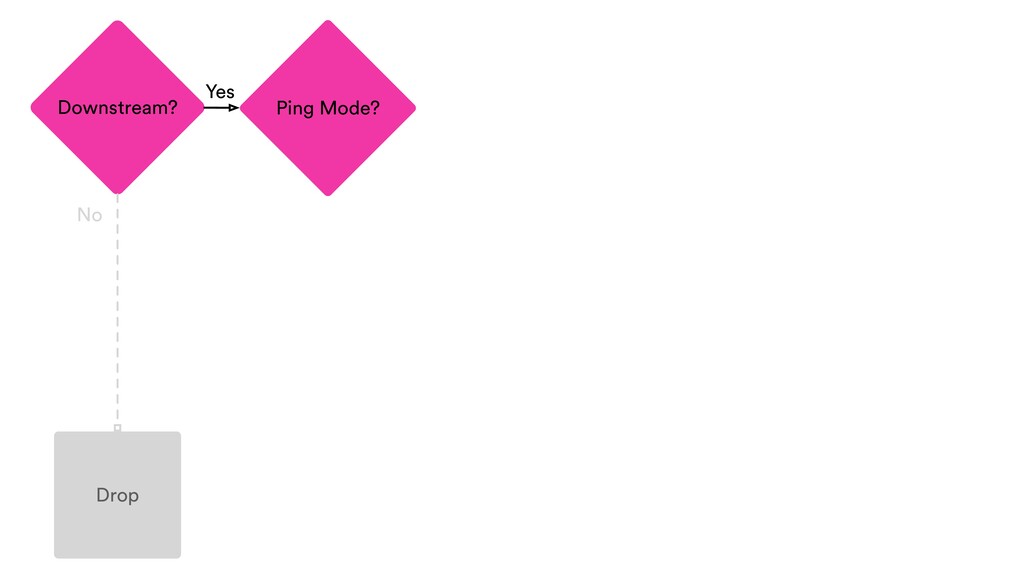
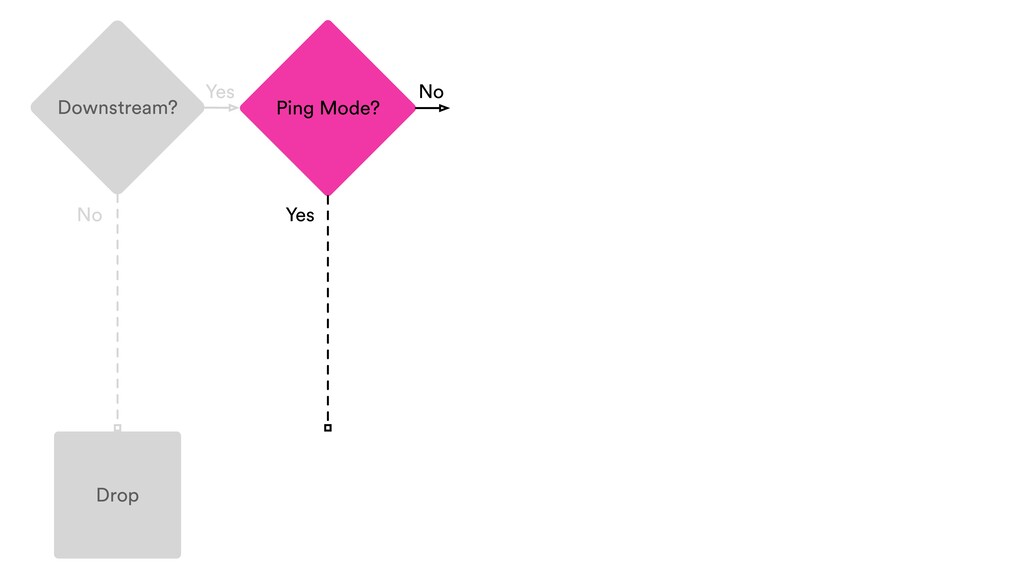
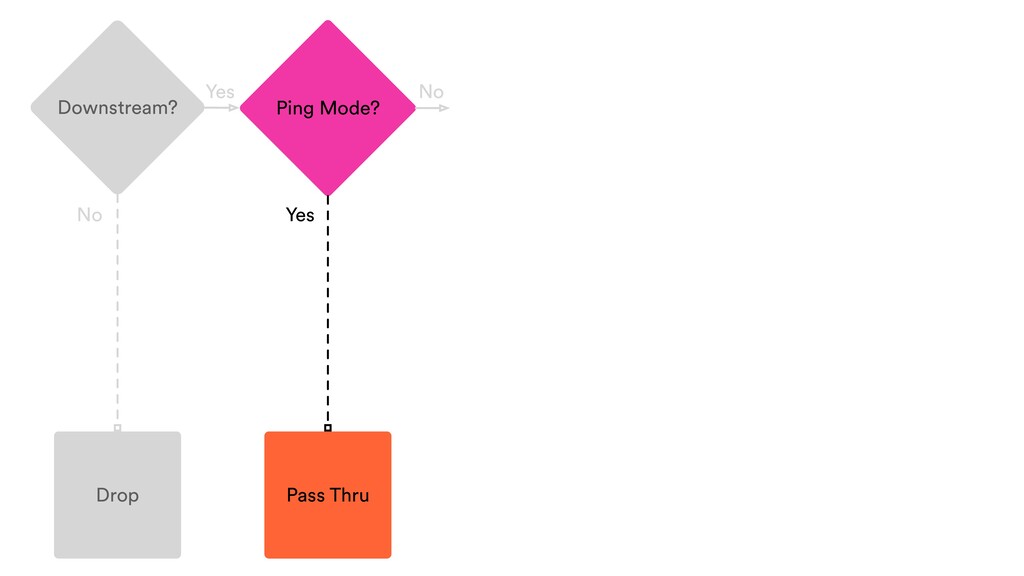
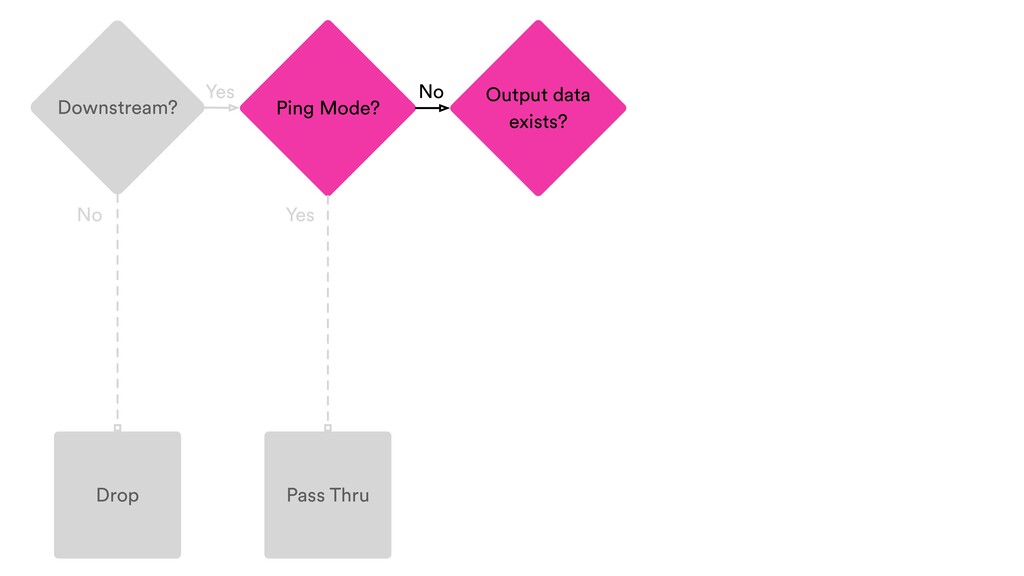
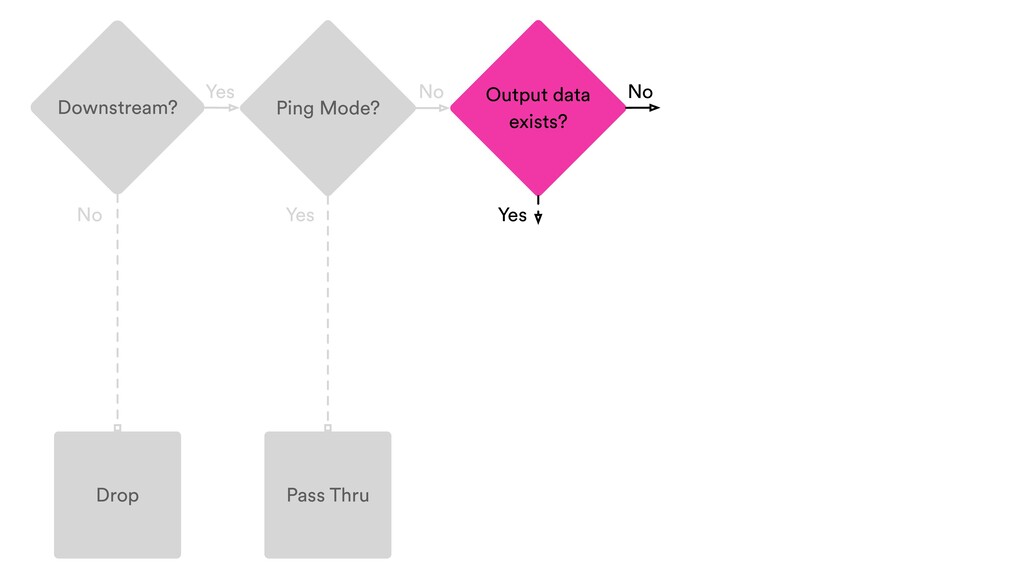
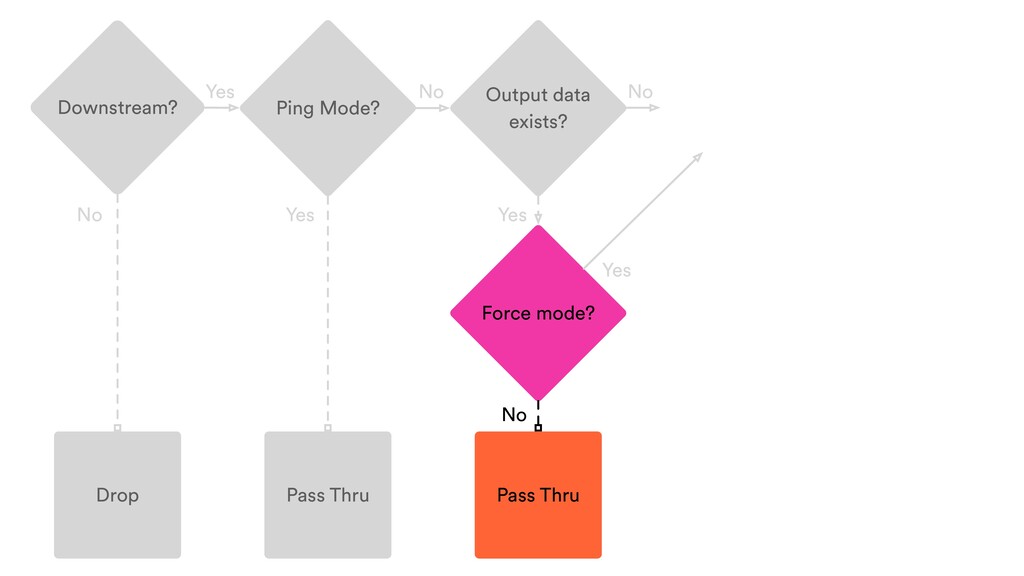
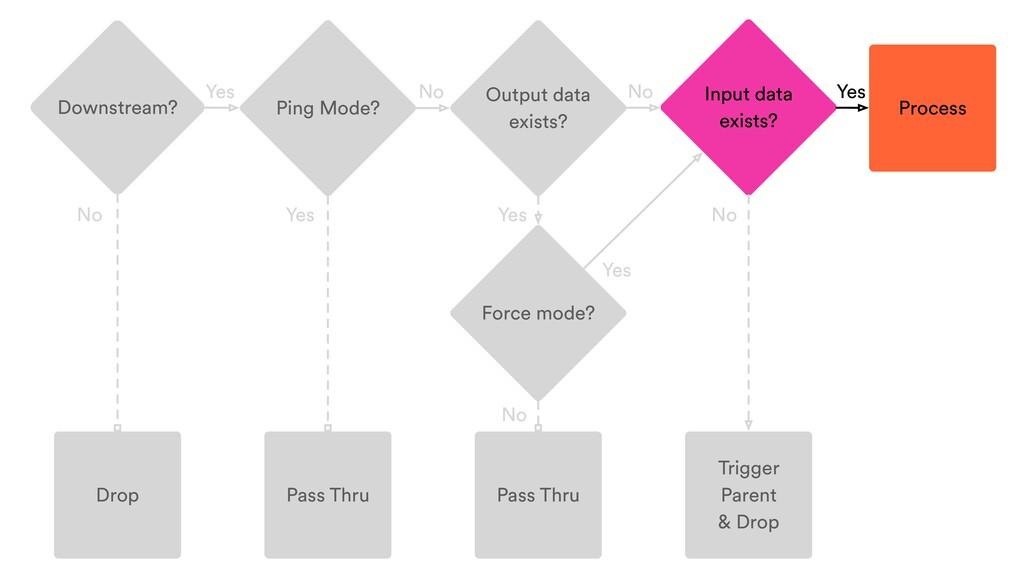
Downstream? Drop Ping Mode? Output data exists? Pass Thru Yes
No No No Yes Yes -
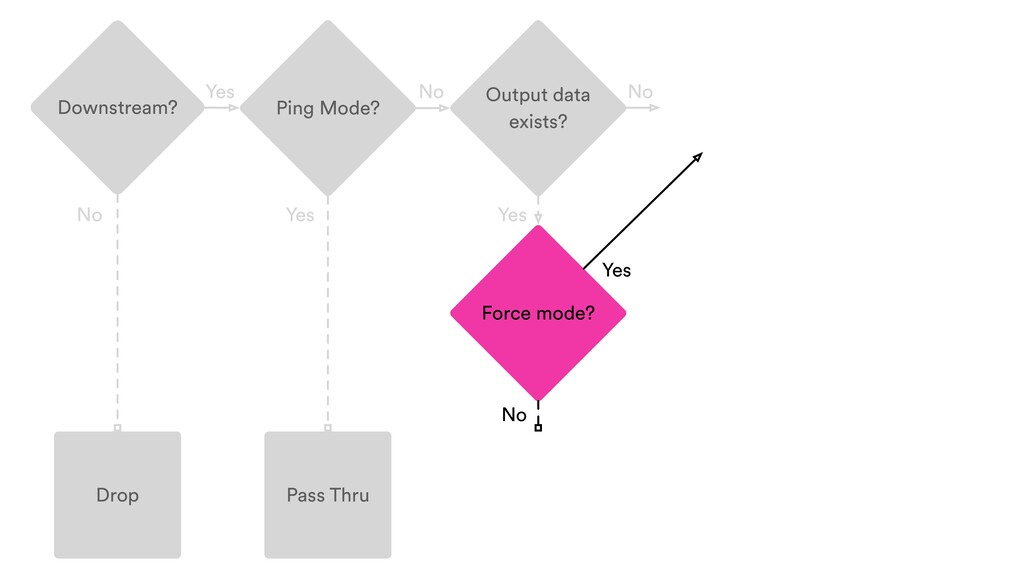
Downstream? Drop Ping Mode? Output data exists? Force mode? Pass
Thru Yes No No No Yes Yes -
Downstream? Drop Ping Mode? Output data exists? Force mode? Pass
Thru Yes No No Yes No Yes Yes No -
Downstream? Drop Ping Mode? Output data exists? Force mode? Pass
Thru Pass Thru Yes No No Yes No Yes Yes No -
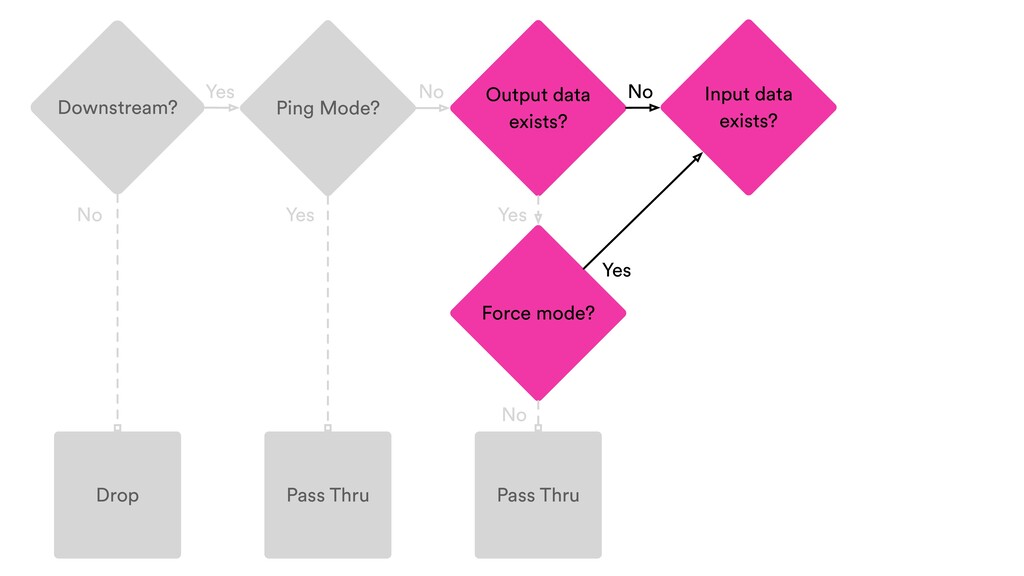
Downstream? Drop Ping Mode? Output data exists? Input data exists?
Force mode? Pass Thru Pass Thru Yes No No Yes No Yes Yes No -
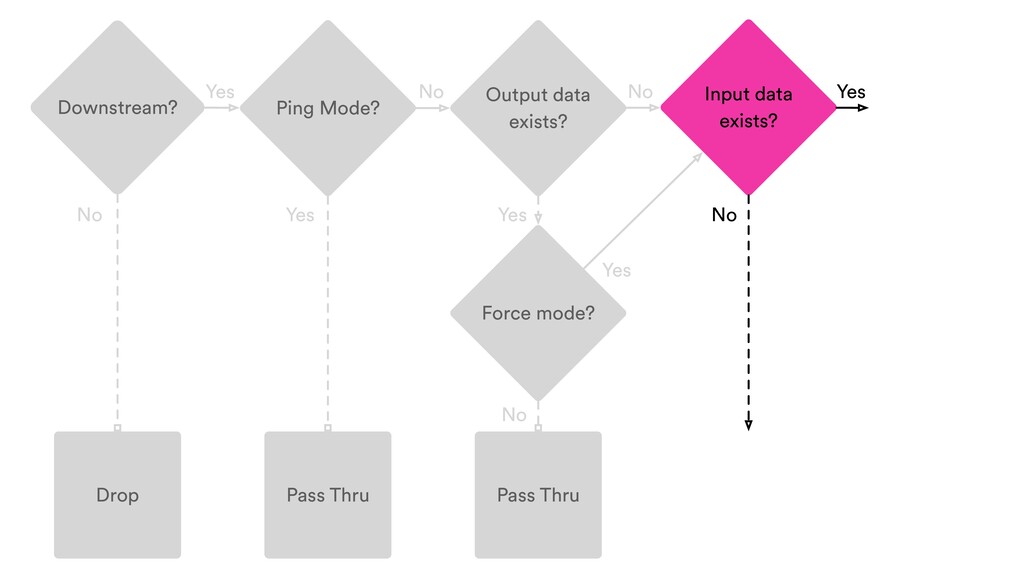
Downstream? Drop Ping Mode? Output data exists? Input data exists?
Force mode? Pass Thru Pass Thru Yes No No Yes Yes No Yes Yes No No -
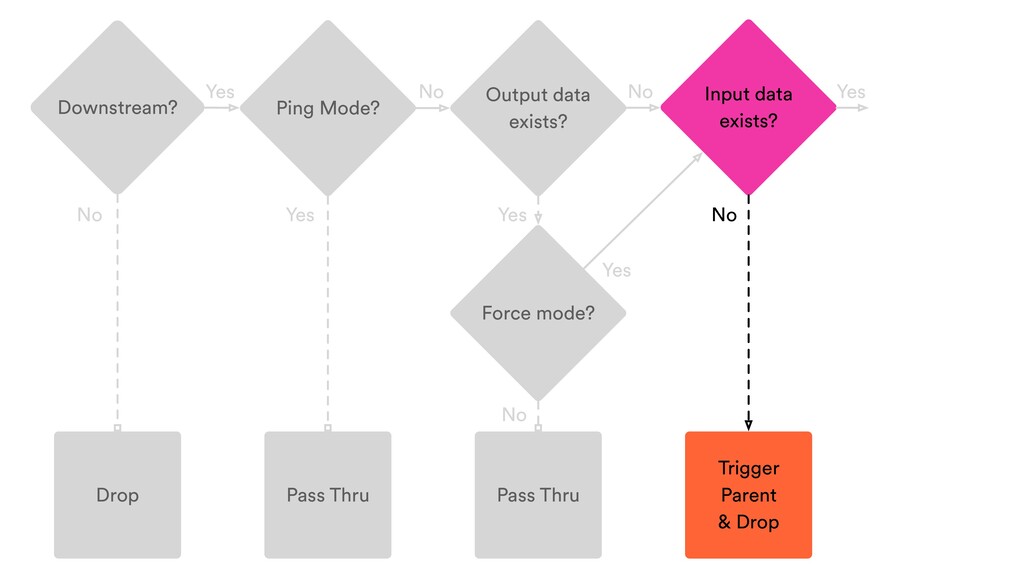
Downstream? Drop Ping Mode? Output data exists? Input data exists?
Force mode? Pass Thru Pass Thru Trigger Parent & Drop Yes No No Yes Yes No Yes Yes No No -
Downstream? Drop Ping Mode? Output data exists? Input data exists?
Force mode? Pass Thru Process Pass Thru Trigger Parent & Drop Yes No No Yes Yes No Yes Yes No No -
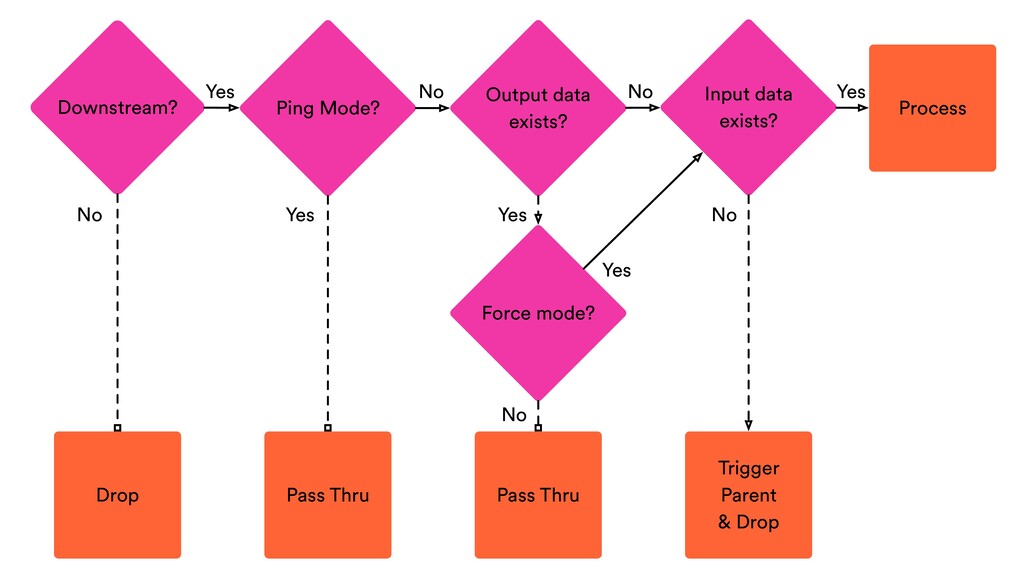
Downstream? Drop Ping Mode? Output data exists? Input data exists?
Force mode? Pass Thru Process Pass Thru Trigger Parent & Drop Yes No No Yes Yes No Yes Yes No No -
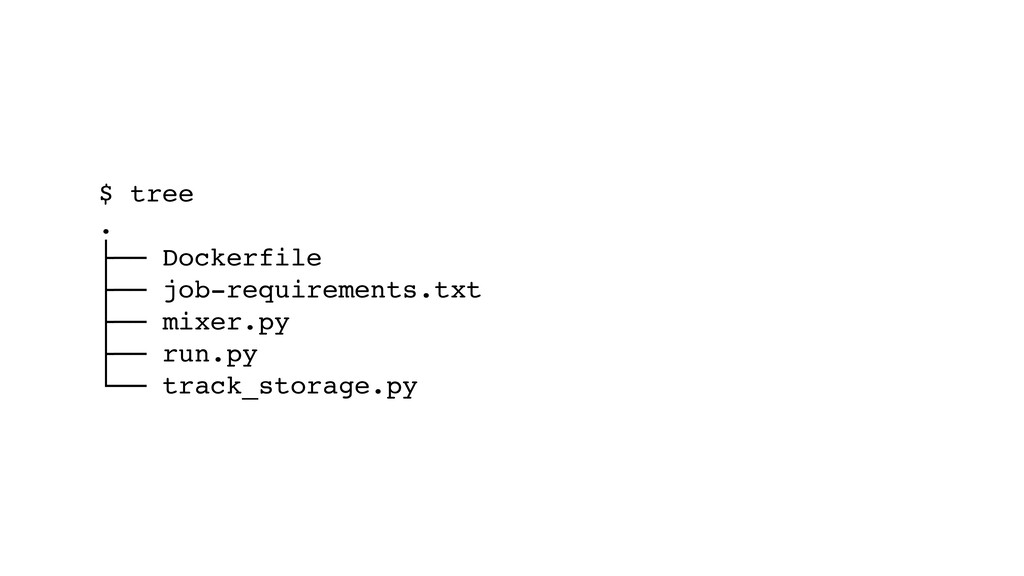
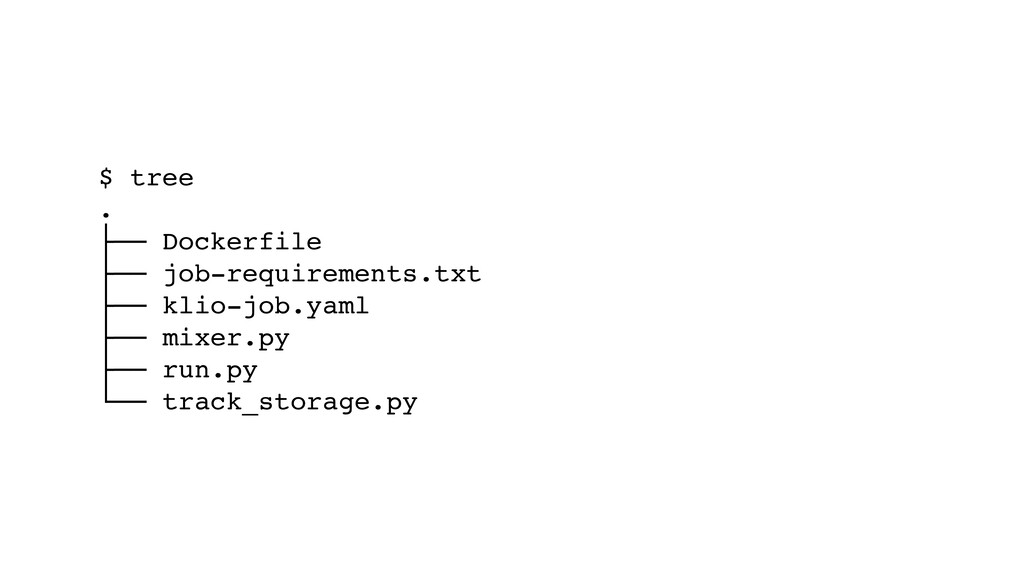
$ tree . ├── Dockerfile ├── job-requirements.txt ├── mixer.py ├──
run.py └── track_storage.py -
$ tree . ├── Dockerfile ├── job-requirements.txt ├── mixer.py ├──
run.py └── track_storage.py -
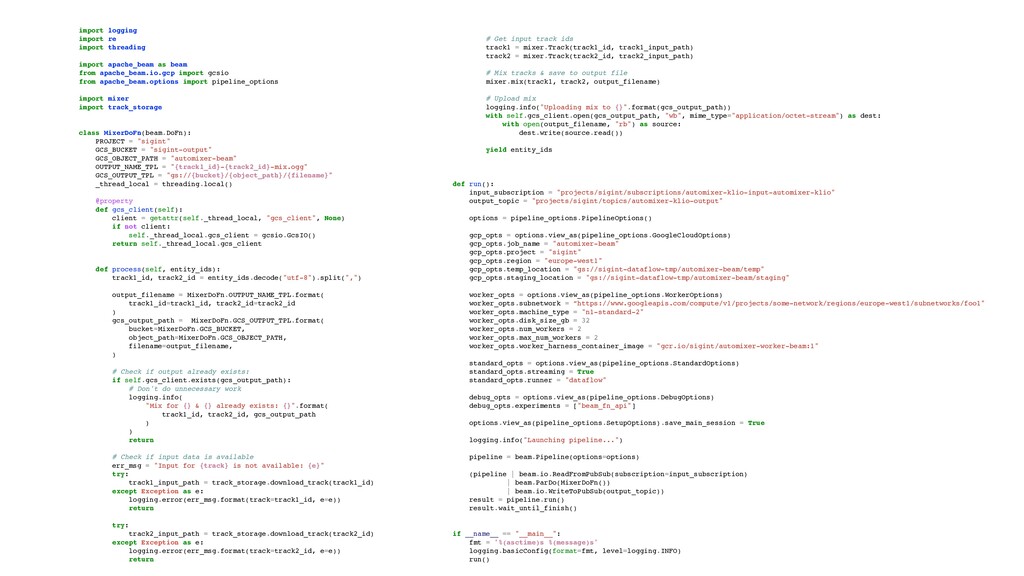
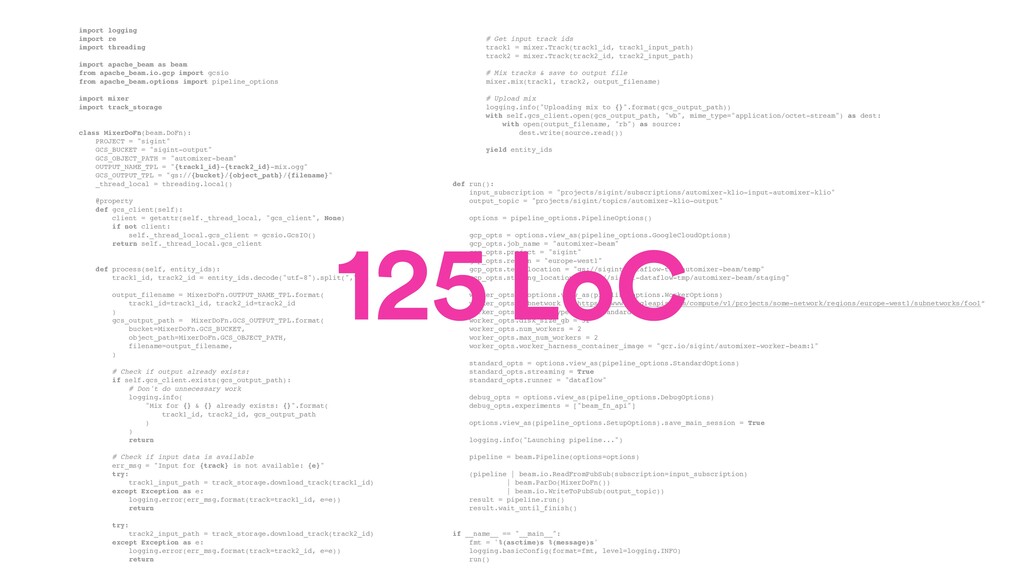
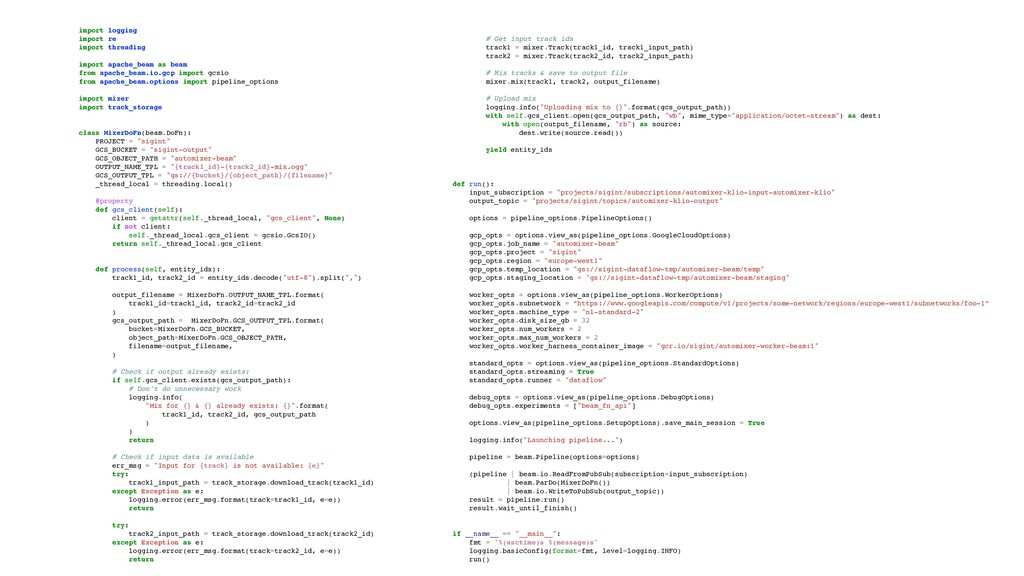
import logging import re import threading import apache_beam as beam
from apache_beam.io.gcp import gcsio from apache_beam.options import pipeline_options import mixer import track_storage class MixerDoFn(beam.DoFn): PROJECT = "sigint" GCS_BUCKET = "sigint-output" GCS_OBJECT_PATH = "automixer-beam" OUTPUT_NAME_TPL = "{track1_id}-{track2_id}-mix.ogg" GCS_OUTPUT_TPL = "gs://{bucket}/{object_path}/{filename}" _thread_local = threading.local() @property def gcs_client(self): client = getattr(self._thread_local, "gcs_client", None) if not client: self._thread_local.gcs_client = gcsio.GcsIO() return self._thread_local.gcs_client def process(self, entity_ids): track1_id, track2_id = entity_ids.decode("utf-8").split(",") output_filename = MixerDoFn.OUTPUT_NAME_TPL.format( track1_id=track1_id, track2_id=track2_id ) gcs_output_path = MixerDoFn.GCS_OUTPUT_TPL.format( bucket=MixerDoFn.GCS_BUCKET, object_path=MixerDoFn.GCS_OBJECT_PATH, filename=output_filename, ) # Check if output already exists: if self.gcs_client.exists(gcs_output_path): # Don't do unnecessary work logging.info( "Mix for {} & {} already exists: {}".format( track1_id, track2_id, gcs_output_path ) ) return # Check if input data is available err_msg = "Input for {track} is not available: {e}" try: track1_input_path = track_storage.download_track(track1_id) except Exception as e: logging.error(err_msg.format(track=track1_id, e=e)) return try: track2_input_path = track_storage.download_track(track2_id) except Exception as e: logging.error(err_msg.format(track=track2_id, e=e)) return # Get input track ids track1 = mixer.Track(track1_id, track1_input_path) track2 = mixer.Track(track2_id, track2_input_path) # Mix tracks & save to output file mixer.mix(track1, track2, output_filename) # Upload mix logging.info("Uploading mix to {}".format(gcs_output_path)) with self.gcs_client.open(gcs_output_path, "wb", mime_type="application/octet-stream") as dest: with open(output_filename, "rb") as source: dest.write(source.read()) yield entity_ids def run(): input_subscription = "projects/sigint/subscriptions/automixer-klio-input-automixer-klio" output_topic = "projects/sigint/topics/automixer-klio-output" options = pipeline_options.PipelineOptions() gcp_opts = options.view_as(pipeline_options.GoogleCloudOptions) gcp_opts.job_name = "automixer-beam" gcp_opts.project = "sigint" gcp_opts.region = "europe-west1" gcp_opts.temp_location = "gs://sigint-dataflow-tmp/automixer-beam/temp" gcp_opts.staging_location = "gs://sigint-dataflow-tmp/automixer-beam/staging" worker_opts = options.view_as(pipeline_options.WorkerOptions) worker_opts.subnetwork = “https://www.googleapis.com/compute/v1/projects/some-network/regions/europe-west1/subnetworks/foo1" worker_opts.machine_type = "n1-standard-2" worker_opts.disk_size_gb = 32 worker_opts.num_workers = 2 worker_opts.max_num_workers = 2 worker_opts.worker_harness_container_image = "gcr.io/sigint/automixer-worker-beam:1" standard_opts = options.view_as(pipeline_options.StandardOptions) standard_opts.streaming = True standard_opts.runner = "dataflow" debug_opts = options.view_as(pipeline_options.DebugOptions) debug_opts.experiments = ["beam_fn_api"] options.view_as(pipeline_options.SetupOptions).save_main_session = True logging.info("Launching pipeline...") pipeline = beam.Pipeline(options=options) (pipeline | beam.io.ReadFromPubSub(subscription=input_subscription) | beam.ParDo(MixerDoFn()) | beam.io.WriteToPubSub(output_topic)) result = pipeline.run() result.wait_until_finish() if __name__ == "__main__": fmt = '%(asctime)s %(message)s' logging.basicConfig(format=fmt, level=logging.INFO) run() -
import logging import re import threading import apache_beam as beam
from apache_beam.io.gcp import gcsio from apache_beam.options import pipeline_options import mixer import track_storage class MixerDoFn(beam.DoFn): PROJECT = "sigint" GCS_BUCKET = "sigint-output" GCS_OBJECT_PATH = "automixer-beam" OUTPUT_NAME_TPL = "{track1_id}-{track2_id}-mix.ogg" GCS_OUTPUT_TPL = "gs://{bucket}/{object_path}/{filename}" _thread_local = threading.local() @property def gcs_client(self): client = getattr(self._thread_local, "gcs_client", None) if not client: self._thread_local.gcs_client = gcsio.GcsIO() return self._thread_local.gcs_client def process(self, entity_ids): track1_id, track2_id = entity_ids.decode("utf-8").split(",") output_filename = MixerDoFn.OUTPUT_NAME_TPL.format( track1_id=track1_id, track2_id=track2_id ) gcs_output_path = MixerDoFn.GCS_OUTPUT_TPL.format( bucket=MixerDoFn.GCS_BUCKET, object_path=MixerDoFn.GCS_OBJECT_PATH, filename=output_filename, ) # Check if output already exists: if self.gcs_client.exists(gcs_output_path): # Don't do unnecessary work logging.info( "Mix for {} & {} already exists: {}".format( track1_id, track2_id, gcs_output_path ) ) return # Check if input data is available err_msg = "Input for {track} is not available: {e}" try: track1_input_path = track_storage.download_track(track1_id) except Exception as e: logging.error(err_msg.format(track=track1_id, e=e)) return try: track2_input_path = track_storage.download_track(track2_id) except Exception as e: logging.error(err_msg.format(track=track2_id, e=e)) return # Get input track ids track1 = mixer.Track(track1_id, track1_input_path) track2 = mixer.Track(track2_id, track2_input_path) # Mix tracks & save to output file mixer.mix(track1, track2, output_filename) # Upload mix logging.info("Uploading mix to {}".format(gcs_output_path)) with self.gcs_client.open(gcs_output_path, "wb", mime_type="application/octet-stream") as dest: with open(output_filename, "rb") as source: dest.write(source.read()) yield entity_ids def run(): input_subscription = "projects/sigint/subscriptions/automixer-klio-input-automixer-klio" output_topic = "projects/sigint/topics/automixer-klio-output" options = pipeline_options.PipelineOptions() gcp_opts = options.view_as(pipeline_options.GoogleCloudOptions) gcp_opts.job_name = "automixer-beam" gcp_opts.project = "sigint" gcp_opts.region = "europe-west1" gcp_opts.temp_location = "gs://sigint-dataflow-tmp/automixer-beam/temp" gcp_opts.staging_location = "gs://sigint-dataflow-tmp/automixer-beam/staging" worker_opts = options.view_as(pipeline_options.WorkerOptions) worker_opts.subnetwork = “https://www.googleapis.com/compute/v1/projects/some-network/regions/europe-west1/subnetworks/foo1” worker_opts.machine_type = "n1-standard-2" worker_opts.disk_size_gb = 32 worker_opts.num_workers = 2 worker_opts.max_num_workers = 2 worker_opts.worker_harness_container_image = "gcr.io/sigint/automixer-worker-beam:1" standard_opts = options.view_as(pipeline_options.StandardOptions) standard_opts.streaming = True standard_opts.runner = "dataflow" debug_opts = options.view_as(pipeline_options.DebugOptions) debug_opts.experiments = ["beam_fn_api"] options.view_as(pipeline_options.SetupOptions).save_main_session = True logging.info("Launching pipeline...") pipeline = beam.Pipeline(options=options) (pipeline | beam.io.ReadFromPubSub(subscription=input_subscription) | beam.ParDo(MixerDoFn()) | beam.io.WriteToPubSub(output_topic)) result = pipeline.run() result.wait_until_finish() if __name__ == "__main__": fmt = '%(asctime)s %(message)s' logging.basicConfig(format=fmt, level=logging.INFO) run() 125 LoC -
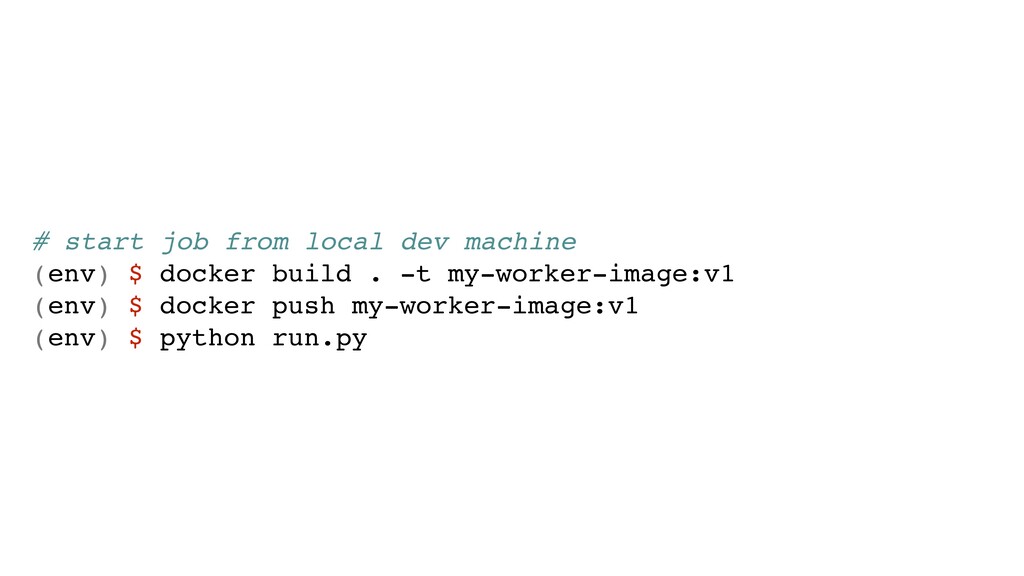
# start job from local dev machine (env) $ docker
build . -t my-worker-image:v1 (env) $ docker push my-worker-image:v1 (env) $ python run.py -
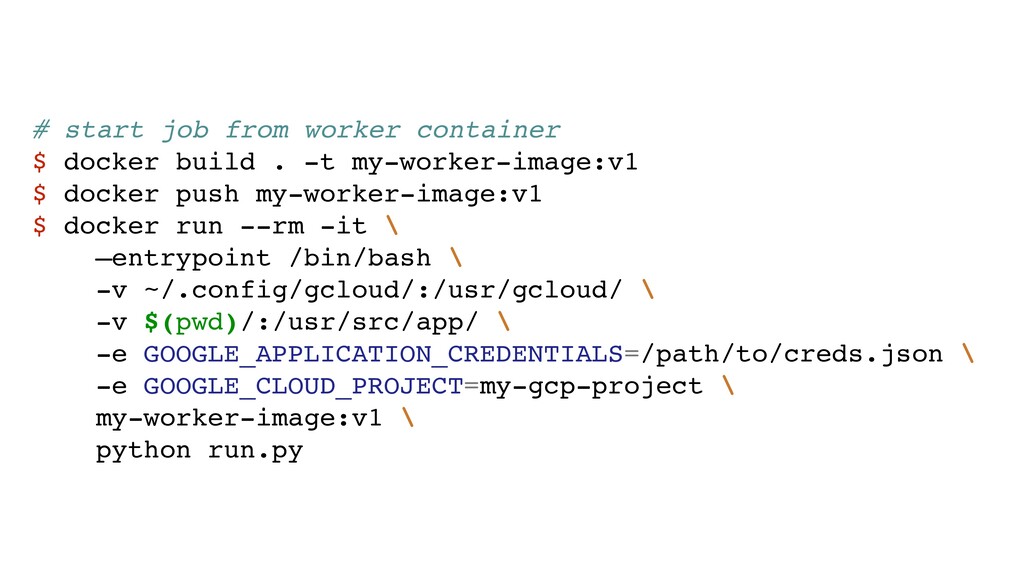
# start job from worker container $ docker build .
-t my-worker-image:v1 $ docker push my-worker-image:v1 $ docker run --rm -it \ —entrypoint /bin/bash \ -v ~/.config/gcloud/:/usr/gcloud/ \ -v $(pwd)/:/usr/src/app/ \ -e GOOGLE_APPLICATION_CREDENTIALS=/path/to/creds.json \ -e GOOGLE_CLOUD_PROJECT=my-gcp-project \ my-worker-image:v1 \ python run.py -
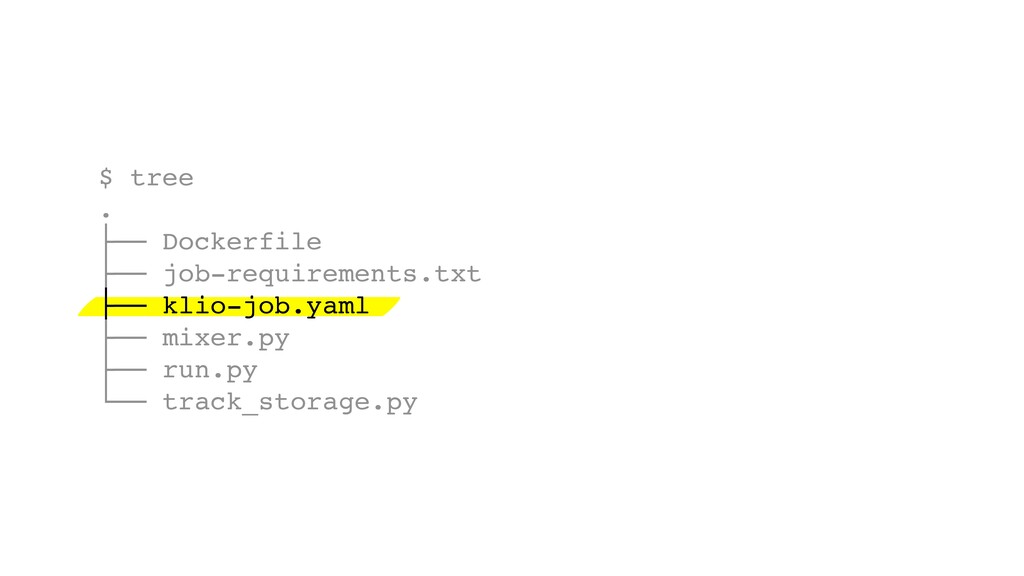
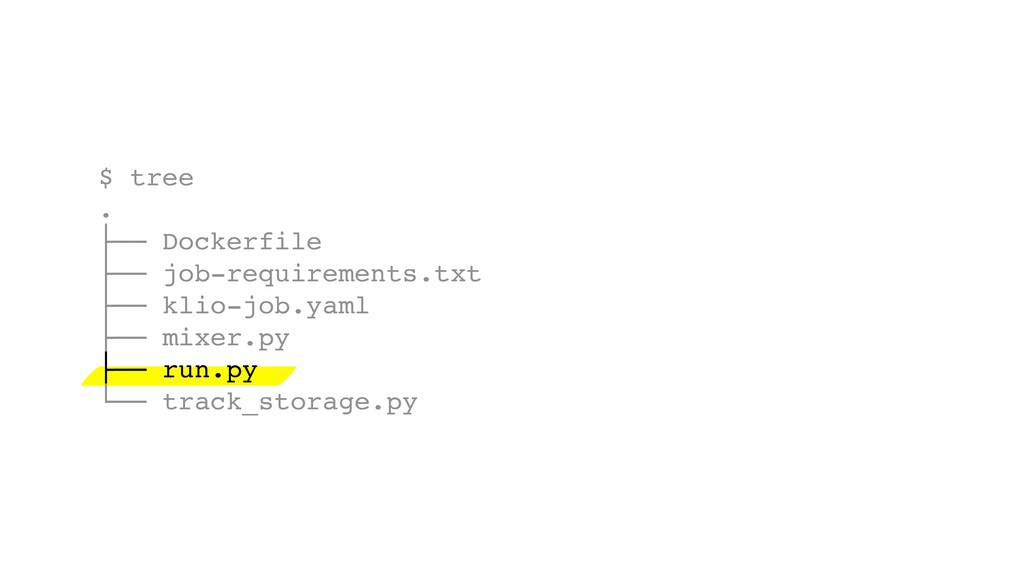
$ tree . ├── Dockerfile ├── job-requirements.txt ├── klio-job.yaml ├──
mixer.py ├── run.py └── track_storage.py -
$ tree . ├── Dockerfile ├── job-requirements.txt ├── klio-job.yaml ├──
mixer.py ├── run.py └── track_storage.py -
$ tree . ├── Dockerfile ├── job-requirements.txt ├── klio-job.yaml ├──
mixer.py ├── run.py └── track_storage.py -
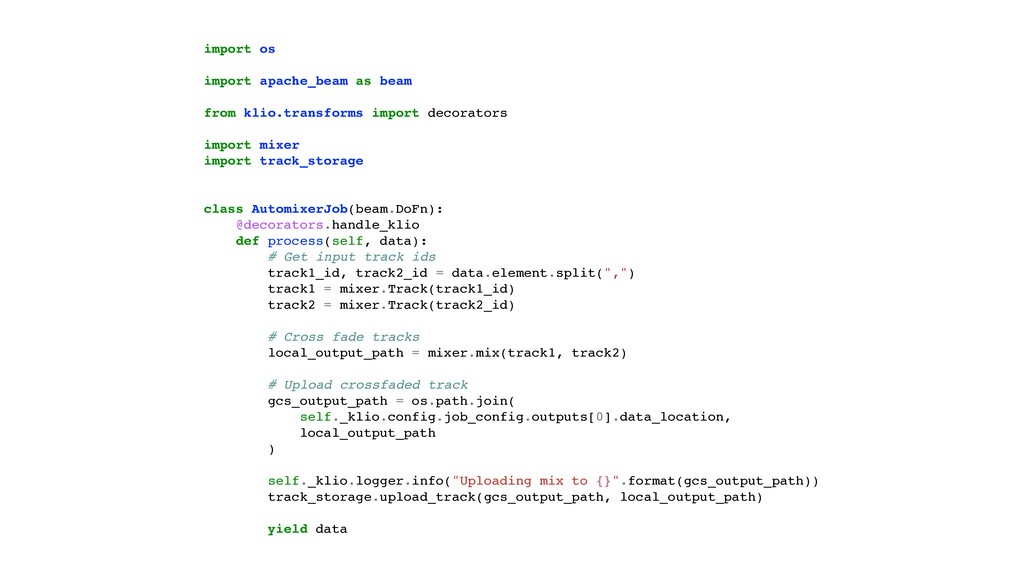
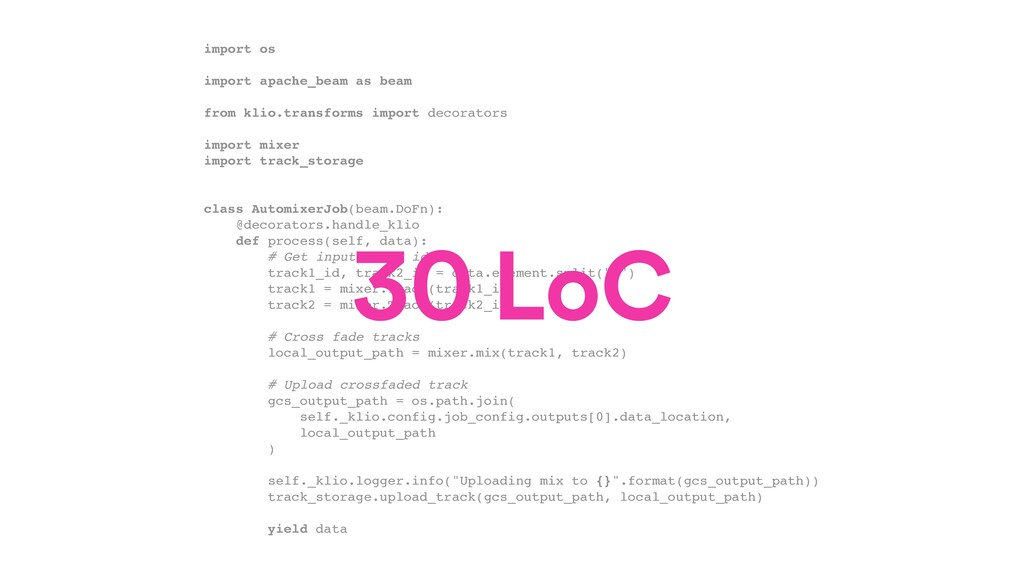
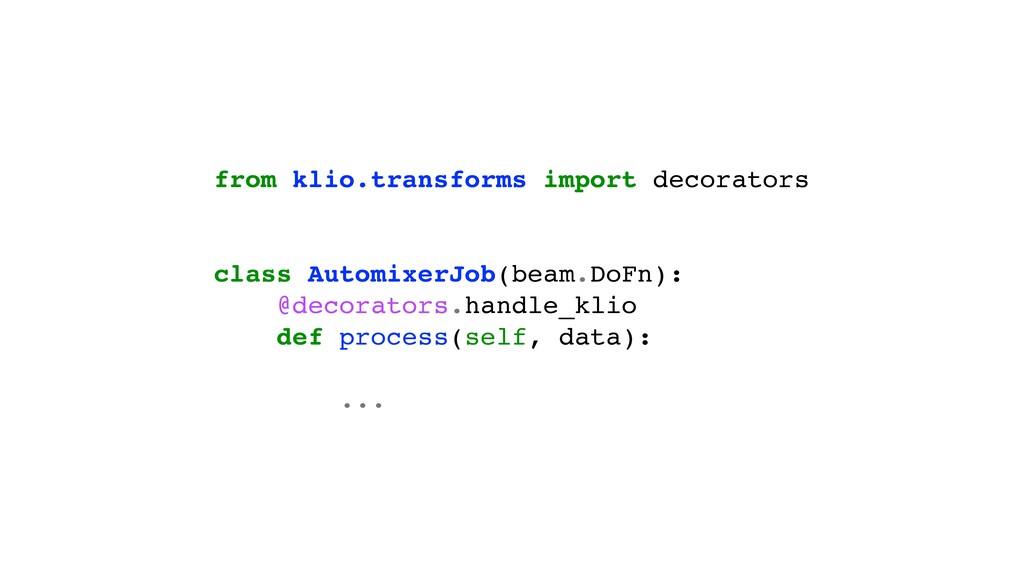
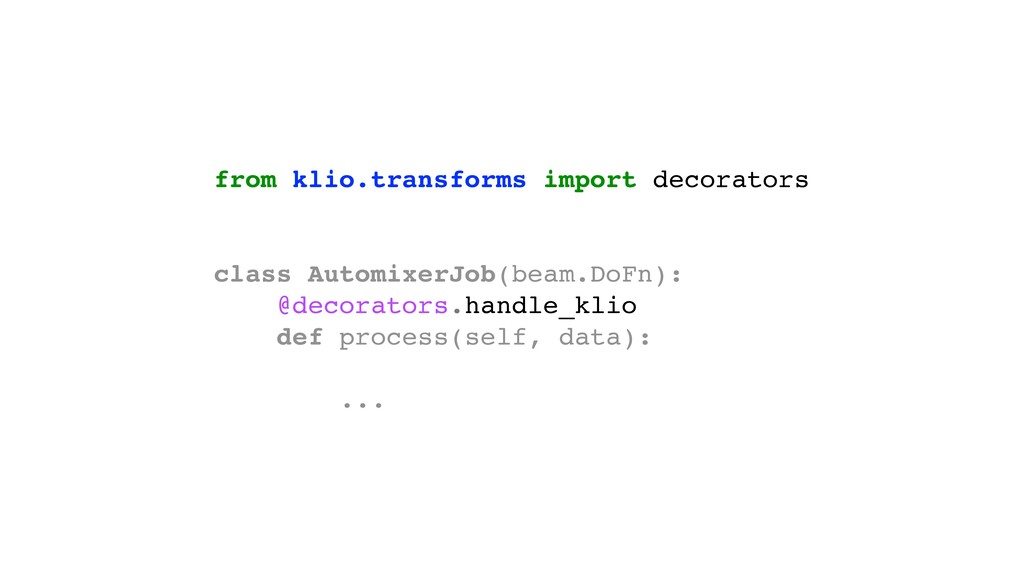
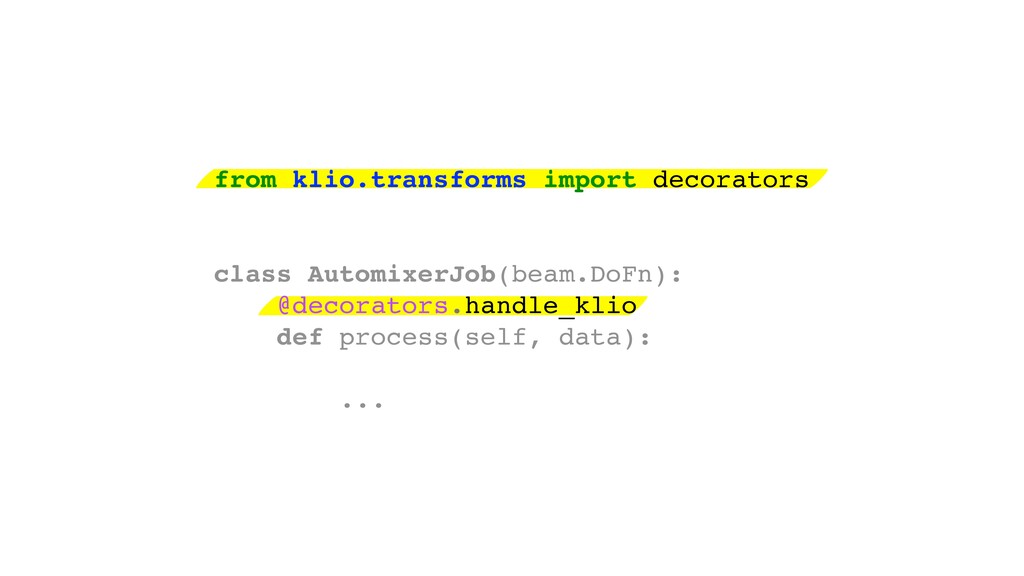
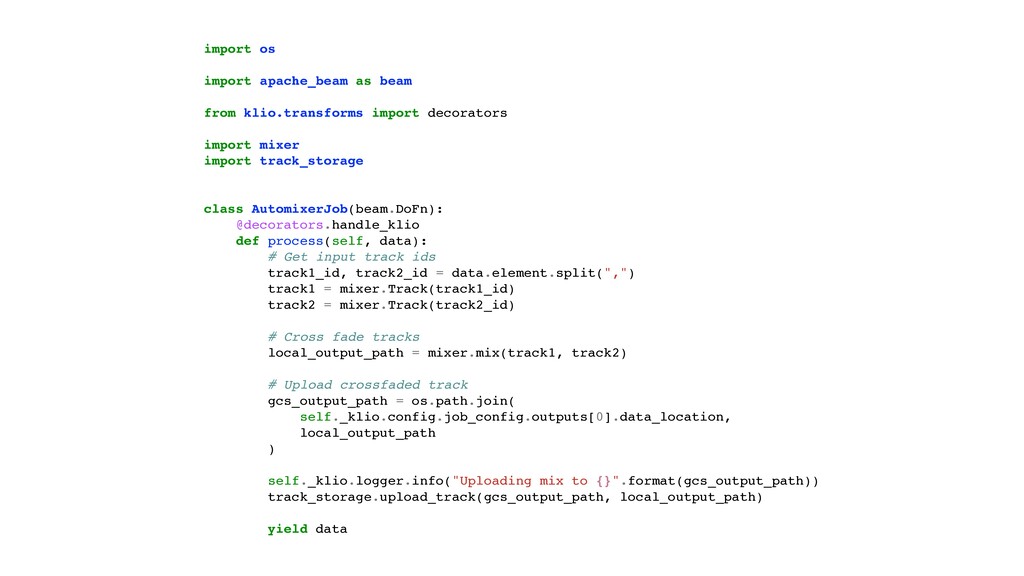
import os import apache_beam as beam from klio.transforms import decorators
import mixer import track_storage class AutomixerJob(beam.DoFn): @decorators.handle_klio def process(self, data): # Get input track ids track1_id, track2_id = data.element.split(",") track1 = mixer.Track(track1_id) track2 = mixer.Track(track2_id) # Cross fade tracks local_output_path = mixer.mix(track1, track2) # Upload crossfaded track gcs_output_path = os.path.join( self._klio.config.job_config.outputs[0].data_location, local_output_path ) self._klio.logger.info("Uploading mix to {}".format(gcs_output_path)) track_storage.upload_track(gcs_output_path, local_output_path) yield data -
import os import apache_beam as beam from klio.transforms import decorators
import mixer import track_storage class AutomixerJob(beam.DoFn): @decorators.handle_klio def process(self, data): # Get input track ids track1_id, track2_id = data.element.split(",") track1 = mixer.Track(track1_id) track2 = mixer.Track(track2_id) # Cross fade tracks local_output_path = mixer.mix(track1, track2) # Upload crossfaded track gcs_output_path = os.path.join( self._klio.config.job_config.outputs[0].data_location, local_output_path ) self._klio.logger.info("Uploading mix to {}".format(gcs_output_path)) track_storage.upload_track(gcs_output_path, local_output_path) yield data 30 LoC -
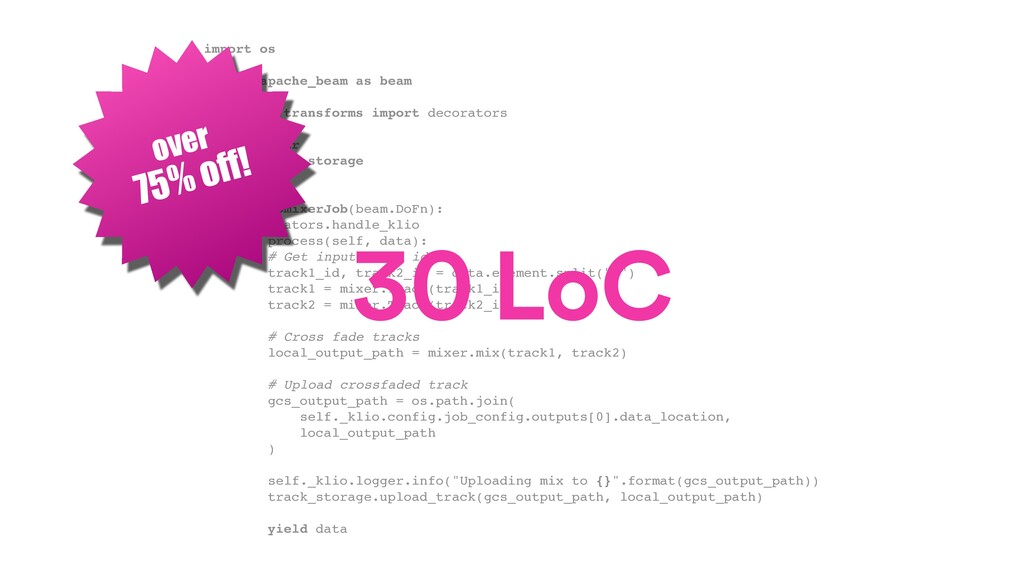
import os import apache_beam as beam from klio.transforms import decorators
import mixer import track_storage class AutomixerJob(beam.DoFn): @decorators.handle_klio def process(self, data): # Get input track ids track1_id, track2_id = data.element.split(",") track1 = mixer.Track(track1_id) track2 = mixer.Track(track2_id) # Cross fade tracks local_output_path = mixer.mix(track1, track2) # Upload crossfaded track gcs_output_path = os.path.join( self._klio.config.job_config.outputs[0].data_location, local_output_path ) self._klio.logger.info("Uploading mix to {}".format(gcs_output_path)) track_storage.upload_track(gcs_output_path, local_output_path) yield data 30 LoC 75% off! over -
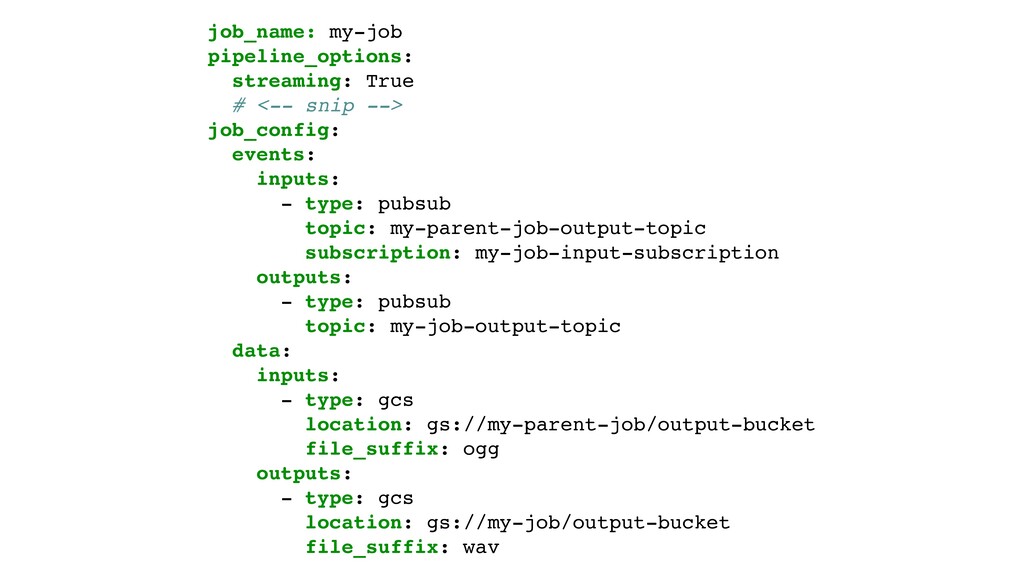
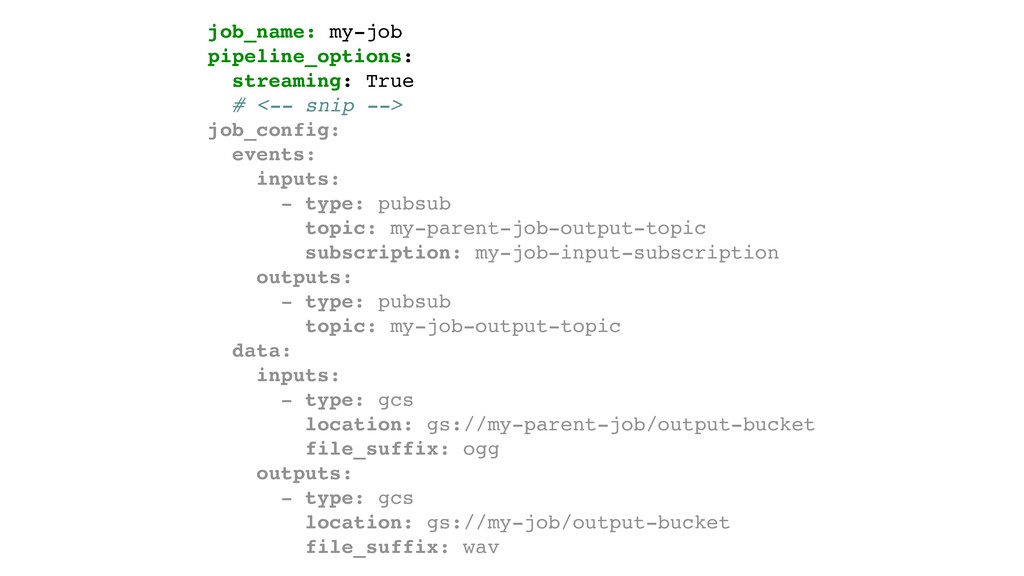
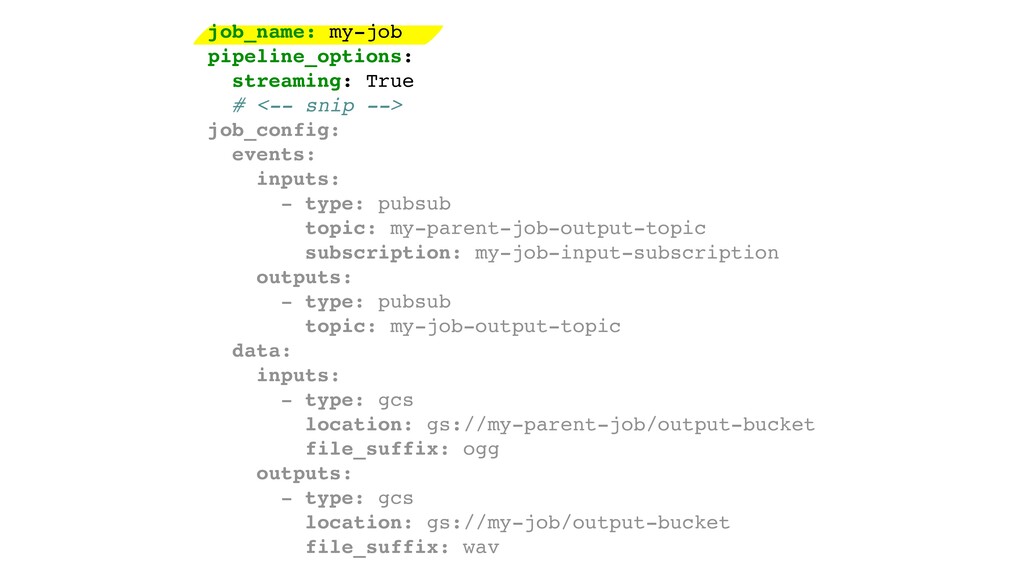
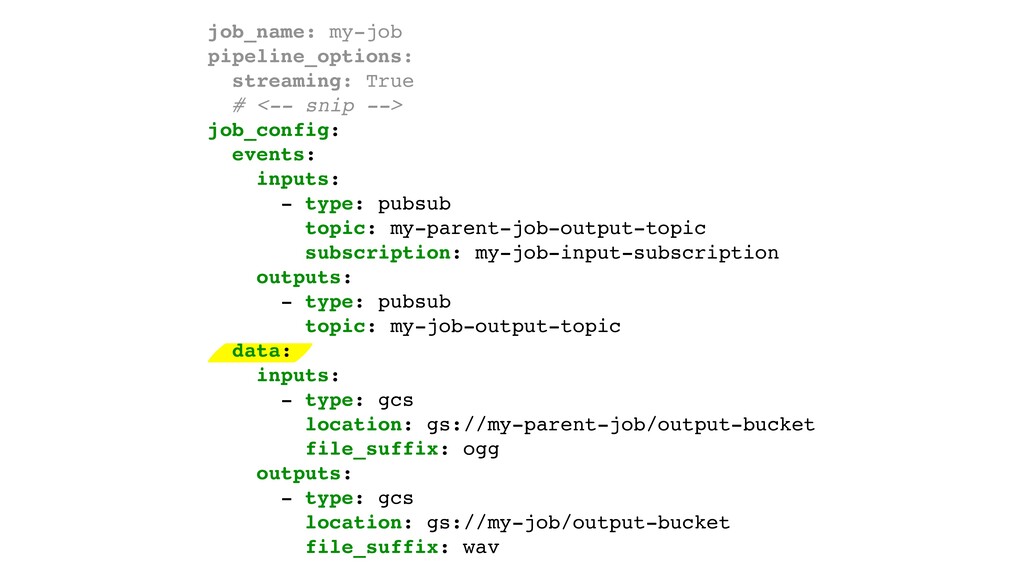
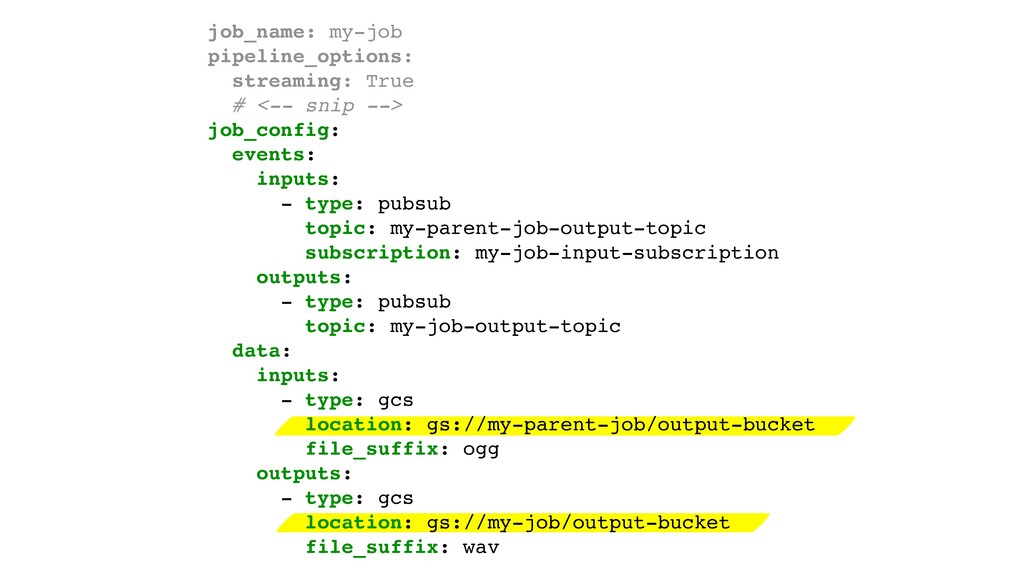
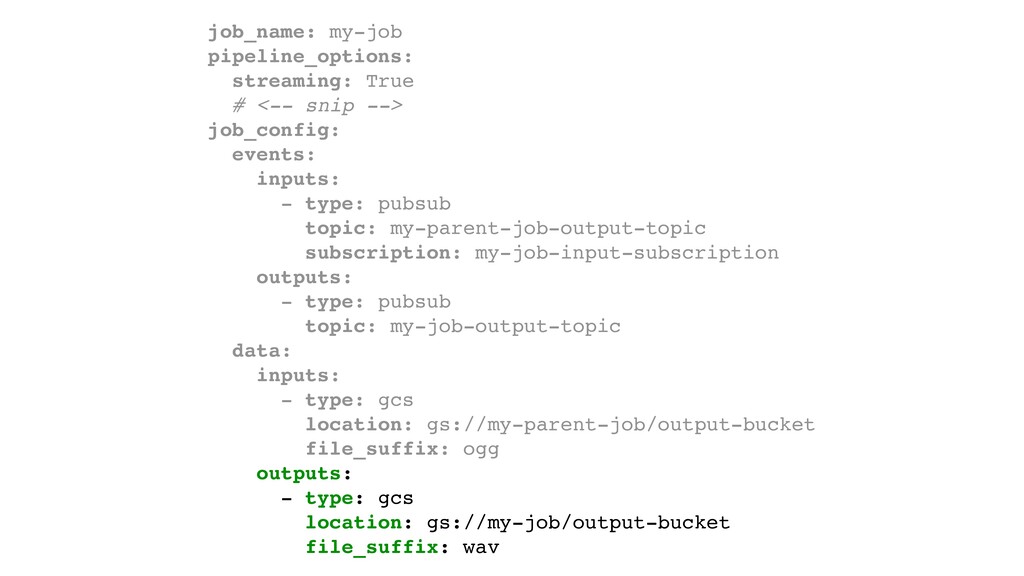
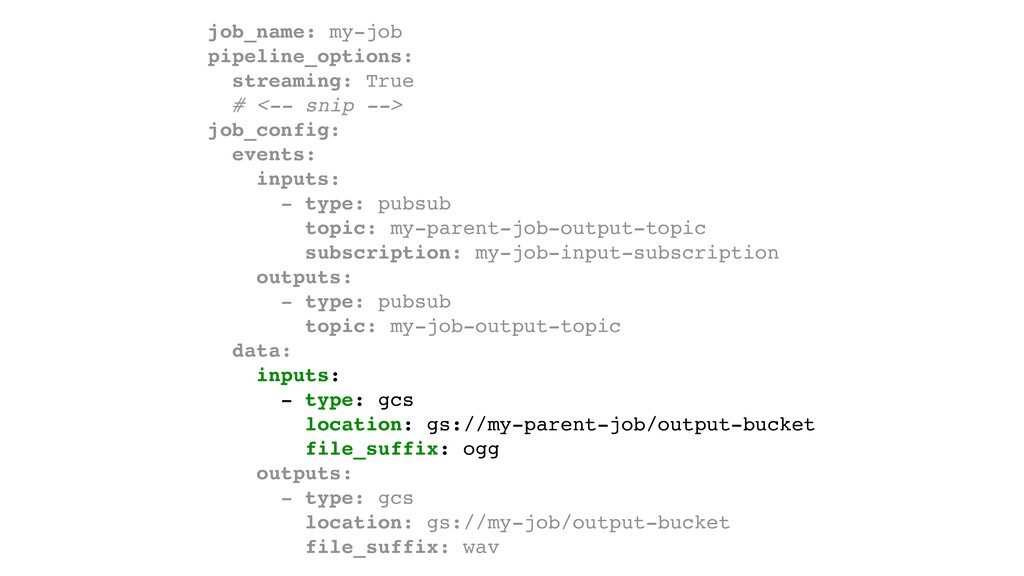
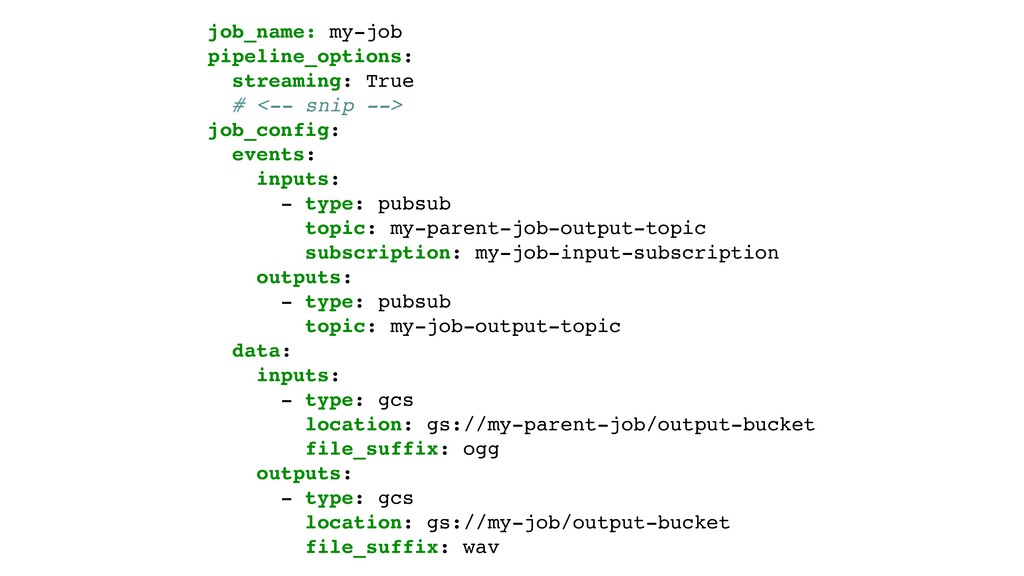
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
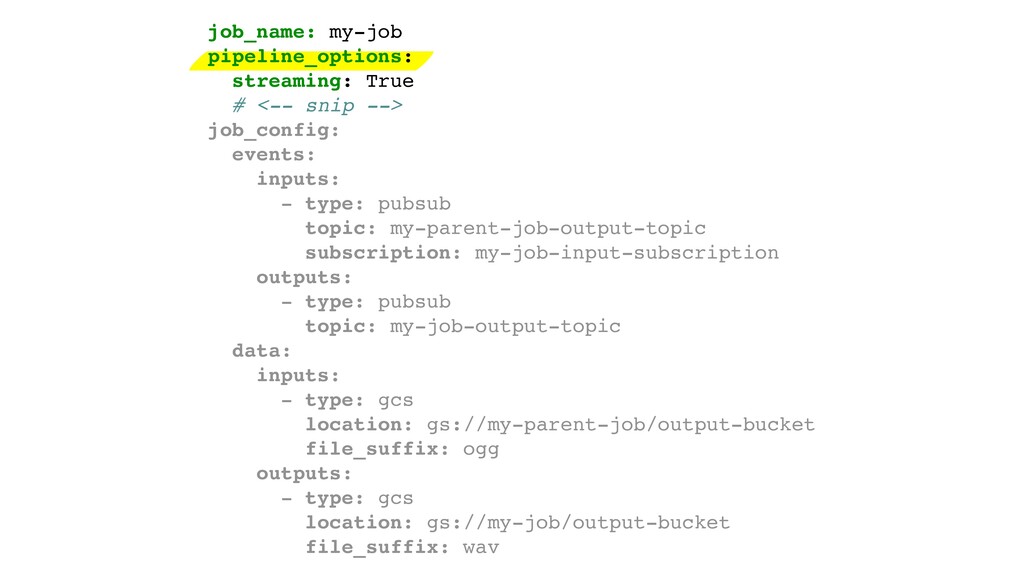
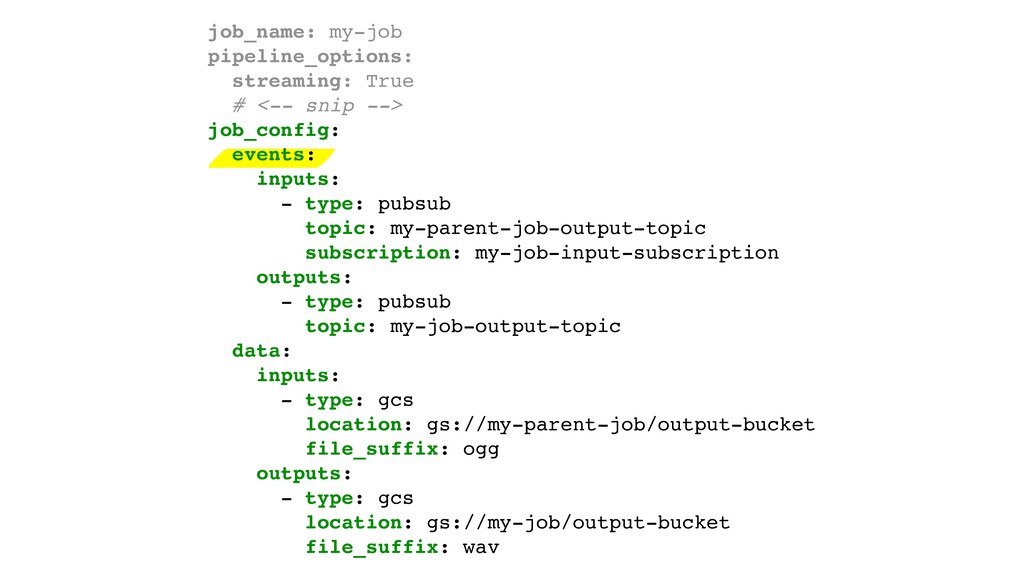
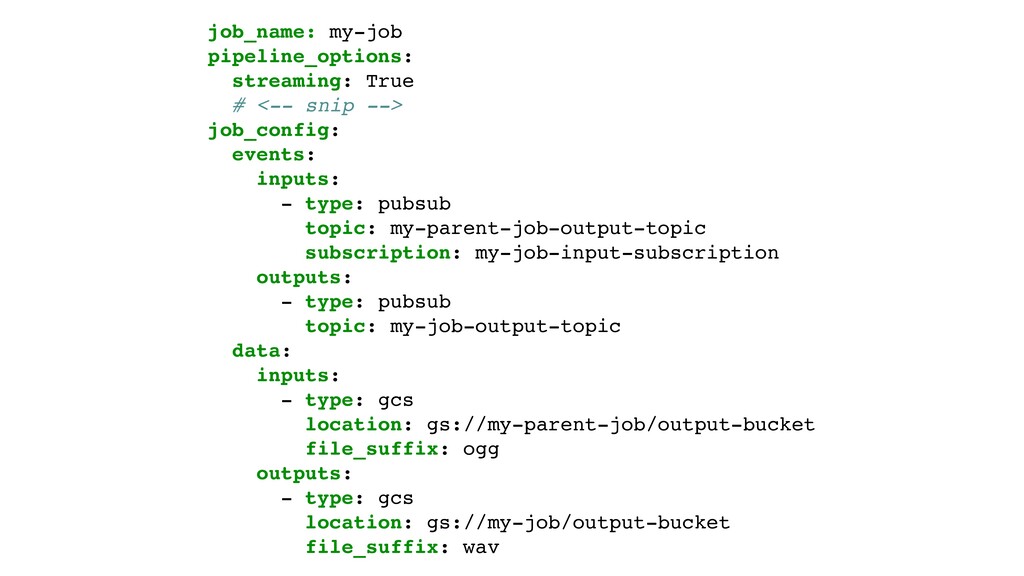
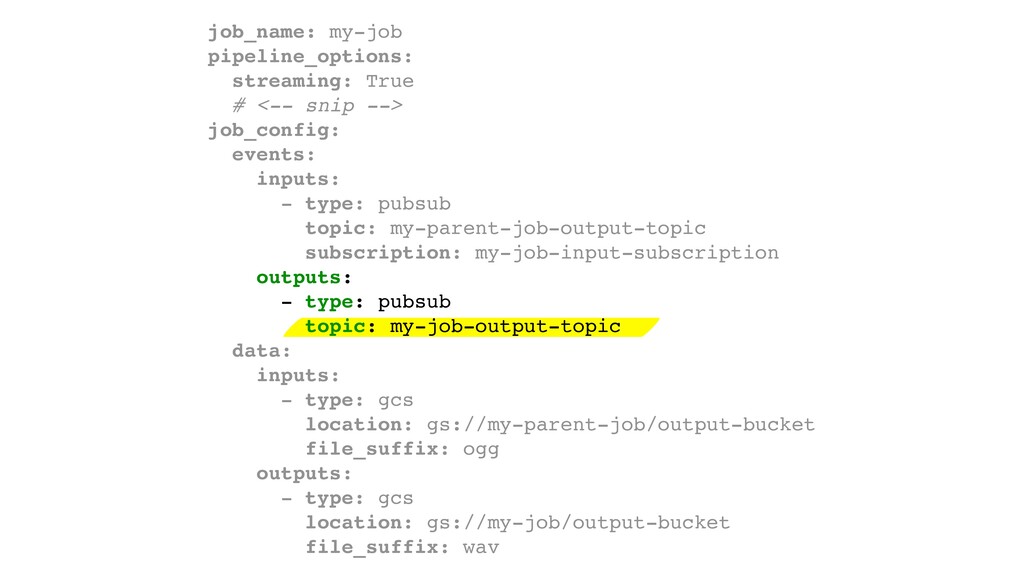
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
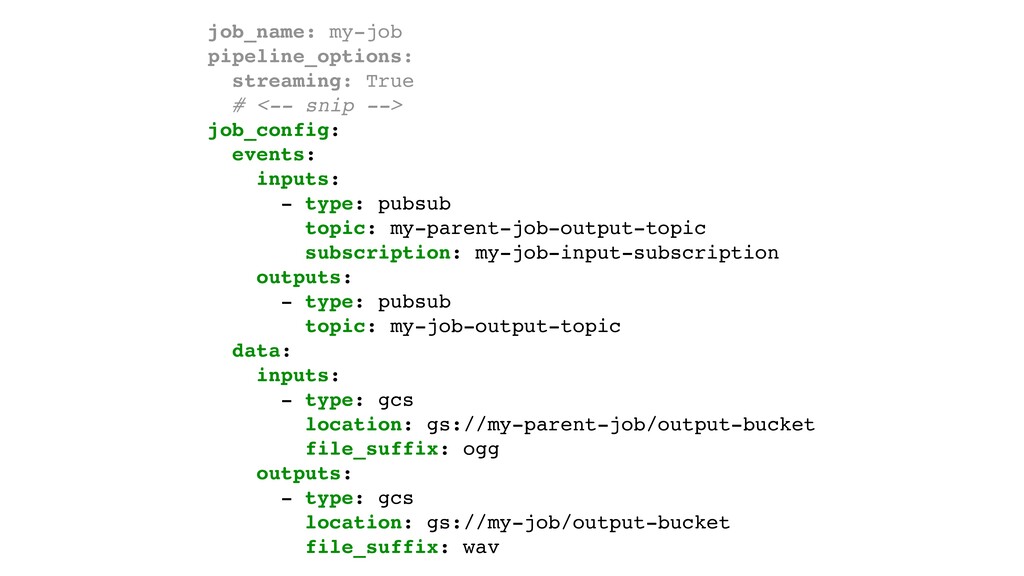
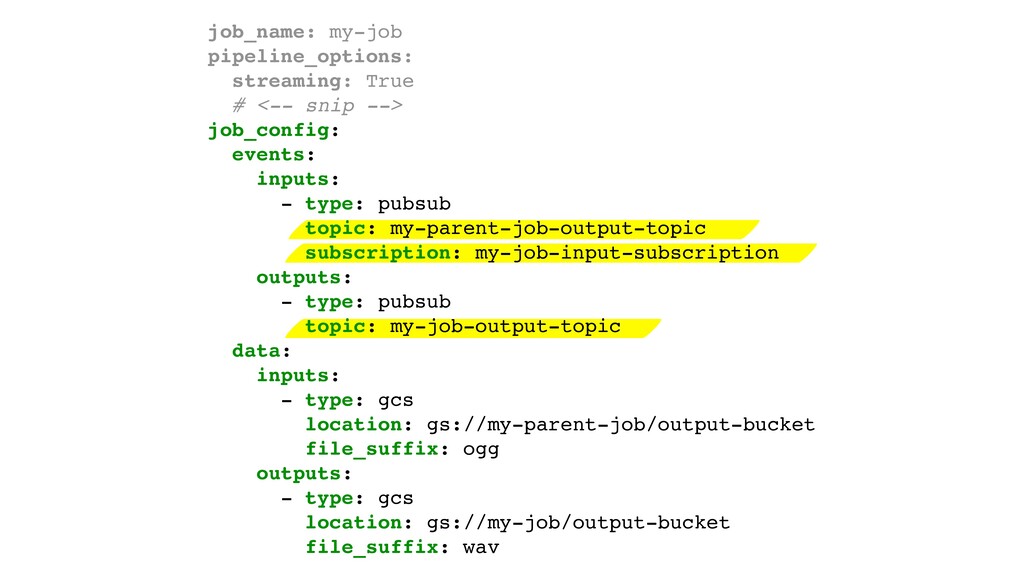
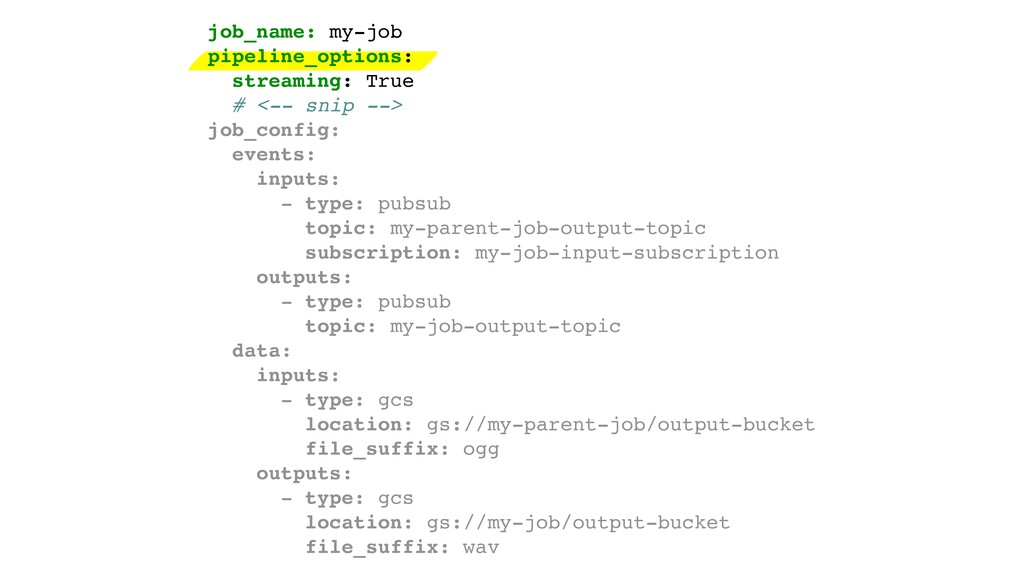
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
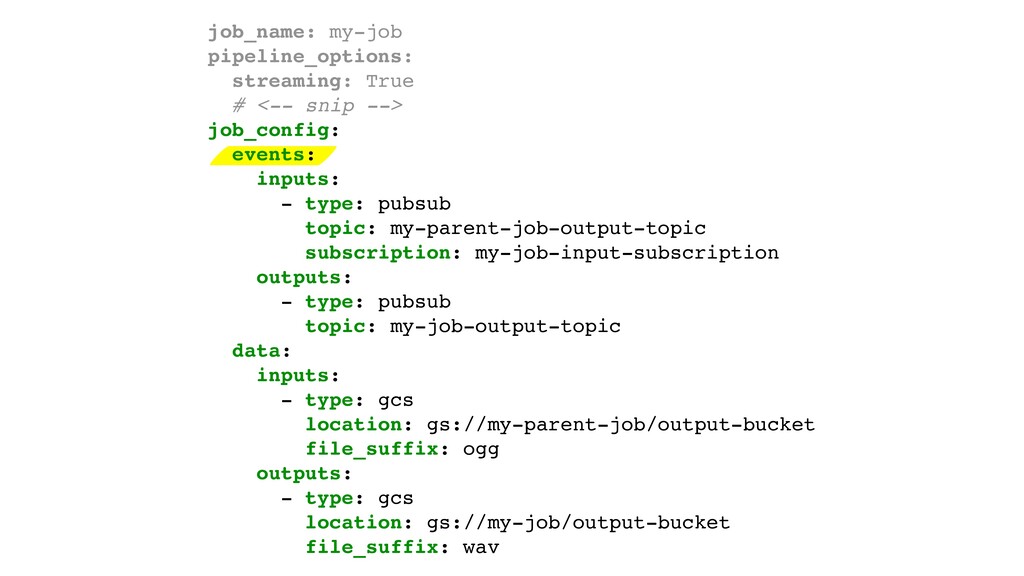
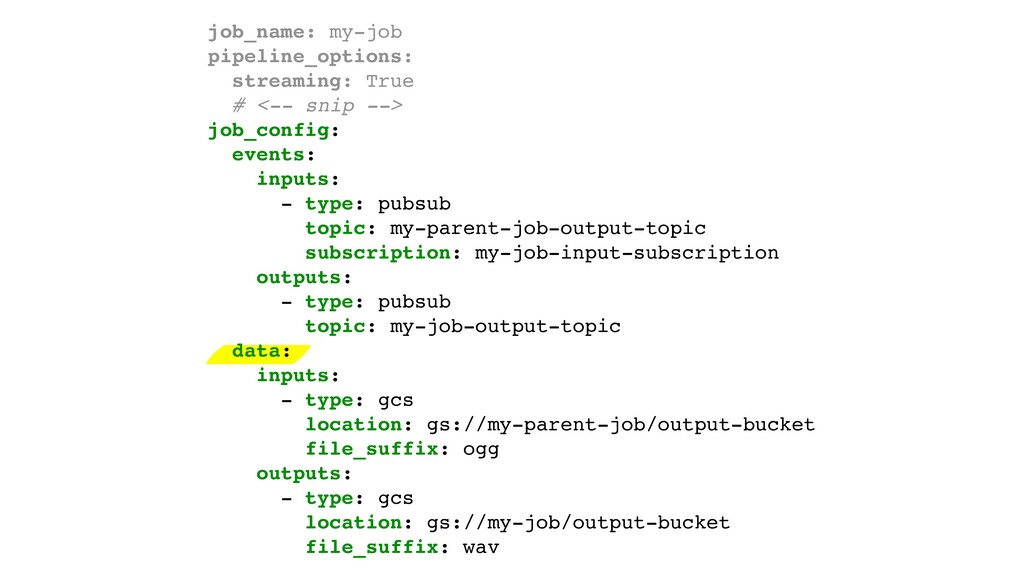
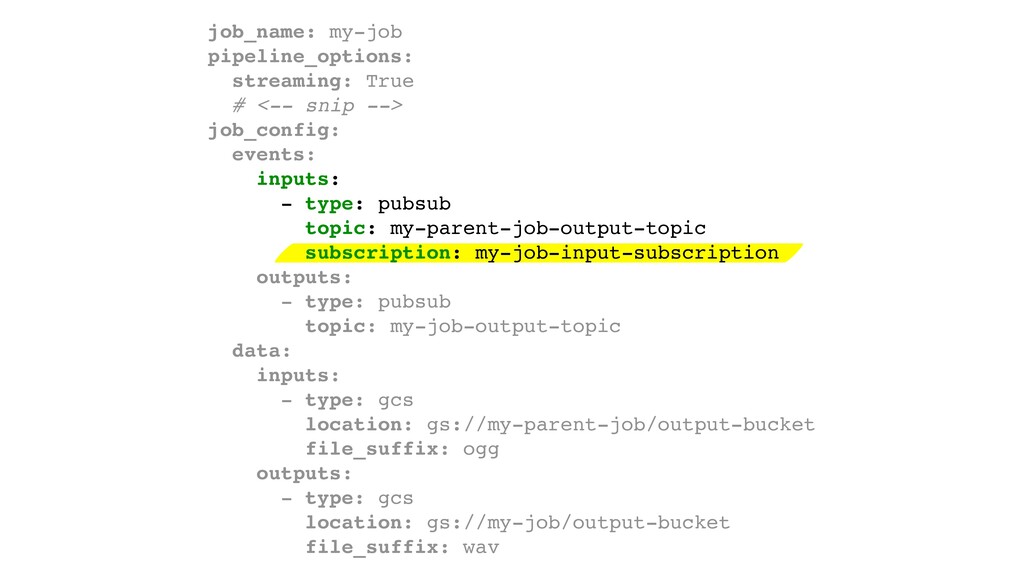
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
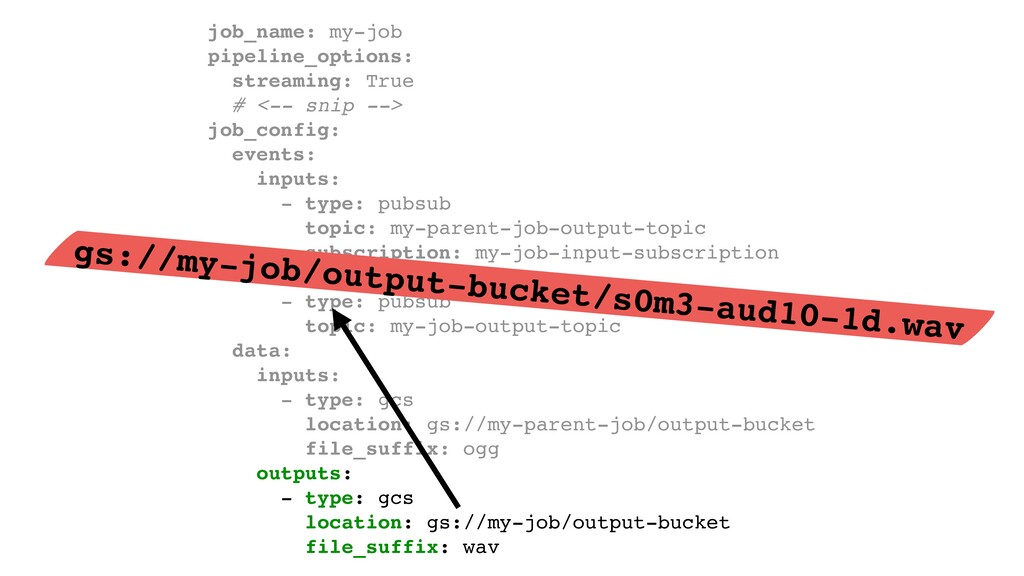
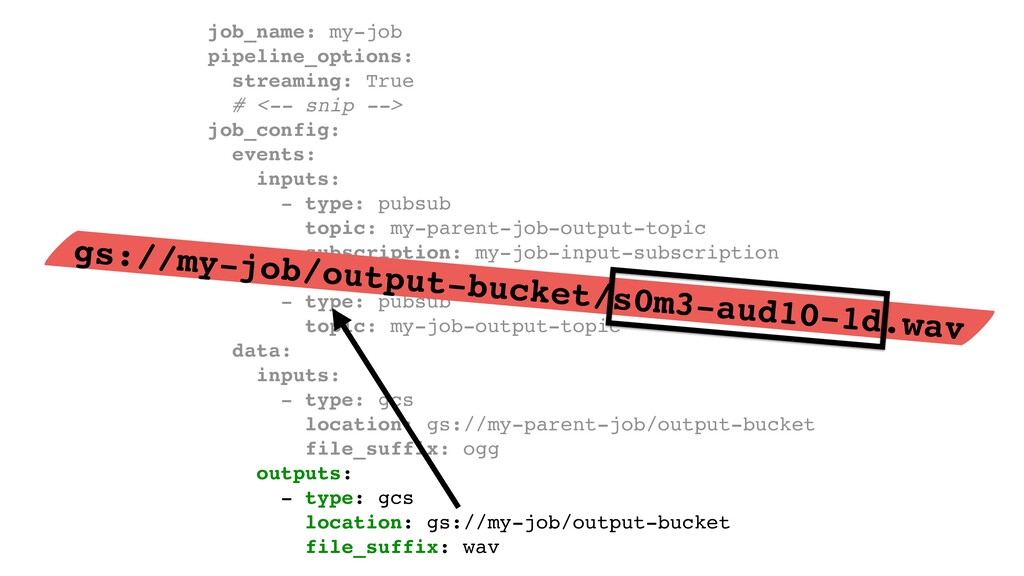
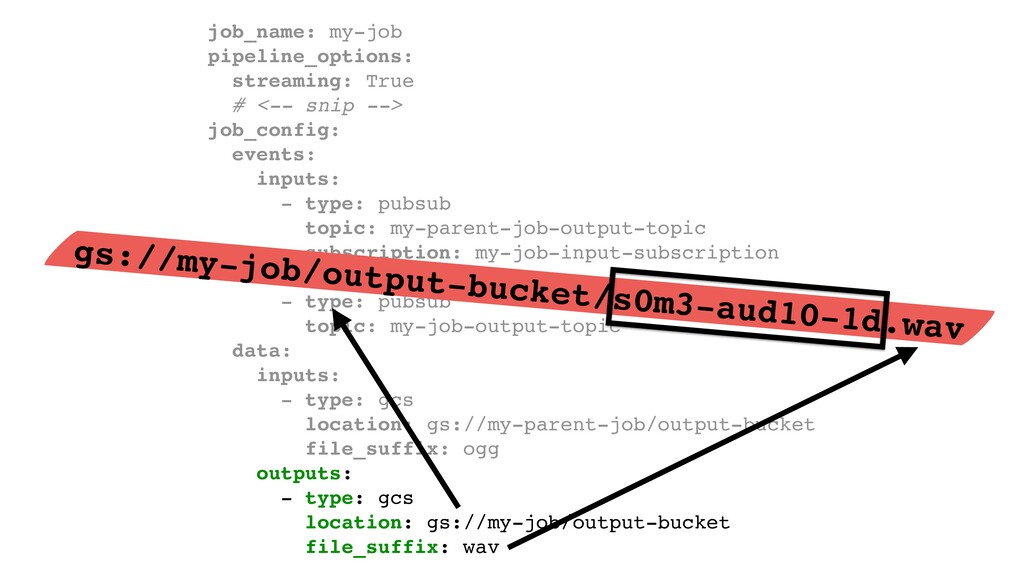
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav gs://my-job/output-bucket/s0m3-aud10-1d.wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav gs://my-job/output-bucket/s0m3-aud10-1d.wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav gs://my-job/output-bucket/s0m3-aud10-1d.wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
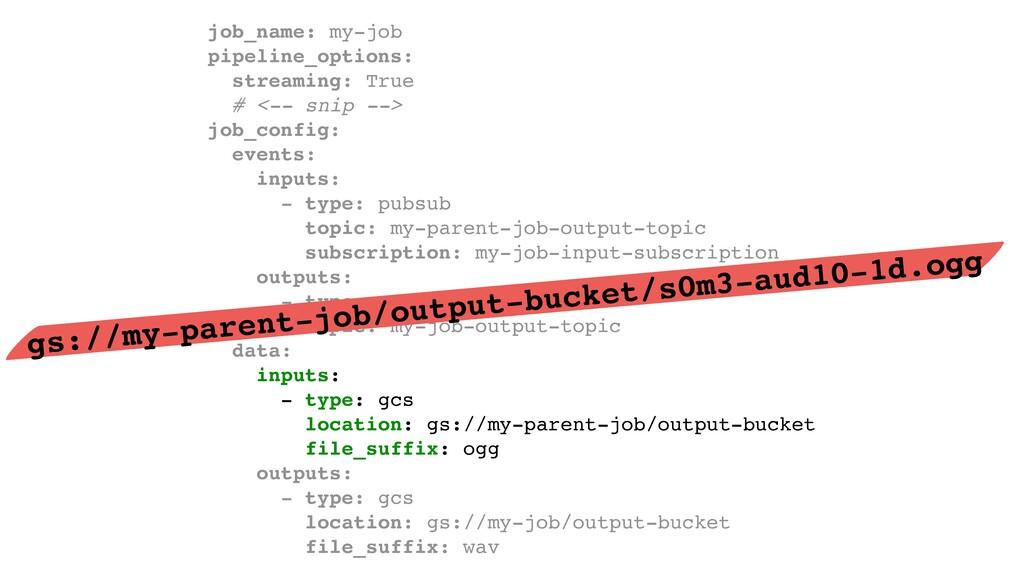
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav gs://my-parent-job/output-bucket/s0m3-aud10-1d.ogg -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
job_name: my-job pipeline_options: streaming: True # <-- snip --> job_config:
events: inputs: - type: pubsub topic: my-parent-job-output-topic subscription: my-job-input-subscription outputs: - type: pubsub topic: my-job-output-topic data: inputs: - type: gcs location: gs://my-parent-job/output-bucket file_suffix: ogg outputs: - type: gcs location: gs://my-job/output-bucket file_suffix: wav -
import logging import re import threading import apache_beam as beam
from apache_beam.io.gcp import gcsio from apache_beam.options import pipeline_options import mixer import track_storage class MixerDoFn(beam.DoFn): PROJECT = "sigint" GCS_BUCKET = "sigint-output" GCS_OBJECT_PATH = "automixer-beam" OUTPUT_NAME_TPL = "{track1_id}-{track2_id}-mix.ogg" GCS_OUTPUT_TPL = "gs://{bucket}/{object_path}/{filename}" _thread_local = threading.local() @property def gcs_client(self): client = getattr(self._thread_local, "gcs_client", None) if not client: self._thread_local.gcs_client = gcsio.GcsIO() return self._thread_local.gcs_client def process(self, entity_ids): track1_id, track2_id = entity_ids.decode("utf-8").split(",") output_filename = MixerDoFn.OUTPUT_NAME_TPL.format( track1_id=track1_id, track2_id=track2_id ) gcs_output_path = MixerDoFn.GCS_OUTPUT_TPL.format( bucket=MixerDoFn.GCS_BUCKET, object_path=MixerDoFn.GCS_OBJECT_PATH, filename=output_filename, ) # Check if output already exists: if self.gcs_client.exists(gcs_output_path): # Don't do unnecessary work logging.info( "Mix for {} & {} already exists: {}".format( track1_id, track2_id, gcs_output_path ) ) return # Check if input data is available err_msg = "Input for {track} is not available: {e}" try: track1_input_path = track_storage.download_track(track1_id) except Exception as e: logging.error(err_msg.format(track=track1_id, e=e)) return try: track2_input_path = track_storage.download_track(track2_id) except Exception as e: logging.error(err_msg.format(track=track2_id, e=e)) return # Get input track ids track1 = mixer.Track(track1_id, track1_input_path) track2 = mixer.Track(track2_id, track2_input_path) # Mix tracks & save to output file mixer.mix(track1, track2, output_filename) # Upload mix logging.info("Uploading mix to {}".format(gcs_output_path)) with self.gcs_client.open(gcs_output_path, "wb", mime_type="application/octet-stream") as dest: with open(output_filename, "rb") as source: dest.write(source.read()) yield entity_ids def run(): input_subscription = "projects/sigint/subscriptions/automixer-klio-input-automixer-klio" output_topic = "projects/sigint/topics/automixer-klio-output" options = pipeline_options.PipelineOptions() gcp_opts = options.view_as(pipeline_options.GoogleCloudOptions) gcp_opts.job_name = "automixer-beam" gcp_opts.project = "sigint" gcp_opts.region = "europe-west1" gcp_opts.temp_location = "gs://sigint-dataflow-tmp/automixer-beam/temp" gcp_opts.staging_location = "gs://sigint-dataflow-tmp/automixer-beam/staging" worker_opts = options.view_as(pipeline_options.WorkerOptions) worker_opts.subnetwork = “https://www.googleapis.com/compute/v1/projects/some-network/regions/europe-west1/subnetworks/foo-1“ worker_opts.machine_type = "n1-standard-2" worker_opts.disk_size_gb = 32 worker_opts.num_workers = 2 worker_opts.max_num_workers = 2 worker_opts.worker_harness_container_image = "gcr.io/sigint/automixer-worker-beam:1" standard_opts = options.view_as(pipeline_options.StandardOptions) standard_opts.streaming = True standard_opts.runner = "dataflow" debug_opts = options.view_as(pipeline_options.DebugOptions) debug_opts.experiments = ["beam_fn_api"] options.view_as(pipeline_options.SetupOptions).save_main_session = True logging.info("Launching pipeline...") pipeline = beam.Pipeline(options=options) (pipeline | beam.io.ReadFromPubSub(subscription=input_subscription) | beam.ParDo(MixerDoFn()) | beam.io.WriteToPubSub(output_topic)) result = pipeline.run() result.wait_until_finish() if __name__ == "__main__": fmt = '%(asctime)s %(message)s' logging.basicConfig(format=fmt, level=logging.INFO) run() -
import os import apache_beam as beam from klio.transforms import decorators
import mixer import track_storage class AutomixerJob(beam.DoFn): @decorators.handle_klio def process(self, data): # Get input track ids track1_id, track2_id = data.element.split(",") track1 = mixer.Track(track1_id) track2 = mixer.Track(track2_id) # Cross fade tracks local_output_path = mixer.mix(track1, track2) # Upload crossfaded track gcs_output_path = os.path.join( self._klio.config.job_config.outputs[0].data_location, local_output_path ) self._klio.logger.info("Uploading mix to {}".format(gcs_output_path)) track_storage.upload_track(gcs_output_path, local_output_path) yield data -
thanks! Lynn Root | @roguelynn We’re hiring: spotifyjobs.com Find more
information on klio at docs.klio.io and github.com/spotify/klio
 roguelynn
 kasacchiful
 ochtum
 barnbarn
 onozaty
 akihisaikeda
 nasa9084
 j5ik2o
 pvcresin
 dayeon
 t0yohei
 sodainc
 shogogg
 addyosmani
 twada
 pwiseman
 lara
 helenjbeal
 techseoconnect
 sergeychernyshev
 csswizardry
 marcelosomers
 eileencodes
 aleyda
 katarinadahlin