Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Factorization Machines
Search
roronya
October 19, 2016
Research
880
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Factorization Machines
大学院の輪講ゼミで発表しました
roronya
October 19, 2016
Transcript
23 slides
Factorization Machines in Proceedings of the 10th IEEE International Conference
on Data Mining (ICDM 2010) @roronya
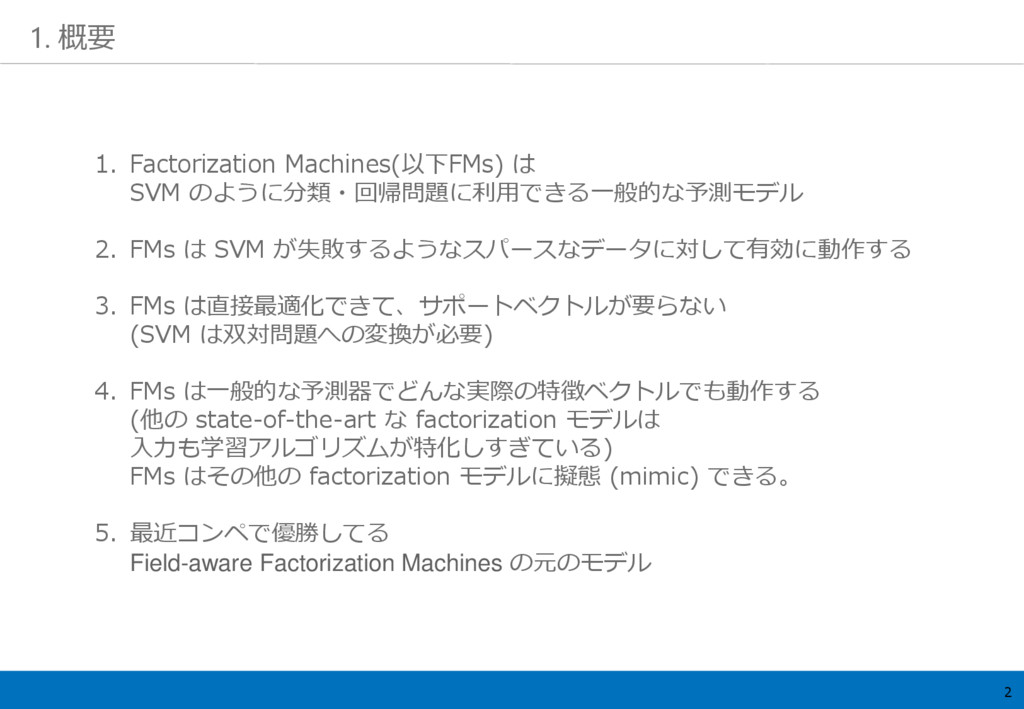
2 1. 概要 1. Factorization Machines(以下FMs) は SVM のように分類・回帰問題に利用できる一般的な予測モデル 2.
FMs は SVM が失敗するようなスパースなデータに対して有効に動作する 3. FMs は直接最適化できて、サポートベクトルが要らない (SVM は双対問題への変換が必要) 4. FMs は一般的な予測器でどんな実際の特徴ベクトルでも動作する (他の state-of-the-art な factorization モデルは 入力も学習アルゴリズムが特化しすぎている) FMs はその他の factorization モデルに擬態 (mimic) できる。 5. 最近コンペで優勝してる Field-aware Factorization Machines の元のモデル
3 Factorization Machines 1. 概要 2. Factorization Machines 1. 説明のためのデータについて
2. 定式化 3. スパースなデータでの学習 4. 計算量 5. 学習 3. SVM との比較 4. 他の Factorization モデルとの比較 5. まとめ
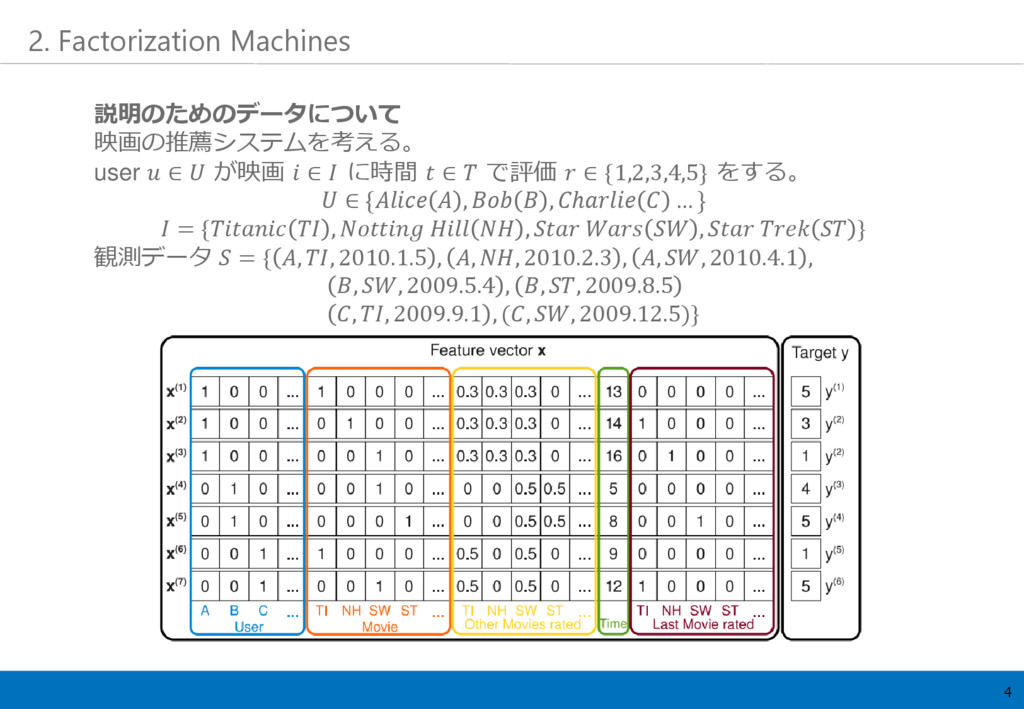
4 2. Factorization Machines 説明のためのデータについて 映画の推薦システムを考える。 user ∈ が映画 ∈
に時間 ∈ で評価 ∈ {1,2,3,4,5} をする。 ∈ { , , ℎ … } = { , , , } 観測データ = { , , 2010.1.5 , , , 2010.2.3 , , , 2010.4.1 , , , 2009.5.4 , , , 2009.8.5 , , 2009.9.1 , (, , 2009.12.5)}
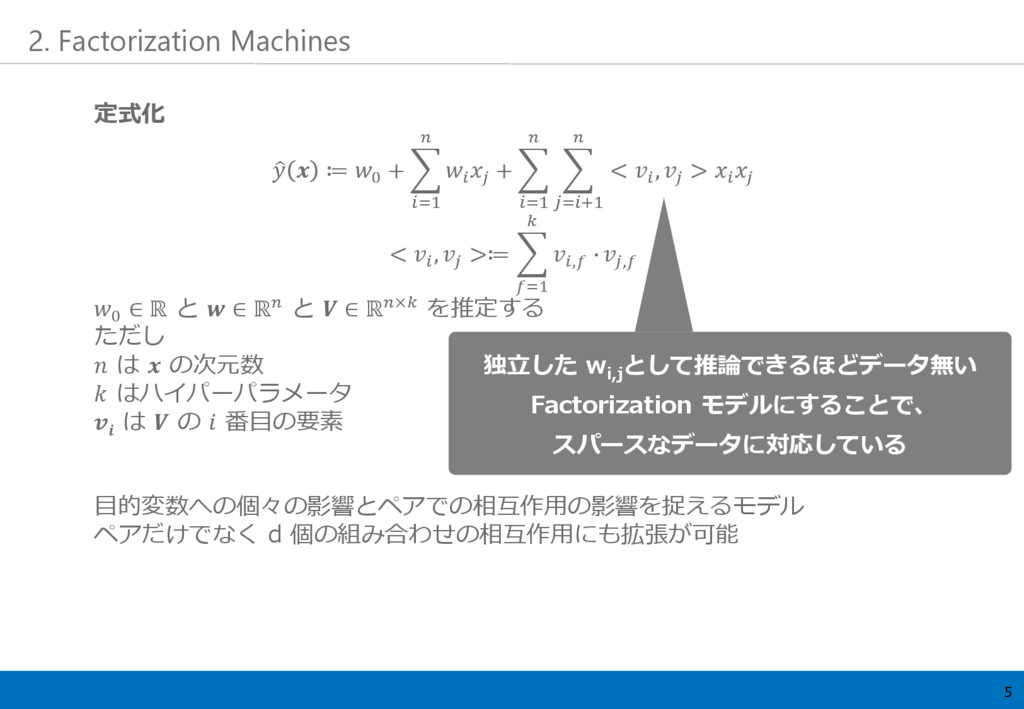
5 2. Factorization Machines 定式化 ≔ 0 + =1 +
=1 =+1 < , > < , >≔ =1 , ∙ , 0 ∈ ℝ と ∈ ℝ と ∈ ℝ× を推定する ただし は の次元数 はハイパーパラメータ は の 番目の要素 目的変数への個々の影響とペアでの相互作用の影響を捉えるモデル ペアだけでなく d 個の組み合わせの相互作用にも拡張が可能 独立した w i,j として推論できるほどデータ無い Factorization モデルにすることで、 スパースなデータに対応している
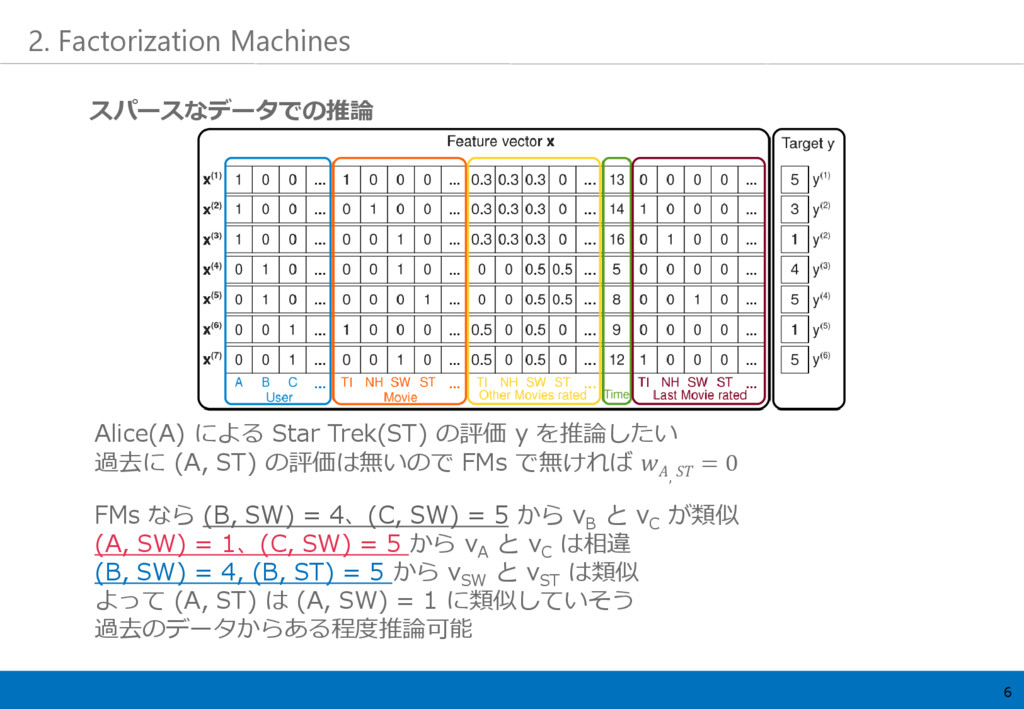
6 2. Factorization Machines Alice(A) による Star Trek(ST) の評価 y
を推論したい 過去に (A, ST) の評価は無いので FMs で無ければ , = 0 FMs なら (B, SW) = 4、(C, SW) = 5 から v B と v C が類似 (A, SW) = 1、(C, SW) = 5 から v A と v C は相違 (B, SW) = 4, (B, ST) = 5 から v SW と v ST は類似 よって (A, ST) は (A, SW) = 1 に類似していそう 過去のデータからある程度推論可能 スパースなデータでの推論
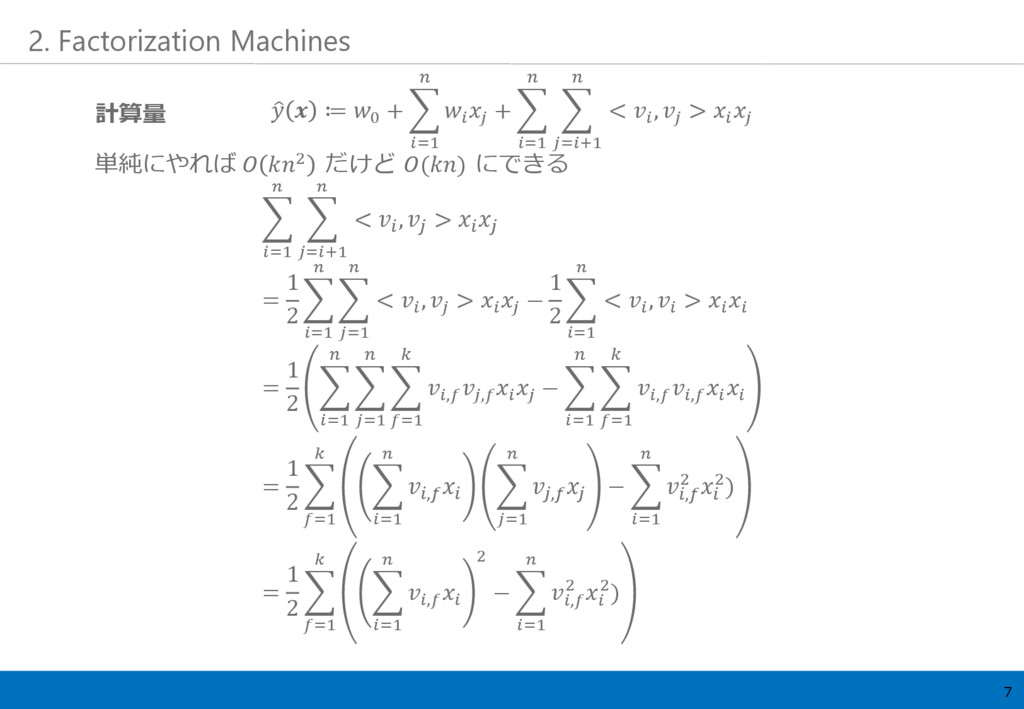
7 2. Factorization Machines ≔ 0 + =1 + =1
=+1 < , > 単純にやれば 2 だけど () にできる =1 =+1 < , > = 1 2 =1 =1 < , > − 1 2 =1 < , > = 1 2 =1 =1 =1 , , − =1 =1 , , = 1 2 =1 =1 , =1 , − =1 , 2 2) = 1 2 =1 =1 , 2 − =1 , 2 2) 計算量
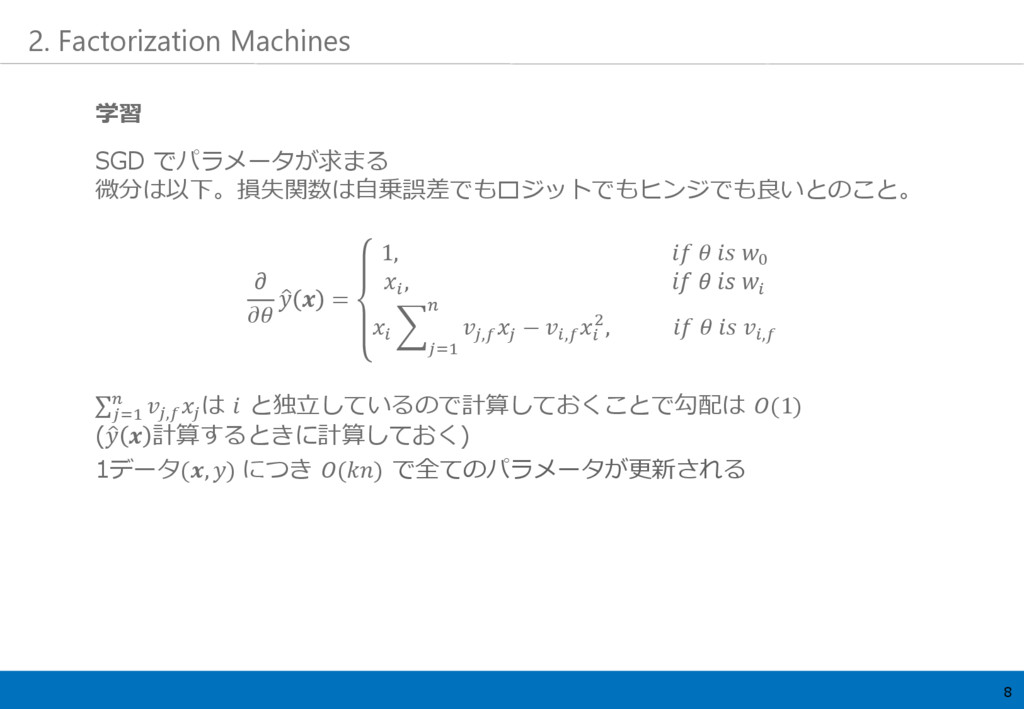
8 2. Factorization Machines SGD でパラメータが求まる 微分は以下。損失関数は自乗誤差でもロジットでもヒンジでも良いとのこと。 = 1, 0
, =1 , − , 2, , =1 , は と独立しているので計算しておくことで勾配は (1) ( 計算するときに計算しておく) 1データ(, ) につき () で全てのパラメータが更新される 学習
9 Factorization Machines 1. 概要 2. Factorization Machines 3. SVM
との比較 1. 線形カーネル 2. 多項式カーネル 3. その他話題とまとめ 4. 他の Factorization モデルとの比較 5. まとめ
10 3. SVM との比較 K ( , ) ≔ 1+
< , > = =1 (1 + ) = =1 + =1 = 0 + =1 FMs の相互作用項の無い式と同じ形 線形カーネル (FMs) ≔ 0 + =1 + =1 =+1 < , > = { 1 , 1 , … , , } のとき識別関数は = =1 ( )() = =1 ( , ) ただし は未定乗数
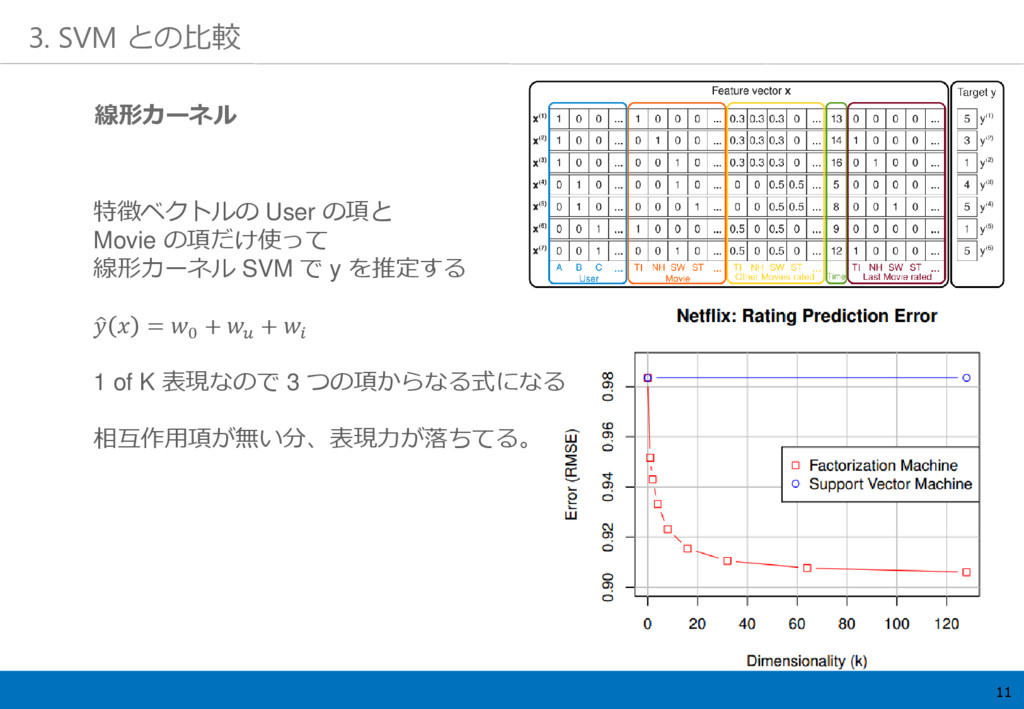
11 3. SVM との比較 特徴ベクトルの User の項と Movie の項だけ使って 線形カーネル
SVM で y を推定する = 0 + + 1 of K 表現なので 3 つの項からなる式になる 相互作用項が無い分、表現力が落ちてる。 線形カーネル
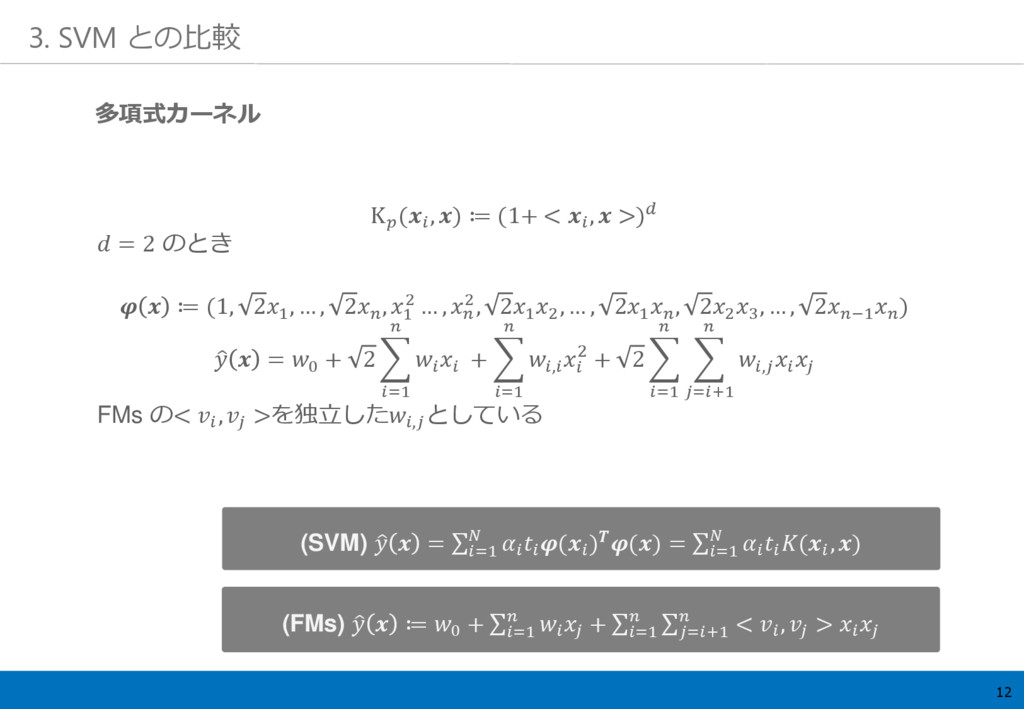
12 3. SVM との比較 K ( , ) ≔ (1+
< , >) = 2 のとき ≔ (1, 21 , … , 2 , 1 2 … , 2, 21 2 , … , 21 , 22 3 , … , 2−1 ) = 0 + 2 =1 + =1 , 2 + 2 =1 =+1 , FMs の< , >を独立した, としている 多項式カーネル (FMs) ≔ 0 + =1 + =1 =+1 < , > (SVM) = =1 ( )() = =1 ( , )
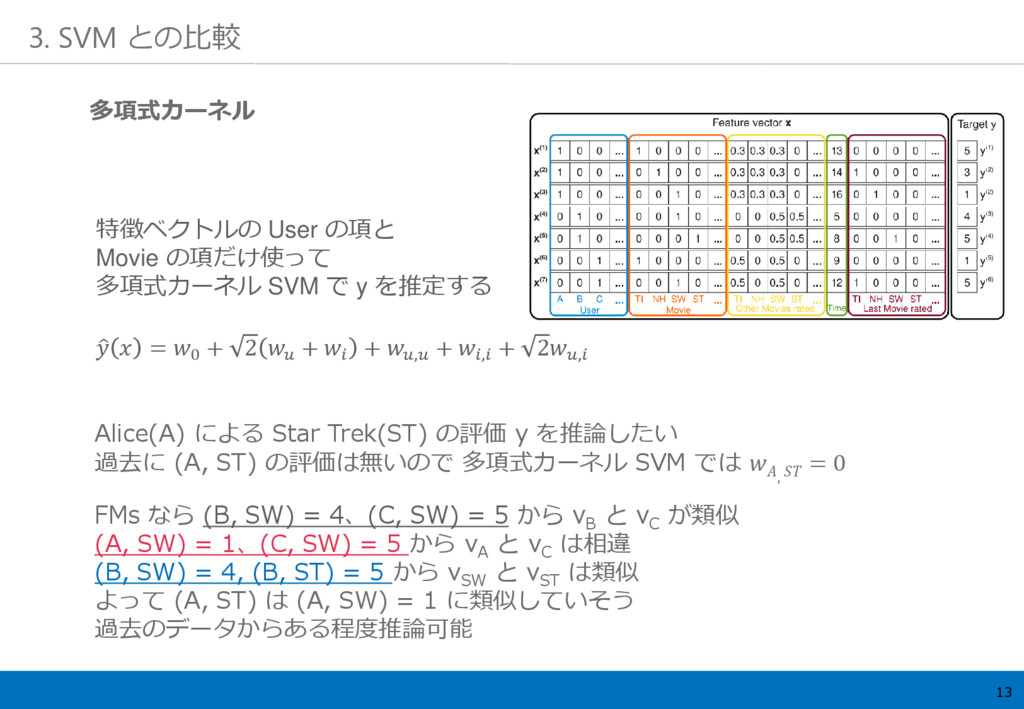
13 3. SVM との比較 Alice(A) による Star Trek(ST) の評価 y
を推論したい 過去に (A, ST) の評価は無いので 多項式カーネル SVM では , = 0 FMs なら (B, SW) = 4、(C, SW) = 5 から v B と v C が類似 (A, SW) = 1、(C, SW) = 5 から v A と v C は相違 (B, SW) = 4, (B, ST) = 5 から v SW と v ST は類似 よって (A, ST) は (A, SW) = 1 に類似していそう 過去のデータからある程度推論可能 多項式カーネル 特徴ベクトルの User の項と Movie の項だけ使って 多項式カーネル SVM で y を推定する = 0 + 2 + + , + , + 2,
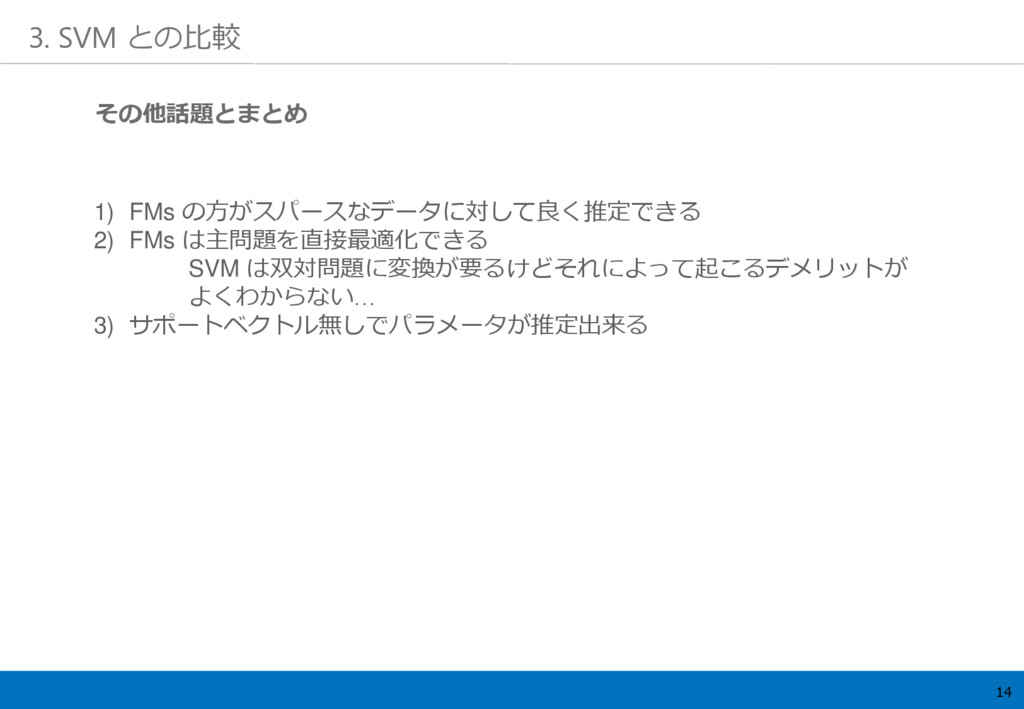
14 3. SVM との比較 1) FMs の方がスパースなデータに対して良く推定できる 2) FMs は主問題を直接最適化できる
SVM は双対問題に変換が要るけどそれによって起こるデメリットが よくわからない… 3) サポートベクトル無しでパラメータが推定出来る その他話題とまとめ
15 Factorization Machines 1. 概要 2. Factorization Machines 3. SVM
との比較 4. 他の Factorization モデルとの比較 1. Matrix Factorization 2. SVD++ 3. PITF 4. FPMC 5. まとめ
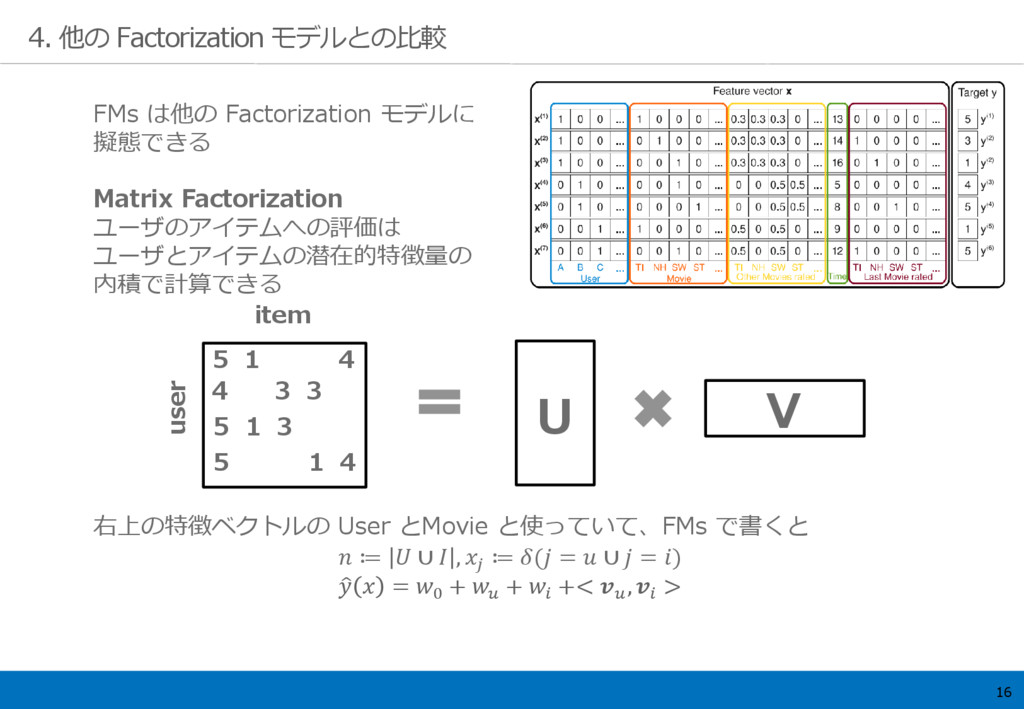
16 4. 他の Factorization モデルとの比較 FMs は他の Factorization モデルに 擬態できる
Matrix Factorization ユーザのアイテムへの評価は ユーザとアイテムの潜在的特徴量の 内積で計算できる 右上の特徴ベクトルの User とMovie と使っていて、FMs で書くと ≔ ∪ , ≔ ( = ∪ = ) = 0 + + +< , > 5 1 4 4 3 3 5 1 3 5 1 4 item user U V
17 4. 他の Factorization モデルとの比較 SVD++ Matrix Factorization の改良モデル 今見たアイテムと
その直前に見たアイテムとの 相互作用を考慮している 右上の特徴ベクトルの User とMovie と Last Movie rated を使っていて、 FMs で書くと ≔ ∪ ∪ , : = 1, = ∪ = 1 , ∈ 0, ただし は評価済みのアイテムの集合 = 0 + + +< , > + 1 ∈ < , > + 1 +< , > + 1 ′∈,′> < , ′ > 本来の SVD++ は ここまで FMs だと その他の相互作用も 考慮することになる
18 4. 他の Factorization モデルとの比較 PITF for Tag Recommendation PITF
= Pairwise Interaction Tensor Factorization) ユーザがアイテムにタグをつけるときに良さそうなタグを推薦したい ECML/PKDD Discovery Challenge で優勝した手法 1 of K されたユーザーとアイテムとタグを特徴ベクトルとする FMs で書くと ≔ ∪ ∪ , : = ( = ∪ = ∪ = ) = 0 + + + +< , >+< , >+< , > PITF のオリジナルモデルだと 1) が無かった 2) < , >+< , >が, + , だった (Factorization してなかった) 右はコンペティションのデータで FMs が PITF と同じくらいスコアが出ている という図
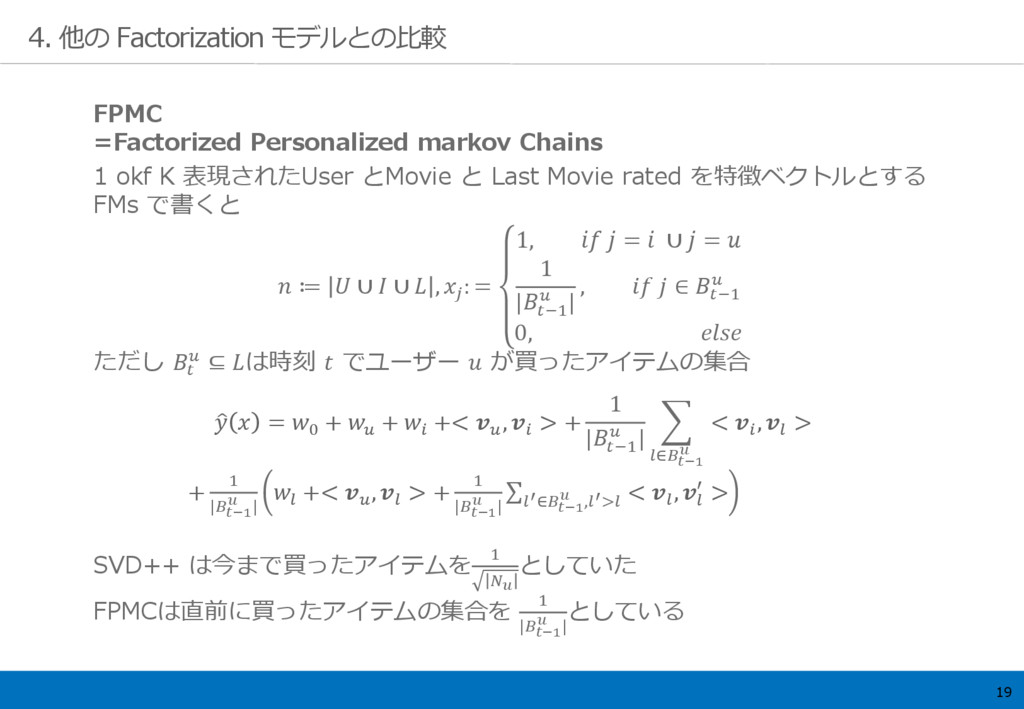
19 4. 他の Factorization モデルとの比較 FPMC =Factorized Personalized markov Chains
1 okf K 表現されたUser とMovie と Last Movie rated を特徴ベクトルとする FMs で書くと ≔ ∪ ∪ , : = 1, = ∪ = 1 |−1 | , ∈ −1 0, ただし ⊆ は時刻 でユーザー が買ったアイテムの集合 = 0 + + +< , > + 1 |−1 | ∈−1 < , > + 1 |−1 | +< , > + 1 |−1 | ′∈−1 ,′> < , ′ > SVD++ は今まで買ったアイテムを 1 としていた FPMCは直前に買ったアイテムの集合を 1 |−1 | としている
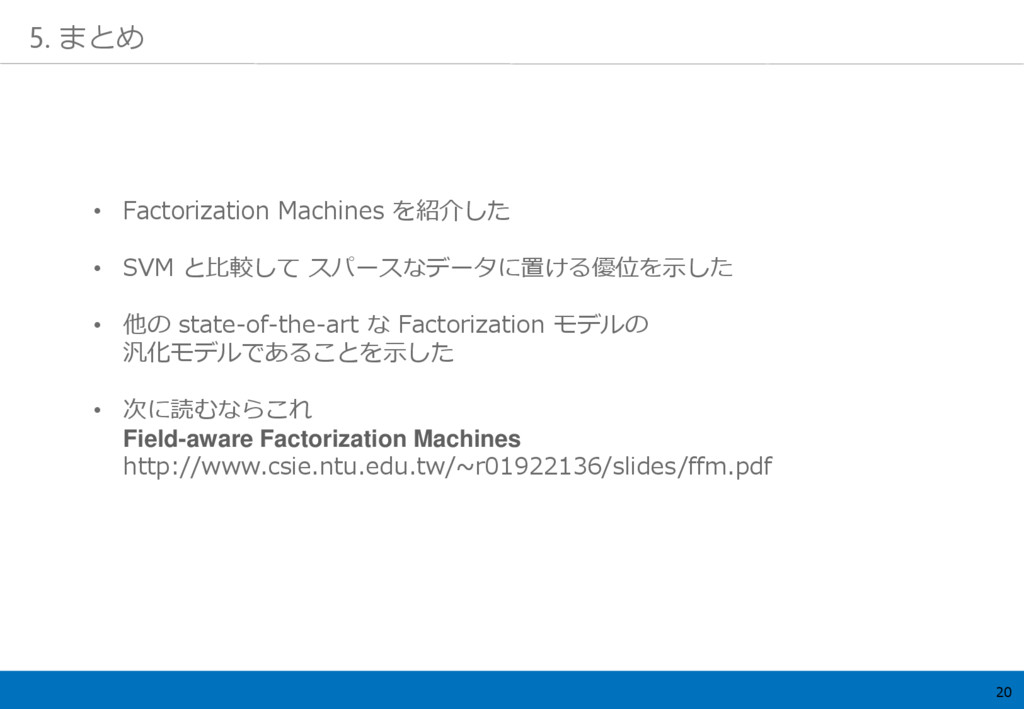
20 5. まとめ • Factorization Machines を紹介した • SVM と比較して
スパースなデータに置ける優位を示した • 他の state-of-the-art な Factorization モデルの 汎化モデルであることを示した • 次に読むならこれ Field-aware Factorization Machines http://www.csie.ntu.edu.tw/~r01922136/slides/ffm.pdf
補足
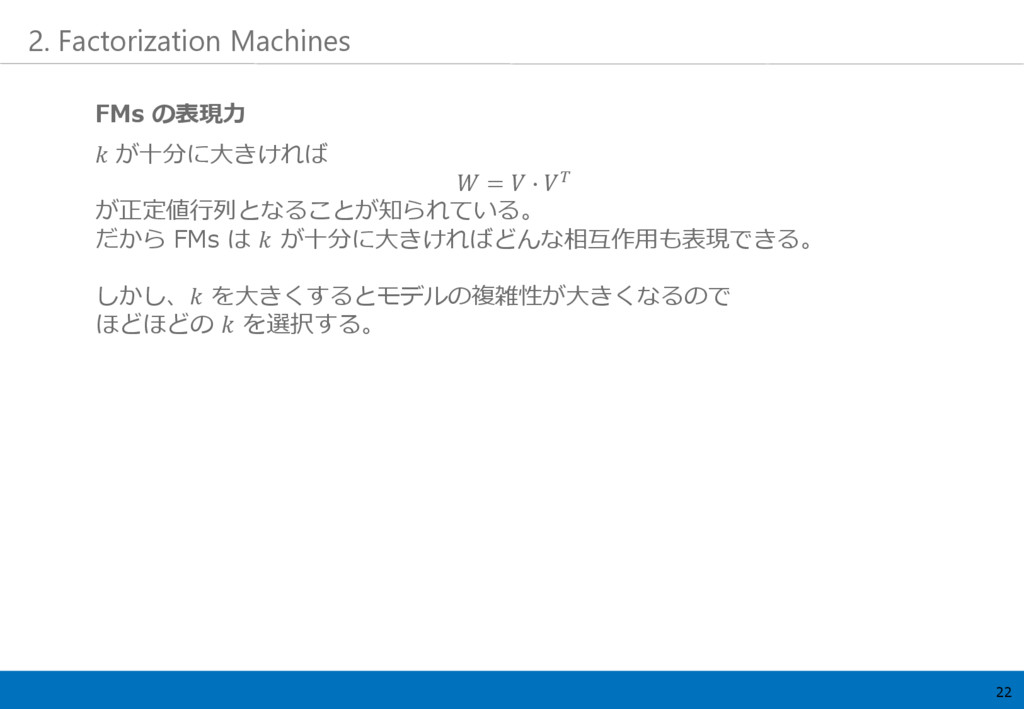
22 2. Factorization Machines FMs の表現力 が十分に大きければ = ∙ が正定値行列となることが知られている。
だから FMs は が十分に大きければどんな相互作用も表現できる。 しかし、 を大きくするとモデルの複雑性が大きくなるので ほどほどの を選択する。
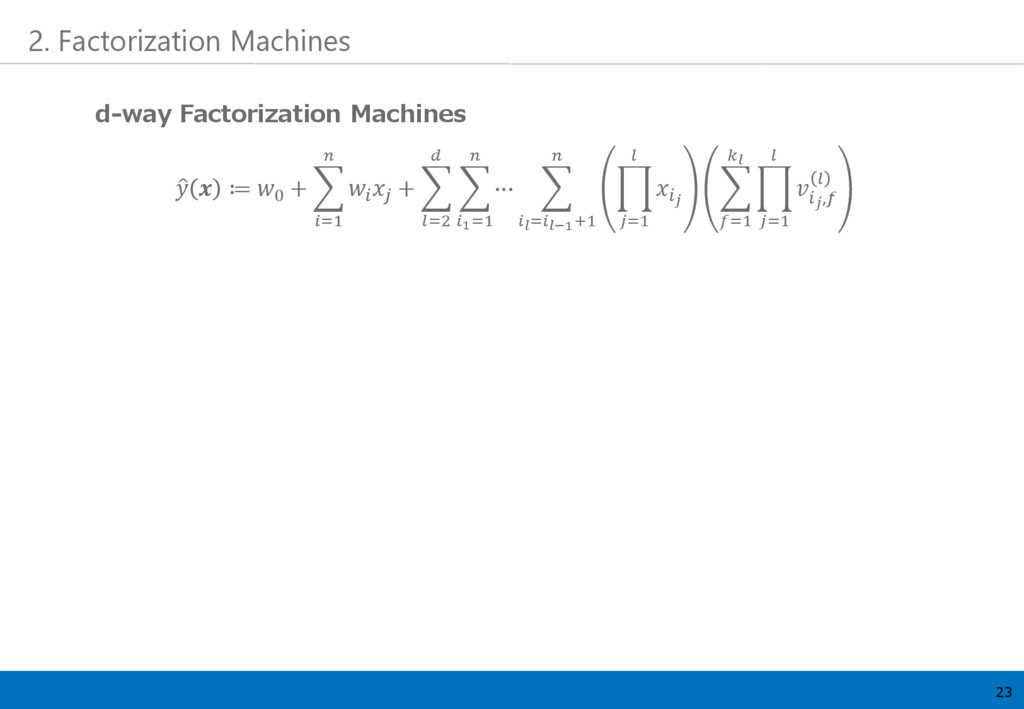
23 2. Factorization Machines d-way Factorization Machines ≔ 0 +
=1 + =2 1=1 ∙∙∙ =−1+1 =1 =1 =1 ,
More Decks by roronya
See All by roronya
速習 Spring AI Gemini CLIのようなLLM CLIを自作しよう
roronya
0
500
TeXの本懐
roronya
0
290
Other Decks in Research
See All in Research
SPACE 2026 - Renforcer l’attractivité des métiers des productions animales dans les établissements d'enseignement agricole
institutdelelevage
PRO
0
120
La génomique au service de la fromageabilité du lait grâce aux spectres MIR
institutdelelevage
PRO
0
230
OWASP AISVS - C7
shiell
2
870
モデル評価を効率的にする方法
ftakahashi
0
250
Empreinte carbone des ovins : une approche globale (technique, économique, environnementale) – 4 années de résultats avec LIFE GREEN SHEEP
institutdelelevage
PRO
0
160
【令和7年度版】内航船 VS 外航船 早見表
anikisencyo
0
240
ICAITD 2026 Oral Presentation
rikkabotan7
0
150
Santé et fertilité des sols : ce que nous disent les pratiques dans les systèmes de polyculture-élevage
institutdelelevage
PRO
0
160
視覚若手の会LENSって何??
mickey_0226
0
430
AI時代に学術情報をどう探し、どう使うか: 研究の様々な場面と一研究者の経験から
masao
0
230
Who’s Behind the Divide?
sirmatrixpage
1
1.6k
Evaluating LLM Reliability Across Facts, Evidence, and Cultures
yukiar
0
250
Featured
See All Featured
Put a Button on it: Removing Barriers to Going Fast.
kastner
60
4.6k
Easily Structure & Communicate Ideas using Wireframe
afnizarnur
194
17k
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
2
990
Visualization
eitanlees
153
17k
Raft: Consensus for Rubyists
vanstee
143
7.9k
Odyssey Design
rkendrick25
PRO
3
970
Unlocking the hidden potential of vector embeddings in international SEO
frankvandijk
0
1.1k
The innovator’s Mindset - Leading Through an Era of Exponential Change - McGill University 2025
jdejongh
PRO
1
400
Technical Leadership for Architectural Decision Making
baasie
4
650
Into the Great Unknown - MozCon
thekraken
41
2.8k
Java REST API Framework Comparison - PWX 2021
mraible
34
9.8k
Avoiding the “Bad Training, Faster” Trap in the Age of AI
tmiket
1
310


 roronya
 institutdelelevage
 shiell
 ftakahashi
 anikisencyo
 rikkabotan7
 mickey_0226
 masao
 sirmatrixpage
 yukiar
 kastner
 afnizarnur
 nmsamuel
 eitanlees
 vanstee
 rkendrick25
 frankvandijk
 jdejongh
 baasie
 thekraken
 mraible
 tmiket