Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
実践オブザーバビリティ
Search
Satoru Takeuchi
PRO
March 11, 2022
Technology
1.2k
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
実践オブザーバビリティ
Observability Conference 2022の発表スライドです
https://event.cloudnativedays.jp/o11y2022/talks/1357
Satoru Takeuchi
PRO
March 11, 2022
More Decks by Satoru Takeuchi
See All by Satoru Takeuchi
119-多機能ファイルシステムBtrfs_のコピー.pdf
sat
PRO
1
81
Linuxカーネルの インタフェースは変わりうる?
sat
PRO
1
110
あなたの知らないバージョン命名規則
sat
PRO
3
930
Rook: Intro and Deep Dive with Ceph
sat
PRO
1
81
Machine Check Exception
sat
PRO
2
73
バイナリダンプの模様を読む
sat
PRO
0
120
cpコマンドはディスク上でデータを コピーしないことがある
sat
PRO
3
120
114-ファイルのshallow_copy.pdf
sat
PRO
2
70
113-Btrfsのスナップショット.pdf
sat
PRO
0
49
Other Decks in Technology
See All in Technology
企画からFlutter実装まで、1つの機能を一貫して開発したプロセスと成果物
khiroyuki1003
0
140
FinOpsを導入してマルチプロダクトのコスト最適化を実現する
kworkdev
PRO
0
120
リアクションエンジニア ― 小さなリアクションから、話しかけやすい組織をつくる ―
ryuguyana
1
120
Claude Codeから見る、エンジニアの世界の変容とその先
oikon48
8
5.3k
基本から分かる!AWSセキュリティ運用の考え方と任せ方
cmusudakeisuke
1
390
AIコーディングはじめました
miso
0
140
cdkd (CDK Direct)
gotok365
2
130
AIエージェント時代、Kaggleにどう取り組むか
takanao
2
490
The future of architectural work
ufried
0
120
cdk deployとcdkd deploy、実際にデプロイして5倍速近くの差を実測した
yama3133
1
160
Agent Loopを組み込んだ アンビエントなAI機能を実現する / Ambient AI fetures with Agent Loop
nekorush14
0
150
Jev の中身は50行で再現できる。でも本物との差はどこにあるのか
hisuzuya
0
290
Featured
See All Featured
Building Adaptive Systems
keathley
44
3.3k
Speed Design
sergeychernyshev
33
2.2k
HU Berlin: Industrial-Strength Natural Language Processing with spaCy and Prodigy
inesmontani
PRO
0
790
Measuring Dark Social's Impact On Conversion and Attribution
stephenakadiri
2
320
Bash Introduction
62gerente
615
220k
Efficient Content Optimization with Google Search Console & Apps Script
katarinadahlin
PRO
1
960
Understanding Cognitive Biases in Performance Measurement
bluesmoon
32
3.1k
The Cult of Friendly URLs
andyhume
79
7.1k
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
Leveraging Curiosity to Care for An Aging Population
cassininazir
1
550
How GitHub (no longer) Works
holman
316
150k
Color Theory Basics | Prateek | Gurzu
gurzu
1
510
Transcript
実践オブザーバビリティ プロダクショングレード監視/ログ基盤とその実用例 Mar. 11th, 2022 サイボウズ ストレージチーム sat 1
もくじ 2 ▌前提知識 ▌サイボウズの監視/ログ基盤 ▌工夫点と課題 ▌実用例
もくじ 3 ▌前提知識 ▌サイボウズの監視/ログ基盤 ▌工夫点と課題 ▌実用例
オブザーバビリティとは ▌システムが外部提供する情報から内部状態を観測できること ▌オブザーバビリティが高いシステムの例 ⚫サービスを提供できているかを観測できる ⚫サービスのレスポンス時間を観測できる ⚫ストレージの容量が足りているかを観測できる 4
システムが外部提供する情報 ▌メトリクス: システムの状態を定量化したもの ⚫例: リクエストが一秒あたりに完了した数 ▌ログ: システムに起きたことを記録したもの ⚫例: “<時刻> request
completed in 0.3 secs”のような文字列 5
オブザーバビリティを高める手段 ▌メトリクス/ログの集約 ▌集約したメトリクスの監視(モニタリング) ▌監視によって検出した異常を通知(アラート) ▌メトリクス/ログの分析、可視化 6
もくじ 7 ▌前提知識 ▌サイボウズの監視/ログ基盤 ▌工夫点と課題 ▌実用例
サイボウズで開発中のインフラ ▌オンプレのKubernetes(K8s)クラスタ ▌マルチテナント ⚫ 1つのK8sクラスタにあらゆるアプリ(Pod)が同居 8 …
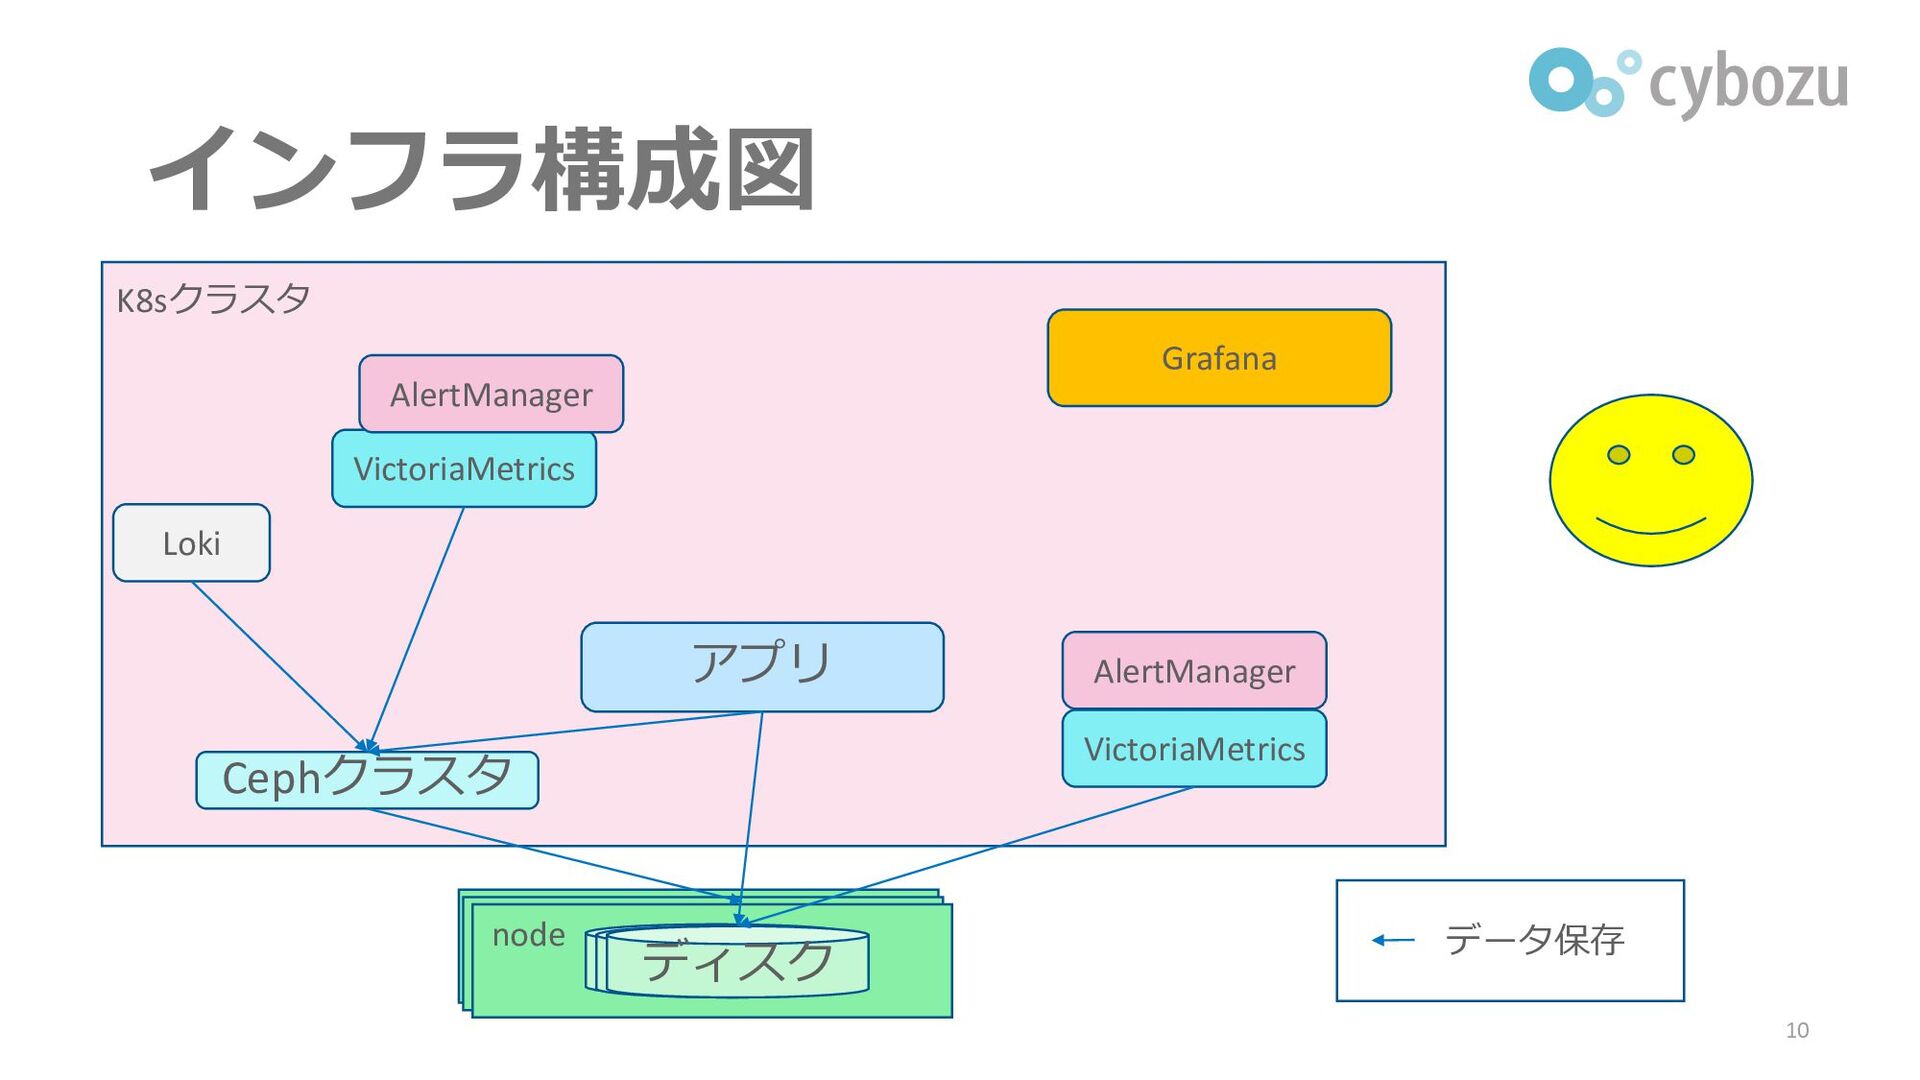
監視/ログ基盤に採用したソフトウェア ▌監視基盤 ⚫VictoriaMetrics: メトリクスの集約、監視 ⚫Alertmanager: 通知 ▌ログ基盤 ⚫Loki: ログの集約 ▌可視化、分析
⚫Grafana: ダッシュボード、VictoriaMetricsとLokiへのクエリ発行 9
インフラ構成図 10 Cephクラスタ HDD node HDD ディスク アプリ Loki VictoriaMetrics
VictoriaMetrics Grafana AlertManager AlertManager K8sクラスタ データ保存
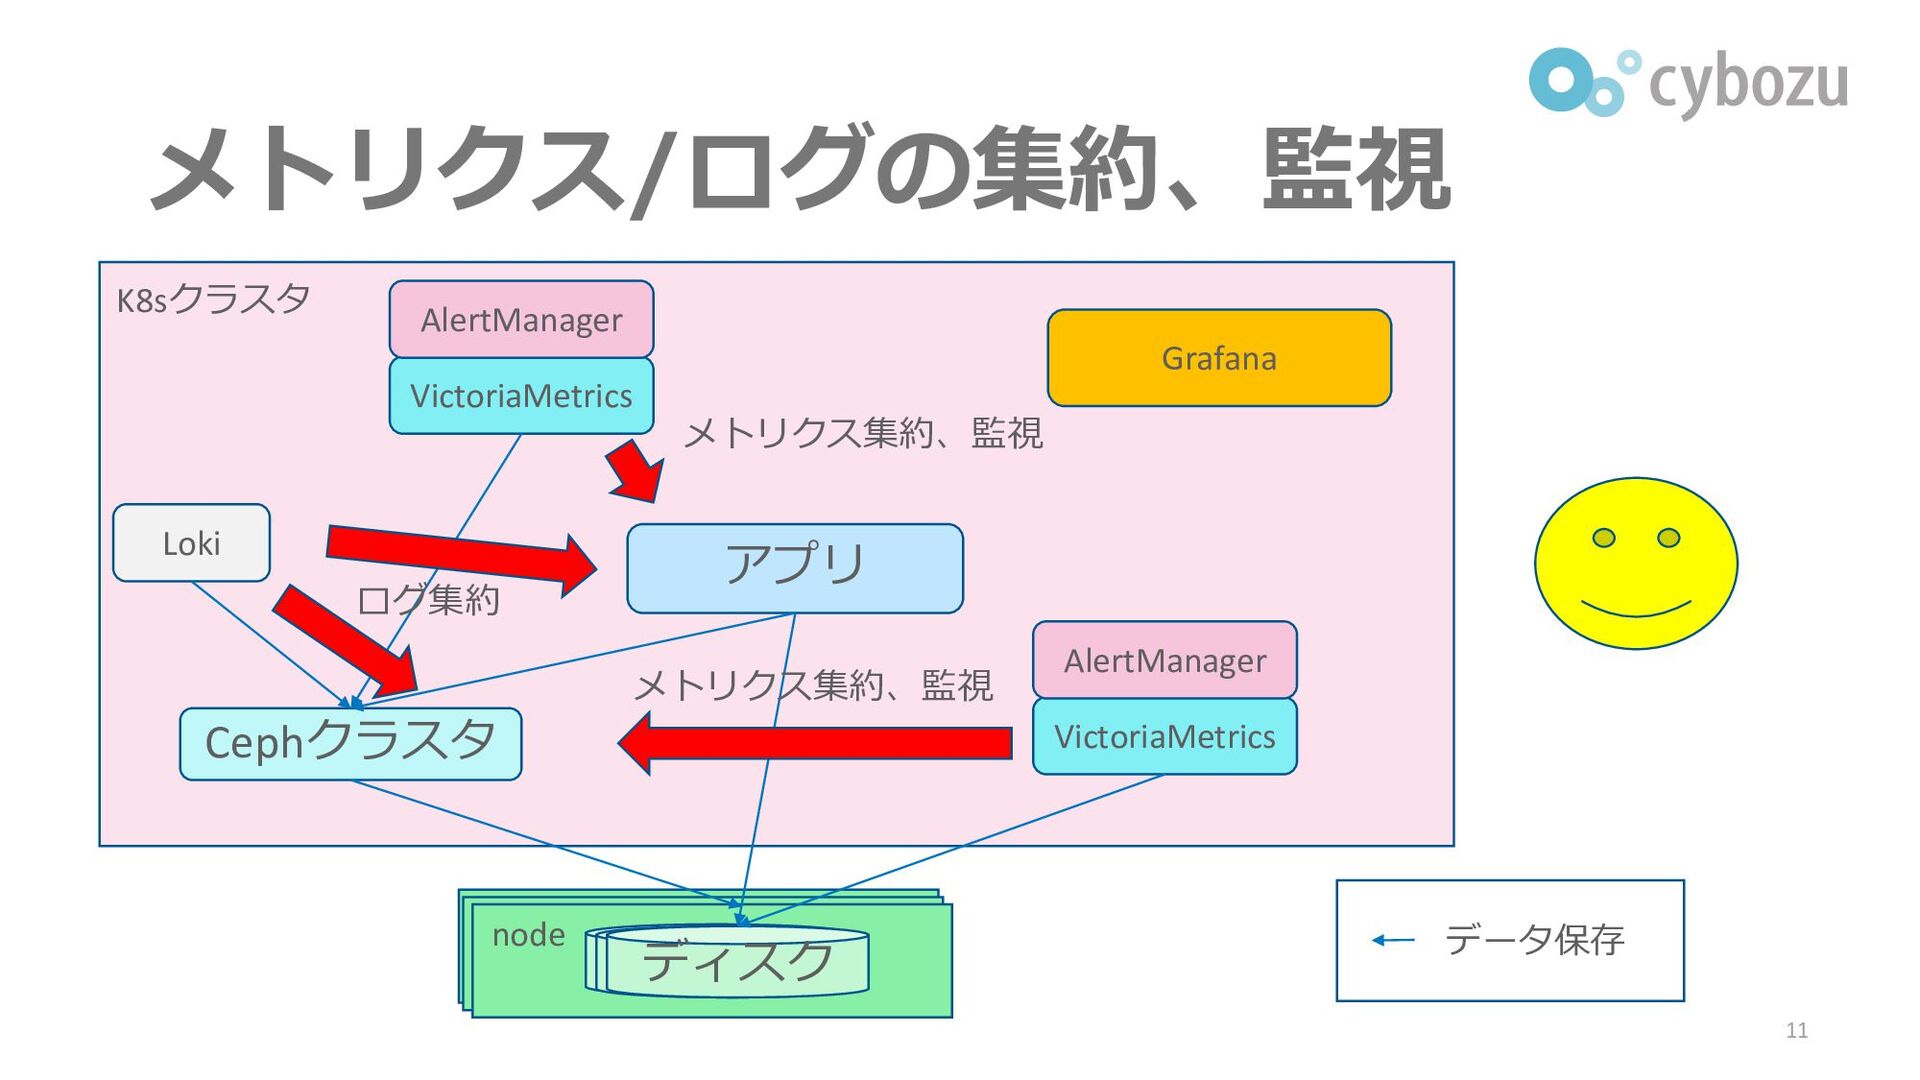
メトリクス/ログの集約、監視 11 Cephクラスタ HDD node HDD ディスク アプリ Loki VictoriaMetrics
VictoriaMetrics Grafana ログ集約 メトリクス集約、監視 メトリクス集約、監視 AlertManager AlertManager K8sクラスタ データ保存
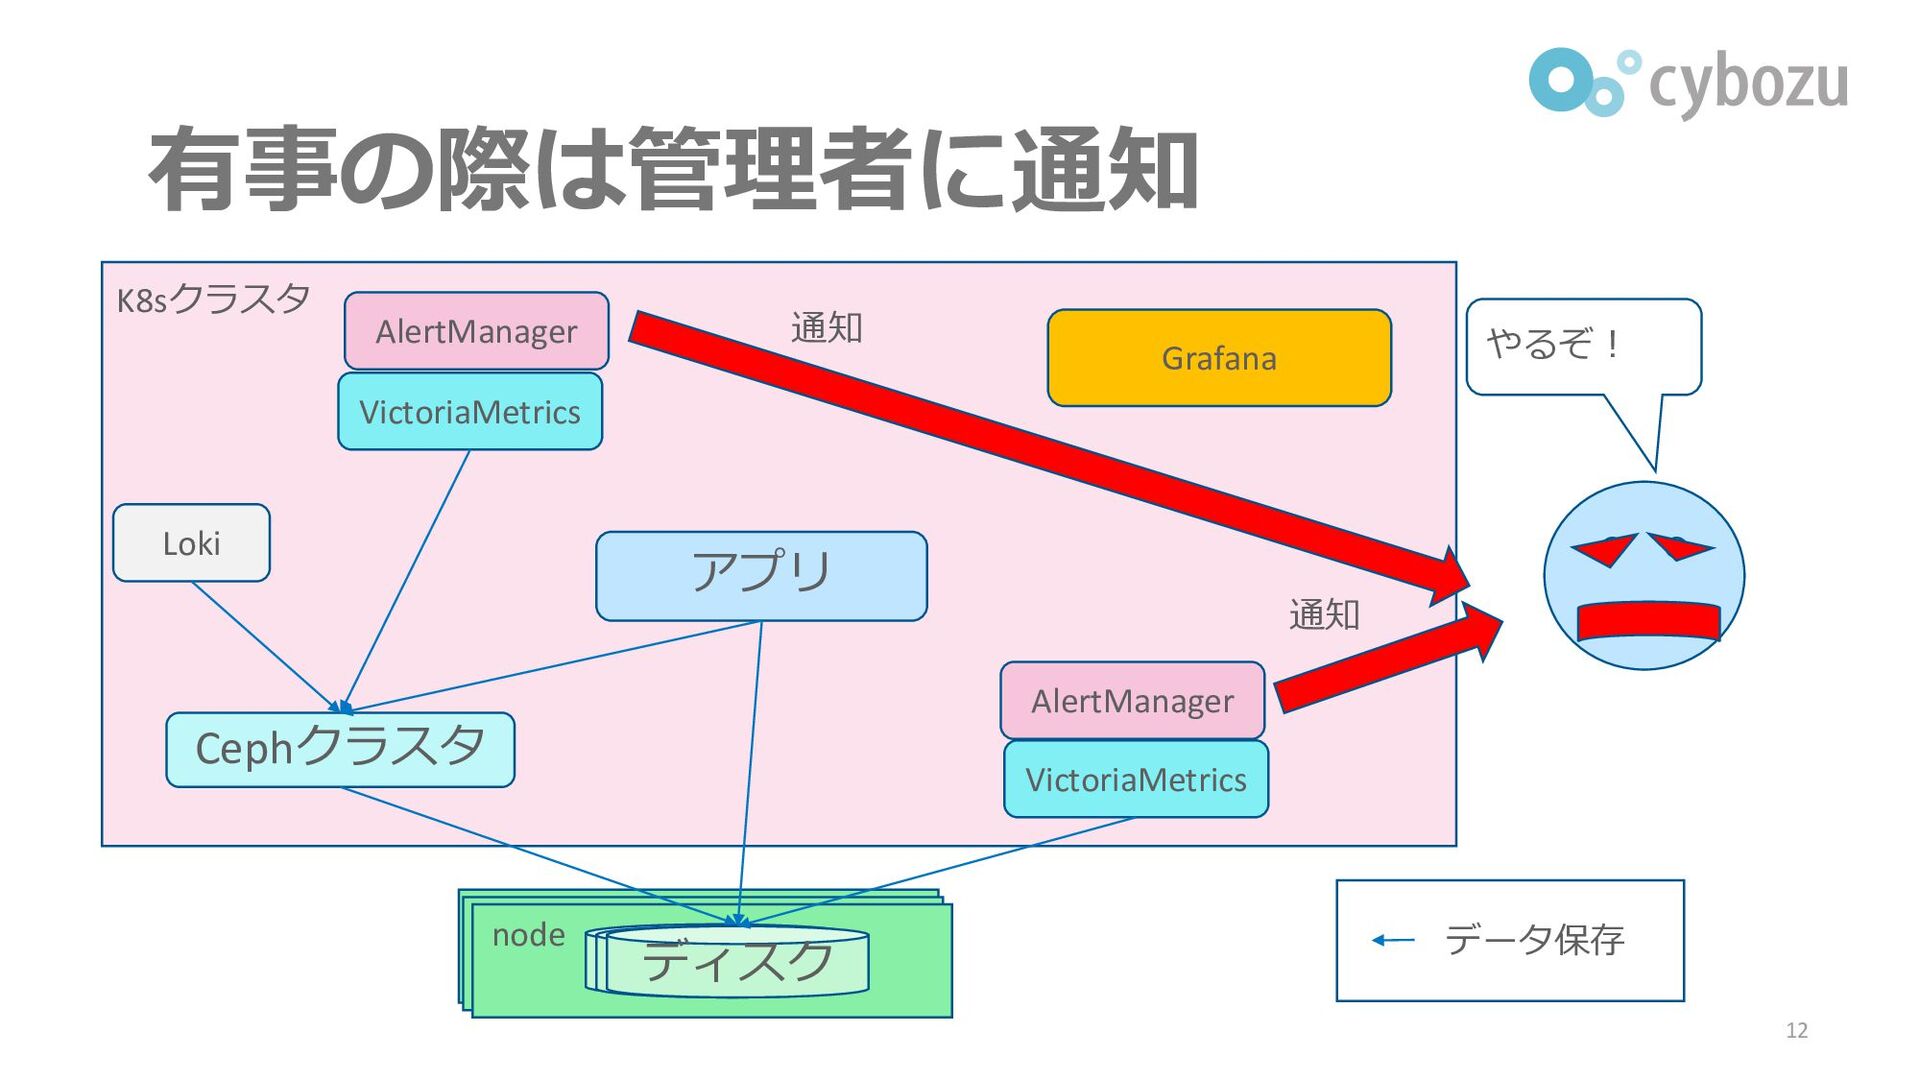
有事の際は管理者に通知 12 Cephクラスタ HDD node HDD ディスク アプリ Loki VictoriaMetrics
VictoriaMetrics Grafana 通知 通知 AlertManager AlertManager K8sクラスタ データ保存 やるぞ!
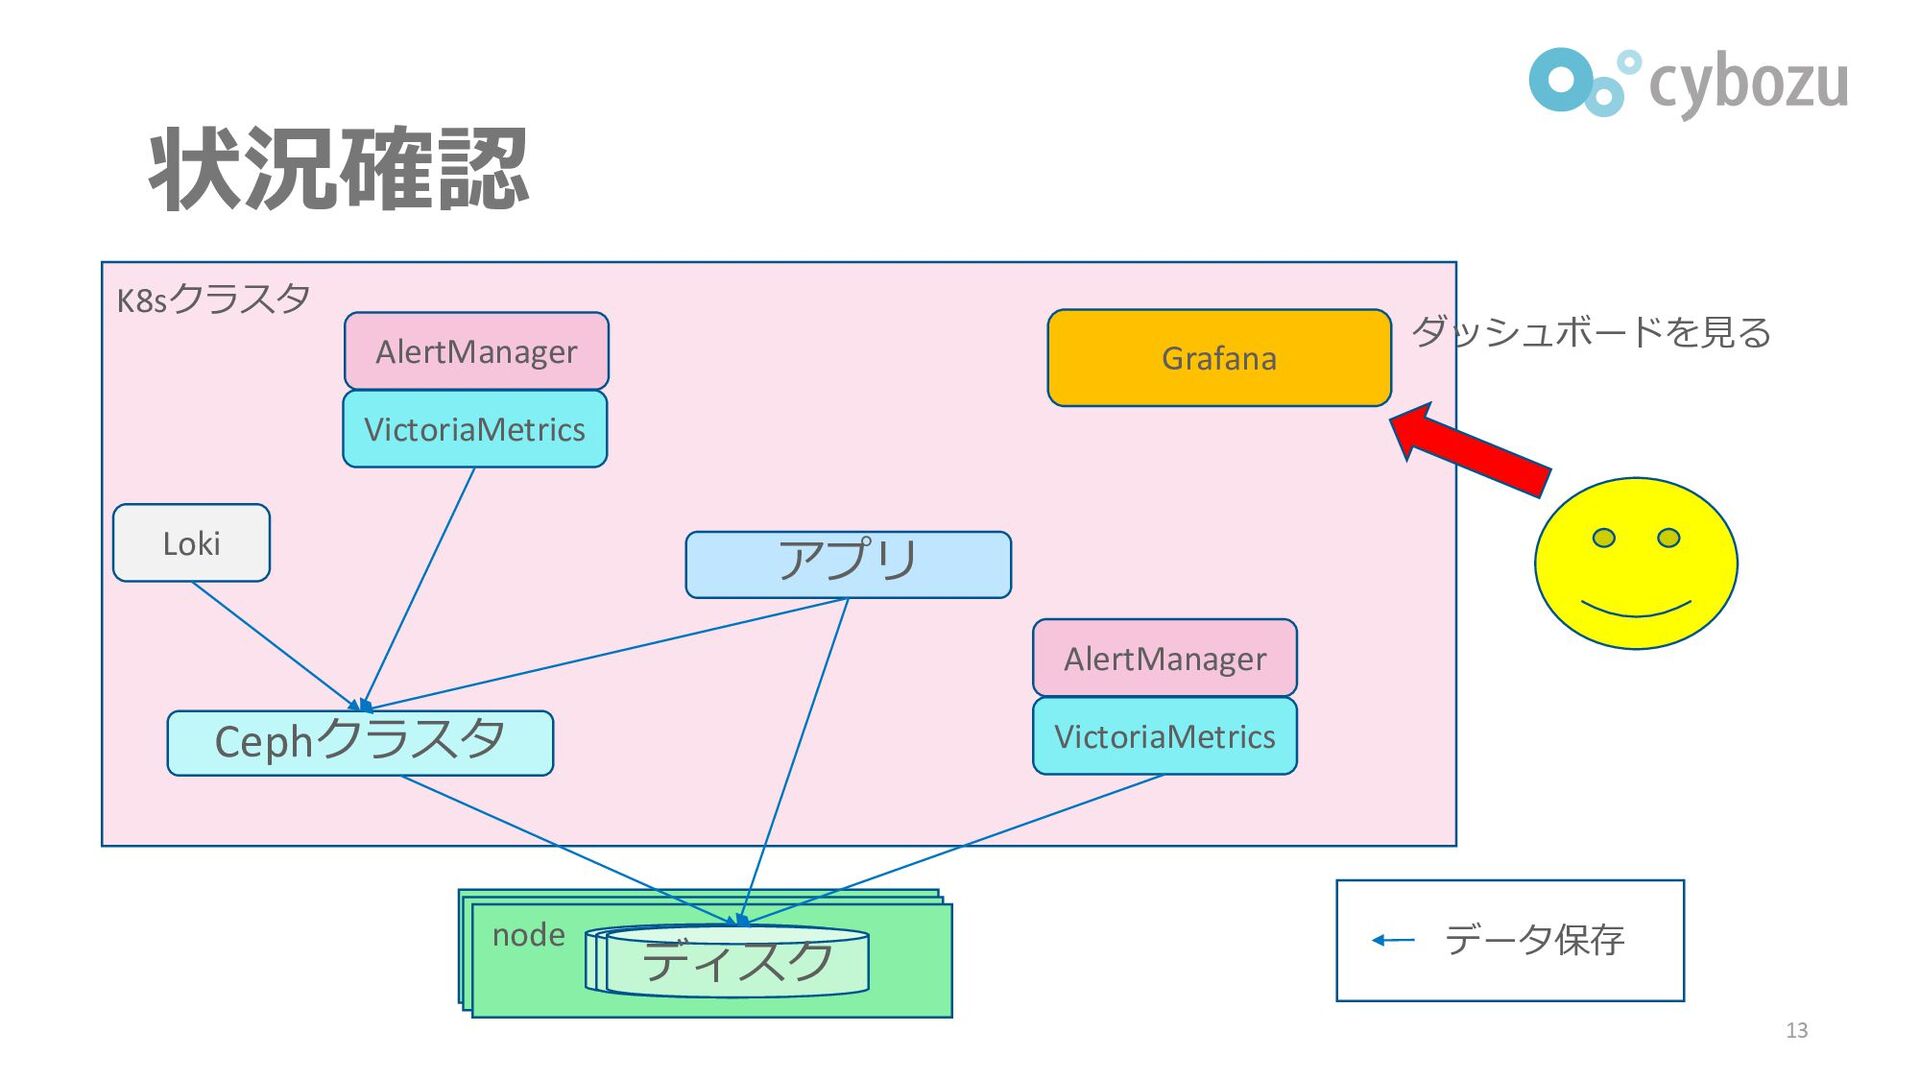
状況確認 13 Cephクラスタ HDD node HDD ディスク アプリ Loki VictoriaMetrics
VictoriaMetrics Grafana ダッシュボードを見る AlertManager AlertManager K8sクラスタ データ保存
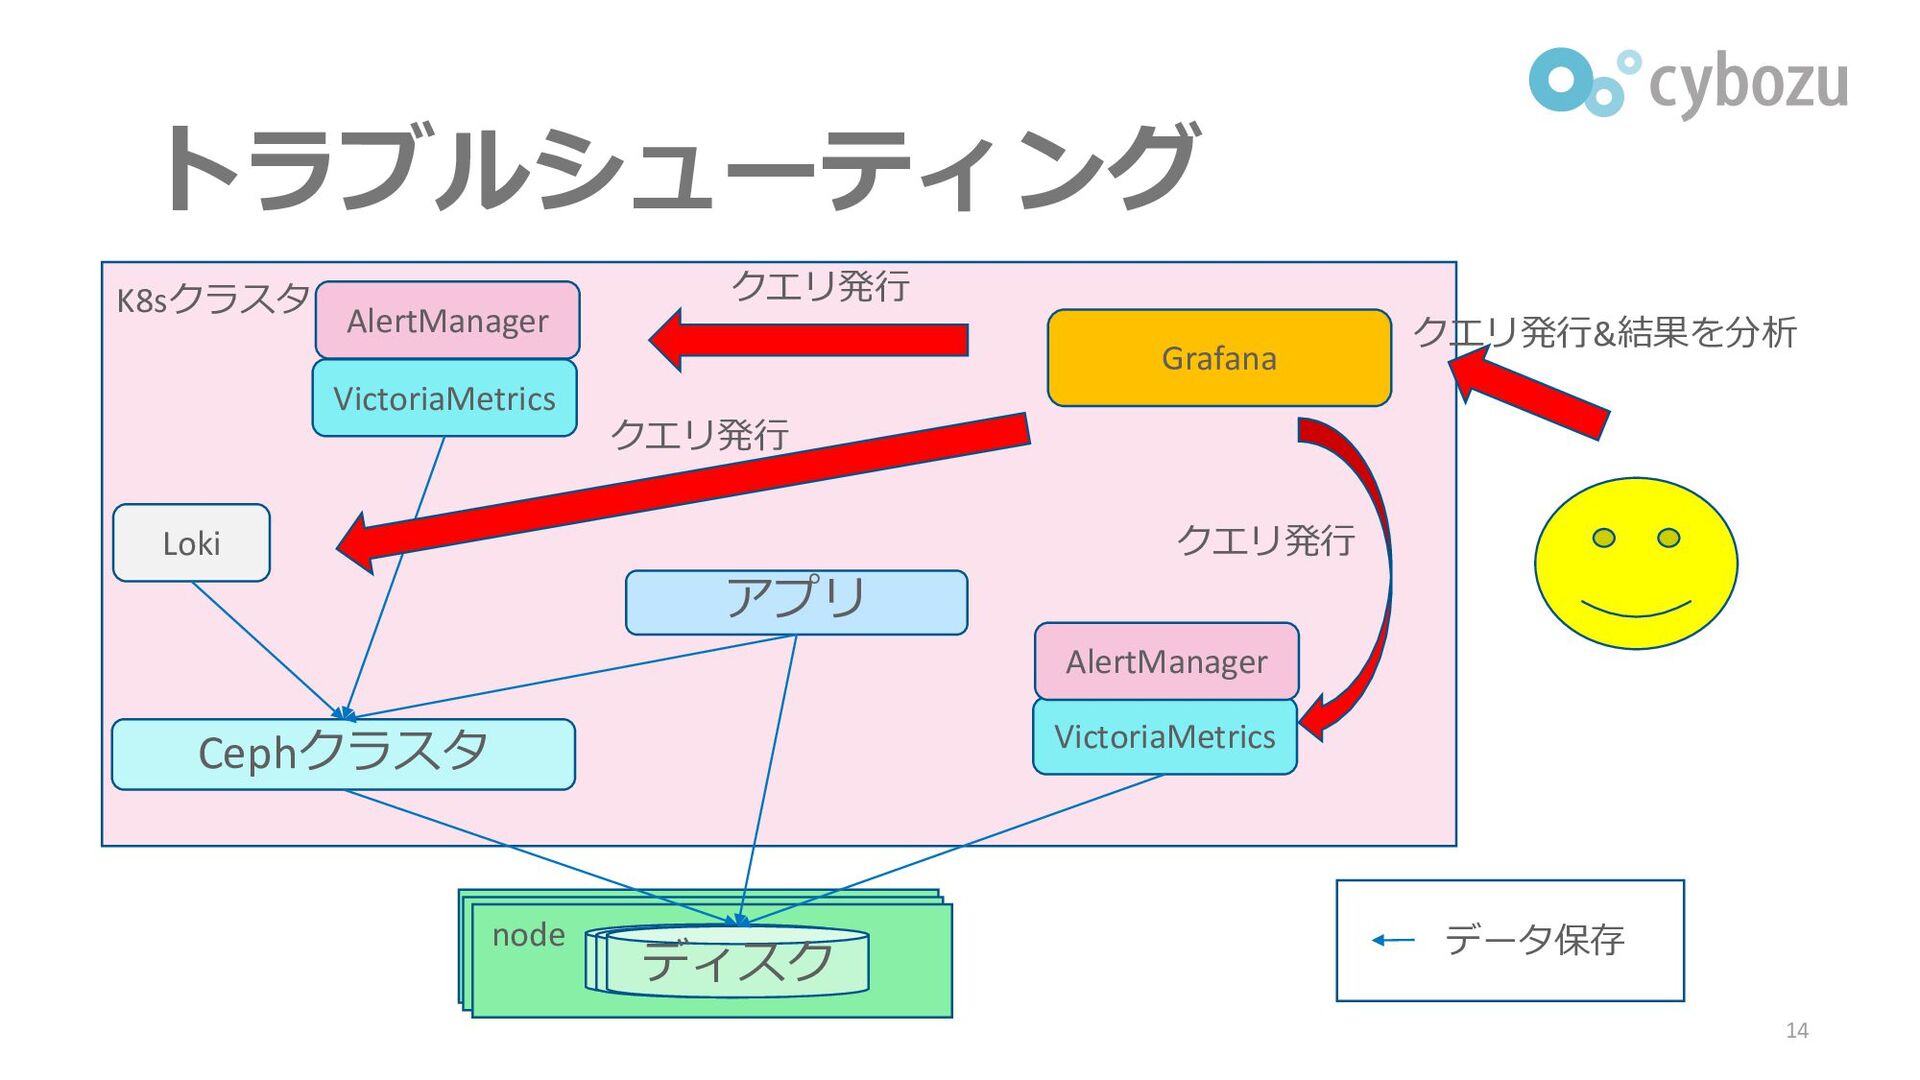
トラブルシューティング 14 Cephクラスタ HDD node HDD ディスク アプリ Loki VictoriaMetrics
VictoriaMetrics Grafana クエリ発行&結果を分析 クエリ発行 クエリ発行 クエリ発行 AlertManager AlertManager K8sクラスタ データ保存
その他Grafanaへのアクセス契機 ▌定期的なダッシュボード確認 ⚫前回確認時以降、変わったところがないか ⚫「何が正常か」を知るのに役立つ ▌インフラユーザからの連絡 ⚫できればなくしたい ⚫問題解決後に、自動検出できるよう改善を検討 15
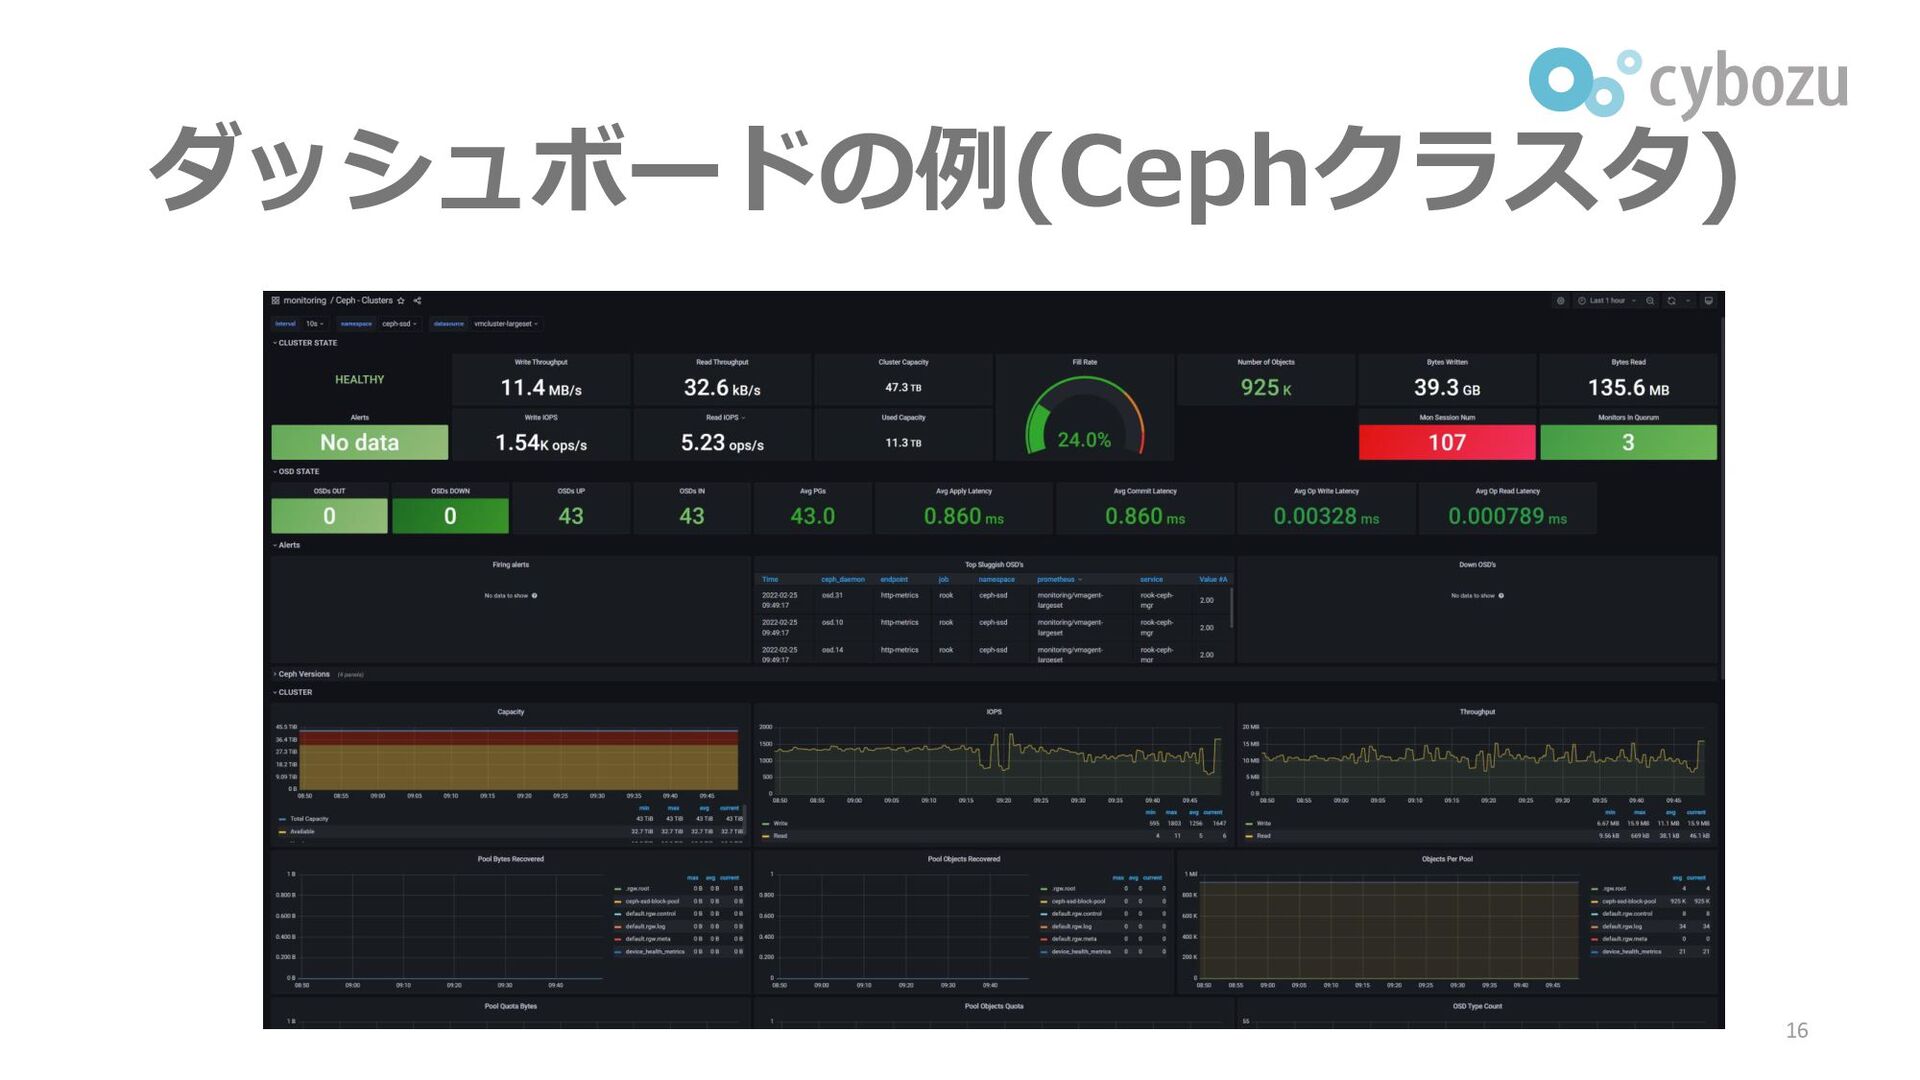
ダッシュボードの例(Cephクラスタ) 16
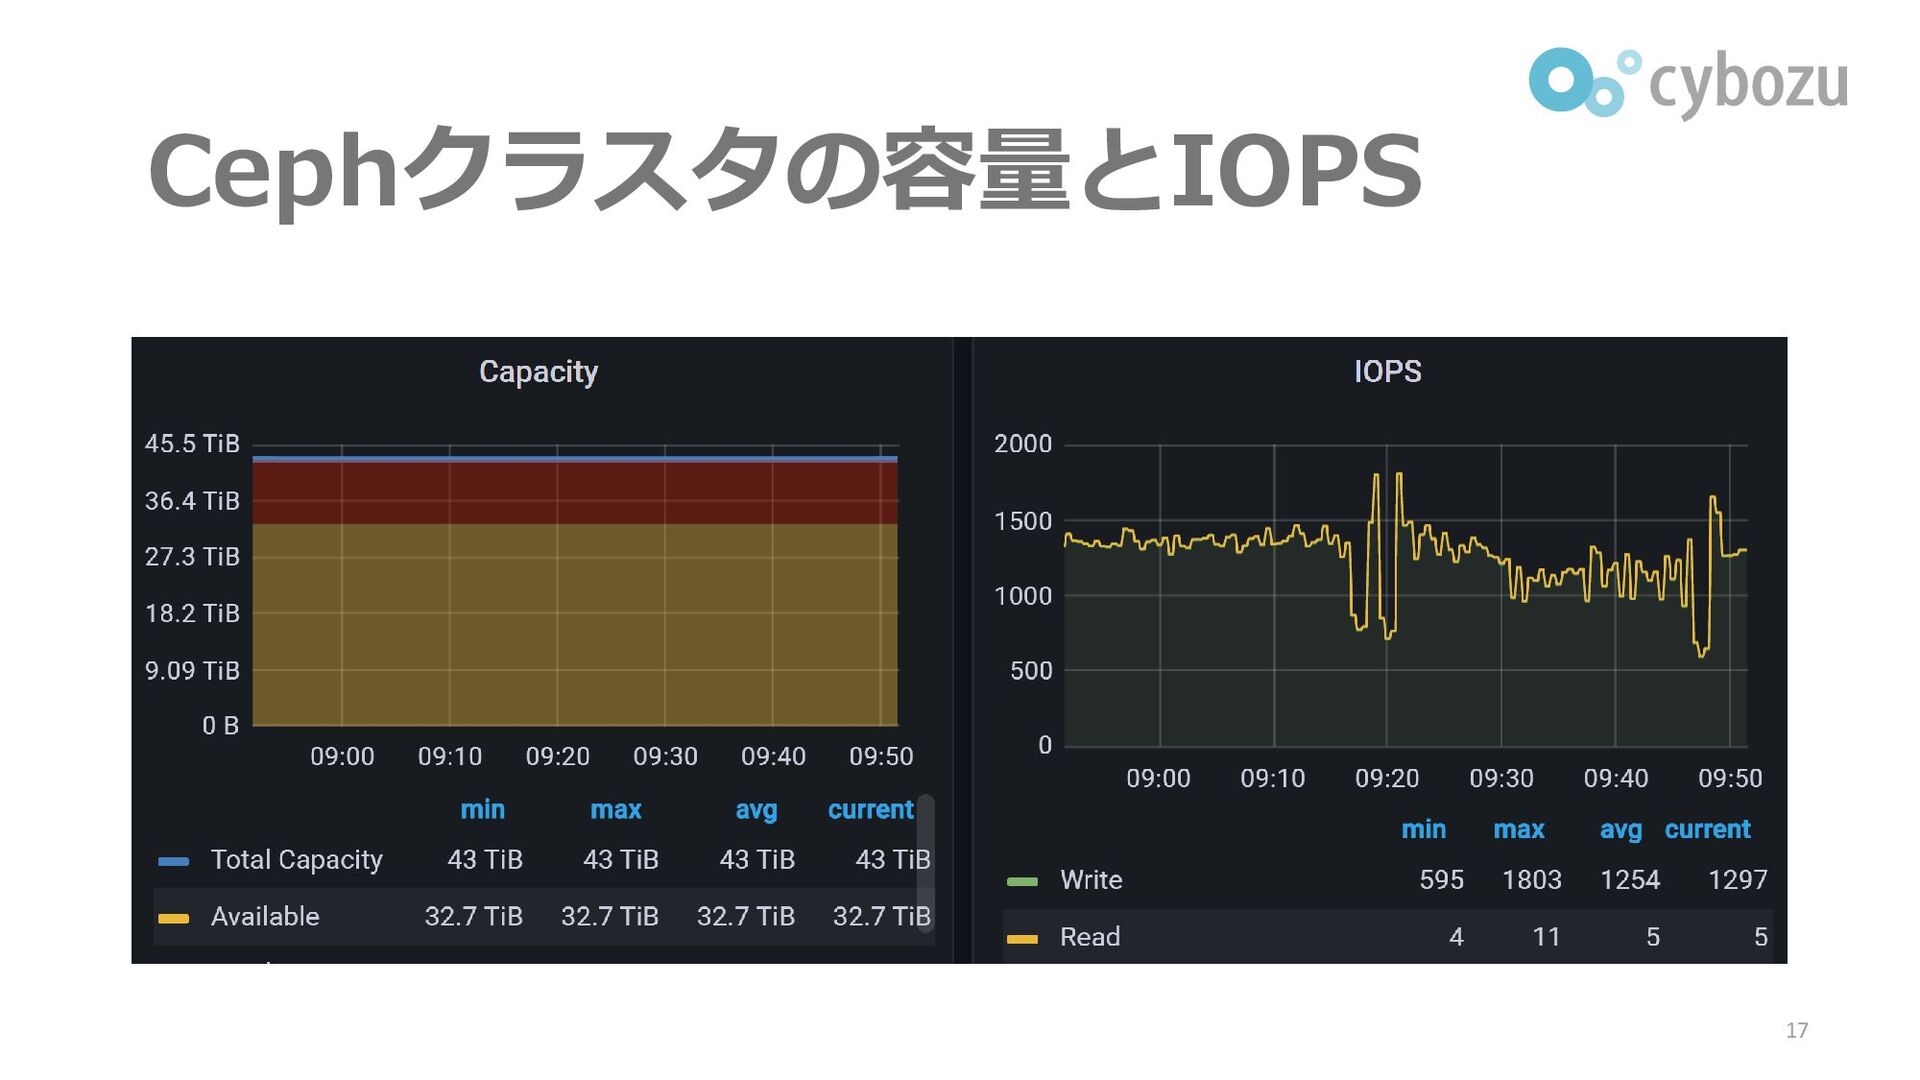
Cephクラスタの容量とIOPS 17
成果は全てOSSとして公開 ▌監視基盤 ⚫https://github.com/cybozu-go/neco-apps/tree/main/monitoring ▌ログ基盤 ⚫https://github.com/cybozu-go/neco-apps/tree/main/logging 18
もくじ 19 ▌前提知識 ▌サイボウズの監視/ログ基盤 ▌工夫点と課題 ▌実用例
工夫点: VictoriaMetricの採用 ▌Prometheus互換 ⚫様々な外部ツールが対応 ▌組み込み機能によってHA構成可能 ⚫構成がシンプルにできる ▌データストアが長期保存向け 20
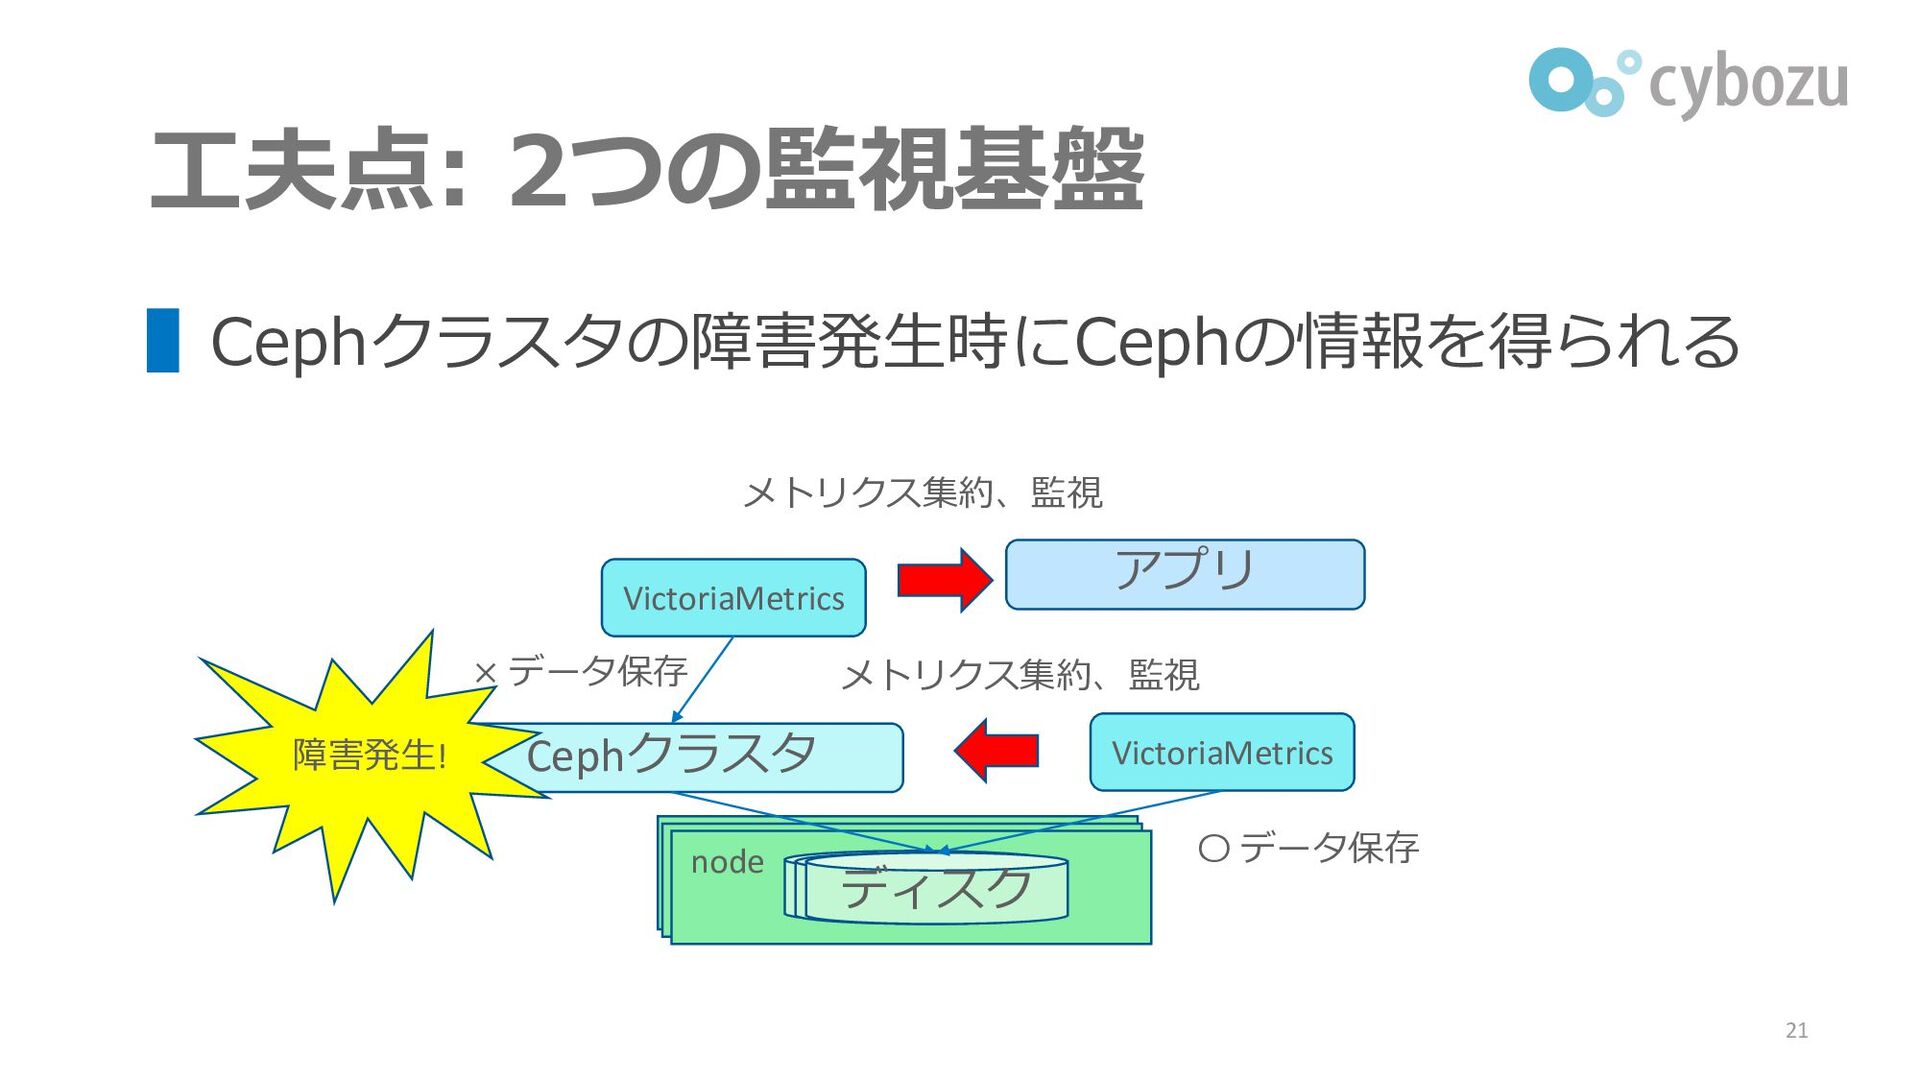
工夫点: 2つの監視基盤 ▌Cephクラスタの障害発生時にCephの情報を得られる 21 Cephクラスタ HDD node HDD ディスク VictoriaMetrics
VictoriaMetrics アプリ メトリクス集約、監視 メトリクス集約、監視 障害発生! × データ保存 〇 データ保存
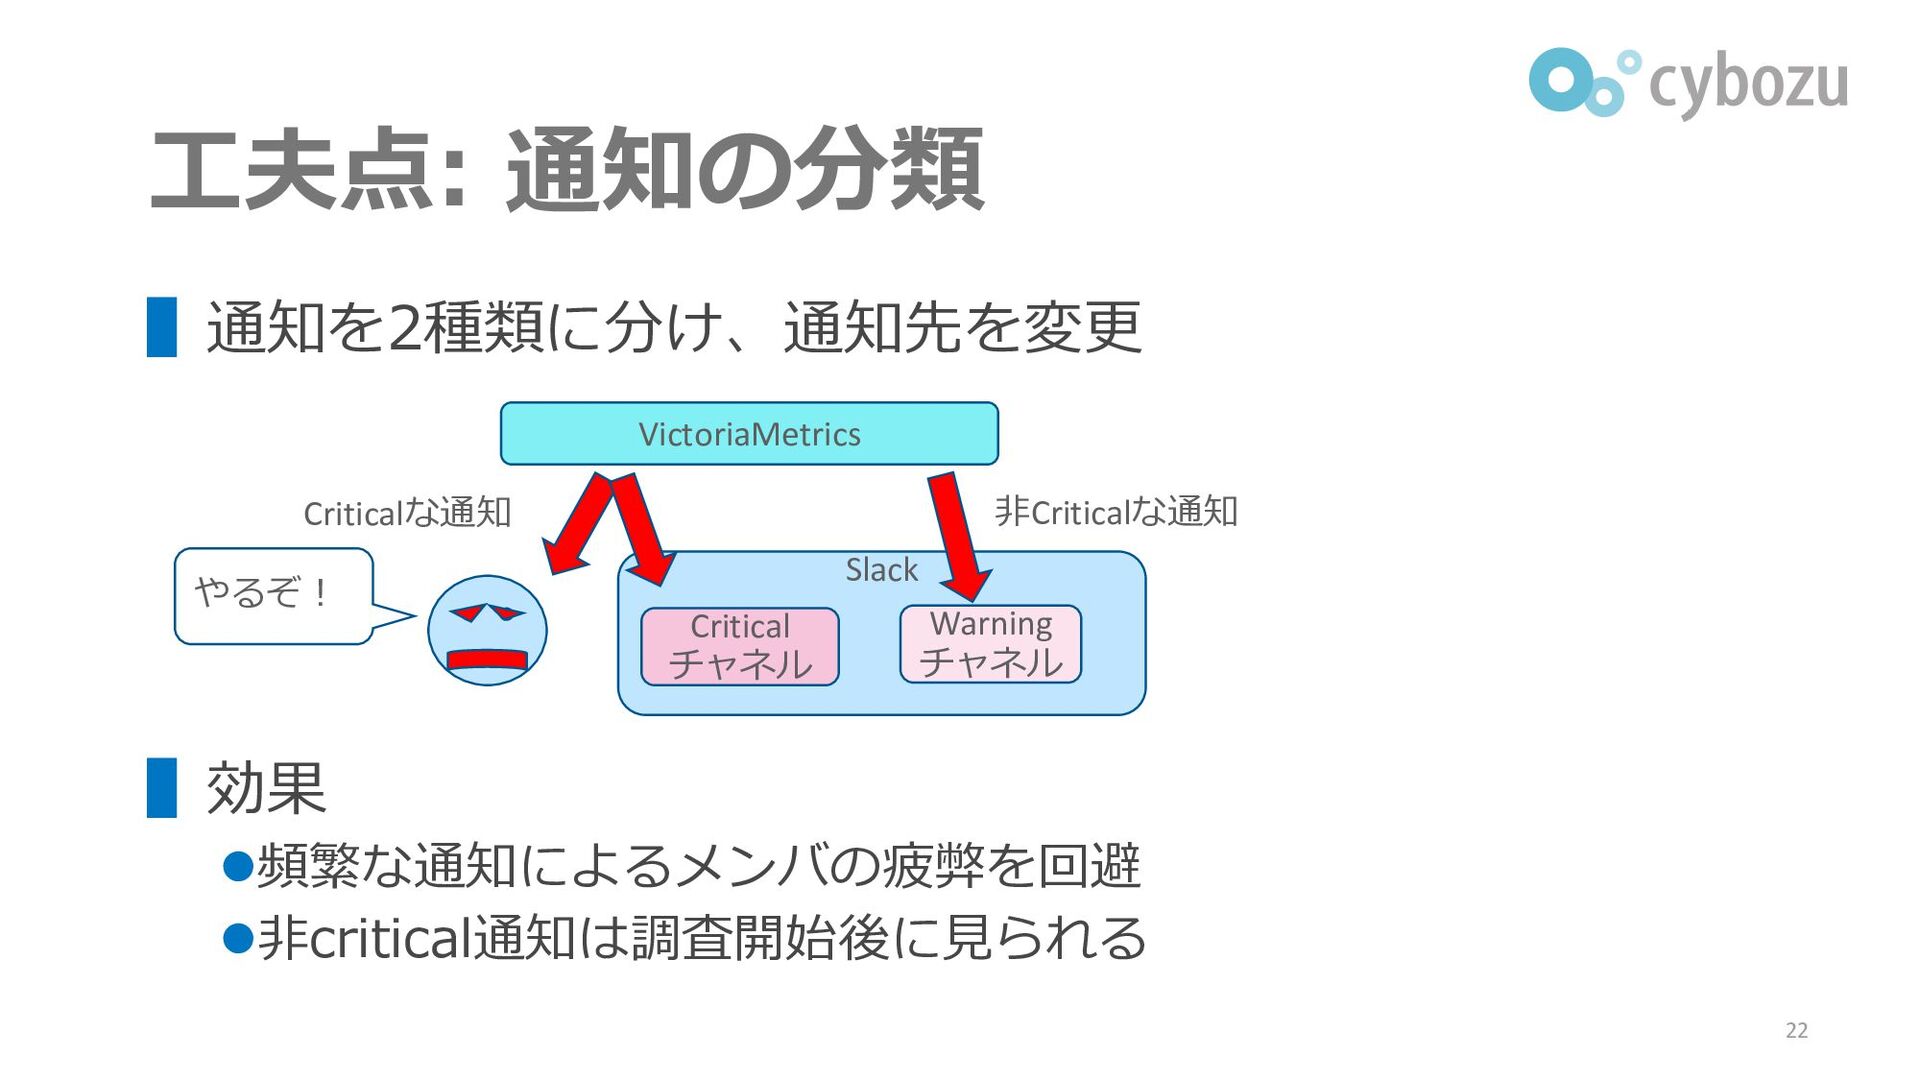
工夫点: 通知の分類 ▌通知を2種類に分け、通知先を変更 ▌効果 ⚫頻繁な通知によるメンバの疲弊を回避 ⚫非critical通知は調査開始後に見られる 22 VictoriaMetrics Criticalな通知 Slack
Critical チャネル Warning チャネル 非Criticalな通知 やるぞ!
課題: LokiがCephに依存している ▌Cephクラスタの障害発生時にlokiにアクセスできない ▌Cephクラスタ専用のLokiを導入予定 23 Cephクラスタ HDD node HDD ディスク
Loki アプリ ログ集約、監視 障害発生! × データ保存
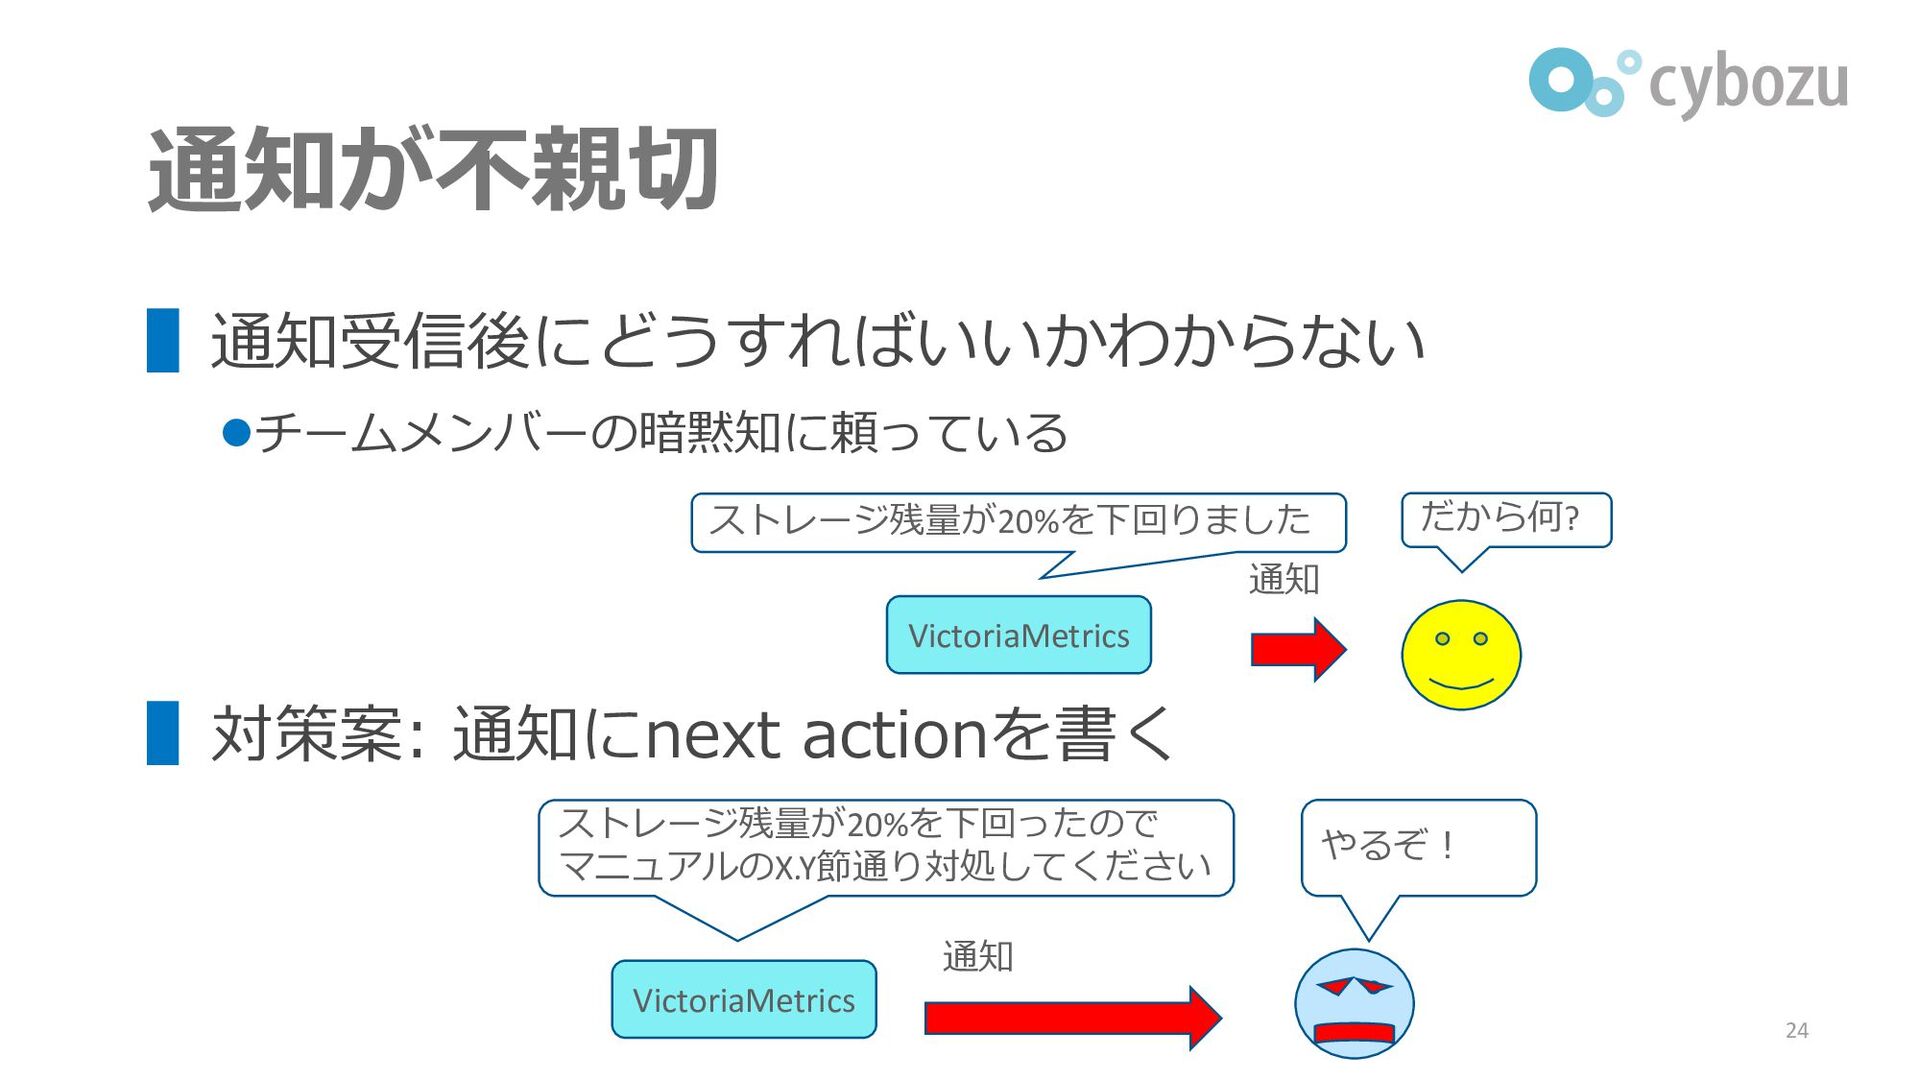
通知が不親切 ▌通知受信後にどうすればいいかわからない ⚫チームメンバーの暗黙知に頼っている ▌対策案: 通知にnext actionを書く 24 VictoriaMetrics ストレージ残量が20%を下回りました だから何?
通知 VictoriaMetrics ストレージ残量が20%を下回ったので マニュアルのX.Y節通り対処してください やるぞ! 通知
もくじ 25 ▌前提知識 ▌サイボウズの監視/ログ基盤 ▌工夫点と課題 ▌実用例
事例: オブジェクトストレージのアクセス障害 ▌前提 ⚫CephはRGWというオブジェクトストレージを提供 ▌問題 ⚫RGWにアクセスできなくなった ▌検出方法 ⚫RGW podの異常終了を示す通知が定期的に発生 26
ダッシュボードの確認 ▌アラート発生時からオブジェクト数が増えていない 27 オブジェクト数→ 時間→ オブジェクト数→ 時間→ 正常時 問題発生時
原因の候補 ▌RGW Pod自らが終了 ⚫何らかのエラーによって異常終了 ▌外部からの強制終了 ⚫例: K8sのprobeへの無応答が続くとシグナルによって強制終了 28
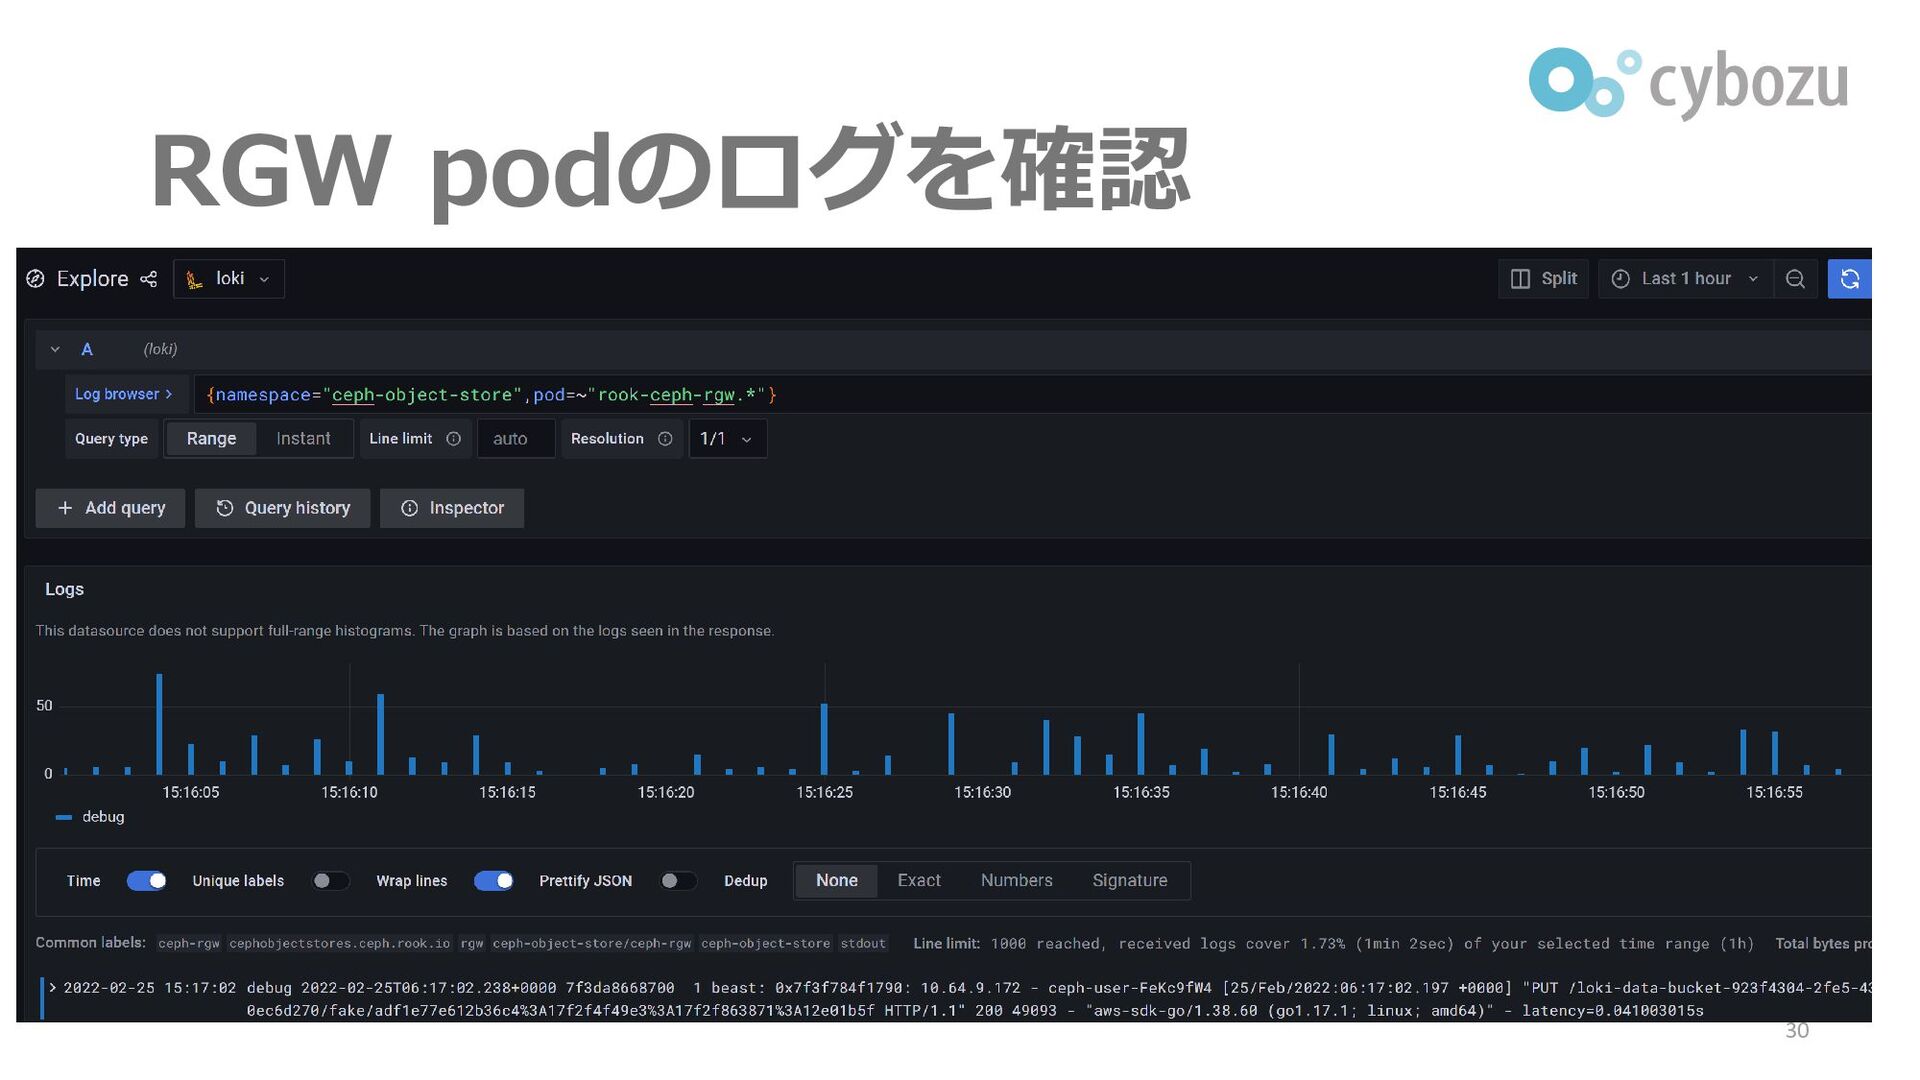
切り分け ▌RGW Pod強制終了時のログを見れば何かわかるはず ⚫RGW Podが自ら終了: エラーログが残る ⚫外部から強制終了: シグナル受信ログが残る ▌幸運: Loki上の直近のログだけは見られる
⚫LokiのストレージはCeph上に保存 ⚫古いログはRGWに保存 ⚫直近のデータはブロックデバイスに保存 29
RGW podのログを確認 30
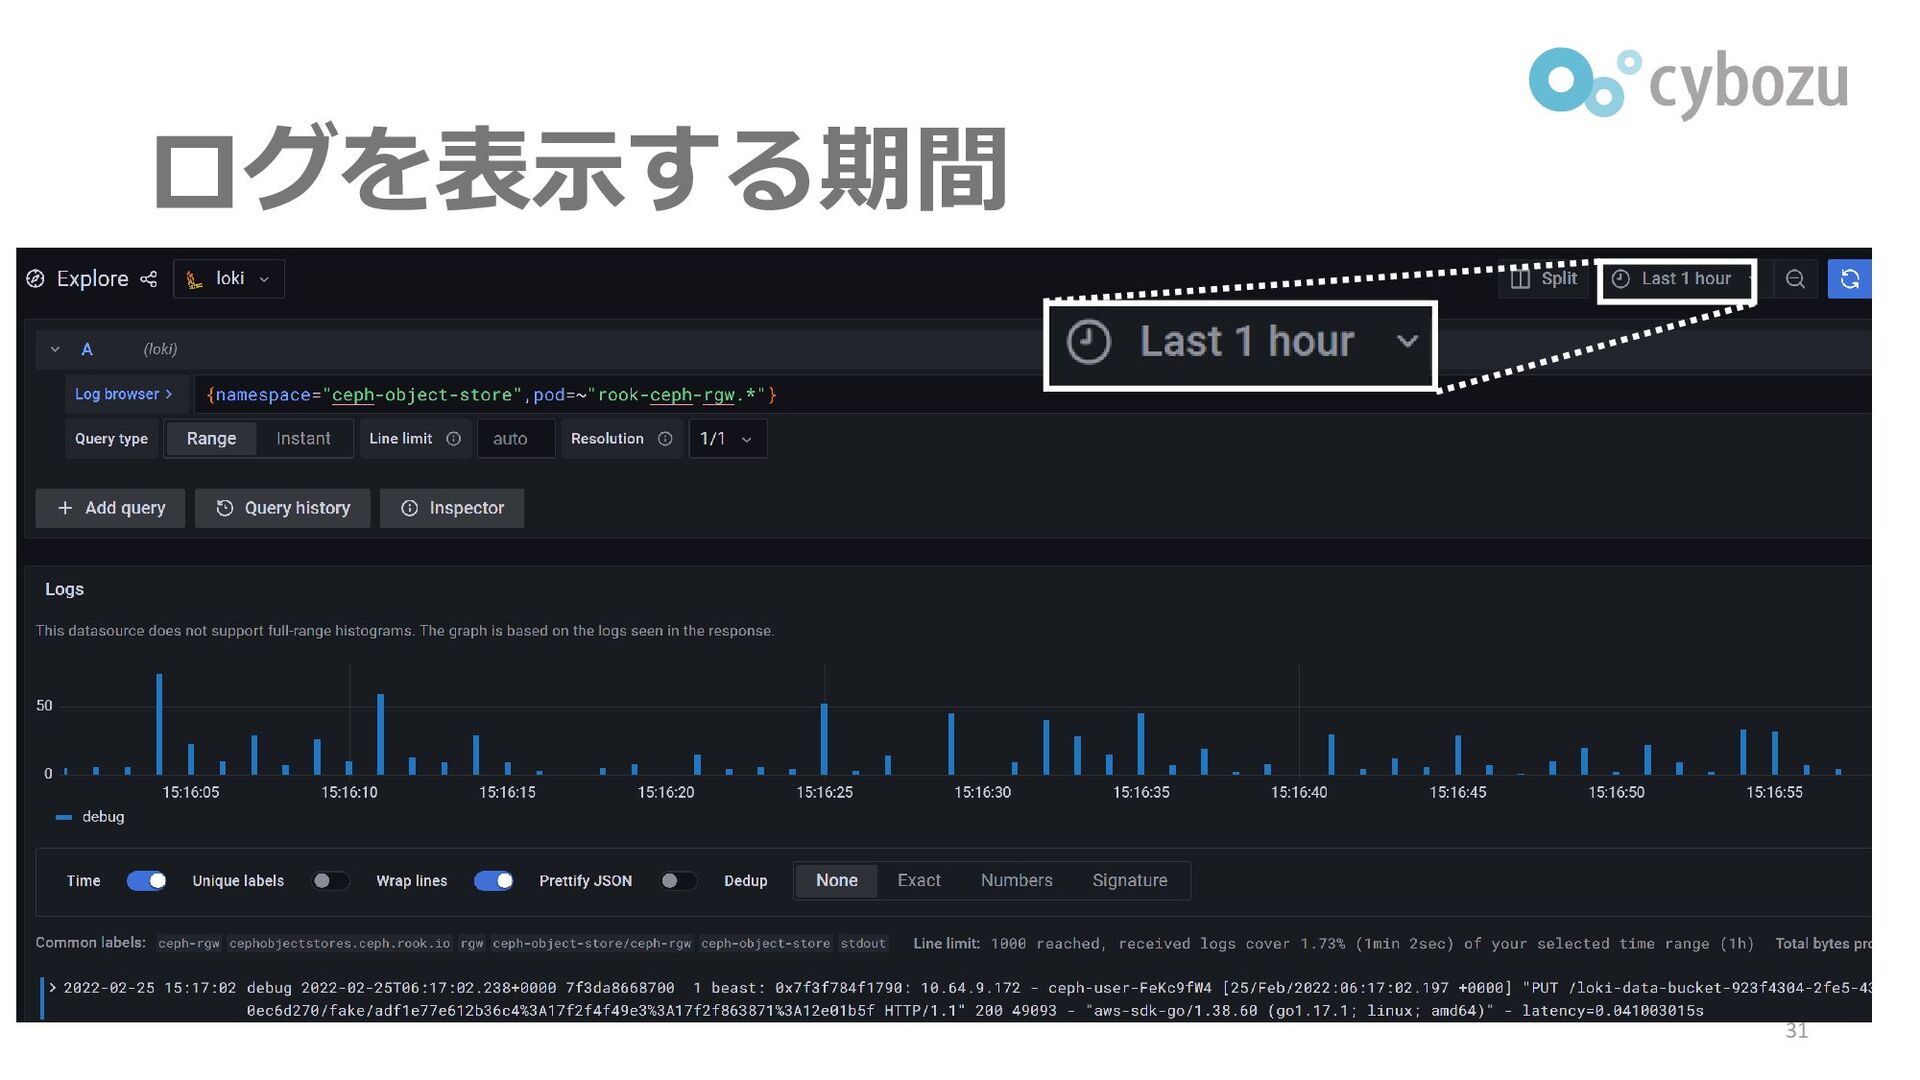
ログを表示する期間 31
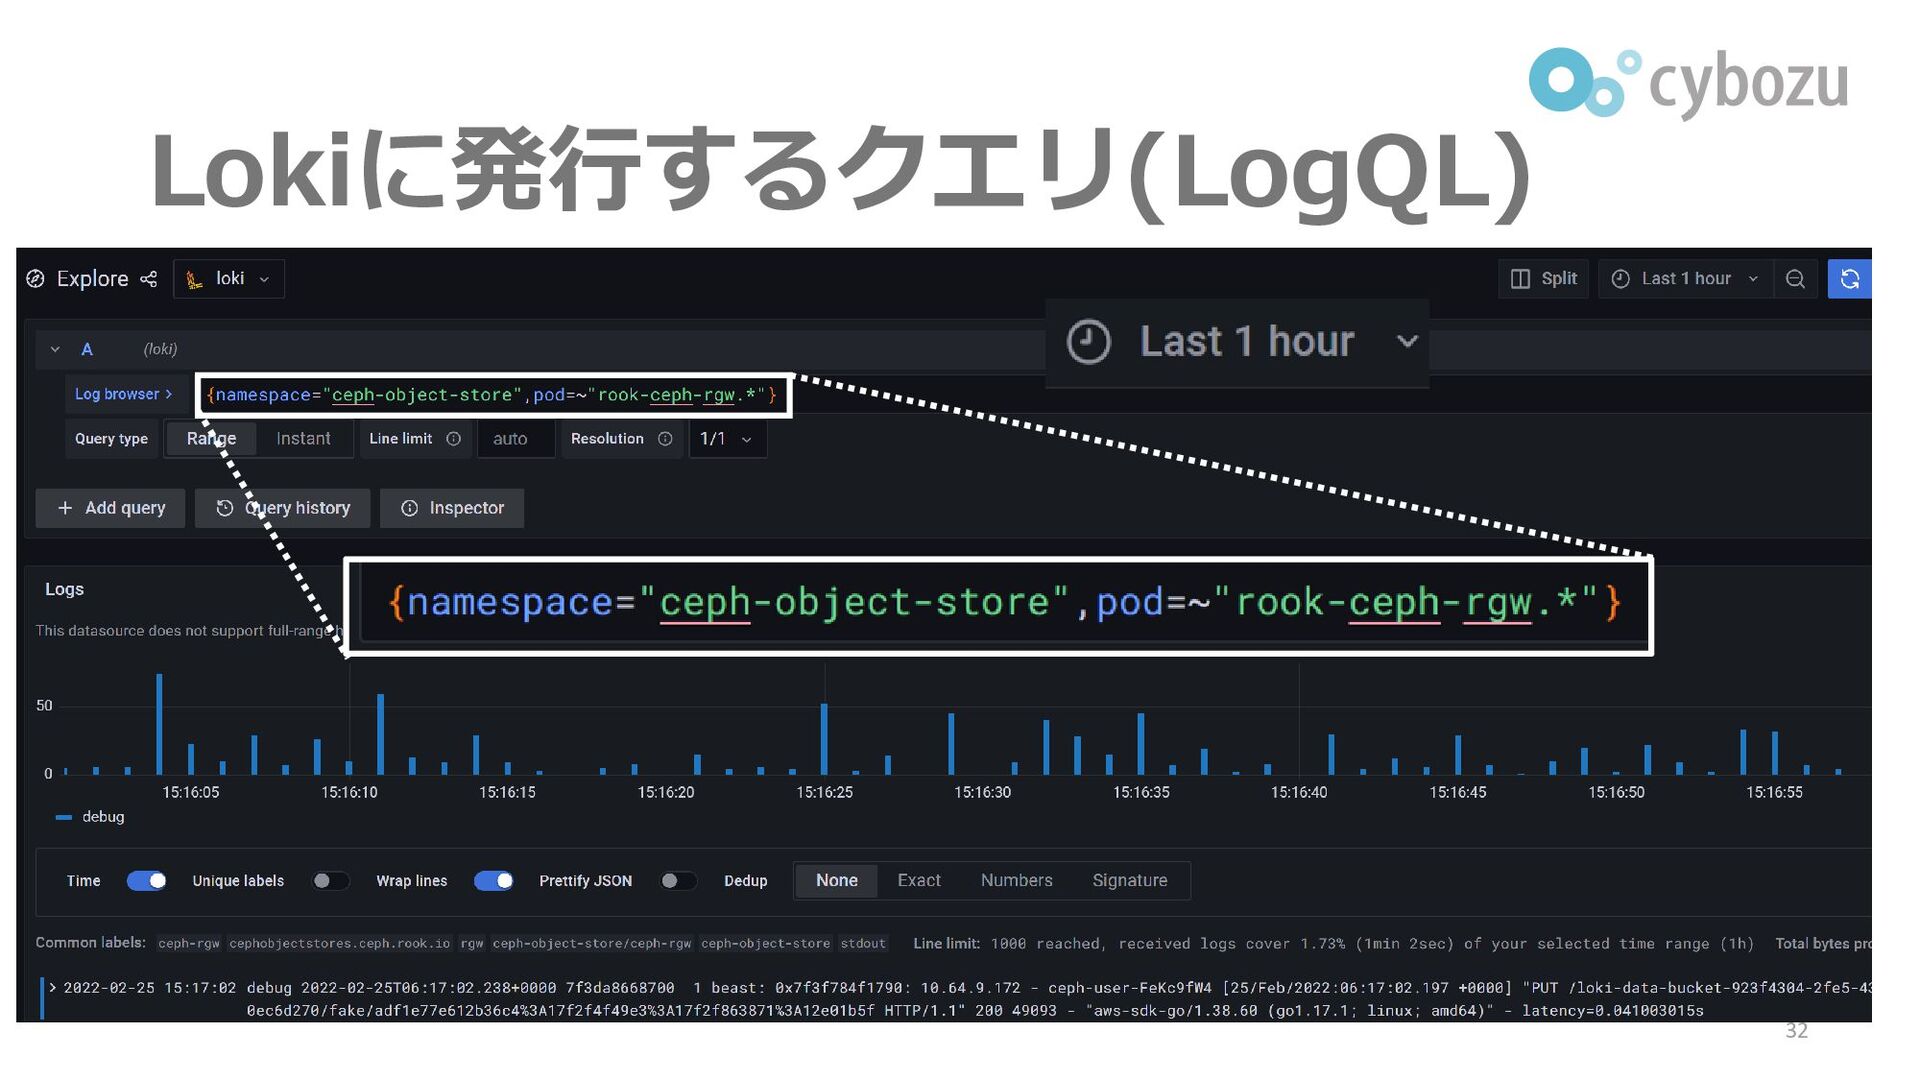
Lokiに発行するクエリ(LogQL) 32
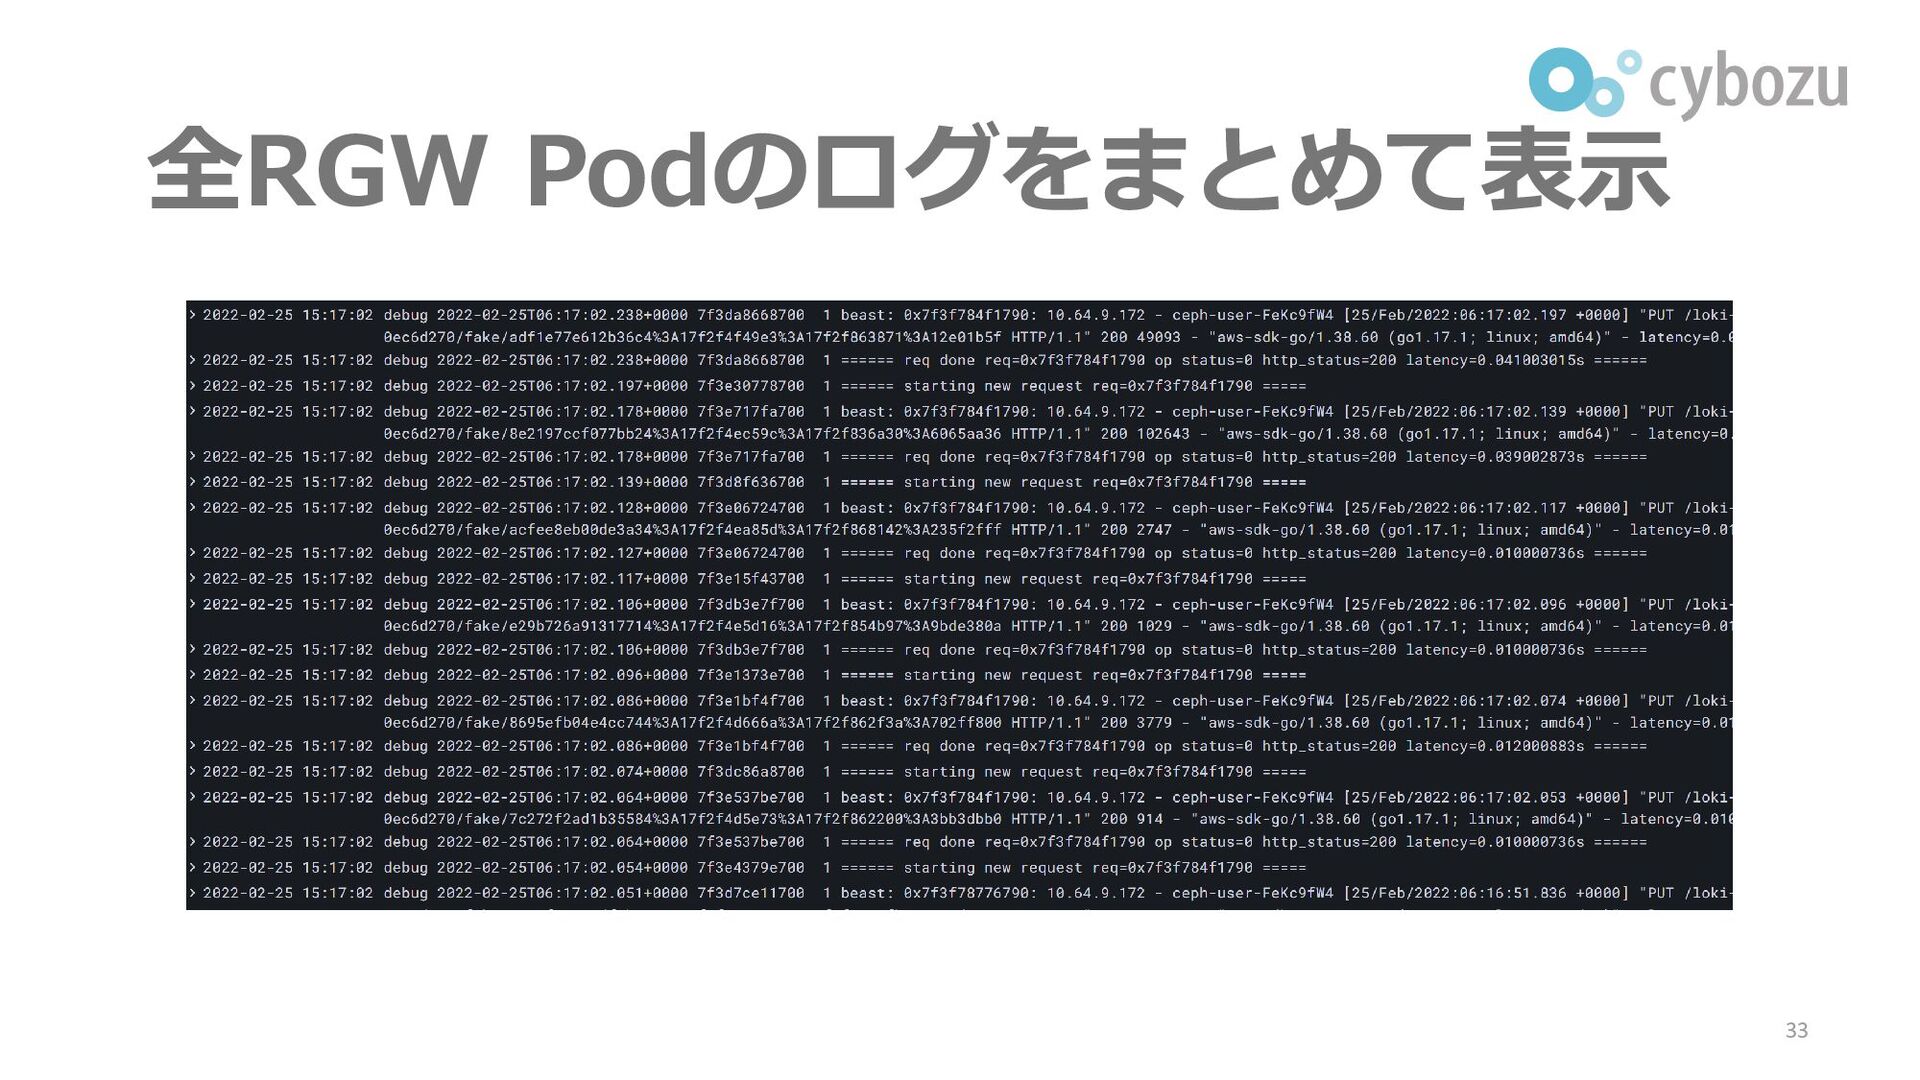
全RGW Podのログをまとめて表示 33
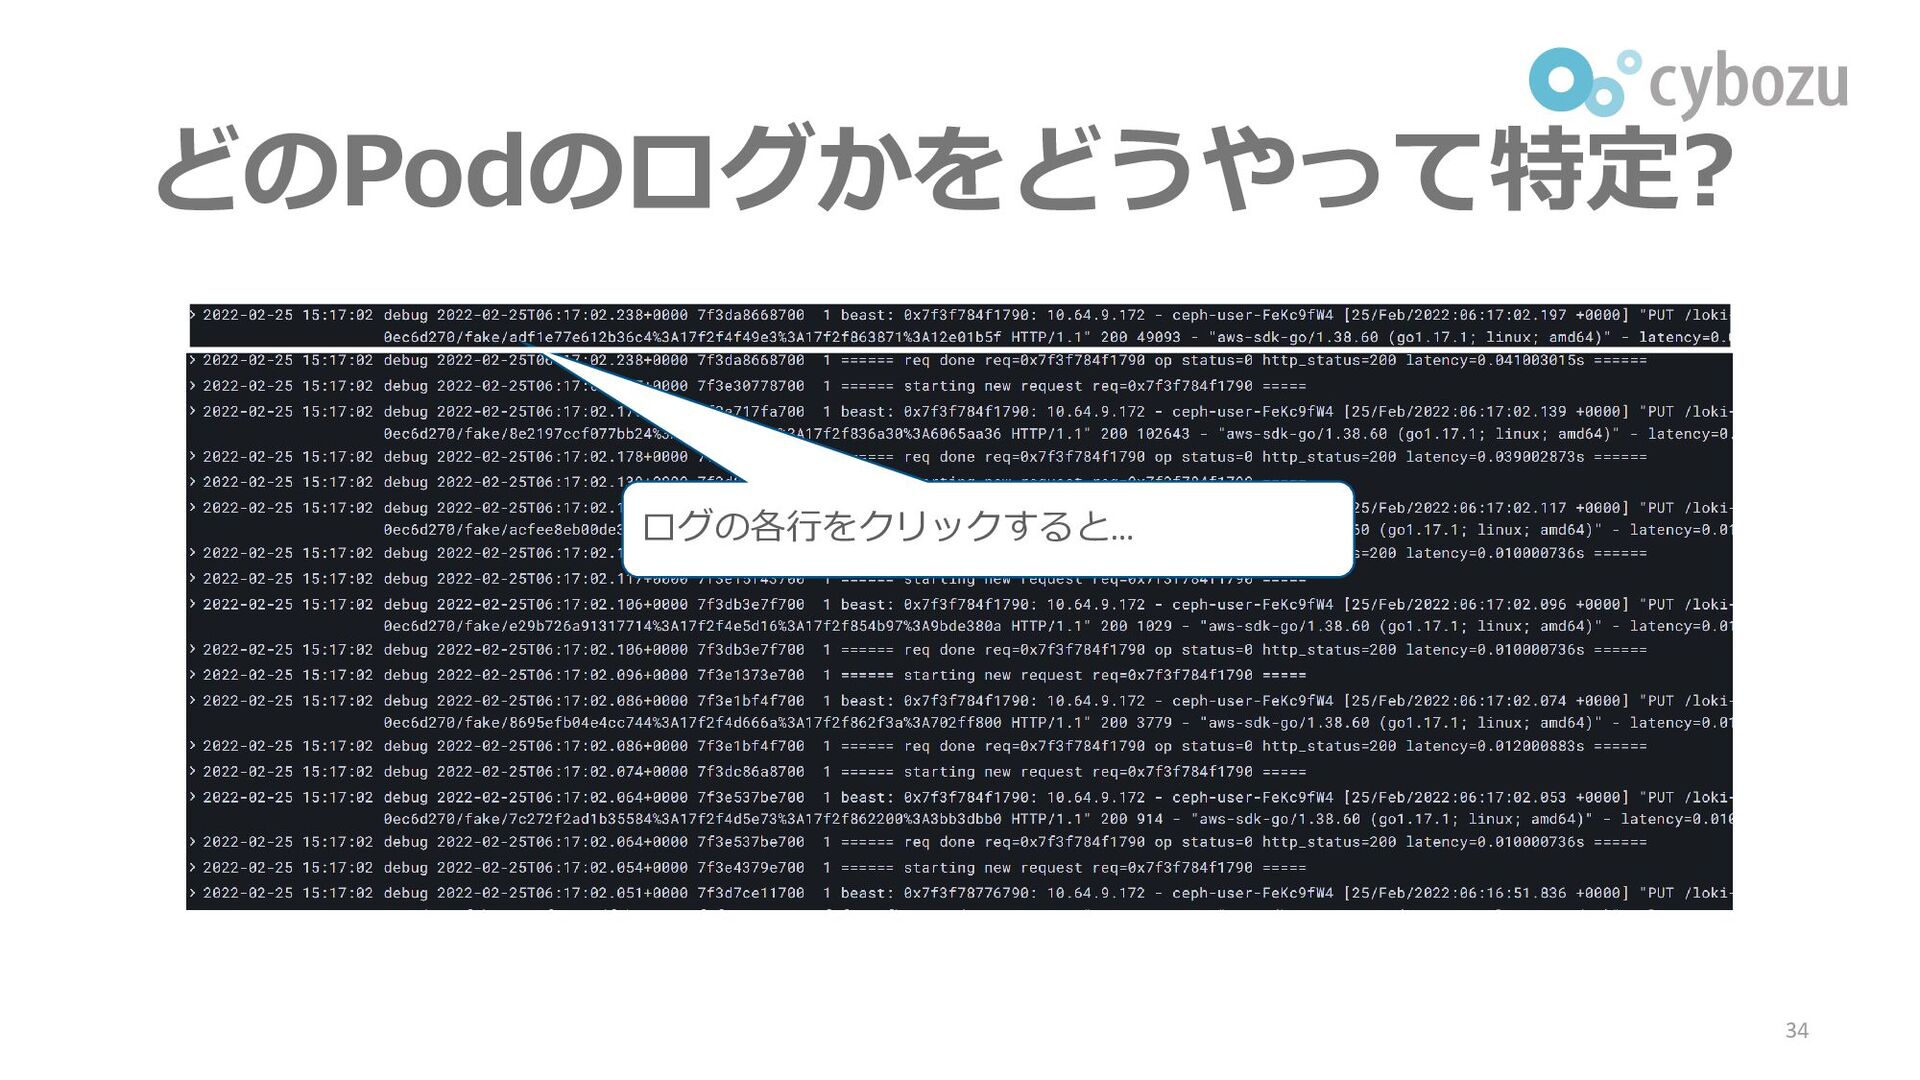
どのPodのログかをどうやって特定? 34 ログの各行をクリックすると…
行をクリックすると詳細情報が出る 35
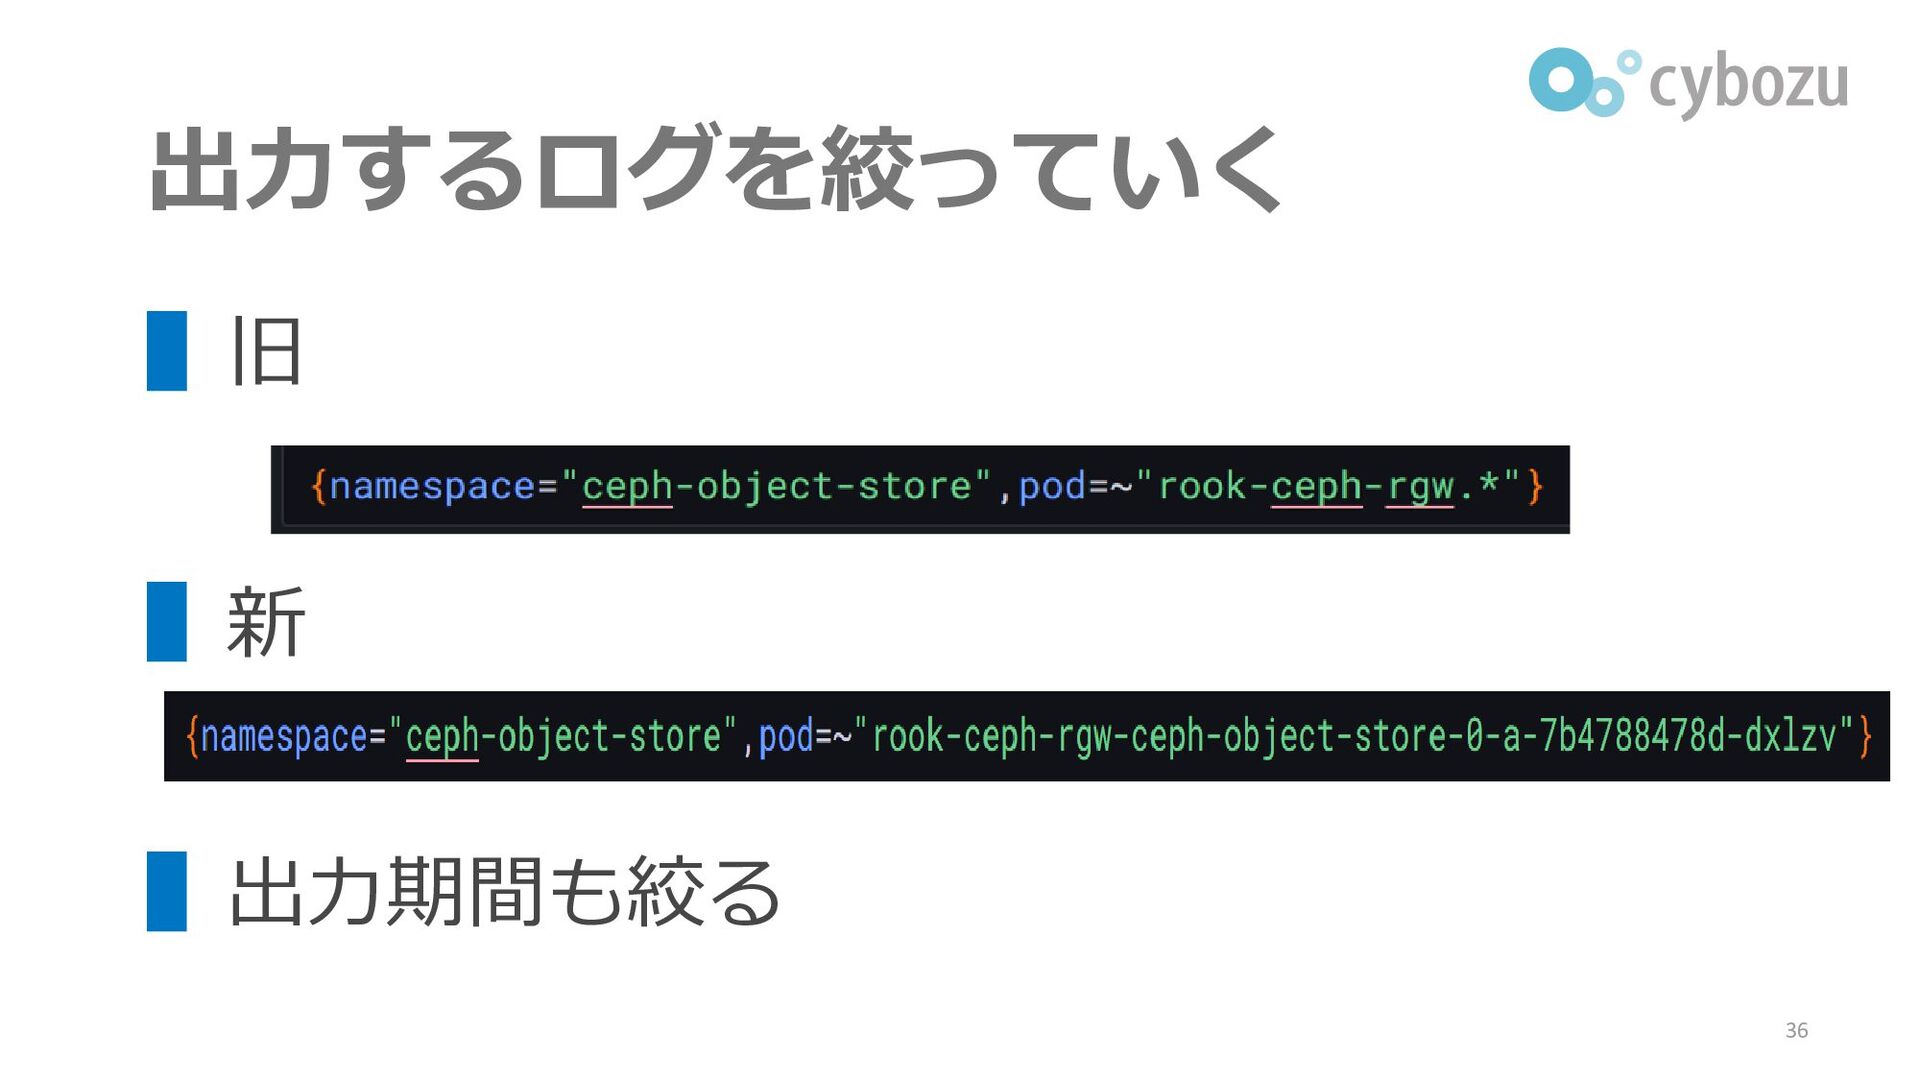
出力するログを絞っていく ▌旧 ▌新 ▌出力期間も絞る 36
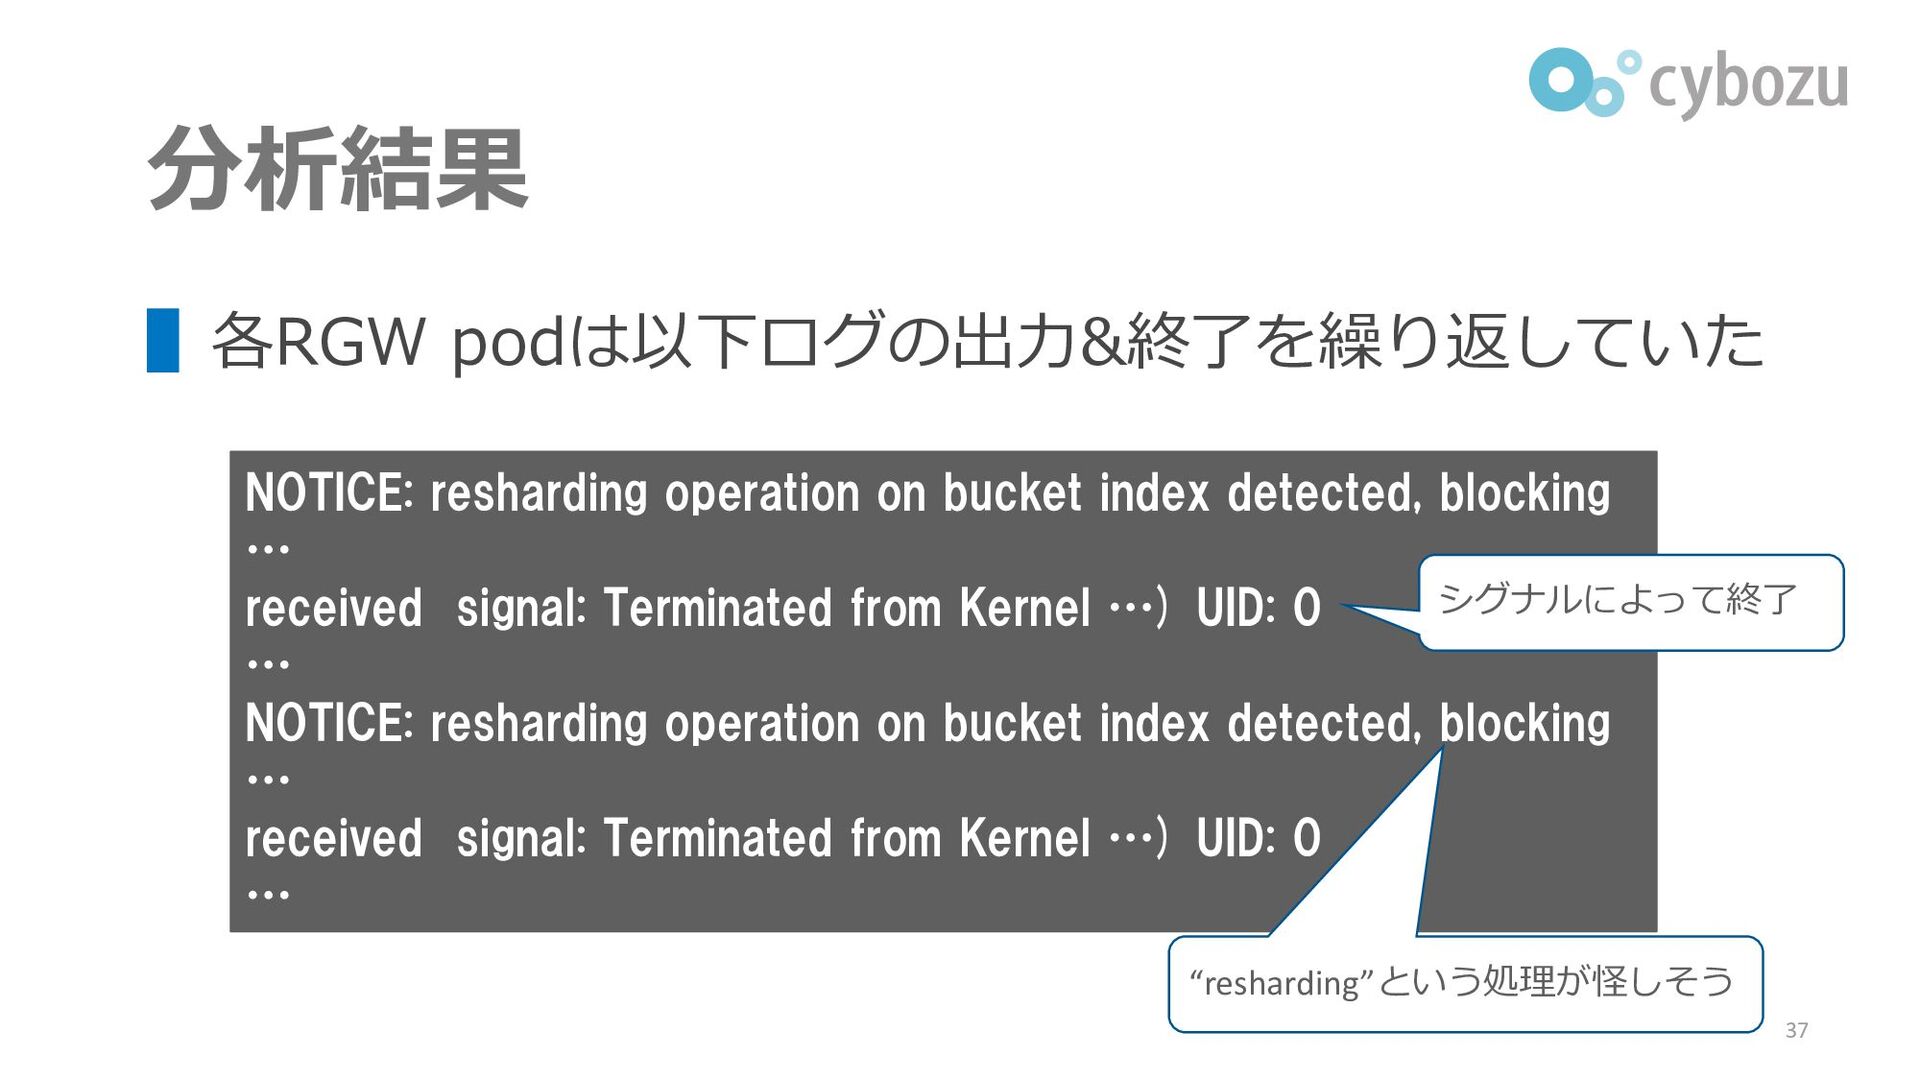
分析結果 ▌各RGW podは以下ログの出力&終了を繰り返していた NOTICE: resharding operation on bucket index detected,
blocking … received signal: Terminated from Kernel …) UID: 0 … NOTICE: resharding operation on bucket index detected, blocking … received signal: Terminated from Kernel …) UID: 0 … 37 “resharding”という処理が怪しそう シグナルによって終了
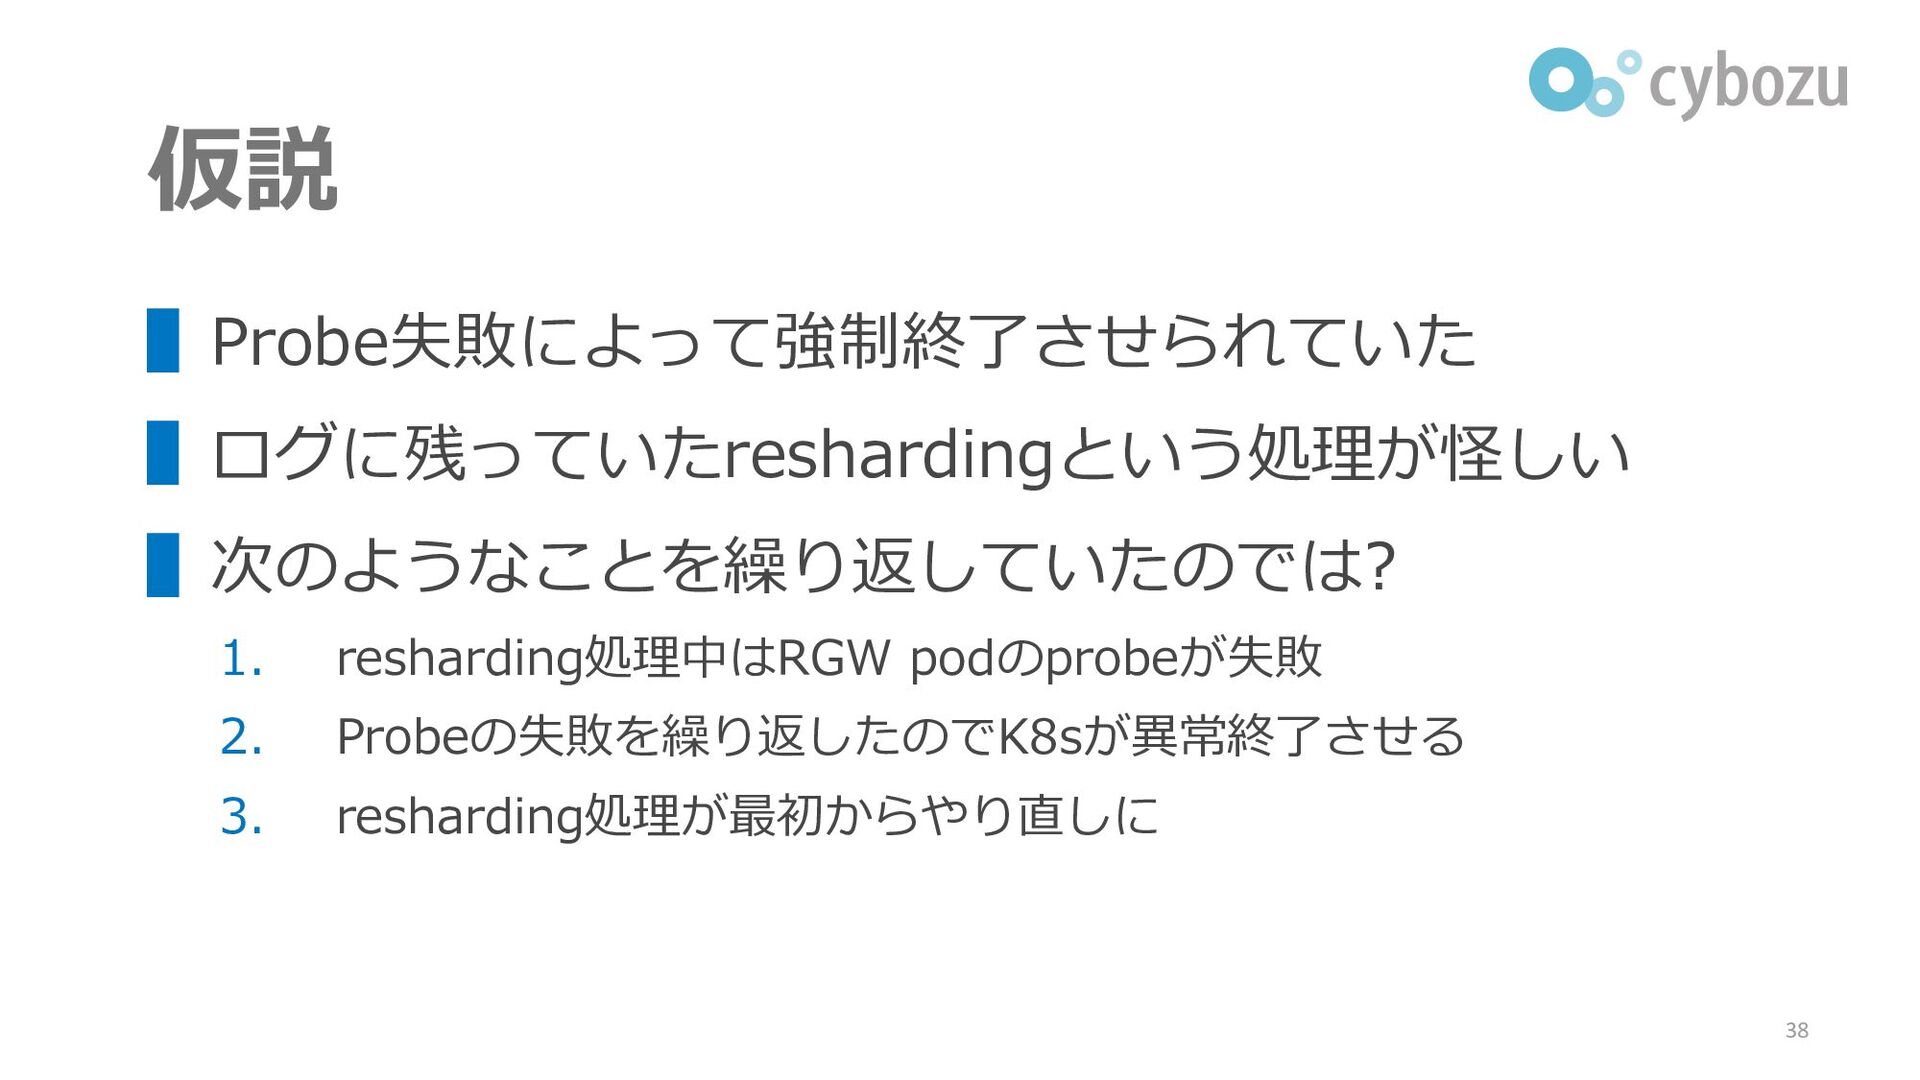
仮説 ▌Probe失敗によって強制終了させられていた ▌ログに残っていたreshardingという処理が怪しい ▌次のようなことを繰り返していたのでは? 1. resharding処理中はRGW podのprobeが失敗 2. Probeの失敗を繰り返したのでK8sが異常終了させる 3.
resharding処理が最初からやり直しに 38
その後の流れ ▌仮説は正しかった ⚫K8sのlivenessProbeが失敗し続けていた ▌詳細は別スライドを参照 ⚫ https://speakerdeck.com/sat/kubernetesshi-jian-toraburusiyuteingu 39
振り返り: よかったこと ▌監視と通知によって問題を早期検出できた ⚫無ければユーザからのクレームまで気づけなかった可能性も ▌ダッシュボードにより問題の概要が一目でわかった ▌メトリクスとログからトラシューの仮説が立てられた ⚫仮説の検証にも役立った 40
振り返り: 改善すべきこと ▌Cephクラスタ専用のLokiが欲しい ▌今回は偶然に助けられた ⚫直近のログにアクセスできなければ調査はさらに難航した ▌次はこうはいかないかもしれない 41
これまでの経験を踏まえたTIPS ▌オブザーバビリティ向上の肝は改善の繰り返し ⚫まずは単純な監視/ログ基盤を作る ⚫使い込んで、不備があれば改善 ▌定期的なダッシュボードのチェック重要 ⚫「何が正常か」が肌感覚でわかる ▌一度監視/ログ基盤を導入したら無い状態が想像できなくなる ⚫問題検知/トラシュー速度が全く違う ⚫可用性向上に投資を惜しまないほうがいい 42
おわり 43


 sat
 khiroyuki1003
 kworkdev
 ryuguyana
 oikon48
 cmusudakeisuke
 miso
 gotok365
 takanao
 ufried
 yama3133
 nekorush14
 hisuzuya
 keathley
 sergeychernyshev
 inesmontani
 stephenakadiri
 62gerente
 katarinadahlin
 bluesmoon
 andyhume
 sugarenia
 cassininazir
 holman
 gurzu