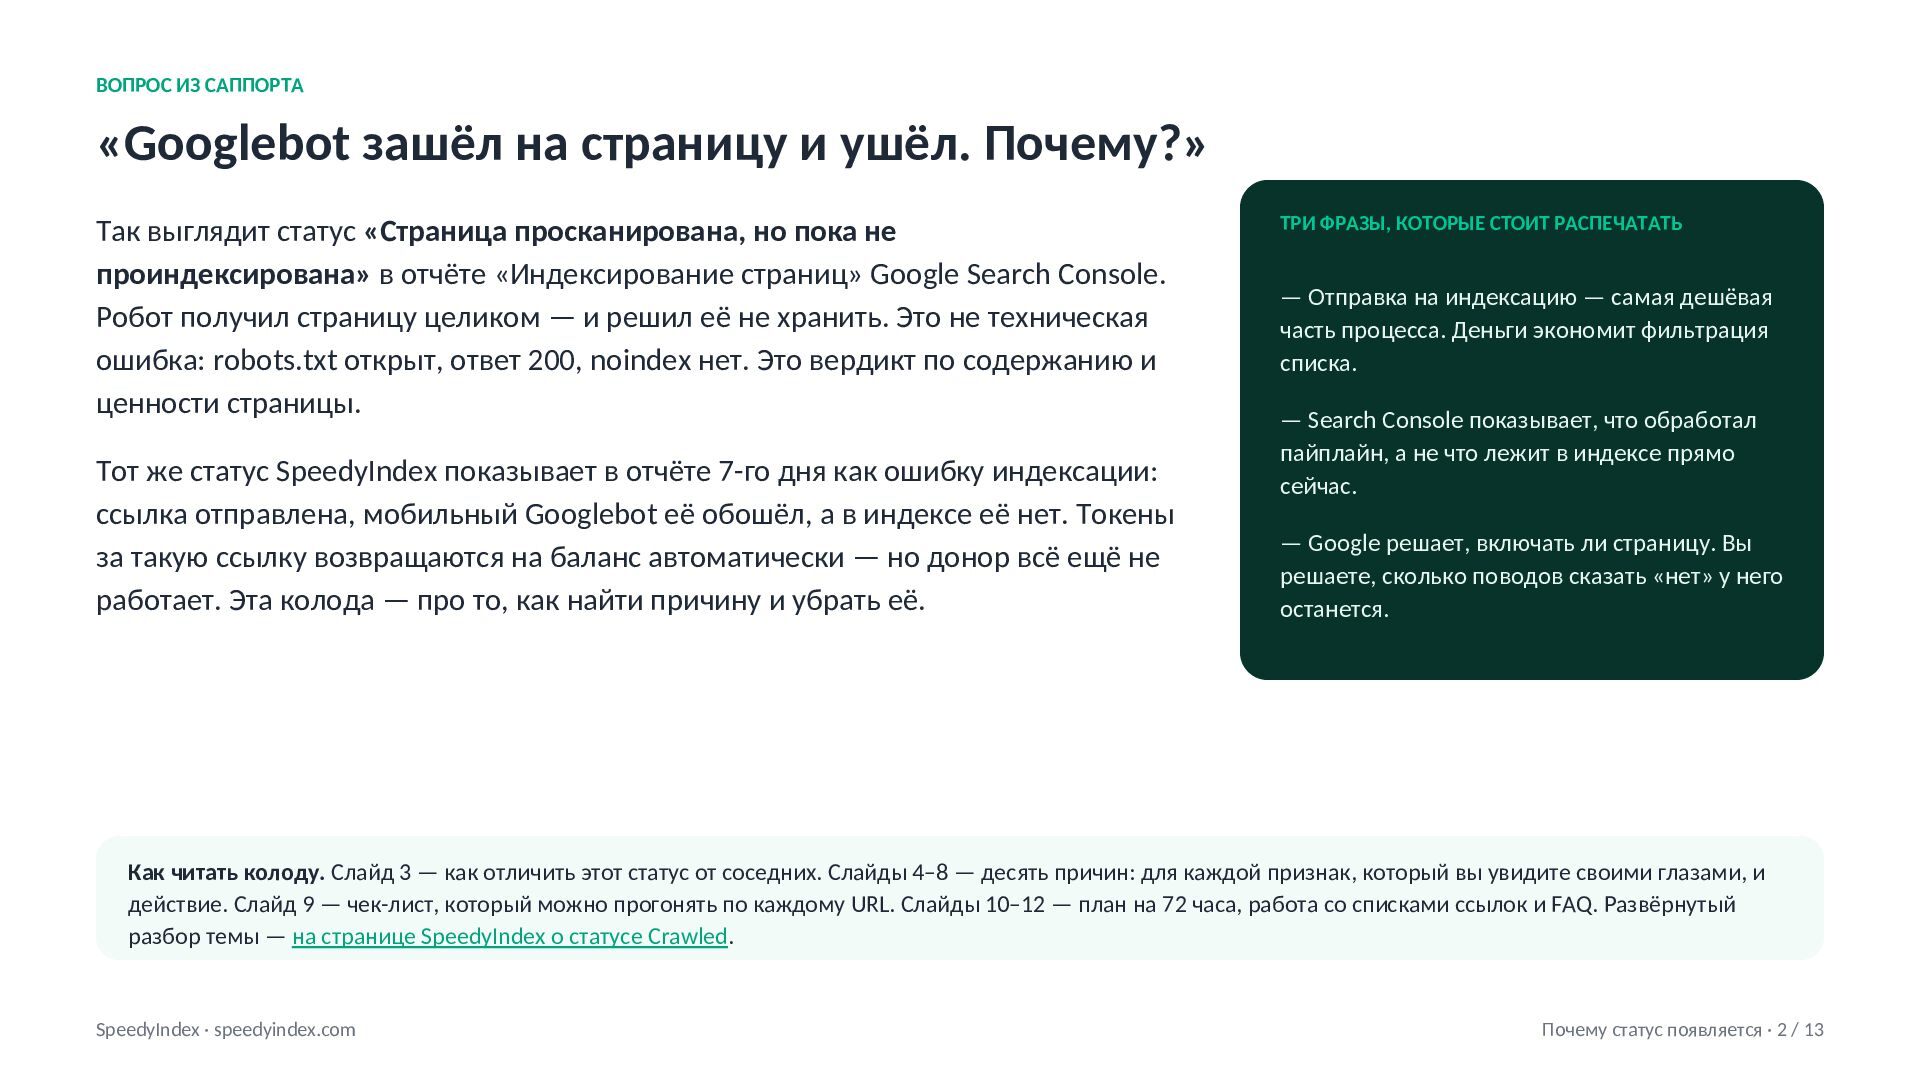
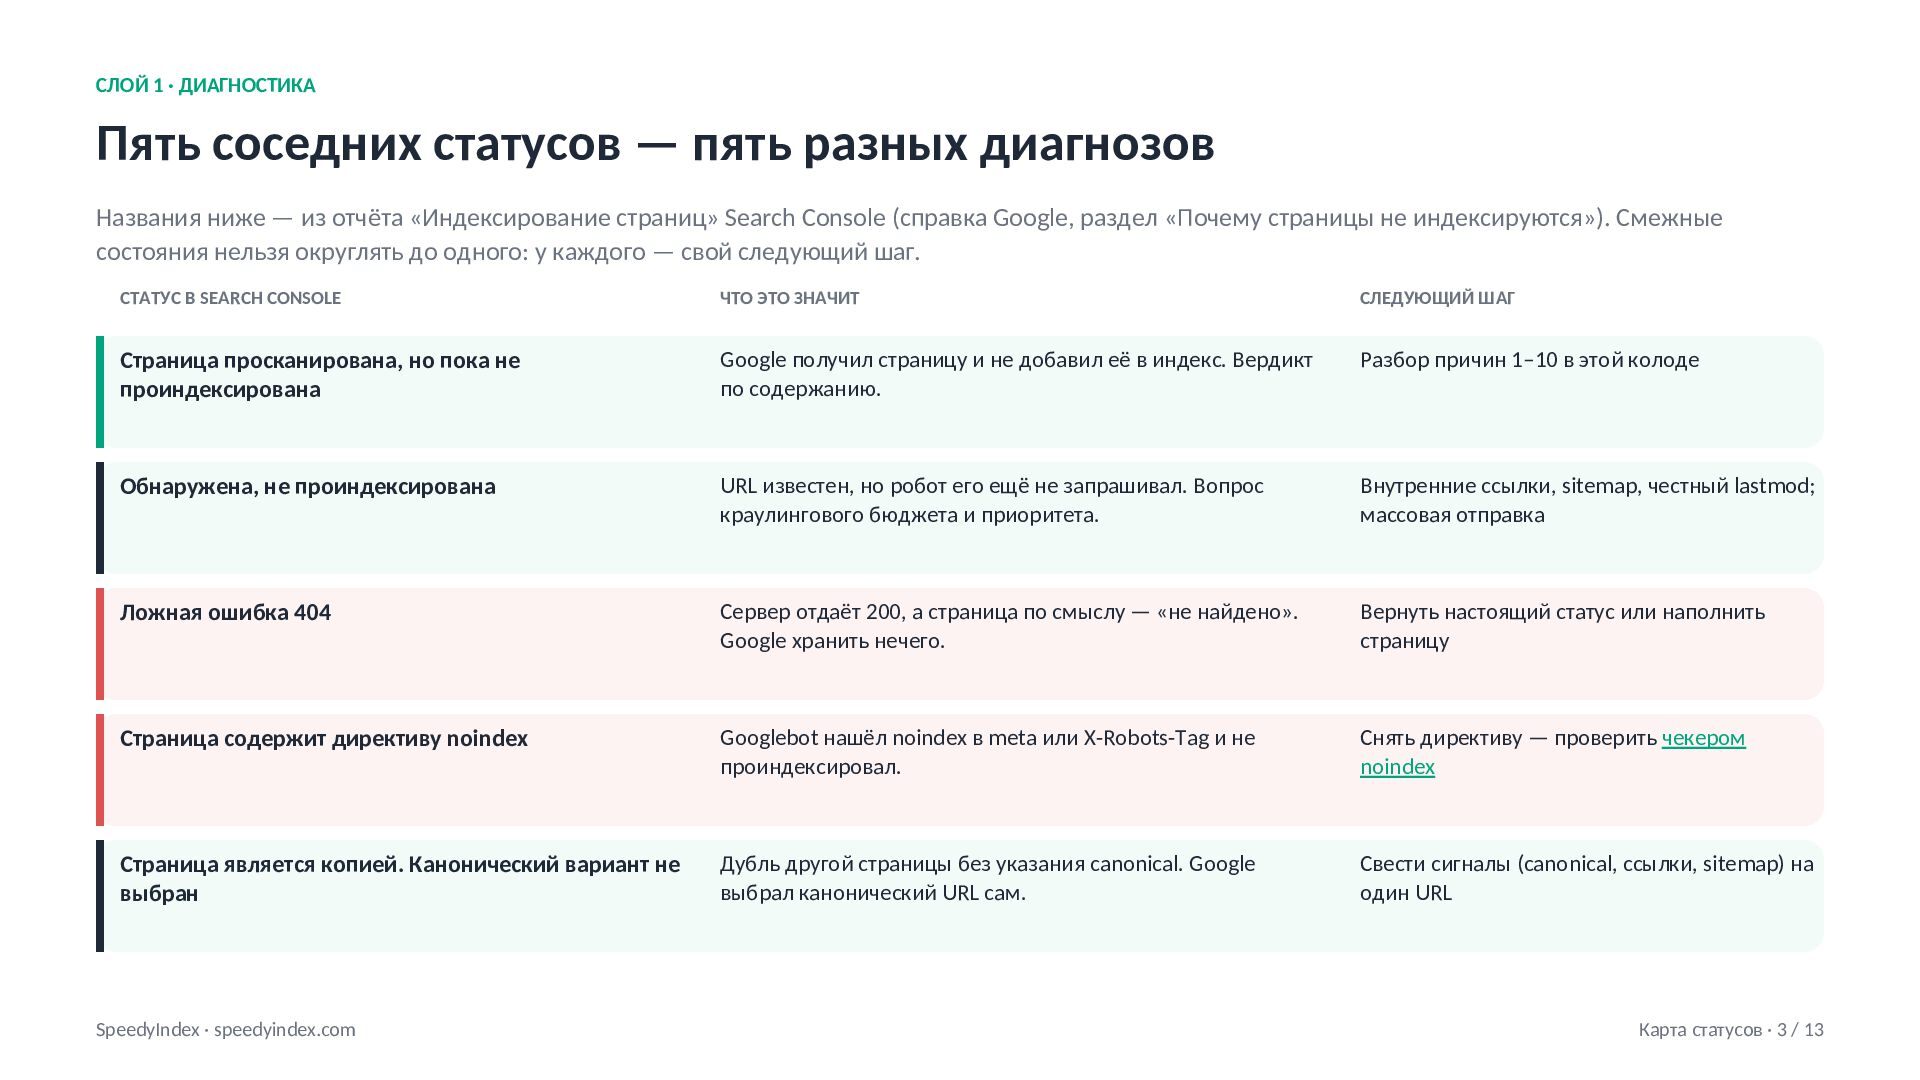
Почему Googlebot зашёл на страницу, скачал её целиком — и не добавил в индекс? Статус «Страница просканирована, но пока не проиндексирована» в отчёте Search Console не техническая ошибка: robots.txt открыт, ответ 200, noindex нет. Это вердикт по содержанию и ценности страницы, и лечится он иначе, чем «Обнаружена, не проиндексирована» или ложная ошибка 404.
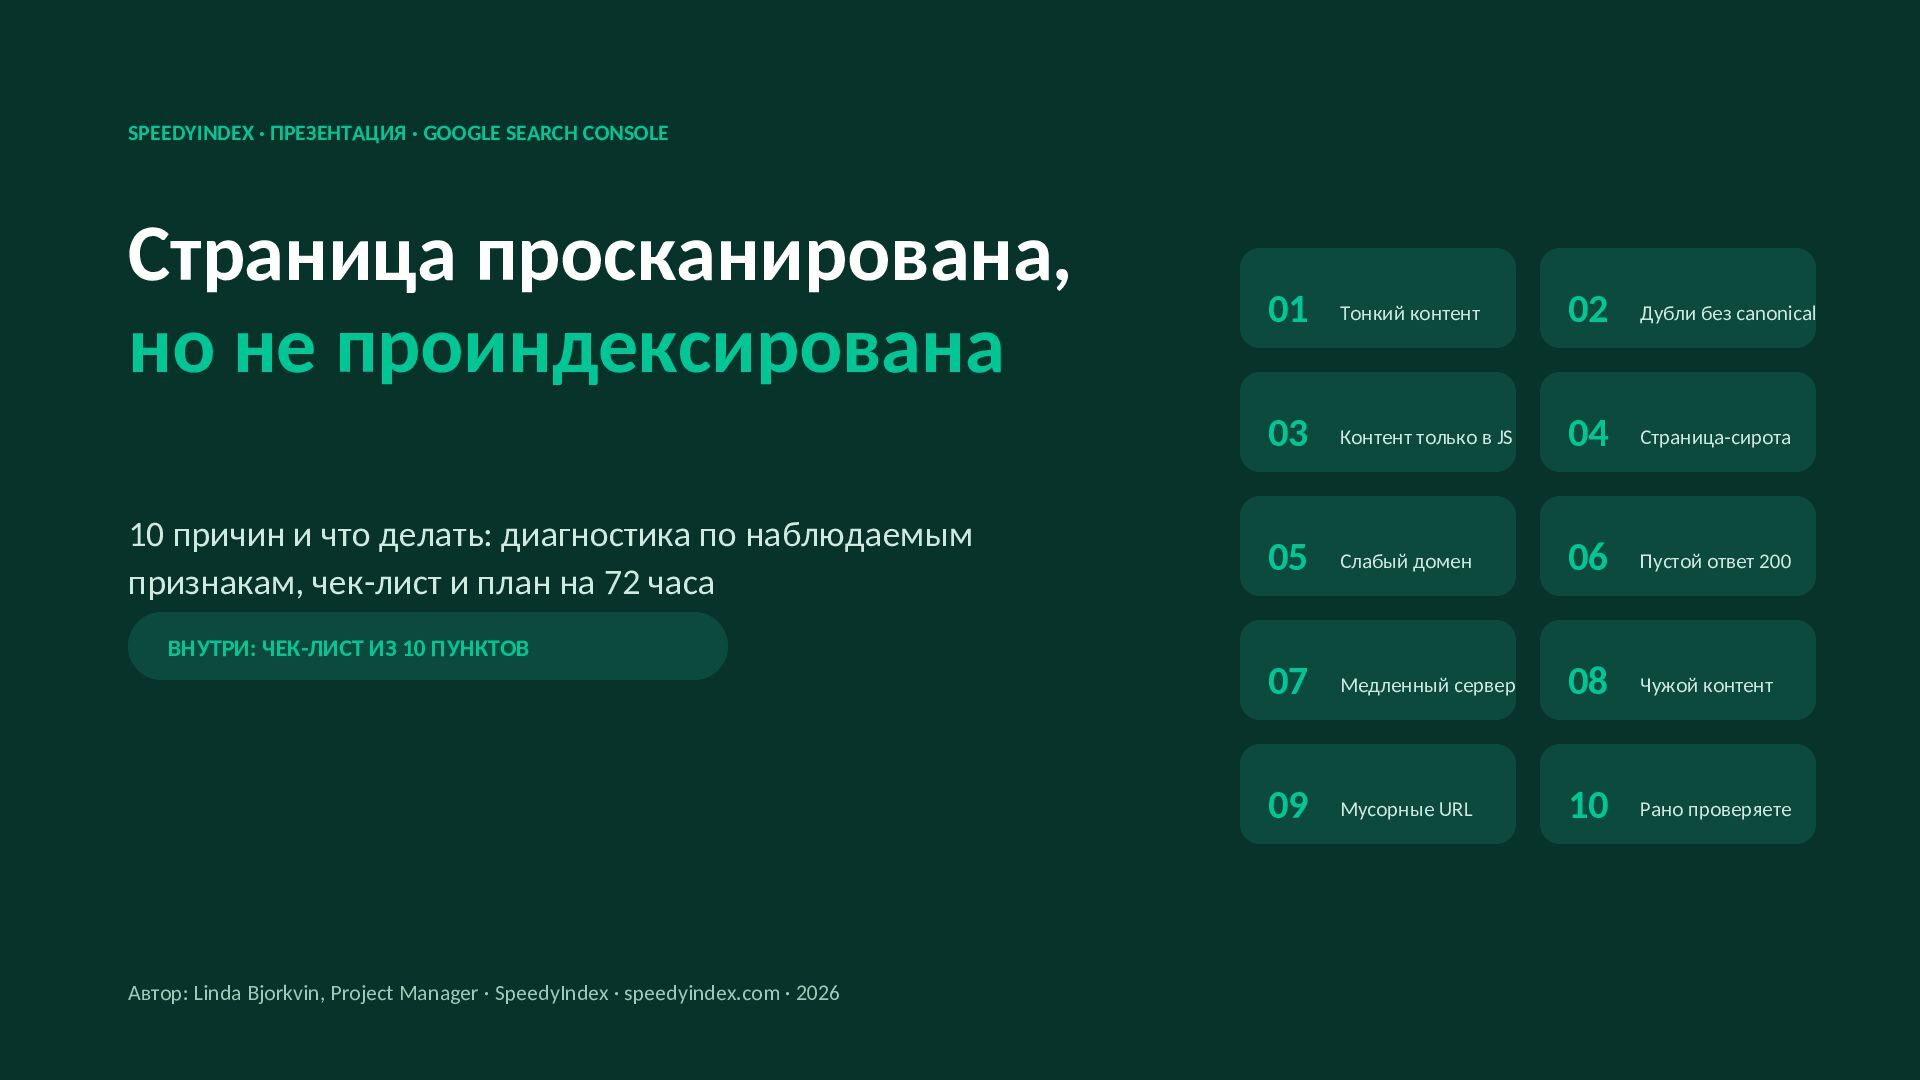
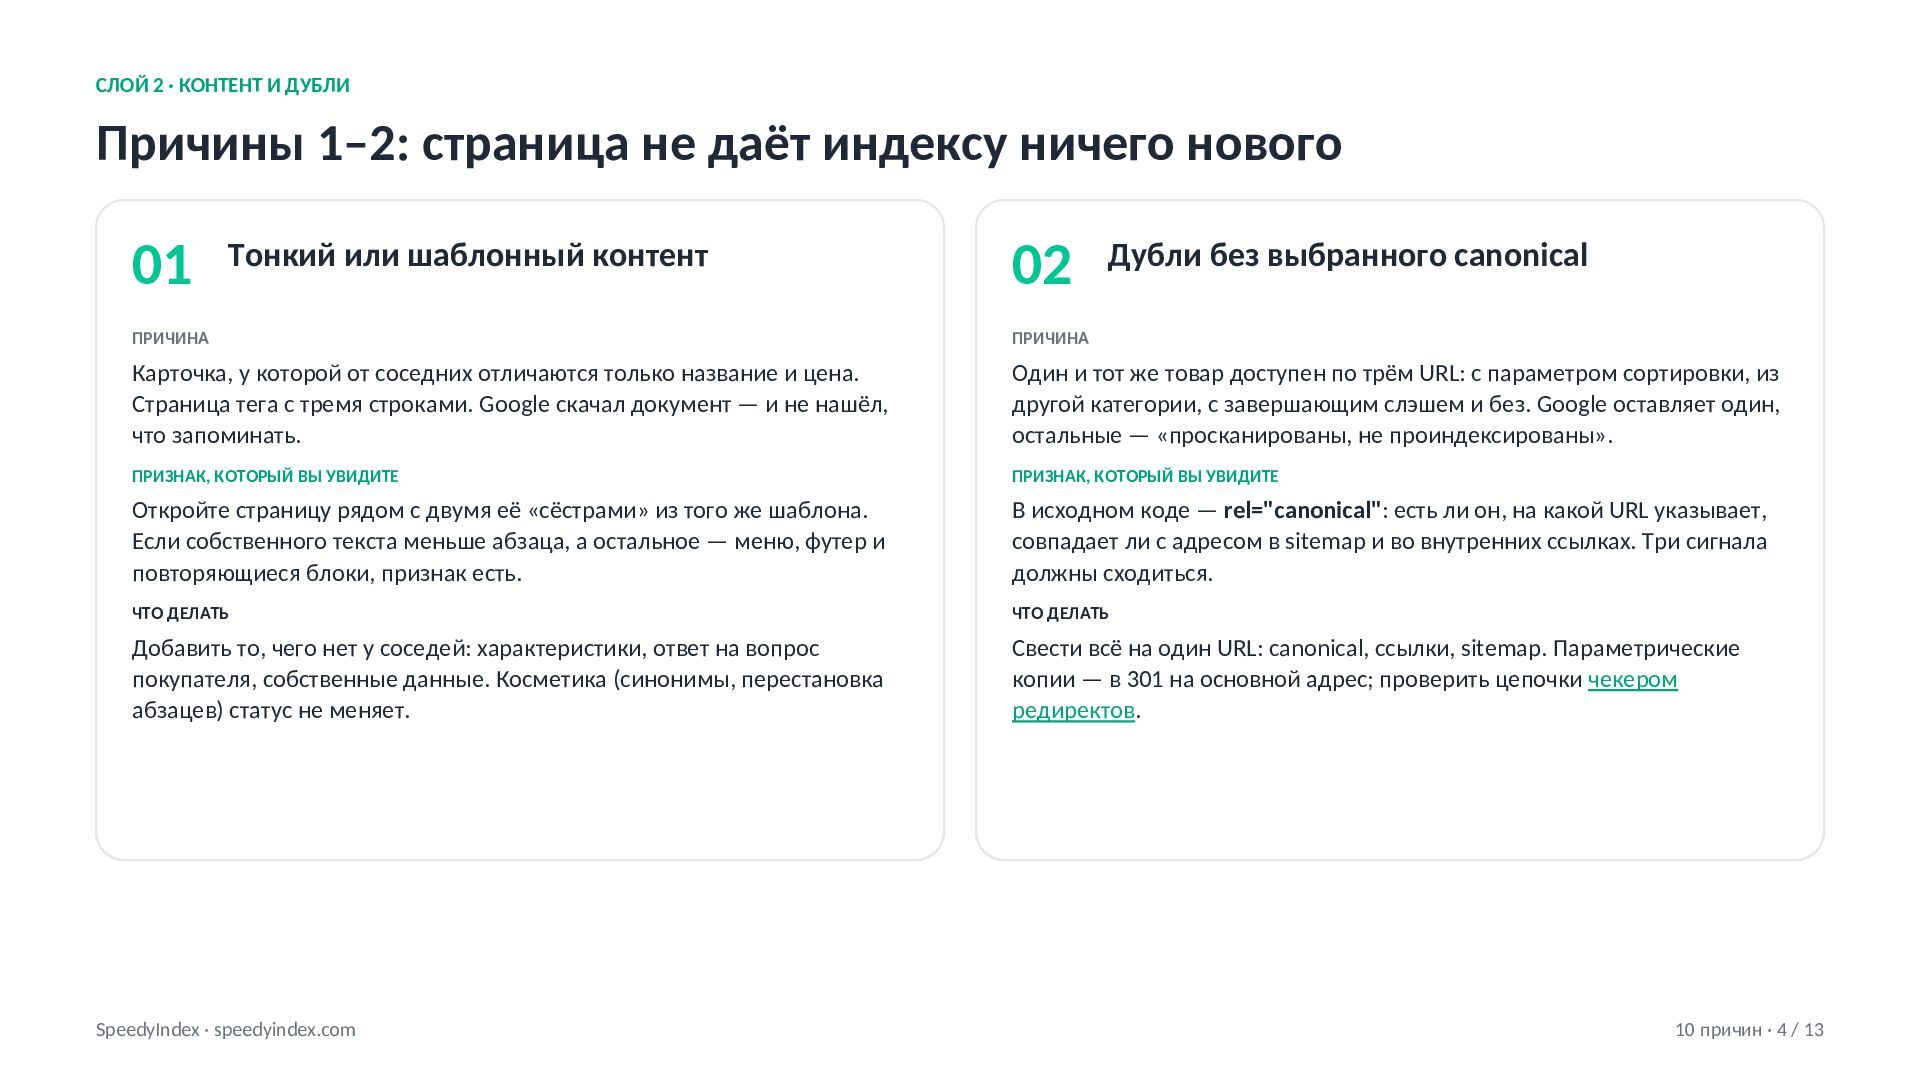
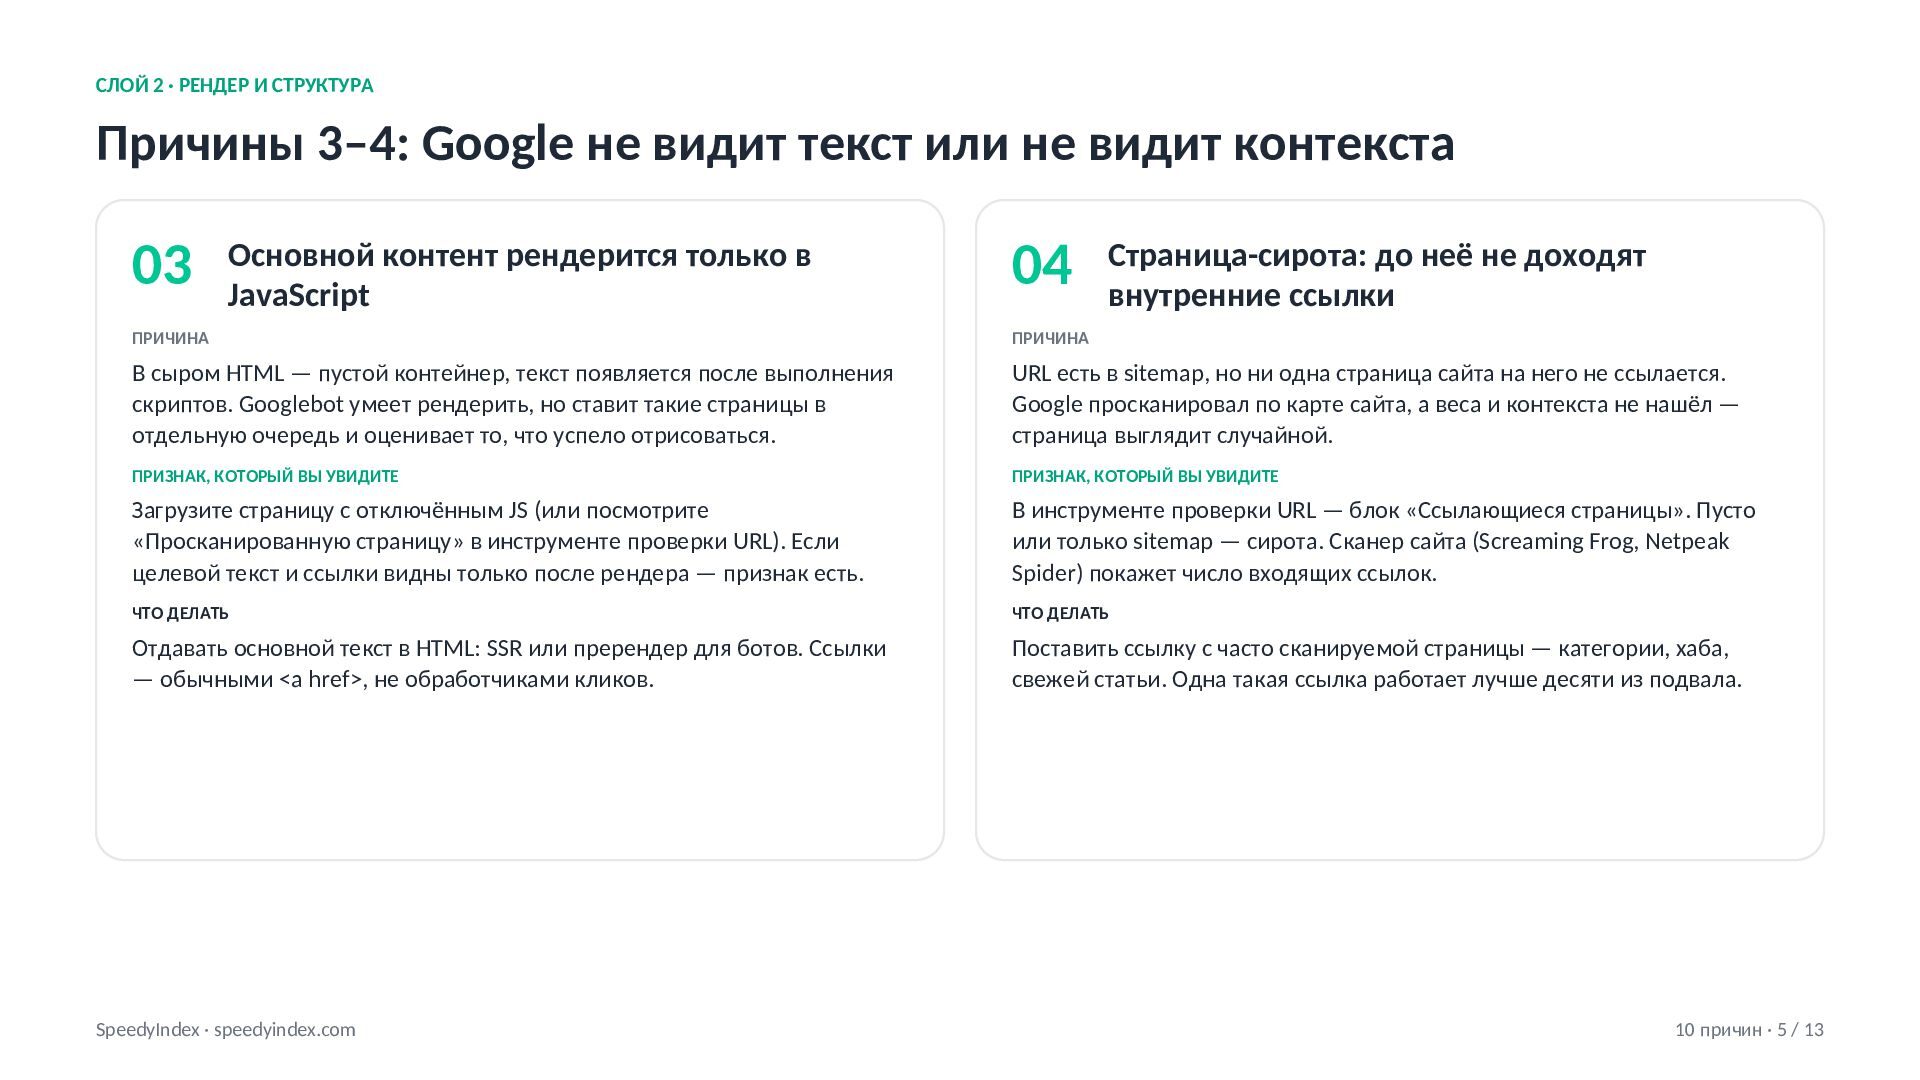
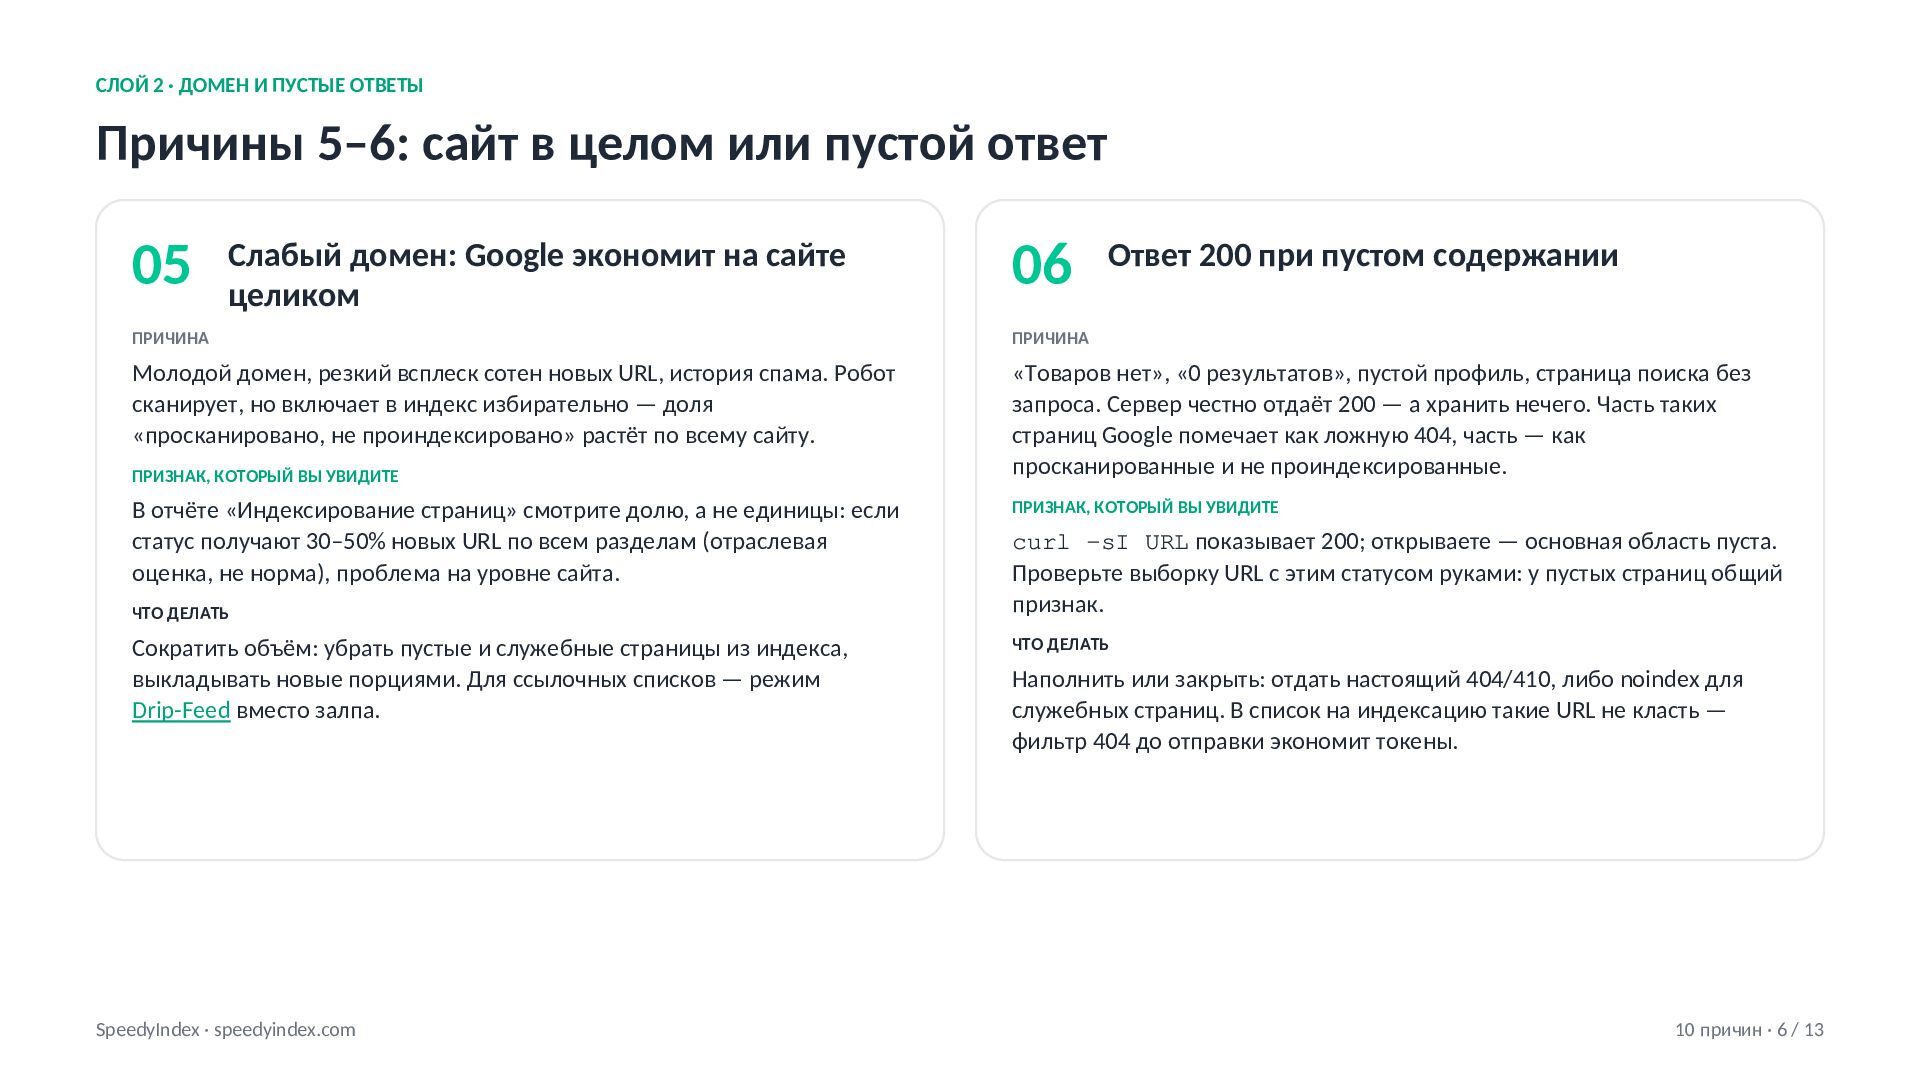
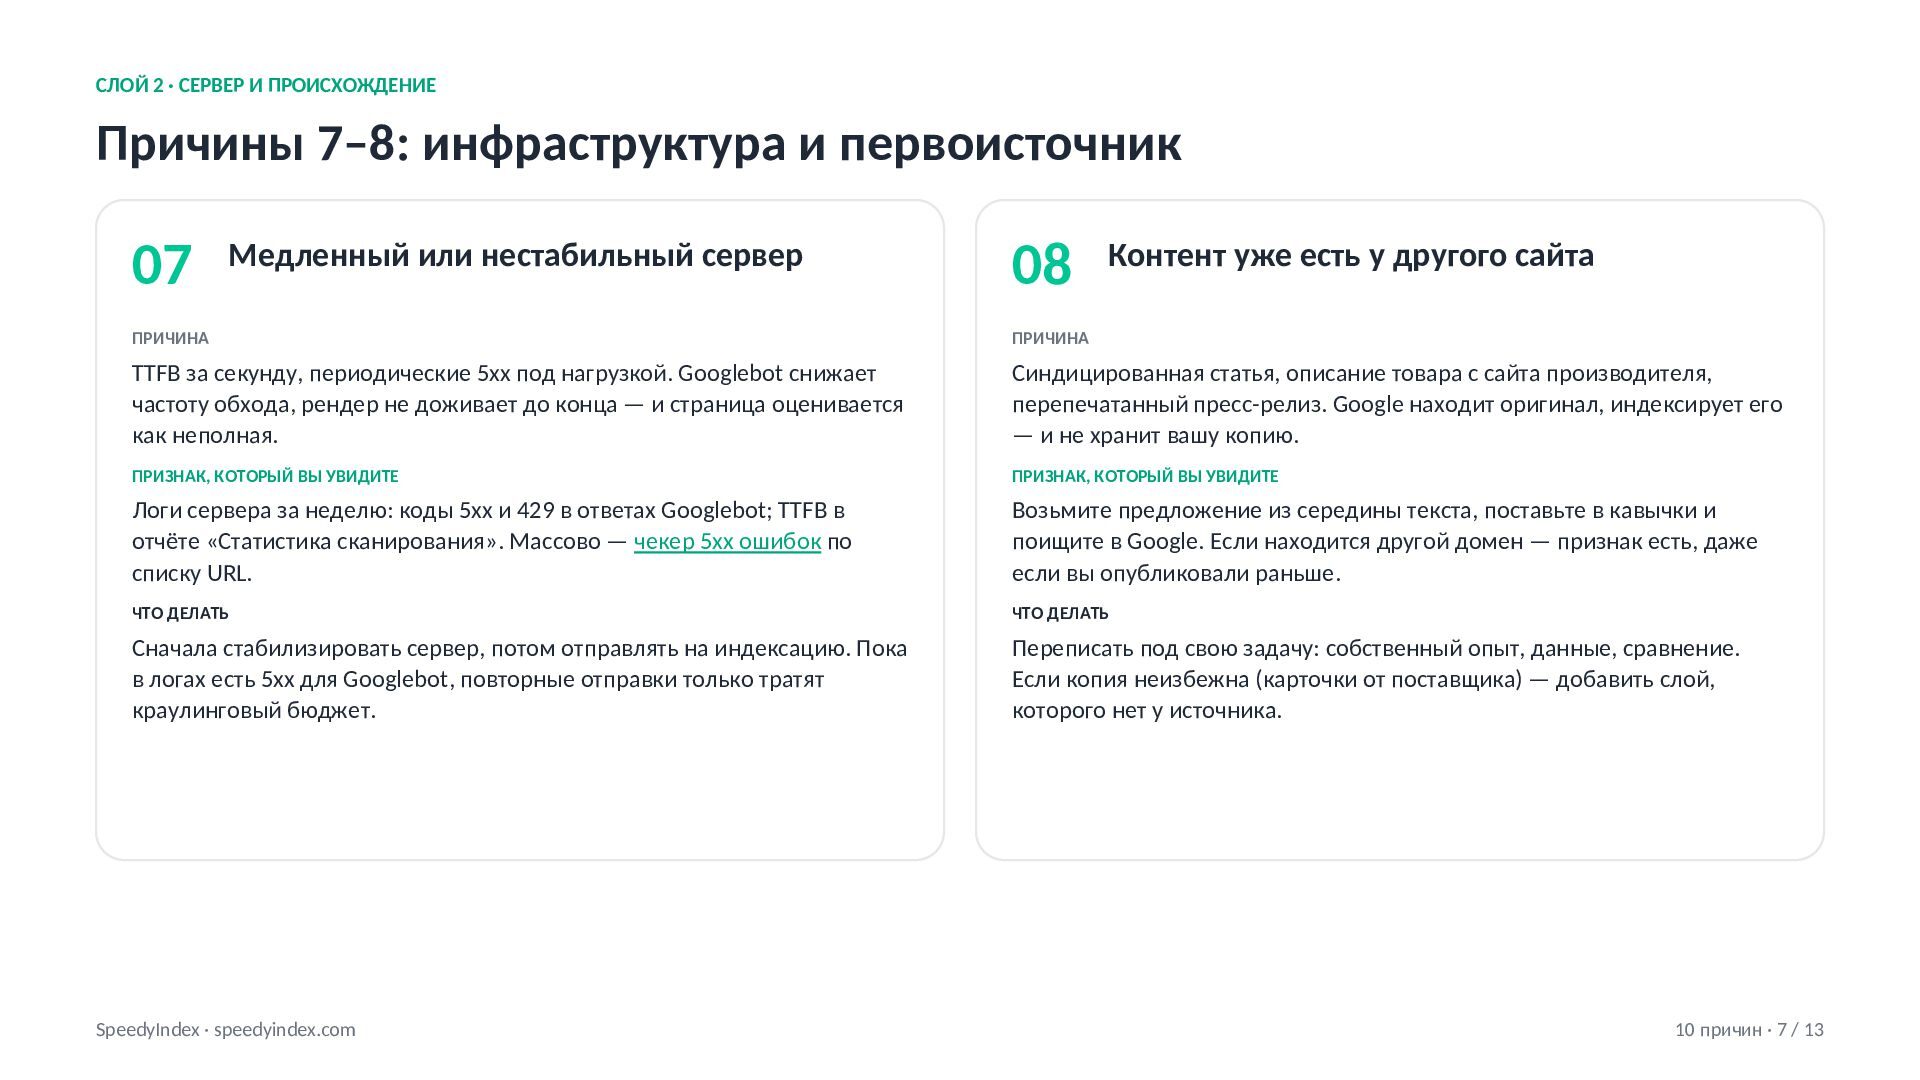
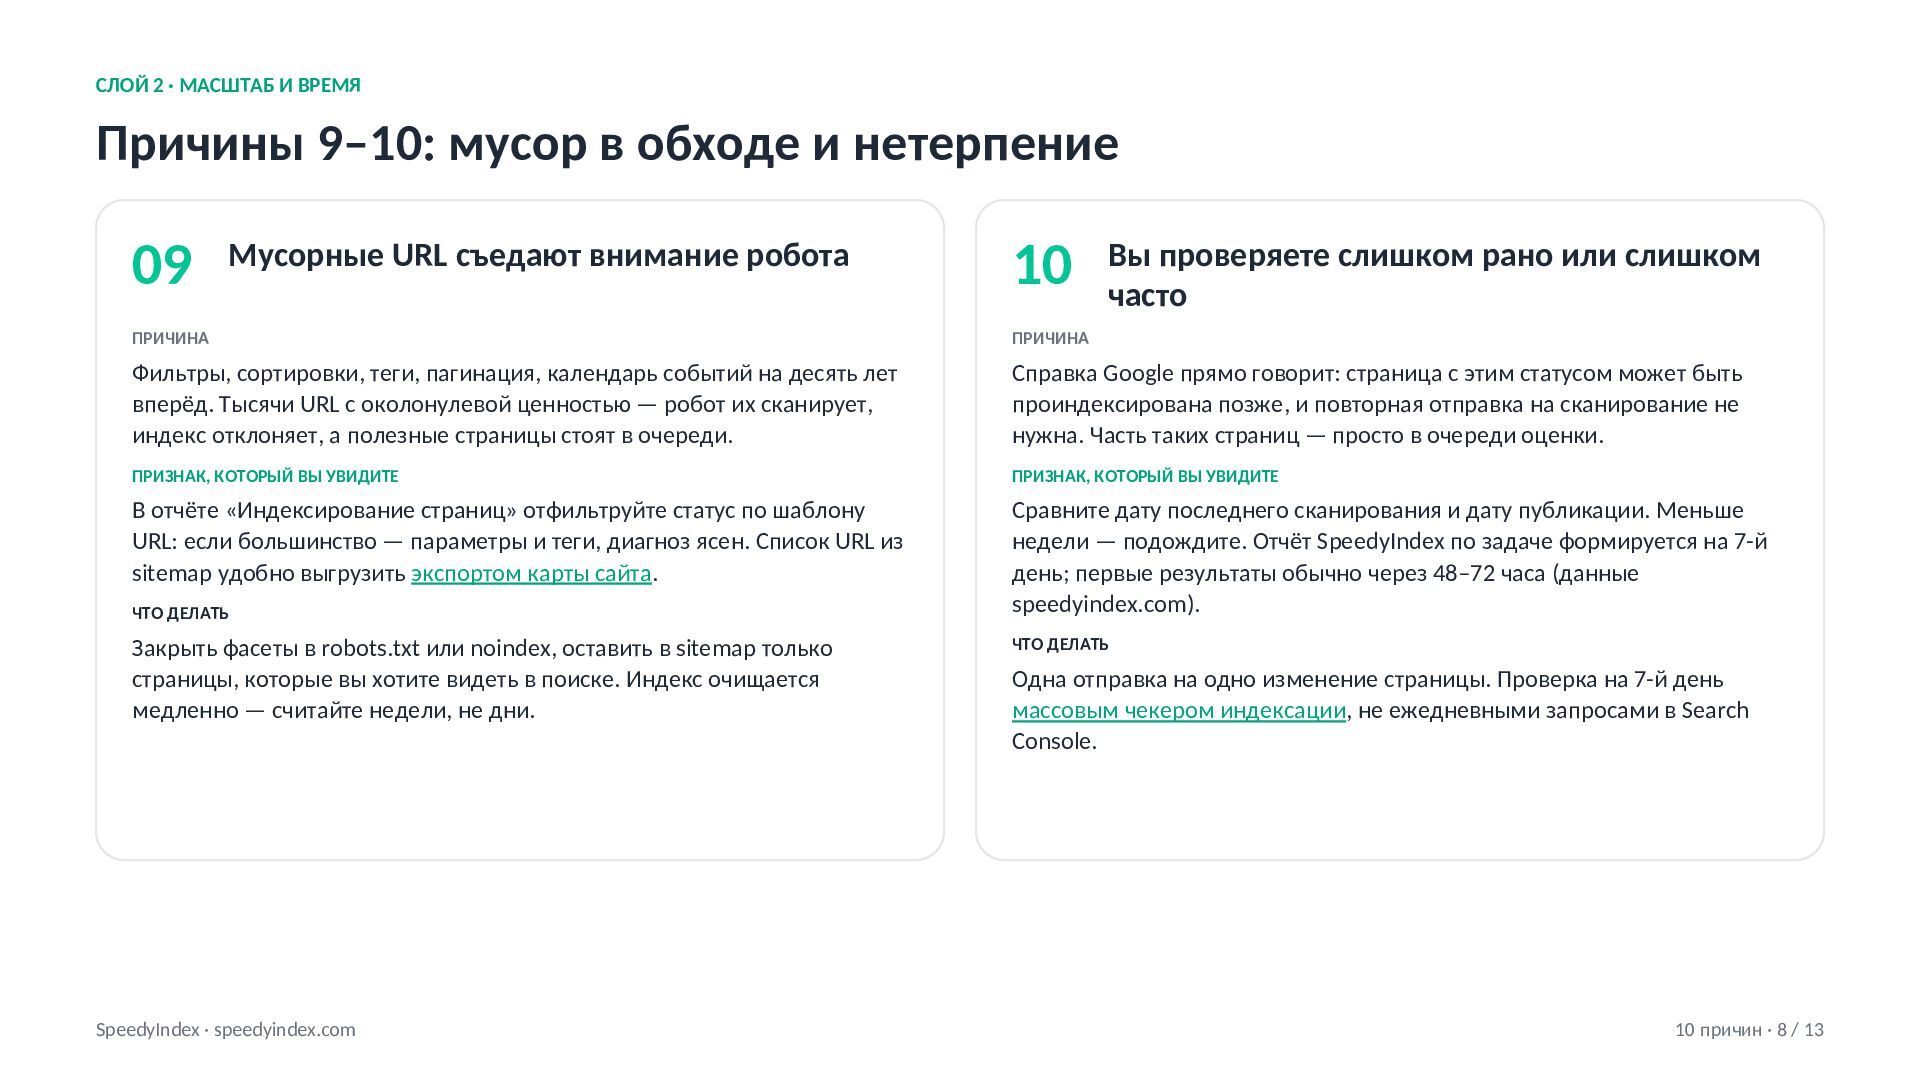
В презентации — 10 причин, по которым Google отказывает странице после сканирования: тонкий и шаблонный контент, дубли без canonical, текст только в JavaScript, страницы-сироты без внутренних ссылок, слабый домен, пустой ответ 200, нестабильный сервер, чужой первоисточник, мусорные URL и слишком ранняя проверка. Для каждой причины — признак, который вы увидите своими глазами, и конкретное действие.
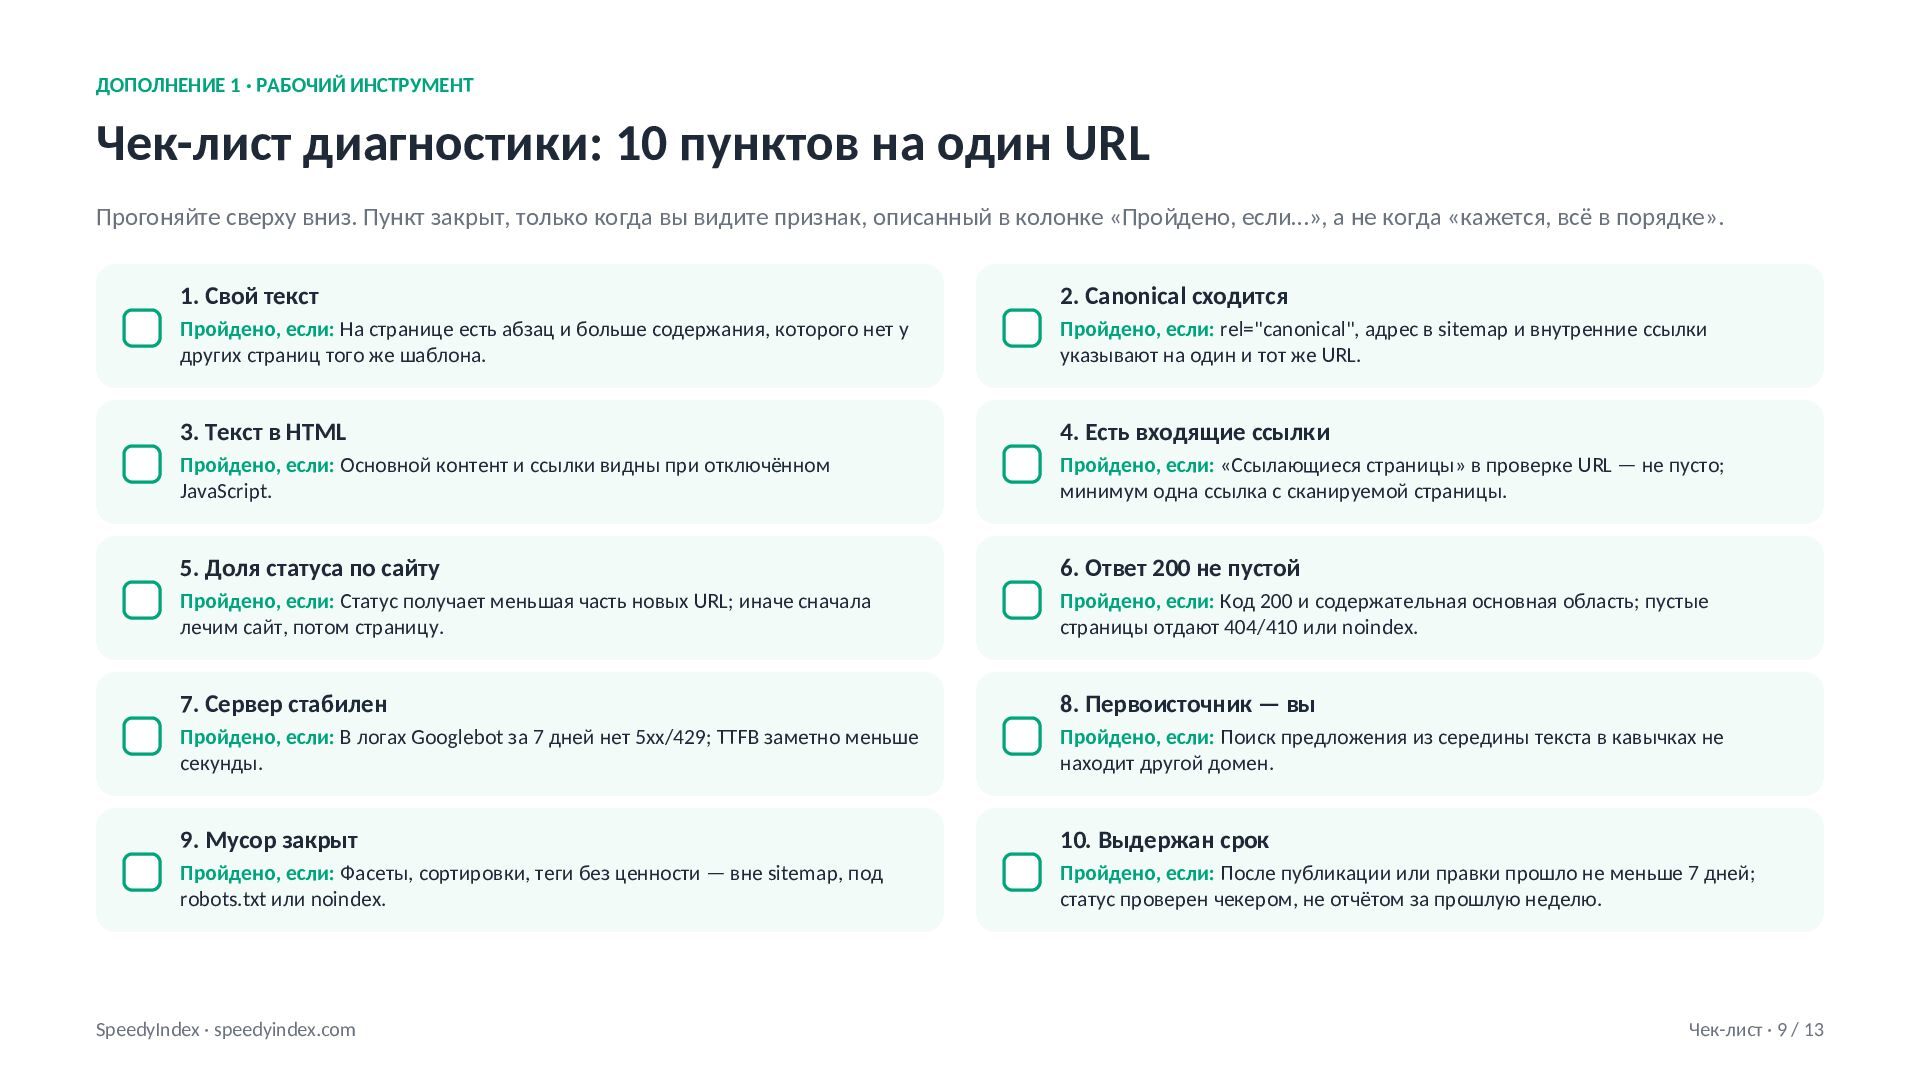
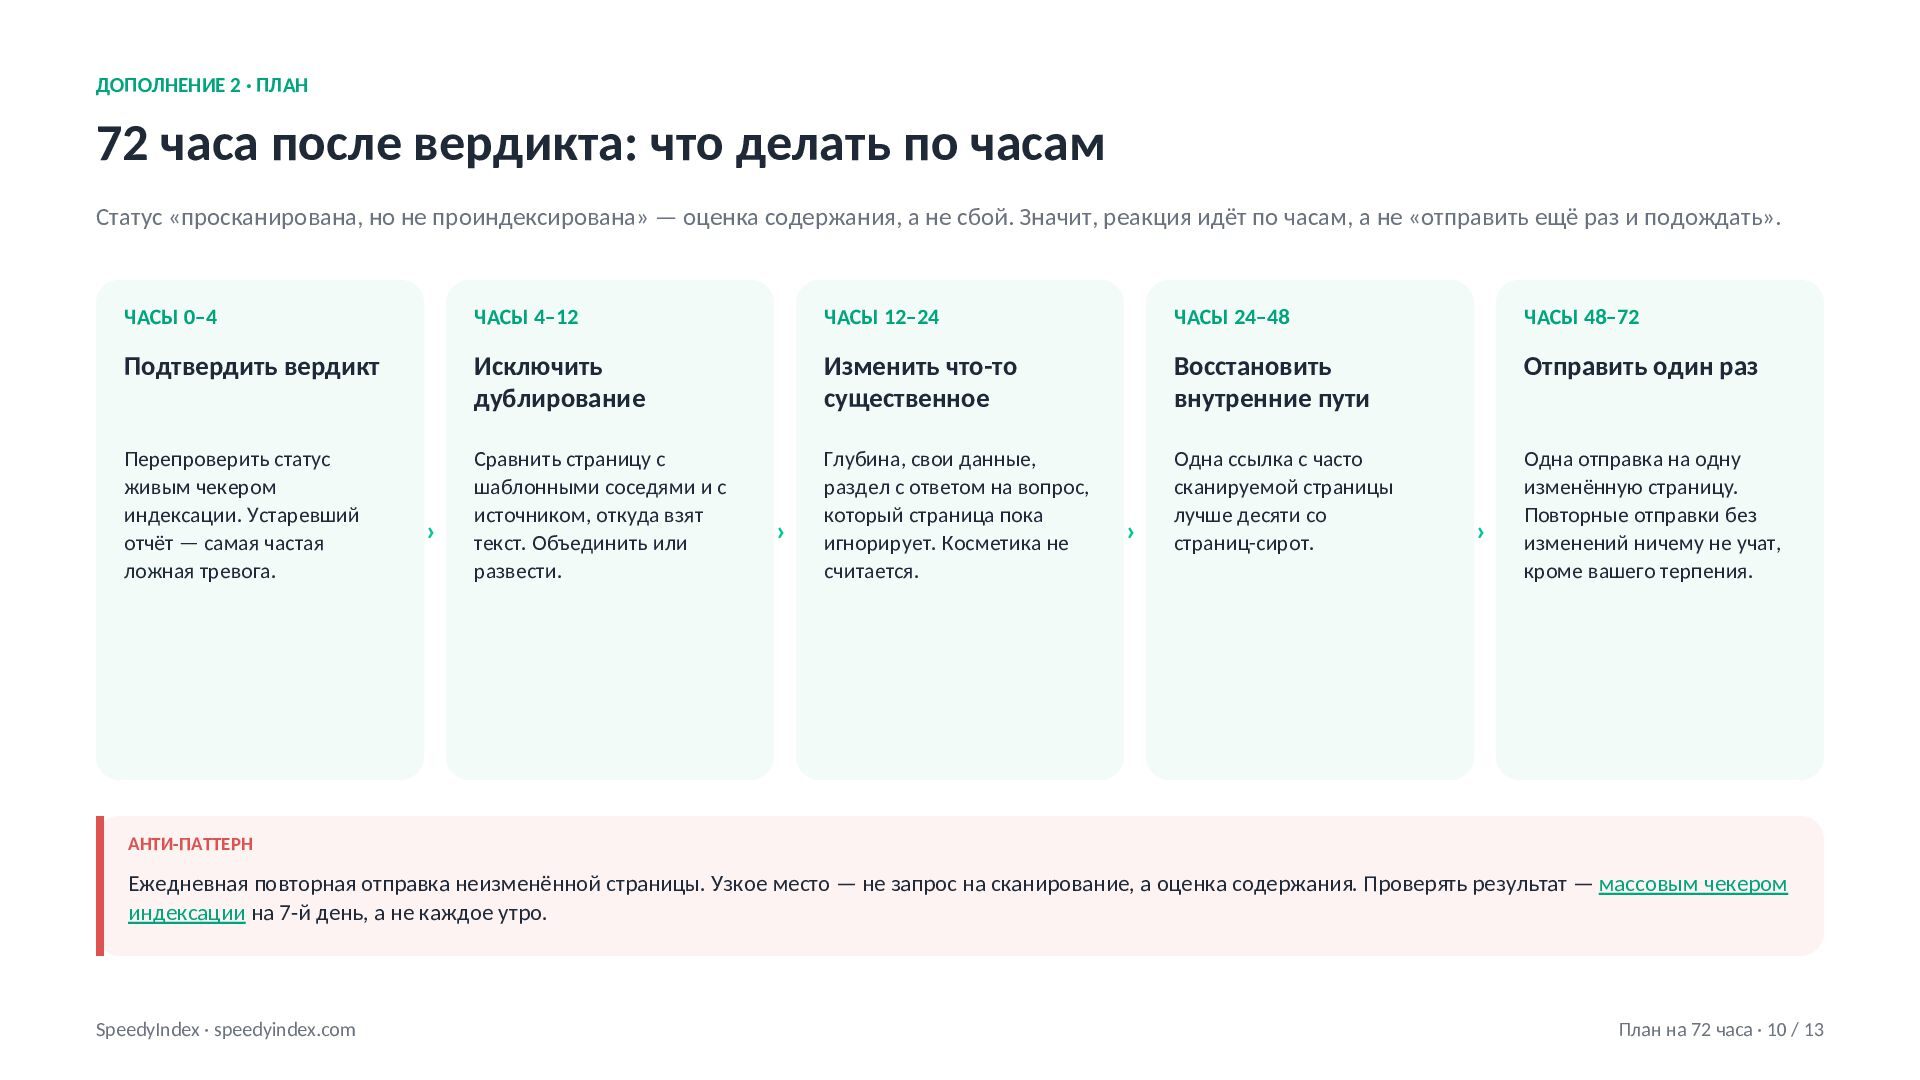
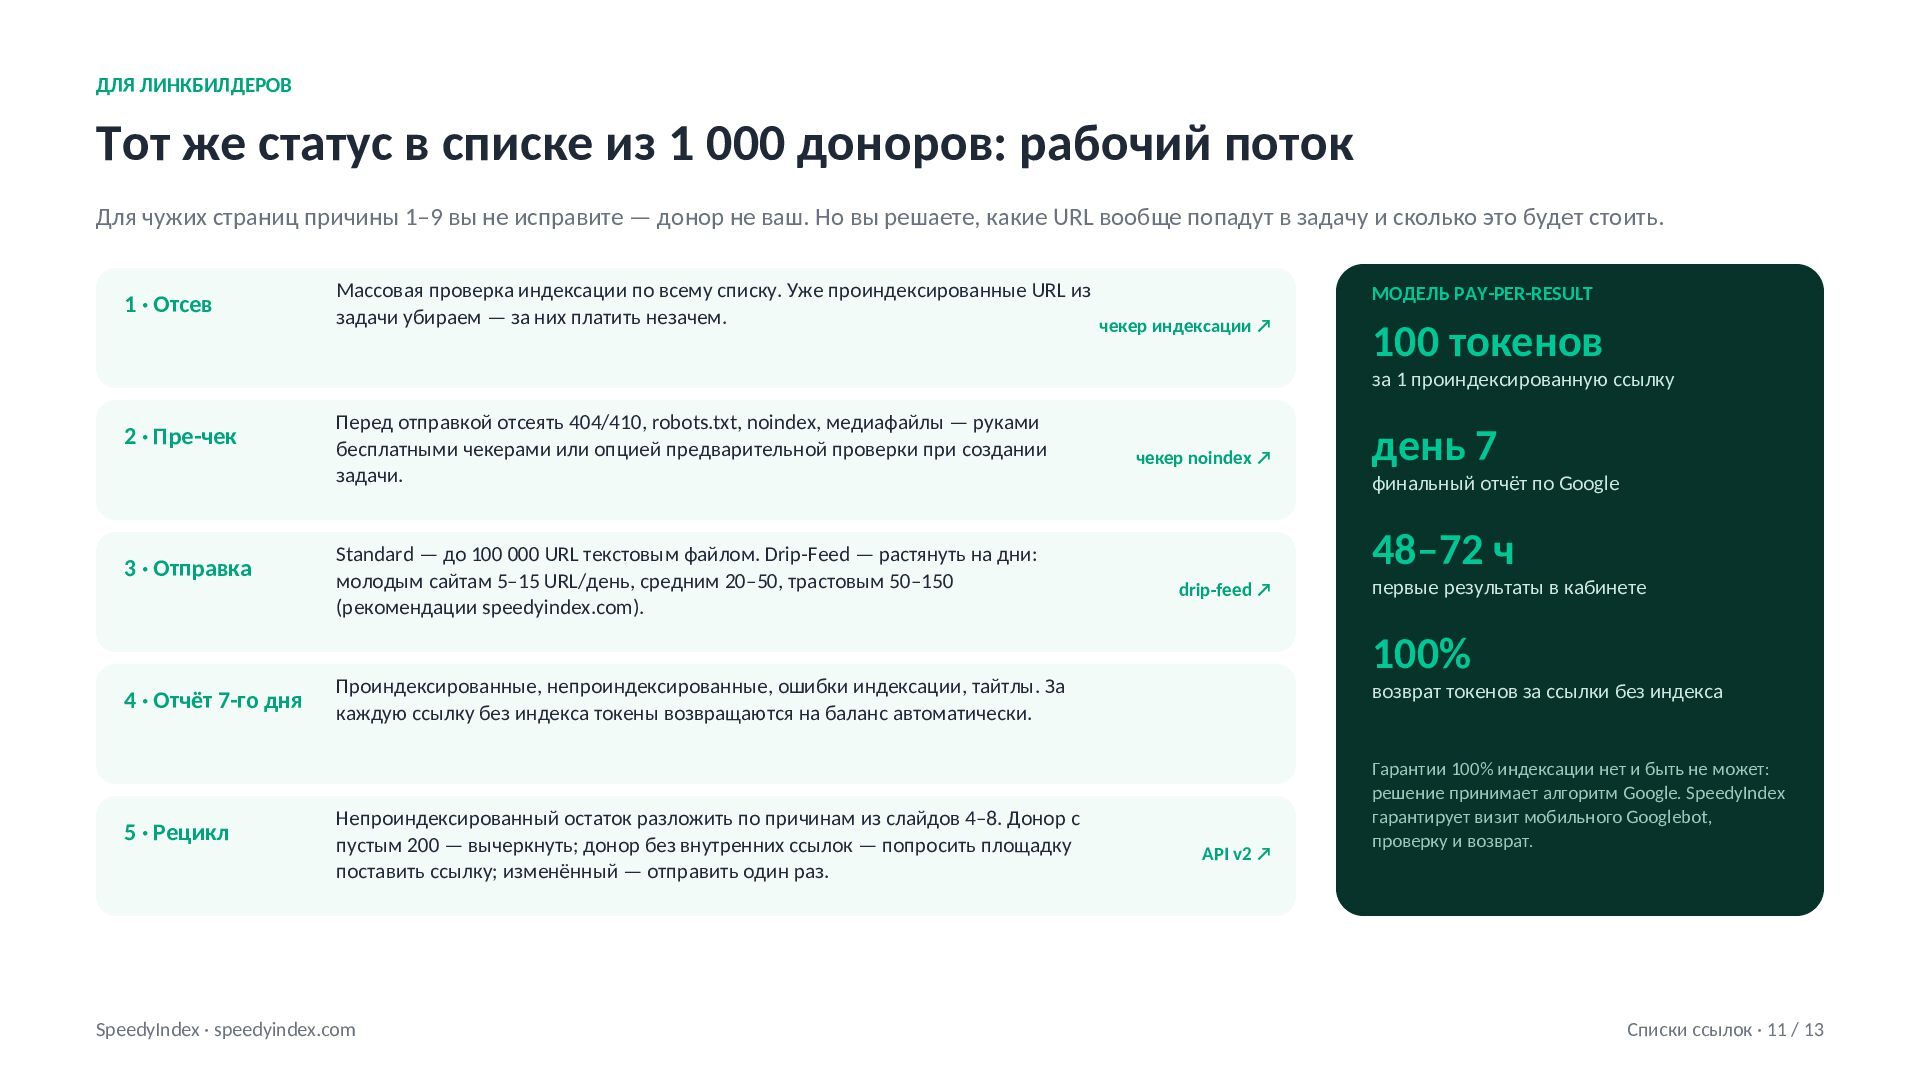
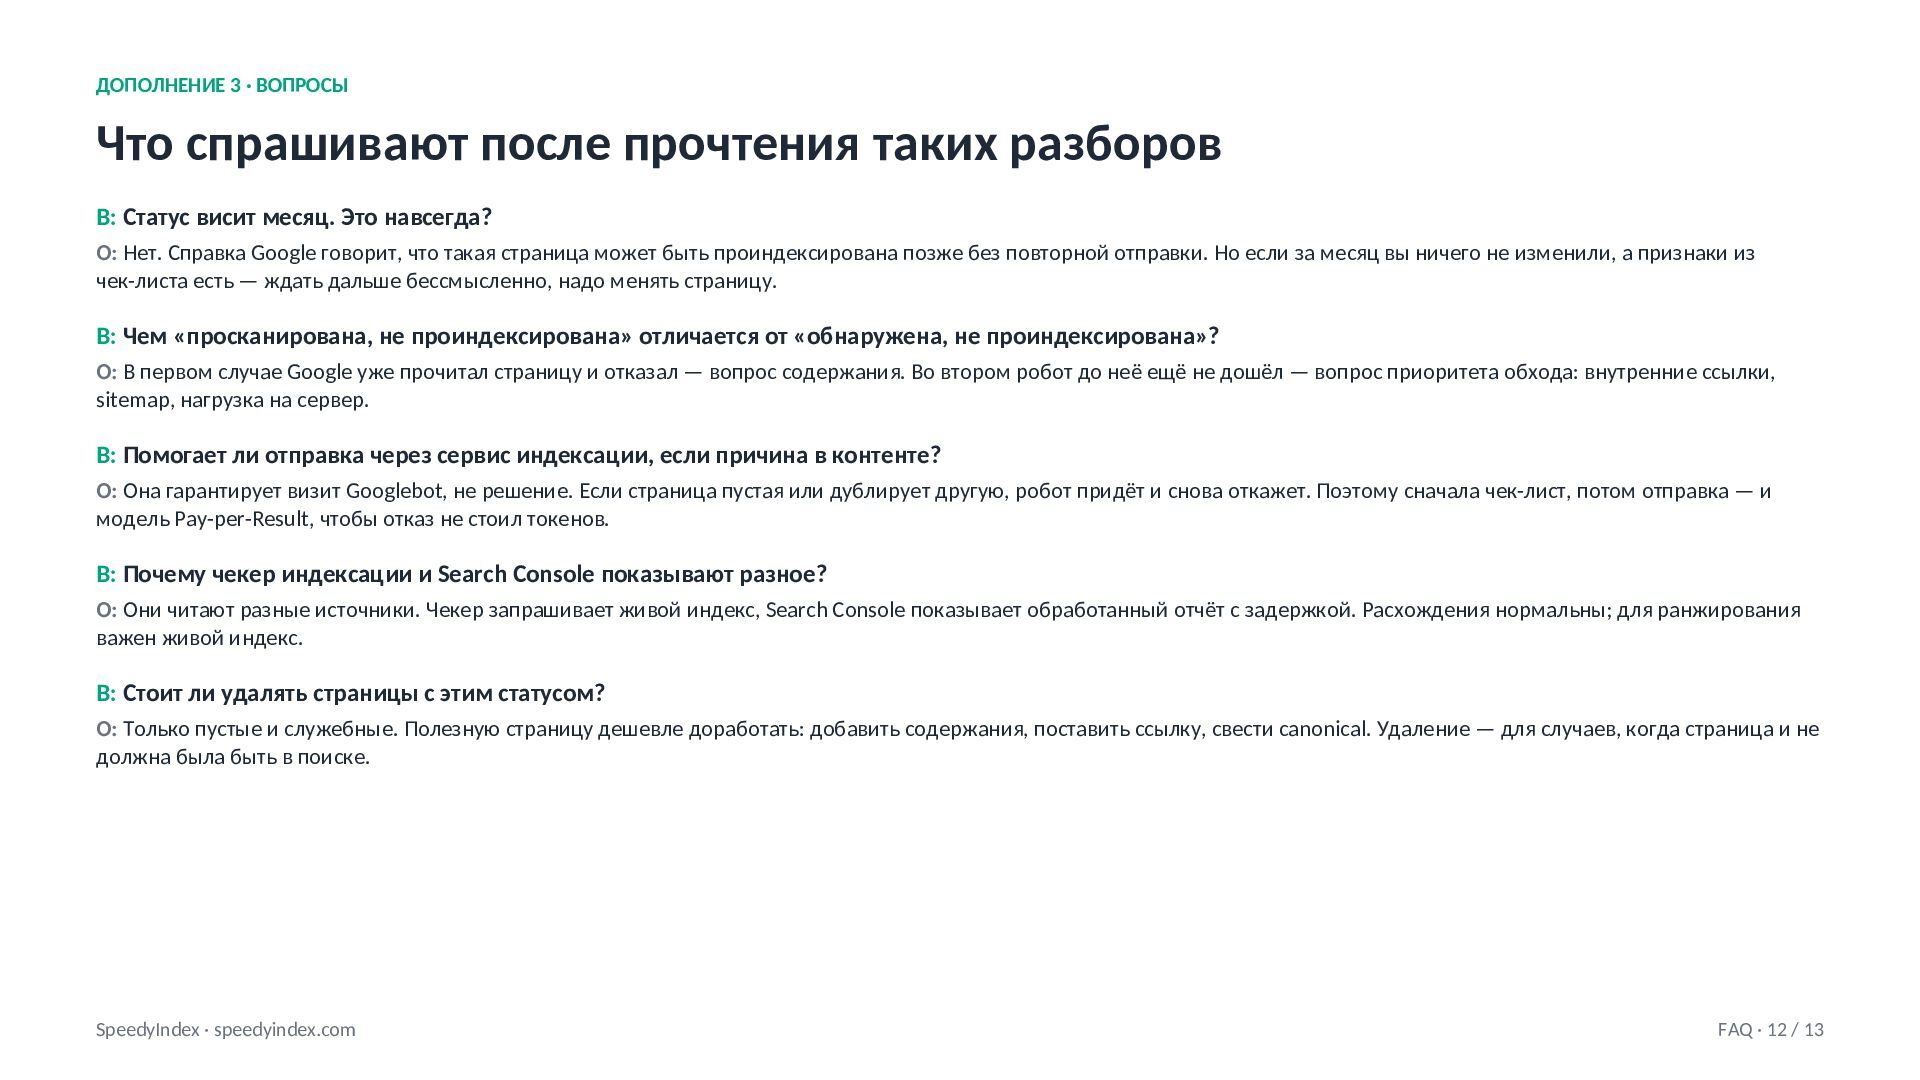
Внутри также чек-лист диагностики из 10 пунктов на один URL с критерием «Пройдено, если…», план действий на 72 часа после вердикта, рабочий поток для списков ссылок и FAQ. Отдельный слайд — что делать линкбилдеру, когда тот же статус получают сотни доноров, которые вы не можете исправить.
Перед тем как отправлять список на индексацию, прогоните его через массовую проверку индексации Google — уже проиндексированные URL и битые страницы отсеются до того, как за них придётся платить: https://speedyindex.com/proverka-indeksatsii-sayta-google/
SpeedyIndex.com (https://speedyindex.com/proverka-indeksatsii-sayta-google)
Массовая проверка индексации в Google онлайн — Чекер ссылок
Профессиональный чекер индексации Google. Проверяйте до 100 000 URL одновременно. Получайте точные данные из выдачи с заголовками Title и API доступом.


 speedyindexteam
 gurzu
 frankvandijk
 yigarashi
 novasell
 decabbit
 edwords
 samtorres
 drmrbates
 ryanlaw
 awsjcpm
 annikahaataja
 alexgalinos
 kevinliebholz
 hatefulcrawdad
 mkilby
 stephenakadiri
 aleyda
 bethany
 jonyablonski
 ianozsvald
 stephaniewalter
 caitiem20
 lynnandtonic
 elsirapls