Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Fluent but Unfeeling_ The Emotional Blind Spots...
Search
Wataru Hirota
August 13, 2026
Research
65
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Fluent but Unfeeling_ The Emotional Blind Spots of Language Models (2026/8/20 ウェブ・ソーシャルメディア読み会)
Wataru Hirota
August 13, 2026
More Decks by Wataru Hirota
See All by Wataru Hirota
(2022-05-28 Machine Learning 15Minutes!) 日本語ニュース分類から見る多言語モデル
tarohi24
0
110
The future of data system
tarohi24
0
100
Serializability and Snapshot Isolation.pdf
tarohi24
0
260
Entity Set Search of Scientific Literature: An unsupervised Ranking Approach
tarohi24
0
110
Other Decks in Research
See All in Research
【ローカルAIに向き合う展示会vol.2】液体時間定数型モジュールを用いた オリジナルの双方向エンコーダーモデルNexteraBERT 推論速度向上検討並びにダウンストリーム評価
rikkabotan7
0
190
Cross-Media Information Spaces and Architectures
signer
PRO
0
370
【Zozo Research 技術共有会】三次元領域の現在と展望
mickey_0226
3
610
Harness Engineering and Al Agent
kzinmr
3
2k
研究室単位での自律的 IPv6接続性確立に向けたAS共同運用モデルの提案と実証
reokashiwa
PRO
0
210
Ghost in the 7‑Zip: The Shadow of Residential Proxies Creeping into Your Life
nttcom
0
2.1k
横浜市長(山中氏)の言動にかかる第三者による調査報告書
y150saya
0
190
JPA2026_NetworkTutorial_JunKashihara
junkashihara
0
140
The story of RefactoringMiner. Slow research, long-term impact
tsantalis
0
150
Claude Code × autoresearch 実践
mathbullet
0
270
VRID: View-Invariant Representation through Dual-Axis Transformation for Cross-iew Pose Estimation
satai
3
100
SOTAのさらに先へ:厳しい推論制約下での高性能モデルのPost-Training
analokmaus
0
1.5k
Featured
See All Featured
End of SEO as We Know It (SMX Advanced Version)
ipullrank
3
4.4k
Keith and Marios Guide to Fast Websites
keithpitt
413
23k
Ethics towards AI in product and experience design
skipperchong
2
370
GraphQLの誤解/rethinking-graphql
sonatard
75
12k
Into the Great Unknown - MozCon
thekraken
41
2.7k
AI in Enterprises - Java and Open Source to the Rescue
ivargrimstad
0
1.5k
技術選定の審美眼(2025年版) / Understanding the Spiral of Technologies 2025 edition
twada
PRO
120
120k
WCS-LA-2024
lcolladotor
0
820
JAMstack: Web Apps at Ludicrous Speed - All Things Open 2022
reverentgeek
1
590
Leadership Guide Workshop - DevTernity 2021
reverentgeek
1
370
Ruling the World: When Life Gets Gamed
codingconduct
0
330
Designing for humans not robots
tammielis
254
26k
Transcript
Fluent but Unfeeling: The Emotional Blind Spots of Language Models
著者: Bangzhao Shu, Isha Joshi, Melissa Karnaze, Anh C. Pham, Ishita Kakkar, Sindhu Kothe, Arpine Hovasapian, Mai ElSherief. (Northeastern University, UC San Diego, UMass) 読み⼿: 広⽥航 (ストックマーク株式会社)
はじめに: この論⽂の3⾏まとめ 研究のモチベーション 「LLM は⼈間の感情を正しく予測出来るか?」という問を検証。既 存の同様のベンチマークは感情カテゴリの推定問題 (悲しい‧嬉しい‧etc..) を扱っている が、もっと細かい粒度で LLM
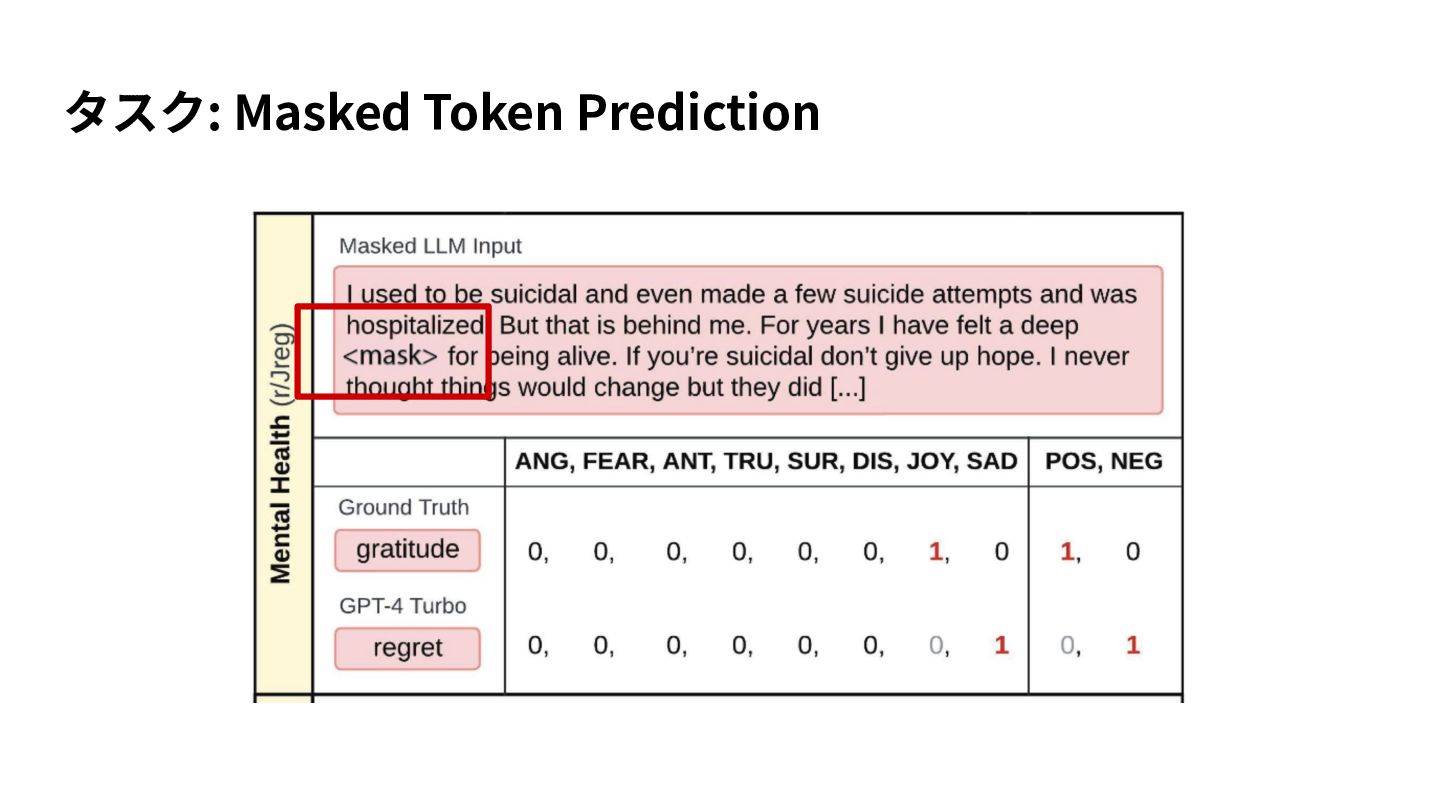
の能⼒を知りたい。また、第三者のアノテーションではな く、その⼈⾃⾝が感じた (self-disclosed) 感情と⽐較してベンチマークしたい。 検証⽅法 感情推定を Masked Token Prediction 問題として定式化。その⼈が書いた感情を 表す トークン の部分をマスクし、その単語が当てられるか?を検証。 結果 2種類の結果が得られた。(1) どのモデルも masked token の特定精度は低い (2) 第三者に LLM と⼈の token をそれぞれ⾒せると、LLM の予測した単語の⽅がより⽂脈に 適した単語だという結果に
タスク: Masked Token Prediction
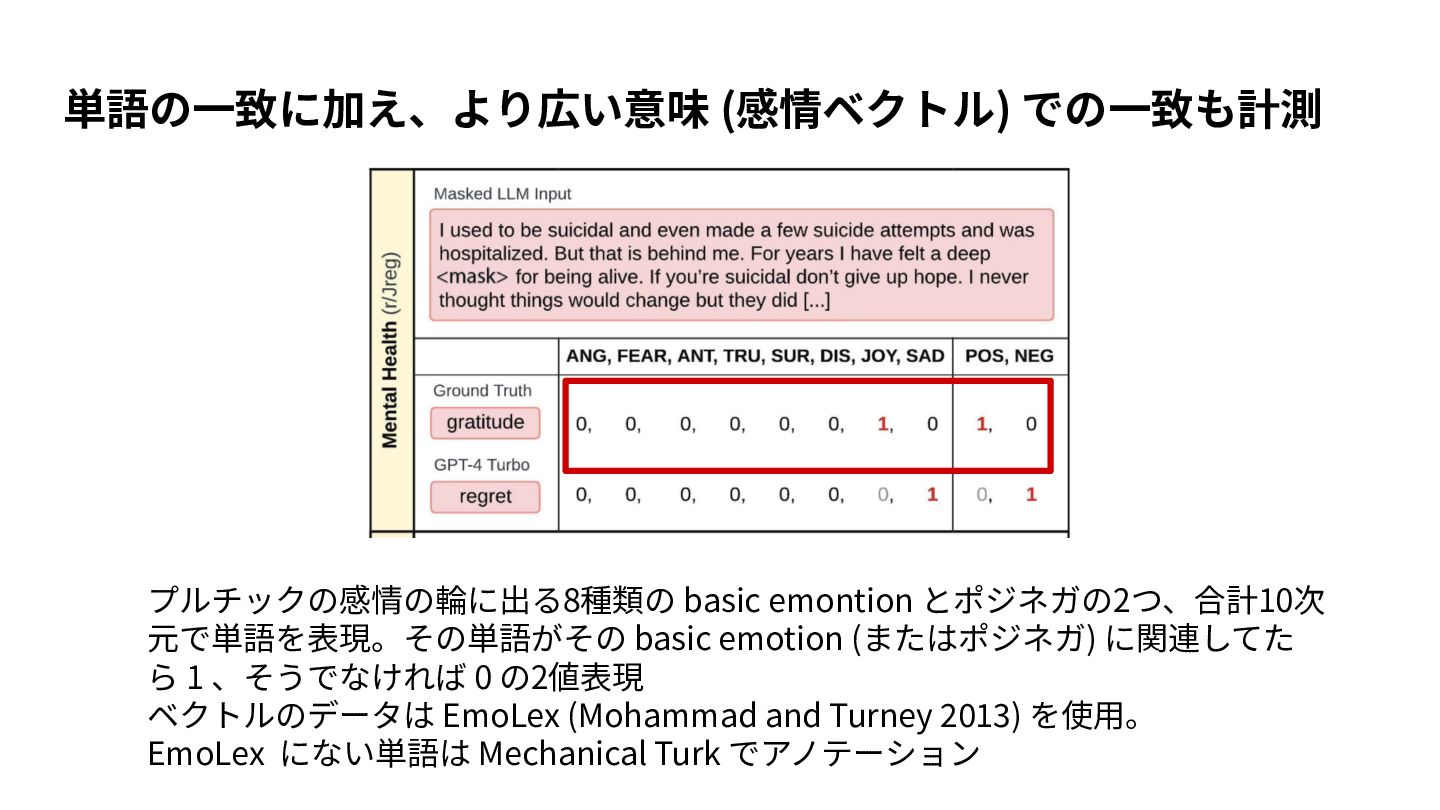
単語の⼀致に加え、より広い意味 (感情ベクトル) での⼀致も計測 プルチックの感情の輪に出る8種類の basic emontion とポジネガの2つ、合計10次 元で単語を表現。その単語がその basic emotion
(またはポジネガ) に関連してた ら 1 、そうでなければ 0 の2値表現 ベクトルのデータは EmoLex (Mohammad and Turney 2013) を使⽤。 EmoLex にない単語は Mechanical Turk でアノテーション
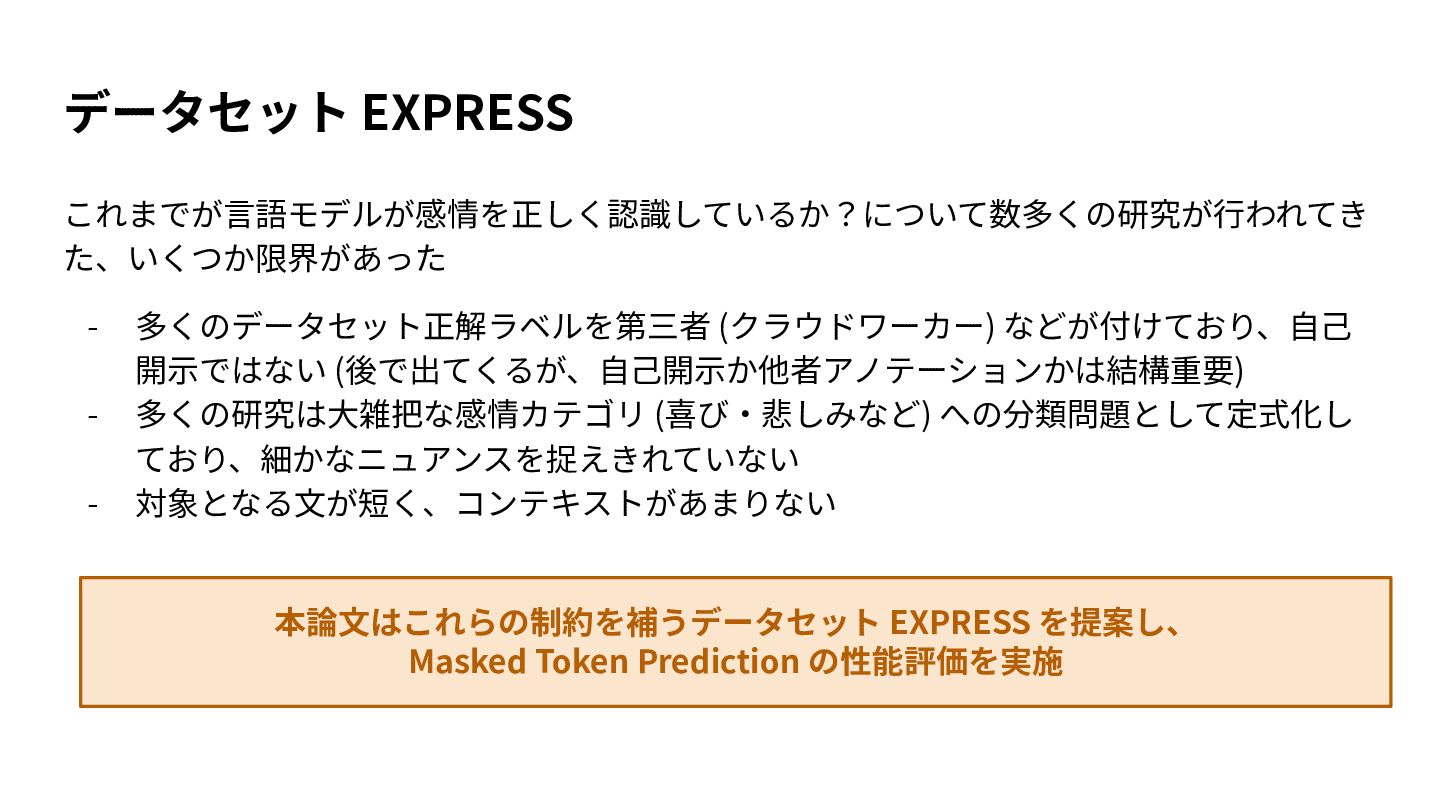
データセット EXPRESS これまでが⾔語モデルが感情を正しく認識しているか?について数多くの研究が⾏われてき た、いくつか限界があった - 多くのデータセット正解ラベルを第三者 (クラウドワーカー) などが付けており、⾃⼰ 開⽰ではない (後で出てくるが、⾃⼰開⽰か他者アノテーションかは結構重要)
多くの研究は⼤雑把な感情カテゴリ (喜び‧悲しみなど) への分類問題として定式化し ており、細かなニュアンスを捉えきれていない 対象となる⽂が短く、コンテキストがあまりない 本論⽂はこれらの制約を補うデータセット EXPRESS を提案し、 Masked Token Prediction の性能評価を実施
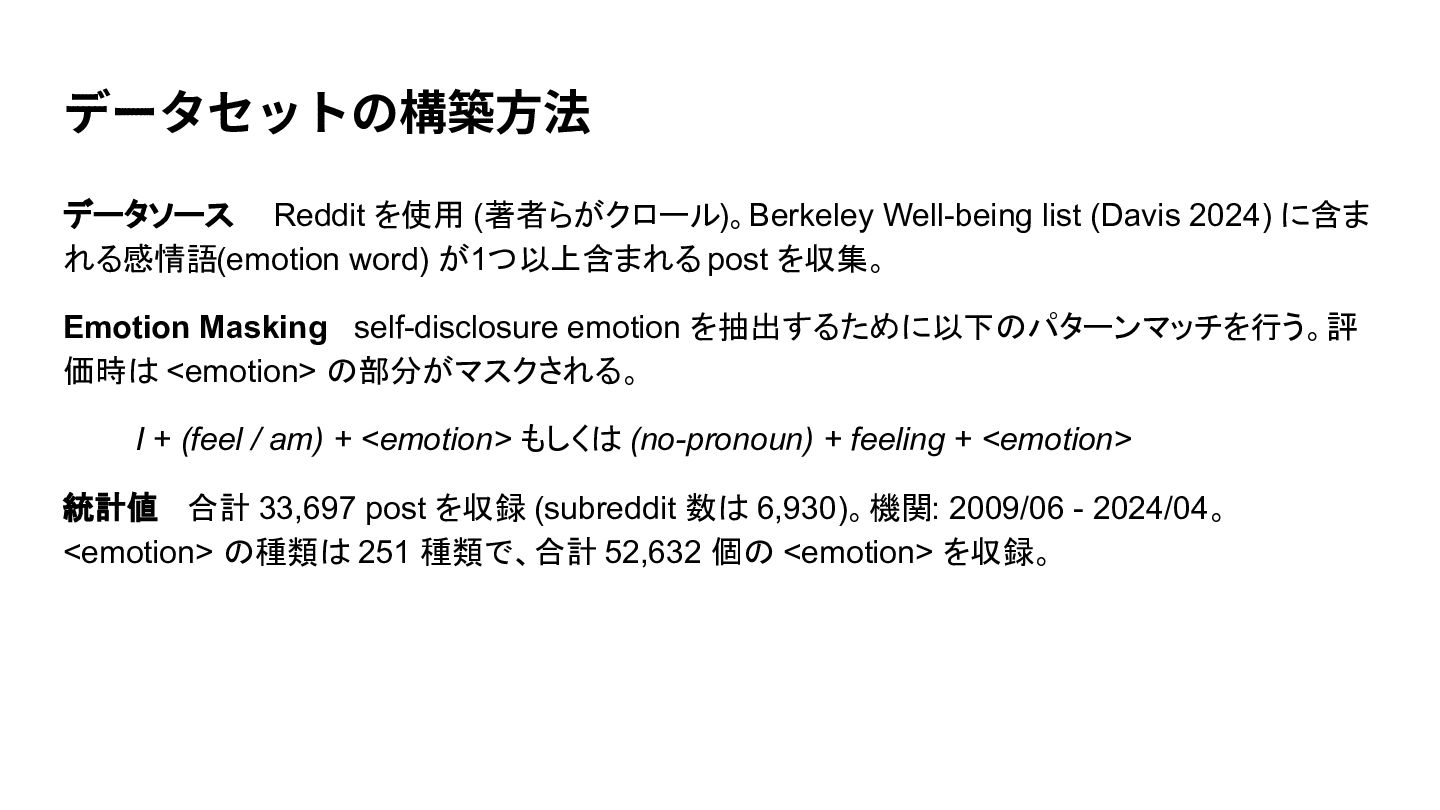
データセットの構築⽅法 データソース Reddit を使用 (著者らがクロール)。Berkeley Well-being list (Davis 2024) に含ま
れる感情語(emotion word) が1つ以上含まれる post を収集。 Emotion Masking self-disclosure emotion を抽出するために以下のパターンマッチを行う。評 価時は <emotion> の部分がマスクされる。 I + (feel / am) + <emotion> もしくは (no-pronoun) + feeling + <emotion> 統計値 合計 33,697 post を収録 (subreddit 数は 6,930)。機関: 2009/06 - 2024/04。 <emotion> の種類は 251 種類で、合計 52,632 個の <emotion> を収録。
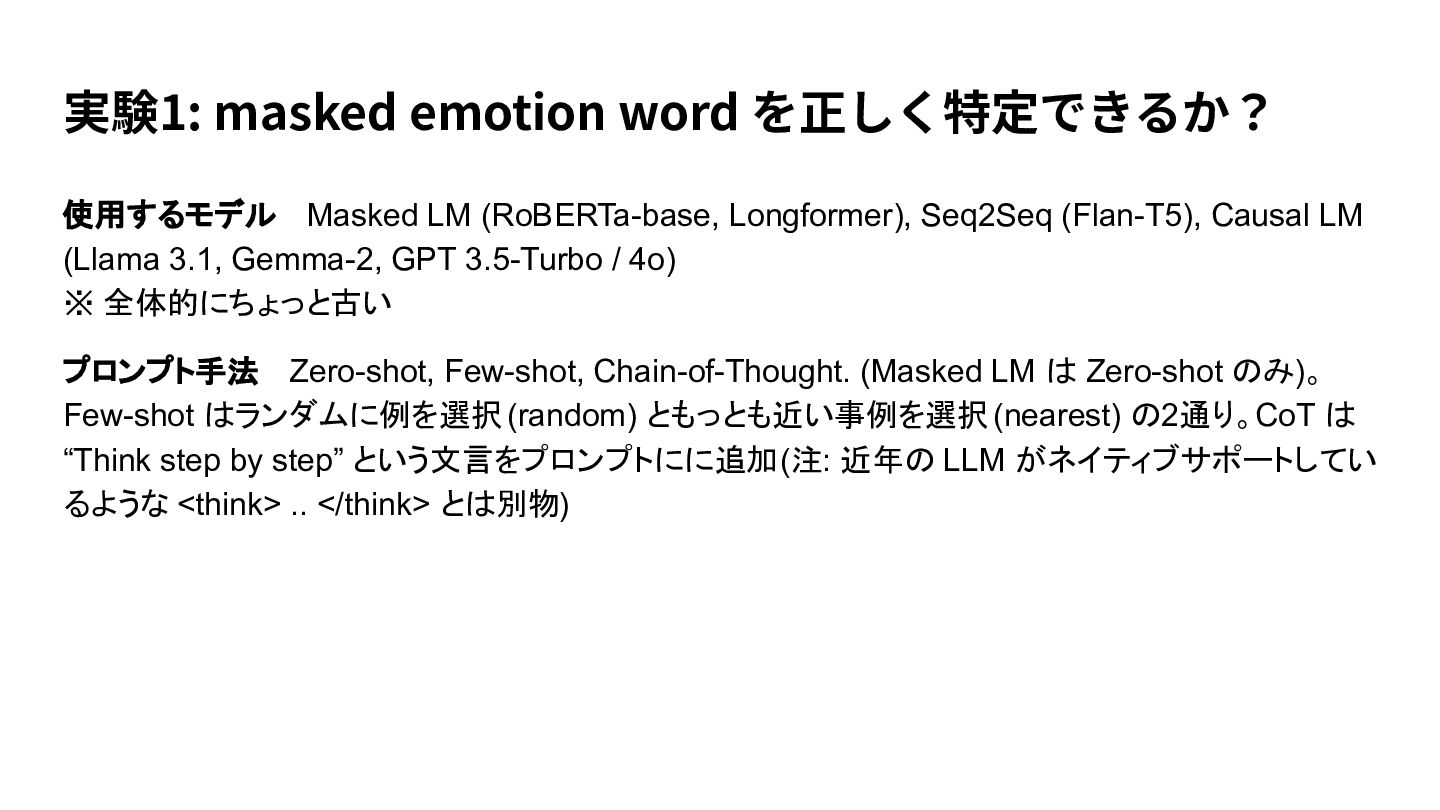
実験1: masked emotion word を正しく特定できるか? 使用するモデル Masked LM (RoBERTa-base, Longformer),
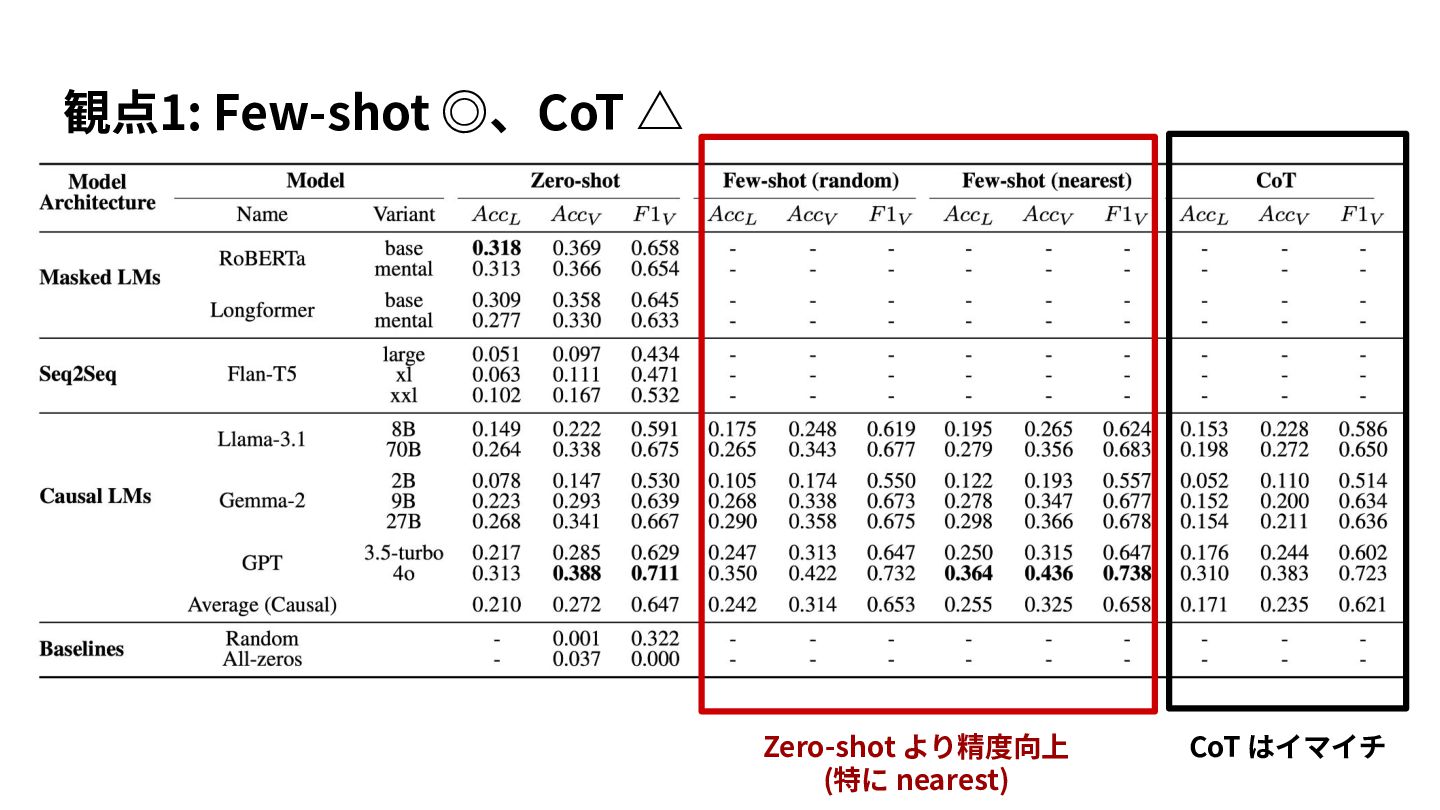
Seq2Seq (Flan-T5), Causal LM (Llama 3.1, Gemma-2, GPT 3.5-Turbo / 4o) ※ 全体的にちょっと古い プロンプト手法 Zero-shot, Few-shot, Chain-of-Thought. (Masked LM は Zero-shot のみ)。 Few-shot はランダムに例を選択 (random) ともっとも近い事例を選択 (nearest) の2通り。CoT は “Think step by step” という文言をプロンプトにに追加 (注: 近年の LLM がネイティブサポートしてい るような <think> .. </think> とは別物)
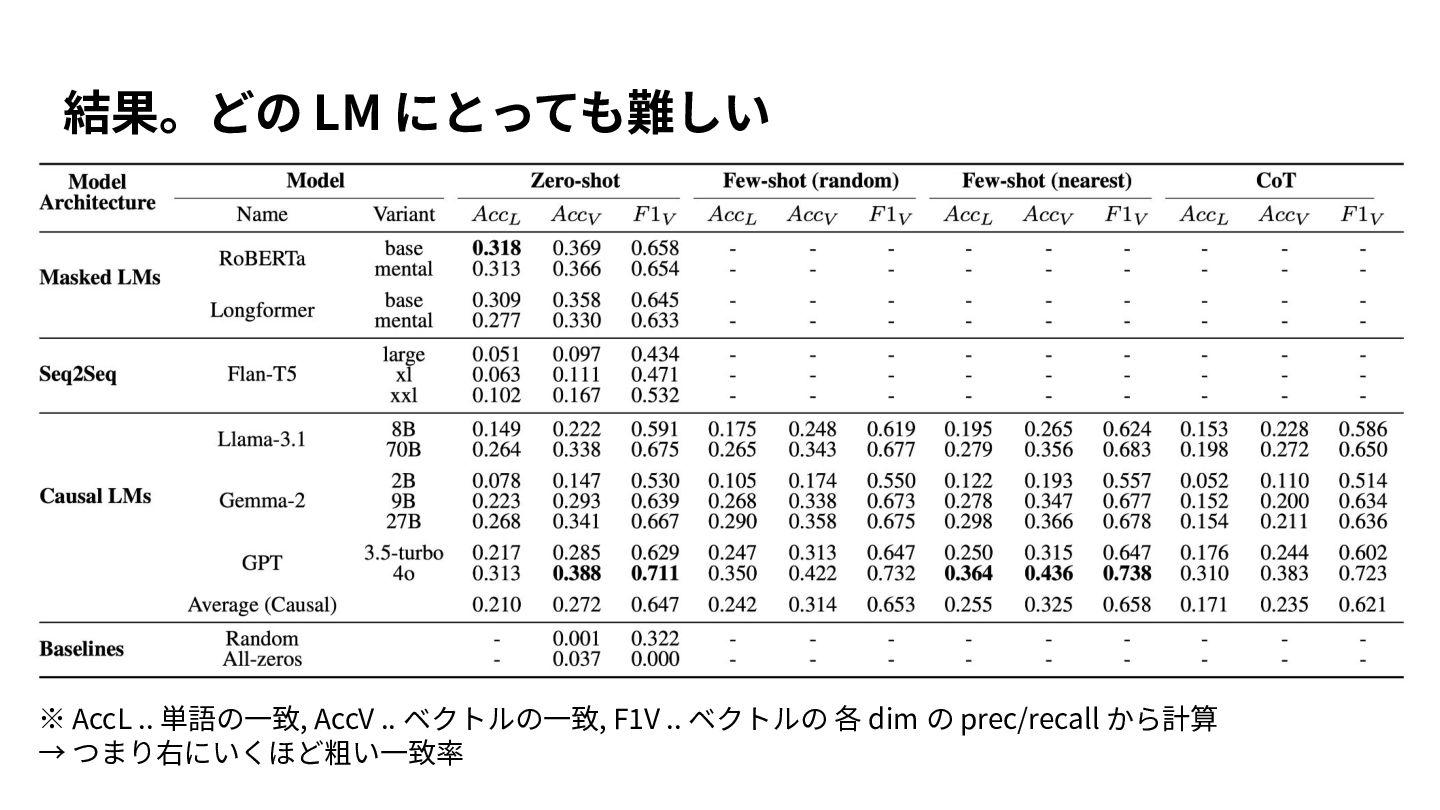
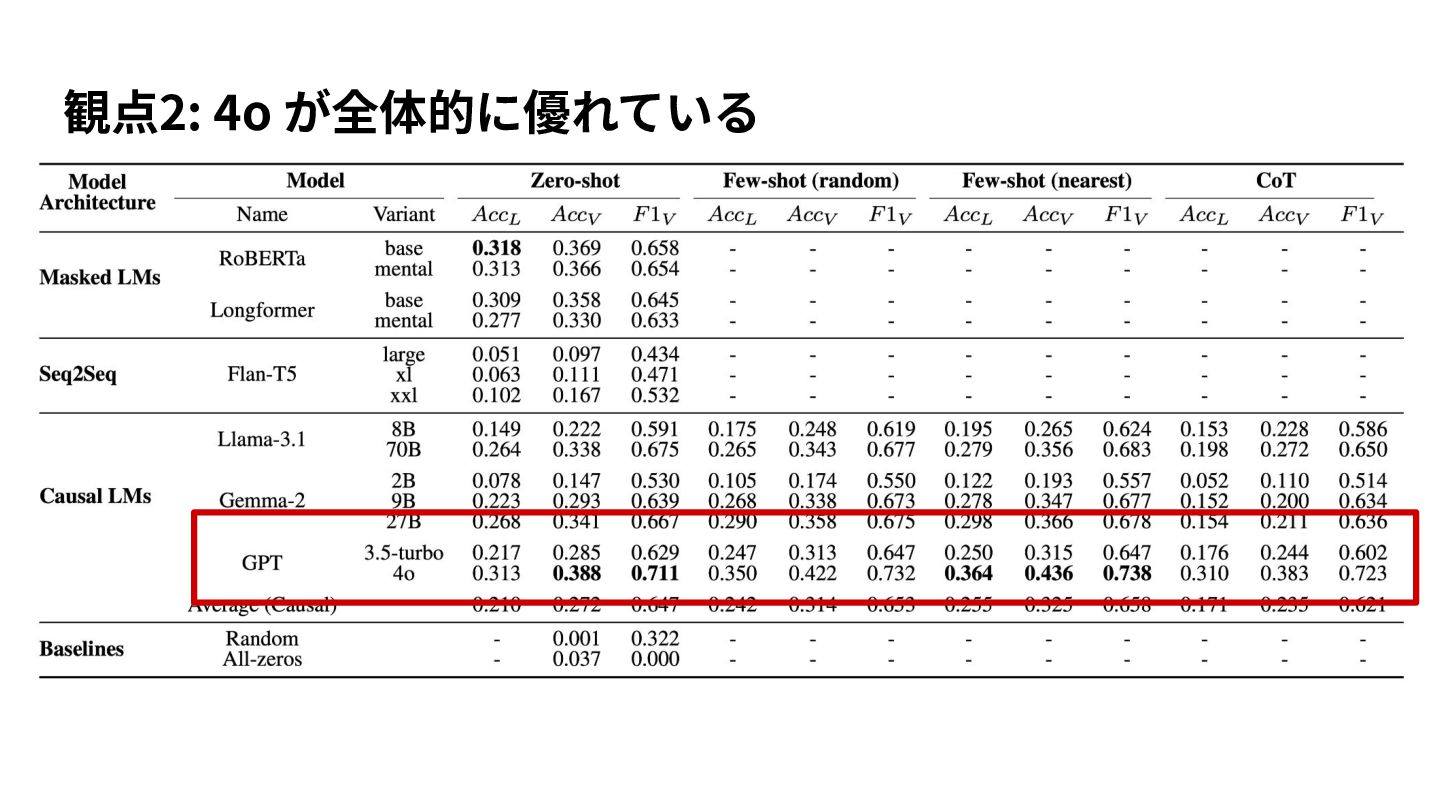
結果。どの LM にとっても難しい ※ AccL .. 単語の⼀致, AccV .. ベクトルの⼀致,
F1V .. ベクトルの 各 dim の prec/recall から計算 → つまり右にいくほど粗い⼀致率
観点1: Few-shot ◎、CoT △ Zero-shot より精度向上 (特に nearest) CoT はイマイチ
観点2: 4o が全体的に優れている
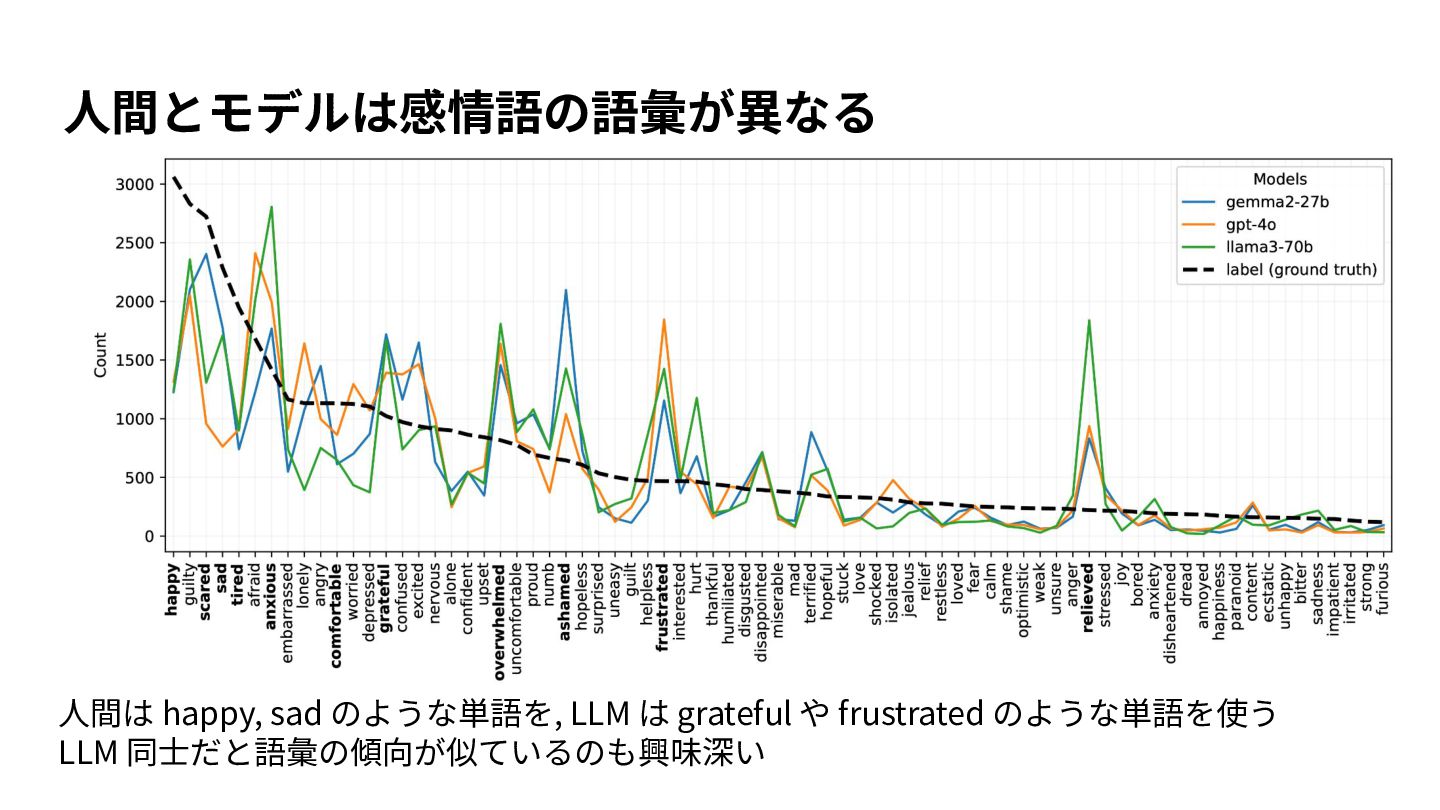
⼈間とモデルは感情語の語彙が異なる ⼈間は happy, sad のような単語を, LLM は grateful や frustrated
のような単語を使う LLM 同⼠だと語彙の傾向が似ているのも興味深い
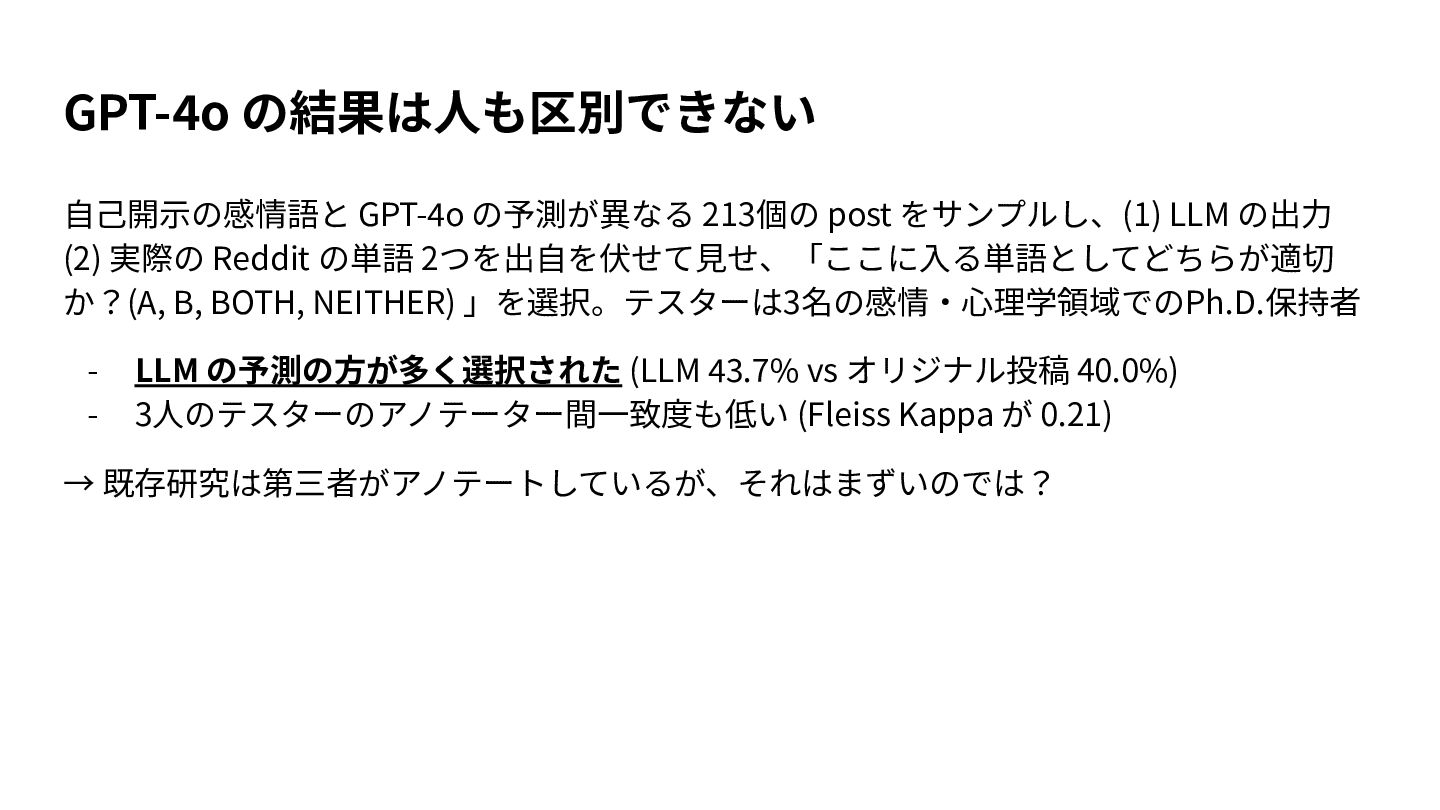
GPT-4o の結果は⼈も区別できない ⾃⼰開⽰の感情語と GPT-4o の予測が異なる 213個の post をサンプルし、(1) LLM の出⼒
(2) 実際の Reddit の単語 2つを出⾃を伏せて⾒せ、「ここに⼊る単語としてどちらが適切 か?(A, B, BOTH, NEITHER) 」を選択。テスターは3名の感情‧⼼理学領域でのPh.D.保持者 - LLM の予測の⽅が多く選択された (LLM 43.7% vs オリジナル投稿 40.0%) 3⼈のテスターのアノテーター間⼀致度も低い (Fleiss Kappa が 0.21) → 既存研究は第三者がアノテートしているが、それはまずいのでは?
最後に: 読み⼿ (広⽥) の感想 - 感情語を当てるというのが思ったより難しそう。最近の LLM だとどの程度なのかが気 になる。 LLM
がシンプルな感情語 (sad, happy, etc..) を⼈と⽐べてあまり使わない理由が気にな る。何かそうなるメカニズムがある? 「本⼈がどの程度許容できるか」も知りたい。第三者が⾒て LLM かオリジナルかはほ ぼ⾒分けられないという結論だったが、post を書いた本⼈がジャッジするとどうなの か?が気になる


 tarohi24
 rikkabotan7
 signer
 mickey_0226
 kzinmr
 reokashiwa
 nttcom
 y150saya
 junkashihara
 tsantalis
 mathbullet
 satai
 analokmaus
 ipullrank
 keithpitt
 skipperchong
 sonatard
 thekraken
 ivargrimstad
 twada
 lcolladotor
 reverentgeek
 codingconduct
 tammielis