Share
Embed
日本語新聞記事を用いた大規模言語モデルの暗記定量化 / LLMC2025
第 22 回 LLM 勉強会での登壇資料 https://llm-jp.nii.ac.jp/news/post-1034/
Shotaro Ishihara
August 25, 2025
Transcript
36 slides
-
日本語新聞記事を用いた 大規模言語モデルの暗記定量化 石原祥太郎 [email protected] 日本経済新聞社 日経イノベーション・ラボ 上級研究員 第 22 回
LLM 勉強会,2025 年 8 月 26 日 謝辞:高橋寛武さん,白井穂乃さん,大村和正さん -
研究開発部署・事業部門・編集部門などが連携 • 事業応用 (「日経電子版」などへの実装や業務効率化) ◦ 新聞記事を用いた質問応答,記事推薦,記事へのラ ベル付け,編集支援 (叩き台作り,校正など)…… • 中長的的な視点での研究
◦ 独自の事前学習済みモデルの構築と評価 ◦ 読みやすさ推定や校閲 (内容誤りの指摘・修正) など 難易度が高い課題の探究 日経での自然言語処理の研究開発 2 -
事前学習済みモデルによる訓練データの暗記 (memorization) に関する研究が盛んになっている. • The First Workshop on Large Language
Model Memorization – L2M2 (ACL 2025 workshop) • The Impact of Memorization on Trustworthy Foundation Models – MemFM (ICML 2025 workshop) 暗記 (memorization) への注目 3 -
• 大規模な事前学習済みモデルの研究開発や実用化が進む中 訓練データが暗記・出力される現象が注目されている. • 暗記性質の解明は著作権・セキュリティ・健全な性能評価 などの観点で重要だが,特に英語以外の言語では実態や課 題が十分に議論されていない. • 本研究では日本語の新聞記事を用いた事前学習済みモデル を構築し,暗記がもたらす可能性や実運用上の課題を,実
証的実験で明らかにする. 日経での取り組みの概要:日本語の事前学習済み モデルによる訓練データの暗記を実証的に調査 4 -
日経電子版などの記事を用いた事前学習済みモデル開発 • 訓練データの文体の模倣:日経電子版 T5 での要約の生成 [自然言語処理a] • 識別タスクの性能改善:日経電子版 BERT での記事カテゴ
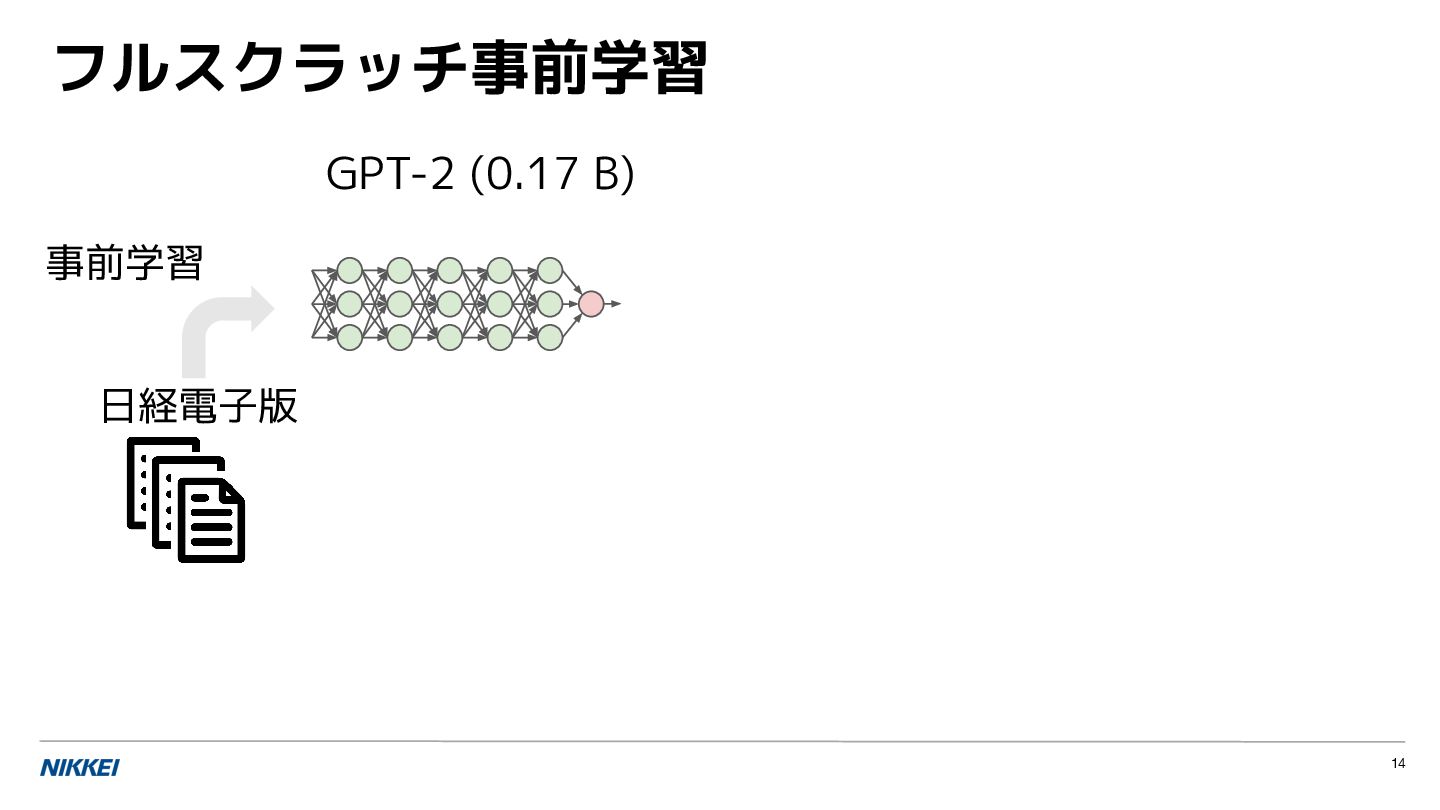
リの予測 [自然言語処理a] • より大規模なモデルの構築:フルスクラッチ事前学習や継 続事前学習,事後学習 [記事] これまでの取り組み (可能性) 8 -
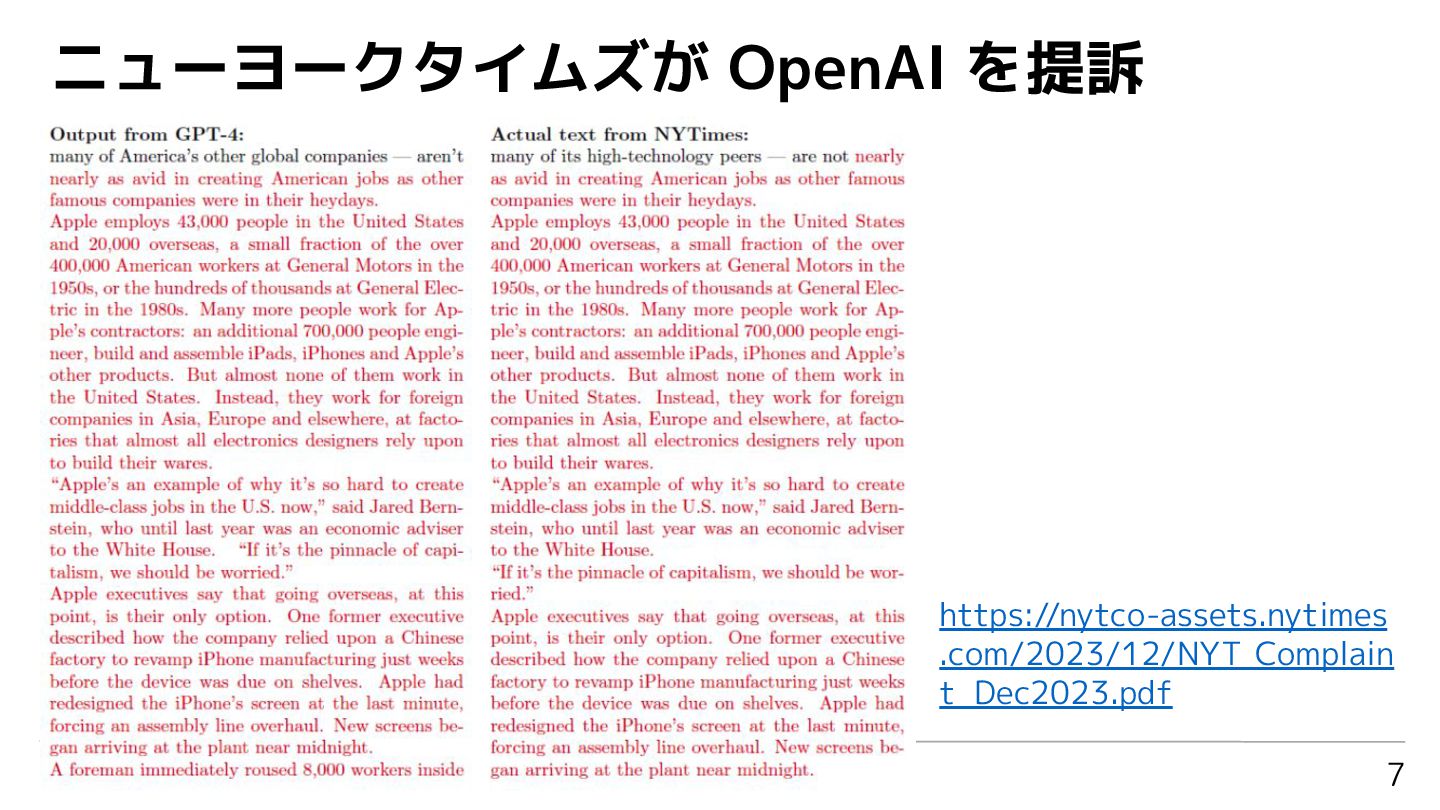
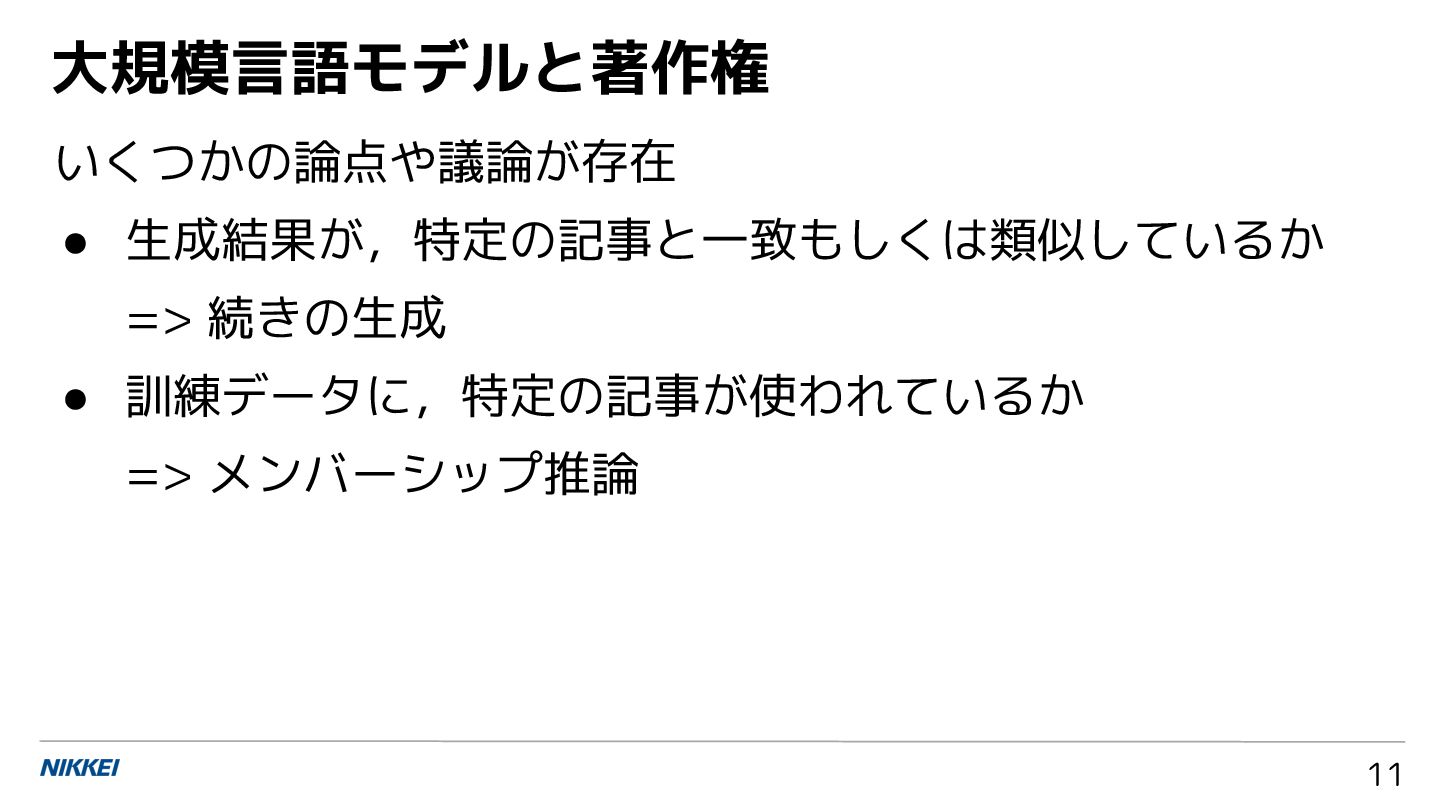
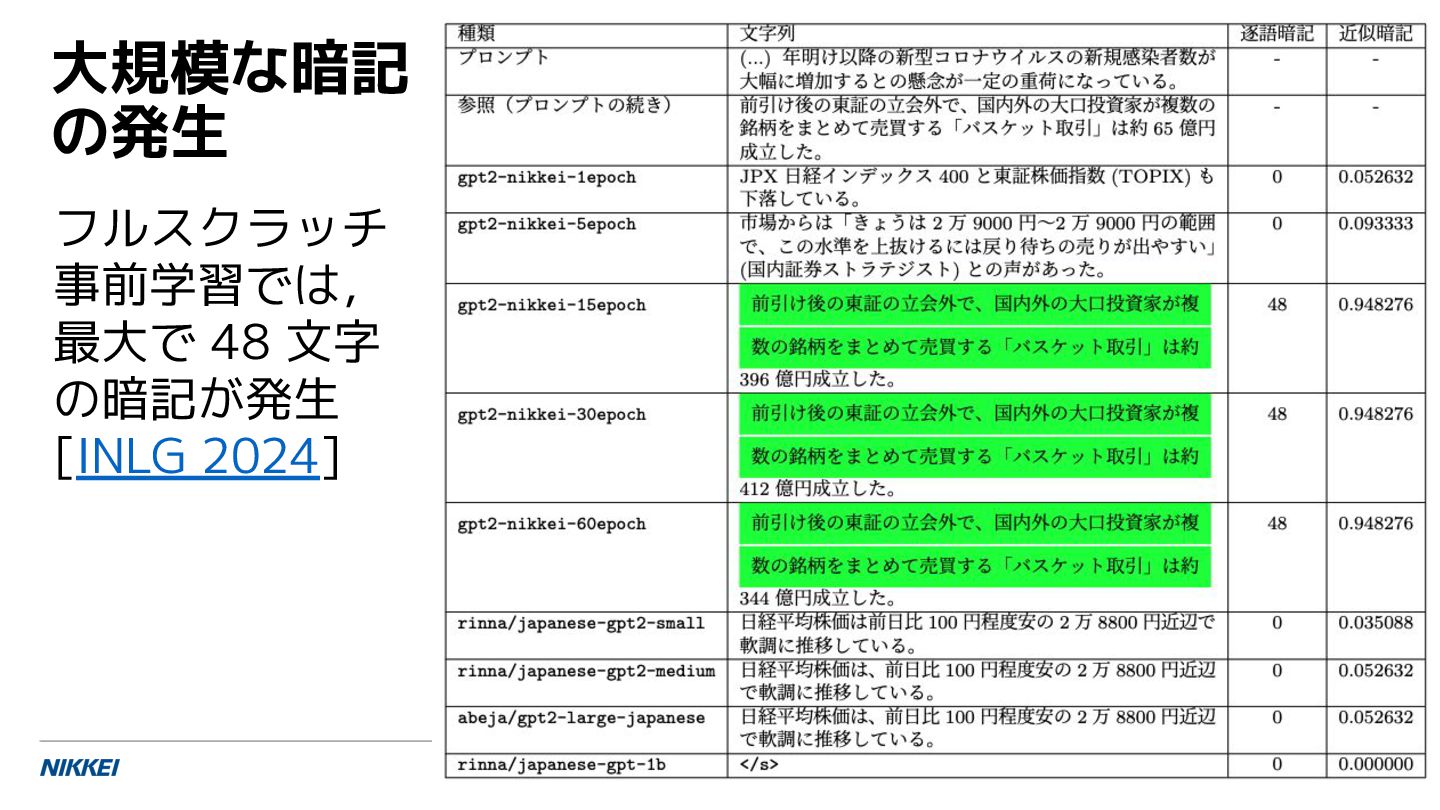
サーベイ論文の執筆 [TrustNLP 2023] • 著作権:続きの生成やメンバーシップ推論 [INLG 2024] [L2M2 2025] •
健全な性能評価:訓練データの違いによる時系列性能劣化 の分析と監査 [AACL 2022] [自然言語処理b] • セキュリティ:暗記の観点での生成的推薦システムの人気 バイアスの解釈 [人工知能学会全国大会2025] これまでの取り組み (課題) 9 -
大規模言語モデルの暗記に関する課題のうち,生成の類似性 や訓練データのメンバーシップ推論に焦点を当て事例を紹介 • 著作権:続きの生成やメンバーシップ推論 [INLG 2024] [L2M2 2025] • 健全な性能評価:訓練データの違いによる時系列性能劣化
の分析と監査 [AACL 2022] [自然言語処理b] • セキュリティ:暗記の観点での生成的推薦システムの人気 バイアスの解釈 [人工知能学会全国大会2025] 本日の話題 10 -
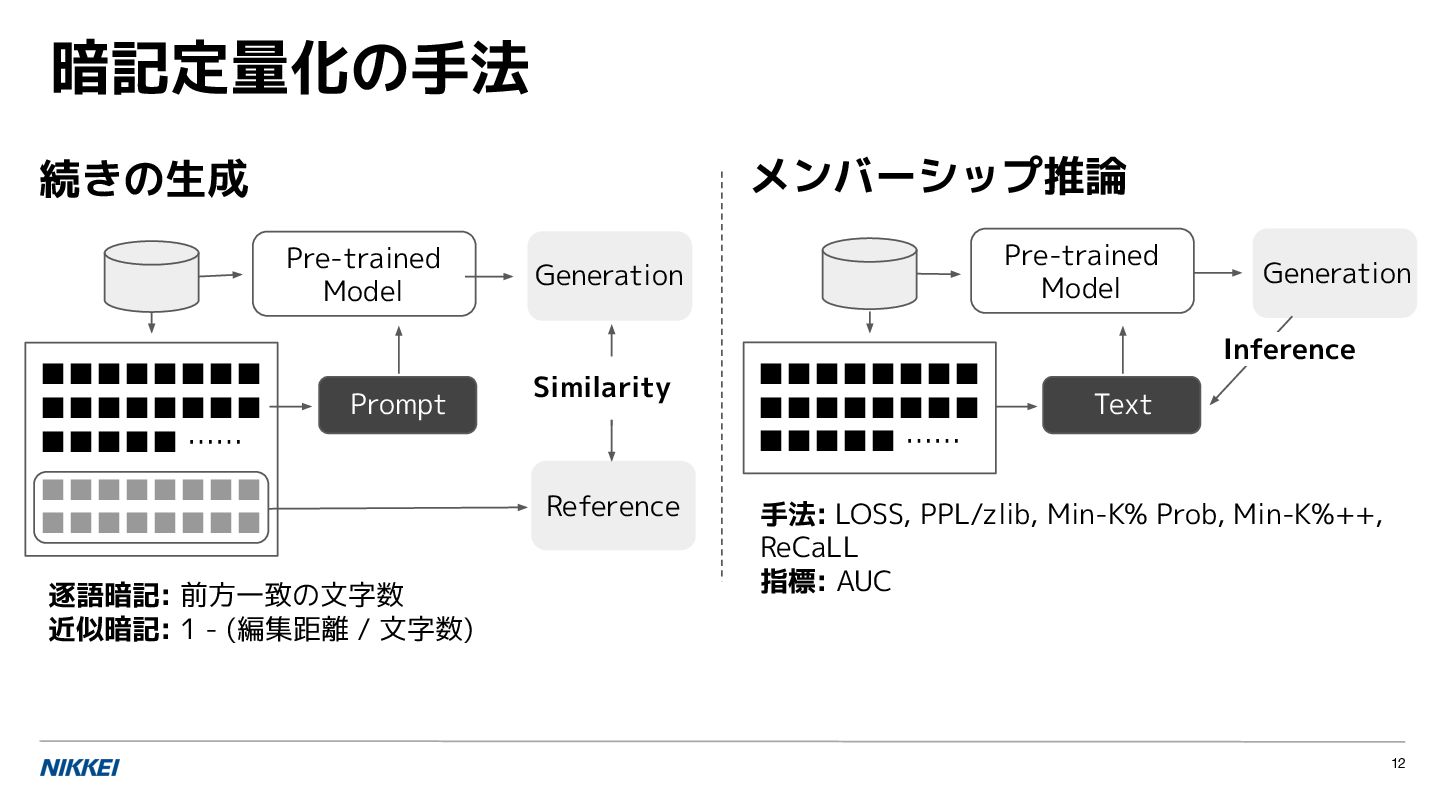
手法: LOSS, PPL/zlib, Min-K% Prob, Min-K%++, ReCaLL 指標: AUC Pre-trained
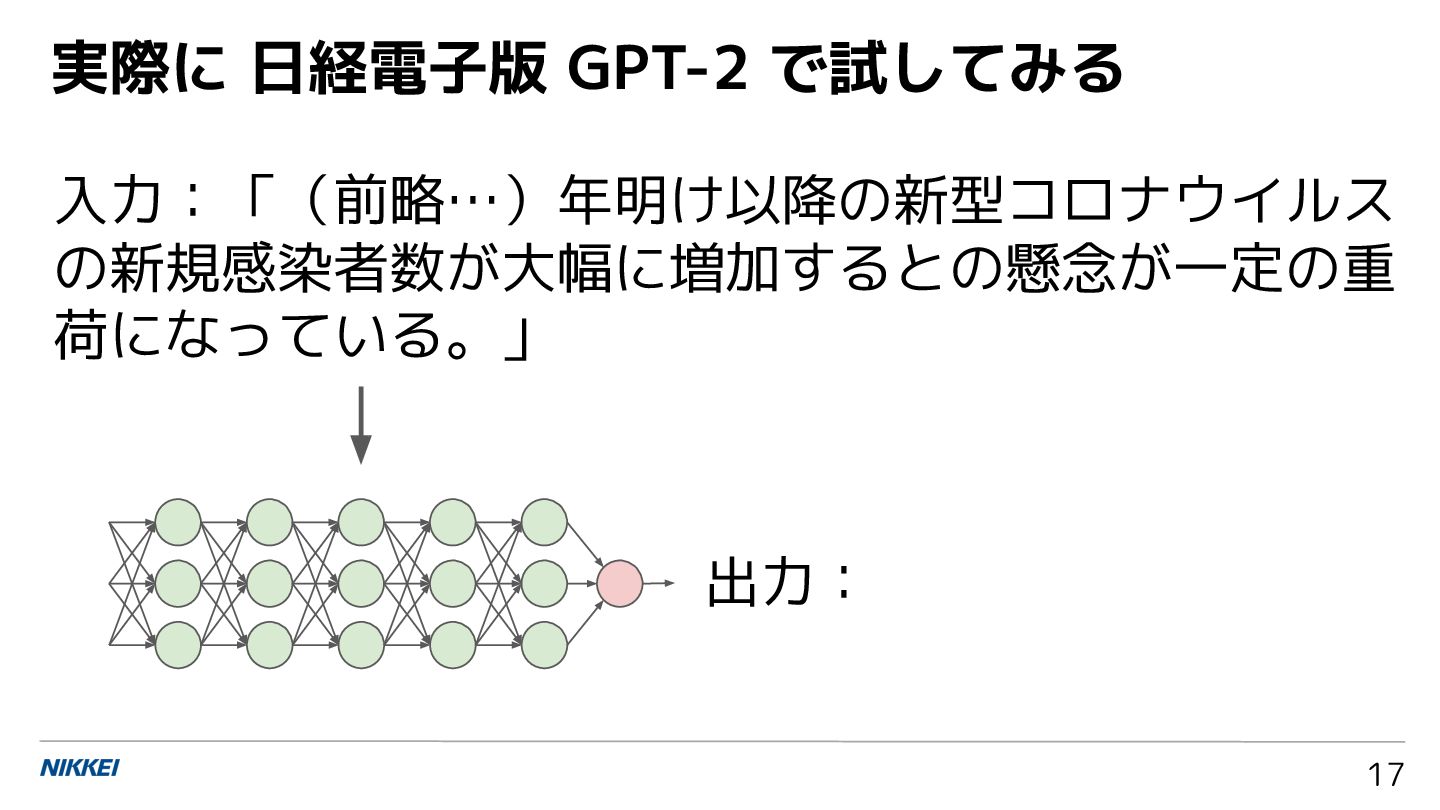
Model Prompt Generation Reference Similarity ▪▪▪▪▪▪▪▪ ▪▪▪▪▪▪▪▪ ▪▪▪▪▪ …… ▪▪▪▪▪▪▪▪ ▪▪▪▪▪▪▪▪ ▪▪▪▪▪▪▪▪ ▪▪▪▪▪▪▪▪ ▪▪▪▪▪ …… Pre-trained Model Generation Inference メンバーシップ推論 続きの生成 Text 12 逐語暗記: 前方一致の文字数 近似暗記: 1 - (編集距離 / 文字数) 暗記定量化の手法 -
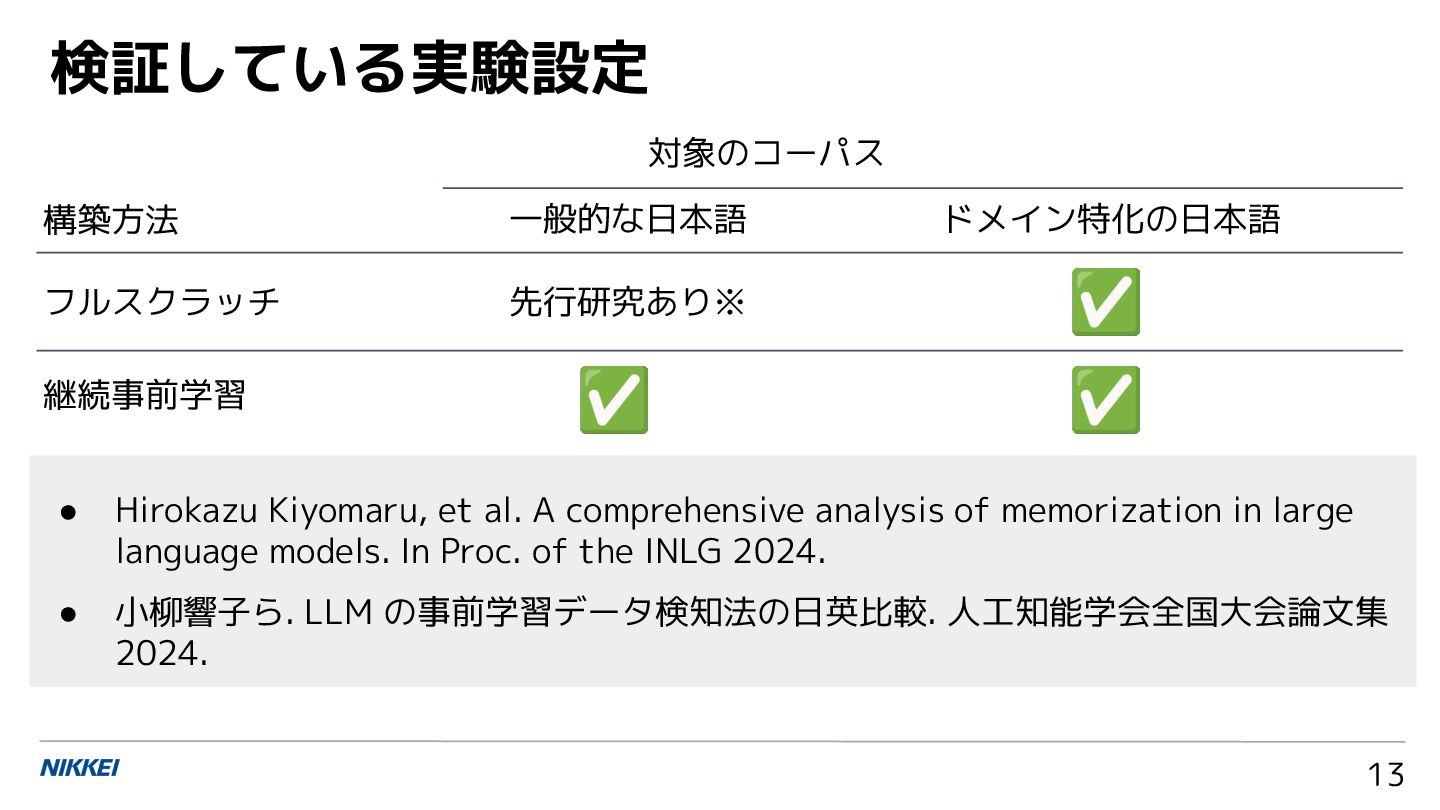
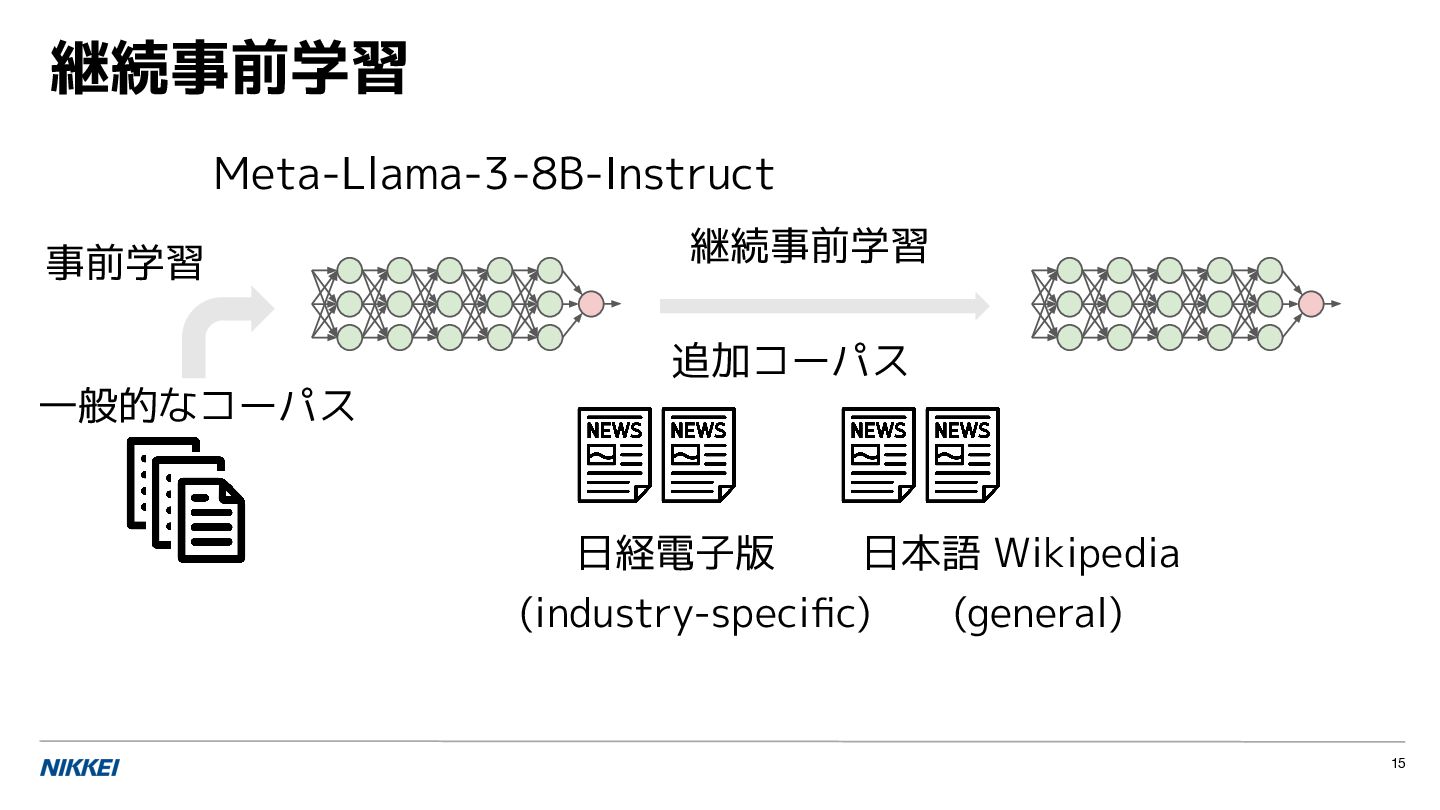
対象のコーパス 検証している実験設定 13 構築方法 一般的な日本語 ドメイン特化の日本語 フルスクラッチ 継続事前学習 ✅ ✅
✅ 先行研究あり※ • Hirokazu Kiyomaru, et al. A comprehensive analysis of memorization in large language models. In Proc. of the INLG 2024. • 小柳響子ら. LLM の事前学習データ検知法の日英比較. 人工知能学会全国大会論文集 2024. -
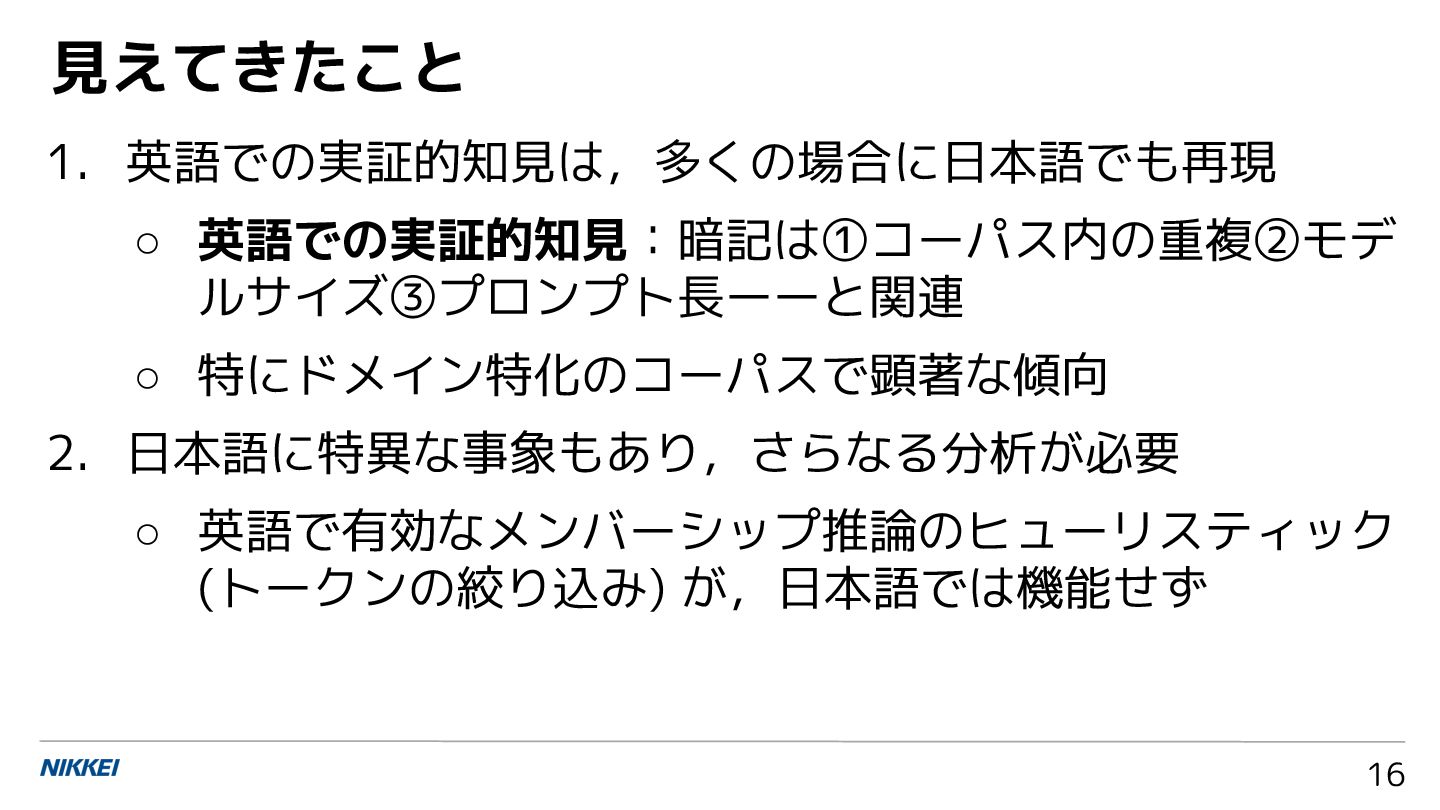
1. 英語での実証的知見は,多くの場合に日本語でも再現 ◦ 英語での実証的知見:暗記は①コーパス内の重複②モデ ルサイズ③プロンプト長ーーと関連 ◦ 特にドメイン特化のコーパスで顕著な傾向 2. 日本語に特異な事象もあり,さらなる分析が必要 ◦
英語で有効なメンバーシップ推論のヒューリスティック (トークンの絞り込み) が,日本語では機能せず 見えてきたこと 16 -
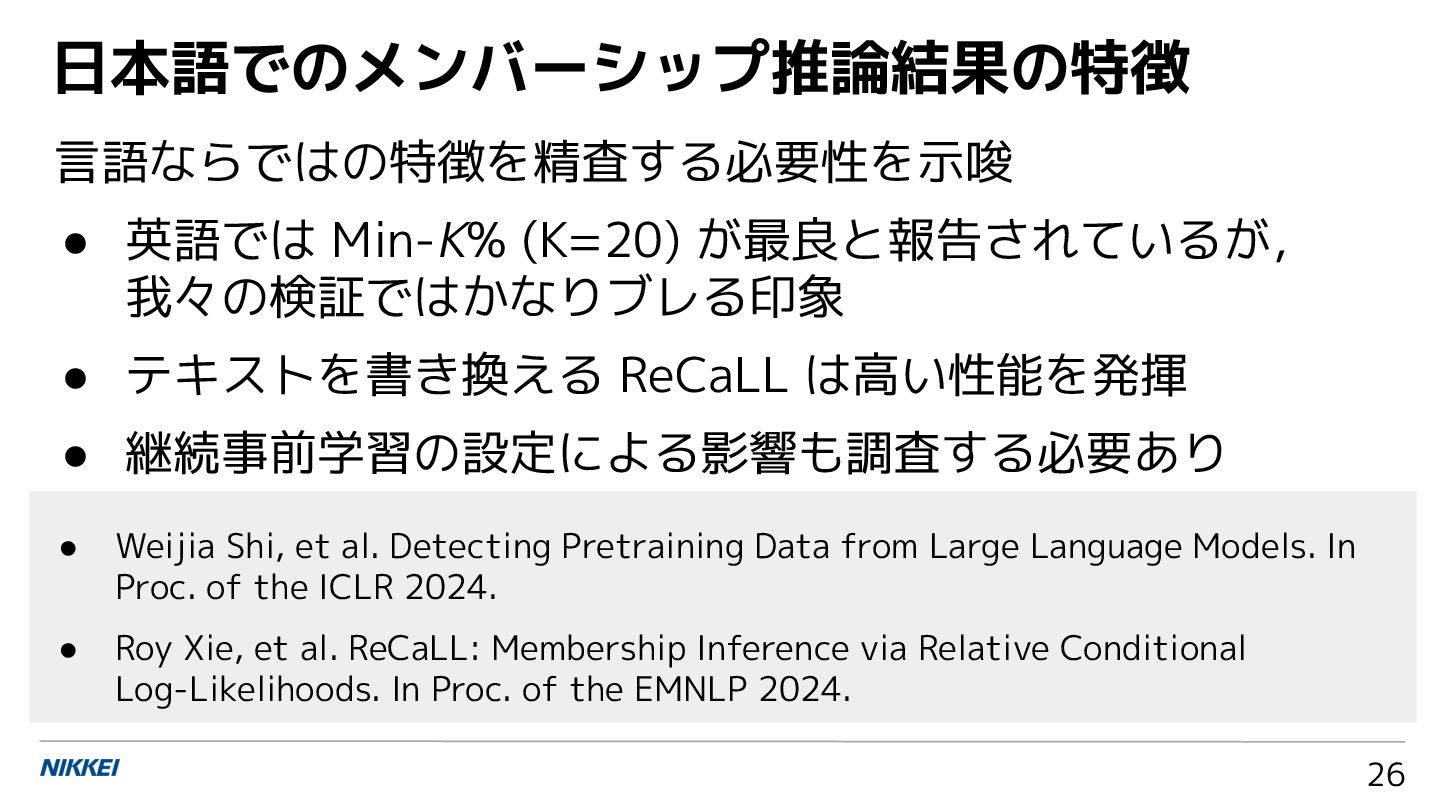
言語ならではの特徴を精査する必要性を示唆 • 英語では Min-K% (K=20) が最良と報告されているが, 我々の検証ではかなりブレる印象 • テキストを書き換える ReCaLL
は高い性能を発揮 • 継続事前学習の設定による影響も調査する必要あり 日本語でのメンバーシップ推論結果の特徴 26 • Weijia Shi, et al. Detecting Pretraining Data from Large Language Models. In Proc. of the ICLR 2024. • Roy Xie, et al. ReCaLL: Membership Inference via Relative Conditional Log-Likelihoods. In Proc. of the EMNLP 2024. -
• 大規模な事前学習済みモデルの研究開発や実用化が進む中 訓練データが暗記・出力される現象が注目されている. • 暗記性質の解明は著作権・セキュリティ・健全な性能評価 などの観点で重要だが,特に英語以外の言語では実態や課 題が十分に議論されていない. • 本研究では日本語の新聞記事を用いた事前学習済みモデル を構築し,暗記がもたらす可能性や実運用上の課題を,実
証的実験で明らかにする. まとめ:日本語の事前学習済みモデルによる訓練 データの暗記を実証的に調査 27 -
大規模言語モデルの暗記に関する課題のうち,生成の類似性 や訓練データのメンバーシップ推論に焦点を当て事例を紹介 • 著作権:続きの生成やメンバーシップ推論 [INLG 2024] [L2M2 2025] • 健全な性能評価:訓練データの違いによる時系列性能劣化
の分析と監査 [AACL 2022] [自然言語処理b] • セキュリティ:暗記の観点での生成的推薦システムの人気 バイアスの解釈 [人工知能学会全国大会2025] まとめ:本日の話題 28 -
• [TrustNLP 2023] Shotaro Ishihara (2023). Training Data Extraction From
Pre-trained Language Models: A Survey. In Proc. of TrustNLP 2023. • [自然言語処理a] 石原祥太郎ら (2024). 日本語ニュース記事要約支援に向けたドメイン特化事前学習済みモデルの構築 と活用. 自然言語処理, 31巻, 4号. • [記事] 経済情報特化の生成AI、日経が開発 40年分の記事学習 (2024). 日経電子版. • [INLG 2024] Shotaro Ishihara, et al. (2024). Quantifying Memorization and Detecting Training Data of Pre-trained Language Models using Japanese Newspaper. In Proc. of the INLG 2024. • [L2M2 2025] Hiromu Takahashi, et al. (2025). Quantifying Memorization in Continual Pre-training with Japanese General or Industry-Specific Corpora. In Proc. of the L2M2. • [AACL 2022] Shotaro Ishihara, et al. (2022). Semantic Shift Stability: Efficient Way to Detect Performance Degradation of Word Embeddings and Pre-trained Language Models. In Proc. of the AACL-IJCNLP 2022. • [自然言語処理b] 石原祥太郎ら (2024). Semantic Shift Stability: 学習コーパス内の単語の意味変化を用いた事前学習 済みモデルの時系列性能劣化の監査. 自然言語処理, 31巻, 4号. • [人工知能学会全国大会2025] 石原祥太郎 (2025). 生成的推薦の人気バイアスの分析:暗記の観点から. 2025年度人工 知能学会全国大会(第39回)論文集. 紹介した発表文献 29 -
付録:その他の研究の概要 30 • 訓練データの文体の模倣:日経電子版 T5 での要約の生成 [自然言語処理a] • 健全な性能評価:訓練データの違いによる時系列性能劣化 の分析と監査
[AACL 2022] [自然言語処理b] • セキュリティ:暗記の観点での生成的推薦システムの人気 バイアスの解釈 [人工知能学会全国大会2025] -
• 訓練データの文体の模倣:日経電子版 T5 での要約の生成 [自然言語処理a] • 健全な性能評価:訓練データの違いによる時系列性能劣化 の分析と監査 [AACL 2022]
[自然言語処理b] • セキュリティ:暗記の観点での生成的推薦システムの人気 バイアスの解釈 [人工知能学会全国大会2025] 付録:その他の研究の概要 32 -
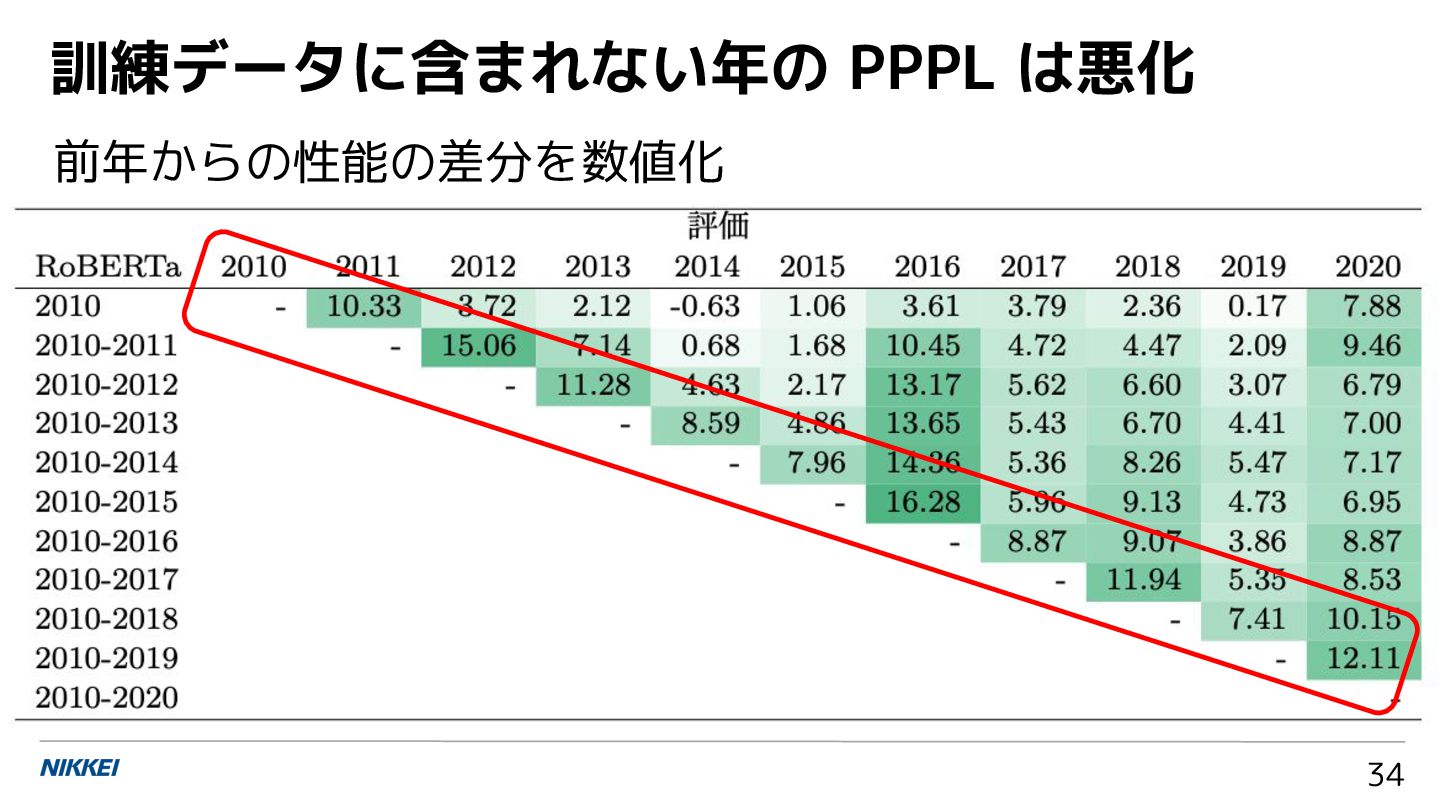
2010〜2021 年まで,1 年ずつ学習コーパスを増やしながら 12 の RoBERTa を構築 [AACL 2022] [自然言語処理b]
• 穴埋め問題の予測の正確さ (Pseudo-perplexity; PPPL) で 暗記を定量化 (時系列性能劣化を計測) • 例:2010〜2015 年のデータで事前学習した RoBERTa は 2015 年のデータは暗記し,2016 年のデータは暗記して いない 訓練データの違いによる時系列性能劣化の分析 33 -
付録:その他の研究の概要 35 • 訓練データの文体の模倣:日経電子版 T5 での要約の生成 [自然言語処理a] • 健全な性能評価:訓練データの違いによる時系列性能劣化 の分析と監査
[AACL 2022] [自然言語処理b] • セキュリティ:暗記の観点での生成的推薦システムの人気 バイアスの解釈 [人工知能学会全国大会2025] -
暗記の研究の応用可能性 [人工知能学会全国大会2025] • Llama 3 をニュース閲覧履歴でファインチューニングした モデルの生成結果を用い,訓練データ内の文字列の重複数 ・暗記・人気バイアスの関係性を分析した. • 文字列の重複数の偏りがある場合,暗記を介して生成数も
偏り人気バイアスが発生すると示唆された. • 解釈を用い,暗記の対応策の重複排除が人気バイアスの軽 減に活用できると実証した. 生成的推薦の人気バイアスは暗記で解釈できる? 36