Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
論文紹介:Doc-to-LoRA: Learning to Instantly Interna...
Search
Yukako Nakano
August 20, 2026
Research
190
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
論文紹介:Doc-to-LoRA: Learning to Instantly Internalize Contexts
Yukako Nakano
August 20, 2026
Other Decks in Research
See All in Research
[最先端NLP勉強会2026] Agentic Rubrics as Contextual Verifiers for SWE Agents
rfujii
1
390
某助成金プロジェクト採択に向けて企業研究所のアウトリーチ専任者がやったこと
afroscript
0
200
SAKURAONE: An Open Ethernet-based AI HPC System And Its Observed Workload Dynamics in a Single-Tenant LLM Development Environment
yuukit
1
670
JICA QUEST 共創×革新プログラム Impact Report(海ノ向こうコーヒー)
ontheslope
0
810
Visual SLAM未来予測 / Future Prediction in Visual SLAM
koide3
1
1.2k
Physical AIでモデリングはどう変わるか/How Physical AI Will Change Modeling
stktu
0
290
Kunai: Toward a Verifier-Safe Layered DSL for Nested Encapsulation Packet Filtering on eBPF
takehaya
1
130
[最先端NLP勉強会2026] Checklists Are Better Than Reward Models For Aligning Language Models
nzw0301
1
330
VRID: View-Invariant Representation through Dual-Axis Transformation for Cross-iew Pose Estimation
satai
3
120
PHTalks Bengaluru - SSRF When All Else Fails
dk999
0
1.2k
長時間動画QAにおけるマルチエージェント推論 ・SVAgent: Storyline-Guided Long Video Understanding via Cross-Modal Multi-Agent Collaboration
murakawatakuya
1
220
Vector Map as Language: Toward Unified Remote Sensing Vector Mapping
satai
3
300
Featured
See All Featured
From Legacy to Launchpad: Building Startup-Ready Communities
dugsong
0
350
Paper Plane (Part 1)
katiecoart
PRO
2
11k
Effective software design: The role of men in debugging patriarchy in IT @ Voxxed Days AMS
baasie
1
560
Taking LLMs out of the black box: A practical guide to human-in-the-loop distillation
inesmontani
PRO
3
2.4k
How to audit for AI Accessibility on your Front & Back End
davetheseo
0
580
Principles of Awesome APIs and How to Build Them.
keavy
128
18k
Jamie Indigo - Trashchat’s Guide to Black Boxes: Technical SEO Tactics for LLMs
techseoconnect
PRO
0
700
Connecting the Dots Between Site Speed, User Experience & Your Business [WebExpo 2025]
tammyeverts
11
1.1k
WENDY [Excerpt]
tessaabrams
14
40k
First, design no harm
axbom
PRO
2
1.3k
Beyond borders and beyond the search box: How to win the global "messy middle" with AI-driven SEO
davidcarrasco
3
280
Fashionably flexible responsive web design (full day workshop)
malarkey
409
67k
Transcript
第18回 最先端NLP勉強会2026 論文紹介 Doc-to-LoRA: Learning to Instantly Internalize Contexts Rujikorn
Charakorn, Edoardo Cetin, Shinnosuke Uesaka, Robert Tjarko Lange ICML2026 発表者:中野由加子(NTT 人間情報研究所) © NTT, Inc. 2026
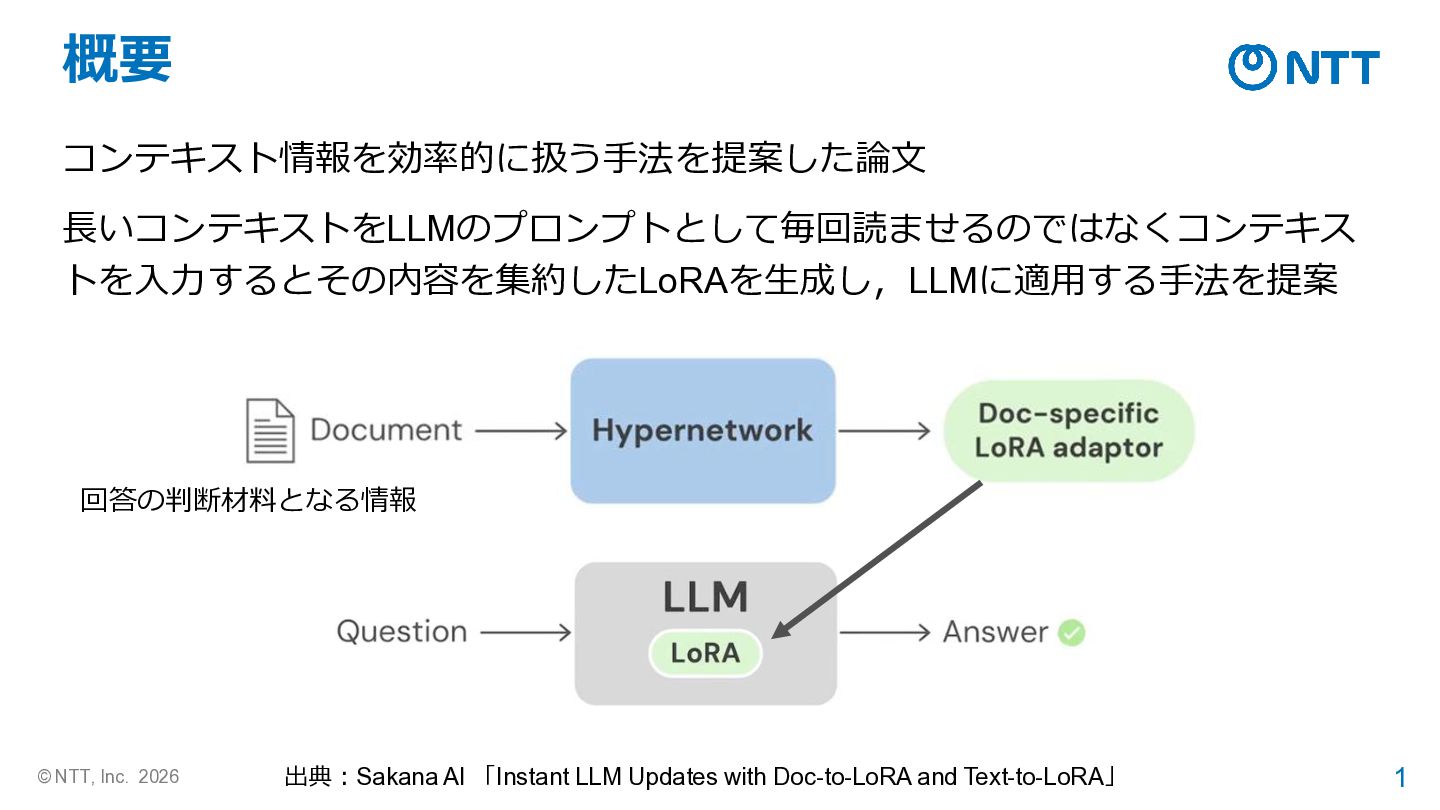
概要 コンテキスト情報を効率的に扱う手法を提案した論文 長いコンテキストをLLMのプロンプトとして毎回読ませるのではなくコンテキス トを入力するとその内容を集約したLoRAを生成し,LLMに適用する手法を提案 回答の判断材料となる情報 © NTT, Inc. 2026 出典:Sakana
AI 「Instant LLM Updates with Doc-to-LoRA and Text-to-LoRA」 1
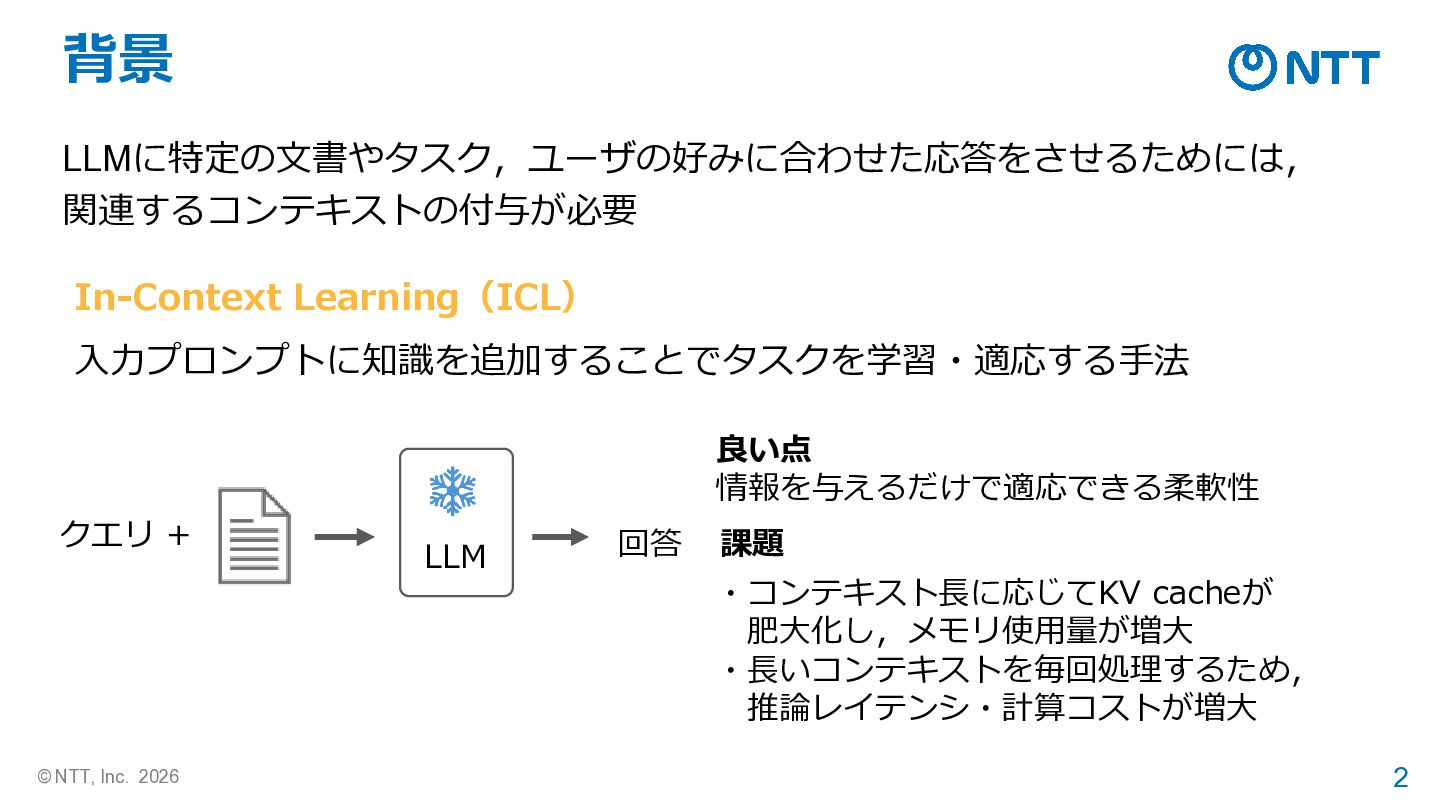
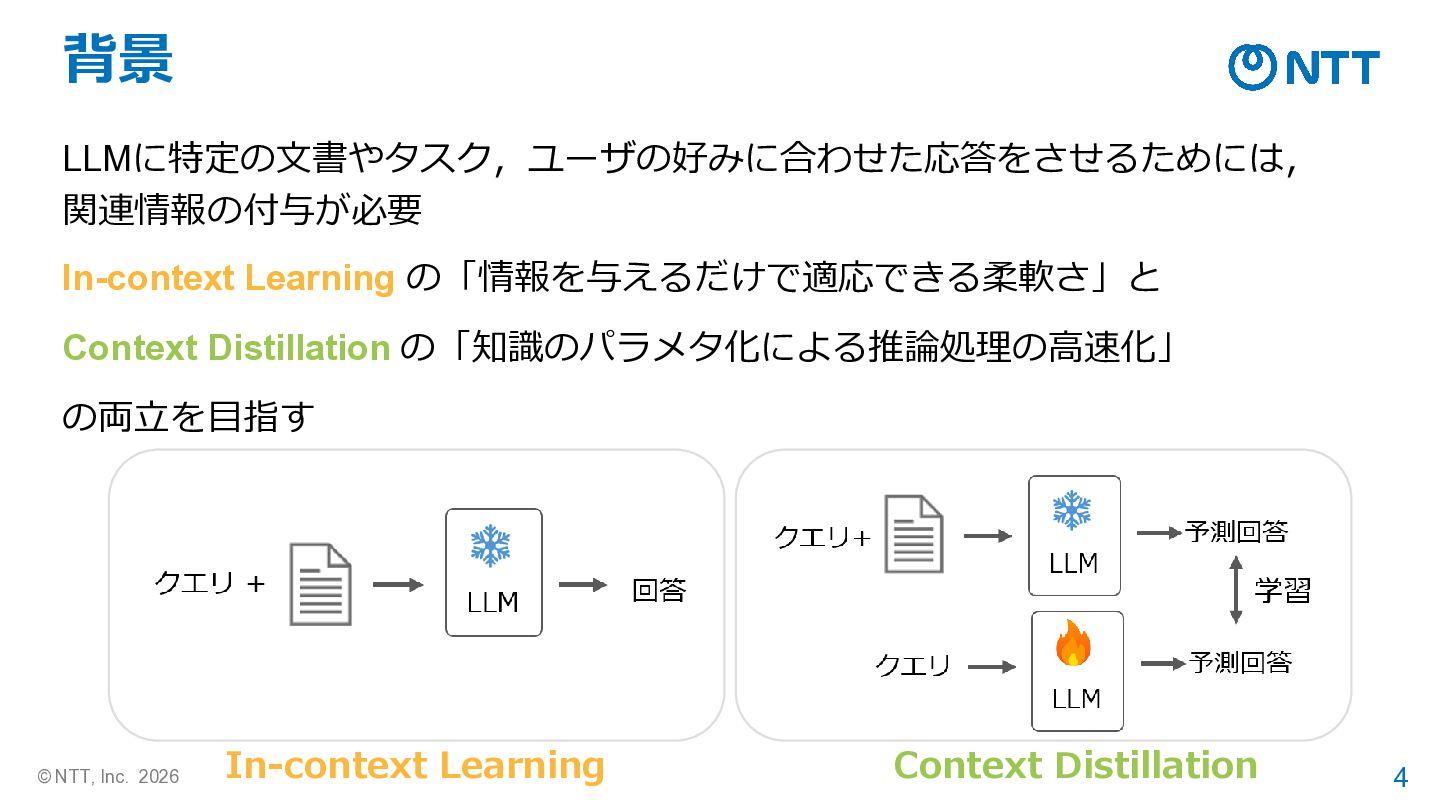
背景 LLMに特定の文書やタスク,ユーザの好みに合わせた応答をさせるためには, 関連するコンテキストの付与が必要 In-Context Learning(ICL) 入力プロンプトに知識を追加することでタスクを学習・適応する手法 良い点 情報を与えるだけで適応できる柔軟性 クエリ +
© NTT, Inc. 2026 LLM 回答 課題 ・コンテキスト長に応じてKV cacheが 肥大化し,メモリ使用量が増大 ・長いコンテキストを毎回処理するため, 推論レイテンシ・計算コストが増大 2
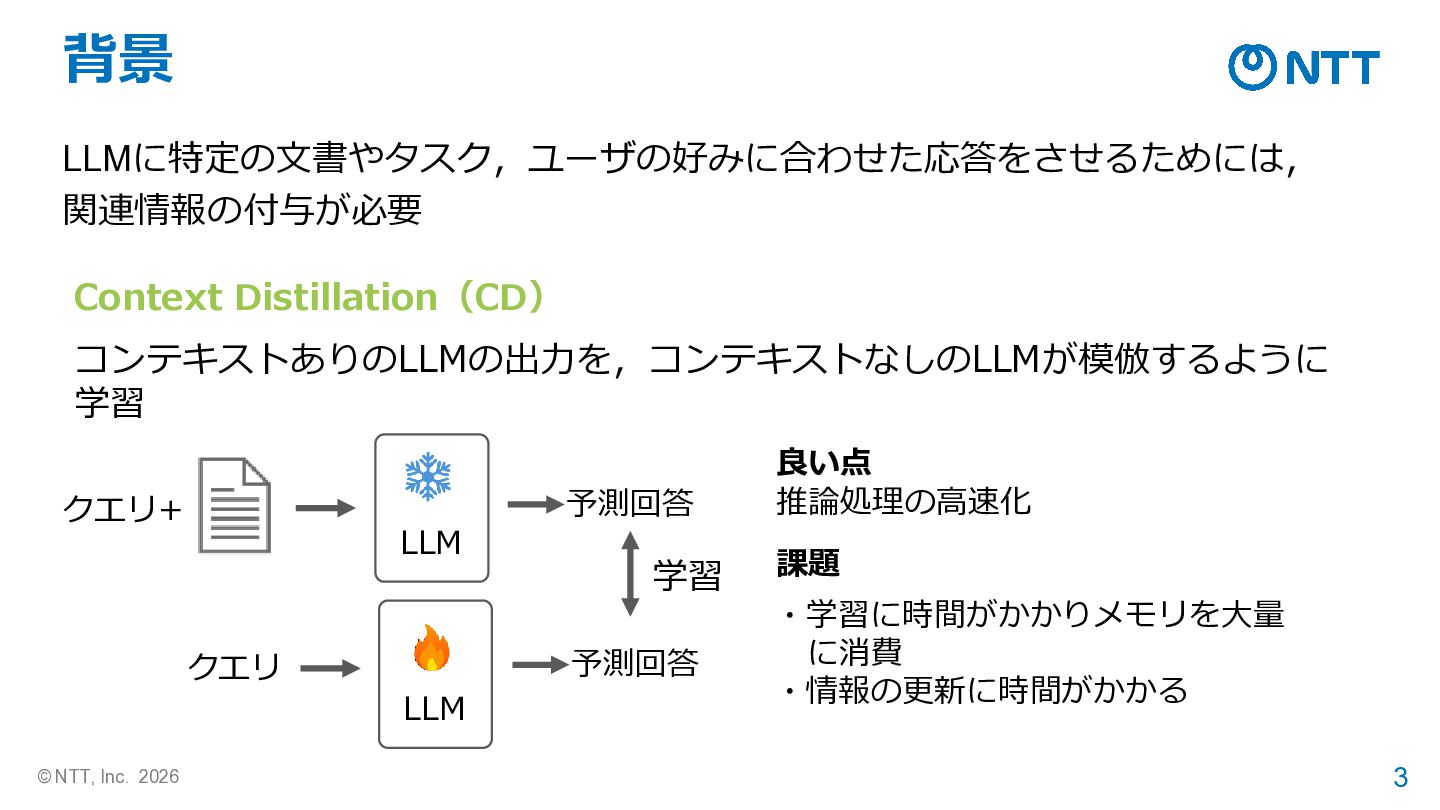
背景 LLMに特定の文書やタスク,ユーザの好みに合わせた応答をさせるためには, 関連情報の付与が必要 Context Distillation(CD) コンテキストありのLLMの出力を,コンテキストなしのLLMが模倣するように 学習 予測回答 クエリ+ LLM
予測回答 クエリ LLM © NTT, Inc. 2026 学習 良い点 推論処理の高速化 課題 ・学習に時間がかかりメモリを大量 に消費 ・情報の更新に時間がかかる 3
背景 LLMに特定の文書やタスク,ユーザの好みに合わせた応答をさせるためには, 関連情報の付与が必要 In-context Learning の「情報を与えるだけで適応できる柔軟さ」と Context Distillation の「知識のパラメタ化による推論処理の高速化」 の両立を目指す
© NTT, Inc. 2026 In-context Learning Context Distillation 4
提案手法 © NTT, Inc. 2026 5
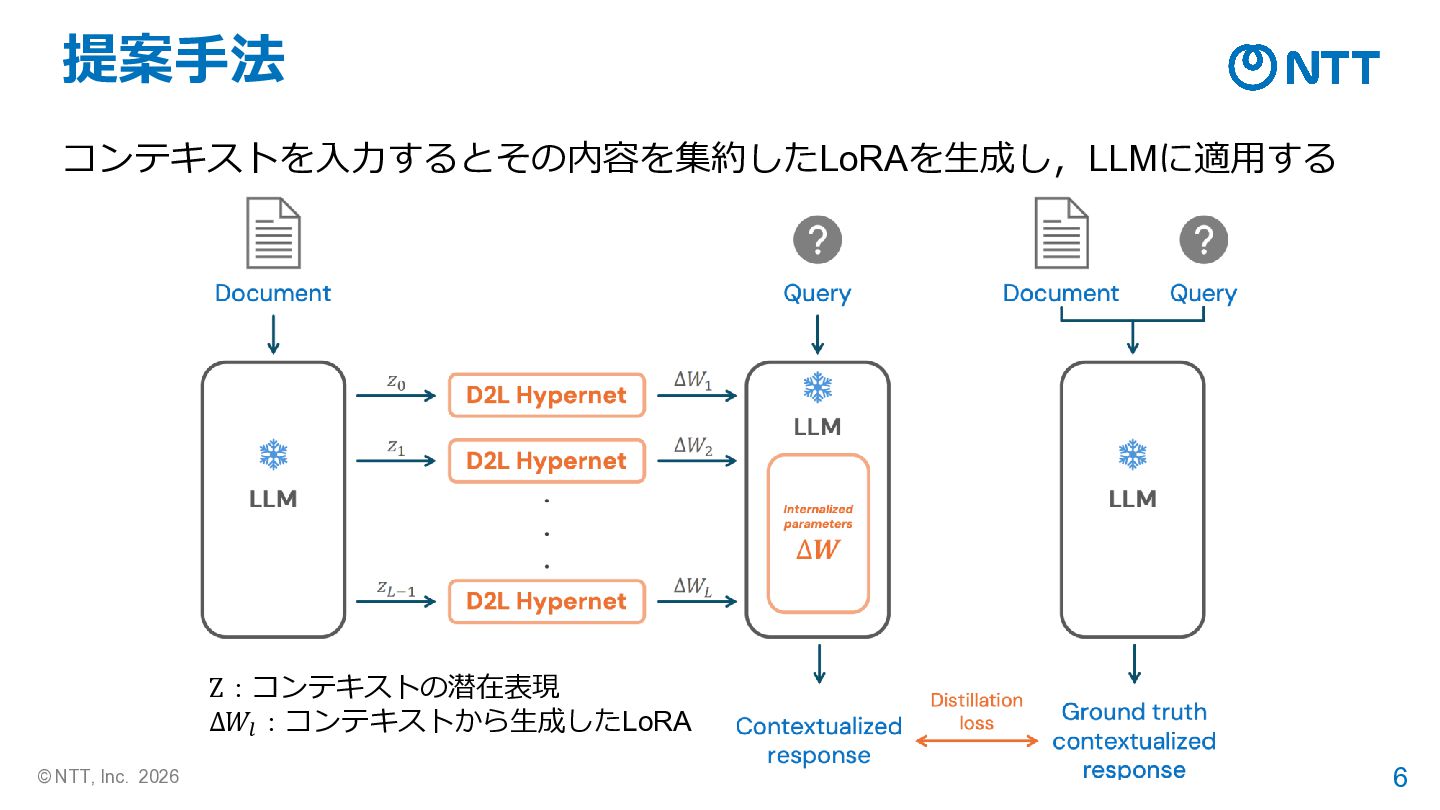
提案手法 コンテキストを入力するとその内容を集約したLoRAを生成し,LLMに適用する Ζ:コンテキストの潜在表現 Δ𝑊𝑙 :コンテキストから生成したLoRA © NTT, Inc. 2026 6
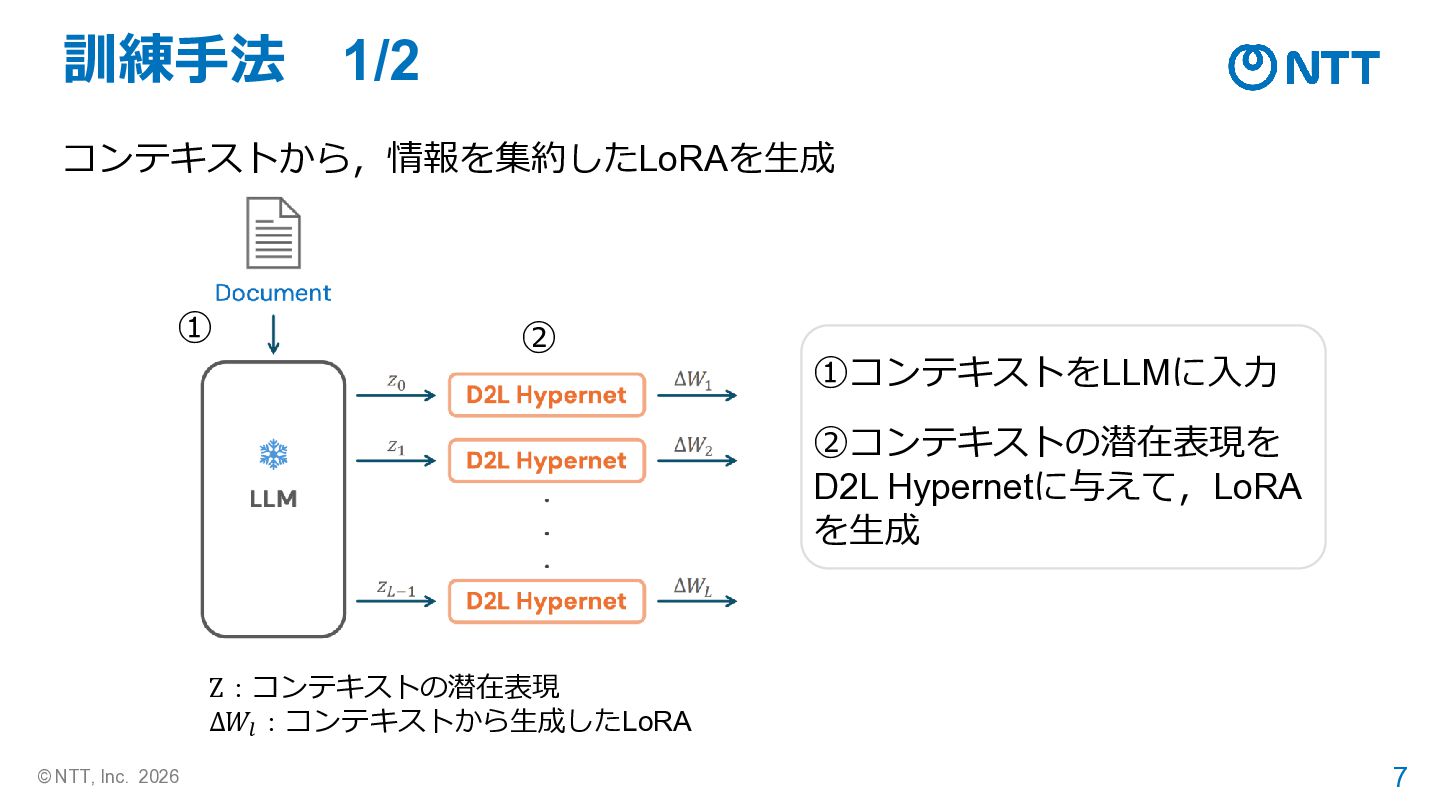
訓練手法 1/2 コンテキストから,情報を集約したLoRAを生成 ① ② ①コンテキストをLLMに入力 ②コンテキストの潜在表現を D2L Hypernetに与えて,LoRA を生成
Ζ:コンテキストの潜在表現 Δ𝑊𝑙 :コンテキストから生成したLoRA © NTT, Inc. 2026 7
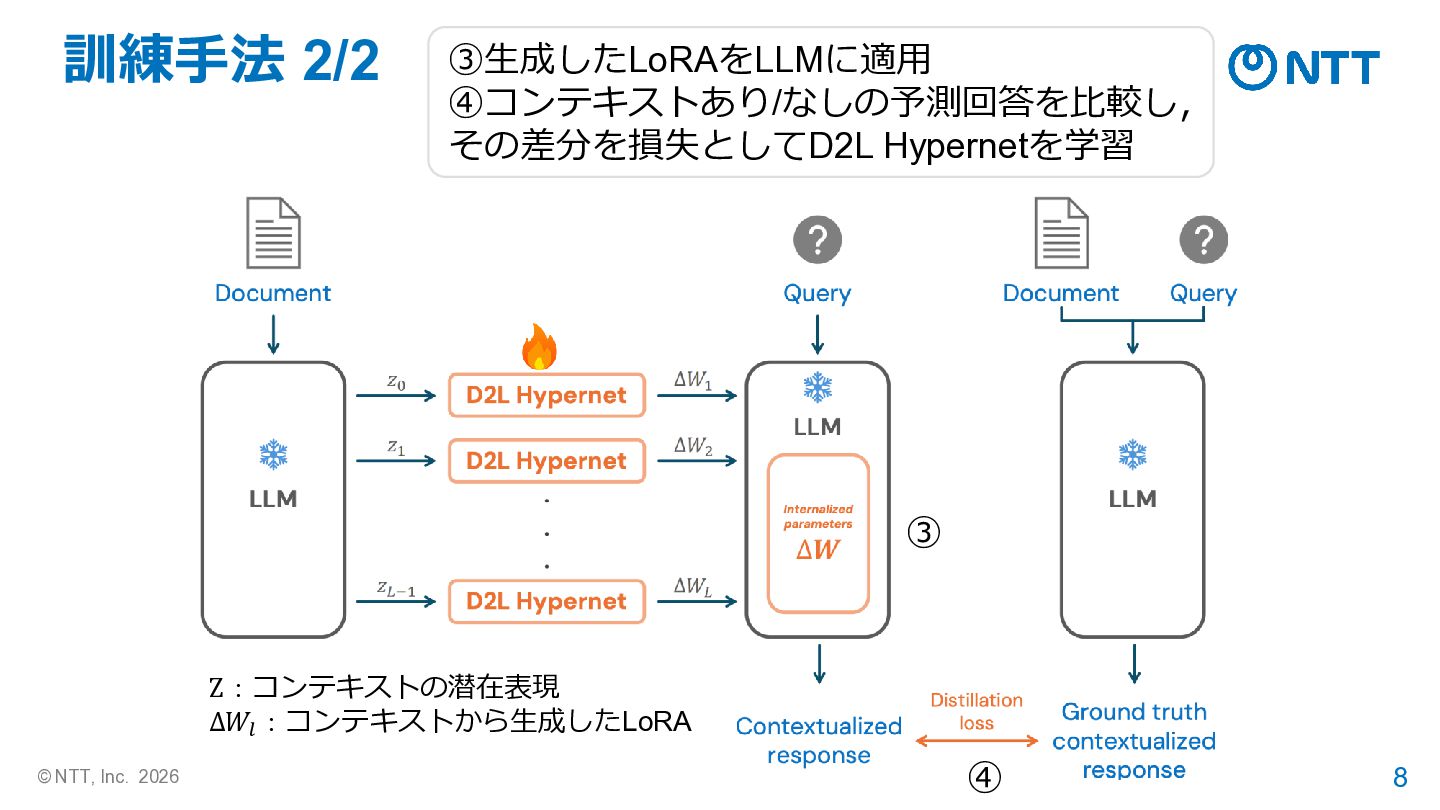
訓練手法 2/2 ③生成したLoRAをLLMに適用 ④コンテキストあり/なしの予測回答を比較し, その差分を損失としてD2L Hypernetを学習 ③ Ζ:コンテキストの潜在表現 Δ𝑊𝑙 :コンテキストから生成したLoRA
© NTT, Inc. 2026 ④ 8
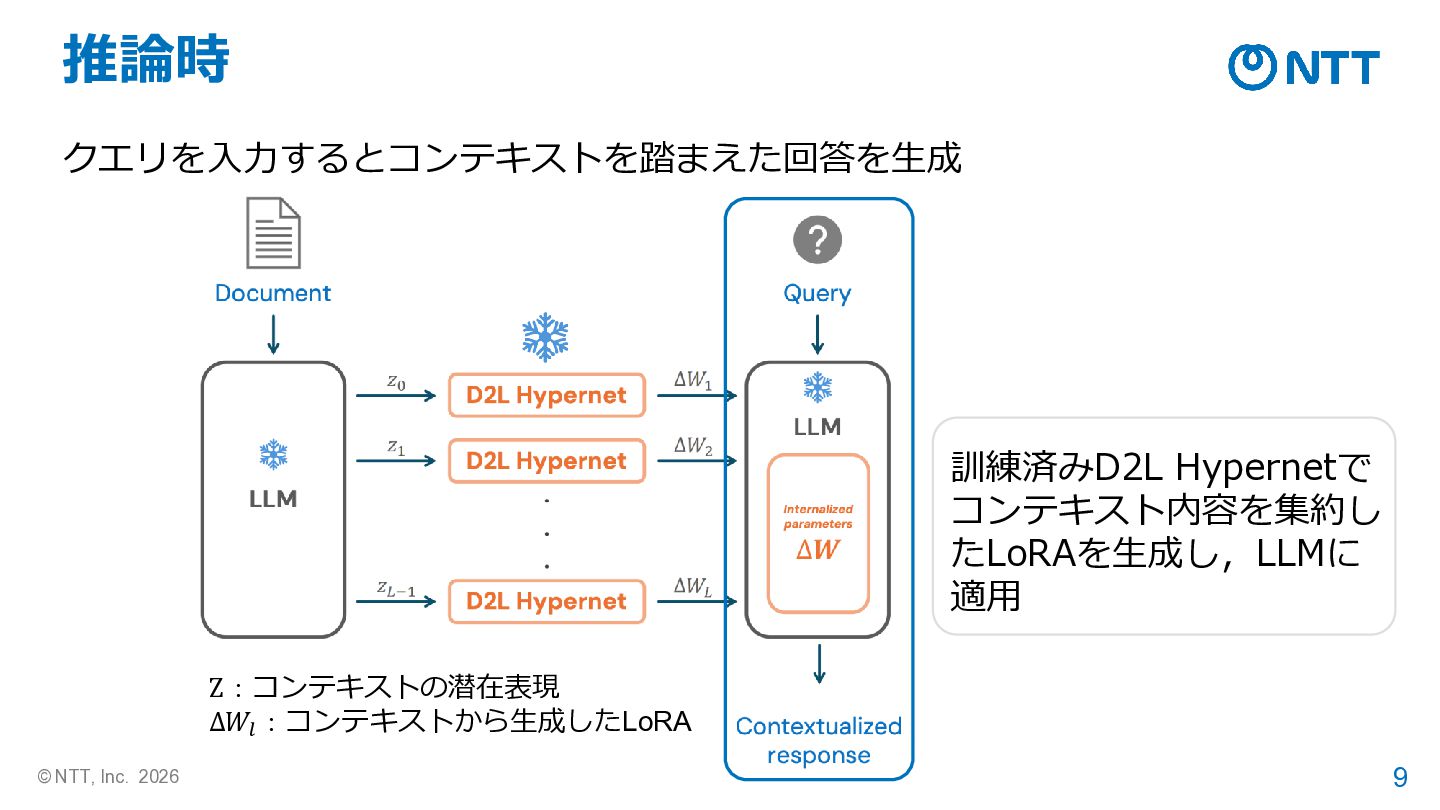
推論時 クエリを入力するとコンテキストを踏まえた回答を生成 訓練済みD2L Hypernetで コンテキスト内容を集約し たLoRAを生成し,LLMに 適用 Ζ:コンテキストの潜在表現 Δ𝑊𝑙 :コンテキストから生成したLoRA
© NTT, Inc. 2026 9
実験 © NTT, Inc. 2026 10
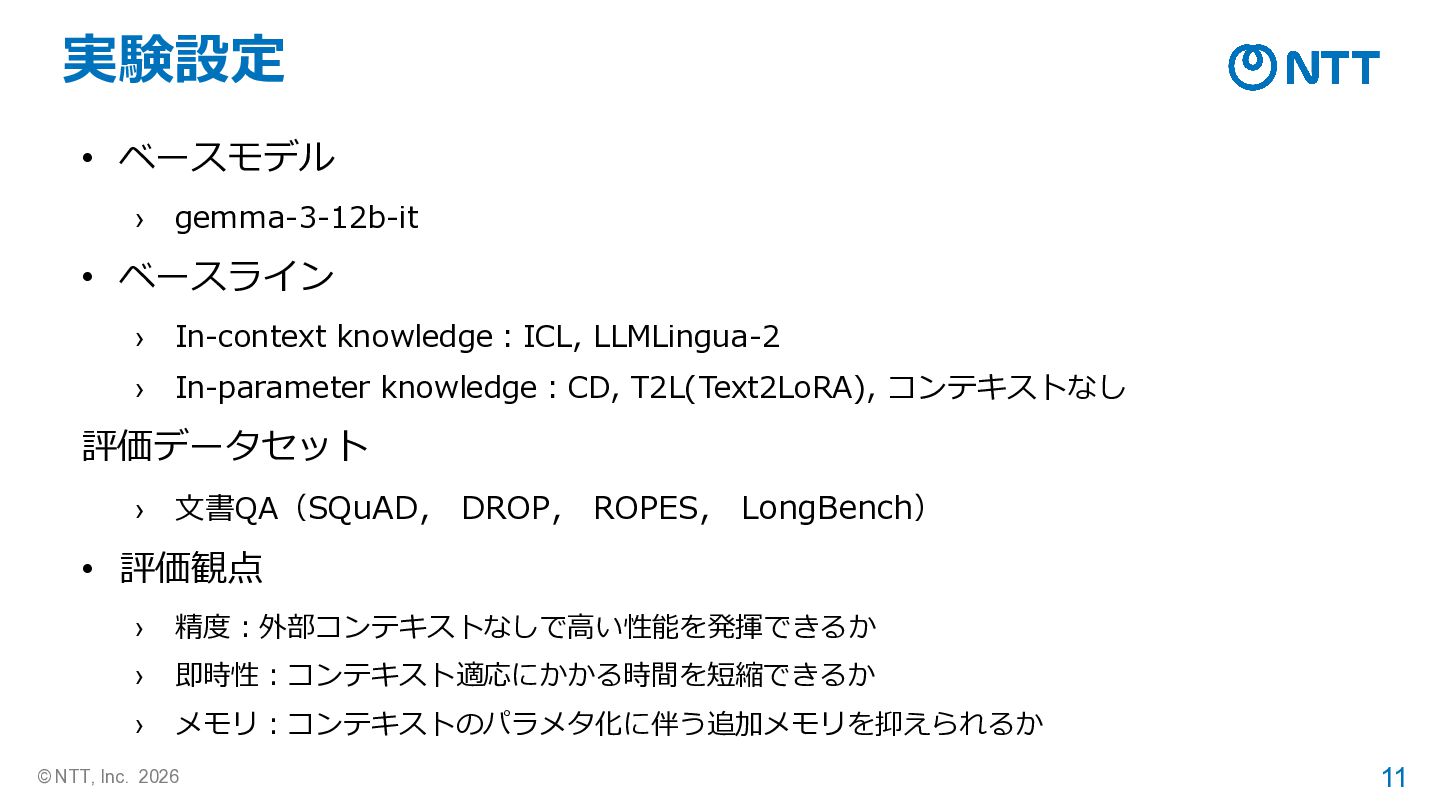
実験設定 • ベースモデル › gemma-3-12b-it • ベースライン › In-context knowledge:ICL,
LLMLingua-2 › In-parameter knowledge:CD, T2L(Text2LoRA), コンテキストなし 評価データセット › 文書QA(SQuAD, DROP, ROPES, LongBench) • 評価観点 › 精度:外部コンテキストなしで高い性能を発揮できるか › 即時性:コンテキスト適応にかかる時間を短縮できるか › メモリ:コンテキストのパラメタ化に伴う追加メモリを抑えられるか © NTT, Inc. 2026 11
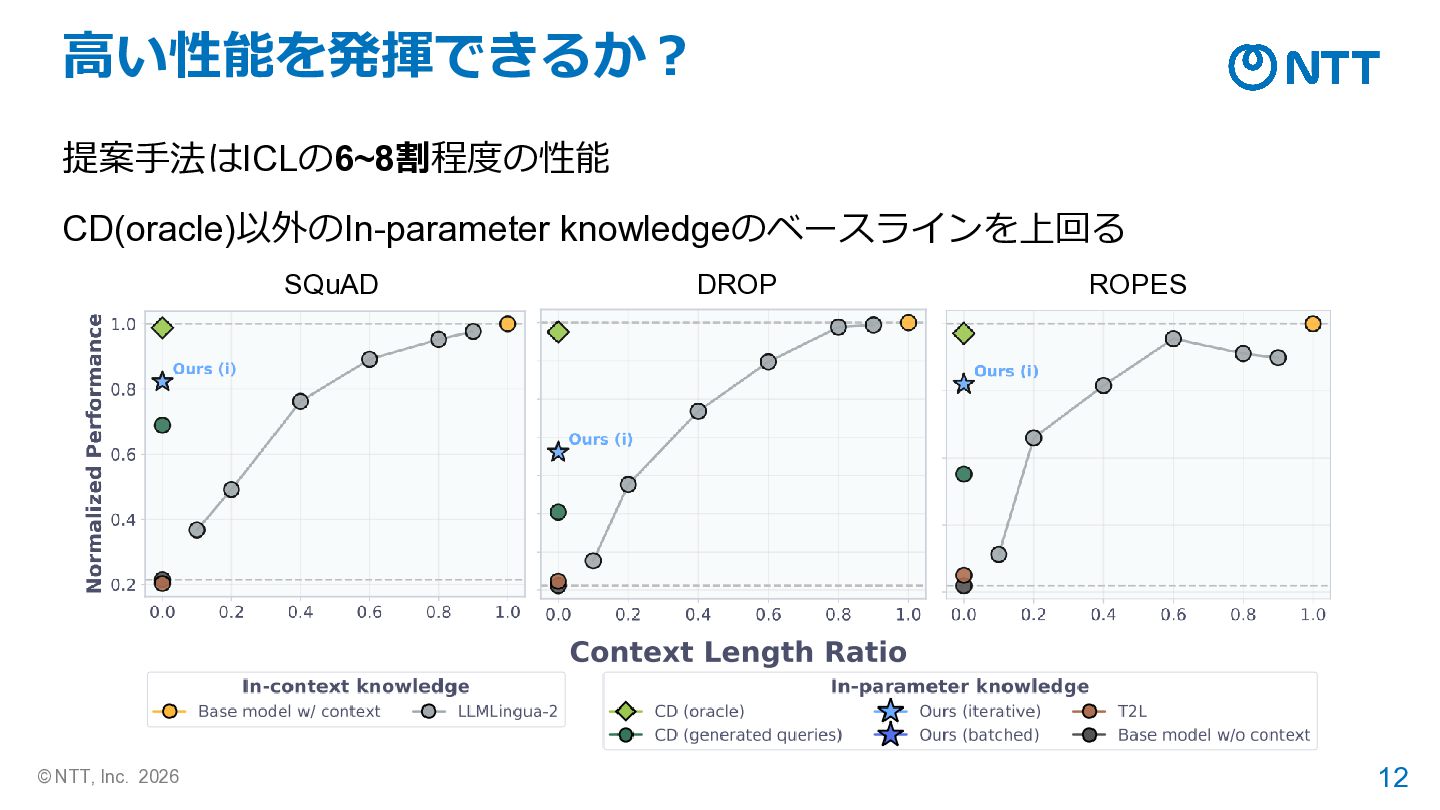
高い性能を発揮できるか? 提案手法はICLの6~8割程度の性能 CD(oracle)以外のIn-parameter knowledgeのベースラインを上回る SQuAD © NTT, Inc. 2026 DROP
ROPES 12
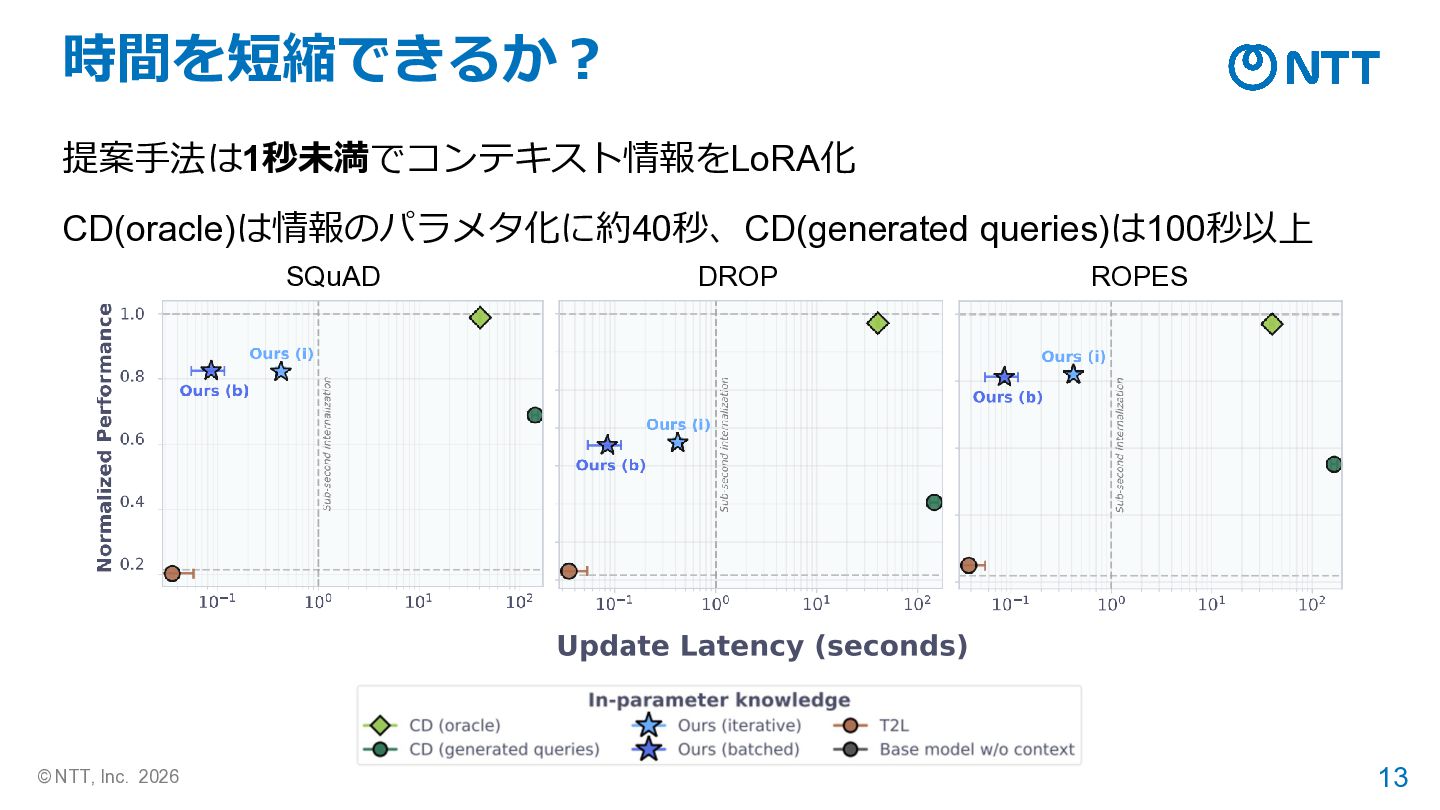
時間を短縮できるか? 提案手法は1秒未満でコンテキスト情報をLoRA化 CD(oracle)は情報のパラメタ化に約40秒、CD(generated queries)は100秒以上 SQuAD © NTT, Inc. 2026 DROP
ROPES 13
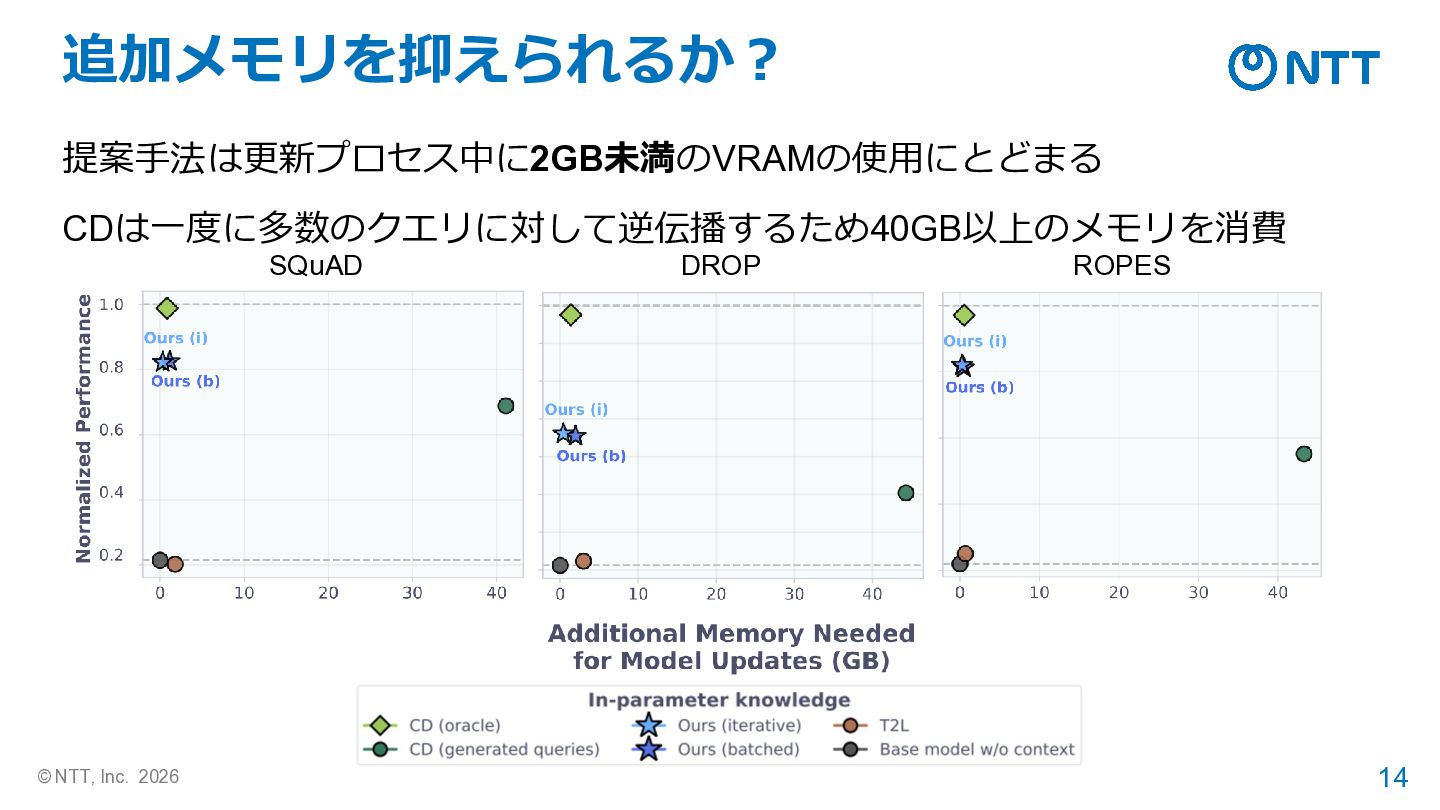
追加メモリを抑えられるか? 提案手法は更新プロセス中に2GB未満のVRAMの使用にとどまる CDは一度に多数のクエリに対して逆伝播するため40GB以上のメモリを消費 SQuAD © NTT, Inc. 2026 DROP ROPES
14
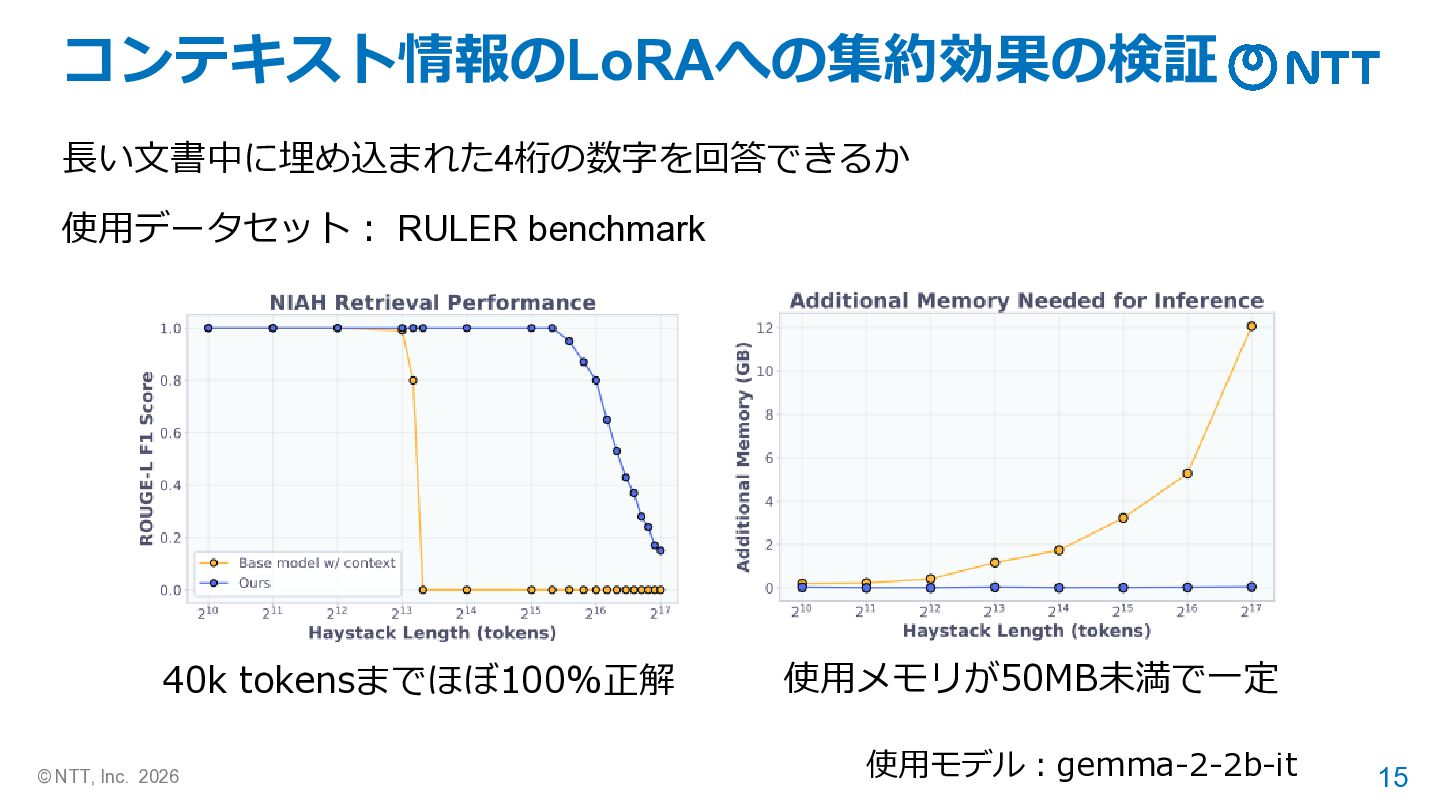
コンテキスト情報のLoRAへの集約効果の検証 長い文書中に埋め込まれた4桁の数字を回答できるか 使用データセット: RULER benchmark 40k tokensまでほぼ100%正解 © NTT, Inc.
2026 使用メモリが50MB未満で一定 使用モデル:gemma-2-2b-it 15
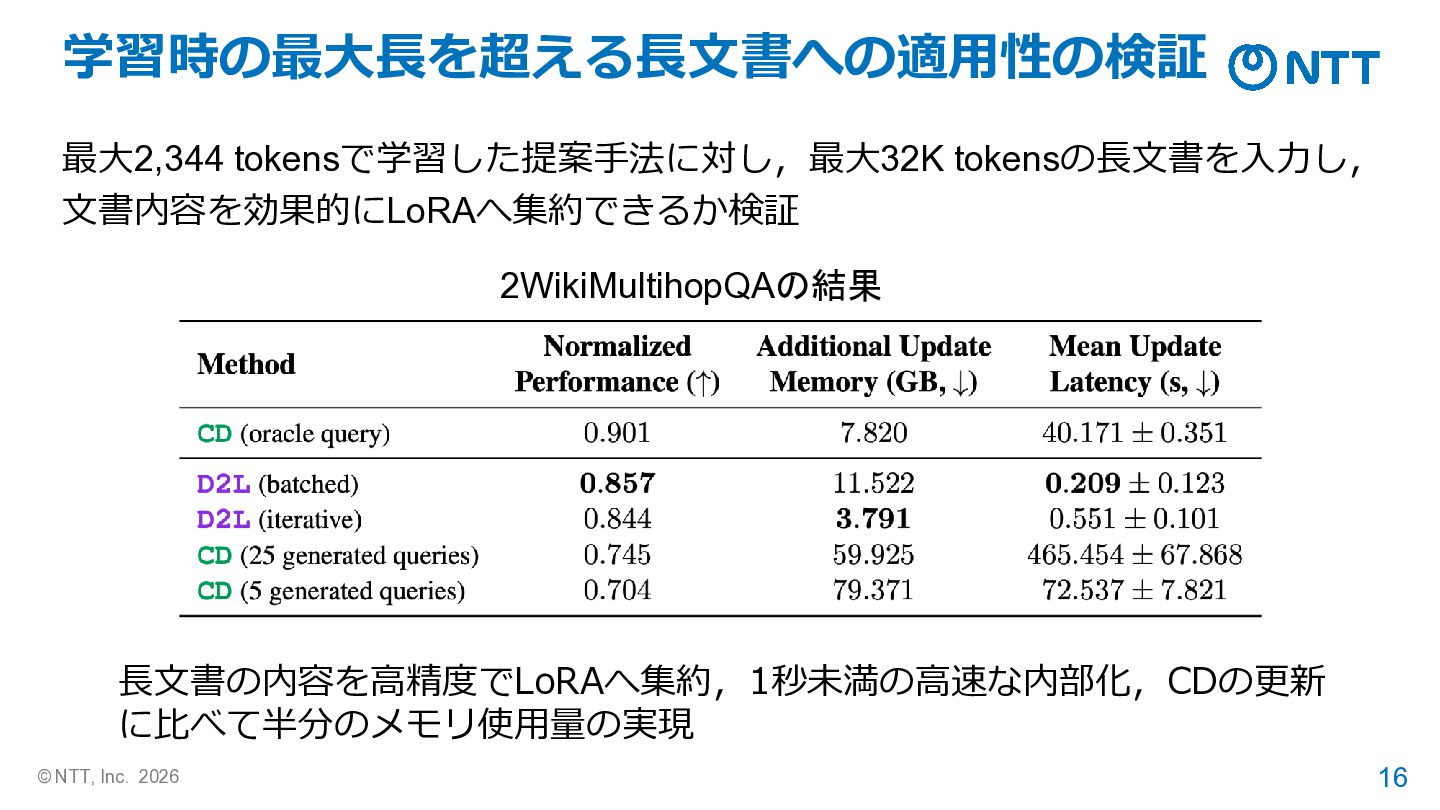
学習時の最大長を超える長文書への適用性の検証 最大2,344 tokensで学習した提案手法に対し,最大32K tokensの長文書を入力し, 文書内容を効果的にLoRAへ集約できるか検証 2WikiMultihopQAの結果 長文書の内容を高精度でLoRAへ集約,1秒未満の高速な内部化,CDの更新 に比べて半分のメモリ使用量の実現 © NTT,
Inc. 2026 16
まとめ • 長い文書をLLMのプロンプトとして毎回読ませるのではなく,文書を入力する とその内容を集約したLoRAを生成する手法を提案 • ICLの6~8割程度の性能を示しながら, 1秒未満でコンテキスト情報をLoRA化 し,更新プロセス中に2GB未満のVRAMの使用にとどまる 感想 •
即時性やメモリ使用量低減というメリットがあるが,ICLと比べるとまだ精度 差がある • 一つのD2L Hypernetを作ればどんなLLMにも適用できるわけではない • LoRAという固定されたパラメータへ集約可能な情報量の限界が気になる © NTT, Inc. 2026 17
Appendix © NTT, Inc. 2026 18
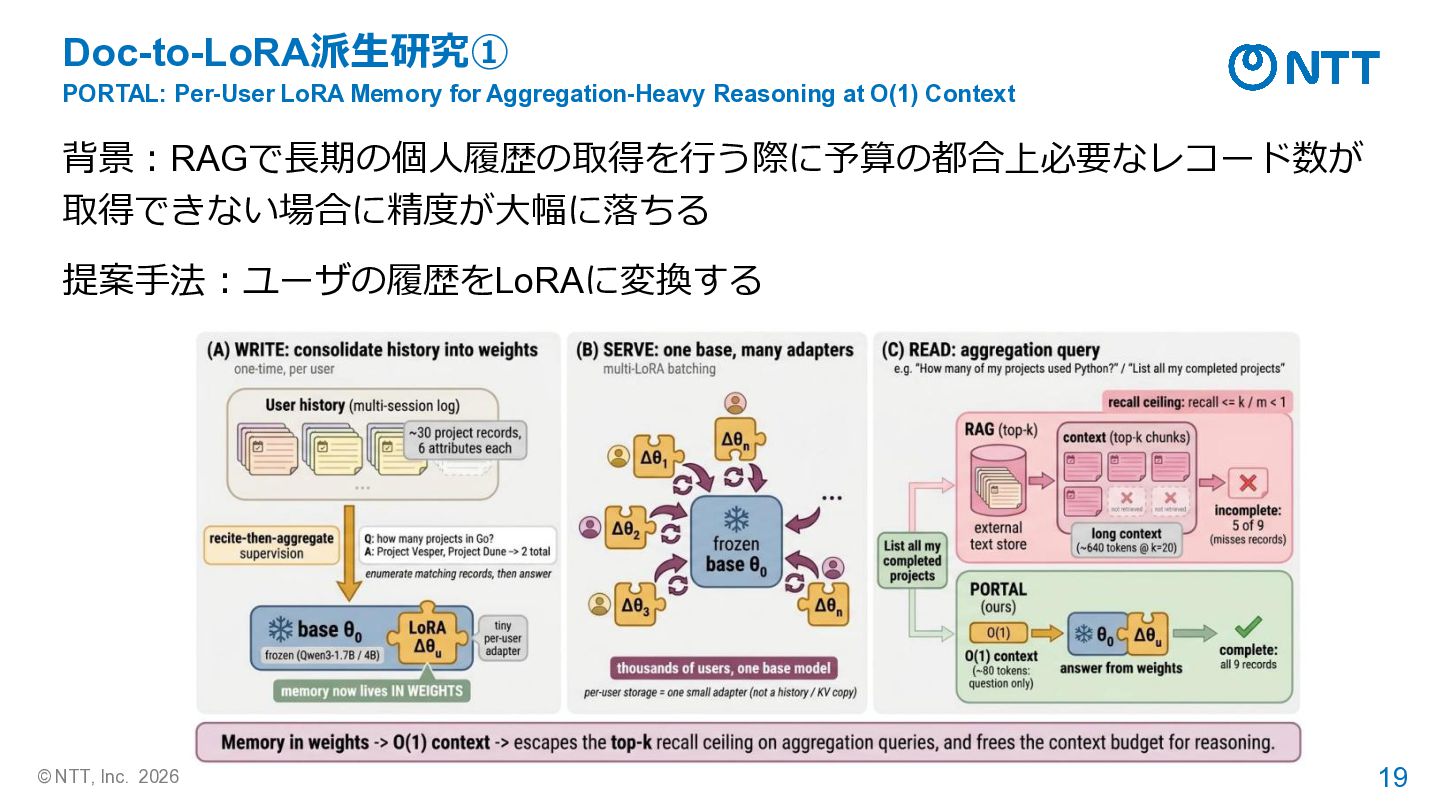
Doc-to-LoRA派生研究① PORTAL: Per-User LoRA Memory for Aggregation-Heavy Reasoning at O(1)
Context 背景:RAGで長期の個人履歴の取得を行う際に予算の都合上必要なレコード数が 取得できない場合に精度が大幅に落ちる 提案手法:ユーザの履歴をLoRAに変換する © NTT, Inc. 2026 19
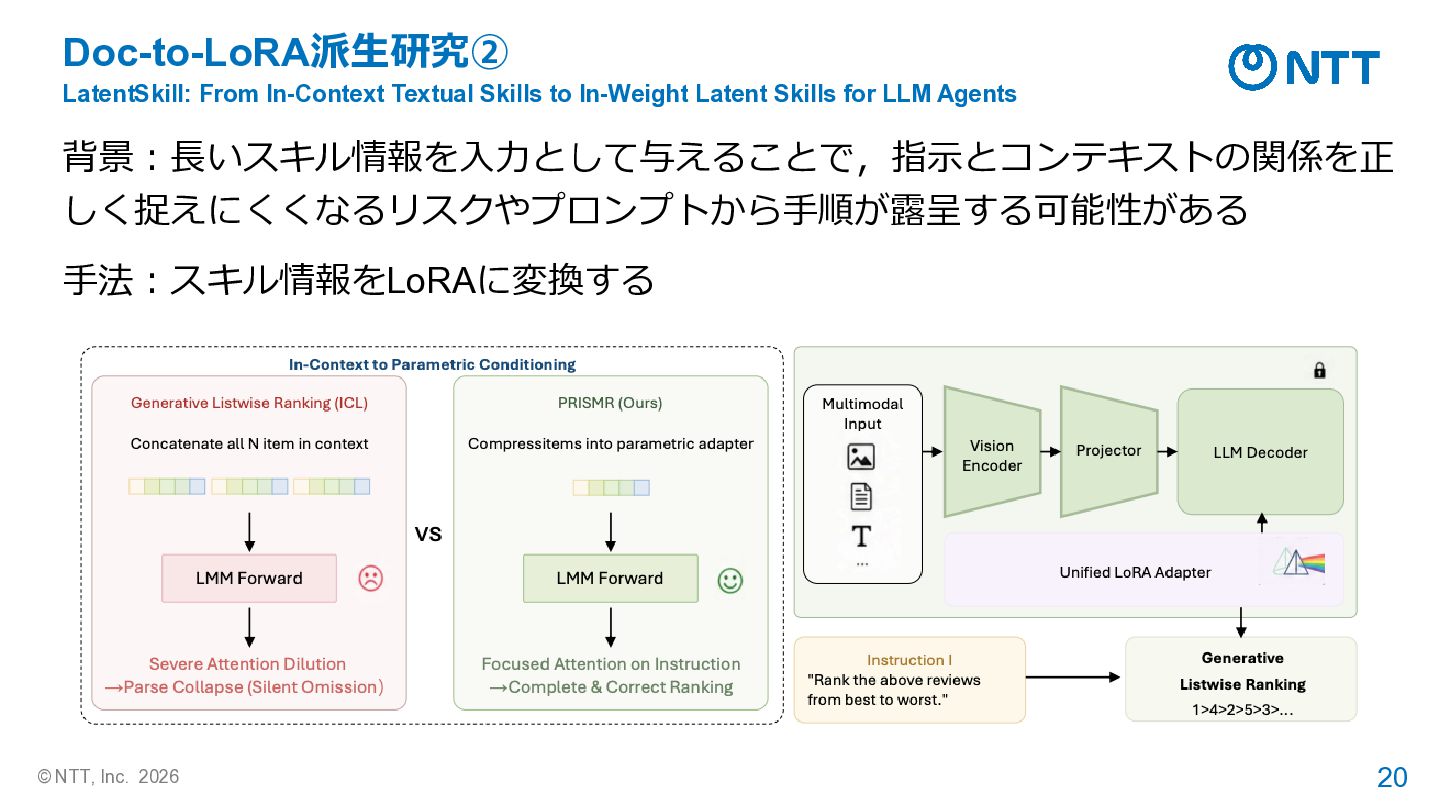
Doc-to-LoRA派生研究② LatentSkill: From In-Context Textual Skills to In-Weight Latent Skills
for LLM Agents 背景:長いスキル情報を入力として与えることで,指示とコンテキストの関係を正 しく捉えにくくなるリスクやプロンプトから手順が露呈する可能性がある 手法:スキル情報をLoRAに変換する © NTT, Inc. 2026 20
None
None


 rfujii
 afroscript
 yuukit
 ontheslope
 koide3
 stktu
 takehaya
 nzw0301
 satai
 dk999
 murakawatakuya
 dugsong
 katiecoart
 baasie
 inesmontani
 davetheseo
 keavy
 techseoconnect
 tammyeverts
 tessaabrams
 axbom
 davidcarrasco
 malarkey